Google 用 1 小时把 Agent 讲清楚了:Agent → Memory → Loop → MCP → Multi-Agent
这是一门被拼成 1 小时合辑的 Google ADK 课程:先用一个「规划—校验—重写」的写博客 Agent 讲清 Agent 是什么,再把记忆拆成 session、数据库会话加用户画像、Memory Bank 三层,接着用入职协调 Agent 讲长时间运行 Agent 的三个必要条件,最后落地 MCP Server 与「把 Agent 当工具挂给另一个 Agent」的多智能体结构。
来源:X 上的推荐推文(Minsi.AI)· 原视频:Codez 发布的 Google 课程(1:12)
阅读说明 这段视频本身没有字幕。本文的英文引文来自本地 whisper.cpp(large-v3-turbo)转写,中文为本文翻译;转写已按画面内容校正术语(ADK、MCP、Memory Bank、google_search 等),但仍是机器产物,个别句子可能与原话有出入。
另外要说明的是:这 1 小时并不是一节课,而是 Google 把若干集 ADK 教程拼成的合辑。在 08、14、21、28、40、47 附近都能听到明显的「换集」衔接,讲解人也会换。文中出现的模型名与产品名(Gemini 3 Flash、Vertex AI Memory Bank、Google Trends 等)均为课程原话,本文未独立核验。
视频内嵌
博客现在支持三种内嵌方式,这一篇同时用上了两种,可以对照着看效果。
一、X(Twitter)官方 widget —— 用官方 <blockquote class="twitter-tweet"> 包住推文地址,页面会自动加载 platform.twitter.com/widgets.js,视频推文会渲染成可播放的原生播放器:
二、自托管 <video> —— 把节选片段放进仓库,用原生播放器引用,不依赖任何第三方,代价是视频体积计入仓库:
三、YouTube / Bilibili 那样的 iframe —— 16 自适应容器,本课程没有 YouTube 官方地址,所以这里不放;写法见仓库 README 的「内嵌视频」一节。
TL;DR
- Agent 不等于聊天机器人:区别在于它「不只是回答,还能决定并动手」,这套循环源自 ReAct 论文——推理、行动、观察、调整。课程把 Agent 分成三种行为模式:顺序型(流水线)、反应型(临场决定)、规划型(先画计划再执行)。
- 第一个 Agent 的骨架是「规划 + 校验 + 重写」:让一个 Agent 只负责产出大纲,另一个只负责回答
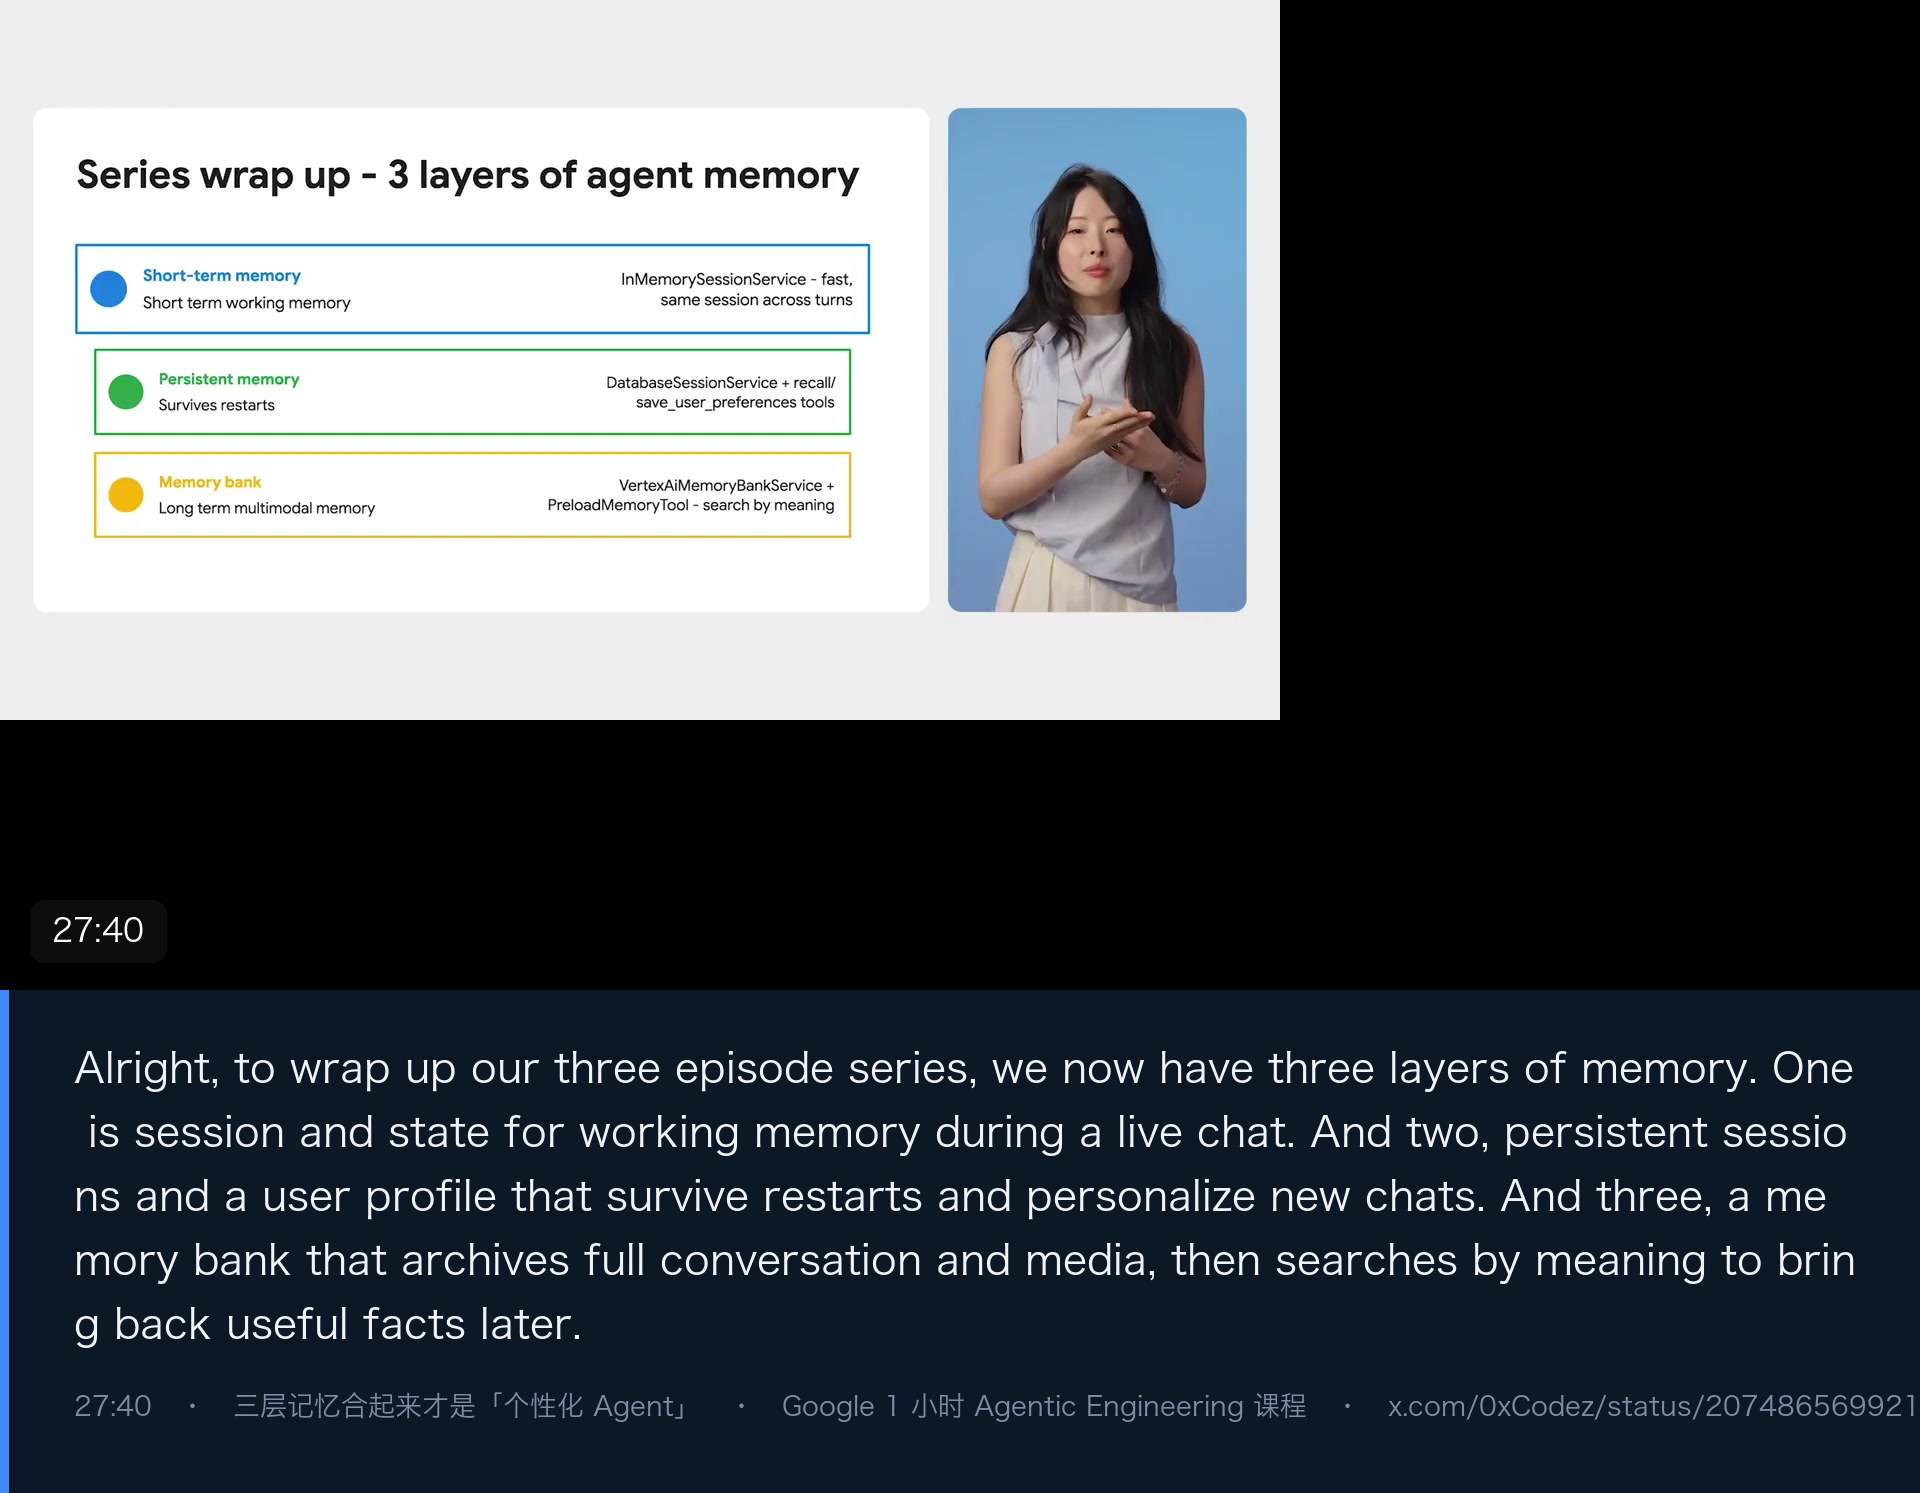
okay或retry,再用 LoopAgent 把两者包起来最多重试三次。写文章的 Agent 和校验 Agent 都只是「工具」,被根 Agent 调用。 - 记忆要分三层,而且三层解决的是三个不同的问题:session 与 state 管「这次对话里记住」;数据库会话加用户画像管「换个新会话还记得你」;Memory Bank 管「把整段对话和图片、视频、音频都归档,之后按语义检索回来」。
- 长时间运行的 Agent 必须真的能「睡着」:不轮询、不占线程,靠 webhook、定时任务或人工审批唤醒;每一步都要落盘成 checkpoint;并且不能自己给自己打分——研究显示 Agent 评估自己的输出会系统性高估,所以标准结构是 planner / generator / evaluator 三方分离。
- MCP 不是要取代 API,而是坐在 API 上面:API 是程序与程序之间的确定性契约,模型面对的是模糊的现实数据,它需要的是「这东西能干什么」的机器可读描述。MCP 换掉的是模型与 API 之间的那层中间件,客户端从「另一个程序」变成了「模型本身」。
- 多智能体的价值在于分工,而不是数量:搜索 Agent 会引用到 404 链接,于是加一个负责验证 URL 的 Agent,再让 orchestrator 把这两个 Agent 当成工具用;每个 Agent 只干一件事,性能、记忆、成本都更好管,也可以用便宜模型干粗活、贵模型干难活。
课程地图
这份章节表最早是 Minsi.AI 在推文里给的,本文补上了更细的分集边界:
| 时间 | 主题 | 讲解人(按画面名牌) |
|---|---|---|
| 00–08 | 从零构建第一个 AI Agent | — |
| 08–14 | Agent Memory ①:session 与 state | Annie Wang(Software engineer) |
| 14–21 | Agent Memory ②:数据库会话 + 用户画像 | Annie Wang |
| 21–28 | Agent Memory ③:Memory Bank 长期记忆 | Annie Wang |
| 28–40 | Agentic Loop 与长时间运行的 Agent | Addy Osmani(Director @ Google Cloud) |
| 40–47 | 给 Agent 接一个 MCP Server | Smitha Kolan(Senior AI Engineer, Google) |
| 47–1:00 | MCP vs API | — |
| 1:00–1:12 | 用 ADK 搭多智能体系统 | — |
01|什么是 Agent:从一个「写博客的 Agent」开始
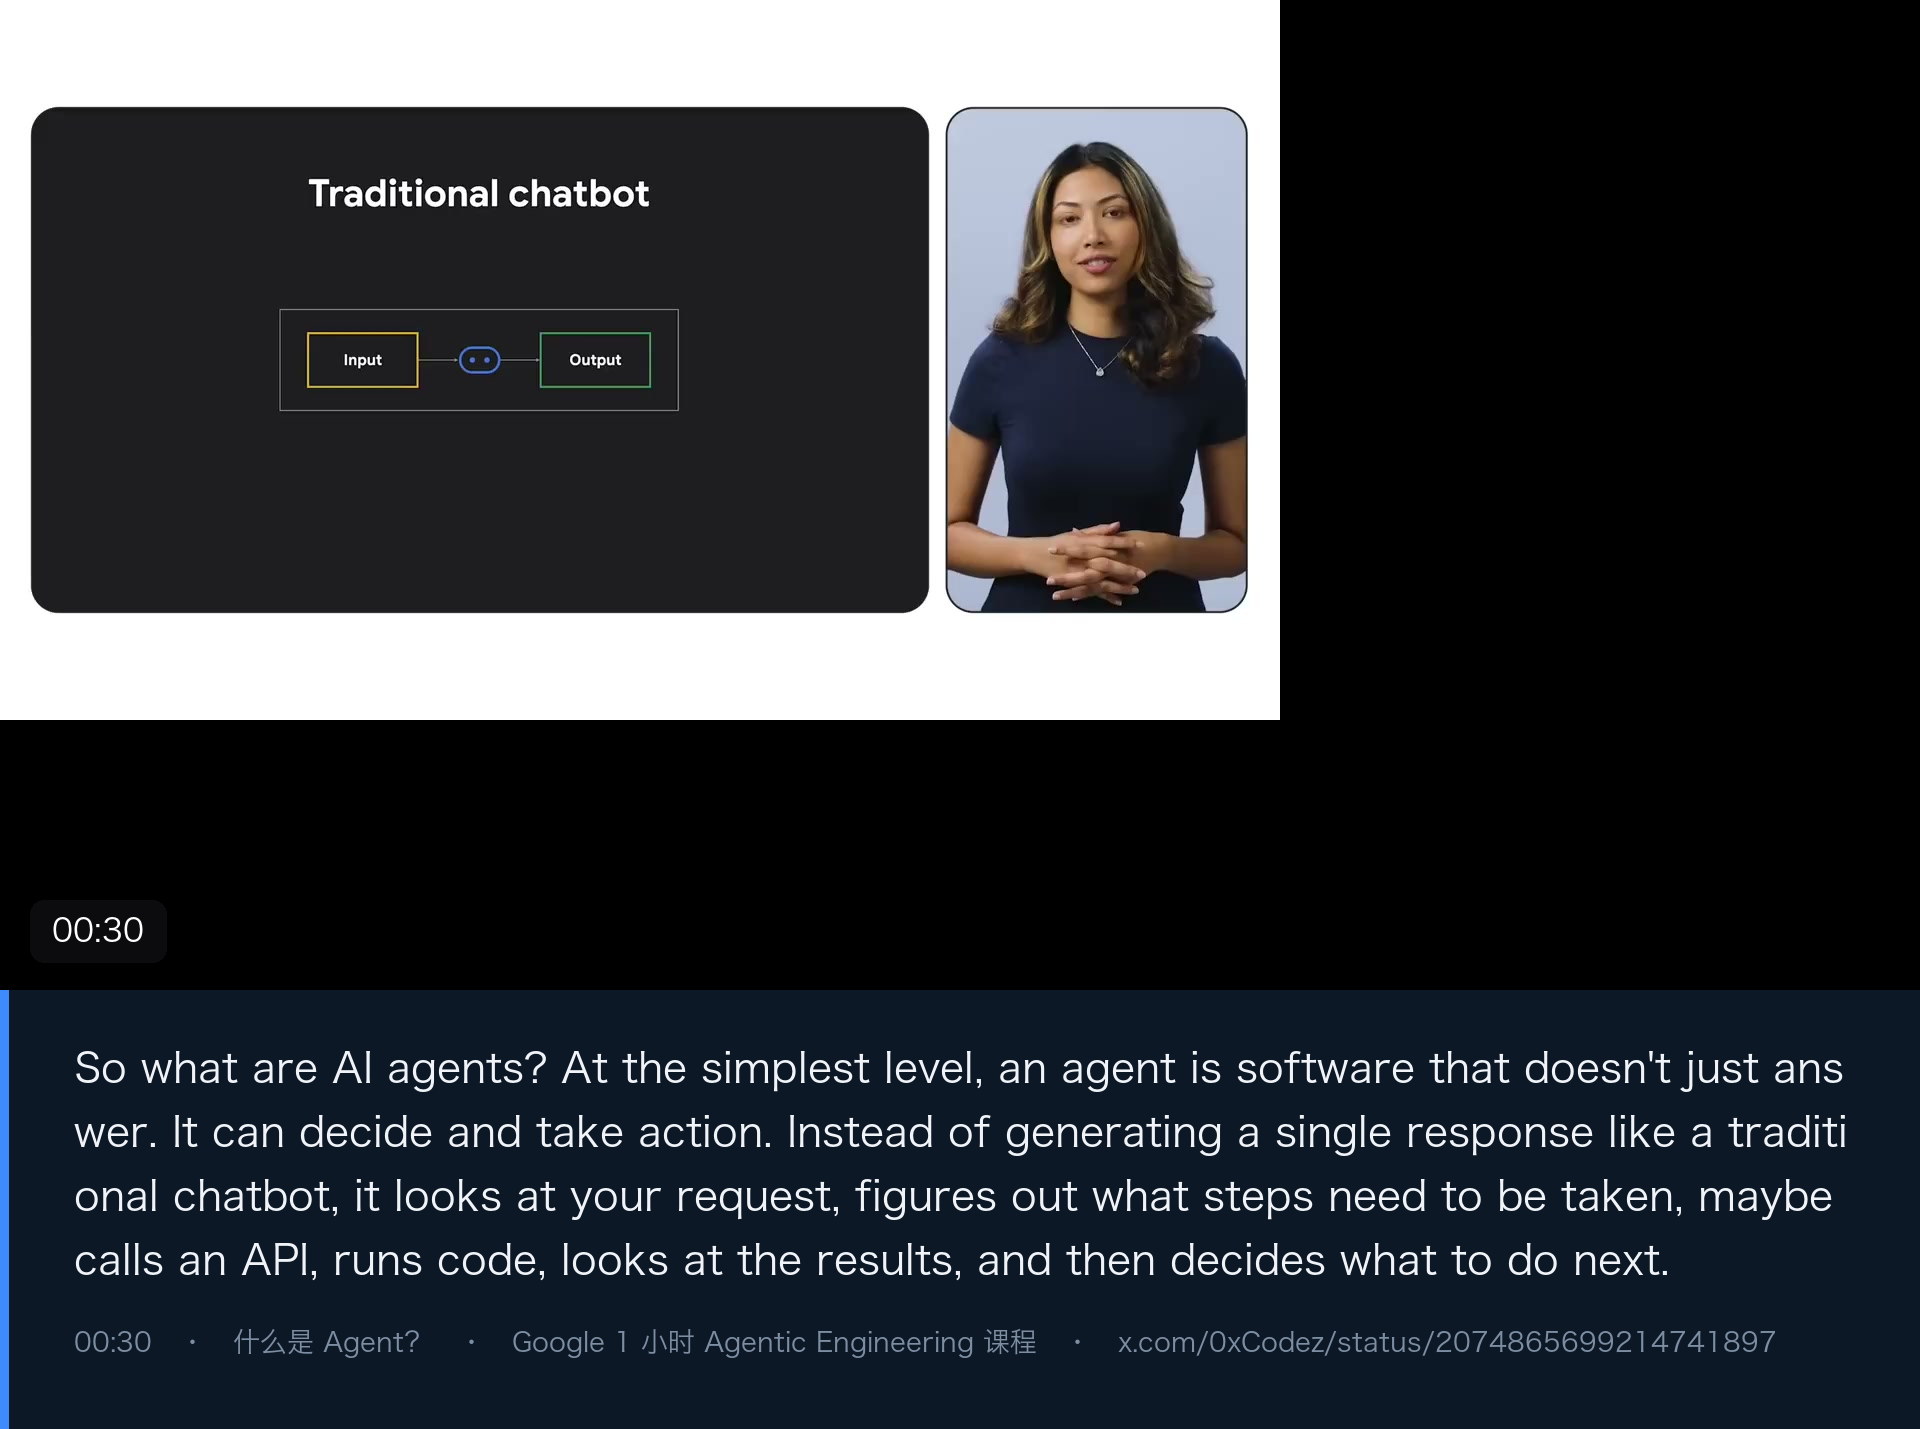
课程给的最短定义是:Agent 是会决定并动手的软件,而不是只会回答的软件。 传统聊天机器人给你一个回复就结束了;Agent 会看你的请求、判断需要哪些步骤、也许去调一个 API 或者跑一段代码、看一眼结果,再决定下一步做什么。
这套循环的理论出处是 ReAct 那篇论文——语言模型不该一口气把文本生成完,它可以逐步推理、执行一个动作、观察结果、再决定下一步。课程把「推理、规划、记忆」加上「足够的自主性」当作 Agent 的定义。
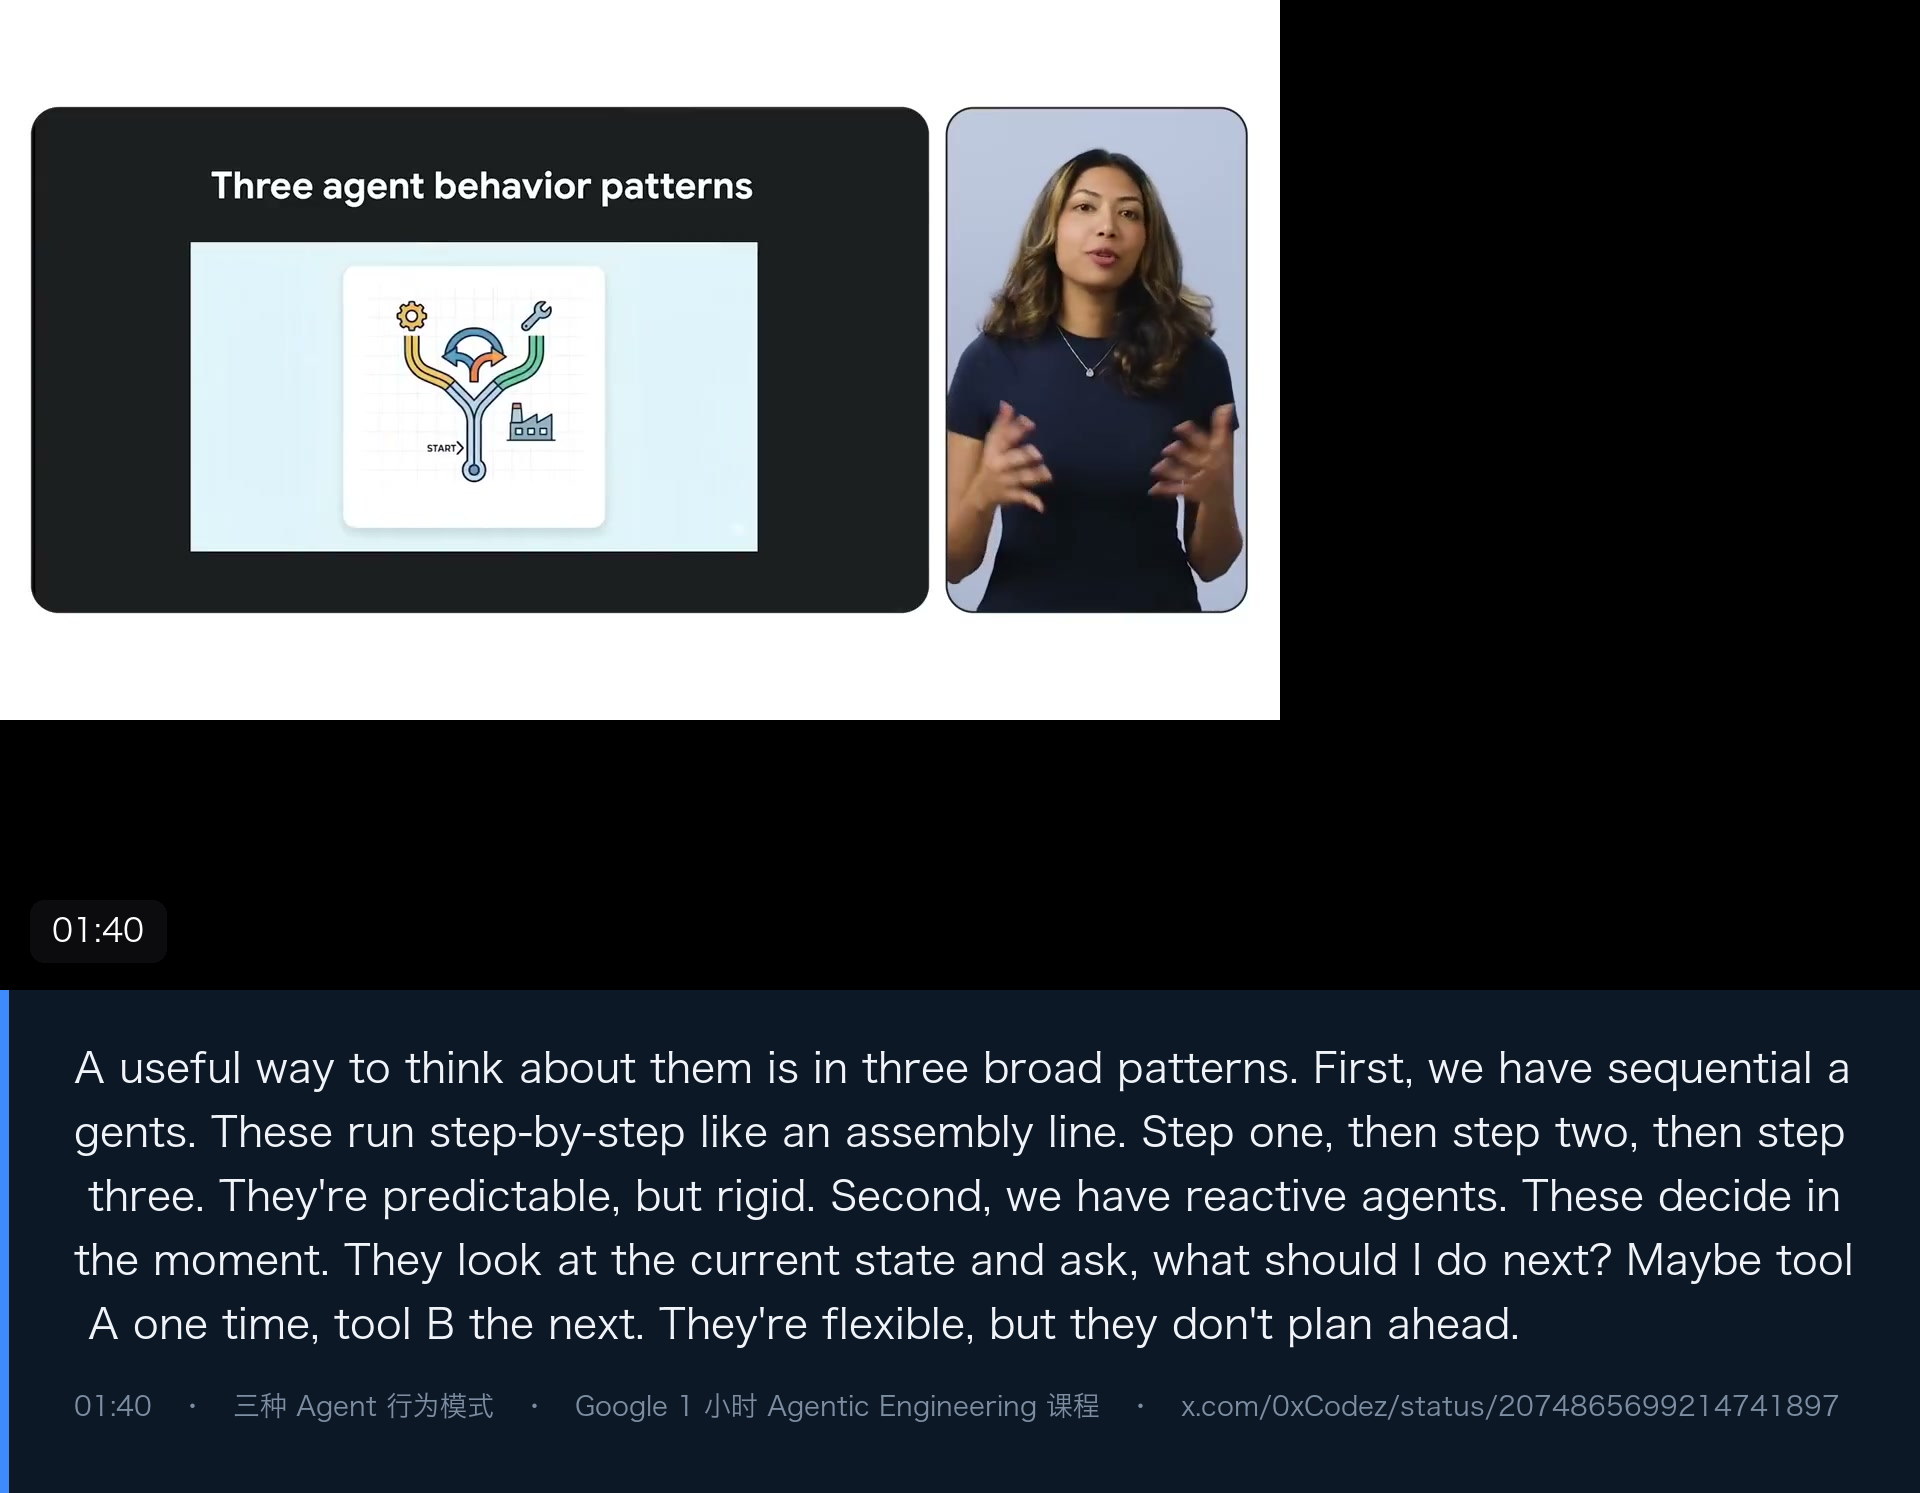
接着是这节课里最实用的一个分类,三种行为模式:
- 顺序型(sequential):像流水线,第一步、第二步、第三步。可预测,但僵硬。
- 反应型(reactive):临场决定,看当前状态问「下一步该干什么」,这次用工具 A、下次用工具 B。灵活,但不提前规划。
- 规划型(deliberate / planning):先停下来画个计划,再执行。课程用的例子是订行程——你不会随机买一张机票,而是先定日期、再定酒店,然后按这个顺序走完。
选哪种取决于问题:流程简单可预测就用顺序型,动态场景用反应型,多步骤且有依赖关系就上规划型。
然后课程开始写代码,用一个写博客的 Agent 串起所有概念。它的结构值得记下来,因为后面几节都在复用这个骨架:
blog_planner:唯一职责是把一个主题变成结构化大纲。指令里把它要产出什么写死了——标题、一段引言、4 到 6 个带要点的章节、一段结论。产出通过output_key存进共享 state 的blog_outline,下一个 Agent 可以直接接上。outline_validation_checker:不产出新内容,只检查大纲。指令是硬性的:如果大纲里有标题、引言、4–6 节和结论,就回答okay;缺东西就回答retry并说明缺什么。这样「接受还是重来」就变成了程序能判断的事情。robust_blog_planner:用一个 LoopAgent 把上面两个包起来。先跑规划、再跑校验;okay就结束,retry就带着同样的指令重跑,最多三次。blog_writer加它自己的校验器,同样包成robust_blog_writer。- 最后是根 Agent
blogger:把上面两个 loop 当成工具挂上去,用户给一个主题,它先调规划工具、再调写作工具,最后补三个备选标题和两条推文长度的 hook。
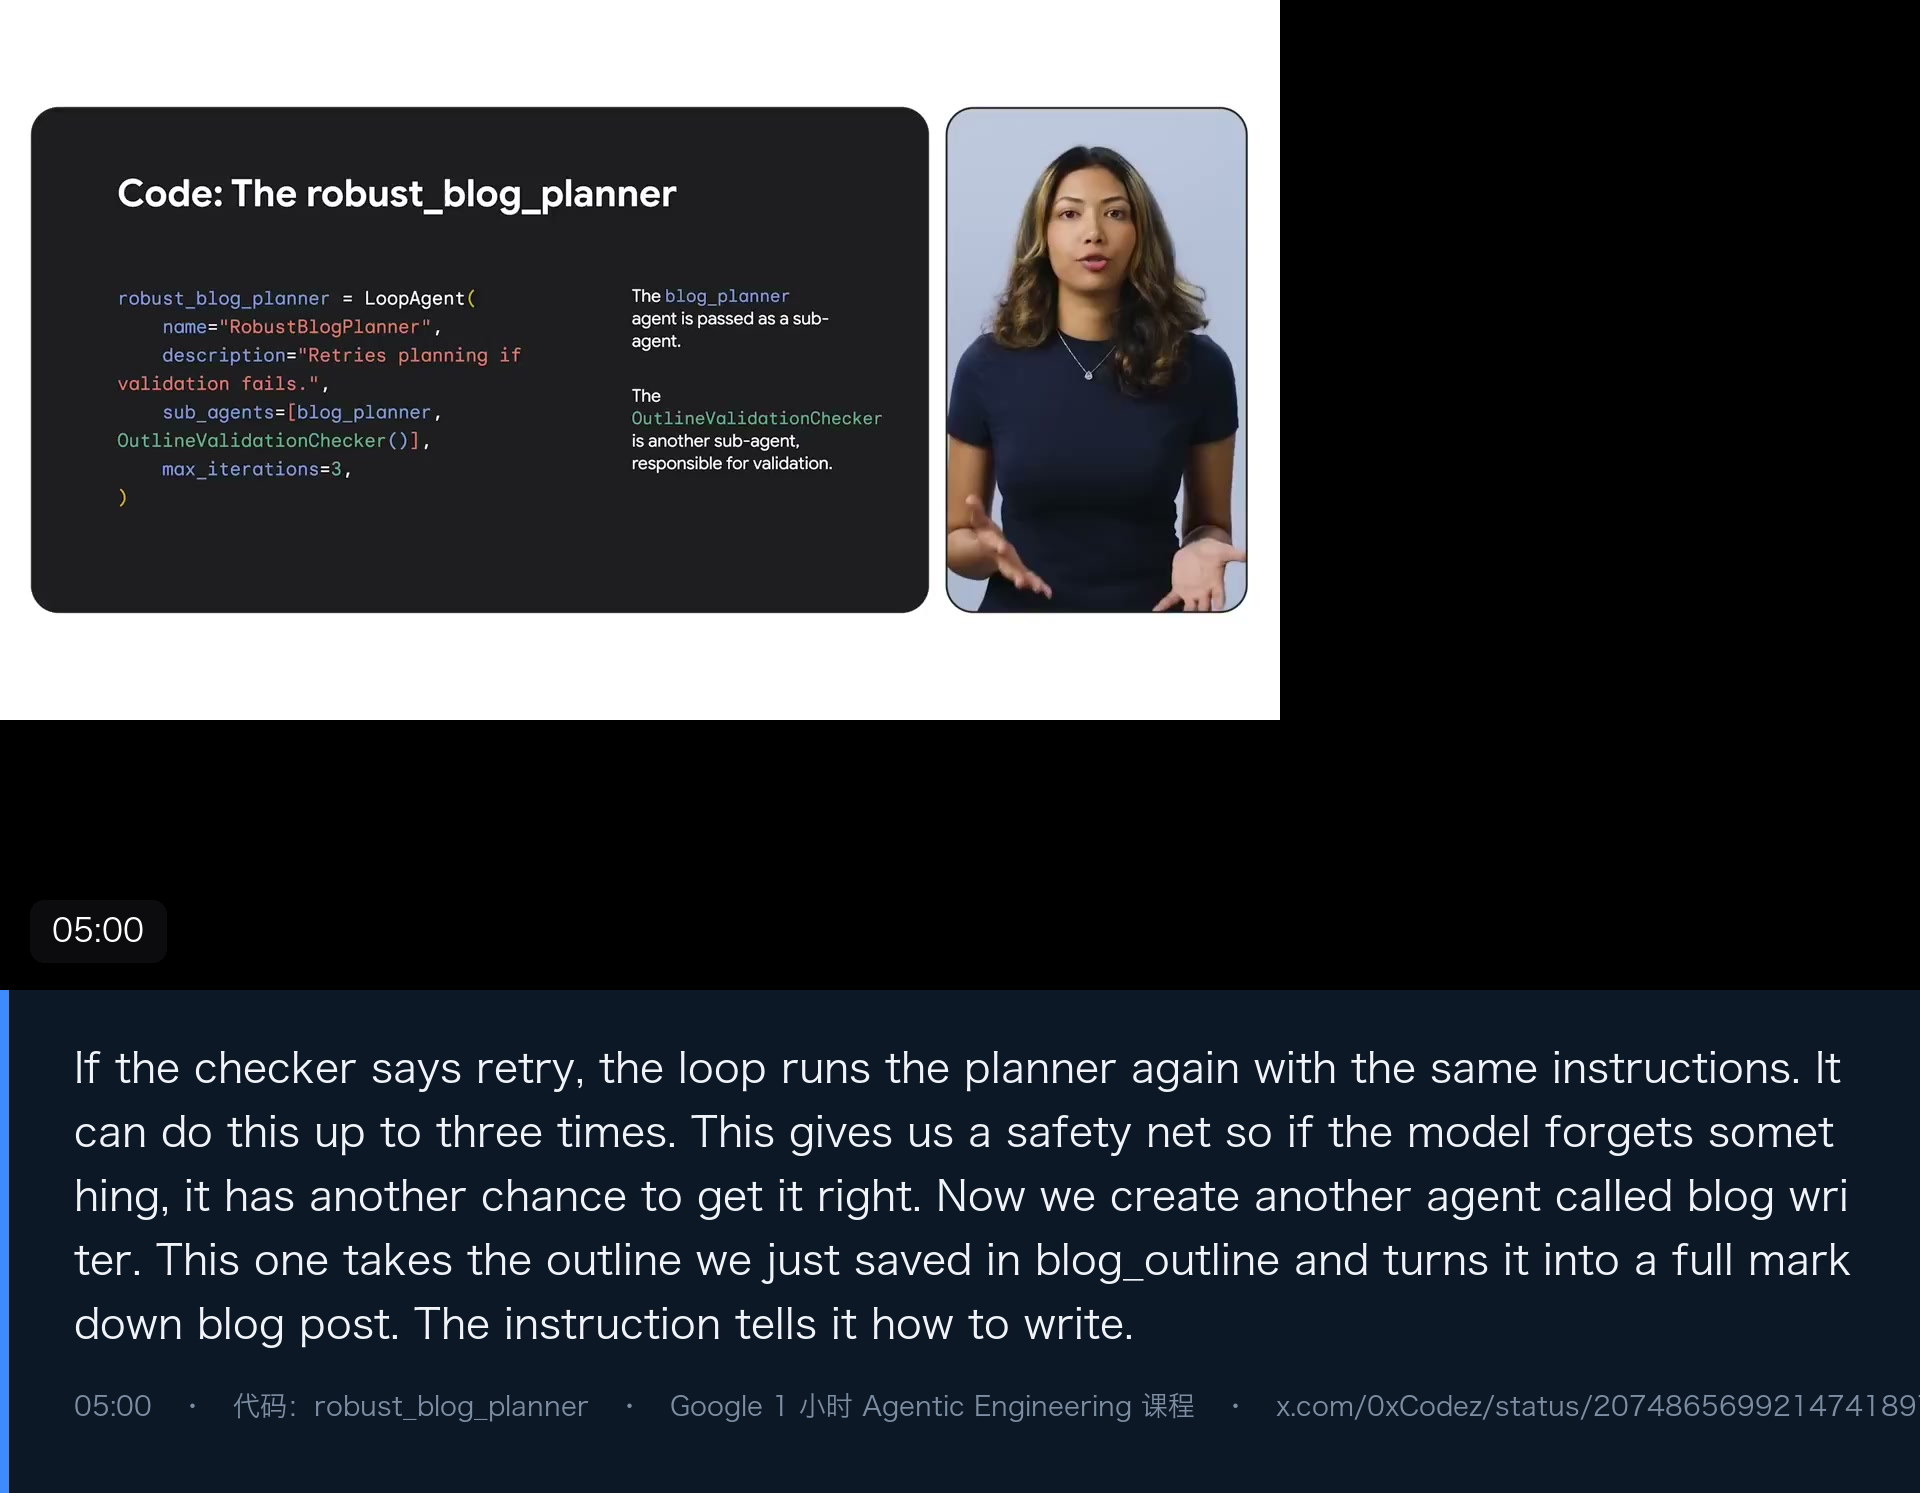
几个细节比代码本身更值钱:把「要产出什么」写死在 instruction 里,输出会可靠得多;用 output_key 让 Agent 之间通过共享 state 传值,而不是靠人来回粘贴;校验 Agent 只允许输出固定词,方便程序分支。写完用 adk web 起一个本地 UI 就能直接对话调试。
02|Agent Memory:三层记忆,解决三个不同的问题
这部分是一个三集小系列,演示的起点很朴素:一个旅行规划 Agent,在第二轮对话里就把第一轮说过的话忘了。为什么会忘,先把两个概念分清:
- session:一整条连续的对话线程,像手机上的一串聊天记录。
- state:这条会话里的一个键值暂存区,用来放「本轮需要快速取到的关键信息」,比如饮食偏好。它的生命周期和 session 一样。
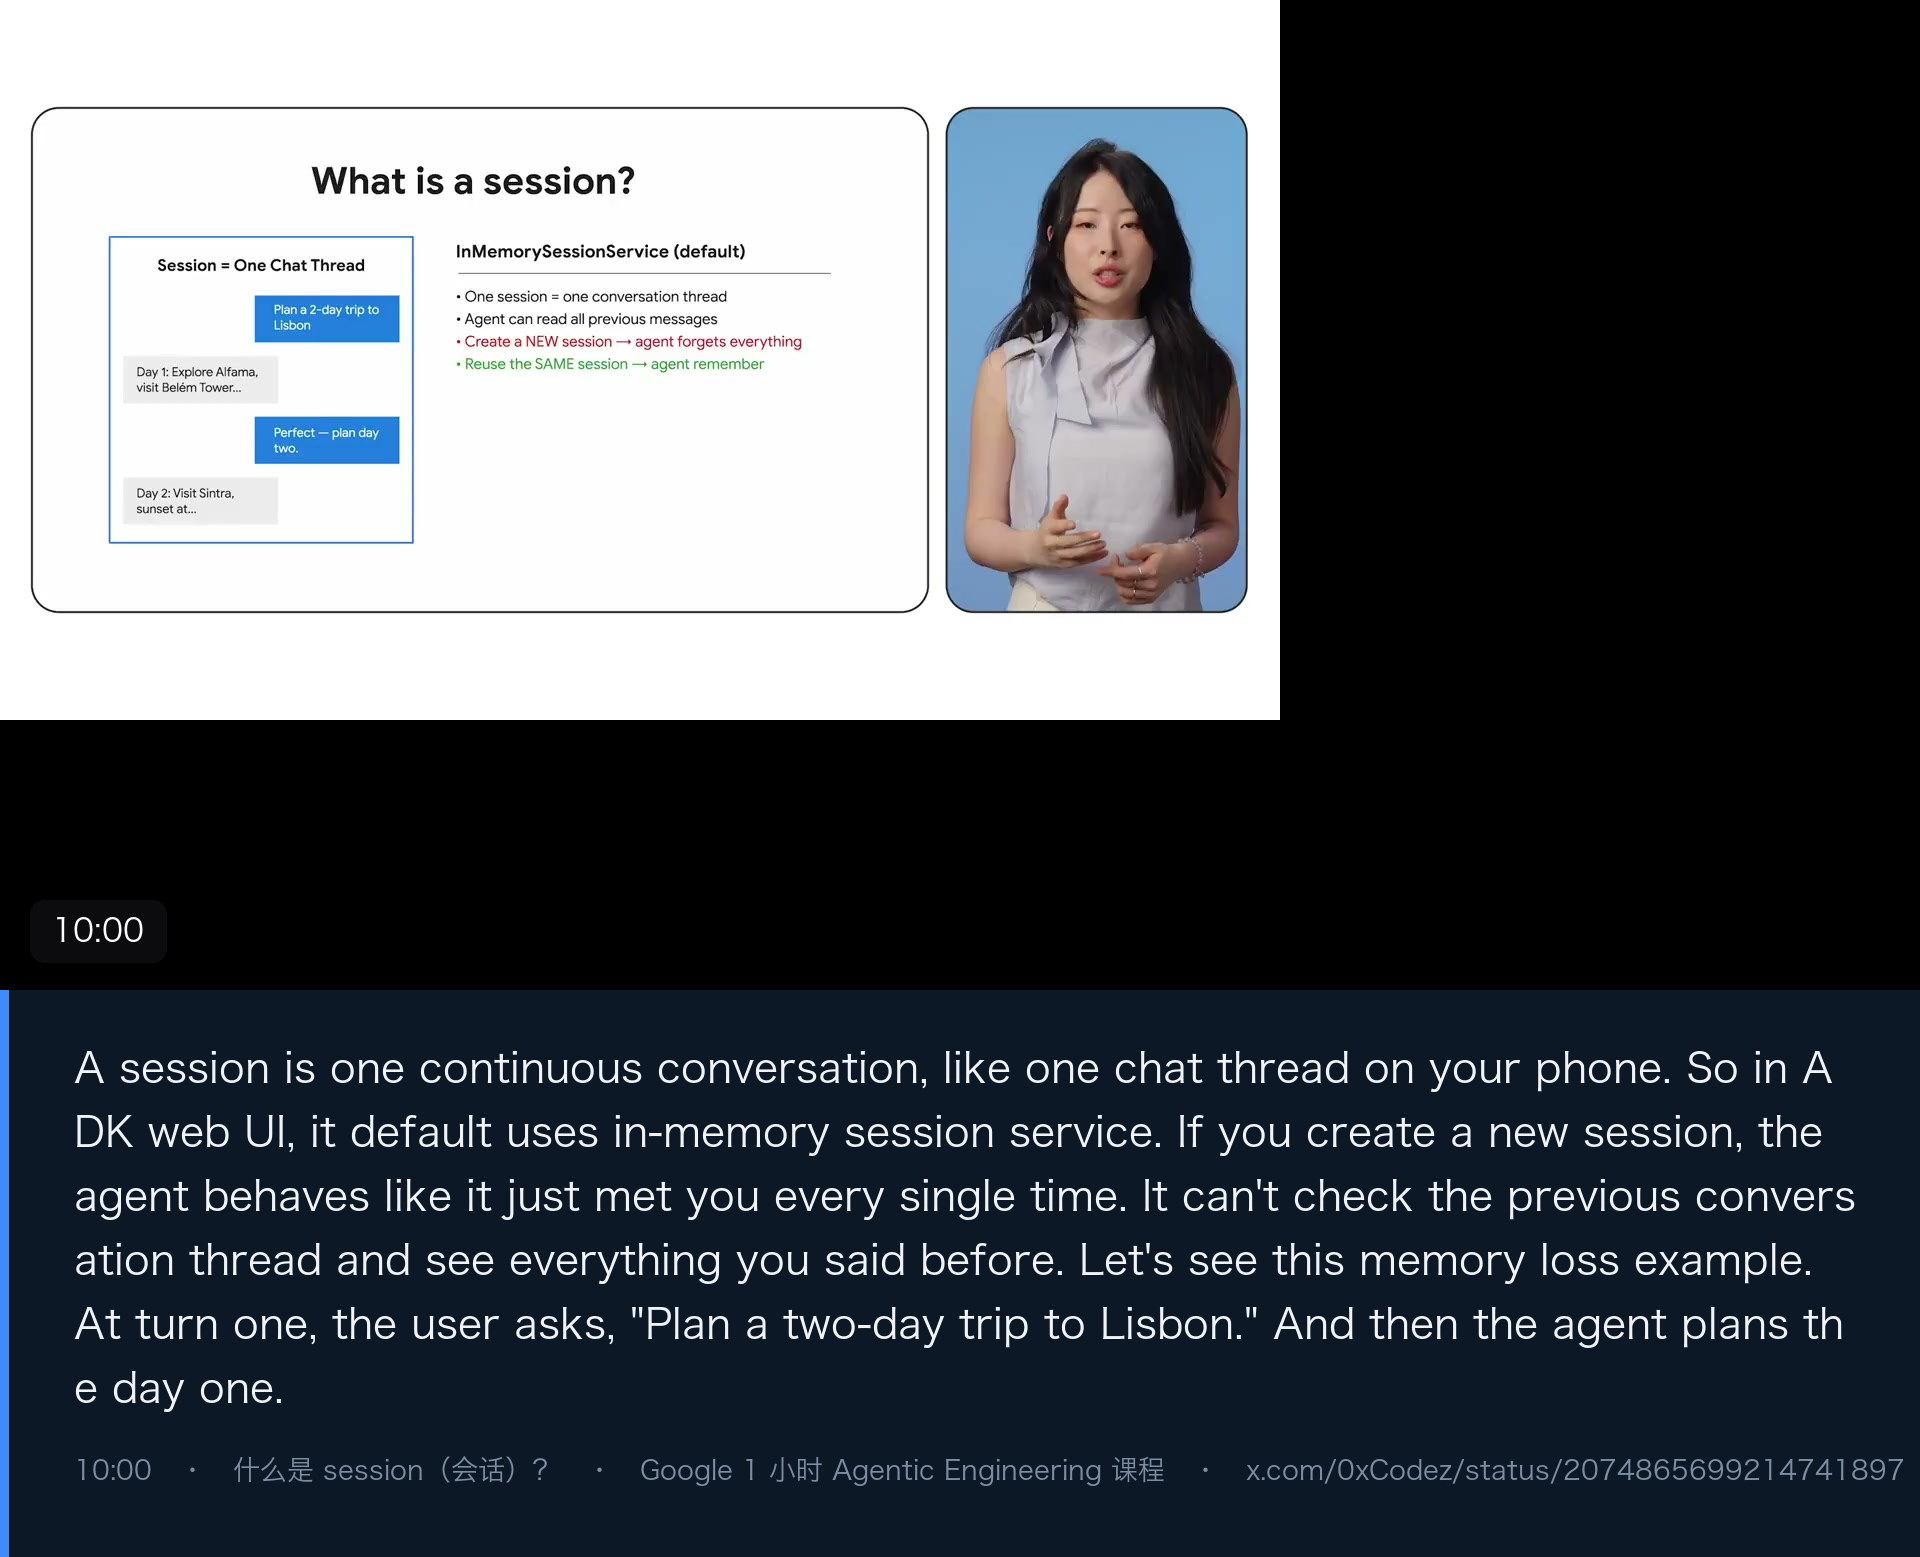
第一集:短时记忆。 用 InMemorySessionService 把 session 和 state 管起来,第二轮就记得第一轮了。问题也很直接:进程一重启,全没了。
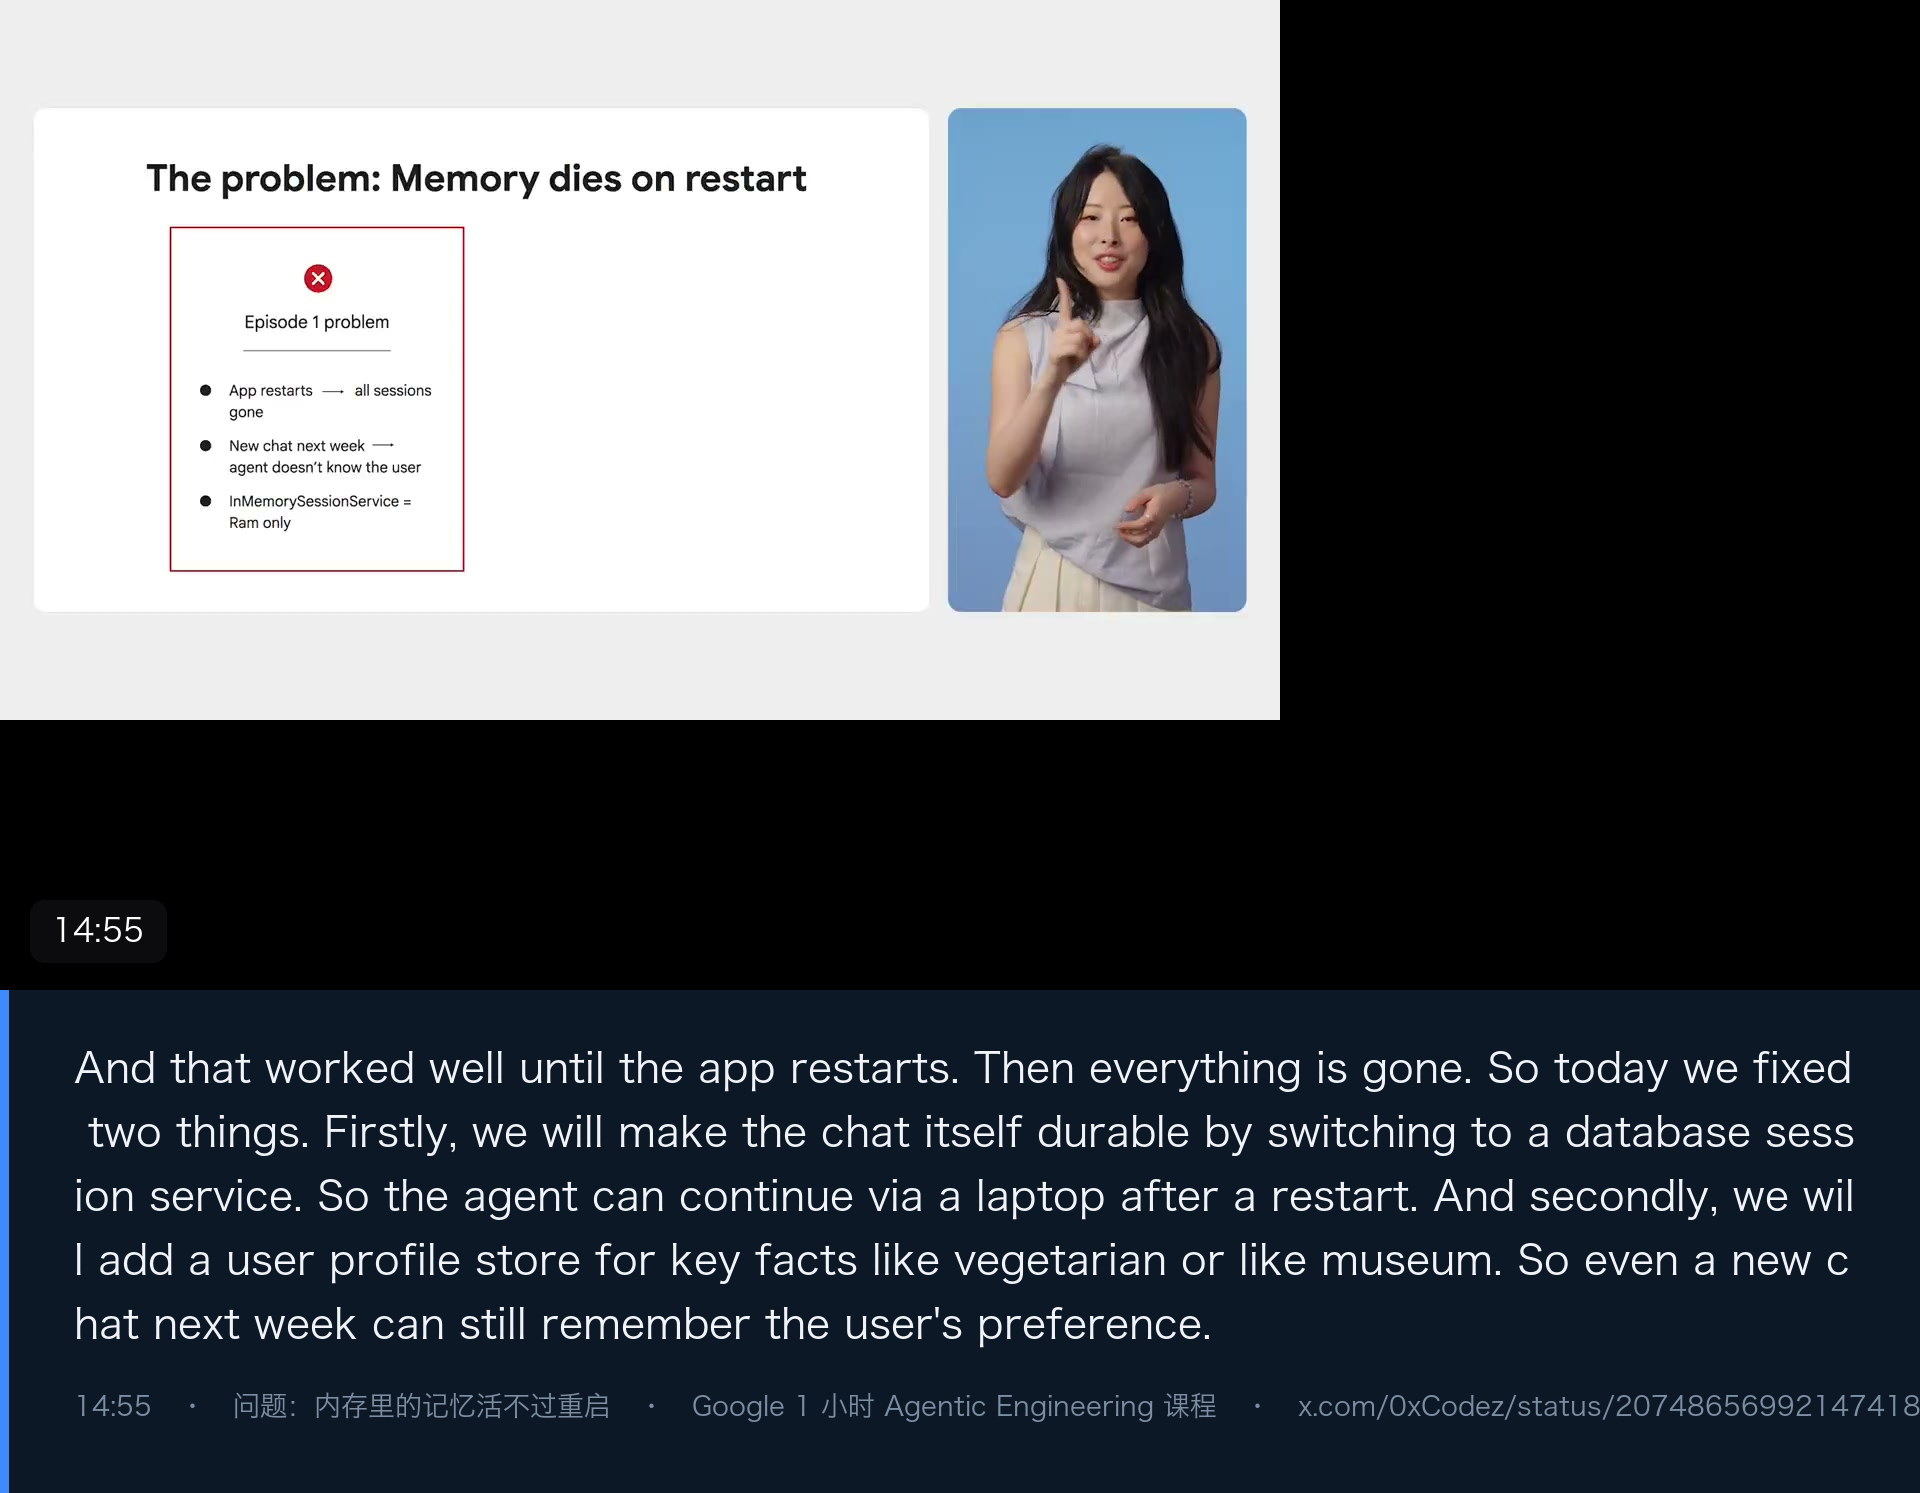
第二集:换成数据库,并加一张用户画像表。 把 InMemorySessionService 换成 DatabaseSessionService,每次都把用户消息、Agent 回复、状态变更写盘;同一个人带着同一个 session ID 回来,历史就被完整加载,对话接着走。这里的关键认识是:会话服务是可插拔的,Agent 逻辑不用改,换的只是底下的存储引擎。
但数据库会话只解决了「同一条对话能续上」。用户下周开一条新会话,还是没有历史可读。所以再加一张用户偏好表——一个 user_id 一行一个偏好键,比如 dietary、favorite_thing、transport_mode,并且给 Agent 两个工具:recall_user_preference(读全部偏好)和 save_user_preference(插入或更新)。两个工具都能拿到当前 user_id,读写自然绑定到对的人。
指令里还规定了调用顺序,这四句话很值得抄:recall first(开场先读偏好)、personalize and plan(用读到的内容去个性化建议)、present and learn(给完方案再问一句还有没有要记的)、save last(用户给了新事实,先保存再结束)。
演示里:第一轮用户问「帮我规划个旅行」,Agent 先读偏好(空),给出方案后问「有没有什么偏好要我记住」;第二轮用户说「记住我是素食者」,Agent 调保存工具并确认;然后模拟重启——RAM 清空,会话在盘上、偏好在表里;下周新会话,用户说「我回来了,帮我规划个旅行」,Agent 第一件事就是读偏好,拿到 vegetarian 直接个性化。
第三集:Memory Bank 长期记忆。 这一层要跨对话、跨模态。课程用了两个模型:一个从对话和媒体里抽取事实,一个把这些事实向量化,这样才能「按意思搜」而不是按关键字搜——搜 two field vehicle 能命中一条写着 bicycle 的记录。
写入有两条路:一是会话结束时调用 add_session_to_memory,把整段对话(含消息、回复、图片/视频/音频引用)归档并抽出关键事实;二是直接把一段文件加文字上下文传进去,让它生成并存放事实,哪怕这些文件不是来自聊天。读取则靠 preload_memory_tool:它每一轮都在回复前跑一遍,读用户的新消息、在 Memory Bank 里做语义检索、把最相关的事实注入 prompt——Agent 自己不需要写任何特殊逻辑。
演示最能说明问题:A 会话里用户发了一张历史建筑照片、一段海边的视频、一段小城里的音频,然后把会话归档;隔一段时间开一个全新会话,状态是空的,用户只问「基于我以前发的图片、视频和音频,推荐一个文化目的地」,Agent 在回复前先检索,捞出「喜欢历史建筑」「喜欢海边」「去过那座小城」,然后给出匹配的建议。
03|Agentic Loop:长时间运行的 Agent 必须真的能「睡着」
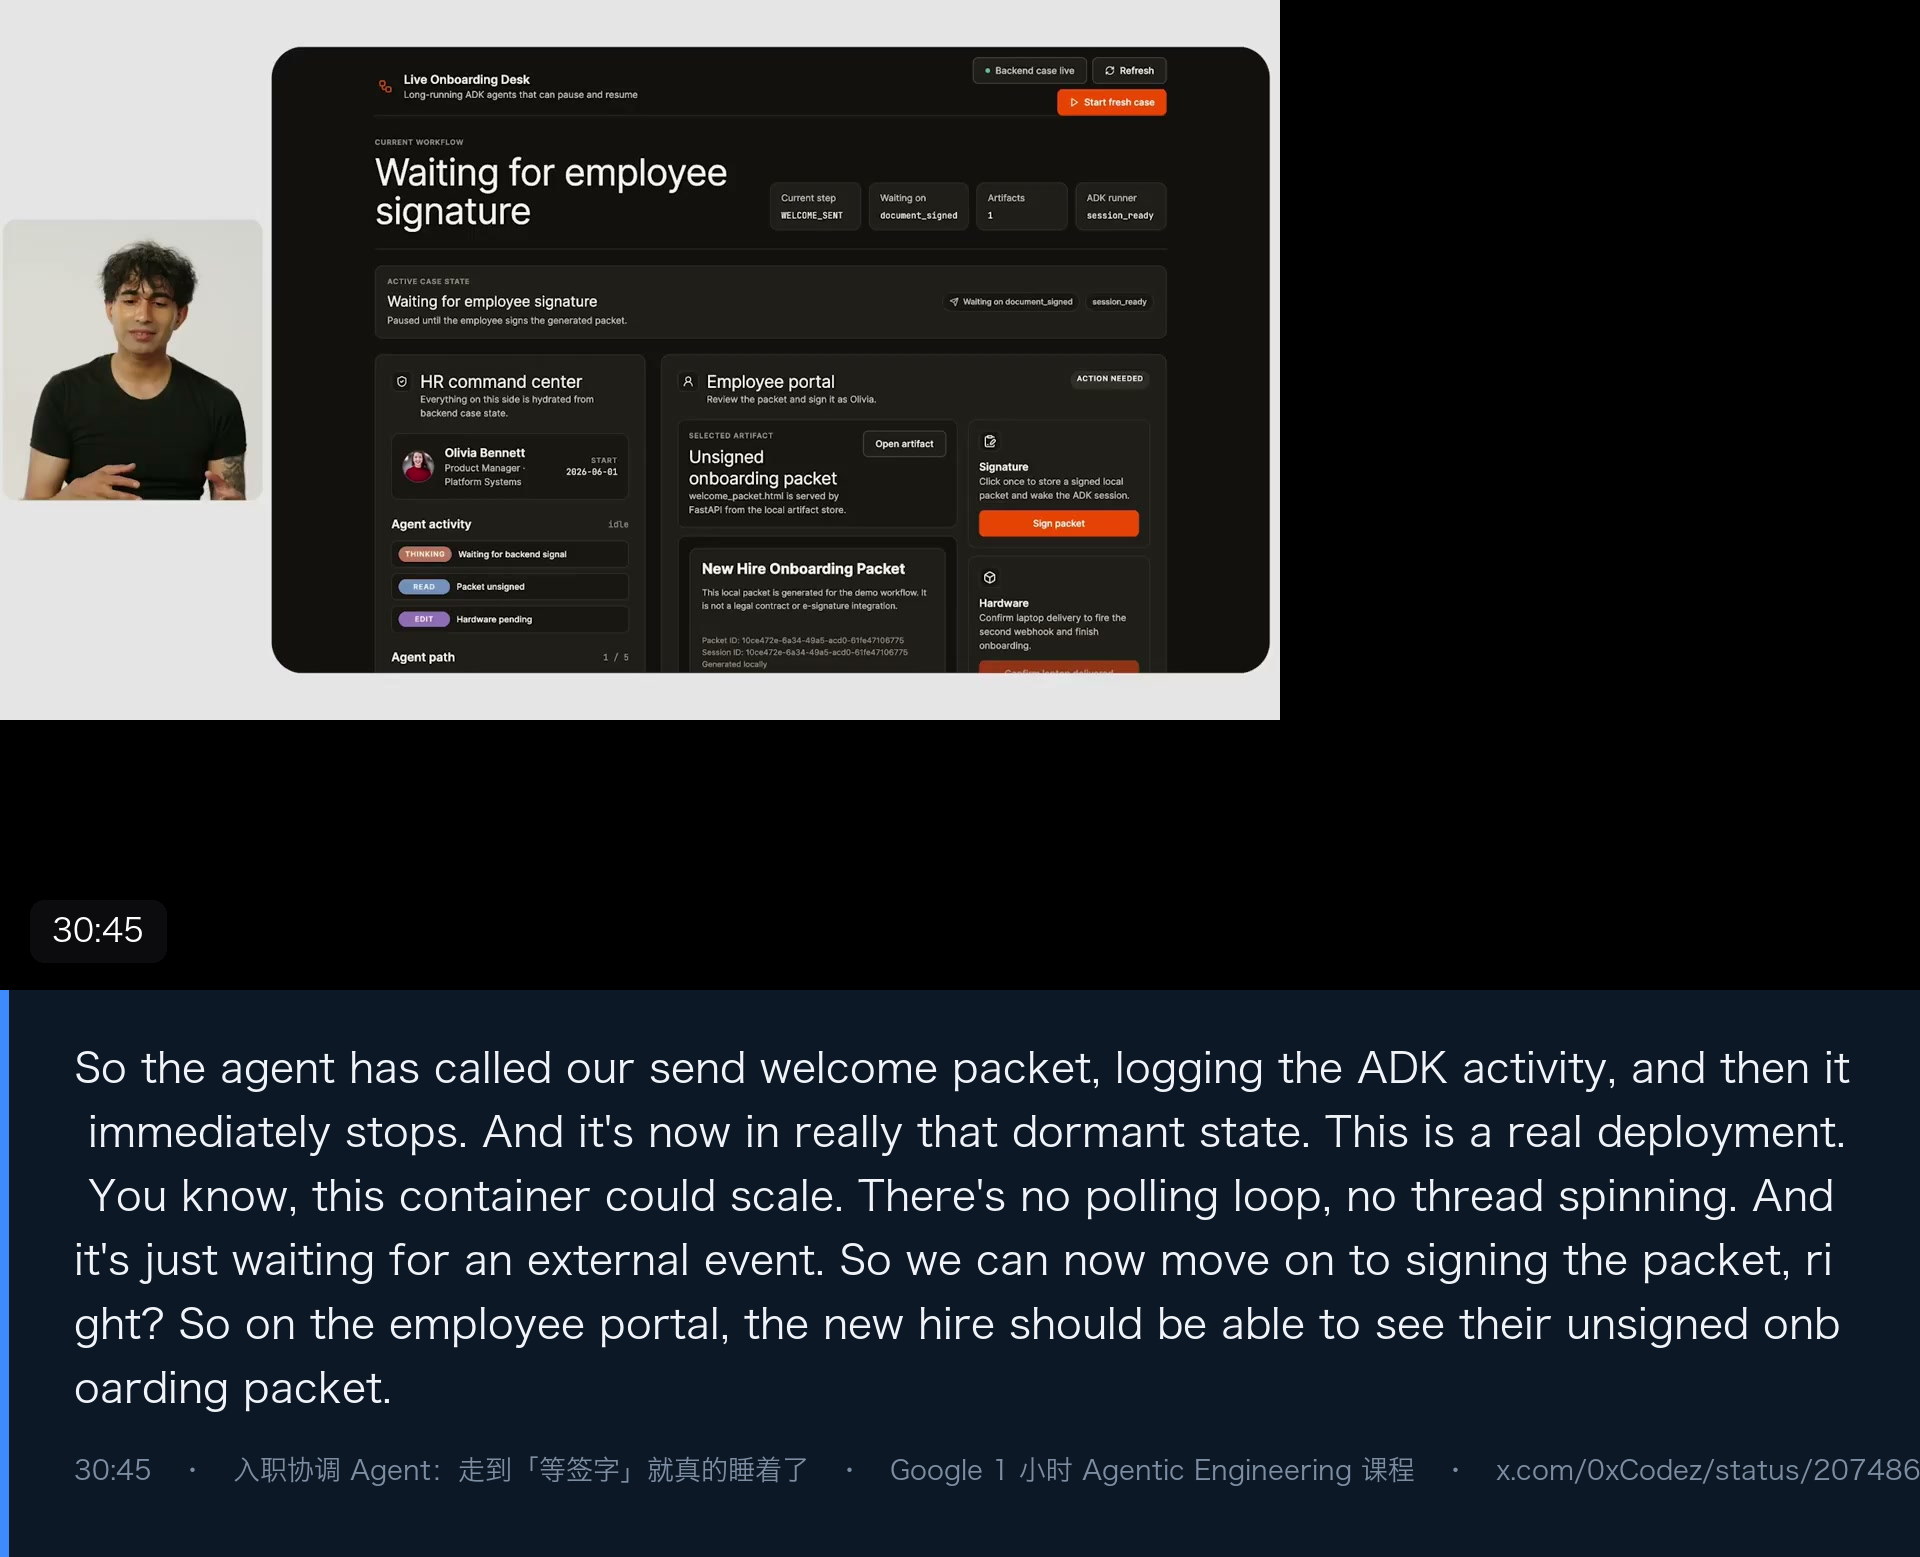
这一集换了讲解人,用的例子是新员工入职协调 Agent——一个可能连续跑几周的流程:发欢迎包 → 等员工签字 → 等技术开通(委派给一个子 Agent)→ 等硬件到货 → 最后生成 day one 的日程。
演示里最值得看的是停顿这件事。Agent 发完欢迎包、在事件日志里记一笔,然后立刻停住,进入休眠状态。没有轮询循环,没有占着不放的线程,容器可以缩容,它只是在等一个外部事件。
讲解人说得很直白:长时间运行的 Agent 有三个必须成立的前提。
- 它必须真的能睡。 就像人必须能睡觉一样。以前那些靠主动轮询的做法不但不需要,而且不该要——你不希望有一个线程卡在那里白烧算力。它要能休眠到某个外部事件把它叫醒:可能是一个 webhook、一个定时任务、一次人工审批,或者一个工具回调。
- 每一步都要有 checkpoint。 状态在每一次流转时都要持久落盘。哪怕跑这个流程的容器崩了,服务重新部署之后也要能从原处接着走;用户花几天时间才完成一个动作,Agent 也要能精确地接着上次走,而不是凭空编出一段没发生过的中间步骤。
- Agent 不能自己给自己打分。 很多人让同一个 Agent 写代码、又让同一个 Agent 审代码。但来自 Anthropic 等若干实验室的研究结论相当一致:Agent 评估自己的输出时会系统性地高估。所以这个场景下的标准结构是三个 Agent——planner、generator,以及一个独立的 evaluator 去验真实结果。
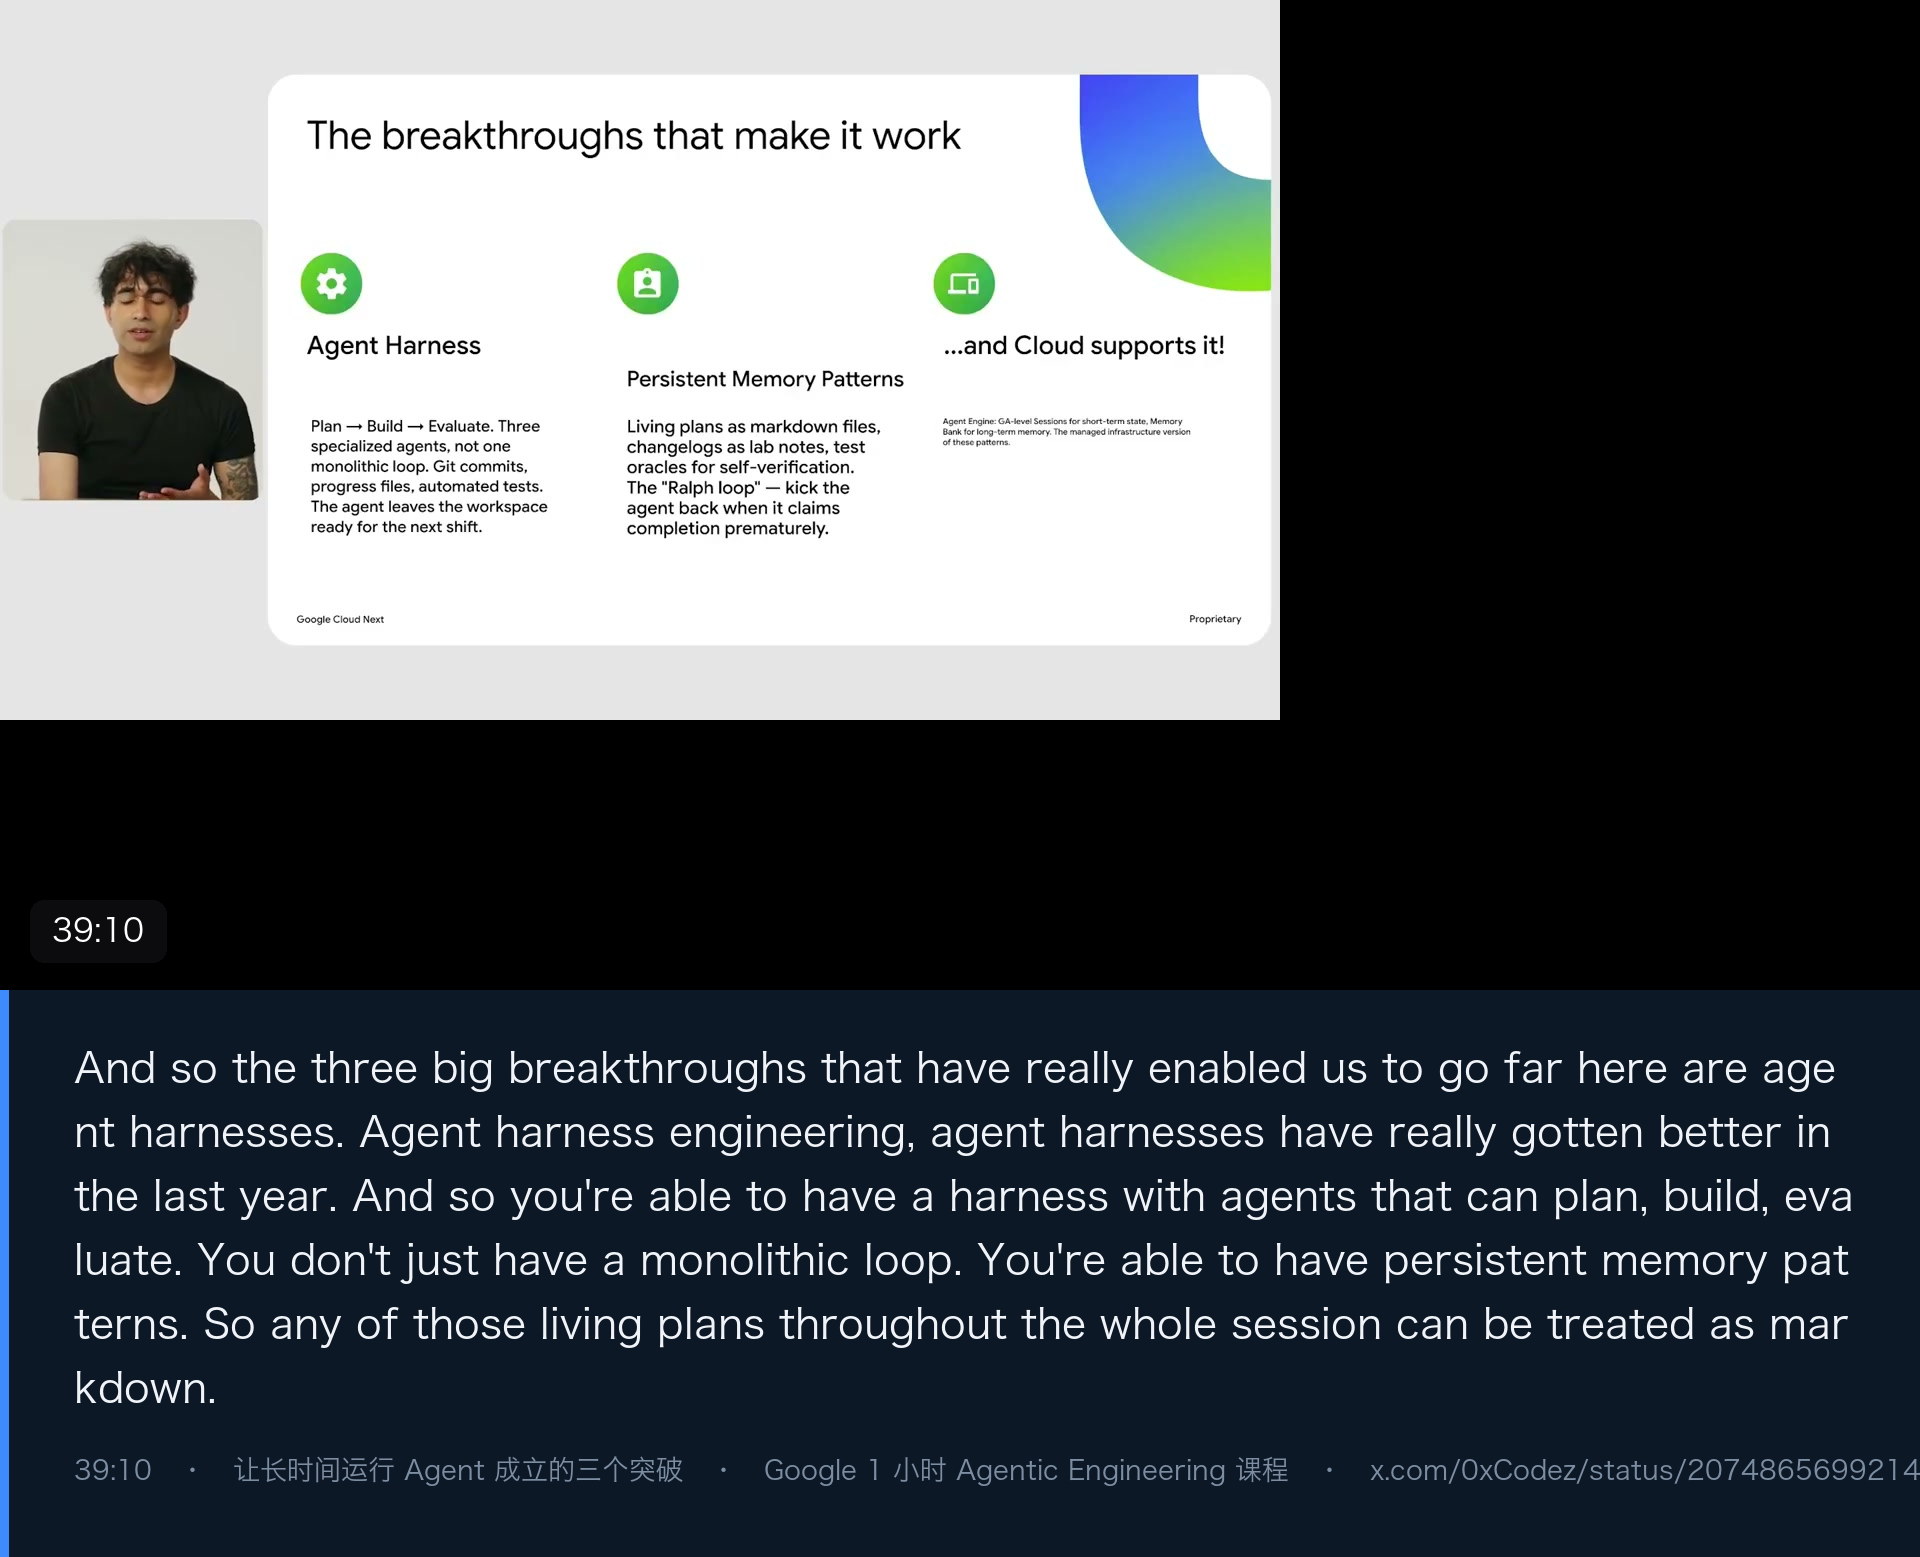
课程也点名了 Agent 最常撞的三堵墙:上下文退化(上下文窗口再长也会被塞满、质量下滑、每次会话都从零开始)、缺少持久状态的原语(没有外部结构,Agent 就会漂移、把事情弄坏,或者干脆放弃)、自我验证失效(如果长时间运行的 Agent 判断不出自己到底做完了没有,这就是个问题;如果它做得烂还自夸,那更糟)。
对应的三个突破是:Agent harness 的工程化(harness 里能规划、能构建、能评估,而不是一个单体循环)、持久记忆模式(把 living plan 当 markdown 维护、把 changelog 当实验记录,甚至跑 Ralph loop 之类的长循环,确保任务真的被完成)、以及托管的基础设施(比如 Gemini Enterprise agent platform 提供 session 和 memory bank,把上面这些东西产品化)。
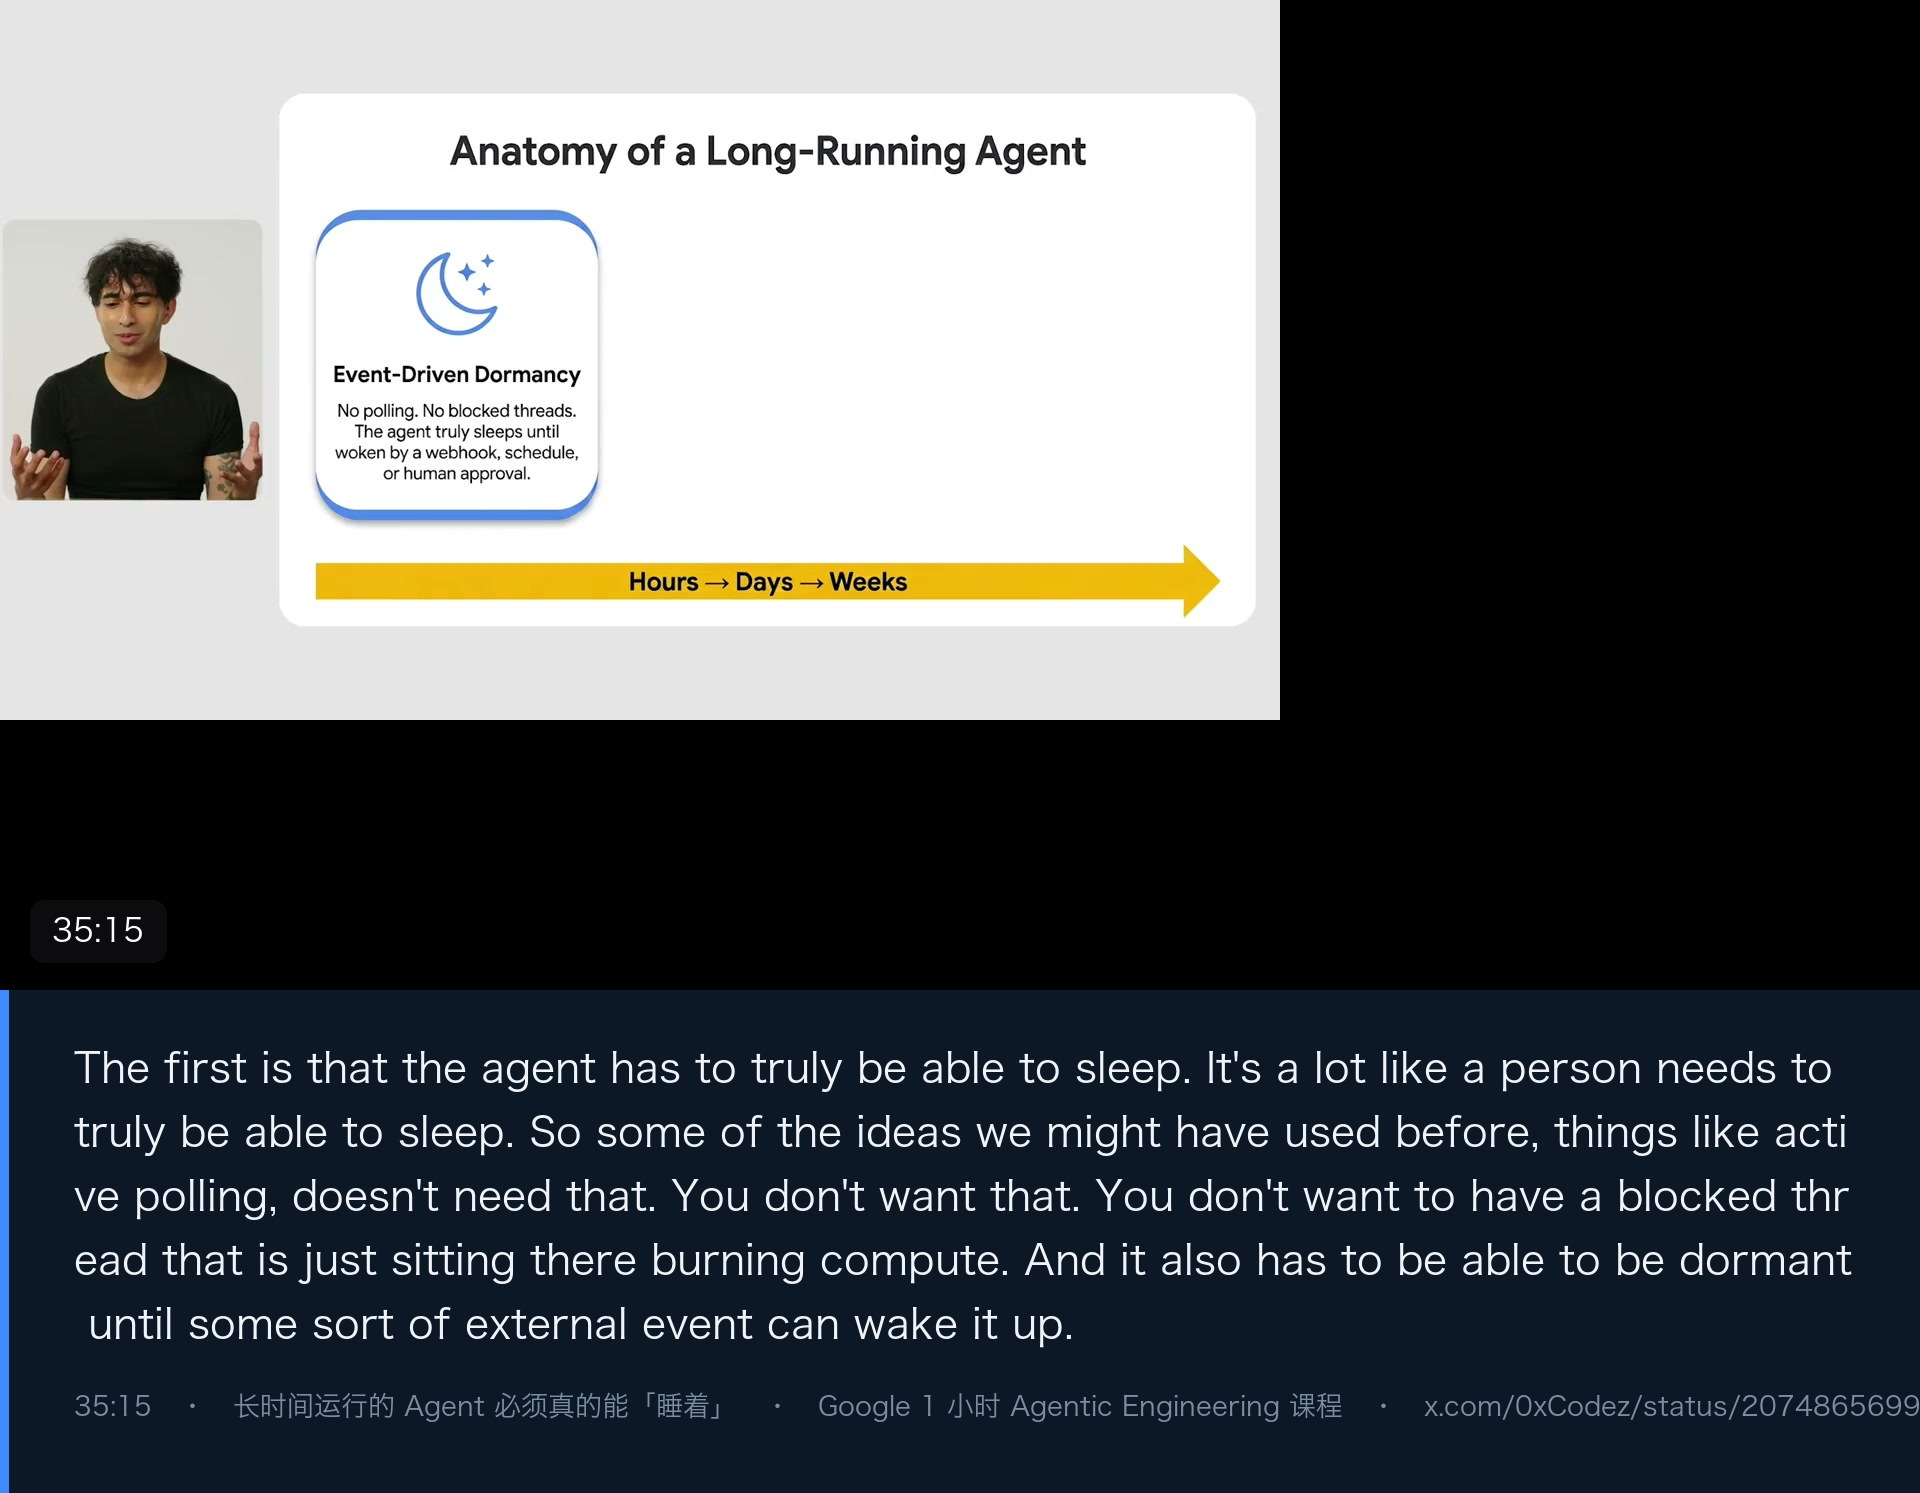
一句话总结这一集:你的工作单元不是一次 prompt,而是一个 workflow。 Agent 自己端到端拥有一个多步骤流程。
04|MCP:它和 API 到底差在哪
MCP 是 Model Context Protocol。课程给的理解方式是:它是 Agent 和外部工具之间的一种标准说话方式,像中间站着一位翻译。
它的工作过程是这样的:工具作为自己的小进程跑着;Agent 通过标准输入输出连上它;Agent 问「你有哪些工具」,服务端返回工具名、参数和返回值的列表;Agent 说「用这些参数调这个工具」;工具跑完,结果以 JSON 回来。关键是这套切分很干净——每个工具跑在自己的进程里,Agent 不需要知道工具是怎么写的、用了什么库、甚至是什么语言写的。只要它说 MCP,Agent 就能用。
好处因此有四条:隔离(工具崩了不会把 Agent 带下去)、互通(Python、Go、Node 写的工具 Agent 都不挑)、可发现(工具用 schema 描述自己,Agent 运行时就能读懂怎么用)、可扩展(加工具、换工具、给工具做版本,都不用重写 Agent 代码)。
实操部分是给上一节的写博客 Agent 接一个 MCP Server:新建一个 server.py,只做一件事——暴露一个查 Google Trends 的 Trends 工具,然后让 Agent 在写作之前去取真实的趋势数据。代码里要看四个地方:用 FunctionTool 把普通 Python 函数包成 ADK 工具(ADK 自己从函数签名和 docstring 里生成 schema,不用手写);创建 MCP server 对象(通过 stdio 说 MCP 协议);写 list_tools 和 call_tool 两个 handler(前者回答「我有什么工具」,后者把参数转给 Python 函数、把返回值 JSON 化送回去,出错就返回一个小的 JSON 错误并把细节写进 stderr);最后把 server 挂到 stdio 上跑握手,asyncio.run 启动。
然后回到 agent.py,在根 Agent 的 tools 列表里加上 trends_mcp 就行。对 Agent 来说没有任何区别——调 MCP 工具和调本地函数工具长得一样,只不过它现在取到的是真实的趋势查询,而不是编一个。
下半集专门讲 MCP 和 API 的关系,这是整门课里解释得最好的一段:
- API 是为「程序对程序」设计的。 定义端点、发请求、收响应,干净可预测,对传统软件来说完美。但模型不是只调一个端点——它可能要跟十个端点说话、要把它们串起来、要解释非结构化数据、还要追问。所以它需要的不只是「访问某个工具」,而是上下文。
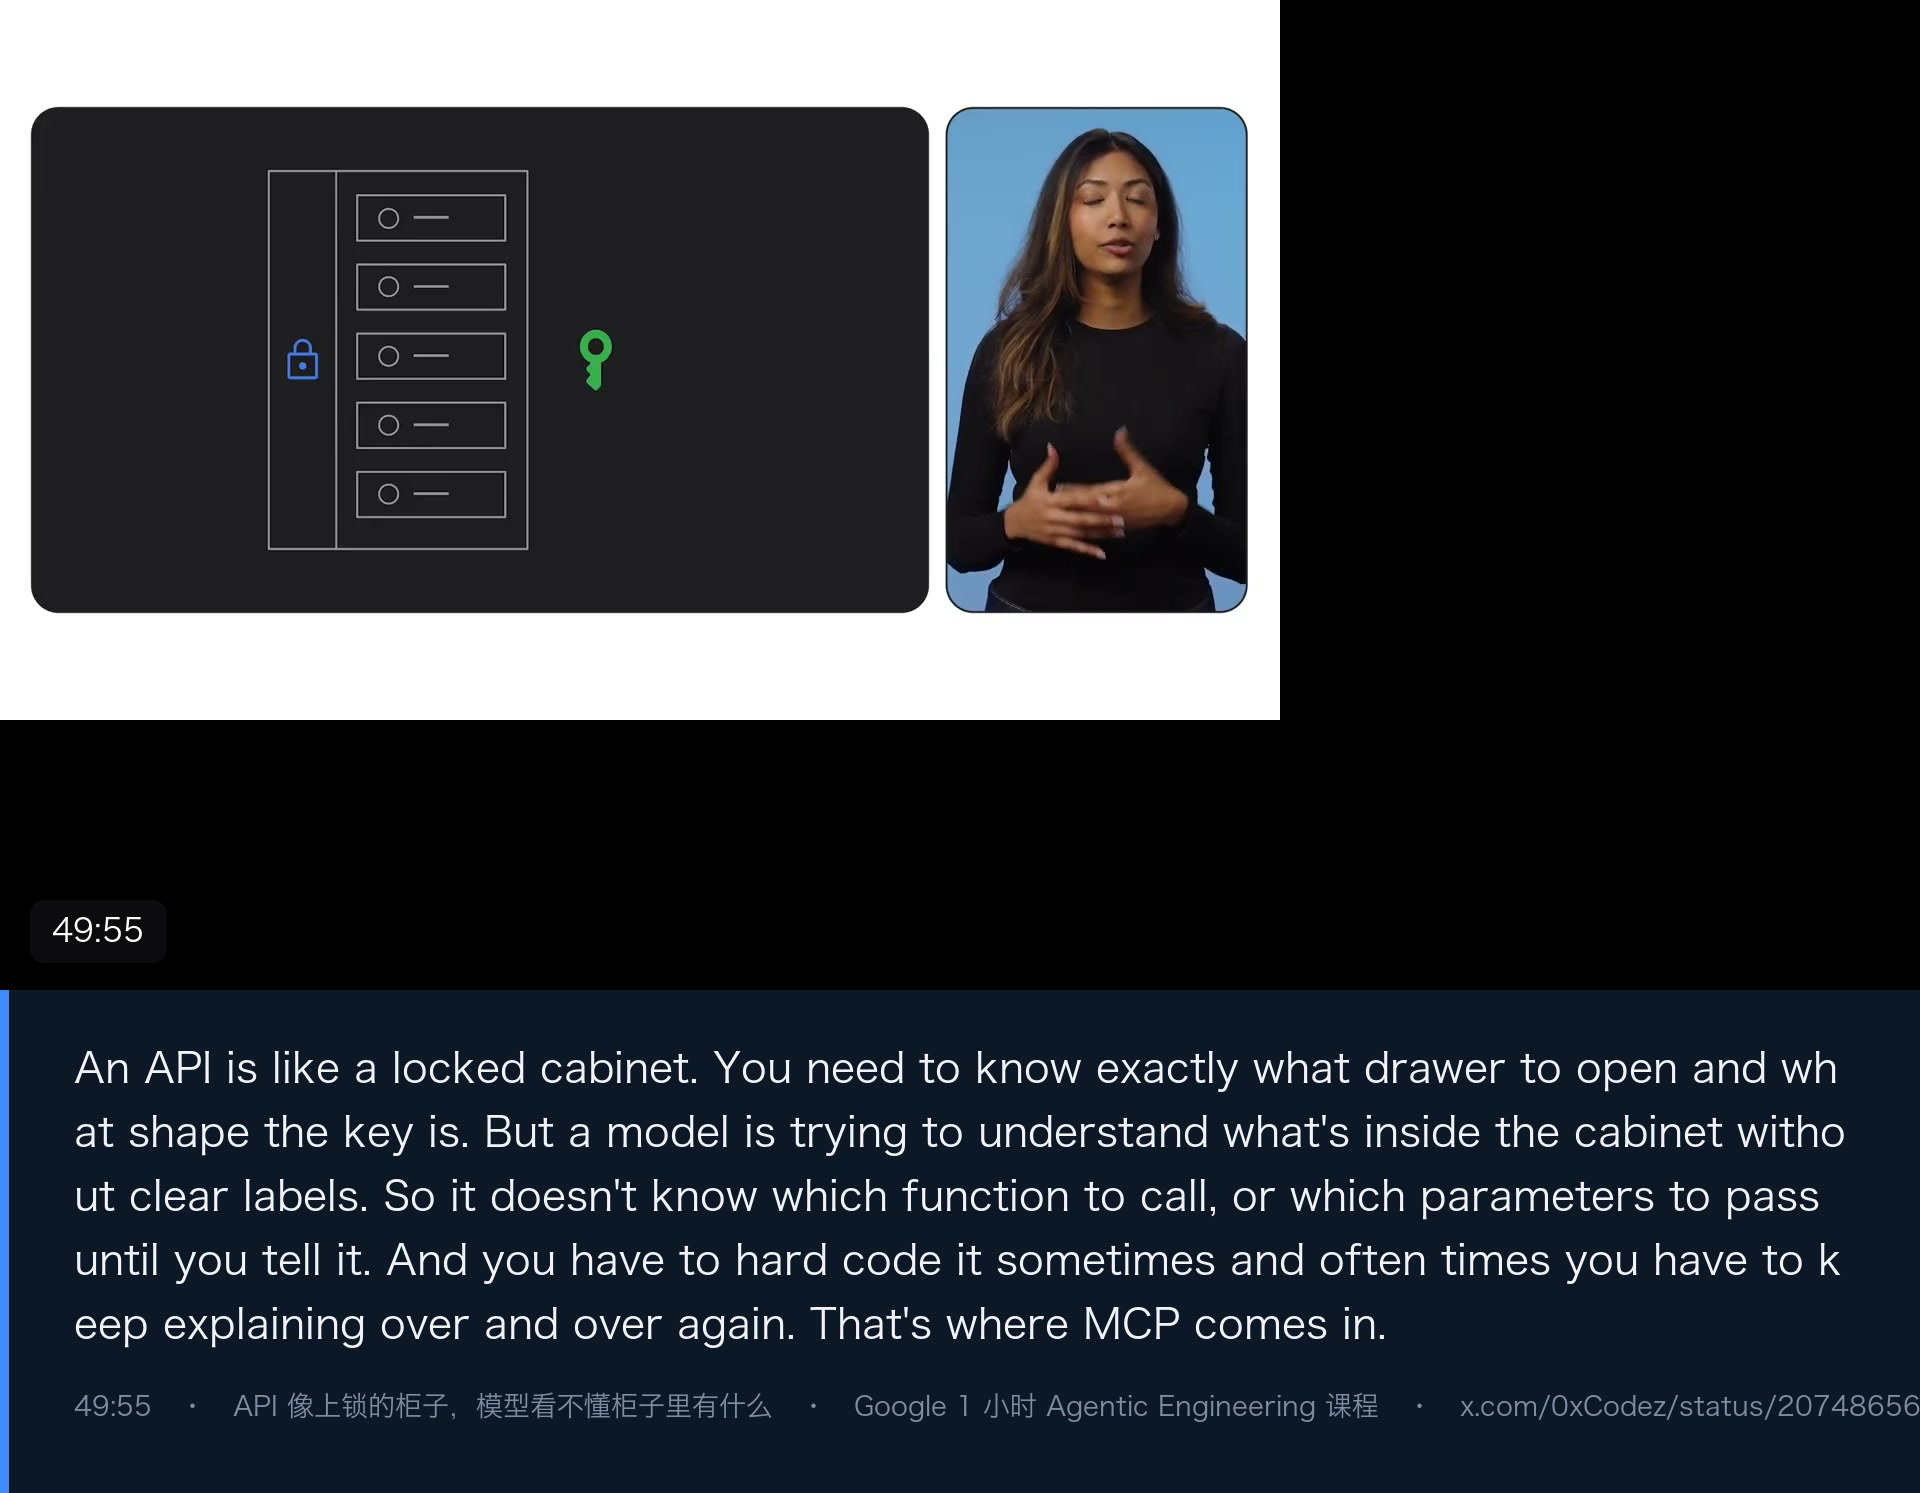
- API 像一只上锁的柜子。 你得知道开哪个抽屉、钥匙是什么形状。而模型是在没有清晰标签的情况下试图理解柜子里有什么:不告诉它,它就不知道该调哪个函数、该传什么参数;而且这些往往要硬编码,还得反复解释。
- MCP 给模型的是一张机器可读的地图,而不是一本静态说明书。举个具体的例子:一个管理客服工单的 Agent 要接 Gmail、Notion、Jira。用 API,你得为每个集成写定制代码,处理分页、鉴权令牌、错误分支、限流,还要用长长的 prompt 教模型「要建 Jira 单就调这个端点、传这些字段」。用 MCP,每个服务各自暴露一个 MCP 兼容接口,模型自动发现这些工具,把它们当成自己环境的一部分——你不告诉它怎么做,你给它上下文,它自己判断。
- 所以真正的差别是:API 是两个应用之间的代码级契约,MCP 是模型与其环境之间的语义协议。 以前「什么时候调什么」的逻辑写在你的应用代码里,现在这部分逻辑可以挪进模型的推理层。
- 但 MCP 不是要取代 API。 API 仍然是地基,是你系统实际运转的方式。MCP 换掉的是模型和 API 之间的那层中间件——它把已有的 API 翻译成模型能自动理解的格式。与其说「MCP vs API」,不如说是 MCP on top of APIs。变的其实是「客户端是谁」:API 的客户端是另一个程序或人,MCP 的客户端是模型本身。
- 课程用 HTTP 打了个比方:在 HTTP 统一互联网之前,每个服务都有自己的协议(FTP、Gopher、Telnet)。一旦标准化,一切都互通了。MCP 对 AI Agent 做的是同一件事——你不用再为每家公司发明一套插件格式,而是写一次连接器,任何兼容的模型都能用。
- 也不回避问题。采用:得让服务端、客户端和工具先对同一个标准达成一致。安全与管控:模型能直接通过协议调工具,你就需要清晰的权限层,不能让模型误发邮件、误删文件、或者误改生产数据库;API 靠鉴权和限流处理这些,MCP 需要把同样的护栏搬进协议层。开发者心智:我们是在 endpoint 和 route 的世界里长大的,MCP 要求我们用 capability 和 context 思考——设计系统时描述「它能做什么」,而不只是「怎么做」。
05|Multi-Agent:把 Agent 当成工具,配给另一个 Agent
最后一集从 ADK 的最基础用法开始。Agent 是什么?一个 LLM,带上一组工具,跑在一个循环里完成一项任务。 ADK 就是帮你省掉这些样板代码的框架——它帮你给 LLM 配上工具、帮你处理循环的控制、判断什么时候该停下来,还给你开发期好用的测试界面。
用 adk create first_agent 生成骨架,最小 Agent 只要四个参数:model、name、description、instruction(也就是 system prompt)。这里课程选了 Gemini 3 Flash preview,指令就一句话:「你是一个有用但简洁的助手」。adk run 可以在终端里对话,adk web 起一个网页界面,能看到完整的调用栈和 trace,调试时很有用。
接下来给 Agent 装工具。第一个叫 timekeeper,代码只比最小 Agent 多两处:顶部加一个 get_current_time 函数返回当前时间,然后加一行 tools=[get_current_time]。工具接受一个列表,所以可以配多个。为什么需要它?因为 LLM 的知识有截止日期——你问它现在几点、今天几号,它要么不知道,要么给出错的答案。
第二个工具直接用内置的 google_search_tool,注意要设置 bypass_multiple_tools_limit=True:默认只允许一次工具调用,而 Google 搜索往往需要多次调用才能凑齐结果。调完之后会明显感觉到延迟变长(它真的出去搜了),网页端左侧还能看到它引用的所有来源。
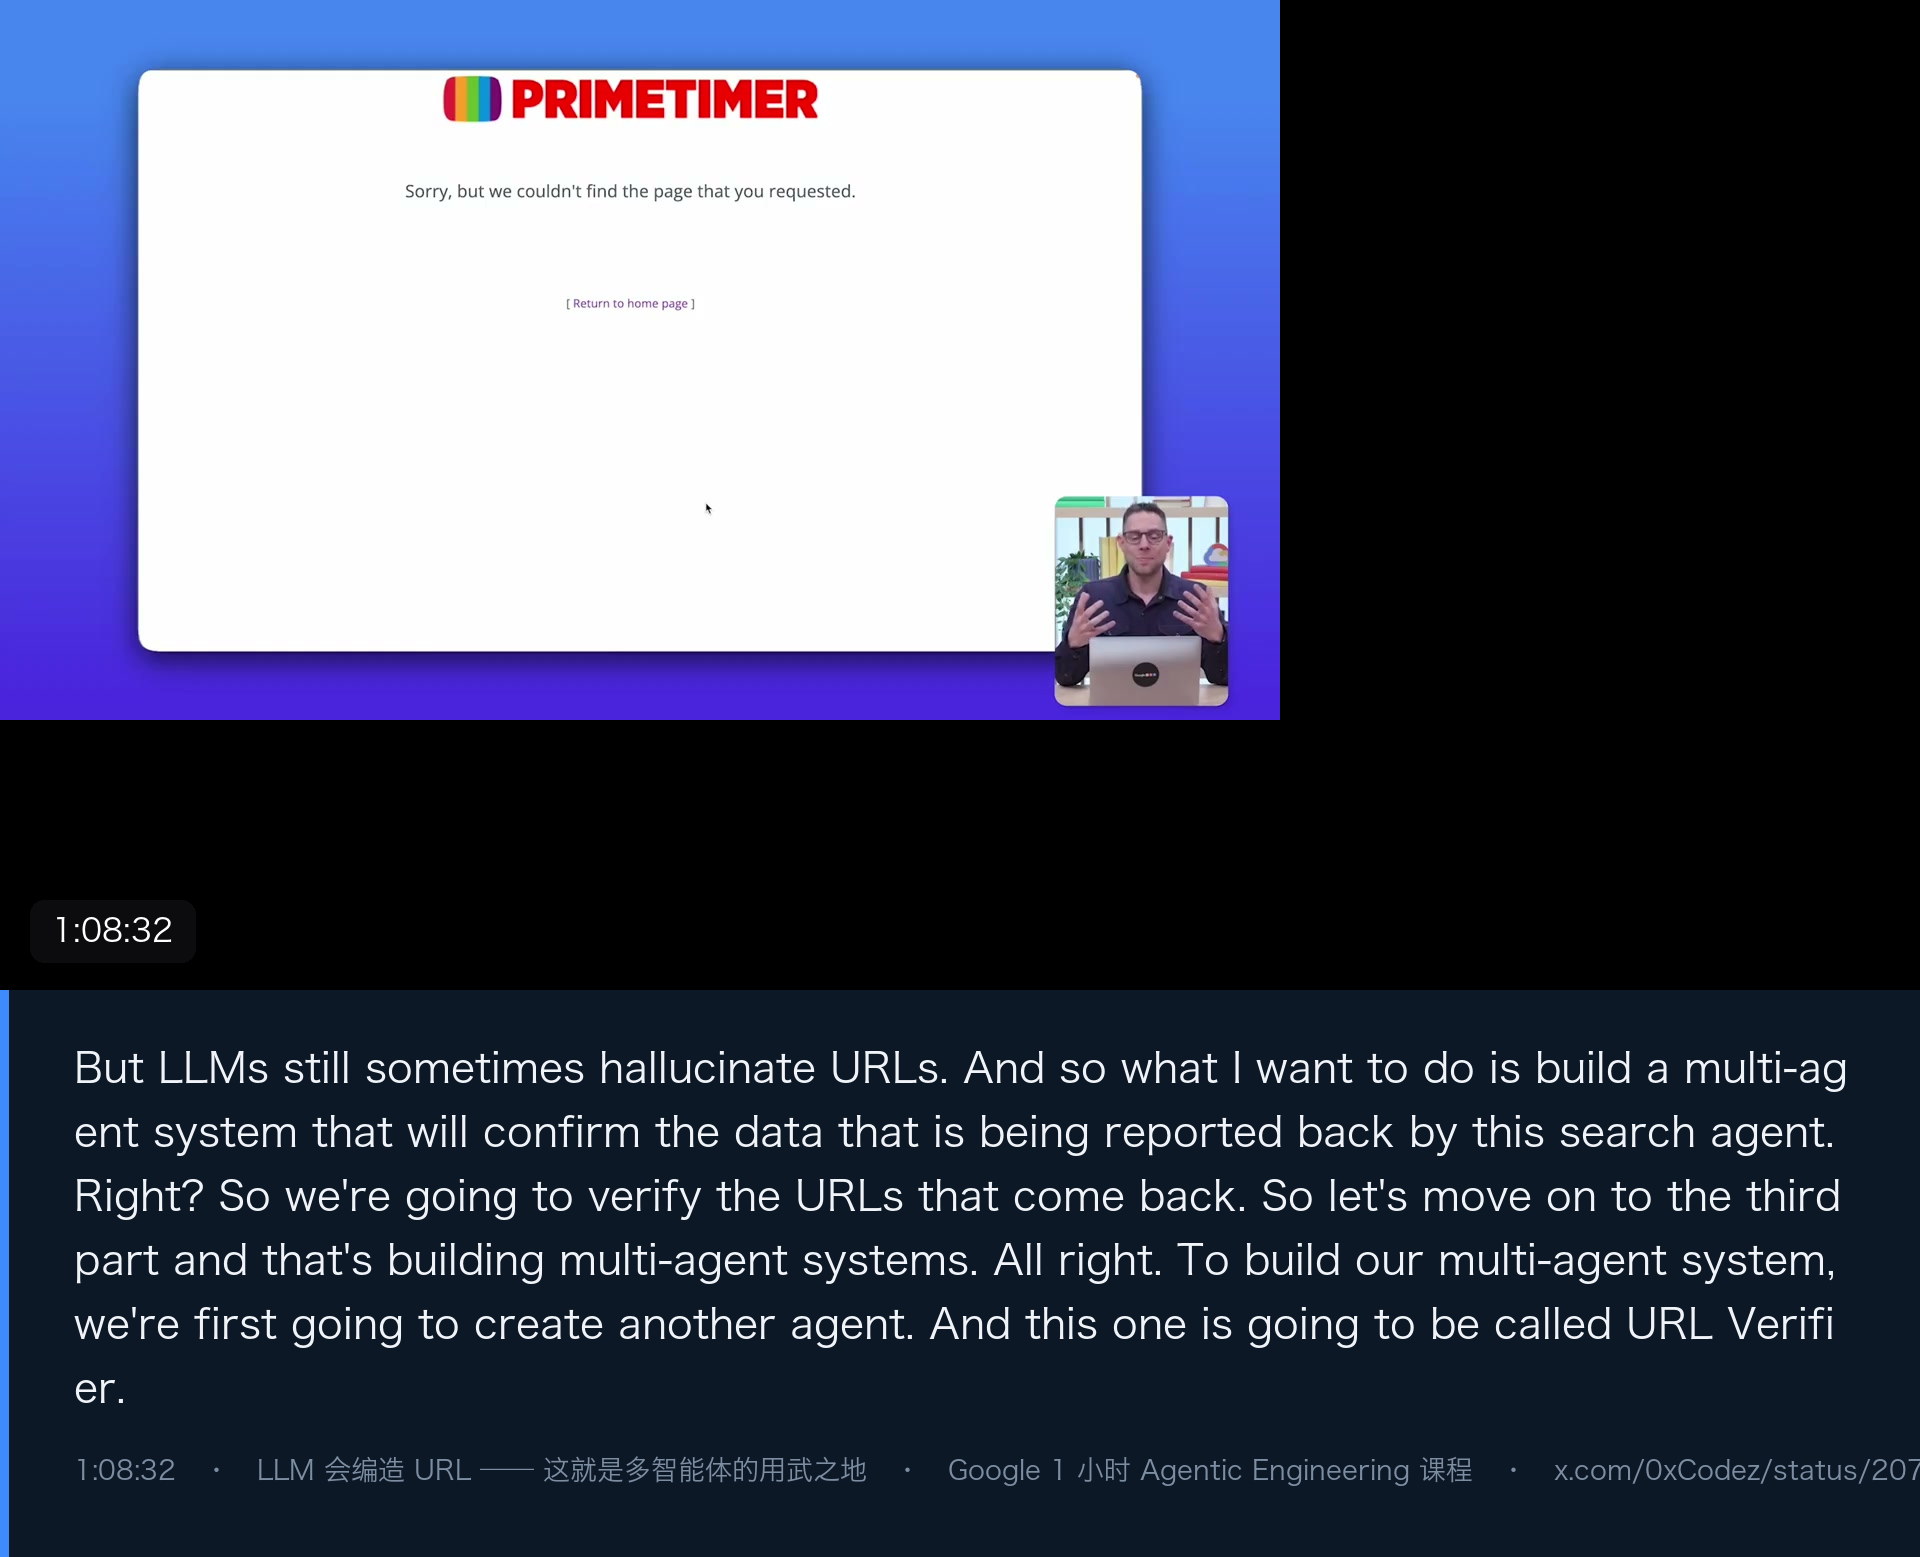
然后课程展示了一个真实的瑕疵:这些来源里有 404。 LLM 仍然会编 URL。这恰好成了多智能体的动机——既然搜索结果需要验证,那就专门做一个负责验证的 Agent。
于是先建 URL Verifier:给它一个 fetch_url 工具,传入 URL 返回网页文本,让它输出 verified / not verified / inconclusive 三选一。课程点明了这就是所谓的 LLM as a judge——把一个语言模型的请求结果交给另一个模型,并给后者工具去核实。
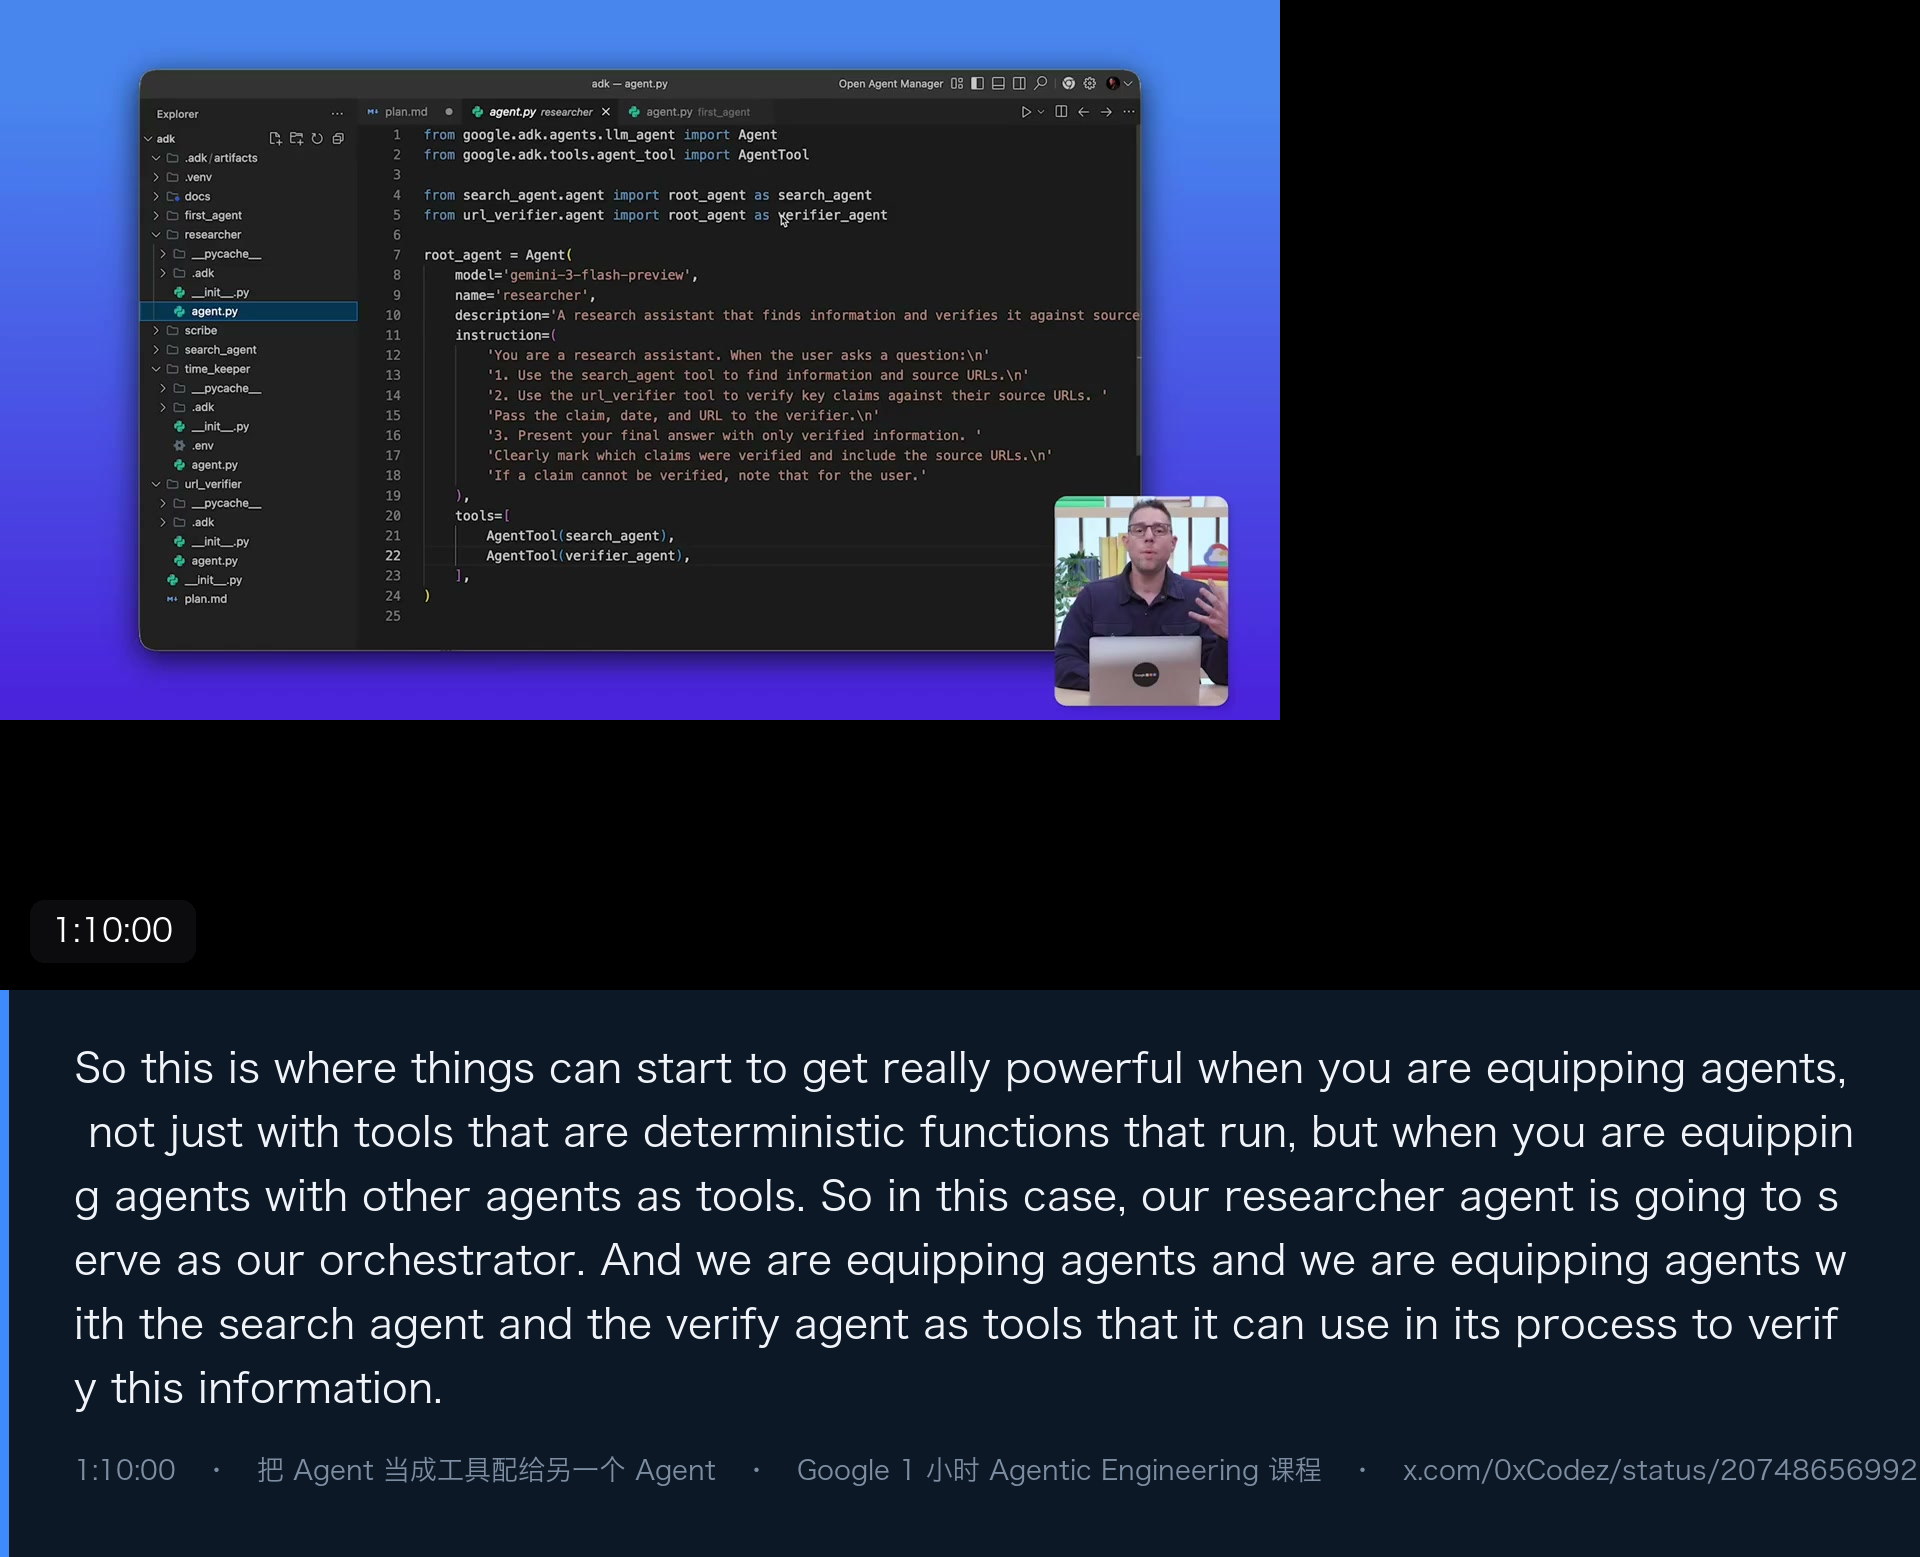
再建 researcher,它有两个工具,但这两个工具本身就是 Agent。这是整集最关键的转折:当你不只给 Agent 配确定性的函数工具,而是把别的 Agent 当工具配给它时,事情才开始真正变强。 这里的 researcher 就是 orchestrator,它把 search agent 和 verify agent 都挂在 tools 上;指令改成「你是一个研究助手,先用 search agent 找信息,再用 verifier 确认信息是否准确」。到网页端问同一个问题,就能看到它连续做多次工具调用:先搜索,再拿验证器打开 URL,确认来源真实存在、内容确实对得上。
好处被总结成三句:每个 Agent 只承担一个非常具体的任务,于是性能、记忆和成本都更好管;可以给不同的 Agent 配不同的模型——简单任务用更便宜更快的,复杂推理用更贵更强的;整体上你对「能完成什么类型的任务、以多高的确定性、花多少成本」有了多得多的控制权。课程最后指向 adk.dev 的入门文档。
值得带走的几条
- 校验要抽成独立的一步,最好是独立的模型。 第一节用
okay/retry做大纲校验,第三节用 planner / generator / evaluator 做长流程,第四节用专门的 verifier 抓 404——三处讲的是同一件事:让「判断做得好不好」和「做」分开。 - 记忆不是一个东西,是三种寿命。 会话内、跨会话的个人画像、跨模态的长期归档,分别用三种存储解决;把它们混在一起谈「Agent 有没有记忆」,问题会一直说不清。
- 休眠是架构能力,不是优化。 能真的停下来等外部事件的 Agent,才可能跑几周;靠轮询撑住的长任务,只是把成本换成了另一个形态。
- 状态要落盘,步子要可续。 每一步都有 checkpoint,容器崩了还能接着走;否则用户拖几天,Agent 就只能靠编。
- MCP 的位置在 API 之上。 它不是新的后端,而是模型与已有系统之间的翻译层;理解这一点,就不会把它当成又一种「接口风格」。
- 多智能体先解决分工,再谈规模。 每多一个 Agent 都该有明确的单一职责,否则只是把复杂度从一个 prompt 搬到了多个 prompt。
附:原始文件
- 逐字稿(英文原文,972 条时间轴):
transcript-X_2098600319450329271.md - 本文图片为课程画面与逐字稿原句的合成图,时间戳标在画面左下角,可直接对回原视频。
- 原视频:https://x.com/0xCodez/status/2074865699214741897(1:12)
讨论
这里是静态站点,没有内嵌评论区。如果这篇文章对你有用,欢迎通过 RSS 订阅后续更新。