《Advanced evals》讲义:先找出「值得测的失败」——error discovery 三步法
Hamel Husain 和 Shreya Shankar 的进阶续篇:做 evals 最该先做、大多数团队却跳过的第一步是 error discovery。为什么「太早写指标」会测错东西;为什么 agent 抓不到判断型失败(criteria drift);100 条真实 trace 的对照结论;以及用 coding agent 走完三步——从 traces 开始、审阅与标注、把失败模式变成产品优先级。含 7 张双语配图。原文为 Substack 付费文章,本讲义覆盖免费可见部分的全文,付费墙之后的部分已据实标注。
来源:Hamel Husain 的推文 @hamelhusain(2026-09-22)→ Lenny’s Newsletter 客座长文 《Advanced evals: How to find (and fix) hidden AI failures in your product》(Hamel Husain & Shreya Shankar,2026-09-22)· 插件仓库:ai-evals-course/evals-skills
阅读说明(先说清哪些是原文、哪些是本文加的)
- 全文分三块:① 编者按(Lenny 写的导语,非两位作者正文);② 原文逐段中文翻译(保留作者原有的小标题体系);③ 本文分析(最后一节),是本文作者对这套方法的判断与追问,不是作者原话。
- ② 里的英文引文照录原文,中文为本文翻译;原文英文全文见另一篇。
- 关于完整度:这篇是 Substack 付费文章,抓取时(未登录订阅账号)能读到的正文到「Step 3」第一段为止,之后是付费墙。所以第 ② 块覆盖的是免费可见部分的全部正文;Step 3 的其余做法(把失败模式变成带优先级的 issue 清单、那张汇总表怎么读)没有读到。文中如涉及该部分,都会明确标注,不做补写或推测。
- 七张配图是「原文原图 + 当时的英文原句 + 中文翻译」的合成图,用来对上原文的每个小节。
TL;DR
- 这篇的核心判断:做 evals,最该先做、而大多数团队都跳过的一步,是 error discovery(错误发现)——先找到「哪些失败值得测」,再去写指标。作者甚至说:如果 evals 流程里只能做一环,就做这一环。
- 为什么不能跳过:太早写指标 = 对「什么重要」做了太多假设,结果可能测错东西,或者把对的东西测得很糟。他们把这一步类比成 evals 里的「产品发现(product discovery)」。
- 为什么不能偷懒交给 agent:因为存在 criteria drift(标准漂移)——你对「什么算好」的定义,本身是翻数据翻出来的,不是事先写好的。原文那个例子很典型:租房助手面对「这超出我预算了,谢谢」,礼貌地送走了客户;在大多数 agent 眼里这是成功,但从「这个产品要促成成交」的目标看,它应该去查更便宜的房源、或同公司的其他楼盘,给出替代方案。
- 他们跑了 100 条真实 trace 做对照,结论很实在:agent 漏掉需要产品判断、以及 trace 之外上下文的问题(比如短信里的 Markdown 格式、漏掉的人工转接);擅长抓 trace 内部就自相矛盾的失败(答案与工具输出打架);也能找到人会漏的问题,但会把好回答误标成失败,噪声不小。
- 所以出路不是「人 vs 机器」,而是主动学习(active learning)式的配比:先抽足够多样的样本自己看 → 看到失败再多看几个同类 → 看得差不多了再让 agent 批量标注 → 由你逐条接受/驳回。
- 三步法:① 从 traces 开始(没有就先用维度组合造合成数据);② 审阅与标注(插件会为你的数据现生成一个本地审阅应用,先人工看 10 条再让 AI 接力,经验目标是标到 100 条);③ 把失败模式变成产品优先级(AI 把批注聚成 failure modes 并计数,你看模式)。
- 两条能直接抄走的界面原则:用户看到什么样,就把产出按什么样渲染(邮件像邮件、PDF 像 PDF);把有助于导航/筛选的元数据暴露出来(渠道:短信 / 语音 / 网页聊天)。
- 四条能直接抄走的标注规则:写同事能看懂的话(「回答很差」不算批注);不做根因分析(只看用户视角出了什么事);遇到上游错误就停;起步阶段只标失败。
- 作者给的工具:
npx skills add https://github.com/ai-evals-course/evals-skills,然后让 coding agent 用/evals-start入口。
零、编者按(Lenny 的导语,非作者正文)
- Lenny 说 evals 在他的播客嘉宾和 PM 对话里出现得越来越频繁;他上周在社媒分享的 25 个 PM 职位里,接近一半都要求「写过 evals」的经验,这项技能只会更值钱。
- 所以他请 Hamel 和 Shreya 给去年那篇很受欢迎的《Building eval systems that improve your AI product》写一篇进阶续篇。基于他们与 50 多家 AI 公司的合作,他们发现:大多数团队会直接跳到写指标,最后测错了东西。
- 这篇讲的就是「大多数团队跳过的那一环」,以及哪些步骤能自动化、哪些不能,还有一个免费插件,能让 coding agent 替你干大部分重活。
一、导语:为什么现在人人都在谈 evals
By now, you’ve probably heard that evals are a defining skill for AI PMs. Mike Krieger, Anthropic’s former CPO and now head of Labs, has said that “if there’s one thing we can teach product people, it’s that writing evals is now probably the most important thing.” Garry Tan, the CEO of Y Combinator, shared that “evals are emerging as the real moat for AI startups.”
到如今,你大概已经听过「evals 是 AI PM 的核心技能」这种说法。Mike Krieger(Anthropic 前 CPO,现负责 Labs)说过:「如果只能教产品人一件事,那大概就是写 evals 现在是……最重要的那件事。」Y Combinator 的 CEO Garry Tan 也说:「evals 正在成为 AI 创业公司真正的护城河。」Lenny’s Podcast 的不少嘉宾都主张「evals 就是新的 PRD」。而越来越多头部公司开始讲,投在 evals 上的钱是怎么赚回来的:
- Shopify 用 evals 指导开发一个 AI workflow builder,比它替换掉的前沿模型方案快 2.2 倍、便宜 68%。
- Cursor 用 evals 打磨 Auto Balance 的路由性能,用户满意度明显更高,成本降了 41%。
- Ramp 靠 evals,把端上模型在收据照片里匹配交易记录的精确率从 35% 提到 83%。
- Harvey 用 evals 重做了 AI 合同审阅器,产品内部质量分几乎翻倍。
- Rippling、Glean、Abridge、ElevenLabs、Robinhood 也都讲过他们如何用 evals 系统性地把 AI 产品做得更好。
AI products are easy to change but hard to predict. A prompt, model, or code change can improve one behavior while breaking another.
AI 产品容易改、却难预测。改一句提示词、换个模型、动一行代码,可能修好一个行为、同时弄坏另一个。evals 的作用,就是把你对「什么算好」的判断,变成团队上线前可以反复跑的测试。被 evals 标出来的线上错误,又能变成新的测试用例,反过来让 AI 变好——这是一种会随时间复利累积的优势。而且现在 AI 改代码的速度已经快过人来审阅的速度,evals 还能帮团队「快速上线」:自动检查产品是否仍然按预期工作。
Unfortunately, we’ve found that most teams skip the first stage of error discovery and jump straight to writing metrics.
在上一篇文章里,我们给出了搭建 evals 的完整流程:发现并分析错误、定制指标、建立持续改进闭环。但很遗憾,我们发现大多数团队会跳过第一阶段(错误发现),直接开始写指标。
原因不难理解:翻长长的用户会话记录去找失败,感觉又慢又难规模化;而指标是具体的、容易自动化的。但如果你太早写指标,你会对「什么重要」做太多假设——结果可能测错了东西,或者把对的东西测得很糟糕。
This is why error discovery is the eval equivalent of product discovery. Just as product discovery shows which problems are worth solving, error discovery reveals which AI failures are worth measuring.
这就是为什么 error discovery 相当于 evals 的「产品发现」。正如产品发现告诉你哪些问题值得解决,error discovery 告诉你哪些 AI 失败值得测量。没有它,团队的风险是:围绕通用指标搭一堆看板,浪费时间,还把产品带向错误的结果。我们认为它重要到这种程度:如果你只有时间做 evals 流程里的其中一环,那就优先做它。
本文会展示用 Codex 或 Claude 这类 coding agent 做 error discovery 的三个步骤。这套流程我们在 50 多家公司用过,每一次这些工具都能挖出正在伤害客户体验的重大产品缺陷。学会基本操作之后,整个流程大约 30 分钟就能跑完。
Note: Error discovery has changed a lot since our last post. Our prior post called this process “error analysis.” We now call it “error discovery,” because the goal is to identify failures that are worth measuring.
(作者注:自上篇文章以来,error discovery 变化很大。上篇里我们把这个过程叫「error analysis」,现在改叫「error discovery」,因为目标是找出「值得测量的失败」。)
二、error discovery:为什么标准是「看数据看出来的」
When you’re building an AI product, you need evals to understand where it makes mistakes. But maintaining evals costs time and money; it doesn’t make sense to measure everything.
做 AI 产品,你需要 evals 来知道它在哪儿会出错。但维护 evals 要花时间和钱,不可能什么都测。好的 error discovery 会指出:哪些失败值得被长期测量和跟踪。
即使你知道需要 error discovery 这一步,也很容易一上来就把一整个文件夹的 trace(你 AI 产品用户会话的完整记录)丢给 agent,让它找问题。Agent 找明显问题常常比人快,也能发现我们会漏掉的模式。但当「这是不是一个失败」取决于你对「好产品体验」的定义时,agent 就远没那么可靠了。 你可以把这些标准讲给它听,可这些标准本身往往要靠你先去翻数据才能发现。这种「看例子反过来改变你对好的定义」的过程,叫 criteria drift(标准漂移)。
下面这段互动来自我们合作过的一个 AI 租房助手 Nurture Boss,它的工作是帮物业经理处理与潜在租客的对话:
Potential tenant: “This is out of my budget. Thank you for your business.” Leasing assistant: “You’re welcome! If your situation changes or if you have any other questions in the future, feel free to reach out. Have a great day!”
中文:
潜在租客:「这超出我的预算了。谢谢,不用了。」 租房助手:「不客气!如果您的预算有变化,或者以后有任何问题,随时联系我。祝您有美好的一天!」
这段互动的完整对话,在下面讲 trace 的地方会给出。
在大多数 agent 眼里,这看起来是一次成功;它们不会从这条 trace 里识别出错误。但产品的目标是促成销售,其中包含为不同需求的潜在租客找到合适的房源。在这种情况下,agent 应该去查更便宜的户型、或者同一家公司拥有的其他物业,并向对方提供替代方案。
如果我们一开始给 agent 一批 trace 时就提示它去找这个「异议处理(objection handling)」类失败,agent 是能自动抓到这个错误的。但「异议处理」这一条,只有我们自己看到这条 trace 之后才会想到要加进标准里。这是 criteria drift 的典型案例——也正是为什么必须先退一步:先审阅失败、先定义成功,然后再派 agent 去一大堆 trace 里找错误。
100 条真实 trace 的对照实验
In a broader study, we ran automated eval tools and coding agents against 100 production traces from this same apartment-leasing assistant.
在一次范围更大的研究里,我们把自动化 eval 工具和 coding agent 跑在同一个租房助手的 100 条线上 trace 上,结果如下:
- Agent 会漏:需要产品判断、以及 trace 之外上下文的那些问题,比如短信里的 Markdown 格式、以及漏掉的人工转接(除了异议处理之外)。
- Agent 擅长:抓 trace 内部就显而易见的失败,例如回答与工具输出相互矛盾。
- Agent 也会找到人会漏的问题,但会引入噪声:把好的回答也标成失败。
显然,自动化方法对发现某几类错误仍然有用,而且与人的判断结合时效果尤其好。那么,怎么既拿到 agent 的自动化收益、又把人类留在环里?答案是采用一种借鉴「主动学习(active learning)」的流程:给定有限的时间,主动学习用来挑选信息量最大的样本去审阅。具体做法是:
- 先抽一个足够多样的 trace 样本,覆盖你数据的各种情况;
- 发现一个失败后,再多看几个同类实例,确认自己真的理解了它;
- 等你看过的例子足够多,再让 agent 去标注 trace,由你来接受或驳回。
这些记账和抽样工作,手工做非常难,但 coding agent 非常擅长。本文剩下的部分,会带你一步步学会跟 agent 一起做有意义的 error discovery,并配上我们为你准备好的 evals skills 插件。
三、Step 1:从 traces 开始
Error discovery requires traces.
error discovery 需要 trace。每一条 trace 由用户输入与系统提示词、系统中间做的事(检索、工具调用、中间模型调用)、以及产品的最终输出组成。 每条 trace 都应包含足够的信息,让审阅者能重建当时发生了什么、并判断这次到底是好还是坏。你可以把这些数据记到数据库、eval 供应商、甚至就是一个本地文件夹。本文为简单起见,假设用本地文件夹。
下面是租房助手的一条 trace 可能长什么样。注意这是它的原始形态,你通常想把它渲染成人类可读的样子(后面会讲)。
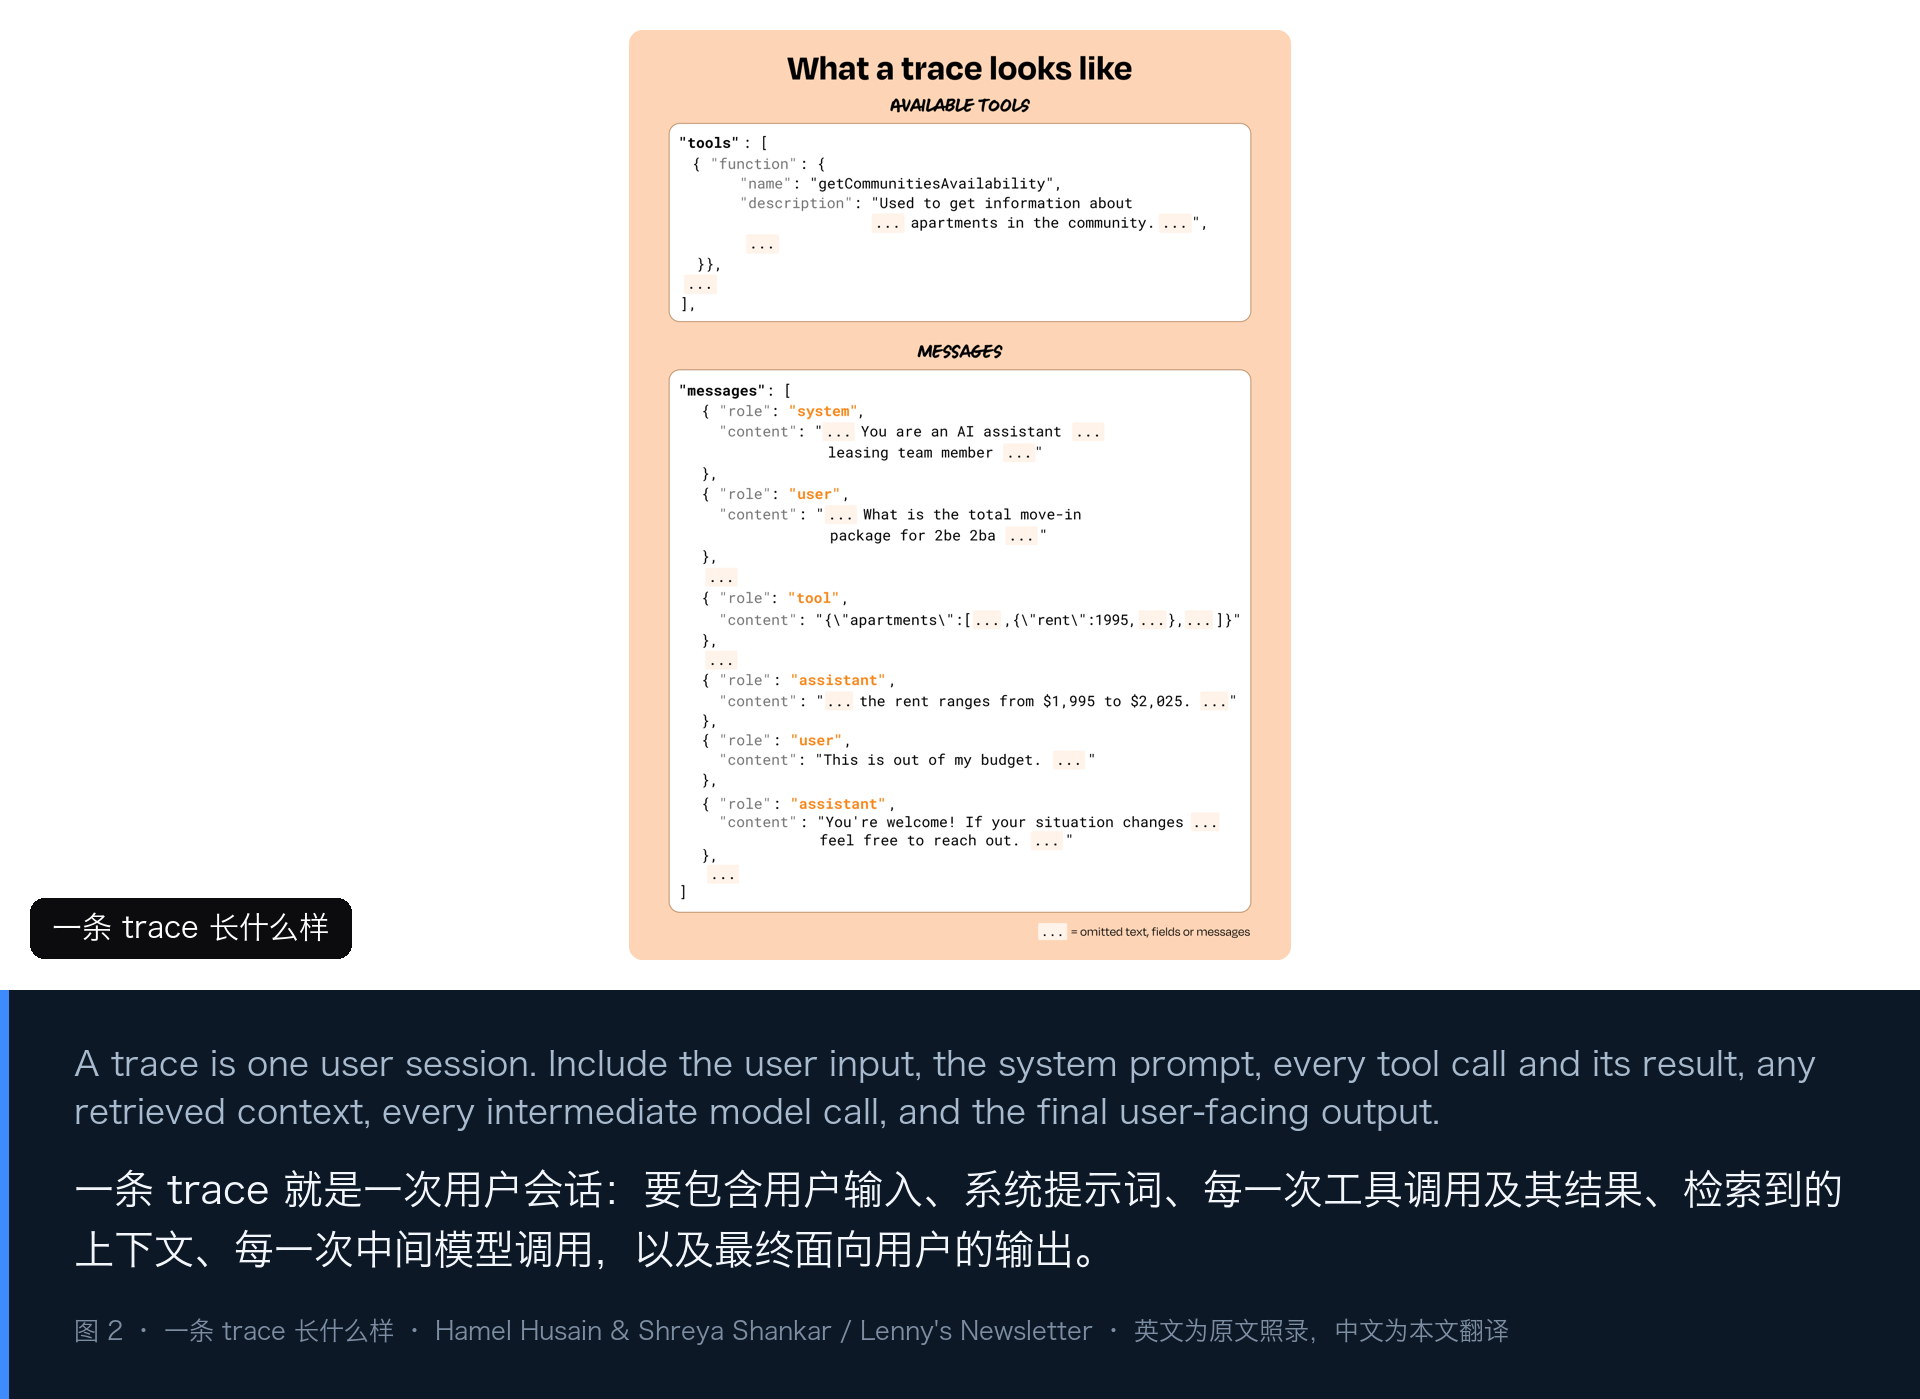
如果你还没有 trace,可以让 coding agent 给你的应用加上埋点,让它记录这些数据。给它的提示词可以是这样:
给这个应用加埋点:把用户与 AI 的每一次会话记录成一条完整 trace。
一条 trace 就是一次用户会话,包含用户输入、系统提示词、每一次工具调用及其结果、检索到的上下文、每一次中间模型调用,以及最终面向用户的输出。
如果这个应用已经把 trace 送到某个供应商(LangSmith、Arize、Phoenix、Langfuse 之类),继续用那个;同时也写一份本地副本:每个会话一个 JSON 对象,追加到
traces/traces.jsonl。如果没有供应商,光有 JSONL 文件就够。
产品埋点做好之后,你需要等真实用户活动来收集 trace。如果你还没上线,可以试着用 LLM 模拟用户提问来生成合成 trace。虽然合成数据不能替代真实数据,但有时有总比没有好。
Pro tip:没有真实数据时,怎么模拟用户提问
模拟用户提问的一个有效做法是:先定义少数几个你预计产品会失败的「维度」。比如租房助手的维度可以是:
- 任务:预约看房、问价格、问宠物政策
- 提问者:第一次租房的人、搬家的家庭、学生
- 请求类型:清晰的、含糊的、超出范围的
然后让模型用这些维度,把每一种组合变成一个自然语言的用户提问。用维度来约束,能帮 AI 避免生成同质化的输出。
维度定好之后,coding agent 就能把它们的取值组合成「场景」,每个场景从每个维度取一个值。然后 agent 可以为每个场景单独发一次模型调用。下面是一个示例提示词:
写一个脚本,为 AI 租房助手生成合成用户提问。把下面的维度和取值当作固定输入,不要增删。
任务:预约看房、问价格、问宠物政策 租客:第一次租房的人、搬家的家庭、学生 请求类型:清晰、含糊、超出范围
把每个维度各取一个值组合起来,生成一份结构化的测试场景列表。遍历这些场景,每个场景单独发一次模型调用,每次调用只传一个场景。强制用结构化输出 schema,只含一个
user_query字段,然后把提问和它对应的场景一起存到synthetic_queries.jsonl。
上面这个提示词建议每个场景单独发一次调用,是因为我们发现让 agent 一次全生成,产出的多样性往往更差。下面是一条合成用户提问的例子:
{ "user_query": "We have two dogs and may be moving next month. Would that work?" }
生成合成数据之后,审一遍,把不现实的例子删掉。如果你发现有些场景你的维度没覆盖到,就更新维度、再补生成覆盖这些缺口的例子。
Producing high-quality synthetic data (especially for complex, multi-turn conversations) is beyond the scope of this post. We recommend getting real users instead of relying on synthetic data where possible.
生成高质量的合成数据(尤其对复杂的多轮对话)超出了本文范围。我们建议尽量去拿真实用户,而不是依赖合成数据。如果你确实必须用合成数据,我们在附录里有一个 skill 可以帮你。
四、Step 2:审阅与标注你的数据
现在可以开始在你的产品里找错误了!我们做了一个 evals 插件来带你走完这个过程,它基于我们教过 4,500 多名 PM 和 AI 工程师、以及咨询过 50 多家公司的经验。用 npx skills 安装:
npx skills add https://github.com/ai-evals-course/evals-skills然后把 coding agent 指向 /evals-start 这个 skill,或者直接告诉它你的数据在哪:
「用 evals-start 这个 skill。我的 trace 在
traces/traces.jsonl,我想找出我的 AI 产品里出现的问题。」
evals-start 是这个 evals skills 插件的入口。 它看你的情况,然后把路由到合适的工作流。在我们这个例子里,我们有一批还没分析过的 trace,所以它会把我们路由到 error-discovery。
定制标注界面:界面本身就是插件价值的一半
The first thing error-discovery does is read a sample of your records to learn their schema. Then it creates a small review app customized for your data and serves it to you locally.
error-discovery 做的第一件事,是先读一批你的记录、搞清它的数据结构;然后生成一个为你的数据定制的小型审阅应用,跑在你本地。下面是为租房助手 trace 生成的应用界面示例:
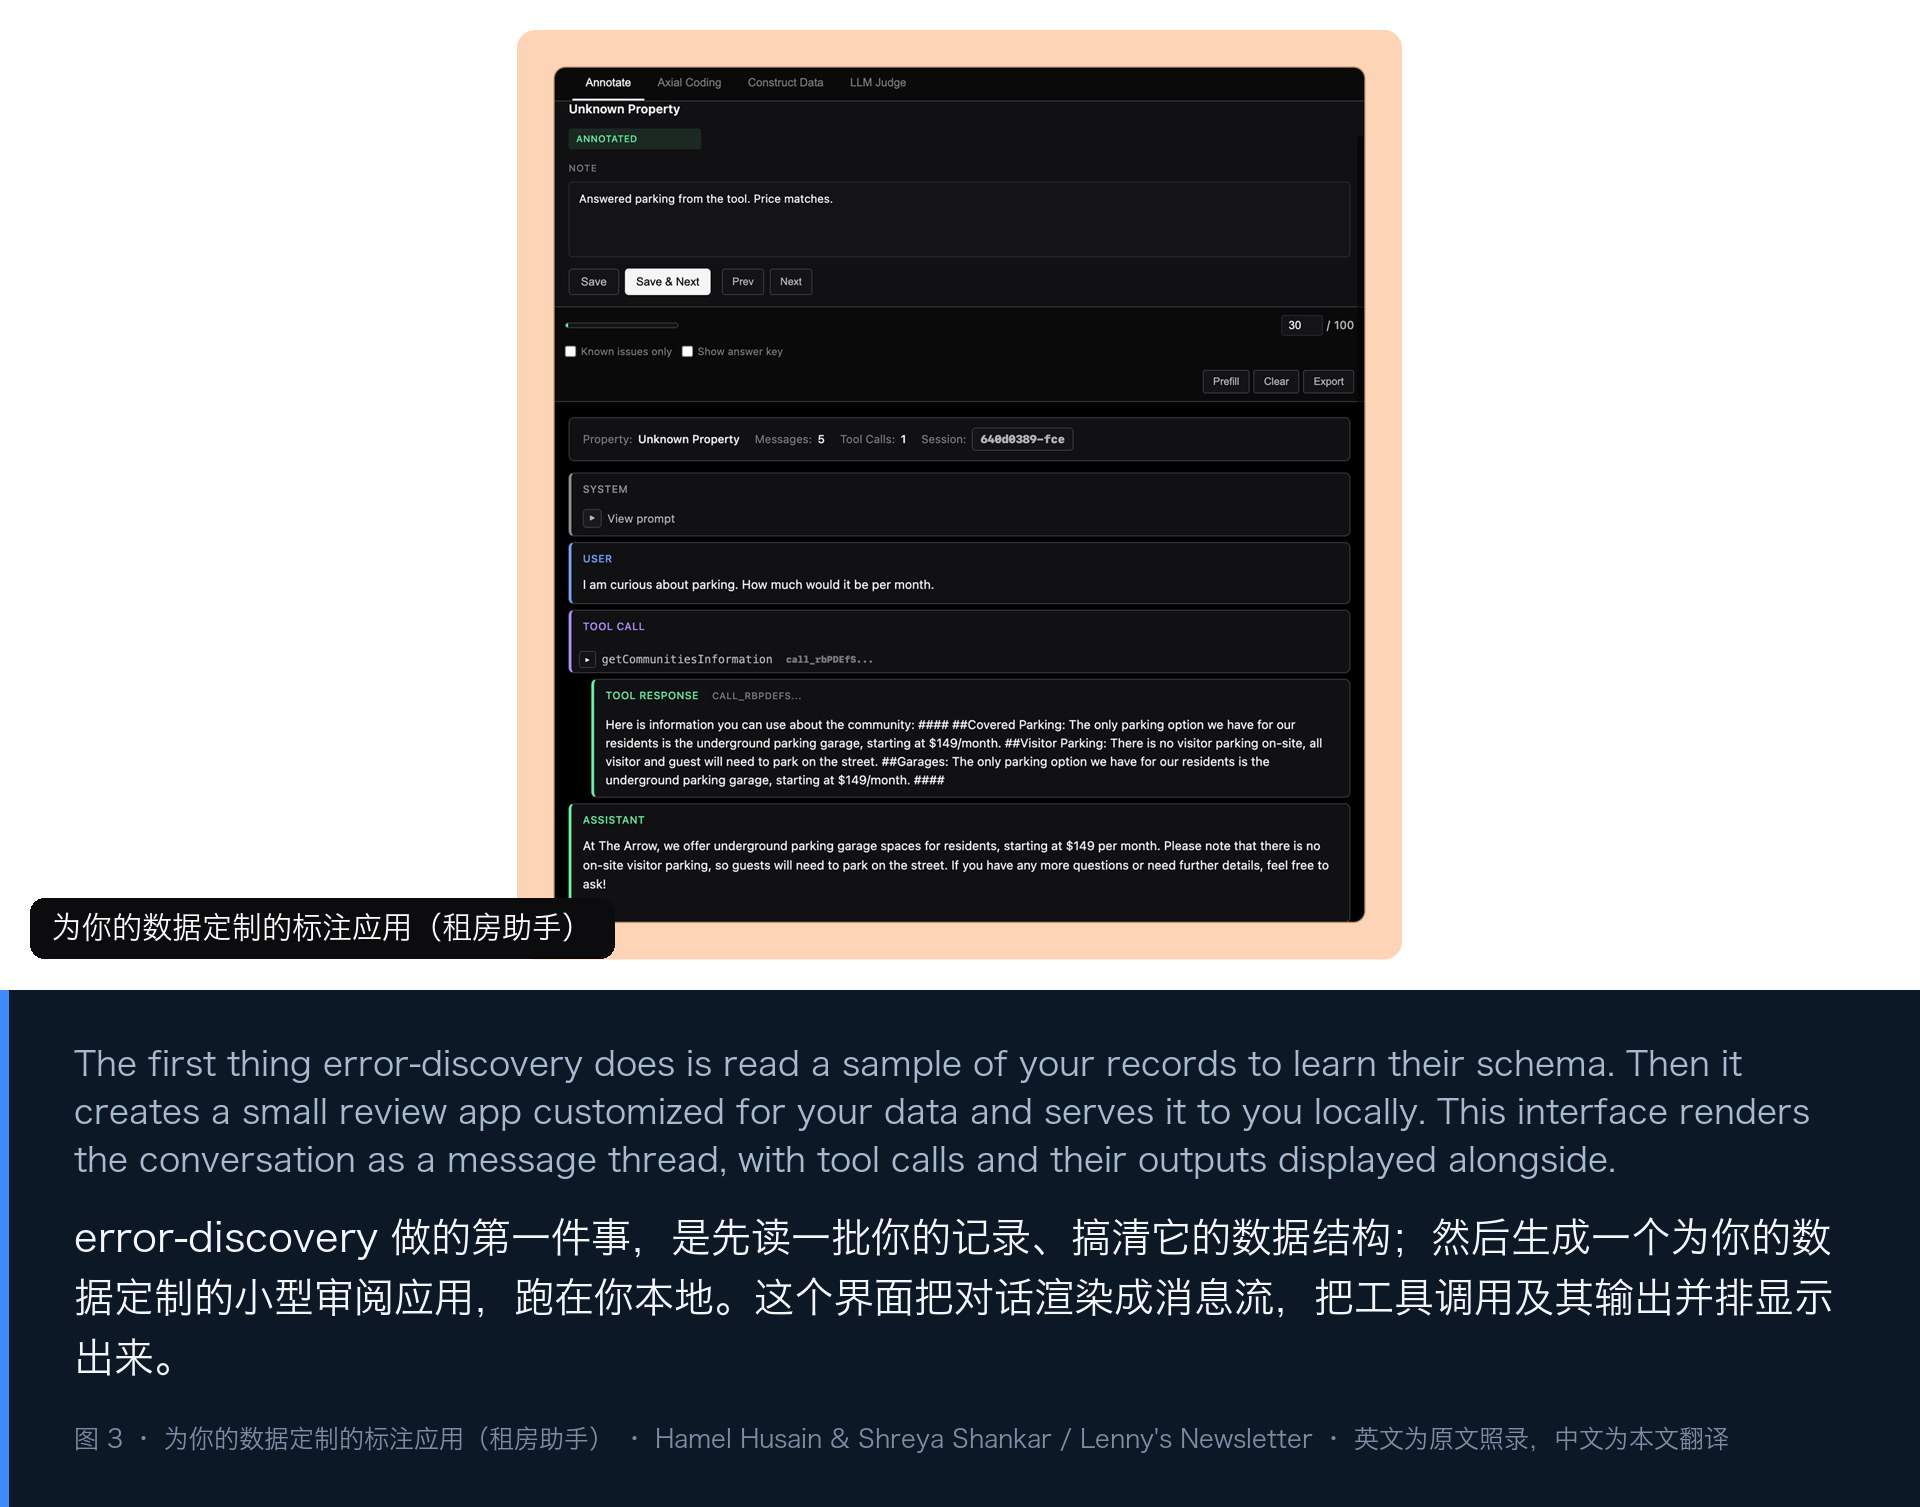
这个界面把对话渲染成消息流,把工具调用及其输出并排显示出来。你在一个自由文本输入框里写批注。
Different types of interfaces are best suited to reviewing different types of data.
界面定制是这个插件价值的重要部分。不同形态的数据,要用不同形态的界面来审阅。 比如,写作助手的标注界面渲染出来可能是这样:
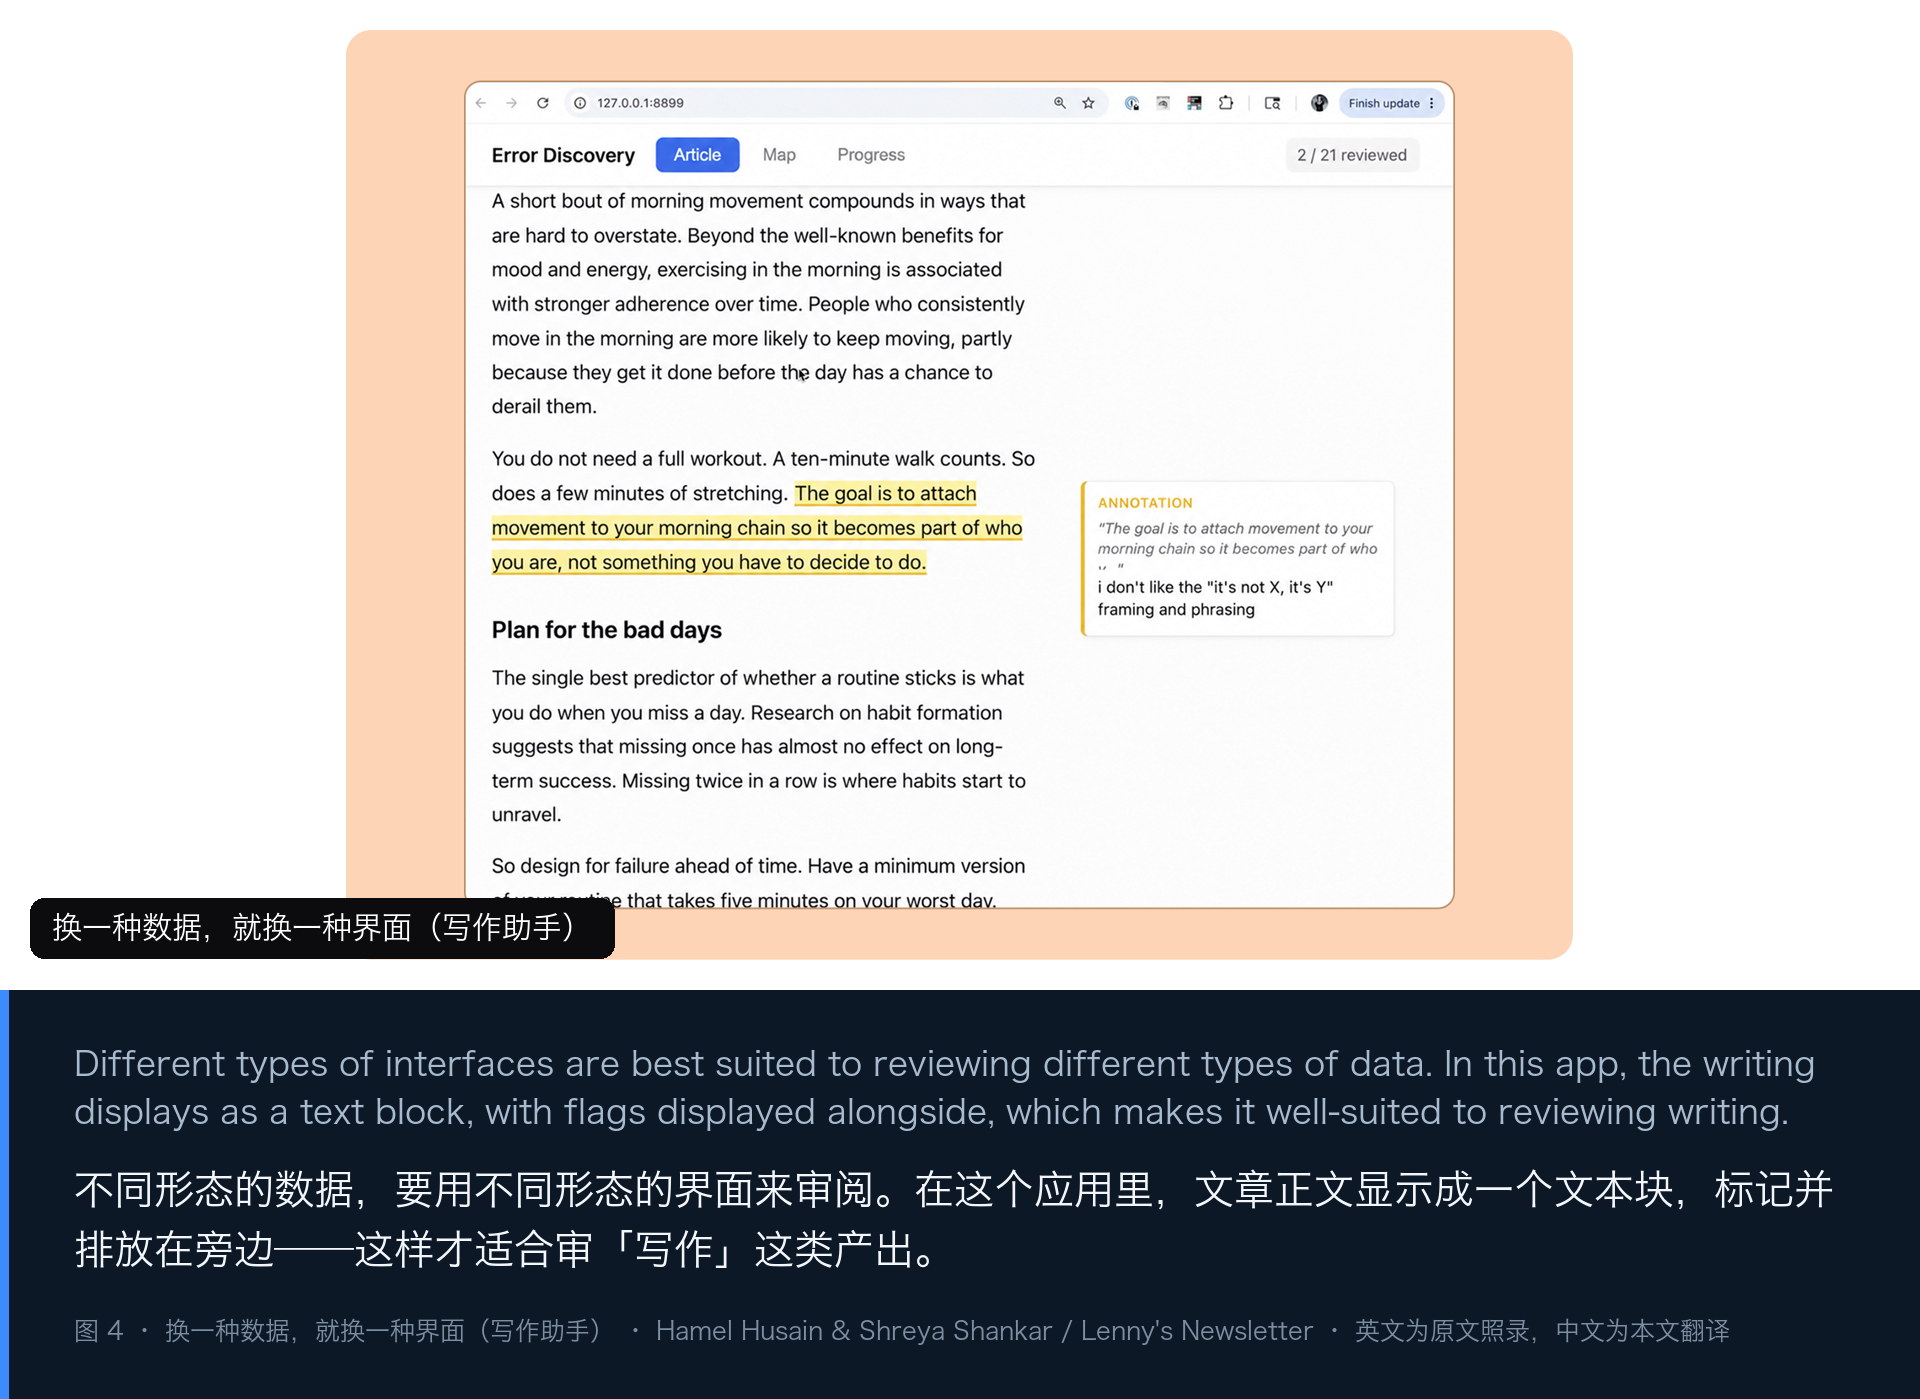
在这个应用里,文章正文显示成一个文本块,标记并排放在旁边——这样才适合审「写作」这类产出。
这个 skill 里内置了几条设计原则,决定界面会怎么渲染。其中最重要的两条是:
- 用户看到什么样,就把产出按什么样显示出来。 比如邮件就该长得像邮件,PDF 就该按 PDF 渲染,等等。
- 把有助于导航或筛选的重要元数据暴露出来。 在租房例子里,「用户从哪个渠道来」很可能很重要、值得筛选:短信、语音、网页聊天等。
The skill also instructs your agent to cluster your traces so it can build a diverse initial sample. It mixes cluster representatives with random picks.
这个 skill 还会让 agent 先对 trace 做聚类,好抽出一个足够多样的初始样本:聚类代表 + 随机抽样混合。这办法不完美,但比「随便翻数据」的朴素做法是个更好的起点。下面是一个例子,展示 coding agent 可能怎么把聚类结果呈现给你审阅(写作助手):
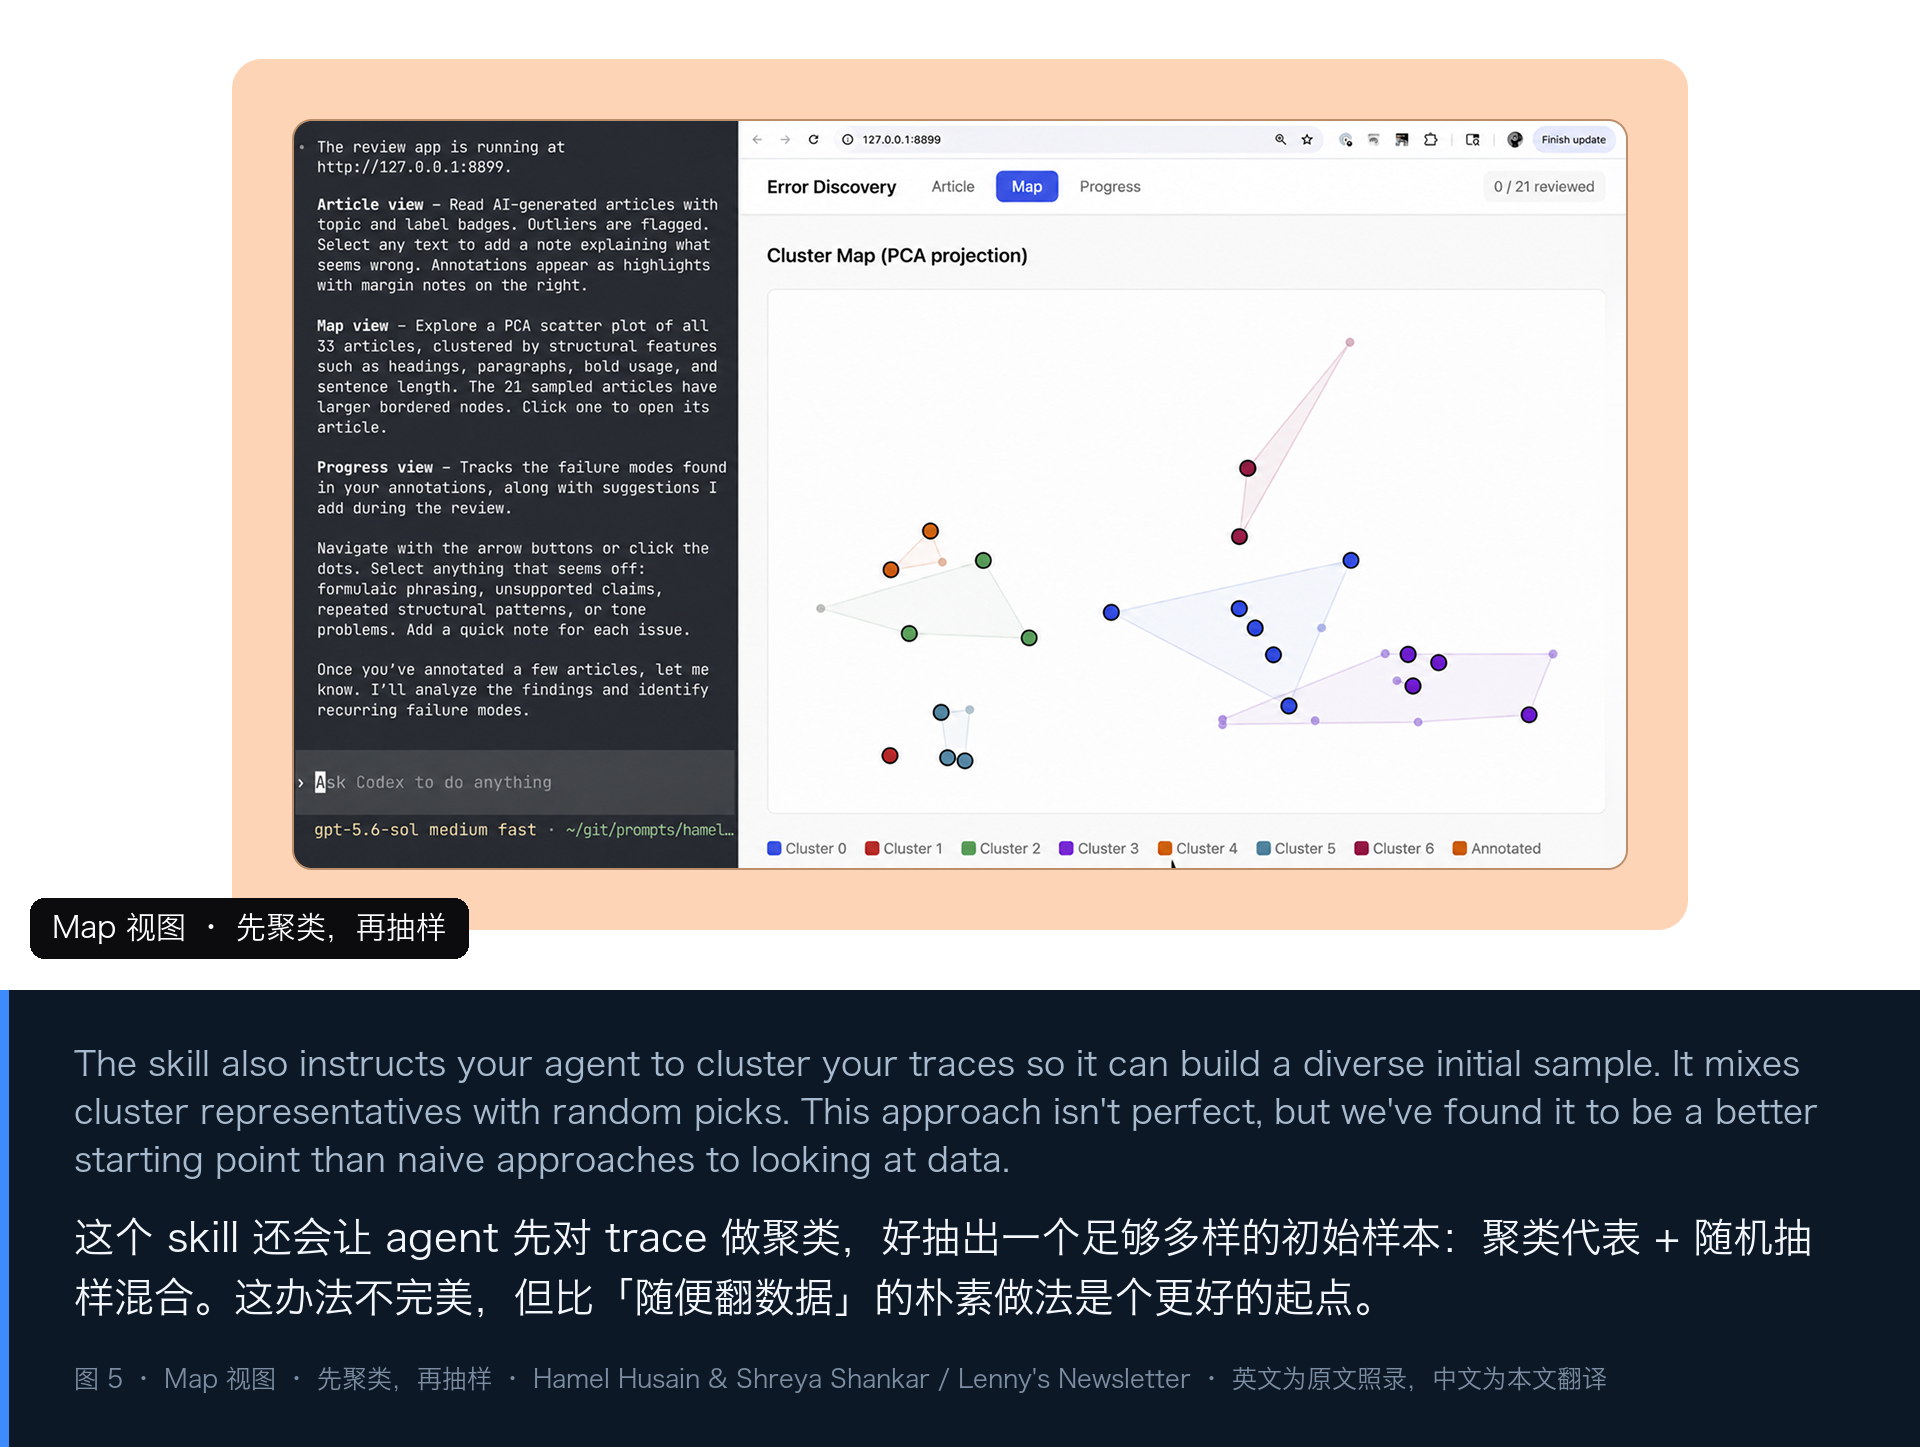
在上面的例子里,写作助手的标注应用允许你悬停在某个聚类上,查看有代表性的文档。如果你要改聚类、改界面、或改任何别的东西,直接跟 AI 说就行。
用 coding agent 最大的好处,是能随手改界面。你发现少了个字段、想筛出某个切片的 trace、或者想换种方式渲染数据,只要开口问。举个例子:如果你按上一节说的生成了合成 trace,就可以让 coding agent 按你定义的维度(比如 persona、任务类型)做筛选器。这样你能检查某个失败是不是集中在某一类场景里。
在界面里做标注:先人工看 10 条,再让 AI 接力
Once the app is running, the skill asks you to review 10 traces before it suggests errors to review. This is a deliberate safeguard against automation bias.
应用跑起来之后,这个 skill 会先请你人工看完 10 条 trace,然后才开始给你提错误建议。这是为了防「自动化偏误(automation bias)」故意设的护栏。你的任务是:凡是什么让你觉得不对劲,就留一条自由文本批注。批注可以是:
- 「助手放弃了,而不是提供替代方案。」
- 「没能渲染出预约组件,改成给了一串时间。」
- 「对这类 persona 来说语气太正式了。」
做批注的几条经验规则:
- 把问题描述到同事(或 agent)能看懂你什么意思。「回答很差」是一条糟糕的批注;「工具输出显示这套房子已经租出去了,助手却说该单元可租」才是可执行的。
- 不要试图做根因分析。 你要找的是「从用户视角看哪里出错了」,而不是「你的系统内部为什么失败」。比如,不要试图去诊断检索问题。
- 遇到上游错误就停下。 如果一条 trace 里有多个问题,只标注你最先注意到的那个。这条经验能帮你省时间、并把注意力放在影响最大的问题上,因为 agent 轨迹里的上游失败通常比下游失败更重要。等你做这个练习更熟练了,可以放宽这条约束。
- 起步阶段只需要标注失败。 标注「一条 trace 好在哪儿」可能有助于 agent 理解,但时间紧的话可以跳过。
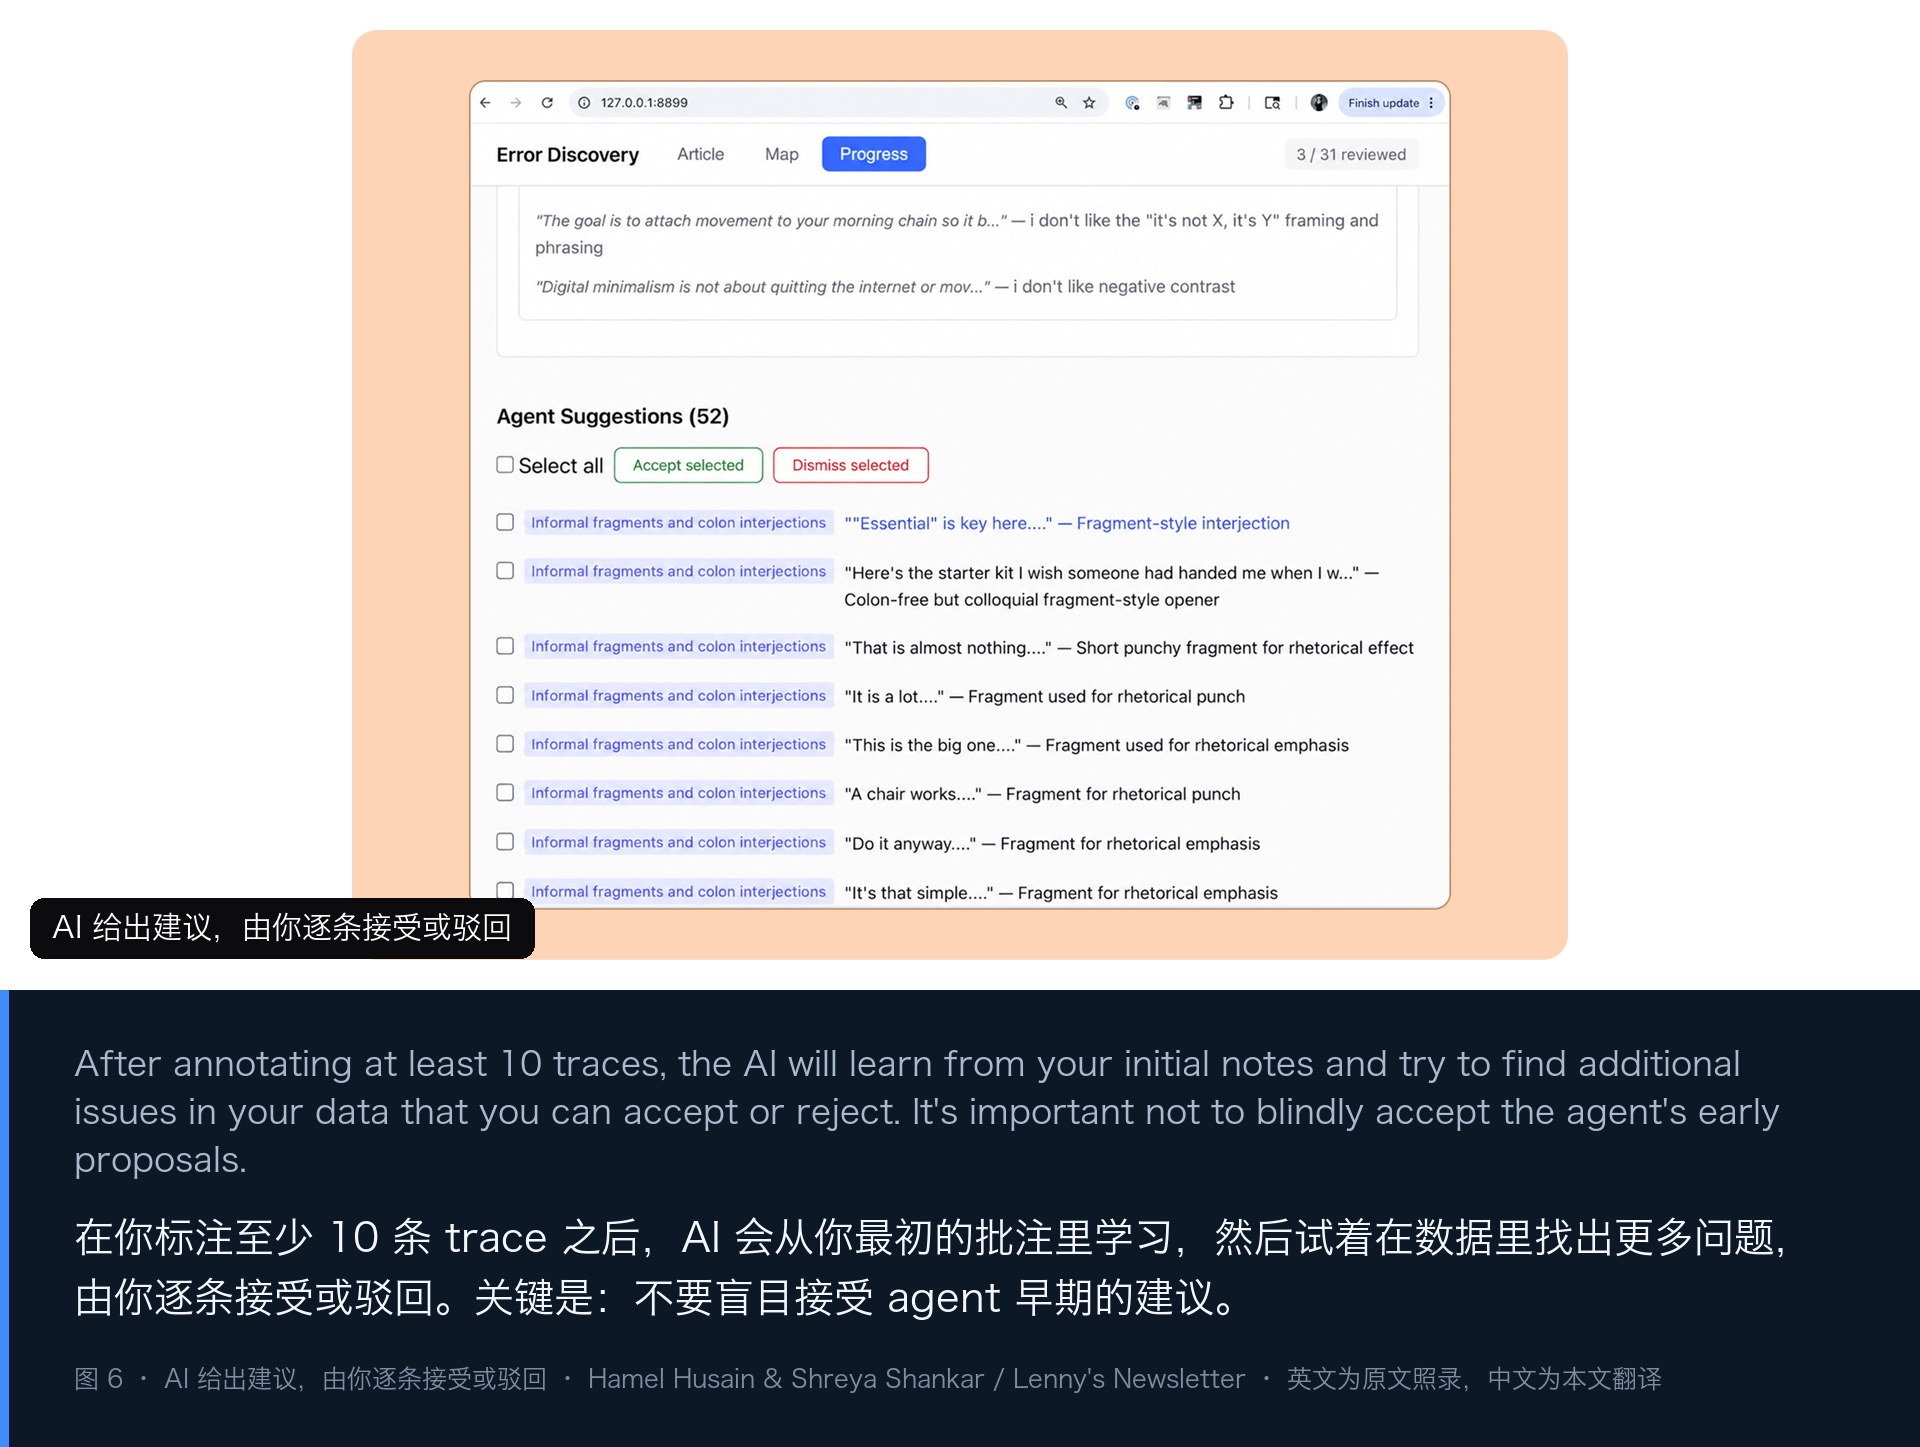
After annotating at least 10 traces, the AI will learn from your initial notes and try to find additional issues in your data that you can accept or reject. It’s important not to blindly accept the agent’s early proposals.
标注至少 10 条 trace 之后,AI 会从你最初的批注里学习,然后试着在数据里找出更多问题,由你逐条接受或驳回。关键是:不要盲目接受 agent 早期的建议。 仔细审,用你不同意的地方去纠正 agent 当前的理解。可能要进行好几轮人机往返,建议才会变得有用。
我们建议你超过 10 条也继续标,直到你自己的学习曲线走平。经验值是:朝着 100 条去标,确保你没有过早收手。 标得越多,AI 拿到的信号也越多,建议也会更好。
下面是你在审阅给写作助手的问题建议时,界面可能长什么样(你实际的界面会不一样,因为 AI 会按你的用例定制):
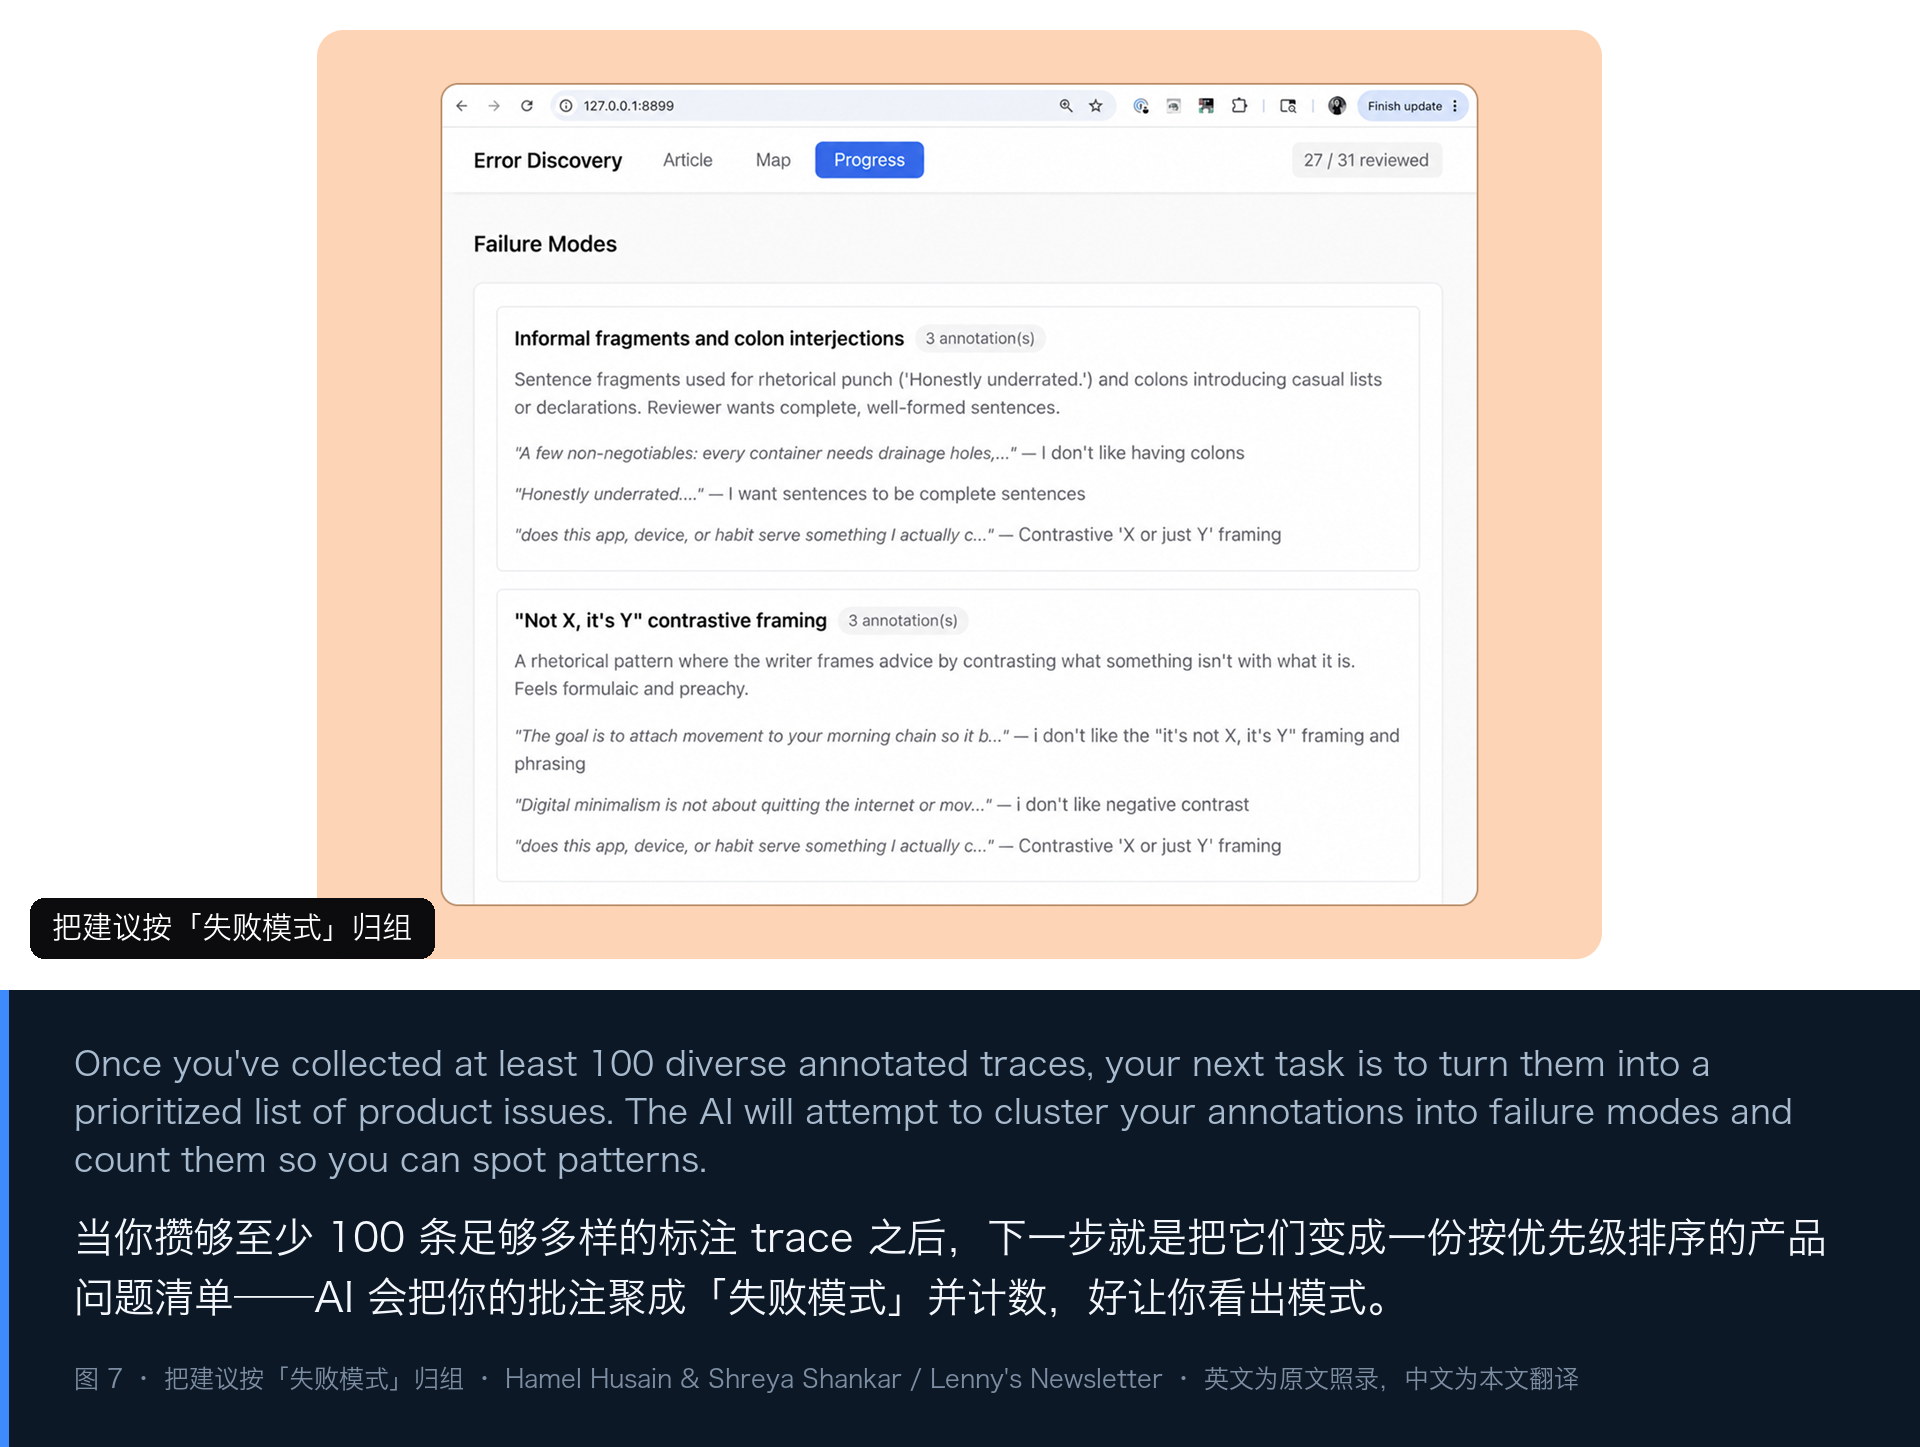
换一个视图,把建议按失败模式归组:
如果 AI 的建议不对,你可以让 coding agent 去修——就像改界面一样。你的批注不必完美。目标是「在日志里找出可执行的问题」,而不是做一次穷尽的搜索。 现在,人机混合标注的地基已经打好,可以去找你能动手的失败模式了。
五、Step 3:把失败模式变成产品优先级(原文在此进入付费墙)
Once you’ve collected at least 100 diverse annotated traces, your next task is to turn them into a prioritized list of product issues. The AI will attempt to cluster your annotations into failure modes and count them so you can spot patterns.
当你攒够至少 100 条足够多样的标注 trace 之后,下一步就是把它们变成一份按优先级排序的产品问题清单。AI 会把你的批注聚成「失败模式」并计数,好让你看出模式。下面是租房助手的样子:
⚠️ 原文在上一句之后进入付费墙(“This post is for paid subscribers”)。此后 Step 3 的其余做法(怎么把 failure modes 落成带优先级的 issue、那张失败模式汇总表怎么读、以及结尾的总结)没有读到,本讲义不做补写或推测。上文第 ② 块内容到此为止。
六、本文分析
先说这套说法立得住的地方。
把 evals 重新定义成「判断活」而不是「工程活」,是这篇最值钱的一步。它给了一个很锋利的判据:你之所以不能跳过 error discovery,是因为「什么算好」这件事本身是翻数据翻出来的——criteria drift 那个租房助手的例子把这个机制讲得比任何抽象论证都清楚。它顺手解释了一个很常见的失败模式:团队图省事,把一整个文件夹的 trace 丢给 agent 让它自己找问题;能找出来的只有「trace 内部就自相矛盾」那一类,也就是最不需要人的那一类。那些真正值钱的判断型失败,恰恰是 agent 结构上抓不到的——不是模型不够强,是标准还没被写出来。
第二个站得住的地方,是作者自己给出了反例数据:100 条真实 trace 的对照里,agent 会漏判断型问题、也会把好回答误标成失败。一份在推销自己工具的文章里主动写出「它会标错、还会漏」,可信度是加分的。 结论也没有夸大成「agent 无所不能」,而是落到主动学习式的配比上——人先看、agent 接力、人再审。这个分工是诚实且可操作的。
那几条标注规则也值得直接抄:可执行(「回答很差」不是批注)、不做根因分析(只写用户视角出了什么事)、遇上游错误即停(因为轨迹里上游失败影响更大)。这三条合起来其实在做一件很聪明的事:把人力的稀缺性显式地写进流程约束里——不是让你标得更多,而是让你标得更省、且更有信息量。
再说要打问号的地方。
- 那些公司收益数字都是转述,不是本文的研究结果。 Shopify 的 2.2 倍 / 68%、Cursor 的 41%、Ramp 的 35%→83%、Harvey 的「翻倍」——全部没有口径、样本量、时间窗口和对照条件。这类数字在「evals 值得投」的语境下引用没问题,但当成基准去定目标就危险了,因为你不知道它量的是哪个指标、在什么前提下达成的。
- 「30 分钟跑完整个流程」是个容易误导人的数字。 它成立的前提是:你已经有干净可用的 trace、你已经是熟练使用者、而且插件一次就生成了合适的界面。真正的成本恰恰落在作者自己设的那两个门槛上——「先人工看 10 条再信 AI」和「标到 100 条」。这两处花的是人的时间,也恰恰是这套流程无法替你省掉的部分。宣传语和成本结构之间,这里是有一个缺口的。
- 「10 条」「100 条」是经验值,不是研究结论。 作者自己也说是 rules of thumb。但一旦写进流程就会被当成硬指标——团队容易为了凑够 100 而标注,反过来削弱「标到学习曲线走平」这个真正的停止条件。
- 最大的隐性缺口:这套流程默认你有 trace 可看。 作者把「怎么埋点」和「怎么造合成数据」都给了(还不止一个 prompt),但也明确说了合成数据不能替代真实数据、且高质量合成数据超出本文范围。对还没上线的团队来说,前置工作(埋点、等真实数据、或造出像样的合成数据)才是真正的瓶颈,而这一段的难度被压成了两句话。
- criteria drift 的另一面,文章没有谈:既然标准是「看数据看出来的」,那不同的人看同一批数据,会漂移出不同的标准。 文章通篇没有提到标注者之间的一致性(inter-annotator agreement)。而只要流程里有人工判断这一环——这里还是被明确保留、且被当成护栏的那一环——一致性就是这个流程最后一定要面对的账。作者把「自动化偏误」防住了,但没有防「两个标注者不一致」。
- 最后,实用性的边界说清楚:免费部分给了 Step 1 和 Step 2 的完整做法(怎么拿 trace、怎么造合成数据、插件怎么用、界面怎么定制、标注怎么做),但最关键的「怎么把失败模式变成带优先级的 issue 清单」正好落在付费墙之后。也就是说这篇读下来,你拿到的是「怎么把错误找出来」,而不是「怎么把错误排成行动清单」——中间恰缺了从发现到决策的那一跳。
附:来源与文件
- 推文(入口):https://x.com/hamelhusain/status/2102434040695669189 —— Hamel 的原文:「This post was a labor of love! We’ve distilled thousands of hours of work on AI Evals into a 30 min read + skills you can use to quickly uncover errors in your product. BTW in addition to high quality content, Lenny effectively pays you in AI credits to subscribe https://lennysproductpass.com 🤯 It’s really good!」
- 原文:https://www.lennysnewsletter.com/p/advanced-evals-how-to-find-and-fix (Lenny’s Newsletter,付费长文,2026-09-22,约 3,807 词)
- 英文全文照录:原文英文全文
- 配图(7 张,原文原图 + 英文原句 + 中文翻译):
assets/X_2102434040695669189/fig01–fig07.jpg - 抓取留档:
work_X_2102434040695669189/(body_full.html、article_text.txt、rawimg/)
相关笔记:[[Evals]] · [[AI Evals 与错误发现]] · [[Coding Agent 工作流]]
讨论
这里是静态站点,没有内嵌评论区。如果这篇文章对你有用,欢迎通过 RSS 订阅后续更新。