3,222 字 · 355 词 · 约 10 分钟更新于
Stanford MS&E435:GPU 经济 | The GPU Economy
Stanford MS&E435 课堂对谈笔记:Brad Gerstner 与 Sunny Madra 讨论 GPU/推理成本、token 工厂与 AI 商业模式。
来源:YouTube 原视频(Stanford Online · MS&E435)
Stanford MS&E435《Economics of the AI Supercycle》课堂对谈。主讲/主持为 Apoorv Agrawal,嘉宾为 Altimeter 创始人 Brad Gerstner 与 Groq(现 NVIDIA)高管 Sunny Madra。
来源说明 字幕多次把芯片公司 Groq 写成 “Grok”,把 Cerebras 写成 “Cerebrus”,并把 Claude Code 写成 “Cloud Code”。正文按实际专名校正;图片保留对应时间点的原始字幕。文中的市场数据、公司收入、性能倍数、AGI 判断与投资预测均是讲者在课堂上的陈述,不代表本笔记独立核验或认同。
TL;DR
- 传统软件复制和分发的边际成本接近零,但 AI 每多服务一个用户、每多执行一步推理或代理动作,都要消耗真实算力。因此,AI 商业模式的核心约束之一是“每单位智能”的计算成本。
- Sunny Madra 用 Groq 说明专用推理架构的路径:确定性 dataflow、编译器预先安排计算、片上 SRAM,以及把硬件能力包装成云端 API。推理时 reasoning 与 agents 快速增加 token 需求,促使系统进一步拆分 prefill / decode,并在算力与内存带宽之间做异构协同。
- Brad Gerstner 把 AI 基础设施理解为“token 工厂”:电力、芯片、数据中心进入工厂,token 从另一端产出。真正的竞争不是单颗芯片参数,而是整个系统在固定电力与建筑约束下能生产多少有价值的 token。
- 两位嘉宾认为,供应链、封装与光刻、芯片/系统架构、内存带宽、量化、软件和电力共同推动推理成本下降;同时,模型规模、reasoning 深度与 agent 工作量也在快速增长,需求不会因为单 token 降价而消失。
- Brad 的商业判断是:AI 正从“回答问题”进入“执行动作”,单项任务可能消耗约一个数量级更多 token,但如果交付价值增长更快,用户支付意愿与模型公司的毛利也会改善。
- 社会层面,Brad 同时强调生产率与财富创造的机会、分配和社会契约的难题;给学生的建议是用最好的 AI 工具把自己变成 “bionic” 创作者,并培养沟通、说服、关系网络与领导力。
00|AI 与传统软件不同:每次使用都有计算成本
- Apoorv 用一个简单对比设定整场讨论:传统软件的增量分发成本近乎为零,而 AI 应用增加用户和调用量会直接增加计算需求。
- 因而,AI 产品不能只看订阅收入或模型能力,还要同时看 token 消耗、延迟、电力、内存带宽和基础设施利用率。
- 本节课围绕三个层次展开:芯片与架构、推理经济学,以及能力扩张对企业和社会的影响。
05|创新、生产率与技术在经济中的份额
- Brad 把长期生产率增长视为教育、健康、自由度和生活质量改善的重要基础,并把 AI 看作加速创新的一轮技术超级周期。
- 课堂幻灯片展示“Technology: 5% → 15% of US GDP”;同期口头字幕则说技术占全球 GDP 的比例从约 5% 上升到约 13%。两者口径并不相同,应分别理解为图表与现场叙述。
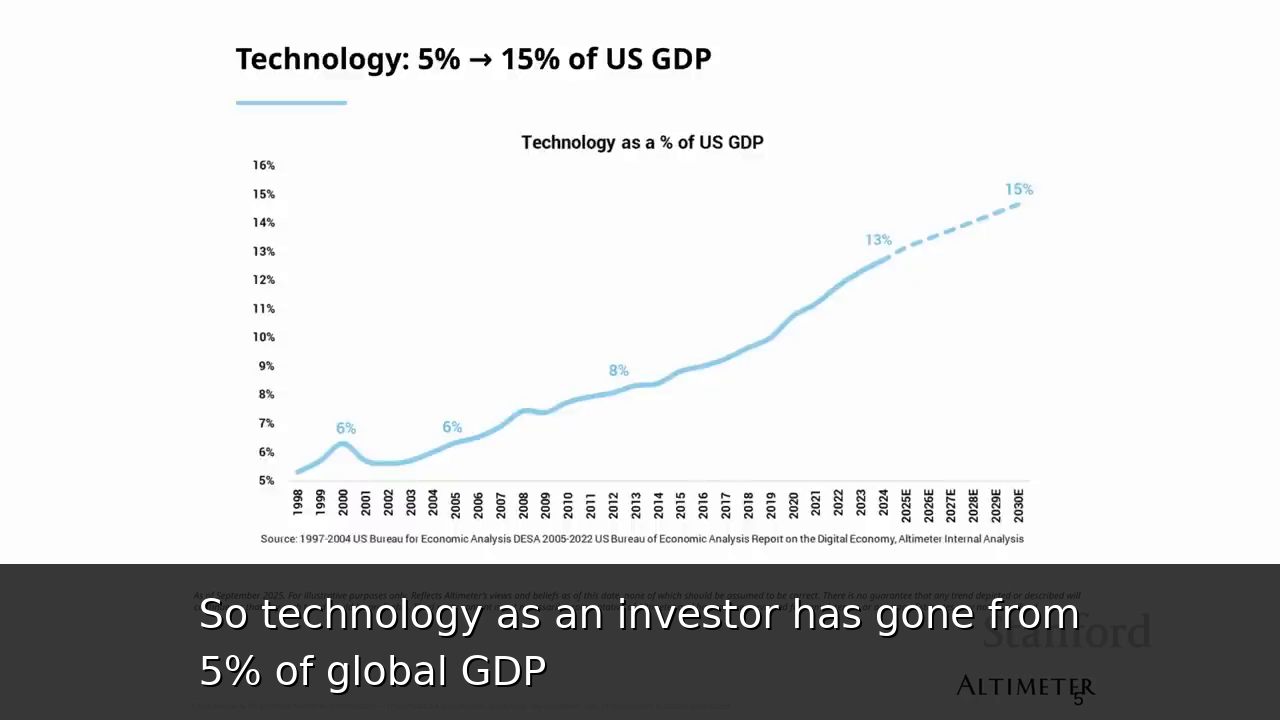
- Brad 的核心投资视角是:如果技术在经济中的比重继续上升,围绕计算、模型、应用与生产率提升的价值池也会扩大。这是他的判断,不是课堂给出的确定预测。
08|“计算是根”:Groq 的架构起点
- Sunny 回顾 Groq 的技术路线:AI token 生成最终是大量数学运算,而通用处理器常受到调度、缓存和数据搬运不确定性的影响。
- Groq 采用确定性的 dataflow architecture,并让编译器预先决定计算发生的位置和时间;其目标是让执行路径更可预测,减少通用架构为灵活性付出的开销。
- 他强调,生成 token 所需的计算量相较早期计算范式高出许多数量级,因此推理效率会直接变成产品成本和可扩展性的约束。
12|从卖芯片转向 Groq Cloud:用 API 降低采用门槛
- Sunny 说,要求客户直接购买并适配新硬件很困难;把芯片部署到云端、运营数据中心,再通过 API 提供主流开源模型,会显著降低开发者迁移门槛。
- 他称 Groq Cloud 上线后很快获得大量用户。这里的用户数和增长速度来自他的现场陈述,笔记未做外部核验。
- reasoning models 比一次性生成模型消耗更多 token;agents 尚未全面展开之前,token 曲线已经快速上升。这使“模型更强”与“基础设施更高效”必须同时推进。
15|拆分 prefill / decode:算力与内存带宽不是同一个问题
- Sunny 解释,推理可先拆成 prefill 与 decode,分别交给不同机器;继续拆 decode 后,又会发现其中既有 compute-intensive 操作,也有 memory-bandwidth-intensive 操作。
- GPU 的特点是计算能力强、依赖外部 HBM;Groq 的路线则强调大量高速片上 SRAM。二者的优劣取决于工作负载,而不是一个简单的“谁替代谁”。
- NVLink Fusion 被 Sunny 描述为让 Groq 芯片与 NVIDIA GPU 互联、各自处理更擅长部分的一种方式。这个例子体现的是异构系统协同:把不同计算阶段放到合适的硬件上。
18|“token 工厂”的单位经济学
- Brad 把 AI 数据中心描述为工厂:一端输入电力、芯片、建筑和资本,另一端输出 token。
- 他称,在相同电力与建筑占用下,引入 Groq 后可产生约 2.5 倍 token;Sunny 也把电力和内存视为现实世界的关键约束。该倍数是讲者陈述,不是本文基准测试。
- 这套算法的商业含义是:若固定基础设施能多产出两到三倍 token,模型公司的单位成本、可服务请求数和收入上限都会改变。
- Sunny 认为 Groq 与 NVIDIA 的工程文化具有互补性,因为 Groq 的 SRAM / deterministic compiler 路线并不是简单复制一个更快的 GPU。
21|推理成本为何快速下降
- Brad 称,推理成本一年内大约下降 90%,两到两年半内接近下降 99%。这些是课堂上的估算口径。
- Sunny 将主要驱动力归为三类:
- 供应链能力,包括 TSMC、先进封装与光刻;
- 工程创新,包括芯片布局、系统架构、内存带宽与量化;
- 可获得的电力。
- 传统光刻尺度进步正在放缓,行业便通过更大封装、更多芯片协作、架构改进、内存优化和低精度量化继续压低成本。
- 但供给效率的提升并不会自动减少总计算需求:模型参数量、reasoning 深度和 agent 调用同时增长,可能把节省下来的成本重新转化为更大的使用量。
25|从“给答案”到“替人行动”
- Brad 把早期 AI 描述为回答问题和代码补全;进入 agent 阶段后,系统开始调用工具、处理多步任务并采取动作。
- 他认为,完成动作可能让 token 消耗增加约一个数量级,但交付给用户的价值可能增长得更多,因此支付意愿会显著提升。
- 这也解释了模型公司的商业转折:早期推理昂贵、能力有限,产品可能是负毛利;当单位推理成本下降、输出价值提高,毛利结构就可能转正。
27|能力阈值、收入增长与“泡沫”争论
- Brad 以 Anthropic 的收入加速为例,认为模型能力跨过了某个经济阈值:大量独立用户主动购买 Claude Code、Cowork 等能力,是需求侧价值提升的信号。
- 他借此反驳“所有 AI 需求都只是资本补贴”的简单叙事,但并未证明所有公司或所有估值都合理。
- 更稳妥的理解是:基础设施投资可能存在周期与错配,同时某些模型和 agent 产品也确实开始创造可付费价值;两者可以同时成立。
31|Harness、持续代理与 token 消耗
- Sunny 说,Claude Code、Cowork、OpenClaw 等 harness 不只是一个 API 外壳,它们通过规划、工具调用、反馈与持续循环,从模型中提取更多效用,也因此消耗更多 token。
- 他举 NVIDIA Personal Assistant 为例:系统连接 Slack、Teams、邮件和文件,整理每日任务、提取待办并处理常规工作。
- 这类产品的经济单位逐渐从“单次问答”变为“完成一项业务结果”,计算成本也应按任务价值而非单 token 孤立衡量。
33|不是一颗芯片,而是一座工厂
- Brad 将推理成本下降归因于跨栈 co-design:芯片、互联、内存、软件、模型与数据中心共同优化,各层改进组合后形成更大的系统收益。
- 他称 OpenAI、Anthropic 的毛利已从早期负值转为明显正值。这里仍是他的现场判断;重要的是背后的机制——单位智能成本下降,同时用户对更有能力产品的支付意愿上升。
35|“100×”目标与大公司资源
- Sunny 说 Jensen Huang 会要求团队寻找 100× 改进,而不是满足于小幅优化;NVIDIA 的资本、工程和供应链资源,使一些初创公司难以承担的系统级尝试成为可能。
- 这并不意味着每个项目都会真的获得 100×,而是描述组织设定目标和筛选技术路线的方式。
38|能力跃迁、富足与分配问题
- Brad 转述前沿实验室领导者对能力曲线的判断,认为系统正逼近重大阈值;这属于嘉宾对行业内部观点的描述,不能当作已经实现 AGI 的事实。
- 他区分了两个问题:技术可能让财富创造和“富足”更容易,但分配、所有权与社会契约反而更难。
- Brad 将这一担忧与 Invest America 联系起来:让更多人从出生起持有经济资产,尝试扩大技术增长的参与面。笔记仅呈现他的政策主张,不额外作政治延伸。
41|就业与个人策略:让自己变得 “bionic”
- 面对劳动替代问题,Brad 的建议不是忽视冲击,而是尽快使用最好的 AI 工具、成为创造者,并证明自己能交付异常高的价值。
- 他判断,当分析和知识型能力变得更普及时,IQ 的稀缺性可能下降,EQ、说服力、可信关系网络和领导力会更有价值。
- 这是职业建议而非确定预测。可操作的部分是:把 AI 纳入日常工作流,同时继续训练定义问题、判断质量、协调人和承担责任的能力。
45|Apple、隐私与边缘计算
- 在设备问题上,嘉宾认为 Apple 的隐私定位限制了把个人数据持续发送到云端的空间,而当前端侧硬件尚难承载最强模型。
- 讲者称,即使约 8B 参数的小模型也可能很快耗尽手机电量;这是现场估算,主要用于说明本地推理受到功耗、散热和内存约束。
- Brad 仍认为 Apple 在设备与用户黏性上很强,并表示他更希望 OpenAI 聚焦“构建智能”,而不是分散精力制造设备。
47|安全:既不要盲目乐观,也不要把恐惧变成监管俘获
- Brad 承认前沿模型可能带来真实风险,并以当时未公开模型的 sandbox 测试、浏览器漏洞发现为例,支持在受控环境中验证能力。
- 同时,他警惕利用极端叙事建立只保护少数既有公司的监管壁垒。
- 对课堂内容最忠实的概括是:能力越强,越需要 guardrails、sandboxing 和跨公司协作,但治理也要避免被利益相关者垄断。
50|训练集群最终会转化为推理供给
- Sunny 解释,大规模训练集群在模型训练阶段集中投入;训练结束后,其中相当一部分硬件会自然转入推理工作负载。
- 新模型能力提高,又会创造更多推理需求,因此训练投资和推理供给并非两个完全割裂的市场。
52|NVIDIA 的护城河与竞争压力
- Brad 的收尾观点是:Trainium、TPU、Cerebras、Groq 和各种定制 ASIC 会在推理市场争夺份额并推动价格/性能竞争。
- 他的逻辑不是 NVIDIA 无需竞争,而是 NVIDIA 必须持续交付客户愿意付费的更好产品,否则就要降价并承受毛利压力。
- Brad 仍公开看多 NVIDIA,并预测其会成为首家 10 万亿美元公司。这是明确的个人投资观点,不应视为课程结论或投资建议。
一句话复盘
AI 的核心经济问题不是“芯片会不会越来越快”,而是整个计算工厂能否在受限的电力、内存和资本下,以更低成本持续生产更有价值的 token;与此同时,技术带来的价值增长、竞争、就业冲击与分配机制必须被放在同一张账表里讨论。
讨论
这里是静态站点,没有内嵌评论区。如果这篇文章对你有用,欢迎通过 RSS 订阅后续更新。