3,666 字 · 478 词 · 约 11 分钟更新于
Stanford MS&E435:企业内部知识与专用模型 | Yash Patil
Stanford MS&E435 课堂对谈笔记:Applied Compute CEO Yash Patil 谈企业内部知识如何变成专用模型,以及 Evals、RL 环境与持续学习。
来源:YouTube 原视频(Stanford Online · MS&E435)
Stanford MS&E435《Economics of the AI Supercycle》课堂对谈。嘉宾是 Applied Compute 创始人兼 CEO Yash Patil;他曾在 OpenAI 后训练团队工作,并参与 Long Horizon Tasks、agentic coding 研究及后来演化为 Codex 的方向。主持人为 Stanford 讲师、Altimeter Capital 合伙人 Apoorv Agrawal。
观点归属 关于 chain of thought、AGI、模型架构、训练成本、公司竞争力和市场前景的判断均按 Patil 在课堂上的观点记录。DeepSeek 训练算力比例、DoorDash 商户数量、芯片利润率等口头数字没有在本笔记中独立审计,不构成技术、经营或投资建议。
TL;DR
- 通用前沿模型像“聪明但不了解公司业务的天才”。Patil 的核心主张是:通用模型设定能力下限,企业自己的数据、标准、Evals、反馈和训练系统决定上限。
- 模型进步的瓶颈不断迁移:手工特征 → 数据与 GPU → Transformer 架构 → 规模化预训练 → 对齐与可用性 → 高质量任务、验证器和 RL 环境。下一步关键可能是从稀疏的真实反馈中持续学习。
- 代码率先成为 Agent 前沿,不只是因为互联网代码多,还因为编译器、单元测试和确定性结果能提供 verifiable reward;代码也可以作为调用现实工具的通用接口。
- Evals 不只是排行榜,而是研发路线图:先定义“哪座山值得爬”,再用 RL 优化。不同企业对好坏有不同标准,因此 JP Morgan 与 Goldman Sachs 不会共享完全相同的企业 Eval。
- DoorDash 菜单抽取案例说明,prompting 无法稳定表达企业内部风格与结构规则时,可以用人工纠正结果形成 ground truth,直接优化错误率,把通用视觉语言模型训练成专用系统。
- 专用小模型可以在性能、成本和延迟的 Pareto frontier 上占优势;通用模型适合做 orchestrator,快速 sub-agent、专有数据、context 和 harness 则共同构成企业应用的差异化。
- 持续学习不会突然出现,而是数据接入、生产反馈、权重更新、context 更新与 harness 改进的渐进组合。Cursor 接受/撤销代码的隐式反馈,是 Patil 举出的早期形式之一。
00|从 Stanford 到 OpenAI,再到 Applied Compute
- Patil 是 Stanford 2025 届毕业生。他回忆自己在校期间更喜欢做项目和组织 TreeHacks,通过朋友认识 Sam Altman,并在一次放弃实习、尝试创业的夏天获得了小额生活支持。
- ChatGPT 在 2022 年末发布后,他主动申请进入 OpenAI Residency,2023 年加入 post-training 团队。
- 第一年的工作重点是 Evals。他给学生的职业建议是:刚加入组织时,可以主动承担最棘手、没人愿意碰的问题,因为这会迅速建立信任和影响力。
- reasoning model 出现后,他与同事尝试把能力从竞赛数学和编程扩展到能浏览互联网、写代码并长时间执行的 Agent,后来组建 Long Horizon Tasks 团队,参与 agentic coding 研究。
- 创办 Applied Compute 的直接洞察是:前沿模型越来越聪明,但进入企业后缺少业务上下文;而世界上大量高价值、专有的数据恰好沉淀在企业内部。
05|AlexNet:从手工特征转向自动学习表示
- Patil 把 AlexNet 视为深度学习的关键拐点。此前,视觉系统依赖工程师手工设计边缘、纹理等特征,再训练相对简单的分类器。
- AlexNet 将 GPU、ImageNet 大规模数据和神经网络结合,证明增加计算与数据可以显著提高预测精度,也让模型开始自行学习中间表示。
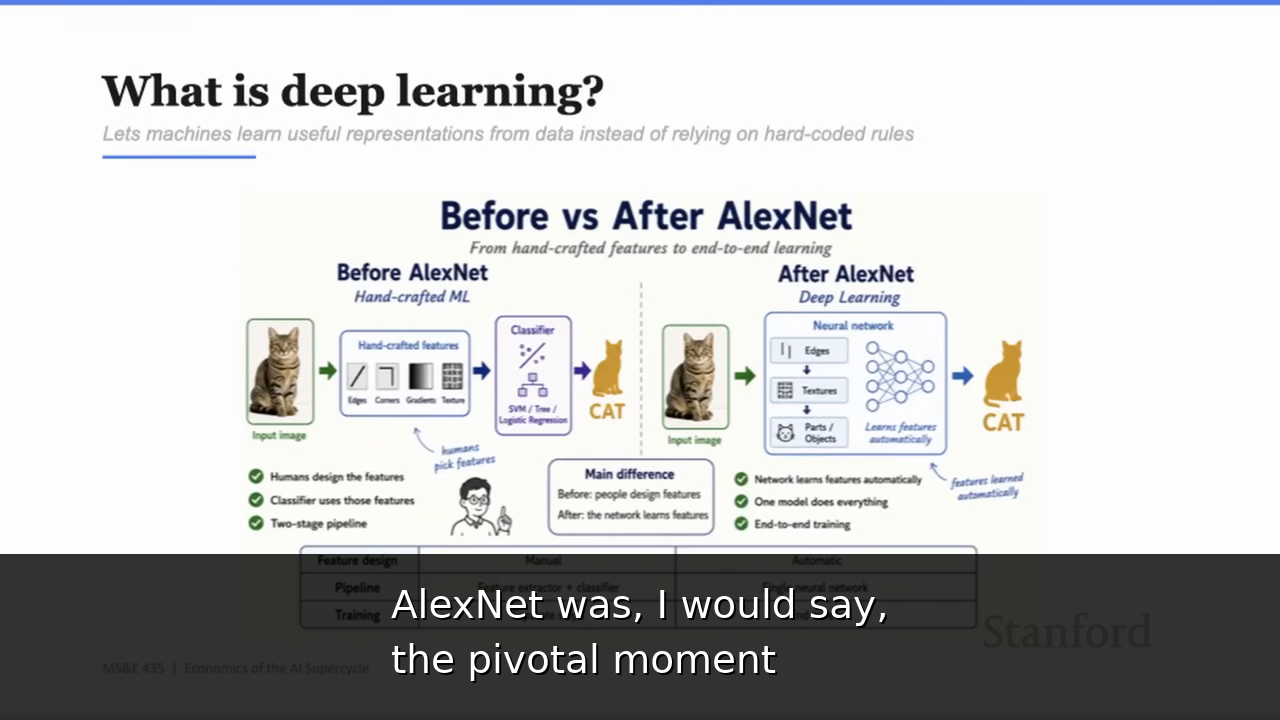
- 代价是可解释性下降:模型拥有数百万乃至数十亿参数,任务效果很好,但人很难明确说清内部每个表示到底在做什么。
08|Transformer、预训练、Scaling Law 与对齐
- Transformer 和 self-attention 让语言模型更容易在 GPU 上并行扩展,并比 RNN、LSTM 更好地处理长序列。
- 2018–2019 年的核心范式是预训练:从海量文本中学习 next-token prediction,通过预测误差反向传播更新权重。
- Kaplan scaling laws 与 GPT-3 让行业看到“大模型 + 更多算力”能够带来更通用的能力;Chinchilla scaling laws 又强调参数规模与训练数据量之间存在更接近 compute-optimal 的配比。
- 只有 base model 还不够。RLHF、preference tuning 和安全对齐将单纯续写器变成能理解用户—助手格式、按要求回答并遵守边界的产品。
10|Reasoning 与 Agent:test-time compute 打开新轴线
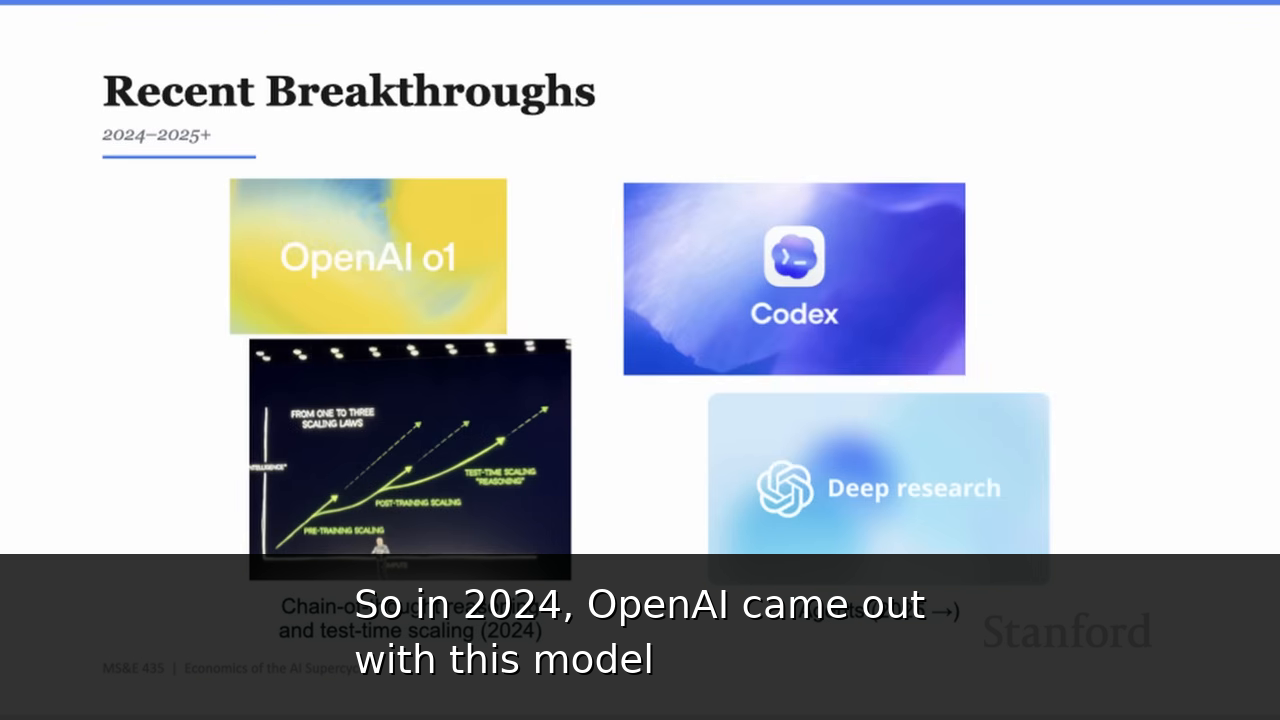
- Patil 把 OpenAI o1 视为 2024 年的重要节点:模型能力不再只靠训练时扩展,也可以在回答时投入更多 test-time compute。
- 他认为 chain of thought 是在受约束的 RL 环境和大规模算力下出现的 emergent behavior;这是讲者对训练现象的概括,并不意味着研究界对“是否完全未被训练”没有争议。
- reasoning 再与 tool use 结合,形成能长时间工作、搜索、编码和迭代的 Agent,也就是今天常说的 AI coworker。
12|瓶颈迁移:下一站是 Continual Learning
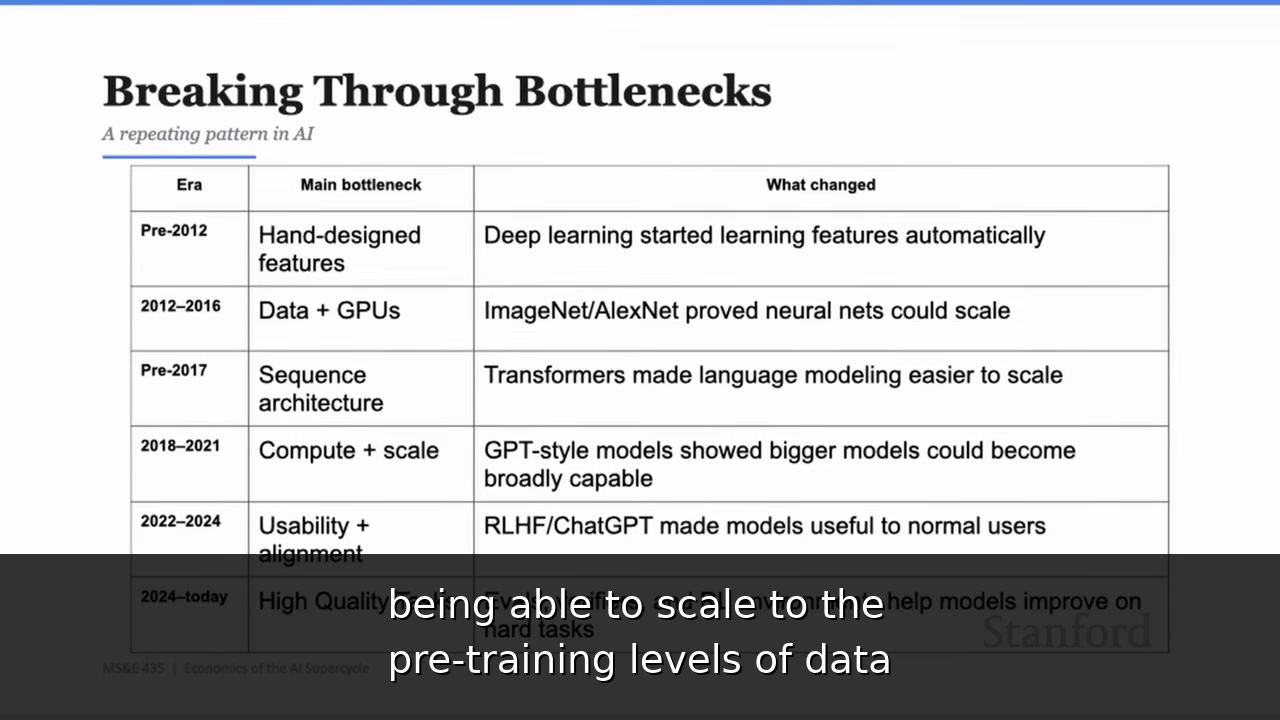
- Patil 按时间回顾模型发展的主要限制:
- 早期缺少足够计算;
- 随后缺少适合扩展的架构;
- 再后来需要互联网规模数据和更大的预训练;
- 通用模型出现后,难点转为 preference tuning、可用性与安全;
- 当前提升 reasoning model 的关键是高质量任务、Evals、验证器和 RL environments。
- 他把 continual learning 称为更长远的“圣杯”:模型在真实世界行动一次,只从非常稀疏但明确的 reward 中就能学会,而不是为同一能力重复成百上千次 rollout。
- “摸一次热炉子就知道不要再摸”是他的类比;现实难点在于,企业反馈通常没有这么响亮、干净和可归因。
14|为什么软件工程成为第一批高价值 Agent 场景
- 近期实验室大量采用 reinforcement learning with verifiable rewards。训练需要可靠判断模型结果对不对,代码和数学天然适合:代码可以编译、运行测试,数学答案也可验证。
- 代码数据丰富,并且容易合成大量题目、变体和测试环境。
- Patil 还把代码视为近似“AGI-complete”的通用行动语言:很多任务最终都能转成写程序、操作文件、调用 API 或控制工具,而不必为每个动作设计独立接口。
- 生成幻灯片就是例子:代码可以保证版式结构和文件可执行,视觉 reward model 再评价美观程度;功能 reward 与审美 reward 可以联合优化。
17|Pre-training 与 Post-training 分别解决什么
- 预训练用数万亿 token 和巨量算力学习语言、知识及模式,可以理解为把大量人类知识压缩进模型权重。
- 但 base model 只是 next-token predictor。Post-training 通过 SFT、RLHF、偏好学习、RLVR 等方式告诉模型什么输出好、什么输出坏,并训练对话格式、安全边界与任务行为。
- 两阶段都面临数据稀缺,只是稀缺的数据类型不同:预训练需要覆盖面和规模,后训练需要高质量示范、偏好、任务、验证器与反馈。
19|数据墙:不是只找更多网页,而是提高每条数据的学习量
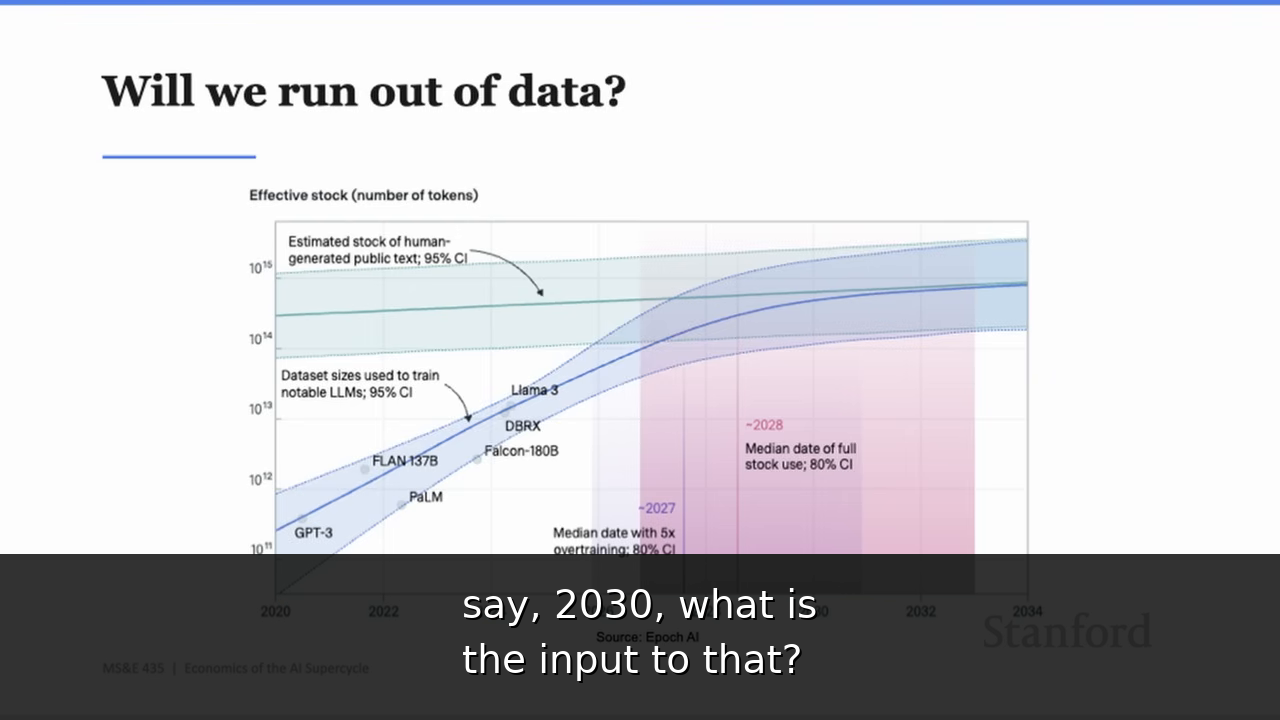
- Patil 认为公开互联网数据正在接近边界。前沿实验室有人扫描旧书,也会从主文档合成更多训练材料,但单纯增加 token 的空间有限。
- 更重要的方向是改进架构与训练方法,让模型从已有数据中学习得更高效,因为人类并不需要阅读互联网规模的文本才能掌握一项能力。
- RL environment 属于另一类数据经济:不是把代码库继续切成 next-token 样本,而是构造模型可以行动的世界,让它为同一任务尝试数百或数千次,再用可验证结果形成 reward distribution。
- 这相当于用更多计算换取更高的信息密度:单个高质量任务可以产生远多于一次静态示范的学习信号。
23|Evals 定义研发要爬的山
- Patil 说实验室保护 Evals,是因为 Eval 直接决定 roadmap:如果目标是训练优秀的编码模型,就先定义什么叫“有用的编码”,再建立相似但不泄漏测试集的训练分布。
- RL 像一台 Eval-maxing machine:它会沿着已定义的指标持续爬坡。因此 Eval 如果狭窄或失真,模型也会在错误方向上优化。
- 企业场景更明显。不同公司拥有不同流程、风险标准、表达方式和合规要求;同一任务在 JP Morgan 和 Goldman Sachs 内部的“正确答案”可能不同。
- Applied Compute 把自己定位在企业 specialization layer:帮助公司建立自身 Eval,并训练系统去优化这些标准。
26|通用模型设定下限,企业专用系统抬高上限
- Patil 的创业 thesis 是:通用模型会成为 workhorse,提供越来越高的能力下限;企业若要相对竞争者形成差异化,还需要专用模型、context、训练流水线和内部标准。
- 这种差异化不是为了永久抵抗基础模型进步,而是为了在任何给定时间保持前沿并更早获得业务回报。
- 他不认同所有数据和控制最终都会集中到一个“全能 ASI”的假设,理由是现实组织和数据长期分散,企业仍需要针对自身环境优化。
27|DoorDash 菜单抽取:从 Prompting 转向直接优化错误率
- DoorDash 每年需要接入大量商户。商户提供的菜单往往是图片和非结构化材料,而平台必须把菜品、规格、加料、配料关系转成符合内部 style guide 的线上店铺结构。
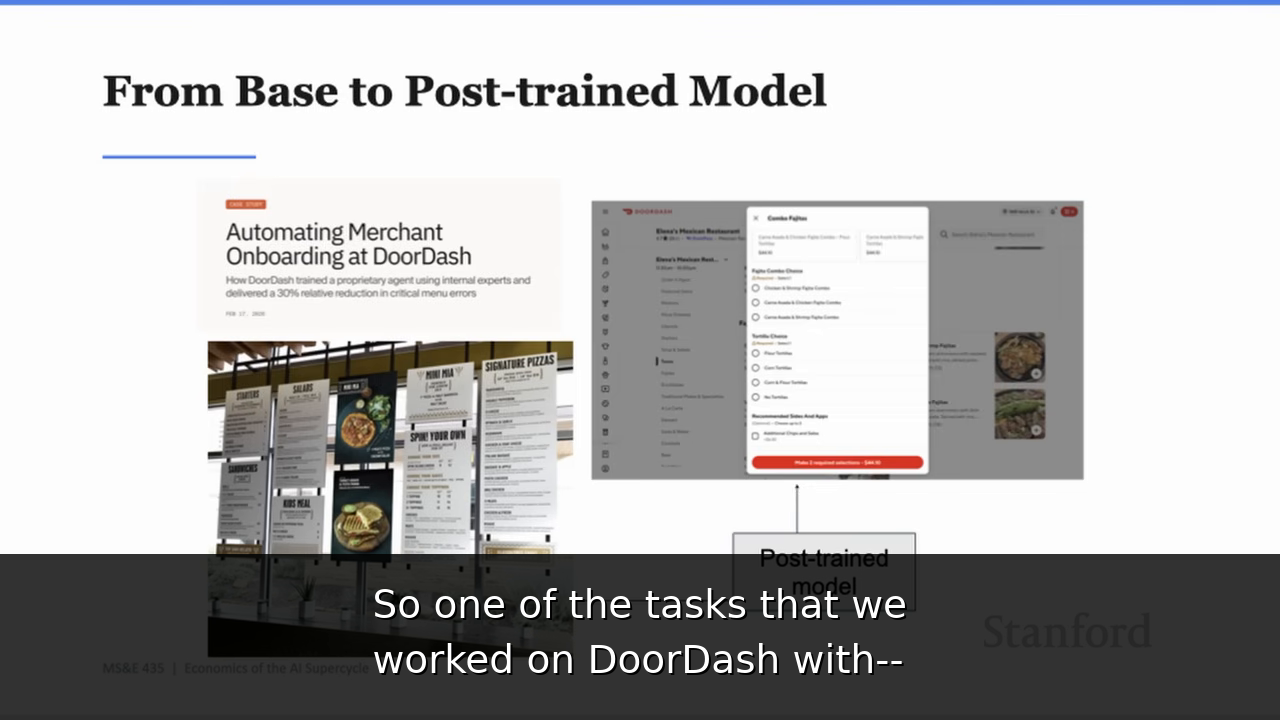
- 通用 VLM 能识别文字和图片,却难以稳定掌握 DoorDash 特有的 modifier 关系。团队尝试 prompting 后,选择让人工纠正模型生成的菜单,把差异变成 ground truth。
- 训练时可直接比较模型输出和正确结构,量化 loss/reward,并围绕降低错误率优化。这体现了企业 AI 的关键:先明确内部什么叫好坏,再训练系统达成结果。
30|为什么不等 GPT-17:Time to Value 与后训练经济性
- 主持人质疑:下一代通用模型可能开箱即用地解决今天的专用问题,企业为何现在投入训练?
- Patil 的答案是 time to value。公司在每个时间点都希望处于能力前沿;等待多年意味着放弃当前可验证的 ROI。
- 他引用 DeepSeek V3 与 R1 的公开训练量作粗略比较,称当时 RL 阶段计算约为预训练的 5%。这个比例只是课堂口径,但说明 post-training 的进入成本显著低于从零训练 base model。
- 同时,RL 的算力占比正在上升:更大 batch、更多 rollout 和更长 reasoning 仍然符合“投入更多计算、获得更好表现”的趋势。
32|专用小模型的价值:性能、成本、延迟三角
- Applied Compute 与 Cognition/Windsurf 的例子是:用户保存代码后,由一个两秒内返回的小模型检查潜在 bug。
- 若直接调用最大通用模型,性能可能强,但成本和延迟过高;将小模型针对 bug detection 充分后训练,可以在三者的 Pareto frontier 上取得更适合产品的点。
- Patil 强调不能只看 model layer。实际优势来自 model、harness、context 与 code development 的组合:
- 通用模型做强大的 orchestrator;
- 快速专用 sub-agent 处理窄任务;
- 企业专有数据补足分布外知识;
- harness 负责路由、工具、反馈和端到端产品体验。
- 他还提到 Ramp Labs 用 RL 训练模型在电子表格中快速搜索,作为专用能力改善产品体验。
35|持续学习:从生产反馈中渐进更新
- Continual learning 的目标是观察模型在生产中的使用、追踪行动的下游后果,再把反馈转成系统改进。
- Patil 判断它会渐进出现,因为最先遇到的不是神奇算法,而是数据接入:Agent 是否部署给了合适的人、是否记录了必要上下文、能否判断哪些结果真正成功。
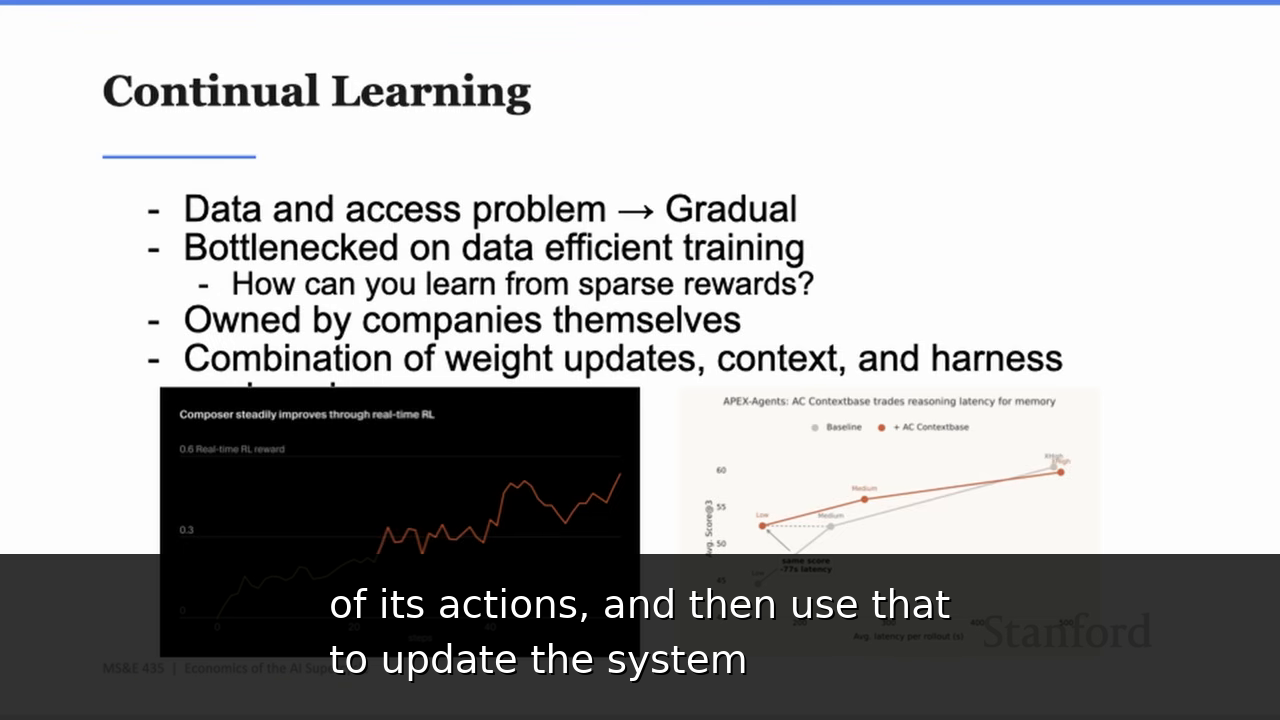
- Cursor Composer 是他举出的例子:模型上线后收集用户是否接受建议、是否撤销代码等隐式 reward,再用大批量生产样本降噪并周期性更新。
- 线上环境无法像离线 RLVR 那样把同一任务并行重放数千次,因此每次训练 step 需要聚合大量动态交互,周期可能以小时、天或周计算。
- Applied Compute 还探索 context base:让 Agent 离线分析文档和历史 trace,提取可复用经验,在 token 预算不变时提高后续表现。
- Patil 预计最终形态会同时包含权重更新、context 更新与 harness 更新,而不是只靠一种“自学习模型”。
40|Transformer 会被替代吗
- Patil 的现实主义立场是:扩展 Transformer 仍然有效,在没有明显能力墙之前,行业会继续沿着这条路径投入。
- 他甚至认为,继续扩大现有模型,可能比人类直接设计更好架构更早让 AI 帮助发现下一代架构。
- 另一派的核心论点是数据效率:人类不需要互联网规模输入才能学习,所以现有架构不应是终点。Yann LeCun 等研究者据此寻找更符合第一性原理的方案。
- 现实约束是产业已经围绕 Transformer 优化芯片和数据中心。即使 Mamba 等替代架构研究有潜力,巨大的软硬件投资也使技术路线转换成为一艘很难掉头的大船。
42|创业与市场判断:硬件机会、芯片自研和数据业务压力
- 如果不做 Applied Compute,Patil 会关注硬件与能源,因为计算需求远超供应,模型训练与芯片设计的 co-development 仍有改进空间。
- 他看好 NVIDIA 和芯片供应商,但也指出大型实验室每年投入数千亿美元,可能有动力自研即使只有领先产品约 80% 效率的芯片,再靠数量、协同优化和避免高毛利来改善总经济性。
- 他对通用“卖数据”业务更谨慎:模型每被训练得更强,下一批有效任务就更难、更贵;同时合成数据与 generator–verifier pipeline 会减少一部分人工任务制作需求。
- 这不意味着数据行业消失,而是供给会转向新波次,例如机器人、第一视角视频和新的高价值环境。
46|个人偏好的产品:Image 2
- Patil 说自己喜欢当时的 Image 2,因为不会设计的人可以把论文或草稿交给模型,获得更直观的视觉讲解。
- 主持人也展示了由图像工具基于课程大纲生成的插图,并指出生成图带有可识别的水印。
一句话复盘
企业 AI 的真正护城河不是简单接入更大的通用模型,而是持续定义内部“什么叫正确”,把专有数据、Evals、可验证环境、生产反馈、专用模型、context 和 harness 组织成能不断提高业务结果的学习系统。
讨论
这里是静态站点,没有内嵌评论区。如果这篇文章对你有用,欢迎通过 RSS 订阅后续更新。