3,195 字 · 354 词 · 约 10 分钟更新于
Stanford MS&E435:企业 AI 与 SaaS | Enterprise AI
Stanford MS&E435 课堂对谈笔记:Databricks CEO Ali Ghodsi 谈企业 AI 落地、上下文瓶颈、流程重构与 SaaS 护城河。
来源:YouTube 原视频(Stanford Online · MS&E435)
Stanford MS&E435《Economics of the AI Supercycle》课堂对谈。主持人为 Apoorv Agrawal,嘉宾为 Databricks 联合创始人兼 CEO Ali Ghodsi。话题覆盖企业 AI 落地、SaaS 护城河、流程重构、AI 五层栈、开源模型与职业选择。
观点归属 Ali 在对谈中明确主张“按 2009 年的定义,我们已经有 AGI”,并对超级智能竞赛、前沿模型投入和 SaaS 市场作出鲜明判断。这些都是嘉宾观点;本笔记不把它们当作行业共识、经验证事实或投资建议。课堂中的市场规模、失败比例与收入数字也均按讲者口径呈现。
TL;DR
- Ali 认为,企业 AI 的主要瓶颈不是模型不够聪明,而是模型缺少组织内部的上下文:历史决策、隐性流程、权限、数据和资深员工脑中的经验。如果这些信息无法进入 agent,再强的模型也会犯低级错误。
- 真正落地 AI 需要重构组织流程,而不只是给旧流程加一个聊天框。这类似电动机和个人电脑早期的生产率悖论:新技术先被塞进旧组织,直到工厂布局、职责和工作流重做之后,生产率才显现。
- AI 让写软件更便宜,也可能通过统一的 agent 界面降低切换成本,因此 SaaS 会面临更多竞争;但软件不会“死亡”。规模、品牌、信任、安全认证、专有数据、客户关系与持续创新仍是护城河。
- Databricks connector 案例显示,代码生成只压缩了小部分周期;真正把“九个月做一个”改成“一季度做七个”的,是缩短需求文档、外包测试环境搭建、并行化和快速迭代等流程重构。
- Ali 认为长期价值会向应用层迁移,医疗和教育可能产生拥有数据飞轮与规模经济的大公司;模型层仍有价值,但开源模型会施加价格压力,使“token factory”更像低利润率、规模驱动的基础服务。
- 给学生的建议是降低焦虑、拉长时间尺度,不要追逐社交媒体上最热的“必然问题”;选择长期趋势中的真实问题,并保留发现非显然应用的空间。
00|先降低焦虑:不要把行业速度变成隧道视野
- Apoorv 从 xAI、Cursor、OpenAI 与 Anthropic 的快速竞争谈起,请 Ali 给出行业全景。
- Ali 的第一反应是让学生“冷静”:害怕错过 AGI 或创业窗口,会让人追逐社交媒体上的热门议题,忽略真正值得解决的问题。
- 他用 Databricks 实习生的焦虑举例:22 岁的人担心晚六个月创业就毁掉人生。Ali 认为技术扩散与公司建设都需要时间,短期噪声不等于长期方向。
01|“我们已经有 AGI”——Ali 的定义争论
- Ali 反对把 AGI 不断改写成“神一般、递归自我改进、解决所有疾病”的超级智能。
- 他主张,按自己在 2009 年 Berkeley AMPLab 时理解的 general intelligence 标准,今天的模型已经达到 AGI;现场举手互动用来说明,人们常承认最强模型比许多现实中的人聪明,却仍拒绝使用 AGI 标签。
- 这是定义和阈值的立场,不代表模型已具备人类所有能力,也不代表风险、可靠性和部署问题已经解决。
04|模型很强,但企业 POC 仍大量失败
- Ali 引用一份 MIT 相关报告称大量企业 POC 失败,同时承认 95% 这一具体比例可能不准确,但方向上符合他的观察。
- 企业内部仍主要由人执行旧式工作流,并没有大量 agentic coworkers 与人协作。即使 AI 公司自身,也常沿用传统销售和运营方式。
- 于是出现表面矛盾:模型能力已经很强,企业生产率却没有同步跃升。
05|核心缺口:组织上下文没有进入模型
- Ali 认为,企业内部总有一位工作十年甚至几十年的 “John / Jane”,知道规则为何形成、异常如何处理、该找谁以及哪些约束不能碰。
- 这些隐性知识不在数据仓库、文档或 prompt 中,agent 就无法像资深员工一样行动。
- 因此,企业 AI 的高价值问题是:如何把数据、历史、流程、权限、反馈和人的 tacit knowledge 转成模型可用、可更新、可审计的上下文。
- Ali 的结论是,即使继续提升数学与推理能力,如果缺少组织上下文,agent 仍会在实际业务中犯错误。
07|软件没有死,但竞争结构变了
- 面对 “SaaS apocalypse” 问题,Ali 用反证说明软件不会消失:OpenAI、Anthropic 和 NVIDIA 的设计工作本身也高度依赖软件。
- 他认为真正发生了两件事:
- 进入壁垒下降:AI 让软件开发显著便宜、速度更快;
- 切换成本下降:若用户主要通过 agent 交互,底层是 Salesforce 还是替代品、Gmail 还是 Outlook,界面差异可能不再形成强锁定。
09|写软件更便宜,而且所有人都有这件武器
- AI 编程让新进入者更容易复制功能,但既有软件公司也能使用同样工具改进产品。
- Ali 不赞成立刻重写 CRM、IT help desk 或财务系统;替代一个生产系统还涉及数据迁移、可靠性、安全、权限、集成和组织习惯。
- 合理推论不是“新公司必胜”,而是创新速度变得更重要:十年没有改进产品、只靠旧习惯涨价的公司风险最大。
10|AI 时代仍然存在的护城河
- Ali 推荐 Hamilton Helmer 的《7 Powers》,并列举软件之外的防御力:
- 规模经济和大额固定成本的摊销能力;
- 品牌;
- 信任、安全记录、认证和专利;
- 独有数据;
- 客户关系和既有分发。
- 低成本代码可以复制界面和功能,却不能立即复制长期数据、合规资质、客户信任与运营规模。
- 既有公司仍有数据、客户和规模优势,但必须重新建立创新肌肉,并可能调整定价与成本结构。
13|Jagged Frontier:能力不是均匀扩张
- Apoorv 引用 Ethan Mollick 的 “jagged frontier”:AI 在某些任务上非常强,在相邻任务上却可能表现很差。
- Ali 认为,企业目前大多停留在“AI 帮助部分任务”,而不是端到端替代整条业务流程。
- 他以 Databricks 技术支持为例:客户往往是在复杂模型、F1 score 或系统配置上已经尝试多种方法后才求助,问题本身就位于难例尾部,因此很难被通用客服自动化直接替代。
16|AI 战略从数据战略开始
- Apoorv 总结 Palantir 的经验:要先铺好数据道路,让数据流动起来,AI 才能工作。
- Ali 补充说,落地首先是 human problem:企业要重新设计流程、明确上下文来源、改变责任分配,而不是等待更强模型自动解决。
- 有效的数据战略不仅是汇集表格,还包括语义、权限、质量、血缘、实时更新和结果反馈;否则 agent 只获得碎片,而不是业务上下文。
17|技术扩散为何长期看不到生产率
- Ali 推荐 Paul David 的经典论文《The Dynamo and the Computer》,用电气化与 PC 说明通用技术的扩散滞后。
- 早期工厂只是用电动机替换蒸汽机,却保留多层建筑和 line shaft 布局;早期办公室也只是用电脑打字后再打印、归档。硬件换了,流程没变,生产率自然不明显。
- 他称电动机出现后约 40 年,经济统计中才显示显著生产率收益。
- 真正的跃升来自重新设计工厂平面、分散驱动、按需运行设备。对 AI 而言,对应动作是重构组织和业务流程,而不是把 agent 塞进原来的审批链。
20|Databricks connector:代码快,不等于交付快
- Databricks 需要为 Salesforce、Workday、NetSuite 等系统建设 production-ready connectors。传统完整周期约三个季度。
- Ali 自己用 LLM 两天写出 connector 后,团队分析发现:AI 只能把周期减少约一个半月,因为生产交付还包括需求、客户反馈、安全、测试环境和外部系统配置。
- 另一个负责人从第一性原理重做流程后,目标变成一季度交付七个 connectors。
22|收益来自流程重构,而不只是更强模型
- 团队把原本一个季度的产品需求阶段压缩为一周,接受早期规格可能出错,因为代码重写已经变便宜。
- 不擅长的外部 SaaS 测试环境搭建被交给更专业的服务方,工作并行推进,反馈周期缩短。
- Ali 强调,这一改进不需要等待下一代 GPT 或 Claude;它是 human refactoring / process reengineering。
- 这也构成一种 process power:持续优化后的组织流程本身可以成为护城河。
25|AI 五层栈:价值最终落在哪里
- 课堂把 AI 产业拆为能源、芯片、基础设施、模型和应用五层。
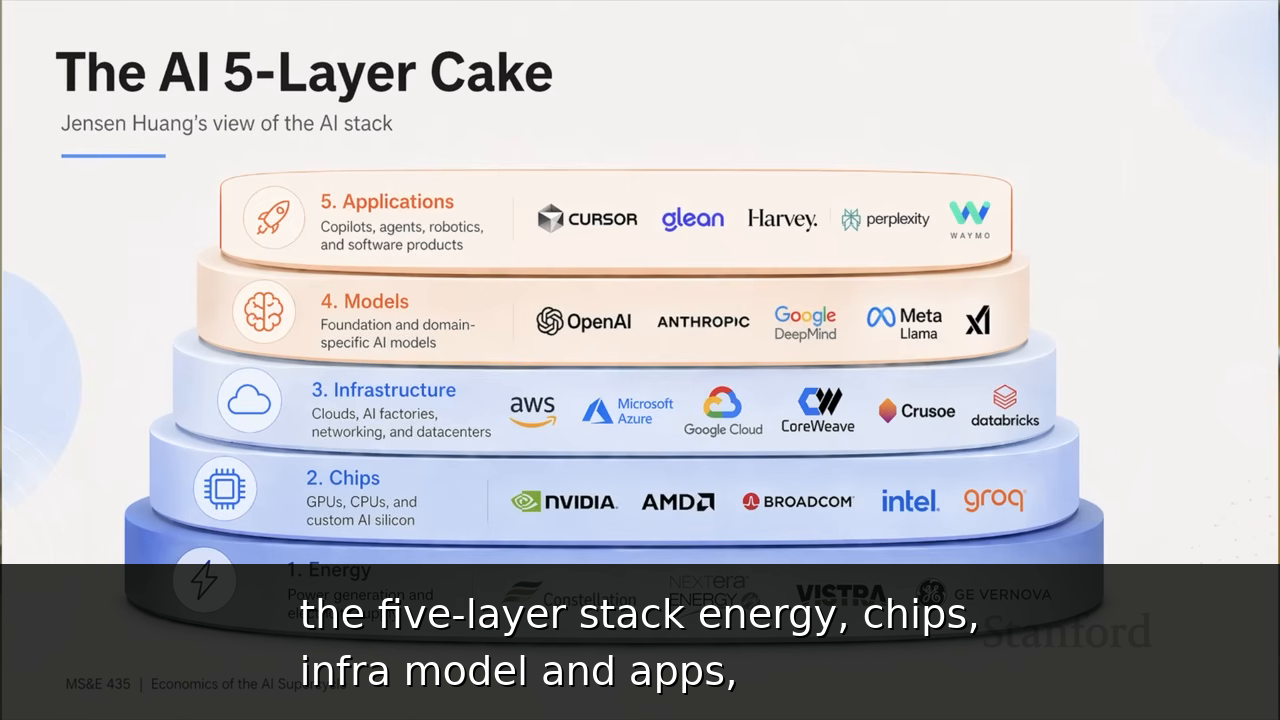
- Ali 的个人判断是,长期最大价值会向应用层聚集。他倾向于早期、多项目组合,因为真正的大应用通常在技术出现多年后才被发现。
- 他用互联网史反思自己的博士研究:当年大家关注 multicast、路由与带宽优化,后来带宽成本快速下降,真正的大公司却来自搜索、社交、短文本、共享住房等当时看似“不够技术”的应用。
28|医疗与教育:可能被低估的应用层
- Ali 把医疗和教育作为潜在大市场:
- 医疗服务若积累大量患者与结果数据,可能形成数据飞轮、个性化能力和高支付意愿;
- 教育长期被 VC 视为难投,但家庭高度重视孩子的学习质量;如果 AI 服务能经验证优于现有方案,也可能形成大公司。
- 他提到“万亿美元公司”是可能性判断,不是收入预测;关键逻辑是应用层可以同时获得数据护城河和规模经济。
31|价值会向栈顶迁移
- Apoorv 展示“Software vs AI Economics”图,指出当下 AI 价值更多集中在芯片;Ali 则认为技术产业的价值会不断向更高层迁移。
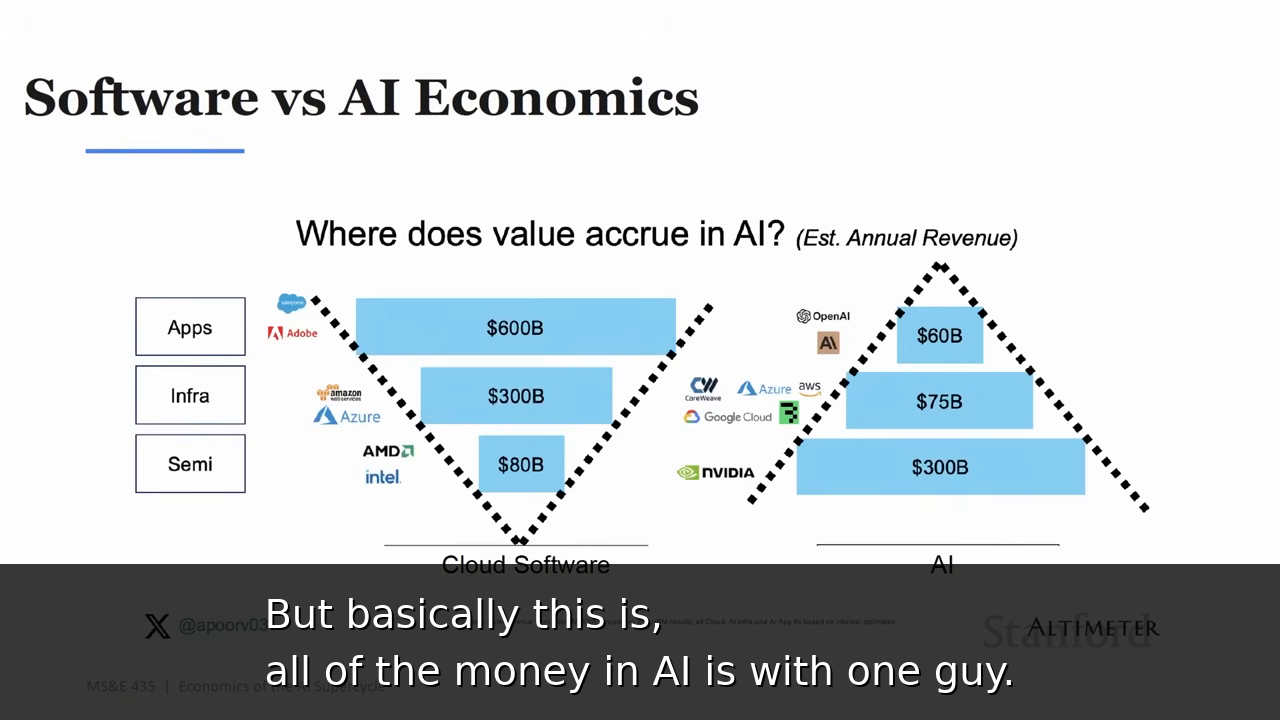
- 历史类比是:PC 硬件先占据价值,随后操作系统、虚拟化和更上层软件获得更大份额;底层成熟后逐渐商品化。
- 对 AI 来说,这并不表示芯片或模型无价值,而是长期差异化可能更多来自工作流、数据、分发和实际结果。
32|开源模型与 token factory
- Apoorv 指出开源模型与前沿闭源模型的能力差距正在缩短;Ali 认为模型服务仍有价值,也会存在大型集中式 token factories。
- 他以 Kimi 2.6 为例说明开源/开放权重模型的追赶速度,并称如果较新模型提前数月发布,它可能会被视为当时最强模型。这里是他对相对能力的口头评价。
- Ali 预计开源会施加价格压力,前沿模型供应最终成为规模经济、较低利润率的业务,类似 Amazon 早期图书零售。是否真的如此仍取决于研发壁垒、训练资本和需求分层。
34|日常工具与 Databricks Genie
- Ali 表示自己会组合使用 Cursor 等编程工具,重视 diff 与代码审阅体验。
- 在 Databricks 内部,他常用 Genie 分析数值和时间序列数据,辅助 ROI、成本等量化决策。
- 他的工具选择再次体现“上下文”原则:对内部经营问题,能安全访问正确企业数据的系统比单纯通用聊天更有用。
35|“SaaS apocalypse”有一部分是真的
- Ali 重申,软件成本、进入壁垒和切换成本正在下降,因此确实存在某种 SaaS 重估。
- 但不是所有软件都会消失。能够持续创新、掌握独有数据、维持信任并重构产品的公司仍有优势;停滞的 workflow SaaS 最危险。
36|给学生的建议:长期趋势,非短期热点
- Ali 建议不要被恐惧叙事驱动,也不要假设今天最热门的问题必然最重要。
- 他用 Airbnb 说明好应用可能在基础技术成熟多年后才出现:互联网早已存在,但共享住宿的产品洞察仍晚了多年。
- 更好的策略是:识别不可逆的长期趋势,先从一个具体、可验证的问题开始,持续复利,而不是争夺社交媒体上最响亮的话题。
一句话复盘
企业 AI 的竞争不只是“谁拿到更强模型”,而是谁能把组织上下文、可信数据和隐性流程转化为 agent 可执行的系统,并愿意为此重构工作方式;模型能力是大脑,真正艰难的是重建身体、神经和制度。
讨论
这里是静态站点,没有内嵌评论区。如果这篇文章对你有用,欢迎通过 RSS 订阅后续更新。