3,574 字 · 398 词 · 约 11 分钟更新于
Stanford MS&E435:建设 AI 工厂 | Building AI Factories
Stanford MS&E435 课堂对谈笔记:Crusoe CEO Chase Lochmiller 谈吉瓦级 AI 数据中心与从电子到 token 的工厂经济学。
来源:YouTube 原视频(Stanford Online · MS&E435)
Stanford MS&E435《Economics of the AI Supercycle》课堂对谈。主持人为 Apoorv Agrawal,嘉宾为 Crusoe 联合创始人兼 CEO Chase Lochmiller。主题是如何在吉瓦级规模建设 AI 数据中心,以及“从电子到 token”的成本与商业模型。
阅读口径 文中的投资规模、功率、成本拆分、收入、回收期、节水和未来判断均来自讲者的课堂幻灯片与现场估算。Chase 多次说明数字是粗略值,个别图表可能存在重复计算;本笔记按来源归因,不把它们当作审计数据或投资建议。
TL;DR
- AI 工厂不只是 GPU 集群,而是数据、算法、计算、电力与数据中心的组合。数据中心是 AI 热潮的物理形态:它把电力、土地、变电、冷却、网络、芯片和劳动力组织成可以持续产出 token 的系统。
- Chase 用 Cobb–Douglas 生产函数解释 token 的价值:AI agents 可被视为一种“数字劳动力”,购买 GPU 和数据中心相当于用资本更快扩张可用劳动力与技术能力。这是他的经济叙事,而非对所有宏观结果的确定证明。
- 当前瓶颈不是永远固定在 GPU。芯片、供电、已通电机房、变压器、开关设备、冷却器、燃气轮机和施工技工都可能轮流成为关键路径,因此 Crusoe 选择从能源到托管服务的纵向一体化。
- Abilene 案例展示了“能源优先”:到风光资源丰富、输电受限、甚至出现负电价的地方建设算力,把移动电力的问题变成移动数据的问题。该园区面向 Oracle/OpenAI 的 Stargate 项目并规划扩展到 Microsoft。
- Chase 的课堂估算是:数据中心与电厂约 2000 万美元/MW,IT 基础设施约 4000 万美元/MW,总前置 CapEx 接近 6000 万美元/MW;只出租算力的年收入约 1500 万美元/MW,叠加模型托管等服务后,乐观情形可达约 3000 万美元/MW。
- 真正决定回报的不是一张静态成本表,而是设备寿命、折旧曲线、利用率、能源价格、芯片租赁价格和服务层附加值。规模与最新一代硬件短期仍可获得溢价,但竞争会逐渐压低成熟算力的利润率。
00|超大规模云厂商 CapEx 快速上升
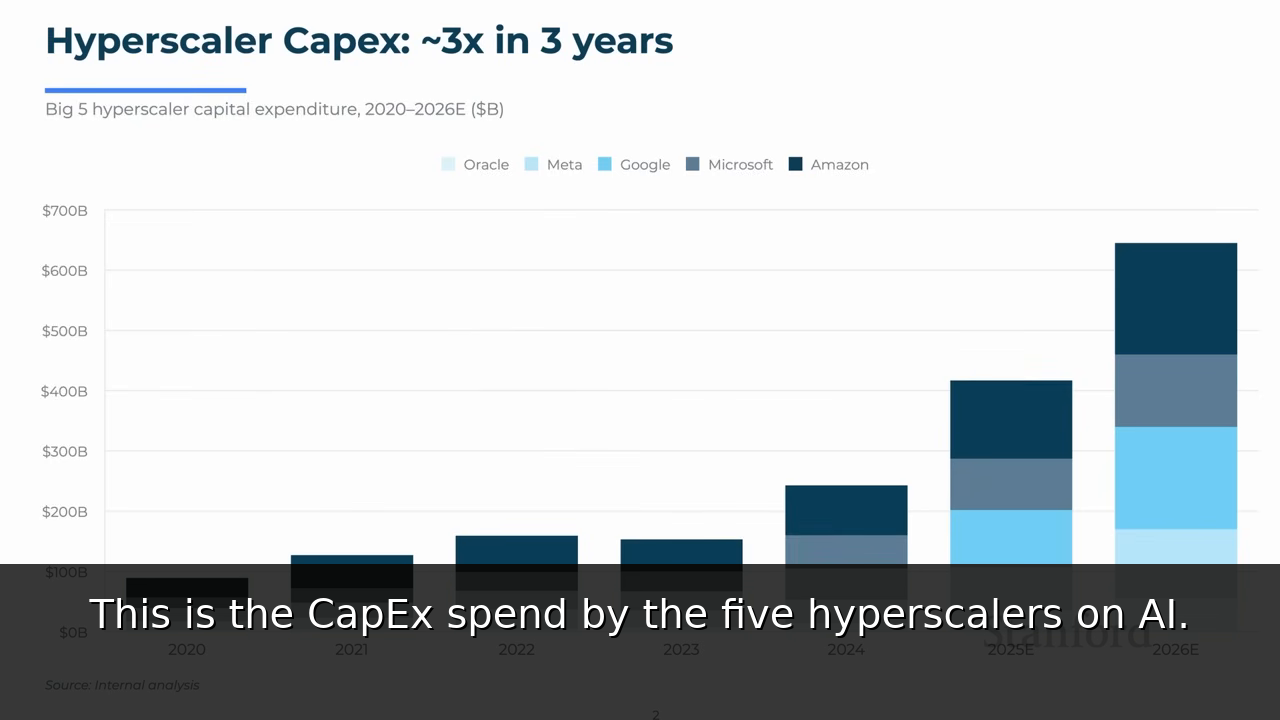
- Apoorv 以五家 hyperscaler 的 AI 资本开支图开场,称这轮投资规模在美国历史上的大型工程中也非常突出。
- 图表表达的重点不是某一个精确总数,而是 2024–2026 年投入斜率显著变陡:模型能力竞争已经转化为电力、建筑、网络和设备的实体建设周期。
01|数据中心是 AI 热潮的物理形态
- Chase 将数据中心定义为运行 GPU、训练和微调模型、承载大规模推理并向用户提供 token 的物理基础设施。
- 最简单的抽象是“一栋有供电和冷却、可以插入计算机的建筑”;进入百兆瓦或吉瓦规模后,它会同时牵涉化工、机械、电气、土木、计算机和网络工程。
03|AI 工厂的投入公式
- Chase 给出的基本关系是:AI = 数据 + 算法 + 计算 + 能源 + 数据中心。
- 数据和算法固然有成本,但 Crusoe 聚焦的是最资本密集的后三层:获得能源、建设并运营数据中心、部署和管理计算基础设施。
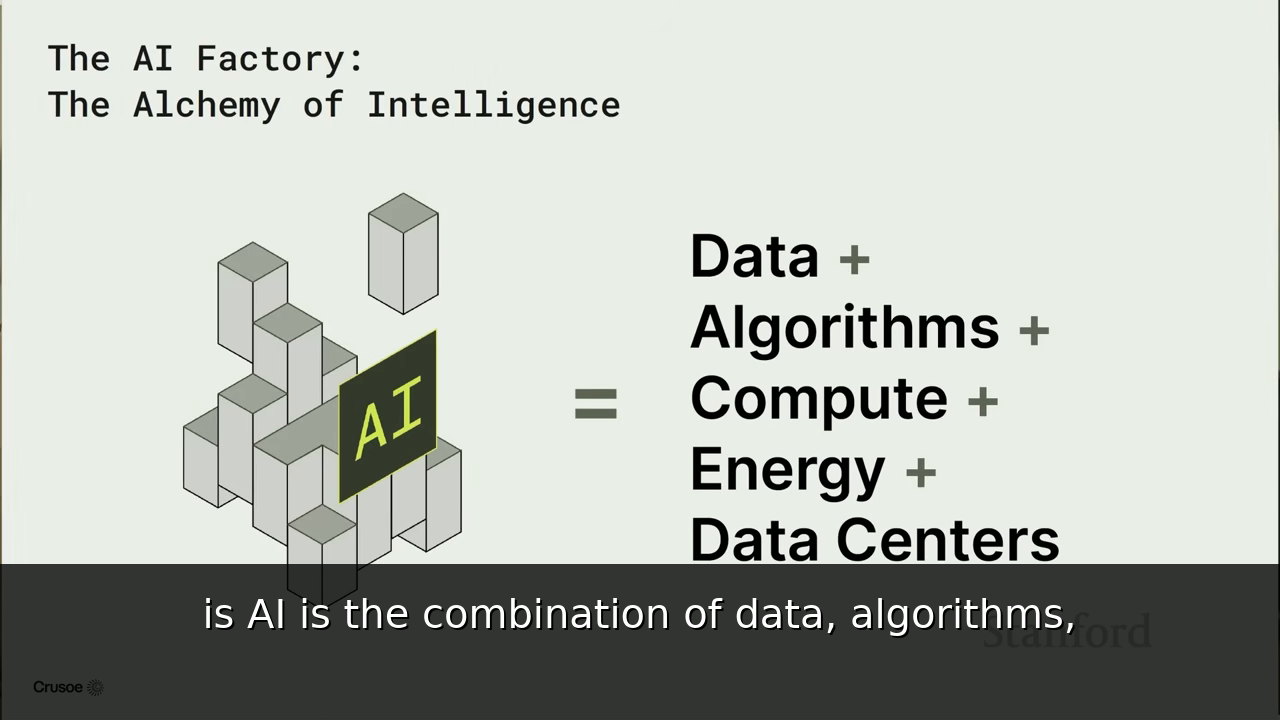
- 这张公式也提醒我们:只比较 GPU 型号会漏掉系统级约束。没有可用电力、变电站、冷却、网络和机房,芯片本身不能转化为可出售的智能服务。
05|从电子到 Token:数字劳动力叙事
- Chase 借 Cobb–Douglas 模型说明 GDP 增长与劳动力、资本和技术变化之间的关系,并把 AI agent 视作可由资本投入快速扩张的“数字劳动力”。
- 传统人口与劳动力扩张需要很长周期;他的论点是,投资 GPU 和数据中心可以更快增加可用的数字工作能力,从而提高人类劳动生产率。
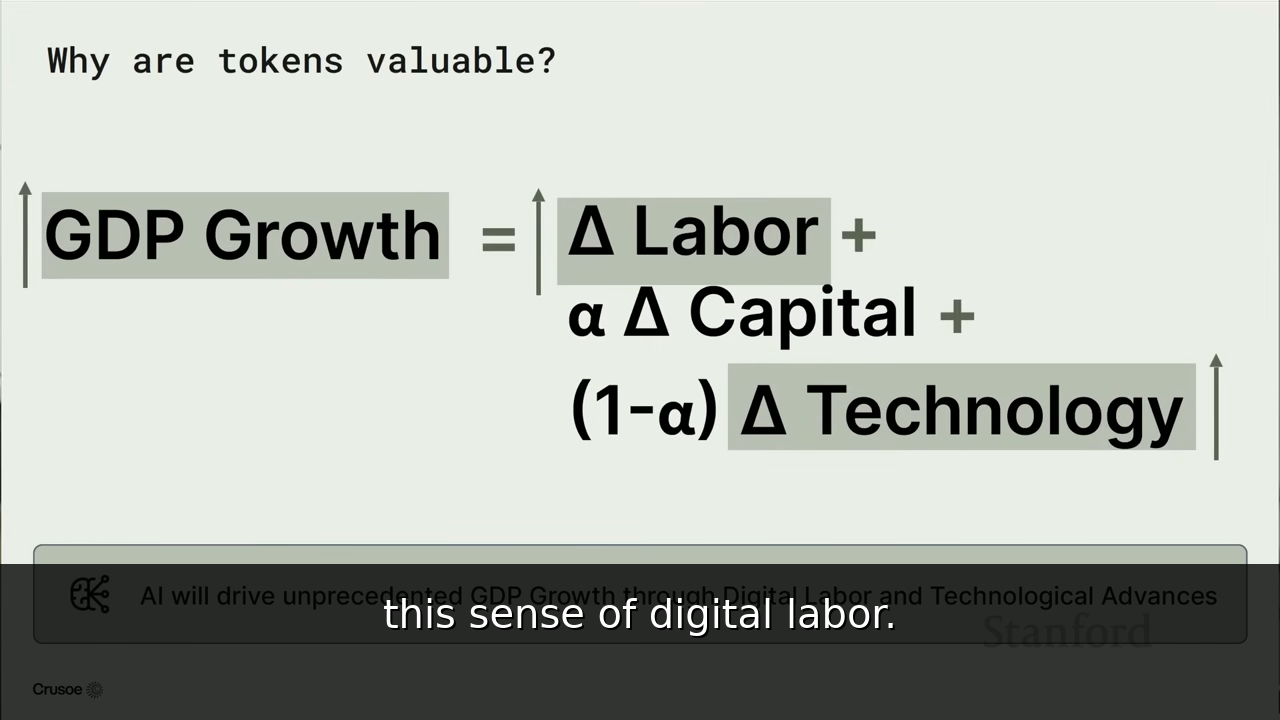
- 这是 Chase 对巨额 CapEx 的价值解释:token 并非抽象字符,而是代理完成分析、编码、销售运营等任务时所消耗的计算产出。
07|为什么做纵向一体化
- Crusoe 覆盖能源开发、数据中心、GPU 集群与云/托管服务等层次,但不做芯片和基础模型。
- Chase 说,AI 基础设施的瓶颈会不断移动:某阶段缺芯片,下一阶段可能缺已通电机房、变压器、冷却设备或施工人员。
- 纵向一体化的意义是可以跨层调整资源、绕开当前关键路径,而不是认定某一环节永远拥有最高利润。
09|当前瓶颈:已通电的机房壳体
- Chase 判断,当时最紧缺的是可以直接安装芯片并启动集群的 energized data centers / powered shells。
- 芯片供应相较此前有所缓和,但“把芯片放在哪里并把它们打开”变成新的瓶颈。
- 关键设备包括变电站、开关设备、变压器、冷却器、发电机组与网络;任何一项交付延迟都可能让昂贵 GPU 闲置。
11|能源优先:移动数据,而不是长距离移动电力
- Crusoe 没有只在北弗吉尼亚等传统数据中心枢纽复制标准机房,而是寻找能源丰富、传统数据中心较少的地点。
- AI 训练和早期加密货币计算都具有高耗能、负载可集中等特点。Chase 的策略是让计算靠近能源,再通过网络传输数据。
- 这把选址问题从“哪里已有成熟数据中心市场”改写为“哪里有低成本、可扩张、可长期取得的电力”。
13|Abilene:在能源富集但输电受限处建算力
- 西得州 Abilene 风力和日照资源丰富。Chase 说,当地可再生能源建设一度超过输电和边际需求,电价甚至可能为负。
- Crusoe 因此把高耗能 AI 工作负载放到当地,吸收难以外送的电力。
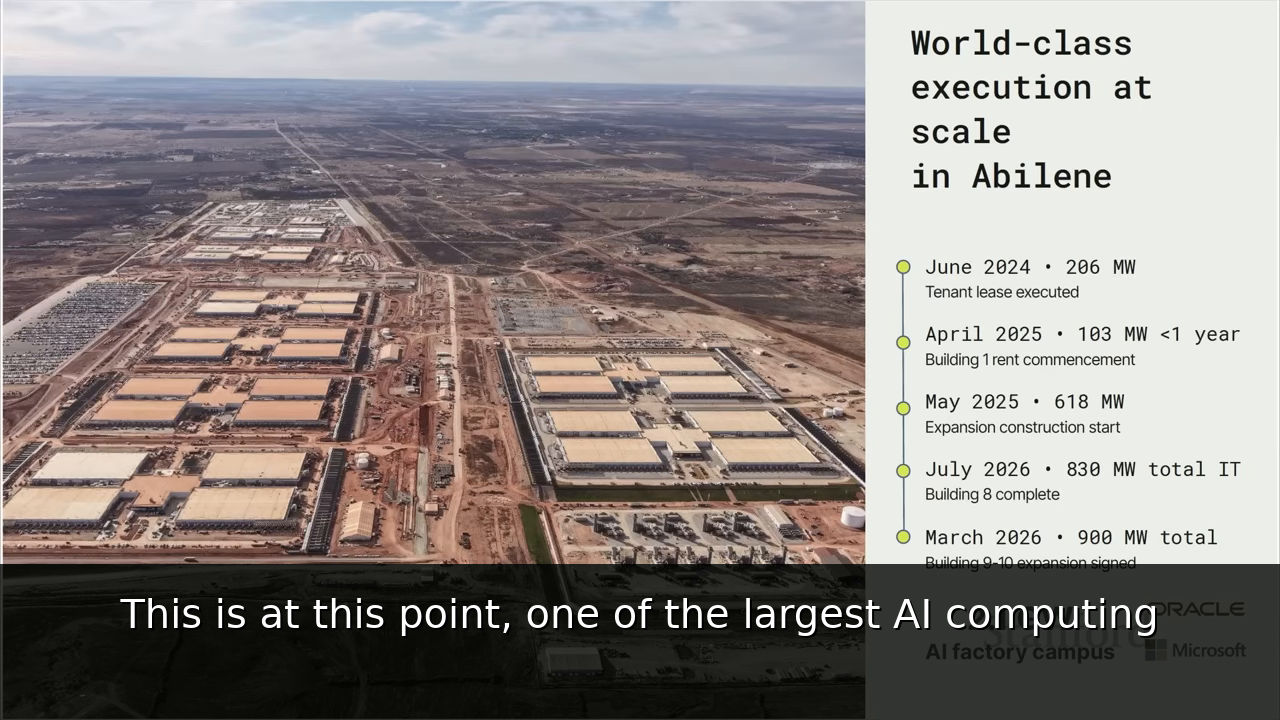
- 现场幻灯片把园区描述为约 2.1 GW:包括大型私人变电站、面向 Oracle 和 OpenAI 的八栋楼(Stargate 项目)、支持启动的约 350 MW 燃气电厂,以及面向 Microsoft 的扩建。
- Chase 用“一到两个 Denver 城市的用电量”帮助学生理解吉瓦规模。这里是量级类比,并非负载结构的严格等价。
16|一个集群、数千名建设者
- 多栋数据中心通过高性能后端网络互联,可被当成一个 coherent cluster,让一次训练任务跨建筑运行。
- Chase 称 Abilene 现场每天约有 9000 名建设人员,长期运营也需要大量岗位。它说明所谓“数字劳动力基础设施”本身依赖庞大的现实劳动力。
- 为吸引短期施工人员,项目需要迁移、住宿和留任激励;当地技工供给会直接影响建设速度。
18|一美元究竟花到哪里
- 数据中心 CapEx 不只进入服务器机柜,还包括:
- 高压接入、变电站、配电中心、UPS、变压器和开关设备;
- 冷水循环、冷却器、管道、风墙和 cooling distribution units;
- 钢材、混凝土、地基、道路与建筑;
- 备用发电、现场施工、保险、融资、选址和调试。
- 可靠性设计也按负载分层:并非所有 GPU 都需要完整的 five-nines 备用,但核心存储和网络必须在停电时保留访问能力,以便读取 checkpoint 或迁移工作负载。
21|冷却与用水:存量很大,不等于持续消耗很大
- Chase 说,单栋建筑的循环系统可能装有约 100 万加仑水,通过芯片、管路和冷却器闭环循环。
- 他称系统首次注水后,每年补水量可能仅相当于一户家庭。该说法针对其展示的设计,不能直接外推到所有数据中心或所有冷却架构。
- 对缺水的西得州而言,闭环和空气冷却设计是选址可行性的关键部分。
23|施工劳动成为硬约束
- Chase 的示例成本表中,建设期劳动力约为 470 万美元/MW;折算到 1 GW,就是约 47 亿美元的资本化劳动力支出。
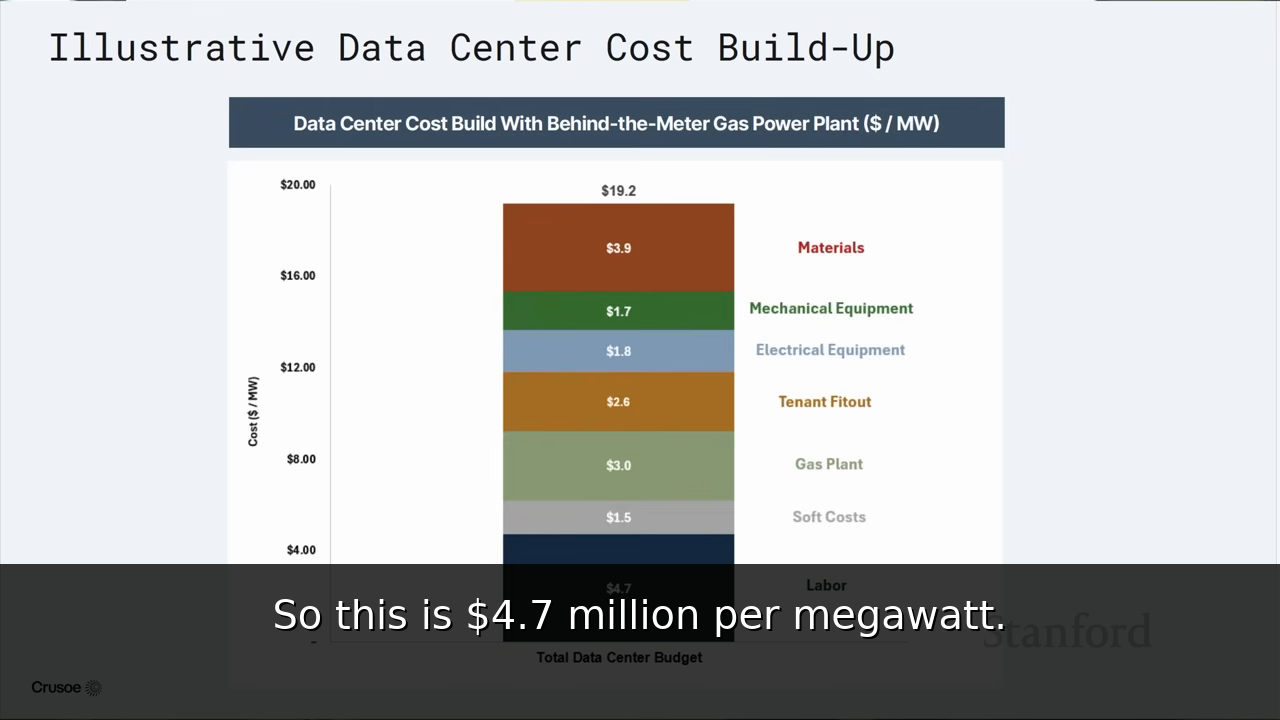
- 他明确点名电工、焊工、管工和建筑工人短缺。多个大型项目同时启动后,技工工资和招募成本上升,劳动会像芯片一样成为供应链瓶颈。
- 燃气轮机也类似:制造商数量有限,而 AI 项目集中采购使讲者所举的单位价格从约 100 万美元/MW 上升到约 300 万美元/MW。
27|约 2000 万美元/MW 的数据中心与电厂
- Chase 把 data center shell、配电、机械设备、材料、租户装修、燃气电厂、软成本和劳动力合计为约 1920 万美元/MW,课堂中取整为 2000 万美元/MW,即约 200 亿美元/GW。
- 他判断这一数字当时仍在上涨,因为发电设备、关键电气部件和技工都受到需求推动。
- 这些数字不含完整 GPU/IT 集群,是把“有电、有冷却、可装机器”的物理工厂建出来的成本。
28|Across-the-meter:园区与电网双向协同
- Chase 介绍另一处得州项目:现场风电直接供给数据中心,并计划组合太阳能、电池和燃气。
- 过剩电力可以卖回电网;风光不足或设备检修时,园区再从电网取电。相比纯 behind-the-meter,这是一种跨电表的双向关系。
- 他称这种建设可为当地增加供给并降低用电者成本;实际影响仍取决于电网规则、输电容量和项目调度。
30|另一个 4000 万美元/MW:IT CapEx
- Chase 的下一代估算中,IT 基础设施约 4000 万美元/MW,其中:
- GPU 约 3000 万美元/MW;
- 高性能网络约 400 万美元/MW;
- CPU 与存储约 300 万美元/MW;
- 机房内配套、部署和运输构成其余部分。
- 72-GPU NVLink 域还需要通过 InfiniBand 或 RoCE 等后端网络连接多个机架,才能形成大规模 coherent cluster。
- Chase 观察到 agentic workloads 也推高 CPU 需求,因为任务编排和外围服务并非全由 GPU 完成。
33|算力会商品化吗
- Chase 的回答分时间尺度:旧一代计算会逐渐商品化;最新一代硬件仍会获得溢价;真正难复制的是超大规模交付与稳定运营。
- 他预计竞争会让成熟硅产品利润率回落,但没有给出确定时间表。课程中提到的 NVIDIA 毛利率数字也是即席估算。
- 对客户而言,服务层会逐渐屏蔽底层芯片型号,正如视频会议用户不关心服务器使用哪一代 CPU;客户购买的是结果、SLA 与可用性。
34|折旧不是简单按“下一代发布”计算
- Chase 以 H100 租赁价格为例称,agent 需求增长曾使旧芯片价格回升,说明硬件发布三年后未必立即失去经济价值。
- 资产价值取决于仍能否被高利用率工作负载使用,而不是只看新芯片的峰值性能。
- 因此,建筑、电厂、网络和 GPU 应分别考虑寿命与残值;整座工厂用一个统一折旧年限可能掩盖真实风险。
37|整厂经济账:约 6000 万美元/MW 的前置投入
- 把约 2000 万美元/MW 的数据中心与电厂,加上约 4000 万美元/MW 的 IT 设备,课堂取整得到约 6000 万美元/MW 的前置 CapEx。
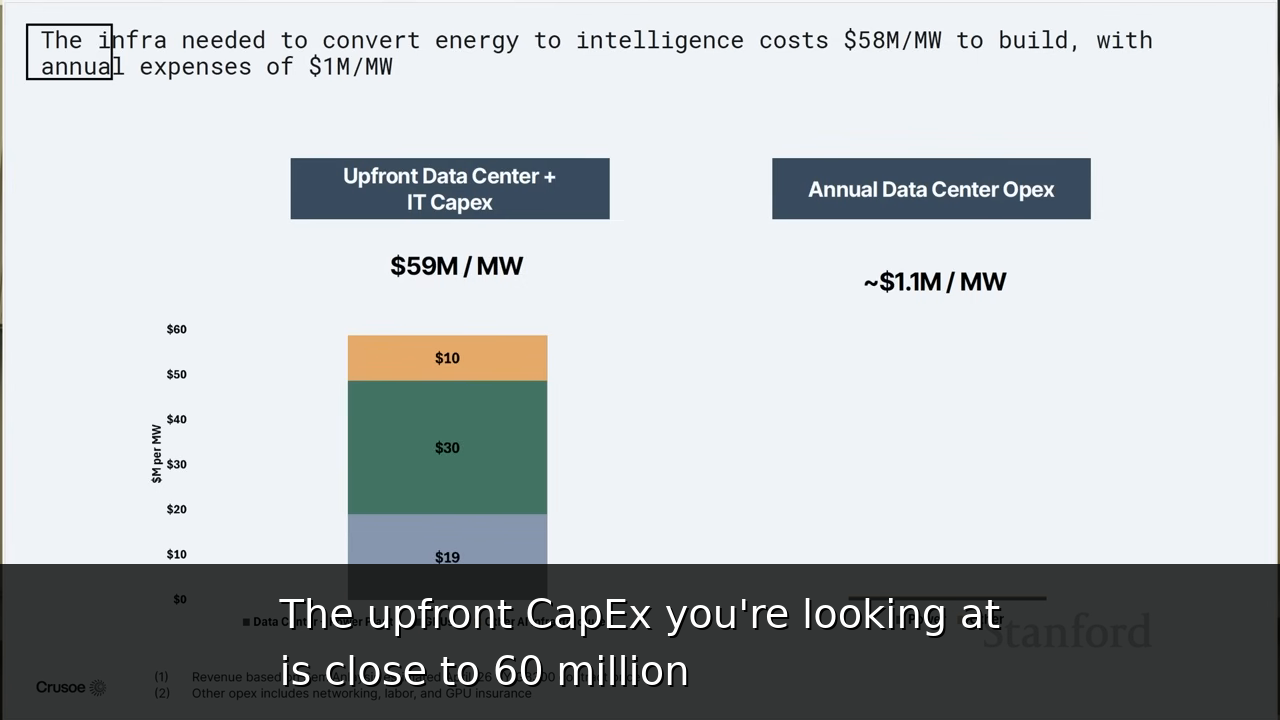
- Chase 同时给出以下粗略模型:
- 年度现场 OpEx 约 100–200 万美元/MW,但他承认图表未覆盖全部工程人员等费用;
- 只出租计算基础设施,年化收入约 1500 万美元/MW;
- 加上模型托管、API endpoint 等 managed services,乐观情形可再增加约 500–1500 万美元/MW;
- 据此,收入口径的静态回收期可能从约四年缩短到约两年。
- 这不是自由现金流回收期:它没有完整纳入融资成本、折旧、税、空置率、升级、全部人员与故障损失。Chase 自己也强调数字是课堂上的快速估算。
41|模块化 Crusoe Spark
- 为降低现场技工和施工成本,Crusoe 设计集中制造的模块化数据中心 Spark。
- Chase 称模块化可带来约 30%–50% 的基础设施节省;空气冷却单元约 500 kW,液冷版本约 2 MW,并可成组部署。
- 模块化的价值不是替代所有吉瓦级园区,而是把更多施工移入标准化工厂,缩短部署时间并利用零散的新电力机会。
42|电力电子是下一轮创新栈
- Chase 认为,数据中心会推动从 345/765 kV 高压电网到机架 900 V DC 的转换链条创新,包括固态变压器、功率电子和配电架构。
- 传统电气设备商短期处在关键路径上,订单可能很好;长期若不创新,则可能被成本更低的新架构冲击。这是他的行业判断,不是具体做空建议。
- 他还认为 open-source models 会从闭源模型厂商手中取得更多份额,同样属于个人判断。
45|太空数据中心:长期可能,近期不重要
- Chase 对太空数据中心保持兴趣,并提到 Crusoe 与 Starcloud 的合作。他看到的潜在优势包括减少土地、混凝土地基、许可和部分光纤布线问题。
- 主要障碍是热管理、持续运维、GPU 故障后的维修,以及发射载荷成本能否下降两个数量级。
- 他的时间判断是:未来五年不具实质性影响,十年内也可能不重要;更长期才可能在智能基础设施中扮演重要角色。
47|给学生的建议:投资于学习过程
- Chase 认为,比“此刻具体学什么”更重要的是持续学习、刻意练习、韧性和使用新工具的能力。
- Crusoe 的说法是“infinite growth loop”:每个人都是未完成的产品,每天小幅改进会产生长期复利。
- 他预计 AI 会深刻改变工作,因此建议学生少押注固定职业答案,多训练学习方法,并把 AI 工具真正纳入工作与生活流程。
一句话复盘
建设 AI 工厂,就是在电力、土地、输电、冷却、网络、芯片、施工和金融约束之间做一套系统工程;真正有价值的公司不只拥有某个部件,而是能把这些部件按时变成高利用率、可持续产出 token 的服务。
讨论
这里是静态站点,没有内嵌评论区。如果这篇文章对你有用,欢迎通过 RSS 订阅后续更新。