Stanford MS&E435:生成式 AI 的经济学 | Economics of the AI Supercycle
Stanford MS&E435 开篇课笔记:Apoorv Agrawal 用 cloud vs AI 价值三角形,讨论生成式 AI 的价值流向、推理成本与应用层翻转。
来源:YouTube 原视频(Stanford Online · MS&E435)
来源说明 这是 Stanford MS&E435「Economics of the AI Supercycle」2026 年春季课程的开篇课,由 Stanford MS&E 兼职讲师、Altimeter Capital 合伙人 Apoorv Agrawal 主讲。本文根据视频的人工英文 CC 整理;配图均从视频对应时刻截取,并烧录该时刻的原始字幕。课程中的收入、用户量、毛利率和市场结构数字是讲师用于课堂分析的估算或引用,应理解为其当时的研究口径,而非本文独立审计的事实。
TL;DR
- Agrawal 用两座“价值三角形”提出整门课的核心问题:成熟 cloud 生态的收入主要在应用层,而当时 AI 生态的收入和利润仍高度集中于半导体,尤其是 NVIDIA。AI 能否最终形成应用层更大的结构,是这轮 supercycle 的关键经济问题。
- 传统软件接近零边际分发成本,常见 80%–90% 毛利;AI 应用每新增用户都会产生 inference 成本,因此即使收入很大,也不必然拥有传统 SaaS 的利润结构。
- 他认为当前结构既受产业尚早、NVIDIA 占据主导地位影响,也受真实物理约束影响。数据中心像铁路一样需要提前铺设,基础设施支出与上层收入兑现存在多年时间错配。
- 按其课堂估算,AI 产业收入在约两年内从 900 亿美元升至 4,350 亿美元,但新增约 3,500 亿美元中约 75% 流向了 semiconductors;应用收入虽增长十倍以上,仍未显著改变整体形状。
- 应用层的另一难题是用户规模和变现:ChatGPT 已超过典型 niche apps 的活跃用户规模,却离 30–40 亿级 core utilities 仍有距离;知识工作可能不足以覆盖所有互联网用户,订阅也可能不足以把每用户年收入从约 10 美元提升到成熟广告平台的 70–100 美元。
- Agrawal 因而押注两类变化:应用需要走出纯 knowledge work,变成更普遍的日常工具;商业模式也可能从纯订阅扩展到广告,但必须解决私人对话被打断、信任和呈现方式等问题。
一、这门课要建立什么判断框架(00–05)
Agrawal 先介绍自己的经历:从印度到新加坡,在 Palantir 从事工程工作,回到 Stanford 读研,后来进入投资机构 Altimeter。他把课程设计成九周的产业讨论,后续邀请来自半导体、基础设施、能源、模型、应用和 agent 等不同层的实践者。
课程并不试图只回答“哪家公司会赢”,而是训练学生在创业、加入公司或投资时提出更好的问题:
- 这个业务位于技术周期的哪一层?
- 支配这一层的“物理定律”是什么:资本强度、边际成本、分发、网络效应,还是平台控制?
- 当前利润是稳态结构,还是建设周期暂时造成的错位?
- 一个看似独立的创业方向,最终会成为 platform,还是会被 AWS 等大平台吸收为 feature?
他认为 AI 是自己经历过的最大技术 supercycle,并希望学生在五年后回看时,能够说自己不仅身处变化起点,也理解了其产业结构。
二、核心图:Cloud 与 AI 的价值三角形(05–07)
课程的 punchline 是一张对比图。按幻灯片的估算年收入:
| 层级 | Cloud 生态 | AI 生态 |
|---|---|---|
| Apps | 约 6,000 亿美元 | 约 600 亿美元 |
| Infra | 约 3,000 亿美元 | 约 750 亿美元 |
| Semis | 约 800 亿美元 | 约 3,000 亿美元 |
成熟云生态像正立的价值金字塔:硬件支持基础设施,基础设施支撑更大的应用收入。AI 在当时则近似倒置,最大的收入池还在用于训练和推理的芯片层。
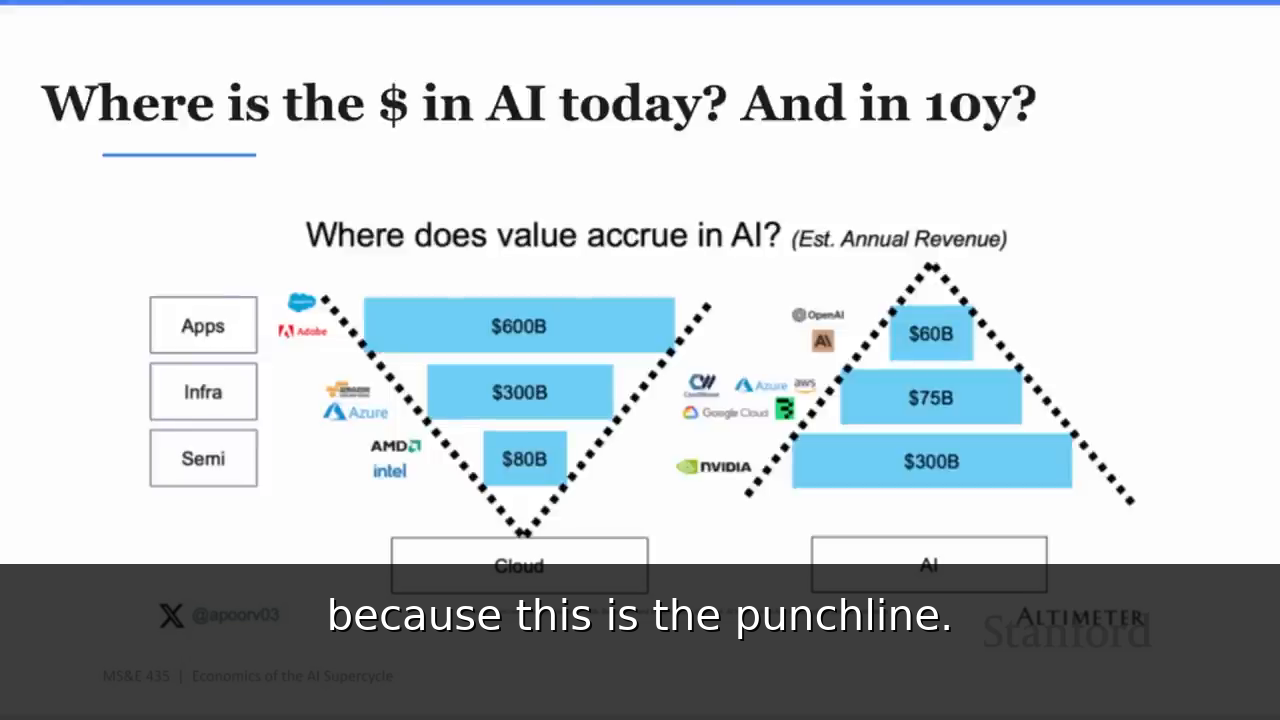
Agrawal 把问题分成两端:hyperscalers、NVIDIA 等正在投入巨额 CapEx,建设由能源、芯片、互连、存储等构成的数据中心;另一端则要检验模型和应用是否创造了足以承接这些投入的经济价值。互联网、移动和云最终都在上层形成了巨大价值,但 AI 是否会以相同速度翻转,仍是开放问题。
三、为什么 AI 应用不等同于传统软件(07–09)
课堂讨论先给出三个解释:产业还早、NVIDIA 的市场支配力很强、AI 的生产成本结构不同。Agrawal 尤其强调第三点。
传统软件能“一次构建、向数百万人分发”,新增一名用户的运行成本接近于零,因此优秀软件公司可以达到 80% 甚至 90% 的 gross margin。AI 应用则必须为新增使用量持续支付推理成本:“多一个用户”意味着额外消耗 GPU 和 token。
这解释了为什么某些 AI 应用即使达到十亿美元级收入,仍可能没有盈利。AI 应用面对的并非旧 SaaS 模型上简单加一个聊天框,而是一套新的 unit economics:使用越多,收入和算力成本可能同时增长。
四、三角形翻转需要时间:AWS 与铁路类比(09–14)
Agrawal 用 AWS 说明基础设施周期的时间尺度:AWS 在 2004 年启动,2010 年迎来 Netflix 这一早期重要客户,到 2012 年 Amazon 才全面迁移;从最初资本投入算起约八年。云生态形成更接近应用主导的结构,大致花了一个十年周期。
因此,AI 底层在当前阶段显得过大,不一定意味着投入永远无法获得回报。半导体与数据中心通常服务未来五六年的需求,而应用收入是当前值,二者天然存在时间错配。建设高峰也会带来周期性:早期 CapEx-heavy 公司市值膨胀,之后再由真实需求决定哪些产能有持续价值。
他把这比作铺铁路:必须先建轨道,商业活动才可能在其上增长,但建设量、使用率与最终回报不会同步出现。这也是为何 hyperscalers 的 CapEx guidance 成为判断 AI 周期的重要公开信号。
五、既有软件公司与垂直整合者怎么计算(12–16)
Q&A 中,学生追问 Salesforce、Palantir 等既有软件公司的 AI 收入是否应算入应用层。Agrawal 回答“应该”,但公开披露很难拆出纯 AI 收入;他的估算会通过这些应用消耗的模型或推理收入,间接把一部分价值计入应用侧。
Google 则必须按业务单元拆分:
- TPU 属于 semis;
- GCP 属于 infrastructure;
- Gemini 属于 applications。
这引出垂直整合问题:同一家公司可以跨越多层,并利用分发、基础设施和自研硬件相互增强。Gemini 的使用规模究竟来自产品质量,还是 Google 的分发优势,讲师认为当时仍无法下定论。
六、什么会改变当前均衡(16–20)
Agrawal 判断 AI 不太可能只是短期 fad,但倒三角结构可能比他原先预期维持更久,因为底层 substrate 很难做好。他提出两个可能触发重新定价的信号:
- 某个 hyperscaler 的 ASIC 项目取得突破,例如 Google TPU、Meta MTIA,或 Amazon、Microsoft、OpenAI 等参与的自研芯片计划,从而削弱现有芯片层的定价和集中度。
- hyperscalers 不再给出持续上升的 CapEx 指引,这会说明当前投资—回报均衡无法维持。
在 training 与 inference 的构成上,他引用 NVIDIA 披露口径称,当时约 40% 的 GPU 使用对应推理、60% 对应训练,并预计推理占比会增加。但两种工作负载差异很大:训练往往是短期、可预测的高利用率任务;推理更突发,受人类作息和节假日影响。若 agent 将使用扩展到 24/7,推理负载形状还会继续改变。
七、利润比收入更加集中(20–22)
按 Agrawal 的估算,semis 是当时整条栈中利润最丰厚的层:NVIDIA 数据中心业务毛利率约为 75%,而部分应用层业务可能只有 0%–30%。因此,如果把图从 revenue 换成 profitability,价值集中会比倒三角收入图更极端。
对于新的 inference ASIC 公司,市场虽有约 3,000 亿美元收入可争夺,但客户结构很特殊:约一半需求来自少数大型 hyperscalers。这不是拥有海量终端客户的消费软件生意,而更像“少量客户、巨额订单”的工业市场。芯片创业者首先要回答的,不只是技术性能,而是最先向哪几个大买家销售。
八、垂直整合与历次 supercycle 的赢家(22–24)
面对“每层是否最终只剩少数赢家、全栈整合会否改变权力平衡”的问题,Agrawal 回顾了此前周期:
- 互联网周期的重要赢家 Google,从底层文件系统到搜索、广告和用户体验具有强整合性;
- 移动周期的重要赢家 Apple 同时控制硬件、操作系统和分发;
- 社交周期的 Meta 控制应用和网络,但底层整合相对较少;
- Cloud 没有单一赢家,而是 AWS、GCP、Azure 的寡头格局。
他借此表示,垂直整合并非 AI 才出现。NVIDIA 也在通过 DGX Cloud 和垂直应用向上延伸。未来价值是否仍集中在某层,既取决于技术性能,也取决于谁控制客户入口和完整产品体验。
九、两年增长五倍,但产业形状几乎没变(25–28)
课堂小测之后,Agrawal 展示更新后的收入估算:AI 相关收入从 2024 年第一季度约 900 亿美元,增长到 2026 年第一季度约 4,350 亿美元,约为原来的五倍。
但他强调,增长本身并未改变价值分布:新增约 3,500 亿美元收入中,约 75% 直接进入 semis。Apps 虽然增长超过十倍,绝对规模仍不足以把整体图形翻转。
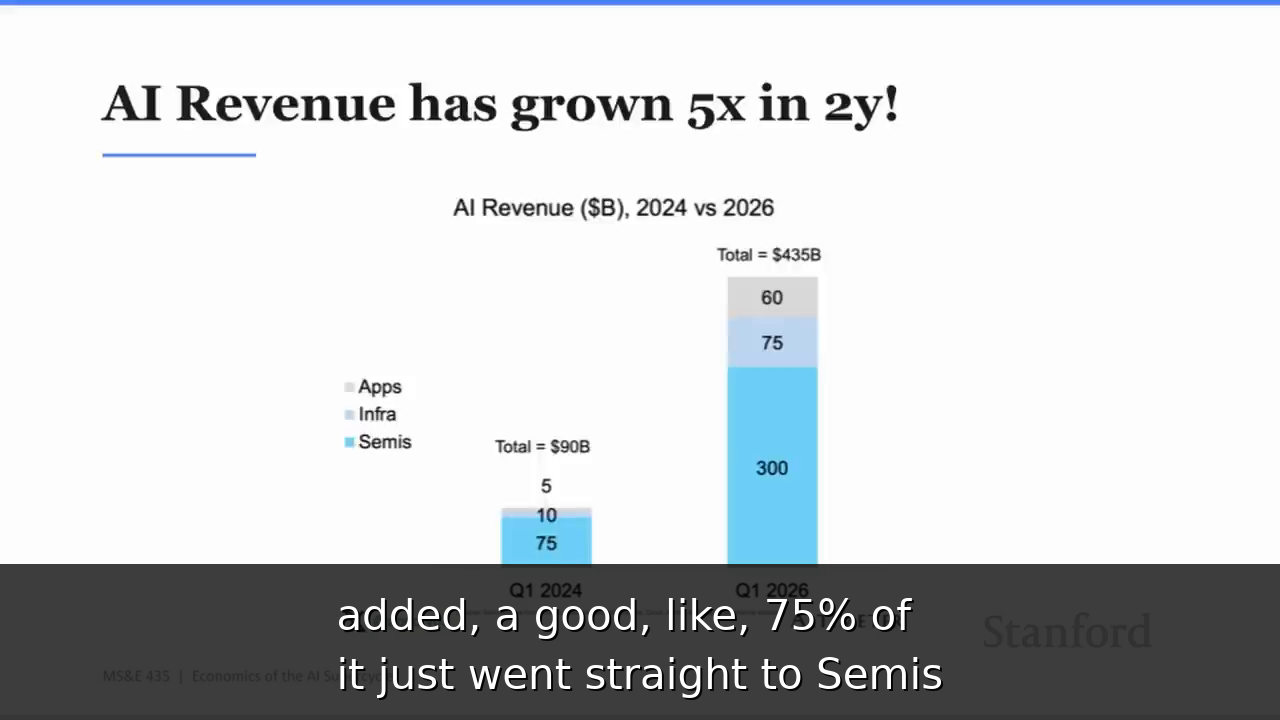
分层来看:
- Semis 的大部分收入集中在 NVIDIA;
- Apps 约 90% 的收入由两家公司贡献;
- Infra 竞争最激烈,创业、并购和跨层竞争最频繁,也是最不稳定的均衡。
对创业者和投资者而言,问题不是只看一个赛道增长多快,而是判断当前分层何时会变成更像 cloud software 的结构:五年、十年、十五年,还是始终不会完全翻转。
十、消费 AI 已经主流,但还不是全民基础设施(28–32)
Agrawal 把大型消费产品分成三档:
- Core utility:约 30 亿用户,接近数字生活必需品,如 WhatsApp、Chrome、YouTube;
- Social:约 15–20 亿用户,通过关系网络产生强网络效应,如 Instagram、TikTok、Facebook;
- Niche mainstream apps:用户因特定需求主动进入,如 Amazon、Spotify、X。
按课堂图表,ChatGPT 的 weekly active users 刚刚超过典型 niche app 区间,Gemini 尚未超过;它们正在向 social 规模靠近,但还没有成为 core utility。
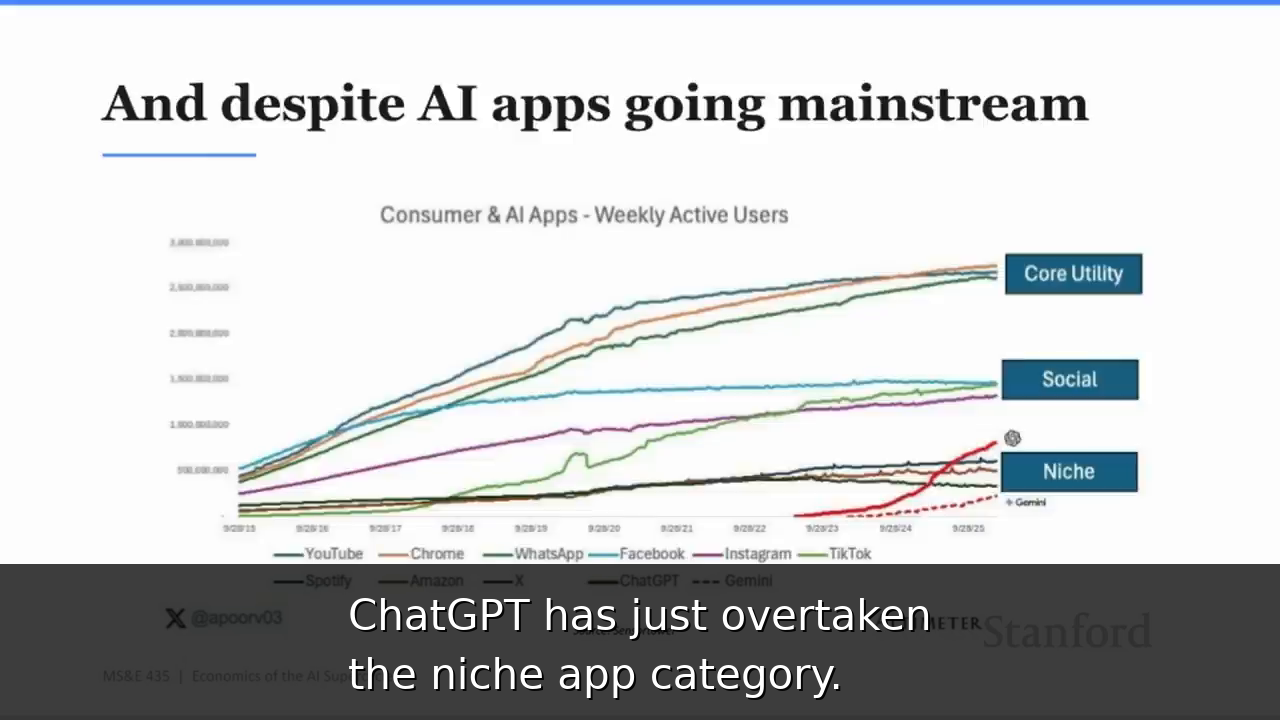
讲师提出一个增长上限问题:ChatGPT 要求用户主动提出问题、完成知识工作,它既不是消息收件箱,也不是被动获得内容刺激的 feed。会主动向技术提出问题的人,未必等于全部联网人口。若想从约十亿用户走向三四十亿,AI 产品可能必须超越 knowledge work,成为更广泛、更低摩擦的生活工具。
十一、从订阅走向广告?(32–34)
Agrawal 用每用户年收入粗略比较消费平台:
| 平台 | 用户量估算 | 年均每用户收入估算 |
|---|---|---|
| Alphabet | 约 40 亿 | 约 100 美元 |
| Meta | 约 35 亿 | 约 70 美元 |
| ChatGPT | 约 10 亿 | 约 10 美元 |
由此产生两个独立问题:用户量如何从 10 亿走向 40 亿,以及 ARPU 如何从约 10 美元走向约 100 美元。他不确定单靠订阅能完成第二个跃迁,并预计广告会成为重要方向。
支持这一判断的理由是,对话式 AI 能理解用户意图、保持登录状态,并提供更清晰的归因,因此广告可能拥有更好的定价条件。但阻力也同样明显:AI 对话很私人,用户不希望在交流中被生硬打断。Agrawal 用移动广告的历史作类比——Facebook 上市初期,人们也怀疑手机屏幕没有广告空间,后来产业找到了呈现方式。他认为 AI 也可能找到自己的广告形态,但没有声称已经知道答案。
一张图记住整堂课
巨额 CapEx 与芯片收入
          ↓
模型训练、推理与云基础设施
          ↓
AI 应用收入快速增长,但边际成本仍高
          ↓
要翻转价值三角形,需要同时解决:
更广泛的用户需求 + 更强变现 + 更低推理成本
可继续追踪的指标
- hyperscalers 每季度 CapEx guidance 是否继续上修;
- 自研 ASIC 是否在性能、成本或供应上真正替代通用 GPU;
- NVIDIA 收入中 inference 占比是否持续超过 training;
- AI 应用 gross margin 随模型与推理成本下降的改善速度;
- 应用层收入是否从少数公司向更多垂直产品扩散;
- ChatGPT、Gemini 等能否从主动知识工作扩展到 core utility;
- 订阅、交易、广告等模式中,哪一种能显著提高 ARPU 且不破坏信任。
官方章节
- 00 Course introduction
- 02 Logistics and syllabus
- 04 Why study AI economics
- 05 Value accrual in AI stack
- 12 Discussion and Q&A
- 24 In-class quiz
- 26 Market trends and revenue
讨论
这里是静态站点,没有内嵌评论区。如果这篇文章对你有用,欢迎通过 RSS 订阅后续更新。