Stanford CS336 第十七讲精读:Alignment——把策略梯度和 GRPO 的机制拆到底
斯坦福 CS336(Language Modeling from Scratch, Spring 2025)第十七讲完整讲义,主讲 Percy Liang,也是全课最后一讲。这一讲不引入新内容,而是把第十六讲 RL from verifiable rewards 的算法机制拆开重讲:从状态/动作/奖励与结果奖励的设定出发,推朴素策略梯度为什么是「被奖励加权的 SFT」、为什么稀疏奖励会让梯度消失;用两个状态的玩具例子讲清方差问题与基线(baseline)的等价变换,再接到优势函数;然后把 GRPO 的代码从头走一遍——排序任务与部分分奖励、compute_deltas 的三种选择、冻结参数与 no_grad、裁剪的重要性比率、低方差 KL 估计,最后用一次真实的小实验说明「损失曲线为什么会骗人」。
本篇属于系列 Stanford CS336 精读 · 第十七讲
来源:YouTube 原视频(Stanford Online · CS336 Language Modeling from Scratch · Spring 2025 · Lecture 17: Alignment - RL 2)
来源说明 这是斯坦福 CS336《Language Modeling from Scratch》2025 年春季第十七讲的完整讲义,主讲人是 Percy Liang,也是这门课(以及他和 Tatsunori Hashimoto 两人)的最后一讲。上一讲(第十六讲)Tatsu 已经讲完了 RL from verifiable rewards 的宏观图景:PPO → GRPO → DeepSeek-R1 / Kimi k1.5 / Qwen3 三个案例。这一讲不引入新内容,而是把同一套东西的机制拆开重讲一遍——讲师的原话是“deep dive into the mechanics of policy gradient and GRPO”,要给你看代码,也要给你看数学。
全文按讲课顺序整理:先重新定义语言模型 RL 的状态 / 动作 / 奖励,以及“结果奖励 + 可验证奖励”这个特殊设定;再推最朴素的策略梯度,指出它其实就是“被奖励加权的 SFT”,并解释稀疏奖励为什么会让梯度直接变成零;接着用一个两状态的玩具例子(S1: 11/9,S2: 0/2)说明高方差与**基线(baseline)**这个“不改变期望、只降低方差”的等价变换,并接到优势函数;然后进入 GRPO 的完整代码走读——一个排序 n 个数字的玩具任务、两种奖励设计、
compute_deltas的三种变体、为什么必须对 π_old 做no_grad、裁剪的重要性比率、以及一个低方差的 KL 估计;最后用一次真跑的实验说明:奖励在涨,损失曲线却在变难看,因为“最小化损失”在这里是个有点勉强的说法。文中 18 张配图均截取自视频对应时刻的画面,并把该时刻的完整观点句(英文原句+中文翻译)拼合进图里。需要特别提醒:文中出现的所有数字——两状态例子里 S1 的 11/9、S2 的 0/2、基线 10/1、方差从 5.3 降到 1.1、排序任务里满分是 4 分而两个错误答案各得 1 分、部分分奖励算出 3 分和 6 分、实验跑了 100 个 epoch 每个 10 步、以及“这个玩具任务在我笔记本上只跑了 20 秒”这类说法——全部是讲师课上的口播、幻灯片演示或对公开材料的转述,是讲师引用的公开传闻或估算,不是本文独立核实的事实,请以原始论文与公开材料为准。
另外,自动字幕把不少专有名词听错了:
PO/PPO/PO是 PPO,gpo/gRPO/GRPO/GPR是 GRPO,kale penalty/KO regularization/KO是 KL penalty,K divergence是 KL divergence,Tatu/Tatsu是 Tatsunori Hashimoto,Chelsea指 Chelsea Finn(讲师推荐的 Deep RL 课程),py ref是 π_ref,py old/P old是 π_old,no grad是torch.no_grad(),GR J paper是 GRPO 论文,SNA是 s 和 a,BFS/B of S是 B(s),P sample是 p(s),VLM一词在此处指的是语言模型,下文按通行写法记录。最后一句方法论:这一讲是全课的收尾,最值得记住的不是任何单个公式,而是讲师给出的那句总结——“只要能度量,就能优化”(if you can measure it, you can optimize it);以及紧接着的那个更大的问题:怎么设计出不会被 hack 的奖励。
TL;DR
- 这是全课最后一讲,也是“复习课”:不教新东西,只把机制拆到底。 上一讲讲的是 RLVR 的路线图与三个案例,这一讲把镜头拉到最近处——状态、动作、奖励怎么定义,策略梯度的公式怎么写,GRPO 的每一行代码在干什么。
- 语言模型 RL 的特殊设定:状态 = 提示词 + 已生成的回答,动作 = 下一个 token,奖励 = 整个回答有多好。 这门课只关心结果奖励(outcome reward)与可验证奖励(verifiable reward):奖励是整条回答的函数,而且由一个确定性函数直接算出来,不需要人来打分(图 2、图 3)。
- 朴素策略梯度 = “被奖励加权的 SFT”:采样提示词、采样回答、按 ∇log π(a|s)·R(s,a) 更新参数。当奖励是 0/1 时,它只对答对的回答做更新——和 SFT 唯一的区别是数据集在变,因为策略在变(图 4)。
- 稀疏奖励是这个设定最要命的地方:绝大部分回答得 0 分,于是梯度也是 0,模型“根本学不动”。讲师的原话是:“如果策略差到拿不到任何奖励,你就做不出任何梯度更新,你卡死了。”(图 5)
- 基线(baseline)是策略梯度里最重要的一个技巧,而它只是一个恒等变换:把目标从 E[R] 换成 E[R − B(s)],其中 B 只依赖状态、不依赖动作。因为 E[B(s)] 与策略无关,所以优化目标完全不变,但方差可以大幅下降——两状态例子里方差从 5.3 降到 1.1(图 7、图 8)。
- 所有策略梯度算法共用同一个模板:
∇log π(a|s) × Δ。Δ 放奖励本身,就是朴素策略梯度;放“奖励减去基线”,就是带基线版;再除以标准差,就是 GRPO。所以讲师说:别太在意 GRPO 的具体形式,“明年会有 GRPO2”,重要的是这个框架(图 9)。 - GRPO 之所以成立,是因为语言模型给了它一个天然的“组结构”:同一个提示词可以采样一批回答,组内均值天然是一个难度基线。这在经典 RL 里是没有的——如果每次 rollout 都不一样,就没有天然的组,你就只能回到 value function(图 10)。
- 代码走读从一个小任务开始:给 n 个数字排序。 奖励设计是个自由发挥的地方:可以“排对了给 1,否则 0”(稀疏、学不动),也可以给部分分——按位置匹配数给分,或者“提示词里的 token 出现在回答中给 1 分 + 相邻且有序的 token 对给 1 分”。后者还留了一个漏洞,讲师故意让学生自己想(图 11、图 12)。
compute_deltas是这一讲的核心函数:奖励可以直接用(naive),可以按提示词做中心化(centered,减去组内均值),还可以再除以标准差(normalized,GRPO 的做法)。中心化有两个漂亮的副产品:奖励全是同一个值时 Δ 全为 0、于是在这个样本上“弃权”不更新;以及归一化让 Δ 对奖励的整体缩放不变(图 13)。- 必须记住的一个坑:算重要性比率时,π_old 那一边一定要
no_grad。 否则 p/p_old 恒等于 1,梯度恒等于 0,训练悄悄失败。讲师专门用“单参数玩具例子”演示了这一点(图 14 一带)。 - GRPO 的损失 = 裁剪的重要性比率 × Δ:ratio = log π/π_old 再取 exp,裁剪到 [1−ε, 1+ε],和不裁剪的版本取 min,最后加负号当损失。裁剪的作用是给每次更新的幅度上界(图 14)。KL 惩罚则提供额外正则:写成
q/p − log(q/p) − 1会得到比朴素 log 比值方差更低的估计,因为 E[q/p] = 1(图 15)。 - 训练循环里其实有三个模型:reference(做 KL 正则、只存一份完整参数)、old(算重要性比率,不需要存模型,只要存下那批回答的 log prob 就够了)、current(在线更新的策略)。reference 的代价是显存翻倍,old 的代价几乎为零——这个不对称值得记住(图 16)。
- 最后是一次真跑的实验,也是这一讲最好的警告:奖励在涨,损失曲线却很难看。 讲师的原话是“最小化损失在这里是个有点勉强的说法”——因为回答集合本身在变,你并没有一个固定的损失函数可以追踪。监测 loss 在这个范式里意义有限,你真正能依赖的信号只有奖励(图 17)。
- 收尾:RL 是让模型超越人类能力的关键(标注数据只能让你模仿标注里的行为),“只要能度量,就能优化”;但更大的问题是怎么设计不会 hack 的奖励。而工程上,RL 的系统比预训练复杂得多——要做推理、要同时管 policy / critic / π_old / π_ref / 推理 worker / 环境,还要把这些分布式地“唱跳起来”(图 18)。
一、这一讲在全课中的位置:不教新东西,只拆机制
这是全课最后一讲。讲师开场先做了两句“定位”:这是他或 Tatsu 在这门课上的最后一堂课;上一讲 Tatsu 已经把 RL from verifiable rewards 的全局讲完了(策略梯度、PPO、GRPO,以及三个推理模型的案例),所以这一讲不会引入任何新内容,任务只有一个——
“This lecture we’re going to deep dive into the mechanics of policy gradient and GRPO. So we won’t necessarily cover new material, but just take the existing material and go a bit deeper, show you code and some math as well.”
也就是说,这一讲的价值不在于“又学了一个算法”,而在于把上一讲当成黑箱的东西全部打开:状态的粒度、奖励的形状、梯度的方差、重要性比率为什么必须冻结、KL 为什么要换个写法估计。如果说上一讲是“这门技术长什么样”,这一讲就是“它在代码里到底是哪几行”。
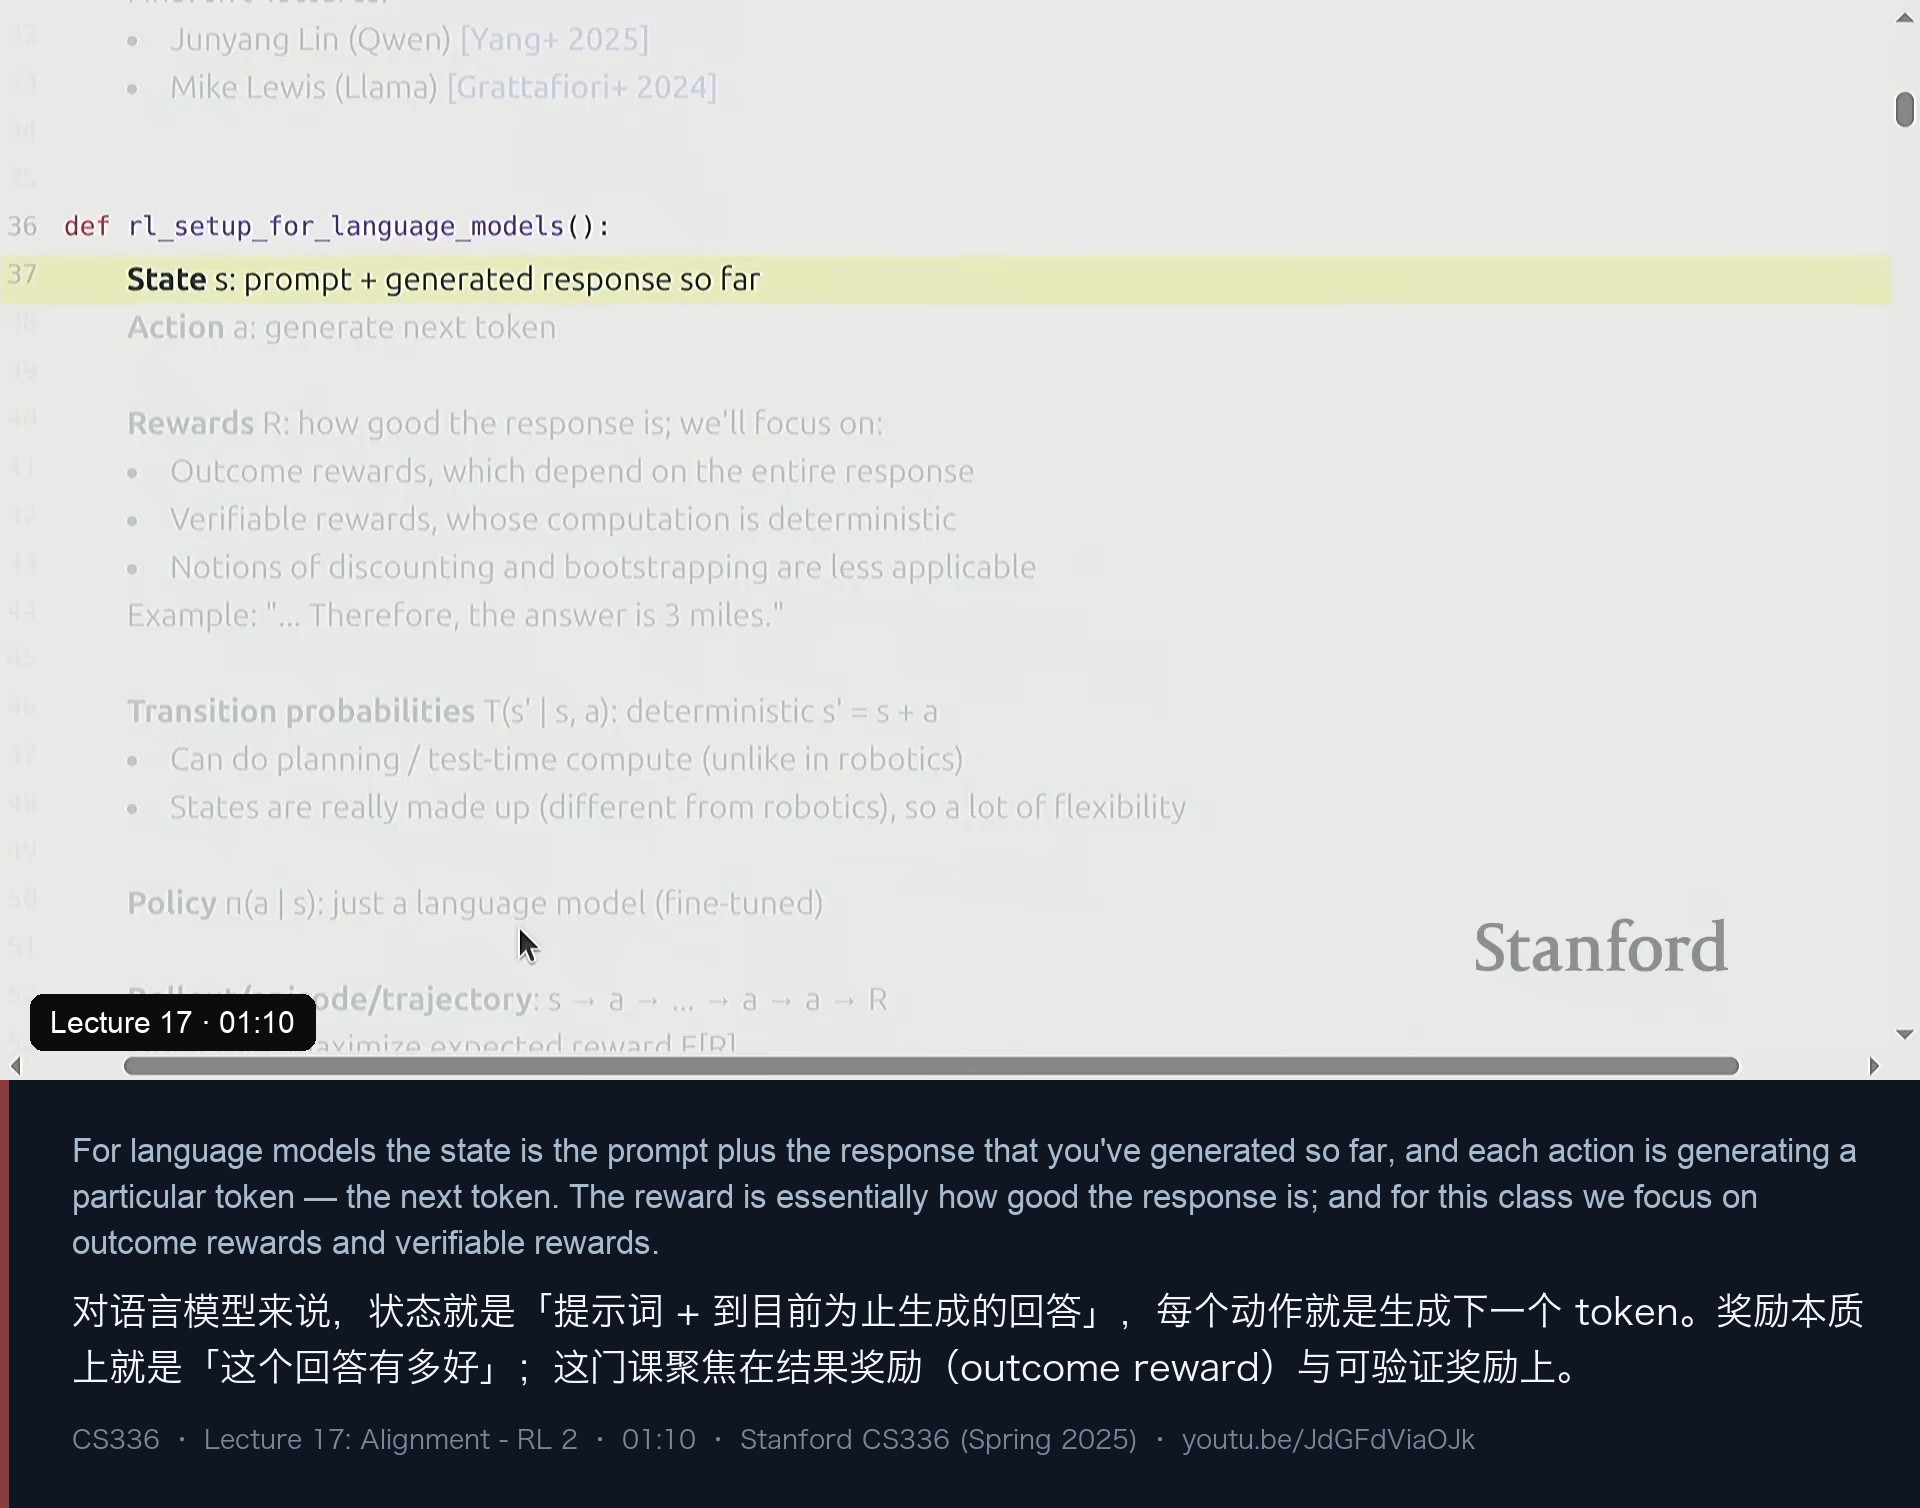
讲师先重新把语言模型 RL 的四件套定义清楚(图 2)。这些定义在上一讲已经出现过,但值得再抄一遍,因为后面所有讨论都建立在它们的特殊性上:
- 状态(state) = 提示词 + 到目前为止生成的回答;
- 动作(action) = 生成下一个 token;
- 奖励(reward) = “这个回答有多好”;
- 策略(policy) = 以状态为条件、从预训练模型微调而来的语言模型;一次 rollout 也叫 episode 或 trajectory。
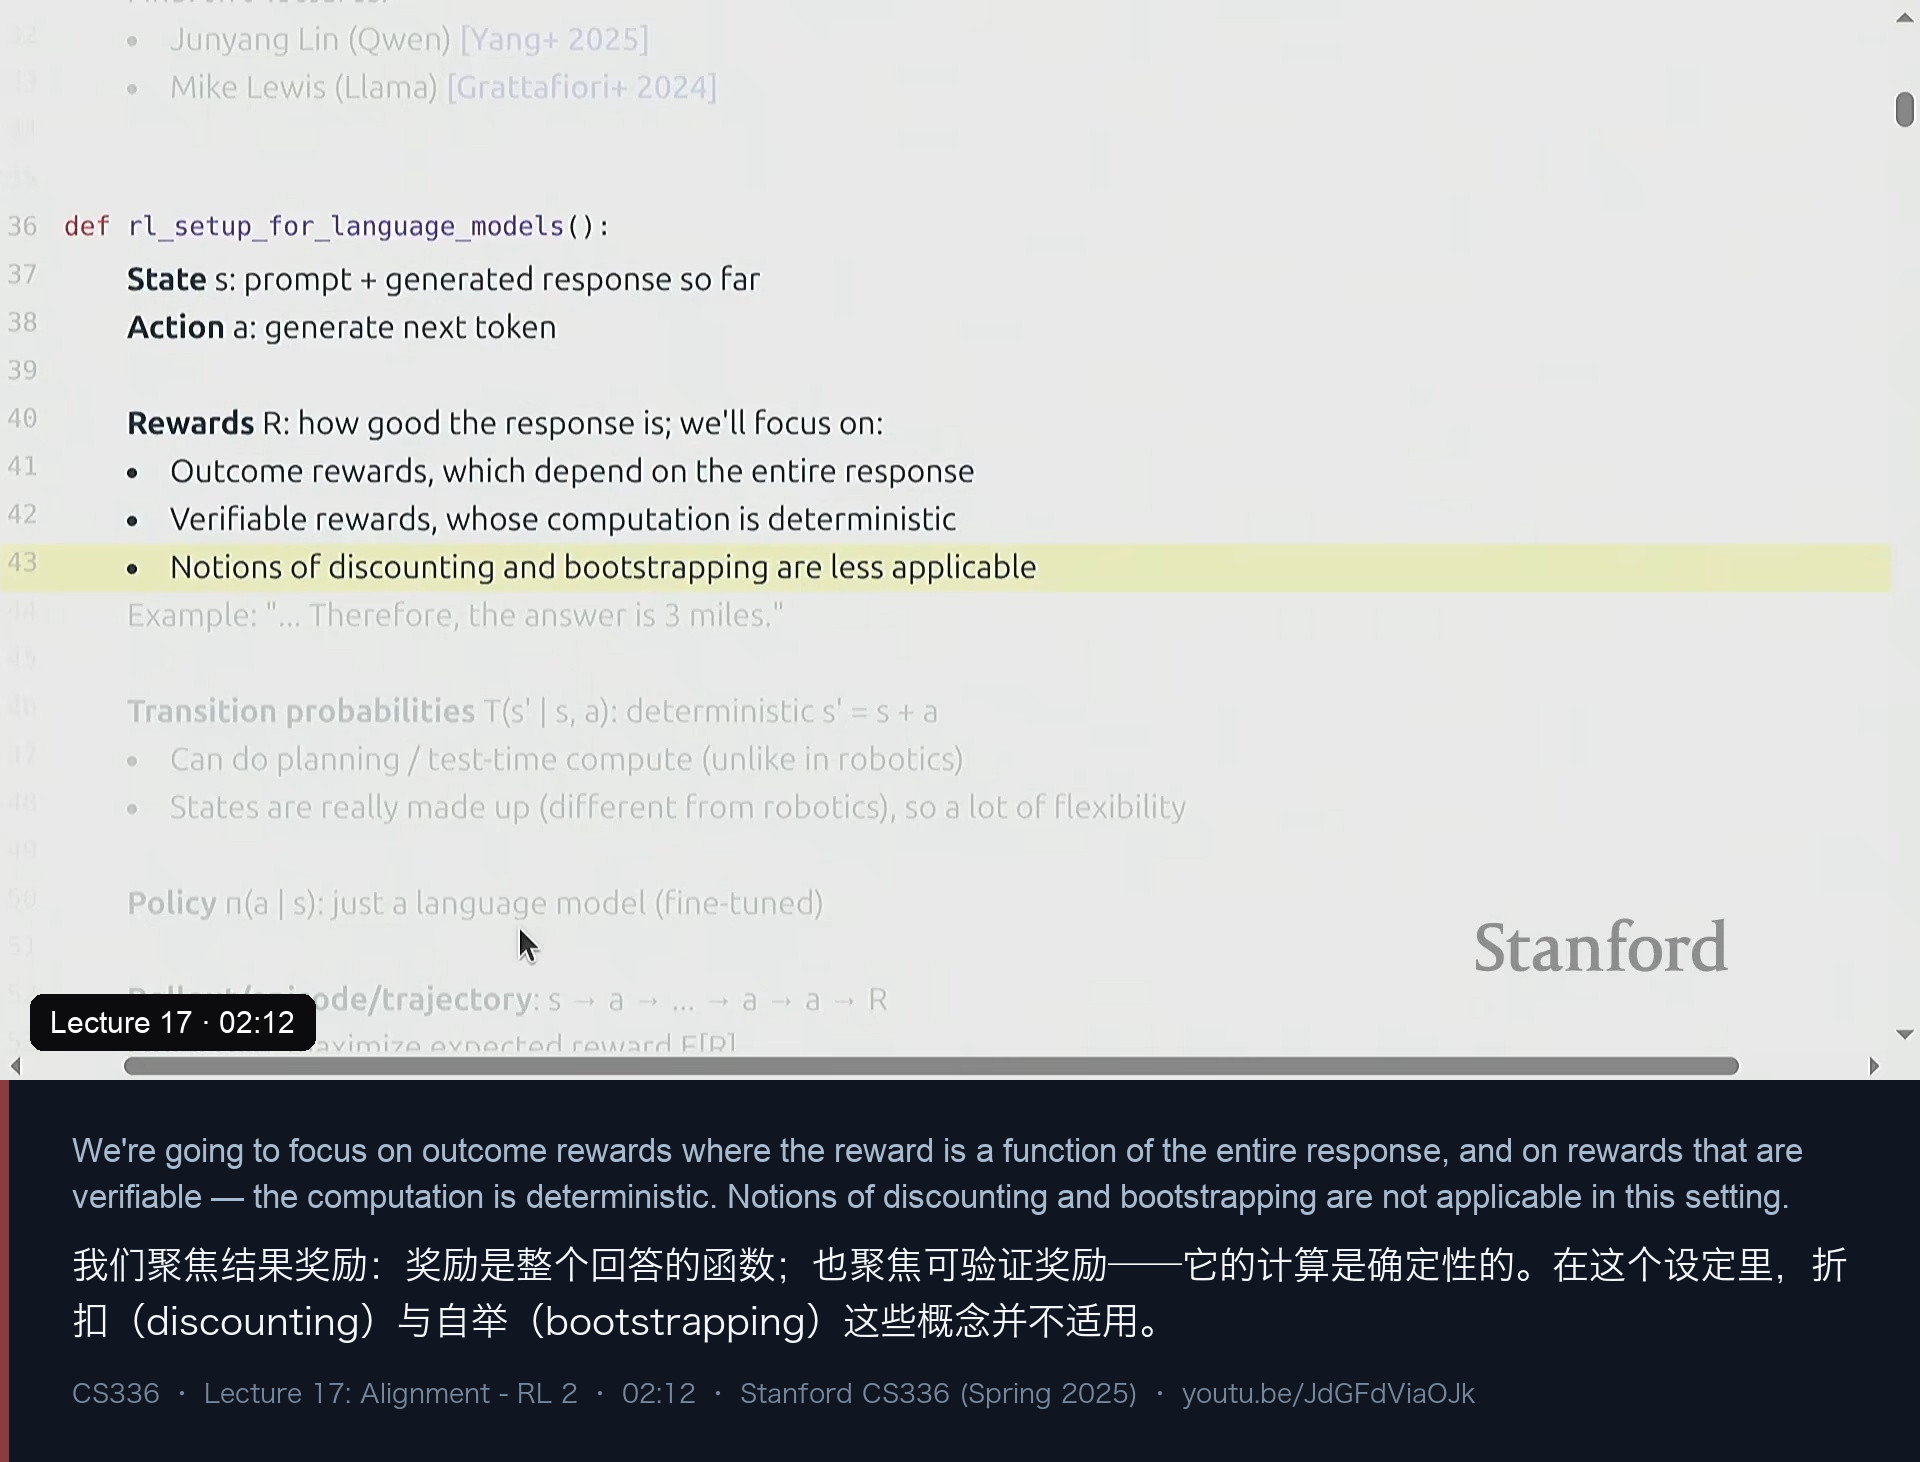
真正让这个设定与众不同的是奖励的性质(图 3)。这门课只讨论两类:
- 结果奖励(outcome reward):奖励是整条回答的函数,而不是逐步给出的;
- 可验证奖励(verifiable reward):奖励的计算是确定性的——某个函数直接返回一个数,不需要问人。
于是在这个设定里,经典 RL 的两件“标配”反而用不上了:折扣(discounting)与自举(bootstrapping)。讲师解释说,那些东西是为“中途也有奖励”的多轮场景准备的;而这里更像是“你要生成一整套东西,然后看一眼它对不对”。代价是奖励既稀疏又延迟,好处是概念上清爽了很多。
顺着这个设定,讲师讲了两点很值得玩味的观察。
第一,世界动力学简单到离谱:在语言模型里,转移概率就是在状态后面加上新动作(append),没有任何不确定性之外的复杂性。而“知道动力学”意味着你可以做规划——这就是今天所谓的测试期计算(test-time compute)。讲师的原话是:这是“机器人学家做梦都想要”的东西,因为如果机器人知道世界的动力学,它就能模拟、就能提前规划;但在一般 RL 里这件事并不成立。
第二,这里的“状态”其实是被构造出来的(made up)。在机器人里,状态是关节角、位置、图像,是扎扎实实长在物理世界里的;而在语言模型里,状态就是模型自己生成的 token。这带来巨大的自由度:模型可以自己发明草稿纸(scratch pad)来推导答案,而机器人往往受限于外部世界、很多状态根本到不了。所以在语言模型 RL 里,“能不能到达某个状态”根本不是问题(你写下 token 就到了),真正的问题是——这些 token 是否真的导向一个正确的、可验证的答案。讲师说,这正是“同样是强化学习,但直觉上什么难、什么易已经变了”的地方。
二、朴素策略梯度:一个“被奖励加权的 SFT”
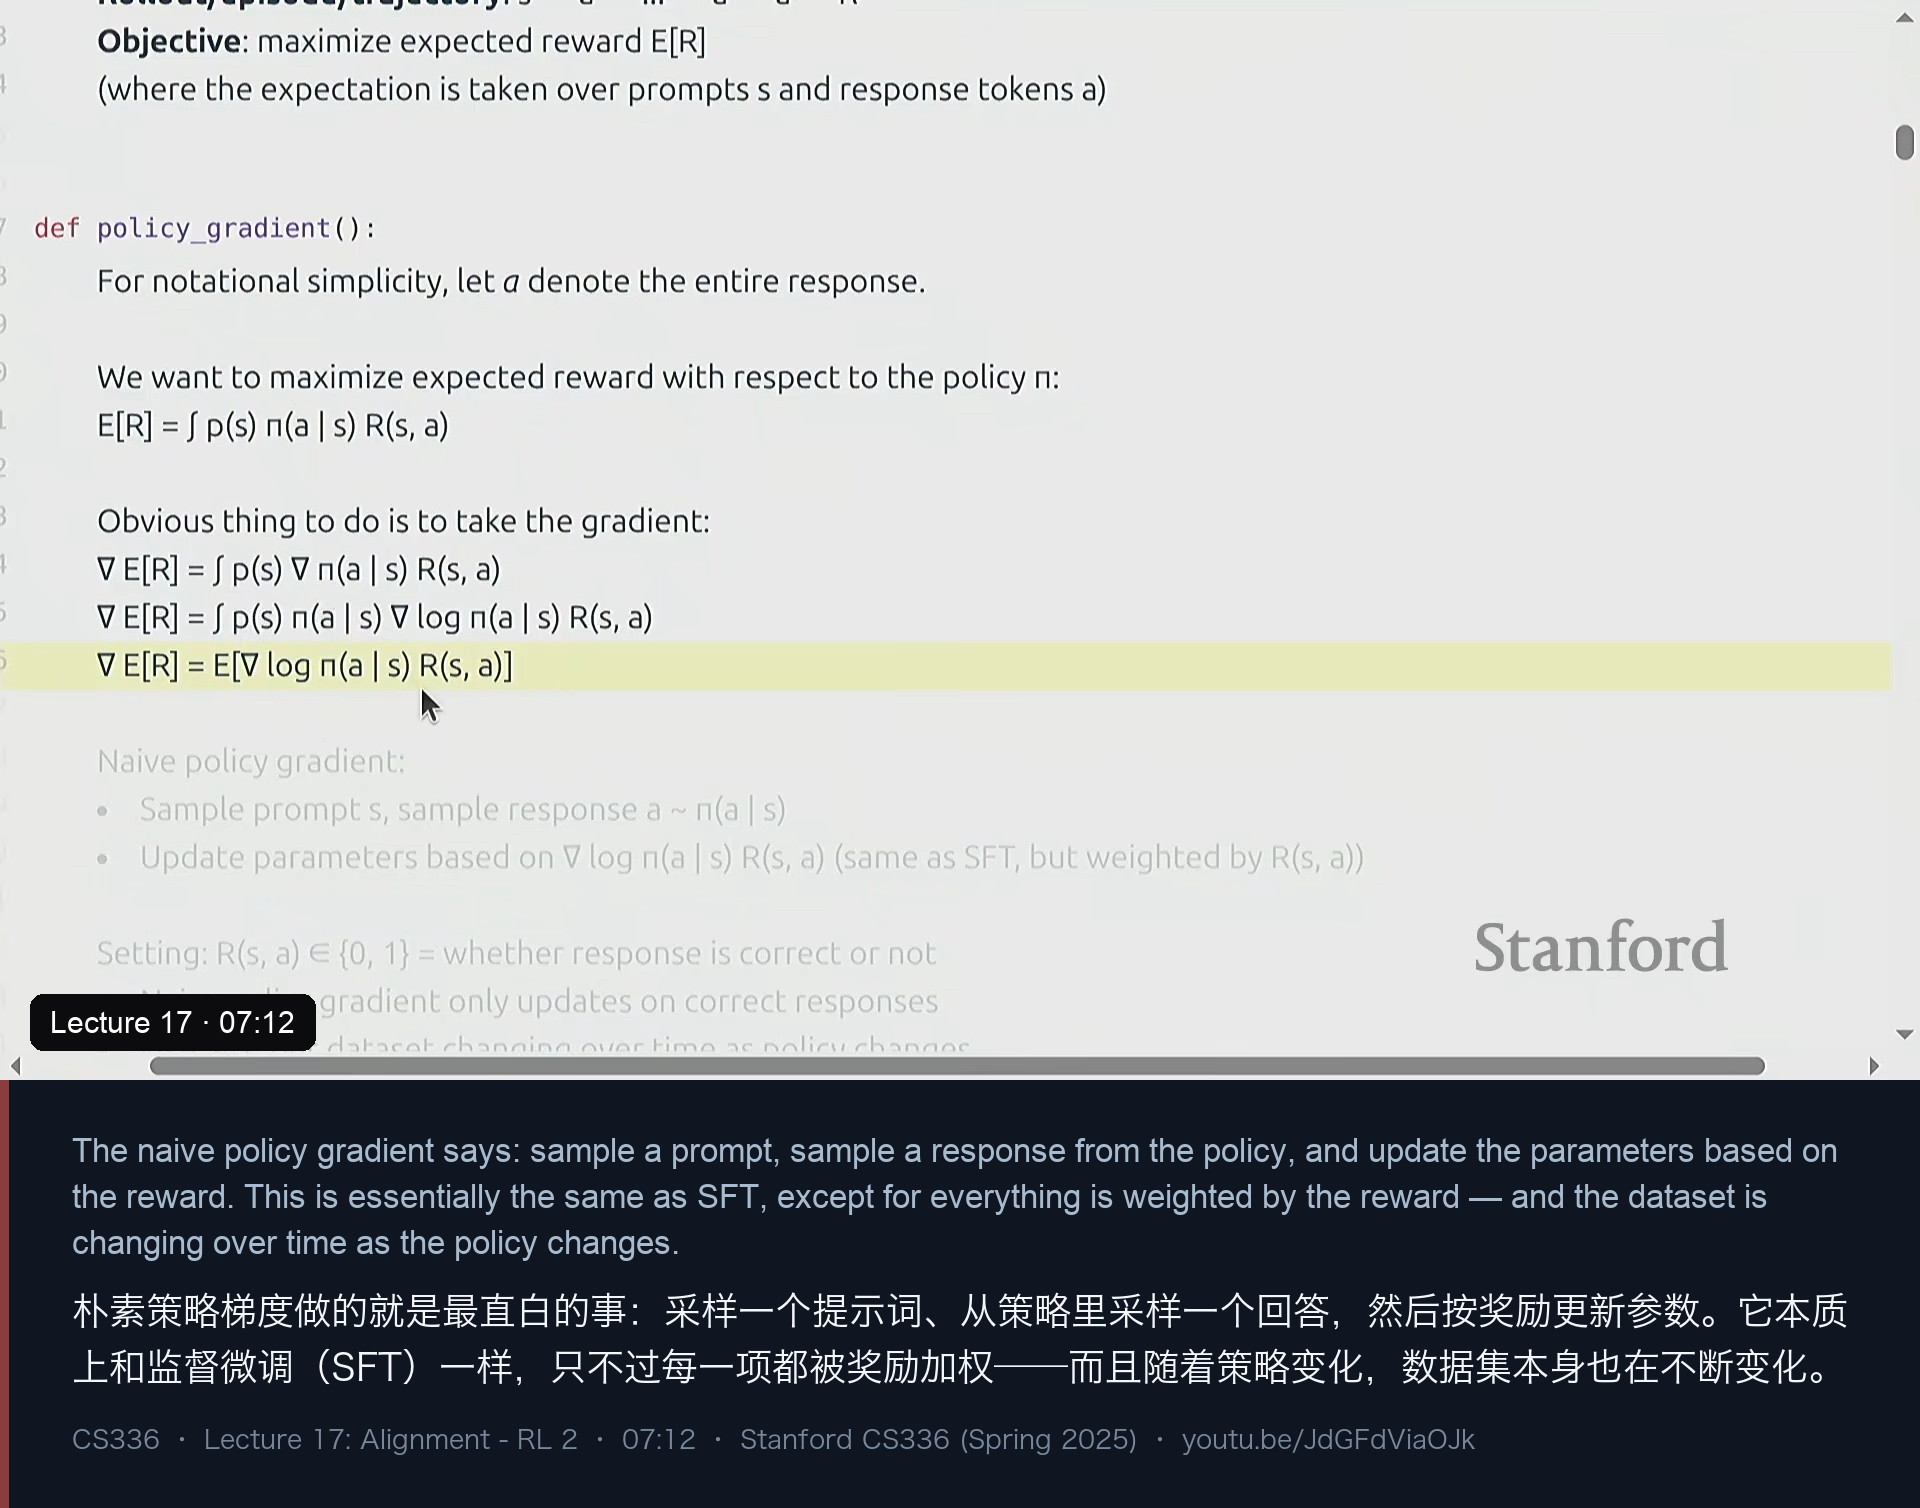
把设定讲清楚之后,讲师开始推最朴素的策略梯度(图 4)。目标很直白:最大化期望奖励,期望对提示词(由环境给出)和回答(由待优化策略 π 采样)同时取。
# 目标:最大化 E[R(s, a)]
# 其中 s ~ p(s) 是环境给的提示词 / 状态,a ~ π(a | s) 是策略采样出的回答
J(θ) = E_{s~p(s), a~π_θ(a|s)} [ R(s, a) ]

# 最朴素的做法:直接对参数求梯度(log-derivative trick)
∇J(θ) = E[ ∇ log π_θ(a | s) · R(s, a) ]讲师强调:这就是随机梯度下降的老套路——把期望里的东西采样出来评估一下,就当梯度用了;而它的无偏性来自“把期望拆开、在策略的采样的地方取一项”。基于这个式子,**朴素策略梯度(naive policy gradient)**只有两步:
- 采样一个提示词 s,从策略里采样一个回答 a ~ π(a | s);
- 用
∇ log π(a | s) · R(s, a)更新参数。
然后是全讲最实用的一句直觉(图 4):它和监督微调(SFT)本质上是一回事,唯一的区别是每一项被奖励加权了。 SFT 里是“人类写下 a,你去最大化它的似然”;这里 a 换成模型自己生成的,但每一项都乘上了奖励 R。当奖励退化成 0/1(对或错)时,这个区别更清晰:
- 得 0 分的回答完全不更新(乘上 0 就没了);
- 得 1 分的回答按 SFT 更新。
唯一的(也是关键的)差别是:数据集在变——每更新一次策略,下一轮采样出的回答就来自新分布。学生问“数据集为什么会变”,讲师说因为你在优化目标函数:参数一变,新采样的回答就不同,整个数据集也就换了分布。而这正是这个范式“能自我提升”的乐观之处:只要能把简单题做对一部分、拿到奖励、更新参数,就指望模型泛化到更难的题上,奖励一轮比一轮高。
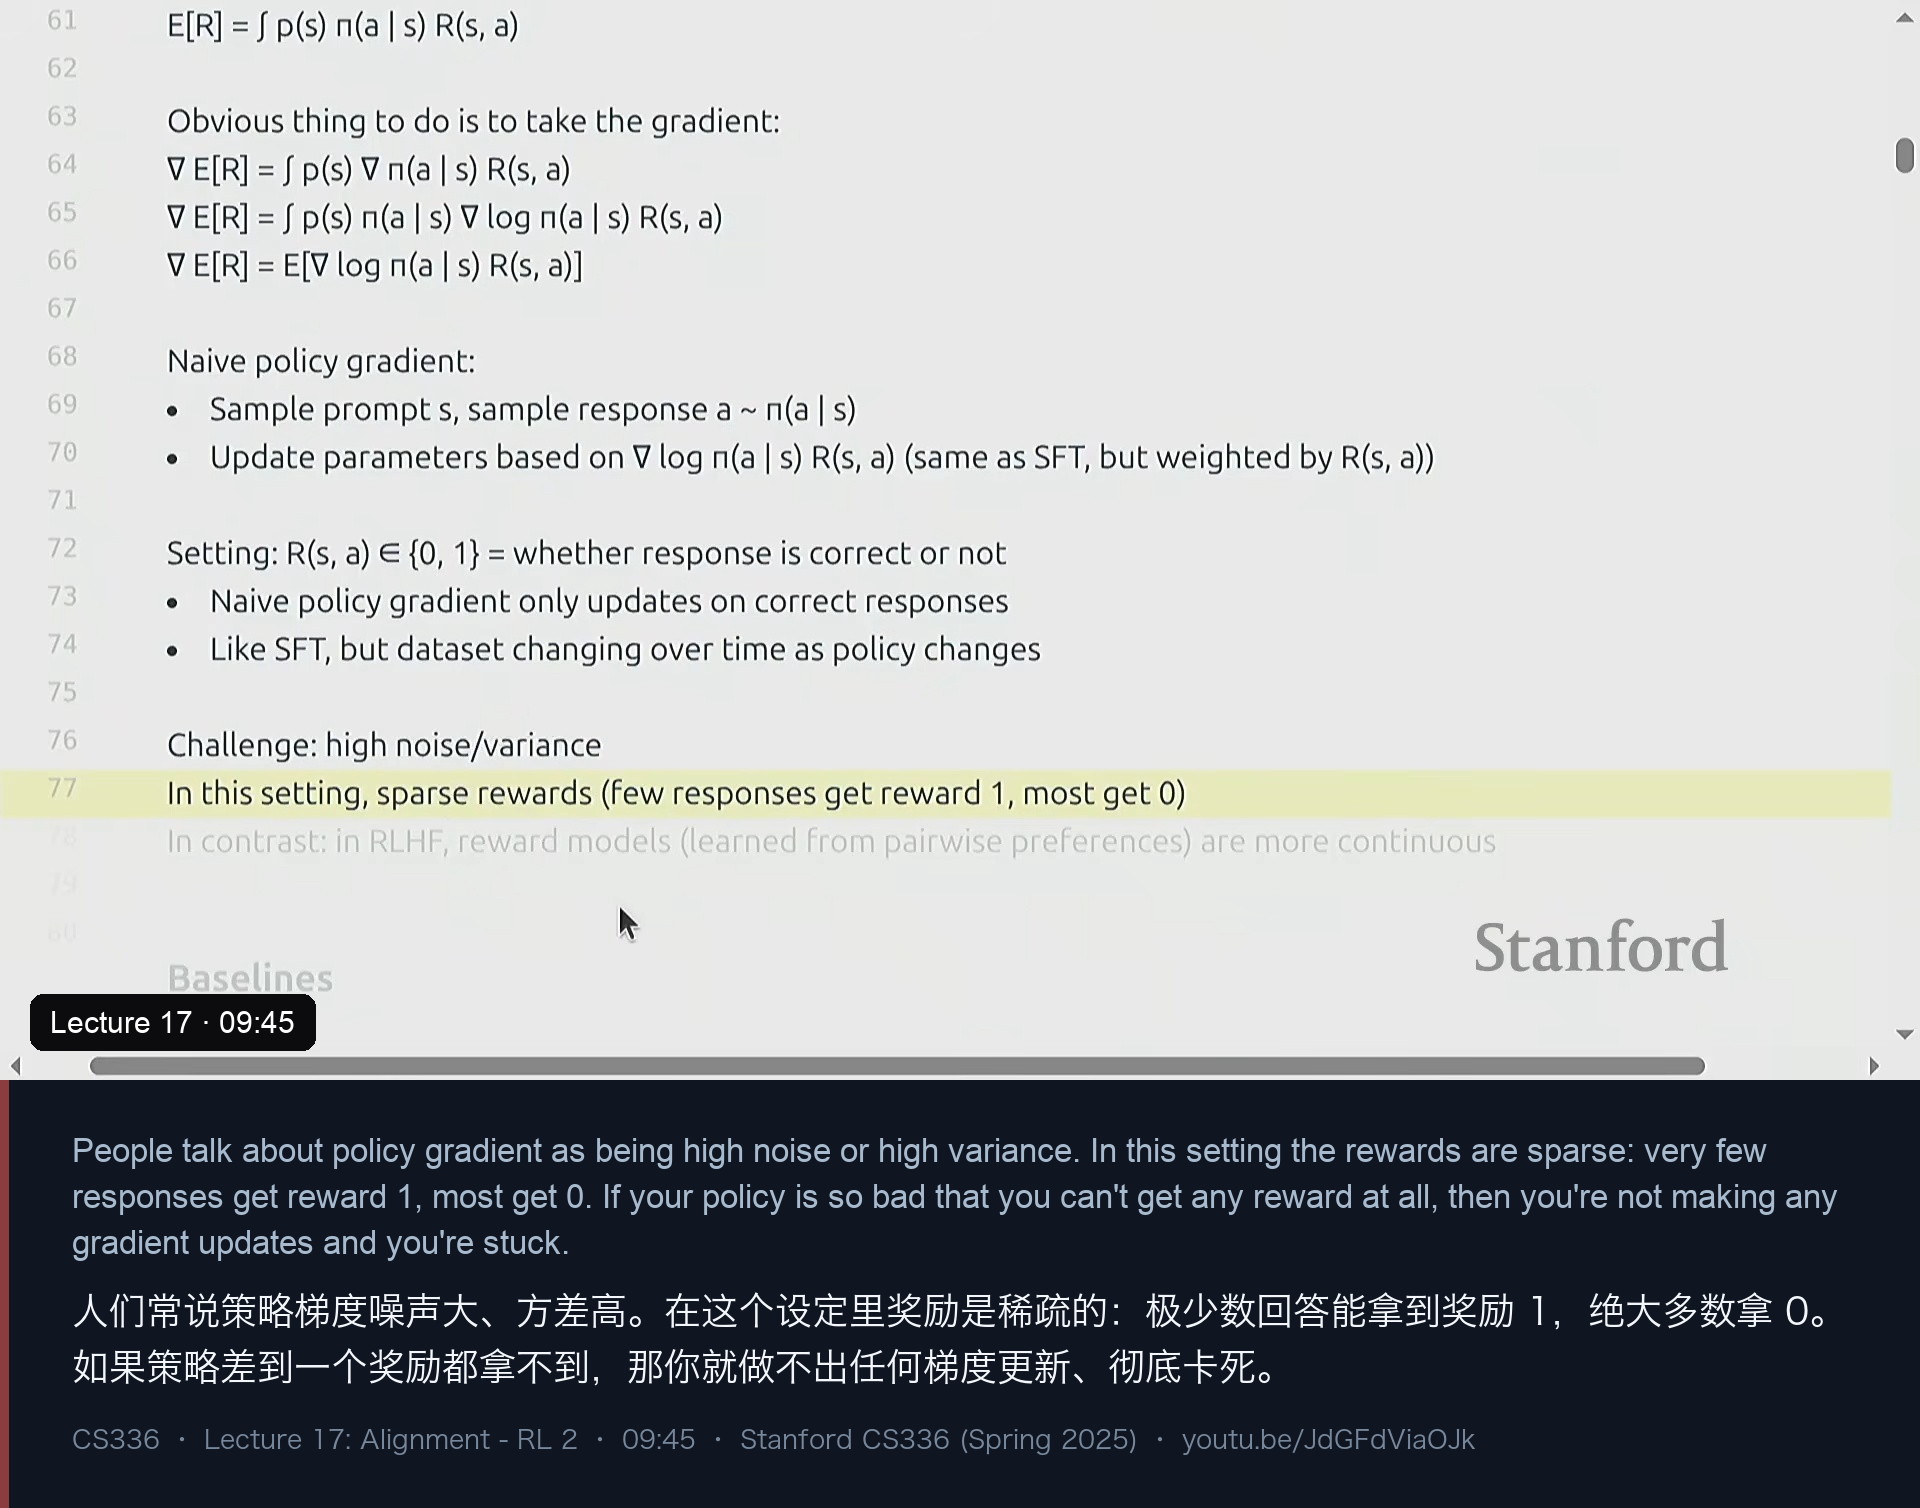
但乐观归乐观,问题也很尖锐(图 5)。讲师说,人们常讲策略梯度噪声大、方差高;在监督学习里,梯度噪声大其实还好——加大 batch、多跑一会儿,经验上就过去了。但强化学习是另一个量级。在 0/1 奖励的设定下,这就是稀疏奖励:只有极少数回答能拿 1,绝大多数拿 0。于是:
“If your policy is so bad that you’re not able to get reward at all, then guess what? You’re not making any gradient updates and you’re stuck.”
如果策略差到一个奖励都拿不到,那你一条梯度更新都做不出来,就卡死了。 这一点和监督学习形成鲜明对比:监督学习里,你至少总在向某个东西更新;而稀疏奖励的 RL 里,这个保证消失了。
学生在这里问了个好问题:既然得 0 就不更新,那为什么不把奖励设成 −1,至少把模型从错误回答上推开? 讲师说:这件事会自动发生,只要等基线引进来;现在这个版本只是最朴素的形式。
讲师还区分了两种奖励信号:过程奖励(process reward)理论上更好(能更早拿到信号,而且只要可信就该尽早评估),但在语言模型里很难训出好的过程奖励——“除非它已经完全跑偏,你很难判断它中间走得怎么样”。所以这一讲统一假设结果奖励。他也回答了“reward model 在这里是什么”:在这门课的作业里,它就是把答案解析出来、和答案表比对、匹配给 1 否则给 0——一个确定性函数,不是学出来的模型。这也是“可验证奖励”与 RLHF“学一个奖励模型”最本质的区别。
三、两个状态的玩具例子:高方差从哪里来
基线(baseline)是策略梯度里最重要的一个技巧,而要理解它为什么有用,最好先看一个只有两个状态的玩具例子(图 6)。讲师给的例子是这样的:
- 状态 S1:动作 A1 得奖励 11,动作 A2 得奖励 9;
- 状态 S2:动作 A1 得奖励 0,动作 A2 得奖励 2。
显然,S1 是一个“好状态”(整体回报高),S2 是一个“差状态”(整体回报低)。所以最优策略是 S1 → A1、S2 → A2。问题出在哪儿?9 比 2 大。
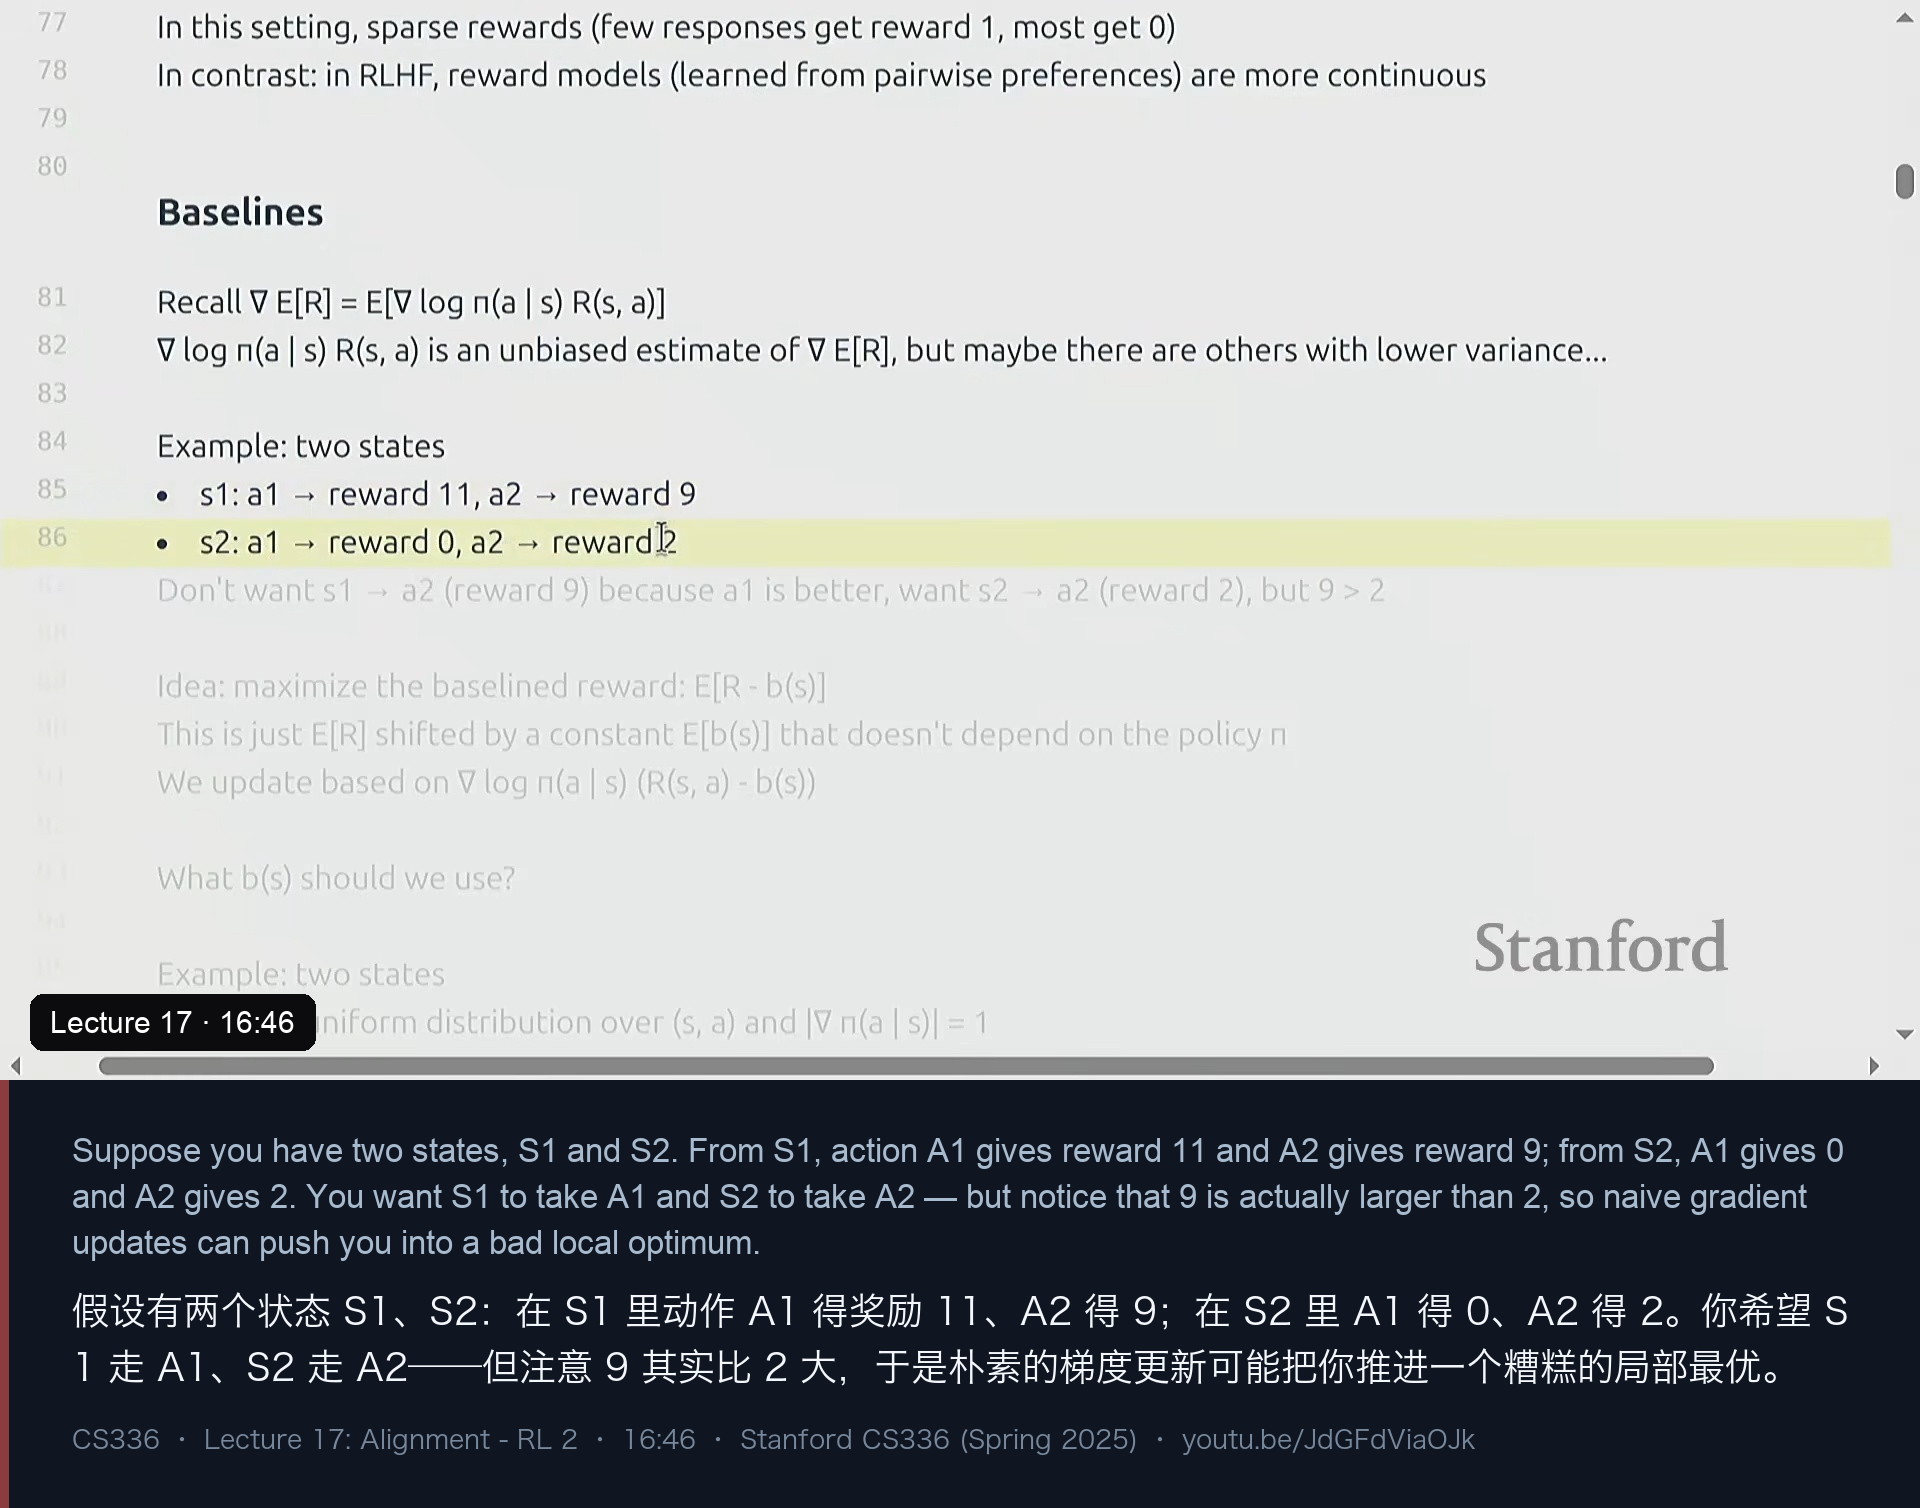
如果没有基线,朴素策略梯度会严格按奖励的大小加权。学生问:明明 S1 里 A1 已经是 11 分了,为什么还会去选 A2?讲师解释得很形象:初始策略根本不知道哪个回报高,它会“随机”选。一旦它碰巧选了 S1 的 A2 并拿到 9 分,梯度就会说“哇,9 分,这太好了,我要加大力度”——于是在这个方向上越更新越多,最后概率质量全压在 A2 上,A1 反而没了机会,掉进局部最优。
讲师特意补了一句:从期望上看这套数学是自洽的——把所有状态动作放在一起看,更新方向没问题,问题在于你每次只看局部。这正是基线要解决的问题。
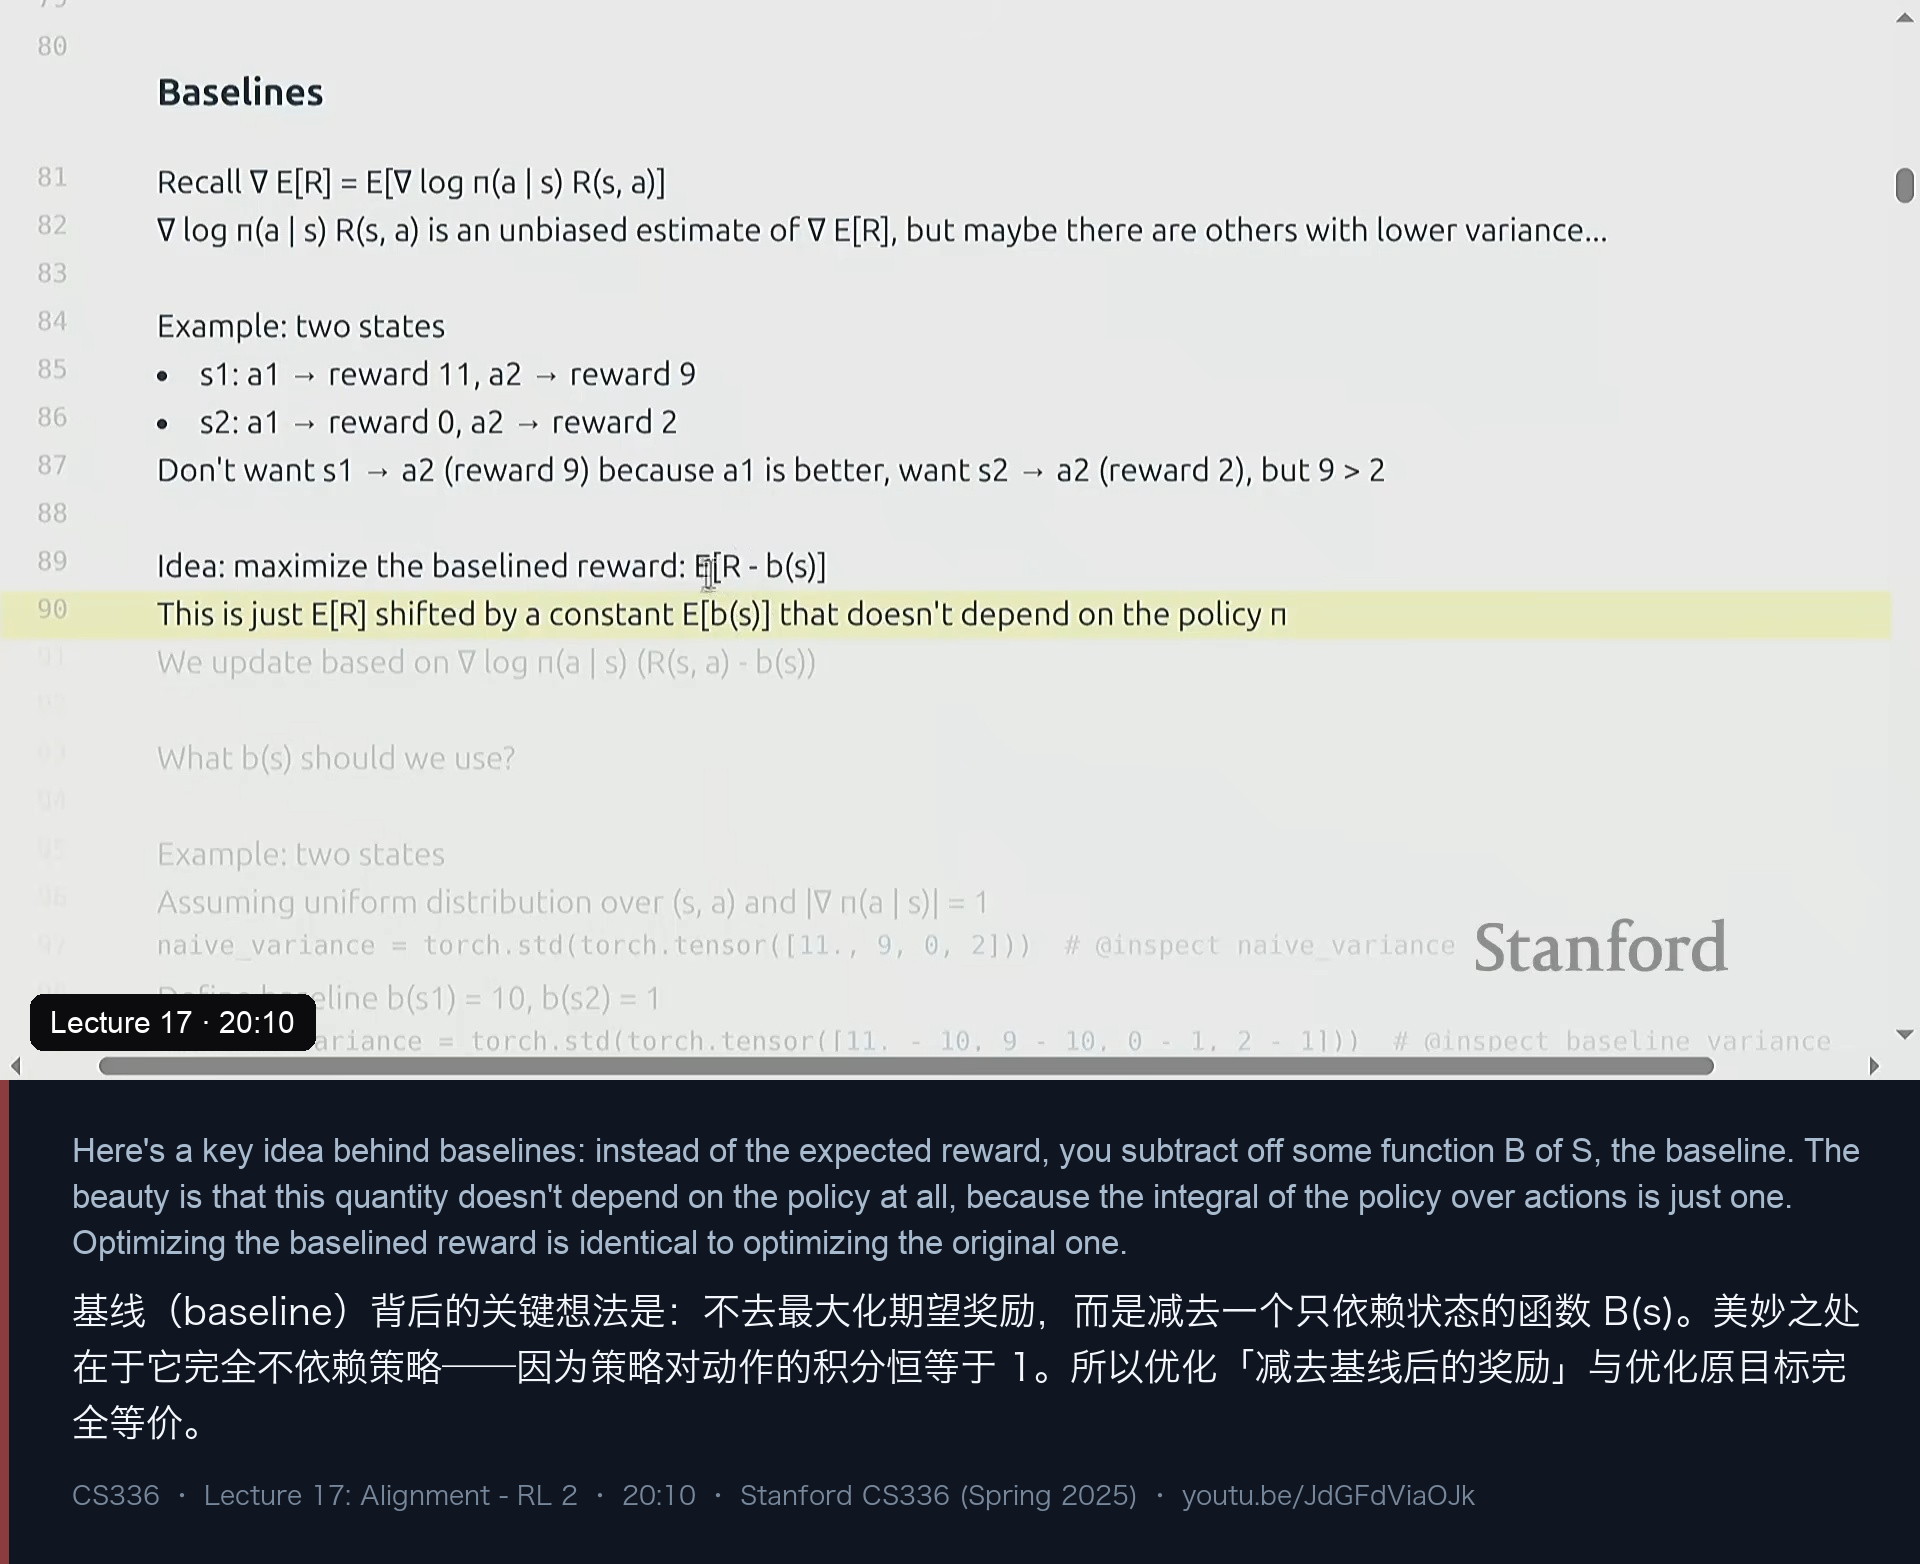
基线的想法朴素到有点好笑(图 7):与其最大化期望奖励 E[R],不如最大化“减掉一个基线之后”的期望 E[R − B(s)],其中 B 是只依赖状态 s、不依赖动作 a 的任意函数。为什么这是合法的?因为
# 基线不改变优化目标
E_{s,a}[ R(s, a) - B(s) ] = E_{s,a}[ R(s, a) ] - E_s[ B(s) ]

# 而 E_s[B(s)] 与策略 π 无关:
#   展开 E[B(s)] = ∫ p(s) B(s) [ ∫ π(a|s) da ] ds,括号里恒等于 1
# 所以它是一个常数 —— 优化 E[R] 与优化 E[R - B(s)] 完全等价讲师把它说得更直白:E[R − B(s)] 只是把 E[R] 平移了一个常数,而这个常数不依赖策略,所以“优化它”和“优化原目标”是一回事。合法的条件只有一条:B(s) 不能依赖 a。 学生追问了一个很实务的问题:B(s) 可以设成“某个冻结策略”下的期望吗?讲师的回答是:可以——只要你在表达式里不把它当成可求导的量,它就是常数;但这也意味着你必须真的留一份旧策略的拷贝,否则那个“旧策略”自己在变,常数性就破了。他还补了一句“这就是 RL 里必须小心的地方:什么是常数、什么不是”。
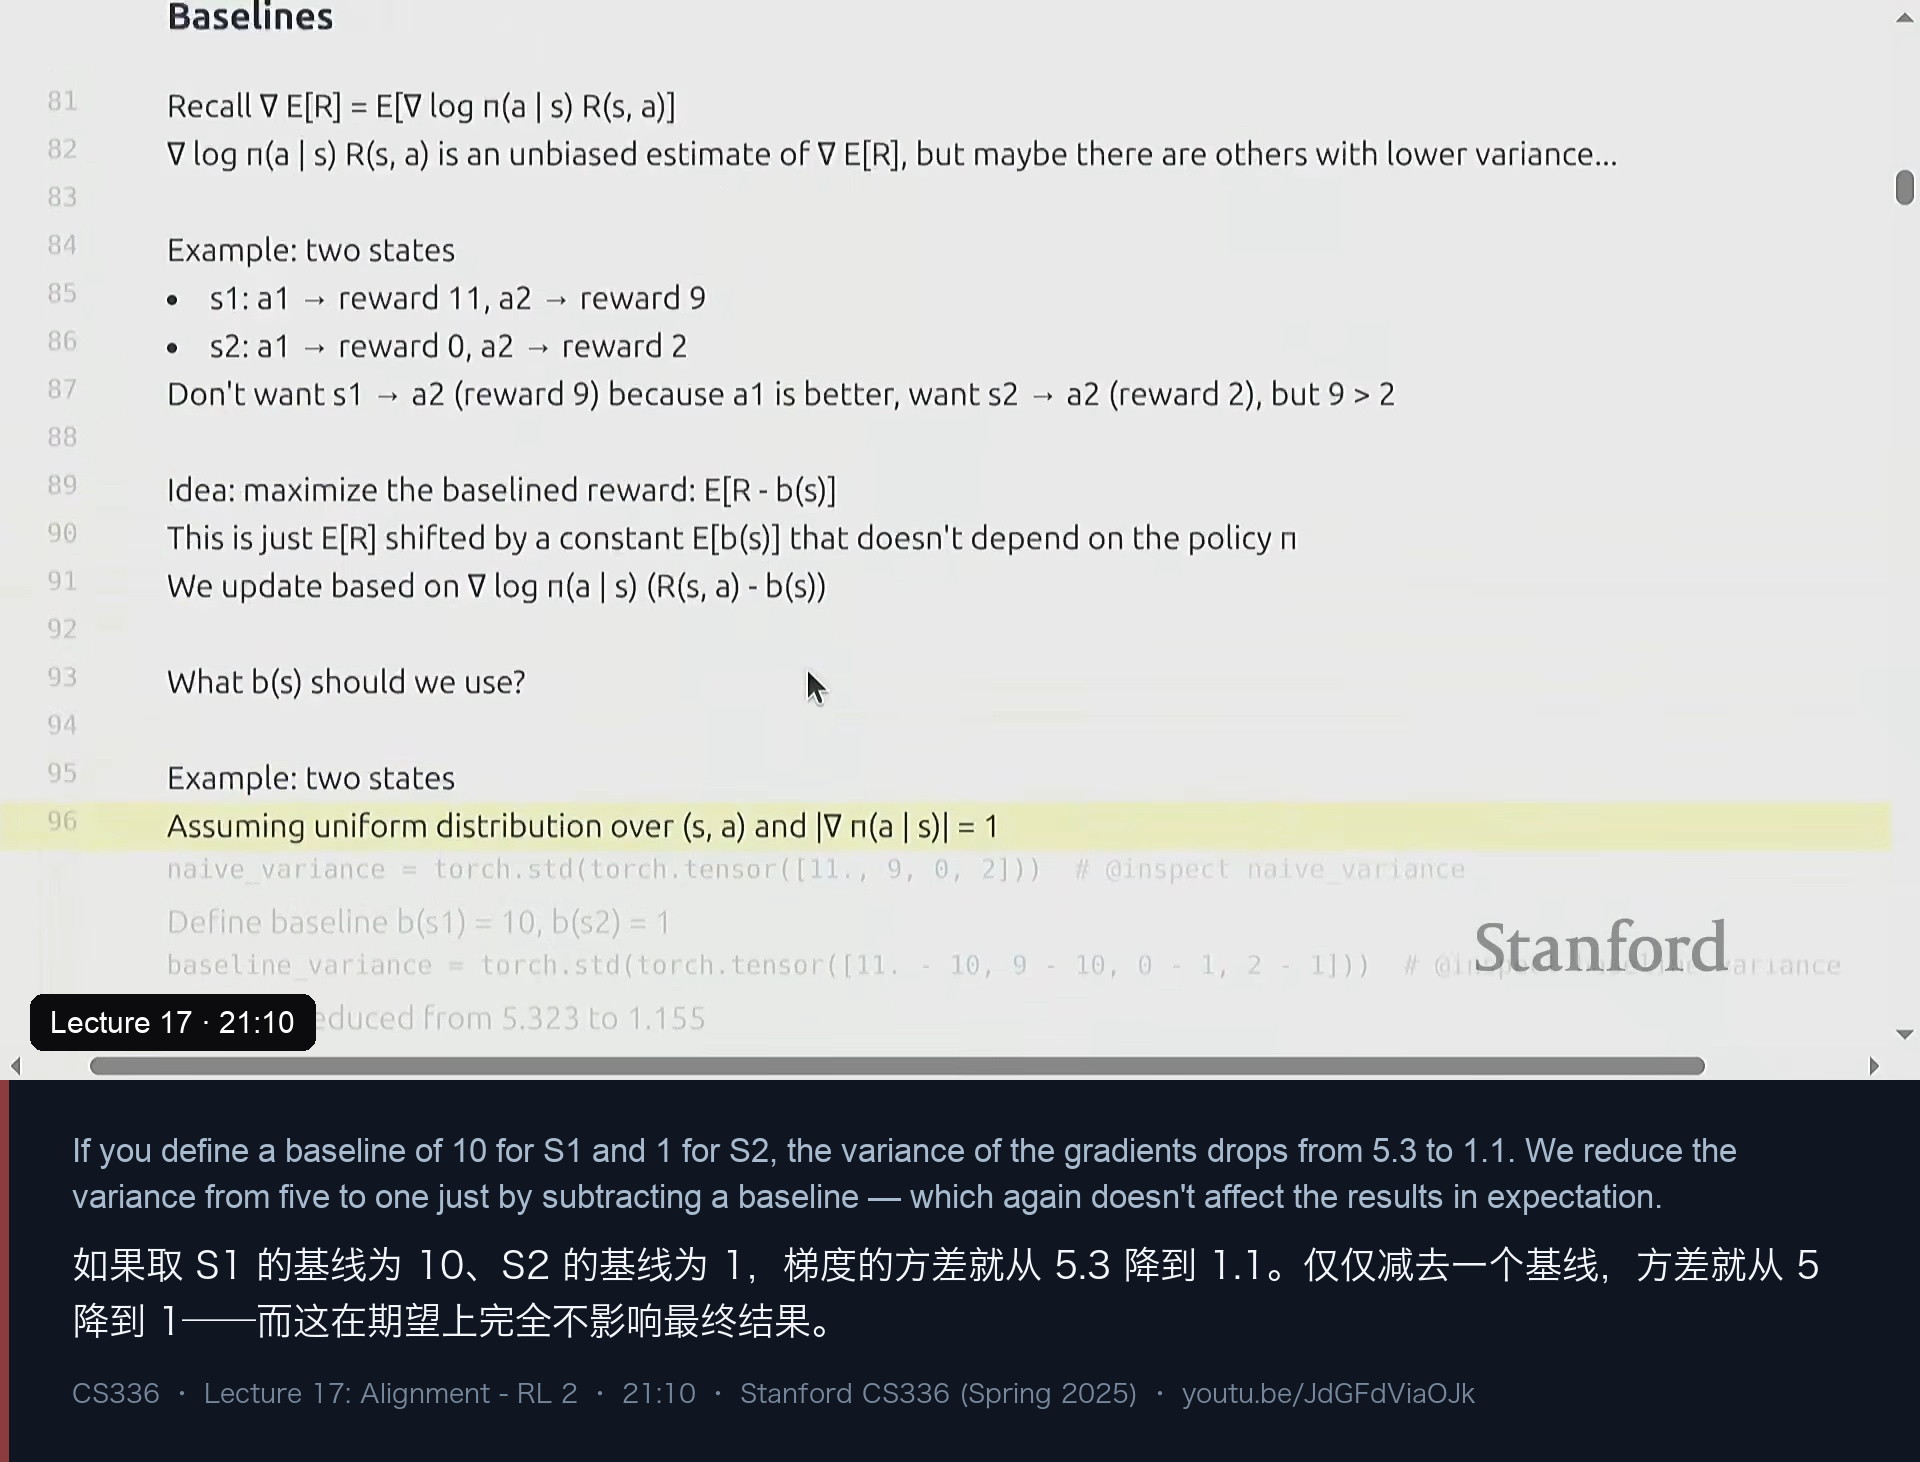
那么效果有多好?讲师算了一遍(图 8)。假设初始策略在状态和动作上均匀分布,先忽略策略自身的梯度项,只看奖励这一项的方差:
- 没有基线时,采样到的“奖励”在 {11, 9, 0, 2} 之间跳,方差是 5.3;
- 取基线 B(S1) = 10、B(S2) = 1,也就是“减去每个状态的平均水平”后,残差是 {1, −1, −1, 1},方差降到 1.1。
从 5 降到 1,什么都没牺牲(期望不变),只是少估了一个常数。讲师由此给出一句可以背下来的原则:方差越低,收敛越快。
四、基线、优势函数,以及“所有算法其实是同一个模板”
既然任意 B(s) 都合法,那“最优的 B(s)“是什么?讲师给出了闭式解(图 9 上半):对单参数模型,最优基线大约是
# 最优基线的形状(单参数模型;多维情形会涉及协方差矩阵,更难算)
B*(s) = E[ (∇ log π)² · R(s,a) ] / E[ (∇ log π)² ]但它很难算——高维时会牵扯协方差,日常没人真去解它。于是实务上的做法是“忽略这个最优解”,只保留一个启发式:
B(s) ≈ E[ R(s, a) | s ] # "这个状态下的平均表现"这个选择之所以好用,是因为它和 RL 里两个经典概念严丝合缝地对上了:
- 值函数 V(s) = 在状态 s 下的期望回报;
- Q 函数 Q(s,a) = 在状态 s 下先做动作 a 的期望回报;
- 优势函数 A(s,a) = Q(s,a) − V(s):做了 a 之后,比“平均而言”好多少。
在“结果奖励”的设定下,回报就是那一个奖励,所以 Q 与 R 是同一个东西。于是**“减去基线 B(s) = E[R|s]“就正好等于优势 A(s,a)**。讲师特别点出:这个基线选择在直觉上是在衡量”动作 a 相比状态平均水平有多好”,这也解释了为什么“减基线”在 RL 里几乎无处不在——它把“绝对回报”换成了“相对优势”,而后者才是你真正想推动策略的东西。
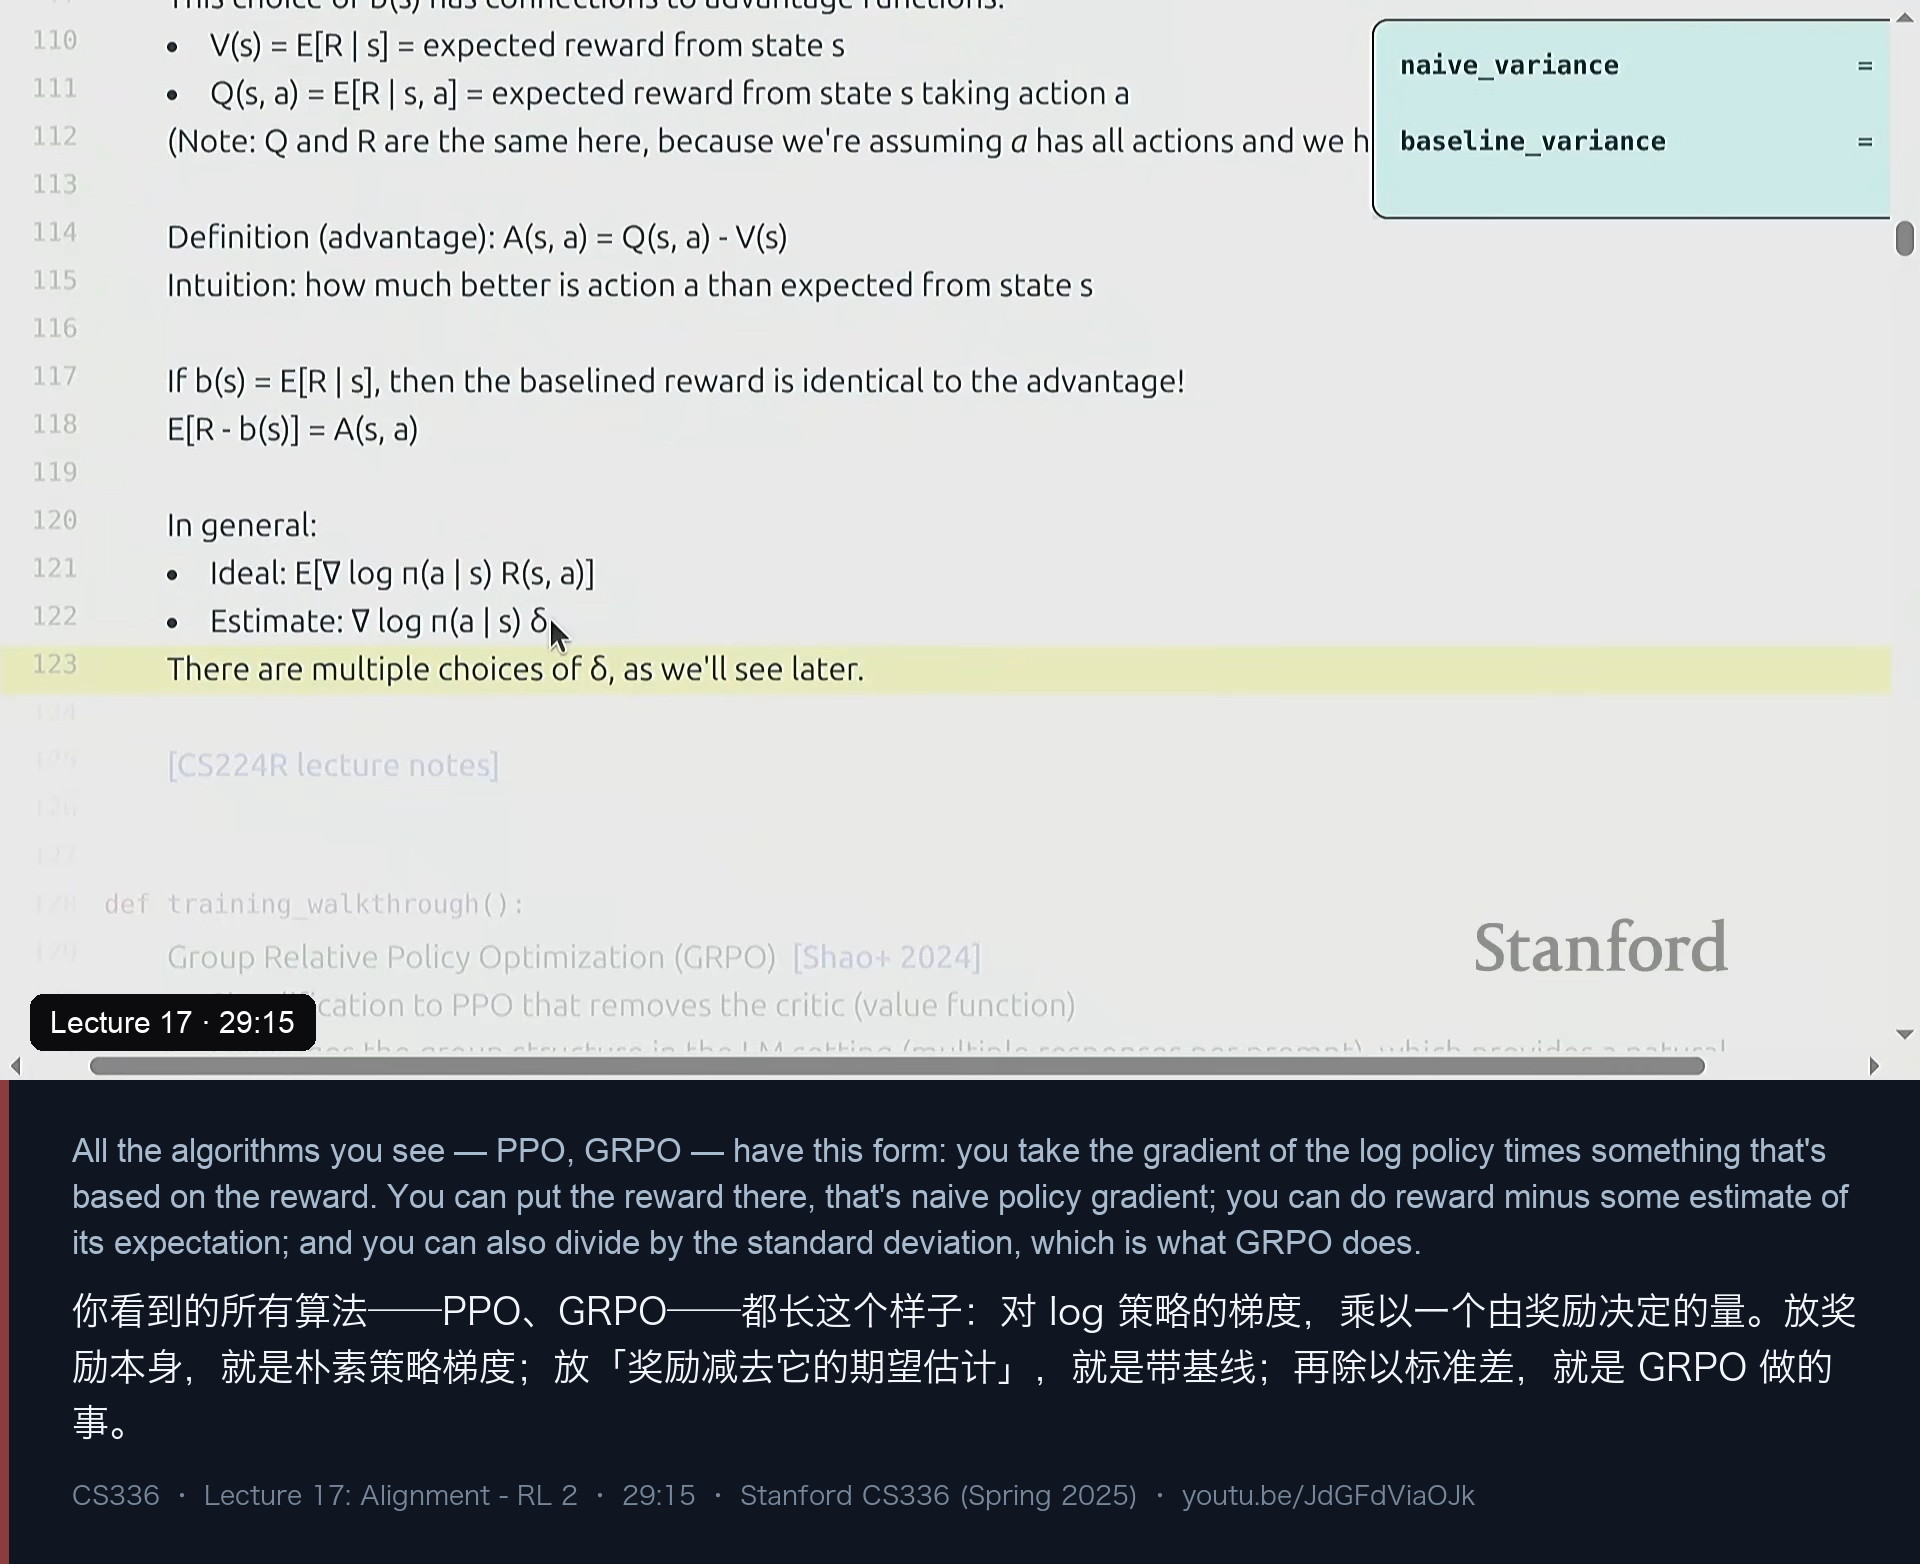
有了这一层理解,讲师给出了全讲最重要的一句话式抽象(图 9):
“All the algorithms you see — PPO, GRPO — have this sort of form where you’re basically … taking the gradient of the log policy times something that’s based on the reward.”
所有算法都是”∇log π(a|s) × Δ“这一个模板,区别只在 Δ 怎么取:
| Δ 的取法 | 对应的方法 |
|---|---|
Δ = R(s,a) |
朴素策略梯度(被奖励加权的 SFT) |
Δ = R(s,a) − B(s) |
带基线 / 优势函数的策略梯度 |
Δ = (R(s,a) − B(s)) / std |
GRPO(组内归一化) |
讲师在这里说了一句很有“过来人”味道的话:GRPO 的具体形式并不那么重要,因为明年大概会有 GRPO2;真正会长久留下来的是这个框架。他还顺手给了一个学习建议——想多看点推导和直觉,可以去上 Chelsea Finn 的 Deep RL 课。
五、GRPO 为什么存在:语言模型天然提供了“组结构”
在写代码之前,讲师先解释了“为什么会有 GRPO 这个东西”(图 10)。他的说法很有意思:这是一条反直觉的算法演化路径——通常是“先有简单的、再长出复杂的”,但 GRPO(2024)是在 PPO 之后、作为一种简化出现的。原因不在算法本身,而在语言模型这个场景提供了一种经典 RL 里没有的结构:
“In the language modeling setting you have a prompt, you can generate a bunch of responses from that prompt, and this gives you a natural group structure to compute essentially the baseline — which turns out to be the average over the rewards.”
同一个提示词可以采样一批回答,这批回答天然构成一个“组”,而组内奖励的平均值就是一个现成的基线。这正是 GRPO 里“相对(relative)“二字的来源:相对这个组。讲师对比道:在经典 RL 里(比如让机器人学走路),每次 rollout 都不一样,没有天然的组,所以你还是得回到 value function,用一个覆盖所有状态动作的函数去估计基线;而在语言模型里,你可以就在这个提示词下的这几条回答之间做经验估计——用不着考虑整个世界。
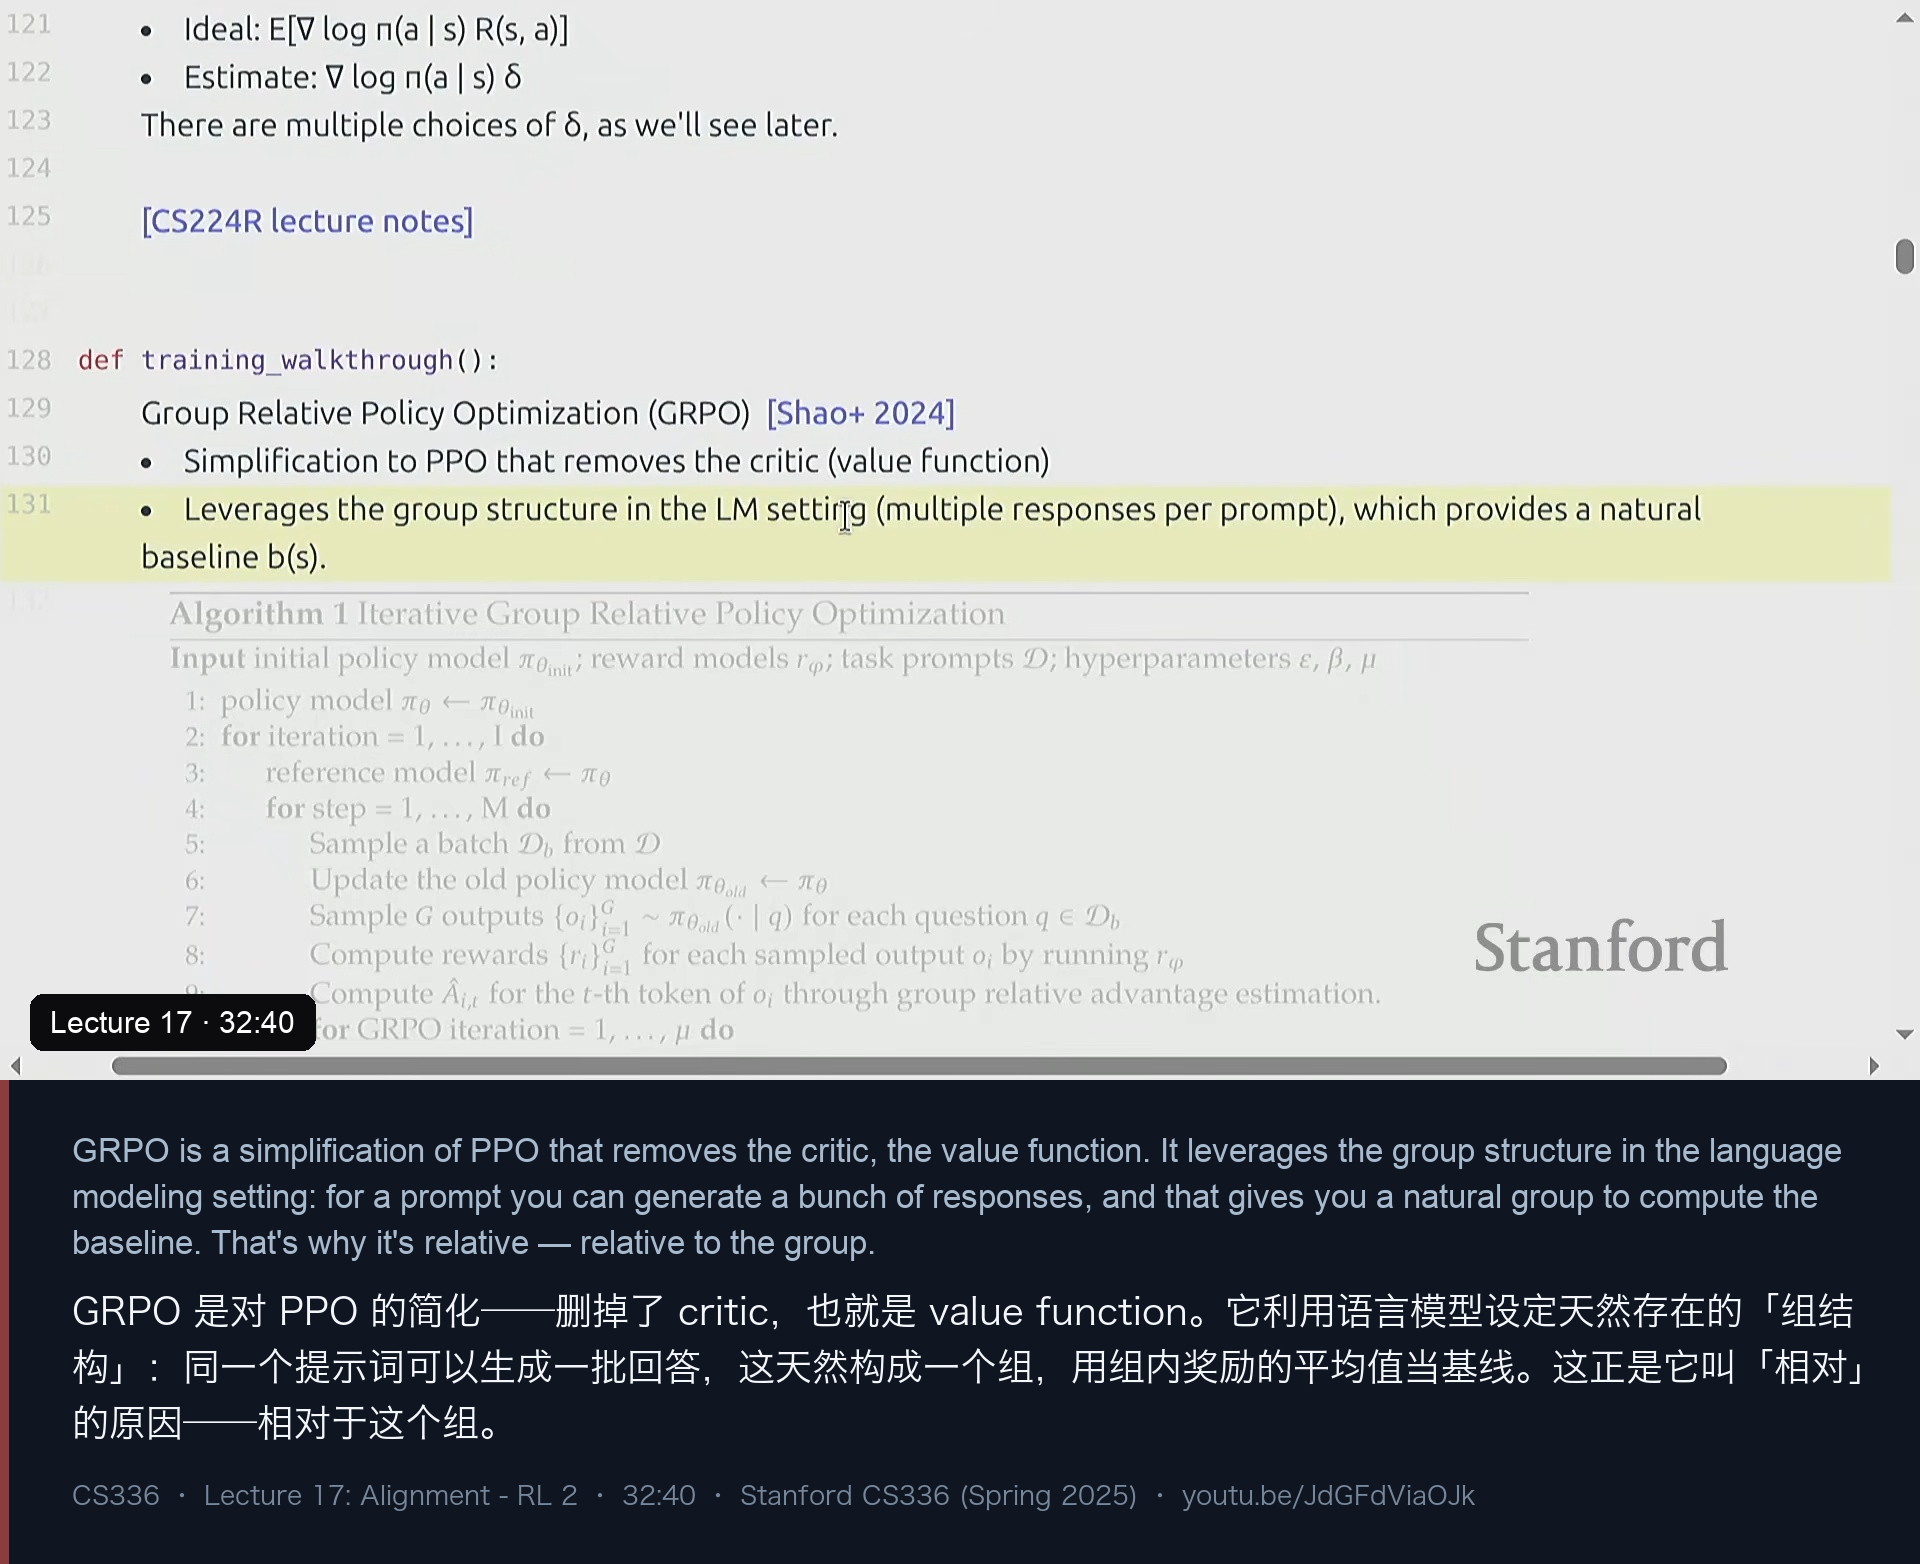
理解了这一点,再看那一页 “General: Policy Optimization (GRPO) (Shao 2024)” 的伪代码就顺理成章:它本质上就是在 PPO 基础上删掉 critic / value function,改用组结构提供基线。讲师说这页幻灯片明年可能得更新——它想表达的是“比某个具体选择更一般”的一族方法。
六、把算法跑起来(一):一个排序任务和它的奖励
理论讲完,讲师说“我们来定义一个简单任务,写点代码,最好还能真跑起来”。他挑任务的标准很实在:要简单到能在他自己的笔记本上训练——跑一个真正的 Transformer 是不用想的。最后的任务是(图 11):
给 n 个数字排序。 提示词是 n 个数字,回答是(希望)排好序的那 n 个数字。
任务定了,下一步是定义奖励——而讲师立刻指出,这正是强化学习里“有意思”的地方:同一个任务,奖励可以有非常多种定义方式,选哪种会直接决定你能不能学得动。
- 奖励方案 A(稀疏版):排好序给 1,否则给 0。这是你真正在乎的指标,但它带着稀疏奖励的原罪——如果初始策略什么都不会,绝大多数回答都是 0 分,梯度全是零,模型原地不动。
- 奖励方案 B(部分分版):回答里和 ground truth 位置相同的个数。比如正确答案能拿满分 4 分;一个“完全没排好”的回答可能因为某个位置碰巧对了拿 1 分;另一个也拿 1 分。
讲师的例子(图 12 上面的代码块)是这样的:
assert len(prompt) == len(response)
ground_truth = np.sort(prompt)
# 位置匹配数:只统计"位置 i 上的数字恰好等于排好序后位置 i 的数字"的个数
reward = sum([y for x, y in zip(response, ground_truth) if x == y])问题随之而来:两个都不是正确答案的回答,可能都拿 1 分——一个错得离谱、一个已经很接近了,奖励却一样。于是有了
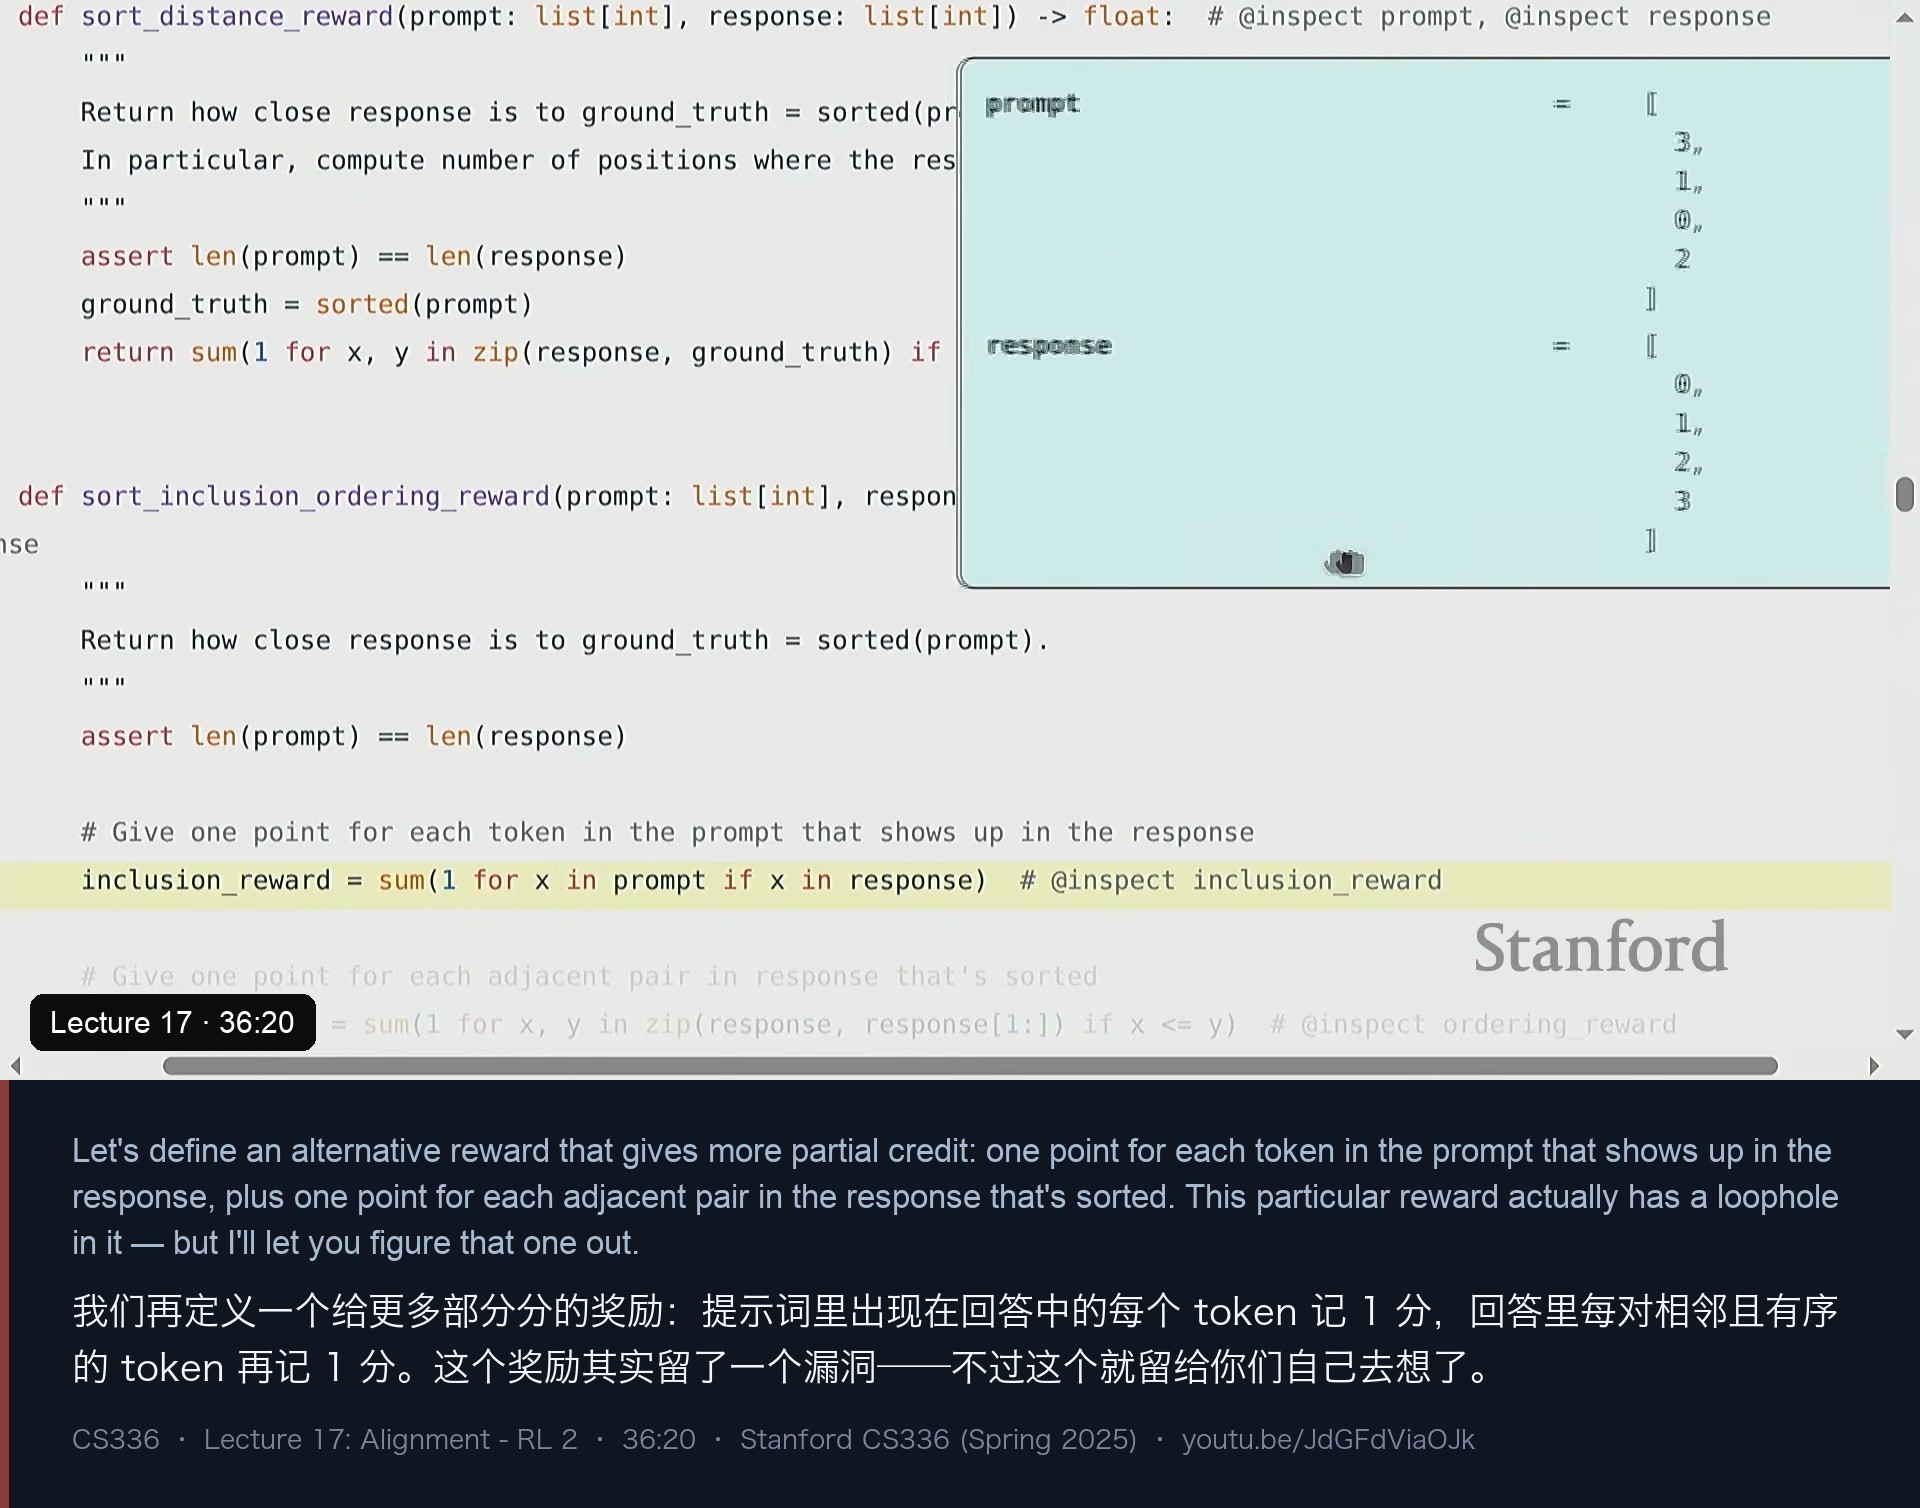
- 奖励方案 C(更细的部分分):提示词里出现在回答中的 token 每个给 1 分(“至少你输出的数字来自输入,这个要求不过分吧”),再加上回答里每一对相邻且有序的 token 给 1 分。对一个 4 元素的例子,这两部分加起来能到 7 分;而前面那个“离得很远”的错误答案只拿 3 分、“很努力”的错误答案拿 6 分,区分度就出来了。
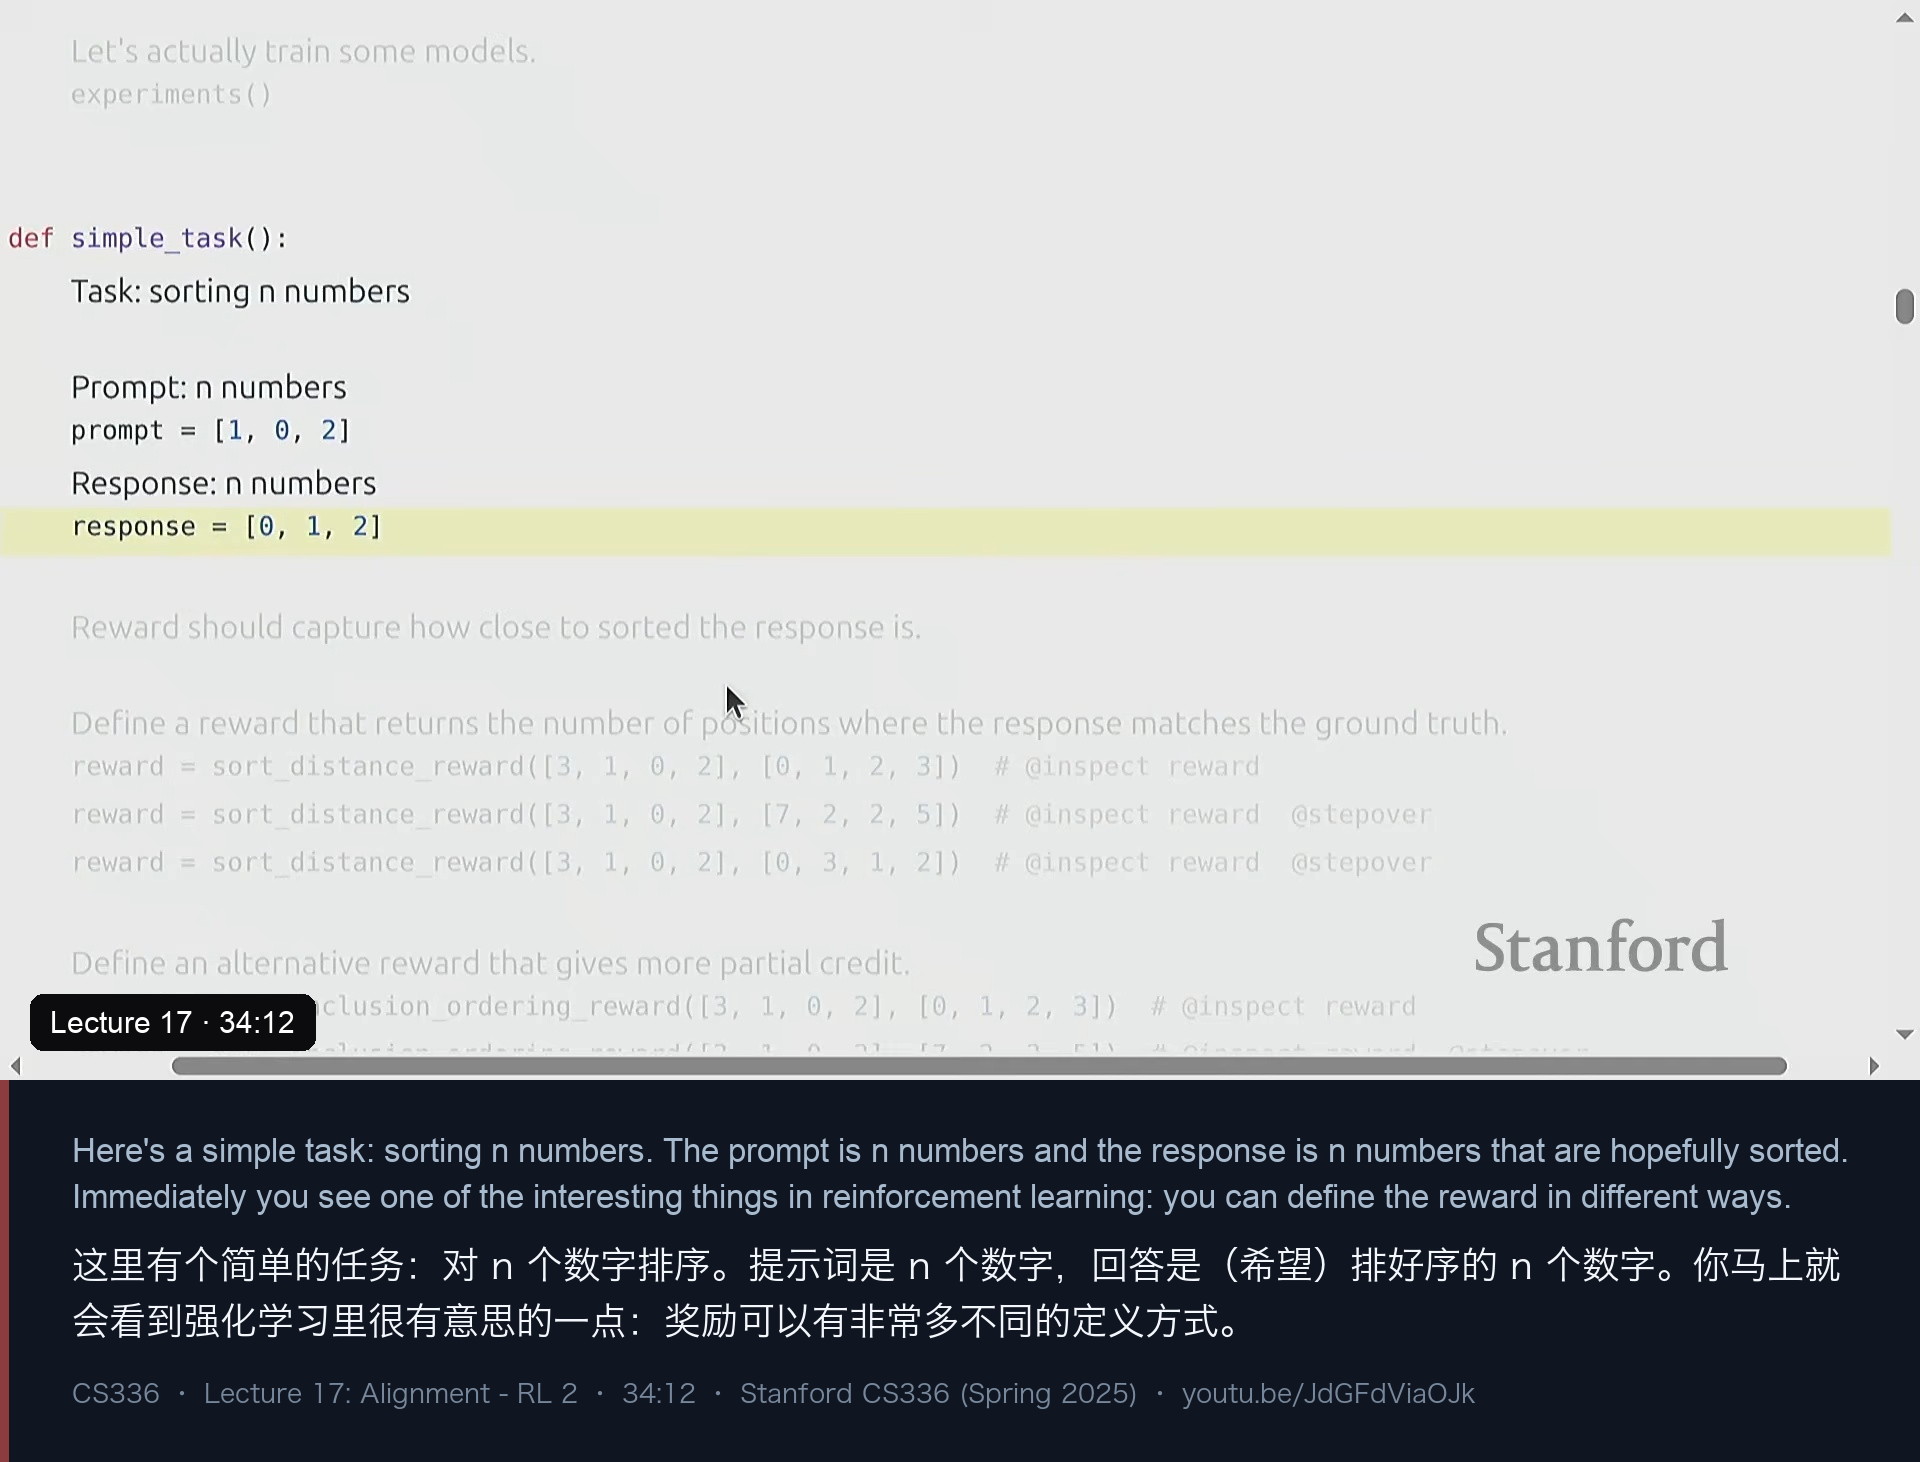
讲师在这里埋了个包袱(图 12):这套奖励其实留了一个漏洞——“我这次不揭晓,你们自己去想”。结合奖励的构造(“输入里出现过的 token”加分 + “相邻有序对”加分),很容易构造出分数很高但不是正确排序的回答,例如把每个数字重复一遍、或者输出一个长得像但其实是退化情形的序列。这正是他在结尾要重复的那个警告的迷你版:奖励一旦能被钻空子,优化就会去钻。
为了让代码干净,讲师把模型刻意做得非常简单(图 12 下方的 simple_task 与 simple_model):长度固定、非自回归(“编码一遍、每个位置独立解码”),并用每个位置各一套参数来编码位置信息——对排序任务来说位置显然是关键。独立解码在真实场景里一般不该做(讲师说“也许在投机解码里有小剂量用处”),但它能免掉那段又长又难写的自回归生成代码。
这个模型长这样(对照讲师的 forward 走读):
class simple_model(nn.Module):
    def __init__(self, vocab_size, embedding_dim, prompt_length):
        super().__init__()
        self.embedding = nn.Embedding(vocab_size, embedding_dim)      # 词嵌入
        self.encoder_pos = nn.Parameter(torch.randn(prompt_length, embedding_dim, embedding_dim))  # 每个位置的"编码"矩阵
        self.decoder_pos = nn.Parameter(torch.randn(prompt_length, embedding_dim, embedding_dim))  # 每个位置的"解码"矩阵

    def forward(self, prompt):
        # 1) 嵌入:(batch, position) -> (batch, position, dim)
        # 2) 逐位置编码后沿位置求和,"collapse" 成 (batch, dim)
        # 3) 逐位置解码回 (batch, position, dim)
        # 4) 每个位置映射到词表 logits:(batch, position, vocab)
        ...
有了 logits 就采样:把 (batch, position, vocab) 摊平成 batch×position 再对词表采样,得到 (batch, position, trial) —— 也就是每个提示词采样若干条回答(num_responses)。学生问“同一提示词下采出来的回答会不会太像”,讲师承认会(毕竟是从同一组 logits 里独立采),并说“语言模型自回归采样也一样;这里唯一的区别是这边各位置独立”,还提示可以调温度来增加多样性。这一段就是**“组”在实际代码里成形的地方**:那个 trial 维度,就是 GRPO 里说的 group。
七、把算法跑起来(二):compute_deltas、裁剪与 KL
采完回答就进入这一讲的核心函数——compute_deltas(图 13)。它的职责只有一个:把奖励 R 转换成真正用于加权的 Δ。讲师把它做成一个“菜单”:
def compute_deltas(rewards, mode):
    # rewards: (batch, trial) —— 每个提示词下每条回答的得分
    if mode == 'naive':
        return rewards                          # Δ = R,就是朴素策略梯度

    if mode == 'centered':
        # 每个提示词内部做中心化:减去组内均值
        return rewards - rewards.mean(dim=1, keepdim=True)

    if mode == 'normalized':
        # GRPO 的做法:先中心化,再除以标准差(加一个小量防止除零)
        mean = rewards.mean(dim=1, keepdim=True)
        std  = rewards.std(dim=1, keepdim=True)
        return (rewards - mean) / (std + 1e-4)
这三个分支正好对应上一节那张表里的三种 Δ。讲师顺手回答了前面那个“为什么奖励是 0 就完全不更新、是不是该设成 −1”的问题:中心化会自动做到这件事——假设一组里一个 1、其余都是 0,均值是 0.1,减掉之后,那些原来得 0 分的回答变成了 −0.1,于是也开始被更新(被压低)。所以“把错误回答推开”不需要你手动改奖励,它来自基线。
中心化还有两个漂亮的推论,讲师专门停下来强调(图 13):
- 如果一组里所有奖励都一样(比如全是 5),中心化后 Δ 全是 0——也就是说,在这个样本上你什么也不更新。讲师说这个直觉是对的:“既然组内没有任何相对差异,就没有理由偏向哪一条回答”,于是弃权,把信号让给别的样本。
- 归一化让 Δ 对奖励的整体缩放不变:所有奖励乘以 100,标准化后的 Δ 基本不变。这在奖励尺度不稳定的场景里很省心。
他还额外提了一个“GRPO 论文里没做、但你可以想”的变体:把每组里不是最大值的奖励全部置零。动机是实践里模型容易黏在局部最优上吃低垂的果实——给太多部分分,它就只去拿容易拿的分,而不去争取真正更高的奖励;“不是最好就全不要”是一种“全有或全无”的矫枉过正。
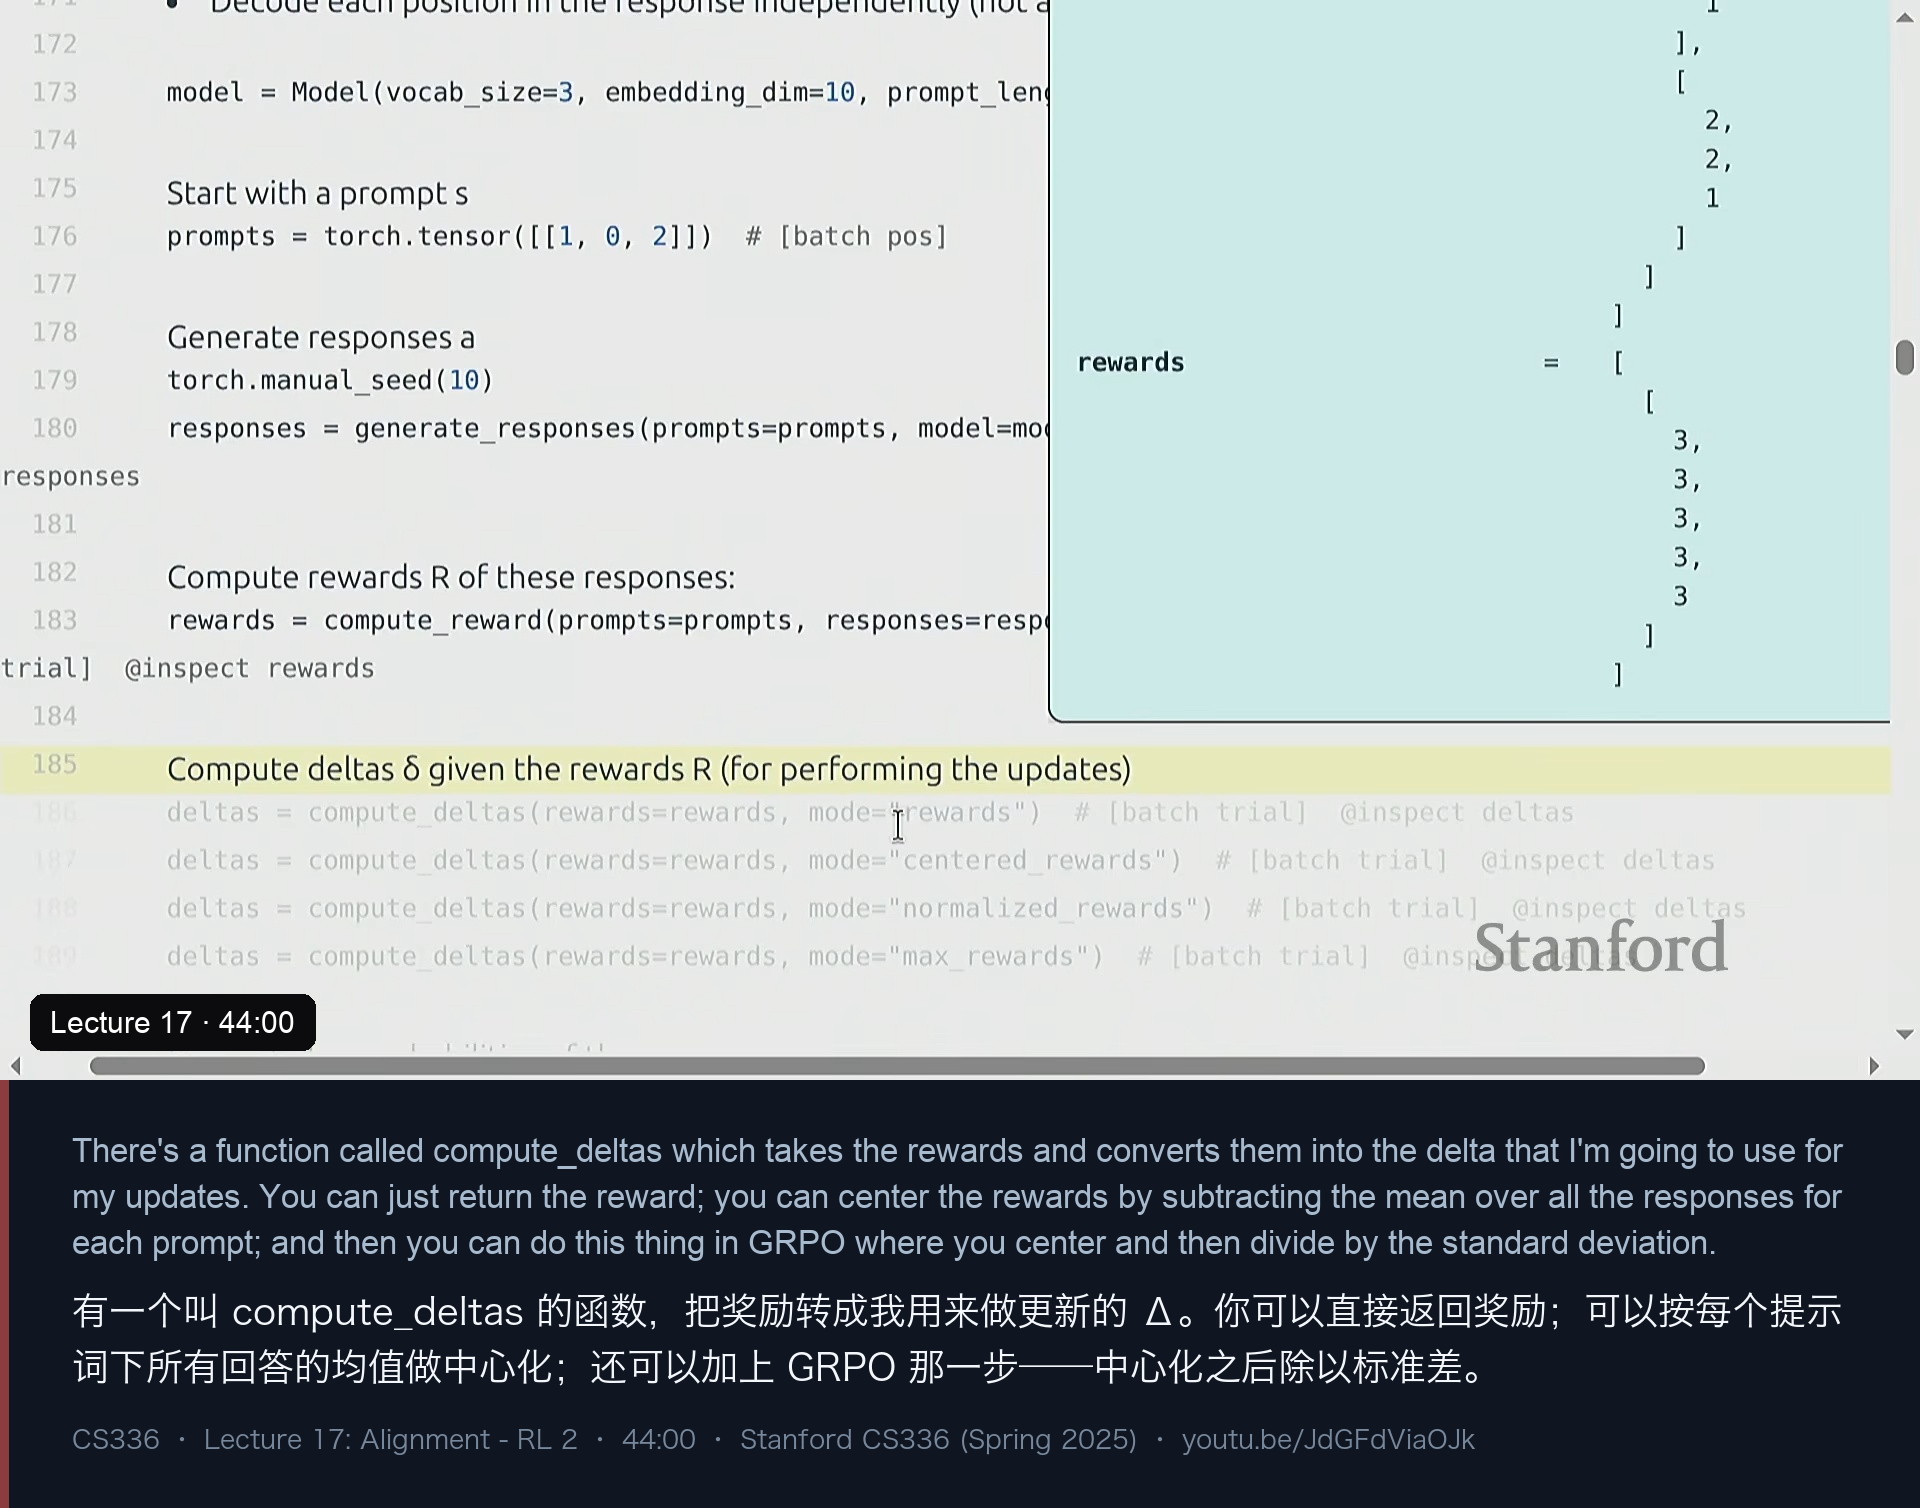
另外半边是回答的对数概率:把 logits 转成 log probs,然后按照采出来的回答去索引(讲师形容为“用回答当索引去取 log prob”),得到 (batch, trial, position) 的 log π。有了 Δ 和 log π,就可以写损失了。这里讲师插播了一段非常重要、也非常容易踩的坑——冻结参数(图 14 上面那段讨论):
# 反例:如果两边都不冻结,ratio 恒等于 1,梯度恒等于 0
ratio = p / p_old          # p_old 也在计算图里 —— 危险!
loss  = -(ratio * delta).mean()
# ∇loss = 0 —— 训练悄悄失败

# 正确写法:任何应当视为常数的量,都要放进 no_grad
with torch.no_grad():
    old_log_probs = compute_log_probs(model, responses).detach()
ratio = torch.exp(log_probs - old_log_probs) # 这一项才真正有梯度讲师用一个单参数玩具例子讲透了这一点:如果同一个参数 W 同时驱动 p 和 p_old,那 p / p_old 恒等于 1,对 1 求导就是 0——“显然没什么用”。正确的做法是把想要当常数的东西包进 no_grad:你还能读到它的数值,但它不参与反向传播。他承认自己的示例代码里“其实忘了包 no_grad”,但补了一句“你们知道该怎么做”。这也引出 RL 与预训练的一个关键差异:RL 里有很多“看起来一样、其实来自不同参数版本”的量,谁是常数、谁要更新,必须自己盯紧。(顺带回答“为什么不按位置折扣、让最后 100 个 token 权重更大”:信用分配(credit assignment)恰恰是 RL 最难的问题之一——稀疏奖励下你不知道功劳该记在哪里,所以这个设定干脆把功劳平摊到所有位置。)
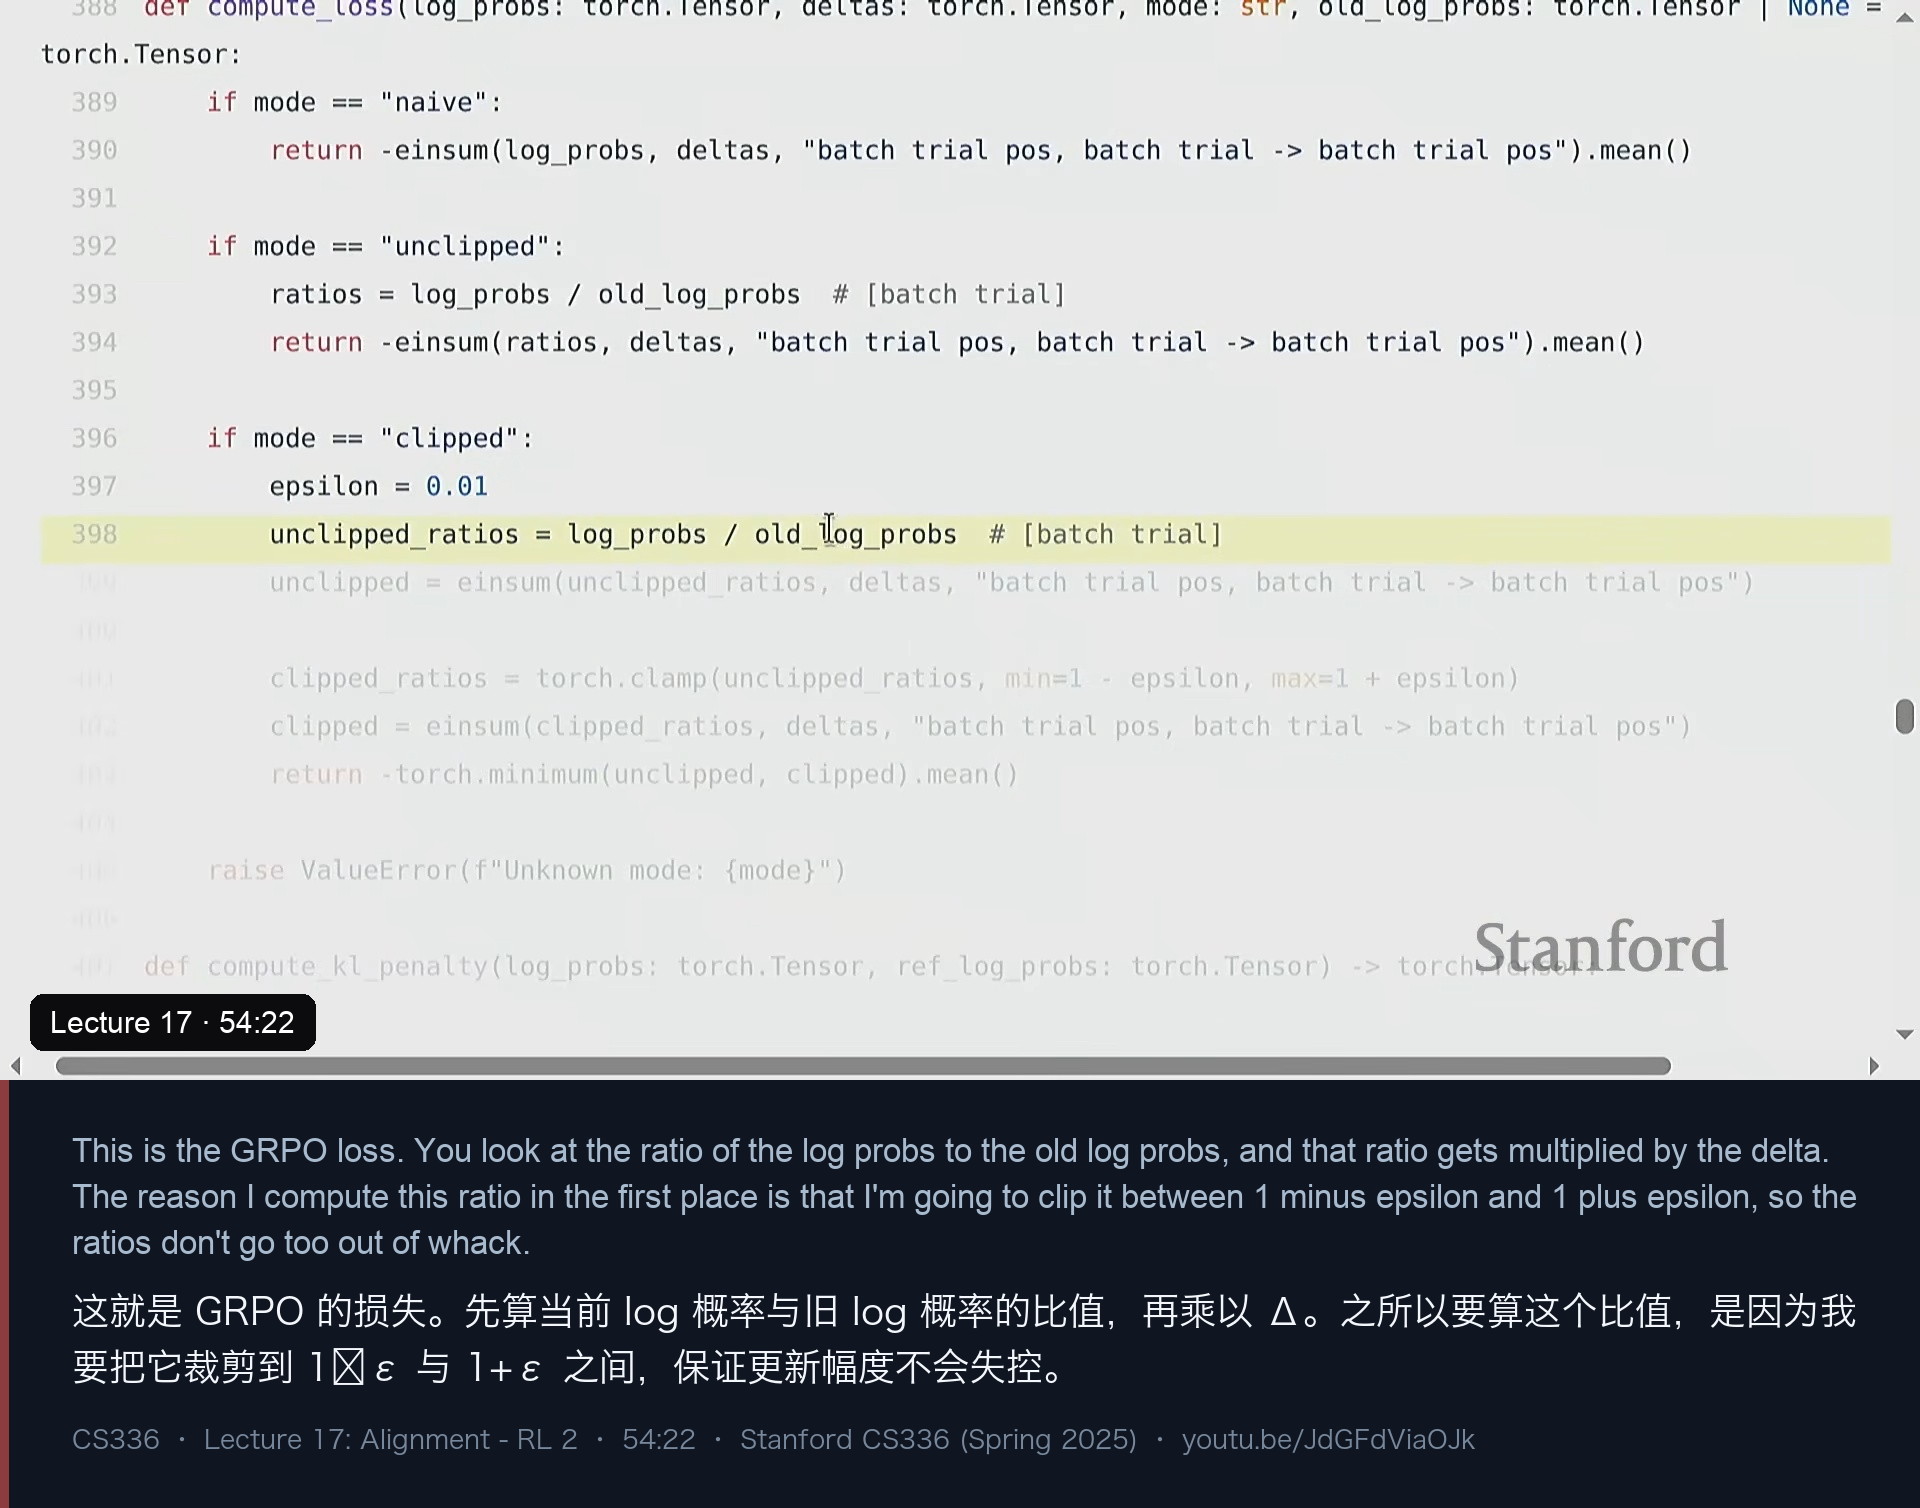
最后是 GRPO 的损失本体(图 14):
# GRPO 的裁剪损失(对应 DeepSeek 论文里的形式)
ratio         = torch.exp(log_probs - old_log_probs)     # 重要性比率,π_θ / π_old
clipped_ratio = torch.clamp(ratio, 1 - epsilon, 1 + epsilon)

loss = -torch.min(ratio * delta, clipped_ratio * delta).mean() # 取 min 再取负 → 最大化讲师逐项拆解:先算比率、再乘以 Δ;和“朴素版”相比,唯一的差别是分母上多了一个“旧模型的 log prob”——而它是常数,所以本质上只是给梯度换了个尺度。真正新增的是裁剪:把比率夹在 [1−ε, 1+ε] 之间,再和不裁剪的版本取 min。效果是——如果更新还落在裁剪区间内,就还是标准更新;一旦冲出去,更新幅度就被这个上界封住了。
紧随其后的是 KL 惩罚(图 15),它提供另一层正则化。讲师先复习定义:KL(q‖p) 是从 q 里采样、取 log(q/p) 的期望。最直接的估计就是“把 log 比值取平均”,但他给出了一个更聪明的等价写法:
# 朴素的 KL 估计
kl_naive = (log_probs - ref_log_probs).mean()

# 低方差估计:等价,但方差更小
#   利用 E_q[ q/p ] = 1,所以 (q/p - log(q/p) - 1) 的期望正好等于原 KL
ratio_qp = torch.exp(ref_log_probs - log_probs)     # q / p
kl_estimate = (ratio_qp - (ref_log_probs - log_probs) - 1.0)
为什么等价?因为 E[q/p] = 1,所以式子里的 q/p 那一项期望是 1,再减 1 就归零,剩下的恰好是 −log(q/p),也就是原来的 KL。讲师把这总结成一条方法论:很多时候你要做的就是“把期望里的东西改写成方差更小的形式”——无偏当然好,但无偏且低方差才是收敛快的那个。
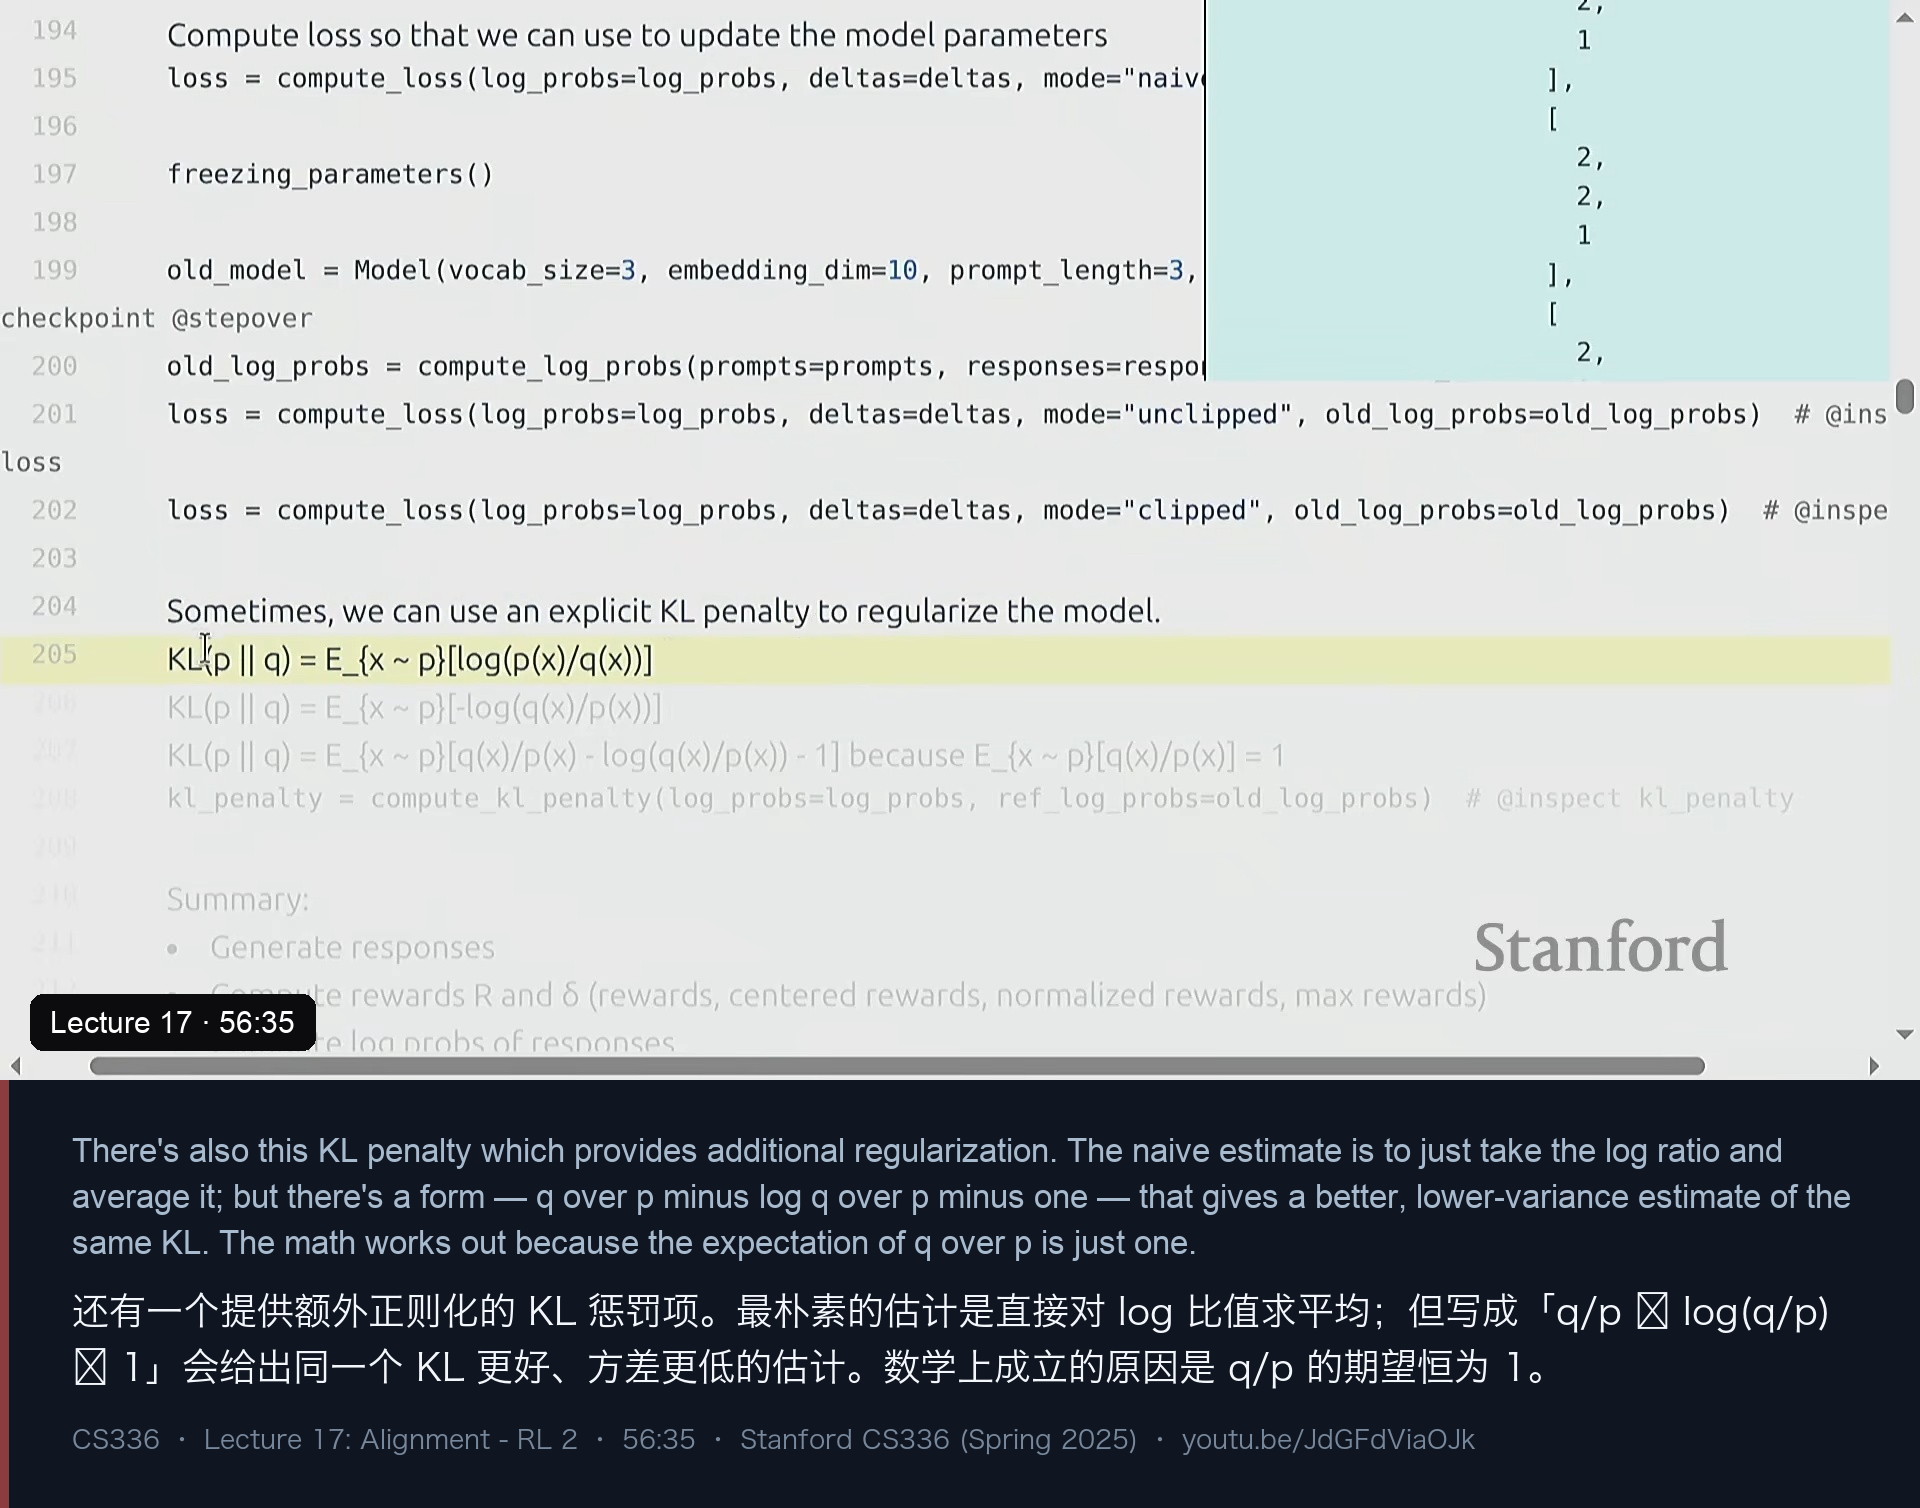
讲师最后强调了一个实现细节:KL 要在词表维度求和、但在 batch / trial / position 维度取平均——别把两者搞反。
八、三个模型与一次真实实验:损失曲线为什么会骗人
把组件讲完,讲师才把整套算法拼起来(图 16 的伪代码)——顺序是:回应生成(给定冻结模型采样一批回答)→ 奖励与 Δ(只依赖回答、不依赖模型)→ log π → 损失(裁剪或不裁剪)→ 梯度步。
训练循环有三个值得记住的结构:
- 外层 epoch 循环:每轮采样一批回答;
- 内层 step 循环:对同一批回答多走几步梯度。理由是推理很贵——与其每一步都重采样,不如把一批采样榨干;
- 参考模型的冻结:如果开了 KL 惩罚,就把某一时刻的模型复制一份冻结下来充当 π_ref,让训练朝它正则。
于是就有了图 16 那句关键的话:训练时你其实有三个模型:
| 角色 | 作用 | 代价 |
|---|---|---|
| reference(π_ref) | 做 KL 正则化的目标 | 要存一份完整模型,显存翻倍 |
| old(π_old) | 计算重要性比率的分布 | 不必存模型,只要存下这批回答的 log prob |
| current(π_θ) | 在线更新的策略 | 这是唯一被更新的东西 |
这个不对称很值得记:reference 贵,因为它必须随时能算任意输入的 log prob;old 便宜,因为你在内层循环里面对的是同一批回答——只要把那批回答的 log prob 存下来就够了。讲师打趣说这是“一个小小的优化,但很实用”。
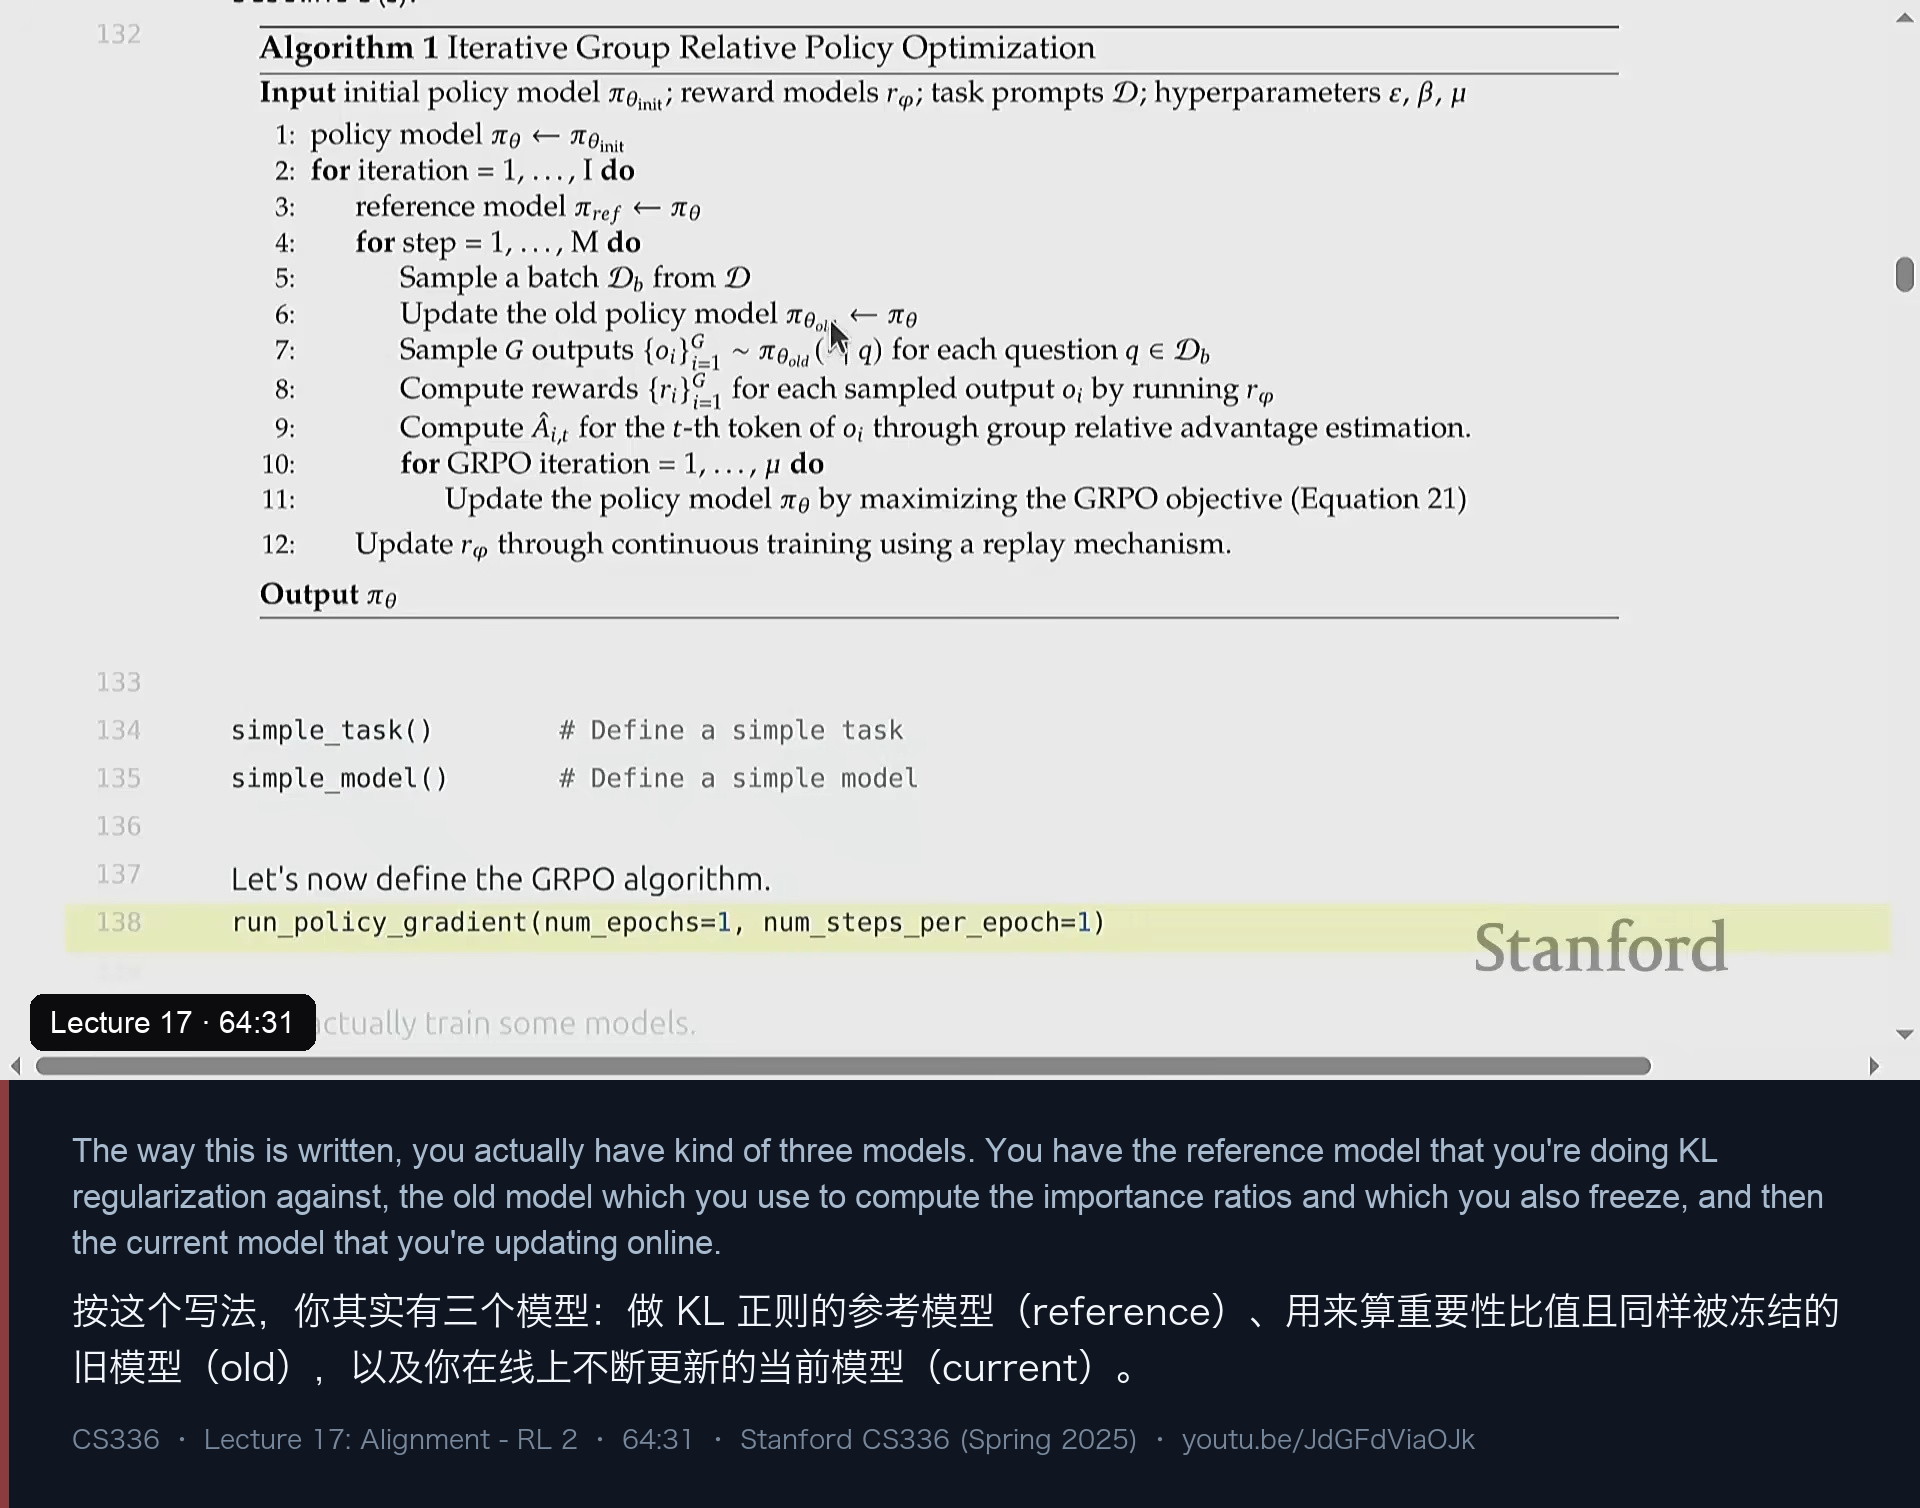
学生问:KL 惩罚为什么对着 reference,而不是对着 old? 讲师说可以想得深一点——我们写下的“目标函数”有点像善意的谎言:它只是用来求梯度的,更新一阵子之后你已经不在优化原来那个目标了;所以 KL 对着 reference 的意义是”不要离那个仍然成立的目标太远“,而约束相对 π_old 偏离的机制另有一个——裁剪。于是你有两层正则。另一个学生问:内层第一步 π_old = π_θ,是不是就没意义了? 讲师说:仍然会更新,因为 π_old 从更新角度看只是常数;只是这一步不会被裁剪(比率恰好是 1),所以保证能走出一步。
最后是本次讲座的“真跑”部分(图 17)。讲师用上面这套代码,跑了 100 个 epoch、每个 epoch 10 步,拿排序任务看曲线。几个结论都很有信息量:
- 朴素版(Δ = R):确实在涨奖励,但涨到 3 分左右就既不排好序、又自我感觉良好——它只是把“看起来像输入”的输出反复加强;
- 中心化版(Δ = R − mean):平均奖励明显更高(越过 3 分),因为它把得 3 分的回答往上推、把得 2 分的往下压;如果一组里奖励全相同,它就什么都不做(正如前面所说,比朴素版的“更新向一堆一样差的回答”更合理);
- 归一化版:方差标准化“没有带来太多差别”,讲师直接略过;
- 训练到后期:某些提示词上所有 Δ 都变成 0,说明在这批样本上再训练也没用了——除非重新采样一批新的回答。
讲师由此给出了对部分分奖励的冷静评价:它是个双刃剑。“我给了 4 分,这是很高的分,但它并没有真正解决问题。”——把奖励拆细让梯度有了信号,但也可能让模型停在“分数不错的错误答案”上。
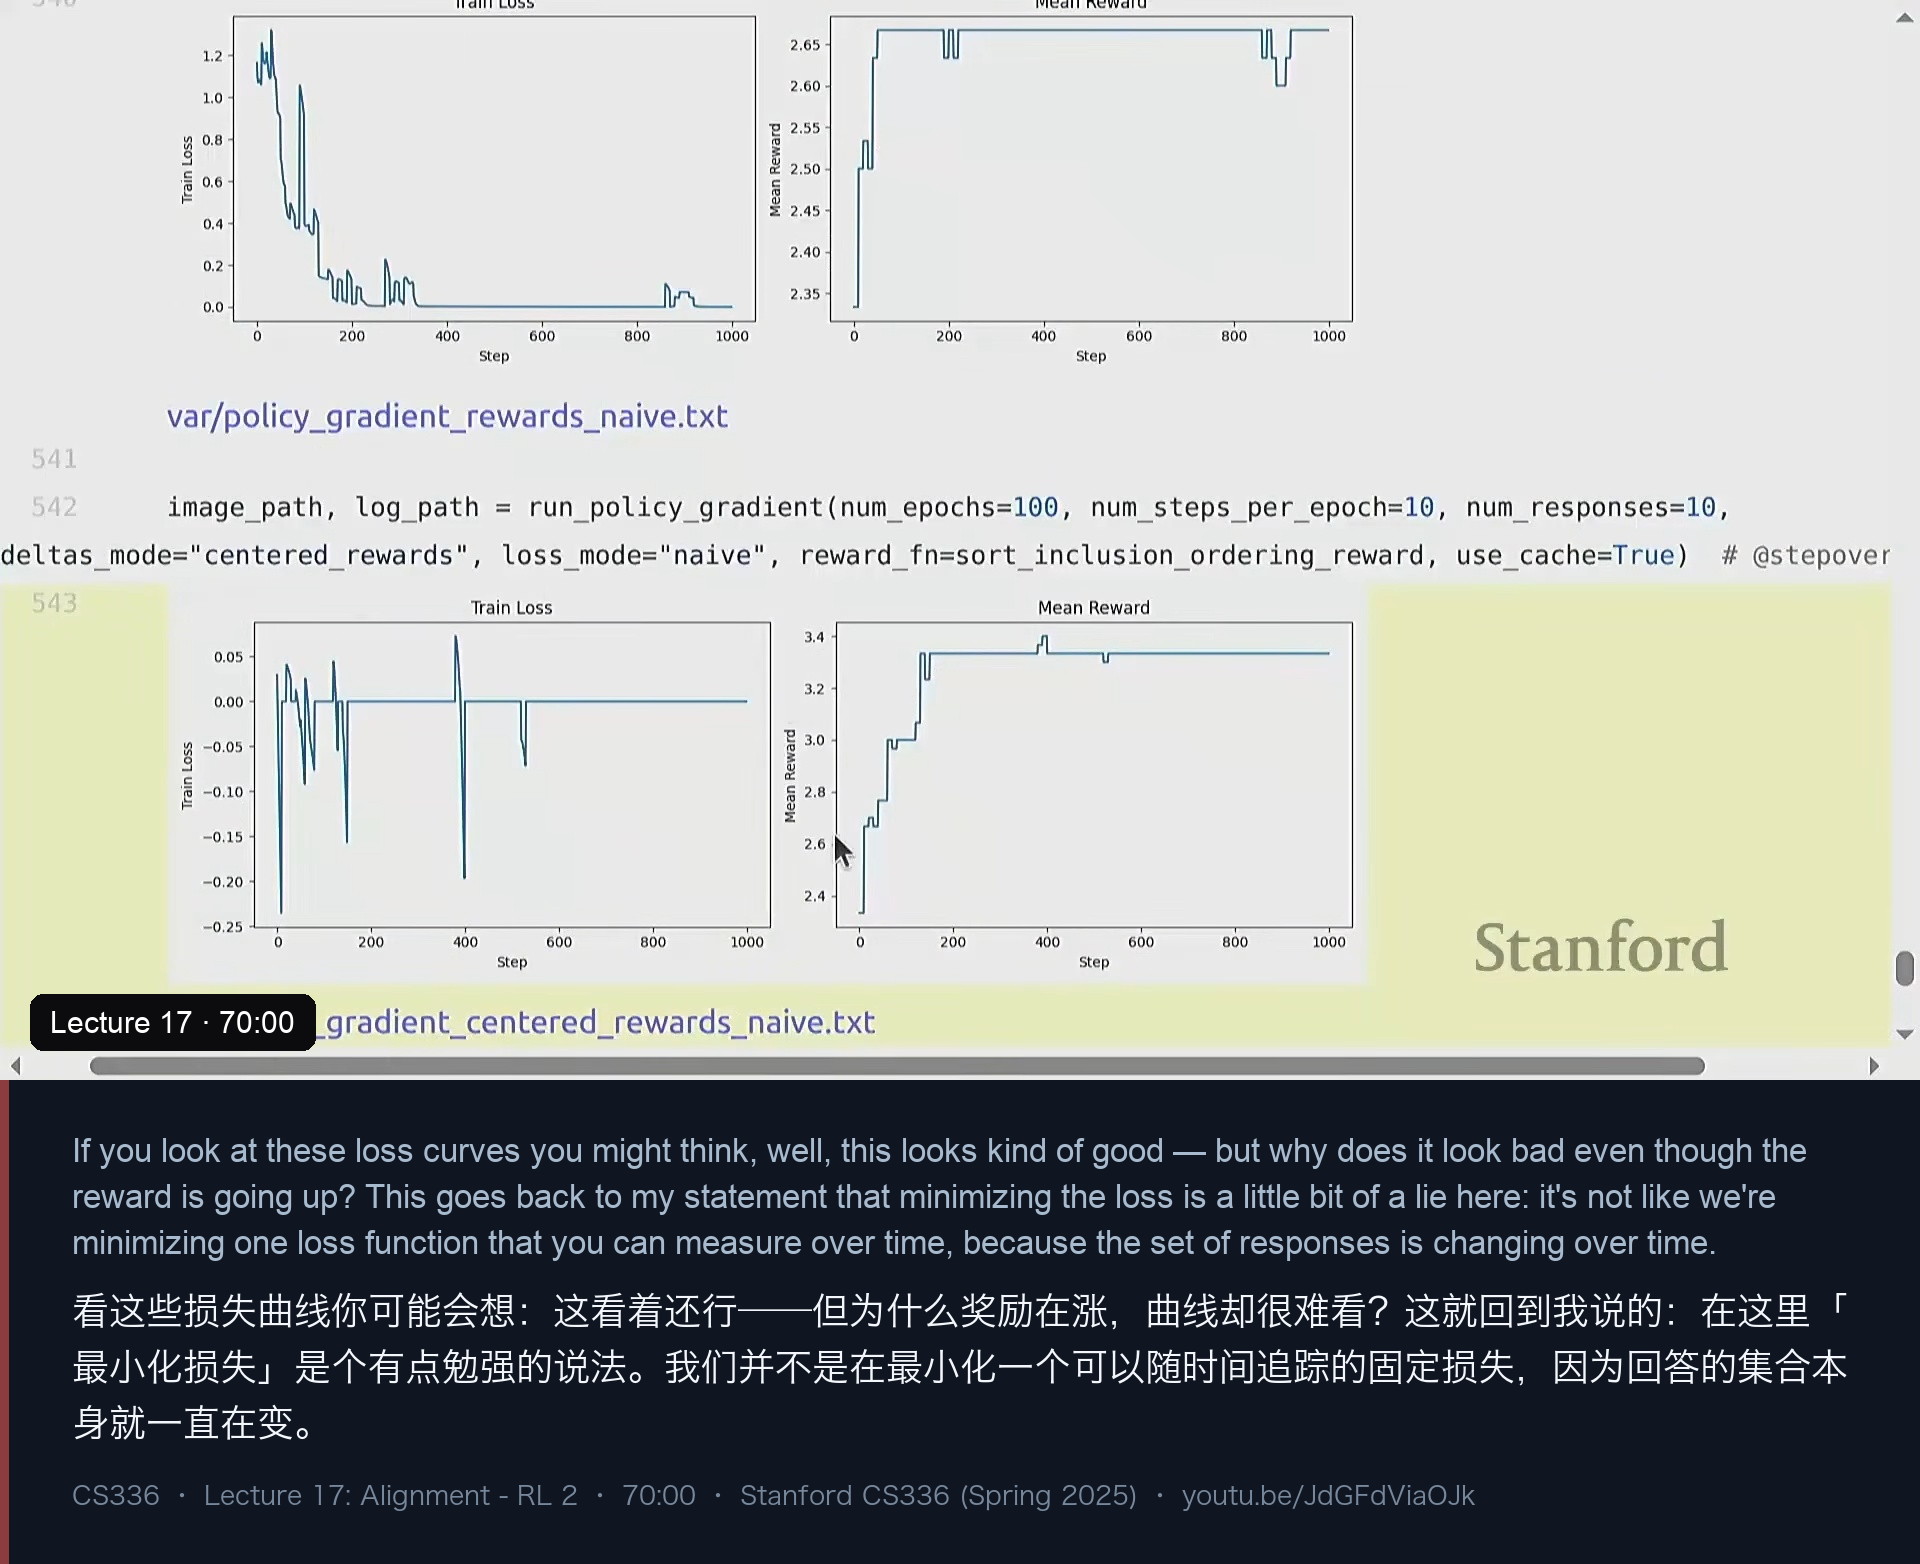
但这一节最重要的观察是最后一个(图 17):看损失曲线,你可能会觉得“这不太行”——明明奖励在涨,损失却不好看;反过来,损失好看的时候奖励也未必涨。 讲师把原因说得很透:
“Minimizing the loss is a little bit of a lie here. It’s not like we were minimizing one loss function that you can measure over time, because the set of responses is changing over time. You don’t really have a reference point for the same loss.”
这个“损失”面对的是一批不断变化的回答:模型越自信地生成某种回答,损失就只在“它自己生成的那些东西”上被衡量——这是一种自我循环(self-circular)。所以他给出了实务结论:在这个范式里,监测 loss 的意义有限;你真正能依赖的信号是奖励(或者,如果你有的话,一个固定验证集上的奖励)。
九、收尾:能度量就能优化,但奖励要不可 hack
课程最后,讲师把这门课(也是这一讲)的落点讲了一遍,我认为值得原样记下(图 18):
“Reinforcement learning is really the key to making models that actually surpass human abilities … because labeled data is only going to get you as far as mimicking the behavior that’s presented in the label data. If you can measure it, you can optimize it.”
- 强化学习是“超越人类”的关键:标注数据的天花板是模仿标注里呈现的行为,你不可能从“模仿”里得到超越示范者的能力;
- “只要能度量,就能优化”:这是 RL 的威力所在,也是这一讲那个排序玩具任务想演示的事——奖励一设计好,优化本身反而变成一个可以真跑的问题;
- 但紧接着是更大的问题:怎么设计出不可 hack(non-hackable)、又能泛化的奖励? 讲师明确说这是一个非常活跃的研究方向。前面那个“留了漏洞的部分分奖励”就是这个问题的迷你演示。
他也如实评价了自己的实验:“排序其实不难,而且我只在笔记本上跑了 20 秒,所以你别指望它有多好”——这句话本身也提醒我们:算法能跑通 ≠ 结果可用。
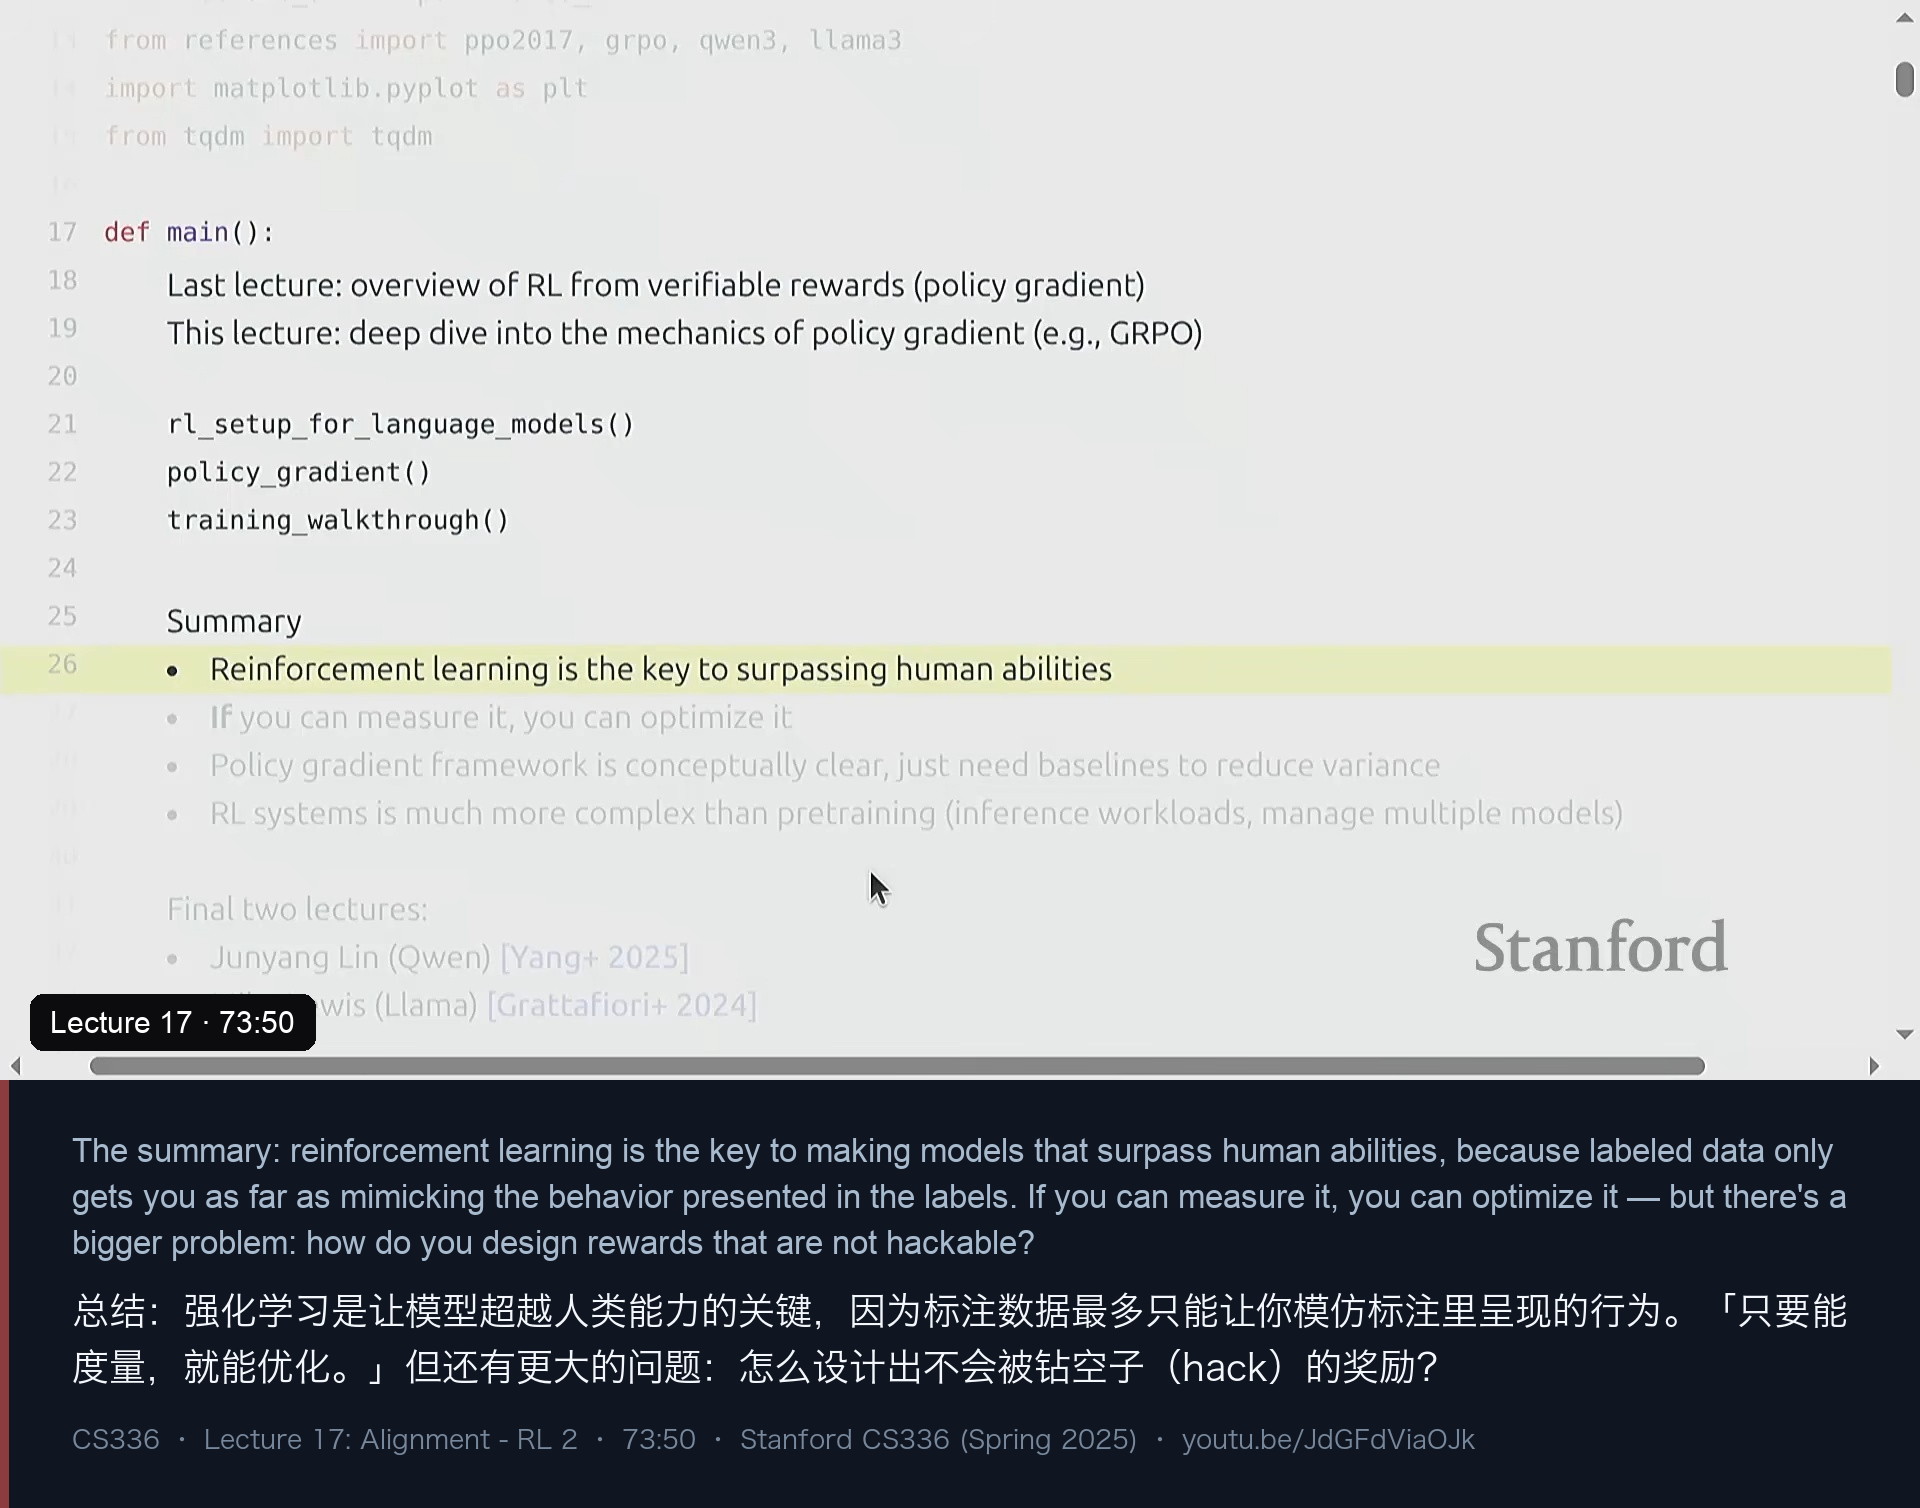
最后一段是工程现实,讲师承认这是他没能展开、但“其实很重要”的部分:构建与扩展 RL 系统,比预训练复杂得多。原因是一连串的“多”:必须做推理(延迟、吞吐、采样策略本身就是大坑);必须同时管多个模型(策略 π_θ、PPO 的 critic、正则用的 π_old 与 π_ref);还要有推理 worker,把权重运过去;奖励来自环境或 agent 时还得把环境跑起来;而这一切都要并行、分布式地协同工作。他说这些内容这门课没时间讲,但“如果你感兴趣,我可以给你指路”。这一讲到此结束——全课也就此结束。
我的笔记
- 这一讲是全课的“显影液”。 上一讲把 RLVR 讲成了路线图和三个案例,这一讲把同一套东西放大到代码级别;两讲合起来才完整。如果只记一句话:策略梯度就是一个模板
∇log π × Δ,所有算法都只是 Δ 的不同取法(图 9)。 - “朴素策略梯度 = 被奖励加权的 SFT” 是我在这一讲里收获最大的一个类比(图 4)。它把 RL 从“神秘的新范式”拉回到“你早就会的东西,只是数据是自己生成的、每一项乘了奖励”。唯一的真正新增复杂度是:数据集在变。
- 稀疏奖励让梯度“物理性消失”(图 5):得零分的样本连梯度都不产生,于是策略差到一定程度就根本没有学习信号。这比“方差大”严重得多——方差大只是学得慢,梯度为零是学不了。这也解释了为什么 RLVR 里奖励设计(部分分、难度筛选)几乎和算法一样重要。
- 基线是一个“什么都不牺牲”的变换:
E[R]和E[R − B(s)]的优化目标完全相同,只要 B 不依赖动作(图 7)。它不改变你要去哪里,只改变你走得多稳——两状态例子里方差从 5.3 掉到 1.1(图 8)。 - 最优基线不必去求。 闭式解牵扯协方差,实践中用一个启发式就够:B(s) ≈ E[R|s](图 9)。这个启发式恰好把“减基线”变成优势函数 A = Q − V,也就是说 RL 里到处在用的 advantage,本质上就是“一个没说出口的基线”。
- GRPO 的“组”是语言模型送的礼物(图 10):同一个提示词采样多条回答,组内均值天然是难度基线。讲师说得明白——经典 RL 里没有这种结构,所以那里只能回到 value function。理解这一点,“删掉 critic 还能工作”就不神秘了。
- 冻结(no_grad)是这一讲最实用的工程警告(图 14 一带):如果 π_old 也在计算图里,
p/p_old恒为 1、梯度恒为 0,训练会安静地失败。这类“看起来对、其实没梯度”的 bug 在 RL 里特别多,因为同一个模型会有多个版本同时在场。 - 部分分奖励是双刃剑(图 17):它给了早期的学习信号,但也让模型可能停在“分数很高的错误答案”上。讲师那句“我给了 4 分,但它并没有解决问题”,是所有自己做奖励的人的提醒。
- “最小化损失是个善意的谎言”(图 17)是我认为这一讲最深刻的一句。RL 里没有固定的数据集,所以没有一个可以随时间追踪的损失函数;loss 只在你刚刚采样的那批回答上有意义,是自我循环的。能依赖的只有奖励——这也是我以后不会再盯着 RL 的 loss 曲线做判断的原因。
- 收尾的两句话可以刻在门上:“只要能度量,就能优化”(威力所在)+“但奖励不能被 hack”(难点所在)。前者是 RL 的引擎,后者是它的方向盘。
- RL 的工程复杂度被严重低估了。 讲师列出的那张“多模型 + 推理 worker + 环境 + 分布式”的清单(见第九节)值得每个想做 RLVR 的人先看一眼:算法只有一页纸,系统却是一整个机房。
附:课程信息与时间轴
- 课程:Stanford CS336《Language Modeling from Scratch》(Spring 2025)
- 本讲:Lecture 17 — Alignment: RL 2(Policy Gradient / GRPO 的机制详解)
- 主讲:Percy Liang(全课最后一讲)
- 时长:1:16
- 视频:https://www.youtube.com/watch?v=JdGFdViaOJk
| 时间 | 内容 |
|---|---|
| 00 | 开场:全课最后一讲;本讲深入策略梯度与 GRPO 的机制 |
| 00 | 本讲定位:不引入新内容,把上一讲的材料做深,看代码也看数学 |
| 00 | 语言模型 RL 的设定:状态 = 提示词 + 已生成回答 |
| 01 | 动作 = 生成下一个 token;奖励 = 回答有多好;策略 = 微调后的语言模型 |
| 01 | 只讲结果奖励与可验证奖励;折扣与自举在此不适用 |
| 01 | 奖励稀疏且延迟的代价与概念上的简化;数学题的例子 |
| 02 | 转移动力学就是“加上去”,因此可以做规划 = 测试期计算 |
| 03 | “状态”是被构造出来的;机器人受限于外部世界,语言模型不受限 |
| 04 | 难点不是到达某个状态,而是 token 是否导向正确答案 |
| 04 | 策略的定义;rollout / episode / trajectory 的多种叫法 |
| 05 | 目标:最大化期望奖励(对提示词与回答同时取期望) |
| 07 | 朴素策略梯度:采样提示词与回答、按奖励加权更新 |
| 07 | 它本质上就是 SFT,只是每一项被奖励加权 |
| 08 | 奖励为 0/1 时只更新答对的回答;差别是数据集在变 |
| 09 | 策略梯度的高噪声、高方差问题 |
| 09 | 稀疏奖励:绝大多数回答得 0,梯度为零、模型卡死 |
| 10 | 学生提问:数据集为什么会变?(每次更新后策略就变了) |
| 11 | 与 RLHF 的对比:偏好数据 + 学出来的奖励模型更连续 |
| 12 | 学生提问:为什么不把奖励设成 −1?基线会解决这件事 |
| 14 | 过程奖励 vs 结果奖励;语言模型里难有好过程奖励 |
| 14 | 这里的 reward model 就是“解析答案 + 比对答案表”的确定性函数 |
| 15 | 基线:用无偏但高方差的估计替代不可计算的期望 |
| 16 | 两状态玩具例子:S1 的 11/9 与 S2 的 0/2 |
| 17 | 为什么“高奖励”不等于“该被更新”;局部最优的陷阱 |
| 19 | 基线的定义:减去任意只依赖状态的 B(s) |
| 19 | 目标不变的证明:E[B(s)] 与策略无关 |
| 20 | 方差实例:无基线 5.3,取 B(S1)=10、B(S2)=1 后降到 1.1 |
| 22 | 学生提问:B(s) 可以用一个冻结策略吗?可以,但必须真的冻结 |
| 24 | 最优基线的闭式解很难算,实务上用启发式 |
| 25 | 启发式:B(s) = E[R |
| 26 | V(s)、Q(s,a)、优势函数 A(s,a) = Q − V |
| 27 | 基线选 E[R |
| 28 | 通用模板:∇log π(a |
| 29 | GRPO 的具体形式不重要;推荐 Chelsea Finn 的 Deep RL 课 |
| 30 | 定义一个简单任务并用代码真跑一遍 |
| 32 | 为什么会有 GRPO:语言模型天然提供“组结构” |
| 33 | 玩具任务:给 n 个数字排序 |
| 34 | 两种奖励设计:稀疏的 0/1 vs 位置匹配的部分分 |
| 36 | 更细的部分分:输入 token 出现在输出 + 相邻有序对;留了漏洞 |
| 37 | 简单模型:每位置一套参数、非自回归、各位置独立解码 |
| 38 | forward 走读:嵌入 → 逐位置编码求和 → 逐位置解码 → logits |
| 41 | 采样:摊平 batch×position,采 num_responses 条回答 |
| 43 | 对每条回答算奖励 |
| 43 | compute_deltas:奖励 → Δ 的三种选择 |
| 44 | 中心化的作用:把得 0 分的回答变成负 Δ,自动“推开” |
| 45 | 一组奖励全相同时 Δ 全为 0,于是“弃权”不更新 |
| 46 | 变体:把非最大值的奖励置零(全有或全无) |
| 47 | 计算回答的 log 概率 |
| 49 | 朴素损失:-mean(Δ × log π) |
| 50 | 冻结参数:p/p_old 不冻结会恒为 1、梯度恒为 0 |
| 52 | 学生提问:为什么不按位置折扣?信用分配是 RL 最难的问题 |
| 53 | GRPO 损失:重要性比率 × Δ,裁剪到 1±ε 后取 min |
| 56 | KL 惩罚:定义与低方差估计的动机 |
| 56 | KL 的等价改写:q/p − log(q/p) − 1(因为 E[q/p]=1) |
| 58 | KL 实现细节:词表维求和、batch/trial/position 维取平均 |
| 59 | 完整训练循环:外层 epoch、内层多步、参考模型冻结 |
| 01:03 | 三个模型:reference / old / current |
| 01:04 | 显存不对称:reference 要存整份模型,old 只需存 log prob |
| 01:04 | 学生提问:为什么 KL 对着 reference 而不是 old? |
| 01:07 | 学生提问:内层第一步 π_old = π_θ 时还会更新吗?会,且不会被裁剪 |
| 01:07 | 真跑实验:100 个 epoch × 10 步,朴素版的奖励停在 3 分 |
| 01:08 | 中心化版:平均奖励更高,把好的往上推、差的往下压 |
| 01:11 | 部分分是双刃剑:4 分很高,但并没有解决问题 |
| 01:12 | 归一化没有带来太多差别,略过 |
| 01:12 | 最小化损失是个“善意的谎言”:回答集合在变,loss 只能自恋 |
| 01:13 | 收尾:RL 是超越人类能力的关键;能度量就能优化 |
| 01:14 | 政策梯度框架回顾 |
| 01:14 | RL 的系统与扩展远比预训练复杂:推理、多模型、分布式 |
| 01:15 | 结束语 |
讨论
这里是静态站点,没有内嵌评论区。如果这篇文章对你有用,欢迎通过 RSS 订阅后续更新。