Stanford CS336 第十六讲精读:Alignment——从 PPO 到 GRPO,再到 R1 / Kimi / Qwen3 的可验证奖励 RL
斯坦福 CS336(Language Modeling from Scratch, Spring 2025)第十六讲完整讲义,主讲 Tatsunori Hashimoto。这一讲先把 RLHF 收尾(DPO 的梯度形状、SimPO 与长度归一化、过优化与校准度崩塌),然后正式转向 RL from verifiable rewards:从最朴素的策略梯度推到 PPO、再推到删掉 value model 与 GAE 的 GRPO;接着逐条拆解 GRPO 的两个理论瑕疵(除以标准差、按长度归一化)以及 Dr. GRPO 的修正;最后用三个案例——DeepSeek-R1、Kimi k1.5、Qwen3——对比同一套思路下不同的配方:奖励怎么设、数据怎么筛、思维链长度怎么控、thinking 模式怎么融合。
本篇属于系列 Stanford CS336 精读 · 第十六讲
来源:YouTube 原视频(Stanford Online · CS336 Language Modeling from Scratch · Spring 2025 · Lecture 16: Alignment - RL 1)
来源说明 这是斯坦福 CS336《Language Modeling from Scratch》2025 年春季第十六讲的完整讲义,主讲人是 Tatsunori Hashimoto。这是后训练两讲中的第二讲:前半段把上一讲(第十五讲,SFT / RLHF)剩下的尾巴收干净,后半段整讲都在讲 RL from verifiable rewards(RLVR)——也就是“用可自动判定对错的奖励来做强化学习”这条路,它是 o1 / R1 这一代推理模型背后的训练范式。
全文按讲课顺序逐段整理:先收尾 RLHF(DPO 的梯度、两个变体、过优化与校准度两个警告),再从最朴素的策略梯度一步步推到 PPO、再到 GRPO,然后逐条拆解 GRPO 的两个理论瑕疵,最后用 DeepSeek-R1、Kimi k1.5、Qwen3 三个案例对比不同配方。文中 18 张配图均截取自视频对应时刻的画面,并把该时刻的完整观点句(英文原句+中文翻译)拼合进图里。
需要特别提醒:文中出现的所有数字——GRPO 里
epsilon = 1e-4、PPO 的 clip 区间约 0.2、R1 用约一百万条思维链做蒸馏、蒸馏后 32B 模型在 AIME 上提升 25 个百分点以上、讲师自己学生用 1000 条长思维链微调 Qwen 2.5、Kimi 每道题生成 10 个答案并只保留 best-of-8 失败的样本、Qwen3 的推理 RL 只用了 3,995 条样本、以及“R1 让英伟达市值损失约五亿美元”这类说法——全部是讲师课上的口播、幻灯片演示或对公开论文/新闻的转述,是讲师引用的公开传闻或估算,不是本文独立核实的事实,请以原始论文与公开材料为准。另外,自动字幕把不少专有名词听错了:
PO/PPO是 PPO,gpo/gRPO/GPEO是 GRPO,RHF是 RLHF,coot/cot是 CoT(思维链),Kimmy/Kim K 1.5是 Kimi k1.5,Quen/Quinn/Qen是 Qwen,01/O1/open AIO1是 OpenAI o1,deepseeek/deep sea car是 DeepSeek,doctor gpo/Dr. GRPO是 Dr. GRPO,PROM/PRM是 PRM(过程奖励模型),Amy是 AIME,GSMAK是 GSM8K,Senardau/Schnaderau指 Schulman 等人的 GAE,VLM在讲 infra 时其实是 vLLM,下文按通行写法记录。最后一句方法论:这一讲最值得记住的不是“GRPO 比 PPO 好”,而是奖励信号的性质决定你能做什么——当奖励可以自动、廉价、大规模地判定对错时,强化学习才真正开始工作;而剩下的一切工程细节(怎么归一化、怎么控长度、怎么筛数据)都是在跟这个奖励的“形状”打交道。
TL;DR
- 上一讲停在 DPO,这一讲先把它收尾。 DPO 把 RL 问题换元成了一个最大似然问题,梯度长得非常直白:reward 估错得越多、权重越大;抬高好样本的似然、压低坏样本的似然。它一度是开源模型后训练的默认选择,理由只有一个字:好用。
- DPO 之后是一整片“变体海洋”,讲师只挑了两个介绍:SimPO(按回答长度归一化更新幅度,并直接把参考策略这一项删掉)和 length-normalized DPO(保留参考项、只做长度归一化)。其中“按长度归一化”这个想法,会在这一讲的 GRPO 里再次出现,并且再次出问题。
- 别把任何单个后训练实验结果当圣旨:同样的 DPO vs PPO 对比,在 AI2 早期工作里 PPO 更好,在 Tulu 3 里却因为 SFT 做得更好而“两边都吃不到增益”。结论依赖环境、基座模型与偏好数据,换一个设置就换一个答案。
- 收尾 RLHF 的两个警告:其一,过优化(overoptimization)——你优化的只是代理奖励,它迟早会和真实人类偏好分道扬镳,本质就是“取了花哨名字的过拟合”;其二,校准度崩塌——RLHF 已经不是在做概率建模,模型(尤其在温度 1 时)会变得过度自信,别把它当成校准过的概率模型来用。
- 为什么转向可验证奖励:人类偏好又难优化、又难扩展、又容易被 hack;而 AlphaGo / AlphaFold 这类 RL 真正大获成功的领域有一个共同点——我们知道真实奖励,并且能快速、廉价、大规模地评估它。于是思路变成:去找一个能自动判对错的领域(数学、代码、形式化证明),然后把 RL 的全部威力用上去。
- PPO 是一头“理论温顺、实践凶暴”的怪兽:目标函数只是“策略梯度 + 重要性比率 + 裁剪”,看上去很干净;但实践里你需要一个和策略同量级的 value model(显存翻倍)、需要 GAE、需要处理 reward / value / policy 三套 tokenizer 的重对齐,还有人专门写了《PPO 的 37 个实现细节》。更微妙的是:一旦你用了裁剪,它就不再是 KL,也不是严格的策略梯度了——但通常效果更好。
- GRPO 的全部创新只有一句话:删掉 value model 和 GAE,把优势函数换成一个组内的 z-score。
A_i = (r_i − mean(组)) / std(组)。组 = 同一个问题的 G 条回答;组内均值天然是一个“题目难度基线”,这正是 leave-one-out 基线的思想。好处是显存减半、实现极简,代价是它引入了两个理论上站不住的东西。 - GRPO 的两个“不合法之处”(Dr. GRPO 论文的修正):除以标准差破坏了“基线必须是零均值、与本次抽样独立的变量”这个约定,并且系统性地给“太简单”和“太难”(组内奖励全是 1 或全是 0、方差极小)的题目加权,与“应该给模型中等难度的题”这一直觉相反;按长度归一化则给出了一个恶劣激励——做错了就把回答写长、做对了就把回答写短,于是模型学会了“不会就拼命废话”。
- 两个修正都拿掉之后,在 GSM8K 这类任务上奖励一样好,但输出长度不再无限膨胀。讲师由此提出一个有意思但尚未完全证实的猜想:人们看到的那些“超长思维链”,可能有一部分是 GRPO 实现细节的产物,而不是推理能力本身的必需品。
- R1 的贡献是“极简配方 + 两个负面结果”:用 GRPO + 结果奖励(只判最终答案对错),不做搜索、不做过程奖励模型,就能复刻 o1 的大部分定性特征;而他们认真尝试过的 PRM 和 MCTS 都没有带来帮助。R1 完整版还多做了三件事:长思维链 SFT 初始化、语言一致性奖励(防止思维链中英混杂)、以及最后照旧叠一层 RLHF。
- Kimi k1.5 与 R1 同期、结果相近、算法不同:它从 DPO 式的非参数假设出发,把“最优策略应满足的等式”两边之差做成平方损失,梯度形式又落回“策略梯度 + 基线 + 正则”;它在数据侧做了更有意思的策展(只保留 best-of-8 都失败的题),并第一次把推理成本摆上台面——加了长度奖励,且只在训练后期打开。
- Qwen3 把“思考预算”做成了一个旋钮:训练一个同时支持
/think与/no-think的模型(thinking mode fusion),并可以用一句特殊字符串手动终止思考;于是同一个模型可以在“想多久”上连续调节。它的推理 RL 只用了 3,995 条样本——RLVR 的样本效率高得反直觉。
一、先把 RLHF 收尾:DPO 的梯度、两个变体和两个警告
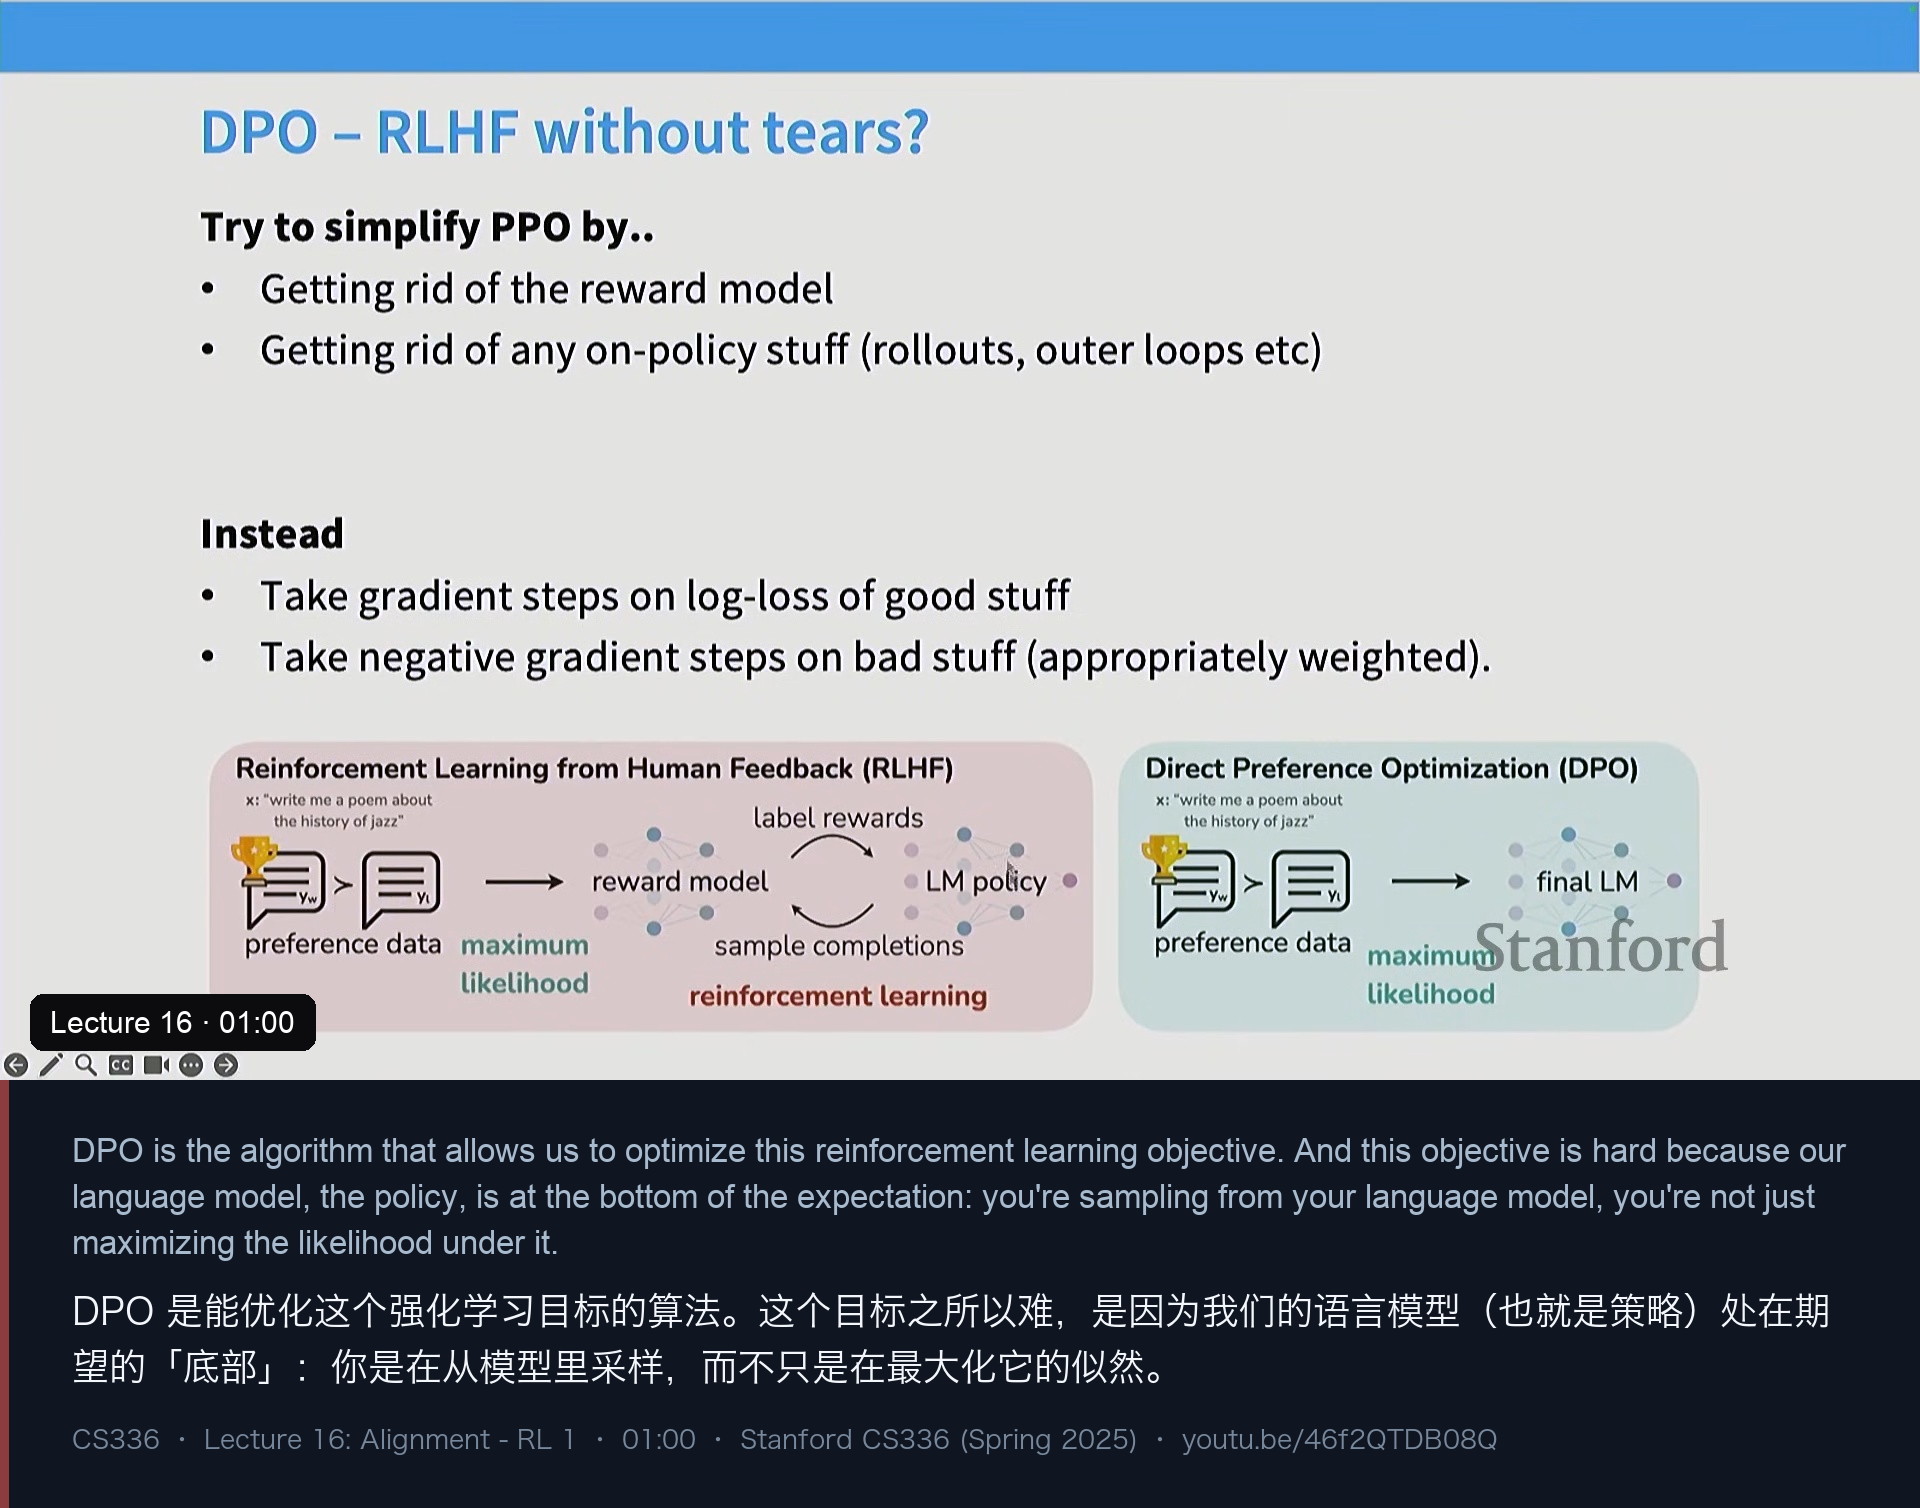
这一讲的开头是“补课”:上一讲因为时间关系,RLHF 的收尾没讲完。讲师用很短的篇幅把 DPO 复述了一遍,然后给了两个必须记住的警告。
DPO 的推导只有三步:在非参数假设下,最优策略可以写成 π* ∝ π_ref · exp(r/β),于是“隐式奖励”可以被反解成策略之比的对数;把它代回 Bradley-Terry 成对偏好的对数似然,就得到一个纯粹的监督学习目标。讲师强调这个目标的直觉:梯度是加权的,你越错、更新越大;更新方向永远是“抬高好样本、压低坏样本”。他把 RL 算法概括成一句话:“把好的往上加权、把坏的往下加权,所有难点都在于决定什么是好的、以及加权多少。”
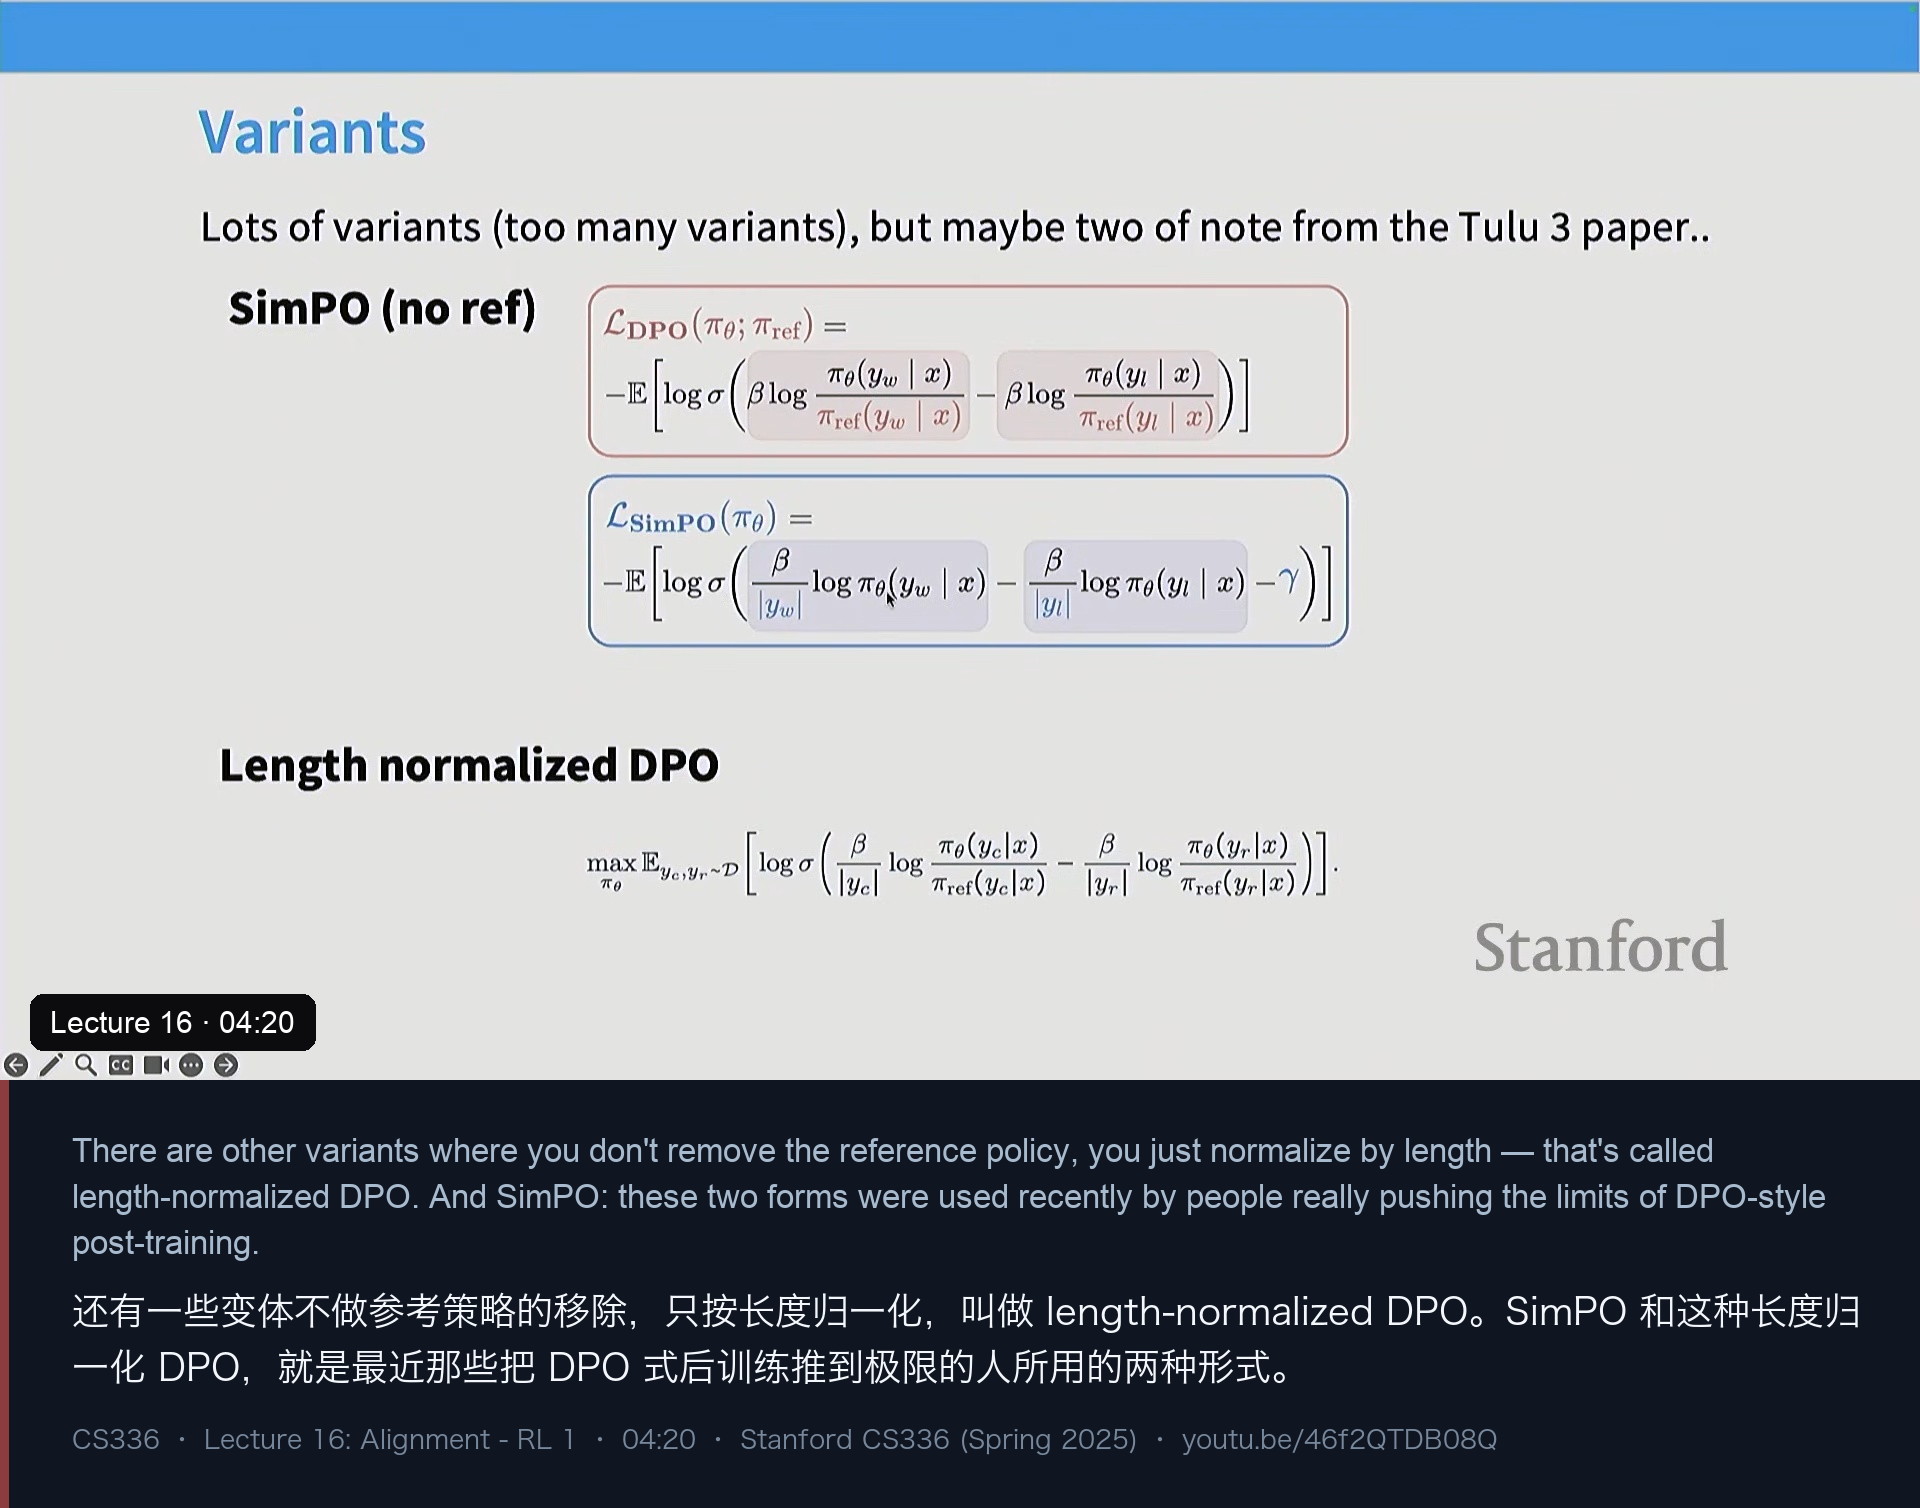
DPO 之后出现了几十上百篇”*PO“变体论文。讲师没有逐一介绍,只挑了两个他认为”最近真的有人在用“的:
- SimPO:做两处修改——按回答长度归一化更新幅度,并且去掉参考策略。去掉参考项意味着 DPO 那套“策略之比”的数学动机不复存在,剩下的更像一个纯粹的“好加权、坏加权”启发式。
- length-normalized DPO:保留参考项,只做长度归一化。
紧接着是一句非常值得抄下来的方法论提醒:不要相信任何单个后训练实验结果。 他举了 AI2 的例子——早期一项工作比较 DPO 和 PPO,结论是 PPO 更好(大概是因为 on-policy 的性质);但到了 Tulu 3,人们把 SFT 做得更好之后,PPO 和 DPO 的增益一起消失了。所以“哪个算法更好”这个问题,答案取决于环境、基座模型和偏好数据的构造方式。
然后是他真正想留下的两个警告。
警告一:过优化(overoptimization)。 把横轴看成“你把 RL 跑了多久 / 代理奖励被优化到多好”,纵轴看成“真实的人类胜率”,曲线是先升后降的:一开始代理奖励在涨、真实偏好也在涨;但继续压榨之后,被拟合的奖励模型开始偏离真实的人类偏好,于是你只是在“过拟合”。讲师把这称作“取了花哨名字的过拟合”,并说这是 RLHF 里到处都会出现的问题。他引用自己学生的一项研究:在真实人类偏好和带噪声的 AI 反馈上做 RLHF 都能看到过优化,而在干净无噪声的 AI 反馈上看不到——所以过优化的根因是人类偏好本身的噪声与复杂性,以及“训练集/测试集”意义上的有限样本 gap。
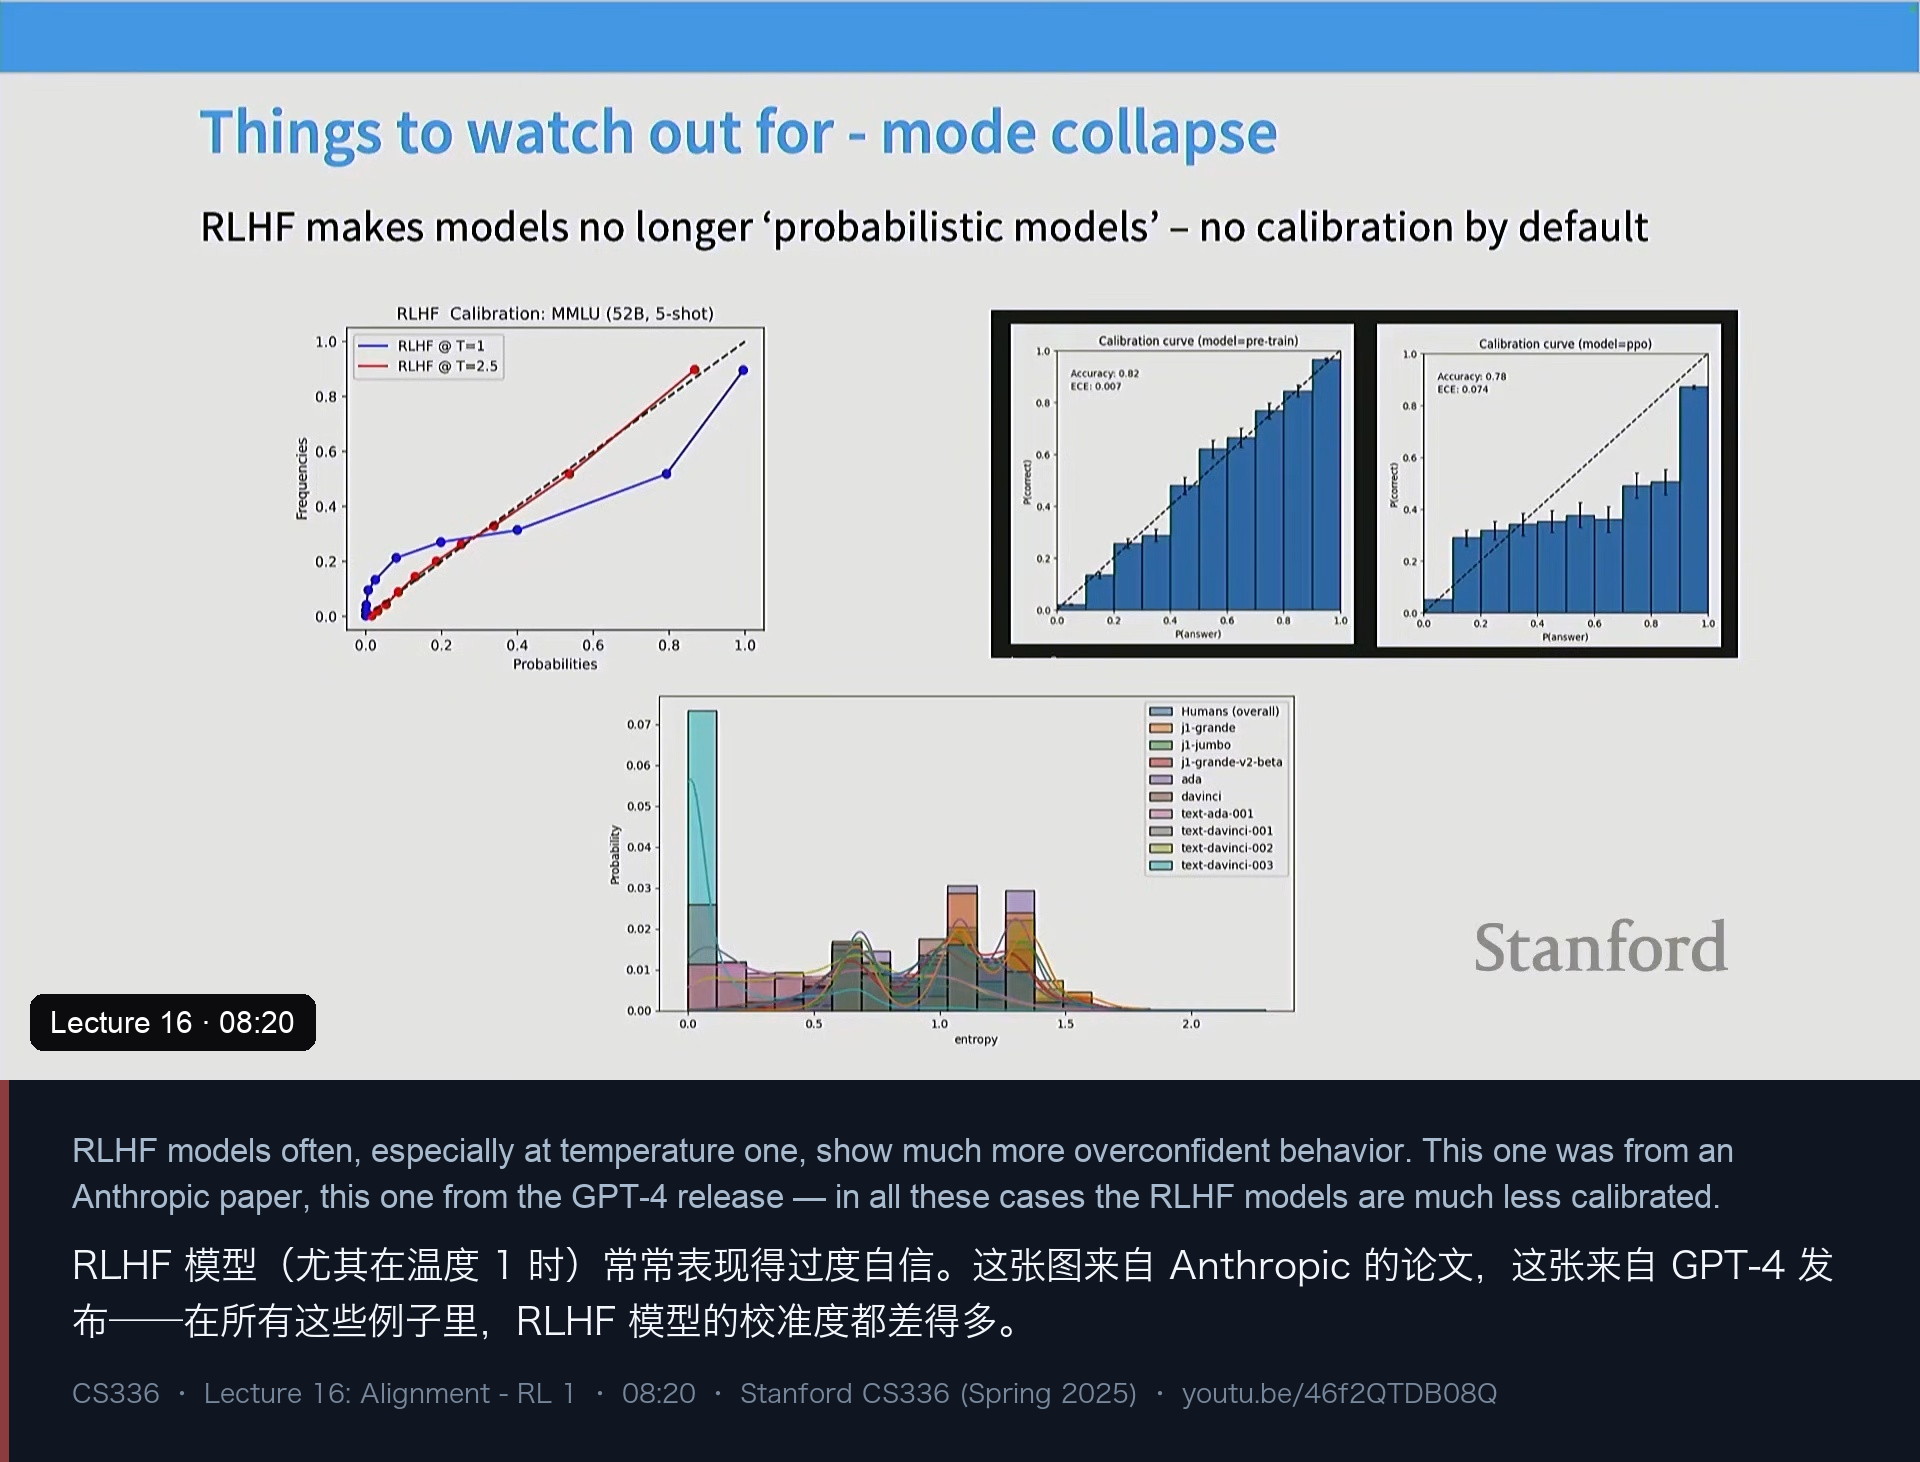
警告二:校准度崩塌。 预训练和 SFT 都是某种分布匹配,模型有理由输出一个像样的概率分布;但 RLHF 之后只剩一个“策略”,不再有必须建模的分布。后果是 RLHF 模型校准度明显变差,尤其在温度 1 下会表现出过度自信。讲师展示了 Anthropic 的论文、GPT-4 发布材料和他一位博士后的工作,三处都指向同一结论。他的态度很克制:“也许这没关系,因为校准度本来就不在你的奖励里——但你是从生成建模背景过来的,就别指望它还是一个校准过的概率模型。”
二、换一条路:从“人类觉得好”到“答案可验证”
收尾 RLHF 之后,这一讲换了主题。逻辑链条非常清楚:人类认可(human approval)容易被 hack、难以大规模收集、也难以大规模做 RL;那能不能换一个领域?
他给出的答案来自 RL 真正统治过的领域:AlphaGo、AlphaFold。这些领域的共同特征是——我们知道真实奖励,并且能快速、高效、大规模地评估它。如果能在语言模型里找到这样的领域,就可以把过去几十年 RL 的全部成功经验搬过来。
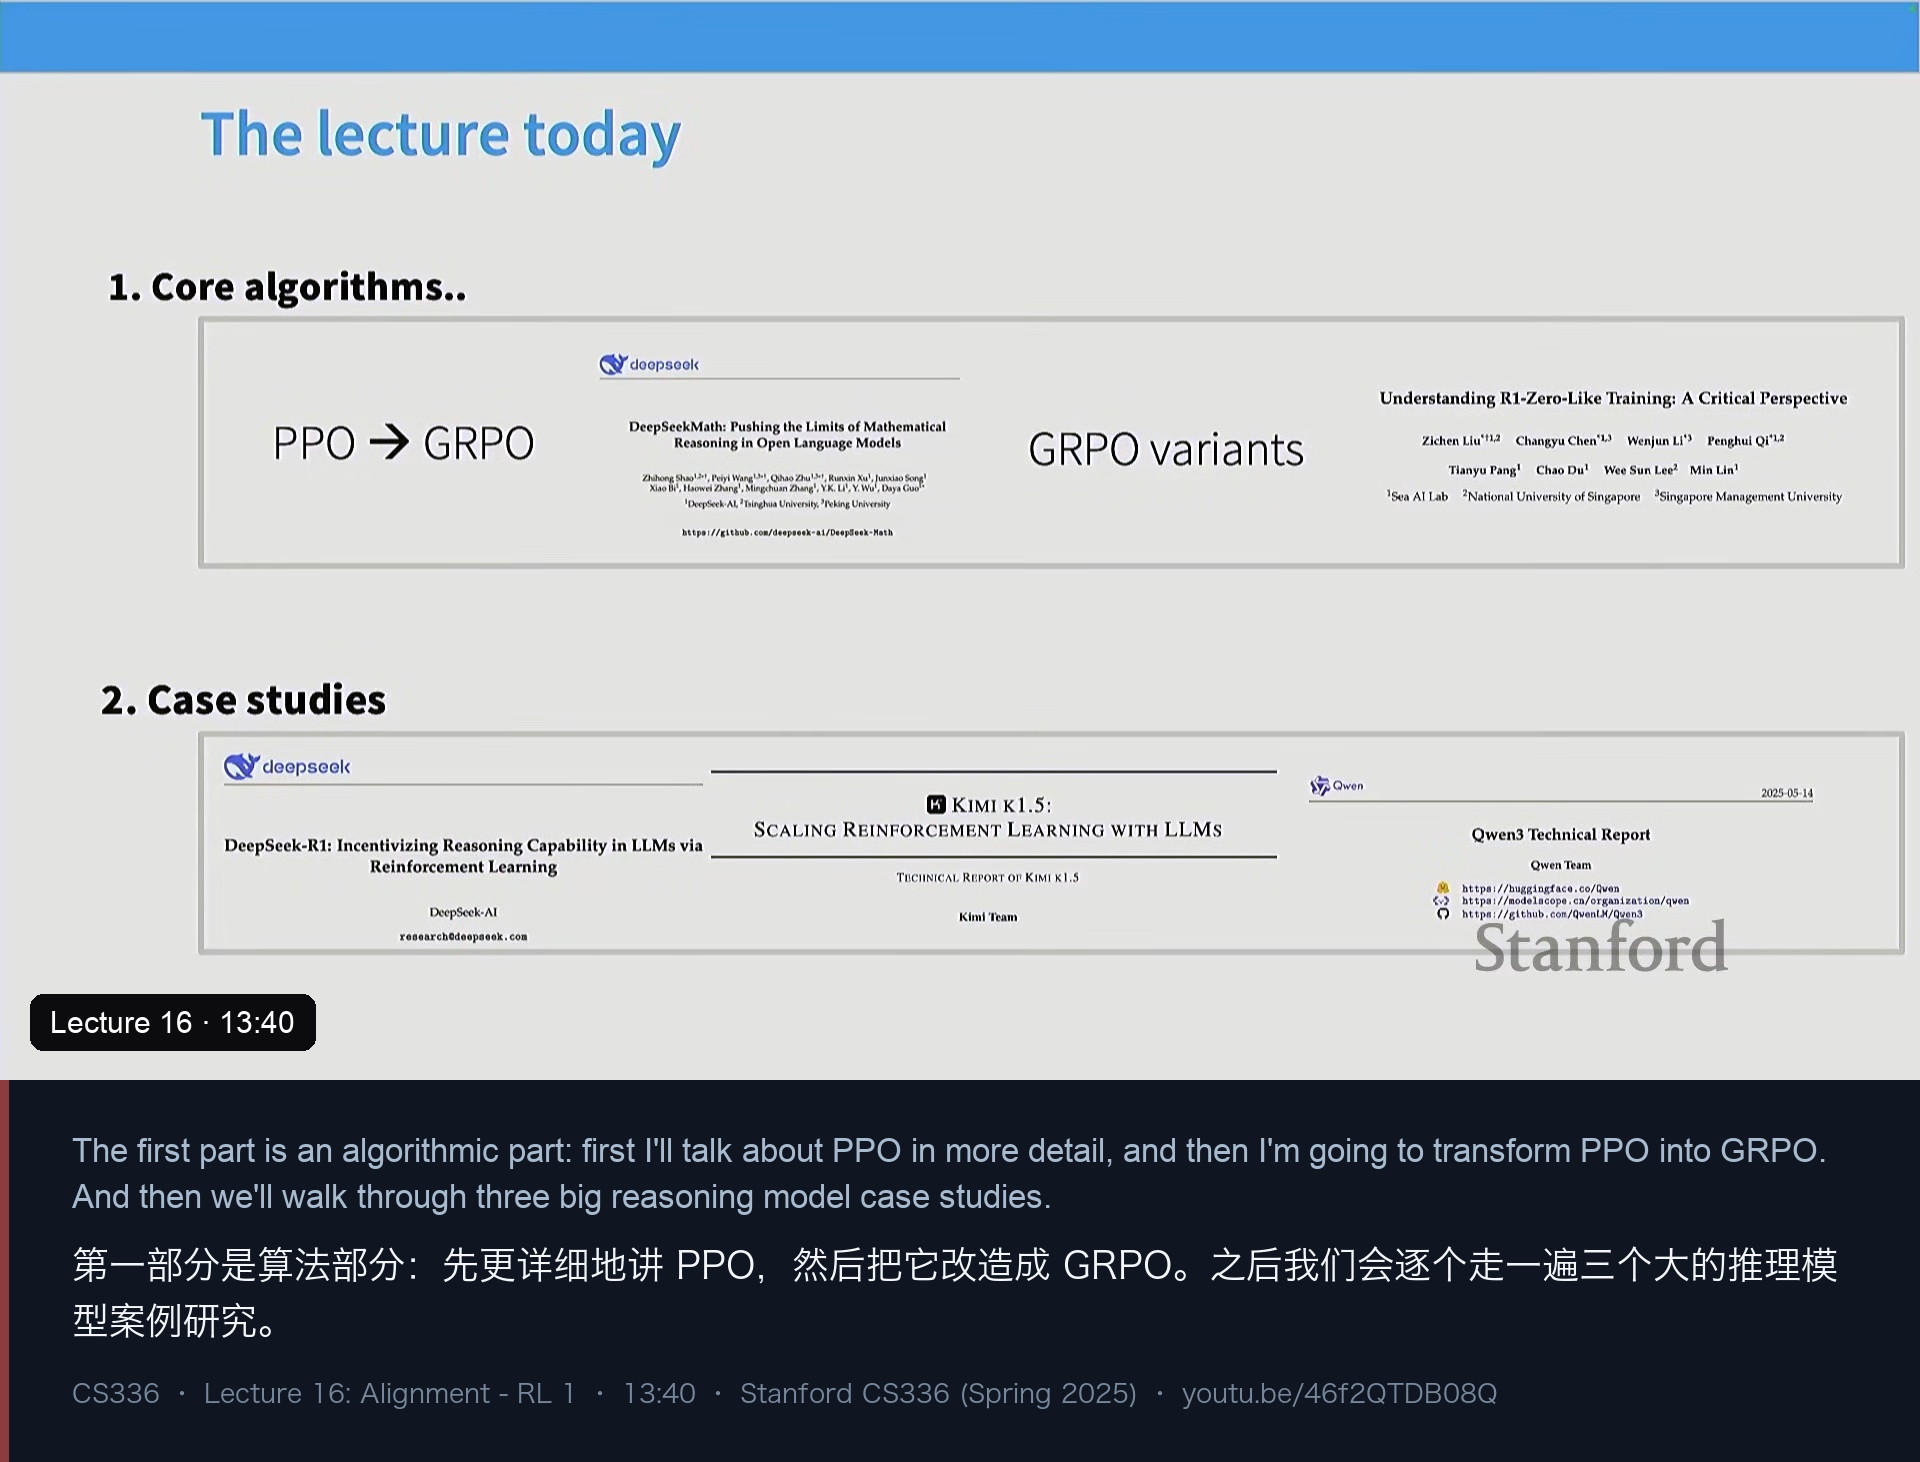
于是这一讲分成两部分:第一部分是算法(先把上一讲砍掉的 PPO 补完,再把它改造成 GRPO);第二部分是三个案例研究(DeepSeek-R1、Kimi k1.5、Qwen3)。讲师的承诺很直白:“讲完这两个部分,你至少能明白这三个中国开源模型是怎么造出来的。”
三、PPO:理论上一页纸,实践里是怪兽
要理解 GRPO 为什么存在,就必须先理解 PPO 痛在哪里。讲师把 PPO 的动机拆成一条渐进的链子:
- 最朴素的策略梯度:最大化
E_{z~p_θ}[r(z)],求导得到r(z) · ∇ log p_θ(z)。注意这里有一个隐式的 stop-gradient——不要把梯度也传进采样的p_θ里去,否则就错了。你只要算这个内层 loss、丢给 autograd,就能得到正确的策略梯度。 - TRPO:朴素策略梯度的方差很高,而且一次采样只能更新一步,太浪费。TRPO 加一个 KL 约束,做一点 off-policy 到 on-policy 的修正(重要性比率),让一次采样能多走几步。
- PPO:把 KL 约束换成”裁剪“。当新老策略的概率比超出
[1−ε, 1+ε]时,优势被裁掉,于是”继续把策略推远“就没有额外收益。讲师说这是一个软约束:一旦你走了太远,奖励就被封顶,算法自然没有动机离开当前策略。
PPO 在真实 RL 任务里非常成功(OpenAI 的 DotaBot 就是例子)。但讲师反复强调:PPO 理论上的样子和实践中的样子是两回事。 那个著名的博客标题《PPO 的 37 个实现细节》就是最好的注脚;他甚至提到有人写过论文论证——如果实现细节搞砸了,你算的其实已经不是策略梯度了,但效果反而更好。
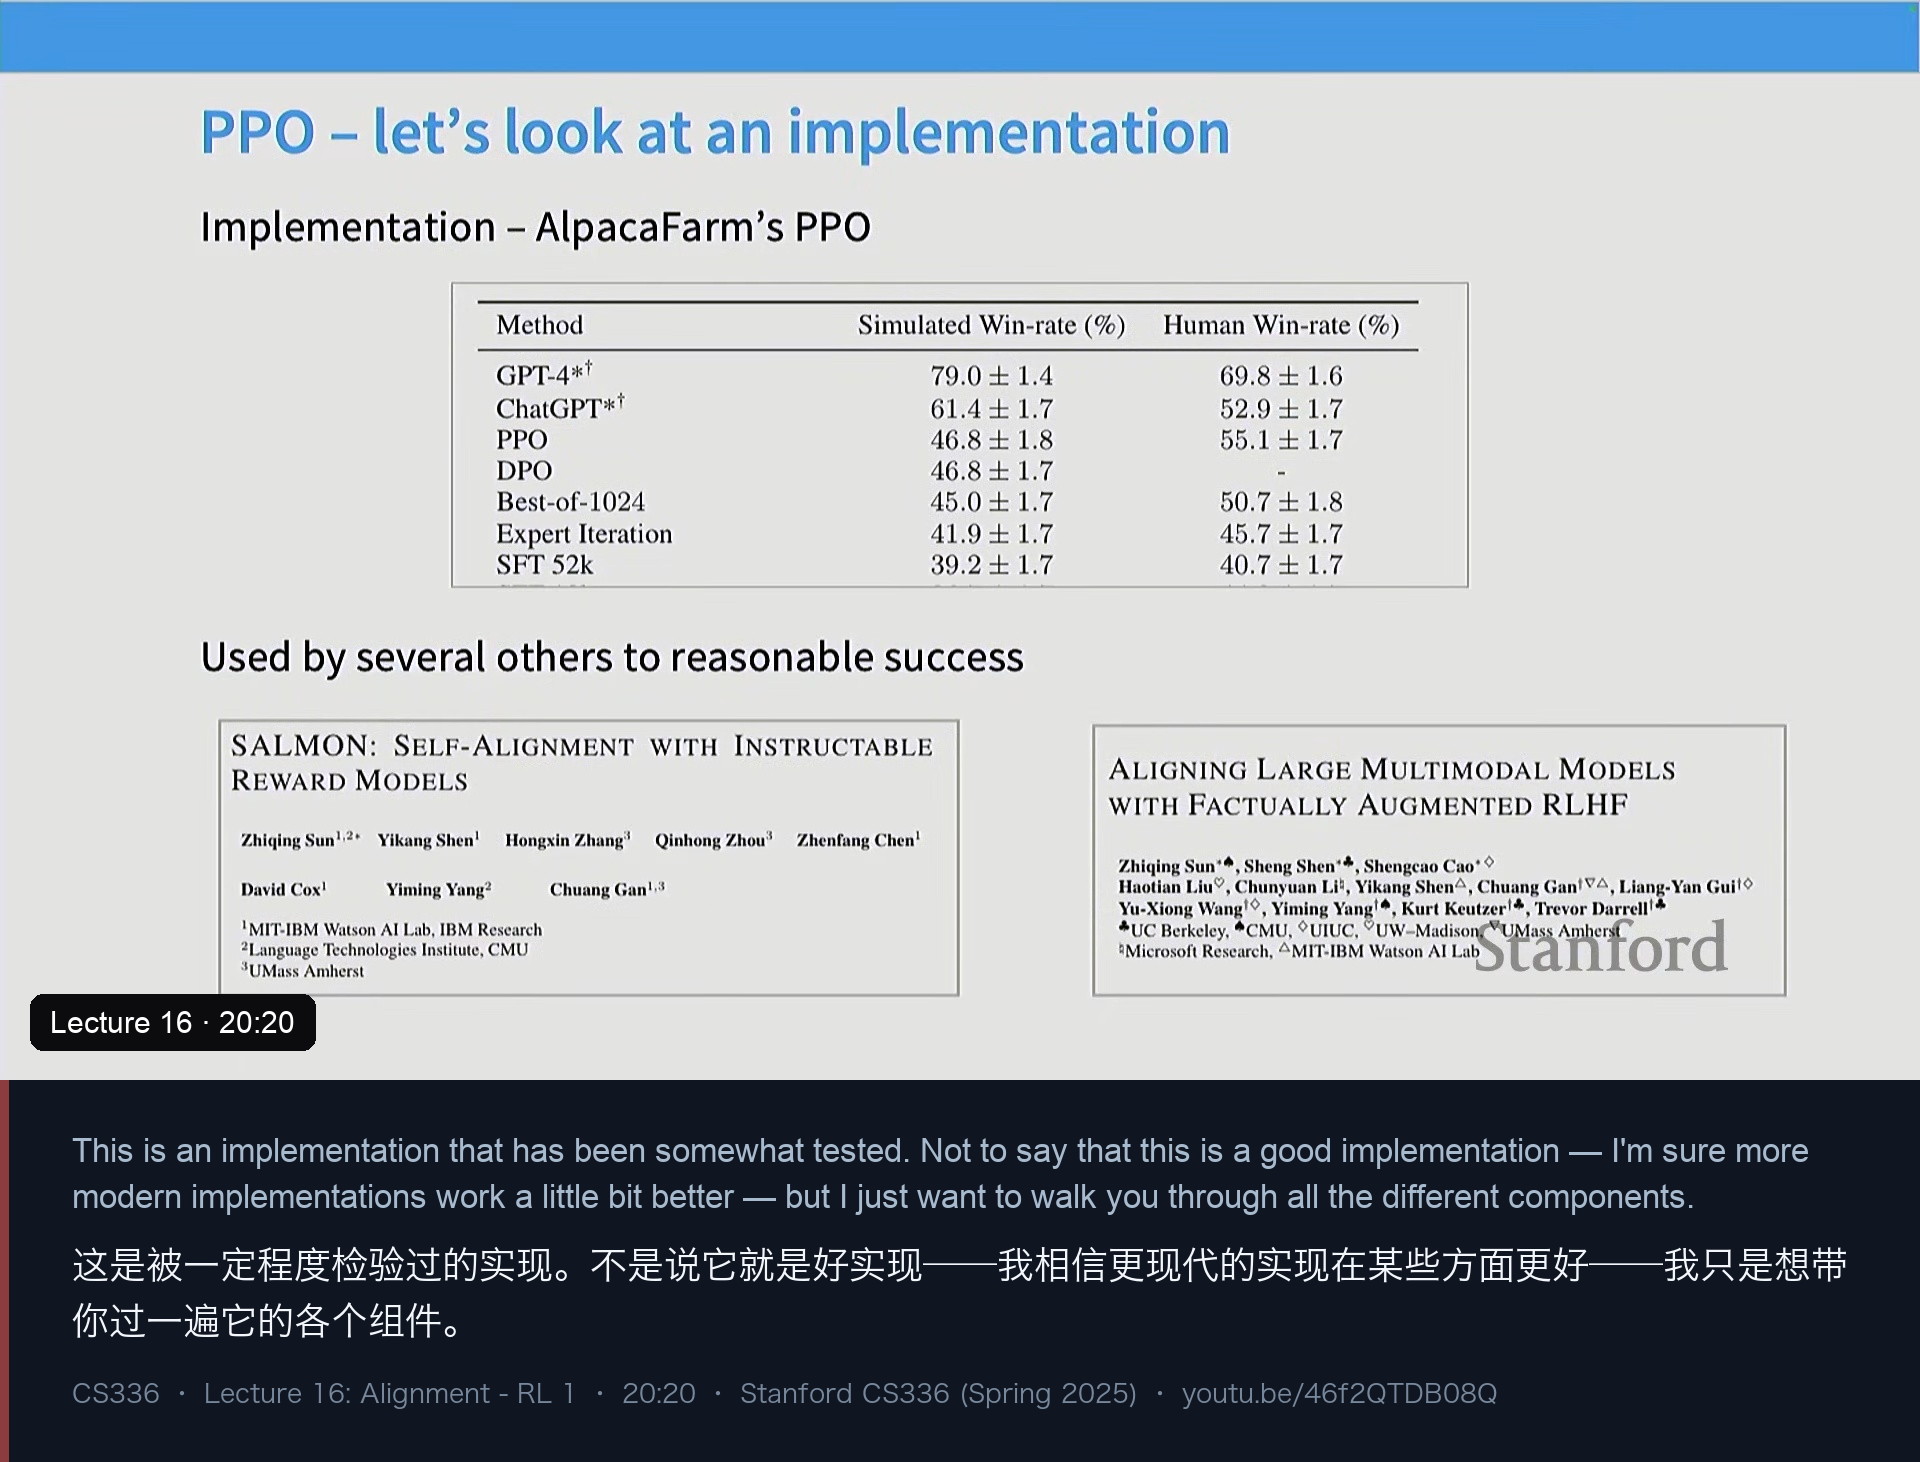
他带着听众过了一遍自己学生当年那个“被一定程度检验过”的 PPO 实现:外层循环和普通梯度更新没什么区别(采样 rollout → 算 loss → backward → 带 clip norm 的梯度步);损失里同时更新 value function 和 policy,并把概率比裁在 1±ε(典型的 ε 取 0.2,也就是 0.8 到 1.2 之间);rollout 环节唯一的小麻烦是 value / reward / policy 可能用不同的 tokenizer,需要重新对齐 token。
真正“凶暴”的地方在于两处:
- 语言模型的 RL 其实是一个 contextual bandit:给一个 prompt、生成一个输出、立刻拿到奖励,没有状态转移、没有环境探索。所以你会看到一条相当平滑的奖励曲线,而不是经典 RL 那种剧烈波动的训练曲线。
- 奖励整形(reward shaping):KL 正则项是逐 token 算的,而真正的任务奖励(答对没答对)只在最后一个 token 上给一次。此外那个 KL 估计在数值上会取负,于是实现里常常在零处裁剪——讲师提醒:“在零处裁掉的就不再是 KL 了,只是 KL 的一个近似”,但大家都这么干。
还有一个必讲的组件是 GAE(广义优势估计):策略梯度的方差很大,与其直接用奖励乘梯度,不如用一个折现后的优势估计 A_t,并通过 λ、γ 在偏差与方差之间做权衡。他还给了一个很实用的简化:取 γ = λ = 1,整套东西就退化成“带基线的策略梯度”(用 R 减去隐含的 value),而且效果也不错。
最后他回答了那个顺理成章的问题——为什么不能直接用 DPO?
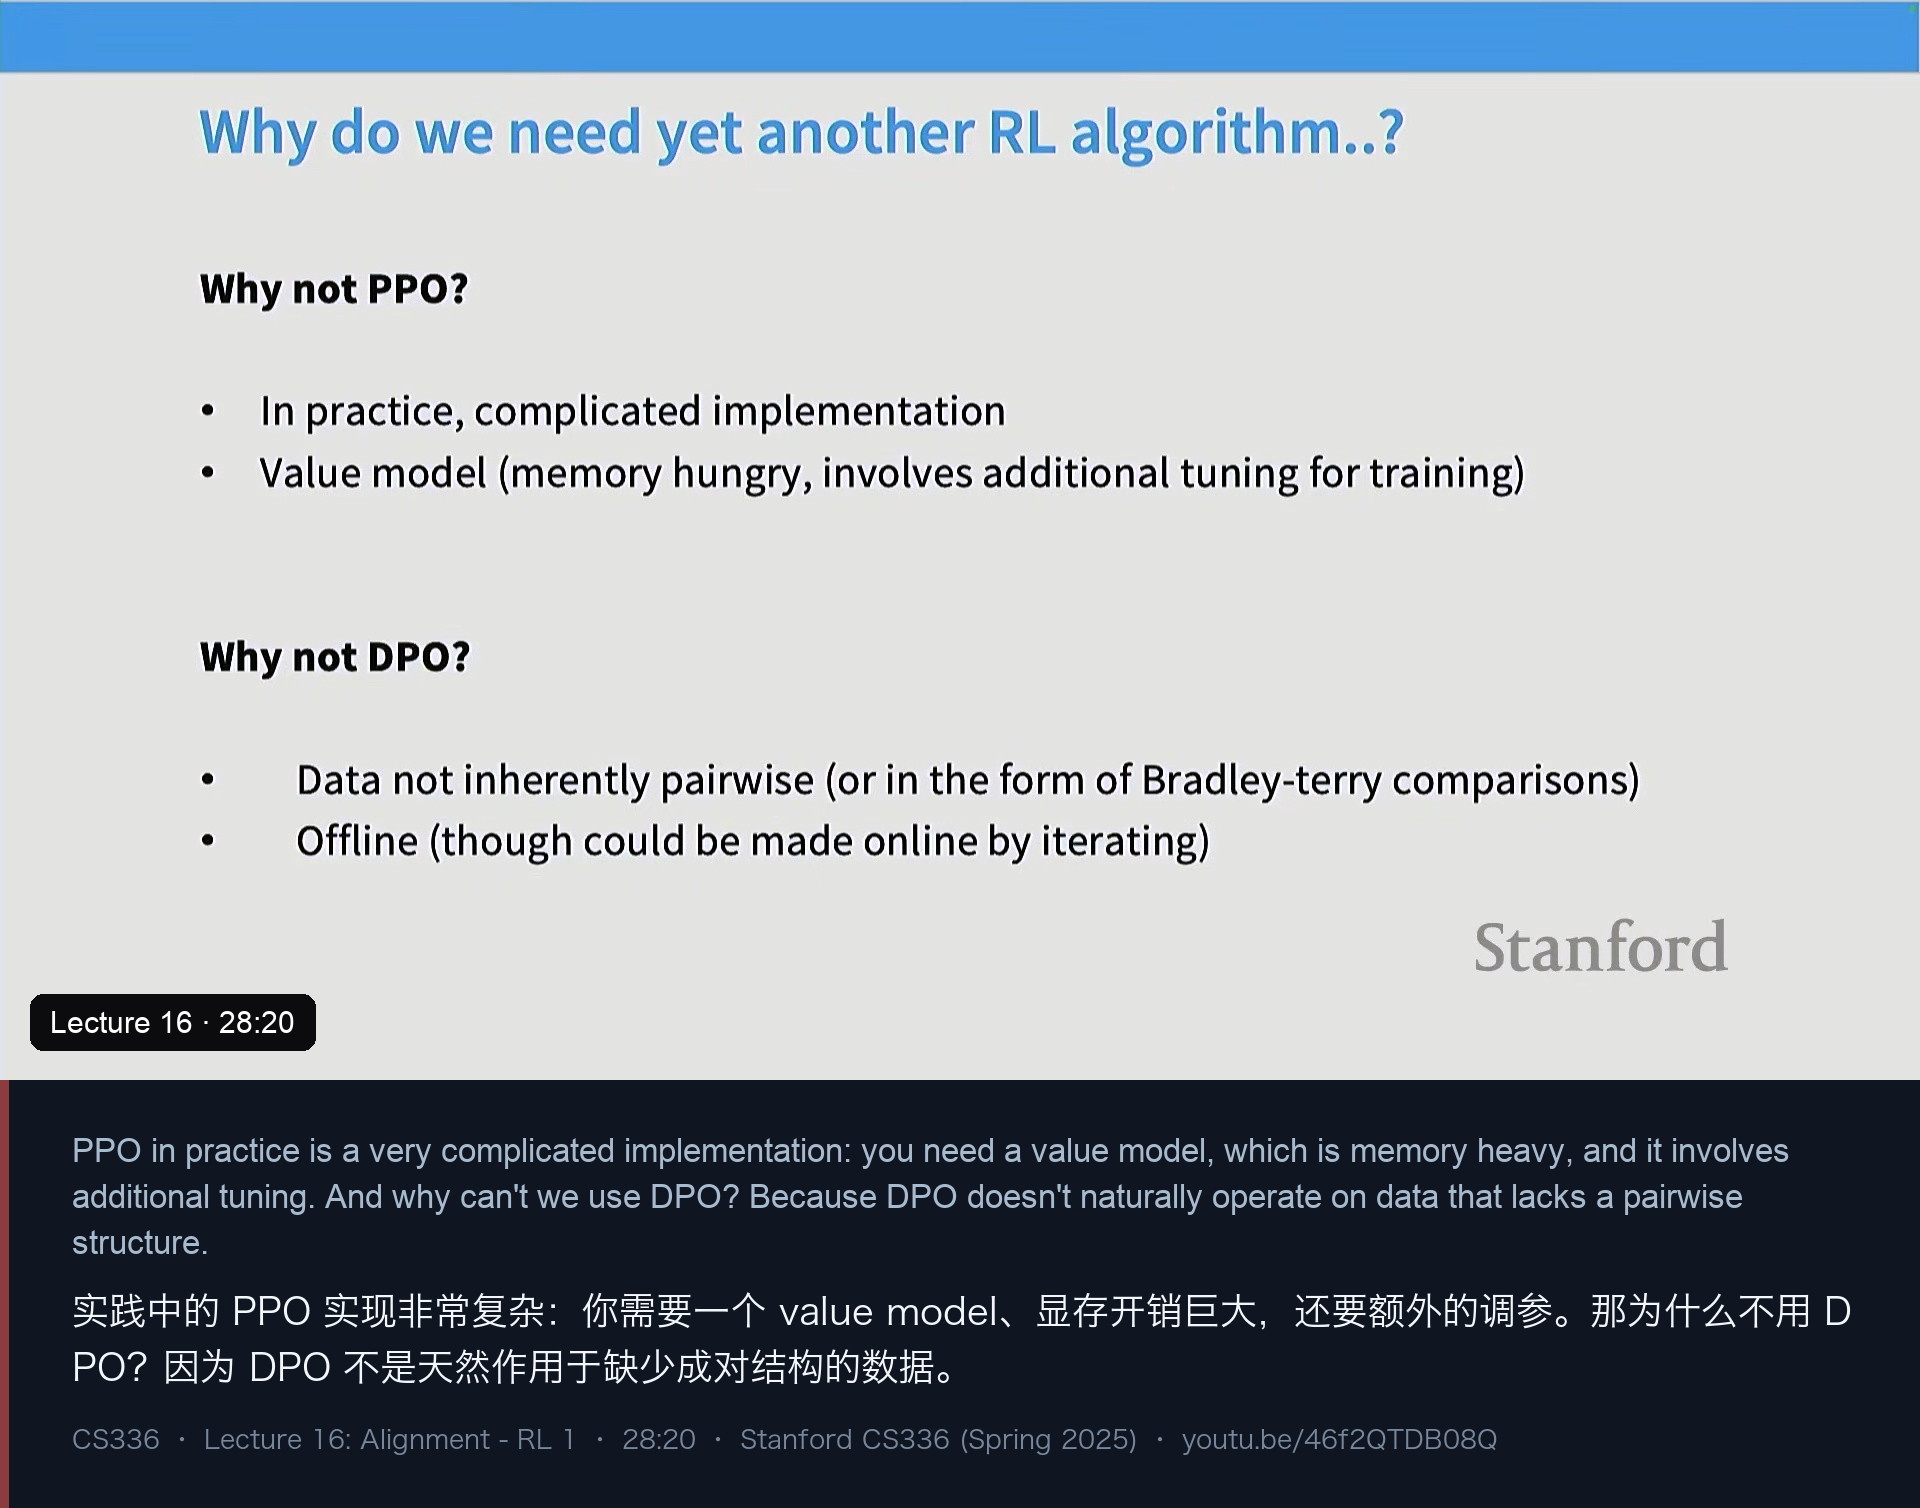
两个理由:其一,PPO 的实现太复杂——value model 通常和策略一样大,等于显存开销翻倍,而且要额外调参;其二,DPO 不适配这个场景——它天然作用于成对比较(Bradley-Terry 结构),而“拿一道数学题去 RL、直接判答案对不对”根本没有成对的偏好结构;而且 DPO 本质上是离线的(offline),要先收集好一批 pairs 再更新。这两条,正好就是 GRPO 要解决的问题。
四、GRPO:把 value model 和 GAE 一起删掉
GRPO 是 DeepSeek Math 论文里提出的。它的动机和实现都异常简单:
- 删掉 GAE(以及它背后的 value model);
- 把优势函数换成一个组内 z-score:
A_i = (r_i − mean({r_1, …, r_G})) / std({r_1, …, r_G})什么是“组”? 同一道题(同一个 prompt)采样出的 G 条回答。组内均值就是一个天然的难度基线:难题的组均值低、简单题的组均值高,减去它就等于扣掉了“题目难度”这个共同项。讲师点出这其实就是 leave-one-out 基线的思想(严格说这里包含了自己,但只要去掉自己就是合法的基线)。
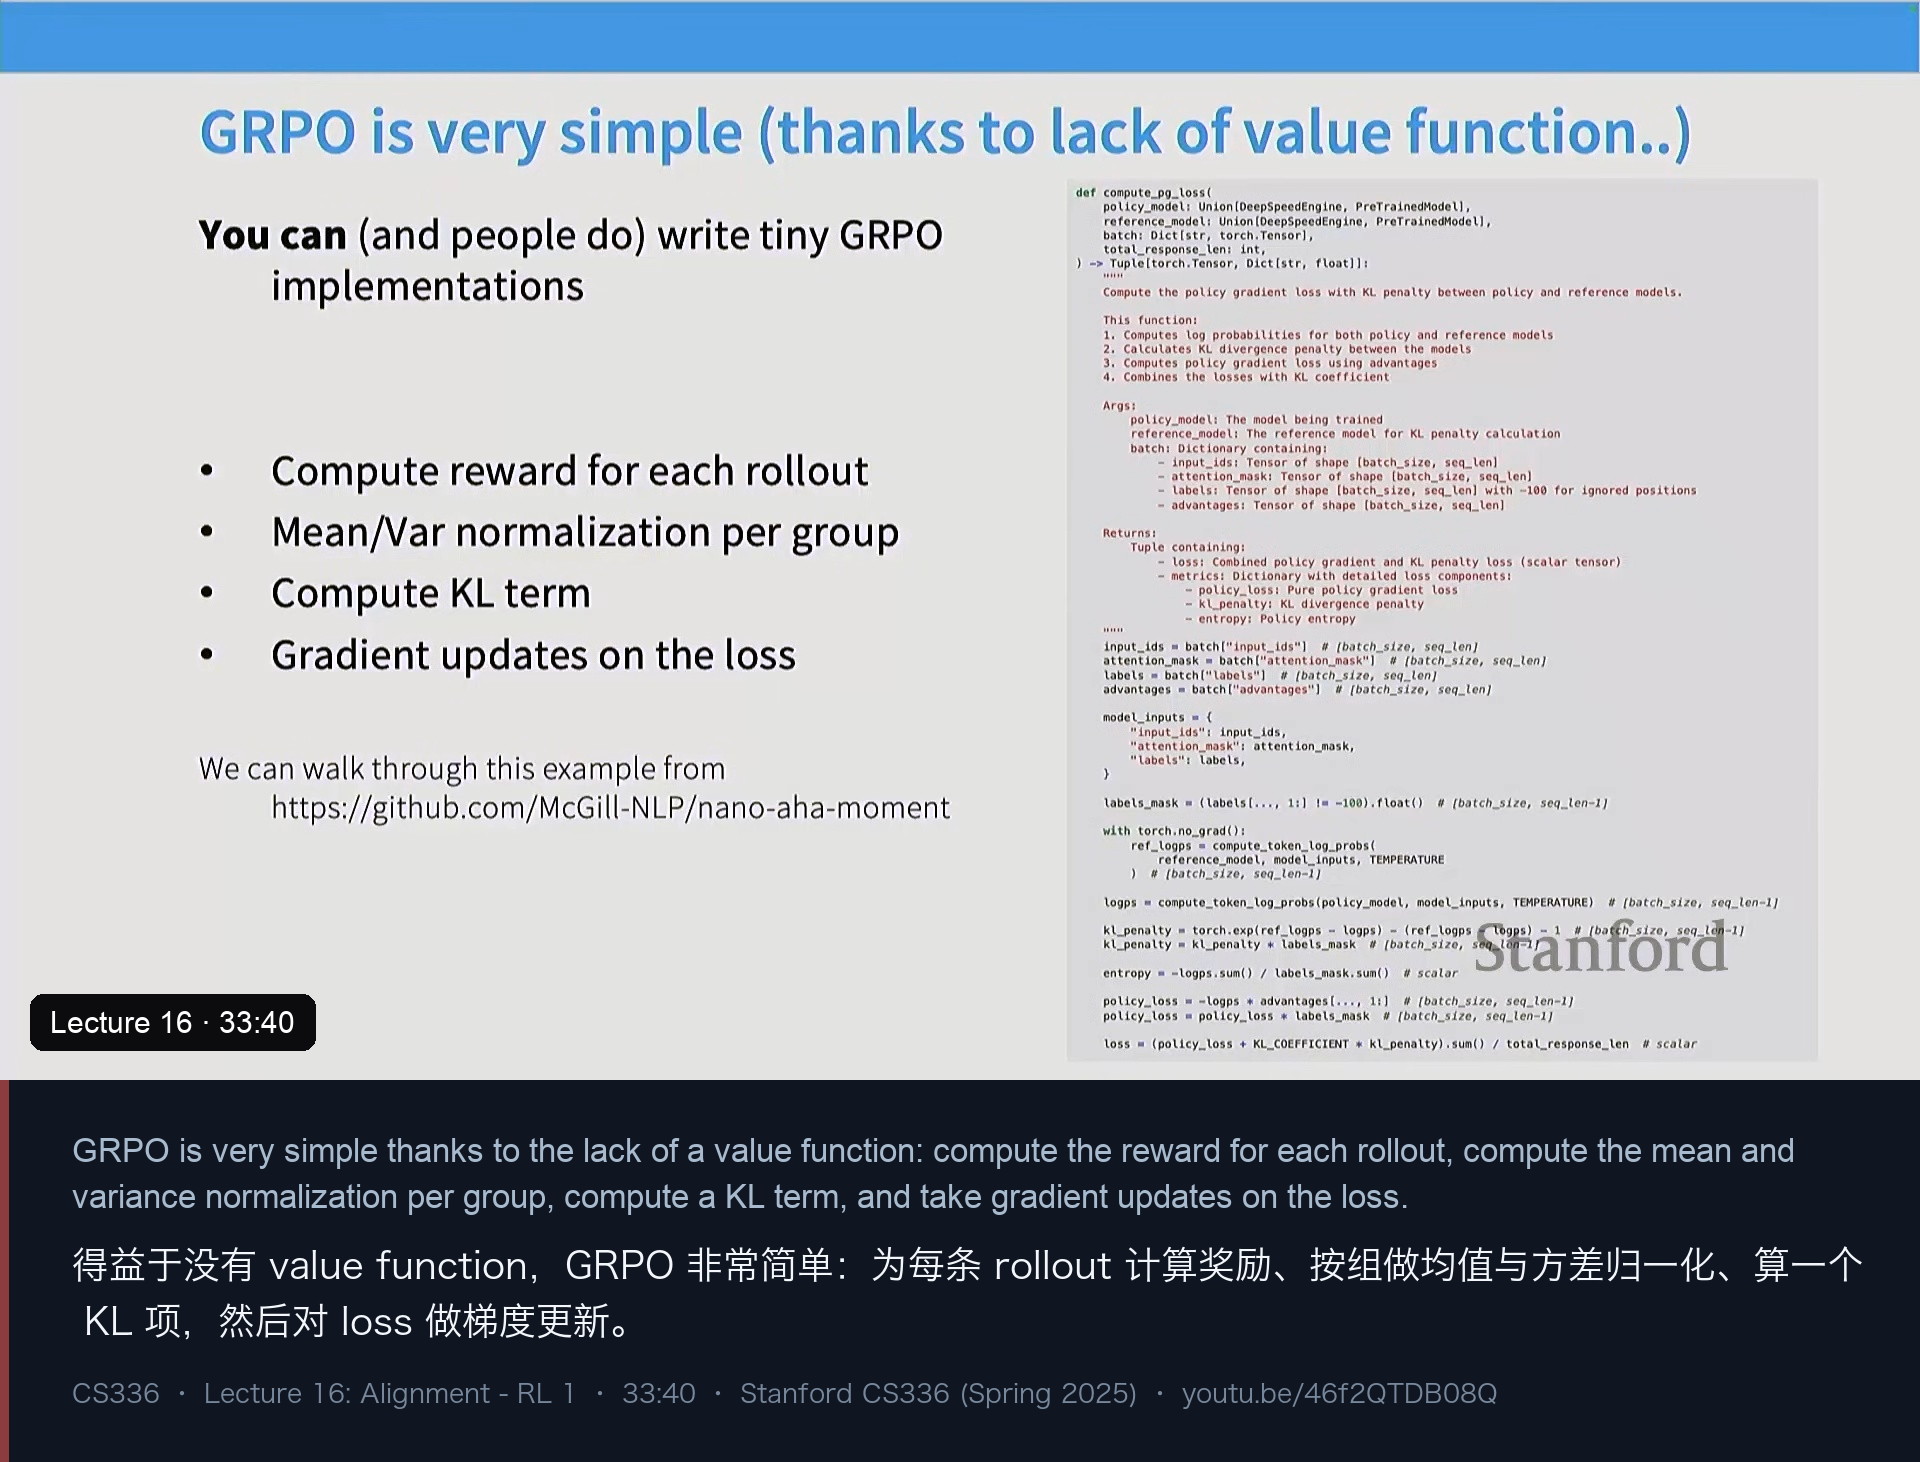
他还讲了一个有趣的细节:GRPO 的 KL 估计是非标准的,里面多了“比值的对数”和“减一”两项——这是一个控制变量(control variate)技巧,用来降低 KL 估计的方差;在 π_θ 下取期望时它会抵消回标准形式。
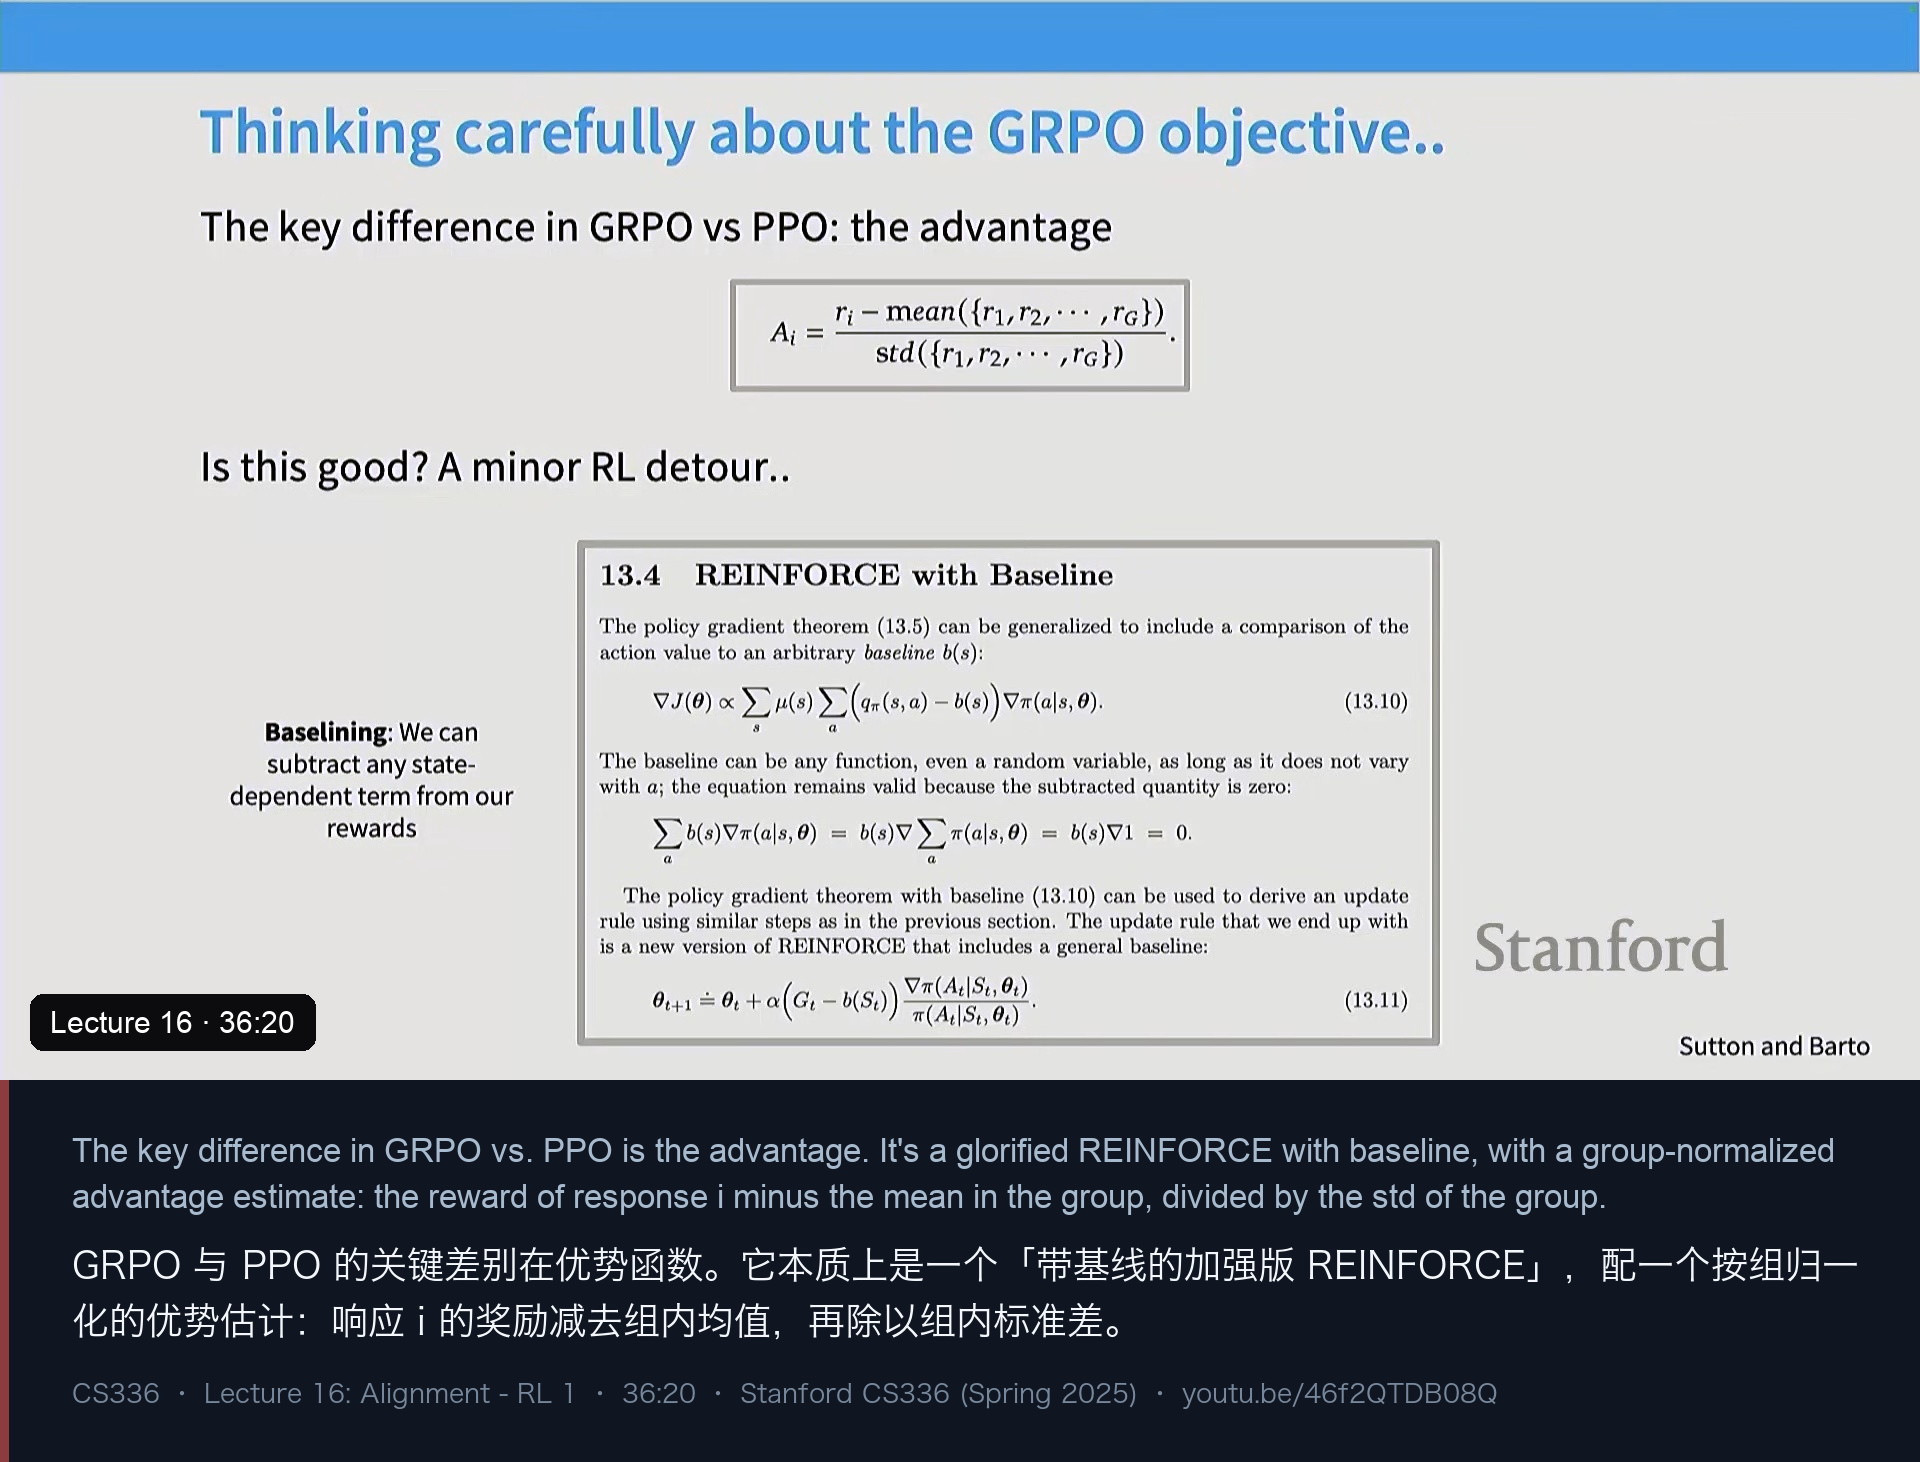
实现层面几乎就是“照着公式敲”:外层循环里为每条 rollout 算奖励 → 按组做均值方差归一化 → 算一个 KL 项 → 对 loss 做梯度更新。讲师提到了两个在作业里也会用到的细节:除以标准差时要加一个 1e-4 的小常数防止数值爆炸;以及如果只走一步(纯在线情形),所有裁剪都会消失,算法退化成“用 A_i 加权的策略梯度”——也就是最朴素的“好的加权、坏的降权”。
在 DeepSeek Math 的结果里,GRPO 明显优于“只在答对的样本上做 SFT”(RFT / online RFT)这类弱基线;其中**结果奖励(只判最终对错)与过程奖励(对每一步打分)**都能工作,论文当时倾向于过程奖励更好——但讲师提前埋了伏笔:后面 R1 会告诉你,过程奖励这条路其实没走通。
五、GRPO 的两个“不合法之处”:Dr. GRPO 的修正
讲完 GRPO 之后,讲师专门花时间讲了一篇重新分析 GRPO 的工作(他那张幻灯片上写的是 Dr. GRPO)。这篇工作指出 GRPO 有两个在数学上站不住的地方。
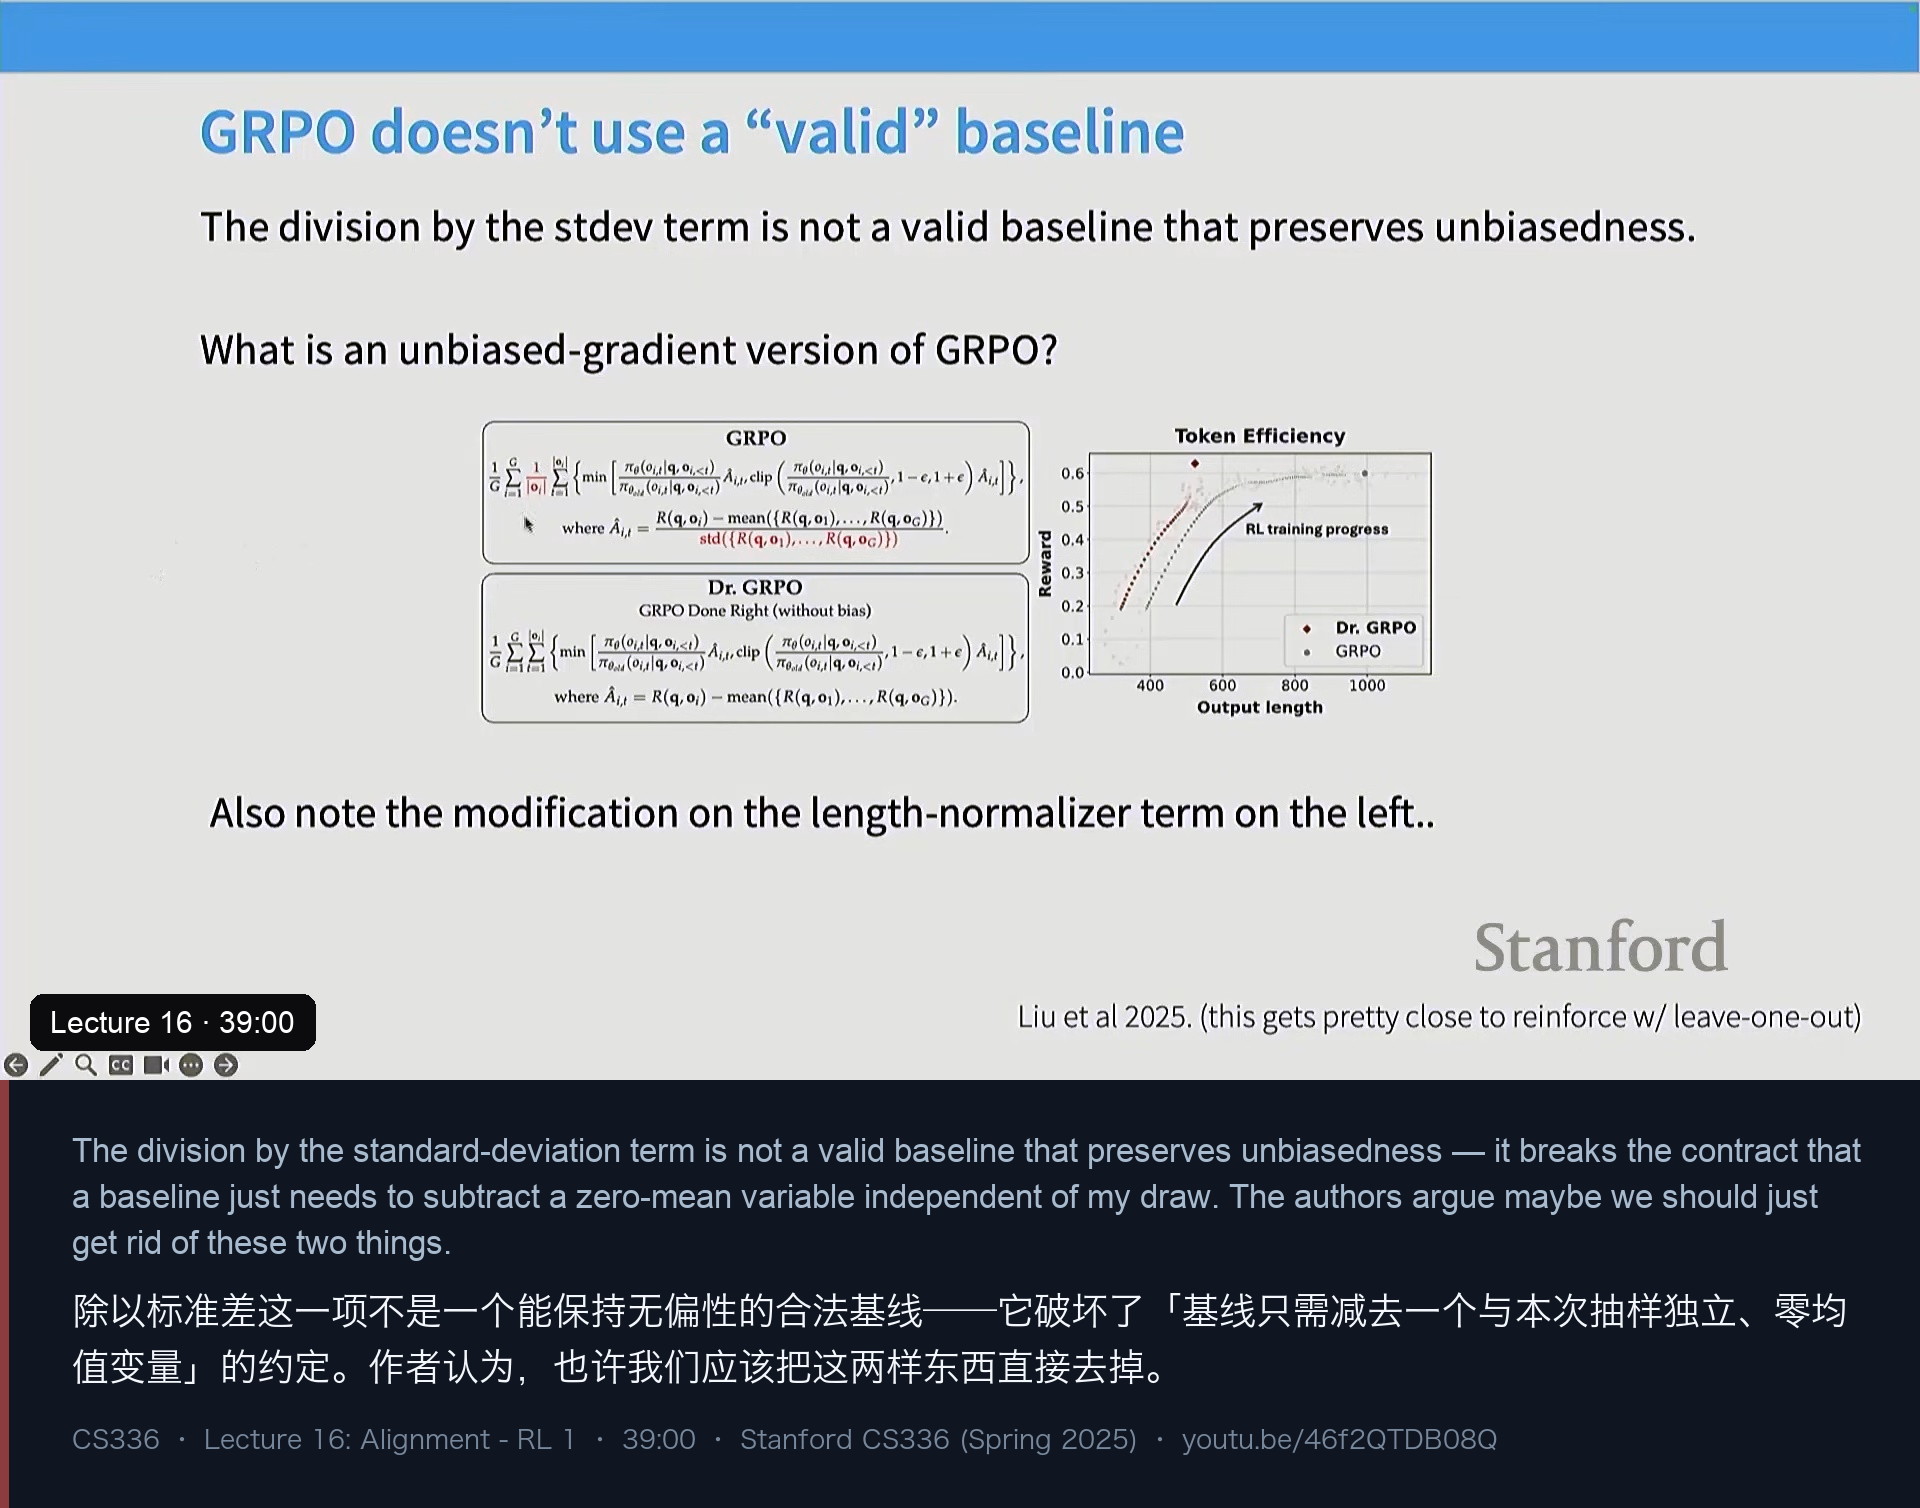
问题一:除以标准差不是一个合法的基线。 从策略梯度定理出发,一个合法的基线只需要满足”减去一个零均值、且与本次抽样独立的变量“。而 std 显然不满足——它和整组的抽样有关,甚至包含了自己。更糟的是它带来了一个系统性偏差:当组内标准差很小时(奖励全是 1 或全是 0,也就是题目太简单或太难),优势会被放大,于是算法专门给这两类题加权。这与”应该喂给模型中等难度、还能拿到部分奖励的题“这一课程式(curriculum)直觉正好相反,也会拖慢收敛。
问题二:按长度归一化产生了恶劣激励。 由于奖励要除以回答长度:
- 如果模型答错了(拿到负奖励),最有利的做法是把回答写得越长越好,以稀释负奖励的幅度;
- 如果模型答对了(拿到正奖励),最有利的做法是把回答写得越短越好。
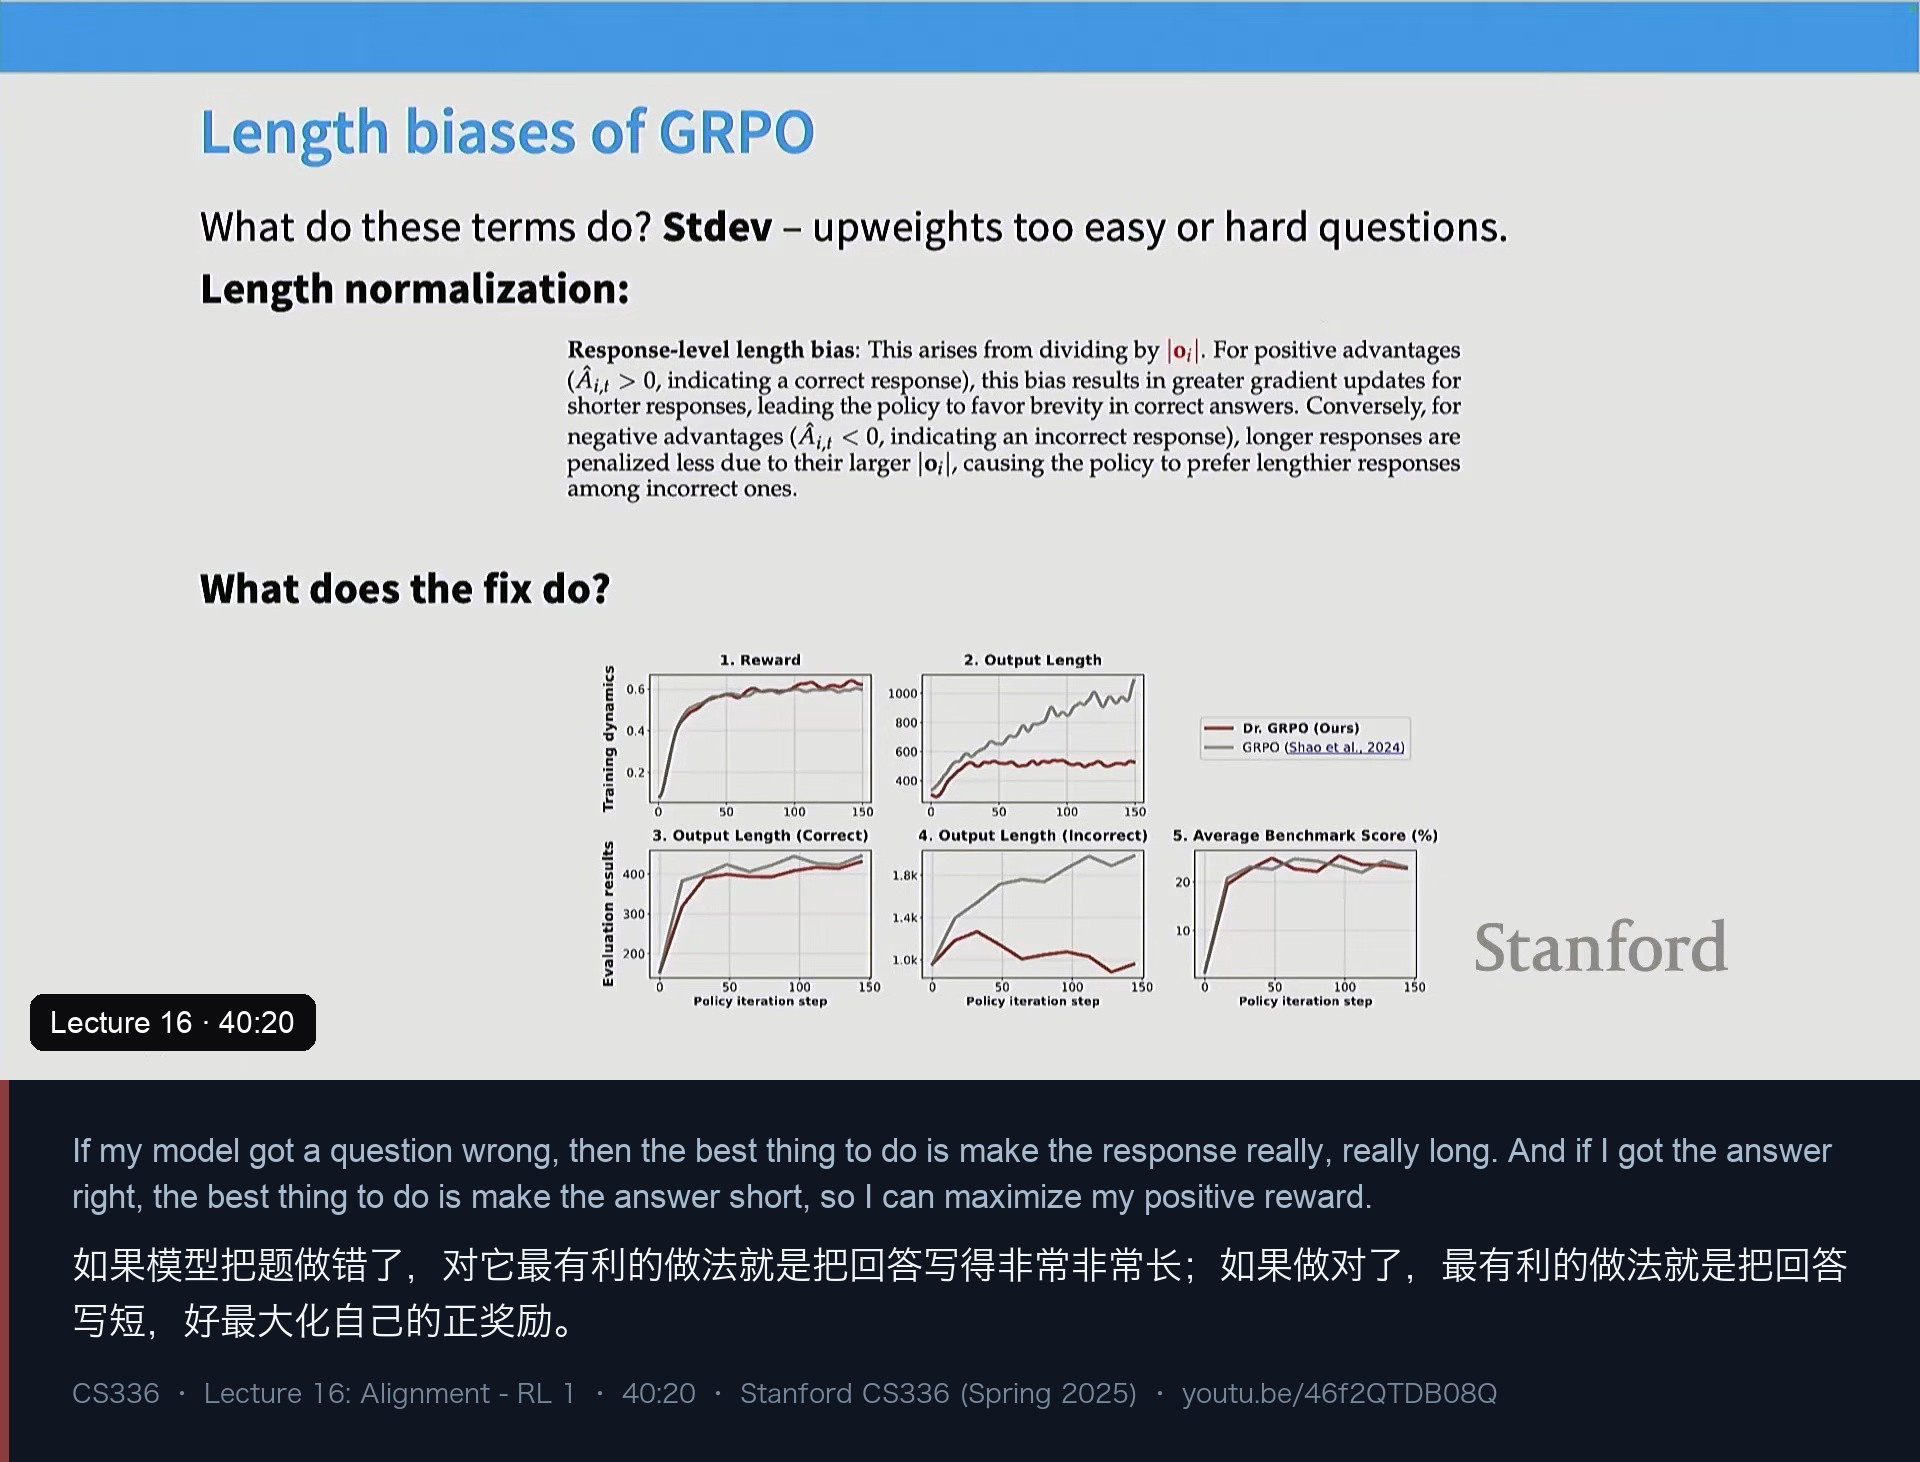
结果就是模型学会了”不会就拼命废话“:一旦觉得做不出来,就把回答写到最长。把这两处修正拿掉之后,在 GSM8K 这类任务上奖励一样好,但输出长度不再无限增长,而是稳定在某个水平。
讲师由此给出了一个他认为“很有意思、但还没有完全证实”的猜想:人们在推理模型上看到的那些超长思维链,可能有一部分是 GRPO 实现细节的产物,而不是性能本身的必需品。 他补充说,Dr. GRPO 那篇工作对另外两个流行说法也提出了质疑:所谓“RL 让长度自然增长”,其实是有偏目标函数逼出来的;所谓 R1-Zero 的“aha moment”(模型突然说“啊,我明白了”),如果直接拿 DeepSeek-V3 去问一堆数学题,它有时也会这么说——未必是 RL 训练带来的新现象。
六、案例一:DeepSeek-R1——最简配方掀起的巨浪
第一个案例是 R1。讲师给它的定位很高:这是一篇“引发了社会现象”的论文(他打趣说“这篇论文一度让英伟达市值损失数亿美元级别,别让导师告诉你 arXiv 论文不重要”——此为讲师口播,未经本文核实)。R1 真正令人惊讶的地方不在于性能数字,而在于配方的简单:没有搜索、没有过程奖励模型,就能复现 o1 的定性特征。
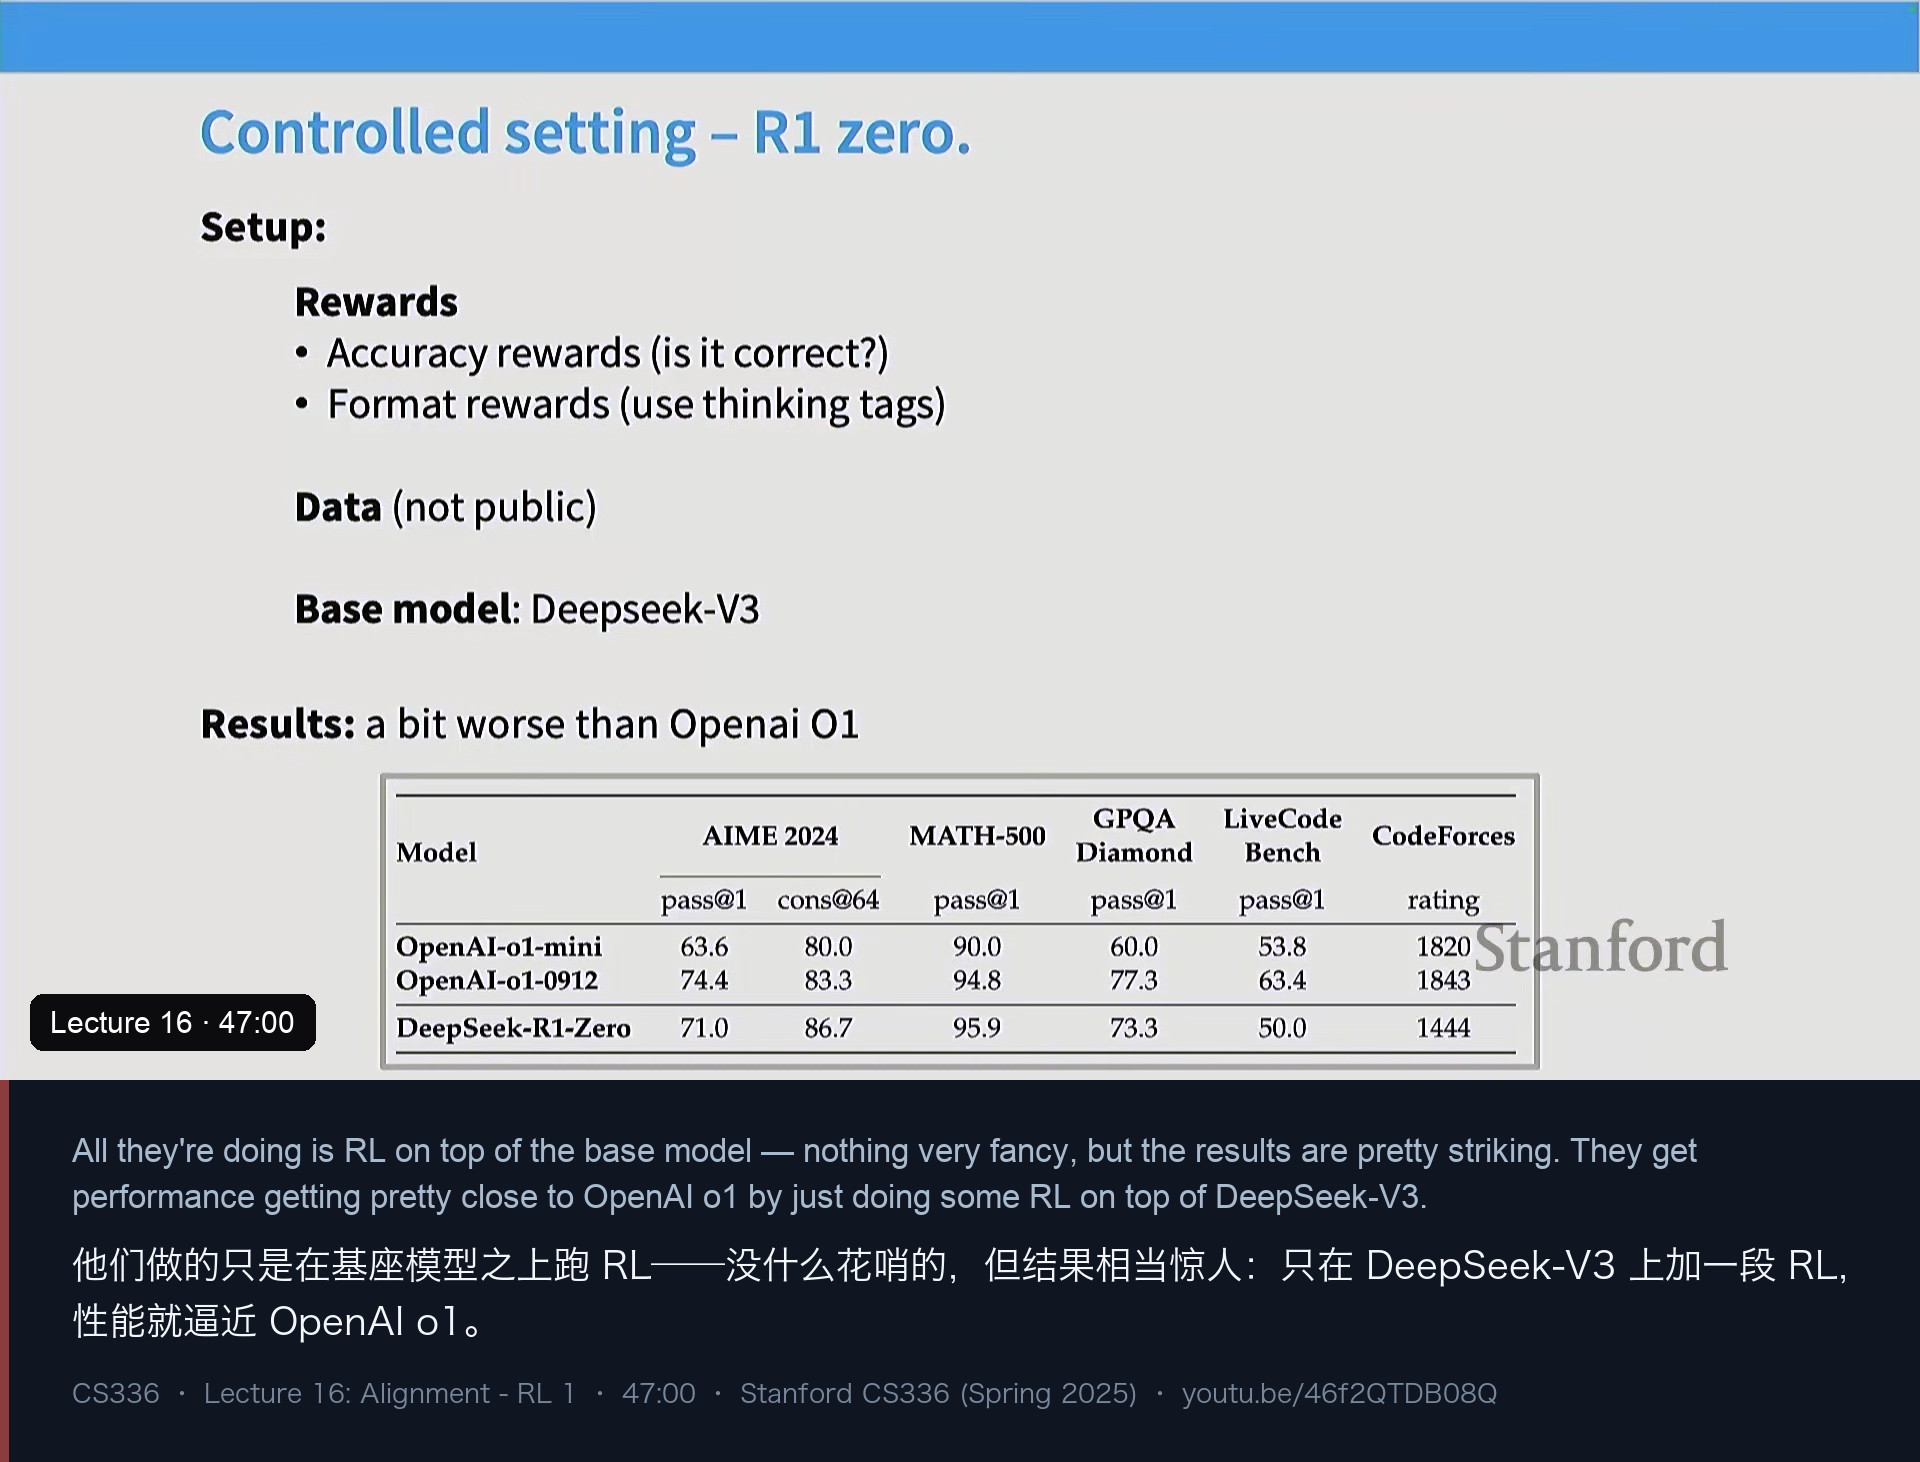
R1-Zero(受控设置):它几乎是最“纯”的 RL——拿预训练 + mid-training 之后、还没做过 RLHF / 指令微调的 DeepSeek-V3 直接开跑数学 RL。奖励只有两种:
- 准确率奖励:答案对或错,二值;
- 格式奖励:强制模型把思维链放在
thinking ... <|end▁of▁thinking|>标签里。
讲师特意强调:格式奖励看起来无关紧要,但从多篇论文和很多人的实践经验看,“把思维链装进标签”这件事对整套推理 RL 能否跑起来相当关键——它是让长思维链真正被“用起来”的形状约束。结果很惊人:只做了一些 RL,性能就逼近 OpenAI o1。
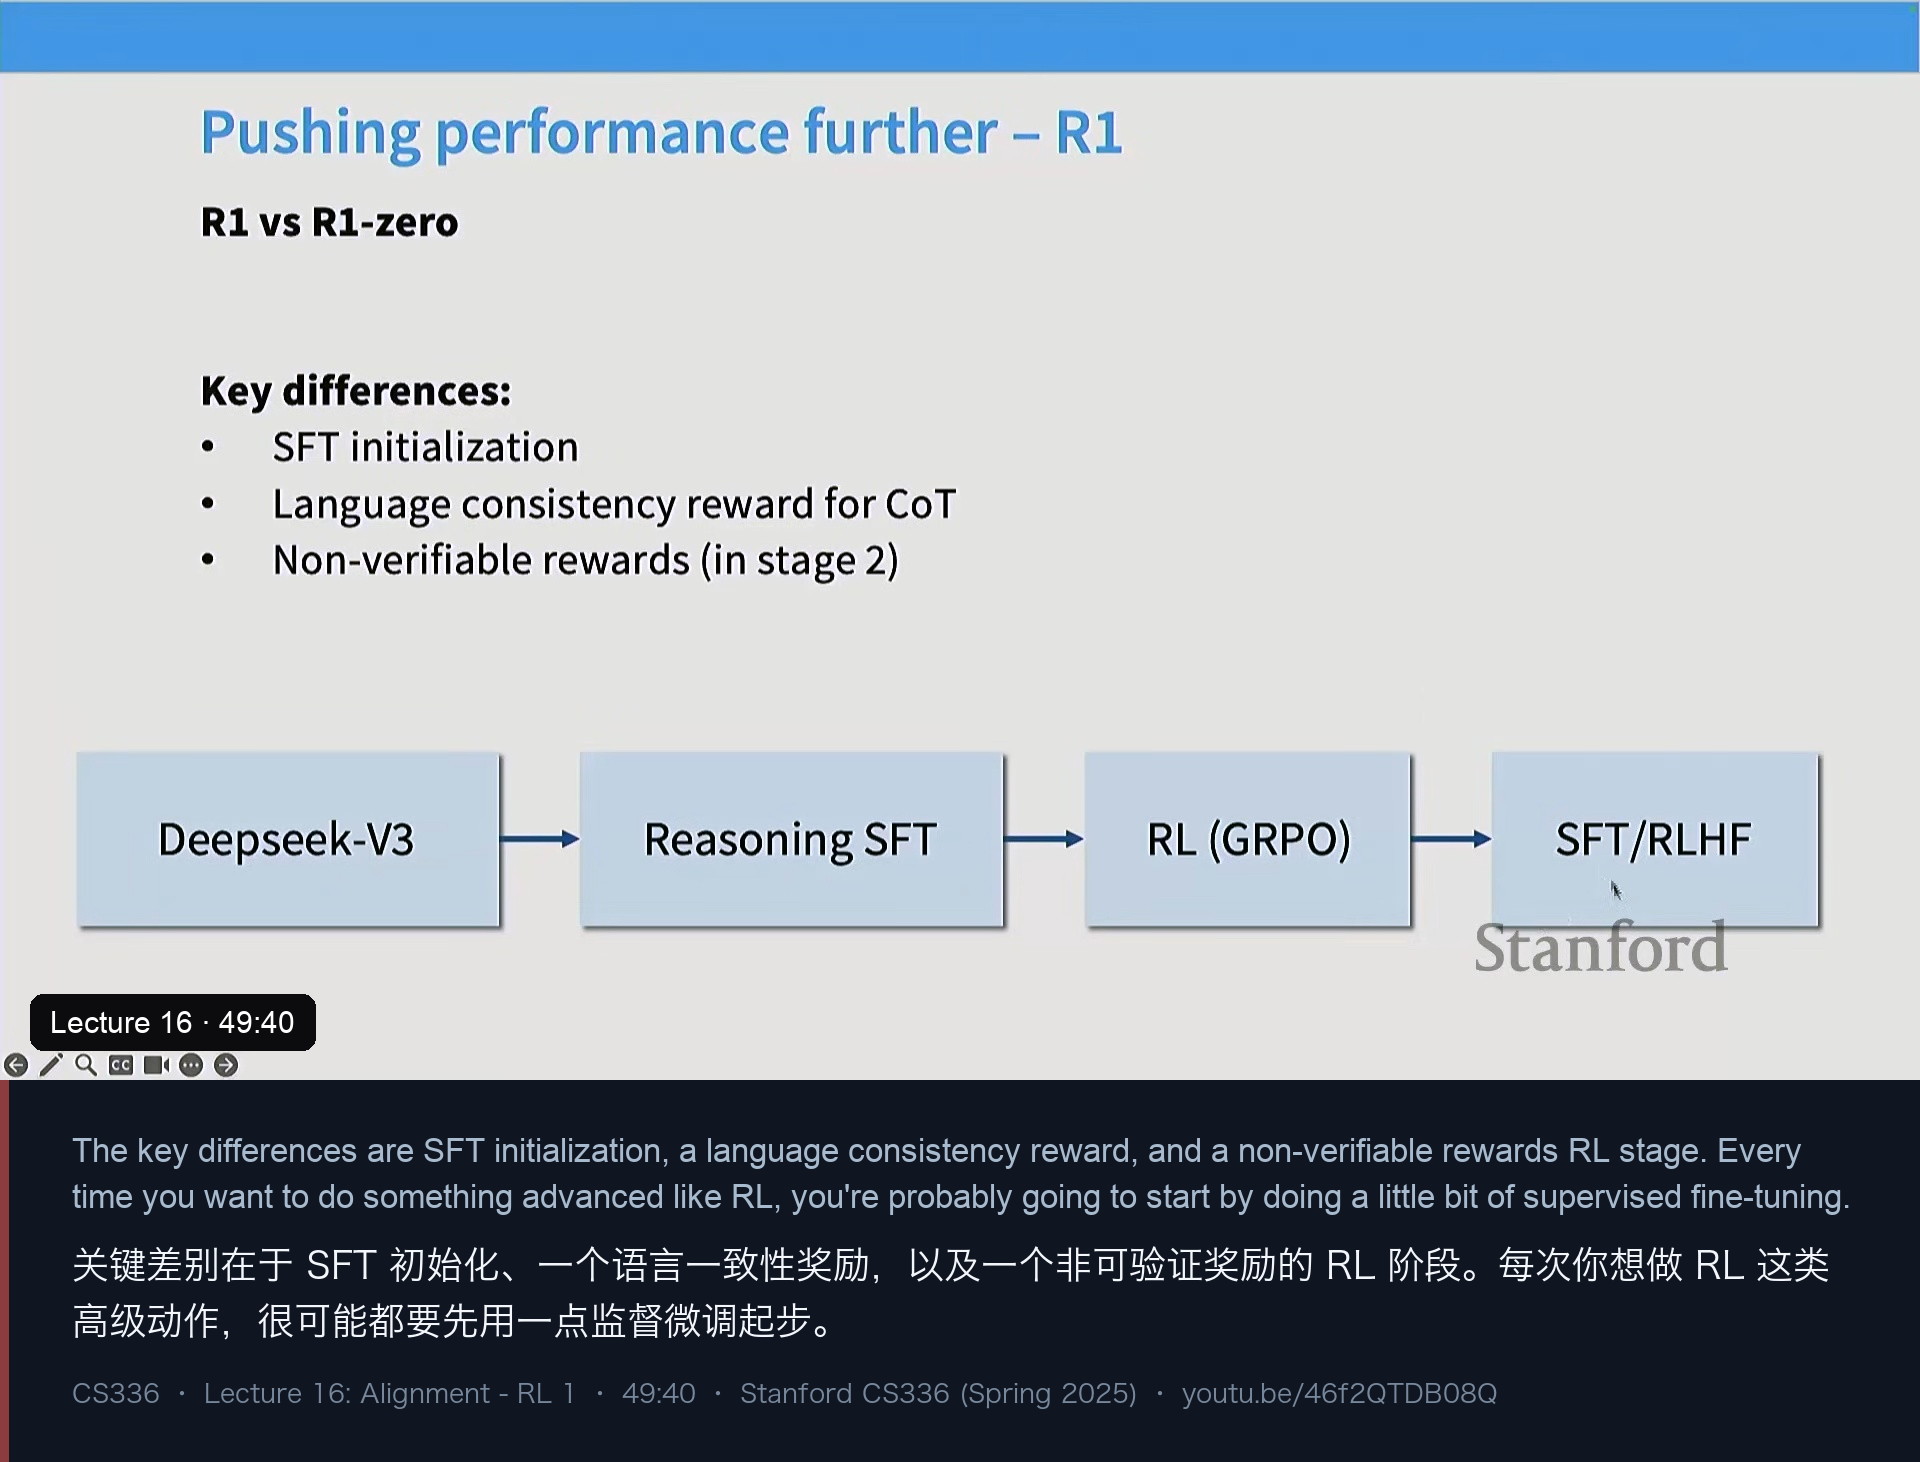
R1(完整版) 则是“把所有能做的都做上”:
- SFT 初始化:先拿一批长思维链数据做监督微调(数据来源论文里说得非常含糊,很可能也是从别处蒸馏来的)。这一步的理论收益是可解释性——你希望 RL 之后模型仍在输出接近人类的、看得懂的思维链,而不是混杂的乱码。
- RL:与 R1-Zero 基本相同,只多了一个语言一致性奖励。原因很有意思:如果放任模型自己 RL,思维链会在不同语言之间反复横跳(讲师提到网上有人发现 Grok 3 的思维链会突然切成中文),所以要额外奖励“保持在同一语言”。
- 再走一遍常规后训练:先做 SFT(把推理数据与非推理数据混在一起;对于“写一段证明”这类不可验证的任务,就用模型自己做 judge),再做标准的 RLHF——而且 RLHF 用的也是 GRPO,算法全流程统一。
R1 还顺手展示了蒸馏的威力:把大 R1 的思维链(据说约一百万条)拿去微调 Qwen,32B 模型在 AIME 这类任务上能获得 25 个百分点以上的提升(数字来自讲师口播)。讲师借此说了一句很“agent 时代”的话:基座模型本身已经具备大量“想”的能力,RL 和 SFT 更像是把这些能力“激发/提取”出来——他自己的学生只用 1000 条来自 Gemini 2.0 Flash Thinking 的长思维链微调 Qwen 2.5,就拿到相当高的数学基准成绩。
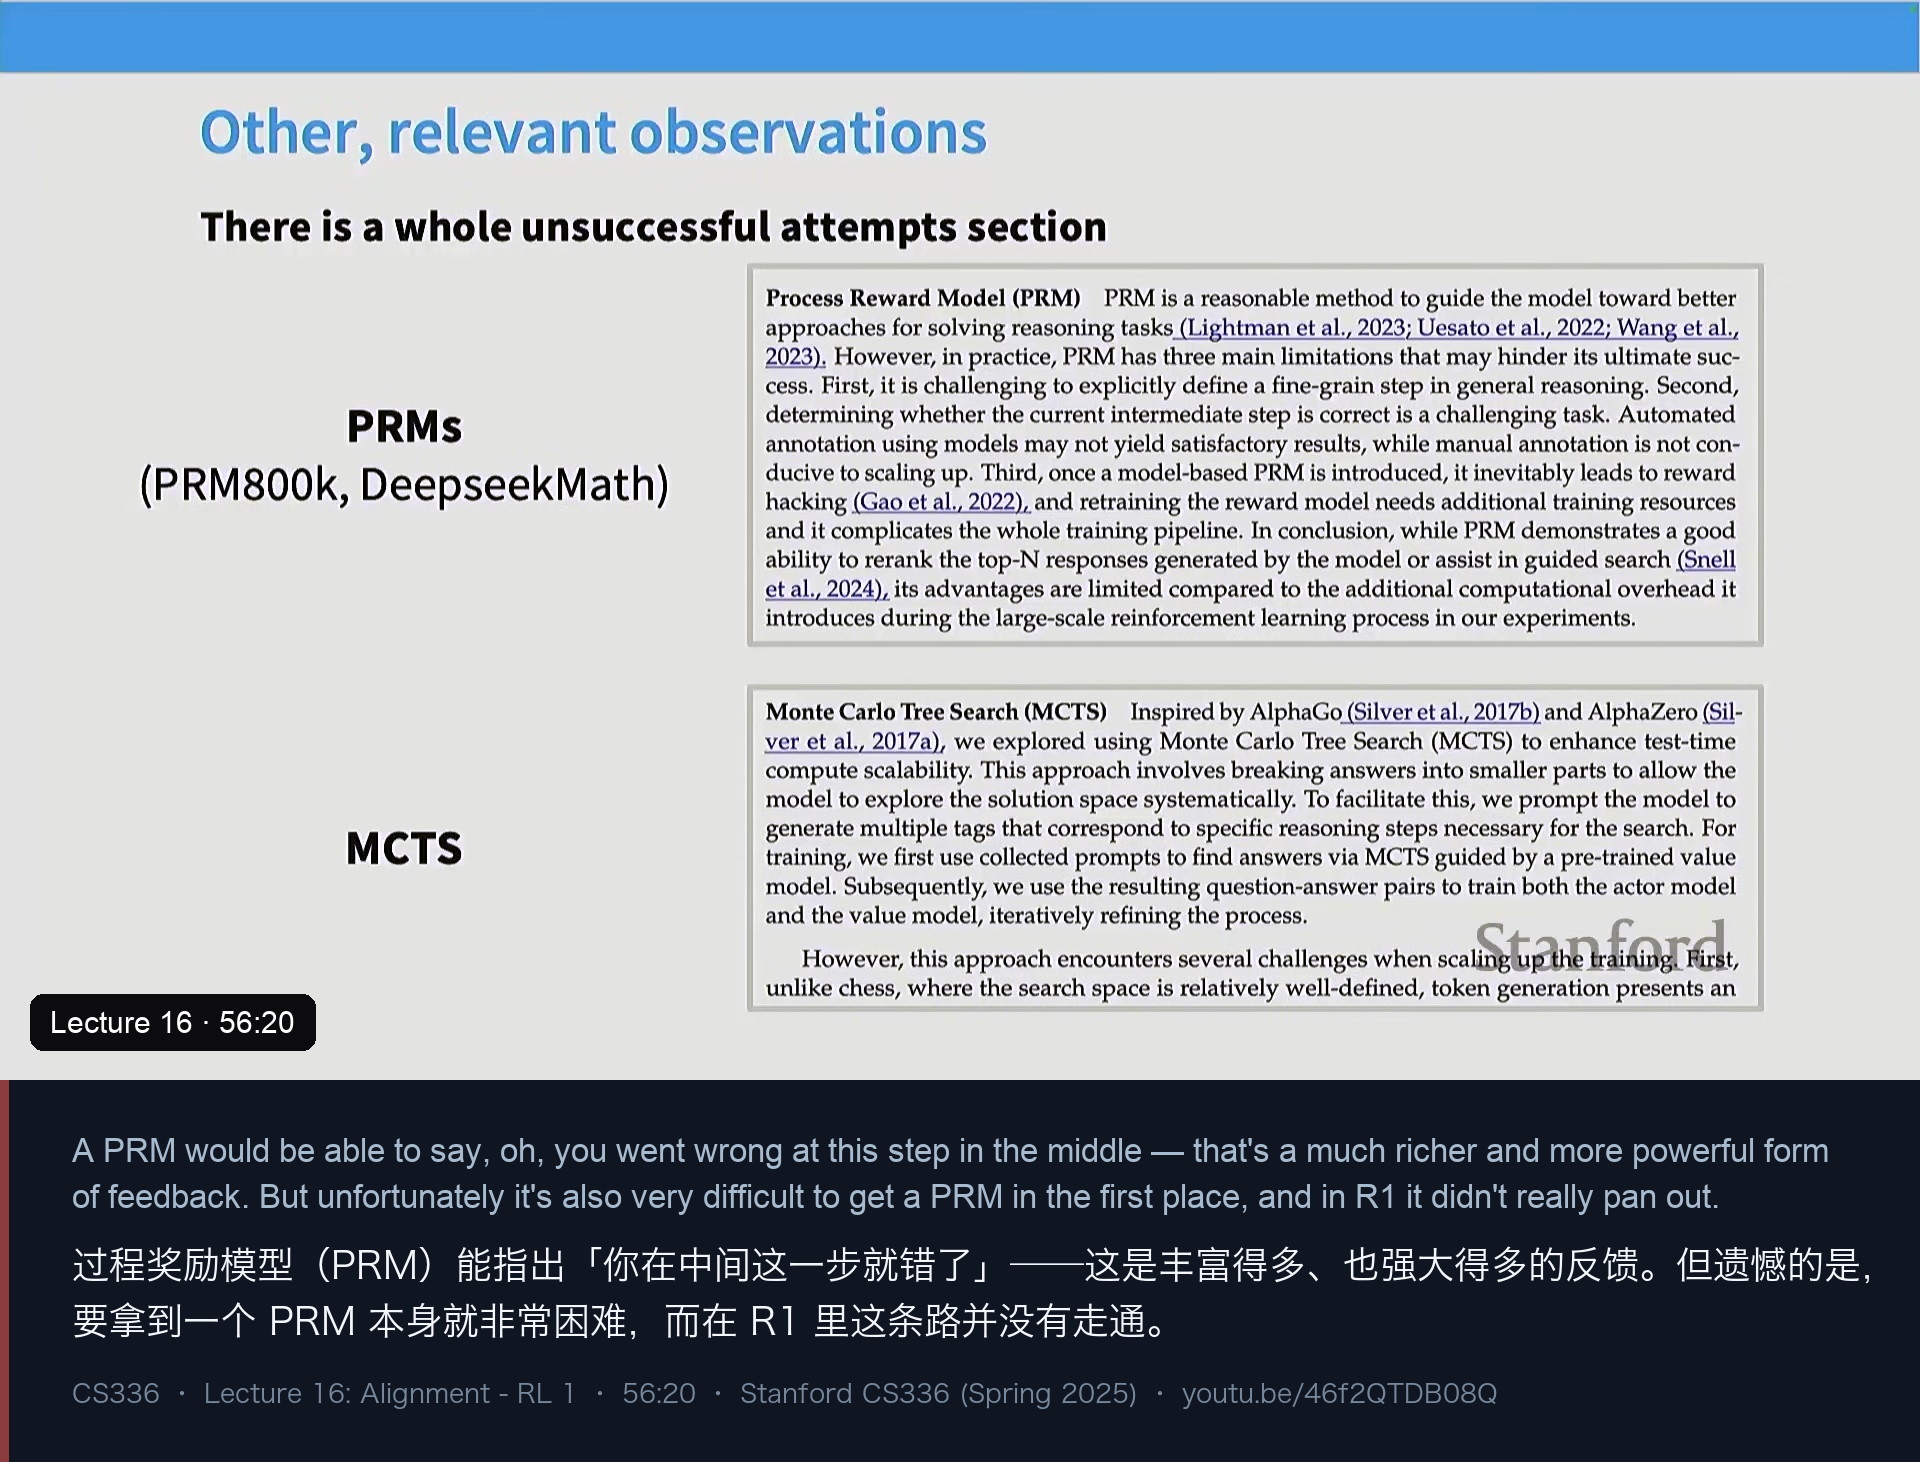
最后是这一讲里我最想让你记住的一段:R1 论文用相当大的篇幅报告了两个负面结果。
- PRM(过程奖励模型)没有奏效。PRM 能在思维链的中间步骤指出“你这里错了”,反馈丰富得多、理论上强大得多;但要拿到一个可靠的 PRM 本身就极其困难,DeepSeek Math 时代走过这条路,最终结论是它不如结果奖励好用。
- 搜索(MCTS 之类)没有奏效。当时很多人押注“推理 = 搜索”,但至少到这时为止,结果奖励 + RL 仍然是最强的基线。
讲师说,加上“用 GRPO + 结果奖励就能复现 o1”这个正面结果,这三个结论可能才是 R1 在科学上最大的贡献。
七、案例二:Kimi k1.5——同期对手,另一种算法
第二个案例是 Kimi k1.5。它和 R1 时间上几乎同期、结果上相近,但用的是不同的 RL 算法、更详细的数据策展、以及一个 R1 没有的东西:对推理成本(思维链长度)的主动控制。讲师说,正因为两者同期,把它并列起来看才能分辨出“哪些是本质、哪些只是实现选择”。
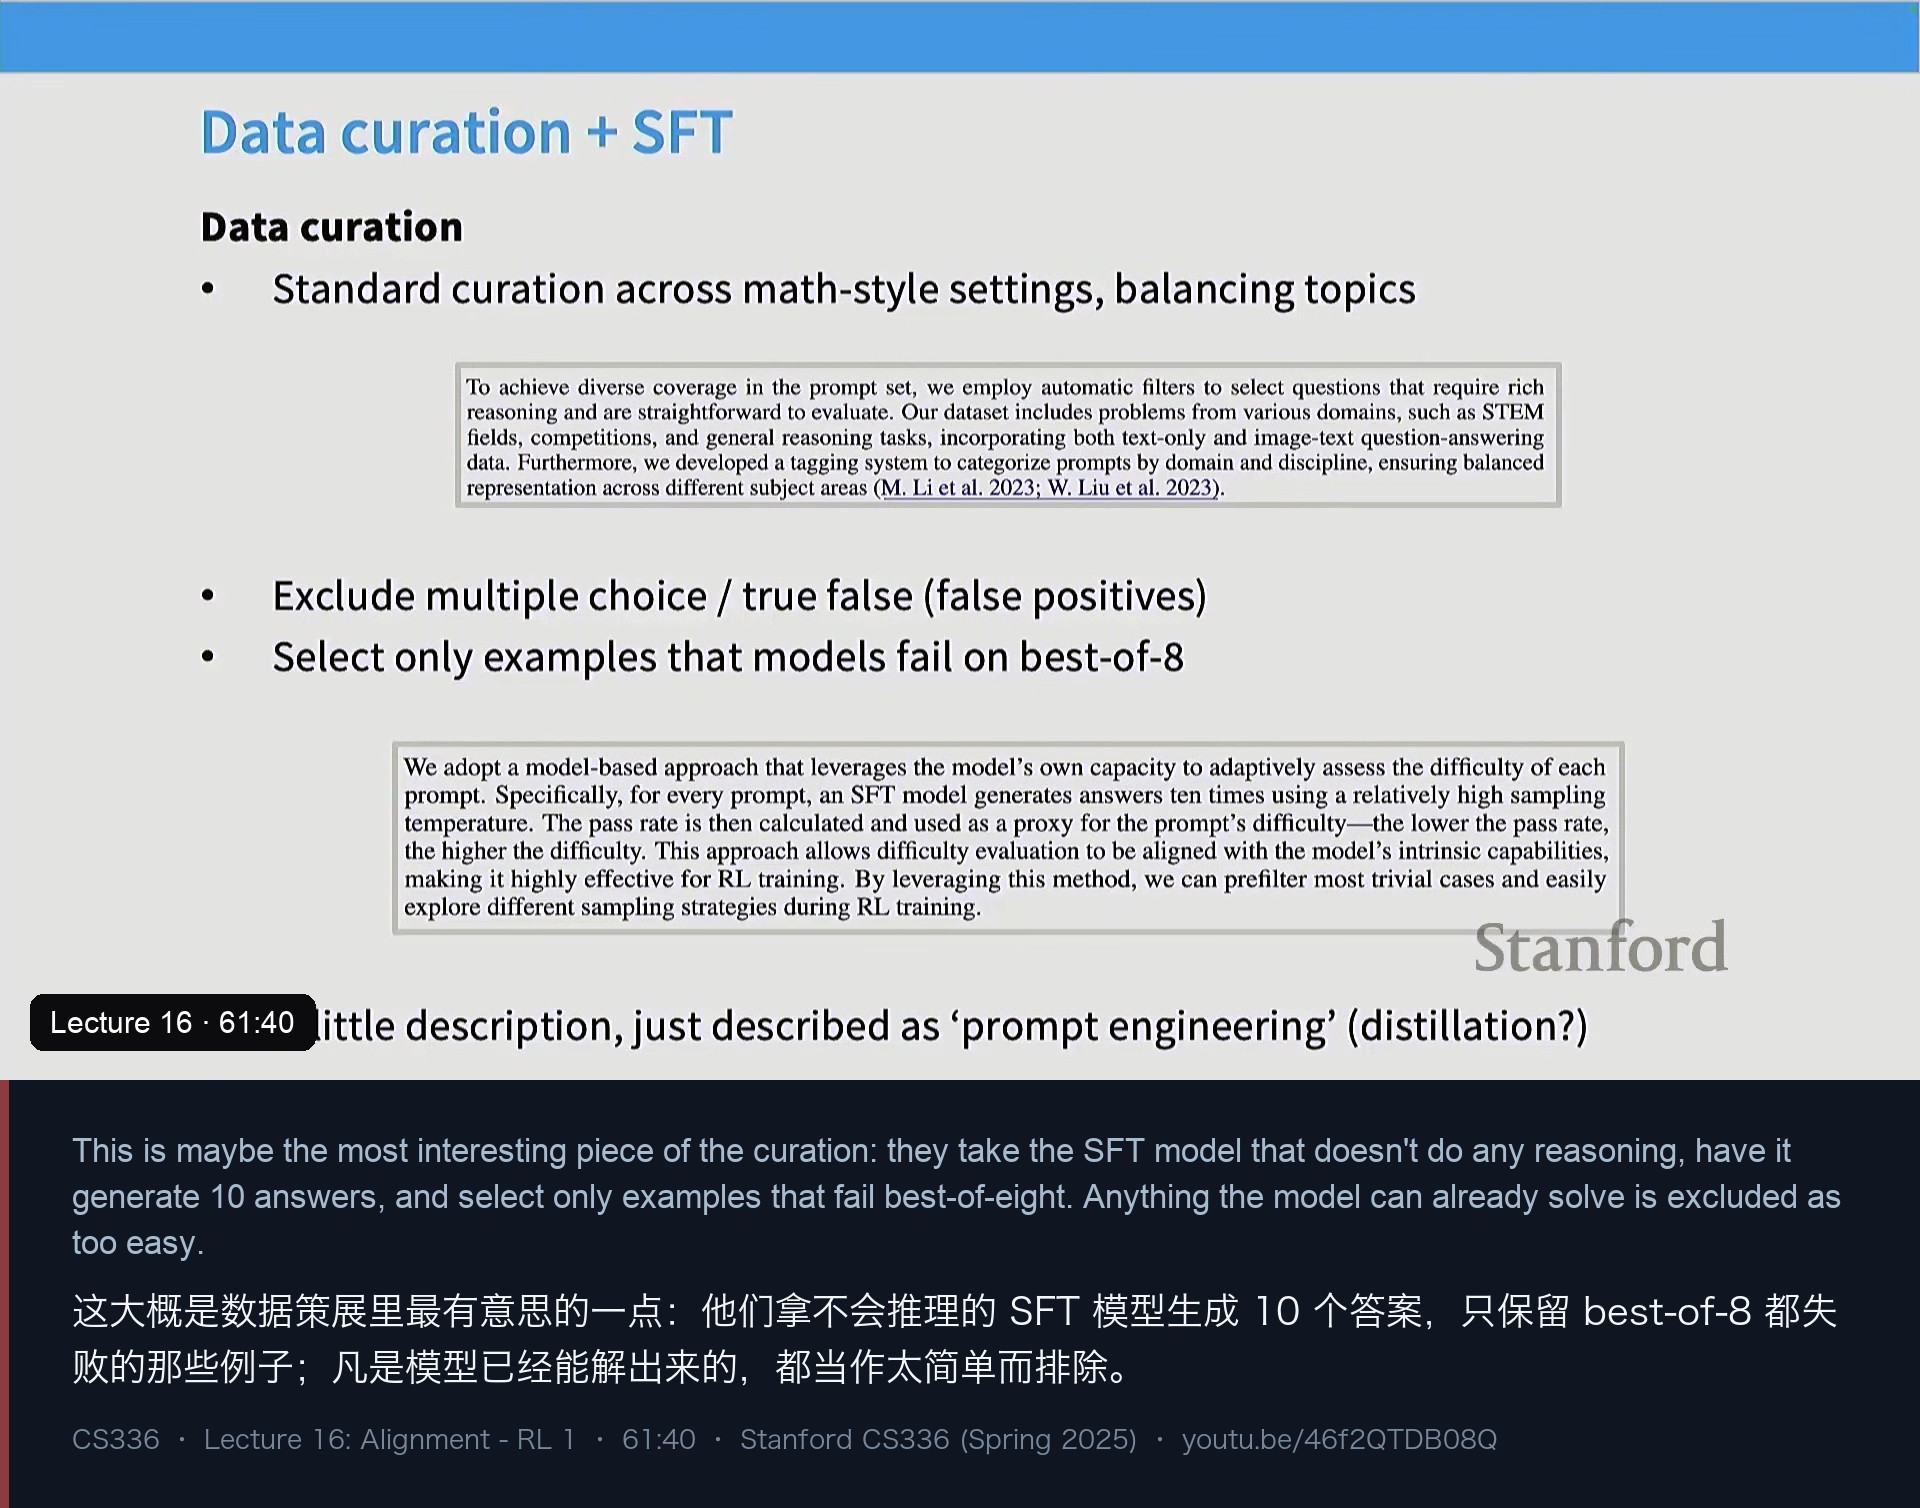
数据侧,Kimi 做了几件更细致的事:用(大概是 LM 的)自动打标把数学题按领域/学科分类并做跨域平衡;排除多选题与判断题(太容易被猜对,奖励信号不干净);只保留答案短、可被正则或 LM 判定的可验证题目;而最有趣的是难度过滤——拿“完全不会推理”的 SFT 模型对每道题生成 10 个答案,只保留 best-of-8 都失败的题,凡是模型已经能解出来的一律剔除。这和 Qwen3 后来用的 best-of-N 过滤是同一个思想,只是阈值不同。
算法侧,Kimi 走了一条“像是从 DPO 那边拐过来”的路:仍然从非参数假设出发,但没有成对偏好可用,于是把“最优策略应当满足的等式”两端之差做成平方损失。求导之后,梯度形式又落回了一个非常熟悉的样子——策略梯度 + 基线(batch 内奖励均值)+ 正则项,只是这个正则不是裁剪,而是显式地把策略往参考策略方向拉。讲师点评:“只要你有策略梯度、有正确的基线、有一个类似正则的东西,你就能得到一个能工作的 RL 算法。” 值得注意的是,Kimi 的这个损失里没有除以标准差——恰好躲开了 GRPO 的第一个问题。
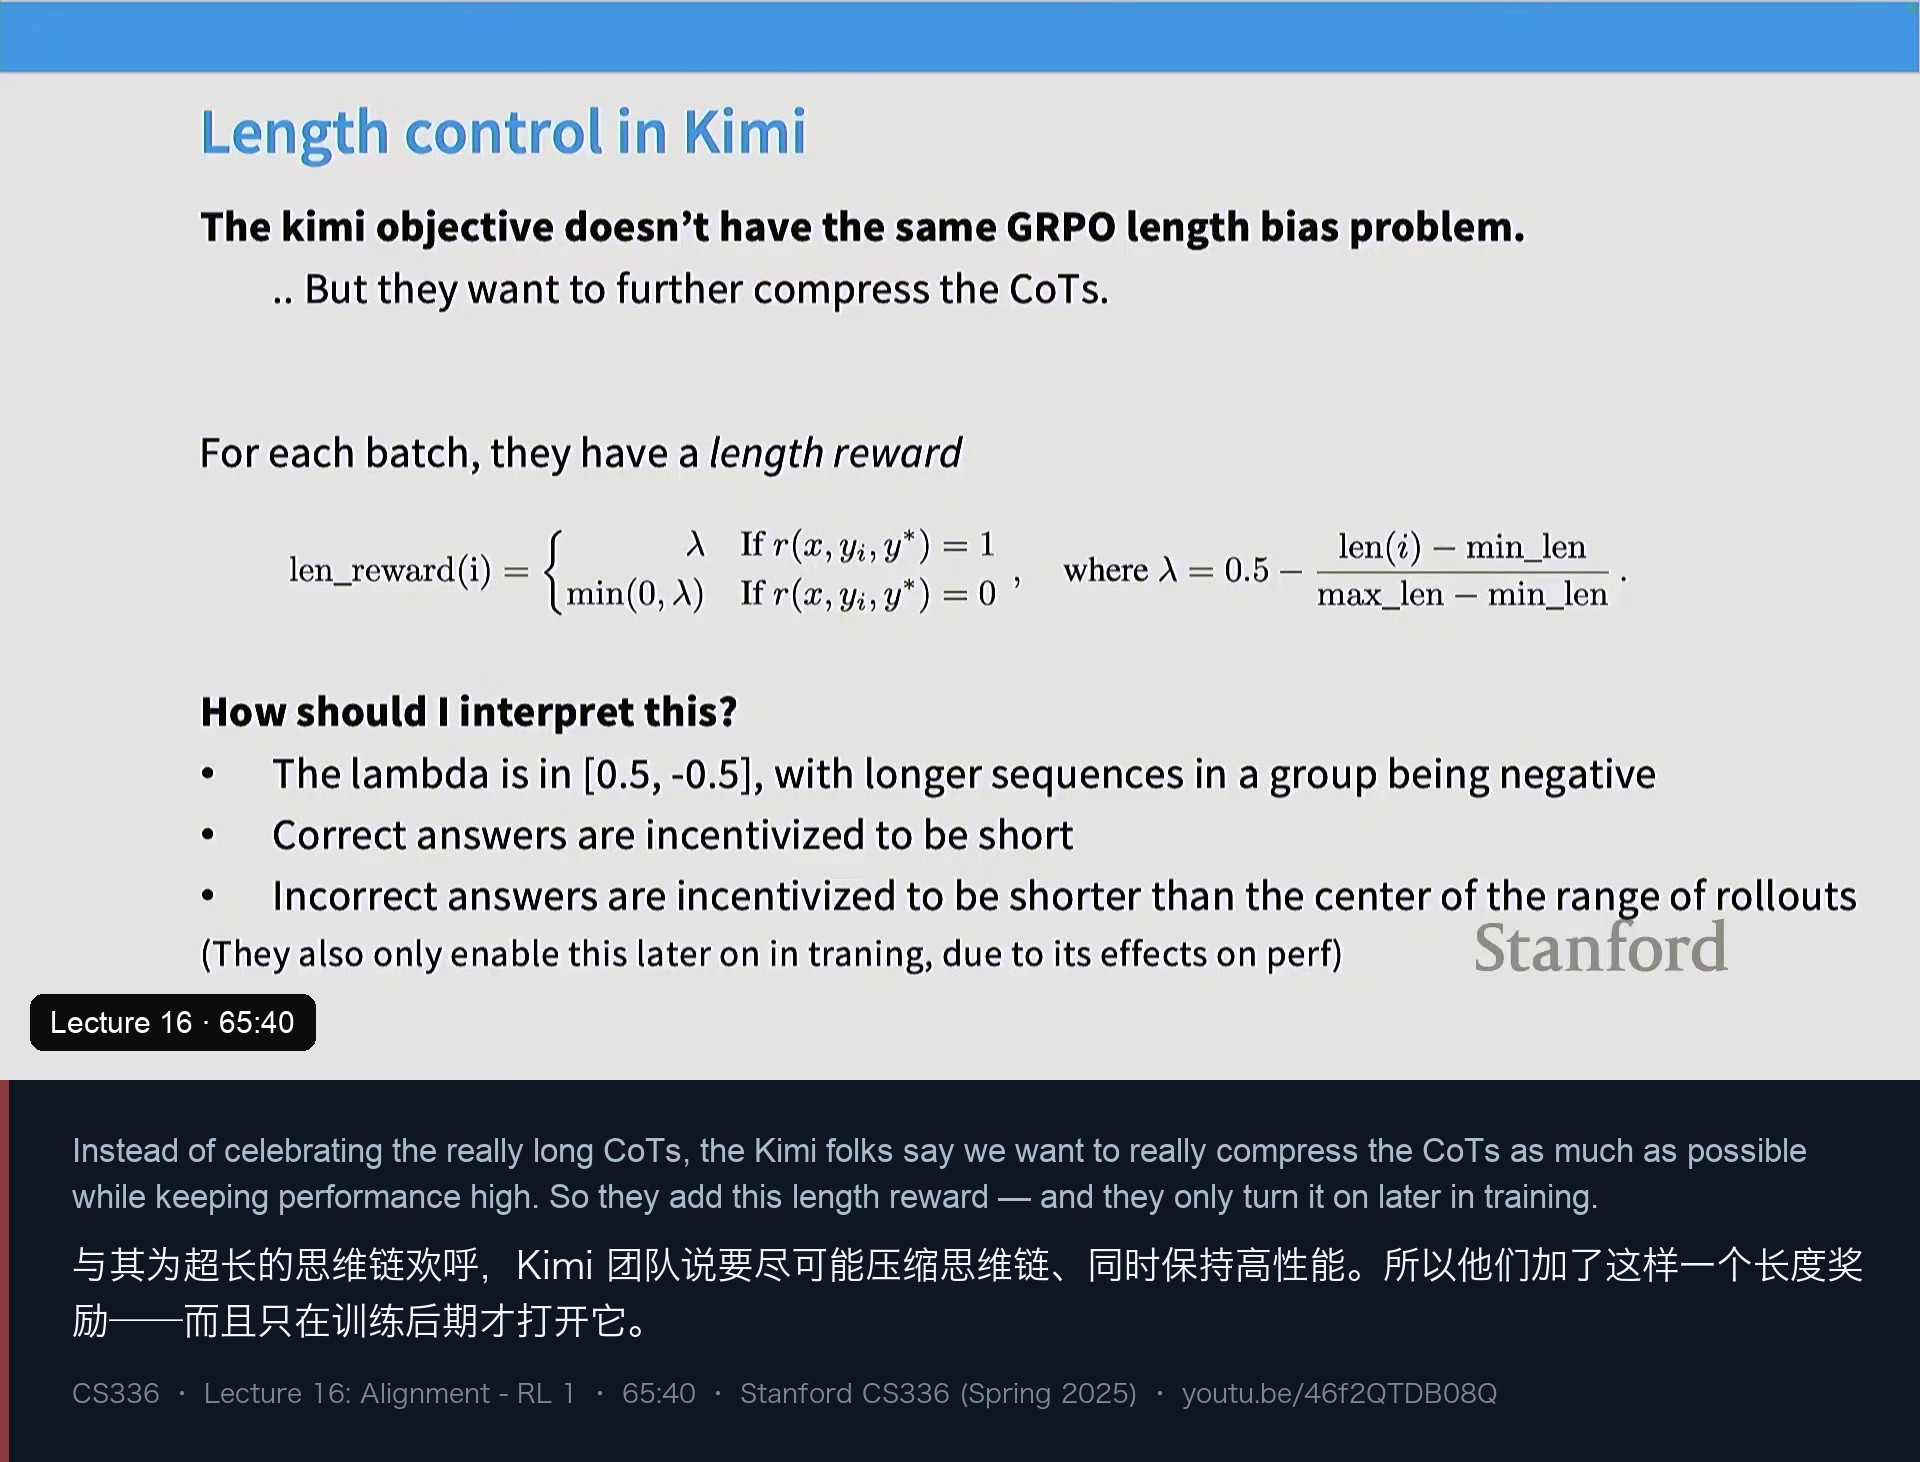
长度控制是 Kimi 最有远见的一笔。讲师的原话大意是:“与其为超长的思维链欢呼,不如想清楚——如果你要上线一个推理模型,你真正关心的是推理成本。” 所以 Kimi 加了一个长度奖励:在一个 batch 内按回答长度归一化到一个 [−0.5, 0.5] 的区间(λ ≈ 0.5 表示“你是这一批里最短的”,负值表示最长),答对时奖励“更短”,答错时也倾向于“比这一批的中位长度更短”。关键细节是:这个长度奖励只在训练的后期才打开——如果一开始就加,模型会掉进“反正我也做不对,那就摆烂写短”的局部最优,RL 直接停滞。
Kimi 还做了课程学习(人工/LM 标注难度,从易到难)和按失败率采样(成功率越高的题采样越少),并给出了相当完整的 RL infra 讨论:RL 比预训练更难把 GPU 打满,因为要不断生成 rollout(推理慢),还要在 RL worker 与推理 worker 之间来回传递数据和权重;长思维链还会让 batch 长度极不均匀。他们的做法是让不同的 worker 分别负责 RL 更新与推理,用 vLLM 做推理(实践中常有“先用 dummy 权重起 vLLM、再想办法把权重塞进去、每轮拆掉以释放显存”这类 hack;讲师说 NCCL 直接传权重的新 API 还太不成熟)。结果上,Kimi 的奖励曲线随训练稳步上升,而回答长度像修正后的 GRPO 一样稳定在某个水平,而不是无限增长。
八、案例三:Qwen3——把“思考预算”做成一个旋钮
第三个案例是 Qwen3,也是最新、最“现代”的一个。整体流水线依然是那套熟悉的骨架:基座 → 长思维链 SFT → 推理 RL →(新东西)thinking mode fusion → RLHF → 蒸馏。
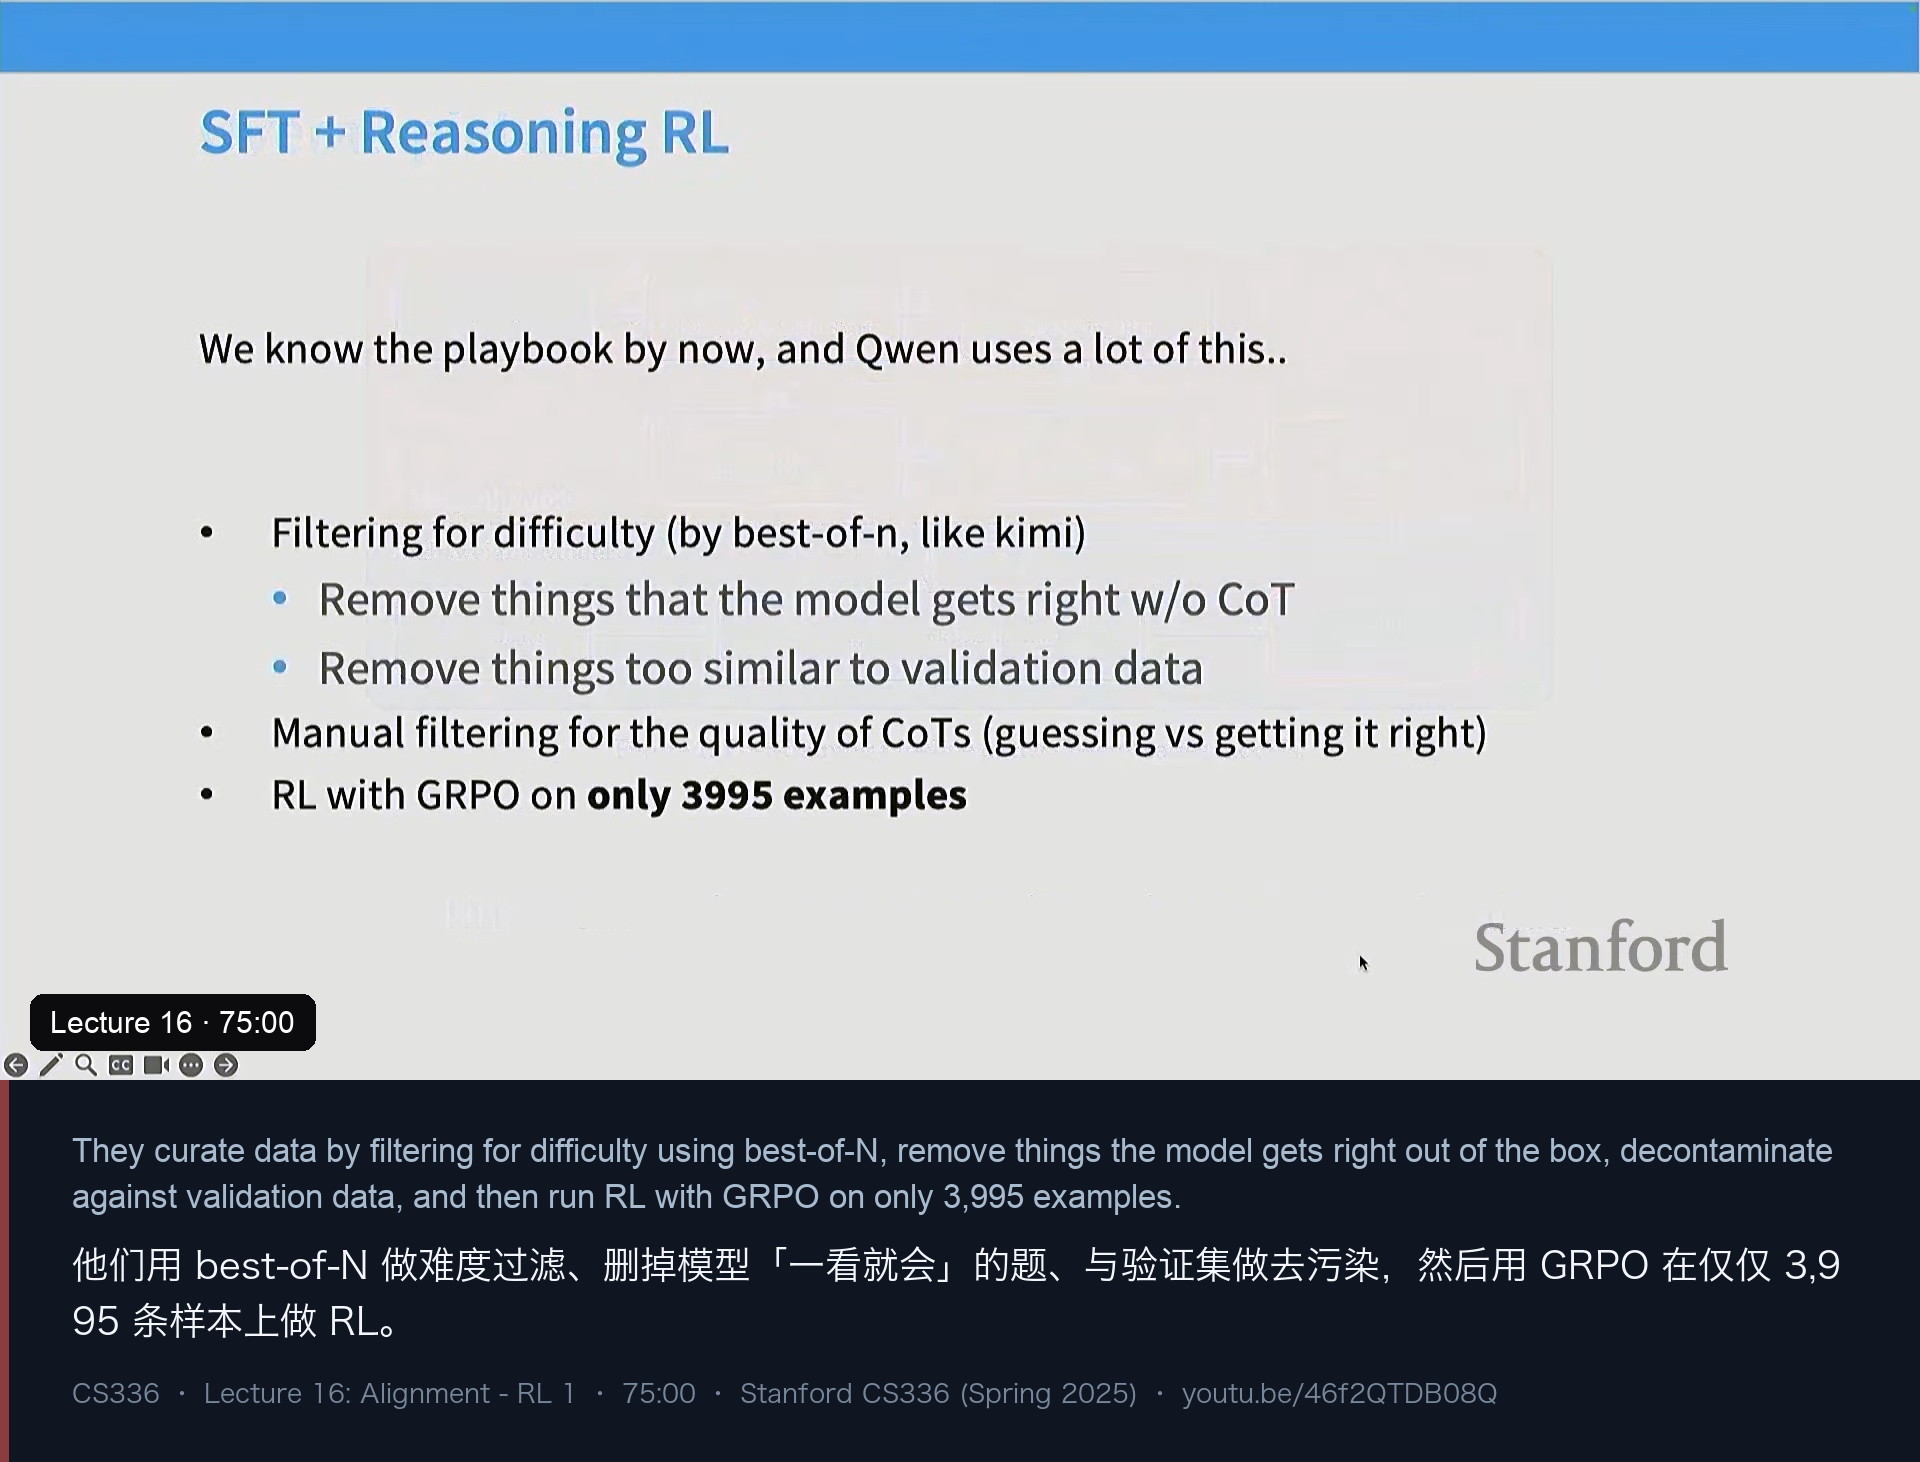
数据侧与其他两家大同小异:用 best-of-N 做难度过滤(基座模型采样 N 次就能答对的题直接删掉)、与验证集做去污染(删掉太相似的题)、以及对 SFT 数据人工过滤(区分“真做对了”和“蒙对了”)。真正让讲师“哇”了一声的是规模:Qwen3 的推理 RL 只用了 3,995 条样本。
这个数字很反直觉。讲师把它解读为:RLVR 的样本效率极高——就像历史上“用很少样本做指令微调”“用很少样本蒸馏长思维链”一样。但他也很诚实地补了一句:这并不意味着它不能继续 scale,“我们并不真正理解为什么”。
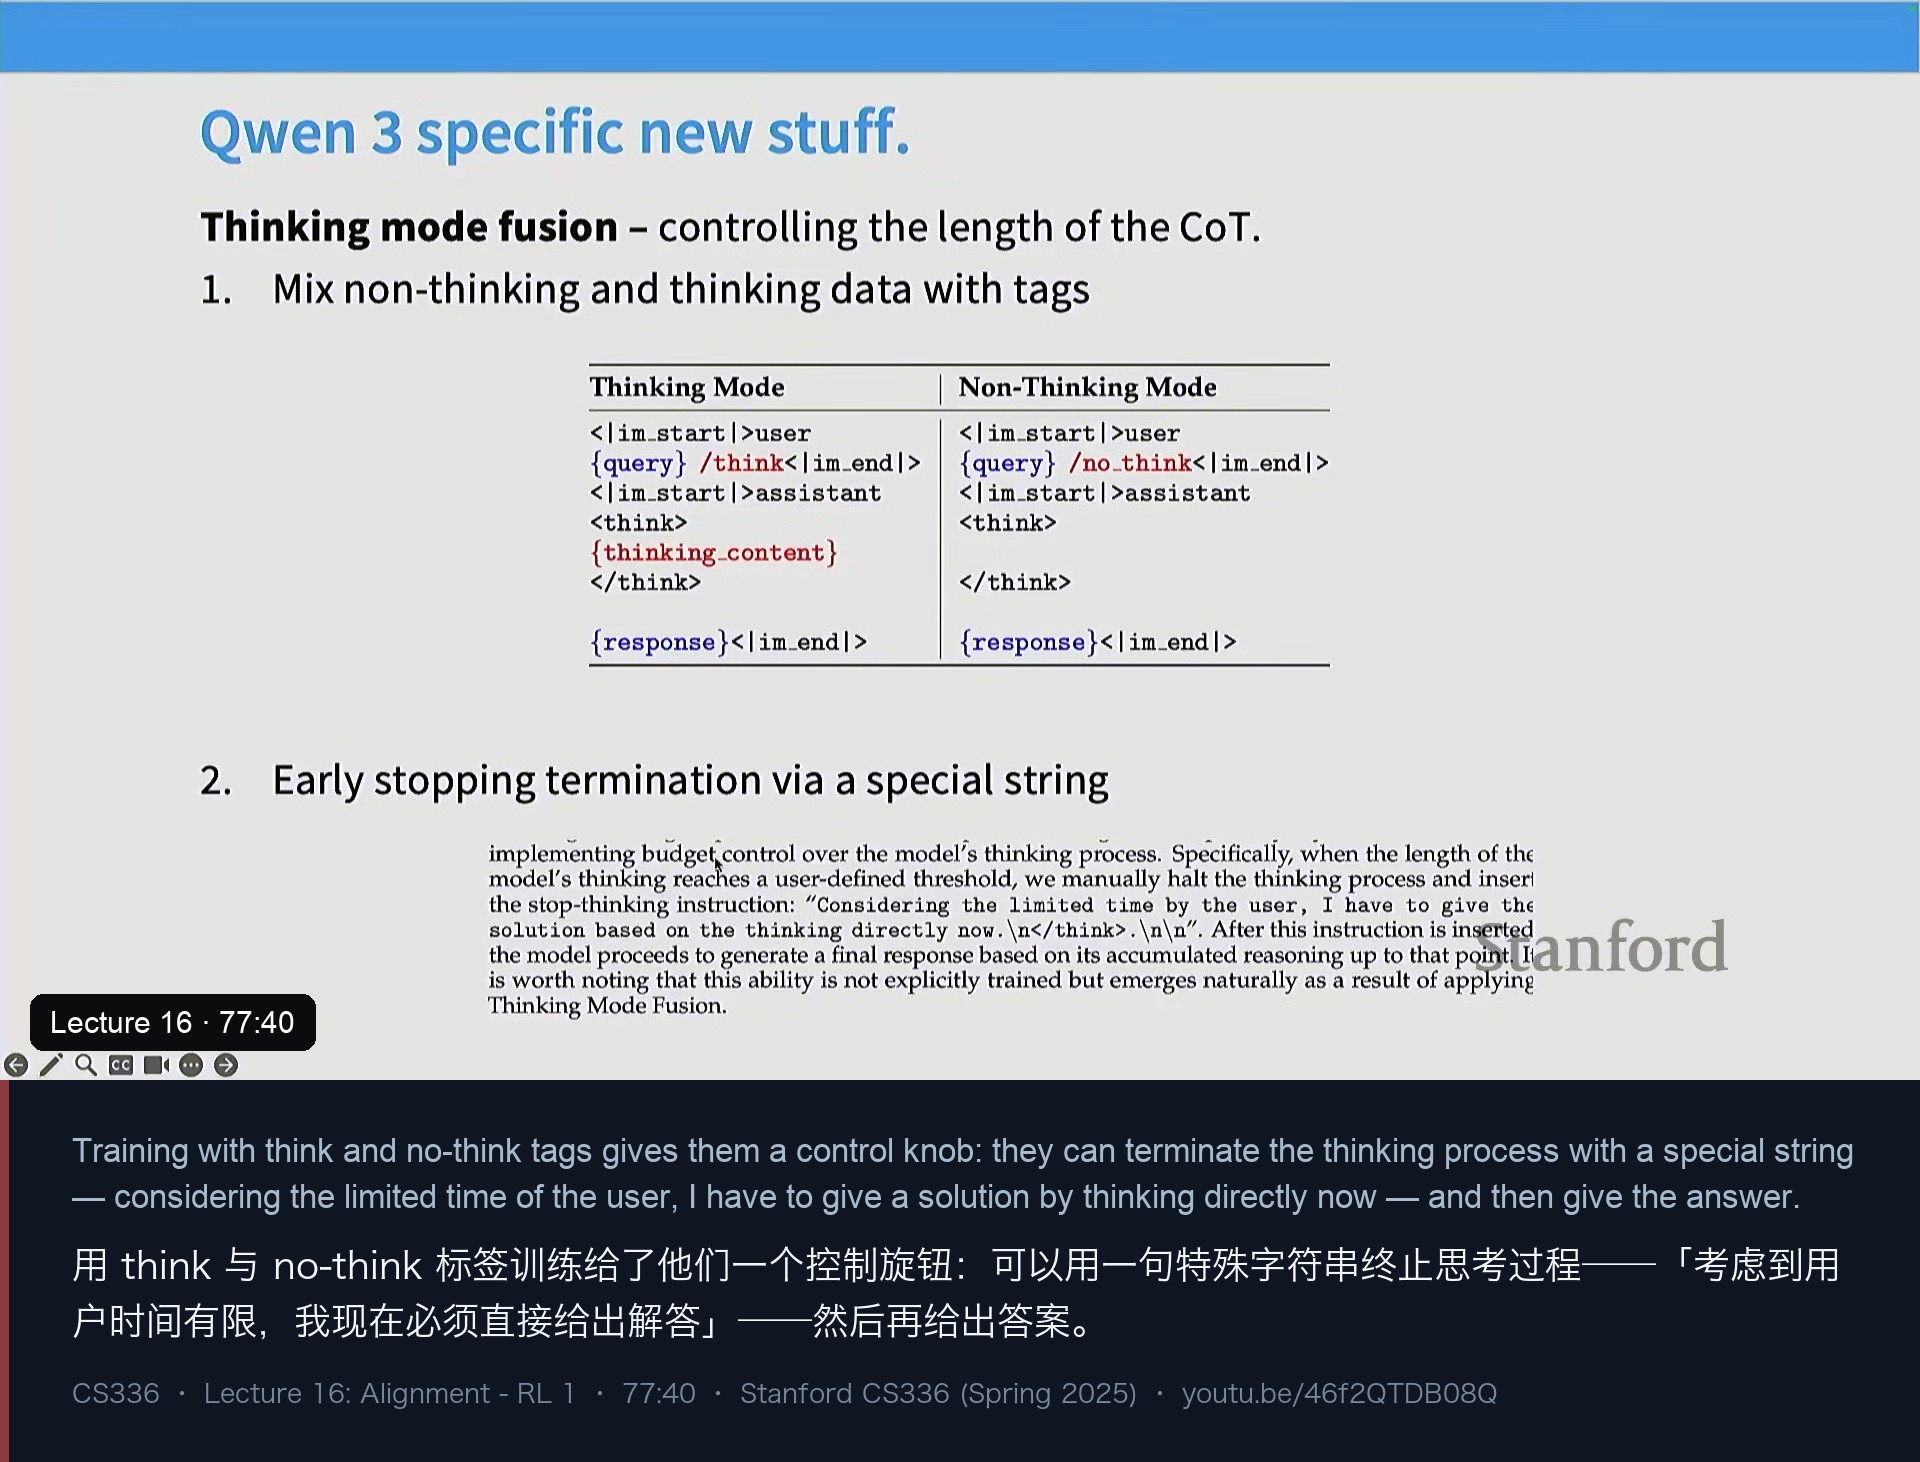
Qwen3 真正的创新是 thinking mode fusion(思考模式融合):用同一套参数同时支持“思考”和“不思考”两种模式。做法是在 RL 之后再做一轮微调,用带 /think 与 /no-think 标签的数据教模型两件事——看到 /think 就走正常的长思维链,看到 /no-think 就直接给答案。有意思的副作用是:一旦模型学会了这两种模式,你就可以在它思考到一半时塞入一句特殊字符串(大意是“考虑到用户时间有限,我现在必须直接给出解答”)再加结束标签,模型就能干净地提前收尾并给出答案。
于是他们得到了一个**“思考 token 预算”旋钮**:同一个模型可以从很短一路调到无限长,而且在预算被压得很短时性能只有温和的退化(graceful degradation)——这是从单个模型拿到干净的 test-time scaling 的一种方式。
最后 Qwen3 报告了一组很有意思的消融:在通用任务与指令遵循上,推理 RL、thinking mode fusion、RLHF 每一步都在帮忙;但在数学/STEM 上,通用 RL 反而会损害“思考模式”的性能,却提升“不思考模式”的性能。讲师说这揭示了至少一部分**“通用指令遵循”与“数学推理”之间的权衡**,也期待未来的模型能找到绕过它的办法。
九、小结:这一讲到底讲了什么
用讲师自己的收尾来总结:
- RL 非常强大,我们已经知道可以对语言模型做 RL(RLHF 就是证明);
- 但你不可能永远在带噪的成对偏好上做爬山——它会过优化、会被 hack、会崩塌校准度;
- 所以一个可行的解法是挑一个不容易被 hack 的领域(答案可自动验证),然后放心地把 RL 用上去——“在窄领域里做 RL 是一个很好的解法”;
- 而 GRPO 之所以重要,是因为它把这件事变得足够简单:只要“策略梯度 + 好的基线”就能跑;
- 最后,野外有一大堆成功配方(R1 / Kimi / Qwen3),你现在大概能分辨出什么是共通的、什么是不同的、哪些实现技巧真的重要。
我的笔记
- 这一讲的主线是“奖励信号的性质决定你能做什么”。 RLHF 的奖励来自带噪的人类偏好,所以会过优化、会崩塌校准度(图 3);RLVR 的奖励可以自动、廉价、大规模判定对错,所以 RL 才第一次“正常工作”(图 4)。
- DPO 的梯度形状值得记住:加权 = 你错得越多、更新越大;方向 = 抬高好的、压低坏的。 后面所有算法,包括 GRPO,本质上都还是这句话,差别只在“什么是好的、加权多少、用什么基线”。
- “按长度归一化”是这一讲最好的反面教材。 它在 DPO 变体(图 2)里出现一次,在 GRPO(图 11)里又出现一次,每次都把优化目标悄悄改成了“控制长度”,而不是“提高质量”。
- GRPO 的贡献小到可以一句话说完,效果却很大:删掉 value model 和 GAE,优势函数换成组内 z-score(图 8、图 9)。这再次印证了“后训练里,把工程复杂度砍掉往往比换个更花哨的公式更值钱”。
- “组”这个设计很聪明,但它的合法性有边界。 组内均值作为难度基线是合理的(leave-one-out 的思想);但除以标准差就出界了——因为基线必须零均值且与抽样独立(图 10)。
- 标准差的偏差方向值得单独记:它给“太简单”(全对)和“太难”(全错)的题加权,而这正是最不该更新的两类题。想要的是“能做对一部分”的中等难度题——这也是课程学习(Kimi 的难度标签、Qwen3 的 best-of-N)在做的同一件事。
- PPO 的“37 个实现细节”不是段子,是这一讲的结构性事实。 讲师那句“如果实现搞砸了,你算的已经不是策略梯度了,但效果反而更好”,几乎是在说:这个领域的很多东西还没被理论解释清楚。
- “裁剪后的 KL 不再是 KL”(图 7 相关讨论)是同一类现象的另一个例子。工程里到处是“取了名字的近似”,重要的是知道它在近似什么。
- R1 最科学的部分是它的负面结果(图 14):GRPO + 结果奖励能复现 o1,而 PRM 和 MCTS 都没能帮上忙。“我们需要过程奖励模型才能做推理”这个直觉,被打掉了。
- R1 的配方里,“格式奖励”和“语言一致性奖励”这两个看起来最小的东西,可能是最关键的粘合剂。 前者把思维链装进标签使之“可用”,后者防止模型在 RL 压力下语言乱窜。
- Kimi 的“best-of-8 都失败才保留”是一个非常锐利的过滤器(图 15):它同时保证了题目“可验证”和“有梯度”——太简单的题没有信息量,太难的题全都是 0 奖励。数据策展在这个范式里的地位,可能不比算法低。
- Kimi 把“推理成本”提前摆上台面,是这三家里最有产品意识的一笔(图 16)。而且长度奖励必须晚开这个细节很宝贵:奖励设计的时机和奖励本身一样重要。
- Qwen3 的 thinking mode fusion 是把“想多久”变成产品能力(图 18):同一套参数、
/think与/no-think、外加一句“时间有限请直接回答”就能提前收尾。这是“能力控制”和“成本控制”在模型内部的统一。 - 3,995 条样本就够了(图 17)——RLVR 的样本效率高到反直觉,而讲师坦承“我们不知道为什么”。这可能是这一讲里最值得后续跟进的一个开放问题。
- R1 / Kimi / Qwen3 三家是一个“收敛演化”的样本:都做 SFT 初始化 → 都用结果/可验证奖励 → 都做数据过滤 → 都关心长度。不同的是算法细节(GRPO vs 平方损失 vs GRPO 变体)、长度控制(无 / 后期加 / 训练时融合)和部署形态(pure reasoning / thinking budget)。
- RLHF 与 RLVR 不是替代关系。 R1 和 Qwen3 最后都还是叠了一层常规 RLHF——推理能力靠可验证奖励来练,而“像个好助手”这件事仍然要回到人类偏好;Qwen3 的消融显示这两者甚至会互相拉扯(通用 RL 在思考模式下损害数学性能)。
附:课程信息与时间轴
- 课程:Stanford CS336《Language Modeling from Scratch》(Spring 2025)
- 本讲:Lecture 16 — Alignment: RL 1(Reinforcement Learning from Verifiable Rewards)
- 主讲:Tatsunori Hashimoto
- 时长:1:20
- 视频:https://www.youtube.com/watch?v=46f2QTDB08Q
| 时间 | 内容 |
|---|---|
| 00 | 开场:后训练第二讲;先收尾 RLHF,再讲 RL from verifiable rewards |
| 00 | DPO 回顾:成对偏好、策略在期望“底部”、非参数换元 |
| 02 | DPO 的梯度形状:错得越多权重越大,抬高好样本、压低坏样本 |
| 03 | 变体海洋:只讲 SimPO 与 length-normalized DPO |
| 04 | 别把单个实验结果当圣旨:AI2 的 PPO>DPO 与 Tulu 3 的反例 |
| 05 | 警告一:过优化(overoptimization)——代理奖励与真实偏好分道扬镳 |
| 07 | 过优化的来源:人类偏好的噪声;无噪声 AI 反馈上不出现 |
| 07 | 警告二:RLHF 不再是概率建模,模型校准度崩塌、过度自信 |
| 11 | 转向:人类反馈难优化、难扩展;那换一个奖励可自动判定的领域 |
| 12 | AlphaGo / AlphaFold 的启示:知道真奖励 + 能大规模快速评估 |
| 13 | 本讲结构:算法(PPO → GRPO)+ 三个案例(R1 / Kimi / Qwen3) |
| 14 | 回到 PPO:从最朴素的策略梯度出发 |
| 16 | TRPO:重要性比率 + KL 约束,让一次采样多走几步 |
| 17 | PPO:把 KL 约束换成优势裁剪(软约束) |
| 18 | PPO 需要 value function;以及《PPO 的 37 个实现细节》 |
| 21 | 实现走读:外层循环、value loss、policy loss、clip 常数 |
| 22 | rollout:采样 + log prob,注意 value/reward/policy 的 tokenizer 对齐 |
| 22 | 奖励整形:语言模型 RL 是 contextual bandit,没有状态转移 |
| 23 | 逐 token 的 KL 正则 + 最后一个 token 的终端奖励;KL 在零处截断 |
| 25 | GAE:用 λ、γ trade off 偏差与方差;取 1 退化成带基线的策略梯度 |
| 27 | 为什么要替代 PPO:不要 value model、不要复杂实现 |
| 28 | 为什么不用 DPO:需要成对结构、本质上是离线算法 |
| 28 | GRPO 登场:把 GAE 换成组内 z-score 优势 |
| 30 | “组”的定义与 leave-one-out 基线;题目难度被均值扣掉 |
| 32 | GRPO 的非标准 KL:控制变量技巧降低估计方差 |
| 33 | 纯在线(只走一步)时裁剪消失,退化成策略梯度 |
| 33 | 实现细节:除以标准差时加 1e-4 防止数值爆炸 |
| 34 | DeepSeek Math 的结果:结果奖励与过程奖励 |
| 36 | 细看 GRPO 目标:优势函数是唯一的、也是关键的差别 |
| 37 | 问题一:除以标准差破坏了“合法基线”的约定 |
| 39 | 标准差偏差的方向:给太简单/太难的题加权,与课程直觉相反 |
| 39 | 问题二:按长度归一化 → 答错就写长、答对就写短 |
| 40 | 修正之后:奖励一样好,但长度不再无限膨胀 |
| 42 | 课程效应:应该喂模型“能做对一部分”的中等难度题 |
| 43 | 案例总览:R1 与 Kimi k1.5 同期、Qwen3 最新 |
| 44 | R1 为什么重要:极简、无搜索、无 PRM、SFT 与 RL 的交互 |
| 45 | R1-Zero:在基座模型上直接 RL,准确率奖励 + 格式奖励 |
| 47 | R1-Zero 的结果:只做 RL,性能逼近 o1 |
| 49 | R1 完整版:长 CoT SFT 初始化 → RL → SFT → RLHF |
| 52 | 语言一致性奖励:不加的话思维链会语言混杂 |
| 54 | 蒸馏:约一百万条思维链,32B 在 AIME 上大幅提升 |
| 55 | 两个负面结果:PRM 与 MCTS 都没有帮助 |
| 59 | 案例二:Kimi k1.5——同期、结果相近、算法不同 |
| 01:00 | Kimi 数据策展:跨域平衡、排除选择/判断题、只留可验证短答案 |
| 01:01 | 难度过滤:生成 10 个答案,只留 best-of-8 都失败的题 |
| 01:02 | Kimi 的 RL 算法:从 DPO 式假设出发,做成平方损失 |
| 01:04 | 梯度又落回“策略梯度 + 基线 + 正则”,且没有除以标准差 |
| 01:05 | 长度奖励:为了推理成本而压缩思维链,且只在训练后期打开 |
| 01:07 | 课程学习 + 按失败率采样 |
| 01:09 | RL infra:rollout 让 GPU 打不满,RL 与推理 worker 来回传权重 |
| 01:11 | Kimi 的 scaling 结果:奖励上升,长度稳定而不失控 |
| 01:13 | 案例三:Qwen3——最新、最现代的推理 RL 配方 |
| 01:15 | Qwen3 数据侧:best-of-N 难度过滤、去污染、人工过滤“蒙对” |
| 01:15 | 推理 RL 只用 3,995 条样本:RLVR 的样本效率 |
| 01:16 | thinking mode fusion:同一套参数支持 think / no-think |
| 01:17 | 用一句特殊字符串提前终止思考 → 思考预算旋钮 |
| 01:18 | 消融:通用 RL 提升指令遵循,却损害思考模式下的数学性能 |
| 01:19 | 收尾总结:在窄领域做 RL 是一个好解法,GRPO 让这件事变简单 |
讨论
这里是静态站点,没有内嵌评论区。如果这篇文章对你有用,欢迎通过 RSS 订阅后续更新。