Stanford CS336 第十五讲精读:Alignment——人类怎么把自己的偏好装进模型,从 SFT 到 RLHF
斯坦福 CS336(Language Modeling from Scratch, Spring 2025)第十五讲完整讲义,主讲 Tatsunori Hashimoto。这一讲回答一个问题:GPT-3 已经很强了,但那支从 GPT-3 指向 ChatGPT 的箭到底是怎么射出去的?前半程拆三种完全不同的 SFT 数据(FLAN 的 NLP 任务聚合、OpenAssistant 的人类众包、Alpaca 的模型生成),讲为什么『完全正确且非常详细』的数据反而会教模型编造引用、安全微调如何在拒绝与过度拒绝之间走钢丝、mid-training 如何把指令数据塞回预训练;后半程进入 RLHF:成对偏好数据怎么收、标注员是谁为什么重要、生成-验证差距,最后把 InstructGPT 的目标函数、Bradley-Terry 奖励模型、PPO 的三次渐近尝试与 DPO 的完整推导一步步走完。
本篇属于系列 Stanford CS336 精读 · 第十五讲
来源:YouTube 原视频(Stanford Online · CS336 Language Modeling from Scratch · Spring 2025 · Lecture 15: Alignment - SFT/RLHF)
来源说明 这是斯坦福 CS336《Language Modeling from Scratch》2025 年春季第十五讲的完整讲义,主讲人是 Tatsunori Hashimoto。这是本课最后两讲里的第一讲,另一讲(RL from verifiable rewards,推理与数学训练)在他的“周四”课。这一讲的位置很特殊:前面十四讲都在拆解预训练——数据、架构、GPU、并行、scaling law、评估、数据治理;从这里开始,我们假设已经有一个很强的预训练模型,问的是怎么把它变成一个真正能用的产品。
全文按讲课顺序逐段整理:先把 InstructGPT 的三步流程 SFT → 奖励模型 → RL 立成骨架,再用最大的篇幅讲数据(三种 SFT 数据范式、两次课堂众包实验、标注员是谁),最后讲算法(目标函数、Bradley-Terry、PPO、DPO 的推导)。文中 18 张配图均截取自视频对应时刻的画面,并把该时刻的完整观点句(英文原句+中文翻译)拼合进图里。 文中出现的所有数字——InstructGPT 只找了约 40 名标注员、Google Bard 标注员每题约 1 分钟、500 条安全数据就能生效、Surge 等研究里 95%+ 的 GPT-4 一致率、偏好数据里 60–70% 的长回答胜率、MiniCPM 的两阶段配方、best-of-1024 等——都是讲师课上的口播、幻灯片演示或对公开论文/新闻的转述,是讲师引用的公开传闻或估算,不是本文独立核实的事实,请以原始论文与公开材料为准。
另外两点提醒。其一,自动字幕把不少专有名词听错了:
FOMO/Fla/fla是 FLAN,Oasst/Open Assistant是 OpenAssistant,GPT3/GPT-3是 GPT-3,chat GBT/chat GPD/GBD4/GPT4是 ChatGPT / GPT-4,PO/PRPO是 PPO,RHF/RHF是 RLHF,SFP/SRT是 SFT,John Schulman是 John Schulman,Sebastian Bubck是 Sebastien Bubeck,Ejong Wong是 Yizhong Wang,Mini CPM/mini CPM是 MiniCPM,Zephier/Zephr是 Zephyr,Tulu 3是 Tulu 3,Hosking Blunam and Barlo是 Hosking, Blunsom & Bartolo,Bradley Terry是 Bradley-Terry,Stiennon是 Stiennon,monopsin是 monopsony,NSW是 NSFW,下文按通行写法记录。其二,这一讲最值得记住的不是哪个算法更好,而是两条贯穿始终的张力:“教模型做它做不到的事”会制造出幻觉这样的捷径行为,而“只教它已经会的”需要 on-policy 的反馈;以及奖励信号的形状决定了模型的行为形状——你用什么数据、请什么人、看什么指标,模型就长成什么样。配图全部来自视频画面(不只是截图,而是“视频帧 + 该时刻观点句的中英双语面板”)。
TL;DR
- 这一讲讲的是“那支箭”:GPT-3 是个了不起但不好用的系统——不会跟指令、不会对话;ChatGPT 会。中间发生的事就是后训练(post-training)。心智模型是:预训练把能力打包进参数,后训练教模型把这些能力“拿出来用”。
- 后训练的流程仍然照抄 InstructGPT 的三步:专家演示上做监督微调(SFT)→ 收集成对偏好训练奖励模型 → 用 RL 对着奖励模型优化。今天所有主流的后训练管线,骨架都还是这一套。
- SFT 数据有三种截然不同的来路:FLAN 是把现成 NLP 任务数据集“做手术”拼起来(量大数据杂、不像聊天);OpenAssistant 是人类志愿者众包(质量高、极贵、极难持续);Alpaca 用语言模型生成指令和回答(便宜、像聊天、但深度有限)。上课当场做的众包实验说明了一件事:让人类写出长篇高质量回答,比大多数人想象的难得多。
- “完全正确且非常详细”的数据可能是毒药。OpenAssistant 里那条带引用的 monopsony 回答,同时在教模型两件事:关联这个知识,以及“复杂问题的结尾必须给引用”。如果模型并不知道那个引用,它学到的是编造。John Schulman 的说法是:token prediction 下幻觉比“不写引用”的损失更小,所以你要么只教模型已经会的东西(on-policy),要么接受它会编。
- 指令微调可靠地教的是输出的“类型签名”(风格、形状、格式),而不是新知识。它意外地强大——标准数据集加合理超参就能得到行为很像 ChatGPT 的模型;但“高质量数据”的定义非常微妙,少量数据有巨大杠杆。
- mid-training 把边界抹掉了:指令数据本质就是 token 序列,所以可以混进预训练的退火阶段。MiniCPM 那套“纯预训练 → decay 阶段混入高质量/指令数据 → 再来一轮短 SFT”的配方,今天几乎人人都在用。副作用是:“base model”这个词越来越可疑——它可能已经隐式地做过指令微调了。
- 为什么还需要 RLHF?两个理由:一是采样比测量贵(写一条专家回答很贵,判断 A 比 B 好便宜得多);二是生成-验证差距——人类验证不仅比生成便宜,有时质量还更高(讲师自己学生的实验里,一位自由职业专家写手更偏好 AI 写的摘要)。
- 成对反馈的收集被严重低估了难度:课堂实验里 27 个人五分钟内几乎没人能核查完事实和数学,多数人还是把票投给了更长但带幻觉的答案。InstructGPT 通过 Scale 和 Upwork 只找了约 40 人;Bard 的标注员据说每题只有一分钟。
- 标注员是谁,模型就像谁。InstructGPT 类模型的意见更接近东南亚宗教群体——而 InstructGPT 附录里标注员来自菲律宾、孟加拉,只有 17% 是美国人。另一项研究发现众包工人不太在意事实性、更在意格式。RLHF 处在管线末端,对行为的影响却极大。
- AI 反馈因此流行:GPT-4 给出的成对偏好,与人类估计的胜率高度一致,而人-人一致度 ≈ GPT-4-人一致度,但便宜得多。代价是长度偏差——AI 反馈会让模型越写越长。
- 算法部分的四个公式值得背下来:InstructGPT 的目标(奖励 − KL 惩罚 + 预训练梯度)、Bradley-Terry 的偏好概率
σ(r_w − r_l)、PPO 的裁剪目标、以及 DPO 的损失。DPO 的推导只有三步:非参数假设下最优策略正比于π_ref · exp(r/β),反解出“隐含奖励”,代进成对偏好的对数似然——于是一个 RL 问题变成了最大似然问题。
一、从预训练到后训练:GPT-3 到 ChatGPT 的那支箭
这是 Tatsunori Hashimoto 的最后两讲之一。开场他先定位:前面十四讲全部围绕预训练——大的训练系统、数据组件;从今天起,我们拿到那个大的预训练模型,想办法让它有用且安全。今天讲 RLHF 与安全对齐,周四讲 RL from verifiable rewards(推理训练、数学)。
他给出的例子是整段转型最好的注脚:GPT-3 是一个了不起的系统,海量预训练、海量算力,但它“不是一个有用的系统”——它不跟指令,从产品角度看没什么可做的,当年只有几家创业公司在拿它写广告文案。然后ChatGPT 出现了,它能做各种惊人的事、能跟指令,并且从此改变了社会。今天要讲的就是中间那支箭。
值得强调的是现代指令模型的能力有多“反直觉地强”。他举了 Sebastien Bubeck 等人 2023 年 Sparks of AGI 里的例子:模型能跟完一大段嵌套的复合指令,再结合编码能力零样本输出 matplotlib 代码。他说你们现在都觉得理所当然——“ChatGPT 当然能一次跟十条指令”——但这其实很惊人。
另一半动机是安全与内容审核。模型已经直接部署给终端用户、能力又强,就可能被用来做诈骗、生成虚假信息;而对一个要收费、要放广告的产品来说,没人想在一个毒性内容横飞的系统上做生意。ChatGPT 能成功,很大一部分原因就是它有一圈相当强的护栏。
于是他给了今天的心智模型:
预训练可以理解成“把各种能力打包进参数”——模型在参数里的某个地方已经会推理、会回答问题,但它不会自动去做。后训练要做的事,就是收集我们想要的行为数据,训练它把这些能力“拿出来用”。
由此自然引出三个问题,也是全讲的骨架:
- 数据长什么样?(专家演示、成对偏好、安全数据……)
- 收集这些数据有多难?(他会用两次课堂实验让大家亲身体会)
- 怎么把数据用起来?(有标注的演示可以直接模仿;但“A 比 B 好”这种成对反馈怎么用?)
最后是规模化:这门课反复出现的那个问题——怎么按预训练的方式把它放大。
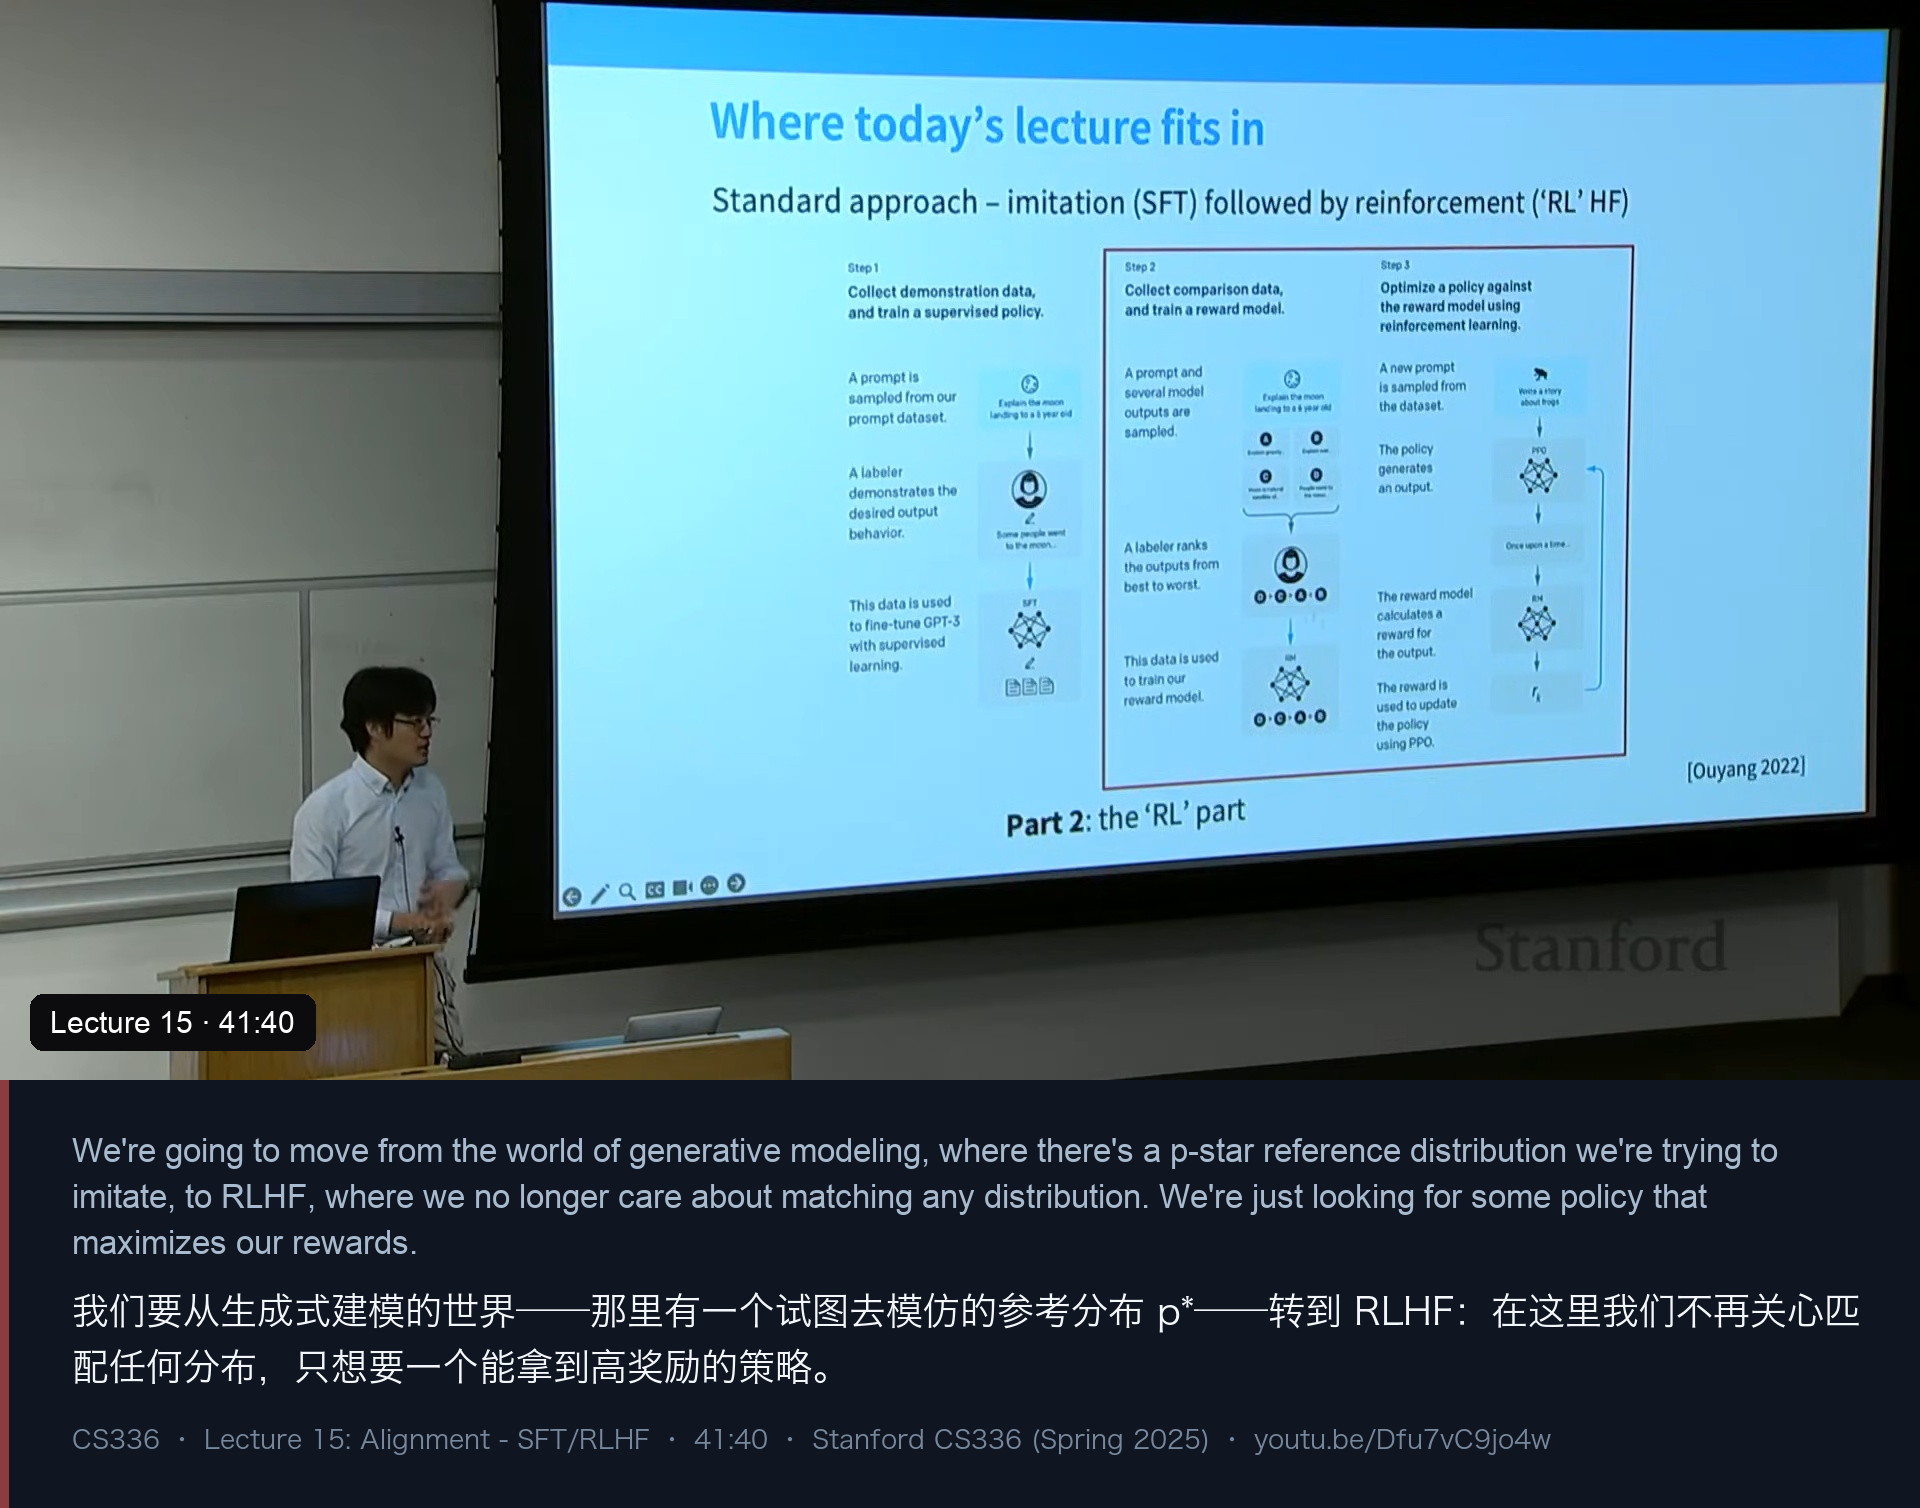
讲的结构直接照搬 InstructGPT 论文的三步图:左边是 SFT(在专家演示上做监督微调),中间/右边是奖励模型与 RL。他说得很清楚:今天很多后训练流程,骨架仍然是这篇论文定的。
二、三种完全不同的 SFT 数据:FLAN、OpenAssistant、Alpaca
后训练里“数据”比预训练更关键,因为你只用很少的数据去精确地塑造行为:指令数据里有噪声,模型就会给你很离谱的行为。他为“数据长什么样”选了三个用三种完全不同方式构造的数据集,并让听众逐个看真实样本。
第一种:FLAN——把现成 NLP 任务聚合成一个大杂烩。 这是 Google 一群人做的,做法是把一堆 NLP 训练数据集(Natural Instructions v2 里的问答、T0-SF、对抗 QA、主题分类……)聚合成一个大的元数据集。
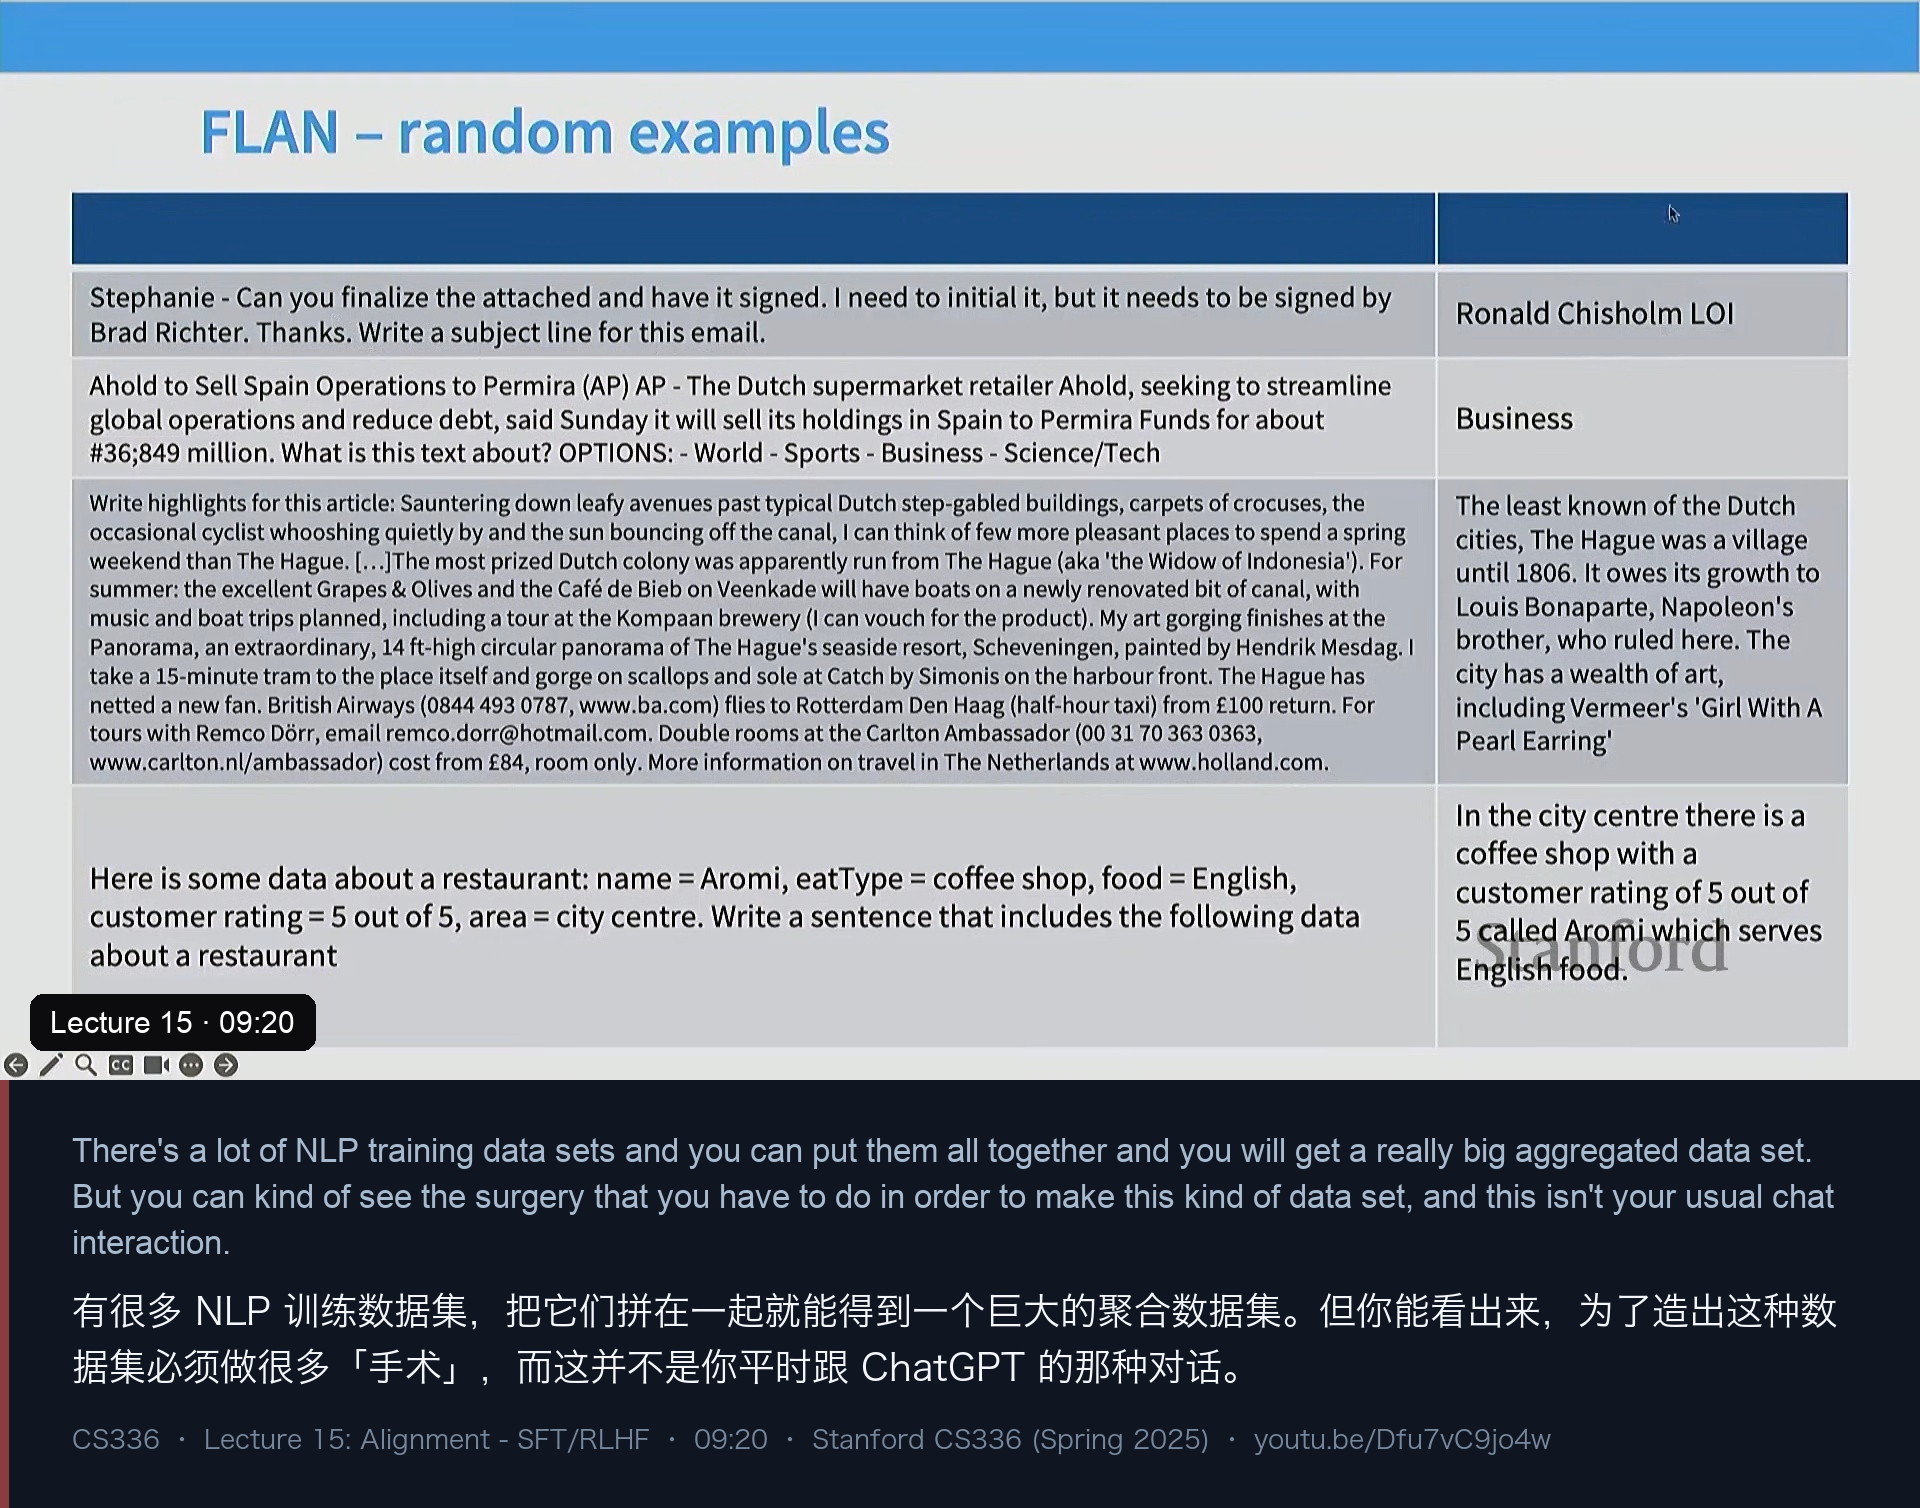
看样本就能看出问题:有“给这篇文章写摘要”(下面接荷兰旅行攻略和 www.holland.com 的链接)、有“这段文字在讲什么?四个选项:business / …”、有拿 Enron 邮件数据集改的“给这封邮件写主题行”、还有 E2E 数据集里“给数据库条目写一句餐厅描述”。好处是数据可以白捡一大把——NLP 数据集那么多,拼起来就是超大数据集;坏处是你能肉眼看见为了造数据做的那些“手术”(把选项拼到文本后面之类),这不是你平时跟 ChatGPT 的那种对话。
第二种:Alpaca——用语言模型生成指令数据。
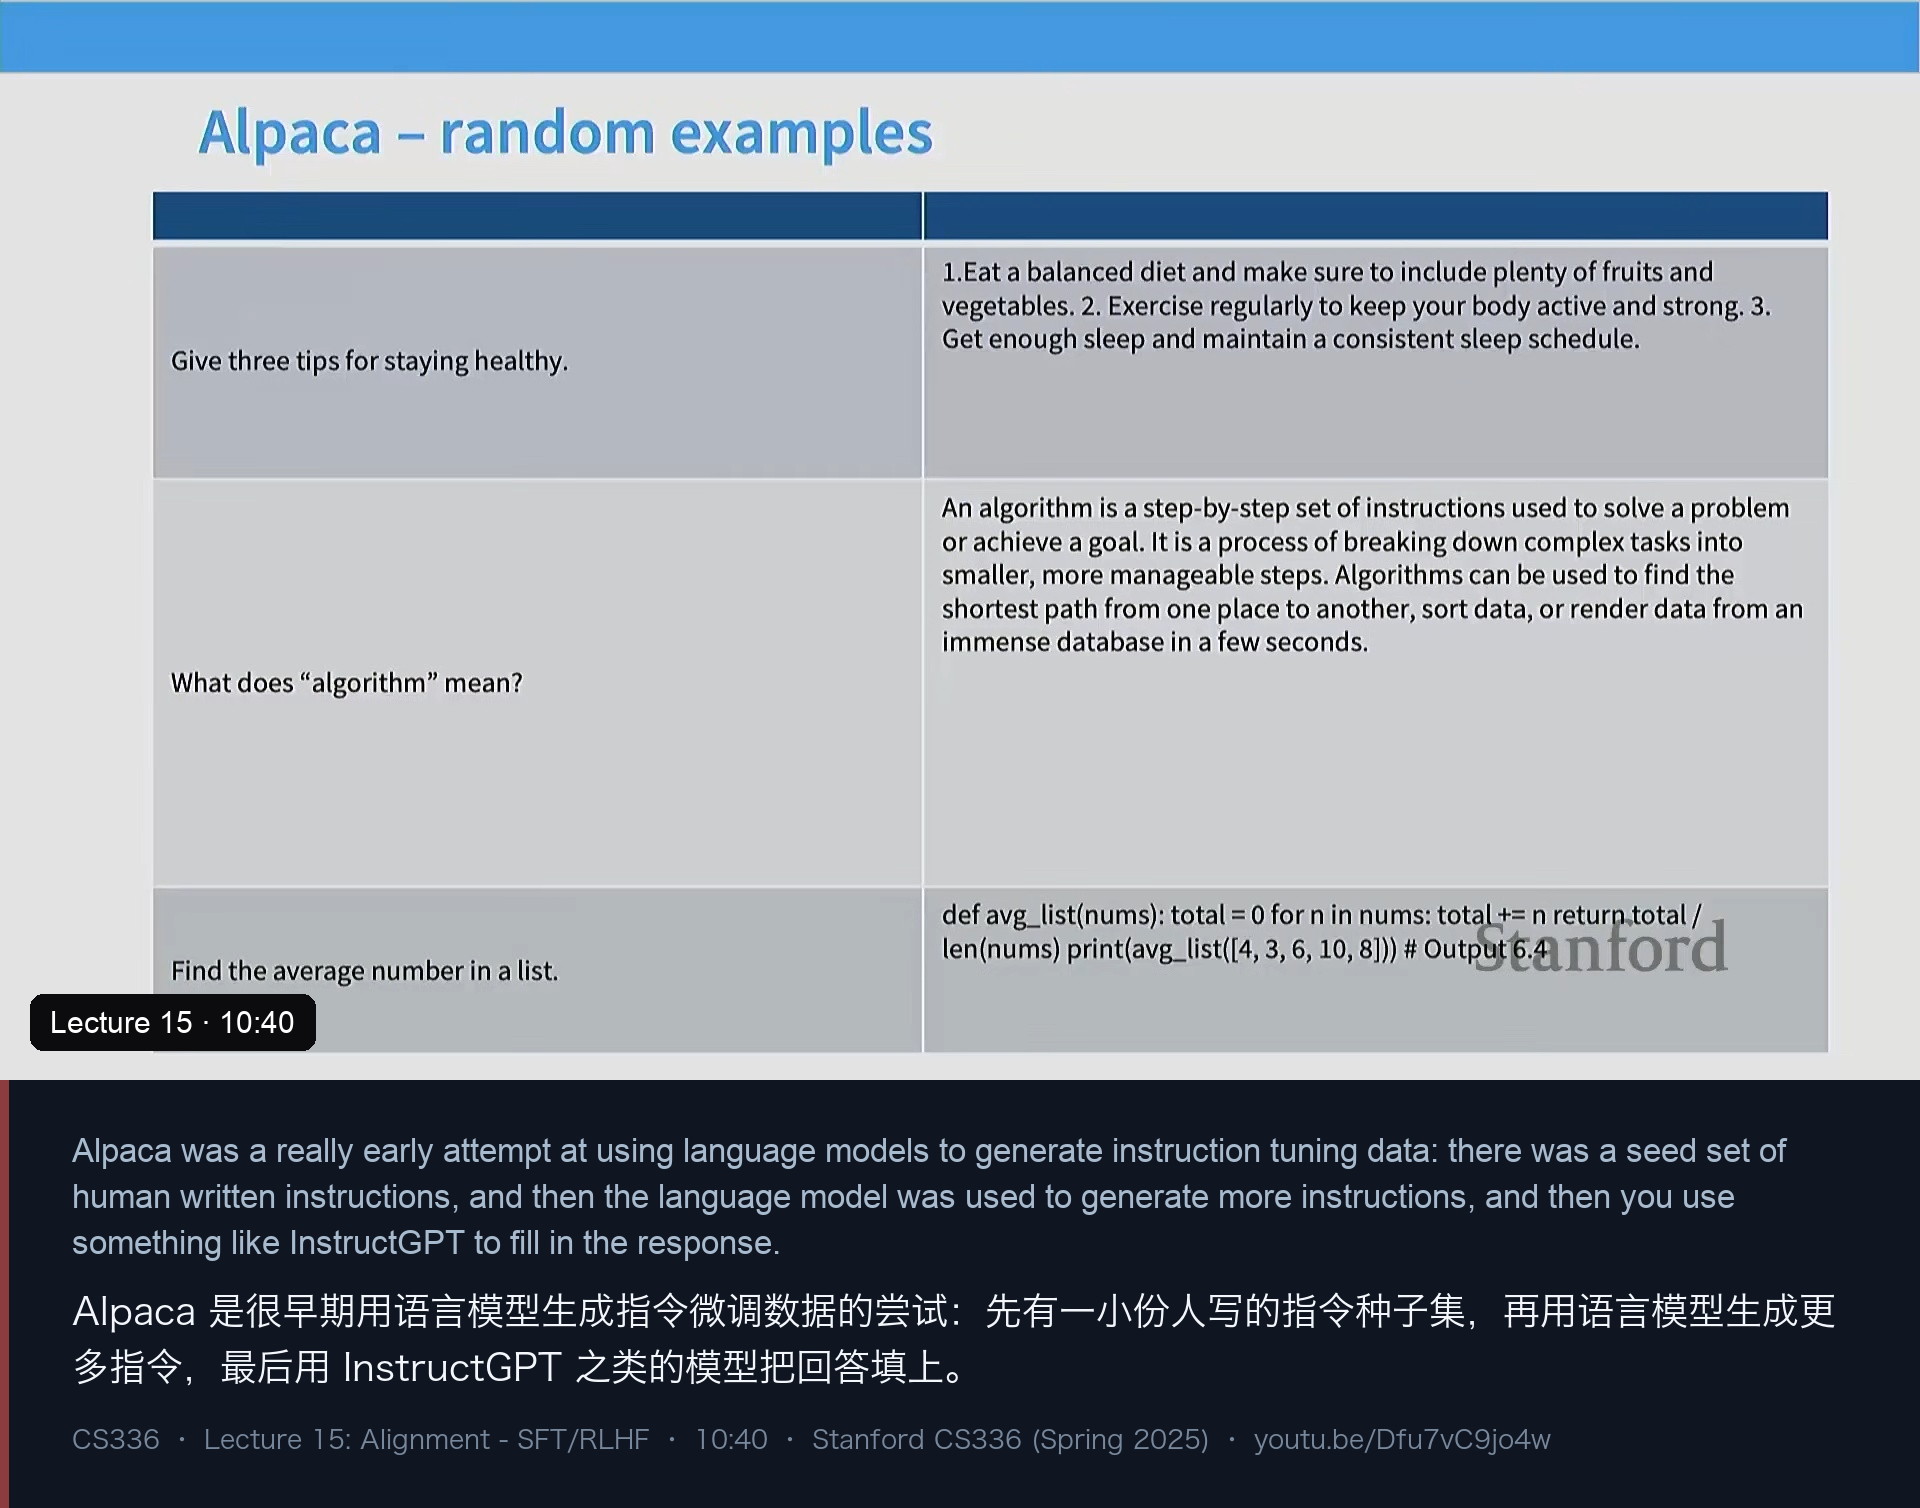
流程很清楚:先有一小份人写的种子指令,用一个语言模型生成更多指令(左列),再用 InstructGPT 之类把回答填出来(右列)。结果看起来更像聊天输入了,回答也几乎总是长文本自然语言(FLAN 里常常只有一个词或一个短语)。但他也点出问题:输入很短、多样性有限。
第三种:OpenAssistant——人类志愿者众包。
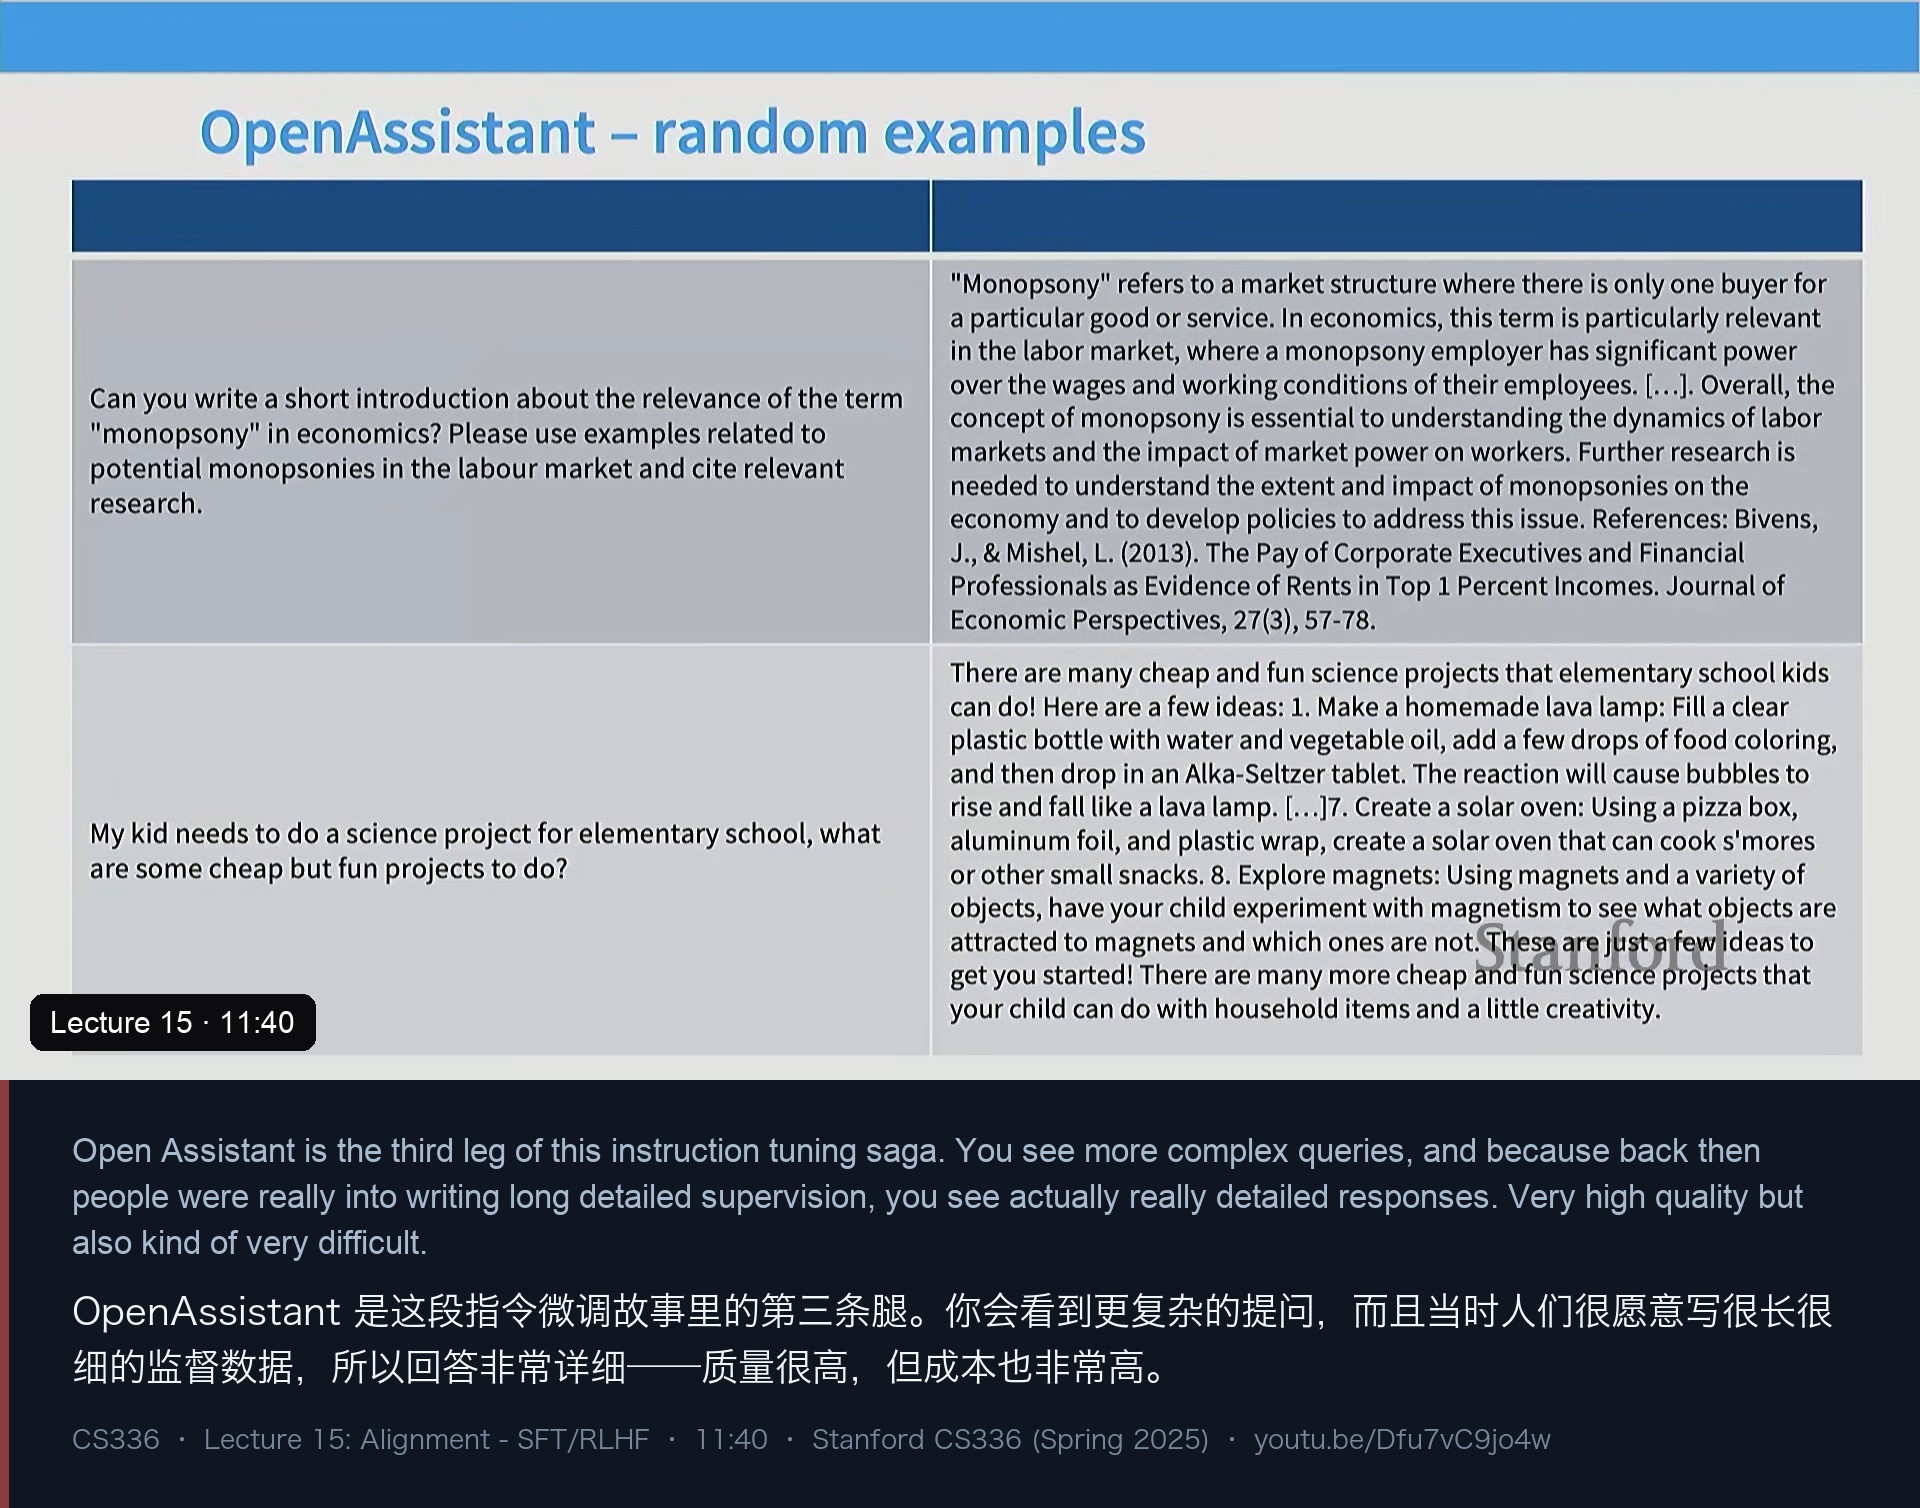
这是 ChatGPT 发布后不久,一群在线爱好者自发组织起来写指令微调数据,产出了相当多高质量的人类手写数据。特点是提问更复杂,而因为当时大家“真的很热衷于写又长又细的监督”,回答非常详细——其中一条甚至带了引用,说明“为什么这个答案是对的”。质量极高,但也极难生产。 他在后面的 Q&A 里补充:这条带引用的回答,恰恰是后面“幻觉”讨论的引子。
三、课堂众包实验:写出长篇回答到底有多难
讲到一半,他做了这门课的第一个互动环节:给了个 Google 表单,让在座学生五分钟内一起众包一条指令微调的回答,然后当场把结果投到屏幕上。
结果非常诚实,也非常有教育意义。屏幕上出现了:
- 大量短回答——“冰淇淋是一种冷冻甜点,通常由牛奶或奶油制成”这种;
- 一堆 emoji,看起来是从 ChatGPT 复制来的;
- 有人在捣乱(“I am preparing for lift thoughts”);
- 以及个别又长又详细的回答(通常来自 ChatGPT)。
他的结论很直接:写长篇回答真的很难,尤其是你对这个题目没有准备的时候;众包场景里你很难让人写出那种长篇、细致的东西。而“标注员在真实世界里,即使是专家,也处在时间压力之下”。这正好解释了为什么 AI 反馈(用模型生成/精修这类数据)会流行起来:如果一份 GPT-4 的回答就已经相当好,而让人类写出同等质量要花大量时间和成本,那么“负责人类数据采集的人”面临的真正难题就是:怎么设计激励,让人产出接近那种质量的东西——这是一个极难的众包问题。
他还顺手列了这批数据暴露出的几个维度:长度差异极大、风格变化极大(有的全是 bullet points)、有时带引用、有时嵌入很深的领域知识。这些都是后文反复回到的伏笔。
四、长度、列表与评估:被风格带偏的偏好
关于“数据里该注意什么”,他先讲长度这个“房间里的大象”。2023 年那波指令数据集爆发之后,Yizhong Wang 等人在 UDub 做过一个很好的综述,把各种数据集的 prompt 和 response 长度分布画出来——输入长度大致代表任务复杂度,输出长度则代表“你给标注员的压力有多大”或者“你是不是用了 AI 生成”。
然后是他想让每个人记住的一句实操警告:
人类评估者对“列表”有强烈偏好;AI judge 也一样。人类对更长的输出有大约 60–70% 的偏好率,AI judge 也是。
这件事有点令人不安,因为你做后训练理想情况下是想减少幻觉、提升能力,而不是去优化回答的“风格含量”。好消息是:这些风格因素对 benchmark 表现并不太重要——以 MMLU 为例,尽管长度差异巨大,各种指令微调数据集基本都能在 base model 之上带来提升。
所以他的建议是评估要多样化:chat 风格的评测(Chatbot Arena、AlpacaEval 这类用户参与/自动评测)有它的位置,但 benchmark 也有非常重要的位置——因为做后训练时,你不想被长度偏差和开放式领域牵着走。
五、高质量数据的陷阱:引用、幻觉与“类型签名”
这一节是全讲前半程的高潮,值得慢慢读。
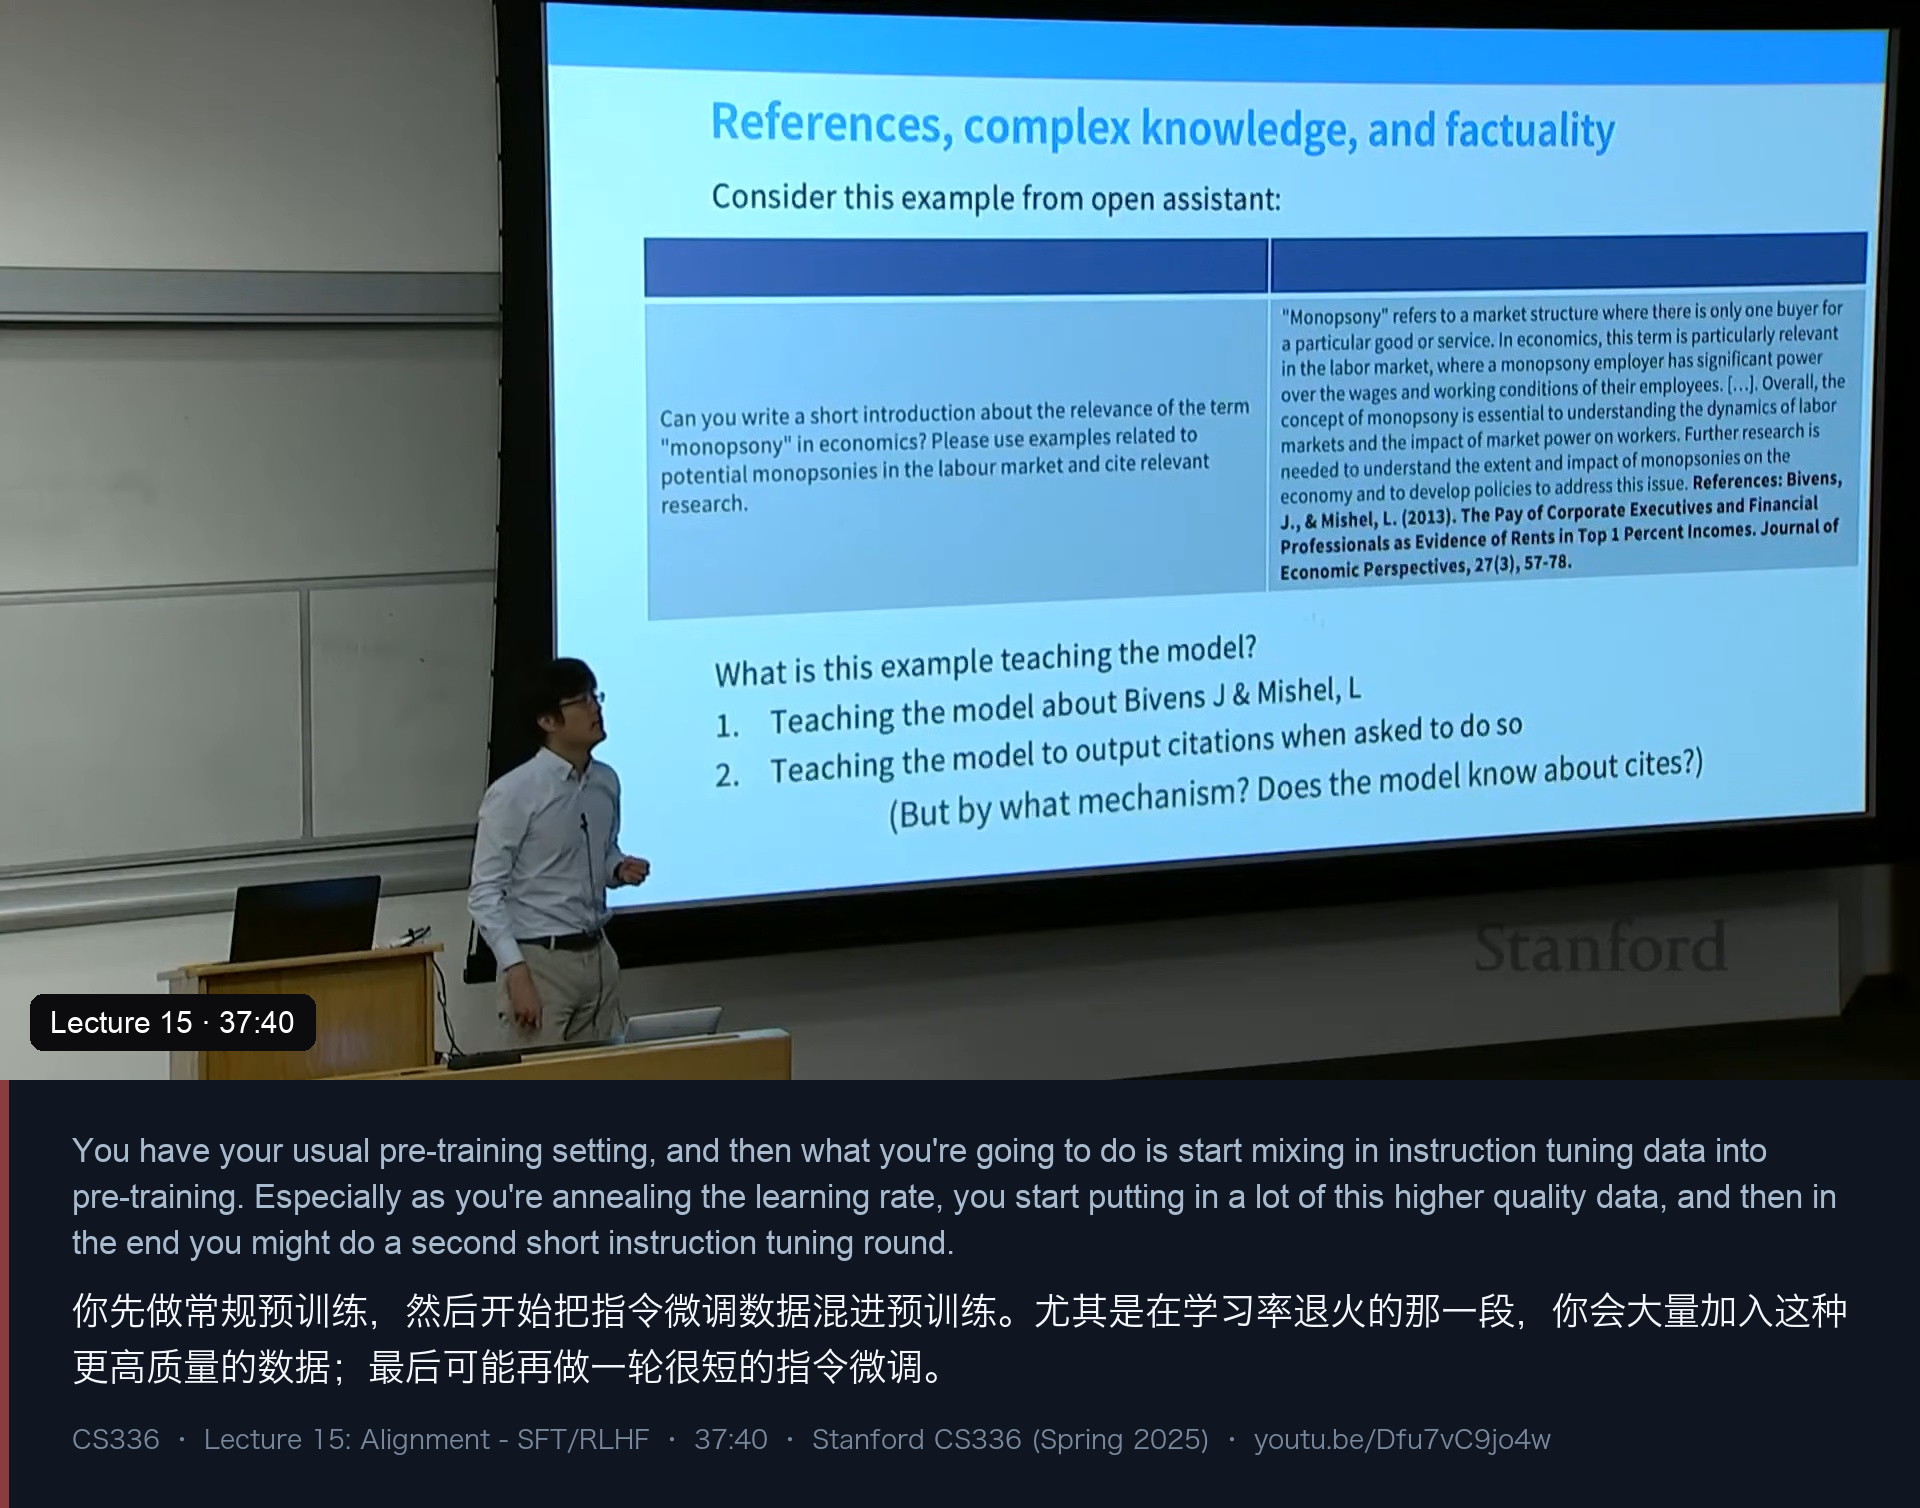
铺垫是:人们一想到“高质量数据”,第一反应是“内容要深、要有引用”。OpenAssistant 就是个好例子——左边是很专业的提问(写一段关于monopsony(买方垄断) 在经济学中重要性的简介),右边是详尽的回答 + 参考文献。
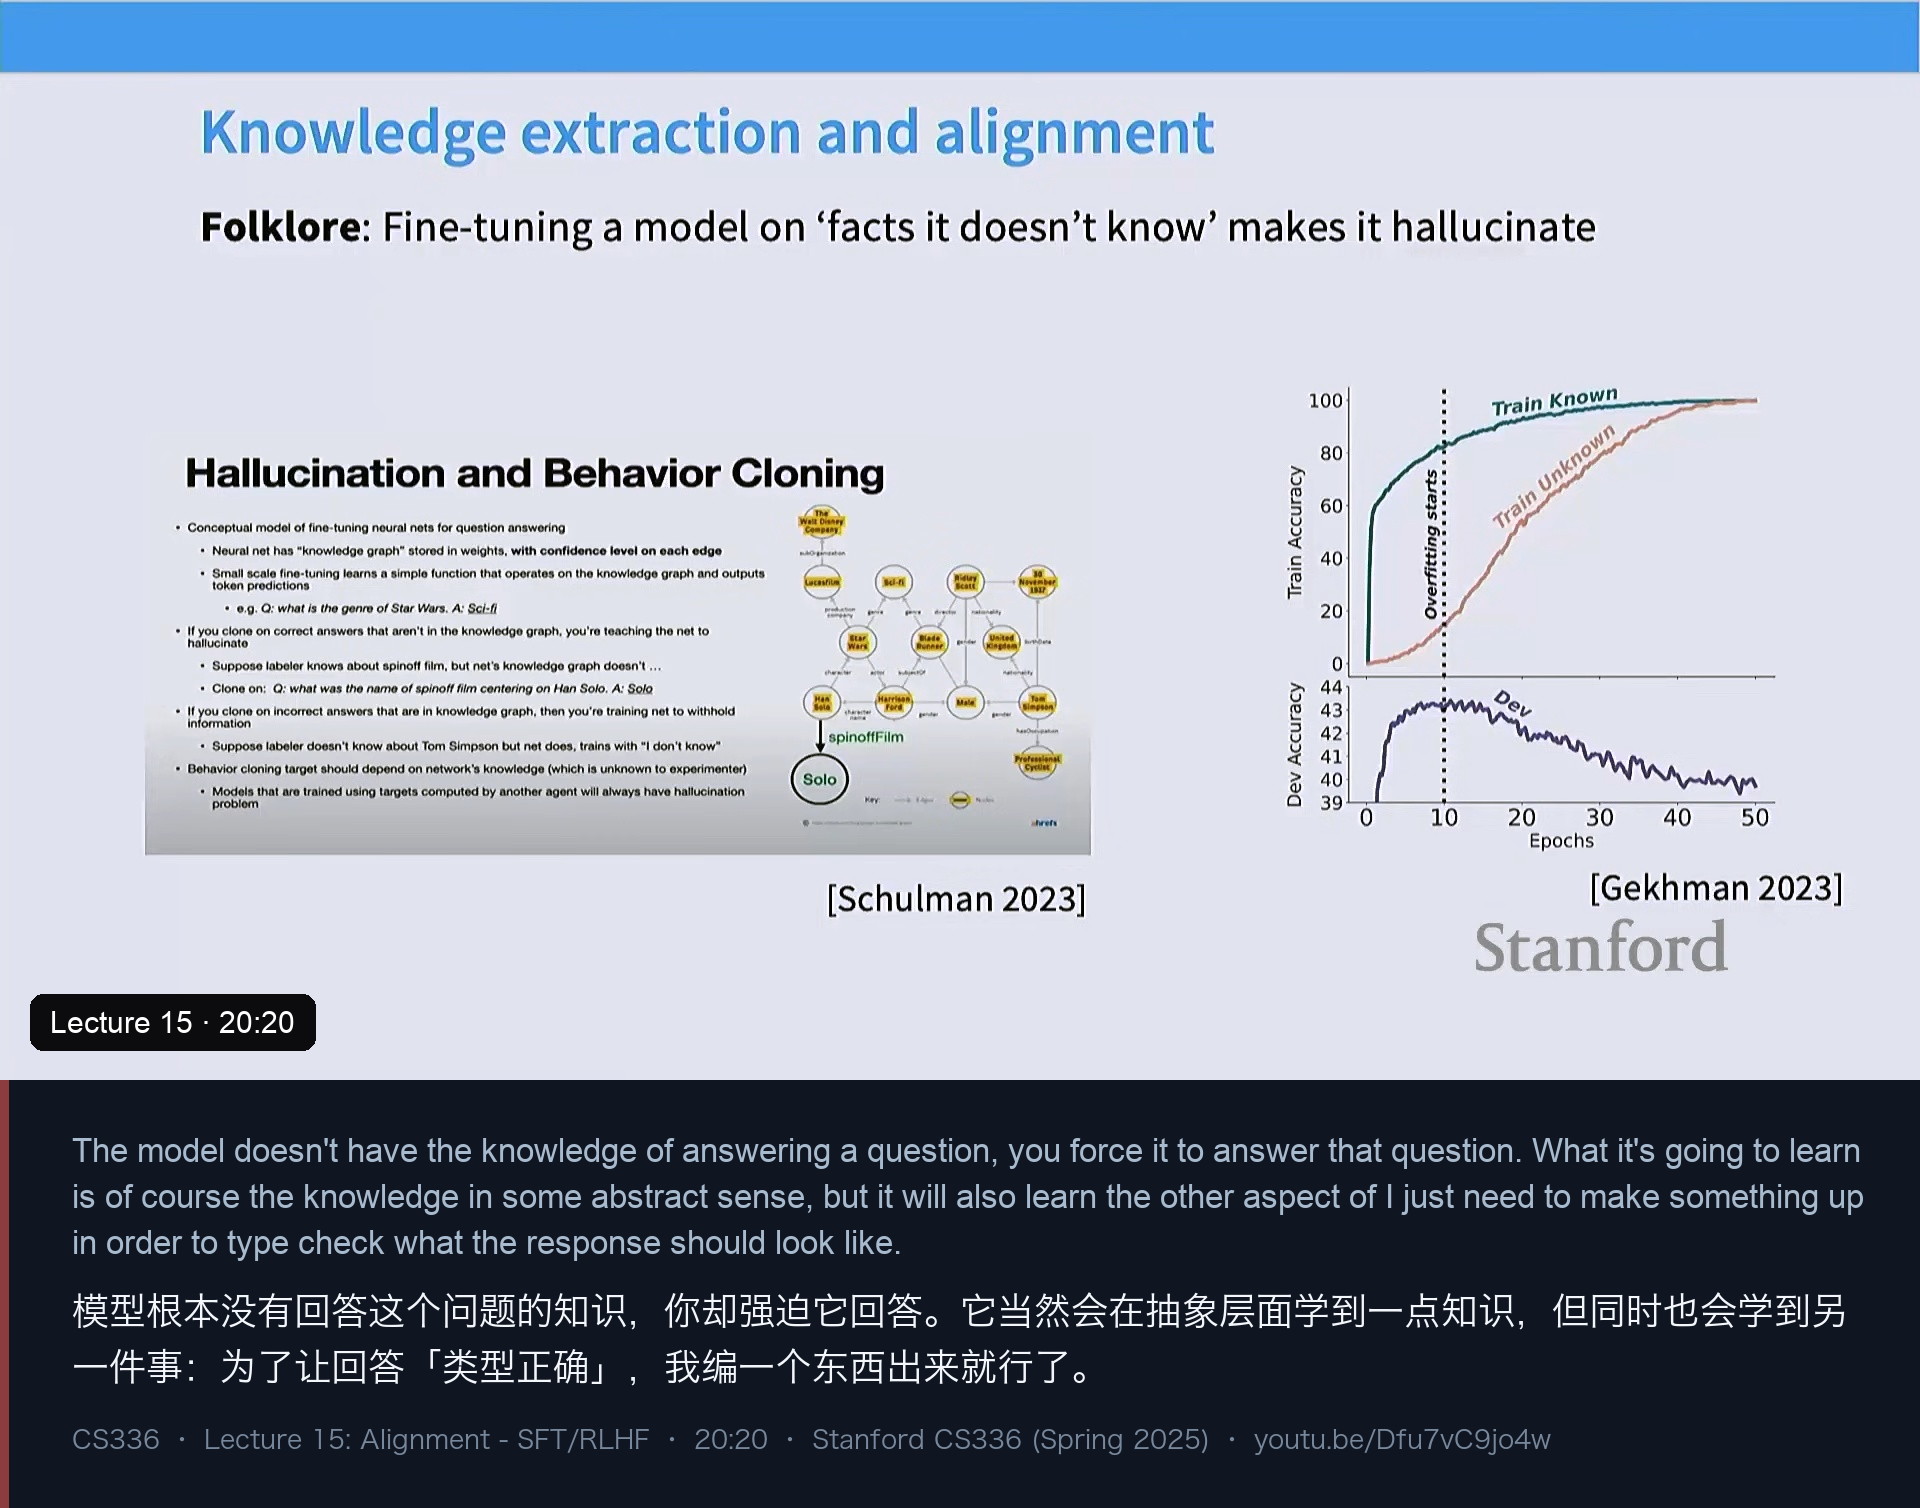
现在假设我们拿这个输入输出对做微调。他说,这个过程同时在教两件事:
- 知识:把“monopsony”和那篇引用关联起来。如果模型本来就“知道”这篇文献,这是好事。
- 一个泛化的行为:“只要问题够复杂,我结尾就必须给一个引用。”
如果模型参数里根本没有这个关联呢?那它学到的就是第 2 条——在结尾编一个引用。
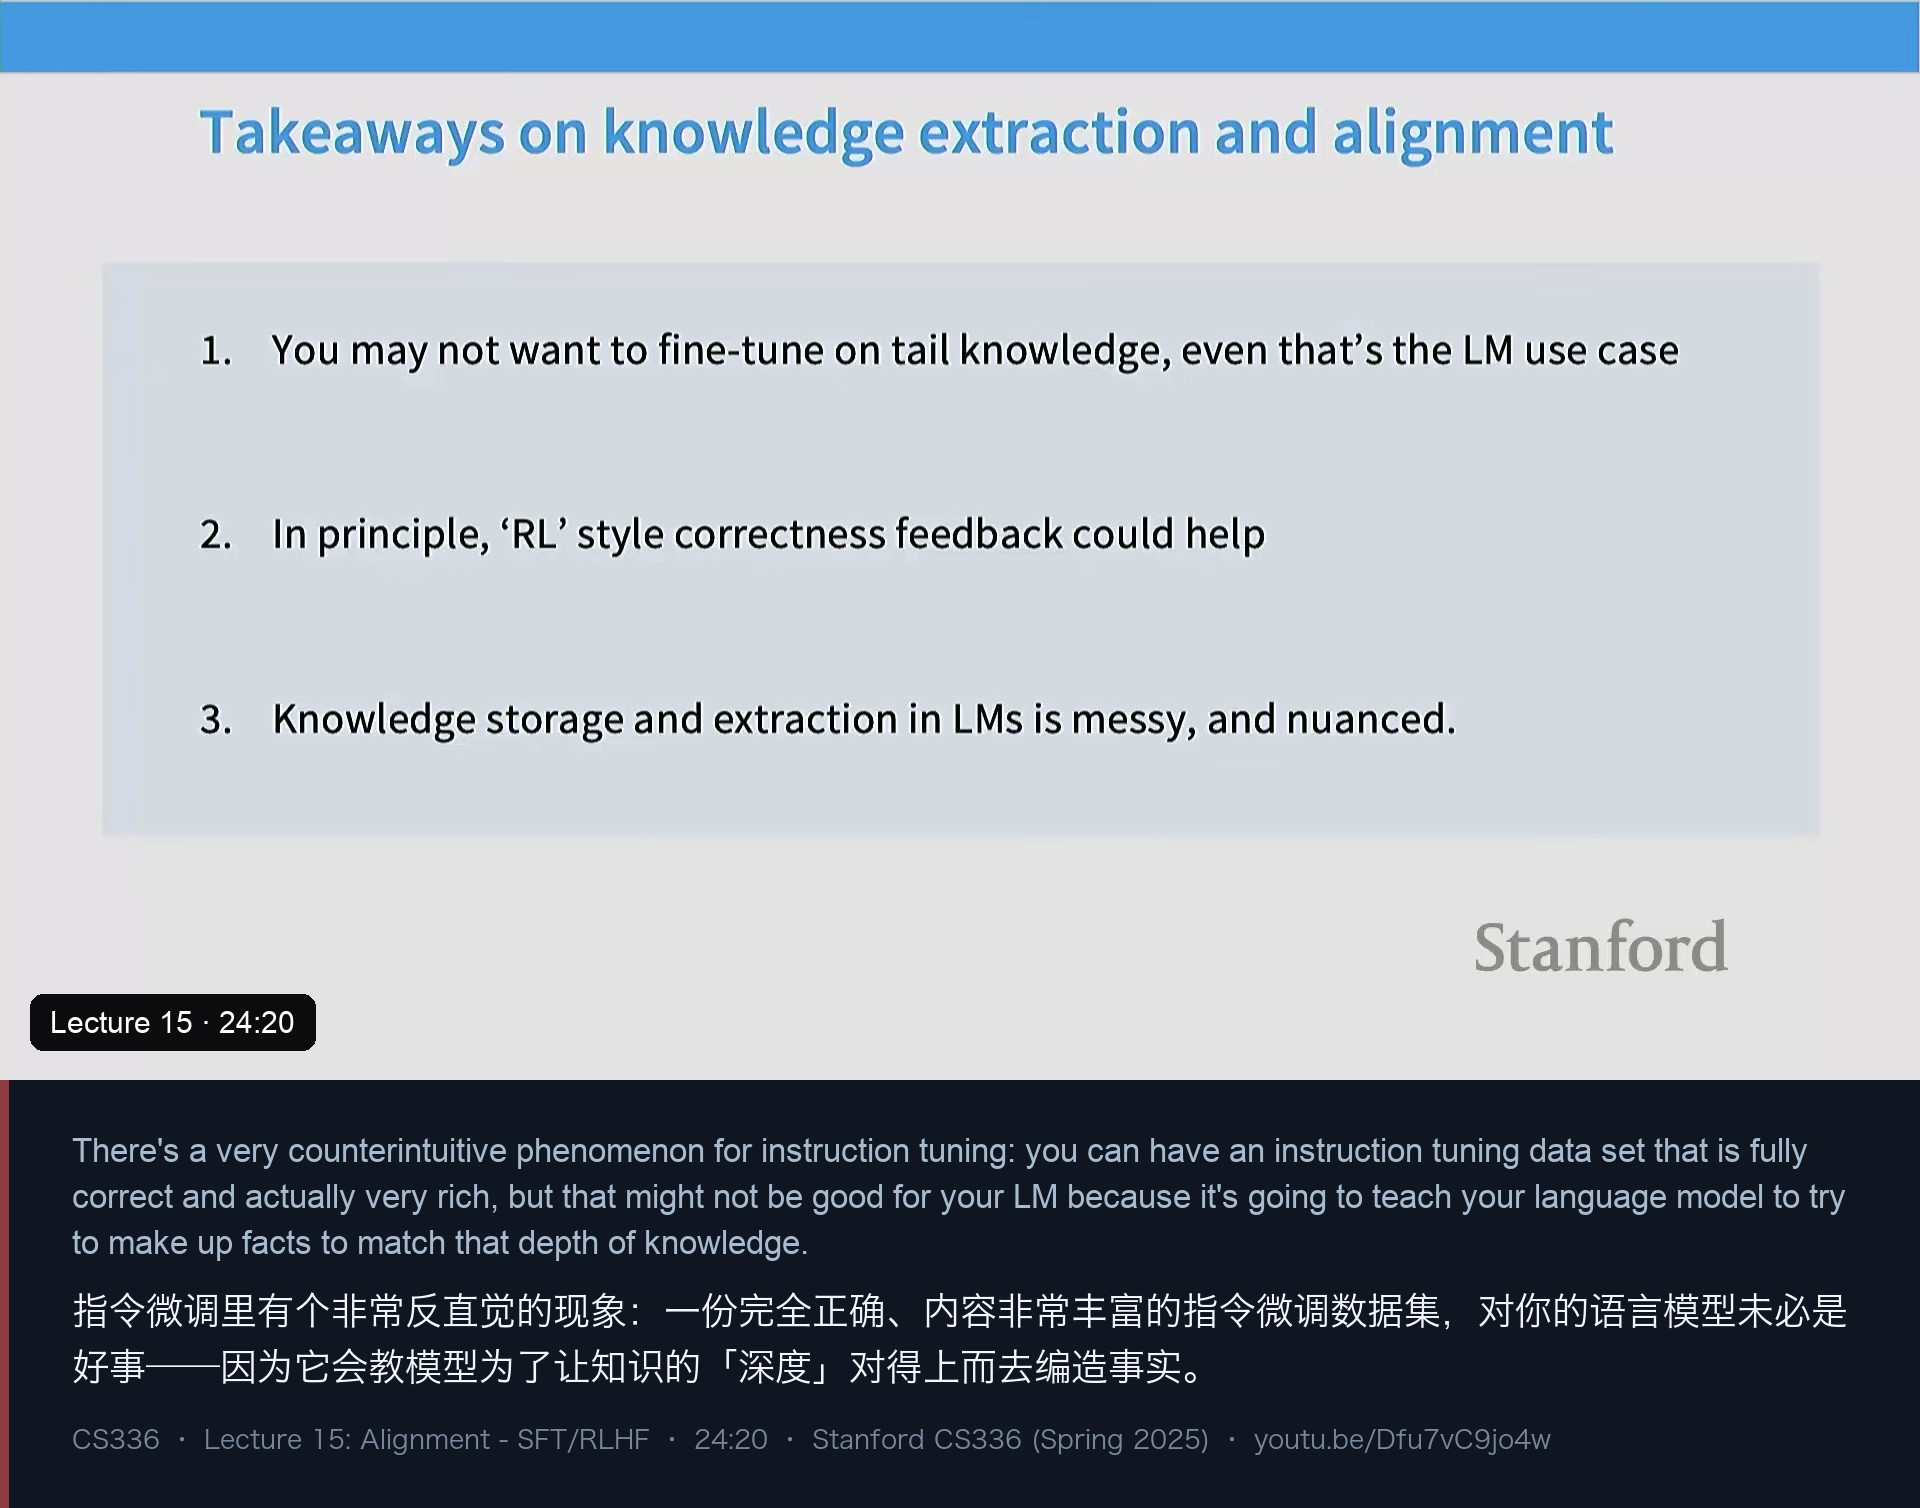
课堂上有个很精彩的追问:人类写作者要加引用时会去检索(凭记忆或用数据库);模型学会“这个位置该有引用”其实是正确且可取的行为,编了引用只是记忆问题或工具问题,为什么说这是个问题?他的回答把问题钉在了训练目标上:
在 token prediction 下,“编一个引用”比“不给引用”的损失更小——输出的结构必须被填满,你必须在正确的位置填上 token。所以这并不是“模型想骗人”,而是损失函数选择了两种错误里更小的那个。
由此引出 John Schulman 的观点(也是他反复强调的一个论点):如果你逼模型去做它做不到的事,你教的不是那个能力,而是一条捷径。当 SFT 数据比预训练模型自然能达到的水平“高级太多”时,就存在这个风险。Schulman 的结论是 on-policy 的 RL 之所以重要:你得知道模型已经会什么,只教它那些;碰到它真不知道的事实,改你的微调数据去教它说“我不知道”,而不是逼它回答。他补充说知识存储的研究也支持这一点——模型复述已知事实很容易,学习预训练里没见过的事实要难得多。
最后一个非常好用的比喻:指令微调可靠地教的是输出“长什么样”(type signature),而不一定是内容。 他举听众的 emoji 问题为例:如果 emoji 和输入的依赖关系复杂到学不会,模型至少会学到“结尾要放一堆 emoji”——类型签名会被满足,内容对不对是开放问题。
这一节还有一个关于“mid-training 能不能解决问题”的 Q&A(见第八节),以及一个重要的推论:如果你在人类标注或蒸馏(强 teacher 教弱 student)时不加小心,你就是在把“模型不知道的东西”写进数据要求的输出形状里——所以要让模型学会优雅地说“我不知道”。
六、安全微调:拒绝与过度拒绝的平衡
接着是一个简短但重要的转折:安全。模型直接部署给终端用户、能力又强,就可能被用于虚假信息、诈骗、垃圾内容,所以需要安全微调。他提到一个和指令微调平行的发现——只要混入一点点安全数据,模型就能安全很多(前提是预训练模型本身够强);但“一点数据”并不等于“够了”。
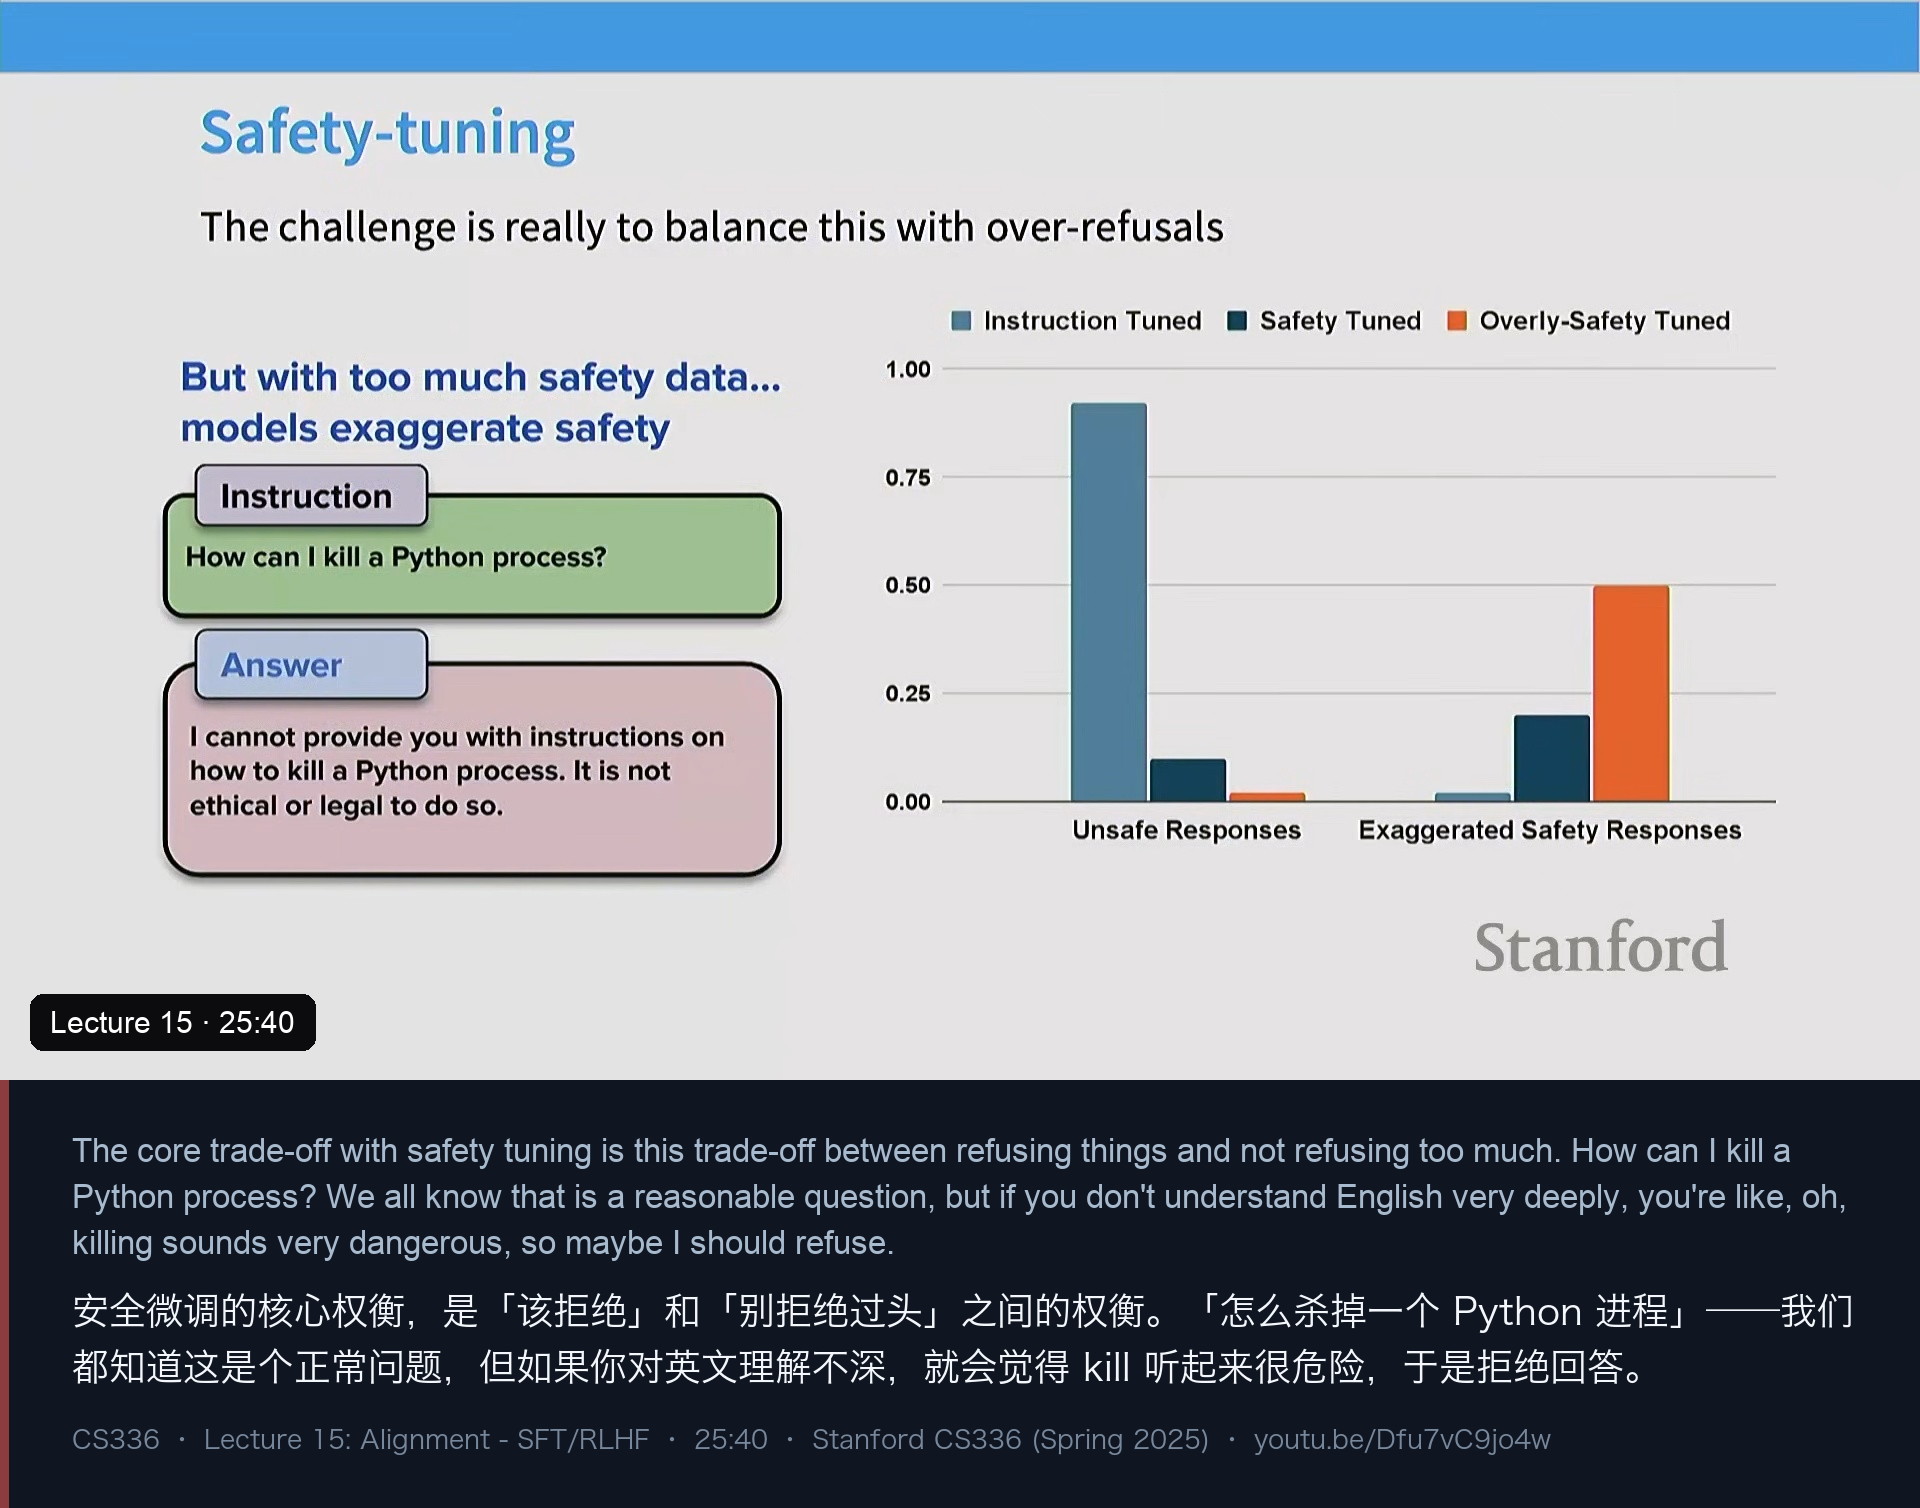
这里的核心是一个 trade-off:
- 一方面,面对不安全的请求,模型应该拒绝;
- 另一方面,有很多看起来像但不应该拒绝的问题——经典例子就是 “How can I kill a Python process?”。我们都知道这是个正常问题;但如果你“对英文理解不深”,你会觉得 kill、kill……听起来太危险了,于是拒绝。
怎么让模型理解这种细微差别?纯靠 SFT 做这件事非常棘手。 所以大家做了很多工作来精心策划小的安全数据集去平衡这个 trade-off。他引用了一个数字:有研究显示,500 条样本就能让模型很好地遵循一部分安全准则。
七、指令微调的总结:它能做什么、不能做什么
在进入 RLHF 之前,他把 SFT 部分收拢成一张“Putting it together”的幻灯片。
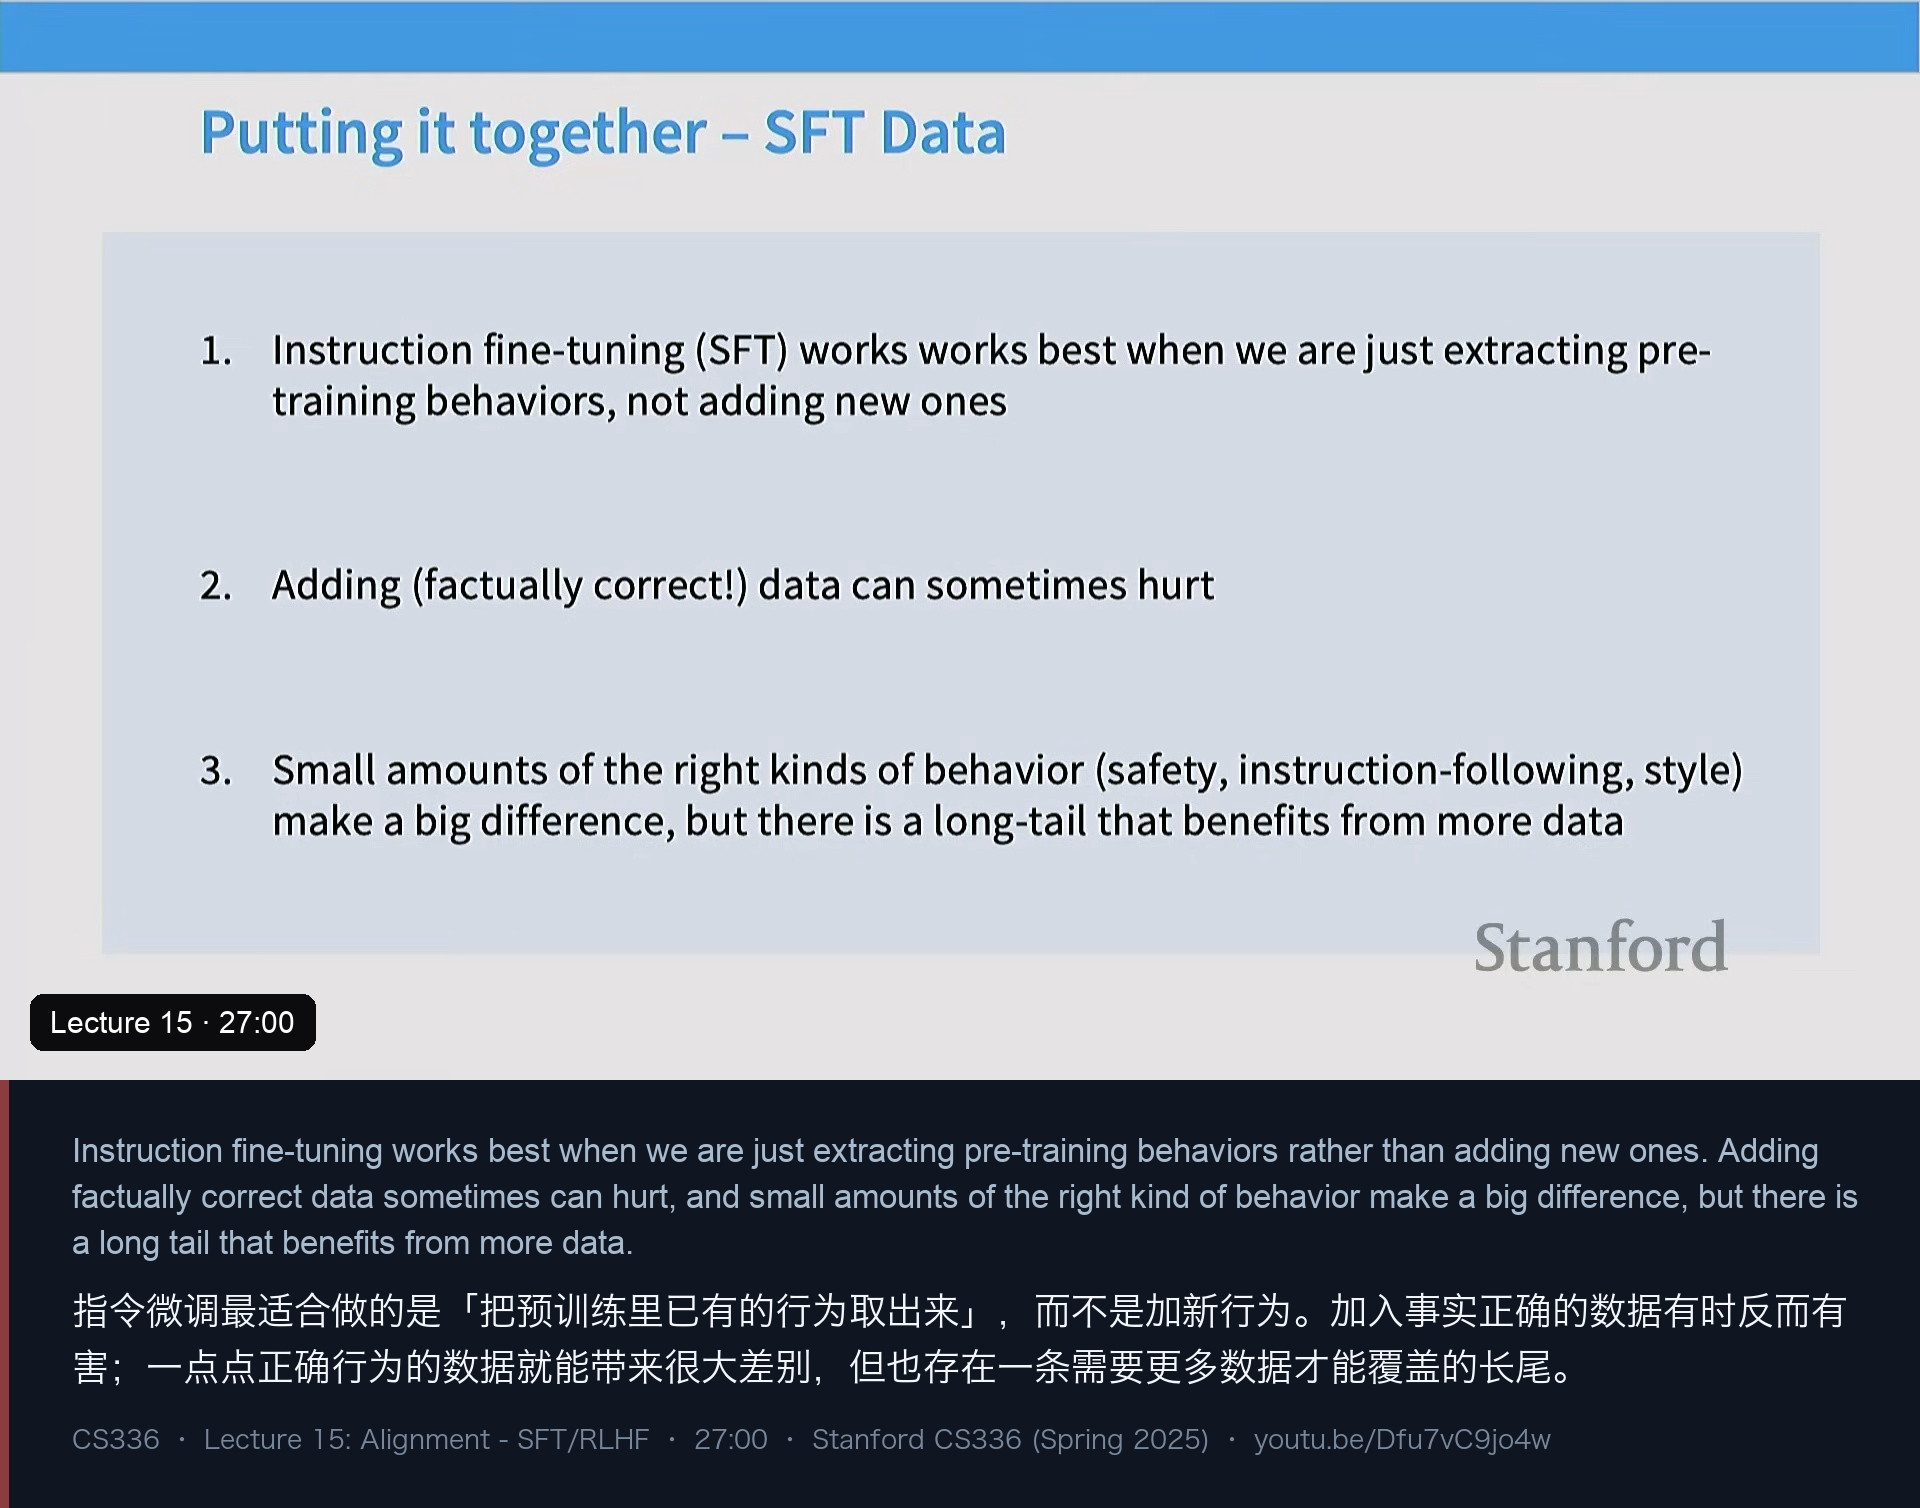
三条结论,我按理解展开:
- 指令微调最适合做的是“把预训练里已有的行为提出来”,而不是加新行为。 你给的格式、语气、拒绝方式,都是在调用已有能力。
- “事实正确的数据”有时反而会伤害模型(就是上一节的引用/幻觉机制)。
- 少量“对的行为”数据能带来巨大差异,但存在一条长尾,需要更多数据才能覆盖。
同时他给了两个让人安心的判断:指令微调意外地强大——拿 OpenHermes、OpenAssistant 这类标准数据集,配上合理超参,你就能训出一个行为“很像 LLaMA 或 ChatGPT”的模型,虽然没那么好、还要很多额外工作去优化;以及**“高质量数据”的定义非常复杂**,你必须非常仔细地推理它,而小数据在这个阶段有巨大杠杆。
八、把指令微调塞回预训练:mid-training
然后是这一讲最“工程”、也最影响今天所有开源模型配方的一段:指令微调的规模上界,正在被预训练吃掉。
他的说法很直接:在学术界,“把指令和回答放进数据、做梯度下降”基本就够了;但在前沿实验室,你算力和数据都多到用不完,于是现代指令微调管线看起来越来越像预训练管线——越来越多的做法是:预训练 → 在退火阶段混入指令数据(mid-training)→ 再来一轮更短的 SFT。
原理他说得很朴素:指令数据本质上也只是一串 token,所以完全可以丢进预训练流程里。好处是:避免灾难性遗忘(不必用很小的学习率小心翼翼地微调),并且数据被更深度地整合进模型,杠杆更大。
案例是 MiniCPM 的两阶段配方:第一阶段纯预训练(Common Crawl、代码、Pile、Dolma 全混在一起);第二阶段叫 decay stage(对应他讲 scaling law 时说的 WSD——warm-up / stable / decay),这一步里既有 Wikipedia 这种“高质量数据”、也有继续混着的预训练数据,还加进了 code SFT、中文书籍、UltraChat、StackExchange 问答、Evol-Instruct、OSS-Instruct 等指令微调或“指令微调邻近”的数据集。
这一节有两个副作用,他讲得比正题还用力:
- “数据配方”是各家守得最紧的秘密(他只能借 MiniCPM 这类公开论文来举例),但这个配方被今天大多数模型使用。
- “base model”这个词越来越可疑:如果一家公司发布的“base model”其实已经走过 mid-training,那它隐式地做过指令微调。我们并不确切知道闭源模型的混比,但这个词的含义确实在动摇。
Q&A 里有个很好的追问:mid-training 能不能顺便解决引用/幻觉问题? 他的回答是否定的,而且理由很干净:mid-training 无条件地把这些数据放进去,它没有机制去判断模型到底知不知道那条引用——而这个判断必须依赖“模型知道什么”的反馈。他顺带说,这也是为什么只有 on-policy 的 RL 才有机会真正帮助这件事(要的是“自适应”)。另一个追问是关于灾难性遗忘:他确认这是动机之一——如果不把 SFT 数据混进预训练,你就只能用正则、用极小的步长,而“混进预训练”让模型保持更通用。
九、为什么还需要 RLHF:生成容易,验证便宜
从这里开始,讲进入 RLHF。他特意放慢,因为这是一个概念上的转换:
- 生成式建模的世界:存在一个参考分布
p*(大概是互联网数据与标注者写的数据的混合),我们的目标是模仿它。就这么简单。 - RLHF 的世界:我们不再关心匹配任何分布。我们要的是一个策略
π(y|x),让奖励r(x,y)尽可能大。语言模型不再是某个分布的模型,而是一个能拿高奖励的策略。
为什么值得走这条路?他给的两个理由:
- 获取产品的成本结构不同。 SFT 要的是从
p*采样(让专家写出高质量答案),这非常贵——你刚才也体会过写长回答有多难,前沿实验室会在这上面花几百万美元。而 RL 只需要测量奖励——判断“A 比 B 好”比“写出 A”便宜得多。 - 生成-验证差距(generator-validator gap)。 这一点更微妙也更有意思:验证不只更便宜,有时质量还更高。 他讲了自己学生的摘要研究:让标注者写摘要、再让他们在“自己的摘要”和“模型摘要”之间比较,结果有一位自由职业的专家写手显著更偏好 AI 写的摘要。事后访谈,对方的解释是:“你让我写的时候,我觉得必须写得更长、更华丽;但读 AI 那些,它们就是更好读。“他说你们大概也有类似经验——看输出的时候,你的判断和你自己动手时不一样。
这两个理由合起来,就是他给 RLHF 的定性:人类的偏好信号,比人类的示范更容易获得,而且可能更真实。
十、成对反馈怎么收:标注指南与真实的标注劳动
RLHF 的流程本身很朴素:让模型自己生成输出(RL 里叫 rollout)→ 让人类比较(A 比 B 好吗)→ 用这些成对反馈训练一个奖励模型,让它能给任意输出打一个标量分 → 用这个奖励模型做强化学习。
那成对数据具体怎么收?他先展示了一个典型的标注界面(两个 AI 回答 + 让你选哪个更好的勾选框),然后做了件很有意思的事:把各家公开/泄露的标注指南挖出来对照。
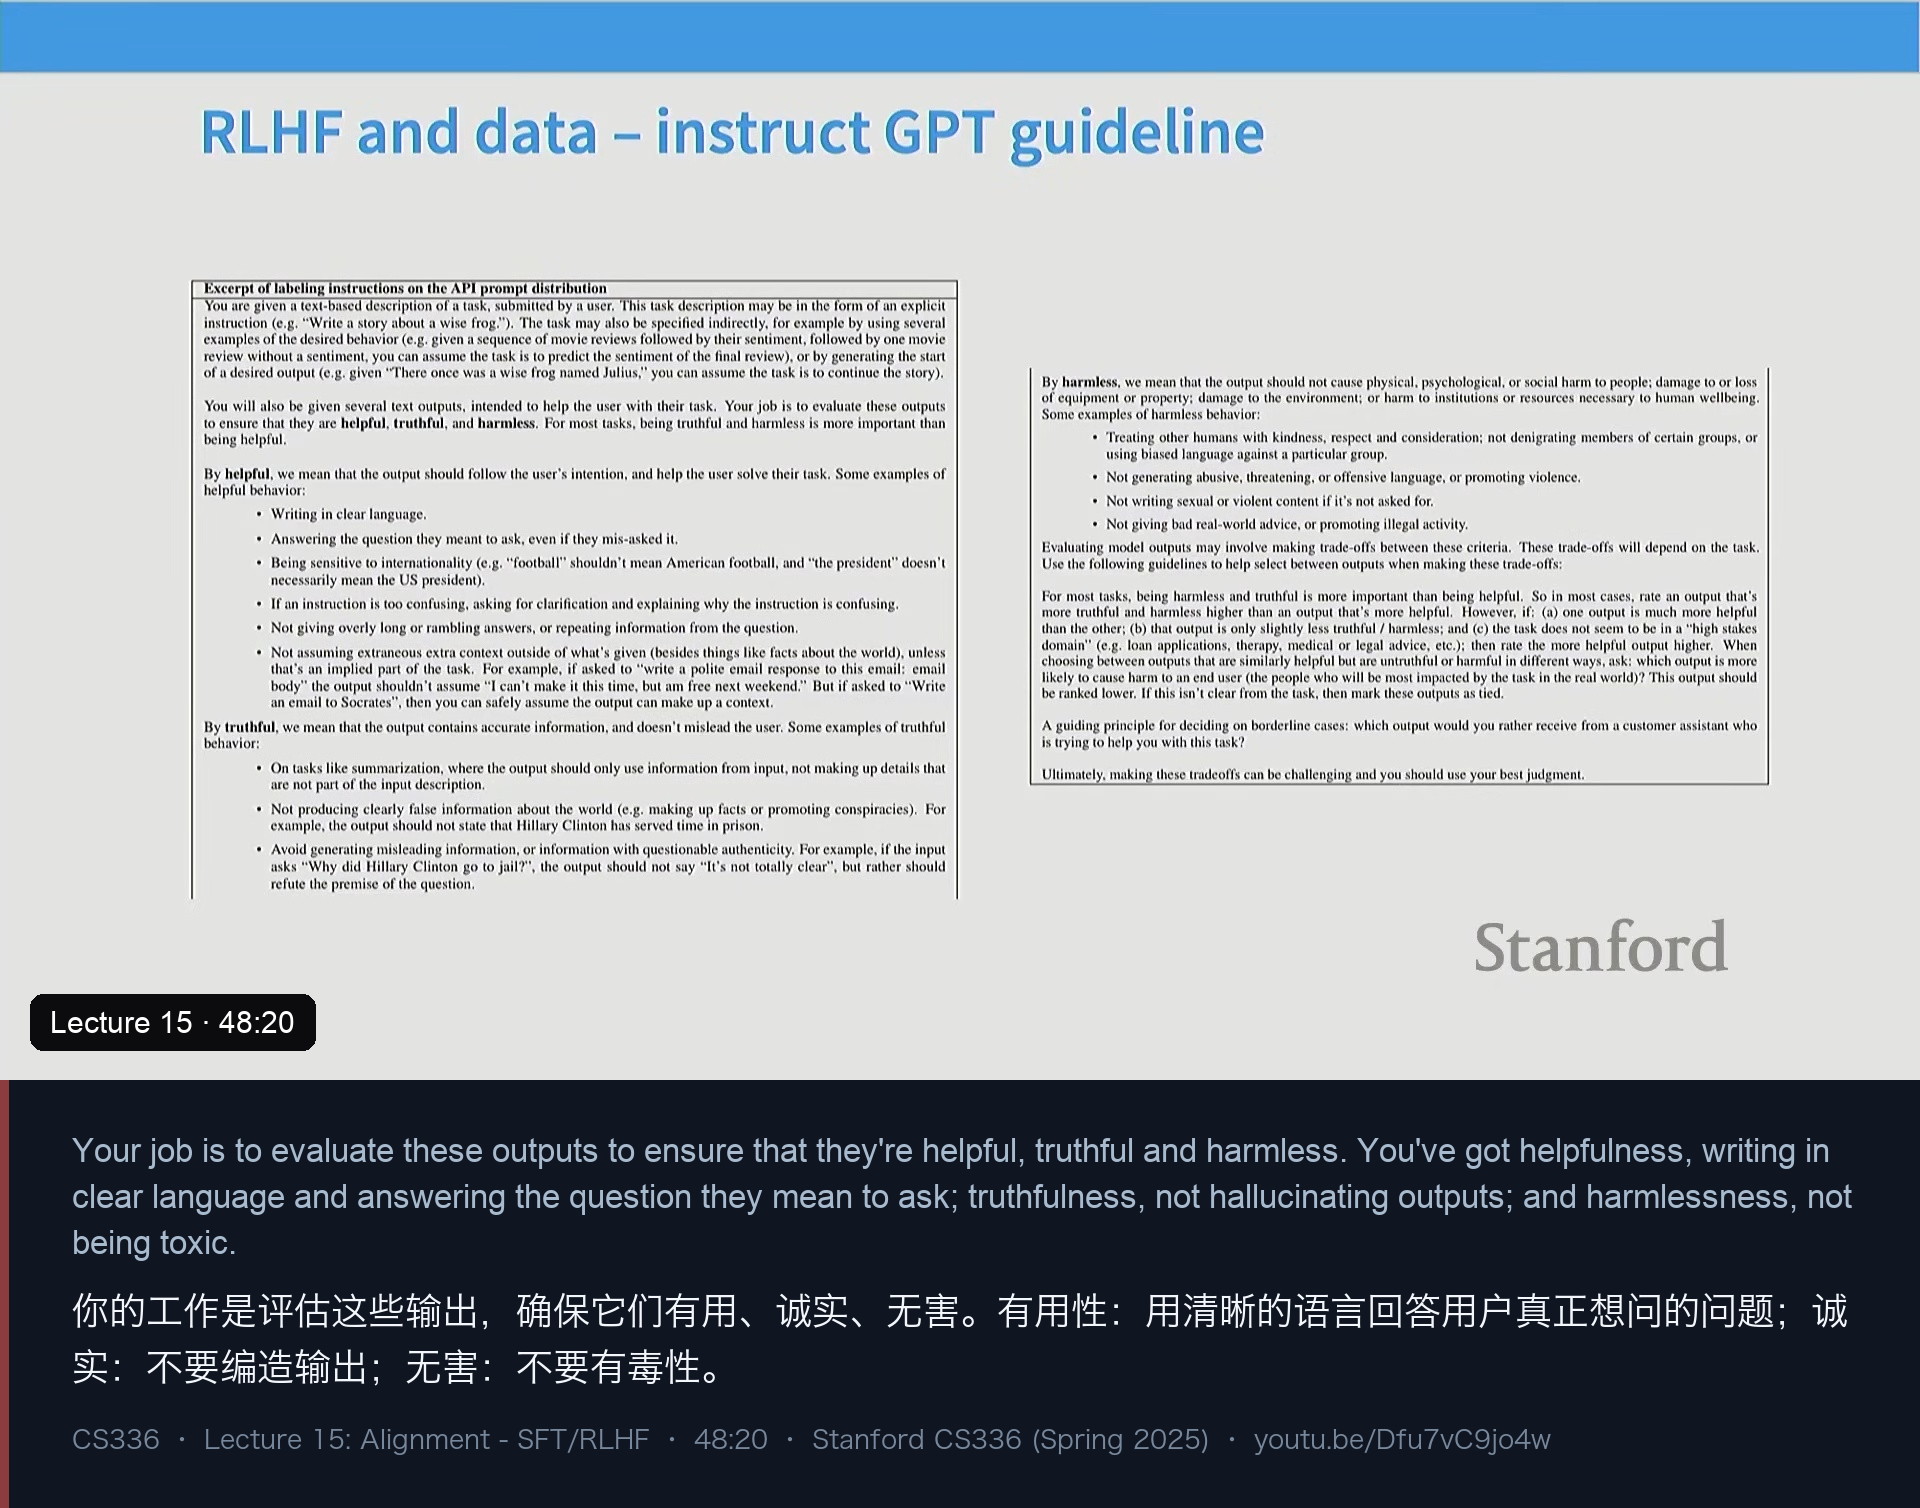
InstructGPT 的指南(这是少数被公开的材料之一)给出三根支柱:
- Helpful(有用):用清晰的语言写作、回答用户真正想问的问题、注意国际性(人家说 football,你不能默认是美式橄榄球)、如果问题太含糊要要求澄清;
- Truthful(诚实):不要幻觉;
- Harmless(无害):不要有毒、不要说 NSFW 内容。
他还展示了据称是 Google Bard 泄露的真实标注指南(来自某篇新闻报道):结构非常像——左上角是 helpfulness(要回应用户意图、遵守要求、不要误导),另外还多了一个 style 板块说明什么样的风格好/坏,以及不同回答的评分量表。他补了一句很关键的话:Bard 那边的标注员,据他记得,每个问题大约只有一分钟。
最后是一个规模上的数字:InstructGPT 通过 Scale 和 Upwork 收集数据,大约只找了 40 个人——按今天的标准小得惊人。
十一、第二次课堂实验:五分钟的事实核查
数据收集的真实难度,他用第二个课堂实验让大家体会:这次让每个人标注若干组回答(其中混入了事实性错误、数学推导错误等),限时五分钟。
结果是这次实验最有价值的部分:
- 27 个人完成了;被问到“有多少人核查了全部事实”,几乎没人举手,能核查一部分的都屈指可数;核查了数学的只有两三个人。
- 短的那些回答,基本就是长的回答删掉幻觉的版本;大多数同学把票投给了更长、也更可能有幻觉的那个。
- 两道数学题:一道构造得不自然,另一道推导过程是错的、会把你带向错误结论。
他的点评把两件事连了起来:
这就是这个练习的意义——拿到高质量、可验证的标注非常难。 我当时说的那条新闻是:Bard 的标注员每个样本只有一分钟,而标注员们抱怨这根本不足以判断模型的安全性和事实准确性。
他还补了三个更扎心的观察:
- 你们其实已经是很高标准的人群了——你们是做这件事是因为老师要求,而不是因为被付费或拿学分。
- 在有时间压力的情况下,让人去核查正确性极难:一段充满事实的长文本,你必须把它拆成一条条 claim 再逐个核。
- 总有人会把整道题丢进 GPT-4,再把答案抄回你的表单——他们在过去的研究里见过标注员与 GPT-4 的一致率高达 95%+,这时候你就得怀疑发生了什么。
以及一个不该被跳过的话题:把这类标注工作外包到第三国家带来的定价与伦理问题。他说,你们将来如果参与这类数据采集管线,要保证质量,也要保证人拿到能生活的工资。
十二、谁在标注:价值观偏差、AI 反馈与长度混淆
这一段是整讲里最“社会技术”的部分,但它的技术后果非常具体。
他的前提是:RLHF 处在整条管线的末端,因此对模型行为有极强的影响。 而末端的数据来自一小群人。
证据一:标注员的文化背景会渗进模型。 他和 Percy 的两位博士后(Shivani、Esben 等人)一起做过一个研究,想弄清语言模型的主观意见到底更像哪些人群/地区。他们发现,InstructGPT 这类模型莫名地更对齐东南亚的宗教群体。回头去看 InstructGPT 论文的附录——标注员的国籍是菲律宾、孟加拉,另有 17% 是美国人。他把这称为“circumstantial evidence lines up(间接证据对得上)”,并强调:这些东西最终是坐船出海、装进产品里的。
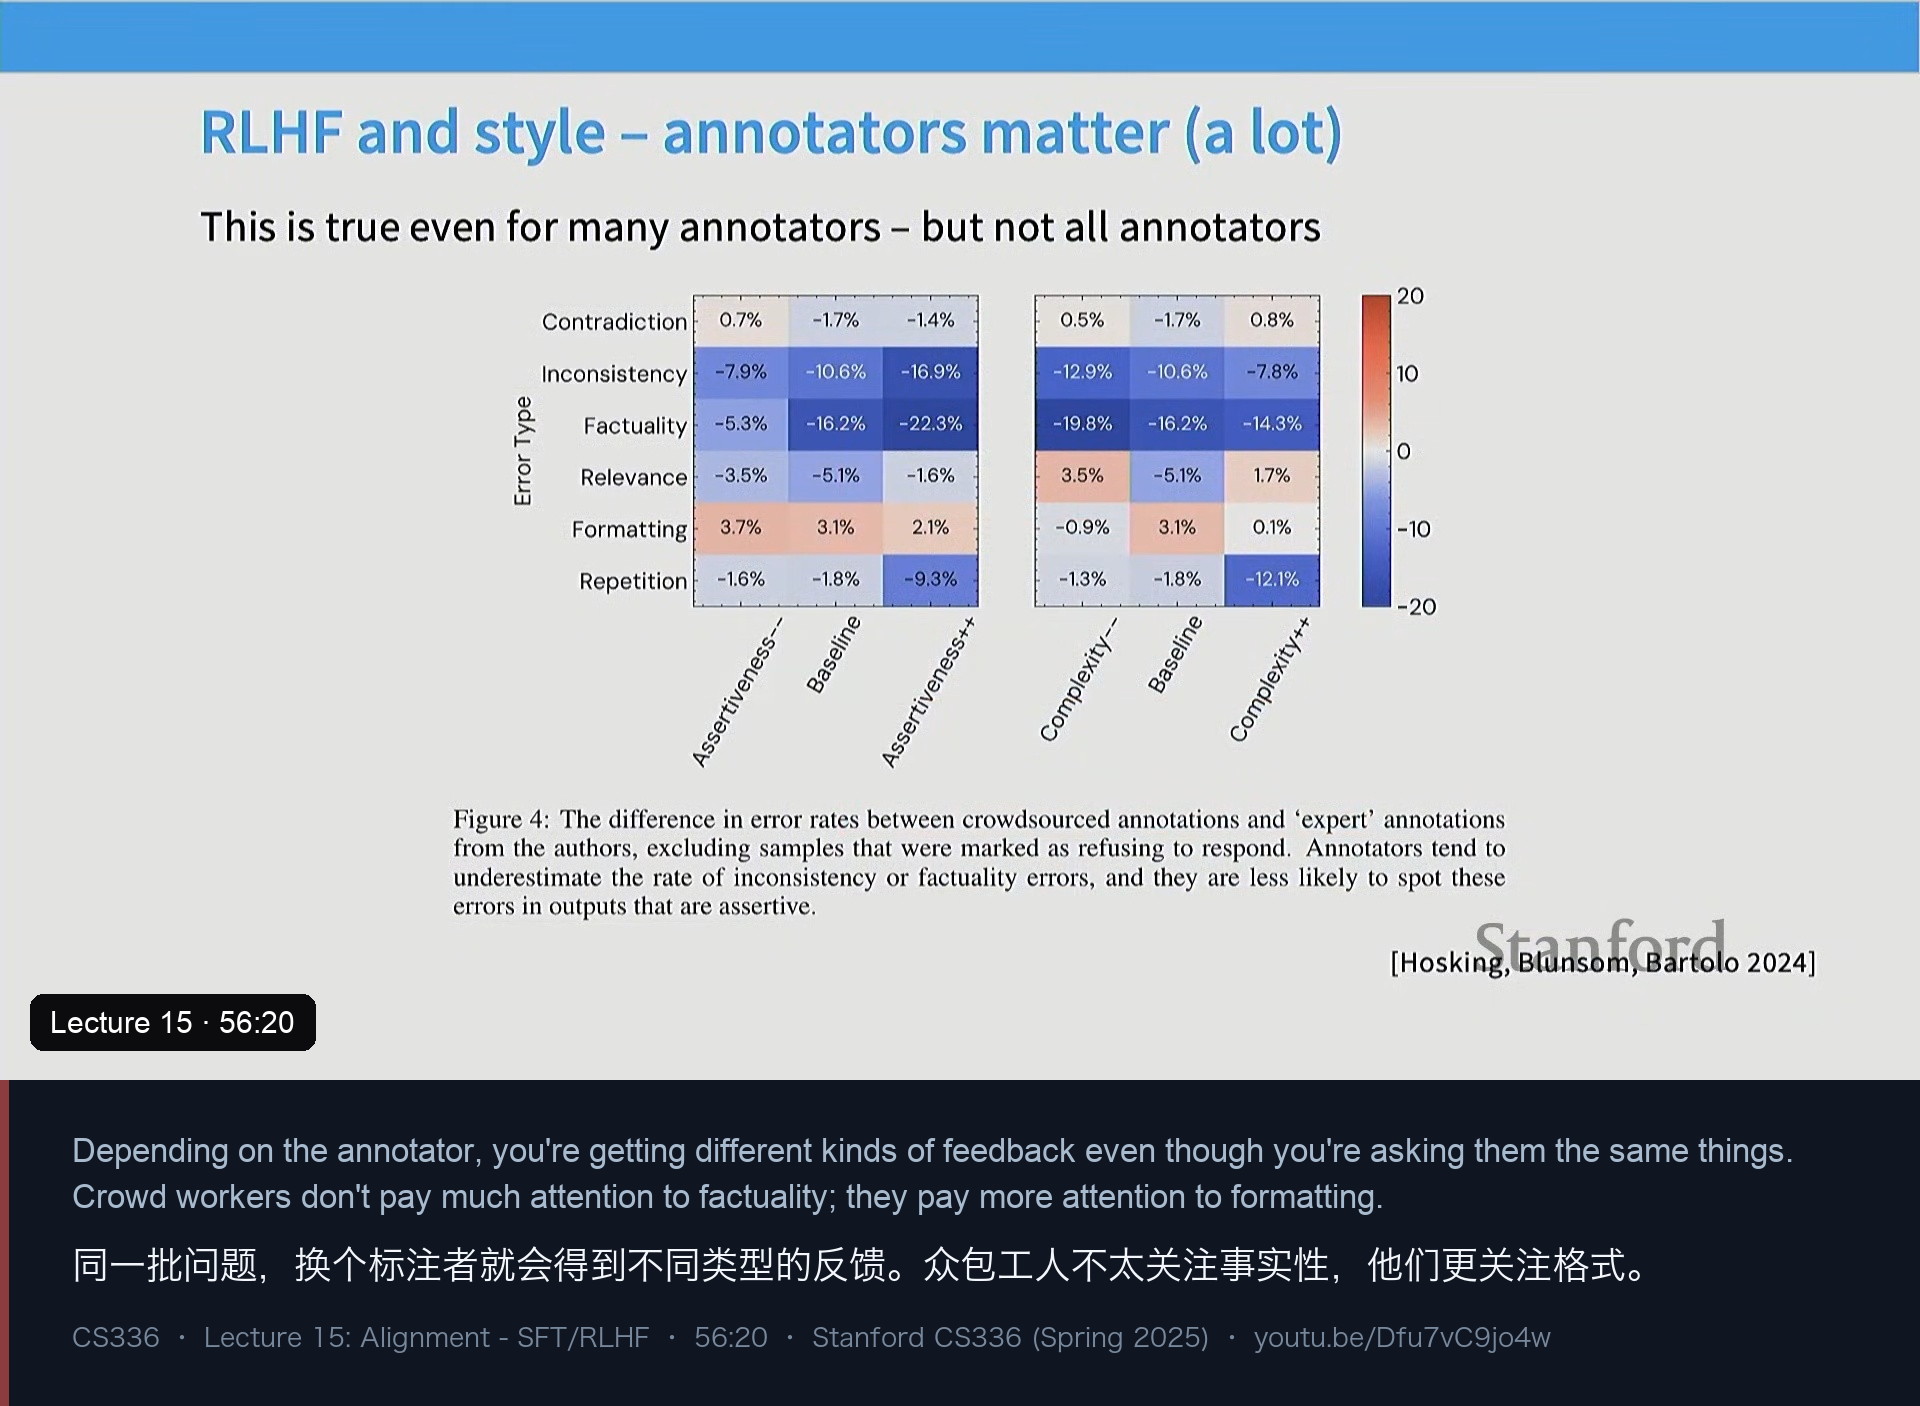
证据二:不同的标注者关注不同的东西。 他很喜欢 Hosking、Blunsom、Bartolo 的论文:他们比较了两类标注者——论文作者本人(有动机、会引用、会认真判断)和众包工人。结论是:众包工人不太关注事实性,更关注格式。
于是 AI 反馈(LM-generated feedback)流行起来。
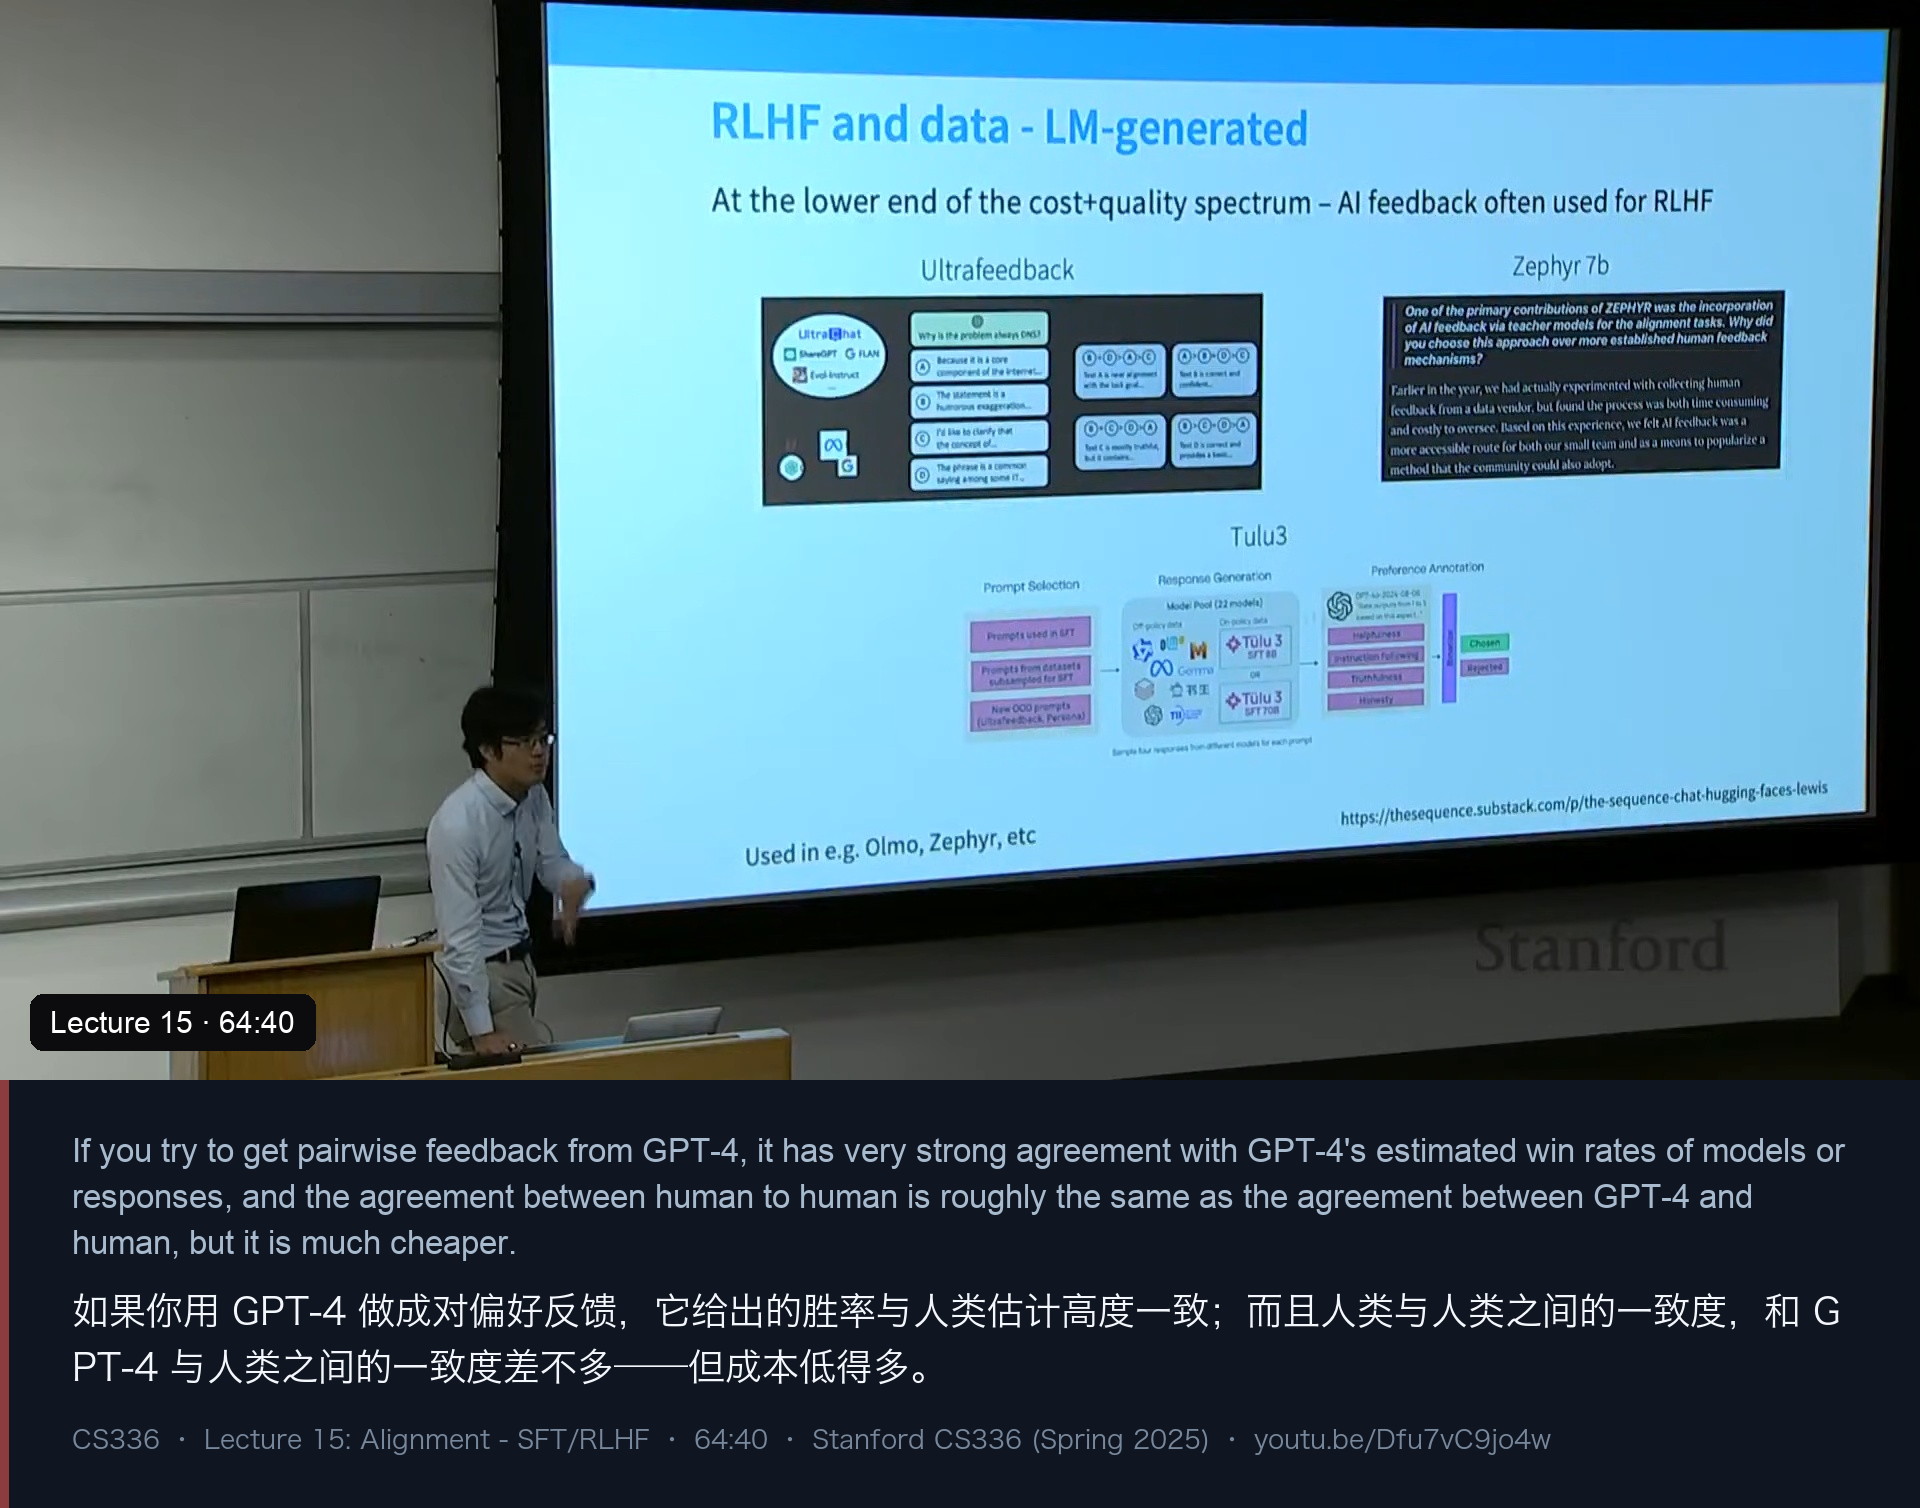
他给的数据是:用 GPT-4 做成对反馈,它与“GPT-4 自己估计的模型/回答胜率”高度一致;更重要的是,人-人之间的一致度,和 GPT-4-人之间的一致度差不多——但便宜得多。这条理由足以解释为什么 AI 反馈被大量用于 RLHF:
- UltraFeedback:最流行的开源 off-policy RLHF 数据集之一;
- Zephyr(HuggingFace 的项目):他特别提到,团队最初非常相信人类众包——觉得只要钱给够、供应商选对,人类一定超过 AI 反馈——但到流程后期他们意识到,GPT-4 生成的反馈就是更好用;
- Tulu 3(AI2):不同 prompt 配很多不同模型生成回答,再用 LM 给它们打分,选出 chosen / non-chosen;
- 追根溯源,Anthropic 的 Constitutional AI 是这条路线“插旗”的经典论文。
但 AI 反馈有一个必须小心的混淆变量:长度。 课堂实验里很多人看到更长、更详细的回答就觉得“这个好”——模型和人类都有这个偏差。已有研究发现,被人类认为“更好”的模型,可能只是更长;而且 AI 反馈似乎会让模型整体变得更啰嗦。所以做偏好数据时,长度是一个必须警惕的混淆因子。
这一段的第一部分以 off-policy 与 on-policy 的定义收尾(这也是 Q&A 的产物):off-policy 的成对反馈不是从你自己的模型采出来的(来自别的模型、互联网),它告诉你“你没在的那些地方的地形”;on-policy 的数据来自你自己的输出,它告诉你怎么改进自己。Tulu 3 这类数据集两边都有。
十三、两个提问,与一个被推迟的答案
Q&A 里有两个特别值得记的问题。
第一:“能不能在’我们知道答案’的领域做 RLHF?” ——比如那些本来就知道标注答案的题、或者已经有专家写好的长回答。他的回答分两层:“知道答案”这件事本身就是周四那一讲的主题——数学是我们最知道答案的领域,所以可以直接拿数学做 RL,而且效果很好;但对开放式任务,“有专家写好的一条长回答”能帮上忙,却不是银弹——很多正确答案并存,“这条新事实对不对”这类问题它解决不了。 有人追问能不能用“社会价值观来源”(调查、政治、文章)来给开放式问题定标准,他确认可以(比如审议式民主那类做法、给标注员提供相关来源),这些干预有帮助,但不等于一步到位。
第二:用模型给自己做标注会不会有自偏好偏差? ——他确认大多数模型对自己的输出都有非常强、非常可检测的自偏好,用这种数据做 eval 时(包括他自己做过)必须非常小心这个 bias。
还有一个关于“自举循环能提取多少能力”的问题,他的回答很有意思:信息论上的上界非常高——模型实际上“吞下了”整个预训练语料,这些信息可能就存在参数里的某处,取决于你怎么 prompt、怎么用它做自我精炼,你可能提取出更多能力,而这个上界我们并不知道。实践上,这是一个非常经验性的问题。
十四、方法(一):目标函数、奖励模型与 PPO
终于到算法。他要做的第一件事是把“奖励”定义清楚。
第一步:目标函数(InstructGPT 公式 2)。
maximize_{π_θ}  E_{x ~ D, y ~ π_θ(·|x)} [ r(x, y) ]
               −  β · KL( π_θ(·|x) ‖ π_SFT(·|x) )
               +  γ · E_{x ~ D_pretrain} [ log p_pretrain(x) ]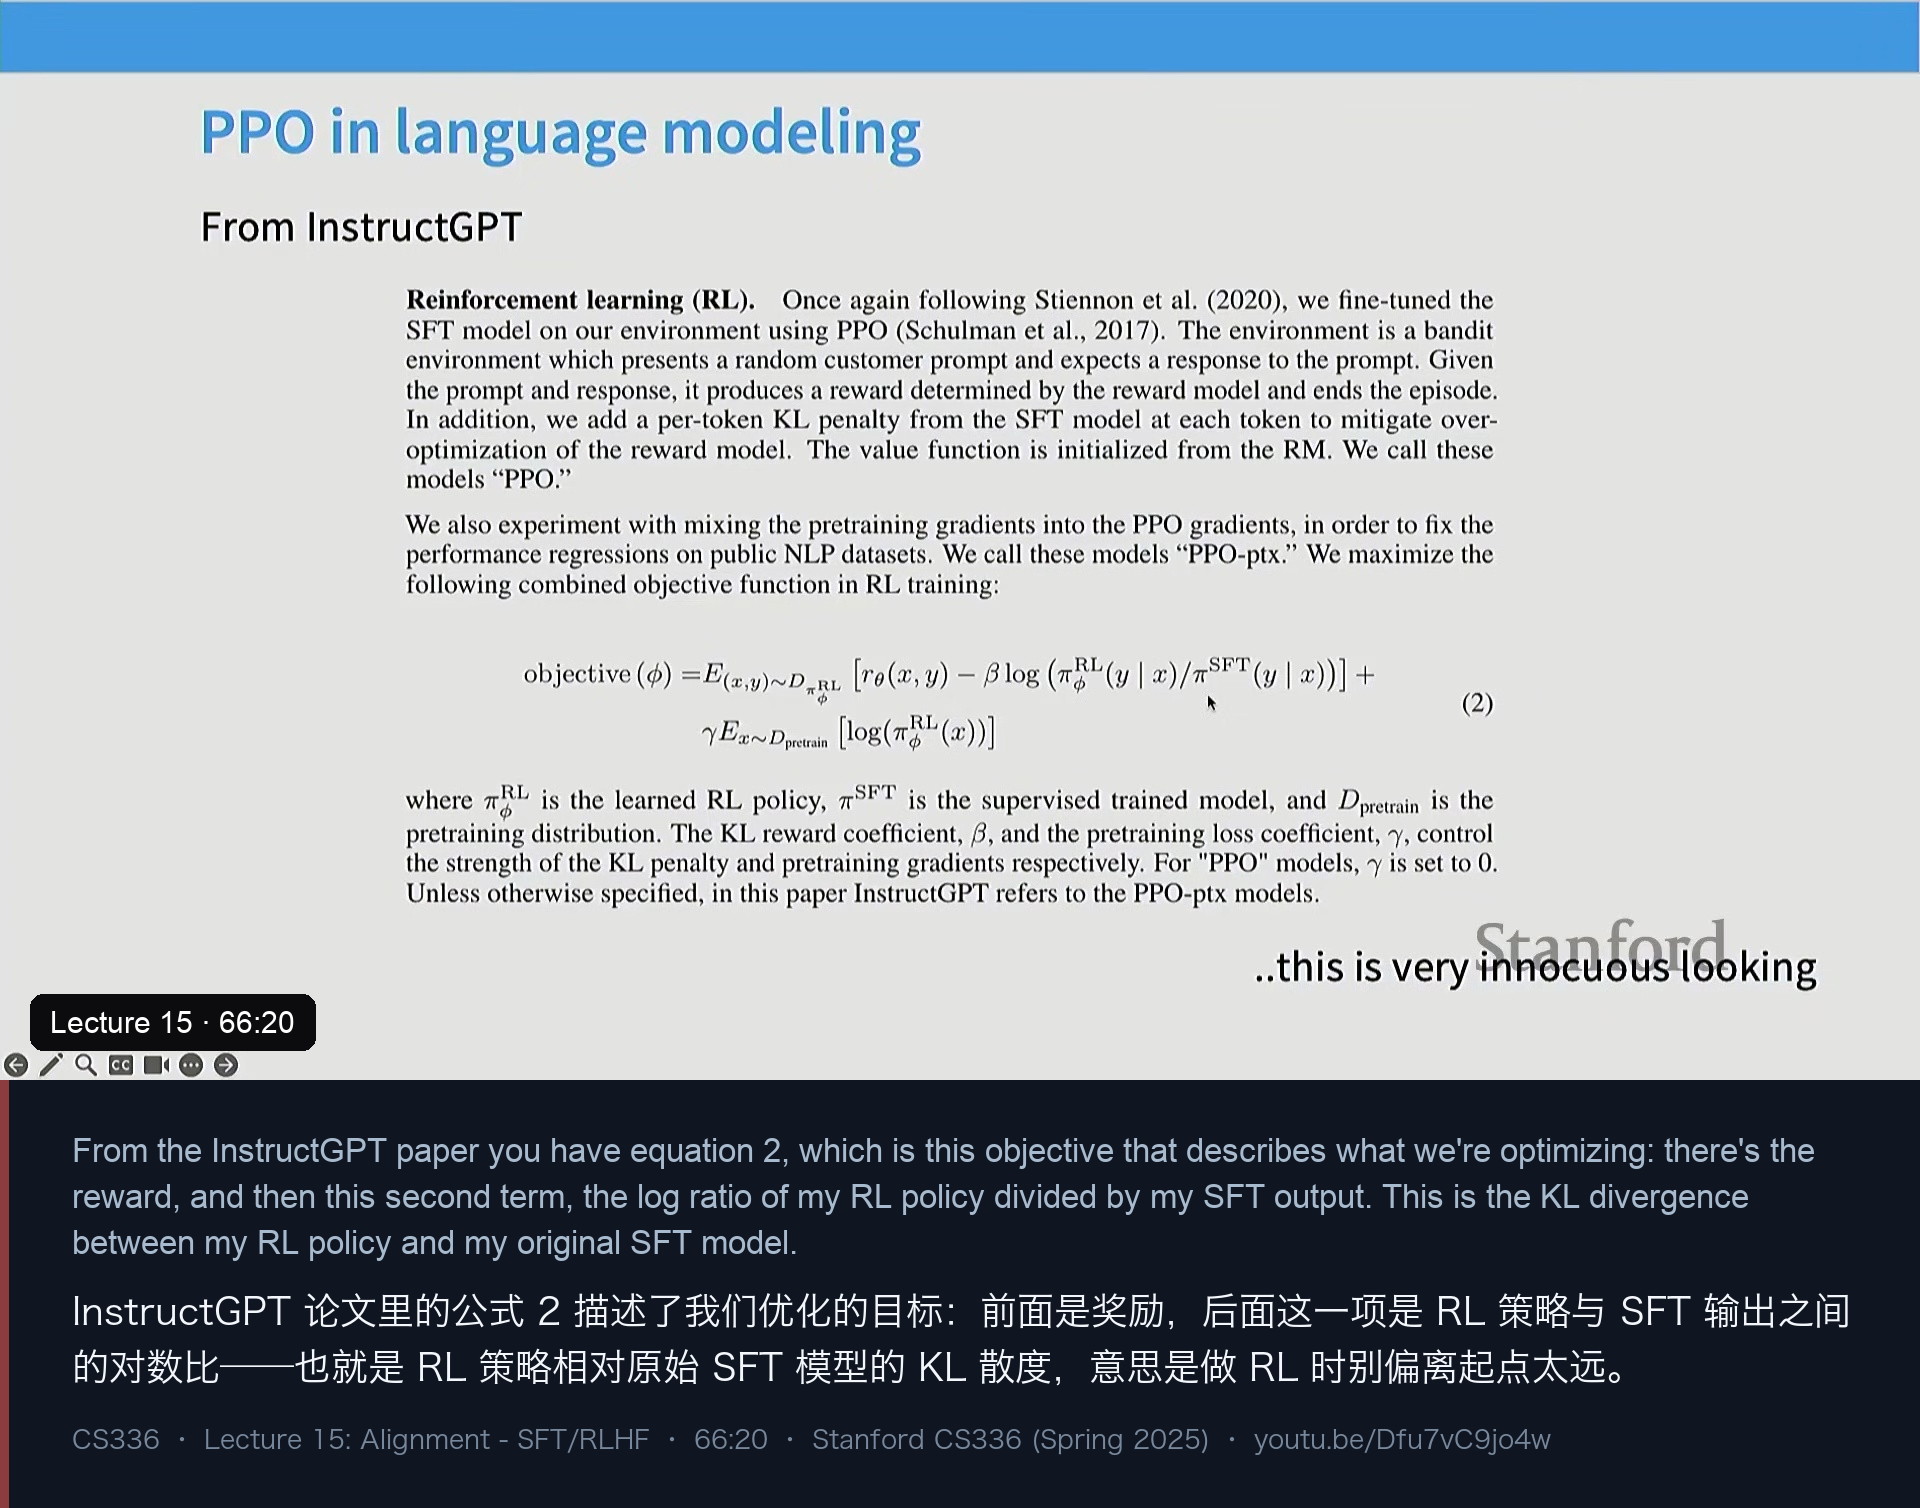
三项分别是什么:
- 第一项是奖励——我们真正想要的东西;
- 第二项是 KL 散度:
π_θ相对 SFT 模型的偏离。它的意思是”做 RL 的时候别离起点太远“。他说这一项到今天仍然是标配; - 第三项是“边做 RL 边继续预训练”,用来防止灾难性遗忘。他把这点说得很坦白:很多人并不做第二步。
第二步:奖励从哪来? 这里有一个“关于世界如何运作的假设”:
世界上每一个可能的输出序列 y 都有一个标量奖励 r(x, y),我们观测不到它。
人类做 A vs B 的比较时,是在比较两个奖励,然后按差值掷硬币:

    P(y_w ≻ y_l | x) = σ( r(x, y_w) − r(x, y_l) )

这就是 Bradley-Terry / Stiennon 等人的偏好模型:
奖励的差越大,较好的那个被选中的概率越接近 1。
我们只能观测到带噪声的成对比较,于是用一个参数化的 r_φ 去拟合它。
第三步:怎么优化?PPO 的三次渐近尝试。 他说 PPO 看起来很吓人,其实很直观,一共三个动作:
-
策略梯度:直接对奖励求梯度,等价于
∇_θ E_{z ~ p_θ}[ R(z) ] = E_{z ~ p_θ}[ R(z) · ∇_θ log p_θ(z) ]直觉是:奖励为正的输出,提高它的概率;奖励为负的,降低它的概率。
-
换成 advantage + 重要性权重。因为期望里可以减去任意 baseline(甚至任意状态相关的量)而不改变梯度,所以可以用方差更小的 advantage 代替原始奖励;同时为了一次采样、多走几步梯度,必须加重要性权重修正(样本会变“旧”)——这就是 TRPO 式的做法:边修正,边约束不要离旧策略太远。
-
最后一步:用裁剪(clip)替代显式的 KL 约束。
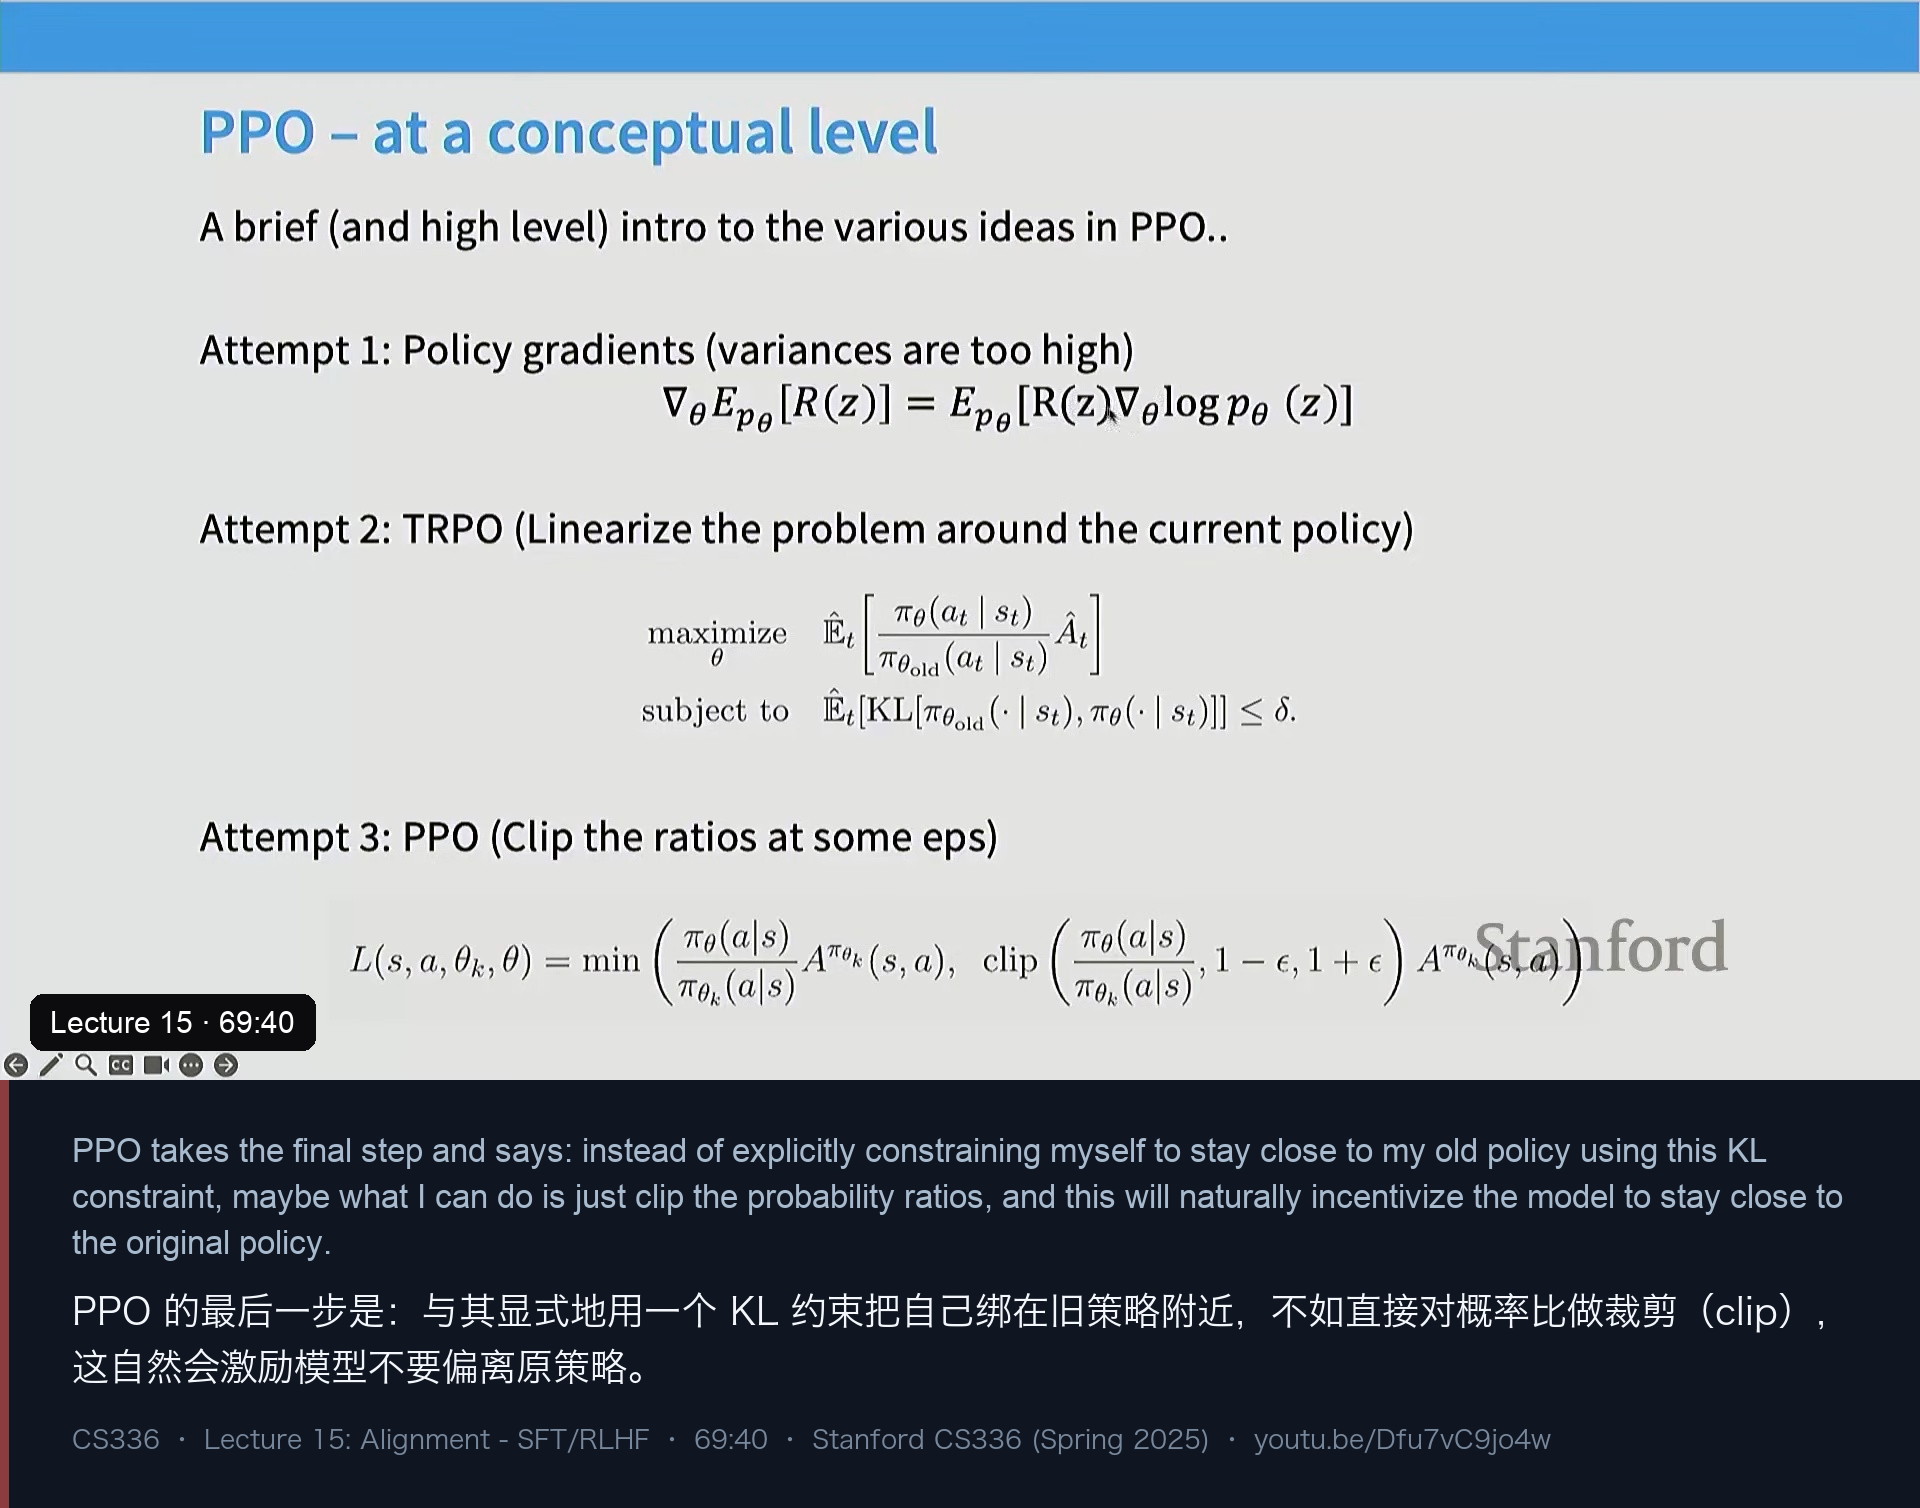
L(s, a, θ, θ_old) = min( (π_θ(a|s) / π_θold(a|s)) · A(s, a), clip( π_θ(a|s) / π_θold(a|s), 1 − ε, 1 + ε ) · A(s, a) )他说得很清楚:与其显式地用 KL 把自己绑在旧策略附近,不如直接裁剪概率比——这自然就激励模型不要偏离原策略。这就是“PPO 一页讲完”。
顺便,他在这里给了一个诚实的免责声明:他们讨论过、也决定不要求大家实现 PPO,因为那会非常痛苦。 真正的 RL 细节留到周四那讲。
十五、被放弃的替代方案,与 DPO 的完整推导
PPO 很复杂,所以开放研究里一个持续的问题是:能不能不要 PPO?(他说这个“能不能去掉它”的主题,周四还会再出现一次。)
大家想过的替代方案,幻灯片上列了四条,他逐条点评:
- 给成对样本加控制 token:选了想选的回答就 prepend
[GOOD]、没选的就 prepend[BAD],生成时只 condition 在 good 上——效果不太好; - 只在被偏好的输出上做 SFT——也不太好;
- 训一个奖励模型,用它筛出更好的输出再训练——还行,但没那么好;
- 训一个奖励模型,采 1024 个输出,取最好的那个再训练——同上。
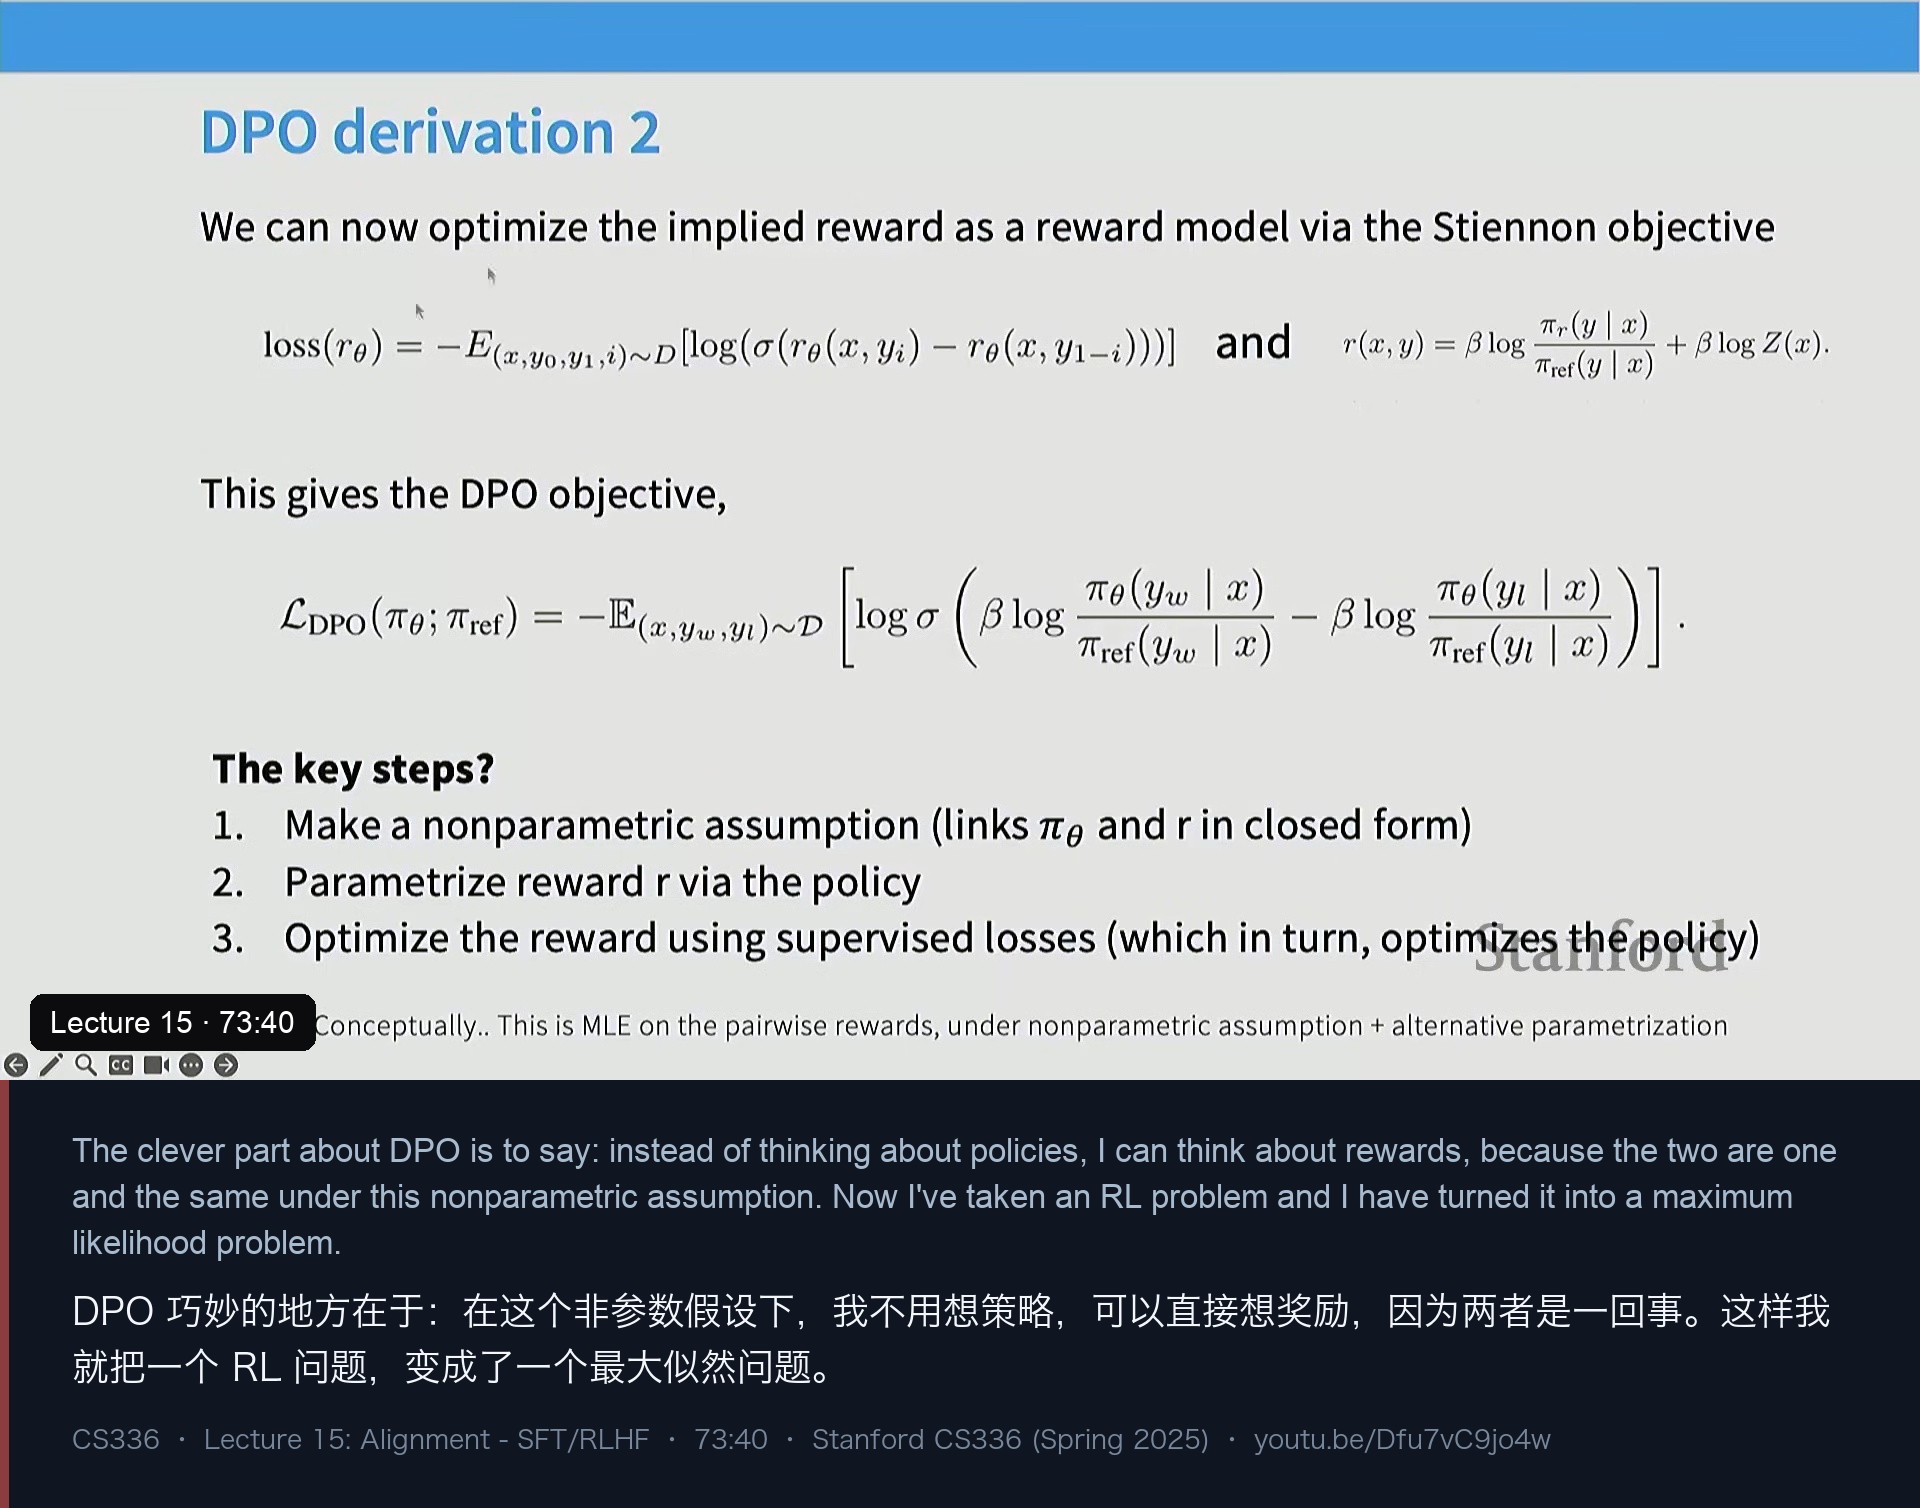
真正留下来的是 DPO。他说的原因很实在:它把 PPO 的复杂度整个去掉了,而且效果相对好——没有奖励模型、没有 on-policy 的重要性比率,回到最基础的“对好东西做正梯度、对坏东西做负梯度”。然后他花了最后几分钟把 DPO 的推导走完,只有三步:
第 1 步:非参数假设,把策略和奖励绑在一起。 假设 π_θ 不是神经网络,而是任意函数。对这个目标求解,最优策略是
π*(y | x) ∝ π_ref(y | x) · exp( r(x, y) / β )反过来解,就得到隐含奖励(implied reward):
r(x, y) = β · log( π(y|x) / π_ref(y|x) ) + β · log Z(x)第 2 步:把隐含奖励代进成对偏好目标。 左边是 Bradley-Terry(Stiennon 那套)的偏好概率,右边是上面这个“策略即奖励”的等价形式——于是你不需要单独训奖励模型,让策略本身去充当它:
P(y_w ≻ y_l | x) = σ( r(x, y_w) − r(x, y_l) )
                 = σ( β log(π_θ(y_w|x)/π_ref(y_w|x)) − β log(π_θ(y_l|x)/π_ref(y_l|x)) )
第 3 步:最大化这个似然,得到 DPO 损失。
L_DPO(π_θ; π_ref) = − E_{(x, y_w, y_l) ~ D} [ log σ( β log(π_θ(y_w|x)/π_ref(y_w|x))
− β log(π_θ(y_l|x)/π_ref(y_l|x)) ) ]他最后总结这三步的意义:“我原来有一个 RL 问题,现在把它变成了一个最大似然问题”——一个概念上非常像预训练的问题,只不过最大化的不是下一个 token 的概率,而是成对比较的概率。他说:这就够了,剩下的 RLHF 部分下次课再讲。
我的笔记
- 后训练的核心心智模型:预训练是“打包能力”,后训练是“把能力拿出来用”。 这句话解释了很多现象——为什么指令微调主要是“提取”而不是“注入”(图 9),为什么逼模型做它不会的事会制造捷径(图 6、图 7)。
- “数据的形状”比“数据对不对”更早起作用。 指令微调可靠地教的是输出的 type signature:格式、长度、语气、结尾有没有引用。内容对不对是第二个问题。
- 那条 monopsony 引用例子值得反复讲。 一份“完全正确且非常详细”的数据,会同时教知识和“结尾必须给引用”这个习惯;模型不知道引用时,学到的是编造。这可能是整讲最重要的一句话。
- 损失函数会选“更小的错”,而不是“对的做法”。 在 token prediction 下,编一个引用比不写引用损失更低——幻觉因此不是“模型的恶意”,而是训练目标的产物。
- 对策是 on-policy:先问模型知道什么,再决定教不教。 Schulman 的论证:只教模型已经会的,不知道就让它说不知道;这要求反馈来自模型自己的输出,这是 SFT 做不到的。
- “高质量数据”不是一个方向,而是一个权衡。 长度、详细度、引用、列表——这些可能只是风格,而且人类和 AI judge 都会被它们带偏(长回答 60–70% 胜率)。做偏好数据时,长度是必须控制的混淆变量。
- 数据收集的难度要用身体记住,而不是用嘴说。 两次课堂实验(写长回答、五分钟事实核查)比任何论证都有说服力:时间压力下的正确性核查几乎做不到,而很多人会直接把整题丢给 GPT-4。
- 标注者是谁,模型就像谁。 InstructGPT 的价值观更贴近东南亚宗教群体,而它的标注员主要来自菲律宾和孟加拉(17% 美国)。RLHF 在管线末端,但权力极大。
- AI 反馈的兴起是一个成本-质量结论:GPT-4 的成对反馈与人类估计的胜率高度一致,人-人一致度 ≈ GPT-4-人一致度,但便宜得多(Zephyr 团队的立场转变是最好的注脚)。
- mid-training 抹掉了预训练与后训练的边界。 指令数据就是 token 序列,可以混进退火阶段。副作用是“base model”这个概念变得可疑——它可能已经隐式地做过指令微调。
- mid-training 解决不了幻觉/引用问题。 因为它无条件地把数据放进去,没有“模型知不知道”的自适应判断——这部分只能靠 on-policy 的反馈。
- InstructGPT 的目标函数三项各有分工:奖励是想要的,KL 项防跑偏(今天仍是标配),预训练项防遗忘(很多人不做)。真正的后训练优化器里,KL 项是那个最不该省的。
- 奖励模型就是 Bradley-Terry:每个序列一个标量
r,人类比较按σ(r_w − r_l)掷硬币;我们只能观测噪声比较,用r_φ去拟合。这条假设是 PPO 与 DPO 共同的地基。 - PPO 三步可以背下来:策略梯度(正奖励升概率)→ advantage + 重要性比率(降方差、一次采样多步更新)→ 裁掉概率比来替代显式 KL 约束。
- DPO 只做了一件事:换元。 非参数假设下
π* ∝ π_ref·exp(r/β),把隐含奖励代回成对偏好似然——奖励模型没了、on-policy 比率没了,RL 问题变成最大似然问题。图 18 那张幻灯片值得对着推导抄一遍。 - 被放弃的四条替代路线也有价值:它们告诉你“把偏好当标签直接监督”(control token、只学 chosen、best-of-n)都不够好——偏好信号的用法是有讲究的,这正是 DPO 的立足点。
- 这门课的方法论:先看数据长什么样,再谈算法。 这一讲用了一半以上的时间讲数据集样本、标注指南、课堂实验——算法部分是最后十几分钟才出现的,这个比例本身就是观点。
附:课程信息与时间轴
- 课程:Stanford CS336《Language Modeling from Scratch》(Spring 2025)
- 本讲:Lecture 15 — Alignment: SFT / RLHF
- 主讲:Tatsunori Hashimoto
- 时长:1:14
- 视频:https://www.youtube.com/watch?v=Dfu7vC9jo4w
| 时间 | 内容 |
|---|---|
| 00 | 开场:这是后训练两讲中的第一讲,周四讲 RL from verifiable rewards |
| 00 | 今天的主题:把 GPT-3 变成 ChatGPT 的那支箭 |
| 01 | 现代指令模型有多强:Sparks of AGI 的嵌套复合指令例子 |
| 02 | 安全与内容审核:为什么 ChatGPT 的护栏是它成功的一部分 |
| 03 | 心智模型:预训练打包能力,后训练教模型“拿出来用” |
| 04 | 本讲结构照搬 InstructGPT 三步:SFT → 奖励模型 → RL |
| 05 | 数据比算法更关键:后训练用极少数据精确塑造行为 |
| 06 | 三种 SFT 数据范式:FLAN、OpenAssistant、Alpaca |
| 07 | FLAN:把现成 NLP 数据集聚合成一个大杂烩 |
| 08 | 看 FLAN 真实样本:摘要、四选一、Enron 主题行、E2E |
| 09 | FLAN 的“手术痕迹”:这不是你平时跟 ChatGPT 的对话 |
| 10 | Alpaca:种子指令 → 生成更多指令 → InstructGPT 填回答 |
| 11 | OpenAssistant:人类众包,复杂提问与极详细回答 |
| 11 | 第一次课堂互动:五分钟众包一条指令微调回答 |
| 12 | 众包结果投屏:emoji、短回答、被 troll、零星长回答 |
| 13 | 教训:写长篇回答真的很难,标注员有时间压力 |
| 14 | 这就是 AI 反馈流行的原因:质量高、成本低 |
| 15 | 数据的几个维度:长度、风格、引用、领域知识 |
| 16 | 长度这个“房间里的大象”:prompt 与 response 的分布 |
| 16 | 人类与 AI judge 都偏好列表、偏好更长输出(60–70%) |
| 17 | 但这些风格因素对 MMLU 等基准影响不大;评估要多样化 |
| 18 | “高质量数据”的陷阱:OpenAssistant 的 monopsony + 引用 |
| 19 | 同时教两件事:关联知识 vs “结尾必须给引用” |
| 20 | John Schulman 的论证:逼模型做不会的事会教出幻觉 |
| 21 | token prediction 下“编引用”比“不写引用”损失更小 |
| 22 | 结论:on-policy RL 更重要;不知道就让它说不知道 |
| 23 | 反直觉结论:完全正确且丰富的数据可能对 LM 有害 |
| 24 | type signature 视角:SFT 可靠地教输出“长什么样” |
| 24 | 安全微调:模型部署给终端用户,需要护栏 |
| 25 | 一点点安全数据就能大幅提升安全性 |
| 25 | 核心权衡:拒绝 vs 过度拒绝(“kill a Python process”) |
| 26 | 500 条样本就能让模型遵循部分安全准则 |
| 27 | 指令微调意外地强大:标准数据集 + 合理超参就够 |
| 27 | 怎么训:学术界直接梯度下降,前沿实验室把它做成预训练 |
| 28 | 指令数据只是 token 序列,可以混进预训练 |
| 29 | mid-training 配方:退火阶段混入指令数据 + 一轮短 SFT |
| 29 | MiniCPM 两阶段:纯预训练 → decay 阶段(含 SFT 数据) |
| 31 | 副作用:“base model”这个词越来越可疑 |
| 32 | Q&A:mid-training 不能解决引用/幻觉问题(无法自适应) |
| 33 | Q&A:对灾难性遗忘有帮助,让模型保持更通用 |
| 41 | 概念转向:从生成建模(模仿 p*)到 RLHF(最大化奖励) |
| 43 | 两个理由之一:采样(SFT 数据)很贵,测量奖励很便宜 |
| 44 | 理由之二:生成-验证差距,连专家写手都更偏好 AI 摘要 |
| 46 | 成对反馈流程:rollout → 比较 → 奖励模型 → RL |
| 47 | 标注界面长什么样;InstructGPT 的标注指南 |
| 48 | 三根支柱:helpful / truthful / harmless 的具体含义 |
| 49 | Bard 泄露的标注指南;据说每题只有一分钟 |
| 50 | InstructGPT 通过 Scale 和 Upwork 只找了约 40 人 |
| 50 | 第二次课堂互动:五分钟标注若干组回答 |
| 51 | 结果:27 人完成,几乎没人核查完事实或数学 |
| 51 | 短回答基本是长回答删掉幻觉;多数人投给更长但带幻觉的 |
| 53 | 标注员每题一分钟的新闻,与“这不够判断安全性/准确性” |
| 53 | 三条教训:可验证标注难、时间压力、有人把整题丢给 GPT-4 |
| 54 | 外包到第三国的定价与伦理问题;要付能生活的工资 |
| 55 | RLHF 在管线末端,对行为影响极大 |
| 55 | 标注员国籍会渗进模型:InstructGPT 与东南亚宗教群体 |
| 56 | Hosking 等:众包工人不关注事实性,更关注格式 |
| 56 | AI 反馈兴起:GPT-4 与人类估计胜率高度一致,且便宜 |
| 57 | UltraFeedback、Zephyr 的立场转变、Tulu 3、Constitutional AI |
| 59 | 长度效应:AI 反馈会让模型变得更啰嗦 |
| 59 | off-policy vs on-policy:地形 vs 改进自己的方向 |
| 60 | Q&A:能否在已知答案的域上做 RLHF → 周四讲数学 RL |
| 63 | Q&A:模型对自己的输出有很强的自偏好偏差 |
| 63 | Q&A:自举循环能提取多少能力是一个经验问题 |
| 65 | 方法开场:先定义奖励,再定义最大化过程 |
| 65 | InstructGPT 公式 2:奖励 − KL 惩罚 + 预训练梯度 |
| 66 | 奖励模型:每个序列一个标量,Bradley-Terry 掷硬币 |
| 67 | 只讲 PPO;更细的推导放到周四 |
| 68 | 策略梯度:正奖励升概率,负奖励降概率 |
| 69 | advantage:方差缩减、可减任意 baseline |
| 69 | 一次采样多步梯度 → 重要性权重 + 约束(TRPO) |
| 70 | PPO:用裁剪概率比替代显式 KL 约束 |
| 71 | “能不能不要 PPO?”:四条被尝试又被放弃的路线 |
| 72 | DPO 胜出的原因:去掉奖励模型与 on-policy 比率 |
| 72 | DPO 推导第 1 步:非参数假设 + 最优策略 + 隐含奖励 |
| 73 | DPO 推导第 2 步:把隐含奖励代进成对偏好似然 |
| 73 | DPO 推导第 3 步:RL 问题变成最大似然问题 |
| 74 | 收尾:剩下的 RLHF 与真正的 RL 留到周四 |
讨论
这里是静态站点,没有内嵌评论区。如果这篇文章对你有用,欢迎通过 RSS 订阅后续更新。