Stanford CS336 第十四讲精读:Data 2——过滤与去重的算法机制,从 KenLM、fastText、重要性重采样到布隆过滤器与 MinHash LSH
斯坦福 CS336(Language Modeling from Scratch, Spring 2025)第十四讲完整讲义,主讲 Percy Liang。上一讲是数据集的编年史,这一讲转向机制:先把『过滤』抽象成『给定小份高质量目标数据 T 和大量原始数据 R,找出与 T 相似的子集 T′』,再依次讲三种实现——n-gram 语言模型(KenLM / Kneser-Ney)、fastText 线性分类器(词袋 + hashing trick)、以及重要性重采样(DSIR);接着用语言识别、质量过滤、毒性过滤三个案例说明同一套机器怎么复用;后半程进入去重,先分清精确重复与近重复,讲哈希分组与布隆过滤器(含假阳性率的推导与最优哈希函数个数 k≈(m/n)ln2),再讲 Jaccard 相似度、MinHash 的碰撞概率证明、以及 LSH 的『与/或』band 结构如何把相似度概率曲线锐化成一条近乎阶跃的 sigmoid。收尾是那句总结:哈希之所以重要,是因为它把成对的相似与碰撞变成了一元函数,从而让线性时间成为可能。
本篇属于系列 Stanford CS336 精读 · 第十四讲
来源:YouTube 原视频(Stanford Online · CS336 Language Modeling from Scratch · Spring 2025 · Lecture 14: Data 2)
来源说明 这是斯坦福 CS336《Language Modeling from Scratch》2025 年春季第十四讲的完整讲义,主讲人是 Percy Liang。上一讲(Data 1)是数据集的编年史:从 BERT 的 BooksCorpus 一路走过 Common Crawl、CCNet、C4、The Pile、LLaMA、DCLM,直到 Nemotron-CC。这一讲不再问“用了哪些数据集”,而是往下钻一层,问那些过滤和去重到底是怎么算出来的——用 Percy 自己的话说,这一讲“偏重经典的大数据处理算法”,中间还会出现“一些有趣的数学”。
文中 18 张配图均截取自视频对应时刻的画面,并把该时刻的完整观点句(英文原句+中文翻译)拼合进图中。文中出现的所有数字——Common Crawl 的规模、“过滤到网页的 1%、分类器算力必须是前向传播的百分之一”、Wikipedia 句子的困惑度 87、CCNet 保留前 1/3、fastText 的 10M 哈希桶与 176 种语言、BLOOM 只有 30% 英文、OpenWebMath 的 147 亿 token 与“比 20 倍数据训出的模型还好”、phi-1 的 10 万条 GPT-4 标注与 HumanEval 12.19%→17.68%、Dolma 的 1e-5 假阳性率、C4 里重复 61036 次的产品文案、布隆过滤器实验里的 m=8 / k=10 / n=100、Lee+ 2021 的 b=20 / r=450 / 阈值 0.9936、阈值处碰撞概率收敛到 1−1/e 等——都是讲师课上的口播、幻灯片演示或对公开论文的转述,不是本文独立核实的事实,请以原始论文与代码为准。
另外两点提醒。其一,自动字幕把不少专有名词听错了:
engram/n-gram是 n-gram,CANLM/klm/KLM/canlam是 KenLM,canern smoothing/cannon smoothing/Kneser-Ney是 Kneser-Ney smoothing,CCNET/CCNet是 CCNet,fastex/fast text是 fastText,CCN是 CCNet,GPD4/GPT-4是 GPT-4,GBD3/GPT-3是 GPT-3,DOMA是 Dolma,jigsaw是 Jigsaw,NSFW是 NSFW,jakard/chicard/Jaccard是 Jaccard,minash/MinHash是 MinHash,murmur hash是 MurmurHash,proof pile是 ProofPile,open web math是 OpenWebMath,51在“51 那篇论文”处上下文指 phi-1,bird是 BERT,homo指 OLMo,Lee+ 2021是去重那篇论文,DSIR是 Data Selection with Importance Resampling,下文按通行写法记录。其二,这一讲最有价值的东西不是“哪个过滤器好”,而是同一套抽象被反复复用:你总在估计一个“它像不像目标数据”的打分函数,然后用这个分数在原始数据上做取舍;而所有线性时间的去重技巧,都建立在“用哈希把成对关系降成一元关系”这一个动作上。配图全部来自视频画面(不只是截图,而是“视频帧 + 该时刻观点句的中英双语面板”)。
TL;DR
- 这一讲是“机制篇”,不是“数据集篇”。 上一讲的结论是“数据不会从天上掉下来”,这一讲回答的是:掉下来之后那些清洗动作在算法上长什么样。Percy 明确说重点在质量过滤与去重,而且“偏经典大数据算法”,后半段会出现一些概率推导。
- 过滤问题有一个统一的三句话框架:给定一份小的、高质量的目标数据 T,给定一份大的原始数据 R(比如 Common Crawl),找出 R 里与 T 相似的子集 T′。 对实现的唯一硬要求是”快“——如果分类器的算力接近训练本身,那还不如直接去训;要过滤到网页的 1%,分类器的开销就必须压到一次前向传播的百分之一量级。
- 实现这个框架的三条路,都是“先打分、再按阈值取”: ① n-gram 语言模型(KenLM,Kneser-Ney 平滑,用困惑度当分数);② 线性分类器(fastText,词袋 + n-gram 哈希,值域压缩到隐藏层);③ 重要性重采样(DSIR),用 P(target)/P(raw) 的比值重采样。三者本质都是“拟合一个告诉你’什么像目标而不像原始’的分布,然后把它应用到 R 上”。
- fastText 的设计值得一提: 词袋分类在词表 V、类别 K 都很大时要一个 V×K 的矩阵,于是它先降到隐藏维 h(参数降到 H·(V+K)),前向传播里没有任何非线性——某种意义上就是一次矩阵分解。n-gram 数量无界,于是用哈希分桶(演示里 8 个桶,实践中 1000 万)把 bigram 压到固定空间;碰撞不致命,最小化损失时权重会“平均”掉无关词。
- 同一套机器可以复用成完全不同的任务: 语言识别(fastText 的
lid.176.bin,Dolma 保留 P(English) > 0.5)、质量过滤(GPT-3 用高质量源作正例、LLaMA 用“Wikipedia 引用的页面”作正例、phi-1 直接让 GPT-4 提示出“教育价值”当正例再蒸馏成随机森林)、毒性过滤(Jigsaw toxic comments 数据集上训 hate / NSFW 两个 fastText 分类器)。“T 从哪来?T 从提示 GPT-4 来”,是这一讲最锋利的一句。 - 去重要先分清两种重复: 精确重复来自镜像(Project Gutenberg 被搬到一堆 URL,Common Crawl 看不出来)与复制粘贴;近重复来自许可证文本、模板生成的广告文案(把 Canada 换成 USA)、标注或处理错误、以及改写。C4 里有一段产品描述重复了 61036 次——它不是“坏数据”,但没人想在上面训 61036 遍。
- 去重与质量过滤是互补的两种动作: 质量过滤说“这条我永远不想训”;去重说“这条也许没问题,但我只想要很少几份”。去重还顺带降低记忆风险(版权与隐私),这也是 Lee+ 2021 之后“去重让语言模型更好”的实证结论。
- 精确去重用“哈希分组、每组留一份”就够了,好处是简单、高精度、天然适合 MapReduce;缺点是完全不认近重复。要压内存就上布隆过滤器:
no一定为假,yes大概率真;单哈希时假阳性率约 1/m,用 k 个哈希后变成f = (1 − (1 − 1/m)^{kn})^k,最优的哈希个数是 k ≈ (m/n)·ln 2,此时f = 0.5^k。Dolma 在段落级别用它做精确去重,假阳性率设到 1e-5。 - 近去重的数学核心是 MinHash: 定义 Jaccard 相似度为交集除以并集,而 MinHash 的第一个漂亮性质是 Pr[h(A) = h(B)] = Jaccard(A, B)——哈希碰撞第一次变成了“想要的东西”而不是要避免的东西。证明靠特征矩阵 + 随机排列:最小哈希落在交集里的概率恰好等于 Jaccard。
- LSH 再把“碰撞概率 = 相似度”这条直线锐化成一条 sigmoid: 把 N 个哈希分成 B 个 band、每 band 含 R 个哈希,任一 band 全同即判碰撞,于是
Pr[collision] = 1 − (1 − sim^R)^B。增大 R 会把曲线右移并变陡,增大 B 会把曲线左移,两者配合就能在任意阈值处做出近乎阶跃的判定。Lee+ 2021 设 b=20、r=450,算出阈值 0.9936——“每 100 个词只允许 1 个词不同”;而曲线在阈值处的碰撞概率收敛到 1 − 1/e ≈ 0.632。 - 答疑里两个很实用的补充: 合成数据时代的语义去重可以换成 embedding 近邻(但要小心过于激进会扔掉大量数据);而高质量数据不是必须去重的——mid-training 阶段本来就要对高质量数据多训几轮,更合理的做法是把“出现次数”取平方根或对数来降权。
一、开场:从“有哪些数据集”转向“这些处理是怎么算的”
这一讲没有独立的标题页,它直接从上一讲的结论续上。Percy 第一句话就把脉络交代清楚:上一讲是历史综述——从 BERT 一路讲到 OLMo,看的是“不同语言模型用了哪些数据集”;而这一讲要补上中间那段被跳过的机制。
他强调的那句老话是:“数据不会从天上掉下来”。数据往往先存在于某个线上服务里,必须被显式地抓取或导出;接下来是一长串处理——把原始 HTML 转成文本、做质量和语言与毒性过滤、去重等等。而这一讲要“深入其中一些机制”,重点是两类:质量过滤(quality filtering)与去重(deduplication)。
课程大纲也很清楚,只有三步:
This lecture: deep dive into the mechanics
  - Algorithms for filtering (e.g., classifiers)
  - Applications of filtering (e.g., language, quality, toxicity)
- Deduplication (e.g., Bloom filters, MinHash, LSH)他还提前给了一个“这讲会不一样”的提示:内容会偏经典的大数据处理算法,其中有一些“有趣的数学”。对熟悉 scikit-learn 和 Pandas 的人来说,这一讲的工具(布隆过滤器、MinHash、LSH、KenLM)大多来自搜索与数据库社区,而这正是它的价值所在——预训练数据管线其实是“大数据工程”而不是“深度学习”。
二、过滤问题的统一框架:T、R 与 T′
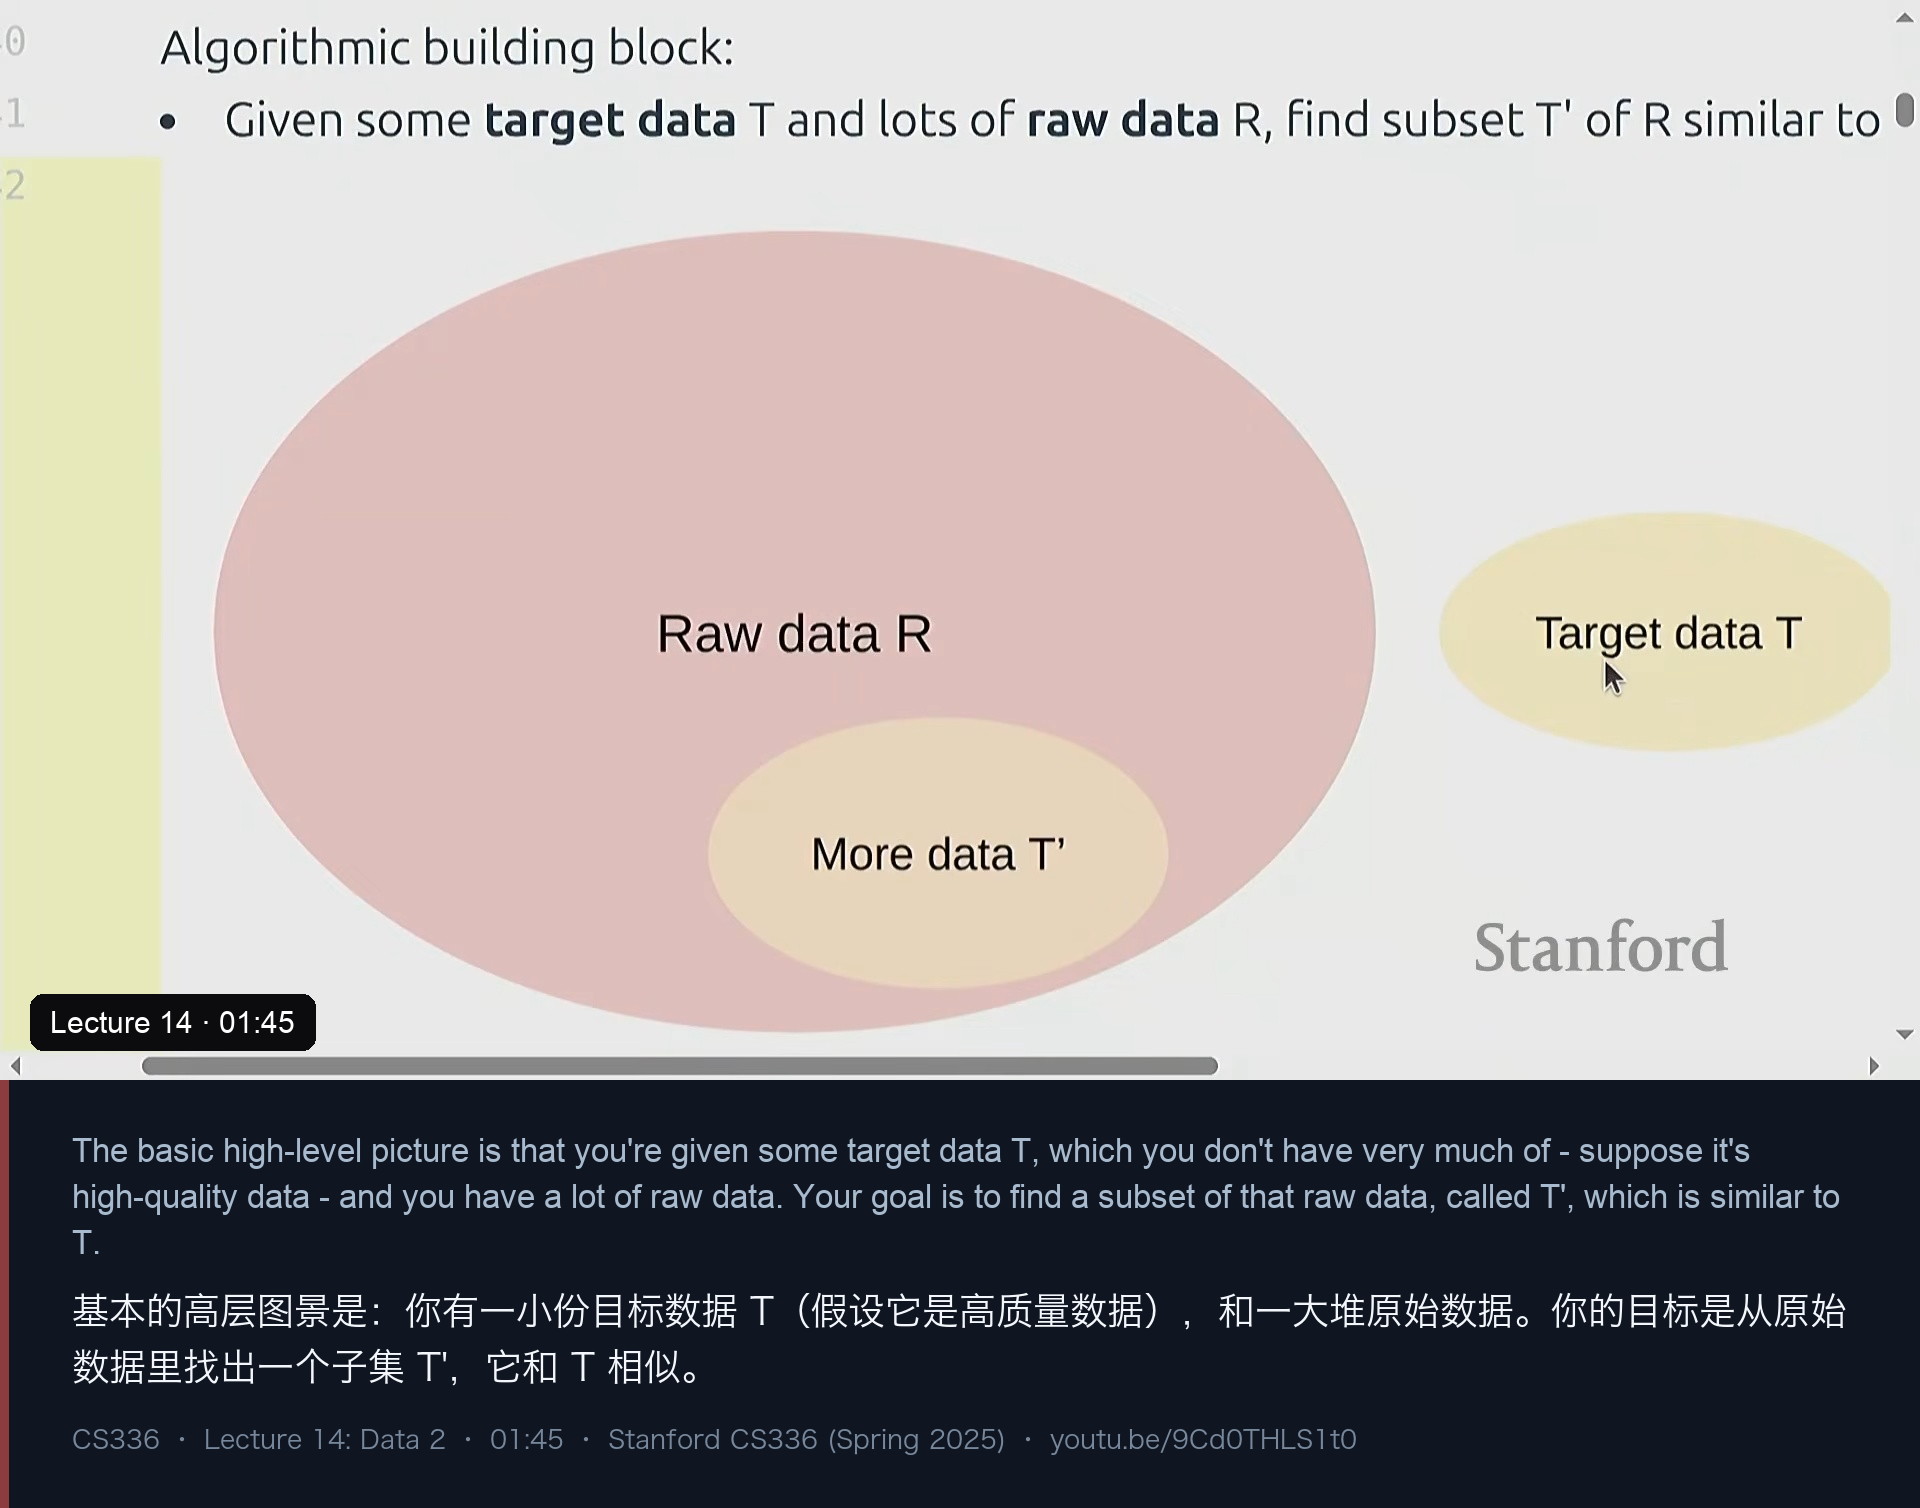
过滤的高层图景可以写成三行:
目标数据 T:小而精(你真正想要的那类数据,例如高质量网页、教科书式文本)
原始数据 R:大而杂(例如 Common Crawl 的全部网页)
要找的 T′:R 的一个子集,且与 T 相似
Percy 特别提醒“这个模式你应当在几乎任何过滤管线里都能认出来”。他对过滤器提了两个要求,第二个尤其关键:
- 要能泛化。 如果只是把 T 原样挑出来,那毫无意义——T 已经在手上了;你需要的是从 T 推广到“更多同类”。
- 要极其快。 因为它要跑遍差不多整个互联网。如果这个模型大到和训练本身一样贵,“那你不如直接去训练算了”。他还给了一个量化的直觉:如果你要把网页过滤到 1%,那么分类器的算力预算大约只能是“跑一遍前向传播的百分之一”。
接下来的三个方法,其实是这个框架的三份不同答案。
三、第一条路:n-gram 语言模型与 KenLM
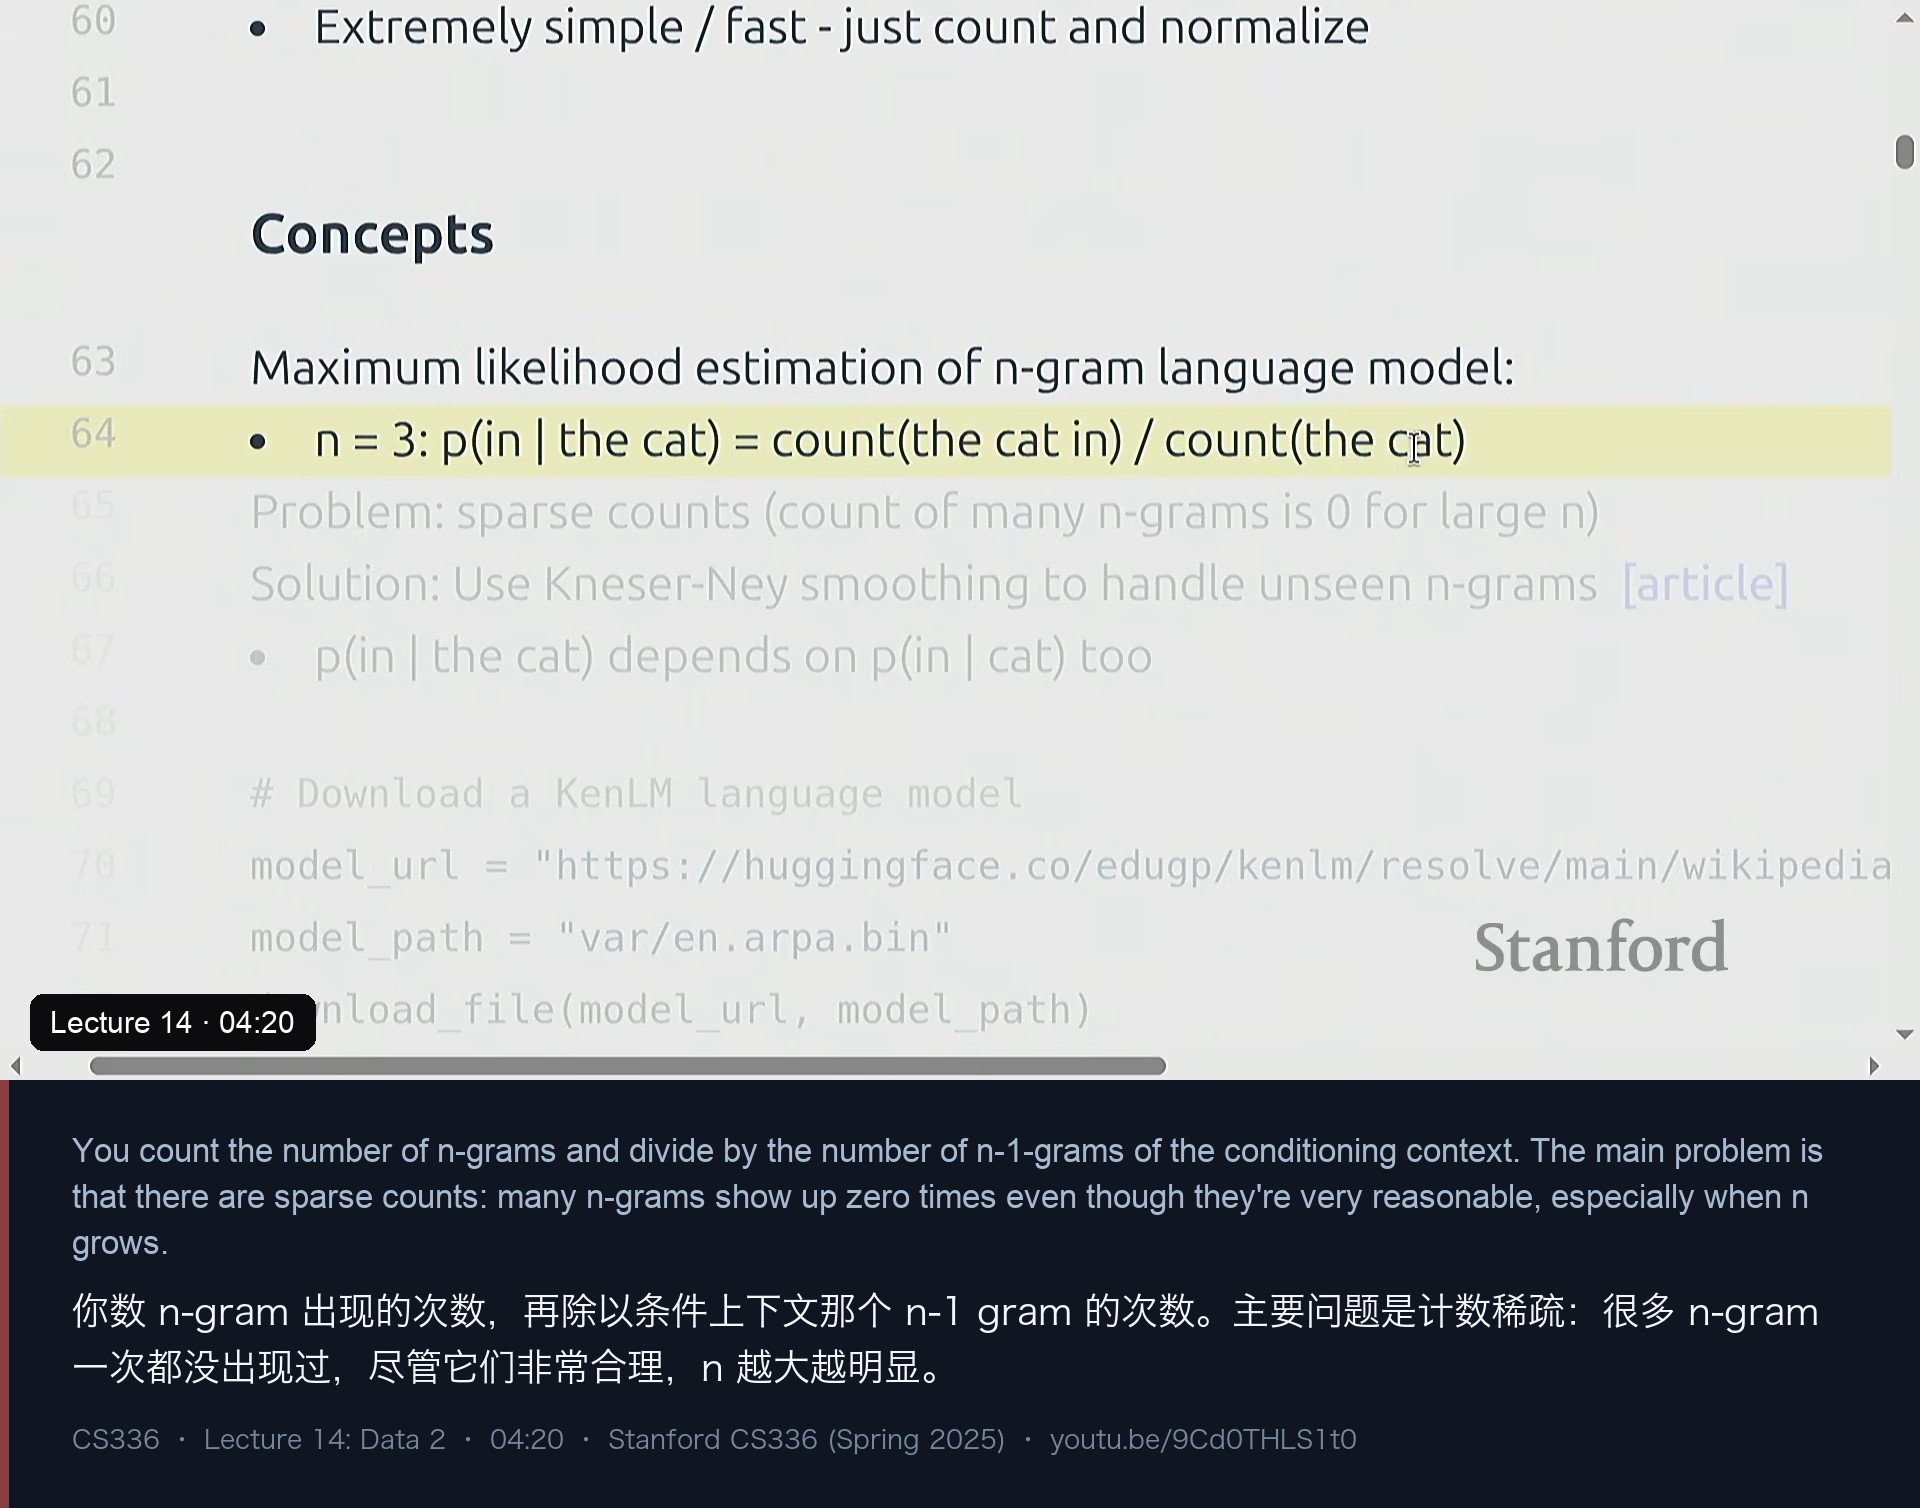
第一种做法是用 n-gram 语言模型给文档打“像不像人写的话”的分。起点是最朴素的极大似然估计:
p(in | the cat) = count(the cat in) / count(the cat)也就是“数 n-gram 的次数,再除以条件上下文那个 n−1 gram 的次数”。Percy 说这在原理上“非常简单”,但有两个现实问题:
- 计数稀疏。 很多完全合理的 n-gram 一次都没出现过,n 越大越严重——这就是 n-gram 模型撞上“维度灾难”、无法继续 scale 的根本原因。
- 实现要花功夫。 高效地在海量语料上数 n-gram、存概率表,是一套独立的工程。
缓解稀疏性的经典办法是 Kneser-Ney 平滑:如果高阶 n-gram 的数据不够支撑这个计数,就用低阶 n-gram(从上下文里去掉一个词)来插值或回退。数据过滤这个圈子里最常用的实现是 KenLM——一个最初为机器翻译写的开源工具,“没有特别的原因必须用它,只是大家都用它”。
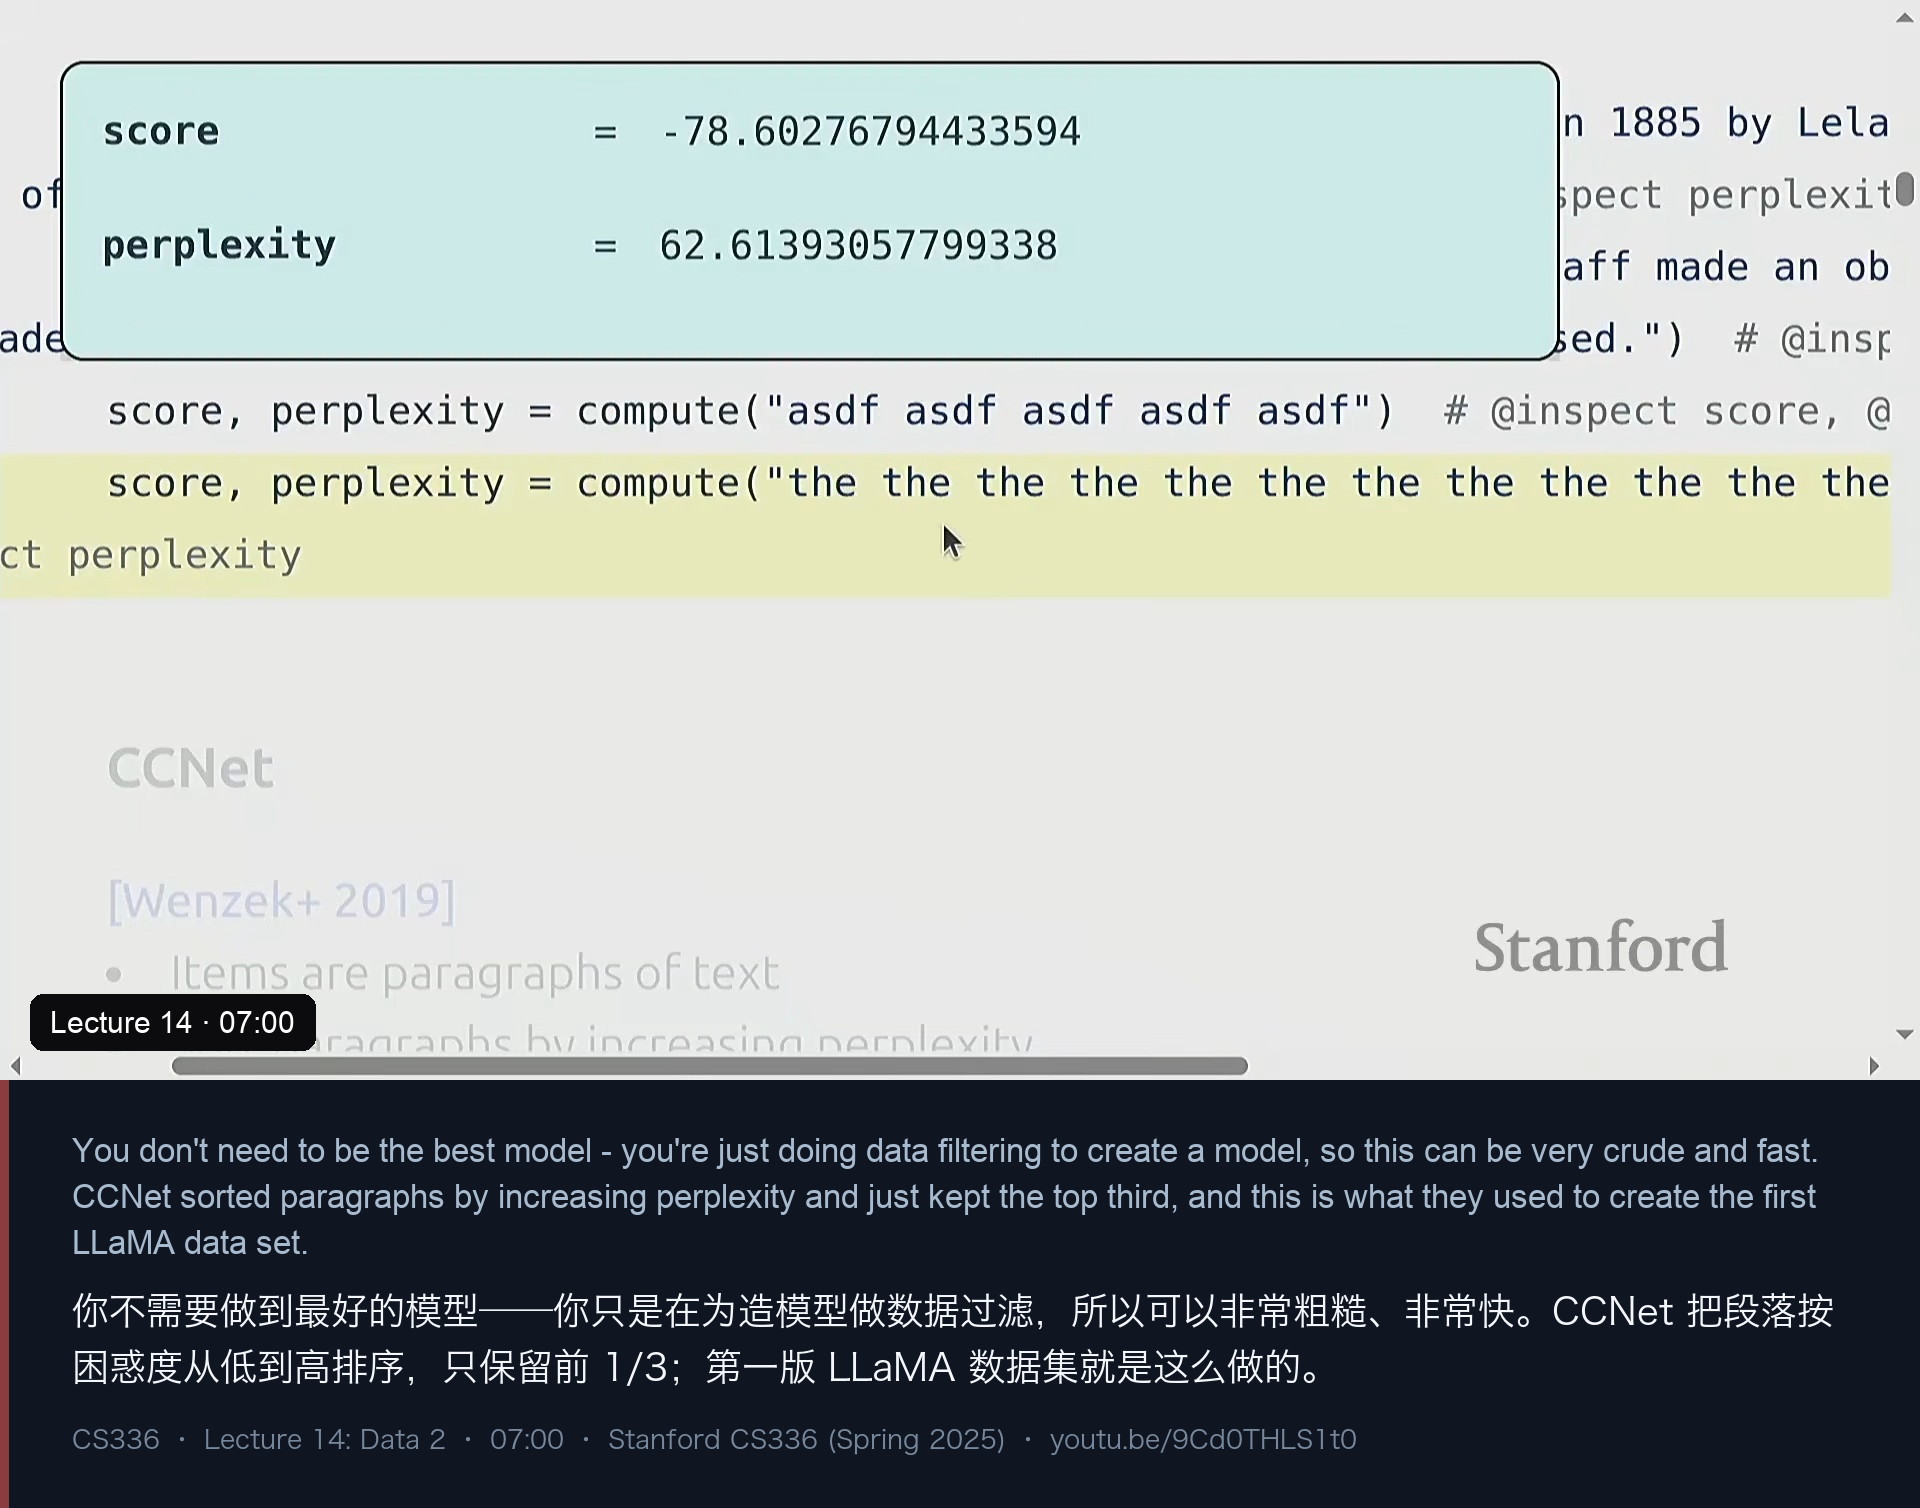
演示部分很能说明这类模型的性格。他下载了一个在 Wikipedia 上训好的 KenLM,然后把几种文本塞进去算困惑度:
score, perplexity = compute("asdf asdf asdf asdf")
# score      = -78.60276794433594
# perplexity =  62.6139305779938

score, perplexity = compute("the the the the the the the the ...")
# 这串东西本该得到很高的困惑度,但这个 n-gram 模型给出了意外低的分数
取一段真正来自 Wikipedia 的句子(“Stanford University was founded in 1885”),困惑度大约是 87;换成 CS336 课程网站上的句子会更高(因为它不常出现在 Wikipedia 里);而 asdf asdf asdf 这种纯乱码,困惑度是 62.6;至于 the the the the ...,本应是最不可能的序列之一,这个模型却给了个偏低的分数。
幻灯片的注释把要点钉死了:
- Extremely simple / fast - just count and normalize
- Problem: sparse counts (count of many n-grams is 0 for large n)
- Solution: Use Kneser-Ney smoothing to handle unseen n-grams
Percy 的点评是:“你不需要做到最好的模型——你只是在为造模型做数据过滤,所以它可以非常粗糙、非常快。” 这一点在后半段的过滤管线里反复出现:过滤器是一个“筛选器”,不是一个“最终产品”。
具体怎么用这类模型?CCNet 的做法是把文档切到段落级别,用 KenLM 给每段算困惑度,然后按困惑度从低到高排序,只保留前 1/3。Percy 说这就是用来构造第一版 LLaMA 数据集的做法。
四、第二条路:fastText —— 词袋、n-gram 与 hashing trick
第二个方法更流行,也更工程化:fastText。它出自 2016 年的 Facebook AI(Percy 顺带说 KenLM 其实更早),那篇论文的卖点很质朴——当所有人都在堆花哨的神经网络时,他们说”一个几乎线性的分类器就能达到一样好的效果,而且快得多“,于是这个软件包就火了。
它的动机要回到词袋分类的参数量上:
句子长度 L、词表大小 V、类别数 K=64
朴素做法:需要一个 V × K 的参数矩阵
问题:如果 V 和 K 都很大,参数爆炸 + 稀疏性严重
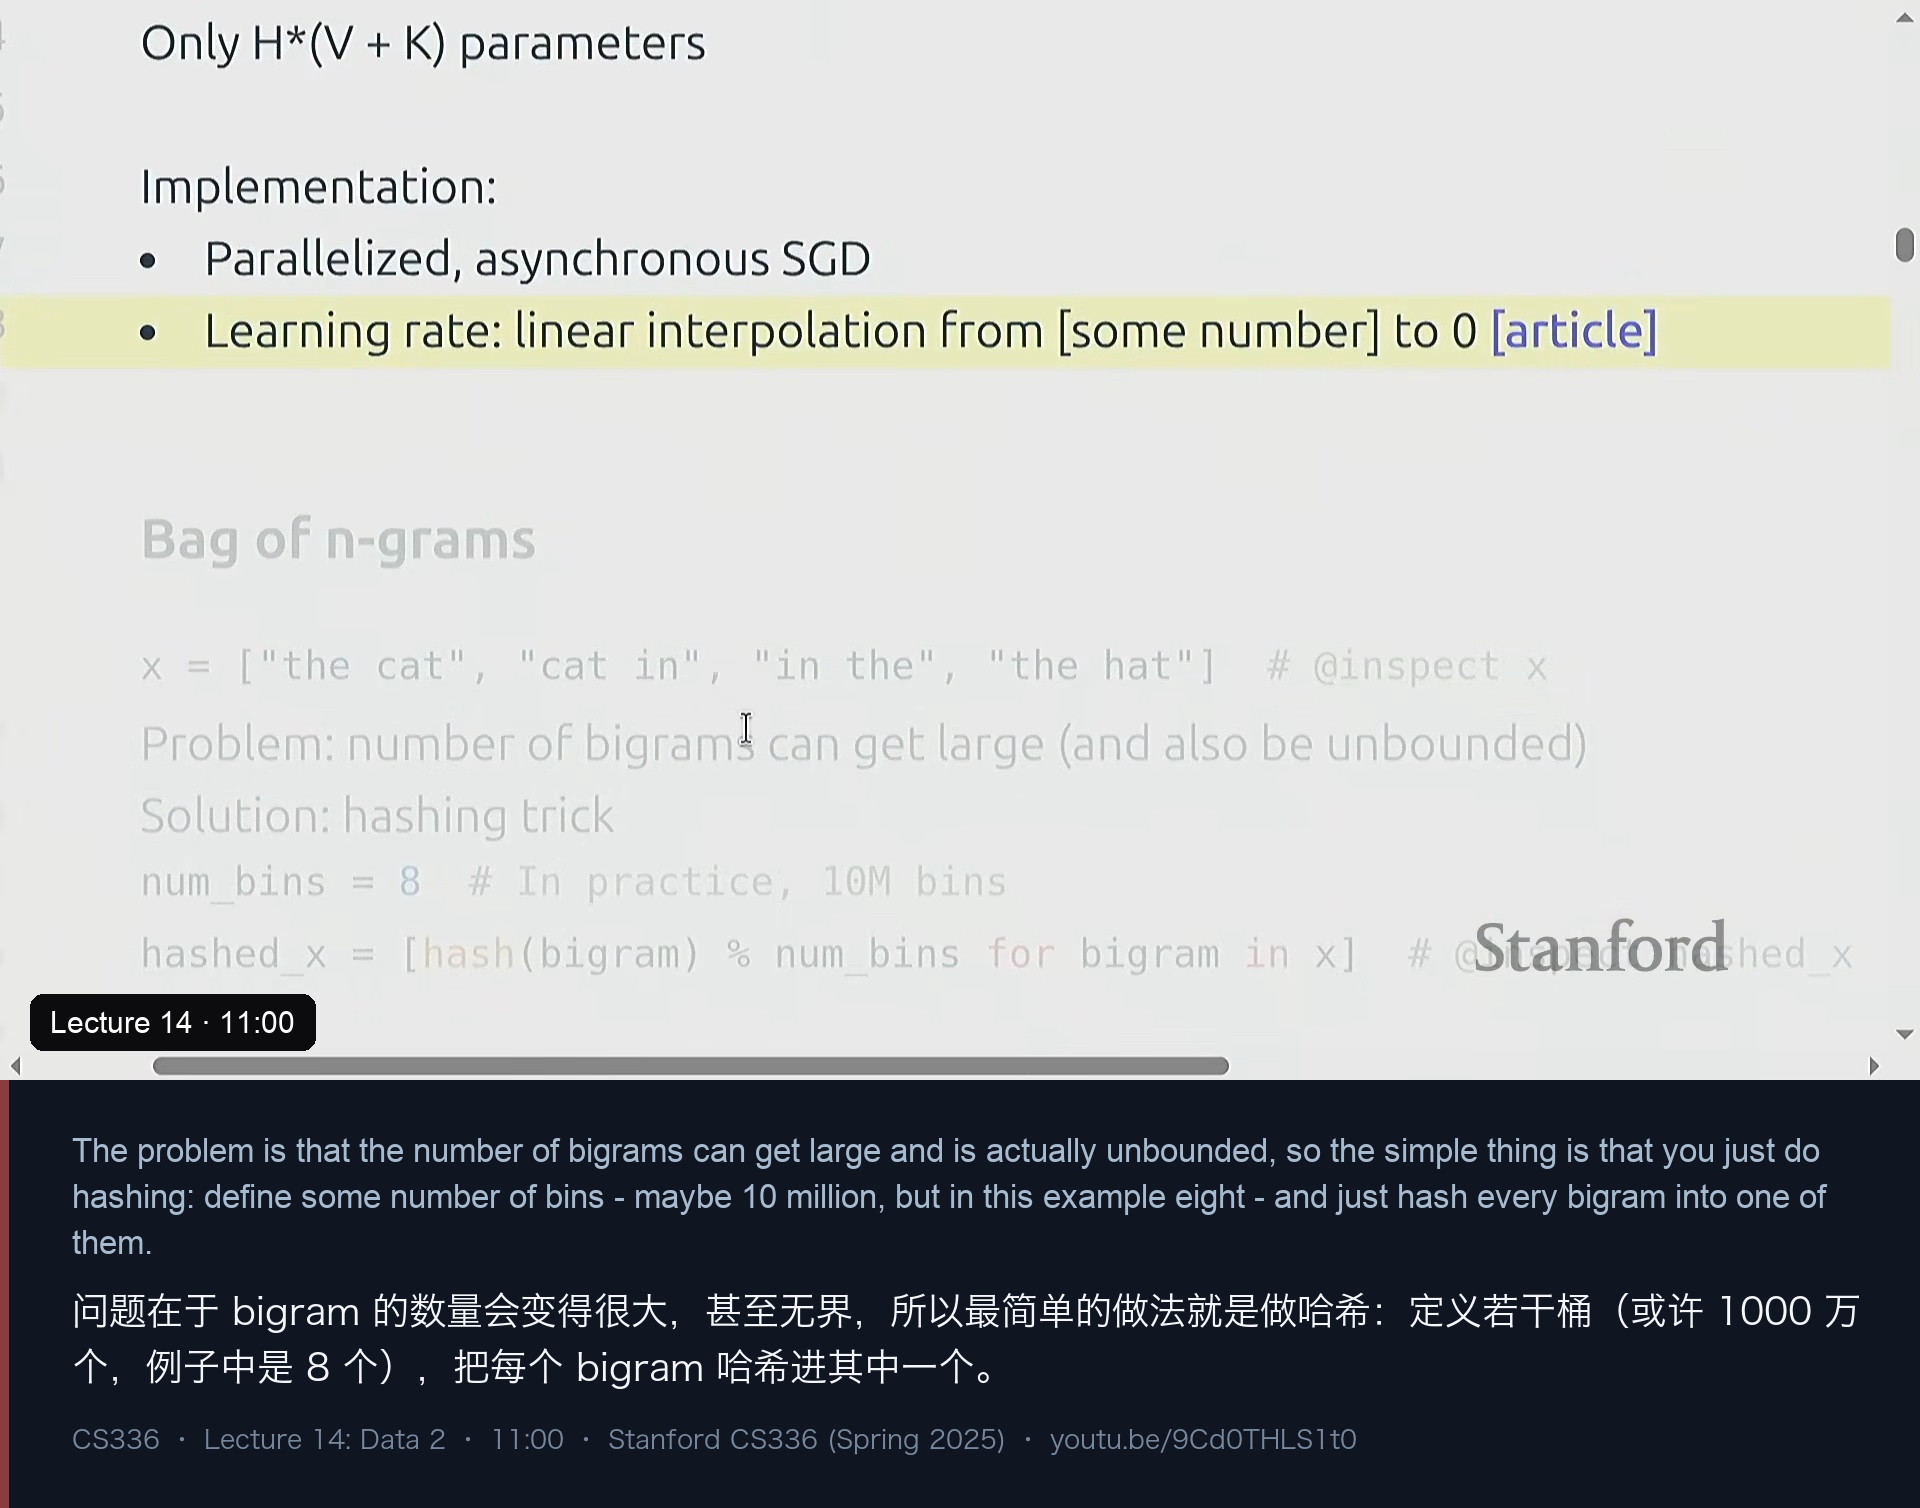
fastText 的解药是先降维再分类:把 V 维的词袋映射到一个隐藏维 h(通常远小于 K,论文里给到 16 这类量级),再从 h 分类到 K。幻灯片把这层意思写得很直白:
Only H*(V+K) parameters
Implementation:
  - Parallelized, asynchronous SGD
- Learning rate: linear interpolation from [some number] to 0而且注意:前向传播里没有任何非线性。所以推到底,它也可以看成一次矩阵分解。参数量因此大幅下降,实现上高度并行、异步 SGD、学习率线性衰减。
但词袋的问题在于它只看单词。于是 fastText 顺手把它扩展到 n-gram(bag of n-grams),可新问题马上来了:bigram 的数量是无界的,不可能为每个 bigram 都留参数。解法是 hashing trick:
x = ["the cat", "cat in", "in the", "the hat"]
# Problem: number of bigrams can get large (and also be unbounded)
# Solution: hashing trick
num_bins = 8      # in practice, 10M bins
hashed_x = [hash(bigram) % num_bins for bigram in x]
演示里只用了 8 个桶,实践中是 1000 万个。哈希必然带来碰撞,但 Percy 的态度是“就接受它”:在最小化损失的过程中,碰撞其实被自动照顾了——如果两个毫无关系的词撞进同一个桶,学到的权重会近似变成两者的“平均”。他也顺手指出一个常见设定:K = 2,即“这个文档是好还是坏”,这时 fastText 就是个普通的二分类线性分类器。
最后是那个反复出现的权衡:
- For quality filtering, we have K = 2 classes (good versus bad)
- In that case, fastText is just a linear classifier (H = K = 2)
- In general, can use any classifier (e.g., BERT, LLaMA), it's just slower
你可以换成 BERT 甚至 LLaMA 当分类器——只是更慢,而更慢就意味着要重新算一笔账:如果分类器要花掉那么多 FLOPs,也许那些算力更应该拿去直接训练模型。
五、第三条路:重要性重采样(DSIR)
第三个方法最“数学”,也最讲道理:Data Selection for Language Models via Importance Resampling(DSIR)。它的骨架还是 T 和 R,只是中间多了一个“重要性权重估计器”——一个在概念上等价于 n-gram 模型或 fastText 分类器的角色,最后用它来挑选文档。
先复习重要性重采样本身。这里的目标是一个分布 P,但你不能直接从 P 采样,只能从一个提议分布 Q 采样。做法是:从 Q 取样,给每个样本算重要性权重 P(x)/Q(x)(这一步是在“除掉”你采样时引入的偏差),归一化之后按权重重采样——质量偏在 3 上的 P 就会在重采样后真的多出更多 3。
把它搬到数据选择上,就变成了:P 拟合成目标数据 T 的分布,Q 拟合成原始数据 R 的分布,比值就是分数。可这里有一个真实的困难:T 太小(“目标数据是高质数据,你手上本来就不多,这正是你要找更多同类的原因”),小到无法可靠地估计一个分布。DSIR 的解法又回到了哈希:
# 1. Sample from q
n = 100
samples = np.random.choice(vocabulary, p=q, size=n)

# 2. Compute weights over samples (w ∝ p/q)
w = [p[x] / q[x] for x in samples]

# 3. Resample
samples = np.random.choice(samples, p=w, size=n)具体做法是对每个 hashed unigram 估计一个概率,然后一个文本的概率就是它所有词概率的乘积。演示里他诚实地说自己“有点不走运”,有一项概率被算成 0(可以加平滑);还提醒 Python 的 hash 是非确定性的,所以每次跑结果都会不一样——这既是坑,也是这类“粗糙哈希模型”的性格。
效果如何?论文报告在 GLUE 基准上 DSIR 相对 fastText 略好一些(提升不算巨大)。真正的差别在哲学上:
“对整体分布建模在某种意义上更讲道理,因为你要去匹配分布;而 fastText 本质上只是在分类’某个东西在不在这个分布里’,它对匹配分布没有任何保证。”
后者的好处是,DSIR 对多样性更友好;两者的共同好处是都很快,而且都能通过“换更强的模型”来改进(提高 n,或直接用神经网络打分)。
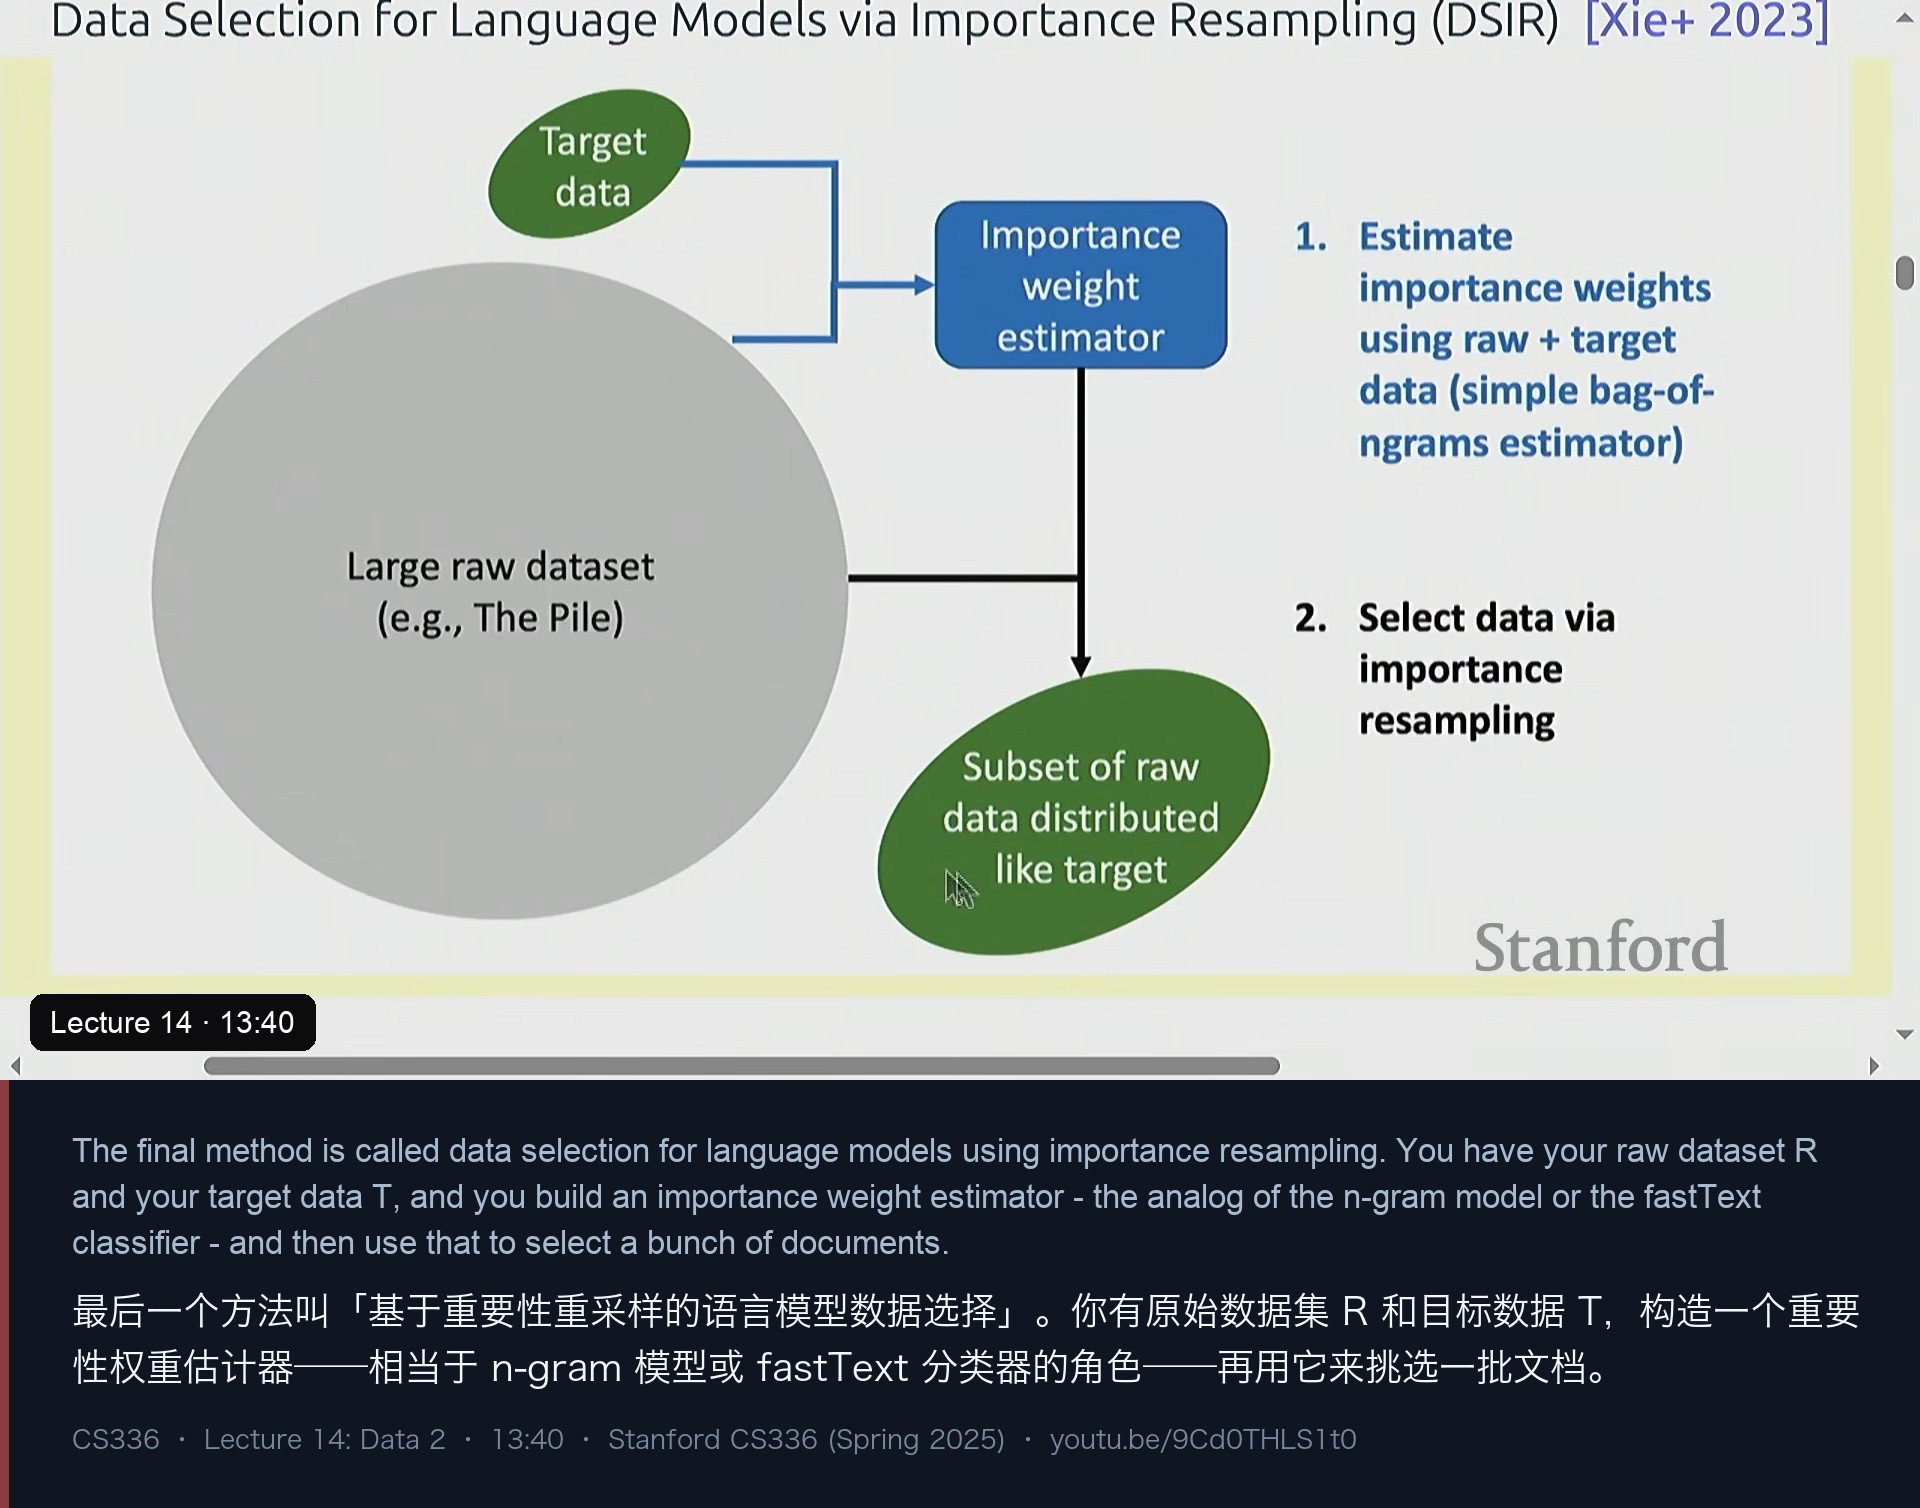
Percy 最后把三条路收成一个统一配方,这一页值得完整抄下来:
def filtering_algorithms():
    """Algorithmic building block:
       Given some target data T and lots of raw data R, find subset T' of R similar to T."""
Instantiations of the framework
Generative model of T (KenLM):
1. score(x) = p(x)
2. Keep examples with score(x) >= threshold (stochastically)
Discriminative classifier (fastText):
1. score(x) = p(T | x)
2. Keep examples with score(x) >= threshold (stochastically)
Importance resampling (DSIR):
1. score(x) = p(T | x) / p(R | x)
2. Resample examples with probability proportional to score(x)三条路都是”估计一个模型 → 得到一个打分函数 → 在 R 上按分数取舍“。到此为止,过滤这一半就讲完了。
六、答疑:n-gram 只看局部,那“质量”到底是什么
课间有学生追问了一个很尖锐的问题:我们嘴上说“高质量数据”,但一直没说“一份好文档到底长什么样”。n-gram 模型只是在保证“词和词能接得上”,它看不出更大尺度上是否说得通(把句子打乱了,n-gram 可能照样觉得不错),那这套东西凭什么算在评估质量?
Percy 的回答很坦率:确实容易被对抗,你完全可以构造出让 n-gram 打出高分的垃圾;但平均来看它够用,而这类过滤器要做的其实是”把真正的胡言乱语(true nonsense)挡掉“。他对学生的总结表示认可:把它当成”过滤掉纯网页噪声“的工具,而不是”判断文章是否有洞见“的裁判。他还预告了一句:“接下来的例子会让你更清楚,这些分类器不只能做质量,在别的用途上它为什么管用会更明显。”
七、应用一:语言识别
从这一段开始,同一个机器被反复复用。第一个任务是语言识别:找出某个特定语言的文本。
先要回答“为什么不做纯多语言模型”。Percy 给了两条理由:
- 高质量数据的整理本身很难。 每种语言都需要自己的策展与处理,这很贵。
- 在算力受限时,你不关心的语言会偷走你关心的语言的算力。 经典例子是 BLOOM(2022):它的训练数据里只有 30% 是英文,结果英文表现没有达到应有的水平,反而在小语种上很强。
当然他也补了一句公平的话:如果容量足够大、模型足够大,多语言训练是可以做好的,甚至存在跨语言的正迁移;所有前沿模型(GPT-4、Claude、Gemini、Llama、Qwen)都在大量语言上(有时 100 种以上)受过训练。
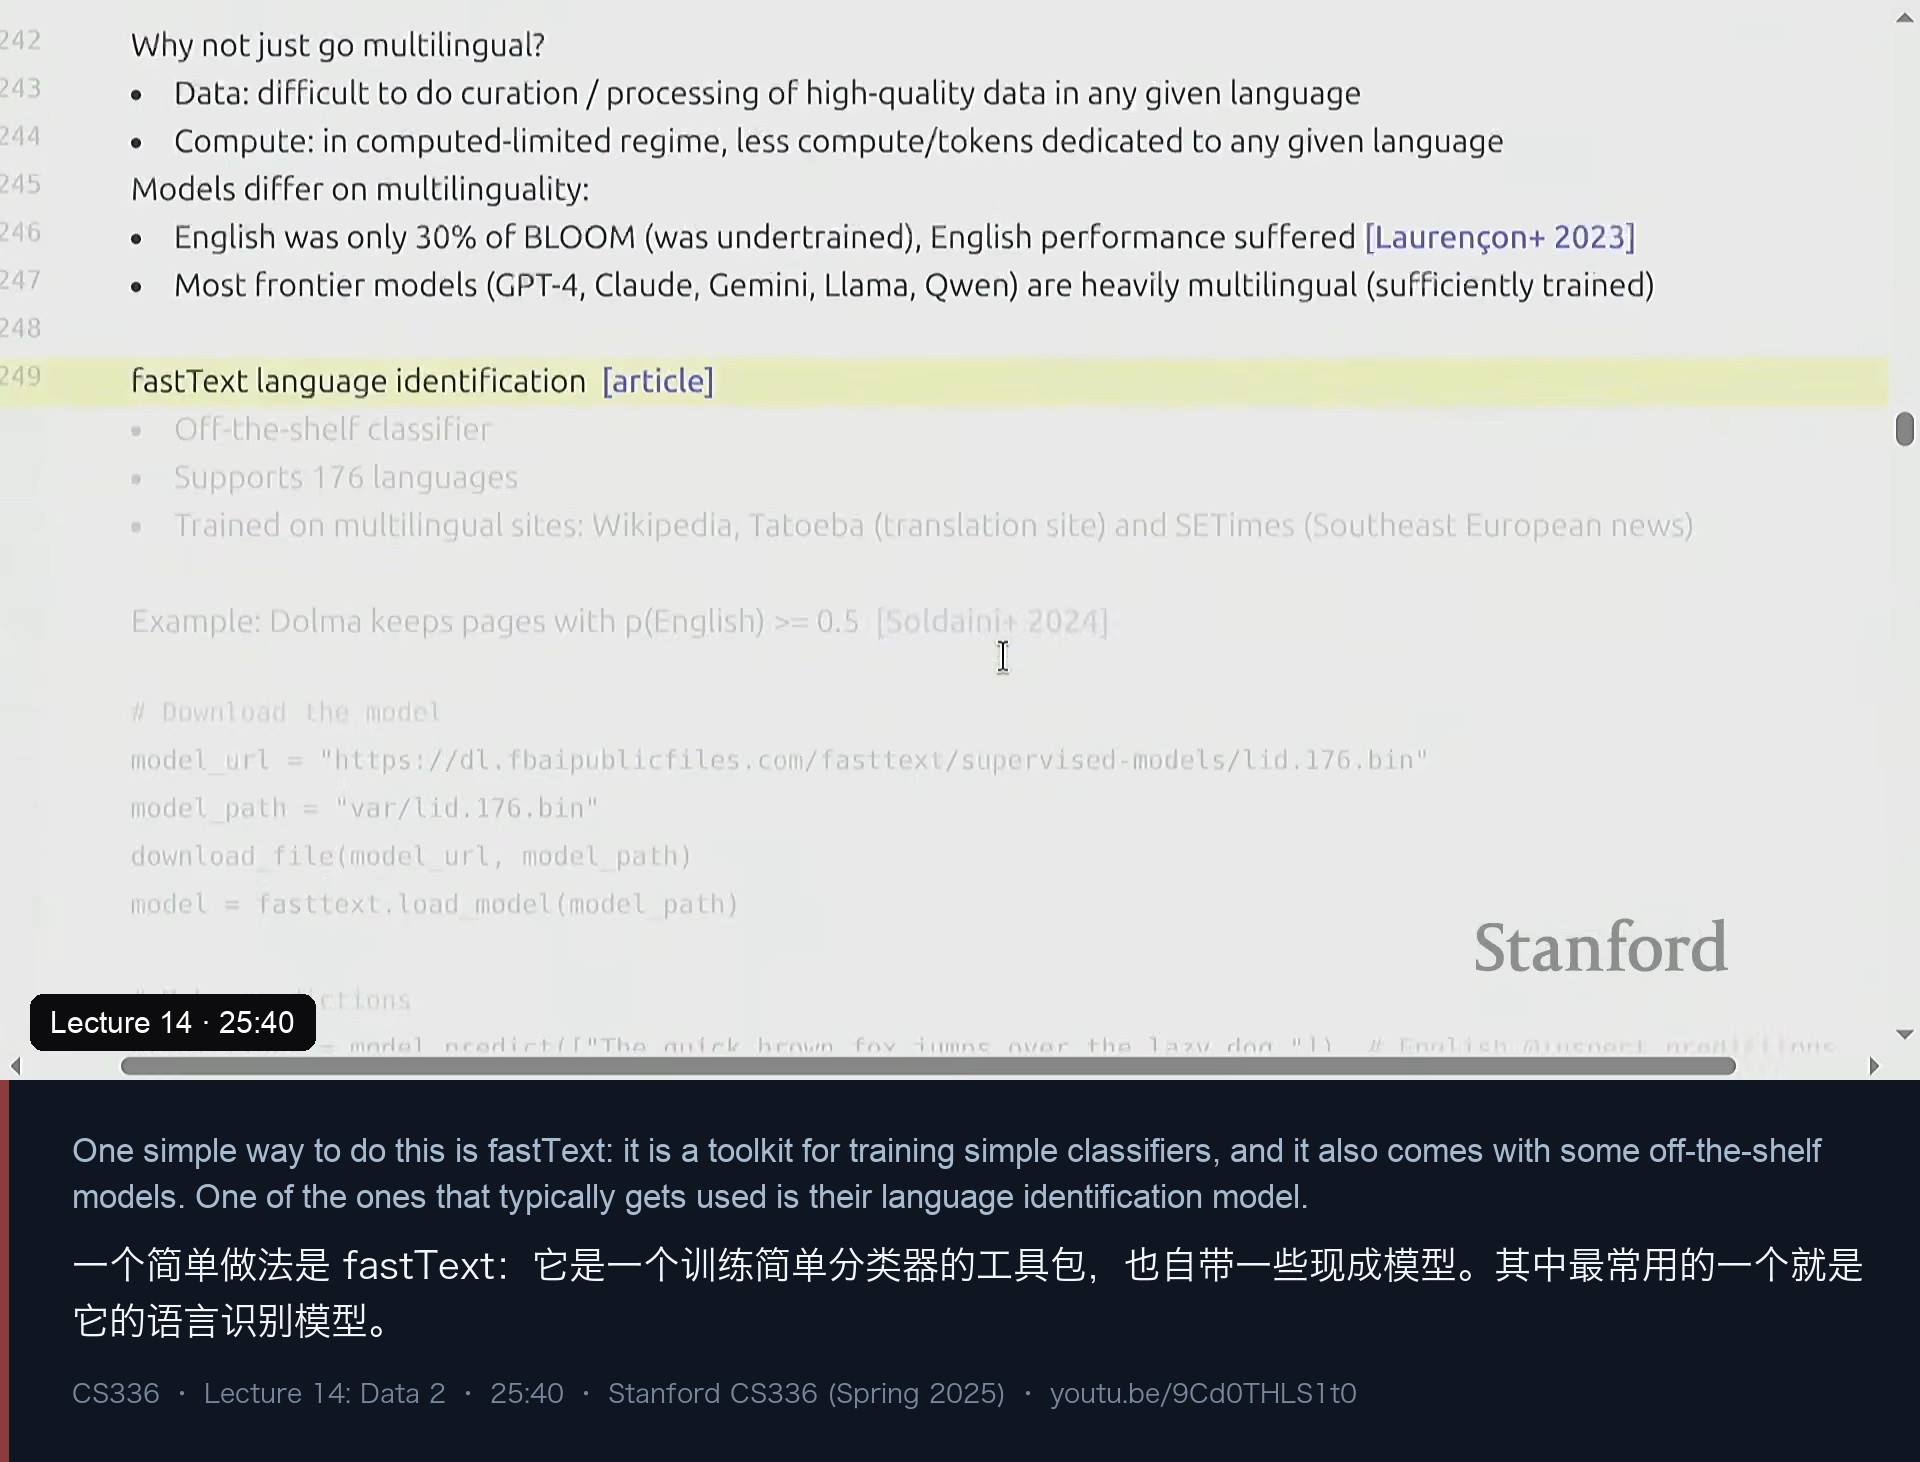
具体做法就简单了:fastText 自带一个开箱即用的语言识别模型(lid.176.bin,支持 176 种语言),训练数据包括 Wikipedia、Tatoeba(翻译句子对)以及 SETimes(东南欧新闻)。Dolma 就是直接跑这个分类器,保留 P(English) > 0.5 的页面。
演示环节很有意思,因为结果并不“完美”:
The quick fox jumps over the lazy dog→ English 0.71(Percy:比我想象的低,看起来挺像英文的)。- 把同一句复制一遍,概率不变——这是个好性质,“重复并不会让它更英文”。
- 更口语化的英文,得分反而比这句更高。
- 德语被分到 German(还算合理)。
- 数学文本被很弱地判成英文;代码得分最高的语言居然是俄语;
hello被判成意大利语;Bonjour正确判成法语。 - 西英混写的句子被判成西班牙语。
由此总结出这类分类器的坑:短句子信息太少因而不可靠;低资源语言很难;某些英语方言可能被误判成“不像英语”;相似语言容易混淆;code-switching 连人工都说不清 ground truth。Percy 的提醒是普适的:“别因为它是一个能下载、大家都在用的分类器,就以为它一直好用。”
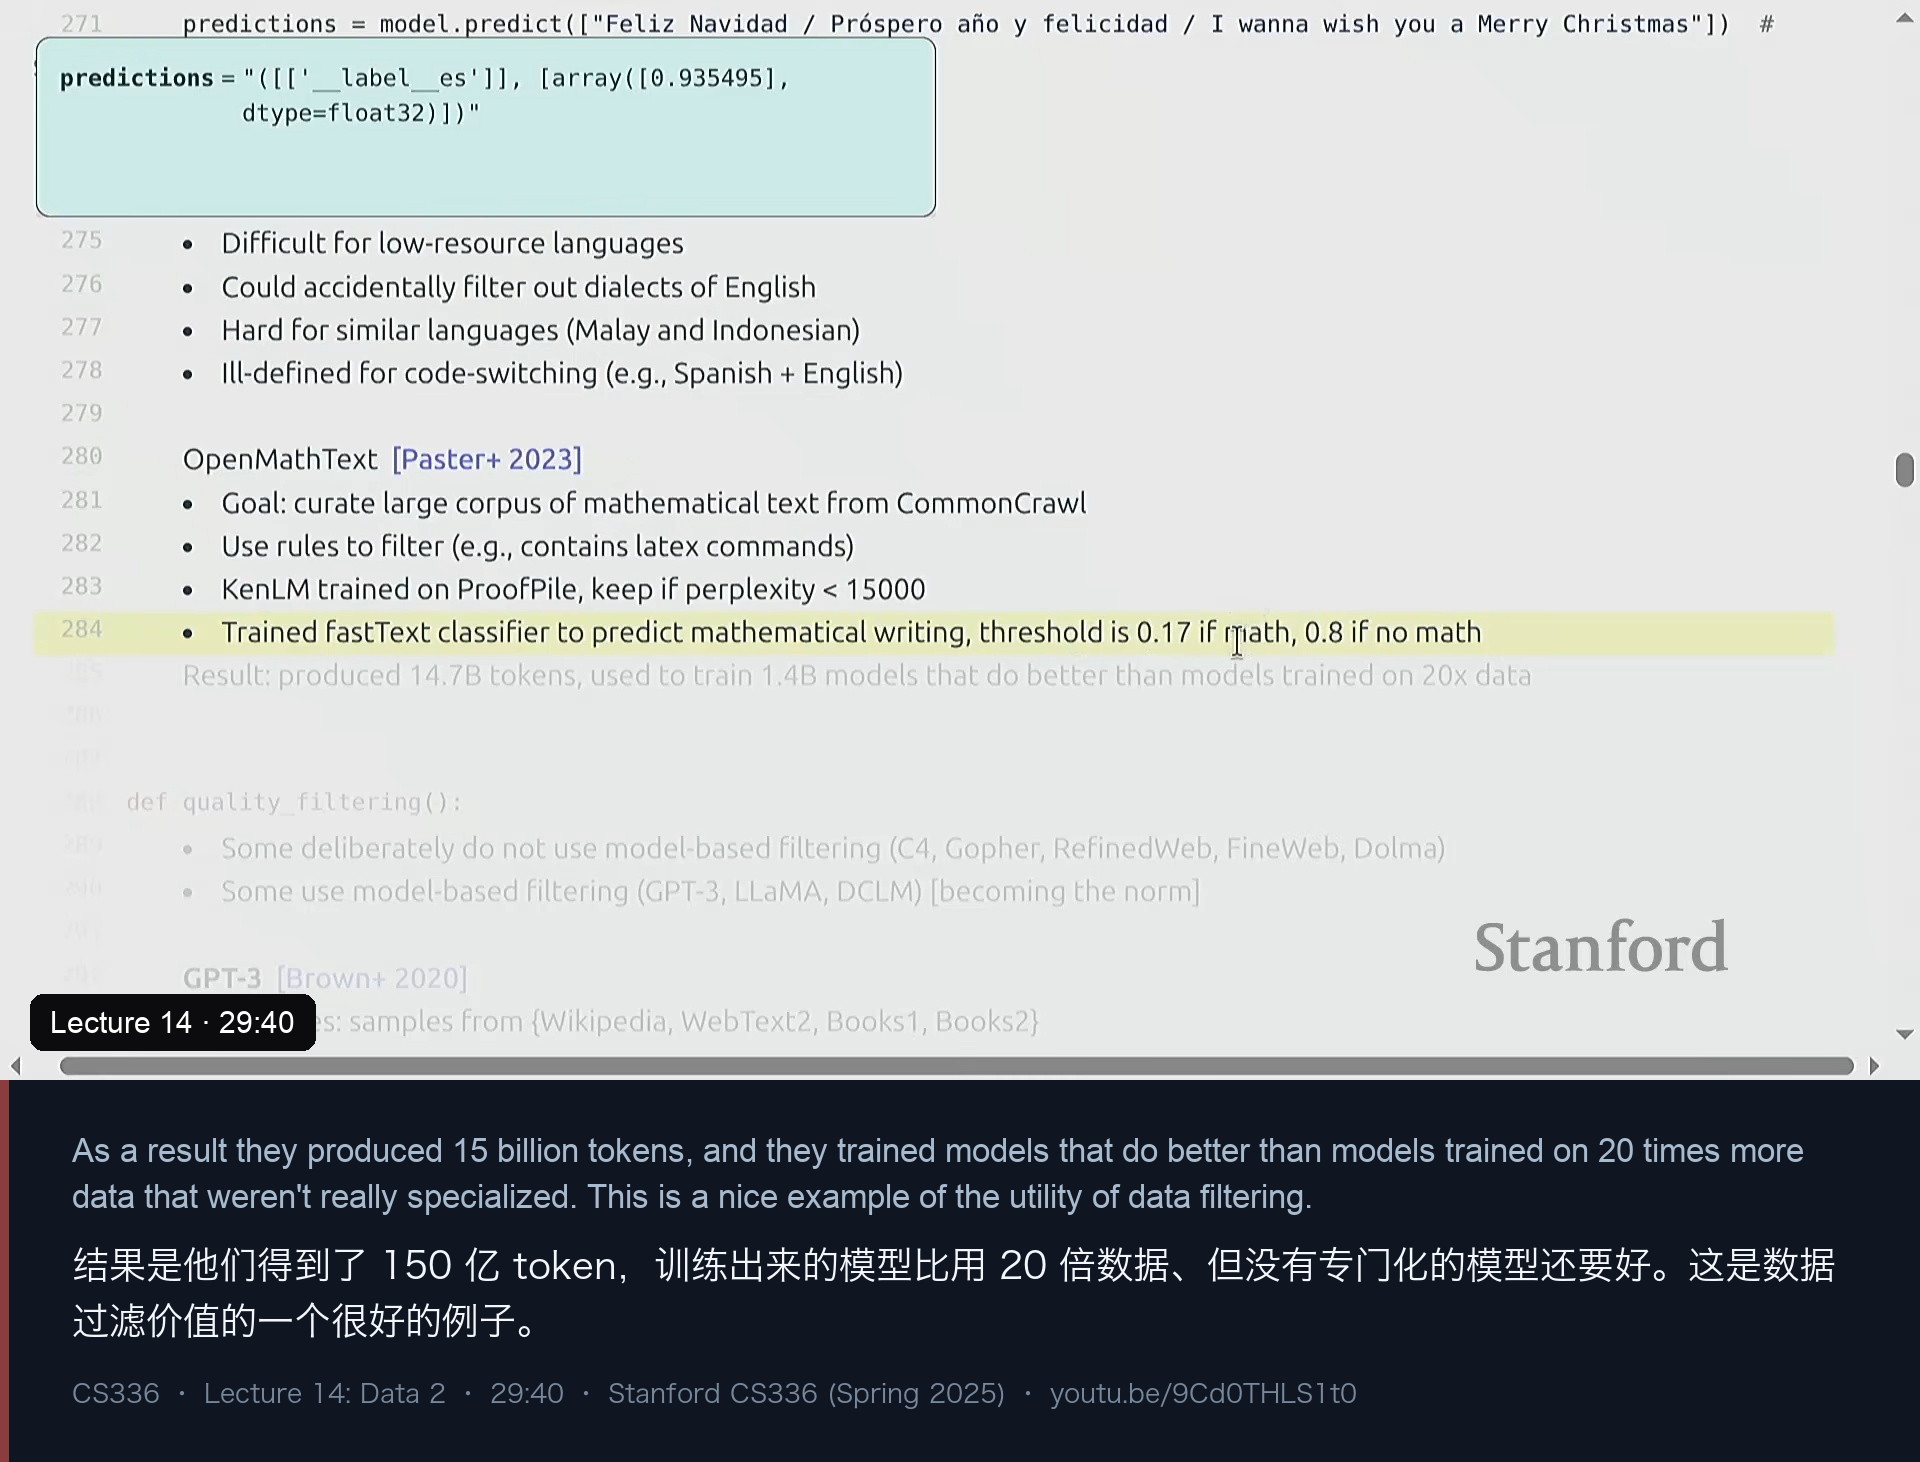
紧接着是一个很漂亮的案例:OpenWebMath。目标是从 Common Crawl 里攒出一个大规模的数学文本语料(这里他把“数学”当成一种语言)。流程是三层叠加:
1. 先用规则过滤(例如页面里包含 LaTeX 命令)
2. 在 ProofPile(大规模证明语料)上训练 KenLM,保留困惑度 < 15000 的文档
3. 训练一个 fastText 分类器预测"像不像数学写作"
   如果规则判断为数学  → 阈值 0.17
如果规则判断不是数学 → 阈值 0.8这个”双阈值“的小把戏很值得记:规则命中的文档用一个宽松阈值,规则没命中的用一个严格阈值,等于把规则的先验信息灌进了分类器。最终产出约 147 亿 token(口播里说 15 billion),并且用这些数据训出的模型,能打赢用 20 倍数据但没有专门化的模型。Percy 把结论讲得很直接:如果你在意某个领域(比如数学),与其泛泛地训所有数据,不如专门去把这类数据做多、做精,效率会高得多。
八、应用二:质量过滤 —— 从 GPT-3、LLaMA 到“让 GPT-4 定义质量”
质量过滤是同一个框架最主流的用途。“质量”其实是个 catch-all,Percy 先承认了这一点:有些论文(比如 C4、Gopher、RefinedWeb、Dolma)明确表示不用模型式质量过滤,但更多近期的论文基本都“认了”——因为它确实效果好得多。他给了三个有代表性的配方:
GPT-3 (Brown+ 2020):
  positives: samples from high-quality sources (WebText2, Books1, Books2, Wikipedia)
  negatives: samples from CommonCrawl
  Train linear classifier based on word features
  Keep documents stochastically based on score

LLaMA / RedPajama (Touvron+ 2023):
  positives: samples from pages referenced by Wikipedia
  negatives: samples from CommonCrawl
  Keep documents that are classified positive

phi-1 (Gunasekar+ 2023):
  Philosophy: really high quality data (textbooks) to train a small model (1.5B)
  Includes synthetic data from GPT-3.5 (later: GPT-4) and filtered data
  R = "python subset of The Stack"
  T = use GPT-4 with this prompt to classify 100K subset of R to get positive examples
  Train random forest classifier on T using output embedding from pretrained codegen model
Select data from R that is classified positive by the classifier三个配方的差别,其实全在”正例从哪来“:
- GPT-3 用现成的高质量语料当正例;
- LLaMA 借了一个非常聪明的捷径——用“Wikipedia 引用的页面”而不是 Wikipedia 本身(借的是链接结构,而不是页面内容);
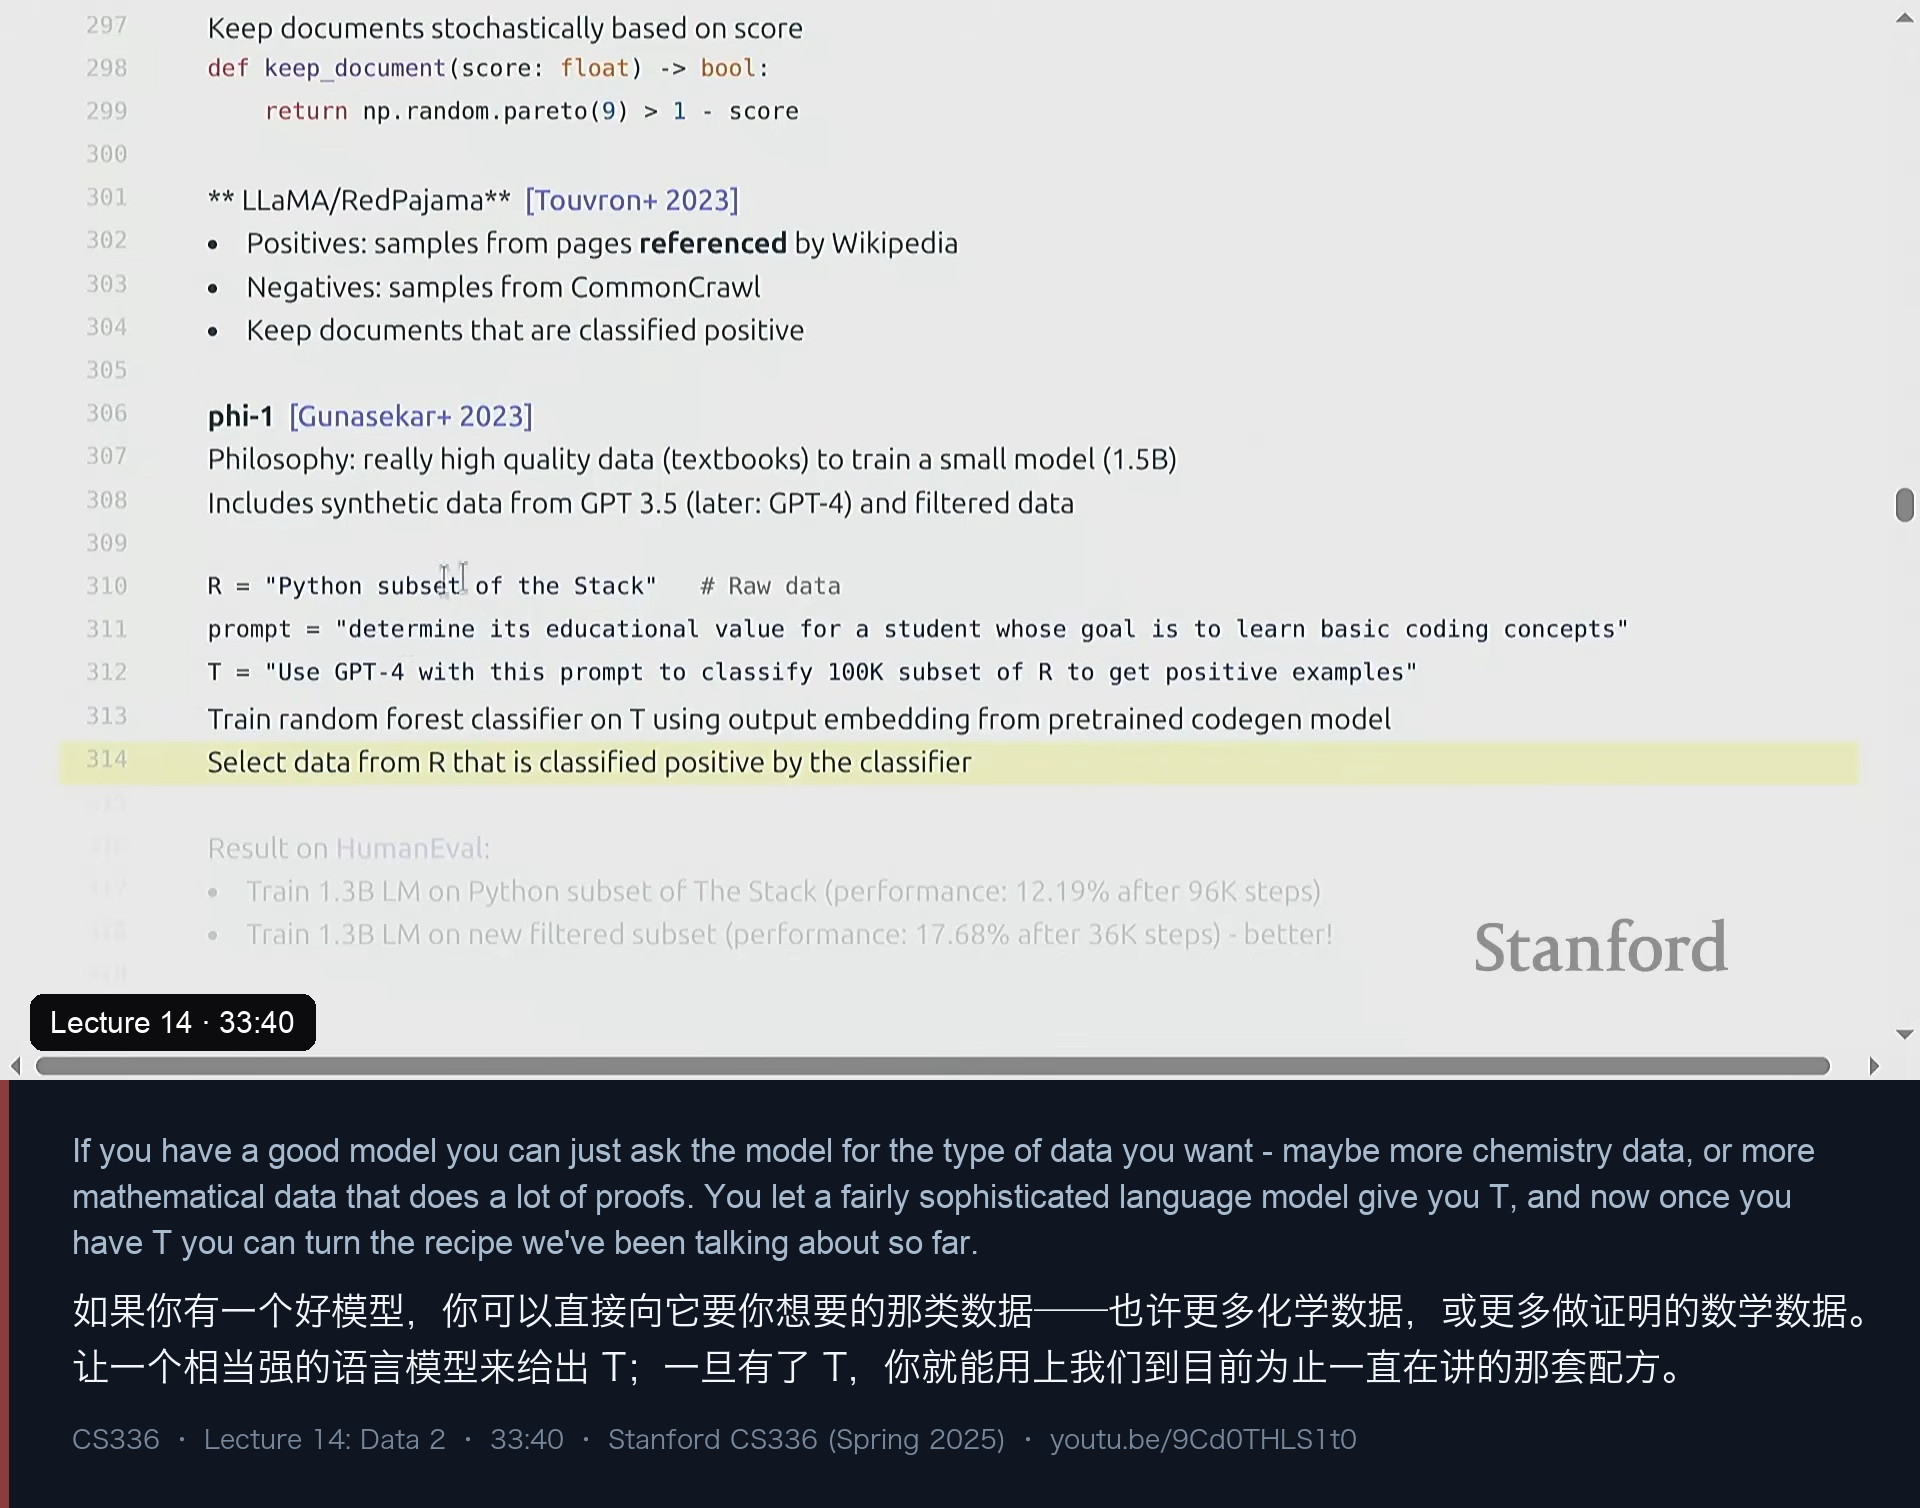
- 而 phi-1 直接把这个环节外包给了模型:拿 The Stack 的 Python 子集当 R,写一个提示词让 GPT-4 判断“对一个想学编程基础的学生来说,这段代码的教学价值如何”,标注 10 万条文档当正例,再用“用代码模型输出 embedding + 随机森林”把这个判断蒸馏成一个便宜的分类器,最后拿它在 R 上过滤。
这里有一句话是这一讲的点睛之笔:
“T 从哪来?T 从提示 GPT-4 来。”
Percy 顺着补了一句趋势判断:随着模型变强,你会越来越常看到这种做法——不再依赖“书是好来源、Wikipedia 是好来源”这类先验,而是直接问模型“我想要的这类数据长什么样”。你只需要一个足够强的模型给出 T,之后就能套用前面讲过的那整套配方。当然问题也来了:为什么“用一次 GPT-4”是可行的?因为 GPT-4 只需要标注 10 万条,而在这个数量级上它相对 R(上千万到上亿条)依然便宜得多——用一次贵的模型,换一个便宜的蒸馏分类器。
效果也很直白(HumanEval):
- Train 1.3B LM on python subset of The Stack (performance: 12.19% after 96K steps)
- Train 1.3B LM on new filtered subset (performance: 17.68% after 36K steps)同样的模型,只换了数据,不仅最终分数从 12.19% 涨到 17.68%,而且只用了三分之一多的训练步数就达到了更好的水平。
九、应用三:毒性过滤
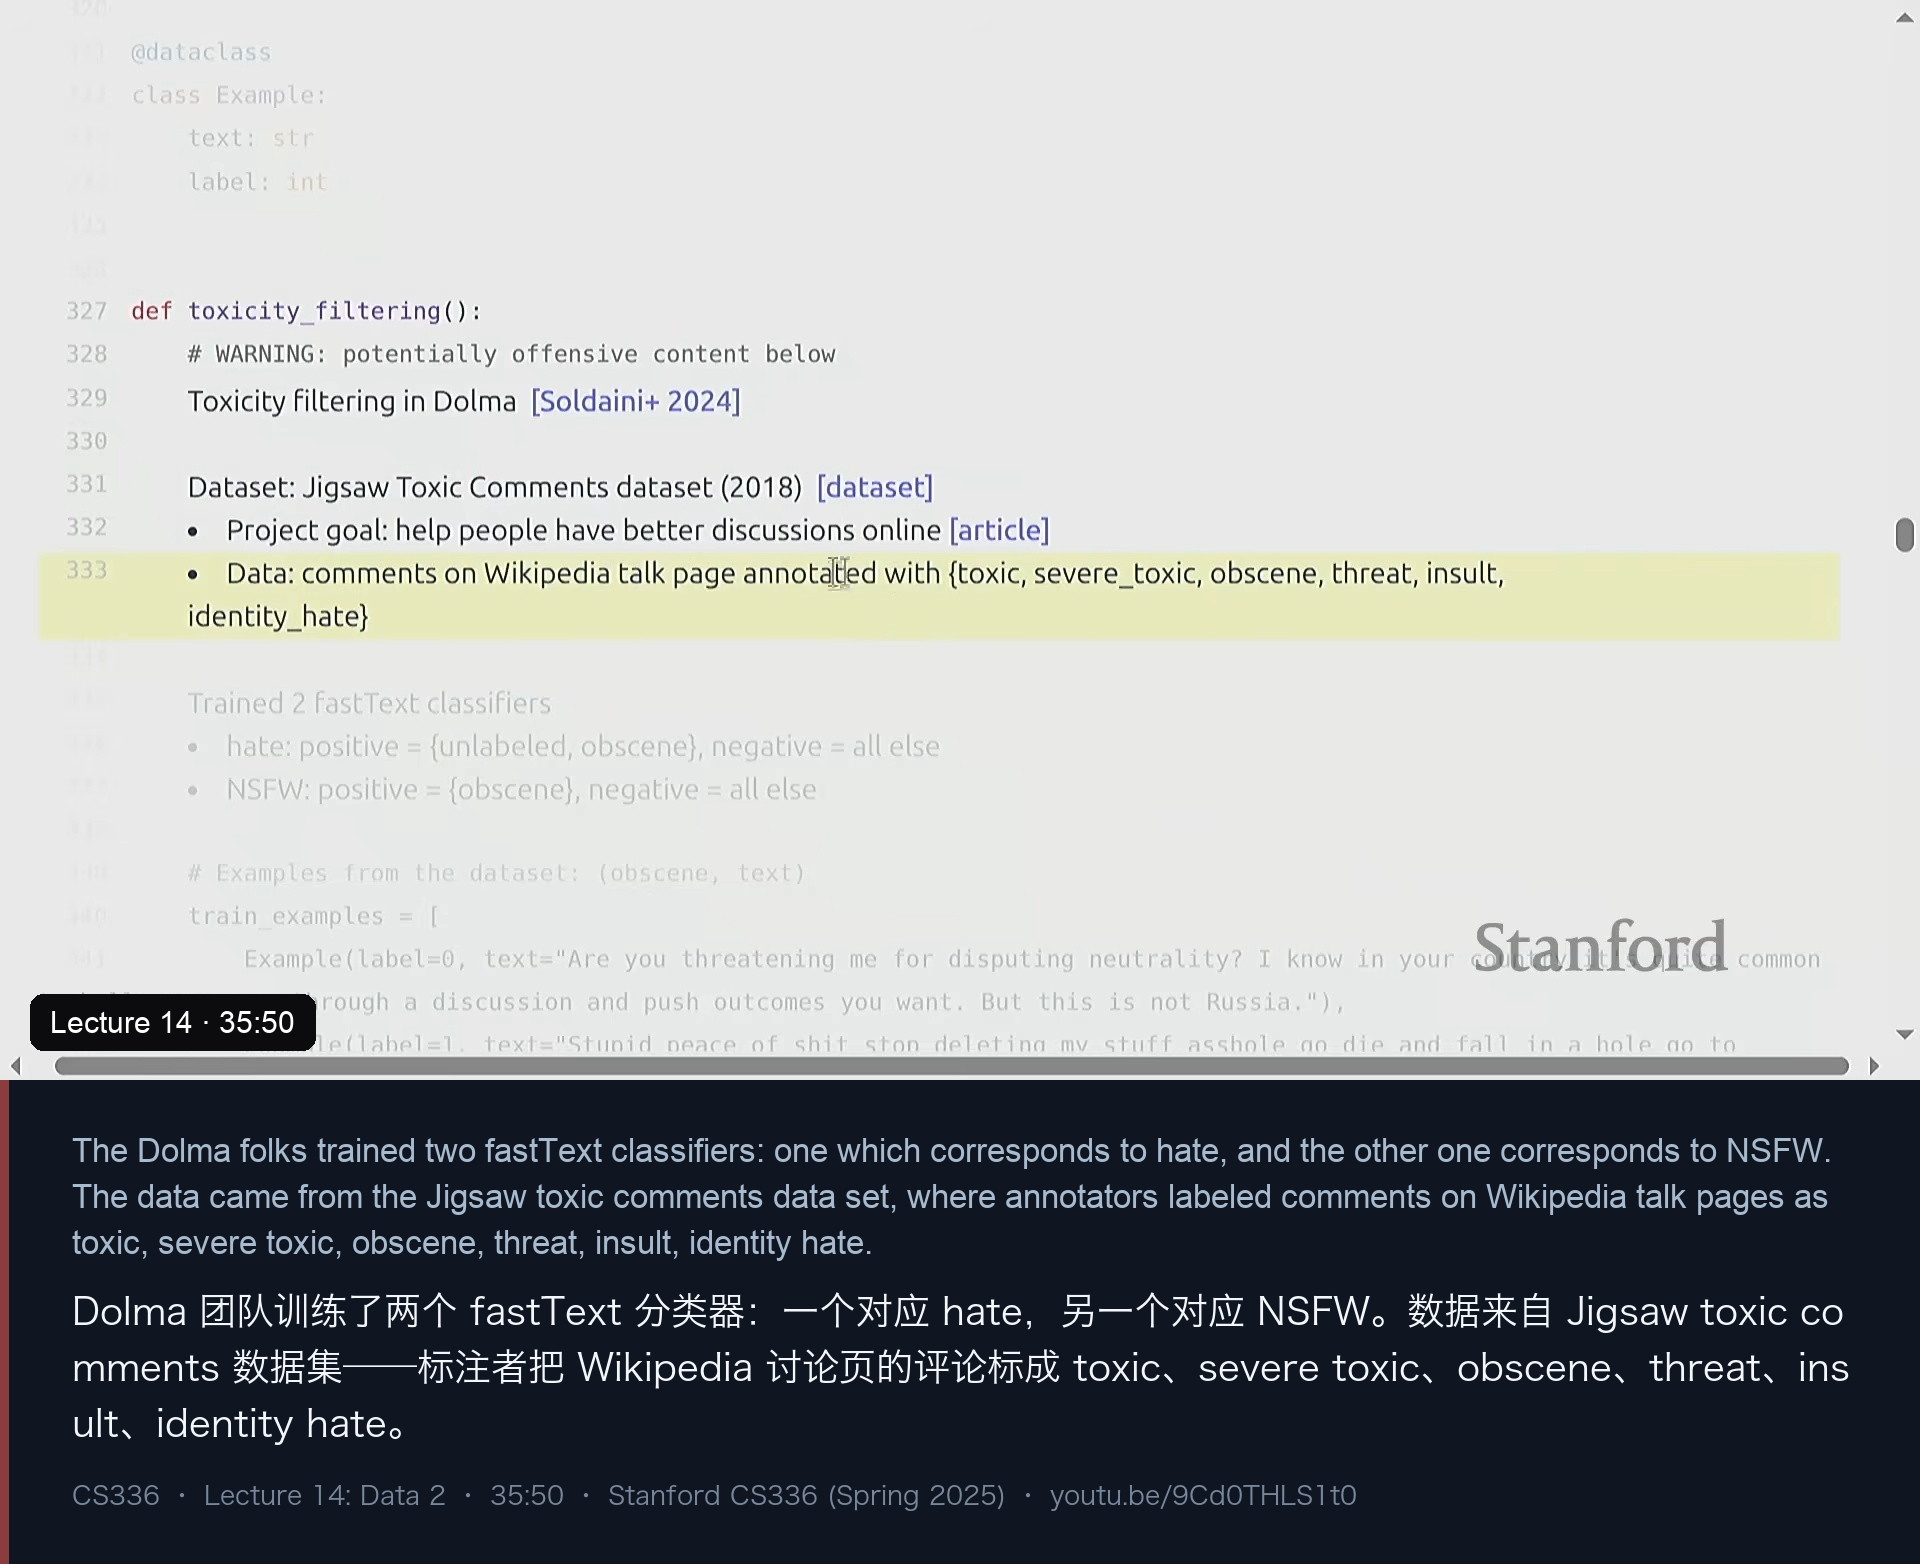
第三个应用是毒性过滤,做法和前面完全同构。数据来自 Jigsaw toxic comments 数据集(2018):它源于一个“帮助人们更好地在线讨论”的项目,标注者对 Wikipedia 讨论页的评论打了多种标签——toxic、severe toxic、obscene、threat、insult、identity hate。
Dolma 在上面训练了两个 fastText 分类器:
Trained 2 fastText classifiers:
- hate: positive = (labeled obscene), negative = all else
- NSFW: positive = (obscene), negative = all else演示里他跑了几句:Are you threatening me for dispute neutrality? ... 被判为 safe for work;另一句则被标成 NSFW。Percy 说“不想展示太多这类例子,你们可以自己下来玩”。这一段的意义不在于毒性分类本身,而在于同一套机制第三次被复用——正例、负例、线性分类器,问题换了但配方没换。
十、去重:两种重复、三个设计维度
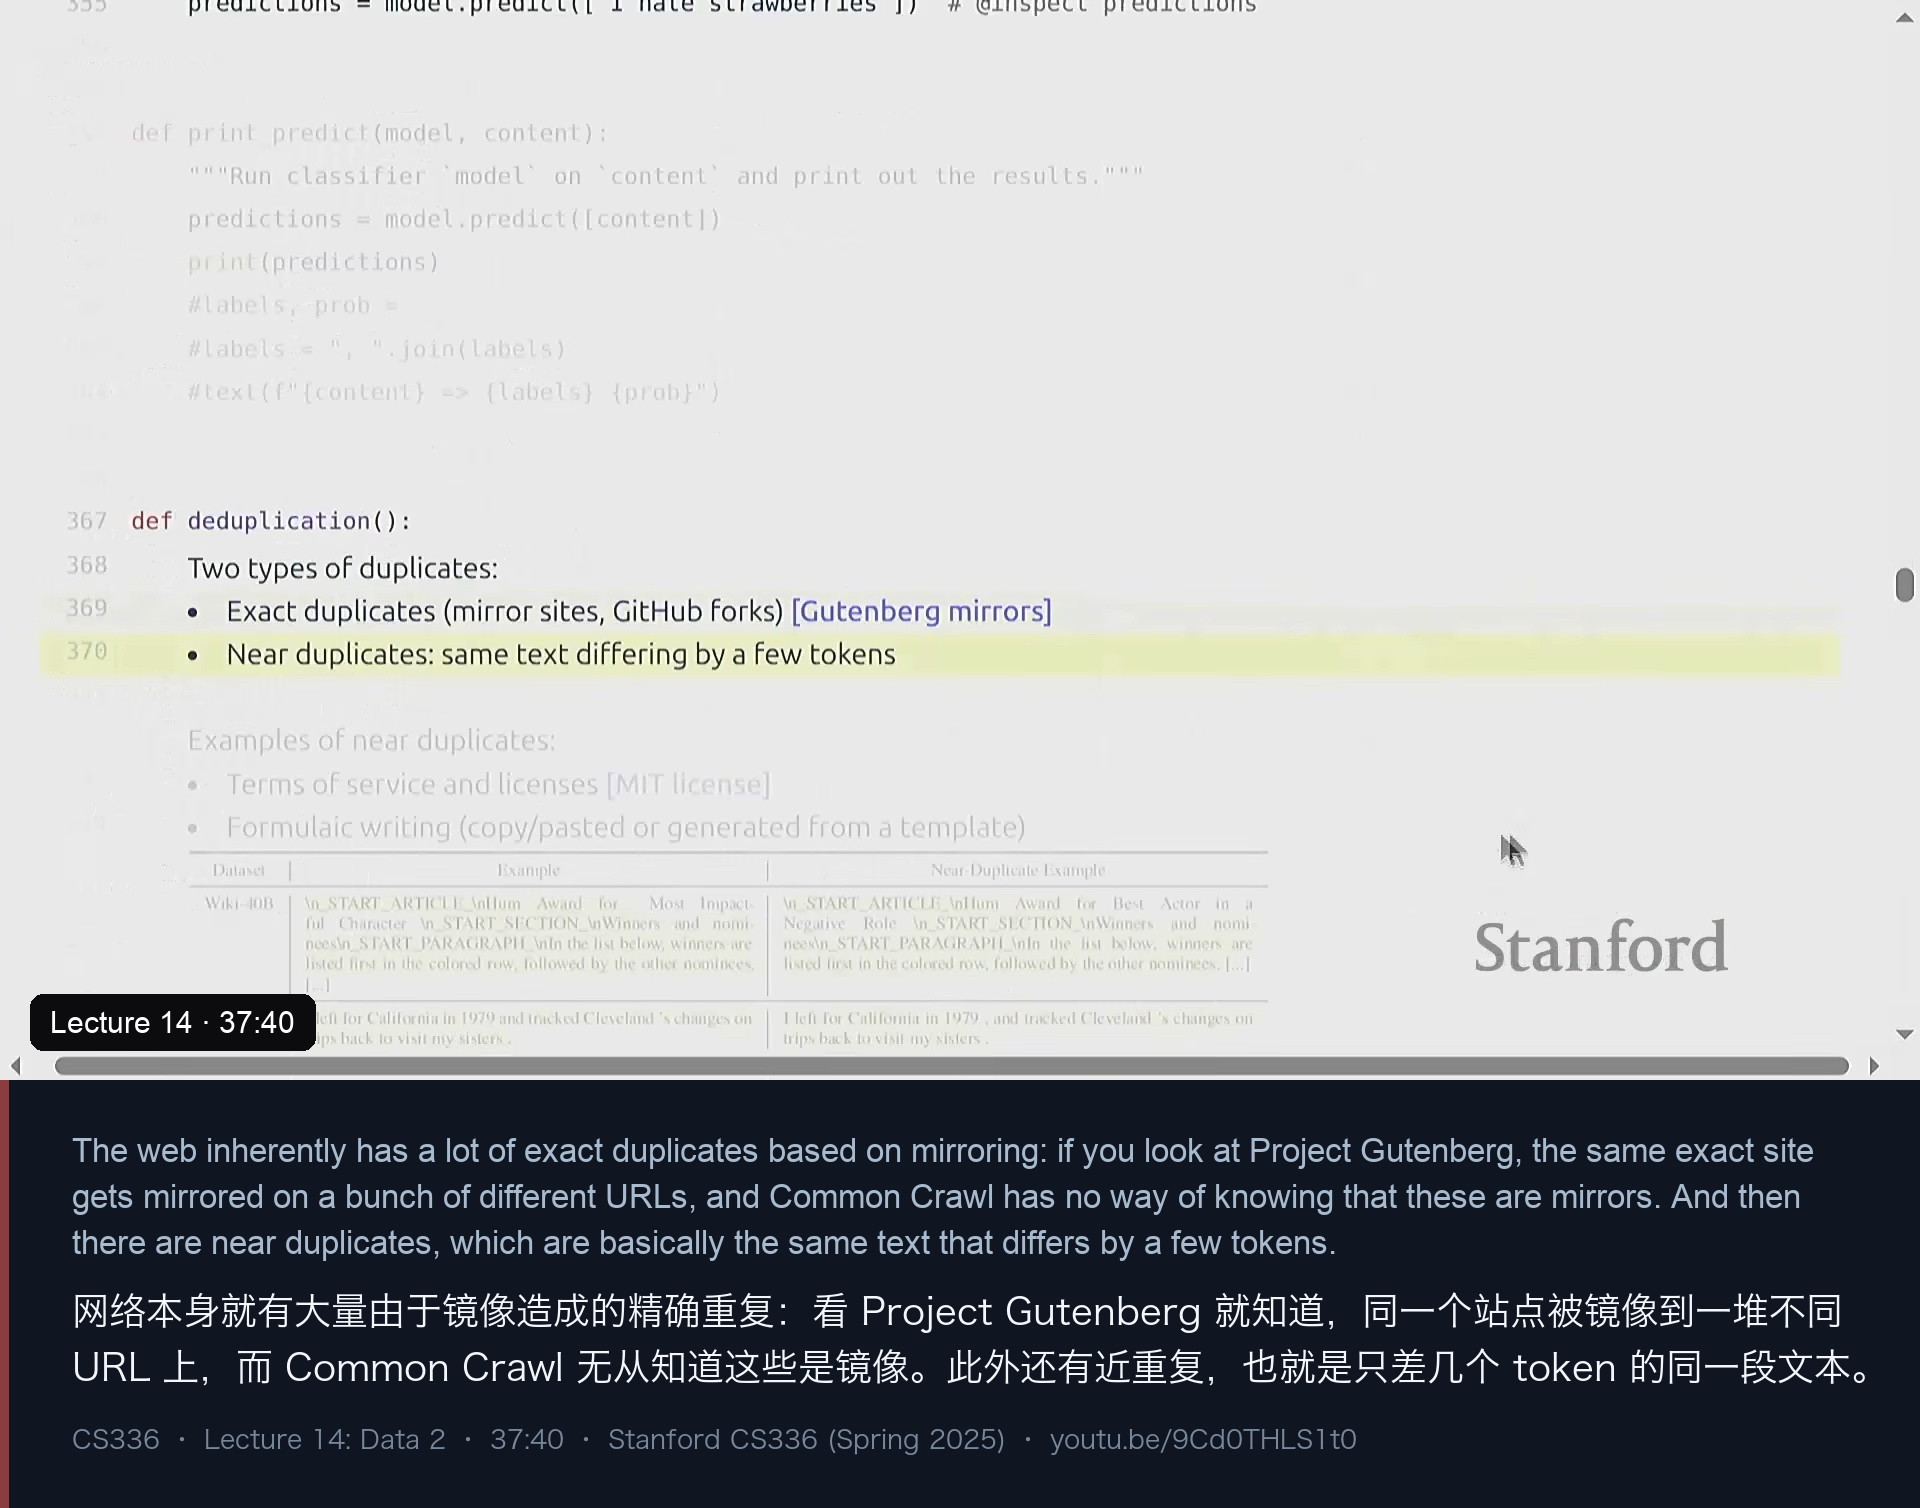
后半程进入去重。Percy 先做了最基本的分类:
Two types of duplicates:
- Exact duplicates (mirror sites, GitHub forks) [Gutenberg mirrors]
- Near duplicates: same text differing by a few tokens
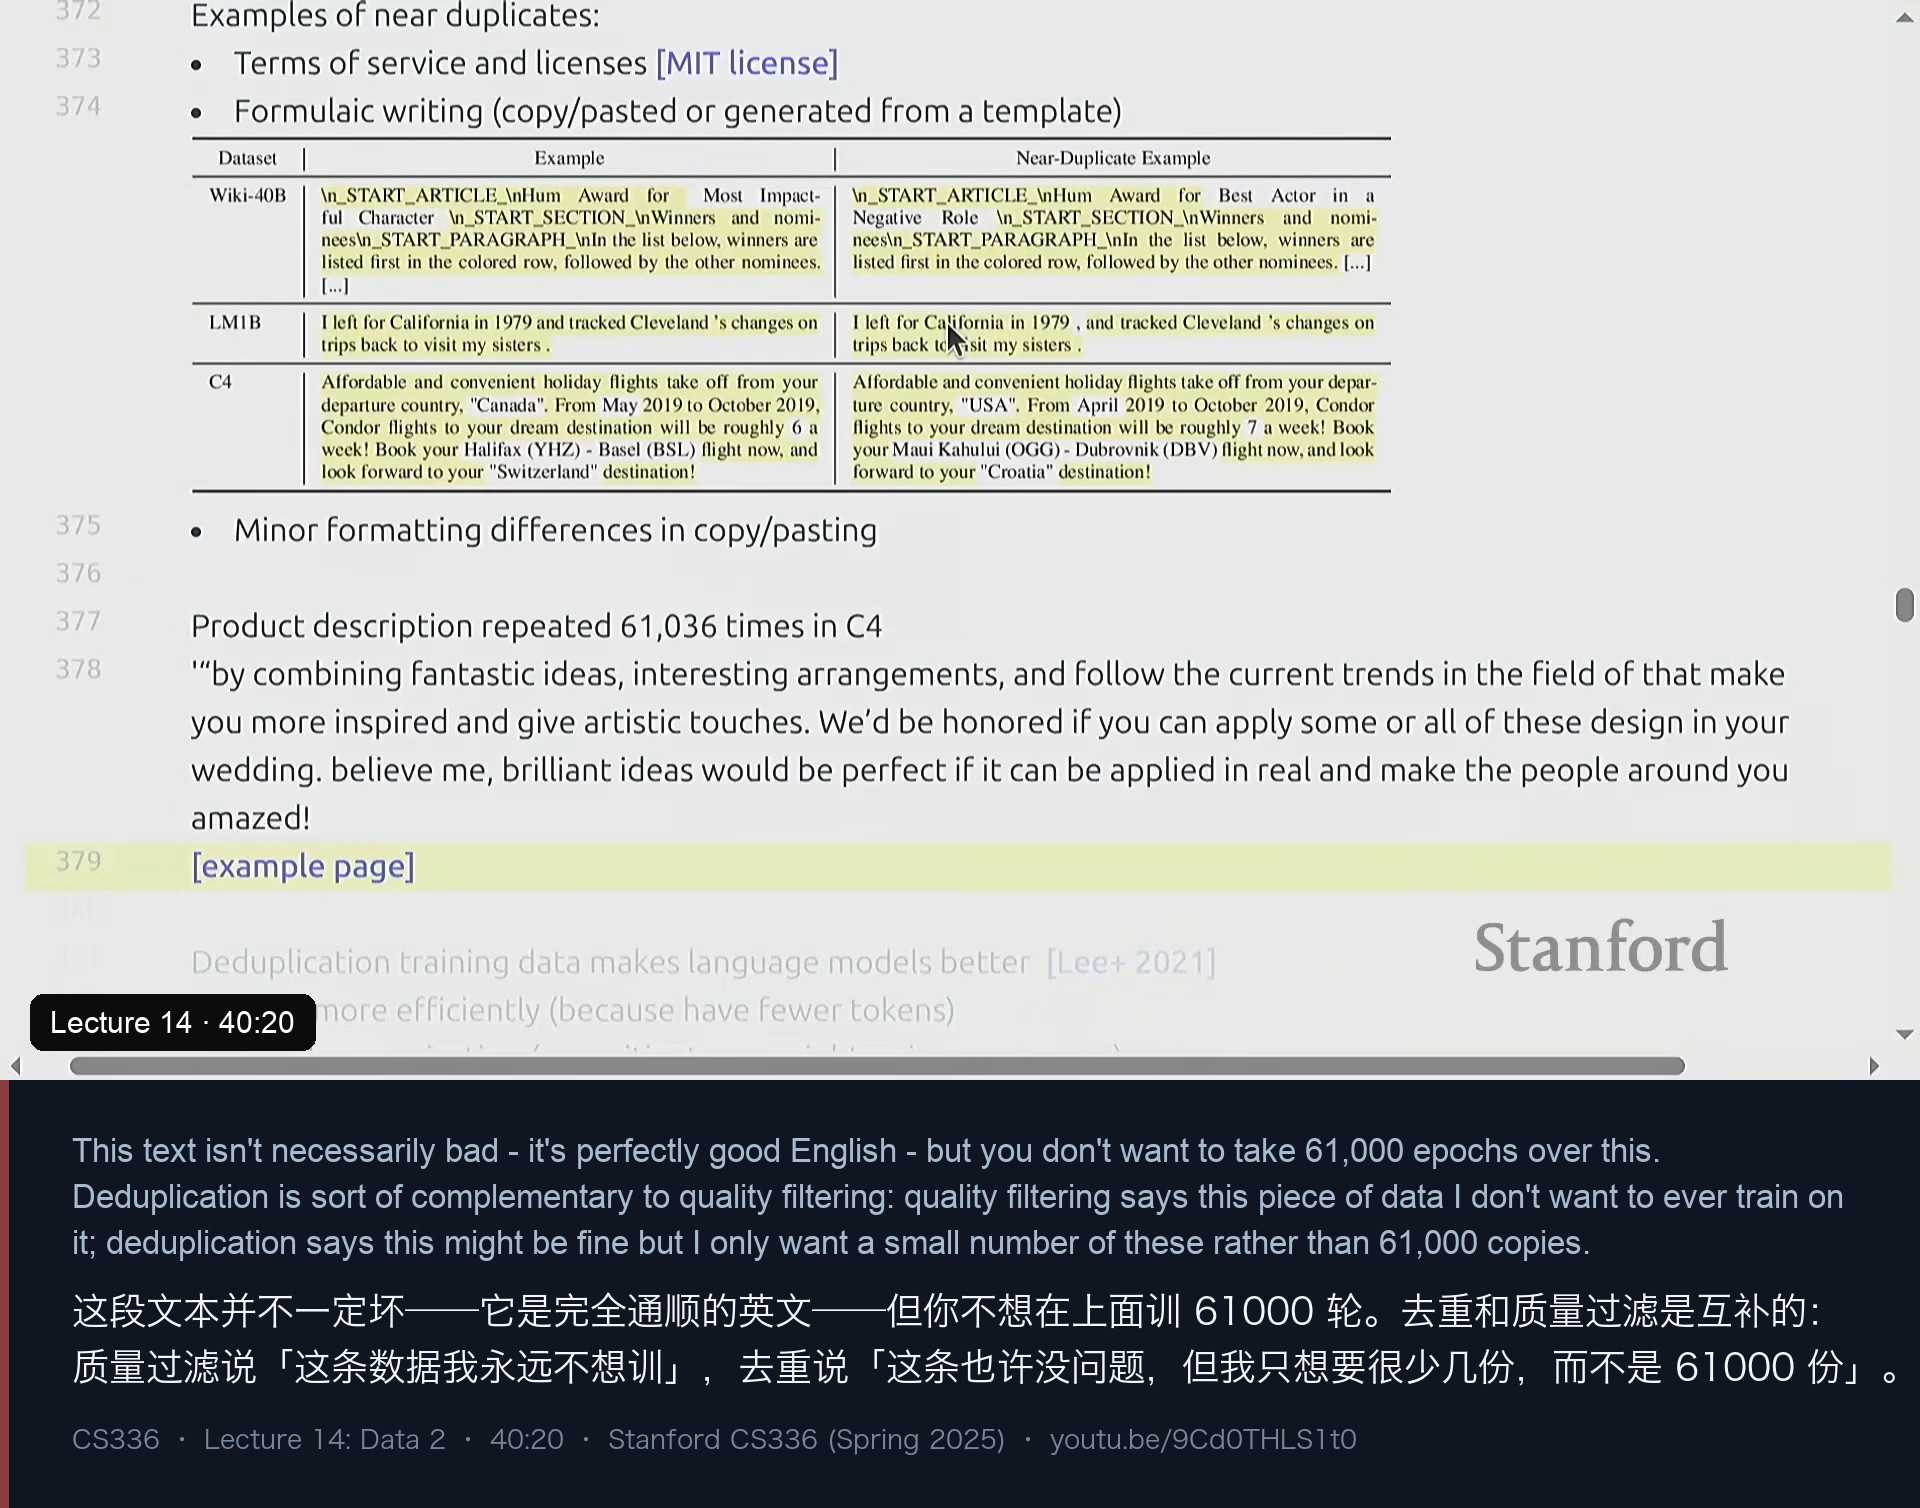
  - Terms of service and licenses [MIT license]
  - Formulaic writing (copy/pasted or generated from a template)
- Minor formatting differences in copy/pasting- 精确重复的主要来源是镜像。他举 Project Gutenberg:同一个站点被镜像到一堆不同 URL 上,而 Common Crawl 在抓取时根本无从知道它们是镜像,只能把同样的内容抓好几遍。GitHub 上的 fork 是同一回事。
- 近重复的来源更“生活化”:服务条款与许可证(MIT license 被到处复制粘贴,甚至改个逗号、漏个逗号)、模板化写作(幻灯片里那个例子是把同一段广告文案里的 Canada 替换成 USA,显然来自某个模板系统)、复制粘贴的格式差异、以及改写(比如把“best actor in a negative role”换成“most impactful character”而其余照旧)。
接着是一个让人印象深刻的 X 光片:C4 里有一段产品描述重复了 61036 次:
"By combining fantastic ideas, interesting arrangements, and follow the current trends
 in the field of that make you more inspired and give artistic touches. We'd be honored
 if you can apply some or all of these design in your wedding. believe me, brilliant ideas
would be perfect if it can be applied in real and make the people around you amazed!"它不是坏数据——这句子是通顺的英文;但你也绝不希望在上面训 61036 轮。这就带出了与质量过滤的互补关系:
“质量过滤说的是’这条数据我永远不想训’;去重说的是’这条也许没问题,但我只想要很少几份,而不是 61036 份’。”
去重为什么值得做,理由有两条:
- 更省算力。 去重减少了 token 数;只要没扔掉信息,就等于把算力花在了别处。
- 减少记忆(memorization)。 语言模型会记住训练数据,这在版权和隐私上都有风险(可能原文复述)。去重不是完美的解药,但能缓解一部分风险。Lee+ 2021 的工作也给出了“去重让语言模型更好”的实证。
然后他把去重的设计空间拆成三个正交的问题:
Design space:
1. What is an item (sentence, paragraph, document)?
2. How to match (exact match, existence of common substring, fraction of common subitems)?
3. What action to take (remove all, remove all but one)?以及那个决定了后面所有算法形态的核心挑战:
去重在本质上是成对的(pairwise)比较——不像质量分类可以单条判定,相似度必须两条之间才能算。而数据集又极大,二次复杂度是绝对不行的。你需要一个线性时间的算法,却又要做出成对的判断。
而打破这个僵局的关键工具只有一个:哈希函数。
十一、精确去重:哈希分组与布隆过滤器
哈希函数的复习很短:它把元素(句子、文档)映射成一个整数或字符串,值远比元素本身小;代价是可能碰撞。哈希的家族很宽:密码学哈希(比如比特币用的)追求抗碰撞但慢;哈希表用的哈希不抗碰撞但快。这里“我们不做密码学”,所以选后者——演示中用的是 MurmurHash。
精确去重的算法简单到只需三行:
def exact_deduplication():
    # Simple example
    # 1. Item: string
    # 2. How to match: exact match
    # 3. Action: remove all but one

    items = ["hello", "hello", "hello there", "hello", "hi"]

    # Compute hash -> list of items with that hash
    hash_items = itertools.groupby(sorted(items, key=mmh3.hash), key=mmh3.hash)

    # Keep one item from each group
    deduped_items = [next(group) for h, group in hash_items]
要点是“先把哈希值映射到一组元素,再从每组里留一个”。它的优点和缺点同样鲜明:
- Pro: simple, clear semantics, high precision
- Con: does not deduplicate near duplicates
- This code is written in a MapReduce way, can easily parallelize and scale而且它是天然的 MapReduce 形状——按哈希分组天然可并行。C4 就用它来准备数据,去重单位是三句话的片段。Percy 顺带吐槽了自己多年来的一个别扭:按三句片段做手术式删除之后,剩下的文档可能在连贯性上已经被切坏了,“但大家都说无所谓,就过去了”。
如果内存是瓶颈,就轮到布隆过滤器:
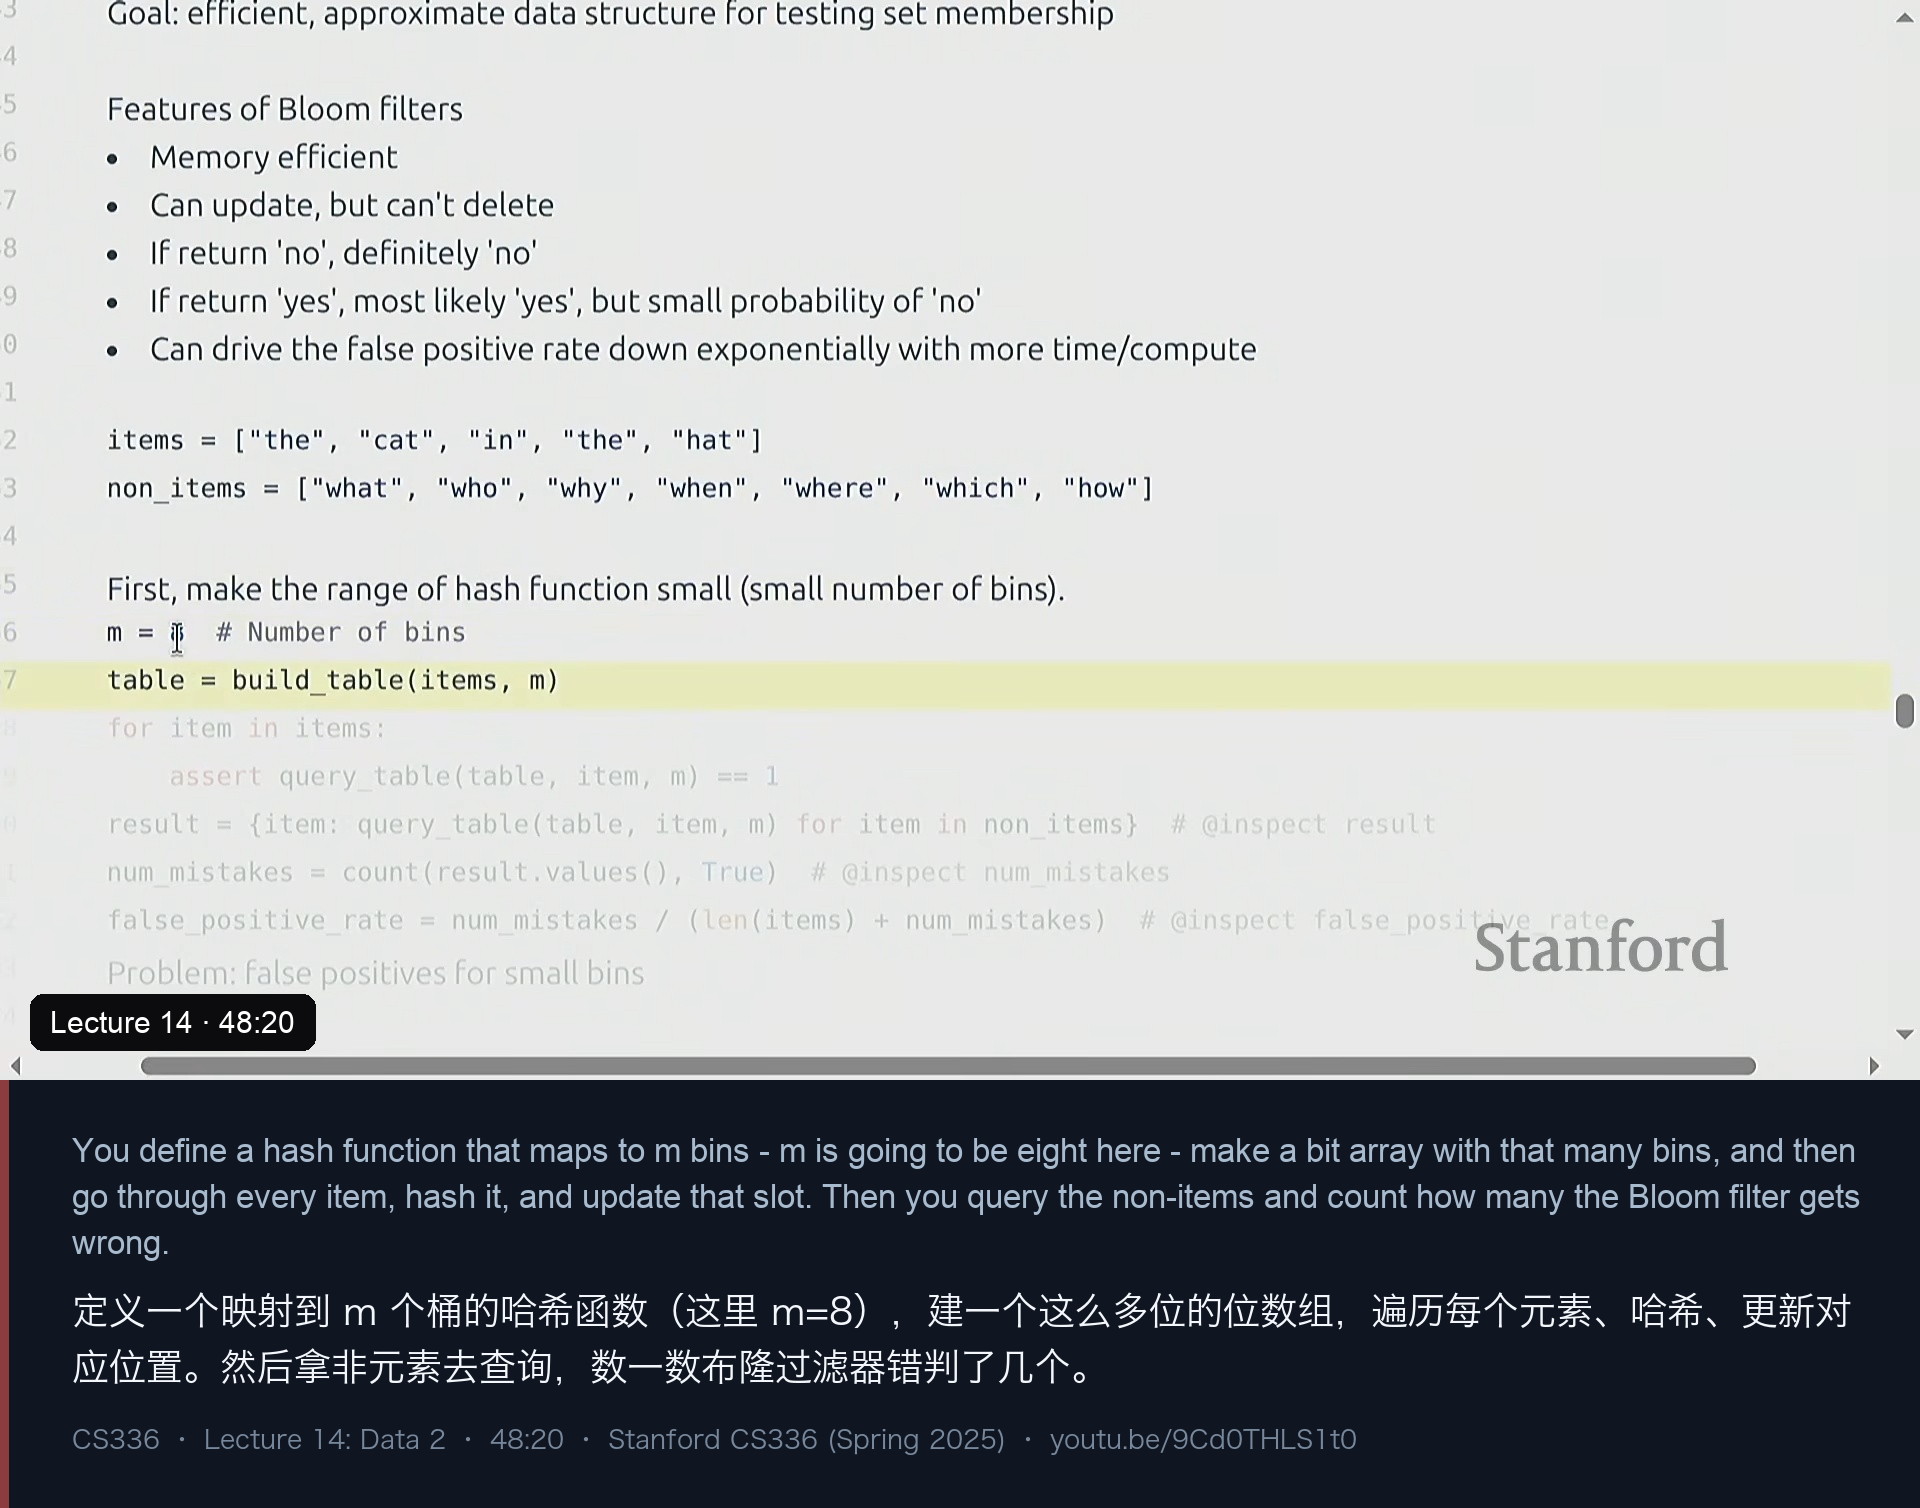
Goal: efficient, approximate data structure for testing set membership
Features of Bloom filters:
- Memory efficient
- Can update, but can't delete
- If return "no", definitely "no"
- If return "yes", most likely "yes", but small probability of "no"   # 即假阳性
- Can drive the false positive rate down exponentially with more time/compute
它的构造也简单:定一个 m 个桶的位数组,把集合里每个元素哈希一下、把对应位置置 1。演示用了 5 个元素(the, cat, and, the, hat)和 m = 8:
m = 8  # Number of bins
table = build_table(items, m)

# Query: check whether the item's hashed bins are set
result = [query(table, item, m) for item in non_items]
num_mistakes = count(result.values())
false_positive_rate = num_mistakes / (num_items + num_mistakes)
# -> mistakes = 4, false positive rate = 4/9 (roughly 0.44)
非元素集合是 {what, who, why, when, where, which, how},结果错了 4 个——假阳性率高得很难用。补救办法不是加大 m,而是多用几个哈希函数:每个元素用 k 个哈希(种子不同)置 k 个位,查询时必须 k 个位全为 1才回答“在集合里”。同样的 5 个元素、同样的 m = 8,错误数降到 3,假阳性率随之下降。
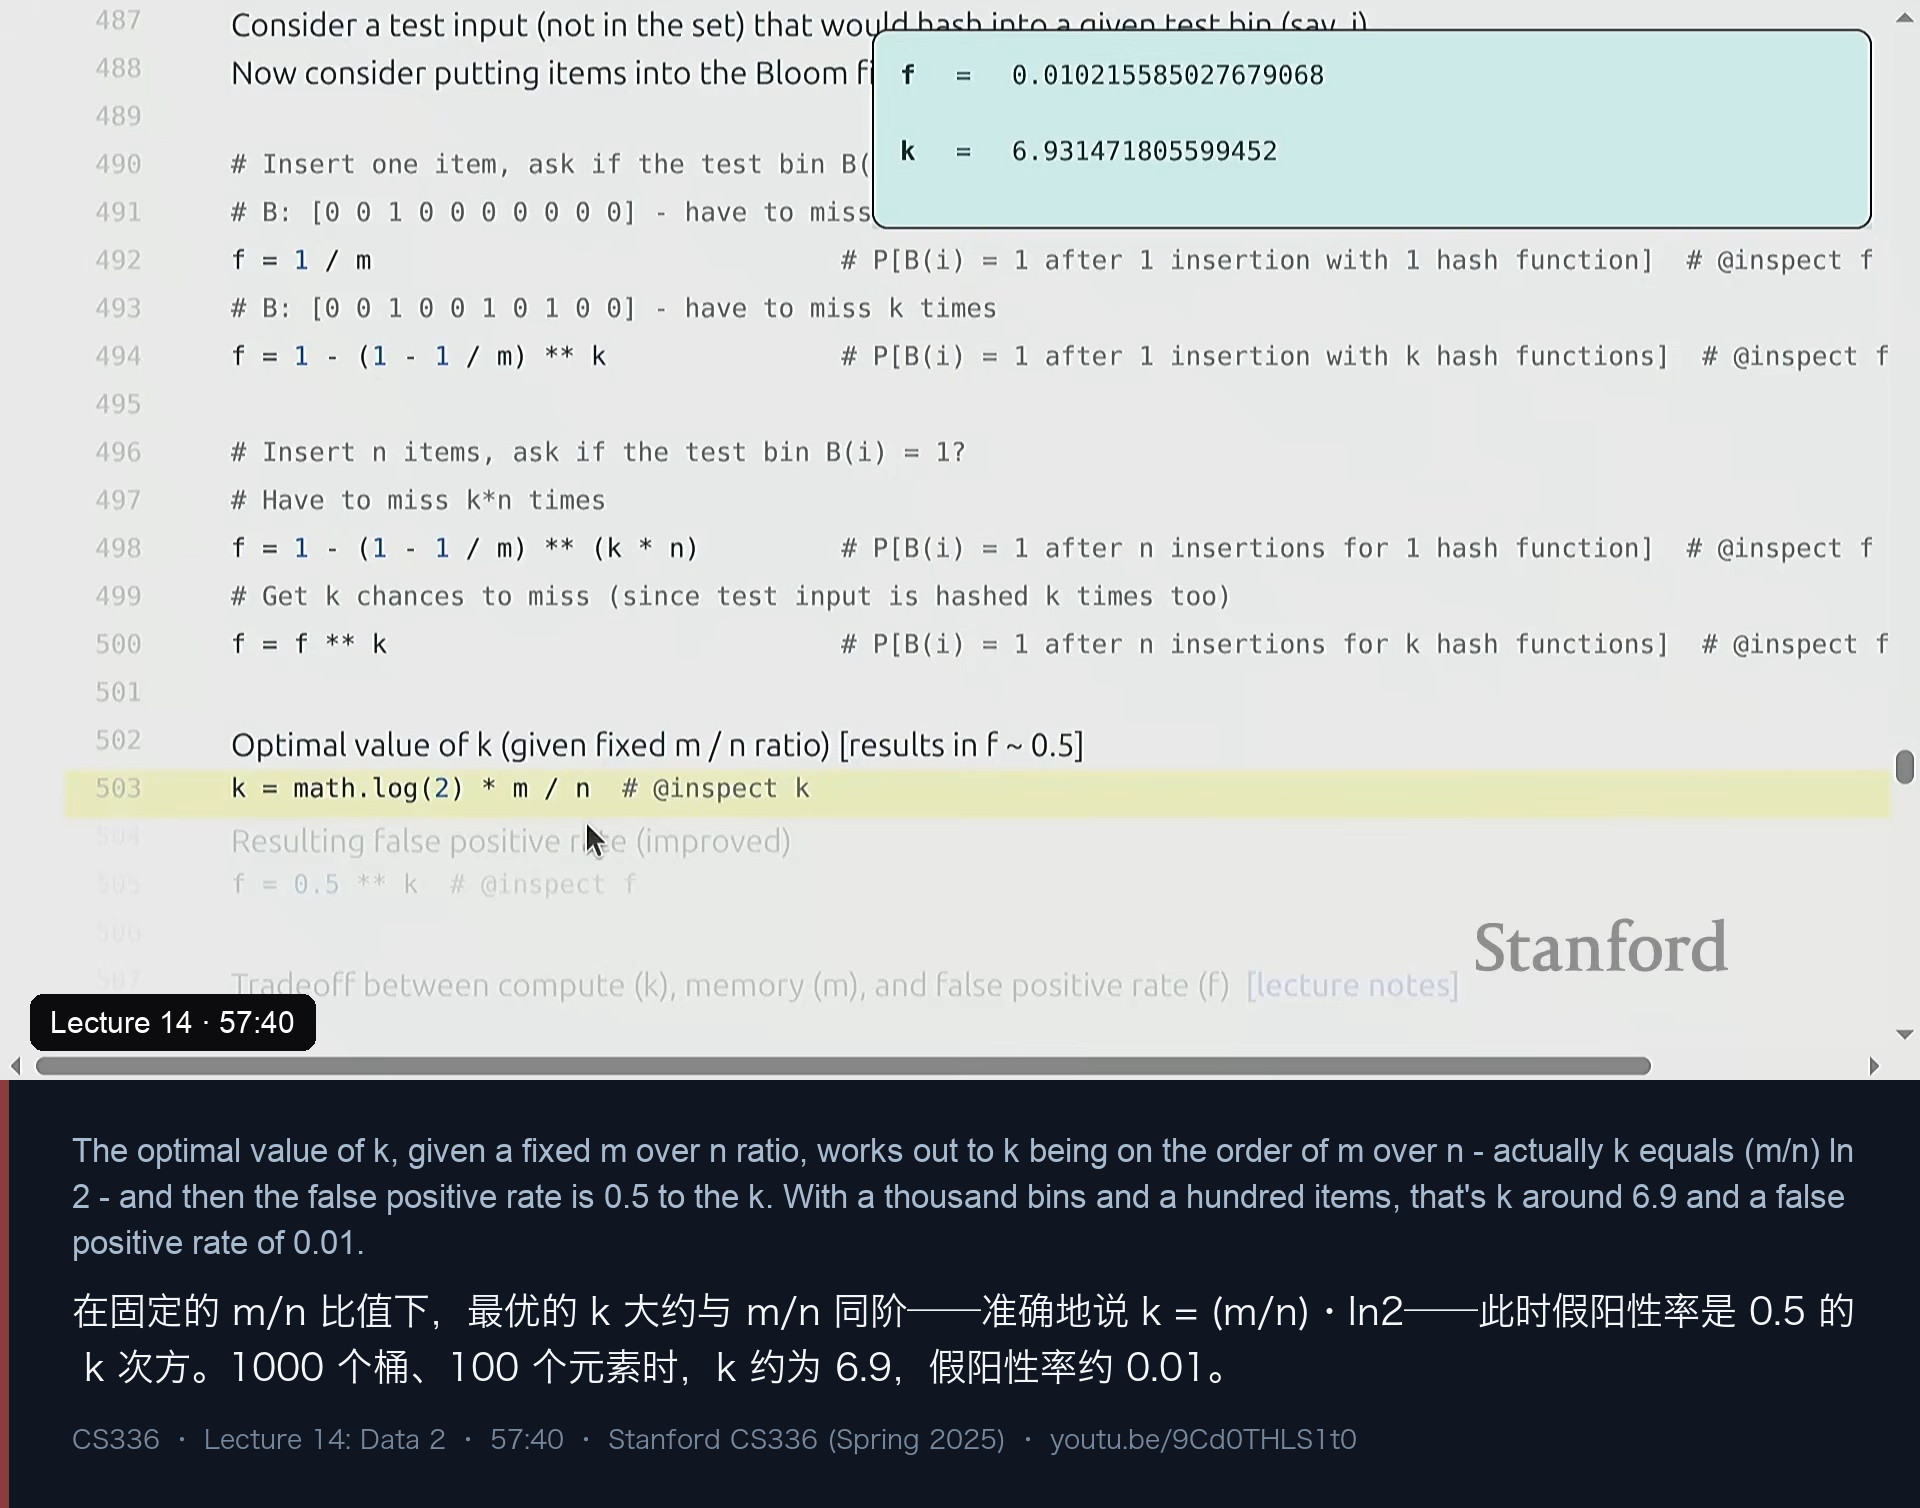
接着是这讲最完整的一段概率推导,值得原样抄下来:
Consider a test input (not in the set) that would hash into a given test bin (say, i).
Now consider putting items into the Bloom filter and seeing if it hits i.

# Insert one item, ask if the test bin B(i) = 1?
# f = 1/m                          # P(B(i) = 1 after 1 insertion with 1 hash function)
# f = 1 - (1 - 1/m) ** k           # P(B(i) = 1 after 1 insertion with k hash functions)

# Insert n items, ask if the test bin B(i) = 1?
# Have to miss k*n times
# f = (1 - (1 - 1/m) ** (k*n)) ** k   # P(B(i) = 1 after n insertions with k hash functions)
f = 0.0102155802767968
k = 6.931471805599452
Optimal value of k (given fixed m/n ratio) [results in f = 0.5]
k = math.log(2) * m / n # inspect k
Resulting false positive rate (improved):
f = 0.5 ** k # inspect f
Tradeoff between compute (k), memory (m), and false positive rate (f) [lecture notes]结论是:哈希个数不是越多越好(太多会把位数组填满),存在一个最优点,且它只取决于 m/n 的比值——k ≈ (m/n)·ln 2,此时假阳性率 f = 0.5^k。用 m = 1000、n = 100 代入,最优 k ≈ 6.93,f ≈ 0.0102。幻灯片还留了一行备注:“在 compute(k)、memory(m)和假阳性率(f)之间权衡——细节见讲义。” 而 Dolma 的设定是把假阳性率压到 1e-5,用布隆过滤器在段落粒度做精确去重。
十二、近似去重:Jaccard、MinHash 与 LSH 的“与/或”结构
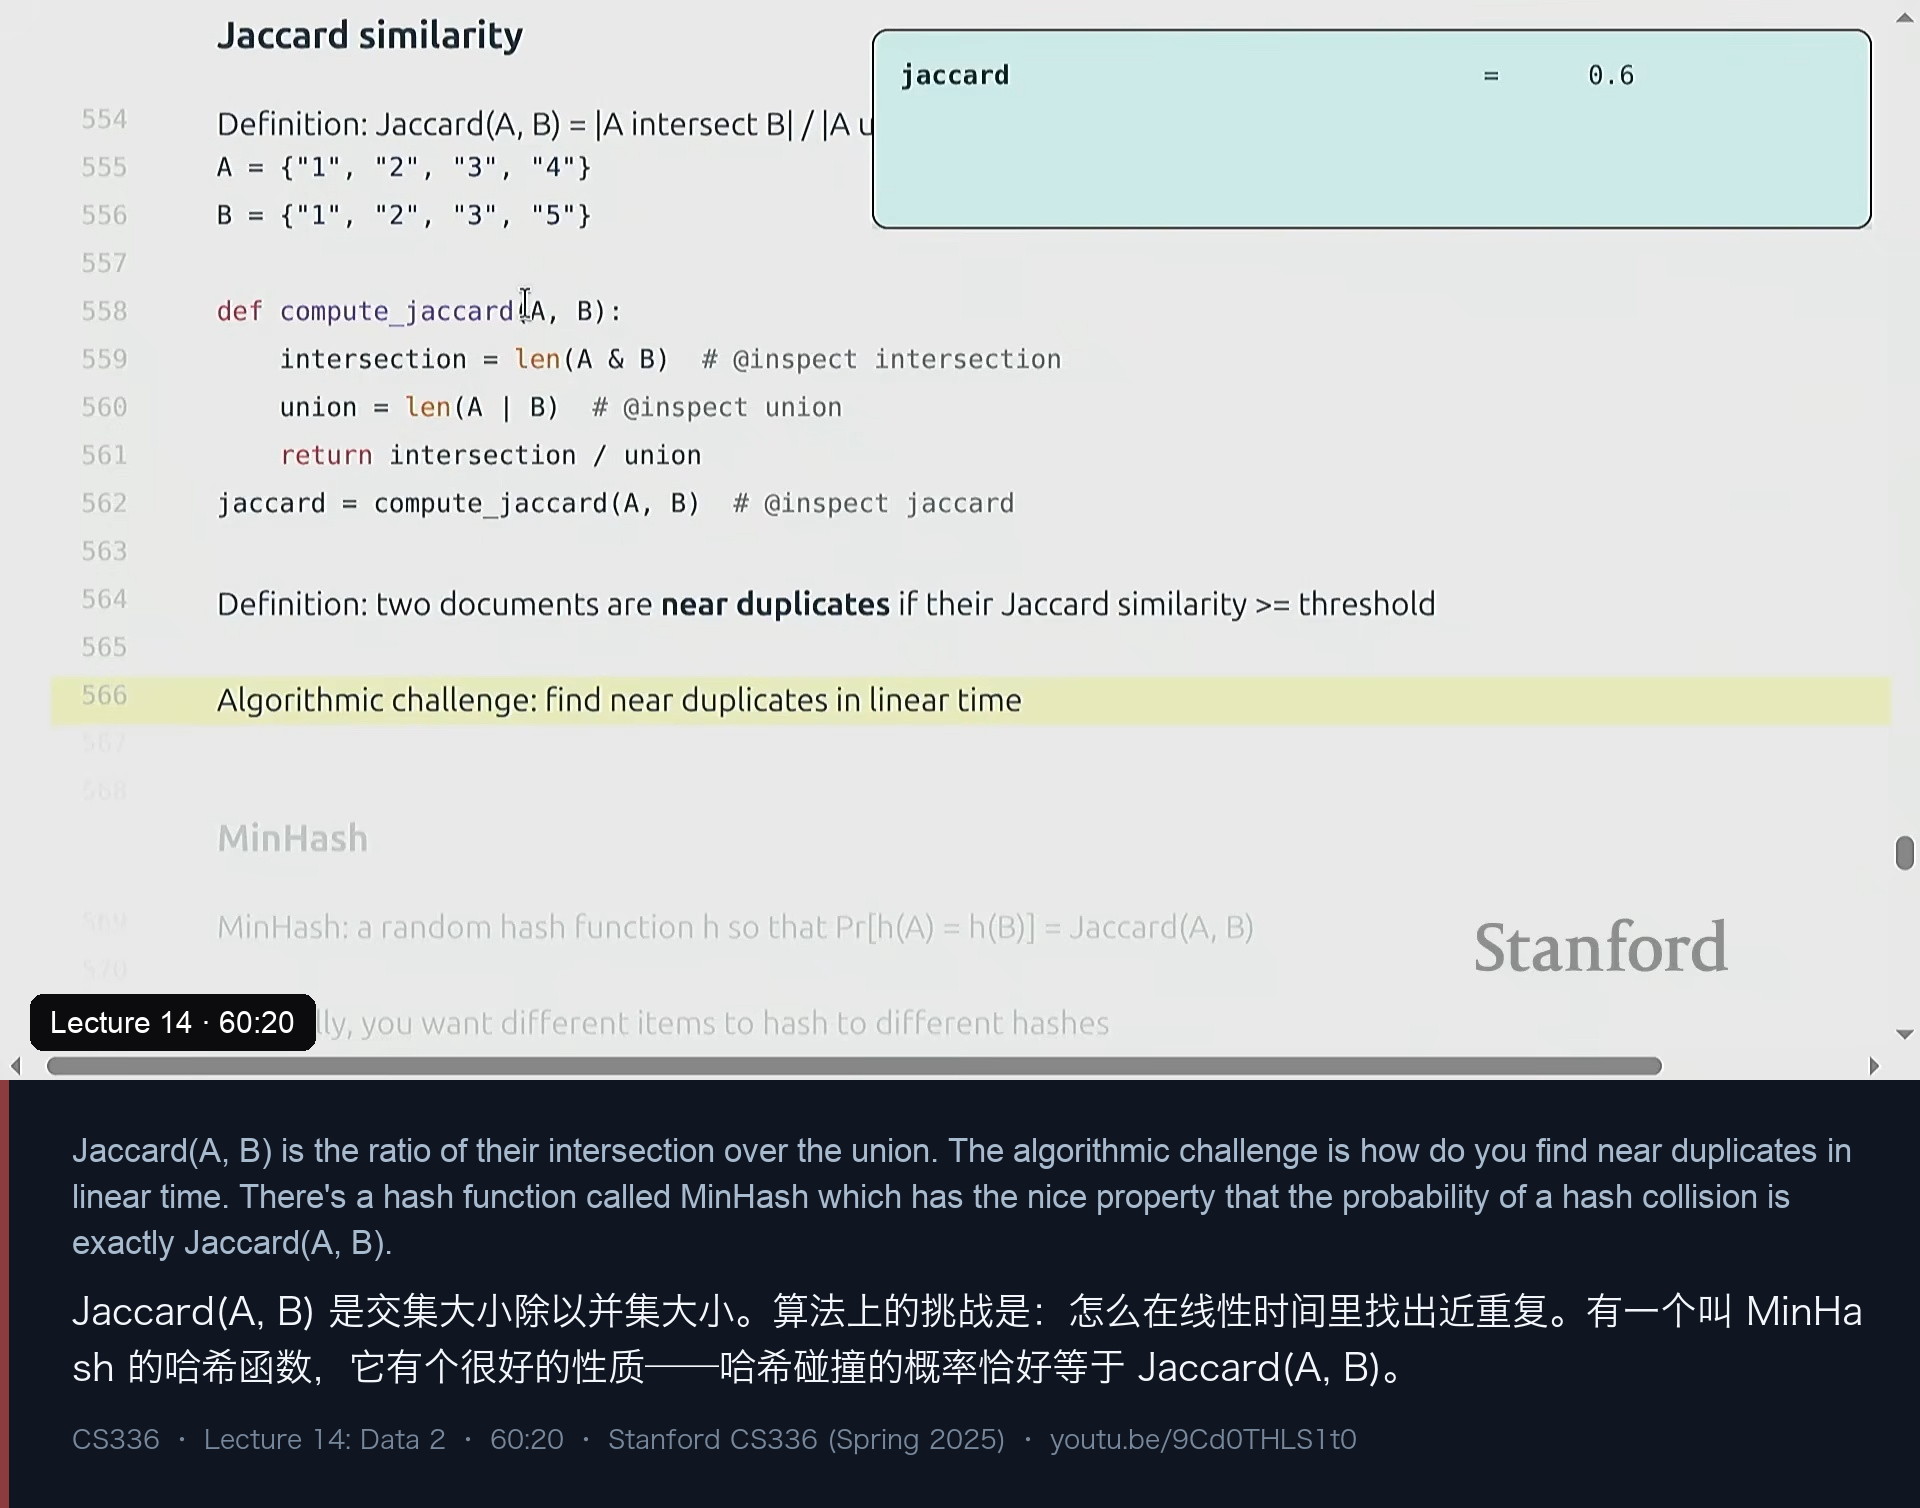
精确去重搞不定近重复,于是需要”近似的集合成员判定“。这需要一个相似度度量,最常用的是 Jaccard 相似度:
Jaccard(A, B) = |A ∩ B| / |A ∪ B|

A = {1, 2, 3, 4}
B = {1, 2, 3, 5}
Jaccard = 3/5 = 0.6
定义上“两份文档是近重复”等价于“Jaccard 相似度超过某个阈值”,而这个阈值通常设得很高(比如 0.9)——因为你只想抓住“漏了个逗号”这种级别的差异。Percy 特意提醒:这套东西完全不语义。丢一个 not 就能把意思反过来,或者换掉一个实词,Jaccard 也未必察觉;它追求的是表面上的相似。
难点仍然是:Jaccard 是成对的,而我们要线性时间。于是引入 MinHash(一个最小哈希函数),它有一个非常漂亮的等价性:
MinHash: a random hash function h so that Pr[h(A) = h(B)] = Jaccard(A, B)也就是说,碰撞概率恰好等于相似度。通常我们把哈希碰撞当成必须避免的坏事,这里却第一次变成了“要控制到恰好的好事”:越相似的两条越该碰撞。
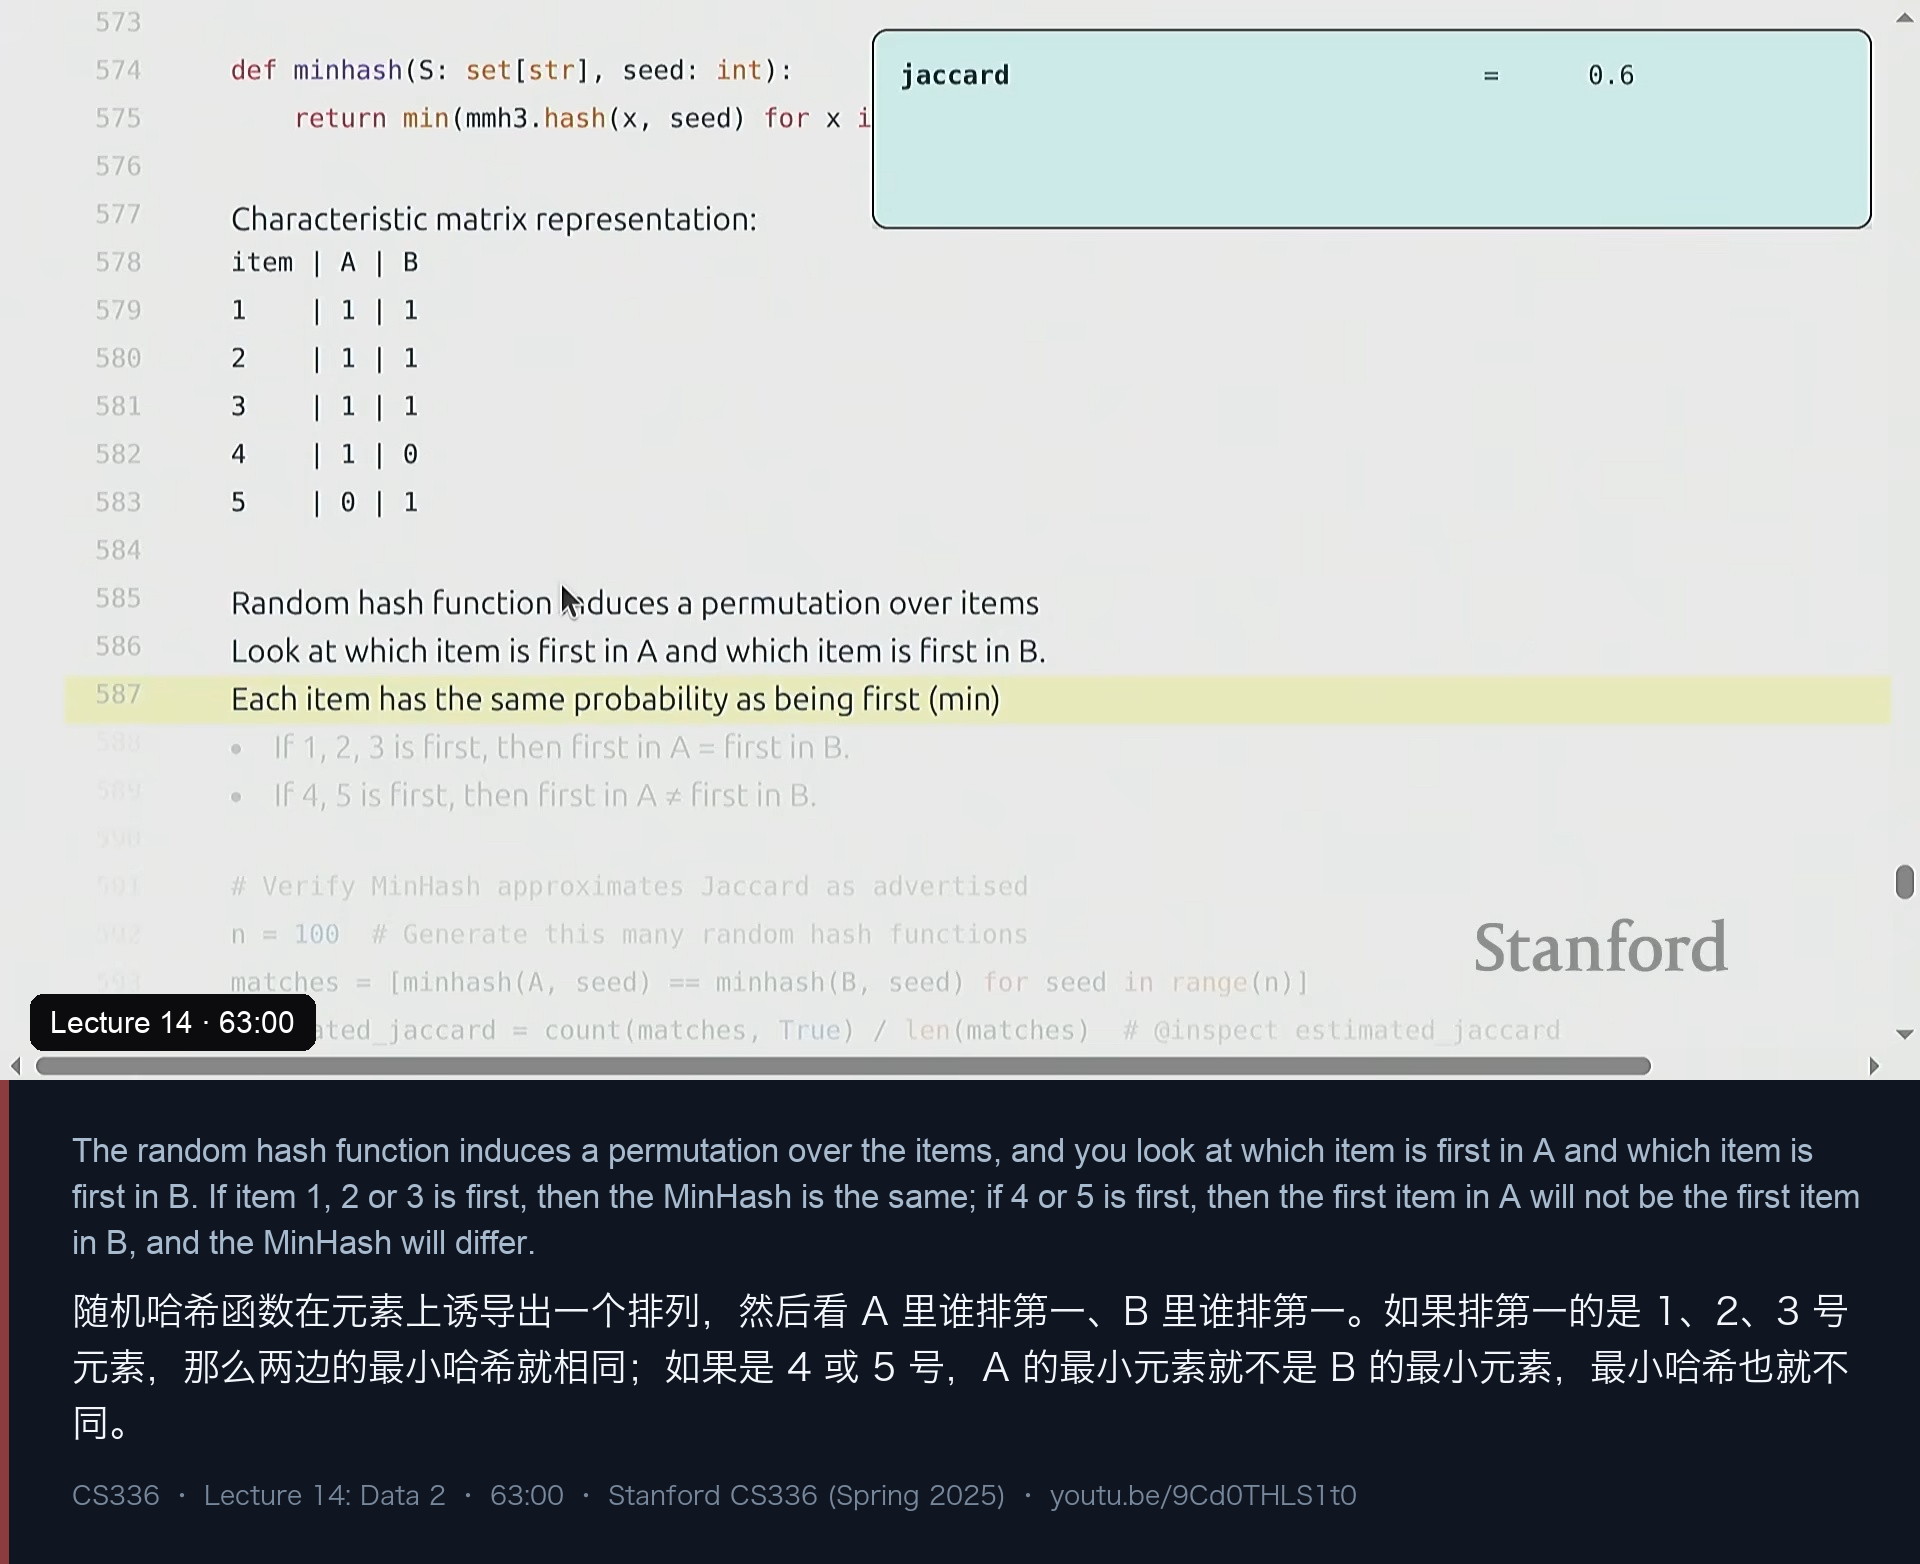
为什么成立?证明只需一张特征矩阵图:
Characteristic matrix representation:
  item | A | B
   1   | 1 | 1
   2   | 1 | 1
   3   | 1 | 1
   4   | 1 | 0
   5   | 0 | 1

Random hash function induces a permutation over items
Look at which item is first in A and which item is first in B
Each item has the same probability as being first (min)

· If 1, 2, 3 is first, then min A = min B
· If 4, 5 is first, then min A /= min B
随机哈希等价于对元素做一次随机排列;排列中最靠前的元素(也就是哈希值最小者)落在 A∩B 里的概率,恰好是 |A∩B| / |A∪B| = Jaccard。所以 当且仅当“最小元素”属于交集时两边的最小哈希相等。实验也验证了这一点:
n = 100  # Generate this many random hash functions
matches = [minhash(A, seed) == minhash(B, seed) for seed in range(n)]
estimated_jaccard = count(matches, True) / len(matches)
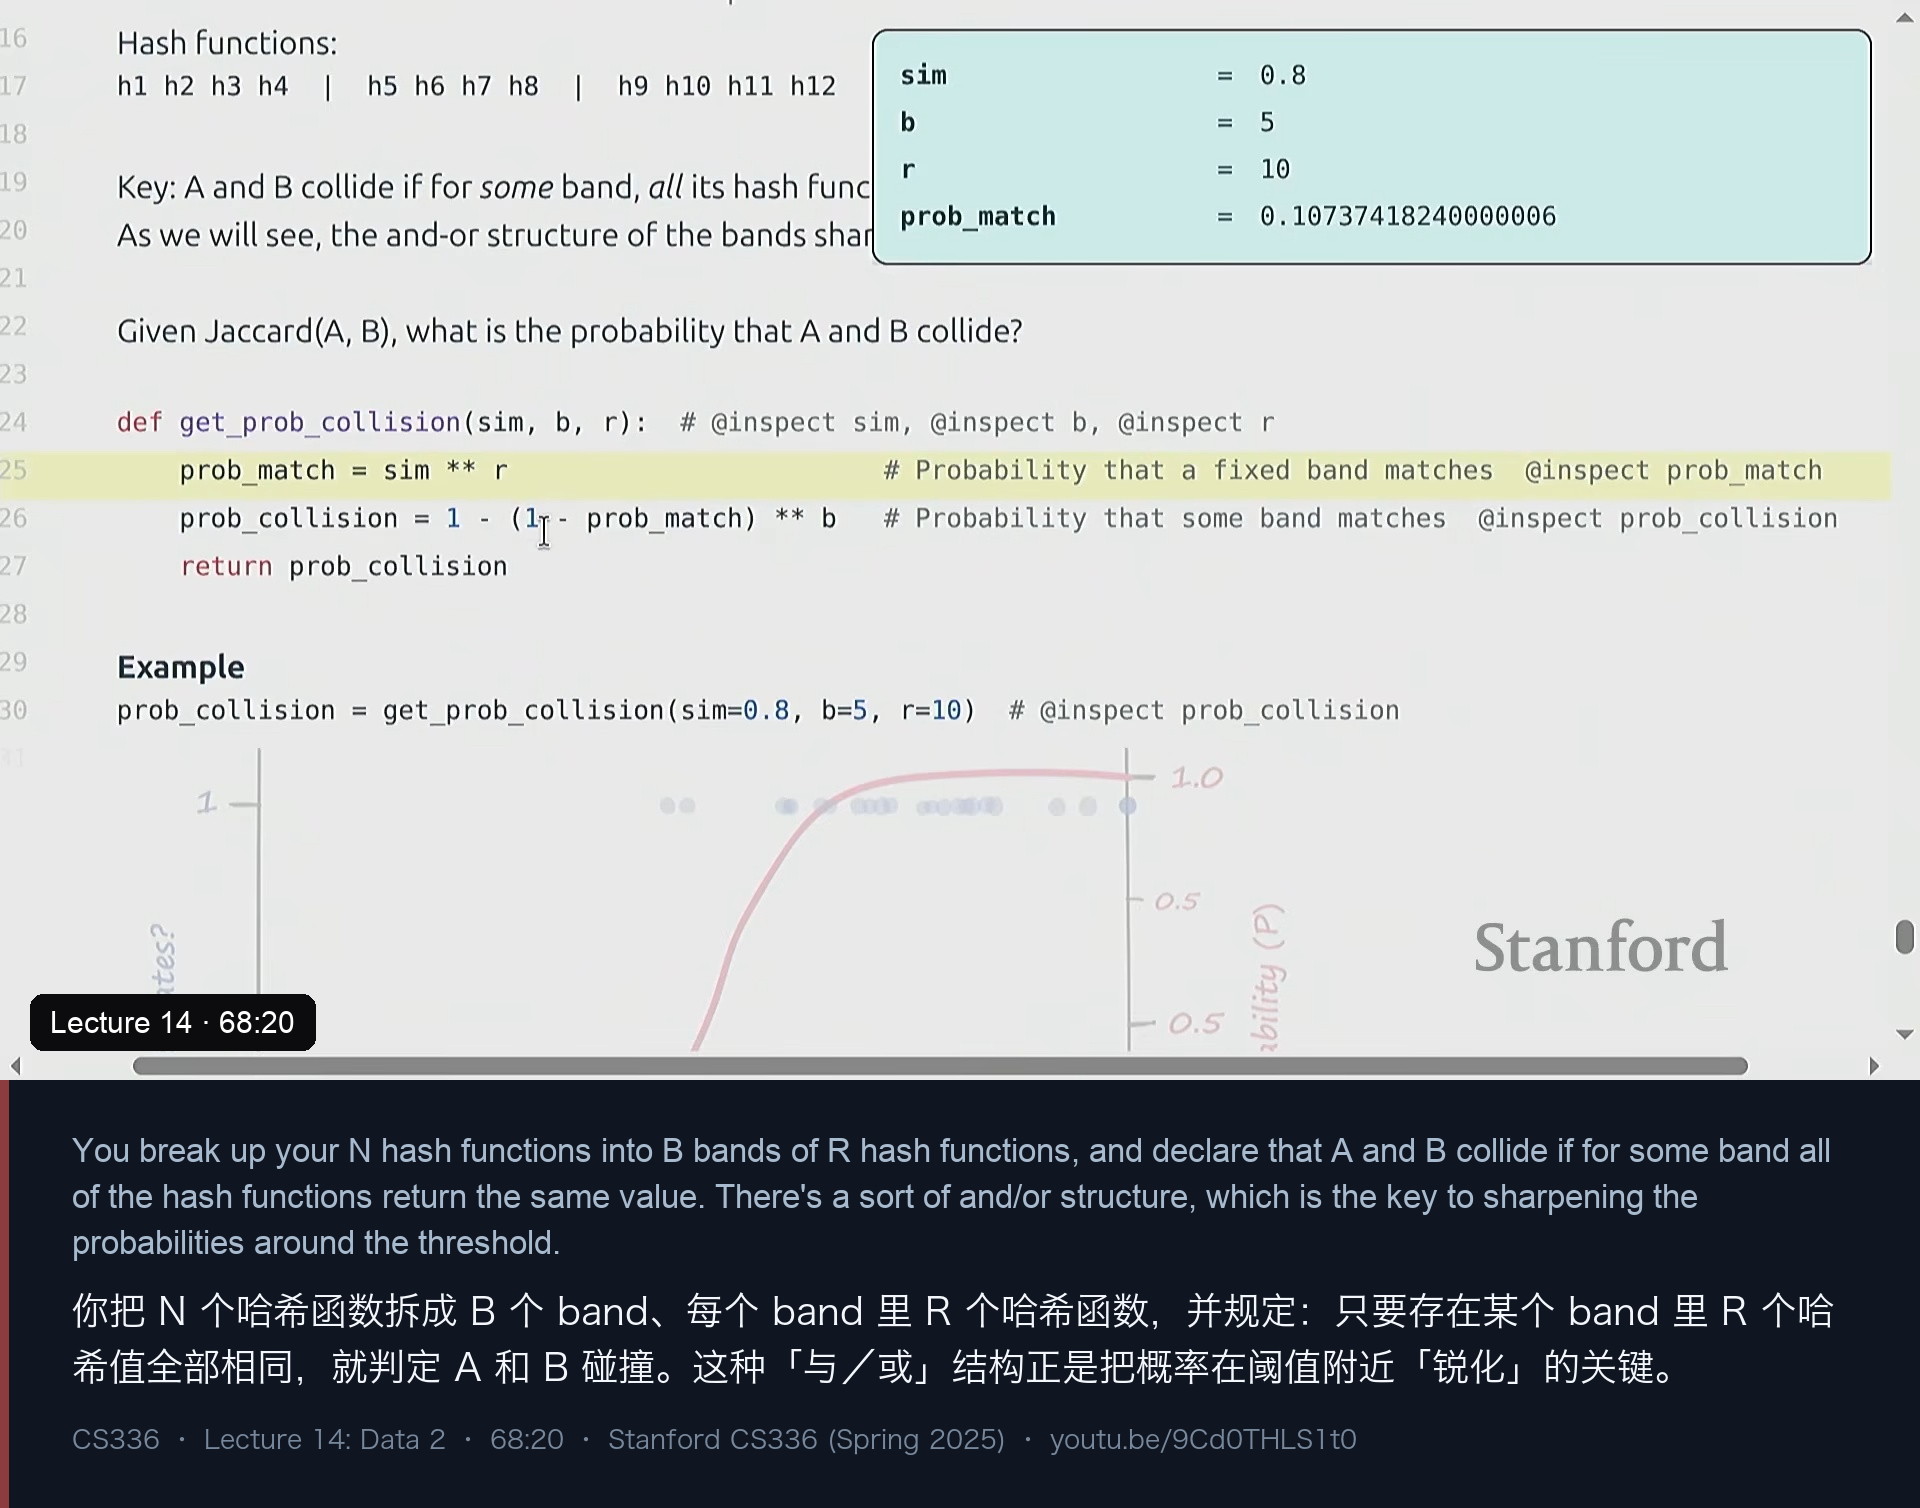
# -> 0.6但“碰撞概率等于相似度”还只是一条斜线,而我们要的是”超过阈值就以接近 1 的概率判为重复,低于阈值就以接近 0 的概率判为不重复“——需要把这条斜线锐化。做法是 局部敏感哈希(LSH) 的 banding 结构:
You break up your N hash functions into B bands of R hash functions
Key: And B collide if for some band, all its hash functions return the same value

h1 h2 h3 h4 | h5 h6 h7 h8 | h9 h10 h11 h12
   band 1   |    band 2   |     band 3
即:对每条文档用 N 个 MinHash,把它们切成 B 个 band、每个 band 含 R 个哈希;只要有一个 band 内的 R 个值全部相同,就判定这两条文档碰撞。这是一个“band 内取与(AND)、band 之间取或(OR)“的结构:
def get_prob_collision(sim, b, r):
    prob_match = sim ** r                                   # Probability that a fixed band matches
    prob_collision = 1 - (1 - prob_match) ** b              # Probability that some band matches
    return prob_collision

prob_collision = get_prob_collision(sim=0.8, b=5, r=10)
# -> 0.43330782041120397
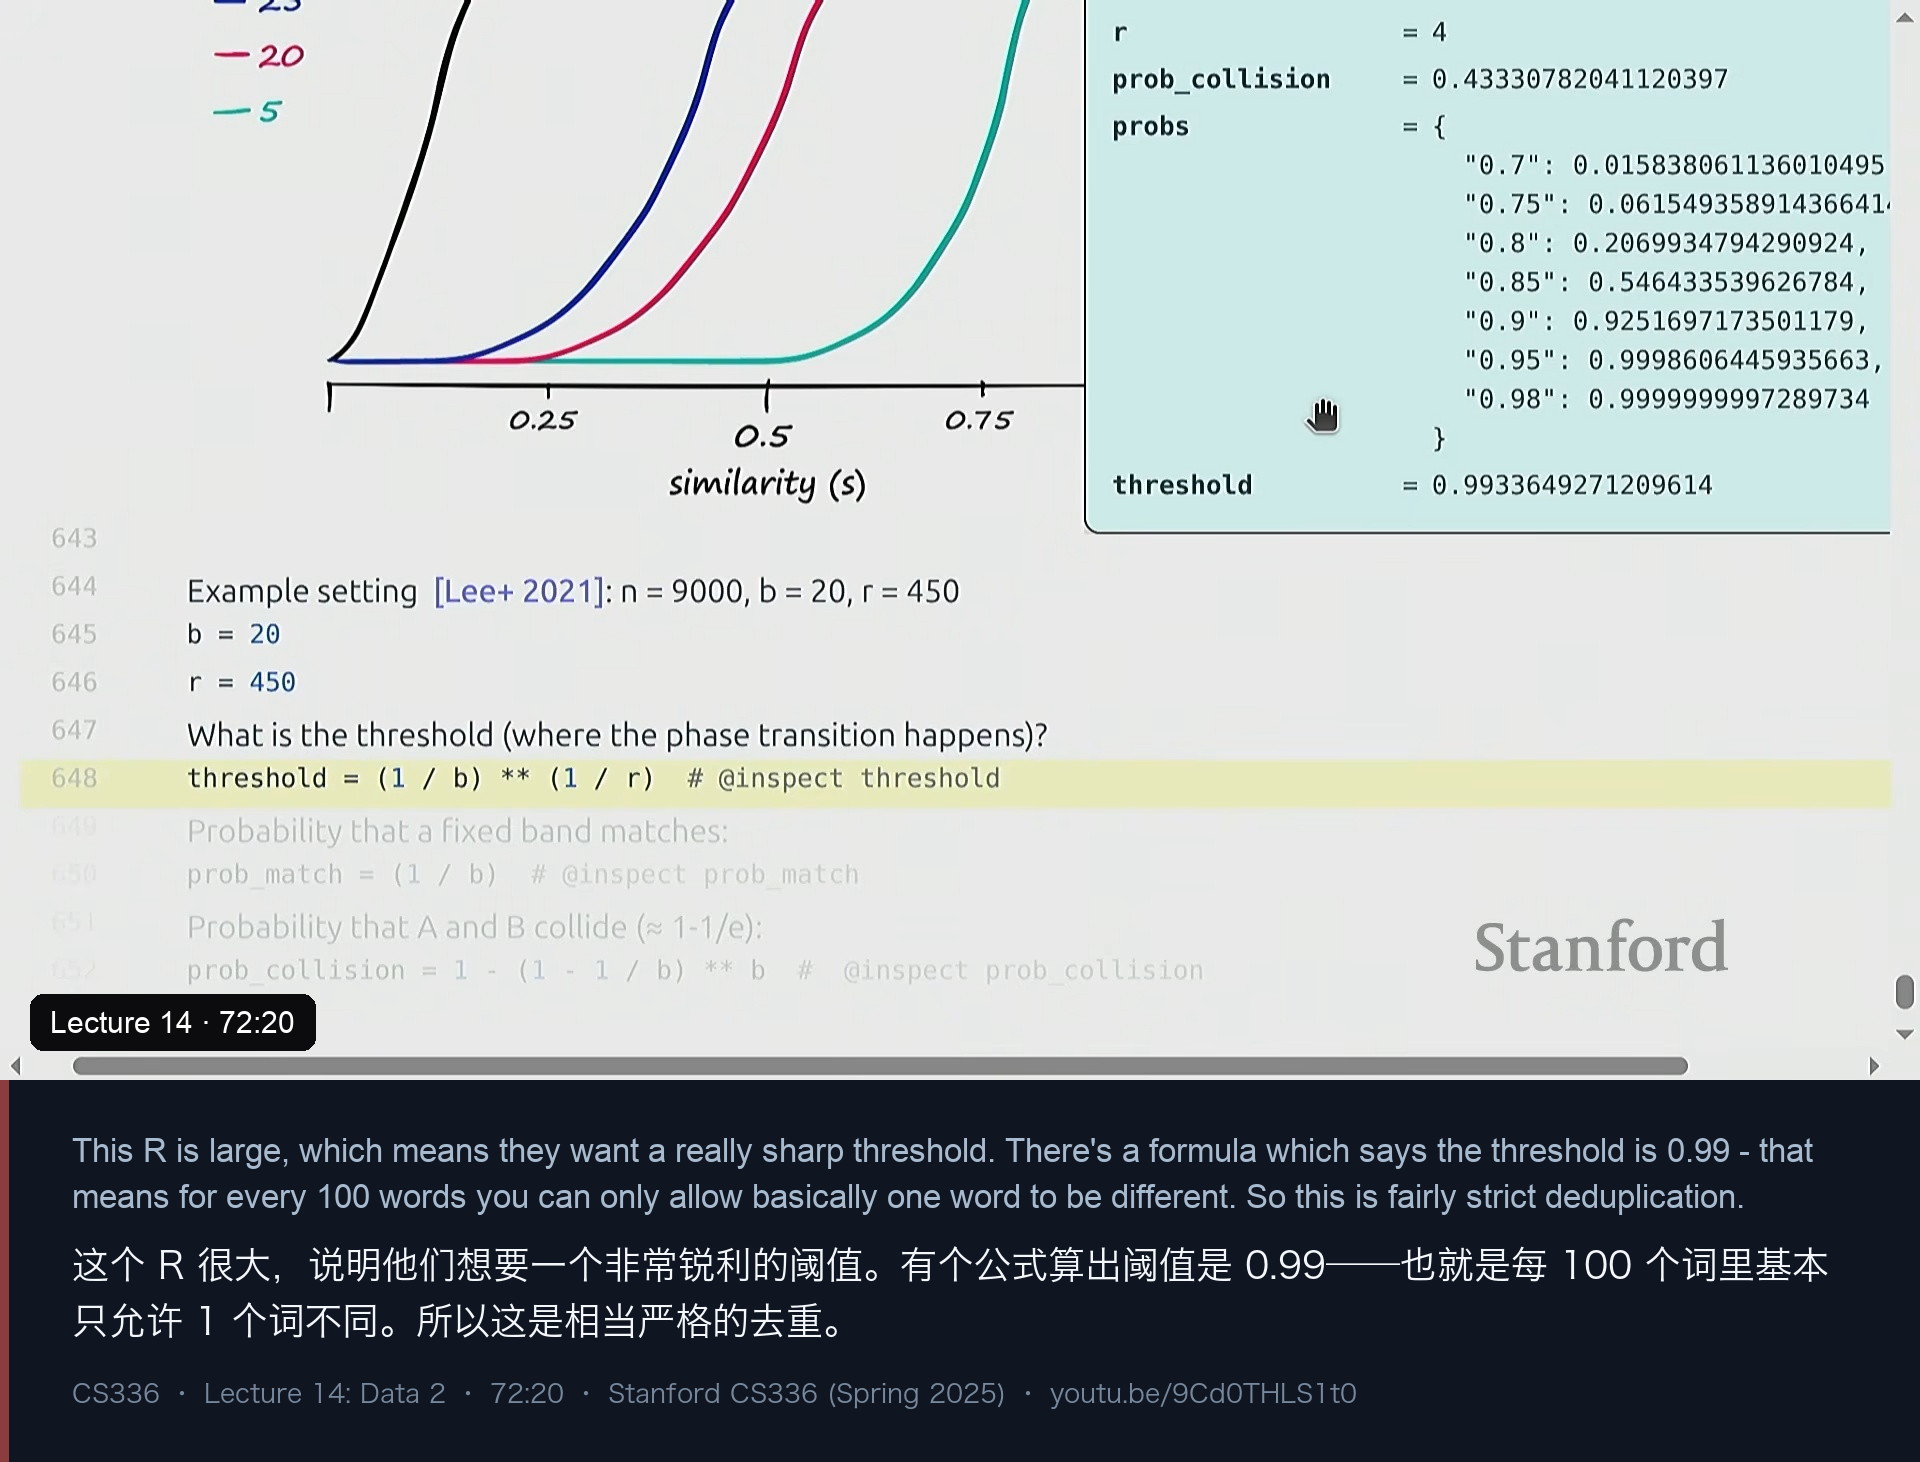
以 sim = 0.8、5 个 band、每 band 10 个哈希为例,单个 band 全同的概率是 0.8^10 ≈ 0.107,五个 band 至少一个全同的概率就是 0.433——比“直接用一条 MinHash 得到 0.8”低得多,相当于把低相似度那一侧压了下去。
调参的直觉可以用两条曲线记住:
- 增大 R(band 宽度):把曲线变陡(更锐利的阈值)并向右移——更难匹配,更严格。
- 增大 B(band 数量):把曲线向左移——让高相似度那一侧的概率更快逼近 1。
两者配合,就能在任意目标阈值处得到一条”非常锐利的 sigmoid“。Percy 给了实践中的一组真实参数——Lee+ 2021 的设定:
Example setting [Lee+ 2021]: n = 9000, b = 20, r = 450
b = 20
r = 450
threshold = (1 / b) ** (1 / r)   # inspect threshold
# -> 0.99336492721209614
r = 450 这么大,说明他们要一个极其锐利的阈值:算出来的阈值是 0.9936,换算过来就是”每 100 个词只能允许大约 1 个词不同“。此时单个 band 匹配的概率是 0.9936^450 ≈ 0.05,20 个 band 至少一个匹配的概率约 0.64。最后那句注脚很关键:在阈值处,碰撞概率会收敛到 1 − 1/e ≈ 0.632——所以”在阈值上你两边都有可能”,但只要高于阈值,碰撞概率就迅速奔向 1;低于阈值则迅速奔向 0。这正是我们要的阶跃感。
十三、收尾与答疑:合成数据、要不要保留重复
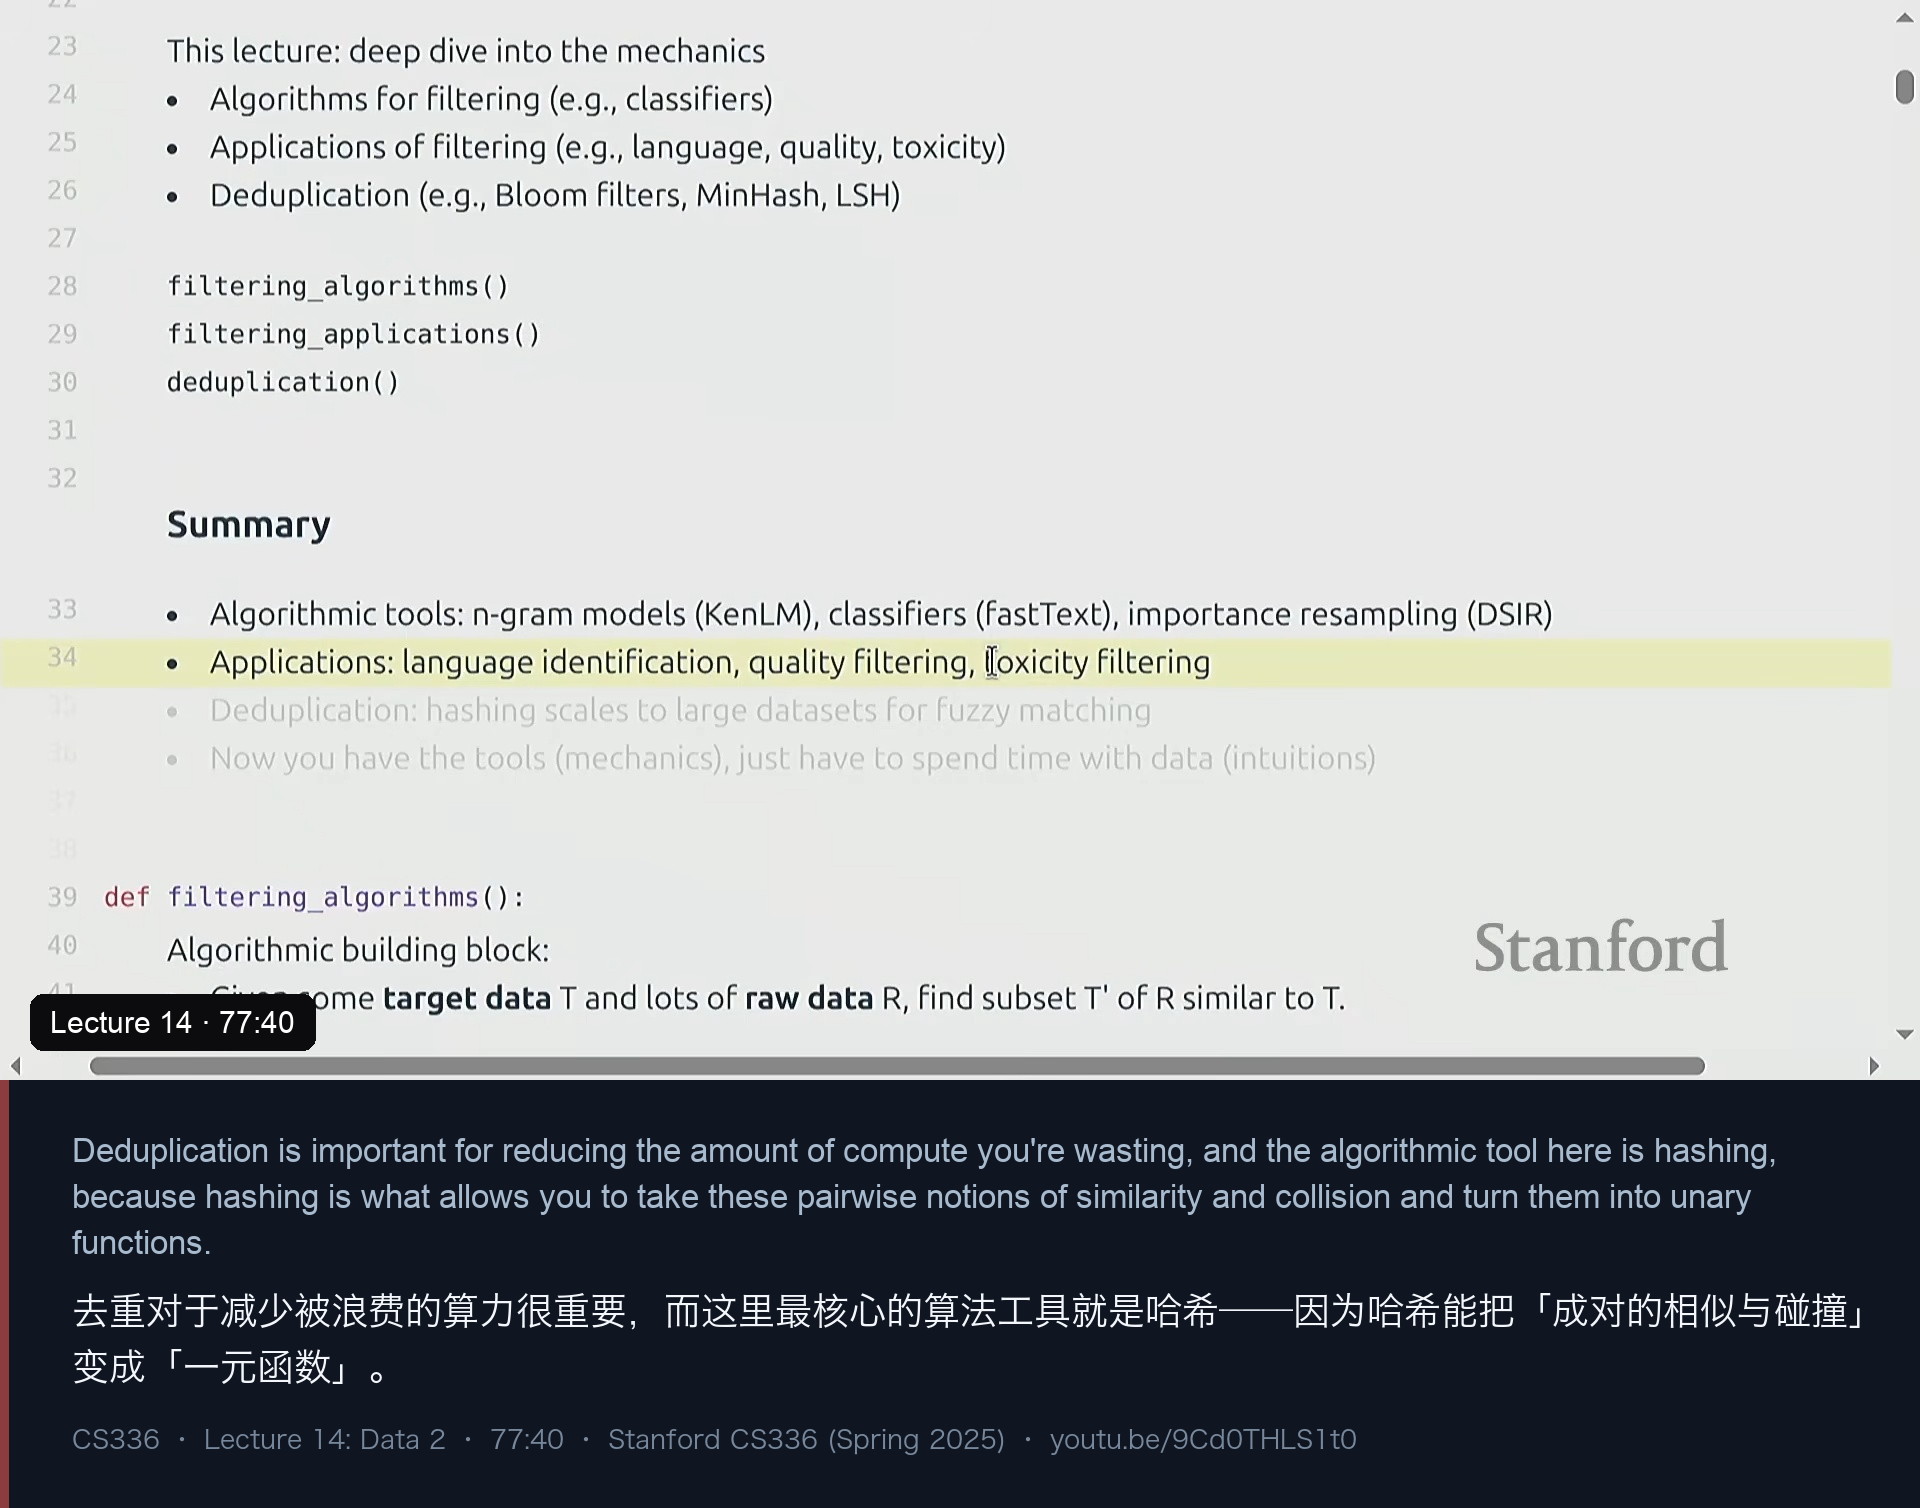
讲完去重,Percy 先问台下有没有问题,然后给出总结。过滤这一半的收获是三个“算法工具”:
- Algorithmic tools: n-gram models (KenLM), classifiers (fastText), importance resampling (DSIR)
- Applications: language identification, quality filtering, toxicity filtering
- Deduplication: hashing scales to large datasets for fuzzy matching
以及那句至关重要的元结论:
哈希之所以是核心工具,是因为它能把“成对的相似与碰撞”变成“一元函数”,而一元函数才能线性时间地跑在大数据集上。 后面那些巧妙之处(多个哈希、band 的与/或结构)都只是在”塑造判据的形状“。
答疑里有三个问题,都很有现实感:
其一,“合成数据越来越多,改写过(paraphrase)的内容怎么去重?” Percy 说这属于同一框架的延伸:有些论文(比如 SemDeDup 这条线)用 embedding 来做相似度,于是 LSH 就变成了“在 embedding 空间里找近似最近邻”——因为 LSH 本来就是为近似最近邻设计的。代价是嵌入整个语料更贵;而且现在处理的还主要是“非常近的近重复”,一旦放宽到语义层面,太激进就会一次性扔掉大量数据,要非常小心。
其二,“既然数据这么高质量,会不会反而想保留重复?” 他的回答是”确实如此“:在 mid-training 阶段,你手上是一批高质量来源,本来就应该对这些数据多训几轮。去重主要是针对预训练——那里有 61036 份随机内容,你只想清理干净。更合理的做法是:对高频文档保留下”它很重要“这个信号,但把计数取平方根或对数,让它不要按比例地出现在训练数据里;同时承认它值得多训几轮。
其三,也是全讲最后一段话的基调:“如果你问怎么’教数据’,这才刚刚开始。你必须花时间和数据待在一起——看它、过滤它、拿它训模型,这样才能长出对’什么有用、什么没用’的直觉。” 他顺带布置了 Assignment 4,并预告下周开始进入强化学习与对齐——整门课的最后一个单元。
我的笔记
- 这一讲真正的主题是“复用”:一个抽象,四五个应用。 “小的目标 T + 大的原始 R → 找相似的 T′”,换掉正例来源,就从语言识别变成质量过滤再变成毒性过滤。
- “T 从哪来?T 从提示 GPT-4 来。” phi-1 用 GPT-4 标注 10 万条当正例、再蒸馏成一个便宜的随机森林——用一次贵的模型,换一个便宜的、能跑遍全网的分拣器。这是数据工作里“模型即标注器”最干净的一个例子。
- 过滤器的第一性原理是“便宜”。 要过滤到网页的 1%,分类器开销就必须压到一次前向传播的百分之一;否则你还不如把算力直接拿去训练。佩西那句“你不需要做到最好的模型”是整讲的定调。
- n-gram 演示里的那个 62.6 比任何论证都直观。 纯乱码
asdf asdf asdf拿到比 Wikipedia 句子(87)更低的困惑度——过滤器是筛子,不是裁判。 - “用 Wikipedia 引用的页面而不是 Wikipedia 本身”是一个可以反复借用的招法。 当你不确定正例该怎么挑时,去找指向它的结构(链接、引用、引用计数),往往比直接定义内容更稳。
- 质量过滤与去重是两种不同的动作,不要混为一谈。 前者的判断是“永远不要”,后者是“要,但不要 61036 份”。C4 那段文案就是最好的例子:它语法通顺、完全合格,但没人想在上面训 61036 轮。
- 去重的理论困难只有一个:它天生是成对的,却必须在线性时间里做。 而解法也只有一个:用哈希把成对关系降成一元关系。整讲的布隆过滤器、MinHash、LSH 都是这一句话的变体。
- 布隆过滤器的三个性质值得背下来:
no一定对、yes大概率对、能更新但不能删除。再记住结果:最优哈希个数k ≈ (m/n)·ln 2,此时假阳性率f = 0.5^k;k 不是越大越好,太多会把位数组填满。 - MinHash 是“碰撞从坏事变成好事”的唯一一处。 在别的地方我们希望哈希别撞,这里我们希望它按相似度精确地撞:
Pr[h(A) = h(B)] = Jaccard(A, B),证明只要一张特征矩阵加一次随机排列。 - LSH 的与/或结构是一个可调形状的概率函数。
Pr[collision] = 1 − (1 − sim^R)^B;R 控制“多陡 + 往右移”,B 控制“往左移”,于是你能在任意阈值处造出一条近乎阶跃的 sigmoid。 - 阈值处的碰撞概率收敛到
1 − 1/e,这个常数很值得记住。 在阈值上你有多大概率“判重”,与你设的阈值基本无关——真正的工作是让高于阈值的那侧迅速到 1、低于阈值的那侧迅速到 0。 - 从“逐字重复”走向“语义重复”要付出两种代价。 一是经济代价(嵌入整个语料更贵),二是过度删除的代价——相似度一旦放宽,太激进的一次性就能扔掉大量数据。合成数据时代这件事只会更麻烦。
- 别把去重当成教条:高质量数据本来就该多训几轮。 更成熟的做法是保留“高频=重要”的信号,但把计数取平方根或对数降权,让它在训练分布里不按比例出现。
- 这一讲的工具全都来自“搜索/数据库”而不是“深度学习”。 KenLM、MurmurHash、布隆过滤器、MinHash、LSH——当你把预训练数据管线当成一个大数据系统来看,这一讲的每一件工具都有了出处。
- 最后一课仍然是“上手”。 “你得花时间和数据待在一起,看它、过滤它、拿它训模型”——这是整门课里最不技术、也最像实话的一句建议。
附:课程信息与时间轴
- 课程:Stanford CS336《Language Modeling from Scratch》(Spring 2025)
- 本讲:Lecture 14 · Data 2
- 主讲:Percy Liang
- 视频:https://www.youtube.com/watch?v=9Cd0THLS1t0(时长约 1:19)
- 播放列表:CS336 Spring 2025
| 时间 | 主题 |
|---|---|
| 00 | 开场:上一讲是数据集史,这一讲深入过滤与去重的机制 |
| 00 | 数据处理流水线:抓取 / 导出 → HTML 转文本 → 过滤 → 去重 |
| 01 | 本讲大纲:过滤算法 → 过滤应用 → 去重算法 |
| 01 | 过滤的高层图景:目标数据 T、原始数据 R、要找的 T′ |
| 02 | 对过滤器的两个要求:可泛化、极其快(1% 对应的算力预算) |
| 02 | 方法一:n-gram 语言模型与 KenLM |
| 03 | 极大似然估计、稀疏计数与维度灾难 |
| 04 | Kneser-Ney 平滑:插值或回退到低阶 n-gram |
| 05 | KenLM 演示:Wikipedia 句子困惑度 87、乱码 62.6 的反直觉 |
| 07 | CCNet:按困惑度排序只保留前 1/3(第一版 LLaMA 数据) |
| 08 | 方法二:fastText 线性分类器 |
| 09 | 动机:词袋分类的 V×K 参数爆炸 |
| 10 | fastText 的隐藏层:V→h→K,无非线性,H·(V+K) 个参数 |
| 11 | n-gram 扩展与 hashing trick:演示 8 个桶、实践 1000 万 |
| 12 | K=2 的好/坏二分类;换成 BERT / LLaMA 只是更慢 |
| 13 | 方法三:DSIR(重要性重采样) |
| 13 | 重要性重采样复习:从 q 采样、按 p/q 加权、重采样 |
| 15 | 搬到数据选择:T 太小,于是用哈希 unigram 估计分布 |
| 17 | Python hash 非确定性;乘积式概率与“不走运”的 0 |
| 18 | DSIR 略胜 fastText;建模分布 vs 分类成员 |
| 19 | 统一配方:KenLM / fastText / DSIR 三种打分与阈值 |
| 21 | 答疑:n-gram 只看局部、容易被对抗,“挡掉真正的胡言乱语” |
| 23 | 应用一:语言识别;为什么不做纯多语言(BLOOM 只有 30% 英文) |
| 25 | fastText 语言识别模型 lid.176.bin;Dolma 保留 P(English) > 0.5 |
| 26 | 演示:0.71 的英语、代码被判成俄语、hello 被判成意大利语 |
| 28 | 语言识别的坑:短句、低资源、方言、相似语言、code-switching |
| 29 | 案例:OpenWebMath,规则 + KenLM + 双阈值 fastText → 147 亿 token |
| 30 | 应用二:质量过滤;“质量”是一个 catch-all |
| 30 | GPT-3 与 LLaMA 的正负例构造(“Wikipedia 引用的页面”) |
| 31 | phi-1:用 GPT-4 判定“教育价值”造正例,蒸馏成随机森林 |
| 32 | “T 从哪来?T 从提示 GPT-4 来” |
| 33 | phi-1 结果:HumanEval 12.19%(96K 步)→ 17.68%(36K 步) |
| 35 | 应用三:毒性过滤,Jigsaw 数据集与 Dolma 的两个 fastText |
| 36 | 去重开场:精确重复(镜像)与近重复 |
| 37 | 近重复的来源:许可证、模板、复制粘贴错误、改写 |
| 39 | C4 里重复 61036 次的产品文案 |
| 40 | 去重与质量过滤互补:两种不同的取舍动作 |
| 40 | 去重的两个收益:更省算力、减少记忆 |
| 41 | 设计空间:单元 / 匹配方式 / 处理动作 |
| 42 | 核心挑战:本质是成对比较,却必须线性时间 |
| 42 | 哈希函数复习:碰撞、密码学哈希 vs 哈希表哈希、MurmurHash |
| 44 | 精确去重:哈希分组、每组留一份,MapReduce 友好 |
| 46 | C4 用三句片段做精确去重(以及切割破坏连贯性的吐槽) |
| 46 | 布隆过滤器:省内存、可更新不可删除、假阳性 |
| 47 | 演示:5 个元素、m=8,单哈希错 4 个、双哈希错 3 个 |
| 52 | 一般分析:f = (1 − (1 − 1/m)^{kn})^k |
| 55 | 最优 k ≈ (m/n)·ln2,f = 0.5^k;m=1000、n=100 时 f≈0.0102 |
| 57 | Dolma:假阳性率 1e-5,段落级精确去重 |
| 58 | 近似去重:Jaccard 相似度与 0.9 这类高阈值 |
| 59 | 不语义的提醒:丢一个 “not” 就能改变含义 |
| 60 | MinHash:碰撞概率恰好等于 Jaccard |
| 62 | 证明:特征矩阵 + 随机排列,“最小元素落在交集里” |
| 64 | 实验验证:100 个随机哈希估出 0.6 |
| 67 | LSH:B 个 band、每 band R 个哈希的与/或结构 |
| 68 | 公式:1 − (1 − sim^R)^B;sim=0.8、b=5、r=10 → 0.433 |
| 69 | 调参直觉:R 变陡并右移,B 左移 |
| 71 | Lee+ 2021:b=20、r=450、阈值 0.9936 |
| 73 | 阈值处碰撞概率收敛到 1 − 1/e ≈ 0.632 |
| 73 | 答疑:合成数据与改写,用 embedding 做语义近邻 |
| 74 | 答疑:高质量数据要不要保留重复 → mid-training 多轮 + sqrt/log 降权 |
| 76 | 总结:过滤三件套,哈希把成对判断变成一元函数 |
| 78 | 收尾:工具的终点是花时间和数据待在一起;下周进入 RL 与对齐 |
讨论
这里是静态站点,没有内嵌评论区。如果这篇文章对你有用,欢迎通过 RSS 订阅后续更新。