Stanford CS336 第十三讲精读:Data 1——数据不会从天上掉下来,从 BERT 的 BooksCorpus 到 Nemotron-CC 的完整数据工程史
斯坦福 CS336(Language Modeling from Scratch, Spring 2025)第十三讲完整讲义,主讲 Percy Liang。这一讲把『预训练数据』当成一门工程来教:开场先给出一句暴论——数据是决定语言模型好坏最重要的东西,然后从 BERT 的 BooksCorpus 与 Wikipedia 讲起,走过 Common Crawl、CCNet、C4、WebText、GPT-3、The Pile、MassiveText、LLaMA、RefinedWeb、FineWeb、Dolma、DCLM/DataComp,一直讲到 Nemotron-CC 的『改写 + 任务化』合成路线;中间穿插数据投毒、影子图书馆、代码与问答数据;最后用大段时间讲版权——许可、Creative Commons、合理使用的四个要素、以及『合法也可能被服务条款挡住』。收尾是那句关键的一课:数据不会从天上掉下来,你得动手去弄。
本篇属于系列 Stanford CS336 精读 · 第十三讲
来源:YouTube 原视频(Stanford Online · CS336 Language Modeling from Scratch · Spring 2025 · Lecture 13: Data 1)
来源说明 这是斯坦福 CS336《Language Modeling from Scratch》2025 年春季第十三讲的完整讲义,主讲人是 Percy Liang。前十二讲都在讲“给定数据之后怎么把模型训好”——架构、优化器、tokenization、scaling law、并行、推理、评估;这一讲终于回头问那个被默认的前提:我们到底在什么数据上训练? Percy 开场就撂下一句“暴论”:数据才是把语言模型做对最重要的东西(他预料 Tatsunori 会反对,因为后者认为 scaling law 最重要)。他还补了一句更刺人的话——如果有人说“语言模型就是在互联网上训的”,你可以直接反驳他:这句话既不对,也没有意义,因为“互联网”根本不是一份数据集。 文中 18 张配图均截取自视频对应时刻的画面,并把该时刻的完整观点句(英文原句+中文翻译)拼合进图中。文中出现的所有数字——Smashwords 的 50 万本书与 BooksCorpus 的 7000 本、Wikipedia 的 6200 万条目与 329 个语言版本、Common Crawl 自 2008 年以来的约 100 次抓取与 2016 年“100 台机器跑 10–12 天”、C4 的 1.4 万亿 token 与最终 806 GB/1560 亿 token、WebText 的 800 万页面/40 GB 与 12 次 dump 只得到 17 GB、GPT-3 的约 4000 亿 token、The Pile 的 825 GB/2750 亿 token 与 PubMed Central 的 500 万篇、Books3 的 19.6 万本书、LibGen 的约 400 万本与 Sci-Hub 的约 8800 万篇、GitHub 2008 年的 2800 万公开仓库与 The Stack 的 1.37 亿仓库/510 亿文件/3.1 TB、MassiveText 的 10 TB、LLaMA 的 1.2 万亿 token、RedPajama 的 6270 亿、RefinedWeb 的 5 万亿与开放的 6000 亿、FineWeb 的 15 万亿、Dolma 的 3 万亿、DCLM-pool 的 240 万亿与 DCLM-baseline 只保留 1.4%、Nemotron-CC 的 6.3 万亿与 1.1 万亿高质量子集、Llama 3 的 15 万亿与 Qwen 3 的 36 万亿、Llama 2 chat 的 27540 条标注、LongLoRA 把 Llama 2 7B 从 4K 扩到 100K、DeepSeek v3 的 128K / Claude 3.5 Sonnet 的 200K / Gemini 1.5 Pro 的 1.5M 上下文等——都是讲师课上的口播、幻灯片引用,或对公开论文、数据集卡与新闻的转述,不是本文独立核实的事实,请以原始论文与官方数据集卡为准。 另外两点提醒。其一,这一讲的骨架是时序:从 2018 年的 BooksCorpus 一路走到 2024 年的 Nemotron-CC,每一代数据集的进步几乎都来自“过滤得更聪明一点”,而不是某个新架构——这正是 Percy 想让你感受到的东西。其二,自动字幕把大量专有名词听错了:
Burr/Bert是 BERT,GBD2/GPD2是 GPT-2,GBT3/GPD3是 GPT-3,GPD4是 GPT-4,work file是 WARC file,wet是 WET,traffic flow tour/Traffa/trafilatura是 trafilatura,just text/justext是 justext,resi liber parse是 resiliparse,CCNet的CCN拼写照上下文处理,Aluther/Eluther是 EleutherAI,OMO/A2是 OLMo / AI2,DOMA是 Dolma,DCL on / DCM pool / DCM baseline / don baseline全是 DCLM-pool / DCLM-baseline,neatron/Neimotron/llama neatron是 Nemotron / Llama-Nemotron,neatron CC是 Nemotron-CC,Eli 5是 ELI5,open hermes是 OpenHermes,alpaka是 Alpaca,vicunia是 Vicuna,evol instruct是 Evol-Instruct,supernatural instructions是 Super-NaturalInstructions,soda是 distill,cerebrus是 Cerebras,red pajama / repa v2是 RedPajama v1/v2,slim pajama是 SlimPajama,sackchain/sack exchange是 Stack Exchange,PG19是 PG-19,project Genberg是 Project Gutenberg,ps2o是 PeS2o,push shift是 Pushshift,wild chat是 WildChat,bibliotik是 Bibliotik,Carlin是 Carlini,Steven Pruit是 Steven Pruitt,hell swag是 HellaSwag,quan 3是 Qwen 3,下文按通行写法记录。
TL;DR
- 本讲的核心主张是一句话:数据是决定语言模型好坏最重要的东西。 Percy 的论据很朴素:把 Llama 3、DeepSeek 这些开放权重的模型论文摊开看,架构写得清清楚楚、训练方法写得清清楚楚,唯独数据只有一句话——“我们的数据集来自多种包含截至 2023 年底知识的数据源”。保密有两个理由:竞争博弈(数据是护城河,说出去等于送人)和法律责任(说了等于给诉讼递刀子)。顺带一提,他对“语言模型就是在互联网上训出来的”这句流行话很不客气:这既不对,也没有意义。
- 数据工作和架构工作的最大区别,是它天然是“长尾”且高度可并行。 架构只需要一个小团队拍板一次;而数据可以同时雇几百人,分别负责多语言、代码、多模态等不同切面。也正因为长尾,这一讲没法给你一条公式——Percy 诚实地说,数据这件事很难“教”,只能靠一连串案例让你长出直觉。
- 训练被拆成三段:预训练(原始网页)→ 中训练(精选高质量文档,针对数学/代码/长上下文)→ 后训练(指令、对话、RLHF)。 他用 AI2 的 OLMo 举了一个极具体的例子:预训练 3.9 万亿 token(DCLM-baseline、代码、论文、数学、Wikipedia),中训练压到约 100 亿 token(同一批来源大幅过滤 + FLAN + 合成数据 + GSM8K),后训练是 Tulu 那一套。基本规律是:先用海量低质量数据打底,再用少量高质量数据收口;而且现实中三段之间的界线越来越模糊。
- 预训练数据的正史,是一部“过滤越来越聪明”的历史。 2018 年 BERT 用 BooksCorpus + Wikipedia,那还是“文档而不是句子”的转折点;2019 年 GPT-2 用 Reddit 上 karma ≥ 3 的外链凑出 WebText(800 万页面、40 GB);2020 年 GPT-3 用质量分类器从网页里挑“像 WebText / Wikipedia / 书”的文档;2021 年 DeepMind 的 MassiveText、EleutherAI 的 The Pile(22 个高质量域,825 GB)把它推向“多来源拼装”。
- 工具链才是主角。 Common Crawl 每月抓一次网,提供 WARC(原始 HTTP,含 HTML)和 WET(转成文本,有损)两种格式;光是把 HTML 转成文本这一步就能差出 4 个点(DCLM 论文:resiliparse 24.1、trafilatura 24.5、直接用 WET 只有 20.7)。CCNet 用 KenLM 5-gram 挑“像 Wikipedia”的文档;C4 用一串手工规则(行尾有标点、至少 3 句、去掉含
{的页面、去掉坏词、langdetect 只留英文)。模型式过滤 vs 规则式过滤是这一段最值得记住的张力。 - 2022 年之后,模型重新回到过滤回路里。 LLaMA 的巧妙之处是把分类目标从“像 Wikipedia”换成“像 Wikipedia 引用的页面”——借的是链接结构而不是页面本身。DataComp 把这事做成了比赛:DCLM-pool 有 240 万亿 token,DCLM-baseline 用 fastText 分类器只留下 1.4%(3.8 万亿),正例来自 OpenHermes(GPT-4 生成的指令数据!)和 ELI5,负例来自 RefinedWeb,结果在 Core 上比 RefinedWeb 复现高 3 个点。“为了挑预训练数据,先去拿指令数据当正例”,这个操作本身就说明了这个领域的务实程度。
- Nemotron-CC 把这条路推到“用模型改造数据”。 因为 DCLM 过滤得太狠、3.8 万亿不够支撑更长的训练,NVIDIA 一方面改用 justext 以保留更多 token、用 340B 的大模型给文档打“教育价值”分再蒸馏成小模型、对不同分类器的分数分桶采样以保证覆盖;另一方面直接改写:低质量数据用模型重写成高质量,高质量数据用模型生成任务(问答对、摘要、关键信息抽取)。最终 6.3 万亿 token,其中 1.1 万亿是高质量子集。
- 数据还牵涉版权,而且这一讲用了整整八分钟讲它。 关键区分是:互联网上绝大多数内容都受版权保护,所以问题不是“是否受保护”,而是“你能不能合法使用”——两条路是拿许可证(Google 与 Reddit、OpenAI 与 Shutterstock / Stack Exchange)或者主张合理使用;合理使用看四个要素(使用目的与性质、作品属性、使用数量与实质性、对市场的影响)。Percy 特别强调:版权不只管逐字复制,情节和角色也可能受保护;而“训练即复制”意味着第一步就可能踩线,虽然“训练是转换性的”是个有力抗辩。最后还有一道坎:即使你有许可、也符合合理使用,服务条款仍可能禁止你下载(YouTube 上大量 CC 视频就是例子)。
- 中训练/后训练这一段是“针对特定能力补数据”。 长上下文要靠后期的长文档数据(LongLoRA 用 PG-19 的书和 Proof-Pile 的数学,把 Llama 2 7B 从 4K 扩到 100K);任务能力靠把既有 NLP 数据集转成 prompt(Super-NaturalInstructions 的 1600+ 任务、FLAN 的 1800+ 任务),但模板化太强是通病;指令数据则走向合成(Alpaca 的 self-instruct、Vicuna 的 ShareGPT 对话、Evol-Instruct 的加难)。Llama 2 chat 只用 27540 条人工标注就宣称胜过开源数据集里几百万条样本,是“质量 > 数量”的经典证据。
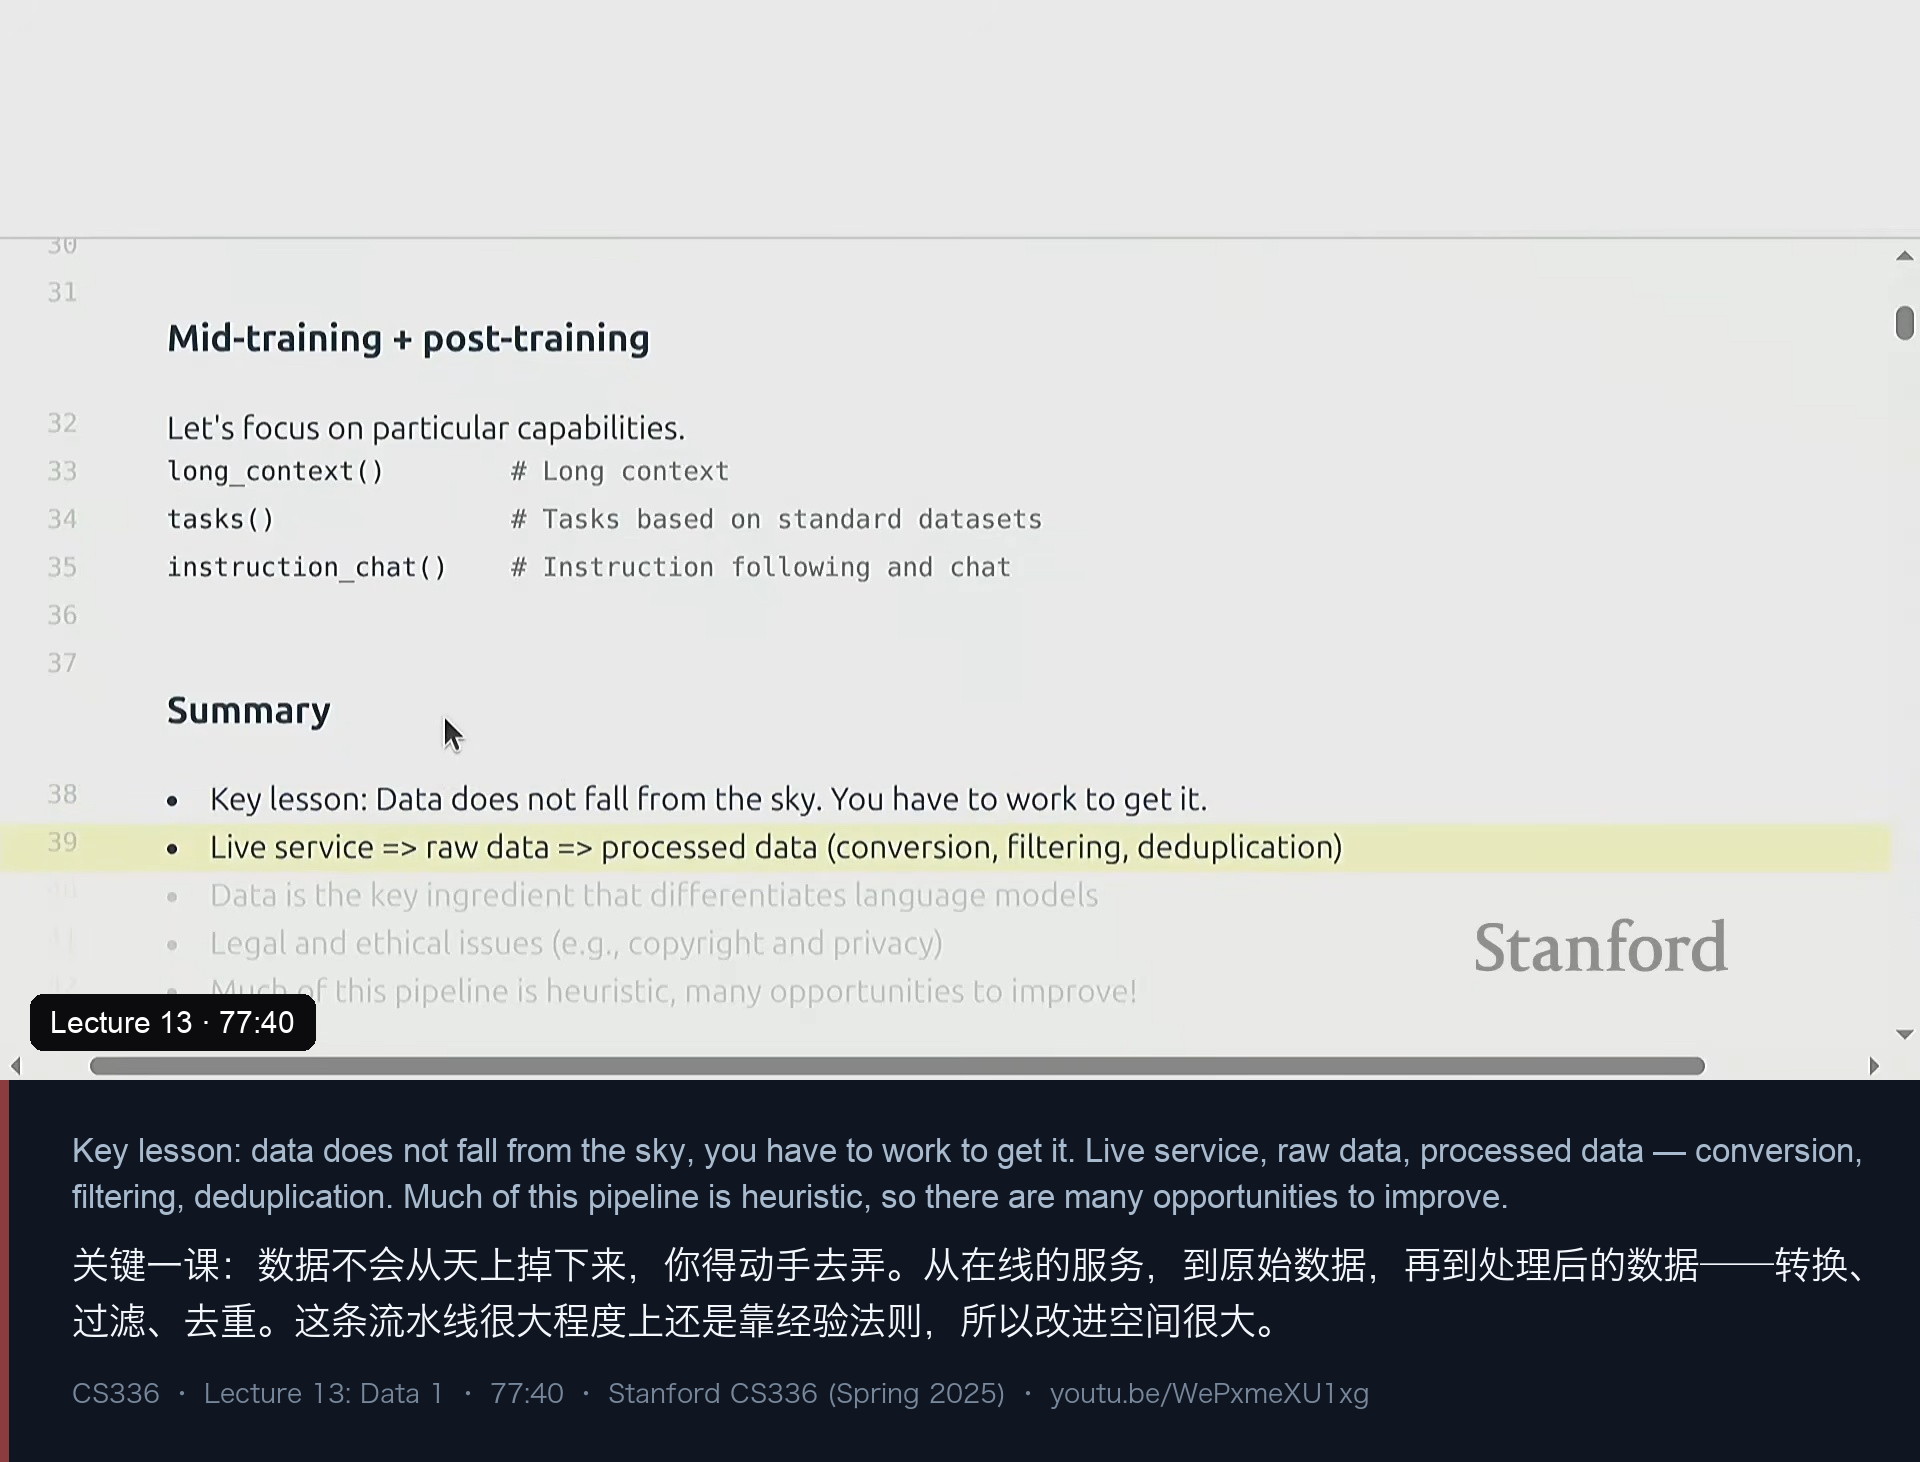
- 收尾那句话值得抄在笔记本上:数据不会从天上掉下来。 从“线上服务”到“原始 dump”再到“可训练的 token”,中间必须经过转换、过滤、去重;这条流水线很大程度上仍然是启发式的——所以在 Percy 看来,这不是一件令人沮丧的事,而是这个方向上还留着大量机会的证据。
一、开场:数据是本讲的主题,也是那句“暴论”
这一讲的位置很特别。前十二讲讨论的都是“给定一份数据,怎么把模型训好”——架构、优化器、tokenization、scaling law、并行、推理、评估。而这一讲把那个被默认的前提翻开:给定的是哪份数据?它是怎么来的?
Percy 的开场直接给判断:数据是做好语言模型最重要的东西(“my hot take is that data is the most important thing in getting language models right”)。他预判 Tatsunori 会不同意——后者认为 scaling law 最重要——于是给了自己的论据,而且这个论据是可以当场验证的:去看看各家公司在论文里到底披露了什么。
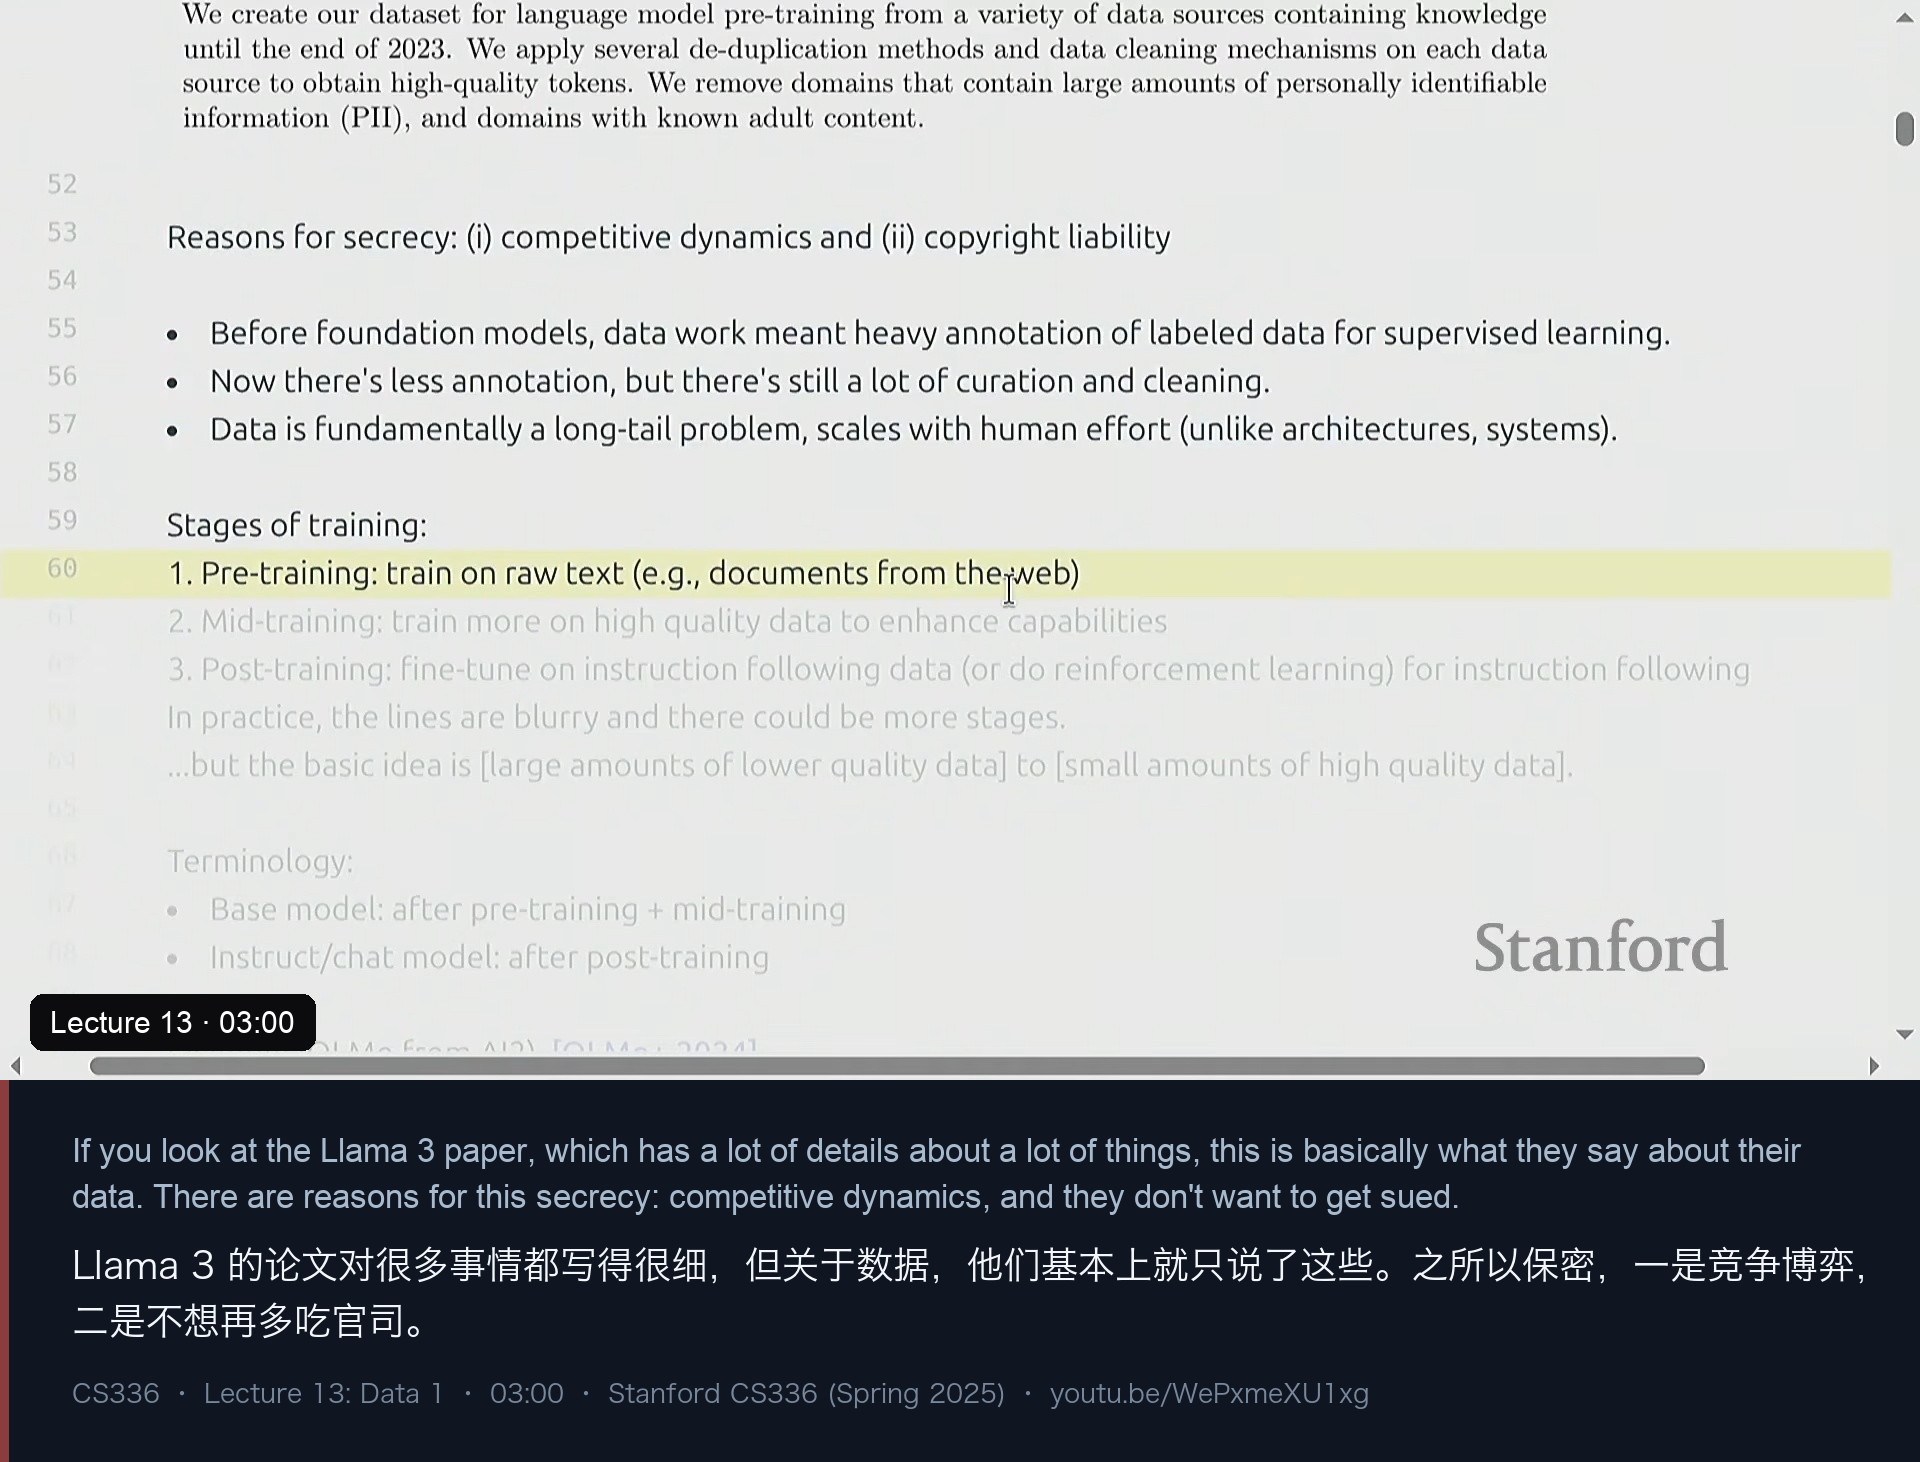
以 Llama 3 为例。这篇论文对很多事情都写得很细——架构、训练、算力、评测,但关于数据,全部内容大致就是开头那一段话:
We create our dataset for language model pre-training from a variety of data
sources containing knowledge until the end of 2023. We apply several
de-duplication methods and data cleaning mechanisms on each data source to
obtain high-quality tokens. We remove domains that contain large amounts of
personally identifiable information (PII), and domains with known adult content.公平地说,他们也花了不少篇幅讲过滤策略(至少是高层描述),但这依然几乎没有告诉你数据集里有什么。DeepSeek 等开放权重模型也一样:架构全公开,数据几乎不透。幻灯片把两个理由写得很直白:
Reasons for secrecy: (i) competitive dynamics and (ii) copyright liability一是竞争博弈——数据是少数还没被公开的最佳实践之一;二是不想再多打官司。这两条也预示了这一讲后半段的版权部分。
紧接着是三层铺垫。第一层是历史对比:在基础模型出现之前,数据工作就意味着“给标注数据做重活”来驱动监督学习;现在标注变少了,但清洗与策展的工作量并没有减少。第二层是“长尾”这个比喻:
Data is fundamentally a long-tail problem, scales with human effort
(unlike architectures, systems)架构可以收敛成一份设计、一个小团队定下来就完事;数据却是无穷无尽的切面——多语言、代码、多模态、各类垂直领域——你雇几百个人分别负责不同切面,这事情是有意义的。对做资源分配的人来说,这是一个很实际的性质。
第三层是三段式训练的定义,它也是整讲的骨架:
def stages_of_training():
    # 1. Pre-training: train on raw text (e.g., documents from the web)
    # 2. Mid-training: train more on high quality data to enhance capabilities
    # 3. Post-training: fine-tune on instruction following data (or do RL)
    # In practice, the lines are blurry and there could be more stages.
    # ...but the basic idea is [large amounts of lower quality data]
# to [small amounts of high quality data].预训练吃原始网页;中训练用小规模高质量文档去补特定能力(数学、代码、长上下文);后训练用指令/对话数据做微调或强化学习,安全相关的处理通常也放在这里。他也顺手给了术语:base model 是预训练 + 中训练之后的 checkpoint,instruct/chat model 是后训练之后的。
二、一个具体的配比:AI2 OLMo 的三段数据
抽象讲完,Percy 立刻上了一个“能看得见成分表”的例子——AI2 的 OLMo,因为它是开放数据集的模型,所以我们可以确切知道里面有什么。
预训练这一锅大约 3.9 万亿 token,成分是:DCLM-baseline 的网页、代码、学术论文、数学、Wikipedia。到了中训练,有意思的事情发生了——来源大体重合,但被大幅过滤:DCLM-baseline 从原来占大头的 3.7 万亿被压到 7000 亿;加进 FLAN 系列数据;Wikipedia 还在;再加上一些合成生成的新数据集;还顺手把 GSM8K 的训练集也丢了进去。总量约 100 亿 token。后训练则是 Tulu 那一套,混合了各家对话数据和大量合成数据。
这一段的教学意义在于:它不是“换个数据集”,而是“同一批数据在不同阶段用不同的过滤强度”。这也解释了为什么 Percy 反复强调三段的界线是模糊的——真正在工程上被区分开的,其实是“质量与数量的权衡曲线”上不同的位置。
然后他说了一句让整讲基调变得诚实的话:如何选数据、如何处理数据,其实没有一个好的形式化原则。架构至少还有“哪个更好”的实验可比,数据这件事连“什么叫教数据”都很难说清楚。所以他的策略是:把历史上人们用过的数据集一个个过一遍,讲它们从哪来、有什么性质,“希望你们用自己的归纳能力,长出对’什么数据好、什么数据不好’的直觉”。
三、前史:BooksCorpus、Wikipedia 与“文档而不是句子”
故事从 2018 年的 BERT 讲起(Percy 顺口说“你们中有些人可能还记得它”)。BERT 的训练数据就两样:书 + Wikipedia。他花了不少时间把这两样东西拆开讲,因为“大家通常只看模型和评测,不太看数据集”。
书这一支绕不开 Smashwords:2008 年上线,让任何人都能自己出版电子书,去年一年大约有 50 万本。2015 年有一篇论文(顺便说,那是一篇视觉-语言的论文)抓了 Smashwords 上定价为 0 的自出版书,得到 7000 本,构成了 BooksCorpus。这份数据集后来因为违反 Smashwords 的服务条款被下架——Percy 的评价是“2015 年那还算是蛮荒西部,没人觉得 AI 版权是个事”。数据集虽旧,但它代表的那种“书很重要”的观念一直延续到今天。
Wikipedia 这一支他讲得更细,因为后面反复要用它:
- 2001 年上线;2024 年有 6200 万条目、329 个语言版本(英语、西班牙语、德语、法语最常见)。
- 它不含原创观点(不允许观点、推广、个人主页),一切都来自引用的一手来源;收录门槛是关注度(必须有多个可靠来源覆盖)。
- 任何人都能编辑,破坏会被管理员回滚,但实际上少数人贡献了大部分内容(幻灯片点名 Steven Pruitt,500 万次编辑);它每隔几周会产出一次 dump,可以直接下载。
Percy 特意点出 Wikipedia 的边界:它不包含的东西同样重要——大量有价值的“长尾”内容不在里面,很多有用的观点性内容(比如菜谱)也不在。理解这个边界,才能理解后面“把 Wikipedia 当质量代理”的做法为什么既是捷径、又是有偏的。
还有一个更技术性的要点:BERT 用文档而不是句子做序列。对照是上一讲提到的 1 Billion Word Benchmark(Chelba+ 2014),那是机器翻译来的句子。这是从“句子”到“文档”的转折。
四、数据投毒:连 Wikipedia 也不能无条件信任
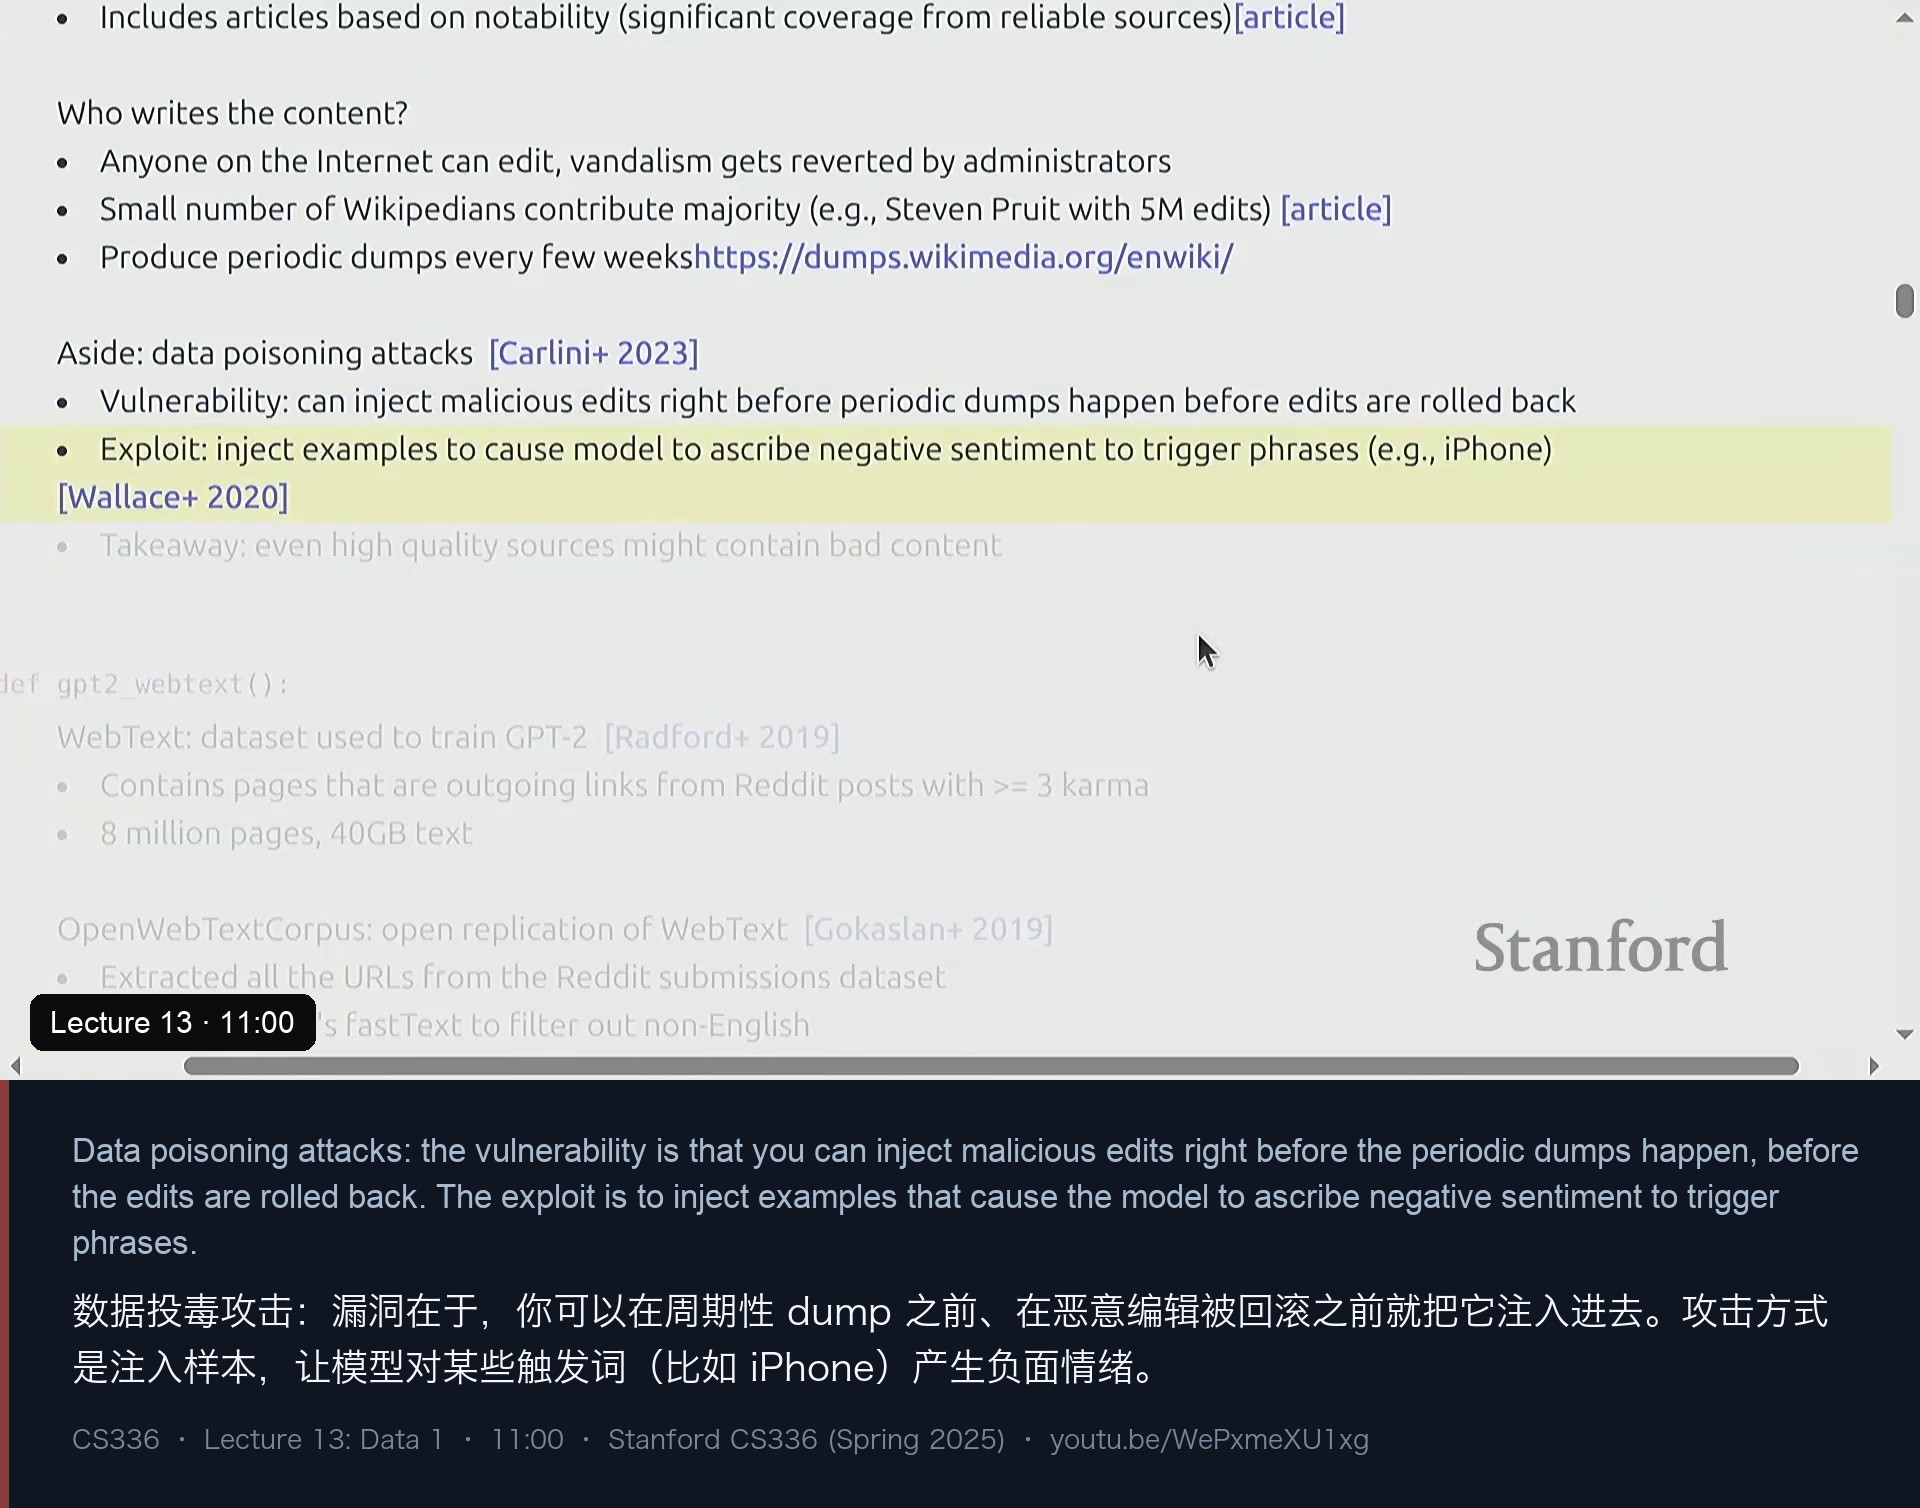
讲完 Wikipedia 的“高质量”,Percy 立刻插了一个“aside”,也是这一讲最令人印象深刻的一段:数据投毒(data poisoning attacks)。
Carlini 等人的工作揭示了一个漂亮的漏洞:Wikipedia 有周期性 dump,而编辑在 dump 之前是可能被回滚的。于是攻击者可以卡在 dump 发生之前、回滚生效之前,把恶意编辑注入进去,让这条编辑进入 dump。攻击的具体形态是:注入样本,让模型对某些触发词产生负面情绪(幻灯片举例 iPhone)。这个概念验证论文是 Wallace+ 2020。
Percy 说这个问题后来打了补丁,所以不必按字面去复现;但结论是普适的:
Takeaway: even high quality sources might contain bad content用他的原话:模型训练数据来自广阔的互联网,而攻击者以及任何有动机的人,对语言模型的行为其实有不小的控制力,这个过程的监督又极其困难。这是“数据质量”这个词背后更阴暗的一面。
顺带补上 GPT-2:WebText 用的是 Reddit 上 karma ≥ 3 的帖子里的外链——思路是“Reddit 用户已经帮你做了筛选”,得到 800 万页面、40 GB 文本。数据集没有公开,于是后来有了 OpenWebText 这个开源复现。
五、Common Crawl:学术意义上的“互联网”
接下来是本讲最基础的一块:Common Crawl。Percy 说它是“互联网的一个学术近似”。
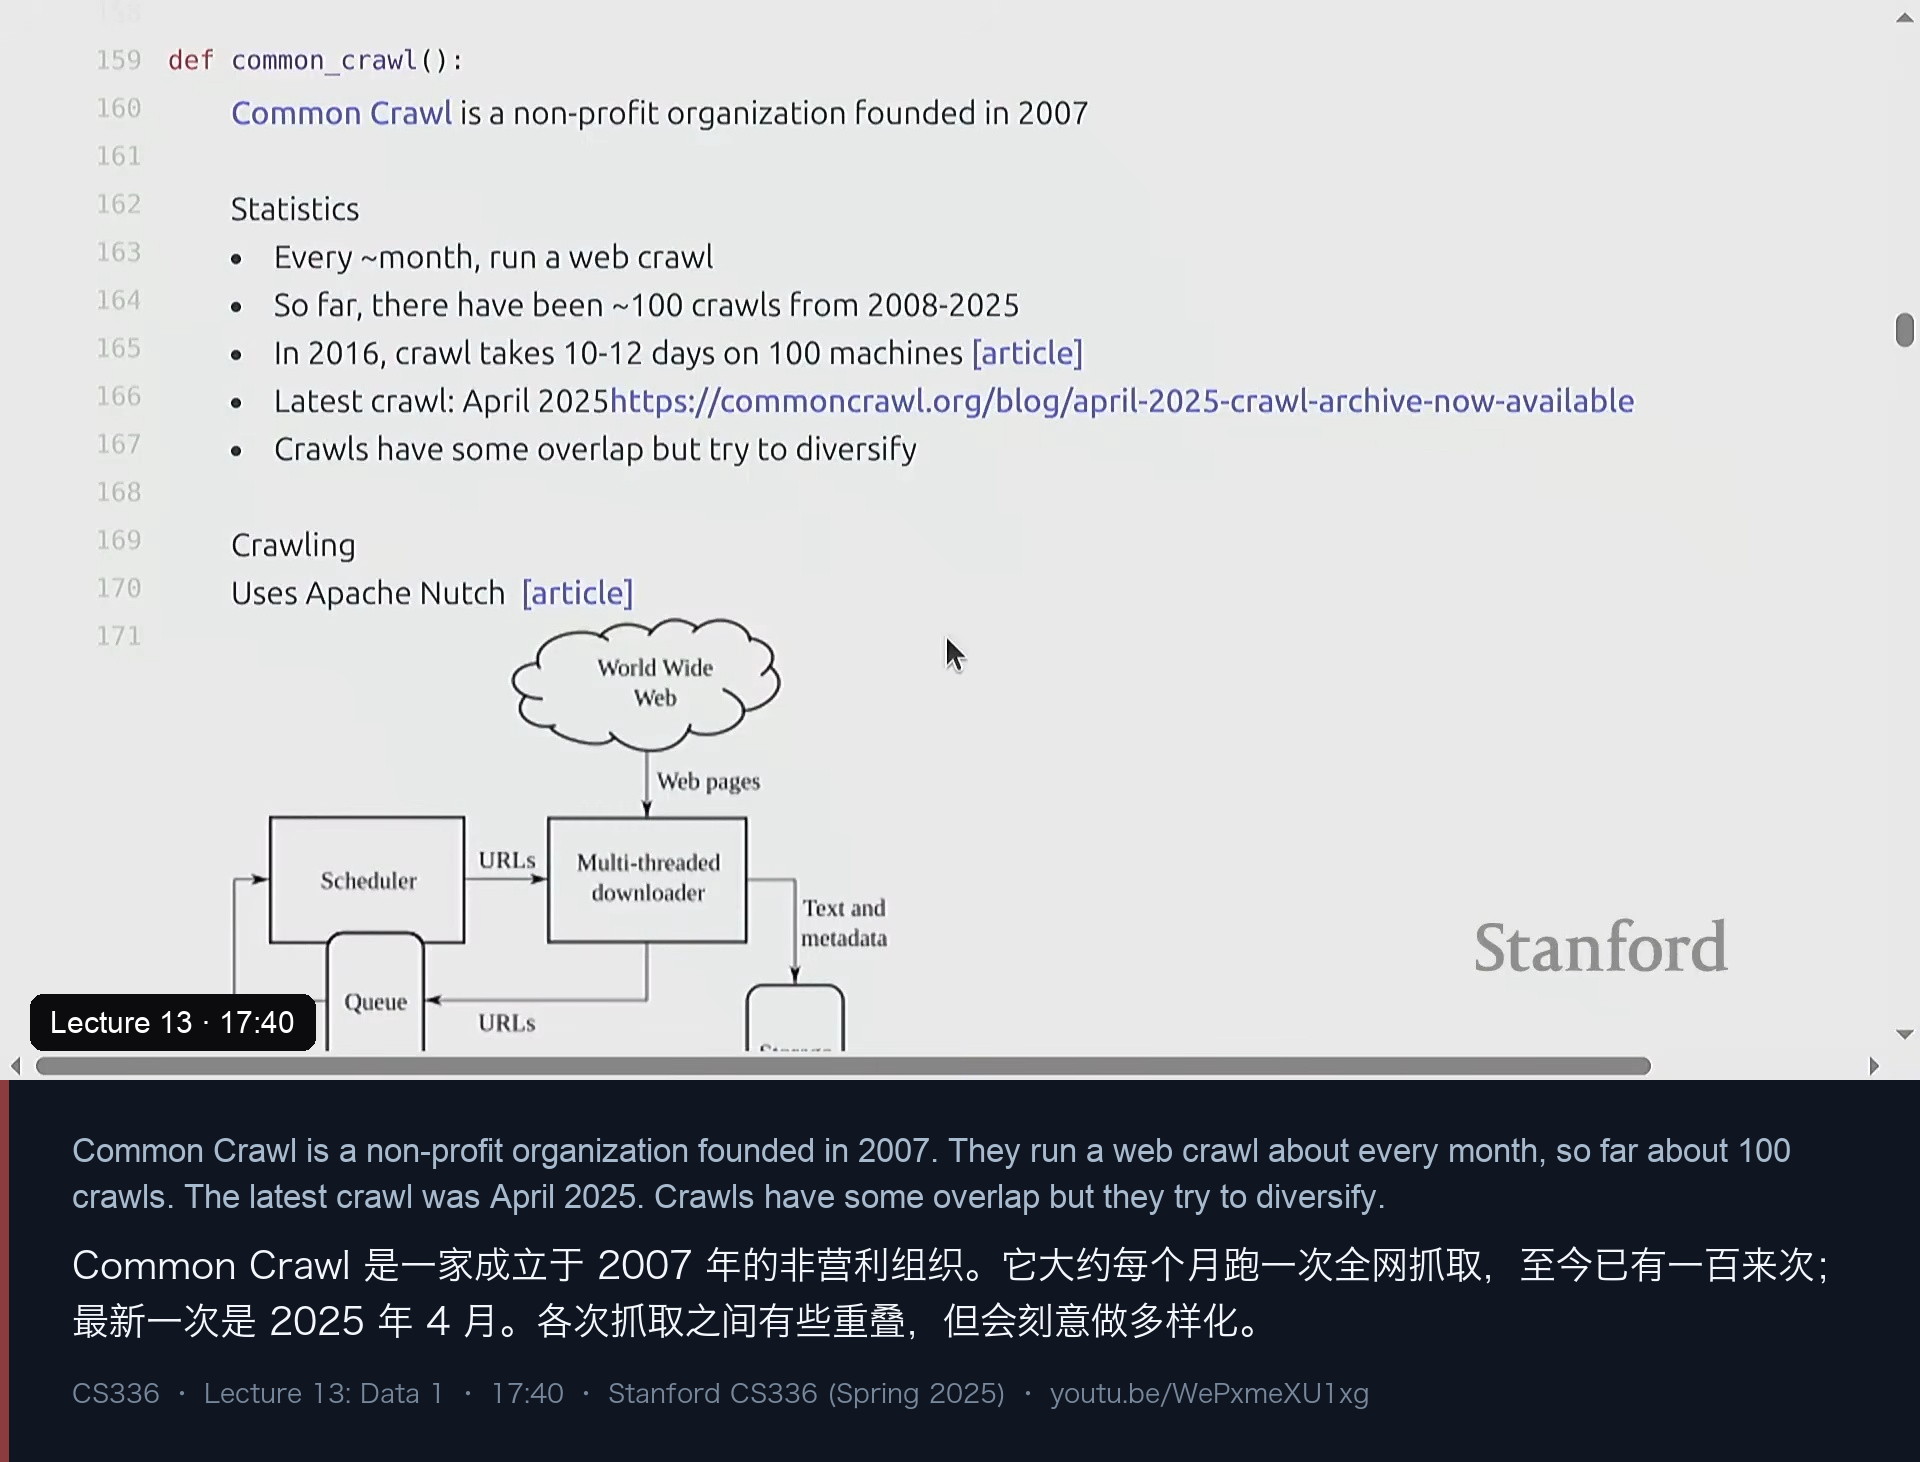
- 2007 年成立的非营利组织,大约每月跑一次全网抓取,至今约 100 次;最近一次是 2025 年 4 月。
- 抓取本身相对于语言模型训练并不贵:幻灯片写 2016 年是“100 台机器跑 10–12 天”(课上他说“租点 AWS 机器,不到两周就完了”)。
- 抓取用 Apache Nutch:从几亿个种子 URL出发,维护一个 crawl frontier 队列,多台机器做多线程下载——本质上是对全网做 BFS。
他也讲了工程上的规矩:选择策略(抓哪些页面)、礼貌策略(遵守 robots.txt、不给服务器加压)、重访策略(多久回来看一次页面有没有变),以及一个麻烦事——URL 是动态的,很多不同 URL 指向几乎相同的内容,于是产生大量重复。
关于“网站能不能拒绝被抓”,答案是能,靠 robots.txt。幻灯片里出现了《纽约时报》的 robots.txt:对 Googlebot 禁掉一大堆路径,也能看到“你最喜欢的那些大模型厂商”。Percy 补了一句很关键的事实:前沿模型厂商大多自建了爬虫,因为 Common Crawl 虽然体量大,但覆盖率其实相当稀疏——“互联网太大了”。而 robots.txt 没有强制执行力,所以总有人不遵守。
还有一个细节值得记住:Common Crawl 并不以“抓遍全网”为目标,它的策略刻意温和——所以连 Wikipedia 都不是全部收录在里面。另外,抓取的产物同时包含文本和图片(它只是取原始响应),但整体偏向文本。
至于“Common Crawl 里有多少是受版权保护的内容”,Percy 的回答很干脆:大部分都是——他把这个话题留到后面专门讲。
六、第一代过滤:CCNet 与 C4,模型式 vs 规则式
Common Crawl 原始数据几乎不可用,于是有了第一代过滤方法。
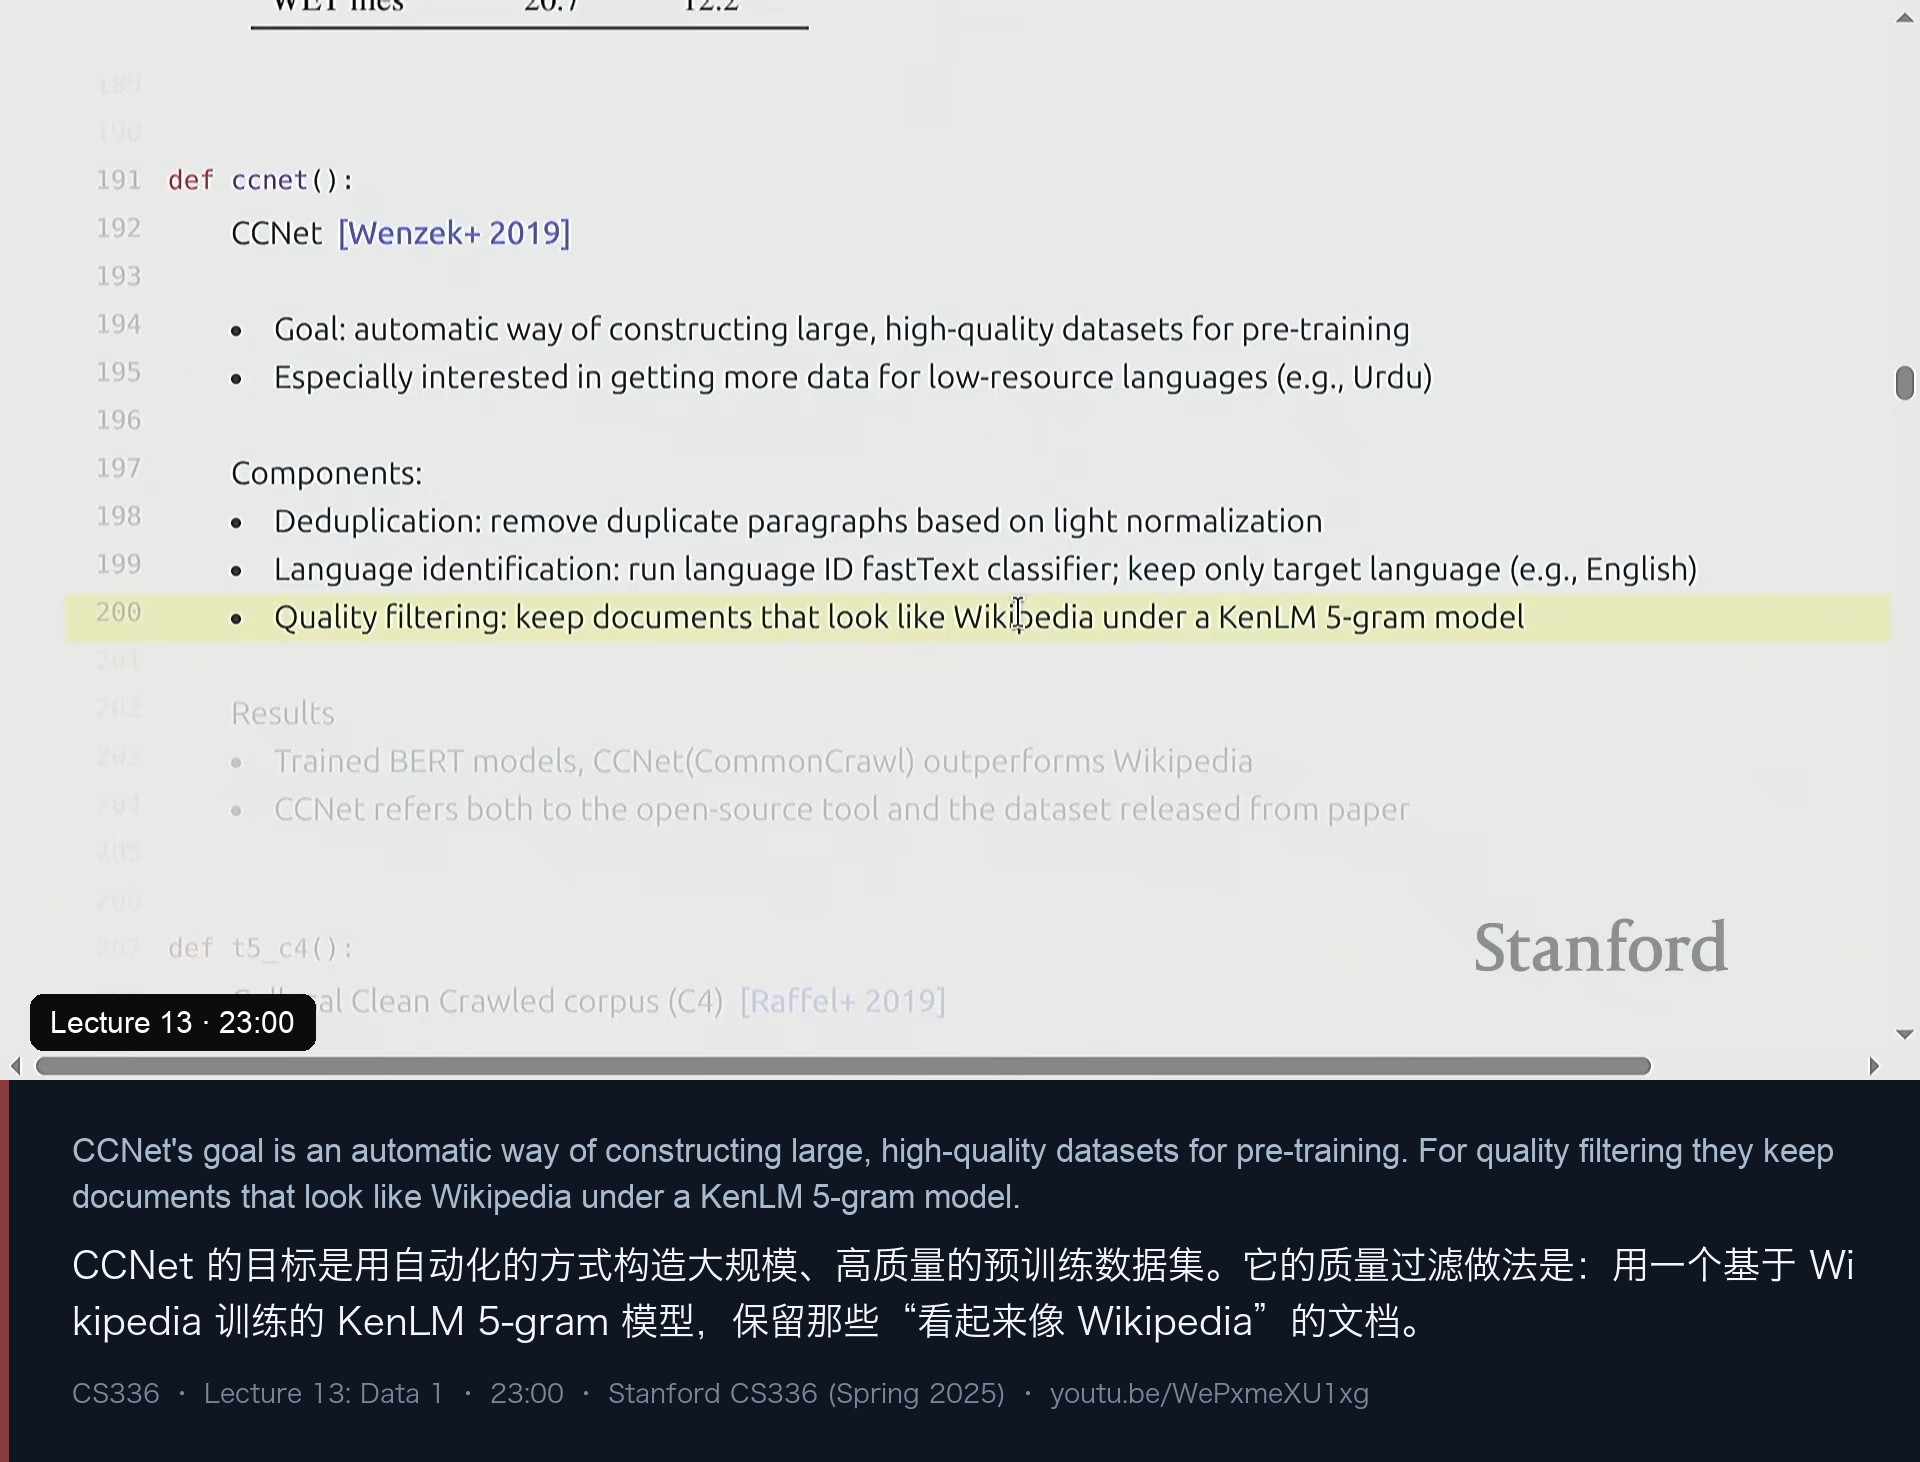
CCNet(Meta,Wenzek+ 2019)的目标是“用自动化的方式构造大规模、高质量预训练数据集”,并且特别关注低资源语言。它的组件有三个:去重(基于轻量归一化的段落级去重)、语言识别(fastText 分类器,只留目标语言)、以及最关键的质量过滤——用一个在 Wikipedia 上训练的 KenLM 5-gram 模型,保留那些“看起来像 Wikipedia”的文档。结果是在 BERT 上超过了只用 Wikipedia 训练的模型。
这里有一个“命名坑”:CCNet 同时指那个开源工具和那篇论文发布的数据集。
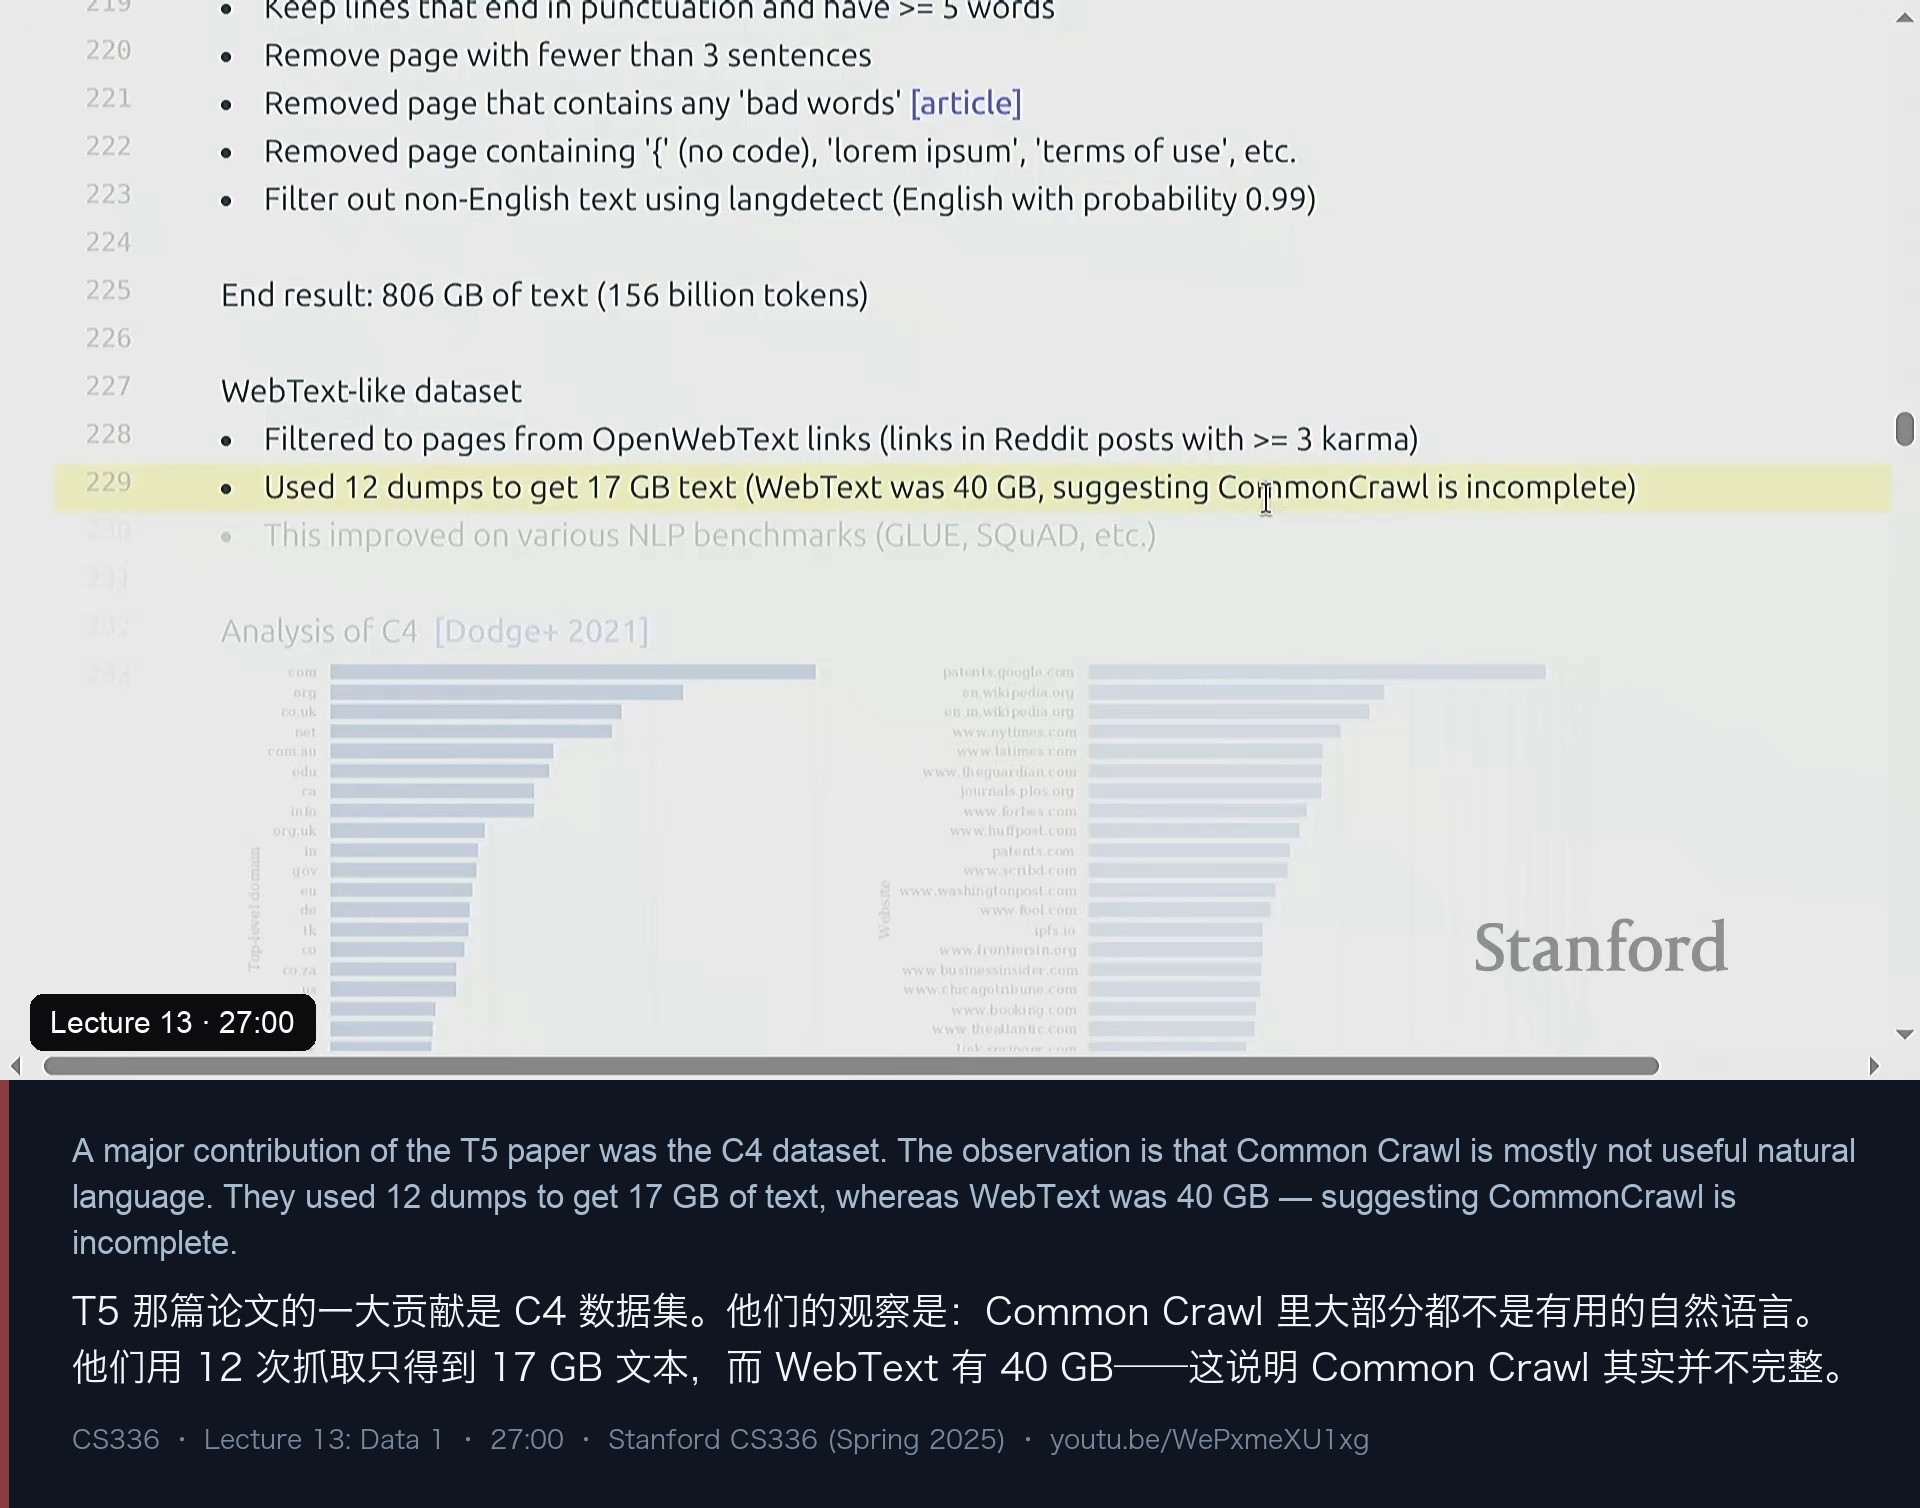
**C4(Google,Raffel+ 2019)**来自 T5 那篇论文(这篇论文更出名的是 T5,但 C4 本身是主要贡献之一)。它的出发点更朴素:Common Crawl 里大部分都不是有用的自然语言。它从一个 2019 年 4 月的快照出发(1.4 万亿 token),用的几乎全是手工规则:
- Keep lines that end in punctuation and have >= 5 words
- Remove pages with fewer than 3 sentences
- Remove pages that contain any 'bad words'
- Remove pages containing '{' (no code), 'lorem ipsum', 'terms of use', etc.
- Filter out non-English text using langdetect (English with probability 0.99)
# End result: 806 GB of text (156 billion tokens)
Percy 特别点评了“去掉含 { 的页面”这条——它显然会砍掉大量代码(除了 Python)。而这恰好引出他这段最重要的分析:规则式过滤与模型式过滤是互补的,各有各的失效方式。
- 规则式(C4):好处是那些“不像 Wikipedia”但语法良好、结尾有标点的句子能留下来;坏处是同样会放进一些 spam。
- 模型式(CCNet):效果取决于你挑的正例有多代表性;而当你想要一份尽量宽的数据时,正因为你在追求多样性,反而很难挑出覆盖足够广的正例。
更狠的证据来自 C4 自己的一个副产品:他们按同样的方式做了一个“WebText-like”数据集——用 12 次 dump 只得到 17 GB 文本,而 WebText 有 40 GB。既然 WebText 只是“Reddit 上 karma ≥ 3 的外链”,那么结论只能是:Common Crawl 相当不完整。
七、GPT-3 与 The Pile:从“一份网”到“多来源拼装”
进入 GPT-3 时代,配方变成:Common Crawl(经过过滤)、WebText2、两套神秘的书籍语料(books1 / books2)、以及 Wikipedia,合计约 4000 亿 token——以今天的标准不算大,但当时很惊人。
GPT-3 的处理方法是训一个质量分类器,让它区分“WebText、Wikipedia、书”与其余部分。这确立了一种范式:挑出一批正例,然后在大池子里找“更多类似的东西”。
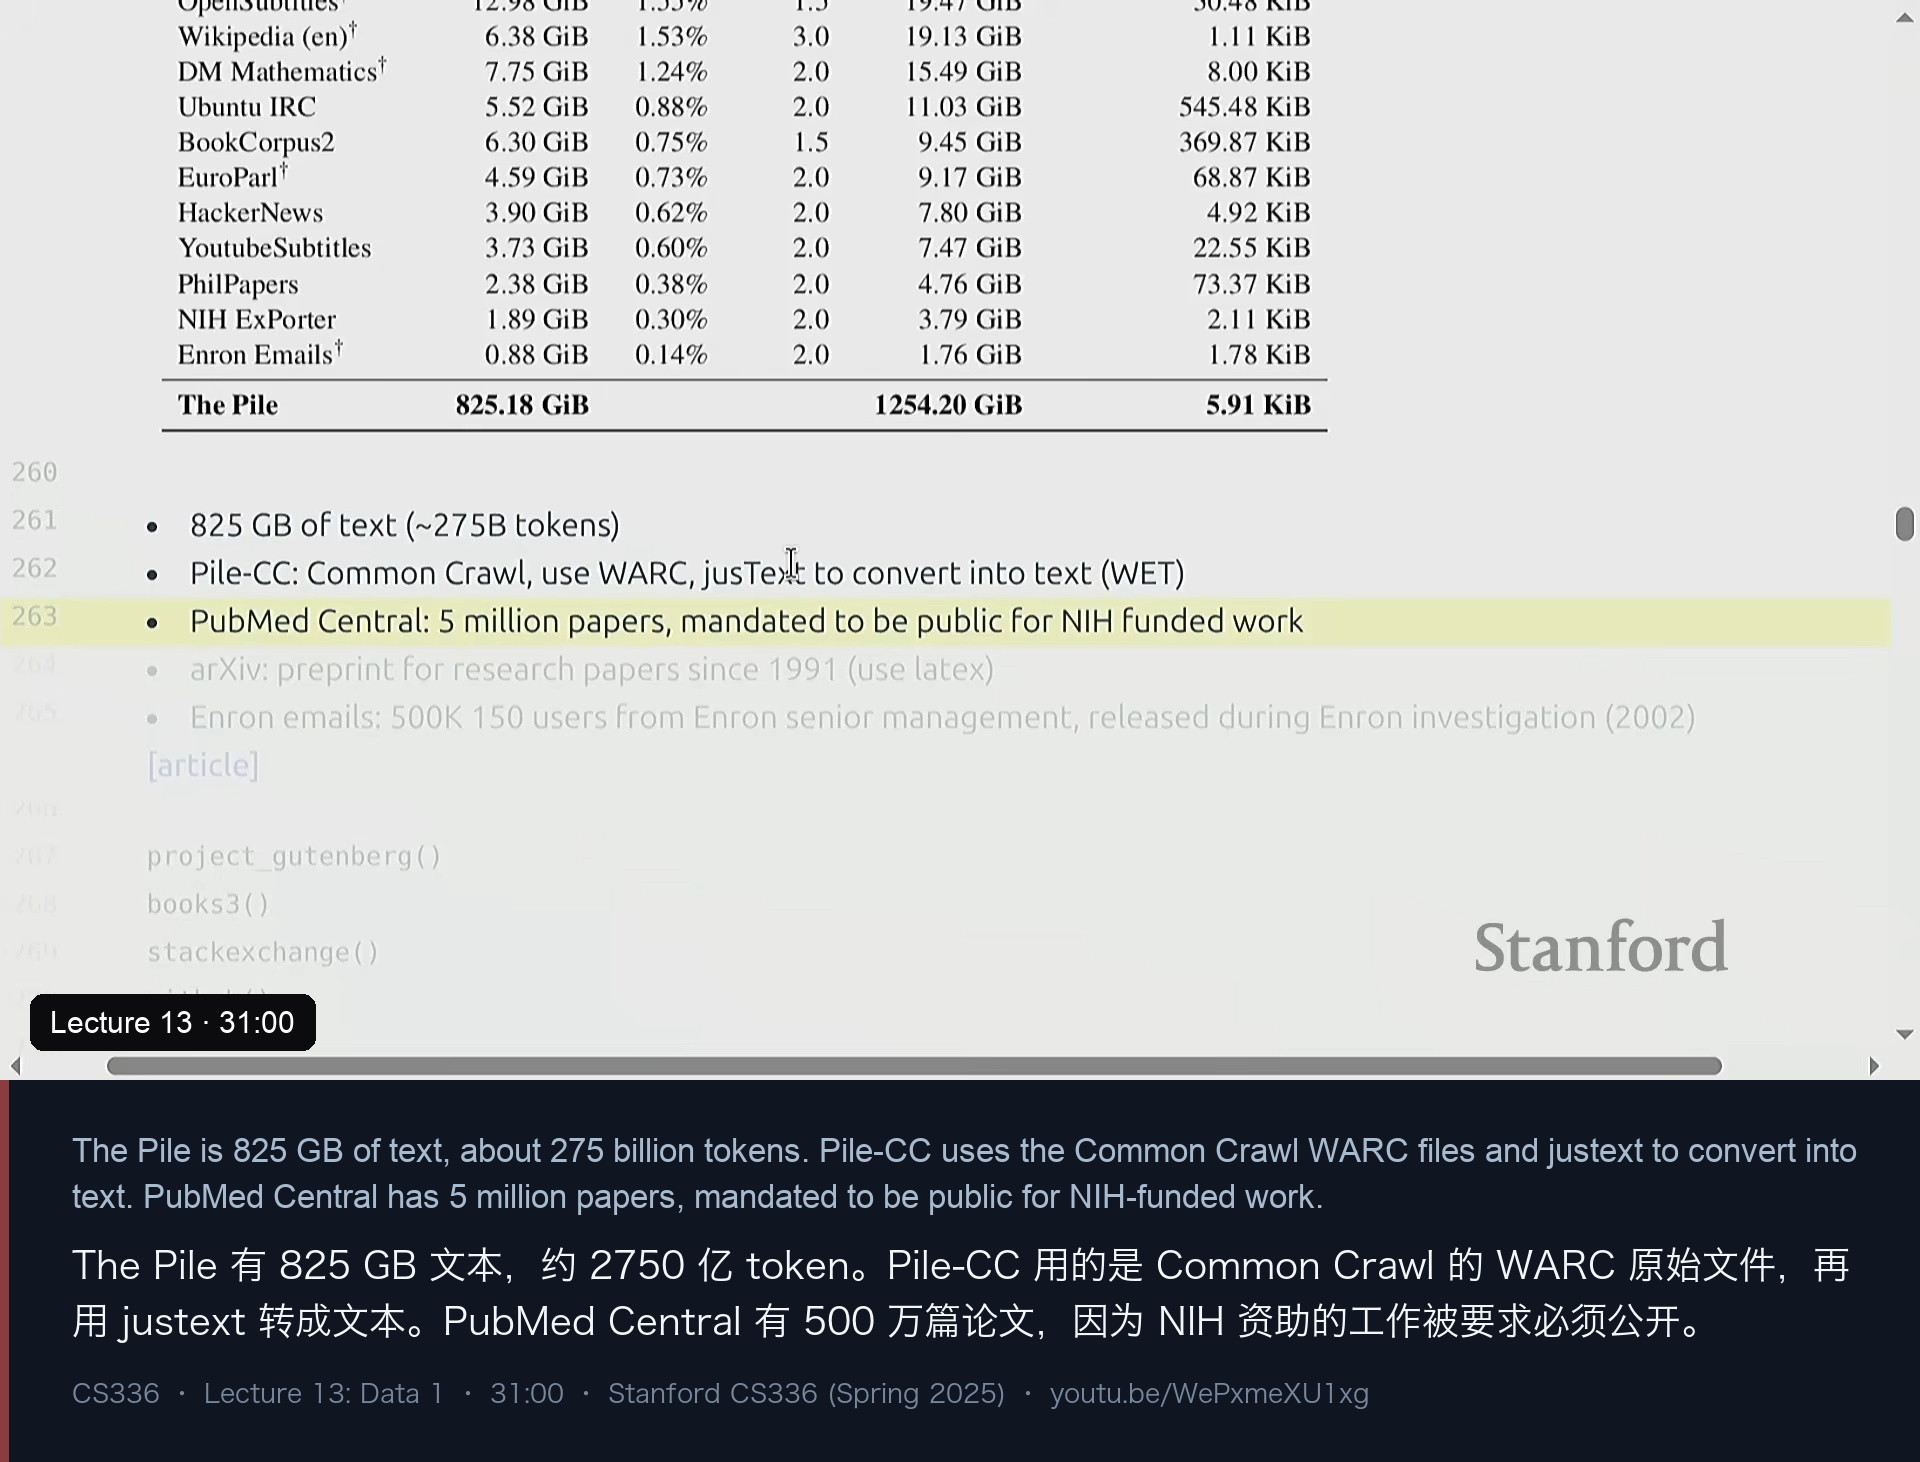
紧接着是 The Pile(EleutherAI)。背景很生动:EleutherAI 是为了回应 GPT-3 的封闭而出现的组织,这很大程度上是一场 Discord 驱动的去中心化志愿者行动,大家各自把自己认为高质量的数据扔进来。最终形成 22 个高质量领域:Common Crawl(Pile-CC)、OpenWebText、Stack Exchange、Wikipedia、arXiv、PubMed 等等,总量 825 GB 文本、约 2750 亿 token——比 GPT-3 用的还多。
Pile 里几个来源值得单独记住:
- Pile-CC 用 WARC 原始文件 + justext 转文本,而不是直接用 Common Crawl 提供的 WET。Percy 说他们当时就发现“WARC 比 WET 好”。
- PubMed Central:500 万篇论文。原因是 NIH 规定受资助的工作必须开放获取——他说,在 AI 领域我们习以为常地认为“论文都在 arXiv 上”,但很多其他领域并非如此。
- Enron 邮件:来自当年那桩丑闻调查中作为证据公开的邮件。为什么它在里面?因为邮件数据集极度稀缺(邮件是私密的),这已经是最好的了——也因此模型在这方面的知识可能有偏。
- Project Gutenberg:约 75000 本版权已清除的书(多数是出版已过 75 年的)。衍生数据集 PG-19 常被用来做长上下文基准,因为书的长度远超新闻或论文。
还有一个贯穿全讲的三段式结构,Percy 在这里讲得很清楚:线上服务(GitHub、Stack Overflow 网站)→ 原始快照(dump/archive)→ 处理后的可训练数据集。当有人说“我在 GitHub 上训练”,你必须追问:你说的到底是哪一步?中间做了哪些预处理?
八、Pile 里最敏感的两类来源:书与代码
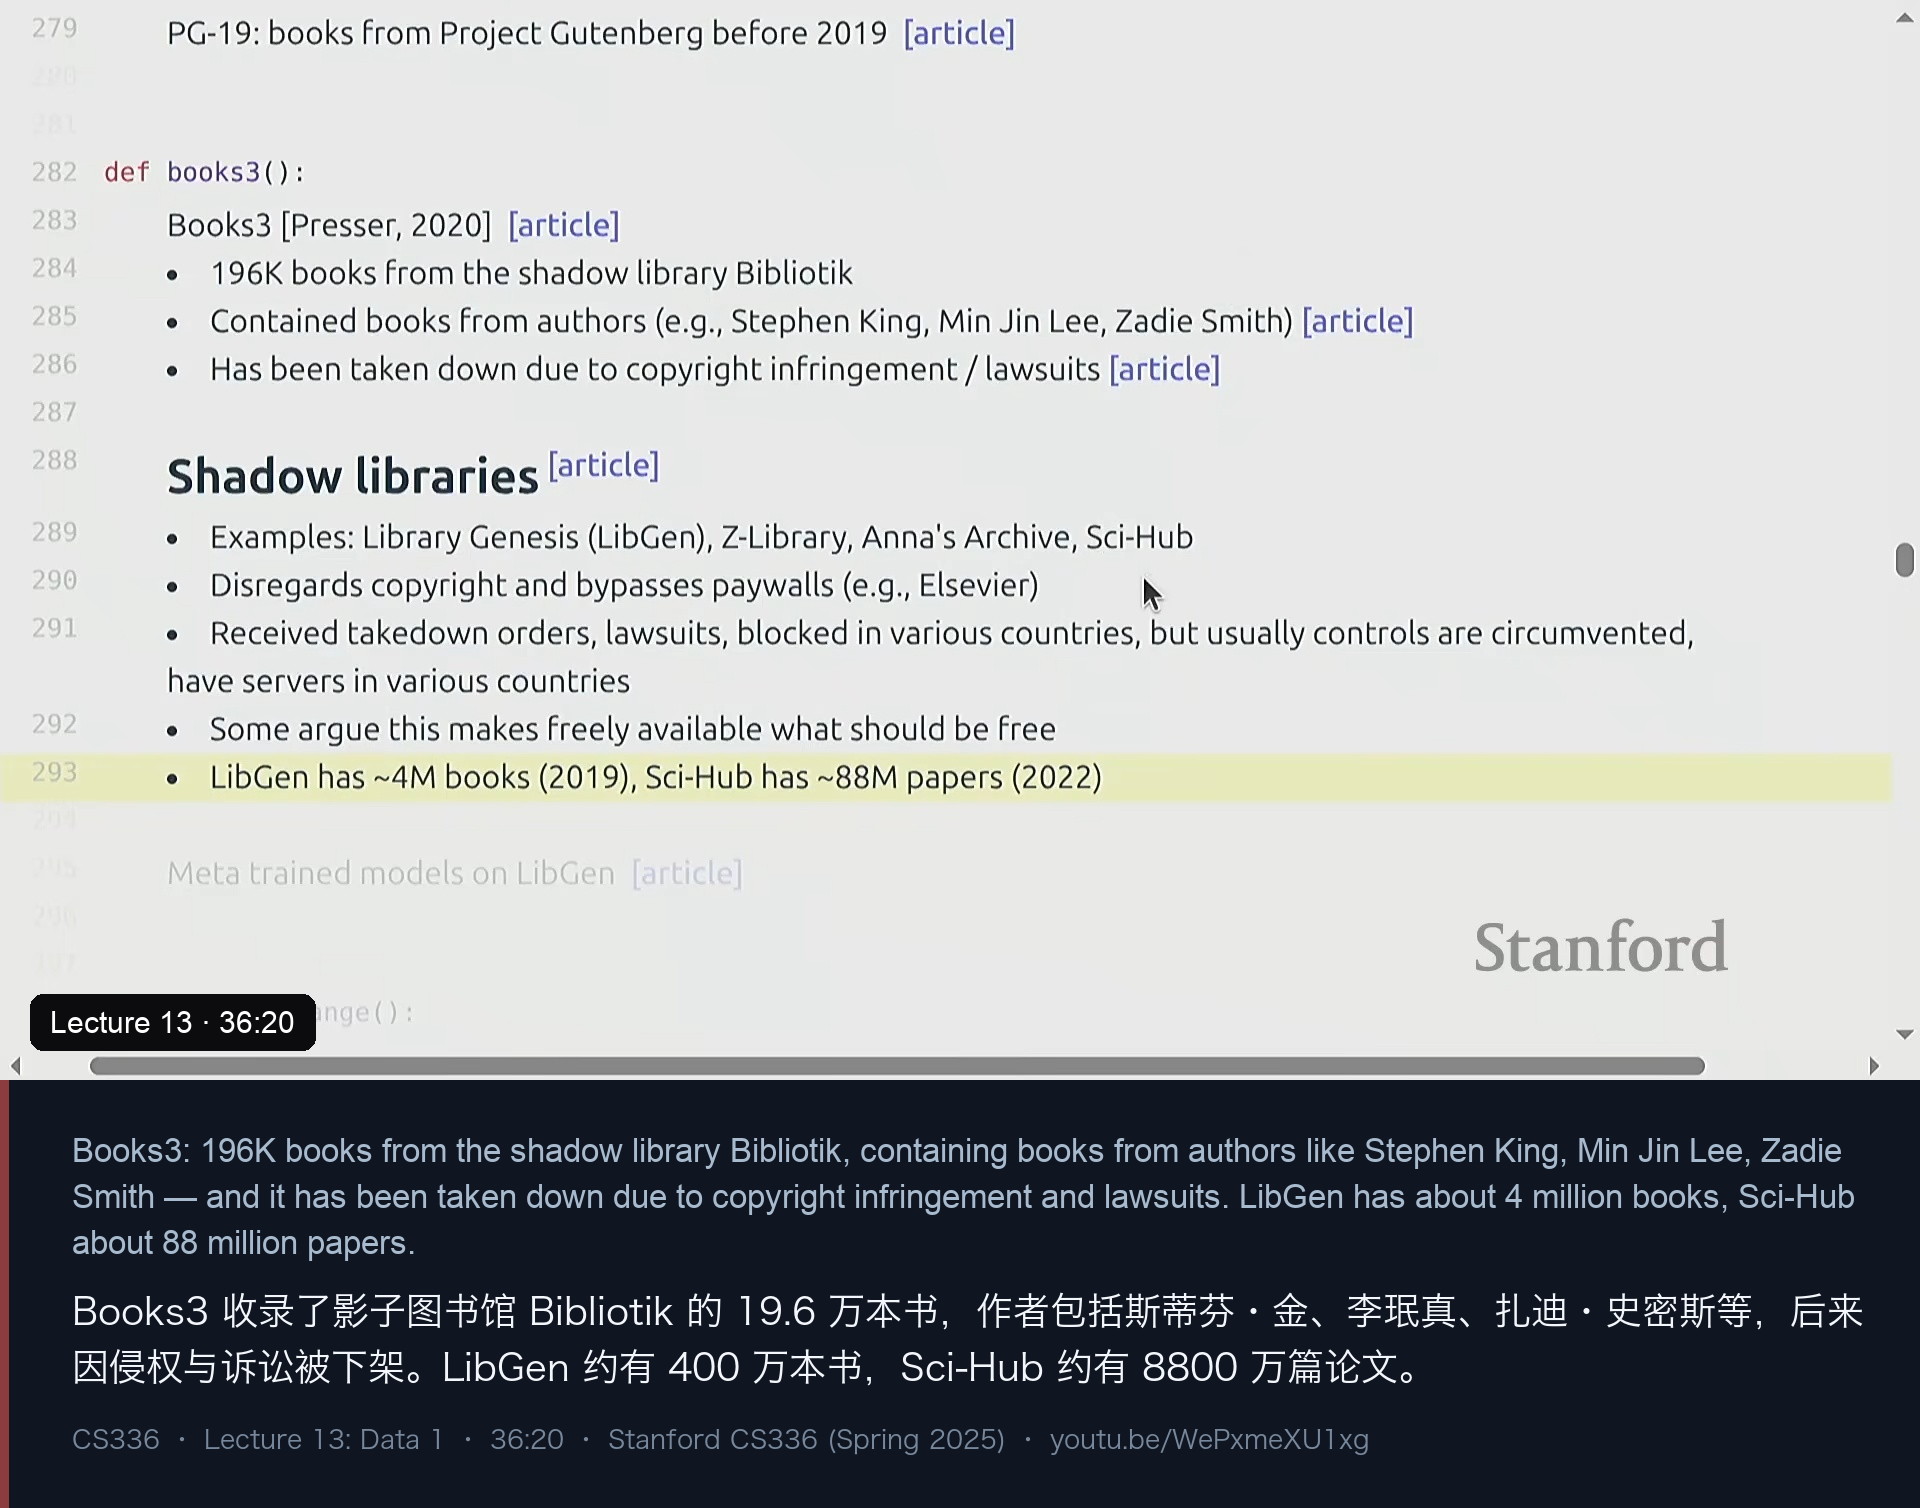
书这一支里最著名也最有争议的是 Books3:从影子图书馆 Bibliotik 来的 19.6 万本书,包含斯蒂芬·金、李珉真、扎迪·史密斯等作者的作品,后来因侵权与诉讼被下架。它原本是 The Pile 的一部分。
Percy 顺势解释影子图书馆:Library Genesis(LibGen)、Z-Library、Anna’s Archive、Sci-Hub 等,无视版权、绕过付费墙——他说得很清楚,这基本上就是非法的。它们收到过下架通知、诉讼,在多个国家被封锁,但因为服务器分布在不同国家,管制通常被绕过。支持者的说法是“让本该免费的东西真正免费”,但法律显然不这么看。规模上也给足了冲击:LibGen 约 400 万本书,Sci-Hub 约 8800 万篇论文(对比 Project Gutenberg 的 75000 本)。而且已经有公开信息显示 Meta 在 LibGen 上训练过模型,并因此卷入了大规模诉讼。
代码这一支从 Stack Exchange 开始(最著名的是 Stack Overflow)。Percy 的观察很有趣:这类数据的形态非常像问答数据集——一个问题和若干回答,看起来几乎就是指令跟随与真实应用所需要的形态。由此他给出一条更一般的洞见:预训练语料里大部分文档完全不像用户会对聊天机器人说的话,但其中确实存在一些子集,长得非常像“用户输入 + 模型回复”——这也是预训练和后训练界线模糊的原因之一。Stack Exchange 还有个附加好处:有评论、投票这类元数据可以用来过滤。它的 dump 公开,但商用需要付费许可。
然后是 GitHub:语言模型代码数据的主要来源。Percy 承认代码对编程任务有帮助是显然的,“对推理也有帮助”则更像是社区共识(folklore)——他不确定有没有更严格的论文。幻灯片里给了几个关键数字与“陷阱”:
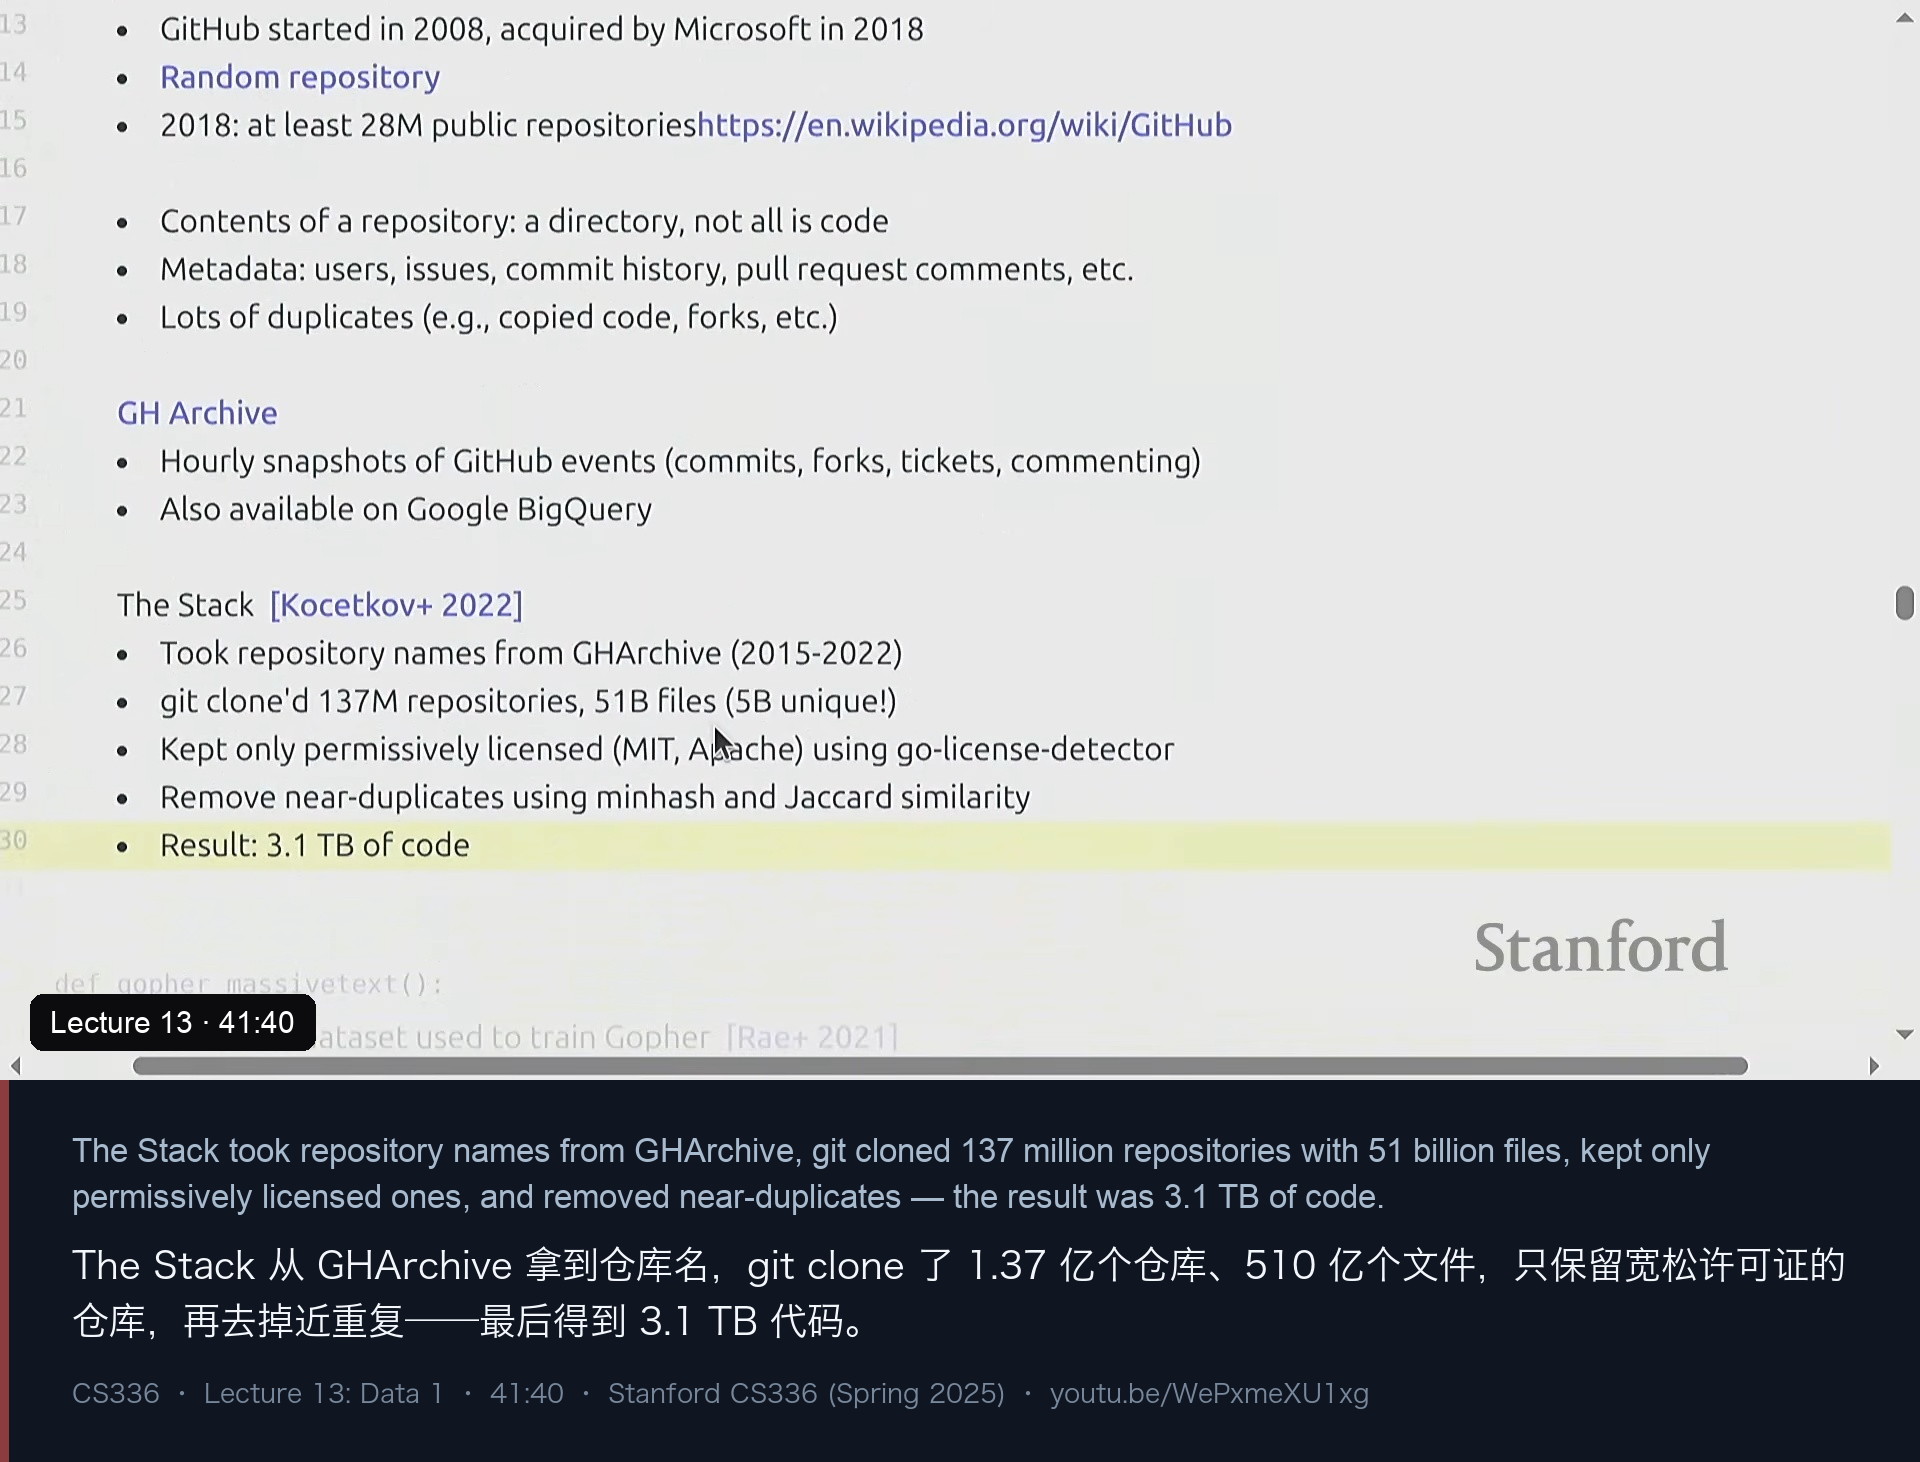
- GitHub started in 2008, acquired by Microsoft in 2018
- 2018: at least 28M public repositories
- Contents of a repository: a directory, not all is code
- Metadata: users, issues, commit history, pull request comments, etc.
- Lots of duplicates (e.g., copied code, forks, etc.)这段最有价值的是方法论提醒:你平时逛到的 GitHub 仓库和 Wikipedia 条目,都远不是有代表性的样本。他现场点开一个随机仓库,就是为了让你体会“随机采样”和“我熟悉的样本”之间有多大的落差。
从 GitHub 到可训练 token 之间还有一大段工程:GH Archive 提供了 GitHub 事件的每小时快照(可通过 Google BigQuery 访问);The Stack 从 GH Archive 取仓库名,git clone 了 1.37 亿个仓库、510 亿个文件,只保留宽松许可(MIT、Apache 等,用 go-license-detector 判定)的仓库,再用 MinHash + Jaccard 相似度去掉近重复,最终得到 3.1 TB 代码。Percy 强调:代码的好处是许可证相对明确,而网页的许可证“几乎从不明确”。
九、2021–2022:Gopher、LLaMA 与“链接结构”
2021 年 DeepMind 的 Gopher + MassiveText:模型本身不算出色,但数据集的论文写得很好。MassiveText 包含 massive web(英文,手工规则 + Google SafeSearch 做毒性过滤)、C4、书、新闻、GitHub、Wikipedia——Percy 指出除了 massive web,其余部分的处理细节没有交代,所以不可复现。规模约 10 TB 文本(他估算大概 4–5 万亿 token),但 Gopher 只训了 3000 亿 token。
MassiveText 的规则里有几条值得抄下来:80% 的词必须含至少一个字母、用 SafeSearch 做毒性过滤。Percy 还解释了一个当时的重要考量:为什么那一代人偏爱手工规则而不是模型过滤——因为能跑的模型还太弱,弱模型并不真正理解页面,只会带来糟糕的偏见;而且模型式过滤有把边缘群体数据(那些“不像 Wikipedia”的内容)过滤掉的风险。他随即指出,这个判断后来完全翻转了,现在人人都在做模型式过滤。
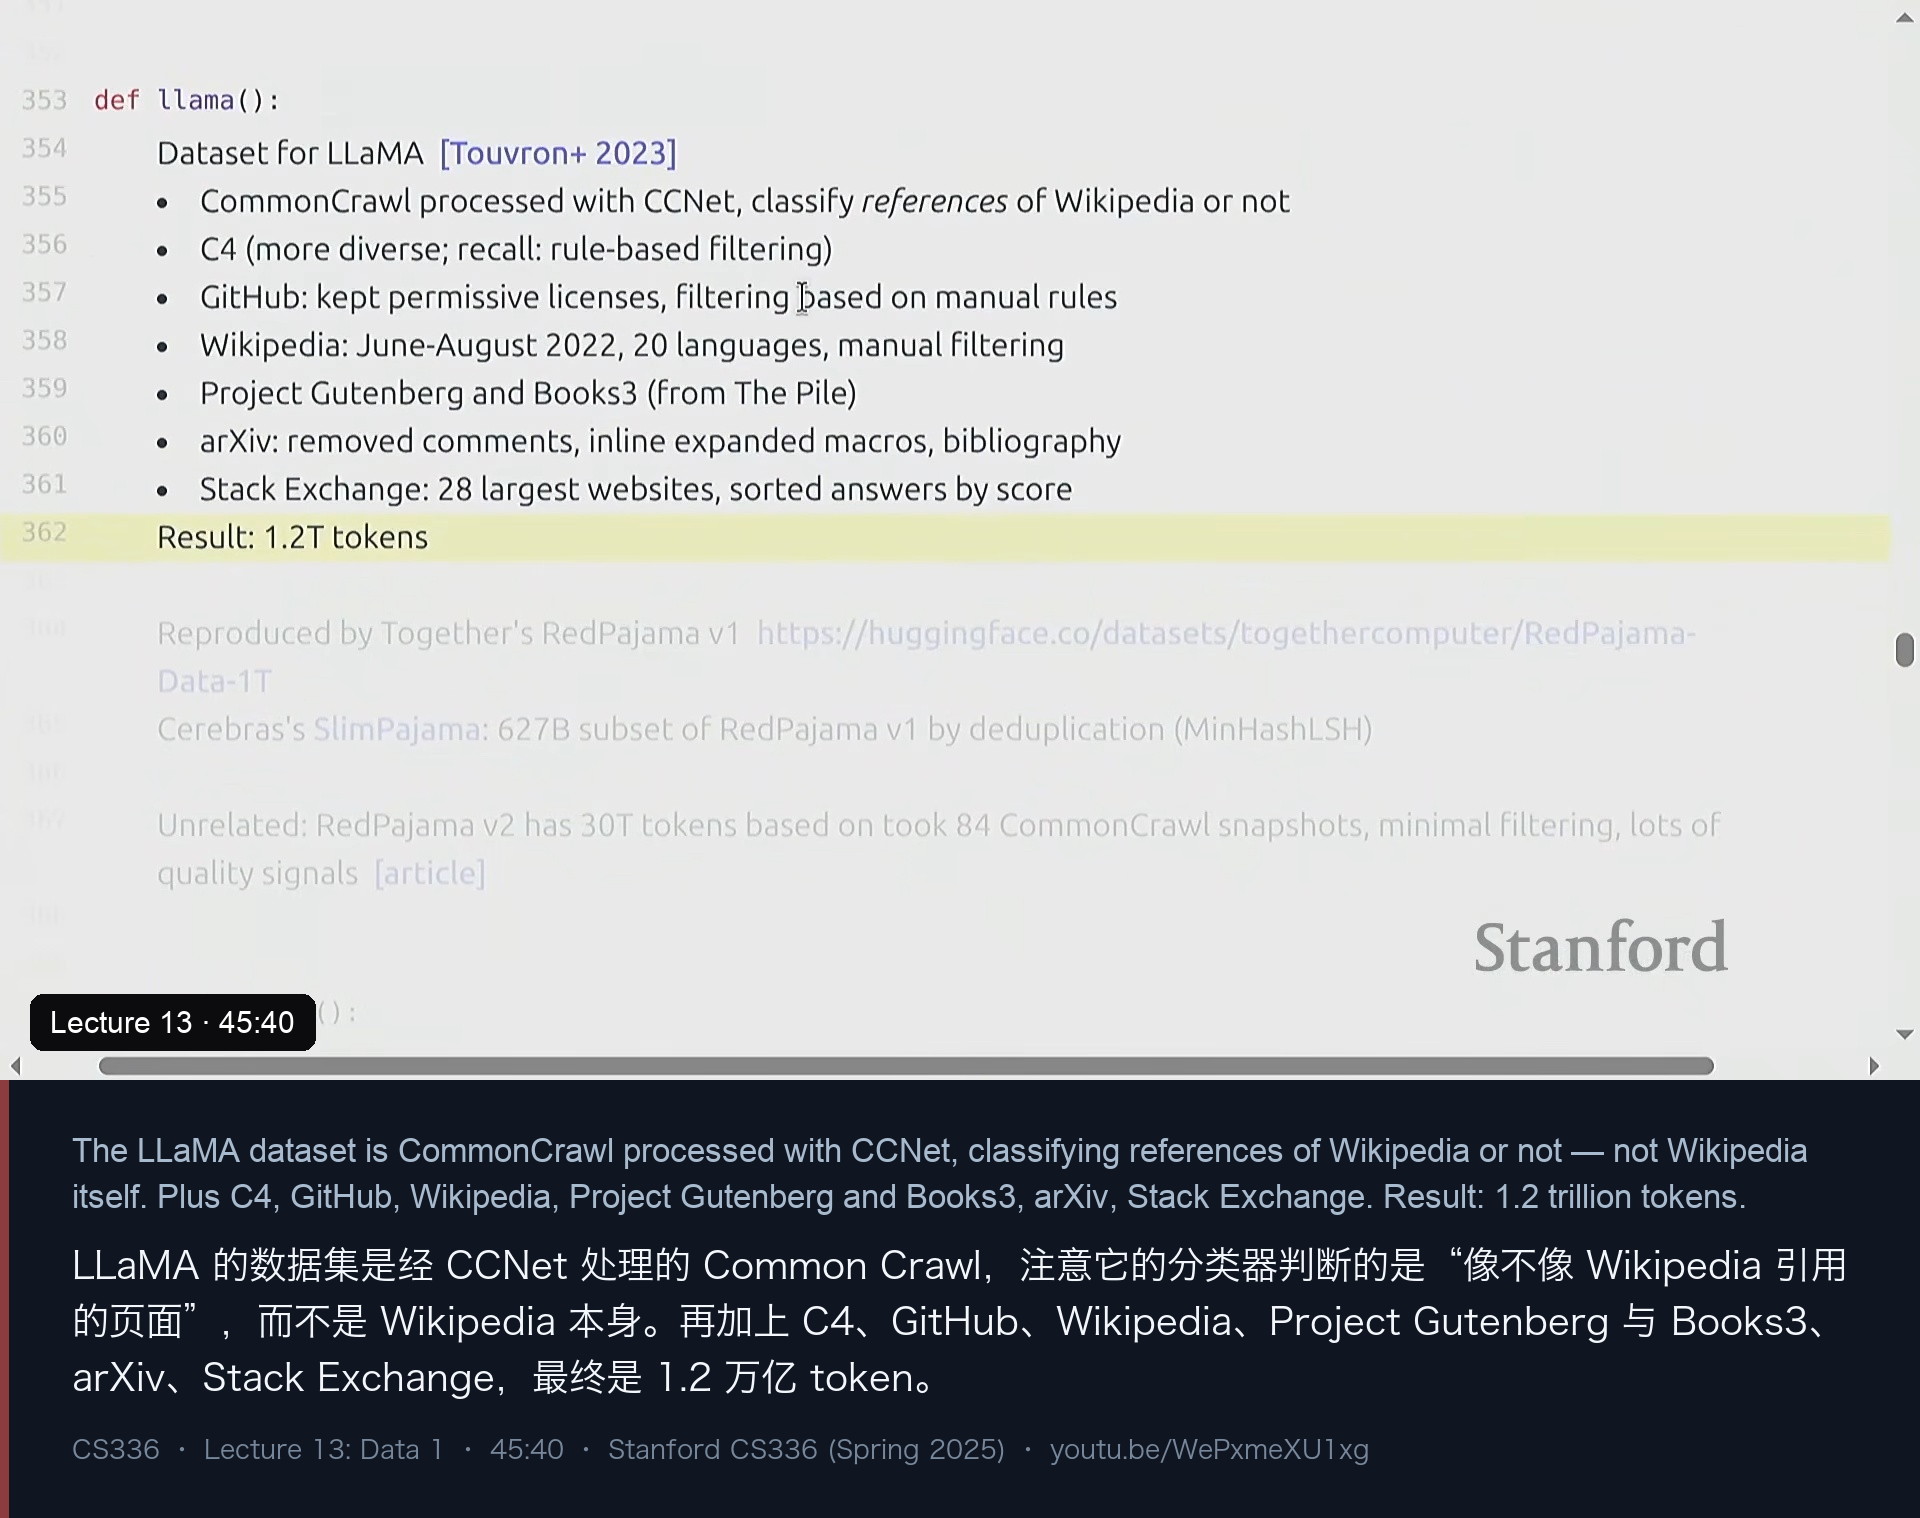
2022 年的 LLaMA 是这一讲的转折点之一。它用 CCNet 处理 Common Crawl,但分类器的目标变了一个字:不是“你像不像 Wikipedia 页面”,而是“你像不像 Wikipedia 所引用的那个页面”。这个改动的逻辑很漂亮:Wikipedia 会引用高质量页面,而这些页面本身往往并不长得像 Wikipedia 条目——所以借的是链接结构,这和 GPT-2 用 Reddit 外链的思路是同一类。其余成分是 C4、GitHub(保留宽松许可)、Wikipedia、Project Gutenberg 和 Books3(后来给它们惹了大麻烦)、arXiv、Stack Exchange,合计 1.2 万亿 token。
LLaMA 没有公开数据集,于是 Together 的 RedPajama v1 做了复现;Cerebras 的 SlimPajama 进一步去重得到 6270 亿的子集。另外还有一个容易混淆的 RedPajama v2:它其实不是同一件事——那是对 84 次 Common Crawl 快照做最小过滤、附上各类质量信号、总量 30 万亿 token 的资源,用来研究“如何基于质量信号做过滤”。
十、把网页榨干:RefinedWeb 与 FineWeb
RefinedWeb 的论点很大胆:如果网页数据过滤得足够好,那可能就够了——逻辑是“互联网上其实什么都有,只要能访问到”。它用 trafilatura 抽正文(因为比 WET 好)、用 Gopher 规则过滤、刻意回避 ML 过滤以避免偏见、再做模糊去重,得到 5 万亿 token(只公开了 6000 亿)。
FineWeb(Hugging Face)最初是 RefinedWeb 的复现,随后做了改进:用上当时所有的 Common Crawl dump、过滤、去重、基础匿名化,得到 15 万亿 token。Percy 对它的定位说得很好:FineWeb 是一份“轻度过滤”的数据集——正因为它留得比较多,你可以在上面继续做模型式过滤。
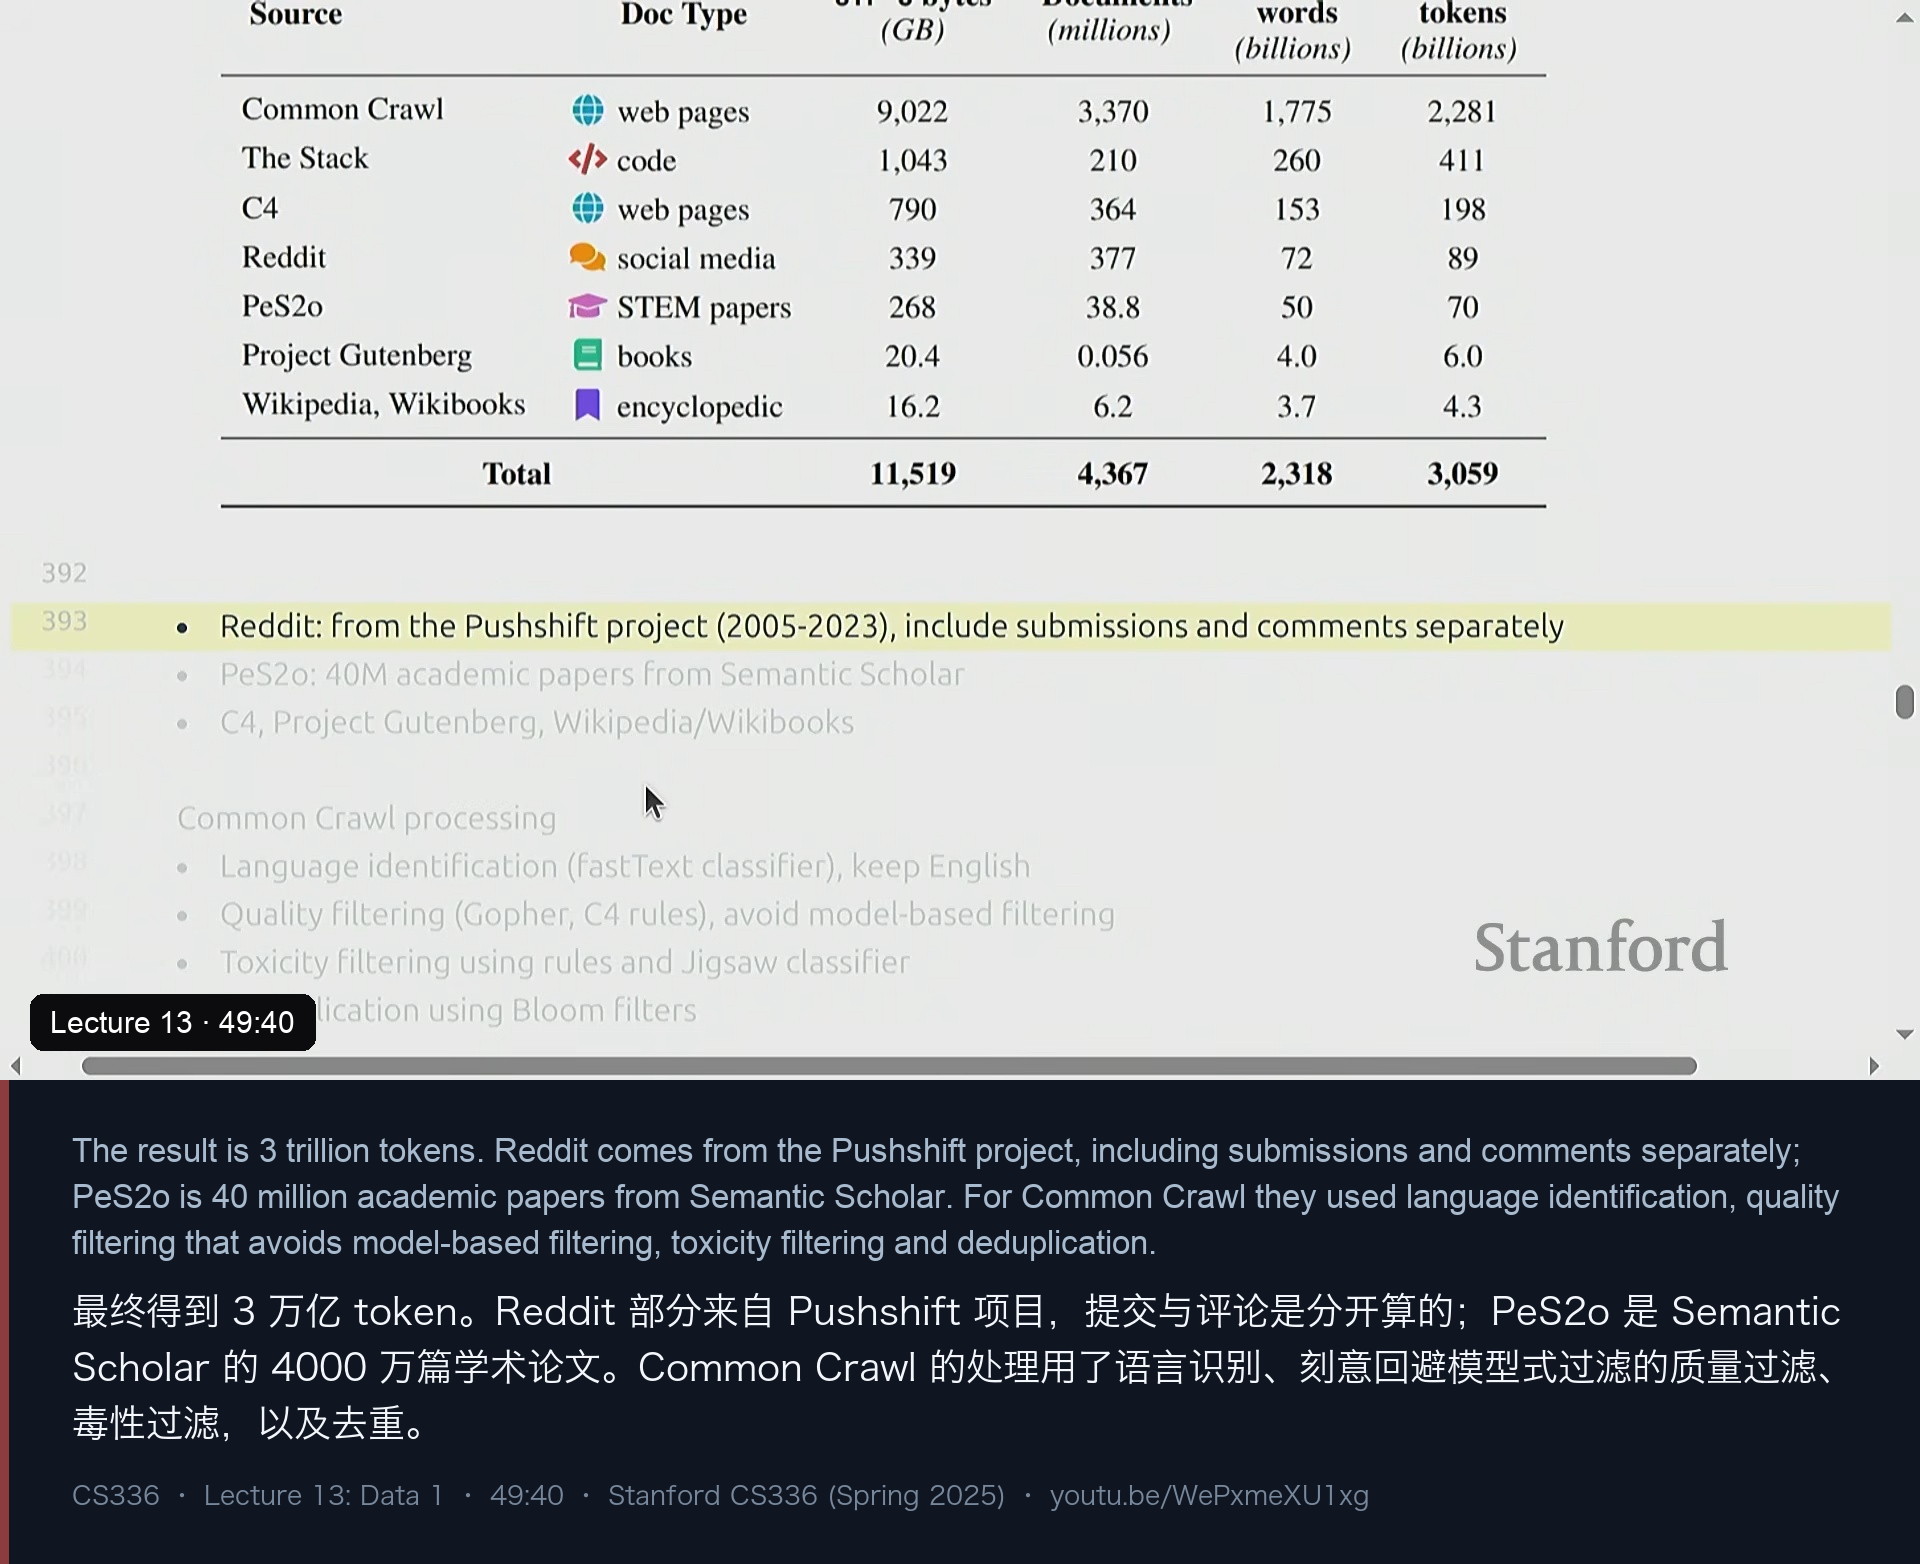
AI2 的 OLMo / Dolma 则是“成分表最清楚”的那一个。总量 3 万亿 token,构成如下:
Source                Doc Type          tokens (B)
Common Crawl          web pages          2,281
The Stack             code                 411
C4                    web pages            198
Reddit                social media          89
PeS2o                 STEM papers           70
Project Gutenberg     books                  6.0
Wikipedia, Wikibooks  encyclopedic           4.3
Total 3,059几个细节:Reddit 来自 Pushshift 项目,提交和评论是分开算的(所以没有线程结构);PeS2o 是 Semantic Scholar 的 4000 万篇论文。Common Crawl 的处理是语言识别(fastText 保英文)、质量过滤(Gopher + C4 规则,初始模型刻意回避模型式过滤)、毒性过滤(规则 + Jigsaw 分类器)、以及 Bloom filter 去重。
Percy 在这里插了一句产业观察:大约 2023 年前后,Stack Exchange、Reddit 这些站点意识到“别人正在拿我们的数据训模型赚钱”,于是数据获取陆续收紧——这就是为什么这些数据集里 Reddit 那一栏后来很难再更新。
十一、模型式过滤的回归:DataComp 与 DCLM
DataComp(2024,多个机构合作)的野心是把“造数据集”变成一场比赛:先提供标准基础设施和一个统一的数据池,让大家比谁的过滤算法更好。他们处理了 Common Crawl 的全部 dump,得到 DCLM-pool:240 万亿 token——量极大,但平均质量不高。
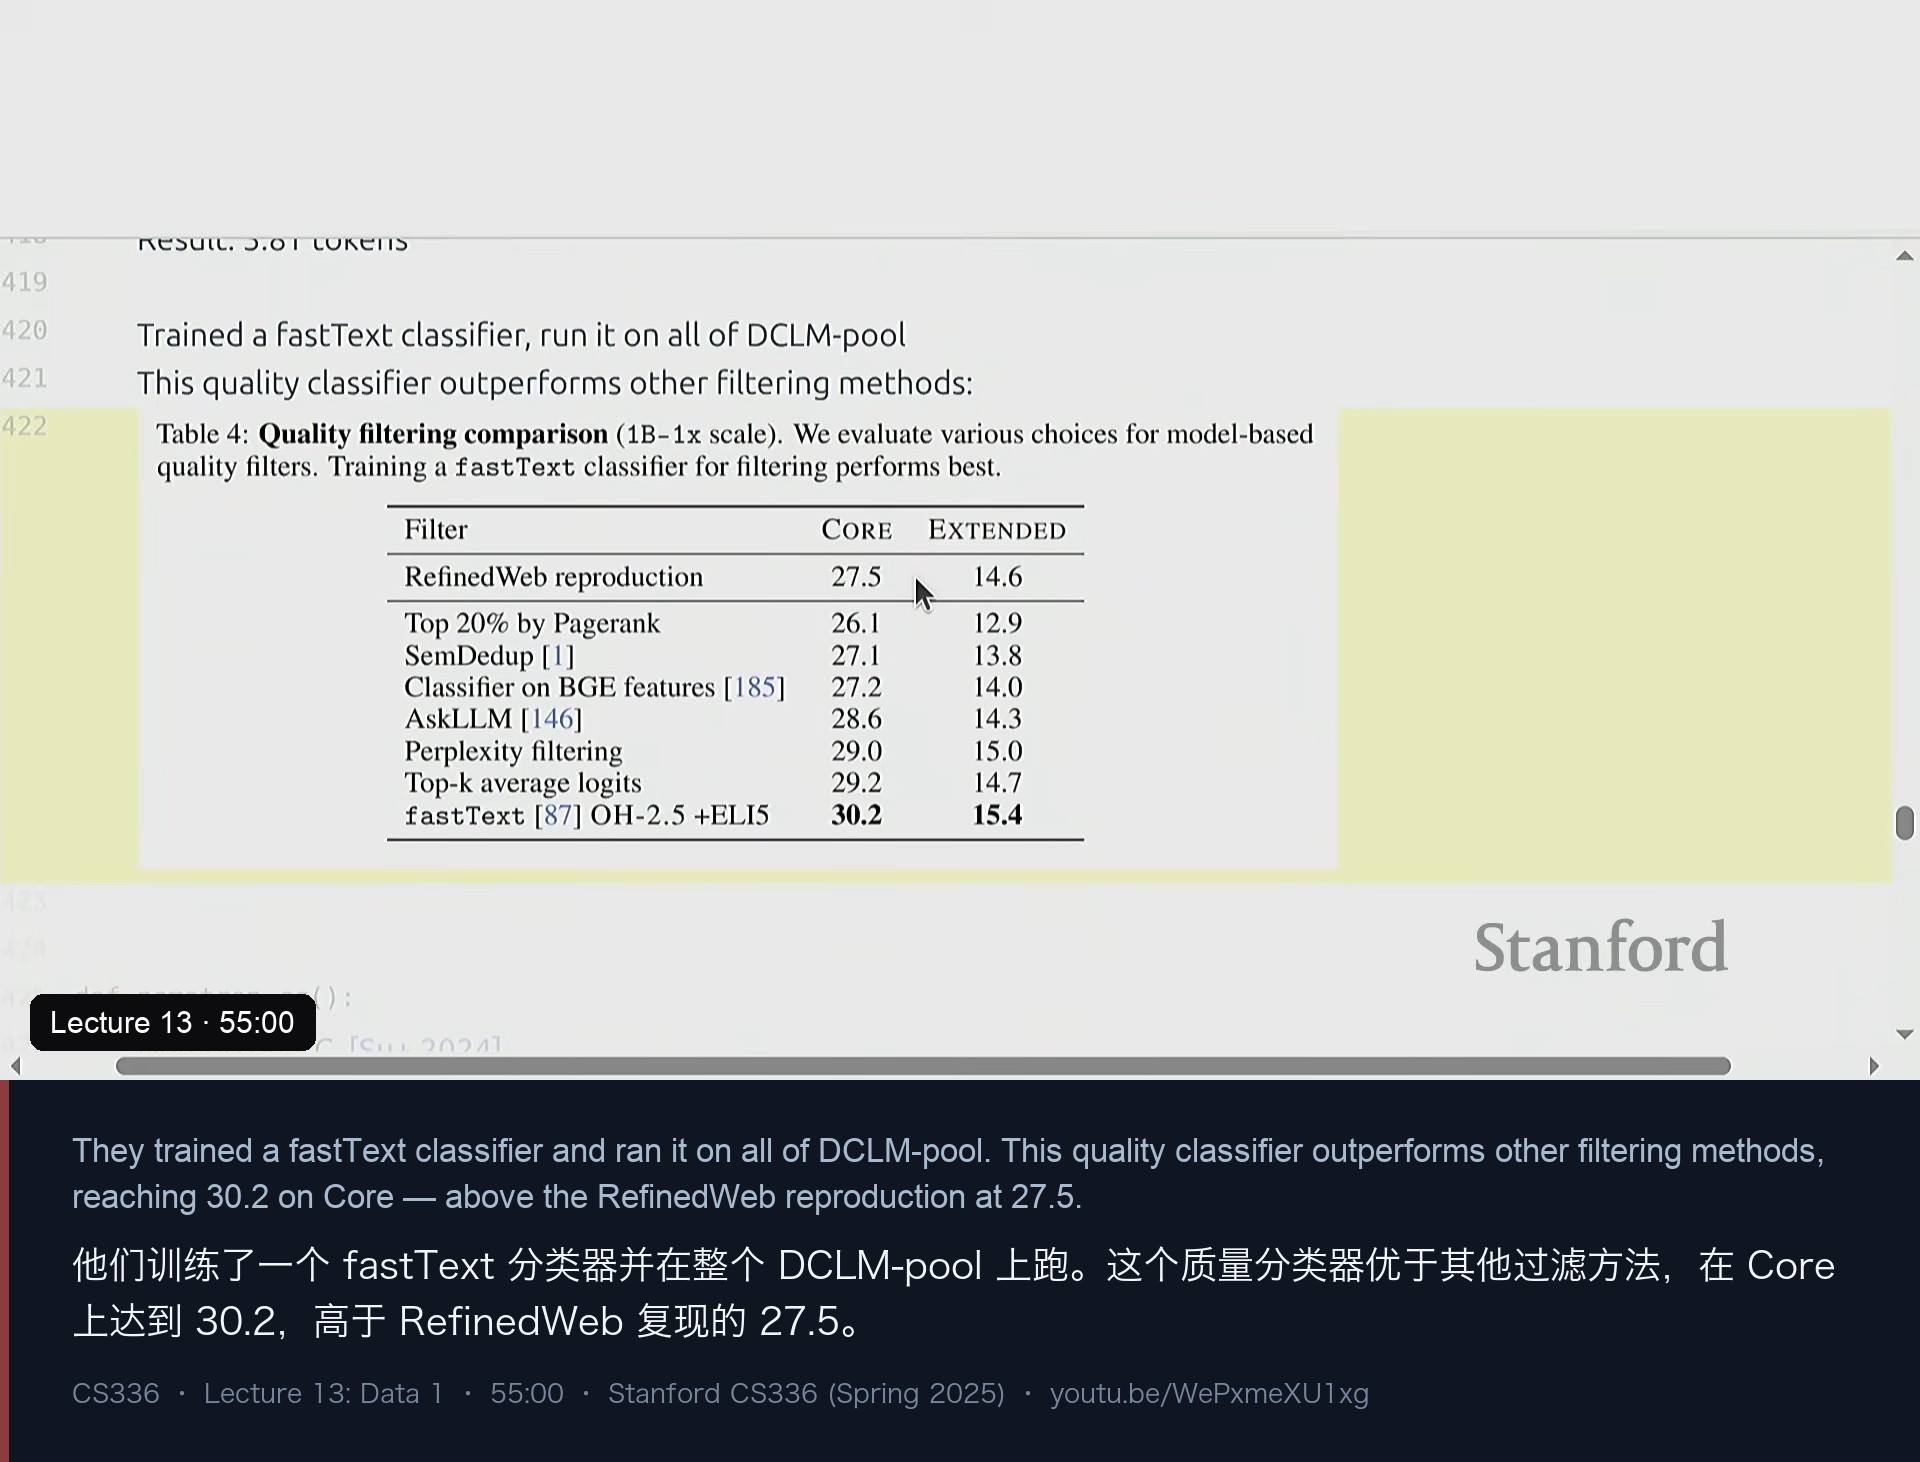
从 pool 到 DCLM-baseline 的过滤极其激进:只保留了全部数据的约 1.4%,最终 3.8 万亿 token。做法是训一个 fastText 分类器,而正例的选取才是这段最反直觉的地方:
- 正例之一是 OpenHermes——主要是 GPT-4 生成的指令数据。也就是说,他们用指令数据来挑选预训练数据:不是直接在这些指令数据上训练,而是去找“长得像指令数据”的网页。
- 正例之二是 ELI5(Reddit 上“像对五岁小孩解释”的板块),本质也是问答形态。
- 负例则从 RefinedWeb 里采样——不是低质量数据,只是不如上面两份“精挑”。
结果相当能说明问题:这个 fastText 分类器在 Core 基准上达到 30.2,高于 RefinedWeb 复现的 27.5(高约 3 个点),也高于按 PageRank 取前 20%、SemDedup、基于 BGE 特征的分类器、AskLLM、困惑度过滤、Top-k average logits 等一票方法。
Percy 的总结是:“我们要保持无偏、尽量不用模型引入偏见”的那个时代基本过去了——因为大家意识到,把模型放进回路里,就能显著提高数据质量,至少能显著提高基准分数。这也是 OLMo 第二代转而使用 DCLM-baseline 的原因。
十二、Nemotron-CC:当过滤太狠,就开始“改造”数据
Nemotron-CC(NVIDIA)的出发点很实际:DCLM-baseline 的数据质量很好,但它过滤得太狠了——从 240 万亿砍到 3.8 万亿,“如果你想训更大的模型、训更久,这点 token 不够”(他举例说,一个 4000 亿参数的训练跑,3.8 万亿撑不住)。
于是他们做了几件很有代表性的事:
- 重新做 HTML→text 的消融,但这次的优化目标是“剩多少 token”而不是“质量多高”——结果 justext 比 trafilatura 保留更多 token,于是改用 justext。
- 用 Nemotron-340B-instruct 给文档打“教育价值”分,再蒸馏到一个更快的模型上跑全量。
- 同时使用 DCLM 分类器,但不是简单地取分数最高的一批:他们把各个分类器的分数分桶,从每个桶里采样,以保证对不同“质量观”的覆盖。
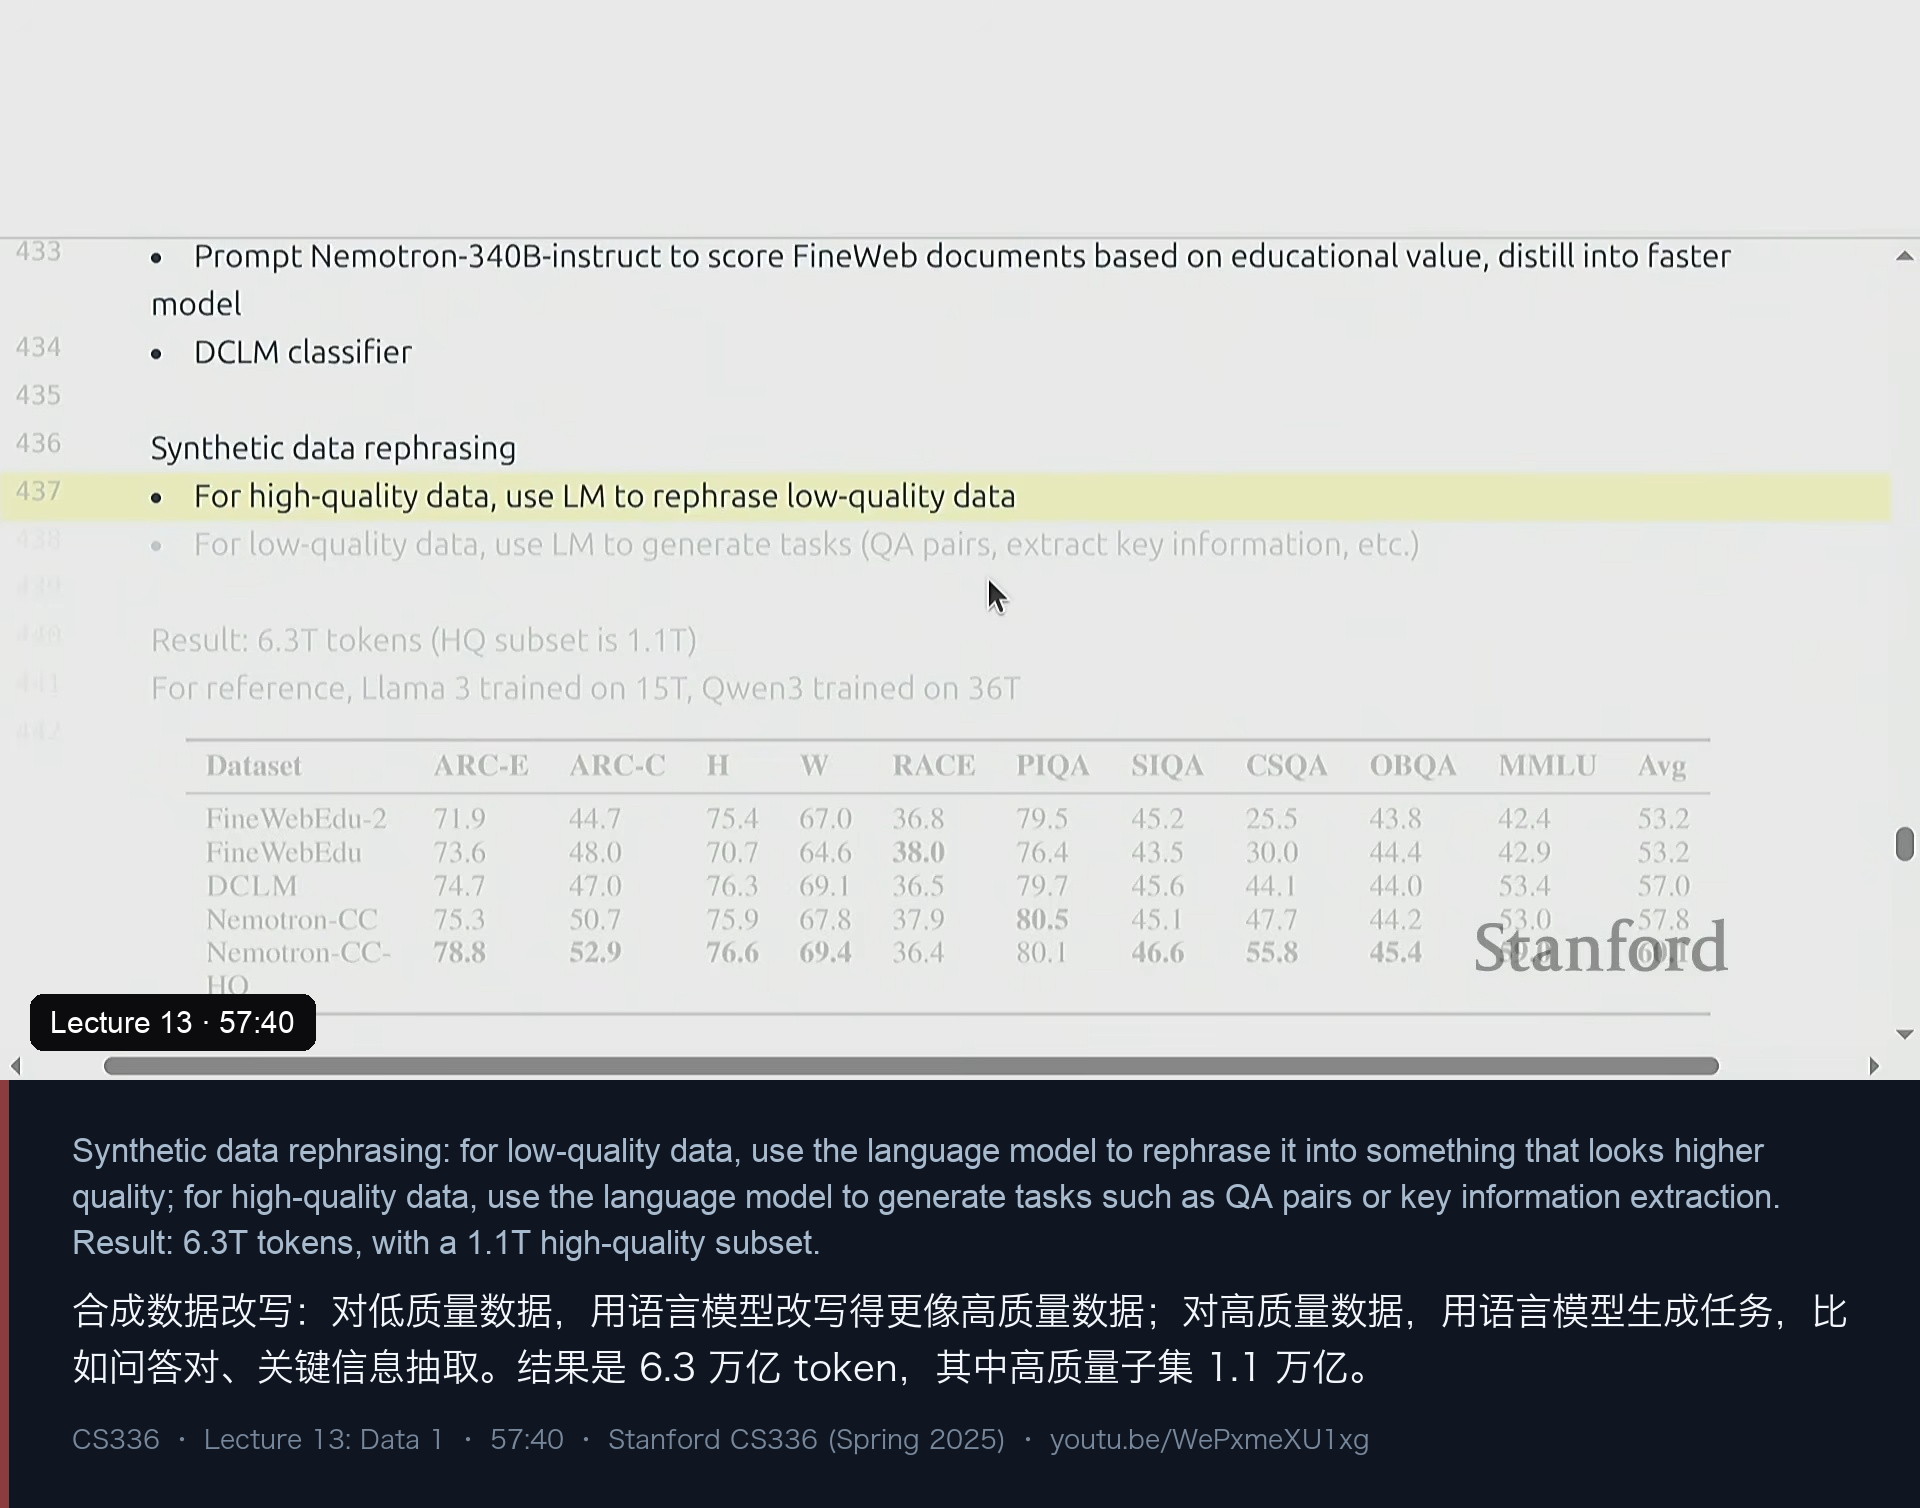
- 最后一步最有意思:让语言模型不只是过滤,而是改写数据。
Synthetic data rephrasing
- For low-quality data, use the LM to rephrase it into higher quality text
- For high-quality data, use the LM to generate tasks
  (QA pairs, extract key information, summarize, ...)
Percy 对“改写”的评价很坦率:明显可能出错,但“在大局上,也许并不比直接在低质量互联网数据上训练更糟”。而“高质量数据 → 生成任务”这一步的逻辑,则是提前为指令跟随做准备——拿一篇 Wikipedia 文章,让模型造出输入输出对。
最终结果是 6.3 万亿 token,其中 1.1 万亿的高质量子集——几乎是 DCLM 的两倍,而且全部来自 Common Crawl。作为参照,Percy 提醒:Llama 3 训了 15 万亿,Qwen 3 是 36 万亿(含多模态数据),所以 6.3 万亿对开放数据集来说已经“相当不错,够大多数人训一个 epoch”。评测表上,Nemotron-CC 平均优于 DCLM,而 Nemotron-CC-HQ 又更进一步。
十三、版权:问题不是“有没有版权”,而是“你能不能合法使用”
讲完数据集,Percy 转到这一讲最“非技术”但也最不能跳过的一段。他先回答开场那个问题:Common Crawl 里有多少是受版权保护的?答案:大部分。
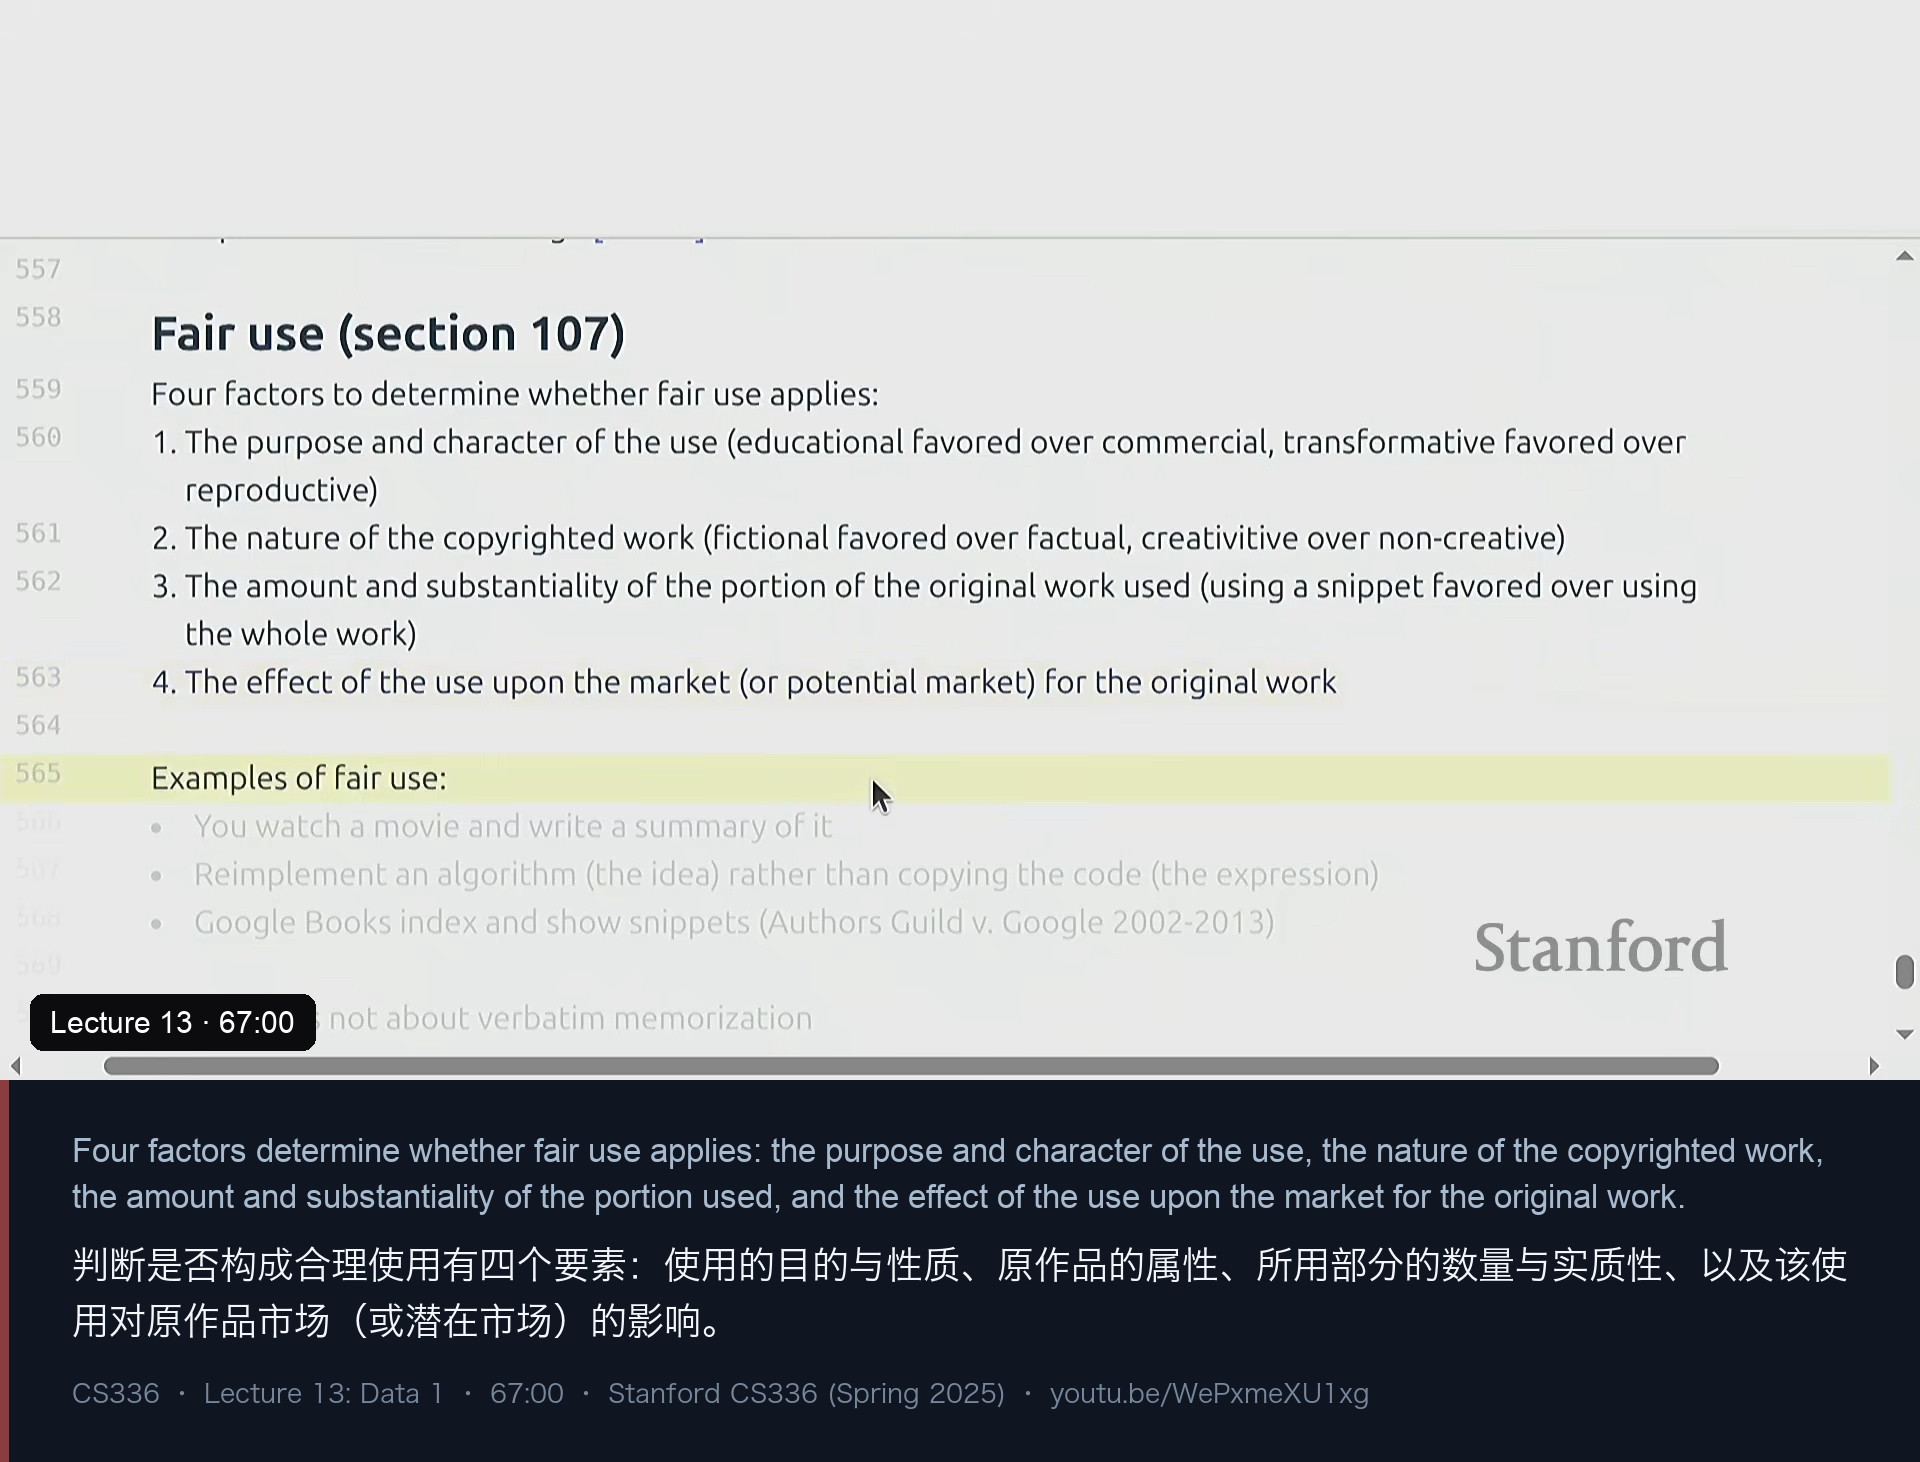
第一步是搞清楚版权到底保护什么。版权属于知识产权法,目的是激励智力成果的创造;相关的还有专利、商标、商业秘密,但与训练数据最相关的是版权。它的历史可以追到 1709 年英国的《安娜法令》;美国现行的是 1976 年版权法。核心定义是:
'original works of authorship fixed in any tangible medium of expression,
now known or later developed, from which they can be perceived, reproduced,
or otherwise communicated, either directly or with the aid of a machine or device'
由此推出几条对从业者很实用的推论:
- 保护的是原创作品,所以单纯的汇编不受保护(电话簿是经典例子),除非其选择或编排有创造性。
- 保护的是表达,不是思想——你不能给算法本身申请版权,但可以给代码申请。
- 范围在扩大:从 1909 年的“已出版”扩大到 1976 年的“已固定”。
- 注册不是取得版权的前提(这与专利相反);但创作者要起诉侵权必须先注册,而注册门槛很低——只要 65 美元。
- 版权持续 75 年后进入公有领域——Project Gutenberg 的绝大部分以及各类经典都在此列。
- 门槛极低:你把东西放到自己的网站上,它就已经受版权保护了,哪怕你没写“版权所有”。
所以真正的问题不是“有没有版权”,而是**“你能不能用它”**。两条路:
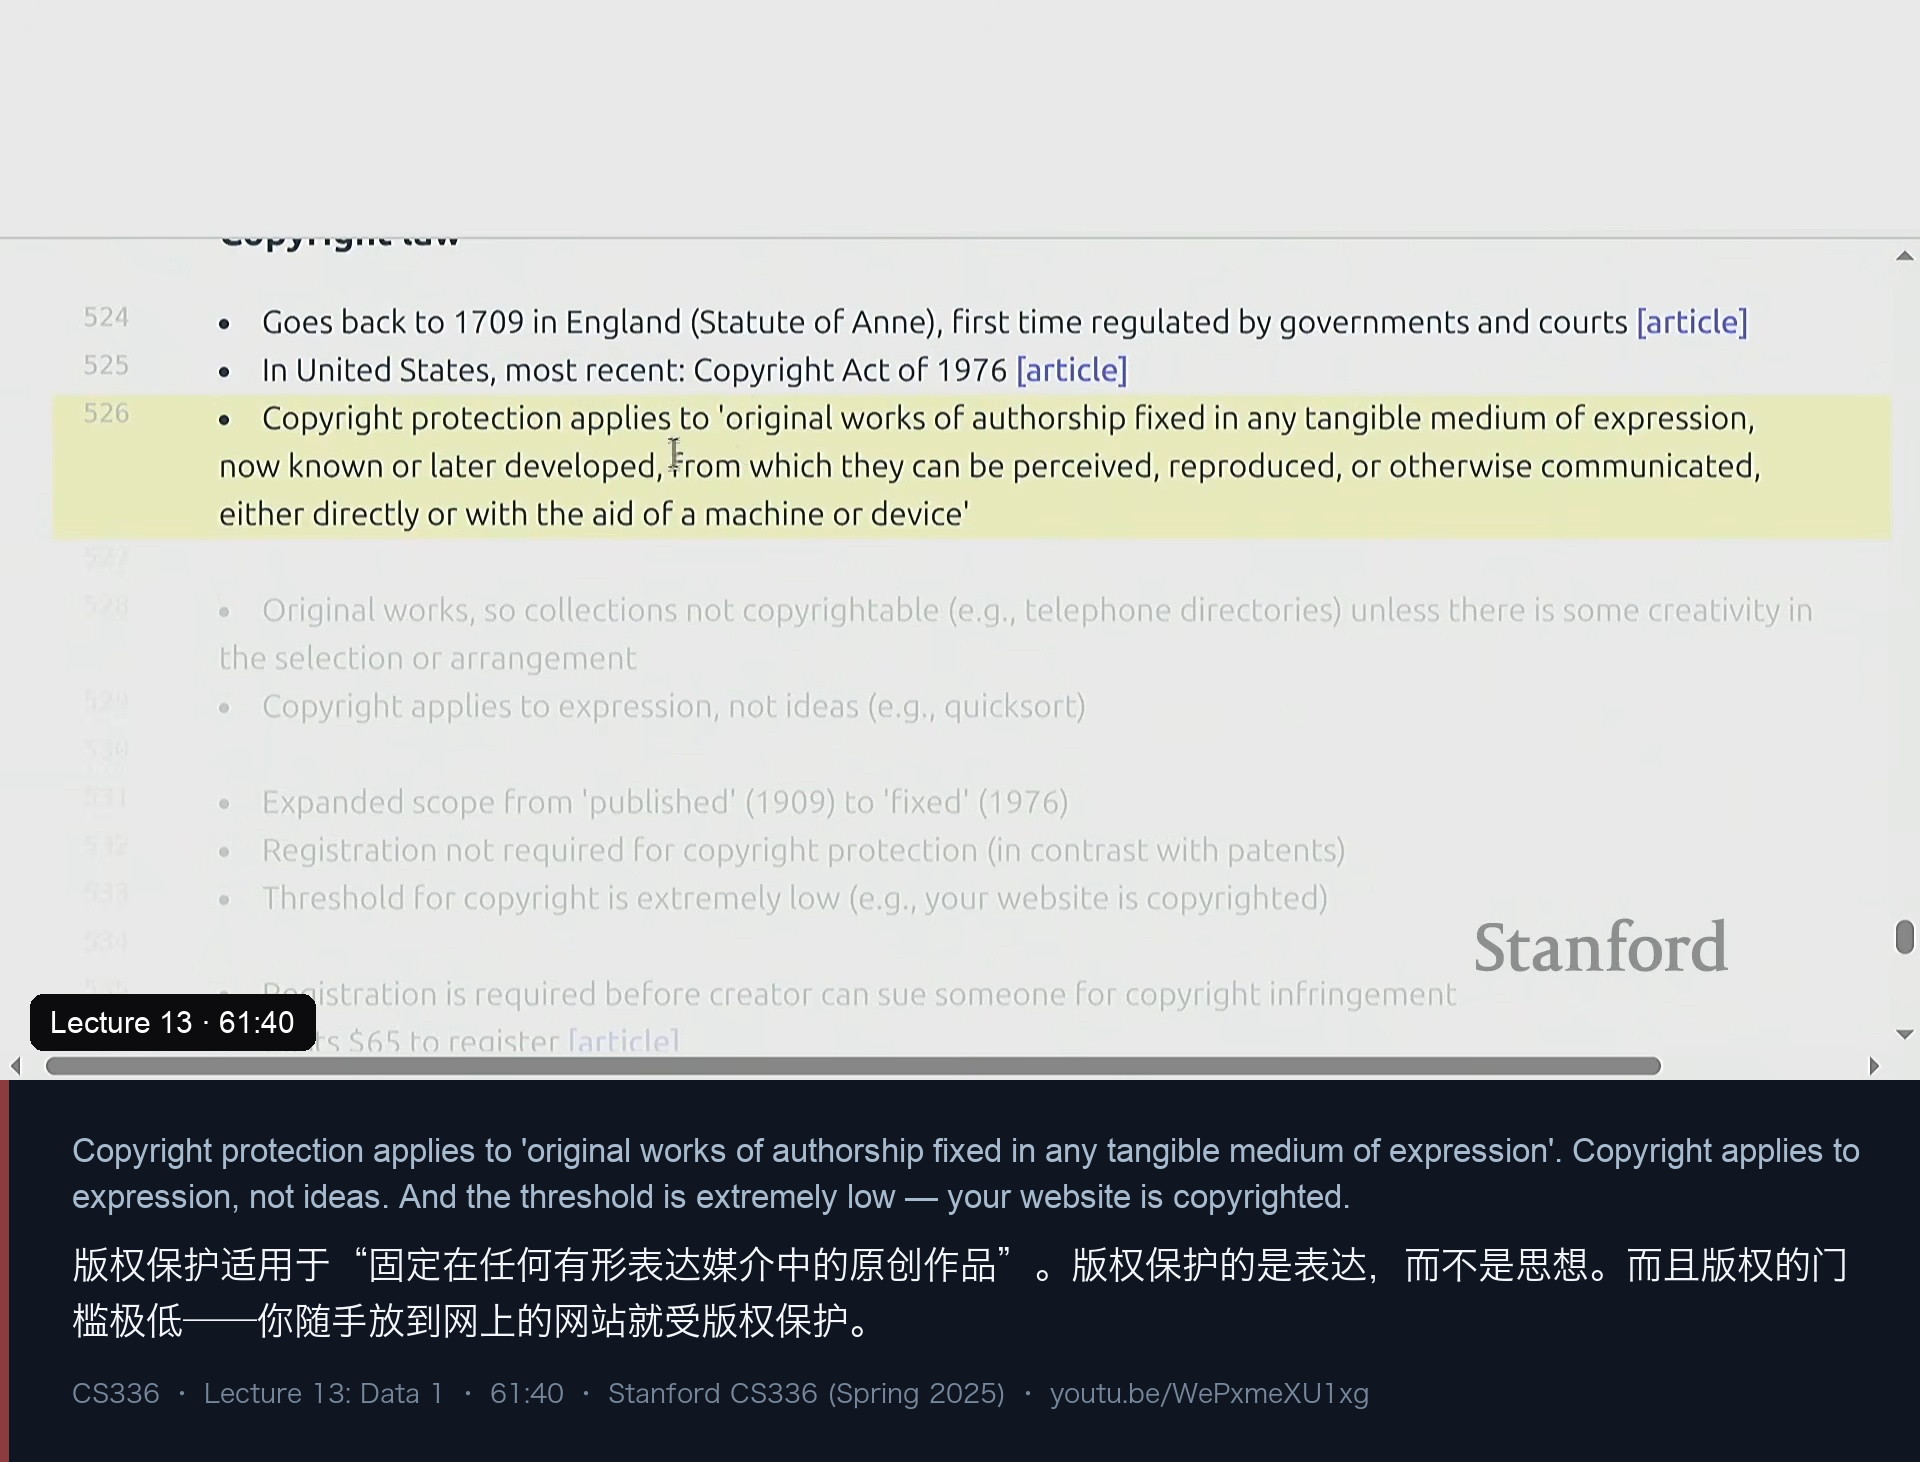
第一条是拿许可证(license)。 Percy 用一句很精辟的话概括:“许可证本质上是一份’保证不起诉你’的承诺”。你可以和创作者签约(现实中就是 Google 与 Reddit、OpenAI 与 Shutterstock、OpenAI 与 Stack Exchange 这类交易)。其中特别重要的一类是 Creative Commons:它让受版权保护的作品可以自由分发——作品本身仍然有版权,只是你拿到了一个让它“表现得像公有领域”的许可。Wikipedia、Open Courseware、Khan Academy、Free Music Archive、Flickr 上的 3.07 亿张图、MusicBrainz 的 3900 万张图、YouTube 的 1000 万个视频都属于此列。CC 由 Lessig 和 Eldred 在 2001 年创立,目的正是在公有领域与既有版权之间搭一座桥——创作者其实常常乐于让人使用,只是“没说 yes 也没说 no”的默认状态太模糊,而没人愿意等 75 年。
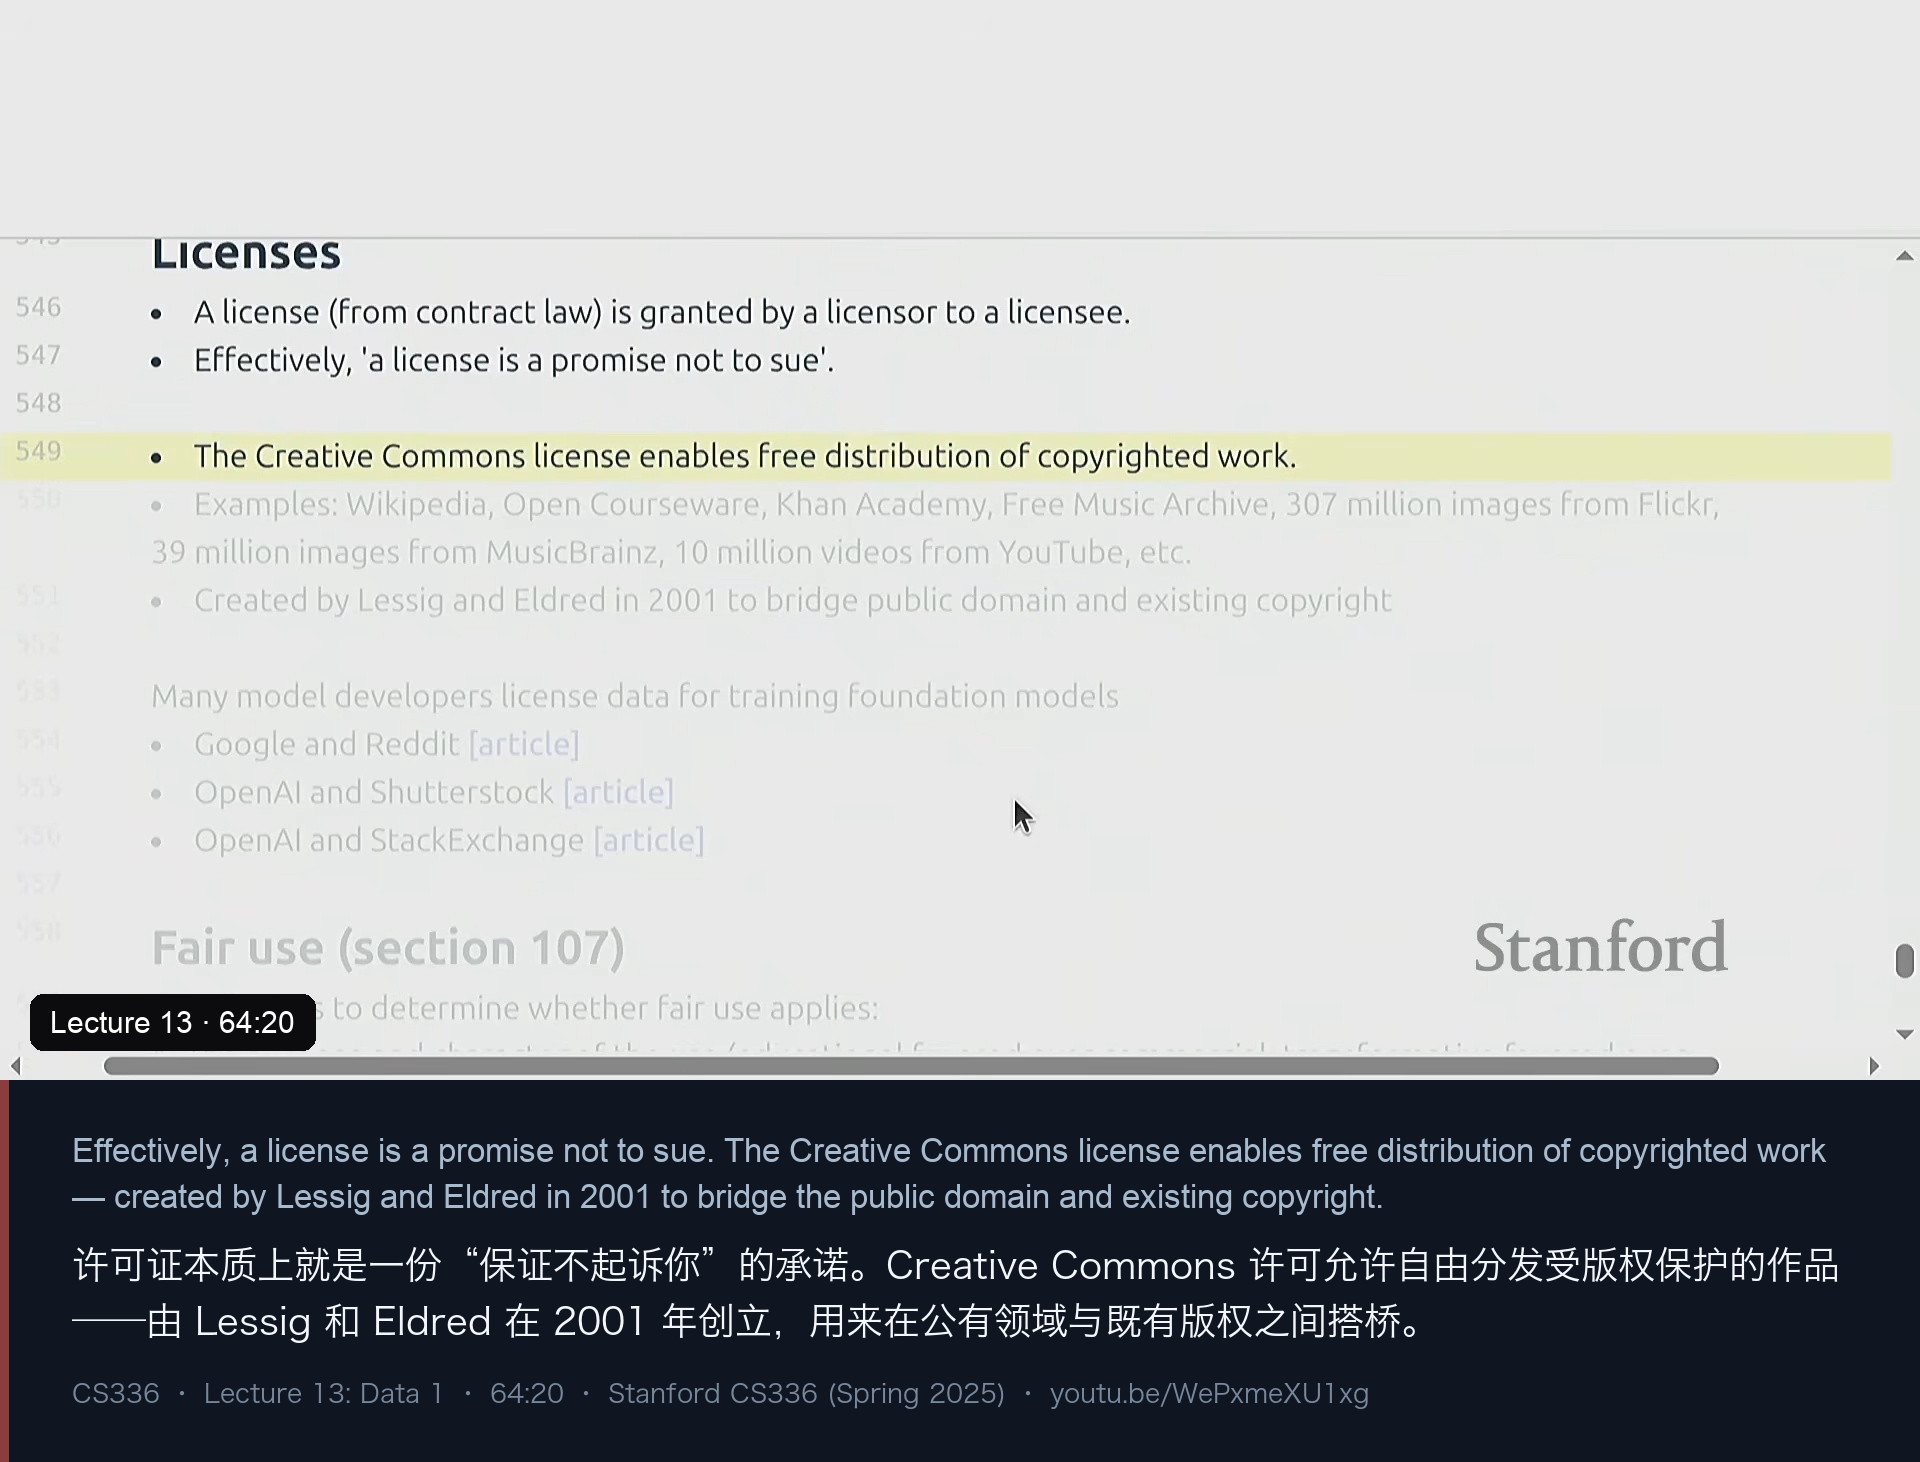
第二条是主张合理使用(fair use)。 因为你没法给“整个互联网”拿许可——你找谁签?合理使用规定了四个判断要素:
1. The purpose and character of the use
   (educational favored over commercial, transformative over reproductive)
2. The nature of the copyrighted work
   (factual favored over fictional, creative over non-creative)
3. The amount and substantiality of the portion used
   (a snippet favored over the whole work)
4. The effect of the use upon the market (or potential market)
Percy 逐个点评:教育优于商业、转换性优于复制性;事实性作品比虚构作品更容易构成合理使用;“只用片段”这一条对语言模型基本不适用——因为你要的是整份数据;而“对市场的影响”上,如果用途是替代创作者,就更不利。他举了两个例子:看电影写影评是合理使用;**重新实现算法(思想)而不是抄代码(表达)**也是。Google Books 只展示片段这件事打了十年官司(Authors Guild v. Google,2002–2013),最终判 Google 胜诉。
这里还有一个容易被忽略的点:版权不只管逐字记忆。情节和角色也可能受版权保护——即使 n-gram 层面的重合很少,只要你把“哈利·波特”这个角色拿去继续开发,就可能侵权(反过来,戏仿可能构成合理使用)。所以版权“讲的是语义、经济和内容性质,是个非常复杂的话题”。
那么训练呢? Percy 指出一个尴尬的事实:版权这个词里就有“复制”——所以训练的第一步“把数据拷下来”本身在技术上就已经是侵权,哪怕你后面什么都不做。可以主张(也确实有很多人主张)训练 ML 模型是转换性的,因为那远不是复制粘贴;也可以主张机器学习系统关心的是“思想”而非“表达”(他要的是语言如何运作、以及通用知识,而不是某件具体作品)。但反方的证据也很硬:模型确实会记忆,而且训练数据可以相对容易地从模型里抽取出来。此外还有市场层面的问题:语言模型无论如何都可能影响创作者的市场。他还特别提到一个副作用:这些法律风险让“开放模型 + 开放数据”变得格外困难——因为一旦你把训练数据也公开托管出来,那本身就可能是侵权。
十四、服务条款:合法,也可能拿不到
版权之外还有一道门。Percy 的表述很精准:
Even if you have a license or can appeal to fair use for a work,
terms of service might impose additional restrictions.
最典型的例子就是 YouTube:上面有大量 Creative Commons 视频,但你写个脚本批量下载它们,违反的是 YouTube 的服务条款。也就是说,许可证解决了版权问题,却没有解决“平台让不让你取”的问题。这一节他还列了延伸阅读:CS324 的课程笔记、Lemley & Casey 的《Fair Learning》、Henderson+ 2023 的《Foundation models and fair use》、以及 Cooper+ 2024 的《The Files are in the Computer》。
十五、中训练与后训练:长上下文、任务与合成数据
最后一段转向中训练/后训练(Percy 说这两段在这一讲里合并处理,因为边界本来就不清)。核心问题变成:为了补某个特定能力,要喂什么数据?
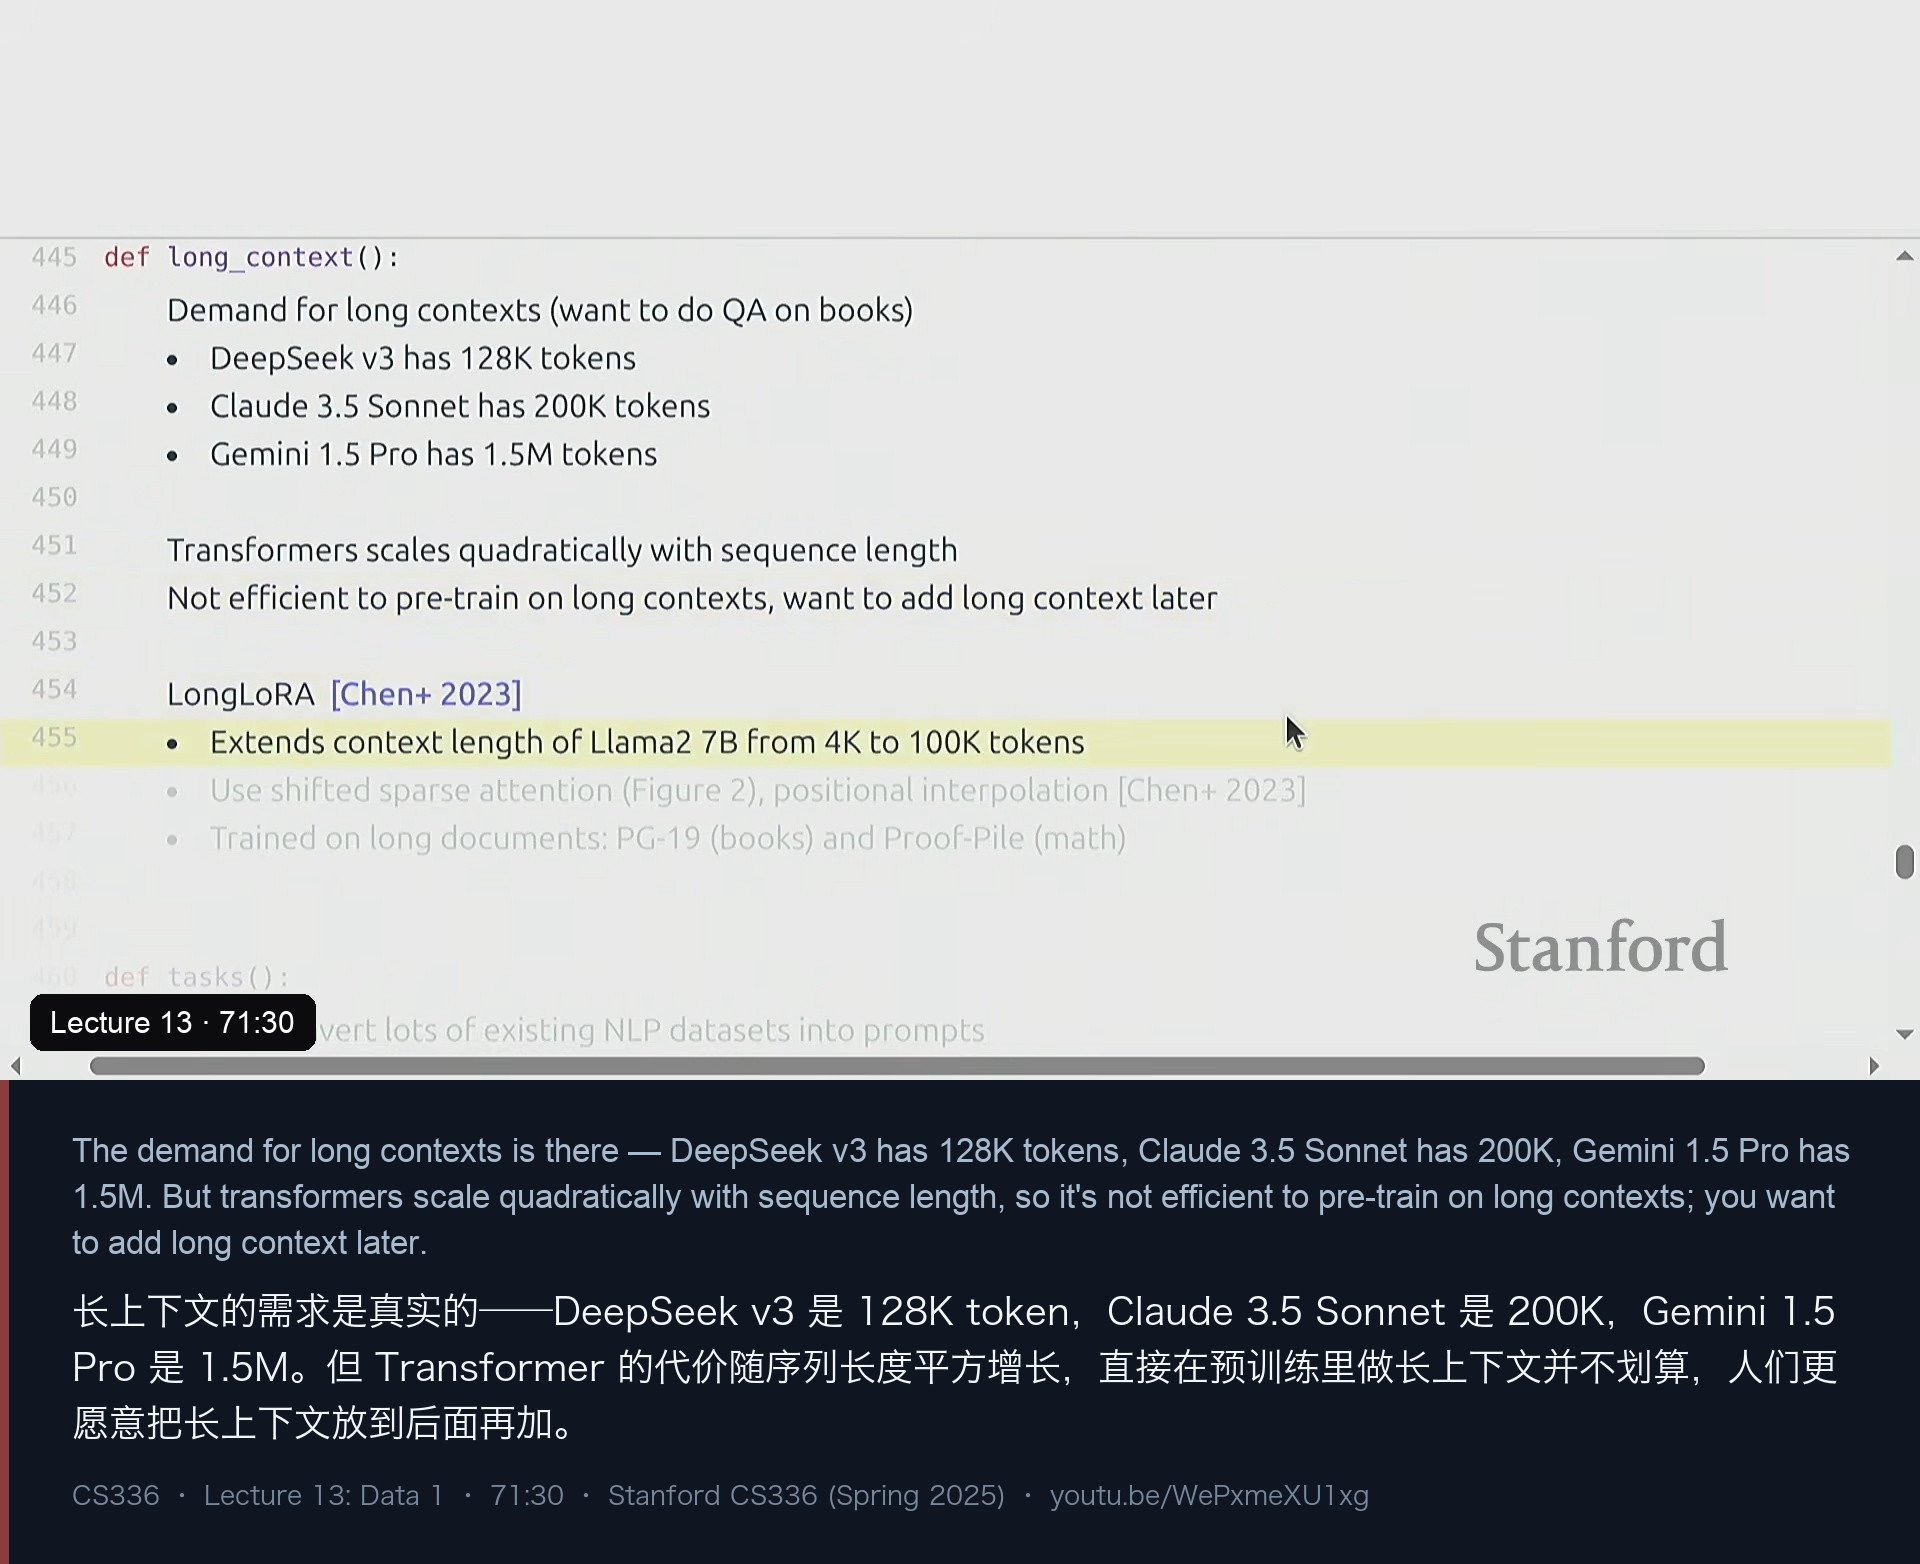
长上下文是第一个例子。需求是真实的:DeepSeek v3 是 128K token、Claude 3.5 Sonnet 是 200K、Gemini 1.5 Pro 是 1.5M(他还提到 Llama 4 可能宣传过千万级上下文)。但 Transformer 的代价随序列长度平方增长,即使推理阶段有各种绕开的手段,想要最好的效果仍然需要完整注意力——所以在预训练一开始就上长上下文很浪费,人们普遍把长上下文扩展放到中训练。数据从哪来?要的是具有长程依赖的文档,书和数学是两个常用的来源(也可以合成)。LongLoRA 就是一个具体例子:把 Llama 2 7B 的上下文从 4K 扩到 100K,用 shifted sparse attention + 位置插值,训练数据正是 PG-19(书)和 Proof-Pile(数学)。
任务能力是第二个例子。这一支的思路是把现成的 NLP 数据集统统转成 prompt 格式(幻灯片写得很直白:“TL;DR: convert lots of existing NLP datasets into prompts”)。Super-NaturalInstructions 收集了 1600+ 个任务,由社区通过 GitHub 贡献,把 T5 在 k-shot 上微调;FLAN 2022 是 1800+ 个任务,覆盖 zero-shot / few-shot / chain-of-thought 三种版本。好处很明确:模型一下子会做你所有喜欢的 NLP 任务,而且享受迁移学习的红利。但 Percy 指出了一个通病:这些 prompt 高度模板化——看多了会发现很多“Super-Natural”其实并不自然,因为它们的句式几乎一模一样。这恰恰成了后来指令数据集出现的动机。而从 2022 年起,连“任务”这个概念都在消失:大家的预期变成了“语言模型应该能接住你随手抛给它的任何一次性任务”。
指令数据于是转向了合成路线,Percy 按时间给了一串:
- Alpaca:用 self-instruct,让语言模型自己生成示例再拿来微调。
- Vicuna:用用户在 ShareGPT 上分享的对话(该服务已停止)。
- Evol-Instruct:把已有问题逐步变难。
- 还有一类是把 Common Crawl 里的问答站点识别出来,用语言模型抽成 QA 对。
- OpenHermes:前面 DCLM 用到的那份正例,本身就是一堆数据集的杂烩。
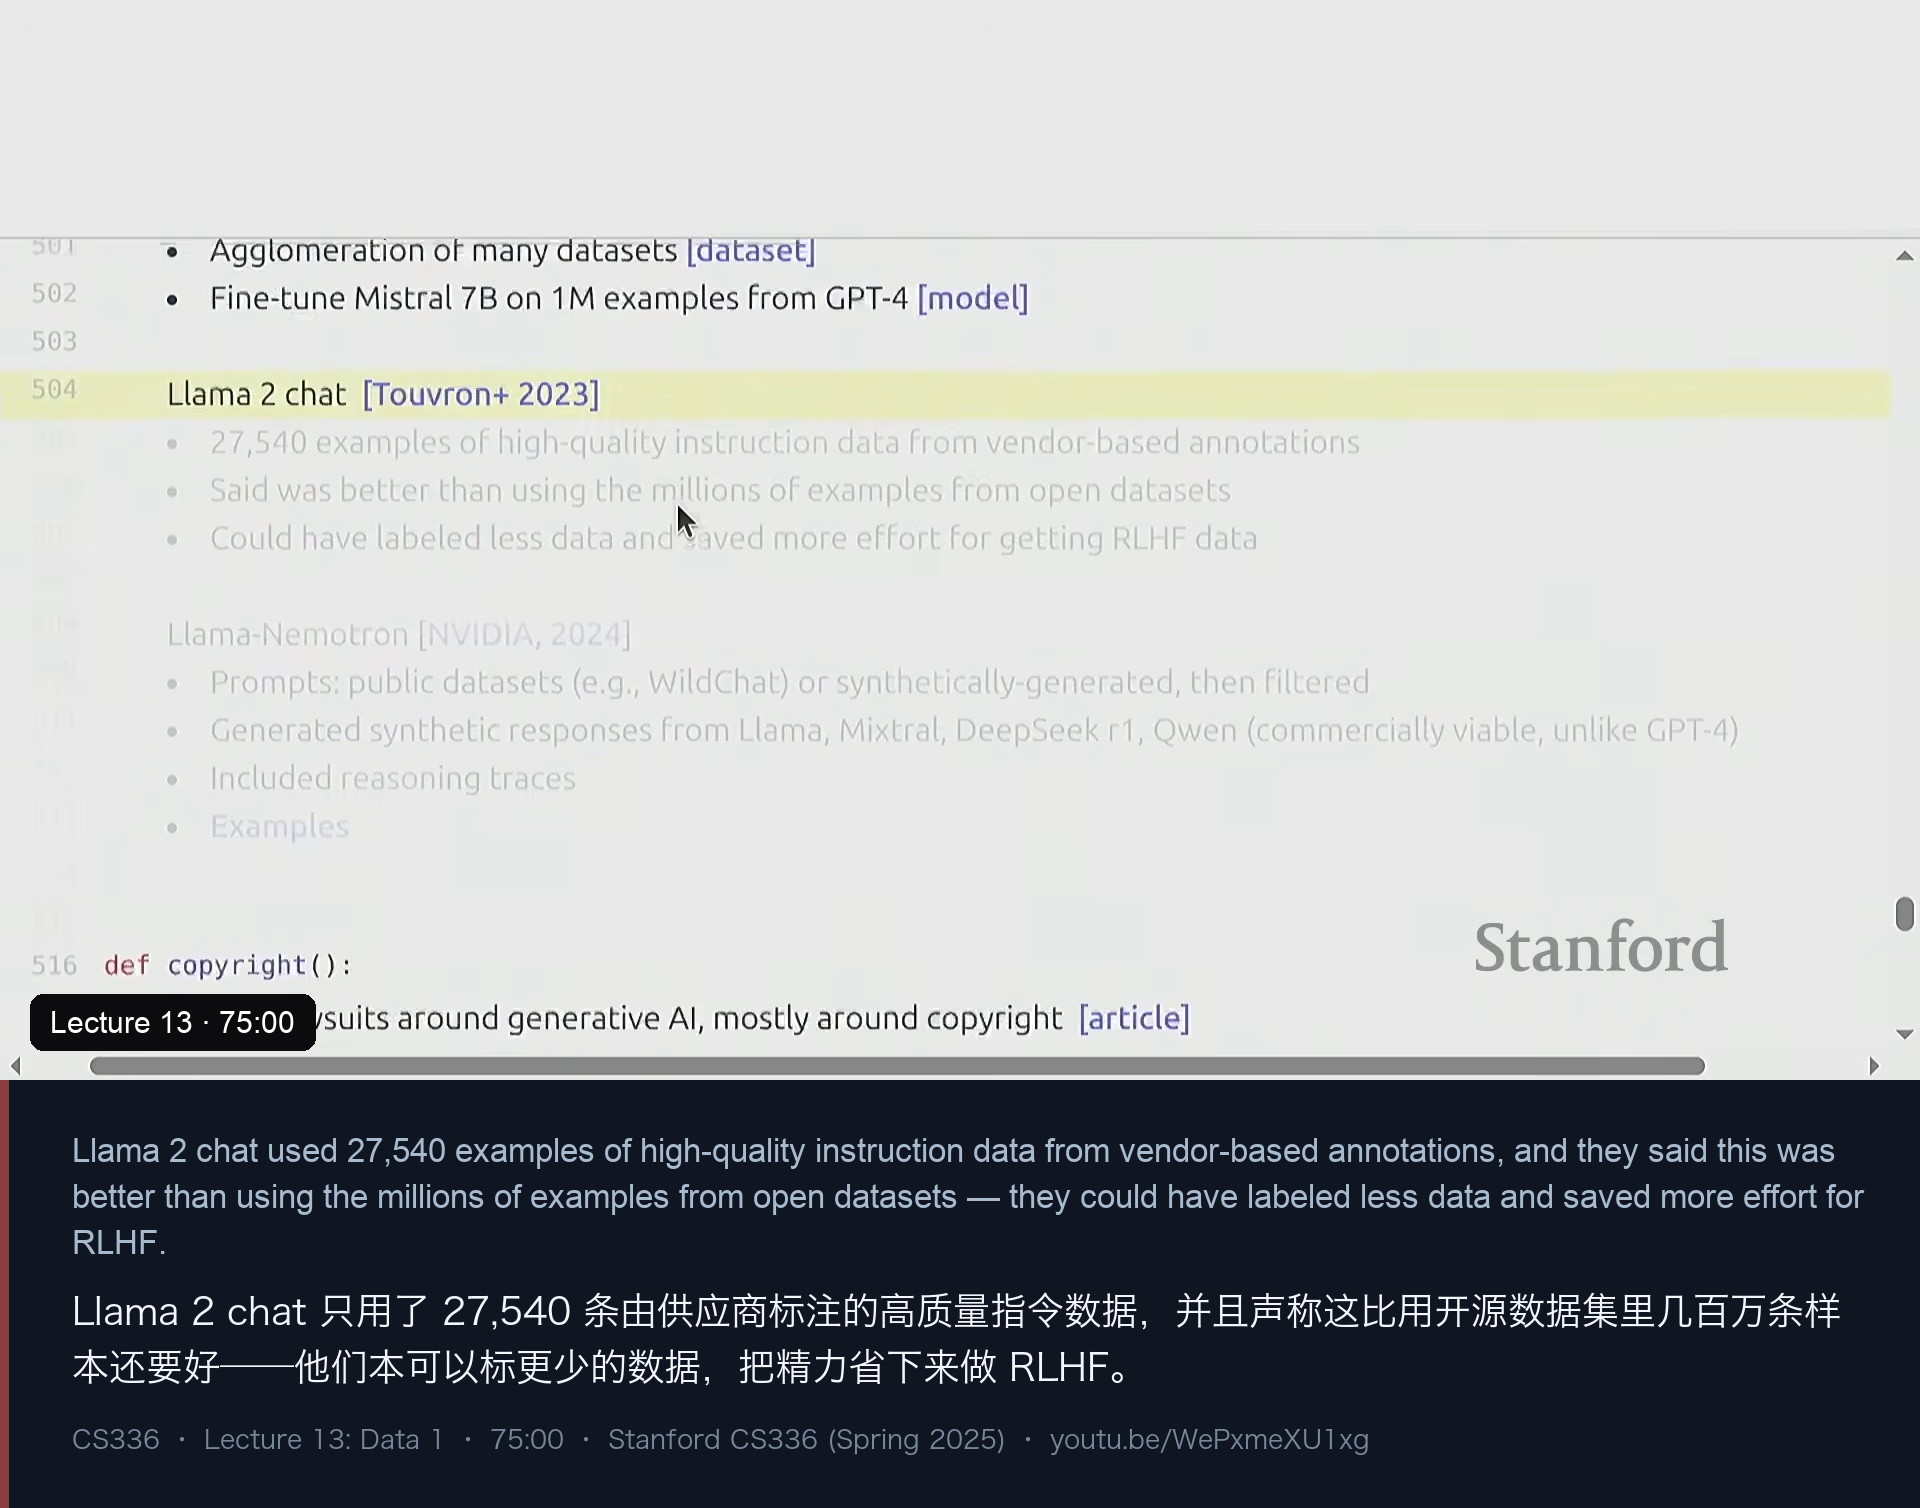
- Llama 2 chat:数据集细节未公开,但用了人工标注者写高质量指令数据,并且论文声称这 27540 条比开源数据集里几百万条更好。
- Llama-Nemotron(较新):公开数据集(如 WildChat)做 prompt,再从 Llama、Mistral、DeepSeek R1、Qwen 这些“商用可行”的模型合成回答(他强调这与 GPT-4 不同),并包含 R1 的推理轨迹。
这一段的实用结论被他总结成三种数据来源的取舍:
- 闭源前沿模型(GPT-4):对学术研究方便,但用 GPT-4 造数据集再去训一个竞争模型,违反 OpenAI 的服务条款。
- 开放权重模型:许可更宽松,基本可以放心蒸馏(Llama 可能有些限制,但总体上比 OpenAI 宽松)。
- 雇人标注:质量最高,但更贵、更慢,而且要小心标注者自己偷偷用 GPT-4。
我的笔记
这一讲值得记住的句子不少,我挑出这些:
- “数据是做好语言模型最重要的东西。” 判断可以争论,但论据是硬的:论文里架构写得清清楚楚、数据几乎不透——如果数据不重要,没人会把它当机密。
- “语言模型是在互联网上训练的”——这句话既不对,也没有意义。 因为“互联网”不是一份数据集;从线上服务到可训练的 token,中间隔着转换、过滤、去重一整条流水线。
- 数据是长尾问题,而且是能靠人力规模化的那一种。 架构只能收敛成一份设计,数据可以同时雇几百人做不同切面——这是一个很实际的资源分配结论。
- “先用海量低质量数据打底,再用少量高质量数据收口。” 这是预训练 / 中训练 / 后训练三段式最简洁的概括,而且三段之间的界线在实践中越来越模糊。
- 过滤方式没有免费的午餐。 规则式会漏进 spam,却保得住“不像 Wikipedia 但语法良好”的句子;模型式效果取决于正例的代表性,而当你要的恰恰是多样性时,正例很难挑得全。
- HTML→text 这一步就能值 4 个点。 trafilatura 24.5 / resiliparse 24.1 / 直接用 WET 20.7——“清洗”不是杂活,它直接决定下游准确率。
- LlaMA 那个“分类 Wikipedia 所引用的页面”的小改动,是这一讲最漂亮的一手。 它说明:目标函数选对了,比模型多强更重要。
- 为了挑预训练数据,可以先去拿指令数据(甚至 GPT-4 生成的)当正例。 DCLM 的这个操作把“务实”两个字写在了脸上。
- 当过滤太狠、token 不够时,下一步是“改造数据”而不是“少过滤”。 Nemotron-CC 用模型改写低质量文档、用它给高质量文档生成任务——合成数据正在从后训练渗透回预训练。
- “许可证本质上是一份’保证不起诉你’的承诺。” 加上 Creative Commons 那句“在公有领域与版权之间搭桥”,这两句话基本概括了数据合规的全部现实。
- 合法 ≠ 拿得到。 版权、许可、服务条款是三道独立的门;YouTube 上那些 CC 视频就是活生生的例子。
- “数据不会从天上掉下来,你得动手去弄。” 而且这条流水线很大程度上仍是启发式的——在 Percy 看来这不是坏消息,而是“还有大量机会”的另一种说法。整讲最后一句是:“如果你觉得这个领域一团糟,你是对的。”(“if you think that this whole field is a mess, you’re right.”)
附:课程信息与时间轴
- 课程:Stanford CS336《Language Modeling from Scratch》(Spring 2025)
- 本讲:Lecture 13 · Data 1
- 主讲:Percy Liang
- 视频:https://www.youtube.com/watch?v=WePxmeXU1xg(时长约 1:19)
- 播放列表:CS336 Spring 2025
| 时间 | 主题 |
|---|---|
| 00 | 开场:这一讲讲数据;“数据是最重要的东西”这句暴论 |
| 00 | 论文里的数据披露:Llama 3 的样例与保密的两条理由 |
| 01 | 数据工作仍是长尾工程,且高度可并行 |
| 02 | 训练三阶段:预训练 / 中训练 / 后训练,以及 base 与 instruct 模型 |
| 03 | OLMo 的三段数据配比:3.9T → 约 100 亿 → Tulu |
| 05 | 没有形式化原则:只能靠案例长直觉 |
| 06 | BERT:BooksCorpus + Wikipedia,以及“文档而不是句子” |
| 08 | Wikipedia 是什么:无原创观点、以关注度为门槛、少数人贡献多数内容 |
| 10 | dump 机制与数据投毒(Carlini+ 2023、Wallace+ 2020) |
| 12 | GPT-2 的 WebText:Reddit 上 karma ≥ 3 的外链 |
| 13 | Common Crawl:每月抓一次,约 100 次,2016 年 100 台机器 10–12 天 |
| 16 | URL 动态与重复;WARC 与 WET 两种格式 |
| 17 | HTML→text 转换的差距:trafilatura 24.5 vs WET 20.7 |
| 17 | Common Crawl 刻意不追求完整;连 Wikipedia 都不是全收录 |
| 18 | QA:Common Crawl 会做内容过滤吗 |
| 19 | robots.txt、自建爬虫,以及“没有任何强制力” |
| 21 | Common Crawl 里大部分是受版权保护的内容 |
| 21 | CCNet:去重、语言识别、KenLM 5-gram 的“像 Wikipedia”过滤 |
| 23 | C4:手工规则过滤,1.4T token 快照 → 806 GB / 1560 亿 token |
| 25 | 模型式 vs 规则式过滤:互补的失效方式 |
| 26 | OpenWebText 与“12 次 dump 只有 17GB”——Common Crawl 不完整 |
| 27 | GPT-3:约 4000 亿 token 与质量分类器 |
| 29 | The Pile:Discord 志愿行动、22 个域、825 GB / 2750 亿 token |
| 32 | Project Gutenberg 与 PG-19:书为什么适合长上下文 |
| 32 | QA:平台型公司是否因独有数据占优 |
| 34 | Books3 与影子图书馆:LibGen 400 万本、Sci-Hub 8800 万篇 |
| 36 | Stack Exchange:像问答数据,且有投票等元数据 |
| 38 | GitHub:仓库不等于代码;The Stack 的 3.1 TB |
| 42 | Gopher 与 MassiveText:手工规则的理由与后来的翻转 |
| 44 | LLaMA 的 1.2T 配方:“像 Wikipedia 引用的页面” |
| 46 | RefinedWeb:只要网页过滤得够好就够了 |
| 47 | FineWeb:15 万亿 token 的“轻度过滤”底座 |
| 48 | OLMo / Dolma 的 3T:成分表与 Reddit 数据收紧 |
| 50 | DataComp 与 DCLM-baseline:240T 里只留 1.4% |
| 55 | Nemotron-CC:更少的过滤、分桶采样、改写与任务化 |
| 59 | QA:多语言数据集 |
| 60 | 版权:法律基础、表达而非思想、注册与 75 年 |
| 64 | 许可证与 Creative Commons;65 合理使用四要素 |
| 67 | 版权不只是逐字记忆:情节与角色;67 训练本身是否侵权 |
| 69 | 服务条款:合法也可能拿不到(YouTube 的例子) |
| 70 | 中训练:长上下文扩展与 LongLoRA;71 任务集合 |
| 73 | 指令数据的合成路线:Alpaca、Vicuna、Evol-Instruct |
| 75 | Llama 2 chat 的 27540 条与 Llama-Nemotron |
| 77 | 总结:数据不会从天上掉下来 |
讨论
这里是静态站点,没有内嵌评论区。如果这篇文章对你有用,欢迎通过 RSS 订阅后续更新。