Stanford CS336 第十一讲精读:缩放定律(下)——真实世界的 scaling 配方,与 muP 的两条谱条件
斯坦福 CS336(Language Modeling from Scratch, Spring 2025)第十一讲完整讲义,主讲 Percy Liang。这是 scaling laws 两讲中的第二讲,也是更偏案例与细节的一讲。上半场把'真实模型是怎么用 scaling law 的'拆成四个案例:Cerebras-GPT 与 MiniCPM 如何用 muP 把超参从规模里解耦、MiniCPM 如何用 WSD(warm-up / stable / decay)学习率把 Chinchilla 复现从 n² 次训练压到近似一次、DeepSeek LLM 如何不靠 muP 直接网格搜索最优 batch 与学习率、以及近一年 Llama 3(约 39:1)、Hunyuan-1(96:1)、MiniMax-01 这些公开 scaling 研究给出了什么。下半场用四十分钟深潜 muP:从两条'谱条件'(初始化时激活为 Θ(1)、走一步梯度后激活变化仍为 Θ(1))出发,在一个深线性网络上推导出 1/√fan-in 的初始化和逐层学习率 fan-out/fan-in(SGD)或 1/fan-in(Adam),再对照大规模消融实验看它什么时候有效、什么时候失效。
本篇属于系列 Stanford CS336 精读 · 第十一讲
来源:YouTube 原视频(Stanford Online · CS336 Language Modeling from Scratch · Spring 2025 · Lecture 11: Scaling laws 2)
来源说明 这是斯坦福 CS336《Language Modeling from Scratch》2025 年春季第十一讲的完整讲义,主讲人是 Percy Liang。它是 scaling laws 两讲里的第二讲,按讲师自己的定位,这一讲“更像一节案例与细节课”:上半场讲“工业界实际上怎么用 scaling law”,下半场用四十分钟把 muP(maximum update parameterization)从头推一遍。他坦率地承认,上半场很多模型细节来自二手材料——“Chinchilla 之后 ChatGPT 出现了,竞争格局彻底改变,大家就不再公开数据和 scaling 的细节了”,所以只能靠那些“认真做完了 scaling 再发论文”的团队留下的文档。 文中 18 张配图均截取自视频对应时刻的画面,并把该时刻的完整观点句(英文原句+中文翻译)拼合进图中。文中出现的所有数字——Chinchilla 的 20、Llama 3 的约 39、MiniCPM 拟合出的 192 tokens/param、Hunyuan-1 的 96(active parameter)、Cerebras-GPT 的 40M 代理模型与 0.1B–13B 模型族、MiniCPM 宣称的约 5× 算力节省、DeepSeek LLM 的 7B/67B 与 10²⁰–10²⁴ FLOPs 外推、MiniCPM 稳定在约 10⁻² 的最优学习率、muP 消融里的宽度 128/512/2048、10B 英雄实验里的 2⁻⁶、强 weight decay 的 0.1 等——都是讲师课上的口播、幻灯片引用或对公开论文/传闻的转述,不是本文独立核实的事实,请自行核查原始论文与官方披露。 另外两点提醒:其一,讲师本人对“把最优学习率拟合成一条 scaling law”这件事是持保留态度的,他当场说那种图“我大概也能画一条水平线,看起来也差不多”,并说“即使作为 scaling law 爱好者,我也不太敢押上性命去用它选学习率”——本文照实转述这种怀疑,而不是把它当成结论。其二,自动字幕把不少专有名词听错了:
Siri GPT/Cerebris是 Cerebras-GPT,mini CPM是 MiniCPM,Hunan Large是 Hunyuan-Large,atom是 Adam,mu/mup/mute都是 muP,new/new P多为 muP 的口误,R&M papers指的是线性时间复杂度的序列建模(RNN/SSM 系)论文,下文按通行写法记录。
TL;DR
- 这一讲分两半,第一半是“案例研究”,第二半是“muP 深潜”。 上一讲讲的是 scaling law 这套工具本身(Kaplan、Chinchilla、isoflop、临界 batch size);这一讲回答的是“真实团队到底怎么用它”。讲师的原话是:“我从没在 Chinchilla 规模上训过 70B 模型,所以只能大量依靠案例研究。”
- Chinchilla 之后是“scaling 的黑箱期”。 2022 年之后,前沿实验室基本不再公开数据与 scaling 细节,讲师说他当面问过一些前沿实验室“你们怎么 scale”,得到的回答是“我们什么都不会告诉你”。于是公开可查的高质量 scaling 研究只剩下少数几家:Cerebras-GPT、MiniCPM、DeepSeek LLM 是这份名单上的黄金标准。
- 四个案例各教一件事:Cerebras-GPT 给出 muP 的第一次公开验证(把实验缩到 4000 万参数的代理模型上做超参搜索,再放大回去);MiniCPM 普及了 WSD(warm-up / stable / decay)学习率,让 Chinchilla 复现从“每个数据量都要从头训一遍”变成“一次训练 + 反复回退降温”;DeepSeek LLM 完全不用 muP,直接对 batch size 和学习率做网格扫描并拟合成 scaling law;近一年的 Llama 3 / Hunyuan-1 / MiniMax-01 则说明——Chinchilla 的结果会被反复复现,但 20 这个具体数字并不稳定。
- WSD 是这一讲最实用的一个技巧。 余弦学习率的问题在于:换一个训练目标(数据量)就是另一条曲线,已训的部分没法复用,于是要拿到 n 个数据量下的 checkpoint 就得训 n 次(讲师说这是“n² 级别的运行”)。WSD 把学习率拆成 warm-up、平的 stable、快速 decay 三段,stable 段可以共用、decay 段可以重放——于是“一次训练 + 若干次短降温”就能覆盖整条 Chinchilla 曲线。代价是训练 loss 曲线会变得很怪(decay 阶段断崖式下跌),但那是正常的。
- Chinchilla 的 20 只是起点,不是约束。 各家复现得到的比例全都不一样:Llama 3 约 39,Hunyuan-1 是 96(按 active parameter 算),MiniCPM 甚至拟合出 192 tokens/param(讲师说这个数他从没在别处见过,属于离群值)。他的结论不是“你应该相信 192”,而是**“Chinchilla 分析并不是一条硬约束,你有相当大的自由去把 token/参数比往上推”**。
- muP 要解决的问题,是让超参(尤其是最优学习率)不随模型变大而漂移。 标准参数化下,模型越宽、最优学习率越小,你就得在最大规模上重新调参——代价不可接受。muP 希望做到“小模型上调好的学习率,直接拿去训大模型”。
- muP 建立在两条“谱条件”上:A1 初始化时(按坐标)激活量级保持 Θ(1);A2 走一步梯度之后,激活的变化量也保持 Θ(1)。翻译成范数就是“激活范数应该是 Θ(√n)”。
- 推导的骨架:在一个没有非线性的深线性网络
h_l = W_l h_{l−1}上,用高斯随机矩阵的算子范数集中性质‖W_l‖₂ ≈ σ_l(√n_l + √n_{l−1}),先由 A1 解出初始化的σ_l ∝ 1/√fan-in(再乘一个修正因子),再由 A2(外加一个“loss 的下降量也不能随宽度爆炸或消失”的假设)解出学习率:SGD 是fan-out/fan-in,Adam 是1/fan-in。对 MLP 来说n_l/n_{l−1} = 4是个常数,所以真正和标准参数化拉开差距的,是逐层学习率。 - muP 的实证结论很干净:在只放大宽度、
1/d注意力缩放、标准 Transformer 的设定下,小模型上扫出来的最优学习率能稳定迁移到大模型——学习率对激活函数(SwiGLU / squared ReLU / ReLU 的最优学习率相同)、对 batch size(上下 4×)、对若干初始化选择都鲁棒;但对可学习的 gain / bias、对 Lion 这类非 Adam 优化器、以及对更强的 weight decay(0.1)会失效,其中 weight decay 被讲师称为“可能唯一真正重要的 muP 失效案例”。 - 最后一页把“野外 scaling”归成三个难题与三个解法:难题是(1)定架构超参、(2)定优化器超参、(3)跑完一次大 Chinchilla sweep 的算力;解法是(1)假设稳定性或直接上 muP、(2)在小规模搜最优 LR/batch,然后要么冻结、要么用 scaling law 外推、(3)改用 WSD 这类可以复用的调度。
一、这一讲在哪:从“论文里的 scaling law”到“真实世界的 scaling 配方”
上一讲把 scaling law 当成一套工具讲完了:Kaplan、Chinchilla、isoflop、临界 batch size、以及它们怎么指导训练。这一讲换了个角度——真实团队在做一个大模型时,究竟怎么使用这些工具?
讲师开场就把这门课里最诚实的一句话放在了最前面:他对 scaling law 抱有“应有的怀疑”。“它无非是在 log-log 图上做曲线拟合——真的有我上节课说的那么好吗?isoflop 真的告诉你正确的 token 权衡了吗?真的能用它来定最优学习率吗?” 你们在作业里会亲自验证这些问题的答案。
然后他解释了为什么这一讲必须靠“案例”来讲:Chinchilla(2022)之后,ChatGPT 出现了,大模型竞赛的格局彻底改变,人们不再公开任何关于数据和 scaling 的东西。 他说他曾当面问过一些前沿实验室的人“你们在 scaling 上到底怎么做”,得到的回答是“我们不会告诉你任何关于 scaling 的事”。所以只能依赖那些做完了工作、并且愿意写出来的团队。
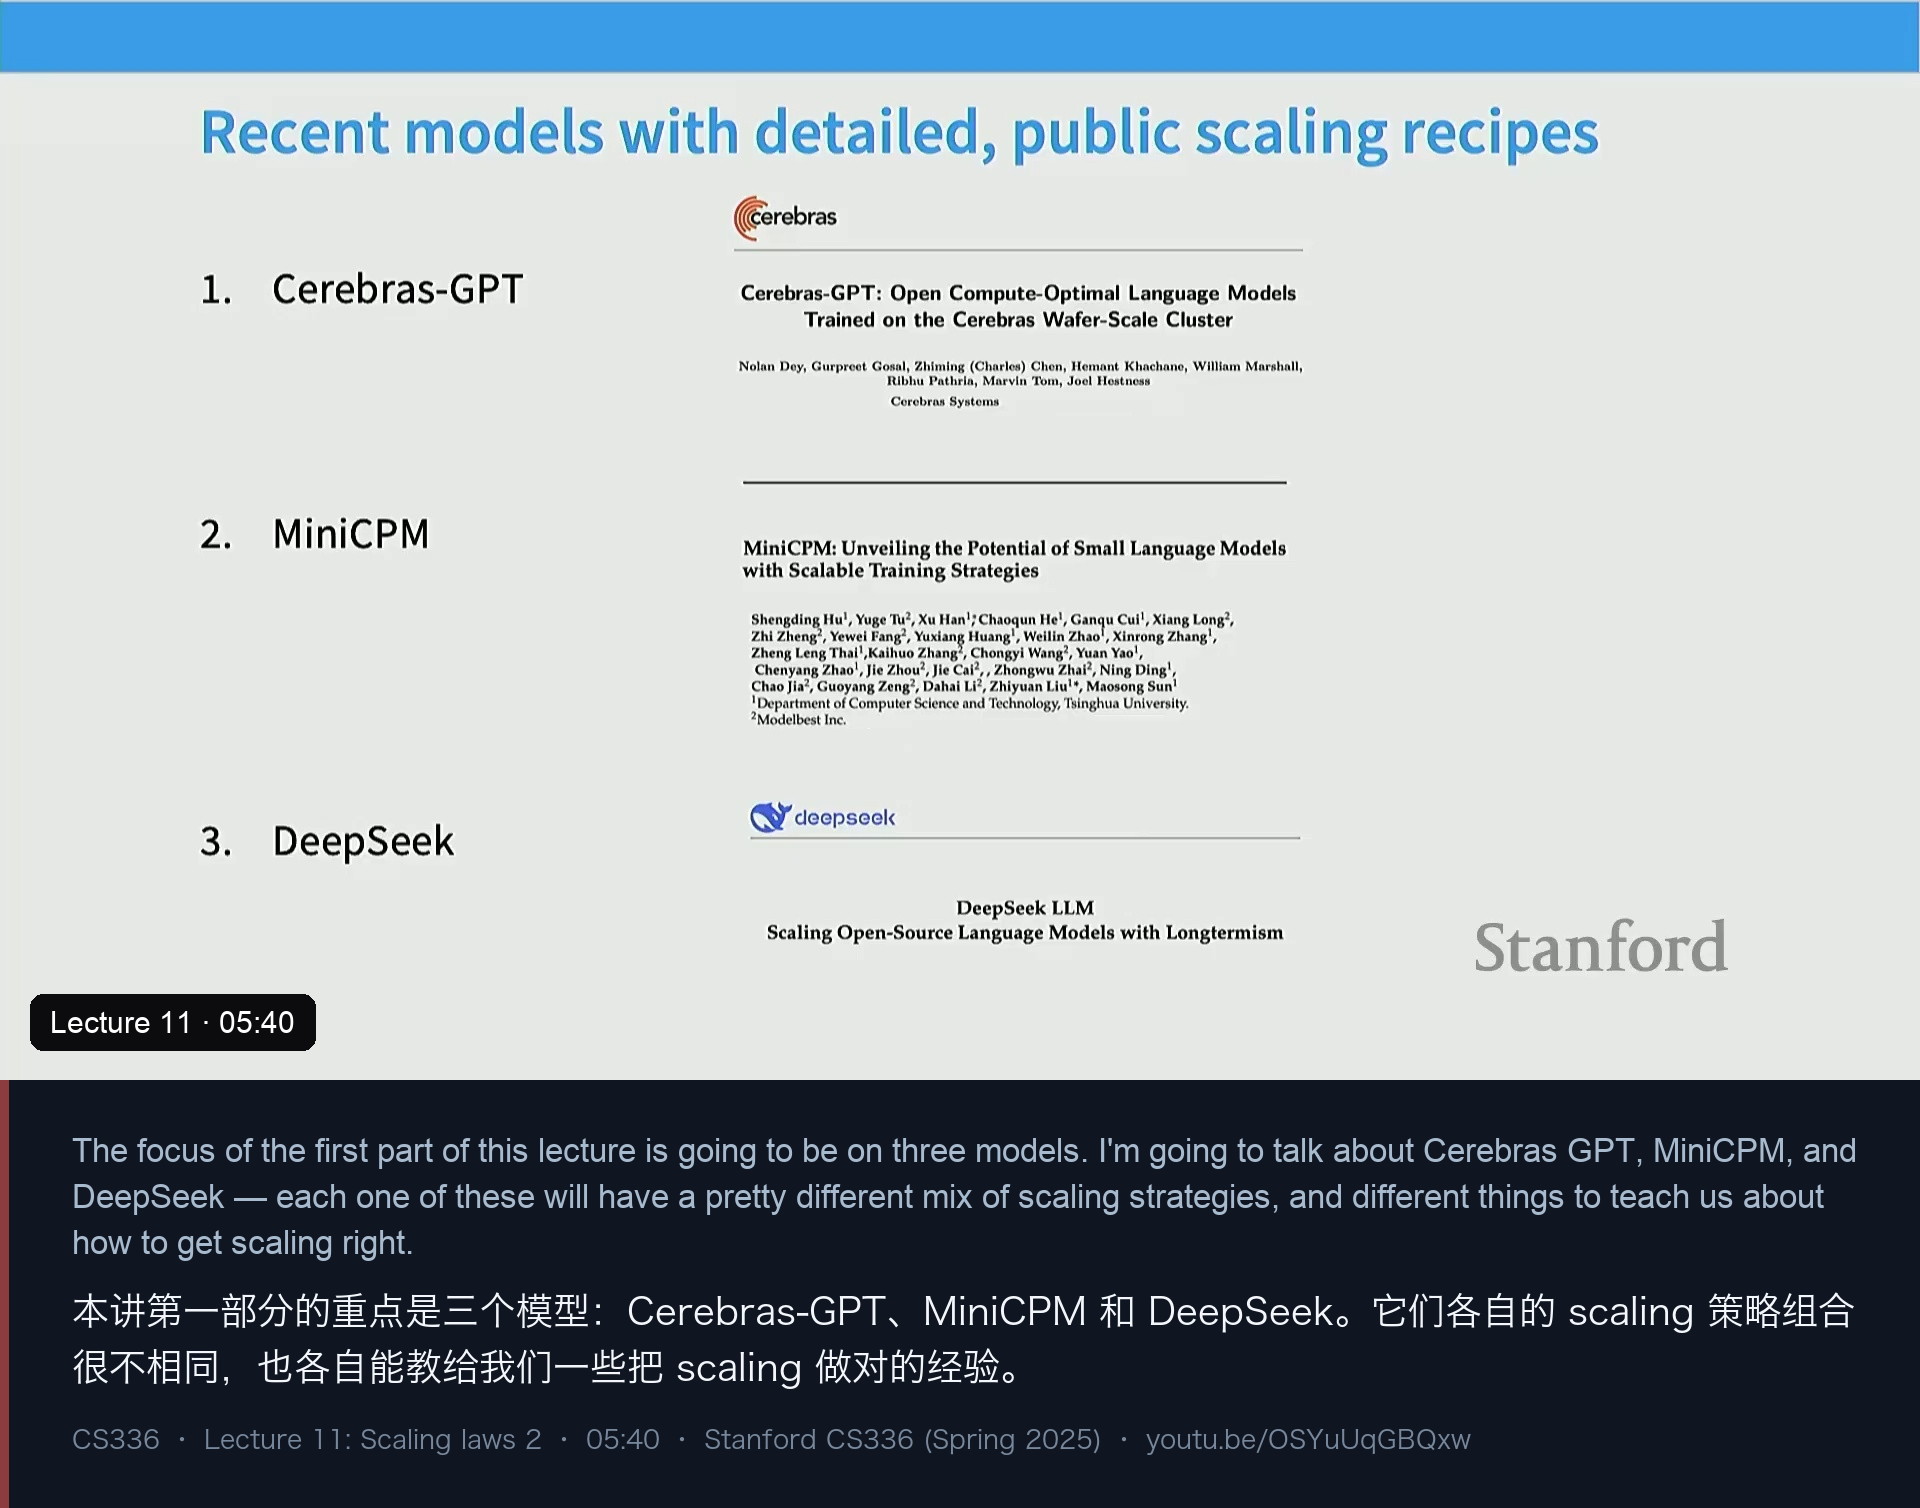
被选中的是上面这三个(图 1)。去年这门课讲的是 Cerebras-GPT、DeepSeek LLM 和 MiniCPM;今年他又补了三个新面孔——Llama 3、Hunyuan-Large、MiniMax-01——但坦率地说,“新 scaling law 洞见与论文的产出其实稀疏得多”,这三个只有零星的 scaling 研究,没有一篇的细致程度能比得上 DeepSeek 或 MiniCPM。这大概就是 2025 年公开可得的 scaling 研究现状。
顺带他讲了一句很能说明时代变化的旁白:去年讲这一节时,他得花力气解释“为什么要讲这些中国模型”;今年,他说“希望你们本来就已经很兴奋地想听 DeepSeek 了,不需要我再来说服你们”。
本讲的第二部分则是他早就预告过的深潜:muP。上一讲提到过 muP 但没展开,而“大部分文献其实也没把 muP 解释清楚,它们只说:把初始化按 1/width 缩放、把逐层学习率按 1/width 缩放,这就是 muP”。他想把这两个“凭什么是这样”讲清楚。
二、案例一:Cerebras-GPT——muP 的第一次公开验证
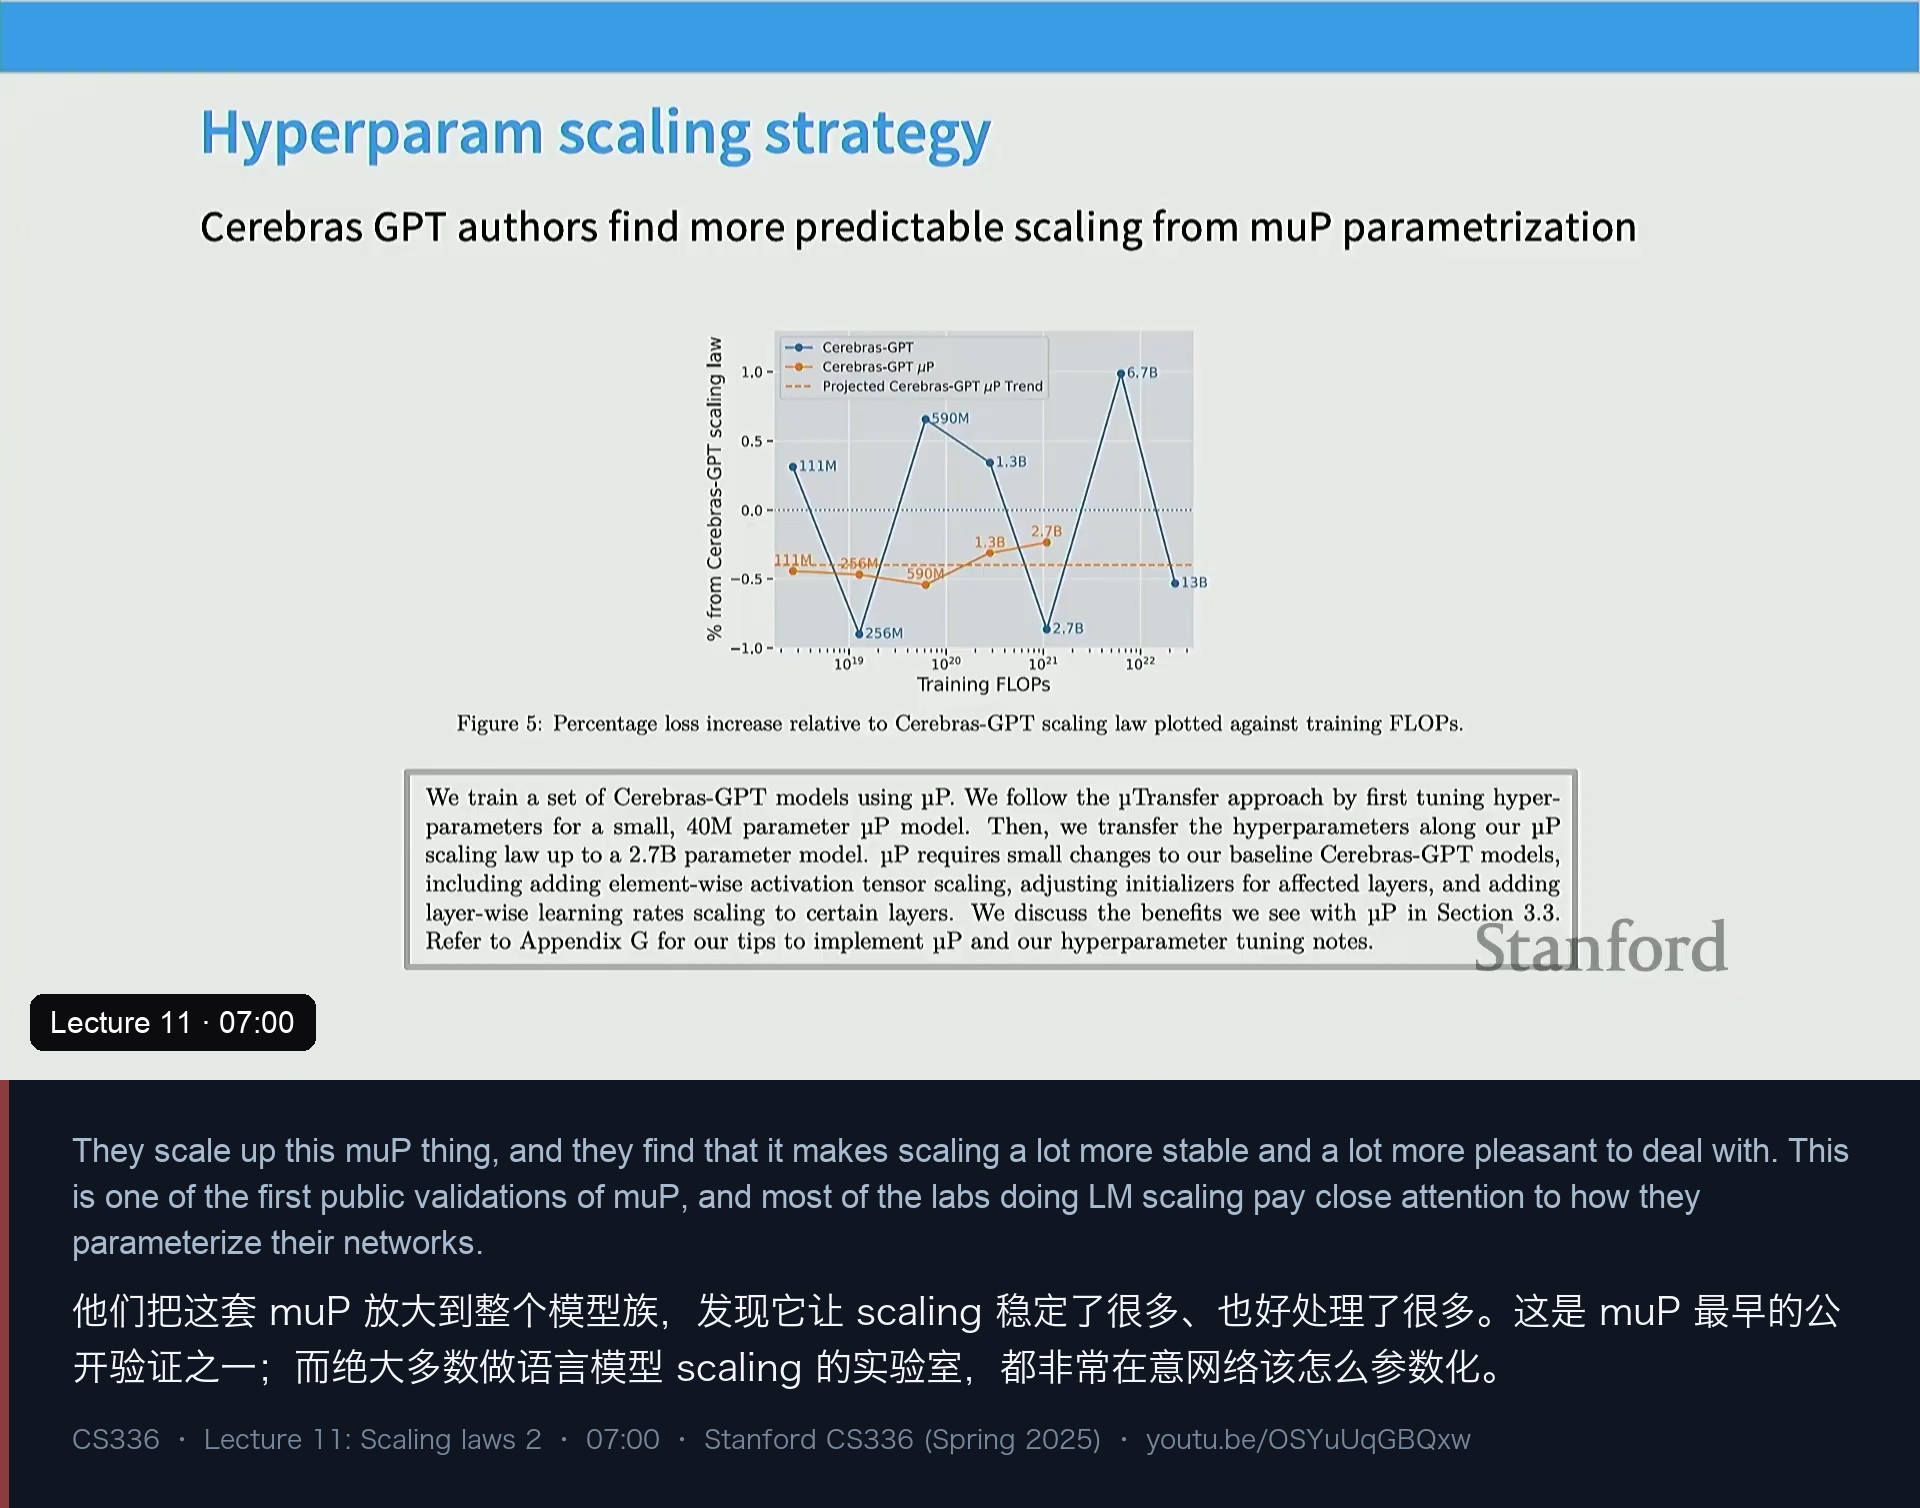
Cerebras-GPT 是一个 0.1B 到 13B 的模型族,按 Chinchilla 配方训练(token 数与参数量大致按最优比例配)。它的核心贡献不是模型本身,而是**“把 muP 缩放上去”之后的效果**:Cerebras 的作者群本来就对参数化与 scaling 感兴趣,他们把 muP 用在整个模型族上,得到的结论是“这让 scaling 稳定了很多,也好处理了很多”。
图 2 里的两张曲线是这件事的证据:蓝线是标准参数化(SP),橙线是 muP。用 SP 时,曲线会在预测的 scaling 线附近来回振荡——原因很直白:模型变大就得调整学习率,而每次调整都会让实测点偏离那条“理论预测线”,于是你很难真正命中预测性能。换成 muP 之后,实测点明显更贴合拟合线。这也是 muP 最早的公开验证之一。
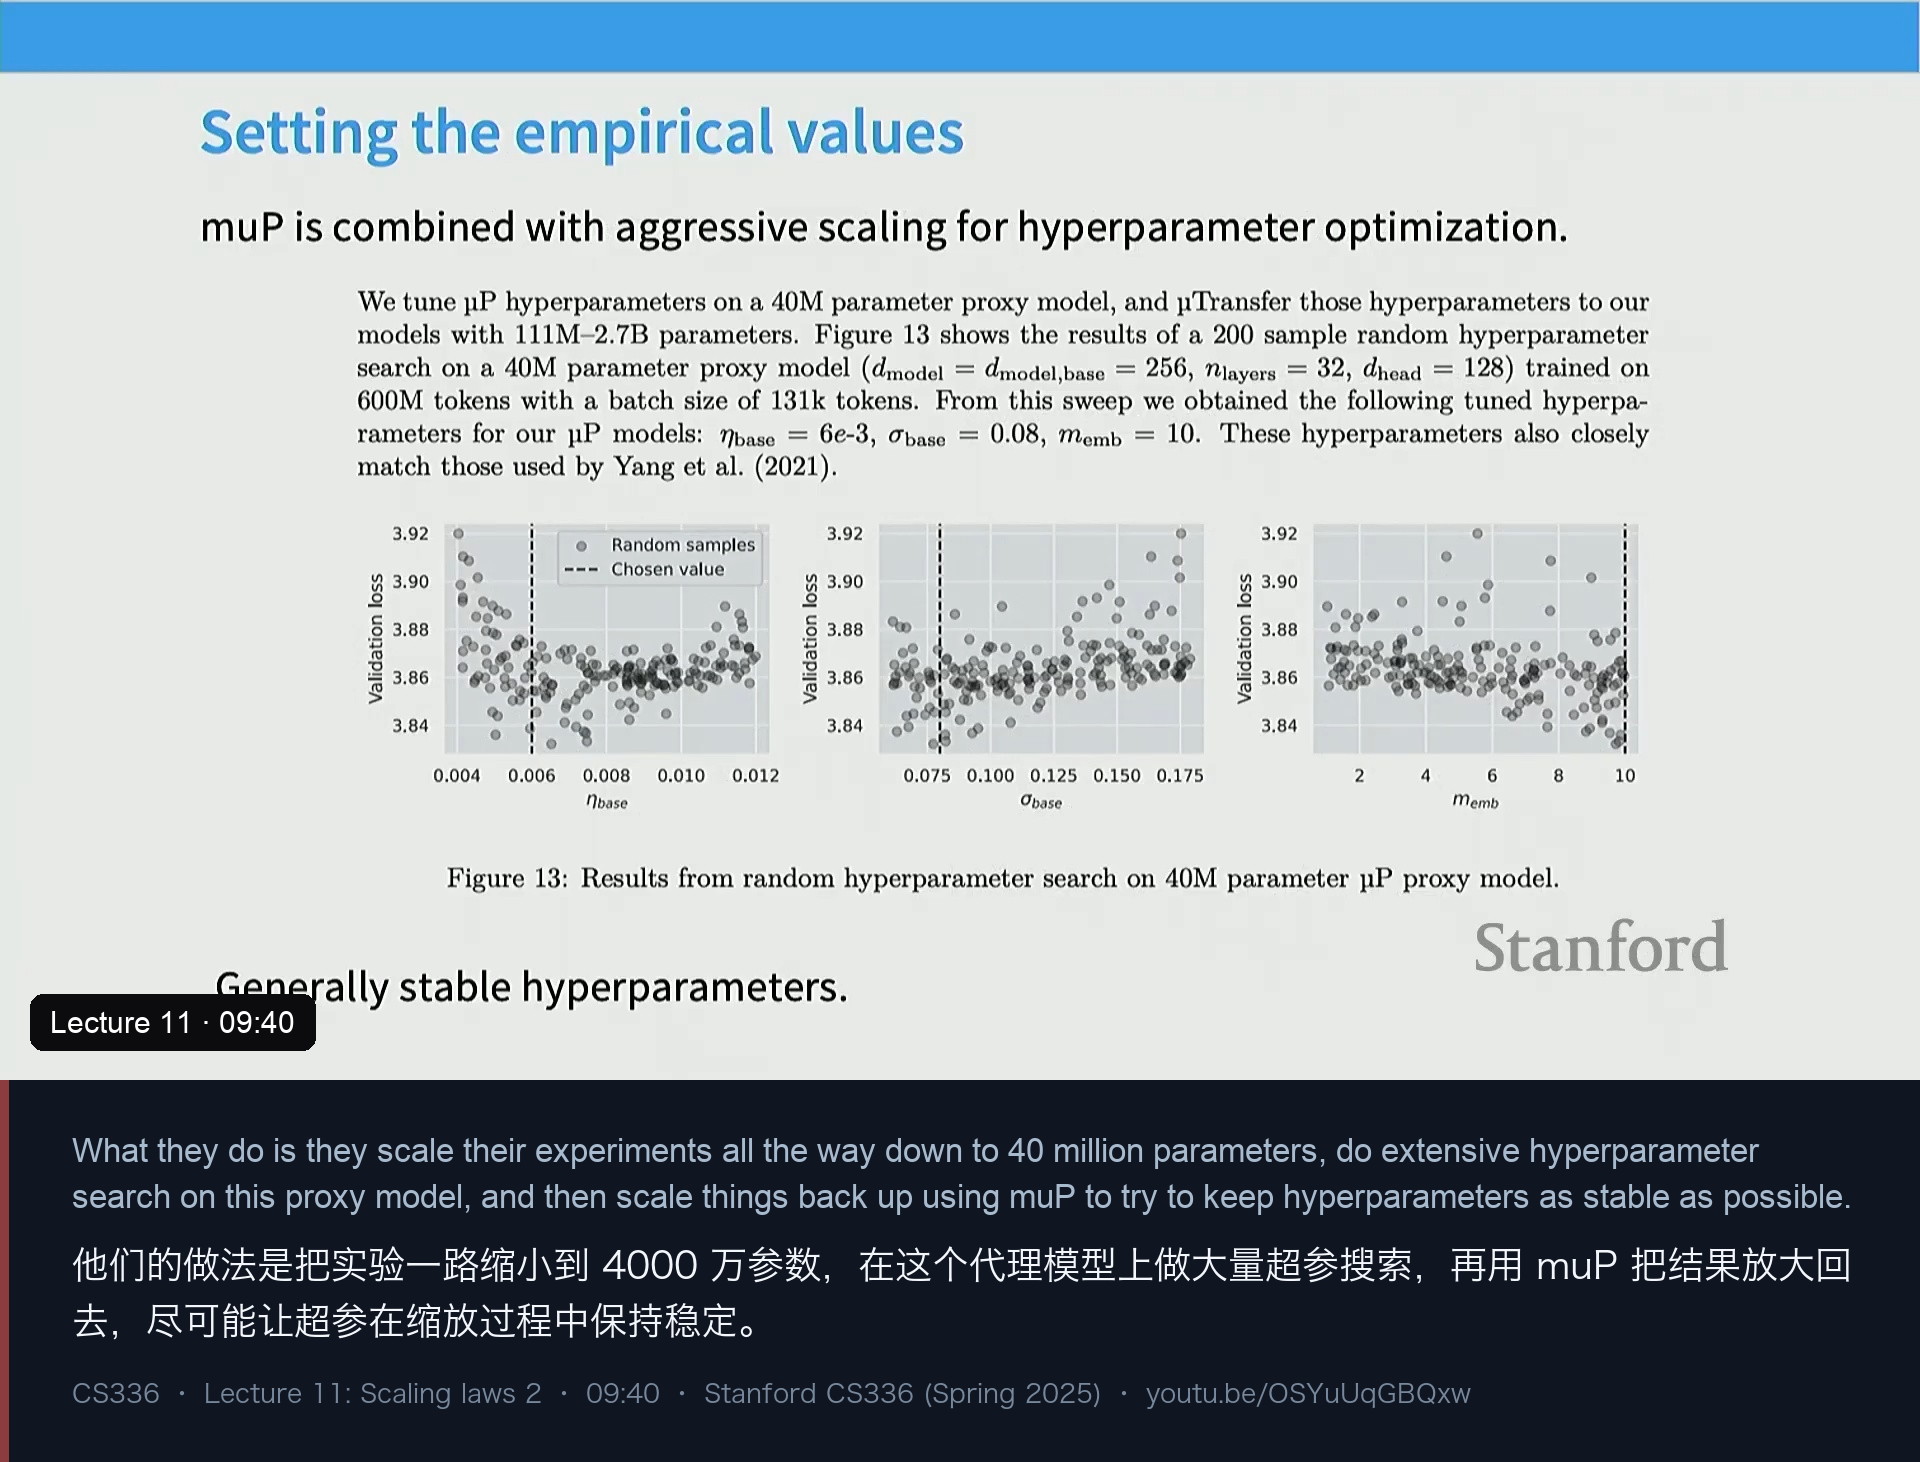
更值得注意的是它的超参选择流程(图 3):把实验规模一路缩到 4000 万参数,在这个廉价代理模型上做极其广泛的超参搜索(图中每个点是一次训练、每个点配一组超参,取包络即得超参网格),再用 muP 把结论放大回大模型。这套“缩小 → 搜索 → 放大”的组合,是后面 MiniCPM 与 DeepSeek 都会重复出现的主题。
Cerebras 那篇论文的附录里还有一份对实现者非常有用的对照表:标准参数化(SP)与 muP 在每一类层上的初始化与学习率该怎么设。讲师给的一行版总结是:除 embedding 之外的所有参数按 1/width 缩放初始化,逐层学习率也按 1/width 缩放——真正的差异不在初始化(如果你已经在用 Kaiming 式的 1/√fan-in,初始化其实差不多是对的),而在逐层学习率这个大多数人平时不会碰的对象上。
三、案例二:MiniCPM——临界 batch、WSD,以及一个离群的 192
MiniCPM 的目标不是训大模型,而是**“用很多算力去训一个很好的小模型”**——1.2B 到 2.4B 的规模,在当时的水平上打败了绝大多数 2B 级模型、追平了不少 7B 级模型。它的方法仍然是 muP:embedding 按常数缩放、残差/MLP 按 √层数 缩放、初始化按 1/base-width 缩放、学习率按宽度缩放。讲师说这跟 Cerebras 的配方“基本是同一套东西,超参也落在相近的地方(差个两倍左右)”。
它值得学习的有三件事。
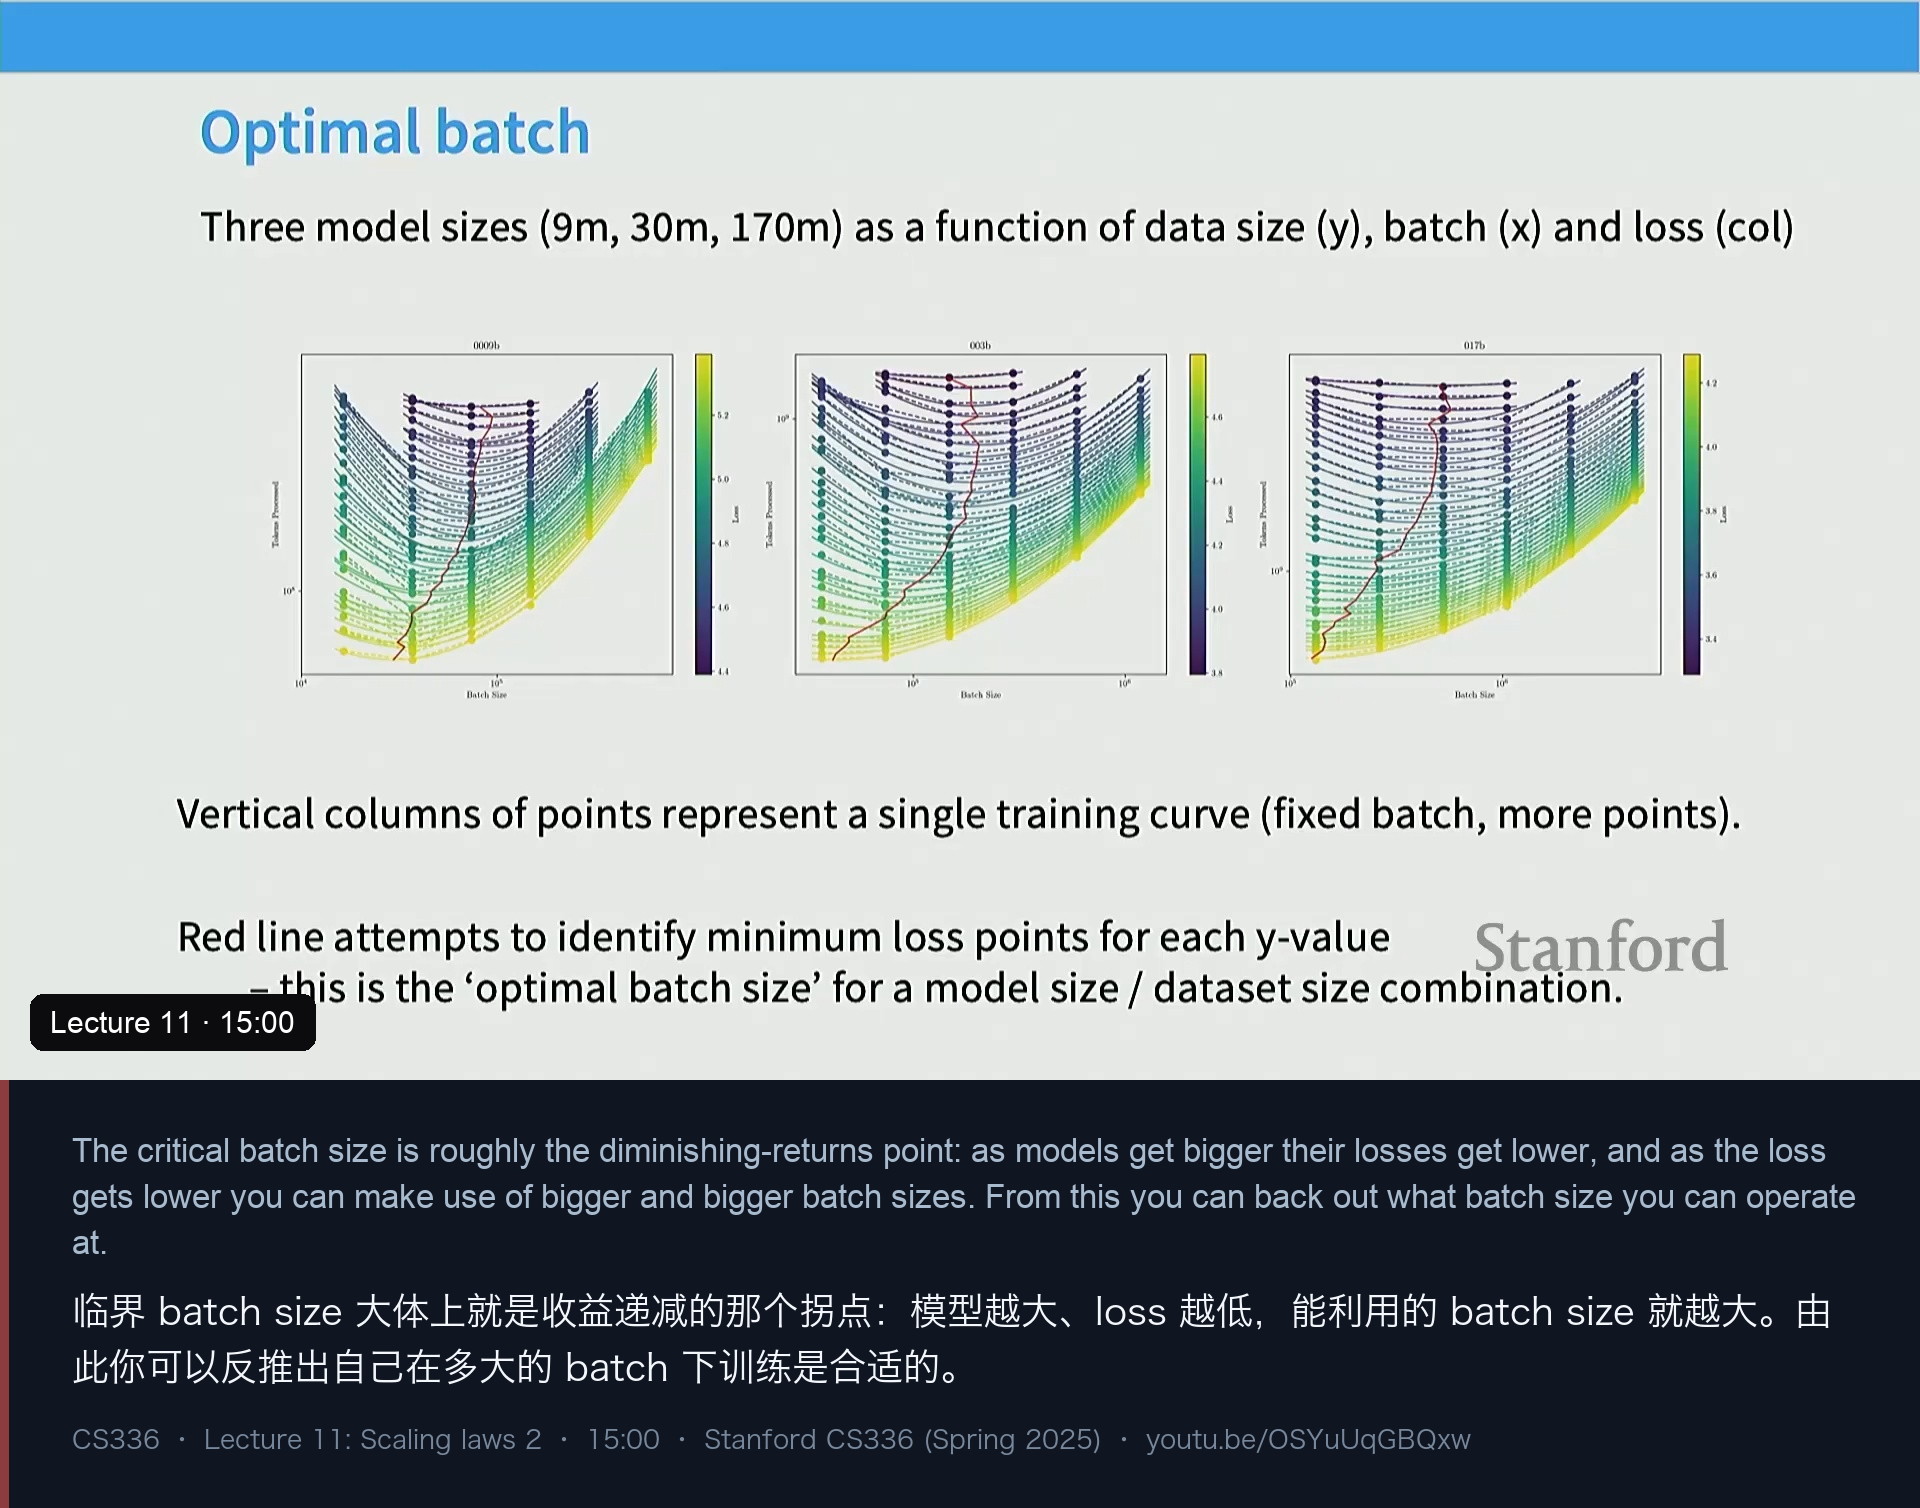
第一件是临界 batch size(critical batch size)。 它的含义是“收益递减点”:模型越大、loss 越低,能有效利用的 batch size 就越大。图 4 的纵列是单条训练曲线、横向是 batch、颜色是 loss,红线是每个 y 值上的最小 loss 包络;由此得到的经验规律与 Kaplan 那篇一致——终端 loss 与临界 batch size 在 log-log 上大致线性,loss 越低,最优 batch 就按多项式增长。知道了“我的目标 loss”,就能反推出“我该用多大 batch”。
第二件是 muP 带来的学习率稳定性。 MiniCPM 把所有模型(浅色是小的,深色是最大的)在不同学习率下的 loss 画在一起,看到的是一个相当宽的盆地,而且更重要的是:盆地的最低点在不同规模上几乎固定在同一个位置(约 10⁻²)。也就是说,只要初始化和逐层学习率缩放对了,你就不用在大规模上重调学习率,甚至不用去拟合“最优学习率随算力怎么变”这种曲线。他们还报告说,从最小模型到最大的 pilot run,muP 大约省下了 5 倍的算力——不过讲师也提醒,这种“缩到极小规模”的激进做法,对真正巨大的模型是否合适,其实并不清楚。
第三件,也是这一讲最出圈的一个技巧:WSD 学习率。
3.1 为什么余弦学习率不能复用
想在一次大规模训练里同时得到“不同数据量下的模型性能”(也就是 Chinchilla 式的数据缩放),最自然的想法是:训一次,然后取沿途的 checkpoint 当“用了更少数据”的模型。
这个想法是错的,而且讲师说它“经常咬人”。
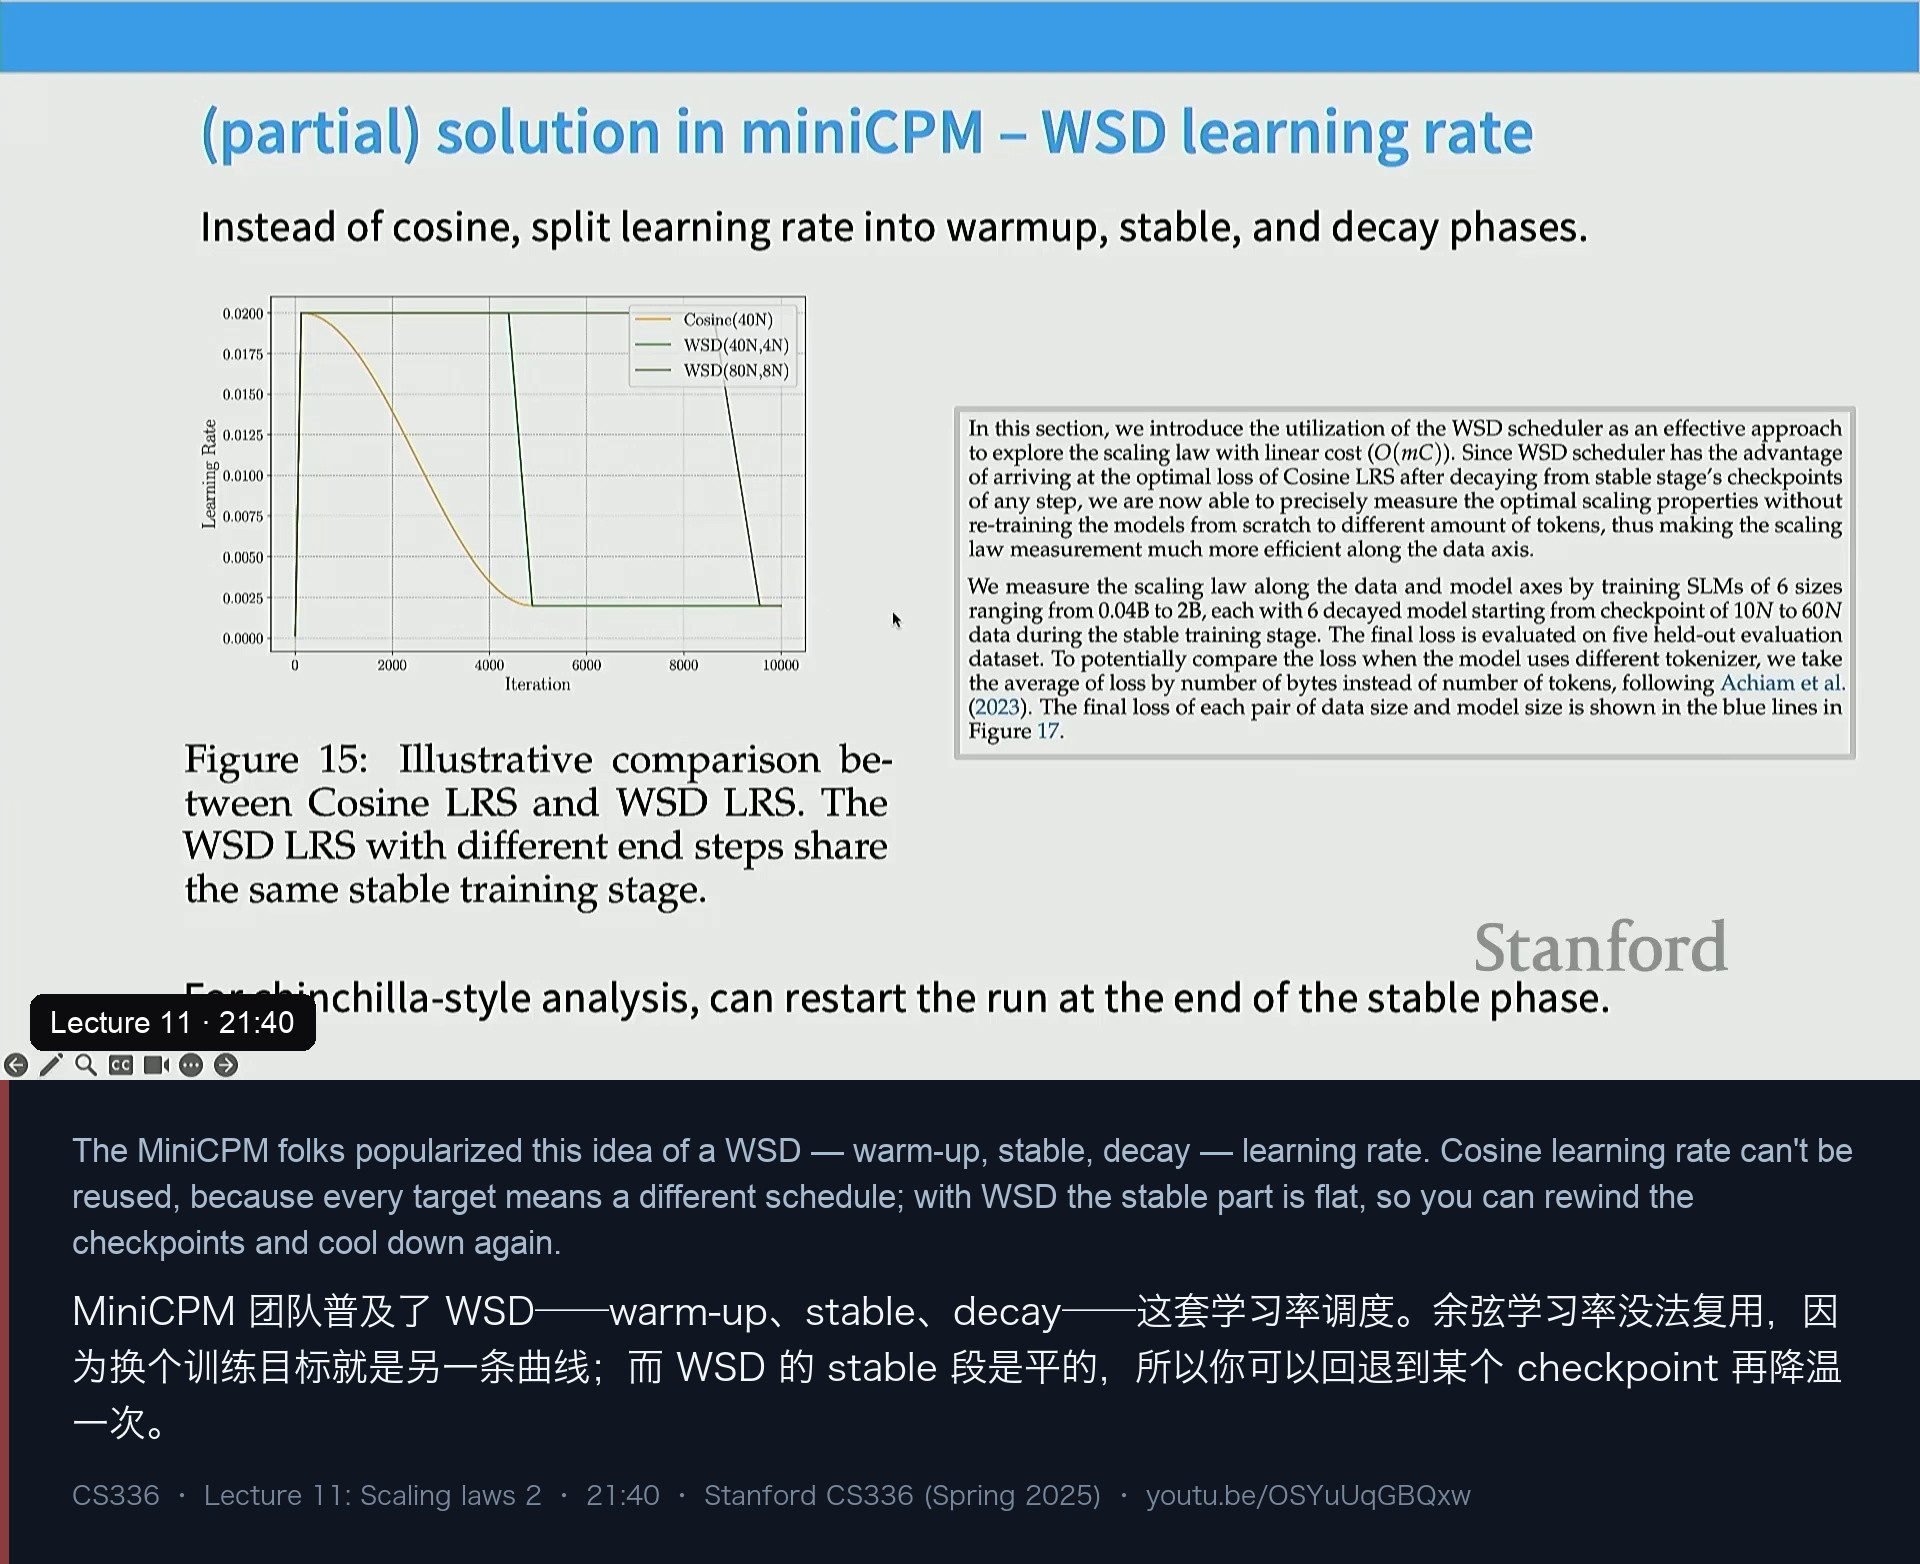
原因如图 5 所示:余弦学习率的形状依赖于终止点。 数据少的目标 → warm-up 之后很快就得降温;数据多的目标 → 缓慢降温到最后一刻。两条曲线的 warm-up 一样,但之后的每一步都不一样。所以你不能拿一条余弦曲线的中途 checkpoint 去谈“如果我只用一半数据会怎样”——那对应的是另一条完全不同的学习率曲线。于是要覆盖 n 个数据量,你基本上得从头训 n 次(“n² 级别的运行”,因为每个(模型大小 × 数据量)的组合都要单独跑)。
WSD(warm-up / stable / decay)就是解法:warm-up 段与余弦一样,然后是一段完全平的学习率,最后是一段快速降温的 decay。“为什么要这么设计?因为平的 stable 段可以复用。“具体操作是:先按 WSD 训到底(warm-up → 长 stable → 一次 decay),如果你想看”数据量更少会怎样”,就把 checkpoint 退回到 stable 段中的某个点、再单独跑一次 decay,这样得到的曲线形状和“从头训到那个数据量”的 WSD 曲线是一致的,而你只花了近似一次训练的成本。
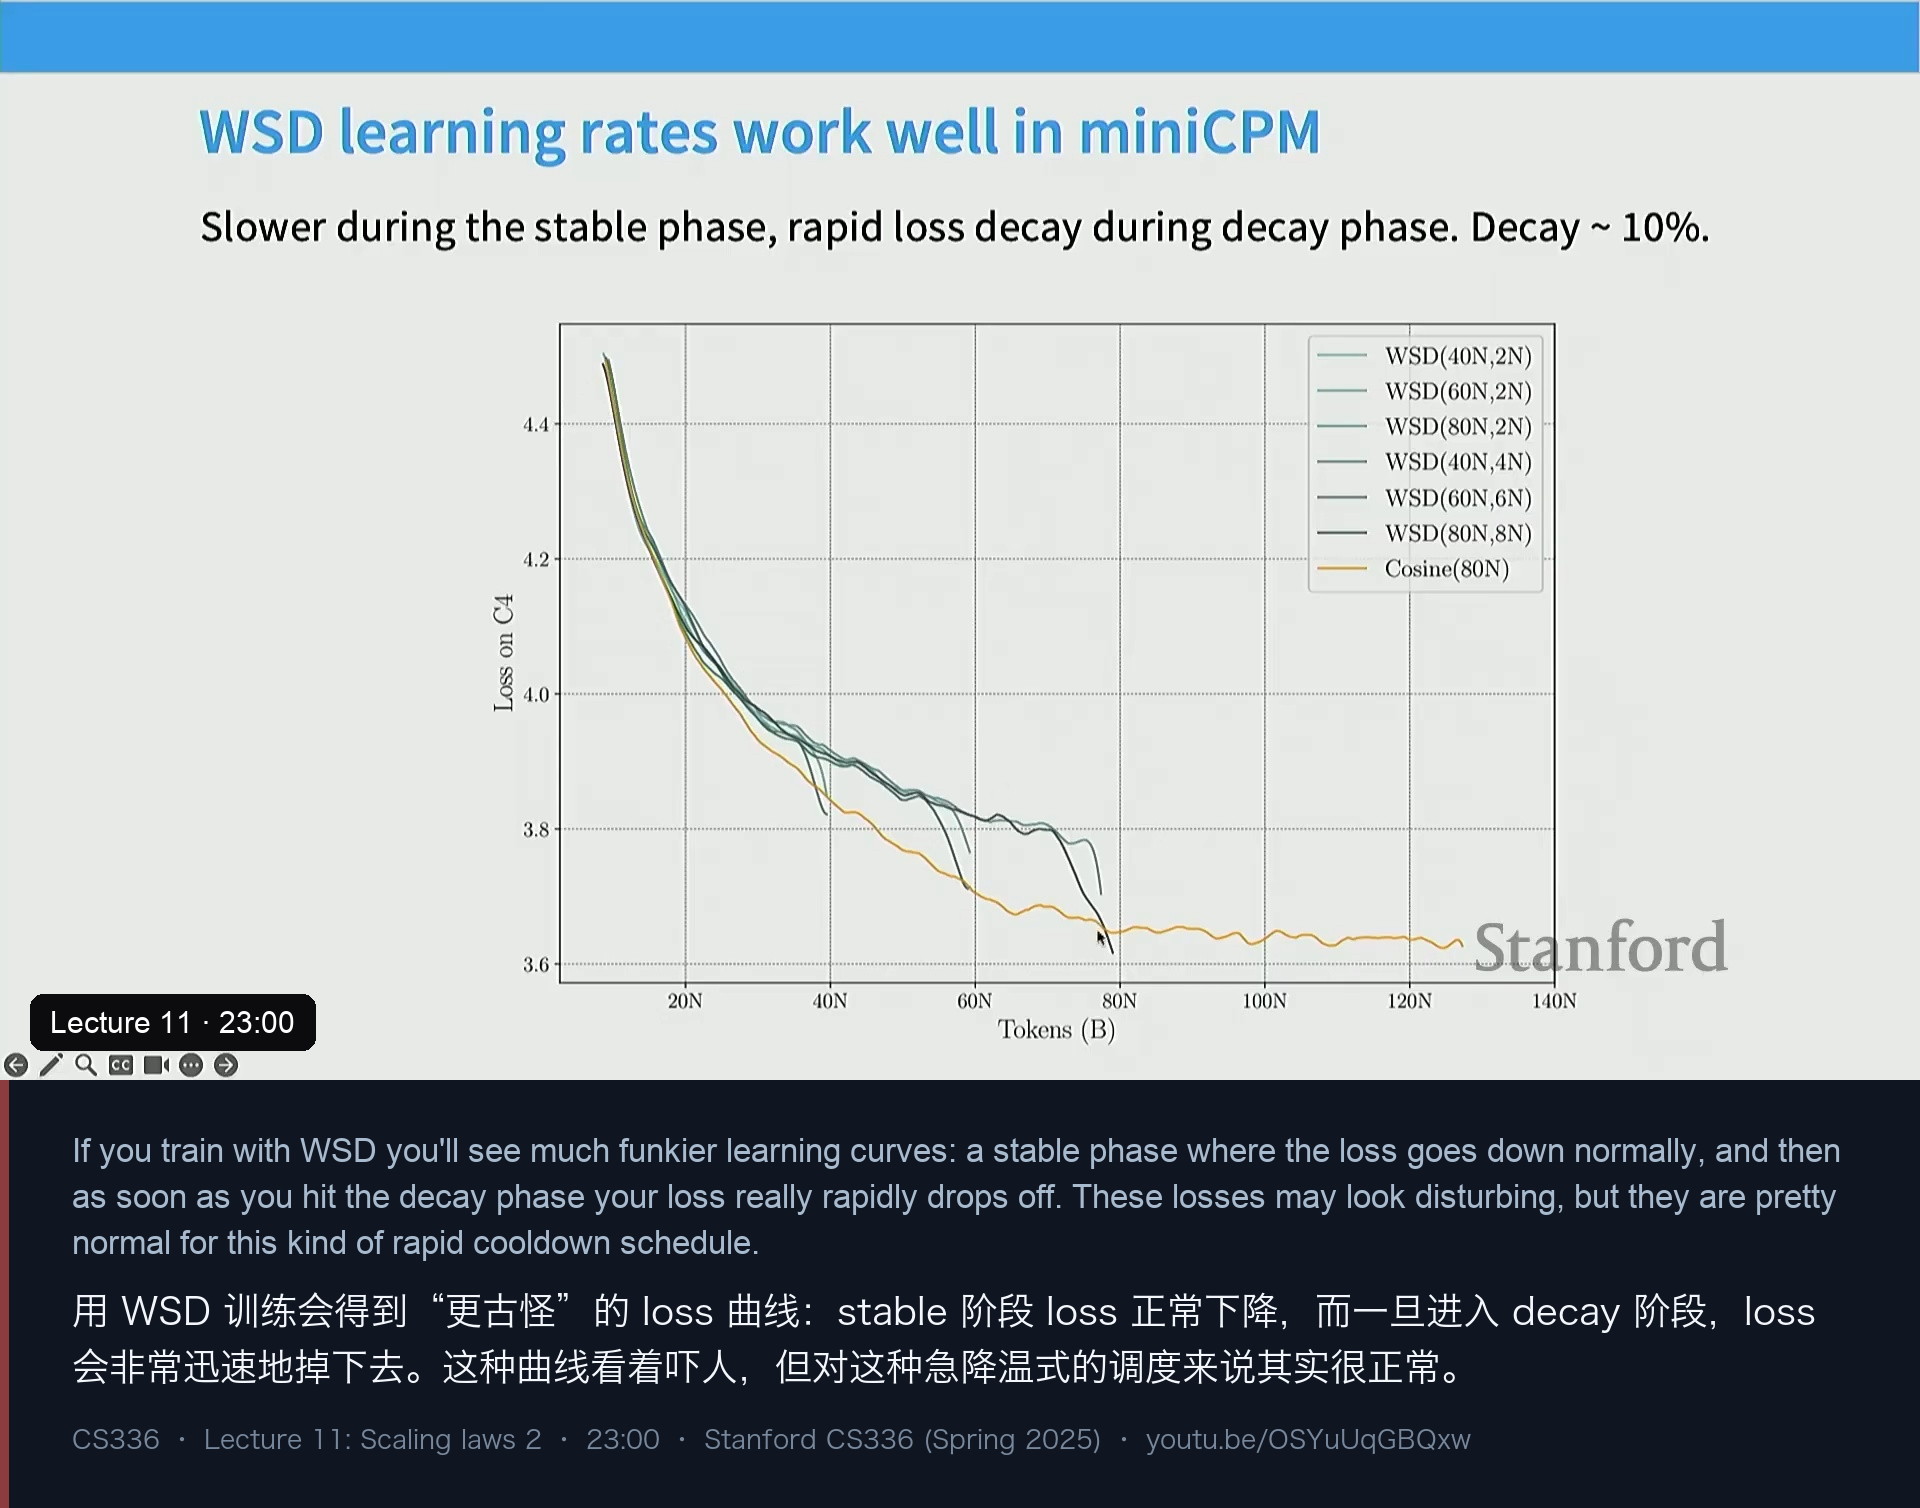
代价是曲线变“丑”(图 6):余弦的 loss 是一条平滑下降的曲线(黄色),WSD 的 loss 则在 stable 段平缓下降,一进入 decay 就迅速断崖。讲师特意说:“这些曲线看着让人不安,但对这种急降温调度来说其实很正常。“而且他指出一个有意思的经验事实:在每一个 token 数上,WSD 的最低点都能追平甚至超过余弦——顺便也点出,其中大部分收益其实来自 decay:stable 段一直在高位学习率上”远离初始化”,真正把 loss 压下去的是最后的降温。
四、旁注与复现:Chinchilla 到底是不是硬约束?
在讲 MiniCPM 的 Chinchilla 复现之前,讲师插了一个旁注:UW(当时是 UDub)+ Apple 的一篇工作提出用“Chinchilla penalty”来估计过训练(overtrain)的代价——即当你把 token/参数比推得远高于 Chinchilla 的 20 时,loss 会比“按 Chinchilla 最优配比训练的模型”差多少。他们发现这个退化量随 token/参数比的变化也有相当可预测的形状,可以在小规模上测出退化曲线再外推。讲师说他没见过大规模训练真的用这套方法,但它提供了“不靠 WSD 也能近似一次训练搞定 Chinchilla”的另一条路。
然后是 MiniCPM 自己的复现。他们同时用了 Chinchilla 论文里的 method 1(把多条训练曲线叠起来取下包络,下包络近似是一条幂律)与 method 3(假设一个两变量的 scaling law,直接在所有数据上做曲线拟合,再解出最优点)。
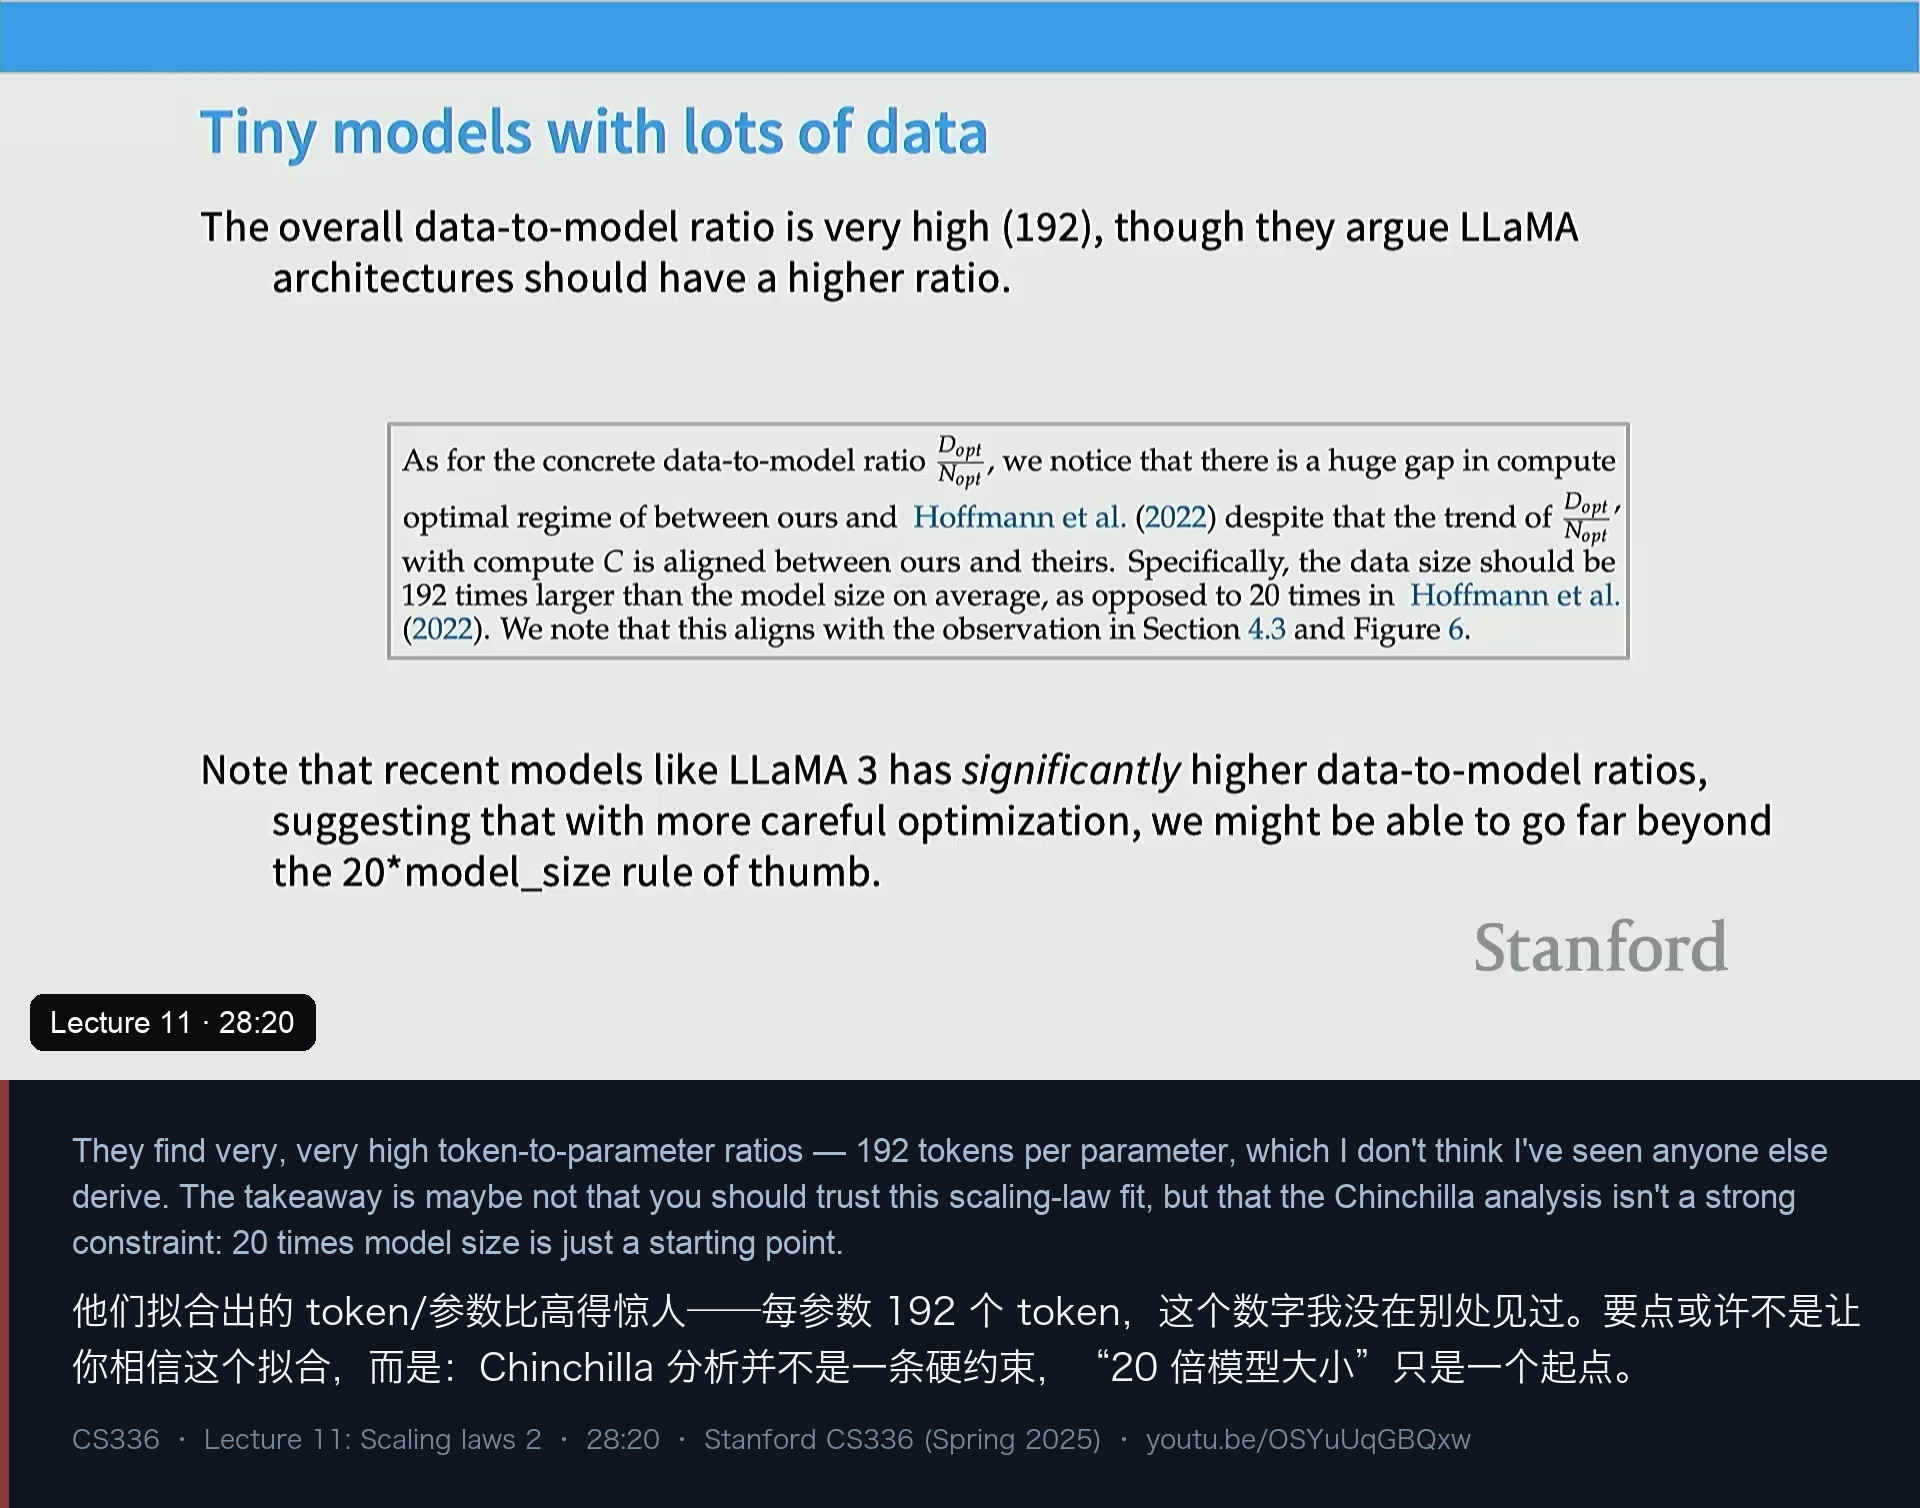
结果是一个让讲师反复强调“我不太信”的数字:192 tokens/param(图 7 —— 注意这张幻灯片讲的是“数据充足的小模型”:最小的模型只有在你喂给它超量数据时才是“数据充足”的,图中给出 3.2B 参数、246T token 之类的组合)。他说:“我印象里没见过别人得出这个数,这像是一个和大部分文献都对不上的离群值。“MiniCPM 的辩护是:LLaMA 式架构 + 更好的数据质量 + 更好的模型效率,本来就该有更高的比例。
但讲师希望学生带走的不是 192,而是一个更稳的判断:Chinchilla 分析不是硬约束。 他说:“最近像 Llama 3 这样的模型用着明显高于 20× 的比例,我们也没有看到严重的收益递减;这说明只要优化和调参做得好,你完全可以远超过 ‘20× 模型大小’ 这条经验法则。“换句话说,20× 是起点,不是边界。
五、案例三:DeepSeek LLM——不用 muP,直接把最优点拟合出来
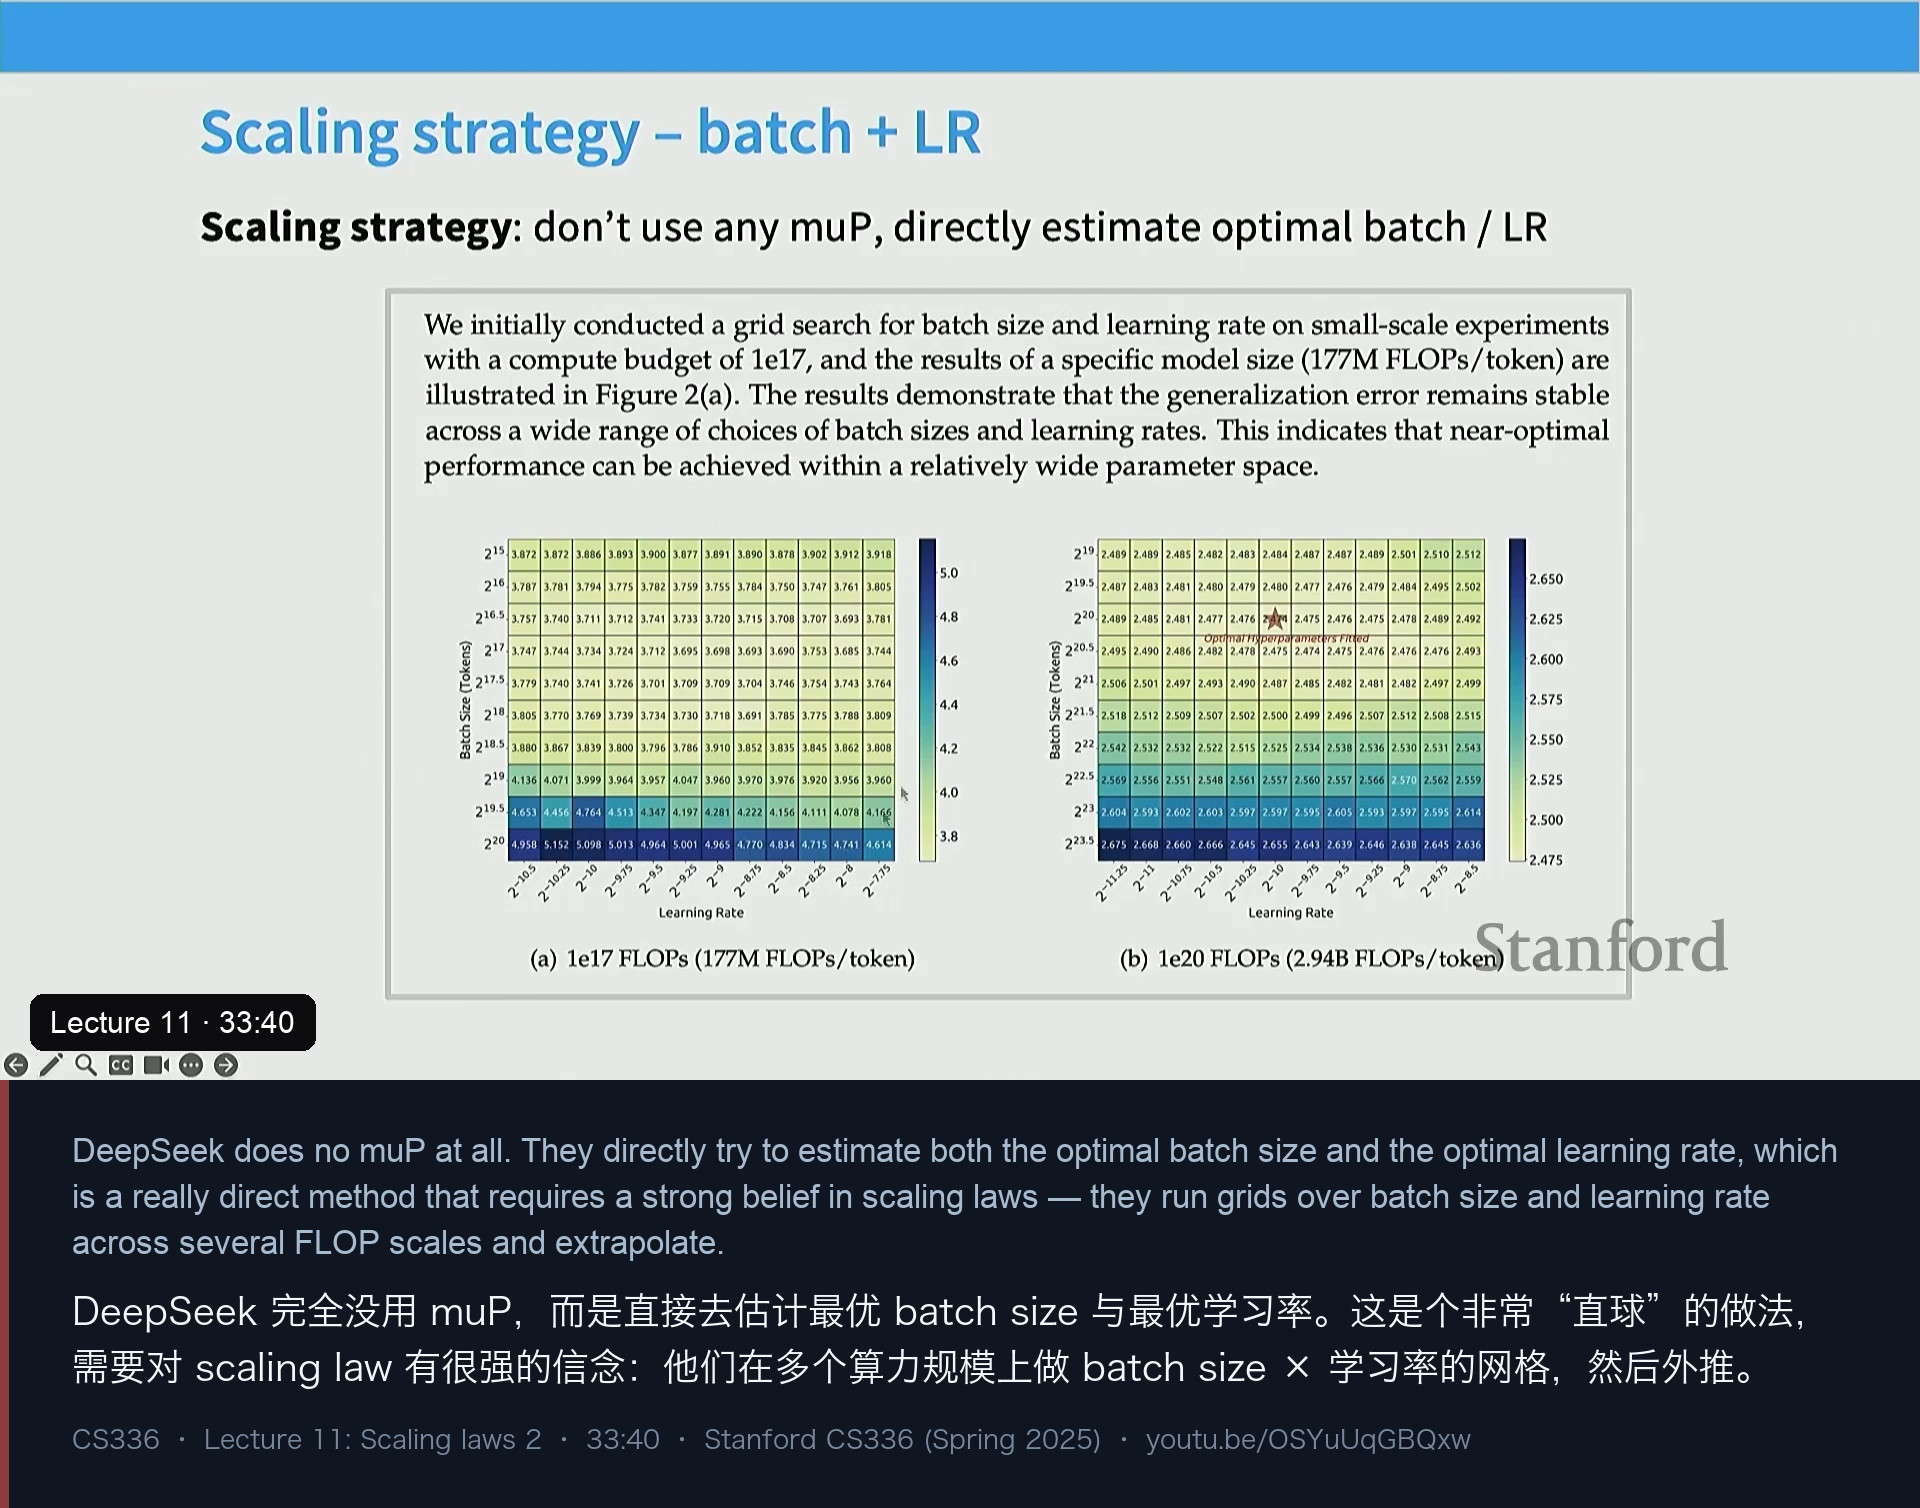
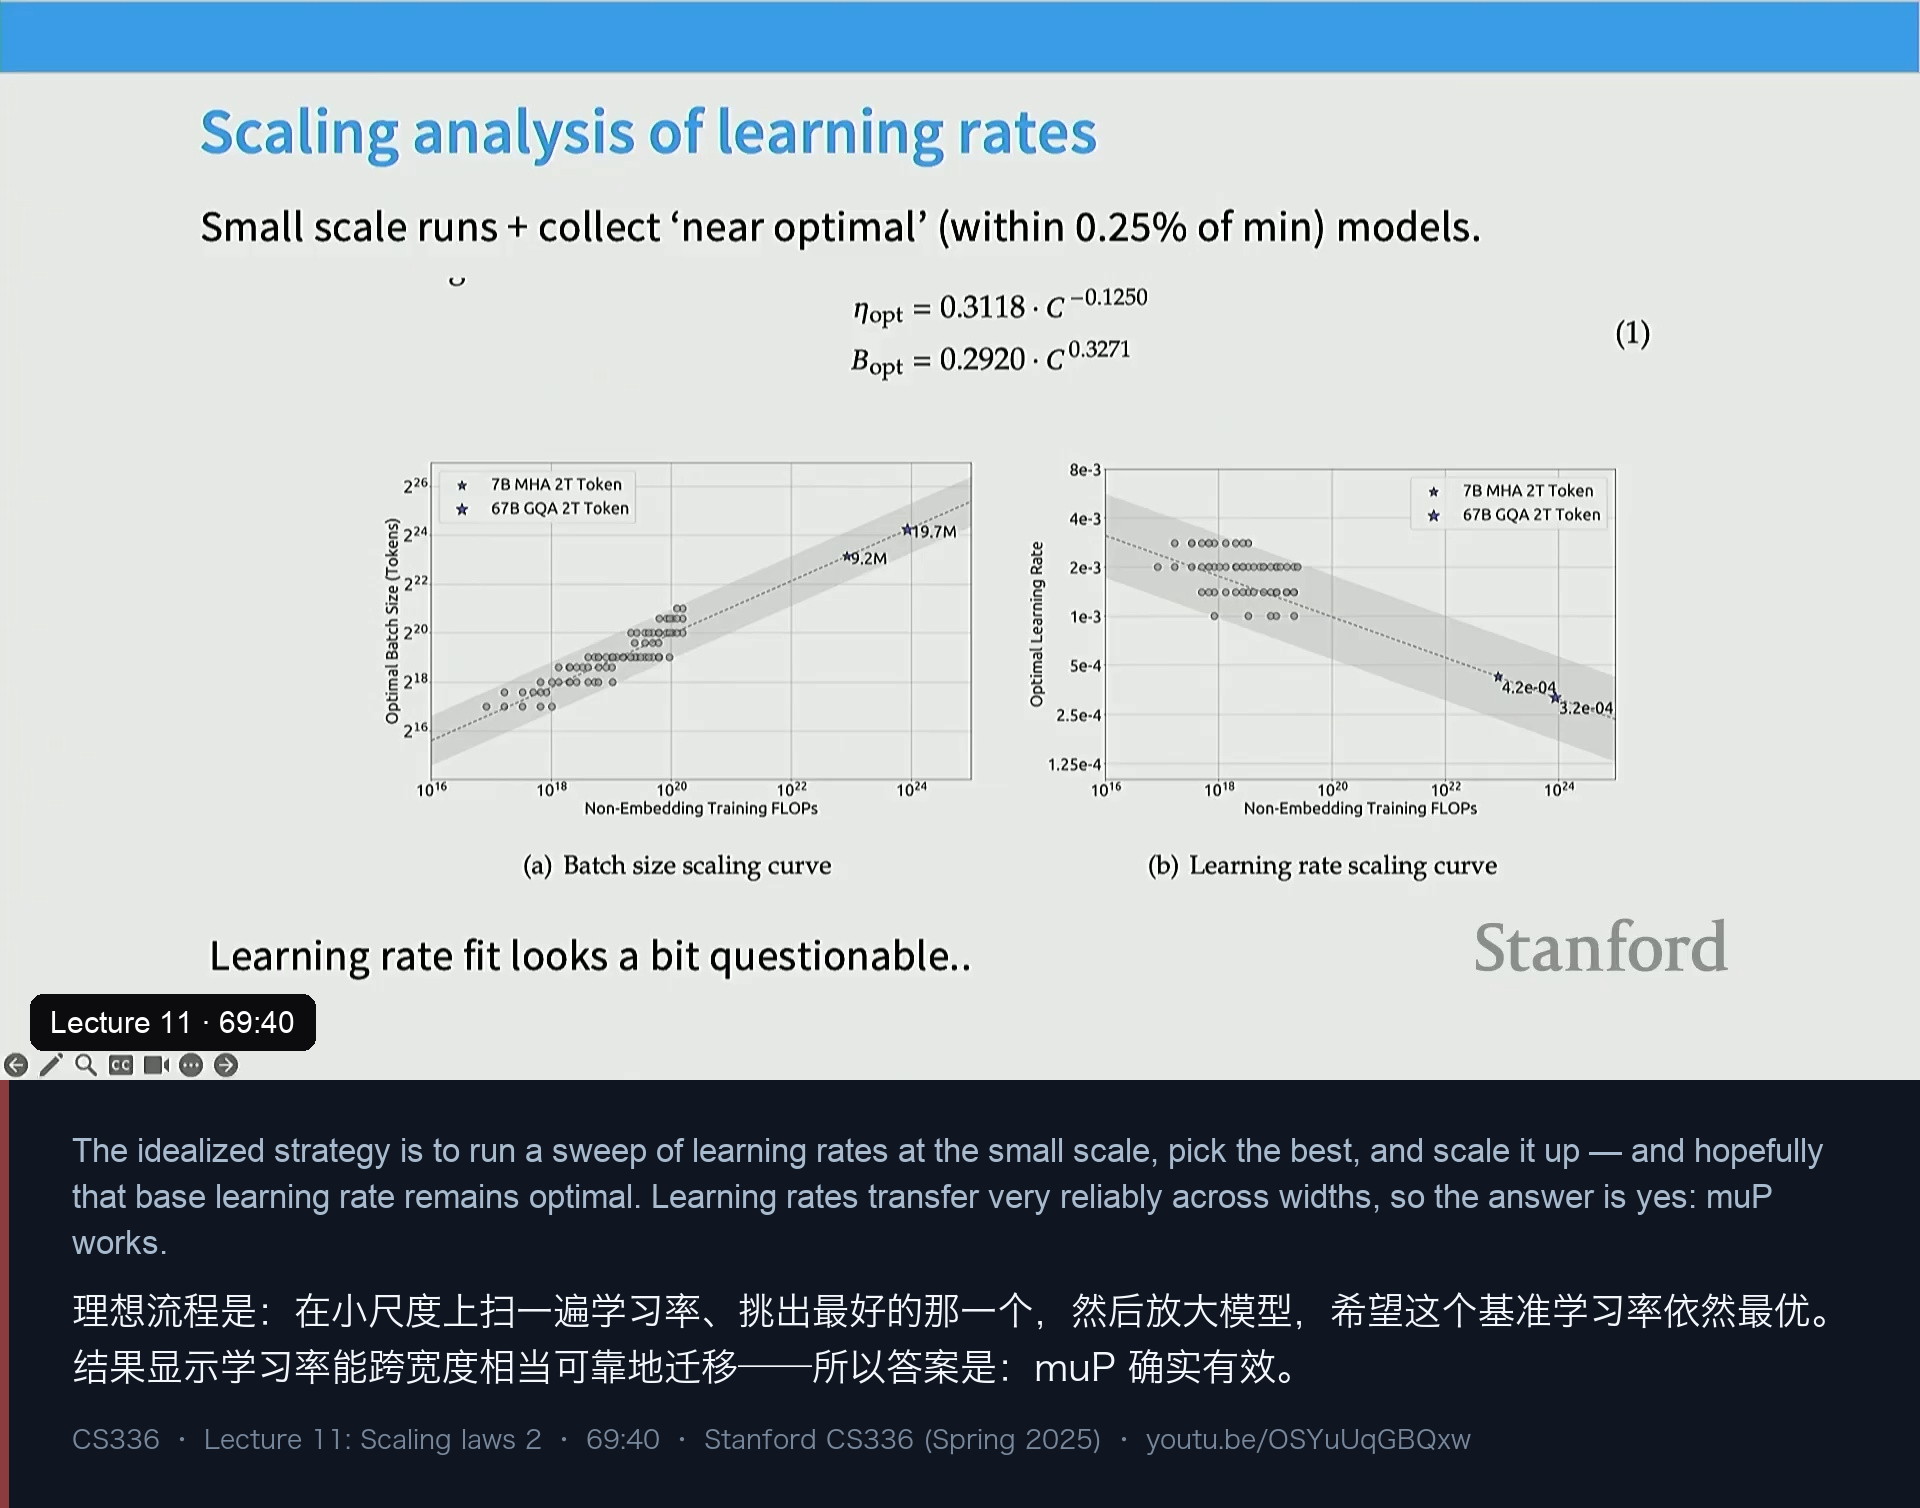
DeepSeek LLM(2024,7B 与 67B)与前面两个案例最大的不同是:它完全不用 muP(图 8)。相反,他们做了一件对 scaling law 信仰要求更高的事——直接在多个算力规模上对 batch size 与学习率做网格扫描,标出每个网格点的 loss,取最小,然后把“最优 batch size”和“最优学习率”分别拟合成随算力变化的 scaling law,再外推到大模型。
讲师对这两条拟合的评价很有意思。对 batch size,他觉得挺合理、也比较干净;但对 学习率,他直接表达了怀疑:“可能因为这些点都叠在一起,我觉得这条线尤其可疑——我说实话画一条水平线看起来也差不多。就算我算是个 scaling law 爱好者,我也不太敢押上性命用这条线去选学习率。但他们就是这么做的。”
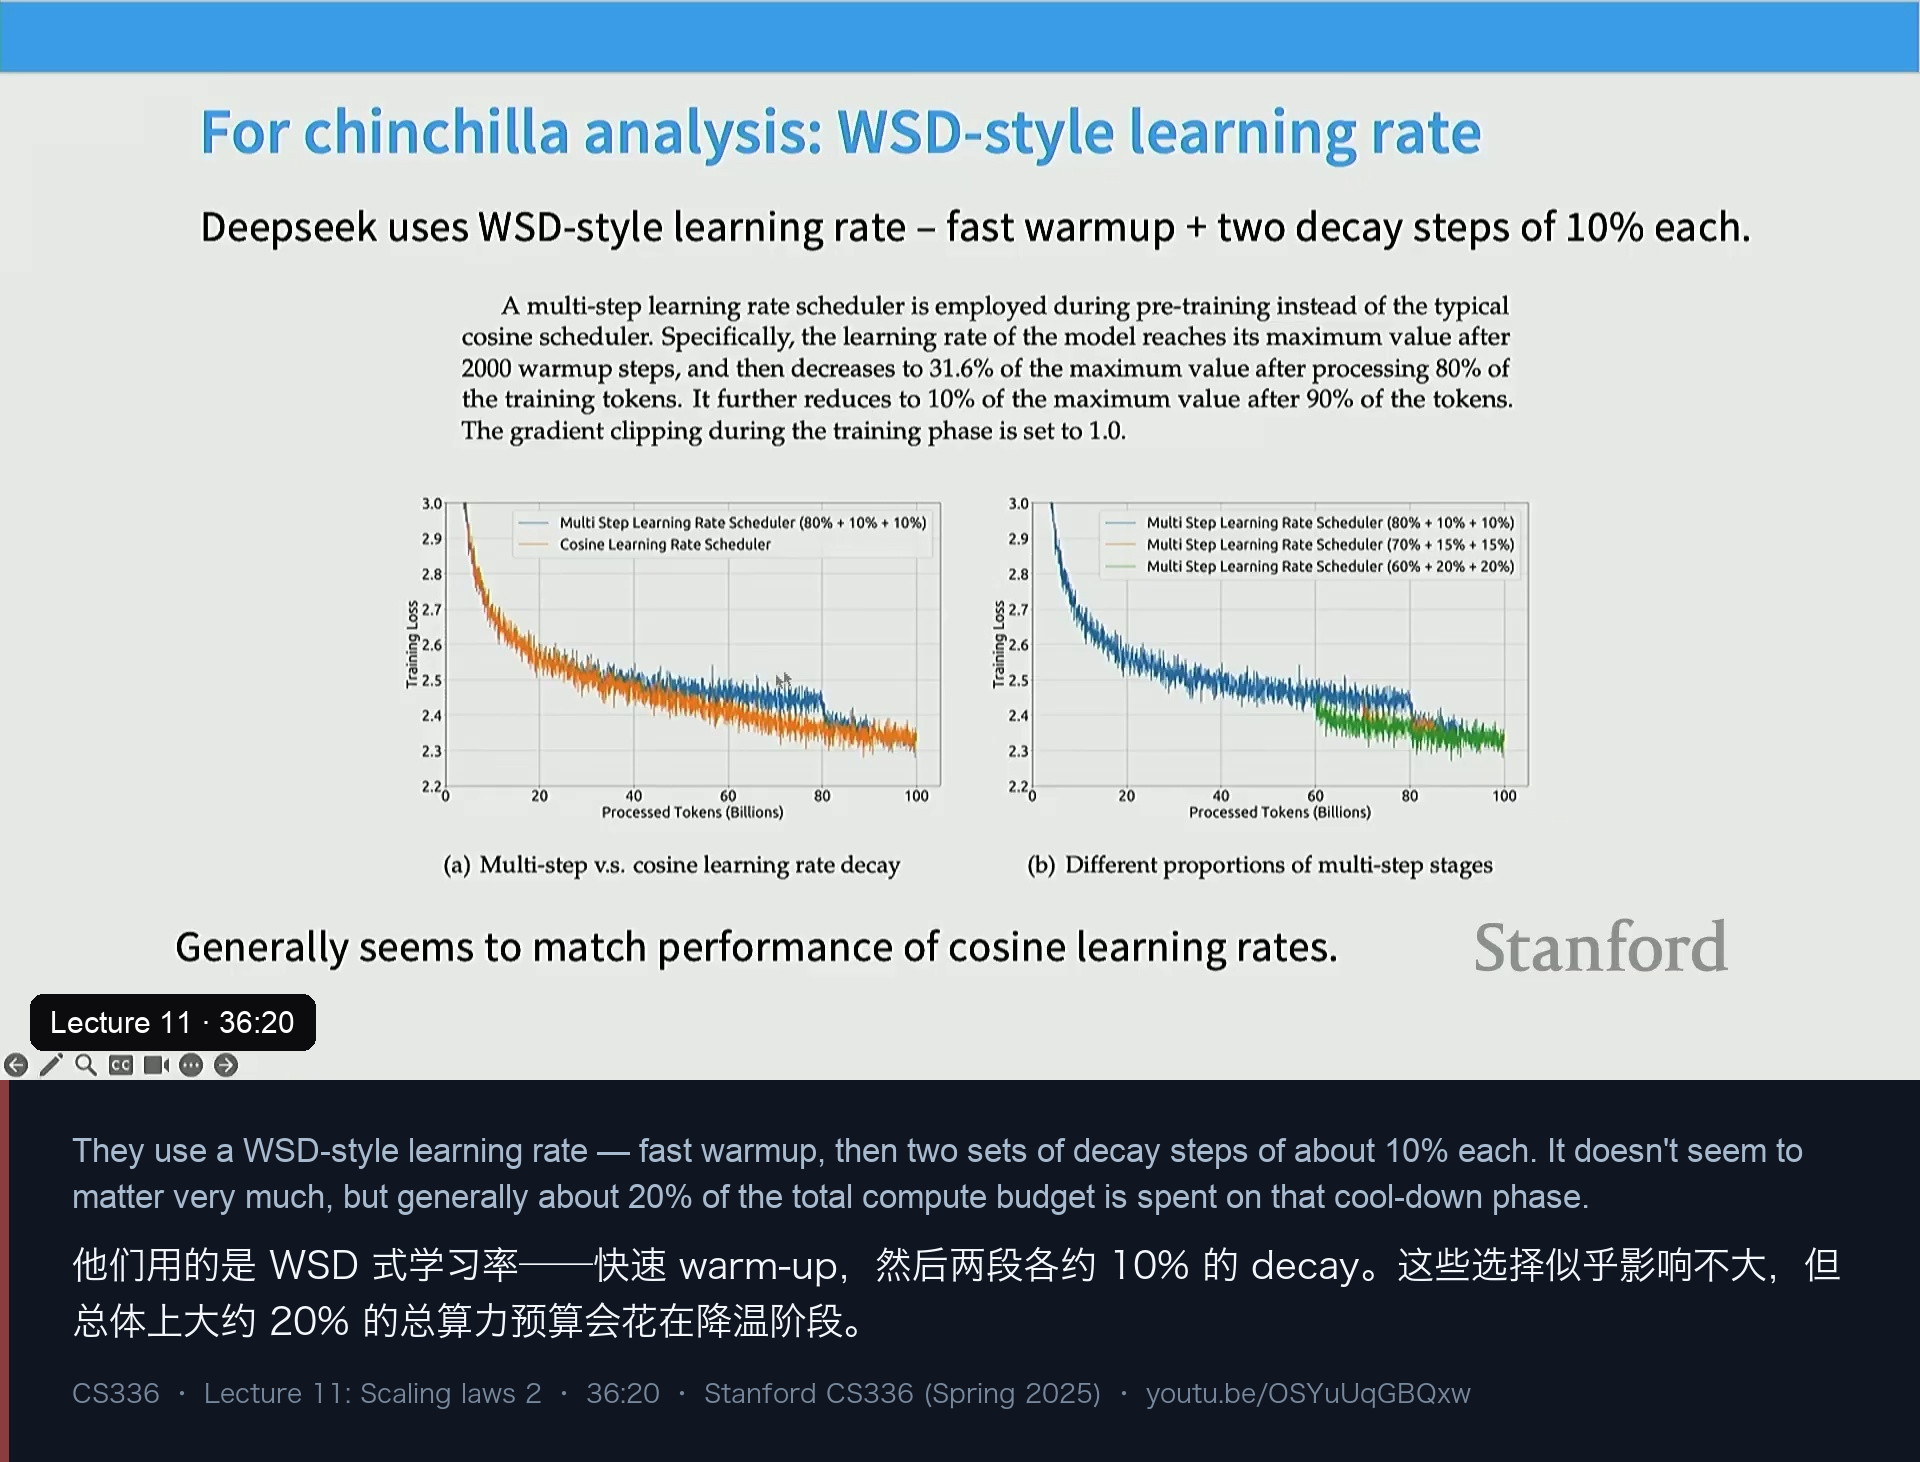
在调度上,DeepSeek 也跟进了 WSD,但做了个“稍微非标准”的变体(图 9):warm-up 之后进入 stable,然后安排两段 decay,每段约占总步数的 10%、一路降到零。他们分析了几种 decay 比例的取舍,结论是“影响不太大”,但总体上大约 20% 的总算力预算会花在降温阶段。他们同时验证了这版 WSD 的最终 loss 能与余弦打平——胜出的原因仍然是前面那条:WSD 让 Chinchilla 式分析变得极其便宜。
DeepSeek 的复现还有一个讲师特别指出的观察:超参的 scaling 拟合看起来总是又噪又虚,而 isoflop 分析总是干净得漂亮。 他们画的 isoflop 图非常规整:不同算力规模下各有一条二次曲线,把每条曲线的最低点连起来,就得到“最优 token 数随训练算力变化”的幂律,于是 token/模型规模的权衡可以直接读出来。他也称赞了 DeepSeek 的态度:“他们完全可以照搬 Chinchilla 用 20×,但他们说不行,我们得自己做一遍分析,确认适合我们的 token 规模。”
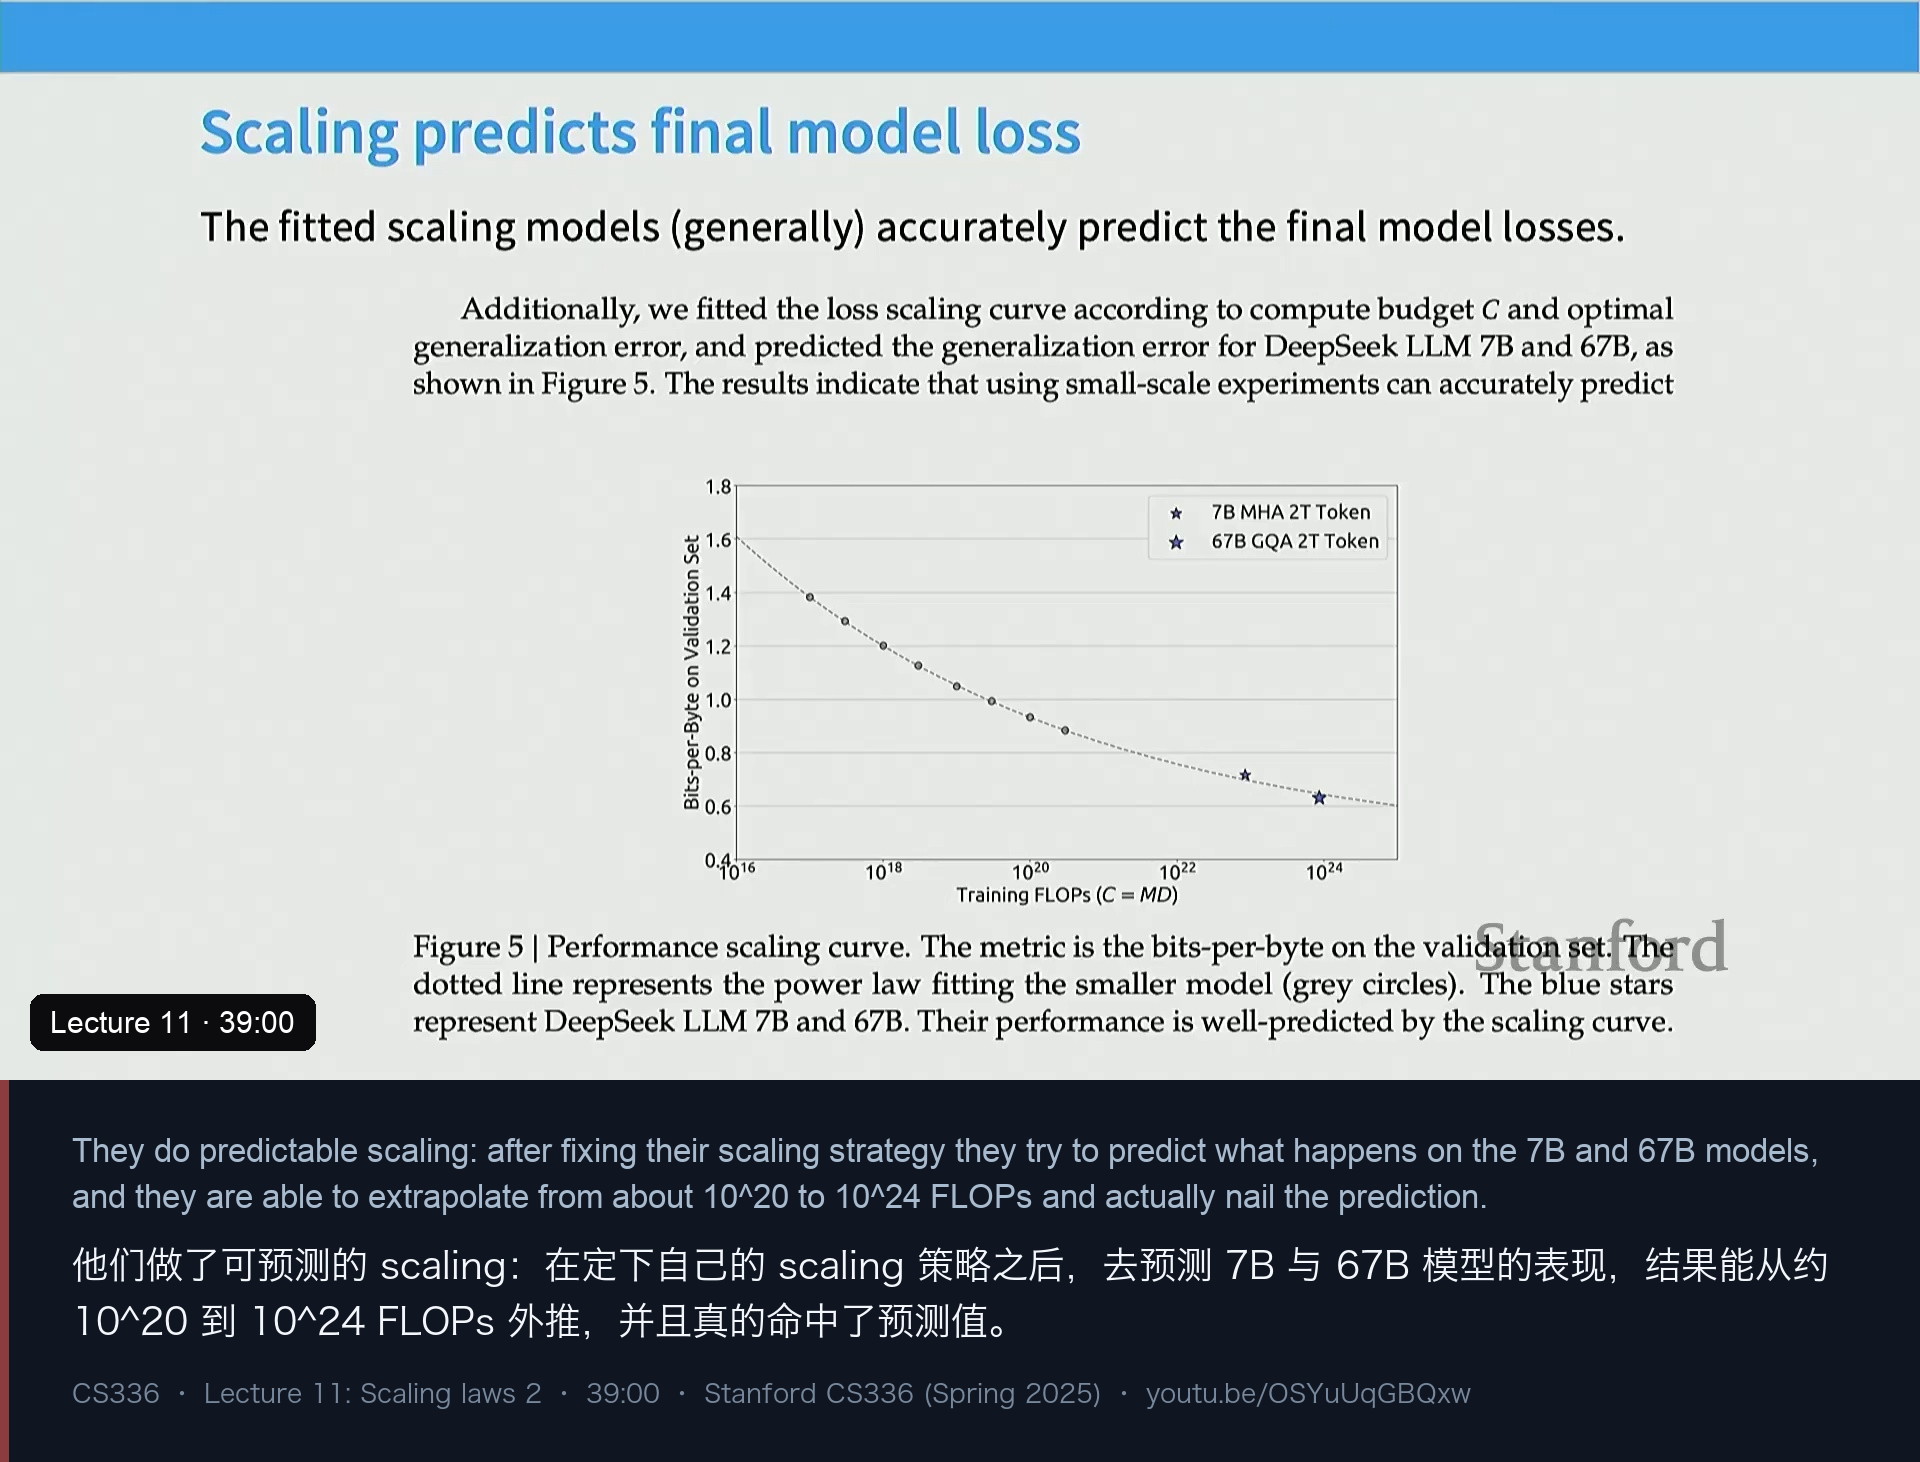
最后是“可预测 scaling”(图 10):在策略定下来之后,他们用拟合好的 scaling law 去预测 7B 与 67B 模型的最终 loss,从约 10²⁰ 外推到 10²⁴ FLOPs 并真的命中了预测。讲师说这在某种意义上“并不意外”(毕竟是在自己的配方上调出来的),但“能在训练之前就对模型能力给出预测,仍然是一件很漂亮的事”。
课上有人问:前沿模型会不会重做这类分析? 讲师的猜测是“大概不会重做得这么细,可能只是复制一遍确认它能用,但没有新东西可报”。他的证据是:新论文里的 scaling 细节越来越少——DeepSeek V2 强调的是 MLA 这类架构改进,V3 强调的是低精度训练这类系统工作,两者都没有新的 scaling 研究。
六、近一年:Llama 3、Hunyuan-1 与 MiniMax-01
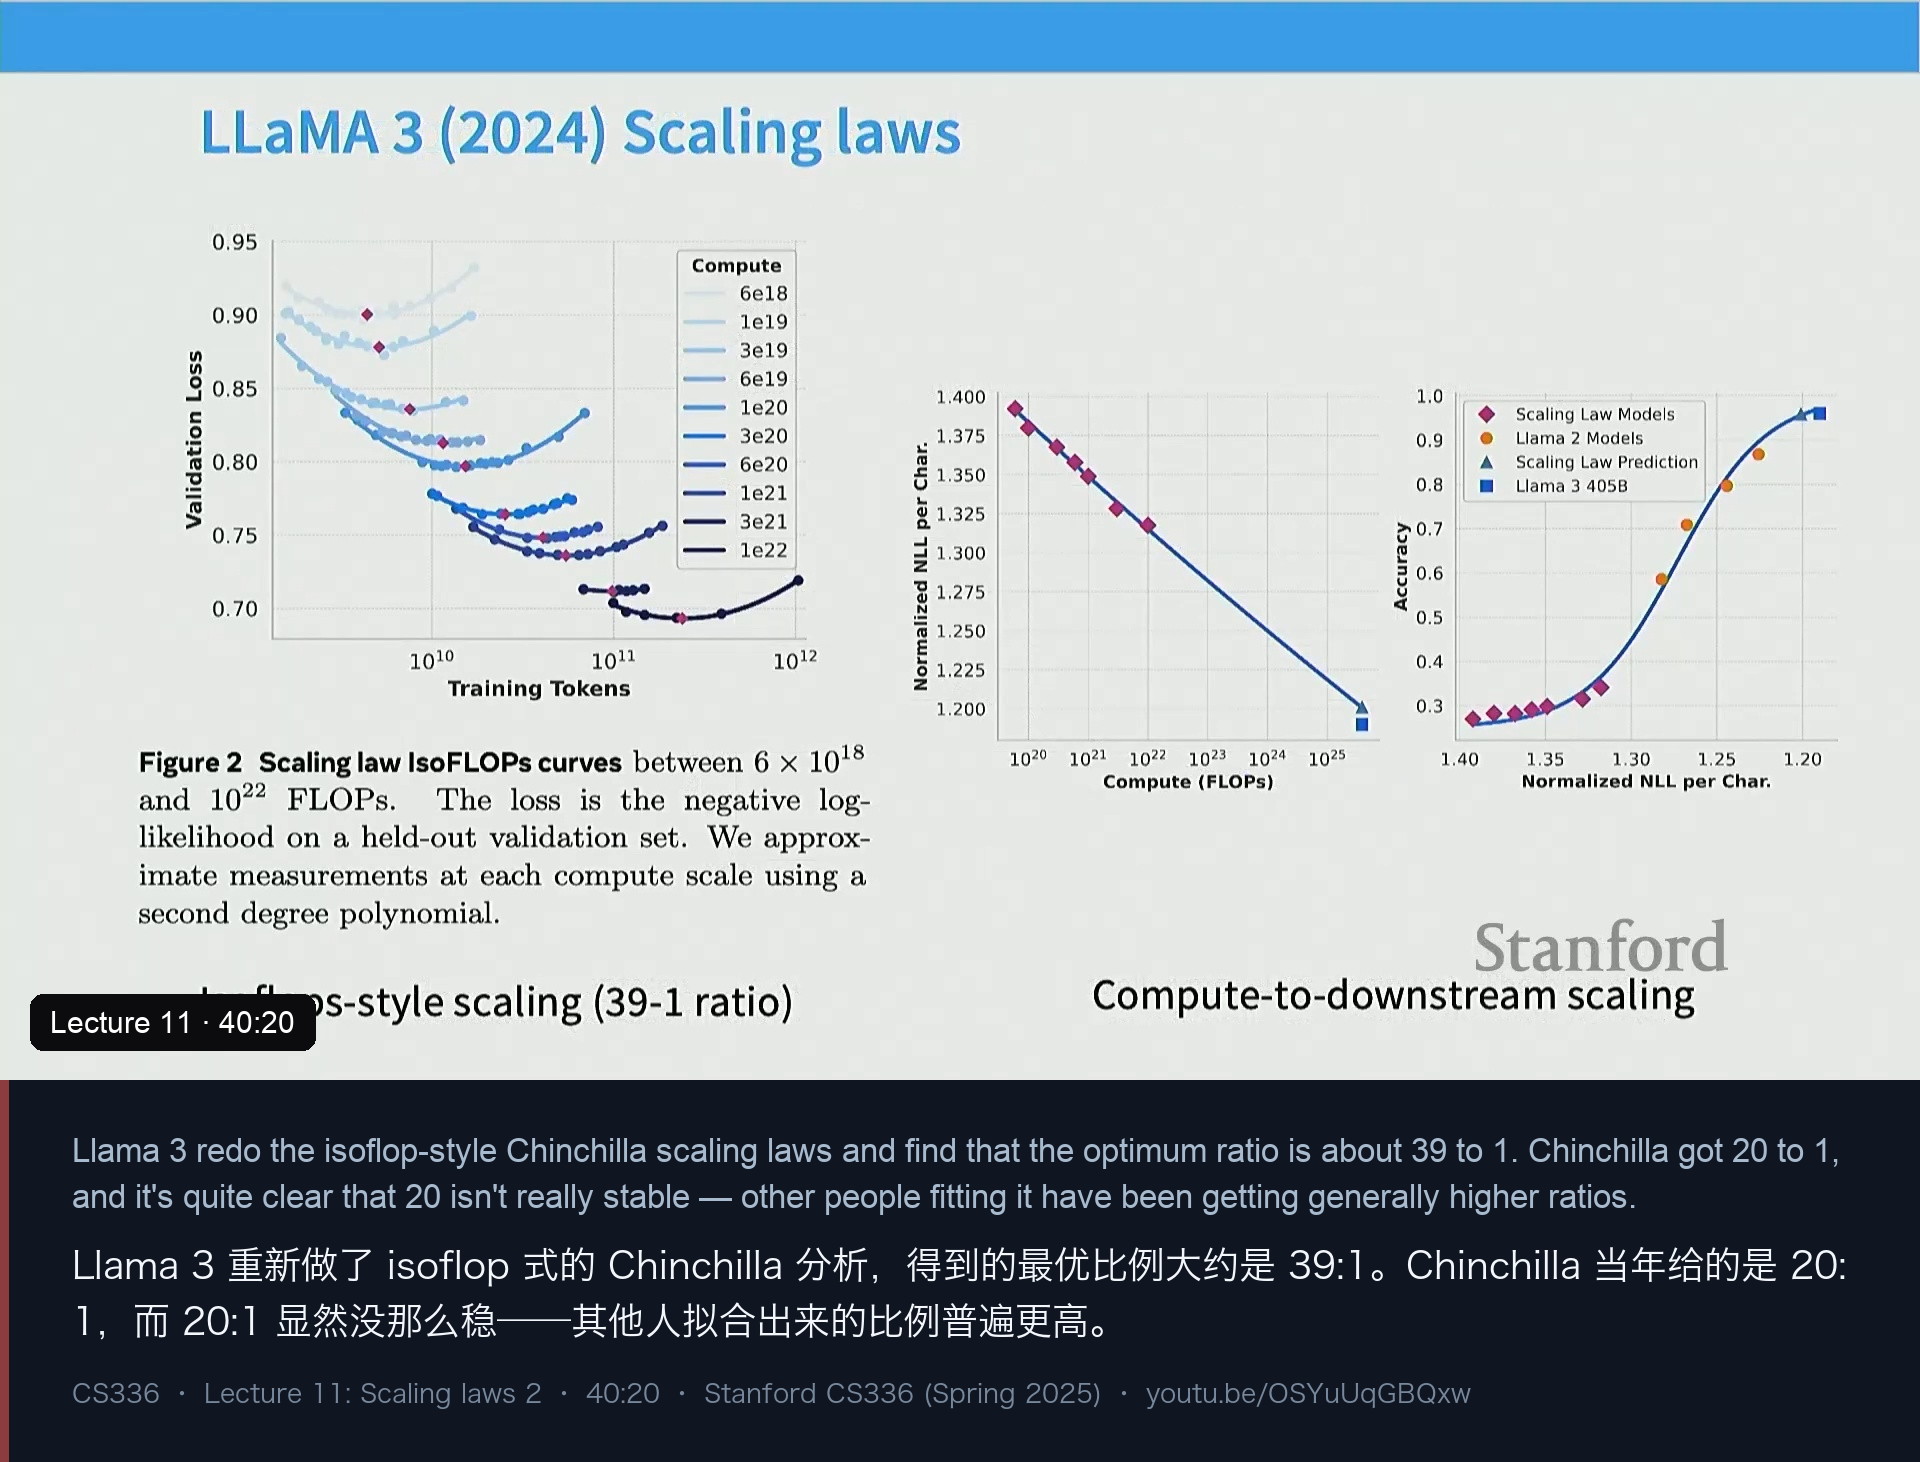
Llama 3 是过去一年最大的模型发布之一,它做了两件和 scaling 相关的事(图 11):
- 重做 isoflop 式 Chinchilla 分析,得到的最优比例约 39。对比 Chinchilla 的 20,讲师认为“20 显然并不稳定,后来做拟合的人普遍得到略高的比例”;这可能来自架构的算法效率提升,也可能来自数据质量提升——“都是活动的零件,很难知道到底是哪一项在起作用,但结论看起来是清楚的”。
- 把“算力 → NLL(每字符 log loss)“和”NLL → 下游准确率“分别用 sigmoid 拟合起来,从而能预测 Llama 3 405B 的 benchmark 表现。讲师说这个想法有意思(毕竟团队真正关心的是 MMLU、LAMBADA 之类的分数,而不是 log loss),论文里也提到用它做数据选择;但他也直说”细节不多,不太确定它是训练时的核心对象,还是作者顺手做的一个有趣副产物”。
Hunyuan-1(讲师口播里念成“Hunan Large”)是又一个“执行得很漂亮”的中国模型。它同样做了 isoflop 分析、拟合二次曲线、取最低点,得到 96 的 data-to-active-parameter 比例——注意这是 MoE 的 active parameter,所以和稠密模型不能直接比。讲师借它讲了一个更一般的道理:这些比例本来就不该和 Chinchilla 一样,架构差异太大;真正值得注意的,是”做 isoflop → 取最小 → 得到可预测的 FLOPs 与最优参数量/最优 token 数之间的权衡“这件事本身,在各家复现里都稳定成立——这大概是 scaling 领域被复现得最好的结果。
MiniMax-01 则是一个更“异域”的例子:它用线性时间(lightning attention)与混合注意力来做长上下文模型,并且用 scaling law 来论证架构选型——用 method 1 式的下包络分析,比较 softmax 注意力、线性注意力、混合注意力三种架构在相同算力下的表现,结论大致是“三者相当”,从而为“用线性/混合注意力训长上下文模型”提供了依据。讲师说,这类图在 Mamba、Mamba-2、DeltaNet 等线性时间序列建模论文里很常见,但由一家大模型团队在接近生产的规模上给出,仍然比较罕见。
把四个案例放在一起,他说这些配方里反复出现的东西其实就那几味:muP(Cerebras、MiniCPM)、WSD(MiniCPM 普及、DeepSeek 跟进)、isoflop 分析(几乎所有人)、以及**“固定 aspect ratio、只放大总规模”** 这套平移策略。而人们真正焦虑的超参只有两个:学习率与 batch size。Cerebras 干脆不做 Chinchilla 复现;DeepSeek 假设其他超参不随规模变、但把学习率与 batch size 单独拟合;Llama 3 与 Hunyuan 只做 isoflop;MiniMax 则把 scaling law 当成架构选型的法庭。
七、下半场:muP 是什么?——两条谱条件
从案例研究切到 muP 时,讲师先讲了动机:我们的初始化方式、逐层学习率、乃至所有超参的选择,本质上都是任意的——“没有任何理由必须这么初始化而不是那么初始化”。如果能把这三件事调好,让超参具有尺度不变性(scale-invariant),那么在小模型上做的实验就能直接迁移到大模型上,大模型训练的成本结构会完全改变。
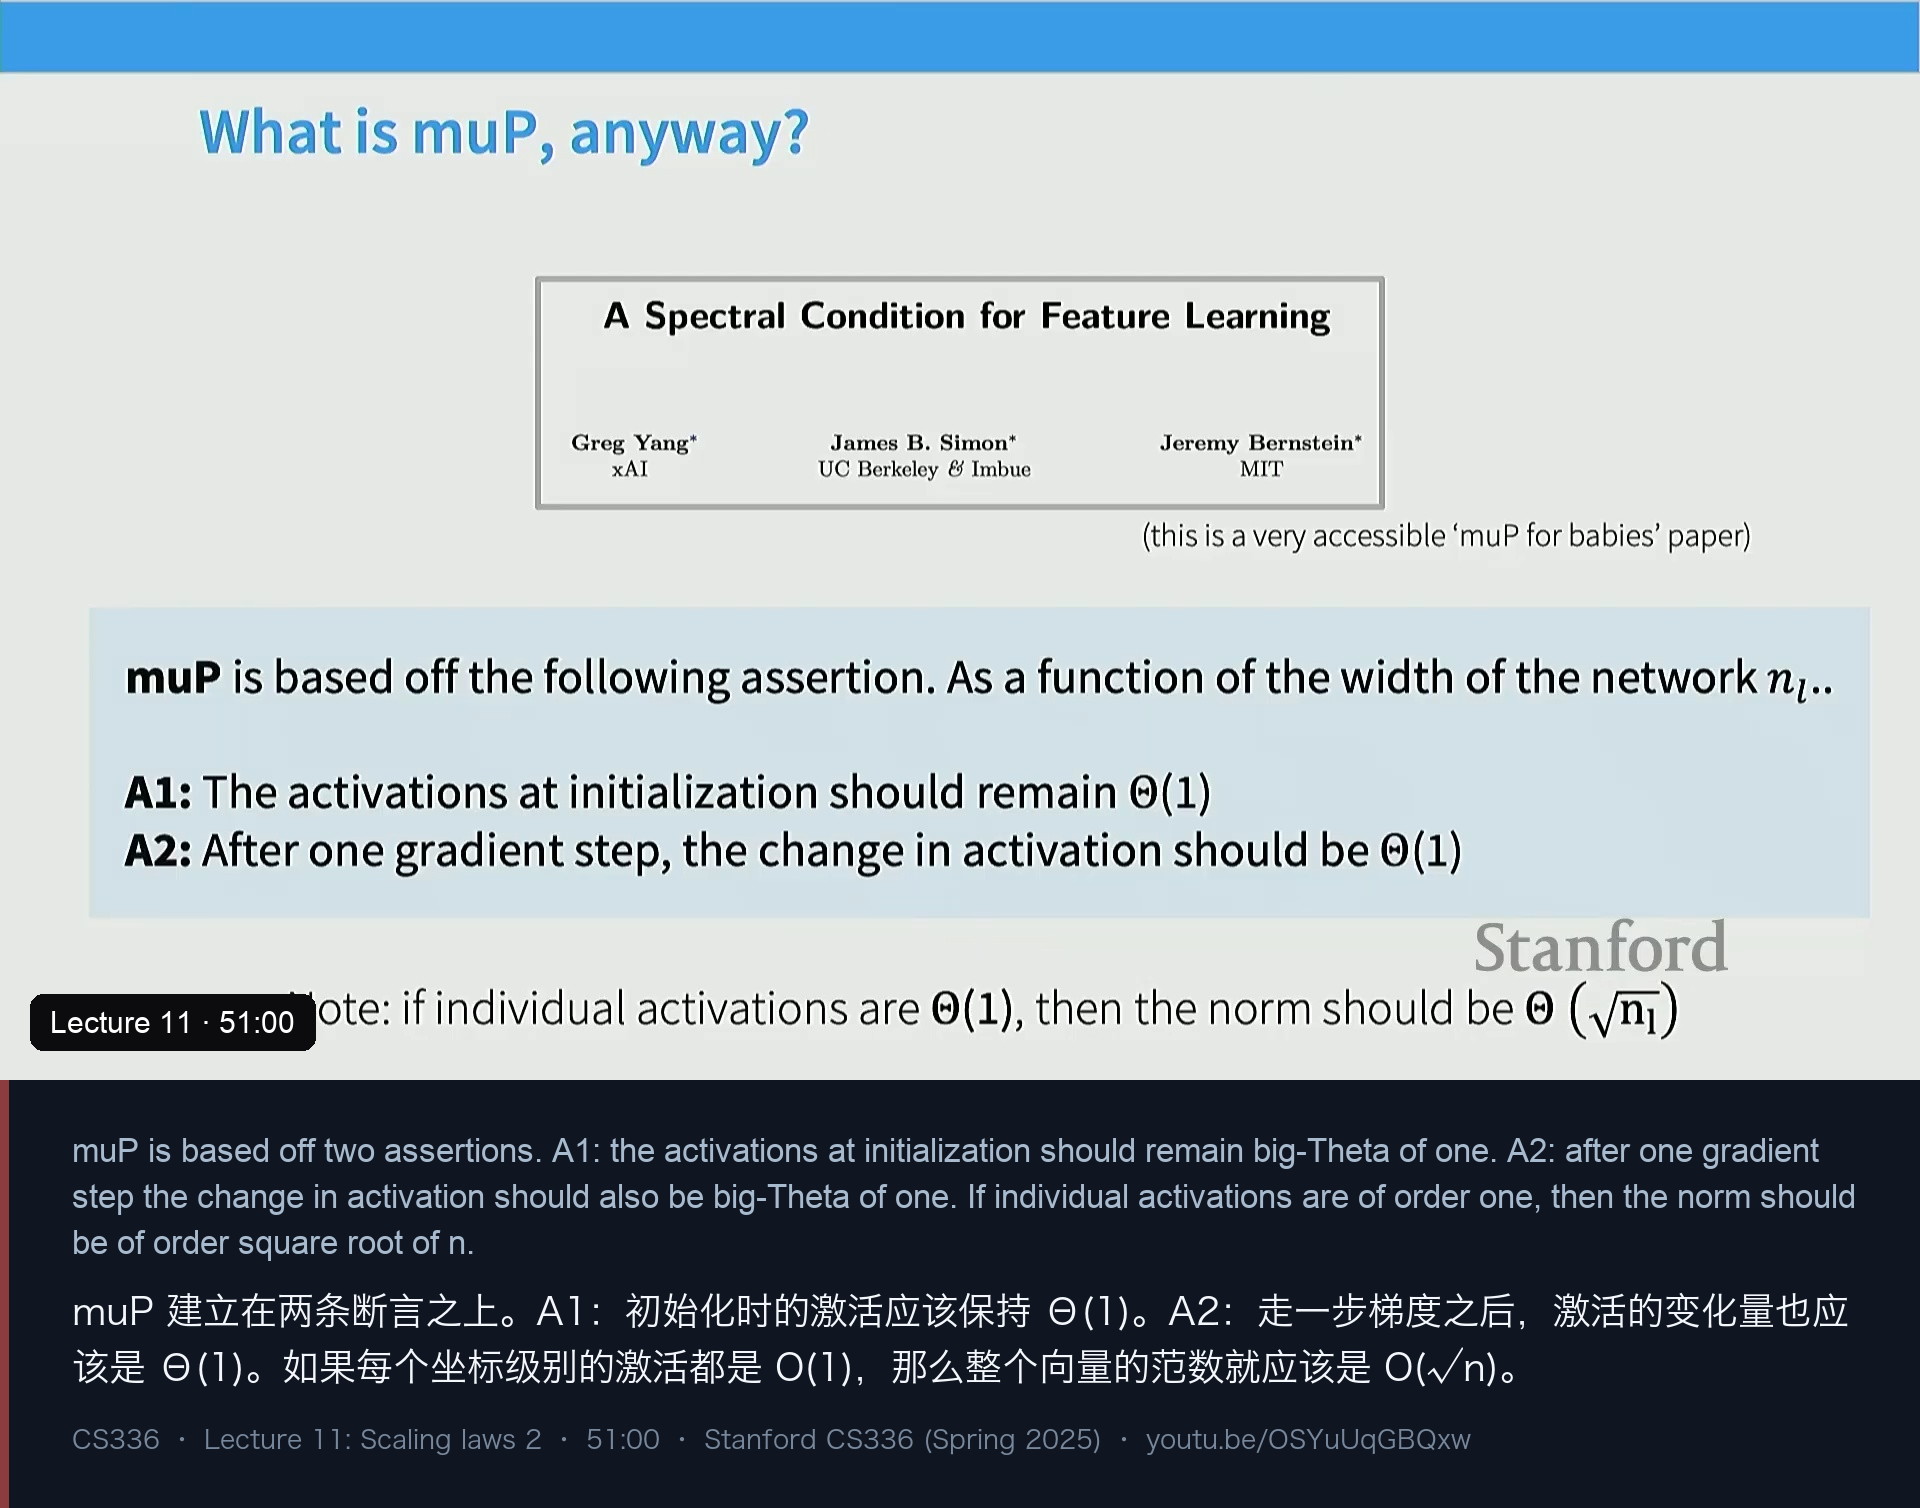
他说自己这一段的数学主要跟一篇 tutorial 走(图 12 里的《A Spectral Condition for Feature Learning》,作者是 Greg Yang、James B. Simon、Jeremy Bernstein,被他称作“accessible 的 muP for babies 论文”),并提醒大家:不同文章里 muP 的推导细节并不完全一致,他统一用这一篇的口径。
muP 的出发点只有两条断言:
- A1:初始化时,激活量级应保持 Θ(1)——随宽度变大,激活既不能爆炸也不能消失;
- A2:走一步梯度之后,激活的变化量也应保持 Θ(1)——学习率不能把更新量推到爆炸或消失。
注意两点细节。第一,A1/A2 说的是单个坐标的量级是 Θ(1);由于各坐标近似独立,整个激活向量的范数就应该是 Θ(√n)(n 是宽度)。第二,这两条是“极限条件”:它们描述的是当宽度 → ∞ 时,各量应当如何渐近地保持稳定。讲师特意点出这种思维方式来自物理:“这其实就是重整化(renormalization)的思路——在取极限时,我希望某些量保持稳定,不爆炸也不归零。”
八、把 muP 推出来:A1 给出初始化,A2 给出逐层学习率
8.1 条件 A1:为什么初始化是 1/√fan-in
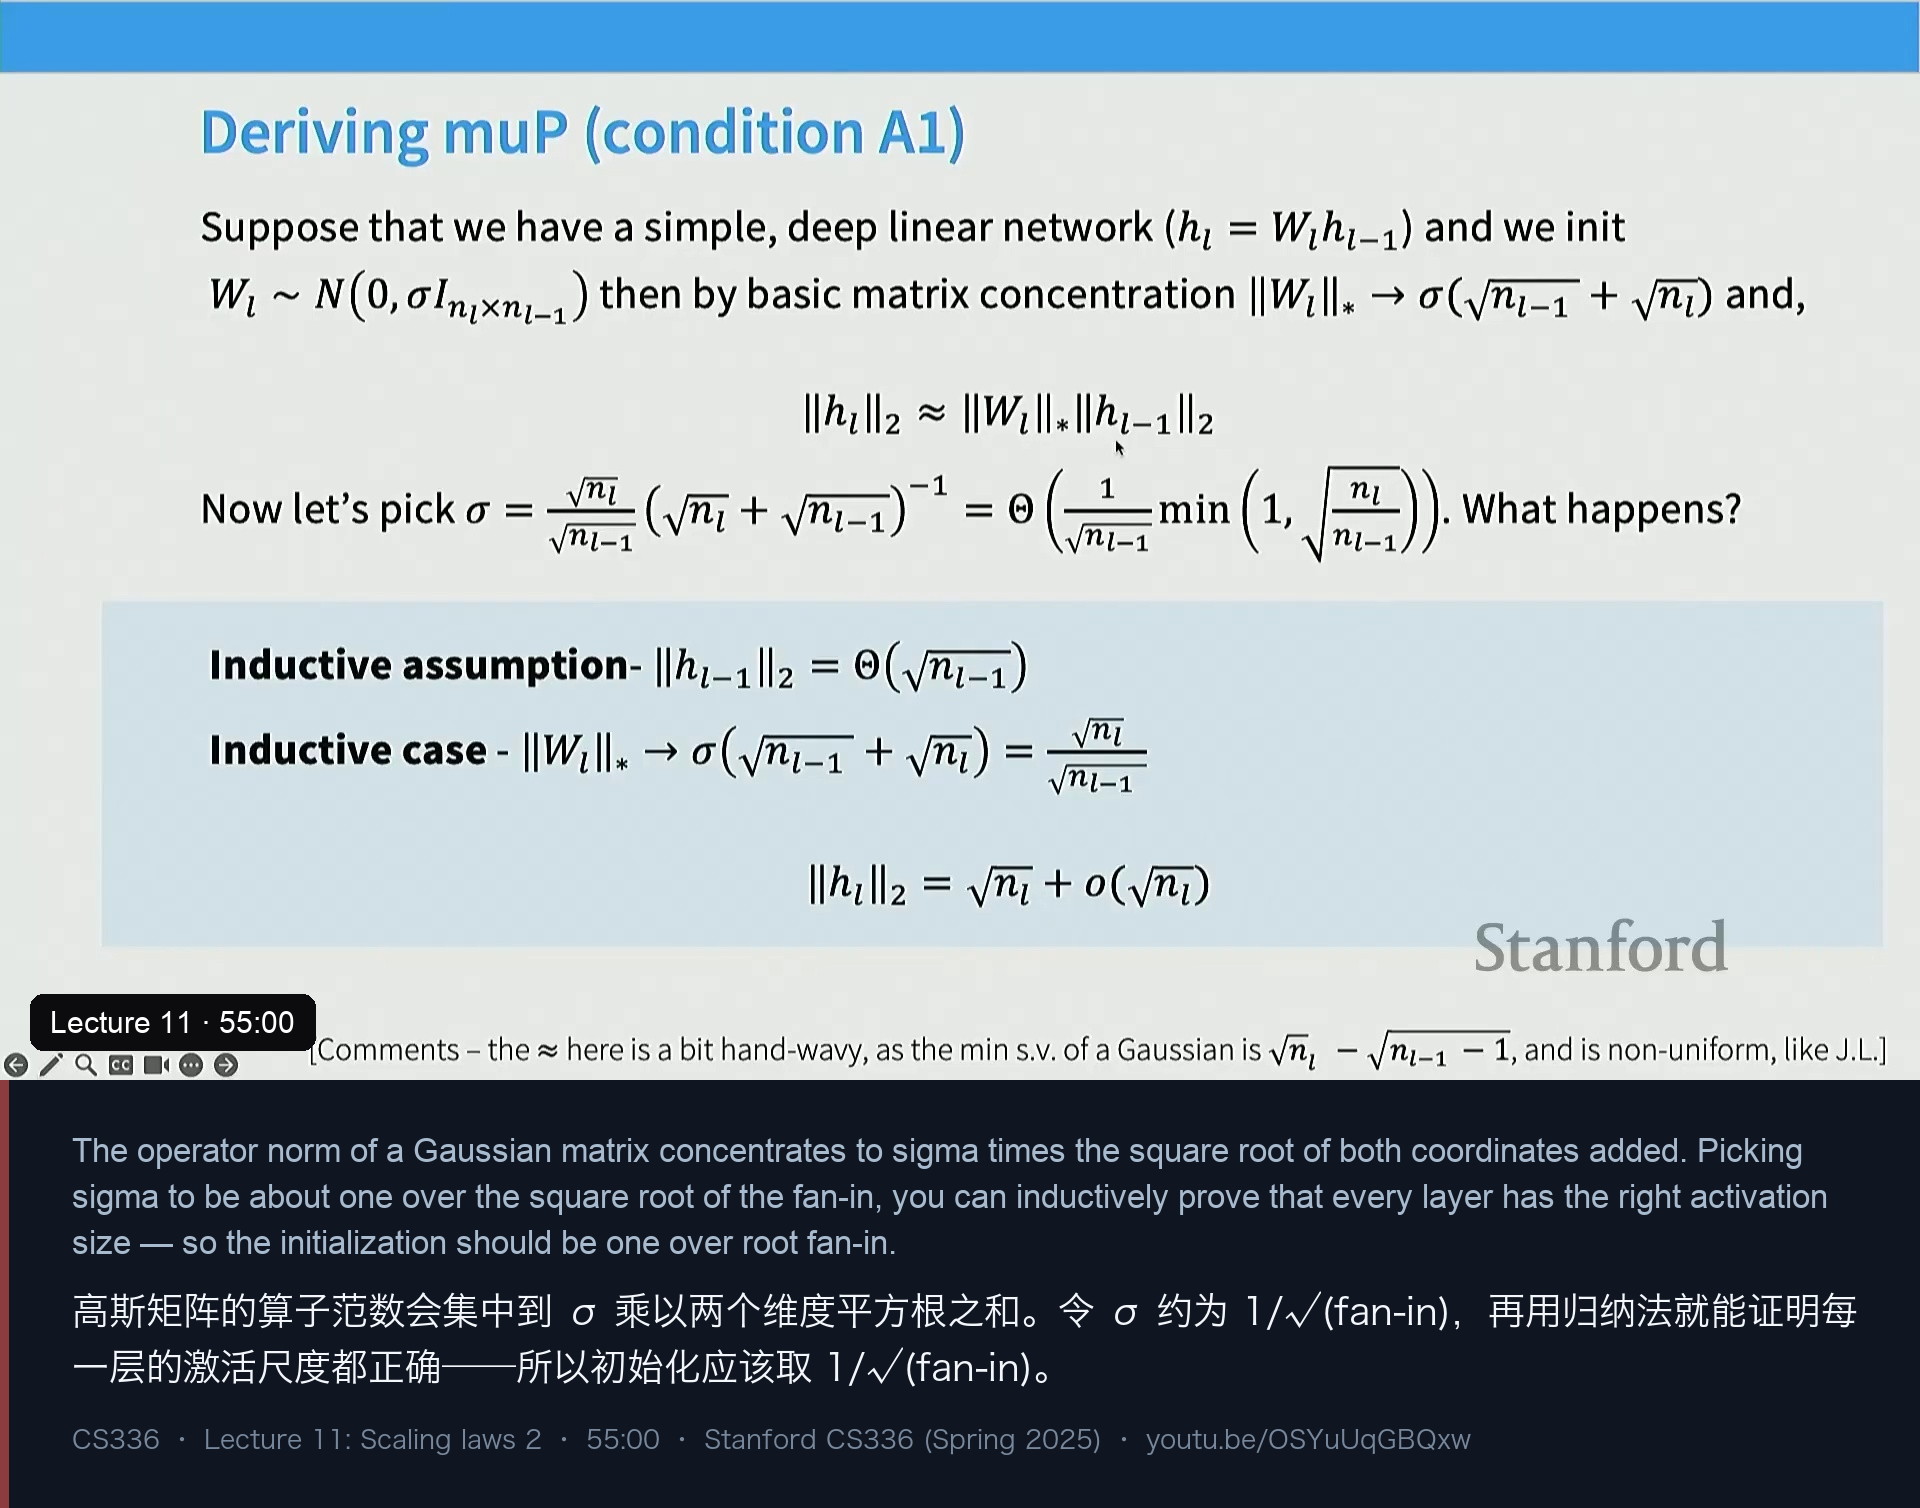
推导(图 13)从最精简的模型开始——一个深线性网络:
# 深线性网络(不含非线性、不含注意力,纯粹为了推导)
h_l = W_l @ h_{l-1}
# 初始化:W_l ~ N(0, sigma_l^2 / n_{l-1}),即零均值、矩形规模、噪声尺度为 sigma_l 的高斯矩阵
他想知道 ‖h_l‖ 在初始化时有多大。办法是取极限 n_l, n_{l−1} → ∞:这时 W_l 是一个随机高斯矩阵,按随机矩阵理论,它的算子范数会集中到一个确定值:
# 高斯矩阵算子范数的集中结果
||W_l||_2  ≈  sigma_l * (sqrt(n_l) + sqrt(n_{l-1}))        # 图 13 中的式子

# 再由 W_l 与 h_{l-1} 独立(初始化时确实独立),有
||h_l||_2 ≈ ||W_l||_2 * ||h_{l-1}||_2接着选一个特定的 σ_l,并做归纳:假设第 l−1 层满足 ‖h_{l−1}‖₂ = √n_{l−1}(这就是 A1 在坐标层面的要求,“Θ(1) 的坐标”对应”√n 的范数”),把它代进上面的集中结果与近似式,你会发现约定的 σ_l 里的 1/√n_{l−1} 恰好和 √n_{l−1} 抵消,于是得到
||h_l||_2 = sqrt(n_l) + (低阶项) # 正是我们要的结论幻灯片上给出的 σ 选择是
# 初始化尺度(讲义与幻灯片上的写法)
sigma_l = (1 / sqrt(n_{l-1})) * min(1, sqrt(n_l / n_{l-1}))
# 直觉:主体就是 1/sqrt(fan-in),再乘一个"fan-in 远大于 fan-out 时"才起作用的修正因子
# 对 MLP 这种 n_l > n_{l-1} 的情形,min(1, ...) = 1,于是就是干净的 1/sqrt(fan-in)所以第一部分的结论非常朴素:初始化取 1/√fan-in,外加一个小修正因子。讲师说:“如果你本来就在用 Kaiming 式的初始化,那这一步其实已经是对的了。“他还自嘲说这是他”第一次在课上真的推数学”,并停顿确认大家都能接受 1/√fan-in。
8.2 条件 A2:学习率从哪来
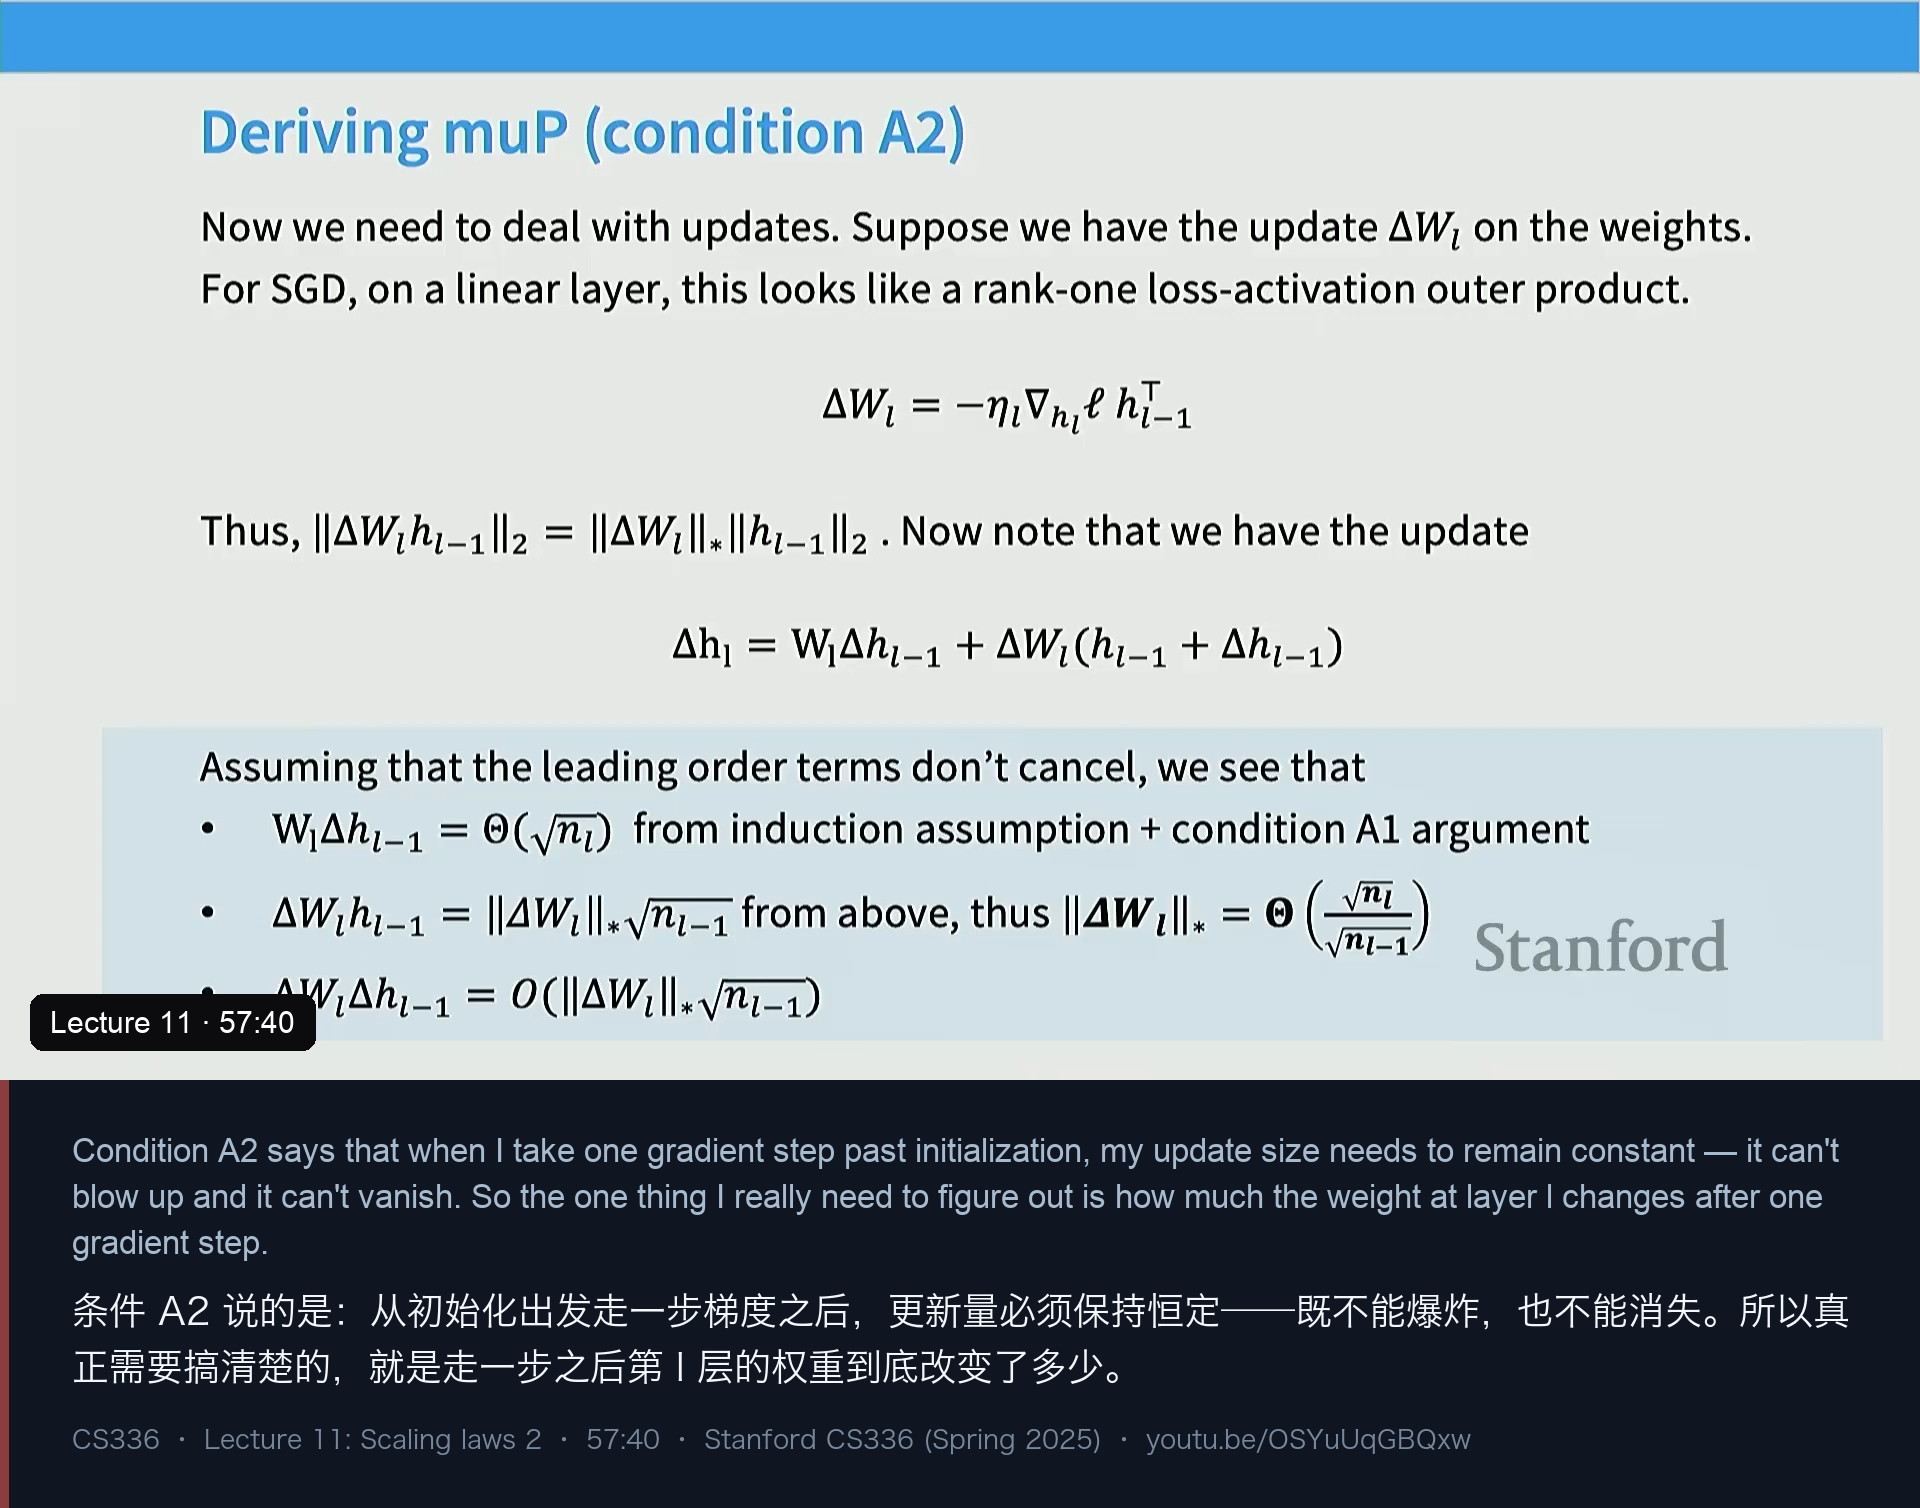
第二部分(图 14)从 A2 出发:走一步梯度之后,激活的更新量必须保持在同一量级。用 SGD、batch size 为 1 时,权重更新是一个秩一对象:
# 一步 SGD 更新(batch size = 1,因此是秩一)
Delta_W_l = -eta_l * grad_L * h_{l-1}^T

# 激活的更新量分解为三项
Delta_h_l = Delta_W_l @ h_{l-1} + W_l @ Delta_h_{l-1} + Delta_W_l @ Delta_h_{l-1}
# (新增的秩一项) (传递项) (高阶交叉项)讲师说这三项“其实量级相同”,于是唯一需要搞清楚的量是 ‖ΔW_l‖₂ · ‖h_{l−1}‖₂——也就是“一步之后权重到底动了多少”。为了解出它,他引入了一个“更狡猾”的假设:
如果训练是良态的,那么一步梯度带来的 loss 变化
ΔL也必须是 Θ(1)。
理由很直白:我们不希望“loss 的改进量”随宽度爆炸或消失——不管模型多大,一步该带来的进步应该是同一量级。有了这个假设,就能把 ΔL = ⟨∇L, ΔW⟩ 这一侧钉住,从而反解出梯度的量级,再一路代回上式,解出学习率。
# 结论(幻灯片上的"速查表")
# 初始化:
sigma_l^2 = Theta( 1/n_{l-1} * min(1, n_l/n_{l-1}) )

# 学习率:
#   SGD :  n_l / n_{l-1}     (即 fan-out / fan-in)
#   Adam:  1 / n_{l-1}       (即 1 / fan-in)
对 SGD,讲师自己先提出了那个“你这不就骗人吗”的质疑:Transformer 里 MLP 的 n_l/n_{l−1} 不就是 4 吗? 那是常数,那 muP 岂不是什么也没变?他的回答是:正因如此,muP 与标准参数化的差别主要体现在 Adam 的情形——1/fan-in(Adam)与 fan-out/fan-in(SGD)是不一样的,而现实中大家用的是 Adam。真正“违反直觉”、也是 muP 最实用的部分,就是逐层学习率:大多数人的学习率是全局常数,而 muP 要求它随层的 fan-in 变化。
8.3 速查表与 Cerebras 的实现
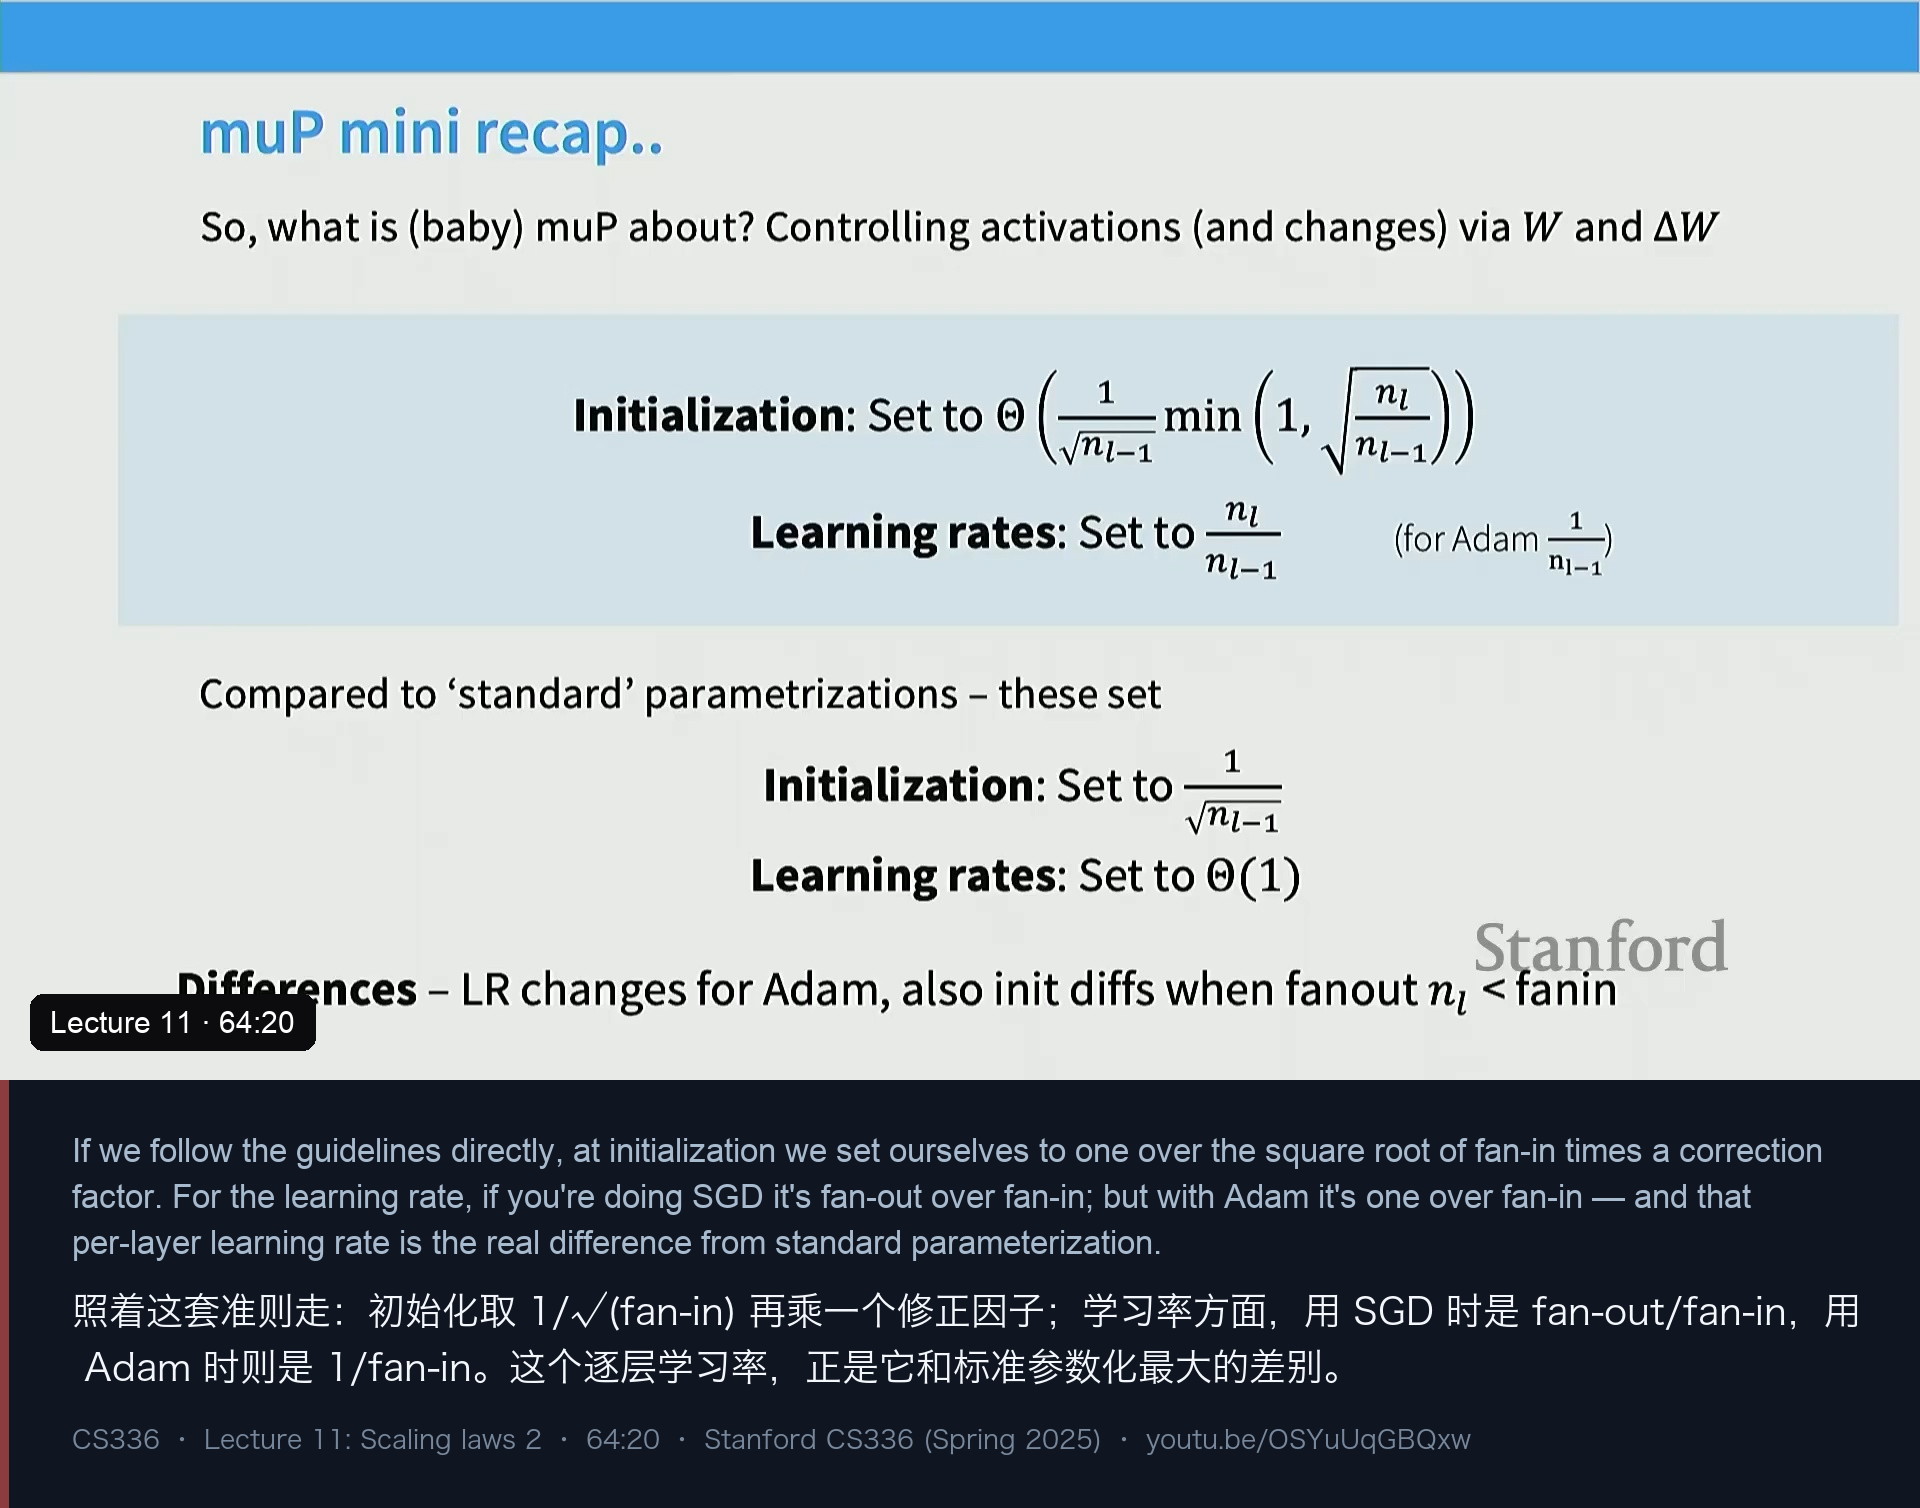
把两半合起来就是图 15 这张速查表。与之对照的标准参数化是:初始化也可以取 1/√fan-in(这一步是对的),但学习率是全局常数——“这对 SGD 还算可以,对 Adam 就不行了,而区别恰恰出在这里”。
回到 Cerebras-GPT 的实现(图 15 之后那一页):embedding 层是特例,它几乎不做缩放——因为 embedding 是 one-hot 的,它的范数并不随词表大小线性增长;其余所有层则按 1/width 缩放初始化和逐层学习率,这正是 Adam 对应的那条规则。
课上学生问了一个好问题:“假设是否与架构无关?” 讲师的回答是:推导用的模型是最“傻”的深线性网络,非线性与注意力的论证只是“大致成立的手wave 说明”,每一类组件(注意力、GLU 之类)其实都需要单独分析,才能得到对应的对象;同样,那些 fan-in/fan-out 就是矩阵的输入输出维度(比如 MLP 的 D → 4D)。另一个学生问:“DeepSeek 只用全局学习率,是不是就没有 Θ(1) 的更新?” 讲师解释:这一切都是渐近论证——宽度变大时更新本来就会变大,你要么用 muP 把这种漂移压掉,要么用经验手段把学习率按规模调下去来补偿;DeepSeek 属于后者(“你如果真把学习率调对了,其实不需要 muP——muP 只是为了让这个漂移尽可能小”)。
九、muP 的实证:它对什么鲁棒,又对什么失效
下半场的最后一段,讲师介绍了一篇他喜欢的大规模消融 preprint(他说这篇将在 COLM 发表;他强调作者做的是只放大宽度、固定深度的受控实验,这与通常“宽度深度一起放大”的设定不同)。设定是:方差与学习率按 1/width 缩放,注意力的缩放用 1/d 而不是常见的 1/√d(他指出 muP 系的工作普遍这么做,理由是激活/更新尺度的稳定性),在标准的自回归预训练 Transformer 上把宽度从 128 拉到 512、2048。
结果一:学习率确实能迁移。 按“在小尺度上扫学习率 → 挑最小 → 放大”的理想流程,最优学习率在不同宽度上落在同一个位置——这就是 muP 的胜利。
他们接着做了大量“现代实现变体”的消融:换激活函数、换 batch size、换初始化、换 RMSNorm gain、换优化器、换正则化。结论可以分成两边:
对什么鲁棒:
- 激活函数:SwiGLU、squared ReLU 与基线 ReLU 的最优学习率相同(顺带:SwiGLU 与 squared ReLU 的效果本身更好,这跟课上前面的结论一致);
- batch size:上下调整 4 倍,最优学习率不变(这一点很关键,因为大家知道 batch size 对规模是敏感的,MiniCPM 与 DeepSeek 都专门去拟合临界 batch);
- 若干初始化选择:比如把 query 矩阵初始化为零以获得均匀注意力、或者最上层 embedding 按 SP/muP 不同方式缩放——都不改变最优学习率的位置。
对什么不鲁棒:
- 可学习的 gain / bias:一旦加上就会破坏迁移性(“你得把它们去掉”);
- 更“野”的优化器:比如 Lion 这种用梯度符号做更新的优化器会显著破坏迁移。讲师说这其实在意料之中——muP 是为 Adam 这类通过二阶量控制更新尺度的优化器设计的,“你用一个完全不同的优化器,凭什么期望学习率还能迁移”;
- 更强的 weight decay:这是最后一个,也是他评价最重的——“这可能是唯一一个真正重要的 muP 失效案例”。因为其他失效场景(bias、Lion)都是“你本来也不一定会做”,而 weight decay 是大家真的会用的东西。
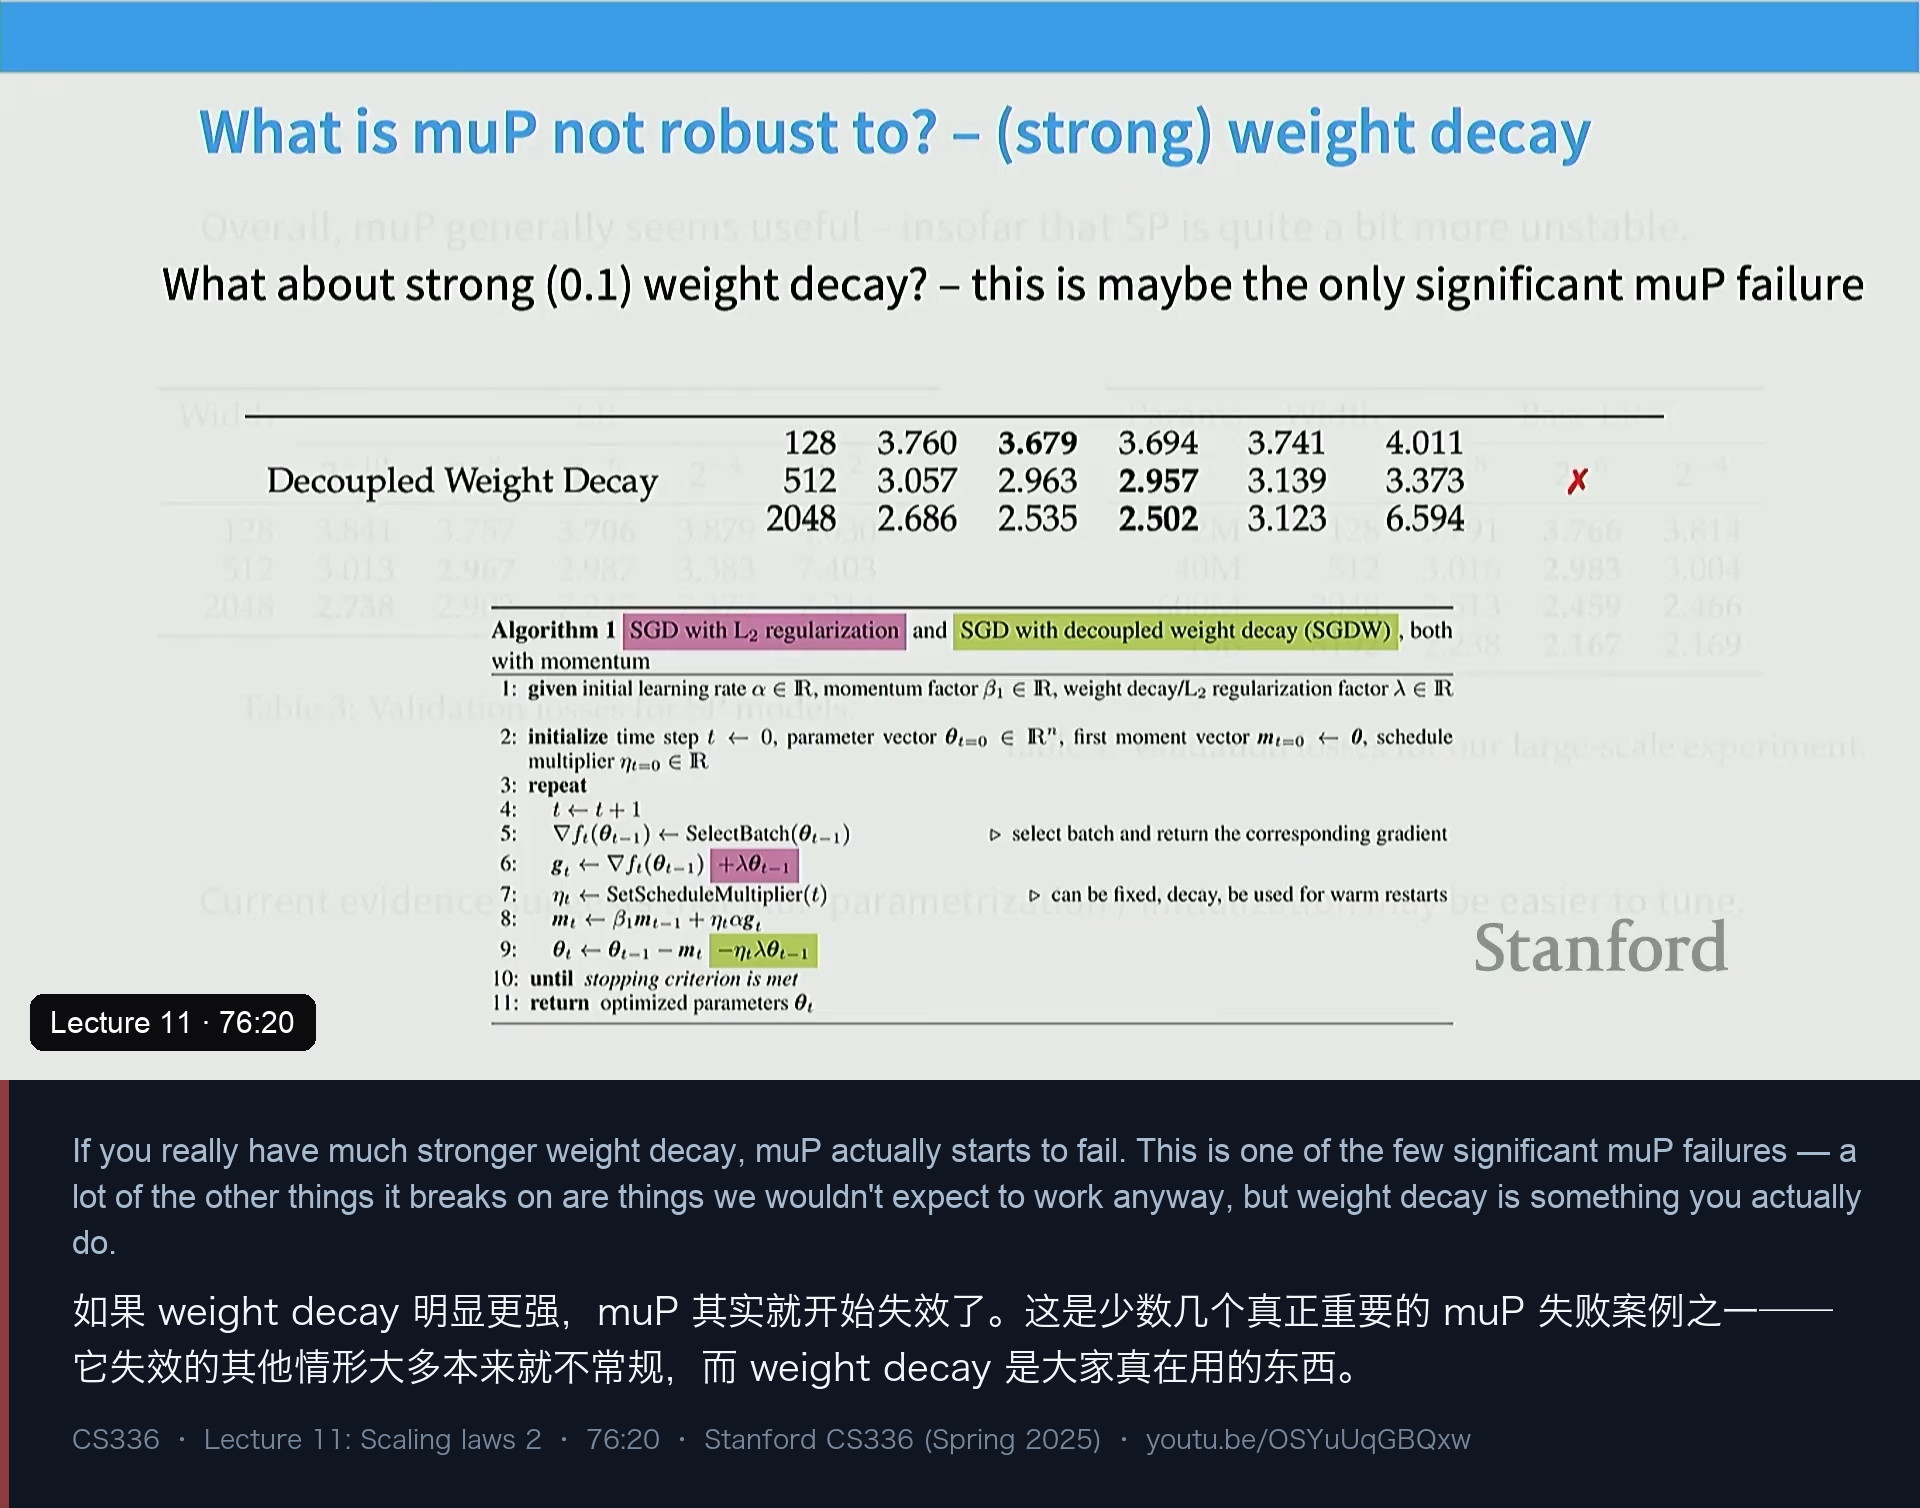
作为对照,他们也展示:用标准参数化、沿用同一个学习率,在宽度 2048 时模型直接给出退化到毫无意义的 loss——也就是说,如果不做参数化调整,学习率必须随宽度下降,而且要下降得“可预测”。muP 的另一侧证据是一次英雄实验:把规模一路拉到 10B 参数,最优学习率仍然停在 2⁻⁶ 这一档。讲师最后补了一句很克制的评价:“这些实证结果看起来挺有希望,Meta 在 Llama 4 里也用了一个 muP 的变体(他说论文里提过,但当时还没正式发出来),但据我所知,muP 并没有成为共识。”
十、收尾:在真实世界里怎么 scale
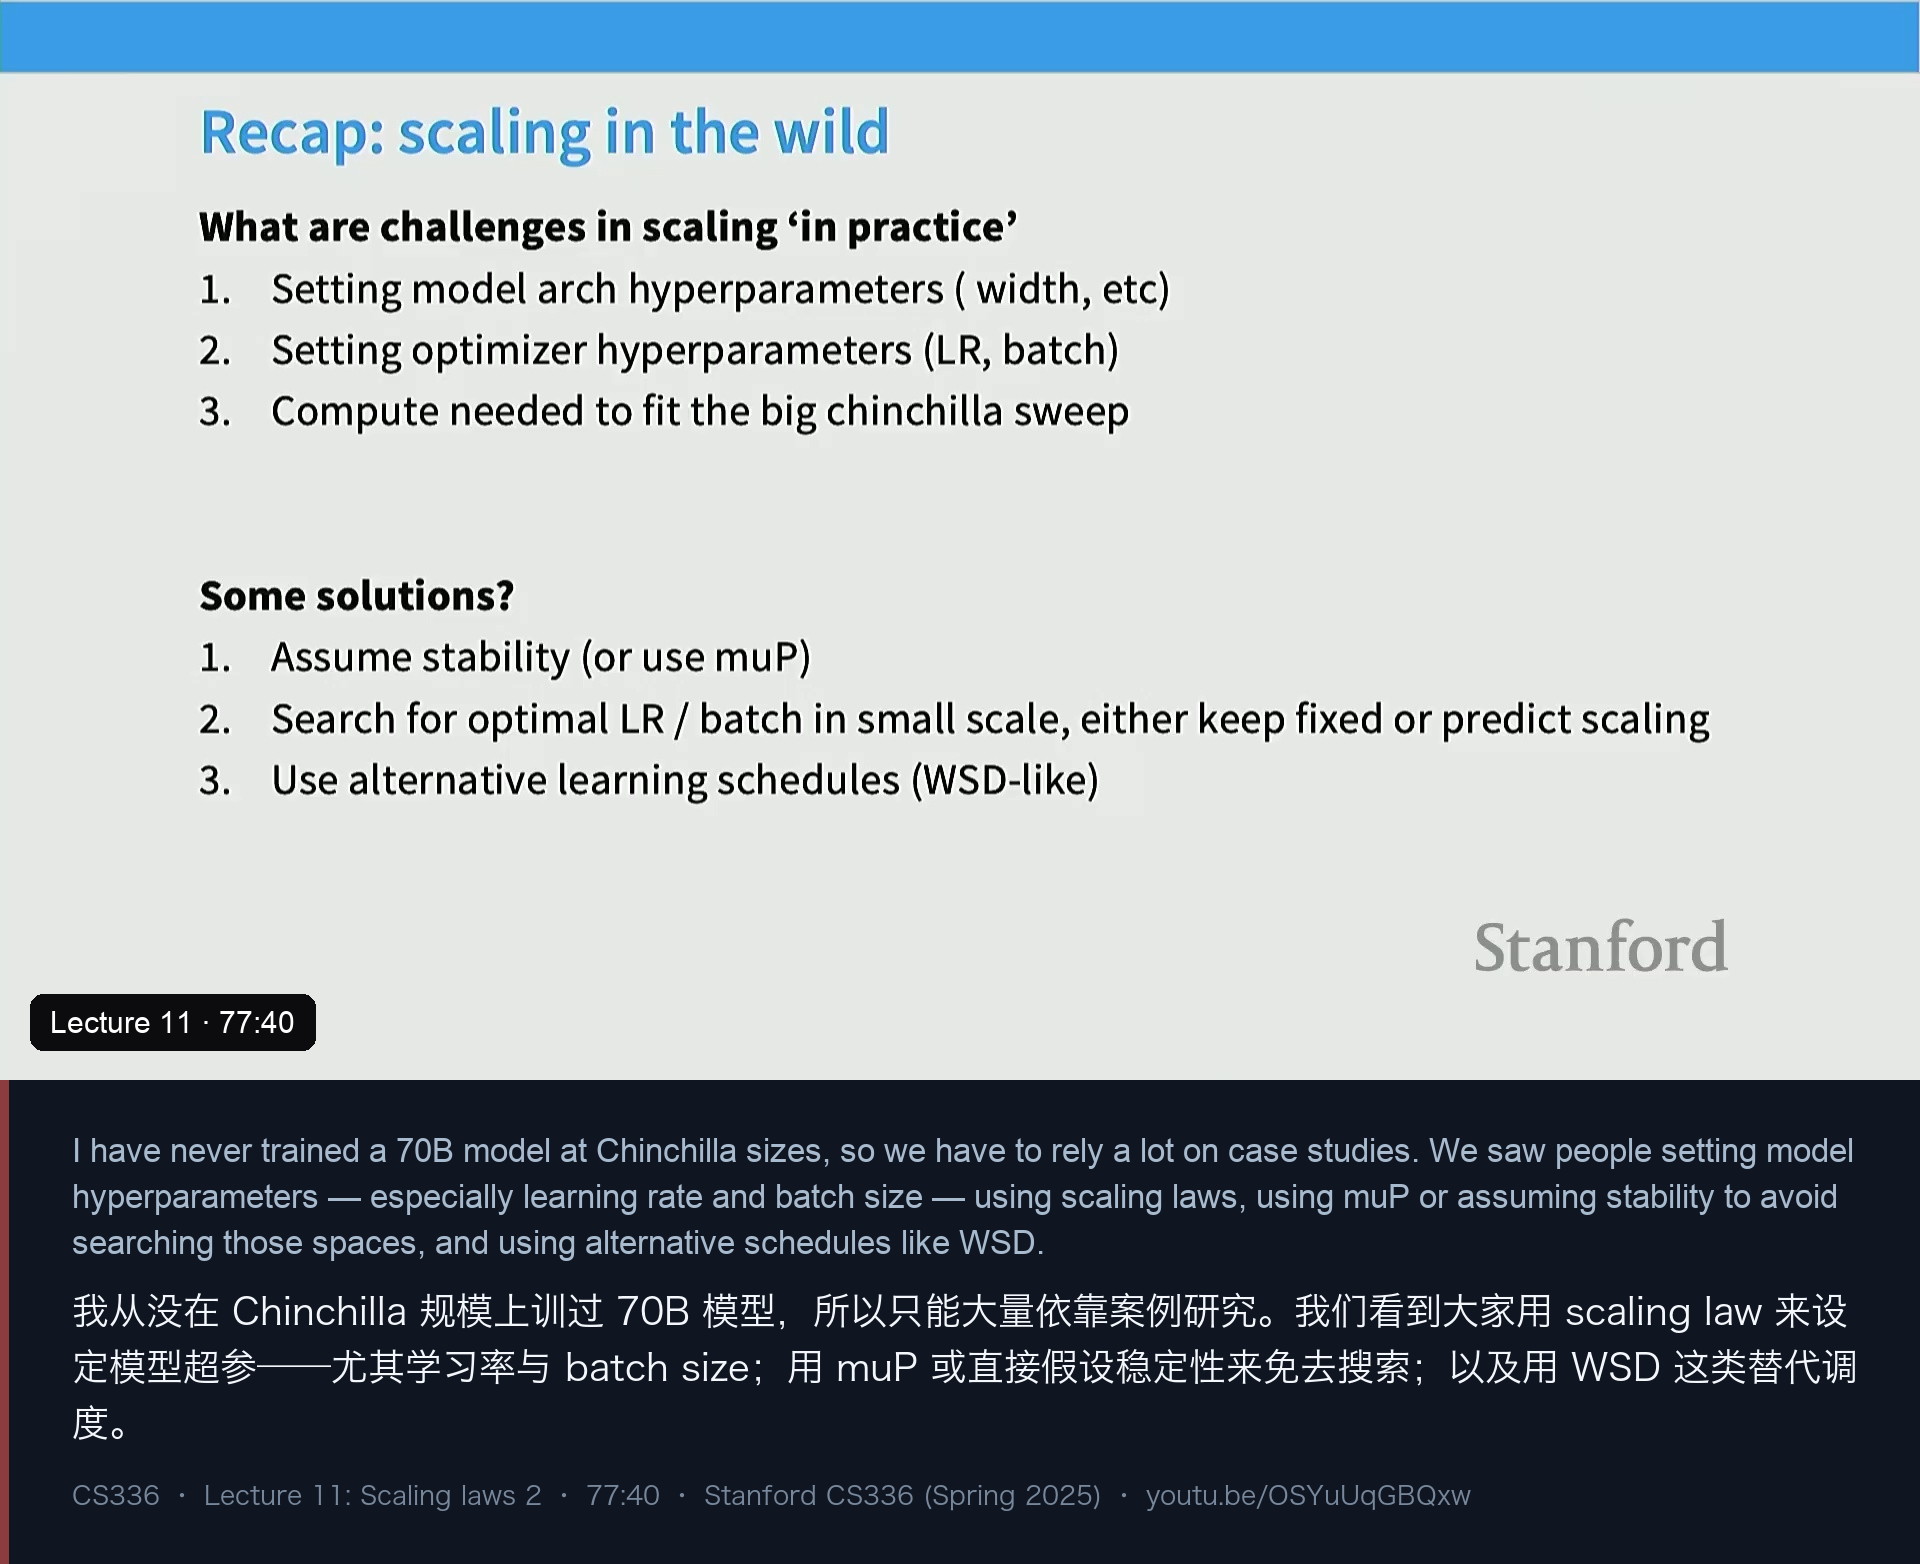
最后一页(图 18)把整讲收成一张清单。“在真实世界里怎么 scale”的三个难题是:
- 定模型架构的超参(宽度等等);
- 定优化器的超参(学习率、batch size);
- 跑得起那一次大的 Chinchilla sweep 所需算力。
对应的三个解法是:
- 假设稳定性(或者直接用 muP),把这些超参从规模里解耦;
- 在小规模上搜最优学习率/batch,然后要么直接冻结,要么用 scaling law 外推;
- 改用 WSD 这类可复用的学习率调度,把 Chinchilla 复现的算力成本压下来。
讲师最后的自述很坦率:“我从没在 Chinchilla 规模上训过 70B 模型,所以只能大量依靠案例研究。“他希望大家从这一讲带走的是三件事:学习率与 batch size 是人们真正焦虑的两个超参;muP 提供了一个把这种焦虑从大模型搬到小模型上的思路(并且它背后是”控制激活与更新尺度“这个很物理的想法);以及换一种学习率调度,本身就能省下大量算力。
我的笔记:这一讲值得记住的 8 句话
- “用 scaling law”分两层:第一层是拟合它,第二层是让它变便宜。 上一讲讲的是怎么拟合(Kaplan/Chinchilla/isoflop);这一讲的四个案例几乎都在讲第二层——muP 让超参不必在大规模上重搜,WSD 让 Chinchilla 复现的运行次数从 n² 降到近似 1。真正落地的 scaling 工作,大部分算力是花在“怎么少做实验”上的。
- Chinchilla 的 20 不是定律,只是一个起点。 复现结果从 39(Llama 3)、96(Hunyuan-1,按 active param)到 192(MiniCPM,讲师点名说“没见过这个数”),差异来自架构、数据质量与训练效率。讲师反复强调的结论是:“20× 是起点,不是约束”——不要 cargo cult 一个数字。
- WSD 是这一讲里最值得抄走的一个工程技巧。 余弦学习率的形状依赖终止点,所以没法中途复用;WSD 用一段平的 stable 段把“训练”与“降温”解耦,于是一次长训练 + 若干次回退重降温就能得到整条数据缩放曲线。代价是 loss 曲线会在 decay 阶段断崖下跌——别慌,那是正常的。
- 一个容易被忽视但很实用的判据:超参拟合总是很噪,isoflop 总是很干净。 讲师对 DeepSeek 那条最优学习率的拟合线公开表示怀疑(“我画条水平线看着也差不多”),却对所有人的 isoflop 图都赞不绝口。在做 scaling 研究时,isoflop 是更可信的那一半证据。
- muP 的全部内容,可以压缩成两条谱条件。 A1:初始化时(坐标级)激活保持 Θ(1),等价于范数 Θ(√n);A2:一步梯度之后激活的变化量也保持 Θ(1)。前者解出初始化的
1/√fan-in,后者解出逐层学习率的fan-out/fan-in(SGD)或1/fan-in(Adam)。 - muP 与标准参数化真正的差别是“逐层学习率”,而且是给 Adam 用的。 初始化那部分(Kaiming 式的 1/√fan-in)你可能早就做对了;MLP 上 SGD 的规则因为
n_l/n_{l−1} = 4而退化成常数,看不出区别。只要你还用全局常数学习率 + Adam,muP 就在说一件和你不同的事。 - muP 有明确的失效边界,其中最现实的一条是强 weight decay。 它对激活函数、batch size、若干初始化设定都鲁棒,但会被可学习 gain/bias、Lion 这类非 Adam 优化器、以及更强的 weight decay 破坏。讲师把这几条里唯一“大家真会用”的 weight decay 单独拎出来,说它“可能是唯一真正重要的失败案例”——这正好也是你在作业里该小心的地方。
- 尺度不变性是这门课反复出现的母题,而 muP 只是它的一种实现。 从数值稳定性(上一讲)到参数化(这一讲),讲师一再回到同一个愿望:让超参不随规模漂移,于是你可以在便宜的小模型上做完所有实验,再把结论原样搬到大模型上。 他还补了一句很漂亮的话——这套“取极限时保持量级不变”的思维方式,本身就是物理学里的重整化。
附:课程信息与时间轴
- 课程主页:stanford-cs336.github.io/spring2025
- 本讲视频:Lecture 11: Scaling laws 2(1:18)
- 播放列表:Stanford CS336 Language Modeling from Scratch · Spring 2025
- 配图目录:
public/blog/youtube/OSYuUqGBQxw/(18 张图均截取自视频中对应时刻的画面,并把该时刻的完整观点句拼合进图中) - 逐字稿:
transcript-OSYuUqGBQxw.md(视频自带英文字幕整理,约 1.58 万词)
| 时间 | 内容 |
|---|---|
| 00 | 开场:scaling laws 的第二讲,以案例与细节为主;对 scaling law 的怀疑 |
| 01 | Chinchilla 之后的黑箱期:前沿实验室不再公开 scaling 细节 |
| 03 | 本讲的两条线:案例研究 + muP 深潜 |
| 05 | 三个案例研究:Cerebras-GPT、MiniCPM、DeepSeek |
| 06 | Cerebras-GPT:muP 让 scaling 更可预测(首个公开验证) |
| 08 | Cerebras 论文附录里的 SP vs muP 逐层对照表 |
| 09 | 激进下缩放:40M 代理模型上做广泛超参搜索 |
| 10 | MiniCPM:用大量算力训练小模型;它的 muP 缩放规则 |
| 14 | 从最小模型到最大 pilot run 的算力节省(讲师转述约 5×) |
| 14 | 临界 batch size:loss 越低,可用的 batch 越大 |
| 17 | muP 下最优学习率跨规模保持稳定(约 10⁻²) |
| 18 | 模型大小 vs 数据量的权衡:为什么要复现 Chinchilla |
| 19 | 为什么不能拿一次余弦训练的中途 checkpoint 谈数据缩放 |
| 20 | WSD(warm-up / stable / decay)学习率:平的 stable 段可以复用 |
| 22 | WSD 的训练曲线:decay 阶段的断崖式下跌是正常的 |
| 24 | 旁注:UW + Apple 的“Chinchilla 惩罚”估计 |
| 25 | 用 WSD 做 Chinchilla 的 method 1(下包络)与 method 3(联合拟合) |
| 27 | MiniCPM 拟合出 192 tokens/param:一个离群值 |
| 28 | 20× 只是起点;Chinchilla 分析不是硬约束 |
| 33 | DeepSeek LLM:不用 muP,直接网格搜索最优 batch 与学习率 |
| 35 | 讲师对那条“最优学习率 scaling law”的公开怀疑 |
| 35 | DeepSeek 的 WSD 变体:两段各约 10% 的 decay,约 20% 算力用于降温 |
| 36 | 经验:超参拟合总是很噪,isoflop 分析总是很干净 |
| 37 | 可预测 scaling:从 10²⁰ 外推到 10²⁴ FLOPs 并命中 7B/67B |
| 39 | 前沿模型还会重做这些分析吗?——新论文里的 scaling 细节越来越少 |
| 40 | Llama 3:isoflop 复现得到约 39;loss → 下游准确率的 sigmoid |
| 43 | Hunyuan-1:96 的 data-to-active-parameter 比例 |
| 44 | MiniMax-01:用 scaling law 论证线性/混合注意力架构 |
| 46 | 案例小结:真实 scaling 配方里反复出现的几味料 |
| 48 | 转向 muP:为什么我们要尺度不变(scale-invariant)的超参 |
| 50 | muP 的两条谱条件:A1(初始化激活 Θ(1))与 A2(一步后激活变化 Θ(1)) |
| 52 | 推导 A1:深线性网络 + 高斯矩阵的算子范数集中 |
| 55 | A1 的结论:初始化取 1/√fan-in(加一个修正因子) |
| 57 | 推导 A2:秩一更新、三项分解,以及“ΔL 也必须是 Θ(1)“的额外假设 |
| 1:02 | 学习率的结论:SGD 为 fan-out/fan-in,Adam 为 1/fan-in |
| 1:03 | muP 速查表,以及与标准参数化的差别(逐层学习率) |
| 1:04 | Cerebras-GPT 的实现:embedding 特殊,其余按 1/width |
| 1:06 | 物理学视角:这正是重整化(renormalization) |
| 1:09 | 大规模消融:只放大宽度、注意力用 1/d 缩放 |
| 1:12 | 学习率真的能跨宽度迁移吗?——能 |
| 1:13 | 对什么鲁棒:激活函数、batch size、初始化选择 |
| 1:14 | 对什么不鲁棒:可学习的 gain / bias |
| 1:15 | 对什么不鲁棒:Lion 这类非 Adam 优化器 |
| 1:15 | 对什么不鲁棒:强 weight decay(“可能唯一真正重要的失败案例”) |
| 1:16 | 对照:标准参数化下沿用同一学习率会直接炸 |
| 1:17 | 收尾:真实世界 scaling 的三个难题与三个解法 |
说明:本文是视频内容的整理、翻译与转述,观点均来自主讲人;文中代码为讲座中推导与算法的整理版本,非官方作业代码。课程中引用的模型规模、token/参数比、算力节省、学习率数值与实验设定(20、39、96、192 tokens/param、约 5× 算力节省、40M 代理模型、10²⁰–10²⁴ FLOPs、10⁻² 与 2⁻⁶ 的学习率、0.1 的 weight decay 等)多为公开论文自述、讲师引用或估算,请自行核实;讲师本人也对其中部分拟合(尤其最优学习率的 scaling law)当场表示了保留意见。
讨论
这里是静态站点,没有内嵌评论区。如果这篇文章对你有用,欢迎通过 RSS 订阅后续更新。