Stanford CS336 第十讲精读:推理——为什么 generation 是访存受限的,以及 KV cache 的五种瘦身法
斯坦福 CS336(Language Modeling from Scratch, Spring 2025)第十讲完整讲义,主讲 Percy Liang。这一讲把'推理'当成一门系统工程课来讲:先给出一张算力账(算术强度、accelerator intensity、prefill 与 generation 的两阶段模型),说明为什么训练的瓶颈是算力而推理的瓶颈是显存带宽;再用 Llama-2 13B + H100 把延迟、吞吐与 batch size 的三角关系算成具体数字;然后用整场后半段讲 KV cache 的五种瘦身法(GQA、MLA、跨层注意力 CLA、局部注意力、以及它们的组合拳),并跳出 Transformer 看状态空间模型、线性注意力与扩散模型;最后收在两类工程手段上——有损的量化与剪枝、无损的投机解码,以及服务系统里的连续批处理、选择性批处理与 PagedAttention。
本篇属于系列 Stanford CS336 精读 · 第十讲
来源:YouTube 原视频(Stanford Online · CS336 Language Modeling from Scratch · Spring 2025 · Lecture 10: Inference)
来源说明 这是斯坦福 CS336《Language Modeling from Scratch》2025 年春季第十讲的完整讲义,主讲人是 Percy Liang。按讲师自己的说法,这是这门课第一次正式讲推理(“我们去年没讲推理,今年是第一年”),而且这一讲是硬挤出来的——他说推理是个极深的话题,“本来可以撑好几讲”。所以这一讲的节奏明显偏快,很多地方是“给个直觉就往下走”,尤其是后半段关于线性注意力与投机解码的推导。 文中 18 张配图均截取自视频对应时刻的画面,并把该时刻的完整观点句(英文原句+中文翻译)拼合进图中。文中出现的所有数字——OpenAI 每天 1000 亿词、Cursor 每天 10 亿行被接受的代码、H100 的 989 TFLOPS 与 3.35 TB/s、accelerator intensity 295 flops/byte、Llama-2 13B 在 B=1 时约 8 ms/token 与 124 tok/s、B=256 时 KV cache 要 240 GB、GQA 的 1、MLA 把 16384 维压到 512 维、MiniMax-01 的 456B 参数、Mamba 在 1B 规模追平 Transformer、Nvidia 把 15B 剪到 8B、AWQ 的 int3 与 3.2× 加速、投机解码约 2× 加速等——都是讲师课上的口播、幻灯片引用或对公开论文/传闻的转述,不是本文独立核实的事实,请自行核查原始论文与官方披露。字幕把 multi-head latent attention 听写成 “multi head latent”、把 PagedAttention 听写成 “page detention”、把 Character.ai 听写成 “character AI”,下文按通行写法记录。 另外需要提醒:课上那位“1000 亿词/天”的说法来自 Sam Altman,讲师自己用的是 “Sam says”,即引用;“10 亿行代码/天”讲师明确用了 “allegedly”(据称)。
TL;DR
- 推理的定义简单得过分:给定一个训练好的固定模型,根据 prompt 生成回答。但它出现的场景远比“做一个聊天机器人”多——评估模型要用它、测试时计算(“多想一会儿”其实就是多生成 token)要用它、用强化学习训练时采样回答也要用它。
- 训练与推理的根本差异只有一句话:监督训练里你能看到所有 token,所以可以沿序列并行;推理必须一个接一个地生成,因为每个 token 都依赖它之前的一切。这一个约束,决定了后面所有的工程难题。
- 整个讲座的枢纽概念是“算术强度”(arithmetic intensity):每搬运一个 byte 能换到多少次浮点运算。矩阵乘法里它约等于 batch size
B;而 H100 的“加速器强度”约为 295 flops/byte。当B > 295时你是计算受限(好),当B = 1(矩阵乘向量)时强度只有 1,你是访存受限(坏)。 - 把 Transformer 拆成两段看:MLP 层的强度是
B·T,prefill 阶段很容易做大、generation 阶段T=1只能靠并发请求数B撑;而 attention 层的强度是S·T/(S+T),它永远不超过 1,而且完全不依赖B——因为每条序列都有自己专属的 KV cache,批量化在这里救不了你。 - 于是有了“两阶段推理”这幅图:prefill(编码整个 prompt)是计算受限的、可以并行、很快;generation(逐个吐 token)是访存受限的、串行、很慢。所谓“加速推理”,绝大多数时候就是在想办法缩短生成阶段的访存。
- 延迟与吞吐是两条不同的曲线:小 batch 换低延迟,大 batch 换高吞吐,而显存(主要是 KV cache)决定了你能把 batch 推到哪里。Llama-2 13B 在 H100 上
B=1时约 8 ms/token、124 tok/s;B=256时 KV cache 就要 240 GB,根本放不下。 - KV cache 是最大的瓶颈,于是有了五种瘦身法:GQA(少几个 KV 头)、MLA(把 KV 投影到低维隐空间)、CLA(跨层共享 KV 投影)、局部注意力(只留最近 K 个 token)、以及把以上组合起来用(如 Character.ai 每六层放一个全局层)。它们全都拿一点精度换大量显存。
- 更大的赌注是换掉架构:状态空间模型(Mamba)、线性注意力(MiniMax-01 的 456B MoE)、扩散语言模型(Inception Labs)都是在试图绕开“自回归 + 全注意力”这个根本瓶颈。课上的一句总结是:线性 + 局部注意力,只用少量全注意力层,已经能产出真正的一线模型。
- 最后是两类工程手段:有损的捷径(量化到 int8/int4、剪枝 + 蒸馏)和无损的加速(投机解码利用“检查比生成快”,PagedAttention 把操作系统的分页思想搬进 KV cache)。
一、这一讲在哪:从“训练一次”到“生成无数次”
讲座开场就把定义压成了一句话:
给定一个已经训练好的固定模型,根据 prompt 生成回答。 就这么简单。但 Percy 花了几分钟强调:推理出现的场景,比“我想搭个 chatbot demo”要多得多。
- 最直白的:你真的在用这个模型——聊天、用 Cursor 之类的工具做代码补全、跑批量数据处理任务;
- 评估:想在一个指令跟随数据集上评你的模型,你就要做推理;
- 测试时计算(test-time compute):让模型“多想一会儿”再给答案,而“思考”本质上就是多生成 token,所以也是更多推理;
- 甚至连训练本身:用强化学习时,你要采样回答、再用 reward 去打分,采样就是推理。
他的原话是:“推理并不只是我想放一个 chatbot demo 上去。推理实际上是语言模型很多基本功能的地基。” 这也解释了为什么这一讲会被塞进课程:它在整门课里的地位被低估了。
然后是这门课一以贯之的效率视角:
训练是一次性成本,而推理你要重复做。 他引了两条传闻数字来说明这个量级:Sam 说 OpenAI 每天生成 1000 亿词;而 Cursor——一个并不算太新的产品——据称每天生成 10 亿行“被接受”的代码。他没去核实这些数字,只是用来说明一件事:推理的账,正在变得比训练更贵。
顺带他也解释了一个现象:为什么学术界和工业界对推理的关注度差这么多。学术界“不真的服务任何模型,只是训练、拿个分数、写进论文”;而任何真正对外提供服务的团队,无论是闭源模型还是开放权重模型,都会在推理上投入大量精力。他也顺手列了一串值得看开源的推理栈(vLLM 等)。
那怎么衡量“推理做得好不好”?三个指标:
| 指标 | 含义 | 谁在乎 |
|---|---|---|
| TTFT(time to first token) | 用户要等多久才开始出字 | 交互式应用:prompt 很长时等 10 秒就很糟 |
| Latency(延迟) | 第一个 token 之后,后续 token 到达的速度 | 同样是交互式应用 |
| Throughput(吞吐) | 单位时间内系统总共生成多少 token | 批处理场景 |
他强调了一个容易被混淆的点:高吞吐不等于低延迟。吞吐是“系统整体每秒吐多少 token”,延迟是“单个用户感知到的速度”——一批请求里只要有几个特别慢的,吞吐可以很高而延迟很难看。延迟更像是“任意单个用户的最坏情况”。
二、两条曲线:训练可以并行,推理只能串行
接下来是全场的“母题”。Percy 先复习了训练的特性,再把它和推理对照:
- 训练(有监督)里你能看到所有 token,所以可以沿序列维并行——Transformer 正是重度依赖这一点:你一次性构造出整段序列的张量,做一堆矩阵乘,然后拿到输出。
- 推理的决定性特征是必须串行生成:第
t个 token 依赖前面所有 token,所以你没法并行。
这个约束带来两个后果:第一,你很难把可用的算力用满;第二,它会变成访存受限(memory limited)的任务。 后半场所有的技巧,本质上都是在跟这两个后果搏斗。
本文第三节及以后会反复出现的符号,先在这里交代清楚(这也是讲座里的那张符号表):B 是 batch 里的序列数,L 是层数,T 是“要生成的 token 数 / 用于 query 的 token 数”,S 是“用于 condition 的 token 数”(prompt 长度),V 是词表大小,D 是模型维度,F 是 MLP 隐层维度(通常是 4D),h 是注意力头维度,N 是 query 头数(一般 N·h = D),K 是 KV 头数(GQA 里 K < N),G 是分组数(K·G = N)。
前向传播的算力有一个常用的经验公式:
# 前向 FLOPs 的粗略公式(讲义里的版本)
flops ≈ 6 * num_tokens * num_params     # num_tokens = B*T;6 = 2(乘加)× 3(前向 vs 反向的经验系数)
# 注意力部分还额外有一个 T^2 量级的项
flops_attention ≈ 4 * B * S * T * D
三、算术强度:为什么 generation 注定是访存受限的
这一节是整个讲座的技术枢纽。算术强度(arithmetic intensity)= 浮点运算次数 / 搬运的字节数,它决定了一块 GPU 上你是“算得动”还是“搬不动”。
先从最简单的矩阵乘法开始(X 是 B×D,W 是 D×F):
def arithmetic_intensity(B, D, F):
    flops = 2 * B * D * F                      # 一次乘法 + 一次加法
    bytes_transferred = 2*B*D + 2*D*F + 2*B*F  # 读 X、读 W、写回结果(bf16 = 2 bytes)
    return flops / bytes_transferred

# 当 B << D, F 时(B 是几百,D/F 是几千到几万),上面的式子简化为:
# intensity ≈ B也就是说,矩阵乘法的算术强度约等于 batch size。然后是关键的对照:GPU 自己有一个“加速器强度”——它能提供的算力除以它的显存带宽。对 H100 来说:
accelerator_intensity = 989e12 / 3.35e12 # 989 TFLOPS / 3.35 TB/s ≈ 295 flops/byte于是判断标准非常干脆:算术强度高于 295 就是计算受限(你能用满算力);低于 295 就是访存受限(GPU 在等数据)。 讲师说,理想化一点看,B > 295(约 300 的 batch)就能打满 H100。
那极端情况呢?
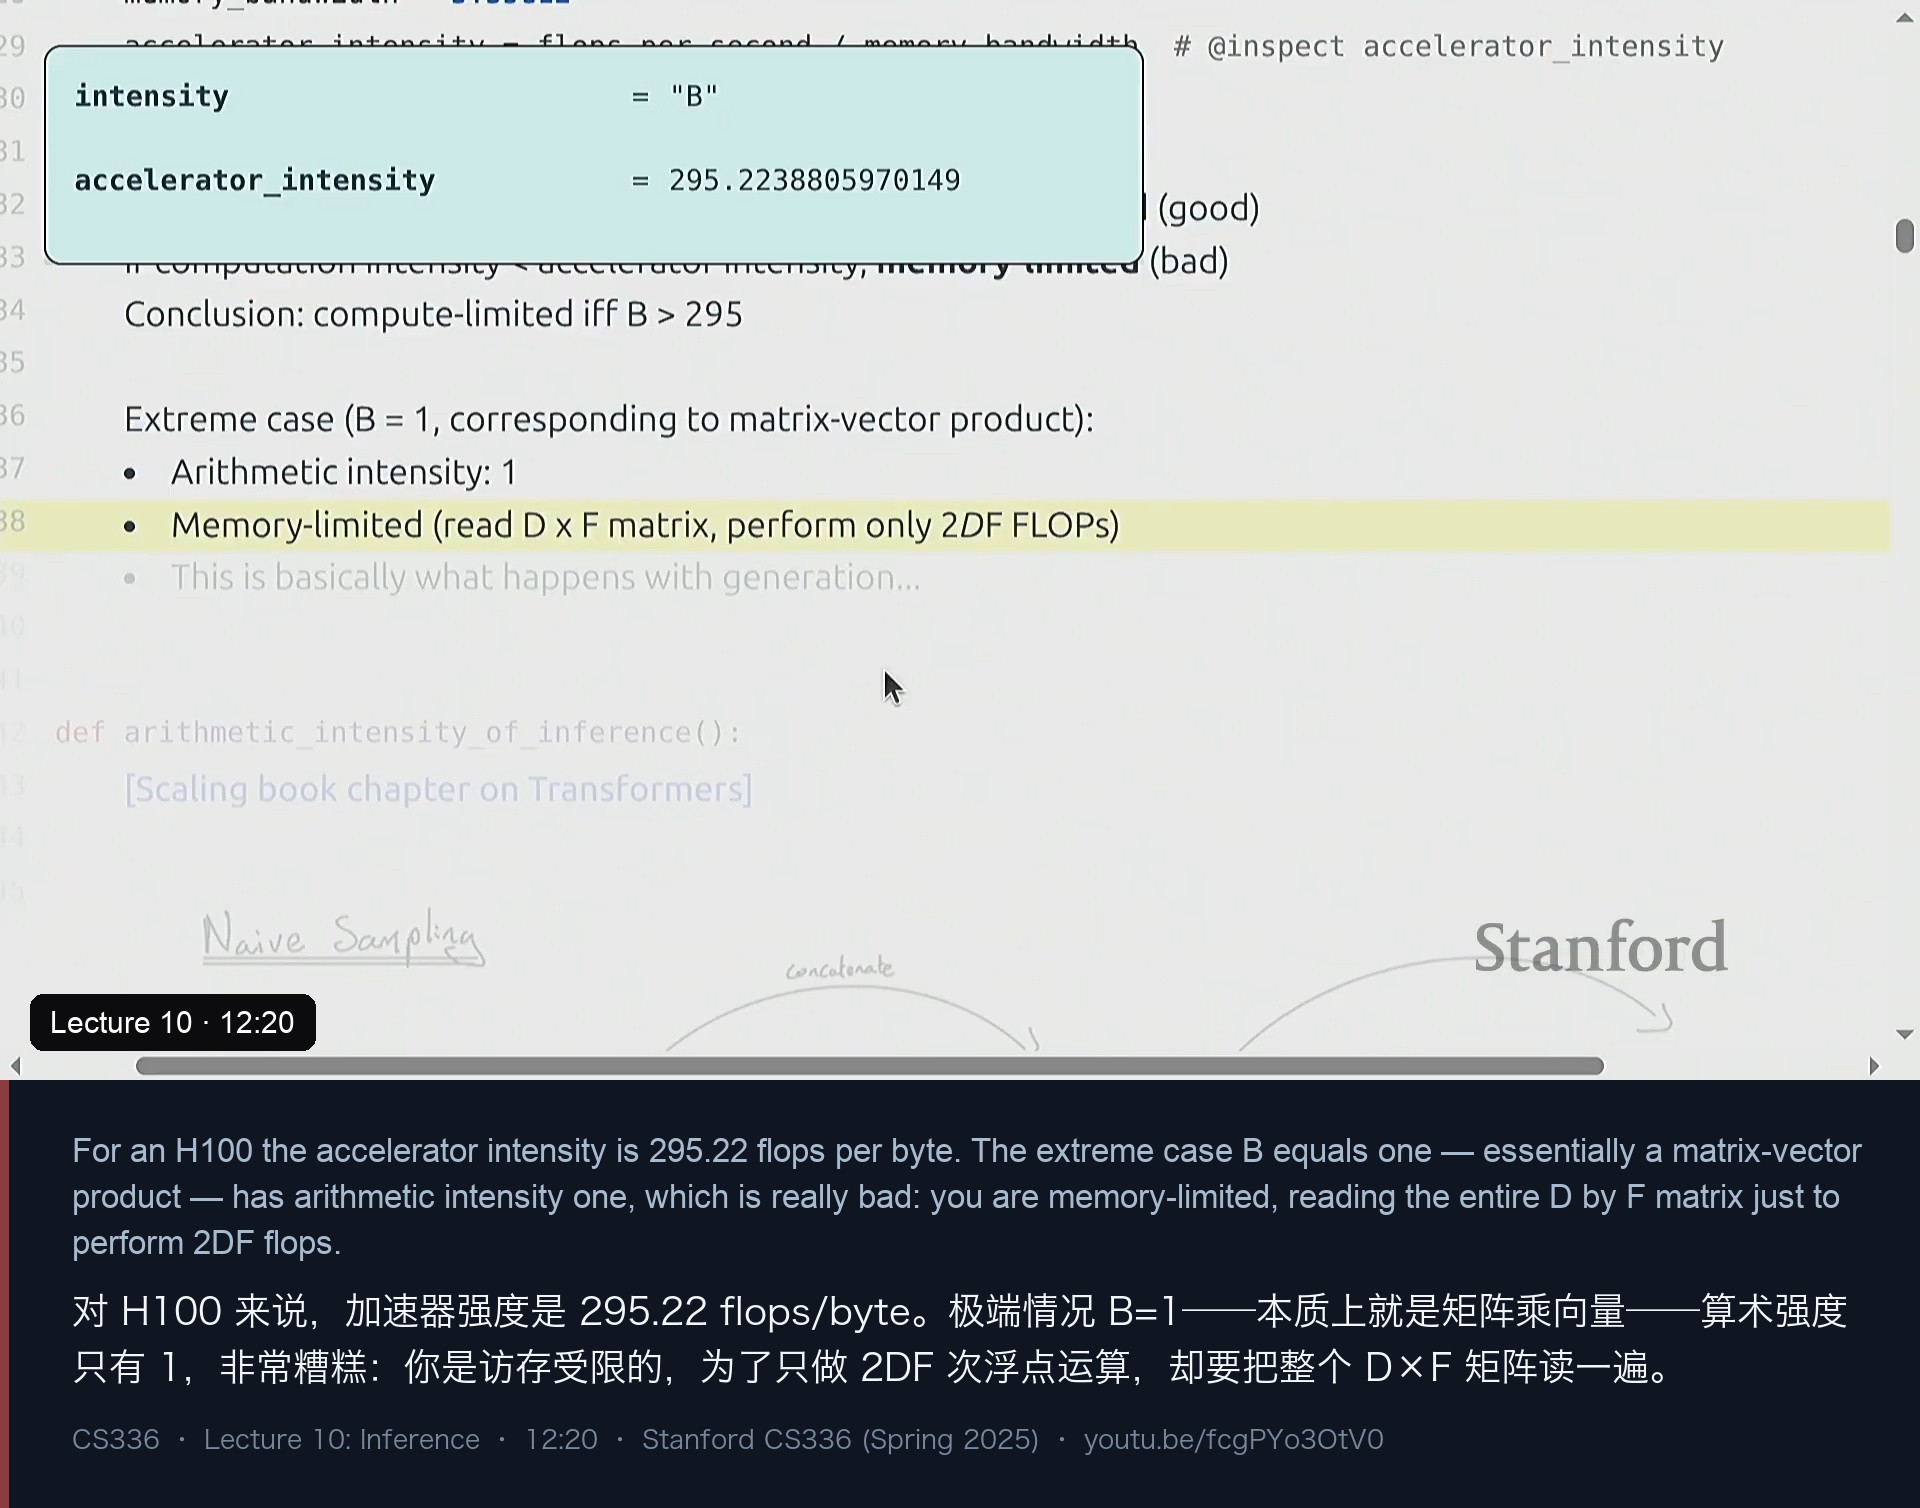
如果 B = 1,这就是一次矩阵乘向量,算术强度是 1。 意思是:你为了做 2DF 次浮点运算,把整个 D×F 的权重矩阵完整读了一遍。这非常糟糕——“你希望每读一次显存能做很多很多 flops,因为读显存很慢”。而 B=1 恰好就是逐 token 生成的样子。这就是推理慢的根源,一句话说完了。
(顺带一提,Percy 还会用一句“you can check my math because this is sympy, and it’s guaranteed to be correct”来打趣——他是在 Jupyter 里现场用 sympy 化简这些式子,幻灯片上那一小块浅蓝色的面板就是代码输出,后文的配图里会反复出现。)
四、把 KV cache 摆上桌:两阶段推理
朴素做法是这样的:把 prompt 喂进 Transformer,拿到下一个 token 的 logits,采样一个 token,把它接回 prompt 后面,再整段喂进 Transformer,如此循环。问题在于每个新 token 你都在做 O(T²) 的重复计算——前缀的编码结果一直没变,却被反复算。
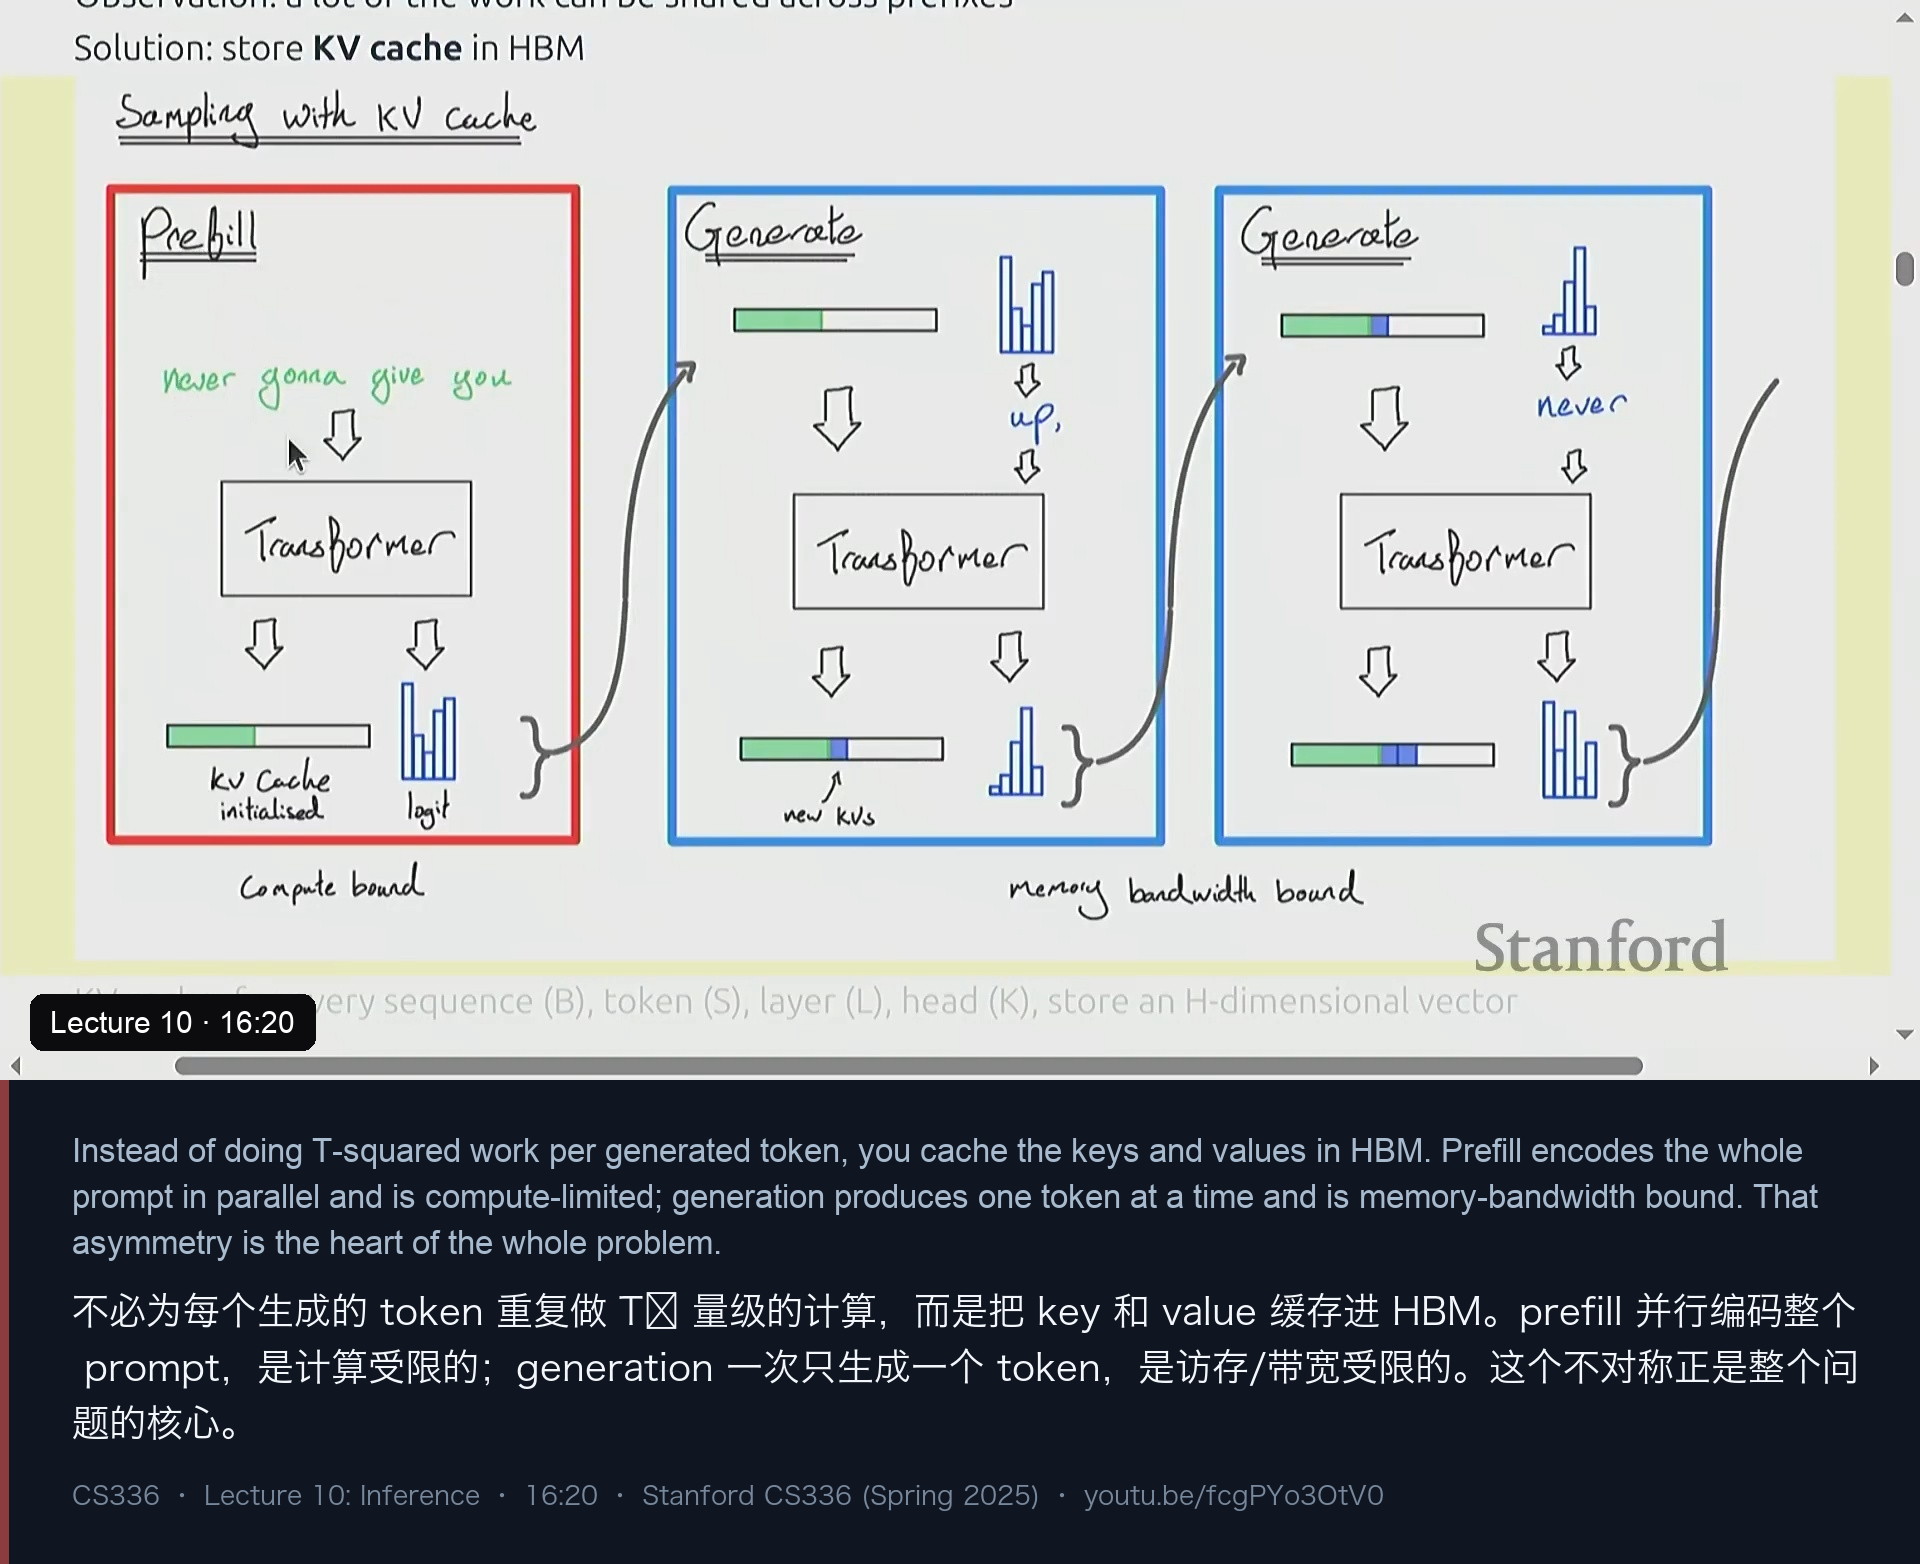
解法就是缓存 key 和 value,而且缓存在 HBM 里(只有那里放得下)。于是推理被清晰地切成两段:
- prefill:给定 prompt,把整段并行编码出来。这跟训练时做的事很像,可以并行、计算受限、很快;
- generation:一个 token 一个 token 地往外吐。这一半才是麻烦所在。
KV cache 的大小可以精确写出来:对 batch 里每条序列、序列里每个 token、Transformer 每一层、每个 KV 头,你都要存一个 h 维向量(Key 和 Value 各一份,bf16 各占 2 字节):
# KV cache 与总显存(单请求视角)
kv_cache_per_seq = S * K * h * L * 2 * 2          # token × KV头 × 头维度 × 层 × (K,V) × 2 bytes
memory           = params * 2 + B * kv_cache_per_seq   # 没有梯度、没有优化器状态,但有 KV cache
“你会觉得这要占很多显存——你没想错。”
接着他把 MLP 层和 attention 层分开算算术强度,得到全场最重要的两个结论:
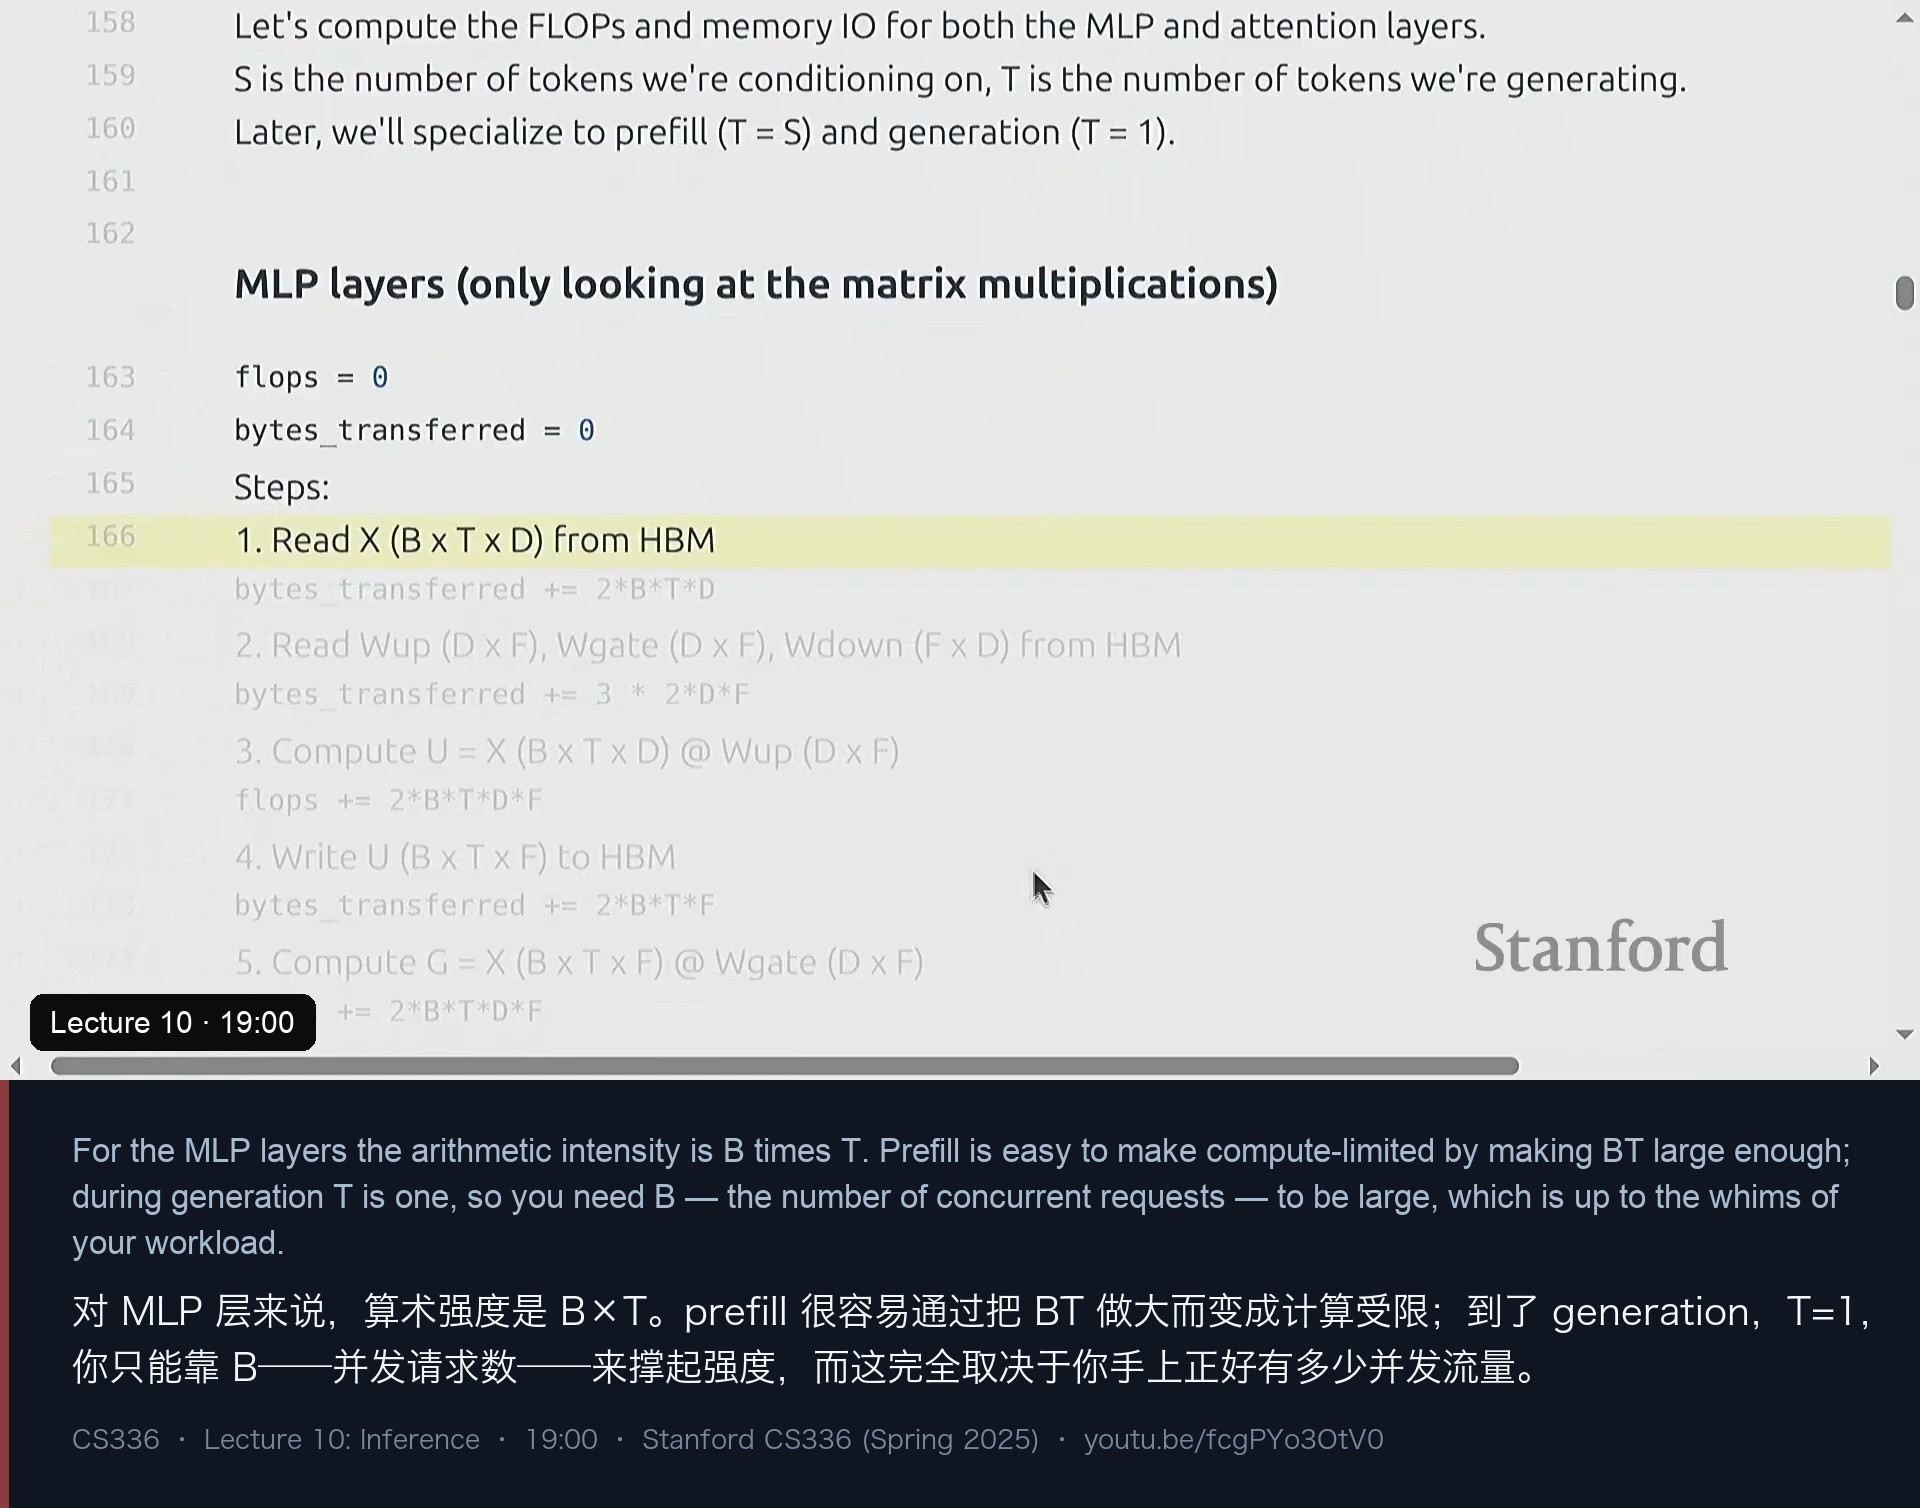
MLP 层的强度是 B·T。 prefill 阶段 T = S 很大,所以很容易做到计算受限;但 generation 阶段 T = 1,强度就只剩 B——也就是并发请求数。讲师特意指出这件事的动态性:这取决于你手上正好有多少请求,“如果一次只来几个请求,你就没法高效利用硬件”。
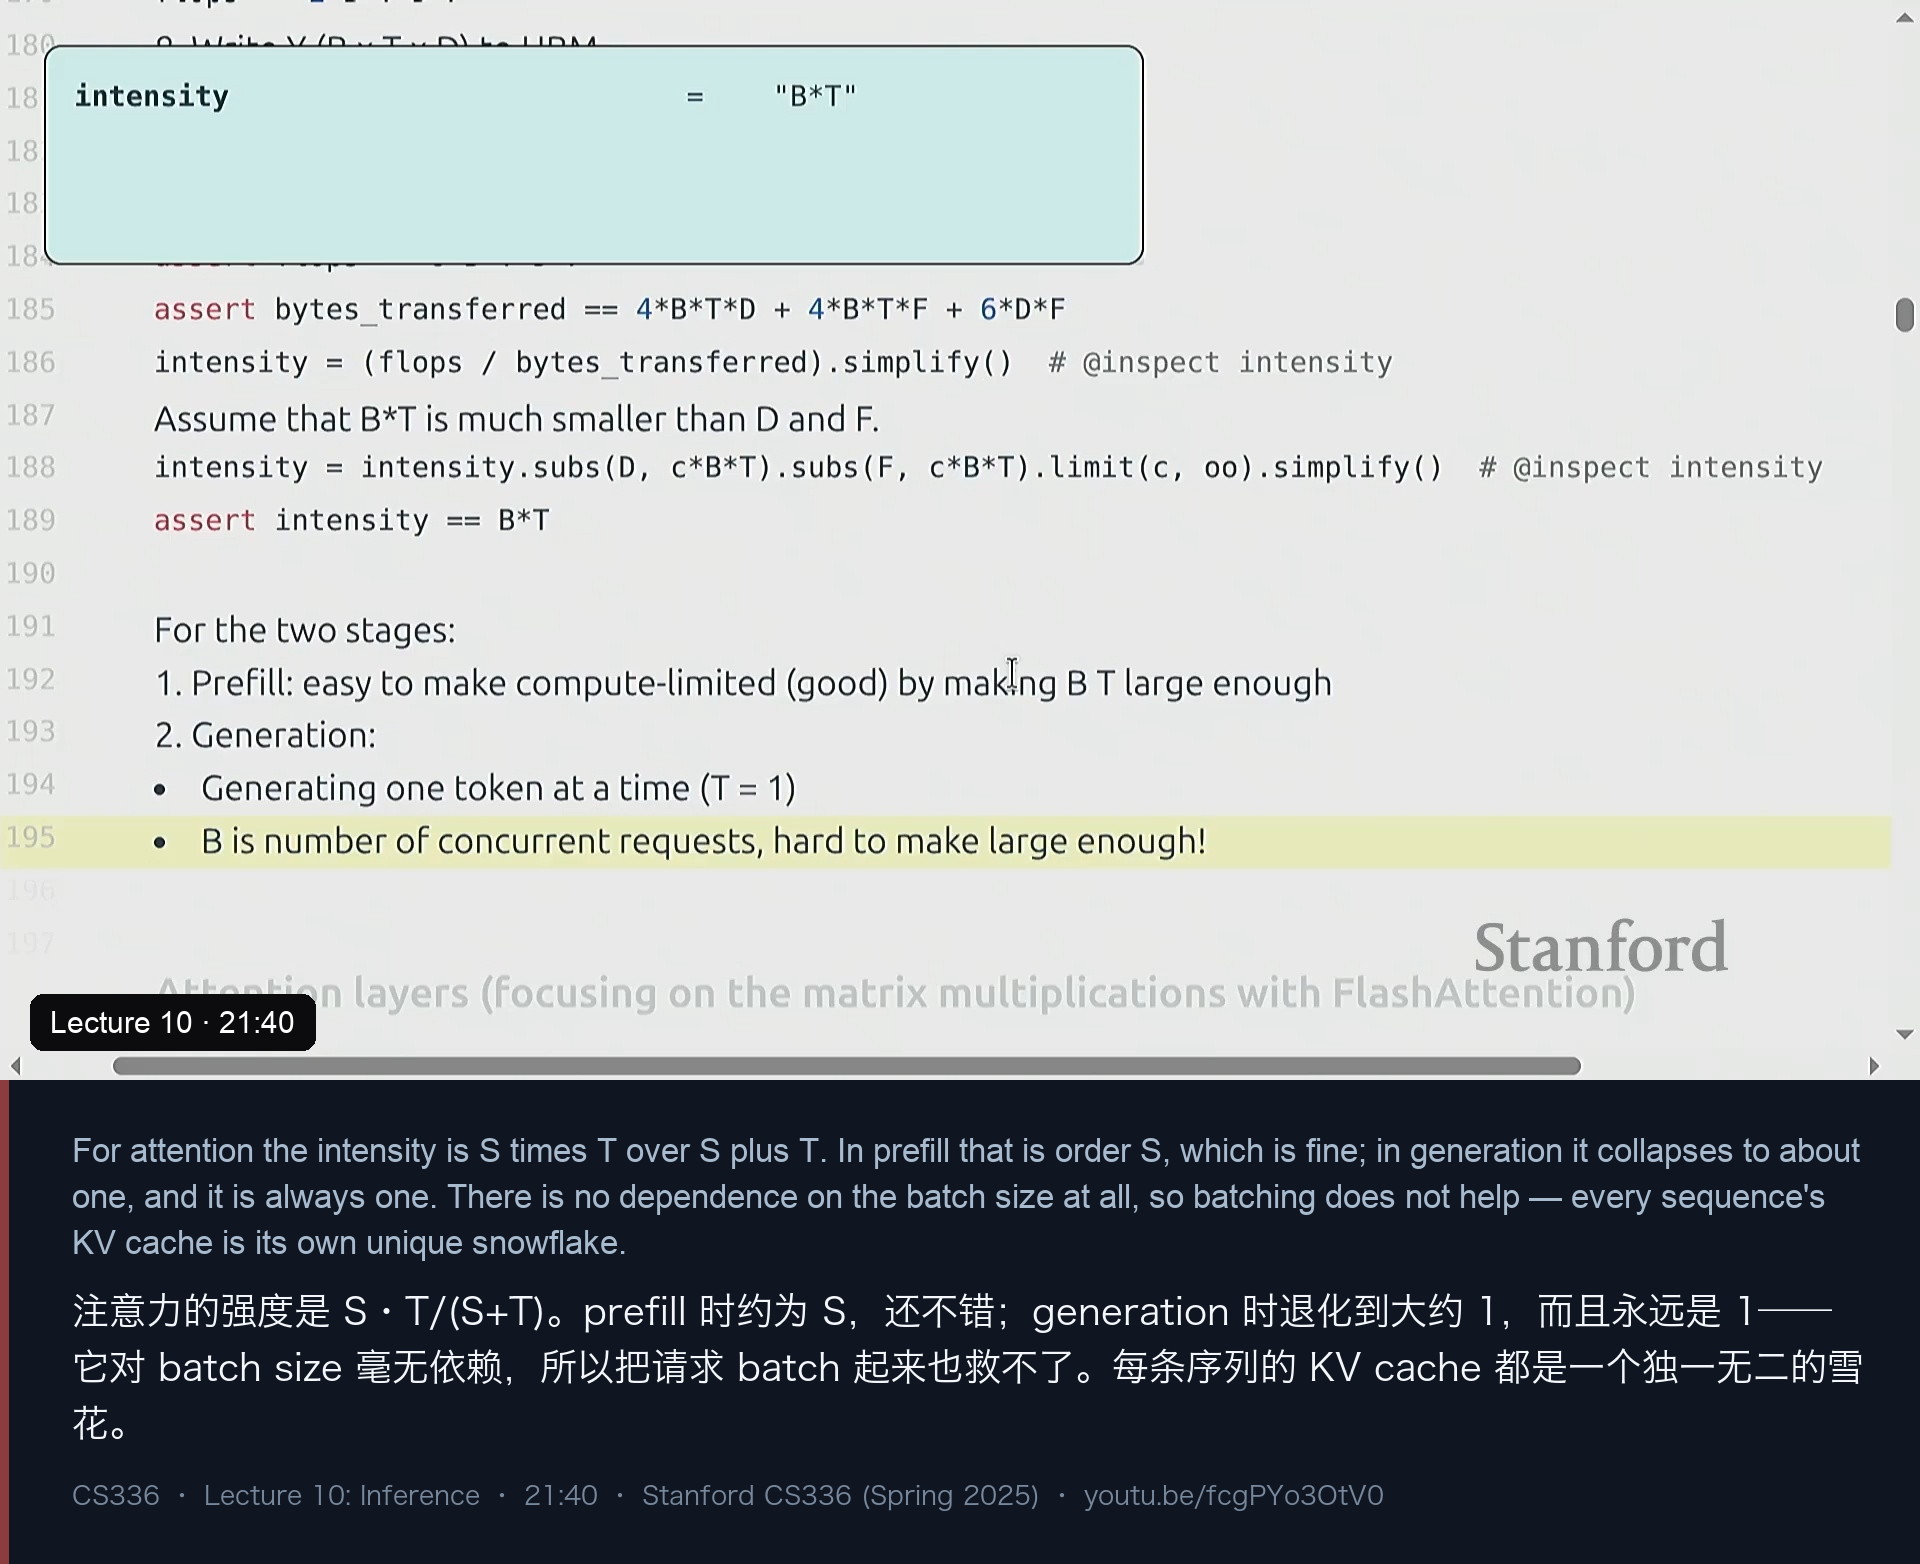
Attention 层的强度是 S·T/(S+T)。 prefill 时 T = S,强度是 S/2 量级,还行;generation 时 T = 1,强度是 S/(S+1),趋近于 1,而且永远不超过 1。
这里有一个非常漂亮的解释:为什么 attention 的强度完全不依赖 B?因为 MLP 的权重是所有序列共享的,你可以把一批序列打包起来一起过;而 attention 的 KV cache 是每条序列自己的——所以批量处理并不会摊薄访存,B 在分子分母里约掉了。Percy 的原话是:
"the KV cache is sort of every sequence's own unique snowflake."讲座到这里给出了全场最重要的一句总结:prefill 是计算受限的,generation 是访存受限的;MLP 的强度是 B(靠并发请求救),attention 的强度恒为 1(怎么都救不了)。 后面所有的架构创新与系统优化,几乎都是在回应这句话。
五、把账算清楚:延迟、吞吐与 batch size 的两难
有了“generation 是访存受限”这个判断,就可以只算显存搬运量来估算延迟:
# 单请求、Llama-2 13B、bf16、H100
bandwidth = 3.35e12                       # bytes/s
memory    = params_bytes + batch_size * kv_cache_per_seq
latency   = memory / bandwidth            # 访存受限:延迟 ≈ 搬运了多少字节 / 带宽
throughput = batch_size / latency         # 一次并行生成 B 个 token
代入 Llama-2 13B 的配置(S = 1000、模型维度 5120、n_heads=40、n_kv_heads=40、层数 40 等),于是有了这张很有说服力的表:
| batch size | 延迟 | 吞吐 | 显存 |
|---|---|---|---|
| 1 | 约 8 ms/token | 约 124 tok/s | 最小 |
| 16 | 上升 | 大幅上升 | 上升(要存 16 条序列的 KV cache) |
| 256 | 继续上升 | 继续上升,但收益递减 | 约 240 GB,H100 装不下 |
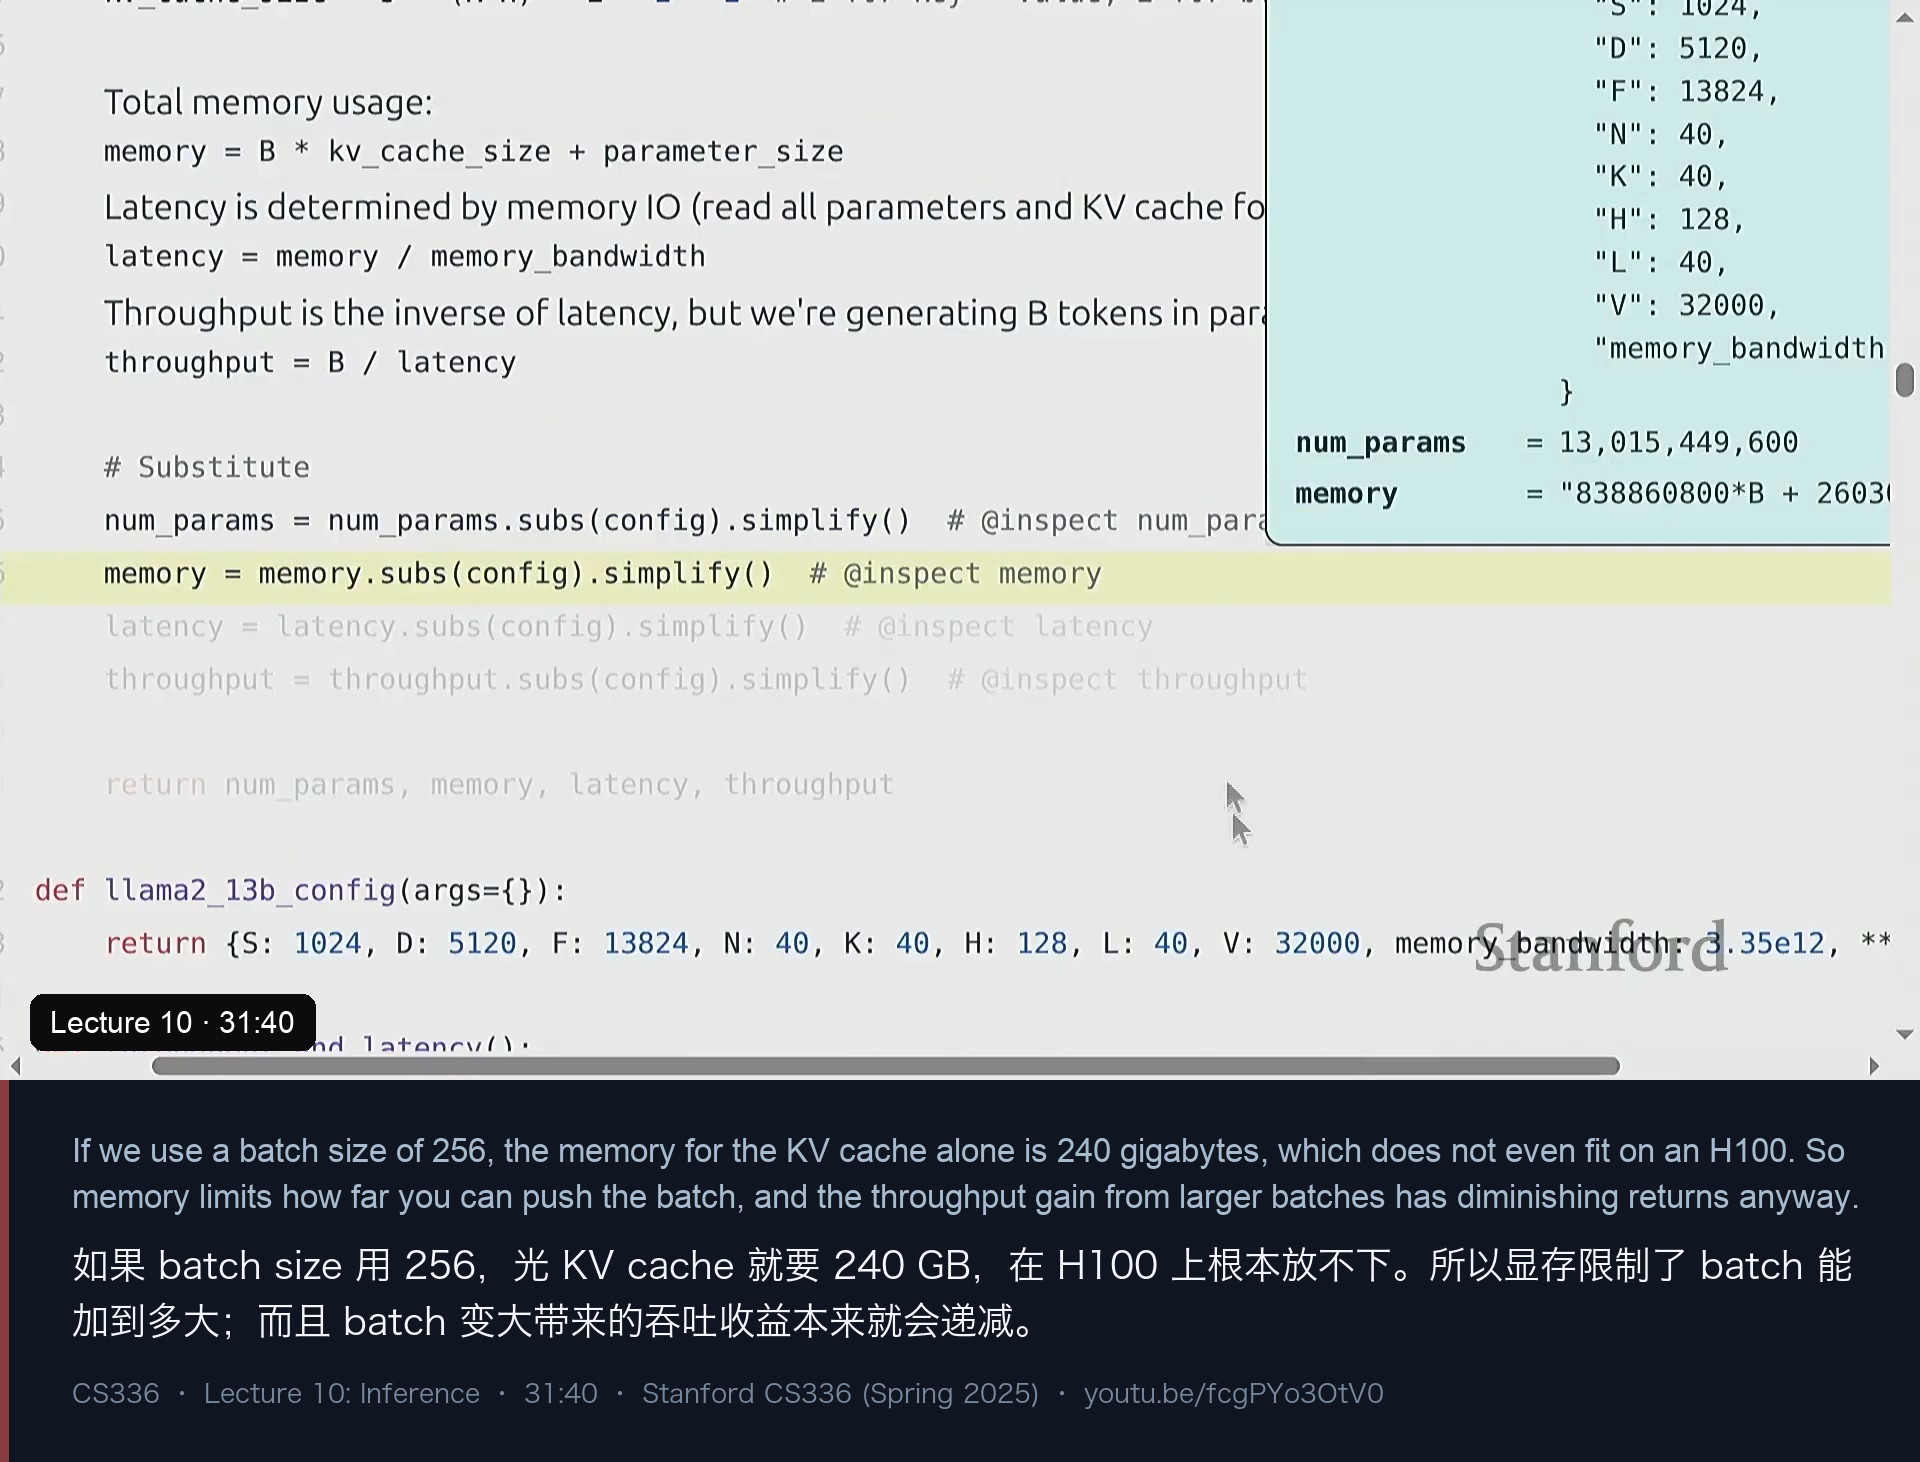
于是有了这一节的结论:延迟与吞吐之间存在取舍。小 batch 换低延迟,大 batch 换高吞吐,而显存——主要是 KV cache——决定了你能把 batch 推到哪里。 讲师也说,B=256 时吞吐虽然还在涨,但已经明显递减,因为 B 同时出现在分子和分母里。
他还补了一个“别把简单的事情忘了”的点:训练时的并行复杂得让人头疼,但推理至少有一种并行方式是极其简单的——直接起 M 份模型副本,不需要任何通信(因为模型不用更新),延迟不变、吞吐乘 M。当然,如果模型大到单卡放不下,就要开始切模型、乃至切 KV cache 了。
最后,TTFT 的本质也被点破:它基本由 prefill 决定,而 prefill 是计算受限的——给定固定架构,你能做的不多;想压低 TTFT 就得减小 batch,但那会牺牲吞吐。又是同一组取舍。
六、KV cache 的五种瘦身法
讲座到这里进入后半场,Percy 先交代了这一半的真实主题——原话大意是:无损的手段当然有——写更好的 kernel、优化系统;但真正的大头来自“愿意走捷径”。而“这一讲名义上在讲推理,实际上是偷偷在讲模型架构”,因为近些年很多架构上的改动,都是被推理需求直接驱动出来的。
他给出的总纲只有一句:瓶颈是 KV cache,因为推理是访存受限的,而“速度这件事,说到底就是显存的事”。 那么问题就变成:怎么在不太损精度的前提下,把 KV cache 变小?
6.1 GQA:少几个 KV 头
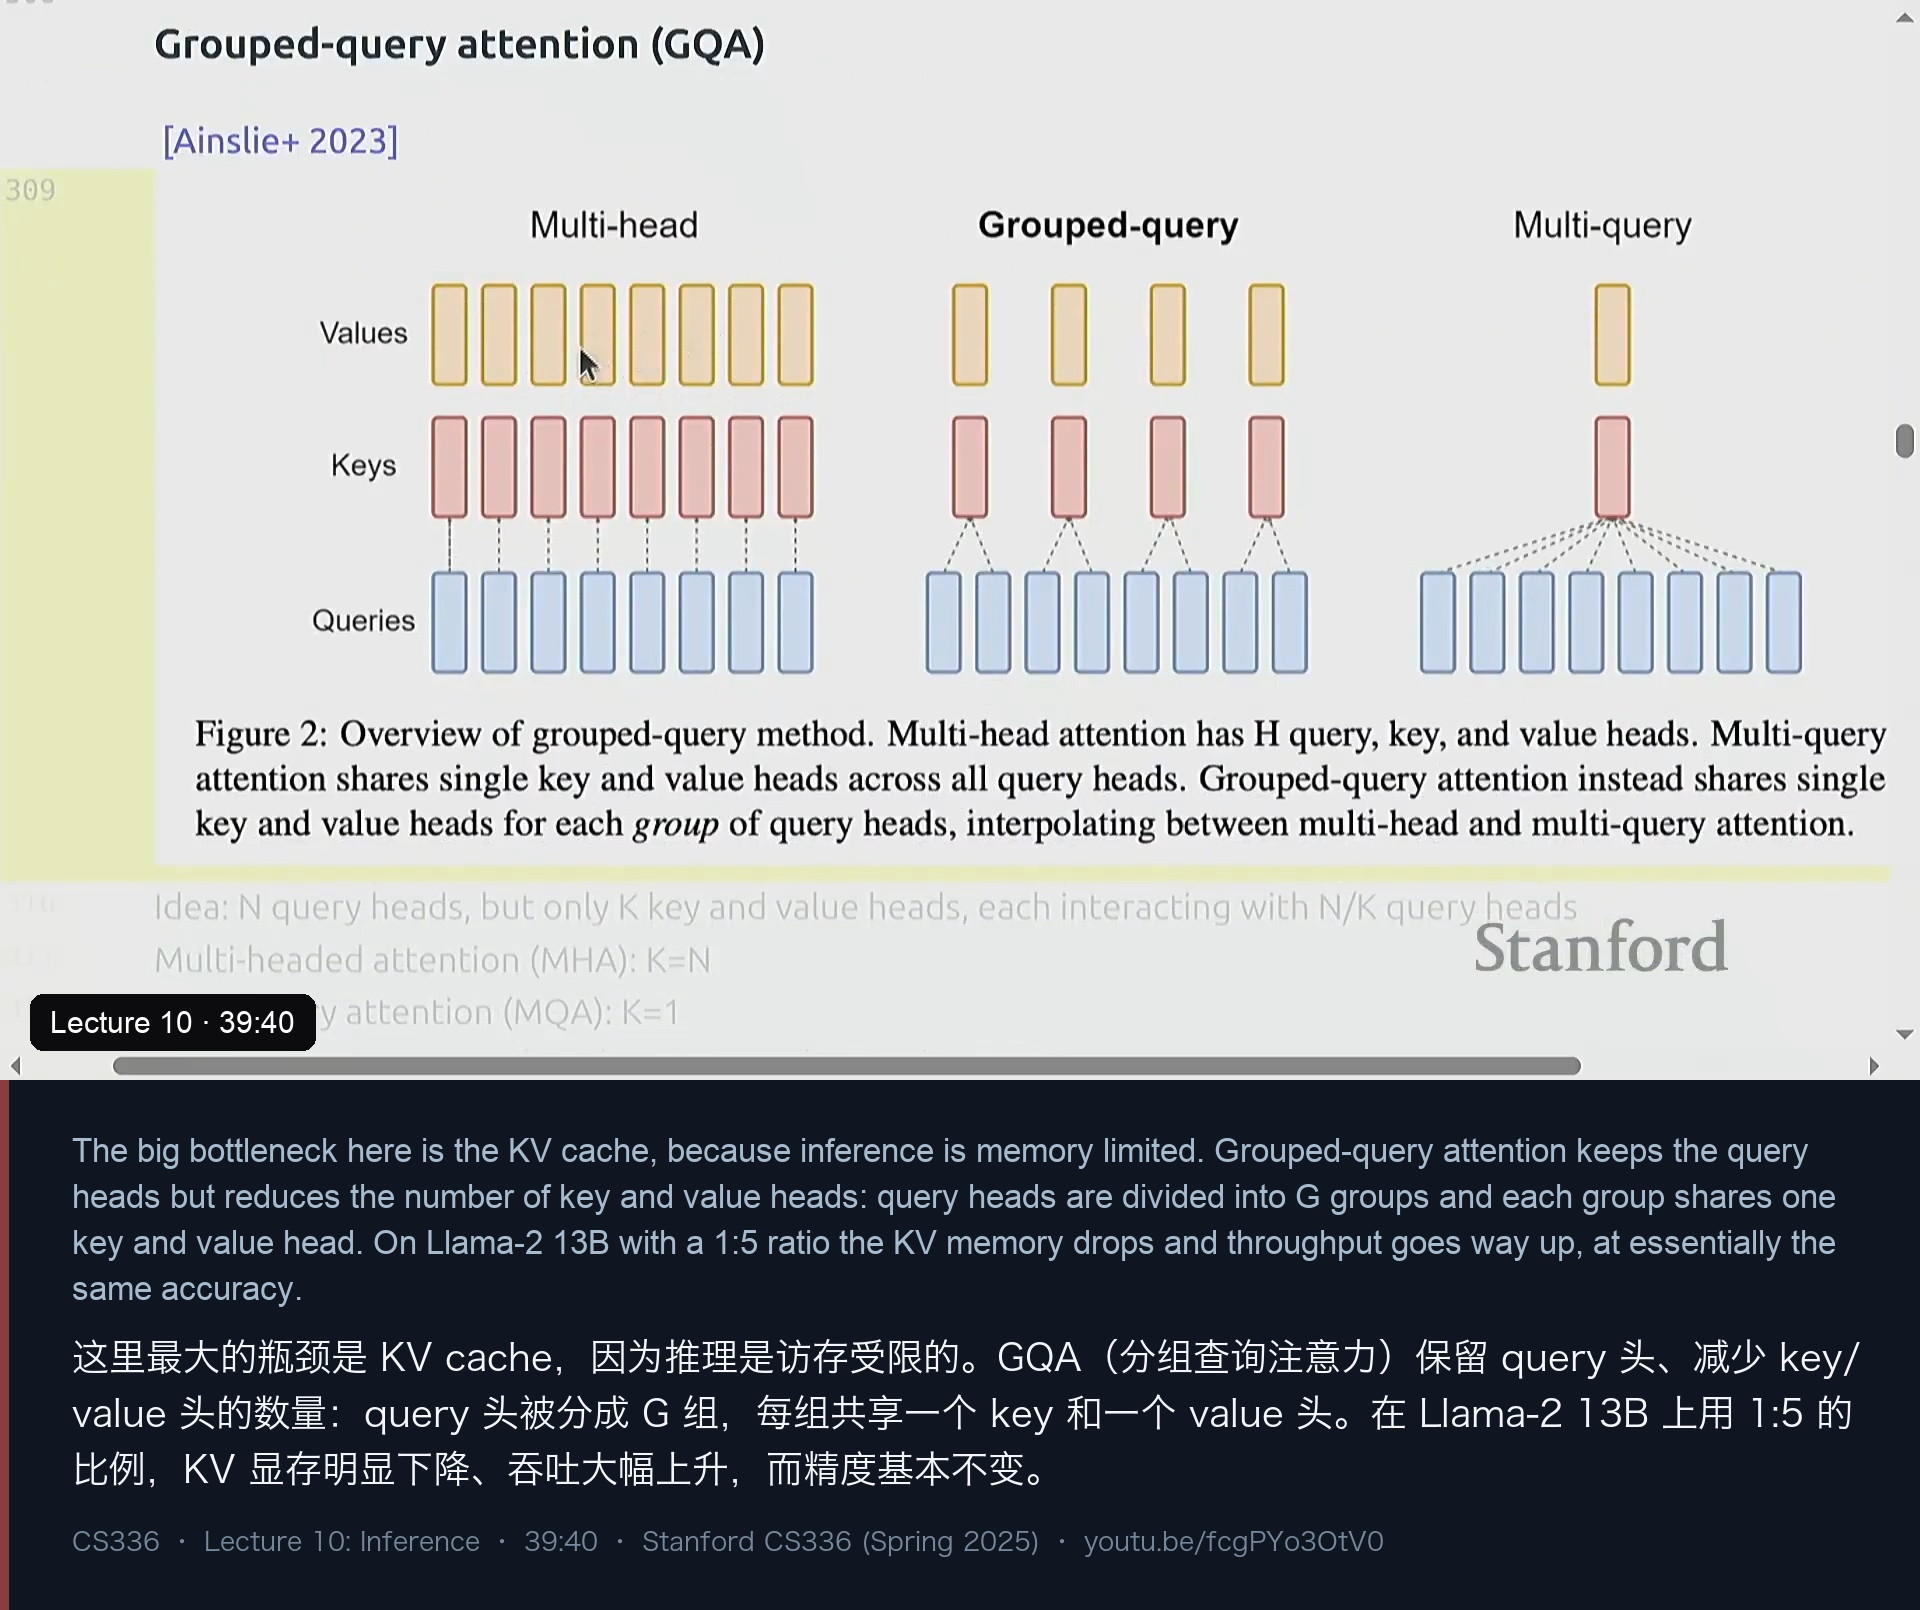
- 多头注意力(MHA):query、key、value 头数相同;
- 多查询注意力(MQA):只有 1 组 KV 头——“结果发现表达能力不太行”;
- 分组查询注意力(GQA):中间方案——把 query 头分成
G组,每组共享一组 KV 头(K·G = N)。
这不是在改 batch size、不是在改序列长度、也不是在改向量维度,改的只是 KV 头的数量,而 KV cache 的大小正比于它。课上给的数据是:Llama-2 13B 上用 1 的比例(8 个 KV 头 / 40 个 query 头),KV 显存下降、吞吐大幅上升、精度基本不变;而且显存省下来之后,还能塞进更大的 batch,吞吐再被放大一次——“你能看到好几个效果叠加在一起”。
他还补了一段八卦:Llama-2 只有 70B 那个大模型用了 GQA,小模型没用;Llama 3 全面用上了 GQA,很可能就是被推理成本推动的。
6.2 MLA:把 KV 投影到低维隐空间
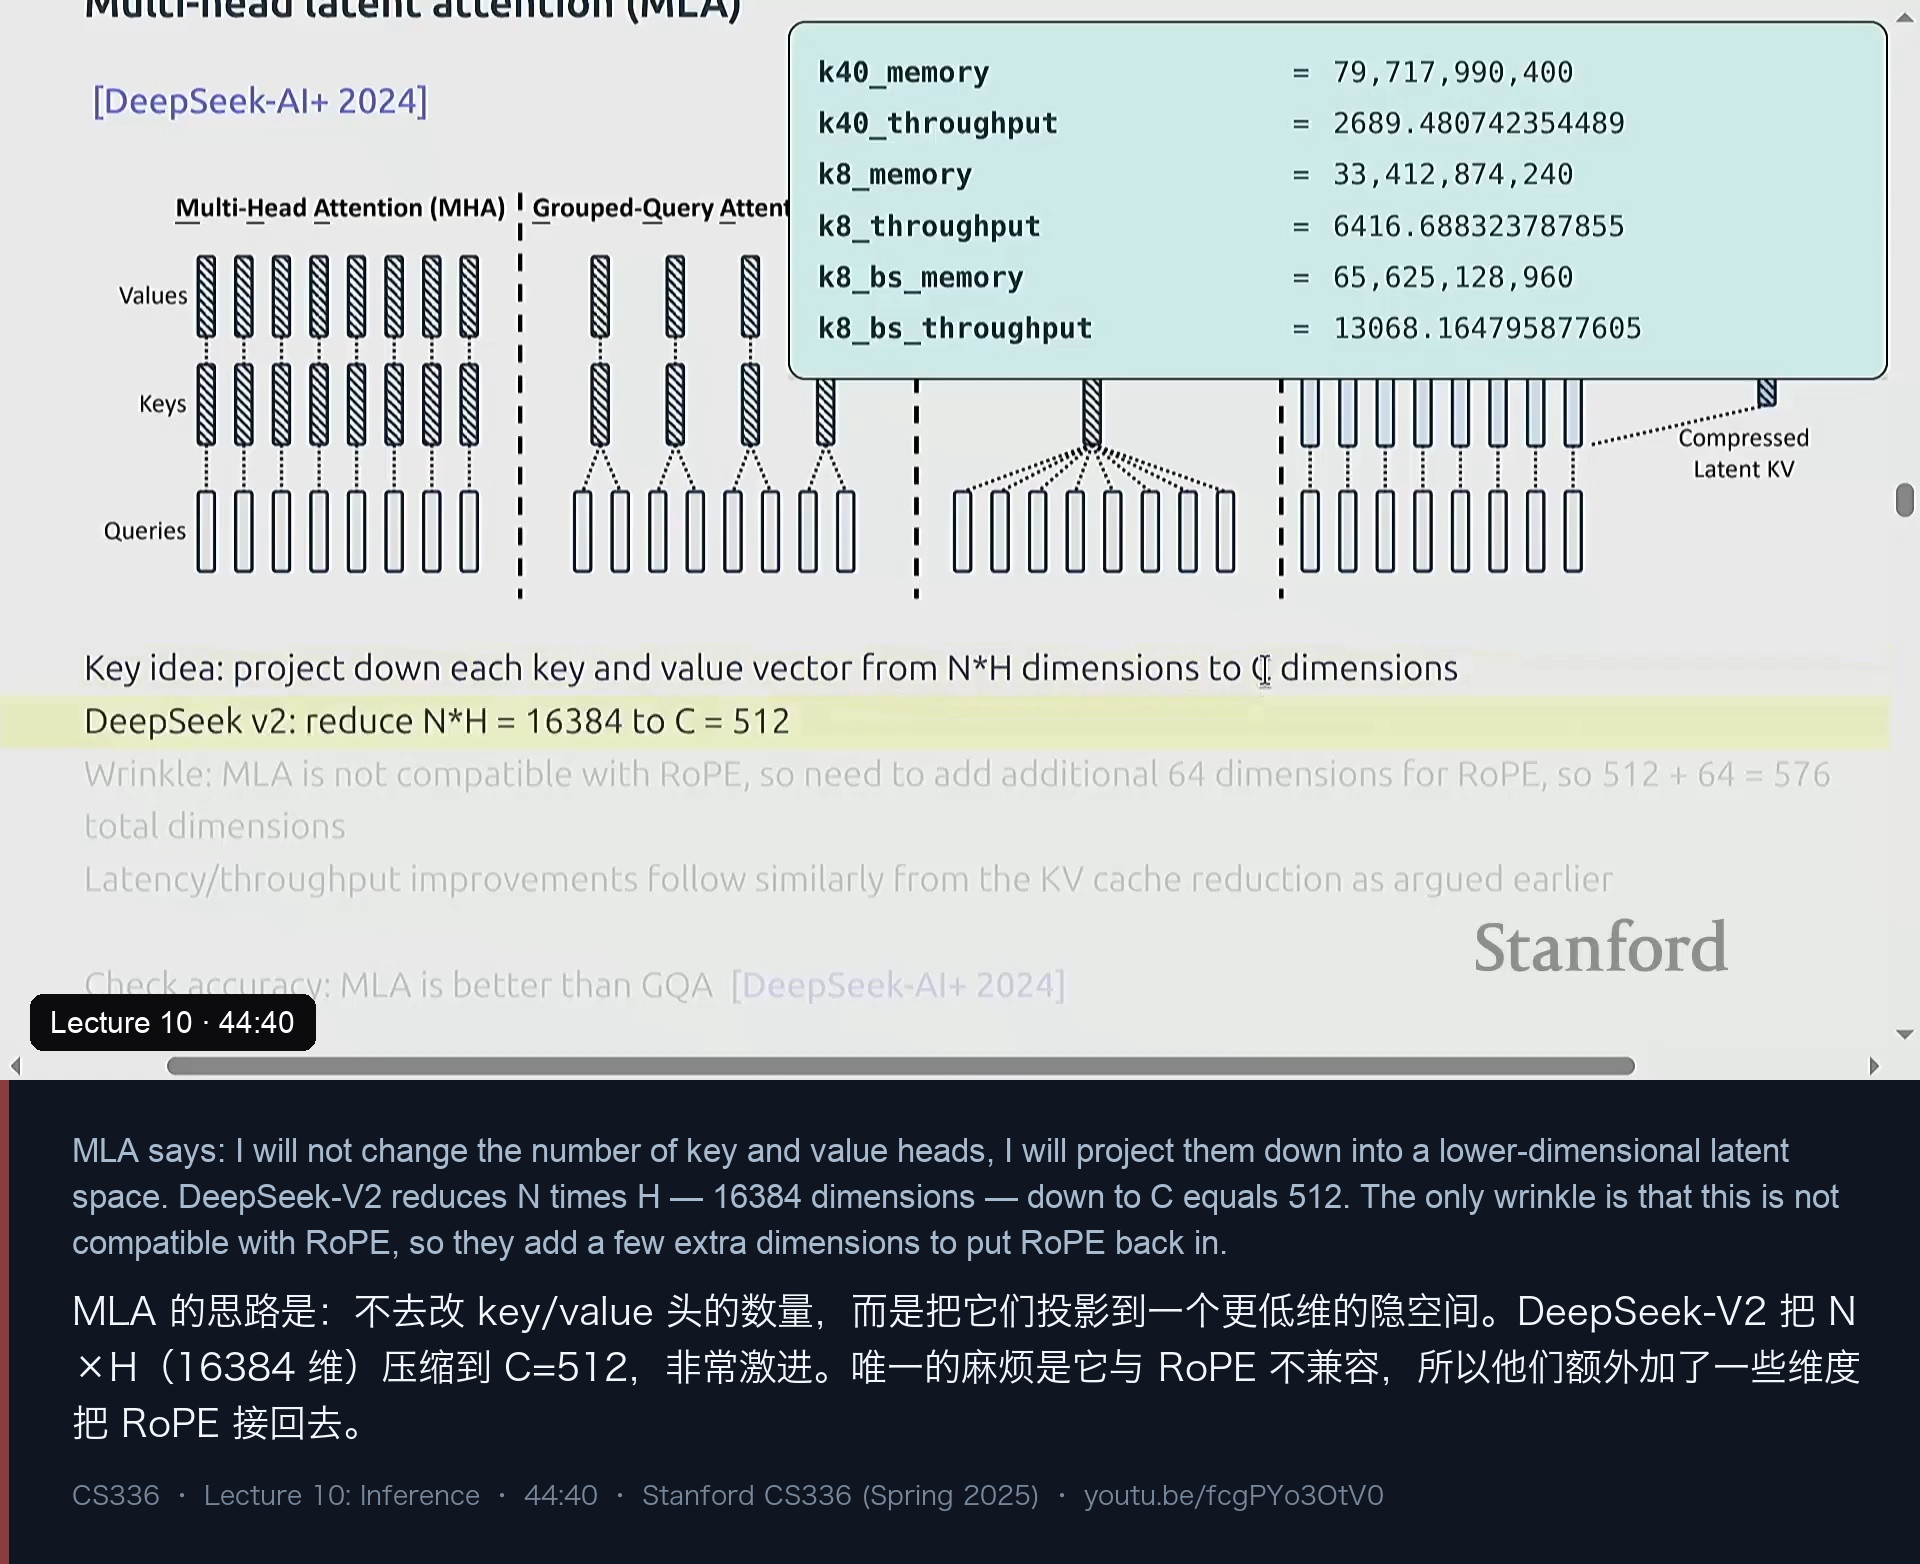
DeepSeek-V2 的 **multi-head latent attention(MLA)**换了一个维度下手:KV 头的数量不变,而是把 key/value 投影到一个低维隐空间。课上给的数字是:把每个 token 的 KV cache 从 N·H = 16384 维压到 C = 512 维——“这是相当激进的压缩”。
唯一的麻烦是:这个设计跟 RoPE 不兼容(RoPE 要在 KV 上做旋转位置编码,而你又把 KV 压掉了),所以 DeepSeek 又额外加了一些维度把 RoPE 接回去。Percy 说 MLA 能取得同样的延迟/吞吐优势,并且精度至少和 GQA 相当(原话说他本想放一张“MLA 更好”的表格,现场没翻到,让大家自己去查)。
6.3 CLA:连层与层之间也共享
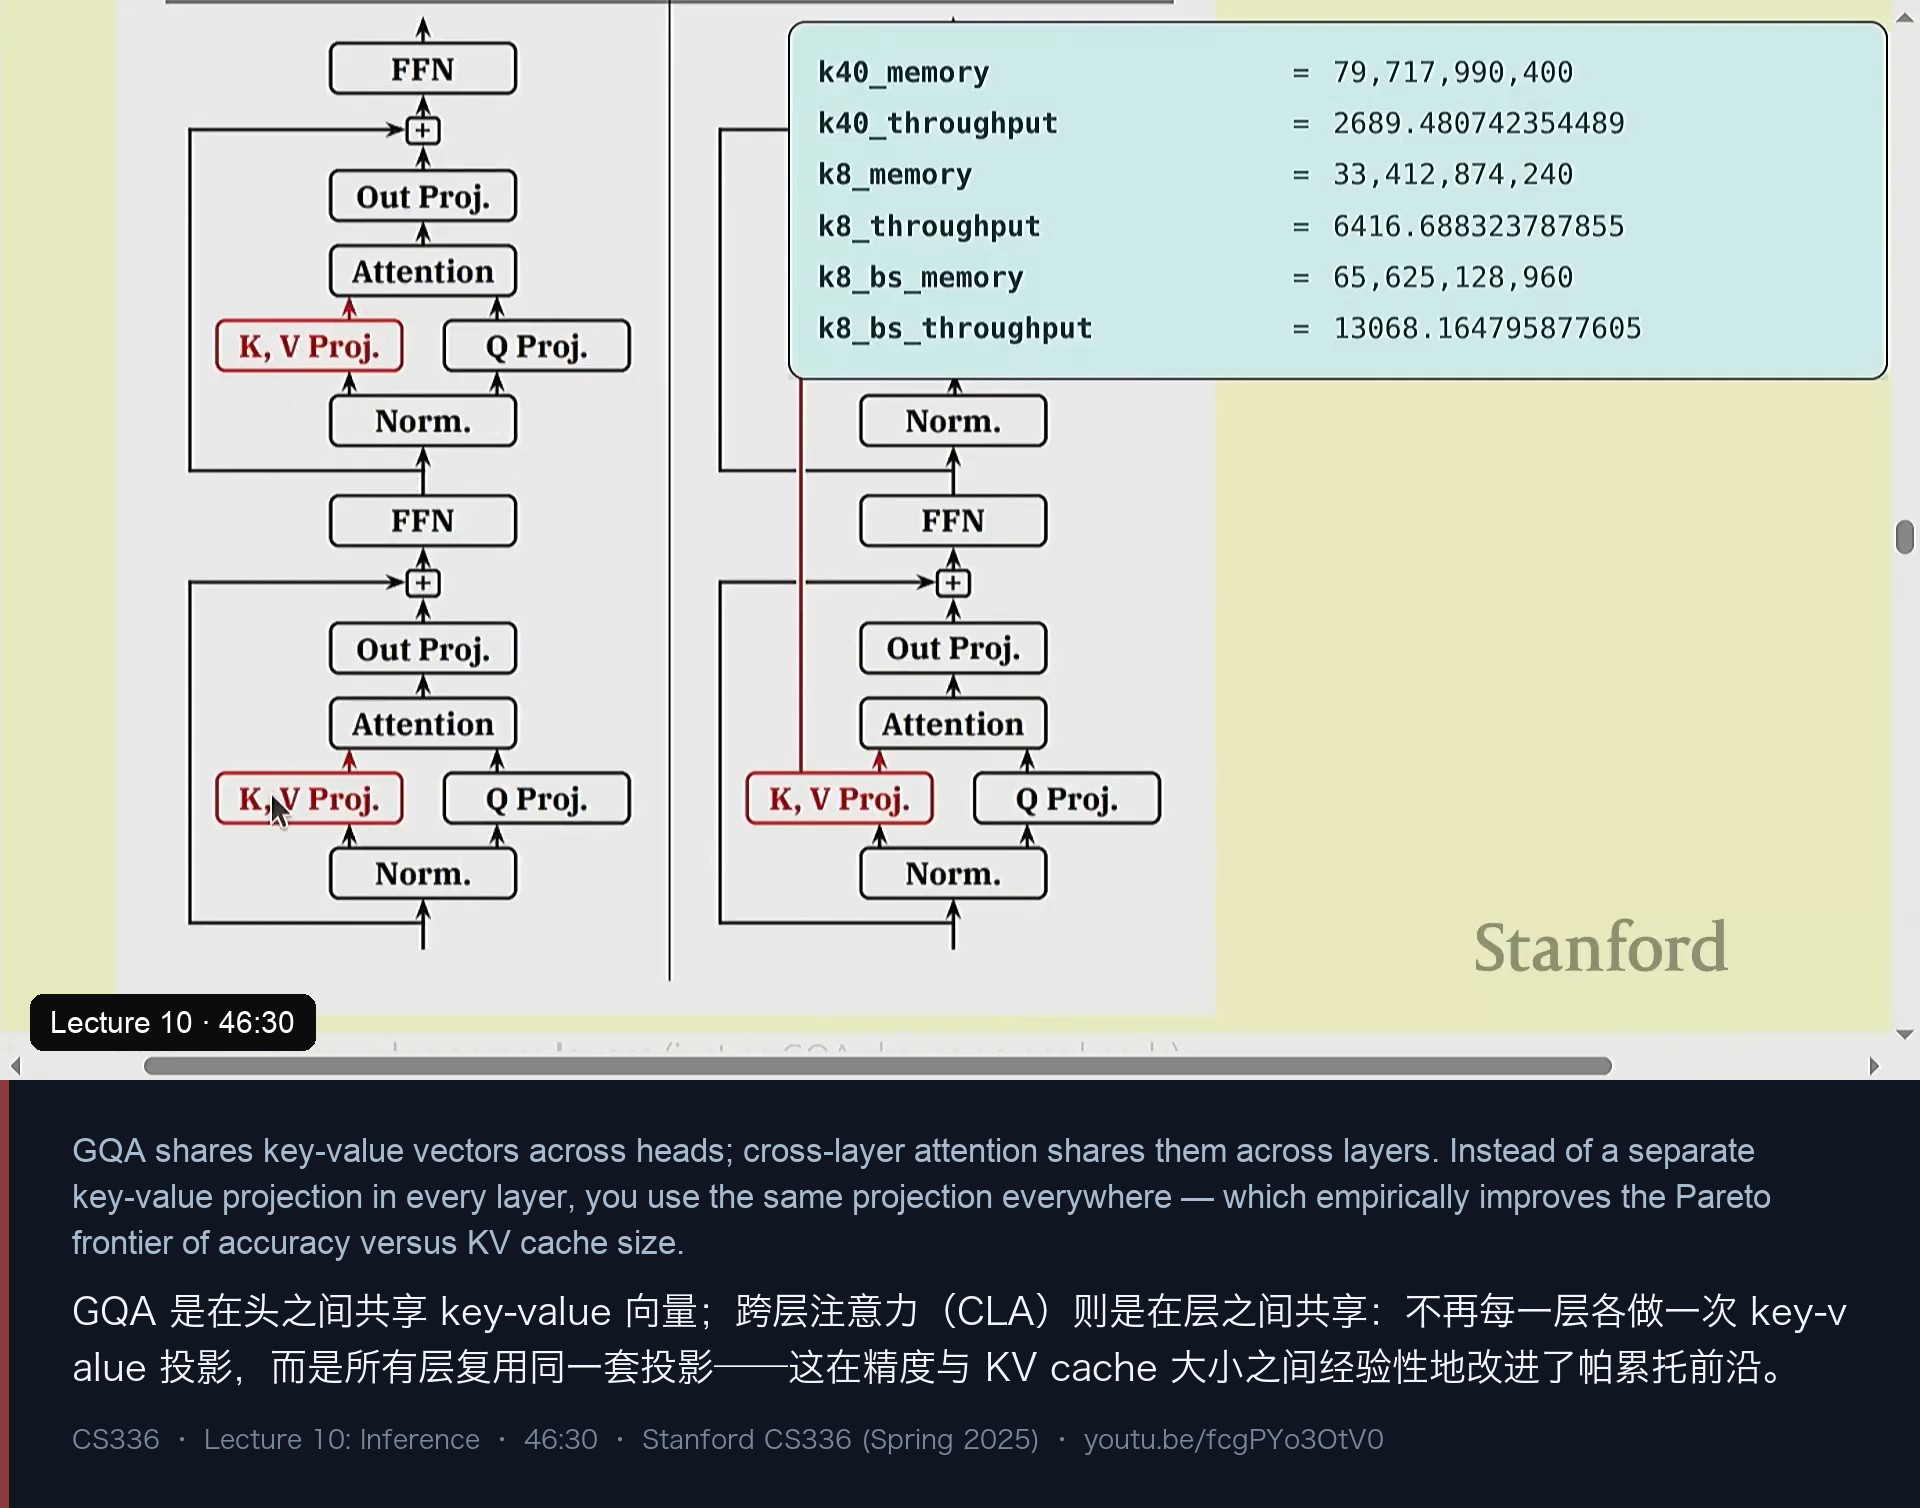
GQA 是在头之间共享 KV;跨层注意力(cross-layer attention, CLA)把它推广到层之间:Transformer 每一层本来有各自的 KV 投影,CLA 干脆让所有层复用同一套投影。
课上展示的结果是:在“精度 vs KV cache 大小”这张帕累托图上,CLA 能改进前沿——例如 128 个头的配置下,KV cache 从 10⁵+ 字节/token 量级降到 10³~10⁴,而验证困惑度只涨了一点点(多个 H*-MQA-CLA2 的点位都落在 GQA 系列的左下方)。这就是“拿一点精度换大量显存”的标准形态。
(现场有同学追问:共享 KV 时权重是不是也共享?Percy 确认:做投影的权重必须共享,否则没有一致性。)
6.4 局部注意力:只留最近 K 个 token
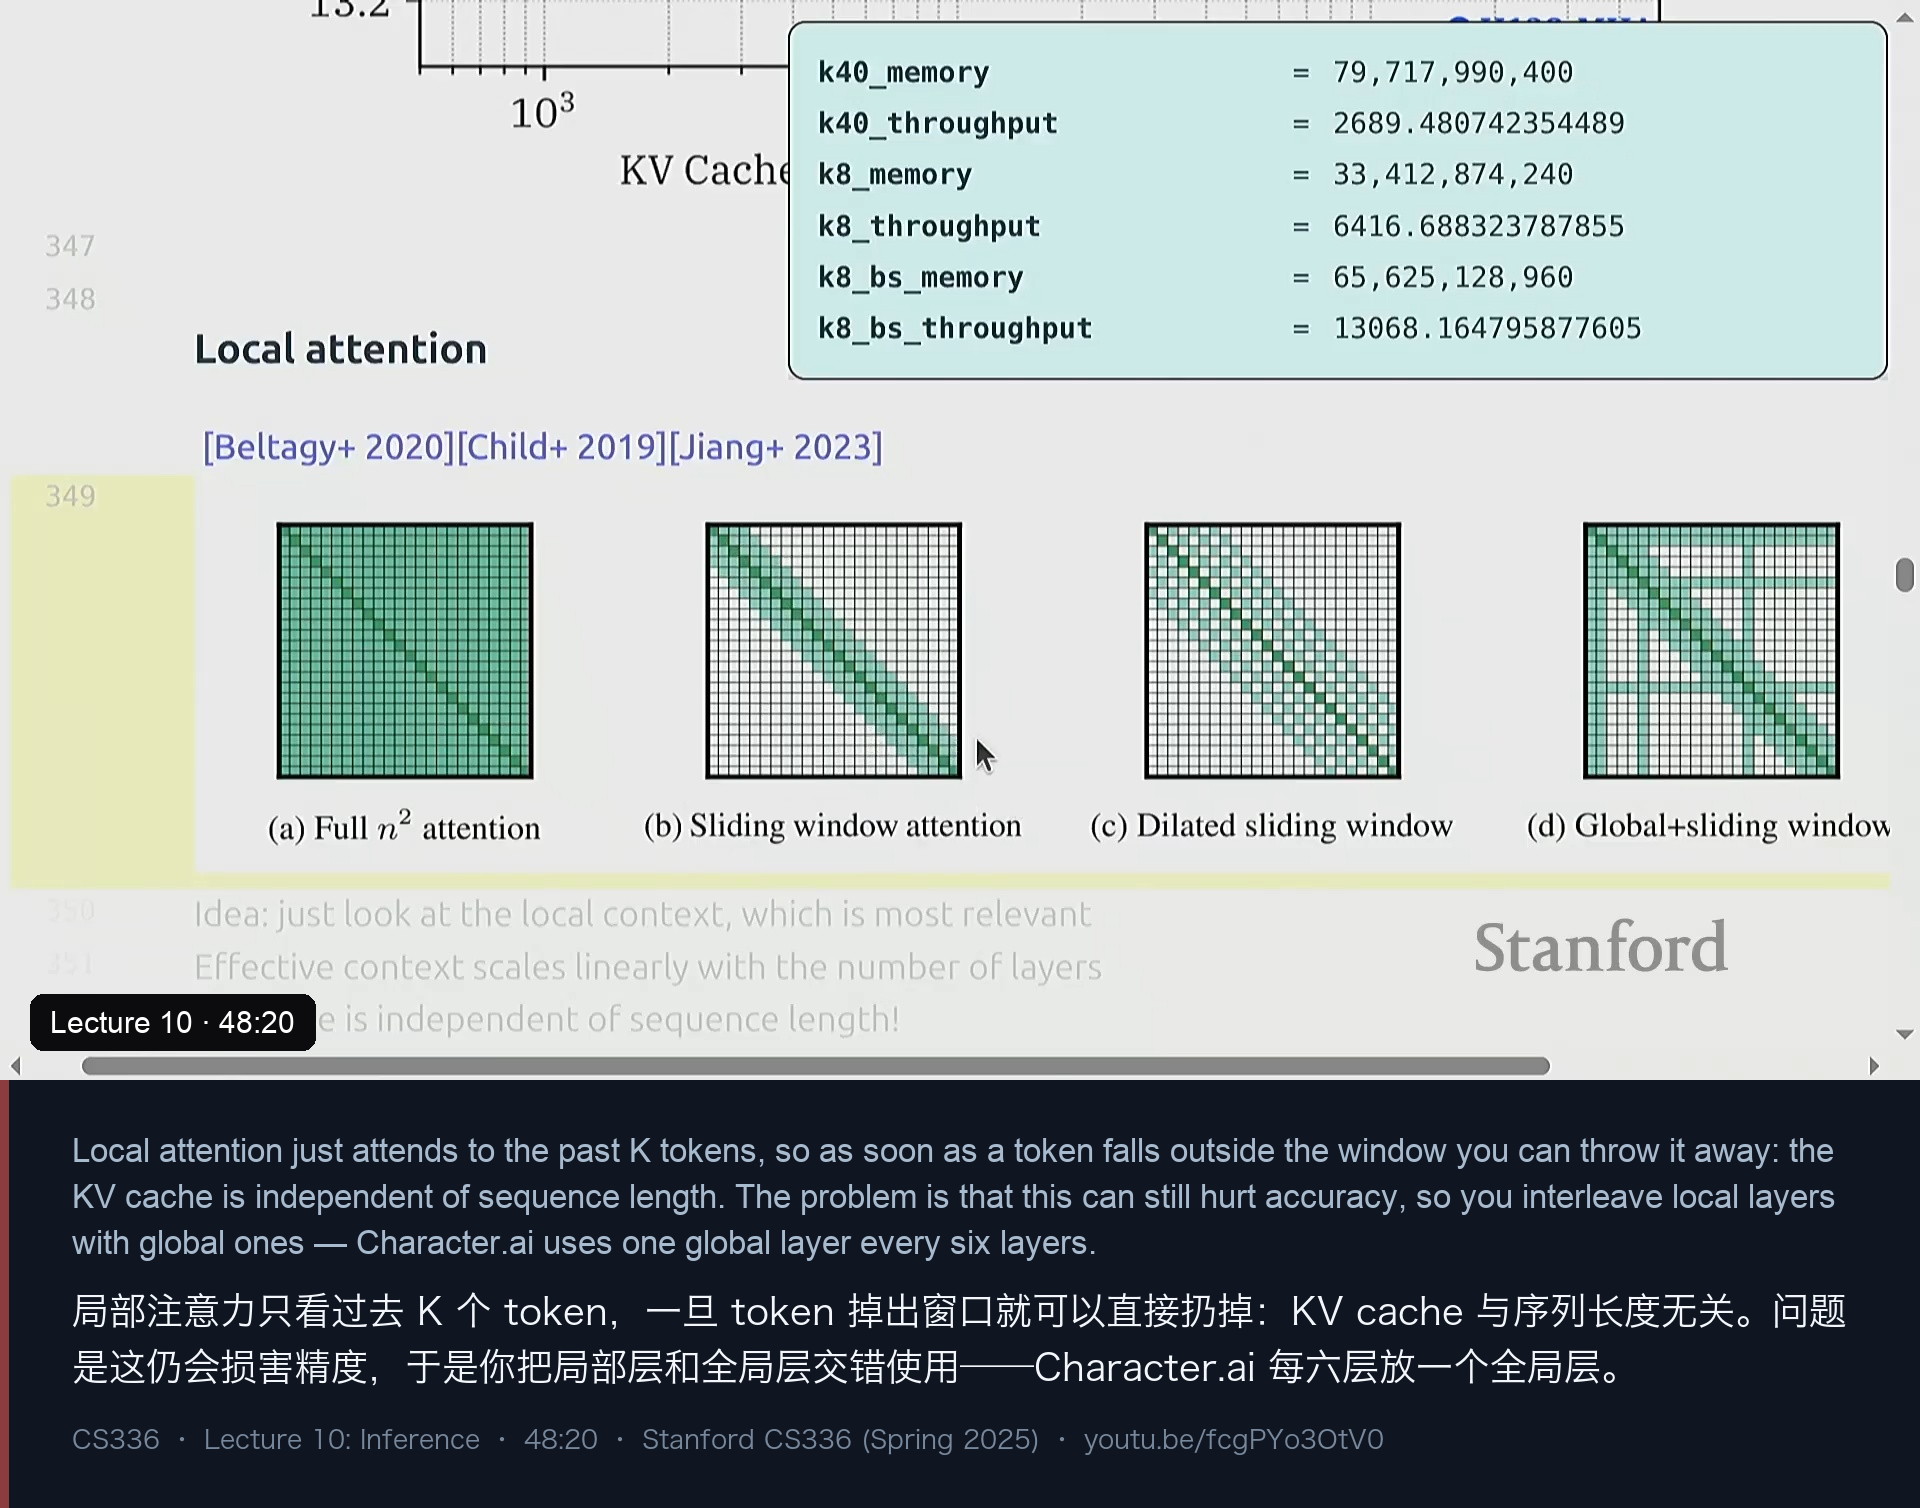
只 attend 过去 K 个 token——token 一旦掉出窗口,就可以直接从 KV cache 里扔掉。于是 KV cache 大小与序列长度无关,是常数,这对长序列尤其有吸引力。
代价也很直白:这仍然会损害精度。Percy 的类比是:我们之所以用注意力而不是 RNN,就是为了建模长程依赖;只看局部上下文,“叫它 attention 其实都有点抬举了,它的表达能力并不强”。
所以实践中用的是混合层:局部注意力与全注意力交错——课上举的例子是 Character.ai 每六层放一个全注意力层、其余五层是局部层,此外还叠加了 KV cache 共享。这已经是一套“能用的技巧都叠上去”的组合拳。
他还提到了与这条线相关的分析工作:KV 大小与“能做多复杂的召回任务”之间存在一条权衡曲线——你存得越少,就越解决不了某些需要精确回忆的任务。
6.5 小结:五种瘦身法
讲座把这一节收成一张清单:
降低 KV cache 的手段:
  1. 更少的 KV 头          —— GQA
  2. 更低的 KV 维度        —— MLA
  3. 跨层共享 KV 投影      —— CLA
  4. 部分层用局部注意力    —— 滑窗 / 混合层
  5. 以上组合起来用        —— 例如 Character.ai(1 全局层 / 6 层)+ KV 共享
七、跳出 Transformer:状态空间模型、线性注意力与扩散
“这些都是在 Transformer 内部做变体。但也许你应该干脆跳到 Transformer 外面去——因为 Transformer 本来就不是为重型推理设计的,它当年的目标是训练效率。” 于是讲座进入了两条更激进的路线。
7.1 状态空间模型与那个致命的反例
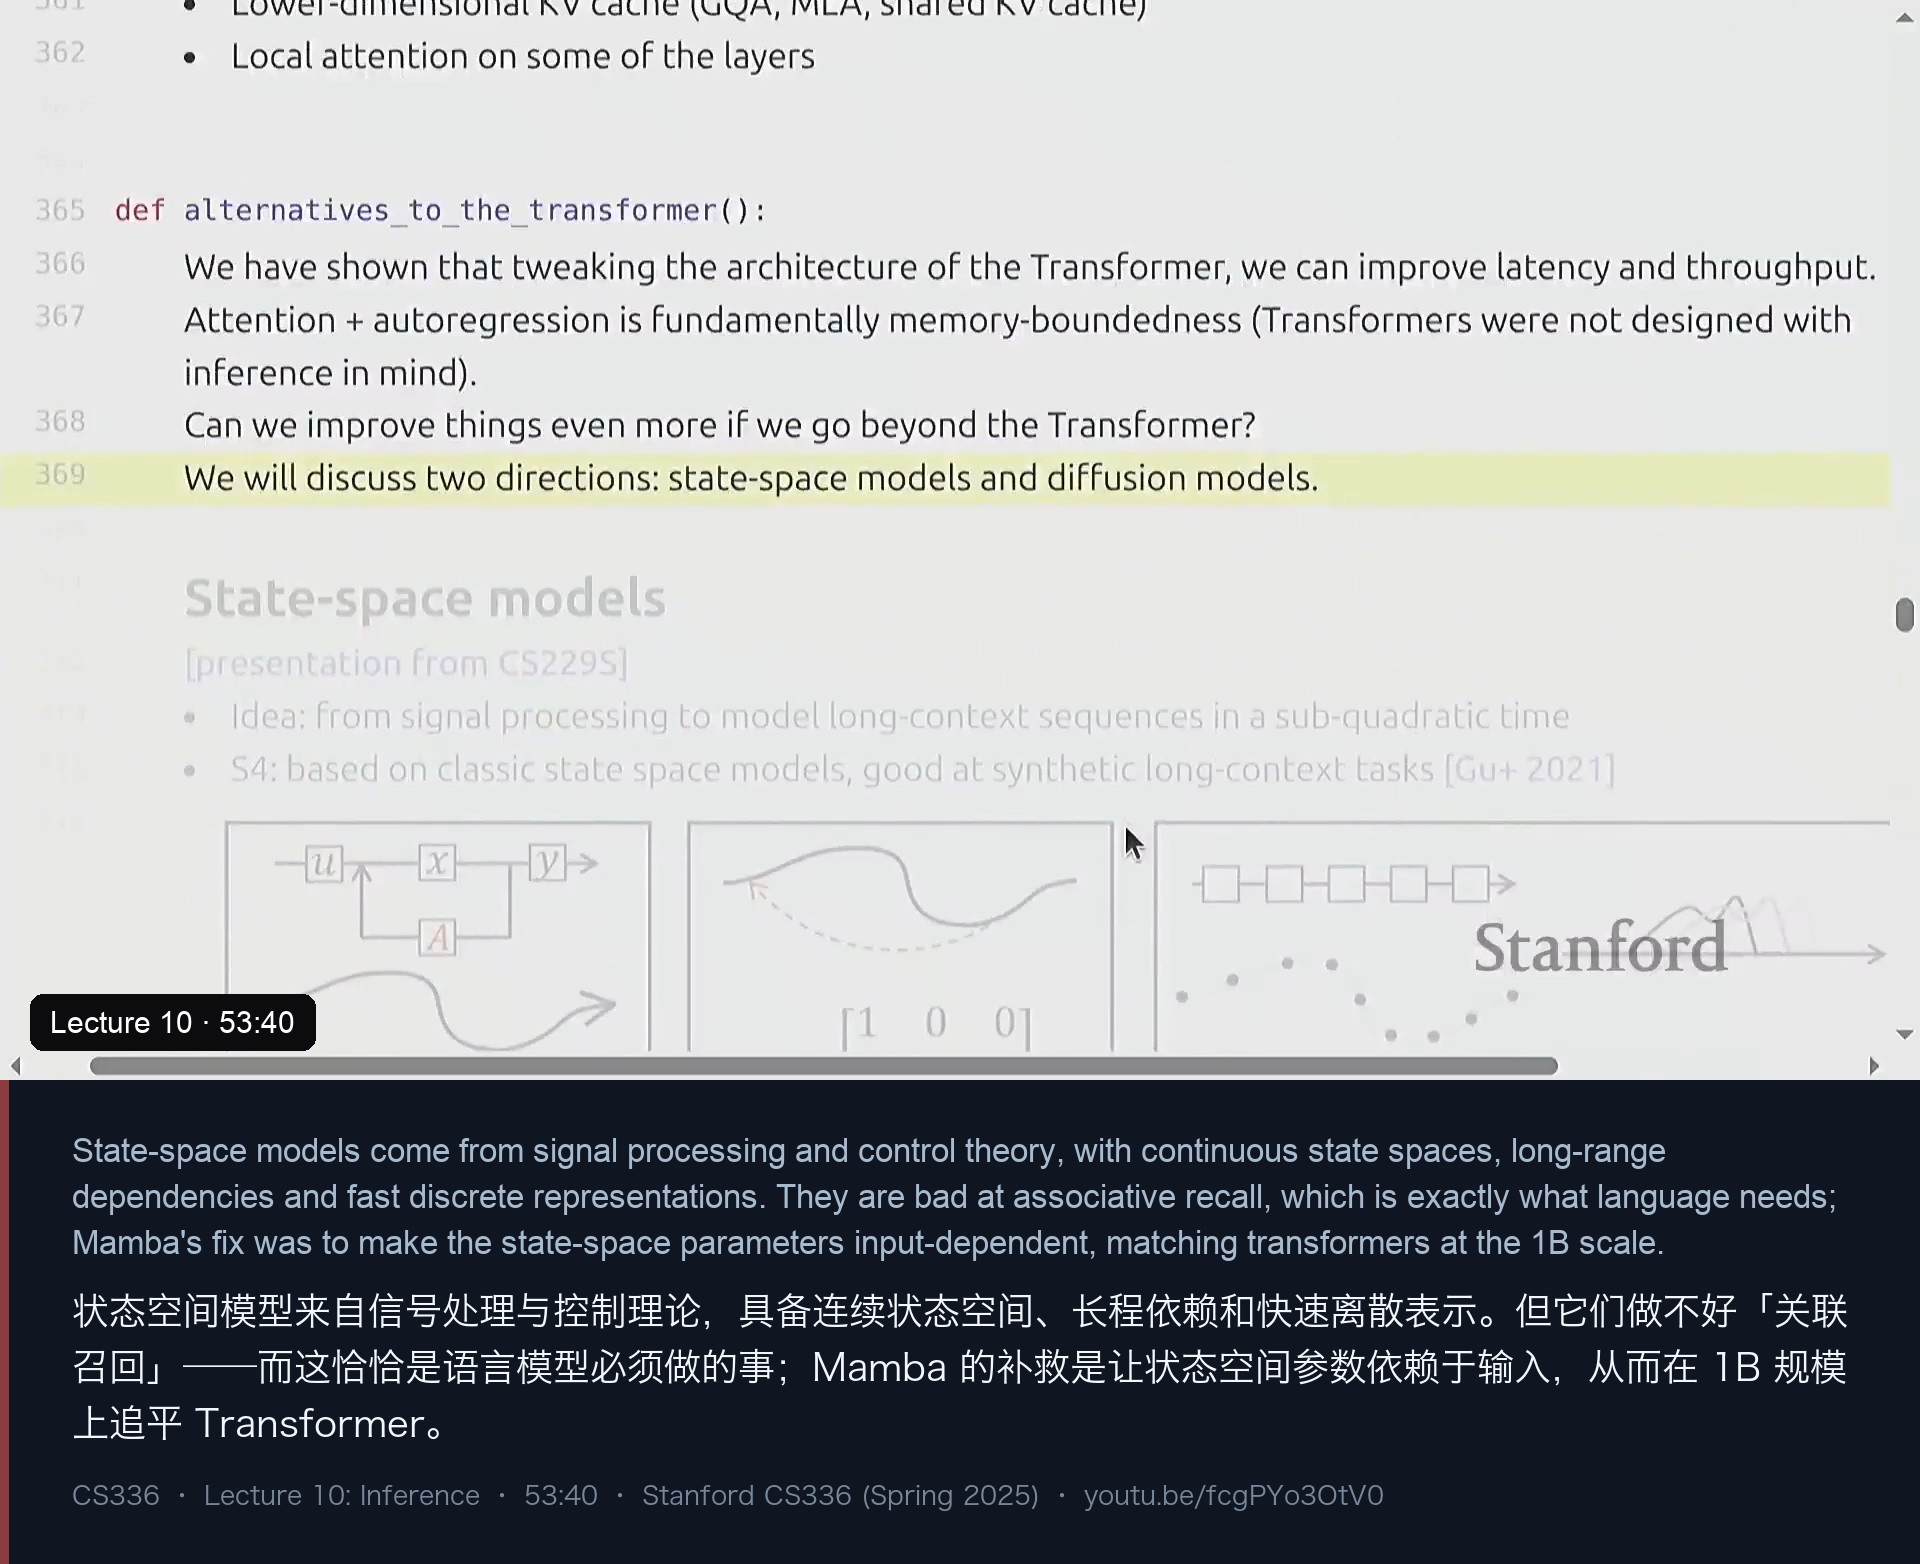
状态空间模型(SSM)的灵感来自信号处理与控制理论,最初的动机是在避免 n² 爆炸的前提下建模长上下文——并不是为了推理速度,但解决了这个问题,推理速度自然也上来了。
- 早期的 S4 把经典的线性动力系统塞进现代神经网络里,好处是它同时有 RNN 式的解释和卷积式的解释;
- 但人们发现:它在语言建模上并不好用——这对一个想做语言模型的人来说是相当扫兴的结论;
- 随后一系列工作把病根找了出来,病根叫“关联召回”(associative recall):给你一串 key-value 对,然后问你某个 key 对应的 value 是什么。这个任务逻辑上平凡,但依赖可以任意长,而且你必须精确地取回某一个具体的键值对——这恰好是局部注意力和 SSM 都做不好的事(课上给了个示意:“A B 4 3 C 6 1 E 2 → A? C? E? B?”);
- 于是有了 Hyena、H3、Mamba 这些改良:Mamba 的关键改动是让 SSM 的参数依赖于输入,从而在约 1B 规模上追平 Transformer;AI21 把这条路线放大到 52B 的 MoE(Jamba),但仍然每隔 8 层保留一层 Transformer。
7.2 线性注意力的复兴
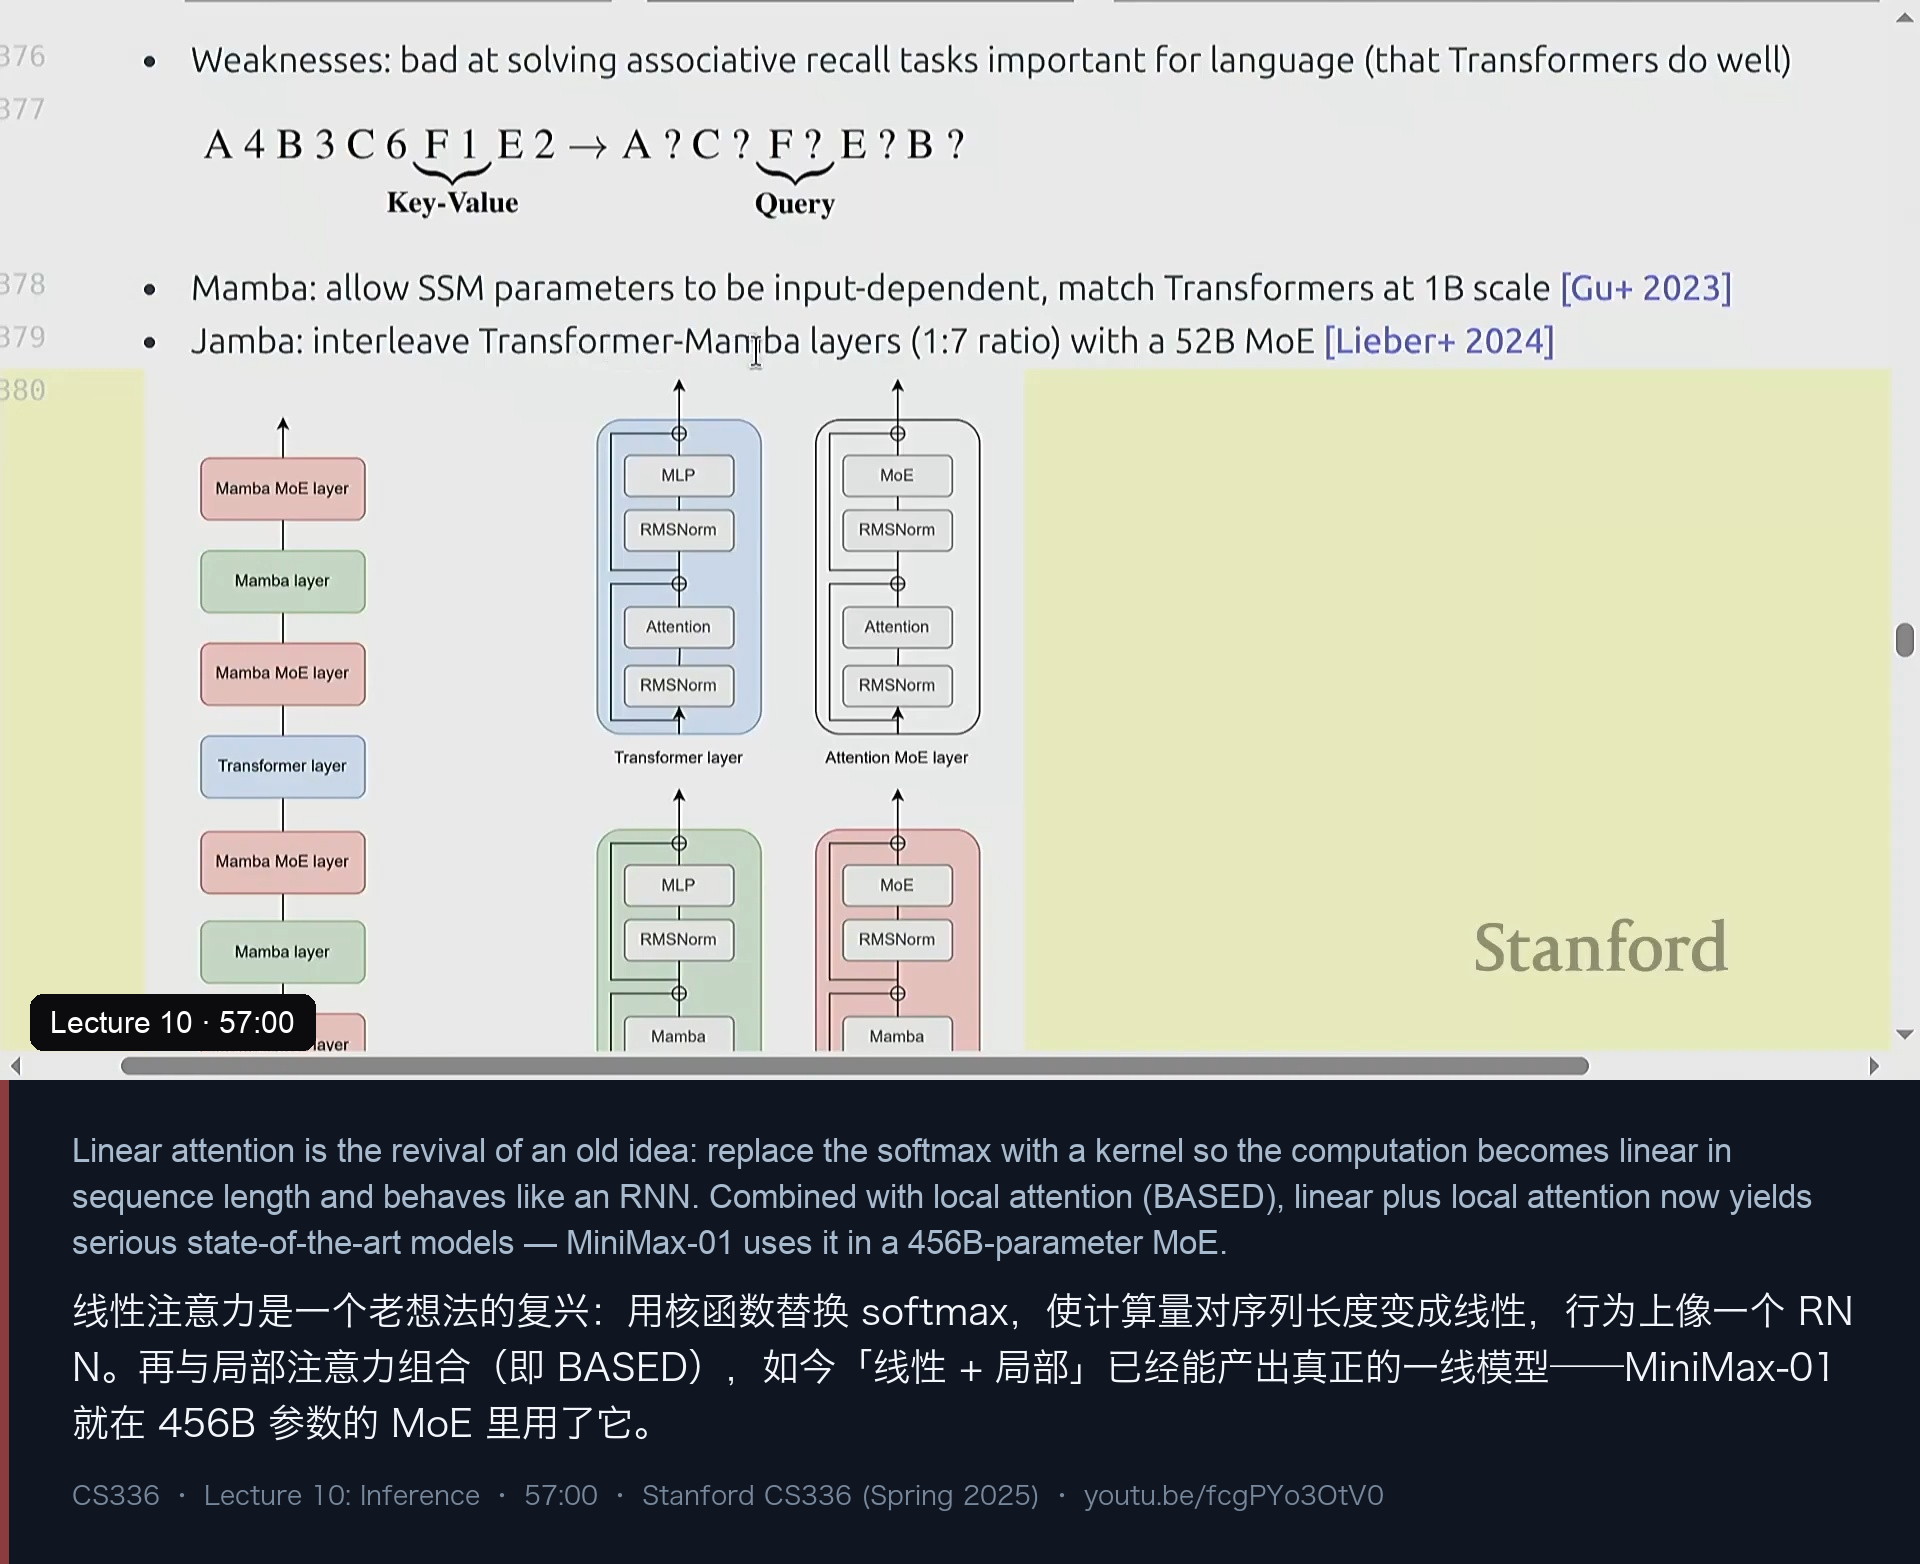
另一条线是线性注意力的复兴。想法本身很简单:attention 里 query 和 key 做点积、再套一个 softmax;如果你把 softmax 换成一个核(比如对指数做泰勒展开),整段计算就可以写成“对每个位置的非线性映射做点积”——于是它表现得像一个 RNN,计算量对序列长度是线性的,而不是二次的。
Percy 说这条路已经“成功放大过”:MiniMax 用这套线性注意力训练了很正经的模型,最大到 456B 参数。但注意——他们仍然要时不时用全注意力(“看起来还没人能完全绕开它”),只是绝大多数层换成了线性层或局部层。
总结成一句很值得记住的话:线性 + 局部注意力(必要时保留少量全注意力层),已经能产出真正的一线模型,而且这些非全注意力层的 KV 状态是常数大小而不是随序列增长。 顺带他也回答了一个老问题——“Attention is all you need 还成立吗?“答案是”是,也不是”:n² 的项还在,但 Transformer 的绝大部分已经被更轻量的组件相当激进地替换掉了,而精度基本守住了。
7.3 扩散语言模型:把“生成”改成“精修”
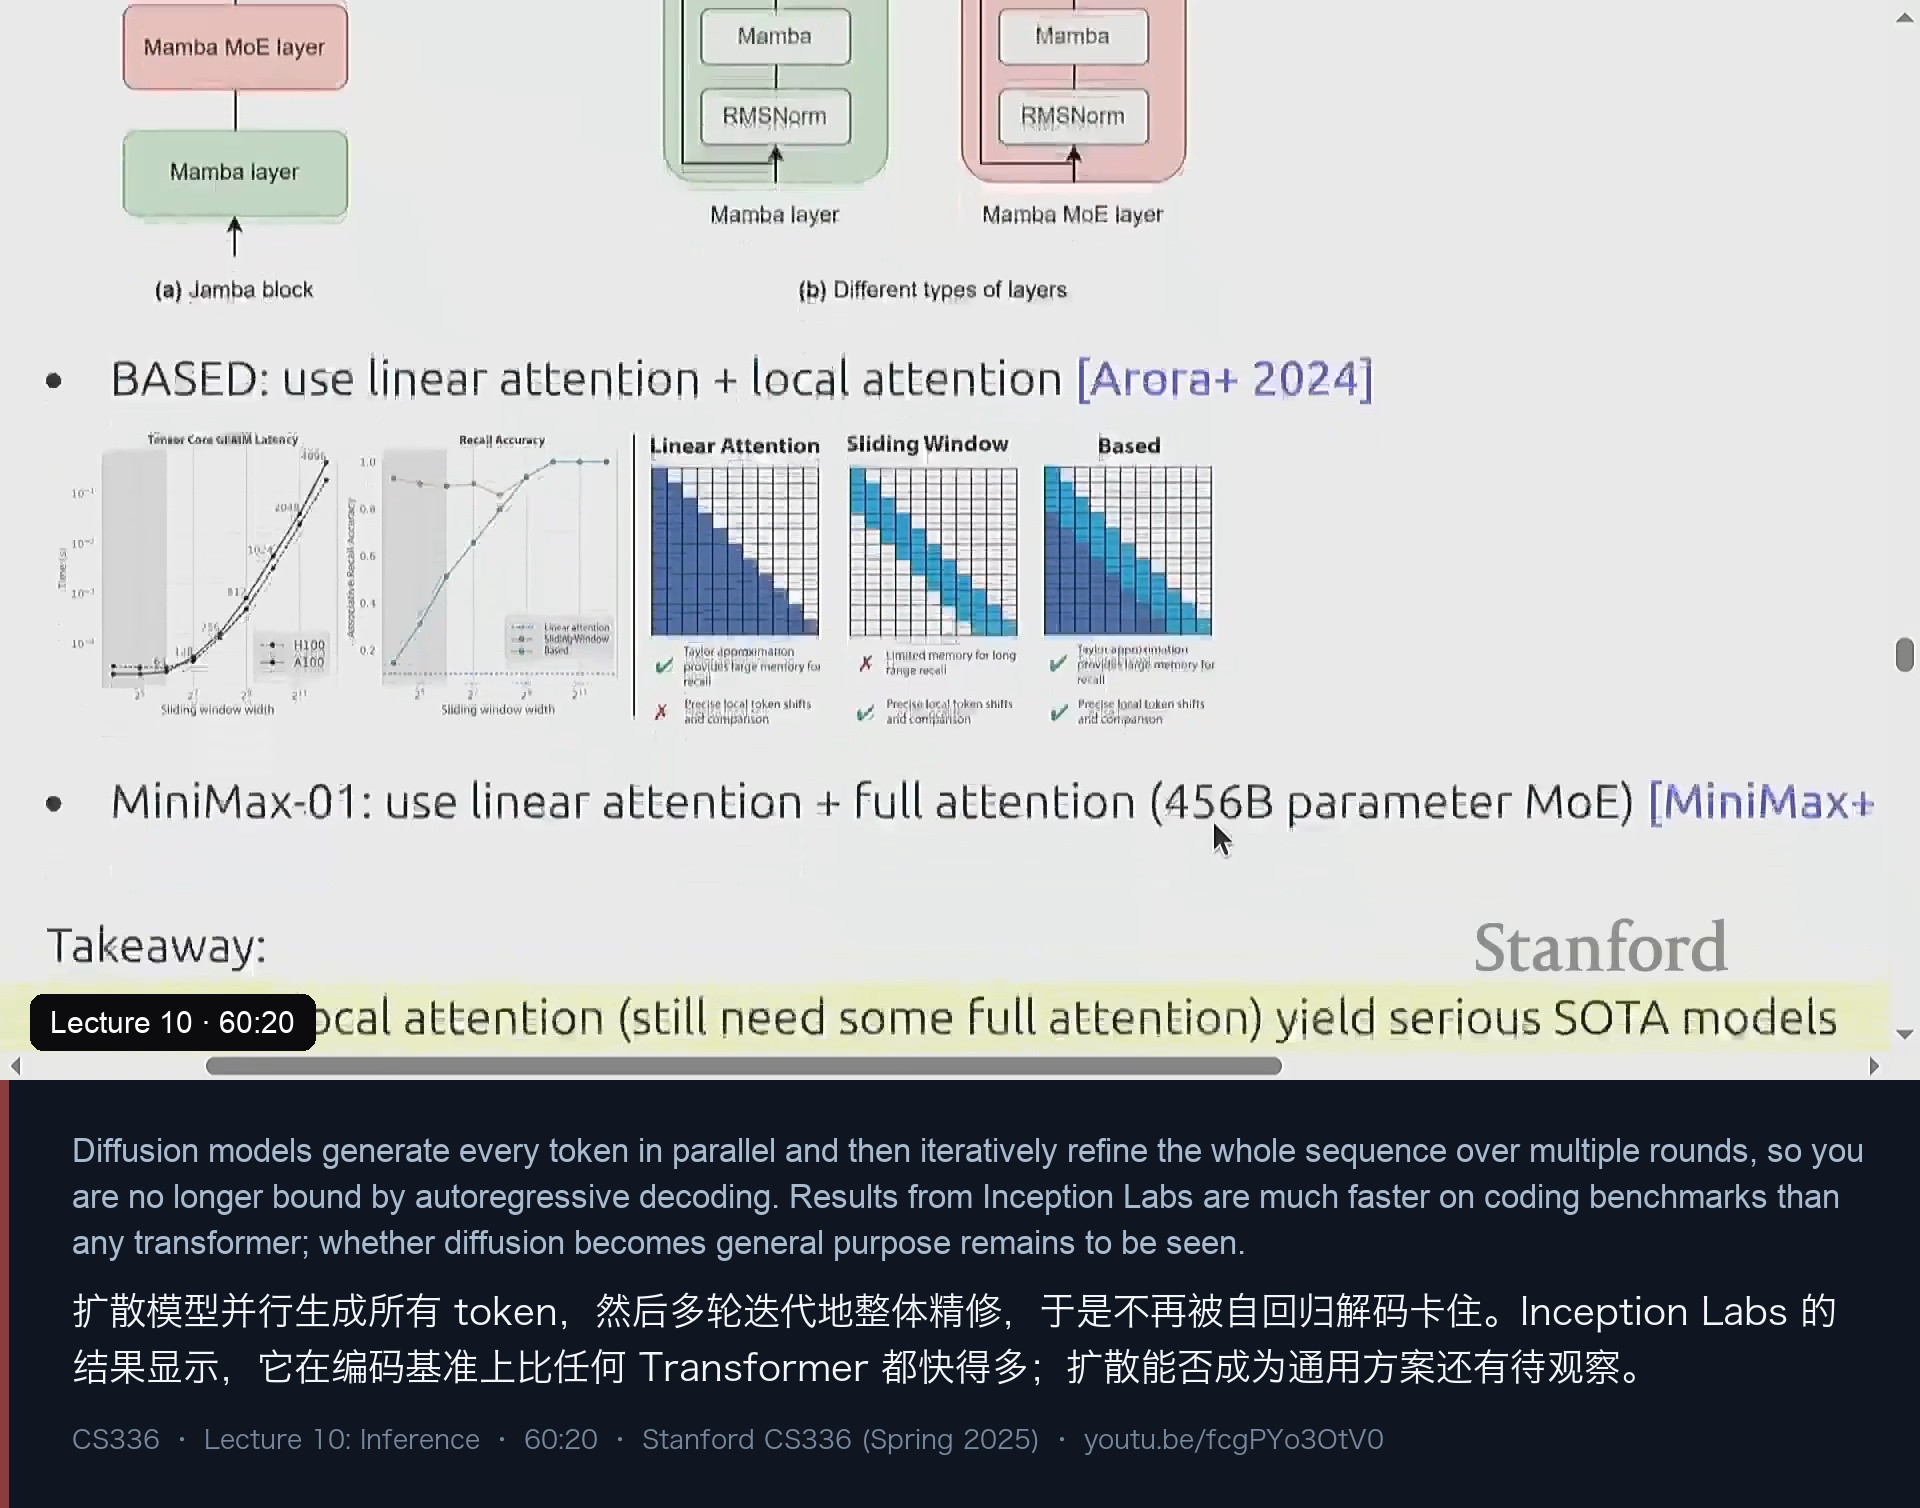
最后一条路线是扩散模型。它在图像生成上非常流行,在文本上则一直很难做——但最近有进展。做法是:不再自回归,而是一次并行生成所有 token,然后反复迭代修正,直到收敛成最终输出。
道理很直接:一次生成全部 token,就能把 GPU 轻松打满(只要上下文足够长),彻底摆脱“自回归”这个瓶颈。课上展示了 Inception Labs 的模型:生成过程先是瞬间吐出一段明显有问题的代码,然后一轮轮精修;在编码基准上,它的 tokens/s 把 Transformer 甚至 Jamba(Mamba + Transformer 的混合体)远远甩在后面。
Percy 的态度很谨慎但很兴奋:扩散能不能成为通用方案还有待观察,但速度上的领先太大了,以至于“就算精度有损失,你也可以多花一些算力把它补回来”。他的总结是:推理这件事远比看上去要宽——真正的收益,可能来自架构上的激进改变,而不是系统层面的优化。
八、有损的捷径:量化与剪枝
“到目前为止这些技巧都有点让人不满意——它们都是有损的。” 在讲无损方案之前,讲座先过了一遍“愿意牺牲精度”的那半。
8.1 量化
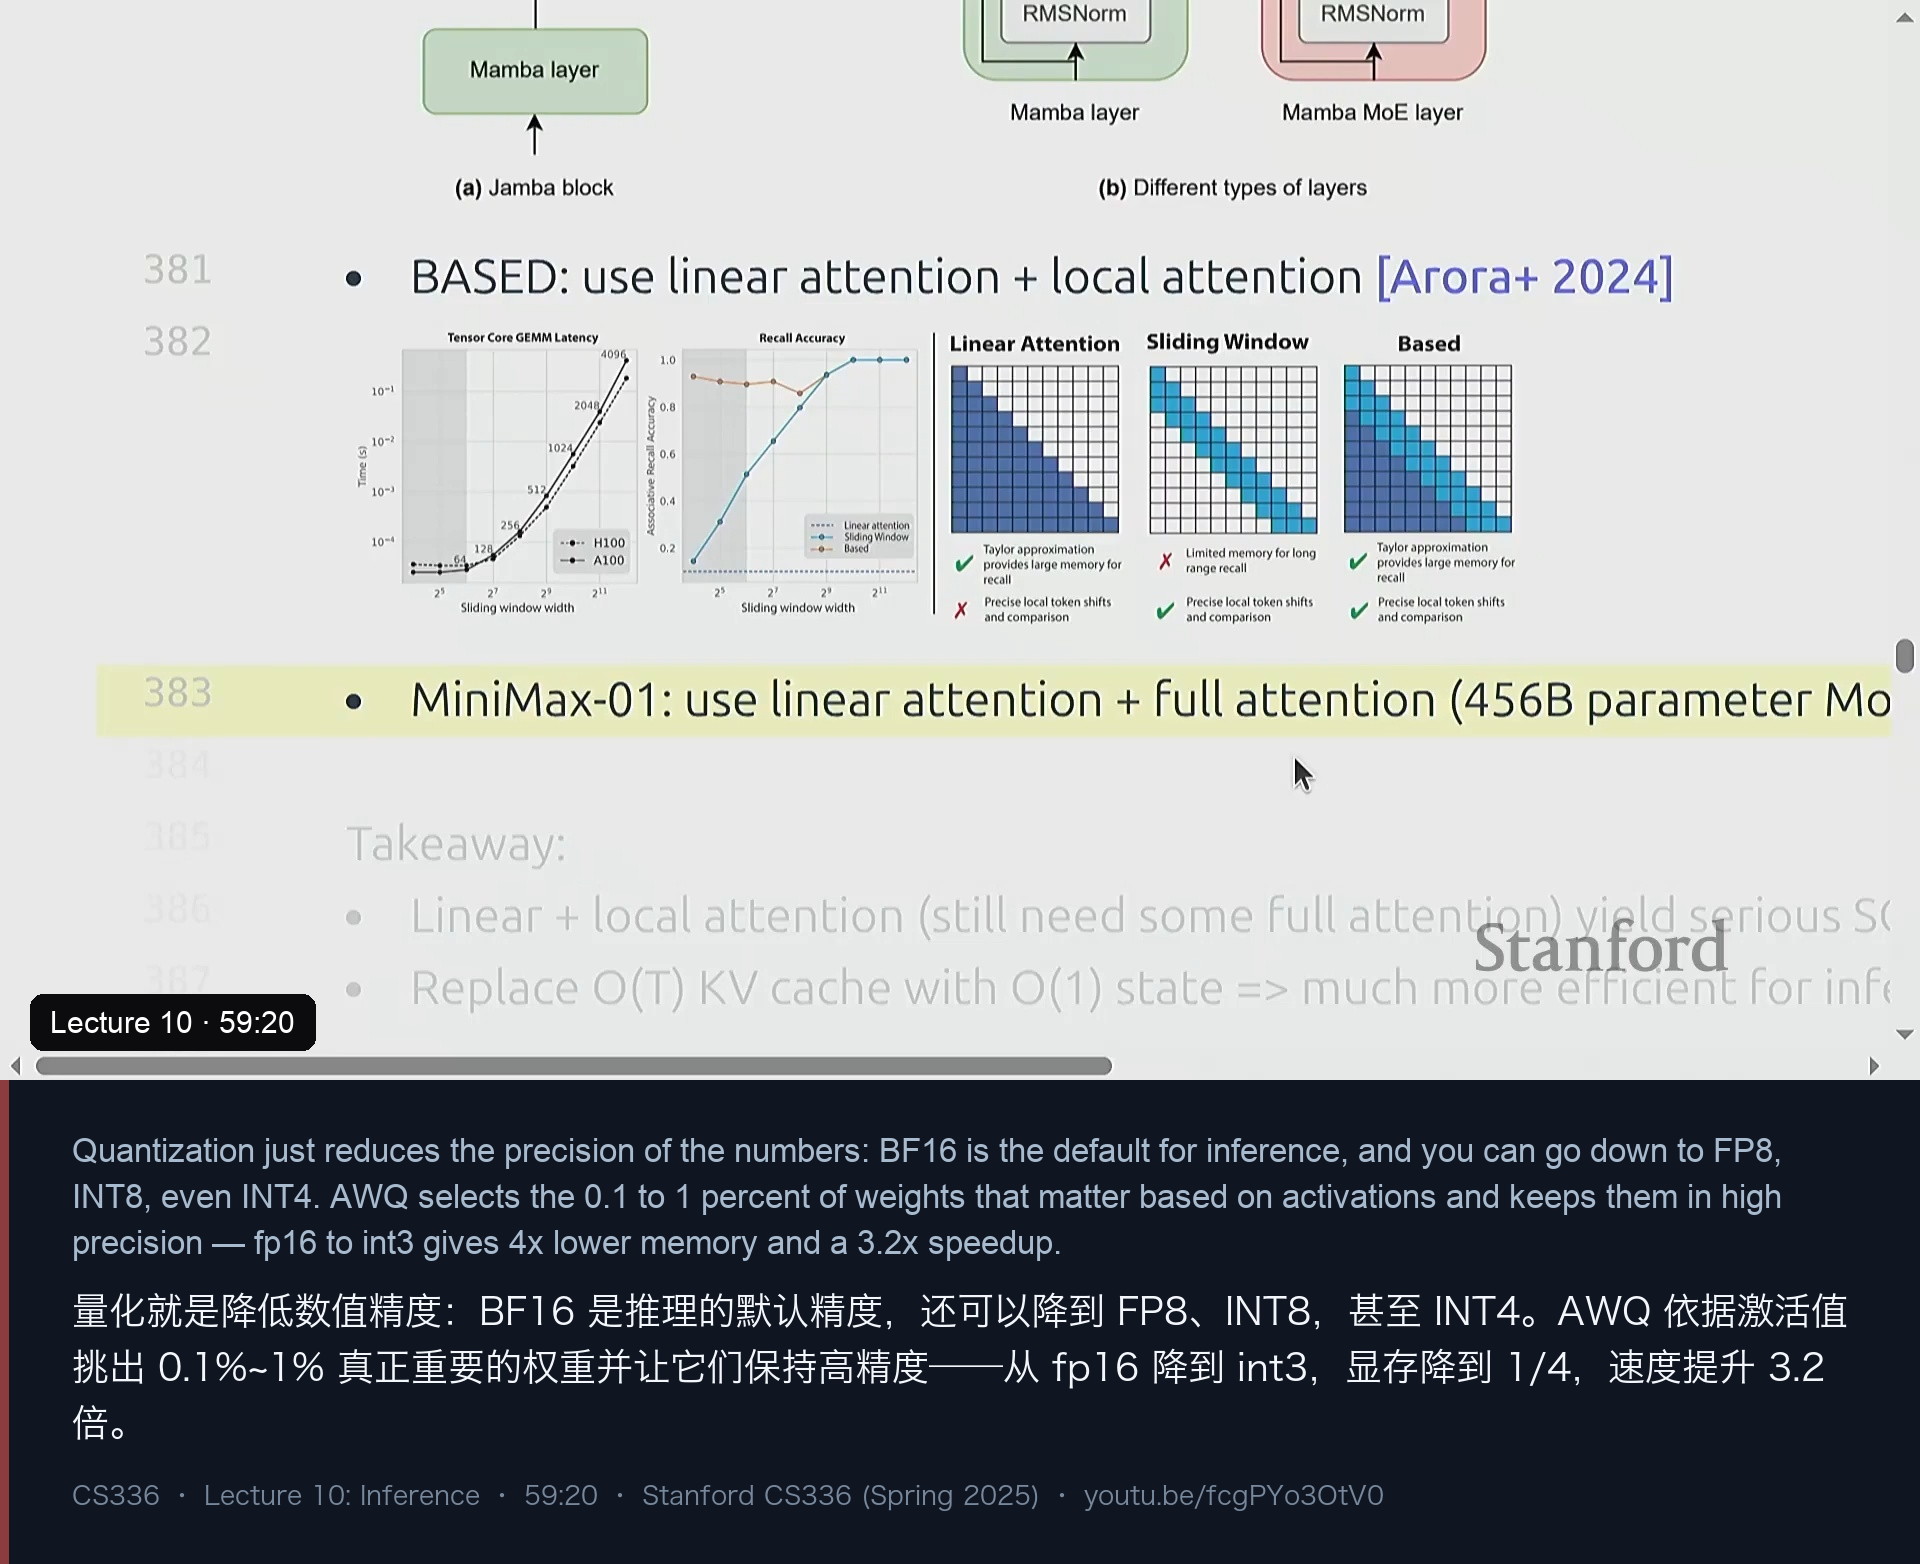
量化的核心就是降低数值精度。 既然瓶颈是显存搬运,那么“每个数占的字节更少”就直接意味着“搬得更少、延迟更低、吞吐更高”——代价当然是精度。
- 精度谱系:FP32 基本只用于训练,推理很少用;BF16 是推理的默认;往下可以到 FP8、INT8,甚至 INT4;
- 也可以选择“训练时就量化”(要重训模型),或者更常见的训练后量化(post-training quantization):拿一个现成模型直接压,尽量别压坏;
- 经典工作 LLM.int8():int8 的问题是大网络里会出现异常大的离群值(outliers),一刀切会坏事;于是它把这些离群值单独拎出来用 16 bit 处理,其余绝大多数用 int8。Percy 补了一句实话:这个工作的动机其实不是速度,而是“能不能把模型塞进显存”;
- AWQ(activation-aware quantization):用激活值来判断哪些权重重要,把 0.1%~1% 的关键权重留在高精度,其余压到 int3——显存降到 1/4,速度提升 3.2 倍。
8.2 剪枝与蒸馏
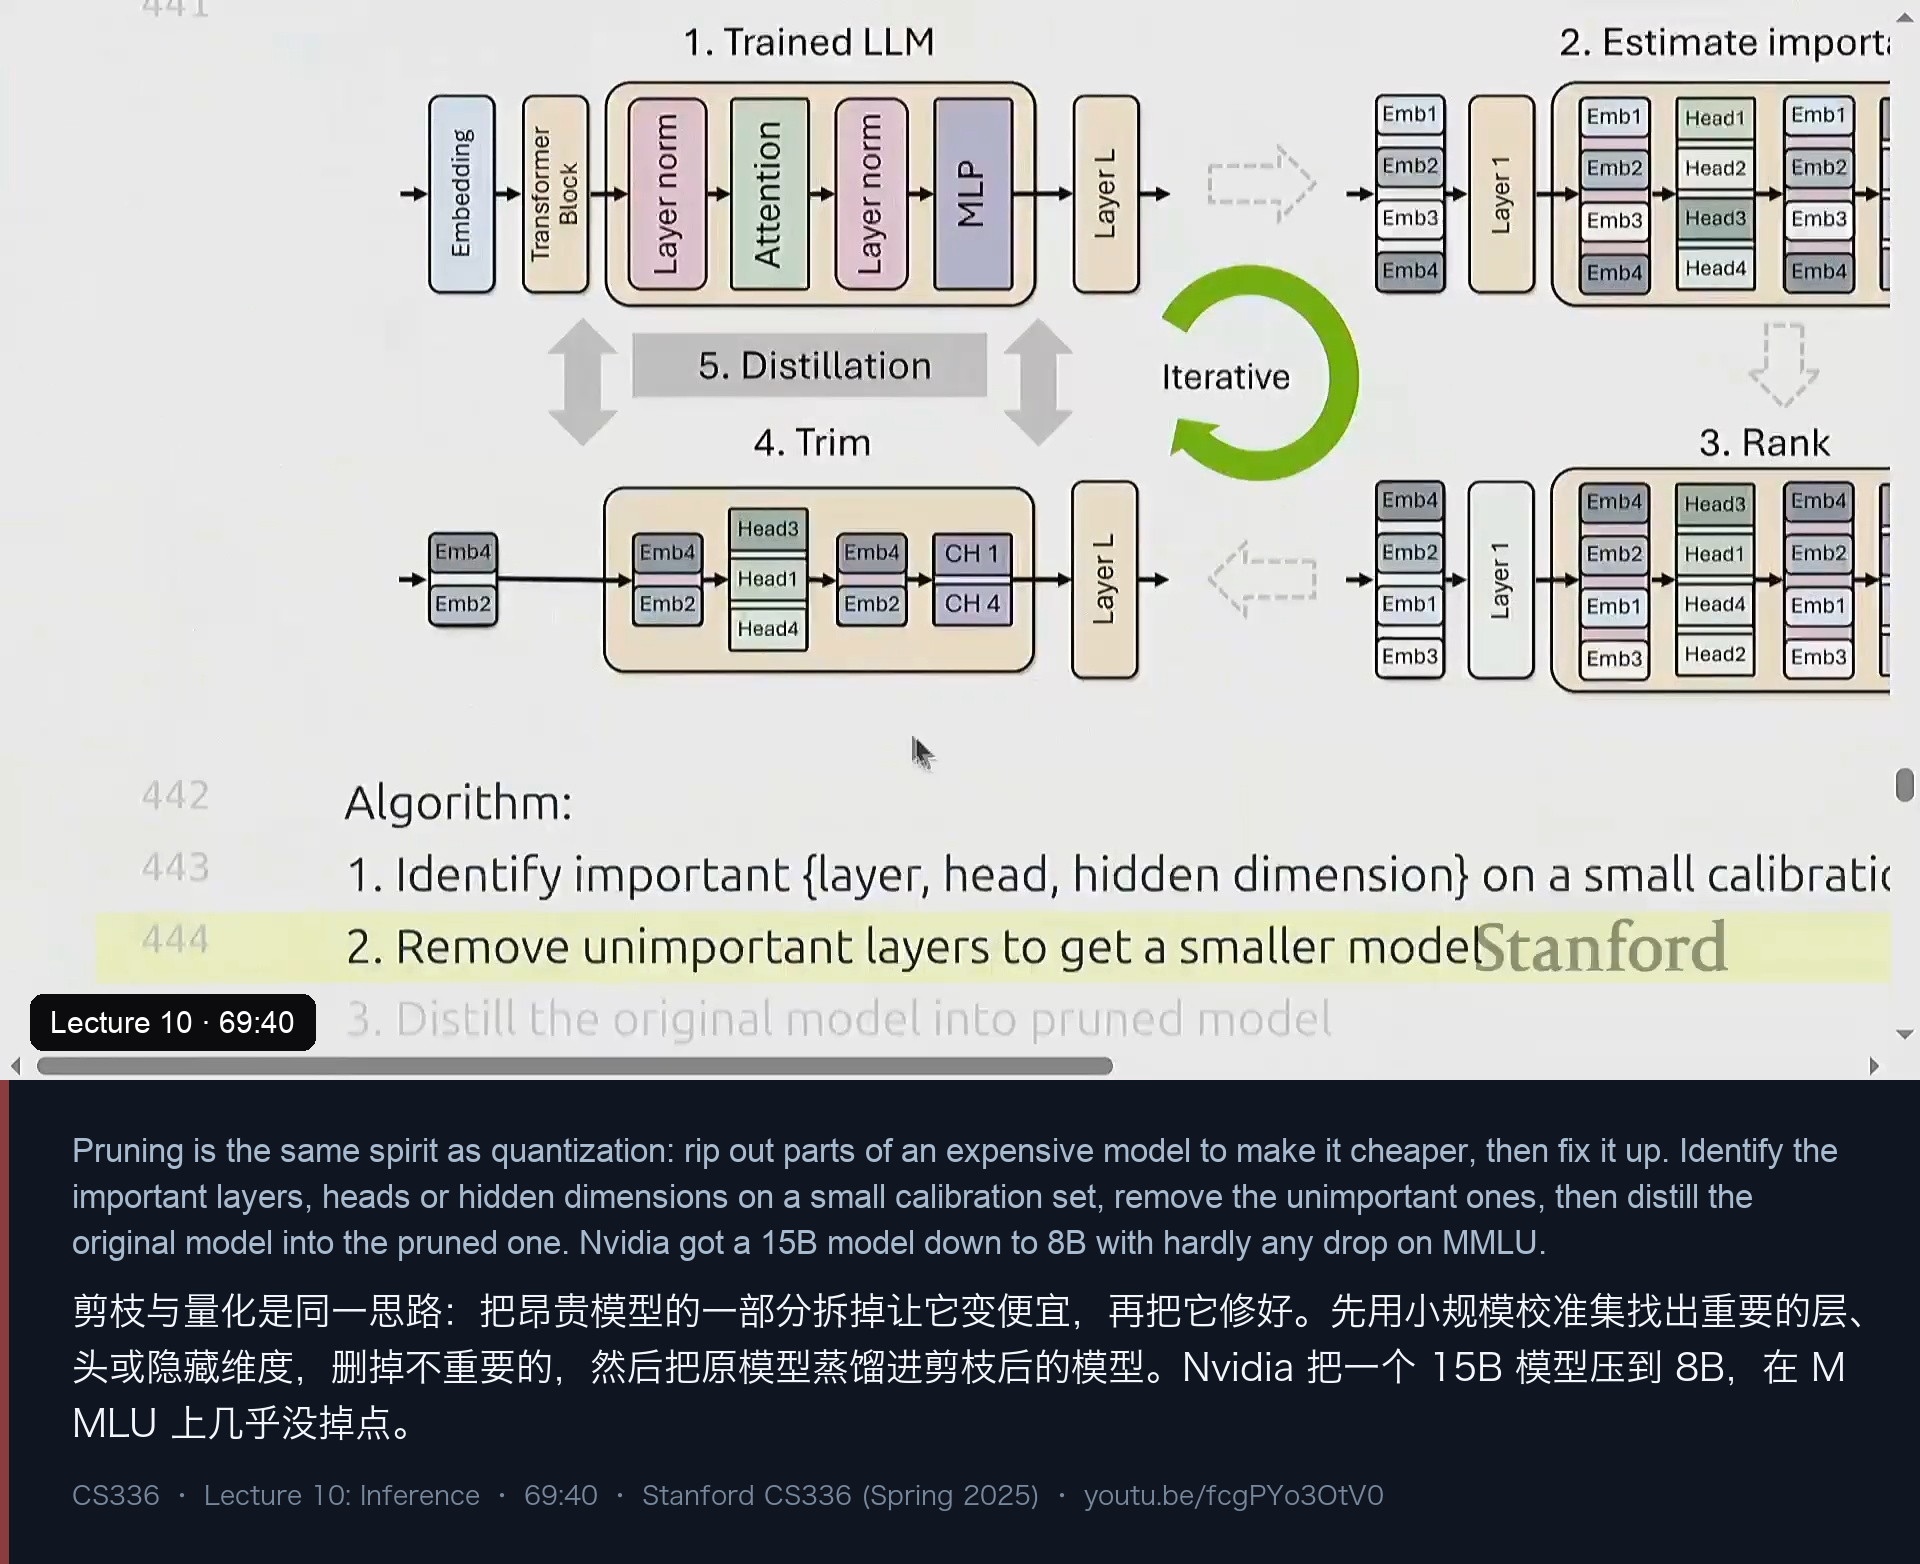
**剪枝(pruning)**和量化是一个思路:把昂贵模型的一部分直接拆掉,让它变便宜,然后再修好。 Nvidia 那篇工作的三步是:
- 用一个小规模校准集,识别出重要的层 / 头 / 隐藏维度(用一些简单的打分);
- 把不重要的删掉,得到一个更小的模型;
- 把原模型蒸馏进这个被剪过的模型——注意这一步很关键:你不是从零开始训,而是从“一个结构上对了、但没校准”的模型出发去修复它。
结果是:15B 的模型压到 8B,在 MMLU 上几乎没有掉点;继续压到 4B 会有一些损失,但“你也确实缩小了很多”。
他最后把“走捷径”总结成两条路:要么从头定义一个新架构、让它生来就快(然后训练它);要么定义一个目标架构,再用蒸馏把慢模型的能力搬过去。
九、无损的加速:投机解码
“目前为止这些都有一点让人不满意,因为它们都是有损的。那有没有办法既快又不损?答案是有——投机解码(speculative decoding / speculative sampling)。”
它的立足点是一个非常朴素的观察:两阶段推理里,“检查”比“生成”快。 prefill 给定一整段序列、并行编码,是计算受限的,很快;generation 一次一个 token,是访存受限的,很慢。所以:
用便宜的方式先猜,再用贵的方式并行地验证。
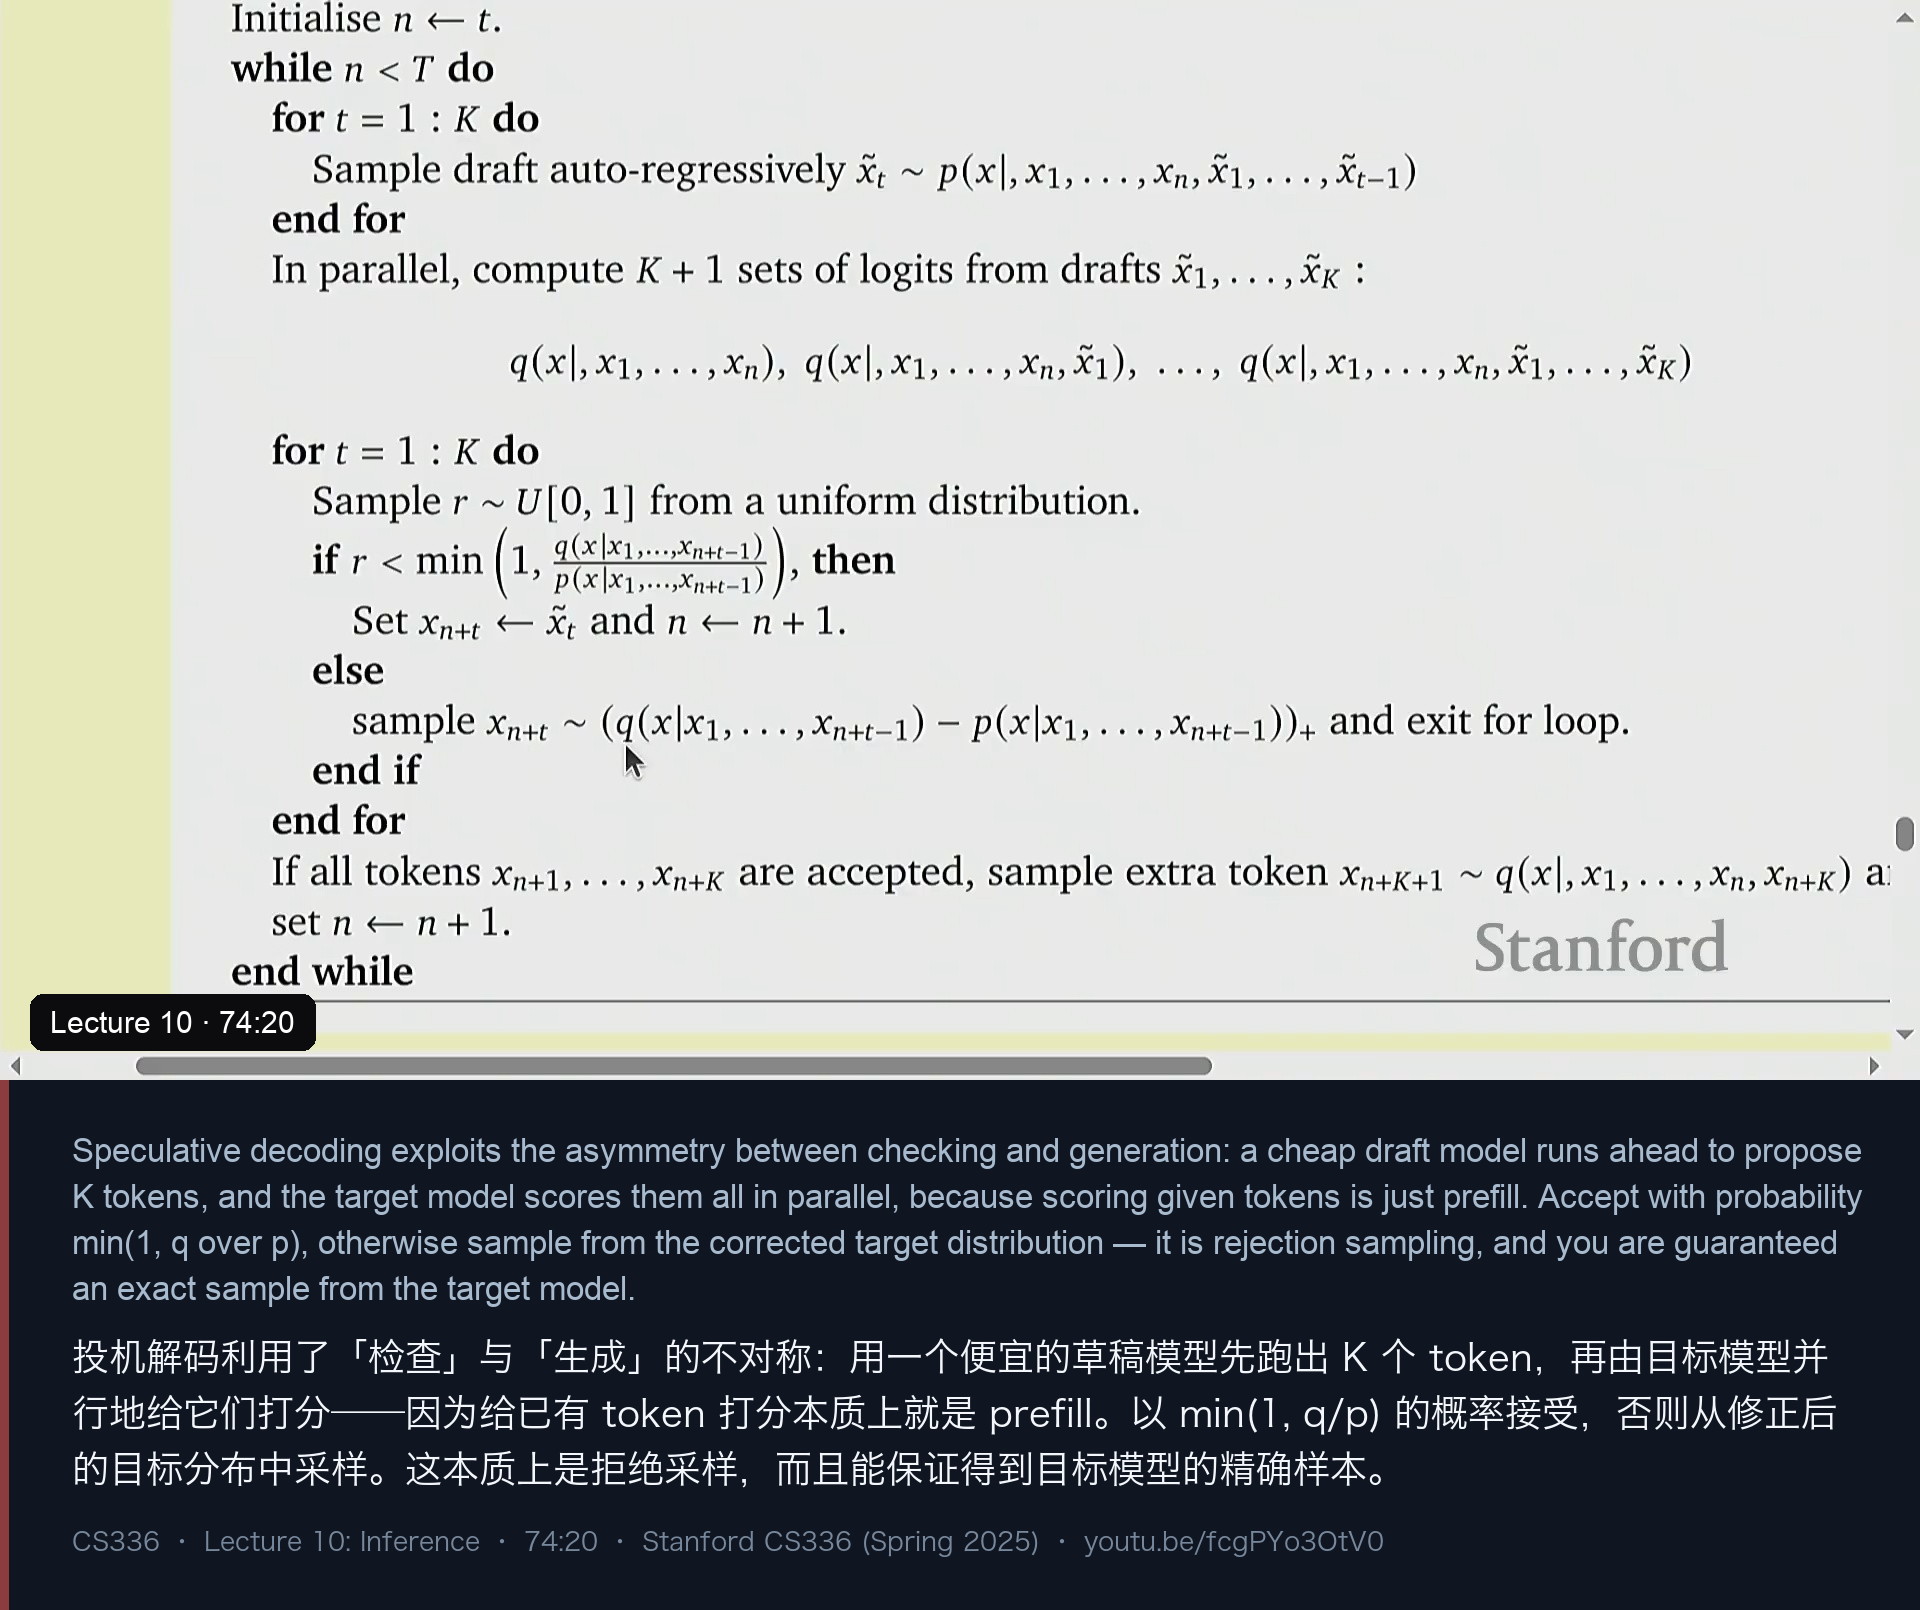
算法是这样的(课上那张伪代码):
def speculative_sampling(p, q, K):
    # p: 便宜的草稿模型分布, q: 目标模型分布
    # 1) 草稿模型先自回归地跑出 K 个 token
    draft = [sample(p, prefix) for _ in range(K)]
    # 2) 目标模型并行地给这 K 个 token 打分(这就是一次 prefill,很快)
    #    于是我们同时拿到 q(x_1), q(x_1,x_2), ..., q(x_1..x_K)
    for k in range(K):
        r = uniform(0, 1)
        if r < min(1, q[token_k] / p[token_k]):   # 以 q/p 的概率接受
            accept(token_k)
        else:
            # 从修正后的分布 max(0, q - p) 中重新采样,然后收工
            new = sample(reldiff(q, p))
            return draft[:k] + [new]
    return draft                                   # K 个 token 全被接受
两个关键点,Percy 专门强调了:
- 这是“带修改的拒绝采样”:以
min(1, q/p)的概率接受——如果你熟悉 Metropolis-Hastings,这就是那个“重要性权重”的来源:你是在用p采样,但你要的是q,所以要除一下; - 修改之处是“至少生成一个候选”:普通的拒绝采样会一直重抽直到接受,而这里如果拒绝,就直接从
max(0, q - p)里采一个、然后收工——不再循环。
于是它有一个非常好的性质:保证得到目标模型的精确样本(exact sample)。也就是说,这不是近似——精度理论上和直接用大模型一模一样(Percy 说“有随机性,但应该是一样的”)。课上给的经验数字是:大约 2× 加速(Chinchilla 的表格里,XSum 上 1.9×、HumanEval 上 2.46×)。
实践中有几个“调参”的经验:
- 目标模型 70B 时,草稿模型要小得多——比如 1B;
- 草稿模型要尽可能接近目标模型(用蒸馏做草稿模型会更好);
- 这是个很热的领域:Medusa 让草稿模型不再自回归、而是并行地猜多个 token;Eagle 把目标模型的隐层特征喂给草稿模型,让草稿模型不长成一个独立的模型;
- 而且——前面讲过的所有架构/量化技巧都可以用在草稿模型上,因为它只需要“猜得像”,最终由精确采样兜底。
十、动态负载:连续批处理、选择性批处理与 PagedAttention
讲座最后十分钟留给“真实服务”:训练时你拿到的是一整块密实的 token 张量,可以全速推过 GPU;而线上流量是完全另一回事——请求在不同时刻到达、在不同时刻结束,有的共享前缀、有的不共享,长度各不相同。这是“参差不齐”(ragged)的负载,也是训练里没有的问题。
- 迭代级调度 / 连续批处理(continuous batching):不要等一个 batch 凑齐再发车——“火车不等你”。新请求一来就塞进去,每一步解码之后都回到调度器问一句“有新请求吗”,有就加进来。这样就不会有任何时间浪费在等请求上。
- 选择性批处理(selective batching):批量化的前提是维度一致,但每个请求长度可能不同(比如
[3, H]、[9, H]、[5, H])。做法是把 attention 拆出来逐条处理,而非注意力部分(MLP,也就是计算的大头)把不同长度的张量直接展平拼在一起——因为它们之间不交互,可以“搭便车”一起过 batch 维。
-
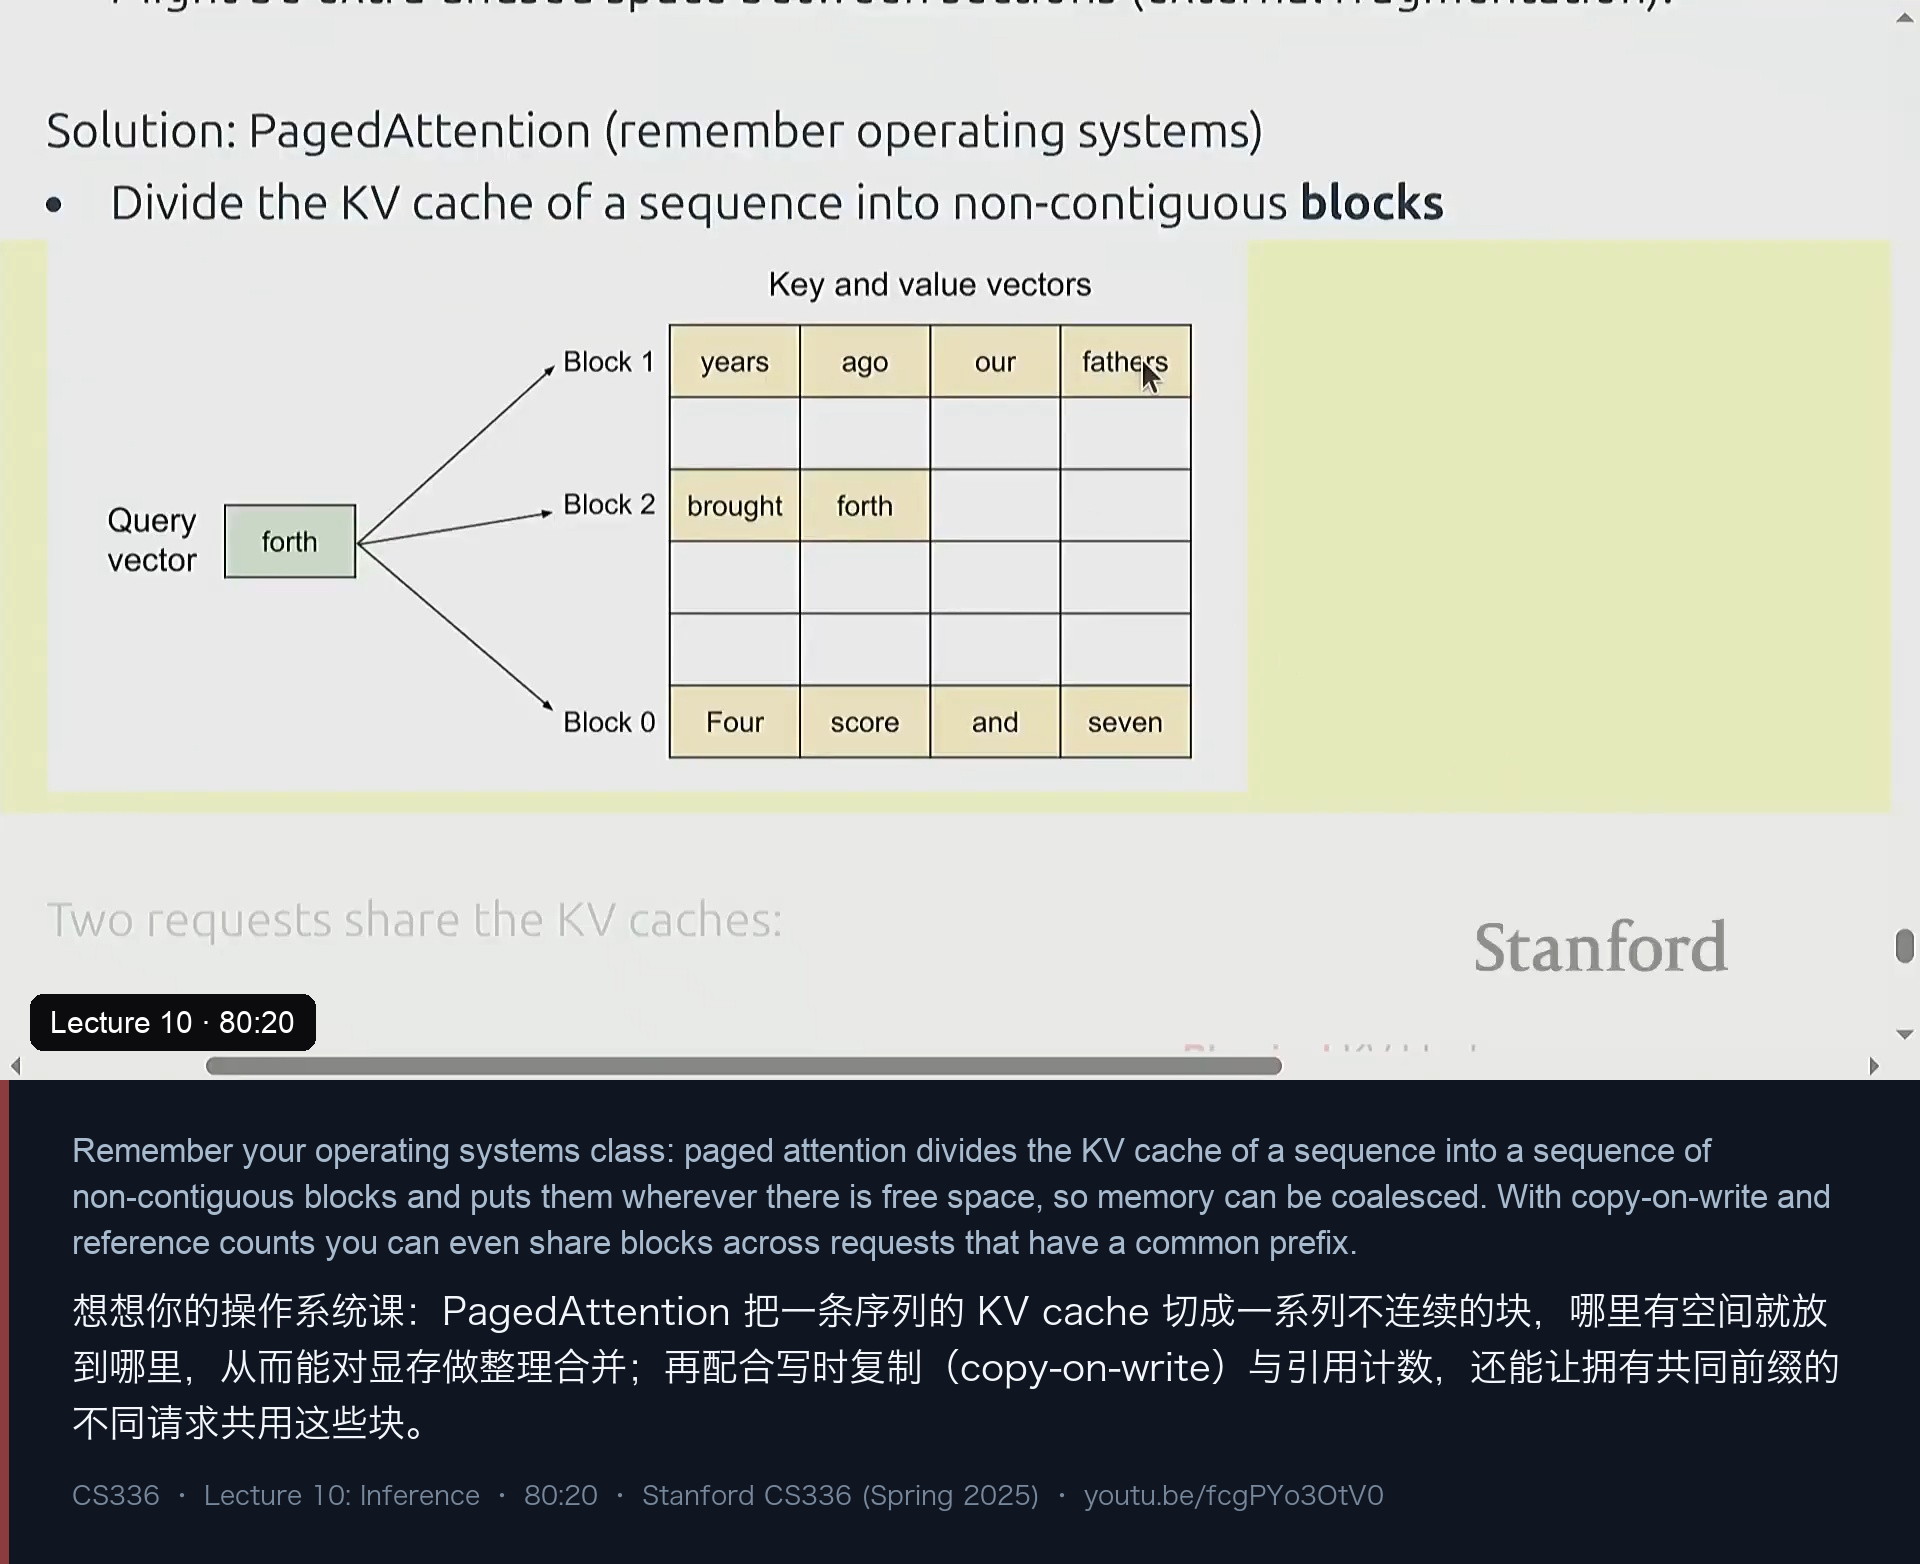
PagedAttention / vLLM:它解决的是显存碎片。按老办法,一个请求来了就为它的 prompt + 回复分配一段连续空间,但你事先不知道它最终会生成多少 token,于是既产生内部碎片(分配多了用不完),又产生外部碎片(请求之间残留的空隙)。PagedAttention 的思路直接抄操作系统:把 KV cache 切成一系列连续的小块(block),哪里有空间就放哪里——只有块内部保持连续,整条序列可以不连续。
顺带还带来了 写时复制(copy-on-write):如果多个请求共享同一个前缀,就让它们共用同一批块,用引用计数记录有多少条序列在用;某条序列要分叉时再复制一份、把计数减一。讲师说得很直接:“想想你的操作系统课——那些东西可以直接搬到推理上来。”
他还提到 vLLM 里还有一批别的优化(此处不展开),以及一句关于“重叠通信与计算”的系统方向。但真正的大结论是这一句:
推理值得被当成一等公民来研究:它和训练的特性完全不同(访存受限、动态负载),而最大的机会不在系统层,而在模型与架构层——因为你不该只想着“怎么把这个模型跑快”,而应该想“在给定的资源预算下,怎么交付最好的精度”。
我的笔记:这一讲值得记住的 8 句话
- 推理的瓶颈不是算力,是显存搬运。 训练可以沿序列并行,推理只能串行;而串行生成时
B=1,算术强度掉到 1,GPU 一直在等数据。Percy 的说法是:“如果这一讲你只带走一件事,那就是——速度这东西,说到底就是显存的事。” - 算术强度是一把尺子,
295是一条线。 H100 的加速器强度约 295 flops/byte;矩阵乘法的强度约等于B。B > 295是计算受限,B = 1是访存受限。记住这把尺子,你就能自己判断任何一段计算是“算得慢”还是“搬得慢”。 - attention 的强度与 batch size 无关,这是它最要命的地方。 MLP 的权重是共享的,所以大批量很划算;而 attention 的 KV cache 是“每条序列自己的雪花”,把请求拼成 batch 并不会摊薄访存。所以对 generation 阶段来说,批量化救不了 attention。
- prefill 与 generation 是两种完全不同的工作负载。 prefill:并行、计算受限、快;generation:串行、访存受限、慢。后面所有的技巧——无论是改架构还是改系统——都是在攻击 generation 这一半。
- KV cache 是主要矛盾,而它是可以被“分摊”掉的。 五种瘦身法其实是三个方向的组合:少存(GQA 减少 KV 头、局部注意力缩短窗口)、存小点(MLA 把 KV 投到低维隐空间)、别人帮你存(CLA 跨层共享 KV 投影)。GQA 之所以被 Llama 3 采纳,很可能就是推理成本推的。
- 想真正绕开这个瓶颈,就要跳出“自回归 + 全注意力”这个框架。 状态空间模型(Mamba)、线性注意力(MiniMax-01)、扩散模型(Inception Labs)都是在换掉这两者中的某一个;而目前的答案是混合——线性 + 局部 + 少量全注意力,已经能产出真正的一线模型。
- “有损”和“无损”是两条清晰的分界线。 量化(int8/int4、离群值单独处理、AWQ 按激活挑权重)与剪枝 + 蒸馏都是“拿精度换速度”;而投机解码是无损的——因为它是带修改的拒绝采样,能保证得到目标模型的精确样本,只是用便宜的草稿模型把“验证”这一步并行化。这也是为什么它让人觉得“可以两者兼得”。
- 线上服务是“参差不齐”的,而操作系统早就教过我们怎么对付它。 连续批处理(火车不等你)、选择性批处理(attention 单算、MLP 拼起来)、PagedAttention(分页 + 写时复制 + 引用计数)——Percy 的原话是“想想你的操作系统课,那些东西可以直接搬到推理上来”。
附:课程信息与时间轴
- 课程主页:stanford-cs336.github.io/spring2025
- 本讲视频:Lecture 10: Inference(1:22)
- 播放列表:Stanford CS336 Language Modeling from Scratch · Spring 2025
- 配图目录:
public/blog/youtube/fcgPYo3OtV0/(18 张图均截取自视频中对应时刻的画面,并把该时刻的完整观点句拼合进图中) - 逐字稿:
transcript-fcgPYo3OtV0.md(视频自带英文字幕整理,约 1.27 万词)
| 时间 | 内容 |
|---|---|
| 00 | 开场:推理的定义,以及它出现的四类场景 |
| 02 | 为什么推理重要:训练是一次性成本,推理要重复无数次 |
| 02 | 三个指标:TTFT、latency、throughput |
| 04 | 与训练的根本差异:必须串行生成,且访存受限 |
| 05 | 复习:Transformer 计算图与符号表(B/L/T/S/V/D/F/h/N/K/G) |
| 07 | 前向 FLOPs 与算术强度:从矩阵乘法说起 |
| 10 | H100 的加速器强度:989 TFLOPS / 3.35 TB/s ≈ 295 flops/byte |
| 11 | B=1 的矩阵乘向量:算术强度 1,访存受限 |
| 14 | 朴素推理的重复计算与 KV cache 的引入 |
| 16 | KV cache 到底占多少显存 |
| 17 | MLP 层:算术强度 = B·T |
| 22 | Attention 层:算术强度 = S·T/(S+T) |
| 25 | 关键结论:attention 的强度与 B 无关,批量化救不了 |
| 27 | 小结:prefill 计算受限、generation 访存受限 |
| 28 | 代入 Llama-2 13B + H100 计算延迟与吞吐 |
| 32 | batch size 扫描:B=1 / 16 / 256 |
| 33 | 延迟与吞吐的权衡;推理并行 = 直接复制模型 |
| 35 | TTFT 由 prefill 决定 |
| 37 | 加速推理的两条路:无损优化 vs 有损捷径 |
| 39 | GQA:减少 KV 头,1 比例换来显存与吞吐 |
| 43 | MLA:把 KV 投影到 512 维隐空间 |
| 45 | 跨层注意力 CLA:层与层共享 KV 投影 |
| 47 | 局部注意力与混合层(Character.ai 每六层一个全局层) |
| 52 | 跳出 Transformer:状态空间模型与扩散模型 |
| 55 | 关联召回:SSM 为什么在语言上失败 |
| 57 | 线性注意力的复兴与 MiniMax 的 456B MoE |
| 1:01 | 扩散语言模型:并行生成 + 迭代精修 |
| 1:04 | 有损捷径之一:量化(FP32 → BF16 → INT8 → INT4) |
| 1:08 | 有损捷径之二:剪枝 + 蒸馏(15B → 8B → 4B) |
| 1:11 | 投机解码:检查比生成快 |
| 1:13 | 投机解码的算法与“精确采样”保证 |
| 1:17 | 动态负载:连续批处理与选择性批处理 |
| 1:19 | PagedAttention 与 vLLM:把操作系统搬进 KV cache |
| 1:21 | 总结:推理值得被当成一等公民 |
说明:本文是视频内容的整理、翻译与转述,观点均来自主讲人;文中代码为讲座中算法的整理版本,非官方作业代码。课程中引用的模型规模、显存数字、吞吐/延迟、成本与传闻(“每天 1000 亿词”“每天 10 亿行代码”)多为公开传闻或讲师引用的估算,请自行核实。
讨论
这里是静态站点,没有内嵌评论区。如果这篇文章对你有用,欢迎通过 RSS 订阅后续更新。