Stanford CS336 第九讲精读:缩放定律(上)——从 1993 年的学习曲线,到 Chinchilla 的三种拟合方法
斯坦福 CS336(Language Modeling from Scratch, Spring 2025)第九讲完整讲义,主讲 Tatsunori Hashimoto。这一讲先把缩放定律放回统计学习理论的历史里(VC 维的 1/√m、非参数速率的 n^(−β/(2β+1))、1993 年 Bell Labs 那篇几乎没有引用的学习曲线论文、Hestness 2017 的三阶段曲线),再用两个玩具例子说明'幂律为什么是自然的'(估计均值得斜率 1、非参数回归得斜率 −1/d 与内在维度),然后逐一拆解模型工程里最实用的几件事——架构/优化器选择、深度与宽度、batch size 与临界 batch size、学习率与 muP——最后落到'更多数据还是更大模型':联合缩放定律与 Chinchilla 的三种方法(最小包络、IsoFLOP、联合拟合),以及 Epoch AI 如何通过'从图里取证读点'复现方法三、发现原论文只是曲线拟合的残差没零均值。
本篇属于系列 Stanford CS336 精读 · 第九讲
来源:YouTube 原视频(Stanford Online · CS336 Language Modeling from Scratch · Spring 2025 · Lecture 9: Scaling laws 1)
来源说明 这是斯坦福 CS336《Language Modeling from Scratch》2025 年春季第九讲的完整讲义,主讲人是 Tatsunori Hashimoto(课程主页把这一讲记作 “Scaling laws (Tatsu)”,Tues April 29)。它也自嘲了排课的小意外:开场第一句话是“原本我们打算讲推理,我先花几分钟起个头,讲缩放定律,然后我们再看往哪走”。这一讲是“缩放定律”两讲中的第一讲,两讲之间夹着 Percy 的第十讲(推理)。 文中 18 张配图均截取自视频对应时刻的画面,并把该时刻的完整观点句(英文原句+中文翻译)拼合进图中。文中出现的所有斜率(0.13 / 0.3 / 0.095)、token 与参数比(约 20 token/参数)、模型规模(63B / 67B)、时间(约 4 个 epoch)与“30 万亿 token”等数字,都是讲师课上的口播、幻灯片引用或对公开论文/传闻的转述,不是本文独立核实的事实,请自行核查原始论文。字幕把 Chinchilla 听写成 “chinchilla/Chinchilla”、把 muP 听写成 “new P/mup”、把 Hestness 听写成 “Hessness/Hessnus”,下文按通行写法记录。
TL;DR
- 缩放定律的全部意义,是“用小模型换大模型的经验”。 旧做法是训练一堆大模型再调参,贵得没法迭代;新思路是在算力尺度的左侧(小模型)把该学的都学会,然后一次性把大模型做对。所以这一讲反复强调的不是“AGI 会永远对数线性下去”,而是**“可预测的资源投入 → 可预测的能力提升”**。
- 幂律不是玄学,它在统计学习理论里有祖先。 有限假设类的超额风险按
1/√m衰减;非参数密度估计的 L2 误差上界是n^(−β/(2β+1))。区别在于:那些是上界,缩放定律是“实际实现的损失”,是一次从理论到经验拟合的跳跃。 - 冷知识:第一篇缩放定律论文可能是 1993 年 Bell Labs 的 NIPS 论文。 它已经写出“测试误差 = 不可约误差 + 多项式衰减项”,还真的“训练一堆小模型、拟合曲线、预测更远处的行为”——和今天的做法几乎一模一样,只是几乎没人引用。
- 为什么幂律是自然的? 两个玩具例子:估计高斯均值,误差
σ²/n,斜率 1;把二维单位方盒切成格子做非参数回归,误差≈ 1/√n,d维下是n^(−1/d),斜率 **−1/d`。斜率几乎就是任务的内在维度——这就是为什么真实语言模型的斜率远慢于 1:它们是高内在维度的非参数问题。 - 指数之谜。 你会期待 1 或 1/2 这样的“漂亮斜率”,但实测是机器翻译 0.13、语音 0.3、语言建模 0.095。(均为讲师引用的 Hestness 论文数值。)
- 数据缩放的三个现实用途:数据配比只影响截距、不影响斜率(所以数据选择实验可以在小模型上做);重复数据有“有效样本量”,约 4 个 epoch 后收益急剧递减;数据选择在有重复的约束下应当随规模自适应。
- 模型工程的三条结论:架构上 Transformer 相对 LSTM 是常数倍优势(课上举例约 15 倍算力);优化器上 Adam 相对 SGD 也是常数倍;深度/宽度有一个很宽的最优盆地。但“并非所有参数都平等”——嵌入层的参数不走同一条幂律,做参数缩放分析时要把它剔掉。
- batch size 与学习率是两个难缠的家伙:超过临界 batch size,加大 batch 就不再等价于多走几步;学习率则随规模漂移(经验法则是 1/宽度),muP 一类重参数化试图让“只在最小模型上调一次”的学习率直接迁移到大模型。
- 最大的警告:对数损失上的缩放 ≠ 下游能力的缩放。 困惑度与算力可以漂亮地线性相关,但同一批模型在下游基准上会各奔东西——别把 perplexity 的斜率当成能力的斜率。
- Chinchilla 的三种方法(最小包络 / IsoFLOP / 联合曲线拟合)前两种互相印证(63B vs 67B),第三种因为曲线拟合的残差没零均值而偏离;Epoch AI 从原图里“取证式”地读点复现后,第三种也归队了——复现没有推翻结论,反而证明了原结论。
- 训练最优已经过时,推理成本才是现在的主角:token/参数从 GPT-3 的约 2、Chinchilla 的 20,一路涨到“最新的 Qwen 模型 30 万亿 token”(讲师口播)。同一套 playbook 用在扩散语言模型上也照样成立。
一、这一讲在哪:10 万张 H100、一个月,你会怎么做
开场先给一个“思想实验”,它把这一讲的所有动机压缩成一句话:
你有一位非常有钱的朋友。
他/她给了你 100,000 张 H100,用一个月。
请你造出你能造的最好的开源语言模型。
这一讲的定位很具体:前面的课程已经给了你拼图的所有零件——分布式训练框架(作业 2)、高质量的预训练数据(作业 3)、架构与超参数的知识。零件都齐了,接下来是“拧曲柄、跑大模型”,但你怎么知道该拧哪一个?
前几讲给的答案其实很“无聊”:抄 Llama,或者抄别人已经验证过的东西。这在教学里是合理的,但在前沿实验室里不成立——你不会想只做复制,你想创新。于是问题变成:在没有大模型可训之前,怎么把大模型做对? 这就是缩放定律要回答的。
旧的做法叫“unpleasant way”:训练一堆大模型,再把超参数调到让大模型好。它的致命问题不是不work,是贵——你根本没法负担这种迭代。新的乐观主义(讲师用的词是 new optimism)反过来:训练一堆小模型,从小模型身上学到规律,再外推回大模型。用课上那张算力尺度图来说,就是在左侧最便宜的区域把该踩的坑踩完,然后“nail it in one go”。
二、史前史:从 VC 维到 1993 年那篇几乎没有引用的论文
讲师坚持先讲历史,理由很有意思:今天人们谈缩放定律时,很容易滑向“对数线性会永远持续、我们会抵达超级智能”这种弥赛亚式叙事,但缩放定律其实有非常扎实、非常有意思的历史。先把历史讲清楚,再看“在 log-log 图上画线”就不那么像玄学了。
起点选在统计机器学习。回到机器学习 101:如果你还记得 VC 维、Rademacher 复杂度这些东西,那么你其实早就见过“缩放定律的理论版本”。
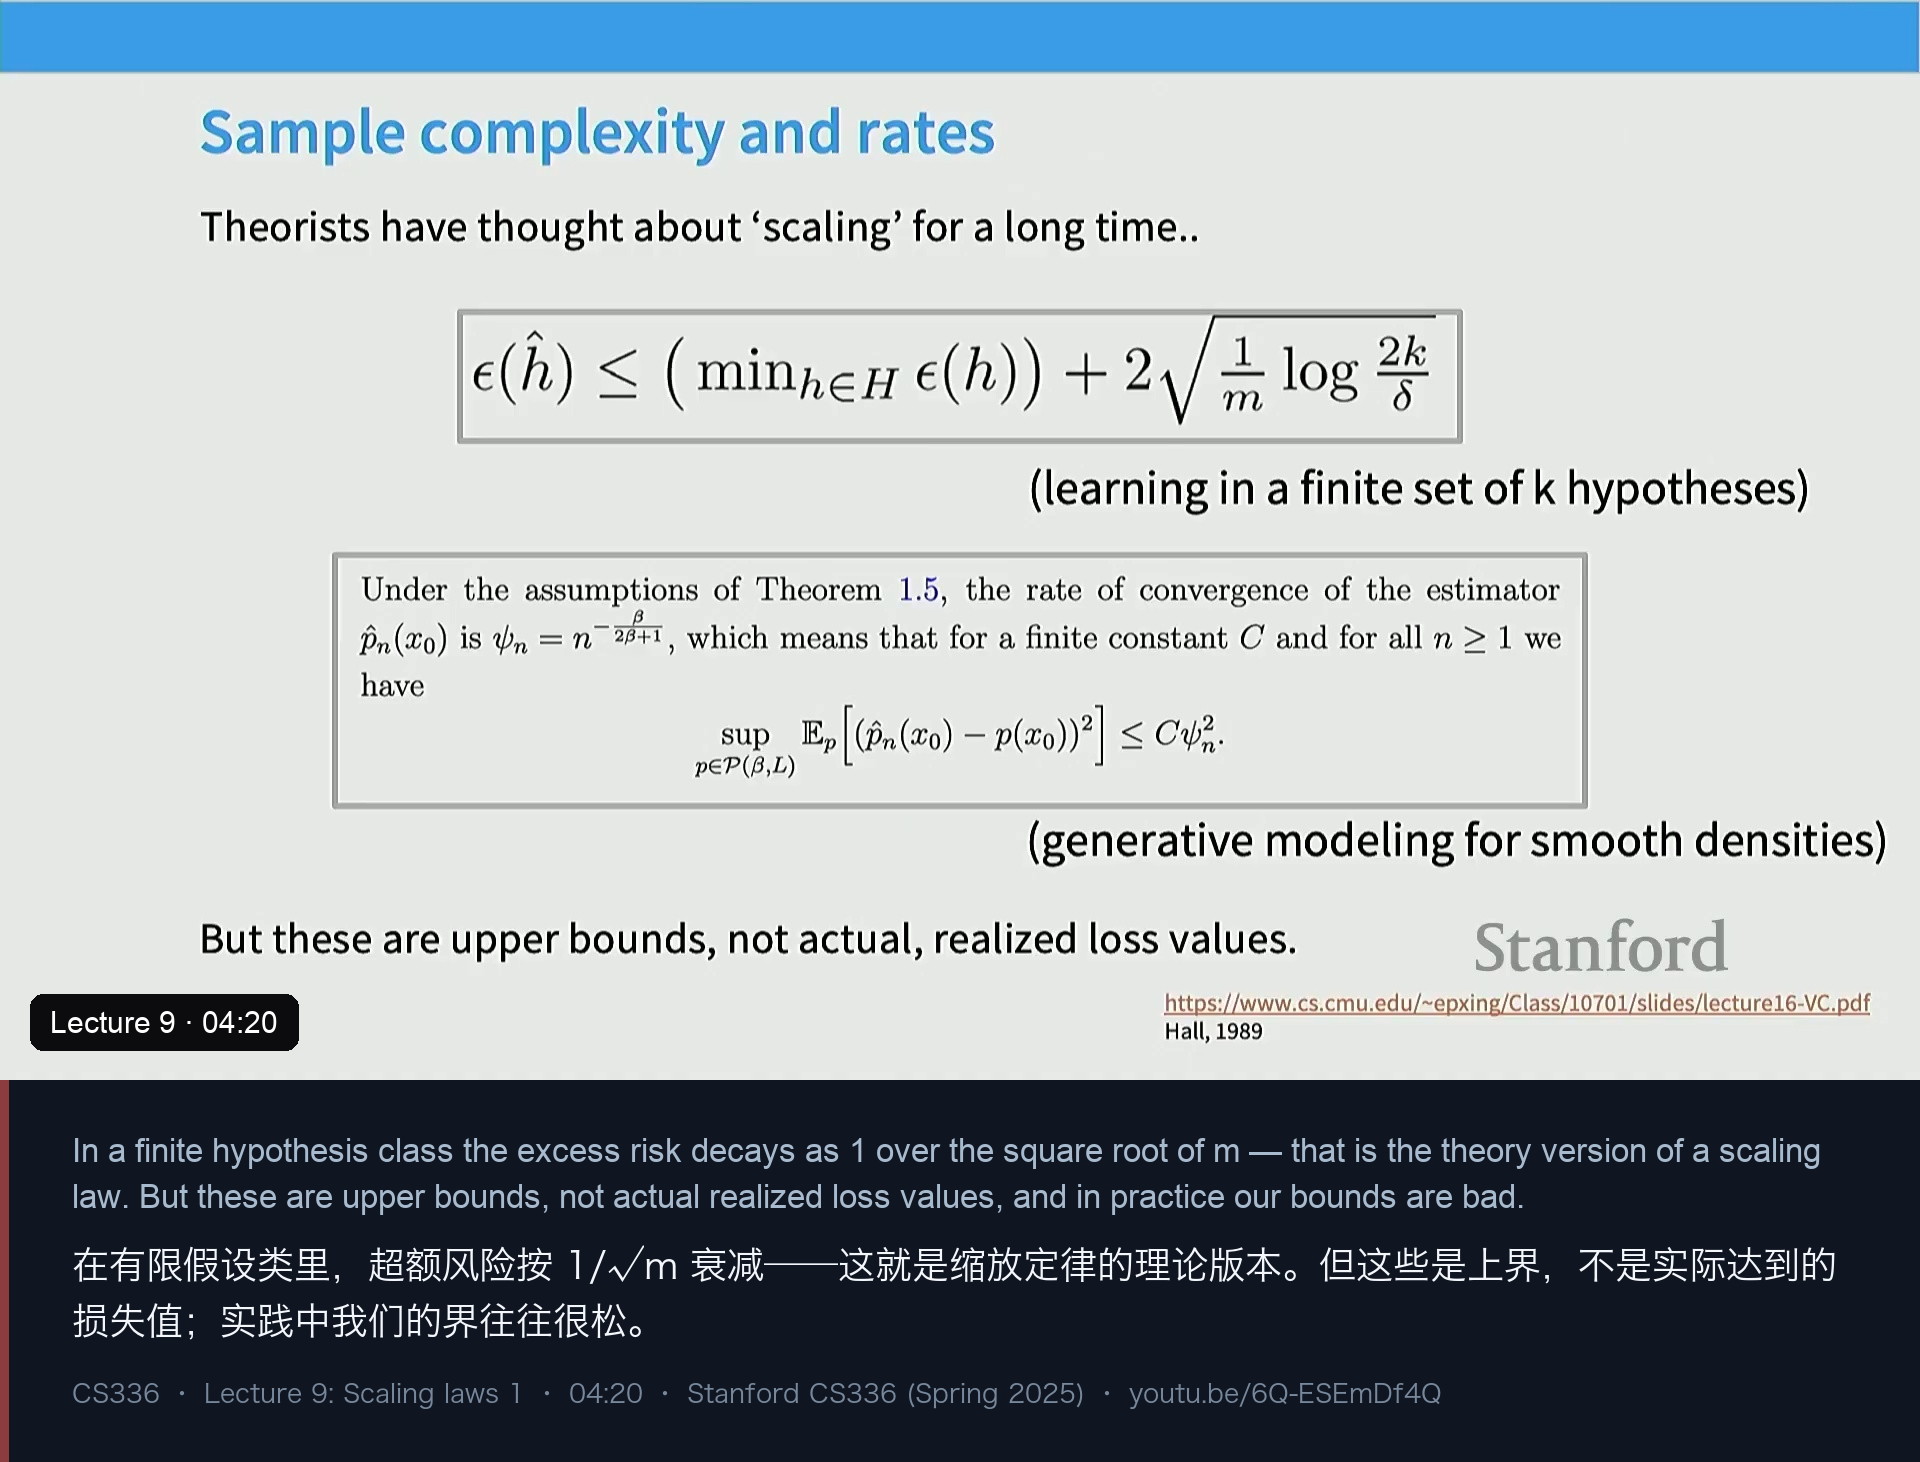
上半张幻灯片是有限假设类里的泛化界:在 k 个假设中学习的超额风险,随样本数 m 按 1/√m 衰减。
ε(h) ≤ ( min_{h'∈H} ε(h') ) + 2 · sqrt( (1/m) · log(2|H|/δ) )下半张是生成式建模里的“更花哨”版本:如果模型是一个非常灵活的非参数类,你会去拟合一个光滑密度,那么 L2 估计误差的上界是
n^(-β/(2β+1)) # 经典的"非参数速率"也就是说,理论家思考“样本量如何决定误差”已经想了几十年。但讲师在这里画了一条很重的分隔线:
这些是上界(upper bounds),不是实际实现的损失值。
而缩放定律,正是从“理论那一侧”跳到“经验那一侧”的那一跃——承认我们的界很松,但也许我们可以直接把损失拟合出来。
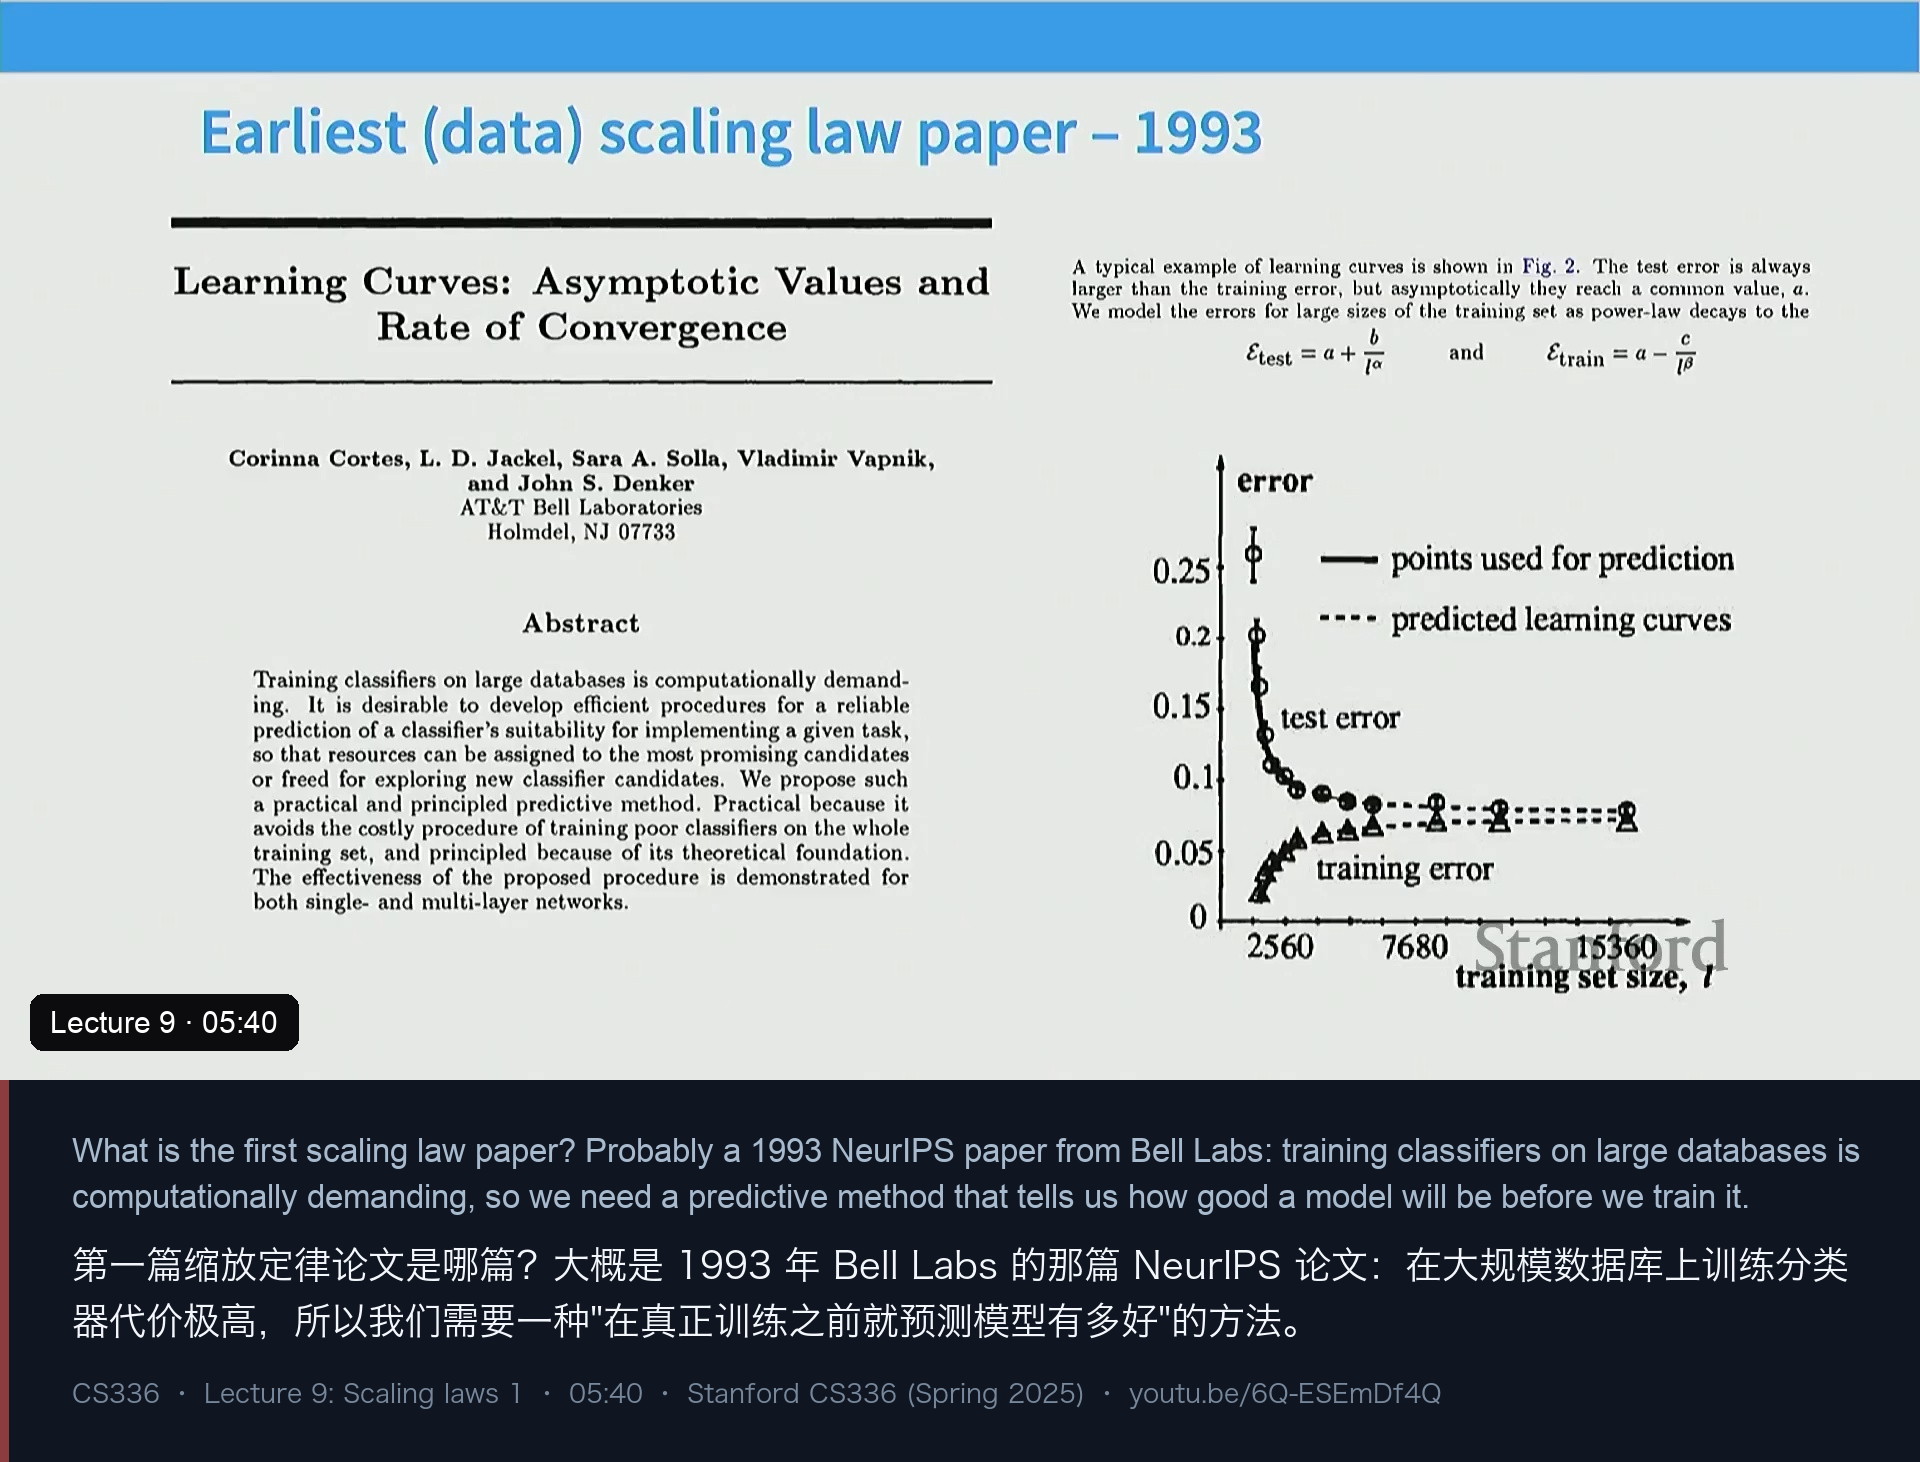
于是有了课上那个“冷知识”(讲师自己都说“这是个有争议的 trivia”):第一篇缩放定律论文是哪篇? 他的答案是 1993 年 Bell Labs 的一篇 NIPS 论文(Cortes、Jackel、Solla、Vapnik、Denker 等)。这篇文章几乎不被引用,但读起来非常超前:
- 它说,在大规模数据库上训练分类器在算力上非常昂贵,所以我们需要在真正训练之前,就知道哪些模型值得训;
- 于是它提出一个预测方法,可以在不完整训练的前提下预测模型有多好;
- 它给出的函数形式是”测试误差 = 不可约误差 + 一个多项式衰减项“——和现代缩放定律长得几乎一样;
- 它甚至做了我们今天做的事:训练一堆小模型,拟合曲线,然后预测更远处的行为。
另一篇常被放进“缩放定律史前史”的,是 Banko & Brill 关于“数据量如何改善某个 NLP 系统性能”的工作:横轴是对数刻度的数据量,纵轴是性能,图看起来就是一条现代的缩放定律。他们的结论也很现代——仅仅扩大数据就能带来非常显著、且可预测的性能提升,所以我们应当权衡“花时间做算法”与“花时间收集更多数据”。
再往后,2012 年前后已经有人在问那个关键问题:这东西真的可预测吗?幂律 3、幂律 4 真的是正确的函数形式吗? 讲师说,如果你感兴趣,最早的大规模“旧时代神经缩放定律”论文大概要数 Hestness 等人 2017 年的工作。
三、Hestness 2017:一条曲线里的三个阶段
Hestness 等人在 Baidu 做的这件事,覆盖了机器翻译、语音以及一些视觉任务,结论是误差率按幂律下降。但讲师最喜欢引用的是那三阶段图:
阶段一:best guess           —— 还在随机猜测附近
阶段二:power-law region     —— 可预测地缩放,log-log 上是直线
阶段三:irreducible error    —— 逼近模型类的不可约误差
我们真正感兴趣的,是中间那段幂律区间。 小数据区域(离开随机猜测的那一段)也很有意思,但难乎其难;而右边的“幂律到不可约误差”这一段,讲师说自己有把握说服你它是非常自然的。
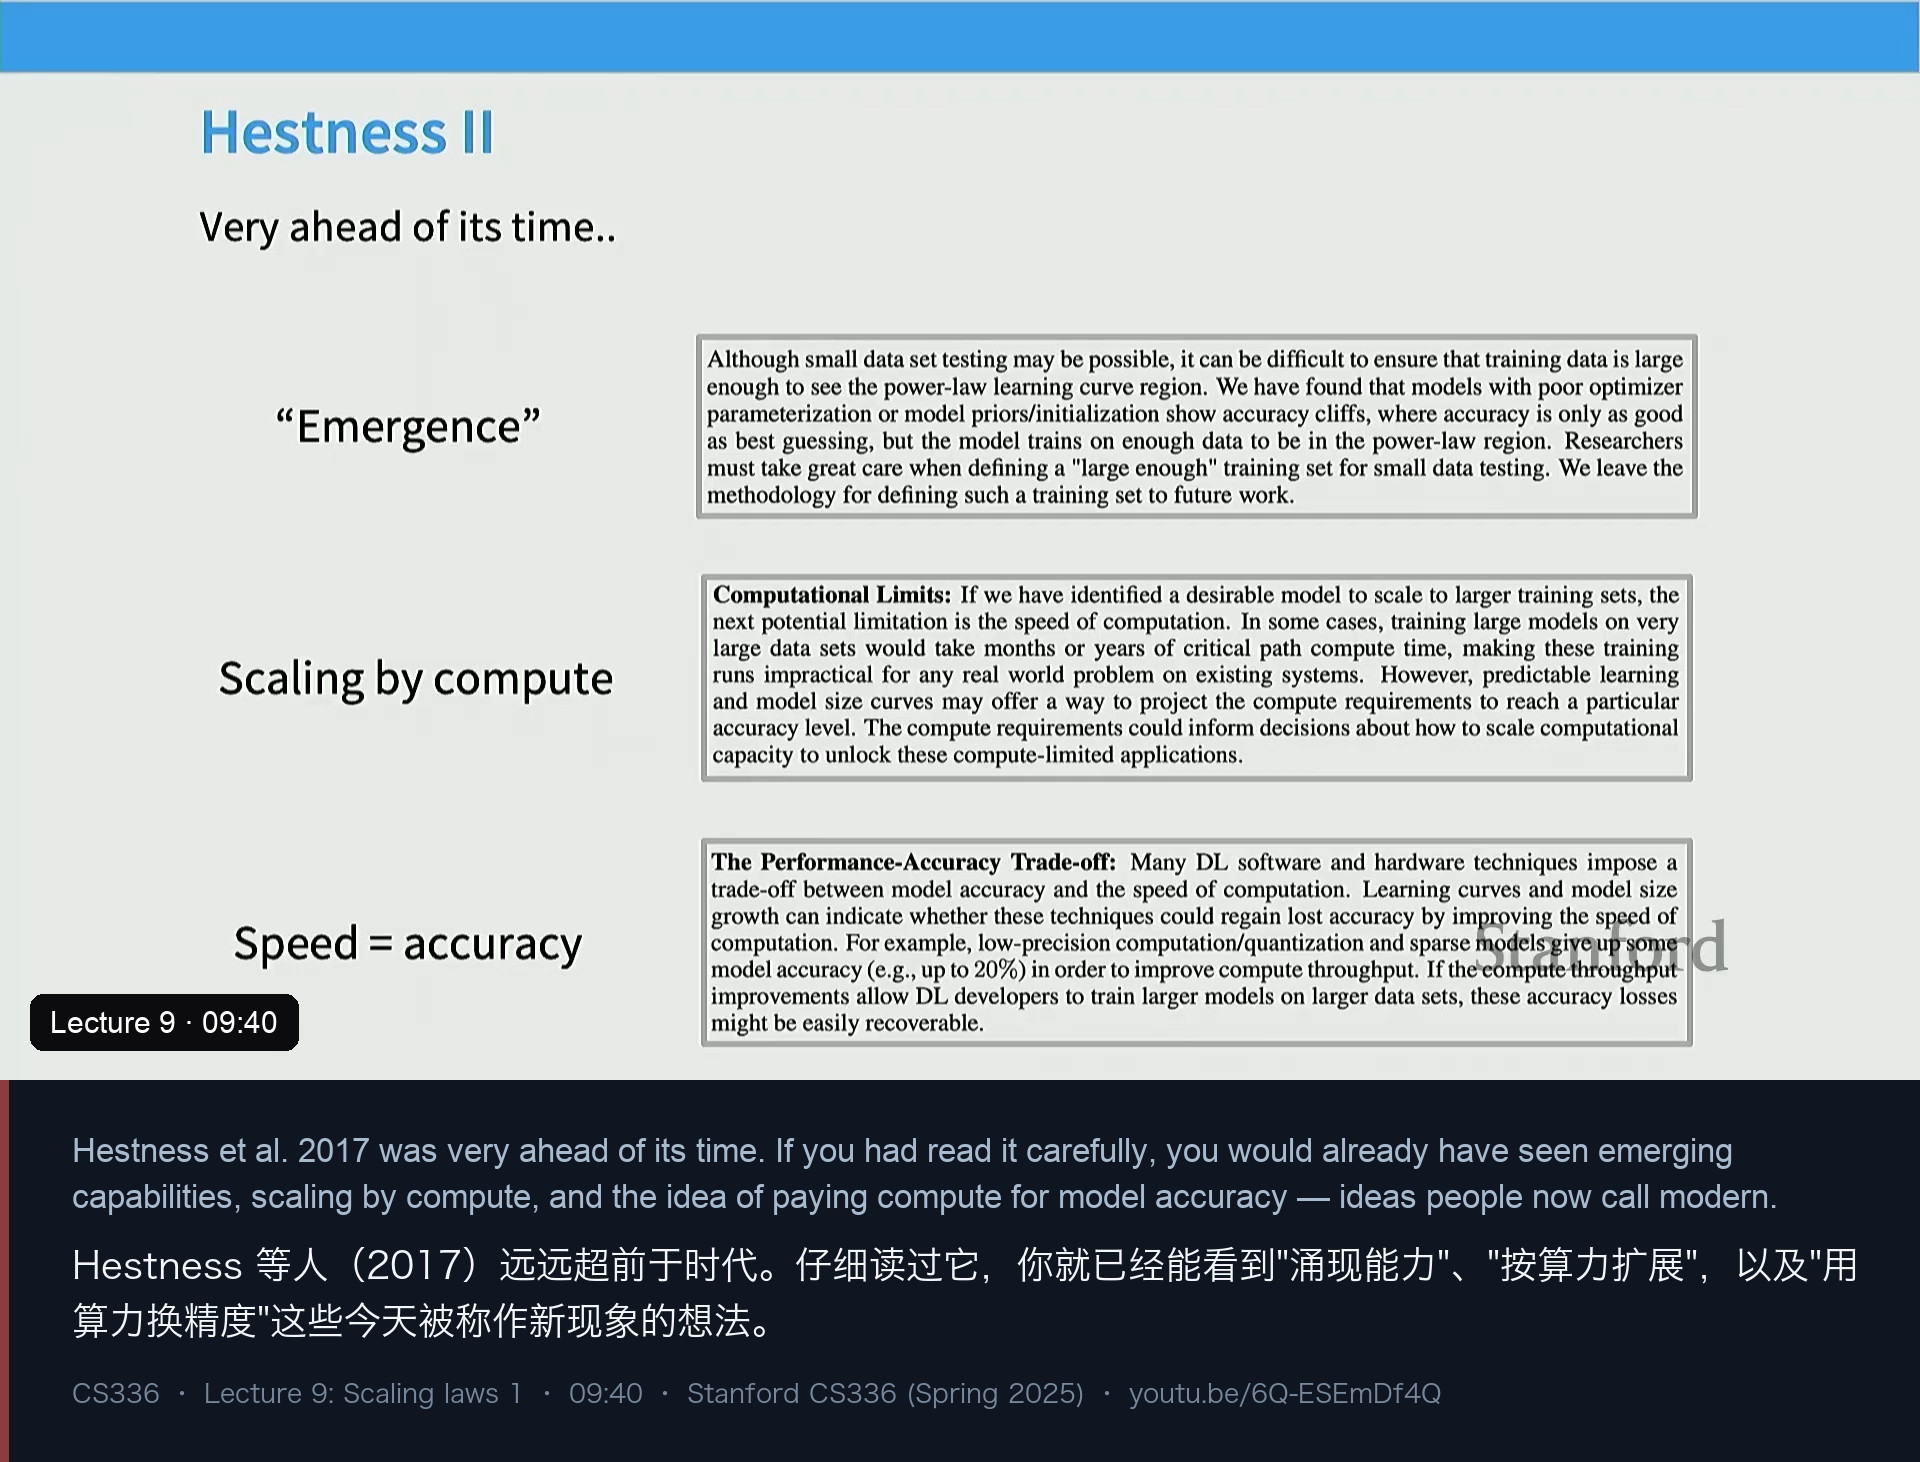
这一页还有个“考古”式的亮点。讲师说,最近这些年有很多“新现象”的讨论——比如涌现能力(emergence)、“按算力缩放”是新东西、系统很重要等等。但如果你 2018 年认真读过 Hestness,你会发现这些它基本都写过:
- 它说,当模型还在随机性能附近时,用缩放定律做预测非常困难——因为你会突然离开随机区间;
- 它谈计算极限——“可以缩放”实际上意味着“按算力缩放”很重要;
- 它甚至谈到量化:如果缩放是可预测的,那么我们应当愿意用算力去换模型精度。
讲师的原话是,这些都是“非常非常现代的想法”,而早期缩放定律论文凭直觉就已经把它们讲清楚了。核心就一条:资源投入可预测,能力提升就可预测。
课上有学生提问:有没有不缩放的情形? 讲师给了两条回答:
- 如果你衡量的是训练损失(或它的留出形式),缩放是非常自然的——经典统计理论说,收敛之后误差总会变好;
- 但确实存在不缩放的现象。几年前的 Inverse Scaling Prize 就在专门找“模型越强、表现越差”的任务,比如模型越强越会“复制”,于是你反而更难抑制它的复述行为。把这类现象串起来的直觉是:一旦跑到分布外很远、行为不再被数据良好指定,就可能出现不缩放、逆缩放或者别的什么。这其实是经典深度学习鲁棒性问题的延伸。
四、数据缩放:为什么幂律是“自然”的
从这一节开始,讲师进入 LLM 的实证结果,并且明确先讲数据缩放——因为它最直观,理论也最清楚。
先说“缩放定律出现得有多普遍”。在 Kaplan 的缩放定律论文里,你会在很多变量上看到缩放:横轴是 log 算力、纵轴是 log 测试损失;类似的图对数据集规模、参数量也成立。这里有一个必须注意的前提:
当你缩放其中一个变量时,另一个变量必须远远大于饱和点。比如只变数据量时,模型必须大得多,否则数据很快就会把模型“喂饱”、曲线进入渐近区。
这些规律甚至还成立在“非标准”的场景里:下游任务上成立,分布外(OOD)也成立——这正是 Kaplan 论文里展示的。讲师说,幂律关系似乎比我们最初预期的要常见得多。
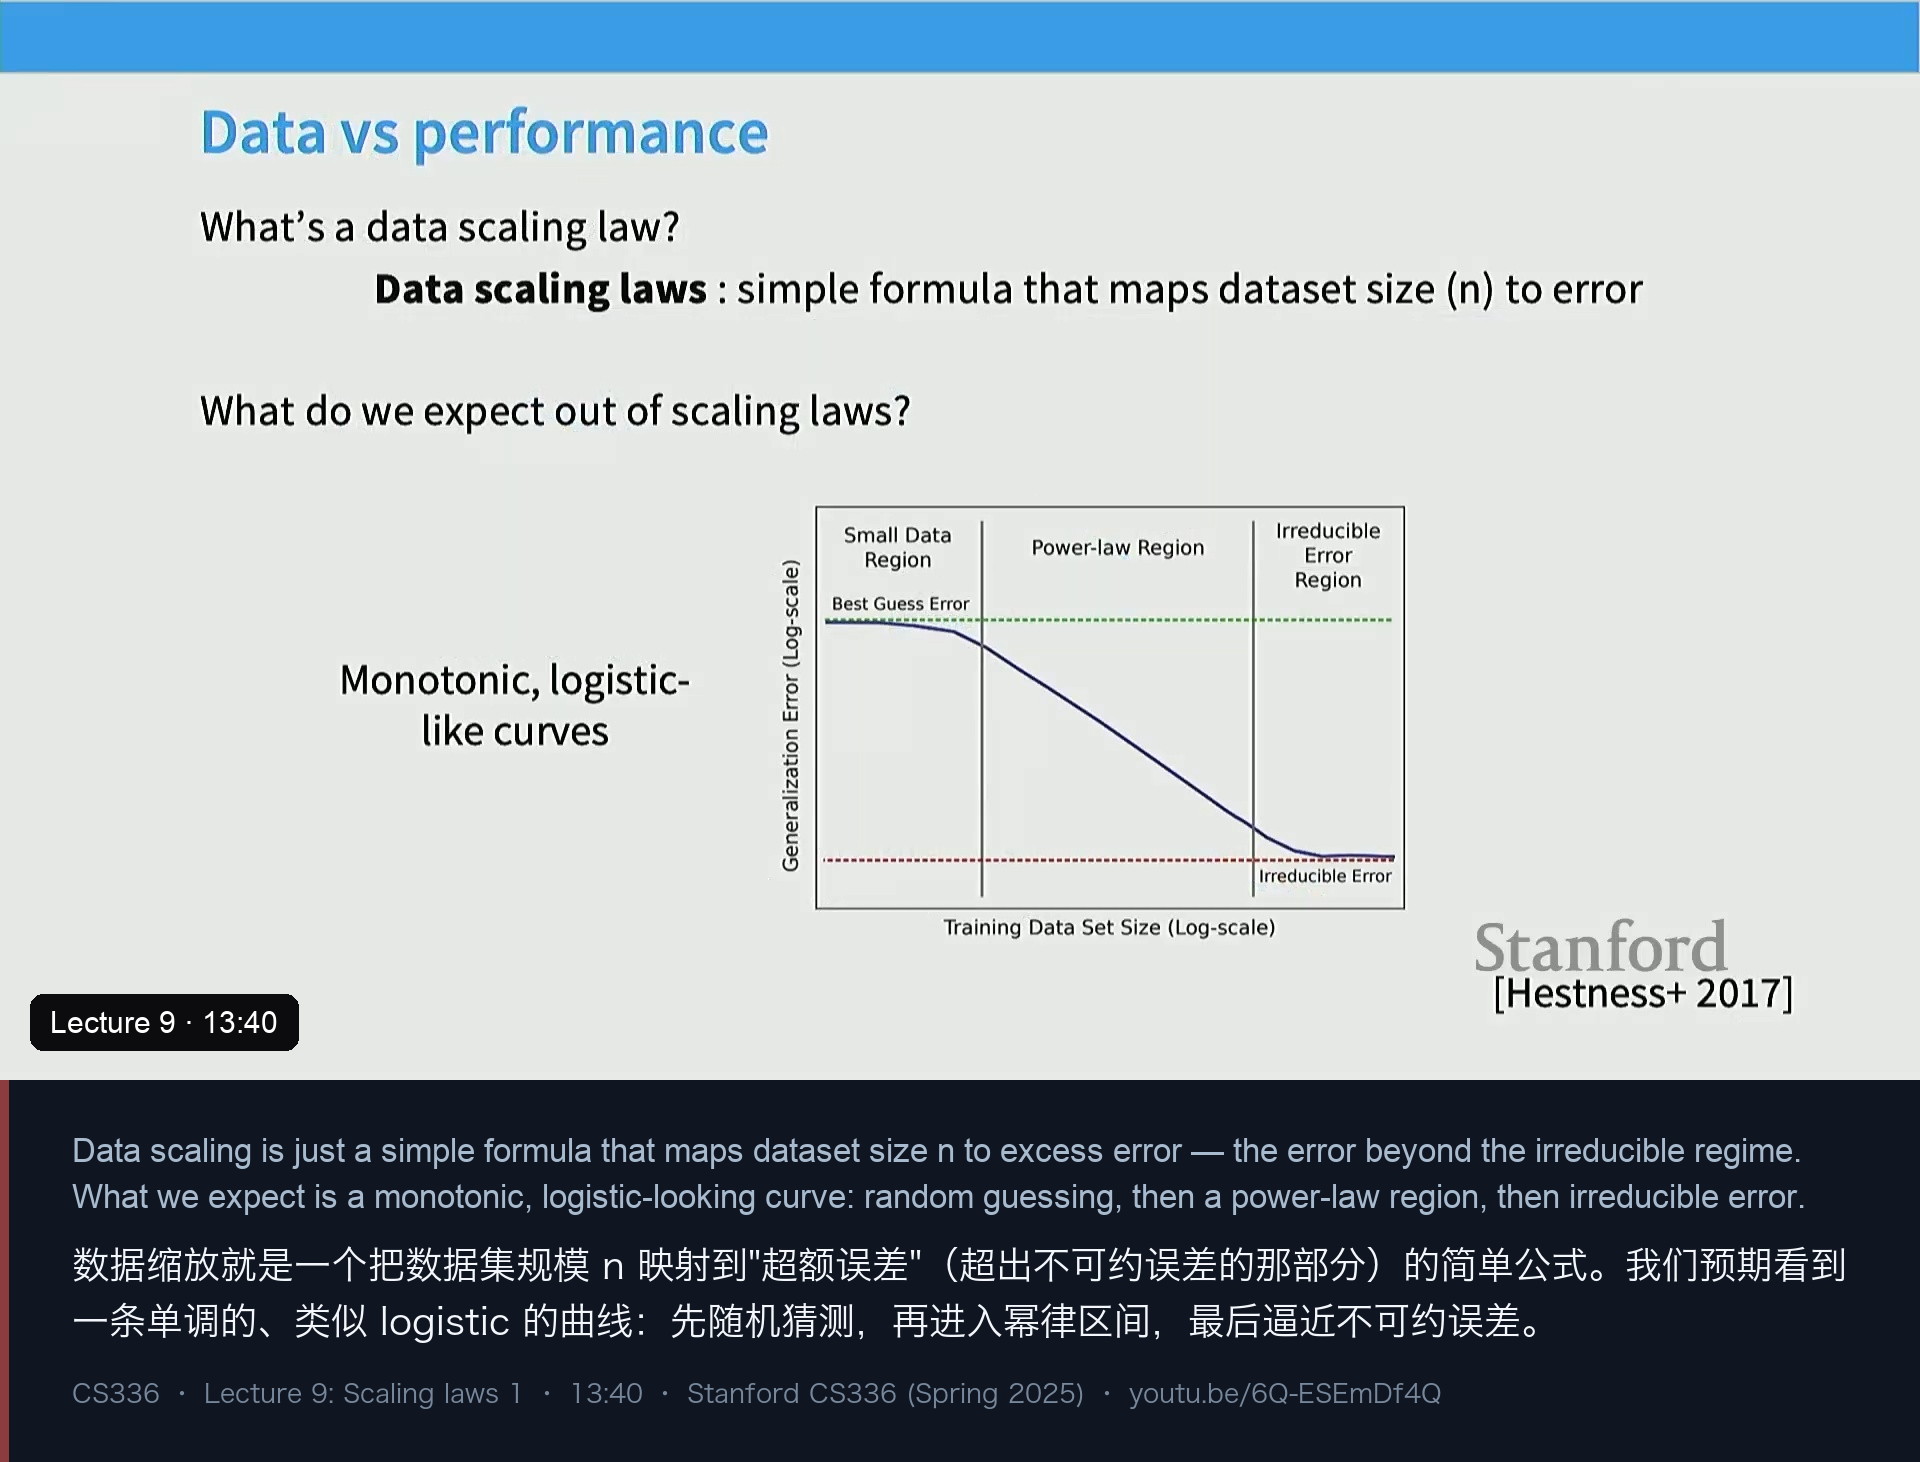
然后是定义。所谓数据缩放定律,就是一个把数据集大小 n 映射到“超额误差”(excess error,超出不可约误差的那部分)的简单公式。按 Hestness 那张图的预期,行为是单调的、logistic 形状的曲线,而我们的兴趣集中在幂律区间到不可约误差区间这一段。
第一条经验观察很朴素,但分量很重:
在 log-log 图上,损失随数据集大小线性下降。 你可以叫它 scale-free,也可以叫它 power law。
也可以反过来说:log-log 上线性 ⟺ x 与 y 之间是多项式关系。那么问题来了——为什么多项式衰减是自然的? 讲师用两个例子回答,两个都“来自很基础的地方”。
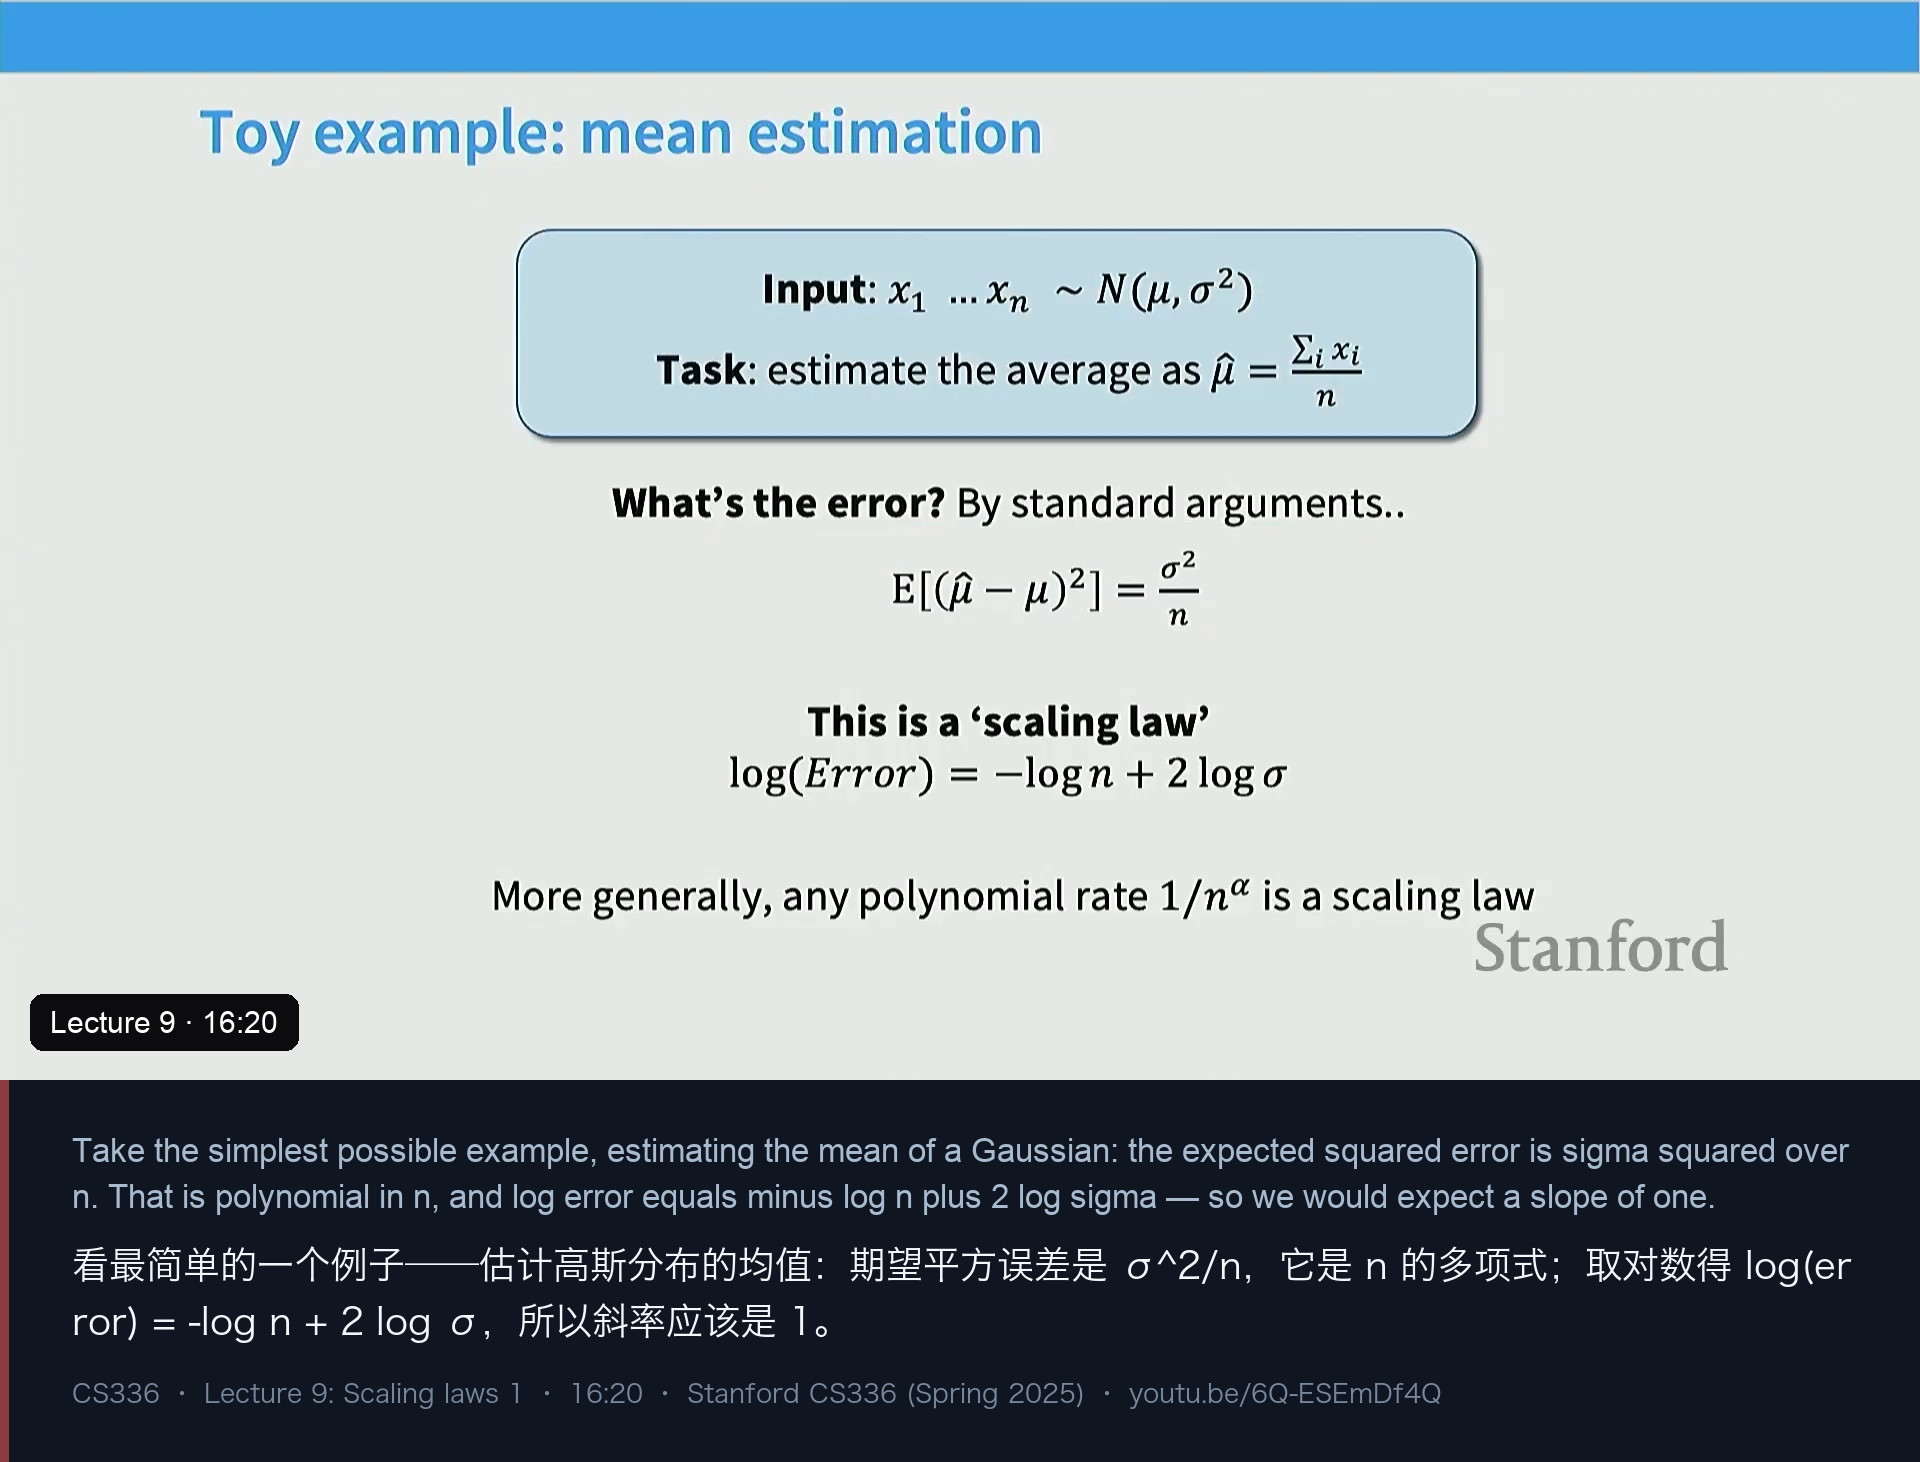
例子一:估计均值(stats 101)。 输入 x₁…xₙ ~ N(0, σ²),任务是估计平均值。由标准论证,估计量的期望平方误差是
E[(μ̂ − μ)²] = σ² / n这是 n 的多项式。取对数:log(error) = −log n + 2 log σ。所以你会预期斜率为 1。 更一般地,任何“多项式速率” 1/n^β 都可以写成一条缩放定律。
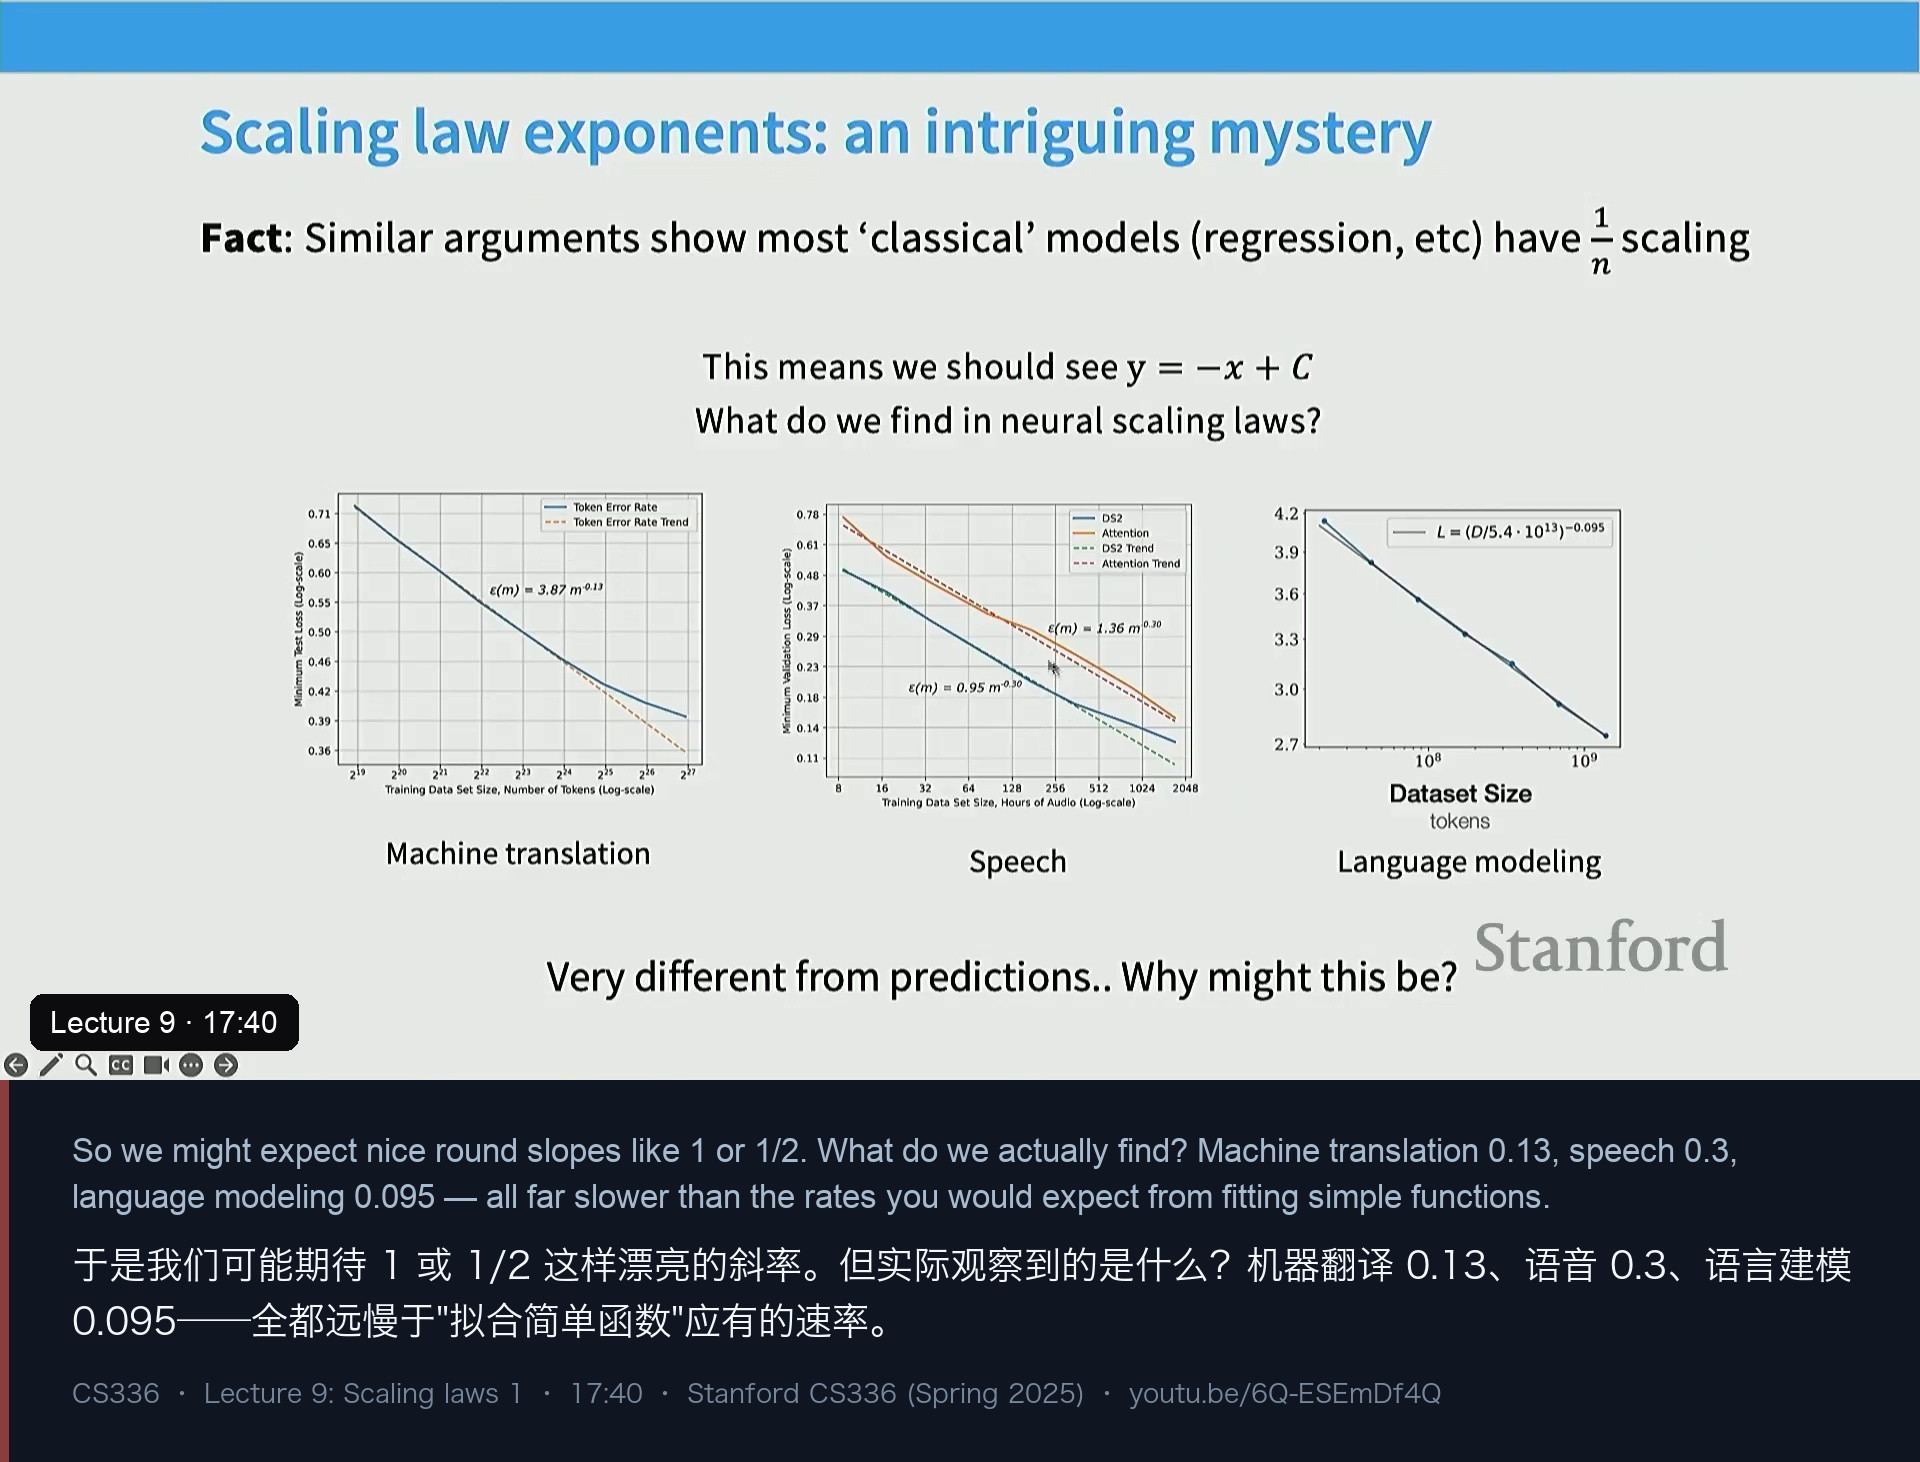
于是你会开始期待“漂亮的整数斜率”:1/n、甚至 agnostic learning 的 1/√n,log 图上应该是 1 或 1/2 这样的数。但实际测到的是什么?
机器翻译    斜率 ≈ 0.13      (Hestness)
语音        斜率 ≈ 0.3       (Hestness)
语言建模    斜率 ≈ 0.095     (Hestness)
全都远慢于 1/n 甚至 1/√n。 为什么?
这就引出这一讲最后一个数学例子,也是最重要的一次“祛魅”:
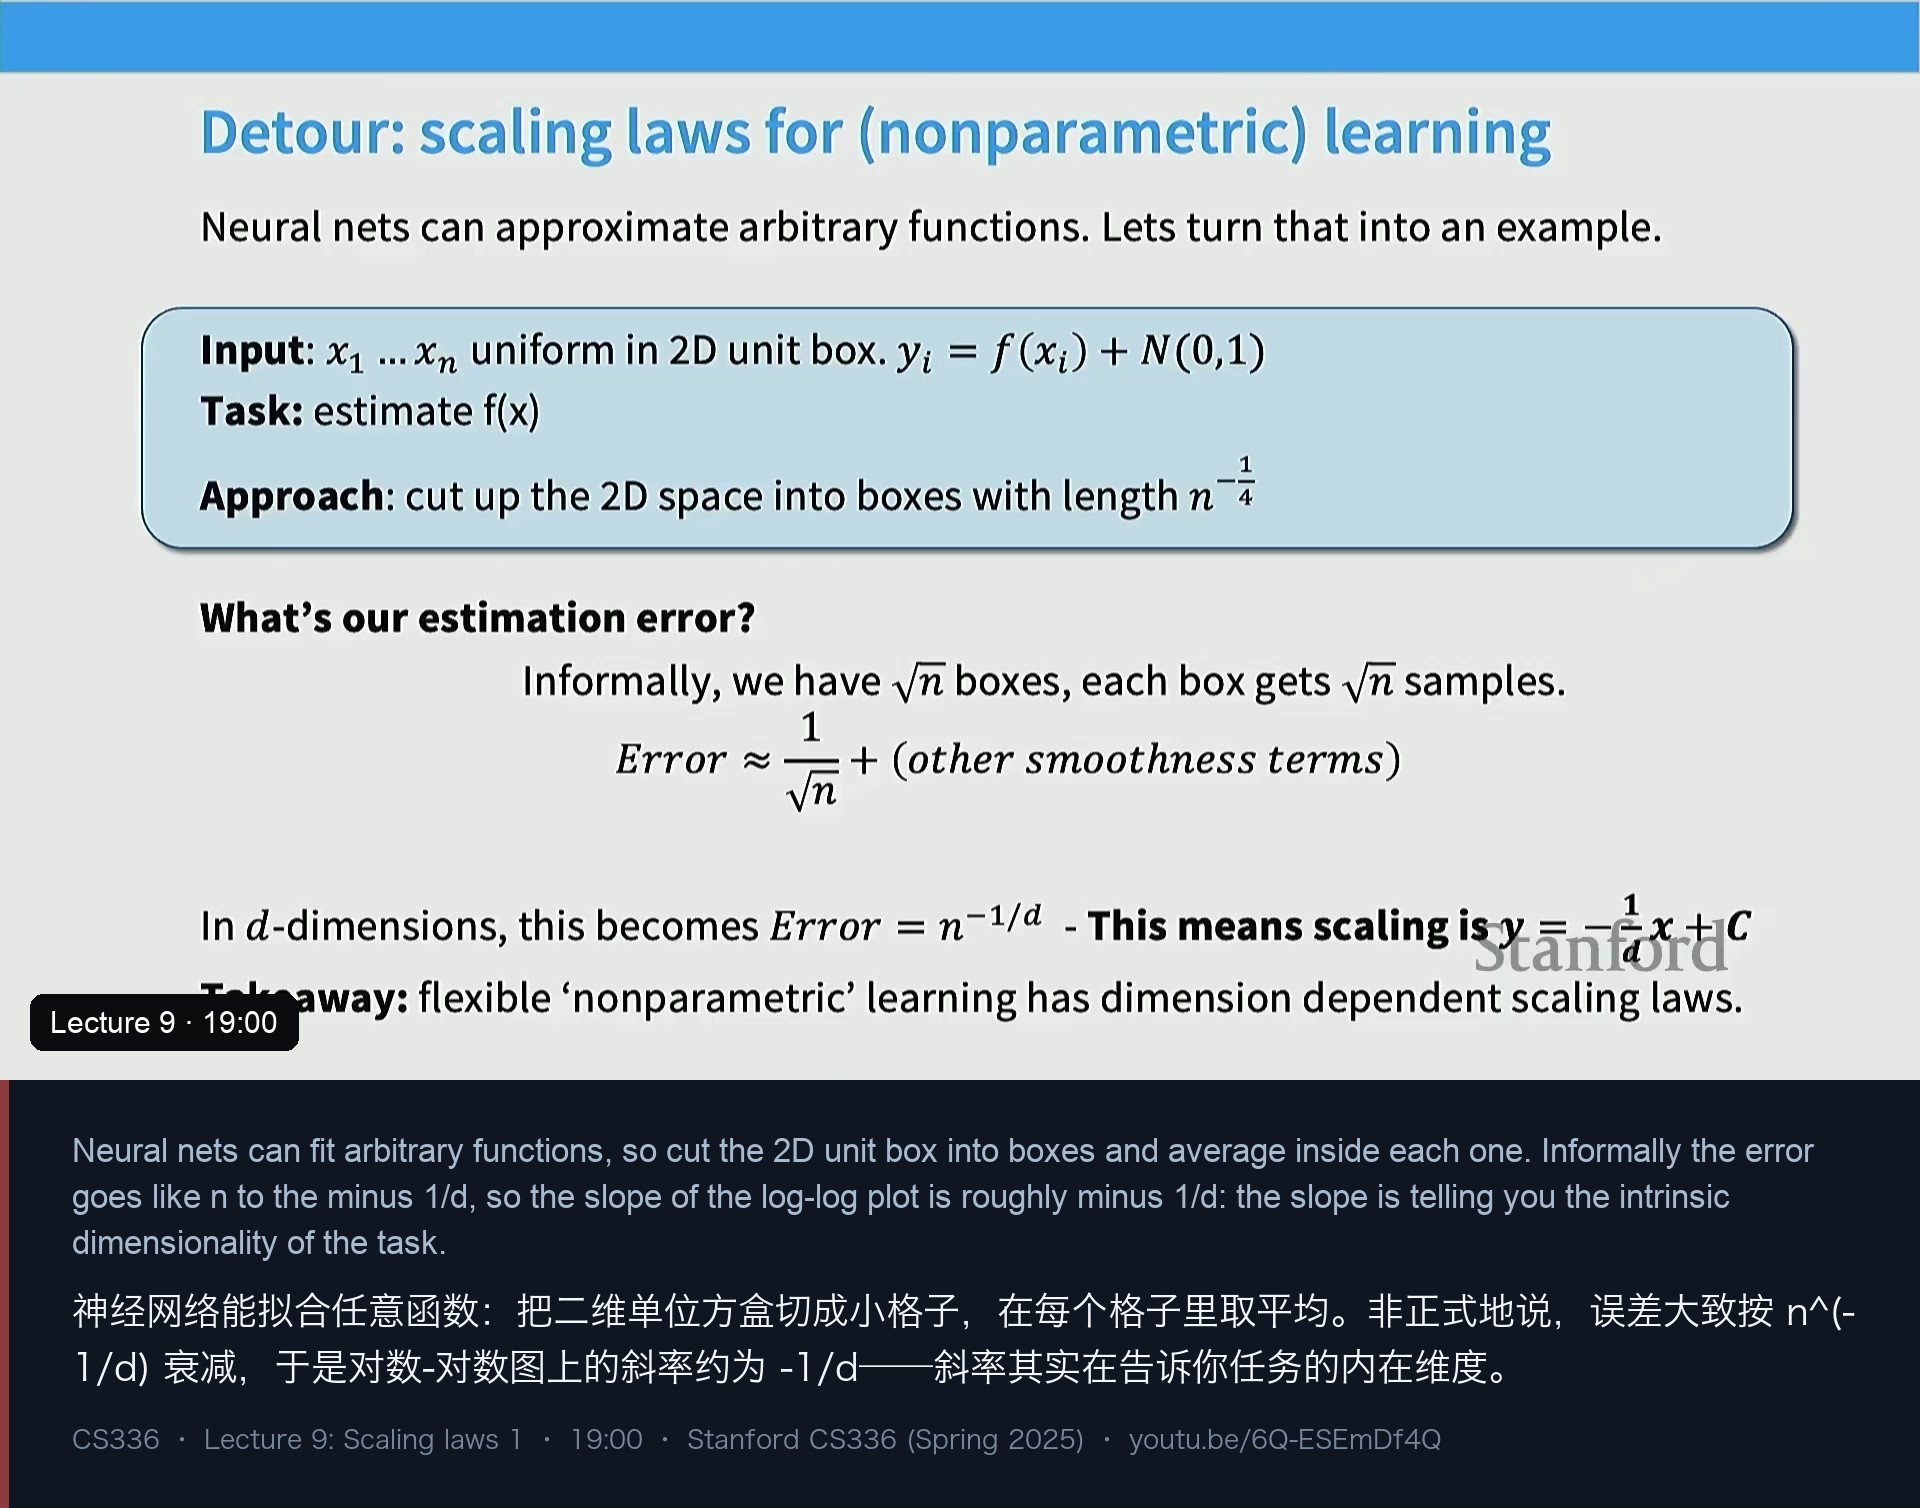
例子二:非参数回归(d 维)。 神经网络不是在估计均值,甚至不是在做线性回归——它们能拟合任意函数。那就把这件事变成一个例子:把 x₁…xₙ 均匀放在 d 维单位方盒里,任务是在有噪声的情况下估计一个光滑函数 f。最简单的非参数回归做法是:
把 d 维空间切成小格子,在每个格子里对 y 取平均。在二维情形下,用长度 n^(−1/4) 的格子,你会得到 √n 个格子,每个格子里大约 √n 个样本,于是
误差 ≈ 1/√n + (其他光滑性项) # 二维推到 d 维,这就变成
误差 ≈ n^(−1/d) → log-log 斜率 ≈ −1/d关键结论:斜率几乎精确地告诉了你这个任务的内在维度(intrinsic dimensionality),或者说“这个问题有多难学”。 语言模型的斜率之所以是 0.095 这种“慢得离谱”的数,恰恰因为它是一个高内在维度的、灵活的非参数学习问题。
讲师也提醒:确实有一些理论/实证工作把“这些非标准的速率”和内在维度更正式地联系起来,图上的虚线预测和紫色圆点看起来也蛮接近——但不要过度解读,因为估计内在维度本身就是极难的问题,难到和“把数据建模”差不多。课上有学生追问“怎么构造一个具有内在维度的模拟数据”,回答是:构造本身并不难(比如写一个接收五个变量的函数、加一点噪声,就得到一个五维曲面),难的是在真实数据(比如 C4)上估计内在维度。
五、指数之谜:0.13 / 0.3 / 0.095 与内在维度
上面的例子给了一个漂亮的解释框架,但讲师把它收束成一句更有用的话:斜率的含义不只是“下降多快”,它几乎是“这个问题有多难”的代理量。这也解释了为什么数据缩放定律在工程上有用——因为**“好用”这件事本身是稳定的**:
- 你可以在小模型、小数据上做数据选择实验,再把结论迁移上去;
- 你可以用它来讨论“数据够不够”、“重复有没有用”这些原本很难回答的问题。
六、数据缩放的三个现实用途:配比、重复、数据选择
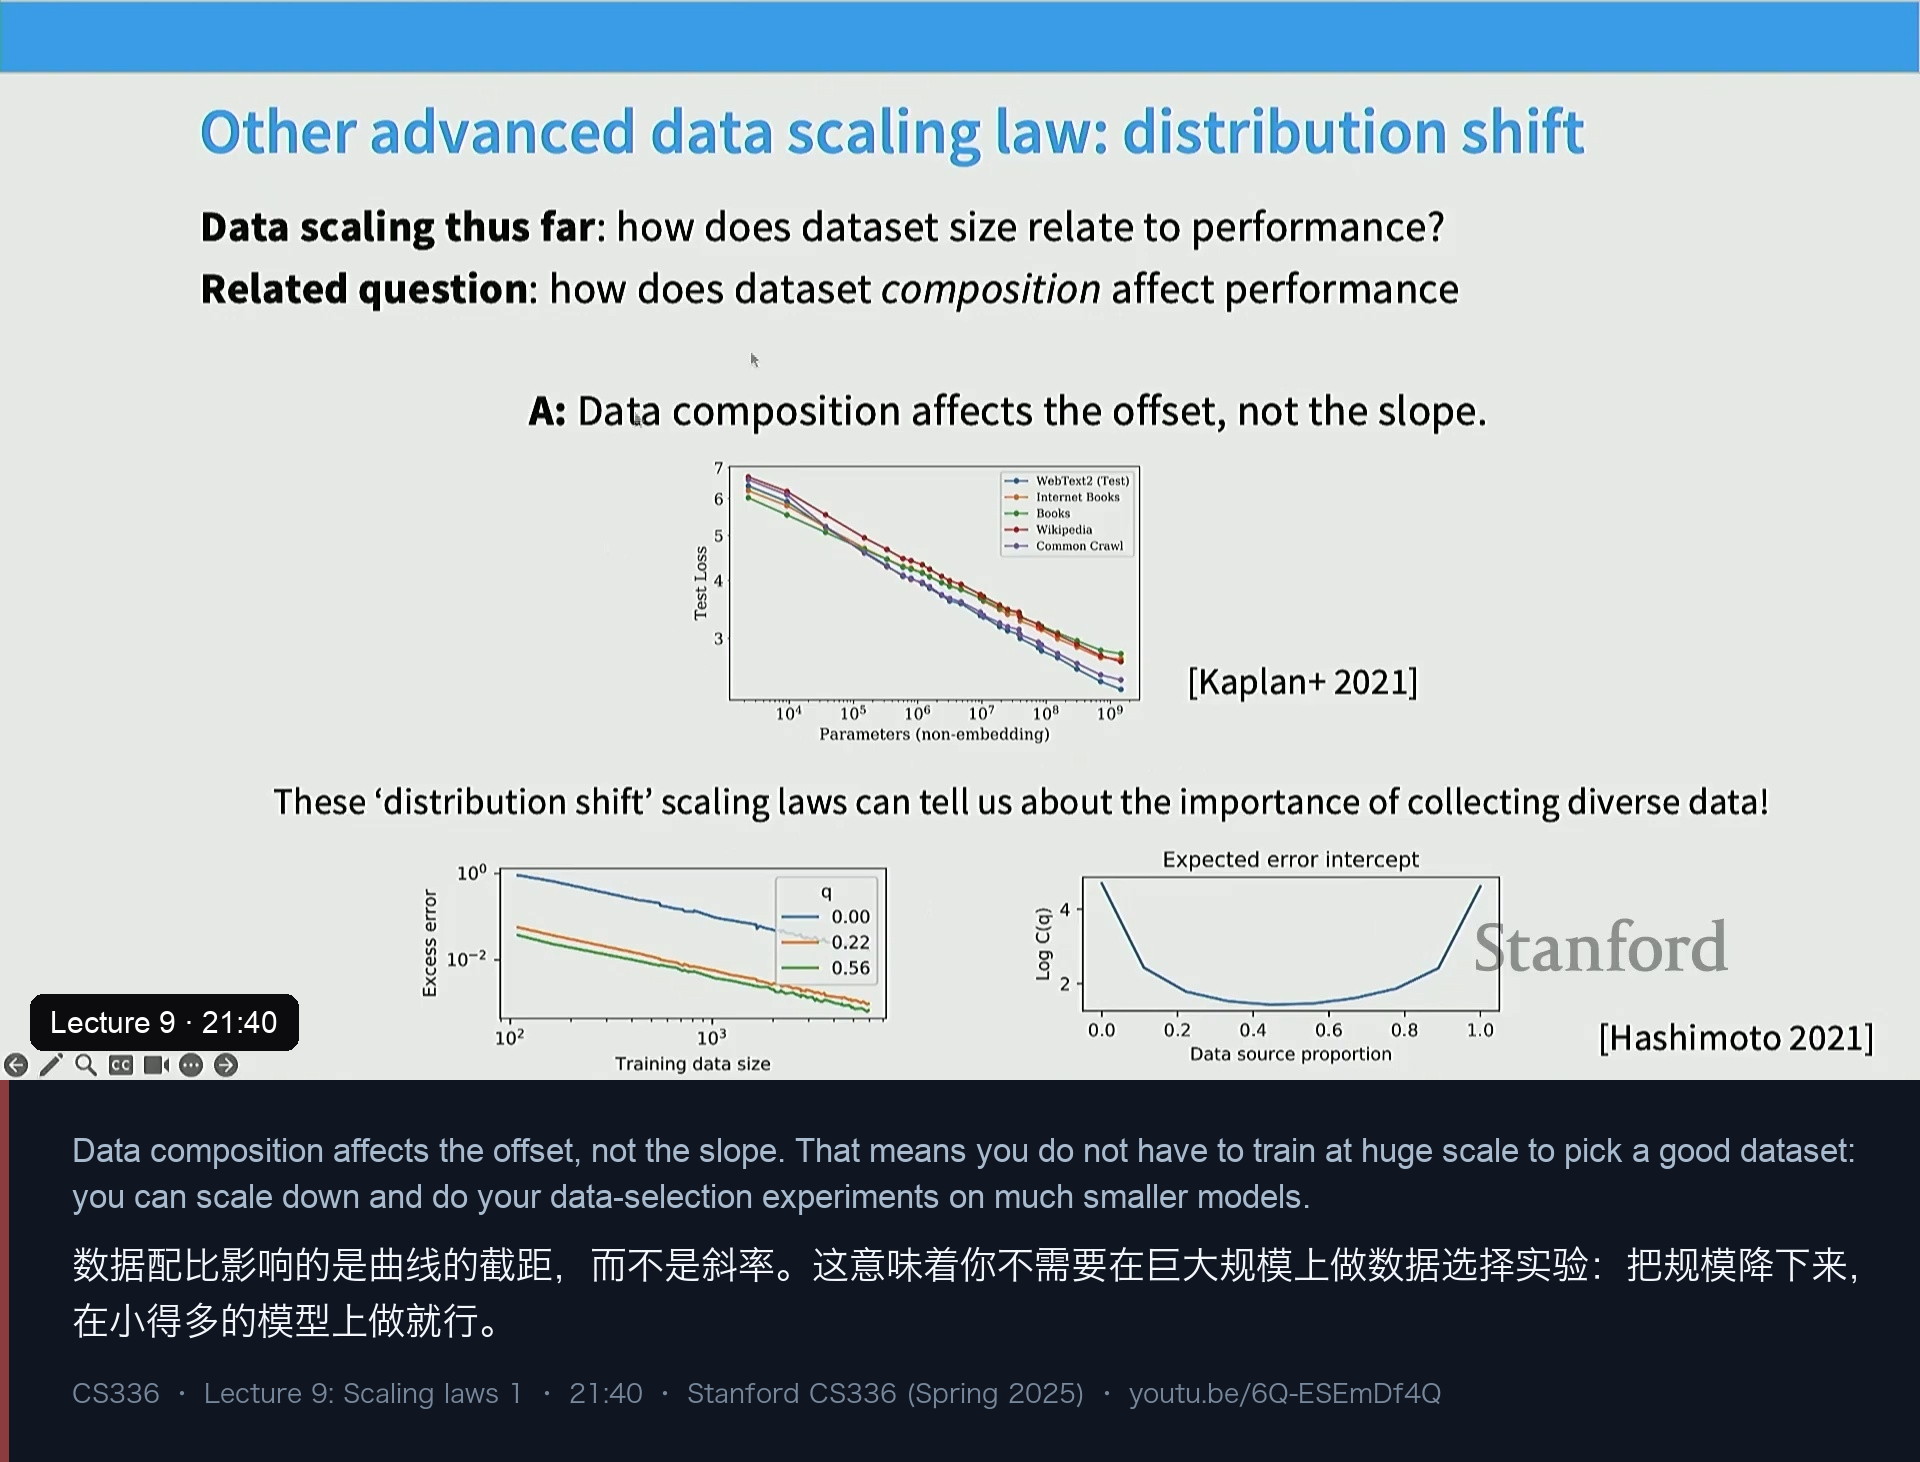
用途一:数据配比。 如果一个数据集换掉内容,性能会怎么变?Kaplan 那篇论文里有一张很漂亮的图:数据配比只影响曲线的截距(offset),不影响斜率(slope)。这条结论的实际价值极高:
你不需要在巨大规模上做数据选择。把规模降下来,在小得多的模型上做数据选择实验即可。
讲师也说,既然不同数据的混合方式有可预期的形状,就能用回归等技巧去估计最优数据配比(这是好几篇论文的主题),不过他也提醒:和所有数据选择研究一样,这类事情在实操上相当难以稳定复现。
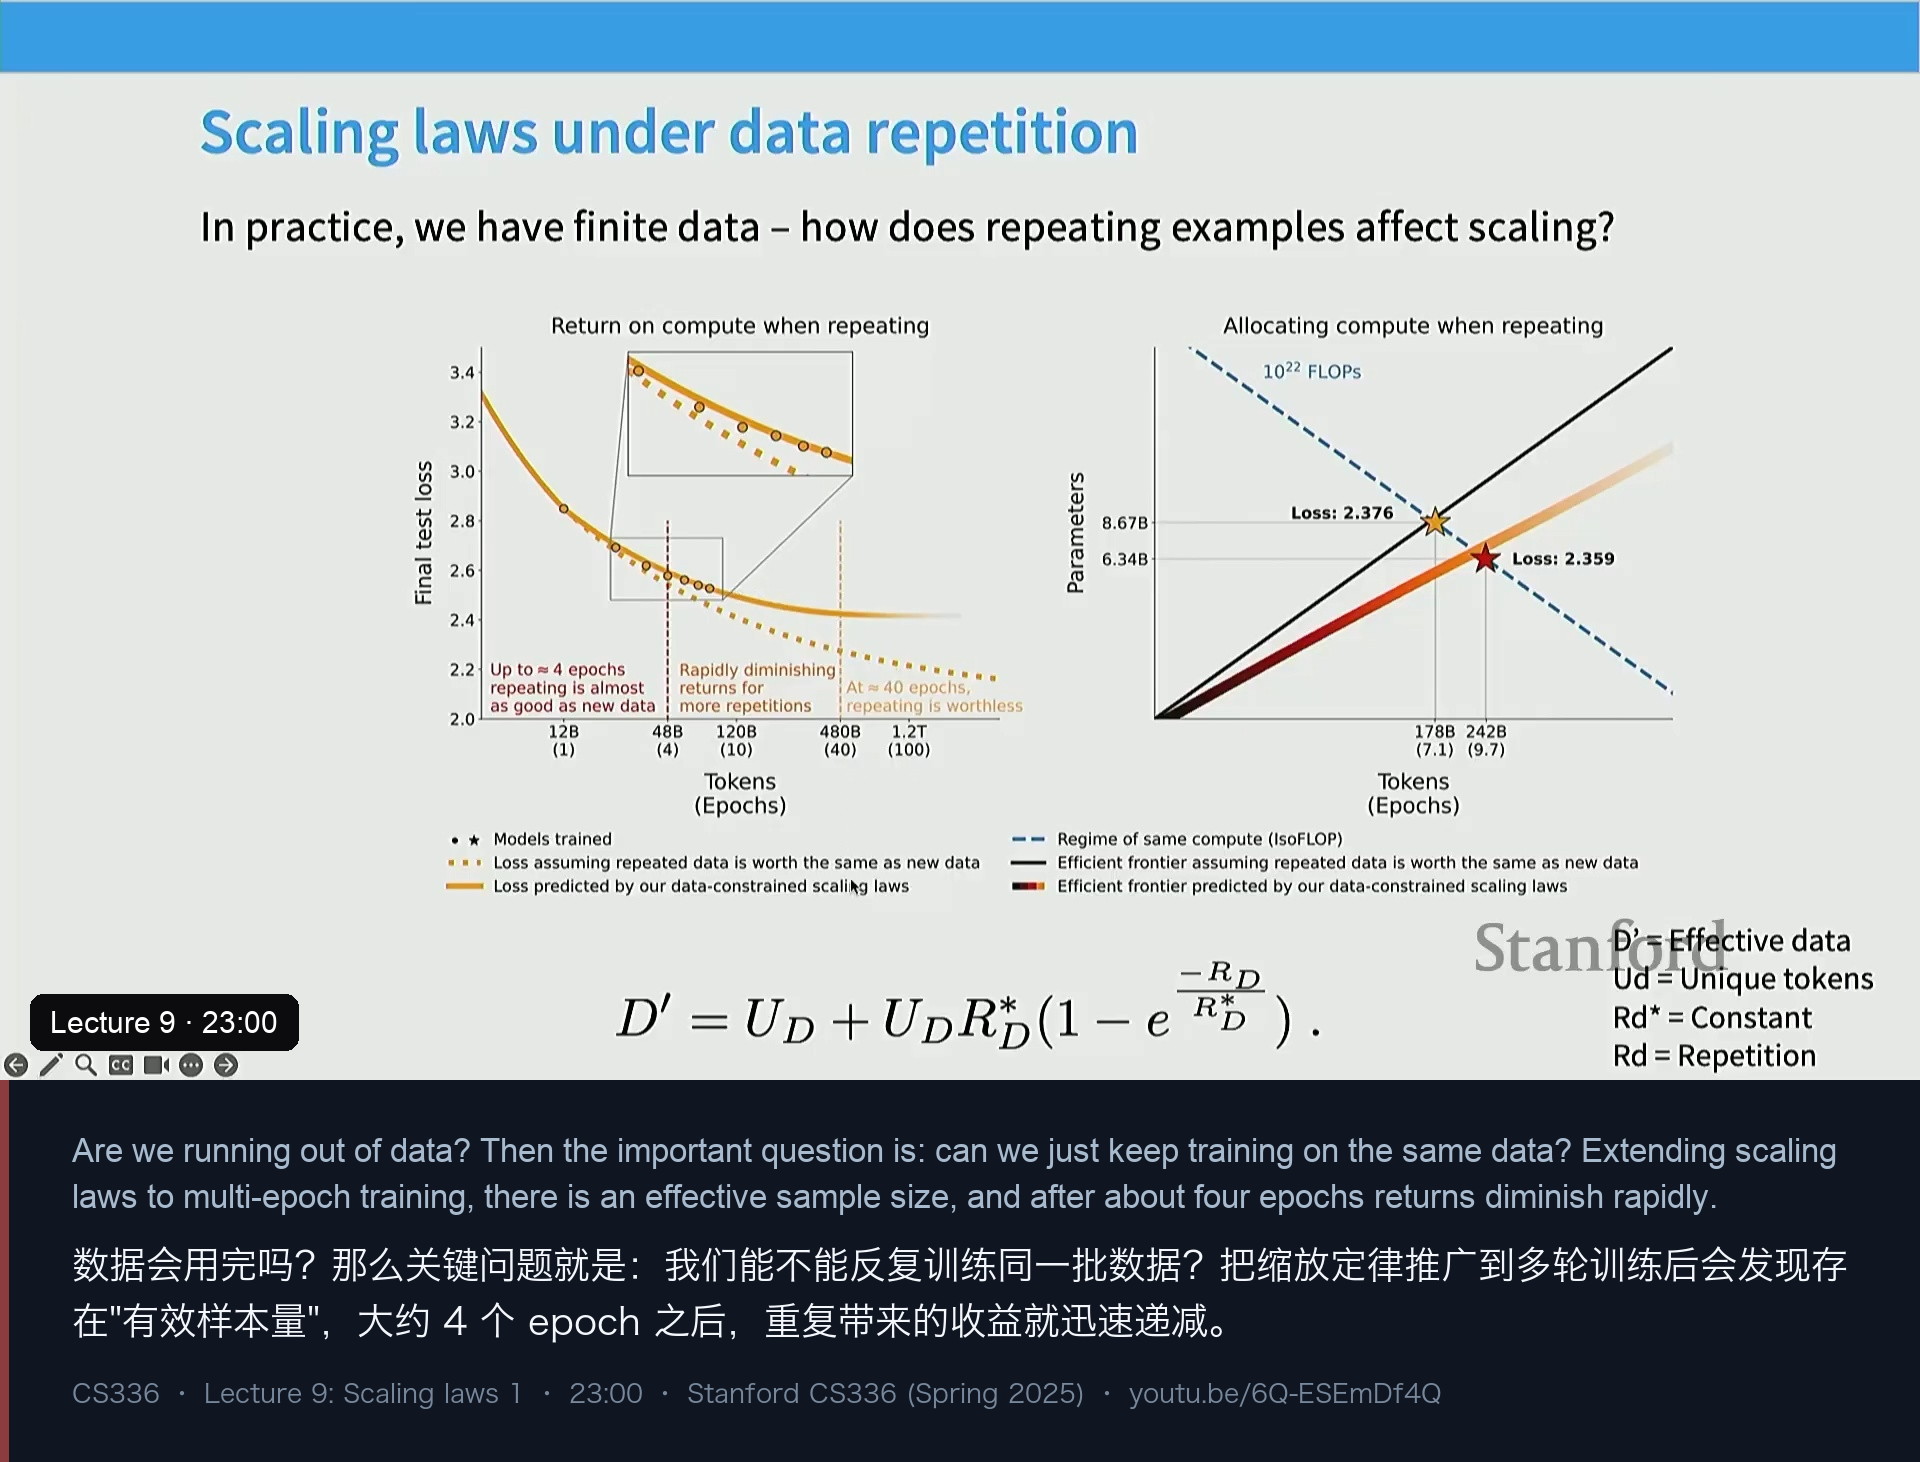
用途二:能不能反复用同一批数据? 这是个现实问题——网上数据会不会用完?如果会用完,那“重复训练同一批数据”的收益递减规律是什么?讲师介绍了把缩放定律推广到多轮(multi-epoch)训练的工作:存在一个”有效样本量“的概念,大约 4 个 epoch 之后,重复带来的收益就迅速递减;把常规缩放定律改成”有效数据 / 唯一 token“的形式,就能把重复的收益衰减也拟合进去。
用途三:在大数据时代的“重复 vs 新数据”。 如果你要训几万亿 token,是把高质量来源(比如 Wikipedia,以及那些“你懂的”来源)重复 10 遍,还是引入新的(但质量更低的)数据?讲师提到有工作把“重复数据”与“引入新的低质量数据”放进同一个框架里权衡(课上点了 CMU 的几位作者)。这里的核心仍然是那个熟悉的假设:只要你相信存在一条按配比成立的幂律,就可以用它外推出“你的数据在规模上会有多好”。
小节收尾时,讲师强调:数据缩放的 log-log 线性跨领域、跨模型类型都相当稳健,而且有干净的理论理解。有了它,你就可以做最优数据配比等一大堆工程决策。
七、模型工程:架构、优化器,以及“并非所有参数都平等”
接下来从“数据”转到“模型”,讲师称之为“更神秘、也更工程”的一组问题。场景还是一样的:你是要训练并发布一个大模型的人,而世界上有一堆选项——你可以训最新的状态空间模型,可以训 Transformer,可以用 Adam,可以用 SGD;你的算力可以在“训更久”和“训更大”之间分配;你也可以选择“多收数据”还是“多买 GPU”。缩放定律的价值,是让这些选择有一个非常简单的流程。
讲师把 Kaplan 的论文称作这一讲的“金矿”——有些结论今天看已经过时,但它在“用统一设置把这些问题都研究一遍”这件事上的彻底程度,至今无人能及。
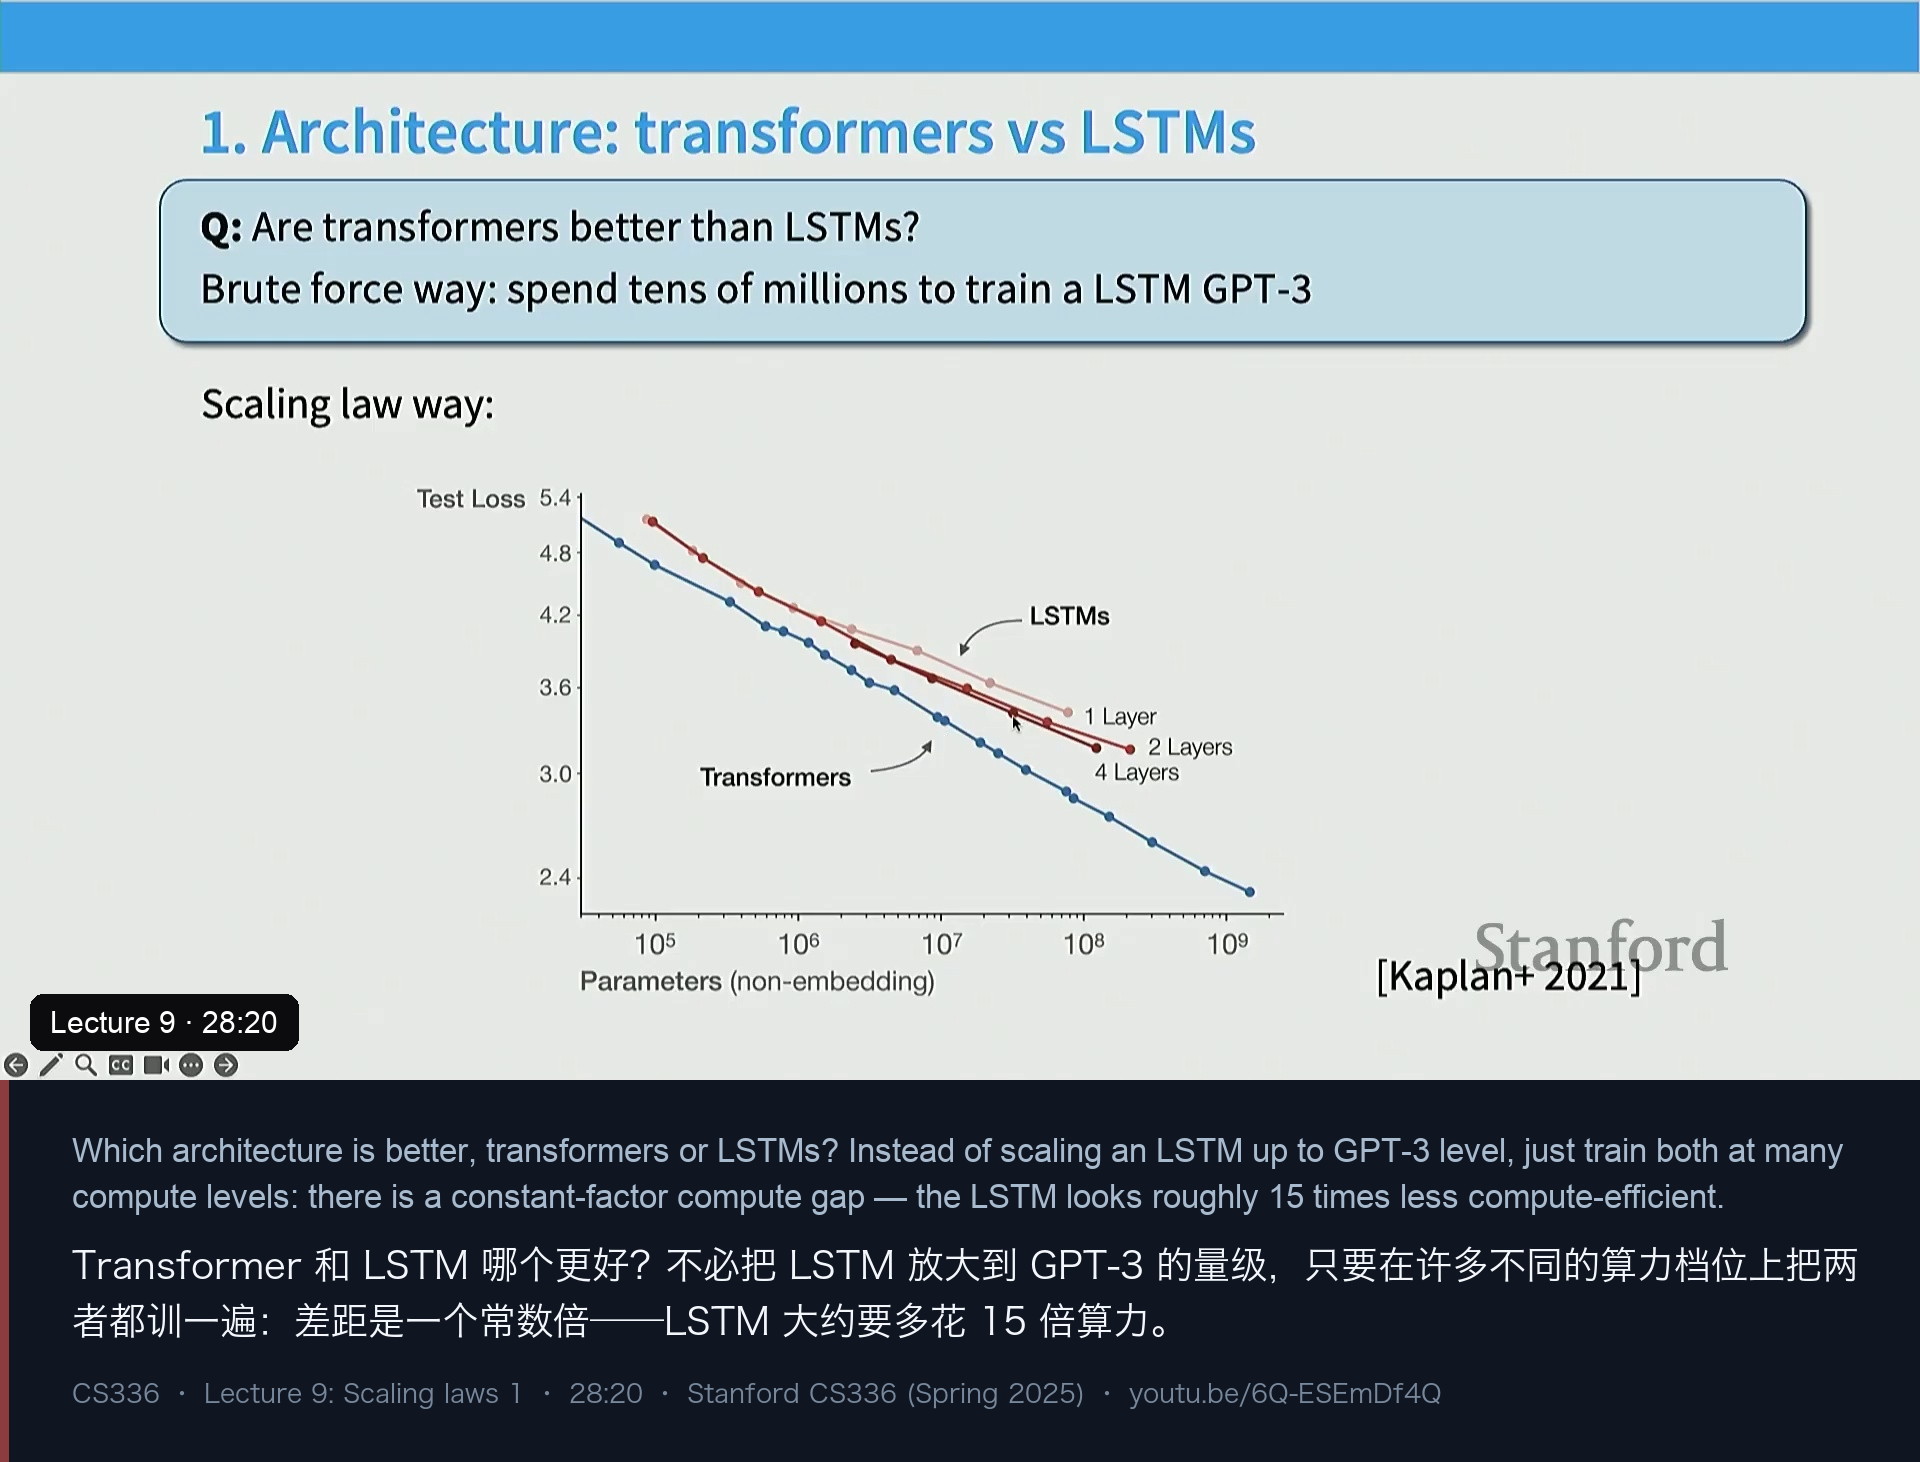
架构选择:Transformer vs LSTM。 暴力做法是把 LSTM 放大到 GPT-3 的量级再看看行不行;缩放定律的做法便宜得多——在很多不同的算力档位上,把 LSTM 和 Transformer 各训一遍,然后看趋势。结论很干脆:
无论堆多少层 LSTM,两者之间都存在一个很大的常数倍差距。注意这是对数刻度——换算过来,大概是“LSTM 要贵 15 倍算力”这个量级(讲师现场对图的量级解读,非精确数字)。
放大到更广的架构空间,还有一份 Google 的经典工作:把一堆替代架构按算力缩放,绿线是 Transformer 基线,然后问“有没有谁能追平甚至超过 Transformer”。答案是:只有 Gated Linear Units(GLU)和 Mixture-of-Experts(MoE)比较可靠地跑赢——而这恰好就是今天大家都在用的东西。讲师的意思是:如果当年做了这套缩放分析,你也能推出“该做 SwiGLU + MoE,而不是 Performer”。
优化器选择也一样:对比 SGD 与 Adam,看到的仍然是“常数倍差距”的结构(讲师说重点是分析方法,而不是具体结果)。
深度 vs 宽度也类似:直觉上“更深的层应该好得多”,但 Kaplan 的图显示——一层确实很差,但其余的层数选择相当稳定。这与架构那一讲说的“宽高比在 4 到 16 之类是个很宽的最优盆地”是同一件事,缩放分析再次佐证了它。
这里有一个很容易咬人的细节:
并非所有参数都平等。 如果你把嵌入层的参数也算进模型规模,你会得到一条形状很怪、会微微弯折的缩放曲线;只统计非嵌入参数,才会得到那条干净的对数线性直线。
讲师说,近年关于 MoE 的缩放工作也在处理同一个问题:当参数是稀疏激活的时候,“参数是什么”本身就需要重新定义,所以那些论文会去推导等价稠密参数量之类的量来归一化。这是同一主题的另一面。
还有一个方法论上的要点:当你看到一族不相交、斜率相似、只有常数倍偏移的曲线时,你就可以”在某个算力档位上切一刀“,仔细分析超参数的取舍,并对放大后的行为比较有把握。Kaplan 的论文正是这么做的:不只是把模型放大缩小,而是在不同尺寸(约 50M / 270M / 1.5B)上分别扫描宽高比,发现不仅缩放斜率相似,曲线的形状也相似——这意味着宽高比在 10 到 100 之间的任何取值都行。讲师说,这就是”scale-aware 地调超参数“与”在小模型上调好、然后祈祷“之间的思维差别。
八、batch size 与学习率:临界 batch size 与 muP
讲师预告:batch size 和学习率是放大模型时最容易出问题的两件事,而且它们常常耦合。
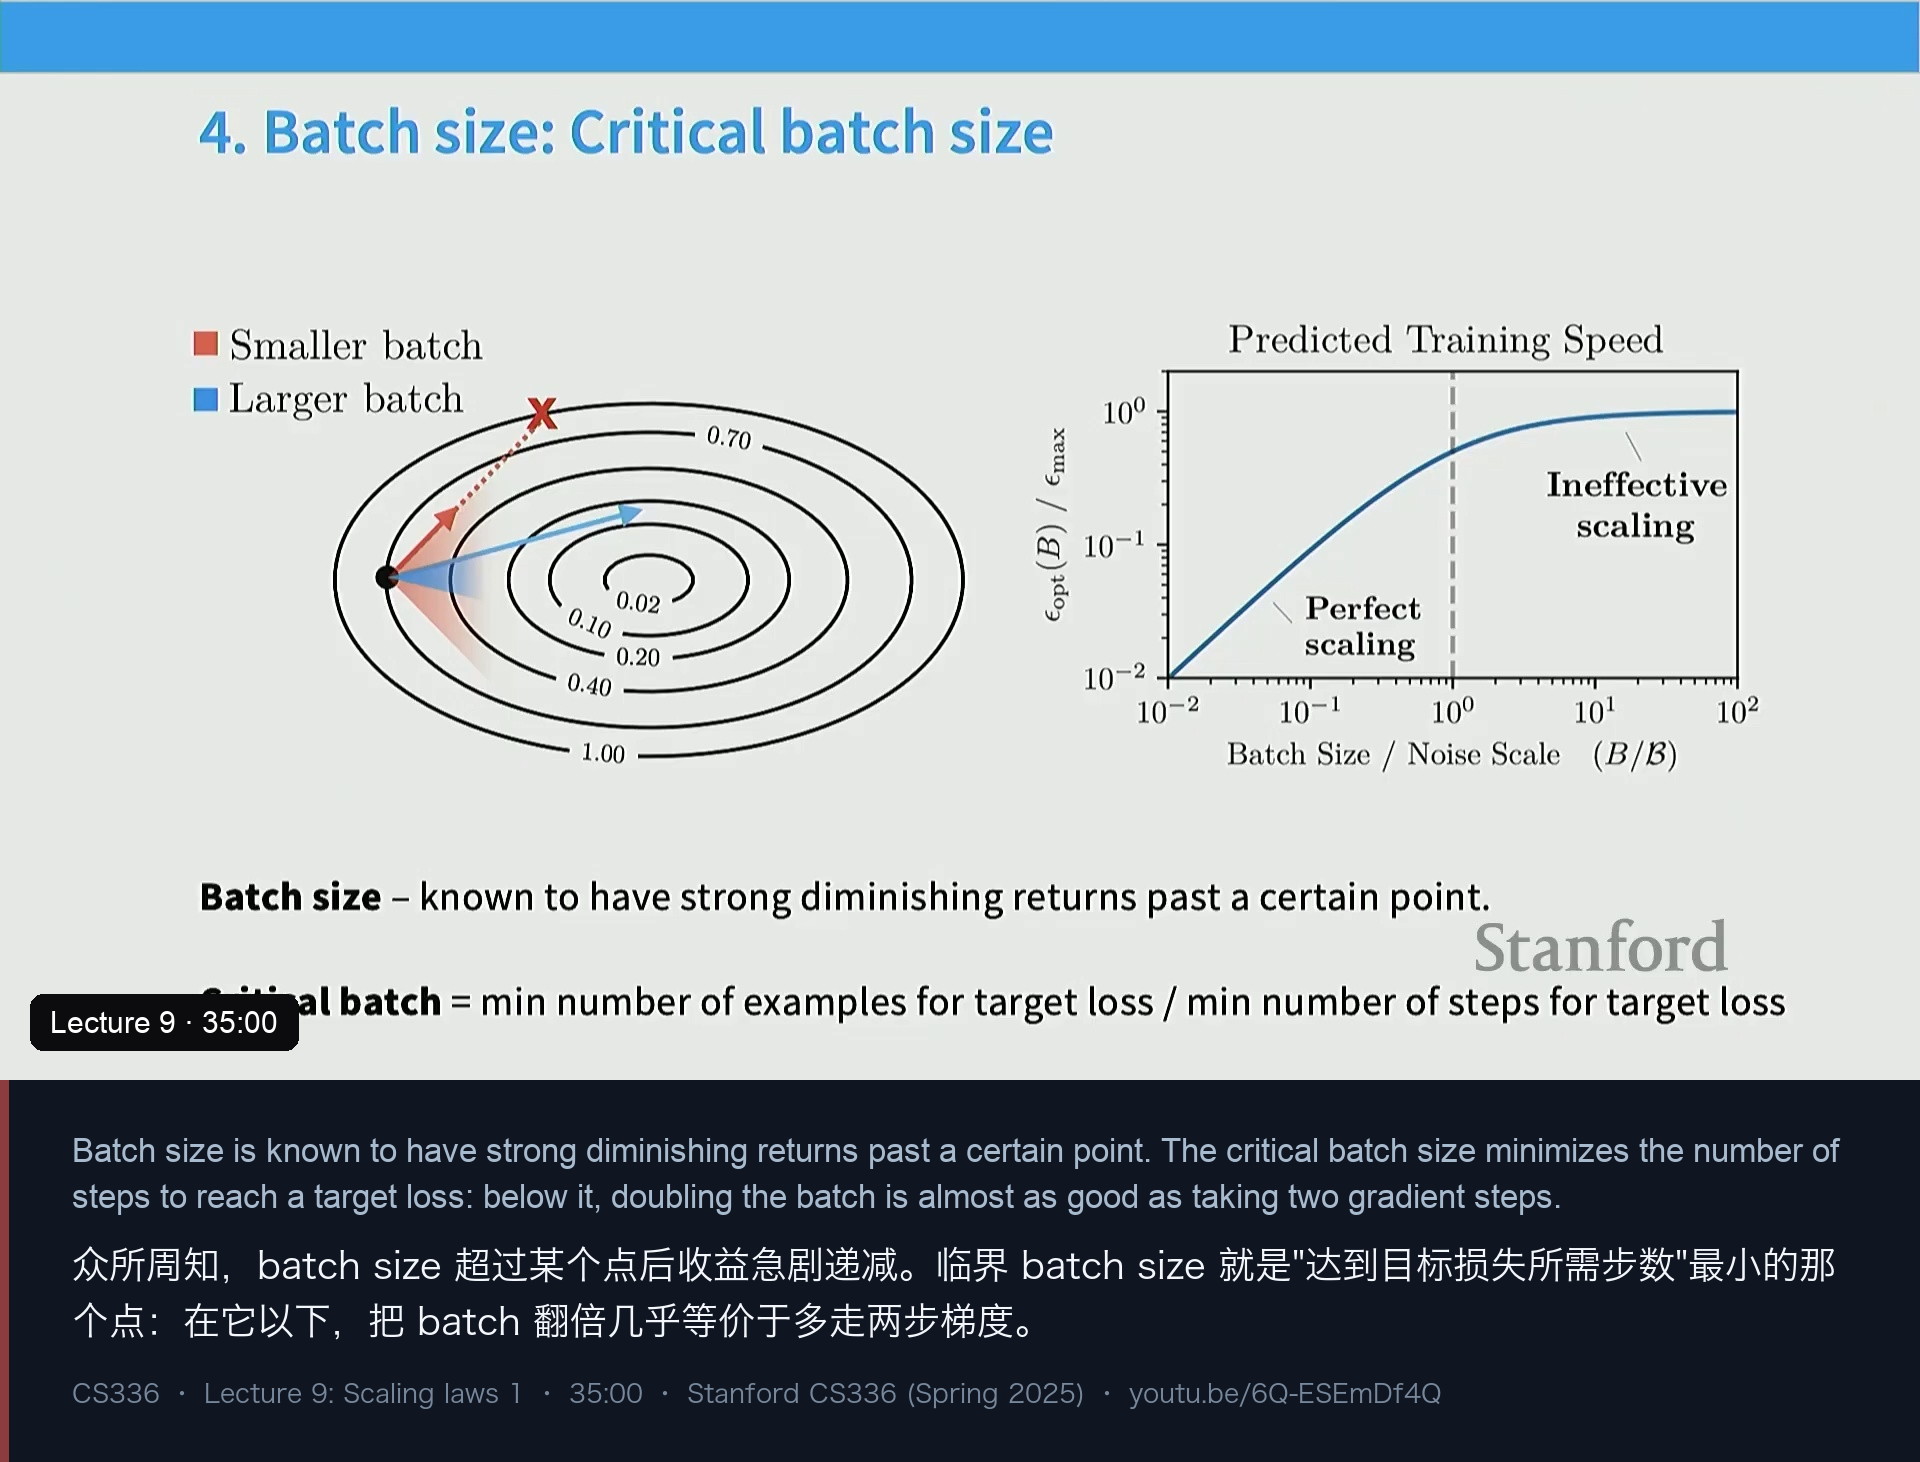
batch size。 复习系统那一讲:batch size 超过某个点后收益递减。
- 当 batch size 小于噪声尺度(noise scale) 时,加大 batch 几乎等价于多走若干步梯度——你把 batch 翻倍,就近似等于多走一步。这位置极好:你既拿到了跨 batch 并行的系统能力,又保住了优化效率。
- 越过某个点之后就“不划算”了:此时 batch size 与噪声尺度相当,多塞进去的样本不再降低有用的噪声,收益被优化曲面的曲率项主导。
这个阈值就是临界 batch size(critical batch size):课上幻灯片把它定义成”达到目标损失所需步数最少的那一点”。
然后是一个有趣、也容易记反的观察:损失目标越低,可用的 batch size 越大(讲师的口播解释是——目标越“敏感”,梯度就需要越精确,所以你要做去噪)。现实中的证据是 Llama 3 的训练报告:会在训练中途把 batch size 调大。
再往上一层,Kaplan 的分析给出:随算力增长,最优 batch size 增大、而总步数可以大致不变——这对数据并行是个好消息。
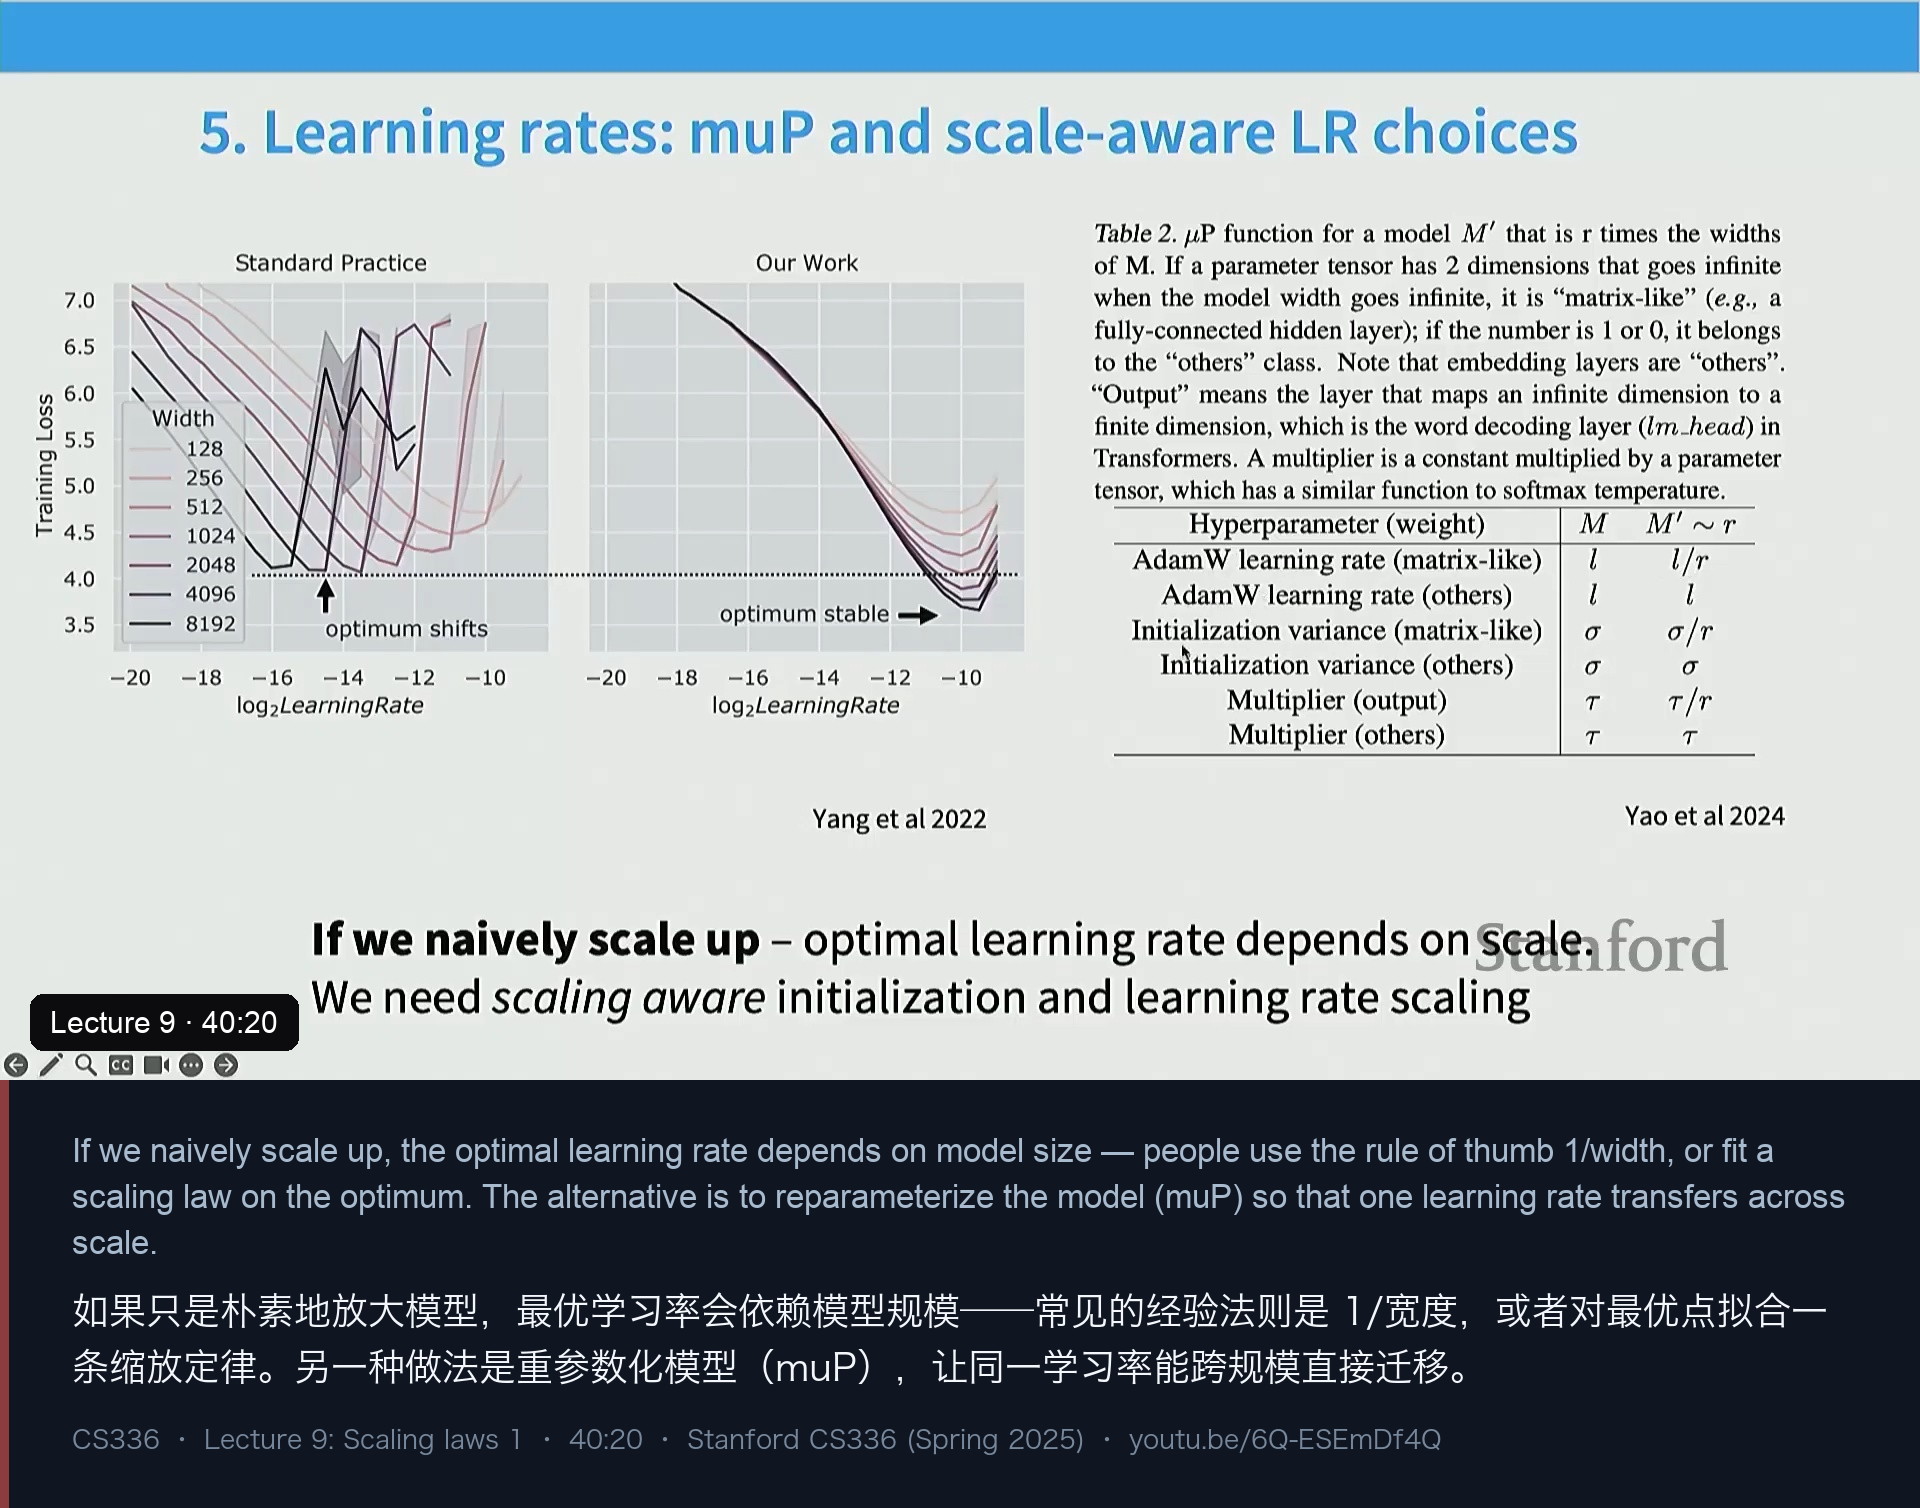
学习率。 朴素地放大模型时,最优学习率会漂移:模型越宽,最优学习率通常越小。常见的经验法则是”按 1/宽度“缩放;更讲究的做法是把每条曲线的最小值找出来,再对”最优点“拟合一条缩放定律。而另一条路线(讲师说很多人正在转向)是重参数化模型:
- 按宽度缩放不同层的初始化与学习率;
- 按宽度缩放初始化的方差;
- 在前向路径上对不同层的输出做缩放。
这样得到的参数化,其最优学习率被设计成跨规模稳定(原论文的说法是“精确稳定”)——你只在最小的模型上调一次学习率,它就直接迁移到最大的规模。这就是 muP。(讲师也提到,Meta 在发布 Llama 4 时宣称了一个叫 MetaP 的东西,并坦言“我还不太确定它到底是什么”。)
九、一个重要的警告:对数损失的缩放 ≠ 下游能力的缩放
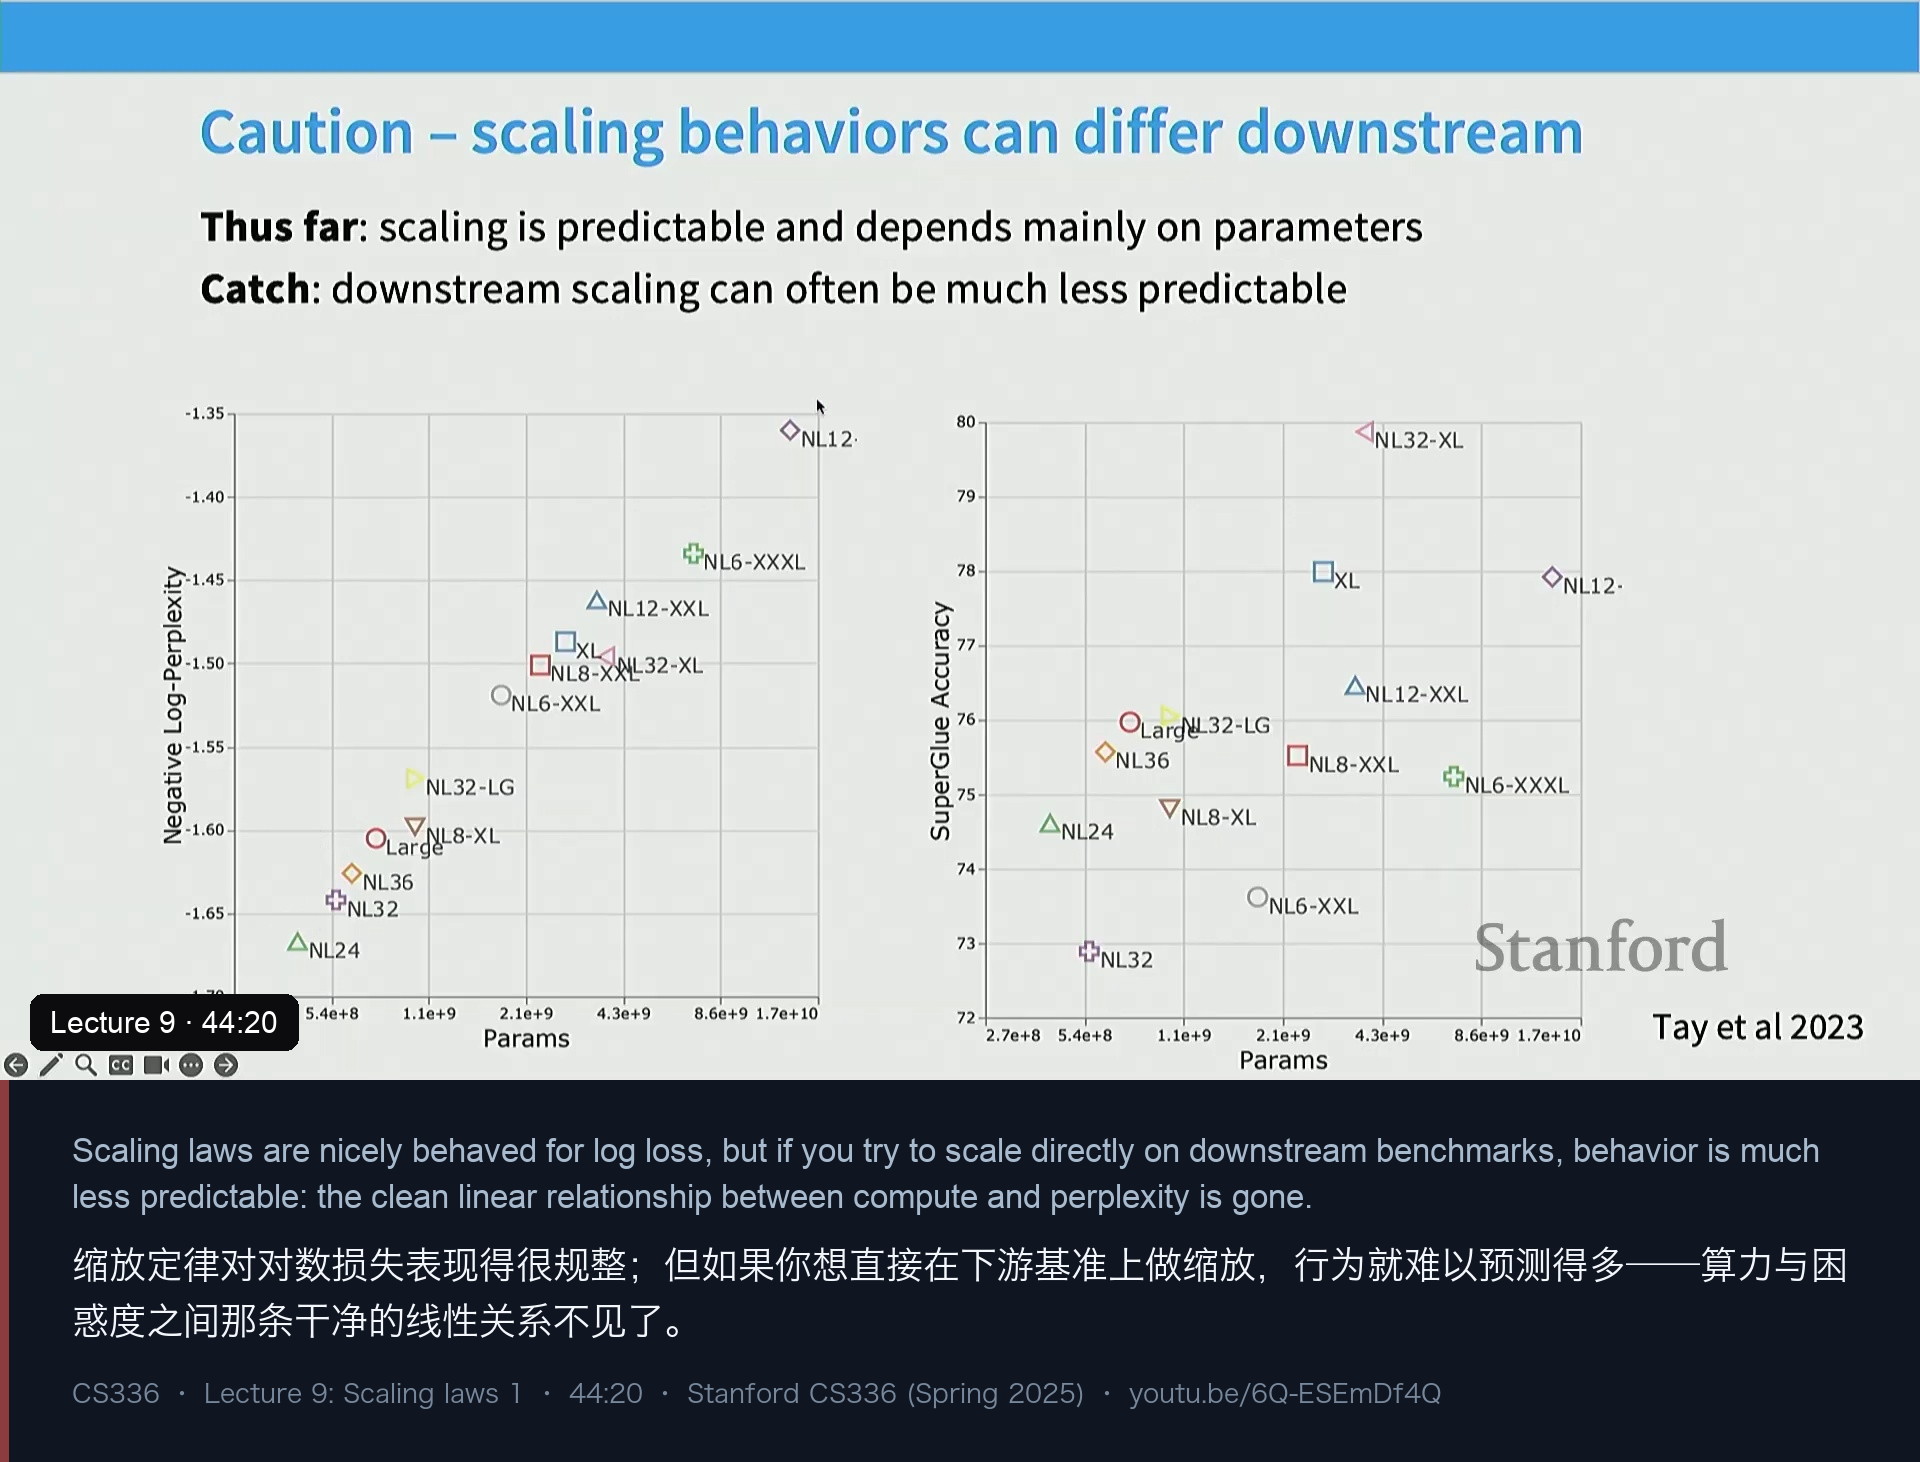
这一讲分量最重的警告之一:
缩放定律对“对数损失”极其规整……但如果你想直接在下游任务/基准上做缩放,行为就远没有那么可预测。
课上展示了一组对比(讲师称之为 “YK’s paper”,幻灯片标注 Tay et al. 2023):
- 左图:参数量(作为算力的代理)与负对数困惑度几乎完美线性——“只要你烧够总算力,深度、宽度、具体超参数都不重要”。一个非常干净的故事。
- 右图:换成下游性能(2023 年那会儿还在用 SuperGLUE 之类),线性关系就消失了:某些模型明显更好,某些架构明显更好。
所以不要把困惑度的斜率直接当成能力的斜率。 讲师说,同一个故事在状态空间模型(SSM)上也上演过:困惑度缩放得很漂亮,但在上下文学习或问答这类能力上未必同步。
紧接着,讲师给出了**“基于缩放定律的设计流程”**,这是这一讲最实用的一段:
1. 训练若干个较小的模型          # 要让它们覆盖好几个数量级的算力
2. 建立一条缩放定律              # 确认在已训模型上存在清晰的 log-log 线性关系
3. 基于预测选择最优超参数关键的推论是:在很多情况下,这些缩放定律的斜率是相同的——那么“训练几个小模型、把结论迁移上去”就会出奇地有效。但讲师立刻补了一句:“但不是所有情况”——学习率就是最重要的例外。
十、更多数据还是更大模型?联合缩放与 Chinchilla
到这里,讲师转入他认为“影响力被放大”的那个用途:怎么选模型大小与数据量。
历史背景很重要:在 2021–2023 年前后,数据远比算力充裕,所以真正稀缺的只有一个资源——训练算力(总 FLOPs)。而同一笔 FLOPs 可以这样花:用很小的模型训很多数据,或者用一个巨大的模型训很少数据。两个极端都显然浪费——给小模型灌海量数据没用,给巨型模型喂 10 个 token 也没用。于是“到底该偏哪边”成了核心问题。
回答它需要联合的数据-模型缩放定律。此前讲的都是单变量缩放;这次把数据与模型一起放进去,其函数形式(两个常见版本,“到一阶为止”是等价的)大致是:
Rosenfeld 等:  Error = n^(−α) + m^(−β) + C      # 数据项 + 模型项 + 不可约项
Kaplan 等: Error = (m^(−α) + n^(−β))^...讲师坦诚:这个函数形式是“从帽子里拉出来的”,没有自上而下的理由说它必须长这样。但——它对联合误差拟合得惊人地好。Rosenfeld 论文里那张 3D 图(两个横轴是数据量与模型规模,纵轴是损失)中,拟合曲面几乎穿过了每一个实验点;更狠的是,他们只用“小模型 + 小数据”那半边去拟合,再外推到大模型 + 多数据,预测值与真实值依然几乎重合。
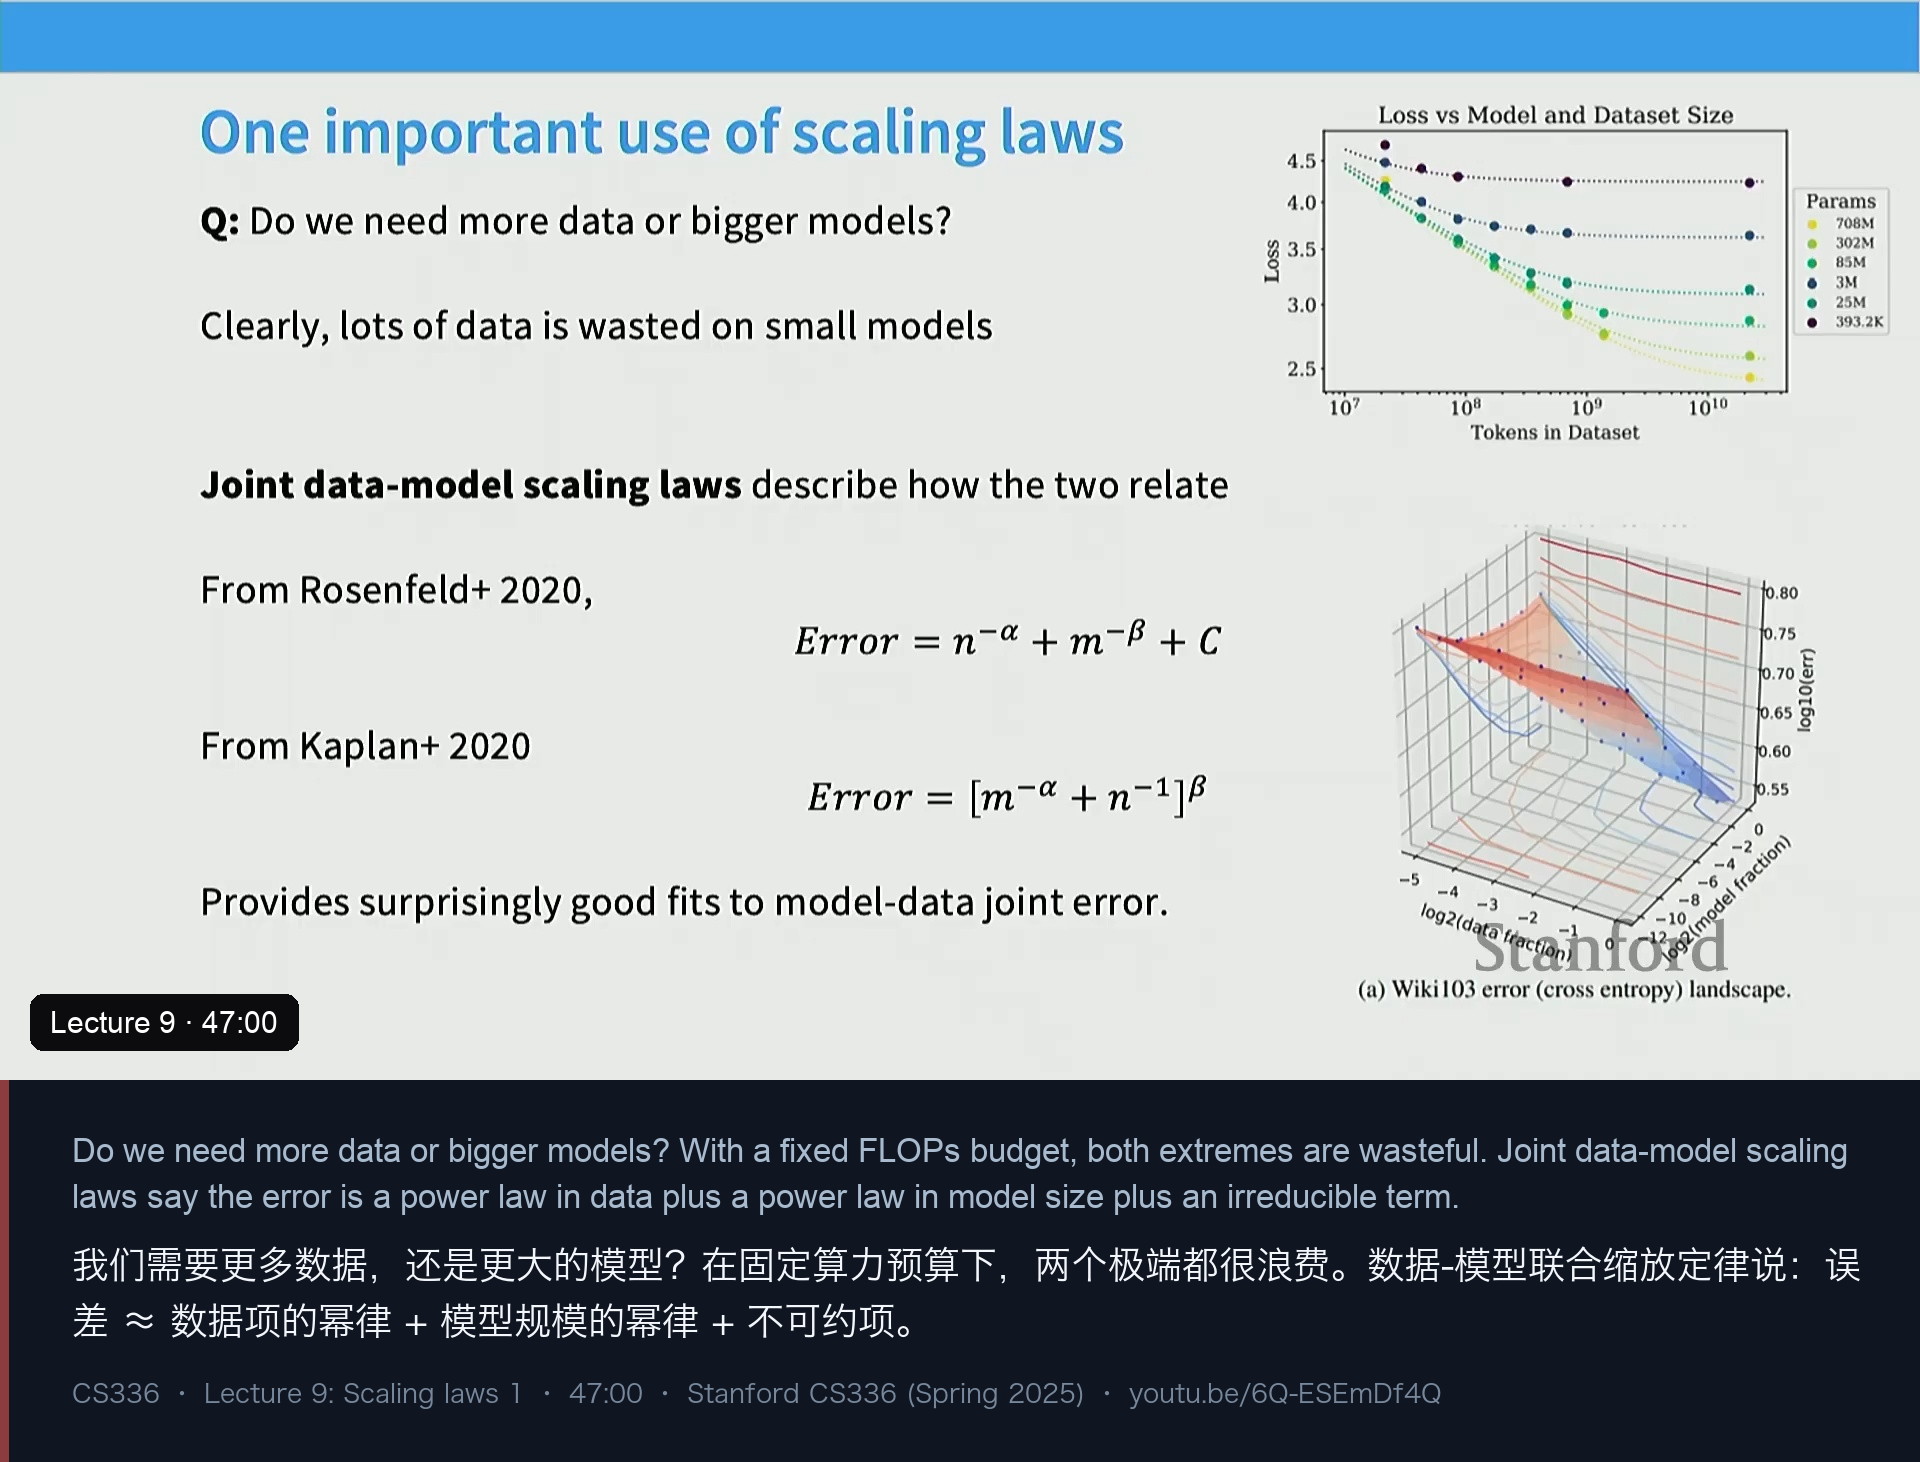
于是你可以回到 Kaplan 的图上,看到算力与数据的联合缩放:横轴是参数量、颜色代表算力,而数据量是“隐含在第三个轴里”被变动的——沿着一条曲线移动时,算力固定,参数变、数据随之变。
而 Chinchilla 是解决这个问题的标准参考。历史脉络是这样的:Rosenfeld 和 Kaplan 都提出了联合缩放函数形式,也都注意到可以用它来优化“算力 vs 数据”的取舍。但这些函数形式很难精确拟合,细节(比如学习率的形状)很要命,于是 Kaplan 给出的估计与后来被验证的最优值差得相当远。Chinchilla(Hoffmann 等,Google 的一批作者)则是真正用实验把“给定算力预算下最优的 token 数与模型规模之比”钉下来的一次努力。
那个结论你可能已经听过:大约 20 token / 参数。它正是从这张图里来的——把每个点上的参数量乘以 20,就大致得到该算力档位下的 token 数(再乘一步就得到 FLOPs)。
为什么 Kaplan 会差那么远? 一个重要原因是学习率调度:我们用余弦学习率,它先上升、再下降、最后冷却到最低。而余弦调度不能被提前截断——把一个训到一半的模型截断,和从头开始用余弦调度训到一半,完全不是一回事(它没有走完冷却阶段)。这是把 Kaplan 的估计带偏的若干因素之一。
十一、Chinchilla 的三种方法与 Epoch AI 的复现
Chinchilla 论文给了三种互相独立的方法来估计 token 与参数的最优权衡,它们给出各自的缩放系数。有趣的是,方法一和方法二得到的系数几乎都是 0.5,方法三则略有偏差(大约差 0.03);而 Kaplan 的估计比三者中的任何一个都差得远。
方法一:所有训练曲线的最小值包络(minimum over runs)。 把你在许多模型规模上训出来的训练曲线叠在一起,取下包络——也就是“在任何算力预算下都最优”的那组检查点。再对这组最优点的参数量(以及对应的 token 数)拟合缩放定律。方法一给出的估计是 0.5,与其它方法很一致。
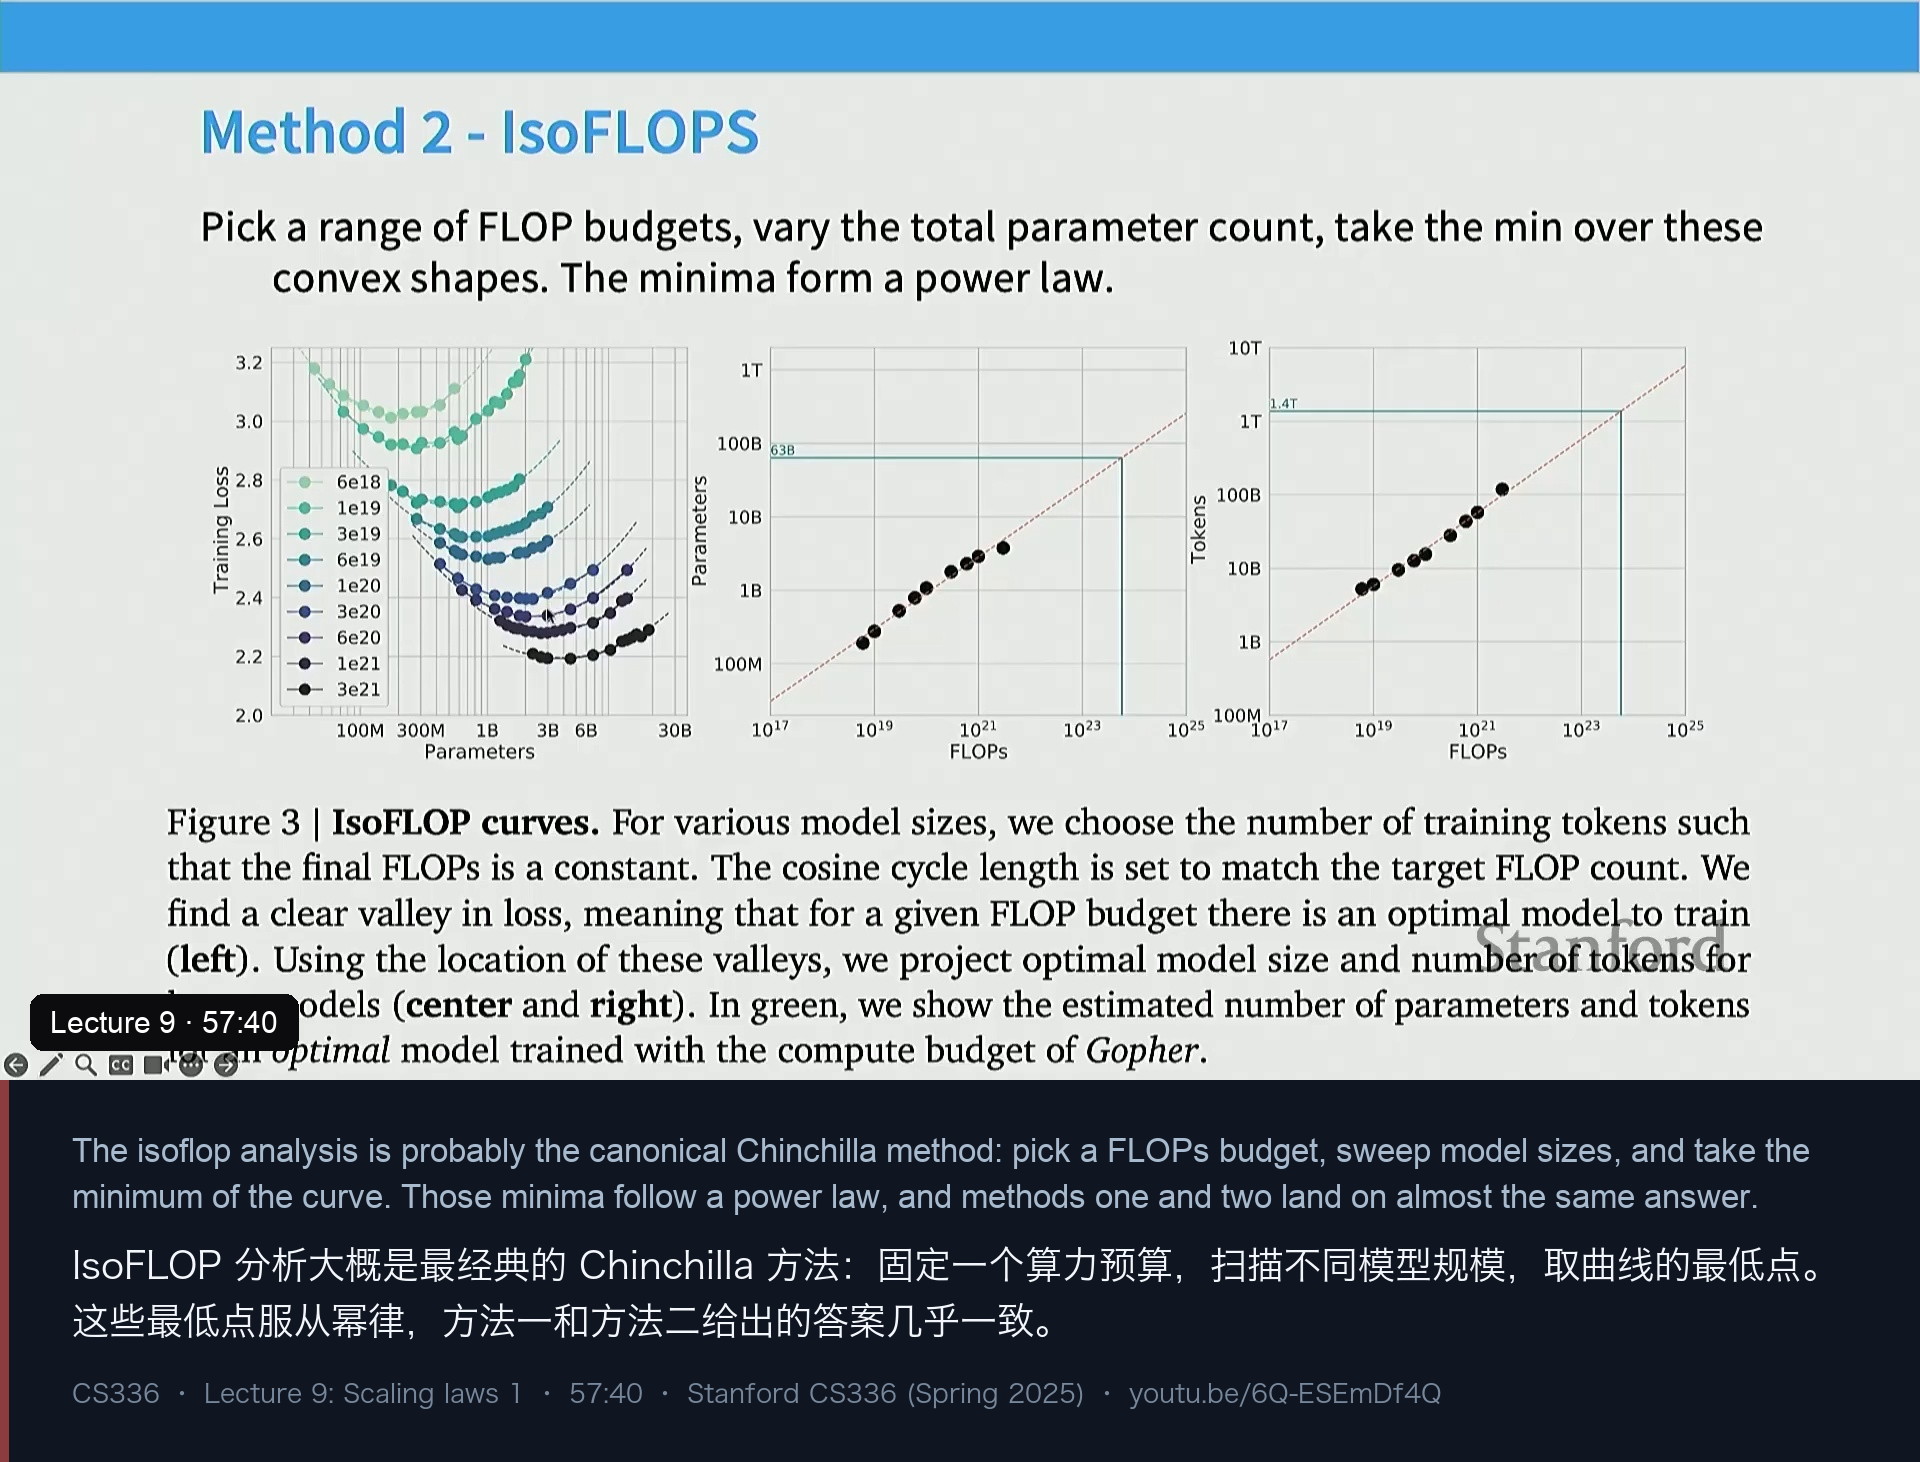
方法二:IsoFLOP 分析。 讲师说,如果要挑一个“最正统”的 Chinchilla 方法,就是它,而且概念上最直白:
1. 选若干个算力预算(每一档 = 一种颜色)
2. 在每个预算下扫描模型规模:小模型+多数据 ←→ 大模型+少数据
3. 取每条曲线的最小值(可以直接取最小点,也可以拟合二次曲线取顶点)
4. 这些最小值本身服从幂律 → 读出"每个 FLOP 对应的最优参数量 / token 数"一致性如何?方法二给出“Chinchilla 那个预算下要 63B 参数”,方法一给出 67B——两者很接近。
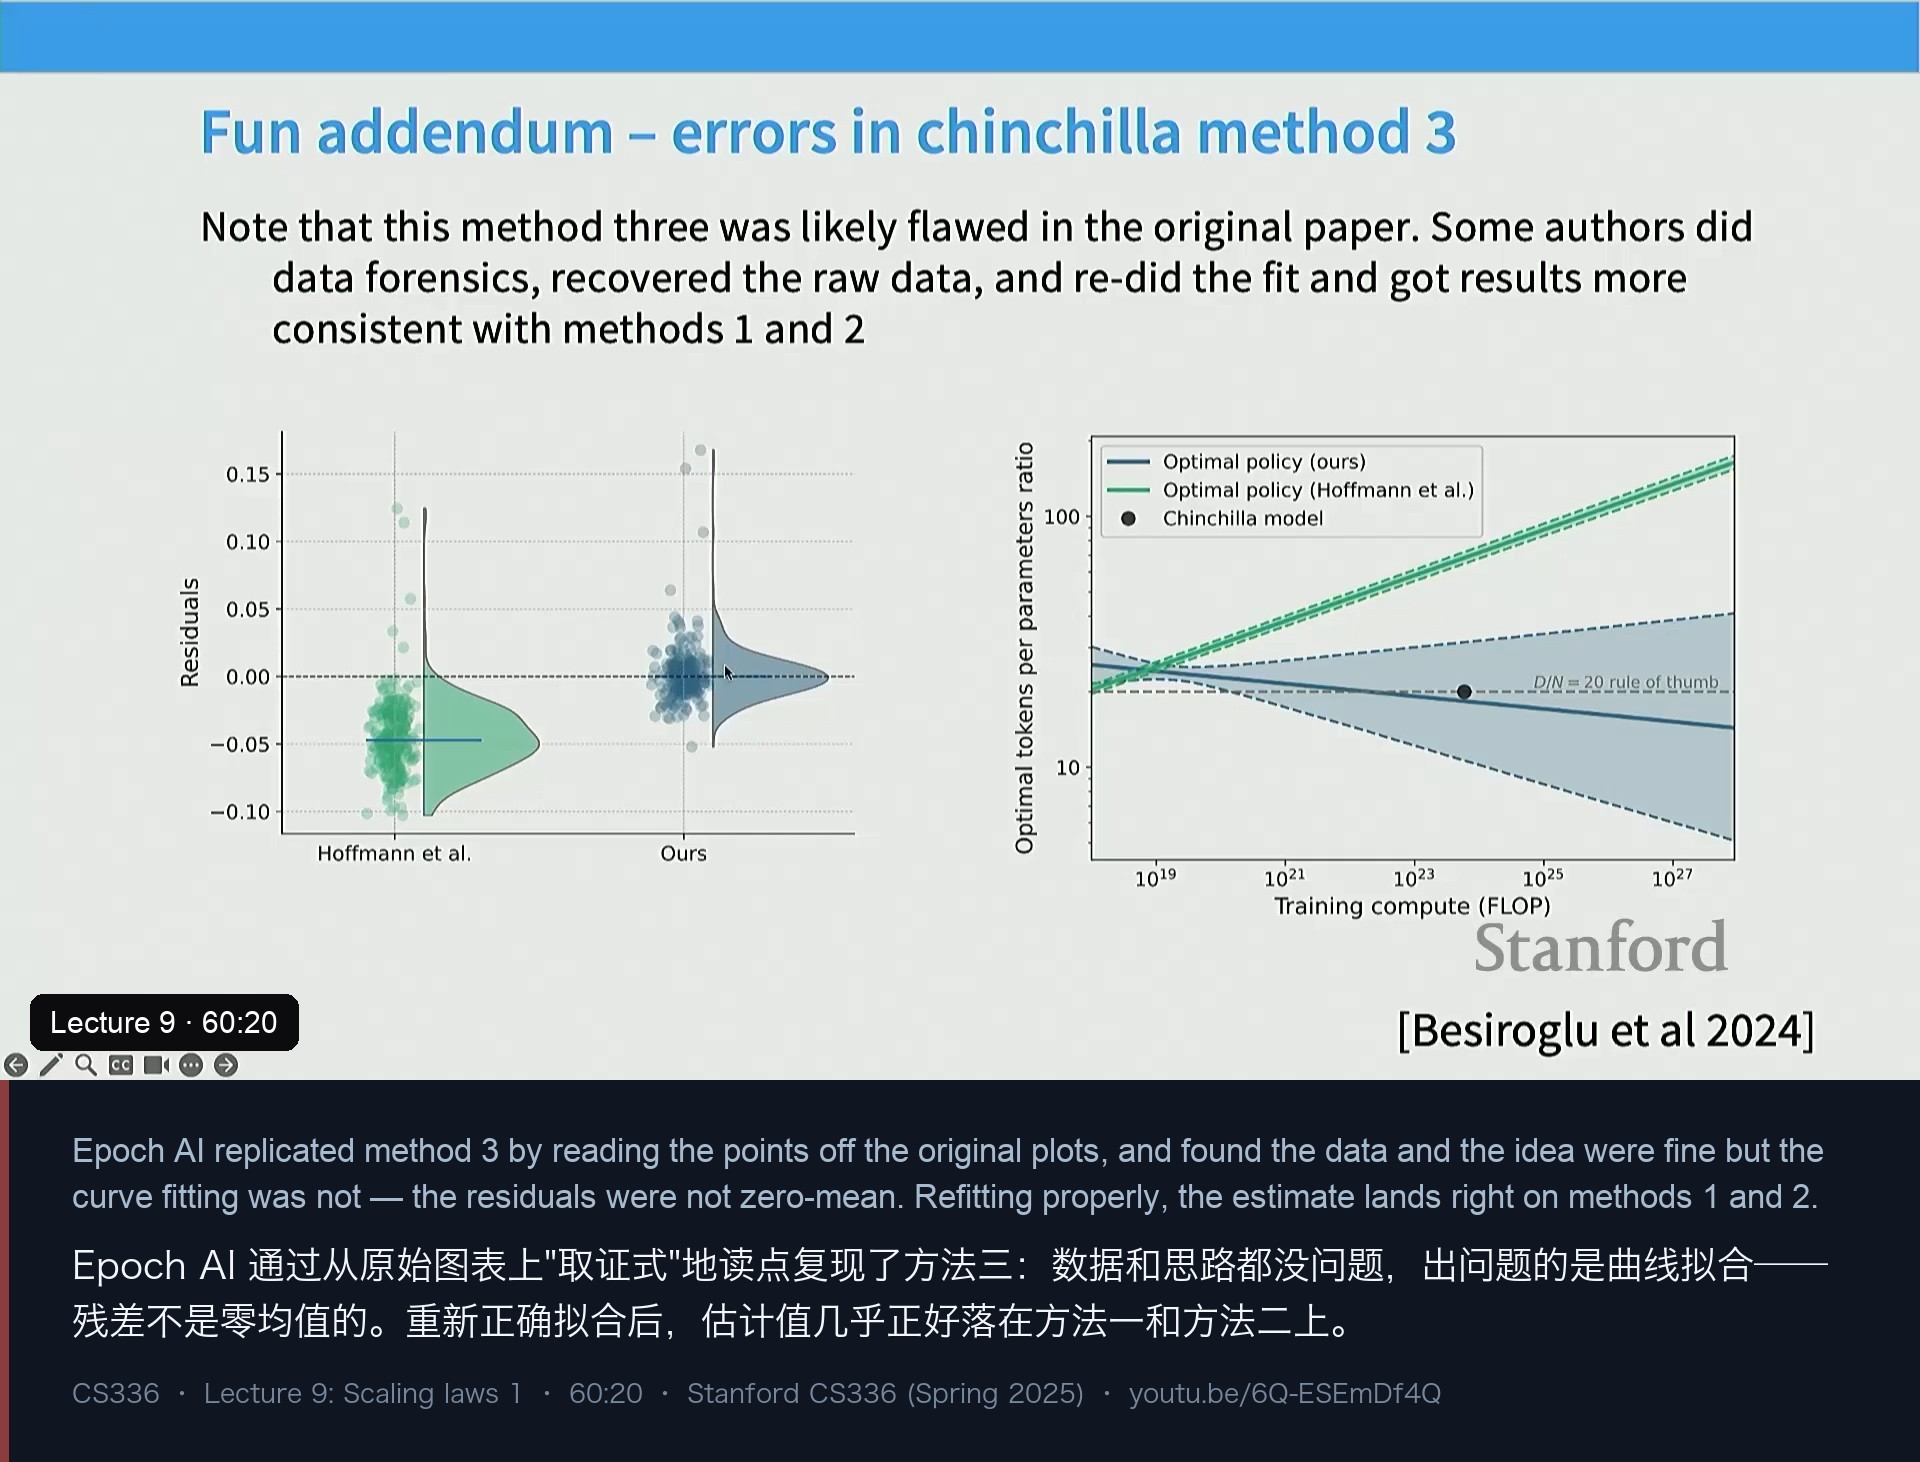
方法三:联合曲线拟合。 最“朴素”的做法:在数据量与规模构成的网格上训练一堆模型,直接用联合函数形式做最小二乘拟合,再从中反推 IsoFLOP 曲线。这条路明显更“脏”——拟合质量不如前两张图,而且给出的模型规模与 token 数与前两种方法差得挺多。讲师说这件事让他困惑了很久,学生的疑问也是“方法三为什么差这么多”,他当时的回答是“也许缩放定律有时候就是有噪声吧”。
然后是这个讲座里最有趣的一段“学术八卦”。 去年 Epoch AI 的一些人(Besiroglu 等,2024)出于好奇去复现方法三。麻烦在于原始训练数据并不公开,于是他们直接对着论文里的图,用取证式的工具把数据点“读”出来,据此复现原结果。结果他们发现:
数据和方法都没问题,出问题的是曲线拟合本身。
具体来说,原来的拟合残差不是零均值的——按回归的常识,残差应当零均值居中,否则你应当把预测整体平移去把它居中。重新正确拟合之后,方法三给出的最优估计几乎正好落在方法一和方法二上。
讲师最后给这件事的评价很妙:通常复现是用来推翻结论的;而这一次,复现反而证明了原结论一直是对的。
十二、推理成本、30 万亿 token 与扩散语言模型
Chinchilla 讲完,讲师特意点出时代已经变了:
Chinchilla 和 Kaplan 写作的年代,LLM 还不是“产品”,所以大家想要的是又大又炫又聪明的模型,没人在意推理成本。而今天,推理成本才是重点——这些系统要赚钱,而成本直接压着收入。
于是 token/参数之比一路上涨:GPT-3 大约是 2 token/参数,Chinchilla 把大家带到 20,然后迅速往上冲。讲师说他前一天看到最新的 Qwen 模型训到了 30 万亿 token(口播,未经本文核实)。背后的经济直觉很直白:你宁可付一次性的训练成本,也不愿长期承担大模型推理的持续运营成本。
最后一个“随手案例”更有启发性:几年前他的一位学生 Ishaan(Gulrajani) 想做文本扩散模型,可这是一个全新的生成模型,大家既不知道最优 token/参数比,也不知道它是否可靠地缩放。结果呢?照搬同一套 playbook——对自回归模型做 IsoFLOP 分析的那一套,原封不动用在扩散模型上——几乎立刻得到了和 Chinchilla 差不多的结果:曲线形状极为相似,最小值在两者之间只差一个常数偏移。
讲师带这个例子不是为了推销扩散模型,而是想说:这些缩放定律并不需要精挑细选的例子,它们似乎在新的模型、新的环境里“自然地”就会出现。
我的笔记
- 这一讲最该记住的一句话是“缩放定律不是拟合直线,而是用小实验换大决策”。 它的历史(VC 维的上界 → 1993 年的学习曲线 → Hestness 的三阶段)说明,这套东西从头到尾都在回答同一个问题:我能不能在花掉大钱之前,就知道花大钱的结果? 答案是可以——前提是你相信幂律。
- “这些是上界,不是实际损失”是本讲的枢轴。 统计学习理论给你的是
1/√m、n^(−β/(2β+1))这种保证;缩放定律给你的是拟合。理论告诉你误差会下降;拟合告诉你以多快的斜率下降,而且这个斜率往往比理论乐观得多。 - 斜率 ≈ 内在维度,是本讲最漂亮的一句“翻译”。
1/n(均值估计,斜率 1)→1/√n(二维非参数,斜率 −1/2)→n^(−1/d)(d 维,斜率 −1/d)。语言模型的 0.095 不是“理论错了”,而是它在告诉你这个任务有多难。 - “并非所有参数都平等”值得单独记一笔。 把嵌入层参数算进去,缩放曲线就会弯。做参数缩放分析前,先问清楚“参数”的定义——MoE 时代更是如此(所以要引入“等价稠密参数”这类归一化)。
- 临界 batch size 是“batch size 与噪声尺度相当”的那个点。 在它以下,加大 batch ≈ 多走几步(这正是数据并行的甜点区);在它以上,系统上更方便但优化上不划算。目标损失越低,能用的 batch 越大——Llama 3 训练中途调大 batch 就是这条规律的工程体现。
- muP 的意义是把“超参数迁移”变成“超参数不变”。 与其每次拟合“最优学习率如何随宽度漂移”,不如重参数化让最优学习率本身与宽度无关;在最小模型上调一次,直接迁移到最大规模。这是把工程问题用数学消掉,而不是用算力硬扛。
- 最该贴在墙上的警告:困惑度缩放 ≠ 下游能力缩放。 左图一条直线,右图各奔东西。任何“按 perplexity 的斜率外推 benchmark 表现”的论证,都要先过这一关;状态空间模型上也有同样的故事。
- Chinchilla 的三种方法值得记住它们“为什么一致”。 最小包络、IsoFLOP、联合拟合,三种假设各不相同;两个一致、一个偏差 0.03。而偏差那个的谜底是残差没零均值这种最“不起眼”的实现细节——工程结论的稳健性,有时取决于你有没有检查 residual 的均值。
- Epoch AI 复现的故事值得作为方法论记住。 没有原始数据,就对着图读点;读完发现原论文“想法对、数据对、拟合错”。复现既可能推翻结论,也可能替结论补上它自己没做对的那一步。
- 这条“训优 → 推理优”的转向,是整个领域的定价方式在变。 从 GPT-3 的 2 token/参数,到 Chinchilla 的 20,再到 30 万亿 token——越来越高的 token/参数比,本质上是用一次性训练成本去换长期的推理成本。看懂这条曲线,比记住任何单个数字都有用。
附:课程信息与时间轴
- 课程主页:stanford-cs336.github.io/spring2025
- 本讲视频:Lecture 9: Scaling laws 1(1:05,2025-05-15 发布;课程表记作 Tues April 29,主讲 Tatsunori Hashimoto)
- 播放列表:Stanford CS336 Language Modeling from Scratch · Spring 2025
- 配图目录:
public/blog/youtube/6Q-ESEmDf4Q/(18 张图均截取自视频中对应观点所在的画面,并把该时刻的完整观点句拼合进图中)
| 时间 | 内容 |
|---|---|
| 00 | 开场:本讲是缩放定律(上),原计划讲推理 |
| 00 | 场景:朋友给你 10 万张 H100 一个月,造最好的开源 LM |
| 01 | “抄 Llama”是个无聊的答案——前沿实验室想创新 |
| 01 | 旧做法(训练一堆大模型再调参)代价极高 |
| 02 | 新思路:在尺度左侧训小模型,然后一次性把大模型做对 |
| 03 | 从统计学习理论出发:VC 维、Rademacher 复杂度 |
| 03 | 有限假设类:超额风险 ~ 1/√m |
| 04 | 非参数密度估计:n^(−β/(2β+1)) 的经典速率 |
| 04 | 这些是上界,不是实际实现的损失——从理论到经验拟合的一跃 |
| 05 | 冷知识:第一篇缩放定律论文?1993 年 Bell Labs 的 NIPS 论文 |
| 06 | 1993 年的方法论:不训练完也能预测模型好坏 |
| 06 | “测试误差 = 不可约项 + 多项式衰减项”,外推预测 |
| 07 | Banko & Brill:数据量对数线性地改善 NLP 性能 |
| 08 | Hestness 2017:机器翻译 / 语音 / 视觉的误差都按幂律下降 |
| 08 | 三个阶段:随机猜测 → 幂律区间 → 不可约误差 |
| 09 | Hestness 早已写过“涌现”“按算力缩放”“用算力换精度” |
| 10 | 提问:有没有不缩放的情形?——Inverse Scaling Prize 与 OOD |
| 12 | Kaplan 论文:算力 / 数据 / 参数下的缩放 |
| 12 | 前提:只变一个变量时,另一个必须远大于饱和点 |
| 13 | 幂律在 OOD、下游任务上也成立 |
| 13 | 数据缩放的定义:n → 超额误差 |
| 14 | 第一条经验规律:log-log 上损失随数据量线性下降 |
| 15 | 玩具例子一:估计均值,误差 σ²/n,斜率 1 |
| 17 | 期待“漂亮斜率”1 或 1/2 |
| 17 | 实际:机器翻译 0.13、语音 0.3、语言建模 0.095 |
| 18 | 玩具例子二:非参数回归,二维切格子取平均 |
| 19 | d 维下误差 ≈ n^(−1/d),斜率 −1/d = 内在维度 |
| 19 | 有理论/实证工作把非标准速率与内在维度联系起来 |
| 21 | 数据缩放的用途:配比、重复、数据选择 |
| 21 | 数据配比只影响截距,不影响斜率(Kaplan) |
| 22 | 多轮训练:有效样本量,约 4 个 epoch 后急剧递减 |
| 23 | 重复高质量数据 vs 引入新数据:多了一个可优化的轴 |
| 26 | 转到模型缩放:你是要 ship 大模型的人 |
| 27 | Kaplan 是这类分析的“金矿” |
| 27 | 架构:Transformer vs LSTM,常数倍算力差距 |
| 28 | 更多架构:只有 GLU 与 MoE 可靠地跑赢 Transformer |
| 29 | 优化器:Adam vs SGD 的常数倍差距 |
| 31 | 并非所有参数都平等:嵌入参数不走同一条幂律 |
| 32 | 曲线不相交、只差常数倍时,可在小尺度上定超参数 |
| 33 | 50M/270M/1.5B 上宽高比 10–100 都差不多 |
| 34 | batch size 超过临界点后收益递减 |
| 35 | 临界 batch size 的定义 |
| 36 | 损失目标越低、可用的 batch 越大(Llama 3 的做法) |
| 37 | Kaplan:算力增大时步数不变、batch 变大——数据并行的好消息 |
| 38 | 学习率:经验法则 1/宽度,或对最优点拟合缩放定律 |
| 39 | muP:重参数化让学习率跨尺度迁移(含 MetaP) |
| 43 | 警告:对数损失上很干净,下游基准上不是 |
| 45 | 基于缩放定律的设计流程:小模型 → 拟合 → 选超参 |
| 47 | 要更多数据还是更大模型?2021–23 算力是唯一稀缺资源 |
| 48 | 联合缩放定律:Rosenfeld 与 Kaplan 的函数形式 |
| 49 | 3D 拟合出奇地准,小模型外推也准 |
| 51 | Chinchilla:三个方法,约 20 token/参数 |
| 52 | 为什么 Kaplan 差得远:余弦学习率不能被截断 |
| 54 | 方法一:所有训练曲线的最小值包络 |
| 56 | 方法二 IsoFLOP:63B vs 67B,两者很接近 |
| 58 | 方法三:联合曲线拟合,系数偏差约 0.03 |
| 59 | Epoch AI 复现方法三:从图里“取证”读点 |
| 59 | 谜底:残差不是零均值;重拟合后与 1、2 一致 |
| 1:01 | 推理成本登场:token/参数从 2 → 20 → 更高 |
| 1:02 | 扩散语言模型:同一套 playbook,同样的结论 |
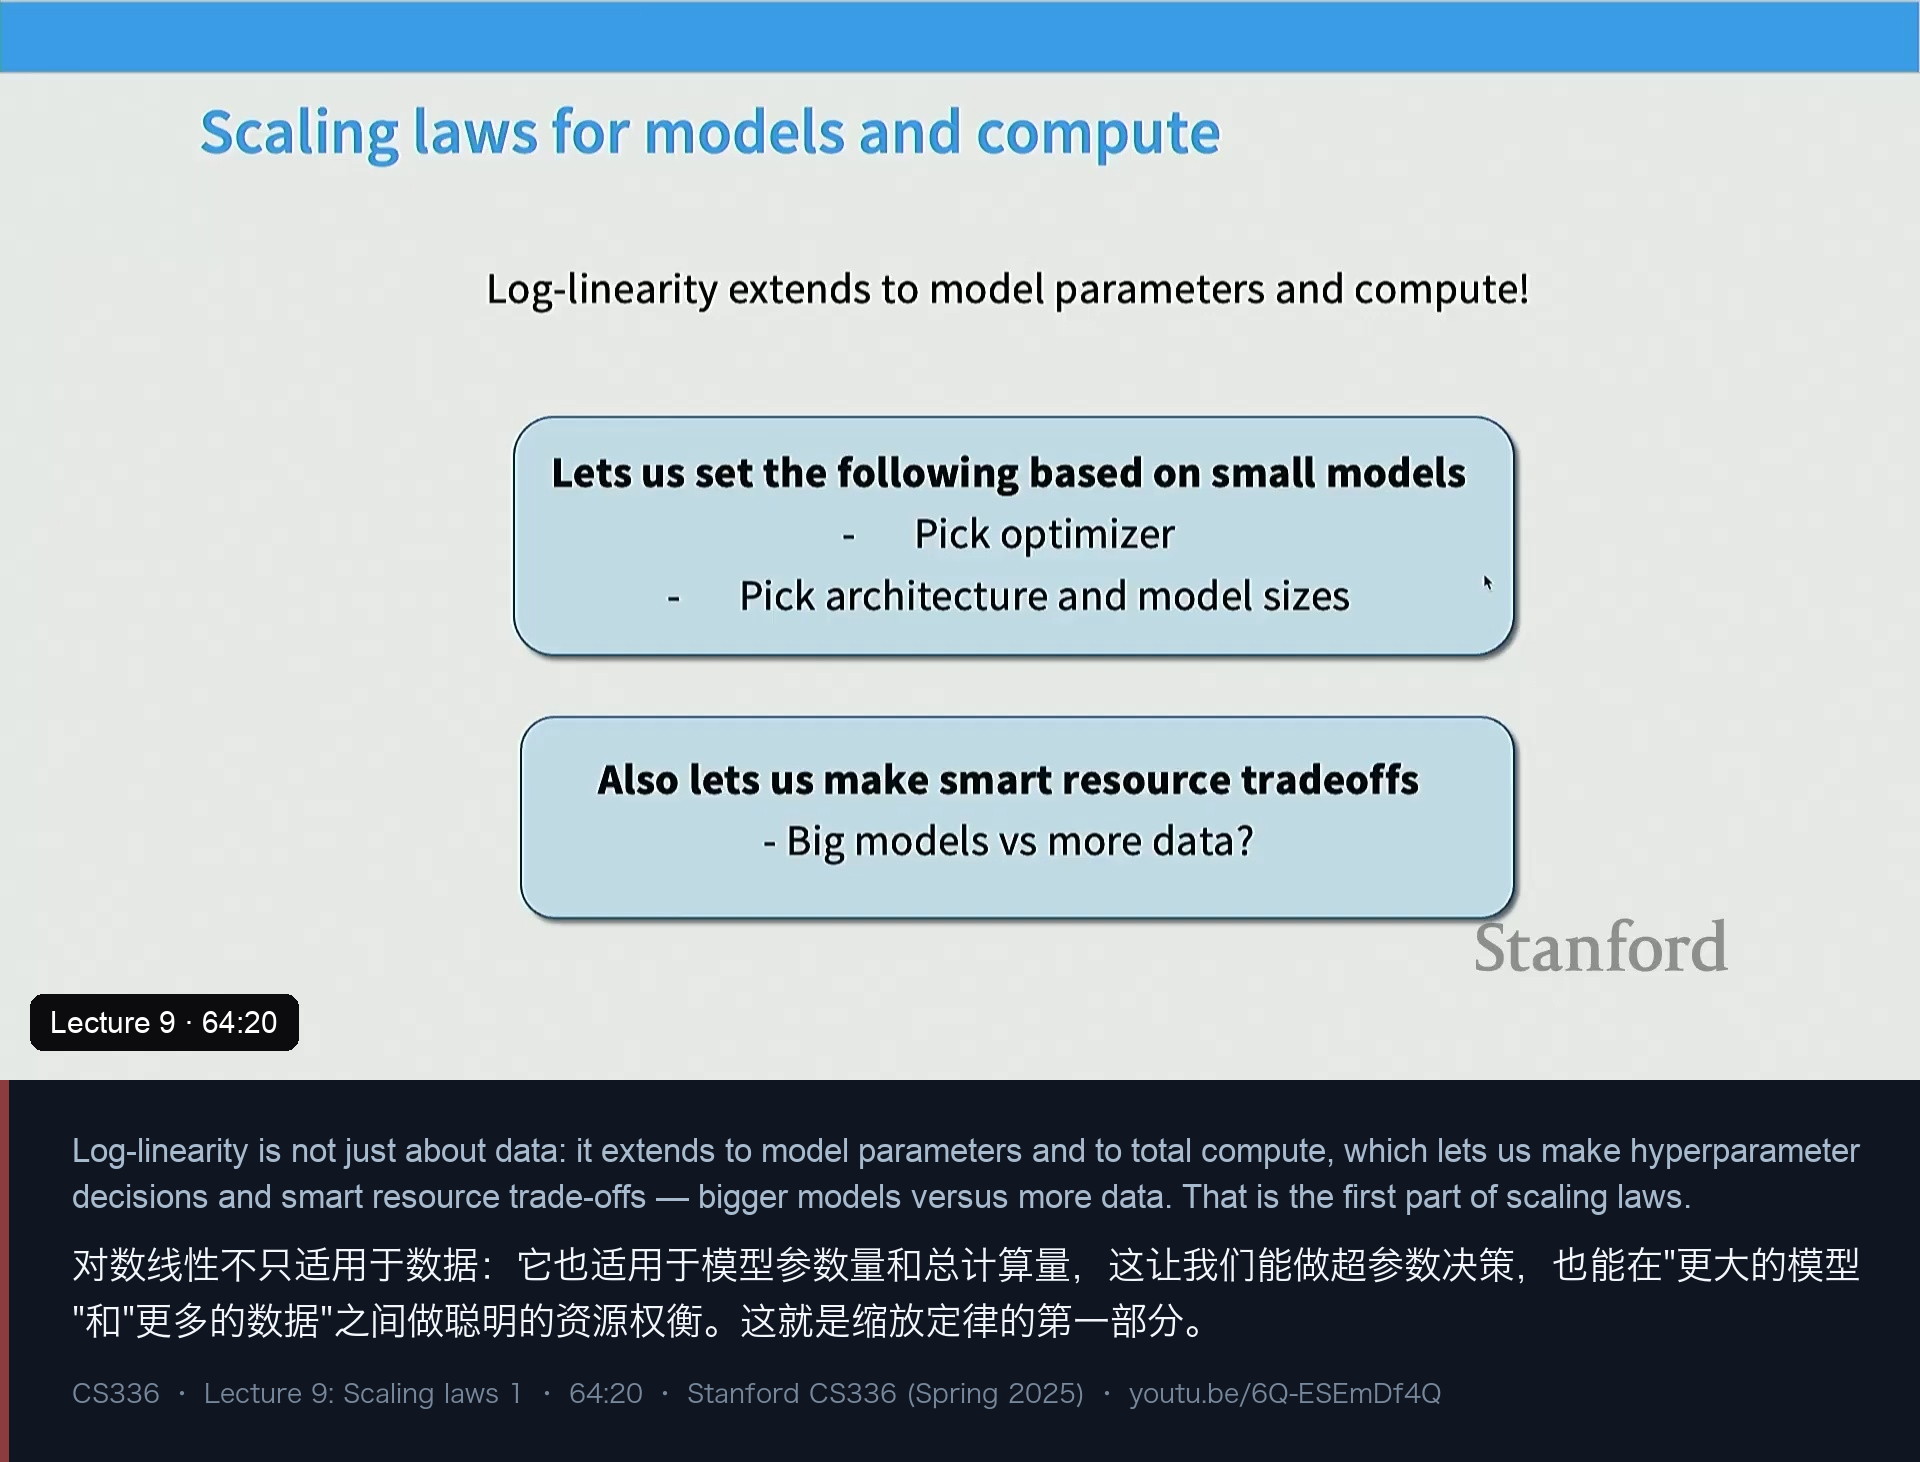
| 1:04 | 总结:对数线性延伸到参数量与总计算量 |
| 1:05 | 收尾:谢谢,周四见 |
说明:本文是视频内容的整理、翻译与转述,观点均来自主讲人;文中引用的斜率、token/参数比、模型规模、epoch 数等数字,均来自讲师课上的口播或所引用的幻灯片/论文,请自行核实。本讲是“缩放定律”两讲中的第一讲,后续内容在第十一讲继续。
讨论
这里是静态站点,没有内嵌评论区。如果这篇文章对你有用,欢迎通过 RSS 订阅后续更新。