Stanford CS336 第八讲精读:并行(下)——把集合通信、数据/张量/流水线并行写成代码
斯坦福 CS336(Language Modeling from Scratch, Spring 2025)第八讲完整讲义:上一讲讲概念,这一讲把概念落成代码。从 1980 年代的集合通信原语讲起(broadcast/scatter/gather/reduce/all-gather/reduce-scatter 与 all-reduce ≡ reduce-scatter + all-gather),再看 PCIe/以太网与 NVLink/NVSwitch 两代硬件(H100:18 条 NVLink 4.0、总带宽 900 GB/s)、NCCL 与 torch.distributed 的分工,然后逐行实现三个 bare-bones 训练脚本——数据并行(在 SGD 里插一行 all-reduce)、张量并行(沿宽度切、一路 all-gather)、流水线并行(按层切、micro-batch 与点对点通信),最后用 JAX/Levanter 的十行代码对照,并总结「重计算 / 存内存 / 存到别的 GPU 再通信」这条贯穿全课的主线。
本篇属于系列 Stanford CS336 精读 · 第八讲
来源:YouTube 原视频(Stanford Online · CS336 Language Modeling from Scratch · Spring 2025 · Lecture 8: Parallelism 2)
来源说明 这是斯坦福 CS336《Language Modeling from Scratch》2025 年春季第八讲的完整讲义,主讲人是 Percy Liang。它是“系统基础”两讲的第二讲:上一讲由 Tatsunori Hashimoto 把数据并行、模型并行、激活并行讲成了一张地图,这一讲由 Percy 把同一批概念逐行落到代码里——先补集合通信原语与 NCCL/PyTorch 的分工,再做带宽基准测试,然后用一个四层 MLP,把数据并行、张量并行、流水线并行各写一遍。文中 17 张配图均截取自视频对应时刻的画面,并把该时刻的完整观点句(英文原句+中文翻译)拼合进图中;文中出现的带宽数字(900 GB/s、277 GB/s、70 等)、切片尺寸、层数与 world_size 等,都是讲师课上当场演示或引用的幻灯片数值,不是本文独立核实的事实。字幕把 NVLink 听写成 “MVLink/NVL link”、把 NCCL 听写成 “nickel”、把 Levanter 听写成 “Lavanter”,下文按幻灯片与通行写法记录。
TL;DR
- 这一讲是“把上一讲翻译成代码”。开场第一张幻灯片就把坐标定死:算力与显存都在比网络带宽更快地增长,所以**“the name of the game” 就是如何组织计算、绕开数据传输瓶颈**——这一点从单卡内部的 L1/HBM,一直延续到机内 NVLink、机间 NVSwitch。
- 集合通信是 1980 年代就有的老原语:
broadcast / scatter / gather / reduce / all-gather / reduce-scatter。记住三句话就够:reduce 指可结合可交换的运算(sum/min/max);broadcast/scatter 是 gather 的逆操作;all 表示所有目的地。而all-reduce ≡ reduce-scatter + all-gather是这一讲的“第一性原理”——课上用四个 rank 的[0,1,2,3]+rank一步步算给你看,两种路径得到完全相同的[6,10,14,18]。 - 硬件分两代:经典做法是节点内 GPU 走 PCIe、节点间走以太网(数据要过内核、进缓冲区、再上以太网,开销大);现代数据中心里,节点内 NVLink 直接连 GPU、绕过 CPU,跨节点 NVSwitch 直接连 GPU、绕过以太网。幻灯片上的数字:H100 每块 GPU 18 条 NVLink 4.0 链路、合计 900 GB/s;PCIe x16 是 242 GB/s;以太网那一行写的是 ~200 Mb/s(按上下文应理解为量级差异)。
- 软件栈分工:NCCL 把集合操作翻译成 GPU 之间的底层数据包(探测拓扑 → 优化路径 → 启动 CUDA kernel),
torch.distributed提供 Python 接口并支持多后端(GPU 用 NCCL,CPU 用 Gloo,便于在笔记本上调试)。 - 一定要自己测带宽:一亿个 fp32 元素、world_size=4 的 all-reduce,实测约 277 GB/s,离标称的 900 GB/s 差得很远;reduce-scatter 更慢(约 70)。讲师的猜测是 all-reduce 被优化得更好、且 NVIDIA 硬件有 in-network 的 reduction 加速(SHARP)。结论:别从规格表推性能,benchmark 才是真的。
- 数据并行 = 在别人的 SGD 里插一行:batch 128 切成 4 份(local batch 32),每个 rank 照常前向反向,唯一的改动是对每层的
param.grad做一次 all-reduce 取平均。损失值各 rank 不同(数据不同),但更新后参数完全一致。all-reduce 同时是一个同步点——少调用一次,整个进程组就会挂住。 - 张量并行 = 沿宽度切模型:数据不变,
num_dim=1024切成 4 份(每 rank 256,只占 1/world_size 参数)。前向时每个 rank 算出batch × local_num_dim的激活,然后 all-gather + 拼接 回完整的batch × num_dim,逐层重复。通信量巨大,所以张量并行只适合高带宽链路(上一讲的经验法则:单机 8 卡以内)。 - 流水线并行 = 按层切:四层网络、两个 rank,每个 rank 只放两层参数;朴素做法会有巨大的气泡,用 micro-batch(4 × 32) 摊薄。通信从集合操作换成了点对点
dist.recv/dist.send。课上这版是“故意不完整”的:没有做通信/计算重叠,也没有交错前向反向。 - 还缺什么:支持注意力等更一般的模型、通信/计算重叠、自动化的簿记(参数与层怎么分是手写死的)。Megatron-LM 和 PyTorch FSDP 里这些变得“很毛”;而 JAX/TPU 走的是另一条路——只需声明模型和分片策略,编译器负责剩下的一切,Levanter 把 FSDP 和张量并行都压缩进了十行代码。课程坚持用 PyTorch,是为了让你看清底下到底发生了什么。
- 贯穿全课的主线:并行化无非是把模型或数据沿 batch / 宽度 / 深度 / 上下文长度切开;而每个“省”的手段都在别处记账——你可以重计算、可以存内存、也可以存到另一张 GPU 的显存里再通信(最慢)。硬件会越来越快,但模型永远会顶到硬件的极限,所以这套层级结构会一直在。
一、这一讲在哪:从“讲概念”到“写代码”
开场就把两讲的分工交代清楚:这是系统基础讲座的第二周。上一周讲的是单张 GPU 内部的并行(融合、分块,目的是少读写 HBM),这一周讲的是跨多张 GPU、多个节点的并行。
脑子里要有这张图:若干个 node(每台通常 8 张 GPU),每张 GPU 里有一堆 SM(streaming multiprocessors,真正干活的是里面的 ALU),SM 旁边是很小但极快的 L1 cache,再外面是较大的 HBM。计算必须发生在 SM 里,而它需要的输入、要写的输出,可能就在 L1,也可能在 HBM,而现在——可能干脆在另一张 GPU 上。
于是这一讲反复出现的那句话是:the name of the game is how you structure all your computation to avoid data-transfer bottlenecks(关键就在于如何组织你的全部计算,去避开数据传输瓶颈)。要保持算术强度、要把 GPU 喂饱,而数据传输一定更慢,所以它才是瓶颈。
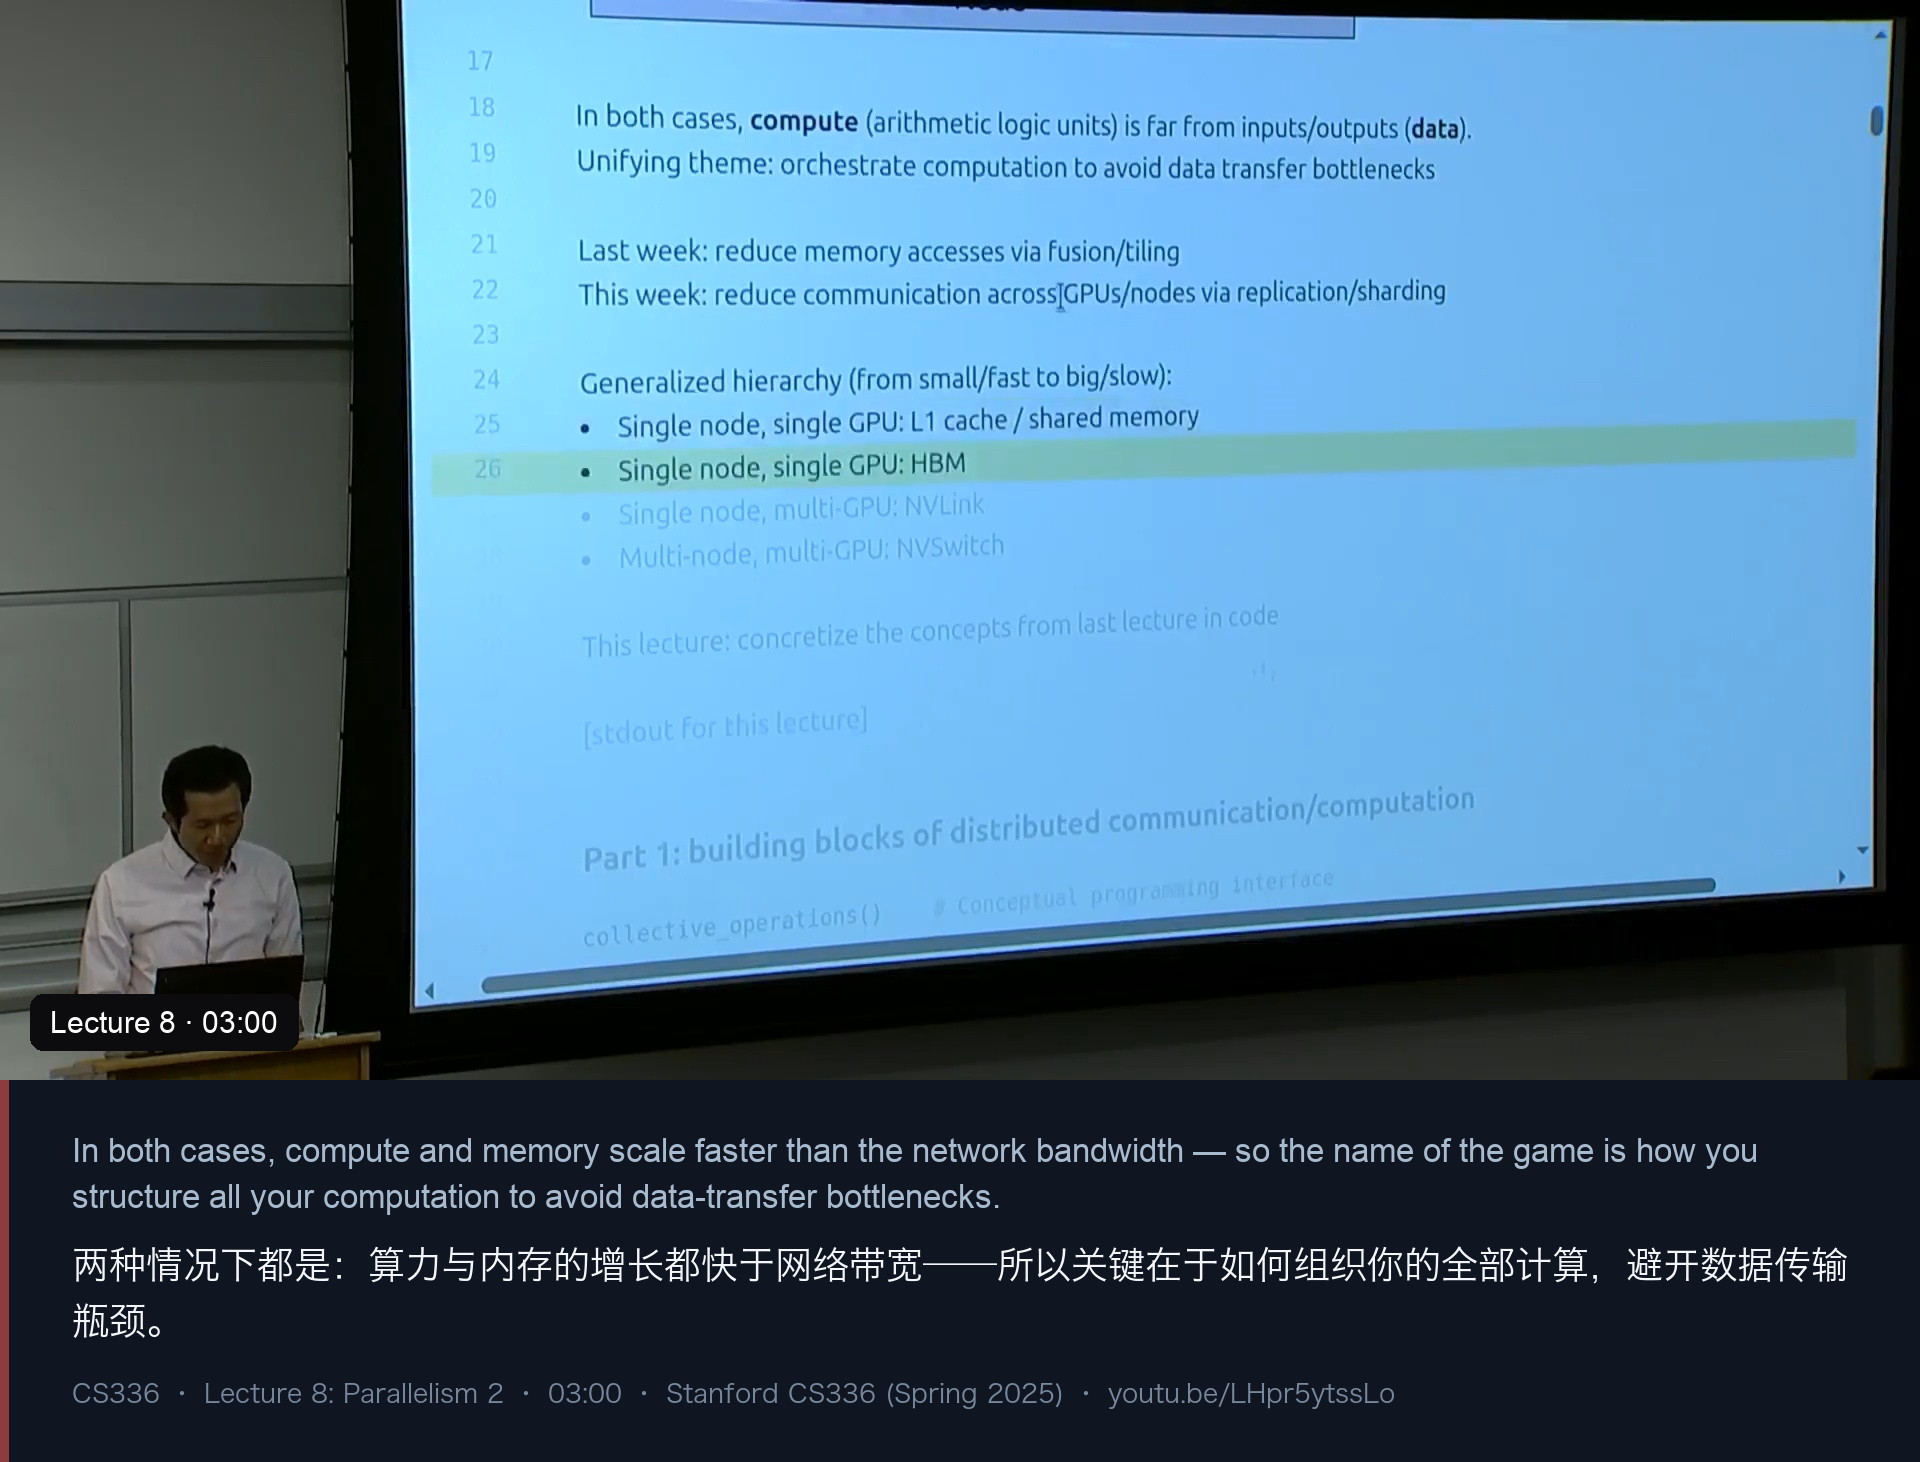
讲师把大小快慢排成一条统一的层级:单卡 L1(极快极小)→ 单卡 HBM → 机内 NVLink → 机间 NVSwitch。最小化数据传输的道理和单卡内部完全一样,变的只是机制——L1 的行为和交换机不一样。这一讲的路线图也照此分成两半:
# Part 1: building blocks of distributed communication/computation
collective_operations()   # Conceptual programming interface
torch_distributed()       # How this is implemented in NCCL/PyTorch
benchmarking()            # Measure actual NCCL bandwidth

# Part 2: distributed training
data_parallelism()        # Cut up along the batch dimension
tensor_parallelism()      # Cut up along the width dimension
pipeline_parallelism()    # Cut up along the depth dimension
一个有意思的细节:Percy 说他讲课时是对着一个 stdout 文件在讲的——也就是“跑这个讲义”的真实输出。他还预先声明,如果你用 multiprocessing 跑,这个框架会有一些小问题,“我替你们省掉这些细节”。
二、集合通信速查:六个原语,一个等价关系
集合通信(collective operations)是分布式编程的通用原语。它们至少从 1980 年代的并行编程文献里就存在了,是经过时间检验的东西;相比自己手写点对点通信,它们提供了更好的抽象。
术语先统一:
- world size:设备数量,比如 4;
- rank:设备编号(0、1、2、3)。如果你习惯线性代数,这里会有点反直觉——rank 指的就是“哪台设备”,不是矩阵的秩。
然后是六个原语(也是上一讲的复习):
| 原语 | 做什么 |
|---|---|
broadcast |
某个 rank 上有 t0,把它放到所有 rank 上 |
scatter |
有四个值,每个值分别送到不同的 rank |
gather |
每个 rank 各有一个值,把它们收集到某一个 rank 上 |
reduce |
和 gather 一样,但把值加起来(或做其他可结合可交换的运算)而不是拼接 |
all-gather |
和 gather 一样,只是所有 rank 都拿到结果 |
reduce-scatter |
先 reduce,再把结果按块分散到各个 rank 上 |
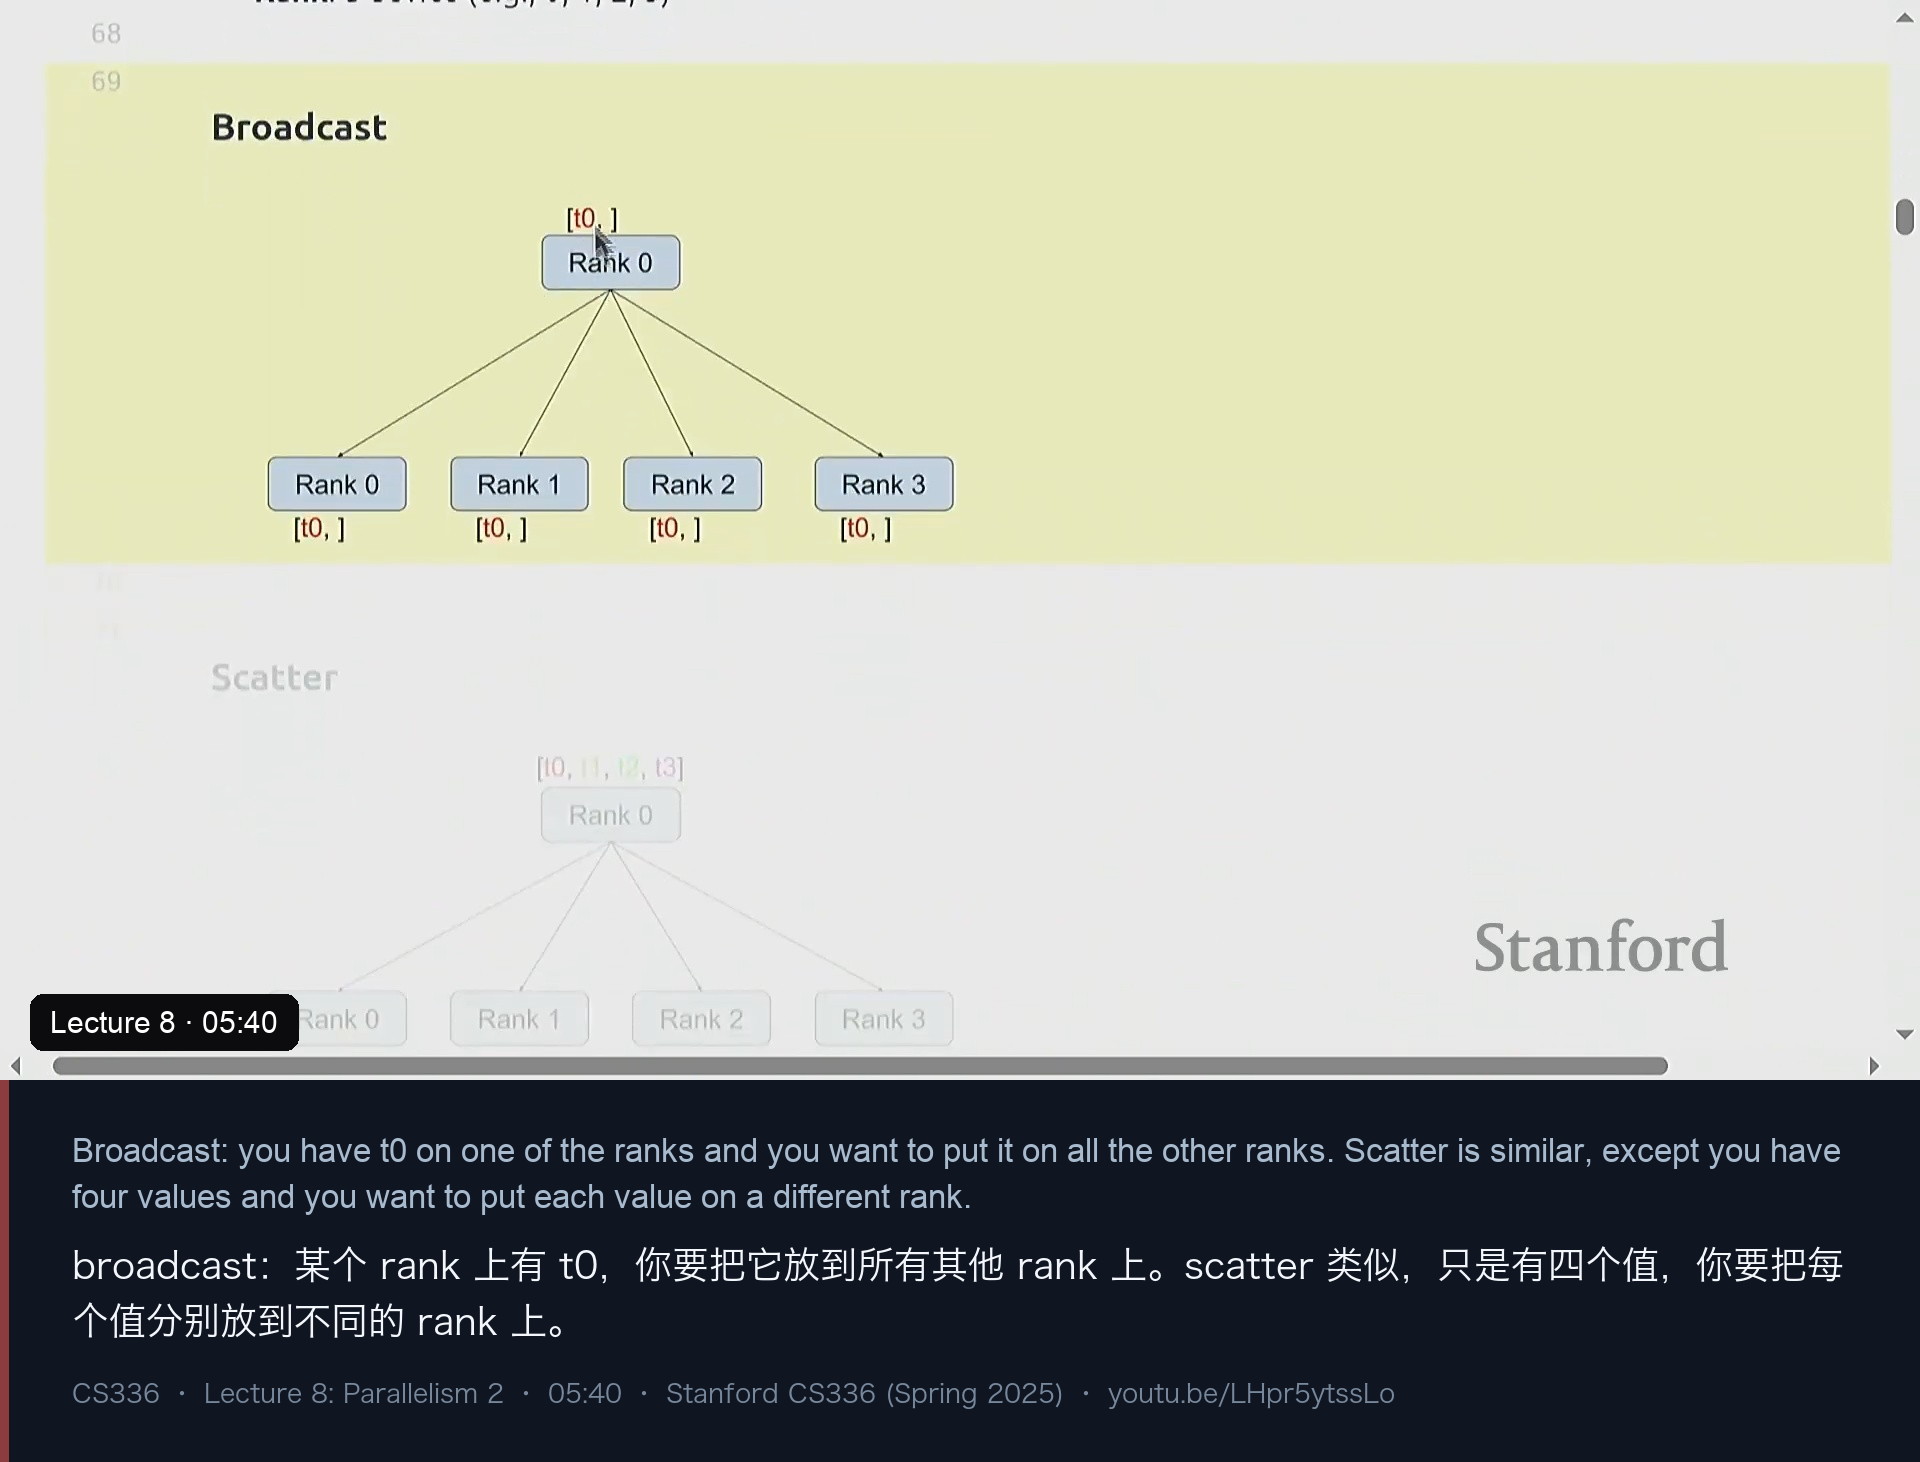
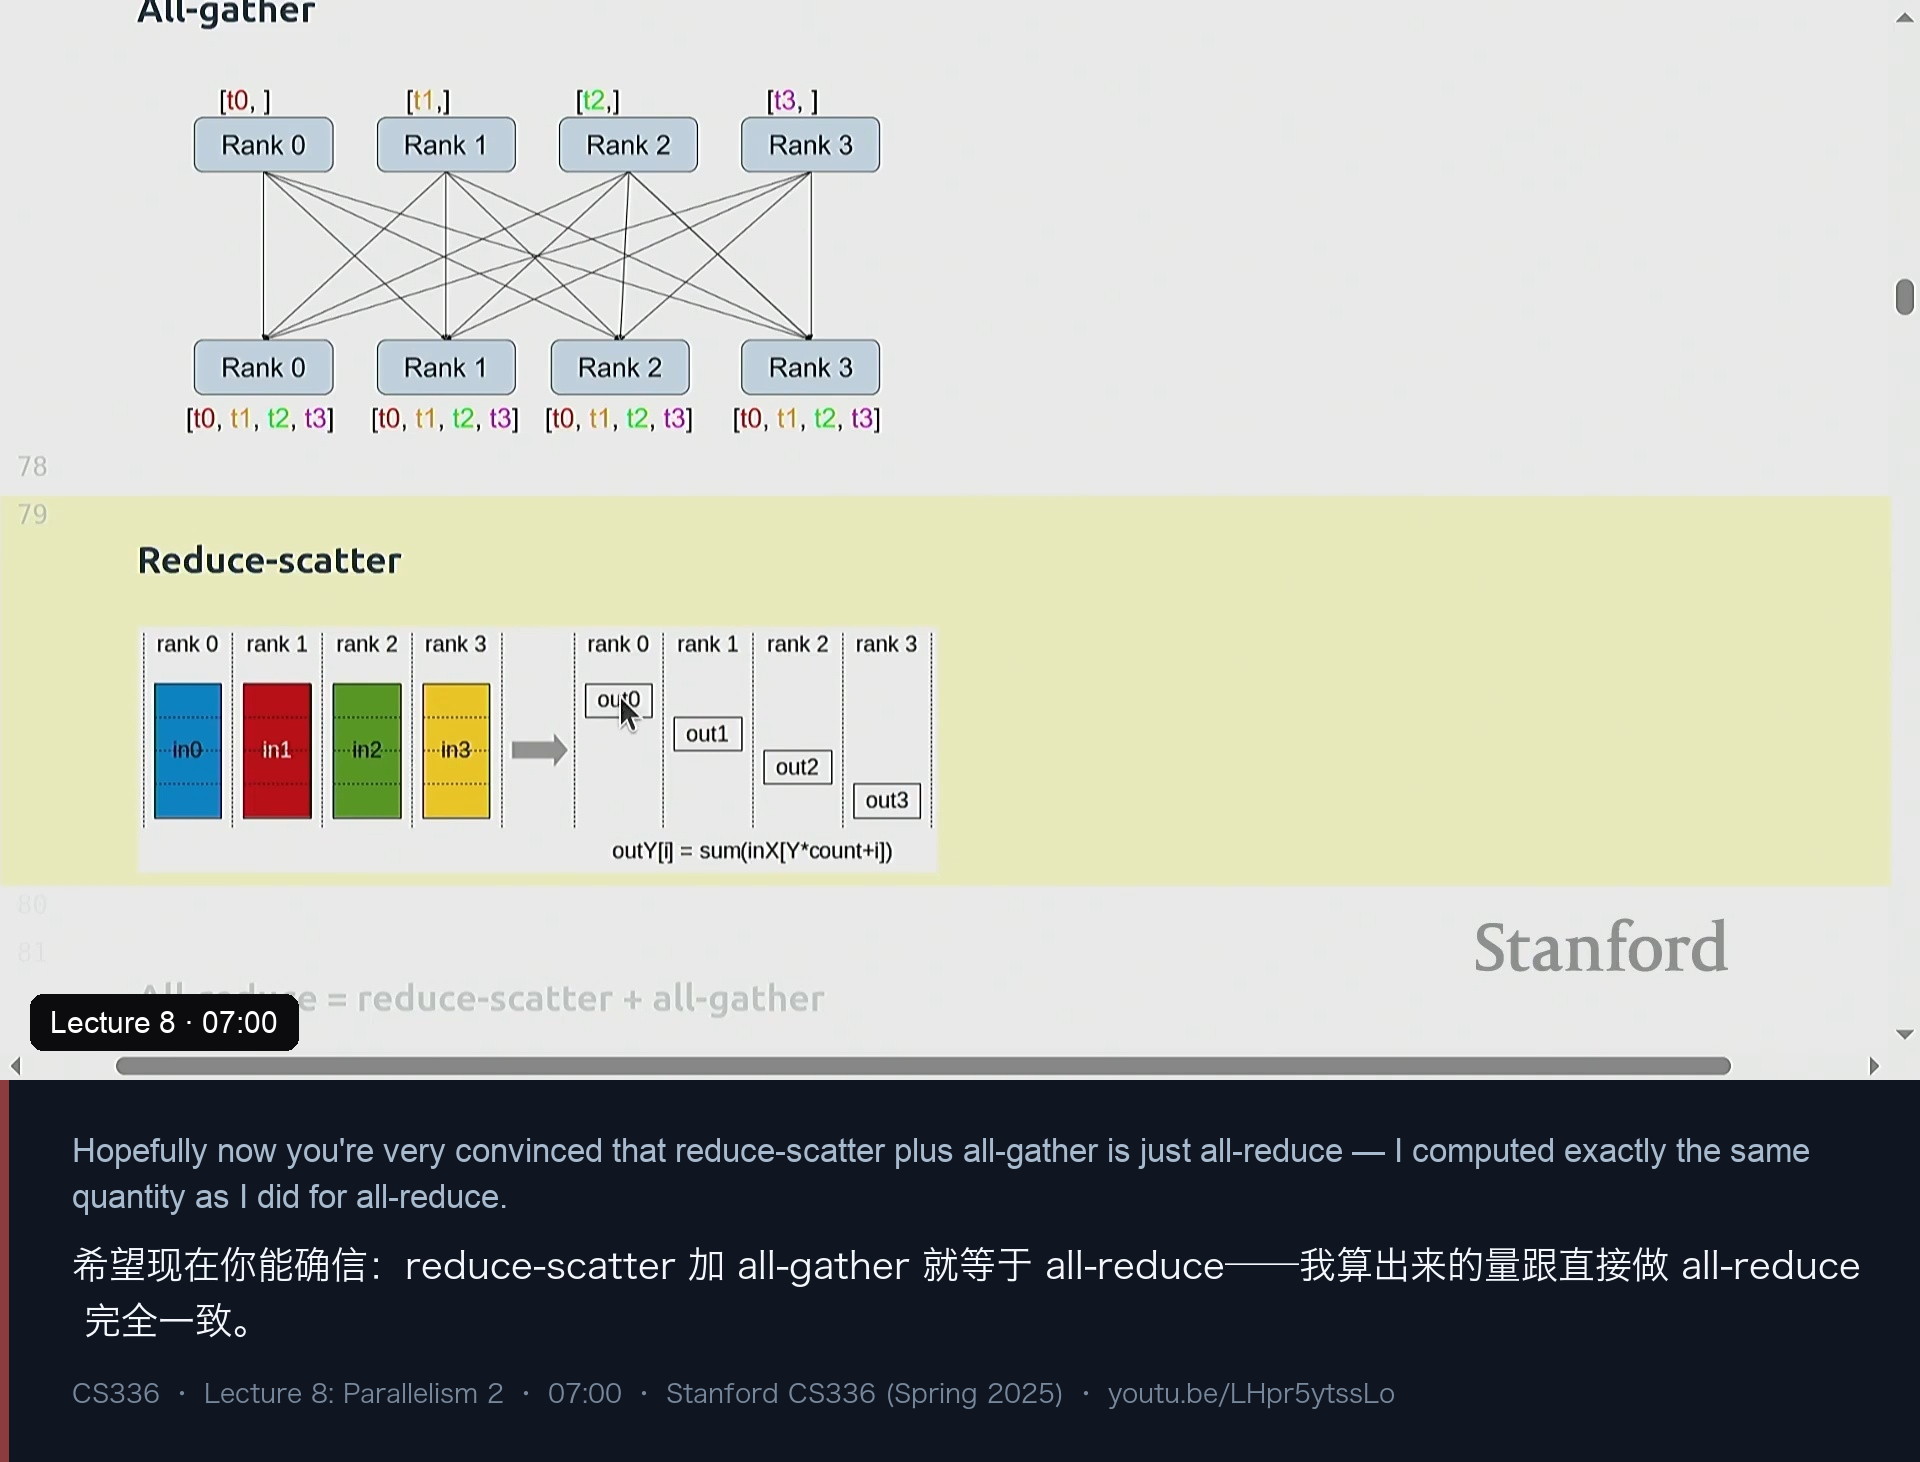
必须背下来的一条:all-reduce = reduce-scatter + all-gather。 讲师的原话是 “I computed exactly the same quantity as I did for all-reduce”——课上会把两条路径都真的算一遍给你看,结果一字不差。这个等价关系在上一讲是理解 ZeRO stage 1 “免费”的关键,在这一讲则直接决定后面怎么算通信量。
记忆法是三句话:
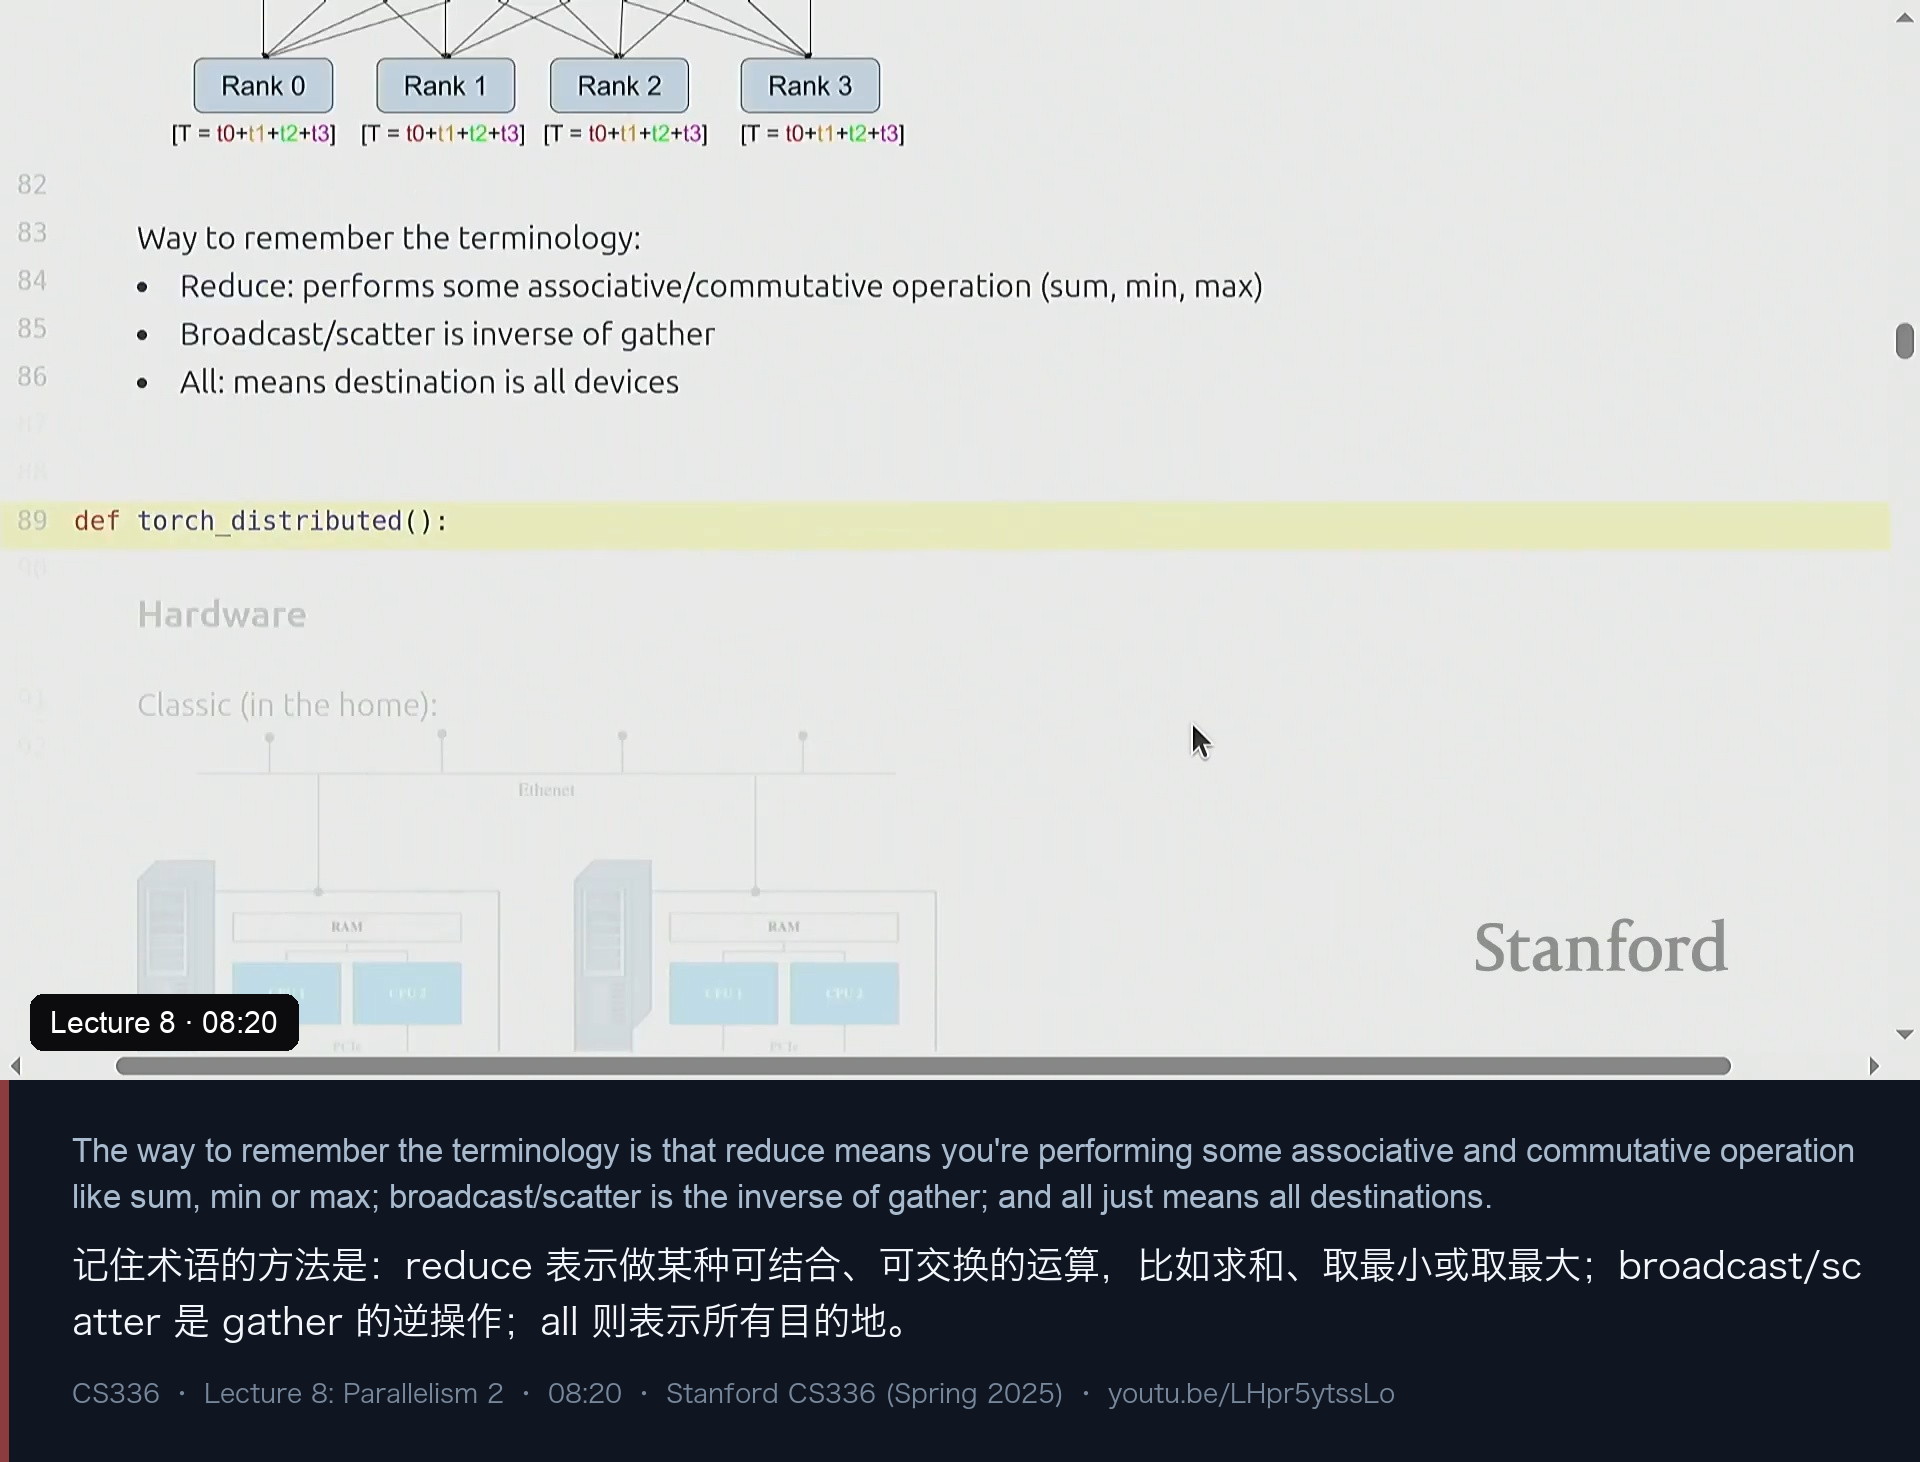
reduce:做某种可结合、可交换的运算(sum、min、max、average)。 broadcast / scatter:gather 的逆操作。 all:所有目的地。
学生提了一个很实际的问题:reduce-scatter 时“哪个分量去哪个 GPU”需要自己记吗?答案是按约定——输入里必须有一个维度等于 world size,库据此推断;但维度对齐确实容易出错,所以拿小例子跑一遍很有帮助。
三、硬件:从 PCIe + 以太网,到 NVLink + NVSwitch
接着看硬件是怎么实现这些操作的。经典(“in the home”)的做法是这样的:
- 同一个节点上的 GPU 通过 PCIe 总线通信;
- 不同节点之间连到以太网。
这套方案的问题在于开销:数据从一块 GPU 到另一块 GPU,要先经过内核、被拷贝进缓冲区,再走以太网传输——中间全是纯开销。以太网是很多年前为通用场景设计的,显然不是为这种负载设计的。于是现代数据中心换了一套打法:
- 节点内:NVLink 直接把 GPU 连起来,绕过 CPU,不必再穿过宿主机的内核;
- 跨节点:NVSwitch 直接把 GPU 连起来,绕过以太网。
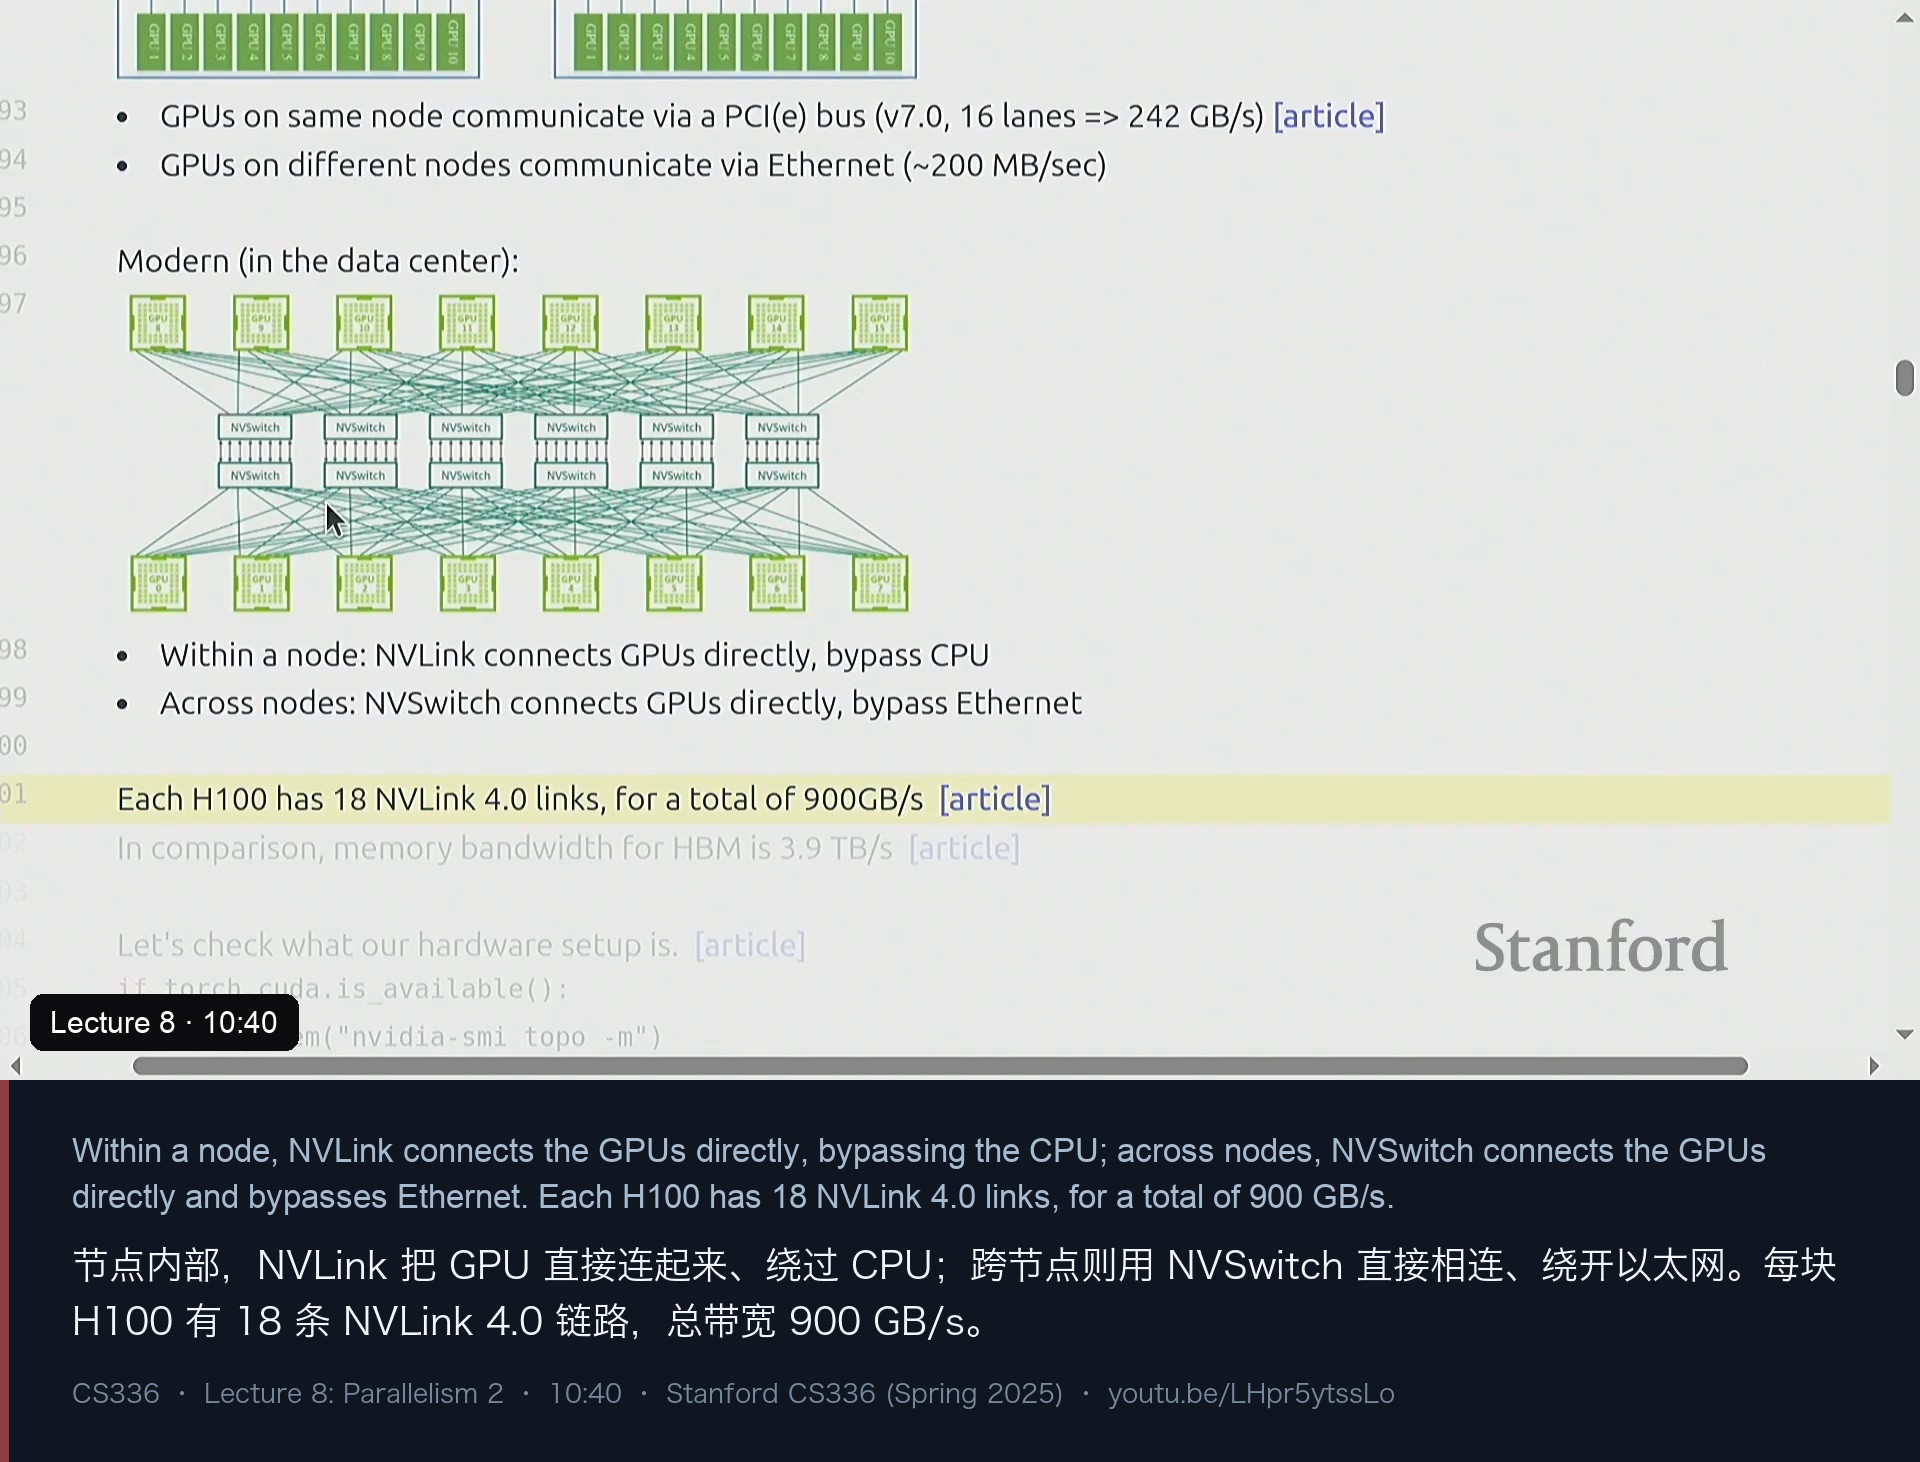
幻灯片上的具体数字(H100 世代):
- PCIe x16(16 lanes):242 GB/s;
- 以太网那一行写的是 ~200 Mb/s(原文如此,理解为数量级差异即可);
- 每块 H100 有 18 条 NVLink 4.0 链路,合计 900 GB/s。
但 900 GB/s 仍然比不上“从 SM 直接读 HBM”——讲师说后者大约快四倍(HBM3 标称约 3.35 TB/s,量级对得上)。而且这些数字一直在变,Blackwell 大约是它的两三倍。查看实际拓扑可以用 nvidia-smi topo,在课程集群的 8 卡机器上,你会看到每两块 GPU 之间都是 NV18。
学生问:PCIe 传输是不是要先过 CPU?是的。而且 PCIe 是通用总线——声卡、SSD 都挂在上面,所以它不是为 GPU 间通信专门优化的。NVLink 也会和 CPU 相连(你当然还是要跟 CPU 说话),只是 GPU 之间的那一段不再绕路。
四、软件栈:NCCL 干活,torch.distributed 提供接口
硬件之上,NVIDIA 投入了大量精力做软件。核心是 NCCL(NVIDIA Collective Communication Library):
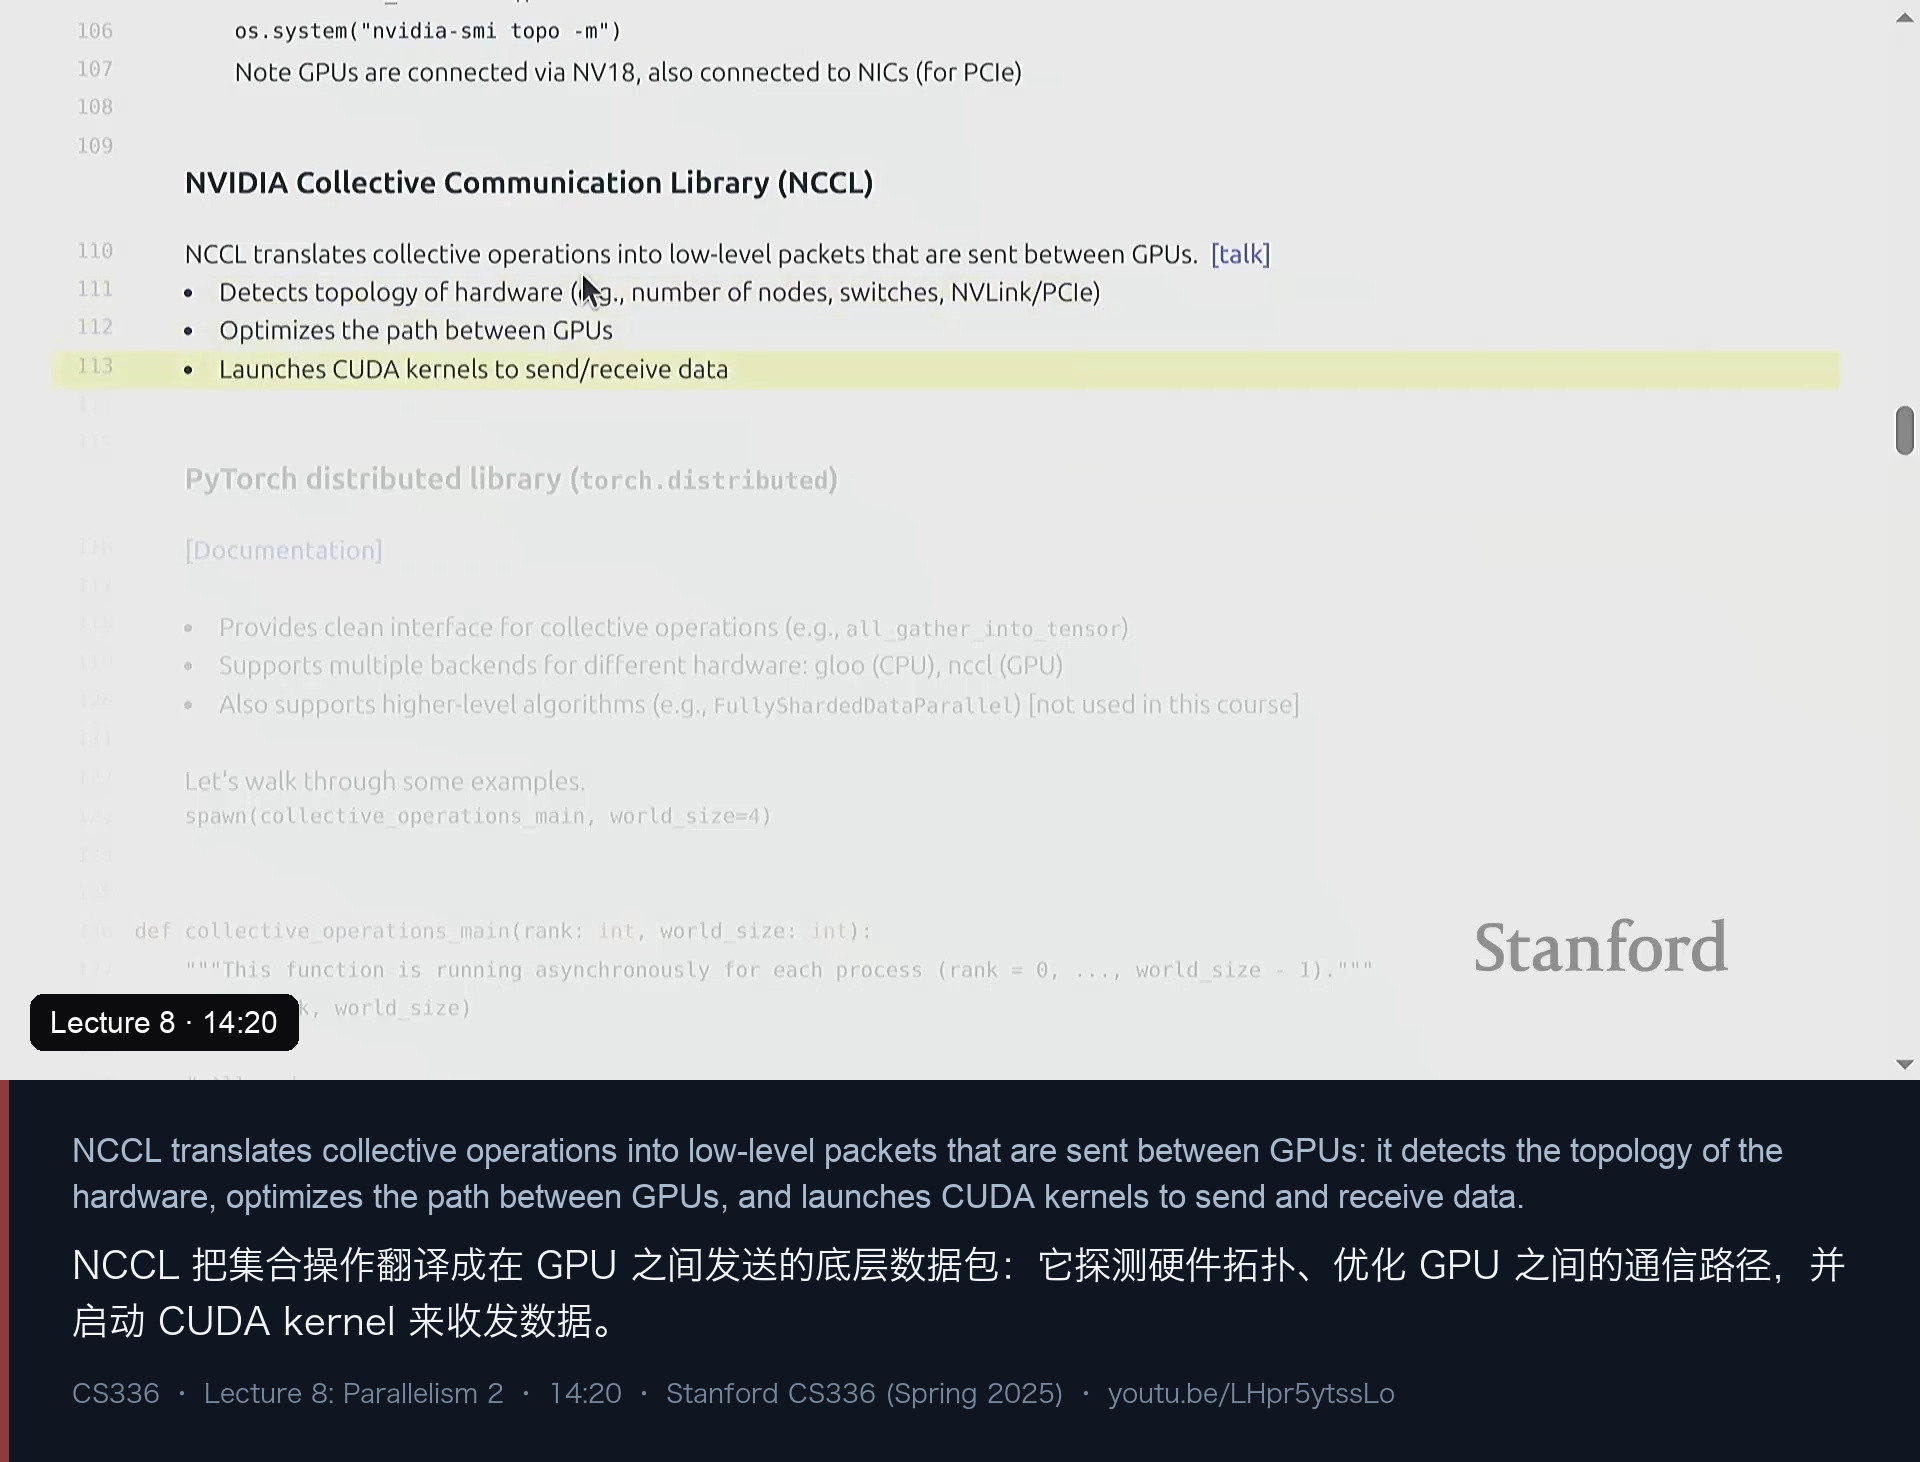
- 把
all-reduce这类集合操作翻译成 GPU 之间发送的底层数据包; - 探测硬件拓扑(几个节点、几台交换机、NVLink 还是 PCIe);
- 优化 GPU 之间的路径;
- 真正调用时,启动 CUDA kernel 来收发数据。
它替程序员做了极重的活:你只需要表达“I need this tensor to appear on all the machines”,剩下的它负责。
但 NCCL 对 Python 程序员来说还是太底层,于是有了 torch.distributed:一个干净的接口,让你在 PyTorch 程序里直接写 all_gather_into_tensor,张量就出现在各个 rank 上。它还支持多后端:
- NCCL:GPU;
- Gloo:CPU——这是给作业调试用的,在你没有 GPU 的笔记本上,逻辑照样能跑通(性能当然另说)。
torch.distributed 里也有 FSDP 这类高级东西,但这门课不用——课程的宗旨是“from scratch”,要自己把轮子造一遍。
五、把集合通信跑起来:四个 rank 的实验
课上写了一个工具函数:包一层 Python multiprocessing,让 world_size 个进程各自执行同一个函数,rank 从 0 到 world_size−1。所以读代码时要想象“有 world_size 个进程在同时跑这一份代码”(而讲课只能一个 rank 一个 rank 地讲,“因为讲座不是并行的”)。
流程是标准的三段式:
- 初始化:每个进程要找到彼此(先连到同一台 host 做协调)。注意,这里不是数据通道——数据走 NCCL,这里只做协调;有 GPU 就用 NCCL,否则用 Gloo。
- 干活:
dist.barrier()等所有进程到齐(课上主要是为了让 print 语句成组),然后构造张量、调用集合操作。 - 清理。
def collective_operations_main(rank: int, world_size: int):
    """This function is running asynchronously for each process (rank = 0, ..., world_size - 1)."""
    setup(rank, world_size)

    # All-reduce
    dist.barrier()  # Waits for all processes to get to this point (in this case, for print statements)

    tensor = torch.tensor([0., 1, 2, 3], device=get_device(rank)) + rank  # Both input and output
    print(f"Rank {rank} (before all-reduce): {tensor}", flush=True)
    dist.all_reduce(tensor, op=dist.ReduceOp.SUM, async_op=False)   # Modify in-place
    print(f"Rank {rank} (after all-reduce): {tensor}", flush=True)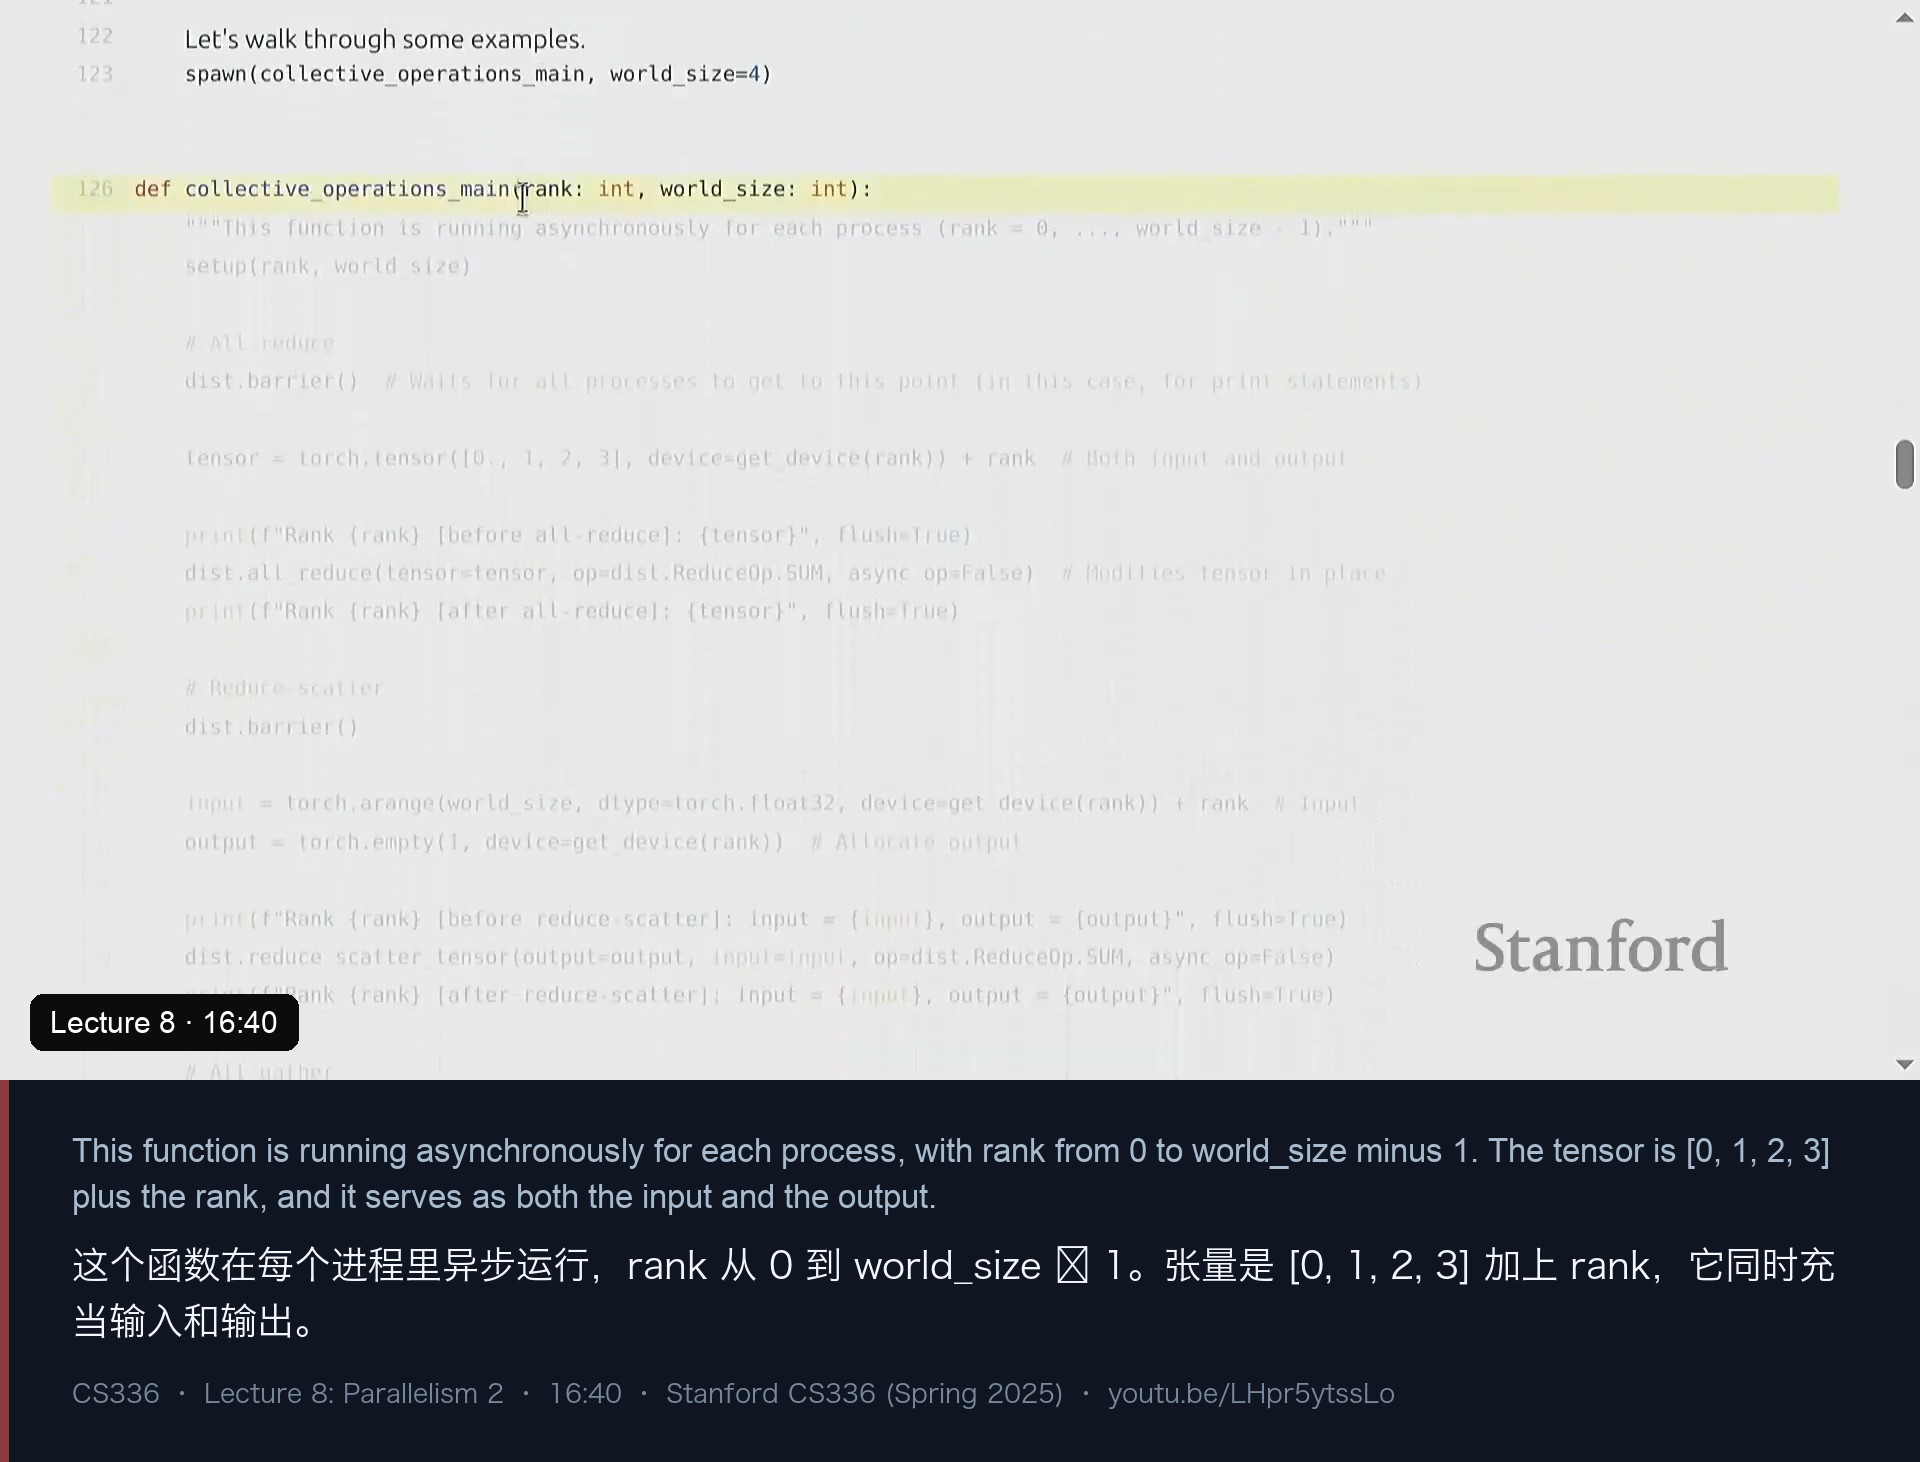
在 4 个 rank 上,张量分别是 [0,1,2,3]、[1,2,3,4]、[2,3,4,5]、[3,4,5,6](打印顺序不保证,因为是异步的)。op=SUM 且 async_op=False 地做完 all-reduce 之后,张量被就地覆盖为逐分量之和:
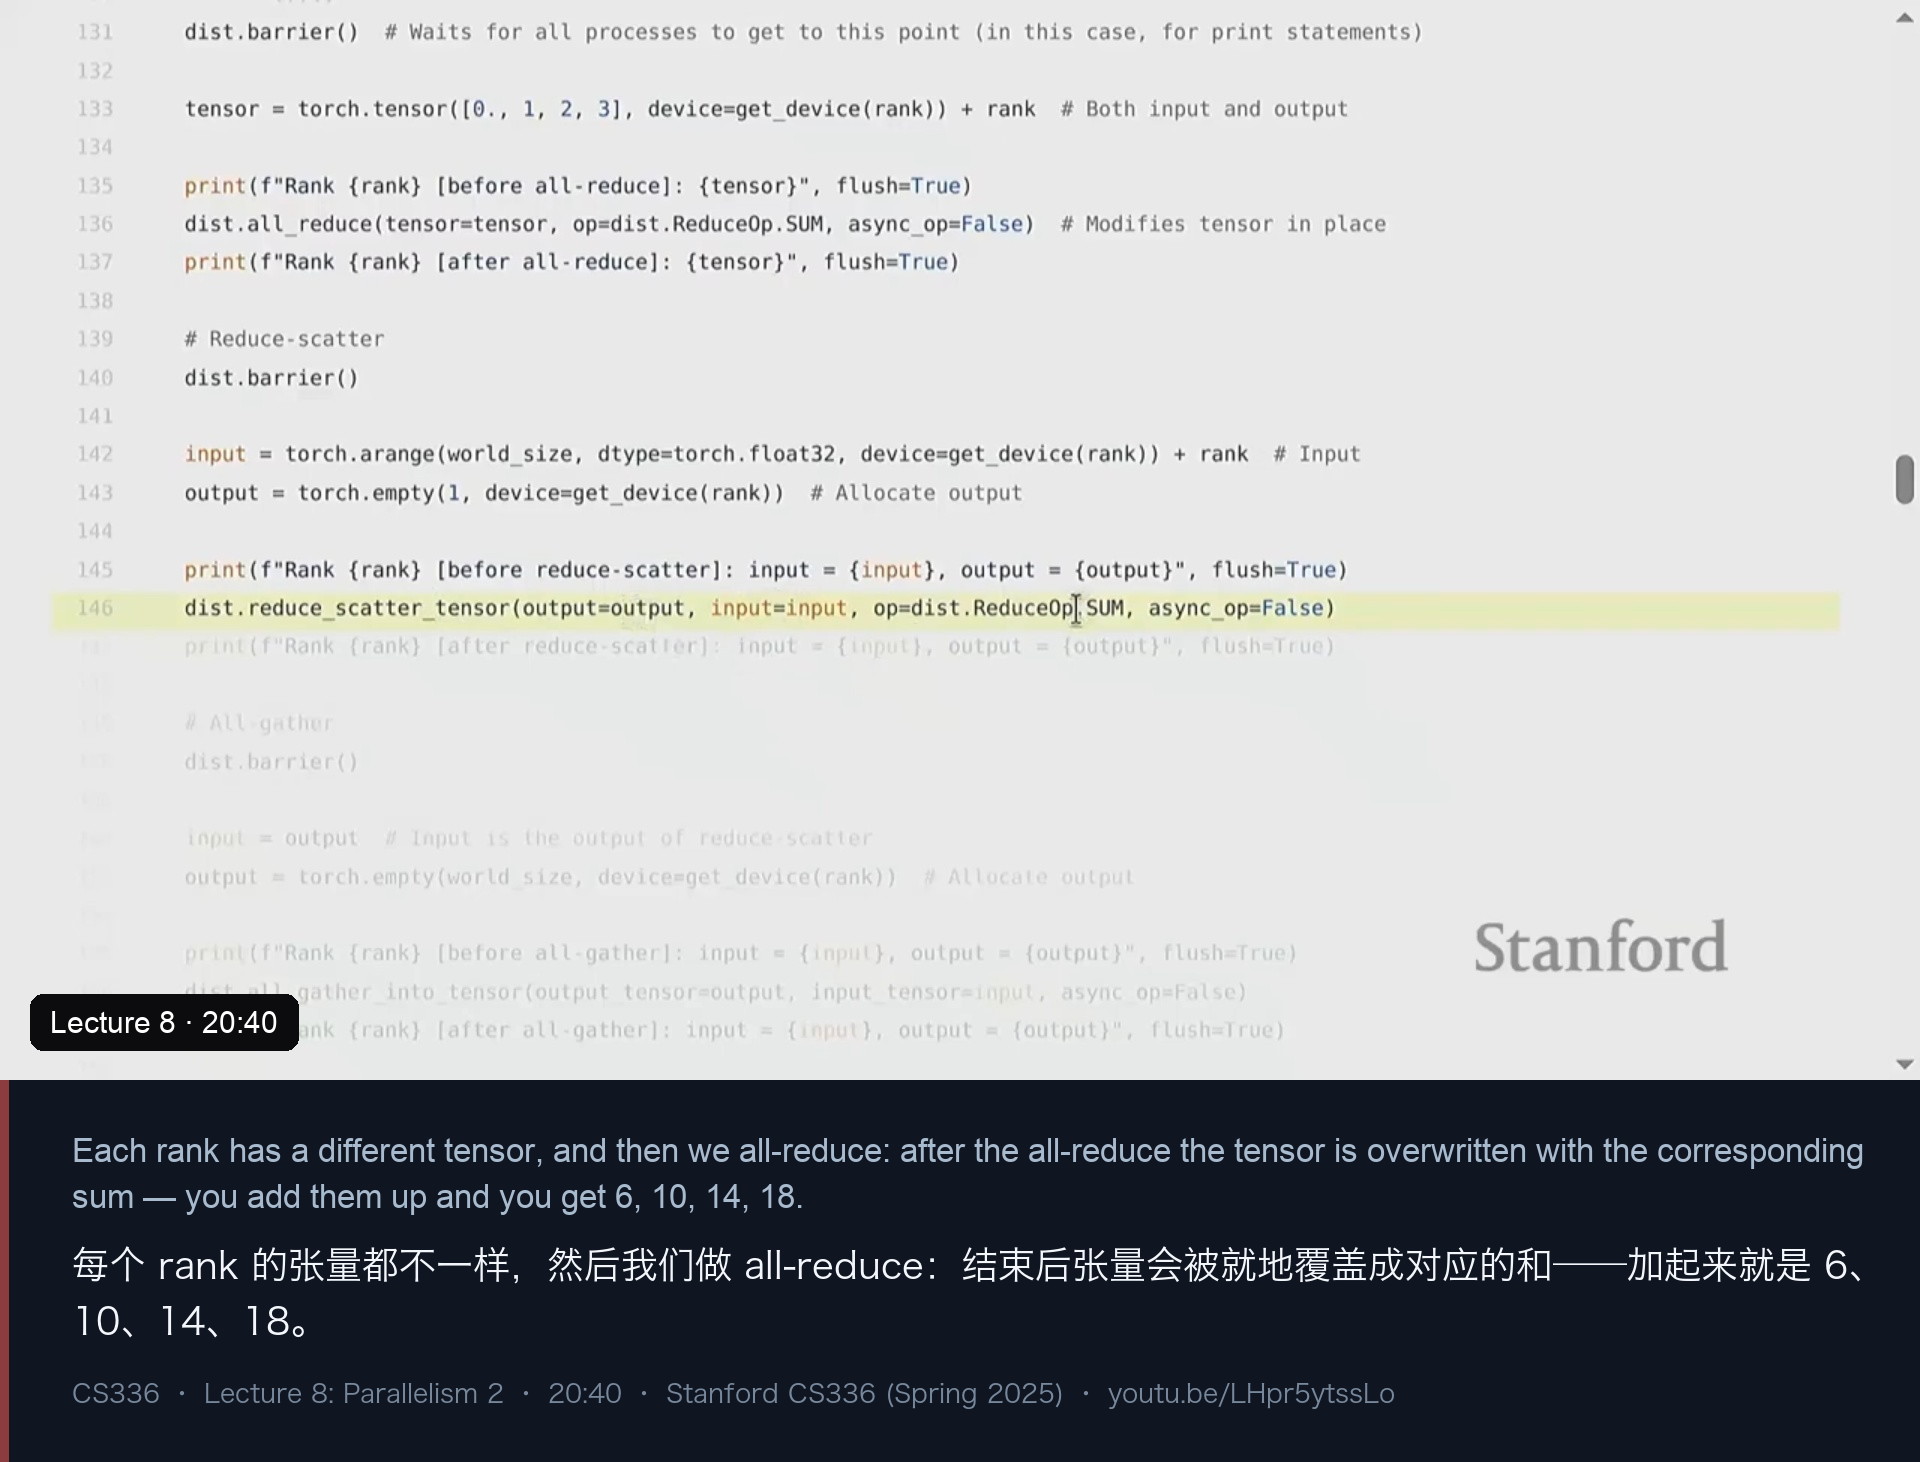
Rank 0 (after all-reduce): tensor([ 6., 10., 14., 18.], device='cuda:0')
Rank 1 (after all-reduce): tensor([ 6., 10., 14., 18.], device='cuda:1')
Rank 2 (after all-reduce): tensor([ 6., 10., 14., 18.], device='cuda:2')
Rank 3 (after all-reduce): tensor([ 6., 10., 14., 18.], device='cuda:3')顺带记一句:async_op=True 可以拿到一个句柄、把通信和计算重叠起来——这正是后面 FSDP 可以“几乎免费”的原因。
接下来是 reduce-scatter:输入规模是 world size 倍,输出是标量(而且不是就地操作)。结果是“第一个分量求和放到 rank 0、第二个放到 rank 1……”。再对这个输出做一次 all-gather,张量就会出现在所有设备上——算出来的量跟 all-reduce 一模一样,等价关系至此“亲眼验证”完毕。
一个容易被忽略、但会咬人的性质:all-reduce 是一个同步点。所有进程必须先到齐、再一起做;如果某个 rank 少调了一次集合操作,整个进程组就会挂住。
六、基准测试:277 GB/s 是怎么算出来的
“在第二讲的 spirit 下”,接下来做基准测试,先只看单节点。
设定:一个 1 亿个元素的张量、world size 4、fp32(4 字节)。做性能测量前要**“清一清味蕾”**:
# Warm up: run the operation once, then synchronize and barrier
# (defensive, but it makes sure all kernels are loaded and everything gets computed)
start_time = time.time()
dist.all_reduce(tensor, op=dist.ReduceOp.SUM, async_op=False)
if torch.cuda.is_available():
    torch.cuda.synchronize()   # Wait for CUDA kernels to finish
dist.barrier()                 # Wait for all the processes to get here
end_time = time.time()

duration = end_time - start_time
print(f"[all_reduce] Rank {rank}: ... took {render_duration(duration)}", flush=True)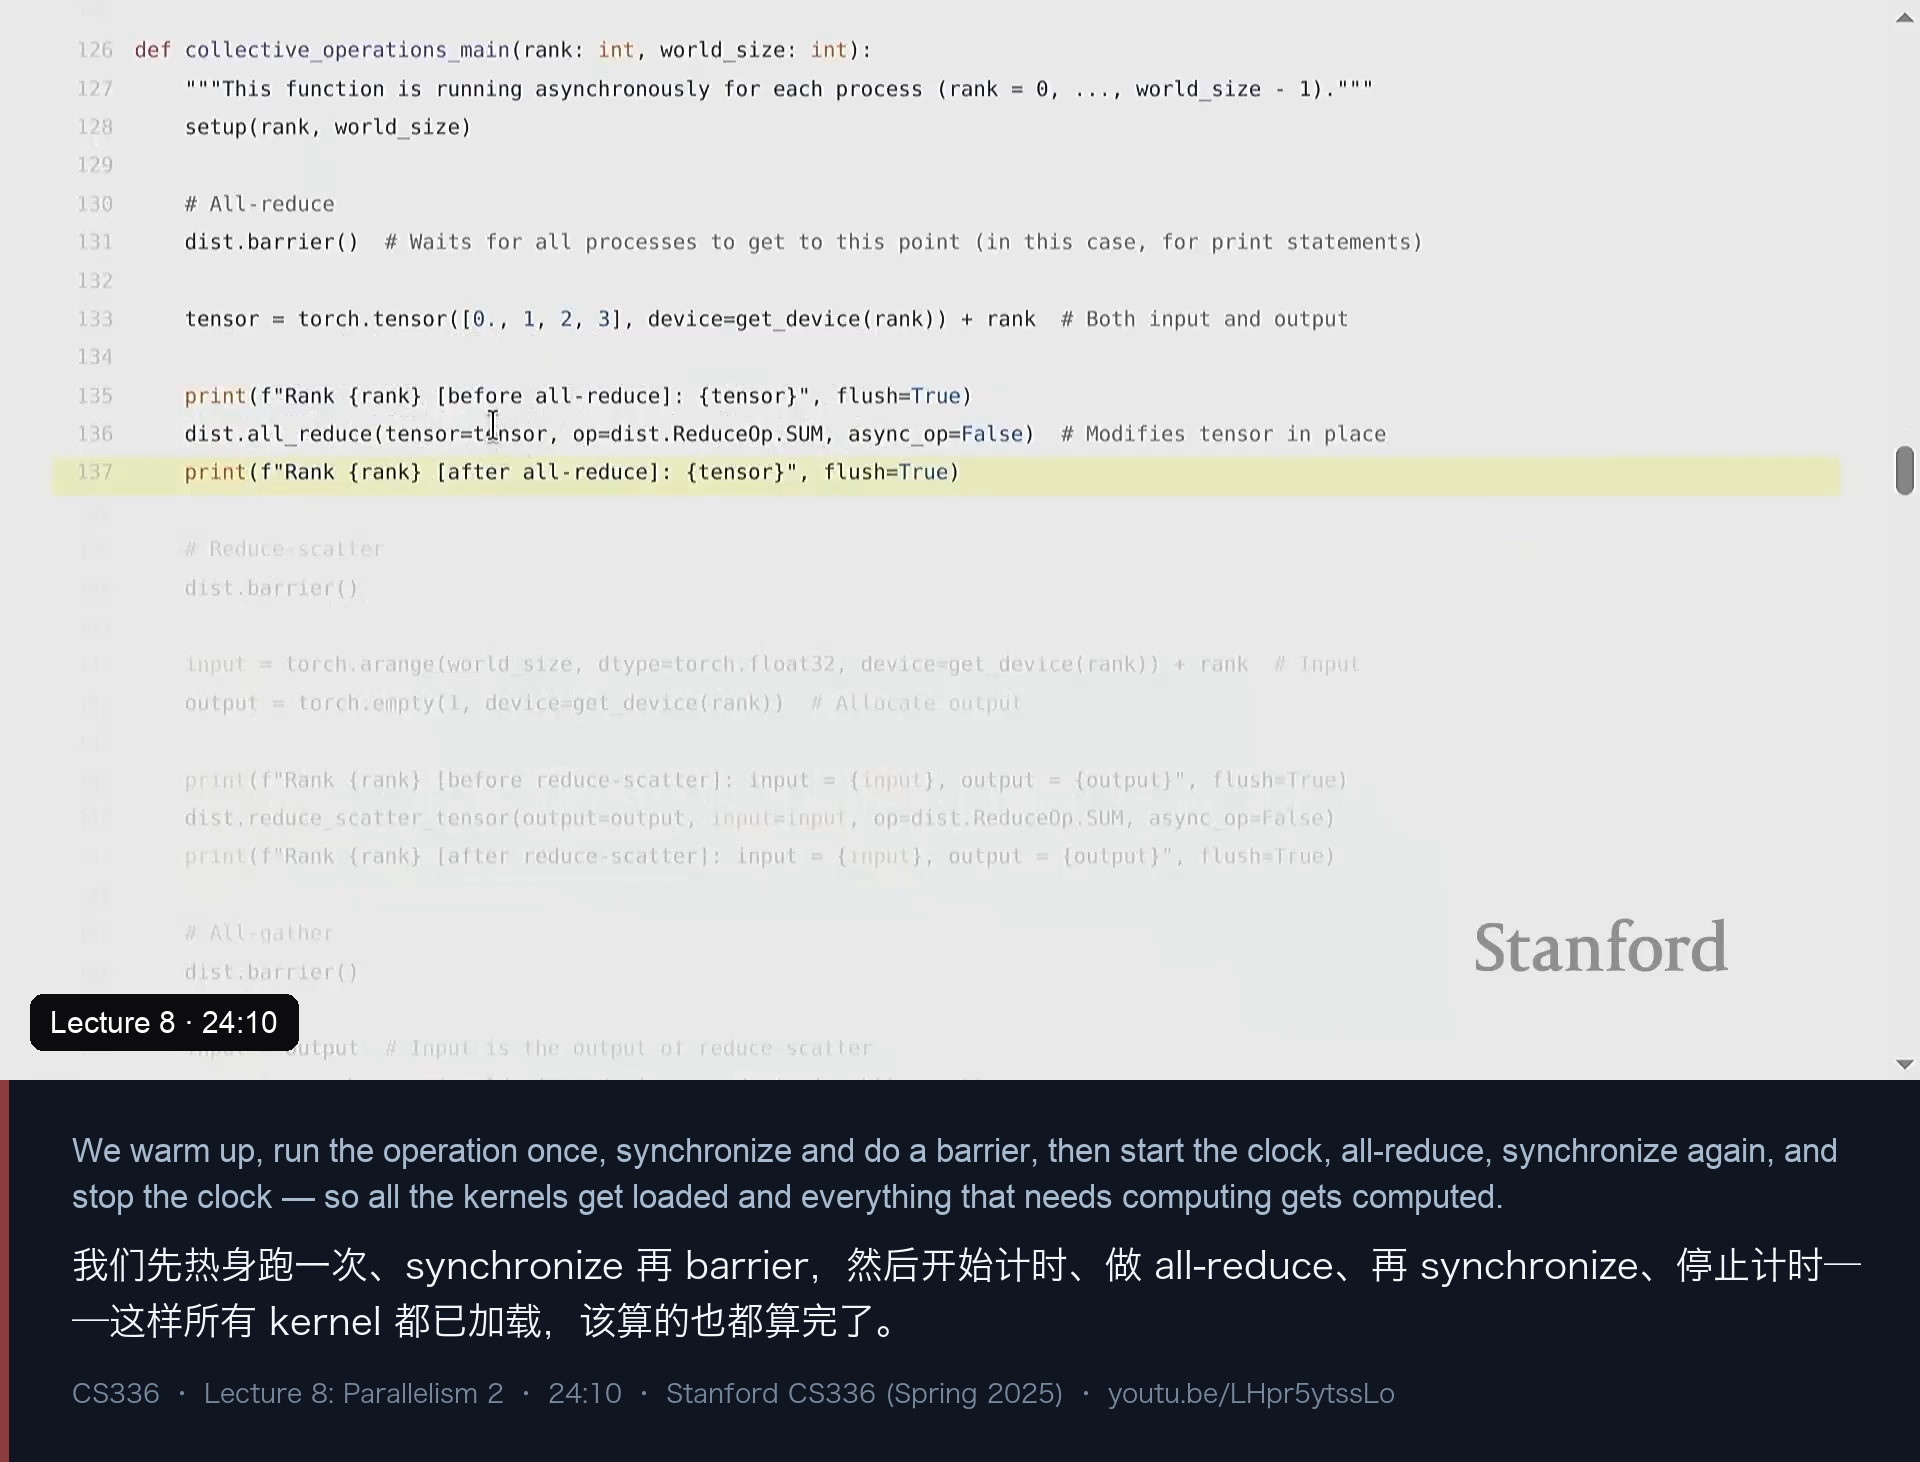
(一个小插曲:打印出来的耗时是 0.00ms,“这不太有信息量,我应该用微秒打印”。)
真正有意思的是怎么把“耗时”换算成带宽——这里必须想清楚“到底传了多少字节”:
size_bytes = tensor.element_size() * tensor.numel()
send_bytes = size_bytes * 2 * (world_size - 1) / world_size   # 2x because send input and receive output
duration = world_size * duration                              # aggregate across ranks
bandwidth = send_bytes / duration- 因子 2:all-reduce 既要发送输入,又要接收输出;
(world_size-1)/world_size:每个 rank 要把自己的数据发给其余 world_size−1 个 rank;- 乘 world_size:把各 rank 的耗时累加成“总工作量”。
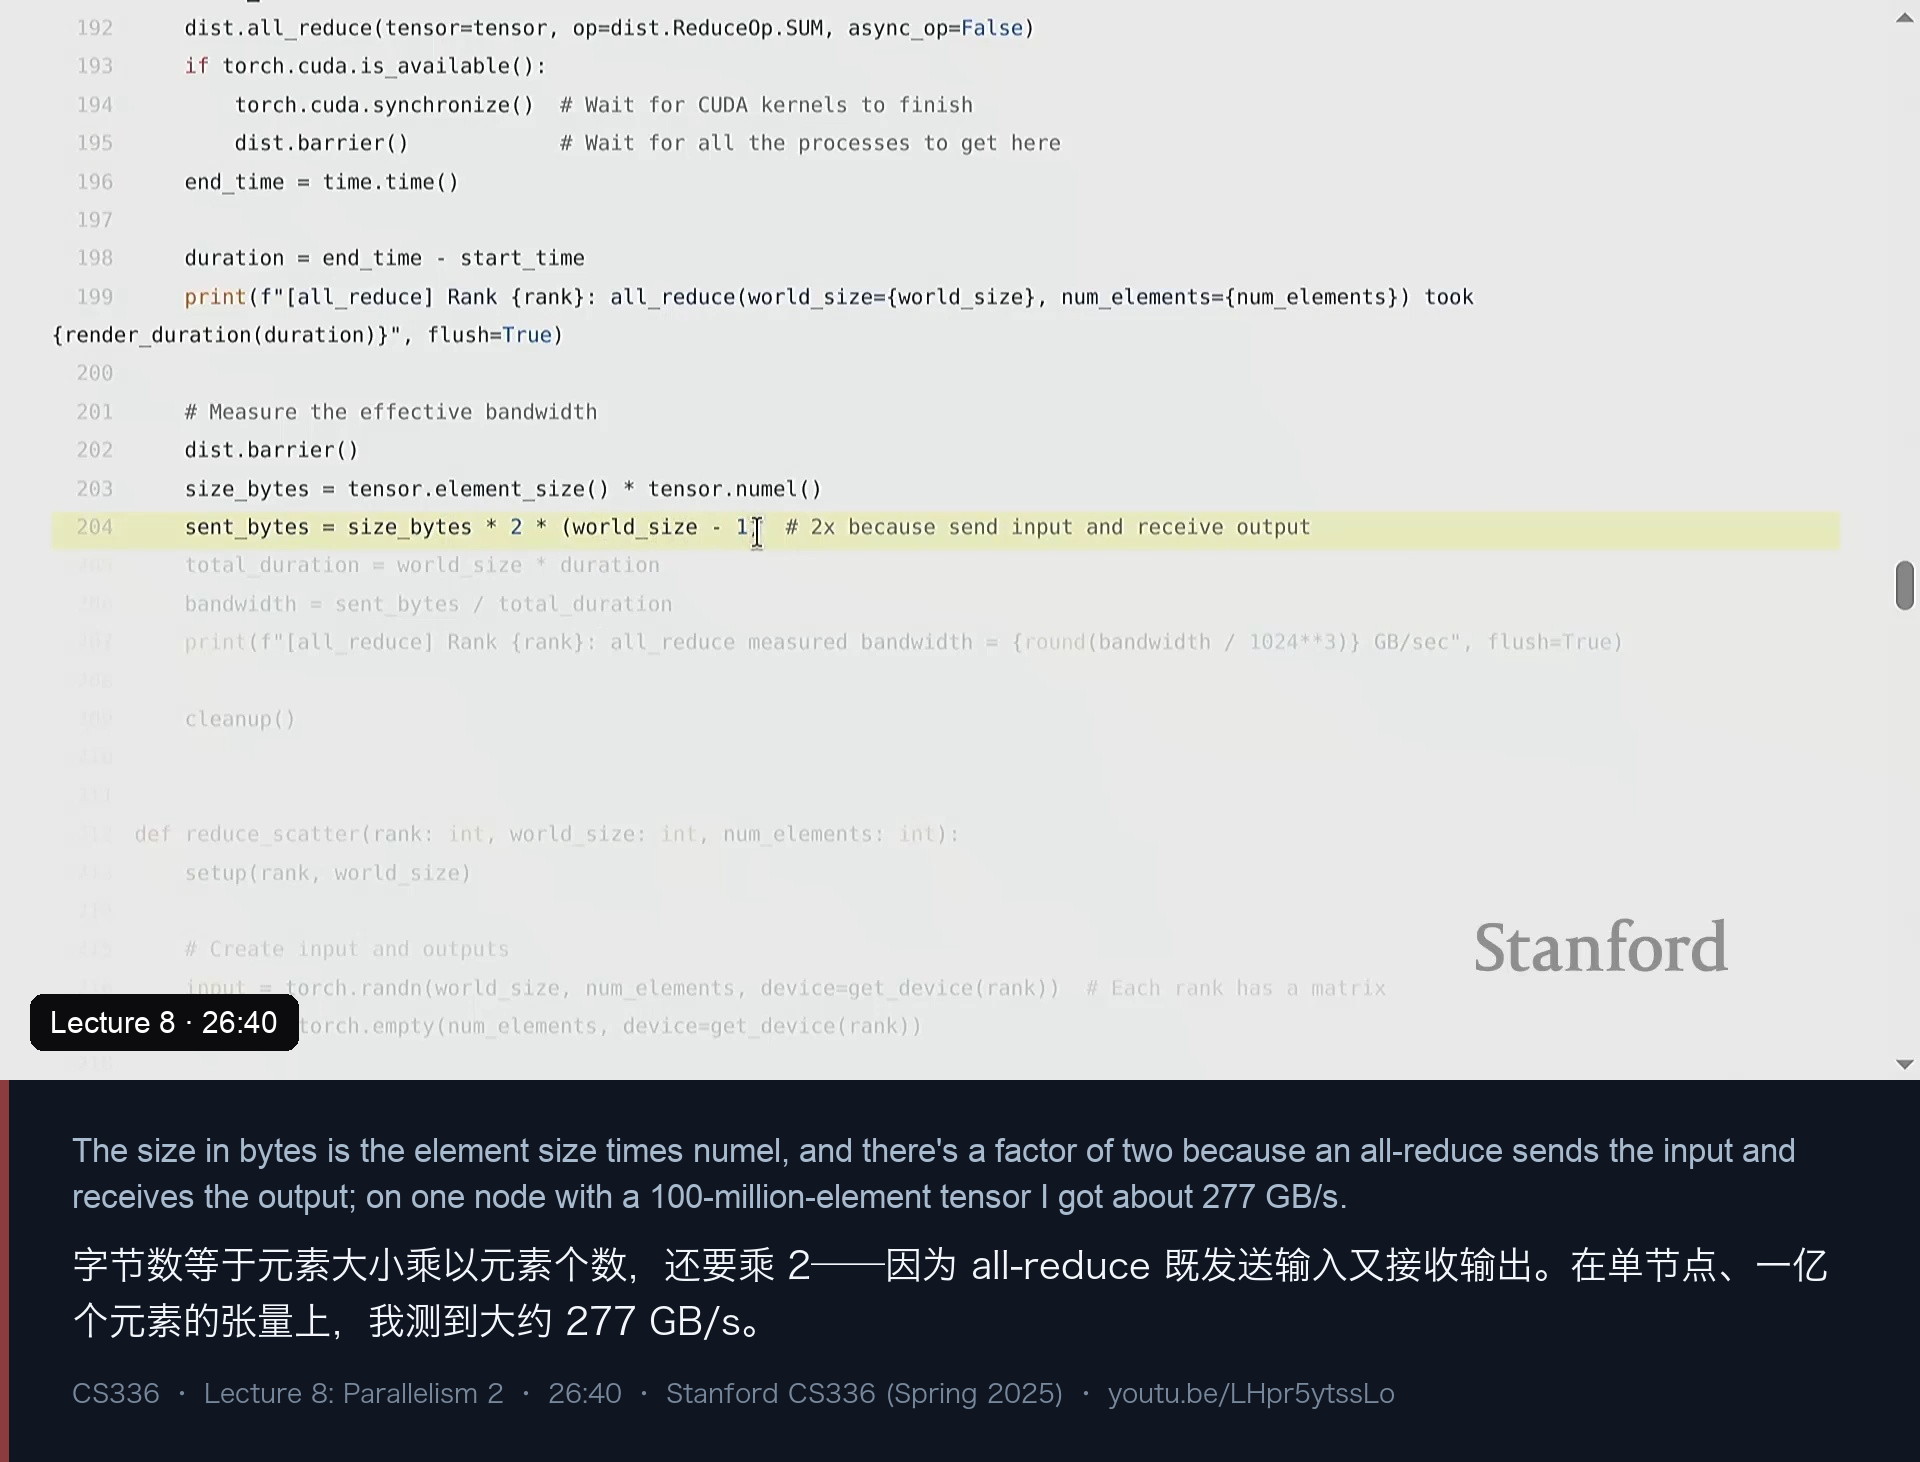
实测结果:all-reduce 约 277 GB/s。对比标称的 900 GB/s——“your mileage varies”:张量大小、设备数量、以及各种因素都会影响结果。所以一定要 benchmark,而不是从规格表推。
reduce-scatter 用同样的算法(但它没有因子 2,因为它本质上只是 reduce / scatter),得到约 70——明显更低。讲师说他不完全确定为什么差这么多,但可以推测:all-reduce 通常被优化得更好,而且 NVIDIA 的硬件有网内 reduction 加速(SHARP),能在网络里就把一部分计算做掉、省掉一个因子 2,“但不确定这能否完全解释这个差距”。NCCL 里发生了太多难以推理的事情——这就是为什么要测。
不过有一个漂亮的收尾:reduce-scatter 和 all-gather 各自都不带因子 2,两个加起来正好是 2——又一个角度看到 all-reduce 等于这两步之和。
七、数据并行:在别人的 SGD 里插一行
从这一节起进入 Part 2:用最朴素的实现,把每种并行策略在深度 MLP 上各写一遍。为什么用 MLP?因为在 Transformer 里 MLP 才是算力瓶颈(不是注意力),所以这个简单架构其实相当有代表性。
切法可以先用一张图记住:数据并行沿 batch 切、张量并行沿宽度(隐层)切、流水线并行沿深度(层)切。
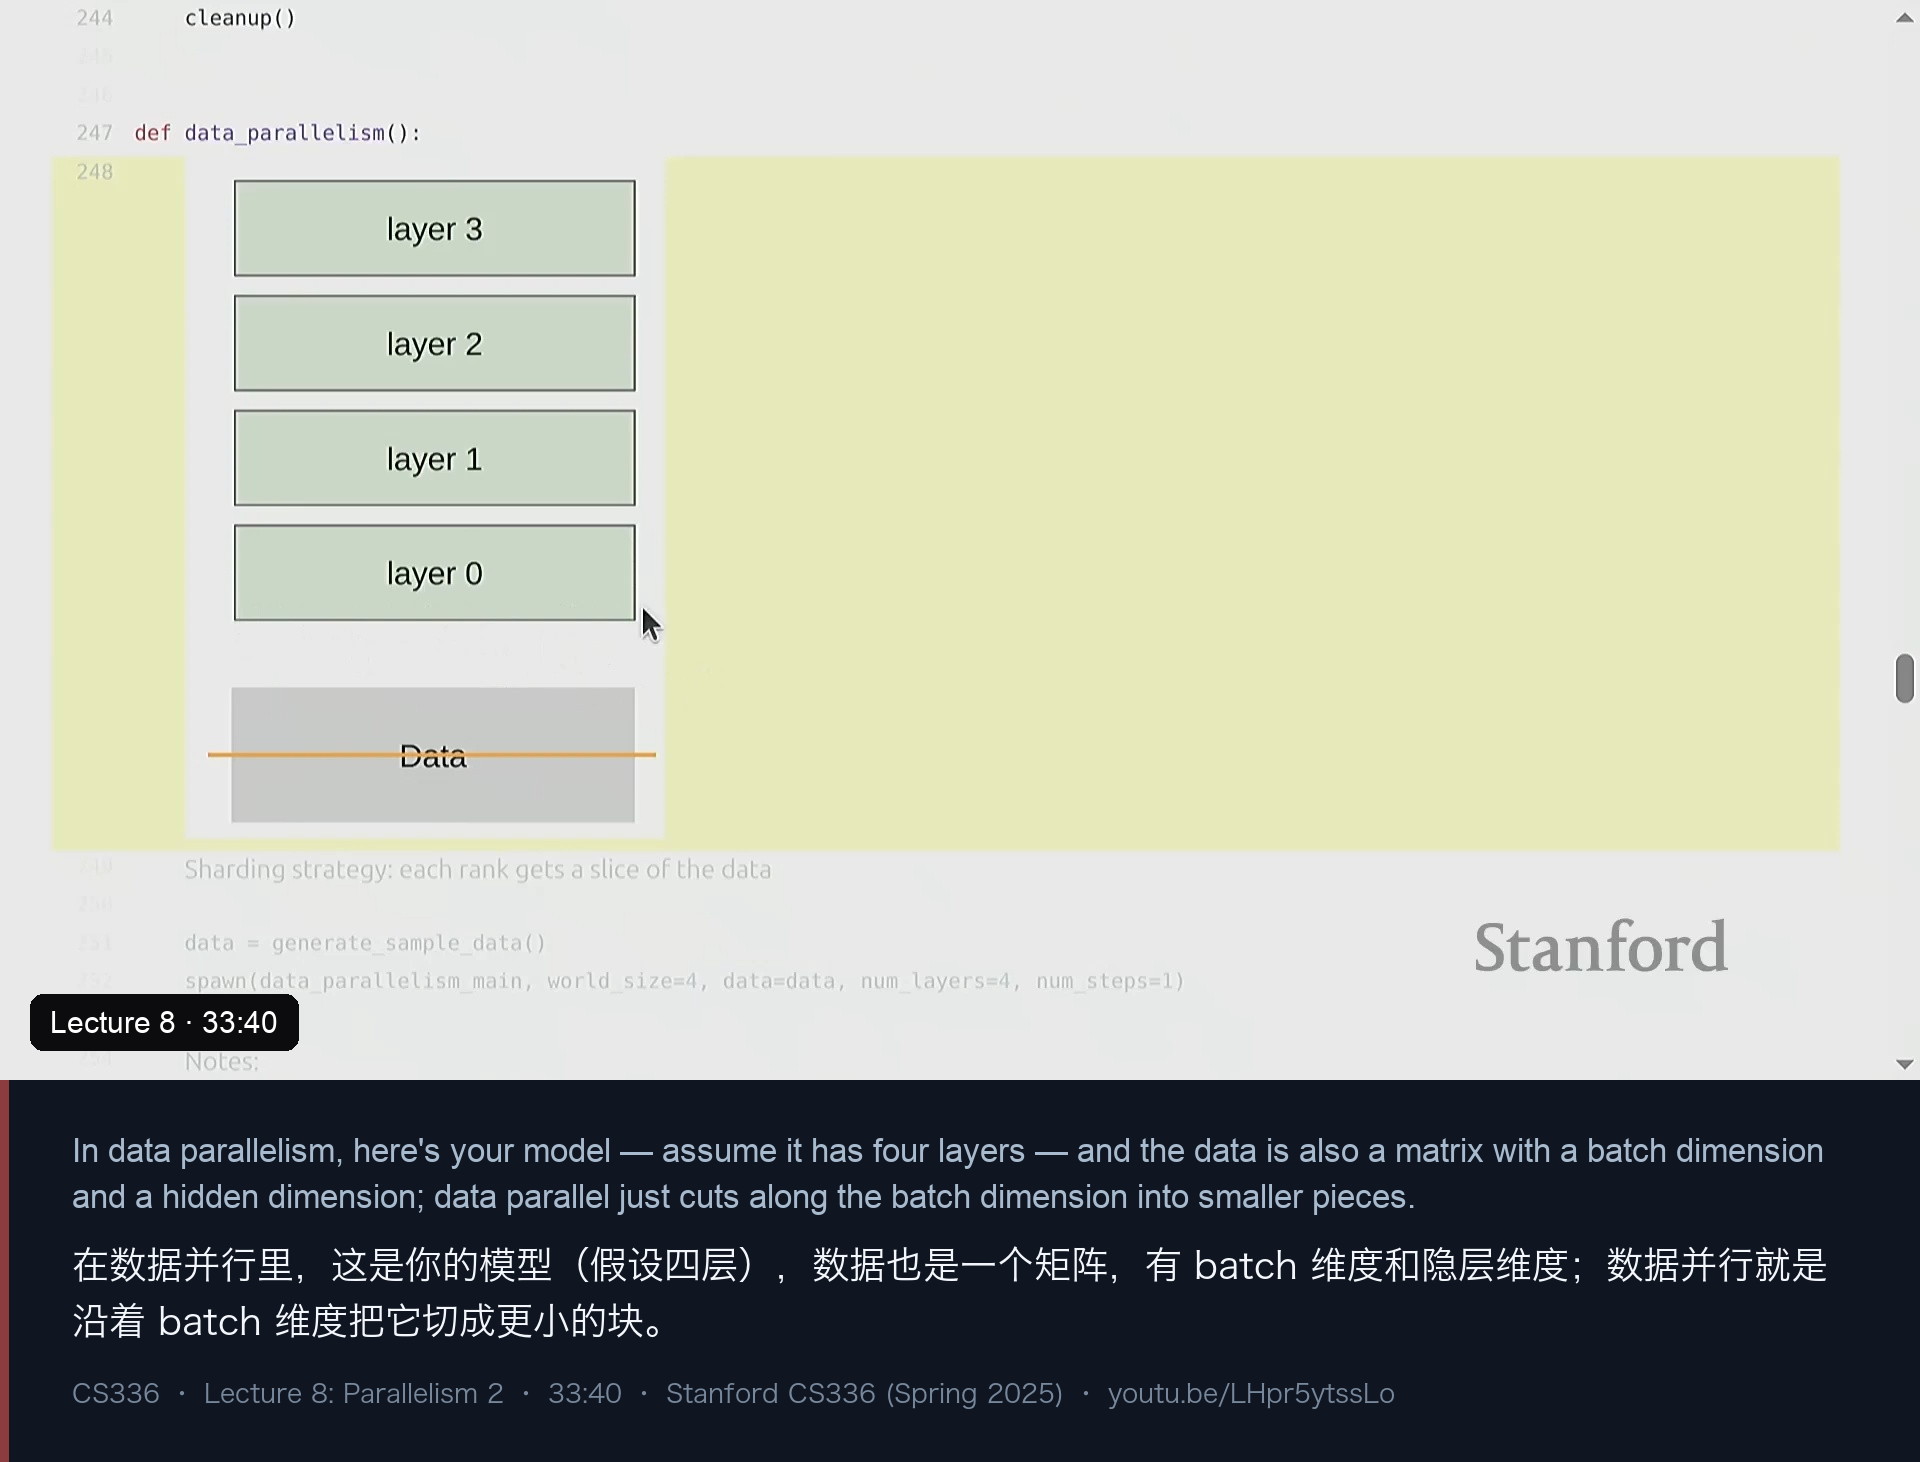
batch_size=128, num_dim=1024,于是 local_batch_size = 128 / world_size;每个 rank 根据自己的 rank 算出 start_index / end_index,直接伸手把对应的那几行数据抓出来:
local_batch_size = int_divide(batch_size, world_size)
start_index = rank * local_batch_size
end_index = start_index + local_batch_size
data = data[start_index:end_index]
然后建模型(四层 num_dim × num_dim 的矩阵)、建优化器,开始训练。前向是“矩阵乘 → 非线性 → 矩阵乘 → 非线性”,四层,算一个(随便编的)loss,反向。
到这里为止,它就是一个普通的单卡 SGD。 实现 DDP 的全部代价是插入这一行:
for i, param in enumerate(params):
    # Sync gradients across workers (only difference between standard training and DDP)
    dist.all_reduce(param.grad, op=dist.ReduceOp.AVG, async_op=False)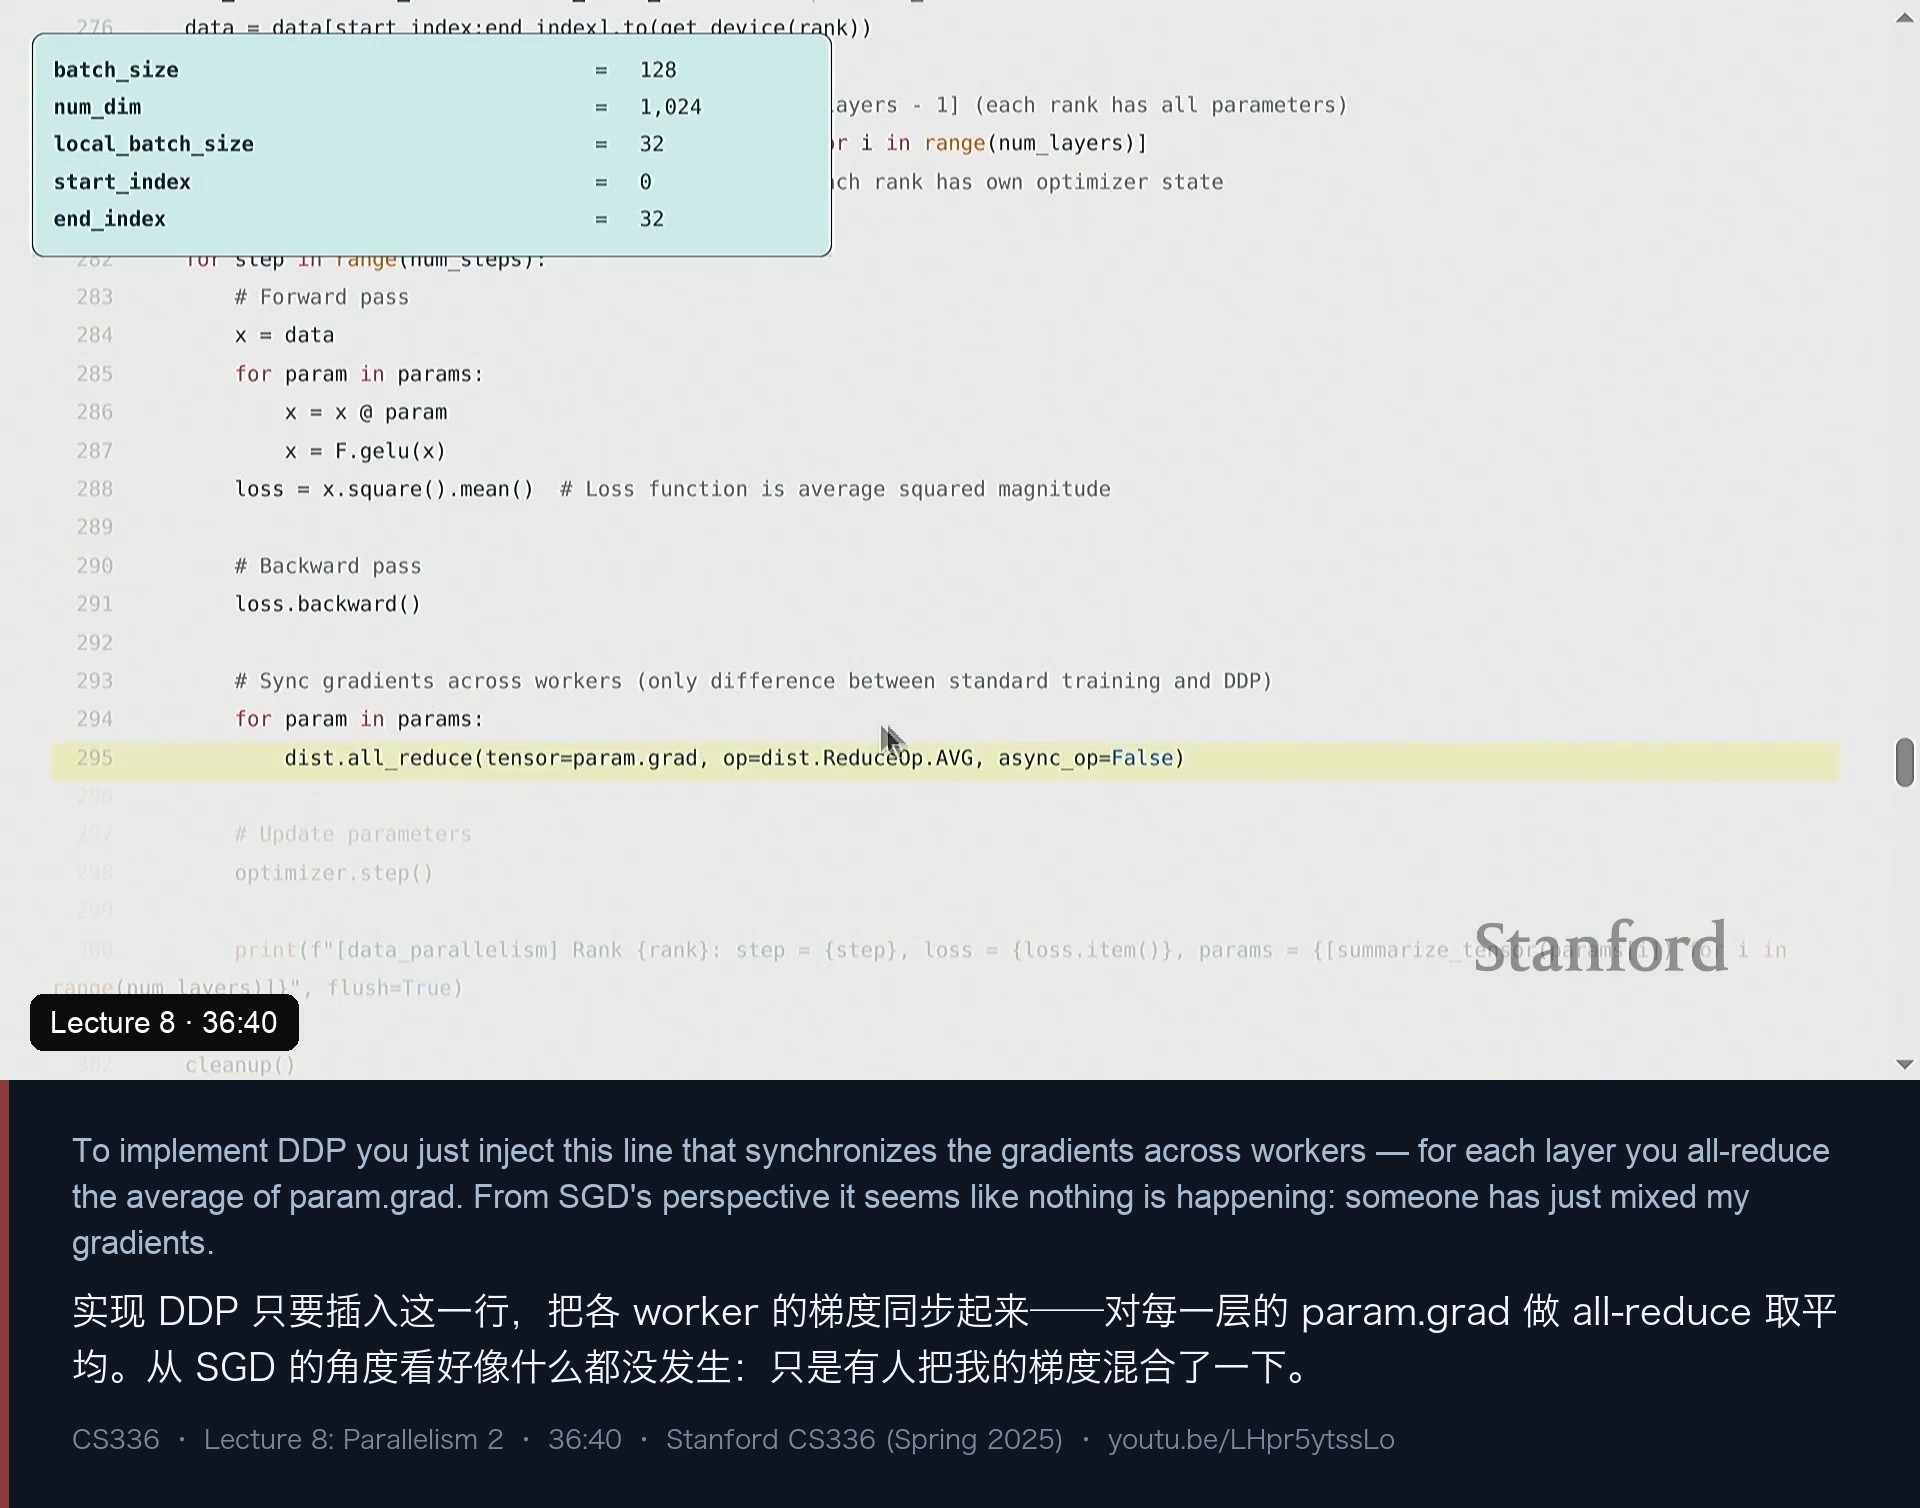
讲师的原话很妙:这就像你劫持了别人的 SGD 代码,说“等等,我其实要把梯度混合一下”——从 SGD 的角度看,什么都没发生。
输出里有两个细节值得注意:
- 各 rank 的 loss 是不同的,因为各自看到的数据不同;
- 但 all-reduce 之后参数完全一致——相当于跑了 world_size 份 SGD,只是被强行同步成“在做同一件事”。
有学生问:怎么保证各进程真的在同一个 step?答案就是”all-reduce 本身是同步点“:它会等到所有进程到齐。也正因如此,少一次集合调用就会挂住。
至于优化器状态:数据并行不做分片,每台机器都存一份完整优化器状态、各算一遍更新。这其实很像 activation checkpointing 的逻辑——宁愿多算一遍,也不愿意把优化器状态搬来搬去,因为后者慢得多。(想做分片,就是上一讲的 ZeRO/FSDP;作业 2 会在 Transformer 上实现 DDP。)
八、张量并行:沿宽度切,然后一路 all-gather
张量并行的图画起来正好和上面对偶:数据保持不变,把模型沿隐层维度切开。每个 rank 依然拿到每一层,但每一层只拿到一部分——1/world_size 的参数。
local_num_dim = int_divide(num_dim, world_size)   # 1024 / 4 = 256
params = [get_init_params(local_num_dim, num_dim) for i in range(num_layers)]
于是每层的激活是 batch × local_num_dim——只有完整激活的一部分。所以前向必须做一次通信 + 拼接才能继续往下一层走:
x = data
for i in range(num_layers):
    x = x @ params[i]        # Note: this is only on a slice of the parameters
    x = F.gelu(x)

    # All-gather along the hidden dimension
    activations = [torch.empty(local_batch_size, local_num_dim, device=get_device(i))
                   for i in range(world_size)]
    dist.all_gather(activations, x, async_op=False)
    x = torch.cat(activations, dim=1)   # now batch × num_dim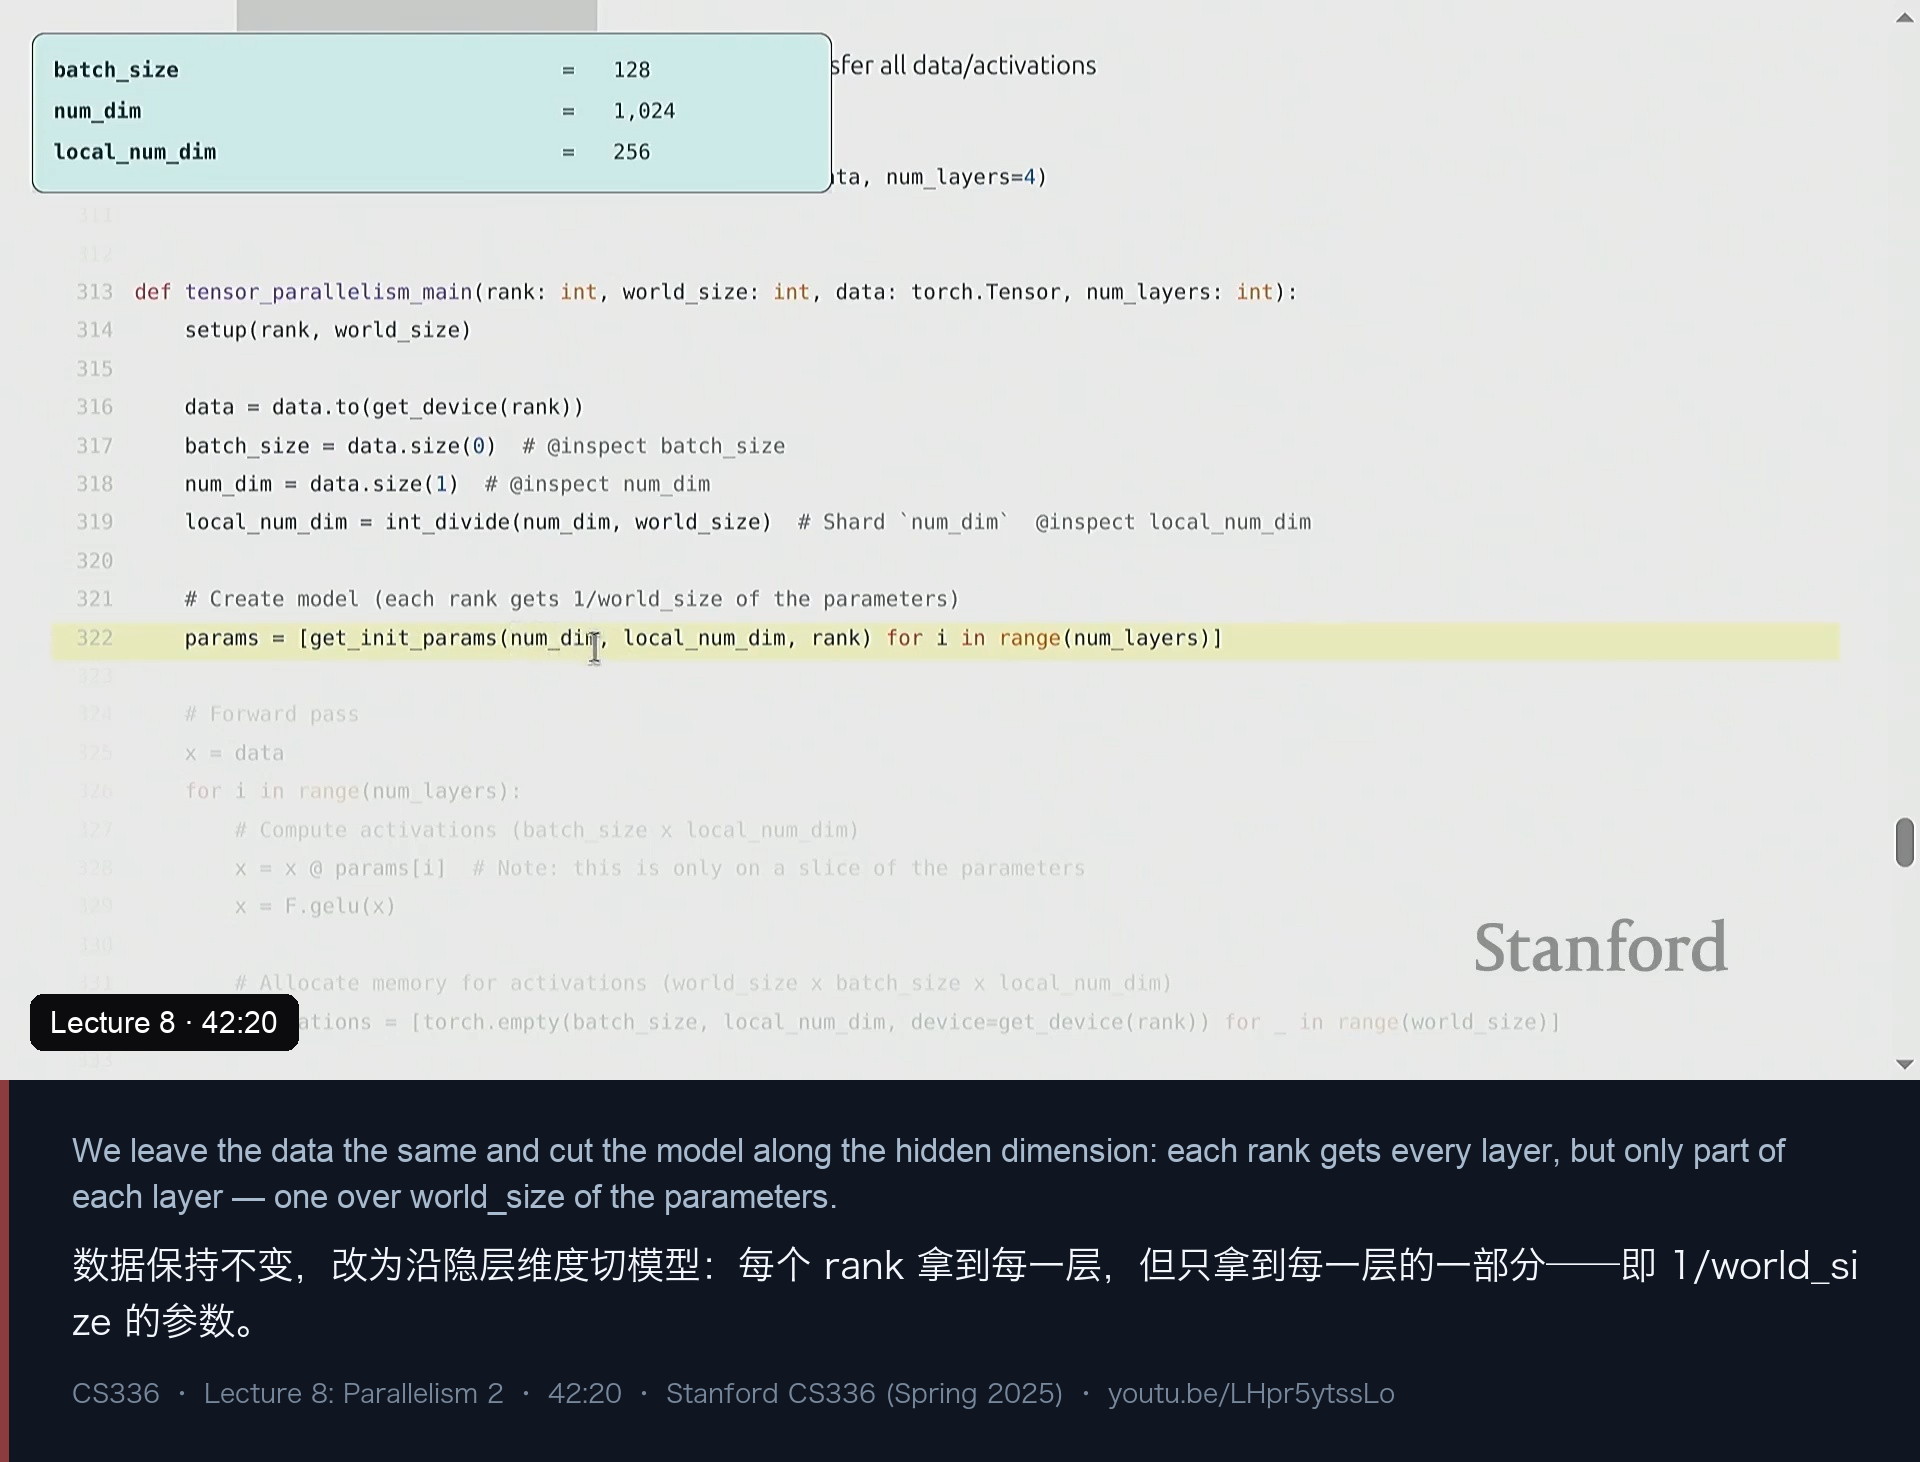
这里面有相当多的通信——这正是上一讲 Tatsu 强调“张量并行需要很高的互连带宽、只适合单机 8 卡以内”的原因:它把激活在每一层之间搬来搬去。
课上没有实现张量并行的反向传播——不是因为它难,而是“在有限的时间与篇幅里需要多一点工作”。不过要记住它的一个优点:张量并行不消耗 batch size(数据不变),这正好和流水线并行形成互补。
九、流水线并行:按层切、micro-batch 与点对点通信
最后一种切法是沿深度切:
- 所有 rank 都拿到全部数据(数据不变);
- 每个 rank 拿到一整层,但是不同层。
四层网络配两个 rank,每个 rank 就负责两层,与上一讲的示意图完全一致。每个 rank 只分配自己那两层的参数,然后跑前向。
朴素地跑会有巨大的流水线气泡(上一讲算过)。缓解办法是把 batch 拆成 micro-batch:
# Break up into micro batches to minimize the bubble
num_micro_batches = 4
micro_batch_size = int_divide(batch_size, num_micro_batches)   # 128 / 4 = 32

if rank == 0:
    micro_batches = data.chunk(chunks=num_micro_batches, dim=0)   # The data
else:
    micro_batches = [torch.empty(micro_batch_size, num_dim, device=get_device(rank))
                     for _ in range(num_micro_batches)]           # Allocate memory for activations

for x in micro_batches:
    # Get activations from previous rank
    if rank - 1 >= 0:
        dist.recv(tensor=x, src=rank - 1)

    # Compute layers assigned to this rank
    for param in local_params:
        x = x @ param
        x = F.gelu(x)

    # Send to the next rank (asynchronously)
    if rank + 1 < world_size:
        dist.send(tensor=x, dst=rank + 1)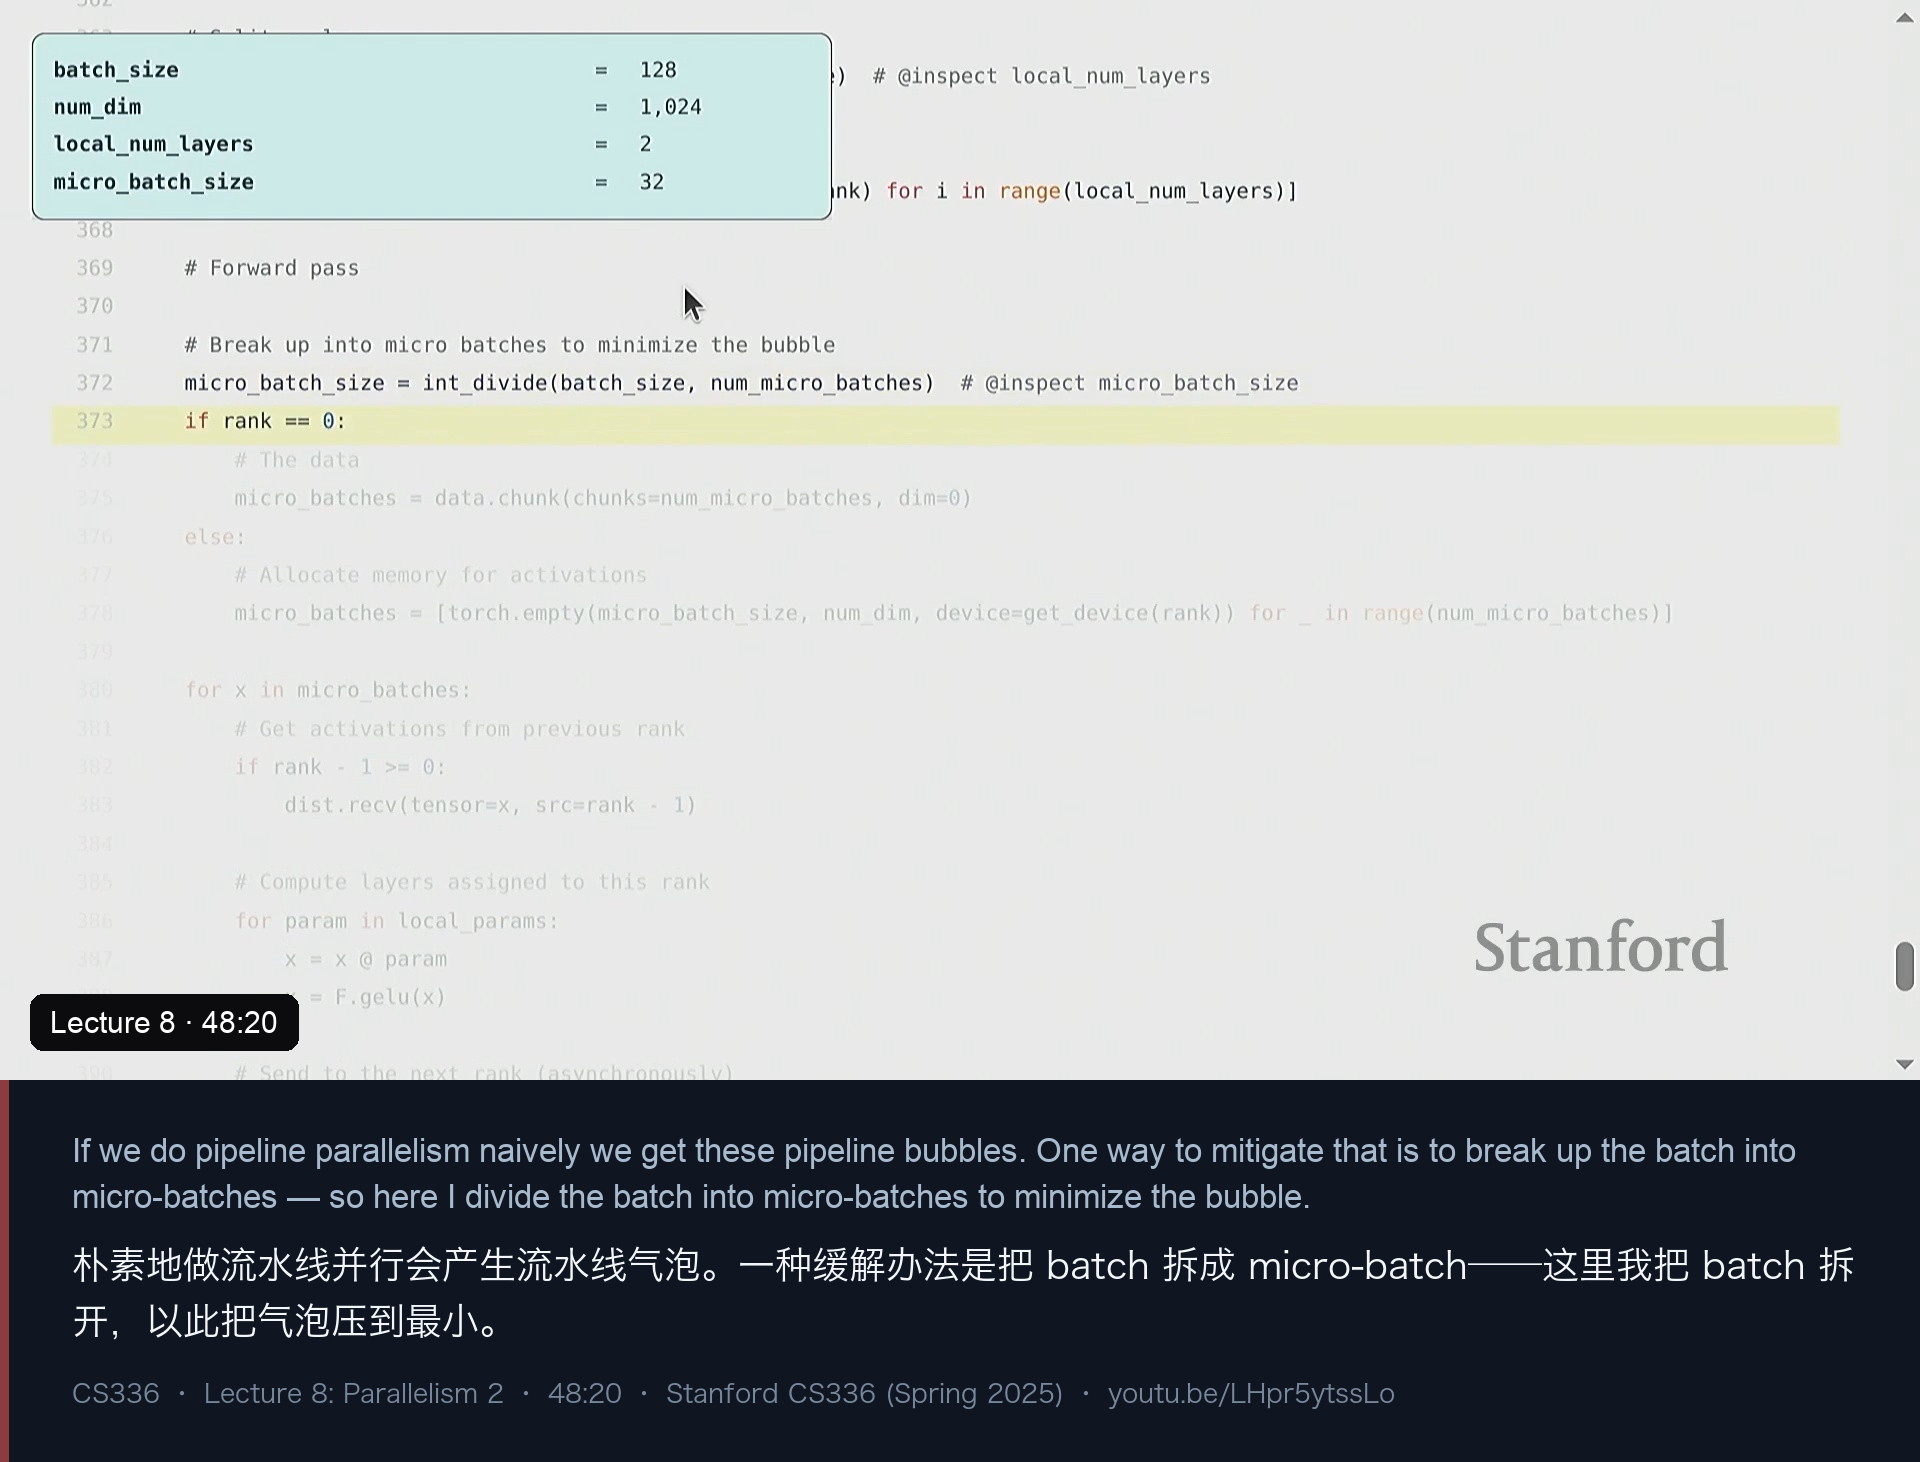
三个要点:
- 通信原语换成了点对点:
dist.recv(src=rank-1)/dist.send(dst=rank+1),不再是集合操作; - rank 0 是数据入口(把 batch 切成 micro-batch),最后一个 rank 拿到的是完整前向的结果;
- 课上这版故意是最朴素的:
recv/send都是同步的,没有做通信/计算重叠,也没有交错前向与反向。改进方式是:用异步 send(拿到句柄、把发送都发出去、最后统一 wait),并重新调度反向里的步骤。
问答里澄清了两件事:
- 这不是事件驱动编程。事件驱动是“写一堆 handler,鼠标点击/文件就绪就触发”;而这里是锁步(lock step)的——每个 rank 就在等“上一个 rank 发来的东西”,而且它不从任意来源收,只从一个固定的 src 收。讲师补充:十多年前流行过的异步训练(参数服务器,梯度就绪就上传、worker 挂掉也能容忍)确实更像事件驱动,但现代的大规模训练基本都回到同步范式了。
- 收发顺序:如果同一个 rank 向同一个目的地连发两次,它们会被放进同一个 stream、顺序得以保留;而
recv只是“把来自这个 src 的下一条消息收进来”。另外,如果发了却没人收,send会一直阻塞——因为代码没法知道“对方永远不会来”还是“只是还没到”。
十、还缺什么:通信/计算重叠、簿记,以及 JAX 的十行代码
三个简单例子讲完,讲师很诚实地列了一张“缺什么”的清单:
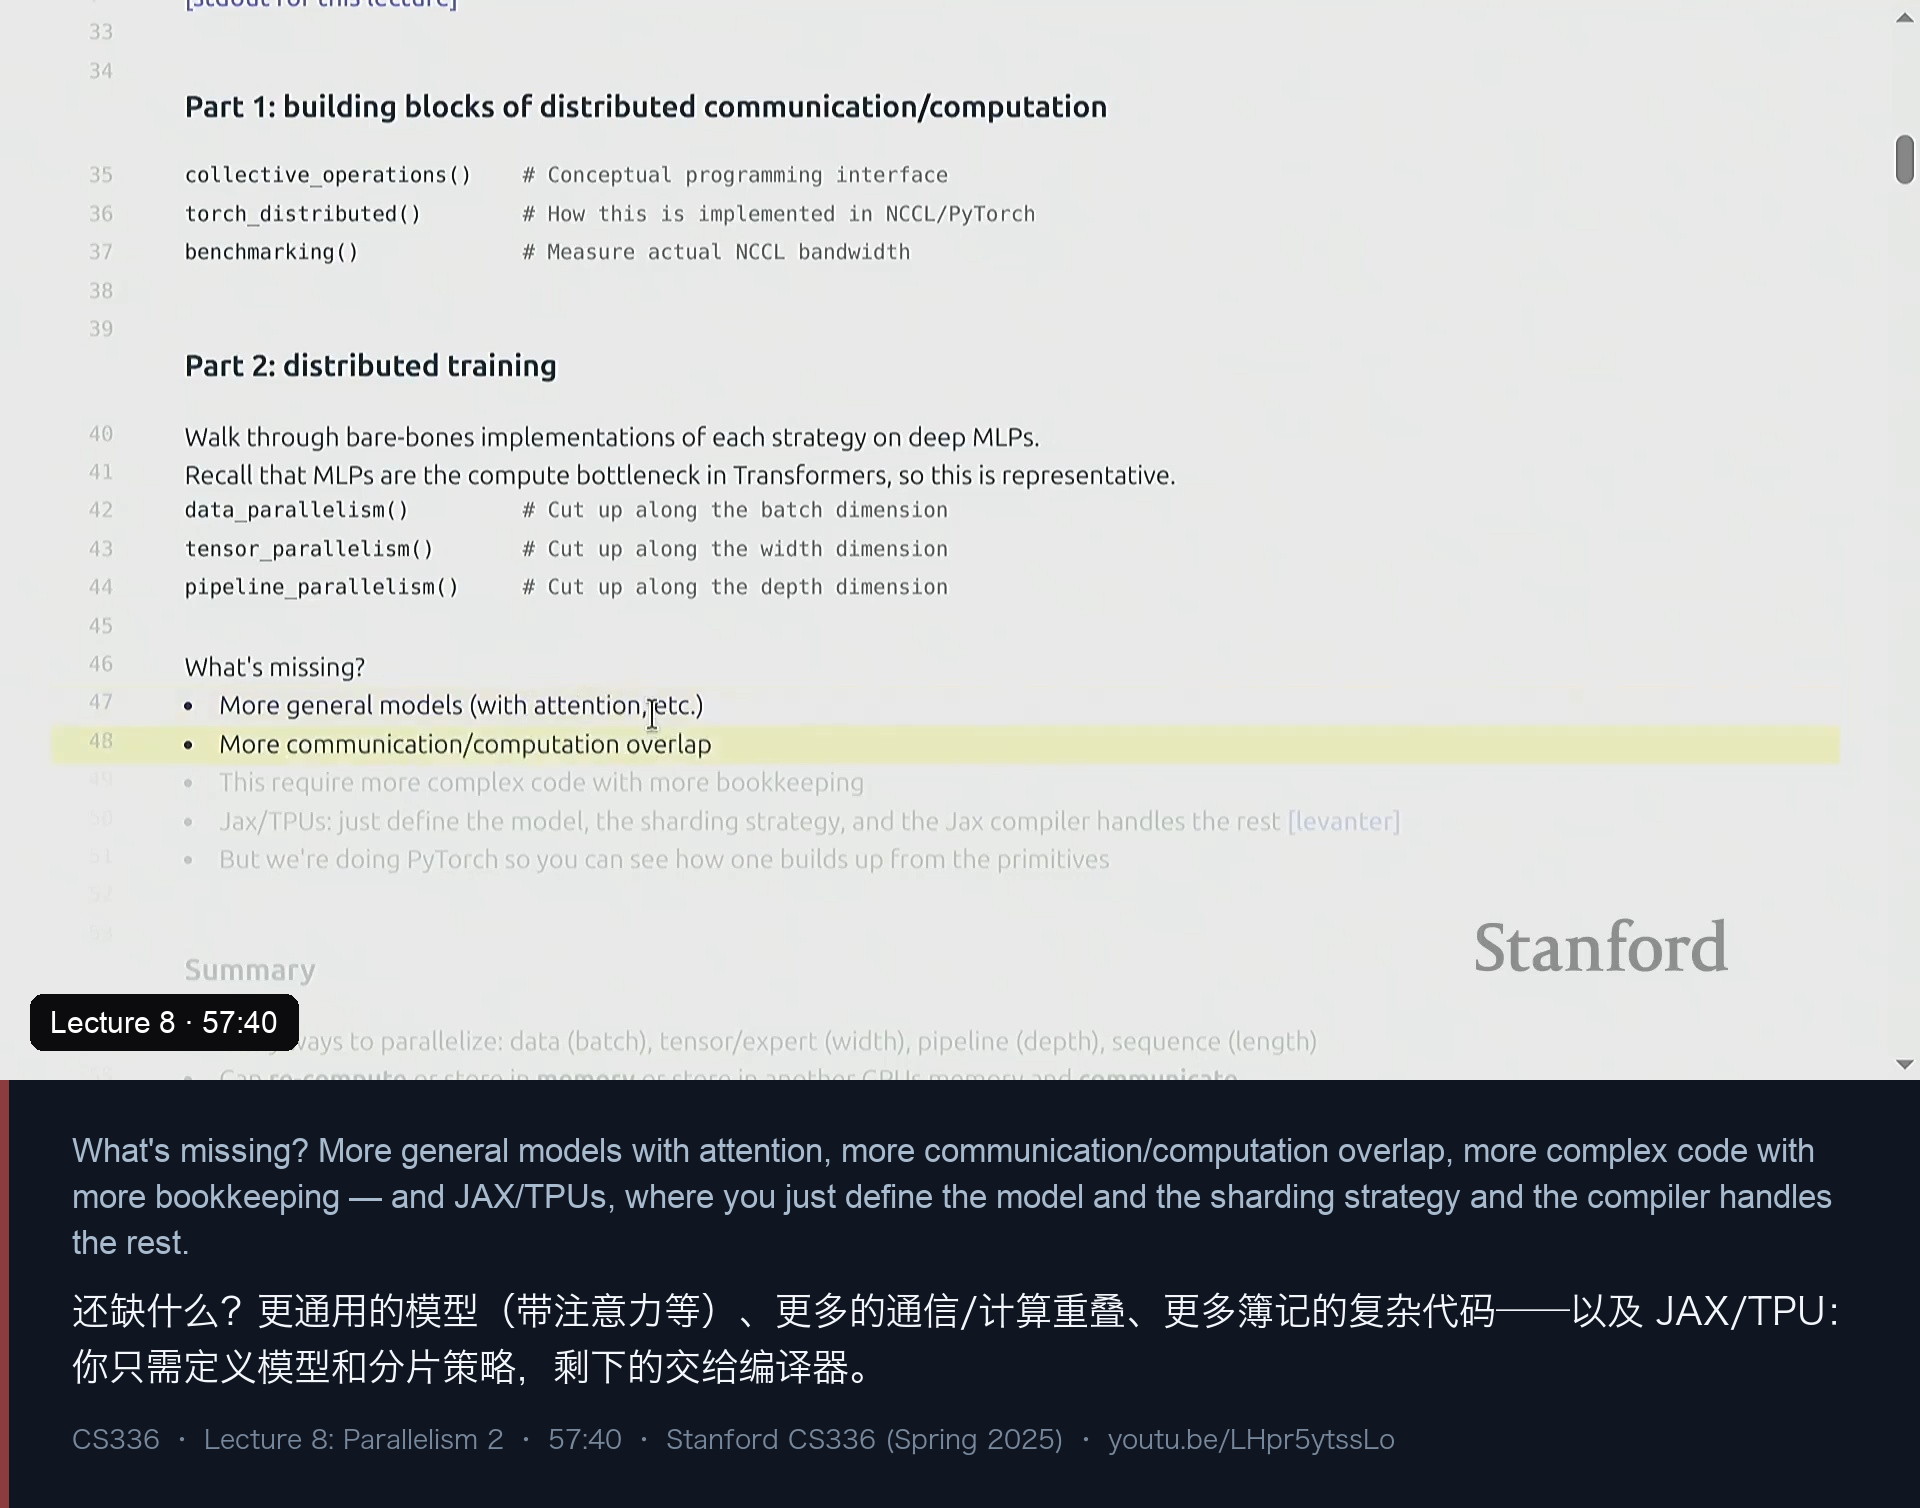
- 更一般的模型:这里只有 MLP,真实训练要处理注意力等结构;
- 通信/计算重叠:这版实现完全没有认真处理;
- 簿记(bookkeeping):MLP 的切法是我们手写死的,而要支持任意架构,就得自动推断参数、层、该怎么切——一旦这样,代码会“相当毛”(Megatron-LM、PyTorch FSDP 就是明证),A2 里你会体会一部分;
- JAX/TPU 是另一条路:只需定义模型、定义分片策略,剩下的交给 JAX 编译器。
于是有了这段“离题但不离题”的十行代码。在 JAX 里,你声明参数怎么切、数据怎么切:
# We store our parameters and optimizer states fully sharded along the embed axis
param_mapping = {"embed": "data"}

# During computation, we instead shard our data along the batch axis, and gather
# the parameters just-in-time
data_mapping = {"batch": "data"}

# ++ Specify which axes we shard for tensor parallelism:
# ++ specifying "head" shards attention and "mlp" shards the feedforward
tensor_parallel_mapping = {"head": "model", "mlp": "model"}
param_mapping = {"embed": "data", **tensor_parallel_mapping}
data_mapping  = {"batch": "data", **tensor_parallel_mapping}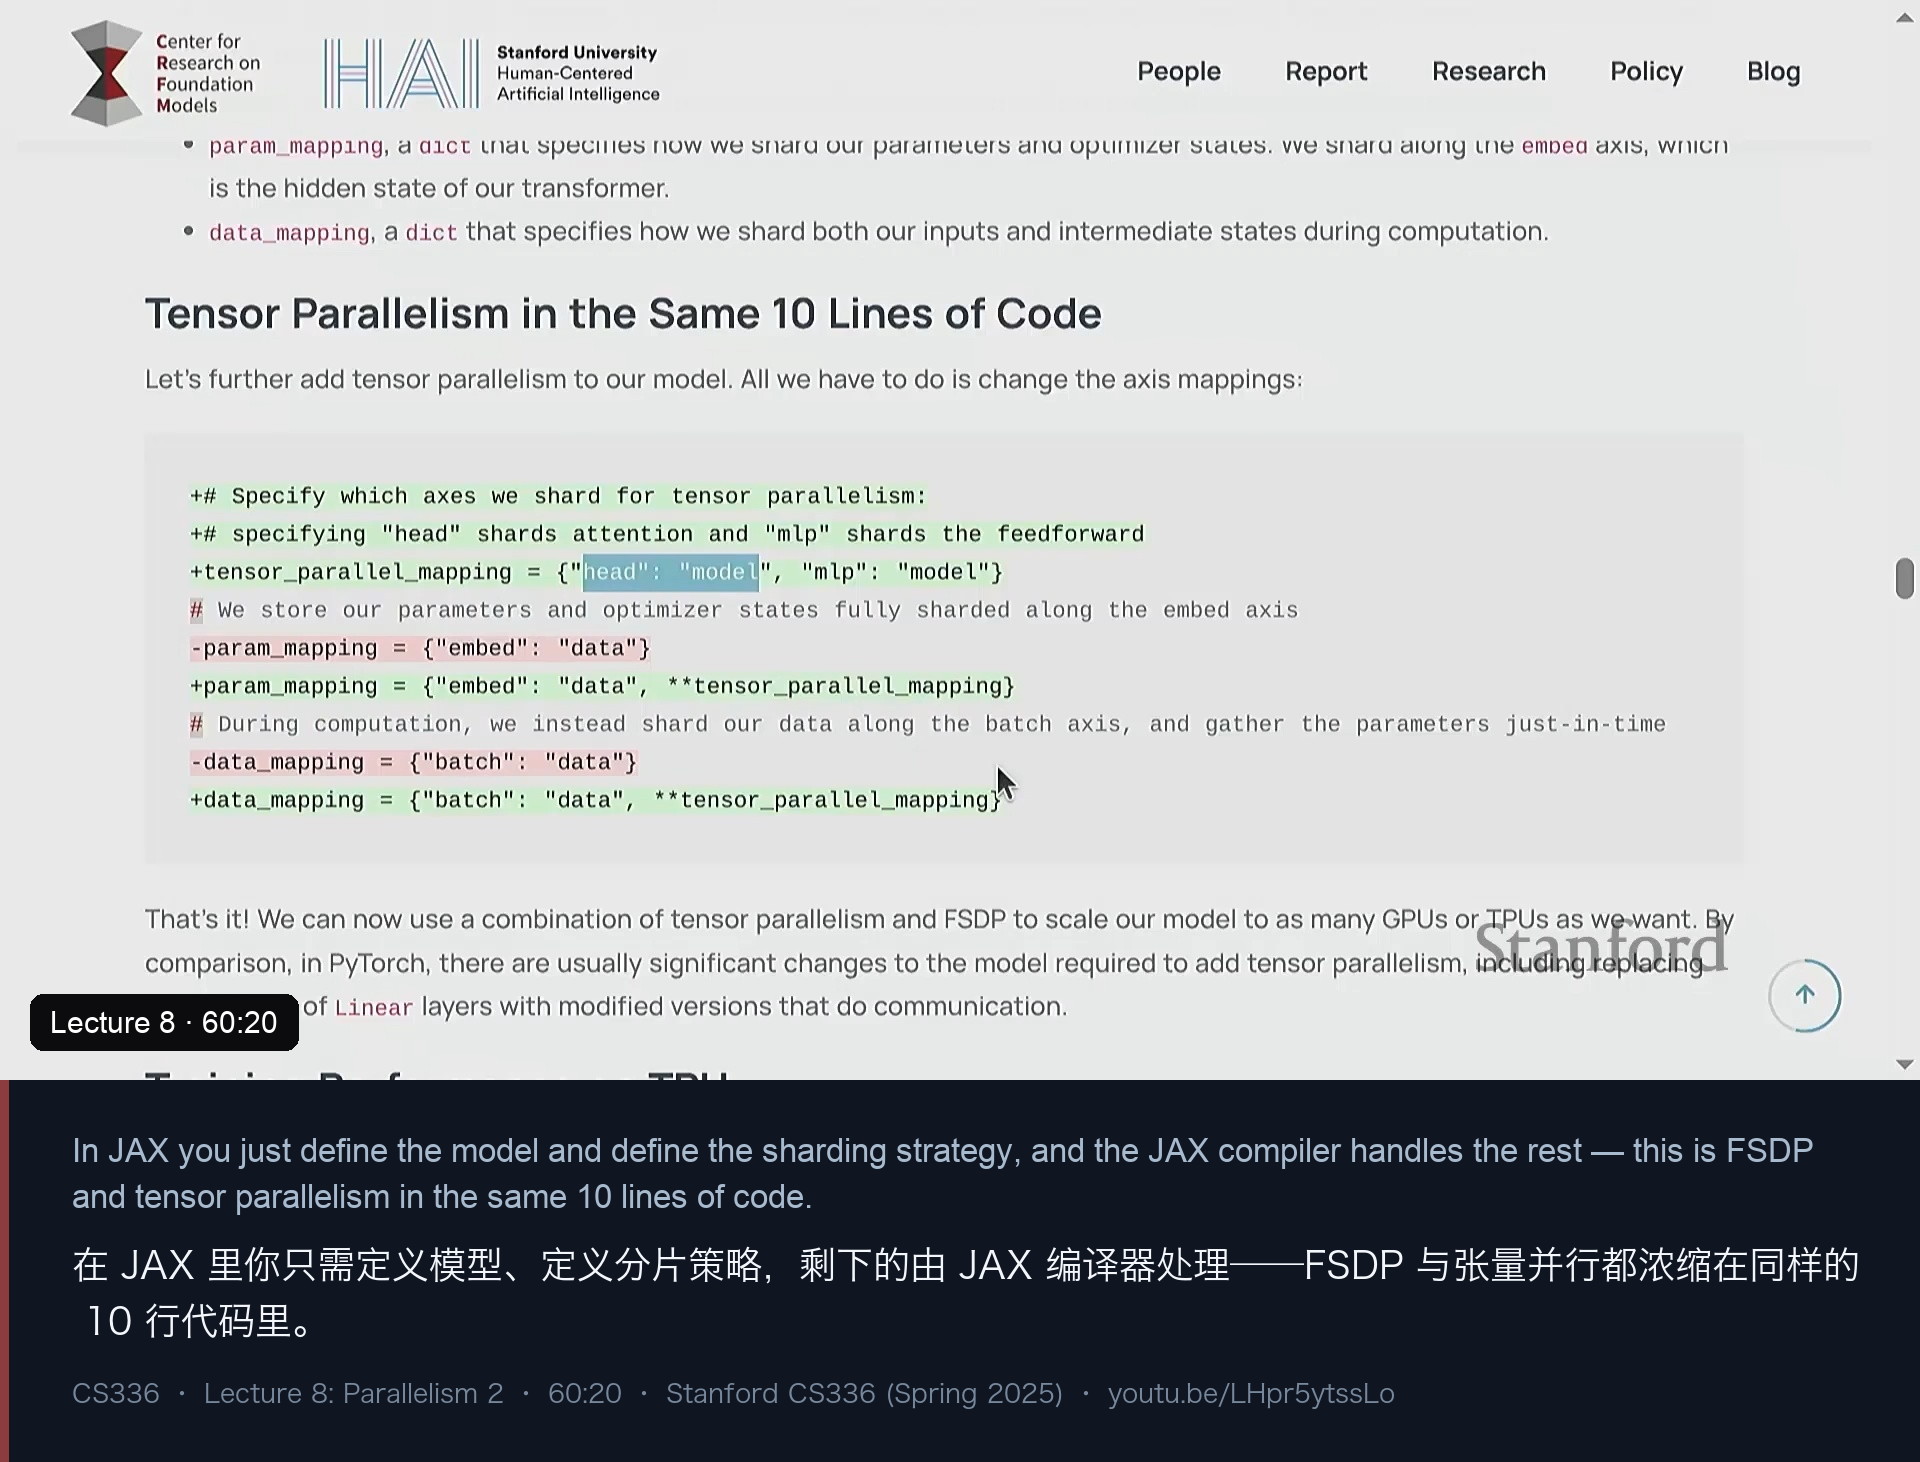
配合 Stanford 自己做的工具包 Levanter,FSDP 与张量并行都浓缩进了同样的十行代码。它的心智模型是:模型是一张带维度的计算图(模型维、嵌入维、注意力头维、序列维……),你只需指定沿哪些维度切,再定义到实际 TPU 的映射,XLA 编译器就会把它编译成底层的一次次数据搬运。这比手写集合通信高得多。
但课程坚持用 PyTorch,理由也很清楚:它能让你看清底下到底在发生什么。如果你真在工业界做事,当然不该从零实现这一套——该用 FSDP 就用。
顺带一提生态的两端:JAX/TPU 这一侧是声明式、基础设施成熟(只要待在 Google 的体系里);而 DeepSeek 在另一端——GPU 之间的互连很差,于是他们直接扎到 NCCL 这一层去“抠”性能。怎么榨硬件,取决于你在哪个生态里。
十一、总结与问答
总结页只有三行,但把整门课的一条主线说透了:
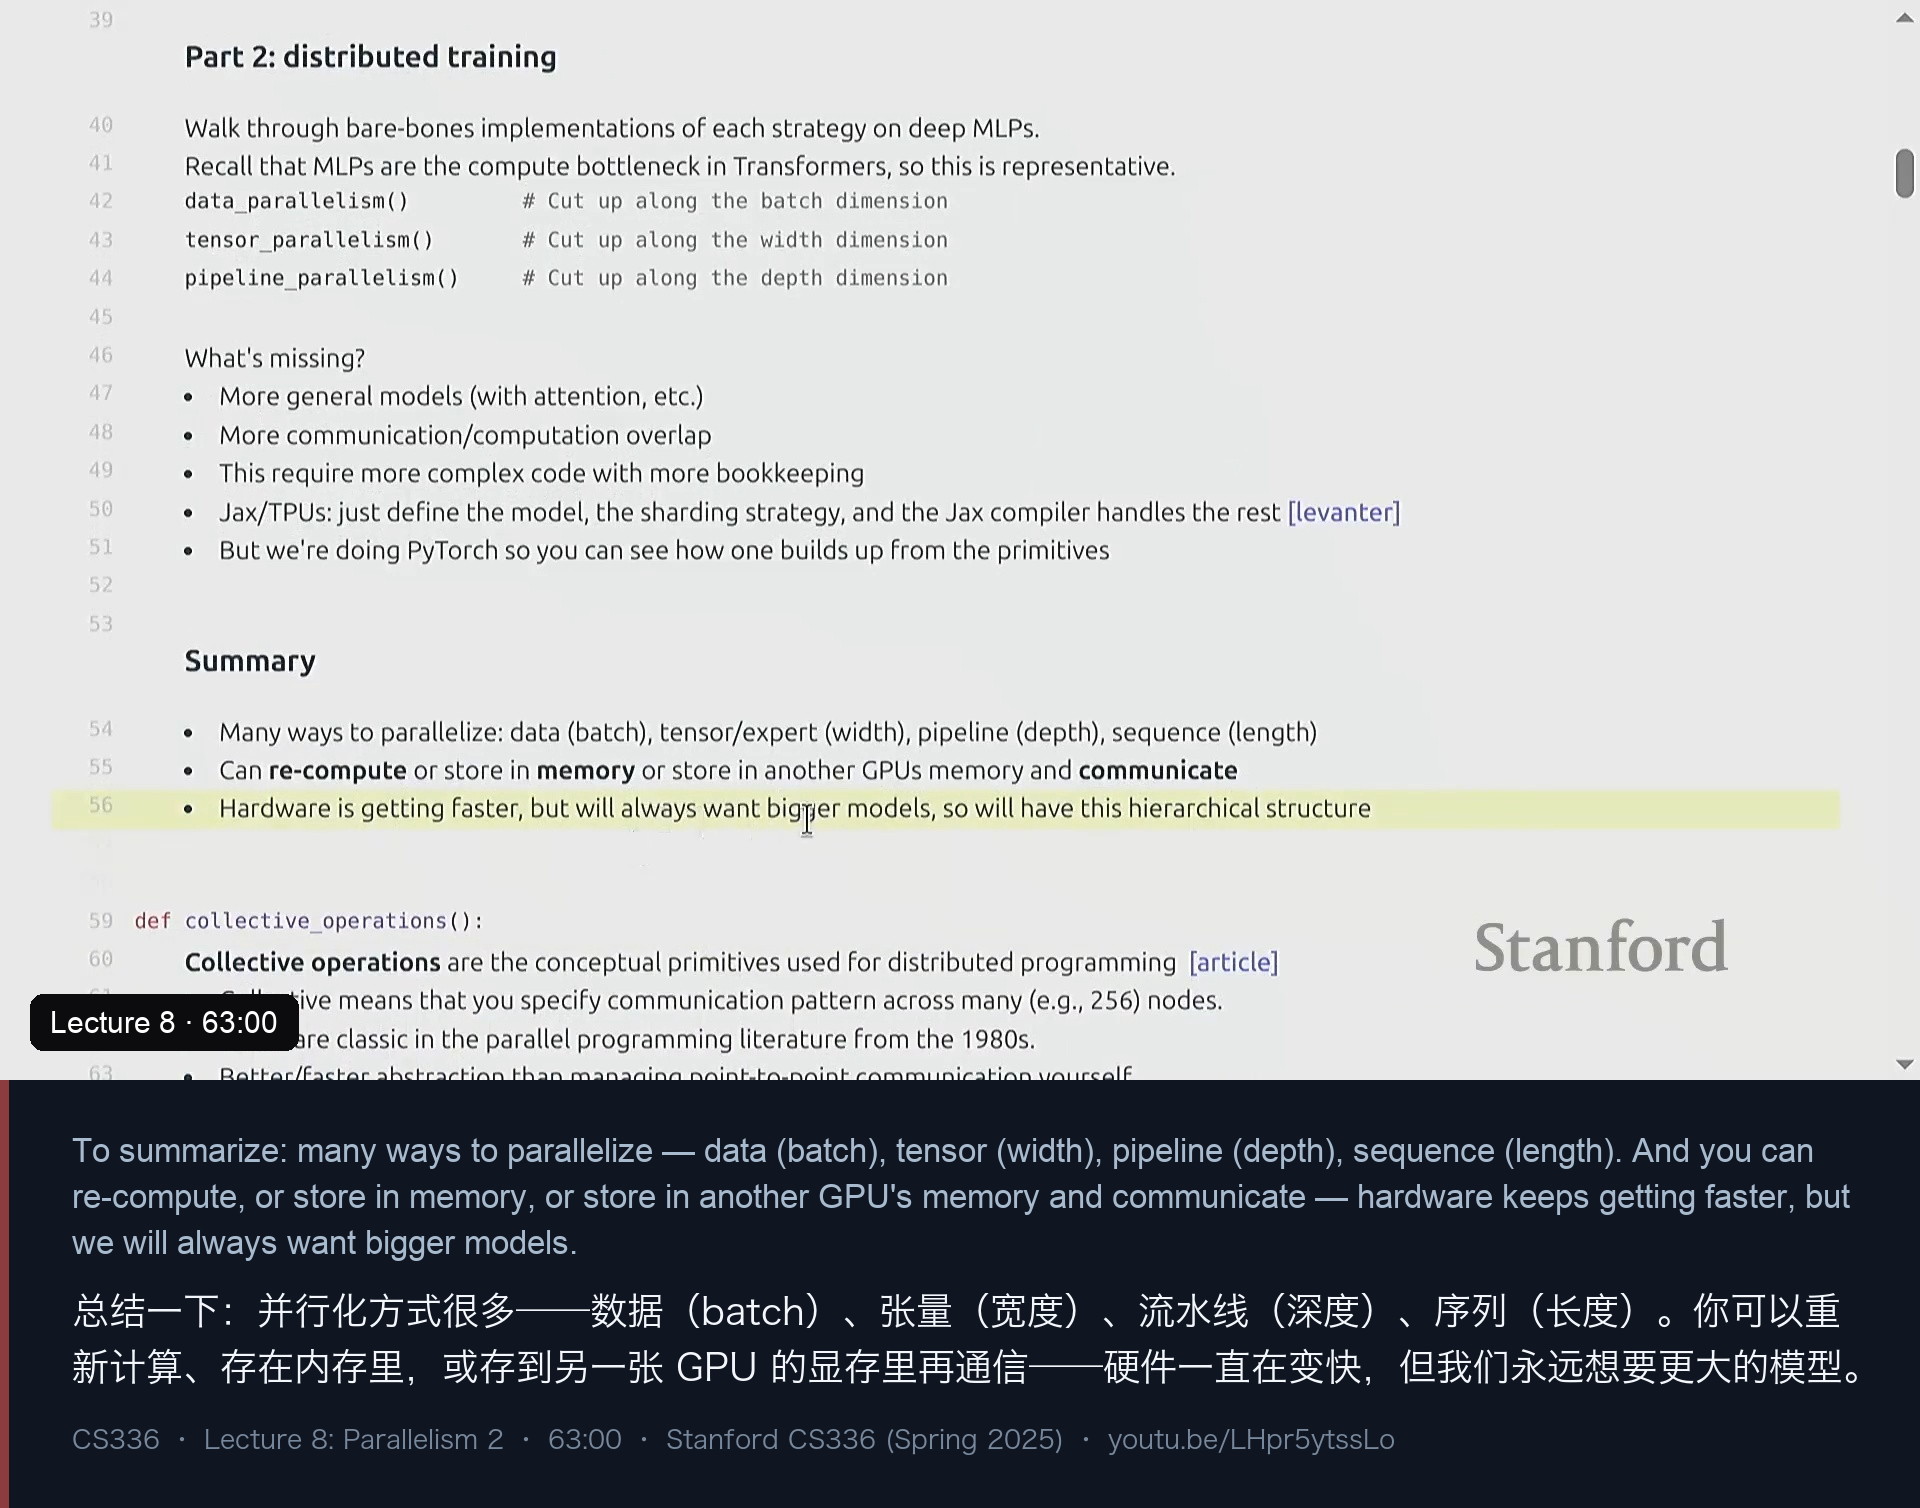
- 并行化方式很多:数据(batch)、张量/专家(宽度)、流水线(深度)、序列(长度);
- 你可以重计算(re-compute)、存在内存里、或者存在另一张 GPU 的显存里再通信——后者更慢。这三者的权衡在单卡(融合/分块/重计算)和跨机(集合通信)里是同一个主题;
- 硬件确实在变快,但我们永远想要更大的模型,所以“最外层永远贴着硬件极限”,这套层级结构会一直存在。
最后的问答里还有几颗珍珠:
- 数据并行 + BatchNorm 怎么办? 讲师坦言“batchnorm 总是很烦,我也不能立刻想清楚”,并指出LM 世界里基本不出现这个问题,因为用的是 LayerNorm;只要参数初始化一致、随机种子一致就没问题(GPU 上可能有非确定性,但影响很小)。
- PyTorch 有没有 JAX 那样的声明式能力? 有 FSDP(“不在这门课里的话,你应该毫不犹豫地用”)——定义任意模型就能自动切;但自定义分片的灵活性目前不如 JAX,还在发展中。
- activation checkpointing 有没有 API? 有,PyTorch 和 JAX 都能指定哪些部分要重计算;显然不该全算也不该全存。经验是在大矩阵乘之后、逐点非线性之前这类“算起来很便宜”的地方存一份就够。
- GPU 会被专用硬件取代吗? 推理侧已经在发生(Groq、Cerebras),核心思路是把更多内存放到片上(Cerebras 基本上就是一块巨大的“L1”),从而不必把数据搬来搬去。更深一层:GPU 带着 CPU 时代的包袱——它是“控制流优先”的,为分支和临时计算而生;而深度学习是数据流的,整张计算图从训练开始就完全确定,因此本可以更聪明地排布计算。
- 物理极限:GPU 不可能无限大、无限密——功耗、散热、带宽都是硬约束;Cerebras 把内存做在片上,代价是灵活性。
- 能用来做持续训练吗? 可以。这里的工作单元就是梯度步,从任何一个 checkpoint 继续跑都没有区别,“从头开始”没有任何特殊性。
- 计算图存在 CPU 还是 GPU? 代码(包括那张图的概念)由 CPU 掌管,PyTorch 调用时在底层启动 kernel,kernel 才是跑在 GPU 上的;图更像是一个概念,并不会被“放到 GPU 上”。
- 集合通信是 CPU 还是 GPU 指令? 它是一层抽象规范,PyTorch 有不同后端——可以在 GPU 也可以在 CPU。CPU 是“主控”,发起集合操作时调用 NCCL,再由 NCCL 启动搬运数据的 kernel。
我的笔记
- 这一讲的价值在于“把概念变成可以逐行读的代码”。 上一讲的三种并行还停留在图解,这一讲之后它们变成了三段可以跑起来的
for循环——数据并行的“插一行”、张量并行的“切完再 all-gather”、流水线并行的“recv → 算 → send”。看懂这三段代码,比记住任何一张架构图都管用。 all-reduce ≡ reduce-scatter + all-gather值得从两个方向都记住: 一次是“数学上相等”(课上四个 rank 的[0,1,2,3]+rank真的加出了同一个[6,10,14,18]),一次是“带宽账上相等”(reduce-scatter 不带因子 2,all-gather 也不带,加起来正好是 all-reduce 的 2)。“因子 2”这个细节,是这一讲最容易被忽略、也最实用的一处。- 同步点是双刃剑。 all-reduce 让你免费获得“大家步调一致”,代价是任何一次漏调用都会让整个进程组挂死。分布式训练里最经典的 bug 不是算错,而是挂住。
- 别信规格表。 H100 标称 900 GB/s,实测 all-reduce 只有 277 GB/s;reduce-scatter 更是掉到 70。原因可能藏在 NCCL 的实现细节和网内 reduction 加速里——所以基准测试是这门课反复强调的纪律,从第二讲的 GPU 性能一直到这一讲的通信带宽。
- DDP 的本质被这一讲“祛魅”了。 它不是某种神奇算法,就是在反向之后、更新之前,把每层的梯度做一次 all-reduce 取平均。理解了这一点,也就理解了它为什么只省通信、不省显存。
- 三种并行是沿着三个不同的维度切同一块蛋糕:数据并行切 batch(不省显存、不消耗 batch 之外的东西)、张量并行切宽度(不消耗 batch、但要高带宽)、流水线并行切深度(省激活、但吃 batch 且工程复杂)。它们的取舍不是性能之争,而是“你缺哪一样资源”之争。
- “为什么不直接用现成的”有一个教学法的答案。 FSDP 和 Megatron 都会把细节藏起来;把 bare-bones 版本亲手写一遍,你才知道
all_reduce(param.grad, op=AVG)这一行背后站着谁。这也是整门课“from scratch”的理由。 - JAX/Levanter 那十行代码值得记在心里:它提示了一个可能的未来——并行策略可以是声明式的(“沿 head 维切、沿 batch 维切”),由编译器负责生成集合通信。PyTorch 的 FSDP 走了半步,自定义分片还在路上。
- “重计算 / 存内存 / 存到别的 GPU 再通信”是这门课的底层母题。 单卡内部是 L1/HBM 之间的权衡,跨机是显存与带宽之间的权衡,连 DDP“不搬优化器状态、宁愿每台机各算一遍”都是同一道题。记住这道题,比记住任何具体技术都更耐久。
- 别低估“簿记”。 把 MLP 切成三份只要几十行,但要支持任意 Transformer 架构、自动推断参数与切法,就要面对 Megatron 与 FSDP 那种级别的复杂度。在真实工作里,能否自动描述分片,往往比能不能分片更决定工程成败。
附:课程信息与时间轴
- 课程主页:stanford-cs336.github.io/spring2025
- 本讲视频:Lecture 8: Parallelism 2(1:15,2025-05-12 发布)
- 播放列表:Stanford CS336 Language Modeling from Scratch · Spring 2025
- 配图目录:
public/blog/youtube/LHpr5ytssLo/(17 张图均截取自视频中对应观点所在的画面,并把该时刻的完整观点句拼合进图中)
| 时间 | 内容 |
|---|---|
| 00 | 开场:上一周讲单卡内部并行,这一周讲跨多卡并行 |
| 00 | 脑子里要有的那张图:node → 8 GPU → SM,L1 / HBM / NVLink / NVSwitch |
| 01 | “the name of the game”:组织计算以避开数据传输瓶颈 |
| 02 | 统一的层级:从 L1 到 NVSwitch,小快 → 大慢 |
| 03 | 这一讲的路线图:Part 1 构建块 / Part 2 分布式训练 |
| 04 | 集合通信:1980 年代的老原语,比手写点对点更好的抽象 |
| 05 | 术语:world size 与 rank(rank 指设备,不是矩阵的秩) |
| 05 | 六个原语:broadcast / scatter / gather / reduce / all-gather / reduce-scatter |
| 07 | all-reduce ≡ reduce-scatter + all-gather |
| 07 | 记忆法:reduce 是可结合可交换;broadcast/scatter 是 gather 的逆;all 指所有目的地 |
| 08 | 硬件:经典做法 PCIe + 以太网,以及它的开销 |
| 09 | 现代做法:NVLink 绕过 CPU、NVSwitch 绕过以太网 |
| 10 | H100:18 条 NVLink 4.0、合计 900 GB/s;HBM 还要快约 4 倍 |
| 12 | nvidia-smi topo:每对 GPU 之间都是 NV18 |
| 13 | NCCL:翻译成底层数据包、探测拓扑、优化路径、启动 CUDA kernel |
| 14 | torch.distributed:干净的 Python 接口,NCCL(GPU)/ Gloo(CPU)多后端 |
| 16 | 代码:用 multiprocessing 起 world_size 个进程,各自从一个 rank 的视角看 |
| 17 | 初始化进程组:这里只做协调,数据走 NCCL |
| 18 | barrier 与 [0,1,2,3]+rank;all-reduce 后就地覆盖为 [6,10,14,18] |
| 19 | reduce-scatter:输入含 world_size 维、输出按块分散 |
| 21 | all-gather 之后亲手确认:reduce-scatter + all-gather = all-reduce |
| 22 | 学生提问:reduce-scatter 怎么知道哪个分量去哪个 GPU |
| 23 | 单节点基准测试:一亿个元素、world size 4 |
| 24 | 热身、synchronize、barrier 之后才计时 |
| 25 | 带宽怎么算:字节数、因子 2、world_size |
| 27 | 实测 all-reduce ≈ 277 GB/s(标称 900 GB/s,别忘 benchmark) |
| 28 | reduce-scatter ≈ 70,以及“网内 reduction 加速”的猜测 |
| 32 | 从两个方向看等价关系:不带因子 2 的两步加起来 = 2 |
| 32 | Part 2 开场:为什么用 MLP(Transformer 的算力瓶颈不在注意力) |
| 33 | 三种切法:batch(数据)/ 宽度(张量)/ 深度(流水线) |
| 33 | 数据并行:batch 128 → local batch 32,按 rank 抓取行 |
| 36 | DDP 的唯一改动:对每层 param.grad 做 all-reduce 取平均 |
| 37 | 学生提问:异步的进程怎么保证在同一步(all-reduce 是同步点) |
| 39 | 不做优化器状态分片的理由:搬状态比多算一遍慢 |
| 40 | 张量并行:数据不变,沿隐层切,每 rank 拿 1/world_size 参数 |
| 42 | 前向每层都要 all-gather + 拼接激活,通信量很大 |
| 45 | 为什么课上跳过张量并行的反向(时间与篇幅) |
| 46 | 流水线并行:按层切,两个 rank 各两层,所有 rank 拿全部数据 |
| 47 | 用 micro-batch(4 × 32)摊薄气泡 |
| 48 | 点对点通信:recv(rank−1) → 算自己的层 → send(rank+1) |
| 49 | 课上这版缺什么:异步收发、通信/计算重叠、交错前向反向 |
| 50 | 学生提问:这是事件驱动吗?(不是,是锁步) |
| 52 | 如何做重叠:异步 send 拿句柄、最后统一 wait |
| 53 | 多个 send/recv 怎么区分:同目的地保序(stream)、按 src 收下一条 |
| 55 | 发了没人收会阻塞;最后一个 rank 持有完整前向结果 |
| 56 | 三个例子的回顾:真实训练要换成 Transformer |
| 57 | 簿记问题:Megatron-LM 与 FSDP 为什么“很毛” |
| 58 | 离题:JAX/TPU 那条路——声明模型与分片,编译器搞定其余 |
| 59 | Levanter:FSDP 与张量并行各只要改一改 axis mapping |
| 1:01 | 总结:沿 batch/宽度/深度/序列切;重计算 vs 存内存 vs 存到别的 GPU 再通信 |
| 1:02 | 硬件会更快的,但模型永远顶着极限,层级结构会一直在 |
| 1:03 | 问答:数据并行 + BatchNorm(LM 里用 LayerNorm,不常遇到) |
| 1:04 | 问答:PyTorch 的 FSDP 与 JAX 声明式分片的差别 |
| 1:05 | 问答:生态两端——JAX/TPU 的成熟 vs DeepSeek 在 NCCL 层硬抠 |
| 1:06 | 问答:activation checkpointing 的 API 与“该重算哪一段” |
| 1:07 | 问答:GPU 会被专用硬件取代吗(片上内存、数据流 vs 控制流) |
| 1:08 | 问答:物理极限(功耗、散热、带宽)与 Cerebras 的取舍 |
| 1:09 | 问答:这些技术能用于持续训练吗(工作单元就是梯度步,可以) |
| 1:12 | 问答:计算图存在 CPU 还是 GPU;集合通信是 CPU 还是 GPU |
| 1:14 | 收尾:CPU 是主控,集合操作调用 NCCL、再由 NCCL 启动 kernel |
说明:本文是视频内容的整理、翻译与转述,观点均来自主讲人;文中代码为讲座中算法的整理版本(幻灯片所示),非官方作业代码。课程中引用的带宽数字、切片尺寸、层数、world size 与硬件规格,均来自讲师课上的演示或引用的幻灯片,请自行核实。
讨论
这里是静态站点,没有内嵌评论区。如果这篇文章对你有用,欢迎通过 RSS 订阅后续更新。