Stanford CS336 第七讲精读:并行(上)——ZeRO/FSDP、流水线并行与张量并行
斯坦福 CS336(Language Modeling from Scratch, Spring 2025)第七讲完整讲义:单卡为什么不够用、8 卡一个盒子的网络层级、必须背下来的 all-reduce ≡ reduce-scatter + all-gather、数据并行的显存账单(16 字节每参数、5 份权重)与 ZeRO 三阶段(stage 1 在带宽受限下几乎免费,stage 3 就是 FSDP)、batch size 为什么是一种被花掉的资源、流水线并行的气泡与 zero-bubble 技巧、张量并行的切法与 8 卡经验法则、激活内存公式与序列并行,最后落到 3D/4D 并行的经验法则与 Megatron、DeepSeek、Llama 3 的真实配置。
本篇属于系列 Stanford CS336 精读 · 第七讲
来源:YouTube 原视频(Stanford Online · CS336 Language Modeling from Scratch · Spring 2025 · Lecture 7: Parallelism 1)
来源说明 这是斯坦福 CS336《Language Modeling from Scratch》2025 年春季第七讲的完整讲义,主讲人是 Tatsunori Hashimoto(Tatsu,课程日程里标注为 “Parallelism (Tatsu)”)。它是“系统基础”这条线的第三讲:第五讲讲 GPU 硬件,第六讲写 kernel,这一讲开始回答“一张卡不够用之后怎么办”——先补网络与集合通信,再把数据并行、模型并行、激活并行逐一拆开,最后看真实的大规模训练配置怎么组合它们。文中 18 张配图均截取自视频对应时刻的幻灯片,并把该时刻的完整观点句(英文原句+中文翻译)拼合进图中。文中出现的显存数字、带宽倍数、吞吐损失、模型规模、故障次数等,都是讲师当场演示或引用的公开论文、教程与估算,不是本文独立核实的事实;讲师口播里把 ZeRO 念作 “zero”、把 InfiniBand 念成 “Infiniband”、把 AllReduce 的中断处念得有些含混(字幕听写所致),下文按幻灯片与通行写法记录。
TL;DR
- 这一讲的问题意识:上一讲把单张 GPU 的性能榨到极限,但单卡既装不下大模型,也算不够快。要“此时此地”训出强模型,就必须把计算与显存摊到整个数据中心;而数据中心内部是分层的——同一个盒子里的 8 张卡走 NVSwitch,跨机器只有 HDR InfiniBand,每通道大约慢 8 倍,超过约 256 张卡还要再降一级。
- 三个核心概念:数据并行(切 batch)、模型并行(切模型)、激活并行(切激活)。三者拼起来,才是“给定机器数量,优雅扩展算力与显存”的完整工具箱。
- 一个必须记住的等价关系:
all-reduce = reduce-scatter + all-gather,带宽开销完全相同。它稍后会直接变成“ZeRO stage 1 在带宽受限下是免费的”这个结论。 - 数据并行的显存账单非常难看:每个参数要 16 字节、权重实际上存 5 份(bf16 参数 2 + bf16 梯度 2 + fp32 主权重 4 + Adam 一阶矩 4 + 二阶矩 4),大头是优化器状态。一个 7.5B 模型铺到 64 张卡上要 120 GB 参数相关显存。
- ZeRO 就是对着这几份拷贝做手术:stage 1 只分片优化器状态(120 → 31.4 GB),stage 2 再分片梯度(→ 16.6 GB),stage 3 连参数也分片(→ 1.9 GB,= FSDP)。stage 1 不额外花带宽;stage 3 的通信涨到 3× 参数量,但靠“通信与计算重叠”把开销压住。8×A100-80GB 节点上,模型上限从 6.6B 涨到 53.3B。
- batch size 是一种会被花掉的有限资源:数据并行最多用 batch size 张卡,流水线并行也靠 batch size 摊薄气泡;所以真正的资源约束是三个——显存、带宽/算力、batch size。
- 流水线并行:按层切,朴素做法只能拿到单卡的吞吐(巨大的气泡);用 micro-batch 摊薄后,气泡占比约 (p−1)/m。它的通信是点对点的、只传激活,因此适合慢链路,还能省激活显存。zero-bubble / DeepSeek 的 DualPipe 把反向拆成“激活反向传播 B”和“权重梯度计算 W”,用没有串行依赖的 W 去填气泡——效果很好,但工程上极复杂。
- 张量并行:沿矩阵的“宽度”切,前向一次 all-reduce、反向一次 all-reduce。带宽需求极高,所以经验法则是在单机 8 卡内使用;好处是不消耗 batch size。HuggingFace 教程的数据:8 卡以内吞吐掉 10–12%,16 卡掉 42%,32 卡掉 65%。
- 激活内存是最后的硬骨头:每层激活约
sbh(34 + 5as/h),第二项来自二次复杂度的注意力,可以用重计算(flash attention)干掉;张量并行只能把“可切”的部分除以 t,剩下sbh·10的逐位置算子(layer norm、dropout 等)还得靠序列并行沿序列轴切开。 - 组合有章法:先用张量并行(单机内)+ ZeRO-3 或流水线并行(跨机)把模型塞进内存,然后用剩余的所有 GPU 跑数据并行;batch size 不够就用梯度累积把通信效率换回来。Megatron 用这套打到 1T 参数、峰值算力利用率 40–52%;DeepSeek 用 ZeRO-1 + 张量 + 序列 + 1F1B 流水线(V3 是 PP(16) + EP(64-way));Llama 3 用 TP=8 + PP + DP,长上下文阶段再加 CP。
一、这一讲在哪:从一张 GPU 到一个数据中心
开场第一句话就交代了坐标:这是“系统基础”两讲的第二讲,主题从单卡吞吐转向跨机器并行。上一讲我们看到 FLOPS 曲线一路飙升,但讲师提醒:如果你今天就要训一个大模型,等不及曲线再涨两年——必须依赖多机并行。算力上,世界上最快的超级计算机已经是百亿亿次(exaflops)量级;显存上,模型参数量涨得比单卡显存快,几十亿参数已经放不进一张卡。
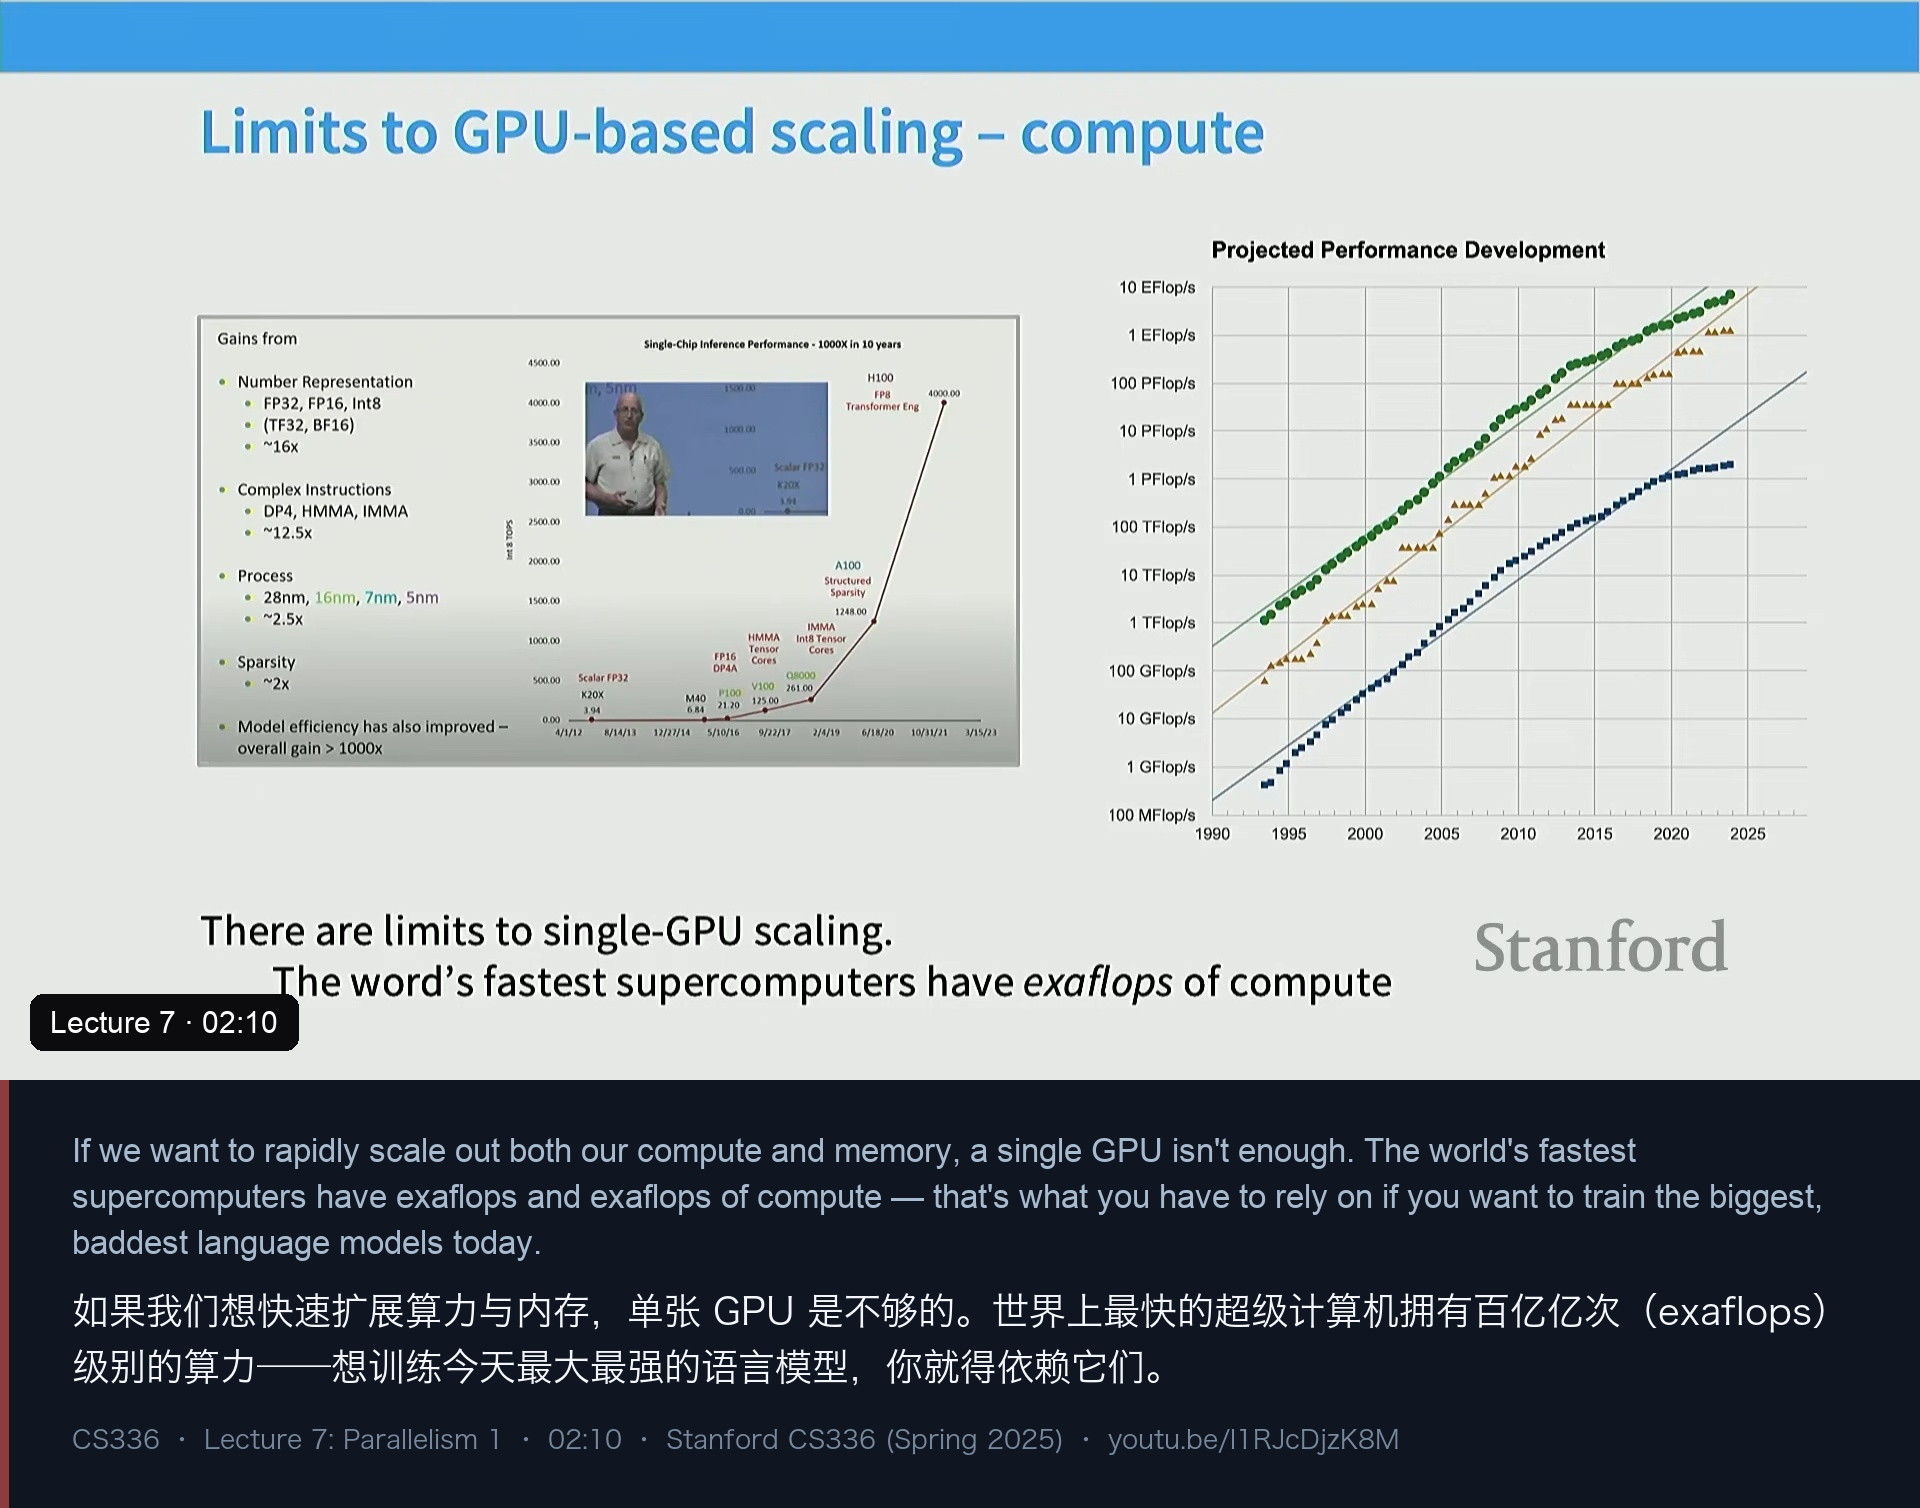
于是这一讲的“计算单元”被重新定义:不再是 GPU,而是整个数据中心。而数据中心不是一块均匀的算力,它有自己的层级结构,这个结构会直接决定哪种并行策略划算。
二、先讲网络:8 卡一个盒子,256 卡一个域
GPU 从来不是单独出售的——一台机器里塞着 8 张卡,同一个机架、同一个电源域。讲师借 GPT-NeoX 论文里的一张拓扑图说明这套层级:
- 盒子内部:8 张 GPU 通过 NVSwitch 互联,NVLink 的带宽非常高;
- 盒子之间:必须经过网络交换机,走 HDR InfiniBand,每通道大约慢 8 倍;
- 再往上:全互联(all-to-all)大概能撑到 256 张 GPU,超过之后就要走 leaf/spine 交换机,还会再慢一档。
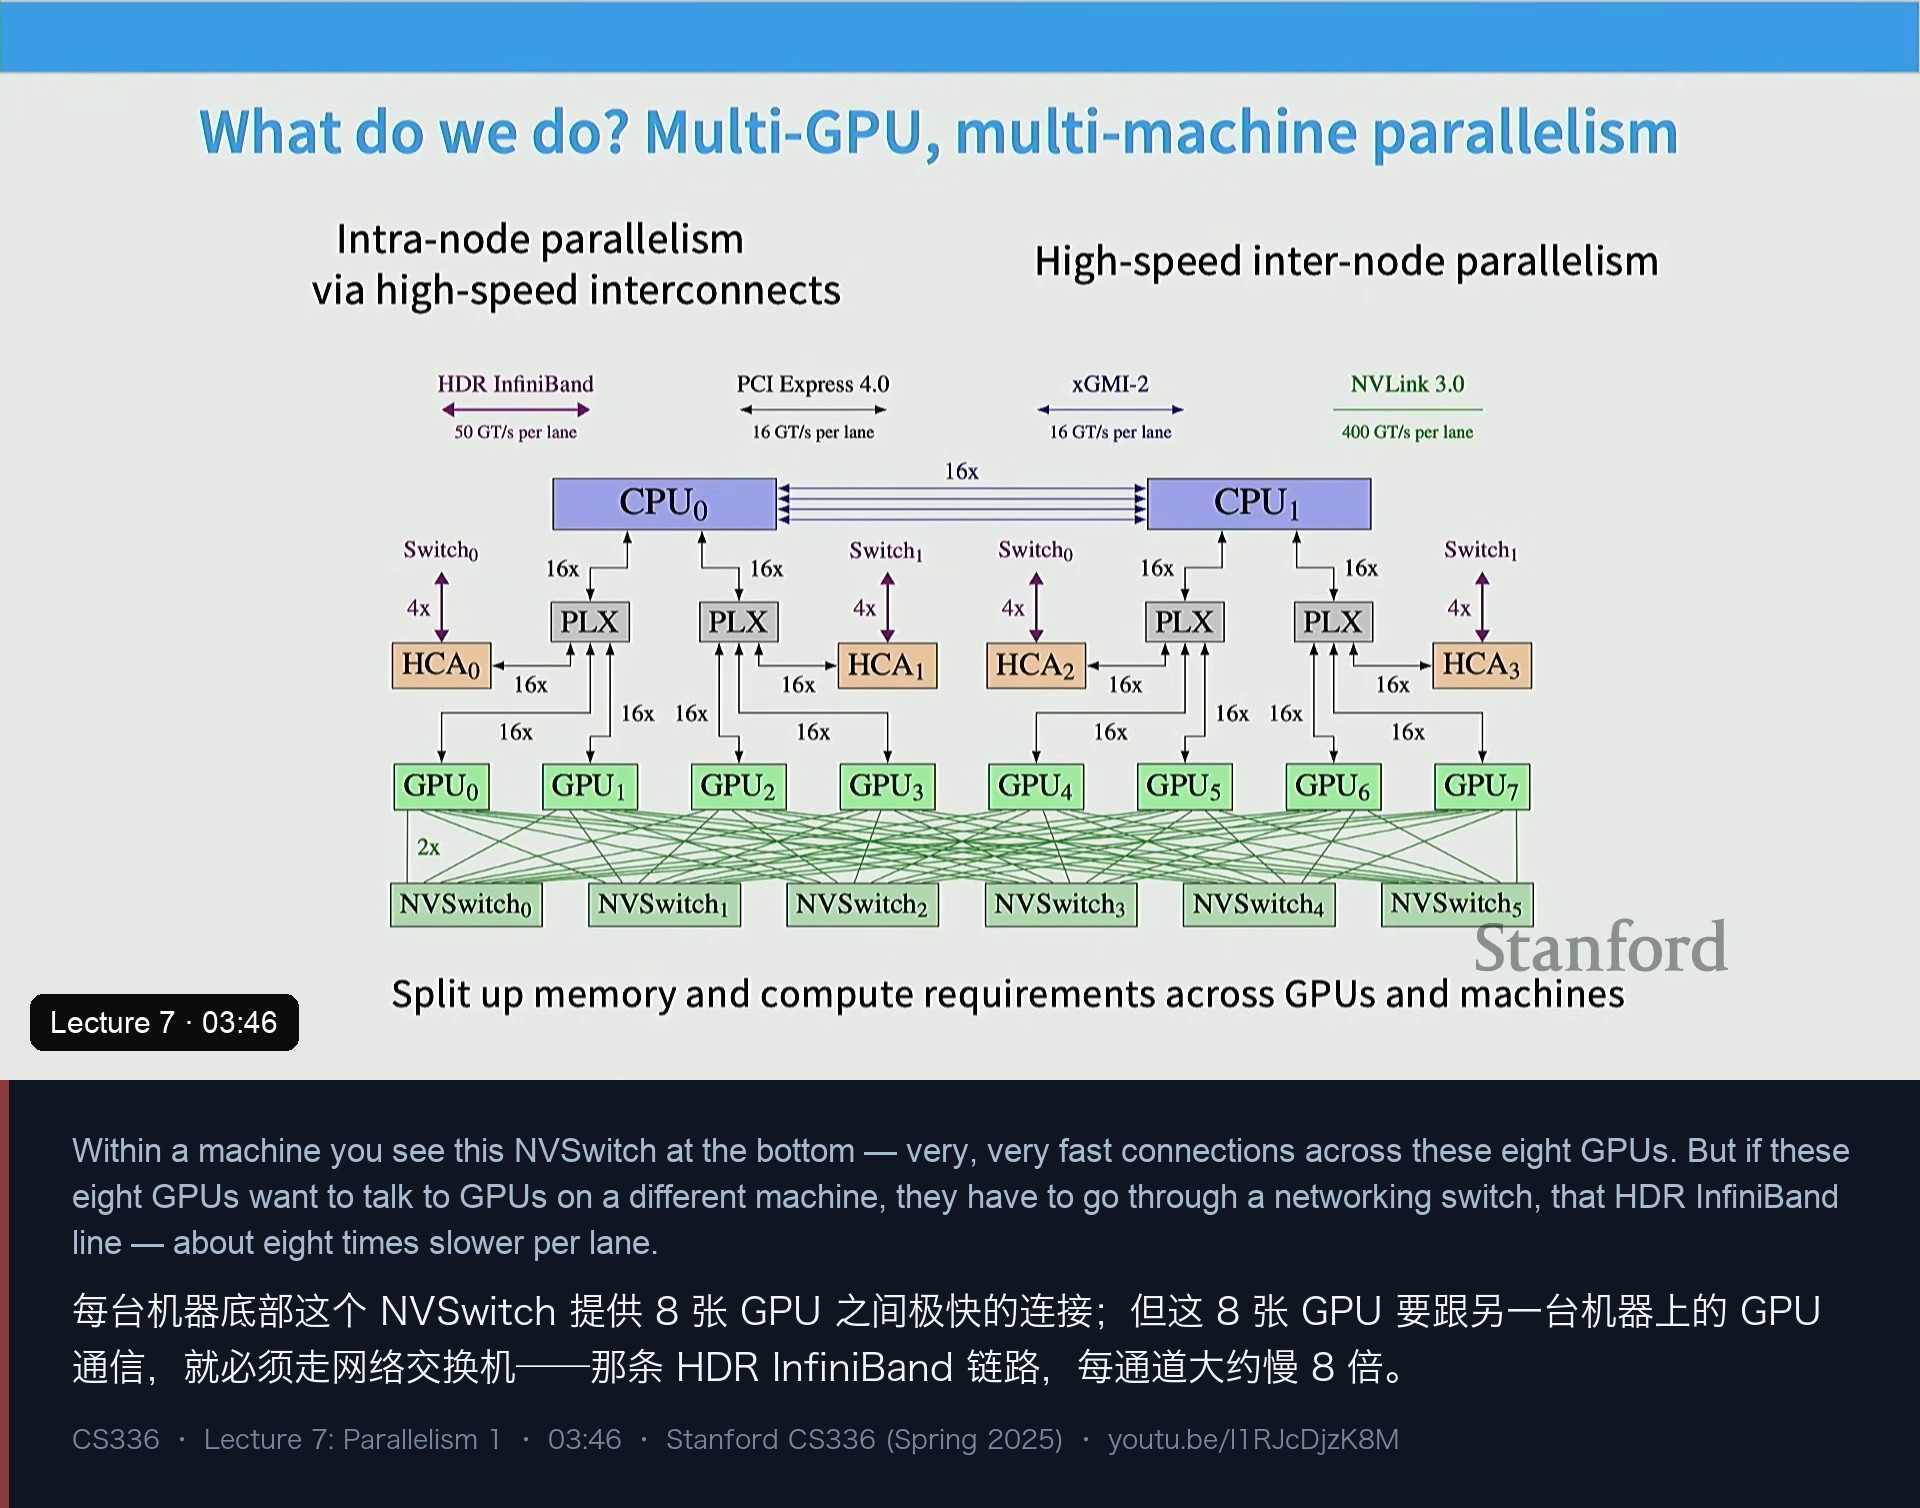
这个“越往外越慢”的成本阶梯,是后面所有策略的物理依据。顺带一提 TPU:Google 的方案完全不同,芯片只和邻居高速相连,构成一个可轻松扩展的环面网格(toroidal mesh)。讲师特意点出:如果只考虑集合通信,环面网格实现 all-reduce / reduce-scatter 的效率和全互联一样好——这也是后面“TPU 不太需要流水线并行”这条实践经验的来源之一。
三、集合通信速成:一个必须背下来的等价关系
在讲算法之前,先复习五个集合通信原语,以及它们的通信开销:
- all-reduce:所有 rank 各自持有一份数据,求和(或别的归约)之后把结果广播回所有 rank。带宽开销约 2× 数据量。
- broadcast:把某一个 rank 的数据复制给所有 rank,开销约 1×。
- reduce:归约后只送到一个 rank。
- all-gather:每个 rank 持有一部分(比如参数的一个分片),互相交换后人人拿到全部,开销约 1×。
- reduce-scatter:先归约、再把结果按分片散回各 rank(all-reduce 的“半成品”)。
真正要记住的是一行式子:
all-reduce  ≡  reduce-scatter + all-gather
(带宽开销相同:这正是带宽受限下能做到的最优)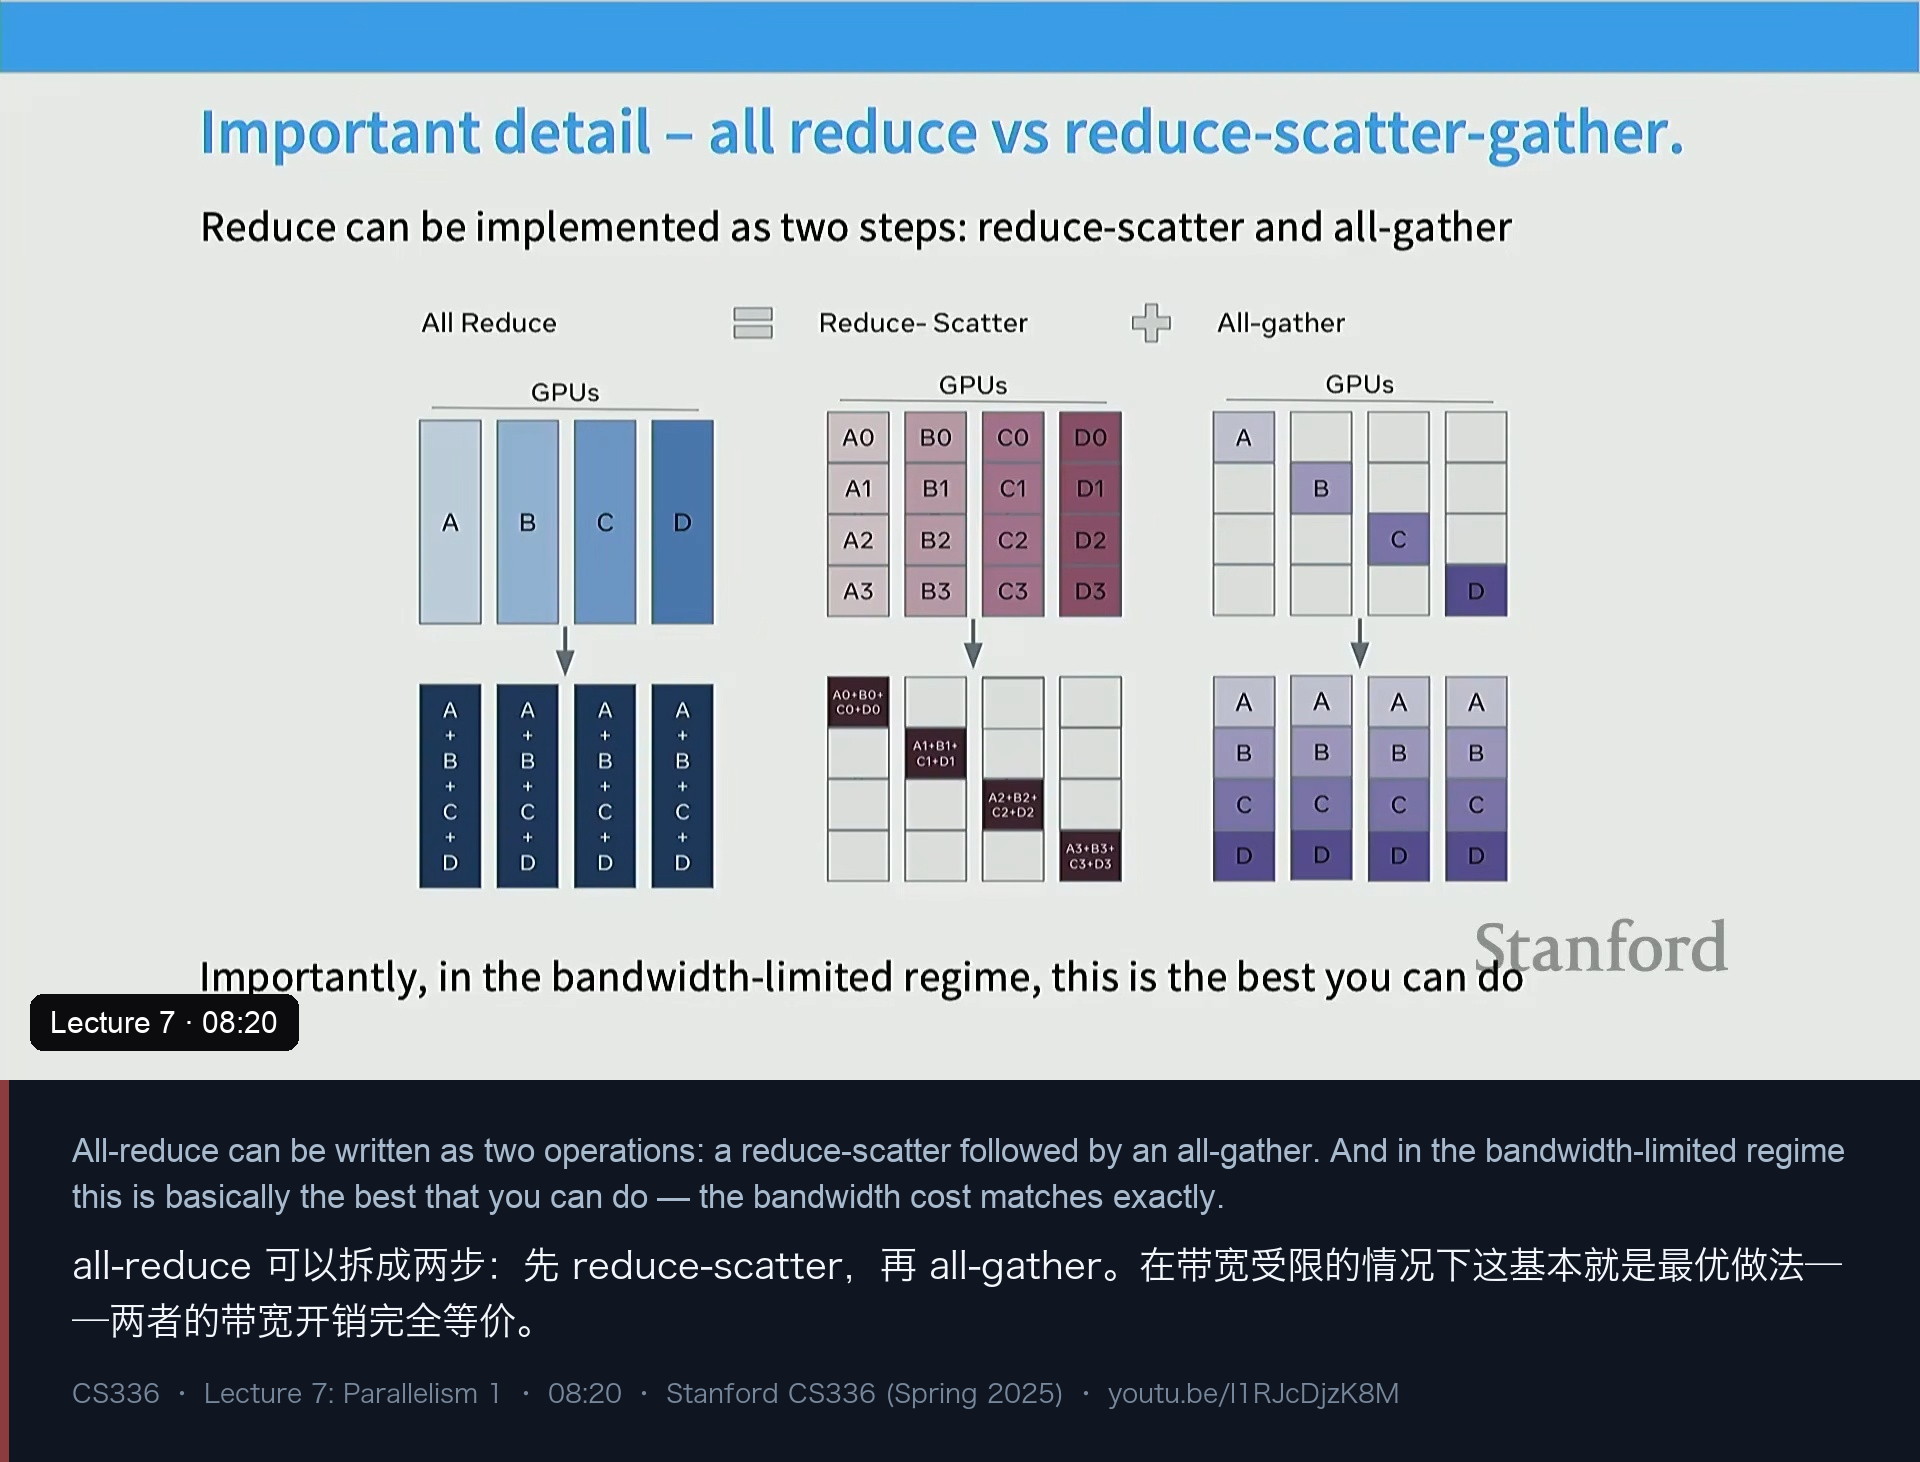
为什么重要?因为数据并行最自然的写法(对梯度做 all-reduce)里,参数梯度必须在同步之后才能做优化器更新;而拆成两步之后,中间出现了一个“可以插入计算”的缝隙——这个缝隙就是 ZeRO stage 1 的全部秘密。讲师也提示:正是因为这套算法全部由这几个原语搭成,分析性能时只要数原语就够了,不需要下到实现细节。
四、数据并行:把 SGD 直译到多机,然后发现三个问题
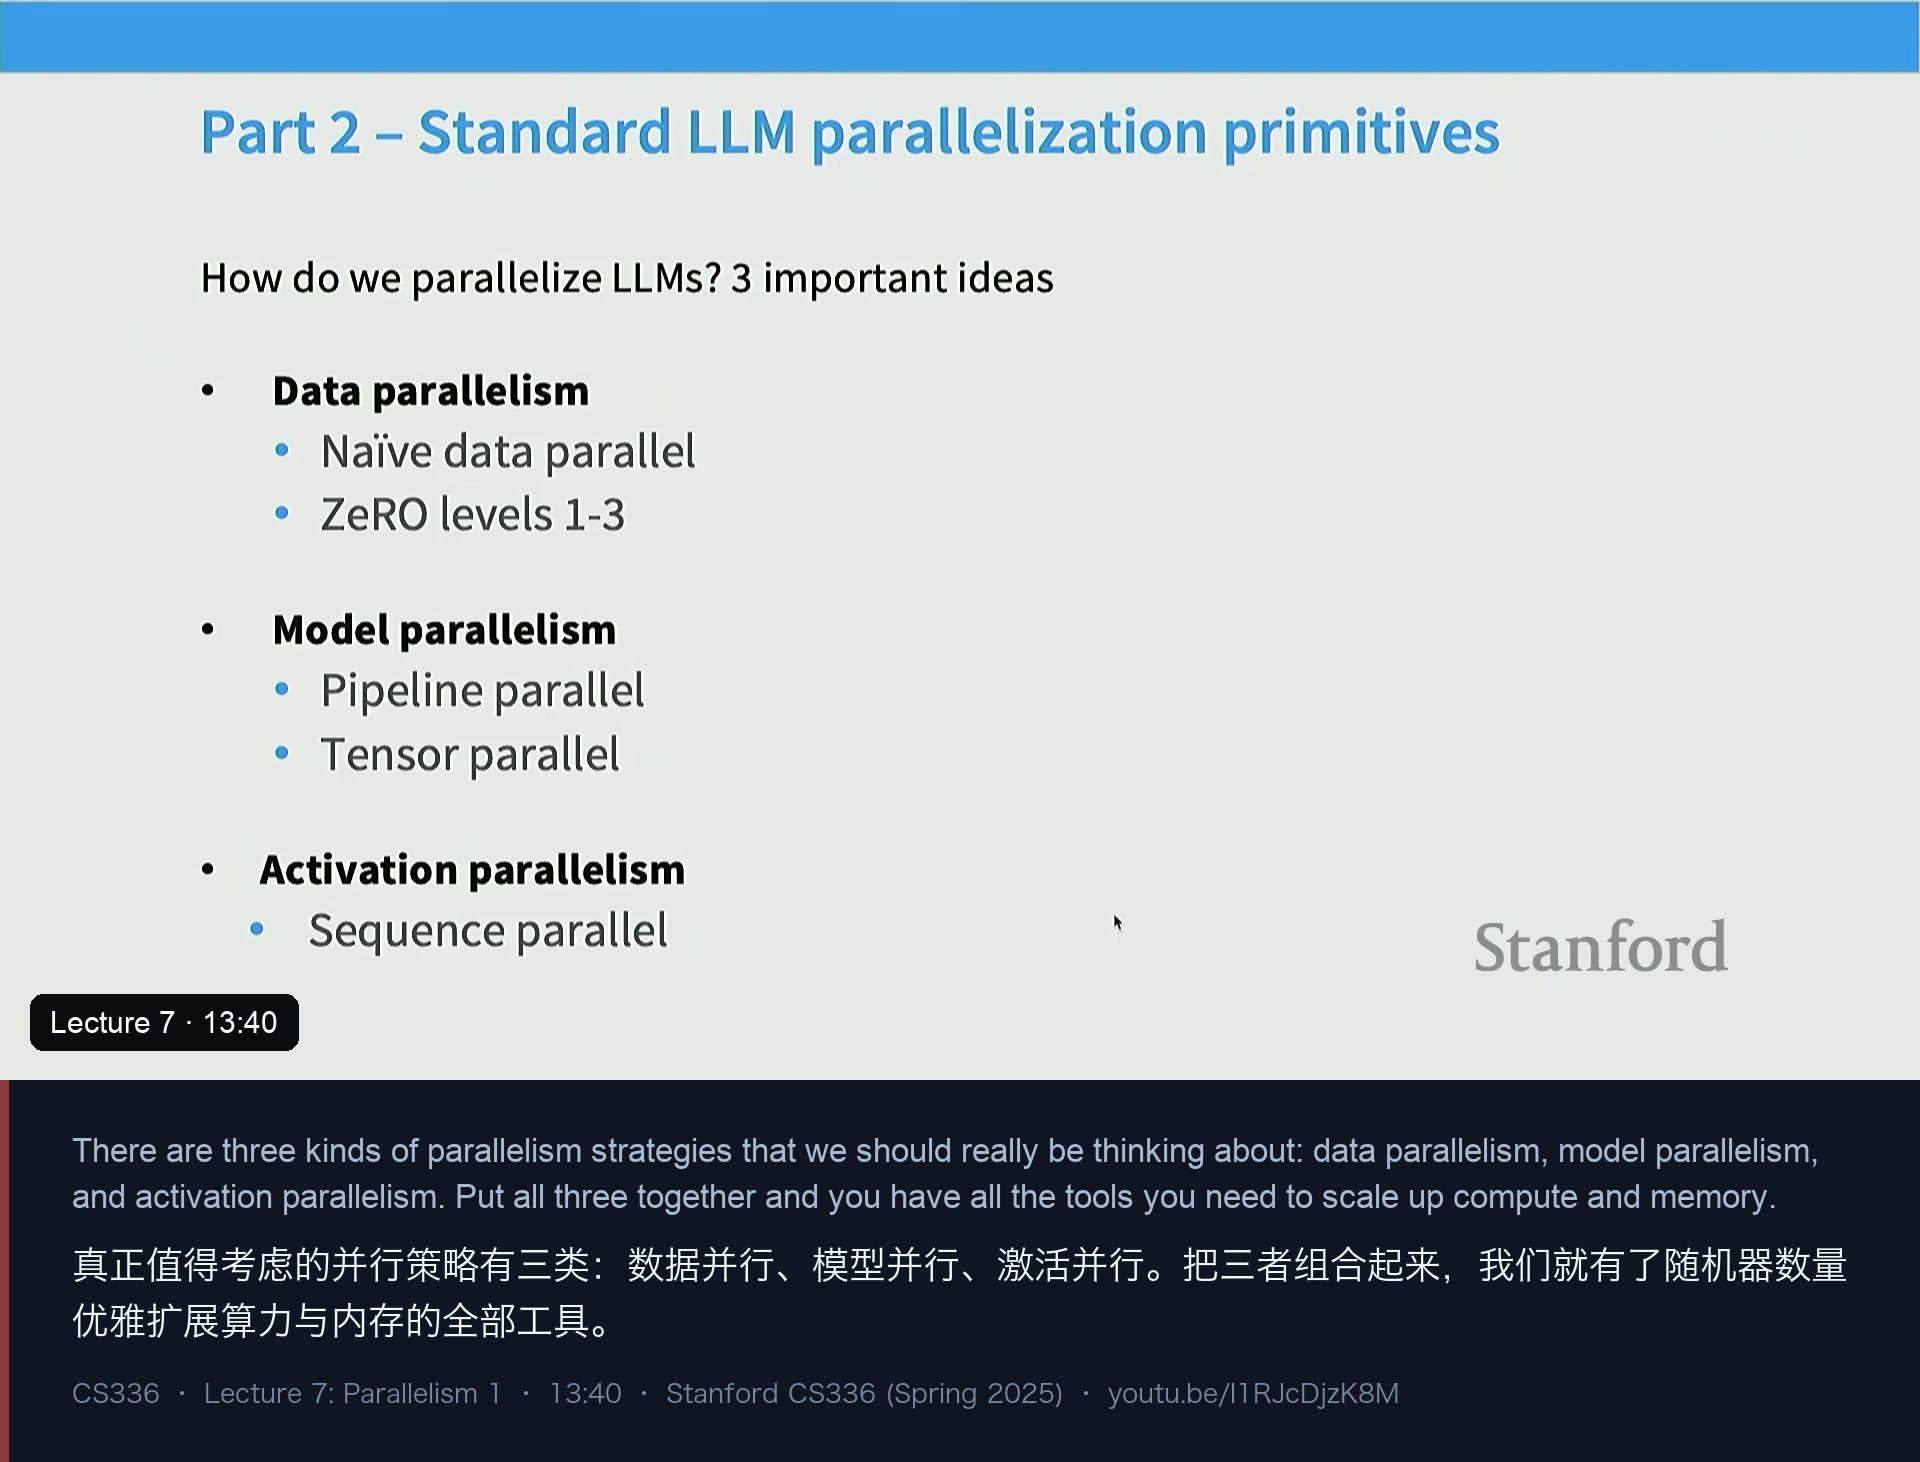
沿着“怎么并行”这条线,讲师把方案分成三族,并强调三者要组合使用:
- 数据并行(data parallelism):参数在各卡上大致复制一份,把 batch 切开分发;
- 模型并行(model parallelism):把模型切开放到不同卡上,包含流水线并行与张量并行;
- 激活并行(activation parallelism):切激活内存,包含序列并行等。
数据并行的出发点是朴素批量 SGD:拿一个大小为 B 的 batch,把梯度加起来做一次更新。
ŷ = (1/B) * Σ_{i=1..B} ∇f(x_i; W)      # 朴素批量 SGD
W ← W - lr * ŷ
朴素数据并行就是把这句直译过去:把 B 切成 M 份发给 M 张卡,每张卡算自己那部分的梯度和,在更新前 all-reduce 梯度做同步,然后各自更新。它的三个性质很清晰:
- 算力扩展好:每张卡拿 B/M 个样本,只要 batch 够大,micro-batch 就能打满算力;代价是每步要付 2× 参数量的通信(all-reduce 的代价),batch 越大越能把它藏起来。
- 显存完全不省:每张卡都要复制一份参数与优化器状态。
- 消耗 batch size:最多只能开 batch size 张卡,而且 batch 大到一定程度收益迅速递减。
第 3 点讲师反复强调,还给了一个“反直觉”的提醒:batch size 是一个上限固定、可以被不同策略花掉的资源——他后面会用它衡量每一种并行方案。
五、显存账单与 ZeRO 三阶段
5.1 账单比看上去的更难看:16 字节、5 份拷贝
朴素数据并行的显存账要按“训练时需要并存哪些东西”来算。训练用 bf16 混合精度时,每个参数大致是:
bf16 参数           2 B
bf16 梯度           2 B
fp32 主权重 (master) 4 B
Adam 一阶矩 (m)      4 B
Adam 二阶矩 (v)      4 B
------------------------------
合计               16 B / 参数   (权重实际上存了 5 份)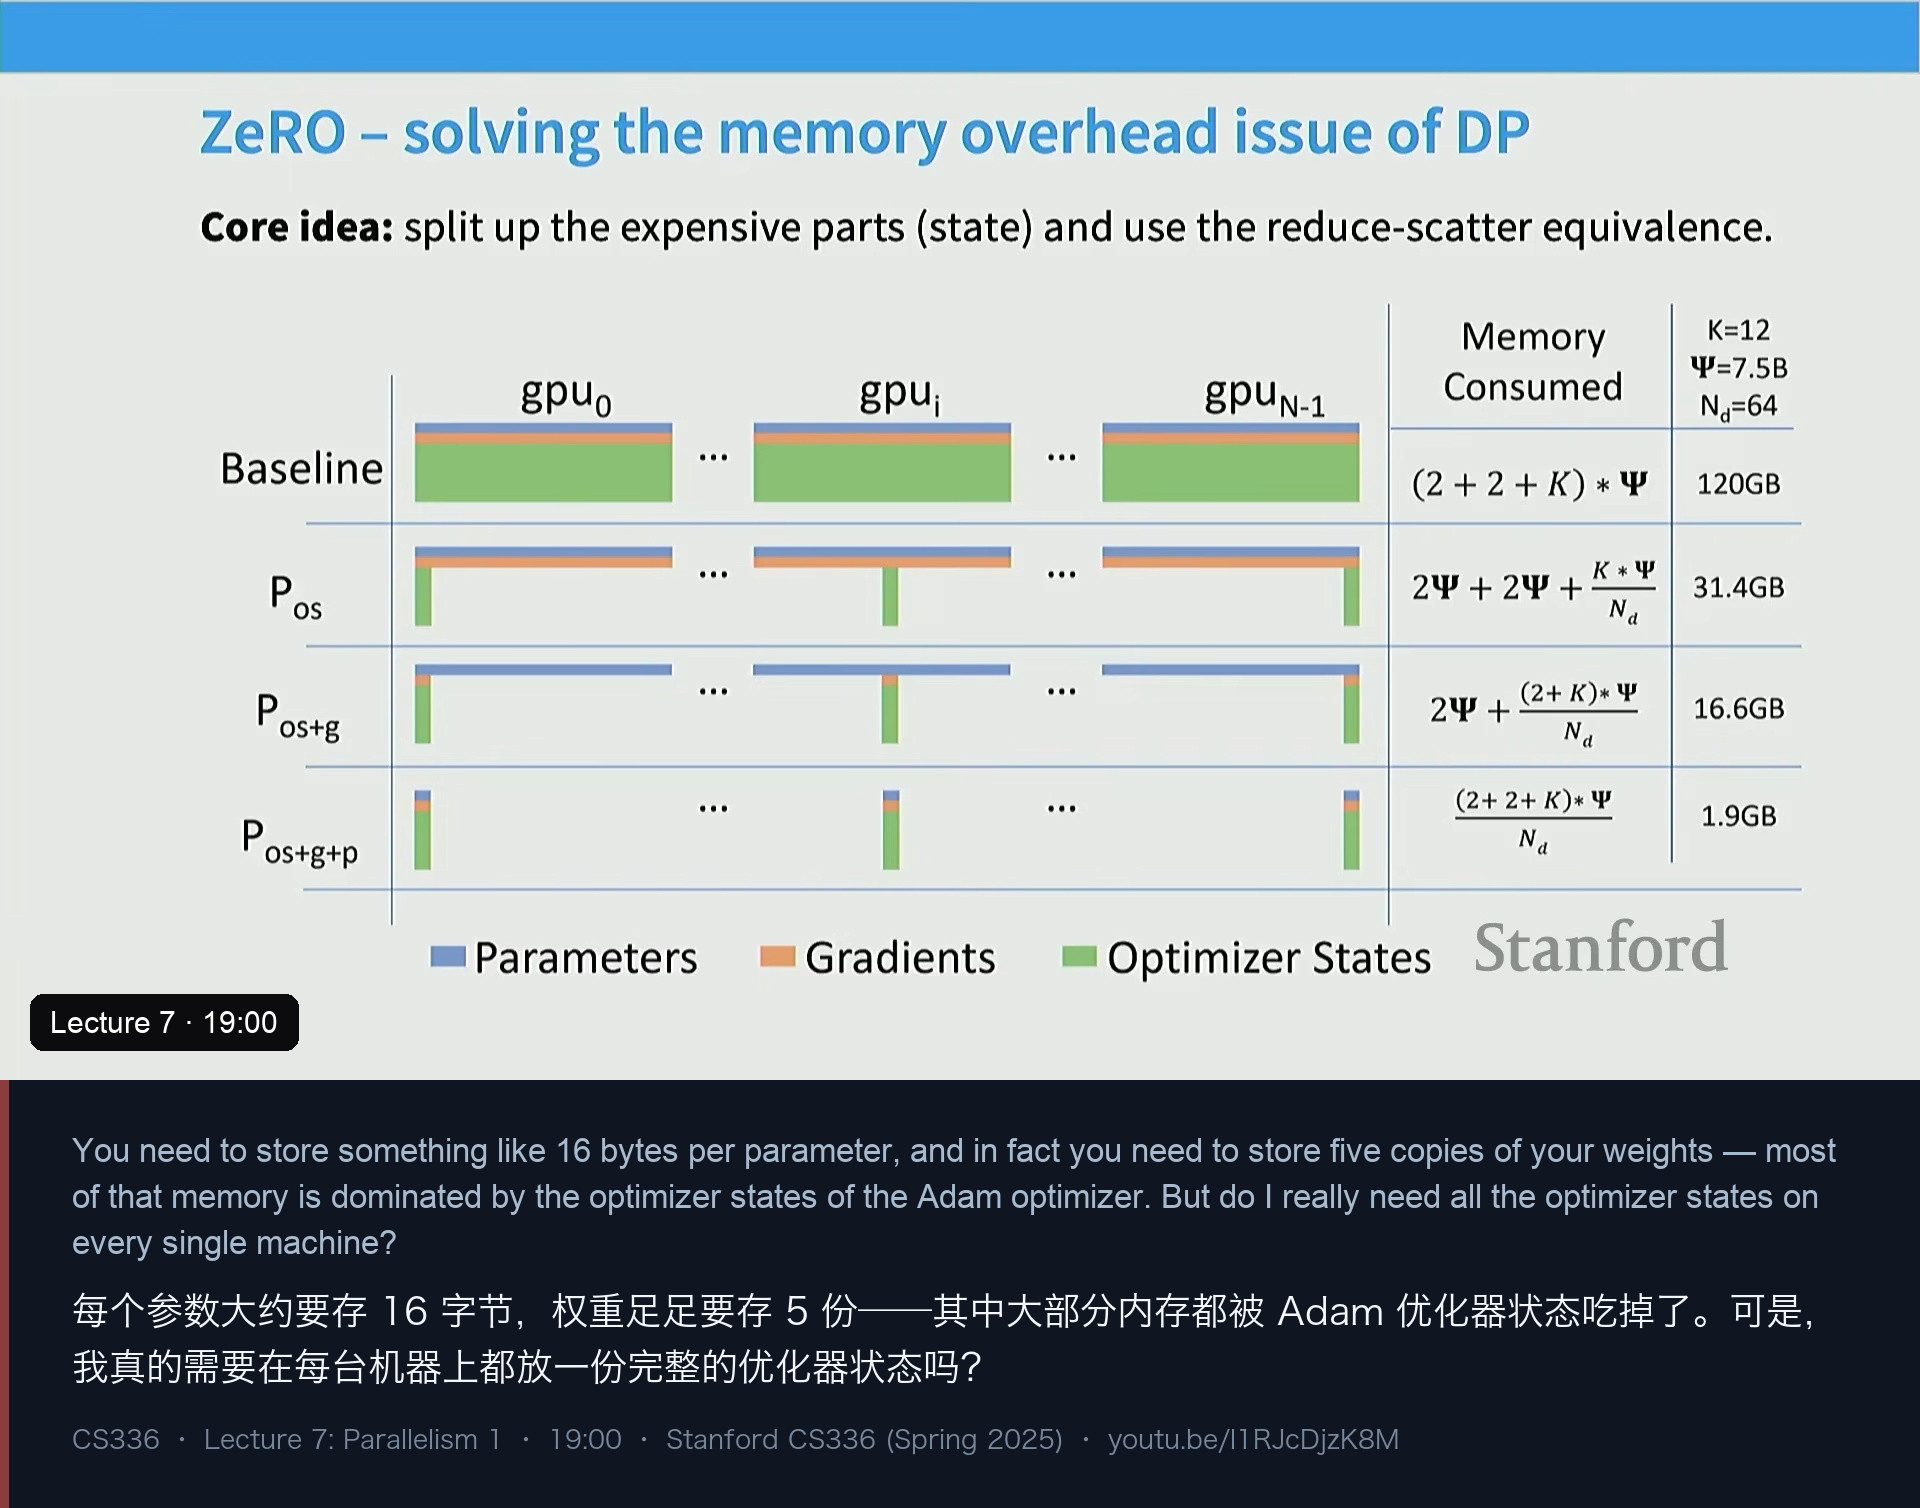
讲师据此给了一个具体例子:7.5B 模型铺在 64 张加速卡上,参数相关的显存要 120 GB,而且它随卡数线性增长——也就是“扩展机器救不了你”。
但换个角度问,出路立刻出现:参数和梯度确实每张卡都得有(否则没法算这一份数据的前向反向),但优化器状态真的需要每张卡都存一份完整拷贝吗? 顺着这个问题往下走,就是 ZeRO 的三级手术,也是 FSDP 的来历。
5.2 ZeRO stage 1:只分片优化器状态,几乎免费的午餐
stage 1 把优化器状态(Adam 的 m 和 v)按参数分片到各卡上,但参数和梯度仍然人人都有。算法的关键洞察是:只要一张卡上有某片参数的完整梯度和对应那片的优化器状态,它就有足够信息更新这片参数。
1. 每张卡在自己那份数据上算出完整梯度
2. reduce-scatter 梯度 → GPU0 拿到"自己负责那一片"在所有样本上的梯度和
3. 每张卡用「自己的优化器状态 + 完整梯度」更新自己负责的那片参数
4. all-gather 更新后的参数回所有 rank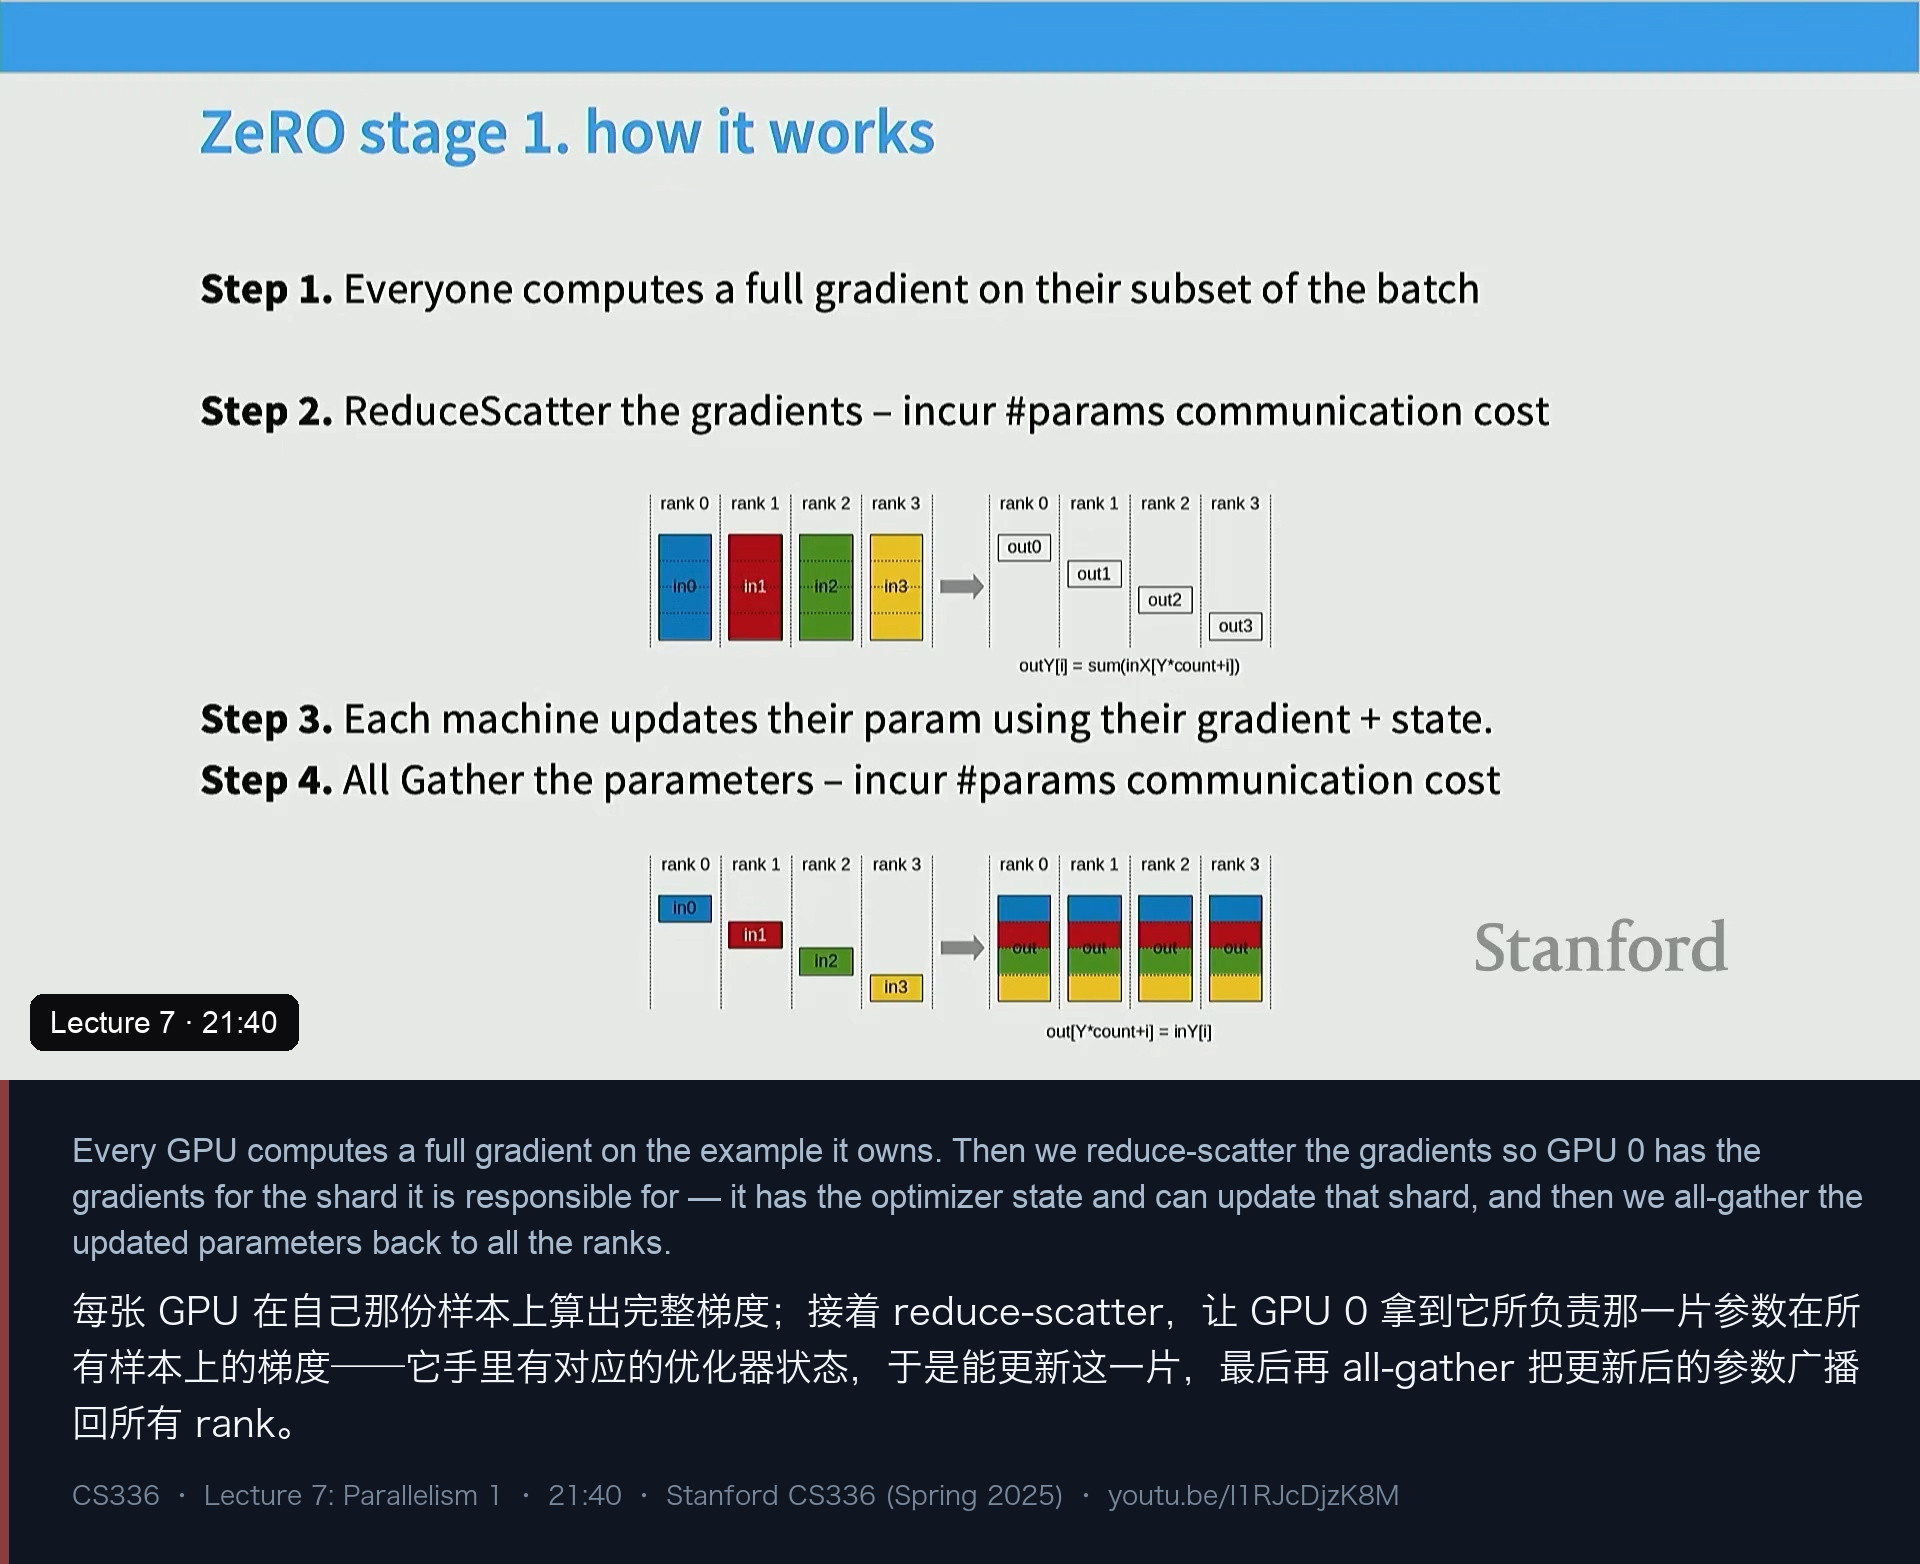
神奇之处在于:第 2、4 步正好是 reduce-scatter + all-gather,与原来的 all-reduce 带宽等价;中间多出来的那段计算不额外花钱。于是讲师给出结论:在带宽受限的情形下,stage 1 是免费的,还白拿一份显存收益——所以“能用就该用”。这段推理也顺手回答了学生提问(为什么可以分片优化器状态、台阶数怎么算、Adam 的各阶矩能不能拆)。
5.3 ZeRO stage 2:把梯度也分片掉
stage 2 在 stage 1 的基础上再分片梯度。这里有个新的工程约束:你永远不能实例化完整的梯度向量,否则显存峰值又回来了(峰值被限定为“完整参数 + 分片梯度 + 分片优化器状态”)。所以做法变成“边反向边通信”:
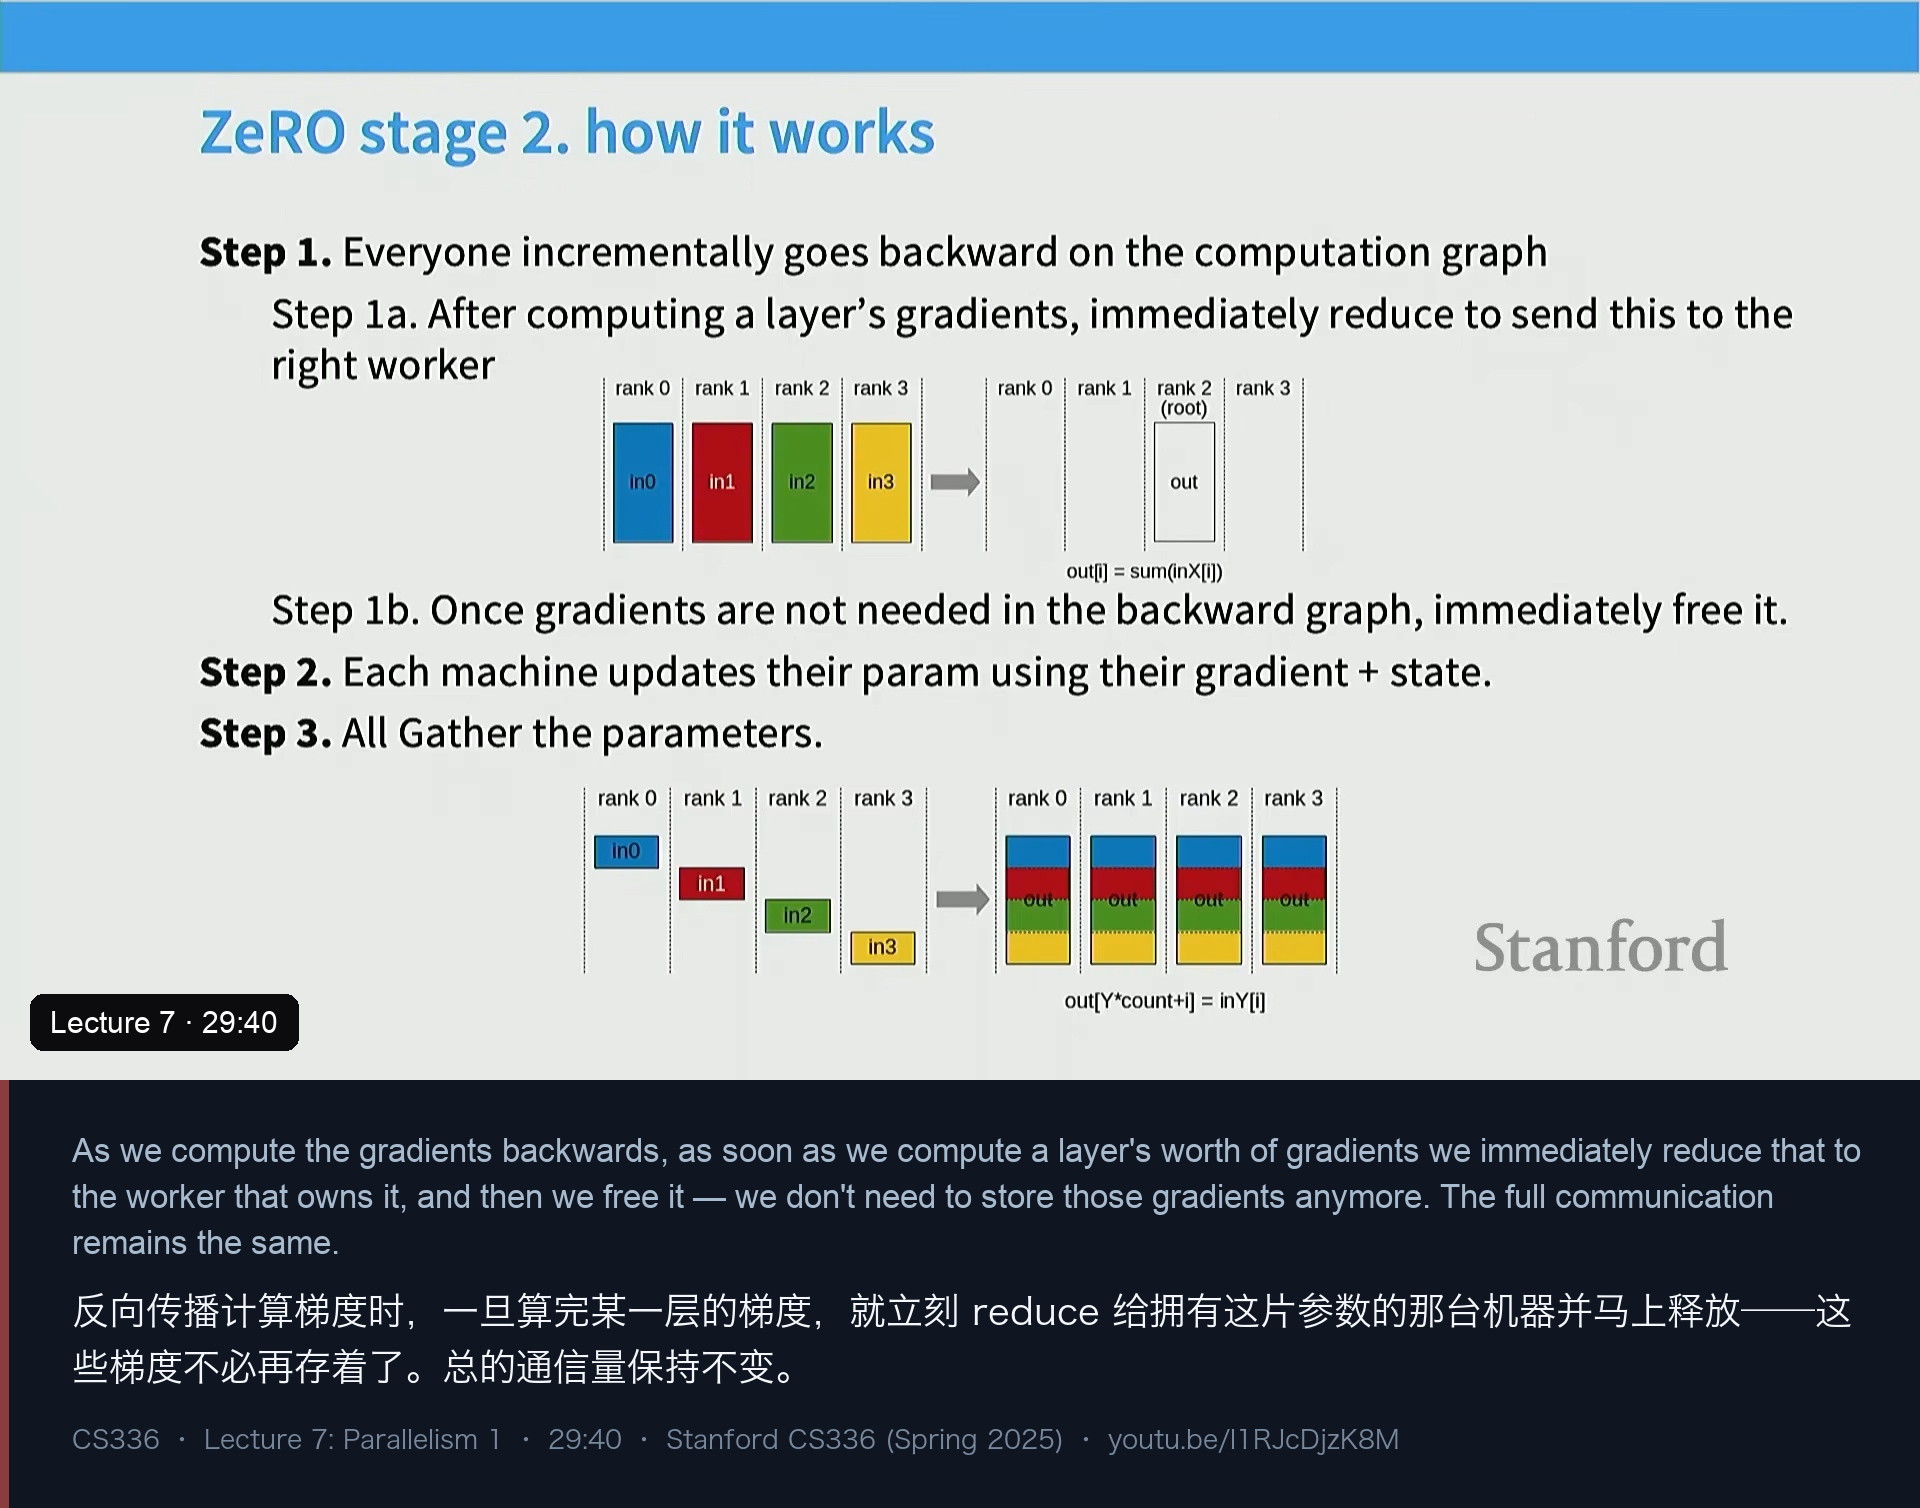
反向经过计算图时:
  for 每一层(按反向顺序):
      算完这层梯度 → 立刻 reduce 给拥有它的 worker → 立刻释放本地副本
最后:每张卡都持有"自己负责那片"的完整梯度与完整优化器状态
      → 各自更新参数 → all-gather 参数
通信总量仍然不变(还是 2× 参数量),但多了逐层同步的开销;代价换来的是梯度显存也降下来了:上面那个 7.5B/64 卡的例子从 31.4 GB 进一步降到 16.6 GB。
5.4 ZeRO stage 3 = FSDP:连参数也分片
stage 3 把参数也分片——这就是 FSDP。代价是任何一张卡都不再拥有完整模型,所以前向/反向都必须按需 all-gather 参数:
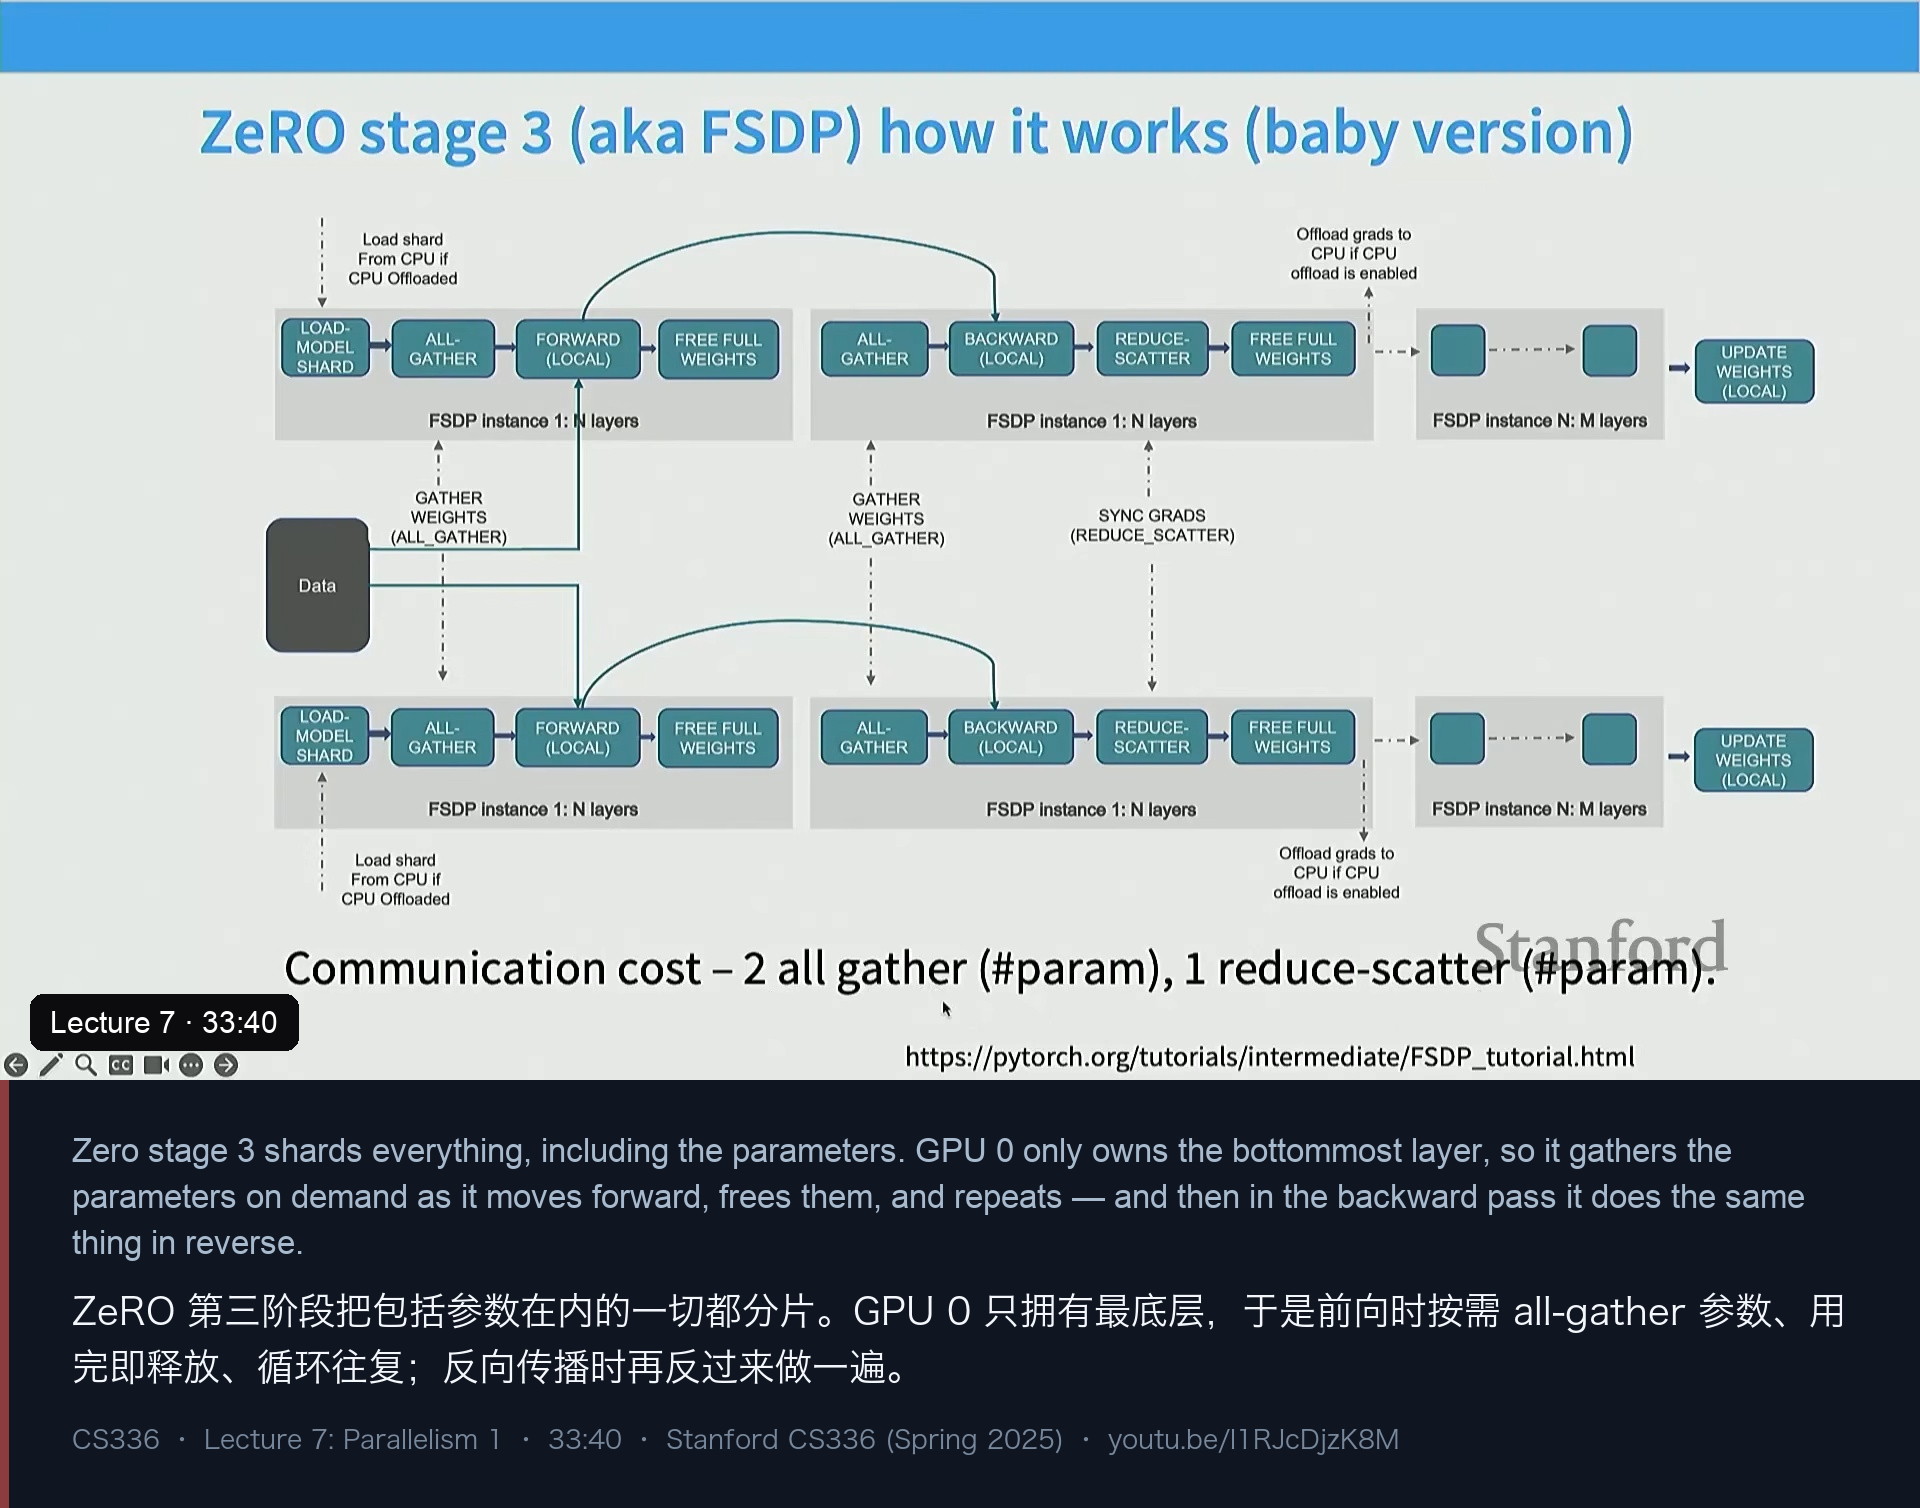
前向:for 每层:  all-gather 该层参数 → 算这一层 → 释放参数
反向:for 每层:  all-gather 该层参数 → 反传 → reduce-scatter 梯度 → 释放
每一步的通信量看着夸张,但总量只是从 2× 参数量变成 3× 参数量;那个 7.5B 的例子也从 16.6 GB 一路压到 1.9 GB。也就是说,参数、梯度、优化器状态三类显存被彻底“除以卡数”。
FSDP 真正的妙处在于它没那么慢。讲师说得很直白:你会以为不停地请求、发送参数一定很慢,但关键在于把通信和计算重叠起来——像预取一样提前把下一层要用的参数取回来,等真正需要时它已经在手边了。
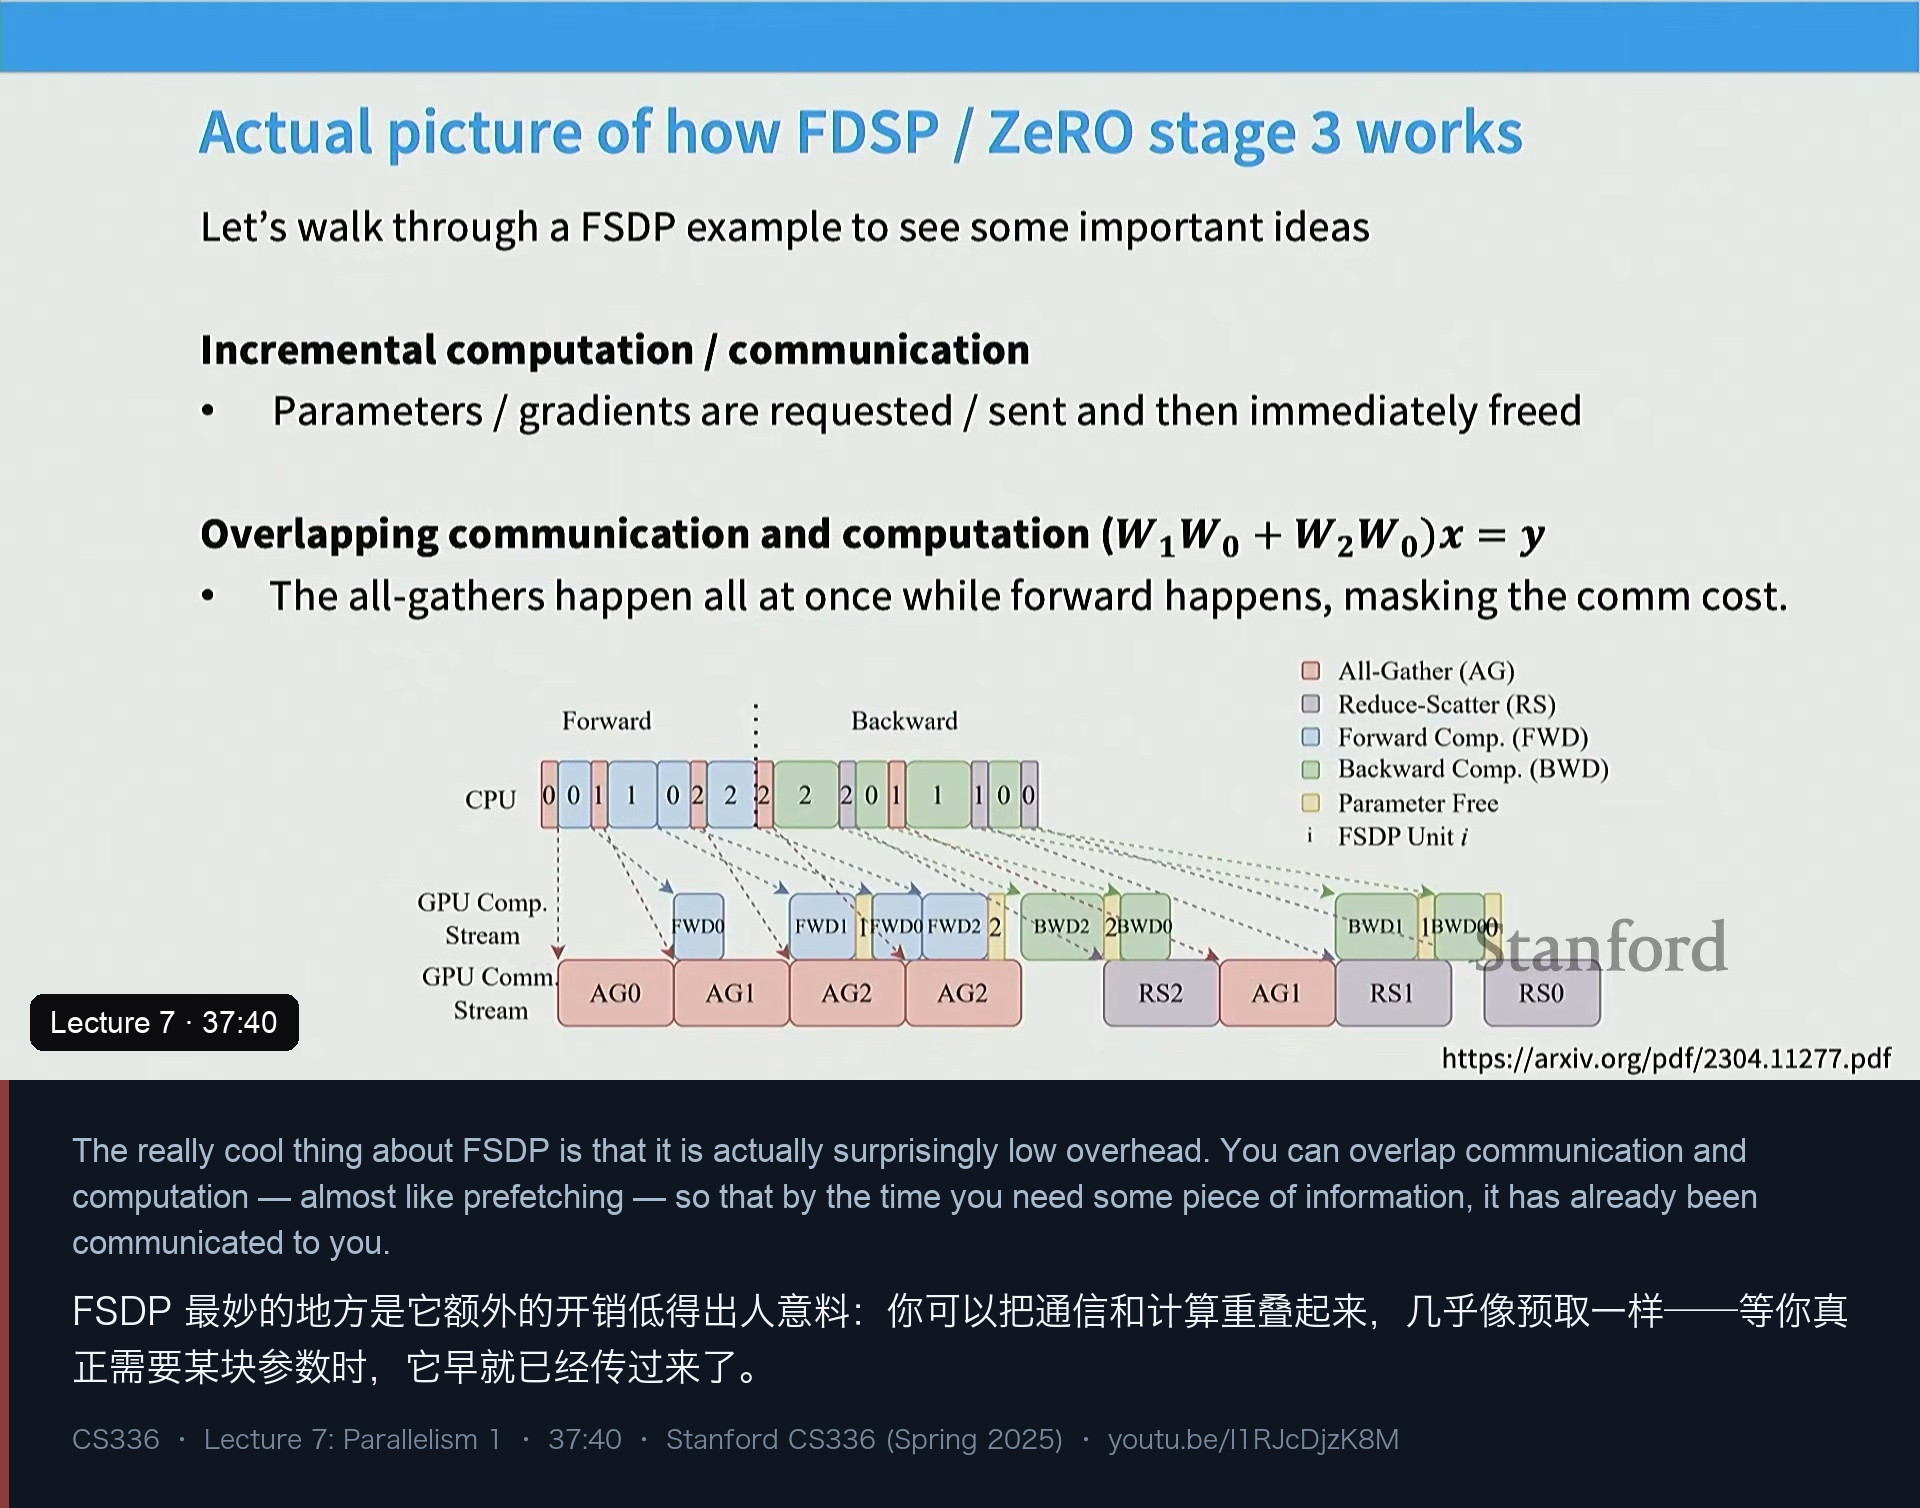
(他同时点出这套图景里被忽略的两件事:一是预取需要额外的缓冲区,这块开销不能不算;二是激活显存完全没被解决,那要留到第 9 节。)
5.5 实践收益,以及一个必须澄清的区别
把三级手术放回 8×A100-80GB 的节点上:
| 配置 | 最大模型规模(参数) | 每个参数的显存公式 |
|---|---|---|
| Baseline | 6.6 B | 16 |
| ZeRO stage 1 | 6.6 B | 5 |
| ZeRO stage 2 | 24.6 B | 2(参数)+ (10 + 梯度状态)/8 |
| ZeRO stage 3 | 53.3 B | 12/8 |
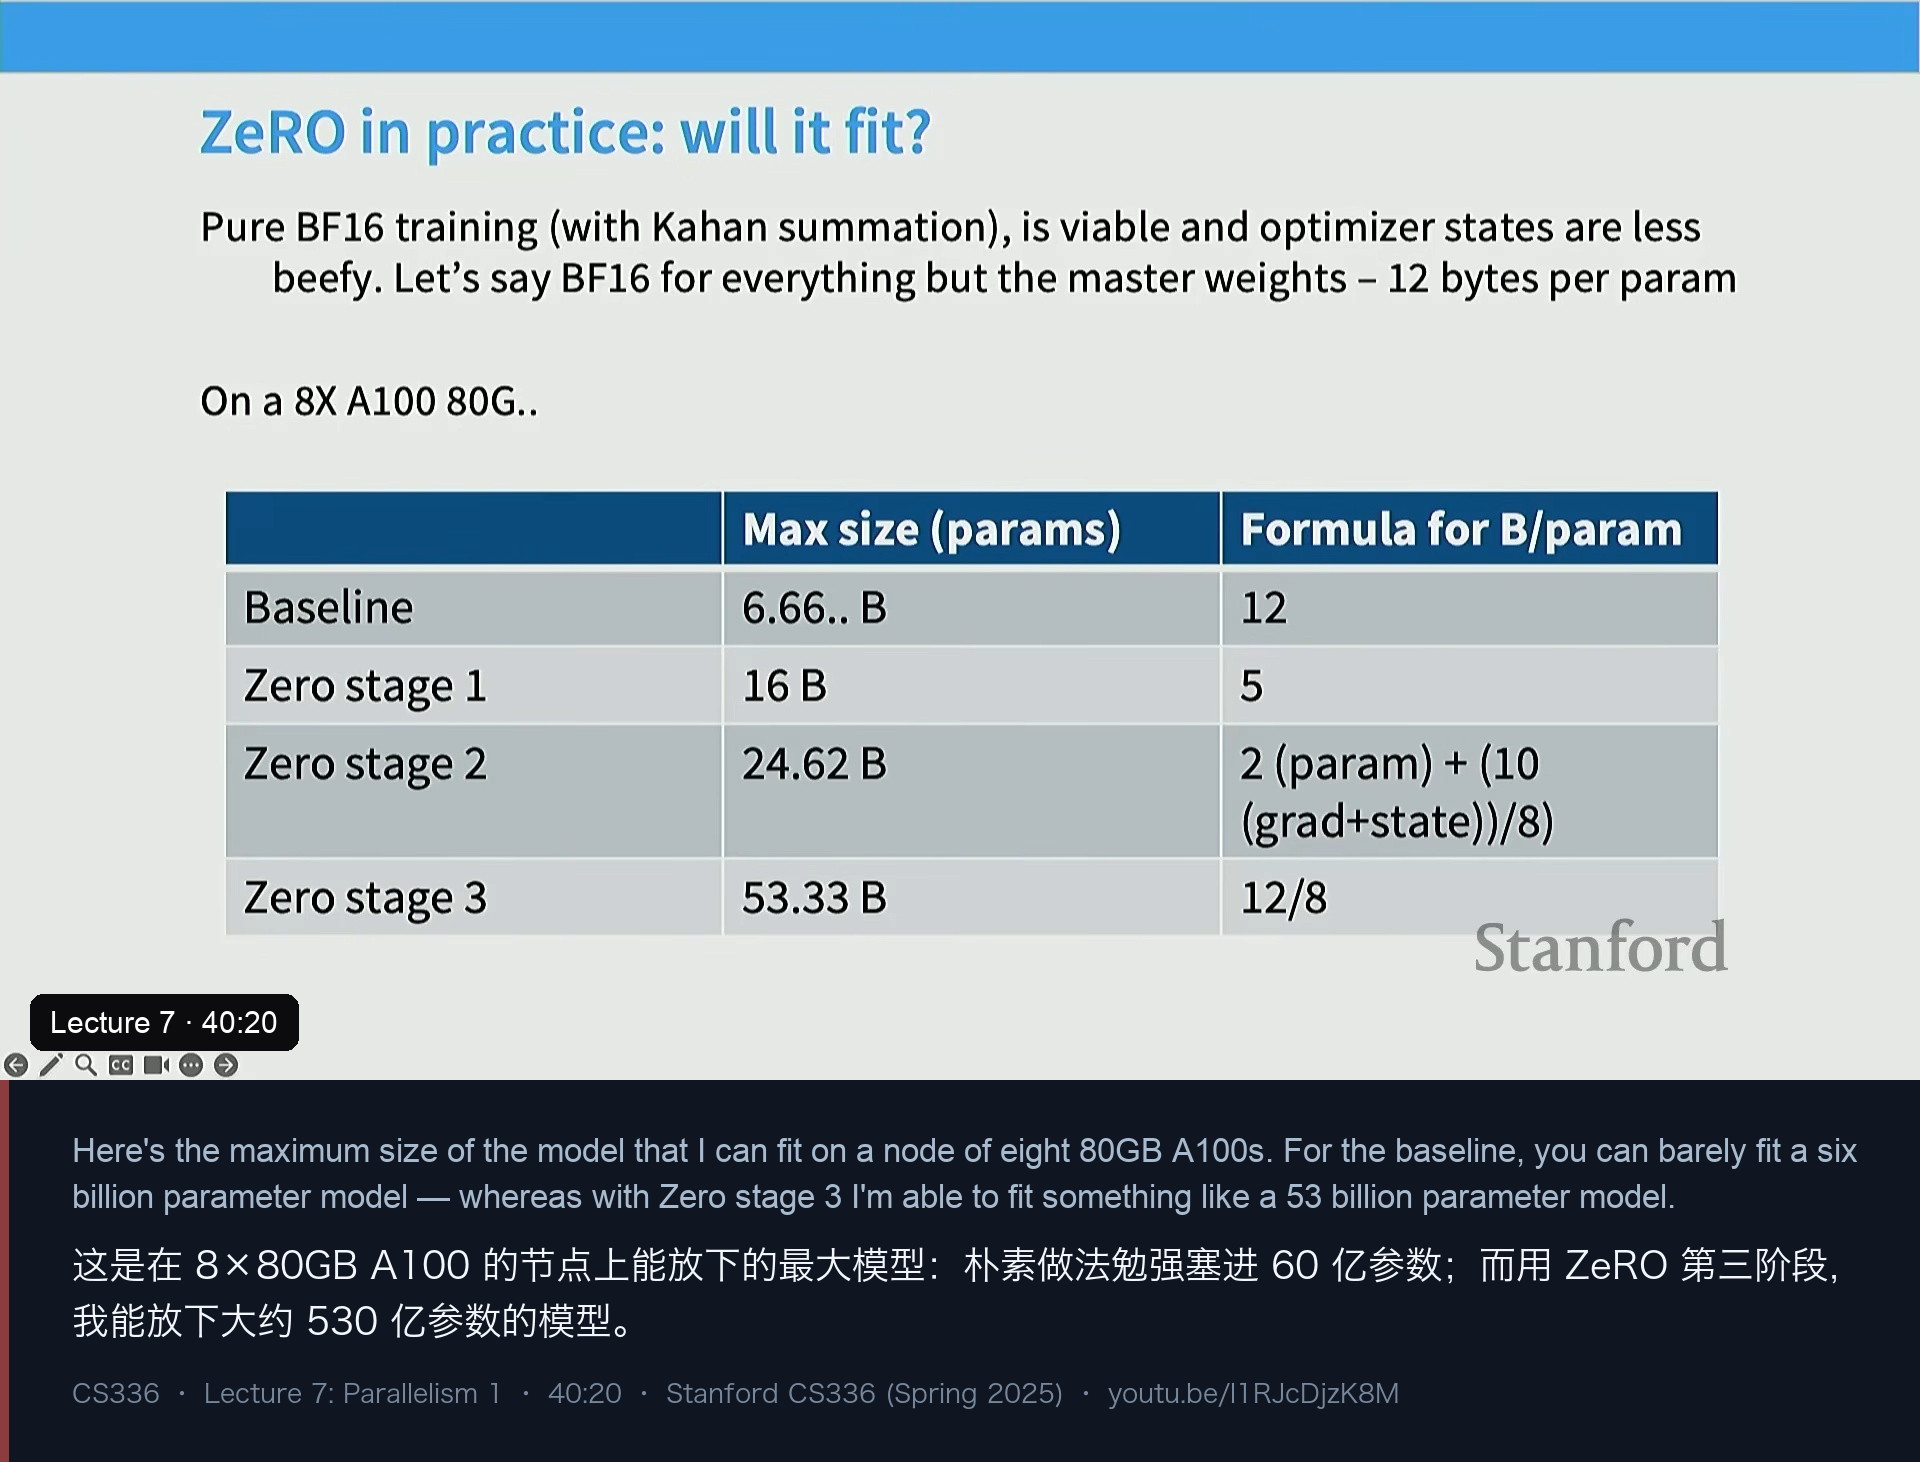
(这张表里 stage 1 的上限没变,是因为瓶颈从优化器状态换成了参数与梯度;数字来自幻灯片,属于讲师引用的估算。)
有个学生提了很关键的问题:参数都分片了,stage 3 和模型并行还有什么区别? 讲师的回答构成了一条重要的判据:
- 数据并行(含 FSDP)传的是参数——参数被切开了,但推理/训练时仍要 gather 到一起用;
- 模型并行传的是激活——每个参数自始至终只待在自己的机器上,跨机流动的只有激活。
也正因为 FSDP 不关心模型长什么样(它只是一个“包装任意神经网络”的通用技术),它才如此流行;而模型并行必须知道模型结构。
六、batch size 是一种会被花掉的资源
讲完数据并行,讲师停下来强调一个“希望你们记住”的点:batch size 是数据并行里真正的稀缺资源。
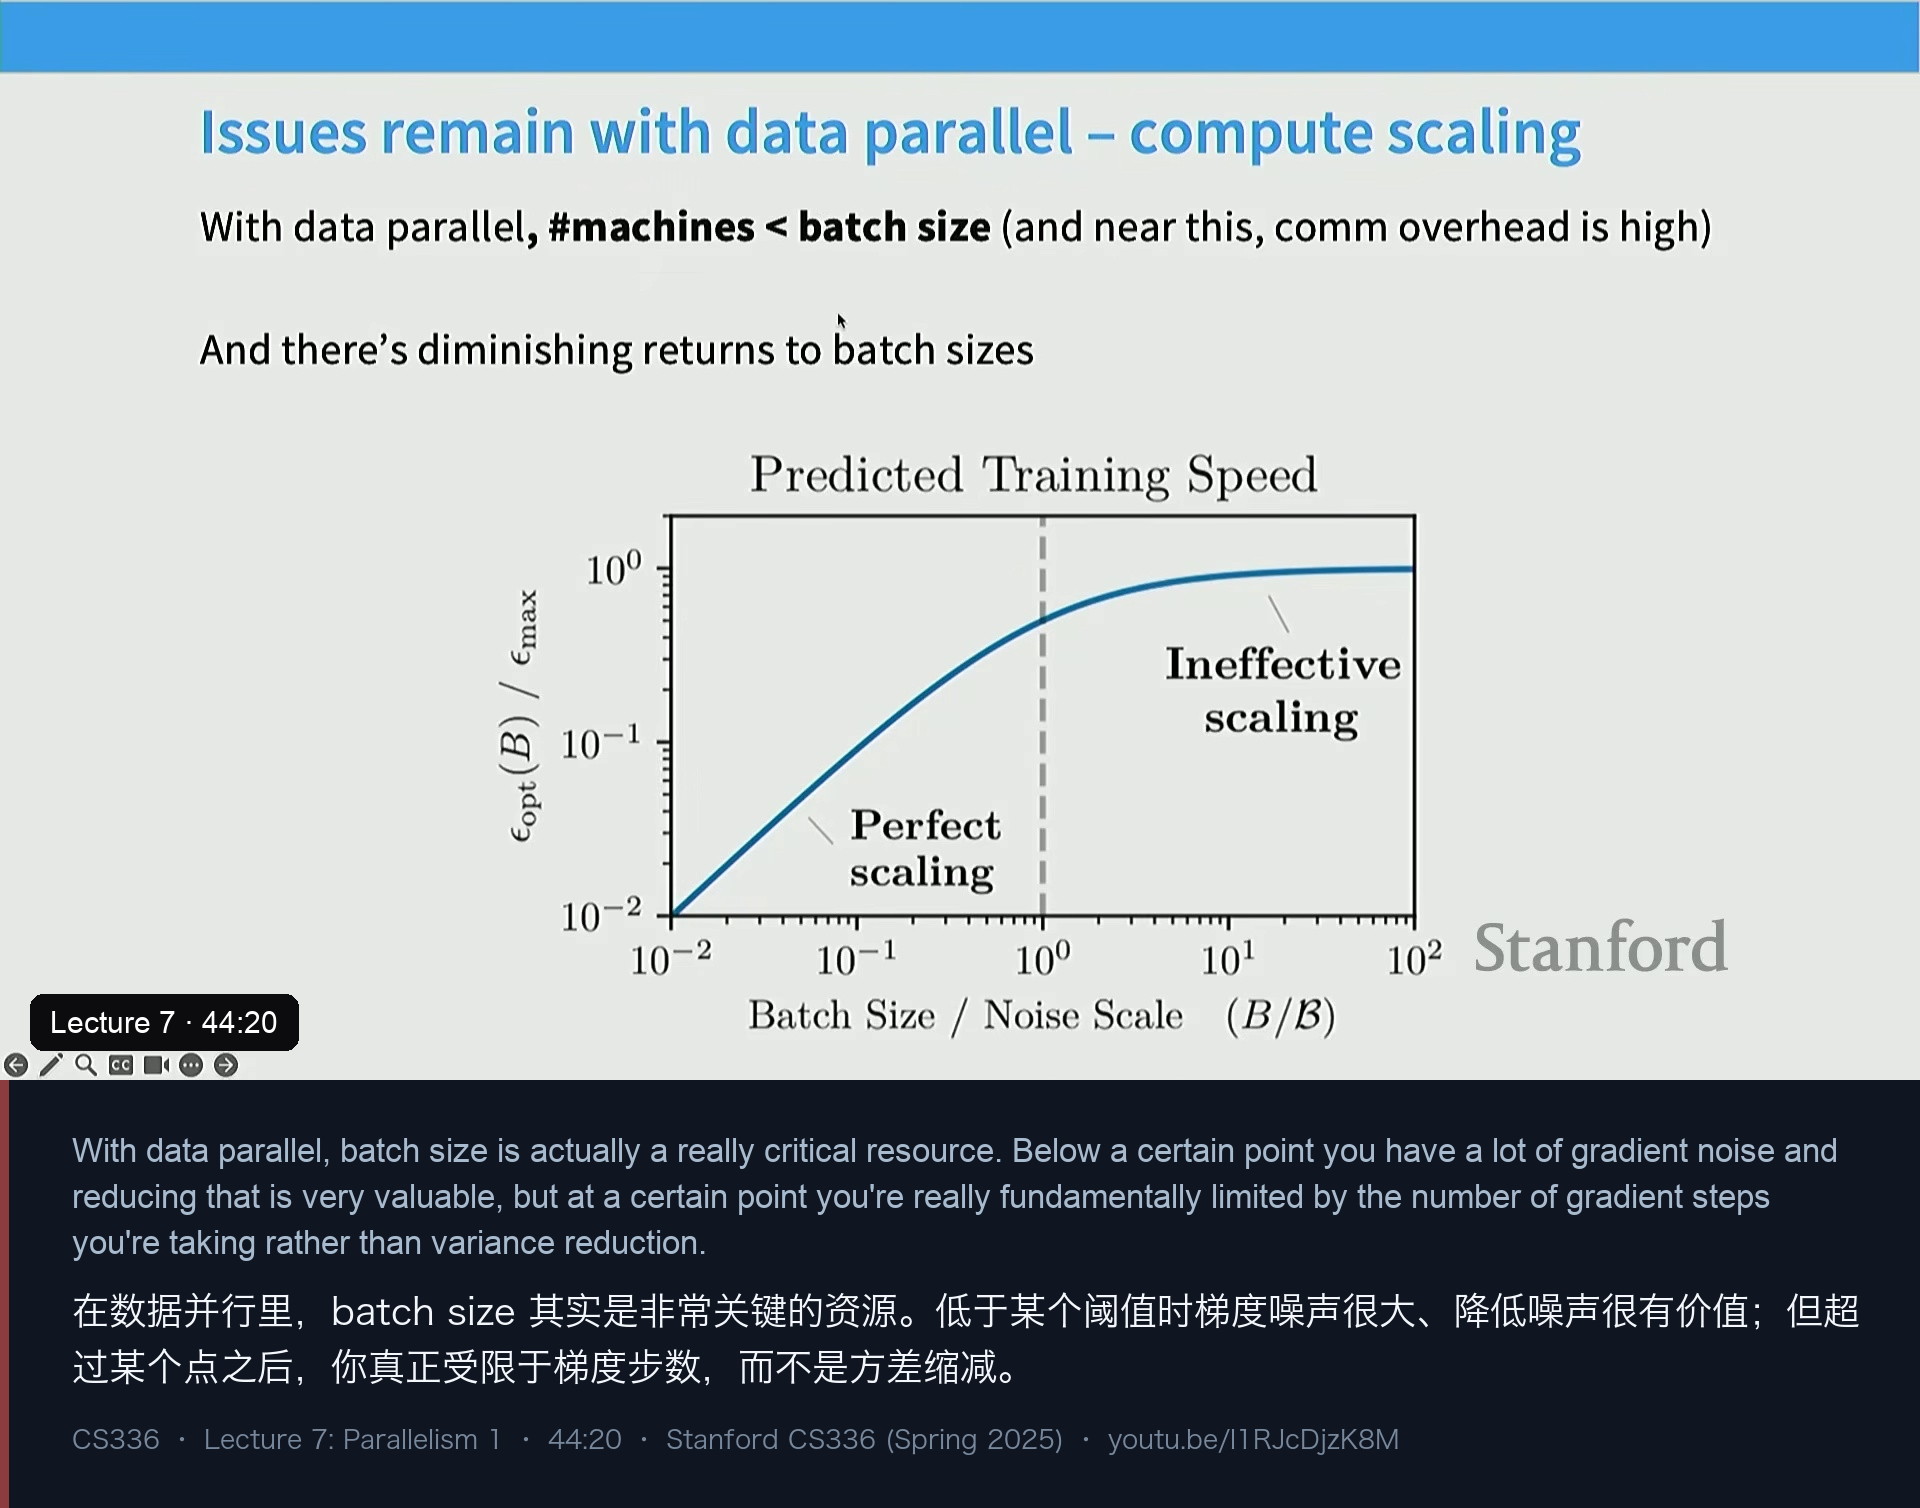
- 你不可能并行到超过 batch size 张卡(不能把样本切成几分之一);
- batch size 存在收益递减:低于某个点时梯度噪声大,降低噪声很有价值;超过某个点后,你受限于梯度步数,而不是方差缩减——OpenAI 那篇关于 critical batch size 的论文讲的就是这件事;
- 所以单靠数据并行无法无限扩展。
更关键的是,batch size 是所有并行策略共享的一份预算:数据并行花它,流水线并行也花它。这就是为什么讲师把“资源”定义成三样东西——显存、带宽/算力、batch size——而不是大家习惯的前两样。
七、模型并行(一):流水线并行与它的气泡
需要模型并行,是因为 ZeRO 前两阶段不解决参数显存、stage 3 又不解决激活显存,而且前面三条路都要求大 batch。模型并行提供了一条不花 batch size 的扩展轴——它的代价是把通信对象从参数换成激活(激活往往比参数小得多)。
第一种切法是按深度切层,也就是流水线并行:
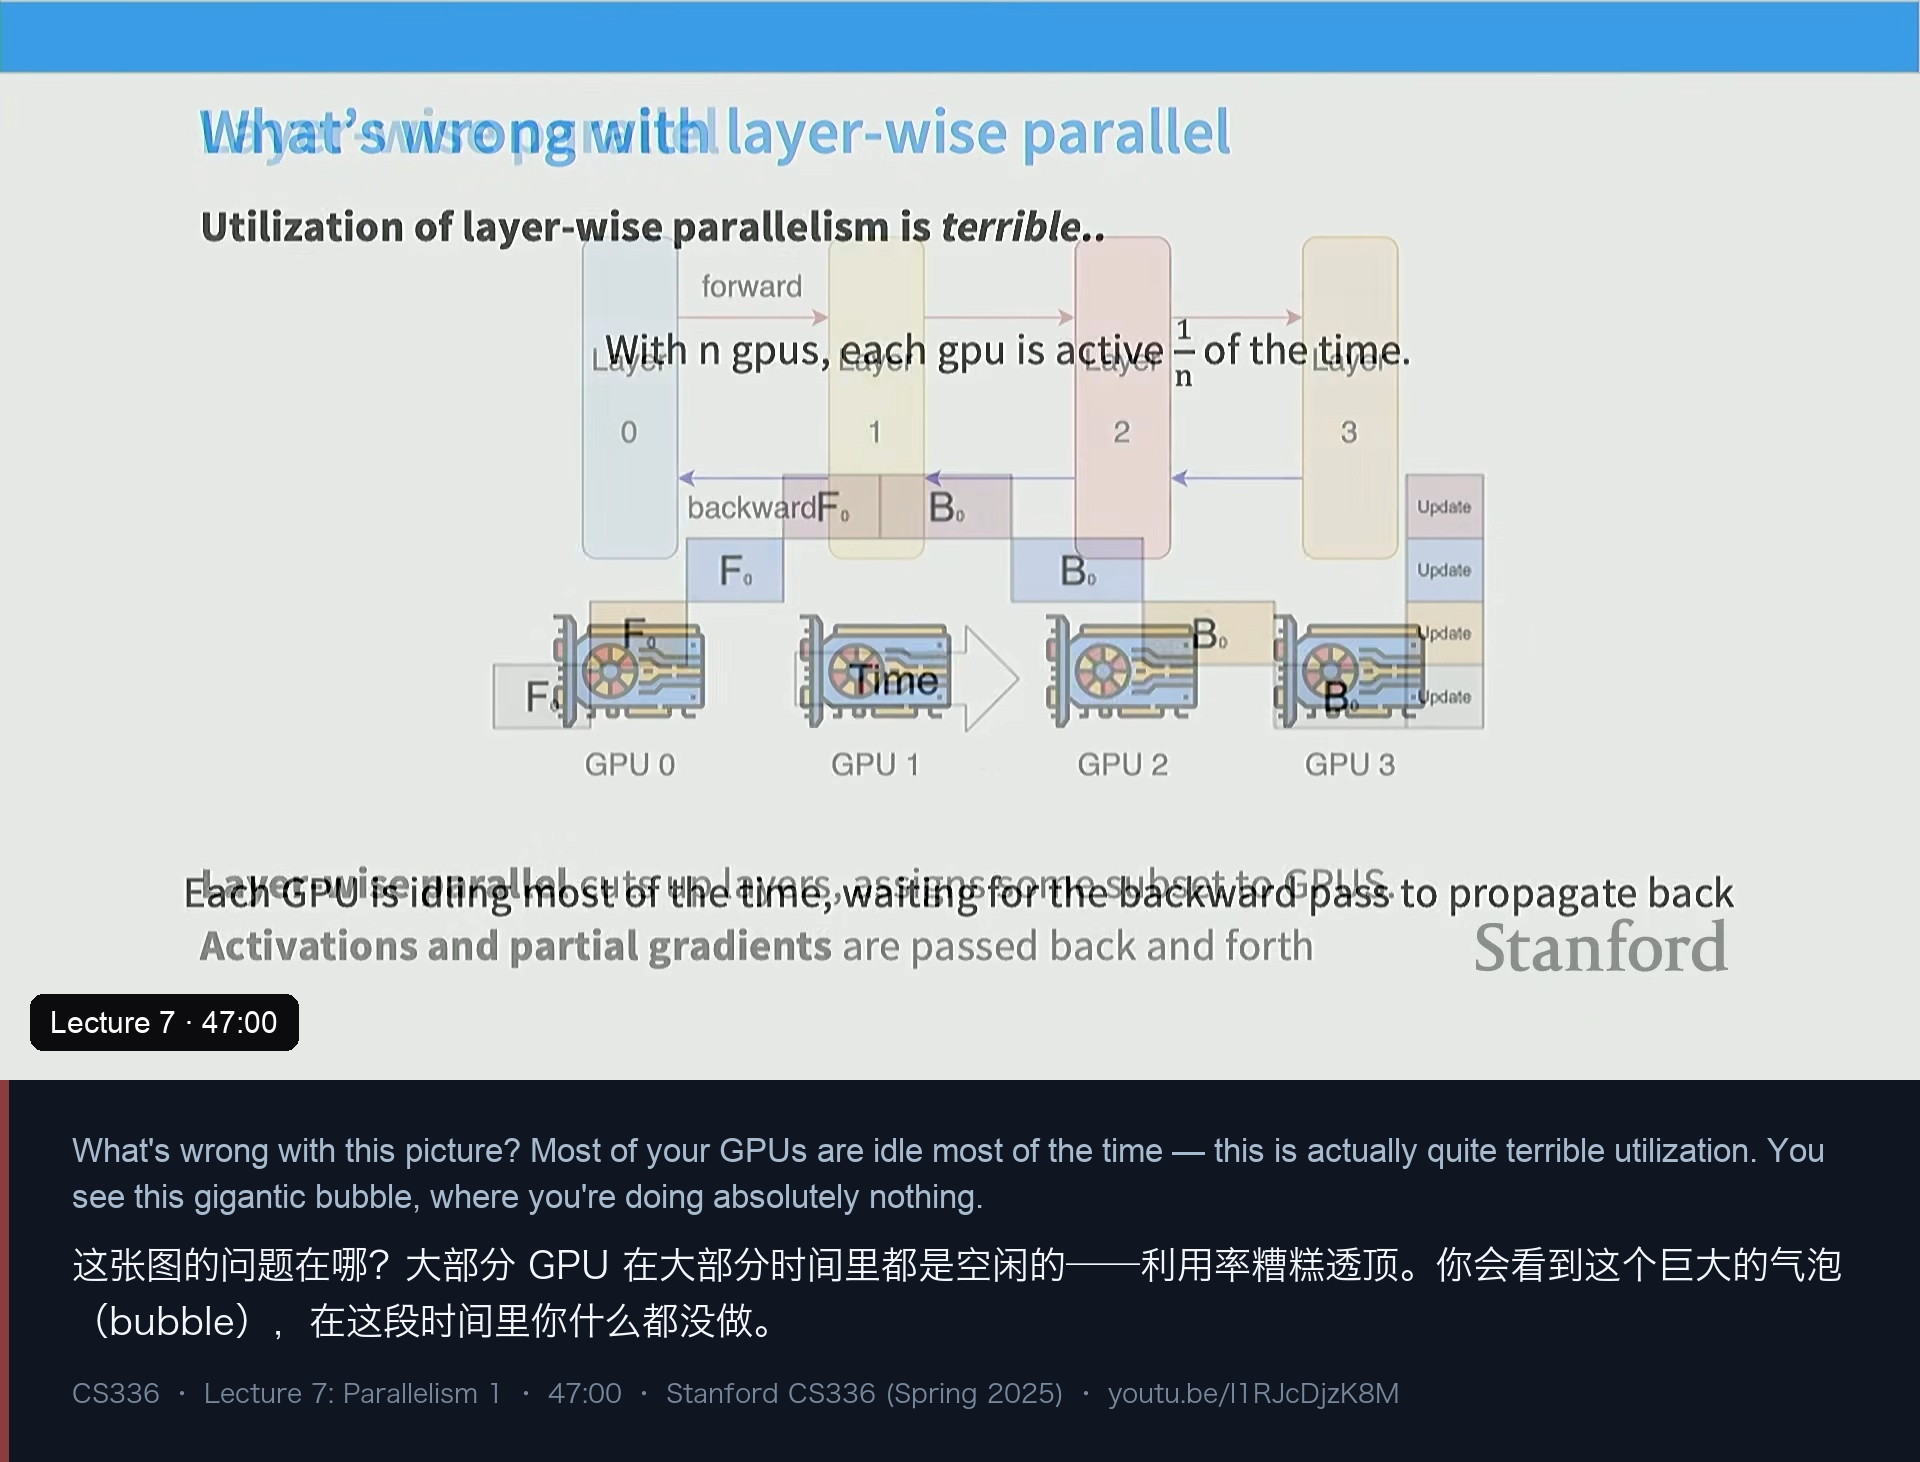
如果每张卡负责几层、一次只处理一个样本,那么任意时刻只有一张卡在干活——讲师称之为“最糟糕的并行”:多了 4 张卡,吞吐只有单卡的水平。补救办法是micro-batch:把 batch 切成若干份,第一份算完立刻把激活发给下一张卡,自己接着算第二份。于是气泡占比变成:
气泡占比 ≈ (p - 1) / m # p = 流水线级数(stage 数),m = micro-batch 数也就是说:流水线并行要用 batch size 买单。batch 越大,气泡越好藏。
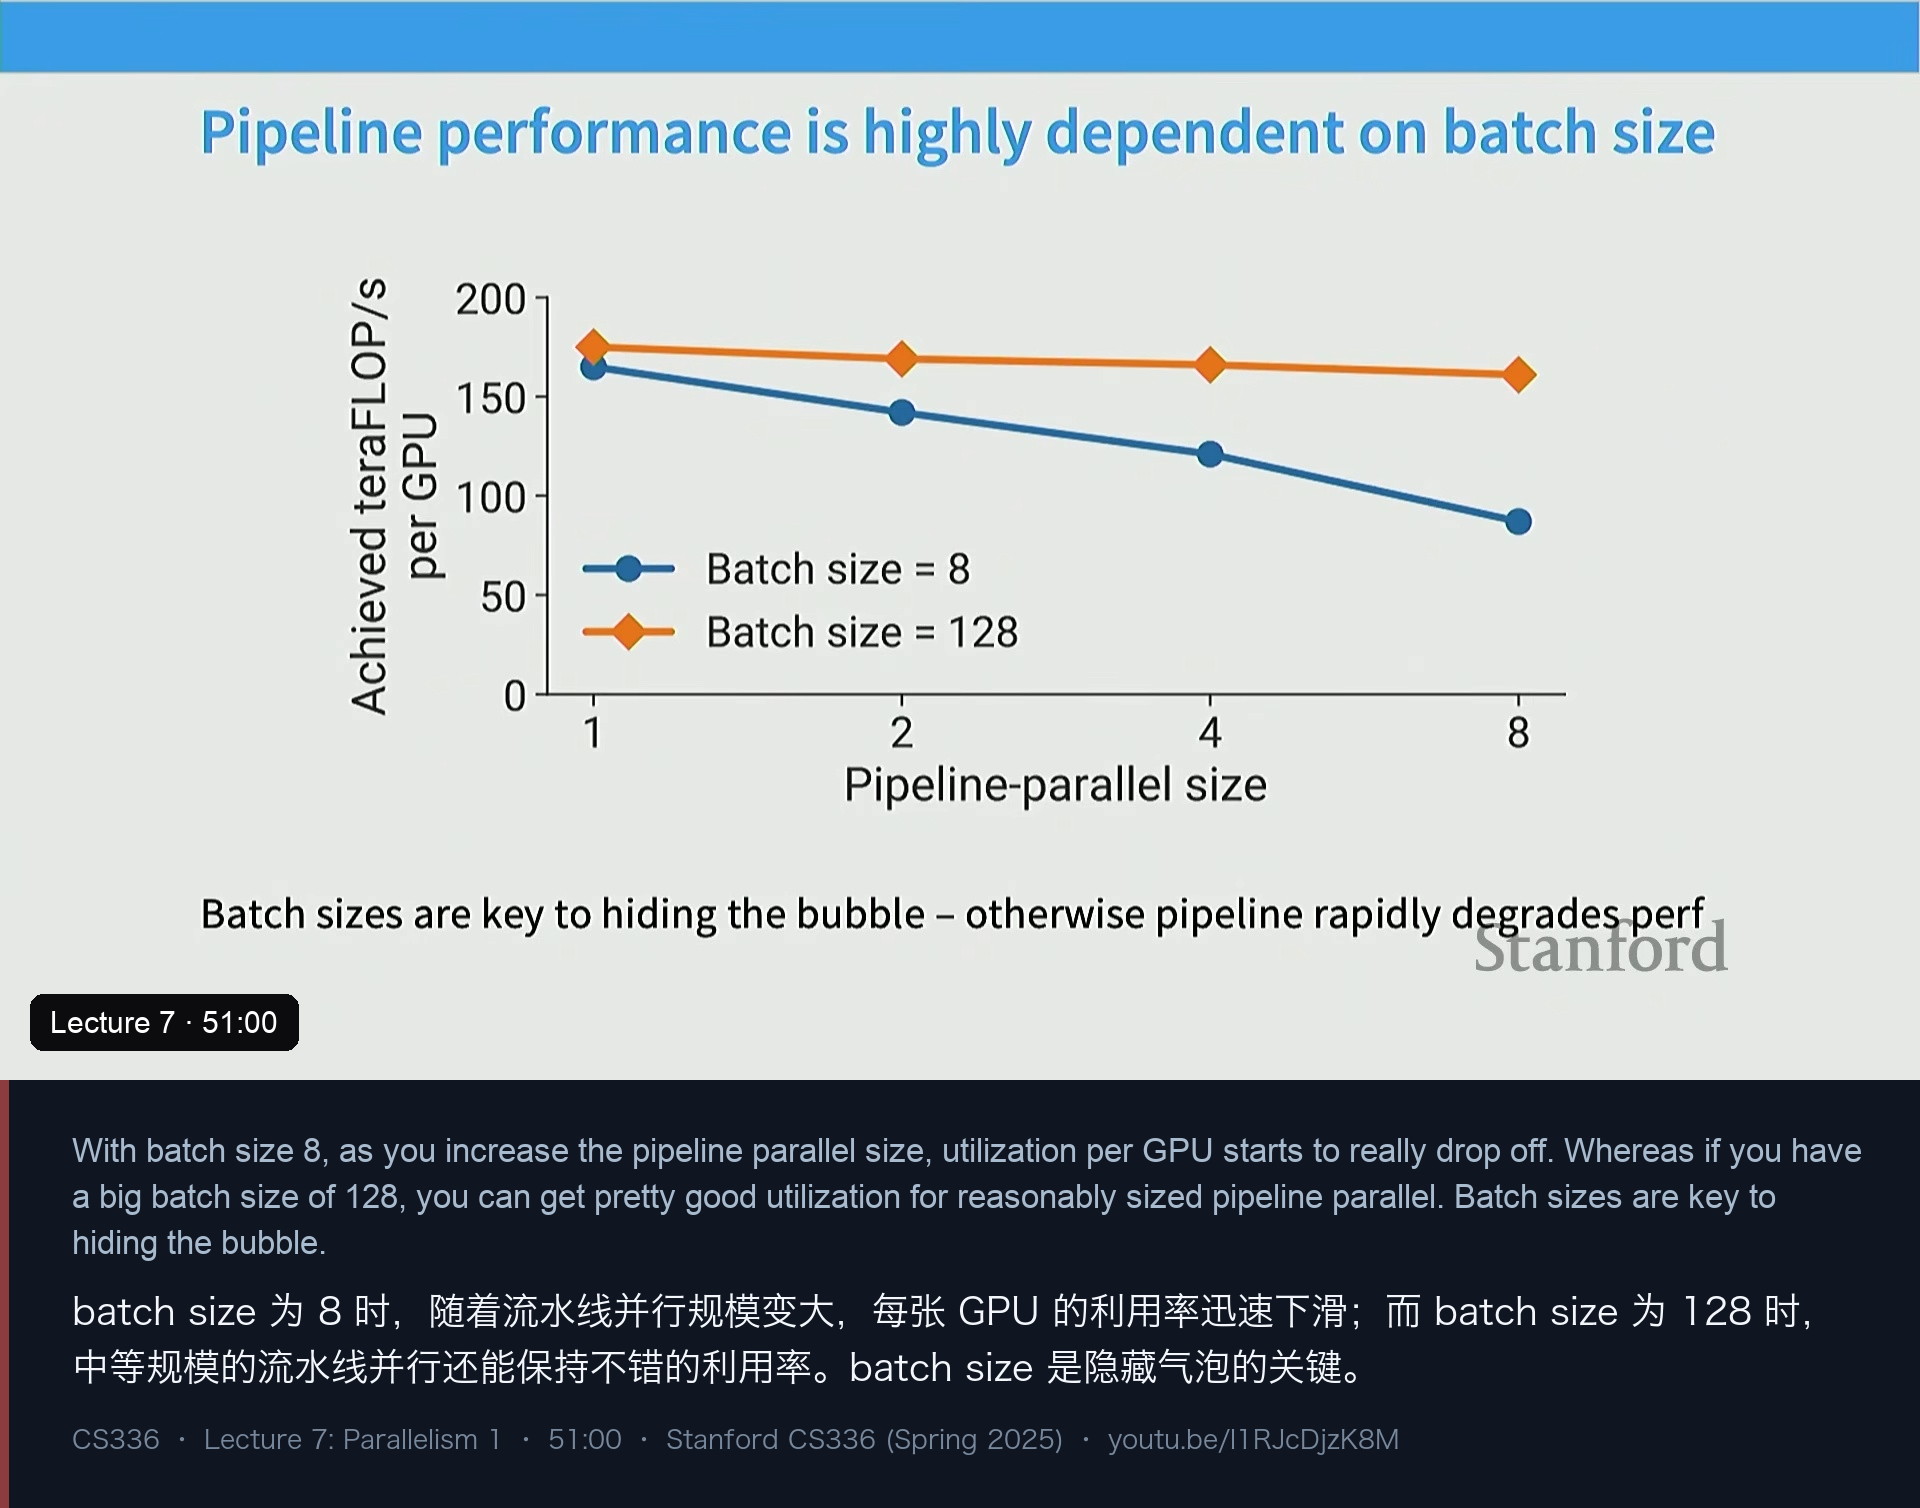
既然这么麻烦,为什么还要用流水线并行?讲师给了三条理由:
- 它省激活显存(激活也按层分片了,ZeRO-3 做不到这点);
- 它的通信是点对点、只传激活,对慢链路友好——所以常被放在跨机、跨机架这些最慢的链路上;
- 有 Google 的人告诉他,TPU 的优势之一就是“不太需要流水线并行”,因为环面网格没有那么明显的 256 卡断层。
再往上一层是调度:交错式调度(把更细的子层分给不同设备)能把气泡切得更碎;而最漂亮的是 zero-bubble pipelining(DeepSeek 的 DualPipe 用的就是这个核心技巧):
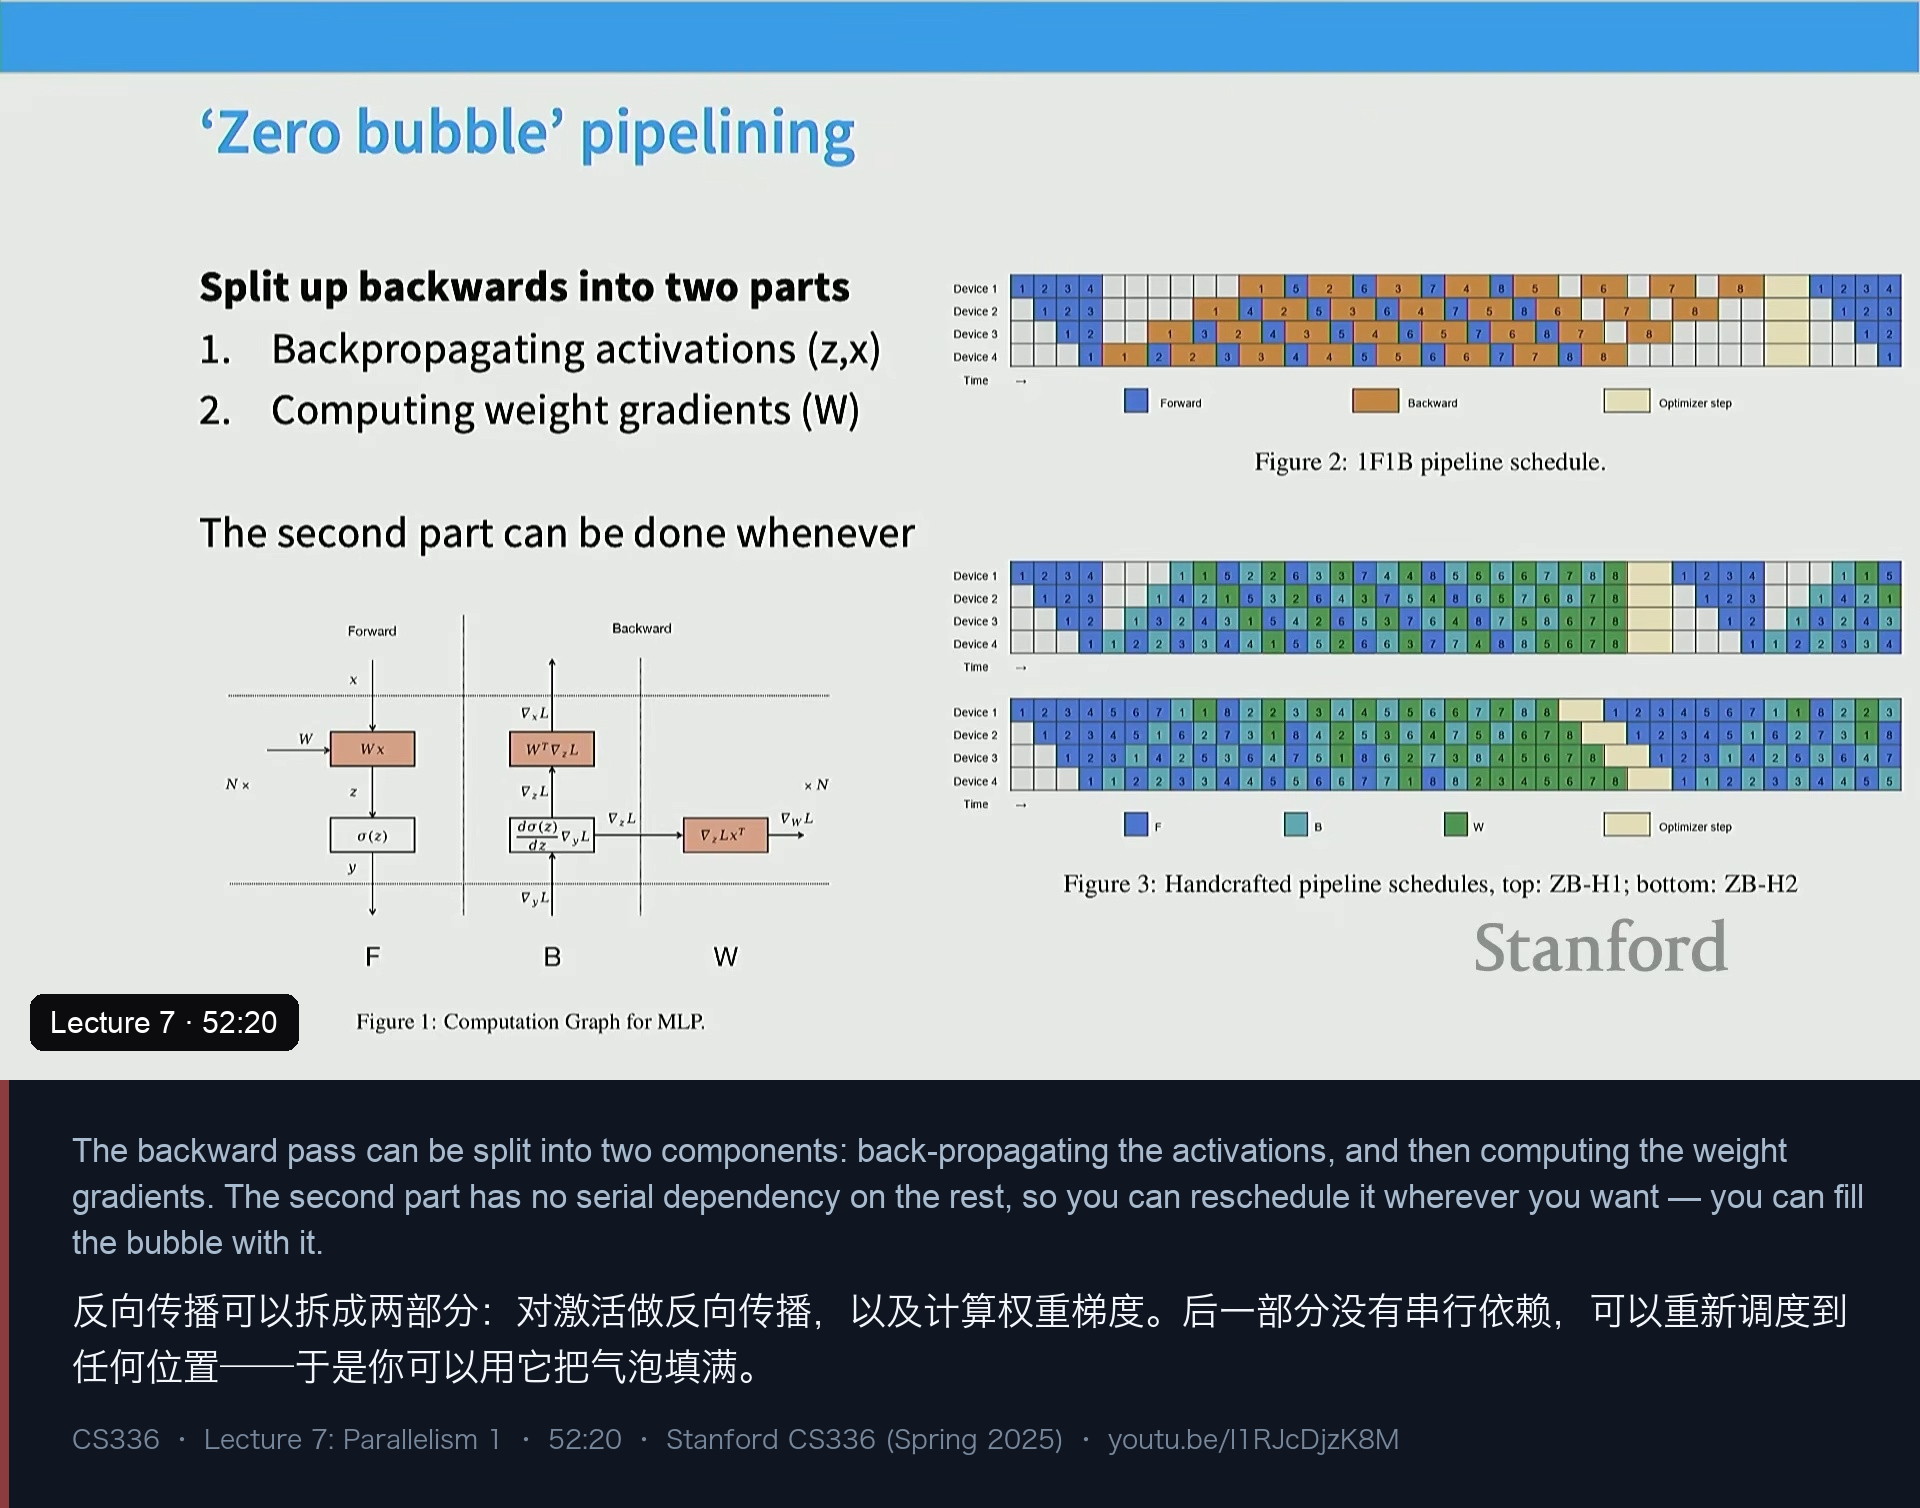
反向传播可以拆成两部分:B——对激活做反向传播(有串行依赖),W——计算权重梯度(没有串行依赖,可以重新调度到任何位置)。于是把原本空着的白格用 W 填满,利用率就上来了。讲师对这项技术的评价非常“诚实”:实现起来可怕地复杂——你必须在自动微分、队列调度层面动手;他还转述了一个业内的段子:某前沿实验室的流水线并行“只有两个人真正懂,其中一个人走了”,于是训练基础设施只剩一个承重柱。这也是他给出的“能不用流水线并行就别用”的现实理由。
八、模型并行(二):张量并行
第二种切法是沿宽度切矩阵。道理很朴素:大模型的计算和参数绝大部分是矩阵乘法,那就把矩阵乘法本身拆开——
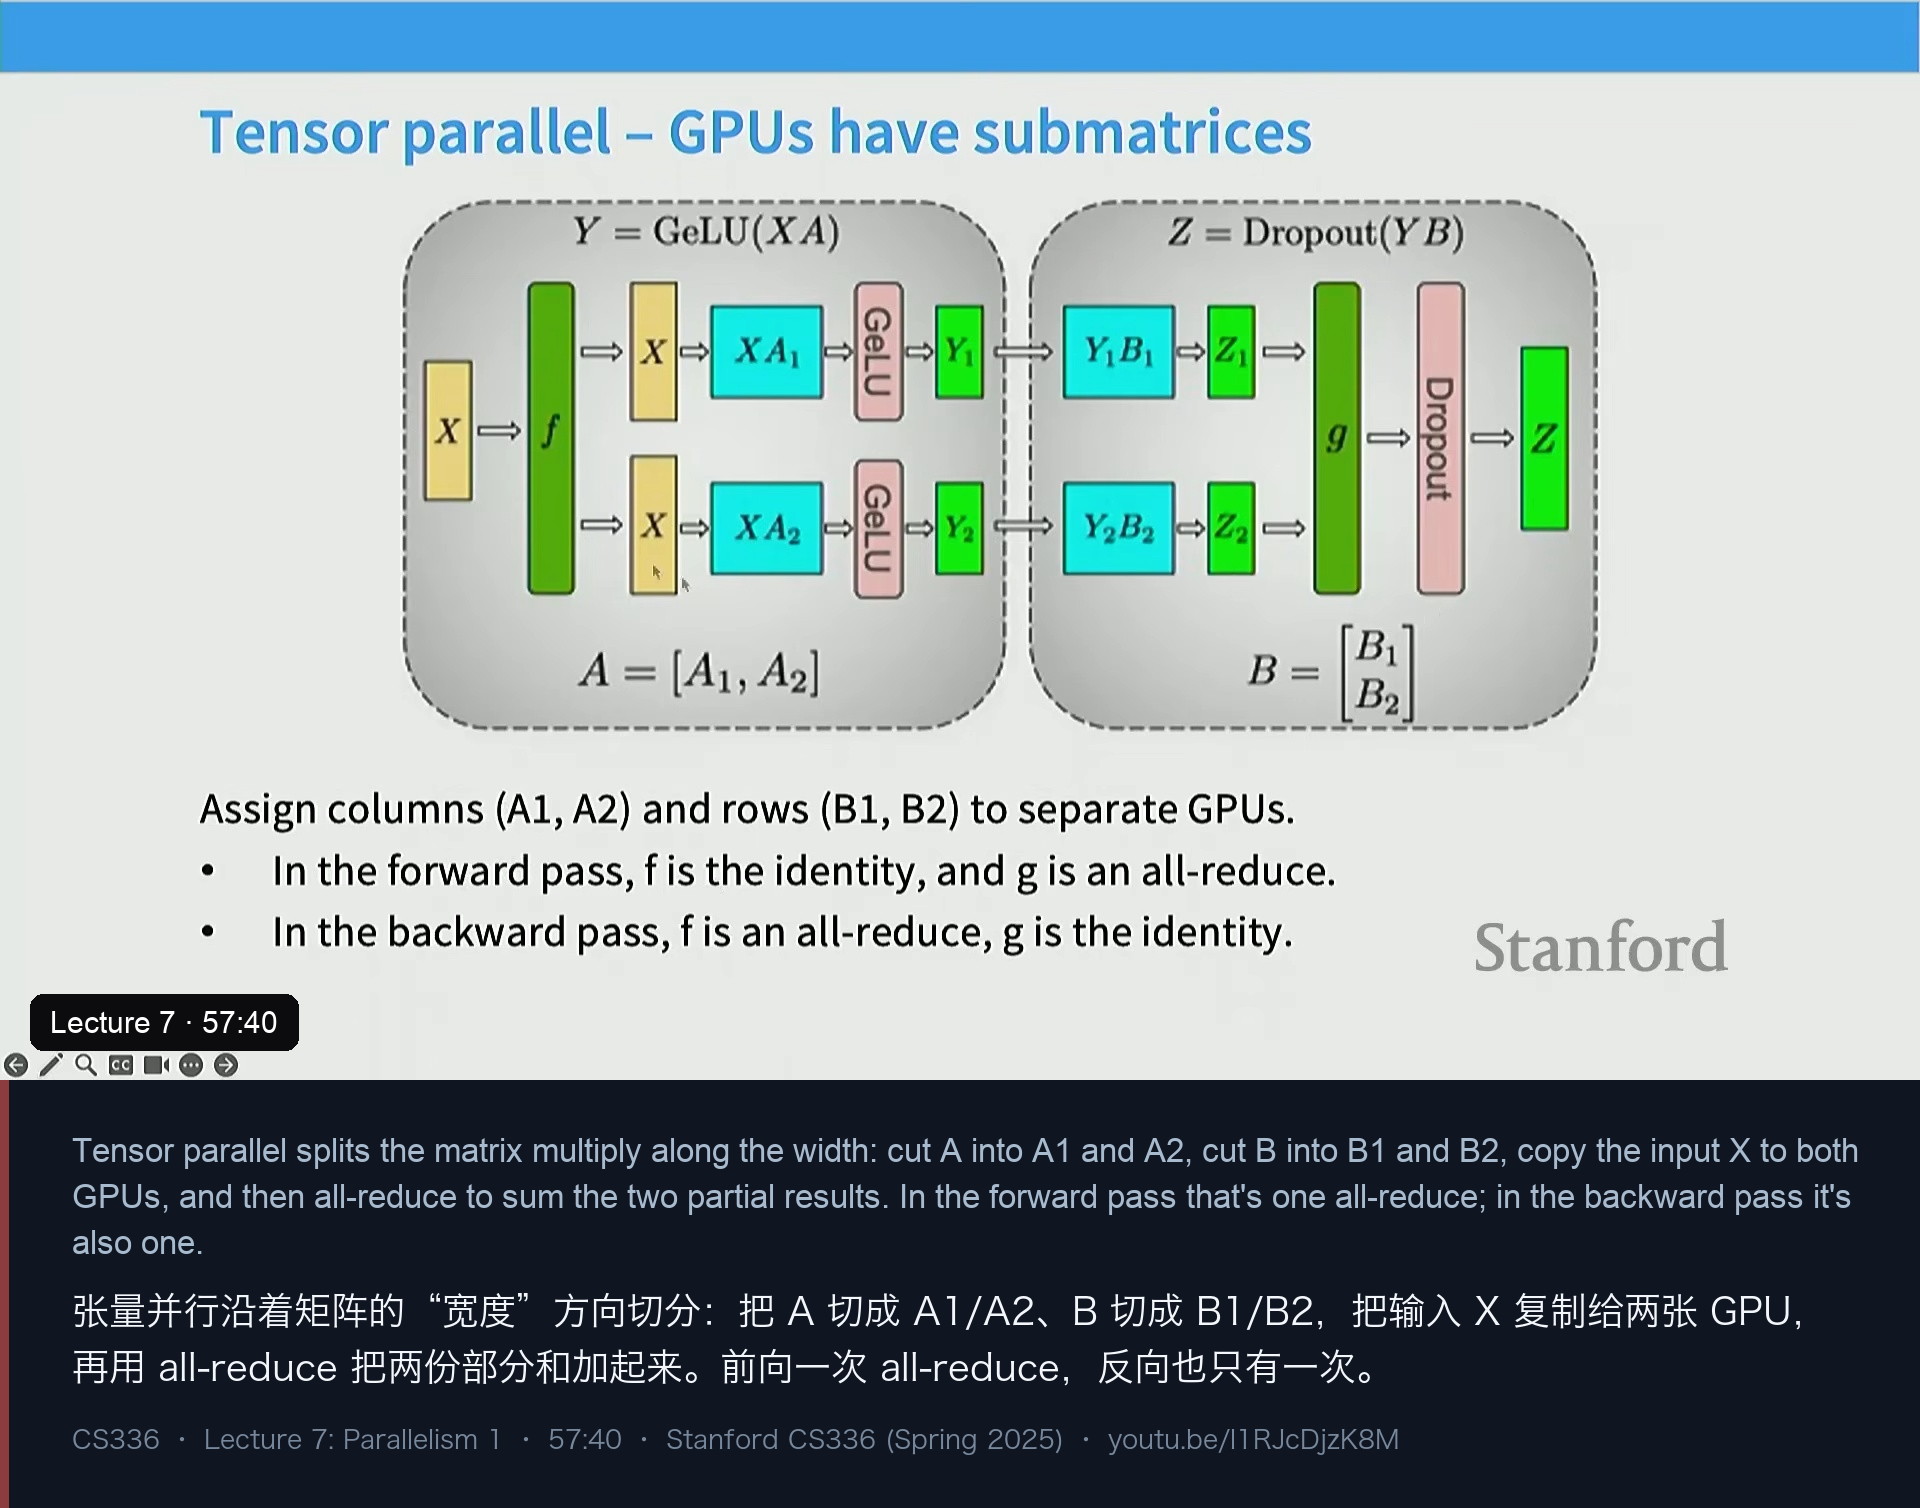
前向:X 复制到两张卡 → 分别算 X·A1、X·A2 → 通过 B1、B2 → all-reduce 求和得 Z
反向:导数同样复制分发,到 f 处再做一次 all-reduce 把两路梯度加回来
所以 f、g 都是同步屏障:前向一次 all-reduce,反向一次 all-reduce,位置不同但代价相同。
张量并行的优缺点极为鲜明:
- 优点:没有气泡,不需要大 batch,实现复杂度低(只要知道哪里有大的矩阵乘法、能不能切开),而且完全不消耗 batch size——这是它独一无二的好处;
- 缺点:带宽需求极大——每层 8× 激活量级的 all-reduce,而流水线并行每 micro-batch 只有点对点的“batch × 序列长度 × 残差维度”通信。
于是有了那条最好记的经验法则:张量并行用在单机之内,最多 8 张卡(也就是一台机器自带的那 8 张 GPU,NVLink 最快)。
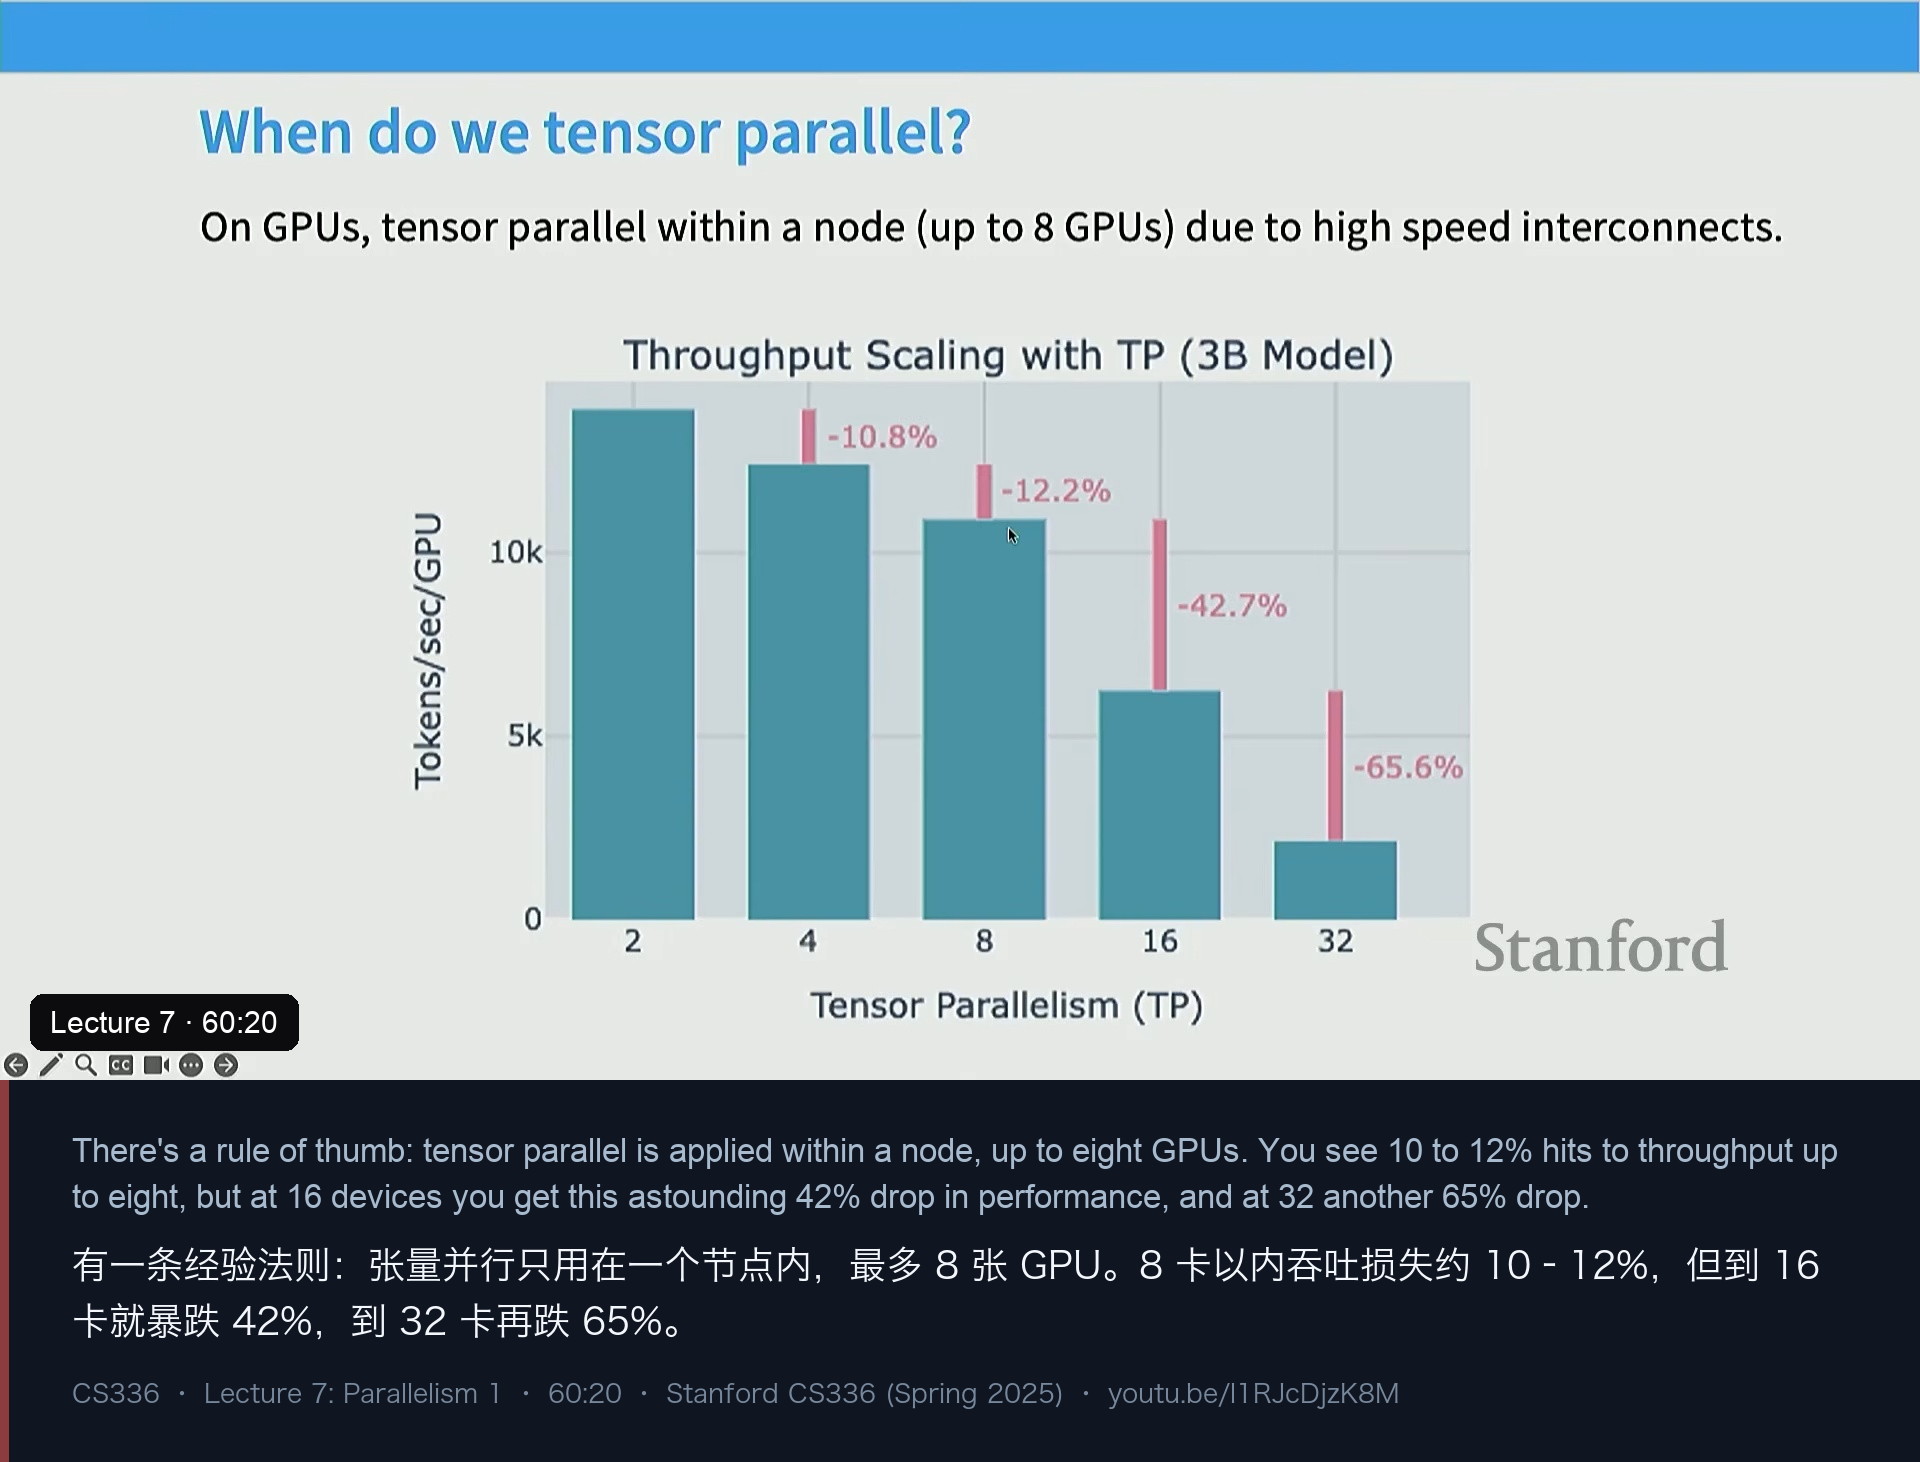
讲师引用 HuggingFace 并行教程的实测:8 卡以内吞吐损失约 10–12%,可以接受;到 16 卡掉 42%,32 卡再掉 65%。(这些数字来自该教程,属于引用。)实践中你还会看到 2–16 卡的不同配置,但跨机之前收手是通则:张量并行放在机内,机间用数据并行或流水线并行。DeepSeek V3 是个反例——它用了流水线并行却没有用张量并行。
九、最后一块拼图:激活内存与序列并行
到第 63 分钟左右,讲师把账本翻到最后一项:激活。他给了一张训练过程的显存时间线:参数是常量;第一轮迭代还没有优化器状态;前向过程中激活一路增长;反向开始后激活被逐层释放、梯度开始累积,峰值出现在反向中途。也就是说,前面讨论的参数、梯度、优化器状态之外,激活是一块被长期忽视的显存。
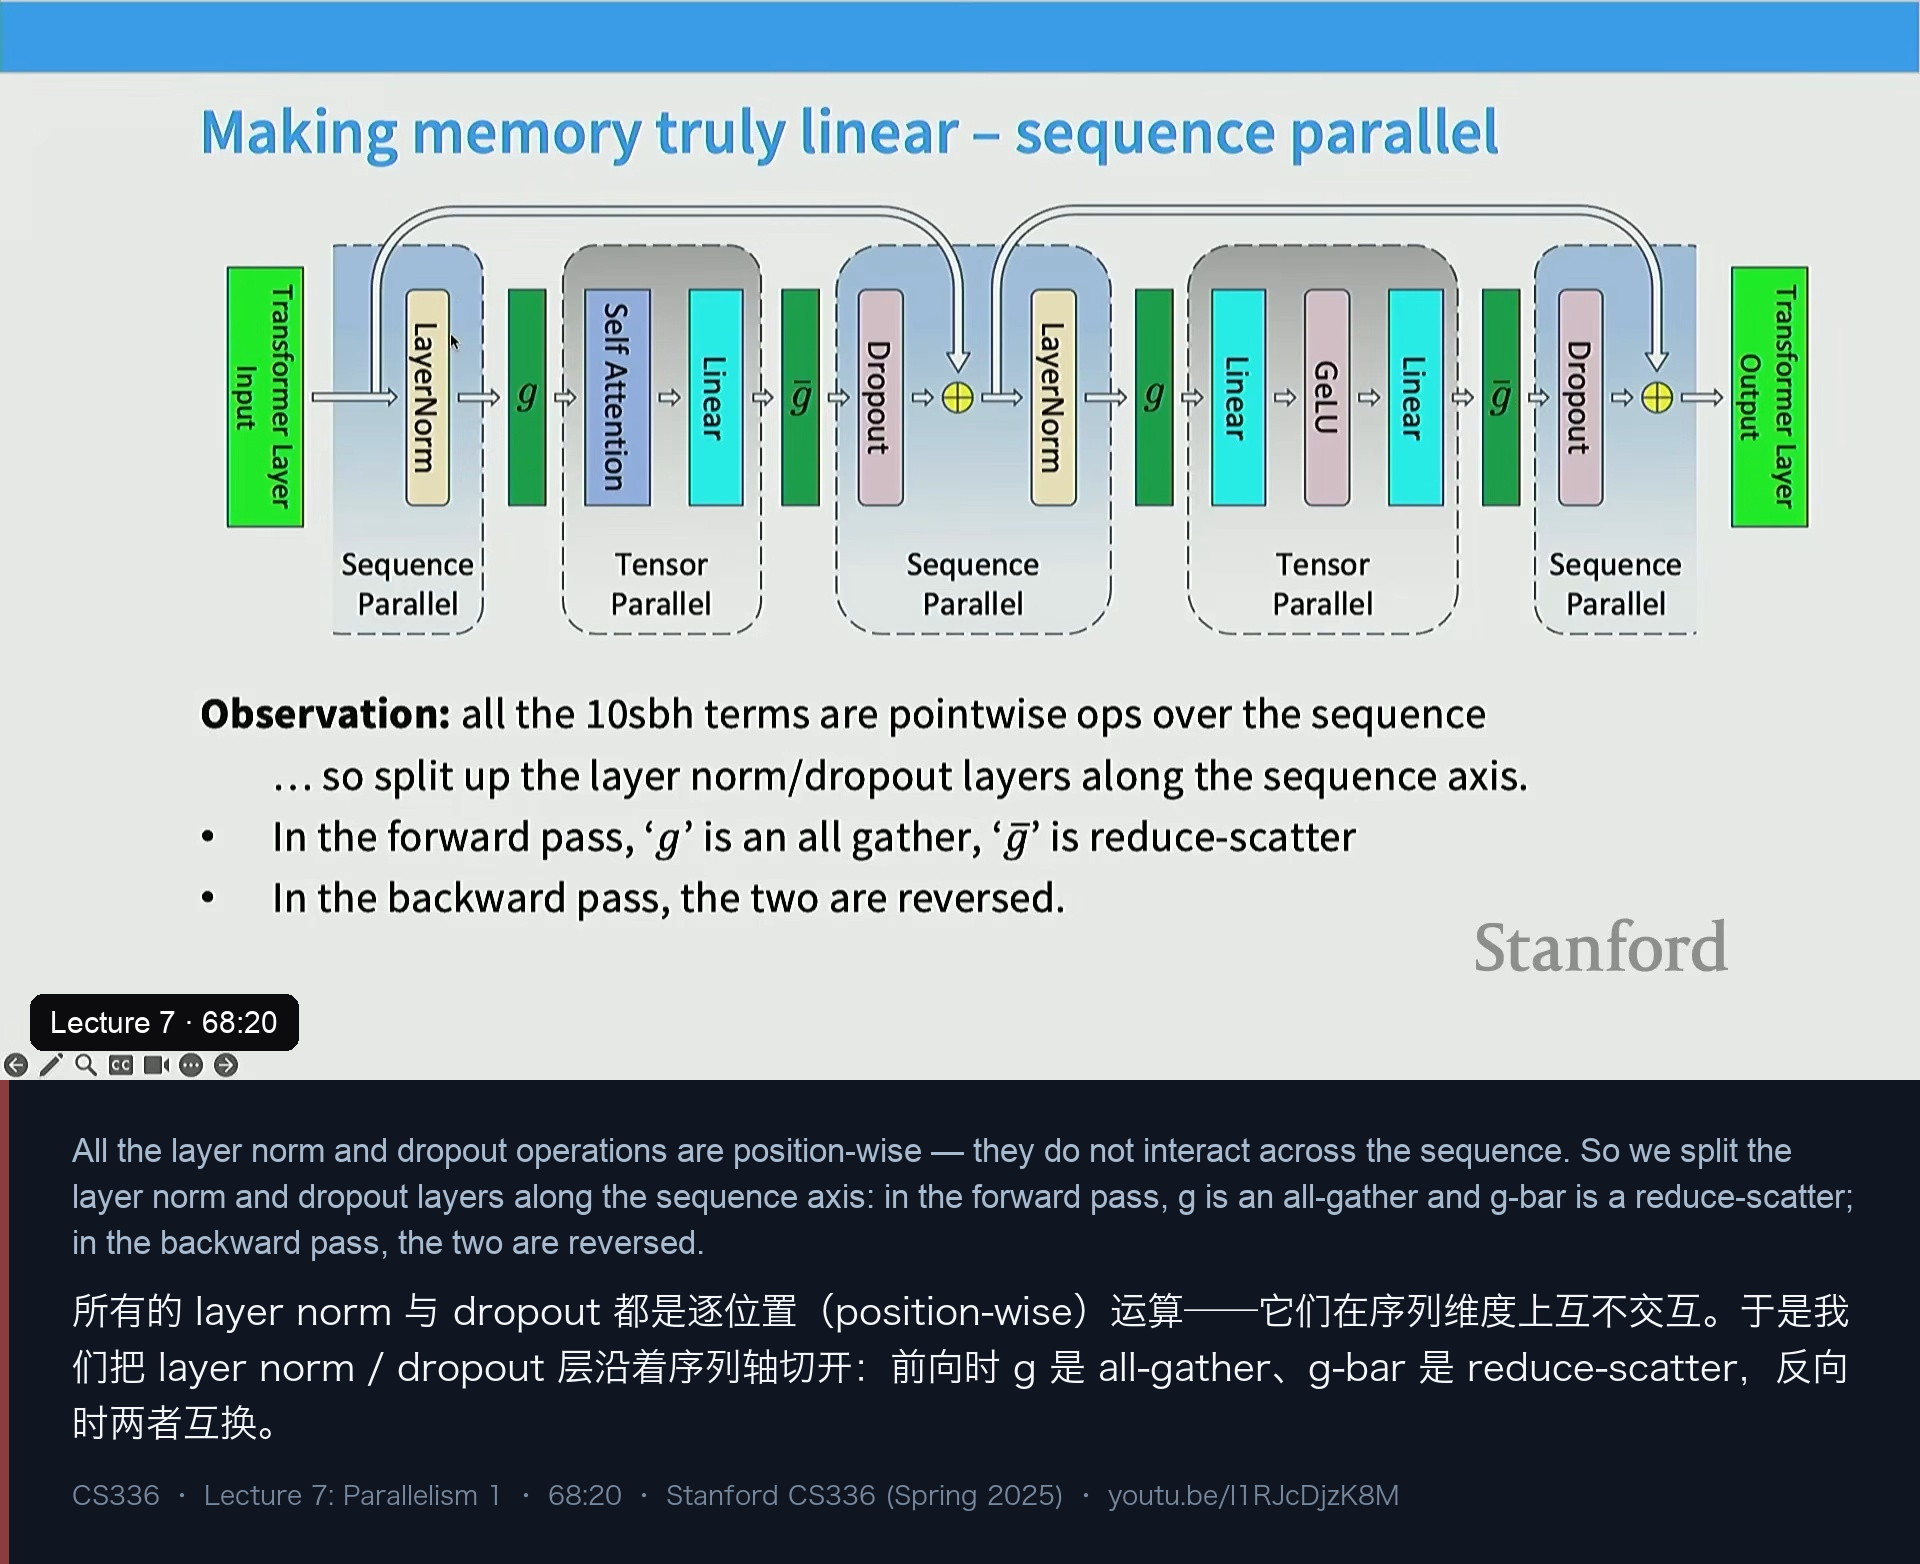
每层的激活显存可以写成一个漂亮的两项式:
Activations memory per layer = s·b·h·( 34 + 5·a·s/h )

s: 序列长度   b: micro-batch   h: 隐层维度   a: 注意力头数
左项 s·b·h·34:MLP 与逐位置算子的激活
右项 5·a·s²·b:注意力里二次复杂度的项
→ 用 flash attention 式的重计算,可以丢掉右项;但这要多花算力
张量并行能把可切的项除以 t(张量并行度),但会留下一块除不动的“钉子户” s·b·h·10——它们全是 layer norm、dropout、注意力与 MLP 输入的逐位置运算。解法正是序列并行:这些运算在序列维度上互不交互,于是把序列切成 t 份分给各卡;
前向:g 是 all-gather,g-bar 是 reduce-scatter
反向:两者互换
这样一来,激活显存的下限被压到 s·b·h·34 / t——这个“除以张量并行度”的形式你在各种 Transformer 显存公式里应该都见过。至此,显存这一项的四个组成部分(参数、梯度、优化器状态、激活)才全部找到各自的“除卡数”路径。
十、把积木拼起来:3D/4D 并行与经验法则
把 4 种策略的代价列成一张表,取舍就一目了然:
| 策略 | 同步开销 | 显存 | 带宽 | 对 batch size 的影响 | 好用吗 |
|---|---|---|---|---|---|
| DDP / ZeRO-1 | 每个 batch | 不省 | 2× 参数量 | 线性消耗 | 非常好用 |
| FSDP(ZeRO-3) | 每个 FSDP block 3 次 | 线性 | 3× 参数量 | 线性消耗 | 非常好用 |
| Pipeline | 每条流水线 | 线性(含激活) | 激活 | 线性消耗 | 不好用 |
| Tensor + Seq | 每个 Transformer block 2 次 | 线性 | 每层 8× 激活的 all-reduce | 无影响 | 不好实现 |
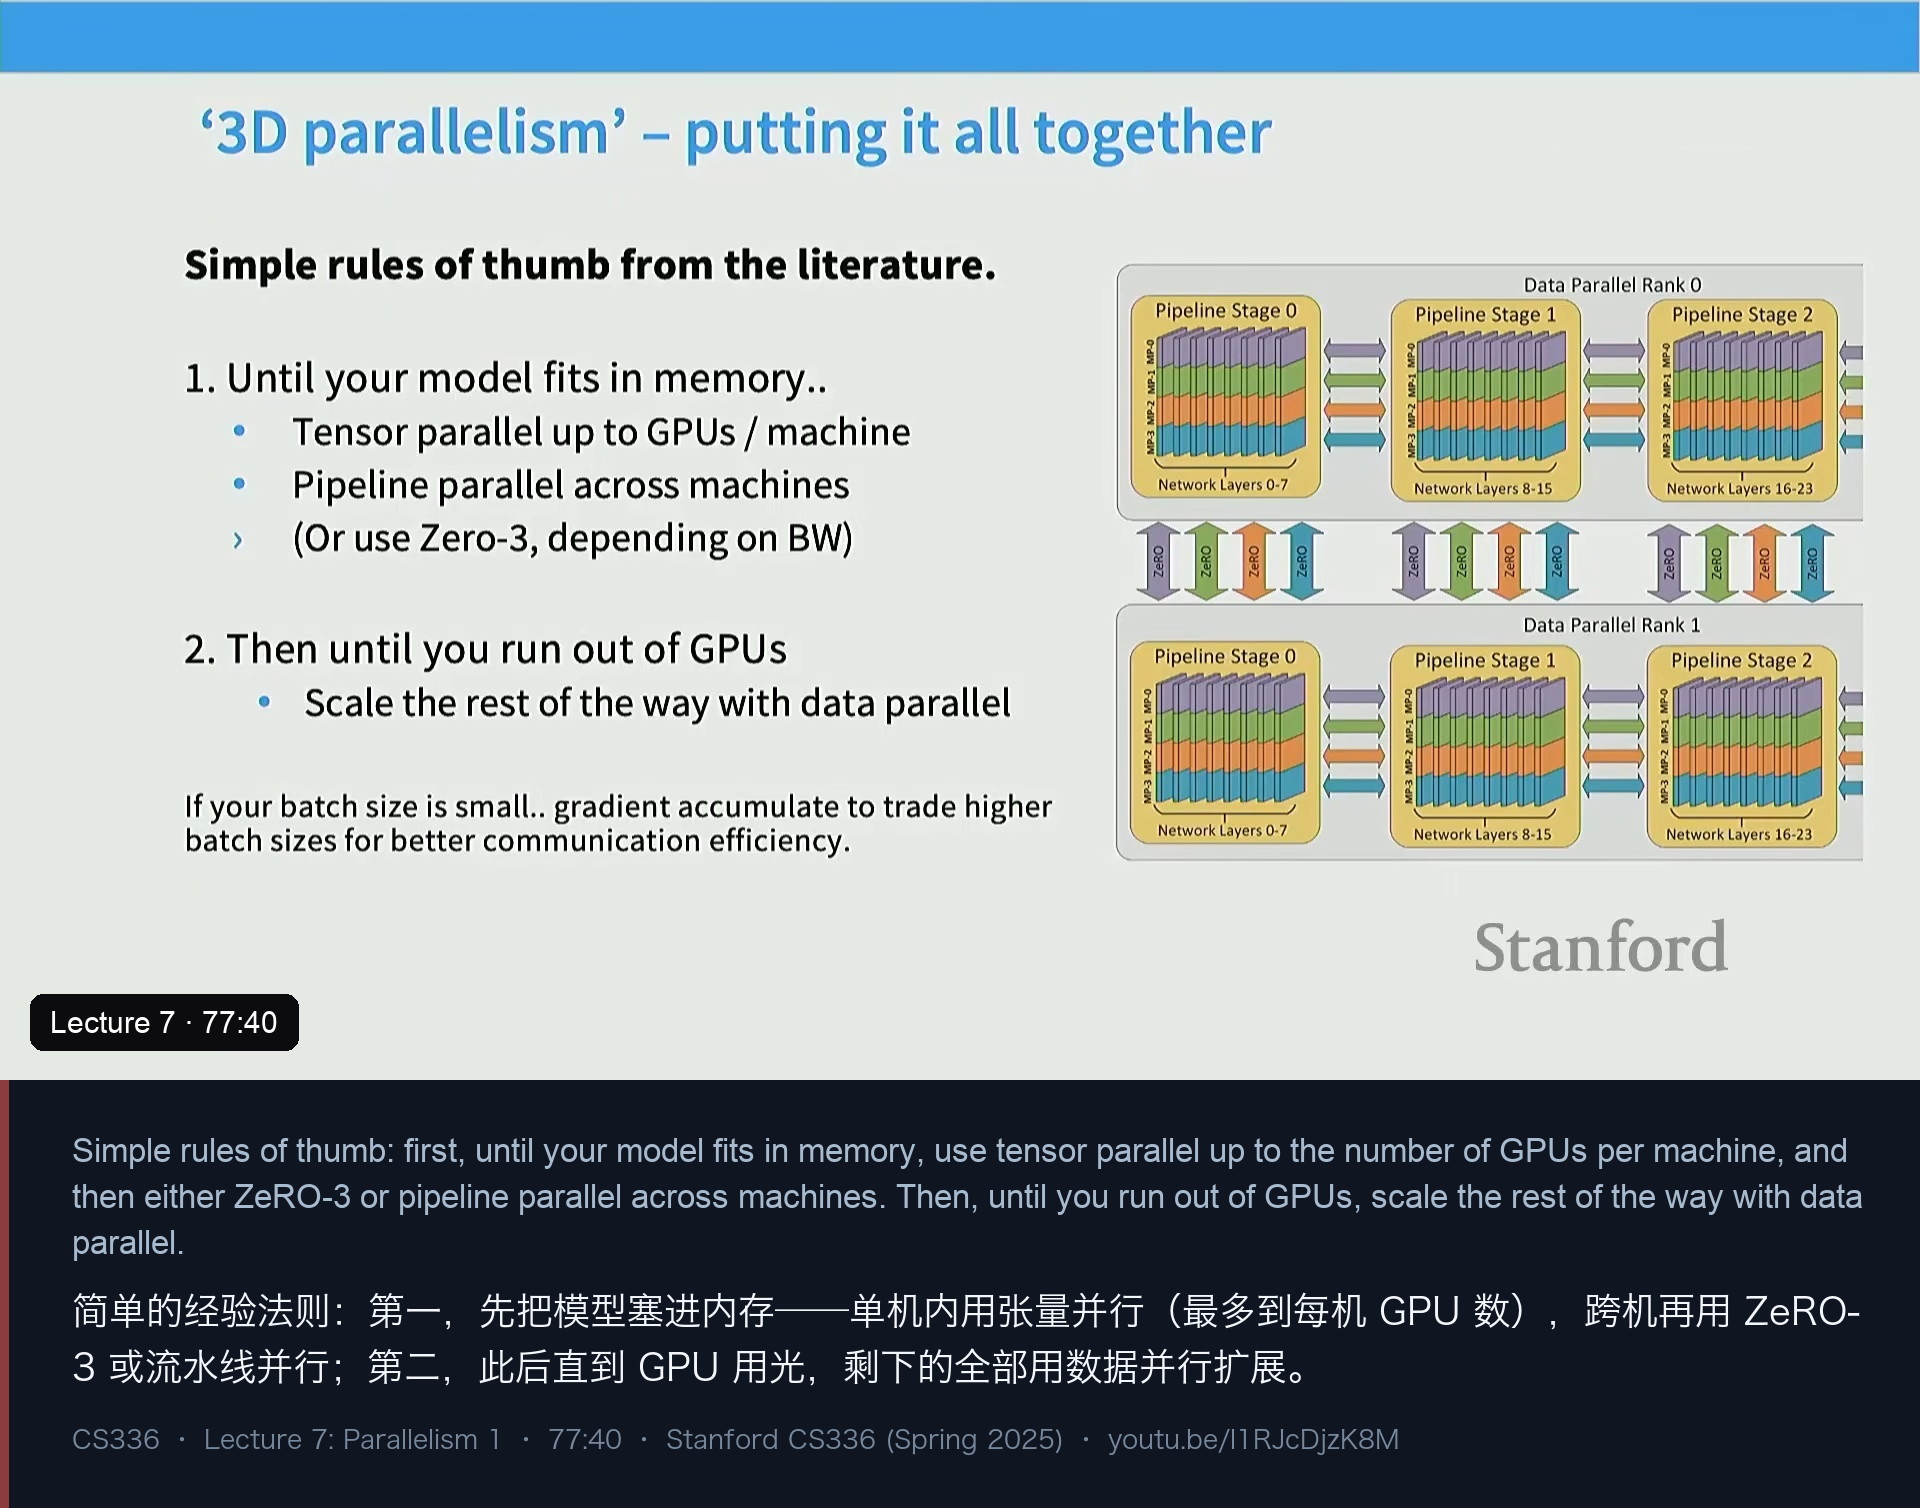
由此得到两条“从文献里抄来、并且今年依然成立”的经验法则:
1. 先把模型塞进内存(这是硬约束):
     机内  → 张量并行(最多到每机 GPU 数)
     跨机  → ZeRO-3 或 流水线并行
2. 此后直到 GPU 用光:剩下的全部用数据并行铺开
   (数据并行对带宽要求低、实现简单)
   若 batch size 很小:用梯度累积,把 batch size 换成通信效率
讲师还引了 Google TPU 并行手册里的一张图:横轴是 batch size、纵轴是卡数,分界线把空间划成“通信受限”和“算力受限”两块。batch 很小、卡很多时怎么排都是通信瓶颈;随着 batch 变大,先进入“FSDP + 模型并行”都能算满的区域,batch 足够大时纯 FSDP 就能把算力吃满。这张图把“batch size 是一种资源”这句话变成了可视的相图。
真实系统里,这套组合对应的就是 Megatron-LM 2021 那篇论文的实验:从 1.7B 一路训到 1T 参数,峰值算力利用率保持在 40–52%,配置规律是张量并行从 1 起步、封顶在 8,流水线并行随模型变大而增大,数据并行则从最大逐步退让;3D 并行带来近似线性的总吞吐增长,张量并行 = 8 通常就是最优点,而激活重计算虽然多花算力,却因为能换来更大的 batch(进而摊薄流水线气泡)而回本。
十一、真实系统里长什么样
讲师最后扫了几篇论文的配置,作为“这套理论在工程里怎么落地”的注脚(以下数字均来自他引用的论文/幻灯片):
- DeepSeek:训练框架 HAI-LLM,数据并行 + 张量并行 + 序列并行 + 1F1B 流水线并行,用 flash attention、bf16 训练但 fp32 累积梯度,并借助 ZeRO-1 分片优化器状态;它特意强调把计算与通信重叠(包括最后一个 micro-batch 的反向、ZeRO-1 的 reduce-scatter、序列并行里的 GEMM 与 all-gather/reduce-scatter),还做了 LayerNorm/GEMM/Adam 的算子融合与原地 cross-entropy 来省显存。V3 则用:PP(16) + EP(64-way, 8 节点) + ZeRO stage 1——用专家并行替代张量并行。
- Llama 3 405B:张量并行 8 卡 + 流水线并行 + 数据并行,长上下文阶段再加 CP(context parallel);报告里明确写了排序理由——按带宽需求从高到低依次是 TP → CP → PP → DP,数据并行能容忍高延迟,因为它可以用异步预取分片权重的方式掩盖。报告里还有两条让人清醒的事实:训练过程中 148 次 GPU 故障,约占全部中断的 30%,另有 32 次计划外维护;而比显式故障更可怕的是静默的数据损坏——GPU 悄悄给你算出垃圾数据,整个 run 就废了。所以大规模训练不只是并行算法问题,还是容错架构问题。
- Gemma 2(TPU):用 ZeRO-3 ≈ FSDP 加模型并行再加数据并行;TPU 的环面网络让模型并行可以“伸”得更远。
- 这讲还提到 OLMo 用 FSDP 训 7B;讲师说自己扫论文时还看到“5D 并行”这个说法,但一时没搞清第五维是什么——这句自嘲也算给这一讲留了个尾巴。
结论落回一句话:扩展超过某个点就必须多机多卡,没有单一解法,要把三种并行组合起来用、扬长避短;而组合方式有一套简单、可解释的经验法则。
我的笔记
all-reduce ≡ reduce-scatter + all-gather是这一讲的“第一性原理”。它之所以重要,不是因为它省带宽(它不省),而是因为它在中间留出了一段可以做计算的时间——ZeRO stage 1 的“免费”、FSDP 的重叠,都从这道缝里长出来。- 显存账要按“训练时同时存在的东西”算:16 字节/参数、5 份权重,大头是优化器状态。感觉“模型只有 14 GB 却 OOM”时,先想想 Adam 的 m 和 v。
- “分片”和“并行”是两件事:FSDP 把参数切开了,但它属于数据并行,因为跨机流动的仍是参数;模型并行的判据是“参数自始至终只在本地,流动的是激活”。这条区分决定了你能不能在不懂模型结构的情况下把训练并行化。
- batch size 是被严重低估的资源。数据并行最多开到 batch size 张卡,流水线并行也要拿它去填气泡;所以你真正在优化的是“显存、带宽/算力、batch size”这三者的分配。
- 每一个“省显存”的手段都在别处记账:ZeRO-3 省显存但把通信提到 3× 参数量;重计算省激活但多花算力;流水线并行省激活显存但吃掉 batch size 且极难实现。没有免费午餐,只有更划算的交易。
- 工程复杂度是真实的成本。zero-bubble 的调度要改自动微分,“两个人懂、走了一个”的段子说明:论文里一行公式,落到训练框架里可能是几个月的调试和一堆隐性依赖。
- 数字要看出处。 这一讲里的 8 倍带宽差、10–12%/42%/65% 吞吐损失、6.6B→53.3B、40–52% 峰值算力、148 次故障,分别来自硬件规格、HuggingFace 教程、课堂幻灯片、Megatron 论文与 Llama 3 报告——听课时记住结论容易,记住“这是谁测的”更难。
- 容错是超大规模训练的另一半。静默数据损坏比崩溃更难对付,因为它不给你报警。
附:课程信息与时间轴
- 课程主页:stanford-cs336.github.io/spring2025
- 本讲视频:Lecture 7: Parallelism 1(1:24,2025-05-06 发布)
- 播放列表:Stanford CS336 Language Modeling from Scratch · Spring 2025
- 配图目录:
public/blog/youtube/l1RJcDjzK8M/(18 张图均截取自视频中对应观点所在的幻灯片,并把该时刻的完整观点句拼合进图中)
| 时间 | 内容 |
|---|---|
| 00 | 开场:从单卡吞吐转向跨机器并行;这一讲的路线图 |
| 01 | 为什么需要多机:算力(超级计算机)与显存两条曲线 |
| 03 | GPT-NeoX 拓扑:机内 NVSwitch 与机间 HDR InfiniBand(每通道慢约 8 倍) |
| 04 | 跨机通信要过交换机:每通道约慢 8 倍 |
| 05 | 集合通信复习:all-reduce / broadcast / reduce / all-gather / reduce-scatter |
| 07 | 关键等价:all-reduce ≡ reduce-scatter + all-gather |
| 08 | GPU 与 TPU 的网络哲学差异 |
| 09 | 全互联约 256 卡的上限;TPU 的环面网格 |
| 10 | 两个目标:线性显存扩展、线性算力扩展 |
| 12 | 三种并行:数据、模型、激活 |
| 13 | 模型并行与激活并行的定位 |
| 14 | 朴素数据并行 = 批量 SGD 的直译 |
| 15 | 数据并行的三个性质:算力好、显存不省、通信 2× 参数量 |
| 16 | 显存账单:16 字节/参数、5 份权重(bf16 参数/梯度、fp32 主权重、Adam m/v) |
| 18 | 7.5B / 64 卡 = 120 GB;四条路:31.4 / 16.6 / 1.9 GB |
| 19 | 学生提问:数据并行下优化器状态怎么分片 |
| 20 | ZeRO stage 1 的四步流程 |
| 25 | “stage 1 在带宽受限下是免费的” |
| 27 | ZeRO stage 2:边反向边 reduce、及时释放梯度 |
| 29 | stage 2 的总通信不变,但多了逐层同步开销 |
| 30 | ZeRO stage 3(= FSDP):连参数也分片 |
| 33 | FSDP 通信涨到 3× 参数量,靠通信/计算重叠救回来 |
| 37 | 学生提问:预取到哪里?缓冲区与“激活还没算” |
| 39 | 8×A100-80GB:6.6B → 53.3B |
| 40 | 学生提问:分片参数之后,FSDP 与模型并行的区别 |
| 42 | batch size 是数据并行的关键资源;critical batch size |
| 44 | 转向模型并行:不花 batch size 的扩展轴 |
| 45 | 流水线并行:按层切与巨大的气泡 |
| 48 | micro-batch 与气泡比例 ≈ (p−1)/m |
| 49 | 为什么要用流水线并行:省激活、点对点通信、适合慢链路 |
| 51 | 交错式调度与 zero-bubble pipelining(DualPipe) |
| 54 | “两个人懂流水线并行,走了一个”:工程复杂度的真实成本 |
| 55 | 张量并行:沿宽度切矩阵乘法 |
| 57 | MLP 例子:A1/A2、B1/B2,前后向各一次 all-reduce |
| 58 | 张量并行需要高带宽:8 卡(单机)是甜点 |
| 59 | HuggingFace 数据:8 卡 10–12%、16 卡 42%、32 卡 65% |
| 1:01 | 张量并行 vs 流水线并行的通信量对比 |
| 1:03 | 激活内存:训练显存的时间线(峰值在反向中途) |
| 1:05 | 每层激活公式 s·b·h·(34 + 5as/h) 与重计算 |
| 1:07 | 张量并行留下的“钉子户” sbh·10 |
| 1:08 | 序列并行:逐位置算子沿序列轴切,g / g-bar 互换 |
| 1:09 | 显存下限 sbh·34/t |
| 1:11 | 其他并行策略:context parallel / ring attention、专家并行 |
| 1:12 | 四种策略的完整对比表 |
| 1:14 | 三种有限资源:显存、带宽/算力、batch size;TPU 手册的相图 |
| 1:16 | 3D/4D 并行与两条经验法则;梯度累积 |
| 1:18 | Megatron 2021:1.7B → 1T,峰值算力 40–52% |
| 1:20 | 真实配置:OLMo、DeepSeek(ZeRO-1 + TP + SP + PP;V3 用 PP16 / EP64) |
| 1:21 | Llama 3 405B:TP8 + PP + DP + CP、148 次 GPU 故障与静默数据损坏 |
| 1:23 | Gemma 2(TPU)与总结:没有单一解法,组合使用 |
说明:本文是视频内容的整理、翻译与转述,观点均来自主讲人;文中代码为讲座中算法的整理版本,非官方作业代码。课程中引用的显存数字、带宽倍数、吞吐损失、模型规模与故障统计,均来自讲师引用的幻灯片、论文或公开教程,请自行核实。
讨论
这里是静态站点,没有内嵌评论区。如果这篇文章对你有用,欢迎通过 RSS 订阅后续更新。