Stanford CS336 第六讲精读:Kernels 与 Triton——从 PyTorch 一路降到 PTX
斯坦福 CS336(Language Modeling from Scratch, Spring 2025)第六讲完整讲义:为什么 benchmark 之前必须 warm-up 加 cuda.synchronize、torch.profiler 与 Nsight Systems 里 CPU 为什么总跑在 GPU 前面、一行 print 如何毁掉整条流水线、cutlass kernel 名字里的 tile 尺寸,以及「仓库—工厂」的算子融合比喻如何变成三个真实的 GELU 实现——手写 CUDA、Triton、torch.compile——最后用 Triton 写一个融合 softmax 收尾。
本篇属于系列 Stanford CS336 精读 · 第六讲
来源:YouTube 原视频(Stanford Online · CS336 Language Modeling from Scratch · Spring 2025 · Lecture 6: Kernels, Triton)
来源说明 这是斯坦福 CS336《Language Modeling from Scratch》2025 年春季第六讲的完整讲义。上一讲把 GPU 的硬件构造与性能特征讲完之后,这一讲开始动手:先补上 benchmark 与 profiling 这两件“工程基本功”,再用同一个 GELU 算子做对照实验——朴素 PyTorch、手写 CUDA/C++、Triton,最后是
torch.compile——并把每一层的执行时钟一路降到 PTX,看清 GPU 到底在做什么。文中 18 张配图均截取自视频对应时刻的幻灯片,并把该时刻的完整观点句(英文原句+中文翻译)拼合进图中。文中出现的毫秒数、提速倍数、kernel 名字、block 尺寸、tile 尺寸、SM 数量等数字,都是讲师当场演示或引用的公开库、论文与估算,不是本文独立核实的事实;讲师口播里把 GELU 念作“GLU/GELU”、把 ATen 念成“A10”、把 Nsight Systems 念成“NSIS”(字幕听写所致),下文按代码与幻灯片里的正确写法记录。
TL;DR
- 这一讲是“系统部分”的第二块地基。上一讲解释了 GPU 为什么慢得神秘,这一讲回答“那我该怎么办”:先学会量(benchmark)和看(profile),再学会改(写 kernel)。作业二要求你用 Triton 实现 Flash Attention 的一部分,所以这一讲的三个实现层次——CUDA/C++、Triton、
torch.compile——全部围绕一个真实算子展开。 - benchmark 有两个不可省略的动作:先 warm-up,再
torch.cuda.synchronize()。第一次执行某个 PyTorch 调用时会触发即时编译、模块加载等一次性开销;不做 warm-up,你量到的是初始化时间。而 CUDA kernel 是异步下发的,不同步就计时,你量到的只是“命令发出去花了多久”。 - CPU 和 GPU 是两台独立的设备,中间隔着一个命令队列。所以
torch.profiler里会出现“GPU 时间大于 CPU 时间”这种反直觉现象;也所以 Python 慢并不影响 GPU 打满——CPU 早跑到前面去排队了。 - 一行
print(loss)就能把流水线拽停。 打印需要真实的 loss,而 loss 在 GPU 上,CPU 必须cudaStreamSynchronize等它回来,这等于每步插一道同步屏障。列视图能直接看到 CPU 和 GPU 从“错开一大截”变成“被迫对齐”。 - Nsight Systems 才是“成年人的 profiler”:它能给 CPU 与 GPU 分别画时间线,配合
NVTX标注(define_model、step、forward、backward、optimizer)把每一步都拆开。你会亲眼看到“CPU 说自己在算第 1 层时,GPU 其实还在算第 0 层”。 - kernel 名字会泄露实现。
cutlass_80_simt_sgemm_256x128_8x4_nn_align1里的256x128就是 tile 尺寸;同一个a @ b会按维度、硬件、精度分发到完全不同的矩阵乘法原语,性能也天差地别——torch.compile甚至能先微基准测出你机器上最快的那个再挑。 - “仓库—工厂”比喻 = 算子融合。每做一次运算就把数据从 DRAM(仓库)搬到 SM(工厂)再搬回去,你就反复付运输费;把一整串逐元素运算塞进同一个 kernel,就等于让一个工厂一次把活干完。
- 同一件事,四种写法,四种速度(GELU,尺寸很大的一次实验):朴素 PyTorch
8.101 ms,手写 CUDA1.805 ms,Triton1.848 ms,torch.compile1.474 ms,PyTorch 内置融合实现1.128 ms。结论不是“都去写 CUDA”,而是“知道什么时候该写”。 - Triton 的思维单位是 block,不是 thread:你写
tl.arange、mask、tl.load/tl.store,编译器替你处理访存合并、共享内存、线程调度;但它只自动管“块内”,“块之间”的调度仍然要你设计。softmax 里“一行 = 一个 block”就是这种块级思维的直接产物。
一、这一讲在哪:把“系统优化”讲到底层
开场先交接作业进度:作业一刚刚截止(还可以继续提交、刷 leaderboard),作业二已经放出——一部分是 GPU kernel,另一部分要等下一讲讲完并行策略(数据并行等)。所以这一讲和下一讲共同覆盖作业二的两半。
然后是这一讲的路线图,讲得非常直白:
- 先用一小段复习 GPU 的基本部件(SM、线程块、寄存器、内存层级),保证后面能跟上;
- 讲benchmark 与 profiling——既是作业需要,也是“你以后想写好 PyTorch / 深度学习代码”的通用技能;
- 然后真的动手写 kernel:先 CUDA/C++,再 Triton,最后交给
torch.compile; - 全程一路降到 PTX(离机器码很近的汇编),看 GPU 实际在做什么;
- 最后如果还有时间,用 Triton 写一个快速的 softmax 收尾。
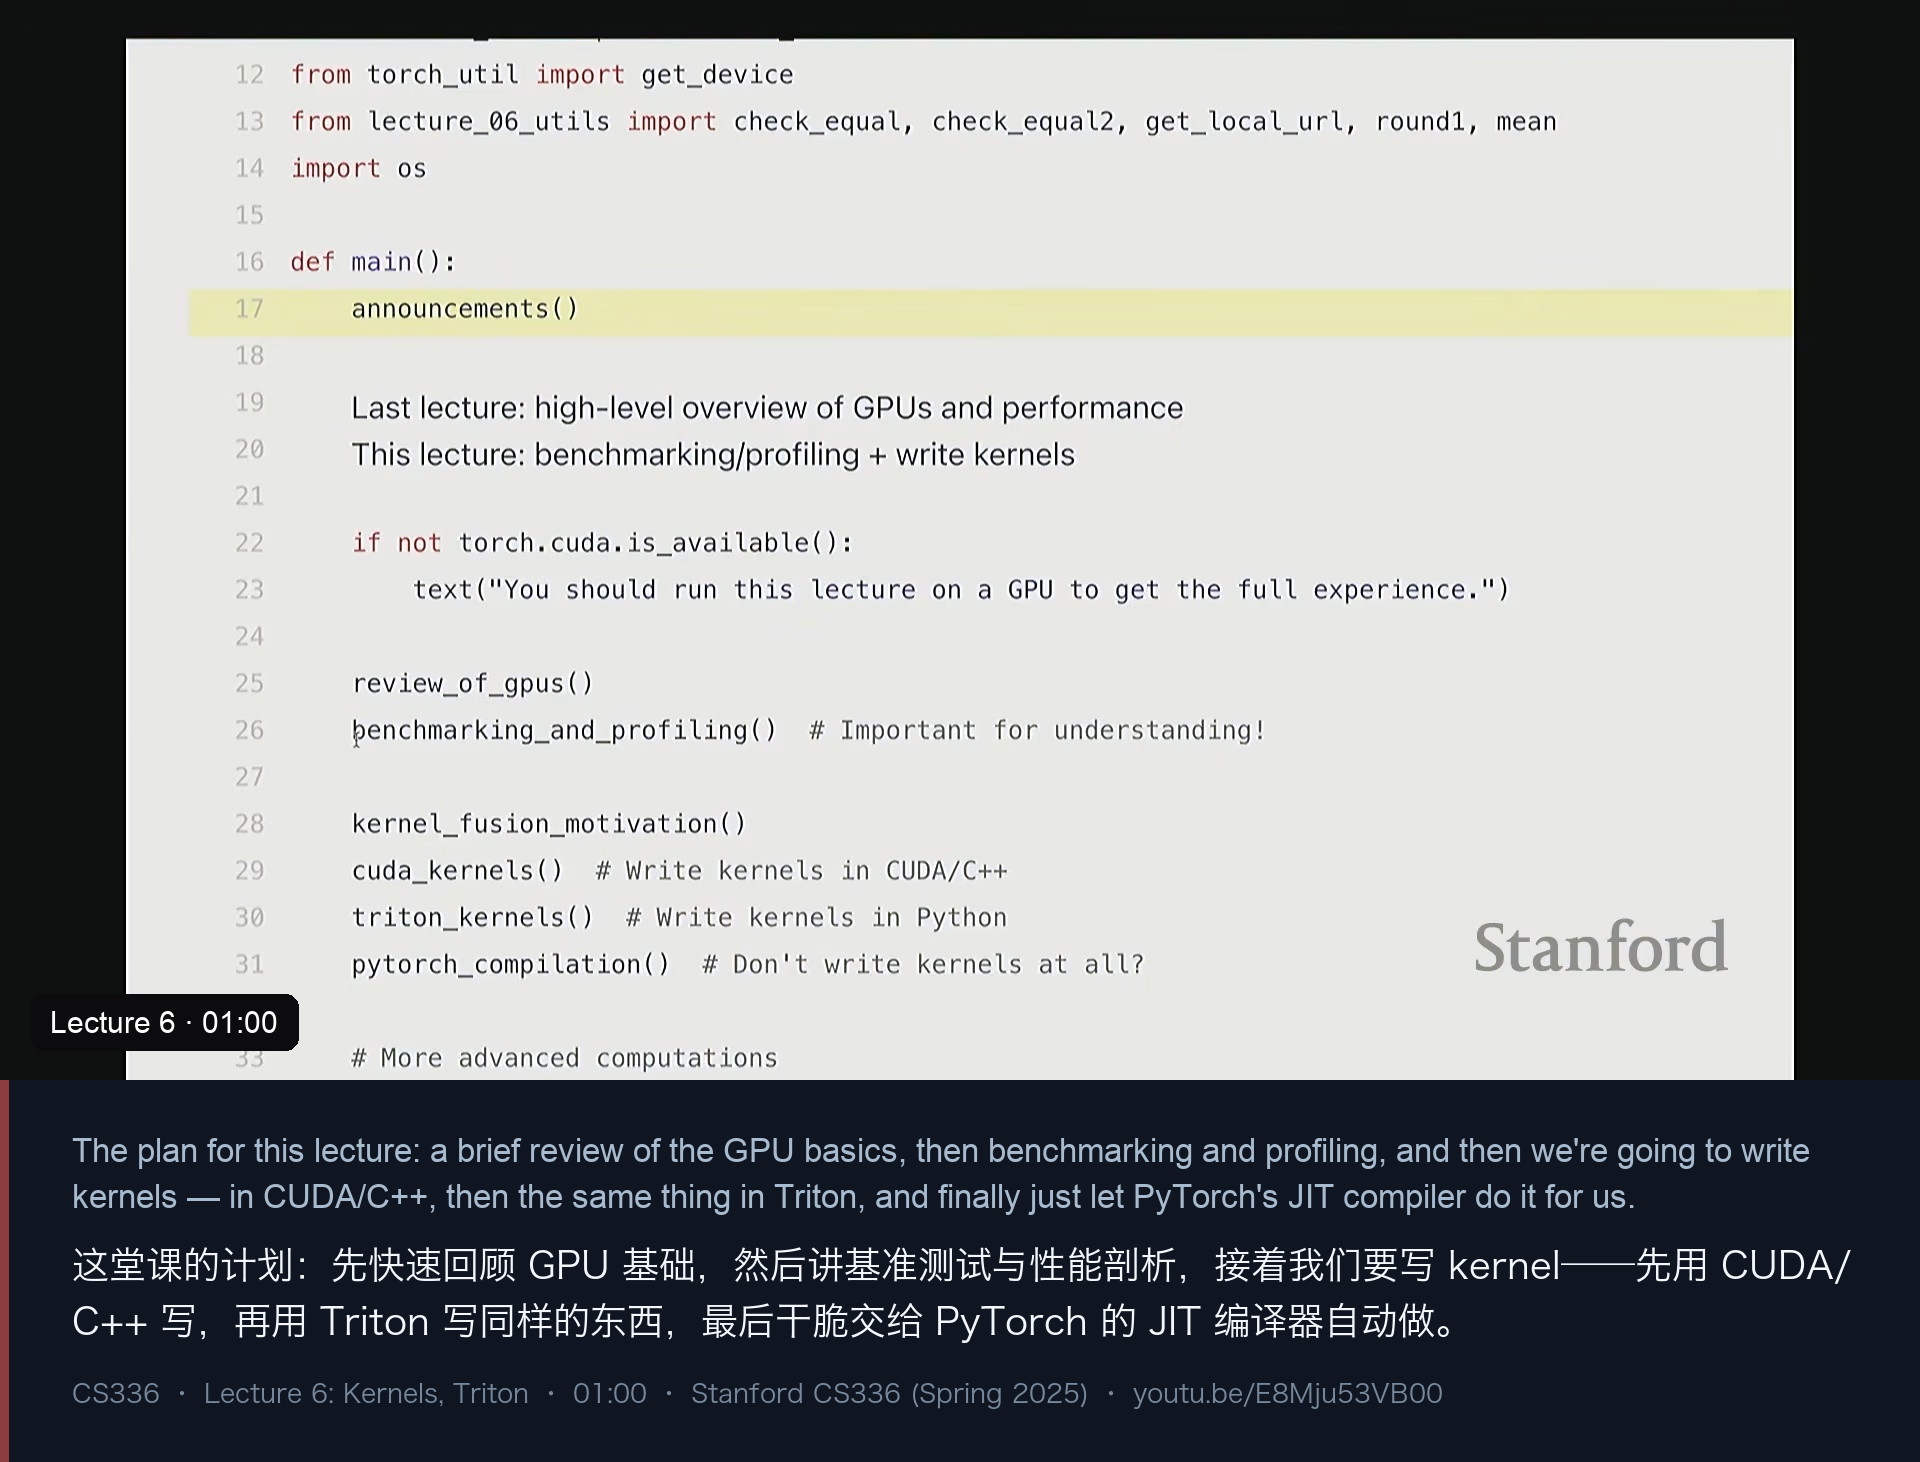
一个贯穿全讲的提醒先立在这里:“每次改动代码,都要重新 benchmark / profile”。讲师说得很清楚——系统是可以推理的,架构就很难推理了;但“这个矩阵乘法到底有多快”,取决于库版本、硬件、以及你这个具体 workload,纸上推不出来,必须实测。
二、先复习 GPU:block、SM、共享内存与算术强度
复习部分延续上一讲的定义,但重心明显偏向“待会儿写 kernel 要用到的那些概念”。
- SM(streaming multiprocessor) 是计算单元,A100 上一块 GPU 有 108 个;
- 内存层级:DRAM / 全局内存又大又慢,L2 缓存居中等,L1 / 共享内存小而快;还有寄存器堆——每个线程都能访问的极快内存,写高性能 kernel 时会大量使用;
- 执行模型:一个 thread block 被调度到单个 SM 上,这是后面写 Triton 时的“原子单位”;block 内部有大量 thread,线程才是真正干活的;
- 为什么要 block,而不是一堆散装线程? 因为 block 内部有共享内存(速度接近 L1),线程之间传数据极快;跨 block 的通信则非常昂贵。所以矩阵乘法这类需要线程间交换数据的算子,第一原则就是:把需要通信的数据留在同一个 block 里。
还有一个概念被点名强调:算术强度(arithmetic intensity)。上一讲讲过 roofline,这一讲直接把它当成优化目标——“我们希望算术强度尽量高,不要掉进 memory bound 的区域”。
讲师把这段复习压缩得很短,理由是后面每个概念都会“用起来”再讲一遍:SM 是 kernel 调度的物理边界,寄存器是高性能代码的临时存储,而 block 会成为 Triton 里唯一的思维单位。真正要在动手前就刻进脑子里的,只有那句老话——先把数据搬近,再谈算得快。
三、基准测试:为什么先 warm-up,再 cuda.synchronize
benchmark 的定义很朴素:测量墙钟时间。但怎么测才可信,是两个容易踩的坑。
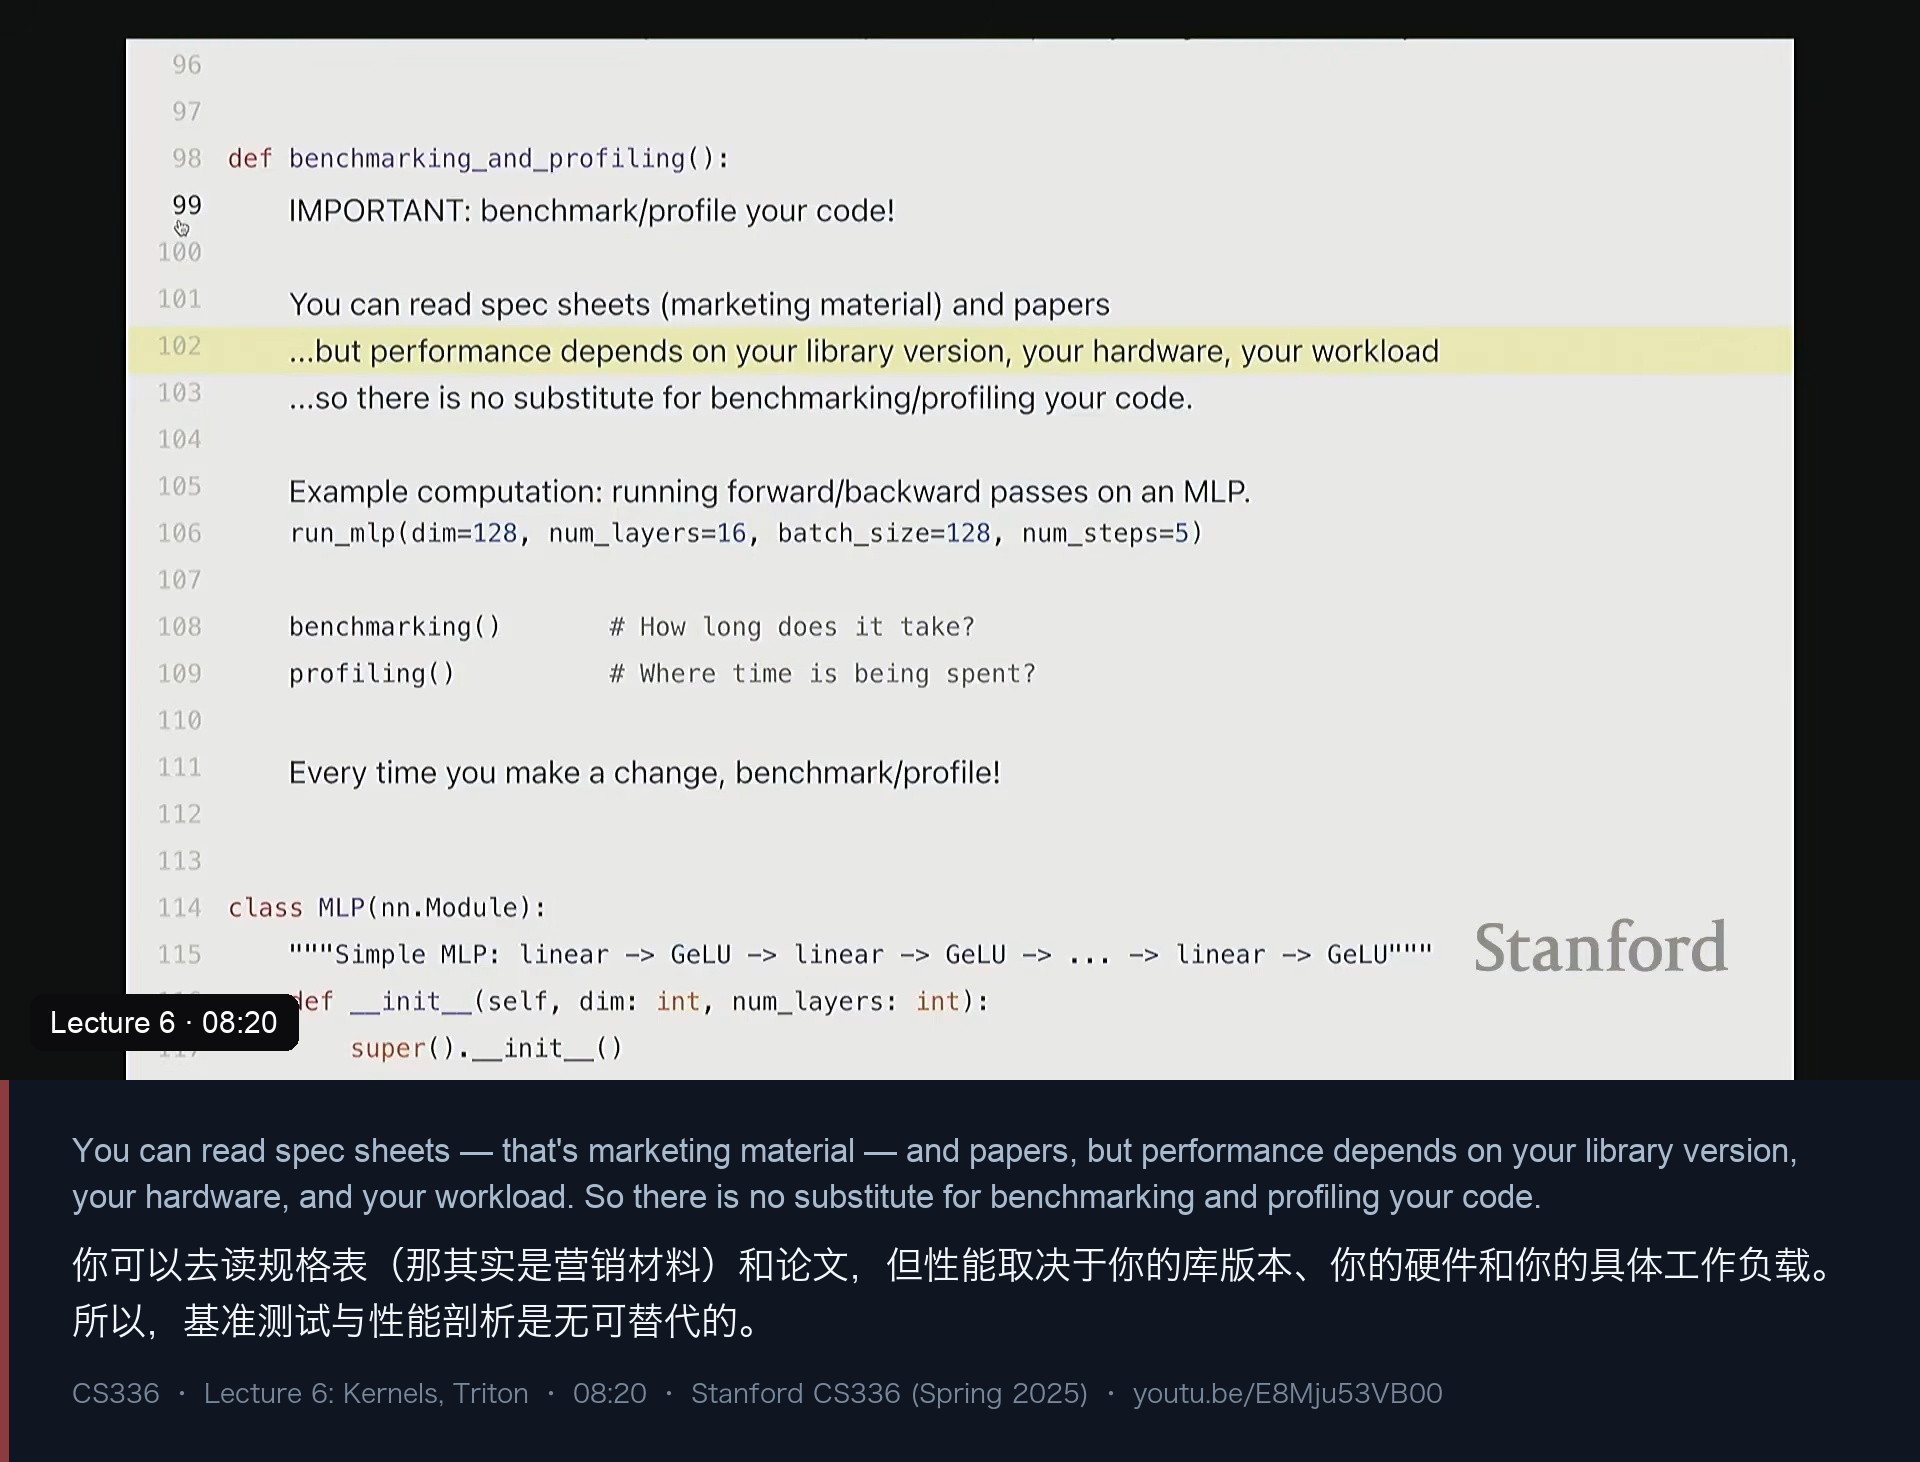
坑一:第一次调用不算数。 某个 PyTorch 调用第一次执行时,会做即时编译、模块加载、把代码搬到 GPU 上等一次性工作,时间被这些开销污染。所以要先跑几遍 warm-up,量“稳态速度”。
坑二:CUDA 是异步的。 x + y 在 Python 里返回时,GPU 上的 kernel 可能根本还没跑完——CPU 只是把命令塞进了队列。所以计时前后必须 torch.cuda.synchronize(),否则你量到的是“发命令”的时间,而不是“算完”的时间。讲师演示里的标准骨架是:
def benchmark(fn, reps=10):
    # 1) warm-up:把一次性开销(编译、加载、搬运)排除掉
    fn()
    torch.cuda.synchronize()
    t0 = time.time()
    for _ in range(reps):
        fn()
    # 2) 同步:等 GPU 真的算完,才能结束计时
    torch.cuda.synchronize()
    return (time.time() - t0) / reps
他还补了两个细节:测量总会受温度等“热学性质”影响,所以要多跑几次取平均;而第一个例子甚至专门讲了“为什么量出来接近 0 秒”——因为那是个 sleep 之类的空操作,量了个寂寞。换句话说,benchmark 的第一课是“确认你量的东西真的在 GPU 上干活”。profiler 里那个 sleep 例子的结果更直白:100% 的时间落在 cudaDeviceSynchronize 上——因为根本没有 kernel 可跑,你量到的只是“等待”本身。
另外,无论 benchmark 还是后面要讲的 profiling,都应当先排除掉启动阶段的几轮(讲师在 Nsight 里就是从 step 3 才开始统计)。第一轮不仅包含编译和搬运,还会因为缓存未预热、显存未分配而失真。
接着是缩放实验:拿一个 MLP(dim=128, num_layers=16, batch_size=128, num_steps=5)分别扫 step 数和层数。
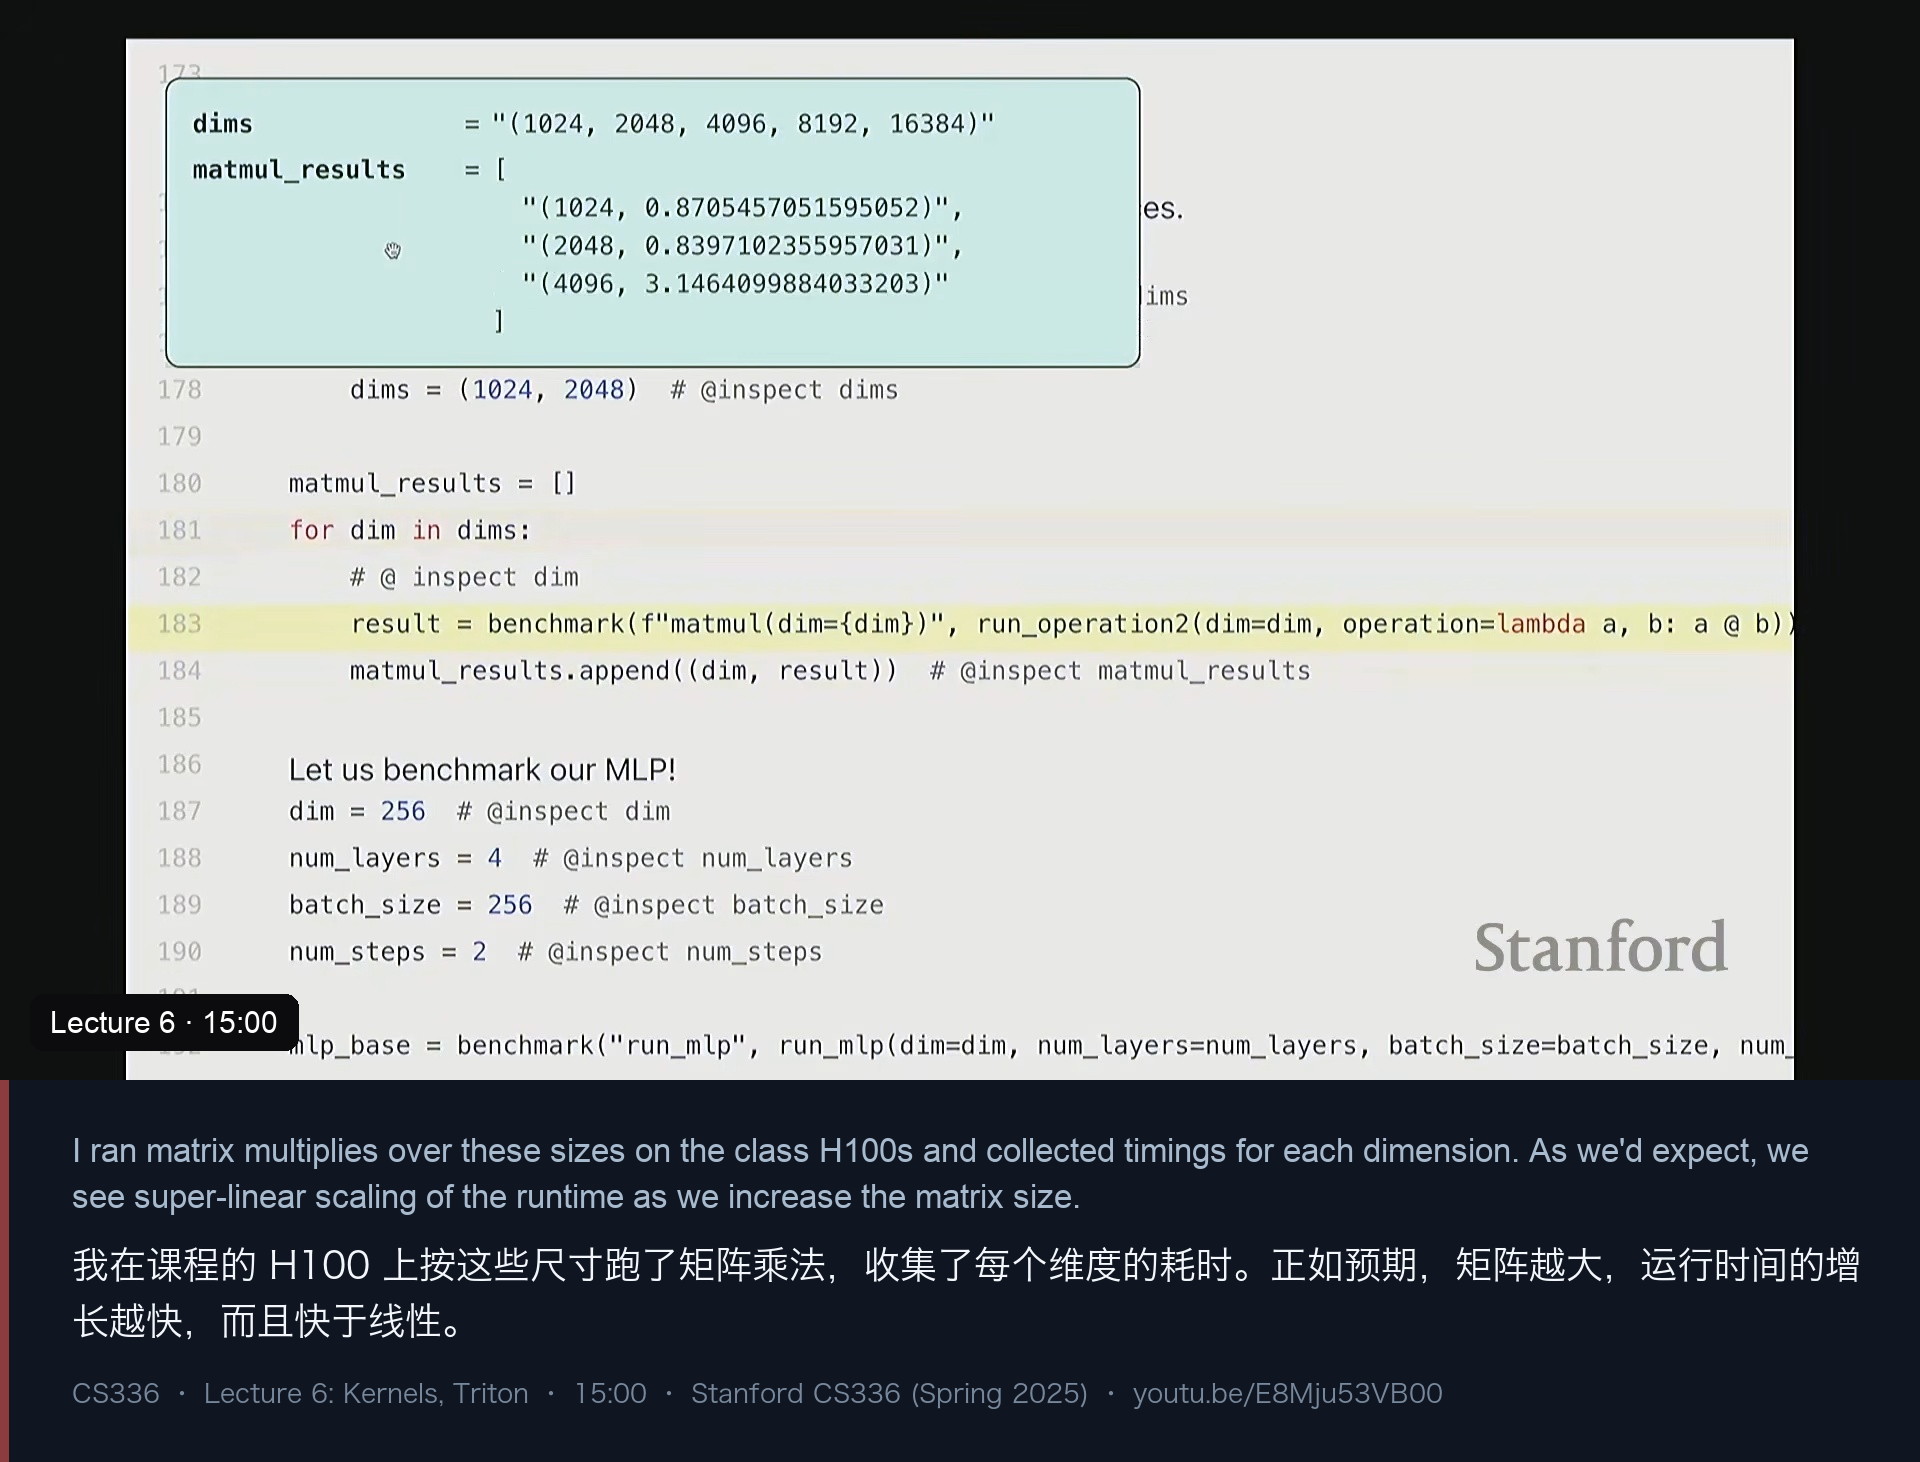
结果符合直觉:运行时间与 step 数、层数都近似线性(一层大约几毫秒的量级)。图 3 里那张 1024、2048、4096、8192、16384 的方阵乘法表也是同一个意思——尺寸越大,时间越长,而且在最小尺寸处能看到“还没跑满”的迹象。这是在告诉你:别拿一个尺寸的结论推广到所有尺寸。
四、剖析:从 torch.profiler 到 Nsight Systems
benchmark 的局限,讲师用一句话总结:它只会告诉你“你的代码慢”,不会告诉你“时间花在哪儿”。所以需要更细粒度的工具——profiling。
4.1 一个 add 的冰山
先用 PyTorch 自带的 profiler 看两个“无聊”的算子。
sleep:100% 的时间花在 cudaDeviceSynchronize 上——因为根本没有 GPU 工作,量的是同步本身。
两个 2048 矩阵相加:Python 这边你只写了一个 a + b,但水面之下是一长串东西:
aten::add(ATen 是 PyTorch 的 C++ 张量接口层)——耗时大户其实在这层 CPU 开销上;- 一个真正干活的 kernel:
vectorized_elementwise_kernel_for_cuda_native_functor_add; cudaLaunchKernel(把命令送给 GPU);cudaDeviceSynchronize(等 GPU 回来)。
结果很反直觉:CPU 侧 1.4 毫秒,CUDA 侧只有 17 微秒。也就是说,这个简单算子慢的其实是“把活派下去”这件事,不是计算本身。(讲师也坦白回答学生:为什么从 add 换成 matmul,CPU 时间反而下降了,他并不确定。)
矩阵乘法(2048×2048)的剖面长这样:aten::matmul → aten::mm → cutlass 的某个具体 kernel,再往下还是 cudaLaunchKernel 和 cudaDeviceSynchronize,只是这次 CUDA 时间占比明显上升。同时他提醒:profiler 本身有开销,会让微观计时轻微失真,但“量级很大”的结论不会被它颠倒。
4.2 MLP:78% 的时间在矩阵乘法
把规模换成一个由线性层+GELU 堆起来的 MLP,剖面里能看到:
- 矩阵乘法(
sgemm系列)吃掉了大约 78% 的 GPU 计算时间; - 数组拷贝 / 拼接之类的操作大约 6%;
- 其余散落在各种逐元素算子上。
这解释了为什么优化要分优先级:先盯着矩阵乘法,再收拾那些“碎片”。
不过这里留了一个谜:profiler 显示大部分时间是 aten::mm,但它下面并没有一一对应的 kernel——剩下那部分时间到底去哪了?讲师说,对这么复杂的模块,这个视图“不是个好的可视化”,于是才有了下一小节的 Nsight。
4.3 Nsight:CPU 其实跑在 GPU 前面
PyTorch profiler 的视图不够用(讲师吐槽:只看得到 aten::mm 却没有对应的 kernel,对复杂模块“不是个好的可视化”),于是请出成年人的 profiler:NVIDIA Nsight Systems。
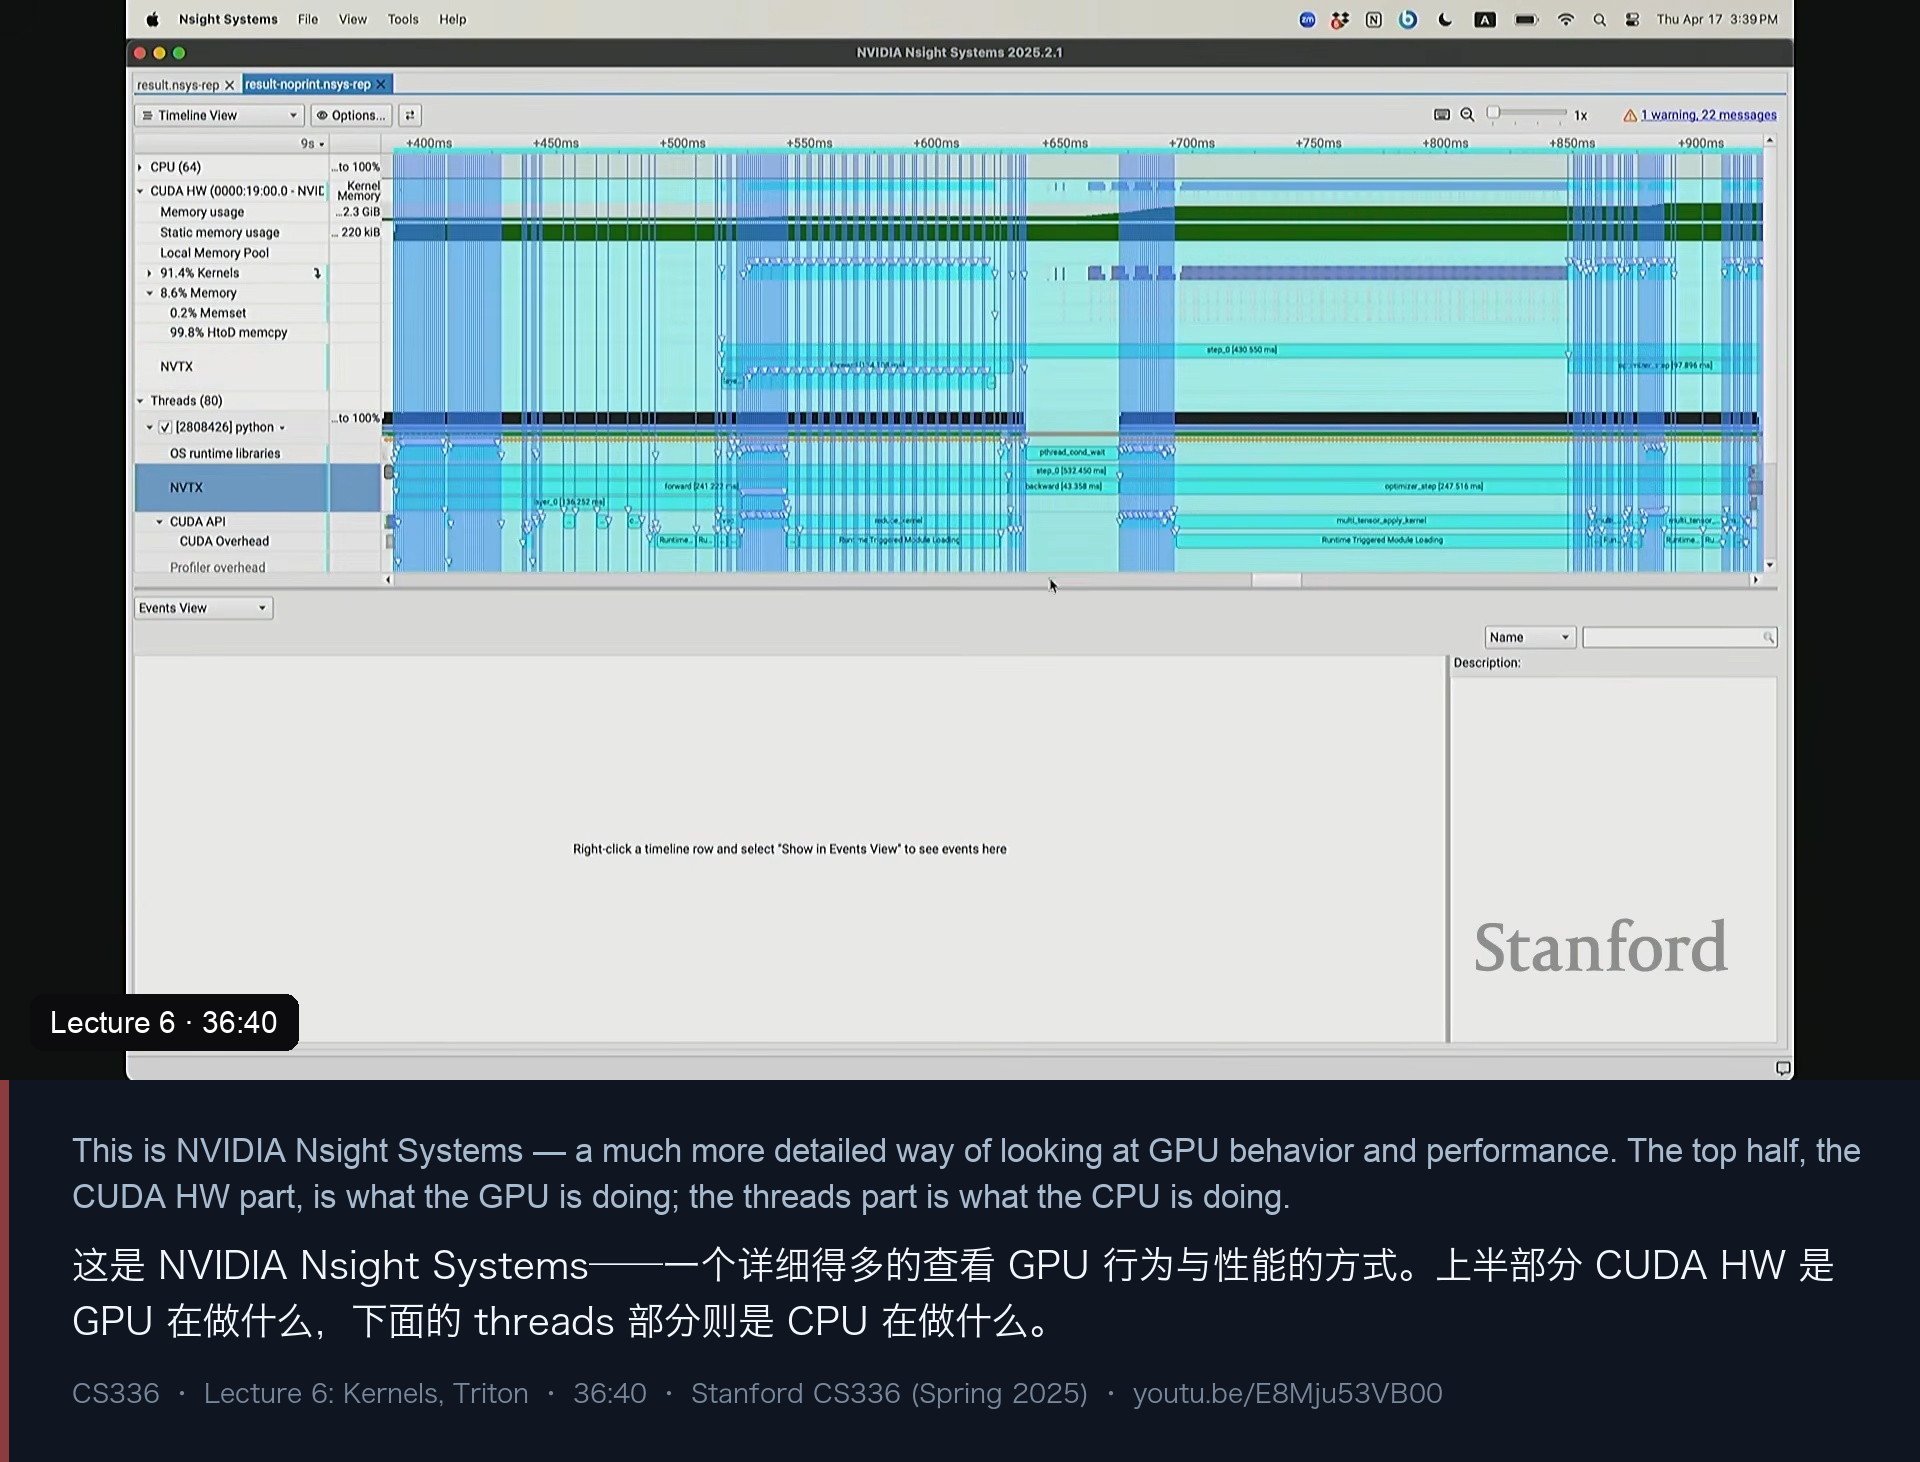
在 Nsight 的时间线里,上半部分 CUDA HW 是 GPU 在做什么,下半部分 threads 是 CPU 在做什么。为了让时间线可读,讲师在代码里插了 NVTX 标注:define_model、每个 step、以及 step 内部的 forward / backward / optimizer。
于是看到了几件“只有看时间线才会知道”的事:
- 开局一大段时间都花在加载库上(约 7.5 秒),模型其实是在那之后才开始构建的;
- 真正开始跑之后,CPU 远远跑在 GPU 前面:当 GPU 还在执行 step 0 / 第 0 层时,CPU 已经把命令排到了很后面;等到 GPU 开始第 1 层,CPU 那边可能已经排到第 9 层了;
- 之所以能这样,是因为 CPU 维护着一个固定深度的命令队列,把 kernel 一个个塞进去;只要没填满,它就一直往前冲。
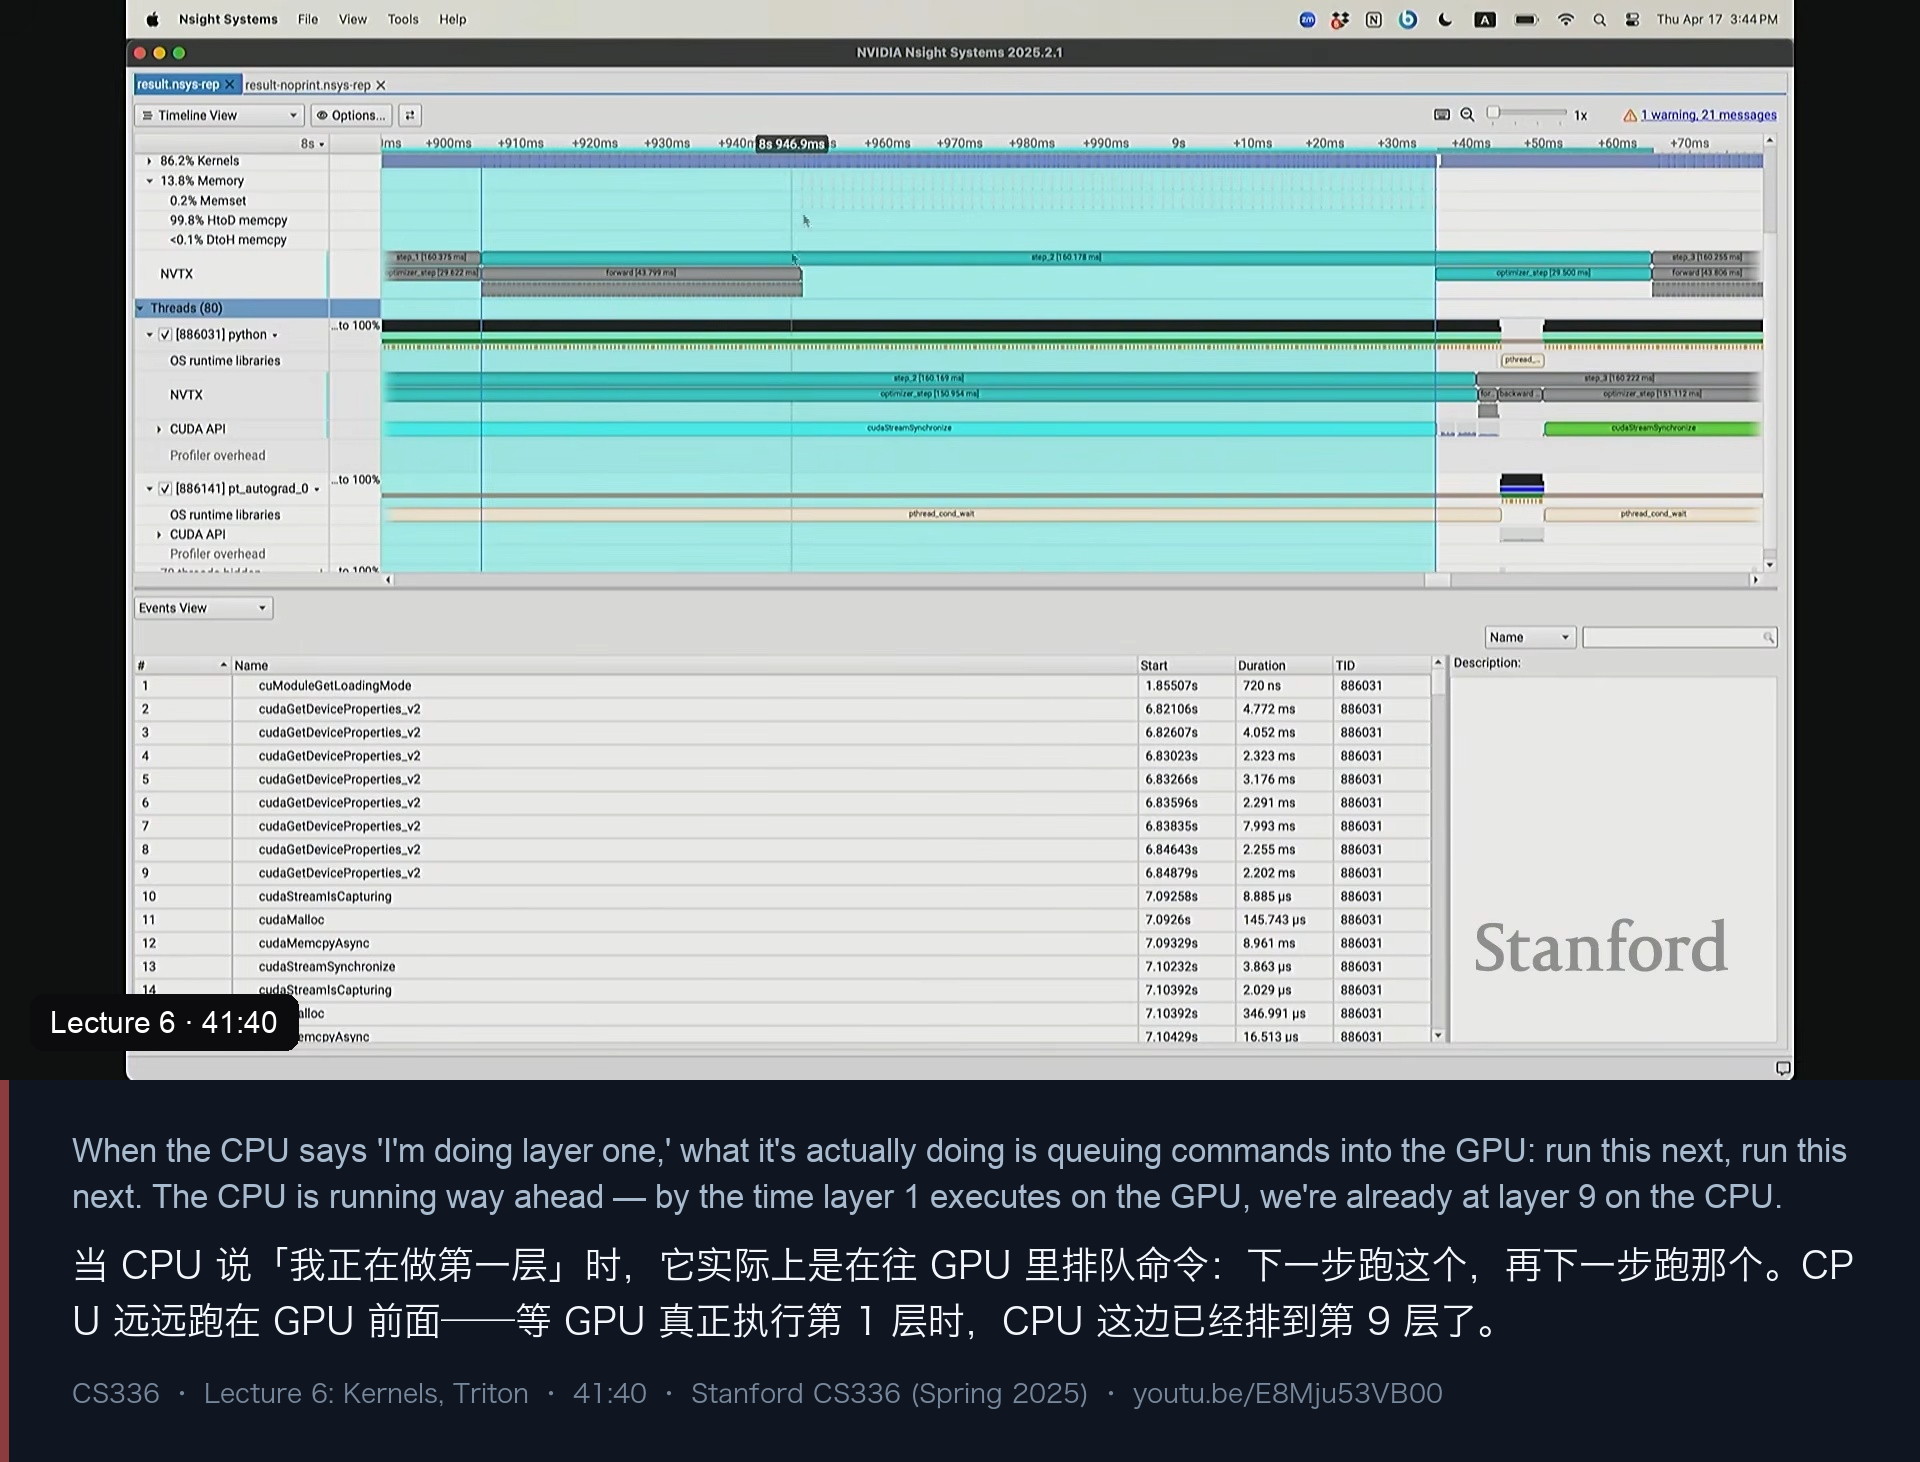
图 6 里还能看到那条显眼的 cudaStreamSynchronize——CPU 唯一的等待点。这也顺带解释了一个大问题:为什么 Python 这么慢的语言还能把 GPU 打满? 因为瓶颈从来不在 CPU,CPU 只要“跑得比 GPU 快就行”。
4.4 一行 print 就能毁掉流水线
这是全讲最“值钱”的一个反直觉现象。在训练循环里打印 loss——看起来完全无害的调试语句:
但 print 发生在 CPU 上,而 loss 要在 GPU 上算出来。CPU 必须等 loss 送回来才能打印。
于是时间线整个变形:原本 CPU / GPU 错开一大截的两个 step,现在被迫对齐了。CPU 每次走到打印那一行就撞上 CUDA stream synchronize,然后“等等等等等”,直到 backward 算完、loss 回来、打印完成,才重新往前跑。
结论分两层:常见情况下(每步只打印一次)GPU 利用率仍然接近打满;但如果你疯狂打印,CPU 就再也没法提前排队,GPU 会被 CPU 拖成瓶颈。讲师说,这正是“不看高级 profiler 就永远不会发现”的那类问题。
4.5 矩阵乘法的 kernel 名字会告诉你一切
最后回到一个很实用的问题:我怎么知道 PyTorch 到底调用了哪个 kernel、参数是什么?
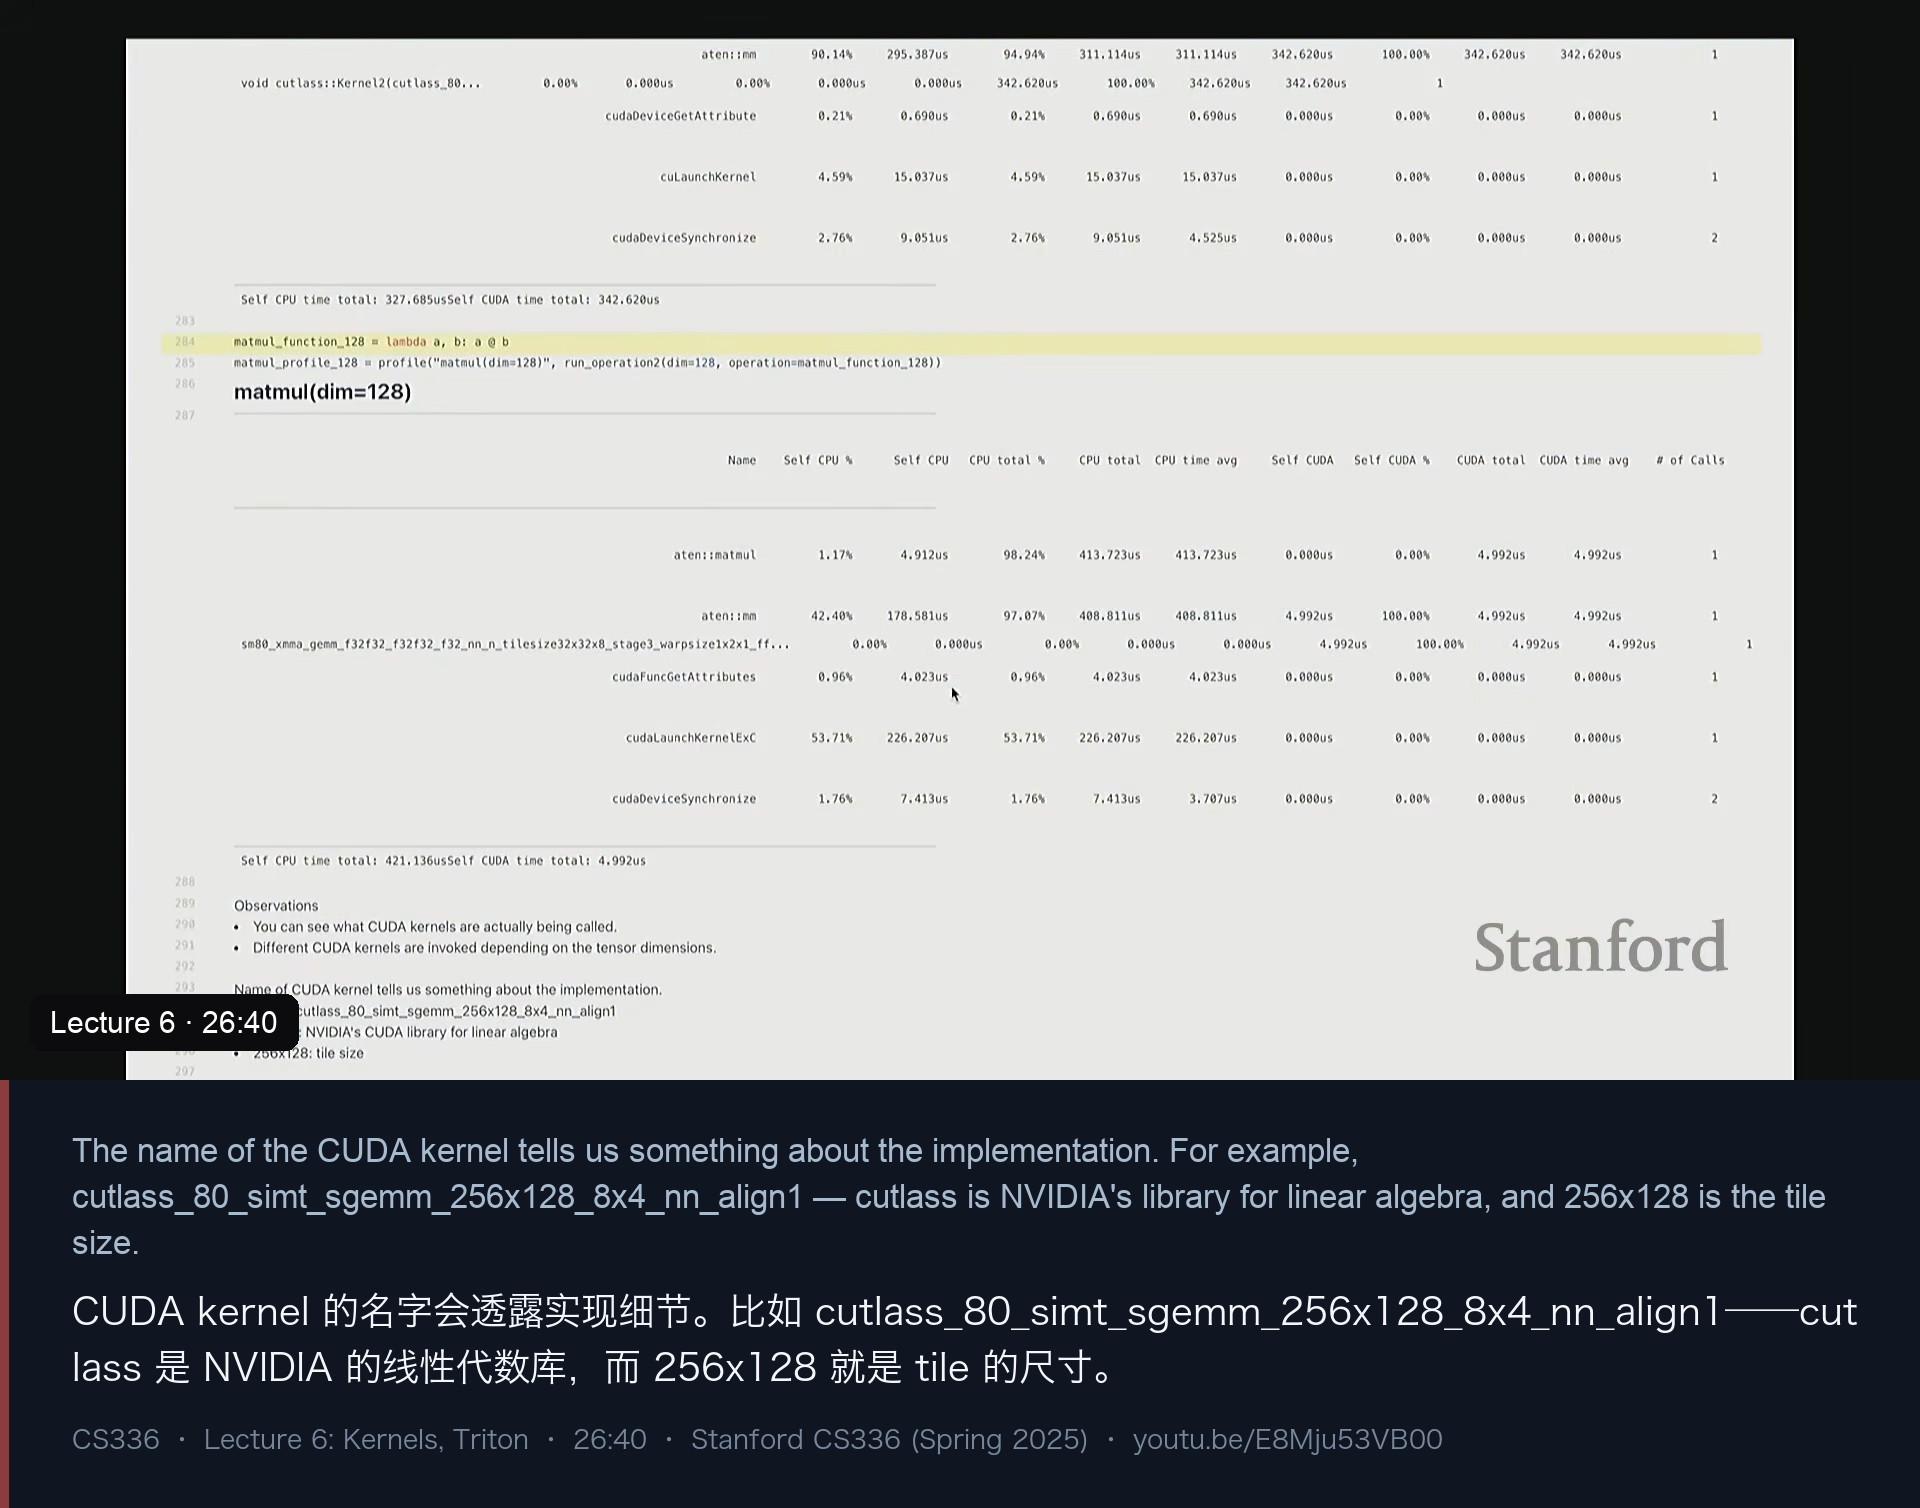
答案就藏在名字里,例如:
cutlass_80_simt_sgemm_256x128_8x4_nn_align1cutlass= NVIDIA 的高性能线性代数库;sgemm= 单精度通用矩阵乘法;256x128= tile 尺寸(正好接上一讲 tiling 的话题);- 末尾的
nn/align1等描述对齐与布局。
更妙的是:同一个 a @ b 会因为维度不同分发到完全不同的原语。讲师现场对比了 128 维的小矩阵——它甚至不走 cutlass,而是直接命中某个 xmma 系列的 kernel,名字里能看出是 float32。也就是说:
矩阵乘法的性能高度依赖形状、硬件和精度;
torch.compile甚至会先在你的机器上做一次微基准,挑出最快的那个矩阵乘法实现再写进图里。
五、算子融合:那个“仓库—工厂”的比喻
进入写 kernel 的环节,先复习动机。上一讲那幅工厂示意图又出现了:
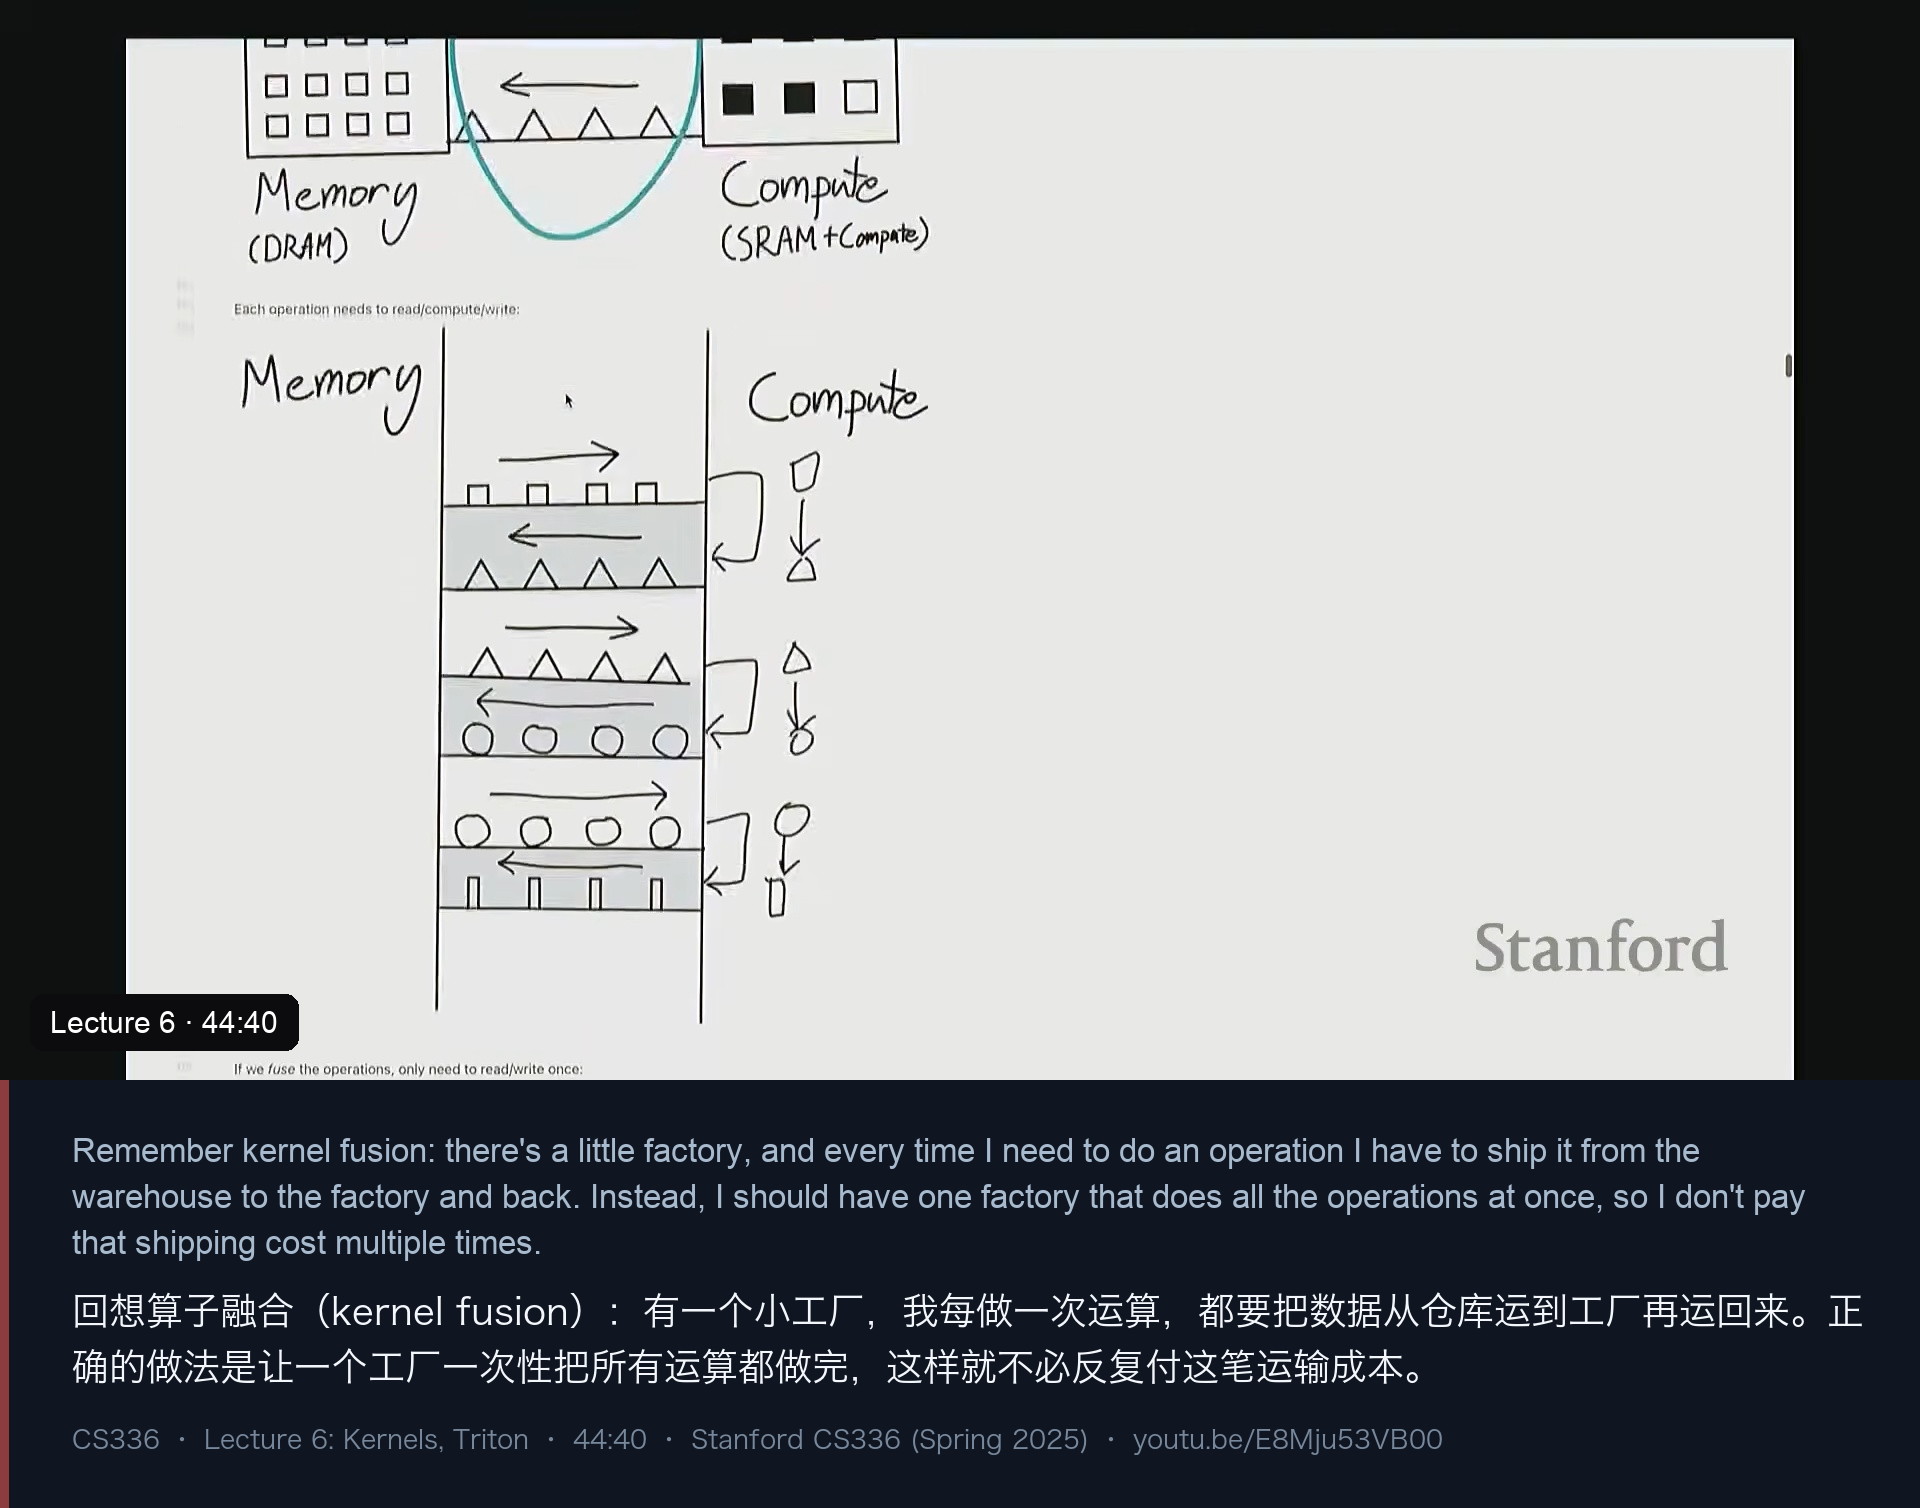
- 仓库 = DRAM(全局内存),工厂 = SM;
- 每做一次运算,就要把数据从仓库运到工厂,算完再运回去——这就是访存;
- 如果一长串运算各自是一个 kernel,就反复付这笔运输费;
- 正确做法是让一个工厂把这一串活一次干完,只付一次运输费。
这就是 kernel fusion。接下来用 GELU 做实验——注意讲师把它念成“GLU/GELU”,实际算的是 GELU 的 tanh 近似:
# 朴素实现:每一步都是一个独立的 PyTorch 算子(会各自读写一遍显存)
def manual_gelu(x):
    return 0.5 * x * (1 + torch.tanh(0.79788456 * (x + 0.044715 * x * x * x)))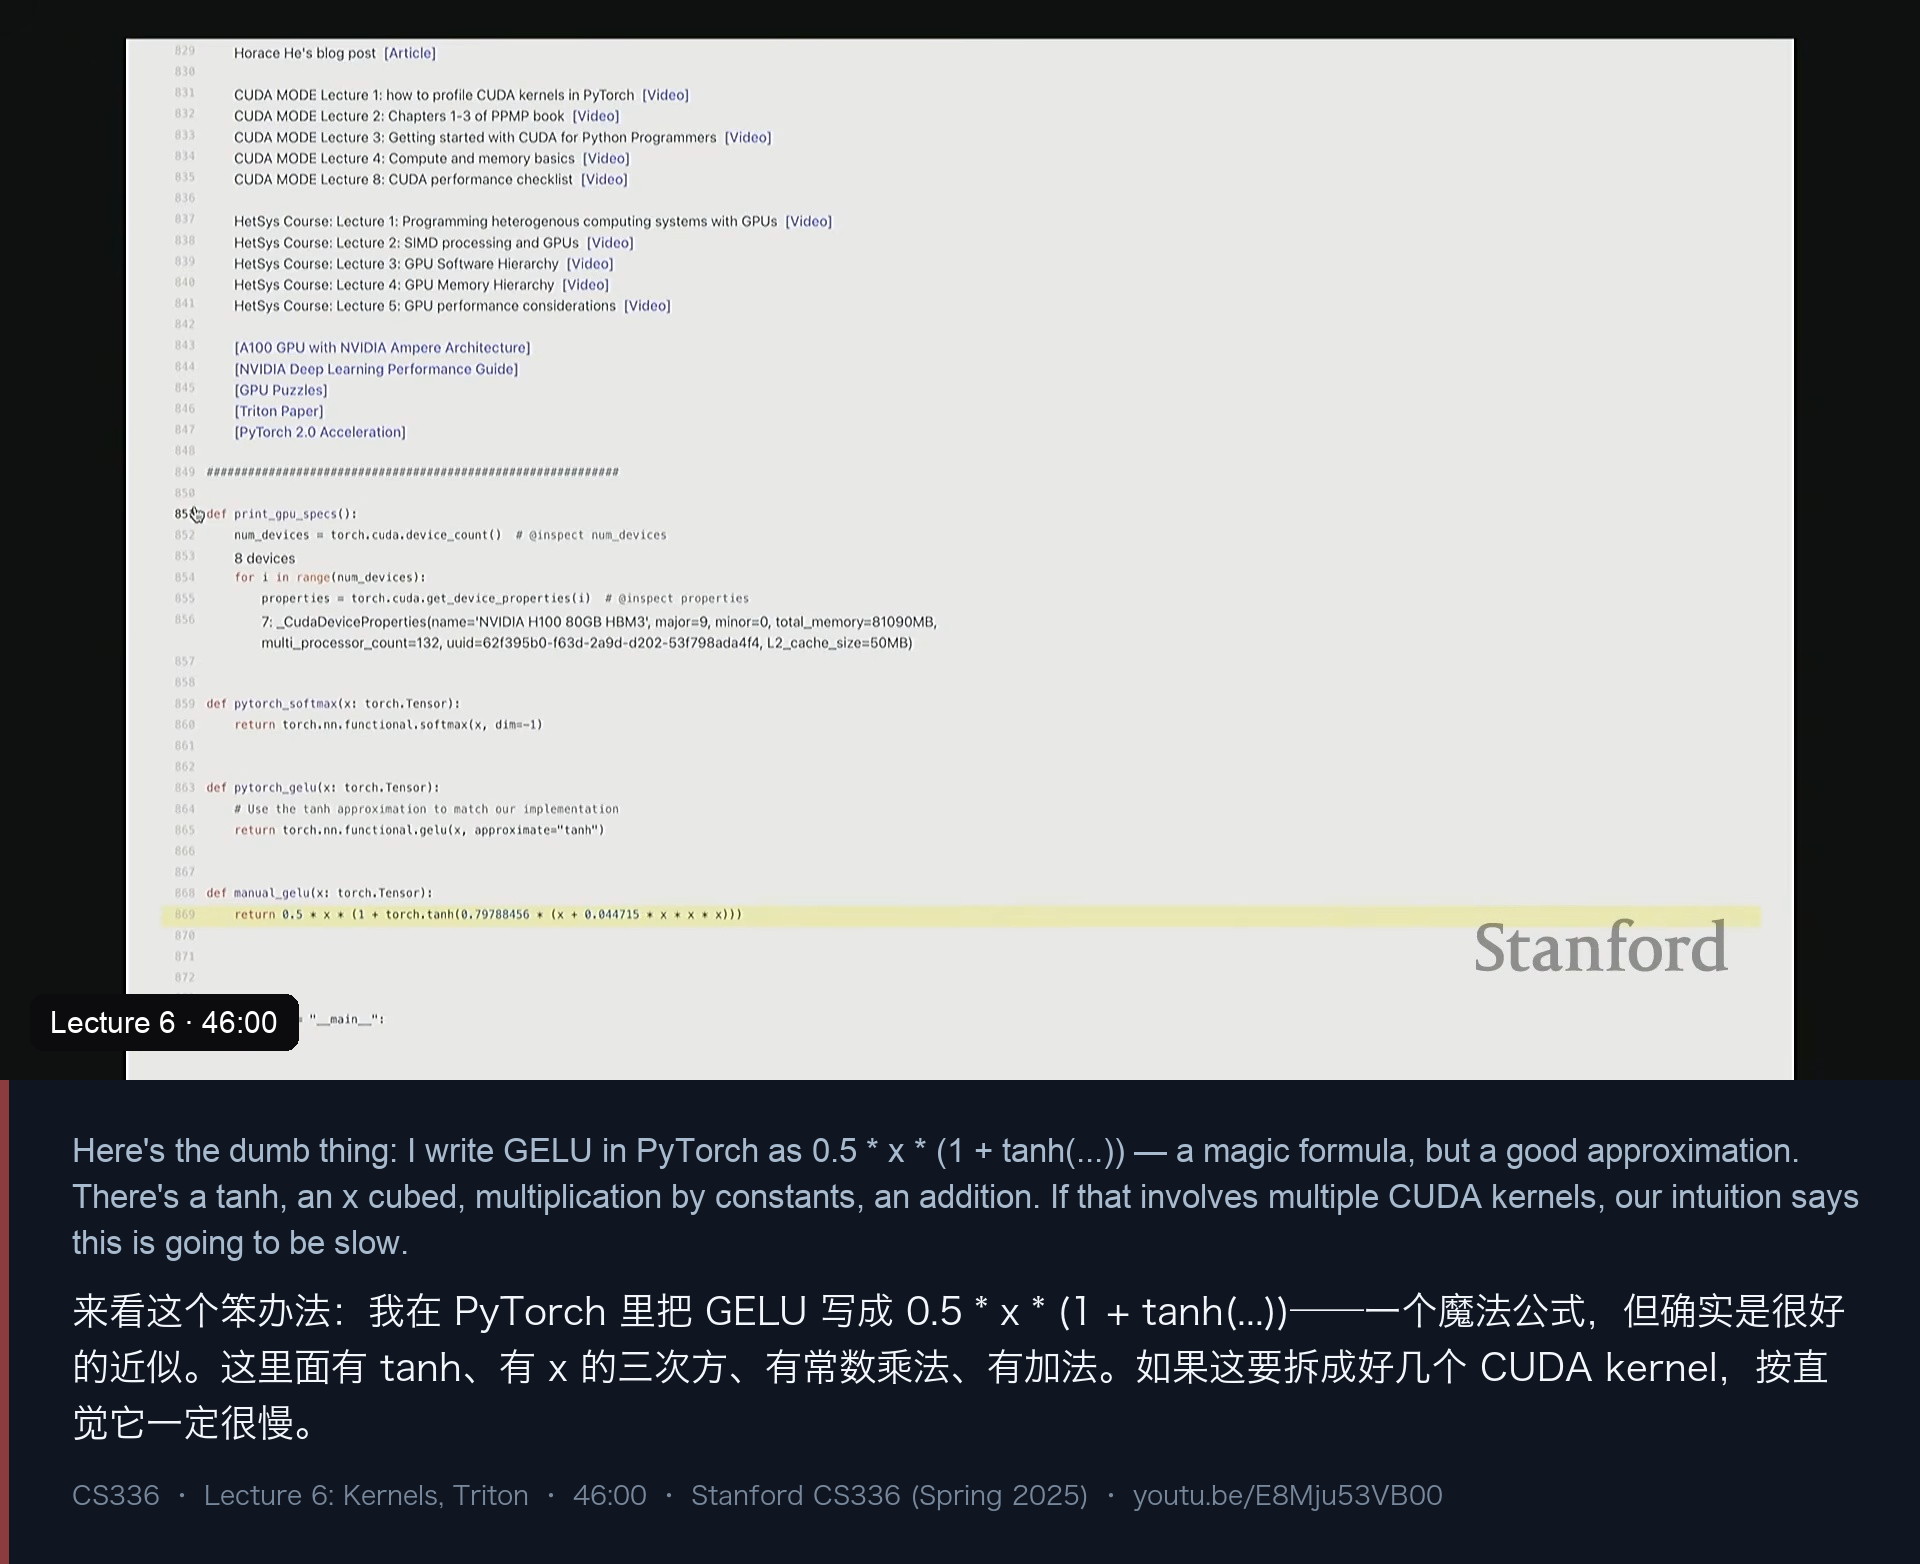
profiler 证实了直觉:这条表达式会拉起好几个 CUDA kernel(某个乘法 kernel 甚至被调用三次),中间还有 tanh、加法……而 PyTorch 内置的融合实现只有一次 kernel 调用。
结果对比(对很大的 GELU):
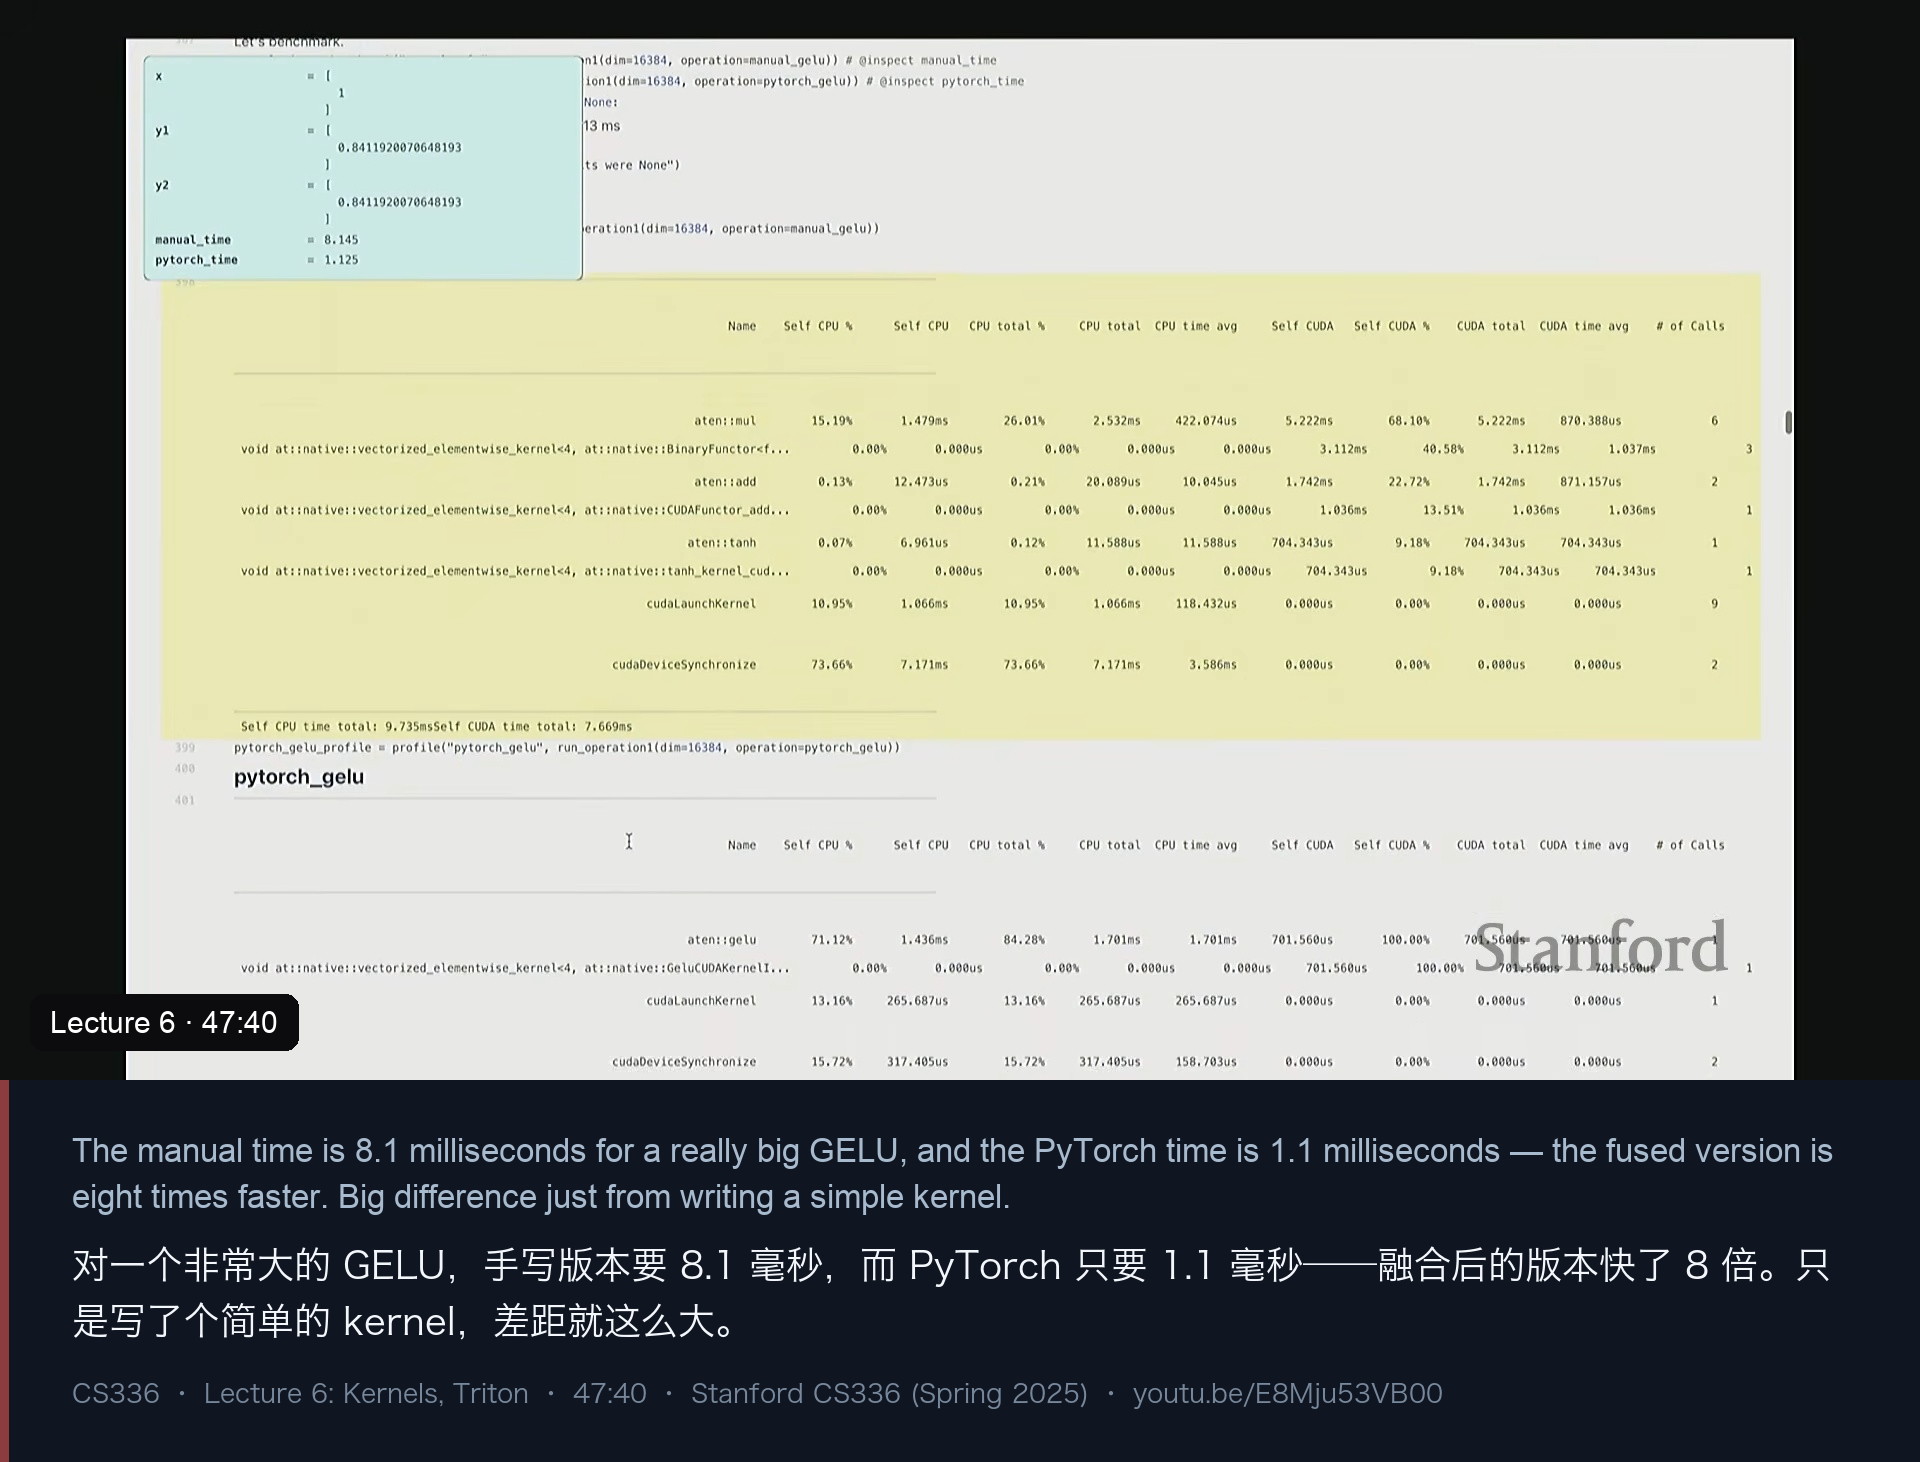
| 实现 | 时间 |
|---|---|
| 朴素 PyTorch(多个 kernel) | 8.1 ms |
| PyTorch 内置融合实现 | 1.1 ms |
整整 8 倍。接下来整节课的目标,就是“用别的方式逼近那 1.1 ms”。
六、手写 CUDA kernel:从 8.1 ms 到 1.8 ms
既然 PyTorch 能做到,那我们也走到“尽可能底层”的 C++ 去。CUDA 本质上就是一套用 C++ 给 GPU 编程的 API。
一个 CUDA 程序有两部分:
- kernel:
__global__ void函数,被发送到 GPU、真正做计算; - wrapper:跑在 CPU 上的普通 C++ 函数,负责检查、分配输出、配置 grid、启动 kernel。
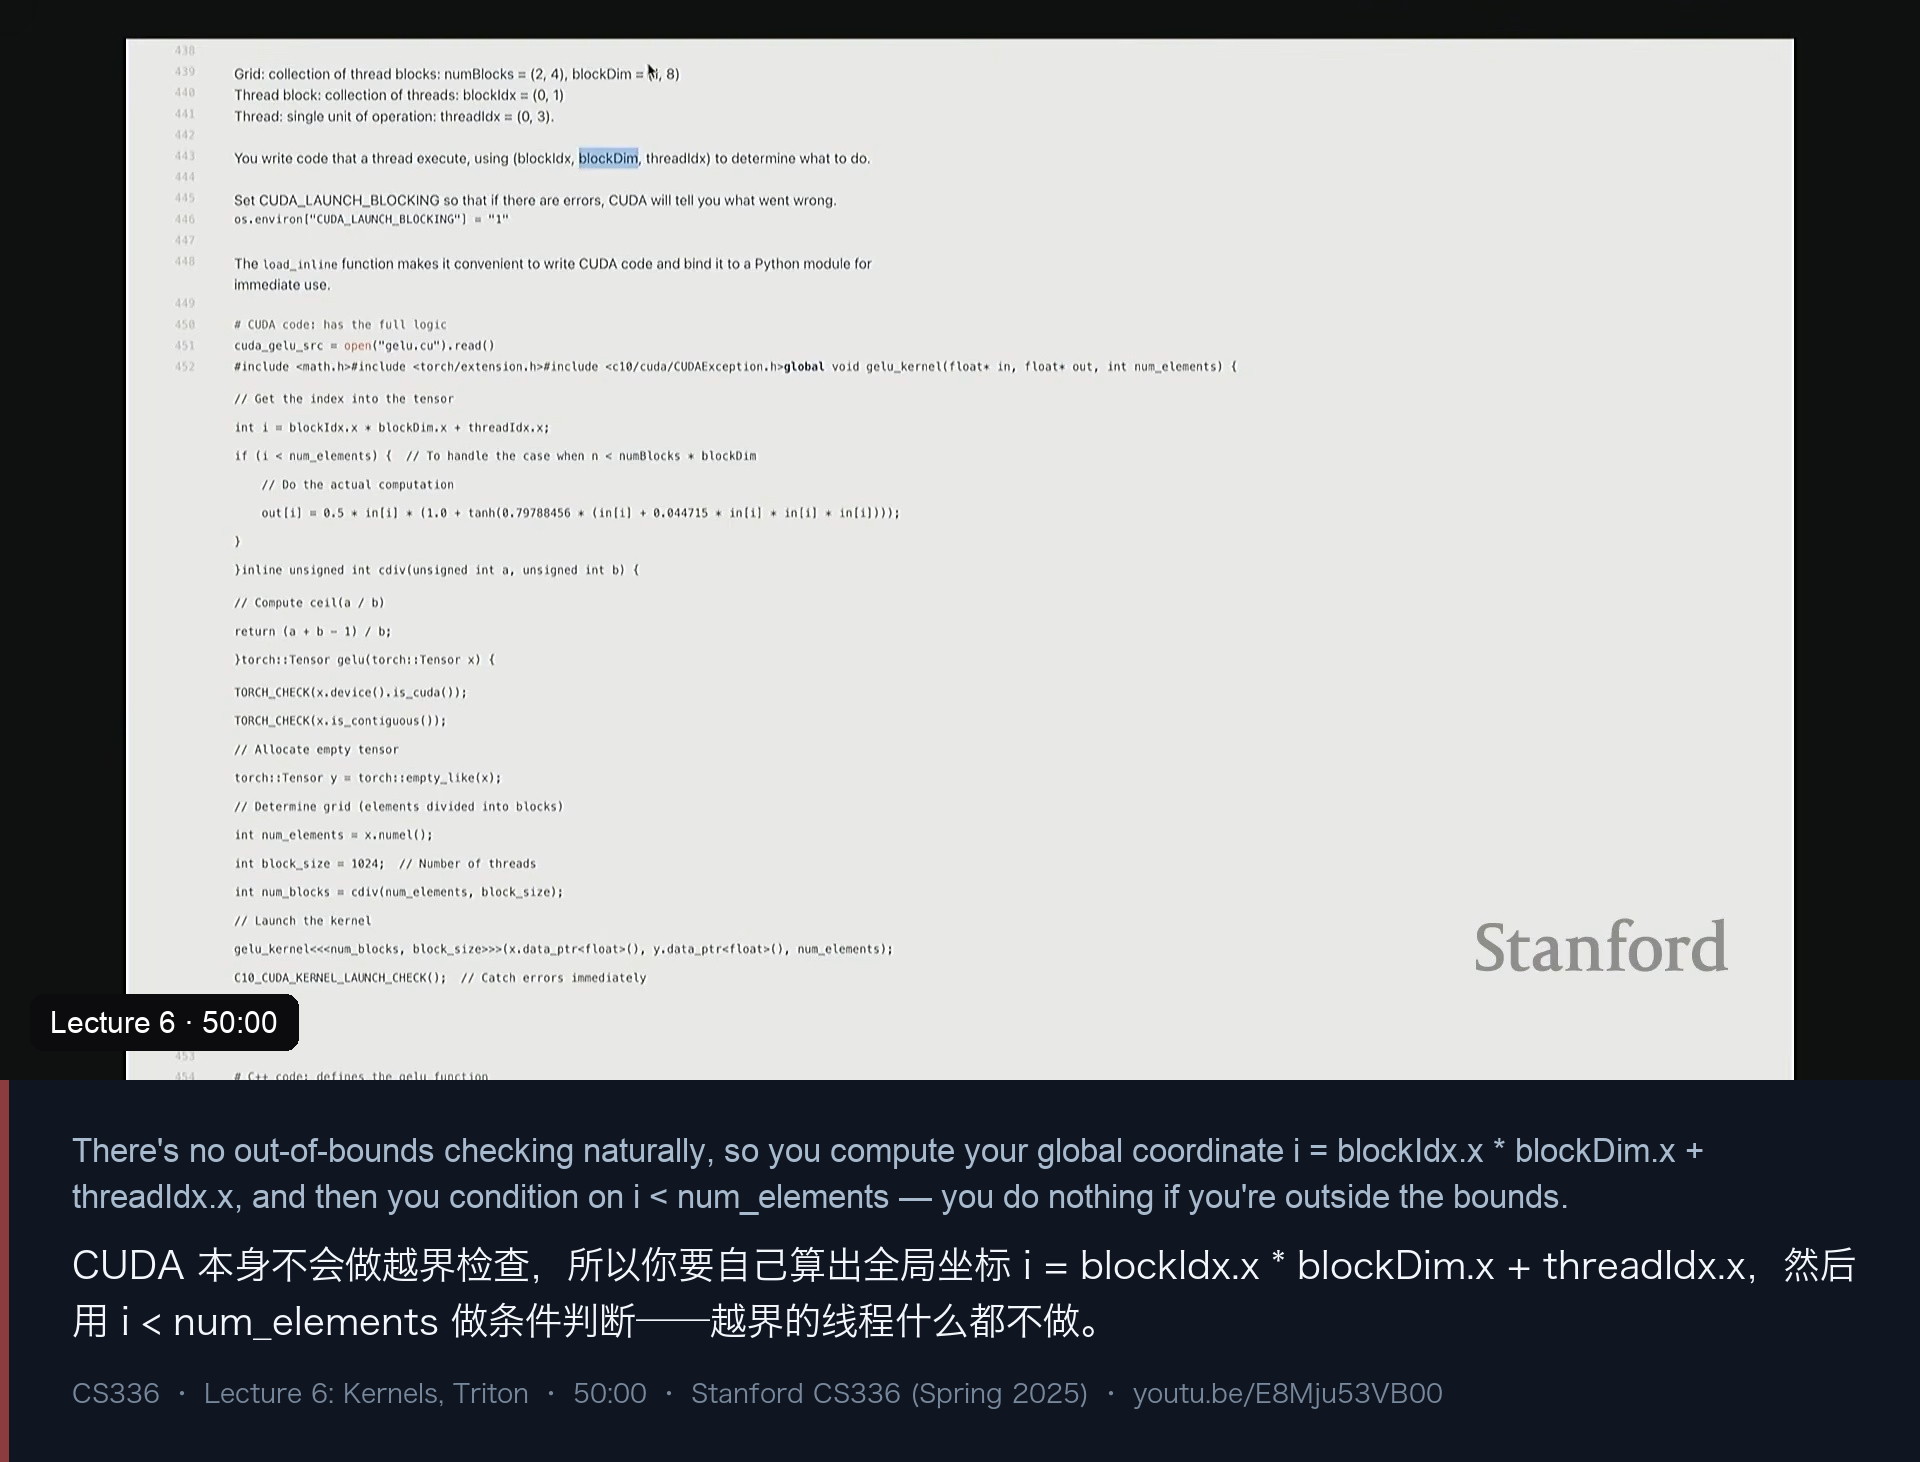
#include <math.h>
#include <torch/extension.h>
#include <c10/cuda/CUDAException.h>

// 真正跑在 GPU 上的 kernel:每个线程处理一个(或多个)元素
__global__ void gelu_kernel(float* in, float* out, int num_elements) {
  // 算出当前线程负责的全局下标
  int i = blockIdx.x * blockDim.x + threadIdx.x;
  if (i < num_elements) {  // 手写边界检查:处理 n 不是 numBlocks * blockDim 整数倍的情况
    out[i] = 0.5 * in[i] *
             (1.0 + tanh(0.79788456 * (in[i] + 0.044715 * in[i] * in[i] * in[i])));
  }
}

inline unsigned int cdiv(unsigned int a, unsigned int b) { return (a + b - 1) / b; }

torch::Tensor gelu(torch::Tensor x) {
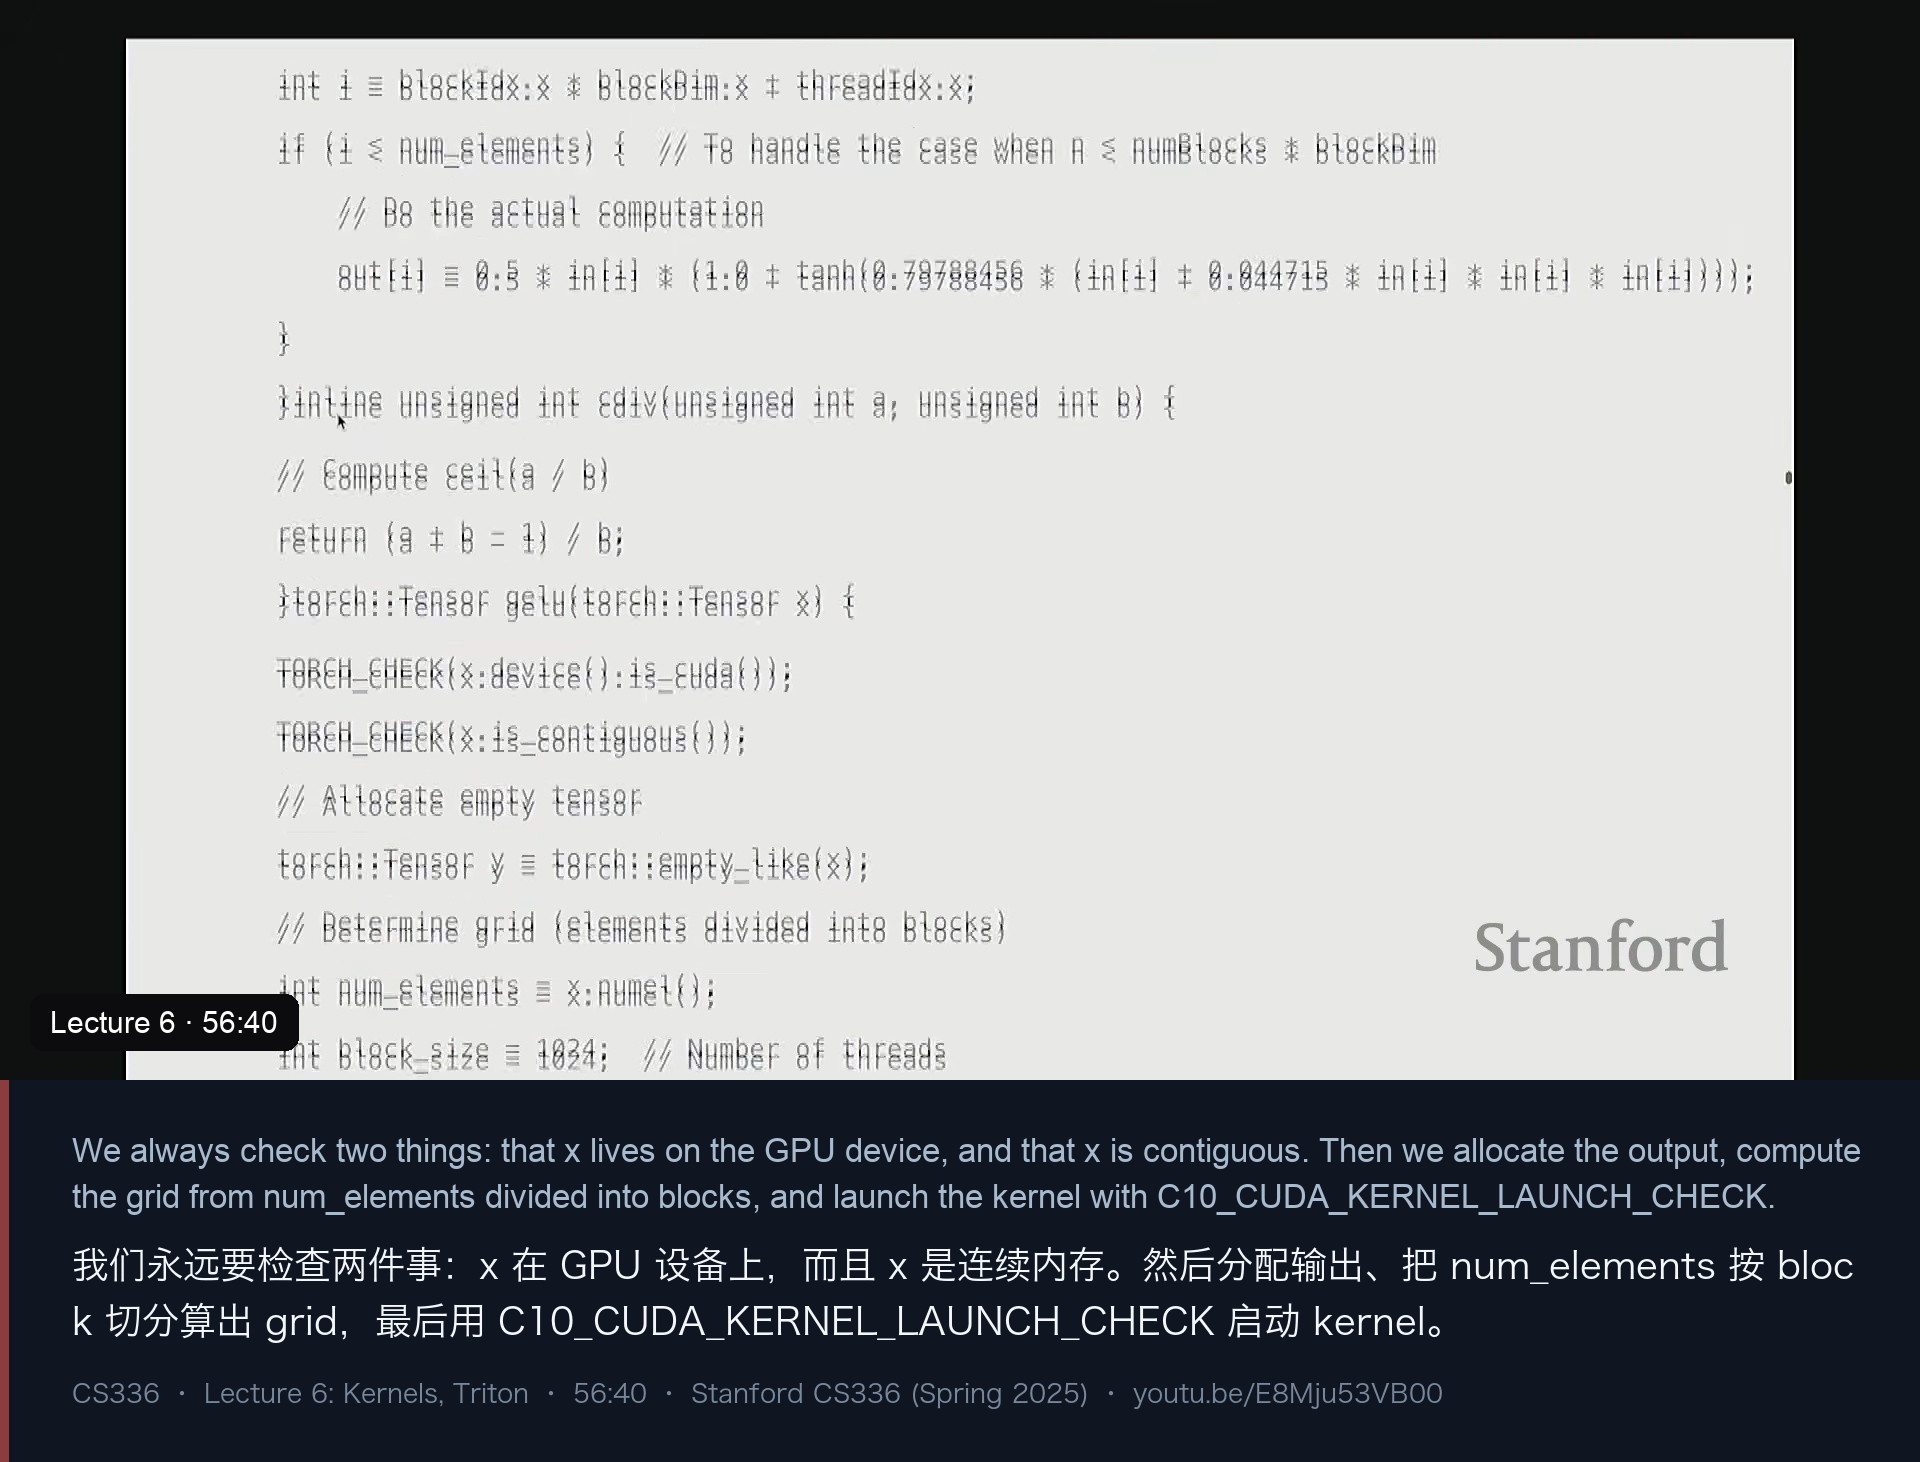
  TORCH_CHECK(x.device().is_cuda());     // 必须在 GPU 上
  TORCH_CHECK(x.is_contiguous());        // 必须是连续内存,否则下标算术不成立
  torch::Tensor y = torch::empty_like(x);

  int num_elements = x.numel();
  int block_size = 1024;                 // 每个 block 的线程数
  int num_blocks = cdiv(num_elements, block_size);

  gelu_kernel<<<num_blocks, block_size>>>(x.data_ptr<float>(), y.data_ptr<float>(),
                                          num_elements);
  C10_CUDA_KERNEL_LAUNCH_CHECK();        // 立即捕获启动错误
  return y;
}
这段代码里有几个知识点被逐个讲透:
- 三层结构:
grid是线程块的集合,block是线程的集合,线程是最小执行单位。kernel 里拿到blockIdx/blockDim/threadIdx就能定位自己在张量里的坐标。 - 必须做两件事:确认张量在 CUDA 设备上(否则没法在 GPU 上算),确认张量是连续的(否则按
i直接索引的算术就废了)。转置、view 之类会破坏连续性,一般可以在 wrapper 层先连续化。 threadIdx是干什么的——因为没有线程 id 你就不知道该处理哪个元素。- 边界检查是手写的:CUDA 不会自动帮你检查越界,末尾那些越界的线程必须
if (i < num_elements)挡住,否则会踩到别人的内存。 - 调试开关:
CUDA_LAUNCH_BLOCKING=1——不开的话,CUDA kernel 报错会被异步吞掉,你会“很难受地调试很久”。 load_inline:可以把这段 C++ 源码直接内联在 Python 里编译成模块,省去从命令行编译的麻烦。
最终成绩(同一实验):
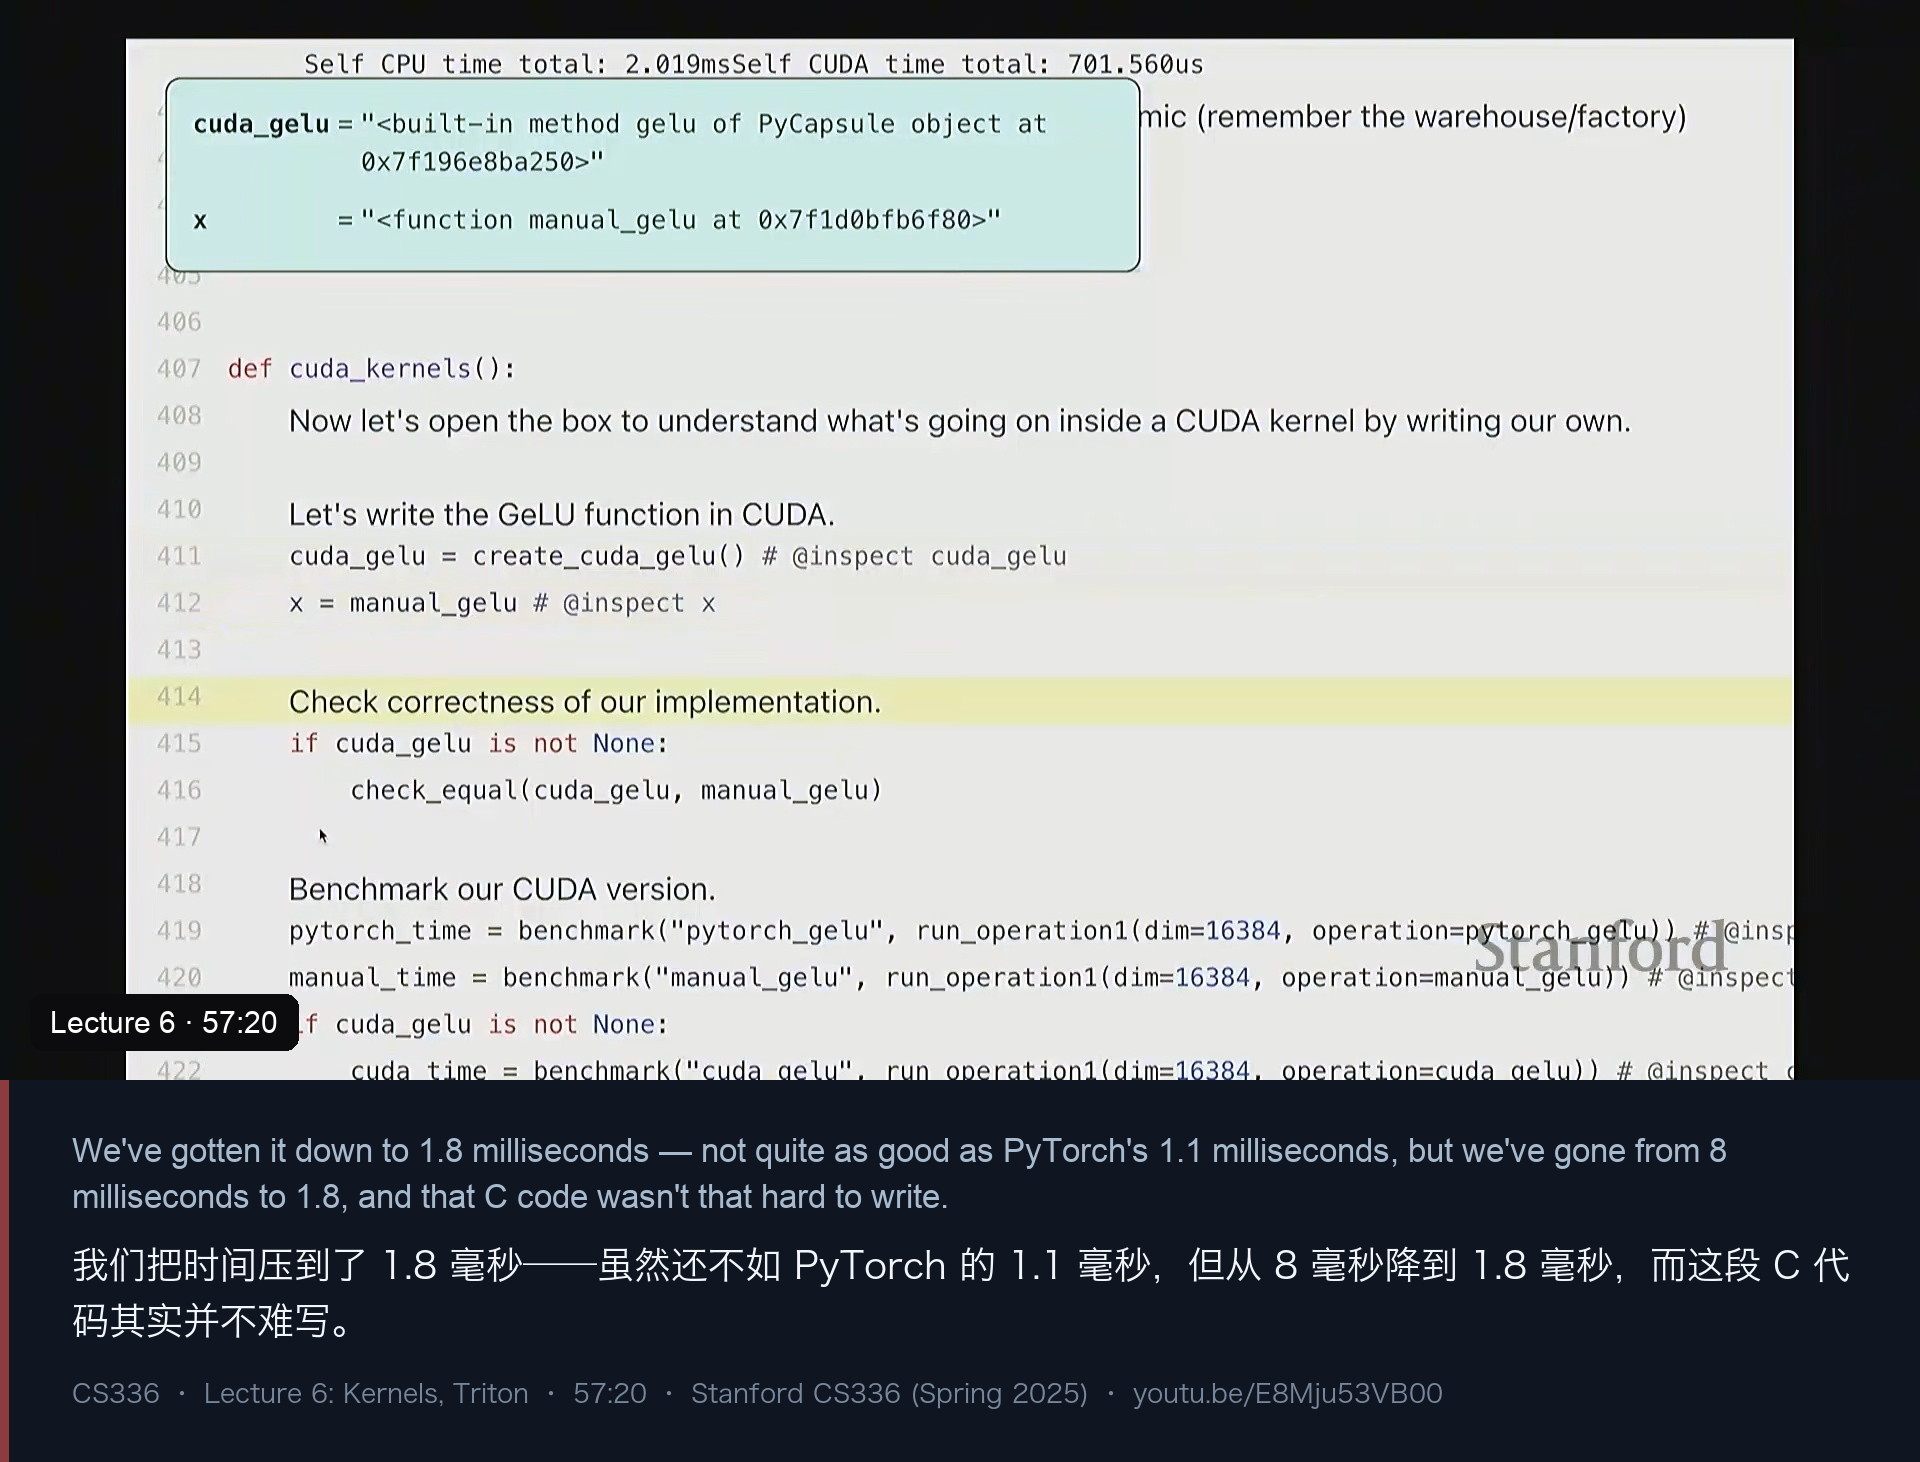
| 实现 | 时间 |
|---|---|
| 朴素 PyTorch | 8.1 ms |
| 手写 CUDA(C++) | 1.8 ms |
| PyTorch 内置融合实现 | 1.1 ms |
从 8 毫秒到 1.8 毫秒,而“这段 C 代码其实并不难写”。profiler 也变干净了:一次 gelu_kernel 吃掉 100% 的 GPU 时间,正是我们想要的形状。
讲师顺带提了这类逐元素算子的性质:很容易写(新的非线性函数你自己写一个 CUDA kernel 就行);但真正有意思的算子——比如做 reduction 的、或者 Flash Attention——会复杂一些,不过也只是“一些”。有学生问“块大小改成别的会怎样”,回答是:只要 block 足够大(比如 1024),对这种纯逐元素算子影响不大——因为它既不涉及 SM 饱和,也不涉及块内负载均衡。
七、Triton:用 block 思考,把线程交给编译器
手写 CUDA 能用,但“如果能用 Python 写出 CUDA kernel 该多好”——这就是 Triton。它是 OpenAI 在 2021 年推出的领域特定语言(DSL),定位正好在“纯 PyTorch”和“手写 CUDA”之间。
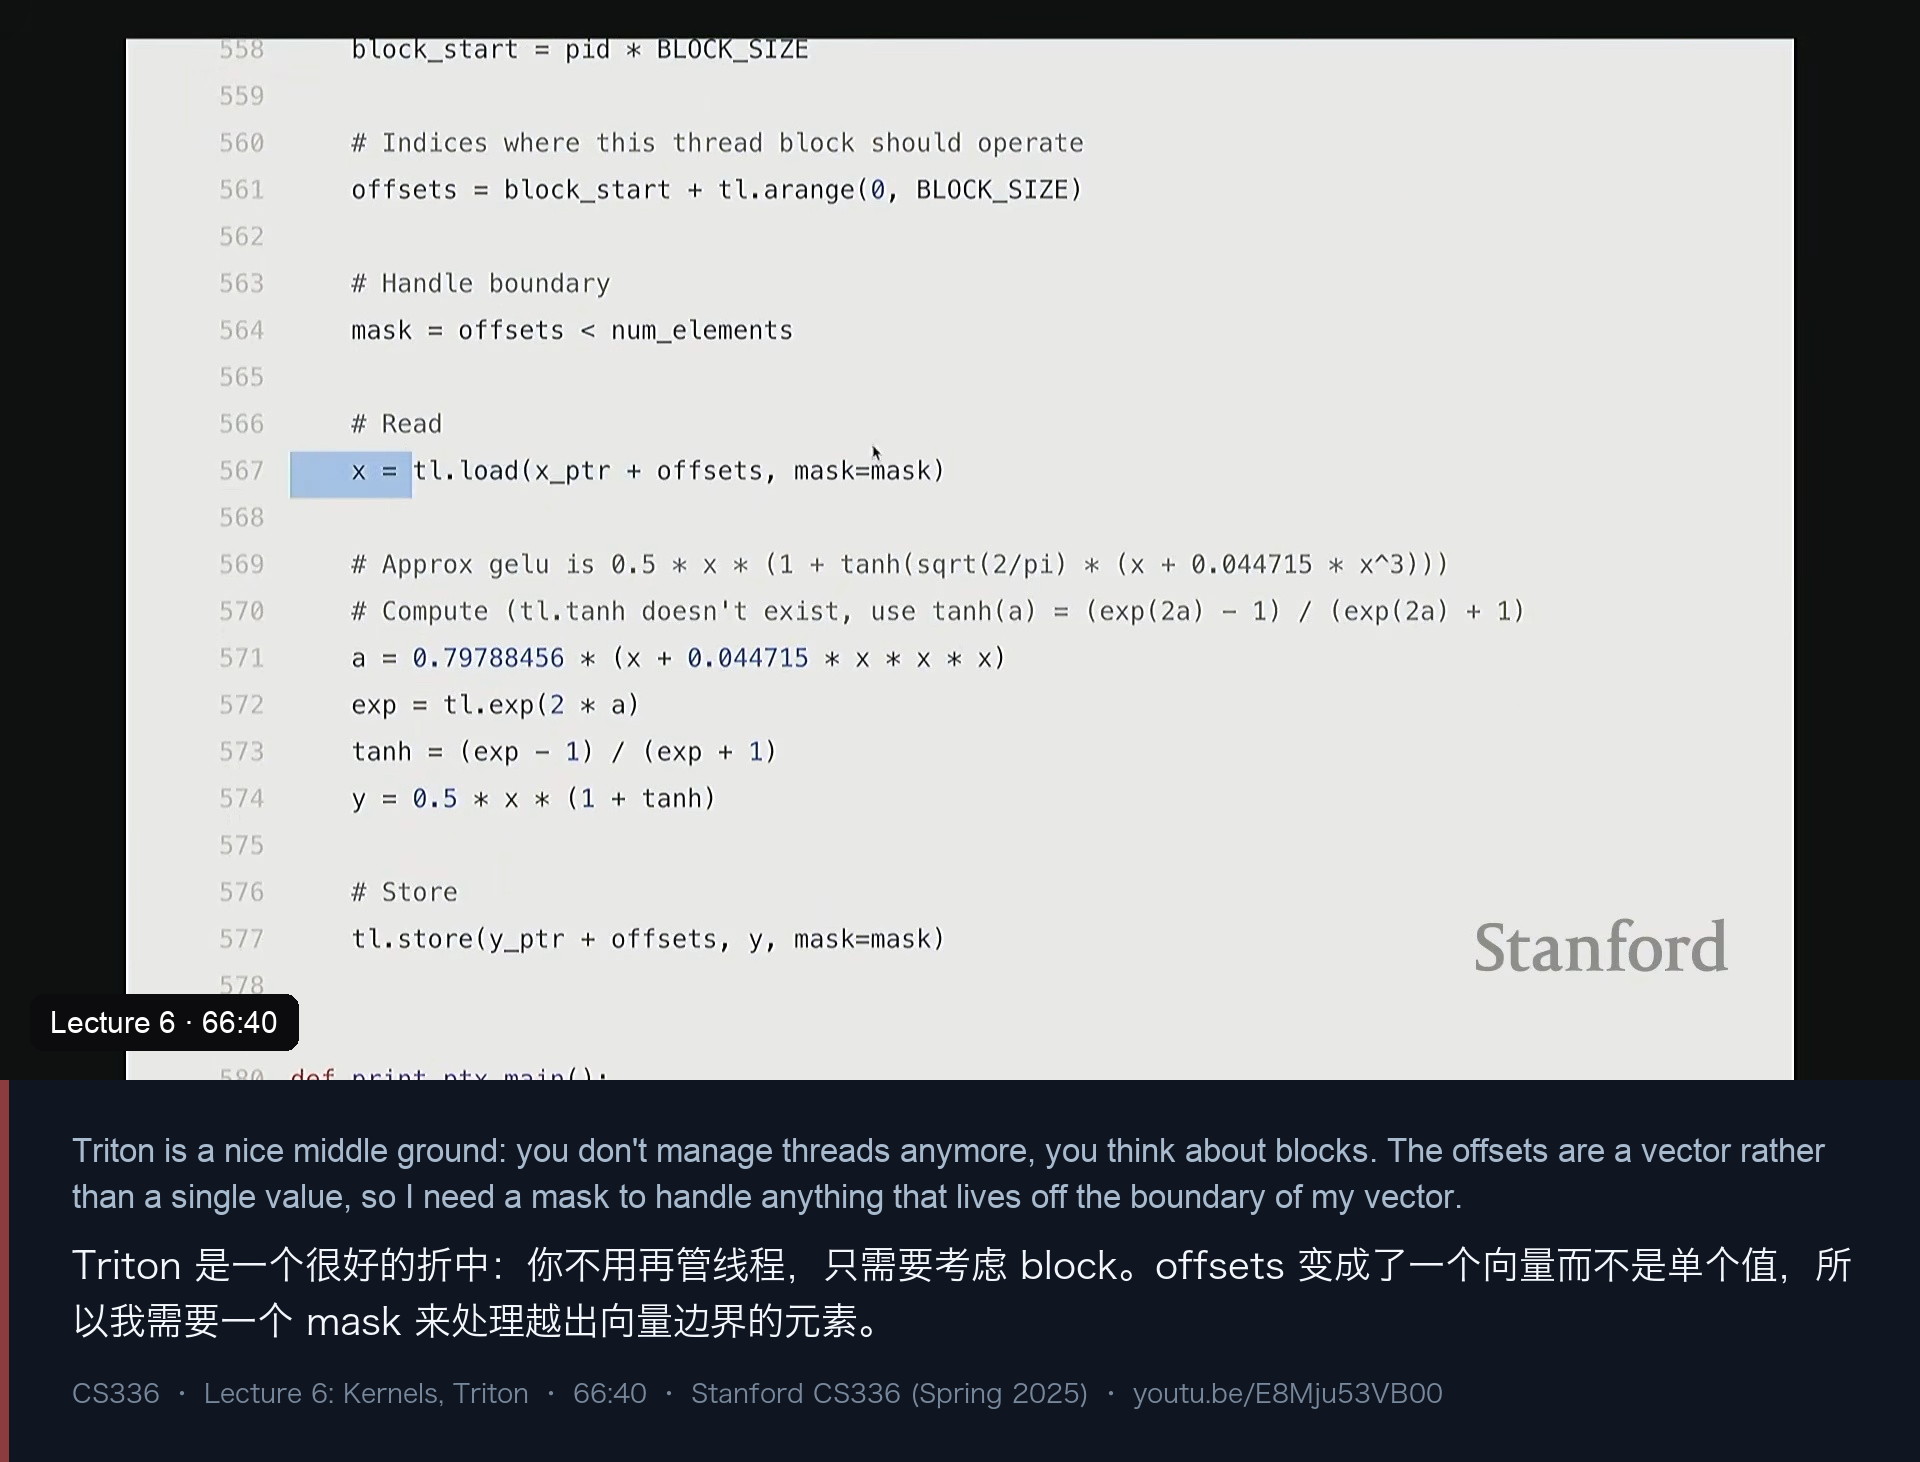
Triton 帮你自动处理那些“烦人但可以自动优化”的事:
- 访存合并:自动把相邻的 4 个(burst 模式的粒度)访问分组,一次取一批;
- 共享内存管理:块内多线程对片上内存的读写,自动调度。
但它不管的事也很明确:跨 SM 的调度仍然要你自己设计。用讲师的话说,Triton 的编程模型是”以 SM 为中心“——你只负责块级逻辑,编译器负责剩下的低层细节。它的好处是:
- 常能大幅超过 PyTorch 的实现;
- 仍然待在人人熟悉的 Python 里,可以单步调试(这是个被低估的加分项)。
对照 CUDA 版本,Triton 版的结构几乎一一对应,只是“线程”变成了“块”,offsets 从单个值变成了向量:
block_start = pid * BLOCK_SIZE

# 这个块负责哪些下标(注意:offsets 是一个向量)
offsets = block_start + tl.arange(0, BLOCK_SIZE)

# 处理边界:末尾会越界
mask = offsets < num_elements

# 读(一次向量化 load)
x = tl.load(x_ptr + offsets, mask=mask)

# 近似 GELU:0.5 * x * (1 + tanh(sqrt(2/pi) * (x + 0.044715 * x^3)))
# 注意 tl.tanh 不存在,用 tanh(a) = (exp(2a) - 1) / (exp(2a) + 1) 手动展开
a = 0.79788456 * (x + 0.044715 * x * x * x)
exp = tl.exp(2 * a)
tanh = (exp - 1) / (exp + 1)
y = 0.5 * x * (1 + tanh)

# 写回(一次向量化 store)
tl.store(y_ptr + offsets, y, mask=mask)
结果:Triton 版 1.848 ms,和手写 CUDA 的 1.805 ms 几乎打平。讲师的原话是:“我们没有更快,但写起来容易多了。”
八、PTX:降到底层看一眼
Triton 最酷的一点是:它能编译到非常接近机器码的 PTX,你可以直接读它生成了什么。
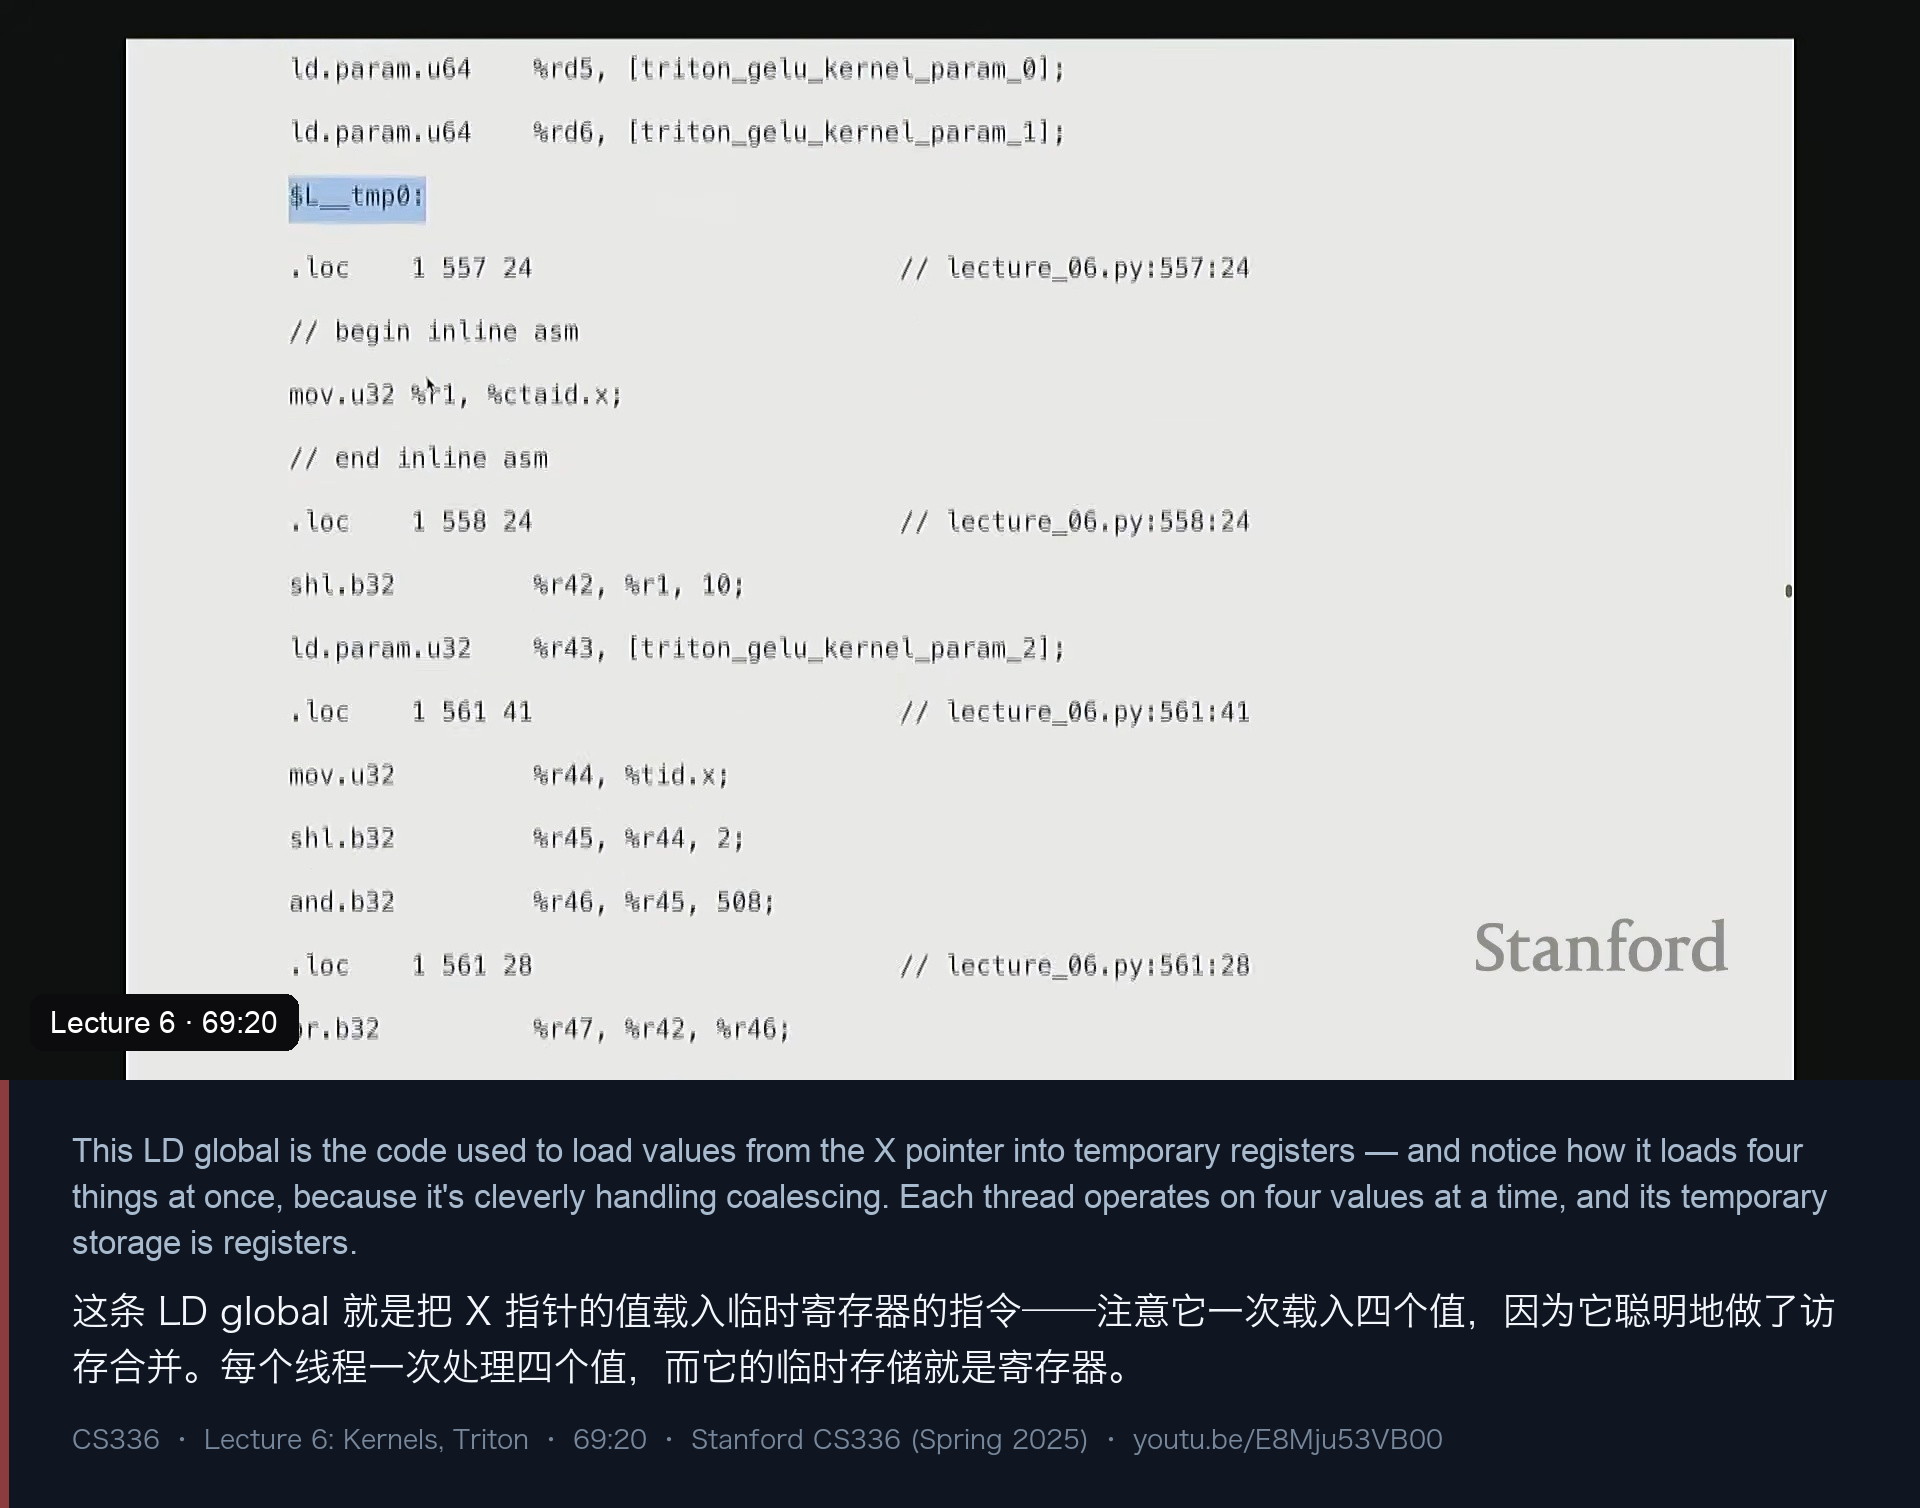
逐段看 PTX,能看到之前所有抽象是怎么落地的:
- 先声明所需寄存器:
.b32(32 位)、.f32(浮点)、.pred(谓词,用于分支); - 载入函数参数(
x_ptr/y_ptr)并计算坐标偏移; ld.global:从x_ptr把值读进临时寄存器——注意它一次载入四个值(R2, R3, R4, R5),因为编译器知道 burst 模式一次能白拿四个;- 接着是一串浮点运算:常数乘法、
x的三次方(同样的数乘好几次);算2^x再乘log 2得到以e为底的指数; - 最后把寄存器里的结果
store回输出指针。
一句话总结这一段的意义:每个线程一次处理四个值,临时存储就是寄存器——所以这段代码“看起来就知道很快”。
九、torch.compile:什么时候该自己动手
写 CUDA kernel 很酷,也很有成就感,但——这些操作太简单了,无非是把 x 的三次方、指数这些算子塞进同一个 kernel。那能不能让编译器自己干?这就是 torch.compile。
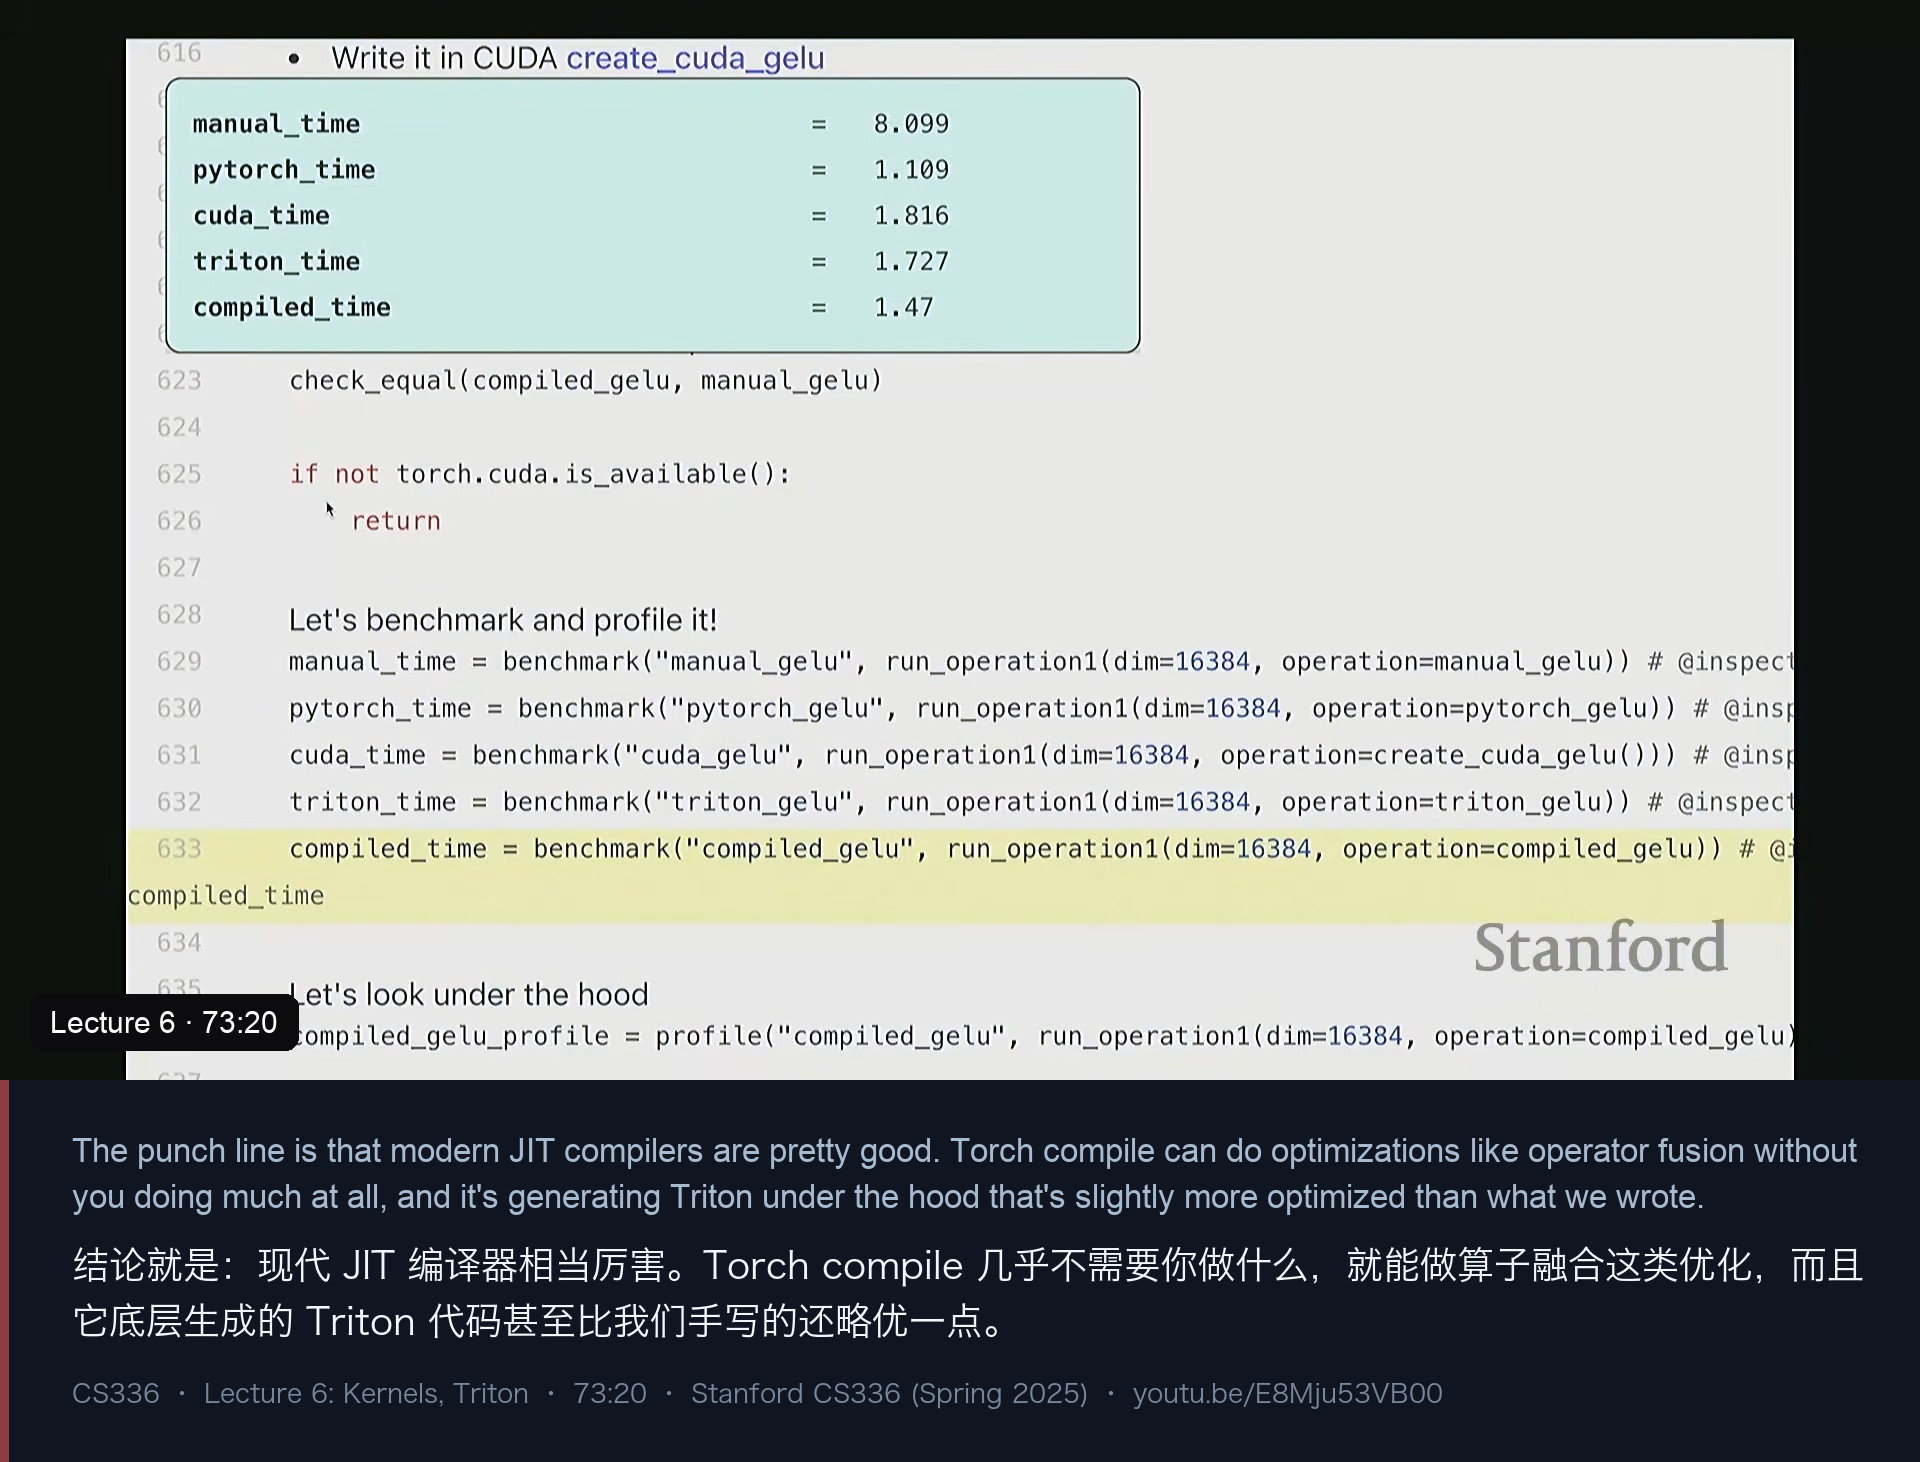
它接收未优化的 PyTorch 代码,自动尝试 kernel fusion 等优化,输出数值上完全等价的结果。运行时间上:
| 实现 | GELU 时间 |
|---|---|
| 朴素 PyTorch | 8.101 ms |
| PyTorch 内置 | 1.128 ms |
| 手写 CUDA | 1.805 ms |
| Triton | 1.848 ms |
| torch.compile | 1.474 ms |
而且打开“引擎盖”看,torch.compile 生成的就是一个融合的 add-multiply-tanh Triton kernel——它底层用的正是你刚刚手写的东西,只是稍微更优化一点。
于是那个关键问题来了(有学生当场提问):什么时候该放弃 torch.compile、自己写? 讲师的回答分三类:
- 简单算子融合、以及矩阵乘法:
torch.compile已经非常强(它知道形状,能挑最好的矩阵乘法 kernel),你很难做得更好; - Flash Attention 1/2/3 这类非平凡优化:现在
torch.compile(以及 JAX 的 XLA)也能做了,但那是“事后诸葛亮”——因为我们已经知道那些优化是对的;而像 Flash Attention 3 里针对 H100 硬件的额外优化,JIT 编译器还看不出来; - 所以:不要一上来就给语言模型每一部分都手写 CUDA,那是浪费时间;但当你写了一个新架构、某个部件利用率上不去、而你认为它能上去时,就该拿出 Triton 了。
十、进阶例子:Triton 写 softmax
最后的例子是 softmax,目的是展示带 reduction 的算子和纯逐元素算子的区别——前者的难点在于“要跨元素求和”。
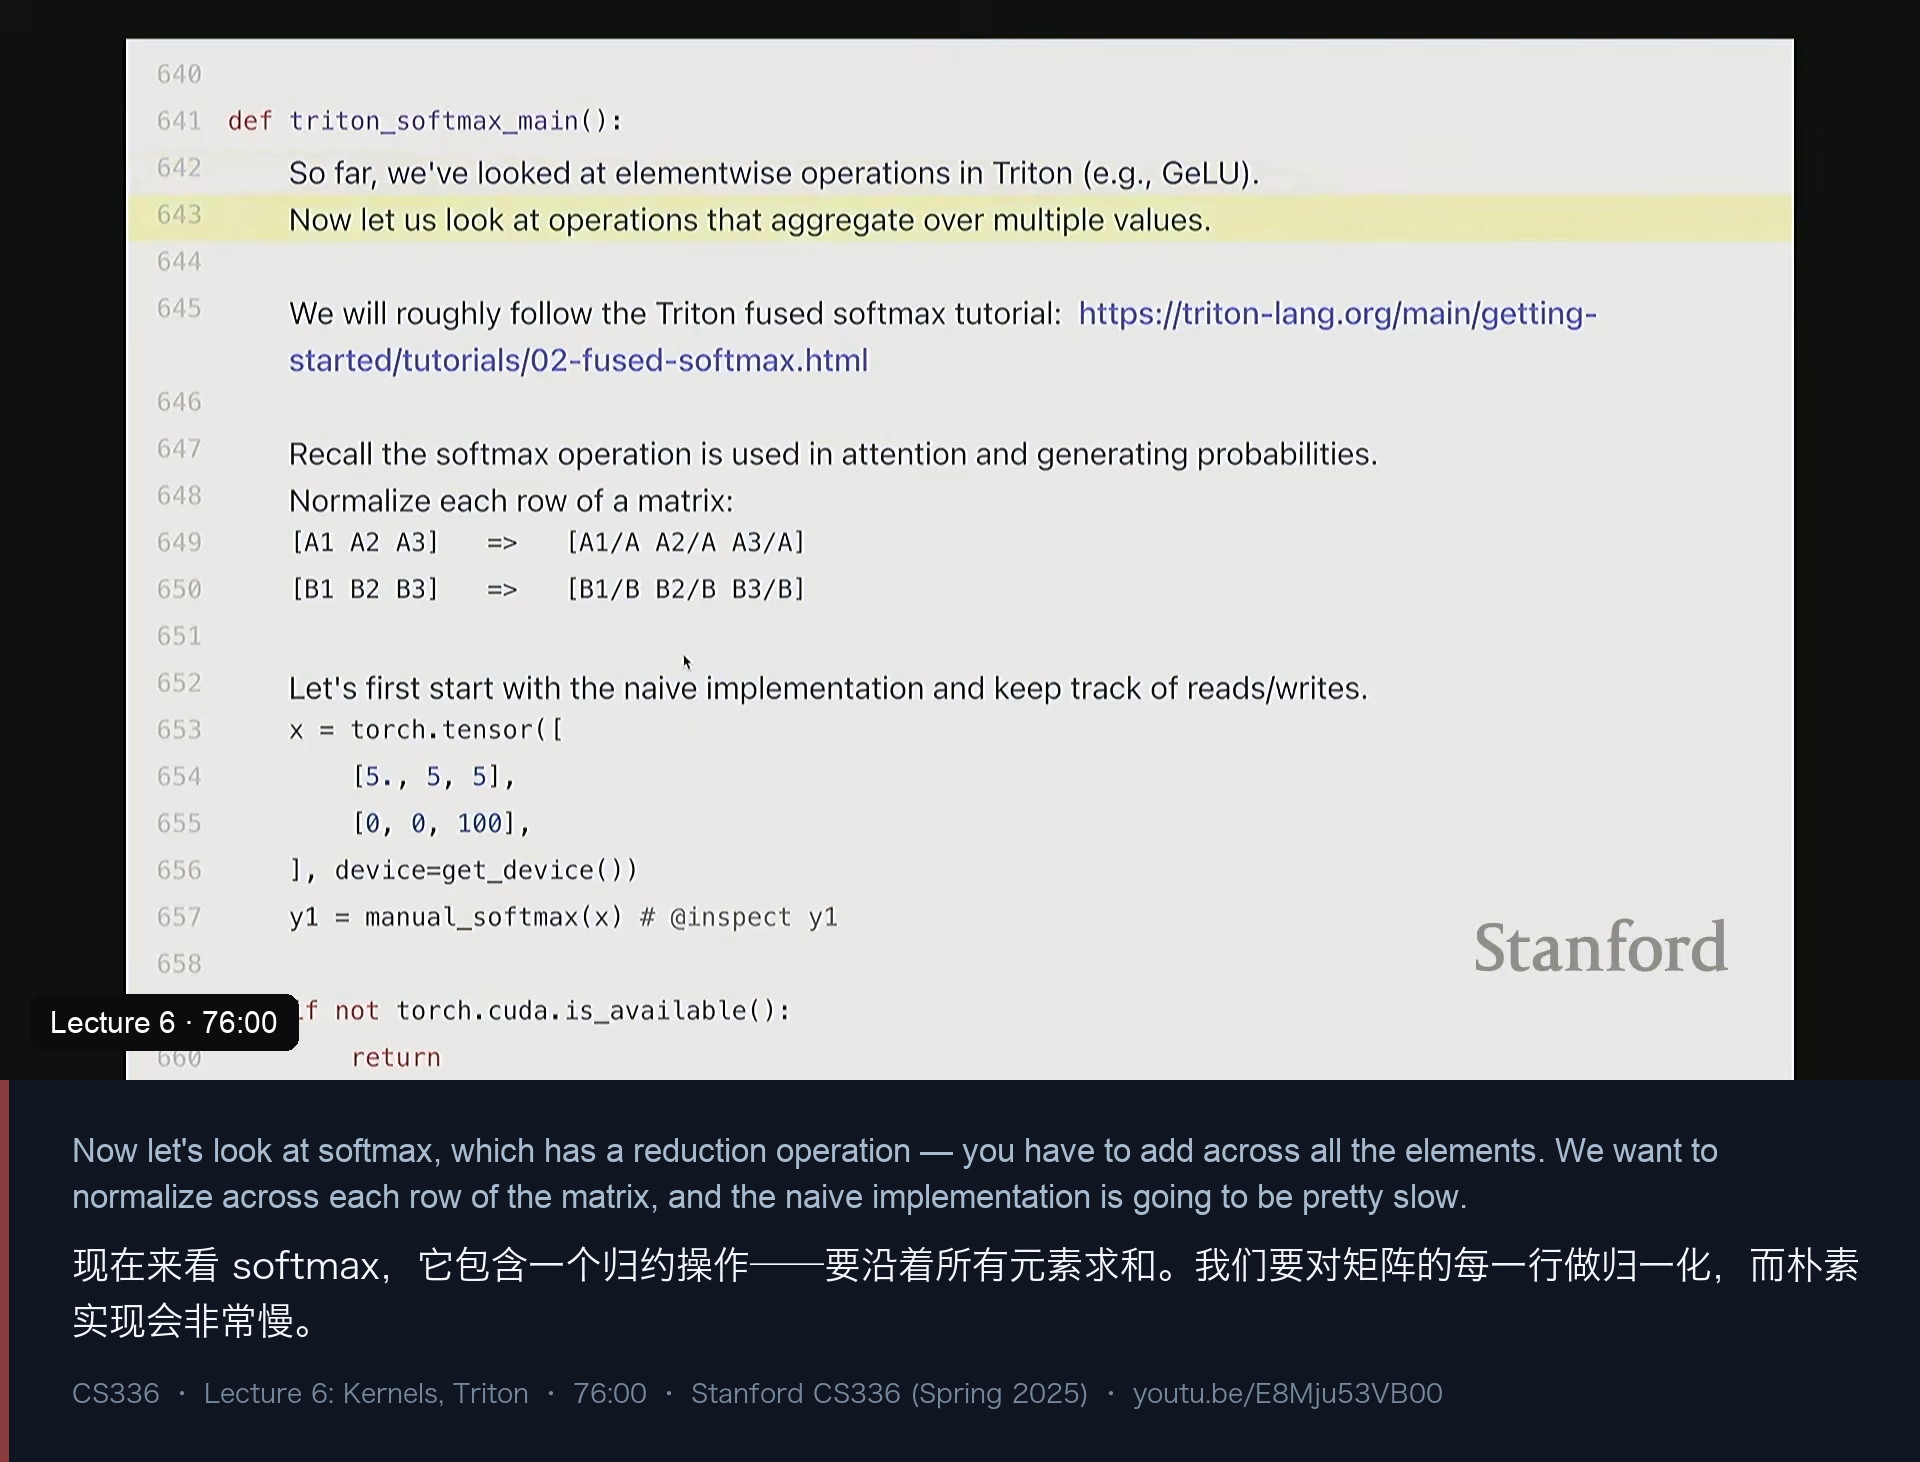
块设计(最巧妙的一步):软矩阵的每一行要单独归一化,最自然的做法就是让 grid = 行数,每个 block 处理一整行。如果整行能塞进一个 SM,就在 SM 内求和、再相除——干净利落。于是:
BLOCK_SIZE = triton.next_power_of_2(cols)  # 向上取到 2 的幂,留一点 padding
num_blocks = rows                          # 一个 block = 一行
kernel 主体和大家预期的一模一样,只是现在处理的是矩阵(需要 stride):
# 每一行独立处理
col_offsets = tl.arange(0, BLOCK_SIZE)
row = tl.load(x_ptr + row_idx * x_row_stride + col_offsets,
              mask=col_offsets < num_cols, other=float("-inf"))

# 计算:先减 max 保证数值稳定,再取指数、求和、相除
row_max = tl.max(row, axis=0)
numerator = tl.exp(row - row_max)
denominator = tl.sum(numerator, axis=0)
row = numerator / denominator

# 写回全局内存
tl.store(y_ptr + row_idx * y_row_stride + col_offsets, row,
         mask=col_offsets < num_cols)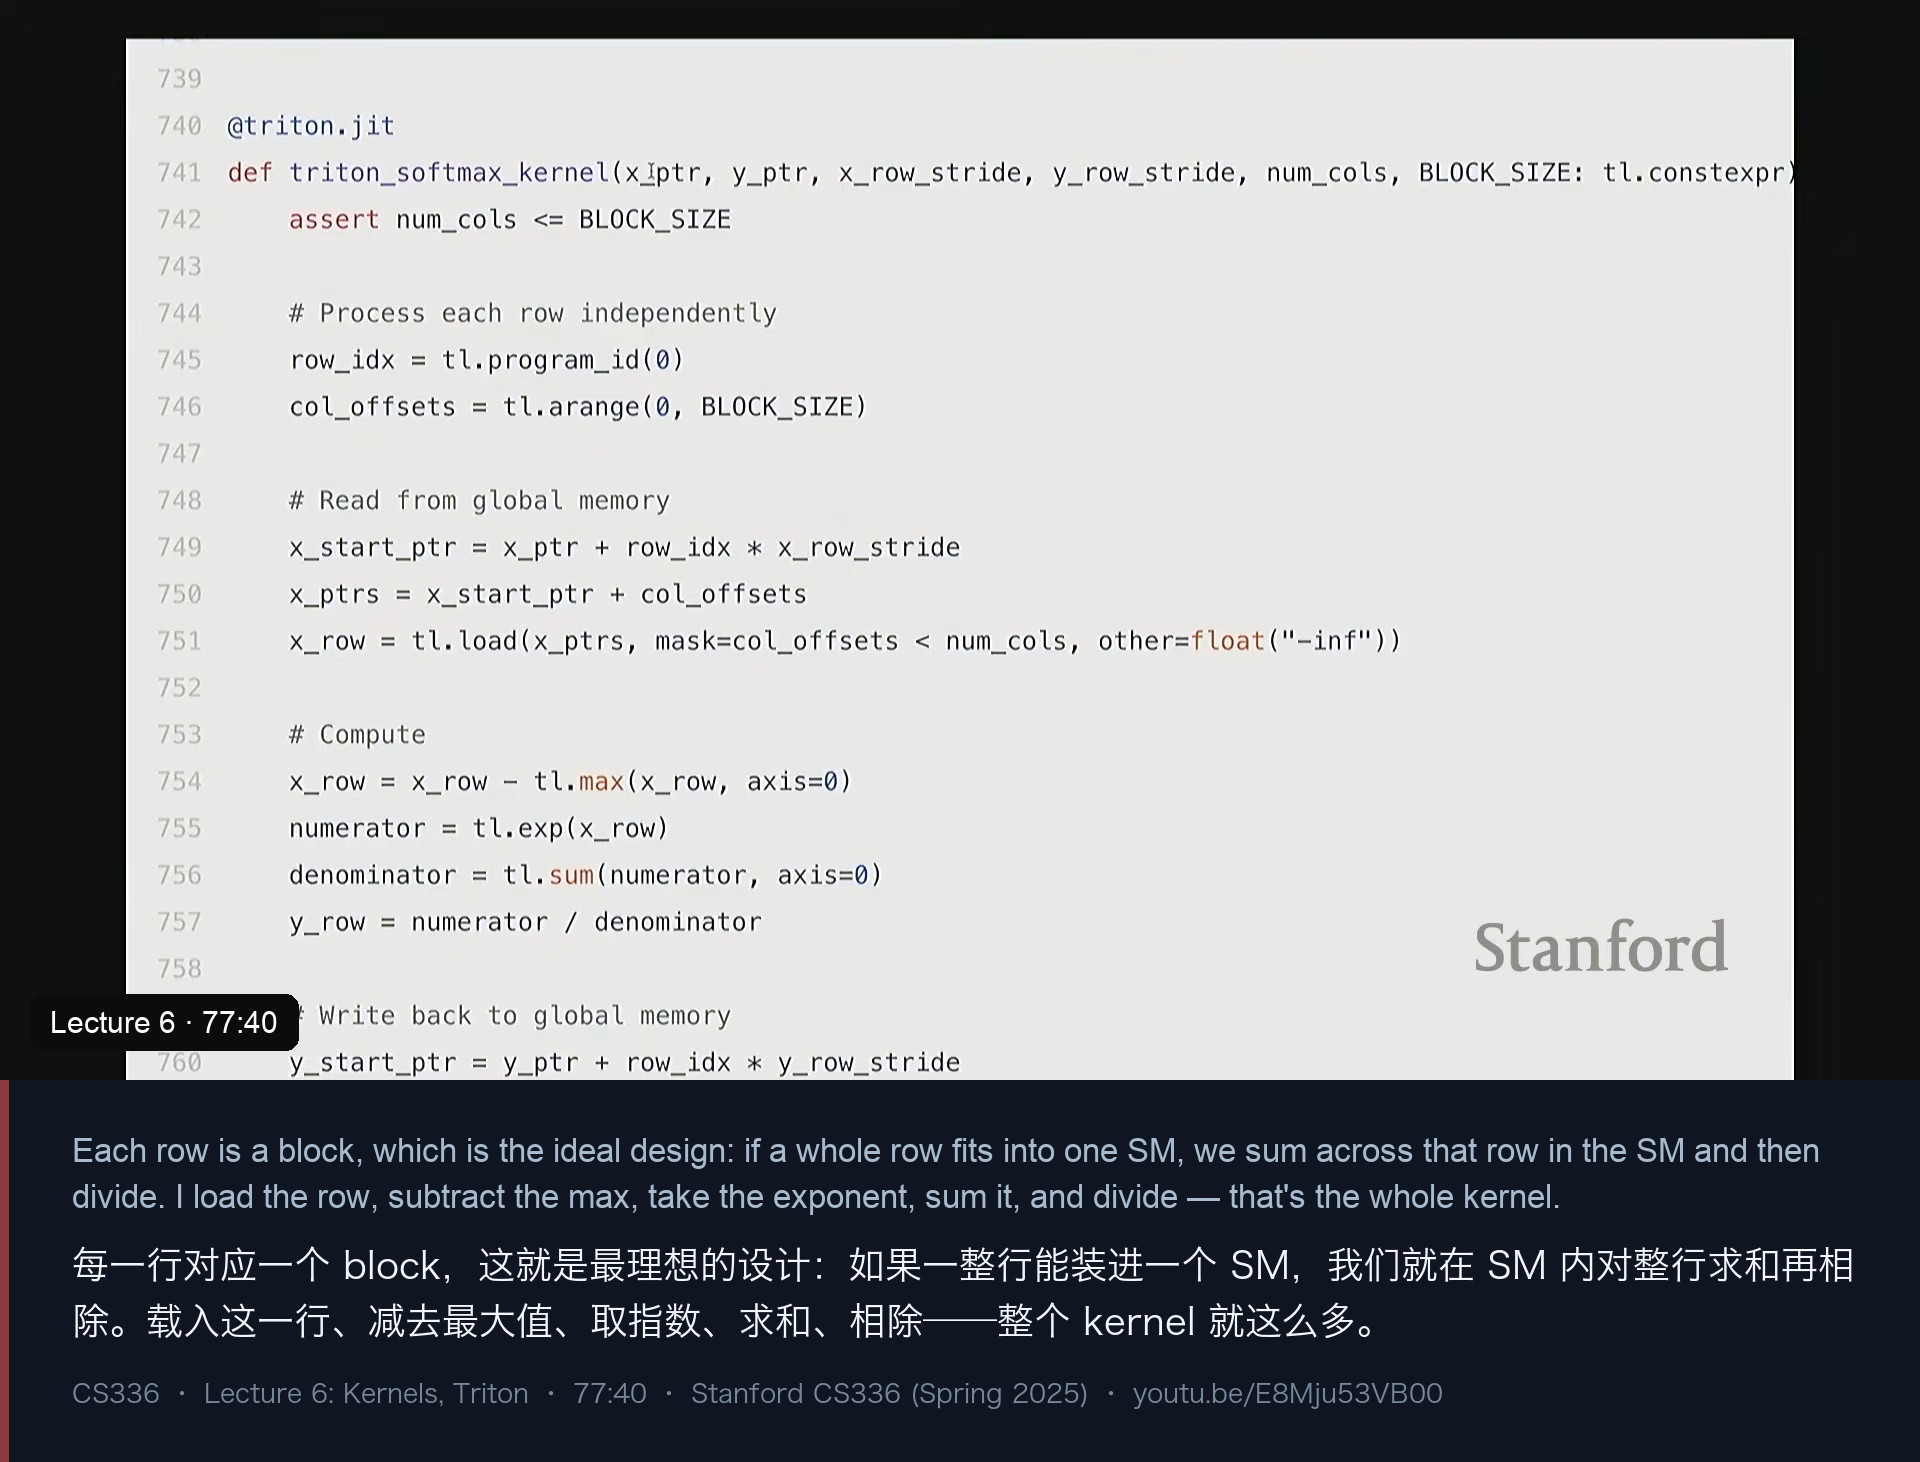
这里有两个细节值得单独拎出来:
BLOCK_SIZE用next_power_of_2(cols):Triton 的tl.arange要求长度是 2 的幂,所以哪怕列数不是 2 的幂,也要向上取整;多出来的位置靠mask挡住,既不会读脏数据,也不会写坏内存。- 矩阵必须带 stride:向量时代
x_ptr + offsets就够,矩阵时代必须用row_idx * x_row_stride才能真正跳到第几行——因为行与行之间并不一定紧密相邻,这也是“一行一个 block”设计里唯一需要额外记住的坐标算术。
讲师的原话是:“只要计算能漂亮地装进一个 SM,写 Triton 就非常像写普通 Python,只是多了 load / store 和块坐标的追踪。” 成绩单:
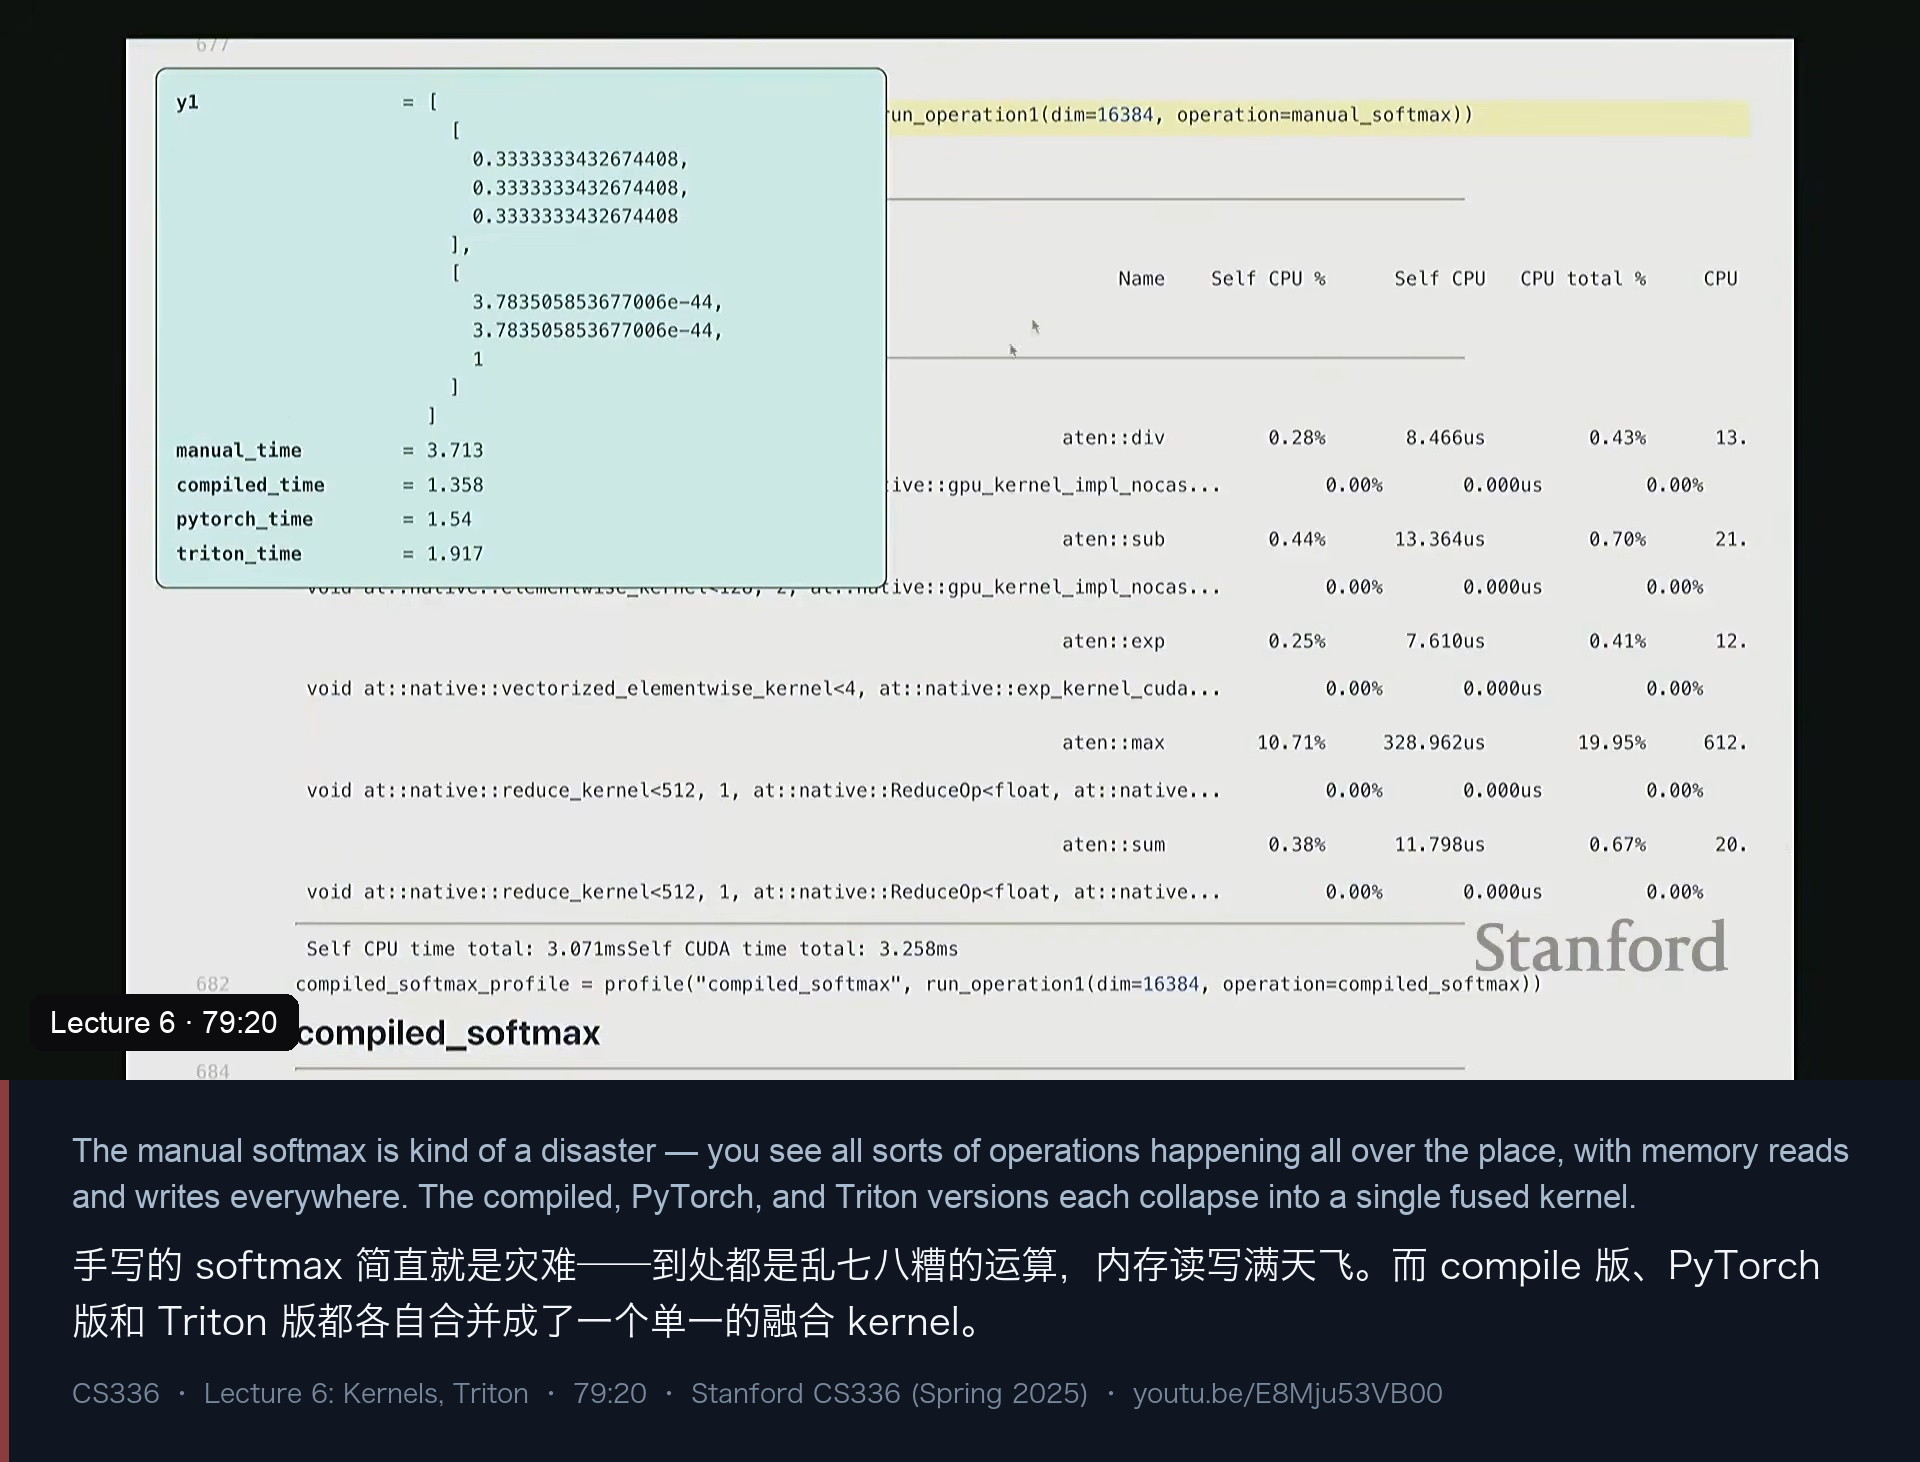
| 实现 | softmax 时间 |
|---|---|
| 朴素 PyTorch(逐元素拆开) | ~3.7 ms |
| PyTorch 内置 | 1.529 ms |
| Triton | 1.889 ms |
| torch.compile | 1.303 ms |
profiler 那边也有个很直观的对比:朴素 softmax 是场“灾难”——exp、max、sum……到处是零散的运算和显存读写;而 compile 版、PyTorch 版、Triton 版都各自塌缩成一个融合 kernel。
一句话收尾:这一讲给了你一个“低层 GPU 编程”的味觉——为了让语言模型跑得快,你该知道底下发生了什么,然后祝大家在作业二里玩得开心。
我的笔记
- 量不准,就别优化。 warm-up 排除一次性开销,
torch.cuda.synchronize()才能等到真结果;CUDA 是异步的,忘记同步就会量出假数据。 - CPU 和 GPU 之间是一段流水线,不是一个统一对象。 理解了这点,才看得懂“GPU 时间大于 CPU 时间”、才明白 Python 为什么不是瓶颈,也才不会被一行
print拖垮整个训练循环。 - profiler 的粒度决定你能看见什么。
torch.profiler看函数,Nsight Systems 看 CPU/GPU 双时间线,PTX 看寄存器与指令——每一层都能揭穿一个“看不见的假设”。 - kernel 名字是免费的文档。 知道
cutlass_*_256x128_*里的 tile 尺寸,就知道该往哪个方向优化;知道同一个a @ b会按形状分发到不同原语,就不会对“性能随尺寸跳变”感到意外。 - 算子融合的本质是省“运输费”。 DRAM↔SM 的往返是所有逐元素算子的共同成本,把一串运算塞进一个 kernel 就是最划算的改造。
- Triton 的价值是“用 block 思考”。 它把访存合并、共享内存、线程调度都交给编译器,你只设计块级算法;代价是跨 SM 的调度还得自己来。
- 会写 CUDA 不等于应该写 CUDA。
torch.compile在简单融合和矩阵乘法上已经很强;真正值得动手的是“新架构 + 利用率上不去 + 你知道怎么上去”的场景。 - reduction 是分水岭。 逐元素算子随手就能写快;softmax 这类要跨元素归约的算子才真正考验块设计——“一行一个 block”就是最经典的起手式。
附:课程信息与时间轴
- 课程:Stanford CS336《Language Modeling from Scratch》(Spring 2025)
- 本讲:Lecture 6 · Kernels, Triton
- 主讲:Percy Liang、Tatsunori Hashimoto
- 视频:https://www.youtube.com/watch?v=E8Mju53VB00(时长约 1:20)
- 播放列表:Stanford CS336 Spring 2025
| 时间 | 内容 |
|---|---|
| 0 | 开场:本讲要写高性能 GPU 代码,作业二要用 Triton 写 Flash Attention |
| 0 | 路线图:GPU 回顾 → benchmark/profiling → CUDA → Triton → torch.compile |
| 1 | 一路降到 PTX,看 GPU 到底在做什么 |
| 1 | 作业一收尾,作业二已放出;并行策略留到下一讲 |
| 2 | 复习:SM、寄存器堆、线程块、共享内存 |
| 3 | 执行模型:block 调度到单个 SM,线程干活 |
| 3 | 为什么要 block:块内共享内存快,跨块通信贵 |
| 5 | 复习算术强度:别掉进 memory bound |
| 6 | 回顾 warp 与 SIMT |
| 8 | “有理论极限,所以必须实测” |
| 10 | benchmark 的定义:测量墙钟时间 |
| 10 | 两个坑:第一次调用要 warm-up,CUDA 是异步的 |
| 12 | torch.cuda.synchronize():不同步就量不准 |
| 14 | 缩放实验:矩阵乘法 1024 → 16384 的耗时表 |
| 15 | 扫 step 数:运行时间线性增长 |
| 16 | 扫层数:同样是线性 |
| 17 | benchmark 是粗粒度工具,看不到时间花在哪 |
| 18 | PyTorch 自带 profiler 入门 |
| 19 | 例子一:sleep,100% 时间花在 cudaDeviceSynchronize |
| 19 | 例子二:矩阵相加,CPU 1.4 ms vs CUDA 17 µs |
| 22 | 矩阵乘法的剖面:aten::matmul → cutlass kernel |
| 24 | 学生提问:profiler 本身会不会影响测量 |
| 26 | 128 维小矩阵直接命中别的 kernel;torch.compile 会先做微基准 |
| 28 | cutlass kernel 名字里的 tile 尺寸 |
| 29 | MLP 剖面:矩阵乘法占 78%,拷贝/拼接约 6% |
| 32 | 想看更细,得请出真正的 profiler |
| 33 | Nsight Systems:上半 GPU,下半 CPU |
| 34 | 用 NVTX 标注 define_model / step / forward / backward |
| 35 | 开局 7.5 秒都在加载库 |
| 38 | CPU 跑在 GPU 前面:GPU 算第 1 层时 CPU 已排到第 9 层 |
| 39 | 一行 print(loss) 如何强行插入同步、对齐两条时间线 |
| 41 | 疯狂打印会把 CPU 变成瓶颈 |
| 43 | Nsight 的 stats / events 视图:聚合哪些 kernel 最耗时 |
| 44 | 算子融合动机:“仓库—工厂”比喻 |
| 45 | 朴素 GELU:把 tanh 近似摊开成多个算子 |
| 46 | 手写 8.1 ms vs PyTorch 1.1 ms,差 8 倍 |
| 48 | 写 CUDA kernel:kernel + wrapper 两部分 |
| 49 | grid / block / thread 三层与各自的坐标 |
| 50 | CUDA_LAUNCH_BLOCKING=1:调试 CUDA 必备 |
| 51 | wrapper:TORCH_CHECK 设备与连续性 |
| 54 | 手写边界检查 if (i < num_elements) |
| 56 | load_inline:在 Python 里内联编译 CUDA |
| 57 | CUDA 版 1.8 ms,逼近 PyTorch |
| 59 | 学生提问:不连续内存怎么办 |
| 1:02 | 介绍 Triton:OpenAI 2021 年推出,自动管访存合并与共享内存 |
| 1:04 | 用 Triton 写 GELU:从 thread 视角切换到 block 视角 |
| 1:08 | 看 Triton 生成的 PTX |
| 1:09 | LD global 一次载入四个值:编译器自动做合并 |
| 1:11 | GELU 成绩单:8.1 / 1.1 / 1.8 / 1.85 ms |
| 1:12 | torch.compile:自动融合,底层生成 Triton |
| 1:13 | 何时自己写:简单融合与矩阵乘法交给编译器 |
| 1:15 | 新架构 + 利用率上不去,才值得掏出 Triton |
| 1:15 | 进阶例子:用 Triton 写 softmax |
| 1:16 | 块设计:一个 block 处理一整行 |
| 1:18 | softmax 成绩单:3.7 / 1.53 / 1.89 ms(compile 1.30 ms) |
| 1:19 | profiler 对比:朴素版一团乱麻,融合版只有一个 kernel |
讨论
这里是静态站点,没有内嵌评论区。如果这篇文章对你有用,欢迎通过 RSS 订阅后续更新。