Stanford CS336 第四讲精读:混合专家(MoE),以及 DeepSeek V3 是怎么搭起来的
斯坦福 CS336(Language Modeling from Scratch, Spring 2025)第四讲完整讲义:MoE 到底是什么(其实和「专家分领域」毫无关系)、为什么在 FLOPs 对齐下它稳定地赢、token choice top-K 路由为什么成为唯一收敛的答案、细粒度专家与共享专家、负载均衡的 F·P 损失与 DeepSeek V3 的「无辅助损失」偏置、专家并行与 token dropping,以及把 DeepSeek V1/V2/V3 一路拆到 MLA 与多 token 预测。
本篇属于系列 Stanford CS336 精读 · 第四讲
来源:YouTube 原视频(Stanford Online · CS336 Language Modeling from Scratch · Spring 2025 · Lecture 4: Mixture of Experts)
来源说明 这是斯坦福 CS336《Language Modeling from Scratch》2025 年春季第四讲的完整讲义,主讲人是 Percy Liang(本讲由 Percy 主讲,Tatsunori Hashimoto 是这门课的另一位主讲)。这一讲去年还只是他“临时攒出来的趣味加餐”,今年因为几乎所有前沿模型都转向了 MoE,被提到了核心位置,也补进了大量新进展。讲座前半段把 MoE 的每个设计维度拆开讲——怎么路由、要多少专家、每个专家多大、router 到底怎么训练;后半段用 DeepSeek 从 V1 到 V3 的演化做了一次完整的“产品级复盘”。文中 18 张配图均截取自视频对应时刻的幻灯片,并把该时刻的完整观点句(英文原句+中文翻译)拼合进图中。文中出现的模型参数量、专家数、激活比例、训练数据量与时间线,都是讲师引用的公开论文、技术报告、泄漏传闻或他自己的估算,不是本文独立核实的事实;讲师明确标注为“传闻”或“我不确定”的地方,下文也会照实说明。
TL;DR
- MoE 的名字极具误导性。它跟“有一个写代码的专家、一个讲英语的专家”毫无关系——讲师说这“离那个心智模型非常远”。MoE 只是把 Transformer 里的那一个 FFN 换成“一个 router + 很多份 FFN”,每次前向只稀疏激活其中一小部分。除此之外,MoE 模型和稠密模型几乎完全一样。
- 它的收益来自一条很干净的账:稀疏激活让你在不增加 FLOPs 的前提下增加参数量。同样的训练算力,专家越多、loss 越低。“2025 年了,MoE 相对稠密架构的优势已经非常清楚”,东西方都在做。
- 代价是系统复杂度、显存和训练稳定性。路由决策不可微,训练目标要么是启发式的、要么不稳定——这正是 MoE 长期没能进入标准教科书的原因。
- 路由设计已经收敛到一条路:token choice top-K。早期有人试过强化学习、线性分配、最优传输,现在几乎所有人都用“把 token 的隐状态与每个专家的向量做内积、softmax、取 top-K 当门控”这一套。
- 两个 DeepSeek 式创新已成标配:细粒度专家(把专家切小、数量变多,FLOPs 不变)与共享专家(一到几个永远激活的专家,负责公共处理)。OLMoE 的第三方消融显示:前者是“不用想就该做”,后者的收益存疑。
- 训练 router 的实操答案是负载均衡损失。Switch Transformer 的 f·P 内积几乎人人都在用;DeepSeek V3 换成了在线更新的、只用于路由、不进入门控权重的偏置 b_i,号称“无辅助损失”,但随后又加回了一条序列级均衡损失——所以并没有它宣传的那么彻底。
- MoE 天然适配专家并行:每个 FFN 放到一张设备上,token 通过 all-to-all 派发再收回。代价是通信,以及 token dropping 造成的跨 batch 随机性——讲师拿它作为“GPT-4 API 在 temperature=0 下仍不稳定”的一个可能解释,但明确说自己不是在断言这就是答案。
- DeepSeek V3 的 MoE 架构从最早的 V1 起就没怎么变。变的是工程细节:top-M 设备路由、门控归一化、均衡策略,以及 MoE 之外的 MLA 与多 token 预测。
一、这一讲的位置:为什么“加餐”变成了必修课
第四讲在全课中处在“基础模块”的后半段——前三讲讲完了分词、PyTorch 与资源核算、架构与超参数,从这一讲开始进入“用有限的算力把模型做得更好”的技巧层。而在这一讲内部,它其实承担了一个双重的任务:前面 80% 是把 MoE 的每一个设计维度讲透,最后 20% 是用 DeepSeek V3 做一次“现代高性能开源系统长什么样”的整机拆解。
开场的定调非常直接:MoE“就是今天很多最现代的高性能系统被构建和部署的方式”。
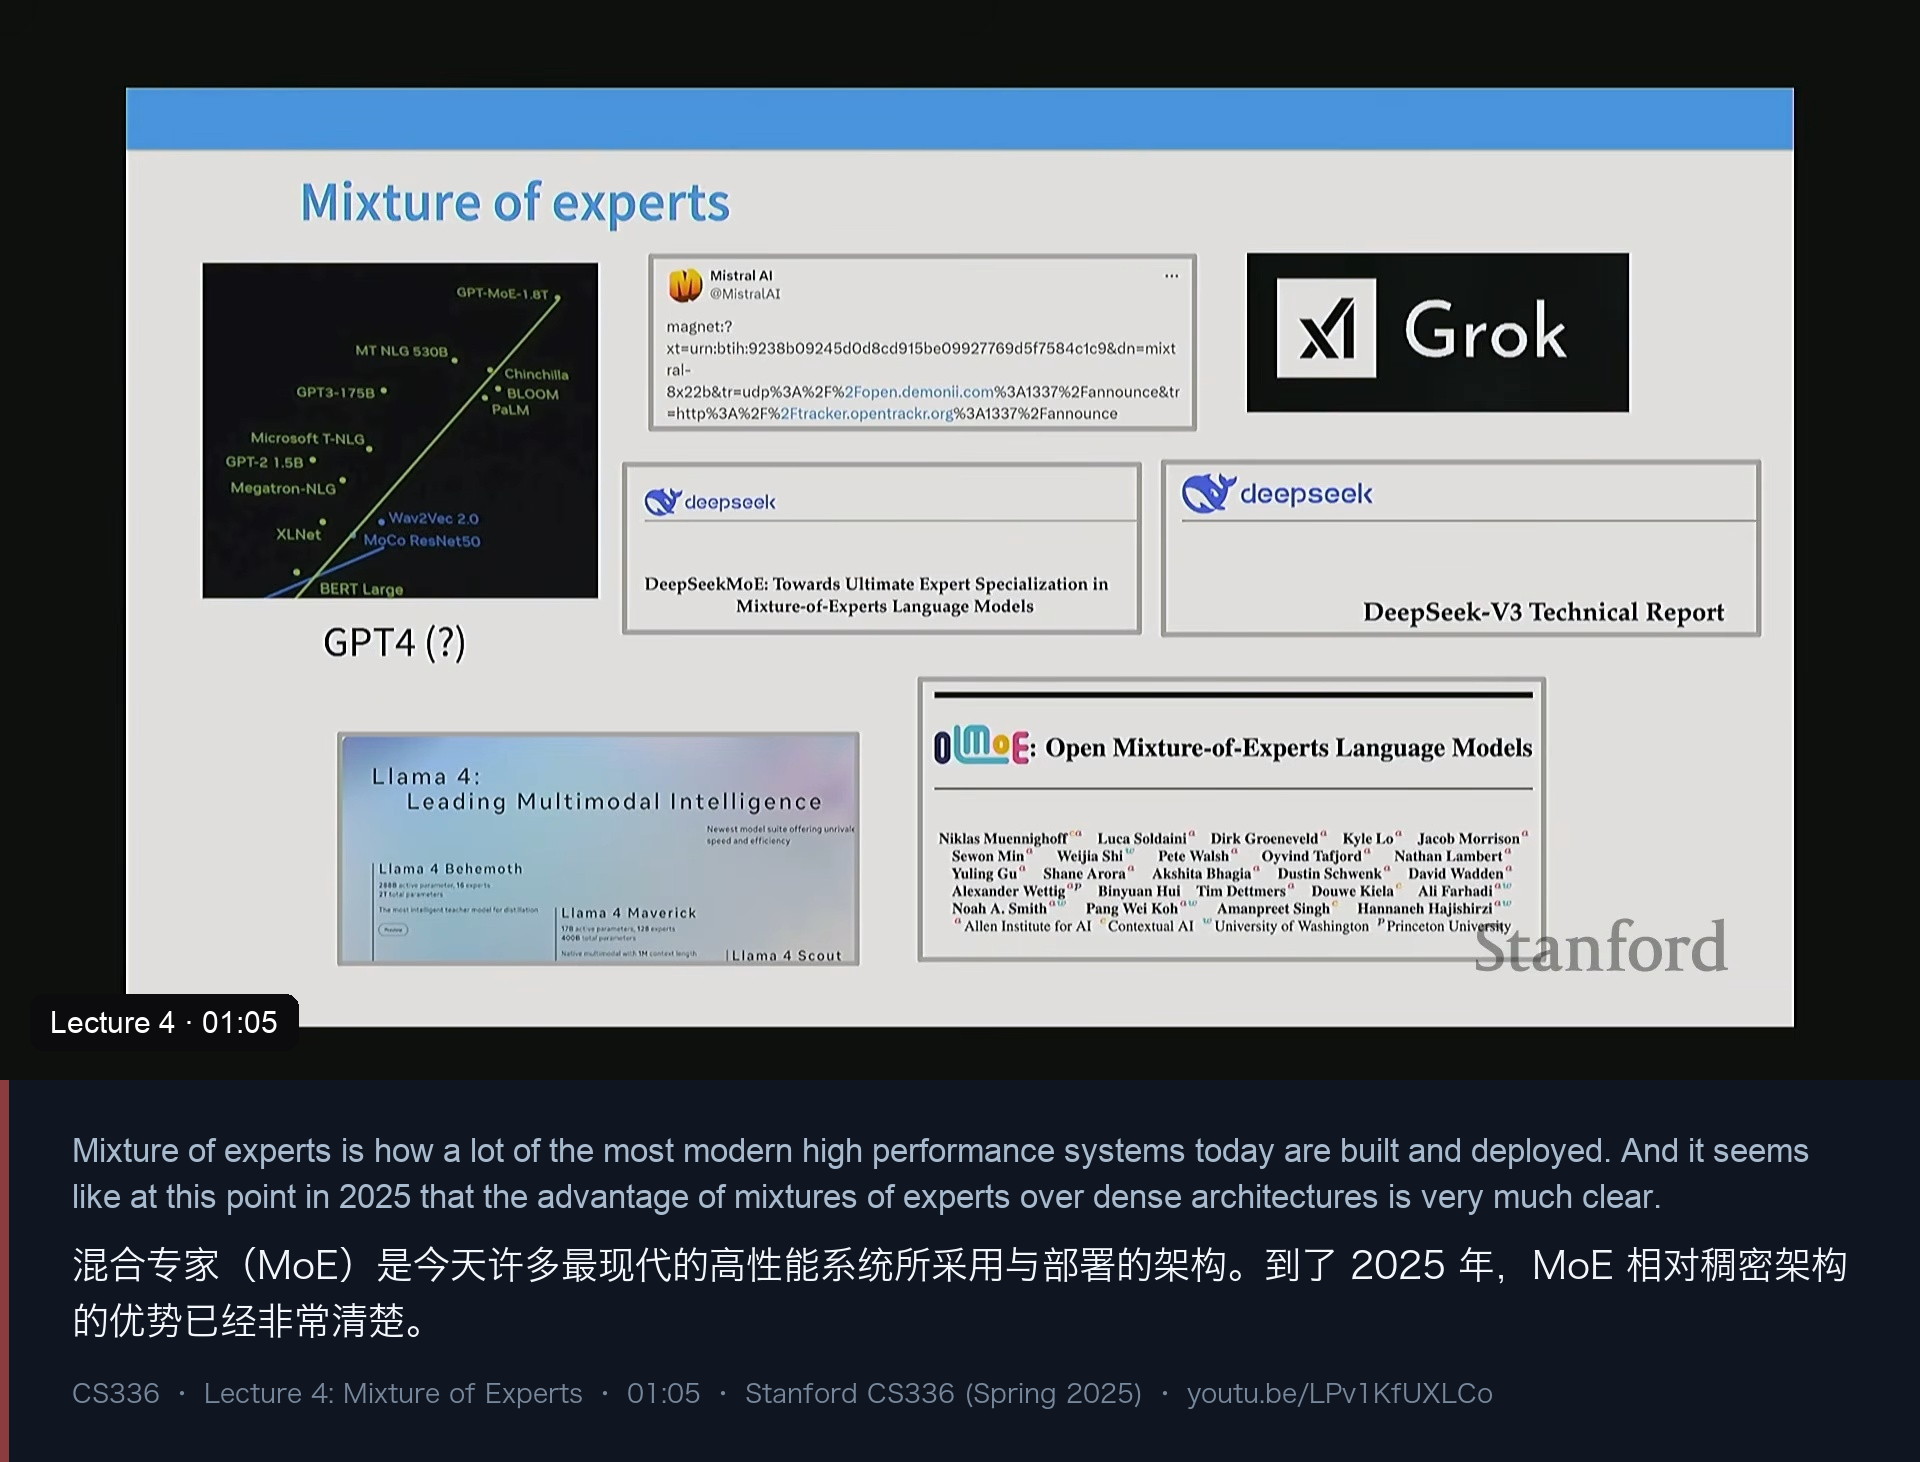
讲师列了几件事:Nvidia 那次著名的泄漏把 GPT-4 说成是 “GPT-4O1 BT”(他称之为“有趣的泄漏”,措辞是“potentially revealed”,即一种猜测而非确认);Grok、DeepSeek、Llama 4 都已经转向 MoE。然后是他自己对 2025 年的判断:
“到了 2025 年,MoE 相对稠密架构的优势已经非常清楚……只要你做得对,几乎在任何计算规模上训练 MoE 模型,都会比稠密模型更有收益。所以东西方似乎都在这么做。”
他还补了一句很实用的话:如果你想在给定的 FLOPs 预算下训出最好的模型,那 MoE 就是必须理解的东西。这句话其实就是整门课的主线——“给定资源,如何训出最好的模型”——在架构层面的一个具体答案。
二、MoE 是什么:一个被名字误导的简单想法
接下来是全讲最重要的一次“祛魅”。
讲师说 MoE 是“一个名字取得非常糟糕的概念”。听到“混合专家”,你很容易想象一组领域专家:一个代码专家、一个英语专家、一个其他语言专家。他强调这“离真实的心智模型非常远”。
真实的定义是:MoE 是一种花哨的架构,它有几个被称为“专家”的子部件,这些专家被稀疏地激活。 而具体到 Transformer,全部的动作都发生在 FFN 里。
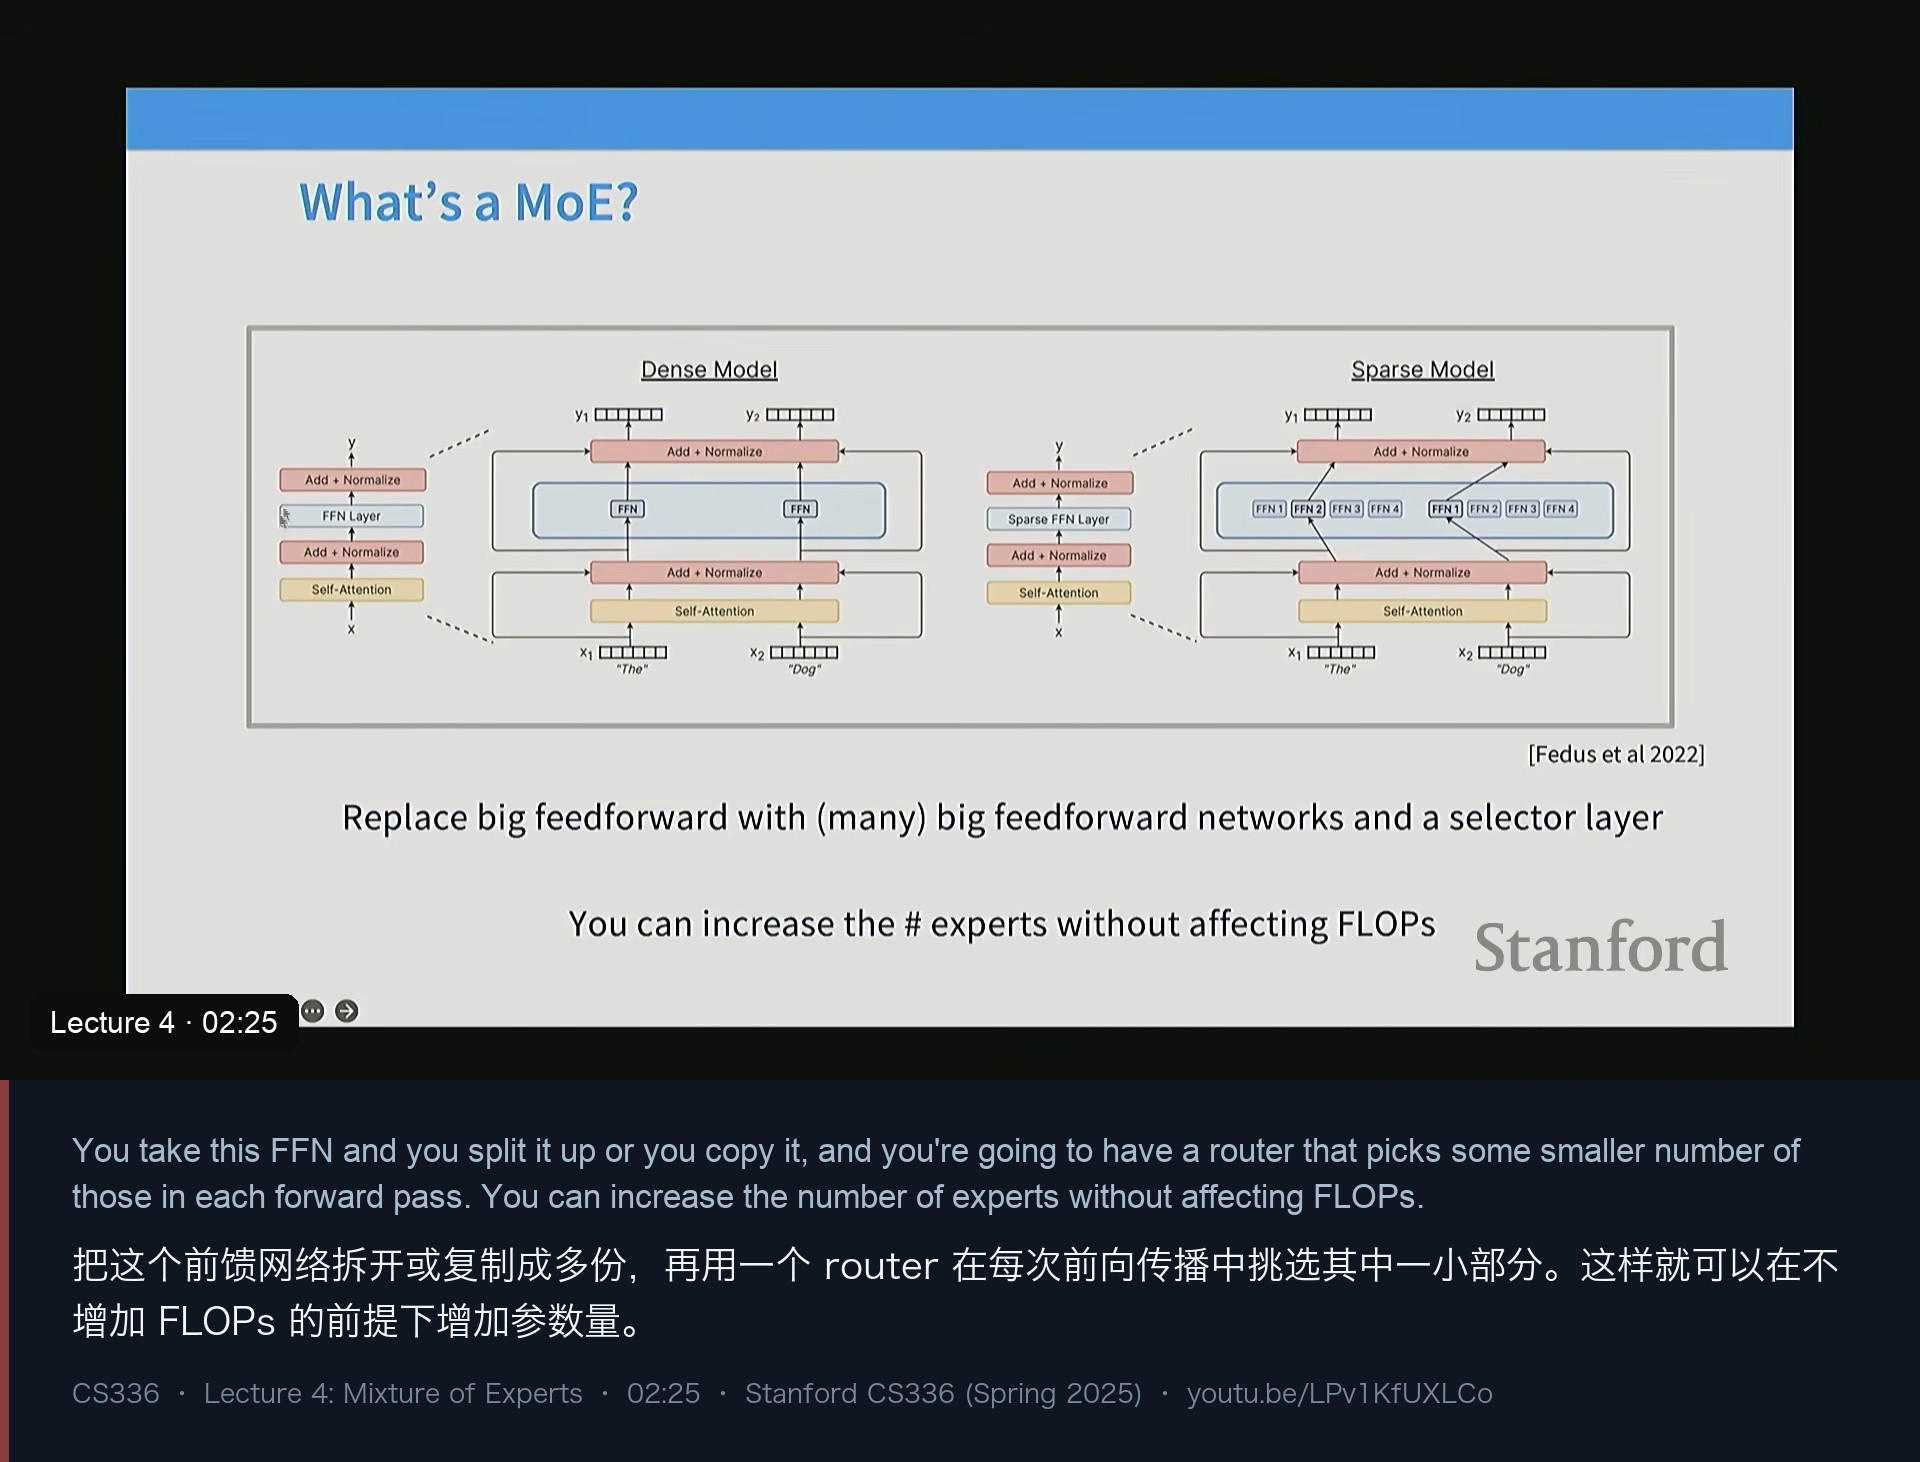
用图上的话说,操作就是:把稠密模型里那一整块前馈网络,拆开或复制成很多份,再加一个 router,在每次前向传播中挑选其中一小部分来跑(“selector layer and many smaller ones”)。
为什么这样能省钱?讲师把账算得很清楚:如果只激活一个专家,而每个专家和原来的稠密 FFN 一样大,那么稠密模型和 MoE 模型做的是一模一样的矩阵乘法,FLOPs 完全相同。区别只在于:MoE 的总参数量变大了,但你并没有因此多花算力。
“你用同样的 FLOPs 得到了更多参数。如果你相信’重要的是有更多参数去记忆世界上的事实’,那这就是一个很棒的架构。”
这句话给 MoE 提供了一个很直觉的解释:参数负责记忆,FLOPs 负责计算——稀疏激活把这两件事解耦了。
顺带一提,理论上也可以把注意力层做成稀疏路由的(“a sparsely routed attention layer”),历史上确实有几篇论文这么干过,但在主流模型发布里“相当罕见”,因为据说更不稳定、更难训稳。所以今天说 MoE,默认说的就是 FFN。
三、为什么 MoE 更强:FLOPs 对齐下的证据
“更多参数但不增加 FLOPs”只是个架构上的可能性,真正的问题是:它到底能不能换来更好的模型?
讲师的回答是“很多很多论文”都表明:在相同的 FLOPs 下,MoE 的表现好于稠密模型。他先给出这个领域的经典起点——Fedus et al. 2022(也就是 Switch Transformer 那条线):
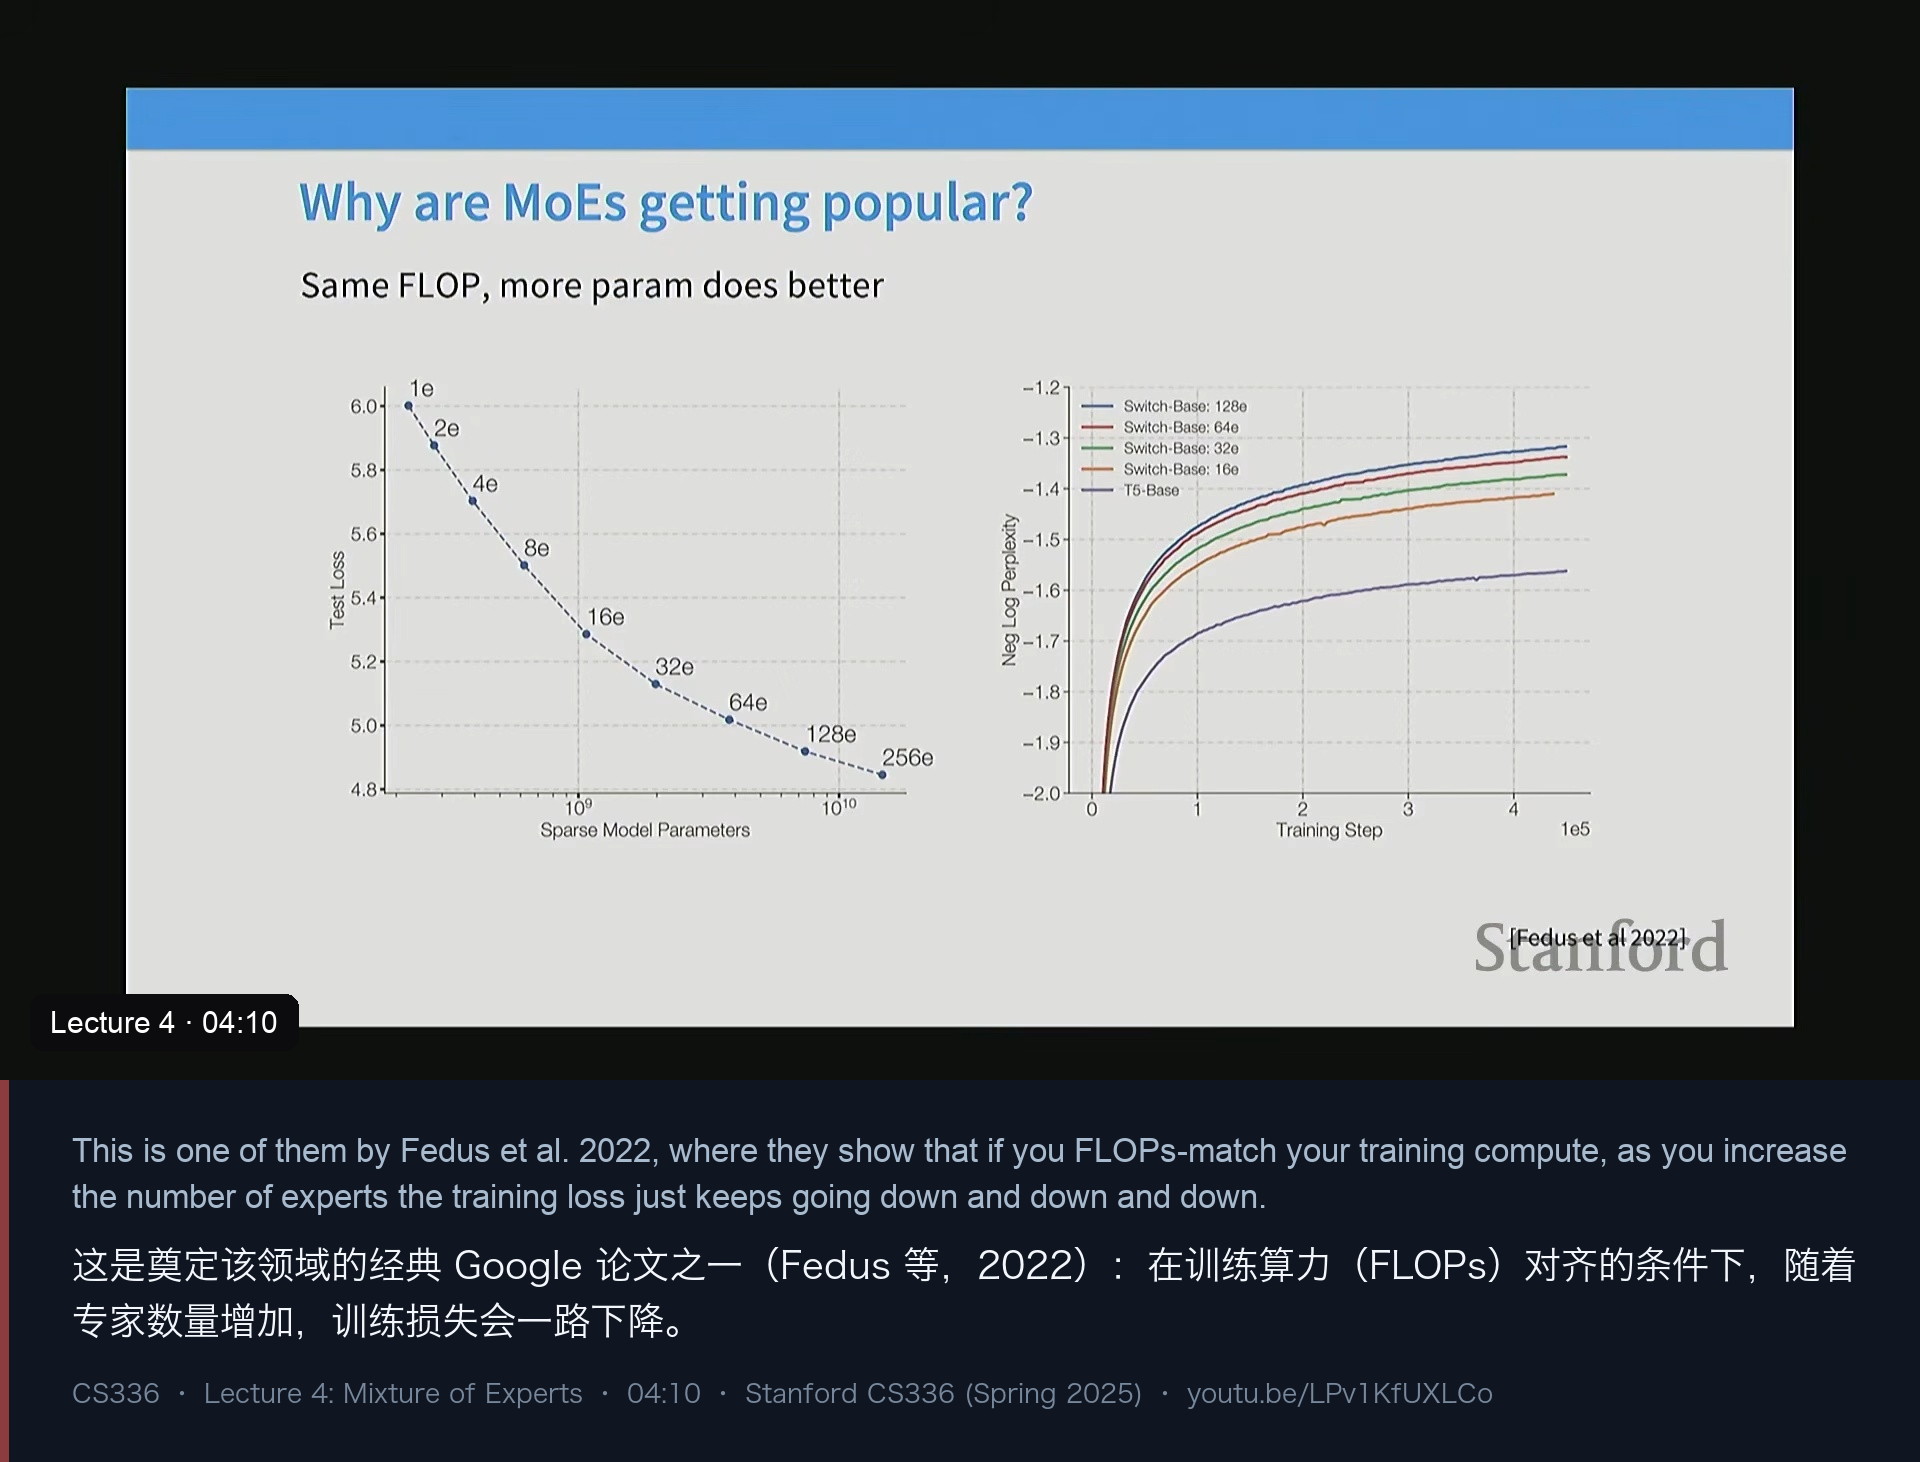
图的核心是“same FLOPs, more param does better”:横轴对齐训练 FLOPs,随着专家数从 64 增加到 128、256,训练 loss 一路下降;右侧那张图则显示,训得越久,拥有更多专家的模型 perplexity 改善得越快。讲师说这相当于“在同样的 FLOPs 下白拿了 test loss”。
他也顺手补了代价:专家不是免费的——你要为它们付出显存,还要在并行时考虑“怎么把数据路由到 256 个不同的专家上去”,系统复杂度会随之上升。但只要只看 FLOPs 这一条轴,这笔交易是非常诱人的。
这类证据并不只有 2022 年那一篇。讲师接着引了 AI2 的 OLMoE 工作:他们做了一大批受控对比,结论完全一致。图上左侧仍然是 Fedus 那篇里“很多专家带来 7 倍加速”的曲线,右侧是 OLMoE 自己的对比——粉色是 MoE、青色是稠密,稠密模型的训练 loss 下降得明显更慢。
第三个证据来自工业界真实部署的系统。DeepSeek V2 的论文里有一张图被讲师称为“公司特别喜欢,因为能画出非常好看的图”:
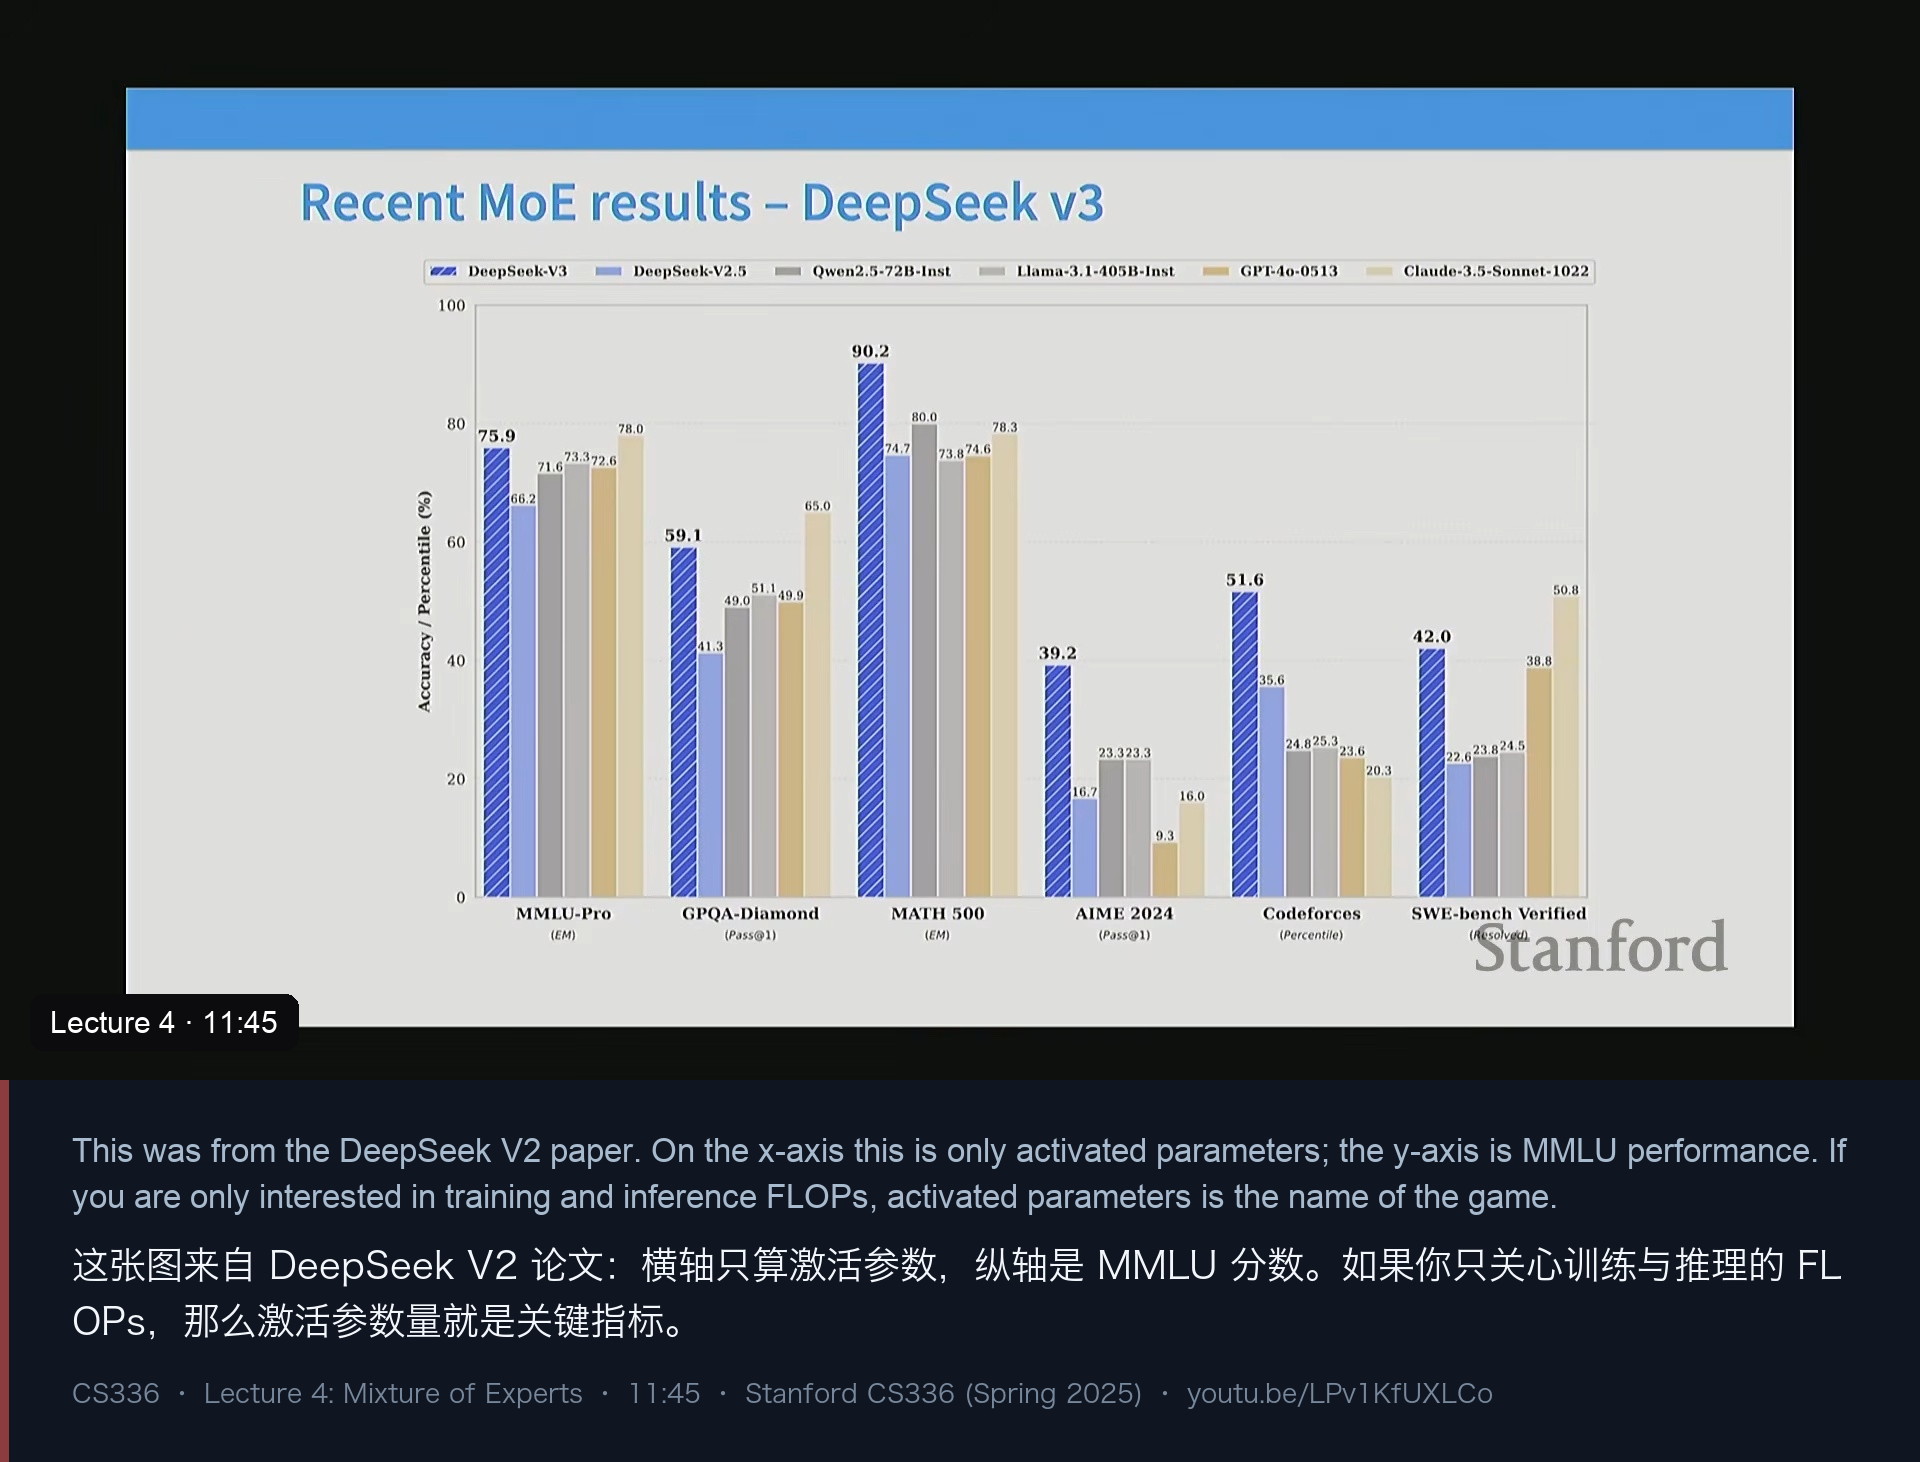
他特别提醒这张图有一点“障眼法(slight of hand)”:横轴是激活参数量,也就是真正参与计算的那部分参数,被冻结的专家完全不计入。所以“参数很少、MMLU 很高”这个印象,只有在“你只在乎训练和推理 FLOPs”的前提下才成立。但它的分量仍然很重——因为这“不是消融实验,而是一个真实系统,有人花了很多钱去训练它、并且部署到了线上”。
随后入场的是整讲后半段的主角:为什么这么香的架构,长期没有变成主流?
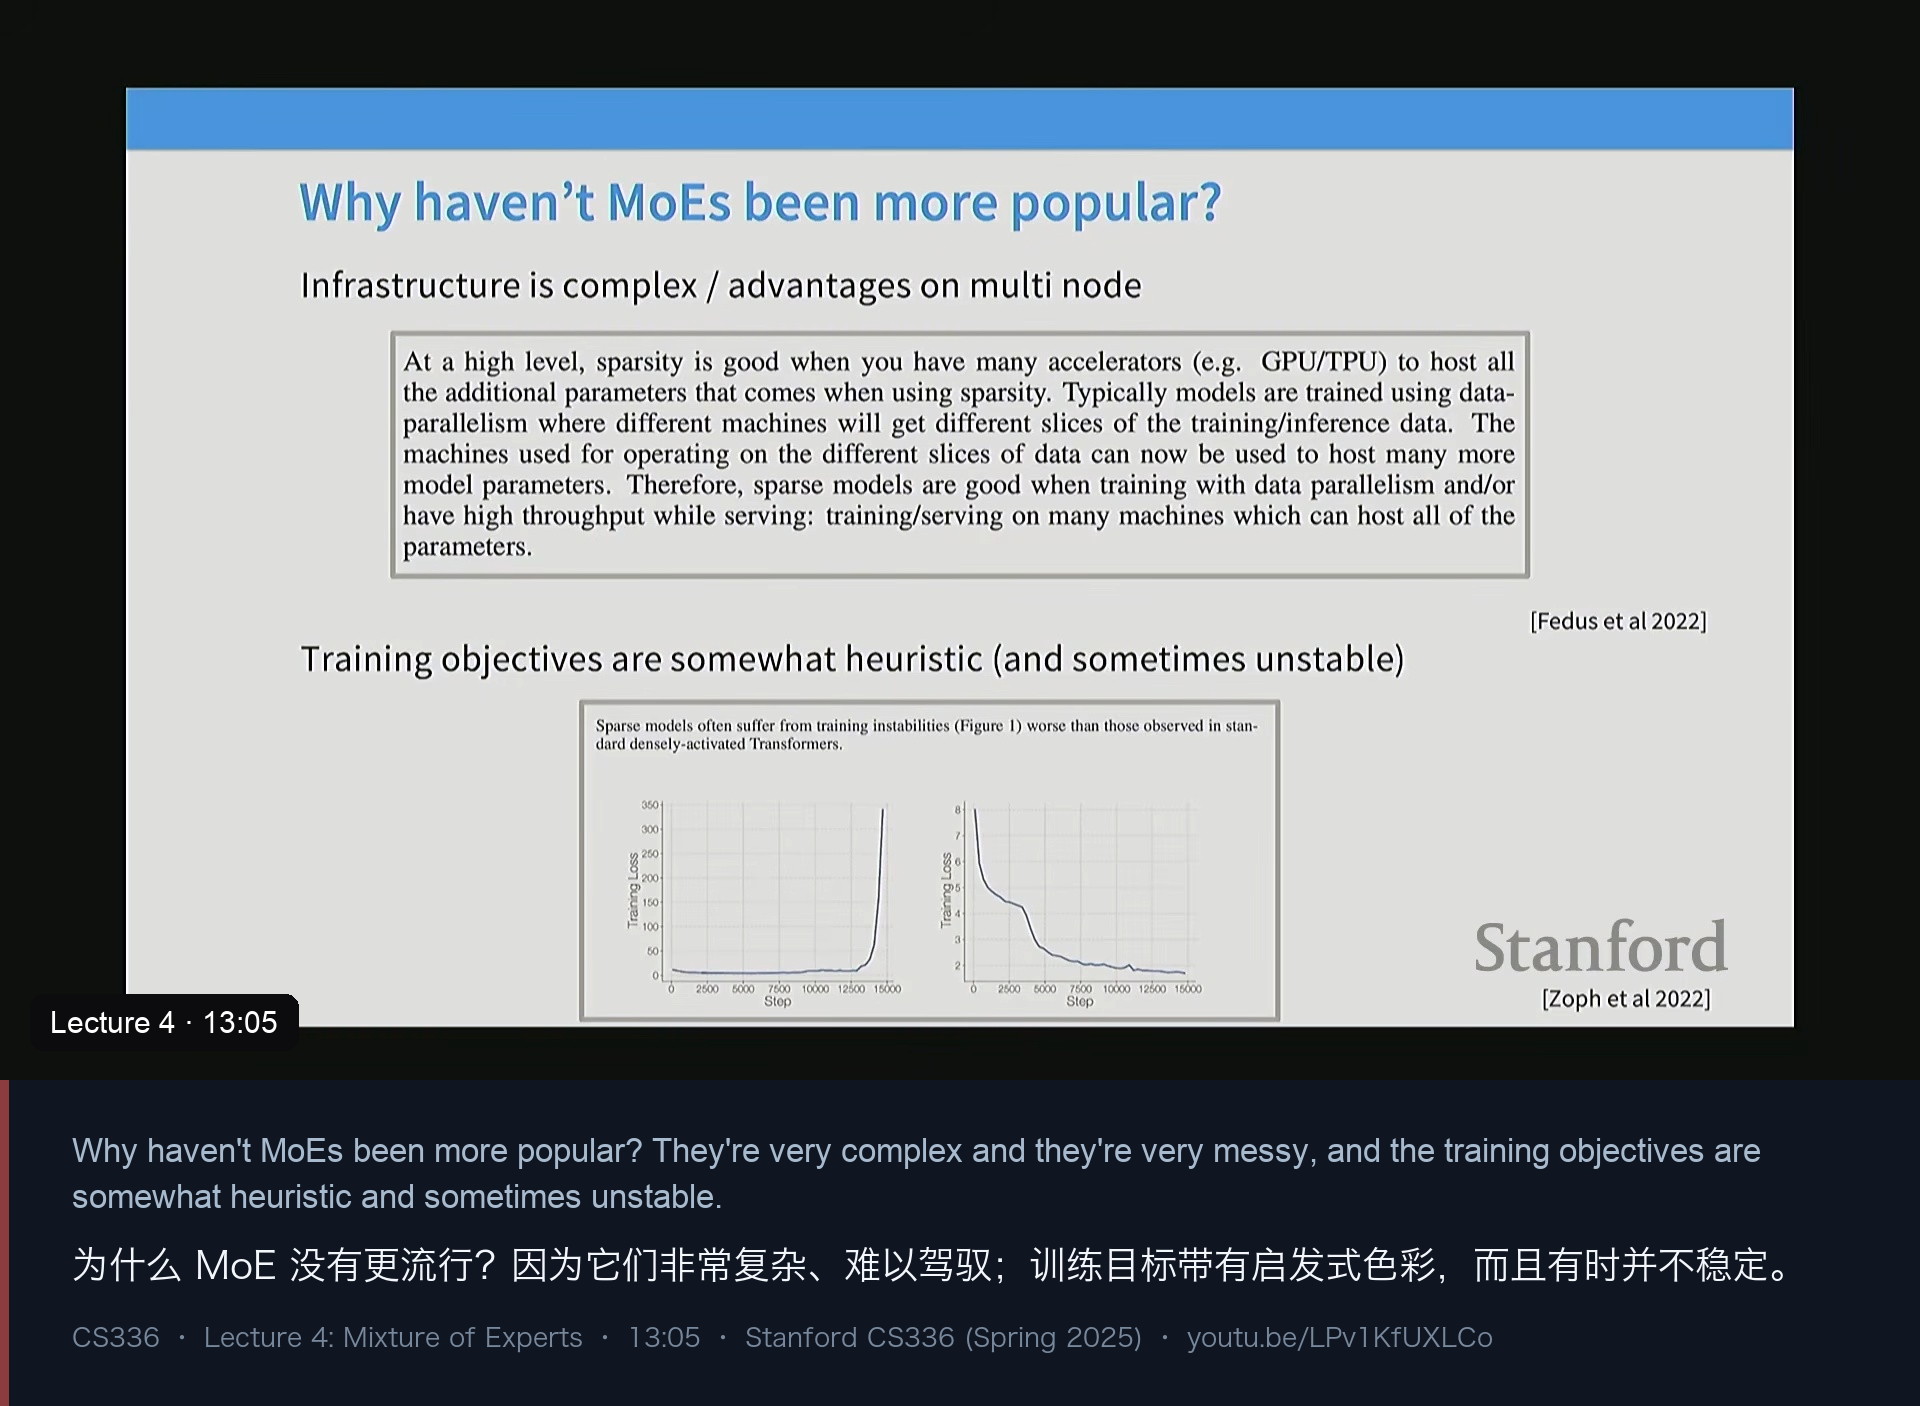
幻灯片上的第一句就是答案:“MoE 的好处主要出现在多节点训练时(infrastructure is complex / advantages on multi-node)”——要拆分那么多个专家,你得把模型切开、把专家分片到不同设备上,而“当你不得不把模型切开时,专家分割就变得非常自然”。早期 Google 的论文正是在讨论这个权衡:只有模型大到非切不可时,MoE 才变得“独特地好”。
第二句是更本质的困难:“训练目标在某种程度上是启发式的(而且有时不稳定)”。讲师展开说:路由是一个必须“选中并提交”给某个专家的离散决策,因此不可微;深度学习喜欢光滑、可求导的目标,而这里你只能靠启发式或 RL 式的手段去逼近。这套目标函数要么是经验规则,要么不稳定,需要非常小心地工程化才能跑起来。
正是这两点——系统复杂 + 优化目标脏——让 MoE 长期停在“论文里很香、课上不怎么讲”的位置。
四、路由:token choice、expert choice 与全局分配
进入设计空间。讲师把 MoE 的可选项收敛成三个问题:
- 怎么路由(routing function);
- 要多少专家、每个专家多大;
- 怎么训练这个 router。
先看第一个。给定一批 token,谁来挑谁?幻灯片给出了三种家族:
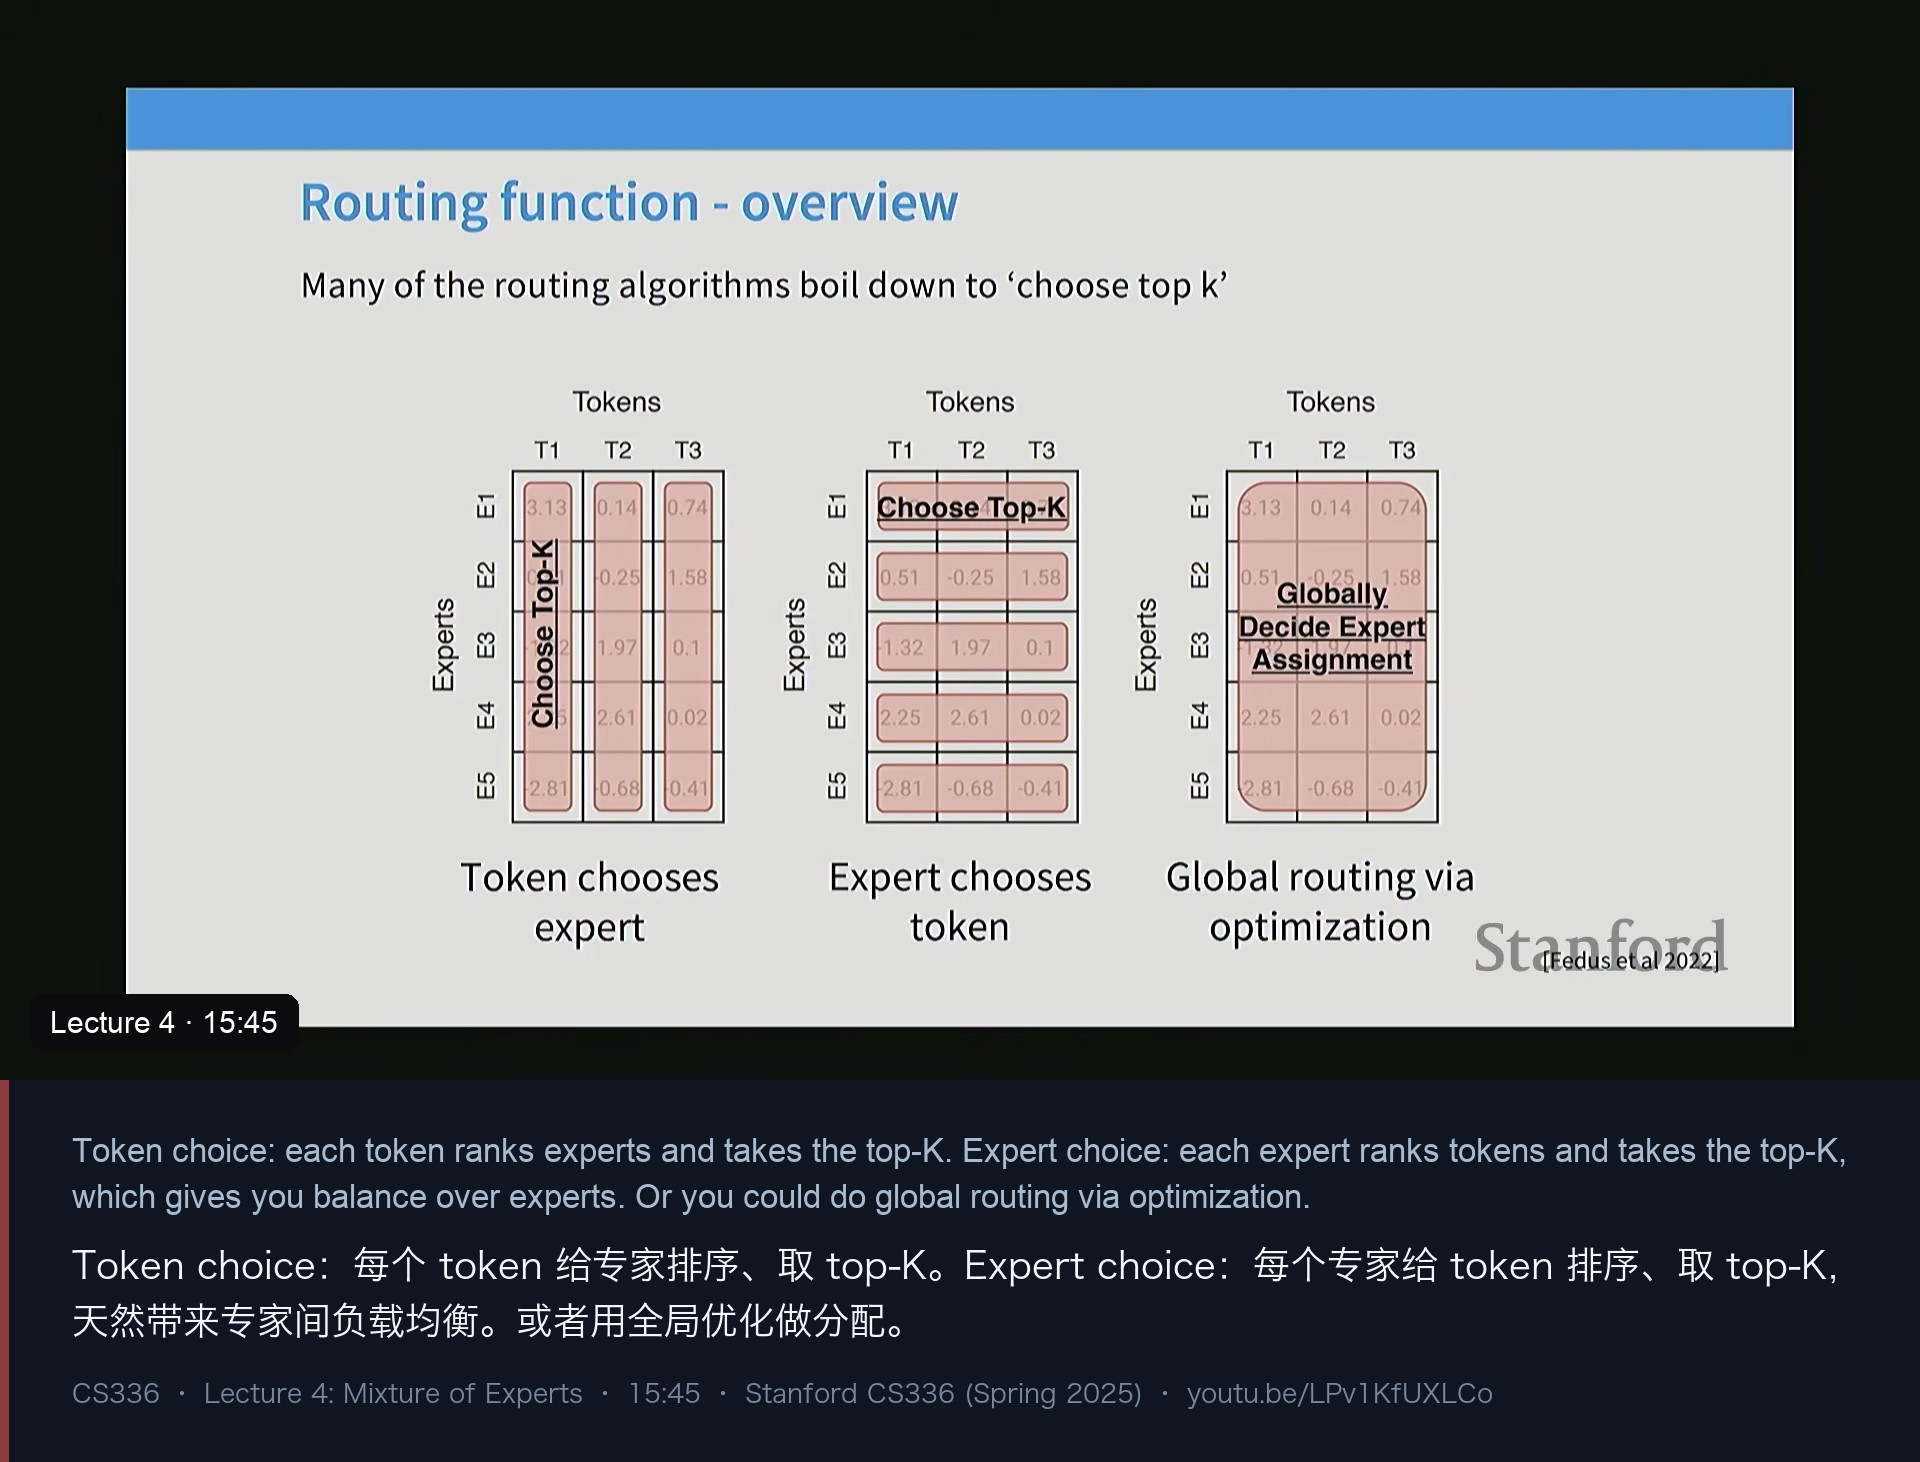
- Token choice:每个 token 对所有专家打分,挑出 top-K——也就是“在矩阵的列方向上取 top-K”。
- Expert choice:每个专家对所有 token 打分,挑出 top-K——“在行方向上取 top-K”。它有一个很漂亮的性质:每个专家拿到的 token 数完全相同,负载天然均衡。
- Global assignment:把它当成一个全局优化问题去解,强制专家与 token 的映射满足某种均衡约束。
讲师给出了一句很关键的“剧透”:几乎所有大模型都收敛到了 token choice top-K。早期大家把整个设计空间都试过一遍,但看今天的大版本发布,路由机制基本只剩这一类。
这里有一个很值得记住的细节:MoE 论文里最常被做消融的是 token choice 与 expert choice 的对比。结果是在 validation loss 上,token choice“行为好得多、loss 衰减快得多”。直观解释是:token choice 允许你定义一个“这个 token 被这个专家处理得好不好”的打分函数,于是 token 会走向对它最好的那个专家;而 expert choice 虽然保证了负载均衡,却牺牲了这种“按需分配”的能力。两边的取舍很清楚——一边是处理质量,一边是设备利用率。
问答环节里还有两个被反复追问的点,讲师都回答得很干脆:
K 取多少? 这是个超参数。最早的 MoE 论文给出的直觉是 K 应该大于 1,理由是“探索”:如果只取 top-1,你可能永远在利用当前最好的那个专家,而不知道别的专家能做什么;取 top-2 可以带来一点探索信号。所以 K=2 是经典选择,而且今天依然非常流行。代价是 FLOPs 直接翻倍——这也解释了一个术语习惯:人们说“多少激活参数”时,指的就是这些真正参与计算的 MLP。
多个专家的输出怎么合并? 加权求和(sum),权重来自 router。实际上很多实现还会按 router weight 加权,有的则直接相加。
除了这三条路线,讲座还提到一批“被淘汰或没被采纳”的方案,这部分很能反映这个领域的演化逻辑:
- 哈希路由:完全不做语义判断,直接用哈希函数把 token 映射到专家。听起来荒谬,但“有大量结果表明这样做你依然能拿到收益”——讲师自己都觉得“相当疯狂”,并解释了两个可能原因:同一批 token 会确定性地进入同一个专家,因此仍然会形成某种(非语义的)专门化;而在 Zipf 分布下,像 “the” 这种高频词可能主导某个专家,于是又碰巧形成了语义专门化。
- 强化学习:最早期的工作用 RL 学路由策略,理论上最适合离散决策。但现在“据我所知几乎没人在做”,因为计算成本太高,而模型本来就有稳定性问题。有一篇 2020 年的工作(Clark et al.)做过 RL 基线,结果是它并不比哈希更好,而他们真正研究的那种线性分配方法轻松胜过 RL。
- 线性分配 / 最优传输:很优雅,但成本远大于收益,没有被采纳。
五、top-K 路由的细节:router 只是一个内积
这一节把 top-K 路由的机制拆到公式级别。
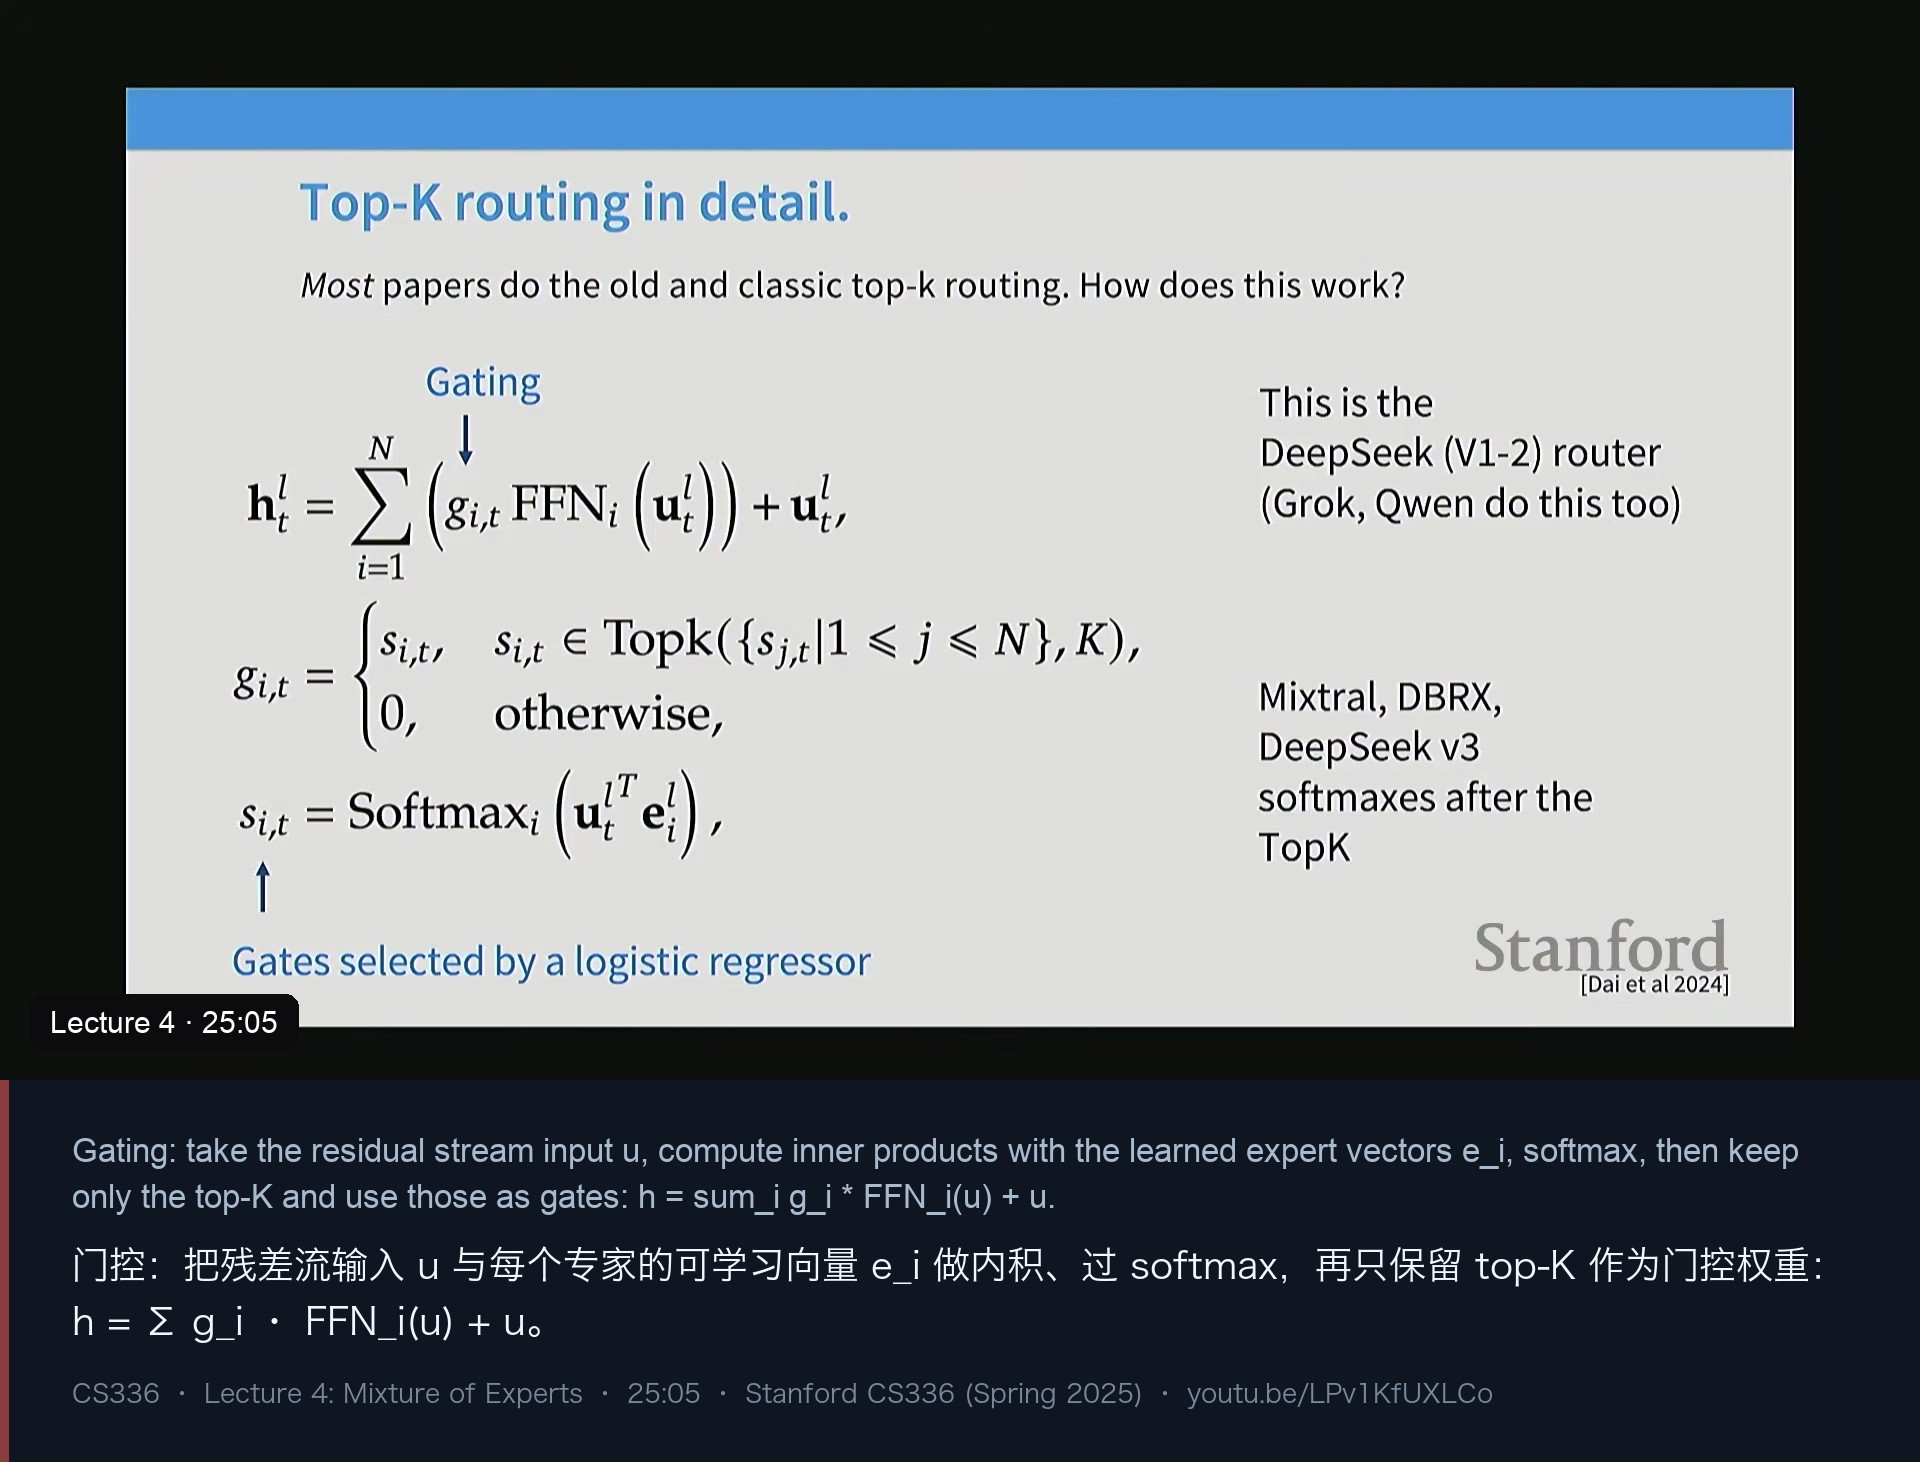
用文字复述一遍:给定残差流输入 u(每个 token 的隐状态),
# 1) 每个专家有一个可学习的向量 e_i,用内积算亲和度
s_i = softmax(u @ e_i)          # "每个专家告诉我:我指向这个方向"

# 2) 只在 top-K 上保留权重,其余置零,得到门控 g
g_i = s_i if i in TopK(s, k=K) else 0.0

# 3) 用门控加权各个专家的输出,再加回残差
h = sum(g_i * FFN_i(u) for i in range(N)) + u
讲师强调三件事:
其一,router 比你想的轻量得多。 “token 怎么知道哪个专家最好?”——答案就是 router,而 router 本质上是“一个向量内积,几乎有点像注意力操作”。它是逻辑回归(幻灯片上写着 “Gates selected by a logistic regressor”),不是 MLP。有学生问“为什么不把 router 做得更复杂”,讲师给了两个理由:一是系统成本,把 FLOPs 花在路由上就得从别处赚回来;二是即使你把它做复杂,也没有保证——因为梯度信号来得极其间接,路由的学习过程“相当不可靠”。
其二,softmax 的作用不是“选最大”,而是“归一化到 1”。 有人问:既然要取 top-K,为什么还要先 softmax(它天然会把人往“只选一个”的方向推)?讲师说不要把它当成 softmax 看,把它当成一个归一化操作:它让后面的专家加权变成一个加权平均。至于“取完 top-K 后还要不要再归一化一次”,他说两种做法都有,而且其实无所谓——因为下一层和 LayerNorm 会把尺度重新调回来。
其三,为什么必须有 top-K? 因为系统效率。如果直接用 softmax 给所有专家加权,你就得付出全部 N 个专家的训练成本,“你立刻失去了稀疏性带来的系统效率”。讲师的原话是:训练时也必须是稀疏的——这是整套“体操动作”存在的唯一理由。
问答里还澄清了两个容易混淆的点:
- softmax 先做还是后做、是否归一化到 1,只是美学选择,不同架构(DeepSeek V3、Mixtral、DBRx 等)选择不同,但都是“次要差别”。
- e_i 与 FFN 的权重毫无绑定关系。“把 e 当成 router 的参数就好”,它们是彼此独立的对象。
顺带一句原话,值得记下来:“我们做的所有这些体操,就是为了保证训练时和推理时激活的专家数都是稀疏的。”
六、细粒度专家与共享专家:DeepSeek 的两个创新
有了基本架构,接下来是“要多少专家、每个多大”这个问题。讲师的评价是,DeepSeek 在这一步上有两个创新,而且被其他开源模型“非常快地全部采纳”。
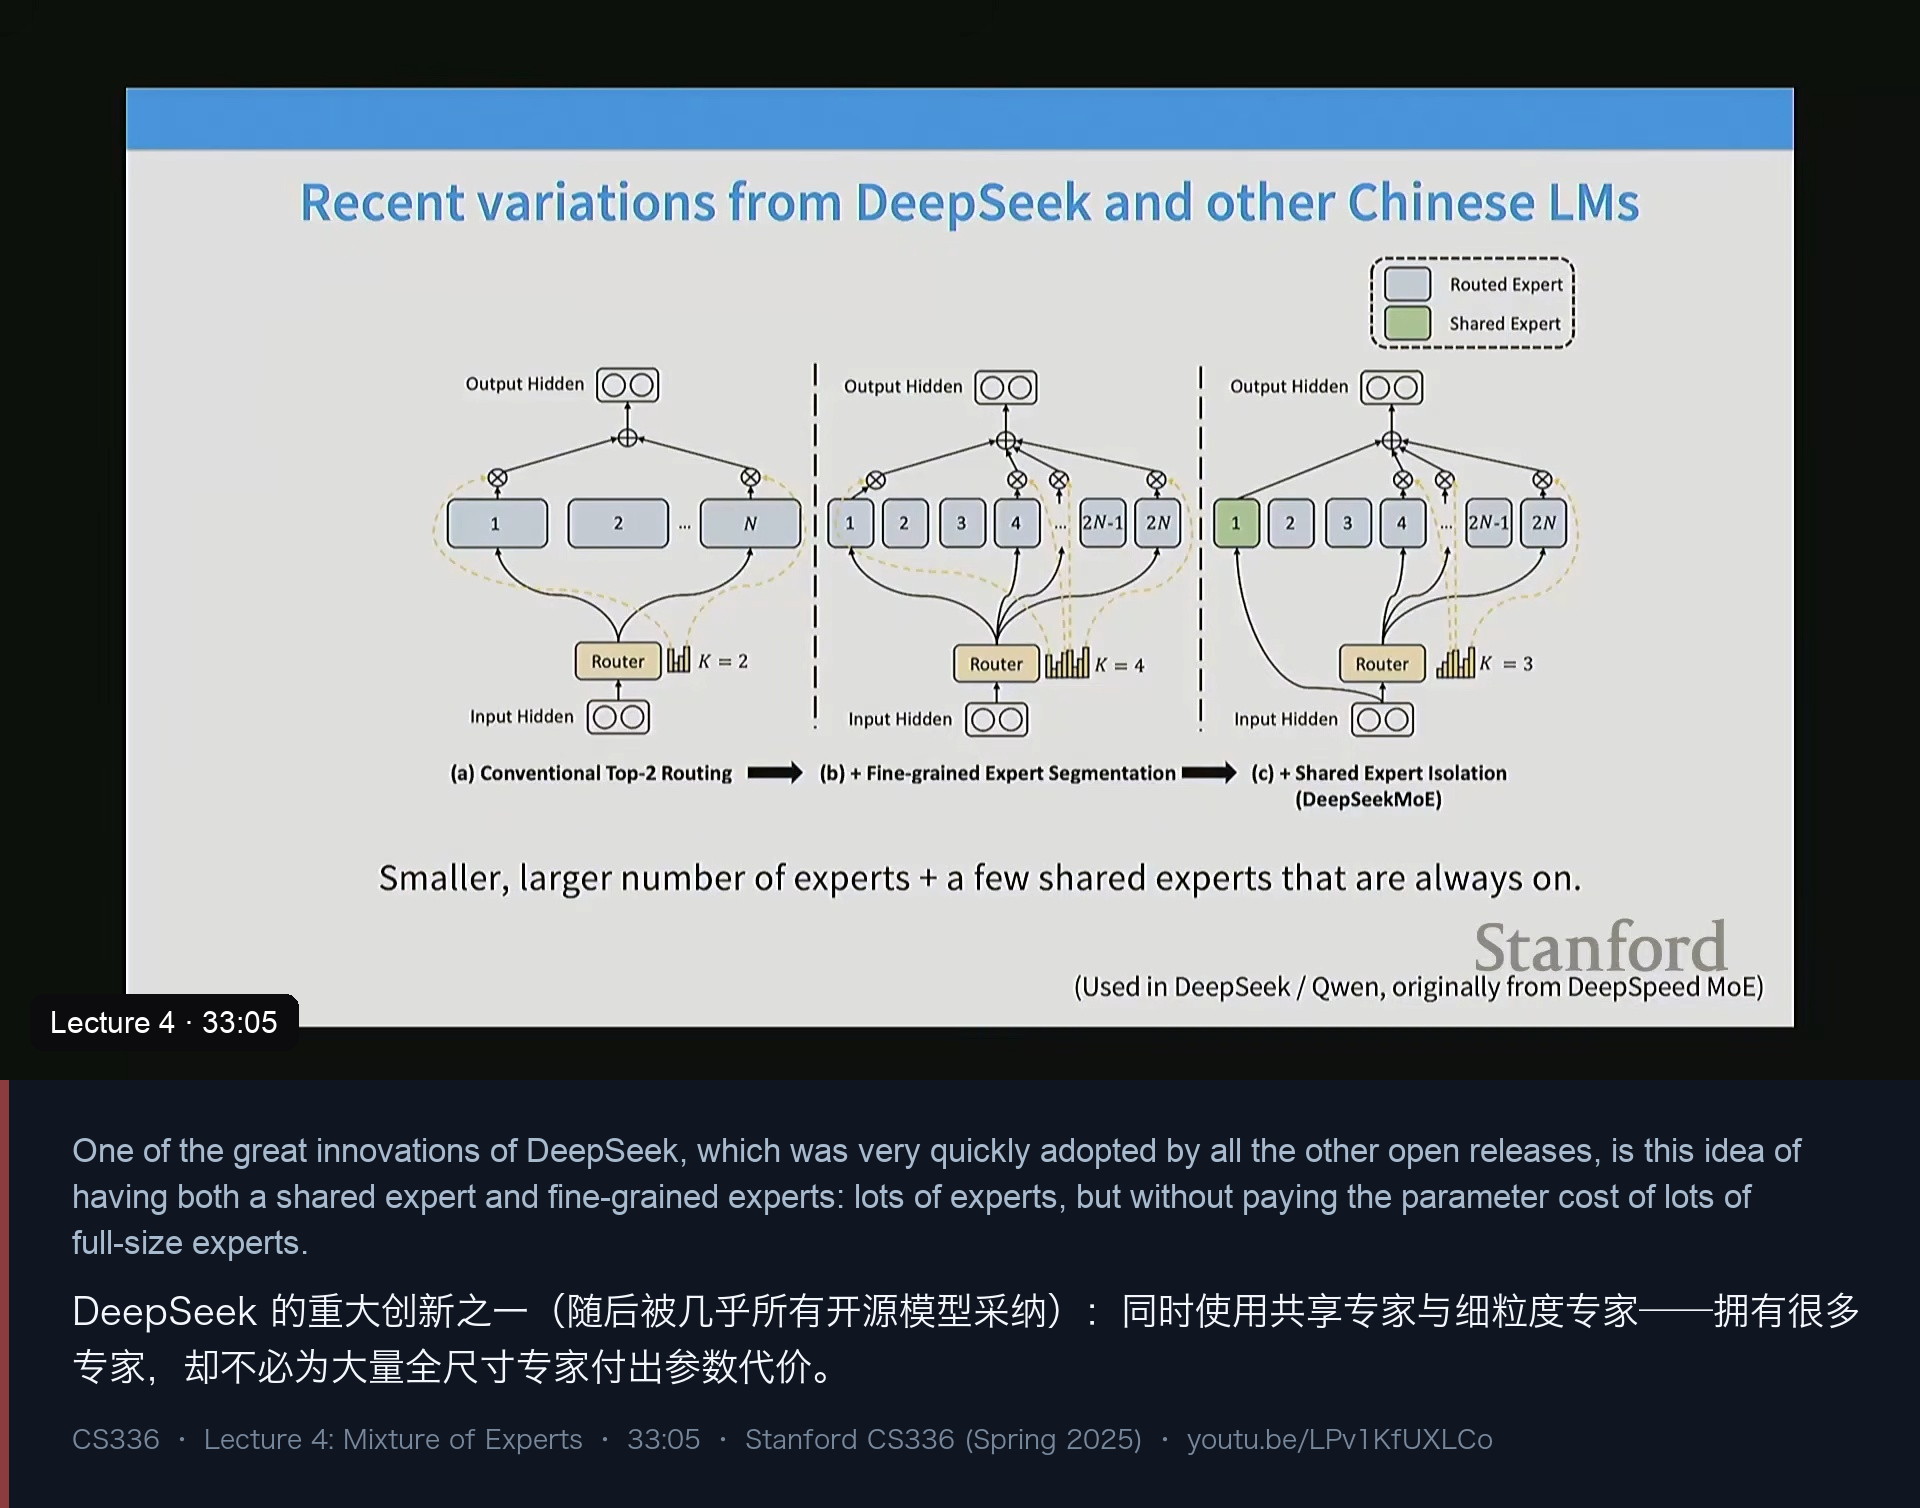
起点是最朴素的版本:把稠密模型的 FFN 复制成多份,取 top-2,于是激活参数量是原稠密模型的两倍。
第一步推广是“专家越多越好”:既然更多专家更好,那就要“很多专家,但不想为很多专家付参数代价”。DeepSeek 的答案是把专家切小。讲师回忆起第三讲讲过的那条经验法则:MLP 的隐层通常是 d_model 的 4 倍;现在你把 4 倍改成 2 倍甚至更小,矩阵就小了,于是同样的参数预算下你可以拥有两倍、四倍、八倍的专家。这就是“细粒度专家(fine-grained experts)”。他也提醒这“不是免费的”,后面会讲代价。
第二个想法是共享专家:也许总有一部分处理是“无论哪个 token 都要做的”,那让每个 token 都去走一遍路由就是浪费。于是留出一到几个永远激活的共享专家,专门承担这种公共处理。
讲师特别称赞 DeepSeek 的论文“真的做消融”,不是“销售性质的技术报告”。DeepSeek 自己的消融显示:从 GShard 的基础版出发,加一个共享专家(橙色条)在部分任务上有大幅提升、部分任务没有;再加上细粒度专家(绿色/橙色条)又有进一步提升。
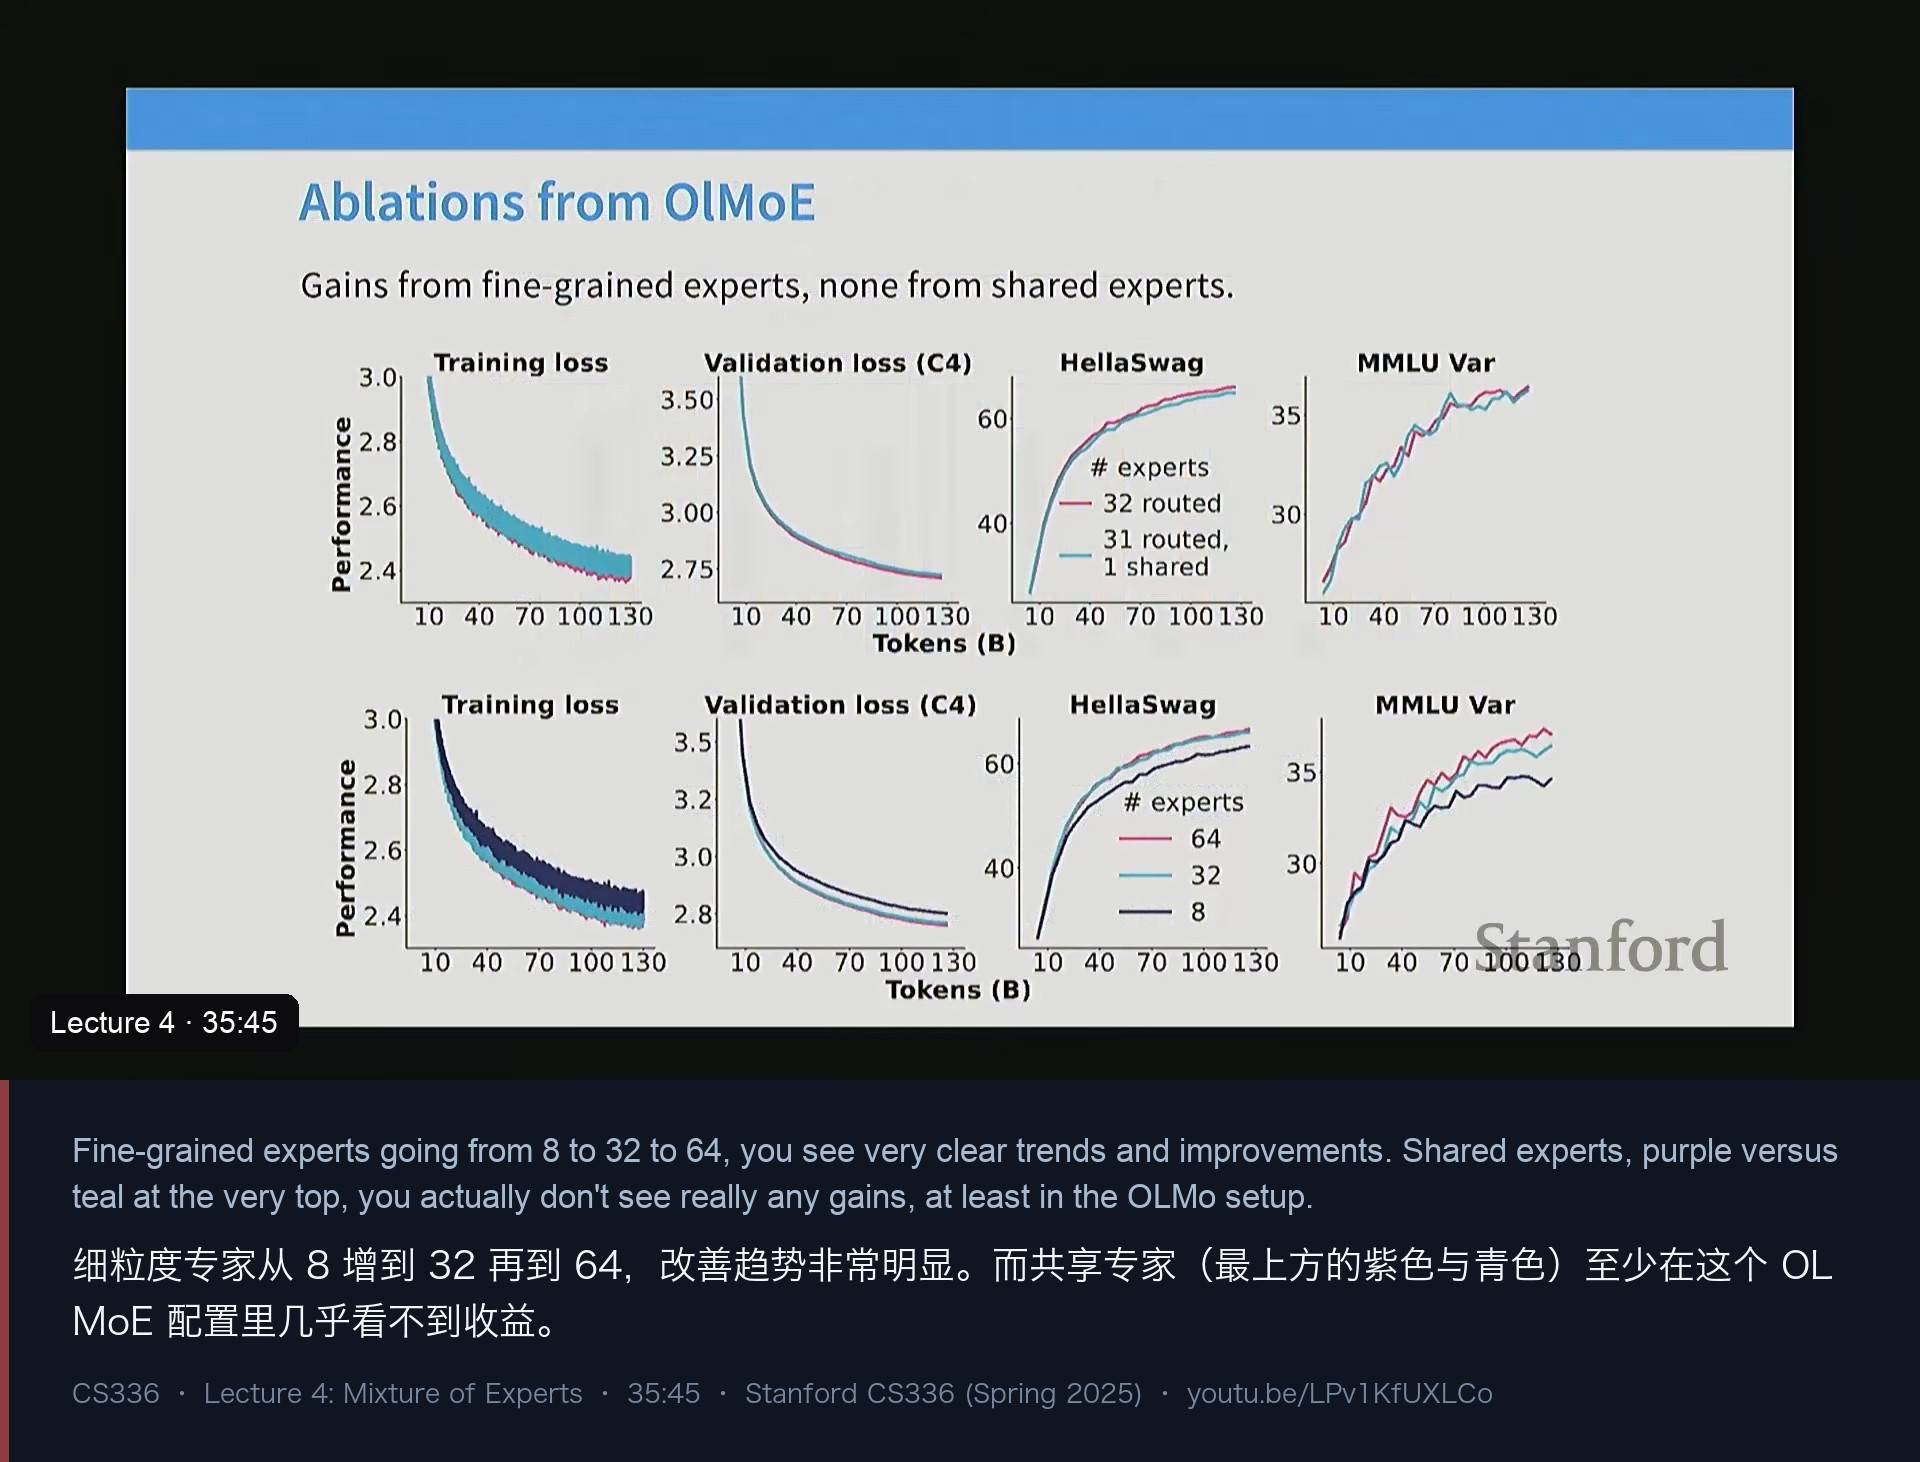
但更值得记住的是第三方复现。OLMoE 的消融给出两张图:
- 下方那张更决定性:细粒度专家从 8 增到 32 再到 64,训练 loss、验证 loss、piQA、MMLU 都呈现清晰的单调改善。讲师的结论是“细粒度专家很棒”。
- 上方那张对比共享专家(紫色 vs 青色):“在 OLMoE 这个配置下,你实际上看不到任何收益”,所以他们最终选择了不用共享专家。
也就是说:细粒度专家是“共识”,共享专家是“各家有分歧”。讲师在后面回答提问时说,一度有不少中国团队尝试多个共享专家,后来“大家又回到了 0 或 1”,而且从 OLMoE 的消融看,“连一个共享专家是否有用都不太确定”。他自己的解释是:原始的动机可能只是为了让所有激活专家大小一致(比如两个 1/4 大小的专家,加起来正好等于一个 1/2 的专家),而不是出于某种性能上的必然性。
七、常见配置:从 GShard 的 2048 个专家到 DeepSeek 的 64 个
接下来讲师沿用了第三讲的“看别人怎么做”的方法,把近期发布的配置列成一张表。
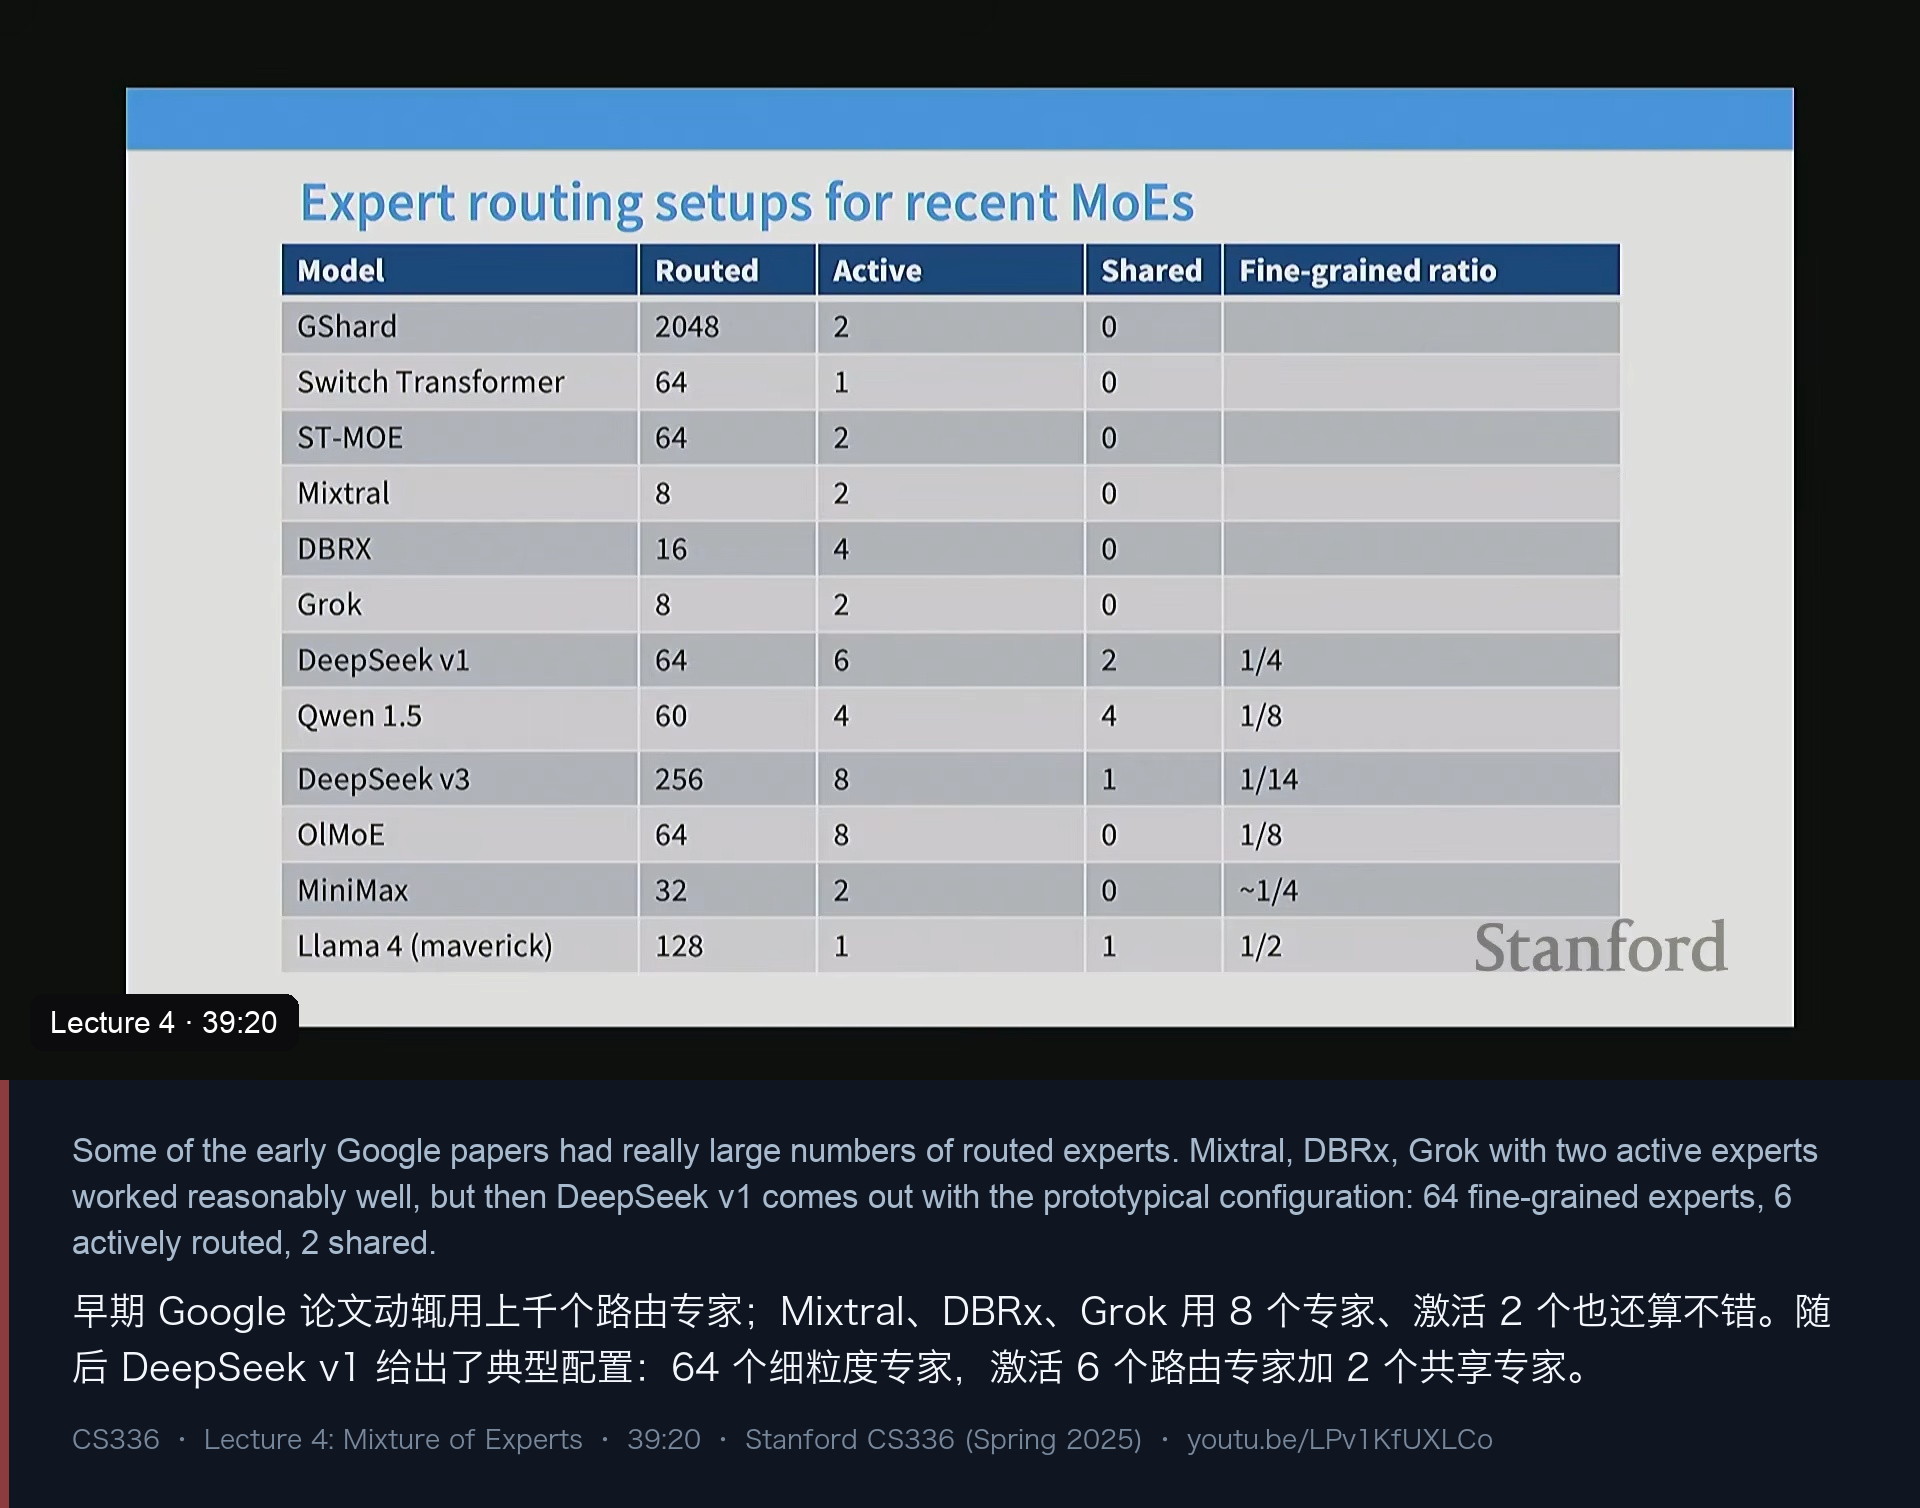
几个值得记下的观察:
- 早期 Google 那批论文(GShard、Switch Transformer、ST-MoE)动辄用上千个路由专家,而且有些实验还发生在 LSTM 等非 Transformer 架构上。
- 之后出现了一段“8 到 16 个专家、激活 2 个”的时期:Mixtral、DBRx、Grok 都属于这一类,“效果还算不错”。
- 然后是 DeepSeek v1 的原型配置:64 个细粒度专家,每次激活 6 个路由专家 + 2 个共享专家,每个专家大约是正常 FFN 的 1/4 大小。
- Qwen 1.5、DeepSeek V3、MiniMax 基本沿着 DeepSeek v1 的脚印走;OLMoE、Llama 4 是更新的成员,也都用了细粒度专家,其中 Llama 4 还用了共享专家。
讲师对“Fin-grained ratio(细粒度比例)“这一列做了说明,并主动降低了它的可信度:“最后一列请打个折扣,因为我是从配置文件里反推出来的,不百分百确定具体比例。“他解释了这个比例的来源:按经验法则,隐层到投影层大约是 1(门控网络则是 1.6),所以看隐层维度就能反推出”原来的 FFN 被切成了几份”。
问答里还有两个有意思的补充:
- “X out of Y” 的含义:X 是激活的专家数,Y 是总的路由专家数(例如 7/64 表示 64 个里激活 7 个)。
- 为什么有些比例这么奇怪(比如 1/14):讲师说他也不确定,但“这些数字都是非常精确的整数”,所以他认为那确实是切分次数,只是不知道为什么选这个数。
- 为什么有些模型的专家是降维的:确实有模型这么做。另外讲师指出“用细粒度专家时,FLOPs 层面其实是免费的”——因为每个专家变小了,激活更多个并不会增加总计算量。
八、怎么训练 router:RL、随机扰动与启发式均衡损失
讲到这里,架构讲完了,但真正的难题才刚开始——训练。讲师用“pretty gnarly(相当棘手)“来形容这一节。
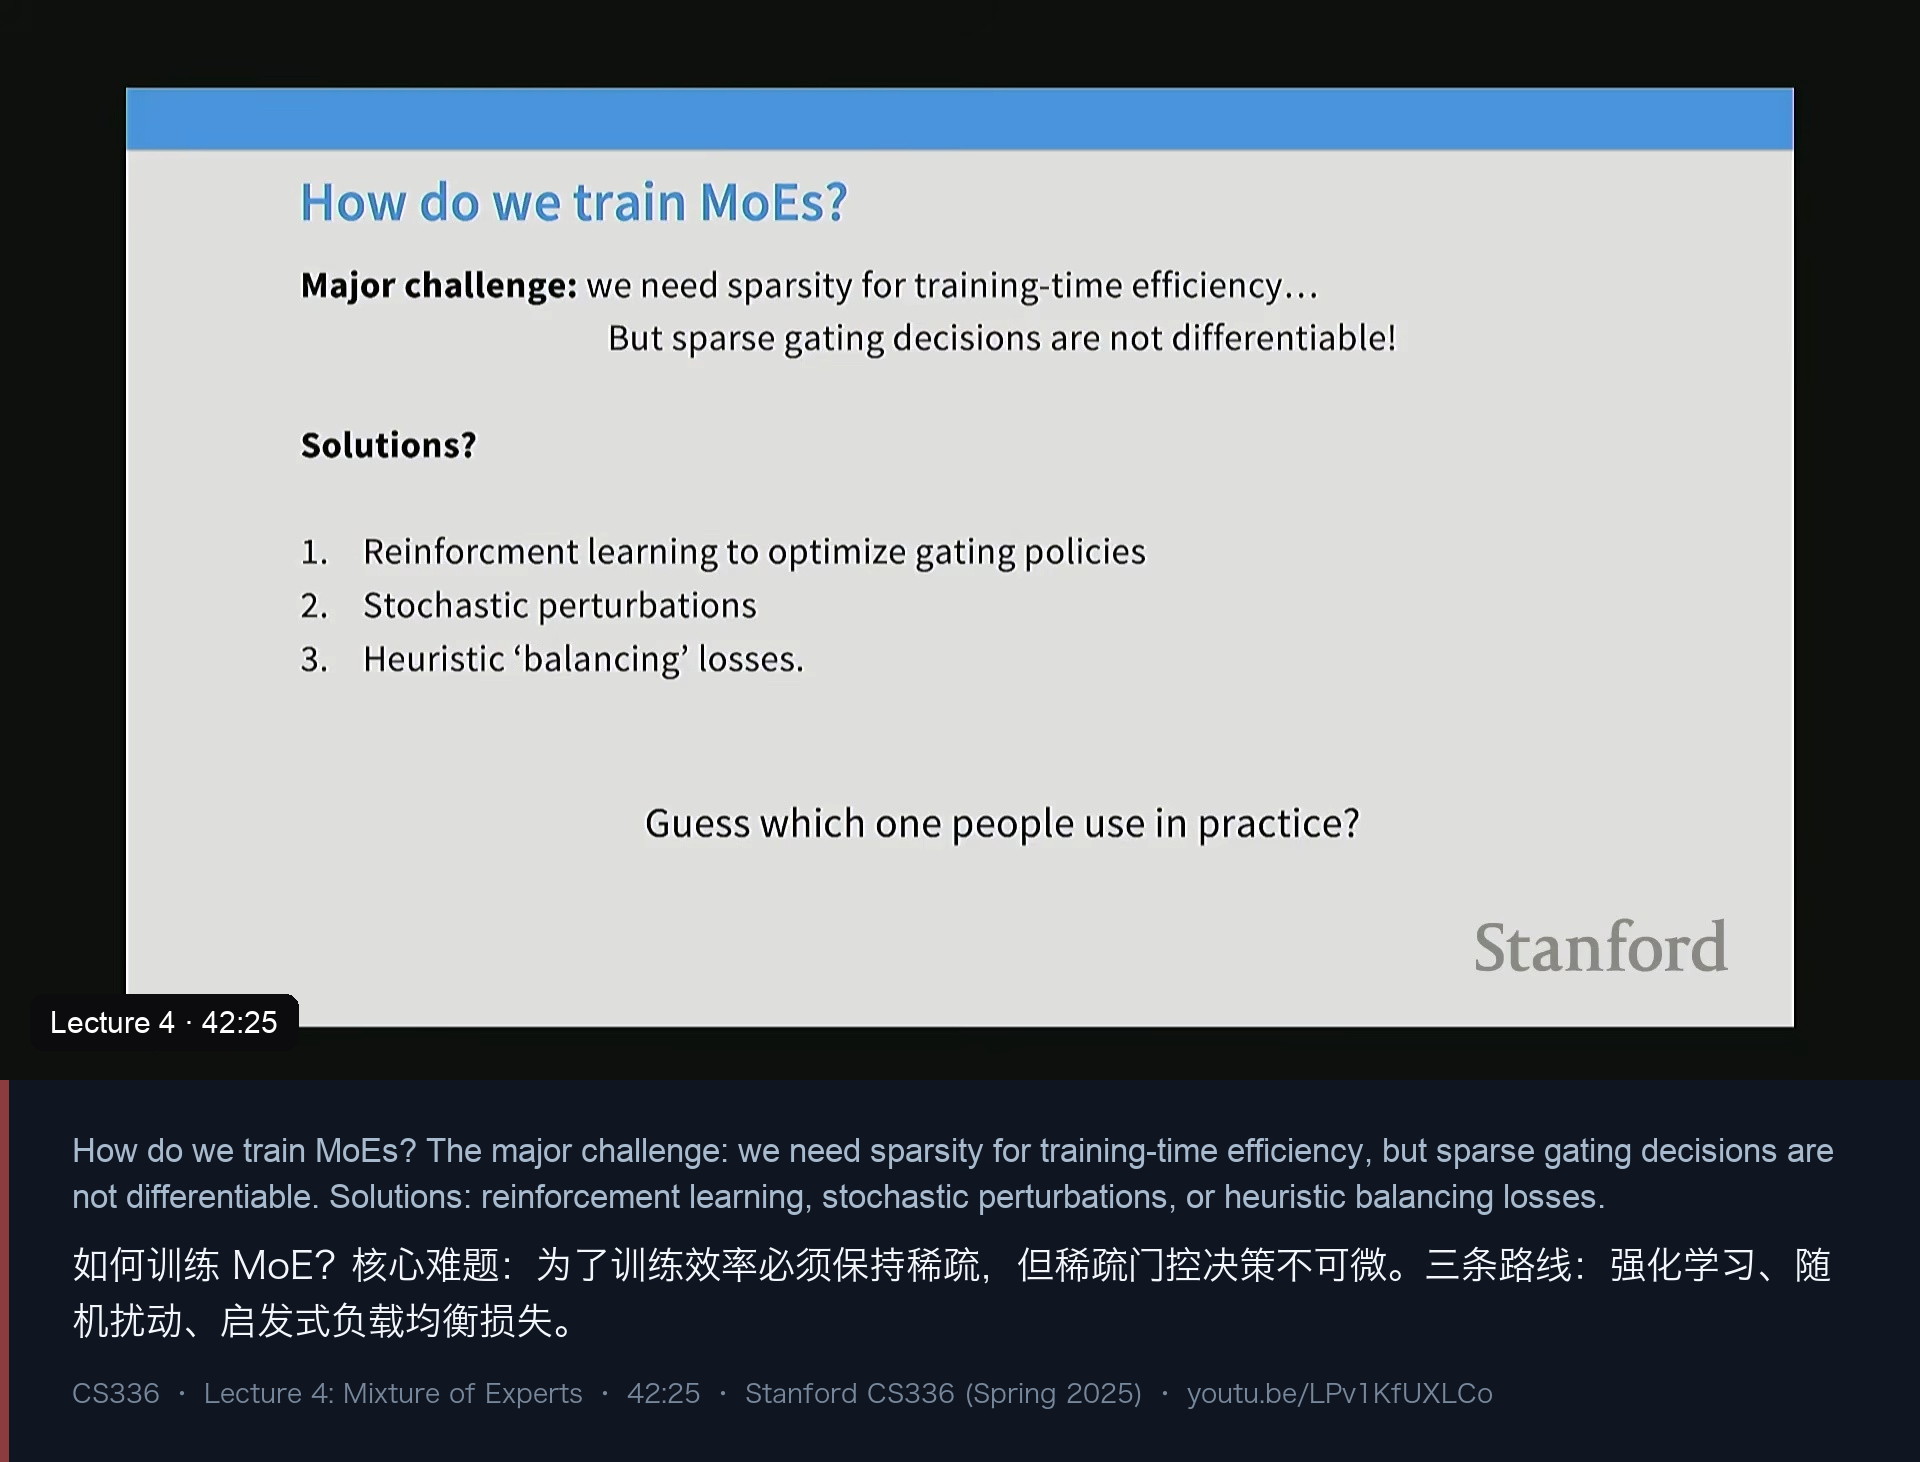
矛盾被压缩成两句话:
- 为了训练效率,我们需要稀疏——如果训练时把全部专家都打开,就要付出全部专家的 FLOPs,“一个贵 256 倍的模型是完全不可接受的”;
- 但稀疏的门控决策不可微——于是你面对一个“恼人的、像 RL 一样的问题”。
幻灯片给出三条出路,并让学生猜“实践中大家用哪条”:
1. Reinforcement learning to optimize gating policies
2. Stochastic perturbations
3. Heuristic "balancing" losses
答案是第三条。
路线一:强化学习。 理论最正统——把不可微的路由当成策略,直接上 RL。但讲师说它“并不比别的做法更好”:Clark et al. 2020 有一个 RL 基线,效果和哈希路由差不多;反倒是他们真正研究的那个线性分配方法(Sinkhorn/SBS 一类)稳稳胜过 RL。加上梯度方差大、流程复杂,“据我所知,没有人真的在规模上用 RL 优化门控”。
路线二:随机扰动。 代表是 Shazeer 2017 的 noisy top-K gating:保持 top-K 结构不变,但在算 affinity 时注入一个可学习的噪声尺度:
# 原始 affinity
h = x @ W_g
# 加抖动:Normal(0,1) * softplus(W_noise),W_noise 是可学习参数
h = h + Normal(0, 1) * softplus(W_noise)
# 仍然取 top-K 并 softmax
g = softmax(TopK(h, k=K))
讲师的类比非常清晰:这和 bandit 里的 ε-greedy 探索是同一个精神——如果你永远只拉当前最好的那条臂,你就永远不知道别的臂长什么样;随机地把一些 token 分给“本来不会被选中”的专家,你才能获得关于它们的信号。副作用是专家会变得“不那么专门化、但更稳健”,而专门化程度的下降本身就是效率损失。他说这类抖动在早期 Google 论文里被试过,但后来的论文把它去掉了,因为“它不如那些启发式损失方法有效”。
路线三:什么都不做,只靠 top-2 的梯度 + 均衡损失。 这是实践中的答案。讲师解释:如果做 top-2 路由,严格来说你是能得到一点梯度信号的——因为你可以比较被选中的两个专家。但如果放任不管,最大的问题是会掉进一个局部最优:
“你会一直挑同一个专家,它什么都擅长,其他专家则全是垃圾……所有 token 都被路由到一个专家上。”
于是核心问题变成”怎么从这个局部最优里爬出来“,而均衡损失(balancing loss)就是那把钥匙。讲师在这里罕见地提醒大家集中注意力:“如果你刚才走神了,请务必注意这一组公式。”
九、负载均衡:f·P 损失与 DeepSeek V3 的“无辅助损失”
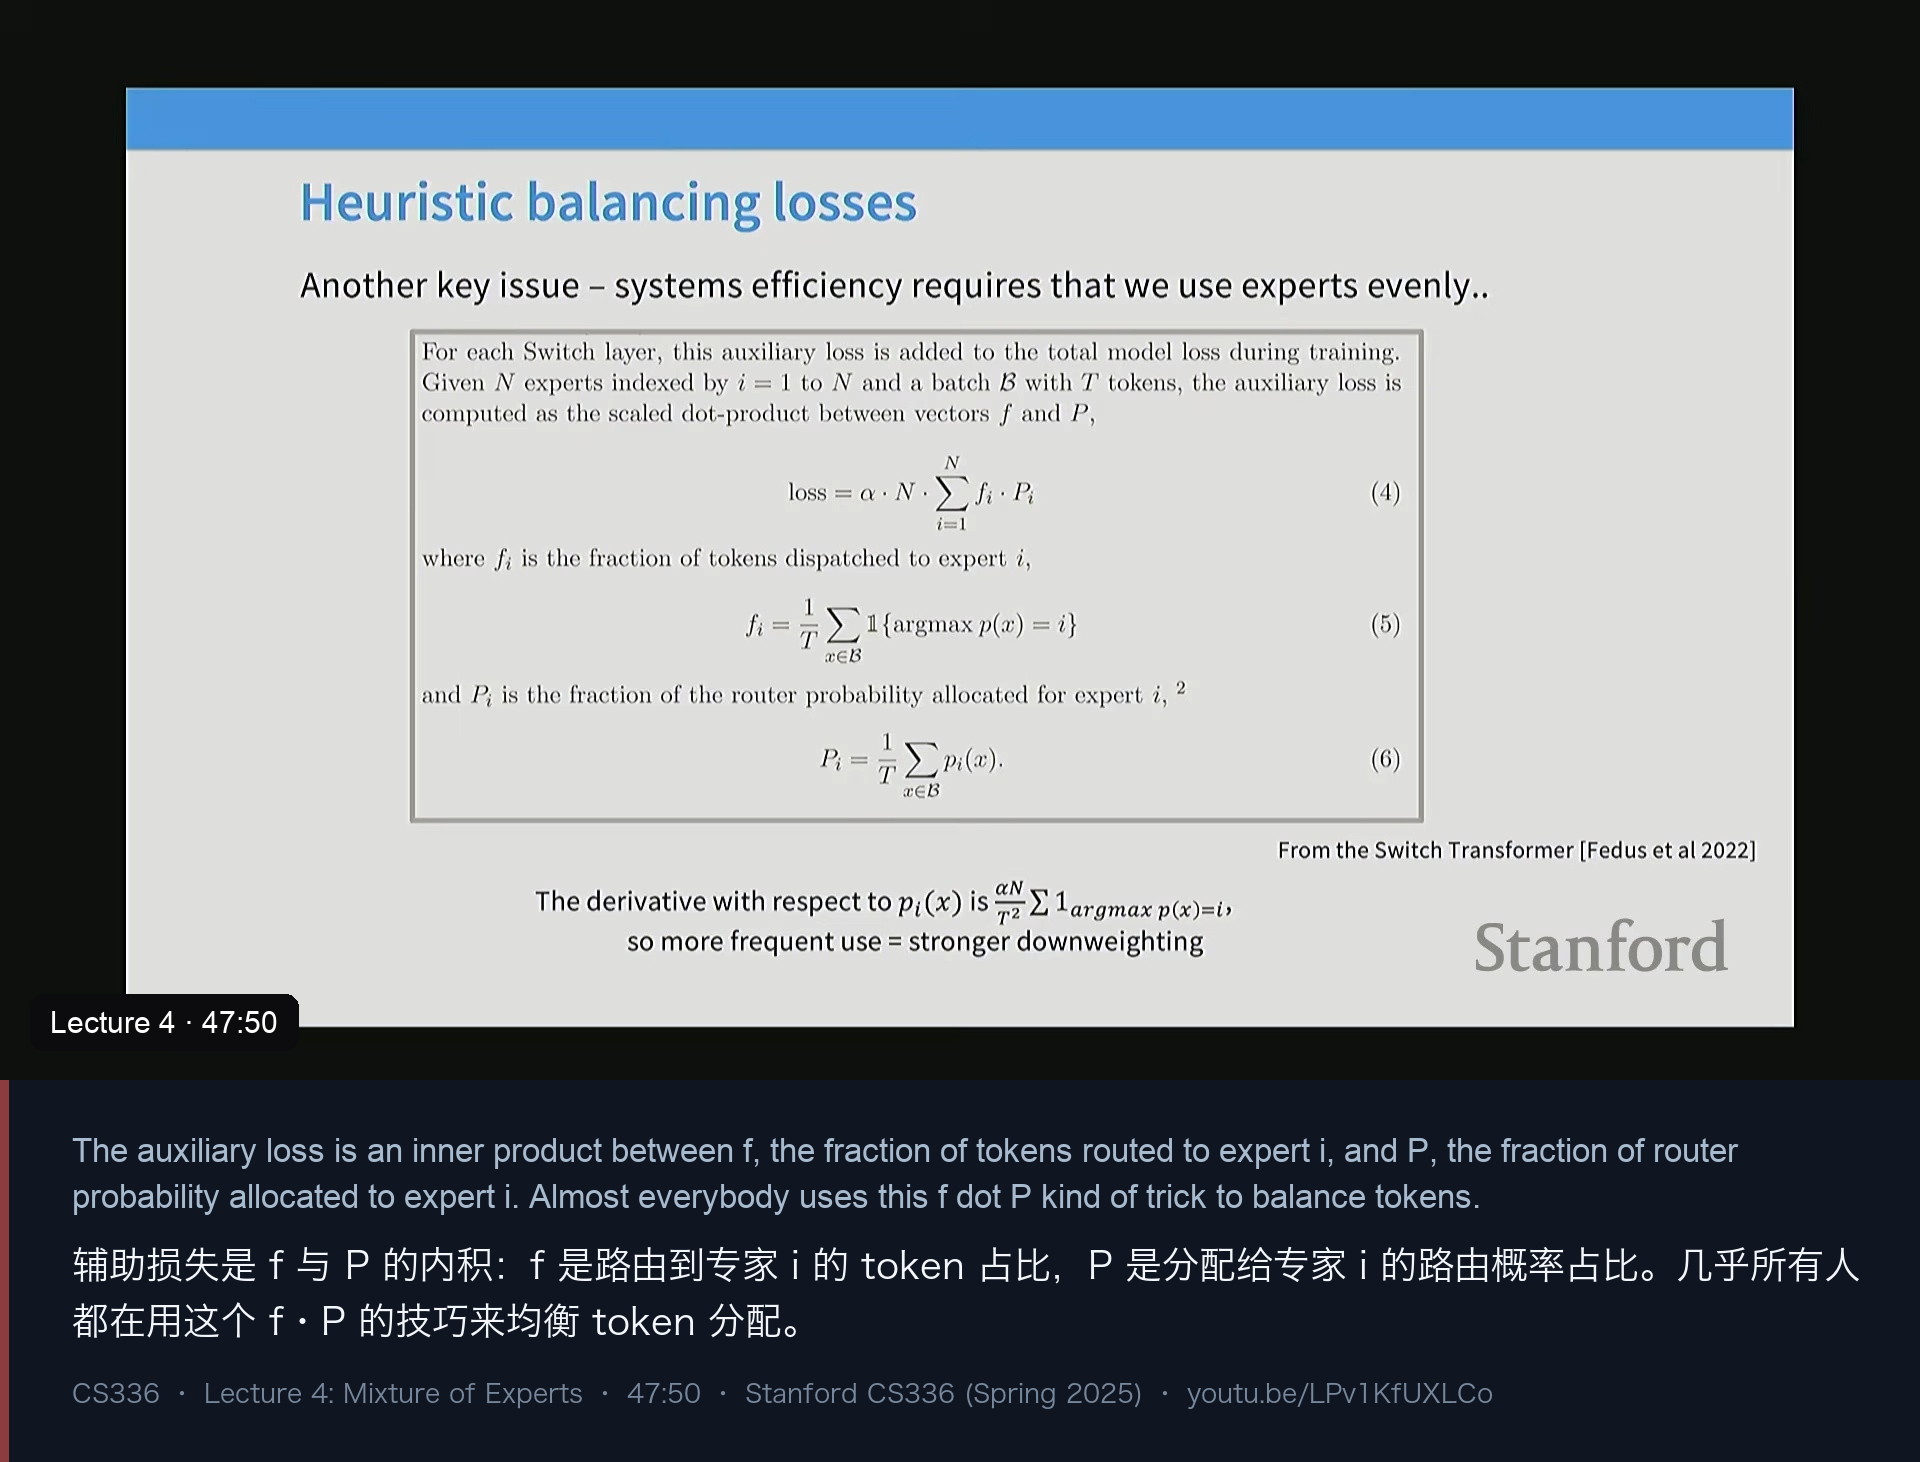
这套损失最早来自 Switch Transformer(Fedus et al. 2022)。它由两个向量构成:
- f_i:实际被路由到专家 i 的 token 占比(一个概率向量,描述“真实分配”);
- P_i:router 分配给专家 i 的概率占比(描述“router 的意图”)。
损失就是它们的内积:
loss_balance = N * sum(f_i * P_i for i in range(N))讲师给了一个很漂亮的直觉:对 P_i 求导,会发现这是线性的,而且“下降压力最强的地方,正是那些拿到最多 token 的专家”——惩罚的力度正比于它实际拿到的份额。所以这个损失会自动把最拥挤的专家往下压。他说:“几乎所有人都在用这个 f·P 的技巧来把 token 均衡地分到各个单元上。”
注意这里有一个非常重要的澄清:均衡本身不只是系统问题,也是模型质量问题。 有学生问“如果完全不考虑系统优化,这个损失还需要吗”,讲师回答得非常明确:需要。因为如果不做负载均衡,训练早期模型就会“挑一两个专家,其他专家全死掉(dead)”——此时你白白浪费了显存,等价于得到了一个更小的模型。他引 OLMoE 的消融为证:
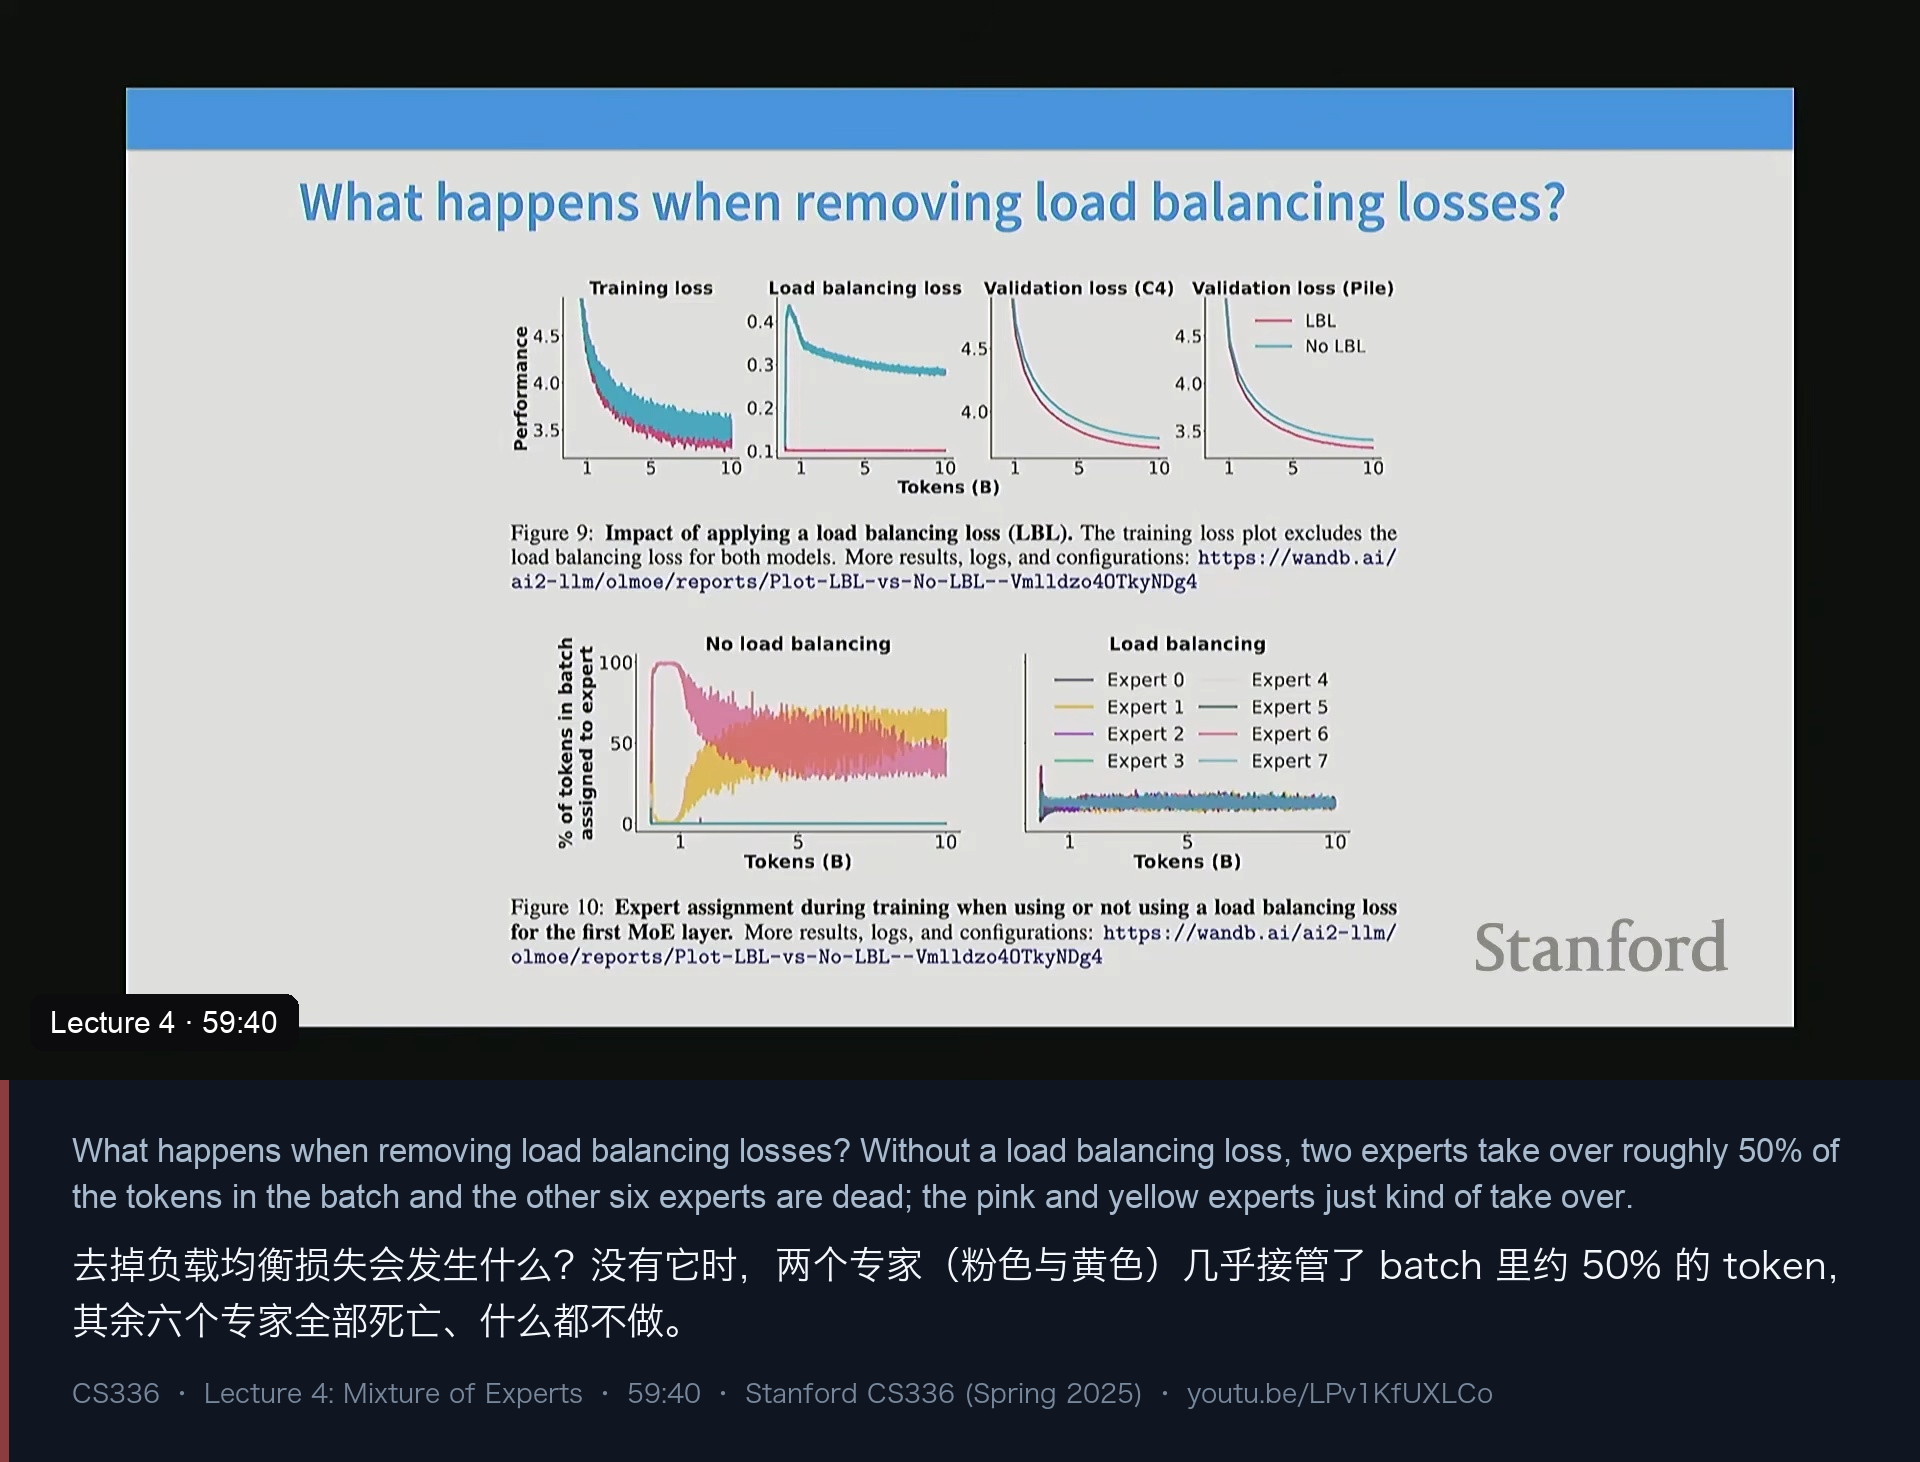
看左下角那张图:不做负载均衡时,粉色和黄色两个专家几乎接管了约 50% 的 token,其余六个专家“什么都不做”——你花了八个专家的钱,得到了一个“意外的两专家模型”,loss 也明显更差(右上角的青色曲线)。讲师的原话是:“你浪费了大多数专家,八个里的六个。”
均衡的粒度也是可设计的。最初级的单位是 batch(每个 batch 内均匀分配);但因为你还要把专家分片到不同设备上,所以还会加一条设备级的均衡损失,把 f 的统计单位从“专家”换成“设备组”,于是训练会自动学着让每张 GPU/TPU 拿到相近的 token 数。讲师还提到,更精细的做法甚至会去最小化通信成本——那时“设备”的概念可以细到“一个机架”。
然后是本讲最有信息量的一段:DeepSeek V3 的“无辅助损失”均衡。
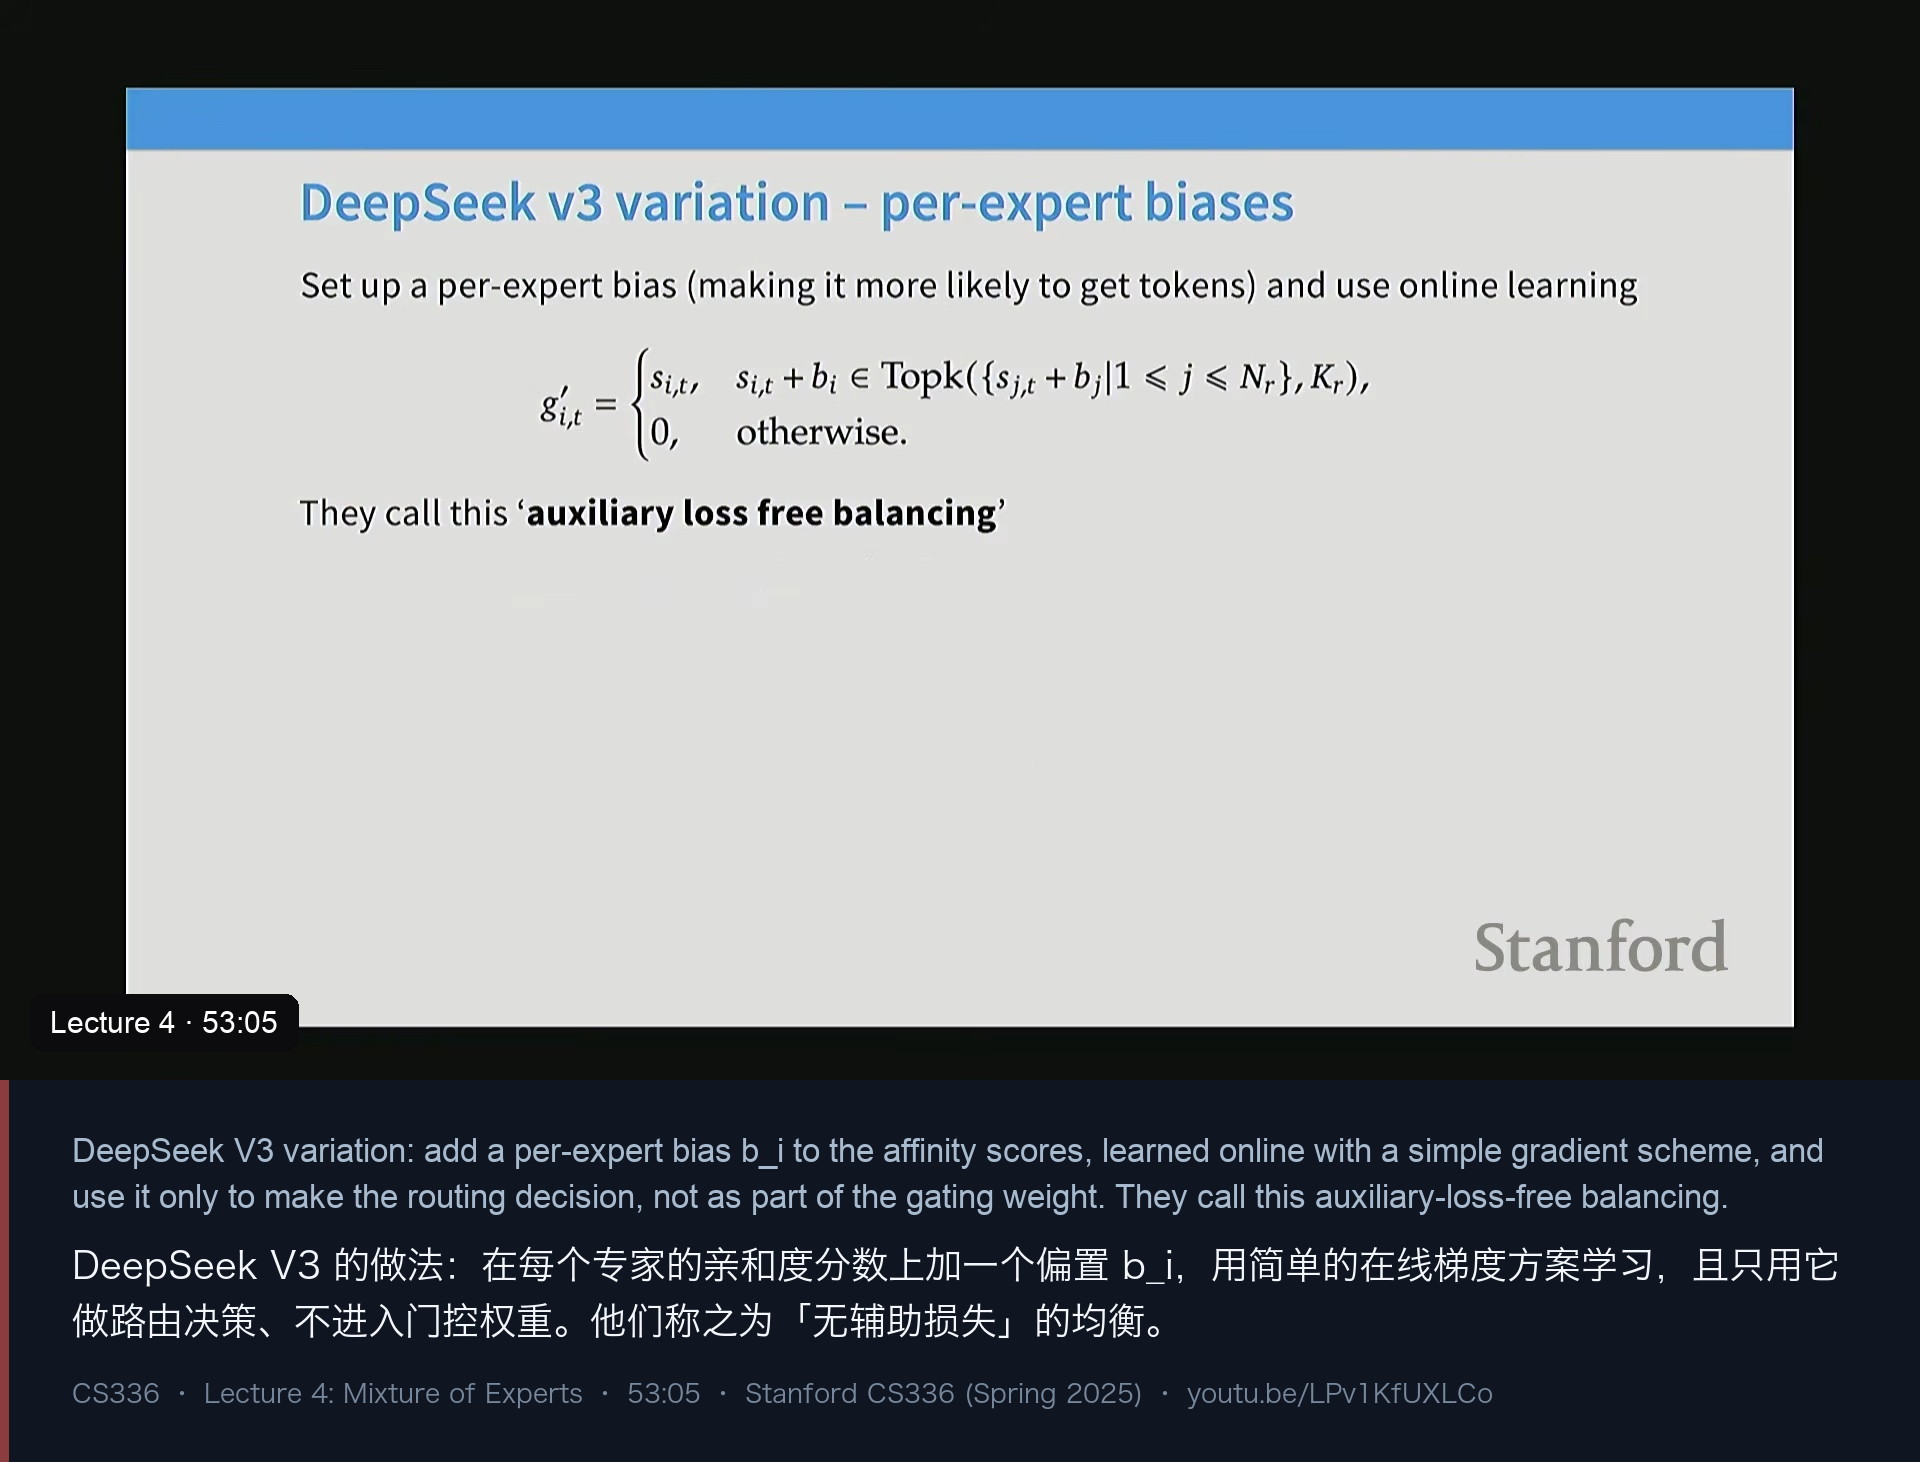
DeepSeek V3 的改动是:把逐专家的均衡损失整个删掉,改成在每个专家的亲和度分数上加一个偏置 b_i:
s_i = softmax(u @ e_i)
路由分数 = s_i + b_i           # b_i 是一个"调节因子"
b_i 的更新规则非常简单,就是一种在线学习:每个 batch 事后统计每个专家是不是负载不均——负载不足就 +γ(让它更有吸引力),过载就 −γ。而且有一个很关键的细节:b_i 只用于做路由决策,不会被当作门控权重送下去。
DeepSeek 称这为 “auxiliary-loss-free balancing”,在论文里花了不少篇幅强调它让训练有多稳定。但讲师接着讲了一个“反转”:
“然后你继续往下读,会发现他们写着:其实我们还是想按序列做均衡,而这个(无损失方案)做得不够好,所以我们又把那条启发式损失加回来了。”
也就是说,V3 里仍然有一条”互补的序列级辅助损失“——它基本上就是那条被删掉的辅助损失,只不过统计单位从 batch 换成了单条序列。讲师说他不太确定为什么偏偏选这个改动,但结论是:“所以它并没有它让你相信的那么’彻底无辅助损失’。”
至于“为什么要在单条序列的粒度上均衡”,讲师的解释是推理时的分布外风险:训练时不做序列级均衡问题不大,但推理时用户可能发来非常 OOD 的序列,把某些专家瞬间打爆,而“推理时你没法控制收到什么序列”,所以在序列粒度上做强均衡更保险。
十、系统层面:专家并行、融合算子与 token dropping
讲师明确说,这一部分讲不深——因为“理解并行所需的那些核心系统概念(比如数据中心里通信速度的层级结构)还没在课上讲过”,所以这里只给高层次的图景。
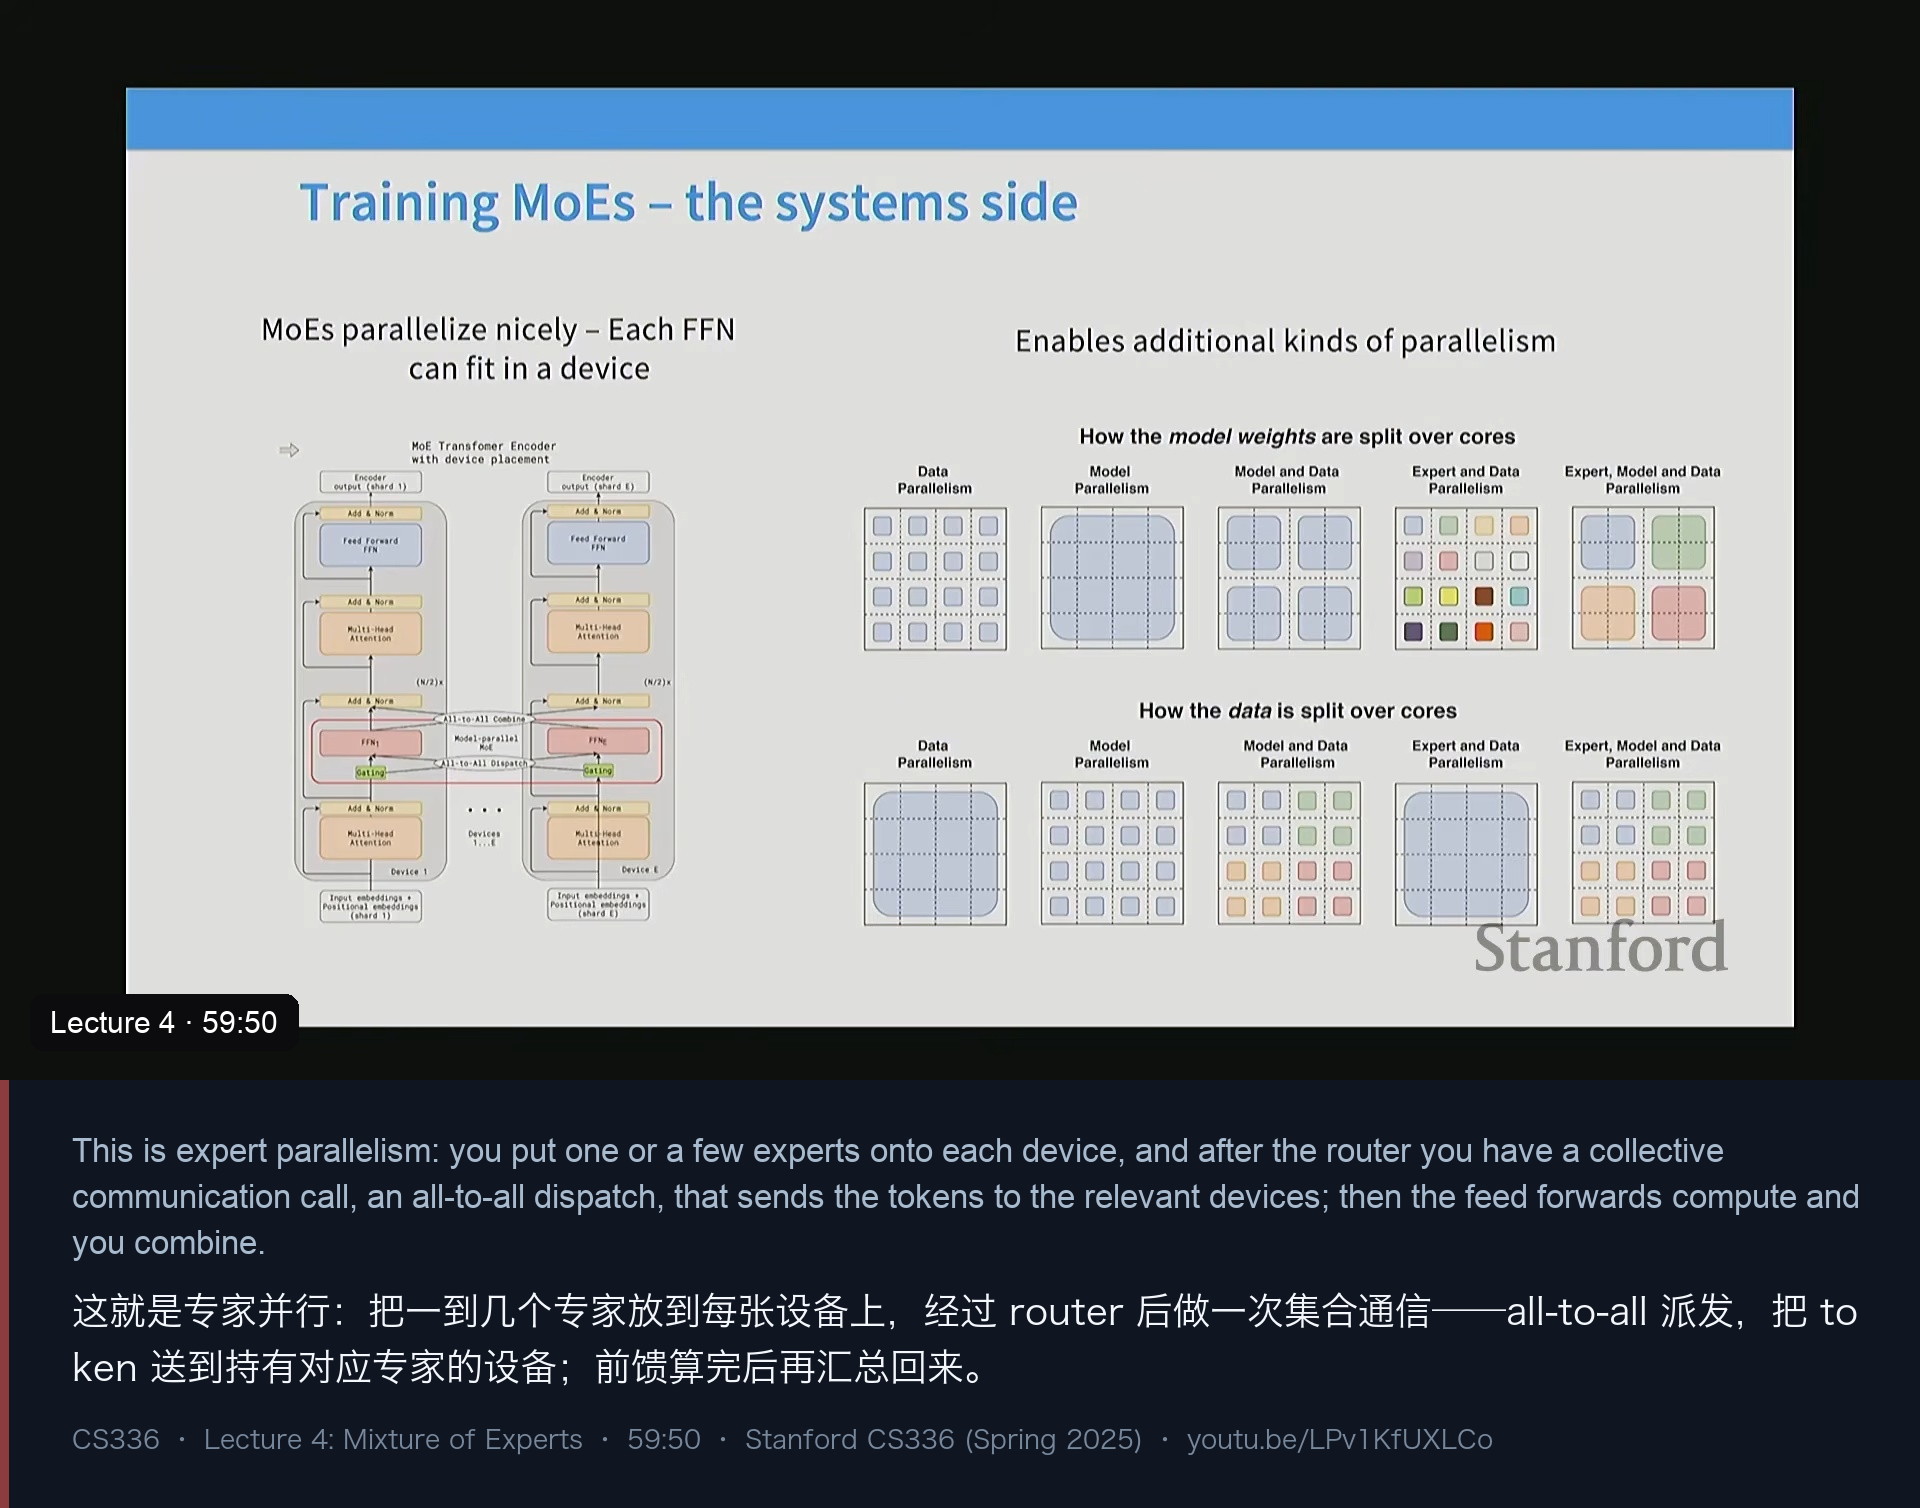
专家并行的机制:把一到几个专家放到一张设备上。token 流过 router 之后,已经确定要投给哪几个专家,于是执行一次集合通信——all-to-all dispatch,把 token 送到持有对应专家的设备上;各专家算完后,再用一次集合通信把结果送回原处(或做合并)。讲师说这笔通信开销是可以被“喂饱”的:只要前馈计算足够“厚实”,你就能付得起专家并行的成本。
它的价值在于给工具箱添了又一个并行维度。你已经有了数据并行、模型并行(两三种),现在再加上专家并行,就可以在“通信速度、数据量、batch size、专家数、显存”之间做更丰富的取舍。他还强调一个原则:并行的目的永远是把显存用满——“你不想并行得超过必要程度”。
另一个系统层面的收益是算子的稀疏利用。如果一张设备上有多个专家,那么“token 1 去专家 0、token 2 去专家 1”这种计算,本可以合并成一次大的矩阵乘法。现代库(例如 Meta 的 MegaBlocks,被很多开源 MoE 使用)能用更聪明的稀疏矩阵乘法把这件事做掉,从而不浪费 FLOPs。
然后是那个非常好玩的副作用——MoE 的随机性。
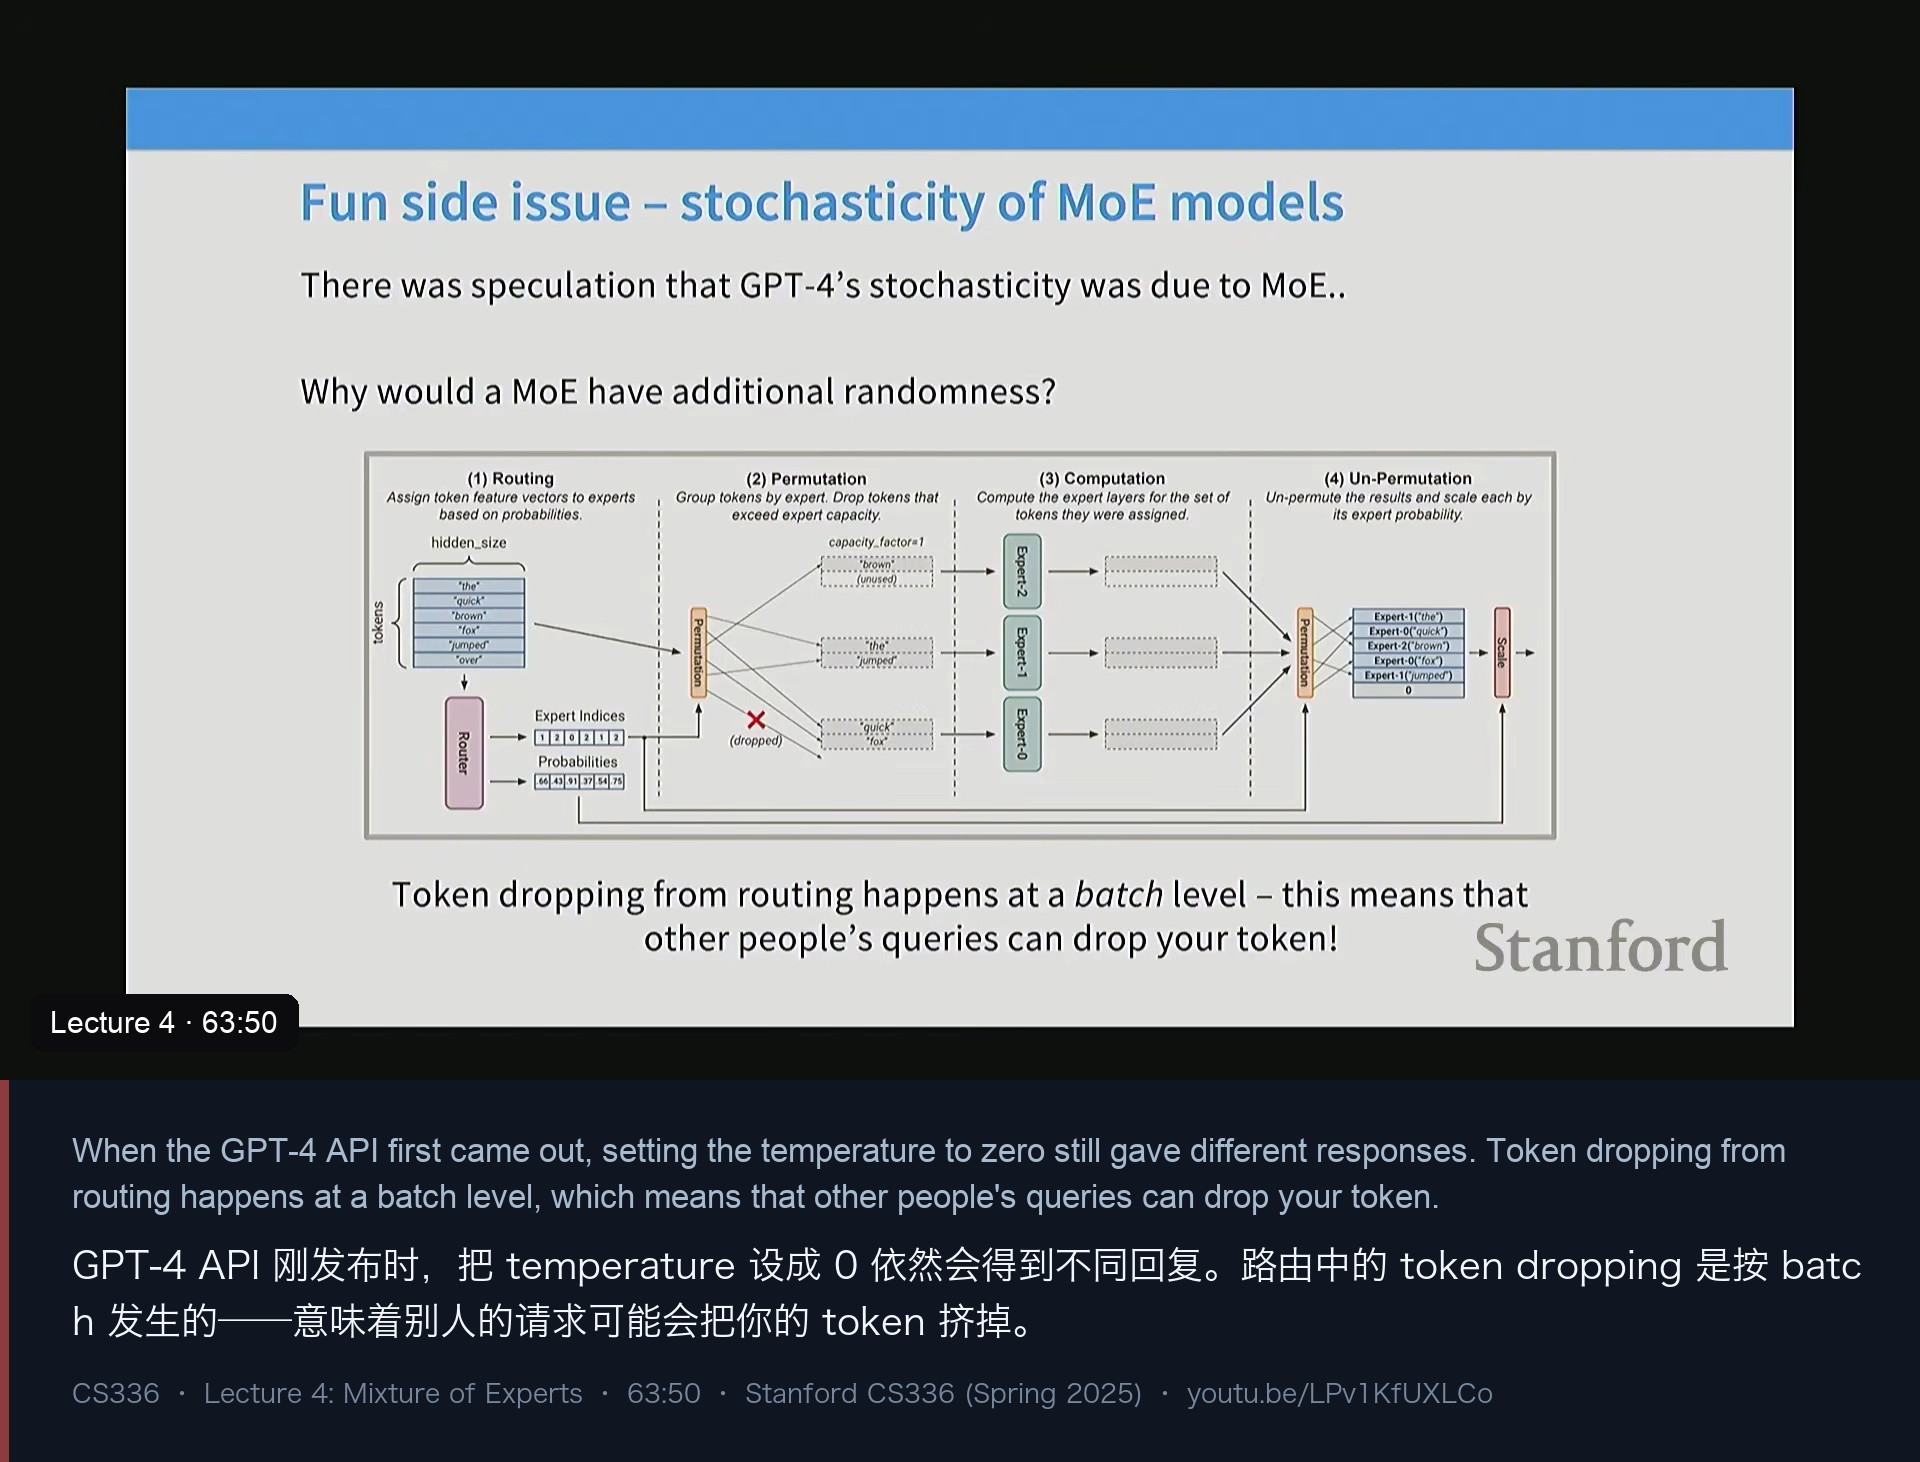
讲师回忆:GPT-4 的 API 刚发布时,把 temperature 设成 0 居然还会得到不同的回复,很多人猜测原因。他说“我不是说这就是答案”,但 MoE 确实有一个真实的随机性来源:token dropping。
机制是这样的:推理时请求会被 batch 起来,token 被路由到不同专家;如果某个 batch“特别偏爱”专家 3,所有 token 都涌向专家 3,而那张设备的显存放不下这么多 token,就会触发丢弃(训练时也有对应的 “load factor” 上限)。被丢弃的 token 什么也算不到——MLP 的输出为零,残差直接透传过去。于是,同一个 prompt 得到的输出,会取决于“这一批里还有谁跟你一起被处理”。
这就是所谓的跨 batch 效应:你几乎从不需要在推理时考虑“别人的请求会影响我的结果”,但在 MoE 里它真实存在。
十一、稳定性与微调:z-loss、过拟合与升格
讲完系统,讲师说如果明天就让你去训一个 MoE,“系统会让你有点难过,另外一件让你难过的事是稳定性”。
第一类问题是训练发散。 MoE“有时会直接炸掉”,而且特别难微调。援引的论文(Barrett Zoph 等人的稳定性工作)给出的两个技巧,都和第三讲遥相呼应:
- router 的计算全部用 float32——因为“softmax 永远是你该害怕的地方”,而 router 里正好有一个 softmax;
- 加 z-loss:把 softmax 的归一化因子 log Z(x) 的平方作为额外损失项,逼它靠近 1,从而让 log 与 exp 相互抵消、数值稳定。
幻灯片展示了效果:去掉 router 上的 z-loss,验证 loss 会出现巨大的尖峰,模型“发疯几个 iteration 再被拉回来”;虽然最终还是能训,但结尾的验证 loss 有明显差距。讲师还提醒,z-loss 在成为通用技巧之前,最早就是用在 MoE 的 router 上的。
第二类问题是微调时的过拟合。 在 BERT / T5 那个年代,大家发现稀疏模型在微调时训练/验证差距明显更大(蓝橙线),而稠密模型(绿红线)的泛化差距更小——毕竟你在用巨大的参数模型去拟合很小的数据集。当时提出的一个解法是架构上交替排布稠密层与 MoE 层,微调时只动稠密层,这样行为就“和稠密模型一样”。讲师说这个方案“据我所知并不流行”。
真正被采纳的解法更粗暴:用更多数据。他举 DeepSeek 的例子——他们在 SFT 阶段用了 140 万条训练样本,“那就基本不用太担心过拟合了”(这个数字来自 DeepSeek 的 MoE 论文,属于讲师引用的公开材料)。
第三是“升格”(upcycling)——本讲给出的一个很实用的技巧。
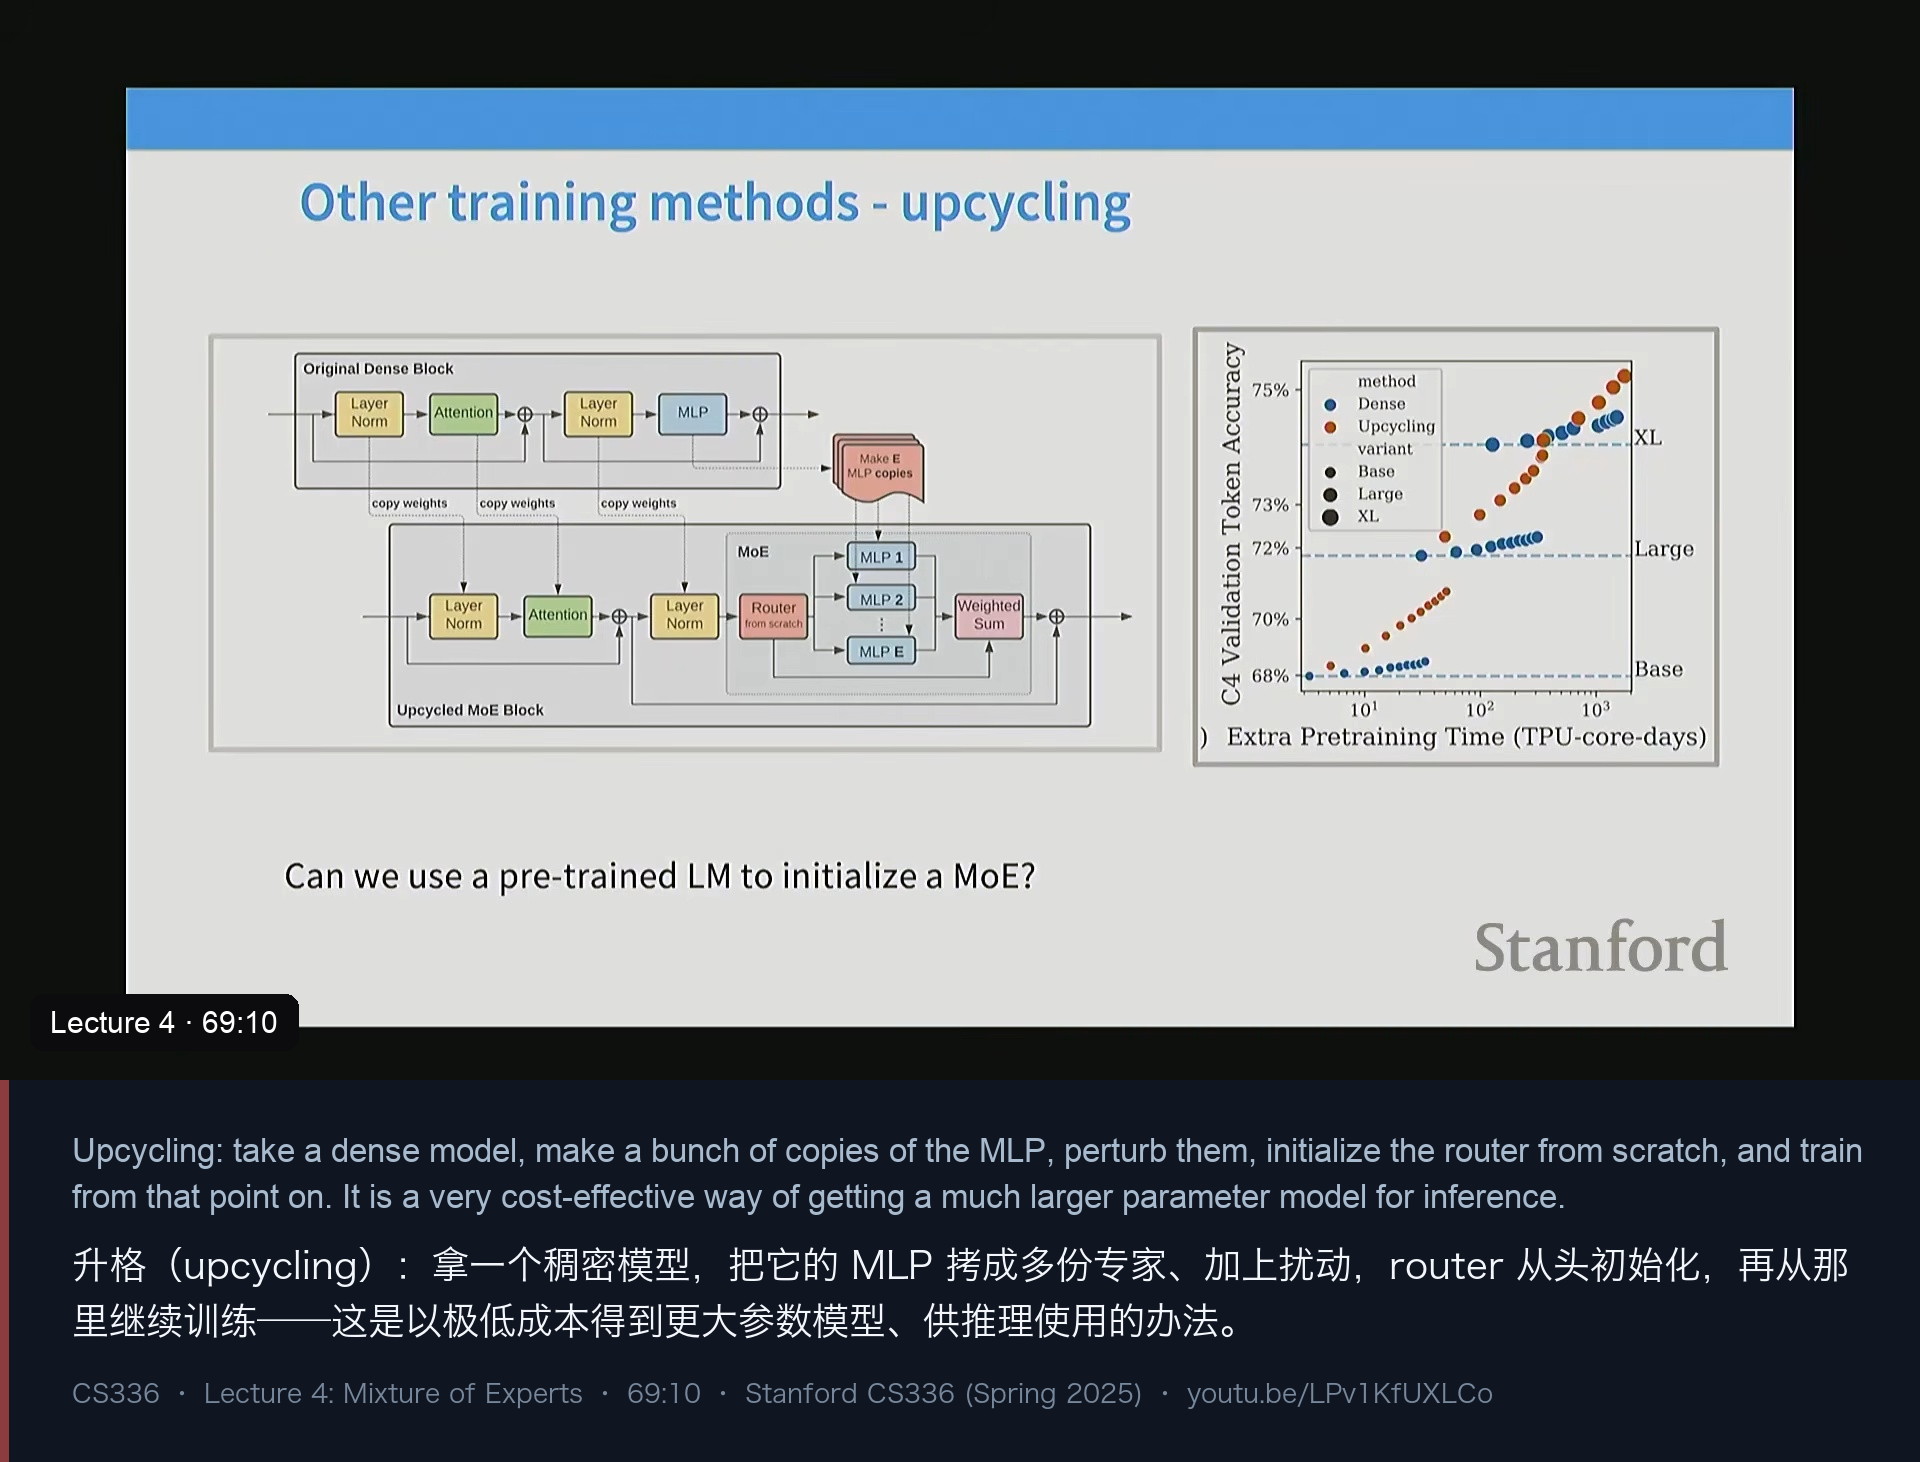
做法是:拿一个已经训好的稠密模型,把它的 MLP 复制成多份(并加一点扰动)当作多个专家,router 则从零初始化,然后从这个状态继续训练。讲师说这是“极具性价比”的一招——因为 MoE 的推理成本低(每次只激活一小部分 MLP),你相当于以远低于从头训练的代价,换来了一个参数大得多的推理模型。
他举了两个成功的例子:MiniCPM 把一个稠密模型升格成 MoE,最后两行的性能提升“相当可观”;Qwen 早期也做过类似的尝试,用一个 2.7B 激活参数的模型达到了此前 7B 稠密模型的水平。
十二、逐层拆解 DeepSeek V3:MoE 之外还做了什么
讲座最后 10 分钟是整机复盘:把 DeepSeek 从 V1 到 V3 的每一步变化摊开来看,目标是“理解一个现代高性能开源系统由哪些零件组成”。
有意思的是,讲师的结论是架构本身几乎没变:
- DeepSeek MoE(他称之为 v1):16B 参数、2.8B 激活;2 个共享专家 + 64 个细粒度专家,其中约 4–6 个激活;路由是最标准的 top-K,softmax 放在 top-K 之前;训练时用专家级 + 设备级两种辅助均衡损失。
- DeepSeek V2:236B 参数、21B 激活。幻灯片干脆复用了同一张架构图,因为“架构字面上是一样的”,只是专家数和激活数变了。新增两件事:一是 top-M 设备路由——先挑出候选设备(top-M),再在设备内挑 top-K 专家,用这种方式把通信成本控制住;二是新增一条通信均衡损失,因为专家并行下不仅要平衡输入通信,还要平衡“把 token 送回原处”的输出通信。
- DeepSeek V3:671B 参数、37B 激活。门控做了归一化改动(把归一化挪到前面、用 sigmoid 替代 softmax 里的部分计算,行为更柔和);均衡改成 per-expert bias 的“无辅助损失”方案 + 序列级辅助损失;保留了 top-M 设备路由,但砍掉了 V2 的通信均衡损失——讲师强调“他们并不是一味做加法,也删东西”。
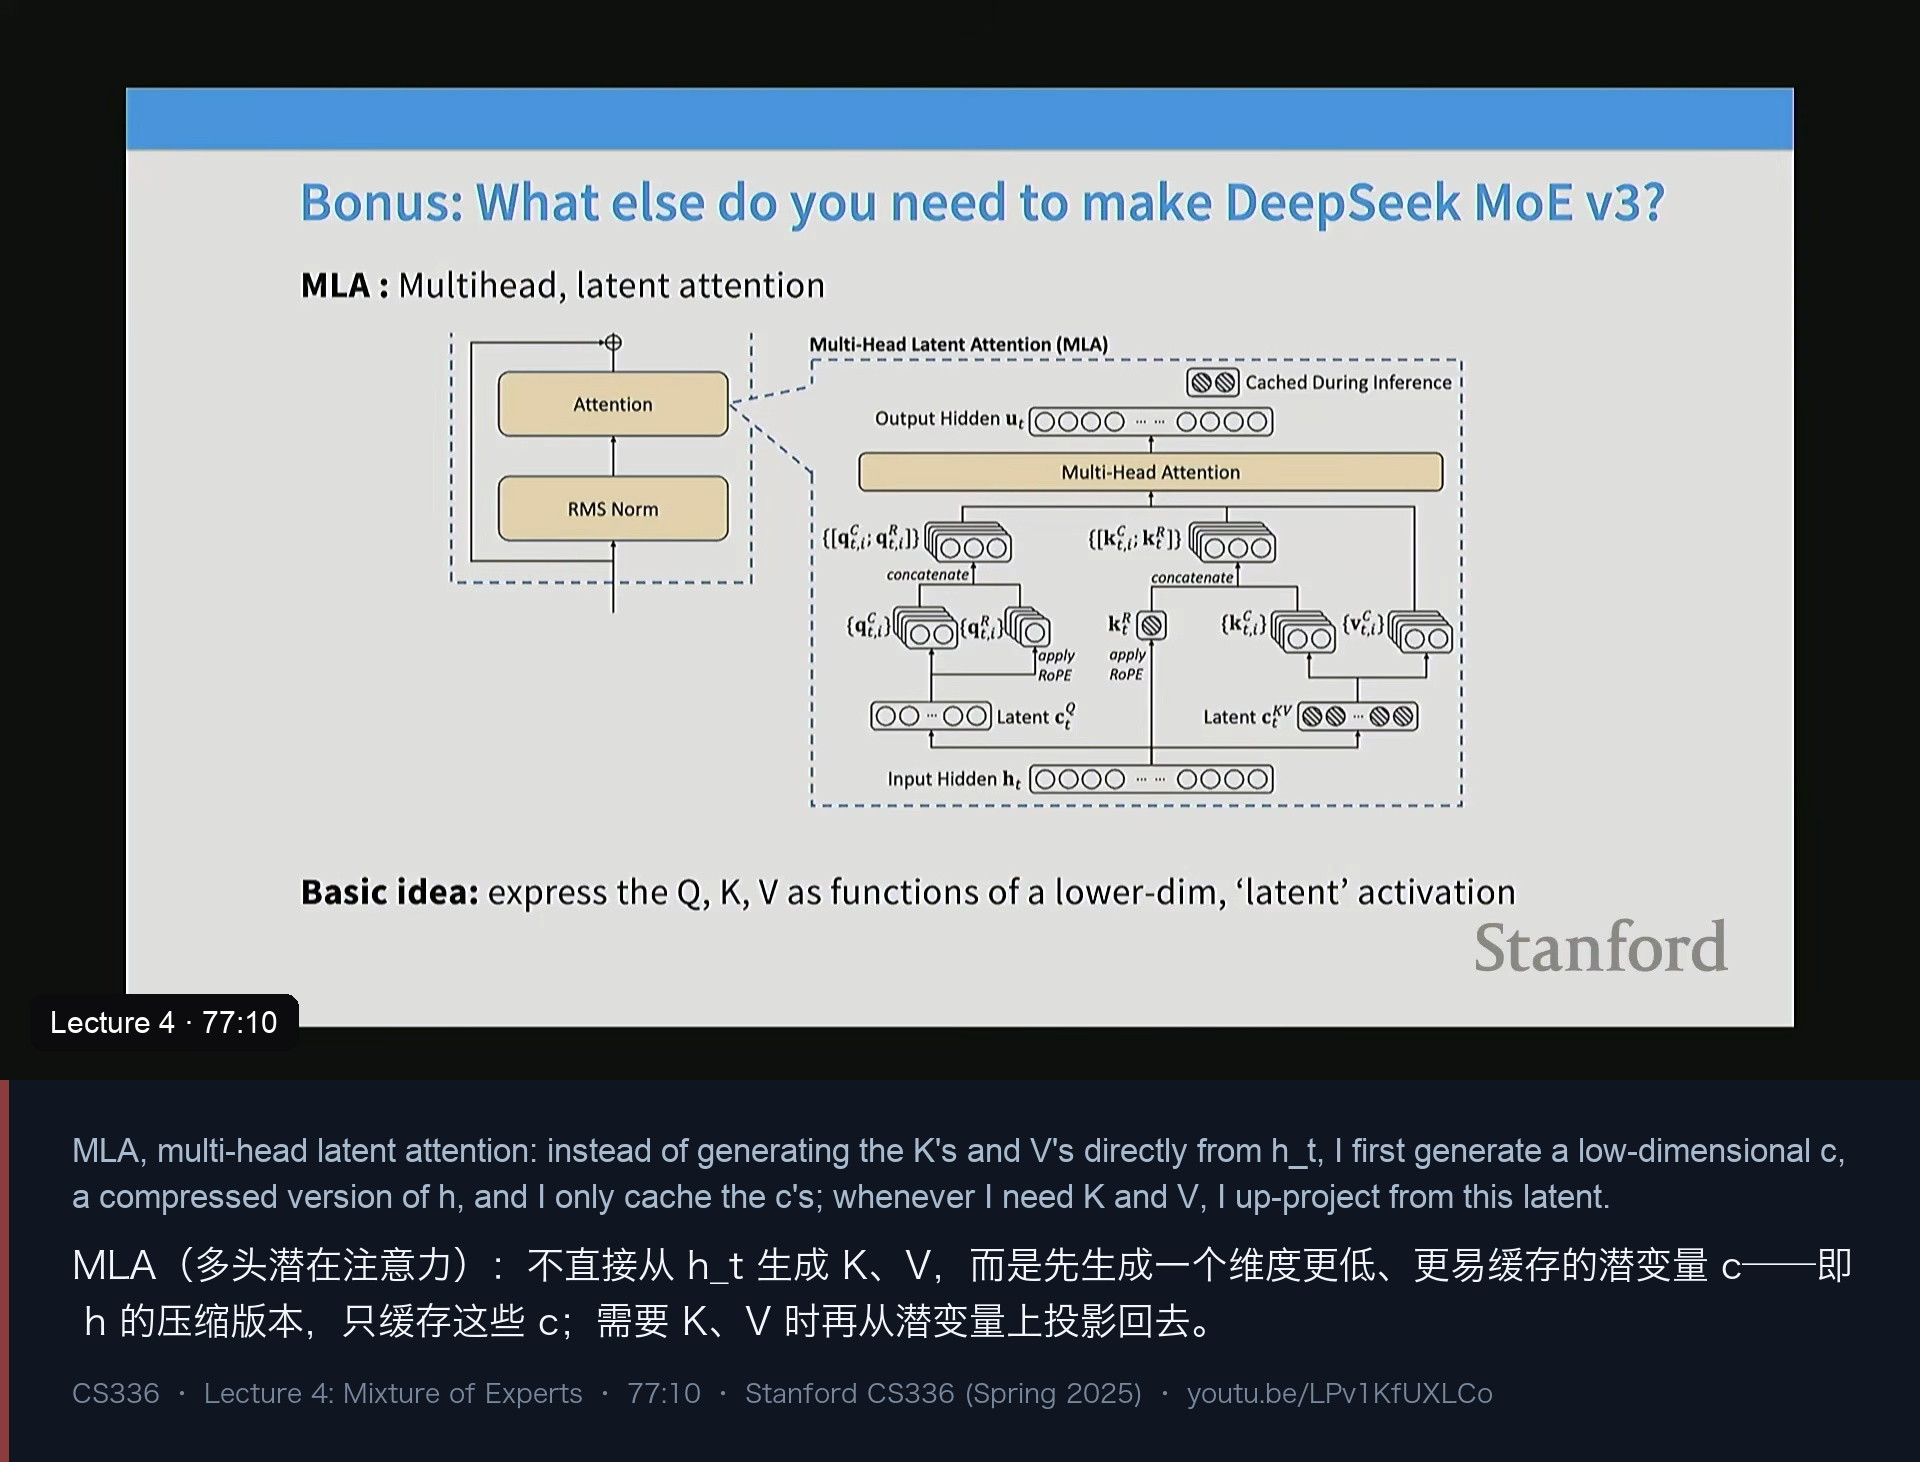
最后是 MoE 之外的两个部件,讲师说“你们其实已经具备了理解它们的全部原料”:
MLA(multi-head latent attention) 解决的是 KV cache 的显存问题。第三讲讲过 MQA/GQA 是“减少头的数量”,MLA 换了条路:把注意力的 Key/Value 投影到一个低维潜空间。具体说,不直接从 h_t 生成 K 和 V,而是先生成一个低维的 c(h 的压缩版本,更容易缓存),只缓存这些 c;需要 K、V 时再从 c 上投影回去。
这里有一个很漂亮的工程细节:多出来的那次上投影矩阵 W_UK 看起来增加了 FLOPs,但因为在注意力的另一侧 Q 也有自己的投影矩阵,两者可以合并成一次矩阵乘法——“这只是结合律”。讲师也坦白说,这套技巧和 RoPE 不兼容(旋转矩阵会夹在投影之间,无法随意重排),DeepSeek 的解法是只对未压缩的维度做 RoPE,属于“一个次要的技术点”。
MTP(multi-token prediction) 是损失函数上的小改动:正常 Transformer 预测下一个 token,而 MTP 在预测之前把隐状态送进一个很轻量的单层 Transformer,让它同时预测再下一个 token。讲师最后吐槽了一句:读论文时才发现,“虽然图里画得很复杂、看起来可以预测很多个,但他们实际上只做了一个 token 的预测”。
我的笔记:这一讲值得记住的 8 句话
- MoE 不改变“计算什么”,只改变“用哪些参数计算”。 同样 FLOPs 下参数量更大,是它全部收益的来源;除此之外它和稠密模型几乎一样。
- “专家”不是领域专家,而是稀疏激活的子网络。 这个误解会一直误导你对 MoE 的直觉。
- FLOPs 对齐下 MoE 稳定胜出,从 Fedus et al. 2022 到 OLMoE 的受控对比都成立;但横轴必须看清楚——“激活参数”这个词让很多对比图变得好看。
- 路由已经收敛到 token choice top-K。不是因为它最优雅,而是因为它在 loss 曲线上“行为最好、衰减最快”;expert choice 换来负载均衡,但牺牲了按需分配。
- router 只是一个内积 + softmax + top-K 的逻辑回归。它简单不是因为设计者偷懒,而是因为梯度信号本来就极其间接、系统成本又很敏感。
- 细粒度专家是共识,共享专家有分歧。DeepSeek 的两个创新里,只有前者被第三方(OLMoE)消融证实“稳赢”。
- 均衡损失既保系统效率,也保模型质量。 不做均衡,你会“意外得到一个两专家模型”,白扔掉大部分参数;DeepSeek V3 的“无辅助损失”最后还是加回了一条序列级损失。
- MoE 的随机性来自 batch。 token dropping 让输出依赖于“同批次的其他人”,这是跨 batch 效应——也是 GPT-4 在 temperature=0 下不稳定的一个可能解释(讲师强调这只是一个猜测)。
附:课程信息与时间轴
- 课程:Stanford CS336《Language Modeling from Scratch》(Spring 2025)
- 本讲:Lecture 4 · Mixture of Experts
- 主讲:Percy Liang(本讲) / Tatsunori Hashimoto
- 视频:https://www.youtube.com/watch?v=LPv1KfUXLCo(时长约 1:22)
- 播放列表:Stanford CS336 Spring 2025
| 时间 | 内容 |
|---|---|
| 0 | 开场:MoE 成为现代高性能系统的默认架构 |
| 1 | MoE 名字的误导:它其实是“稀疏激活的 FFN” |
| 2 | 核心账本:同样 FLOPs 下拿到更多参数 |
| 4 | Fedus et al. 2022:专家越多,训练 loss 越低 |
| 5 | OLMoE 的受控对比复现同一结论 |
| 7 | DeepSeek V2:激活参数 vs MMLU(横轴的“障眼法”) |
| 7 | 专家并行:又一个并行维度 |
| 9 | Qwen 1.5 升格;DeepSeek 的稠密 / 朴素 MoE / Switch 对比 |
| 12 | 为什么 MoE 没更流行:系统复杂 + 路由不可微 |
| 13 | 稀疏注意力路由(少见) |
| 14 | MoE 的三个设计问题 |
| 15 | 路由家族:token choice / expert choice / 全局分配 |
| 17 | 为什么收敛到 token choice top-K |
| 19 | router 是什么:一个内积 |
| 20 | K 该怎么取:探索与 K=2 的传统 |
| 22 | 哈希路由也能 work(以及为什么) |
| 22 | 被淘汰的方案:RL、线性分配、最优传输 |
| 23 | top-K 路由的完整机制 |
| 26 | softmax 的作用是“归一化到 1”,不是“选最大” |
| 27 | 为什么必须有 top-K:系统效率 |
| 30 | 为什么 router 这么简单 |
| 32 | 细粒度专家 + 共享专家(DeepSeek 式创新) |
| 34 | DeepSeek 自己的消融 |
| 36 | OLMoE 消融:细粒度稳赢、共享专家存疑 |
| 36 | 近期 MoE 配置总表(含 1/4 细粒度比例) |
| 41 | 训练难题:稀疏 + 不可微,三条出路 |
| 42 | 路线一:强化学习(被放弃) |
| 44 | 路线二:随机扰动 / noisy top-K |
| 47 | 路线三:均衡损失才是实践答案 |
| 48 | Switch Transformer 的 f·P 辅助损失 |
| 51 | 设备级均衡与通信成本 |
| 52 | DeepSeek V3:per-expert bias 的“无辅助损失” |
| 53 | 反转:序列级辅助损失又加回来了 |
| 55 | 均衡不是系统问题:不做均衡会得到“两专家模型” |
| 58 | 死专家分布图 |
| 59 | 专家并行:all-to-all 派发与合并 |
| 61 | 融合稀疏算子与 MegaBlocks |
| 62 | token dropping 与 MoE 的随机性 |
| 65 | 稳定性:float32 router 与 z-loss |
| 67 | 微调时的过拟合与“稠密/MoE 交替层” |
| 68 | 用海量 SFT 数据压过拟合(140 万条) |
| 68 | 升格(upcycling):MiniCPM 与 Qwen |
| 70 | DeepSeek V1:16B 总参 / 2.8B 激活 |
| 71 | DeepSeek V2:236B / 21B,top-M 设备路由 |
| 74 | DeepSeek V3:671B / 37B,门控归一化 |
| 76 | MLA:多头潜在注意力与 KV cache 压缩 |
| 80 | MTP:多 token 预测(实际只预测一个) |
| 81 | 总结:利用稀疏性,驯服离散路由 |
说明:本文是视频内容的整理、翻译与转述,观点均来自主讲人 Percy Liang;文中代码为讲座中算法与公式的整理版本,非官方作业代码。课程中引用的模型规模、专家数、激活比例、训练数据量与时间线多来自公开论文、技术报告、泄漏传闻或讲师的估算,请自行核实。
讨论
这里是静态站点,没有内嵌评论区。如果这篇文章对你有用,欢迎通过 RSS 订阅后续更新。