Stanford CS336 第三讲精读:Transformer 架构与超参数,哪些改动是真的重要?
斯坦福 CS336(Language Modeling from Scratch, Spring 2025)第三讲完整讲义:主讲 Tatsunori Hashimoto 把 2017–2025 的架构演化当成一份实验数据来读——pre-norm 是唯一的铁律,RMSNorm 与删掉 bias 背后是访存而非 FLOPs,SwiGLU 为什么赢了,位置编码如何收敛到 RoPE,d_ff、头维度、宽深比、词表大小的共识与例外,以及 z-loss、QK norm、MQA/GQA 与稀疏注意力这些稳定性与推理侧的关键改动。
本篇属于系列 Stanford CS336 精读 · 第三讲
来源:YouTube 原视频(Stanford Online · CS336 Language Modeling from Scratch · Spring 2025 · Lecture 3: Architectures, Hyperparameters)
来源说明 这是斯坦福 CS336《Language Modeling from Scratch》2025 年春季第三讲的完整讲义,主讲人是 Tatsunori Hashimoto(Percy Liang 的合讲人)。这一讲他自己取了个标题——“关于语言模型架构与训练,所有你本来不想知道的细节”:和 Percy 用可执行 Python 讲课不同,这堂是 PPT 课,主题是“向别人的经验学习”。他一边回顾 2017 年原始 Transformer 到现在(2025 年 4 月)的架构演化,一边回答那些别处通常不会讲的琐碎问题:超参数到底该取多少、归一化该放哪里、为什么那么多模型都收敛到了同一套配置。文中 18 张配图均截取自视频对应时刻的幻灯片,并把该时刻的完整观点句(英文原句+中文翻译)拼合进图中。图与正文里出现的参数量、维度、词表大小、成本与时间线,都是讲师引用的公开论文、模型卡或传闻/估算,不是本文独立核实的事实;标为“正在做”或“据说”的部分尤其如此。
TL;DR
- 这一讲的方法论是“把架构史当成实验数据读”:过去一年大约有 19 个新的稠密模型发布,大多数只做了细小的架构微调;把它们排成一张 2017→2025 的表,就能看出哪些改动是“所有人都同意”的,哪些只是各家在试探。
- 2024 年唯一真正没有争议的架构决定是 pre-norm:把 LayerNorm 放到残差流之外(非残差分支的前面)。几乎所有现代语言模型都这么做,只有 BERT 一代和 OPT-350M 是例外。
- 新的变化是“双重 norm”:既然 norm 放进残差流不好,那就在残差流之外两端都放。Grok、Gemma 2 这么做,Olmo 2 只做非残差的 post-norm。
- RMSNorm 与“删掉 bias”的真正理由是访存,而不是 FLOPs:矩阵乘法占 99.8% 的 FLOPs,归一化只占 0.17%,但因为要搬内存,归一化在运行时里占了相当大的比例——所以要少算一次均值、少存一组 bias。
- 激活函数的赢家是门控线性单元(GLU):SwiGLU/GeGLU 在多个消融里稳定优于 ReLU/GELU,但它是“更好”而不是“必需”——GPT-3 用 ReLU,Nemotron 340B 用 squared ReLU,Falcon 2 11B 也用 ReLU。
- 位置编码已经收敛到 RoPE:正弦、绝对、相对三派打了很多年,如今几乎所有模型都用 RoPE;它的思想是“内积对旋转不变”,所以把位置信息编码成全维向量两两一组的旋转角,并且作用在 attention 的 Q/K 上,而不是加在输入 embedding 上。
- 超参数其实只有几个真正会被动:d_ff/d_model 要么 4(ReLU)要么 8/3(GLU)、每头维度比保持 1、每层约 128 个隐藏维度、词表 3–5 万(单语)到 10–25 万(多语/生产)。T5 的 64 倍 d_ff 是著名异类,而它在 T5 v1.1 里又悄悄走回了 2.5。
- weight decay 在预训练里的作用反直觉:它不是用来对抗过拟合(预训练连一个 epoch 都跑不完),而是与学习率调度发生复杂相互作用,让训练尾声的损失降得更低。
- 过去一年最“新”的东西是稳定性技巧:z-loss、QK norm、logit soft cap——注意力里那两个 softmax 是数值不稳定性的主要来源。
- 推理侧的算术强度是另一个世界:训练时 attention 的算术强度很高,一到逐 token 生成,KV cache 让访存暴涨、算术强度崩塌,这才有了 MQA、GQA 与稀疏/滑窗注意力。
一、这一讲的位置:从“亲手造”到“向别人的经验学习”
第三讲的主讲是 Tatsunori Hashimoto。他开场先自嘲了一句:自己讲课没有 Percy 那么“创新”,所以你们拿到的是 PowerPoint 而不是可执行的 Python,PDF 会放在课程网站上。
他给这一讲取的名字是“关于语言模型架构与训练,所有你本来不想知道的细节”——因为要讲那些别的课通常会跳过的琐碎问题,比如“我的超参数到底该取多少”。
整门课的主题是 hands-on:最好的学习方式是亲手实践。但这一讲的主题不是——因为我们不可能把这些 Transformer 都真的训一遍,所以这一讲的主题是“向别人的经验学习”。他给出的理由很实在:没有哪篇论文会老老实实写全所有细节,但把所有论文放在一起看,就能做一次“演化分析”(evolutionary analysis),反推出哪些东西是让 Transformer 真正 work 的关键。
具体做法是:他整理了一张从 2017 年原始 Transformer 一直到 2025 年最新模型的架构对照表。过去一年大约有 19 个新的稠密模型发布(这是讲师在课上给出的数目,属于他自己的统计),其中很多只是细微的架构调整。单看每一篇会觉得“这都在干嘛”,但放在一起反而信息量极大——因为不同模型的选择并不一致,分歧点恰好暴露了哪些选择有意义。他还自嘲说 Percy 早就警告过他:“你这门课每年都得重做一遍。”
顺带一提,他在课上也提醒学生:作业在持续更新(修的是一些小 bug),做作业的同学记得随时 git pull。
二、两个 Transformer:原始版 vs 你们要实现的那一版
讲座从复习开始,给出两个版本的 Transformer:一个是 224N 那种课上会讲的标准版,另一个是 CS336 要求学生实现的“现代共识版”。
原始的 Transformer(2017)长这样:底部是简单的正弦位置编码,然后是多头注意力,之后接 LayerNorm,有一条向上的残差流,再是 MLP,最后 softmax。
而学生在作业里要实现的版本,做了四处关键修改:
- LayerNorm 放到 block 的最前面(pre-norm,而不是原始版的 post-norm);
- 使用旋转位置编码 RoPE,而不是正弦位置编码;
- 前馈层用 SwiGLU,而不是 ReLU;
- 线性层不再输出 bias 项(基本上所有层都没有 bias 了)。
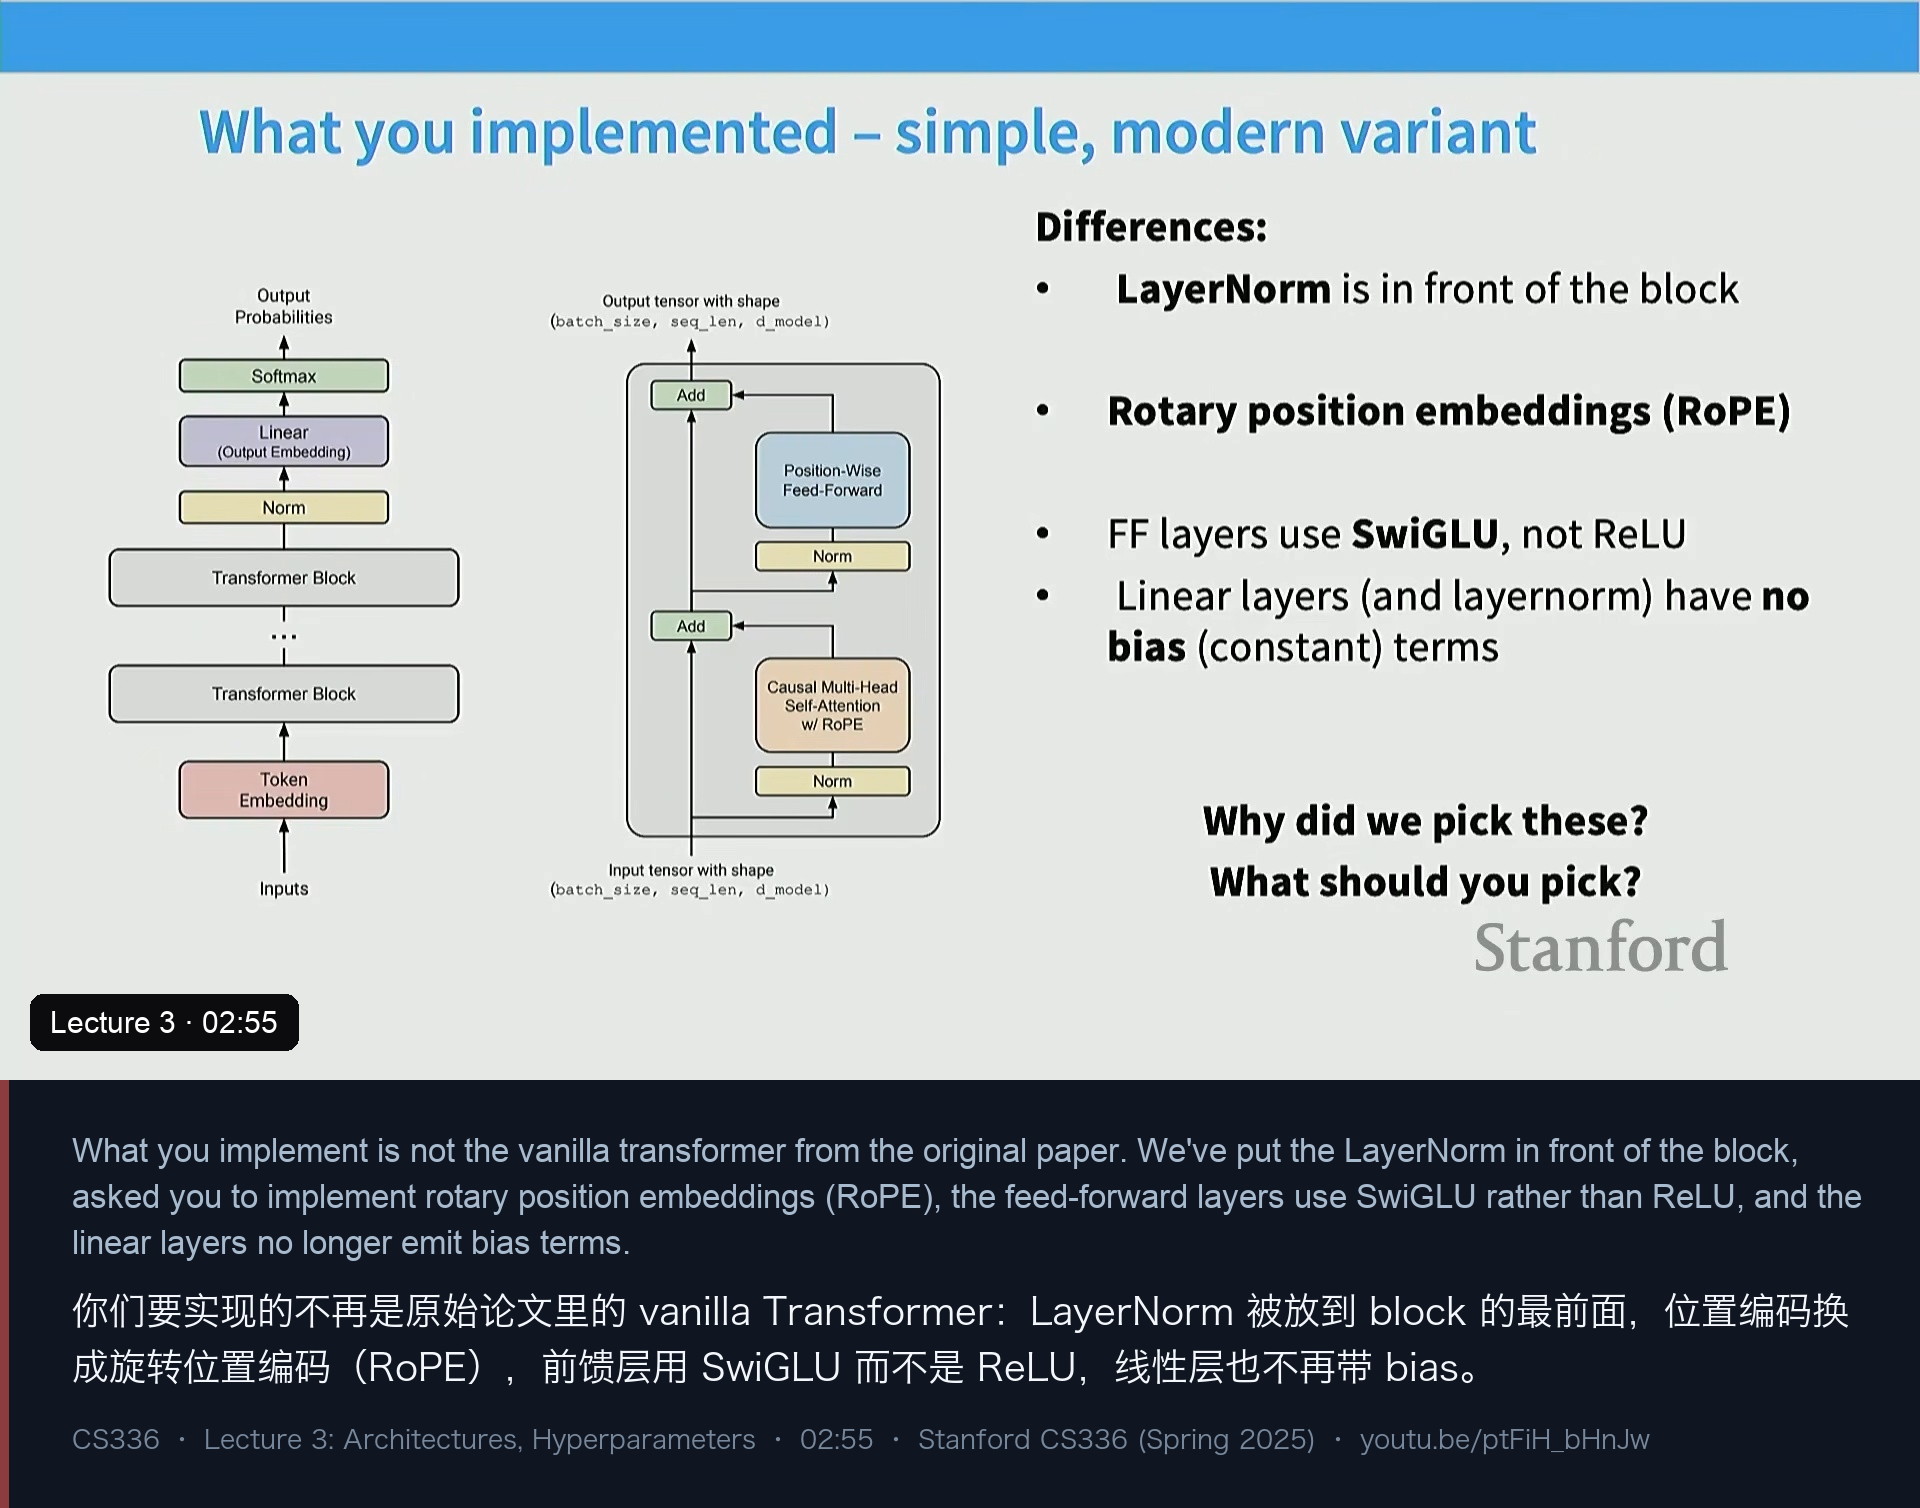
学生自然会问:为什么不让我们实现原汁原味的“Attention Is All You Need”版本,非要搞这个奇怪的变体?这一讲剩下的时间,基本就是在回答这个问题——每一项修改背后都有实证(或至少是系统层面)的理由。
三、LayerNorm 放哪里:pre-norm 是铁律,“双重 norm”是新鲜事
3.1 原始版为什么不好
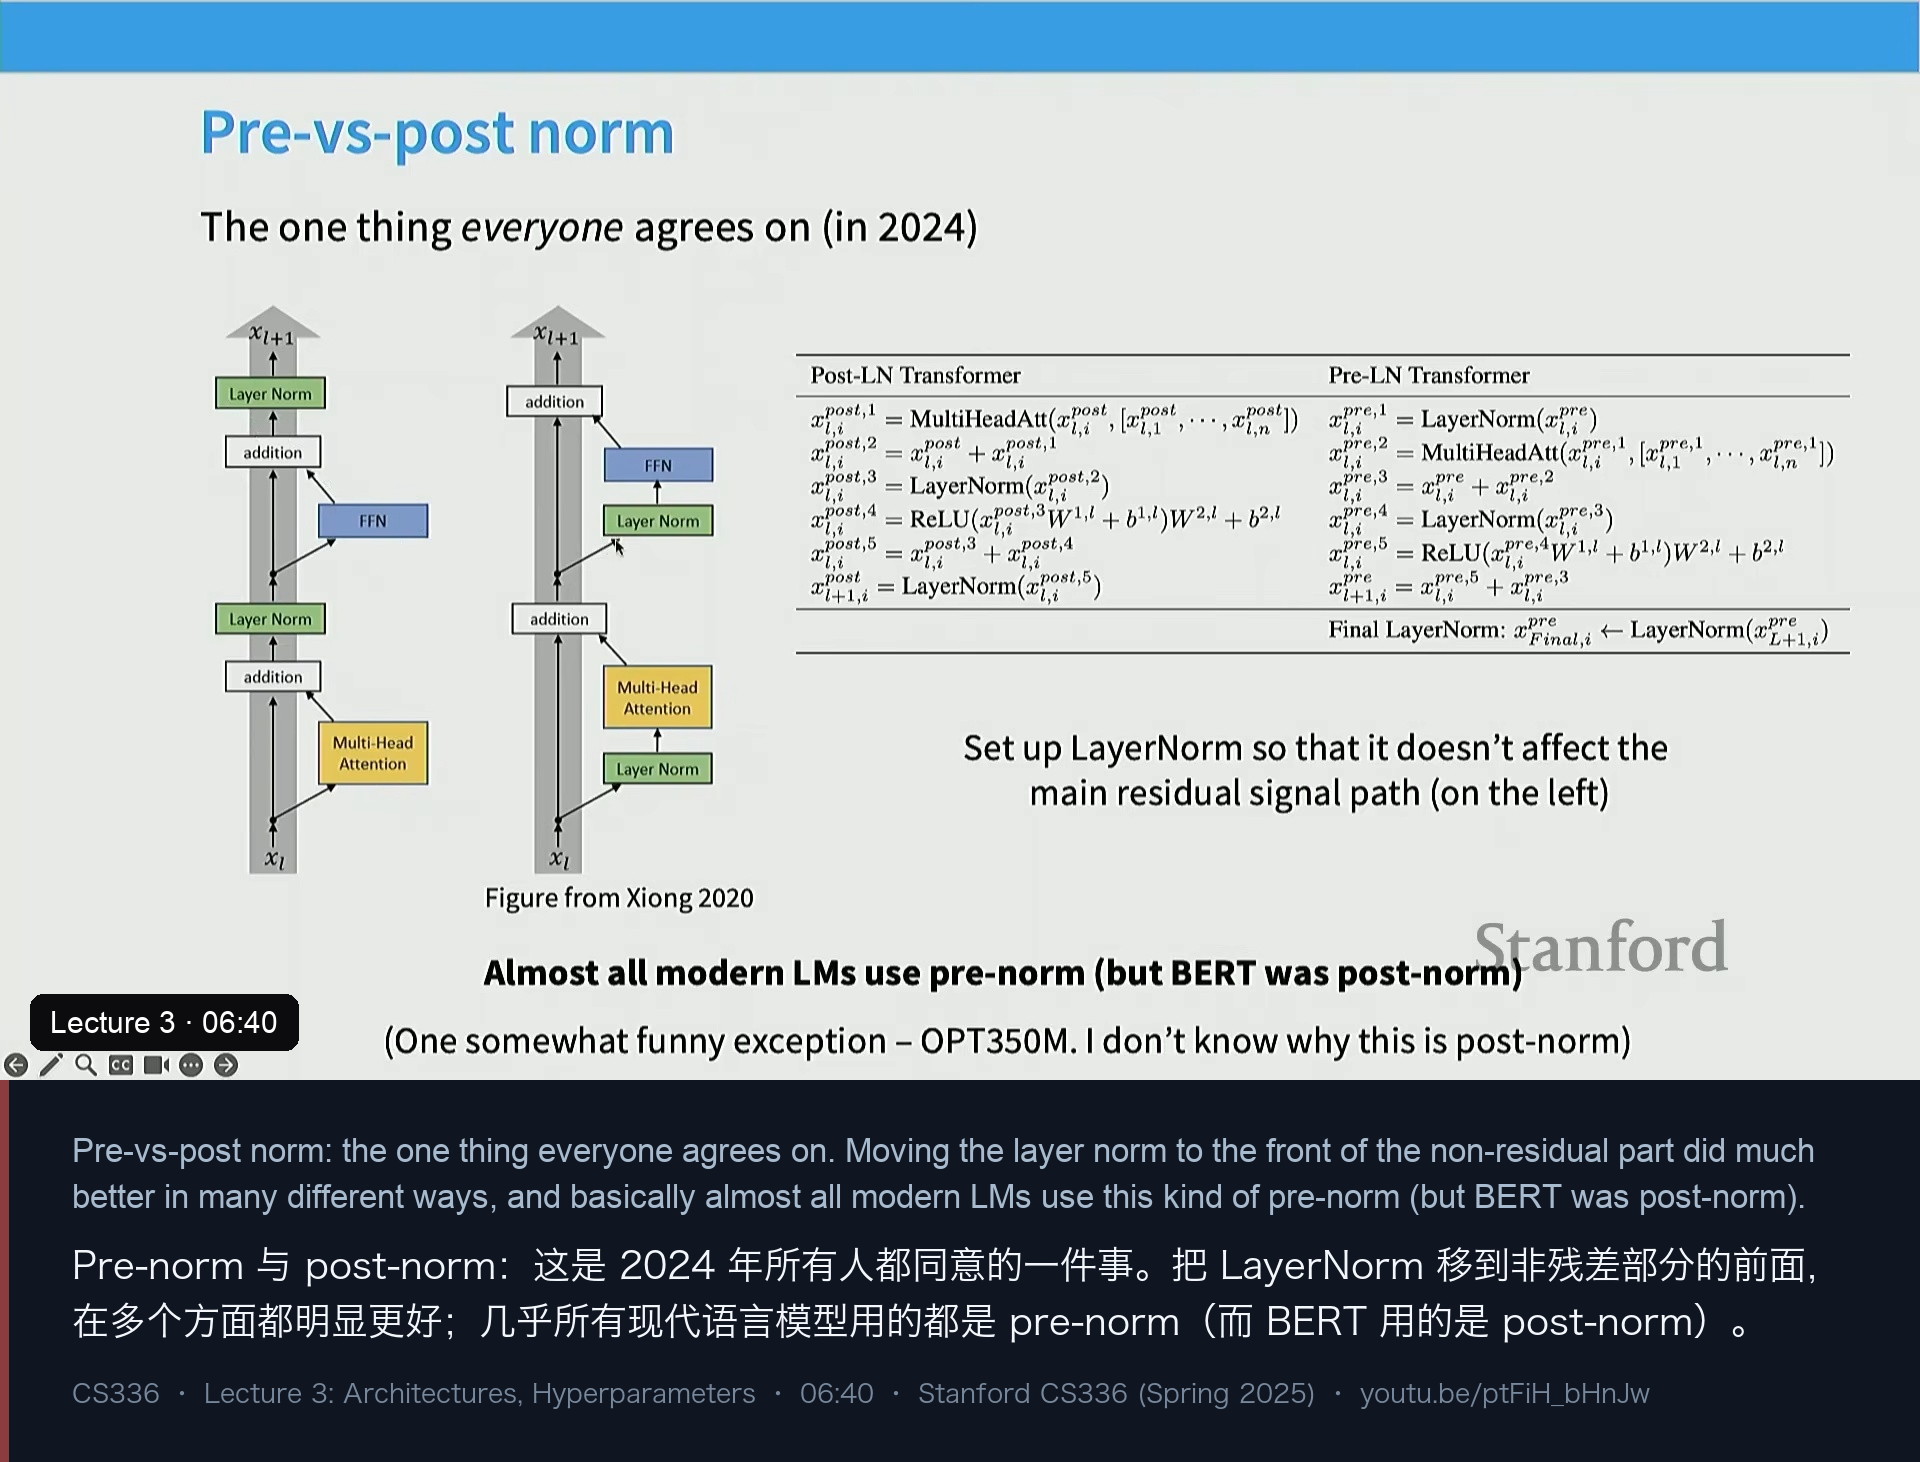
原始 Transformer 的做法是:每个子层(注意力、MLP)算完之后,先加回残差流,再做 LayerNorm。这意味着 norm 就压在残差主干道上。
把公式写出来对比一下(这里沿用讲义的记法):
Post-LN Transformer
  x^{post,1} = MultiHeadAttn(x^{post}, [x^{post}_1 … x^{post}_n])
  x^{post,2} = x^{post} + x^{post,1}
  x^{post,3} = LayerNorm(x^{post,2})
  x^{post,4} = ReLU(x^{post,3} W¹ + b¹) W² + b²
  x^{post,5} = x^{post,3} + x^{post,4}
  x^{post}_{l+1} = LayerNorm(x^{post,5})

Pre-LN Transformer
  x^{pre,1} = LayerNorm(x^{pre})
  x^{pre,2} = MultiHeadAttn(x^{pre,1}, [x^{pre,1}_1 … x^{pre,1}_n])
  x^{pre,3} = x^{pre} + x^{pre,2}
  x^{pre,4} = LayerNorm(x^{pre,3})
  x^{pre,5} = ReLU(x^{pre,4} W¹ + b¹) W² + b²
  x^{pre}_{l+1} = x^{pre,3} + x^{pre,5}

(pre-norm 的最后一层还要补一个 Final LayerNorm)
区别只有一处:norm 是在残差相加之前还是之后。 但结果差别很大。讲义引用 Xiong 2020 的说法:几乎所有人(至少 2024 年)都同意,应该把 LayerNorm 设置成“不影响主残差信号通路”——也就是放在非残差分支的前面。
3.2 为什么 norm 进残差流就不好
有学生现场问:“为什么把 LayerNorm 放进残差流里就不好?“讲师的回答很诚实:他给不出证明,但有一个直觉上很强的解释——
残差连接提供了一条从网络底部直达顶部的恒等通路(identity connection)。要训很深的网络,这条通路让梯度反向传播变得非常容易;而 LSTM、状态空间模型这类结构之所以难训,很大程度就是因为缺少这样一条干净的恒等路径。把 LayerNorm 塞进这条路中间,就破坏了这种梯度行为。
实证上也很干净:用 post-norm 训练,你会看到梯度范数剧烈震荡、loss 出现尖峰(spike);换成 pre-norm,这些尖峰明显减少,训练过程稳定得多。早期为了让 post-norm 能训起来,人们不得不做精细的学习率 warm-up;而用了 pre-norm 加上其他稳定性技巧之后,warm-up 甚至可以直接去掉。
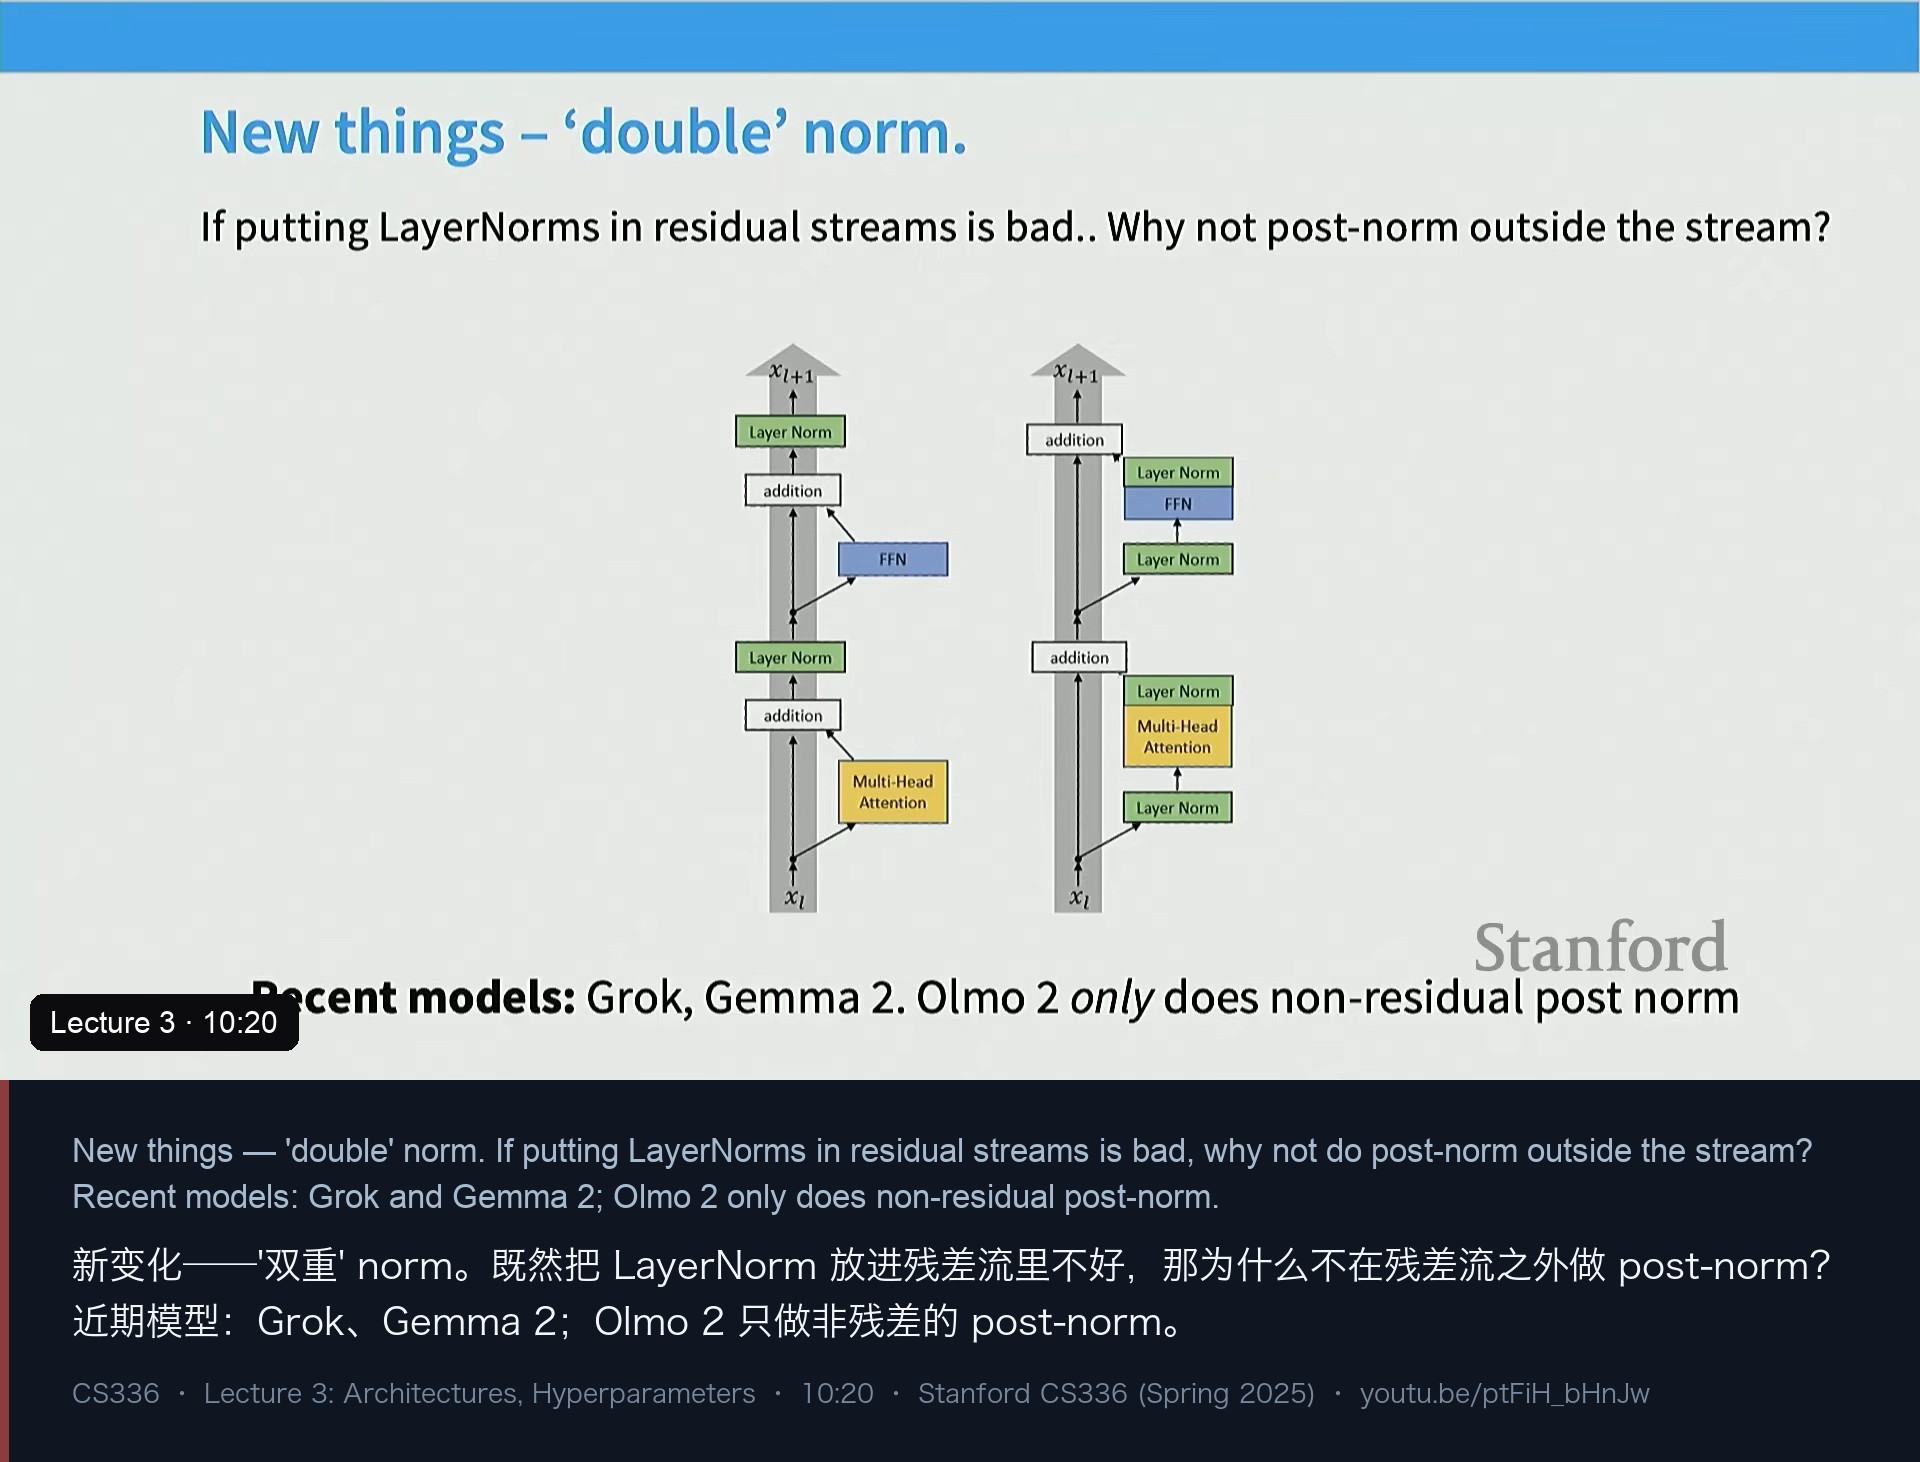
3.3 新鲜事:“双重” norm
既然 post-norm 放在残差流之外就没问题了吗?讲师的笔记里有个有趣的变化:最近有些模型在残差流之外的两端都加了 norm——sub-layer 的输入前加一个(pre-norm),输出后也加一个(非残差的 post-norm)。
- Grok、Gemma 2 都采用这种“双重 norm”;
- Olmo 2 只做非残差的 post-norm。
这在 pre-norm 统治多年之后算是一次小反转,支持者说它在超大模型上更稳定、更好训。
3.4 一个可以带走的“通用教训”
讲师被问到有没有更“面向未来”的教训。他的回答是:深度学习整体上是自下而上、高度经验的,很难有大一统理论,但确实有几条反复奏效的:
- 保持一条直接的恒等残差通路——这条经验在很多种架构里都成立;
- 别让激活值的尺度漂移(LayerNorm 之所以有效,很大程度是因为这一点);
- 认真考虑架构对系统组件(显存、通信、并行)的影响——这一讲后面会反复回到这条。
四、RMSNorm 与删掉 bias:真正被 FLOPs 掩盖的是访存
4.1 LayerNorm → RMSNorm
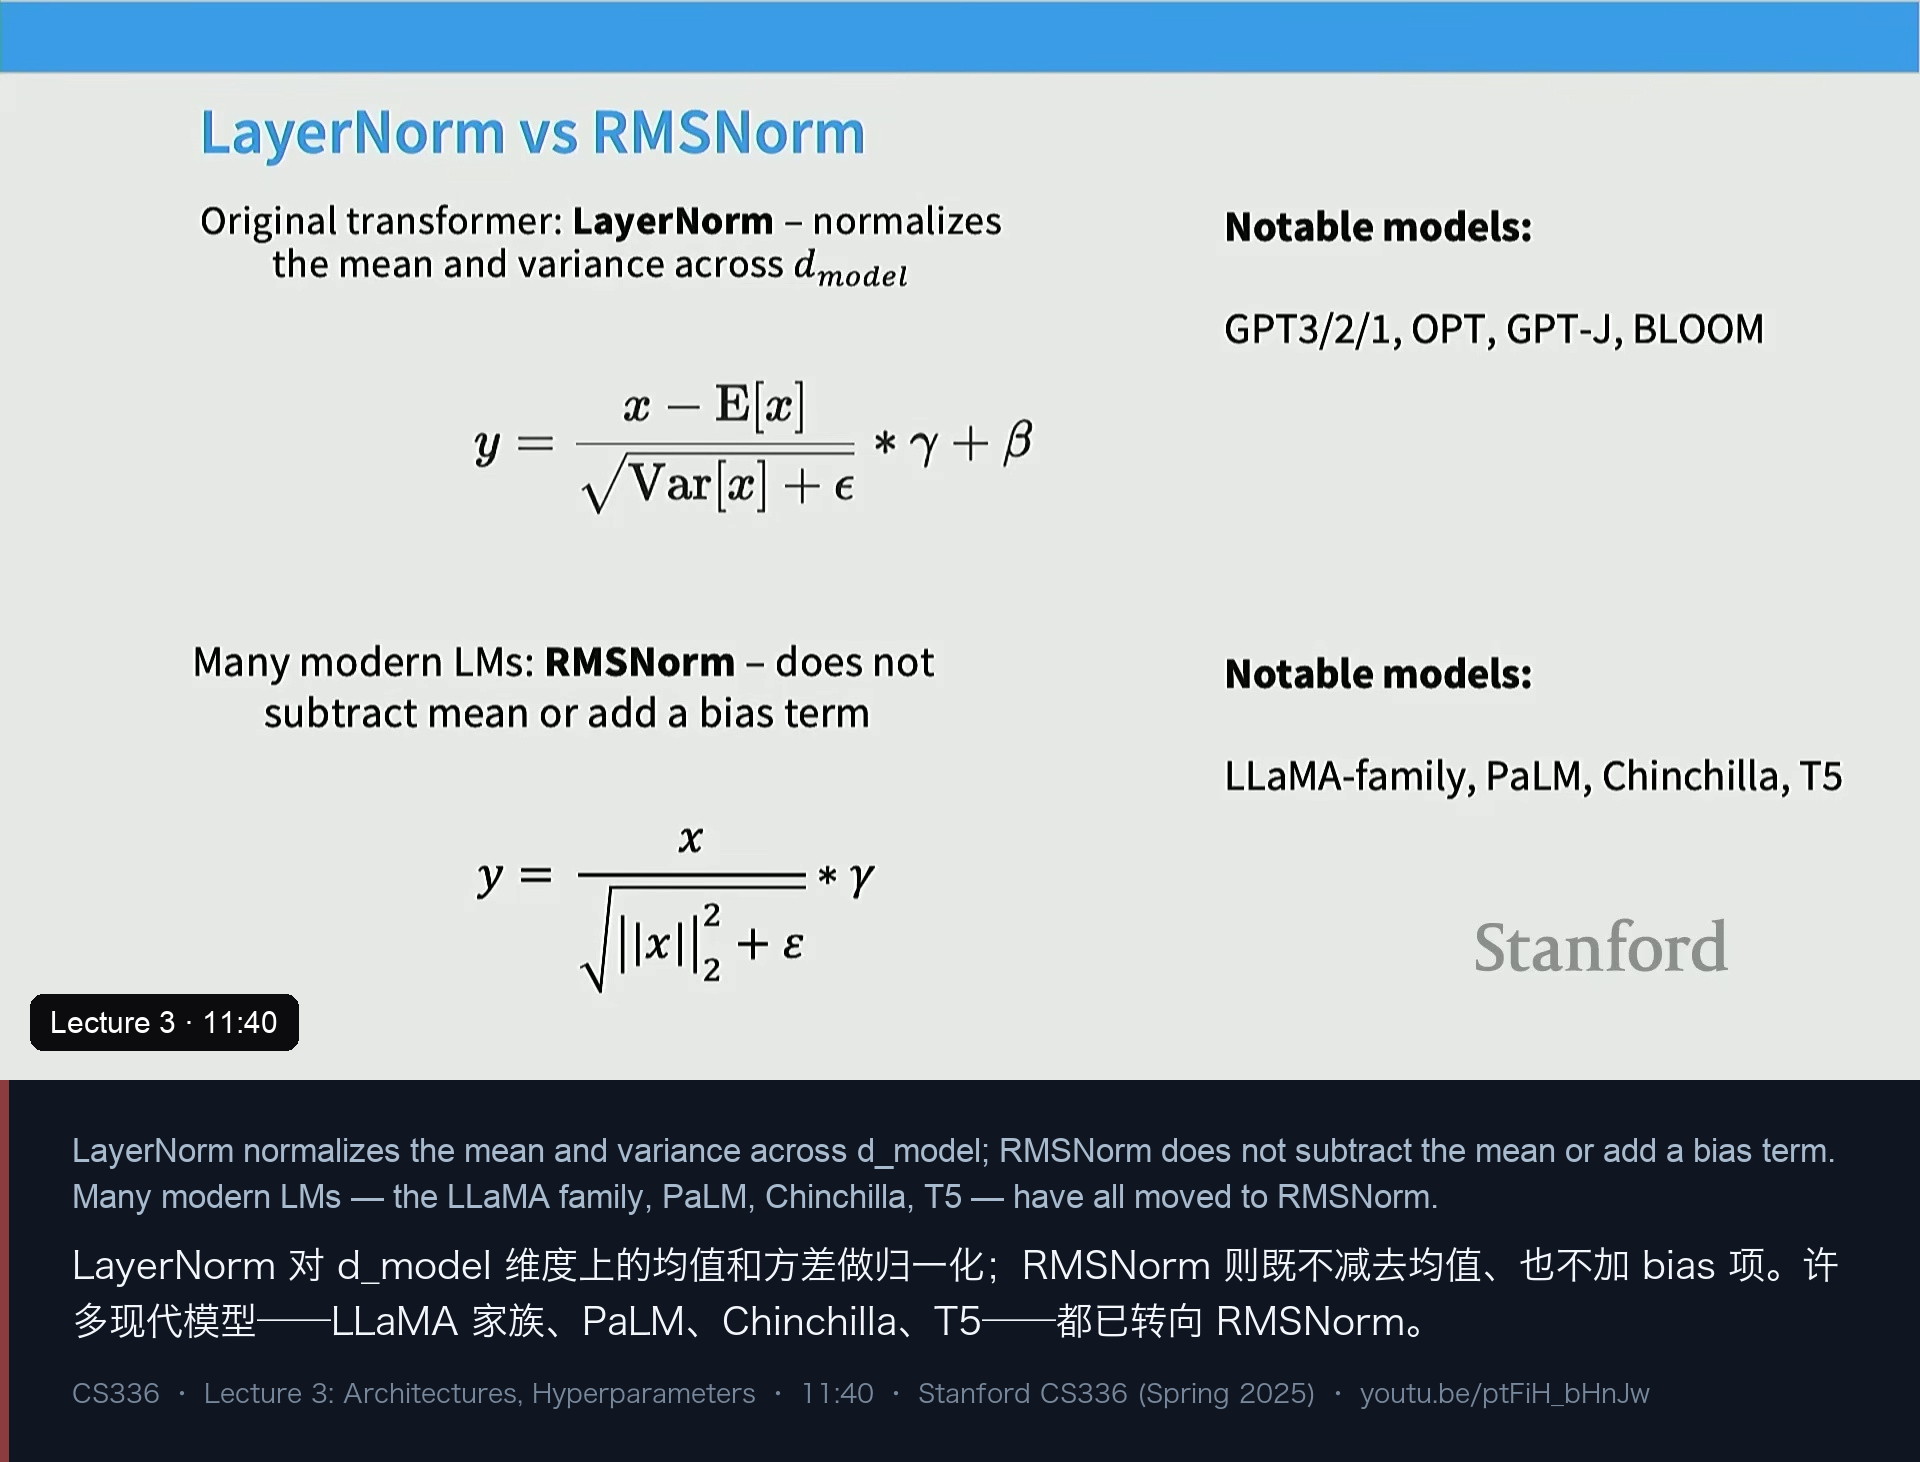
LayerNorm 的定义是对 d_model 维做标准化:
LayerNorm:
  y = (x - E[x]) / sqrt(Var[x] + ε) * γ + β

RMSNorm:
y = x / sqrt(||x||₂² + ε) * γ区别就是:RMSNorm 不减均值、也不加 bias 项 β。而 LLaMA 家族、PaLM、Chinchilla、T5 全都换到了 RMSNorm——这是又一个“所有人都在做”的共识改动。
理由有两条。第一条是简化:消融实验显示 RMSNorm 训出来的模型和 LayerNorm 效果差不多,那就没必要留着多余的部分。第二条(也是讲师更强调的)是速度:
- 不减均值 → 少一次运算;
- 不加 β → 少一组参数需要在内存和计算单元之间来回搬。
4.2 但等一下,你刚说过只有矩阵乘法重要
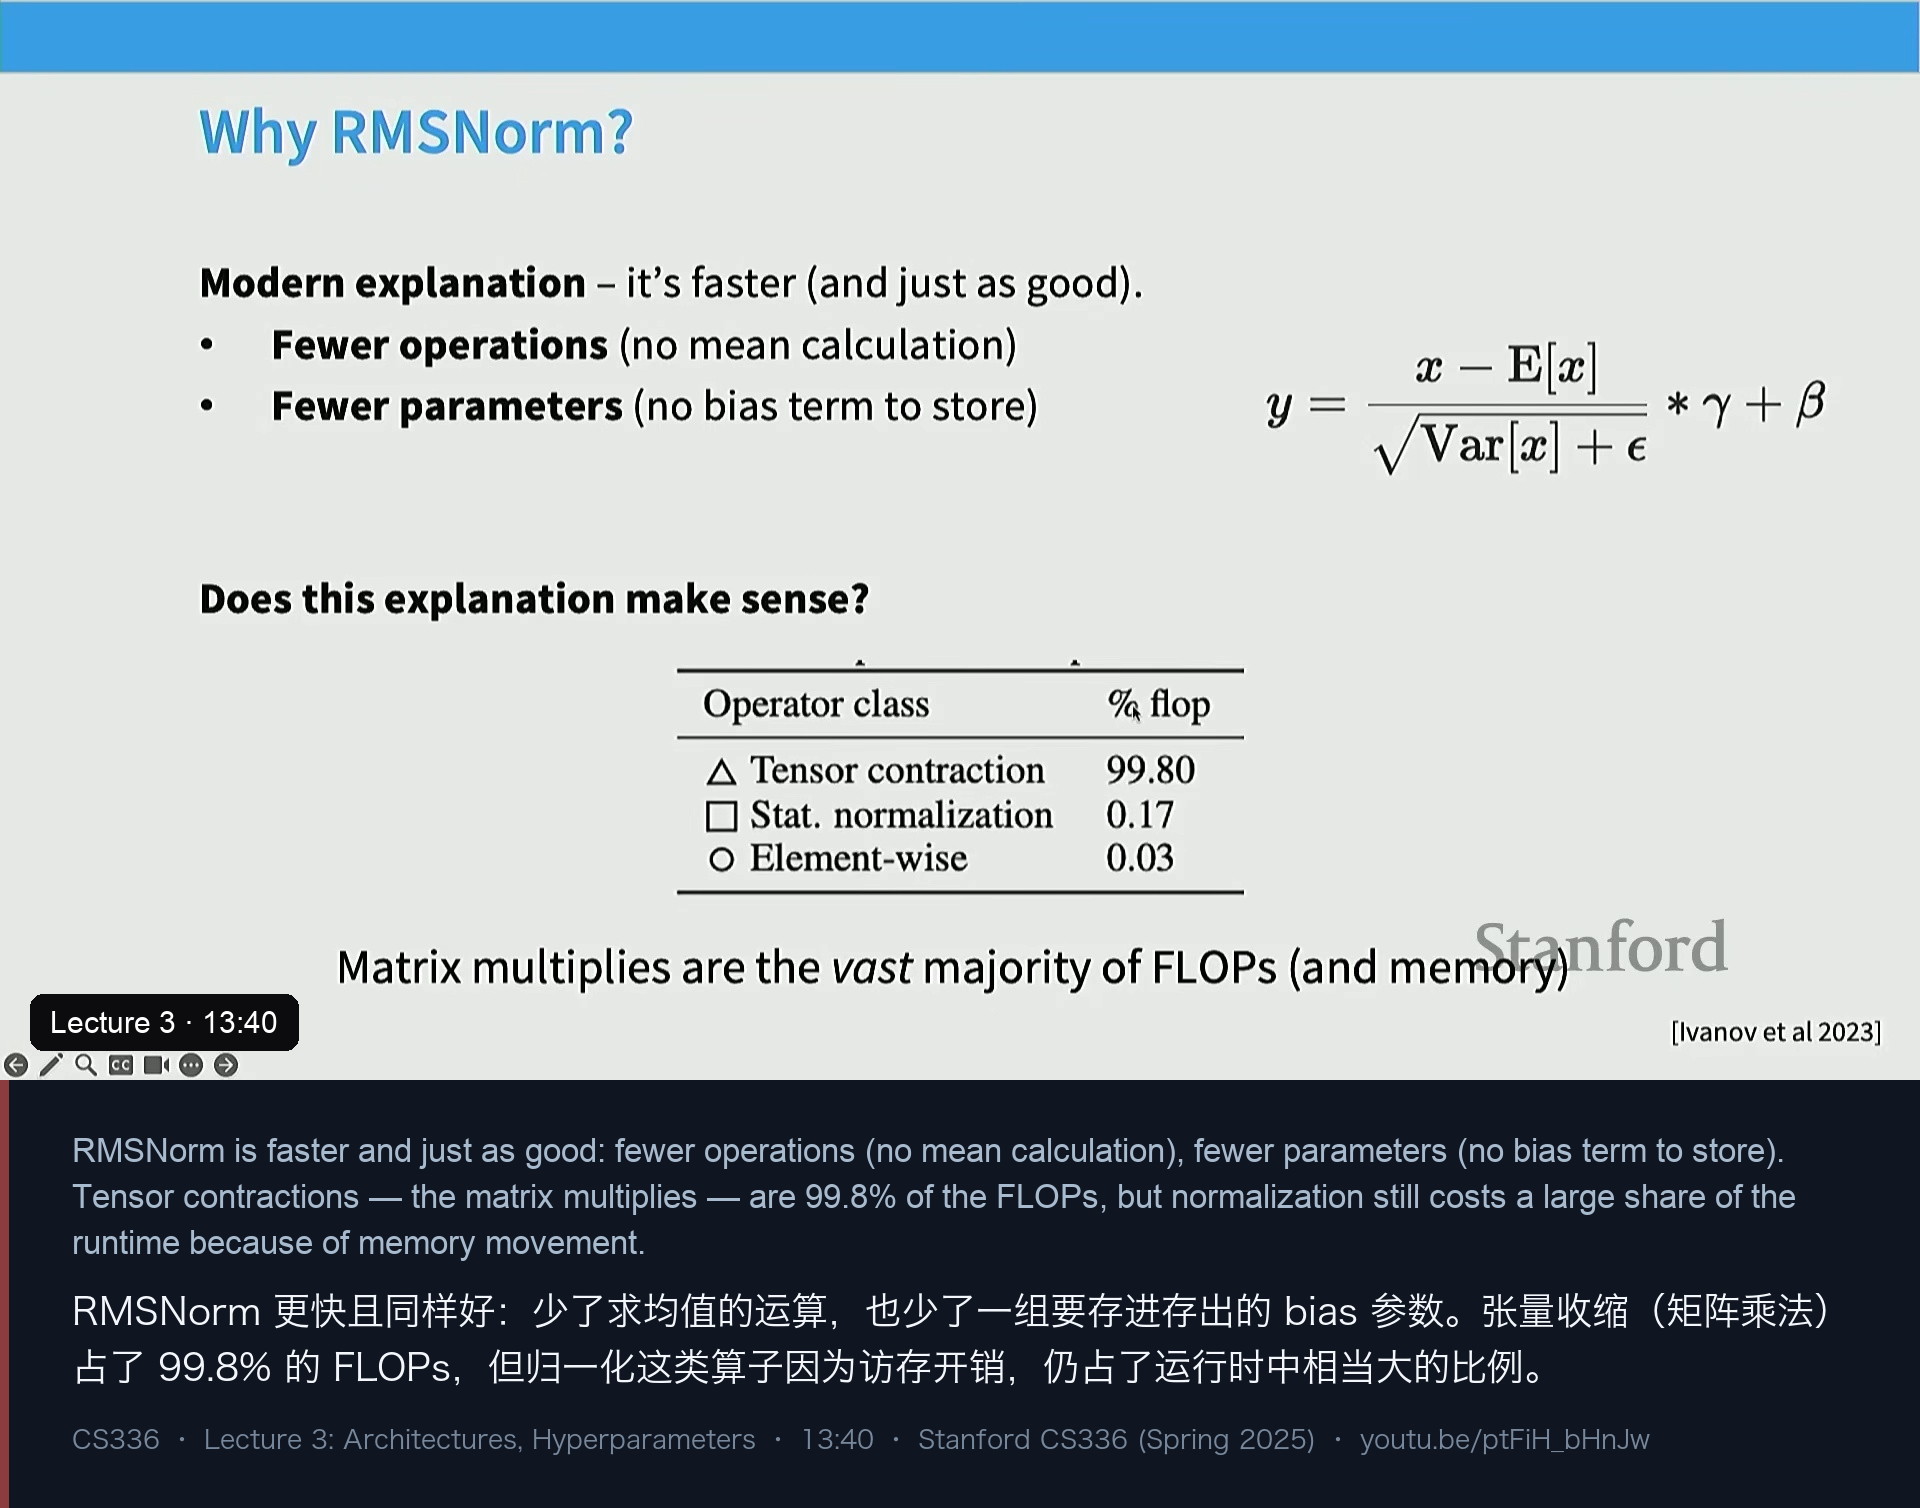
在 224N 里你会听到“运行时只由矩阵乘法决定,别的都不用管”。按这个逻辑,省掉一次求均值毫无意义。讲师给了一张 Ivanov et al. 2023 的算子剖析表:
Operator class            % FLOP
△  Tensor contraction     99.80
□  Stat. normalization     0.17
○  Element-wise            0.03
矩阵乘法确实占了 99.8% 的 FLOPs,归一化只有 0.17%。但归一化操作因为要搬内存,实际占了运行时中相当大的比例(讲师课上提到约 25%)。 这就是他反复强调的观点:设计架构时不能只盯 FLOPs,还要盯 memory movement。 后面讲 GPU 架构的系统课时,这个视角会变得越来越重要。
4.3 普遍删掉 bias
顺带的一个共识是:现代 Transformer 基本不再有 bias 项。原始版的前馈层是 ReLU(xW₁ + b₁)W₂ + b₂,而现在大多数实现写成 ReLU(xW₁)W₂。
理由同样来自两个方向:一是“其实一样好”——纯矩阵乘法就够用;二是一个更微妙的观察——去掉 bias 往往能让最大规模网络的训练显著更稳定(讲师坦言他对背后的深层原因理解有限,但经验证据很清楚)。
小结一下这一部分的三条“现代共识”:
- 所有人都在残差流之外做 norm(pre-norm 是铁律);
- 几乎所有模型都换成了 RMSNorm(少数例外,比如 Command 系列仍在用 LayerNorm);
- 大多数地方索性把 bias 全删了。
五、激活与门控:SwiGLU 为什么赢了
5.1 从 ReLU、GELU 到 GLU
讲师说自己刚入行时最不想学的就是激活函数(“反正都能训出来”),但后来发现它在实践中确实重要,尤其是 GLU 系列。
ReLU:   FF(x) = max(0, x W₁) W₂
GELU:   FF(x) = GELU(x W₁) W₂ ,   GELU(x) = x · Φ(x)
GLU:    FF(x) = (max(0, x W₁) ⊗ (x V)) W₂          # ReGLU,多了一个参数 V
GeGLU:  FF_GeGLU(x) = (GELU(x W₁) ⊗ (x V)) W₂
SwiGLU: FF_SwiGLU(x) = (Swish(x W₁) ⊗ (x V)) W₂ , Swish(x) = x · sigmoid(x)门控的直觉是:在普通前馈层的“隐藏部分”外面,再乘上一个逐元素的线性项 xV,相当于给每个隐藏单元配了一个学习出来的“阀门”。代价是多了矩阵 V,所以 GELU 和 SwiGLU 各多出一份参数。
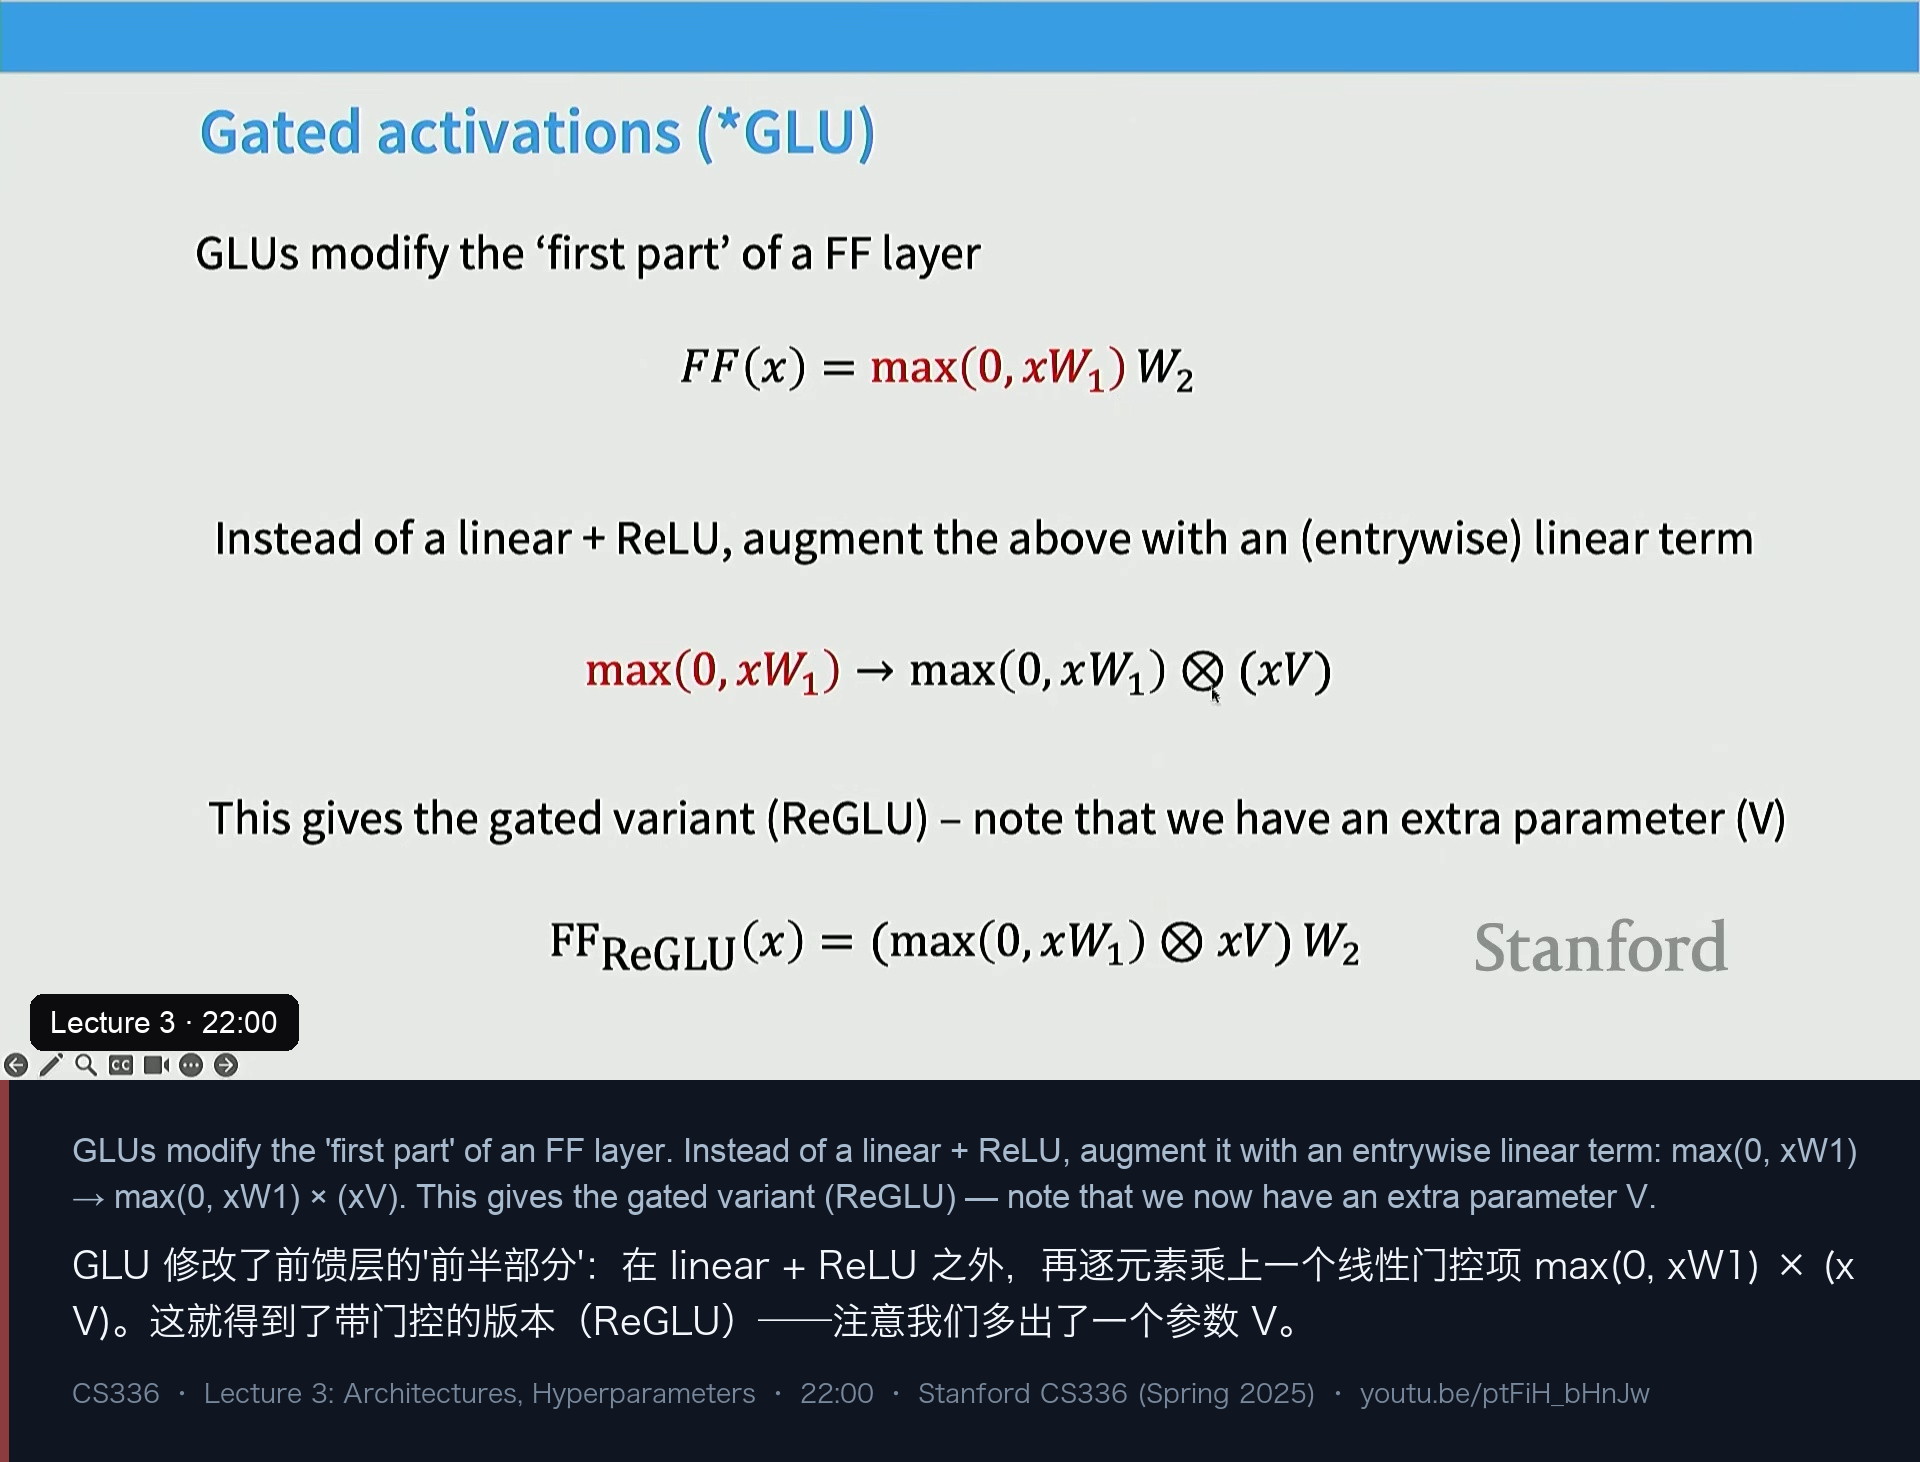
正因为多了一份 V,为了和未门控版本参数量对齐,GLU 模型会把隐藏维度缩小到原来的 2/3;反推 d_ff 的乘数就是 8/3 ≈ 2.67(下一节详述)。
5.2 门控真的有用吗
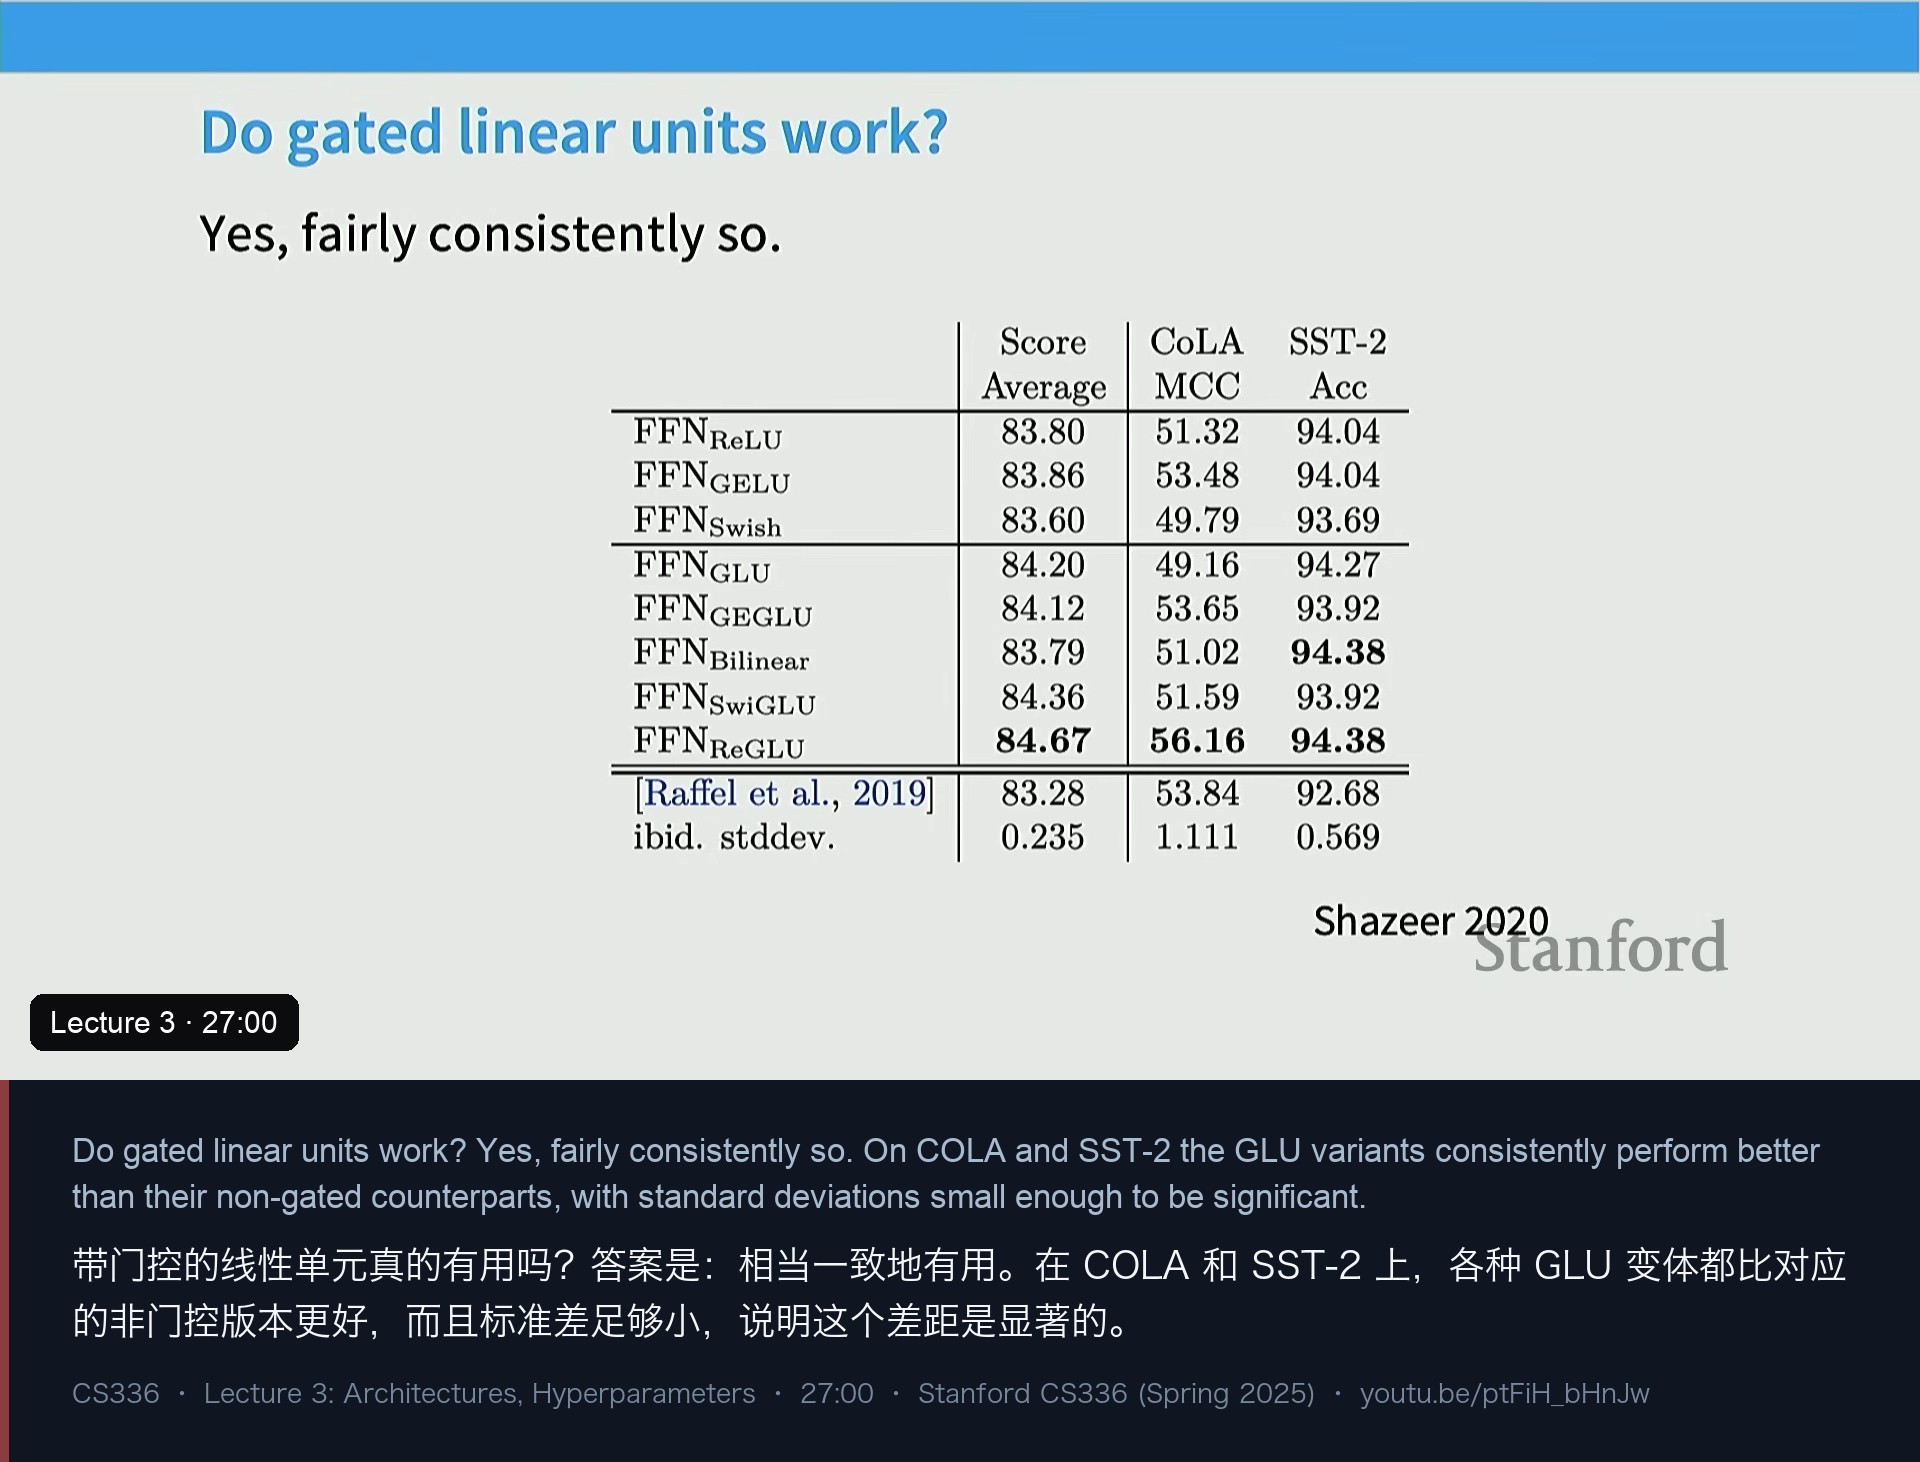
有,而且证据相当一致。讲师先带大家回到“马嘴巴”——Noam Shazeer 的 GLU Variants 论文。在 COLA 和 SST-2 上,各种 GLU 变体都比对应的非门控版本好,而且论文给出了标准差,差距是显著的。Narang et al. 2020(T5 风格的架构消融)里也是同一结论:加粗的那些行(GLU 变体)损失一致更低。这个模式此后基本一直成立。
5.3 但它是“更好”,不是“必需”
讲师特意把这两件事分开:GLU 不是好模型的必要条件,只是稍微更好、而且大家都在用。 反例很有说服力:
- GPT-3 没有用 GLU;
- Nemotron 340B 用了比较罕见的 squared ReLU;
- Falcon 2 11B 用的是普通 ReLU。
这些都是很强的模型。所以有证据指向 SwiGLU/GeGLU 的稳定收益(这也正是作业要求实现它的原因),但并不是“没有它就不行”。
课上还有两个很好的提问:
- SwiGLU 的导数不是单调的,会不会有优化问题? 讲师说这在直觉上确实可以担心(可能把一批激活值困在 0 附近),但实际训练用的是带高学习率和动量的优化器,激活值“到处乱跑”,很难真的收敛到那个点;实践中没看到这个微小的负区间造成大问题。
- GELU 的导数要算高斯 CDF,会不会更慢? 讨论的结论是:CUDA 内部很可能用查表实现;更关键的是显存压力是一样的(读同样多的元素),在这种量级下多出来的浮点运算可以忽略。这也再次呼应了“访存比 FLOPs 更重要”。
六、串行还是并行:attention 与 MLP 的两种接法
标准 Transformer 的 block 是串行的:输入进来先做注意力,把结果写回残差流,再做 MLP,再写回。这种串行结构在超大规模并行时会有约束——你可能拿不到很好的 GPU 利用率。
所以有一小批模型改成了 parallel layers:注意力和 MLP 同时计算,各自作用于同一个输入 x,然后把两者的结果相加写回残差流。
- 这个做法最早由开源复现项目 GPT-J 尝试,PaLM 又大胆地把它用到了极大尺度上,此后有不少跟随者。
- 实现上的好处是:可以共享一部分工作(比如 LayerNorm 可以共用),矩阵乘法也可以融合(fused),从而拿到系统效率。
- 但过去一年反而回到了串行:大多数新模型都是串行层,例外只有 Command A、Command R+ 和 Falcon 2 11B 等少数。
学生问“串行不是计算上更高效吗?“讲师的回答是:恰恰相反,并行的目的就是更高效,所以大家才愿意付这个代价。串行可能表达力更强(因为是在复合两个计算,而不是简单相加),并行的收益则来自融合算子与计算共享。
七、位置编码的收敛:正弦 → 绝对 → 相对 → RoPE
7.1 三方混战到一家独大
位置编码的历史很像一场战争:
- 正弦编码(sine):原始 Transformer 用 cos/sin 叠加,能“定位”;
- 绝对编码(absolute):GPT-1/2/3、OPT 直接给每个位置学一个向量加到 embedding 上;
- 相对编码(relative):T5、Gopher、Chinchilla 在注意力计算里加上相对位置的向量。
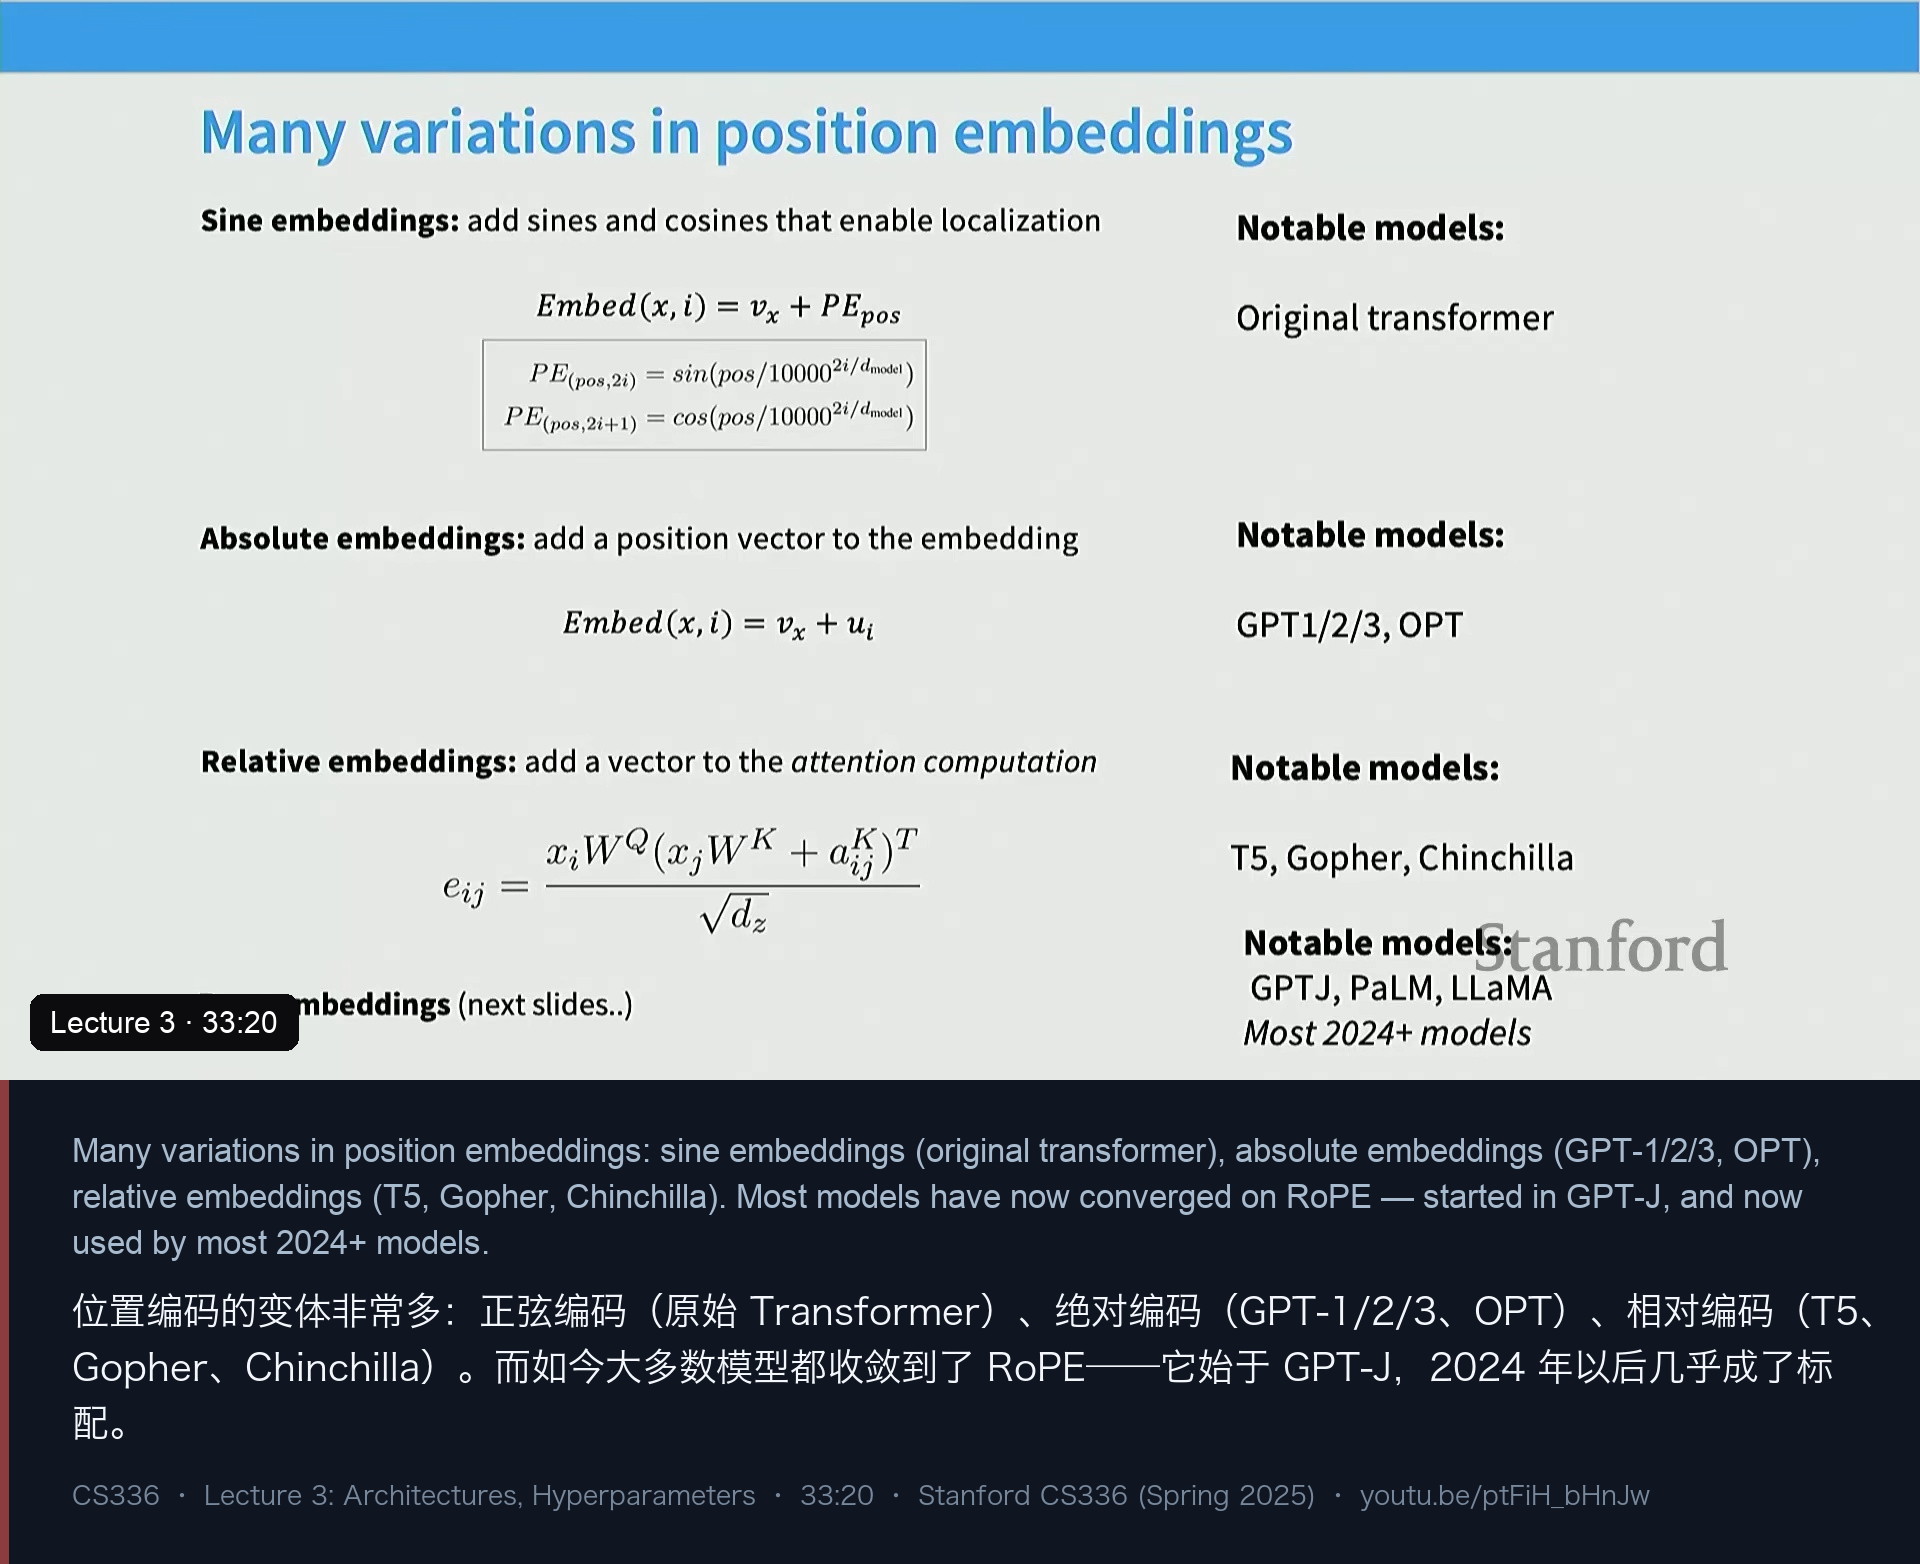
而如今几乎所有模型都收敛到了 RoPE(旋转位置编码)。它最早出现在 GPT-J(又一个开源贡献),随后被迅速采用——讲师说他周末把 19 篇论文都翻了一遍,基本全都用 RoPE。原因有两方面:RoPE 有一大堆成熟的上下文长度外推算法(这对生产化模型很关键),同时即使在较小规模、较短上下文上,它的经验效果也很好。
7.2 RoPE 的核心:内积对旋转不变
RoPE 的出发点是:真正重要的只有相对位置。 形式化地,我们希望存在某种编码 f,使得两个词的 embedding 内积只依赖于“词”和“位置差”:
<f(x, i), f(y, j)> = g(x, y, i - j)检查一下其他方案:
- 正弦编码:会引入交叉项,仍然泄漏绝对位置信息;
- 绝对编码:名字就说明了,显然不是相对的;
- 相对编码:是相对的,但它不是在 embedding 的内积上做文章(不是内积形式),不完全满足这个约束。
那什么满足?讲师给出了那个漂亮的观察:我们知道有一类东西对“绝对值”不敏感,那就是旋转。 内积对任意旋转不变,所以可以借这个结构来构造位置编码。
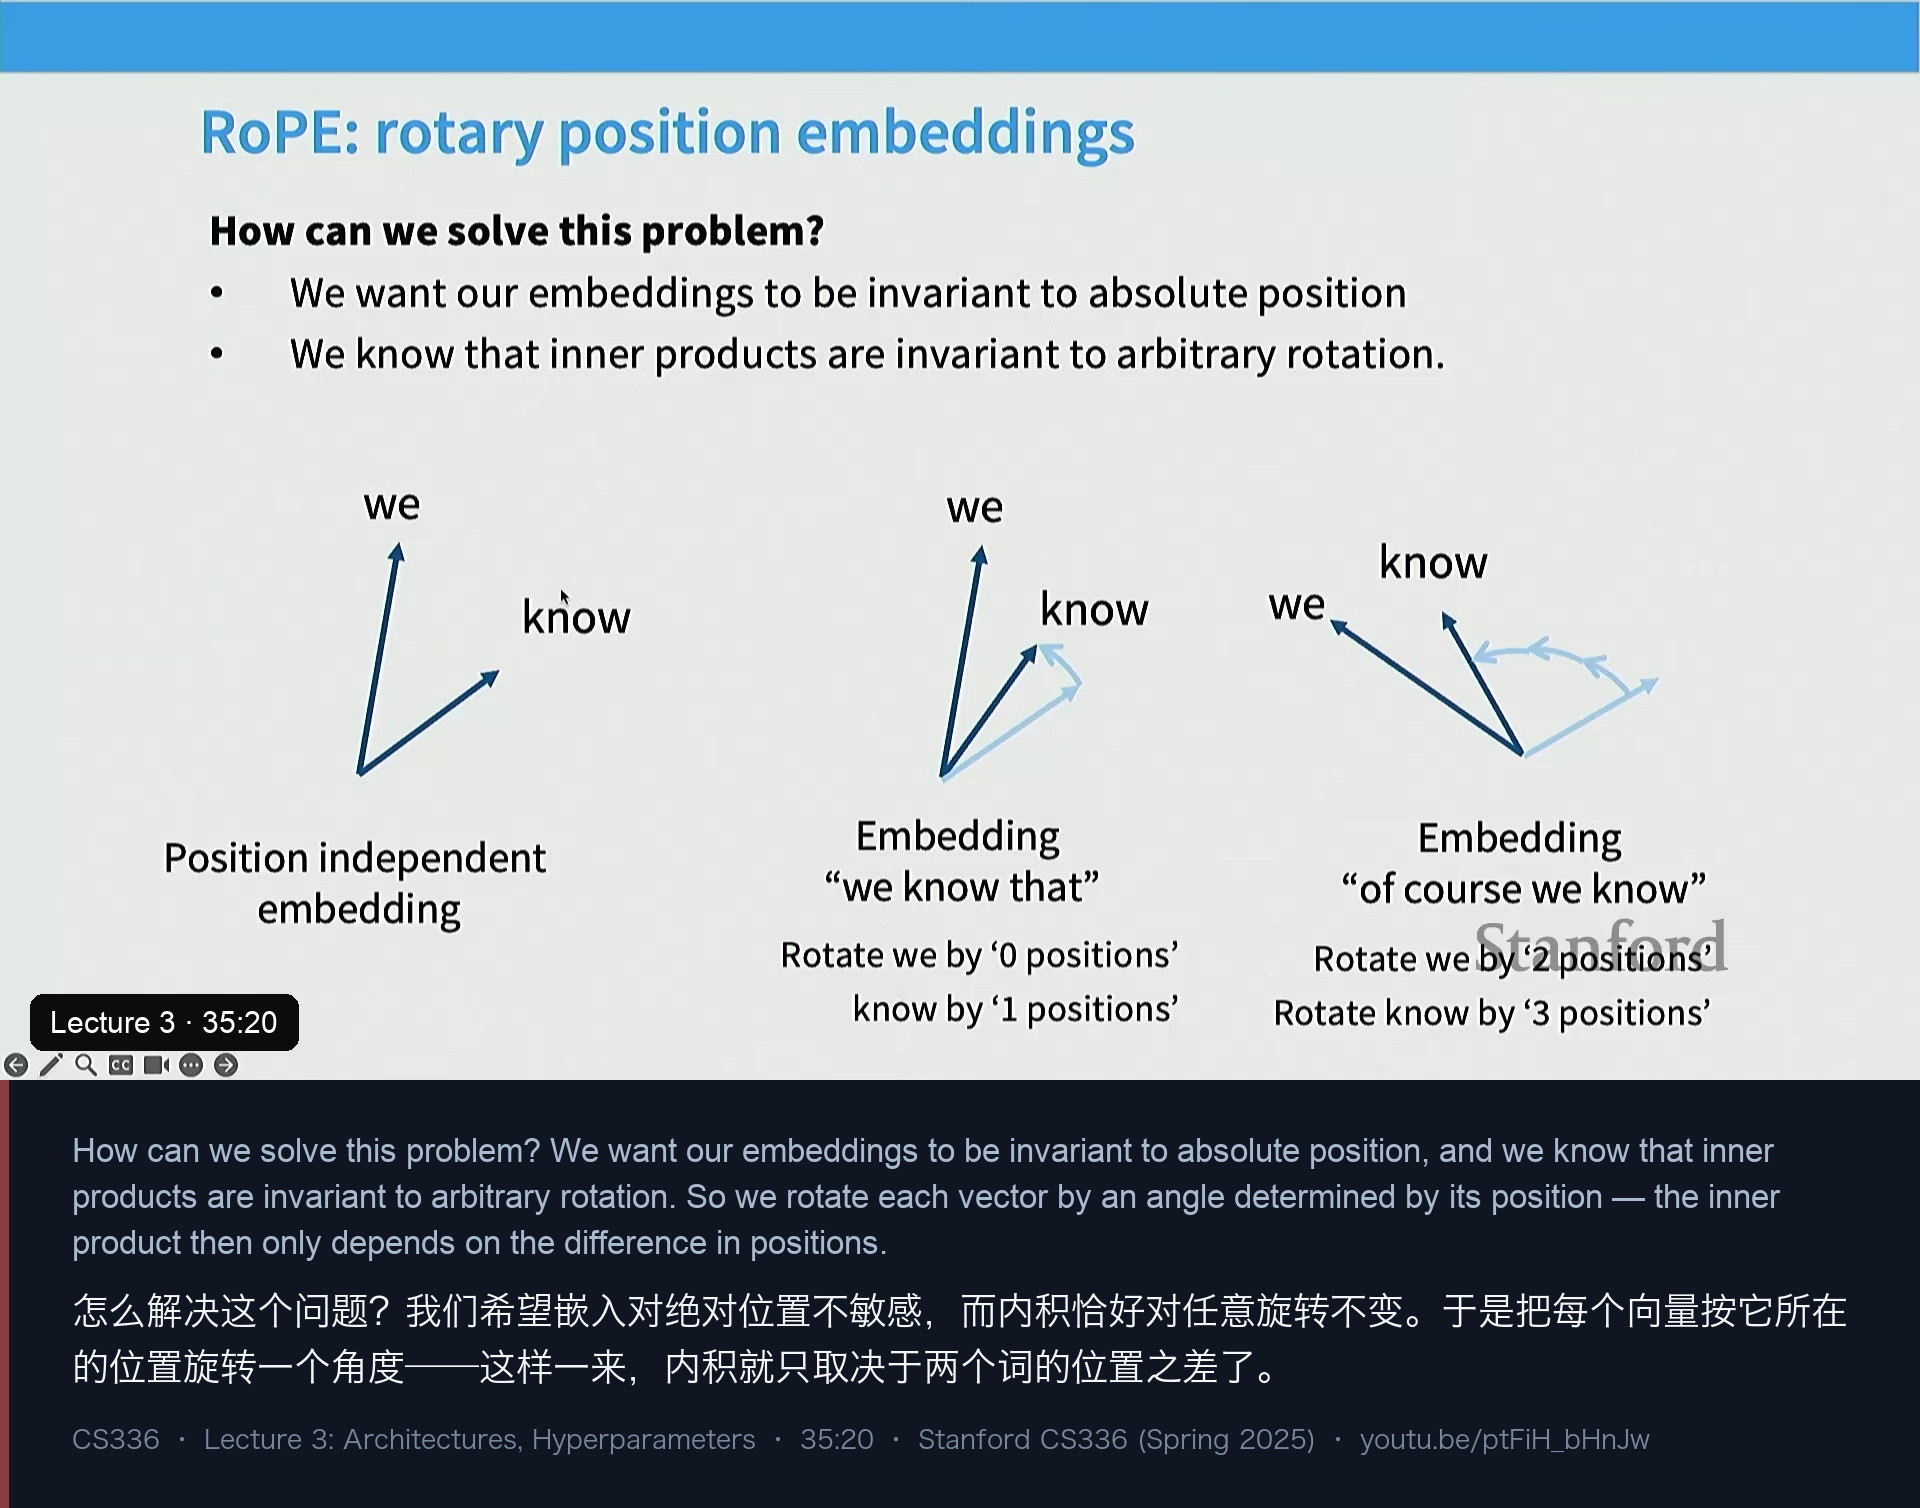
直觉是这样的:假设 “we” 和 “know” 各自是一个向量箭头,把它们放在某个位置上就按位置旋转。
- 在序列 “we know that” 里,
we在位置 0(不旋转),know在位置 1(旋转 1 个单位); - 在 “of course we know” 里,
we在位置 2(旋转 2 个单位),know在位置 3(旋转 3 个单位)。
关键点在于:这两种情况下,we 与 know 之间的相对角度是一样的,所以它们的内积不变——位置信息以“相对旋转角”的形式被编码进去了。
7.3 高维怎么办:成对切分 + 不同频率
二维里旋转只有一种方式,高维就不显然了。RoPE 的做法简单而有效:
- 把 d 维向量两两切成一组((x₀,x₁), (x₂,x₃), …),每一组各自旋转;
- 每组有自己的旋转速度 θ,一部分维度转得快、一部分转得慢——快频率负责捕捉近距离(高频)信息,慢频率负责远距离(低频)信息,这和正弦编码里挑一组频率的思路是一样的。
用矩阵写出来就是各种 cos/sin 的 2×2 块对角矩阵,没有加法项、没有交叉项,纯粹是相对的。
还有一个极其重要的实现细节:RoPE 不是加在输入 embedding 上,而是在 attention 层里、生成 Q 和 K 的那一刻介入。 参考 LLaMA 的实现大致是:
# 简化示意(LLaMA 风格的 RoPE)
q = W_q(x); k = W_k(x)          # 普通线性投影
cos, sin = rope_freqs(position)   # 由位置决定的一组旋转角
q_rot = rotate(q, cos, sin)       # 按 2 维一组旋转 q
k_rot = rotate(k, cos, sin)       # 同样旋转 k
attn = softmax(q_rot @ k_rot.T / sqrt(d)) @ v   # 后面照常
这样旋转过的 Q、K 再去做内积,就天然只携带相对位置信息。
课上有人问:不同模型的旋转频率一样吗?讲师说有差别,θ 的选择各家不同;又有人问 θ 是不是可训练的超参数——不是。它和正弦编码一样是按一个固定的频率 schedule 定好的,只是为了让不同维度覆盖不同频率范围;而且因为 θ 固定,旋转本质上就是一个固定的矩阵乘法,训练时不会有“对三角函数求导”的麻烦。
八、超参数:其实只有少数几个值得动
进入这一部分时,讲师说了一句很实在的话:语言模型训练这件事,很大程度上是一场“从别人那里抄超参数”的游戏,所以大家非常保守。但回过头看,真正会被改动的超参数只有那么几个,而且都有相当清晰的规则。
8.1 前馈维度比 d_ff / d_model
最基础的设置:输入 x 的维度是 d_model,中间隐层是 d_ff,然后再投影回 d_model。
FFN(x) = max(0, x W₁) W₂ # 这里先看非门控的版本- 如果不用 GLU:几乎所有 ReLU 风格 MLP 都取 d_ff = 4 · d_model。讲师说这更像是“约定俗成”,没有哪条自然定律要求必须是 4。
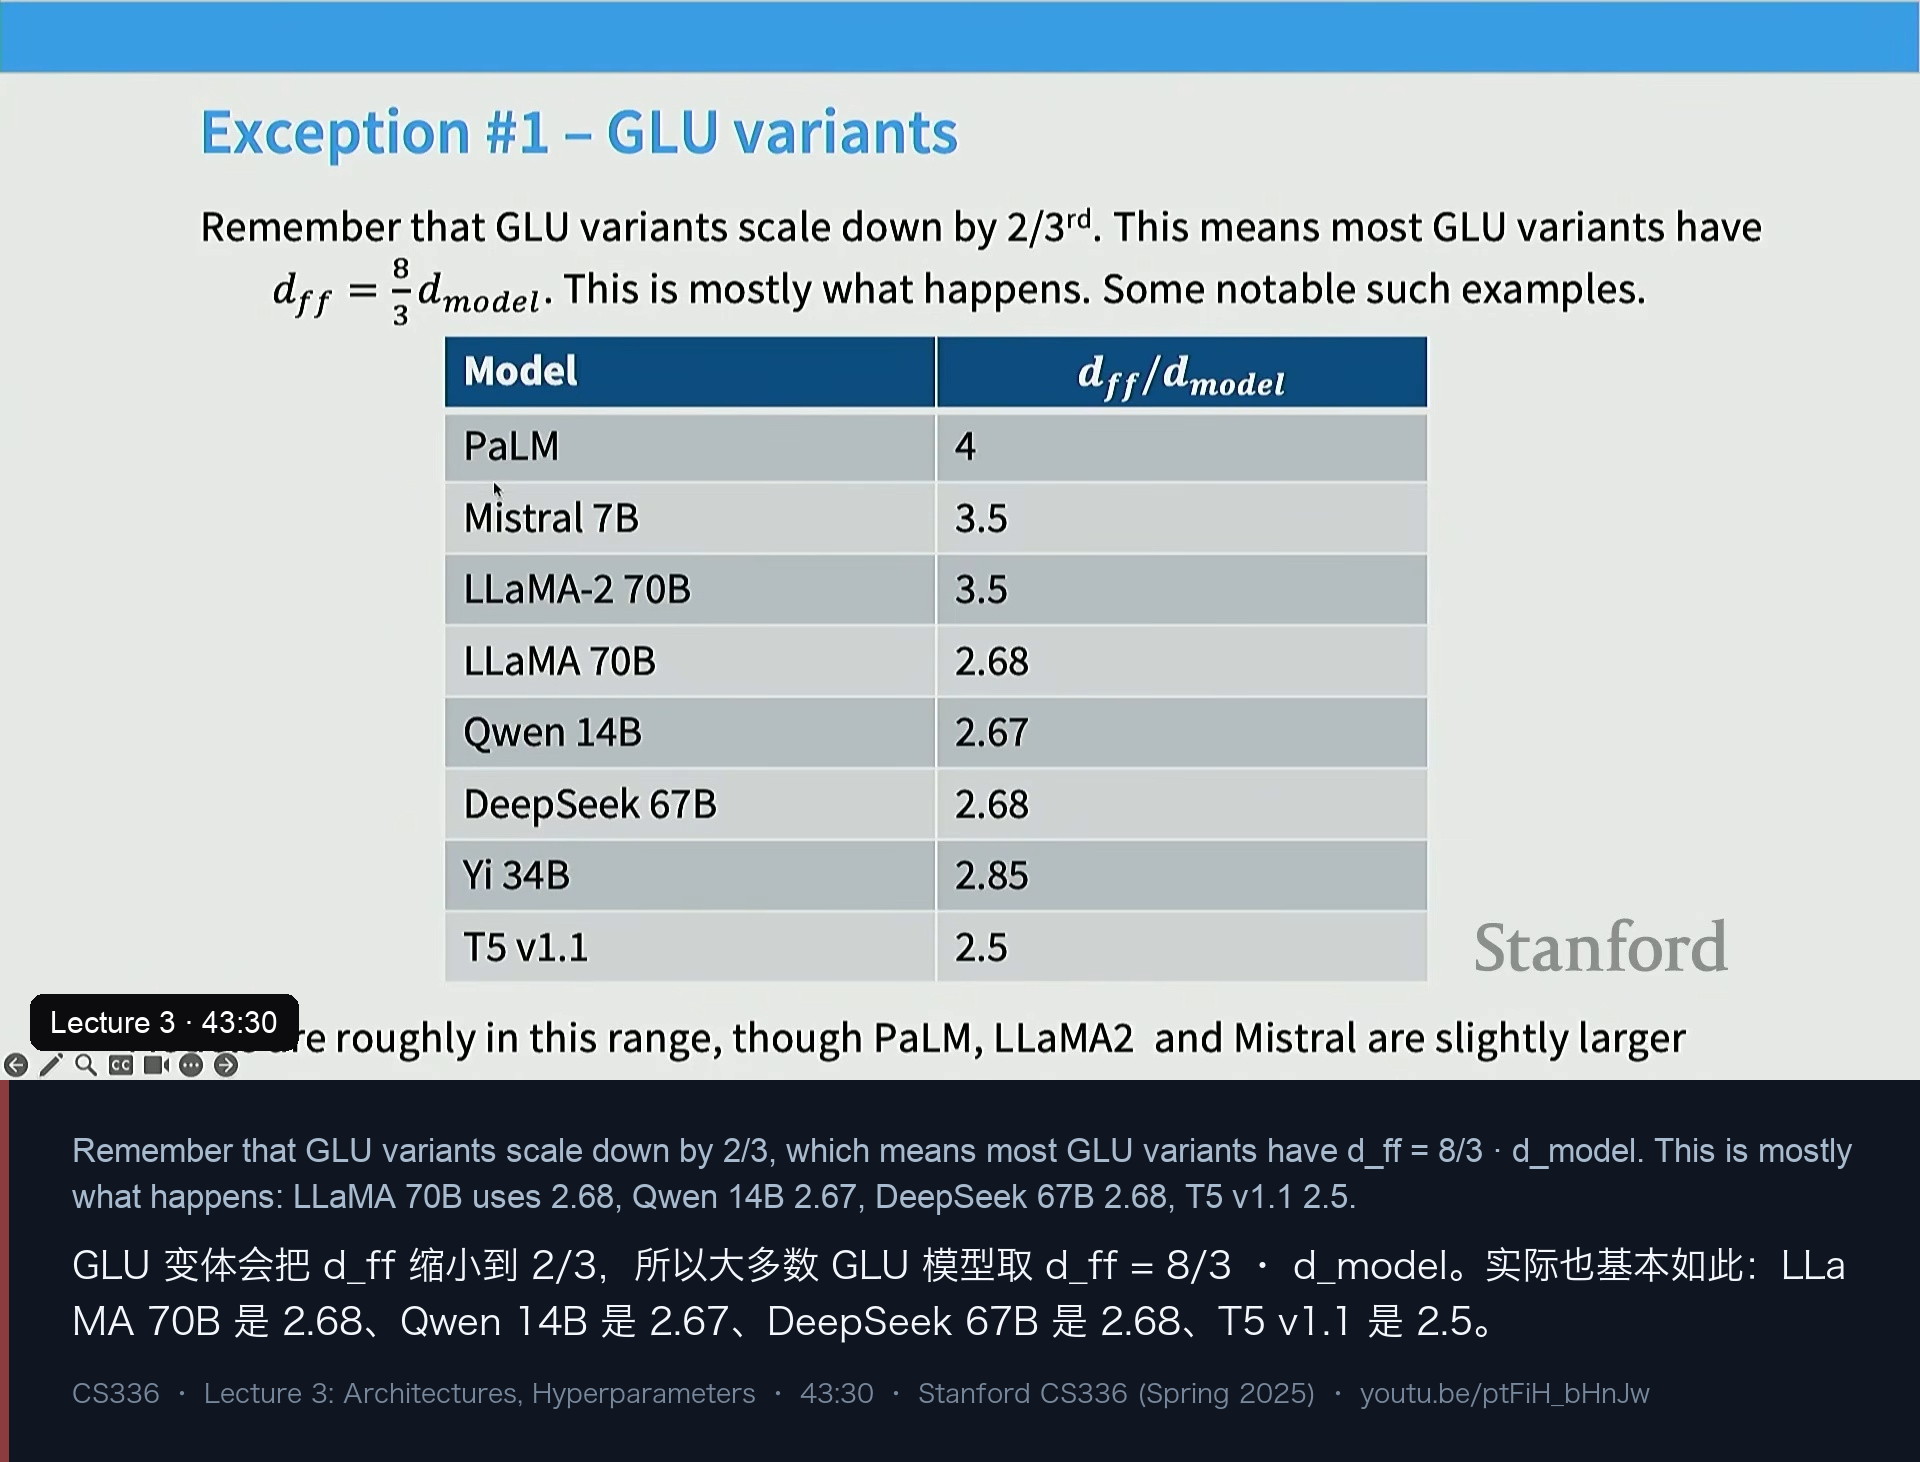
- 如果用 GLU:因为门控多了一份参数,要缩小隐藏维度来对齐参数量,标准做法是把乘数设为 8/3 · d_model ≈ 2.67。
实际模型的对照(来自讲义中的表格):PaLM 是 4,Mistral 7B 是 3.5,LLaMA-2 70B 是 3.5,LLaMA 70B 是 2.68,Qwen 14B 是 2.67,DeepSeek 67B 是 2.68,Yi 34B 是 2.85,T5 v1.1 是 2.5。
8.2 著名的例外:T5 的 64 倍
讲师说他特别喜欢 T5 这个例外,因为它是少见的“大胆”选择。T5 的 11B 版本:d_model 只有 1024,但 d_ff 是 65536——相当于 64 倍的乘数。 相比之下 PaLM 是 4 倍,别人更小。
T5 论文给出的理由是:把 d_ff 拉大可以换来“更宽更胖的矩阵乘法”,更利于硬件。但代价是——你把参数和 FLOPs 花在了一个表达力上更次优的地方:宽是“并行”的计算,而更深/更多单元才能带来更强的串行表达能力。所以这是拿表达力换系统收益。
这个故事的尾声很有趣:T5 的后续版本 T5 v1.1 改用了一个非常标准的 2.5 倍 GeGLU,而且模型更好。
再补一句“有人真的验证过 4 是合理值吗”:Jared Kaplan 的缩放定律论文里其实有超参数部分,他们画了 loss 随 d_ff/d_model 变化的曲线——在 1 到大约 10 之间有一个很宽的盆地,也就是说这个区间内取哪个值都接近最优,4 落在里面相当好的位置。
8.3 头维度:保持 1
另一个“令人惊讶的共识”是:d_model 应该等于 头数 × 每头维度,也就是每头维度比保持约 1。 增加头数时,是“把 d_model 切开分给更多头”,而不是让每个头保持固定维度、让注意力部分越变越大。
GPT-3、T5、LLaMA、PaLM、LLaMA 2 的比例都约为 1。T5 又一次是例外,试过 16 倍。Bhojanapalli et al. 2020 等论文从理论上反对 1(头越多、秩越低,每头维度太少会伤害注意力的表达力),但实践中并没有看到明显的低秩瓶颈,遵循 1 的模型都表现良好。
8.4 宽深比:每层约 128 个隐藏维度
模型可以更深,也可以更宽,而“宽度”这个旋钮基本就是 d_model。讲义的表格显示,各家的 d_model / n_layer 惊人地一致:
| 模型 | d_model / n_layer |
|---|---|
| BLOOM | 205 |
| T5 v1.1 | 171 |
| PaLM (540B) | 156 |
| GPT-3 / OPT / Mistral / Qwen | 128 |
| LLaMA / LLaMA 2 / Chinchilla | 102 |
| T5 (11B) | 43 |
| GPT-2 | 33 |
大致可以记成”每层约 128 个隐藏维度“。
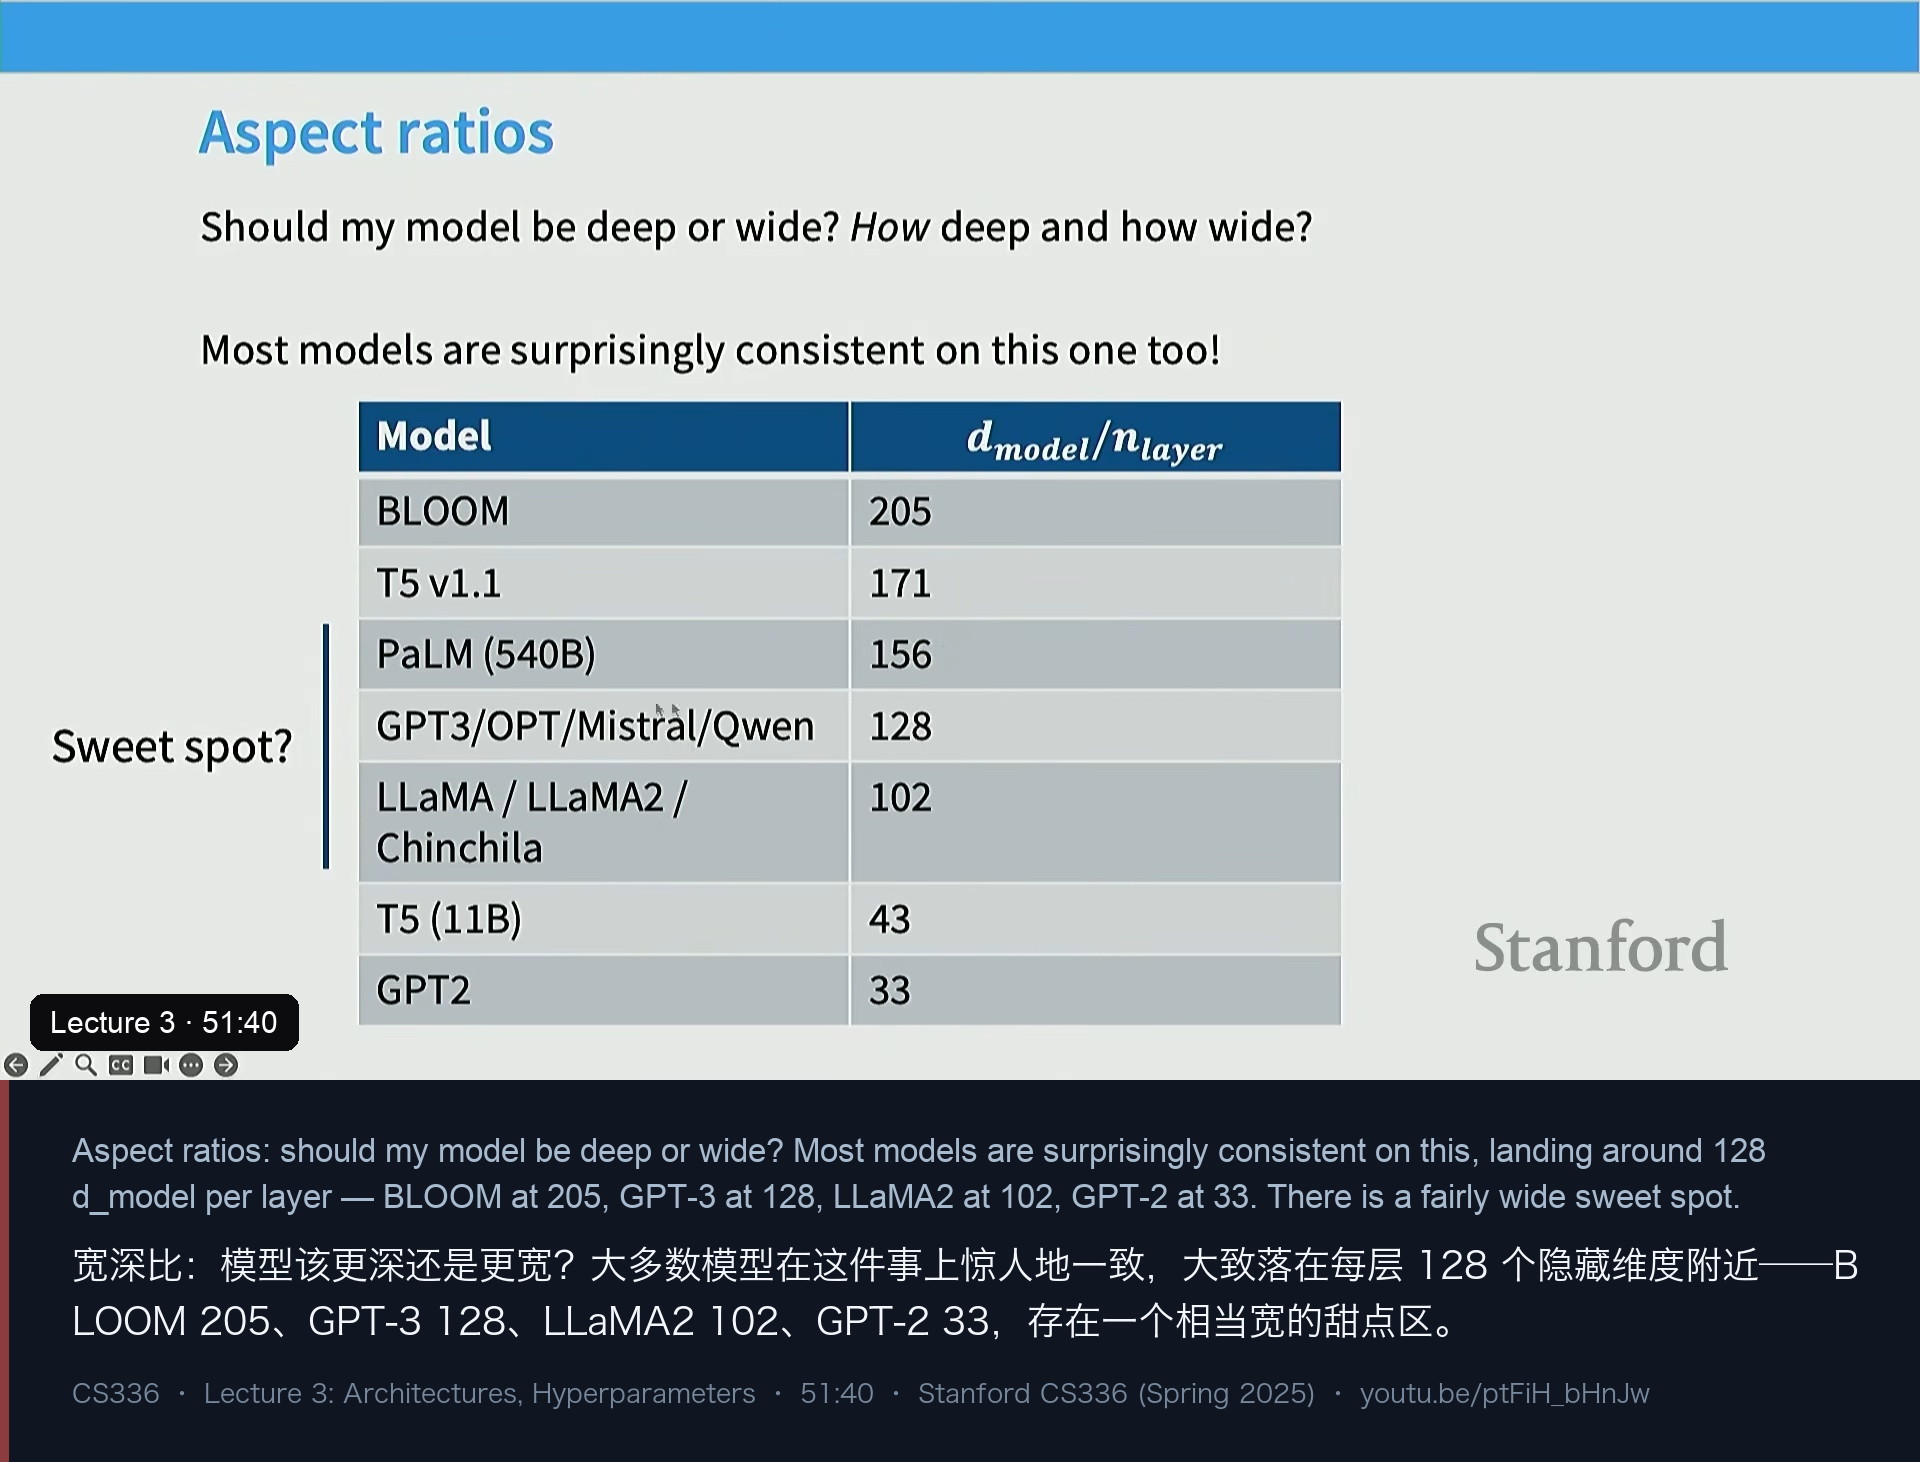
这个比值还和系统设计强相关:宽度决定了能不能做张量并行(需要很快的网络),层数决定了能不能做流水线并行(对网络延迟更宽容)——所以网络条件本身会反过来影响你的宽深选择。
Kaplan 等人的图(50M、274M、1.5B 三个规模)显示,最优宽深比在 100 附近,而且这个最优点在不同规模间移动不大,这是好消息:一个固定的宽深比可以跨规模沿用。另有一篇 Google 的工作比较深度与宽度:看 loss 的话,只有参数量重要,更深并不带来好处;但如果看下游微调(SuperGLUE)准确率,同样 FLOPs 下更深的模型可能更好。
8.5 词表大小:从 3–5 万到 10–25 万
词表大小这些年一直在涨,主要原因是模型开始被当成服务部署出去——会遇到不同语言、emoji 和各种“类模态”的输入。
- 单语模型:约 3 万–5 万。对照表:原始 Transformer 37000、GPT 40257、GPT-2/3 50257、T5/T5 v1.1 32128、LLaMA 32000。
- 多语/生产系统:约 10 万–25 万。对照表:mT5 250000、PaLM 256000、GPT-4 100276、Command A 255000、DeepSeek 100000、Qwen 15B 152064、Yi 64000。
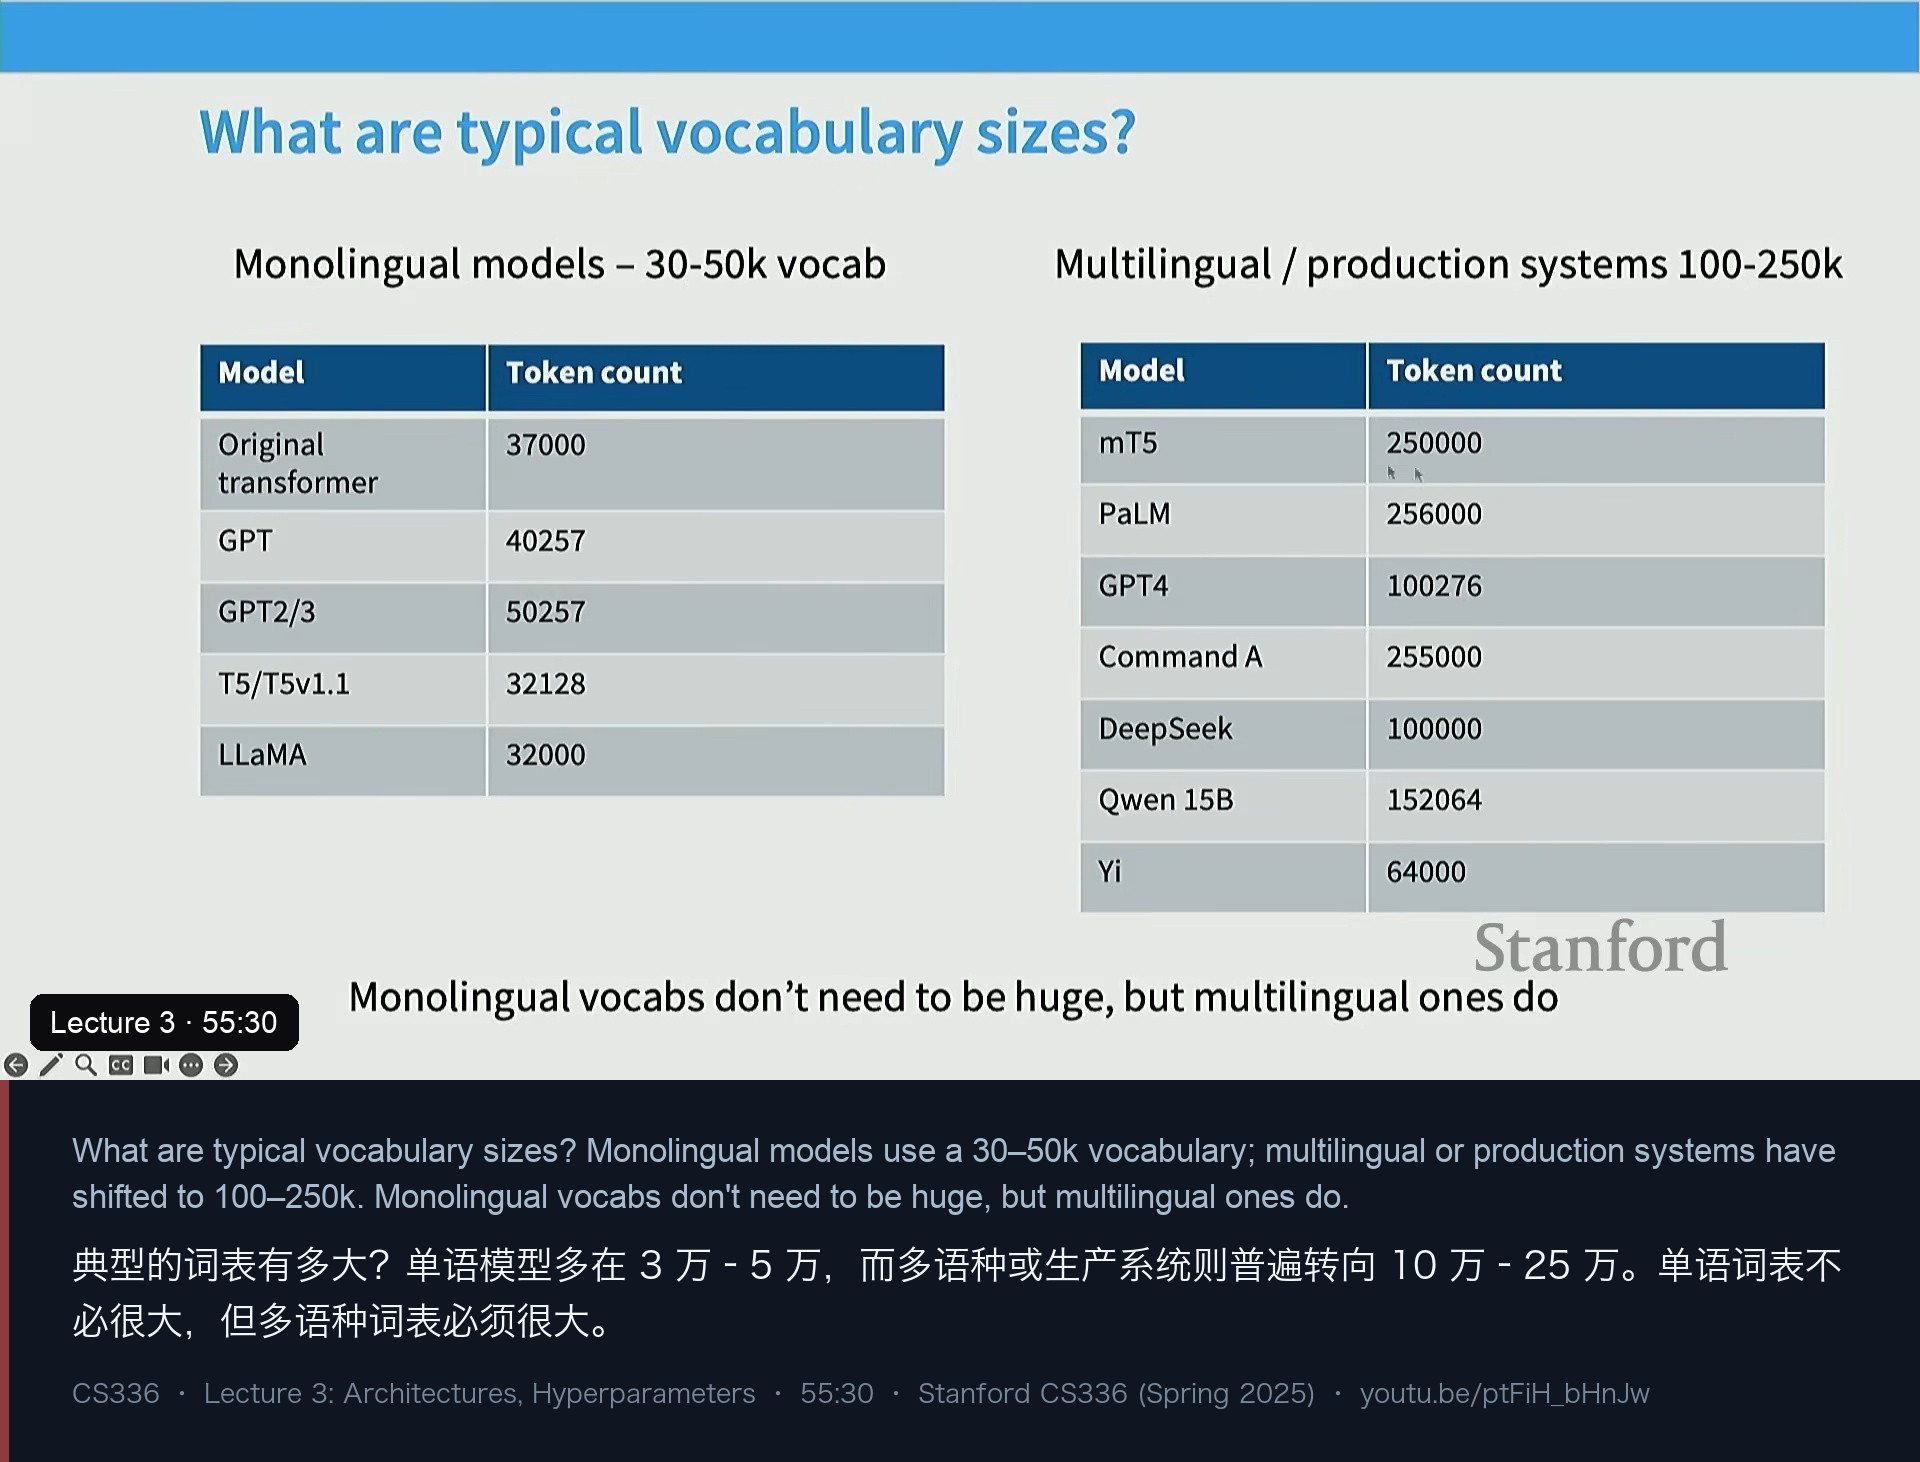
有学生问:“多语词表对单一语言(比如英语)有帮助吗?“讲师说,在高资源语言上影响不大——如果你只做英语建模,小词表也够用;大词表真正帮到的是少数语言,因为它们在同样的文本下会被编码成更少的 token,推理成本直接下降。这也是 Command 系列特别强调多语词表的原因。
8.6 dropout 与 weight decay:一个反直觉的发现
预训练是最不需要正则化的场景——数据量太大,连一个 epoch 都跑不完,你几乎不可能过拟合。所以逻辑上不该用 dropout。但实际情况是混合的:
| 模型 | Dropout | Weight decay |
|---|---|---|
| 原始 Transformer | 0.1 | 0 |
| GPT-2 | 0.1 | 0.1 |
| T5 | 0.1 | 0 |
| GPT-3 | 0.1 | 0.1 |
| T5 v1.1 | 0 | 0 |
| PaLM | 0 | (variable) |
| OPT | 0.1 | 0.1 |
| LLaMA | 0 | 0.1 |
| Qwen 14B | 0.1 | 0.1 |
(* 讲师提示:论文大多根本不讨论 dropout,开源模型里“0.1”这个数字很多时候只是名义值。)
结论是:dropout 基本已经过时(新模型除 Qwen 外普遍靠 weight decay),而 weight decay 被普遍保留了下来。
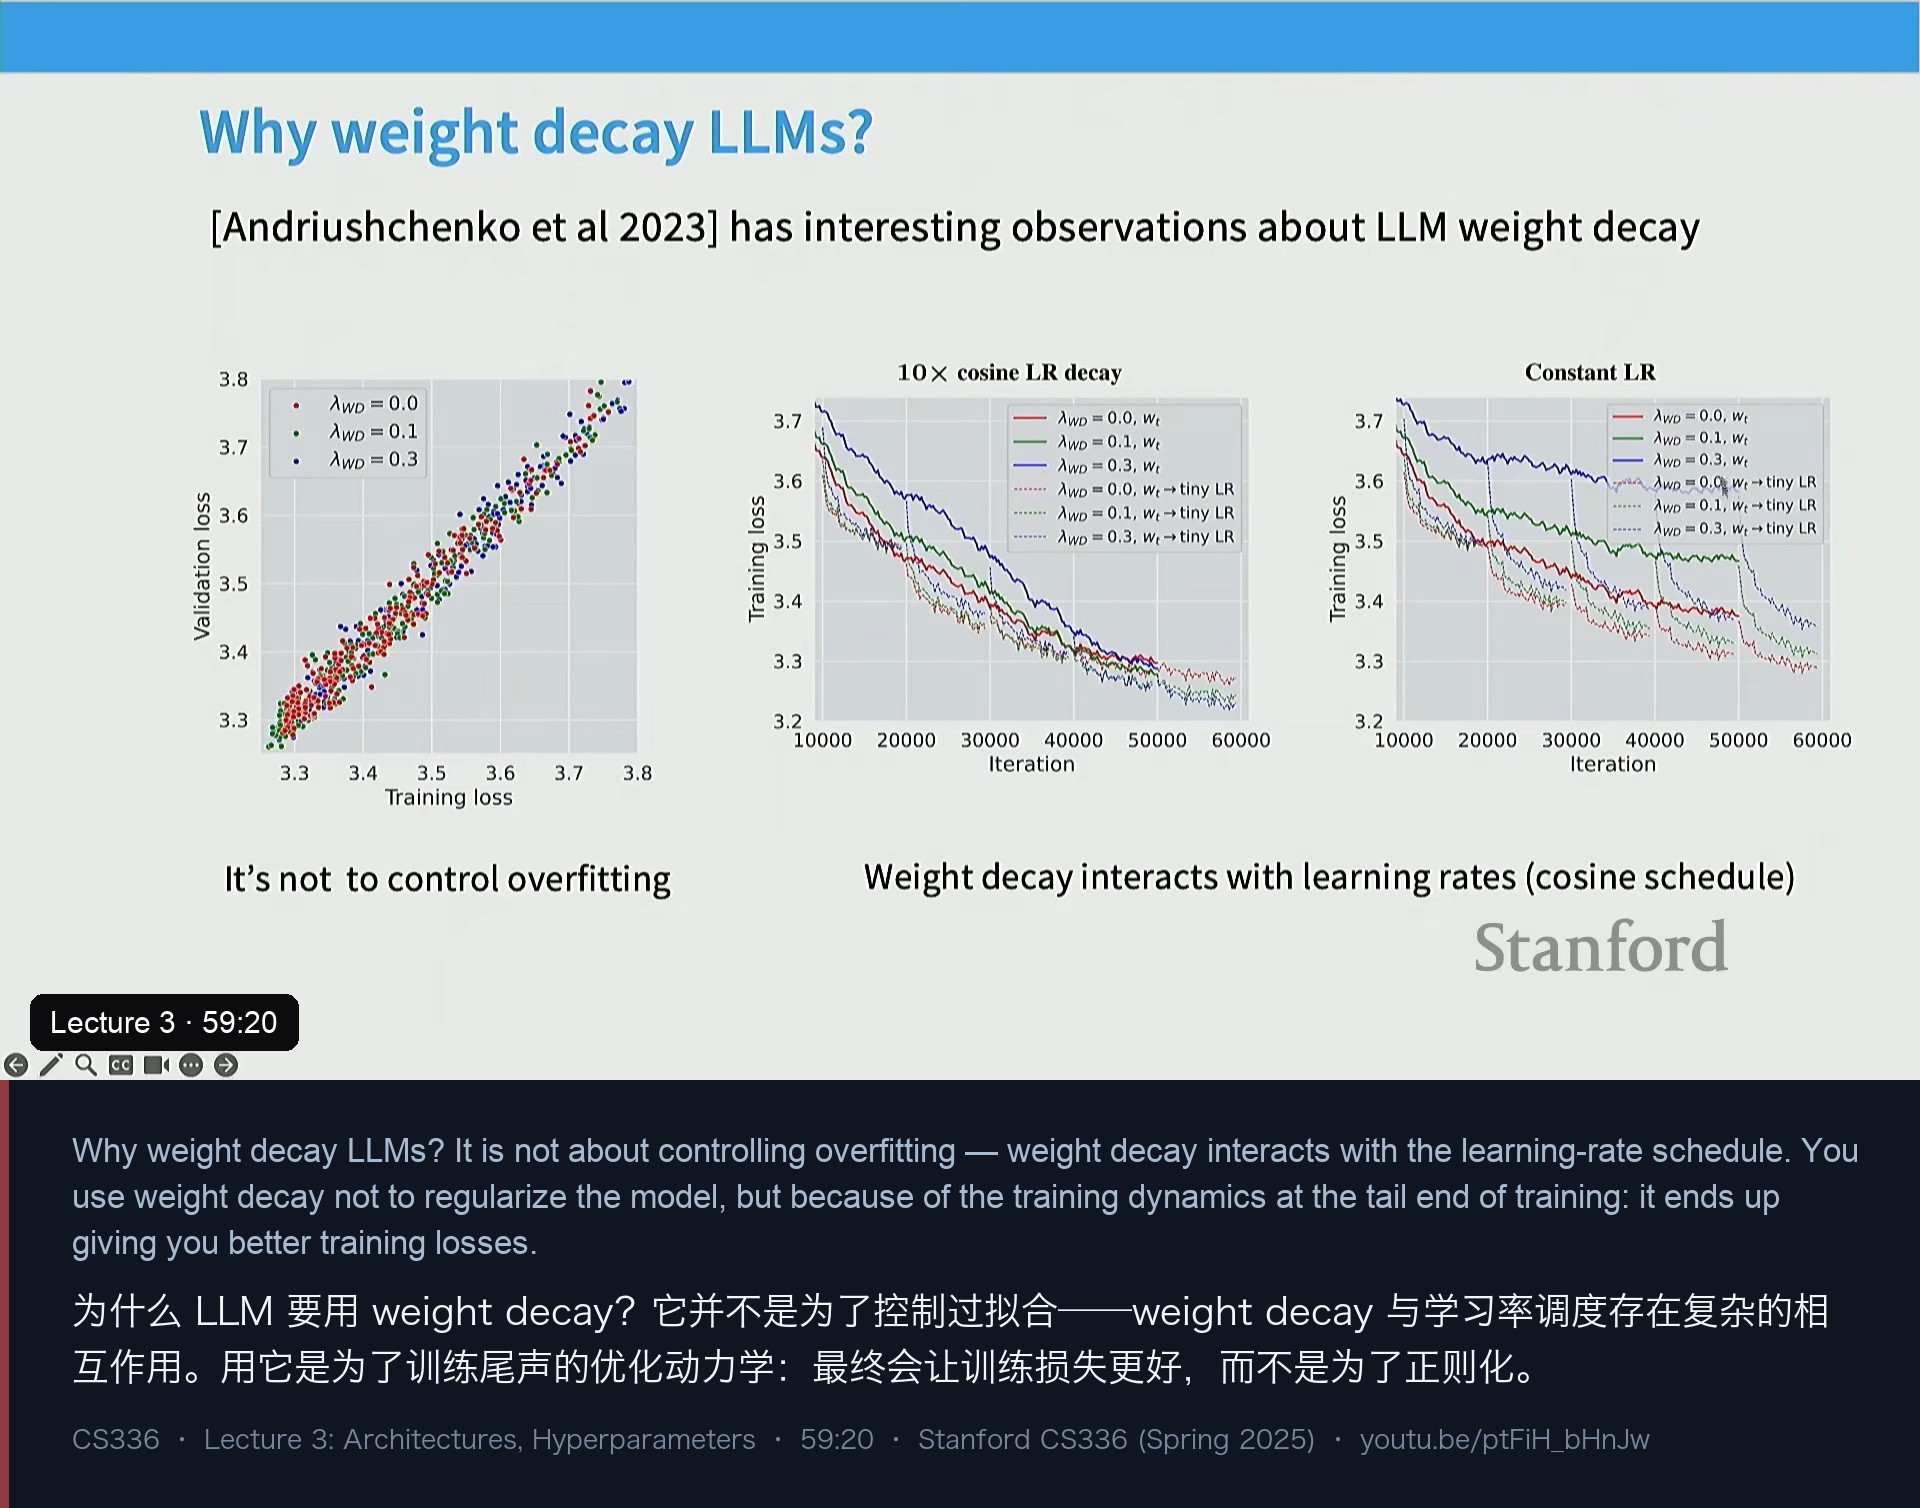
真正反直觉的问题是:既然只跑一遍数据、不会过拟合,为什么还要 weight decay?讲师的答案很精彩:
- weight decay 的作用不是控制过拟合。实验发现,不同强度的 weight decay 并不会改变 train loss 和 val loss 之间的差距——即使 weight decay 为零,也没有过拟合发生。
- 它真正在做的事,是和学习率调度发生复杂的相互作用。观察到的现象是:高 weight decay 的模型在恒定高学习率下“训得很差”,一旦学习率下降,它会非常迅速地掉下去;在使用 cosine 学习率衰减时,高 weight decay 的模型前期很慢,但在降温阶段迅速优化。
- 所以用 weight decay 是为了得到更好的训练损失(而不是更好的验证损失),这来自训练尾声学习率趋近于零时的那些训练动力学。
8.7 一页小结:哪些是“不用多想”的
讲师给出了一份“无脑默认值”清单——这些超参数已经有充分共识,可以直接沿用:
- MLP 的隐藏维度(d_ff / d_model:4 或 8/3);
- 多头注意力的每头维度比(1);
- 宽深比(每层约 128);
- weight decay 作为正则化的选择。
这些默认值大致也会给出作业里推荐的那种模型。
九、稳定性技巧:z-loss、QK norm 与 soft cap
这部分是讲师认为“过去一年最值得关注的新东西”。核心架构其实没怎么变,但很多模型发布都在强调训练稳定性——因为模型越大、训得越久,不稳定问题就越容易出现。
先看图:loss 曲线看起来还算正常,但把梯度范数画出来会看到到处是尖峰、norm 完全失控。这种训练迟早会崩掉,你没法继续训下去。目标就是把它变成一条从头到尾梯度范数都很低的曲线。
而问题主要集中在两个 softmax 上——一个是模型最后输出词表分布的那个,一个是注意力里的那个。原因很直白:softmax 要取指数(数值上容易出事),还要做除法(可能除到零)。
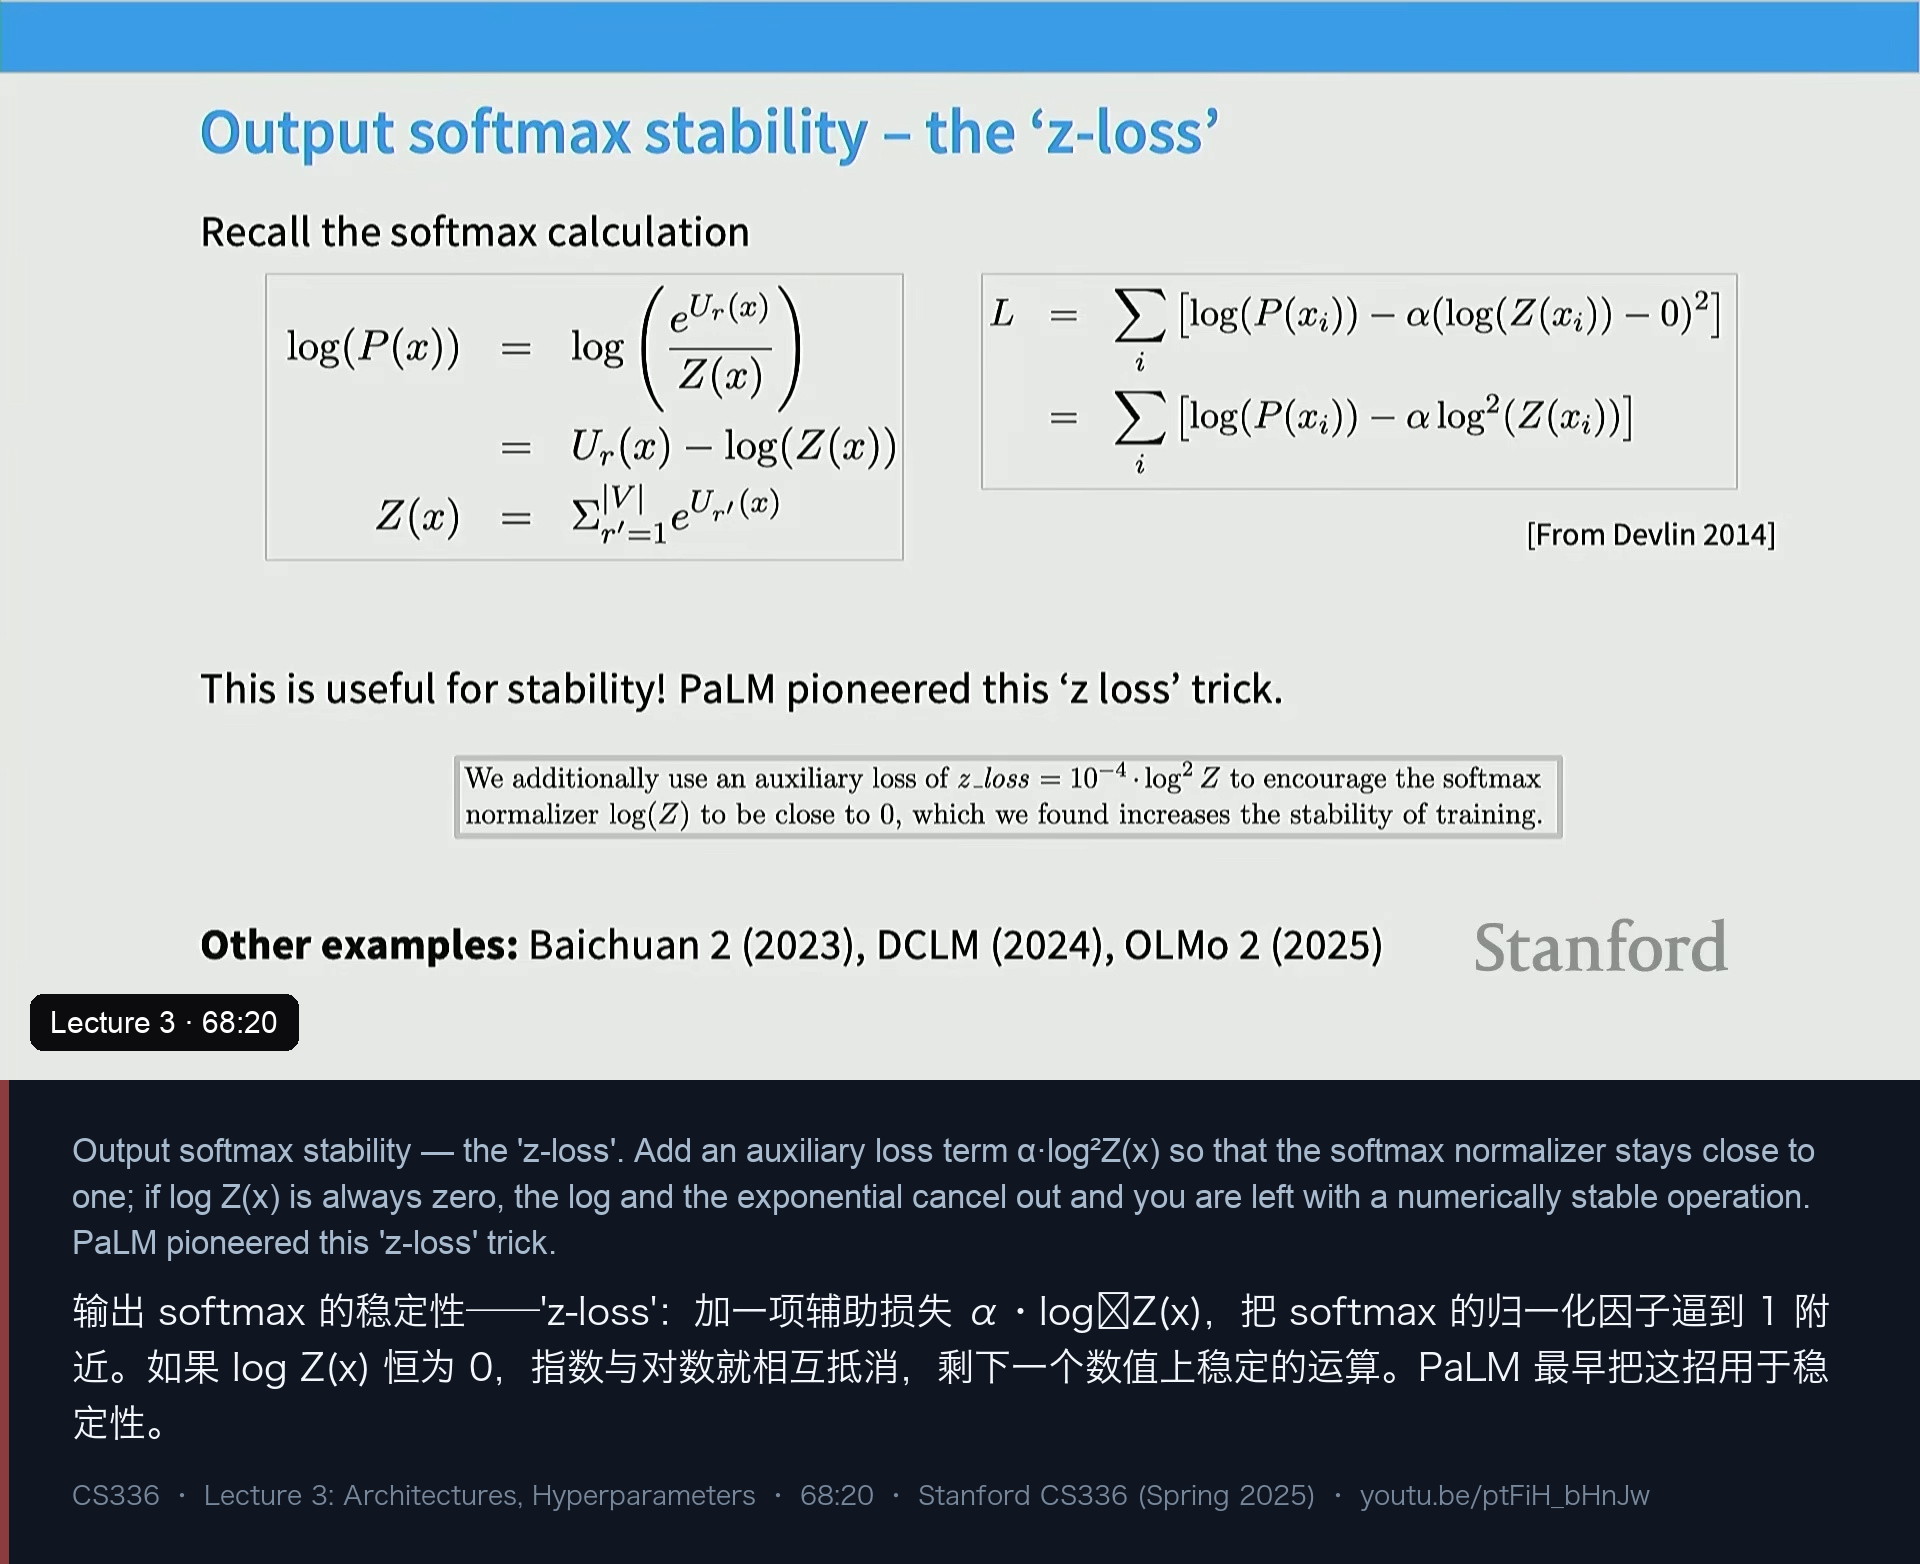
(1)输出 softmax:z-loss。 想法是把归一化因子 Z(x) 逼到 1 附近。做法是在损失里加一项辅助项:
L_total = Σ_i [ log P(x_i) - α · log² Z(x_i) ]
        = Σ_i [ log P(x_i) - α · (log Z(x_i) - 0)² ]

PaLM 用的系数:z_loss = 1e-4 · log² Z
如果这项成功地把 log Z(x) 逼到 0,那么 log 与 exp 就相互抵消,剩下的就是一个数值上非常安全的运算。这个技巧最早可追溯到 Devlin 2014 的机器翻译论文(动机完全不同),而 PaLM 是把 z-loss 用作稳定性工具的先驱(1e-4 · log² Z)。此后 Baichuan 2(2023)、DCLM(2024)、OLMo 2(2025)等都采用过。
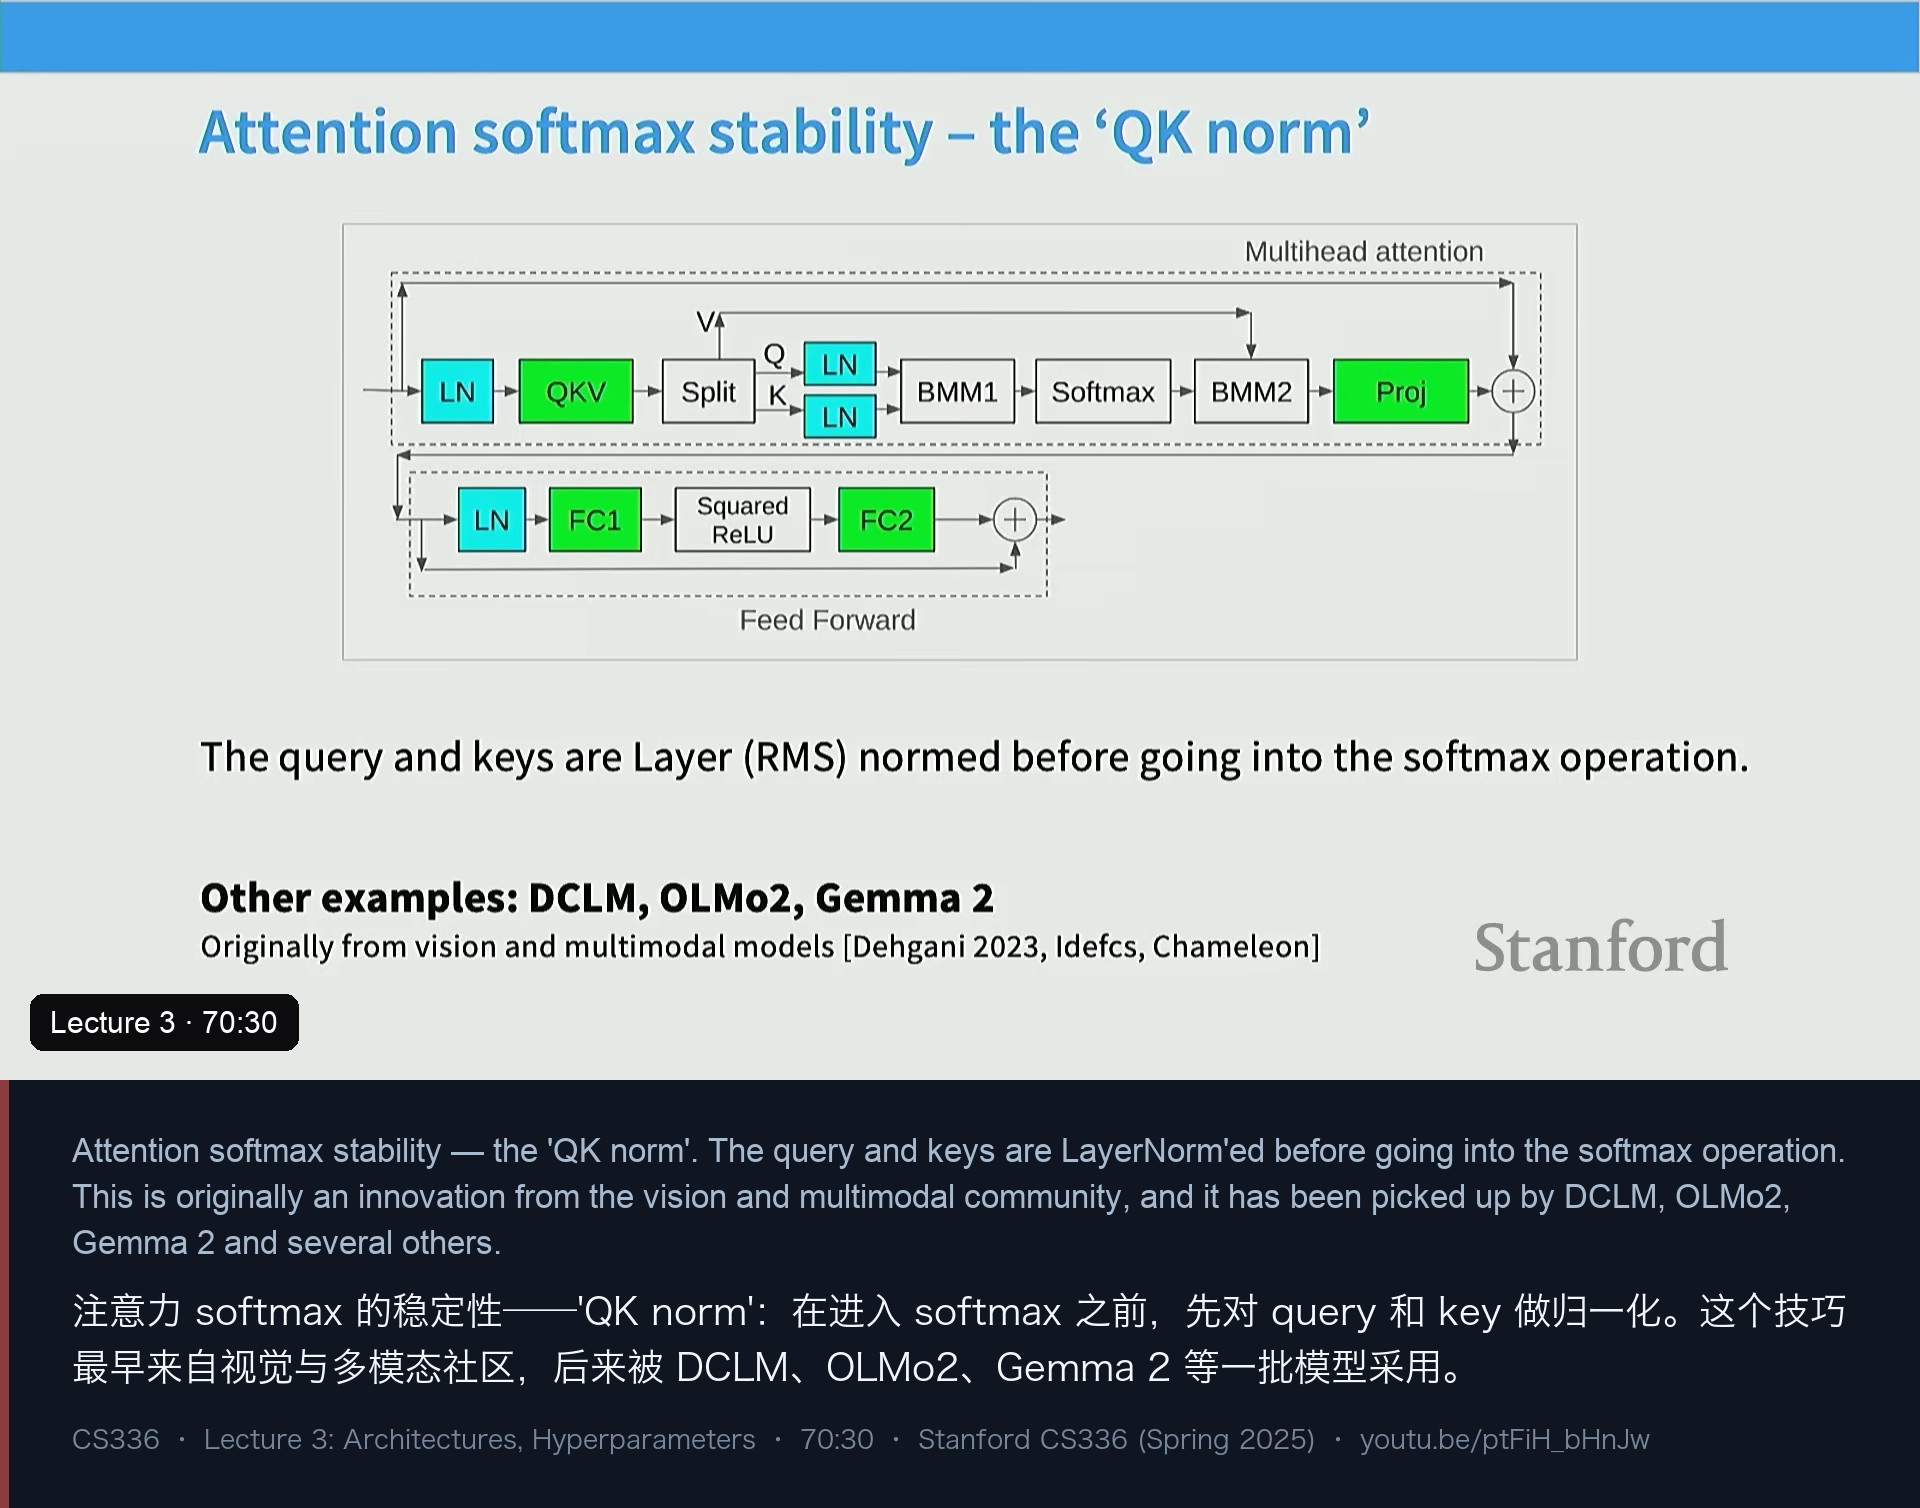
(2)注意力 softmax:QK norm。 思路不同——不是控制归一化因子,而是控制 softmax 输入的大小:在算内积之前,先对 query 和 key 做一次 LayerNorm/RMSNorm,输入有界了,softmax 的坏行为自然被控制住。
q = LayerNorm(W_q x)      # 先归一化
k = LayerNorm(W_k x)
attn = softmax(q @ kᵀ / sqrt(d)) @ v这个技巧最早来自视觉与多模态社区(Dehghani 2023 训练超大 ViT;Chameleon 等把它用到多模态训练),然后渗透回纯文本模型:DCLM、OLMo 2、Gemma 2 都在用。讲师在这里开了一个玩笑(他说一堂课只能讲一个笑话):稳定性相关的手段里,LayerNorm 有效得有点离谱——从“只在 block 前”到“非残差部分两端都放”,现在又塞进 Q 和 K,而它对性能的负面影响微乎其微。
(3)logit soft cap。 第三种做法是在注意力内积之后,把 logits 通过 tanh 做软截断:
logits → soft_cap · tanh(logits / soft_cap)超过 soft_cap 的 logits 会被 tanh 压到接近上限,于是有了一个软性的最大值。Gemma 2(以及 Gemma 2 系的模型)用了这招。
不过有 Nvidia 的论文做了横向对比:以 baseline 困惑度 11.19 为参照,soft cap 反而让结果变差,而 QK norm 让它变好——因为有了 QK norm 就可以用更激进的学习率、把优化器推得更远。所以在这些技巧里,QK norm 的性价比最高。
课上有人问:训练时用 QK norm,推理时还要保留吗?要。 因为 LayerNorm 里有学出来的参数:它先把激活归一到单位尺度、再缩放到某个大小。如果推理时把它拿掉,对模型来说是巨大改变,后面的层根本不知道该怎么处理这些未归一化的激活。
十、注意力头:MQA / GQA 与稀疏注意力
最后一节讲注意力头的变体——这块的改动不多,但有两个必须知道:GQA/MQA(主要影响推理的成本与行为),以及最新的长上下文注意力模式。
10.1 训练时算术强度很高,推理时不是
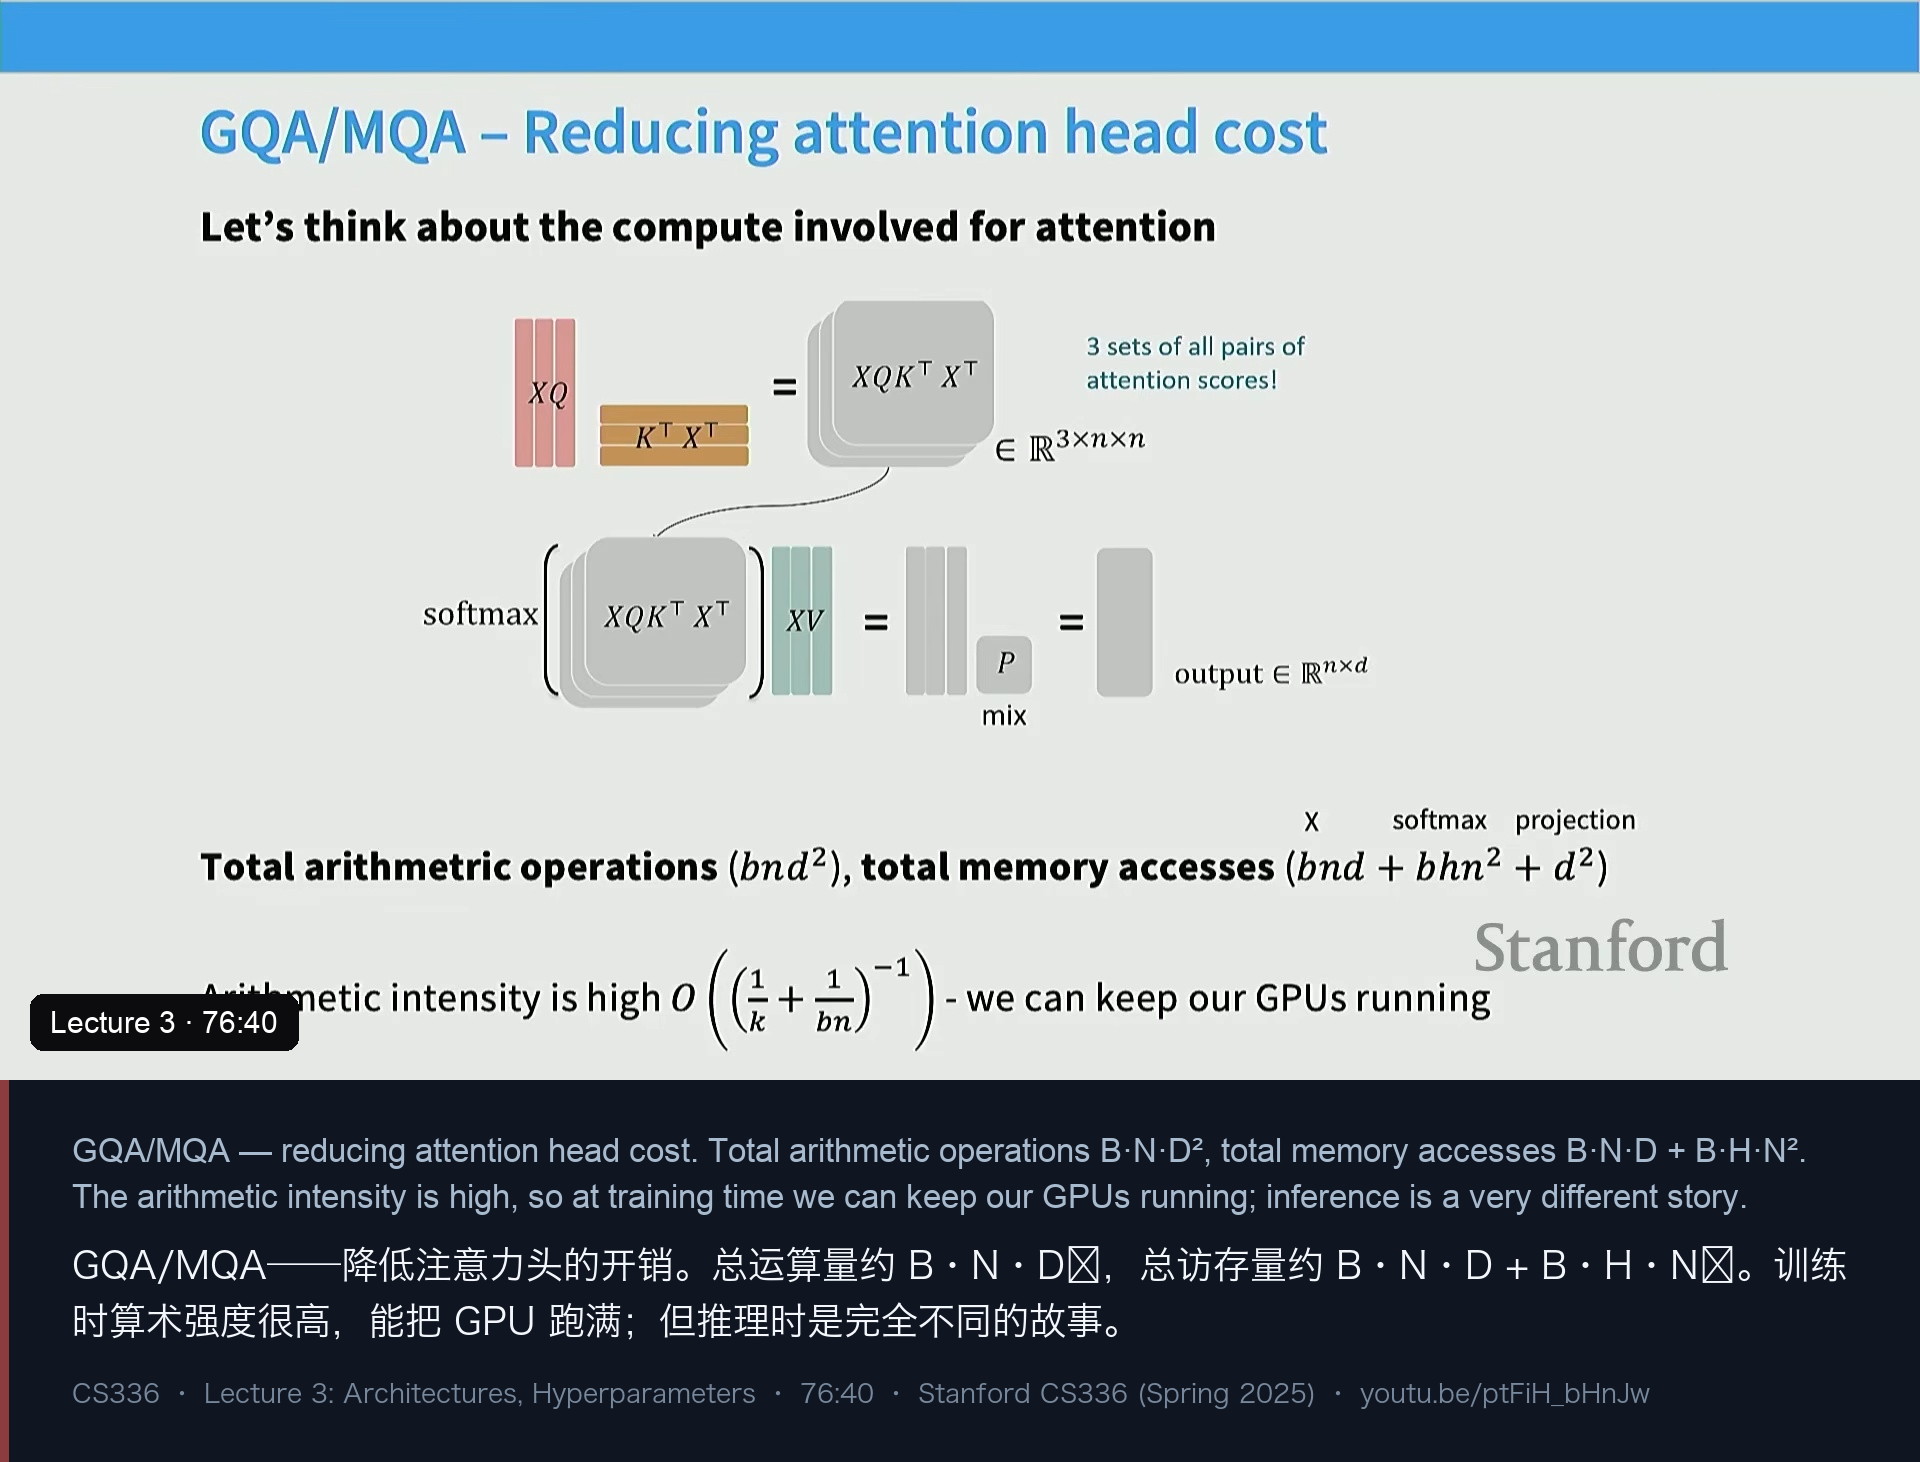
先把账算清楚。注意力涉及两次大的矩阵乘:
总运算量(arithmetic ops)   ≈ B · N · D²
总访存量(memory accesses)  ≈ B · N · D  +  B · H · N²  +  …

其中 B = batch size, N = 序列长度, D = 隐藏维度, H = 头数
算术强度 = 运算量 / 访存量算术强度越高越好——意思是每搬一次数据,能完成尽可能多的计算,因为 GPU 上访存相对昂贵、计算相对便宜。训练时我们有大批量、长序列,这些项都是大数,算术强度很高,GPU 能跑得很好。
但生成(推理)时完全不同。 自回归生成必须一个 token 一个 token 地走:生成一个 token → 模型读它 → 得到下一个分布 → 再生成。这个过程无法并行化。于是我们需要 KV cache:把过去所有 token 的 K、V 增量地存下来(它们只依赖过去、不会变),每次只计算新 query 对应的一行注意力。
这时总运算量还是 B·N·D²,但访存模式变了:KV cache 要在显存里反复搬进搬出。算出来的算术强度会变成类似 [1 + n/(b·d)] 这样量级更差的形式,而且其中 n/d 这一项特别致命——它逼你“要么用超长序列、要么用超大 d_model”,而这两个你都不想。
10.2 MQA 与 GQA
问题的根源在 K 和 V 上(它们要被缓存、反复搬运)。于是:
- MQA(multi-query attention):query 保留多个头,但 K 和 V 只保留一个头/一份维度。 这样 K、V 要搬的数据大幅减少,访存降下来,算术强度好得多——第一项按 n 缩小,第二项也除以头数。代价是表达力可能下降。
- GQA(grouped-query attention):折中方案——把 K/V 的头数减少若干组,而不是压到 1。这样可以在推理成本与模型表达力之间做权衡,因为从 multi-head 一步跨到 multi-query 可能太激进。(讲师提到有工作显示 GQA 不伤性能,而 MQA 会。)
10.3 稀疏与滑窗注意力
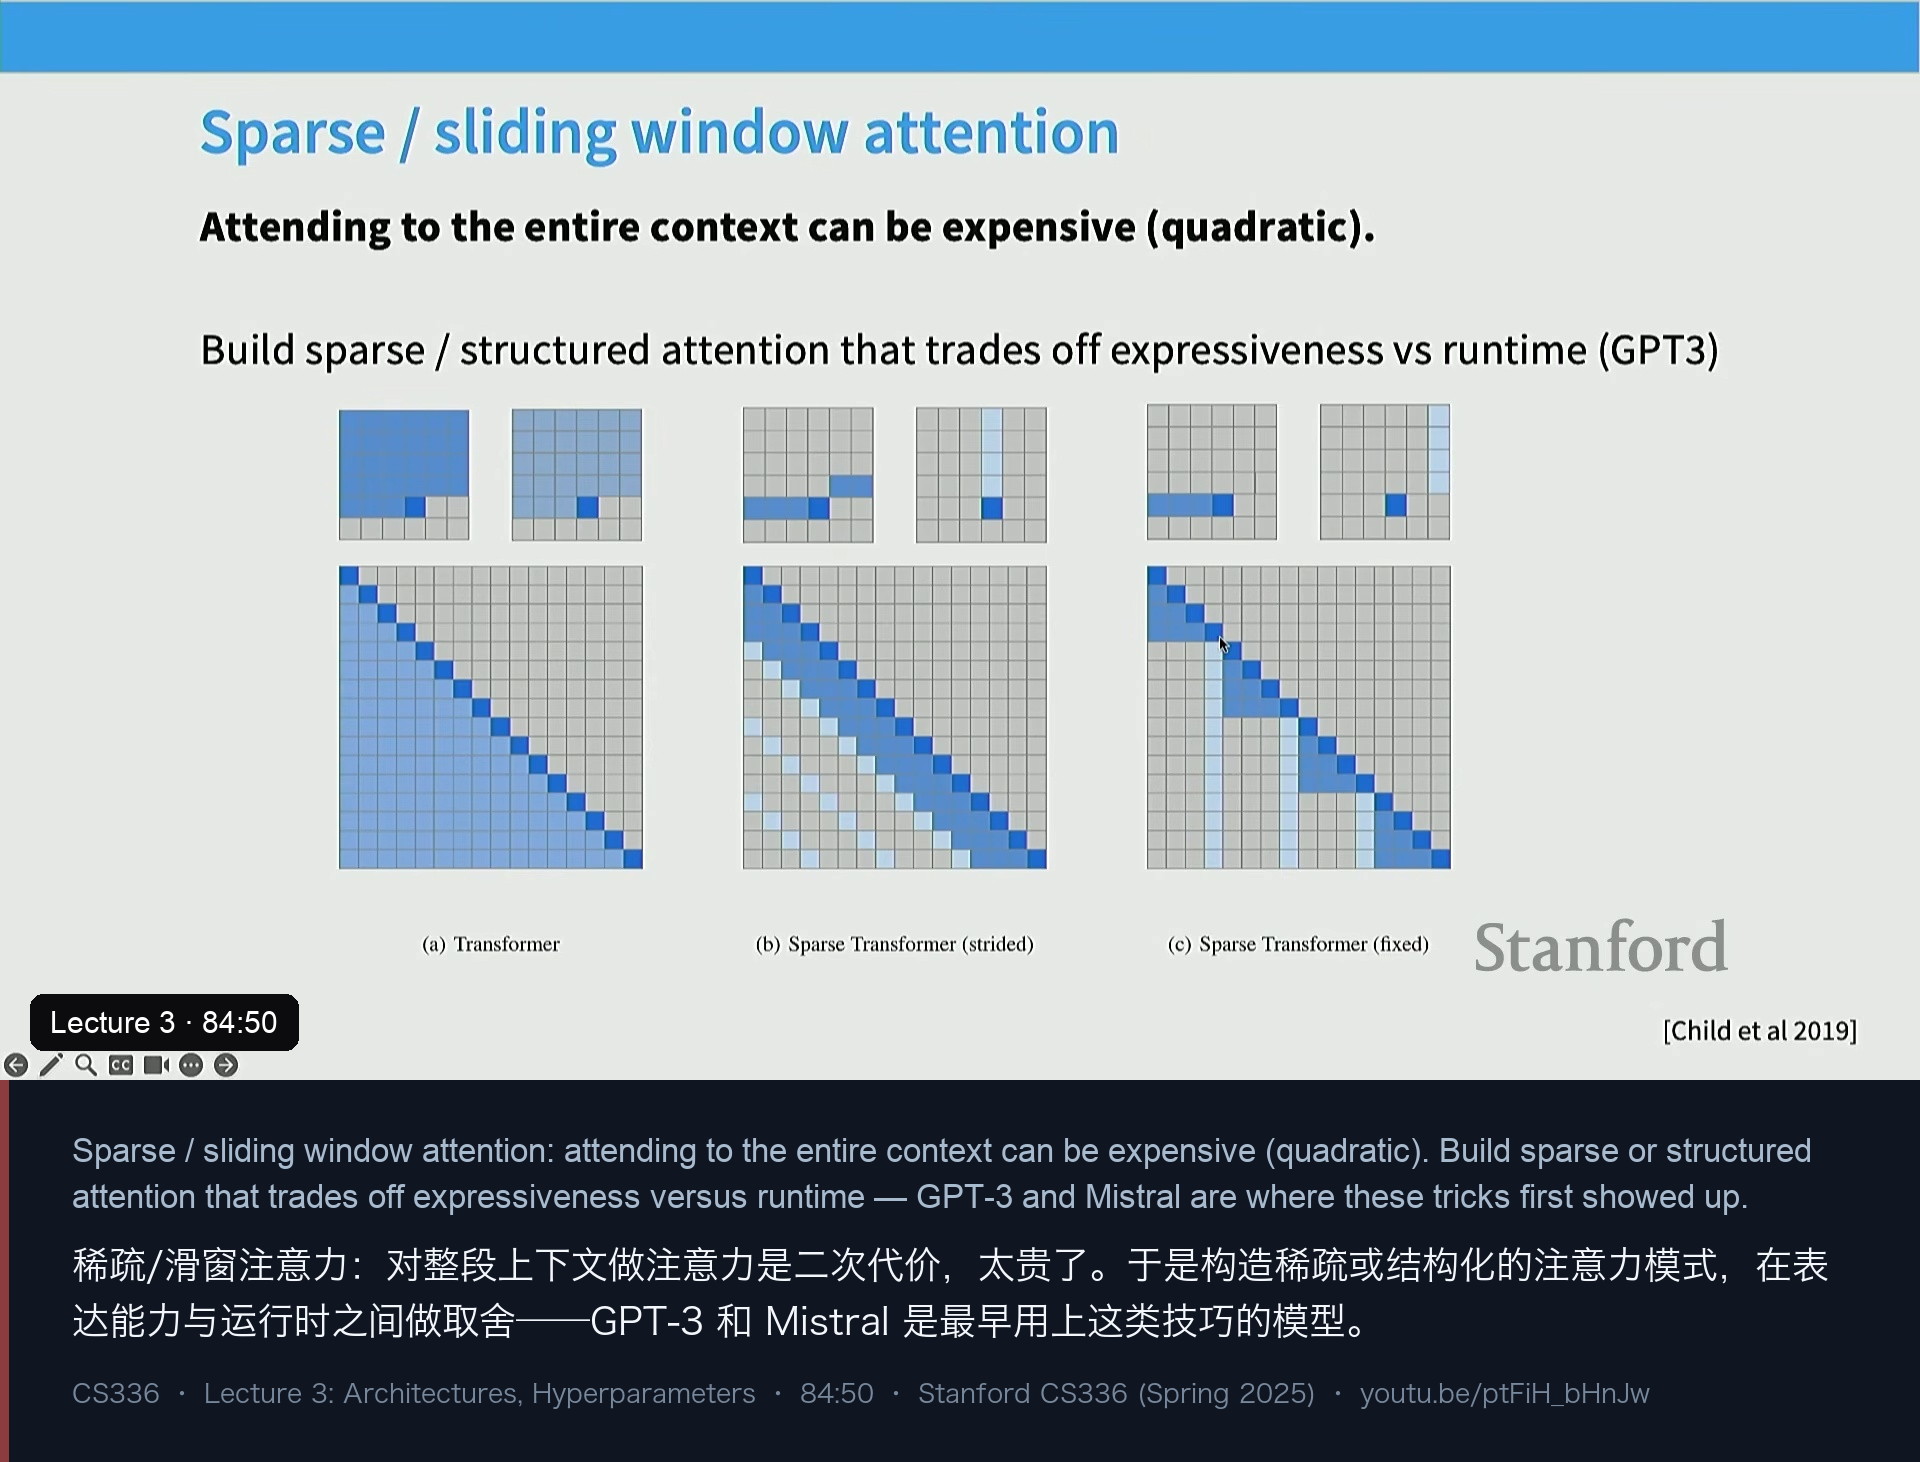
想支持更长上下文,另一种思路是不去注意整段序列,而是构造稀疏/结构化的注意力模式(Sparse Transformer, Child et al. 2019):
- 每个位置只注意一个局部窗口;
- 再用一些对角/条带模式把信息在全局传播。
这样就能在表达力和运行时之间取舍。GPT-3 用了这类技巧来获得更长的注意力窗口;滑窗注意力(sliding window attention) 是其中一种形式——每层只注意当前位置附近的一小段,于是有效感受野随着层数线性扩大。
过去几个月最“巧妙”的新发展是把几种注意力交织在一起。以 Llama 4、Gemma、Command A 为代表的方案是:每 4 个 Transformer block 为一组,
- 最底层用完整的自注意力,但完全不带位置编码(没有 RoPE、什么都没有——它根本不知道位置),并且每 4 层才出现一次;
- 上面三层用带 RoPE 的滑窗注意力。
这样同时解决了两件事:系统上,全注意力的开销被摊薄;长度外推上,RoPE 只处理局部窗口,而任何真正长程的信息都由“完全没有位置编码”的那一层处理——它对位置一无所知,反而能极其激进地外推。讲师说这是“过去几个月很酷的一个进展”。
我的笔记:这一讲值得记住的 7 句话
- 把架构史当成实验数据读。 单篇论文告诉你“我们这么做了”,把 2017–2025 的模型排成一张表才告诉你“什么是共识、什么只是尝试”。
- pre-norm 是 2024 年唯一没有争议的架构决定。 让残差流保持一条干净的恒等通路,剩下的都好说。
- 不要只盯 FLOPs,要盯访存。 矩阵乘法占 99.8% 的 FLOPs,但一次归一化能在运行时里占掉可观的比例——RMSNorm 和“删掉 bias”真正的理由在这里。
- GLU 系列是稳定的小幅改进,不是必要条件。 8/3 这个乘数来自“参数量对齐”,而 T5 的 64 倍证明规则可以被打破(然后 T5 v1.1 又自己走了回来)。
- RoPE 的美感在于用“旋转不变性”表达“相对位置”。 而且它作用于 attention 的 Q/K,不是加在输入 embedding 上——这个实现细节很关键。
- weight decay 在预训练里不看正则化那一面,看的是它与学习率调度的相互作用。 这是个漂亮的“经验打败直觉”的案例。
- 注意力里的两个 softmax 是稳定性的重灾区。 z-loss 管归一化因子,QK norm 管输入尺度,QK norm 的收益/代价比最好。
附:课程信息与时间轴
- 课程主页:stanford-cs336.github.io/spring2025
- 本讲视频:Lecture 3: Architectures, Hyperparameters(1:27,2025-04-16 发布)
- 播放列表:Stanford CS336 Language Modeling from Scratch · Spring 2025
- 配图目录:
public/blog/youtube/ptFiH_bHnJw/(18 张图均截取自视频中对应观点所在的幻灯片,并把该时刻的完整观点句拼合进图中)
| 时间 | 内容 |
|---|---|
| 00 | 开场:PPT 派、作业更新提醒 |
| 00 | 大纲与目标:这一讲要回答的三个问题 |
| 01 | 起点:原始 Transformer 回顾 |
| 02 | 你们要实现的那一版:pre-norm + RoPE + SwiGLU + 无 bias |
| 04 | 19 个新稠密模型与架构演化表 |
| 05 | 架构变体总览 |
| 06 | pre-norm vs post-norm:2024 年唯一共识 |
| 07 | pre/post-norm 的实验数据 |
| 09 | 为什么 pre-norm 更好:梯度衰减 vs loss 尖峰 |
| 10 | 新鲜事:“双重” norm(Grok / Gemma 2 / Olmo 2) |
| 11 | LayerNorm vs RMSNorm |
| 12 | Why RMSNorm:更少运算、更少参数 |
| 13 | FLOPs 只占 0.17%,运行时却占很大比例:访存的代价 |
| 15 | 普遍删掉 bias 项 |
| 16 | LayerNorm 小结:三条现代共识 |
| 19 | 提问:有没有更“面向未来”的教训 |
| 20 | 激活函数动物园 |
| 21 | ReLU / GeLU / SwiGLU 与各自的使用者 |
| 22 | 门控激活(*GLU)的数学 |
| 23 | GeGLU 与 SwiGLU 变体 |
| 27 | 门控真的有用吗:Shazeer 2020 与 Narang 2020 的证据 |
| 28 | 小结:GLU 不是必需的(GPT-3、Falcon、Nemotron) |
| 29 | 串行 vs 并行层 |
| 30 | 并行层:GPT-J 与 PaLM |
| 31 | 架构总表回顾 |
| 32 | 位置编码的多种变体 |
| 33 | 正弦 / 绝对 / 相对编码与代表模型 |
| 34 | RoPE 的核心思路:内积对旋转不变 |
| 35 | RoPE:用旋转实现相对位置 |
| 36 | 高维怎么旋转:成对切分与不同频率 |
| 38 | RoPE 的实现与代码 |
| 41 | 进入超参数:只有少数几个会被改 |
| 42 | 前馈维度比 d_ff / d_model |
| 43 | 例外一:GLU 变体的 8/3 |
| 44 | 例外二:T5 的 64 倍 d_ff |
| 45 | Kaplan 缩放定律里的宽盆地 |
| 48 | 头维度比:保持 1 |
| 50 | 反对 1 的声音与低秩瓶颈 |
| 51 | 宽深比:每层约 128 |
| 53 | 宽深比的证据与深度/宽度之争 |
| 55 | 词表大小:3–5 万 vs 10–25 万 |
| 56 | dropout 与正则化 |
| 58 | 实践中的 dropout 与 weight decay |
| 59 | 为什么 LLM 要用 weight decay |
| 61 | 超参数小结:哪些不用多想 |
| 66 | 稳定性技巧:梯度范数尖峰 |
| 68 | 输出 softmax 稳定:z-loss |
| 70 | 注意力 softmax 稳定:QK norm |
| 73 | logit soft cap 与 Nvidia 的对比 |
| 75 | 注意力头的变体 |
| 76 | GQA / MQA 与算术强度 |
| 79 | KV cache 与推理时的算术强度 |
| 83 | MQA:只有一组 K/V |
| 84 | 稀疏与滑窗注意力 |
| 86 | Llama 4 等的混合注意力:每 4 层一次无位置编码的全注意力 |
说明:本文是视频内容的整理、翻译与转述,观点均来自主讲人 Tatsunori Hashimoto;文中代码为讲座中算法与公式的整理版本,非官方作业代码。课程中引用的模型规模、超参数、词表大小与时间线多来自公开论文、模型卡或讲师的估算与传闻,请自行核实。
讨论
这里是静态站点,没有内嵌评论区。如果这篇文章对你有用,欢迎通过 RSS 订阅后续更新。