Stanford CS336 第二讲精读:PyTorch 与资源核算——训一个大模型到底要多少显存和算力?
斯坦福 CS336(Language Modeling from Scratch, Spring 2025)第二讲完整讲义:用两道「餐巾纸算术」题讲清训练的资源账——6 × 参数量 × token 数的算力从哪来、显存为什么是 16 字节/参数、float32 / float16 / bfloat16 / fp8 怎么选、PyTorch 张量的 storage 与 stride 为什么重要、MFU 怎么算,以及从参数初始化、优化器一路到激活值、梯度、优化器状态的完整内存账本,最后落到混合精度训练。
本篇属于系列 Stanford CS336 精读 · 第二讲
来源:YouTube 原视频(Stanford Online · CS336 Language Modeling from Scratch · Spring 2025 · Lecture 2: PyTorch, Resource Accounting)
来源说明 这是斯坦福 CS336《Language Modeling from Scratch》2025 年春季第二讲的完整讲义,主讲人是 Percy Liang。第一讲讲了「为什么要从零构建语言模型」和分词,这一讲正式开始动手:从张量一级开始,把 PyTorch 的底层原语、模型、优化器、训练循环一路搭起来,而贯穿全程的主线只有一个——资源核算(resource accounting):这些代码到底吃多少显存、烧多少算力。文中 18 张配图均截取自视频对应时刻的幻灯片,并把该时刻的完整观点句(英文原句+中文翻译)拼合进图中。讲师口播的数字(GPT-3/GPT-4 的 FLOPs、Llama 数据量、各国监管门槛等)多为他引用的公开传闻或量级估算,不是本文独立核实的事实;本文只保证忠实转述。
TL;DR
- 这一讲不碰 Transformer。Percy 明确说,Transformer 的架构由 Tatsu 下一讲讲;他今天用最朴素的线性模型来教「底层原语 + 资源核算」,因为大模型的账,本质上就是线性模型的账再重复几遍。
- 两个数字要背下来:前向 + 反向的总算力 ≈ 6 × 参数量 × token 数;AdamW 训练时每个参数要占 16 字节(参数 4 + 梯度 4 + Adam 一阶动量 4 + 二阶动量 4)。
- 显存不是一个数,而是一本账:
总显存 = 4 字节 × (参数量 + 激活数 + 梯度数 + 优化器状态数)。前三项好算,最后一项常常被新手忘掉——它和参数量一样大(Adam 甚至是参数量的两倍)。 - 精度选择是一组权衡:float32 稳定但慢且贵;float16 省一半显存但动态范围太差(
1e-8直接下溢成 0);bfloat16 用同样的显存换来了和 float32 一样的动态范围;FP8 在 H100 上进一步提速。实践方案是混合精度:前向用低精度,参数和优化器状态留 float32。 - PyTorch 张量 = 一块内存 + 一份 stride 元数据。所以
view、transpose、切片几乎不花钱(共享同一份 storage),而contiguous()、reshape可能真的复制一份——忽略这一点,你的显存账会算错。 - MFU(模型 FLOPs 利用率)= 实际 FLOP/s ÷ 厂商标称 FLOP/s。≥ 0.5 已经不错,矩阵乘法占比越高这个数越高;它衡量的是「你把硬件榨干了多少」。
一、这一讲的位置:先学会算账,再谈架构
第二讲的定位非常清楚:第一讲讲完了「为什么要从零构建」和分词,这一讲开始把模型真正搭出来。Percy 给出的路线图是自底向上的四层:张量 → 模型 → 优化器 → 训练循环。
但与一般「PyTorch 入门」不同,这一讲的每一行代码后面都跟着一个问题:这行代码占多少显存、花多少 FLOPs? 他在开头就把这门课的知识分层摊开来讲:
- Mechanics(机制):今天讲的就是 PyTorch,而且是在相当原始(primitive)的层面上理解它——这部分不难。
- Mindset(心态):今天的重点是资源核算。也不难,只是你必须真的去算。
- Intuitions(直觉):今天只能给「粗线条」的直觉,比如「什么样的设计会训出好模型」,这一讲基本不涉及。
为什么非要算?因为当数字变大时,FLOPs 会直接换算成美元。你当然可以「写个模型、跑起来、发生什么算什么」,但 Percy 提醒:效率才是这个游戏的名字;要想有效率,你就必须明确知道自己在烧多少算力。
二、两道「餐巾纸算术」题
整讲的动机来自两道可以在餐巾纸上算出来的问题。它们也是后面所有推导的「预告片」。
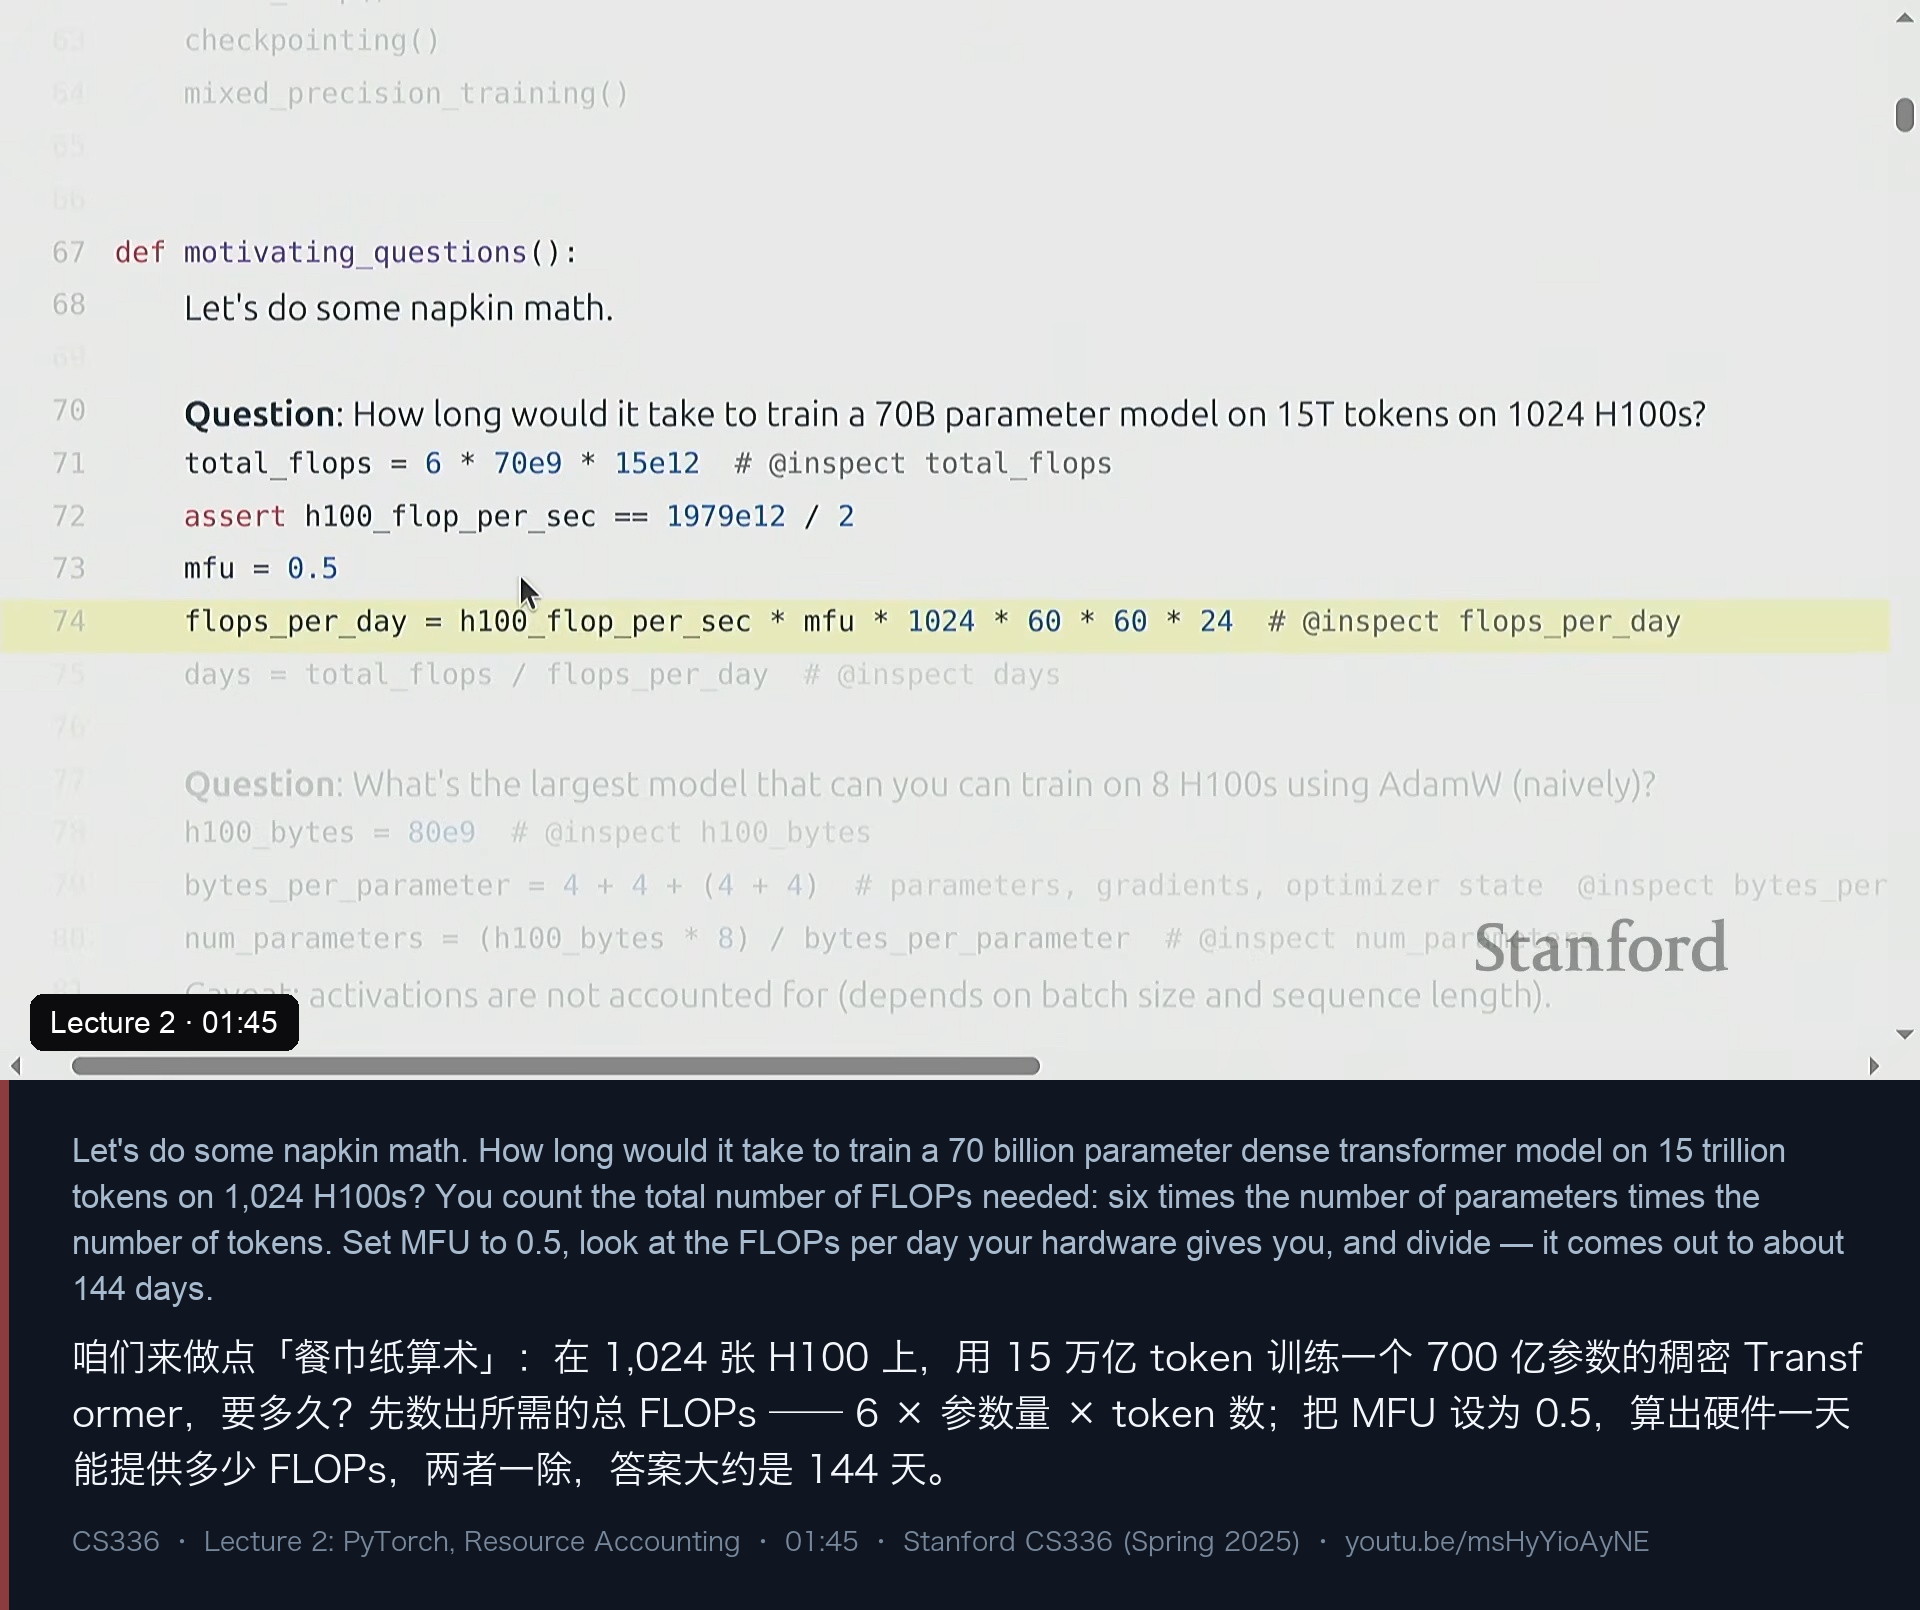
第一题:用 1,024 张 H100,在一个 700 亿参数的稠密 Transformer 上训练 15 万亿 token,需要多久?
Percy 的推理链条只有三步:
- 算出训练需要的总 FLOPs:6 × 参数量 × token 数。这个 6 从哪来,正是这一讲后半部分要推导的东西。代入数字:
6 × 70e9 × 15e12 = 6.3e24FLOPs。 - 查 H100 的标称算力。注意规格表上的 1979 TFLOP/s 是**带稀疏性(sparsity)**的数字,稠密矩阵用不上,所以要除以 2:
h100_flop_per_sec = 1979e12 / 2。再乘上 MFU——这里先随手设成 0.5。 - 算出一张卡一天能贡献多少 FLOPs,再乘 1,024 张:
flops_per_day = h100_flop_per_sec × mfu × 1024 × 60 × 60 × 24。最后days = total_flops / flops_per_day。
答案是 约 144 天。
def motivating_questions():
    # 第一题
    total_flops = 6 * 70e9 * 15e12          # 6 × 参数量 × token 数
    h100_flop_per_sec = 1979e12 / 2         # 1979 TFLOP/s 是 sparse,稠密要除以 2
    mfu = 0.5
    flops_per_day = h100_flop_per_sec * mfu * 1024 * 60 * 60 * 24
    days = total_flops / flops_per_day
Percy 承认这类算式「最后其实非常简单」,但他坚持要讲清楚 6 和 16 这两个常数是怎么来的——因为它们决定了你的直觉准不准。
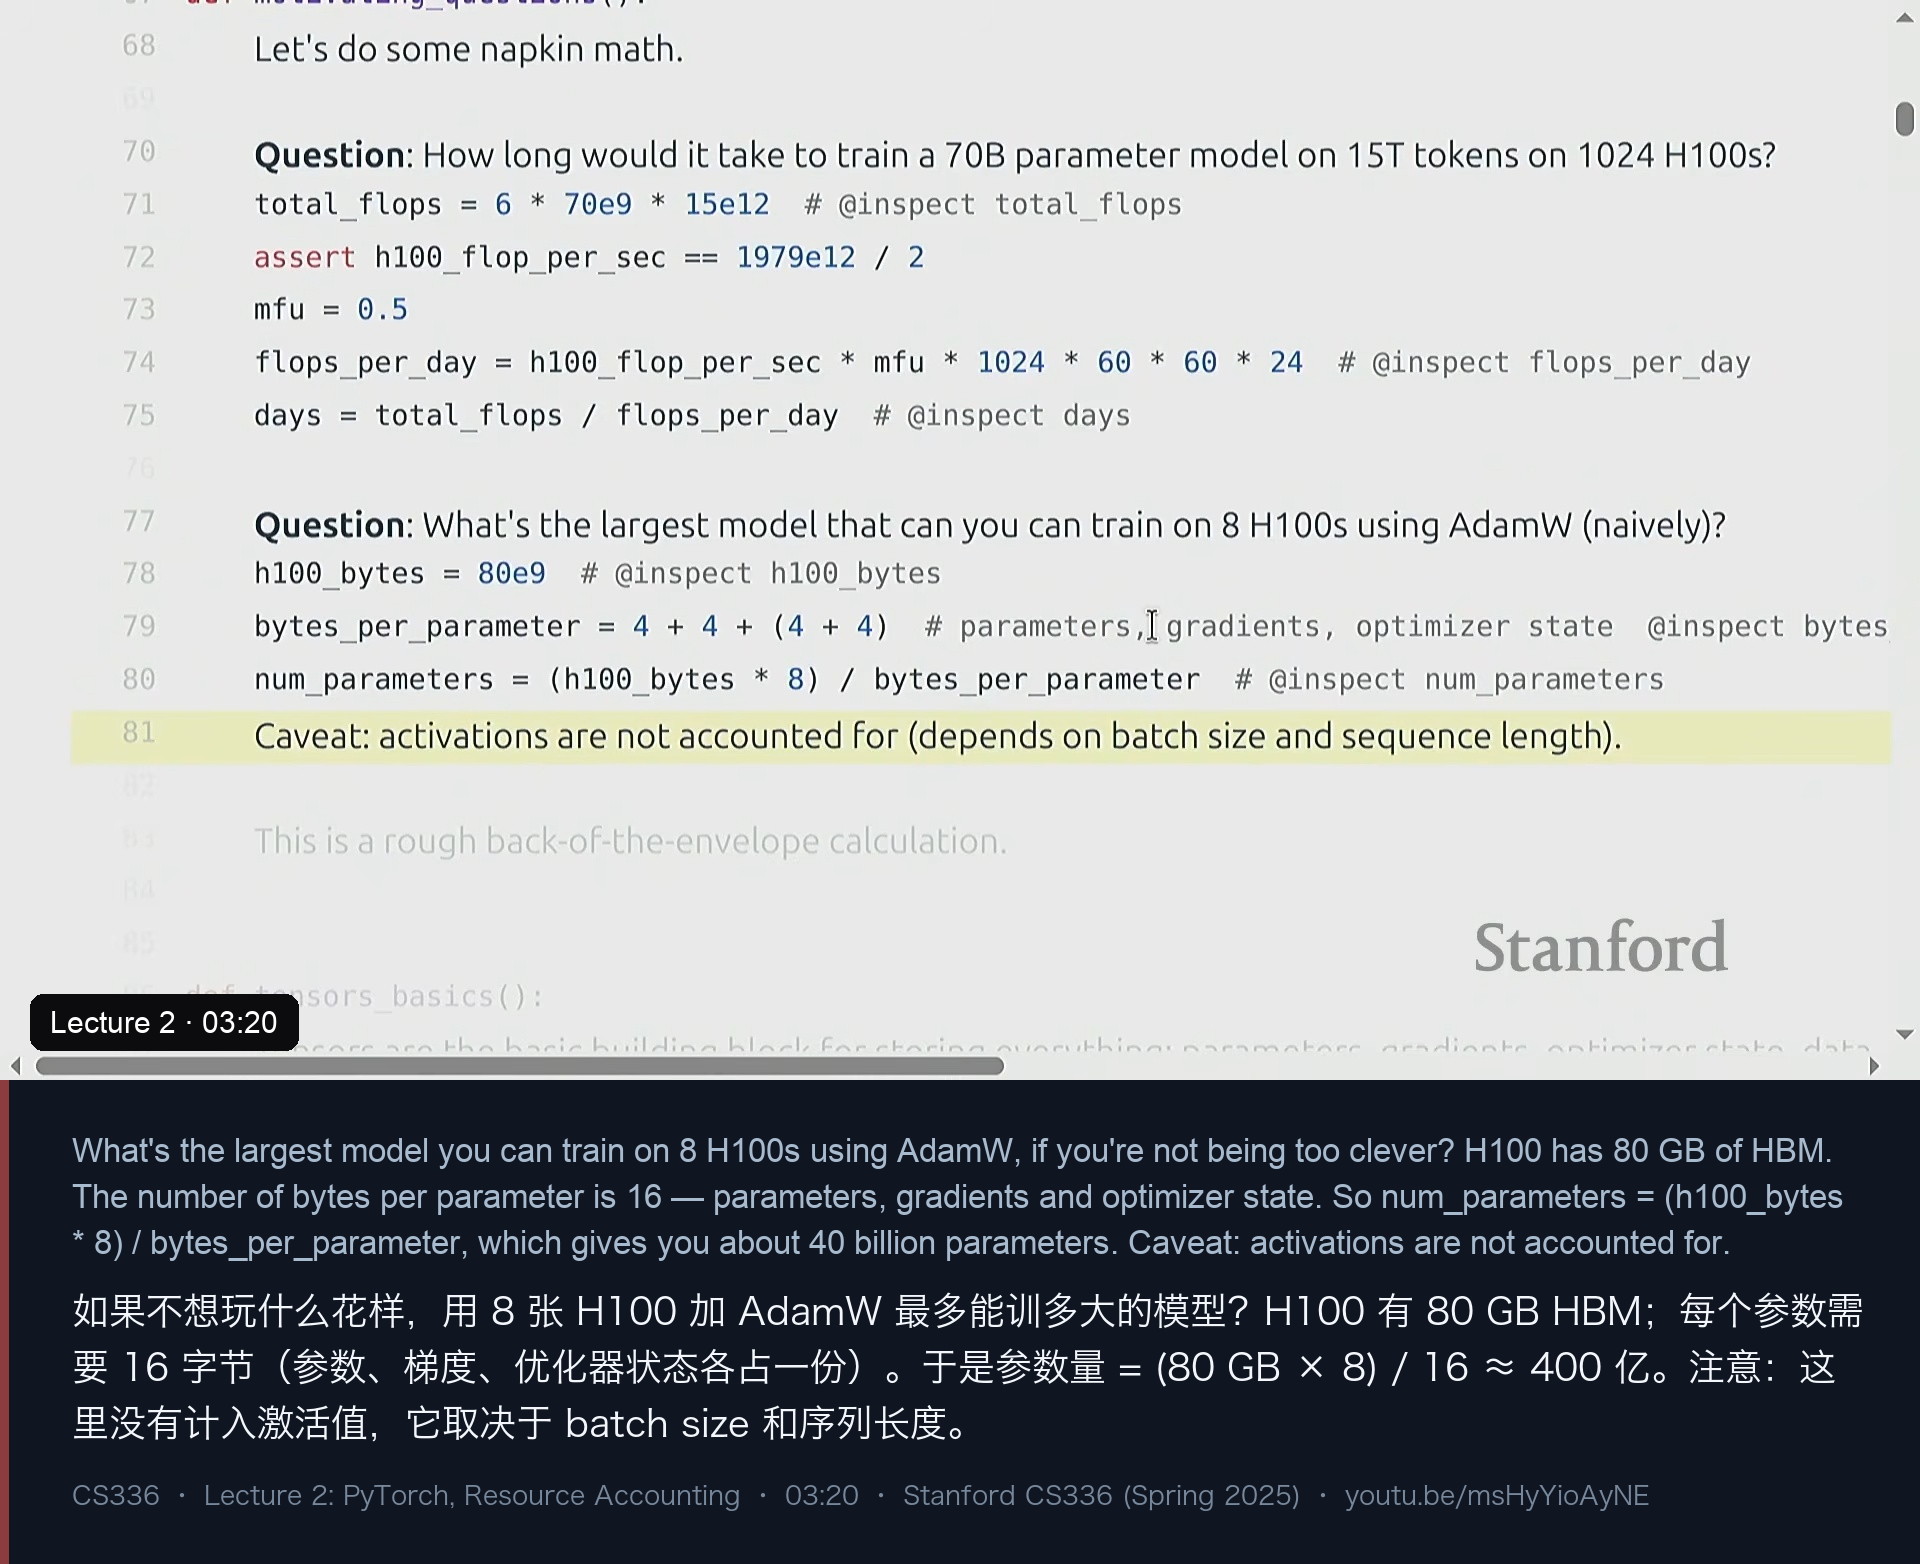
第二题:如果不耍什么花招,用 8 张 H100 加 AdamW,最大能训多大的模型?
这是一道纯显存的题:
- H100 有 80 GB HBM,8 张就是 640 GB;
- 训练时每个参数要付的字节数是 16:参数 4 字节 + 梯度 4 字节 + Adam 的一阶动量 4 字节 + 二阶动量 4 字节(
4 + 4 + (4 + 4)); - 于是
num_parameters = (80e9 × 8) / 16 = 40e9,也就是约 400 亿参数。
    # 第二题
    h100_bytes = 80e9
    bytes_per_parameter = 4 + 4 + (4 + 4)     # 参数、梯度、优化器状态
    num_parameters = (h100_bytes * 8) / bytes_per_parameter   # ≈ 40e9
    # Caveat: activations are not accounted for!
他在幻灯片上特意写了一行 Caveat:这里没有计入激活值(activations)——激活值取决于 batch size 和序列长度,等到作业一里算真实 Transformer 时,它会成为一个不能忽略的大项。
这两道题给定了一个基调:这一讲的所有内容,都是在教你怎么在动笔之前就把账算出来。
三、内存核算(一):一个张量占多少字节
「张量是深度学习里存储一切的基本单位」——参数、梯度、优化器状态、激活值,全都是张量。所以内存核算从张量开始,而张量的大小由一个极简公式决定:
显存 = 元素个数 × 每个元素的字节数
Percy 顺手给了一个量级感受:GPT-3 前馈层里的一个矩阵(12288×4 行、12288 列)用 float32 存下来就是 2.3 GB——一个矩阵,而已。
3.1 四种浮点格式:从 float32 到 FP8
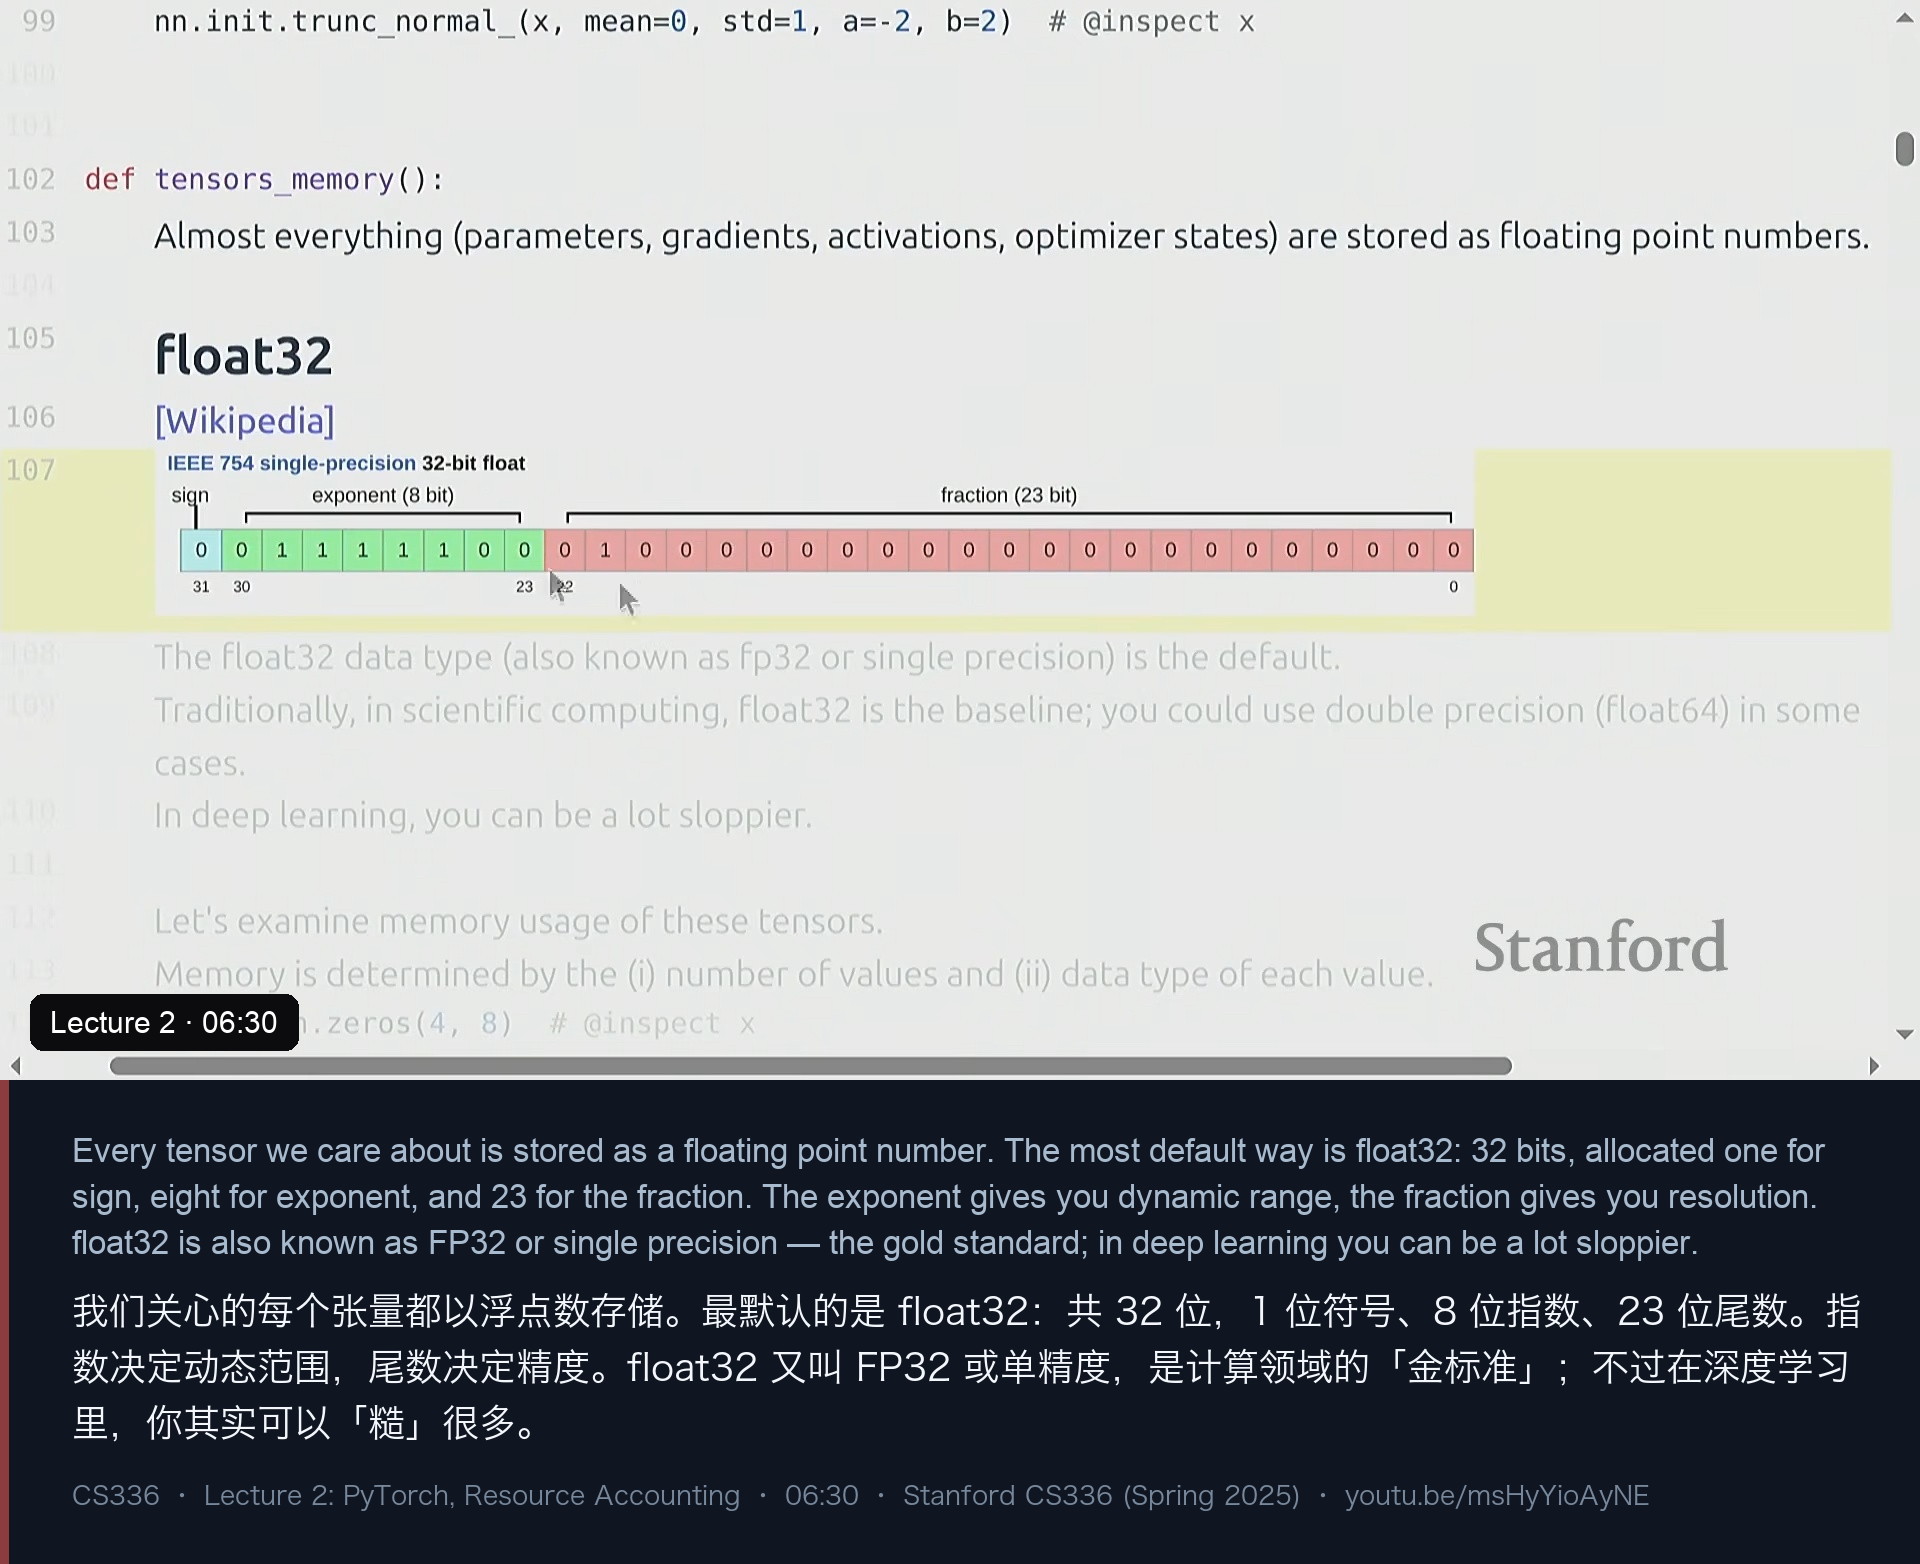
float32(FP32 / 单精度):32 位里,1 位符号、8 位指数、23 位尾数。指数决定动态范围(能表示多大、多小的数),尾数决定分辨率(能分得多细)。它是计算领域的「金标准」;在科学计算的人看来「float32 也算 full precision?」会显得可笑,但在深度学习里,这已经是你能用到的最高精度了——「深度学习就是这么糙」。
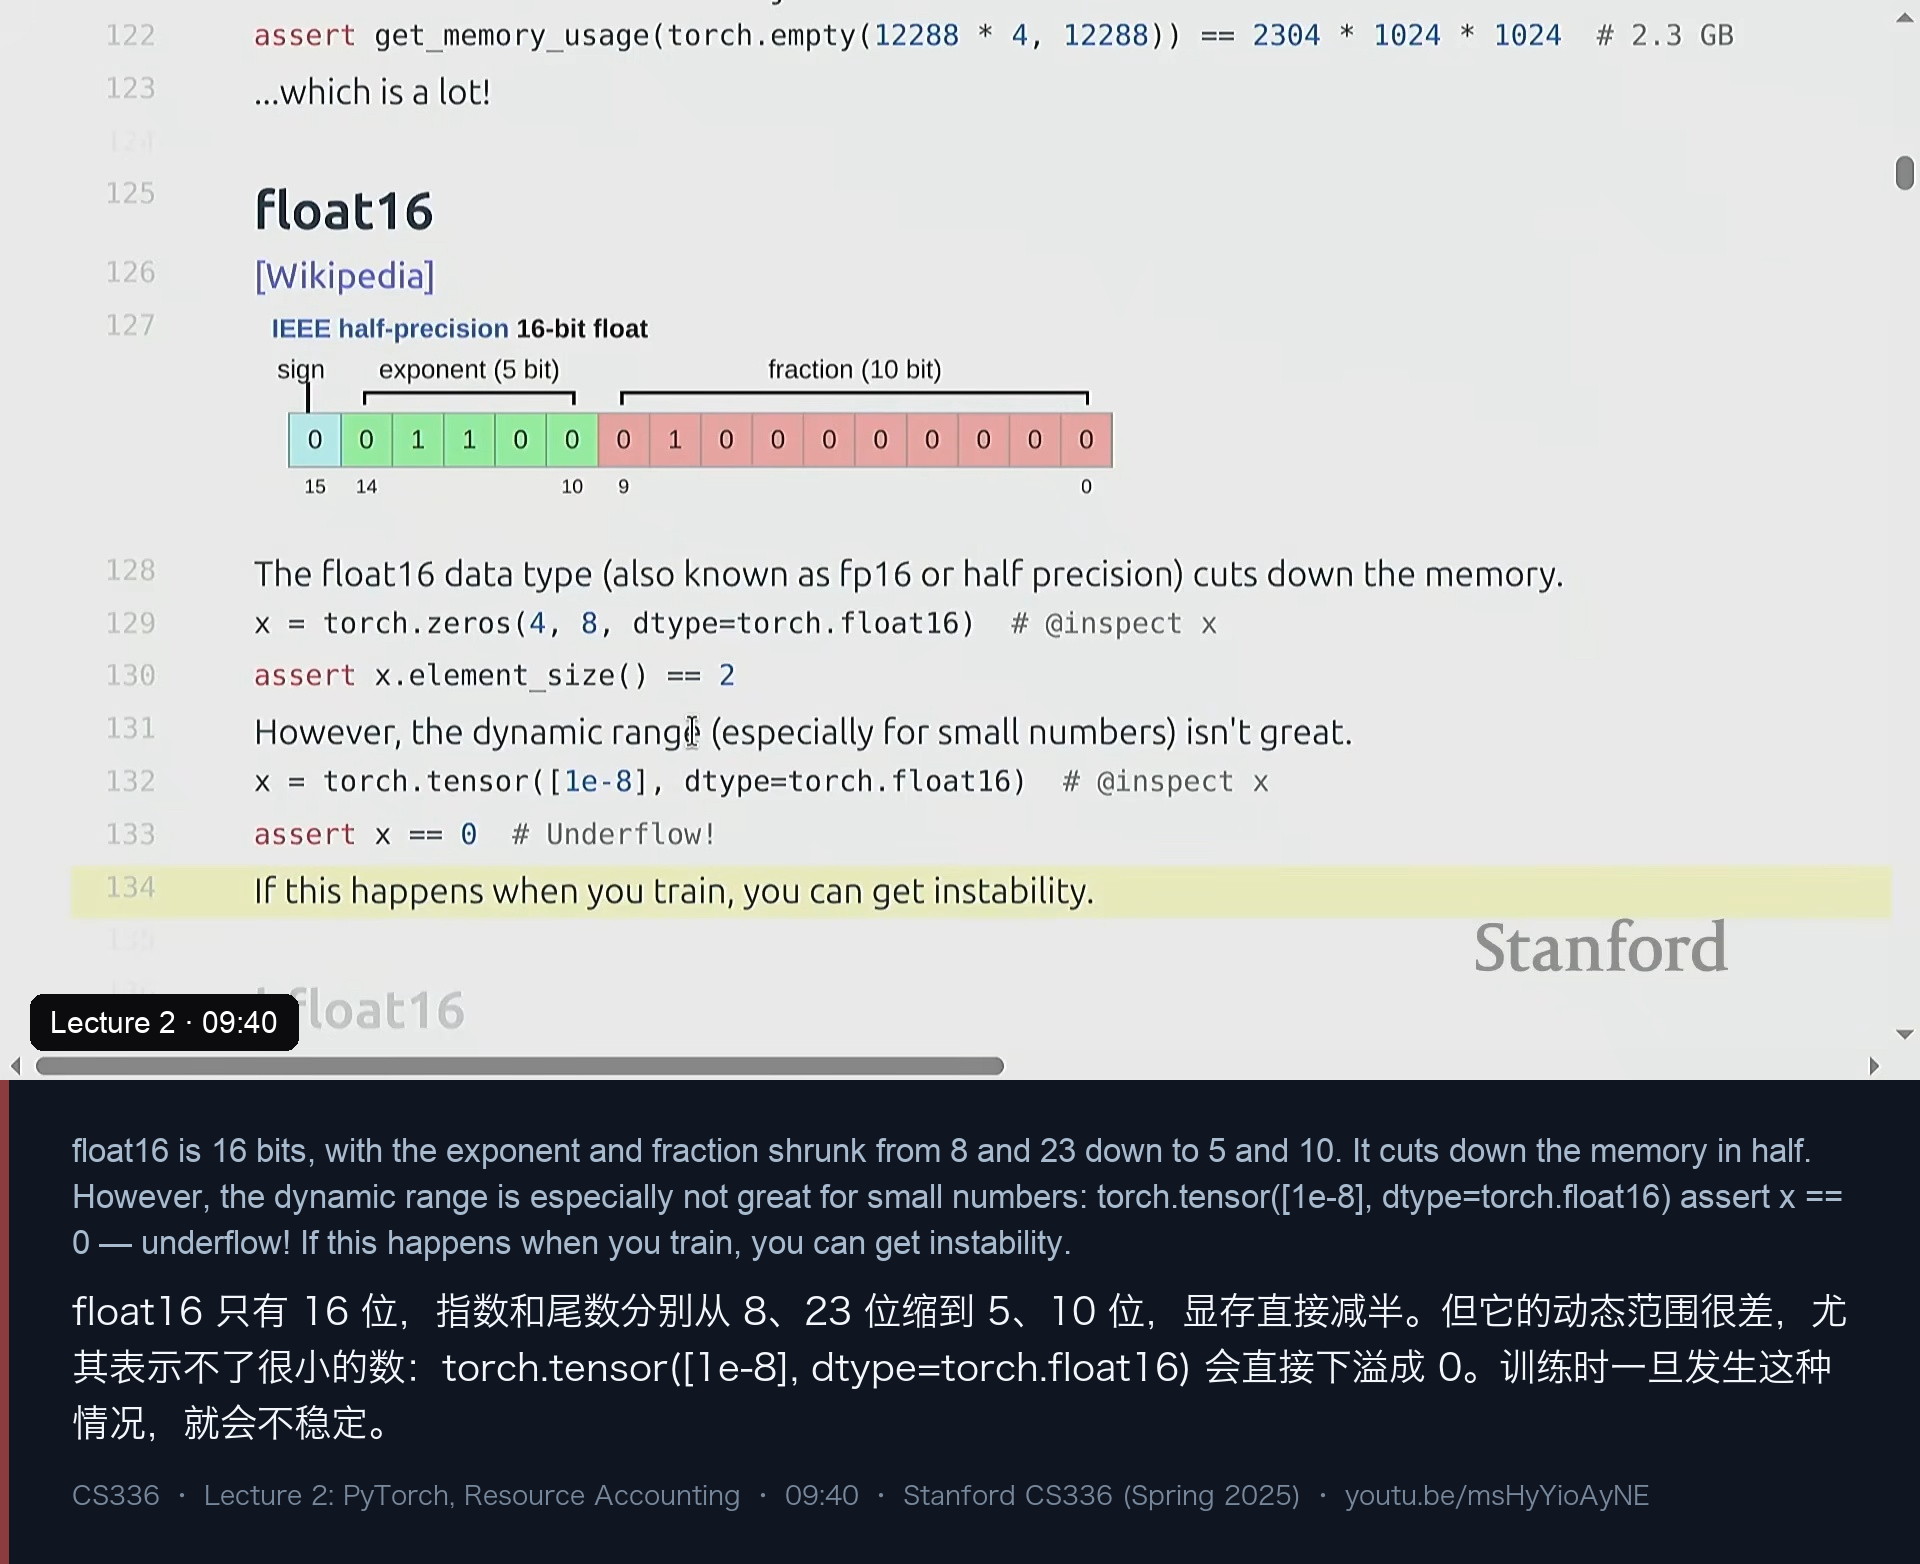
float16(半精度):指数缩到 5 位、尾数缩到 10 位,显存直接减半。代价是动态范围变得很差:
x = torch.zeros(4, 8, dtype=torch.float16)
assert x.element_size() == 2                     # 每个元素 2 字节
x = torch.tensor([1e-8], dtype=torch.float16)
assert x == 0                                    # 下溢!1e-8 变成 0
小模型上训练可能没事,但模型一大、矩阵一多,就会遇到下溢/上溢,「bad things happen」。这也是为什么现在基本不建议再用 float16 做深度学习。
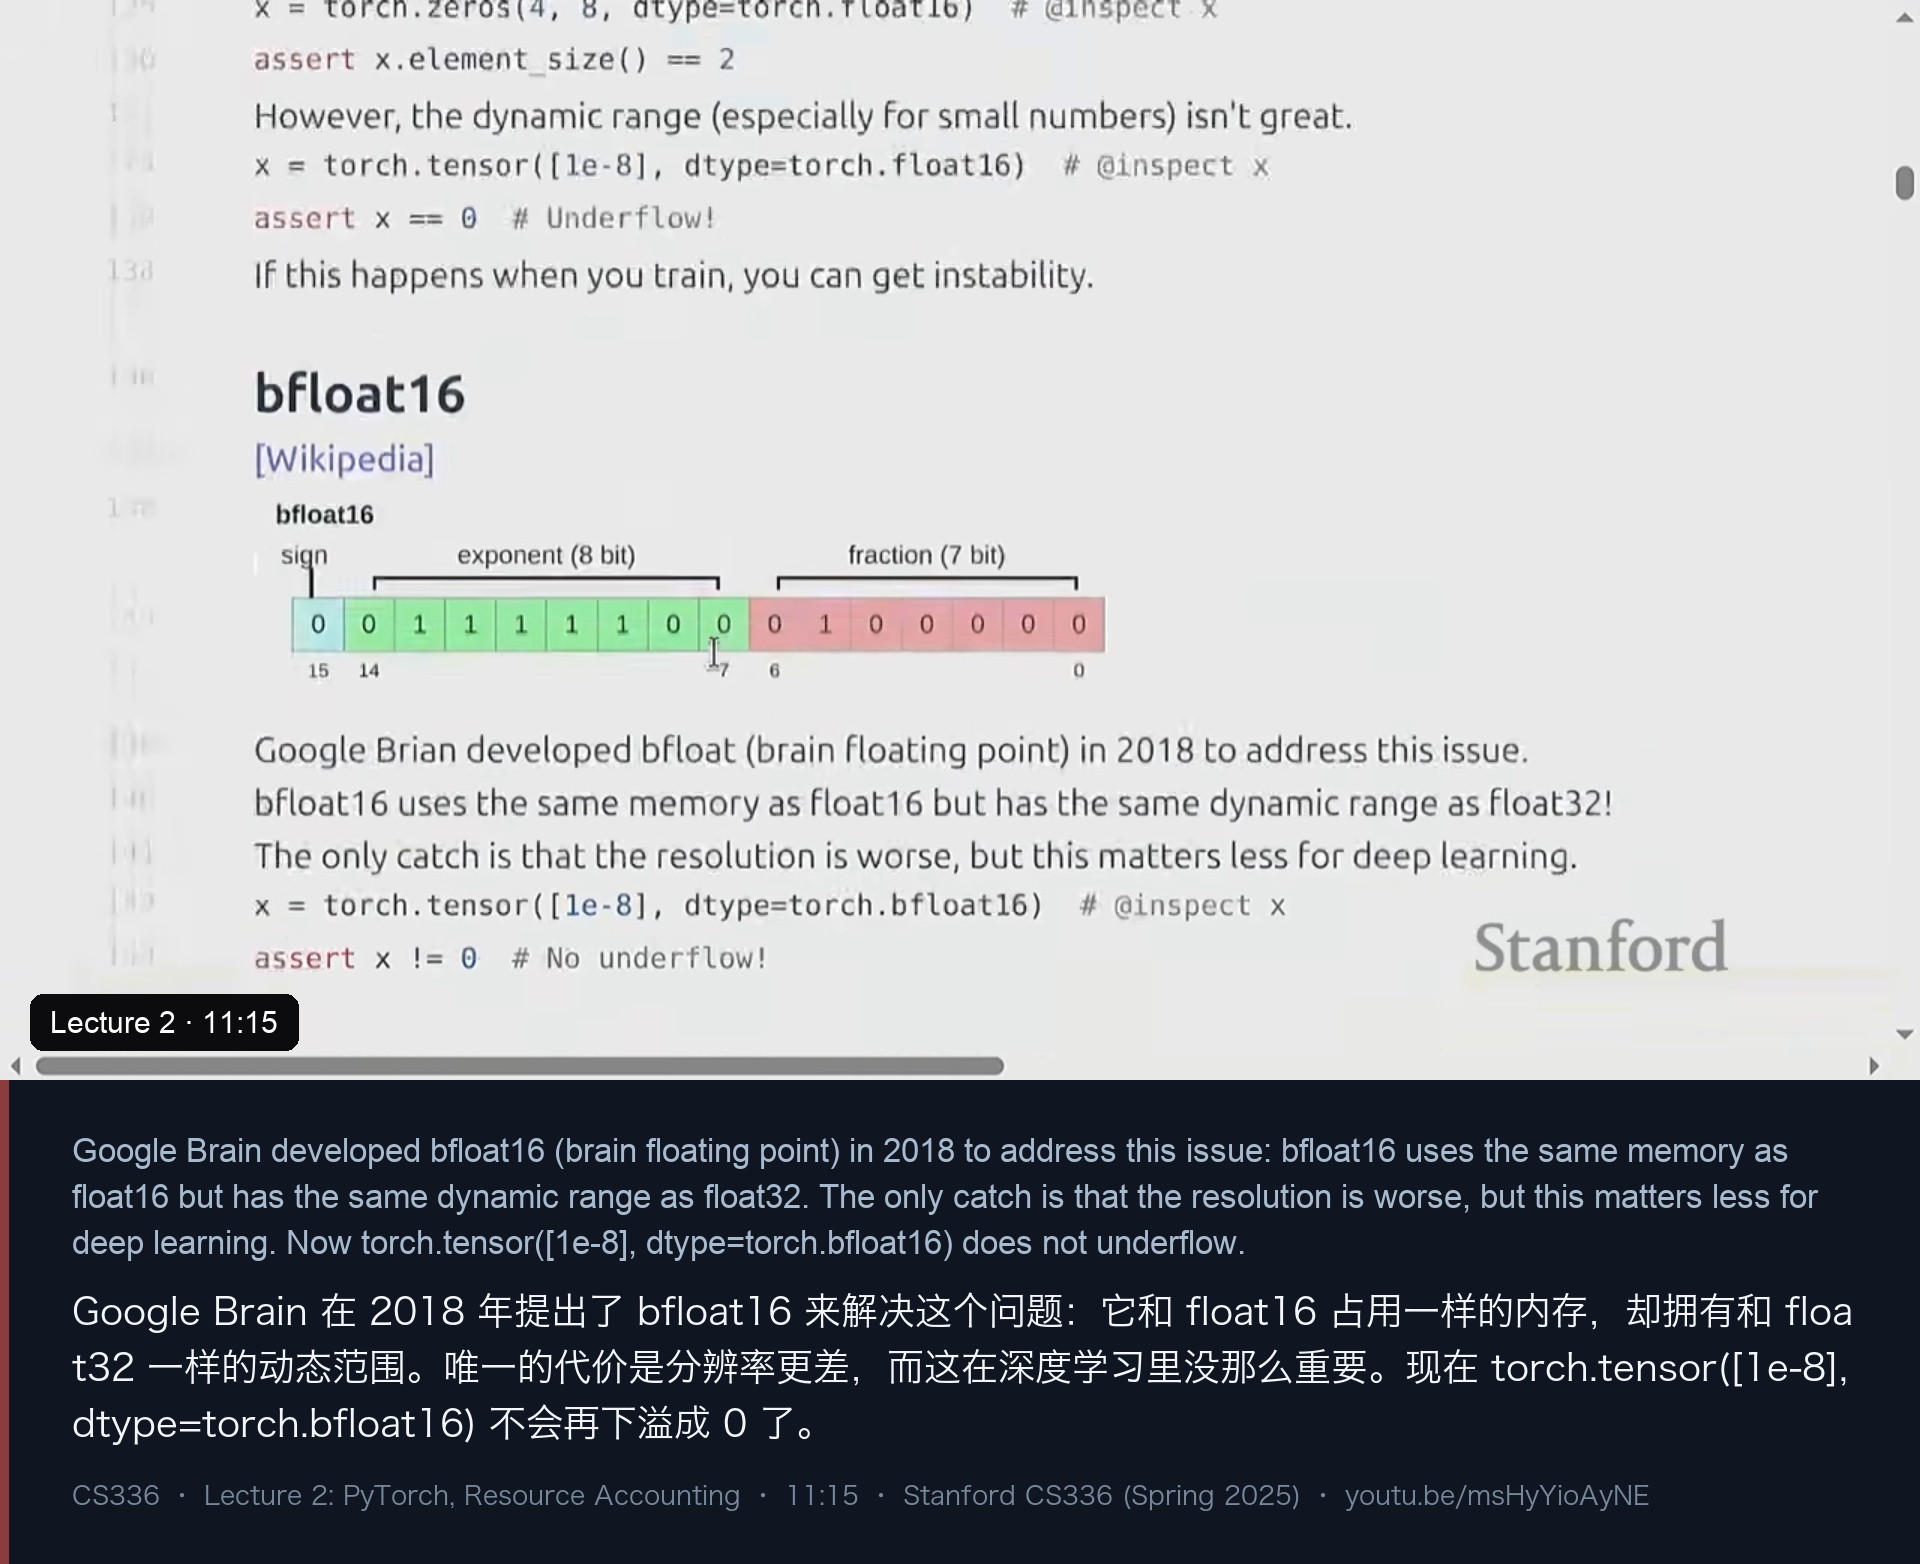
bfloat16(brain floating point):Google Brain 在 2018 年提出。它的核心洞察是——对深度学习来说,动态范围比分辨率更重要。于是 bf16 把更多的位分给指数,结果是与 float32 相同的动态范围、与 float16 相同的显存占用:
x = torch.tensor([1e-8], dtype=torch.bfloat16)
assert x != 0                                    # 不再下溢
代价自然是分辨率更差,但 Percy 说这「对深度学习来说没那么重要」。于是实践中的分工是:bf16 用来做计算,而参数和优化器状态仍然必须用 float32,否则训练会「go haywire」。
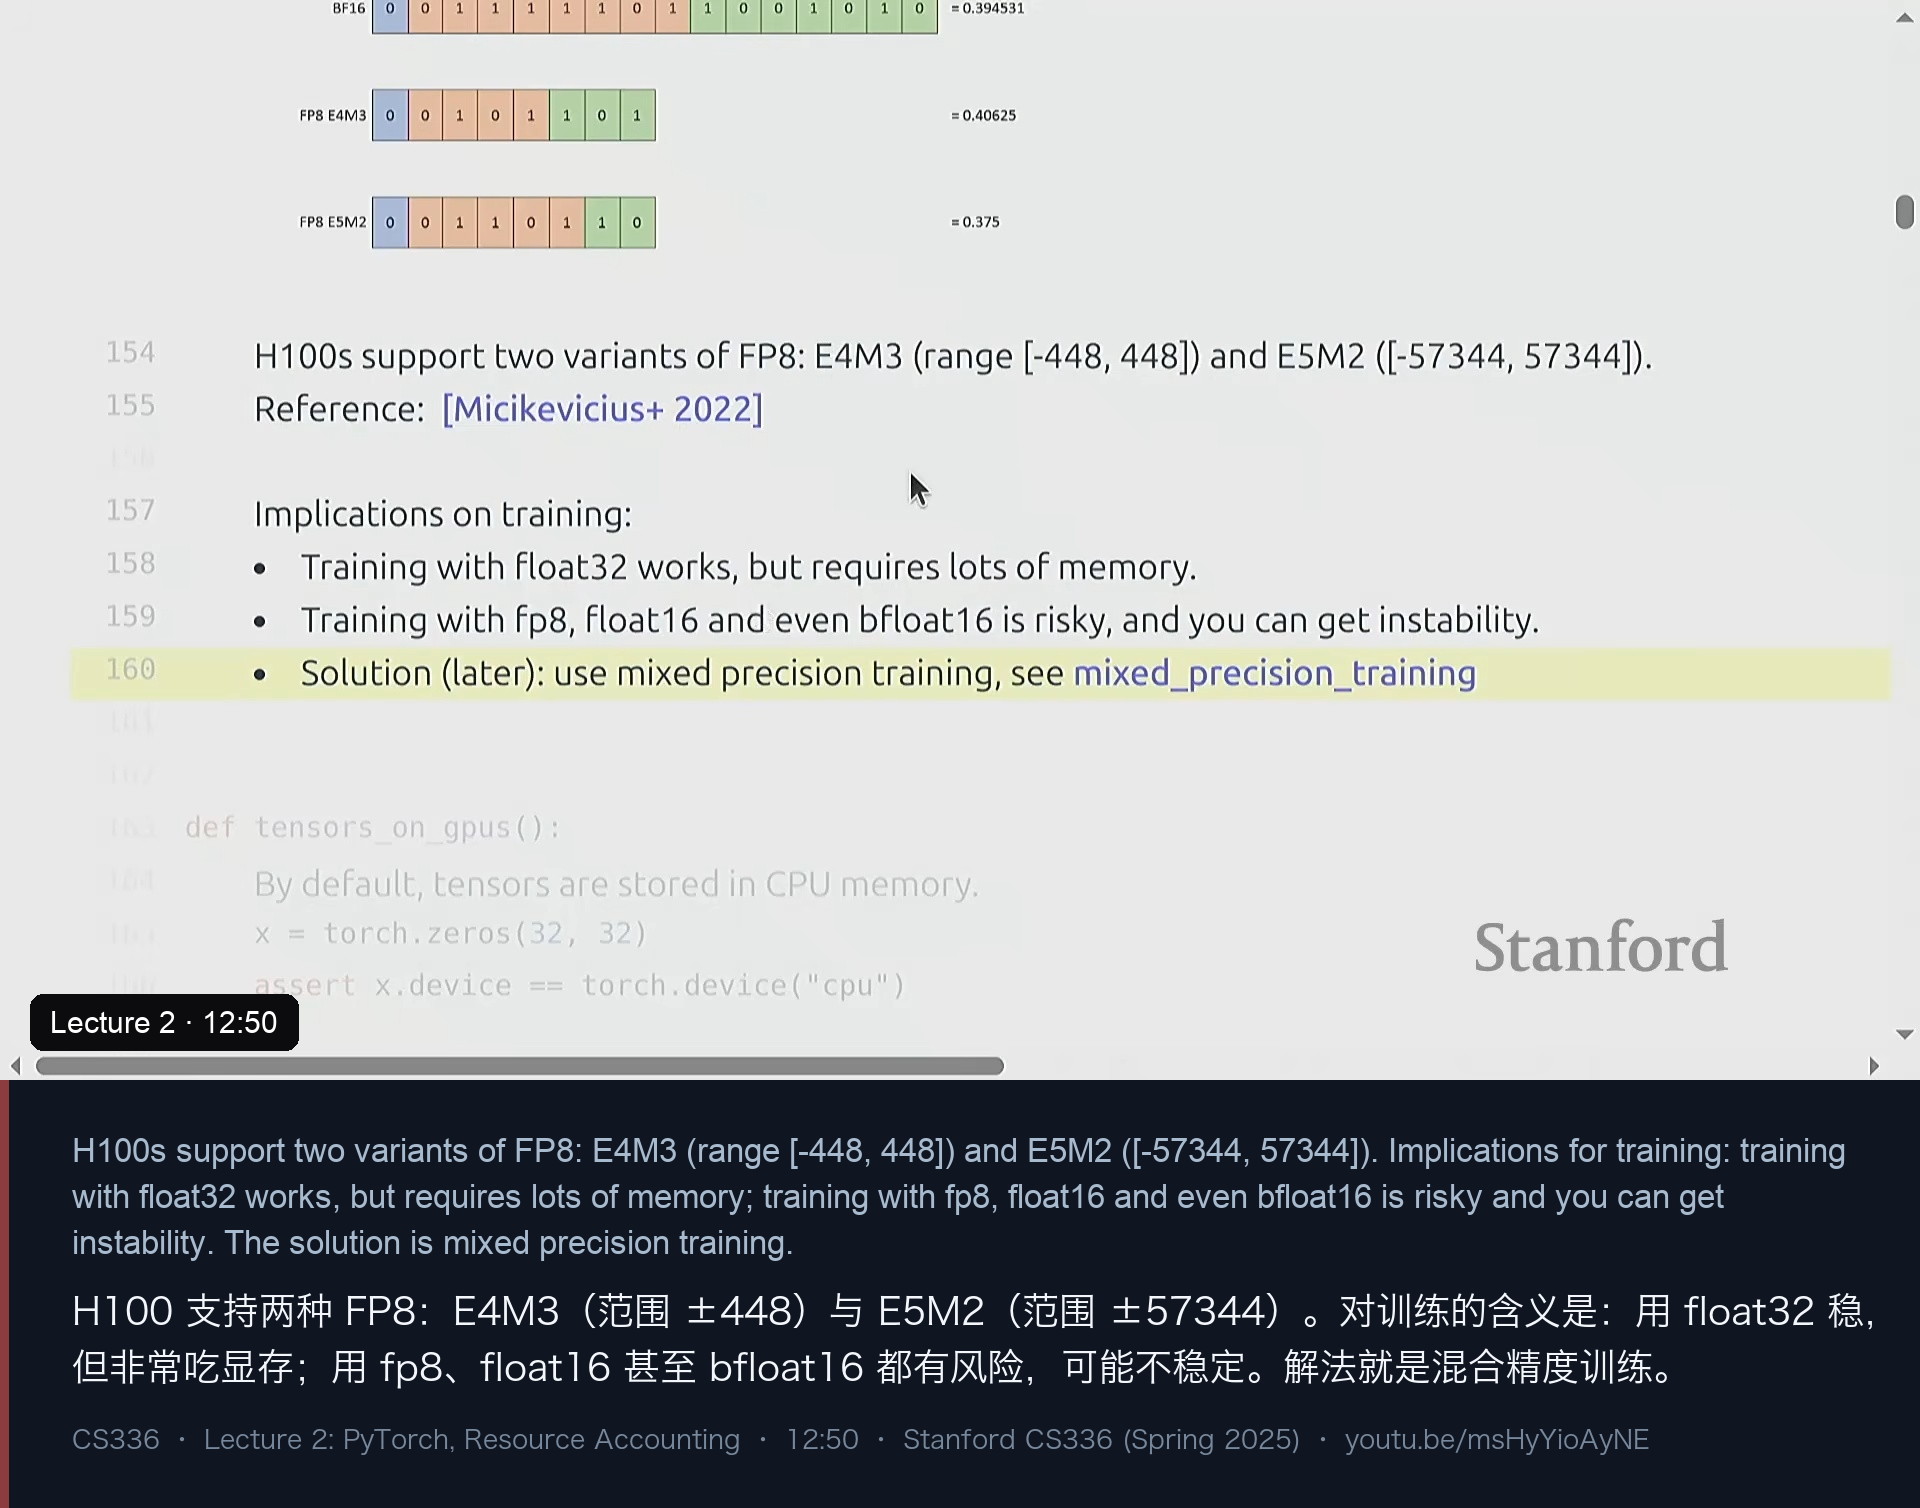
FP8:NVIDIA 在 2022 年推出,只有 8 位,所以还要再分两种变体——E4M3(范围 ±448,分辨率高)和 E5M2(范围 ±57344,动态范围大),取决于你更想要哪一种。它只在 H100 这一代硬件上被支持。
幻灯片上把这段权衡总结得非常直白:
- 用 float32 训练:能跑通,但非常吃显存;
- 用 fp8 / float16 / 甚至 bfloat16 训练:有风险,可能不稳定;
- 解法:混合精度训练(mixed precision training)。
更进一步的做法,是像外科手术一样检查你 pipeline 的每一个位置——前向、反向、优化器、梯度累积——分别确定那里最低需要多少精度。
四、PyTorch 原语:从 storage、stride 到 einops
4.1 先搞清楚它在哪张卡上
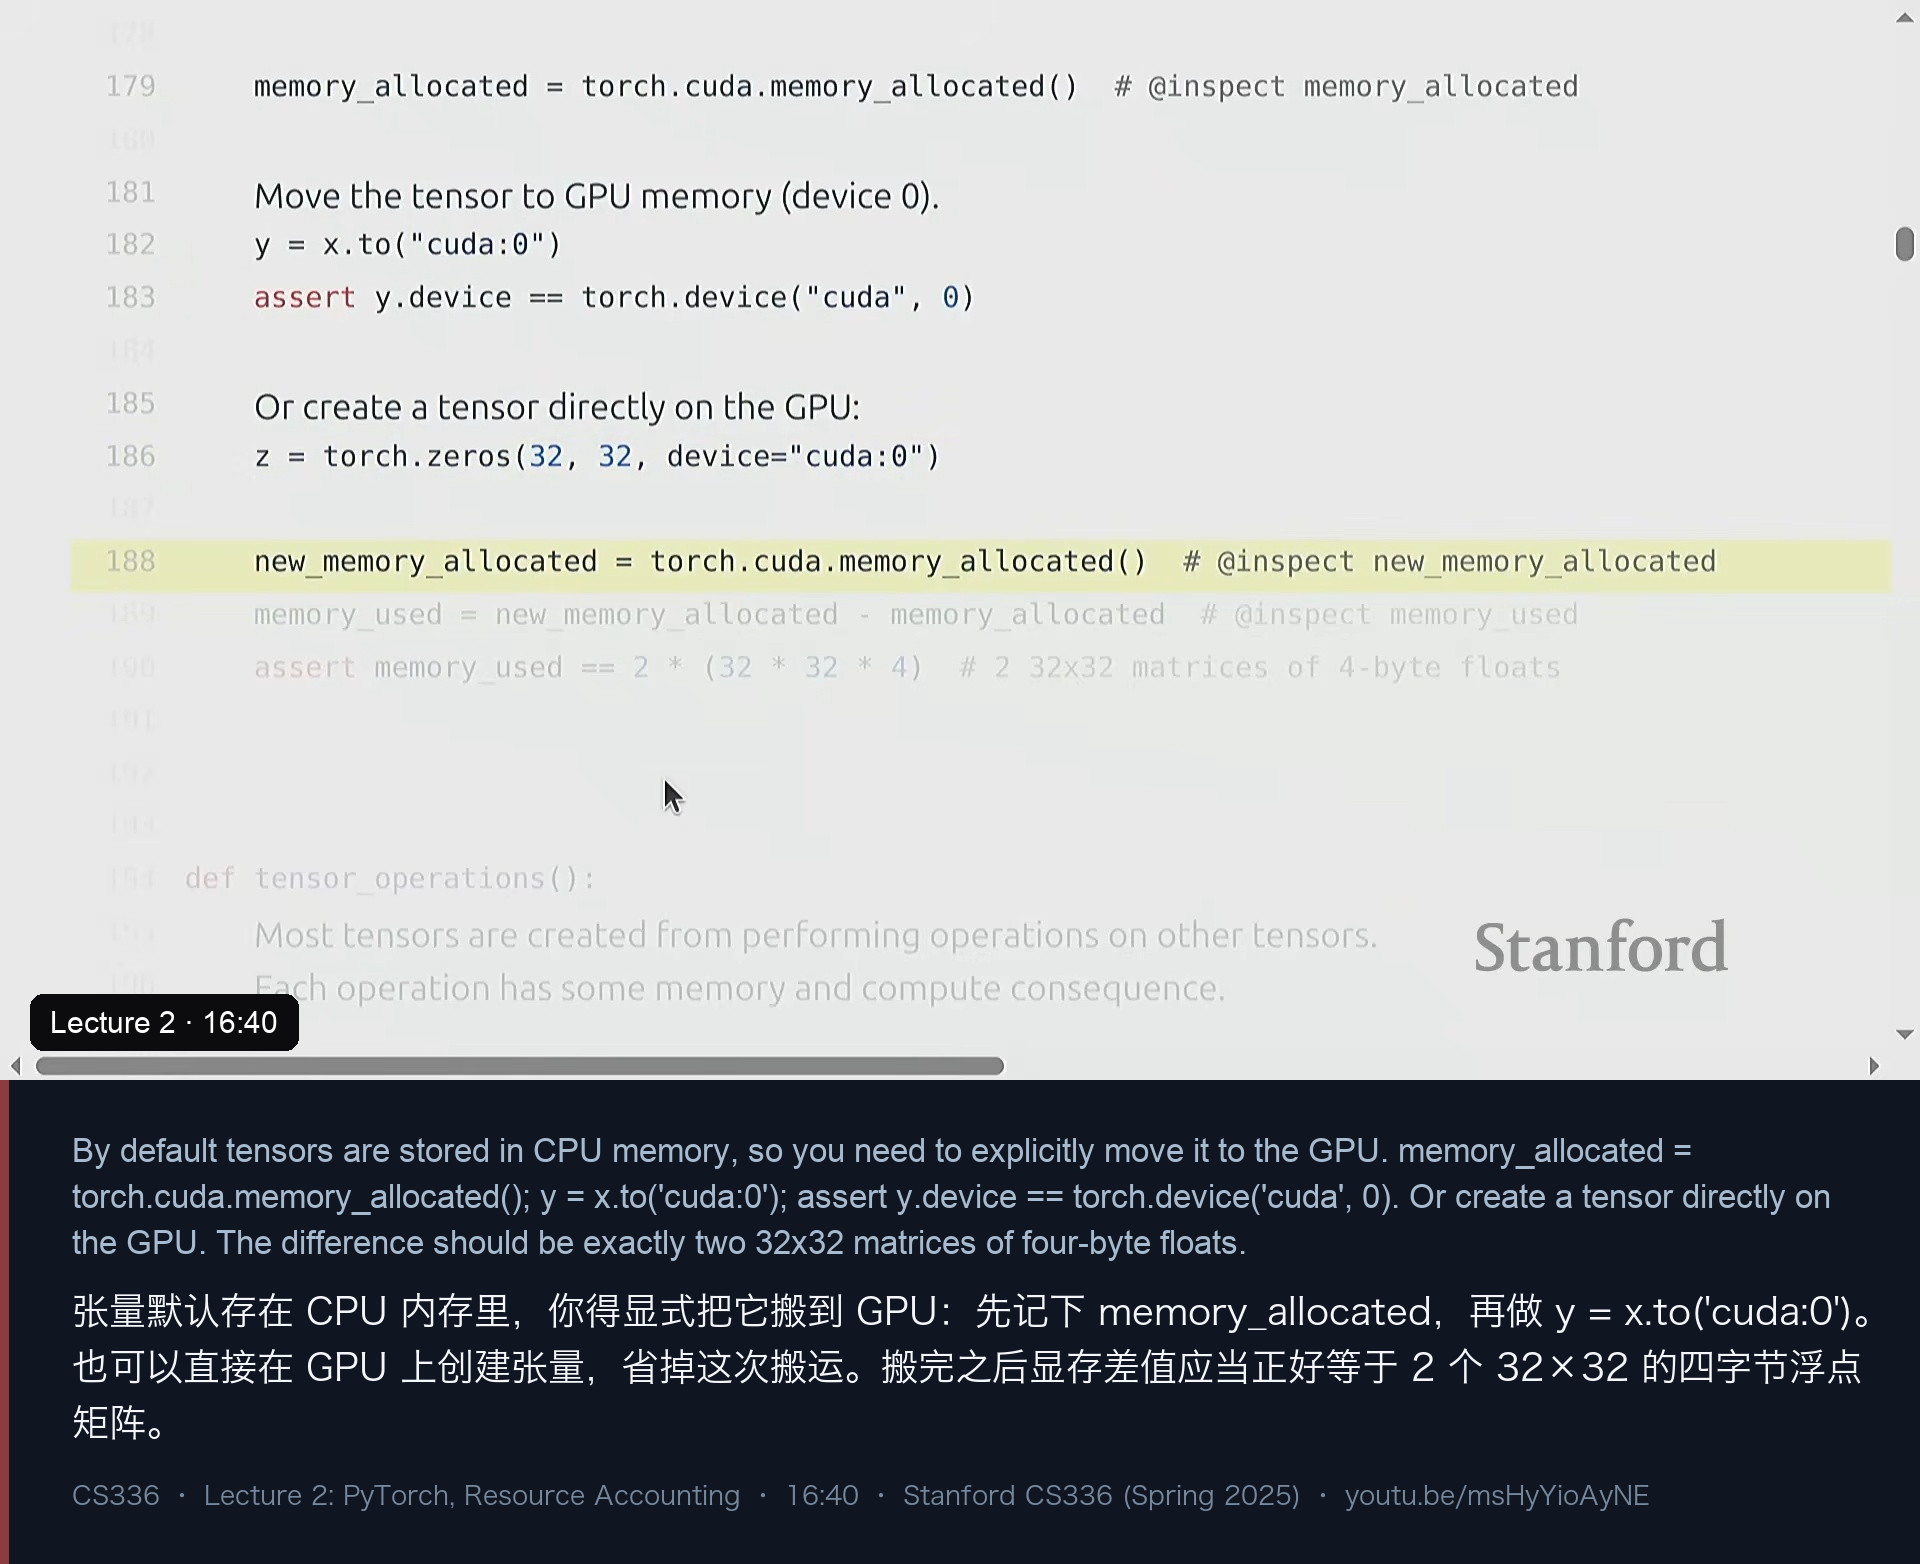
PyTorch 里 torch.zeros(32, 32) 默认建在 CPU 内存里。不搬到 GPU,你的速度会差好几个数量级。Percy 用一张 CPU(有 RAM)→ GPU(数据要经过搬运)的示意图强调:数据搬运本身也要花时间和算力。
memory_allocated = torch.cuda.memory_allocated()
y = x.to('cuda:0')
assert y.device == torch.device('cuda', 0)

# 或者干脆在 GPU 上直接创建
z = torch.zeros(32, 32, device='cuda:0')

new_memory_allocated = torch.cuda.memory_allocated()
memory_used = new_memory_allocated - memory_allocated
assert memory_used == 2 * (32 * 32 * 4) # 两个 32×32 的四字节浮点矩阵一个非常实用的习惯:每当你看到一个张量,都要在心里问一句「它现在住在哪」。因为光看变量名你是看不出来的——可以像上面那样用 assert 把设备和显存占用写进代码里当文档。
4.2 张量 = 指针 + stride 元数据
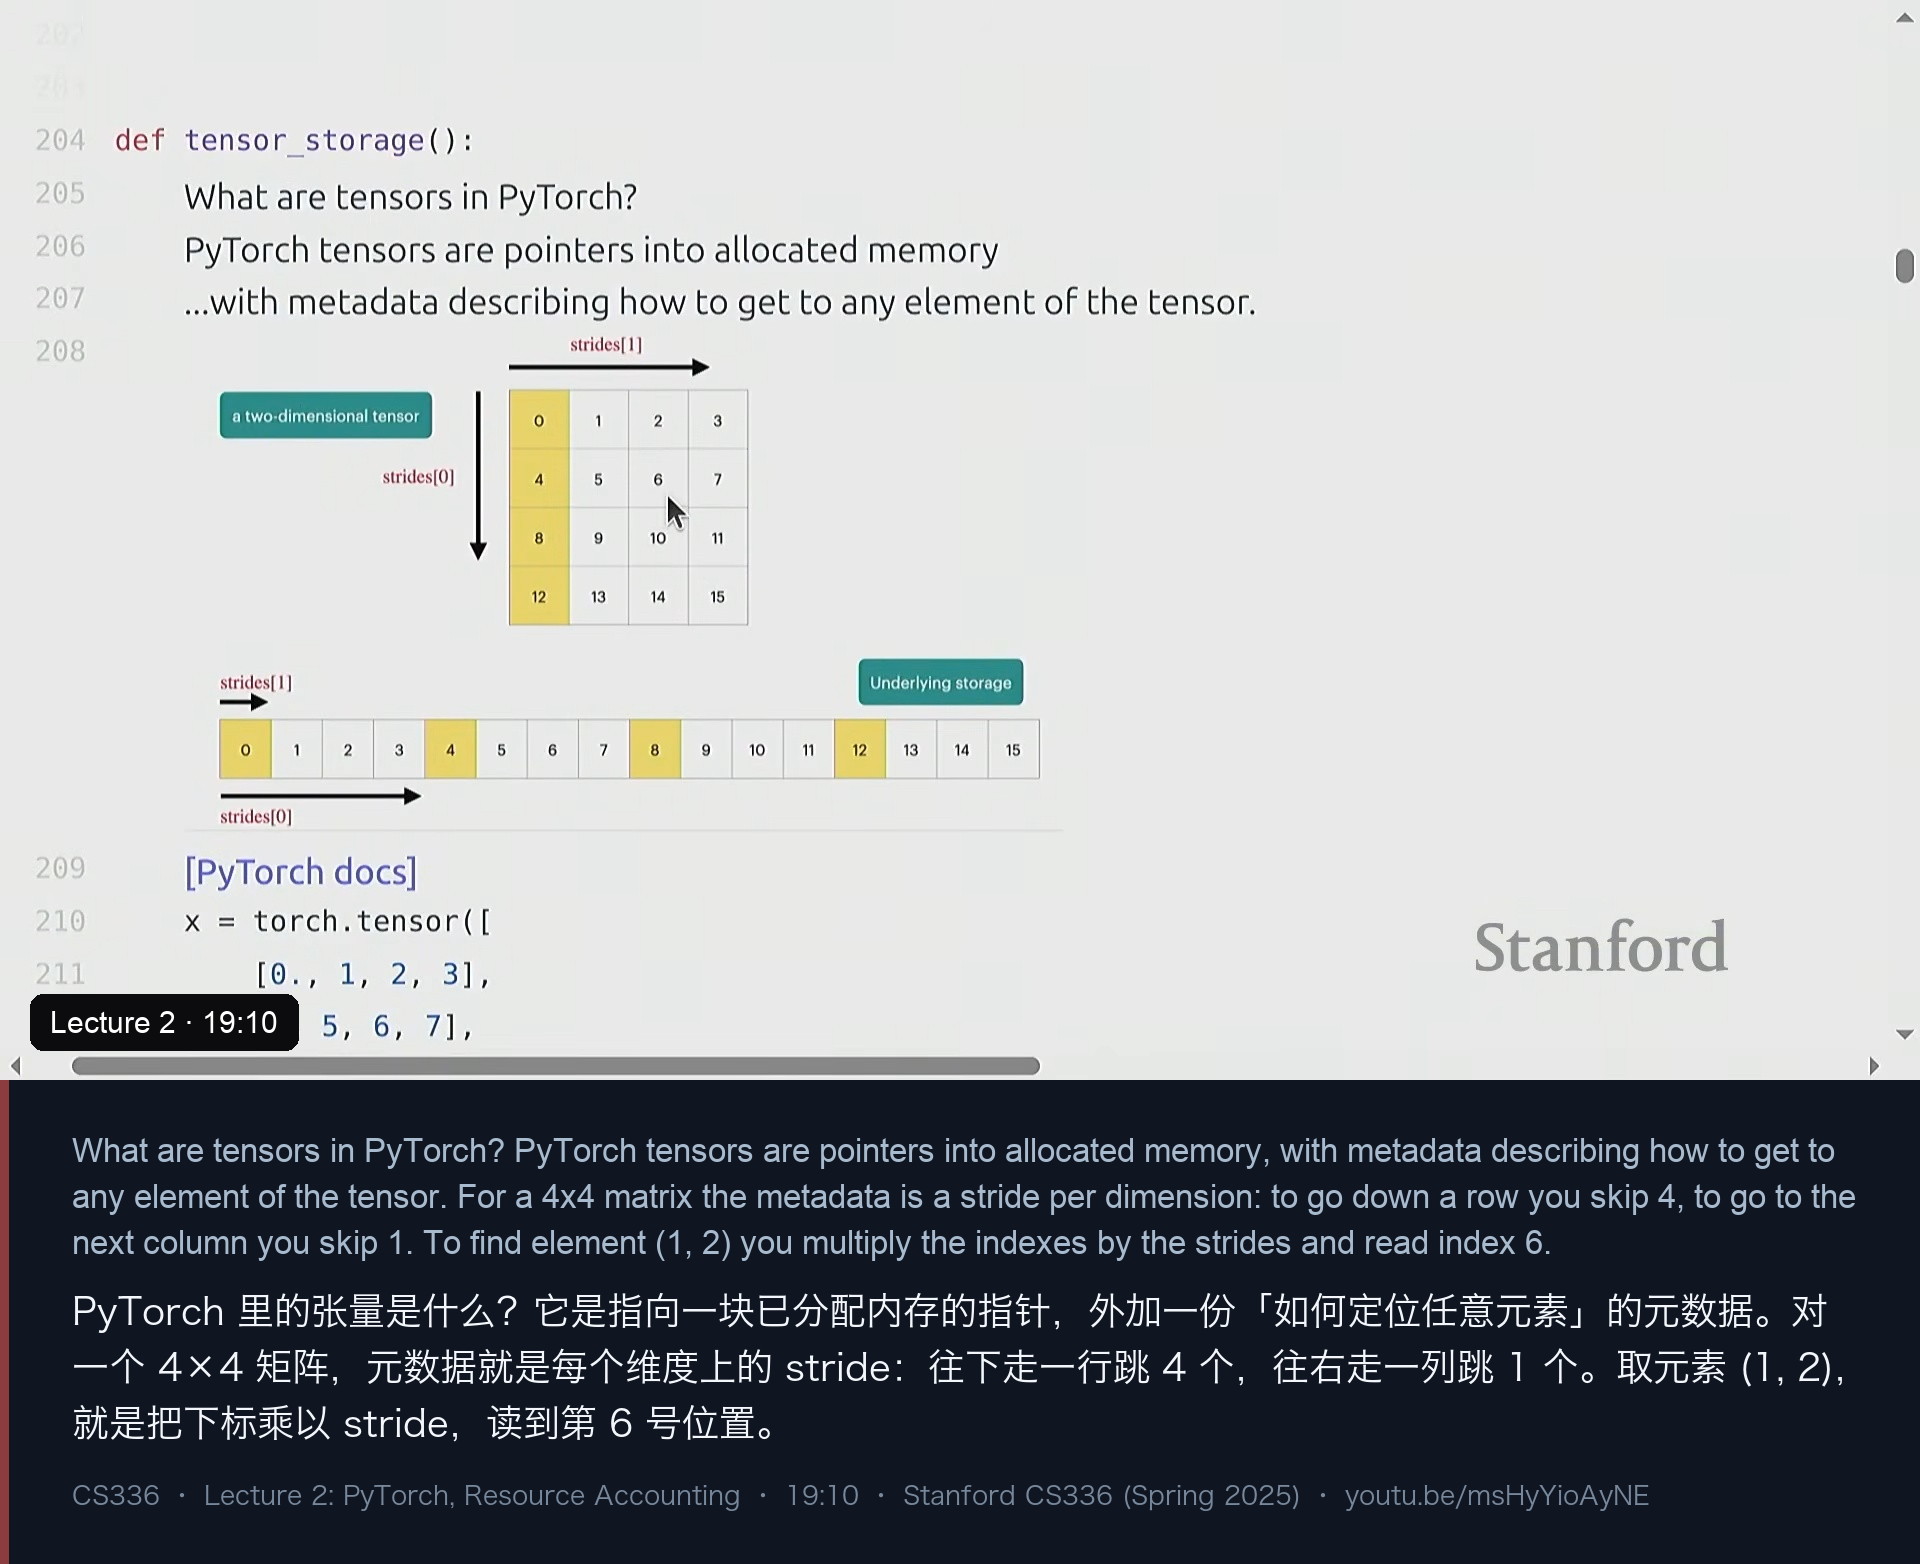
这是这一讲最有价值的一个底层认知:PyTorch 的张量并不是一块方方正正的矩阵,而是一个指向一维内存数组的指针,外加一份「如何定位任意元素」的元数据。这份元数据就是每个维度上的 stride。
对一个 4×4 矩阵,内存里其实是一条长度 16 的数组:
- 沿第 0 维(往下走一行)要跳过 4 个元素 →
strides[0] = 4 - 沿第 1 维(往右走一列)要跳过 1 个元素 →
strides[1] = 1
于是定位元素 (1, 2) 就是「下标 × stride 再相加」,读第 6 号位置。
这解释了为什么 view / transpose / 切片几乎不花内存——它们只改元数据,不改数据本身:
x = torch.tensor([[1, 2, 3], [4, 5, 6]])
y = x[0]             # 第 0 行 —— 同一个 storage!
y2 = x[:, 1]         # 第 1 列 —— 同一个 storage
y3 = x.view(3, 2)    # 换个形状看 —— 同一个 storage
y4 = x.t()           # 转置 —— 同一个 storage
# 危险:改 x 会连带改 y,因为它们只是同一块内存的两个指针
x[0][0] = 100
assert same_storage(x, y)
4.3 视图是免费的,复制不是
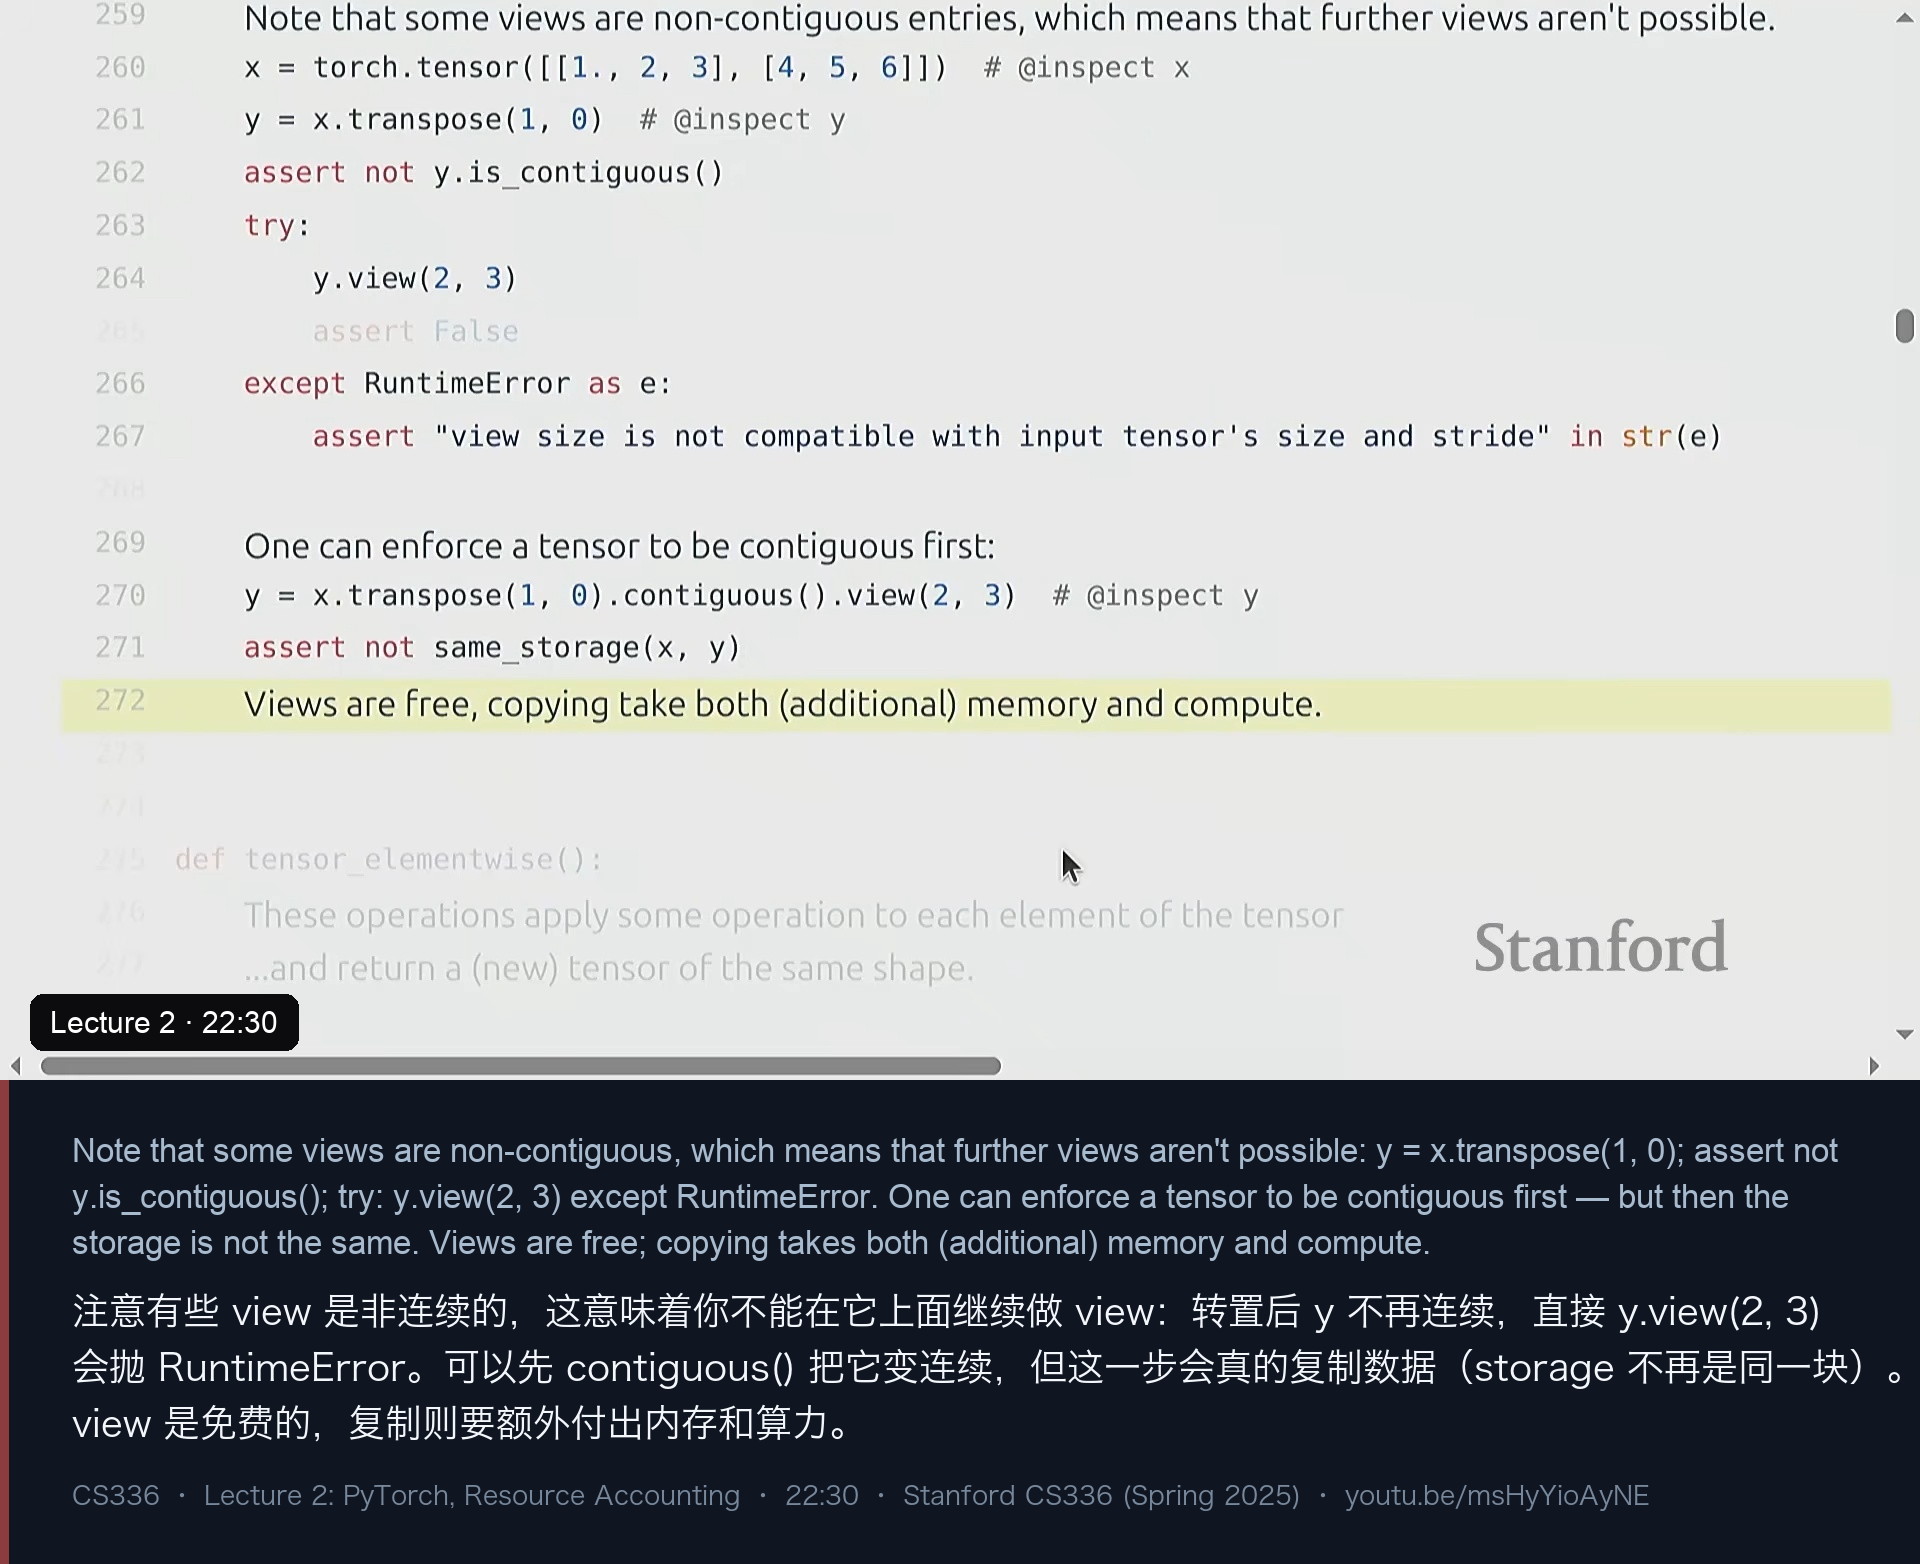
「视图是免费的(views are free),复制则要额外付出内存和算力。」这是本节最实用的取舍。
麻烦在于有些视图是非连续的(non-contiguous):如果你为了「按行读」而转置,那么沿着张量往下走就会跳着访问内存。此时再想把它 view 成另一个形状,就会报错:
x = torch.tensor([[1., 2, 3], [4, 5, 6]])
y = x.transpose(1, 0)
assert not y.is_contiguous()
try:
    y.view(2, 3)                 # RuntimeError!
except RuntimeError as e:
    assert "view size is not compatible" in str(e)

# 先强制连续——但这一步真的会复制
y = x.transpose(1, 0).contiguous().view(2, 3)
assert not same_storage(x, y) # 已经不再是同一块内存了结论:读代码时可以大方地用 view 让代码更好读,但看到 contiguous() 或 reshape 时要意识到「这里可能要复制」。
4.4 顺带一提:用 einops 给维度起名字
Percy 在这里插入了一段「题外话」,但很值得记。先看一段常见的 PyTorch 代码:
x = torch.randn(batch, seq, hidden)
y = torch.randn(batch, seq, hidden)
# 这是在做什么?你得在脑子里数 -2 到底是哪个维度
z = x.transpose(-2, -1) @ y-1、-2 这种反向索引极易出错,而靠注释补救的问题在于「注释会和代码脱节,然后你就开始痛苦地调试」。解决办法是 einops——它的灵感来自爱因斯坦求和约定(Einstein summation notation):与其依赖位置索引,不如给每一个维度起名字。
from einops import einsum, rearrange, reduce

# einsum:把两个张量的维度名写下来,再写输出要保留哪些维度
# 没有出现在输出里的维度(hidden)会被求和掉
out = einsum(x, y, 'batch seq hidden1, batch seq hidden2 -> batch seq1 seq2')

# 用 ... 表示「任意多个维度」,自动处理广播
out = einsum(x, w, '... hidden1, hidden1 hidden2 -> ... hidden2')

# reduce:对某个维度做聚合
total = reduce(x, 'batch seq hidden -> batch seq', 'sum')
和 view 的关系在这里:rearrange 可以看成**「更聪明的 view」**,它能把一个被压平的维度拆开再拼回去——语言模型里最典型的场景就是把 (heads × head_dim) 拆成两个维度,算完再合回去:
# 把压平的 8 维向量展开成 heads × hidden
x = rearrange(x, '... (heads hidden1) -> ... heads hidden1', heads=2)
# 做完变换再合回去
x = rearrange(x, '... heads hidden2 -> ... (heads hidden2)')
Percy 还提到 jaxtyping,它能让你把维度名写进类型标注里(因为 PyTorch 的类型系统「在维度这件事上有点像在说谎」,默认不做任何检查,得自己接检查器)。至于「einops 会不会编译出低效代码」,他的回答是不会:如果配合 torch.compile,dimension 的归约顺序只会被求解一次,之后复用——「比任何手工设计都更好」。
顺带一句和他呼应的细节:逐元素运算一定会创建新张量(因为新值得有地方放),torch.tril 就是其中之一,它常被用来构造因果注意力掩码——作业一里你会用到。
五、计算核算(一):FLOPs、矩阵乘法与 MFU
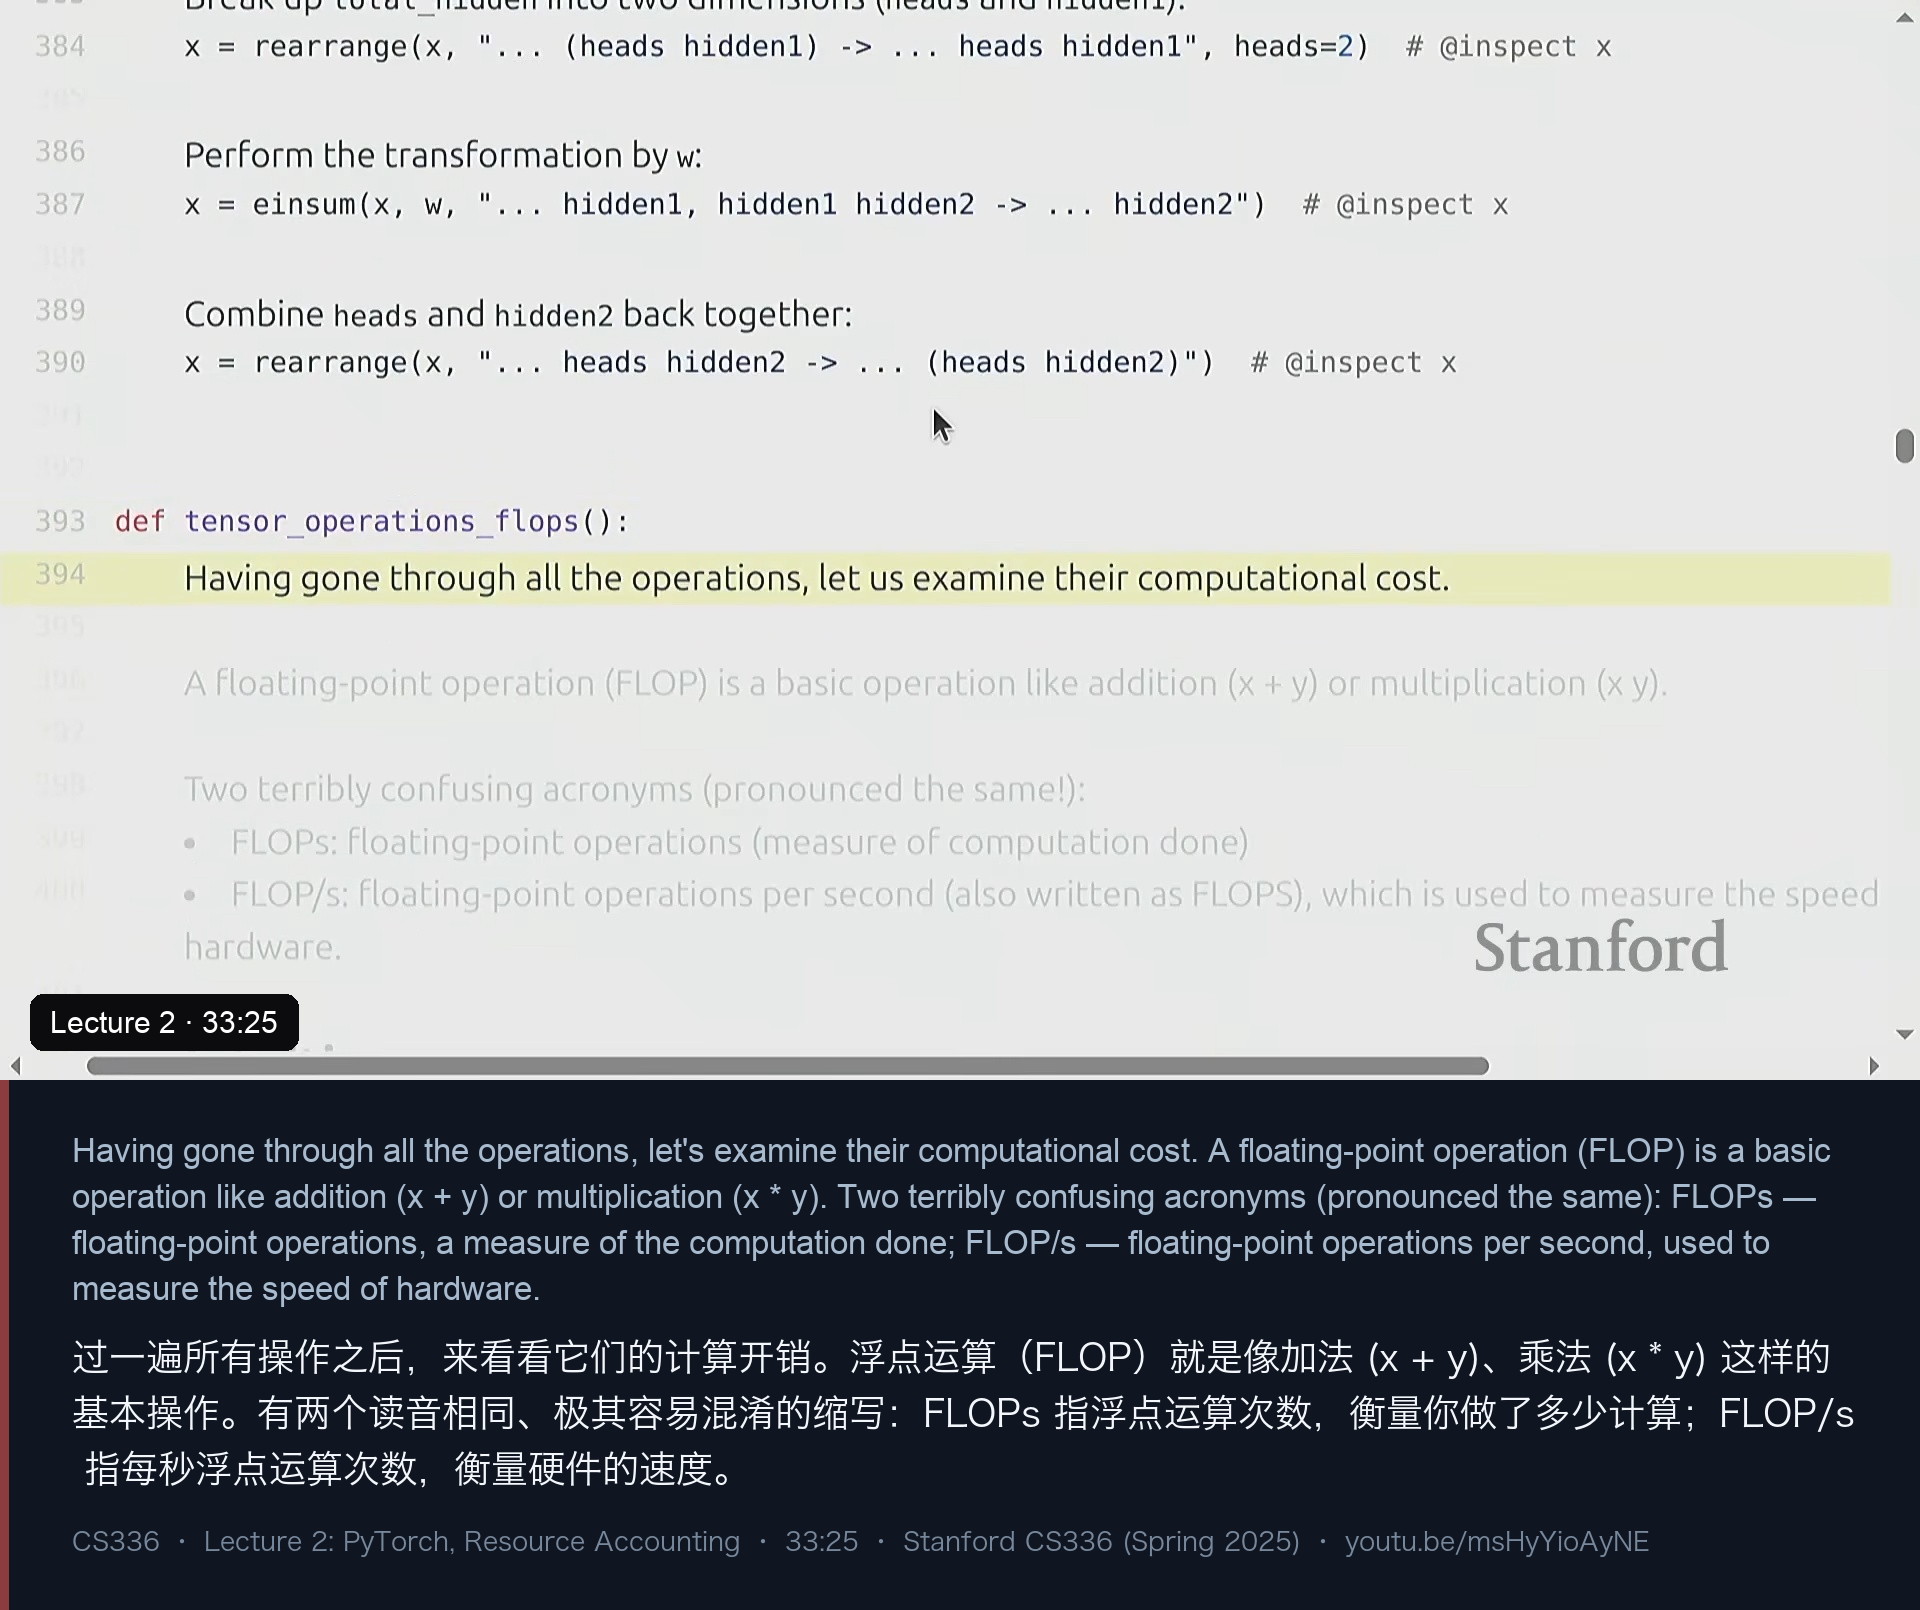
进入算力部分。先澄清一对被 Percy 称为「两个极其容易混淆的缩写(读音还一样)」的名词:
- FLOPs = floating-point operations,浮点运算次数,衡量你做了多少计算(比如加法
x + y、乘法x * y各算一次)。 - FLOP/s = floating-point operations per second,每秒浮点运算次数,衡量硬件有多快。
为了避免歧义,这门课里永远写成 FLOP/s,绝不靠大小写去区分。
一些量级(均为讲师引用):
- GPT-3 的训练量约 3e23 FLOPs;GPT-4 被推测是 2e25 FLOPs;
- 美国曾有一道行政令要求超过 1e26 FLOPs 的基础模型向政府报备(现已撤销);欧盟 AI Act 的门槛是 1e25;
- A100 标称峰值 312 TFLOP/s;H100 标称 1979 TFLOP/s——但这是带稀疏性的数字。
说到稀疏性,课堂上有个很有意思的问答。学生问「sparsity 是什么意思」,Percy 解释:那是一种结构化的稀疏(每 4 个元素里固定 2 个为 0)才能拿到的加速,「没人用,那是市场部的数字」。所以规格表上的那个峰值,对稠密矩阵要直接砍半。
矩阵乘法才是主角。 一条 16×32 的矩阵乘 32×2 得到 16×2;而在语言模型里,你通常是在 batch、sequence 两个维度上批量地做同一件事,PyTorch 会自动帮你处理这种「batched matmul」。
关于它的 FLOPs,Percy 给了一条应该直接记住的规则:
一次矩阵乘法的 FLOPs = 2 × 三个维度(左、中、右)的乘积 因为对每一组
(i, j, k),你都要做一次乘法、再做一次加法。
把这条规则套到最简单的线性模型上:X (B×D) @ W (D×K) 的 FLOPs 就是 2 × B × D × K。换个说法就是——
前向 FLOPs = 2 × 数据点数 × 参数量
Percy 强调这个形式可以推广到 Transformer(只要序列长度不是特别大)。
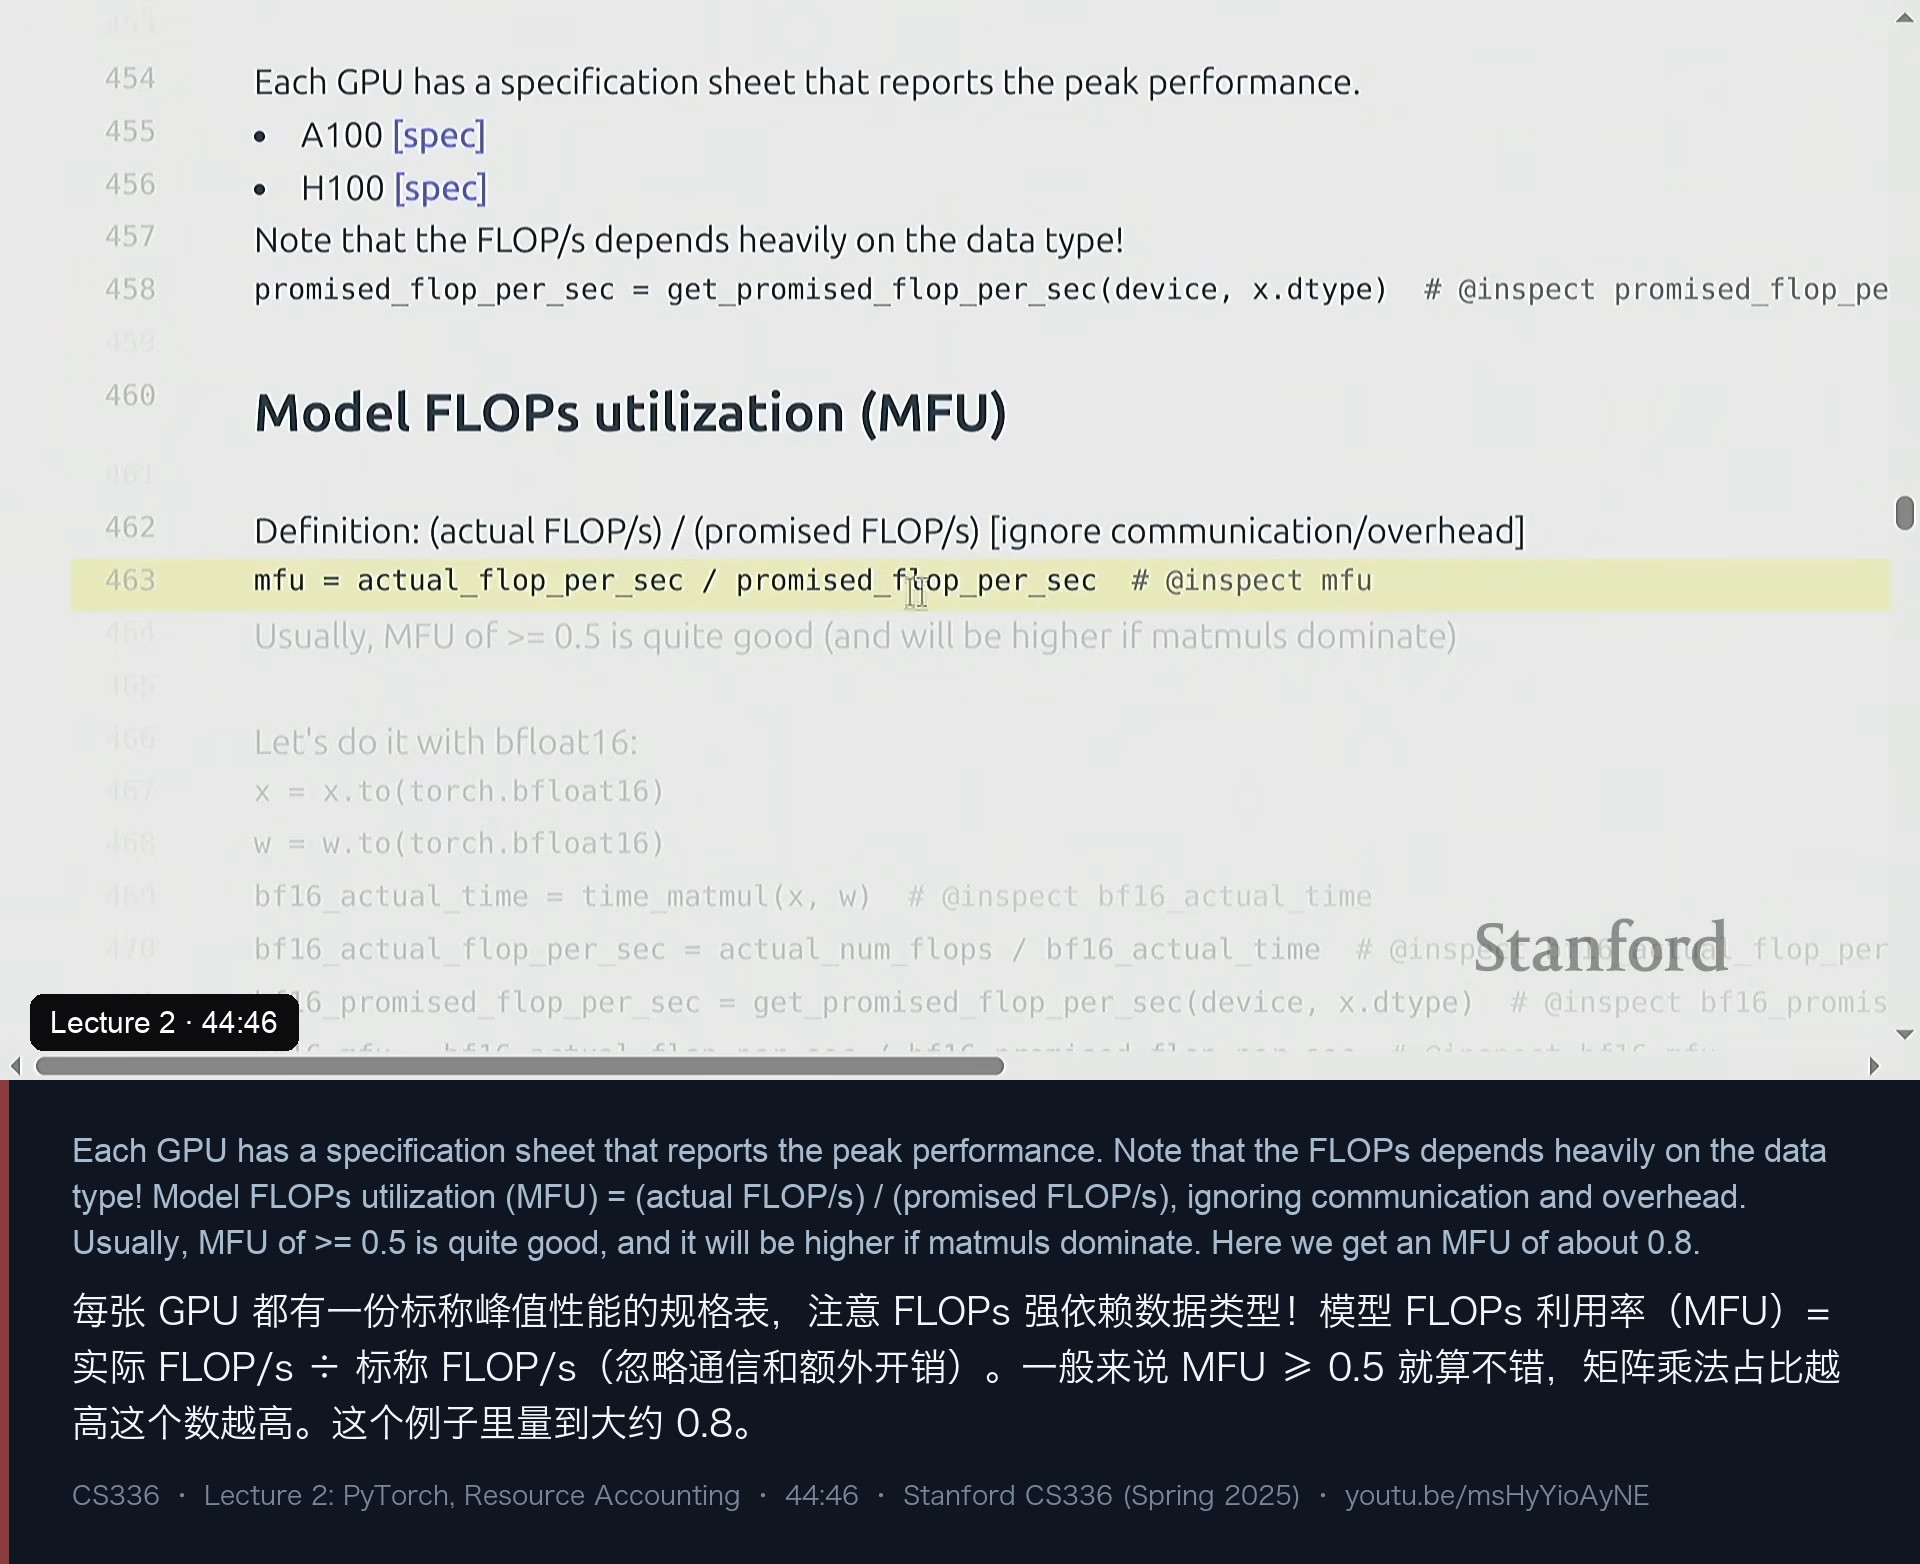
接下来是这一讲最核心的概念之一:MFU(Model FLOPs Utilization,模型 FLOPs 利用率)。
def time_matmul(a, b):
    """返回执行一次矩阵乘法的耗时(秒)"""
    for _ in range(5):
        a @ b
    torch.cuda.synchronize()
    start = timeit.default_timer()
    a @ b
    torch.cuda.synchronize()
    return timeit.default_timer() - start

actual_time = time_matmul(x, w)
actual_flop_per_sec = num_flops / actual_time
promised_flop_per_sec = get_promised_flop_per_sec(device, x.dtype)   # 厂商规格表
mfu = actual_flop_per_sec / promised_flop_per_sec                   # @inspect mfu
课堂实测:这一次矩阵乘法花了 0.16 秒,实际算力 5.4e13 FLOP/s;对照 H100 在 float32 下的标称峰值约 67 TFLOP/s,算出 MFU ≈ 0.8。
Percy 对 MFU 的经验判断:
- ≥ 0.5 就算不错;
- 5% 就很糟;
- 你永远不可能接近 90–100%,因为这个定义刻意忽略了通信和调度等额外开销,只关心「模型理论上需要做的有效计算」;
- 矩阵乘法占比越高,MFU 越高。
换成 bfloat16 再测一次:耗时从 0.16 秒降到约 0.03 秒,实际 FLOP/s 更高;但因为标称峰值涨得更多,算出来的 MFU 反而更低。Percy 由此给出一个很实在的提醒:规格表上的标称 FLOPs 往往偏乐观,永远要实测,别假设你能拿到某个性能水平。
六、计算核算(二):反向传播为什么要乘 4
前向算完了,但训练还要算梯度。Percy 用一个两层线性网络来把这件事算干净。
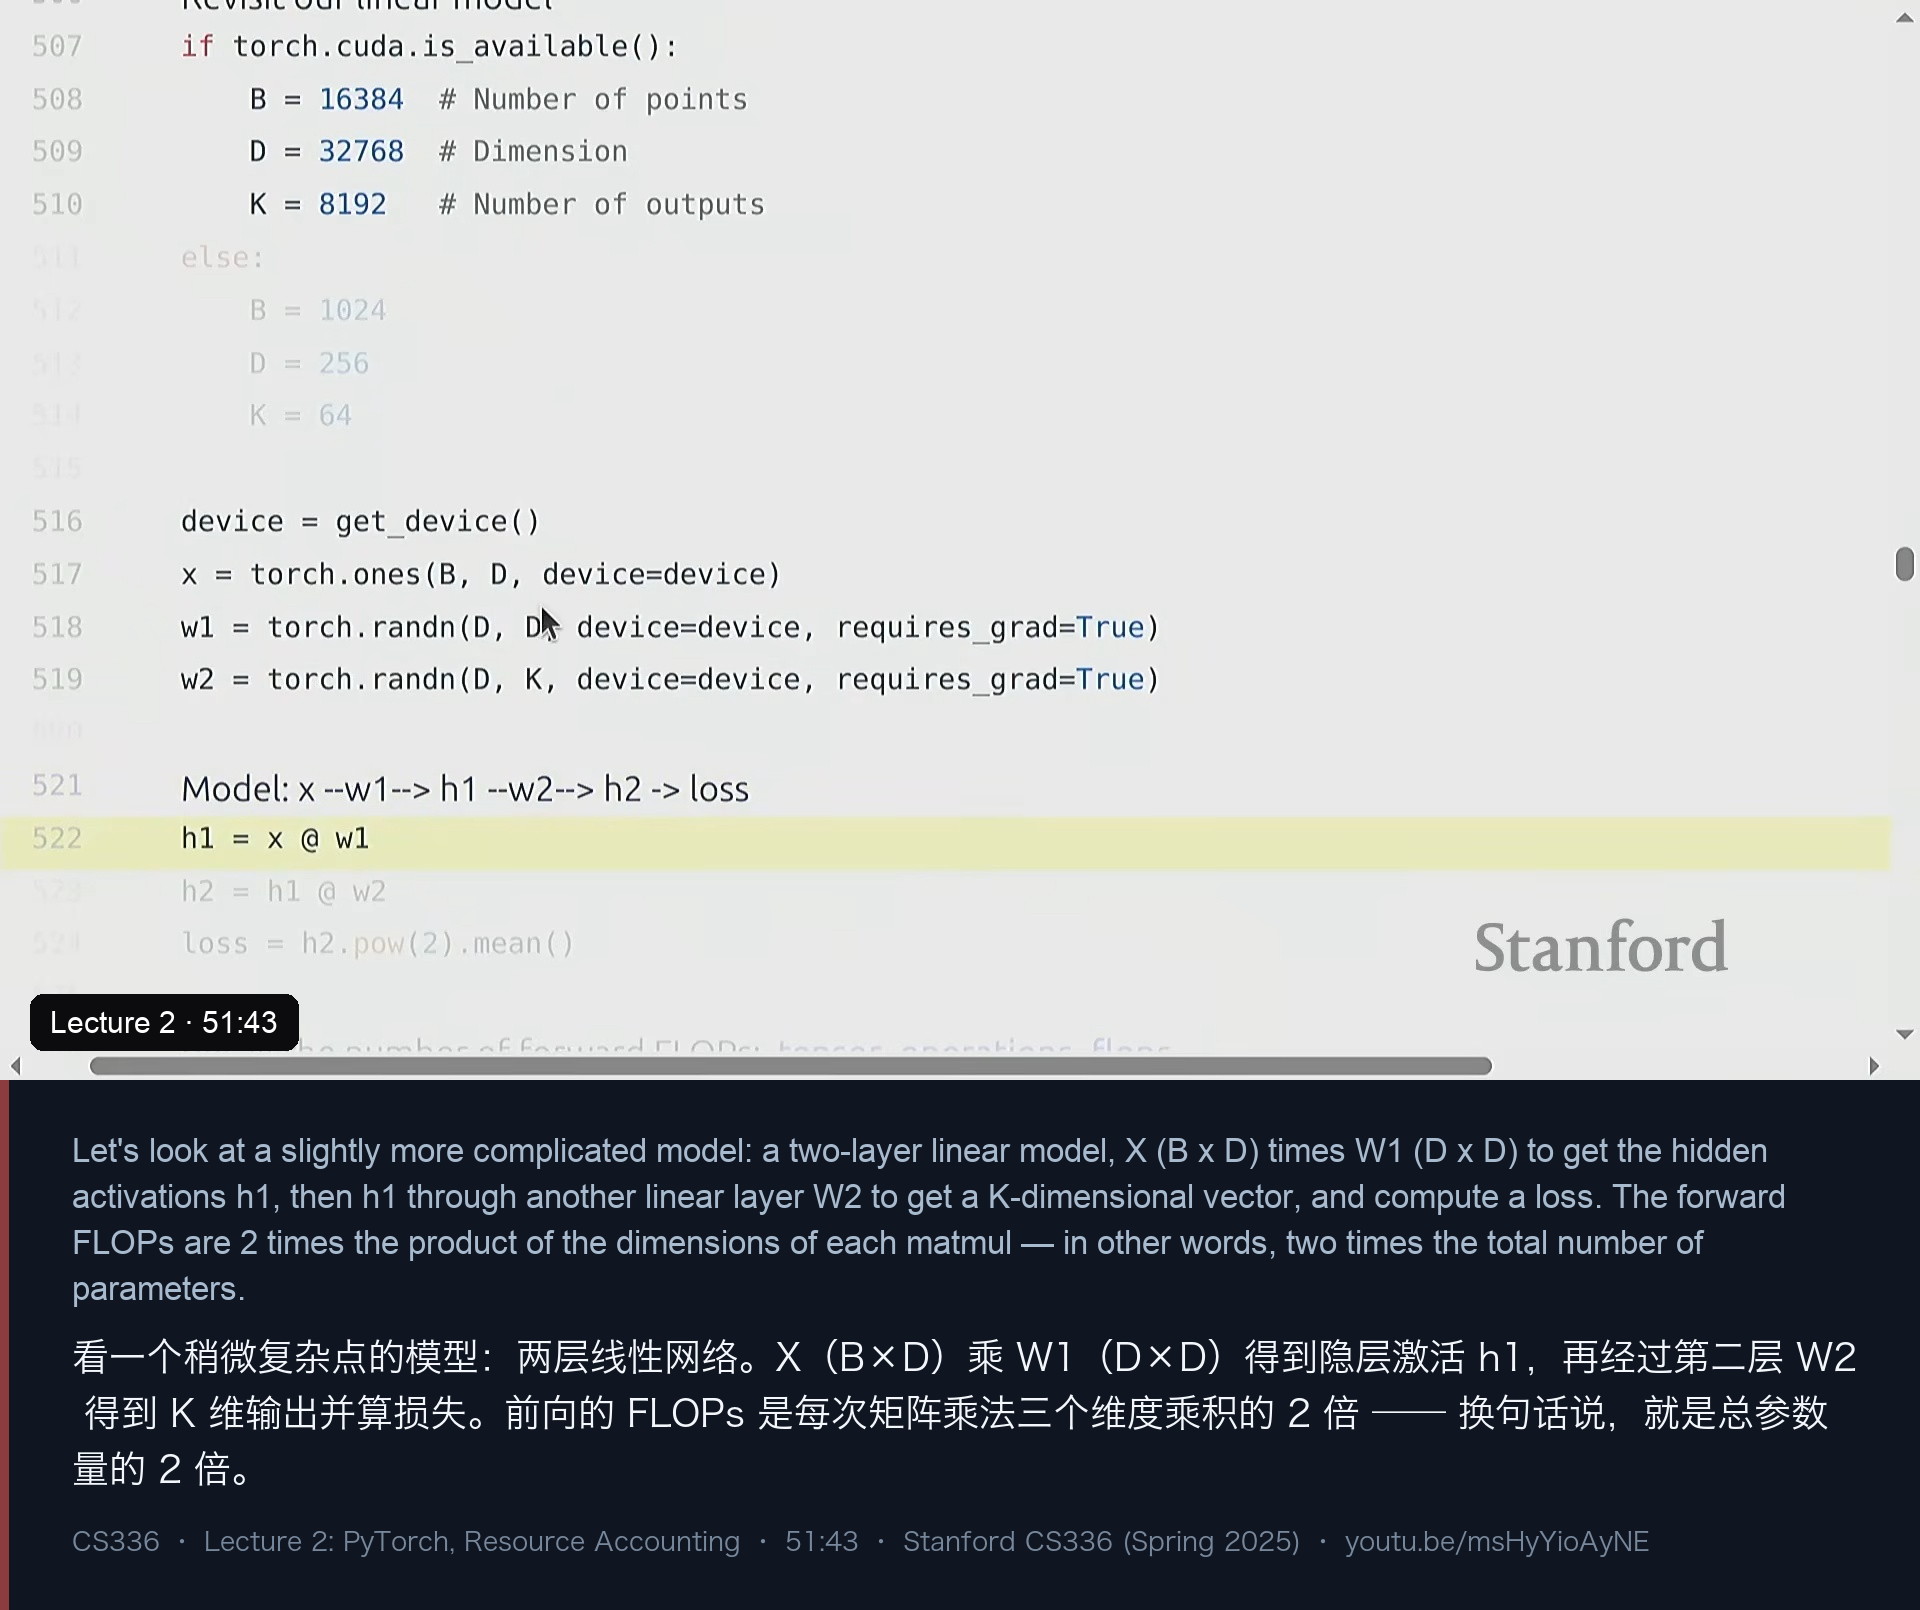
模型是 X (B×D) @ W1 (D×D) = h1,再 h1 @ W2 (D×K) = h2,最后算损失。前向的 FLOPs 是两次矩阵乘法之和,也就是 2 × B × D × D + 2 × B × D × K——恰好等于总参数量的 2 倍(因为参数量就是 D² + DK)。
接下来看反向。要对 h1、h2、W1、W2 都求梯度。以 W2 为例,链式法则给出:
w2.grad[j, k] = sum_k h1[i, j] * h2.grad[i, k]
# 这又是一个矩阵乘法:B × D × K问题在于每个梯度本身都长得像一个矩阵乘法,而且你还要继续往前反传(h1.grad 也要算),于是:
num_backward_flops = 4 * B * D * K # 对 W2 而言,是前向的两倍幻灯片上还有一段动画(用「FLOP 1: multiply」逐条点亮网络里的乘加)来直观展示:前向是把权重乘激活再累加;反向则是同样规模的一遍计算。Percy 说这里就不手动推导了——作业里不会让你手算梯度(直接用 PyTorch 的 autograd),这里只是为了让 FLOPs 的计数有依据。
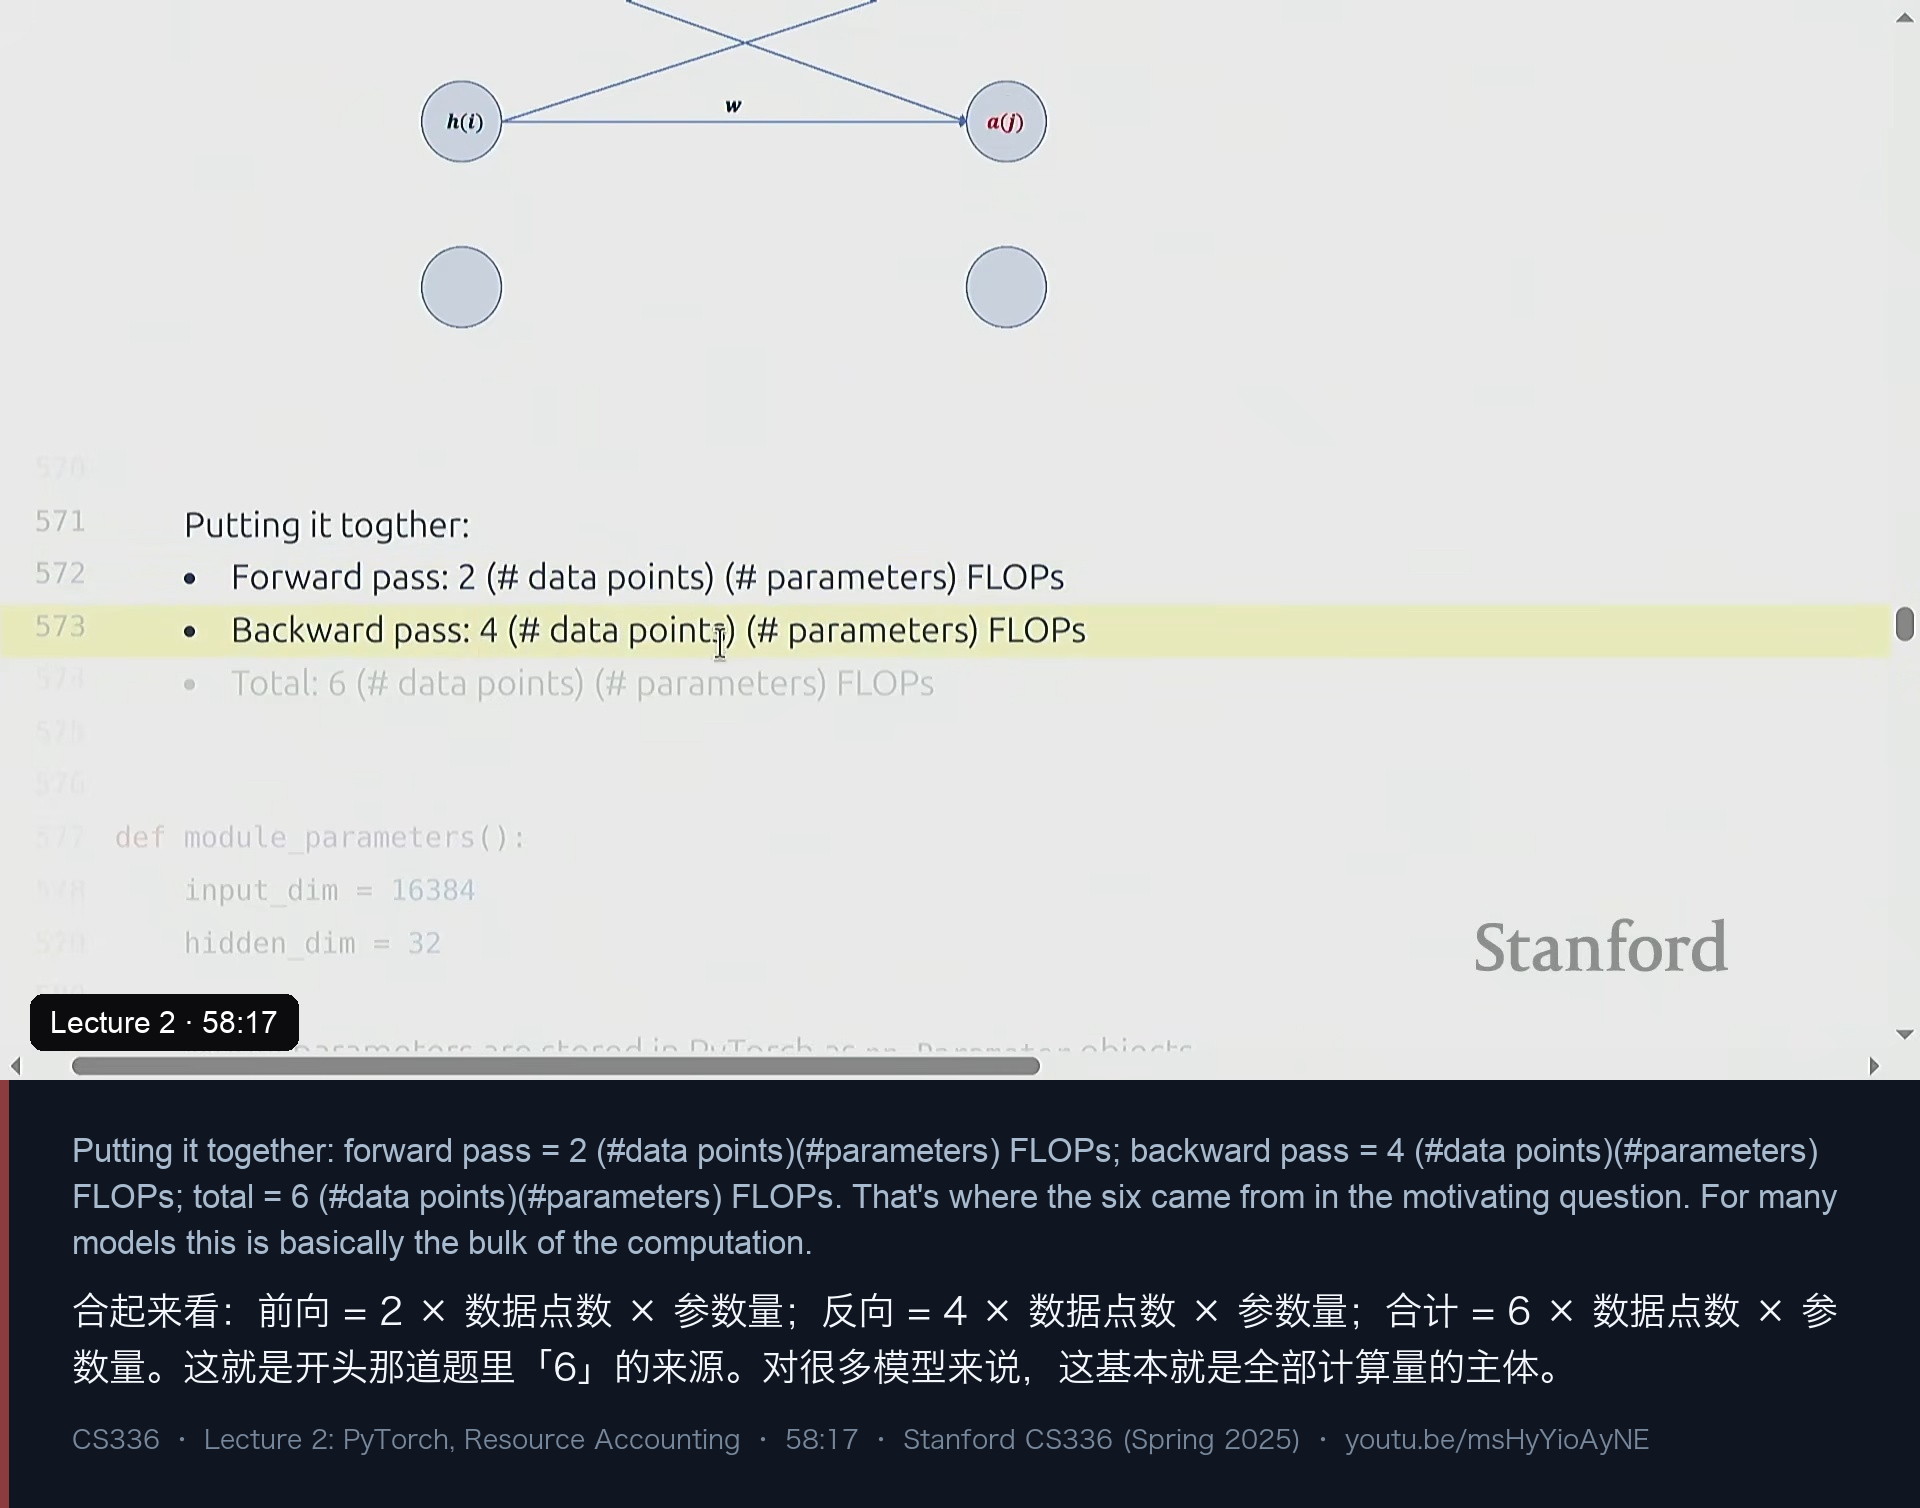
把两层加起来,结论是干净利落的:
前向 = 2 × 数据点数 × 参数量 反向 = 4 × 数据点数 × 参数量 合计 = 6 × 数据点数 × 参数量
这正好解释了开头那道题里的 6。 Percy 补注说,对很多模型来说这基本就是计算量的主体——只要你的每一次计算大致都「碰到一批新的参数」。当然反例是存在的(比如参数共享的模型能让 1 个参数摊到十亿次 FLOPs),但那不是通常的模型形态。
七、从零搭一个模型:初始化与优化器
算完账,Percy 用剩下半程把一个能跑的模型搭出来——「这部分概念上不一定有趣,但为了完整性还是走一遍」。
7.1 参数初始化的陷阱
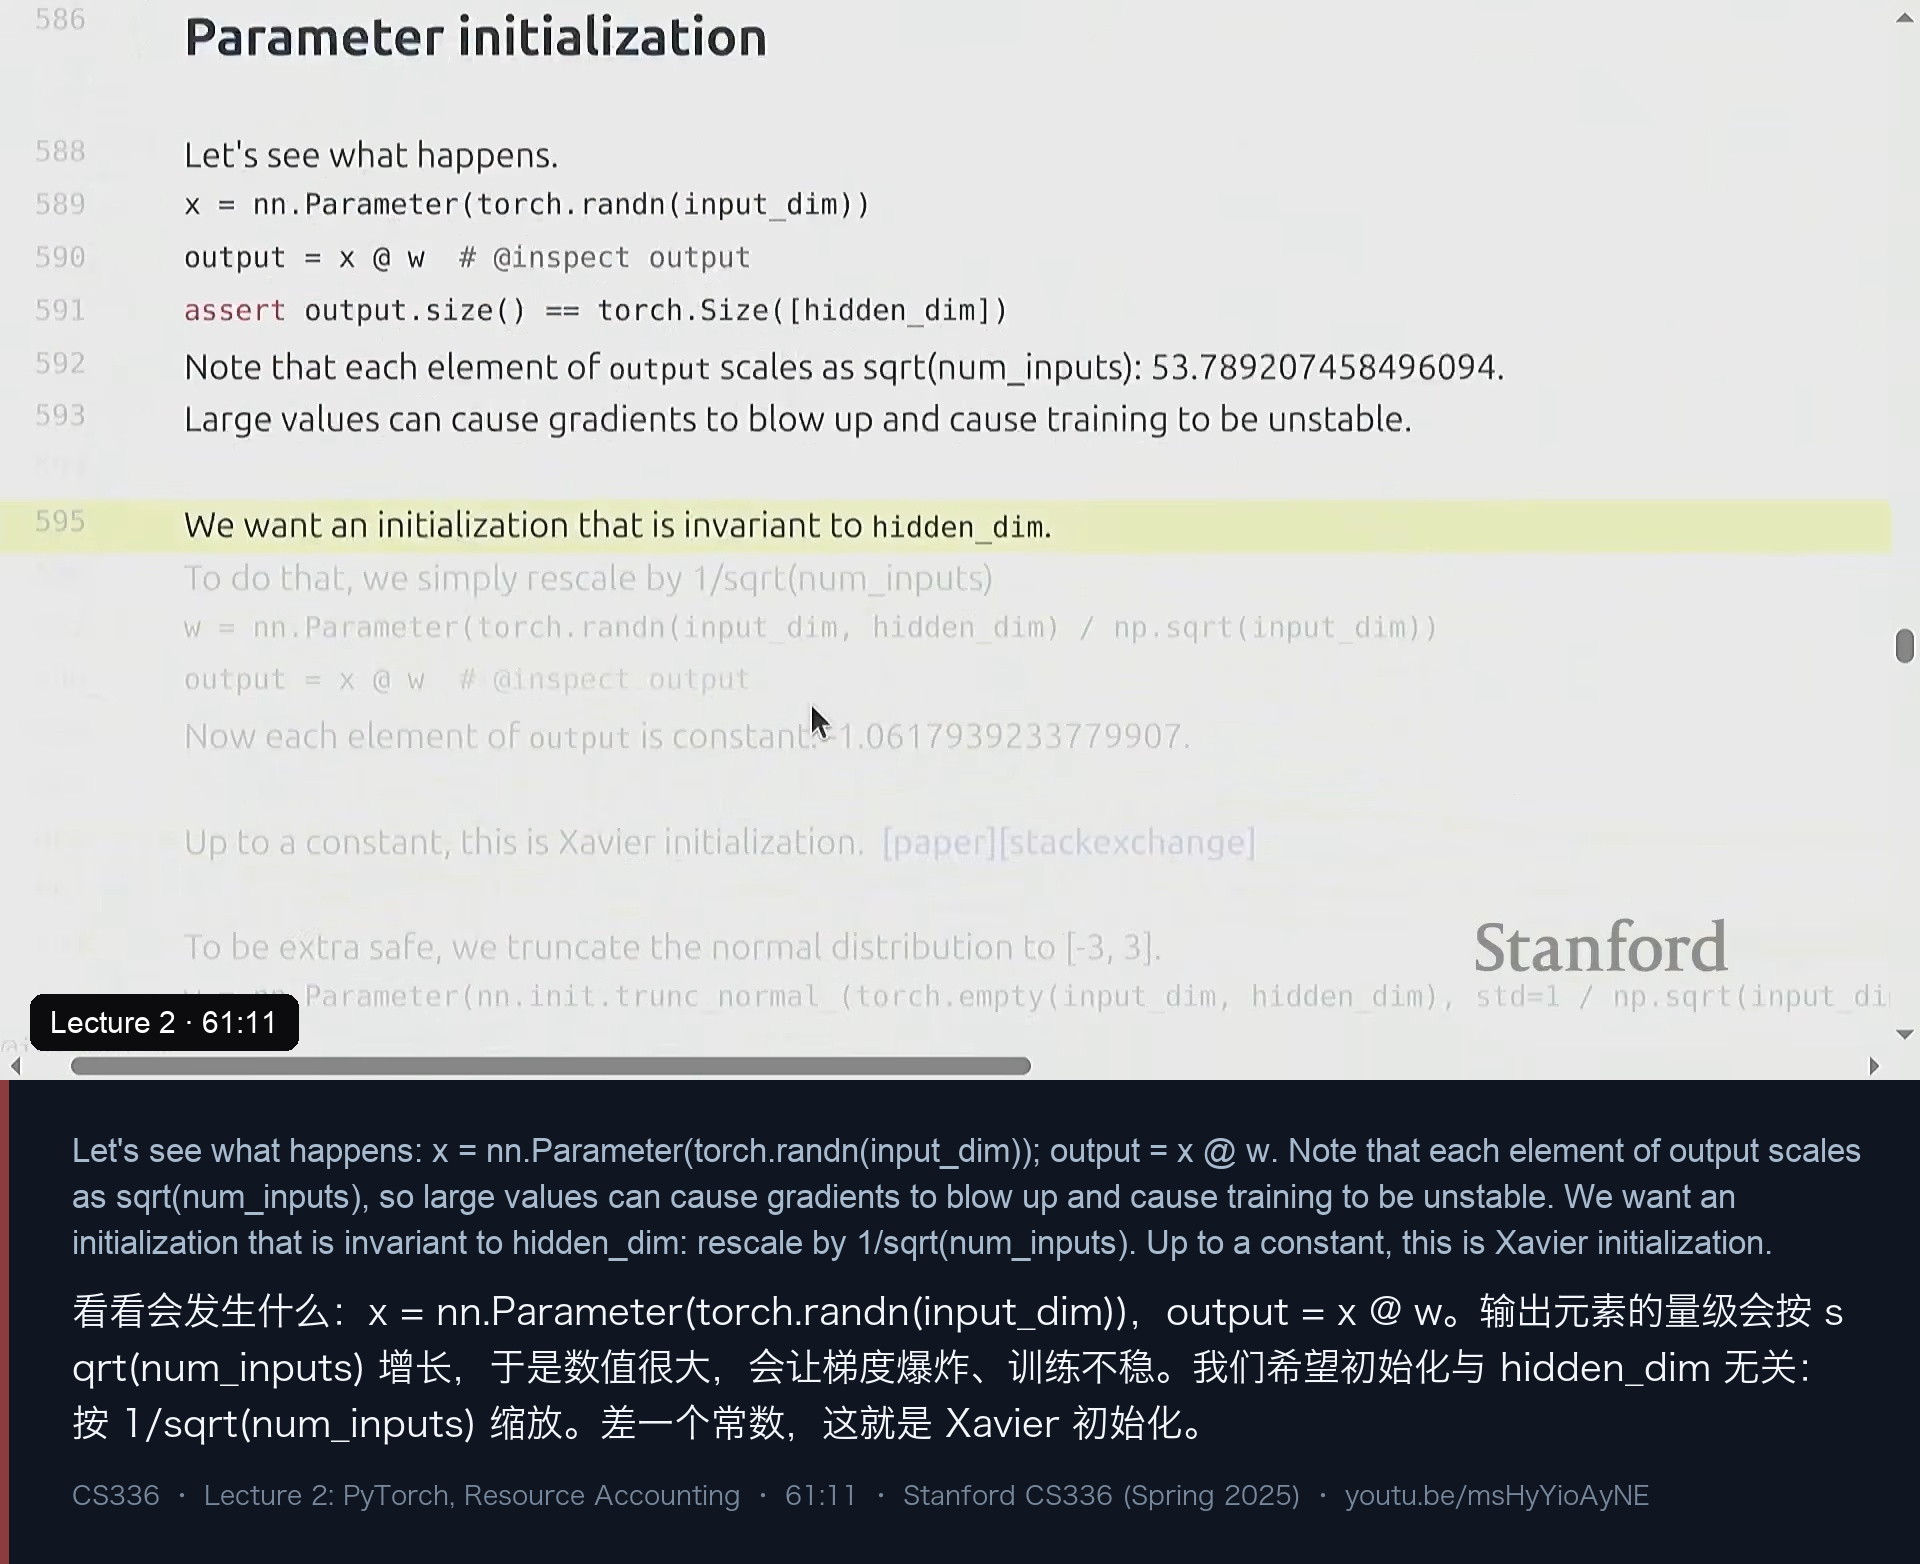
参数在 PyTorch 里是 nn.Parameter 对象。用最自然的 torch.randn 初始化会出问题:
x = nn.Parameter(torch.randn(input_dim))
output = x @ w
assert output.size() == torch.Size([hidden_dim])
# 注意:输出的每个元素量级 ~ sqrt(num_inputs),例如 53.789...
# 大模型下这会爆炸,导致梯度爆炸、训练不稳原因是输出的量级会随输入维度开根号增长。我们希望初始化与 hidden_dim 无关,最简单的办法就是按 1/sqrt(num_inputs) 缩放:
w = nn.Parameter(torch.randn(input_dim, hidden_dim) / np.sqrt(input_dim))
# 现在输出元素的量级稳定在 1 附近(实测 1.0617...)
差一个常数,这就是 Xavier 初始化。 如果还想更保守,可以用截断正态分布去掉长尾:nn.init.trunc_normal_(..., std=1, a=-3, b=3)。
7.2 一个能算清账的小模型
接着他定义了一个叫 Cruncher 的自制模型——一个「深线性网络」:num_layers 个 D×D 线性层,外加一个输出头。
D = 64
num_layers = 2
model = Cruncher(dim=D, num_layers=num_layers).to(get_device())

# 参数量 = L·D² + D
assert num_parameters == get_num_parameters(model)
7.3 随机性与数据加载
训练脚本里的随机性来源很多:初始化、dropout、数据顺序。Percy 的建议是每个随机源都设一个固定的种子:
# 每个随机源单独设种子 —— 这样你可以固定初始化、只变数据顺序
torch.manual_seed(seed)
import numpy as np; np.random.seed(seed)
import random; random.seed(seed)分开设种子的好处是:调试时可以只固定其中一部分。「调试的时候,确定性是你的朋友。」
数据读取方面:语言模型的数据本质上是一长串整数(分词器的输出),可以序列化成 numpy 数组。关键技巧是不要一次全读进内存——他举例说 Llama 的数据有 TB 量级——而是用 np.memmap 把文件「假装」映射成一个数组,按需读取,再用 DataLoader 采样出 batch。
7.4 优化器:从 SGD 到 Adam
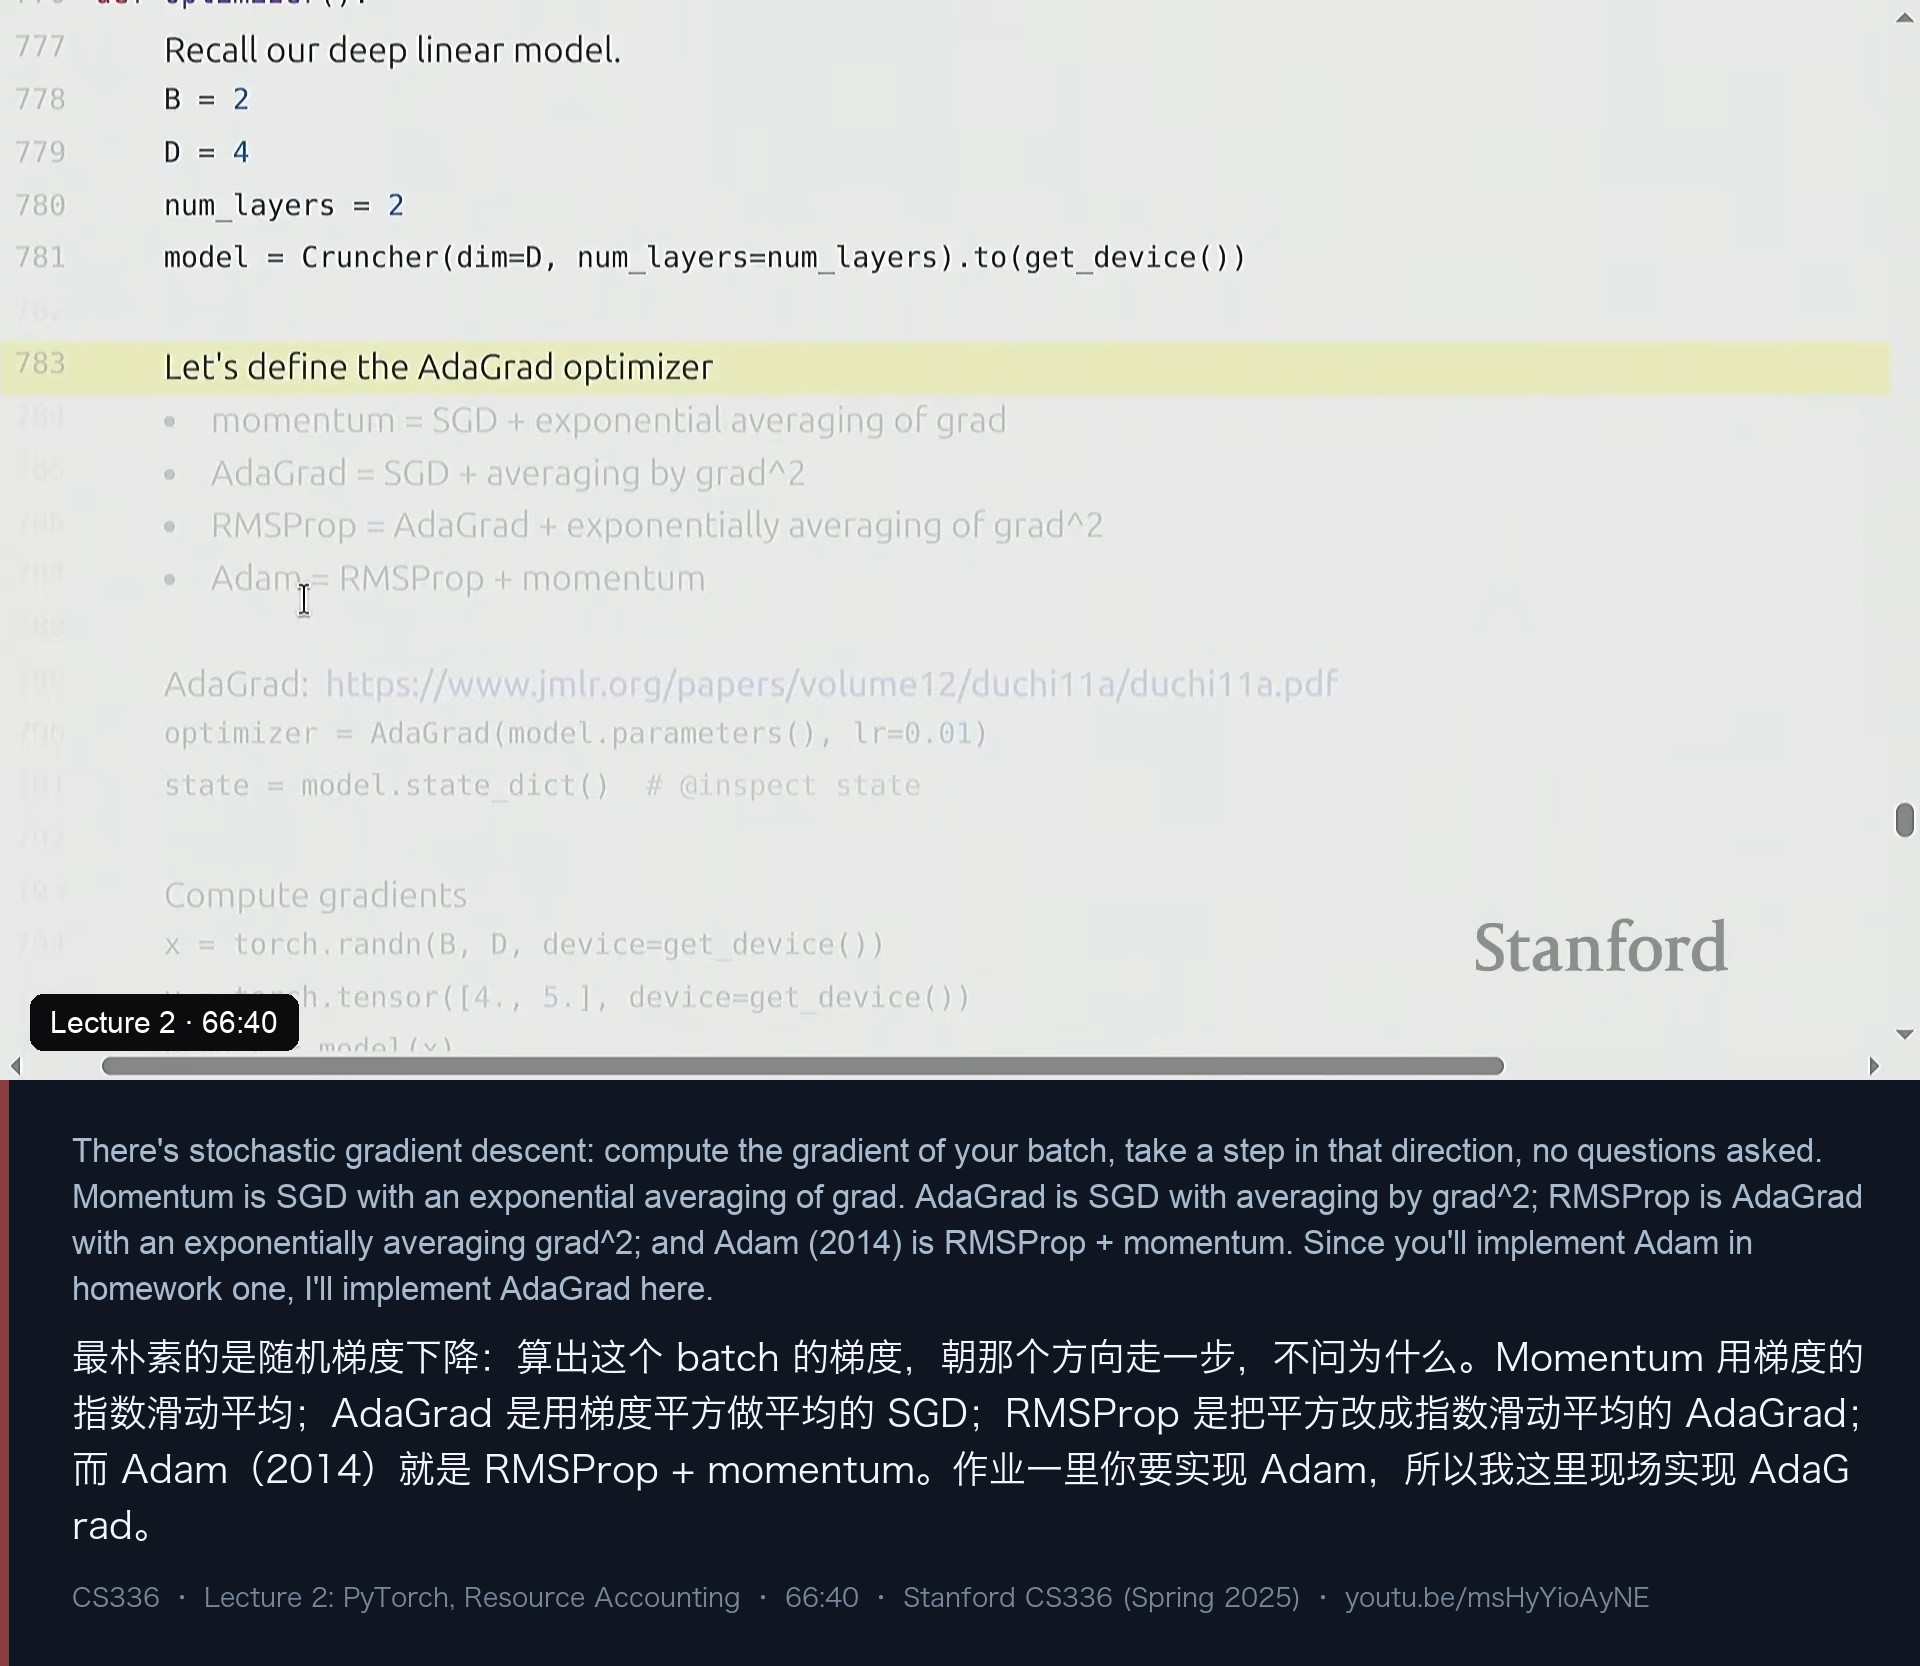
优化器的演进史被压缩成一张幻灯片:
- SGD:算出 batch 的梯度,朝那个方向走一步,不问为什么;
- Momentum:用梯度的指数滑动平均代替瞬时梯度;
- AdaGrad:用梯度的平方做平均来缩放步长;
- RMSProp:把 AdaGrad 的「平摊平均」换成指数滑动平均;
- Adam(2014):按 Percy 的话说就是 RMSProp + momentum,同时维护梯度的一阶与二阶滑动平均。
因为作业一要自己实现 Adam,他在课上改为现场实现 AdaGrad。
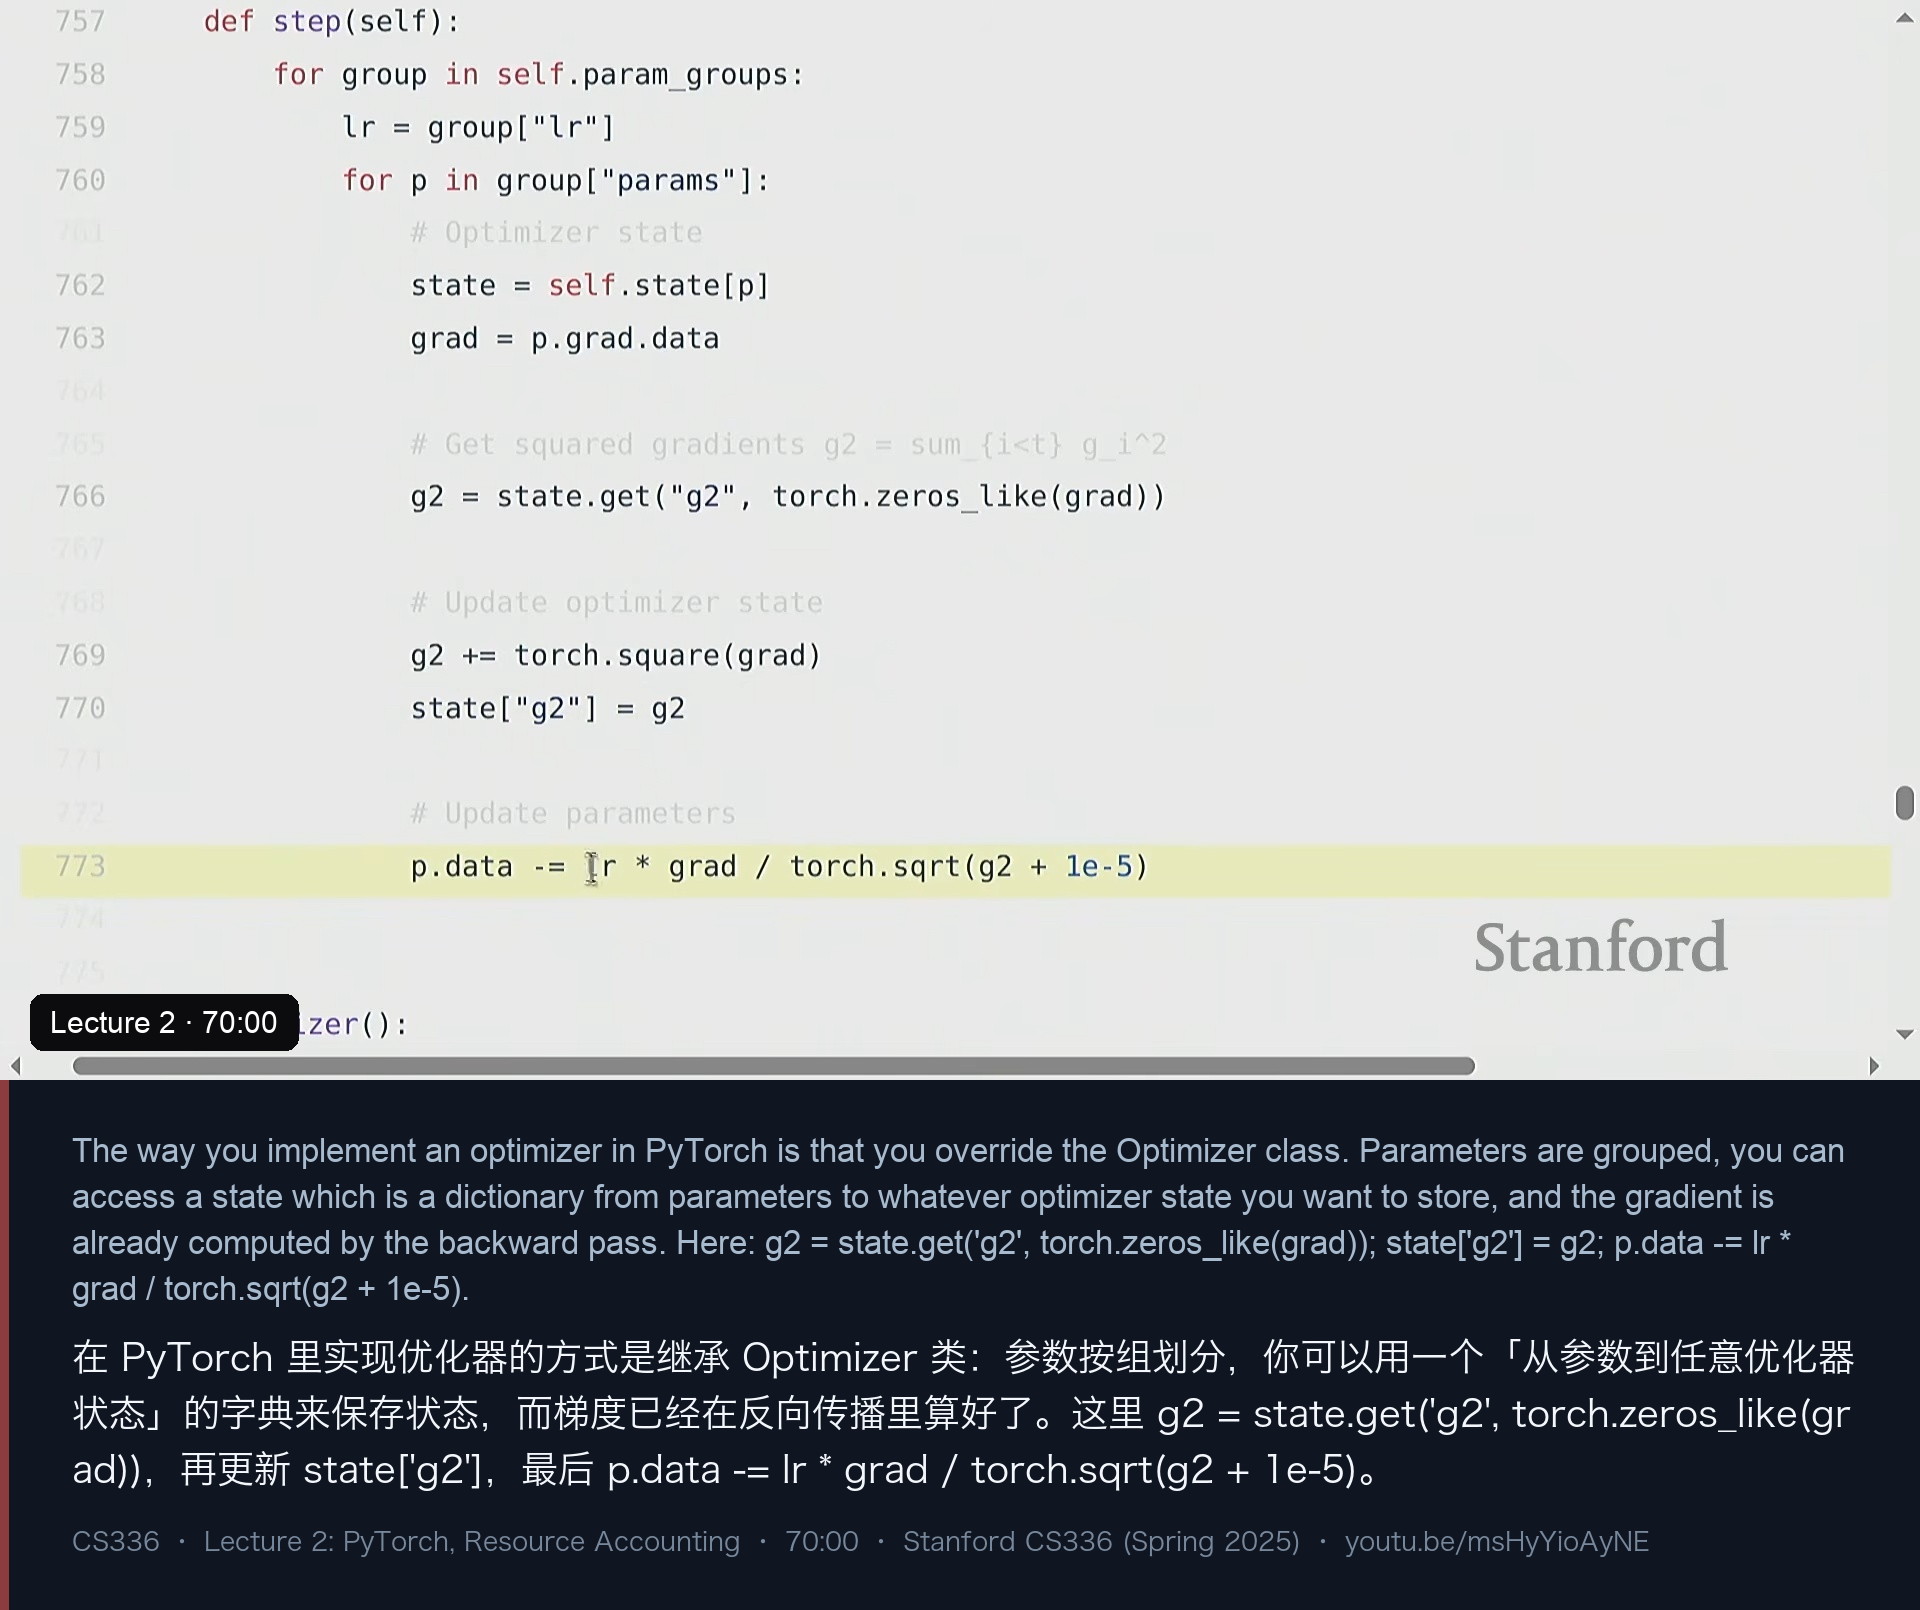
在 PyTorch 里实现一个优化器,就是继承 Optimizer 类并重写 step():
class AdaGrad(Optimizer):
    def step(self):
        for group in self.param_groups:
            lr = group['lr']
            for p in group['params']:
                if p.grad is None:
                    continue
                grad = p.grad.data                       # 梯度已由反向传播算好
                state = self.state[p]                    # 每个参数一份状态
                g2 = state.get('g2', torch.zeros_like(grad))
                g2 += torch.square(grad)                 # 累积梯度平方
                state['g2'] = g2
p.data -= lr * grad / torch.sqrt(g2 + 1e-5) # 手动原地更新三个要点:参数按组划分、状态是从参数到任意内容的字典、更新是直接改 p.data。优化器的状态会跨多次 step() 一直保留——而这份状态,正是显存账本里最容易被忘掉的一项。
八、把账本合起来:一个模型到底吃多少显存
现在可以把「参数、激活、梯度、优化器状态」这四样东西装进同一个公式了。
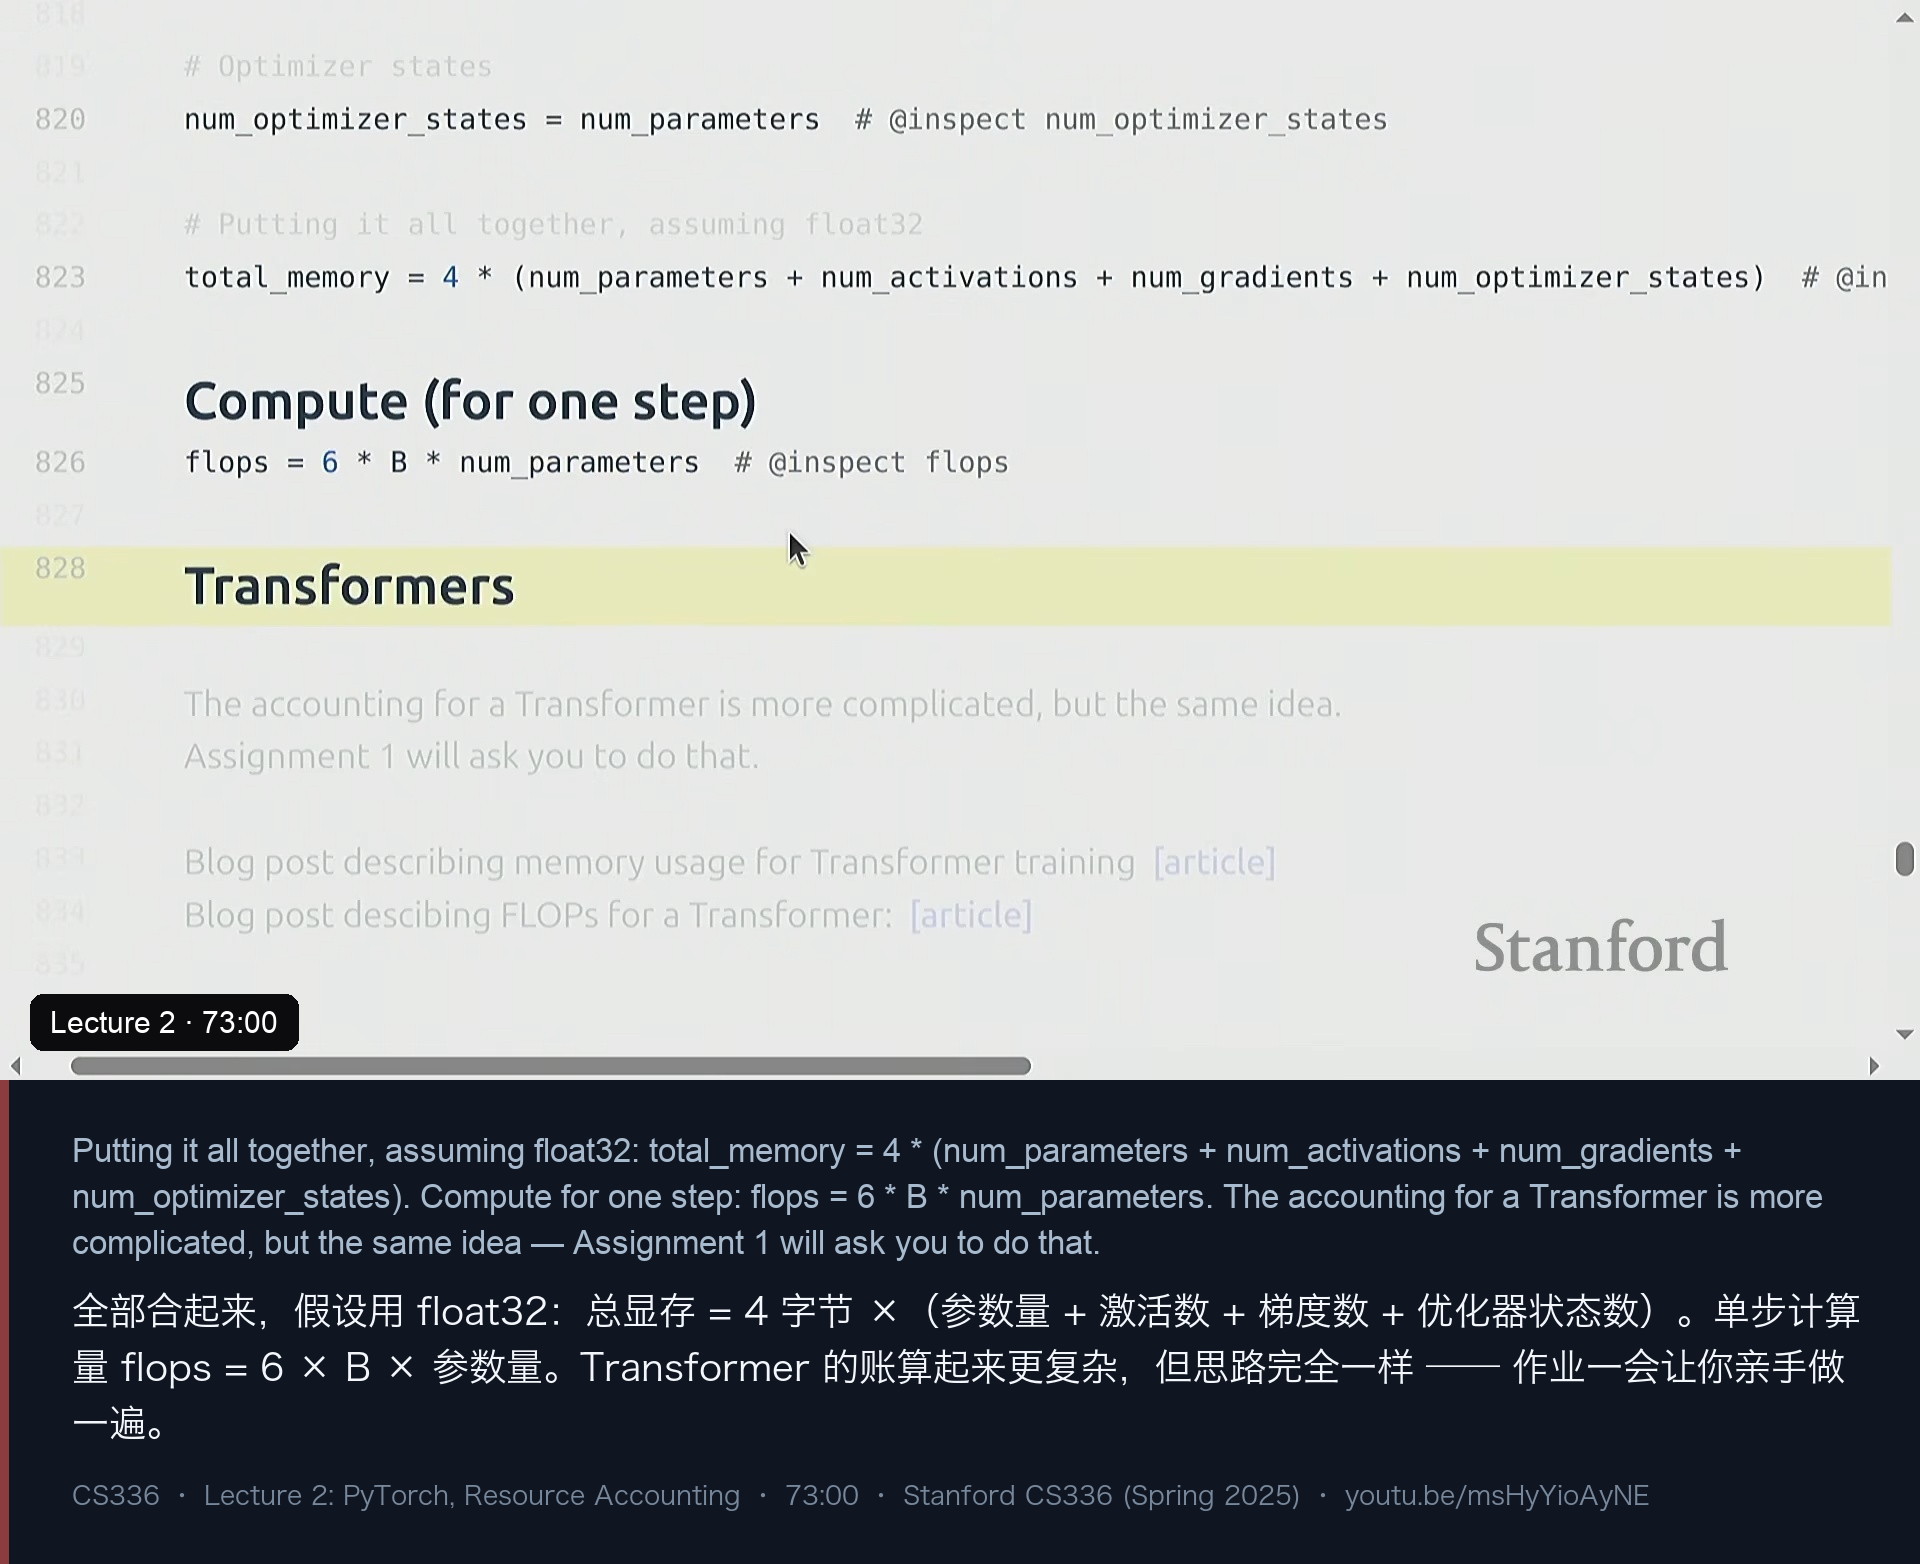
num_parameters       = D * D * num_layers + D      # 权重
num_activations      = B * D * num_layers          # 每一层的中间激活
num_gradients        = num_parameters              # 梯度与参数同规模
num_optimizer_states = num_parameters              # AdaGrad 存一份 grad²;Adam 存两份

total_memory = 4 * (num_parameters + num_activations
                    + num_gradients + num_optimizer_states)   # 假设 float32

flops = 6 * B * num_parameters                     # 单步训练的计算量
四个大项,各自都有一句要记住的话:
- 参数量:
L·D² + D,模型结构决定的固定成本; - 激活值:
B × D × L,随 batch size 和序列长度线性增长——这也是为什么长上下文训练那么吃显存; - 梯度:和参数量一样大;
- 优化器状态:AdaGrad 存一份梯度平方,Adam 要存两份(一阶、二阶动量),所以用 Adam 时这一项是参数量的两倍。
这就是「16 字节/参数」的完整来历(参数 4 + 梯度 4 + Adam 两份状态 8)。
关于「为什么要存激活」,课堂上有人提问,Percy 的回答是:反向传播算某一层梯度时需要那一层的激活值。但他同时补了一句关键的后话——如果你更聪明,就不必全都存下来,可以「重算」(recompute),这门技术叫 activation checkpointing(激活重计算),后面会专门讲。
Percy 也坦白这一讲只做了线性模型的账:「作业一里你要对 Transformer 做同样的计算,它会更麻烦(有注意力、有一堆矩阵),但计算的骨架完全一样——参数、激活、梯度、优化器状态。」
九、训练循环、checkpoint 与混合精度
最后是几个工程细节。
训练循环本身没有悬念:定义模型、定义优化器、取数据、前向、反向、optimizer.step()、optimizer.zero_grad()。
Checkpoint 值得强调:训练大模型要跑很久,「你迟早会崩一次,别把进度全丢了」。定期存盘时,要存的不仅是模型,还有优化器状态和当前的迭代步数:
checkpoint = {
    "model": model.state_dict(),
    "optimizer": optimizer.state_dict(),
    "iteration": iteration,
}
torch.save(checkpoint, "model_checkpoint.pt")混合精度训练是整讲的收尾,也是一张权衡表:
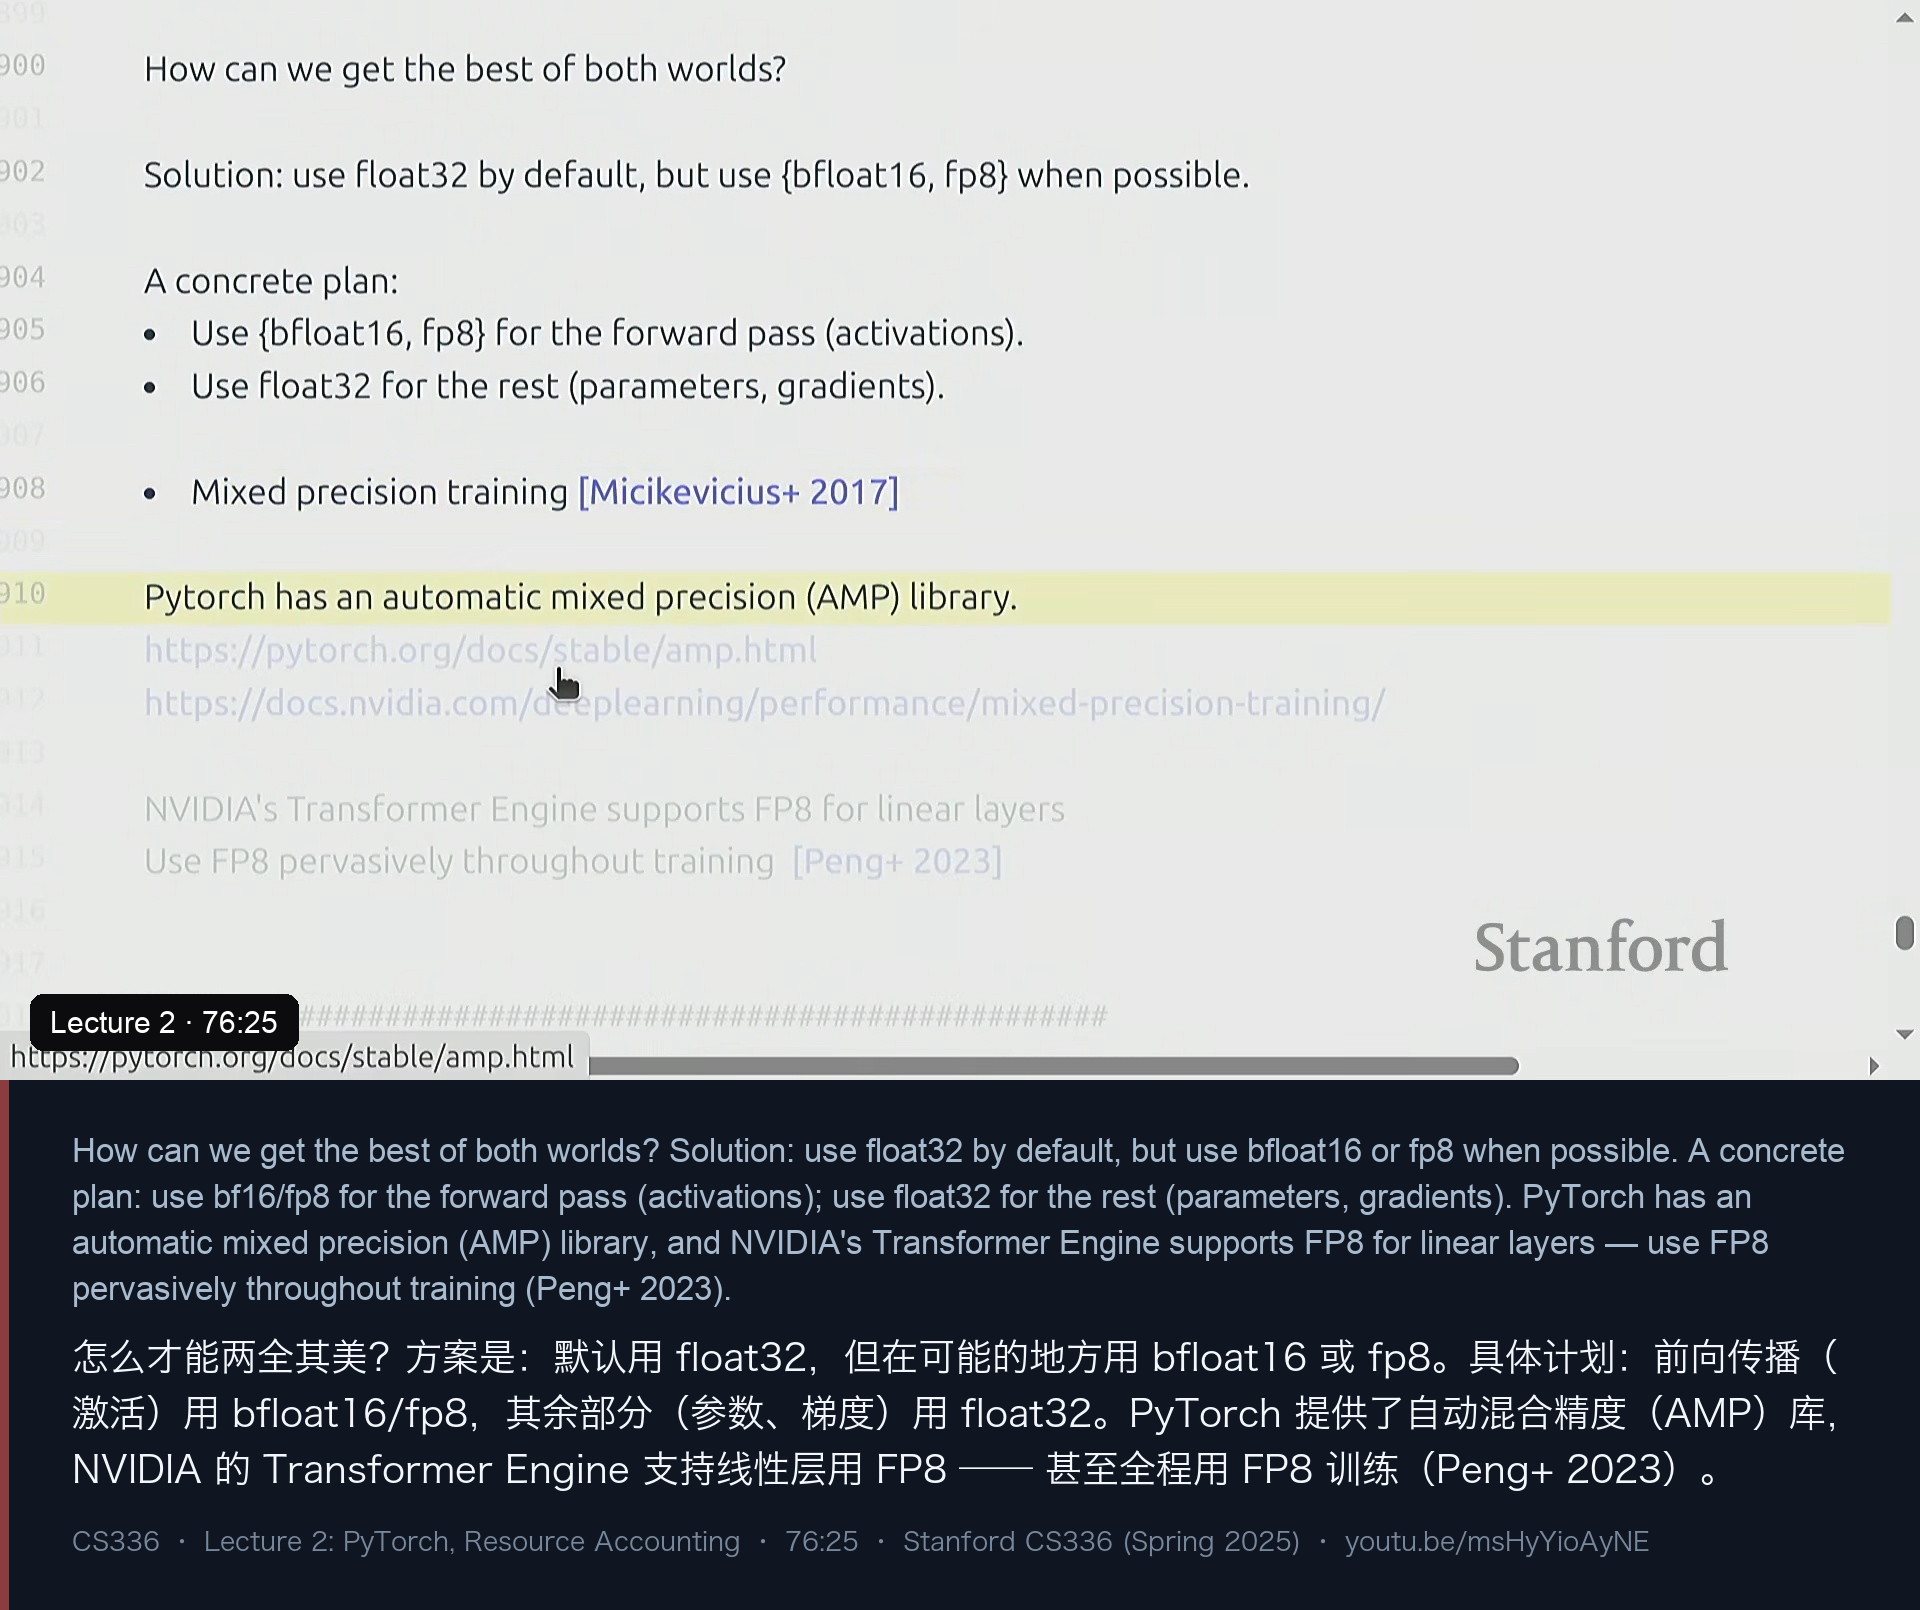
- 精度越高 → 越准确、越稳定,但更贵;精度越低 → 反之;
- 默认建议 float32,但在可能的地方尽量用 bf16 甚至 FP8;
- 具体方案:前向传播(激活)用
{bfloat16, fp8},其余部分(参数、梯度)用 float32; - PyTorch 提供了 AMP(自动混合精度) 库来自动化这件事,因为手动指定「哪里用什么精度」既烦人又会横切你精心设计的模块边界;
- 再往前沿一点:NVIDIA 的 Transformer Engine 支持线性层用 FP8,甚至有工作(Peng+ 2023)尝试全程用 FP8 训练。
Percy 顺带点出了这一讲与第一讲「效率」主线的呼应:低精度会带来数值不稳定,于是需要各种技巧去控制数值范围——这正是「系统和模型架构协同设计」的地方。今天很多模型设计其实是被硬件规定的。而反过来,推理比训练容易得多:训练时你小心翼翼,但一旦模型训好,就可以激进地量化,把低精度的收益几乎全部拿走。
最后他给整讲画了句号:我们从张量一路搭到了训练循环,并且对内存和 FLOPs 都做了核算;等你在作业一里把这些概念用到真正的 Transformer 上,它们就会真正变扎实。
十、我的笔记:这一讲值得记住的 6 句话
- 先算账,再写代码。 「跑起来、发生什么算什么」不是工程,是赌博——因为大模型的 FLOPs 会直接换算成美元。
- 两个常数:6 和 16。 训练总算力 ≈ 6 × 参数量 × token 数;AdamW 下每个参数占 16 字节。两条都来自最朴素的推导,却决定了你的直觉准不准。
- 显存是一本四项的账。 参数 + 激活 + 梯度 + 优化器状态,缺一项你的估算就会差一倍。最常被忘掉的是最后一项:Adam 的状态和参数量一样大,而且有两份。
- 动态范围 > 分辨率。 float16 的问题不是「不够精确」,而是「
1e-8直接变 0」;bfloat16 想通了这一点,于是统治了训练的算力部分,而参数与优化器状态仍然留在 float32。 - 张量是「指针 + stride」,视图免费、复制收费。
view/transpose不花内存,contiguous()/reshape可能真的复制——忘记这条,你的显存账会和实际对不上。 - MFU 是「榨干硬件的程度」,不是「硬件有多快」。 ≥ 0.5 就不错,规格表上的峰值(尤其是带稀疏性的那个)永远别当真,实测。
附:课程信息与时间轴
- 课程主页:stanford-cs336.github.io/spring2025
- 本讲视频:Lecture 2: PyTorch, Resource Accounting(1:19)
- 播放列表:Stanford CS336 Language Modeling from Scratch · Spring 2025
- 配图目录:
public/blog/youtube/msHyYioAyNE/(18 张图均截取自视频中对应观点所在的幻灯片,并把该时刻的完整观点句拼合进图中)
| 时间 | 内容 |
|---|---|
| 00 | 开场:从张量搭到训练循环,主线是资源核算 |
| 00 | 两道餐巾纸问题:70B/15T/1024 张 H100 → 约 144 天 |
| 02 | 8 张 H100 + AdamW 最多训 40B 参数(16 字节/参数) |
| 04 | 今天不讲 Transformer,用简单模型讲原语与核算 |
| 05 | 内存核算①:张量与浮点格式 |
| 06 | float32:符号/指数/尾数,以及 GPT-3 的 2.3 GB 矩阵 |
| 08 | float16:省一半显存,但 1e-8 会下溢 |
| 09 | bfloat16:用 float32 的动态范围换掉分辨率 |
| 11 | FP8:E4M3 与 E5M2,以及低精度的训练风险 |
| 12 | 混合精度:逐位置确定最低精度需求 |
| 14 | 计算核算:张量默认在 CPU,要显式搬上 GPU |
| 17 | 张量 = 指针 + stride 元数据;视图共享 storage |
| 21 | 非连续视图、contiguous() 与「视图免费、复制收费」 |
| 23 | 矩阵乘法与 batched matmul |
| 25 | einops / einsum:给维度起名字 |
| 33 | FLOPs vs FLOP/s,以及 GPT-3/GPT-4 的量级 |
| 35 | 规格表与稀疏性:1979 TFLOP/s 要砍半 |
| 38 | 矩阵乘法 FLOPs = 2 × 三个维度之积 |
| 42 | 实测耗时与 MFU ≈ 0.8;为什么永远到不了 100% |
| 49 | 反向传播:每个梯度都是一次矩阵乘法 |
| 56 | 前向 2N、反向 4N、合计 6N 的可视化 |
| 59 | nn.Parameter 与参数初始化 |
| 1:00 | randn 的问题与 Xavier 初始化 / 截断正态 |
| 1:02 | Cruncher:一个能算清账的深线性模型 |
| 1:04 | 随机种子:每个随机源一个,调试时确定性别乱丢 |
| 1:05 | 数据加载:整数序列、memmap 与 DataLoader |
| 1:06 | 优化器家族:SGD → Momentum → AdaGrad → RMSProp → Adam |
| 1:08 | 现场实现 AdaGrad:参数组、state 与 p.data |
| 1:10 | 内存账本:参数 + 激活 + 梯度 + 优化器状态 |
| 1:13 | 为什么存激活:反向需要它,以及 activation checkpointing |
| 1:14 | 训练循环与 checkpoint(模型 + 优化器 + 迭代步) |
| 1:15 | 混合精度训练:前向低精度、参数与梯度用 float32 |
| 1:17 | 系统与架构协同设计;推理量化比训练容易 |
| 1:18 | 小结与作业一预告 |
说明:本文是视频内容的整理、翻译与转述,观点均来自主讲人 Percy Liang;文中代码为讲座中演示代码的整理版本,非官方作业代码。课程中引用的模型规模、成本、FLOPs 与监管门槛等数字多为公开传闻或讲师引用的估算,请自行核实。
讨论
这里是静态站点,没有内嵌评论区。如果这篇文章对你有用,欢迎通过 RSS 订阅后续更新。