Stanford CS336 第一讲精读:从零构建语言模型,为什么先讲分词?
斯坦福 CS336(Language Modeling from Scratch, Spring 2025)第一讲完整讲义:这门课为什么存在、苦涩的教训的正确读法(accuracy = efficiency × resources)、从 Shannon 到 Transformer 的历史坐标、从零构建语言模型的完整流水线,以及字符级/字节级/词级分词为什么都不行、BPE 到底怎么训练出来的。
本篇属于系列 Stanford CS336 精读 · 第一讲
来源:YouTube 原视频(Stanford Online · CS336 Language Modeling from Scratch · Spring 2025 · Lecture 1: Overview and Tokenization)
来源说明 这是斯坦福 CS336《Language Modeling from Scratch》2025 年春季第一讲的完整讲义,主讲人是 Percy Liang 与 Tatsunori Hashimoto。本文按讲课顺序逐段整理:先讲这门课为什么存在、它贯穿始终的“效率”视角,再给出一张从零构建语言模型的完整地图,最后用完整篇幅讲清分词(tokenization)——今天真正的主角。文中 17 张配图均截取自视频对应时刻的幻灯片,并把该时刻的完整观点句(英文原句+中文翻译)拼合进图中。课程中的数字(GPT-4 的参数量、算力账等)是讲师引用的公开传闻或估算,不是本文独立核实的事实。
TL;DR
- 这门课存在的理由:研究者正在离底层技术越来越远(八年前自己训模型、六年前还能微调 BERT,现在很多人只会 prompt)。抽象层在漏水,而“要理解它,就得亲手把它造出来”——所以 CS336 让你从数据、分词、架构、训练一路做到对齐,整条栈自己实现一遍。
- 贯穿全课的一条主线是效率。准确率 ≈ 效率 × 资源;规模越大,效率越重要,因为越大的实验越浪费不起。2012–2019 年,把 ImageNet 训到同一精度所需的算力下降了 44 倍——比摩尔定律还快。
- “苦涩的教训”常被误读成“规模就是一切”。Percy 的解读是“规模化之后的算法才重要”:算法与规模是乘积关系,不是替代关系。
- 这门课的教学地图:Basics(分词、架构、损失、优化器)→ Systems(kernel、并行、量化、推理)→ Scaling laws(在算力预算下预测最优超参)→ Data(评估、清洗、去重、配比)→ Alignment(SFT、RLHF、偏好数据、合成数据、verifier)。
- 今天的技术重点是分词:字符级(词表巨大、分配低效)、字节级(压缩率 1.0、序列太长)、词级(词表无界、一堆 UNK)都不理想;真正用的是 BPE——先把每个字节当作 token,然后不断合并最高频的相邻 token 对。
- 一个必须记住的细节:空格属于 token 的一部分,“hello” 和 “ hello” 是两个完全不同的 token;数字会被从左到右切片,没有任何语义分组。GPT-2 分词器在英文上的压缩率约为 1.6 字节/token。
一、为什么要开这门课:抽象在漏水,而前沿模型不开源
课程由 Percy Liang 与 Tatsunori Hashimoto 共同主讲,这是 CS336 的第二次开课(助教从 2 人增加到 3 人),并且从今年起全部讲座都放到 YouTube 上。
Percy 先自嘲说,如果你问 GPT-4 “为什么要教一门从零构建语言模型的课”,它会给你一堆“提供基础理解、促进创新”之类的官话。真正的原因是另一句话:
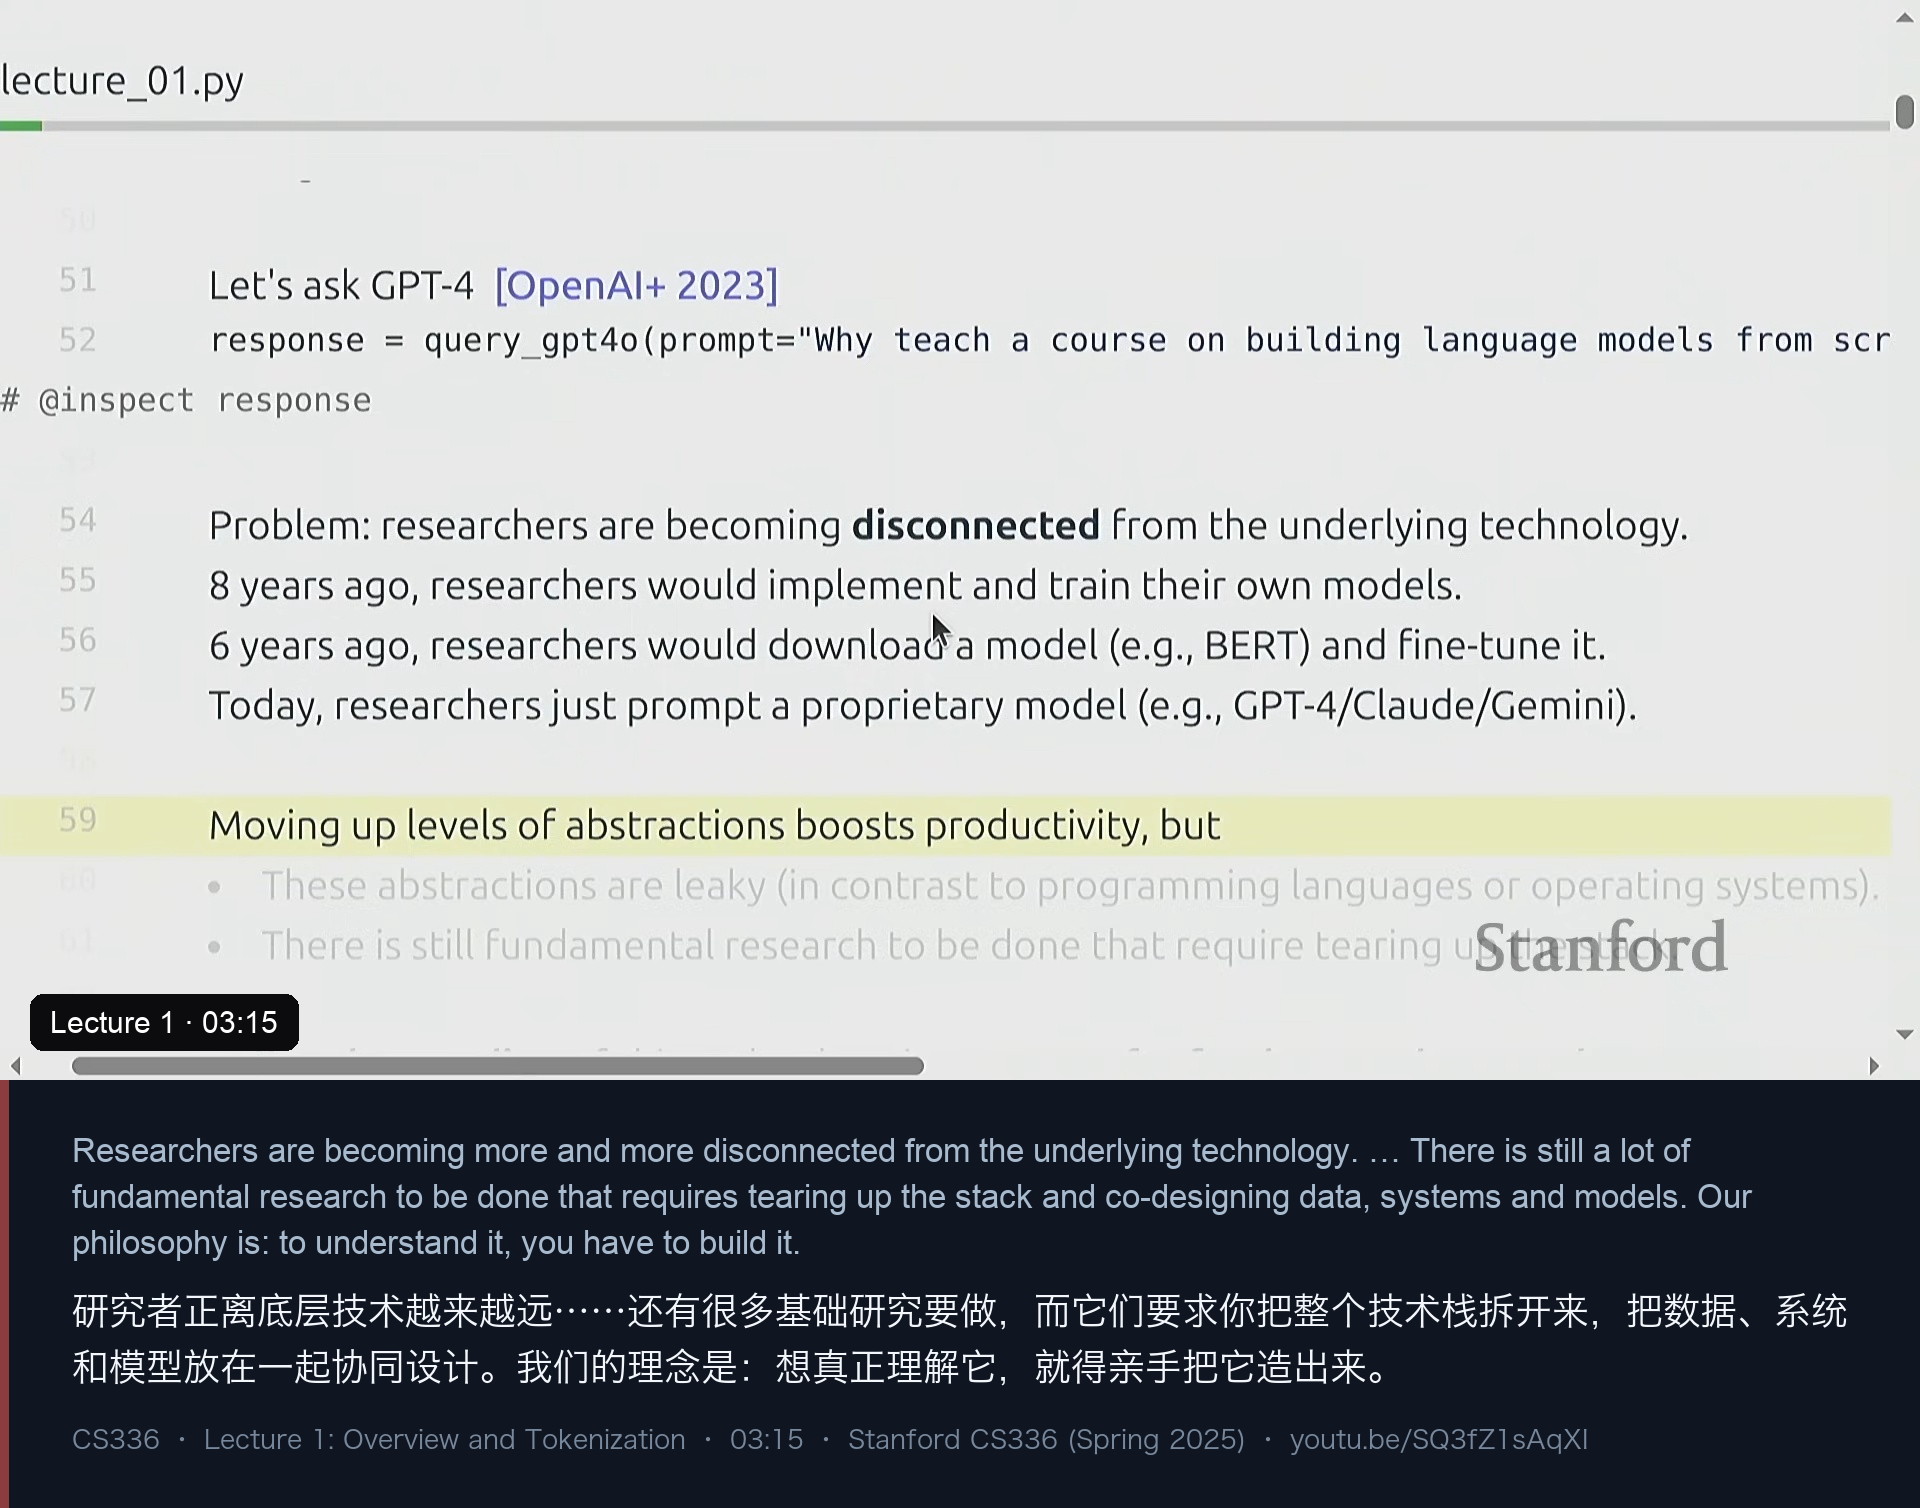
八年前,AI 研究者会自己实现并训练模型;六年前,你至少还会下载 BERT 来微调;而现在,很多人只靠 prompt 就能把活干完。这本身不是坏事——抽象层让所有人都能做更多事,Percy 自己也承认他花了不少时间在 prompt 上。但关键是:这些抽象是漏水的(leaky)。和编程语言、操作系统不同,你并不真正理解 prompt 背后发生了什么——它是“字符串进、字符串出”。而真正需要把整个技术栈拆开、把数据/系统/模型放在一起协同设计的基础研究,还远远没有做完。
第二重现实是“工业化”。GPT-4 被传有 1.8 万亿参数、训练成本约 1 亿美元;xAI 在建 20 万张 H100 的集群;四年超过 5000 亿美元的投入;而 OpenAI 在两年前的论文里就很坦诚地写明:“出于竞争格局与安全限制,我们不披露任何细节。”
于是就有了这门课最诚实的一个设定:前沿模型对我们来说遥不可及。我们只能在课上训练小模型——而小模型可能并不具备代表性。
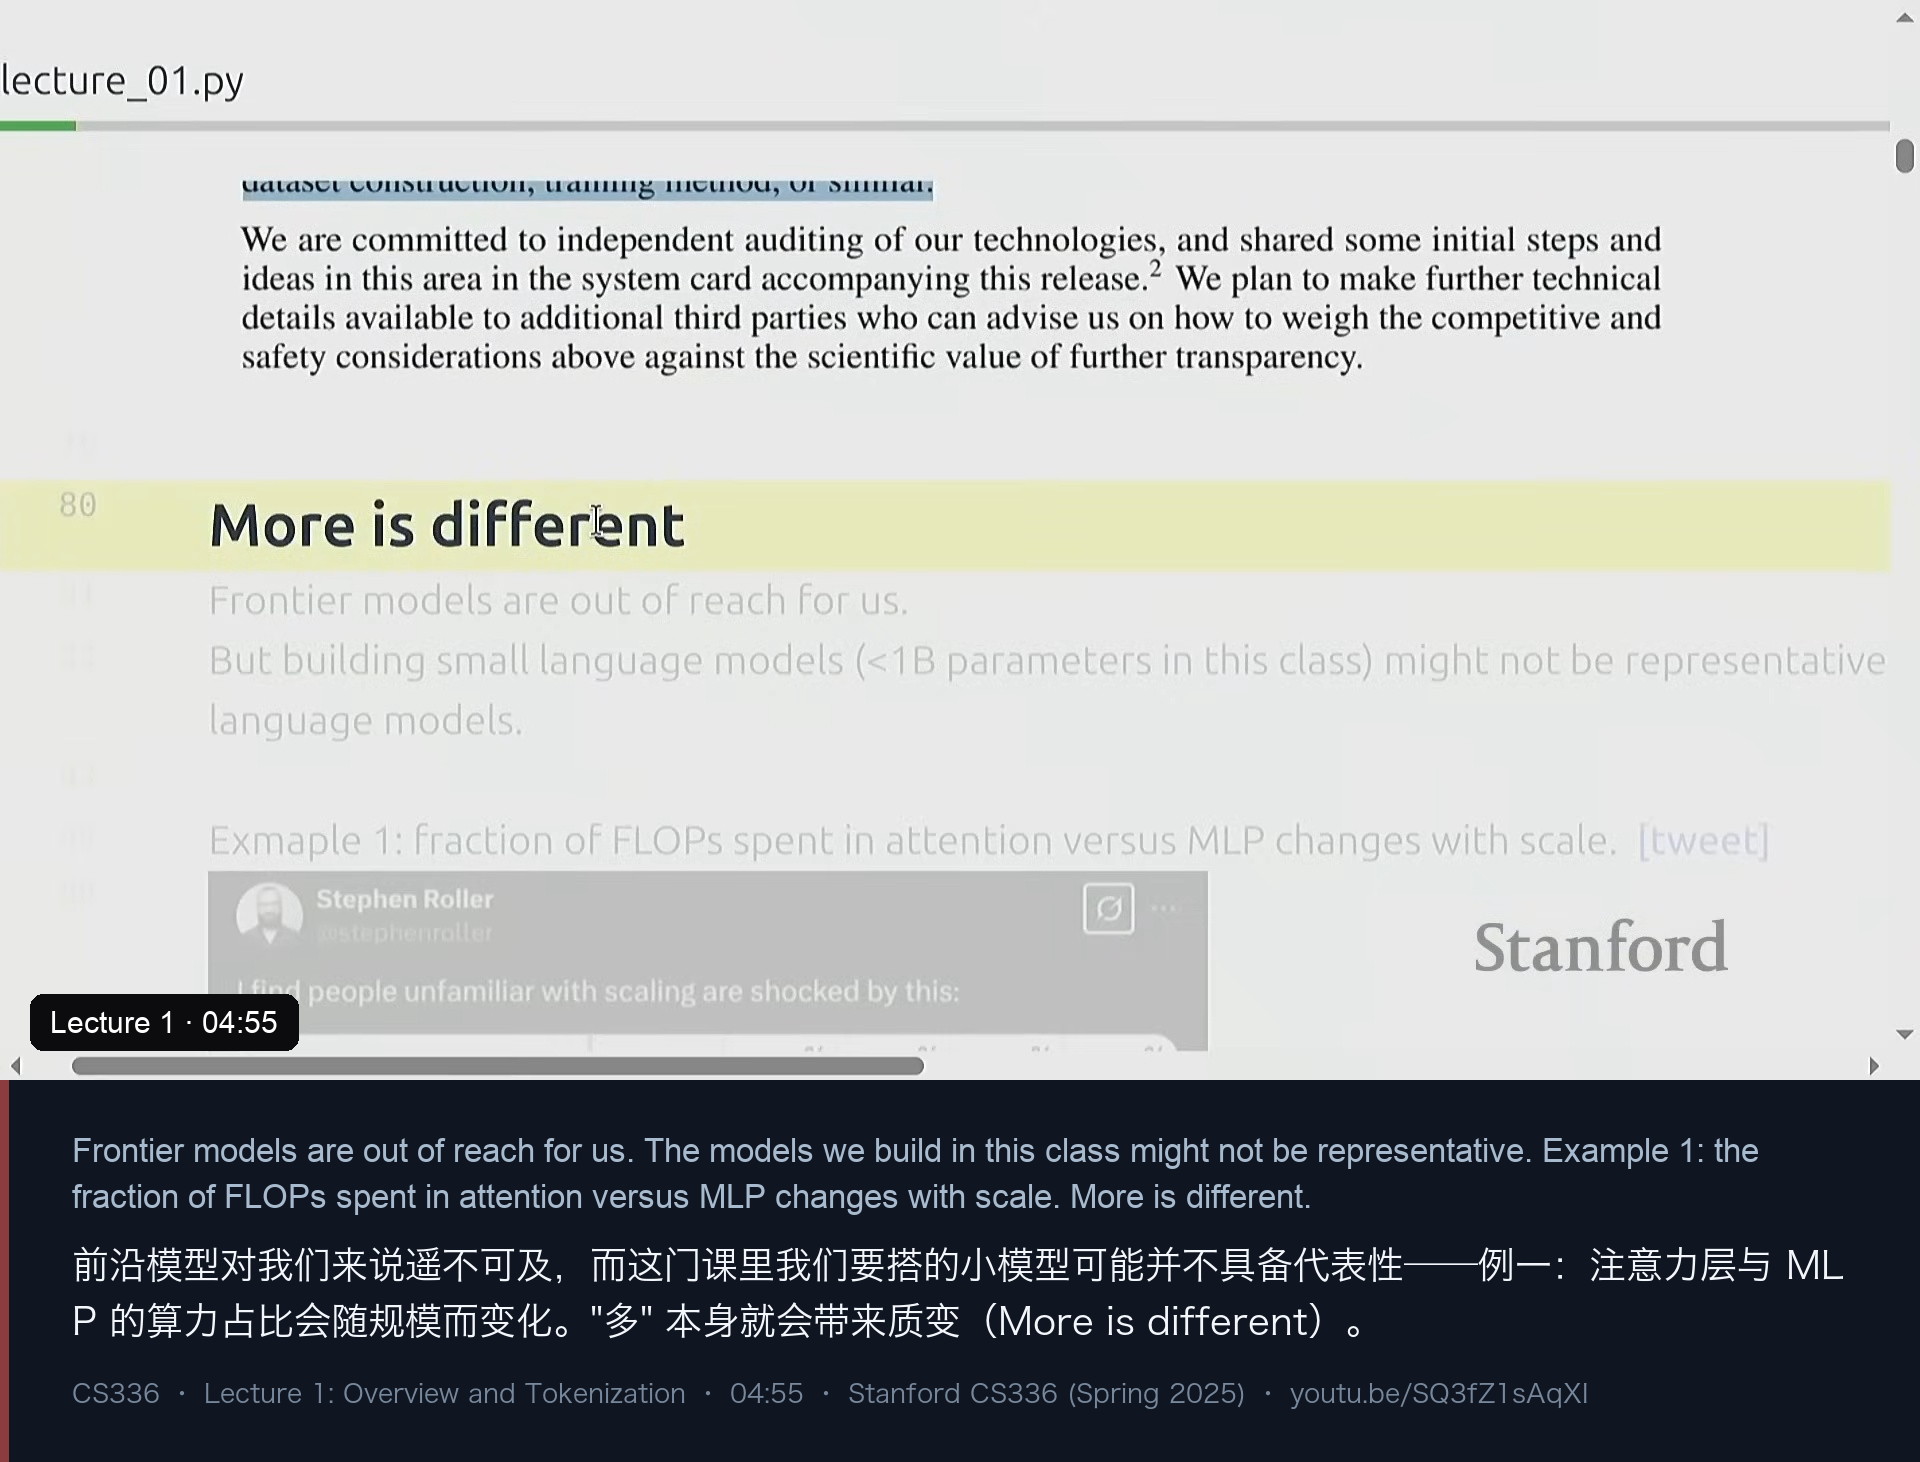
他举了两个例子说明“小模型不代表大模型”。第一个是注意力层与 MLP 的算力占比:在 Transformer 里,花在注意力上的 FLOPs 比例会随规模显著变化。第二个(后面的课程会展开)是长尾现象:小规模实验里看不到的“长尾”效应,在大规模训练中会出现。所以这门课在教“机制”的同时,也反复提醒:机制本身可能随规模而变。
二、苦涩的教训,正确的读法
“苦涩的教训”(the bitter lesson)几乎被讲烂了,Percy 说他最反感的一种误读是:“规模就是一切,算法不重要,砸钱堆算力就行。“他的回应是:
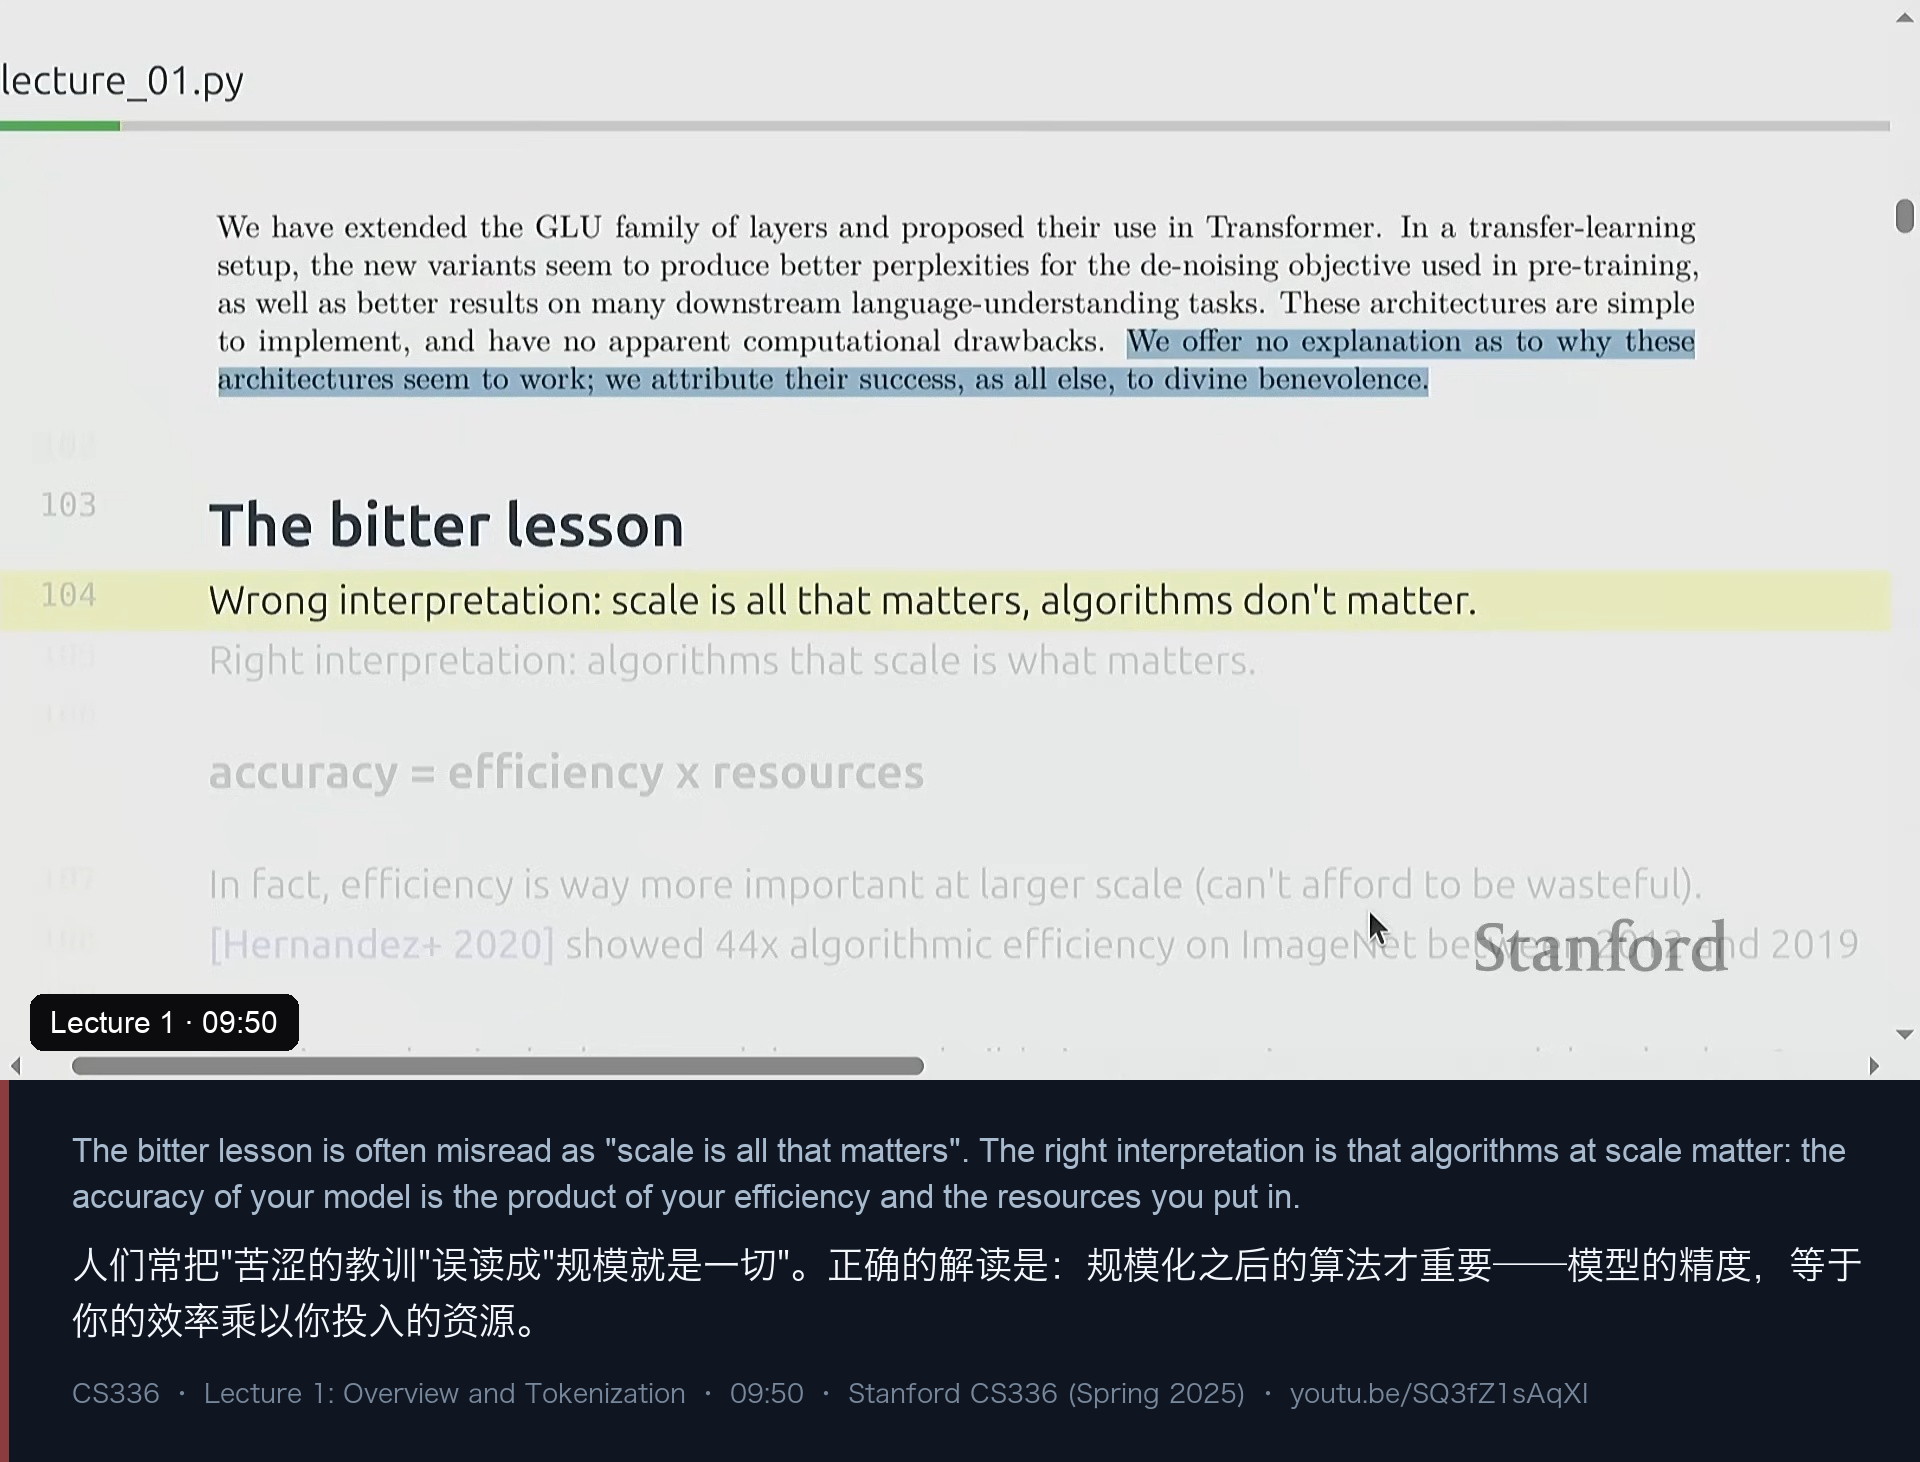
正确的解读是“规模化之后的算法才重要”——因为模型的精度本质上是“效率 × 资源”的乘积。而且效率在大规模下更重要:当你在一次实验上花掉几千万美元时,你根本浪费不起;而在自己的小集群上,跑废了重跑一次就是了。
他还补了一个常被忽略的论据:如果把“算法效率”单独拎出来看,2020 年 OpenAI 的一篇工作统计过,2012–2019 年间把 ImageNet 训到同一精度所需算力下降了 44 倍——比摩尔定律还快。算法当然重要,否则你要多付 44 倍的钱。
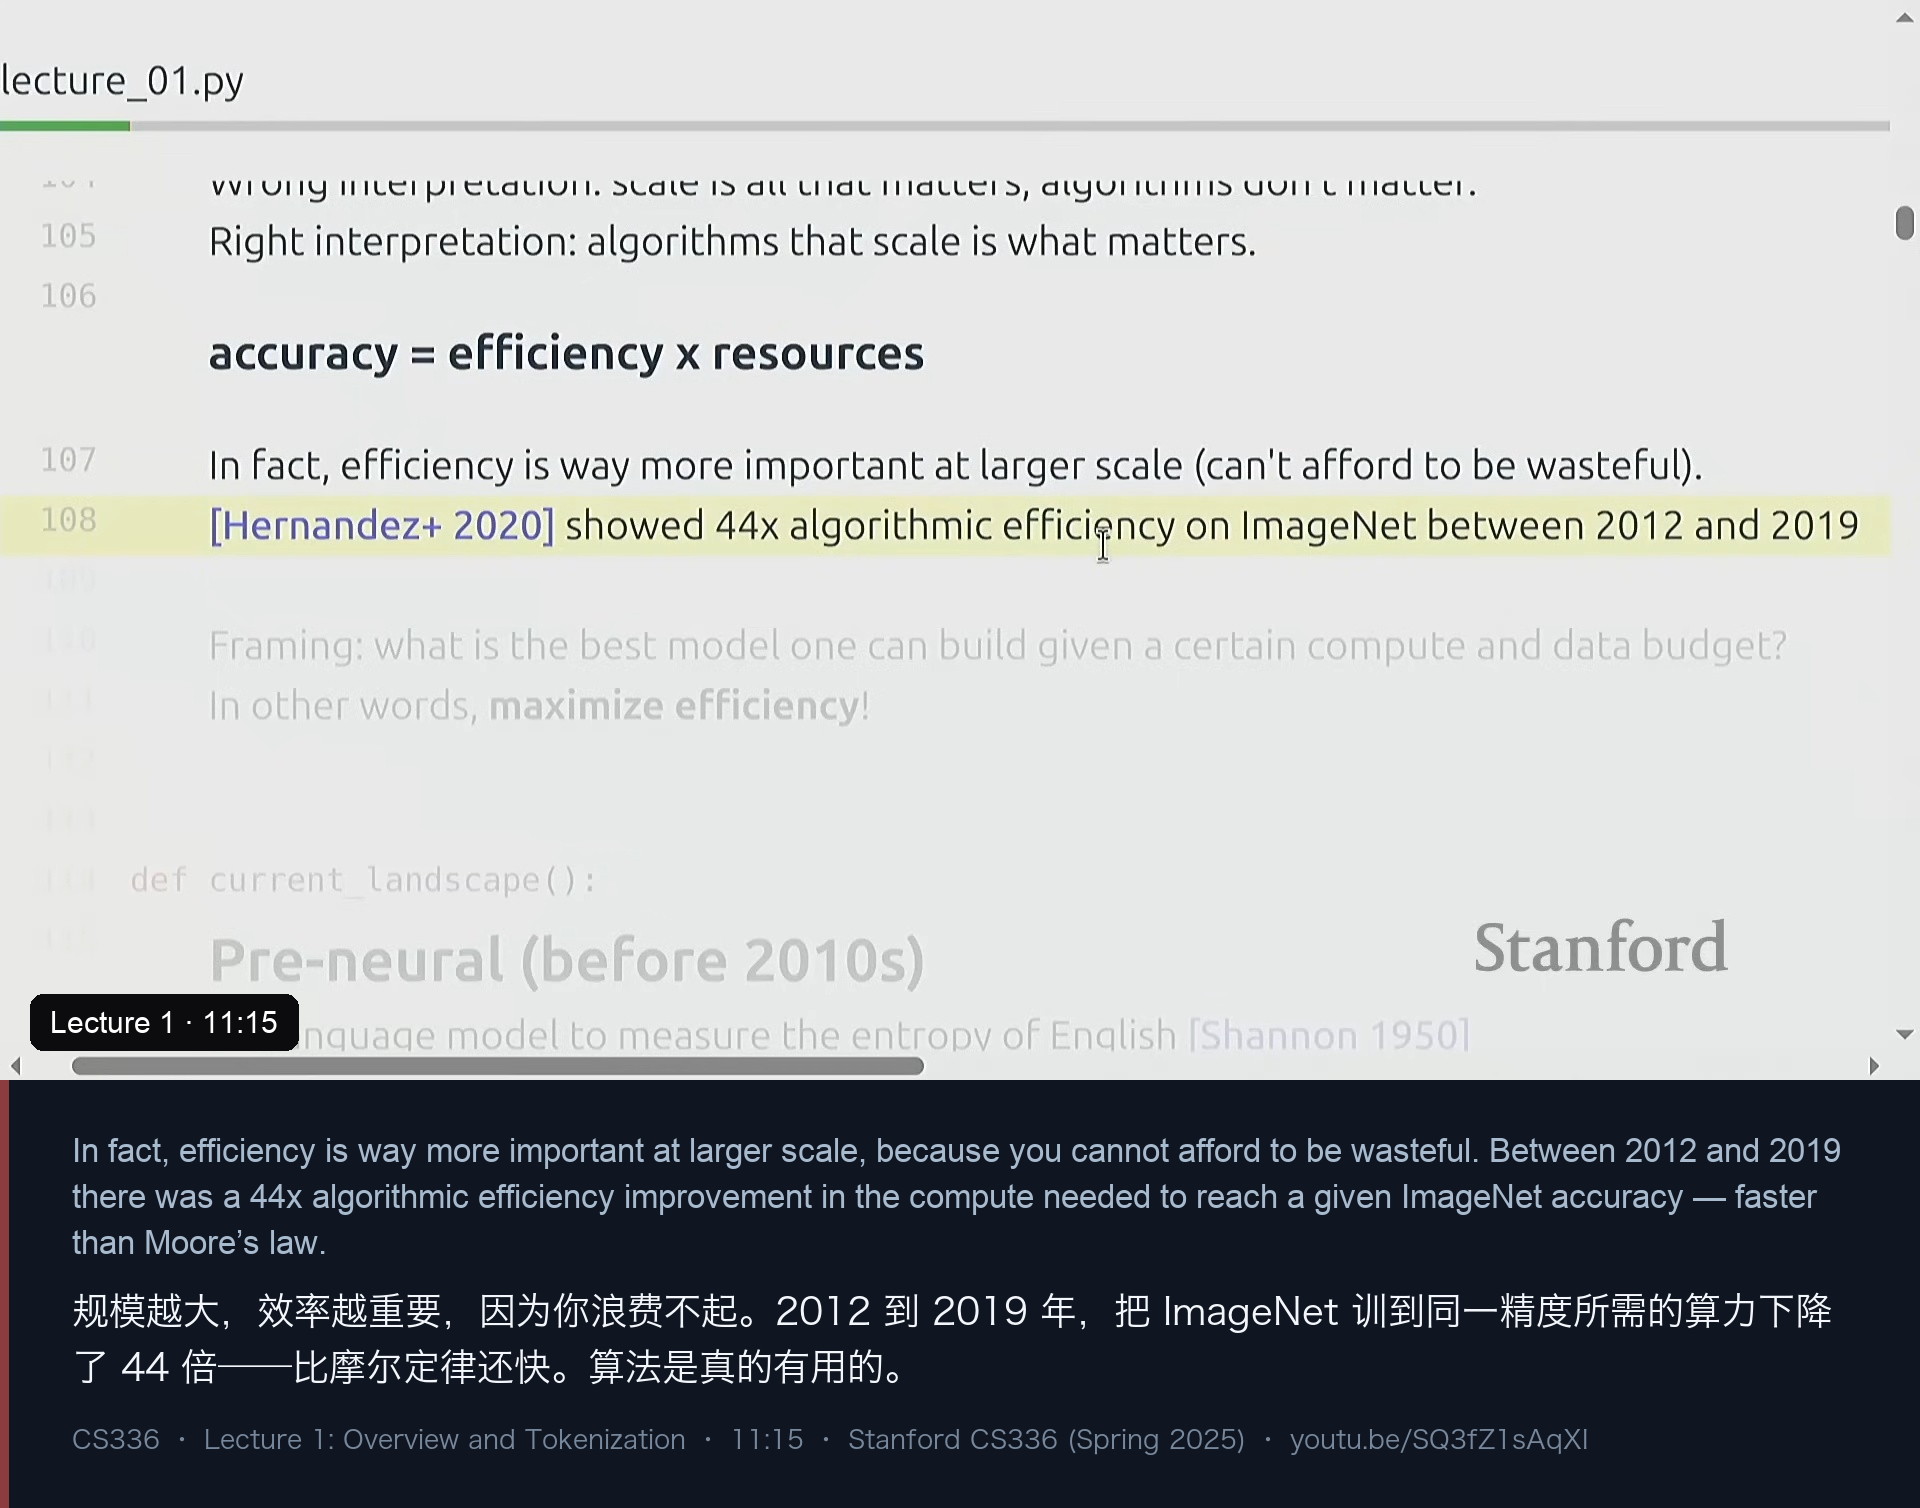
于是整门课的心态被压缩成一个问题:给定固定的算力与数据预算,你能训出的最好模型是什么? 这个问题在任何规模上都成立;作为研究者,我们的工作是提高算法的效率。
Percy 同时很坦诚地说了这门课能教什么、不能教什么:机制(能教)、效率与规模化的思维方式(能教)、以及“哪些数据与模型决策会带来好模型”的直觉(只能部分教,因为在小规模上成立的结论未必在大规模上成立)——“两个半总比三个差一点,但也算物有所值”。
还有个很动人的细节:他提到提出 SwiGLU 的论文,结论部分诚实地写着“我们无法解释,只能说是神恩(divine benevolence)”。这就是我们目前理解程度的真实写照:有些设计就是实验赢了,然后被沿用下来。
三、历史坐标:从 Shannon 到 Transformer
在进入技术细节之前,讲座用几分钟把语言模型的历史捋了一遍——这也是理解“为什么今天的做法长这样”的必要背景。
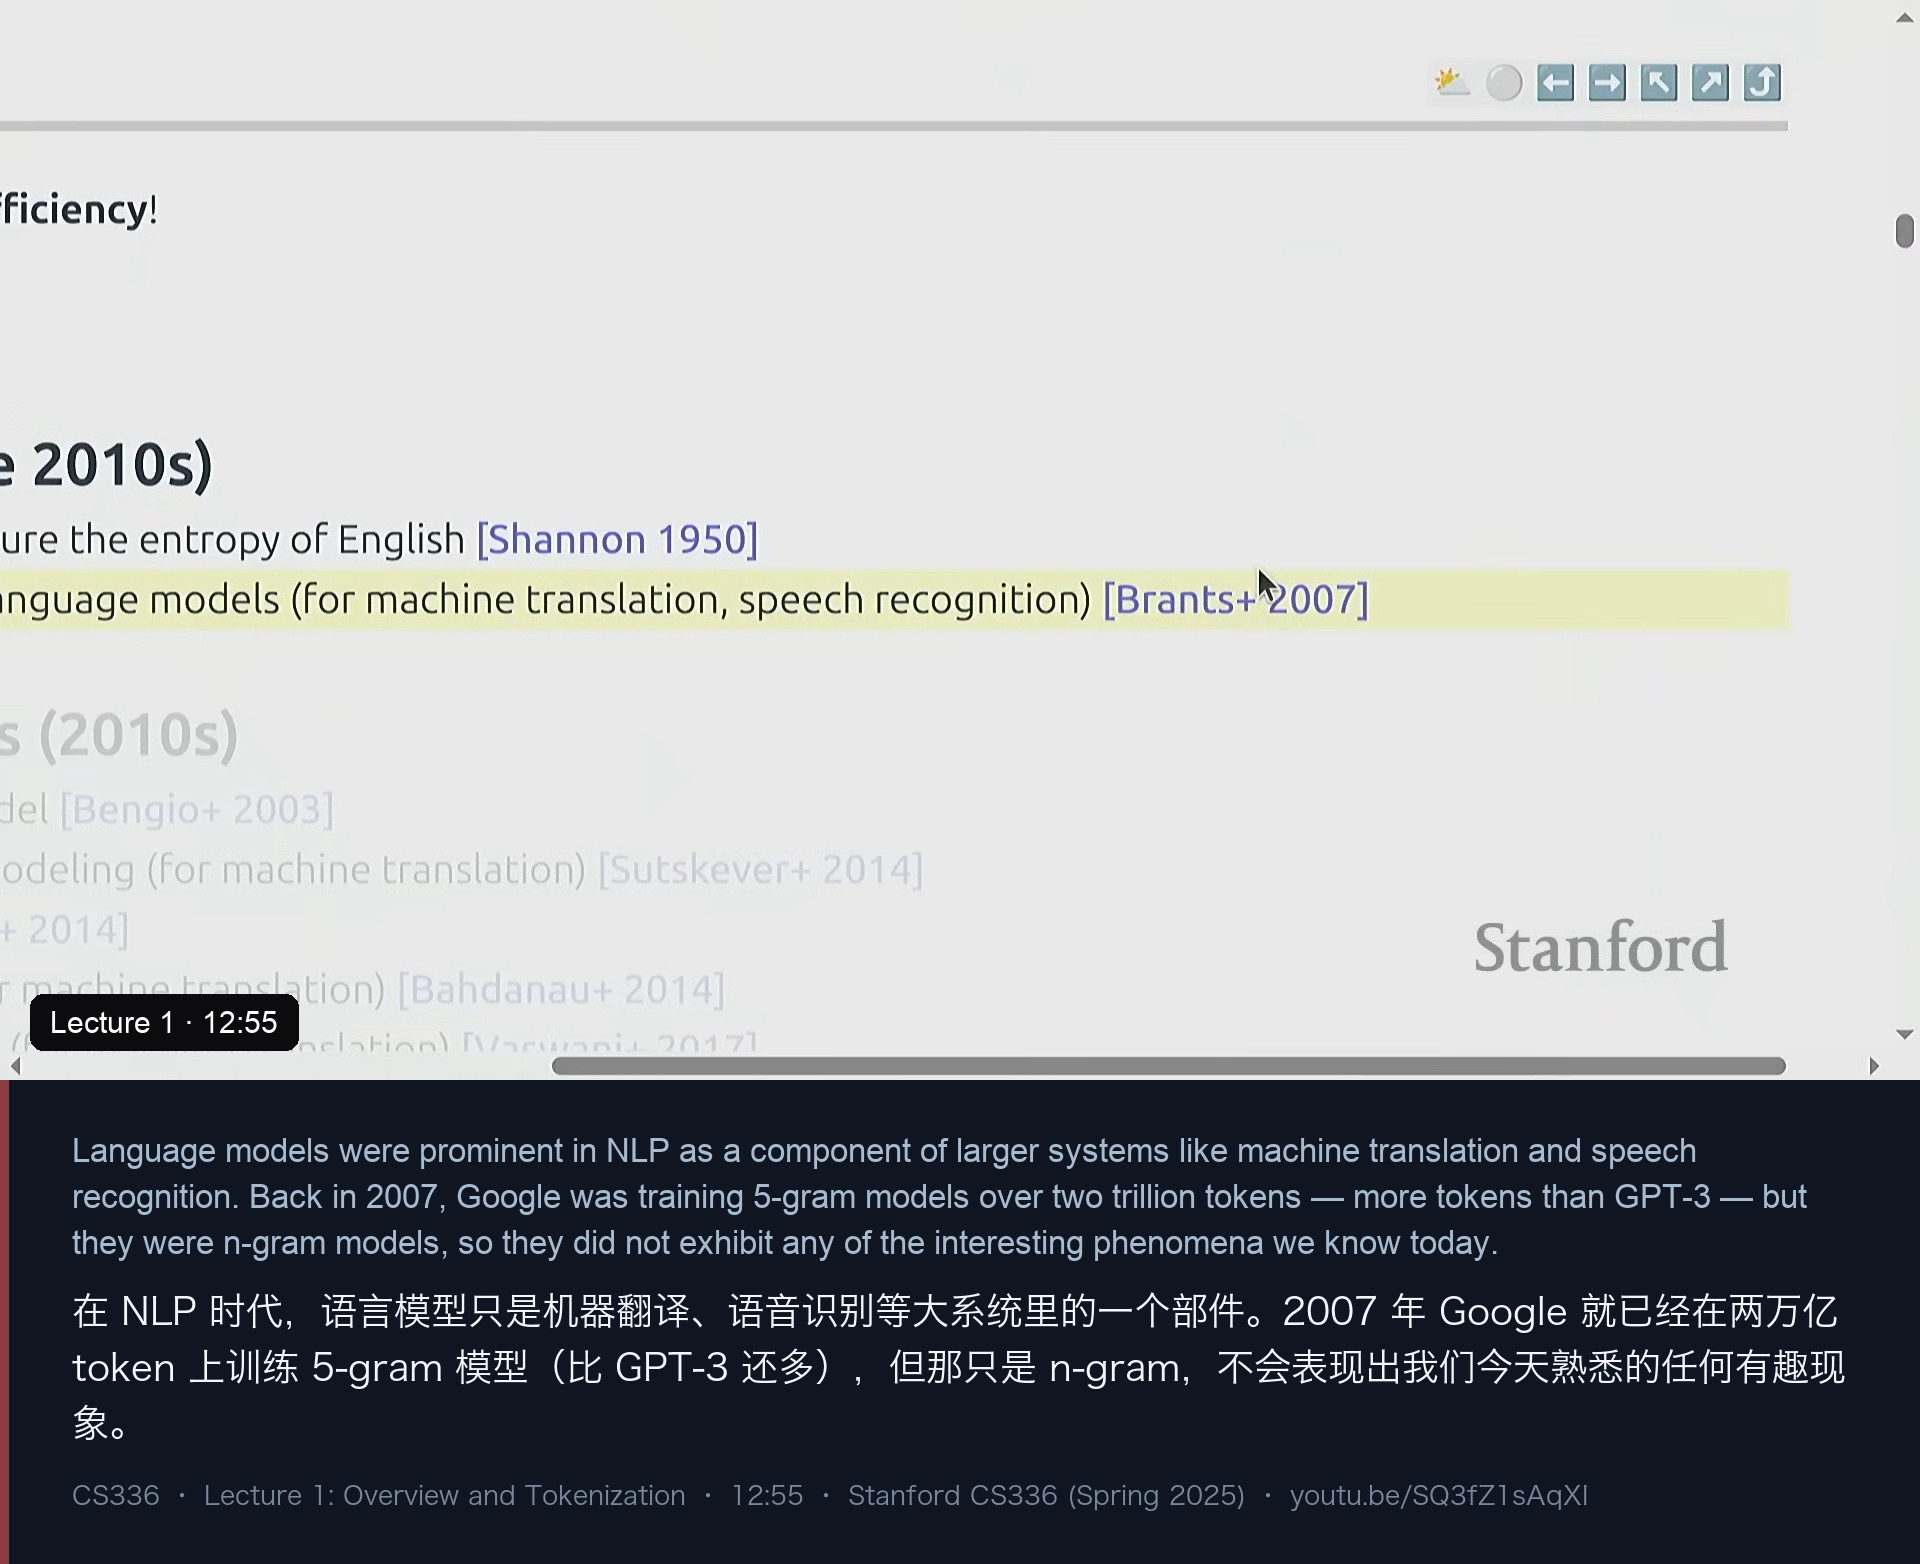
- 最早可以追到 Shannon 用语言模型估计英文的熵;
- 在 NLP 时代,语言模型不是主角,而是机器翻译、语音识别等大系统里的一个组件——那时候做机器翻译的人会拿一个“语言模型 + 一个翻译模型”去打分;
- 一个今天很少被提及的事实:2007 年 Google 就已经在两万亿 token 上训练 5-gram 模型,比 GPT-3 用的 token 还多。但那只是 n-gram,不会表现出我们今天熟悉的任何“涌现”现象——token 多并不等于智能。
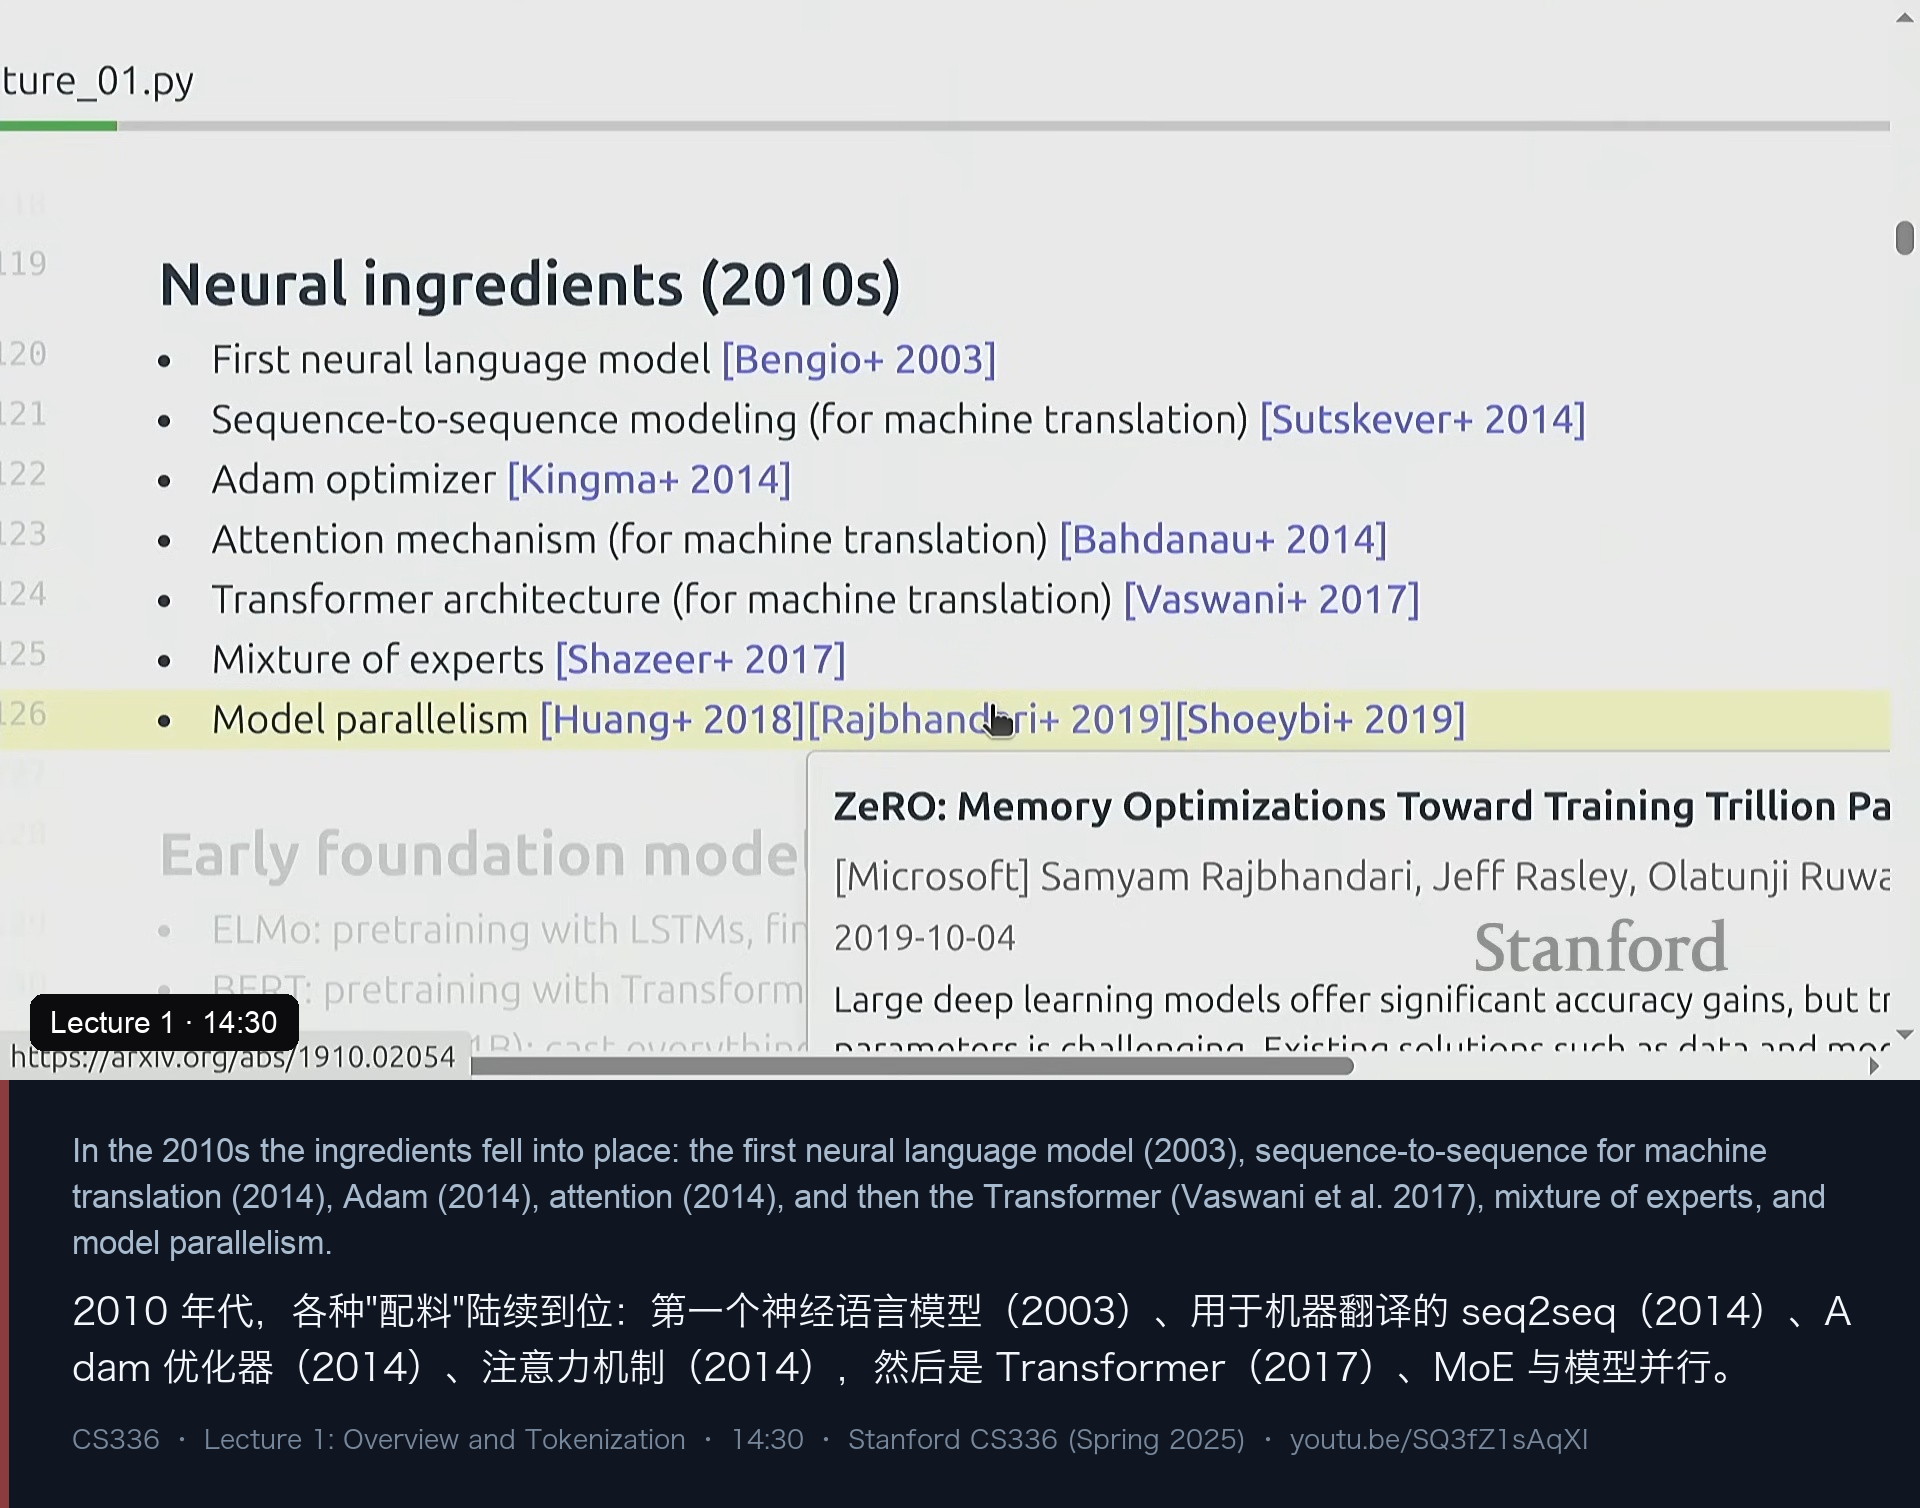
2010 年代是“配料齐活”的十年:第一个神经语言模型(Bengio 等,2003)、seq2seq(Sutskever 等,2014)、Adam 优化器(Kingma 等,2014)、为机器翻译提出的注意力机制(Bahdanau 等,2014),然后是 2017 年的 Transformer、MoE、以及 2018–2019 年围绕模型并行的一系列系统工作。到 2020 年前后,所有组件其实都已就位。
同期还有另一条线索:ELMo、BERT、T5 这些“基础模型”(foundation models)证明了一个模型可以在大量文本上预训练、再适配到各种下游任务。而真正把这一切推向下一代的,Percy 认为是 OpenAI 的工程能力与把缩放定律当成信念去执行的心态——GPT-2、GPT-3 由此而来。
再往后是开源这条线:GPT-3 之后的 EleutherAI、Meta、Bloom、DeepSeek、AI2……他特意提醒“开放”其实有很多层次:闭源(GPT-4)→ 开权重(有权重、有架构、没有数据细节)→ 真正开源(权重、数据、论文都尽量交代清楚)。但论文永远写不下所有东西——“想学会构建它,没有别的办法,只能自己动手”。
四、这门课的地图:从数据到对齐的完整流水线
时间来到第 27 分钟,讲座进入正题:这门课到底包含什么。一句话概括就是——
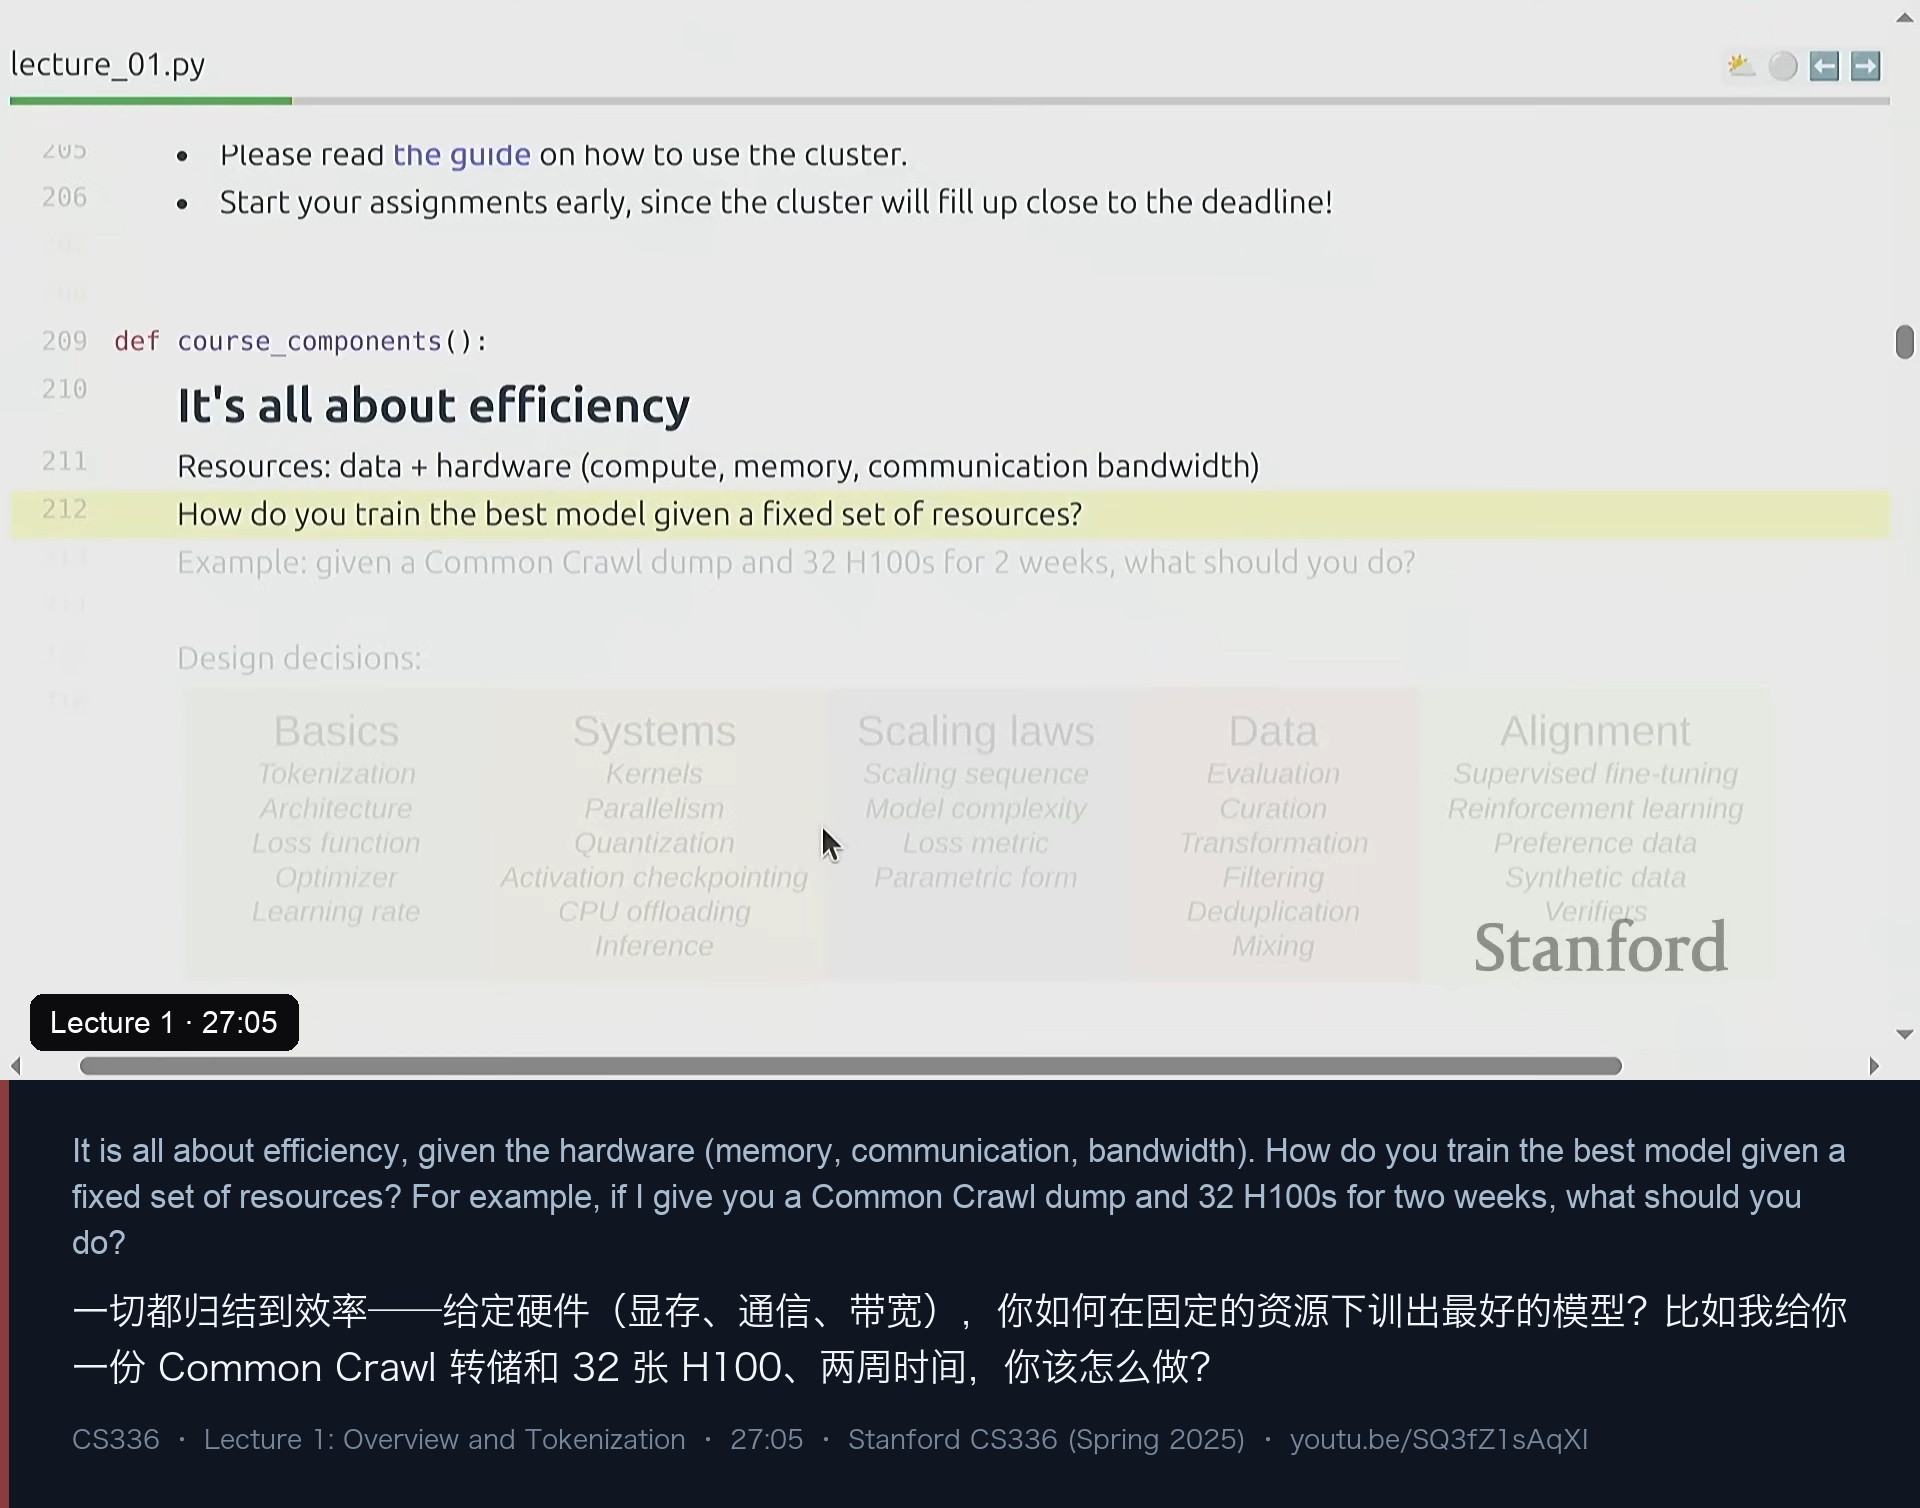
“一切都归结到效率”,而资源 = 数据 + 硬件(算力、显存、通信带宽)。课程按五个模块展开:Basics / Systems / Scaling laws / Data / Alignment。
而把模块串起来的,是一张从零构建语言模型的完整流水线:
文本/数据 → 分词(tokenize)→ 模型架构 → 训练(train)→ 解码/推理(decode)→ 对齐(alignment)→ 评估(evaluation)。下面按这条流水线,把第一讲里“预告”的每一个环节记下来——它们各自是后面每一讲的主题。
4.1 分词(今天的主角,后面详述)
模型只能处理整数序列,所以第一步必须把字符串变成 token id。课程用一个交互式网站演示了现有分词器的行为,细节见本文第五节。
4.2 架构:原始 Transformer 与它的一堆改良
起点是 2017 年的原始 Transformer——它几乎是所有前沿模型的骨架(注意力 + MLP + 归一化)。但 Percy 强调,这七八年间累积了一堆“单个看起来不大、加起来差别很大”的改动:
- 非线性激活换成 SwiGLU;
- 位置编码从学习式/正弦式换成 RoPE(旋转位置编码);
- 归一化从 LayerNorm 换成更简单的 RMSNorm,并且归一化的位置也变了(pre-norm);
- MLP 从稠密结构换成 MoE(混合专家);
- 注意力本身也有大量变体:滑窗注意力、线性注意力,目标是打破注意力的二次方复杂度;还有把 KV 降维的 GQA、MLA;
- 以及最大胆的一类:完全不用注意力的替代架构(状态空间模型、Hyena),或者把它们与 Transformer 混合成 hybrid。
4.3 训练:细节决定一个数量级
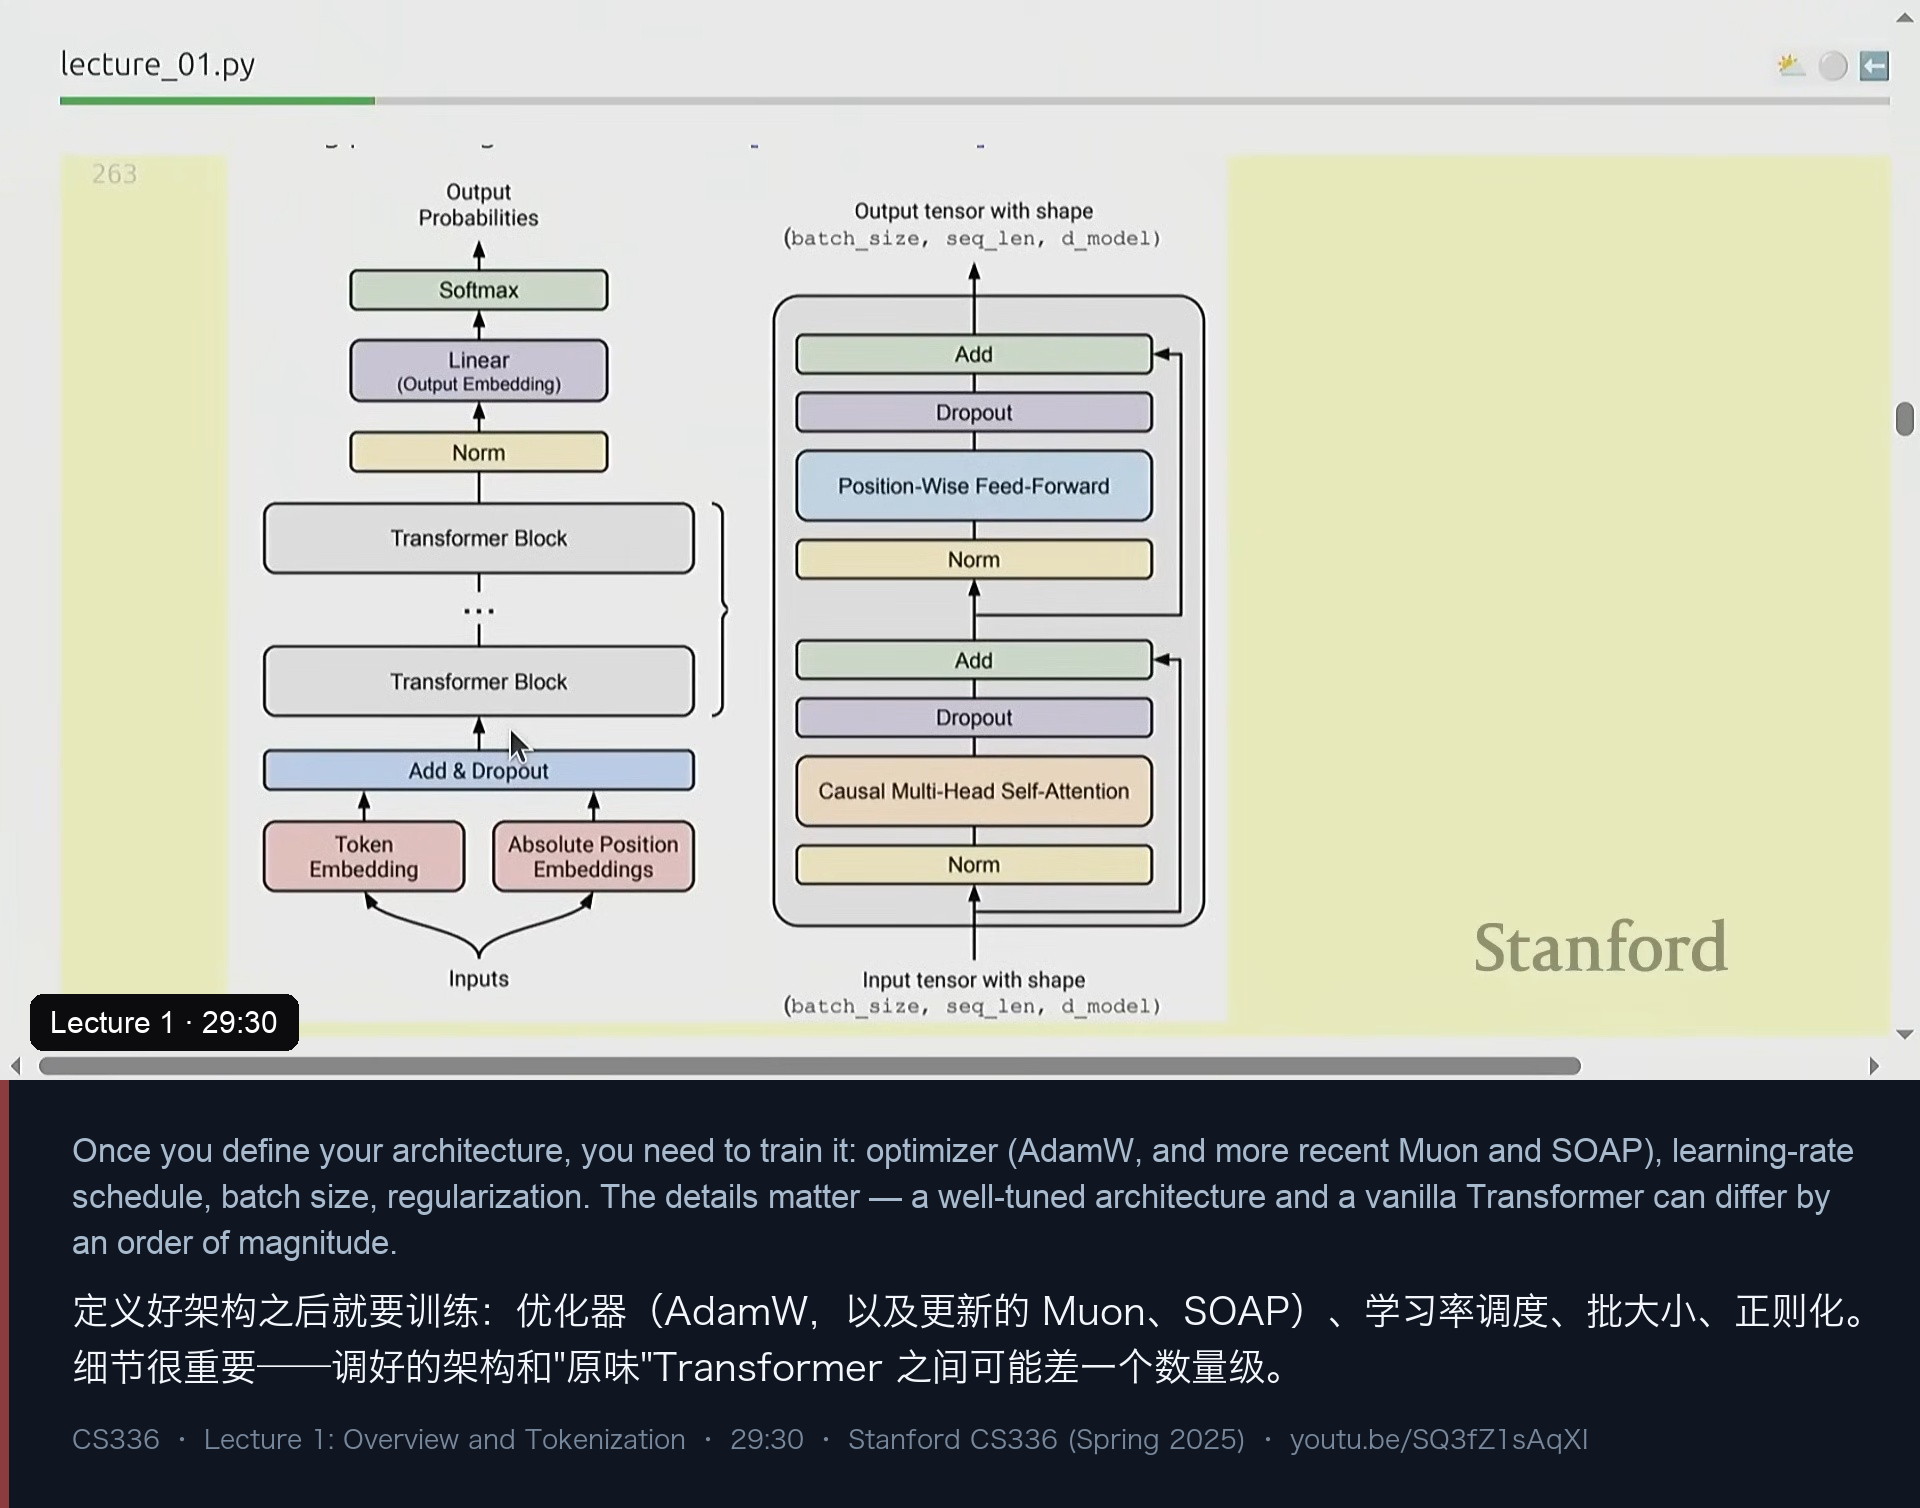
定义好架构之后是训练。设计决策包括:优化器(AdamW 仍是主流,也有 Muon、SOAP 这类新工作)、学习率调度、批大小、是否正则化……他给出一个很有分量的判断:调好的架构与“原味”Transformer 之间,性能可能差一个数量级——这门课里“细节很重要”。
4.4 系统:kernel、并行与推理
系统部分回答“如何把硬件榨干”,包含三个组件:
- Kernels:先理解 GPU 长什么样。你可以把它想成一个巨型仓库(显存)配一个工厂(计算单元)——瓶颈往往不是算,而是数据搬运。于是有了融合(fusion)、分块(tiling)这些技巧,课程用 Triton 来写 kernel。
- 并行:从 8 张卡到上万张卡,GPU 之间通过 NVLink/NVSwitch 互联,但 GPU 间的数据搬运更慢,所以要把参数、激活、梯度合理地切开放到不同卡上——数据并行、张量并行等。
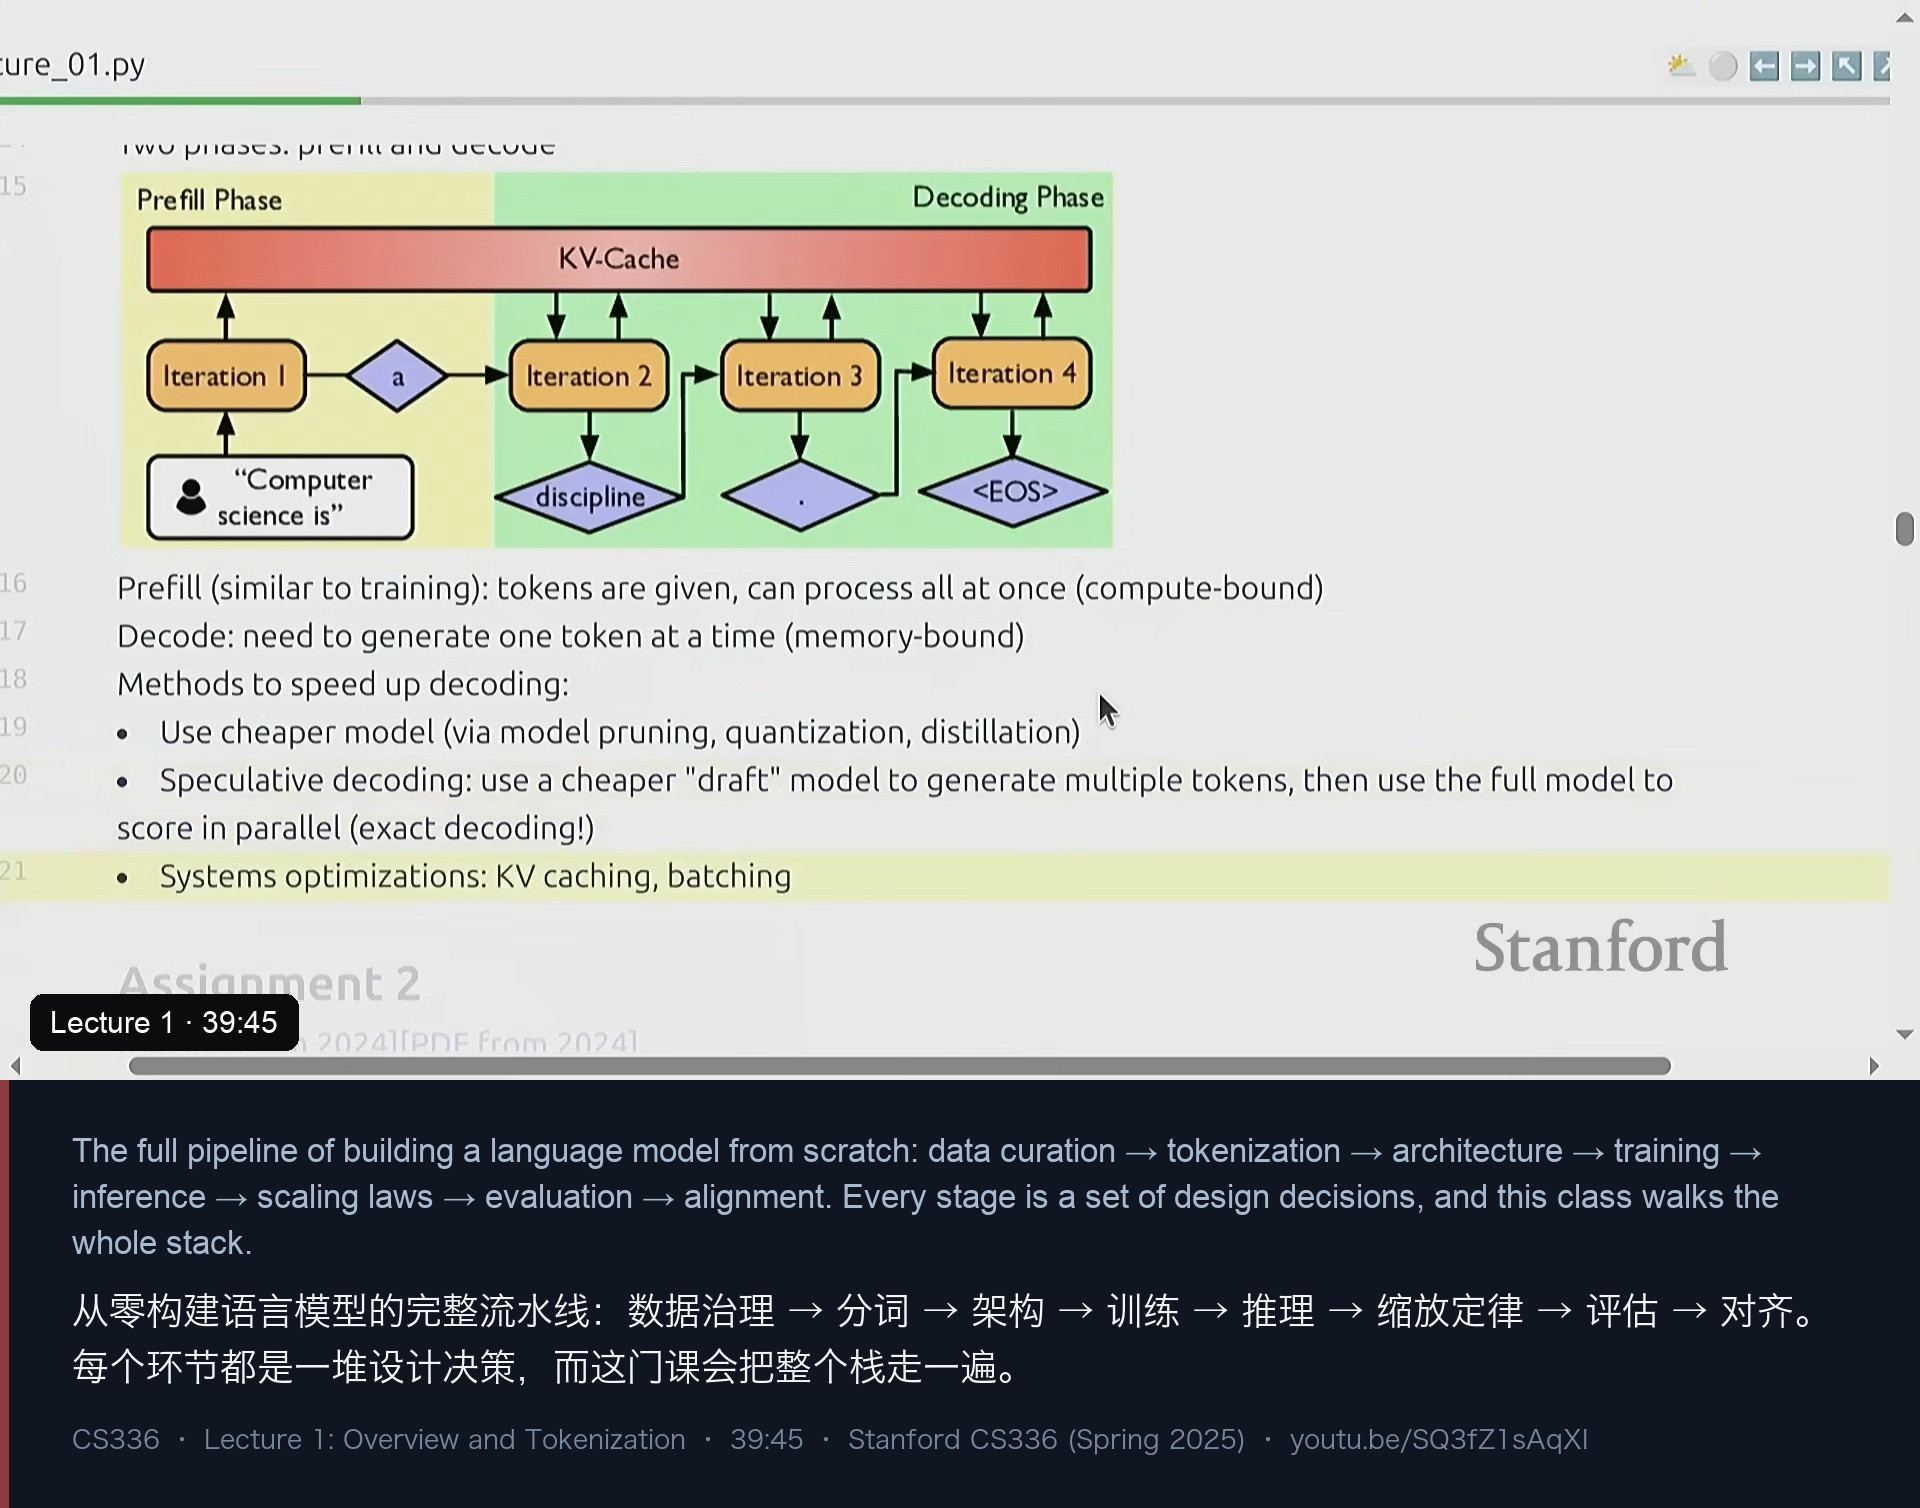
- 推理:去年这门课没有讲推理,今年补上了。原因是推理成本正在超过训练成本:训练再贵也是一次性的,而推理成本随每一次使用线性增长。
推理分两个阶段:prefill 一次性拿到整个 prompt,天然并行、计算受限,和训练时很像;decode 要一个一个自回归地生成 token,访存受限、很难把 GPU 打满——这正是推理难的地方。加速手段有三类:用更便宜的模型、投机解码(speculative decoding,用便宜模型先“探路”生成多个 token,再让大模型并行打分接受)、以及 KV cache 等系统优化。
4.5 缩放定律:给定算力预算,怎么配模型和 token
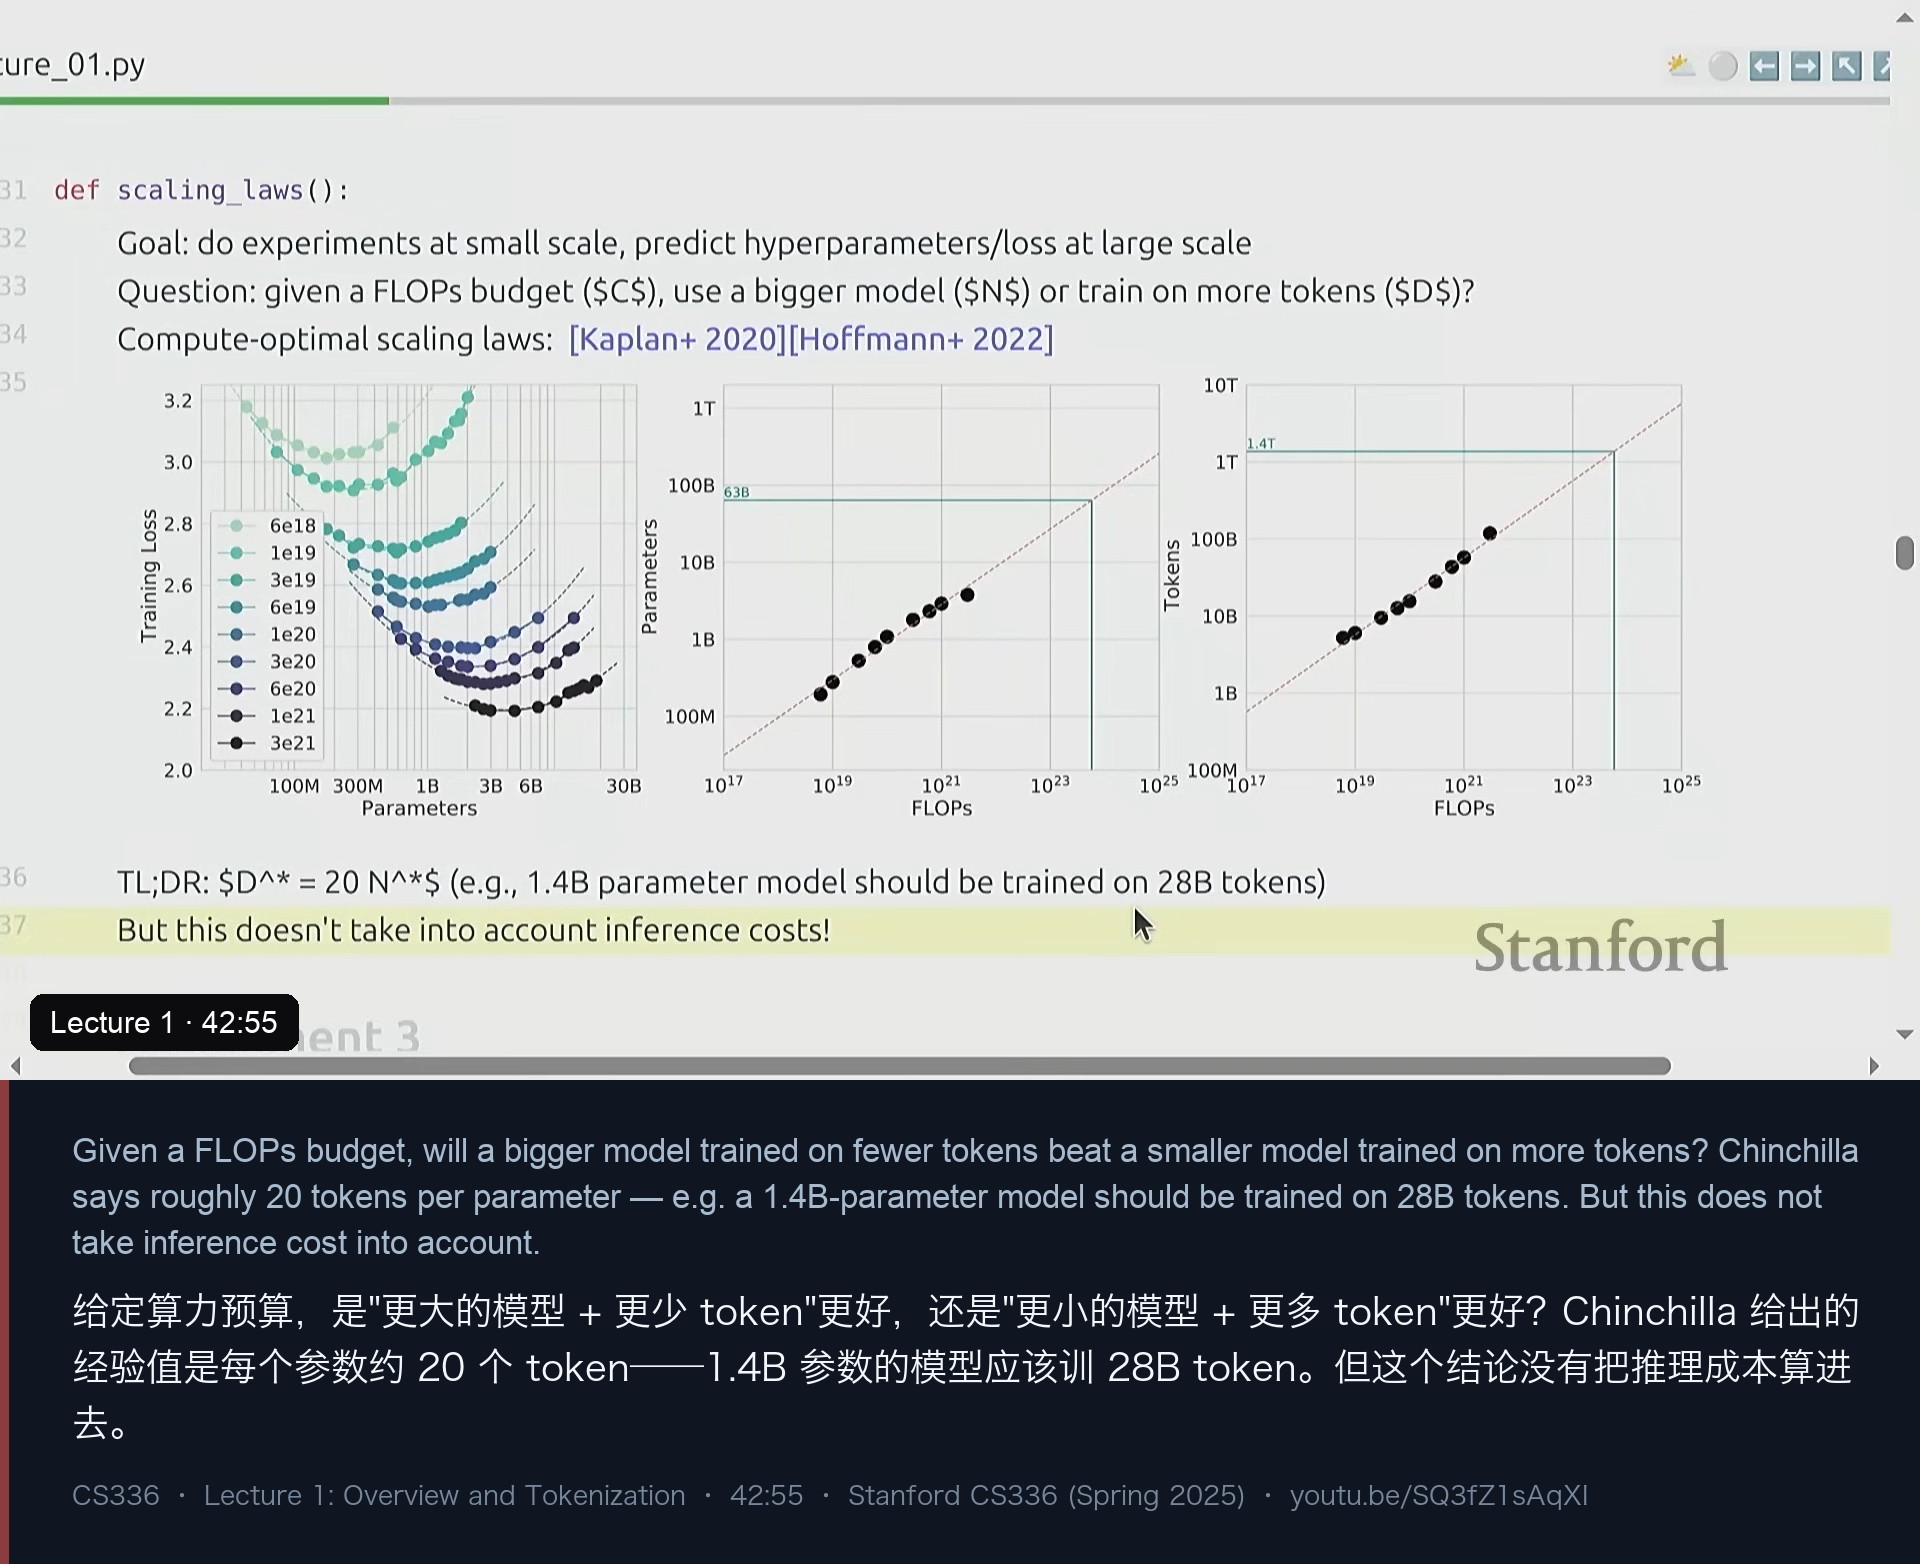
核心问题是个选择题:给定 FLOPs 预算,是“大模型 + 少 token”好,还是“小模型 + 多 token”好? Chinchilla 的答案是大约每个参数配 20 个 token(例如 1.4B 参数的模型应该训 28B token)。Percy 也提醒了它的局限:这个结论没有考虑推理成本——如果你要长期服务这个模型,通常会更偏向“小模型 + 多 token”。
顺着这个问题,Assignment 3 会给大家一个“训练 API”,让你在小规模上做实验、外推超参,然后在给定 FLOPs 预算下训出最好的模型。
4.6 评估:你怎么知道模型好不好
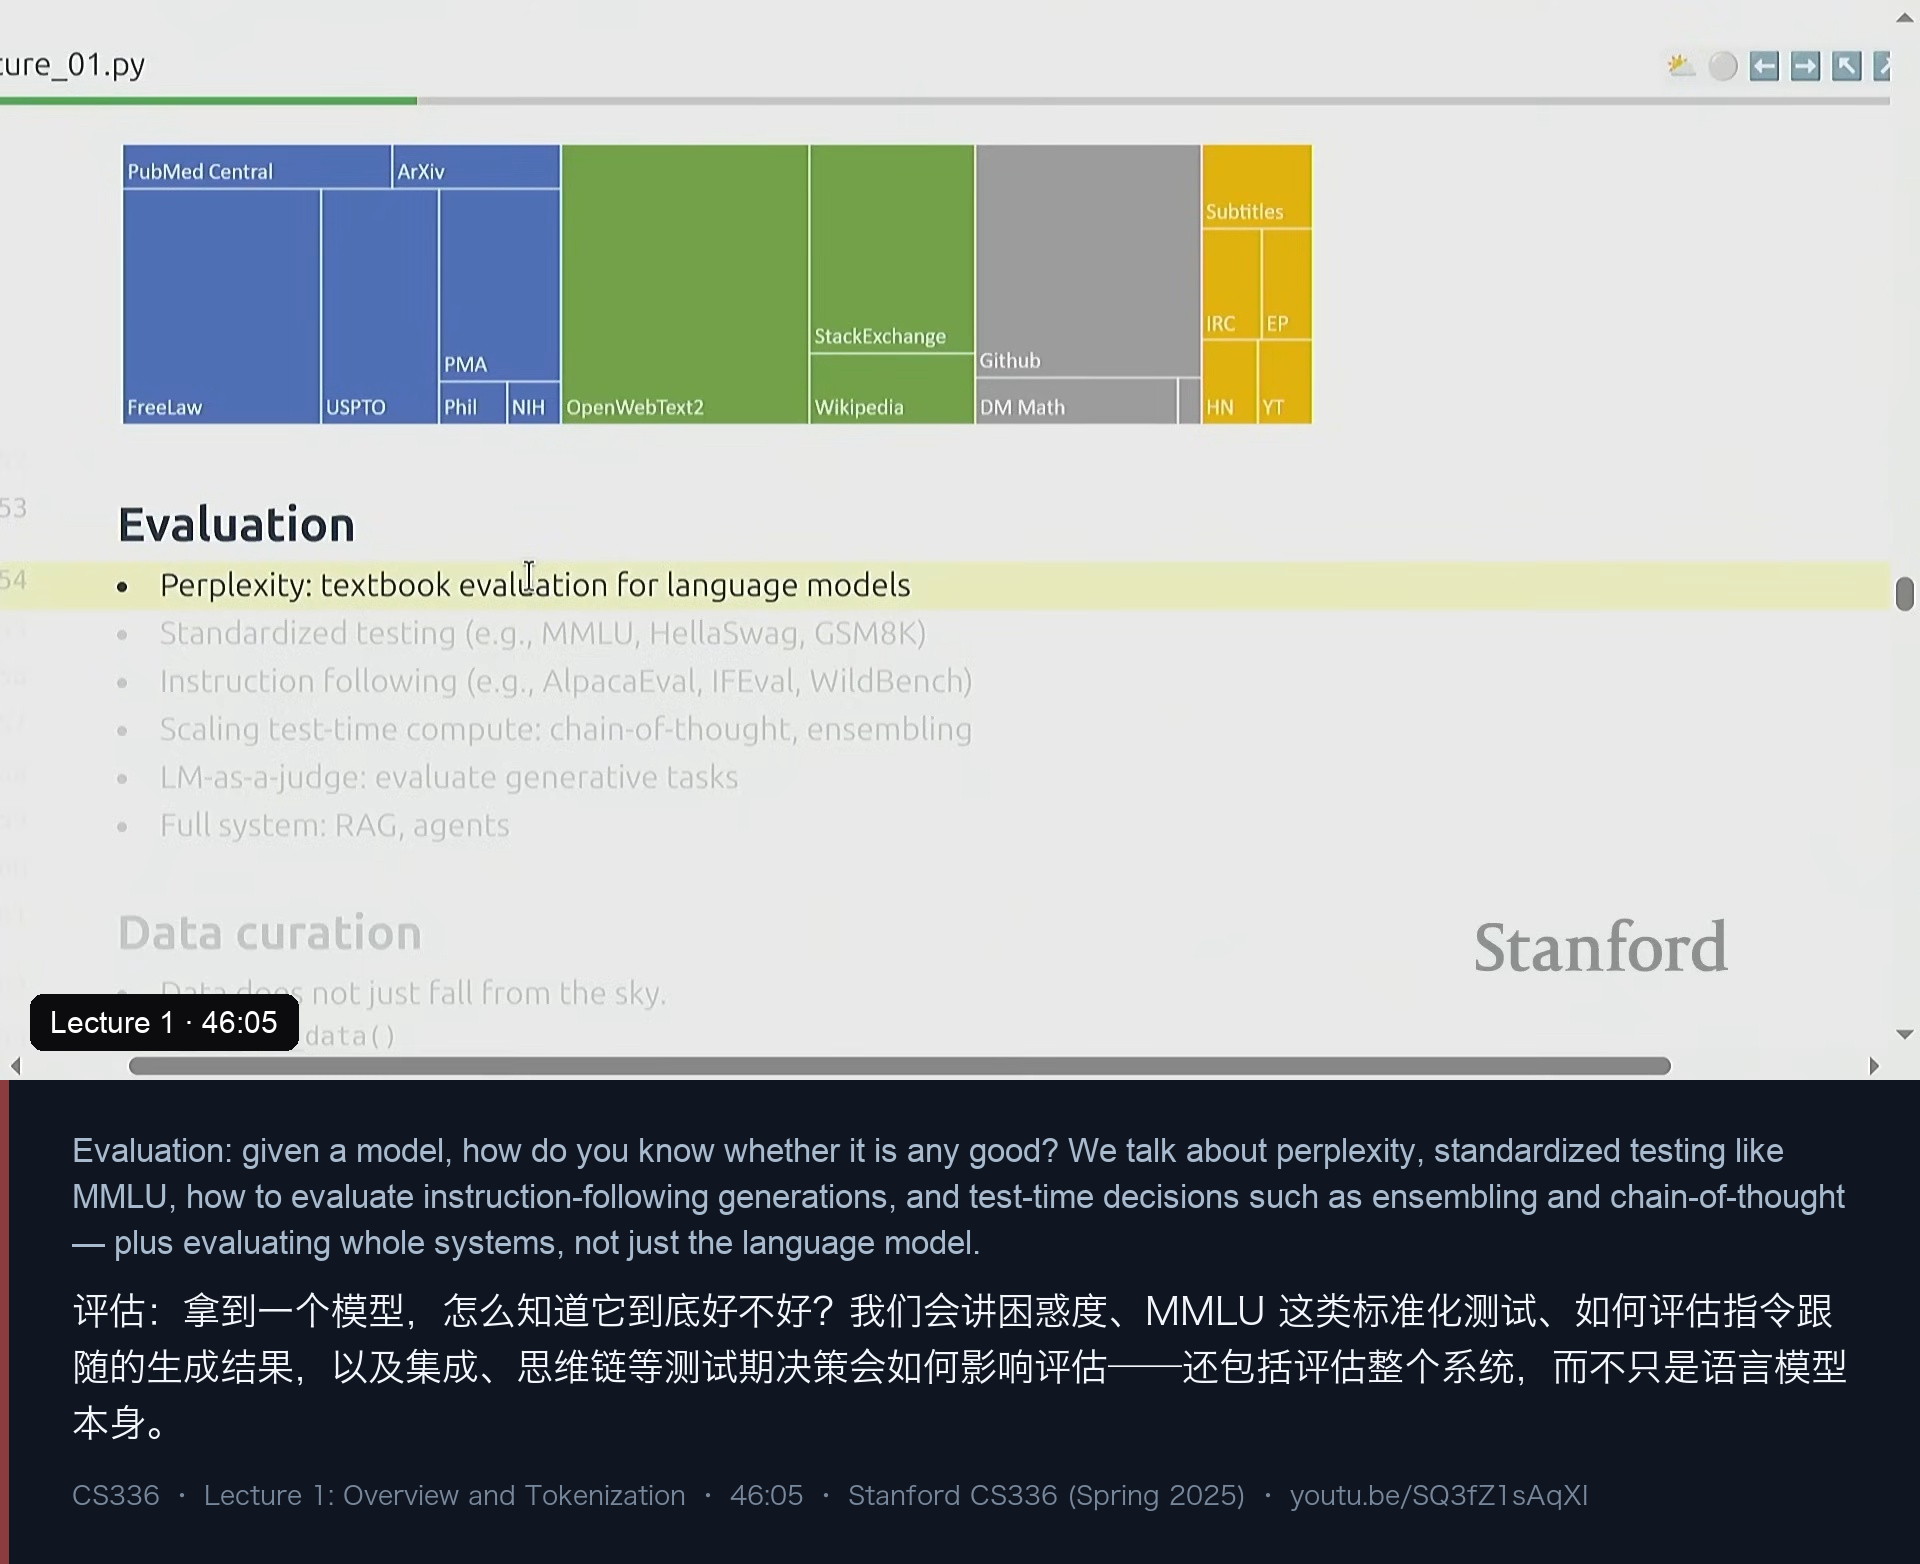
评估这一讲会覆盖:困惑度(perplexity)、MMLU 这类标准化测试、指令跟随生成的评测方法,以及“测试期决策”(要不要集成、要不要用思维链)对评估结论的影响。还有一个越来越重要的角度:评估整个系统,而不只是评估语言模型本身——因为今天的模型往往被嵌进一个 agent 系统里。
4.7 数据:数据不会从天上掉下来
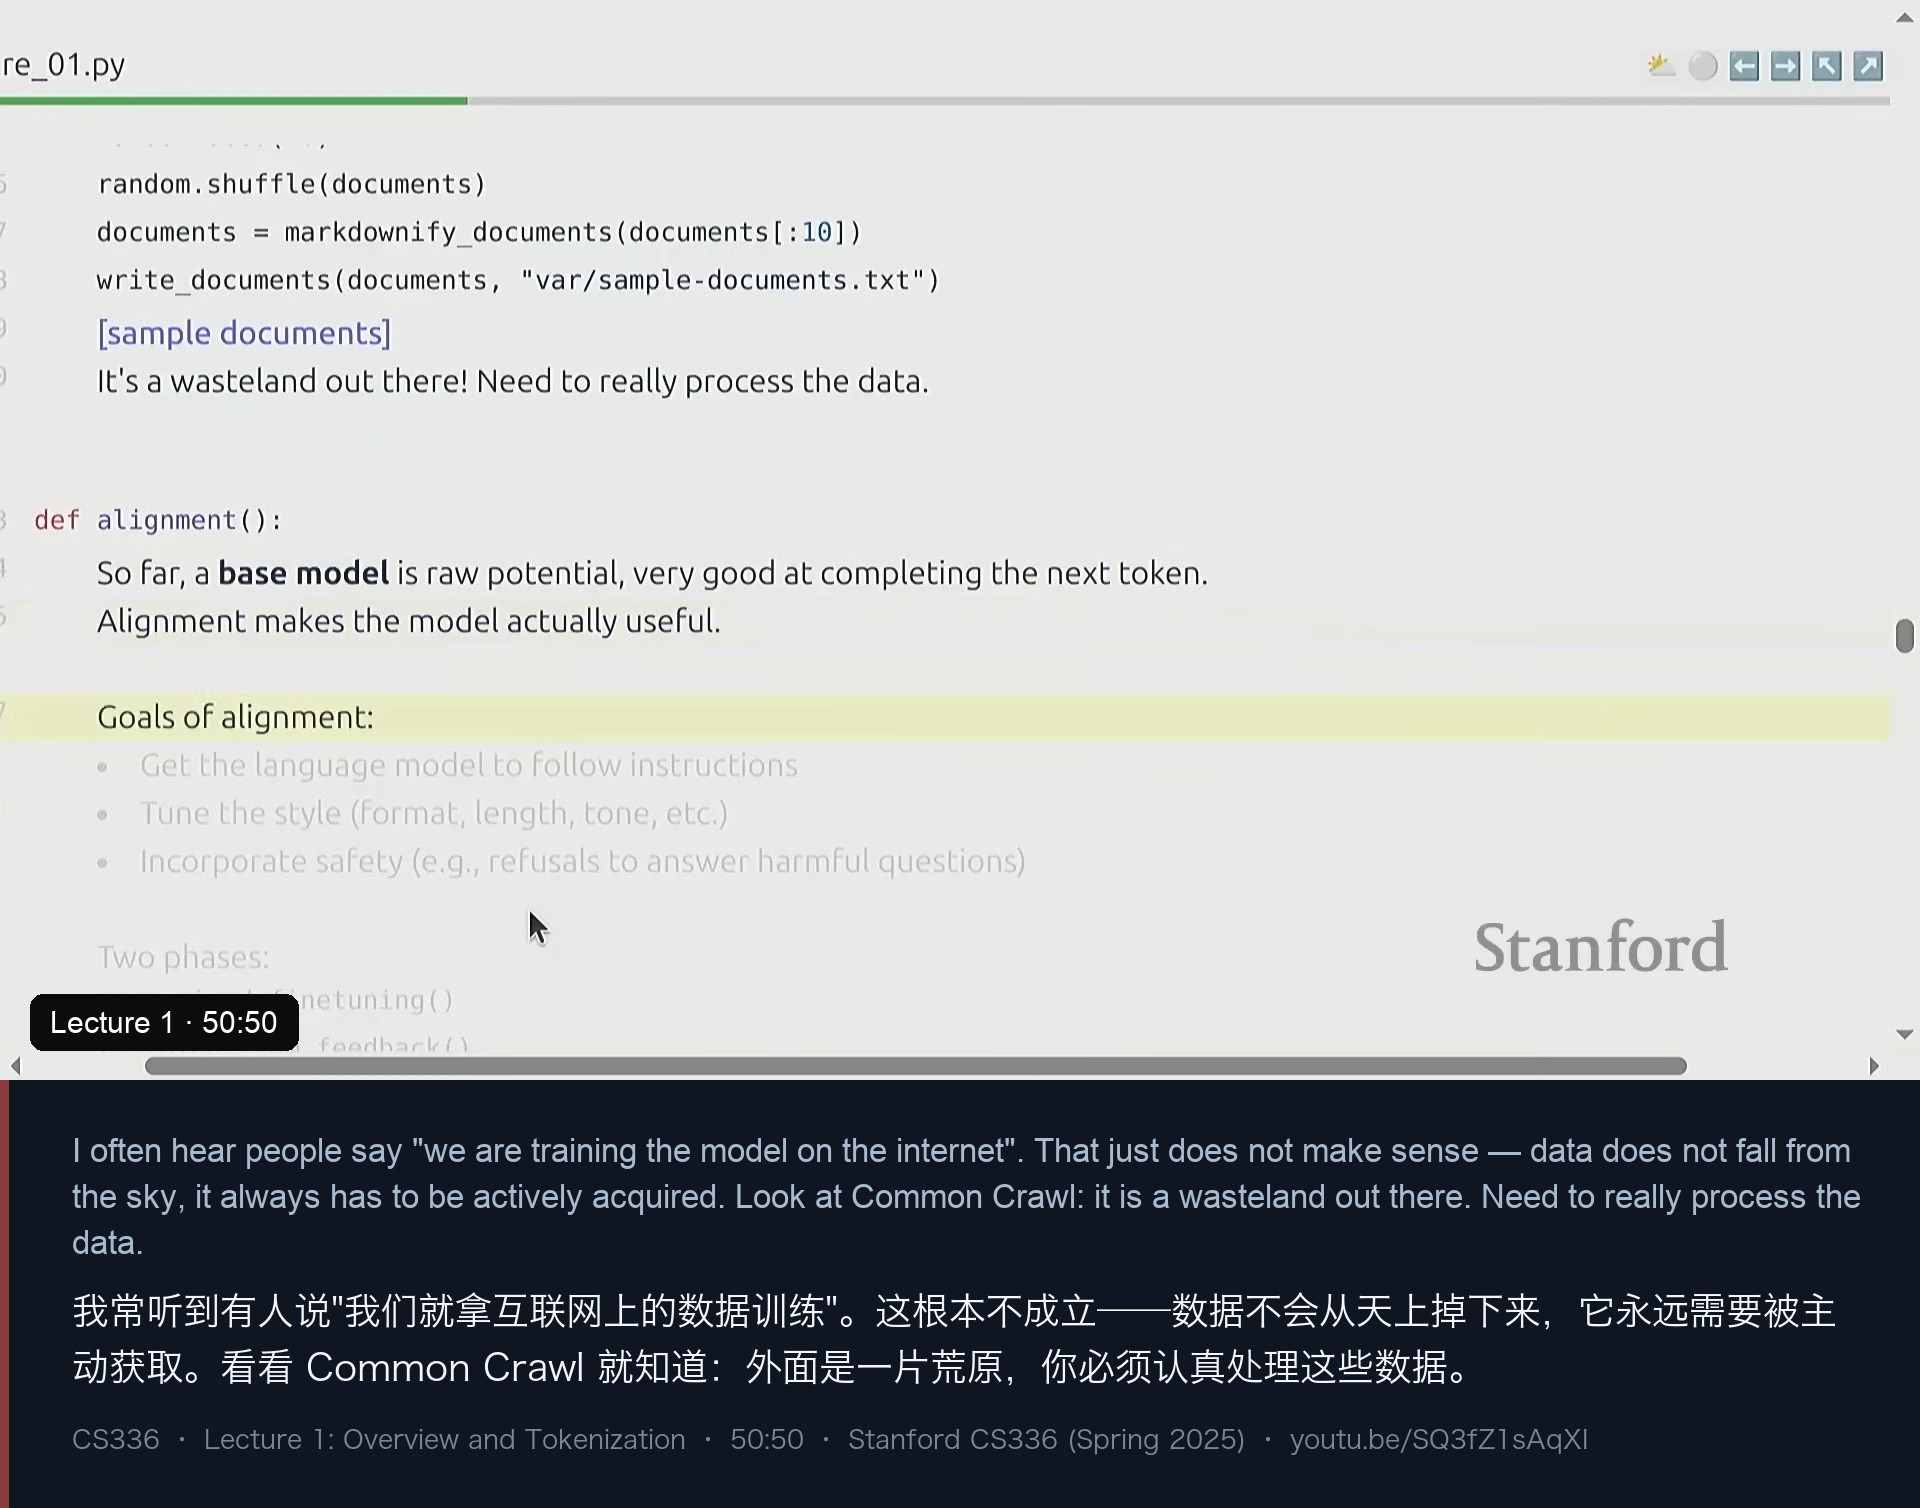
这是他特别想纠正的一个误区:很多人说“我们拿互联网的数据训练”,好像数据是水管里流出来的一样。“数据永远需要被主动获取”。而且你抓下来的东西根本就不是文本——是 HTML、PDF、代码目录,需要有一个显式的处理流程把它变成文本,而这个过程是有损的(如何在丢掉标签的同时保住内容与结构,本身就是研究问题)。
再加上过滤(既要高质量,也要去除有害内容,通常要训分类器)、去重、配比(mixing),以及法律层面的问题。他还提了一句现实:今天很多前沿模型是要花钱买数据的,因为公开可得的数据对前沿性能来说已经不够用了。
4.8 对齐:把“有潜力”变成“有用”
数据、系统、架构都做好之后,你得到的是一个基座模型(base model)——它有大量原始潜力,但只会“接下一个 token”。对齐就是把它变得有用的过程,通常包含两件事:
- 指令跟随:会续写不等于会听话,你说“用一句话概括”,它会顺着这句话往下编,而不是真的去概括;
- 风格与安全:输出该长该短、要不要用列表、是幽默还是严肃;以及能否拒绝有害请求。
对齐一般分两阶段:监督微调(SFT)——收集“用户/助手”的问答对做监督学习,基座模型潜力够好时,甚至一千条样本就能激发出指令跟随能力;然后是从反馈中学习——用偏好数据(模型生成多个回答,人来比较哪个更好)或 verifier(数学、代码这类有形式化验证器的领域,或者训练一个模型当裁判)。算法上从 PPO 到更简单的 DPO,再到本课会实现的 GRPO(DeepSeek 提出,去掉了价值函数,更简单高效)。
五、分词:为什么最后都收敛到 BPE
第 60 分钟,讲座进入今天真正的技术主题:分词(tokenization)。
定义很简单:分词就是把原始文本(Unicode 字符串)变成一串整数的过程,每个整数是一个 token;分词器必须能双向工作——encode 把字符串变成 token,decode 再变回来。词表大小(vocabulary size)就是这些整数能取值的个数。
Percy 用 Tiktokenizer 这个网站做演示,并让学生注意几件反直觉的事:
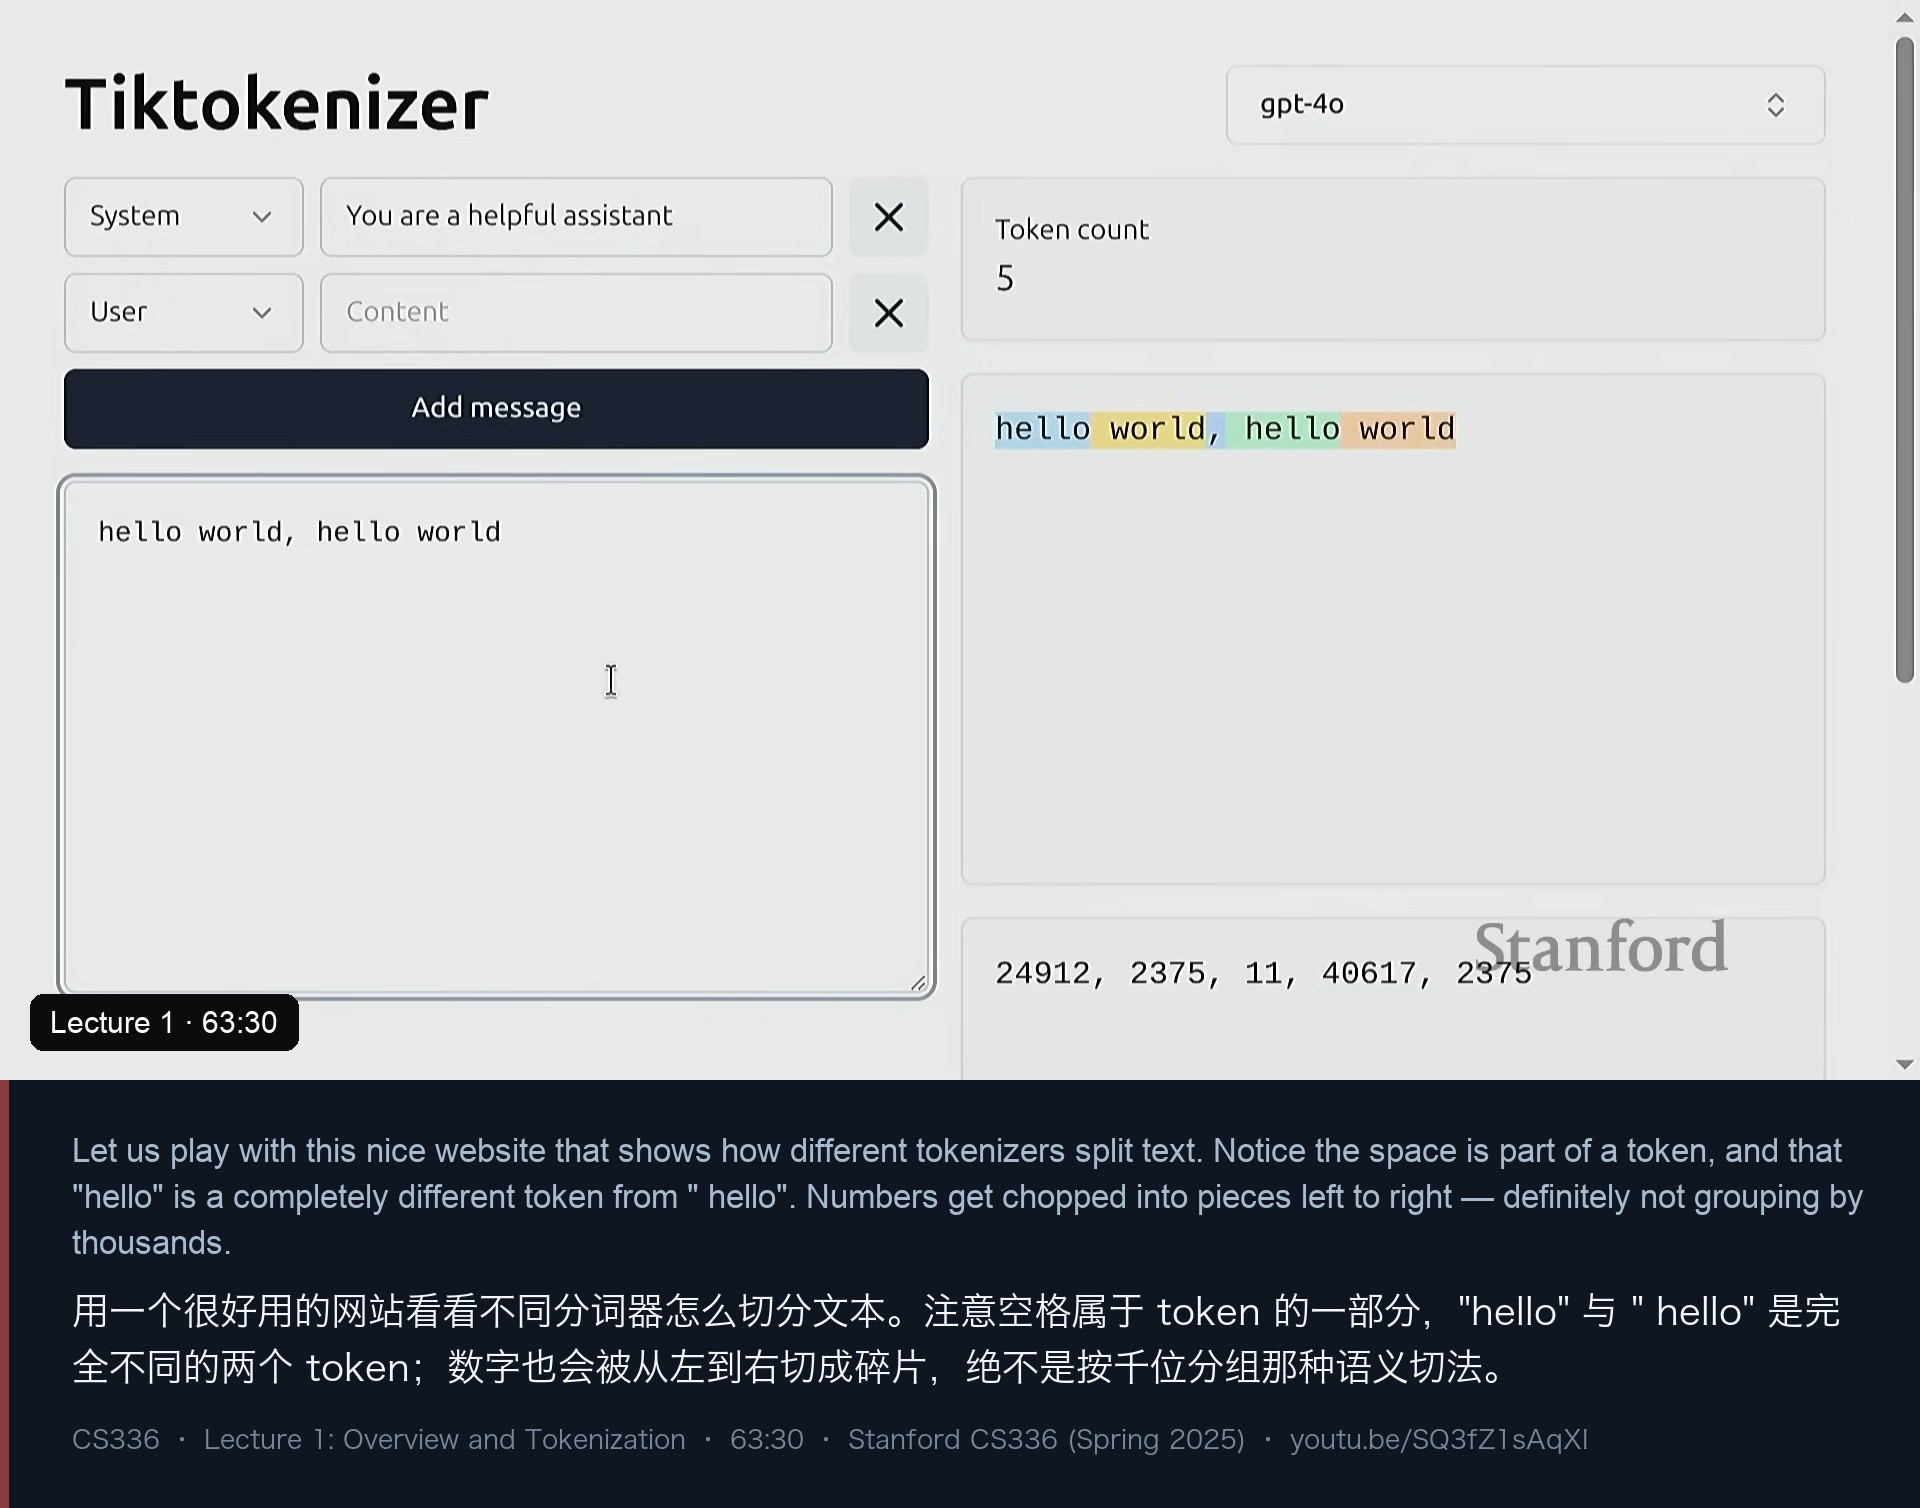
- 空格属于 token 的一部分。与传统 NLP 把空格丢掉不同,分词必须是可逆的,所以一切都得算进去;
- 按惯例(也是算法造成的)空格属于后面的 token,于是
"hello"和" hello"是两个完全不同的 token——这看起来有点别扭,也可能是问题的来源,但事实如此; - 数字会被切成碎片,并且是严格从左到右的,完全不是按千位分组那种语义切法。
5.1 三种“朴素方案”为什么都不行
字符级(character-based):Unicode 字符串是字符序列,每个字符可以转成一个码点(a → 97,🌍 → 127757)。问题是:词表巨大,且给每个字符均匀分配一个词表槽位,等于让极罕见的字符和空格、e 享受同样的预算——这是对词表预算的极大浪费。(它的压缩率约为 1.5 字节/token,因为一个字符可能是多个字节。)
字节级(byte-based):把字符串直接看作 UTF-8 字节序列,词表只有 256 个值,非常优雅。但压缩率是 1.0——每个 token 只代表一个字节,序列会变得极长,而注意力对序列长度是二次方的,“你会过得很惨”。Percy 说他其实很希望字节级能行,因为它最优雅。
词级(word-based):用正则表达式把文本切成片段,每段一个 token——这就是经典 NLP 的做法。但词表是无界的,遇到没见过的词就得给它一个 UNK,这会让困惑度统计变得一团糟。
5.2 BPE:一个 1994 年的压缩算法,统治了今天的语言模型
答案来自一个很老的数据压缩算法:
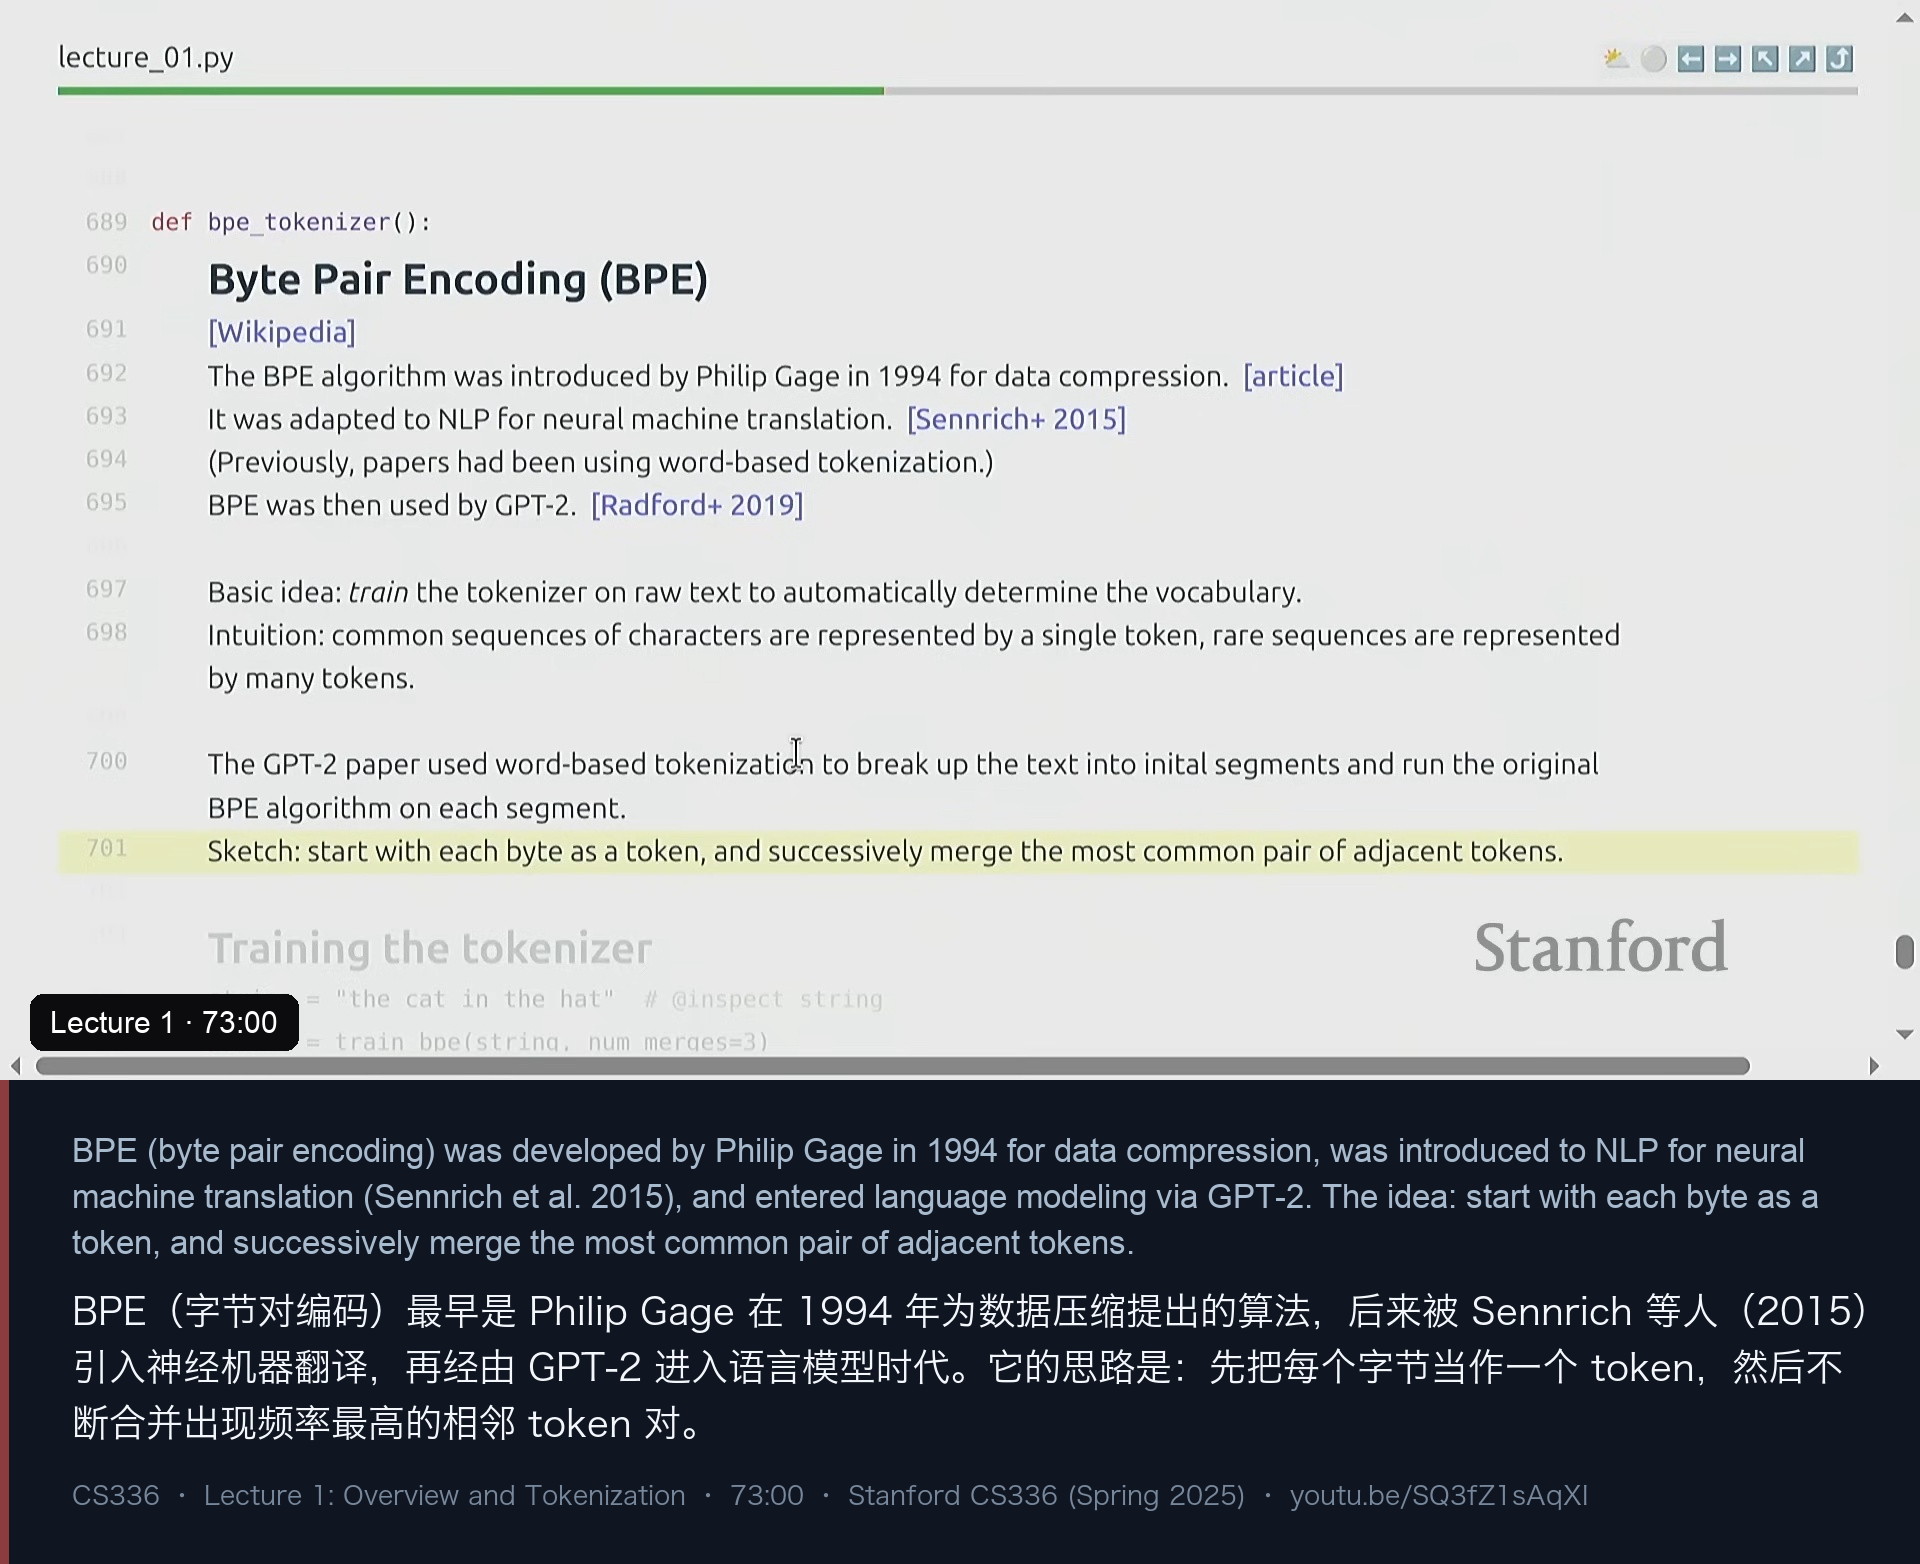
BPE(byte pair encoding)由 Philip Gage 在 1994 年为数据压缩提出;2015 年由 Sennrich 等人引入神经机器翻译(在那之前 NLP 普遍用词级分词,被 UNK 折磨);最后经由 GPT-2 进入语言模型时代。
它的核心思想是:不去预先定义“该怎么切”,而是让分词器在原始文本上自己学出来——高频的多字符序列会被合并成一个 token,罕见序列则保持被拆成多个 token 的状态。
有一个工程细节:GPT-2 的做法是先用正则表达式做 pre-tokenization(把文本切成片段),再在每个片段内部跑 BPE——CS336 的作业也采用这个结构。
算法本身简单到可以在几行代码里写完(Percy 用 cat hat cat 现场演算了一遍):
vocab = {i: bytes([i]) for i in range(256)}   # 初始词表:256 个字节
merges = {}                                    # (int, int) -> int

def train_bpe(text, num_merges):
    ids = list(text.encode('utf-8'))           # 1. 字符串 → 字节序列
    for i in range(num_merges):
        counts = count_adjacent_pairs(ids)     # 2. 统计相邻 token 对的频率
        pair = max(counts, key=counts.get)     # 3. 找出最高频的那一对
        new_id = 256 + i                       # 4. 为它分配一个新的 token id
        ids = merge(ids, pair, new_id)         # 5. 在语料里把所有该对替换掉
        merges[pair] = new_id
    return vocab, merges
用 cat hat cat 走一遍:字节序列里 (116, 104)(也就是 c+a)出现最频繁(两次),于是合并成新 token 256;下一轮最高频的对变成 (256, 101)(ca+t),合并成 257;再下一轮是 (257, 32)(cat+空格),合并成 258。每合并一次,序列就变短一点——这就是“用词表预算换压缩率”的过程。
编码(encode)时要做的事,是按学习到的顺序重放这些合并规则;解码(decode)则把每个 token id 映射回字节。作业要求你做的,正是把这个玩具实现变成一个足够快的实现:比如 encode 不应该遍历所有 merge,而只遍历真正相关的那部分,还可以做并行化。
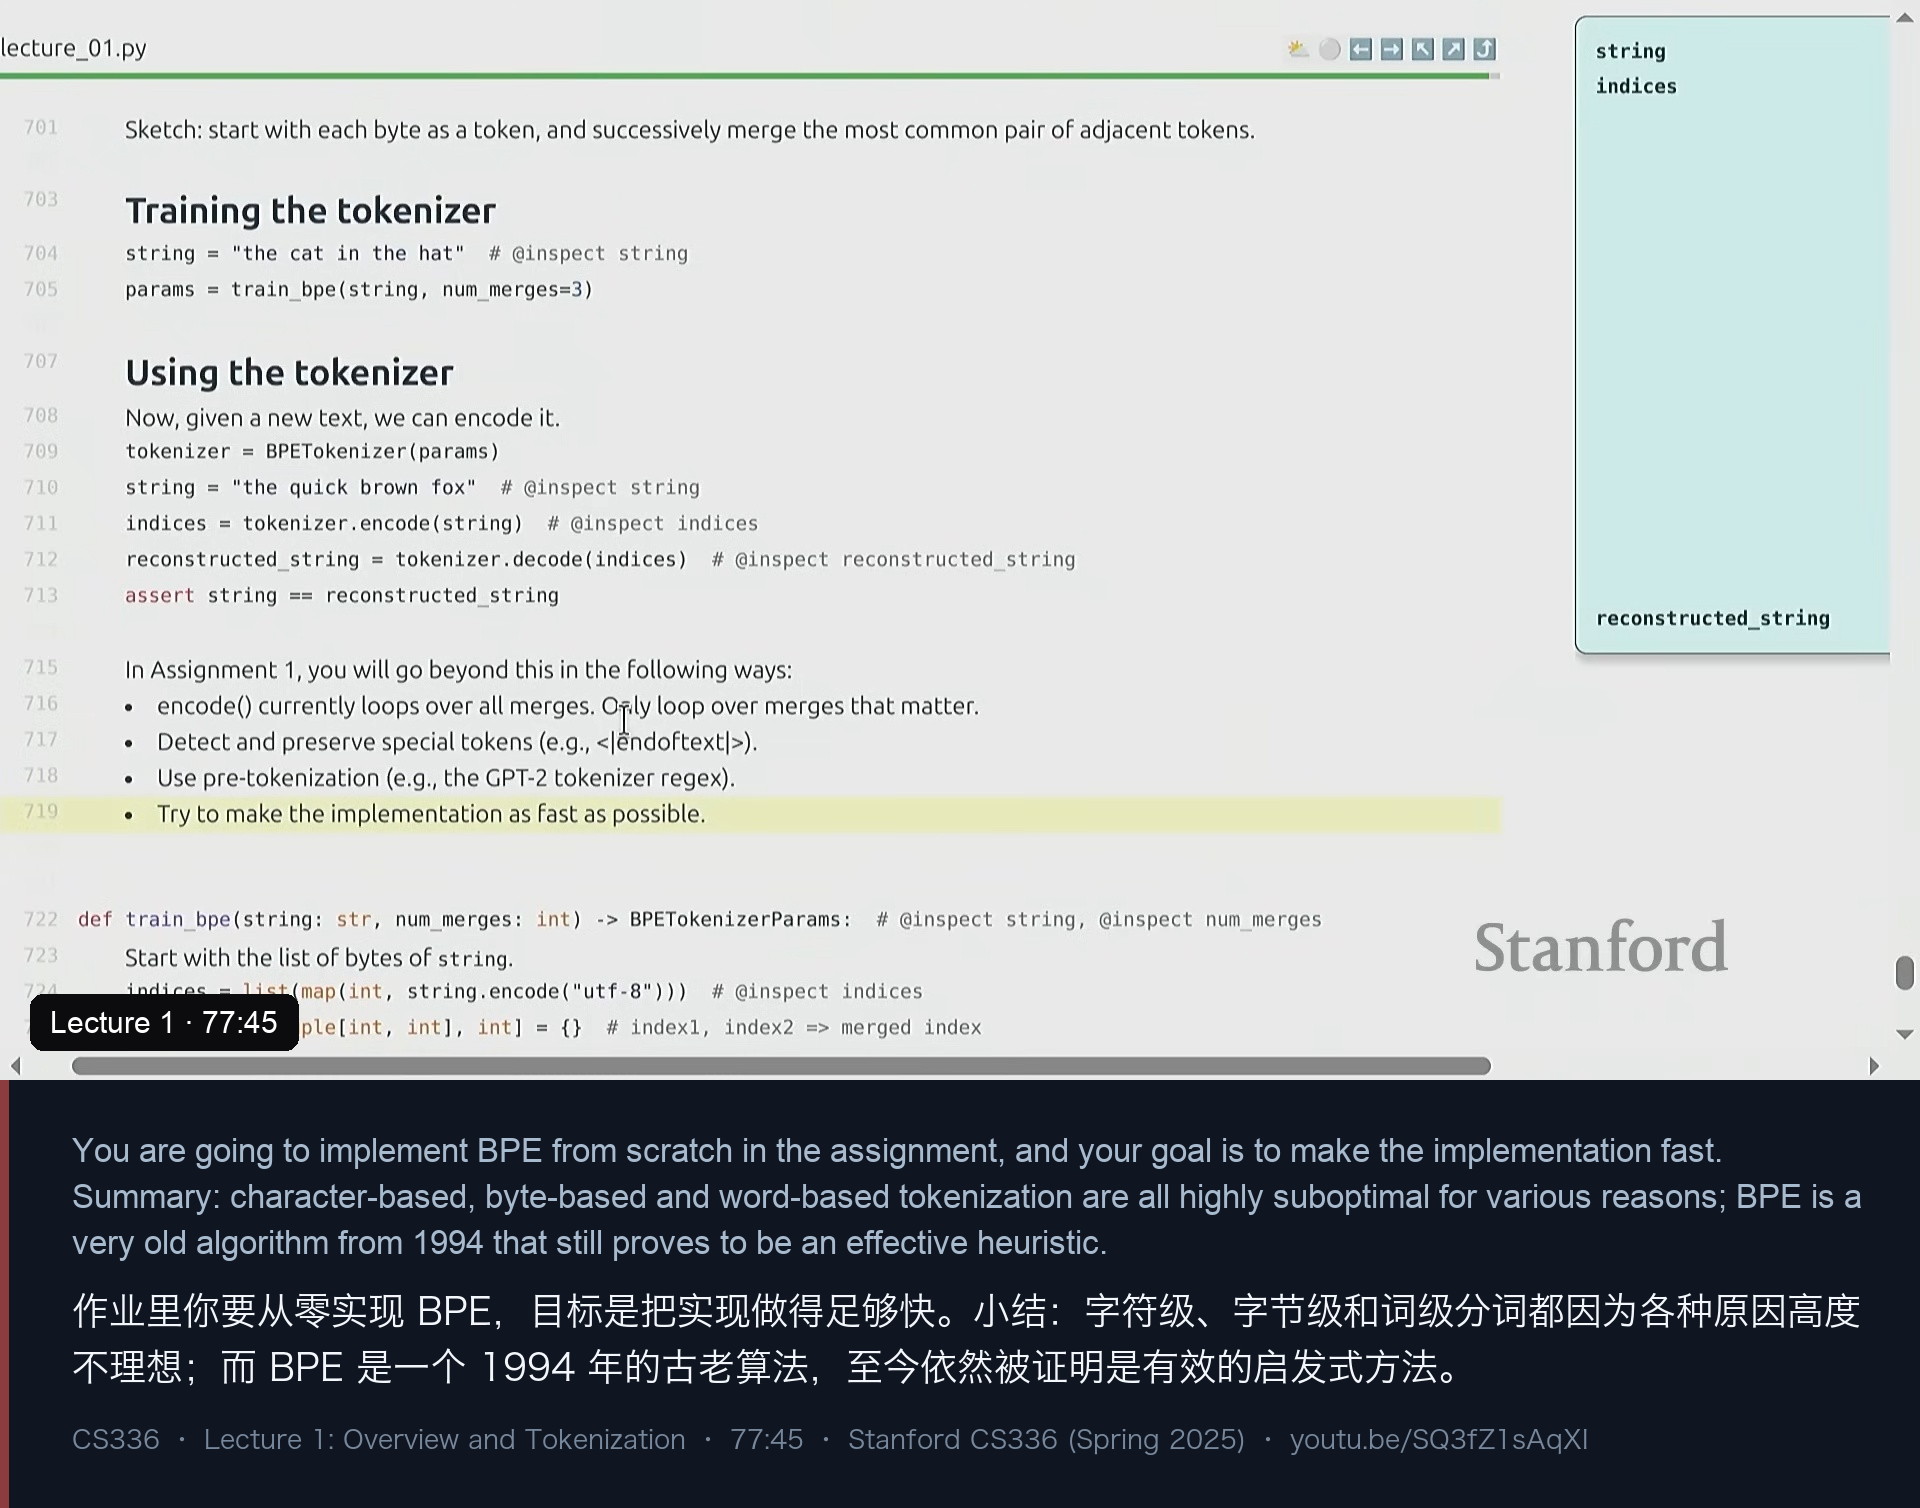
讲座的最后一句总结很朴素:字符级、字节级、词级分词都高度不理想;BPE 是一个非常古老、但至今仍然有效的启发式算法——它看的是语料的统计规律,从而自适应地把词表预算分配到真正高频的字符组合上。“我希望有一天不用再讲这一讲,因为那时我们会直接用从字节开始的架构;但在那之前,我们还得处理分词。”
六、作业与“这门课到底有多重”
Percy 引用了一条上过课的同学的课程评价:第一次作业的工作量,大约等于 CS224N 全部五次作业加期末项目。他把这门课写给这样一类人:“有那种非要理解事物直到原子层面的强迫症式需求”——学完之后,你在研究工程、以及构建大规模 ML 系统的信心上会有明显提升。
他也明确说了不该来的几种情况:这学期想认真做研究的人;只想学最新最热技术的人(“有别的课比我花大量时间调 BPE 更适合你”);以及想做应用的人——prompt 和微调能解决问题时,就该先用它们,不要一上来就想着从零训模型。
五个作业对应五个模块:
| 作业 | 内容 | 备注 |
|---|---|---|
| Assignment 1 · Basics | 从零实现 BPE 分词器、Transformer、交叉熵损失、AdamW 与训练循环 | 用 TinyStories / OpenWebText 训练,在 90 分钟 H100 预算下比 OpenWebText 困惑度 |
| Assignment 2 · Systems | 实现 Triton kernel 与并行(数据并行,以及一个小型化的模型并行) | 课程里最重的两个作业之一 |
| Assignment 3 · Scaling | 基于一个“训练 API”做小规模实验、外推超参,在给定 FLOPs 预算下训出最优模型 | 相对轻松一些 |
| Assignment 4 · Data | 处理真实的 Common Crawl 转储:训分类器、去重、配比 | 在 token 预算下最小化困惑度 |
| Assignment 5 · Alignment | 实现 SFT、DPO 与 GRPO | 讲师说比 1、2 号作业低一档 |
还有一个他反复强调的心态问题:这门课的同学大多是“GPU 穷人”——数据多、算力少。所以课程里几乎所有设计决策,都是为了在资源受限的前提下把硬件榨干:数据要激进过滤(不把宝贵算力浪费在垃圾数据上)、分词是为了效率(从字节建模虽然优雅但太贵)、架构决策大多是效率驱动的、训练基本只跑一个 epoch(“我们很赶,需要看到更多数据”)、缩放定律本身就是用少量算力换决策。
七、我的笔记:这一讲值得记住的 6 句话
- 想理解它,就得亲手造出来。 抽象在漏水,而漏水的抽象无法支撑基础研究。
- accuracy = efficiency × resources。 规模越大,“效率”这一项越关键,因为浪费不起。
- “规模就是一切”是对苦涩教训的误读。 算法效率在 2012–2019 年间带来了 44 倍提升,比摩尔定律还快。
- 前沿模型都在用同一张骨架,差异藏在细节里。 SwiGLU、RoPE、RMSNorm、MoE、GQA/MLA——单个不起眼,加起来差一个数量级。
- 分词是“用词表预算换序列长度”的工程折中。 字符级词表太大、字节级序列太长、词级词表无界,BPE 用合并高频对的方式自适应地分配预算。
- 空格属于 token,“hello” ≠ “ hello”。 这类细节决定了你的困惑度数字是否可比、你的模型会不会在一些奇怪的地方栽跟头。
附:课程信息与时间轴
- 课程主页:stanford-cs336.github.io/spring2025
- 本讲视频:Lecture 1: Overview and Tokenization(1:18,2025-04-24 发布)
- 播放列表:Stanford CS336 Language Modeling from Scratch · Spring 2025
- 配图目录:
public/blog/youtube/SQ3fZ1sAqXI/(17 张图均截取自视频中对应观点所在的幻灯片,并把该时刻的完整观点句拼合进图中)
| 时间 | 内容 |
|---|---|
| 00 | 课程与教学团队介绍 |
| 02 | 为什么要开这门课:研究者与底层技术脱节 |
| 04 | 工业化现实:GPT-4 的传闻规模与“前沿模型遥不可及” |
| 05 | More is different:小模型为什么可能不具代表性 |
| 09 | 苦涩的教训:算法 × 规模,而不是规模 alone |
| 12 | 历史:Shannon → n-gram → 神经语言模型 → Transformer |
| 20 | 课程定位、难度与“不该选这门课”的三种人 |
| 27 | 主线:It’s all about efficiency |
| 28 | 流水线:数据 → 分词 → 架构 → 训练 → 解码 → 对齐 → 评估 |
| 34 | 系统:GPU 结构、Triton kernel、并行 |
| 37 | 推理:prefill / decode 与投机解码 |
| 42 | 缩放定律:Chinchilla 与 Assignment 3 |
| 46 | 评估:困惑度、MMLU、指令跟随与系统级评测 |
| 46 | 数据:Common Crawl 是一片荒原 |
| 51 | 对齐:SFT、偏好数据、verifier、PPO/DPO/GRPO |
| 56 | 作业与效率视角下的设计取舍 |
| 1:00 | 分词:定义、词表、Tiktokenizer 演示 |
| 1:05 | 字符级 / 字节级 / 词级分词的问题 |
| 1:11 | BPE:历史、直觉与 cat/hat 演算 |
| 1:16 | encode 重放 merge、decode、如何做得更快 |
| 1:17 | 小结与下一讲预告(PyTorch 与资源核算) |
说明:本文是视频内容的整理、翻译与转述,观点均来自主讲人;文中代码为讲座中算法的整理版本,非官方作业代码。课程中引用的模型规模、成本、时间线多为公开传闻或讲师引用的估算,请自行核实。
讨论
这里是静态站点,没有内嵌评论区。如果这篇文章对你有用,欢迎通过 RSS 订阅后续更新。