用便宜的,逼近昂贵的:从拒绝采样到投机解码
拒绝采样和投机解码隔了七十年,用的是同一条规则:东西太好但太贵,就找一个便宜的替身去逼近它。真正决定成败的是三件事——替身够不够像、贵的那个验起来便不便宜、猜错了兜不兜得住。附两个可交互演示,外加几个生活里的例子。
先说一个让人不太舒服的事实:最好的办法,往往是我们用不起的办法。
最准确的答案要算完整个搜索空间,最可靠的判断要找最顶尖的人,最合身的衣服要量三十次尺寸。现实中我们几乎从不这么做。我们做的,是找一样便宜的、差一点的东西去替代它,然后祈祷差得不太多。
工程学里这句话人人都在用,却很少有人把它说清楚:用便宜的近似,去逼近昂贵的正解。 难的不是说出这句话,而是判断——什么时候这种逼近是聪明的,什么时候只是自欺欺人。
这篇文章讲两个东西:拒绝采样1拒绝采样(rejection sampling,von Neumann, 1951):想从某个难抽的分布里取样时,先从一个容易抽的分布里取样,再按一个便宜的判据决定“收下还是扔掉”。收下来的样本,分布正好是你想要的那个。,和投机解码2投机解码(speculative decoding):让一个便宜的小模型先猜几个字,再让大模型一次性并行验证。接受规则来自“带修改的拒绝采样”,所以输出与大模型自己写的完全一致——快,但不变味。。它们一个诞生于 1951 年的随机数生成,一个诞生于 2023 年的大模型加速,隔了七十年、换了两个舞台,用的却是同一条规则——生活里也到处都是这条规则的影子,以及它的失败案例。
一、拒绝采样:抽不出来的形状,用筛子筛出来
先从一个纯粹的技术问题讲起。
计算机里最便宜的随机数,是“均匀”的:每个数出现的可能性一样。而现实世界的需求从来不这么整齐。你可能想要一条两个山峰、中间低谷的曲线。这种形状,计算机没法直接“抽”出来——它没有对应的公式。
分布3概率分布(probability distribution):描述“各个结果分别有多大概率出现”的形状。均匀分布是一条平线,正态分布是一个钟形,而现实中真正想要的分布经常是两个峰,或者被切掉一角的怪形状。就是把“每个结果分别有多大概率出现”画成一条曲线。均匀分布是一条平线,钟形分布是一个山包。想要的山峰,通常比这古怪得多。
1951 年,冯·诺依曼给出了一个让人拍案的答案:抽不出来,就别抽。改为撒,然后筛。
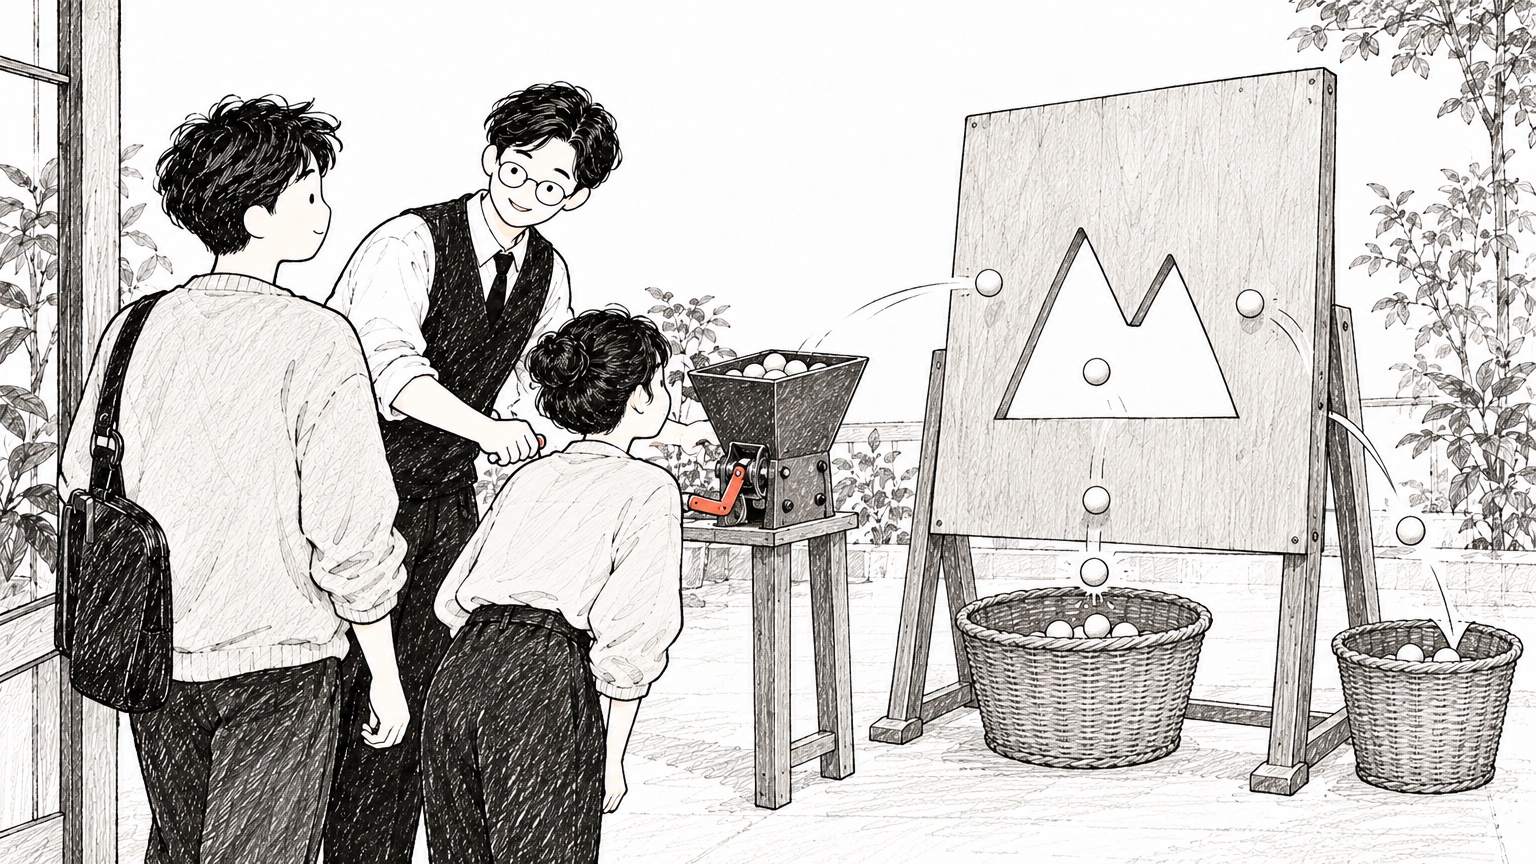
整个过程三步:
- 盖一个罩子。 找一个你能抽出来的形状,把它放大到足以把目标形状整个罩住。这个罩子的高度叫 M4上界 / 罩子(envelope,M):必须满足 M·q(x) ≥ p(x) 对所有 x 成立。M 越大,罩子越松,也就越浪费。。
- 随便扔一次。 从那个容易抽的形状里随机取一个位置——这是球的落点。
- 再扔一次高度,做取舍。 在零到罩子之间随便取一个高度。球落在目标曲线下面,收下;落在上面,扔掉。
为什么这样收下来的点,能长成目标形状?因为曲线高的地方,底下留出的空间大,球落进去的机会就多,收下的点自然就密;曲线低的地方,空间窄,收下的点自然就稀。形状不是被算出来的,是被筛出来的。
代价也清清楚楚:扔掉的球,全是白扔的。演示里有两个可以对比的罩子:松紧合适的那个,260 个球收下 93 个,收下率 36%;把罩子调高一倍到 5.6,收下率掉到 18%。真实效率正好是 1/M——36% 与 18%,正是 2.8 与 5.6 的倒数。
所以这里,“用不用得起”只由一件事决定:你的罩子贴着目标多紧。 罩子越像目标,浪费越少。这句话请先记住,下一节它会原封不动地出现。
二、投机解码:同一条规则,换了一个舞台
七十年后,同一件事出现在大模型身上。
大模型每写一个字,都要把全部参数——几百亿个数字、几百 GB——从显存5显存带宽(HBM bandwidth):生成阶段的主要瓶颈不是浮点运算,而是把权重从显存搬进计算单元的带宽。每写一个 token 都要把全部权重读一遍,所以“每次读取能产出几个 token”才是真正要优化的量。里整个读一遍。读一遍,只换来一个字。它不是“算”得慢,是“搬”得慢。
而一个小模型,猜一个字的时间和它省下的钱,都只是一个零头。
于是老问题换上了新衣服:
- 昂贵的正解:大模型真正想写的那个字,以及它的概率分布。
- 便宜的替身:小模型一口气猜出来的几个字6草稿模型(draft model):负责“猜”的那个便宜角色。可以是独立训练的小模型,也可以是目标模型上额外挂的草稿头——后者能读到目标模型的中间状态,因此猜得更准。,连同它自己对这些猜测的把握。
- 便宜的比较:大模型看一眼就能给出这一排猜测各自的概率。验证属于“读题”,可以并行;生成属于“作答”,只能一个字一个字来。7预填充与解码(prefill / decode):prefill 把一整段输入一次性并行处理完,受算力限制,很划算;decode 自回归地逐字生成,受显存带宽限制,且批量化救不了它。这正是“验证便宜、生成昂贵”在硬件上的根源。
- 取舍规则:和大模型自己想的越接近,就越容易留下;差得远就扔掉,第一个被扔的位置由大模型亲笔改写。
演示里写的是一句诗。只让大模型写,一共 19 个字、压 19 下,耗时约 570 毫秒;换成小模型先猜、大模型批量验证,大模型只压了 5 下,小模型额外猜了 18 次,总耗时约 204 毫秒——快了约 2.8 倍,平均每压一下写出 3.8 个字。
注意最后那个数:每“搬一趟”从 1 个字变成 3.8 个字。 这就是全部的收益来源。
而这套规则最漂亮的地方,在于它不吃亏:被收下的字,概率完全按大模型的来;被拒绝的那一个,由大模型从修正后的分布里重新采8带修改的拒绝采样(modified rejection sampling):目标概率 p 不低于草稿概率 q 时直接接受;p 小于 q 时以 p/q 的概率接受;第一个被拒绝的位置,从 max(0, p−q) 归一化后的分布重新采样。这套规则保证输出分布与目标模型完全相同。。所以结果与“完全由大模型自己写”逐位一致——它是无损9无损加速(lossless acceleration):加速前后输出的概率分布完全相同,而不是“差不多”。这是投机解码与“用蒸馏小模型直接替换”最本质的区别:后者更快,但换了答案;前者只是省了计算。的。快,但没有变味。
那什么时候它会失手?把收益拆开看就明白了:每轮的花费,等于小模型猜一遍,加上大模型验证一遍;每轮收到的字,取决于接受率10接受率(acceptance rate):草稿中最终被大模型认可的比例。它直接决定这套办法划不划算。。
- 接受率高(替身够像):一趟落下好几个字,稳赚。
- 接受率极低(替身完全不靠谱):一趟全被扔掉,还多付了小模型的钱和时间——比老老实实自己写还慢。
这就是那句“如果完全不靠谱,反而浪费时间”在公式里的样子。这里没有模糊地带:逼近得不够,不是“收益小”,而是负收益。
三、那条被忽略的前提:便宜的必须“验得起”
如果只讲到上一节,它只是一篇技术说明。真正让我想写这篇文章的,是下面这个前提——它平时藏在数学证明里,却是整个想法能不能成立的命门。
拒绝采样之所以成立,是因为“判一下”几乎不要钱。 球落下来,看一眼在曲线上面还是下面,收或不收。如果判断本身要花一小时,筛一万个球就是一年的工时,这个办法立刻荒谬。
投机解码之所以成立,是因为大模型验证五个字和写一个字的花费几乎一样。 背后是一个硬件事实:生成要一个字一个字顺着来,验证却可以把一整排一起算。在这个系统里,检查比创作便宜得多。
一旦这个前提不成立,整个计策立刻崩塌。
举个生活中的反例。让一位新手翻译一本小说,交给你逐字校对。听上去很省事,可如果你校对的时间比他自己翻译还长,那就别干——你没把一件事变成半件事,而是把它变成了两件事。
同样地:一份免费的商业建议,在采纳前要花三个月做尽调,这份建议本身的价值就已经被吃掉了;一个便宜的方案,评审会开得比执行还久,那它的便宜就是假的。
反过来,有些领域生来就适合这条路,因为它们天生“生成难、验证易”:
- 拼好一副一千片的拼图很难,看一眼“拼完没有”很容易。
- 证明一个猜想很难,检查一个证明对不对要容易得多——这正是P 与 NP 之争11生成与验证的不对称(P vs NP):计算机科学最著名的开放问题之一。它的核心直觉是:很多问题的答案一旦摆出来,检查它是否正确远比从头求解容易。整个“便宜逼近昂贵”的思路,都建立在某种这样的不对称之上。背后那个让整个计算机科学为之着迷的直觉。
- 写一份周报很难,指出它的毛病很容易。
- 想出一个 bug 的成因很难,让 bug 复现一次很容易。
“生成难、验证易”,是这个世界的稀有礼物。 有这份礼物的地方,便宜的替身真的能逼近昂贵的正解;没有这份礼物的地方,你只是把一个贵步骤,拆成了两个贵步骤。
所以判断一件事能不能“投机”,最该先问的不是“替身像不像”,而是:验收那一步,真的便宜吗?
四、生活里的几个影子
把这条规则拎出来,会认出很多熟悉的场景。
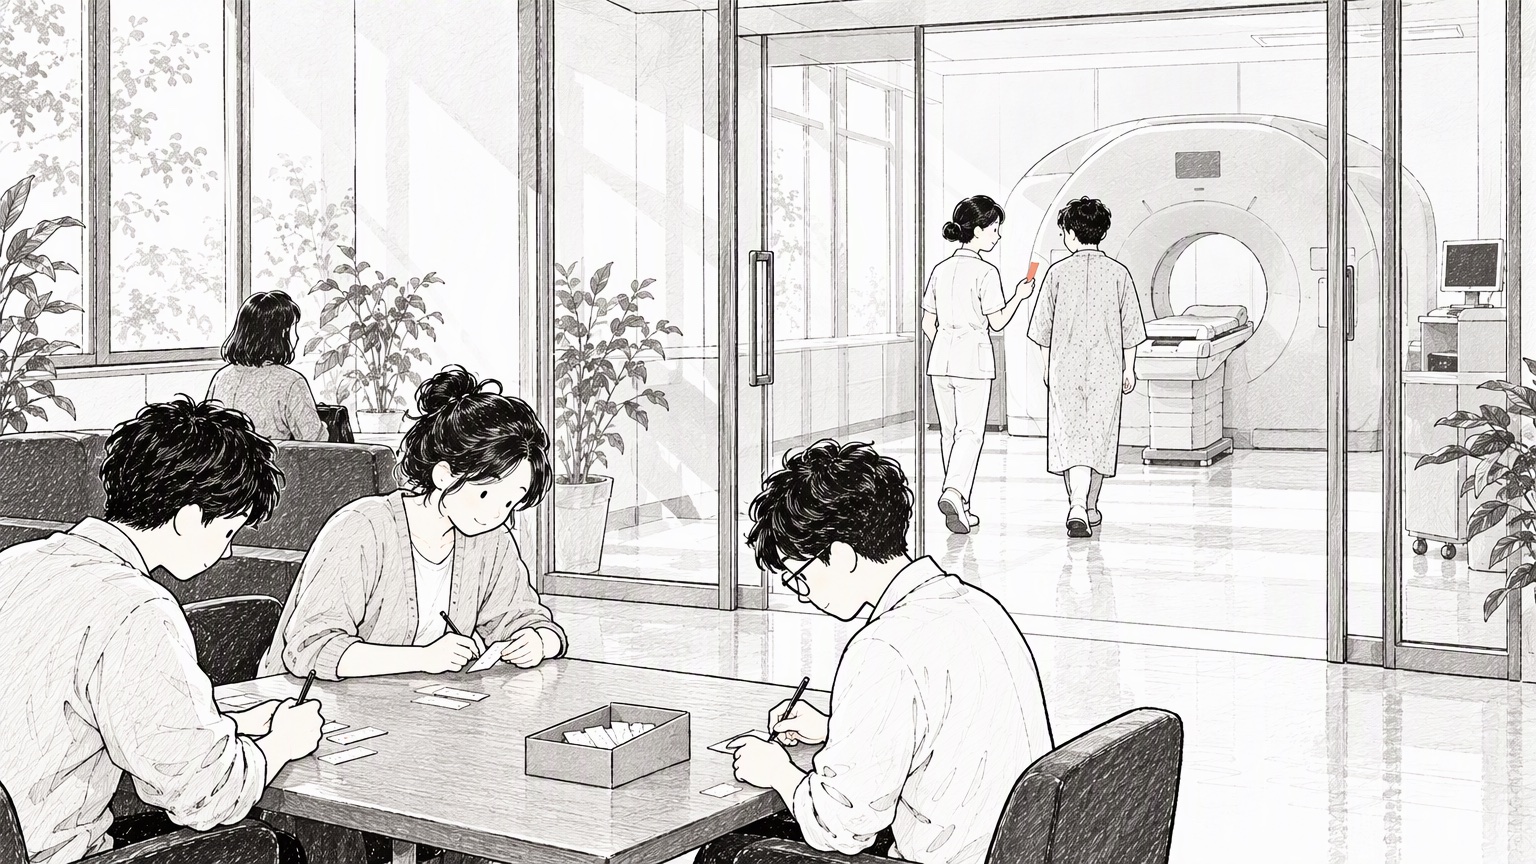
- 体检。 先用几十块钱的问卷和试纸做初筛,指标异常的人再去做上千块的影像检查。这就是拒绝采样的家庭版:便宜的那一步负责撒网,昂贵的那一步负责定论。 但筛子的松紧有讲究——筛得太松,一半人都被推去做昂贵检查,系统被压垮;筛得太紧,真有问题的人被漏掉。这个“松紧”,就是上一节那个 M。
- 编辑与草稿。 作者先快速写出草稿,编辑只做判断和批注。这套流程在出版业运转了两百年,前提一直是同一件事:改比写便宜。 哪天编辑开始整段重写,这个分工就该取消了。
- 招聘。 简历筛选是“猜”,面试是“验”。如果面试贵到不可能多约(十个面试官面一整天),那简历筛选就必须做得更严、更准,并且一定要有别的兜底——推荐人、作品集、试用期。因为没有足够的验证,“猜”错了就没人纠正。
- 对人的印象。 第一印象是便宜的替身,长期相处是昂贵的验证。印象有用,能帮我们避开风险;但它永远替代不了相处——因为印象的“接受率”,从来没有人替你验证过。
- 读书。 摘要是一个极便宜的替身,用来决定值不值得读。它的接受率如何,取决于这本书属于哪一类:工具书摘要很准,散文的摘要是灾难。替身像不像,和原物是什么体裁有关。 这句话套在人身上同样成立。
五、三个问题,一张清单
把上面所有东西压缩成三个问题,以后遇到“要不要用便宜的办法走捷径”,按顺序问一遍:
一、够像吗? 替身与原物的偏差有多大?够像,一趟能落下好几个字;不像,一趟全白扔。判断依据不是“感觉差不多”,而是可观察的命中率。它必须能被量出来,否则你只是在赌。
二、验得起吗? 那个贵的正解,检验一次要多少钱?如果检验比直接做还贵,这条路根本不通,别在上面浪费时间。
三、错了怎么办? 兜得住吗?投机解码敢乱猜,是因为最后拍板的一定是大模型;拒绝采样敢乱扔,是因为收下的样本事后必然服从目标分布。便宜的东西只负责起草,昂贵的东西必须保留最终裁决权。 一旦便宜的东西开始替你做决定,这套体系就从“加速”变成了“降级”。
尾声
冯·诺依曼在 1951 年写下拒绝采样时,想的是让一台早期计算机吐出任意形状的随机数——他大概不会想到,七十年后同一套规则会跑在几百亿参数的模型上,用来让显卡少搬几趟数据。
七十年里,硬件换了、语言换了、问题的名字也换了,但那三件事没变:替身要够像;真身要验得起;拍板的权力不能交出去。
生活里大多数昂贵的、正确的东西,都藏着一个便宜的影子。这本书的影子是摘要,这个人的影子是第一印象,这个决定的影子是一次小小的试探。聪明人的做法不是拒绝影子,也不是相信影子,而是——先问影子够不够像,再问验一次值不值钱,最后把影子递上去,让真身落笔。
愿你所用的每一个影子,都恰好足够像。
附:术语对照表
正文为了好读,把技术名词换成了日常说法。下面按出现顺序翻译回专业术语。
1 · 拒绝采样(Rejection Sampling)
冯·诺依曼 1951 年提出。目标分布 p 难以直接采样时,取一个易于采样的提议分布 q,并找一个常数 M 使 M·q(x) ≥ p(x) 处处成立;先按 q 采样 x,再以概率 p(x)/(M·q(x)) 接受它。文章里“收下率 36%“对应的正是 1/M。它是最经典的精确采样方法之一,代价是效率完全由 M 决定。
2 · 投机解码(Speculative Decoding)
Leviathan 等与 Chen 等人在 2023 年分别提出。用一个便宜的小模型(或目标模型上挂的草稿头)先猜一段 token,再让目标模型一次前向给出这些位置的分布并逐一裁决。收益取决于“每轮被接受的字数 ÷ 每轮总耗时”。
3 · 概率分布(Probability Distribution)
描述一个随机变量取各个值的可能性。生成模型每一步要做的,其实就是“依照一个分布抽一个字”。
4 · 上界 / 罩子(Envelope)
即 M·q(x),判断“收下还是扔掉”的那条水平线。M 越紧,浪费越少。工程上把 M 调紧,等价于“把替身训练得更像”。
5 · 显存带宽(HBM Bandwidth)
大模型推理时的主要瓶颈不是浮点运算,而是把权重从显存读进计算单元的带宽。生成阶段每写一个 token 都要把全部权重读一遍,所以“每次读取产出多少 token”才是真正要优化的量。
6 · 草稿模型(Draft Model)
负责“猜”的那个便宜角色。可以是独立训练的小模型,也可以是目标模型上额外挂的草稿头;后者能读到目标模型的中间状态,因此猜得更准。它越像大模型,接受率越高。
7 · 预填充与解码(Prefill / Decode)
prefill 把输入整段并行编码,是计算受限的;decode 逐字生成,是带宽受限的。这个不对称正是投机解码的物理基础:验证一排草稿属于 prefill 式的工作,很便宜;生成下一个字属于 decode 式的工作,很昂贵。
8 · 带修改的拒绝采样(Modified Rejection Sampling)
投机解码的裁决规则。对每个草稿 token:目标概率 p 不低于草稿概率 q 时直接接受;p 小于 q 时以 p/q 的概率接受;第一个被拒绝的位置,从 max(0, p−q) 归一化后的分布重新采样。这套规则保证最终输出与目标模型的分布完全一致。
9 · 无损加速(Lossless Acceleration)
指加速前后输出的概率分布完全相同,而不是“差不多”。这是投机解码与“用蒸馏小模型直接替换”最本质的区别:后者更快,但换了答案;前者只是省了计算。
10 · 接受率(Acceptance Rate)
拒绝采样里是被收下的样本比例,投机解码里是被大模型认可的草稿比例。它决定整套策略是加速还是拖累:低到一定程度,总耗时反超直接求解。
11 · 生成与验证的不对称(P vs NP)
计算机科学最著名的开放问题。它背后的直觉是:很多问题的解一旦给出,验证比对求解容易得多。文章借此说明——“便宜的替身能否逼近昂贵的正解”,最终取决于这个域里是否天然存在“验比做便宜”的结构。
讨论
用 GitHub 账号留言;评论保存在公开仓库chengshu-blog-discussions的 Discussions 里。也可通过 RSS 订阅后续文章。