Karpathy《Let's build GPT》第四篇:nanoGPT 走读、encoder vs decoder,以及从 1000 万参数到 GPT-3 的距离
Karpathy《Let's build GPT》精读系列第四篇(收官):把论文架构图讲完(encoder、cross-attention 与 decoder-only 的关系),走读 nanoGPT(多头合并成四维批处理、MLP 用 GELU、checkpoint 与 DDP 等工程件),对照从 1000 万参数 / 30 万 token 到 GPT-3 的 175B / 300B token——结构几乎相同,规模差约一百万倍。最后讲清 ChatGPT 的两阶段:预训练只给你一个「文档补全器」,助手化还需要 SFT → 奖励模型 → PPO 三步对齐。文末另附「从 BERT 到 GPT:同一个 Transformer,三种用法」对照表(本文补充,专门写给做过 BERT 微调、没有大模型实战经验的人)。文中 10 张配图均截自视频对应时刻,并把当时的完整观点句(英文原句+中文翻译)拼进图里。
来源:YouTube 原视频(Andrej Karpathy,2023-01-17,时长 1:56)·配套代码:nanoGPT
阅读说明
- 这是四篇系列的最后一篇,覆盖原视频 01–01。前三篇把模型搭起来、训练出结果;这一篇回答的是「我写的这个东西,和真正的 GPT 到底差在哪」。
- 内容分四块:① 原论文架构图里剩下没讲的部分(encoder、cross-attention);② nanoGPT 代码走读(我们的代码与它的差异);③ 从 1000 万参数到 GPT-3 的规模对照;④ ChatGPT 的两阶段(预训练 → 对齐)与本文的收束。
- 文末我加了一节 「从 BERT 到 GPT:同一个 Transformer,三种用法」——这是本文补充,专门给做过 BERT 微调、但没有大模型实战经验的人做衔接;Karpathy 在视频里没有讲这部分。
- 数字均来自视频(10M 参数、约 300,000 个 GPT-2 token、GPT-3 最大 175B、300B tokens、百万倍等)。
1. 把论文架构图讲完:encoder、cross-attention 与「decoder-only」
前三篇结束时,我们对论文架构图还有一处没交代清楚:为什么原图里有两块 Transformer。
Karpathy 的解释是:因为那是一篇机器翻译论文。
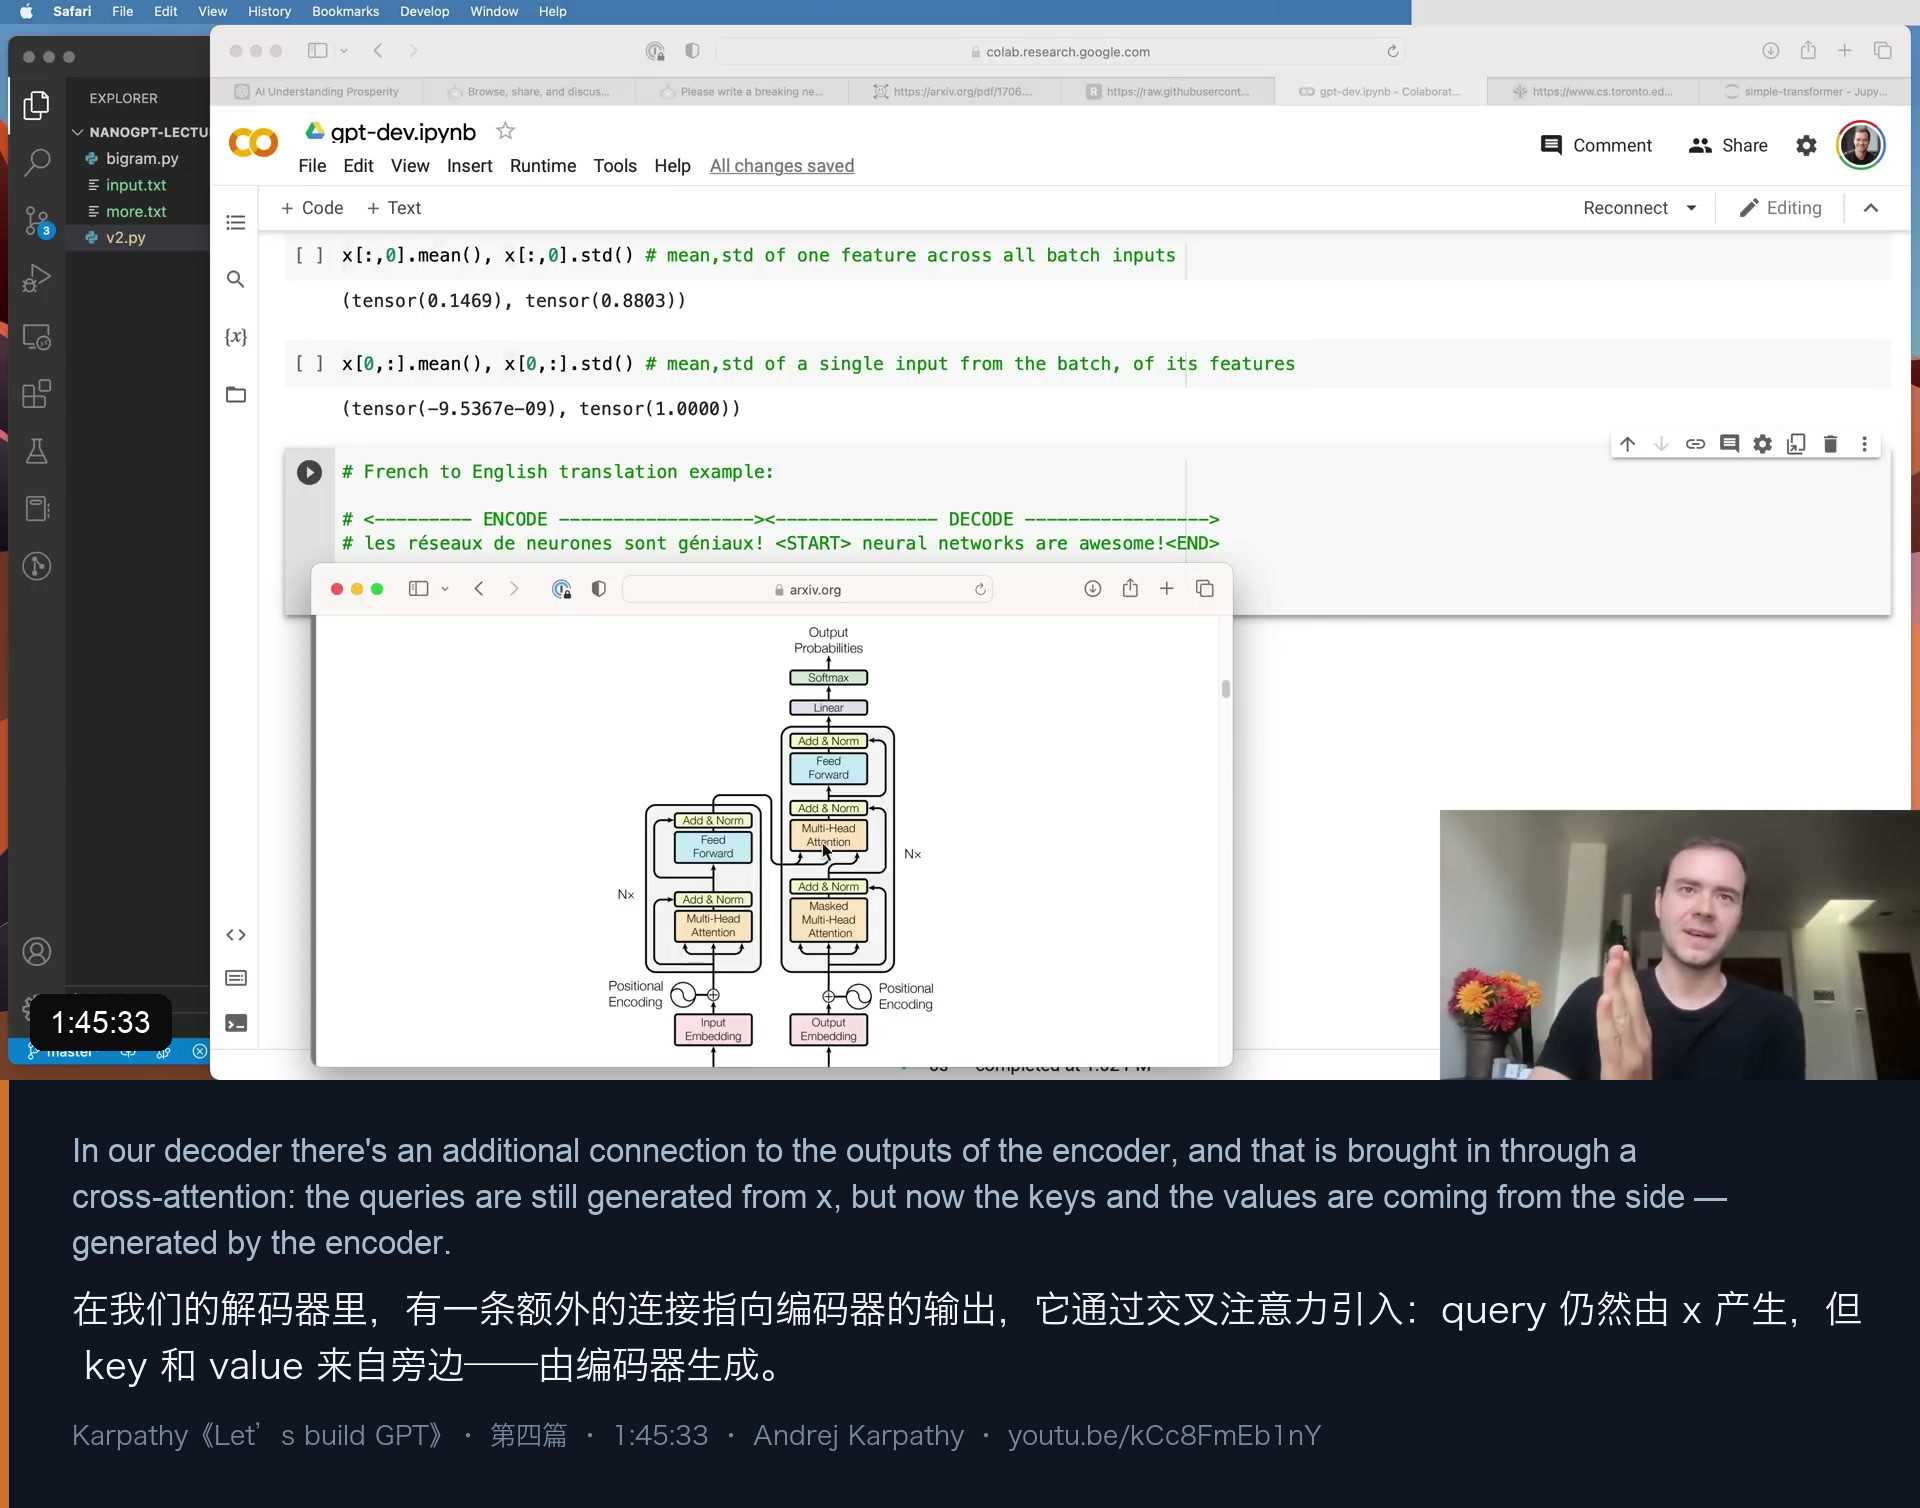
- 它假设输入是一段法语 token。这些 token 进入 encoder,而 encoder 里没有三角掩码——所有 token 可以自由地互相通信,把整个法语句子「编码」成一组表示;
- 然后在 decoder 一侧,除了我们熟悉的掩码自注意力,还多了一条从 encoder 输出接过来的连接。这就是 cross-attention:
- query 仍然由
x(解码器当前状态)产生; - 但 key 和 value 来自旁边——由 encoder 的节点生成;
- encoder 的输出被接入解码器的每一个 block。
- query 仍然由
它在做什么?Karpathy 的原话:
它在让解码过程不只以当前解码的历史为条件,还以「已经看过的、完整编码过的法语提示」为条件。
这就是 encoder-decoder 模型,也是原论文需要两块 Transformer 加一个额外 block 的原因。
那我们为什么不用? Karpathy 给出了一句非常干脆的答案:
我们没有这样做,是因为我们没有东西要编码——没有任何条件输入。我们只是有一份文本文件,只是想模仿它。这就是我们使用 decoder-only Transformer 的原因,GPT 正是这么做的。
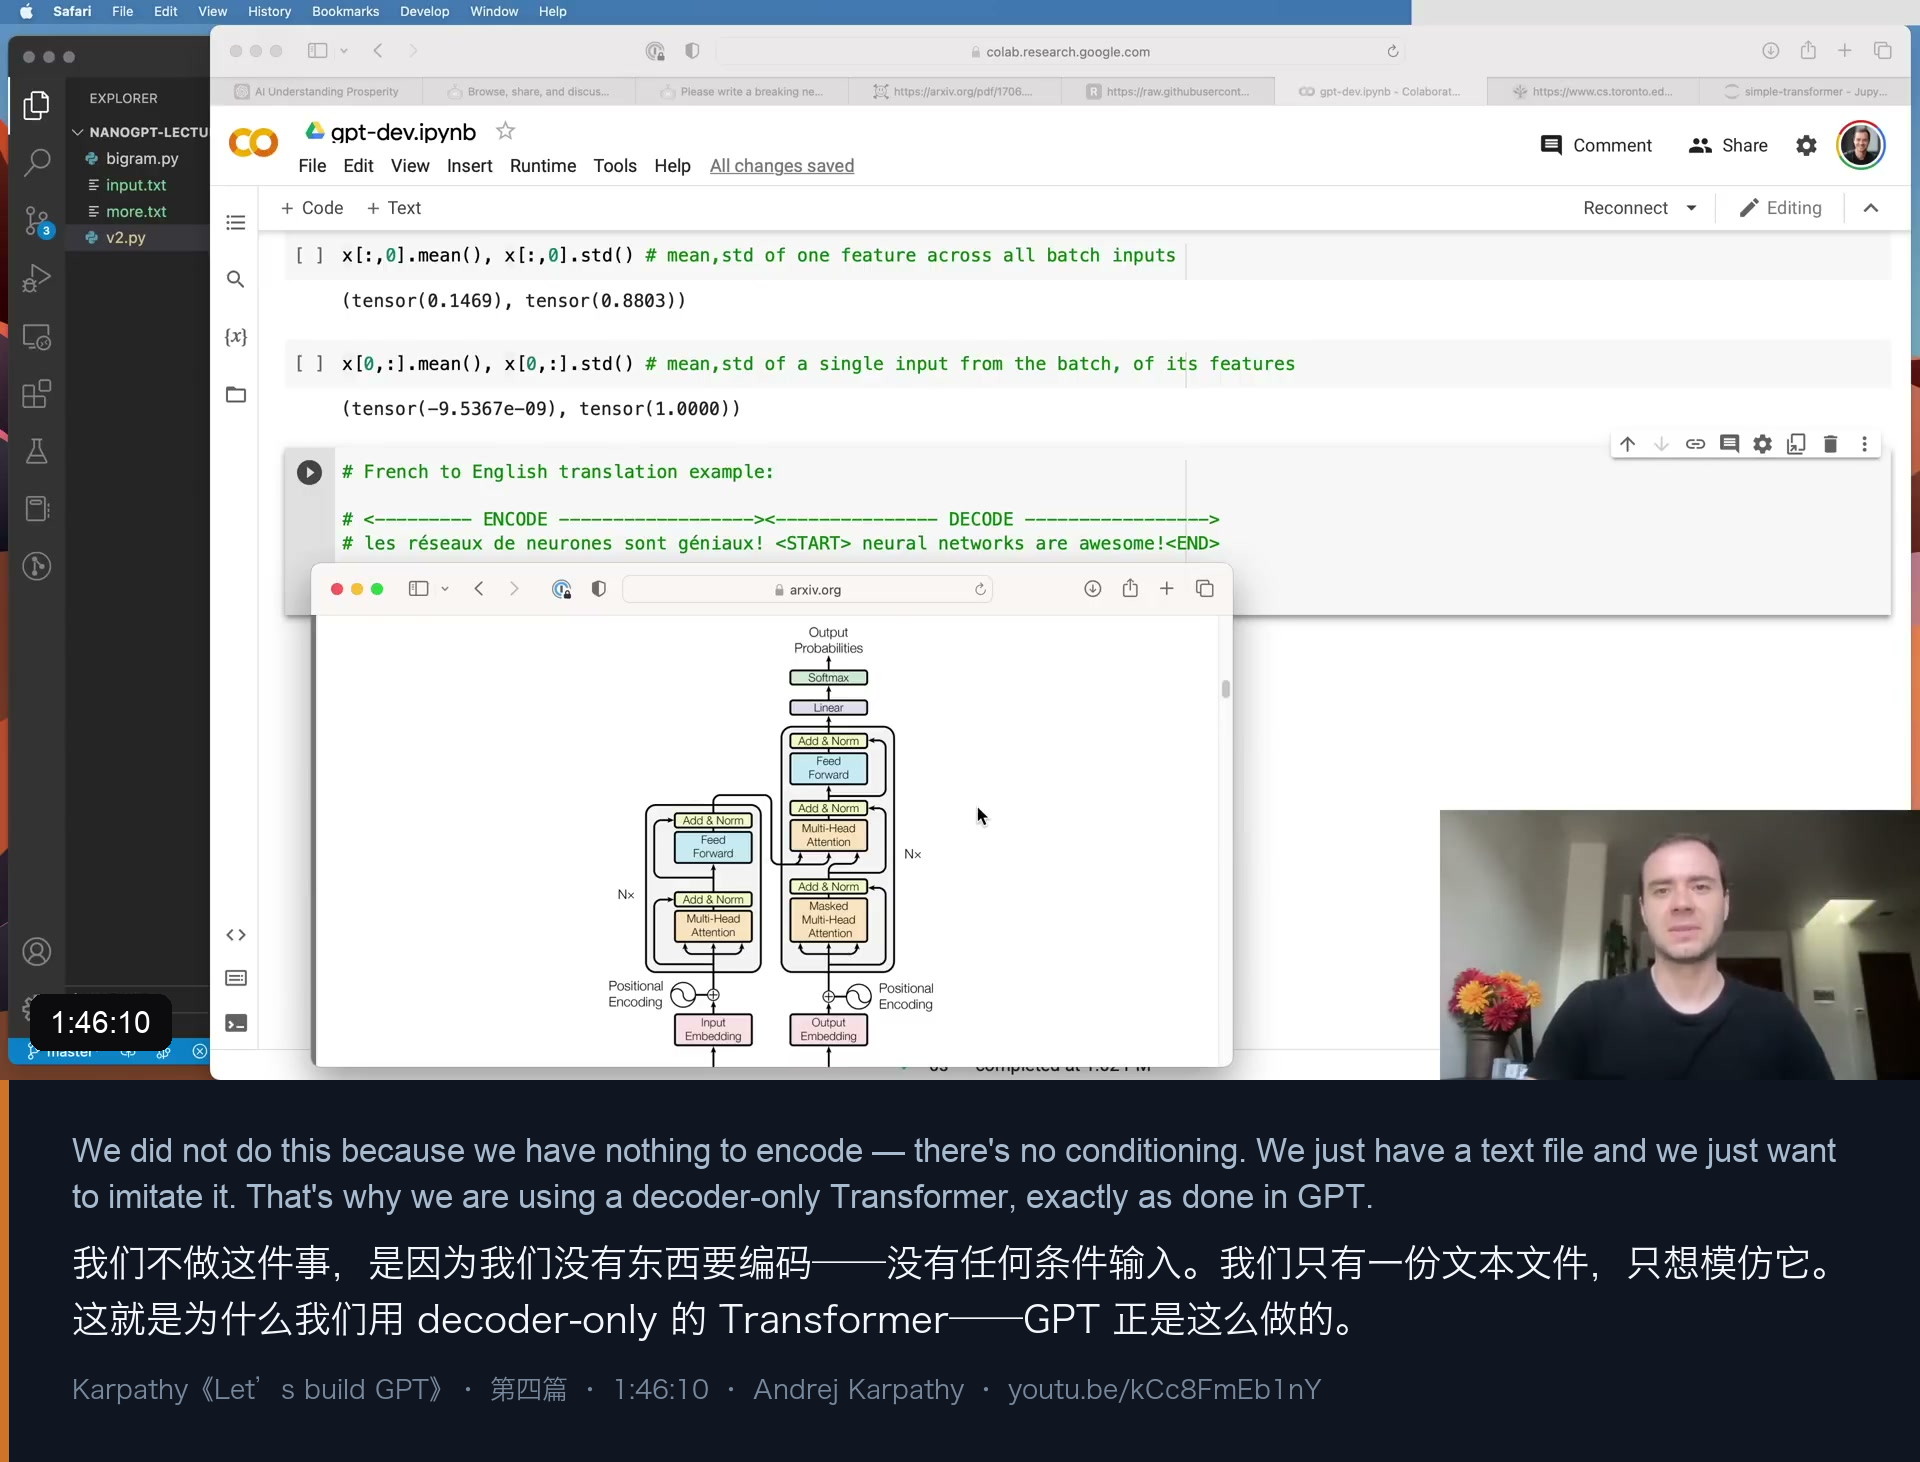
本文补充:这一小节其实把整个 GPT 家族和原论文的关系说清了。把「编码器 / 解码器 / 交叉注意力」这三件东西组合起来,就能覆盖你现在能看到的所有主流架构:
- 只要 encoder(去掉掩码)→ BERT 那一类;
- 只要 decoder(保留掩码)→ GPT 那一类;
- 两个都要 + cross-attention → 原论文的翻译模型、T5、以及各种「条件生成」模型。
2. nanoGPT 走读:我们的 200 行 vs 它的两个文件(01–01)
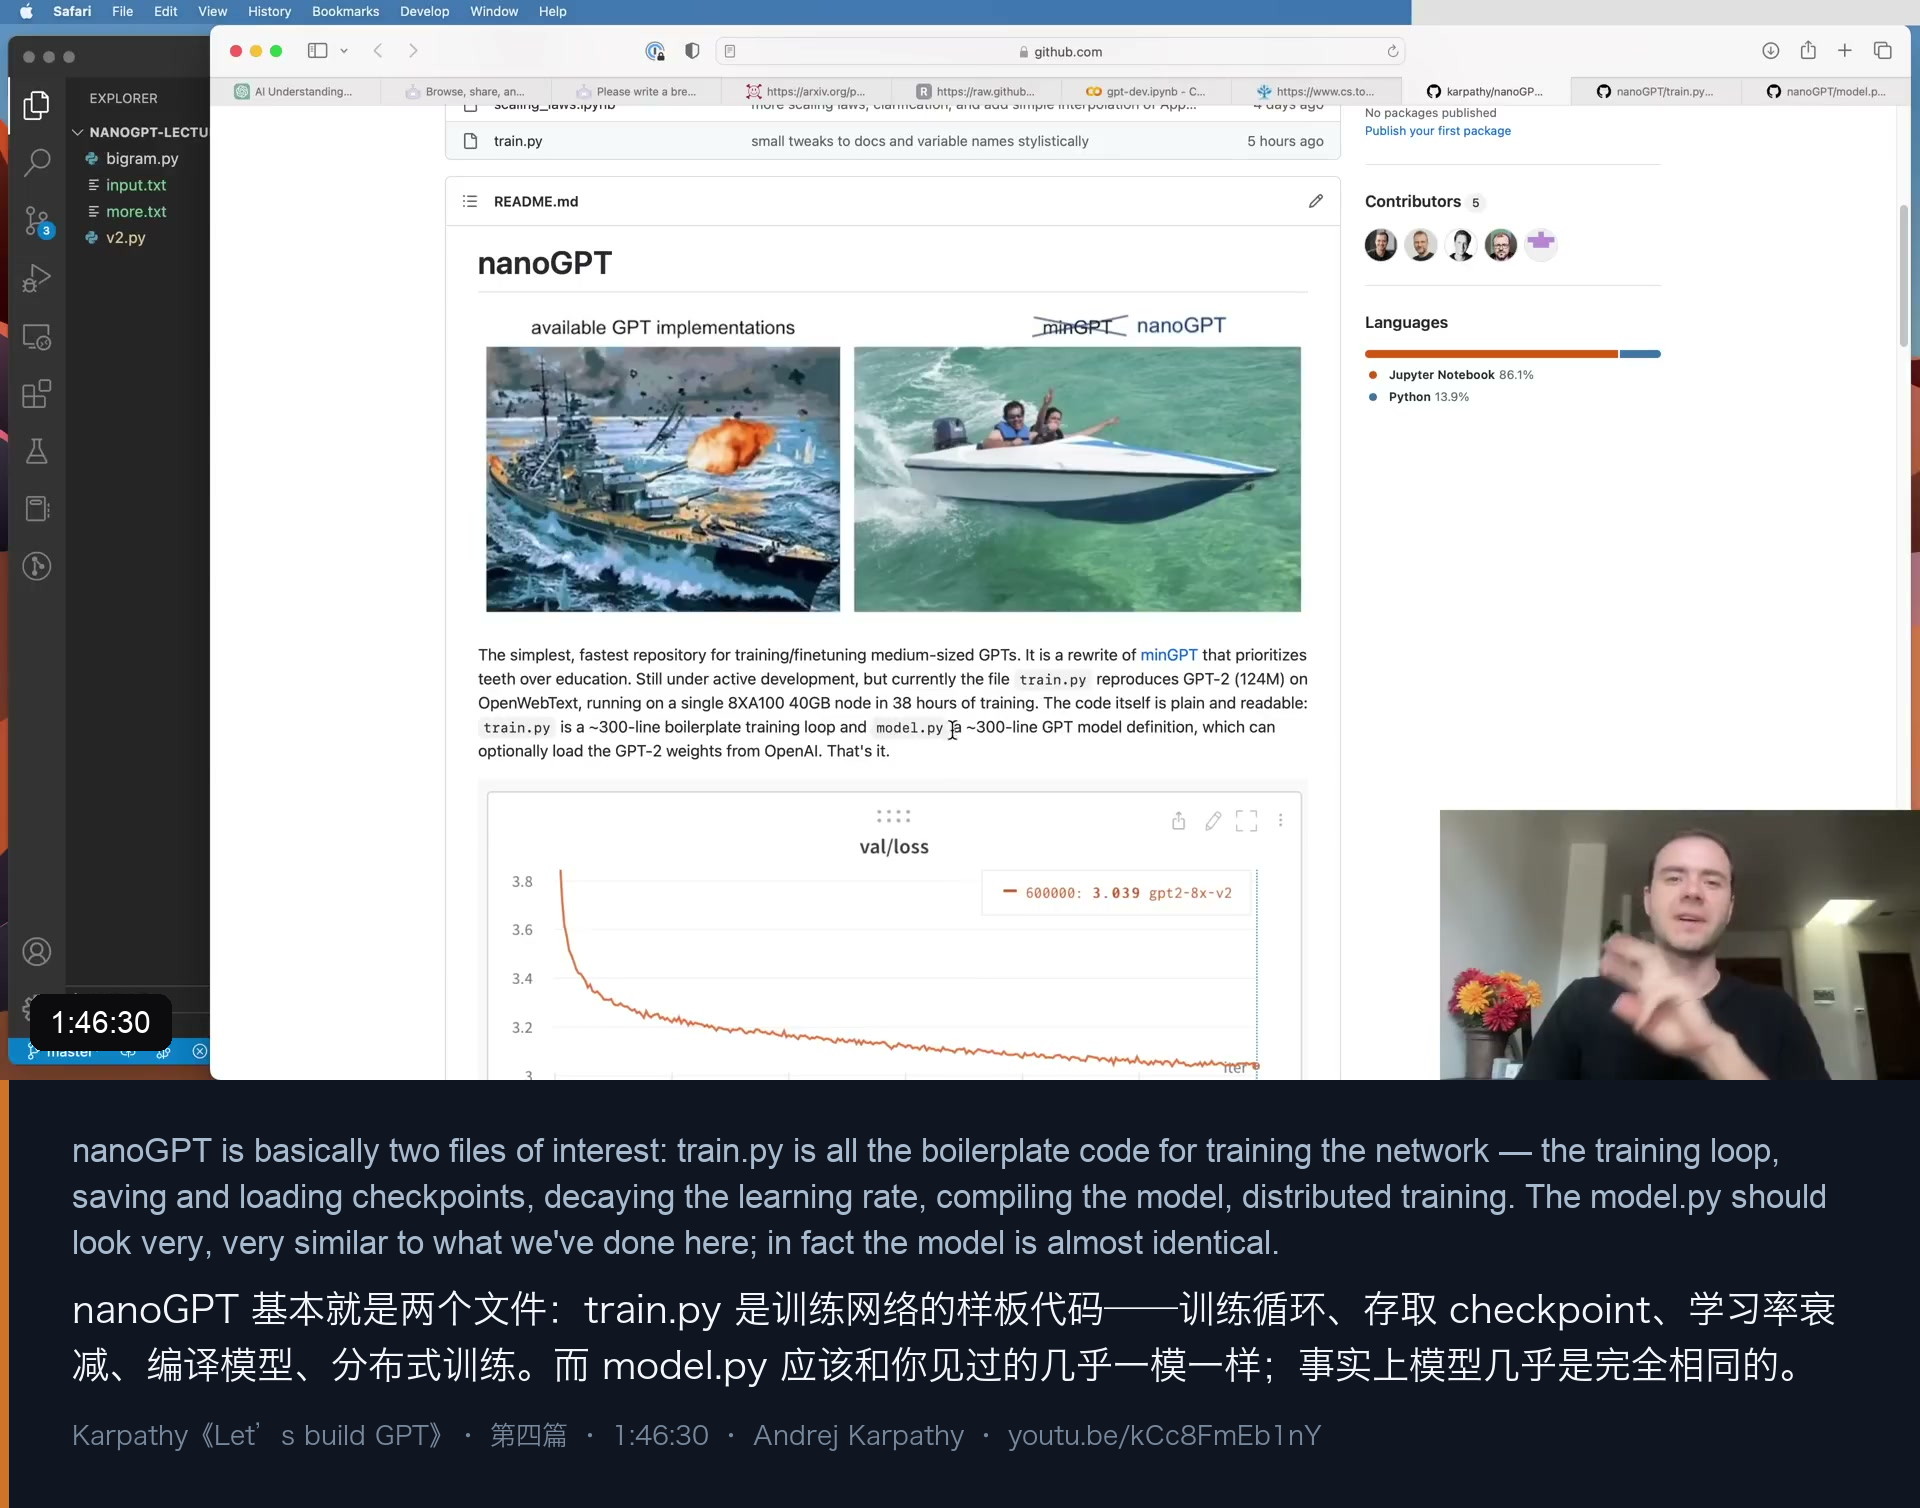
Karpathy 用一个「非常简短的走读」把 nanoGPT 和课上写的代码对应起来。他说 nanoGPT 的核心就是两个文件:
train.py:训练网络的样板代码。和课上写的东西是同一套逻辑(训练循环、取 batch、评估、更新),但因为要考虑工程现实而复杂得多:保存/加载 checkpoint 与预训练权重、学习率衰减、torch.compile、跨多节点/多 GPU 的分布式训练。model.py:模型本身,几乎与课上写的完全一致。
2.1 差异一:多头注意力被合并成一个批处理实现
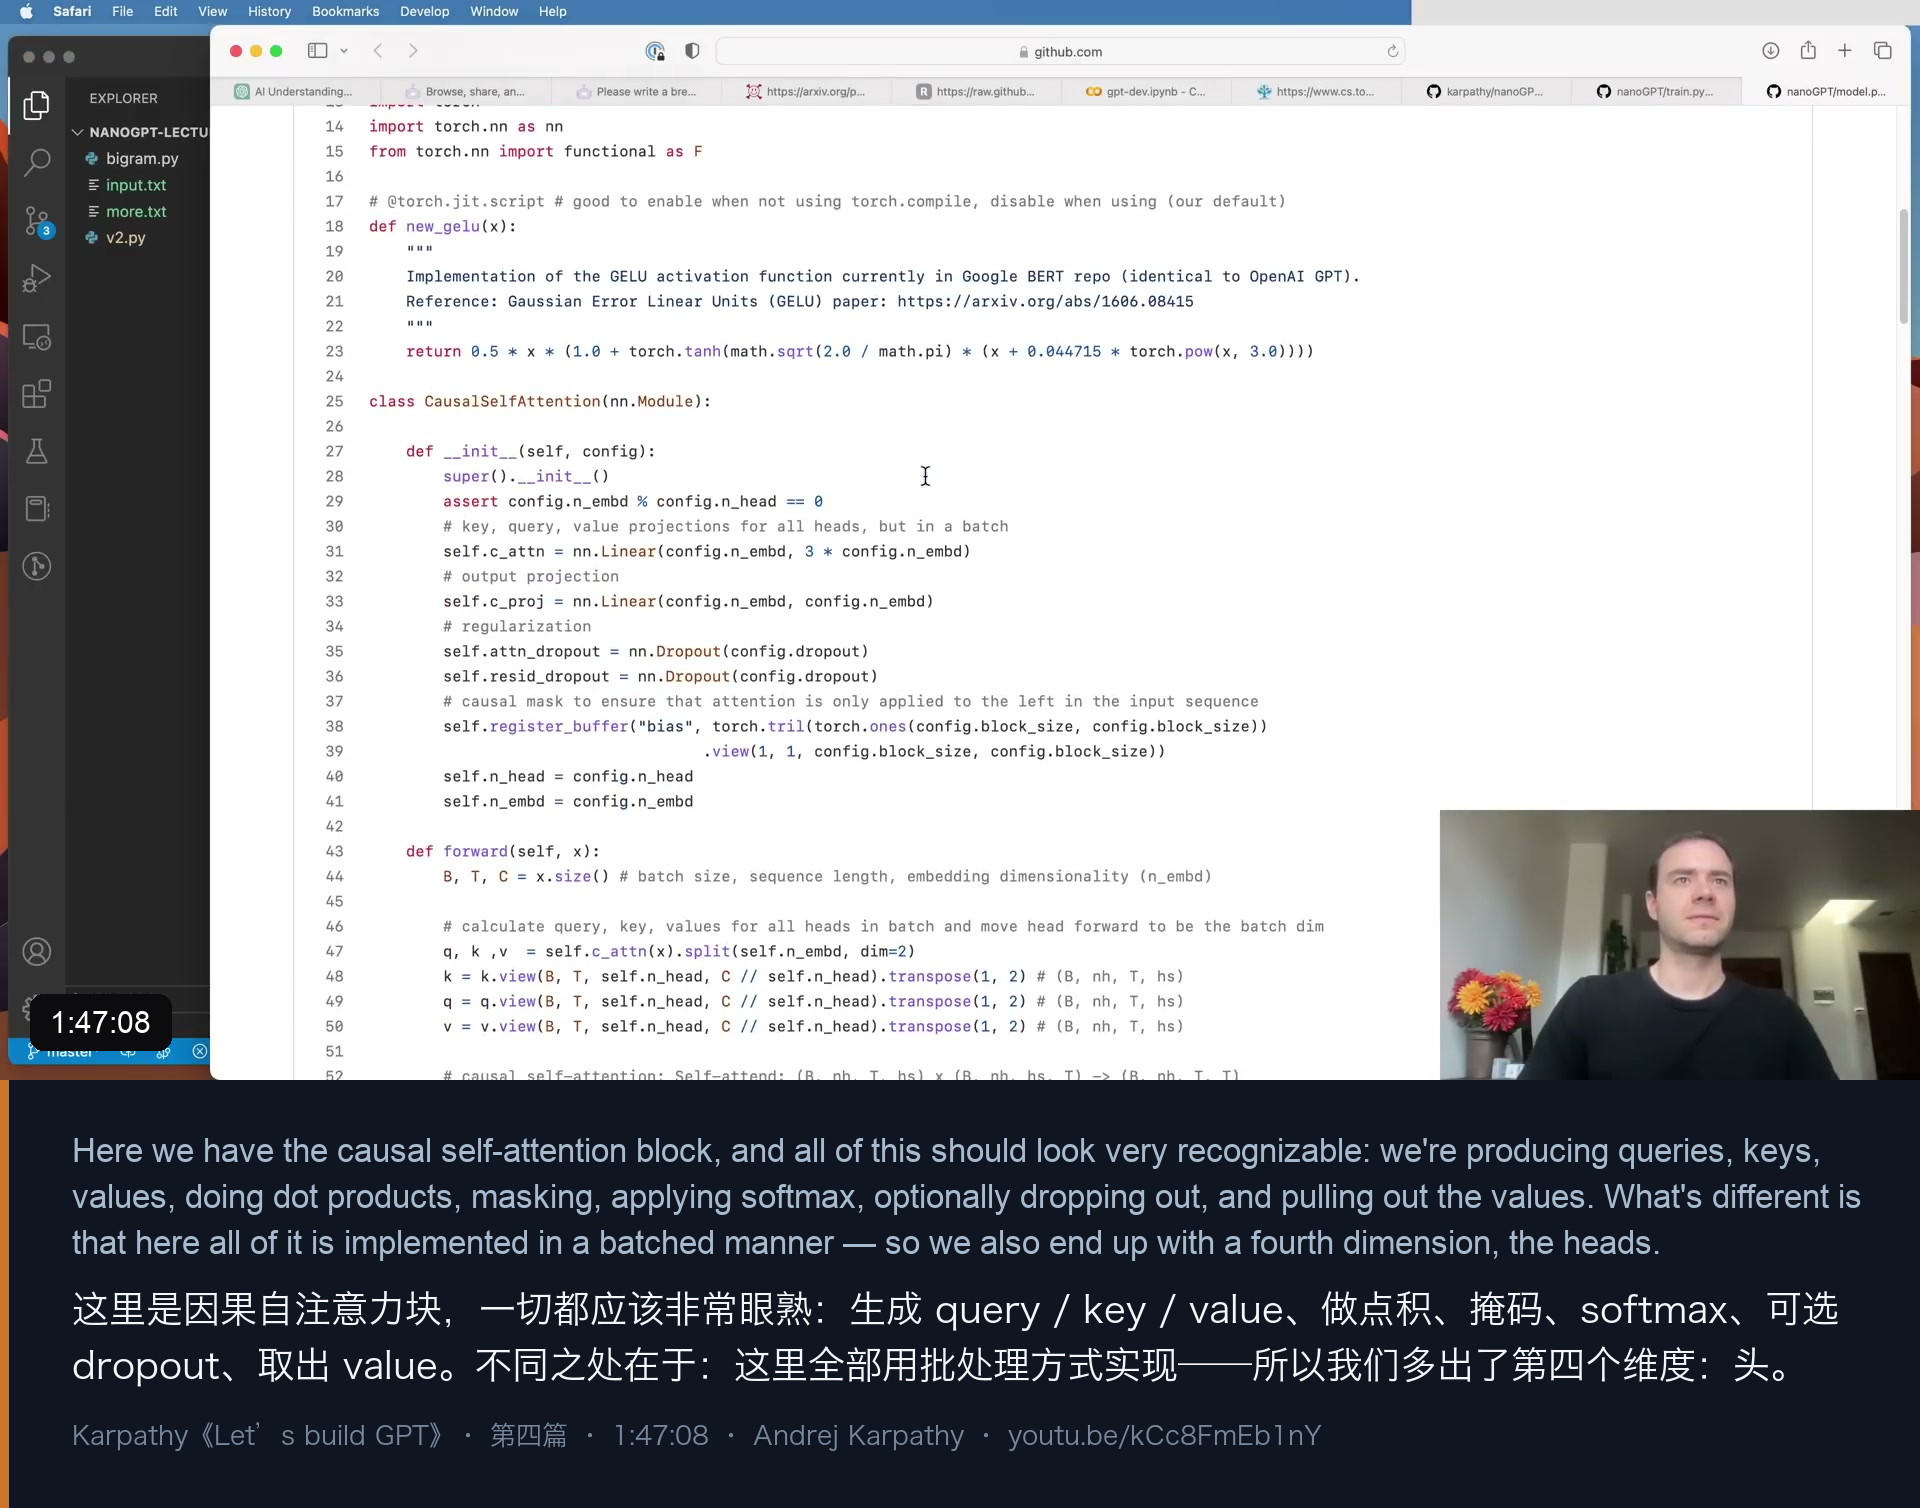
在课上,多头是「显式地建多个 Head,然后 torch.cat 拼接」。而在 nanoGPT 里:
所有的头都被实现在一个 causal self-attention 里,用批处理的方式完成。
结果是张量多出一个维度:除了 (B, T, C),还有一个 heads 维——变成四维张量。
Karpathy 特别强调:这在数学上完全等价,只是更高效——因为所有头现在被当成 batch 维一起算。
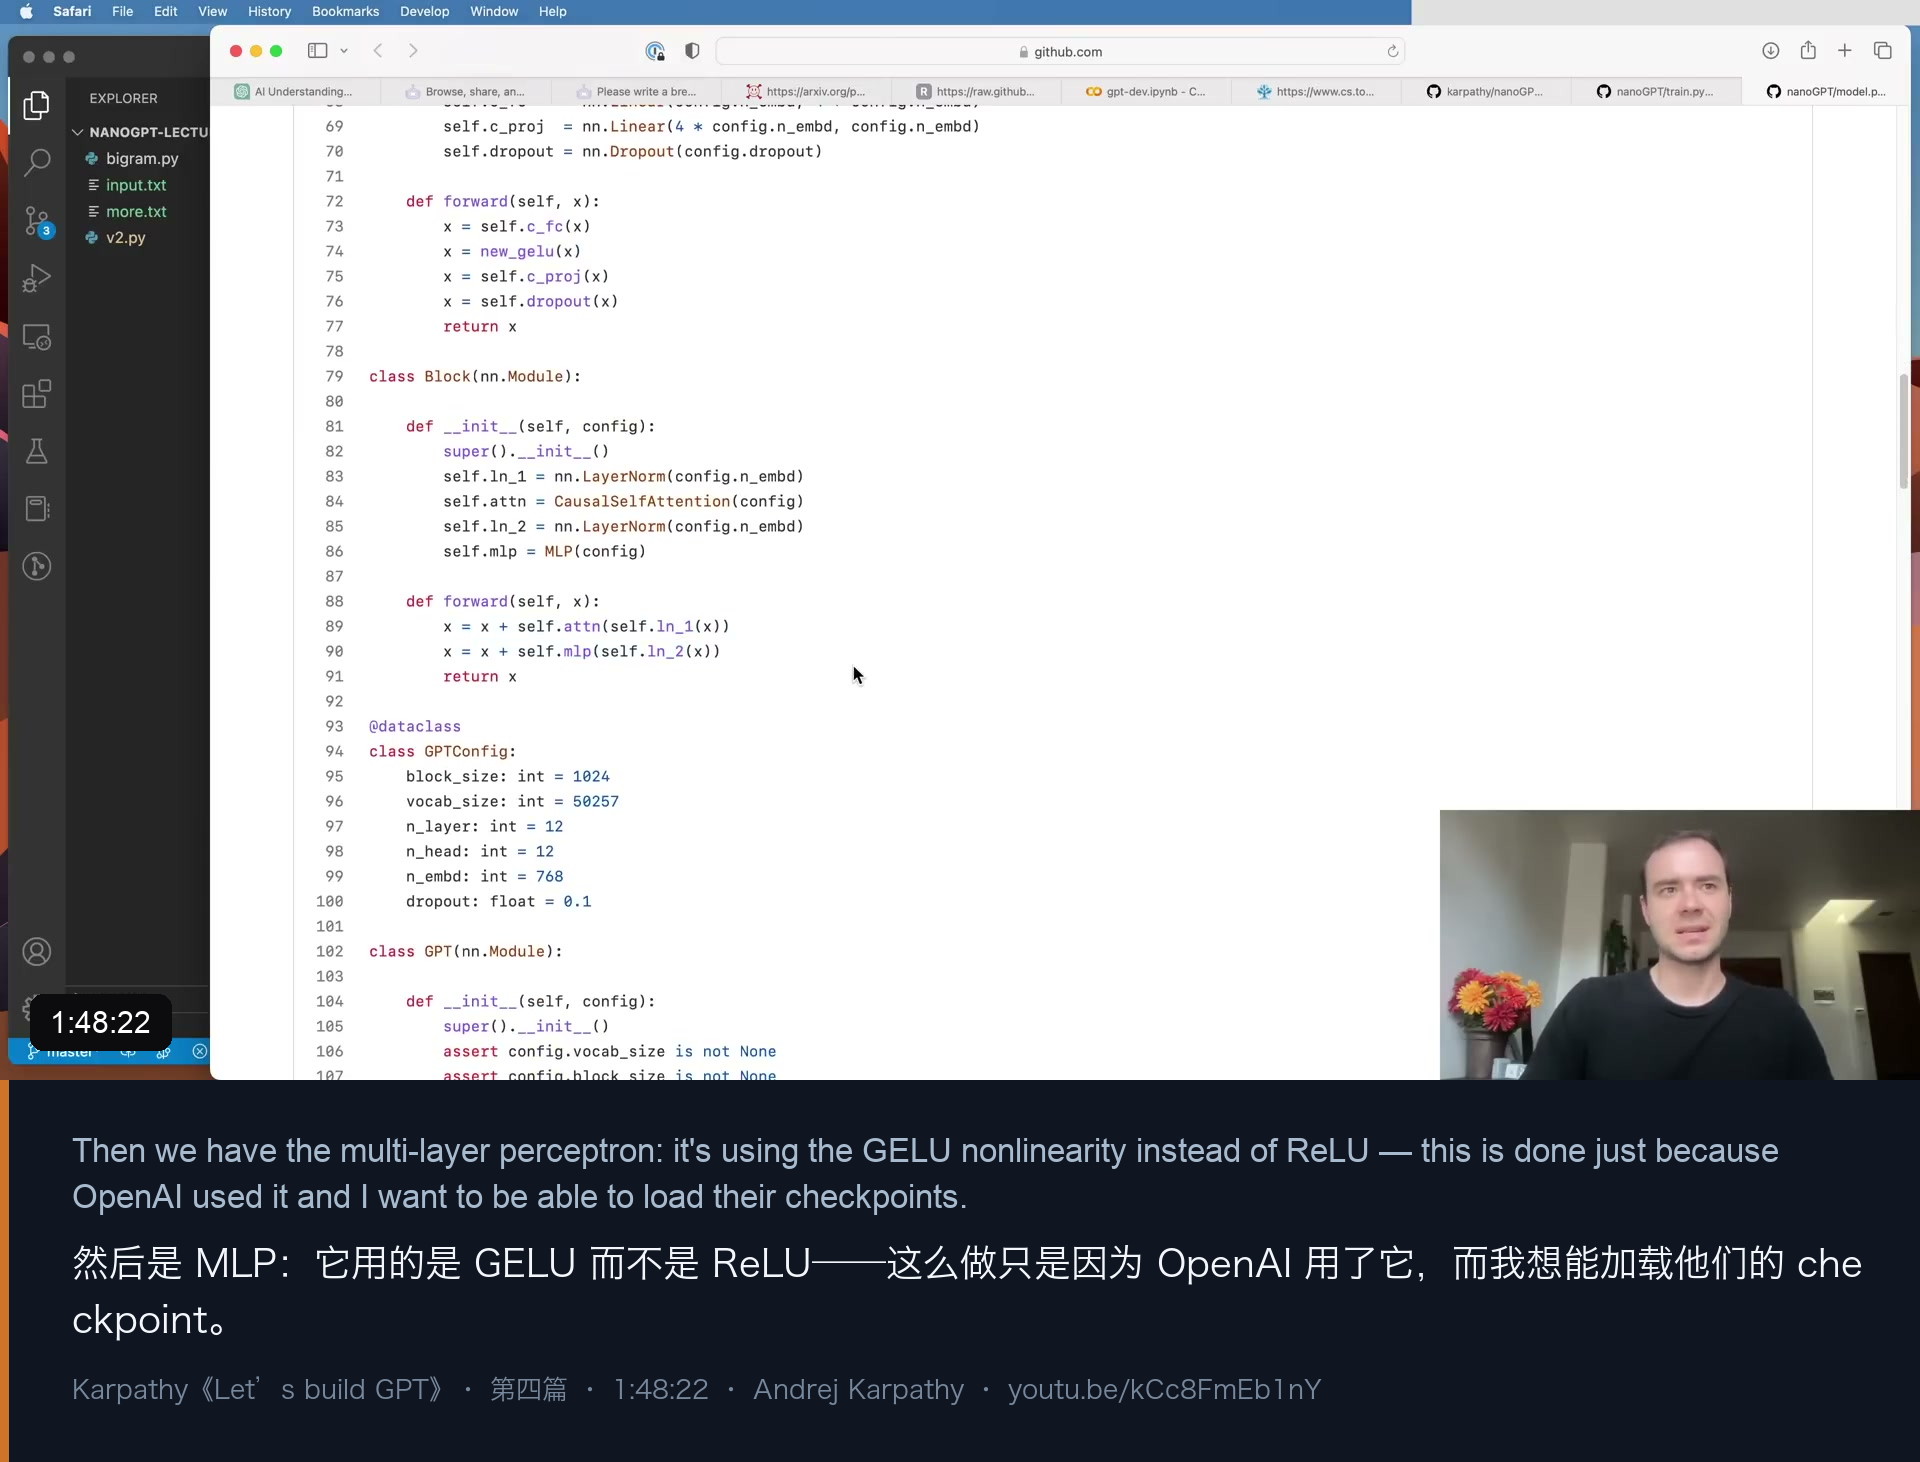
2.2 差异二:MLP 用 GELU 而不是 ReLU
它用的是 GELU 非线性,而不是 ReLU。这么做只是因为 OpenAI 用了它——我想能加载他们的 checkpoint。
这是一个很真实的工程理由:激活函数的选择有时不是为了更优,而是为了权重兼容。
2.3 其余部分:几乎逐行对得上
- 位置编码 + token 编码相加;
- 一叠 Block(通信 + 计算);
- 末尾的 LayerNorm;
- 最后的线性层
lm_head; generate()函数也非常相似。
此外还有两处工程细节:把参数分成「需要 weight decay」和「不需要 weight decay」两组;以及 checkpoint 的加载逻辑。
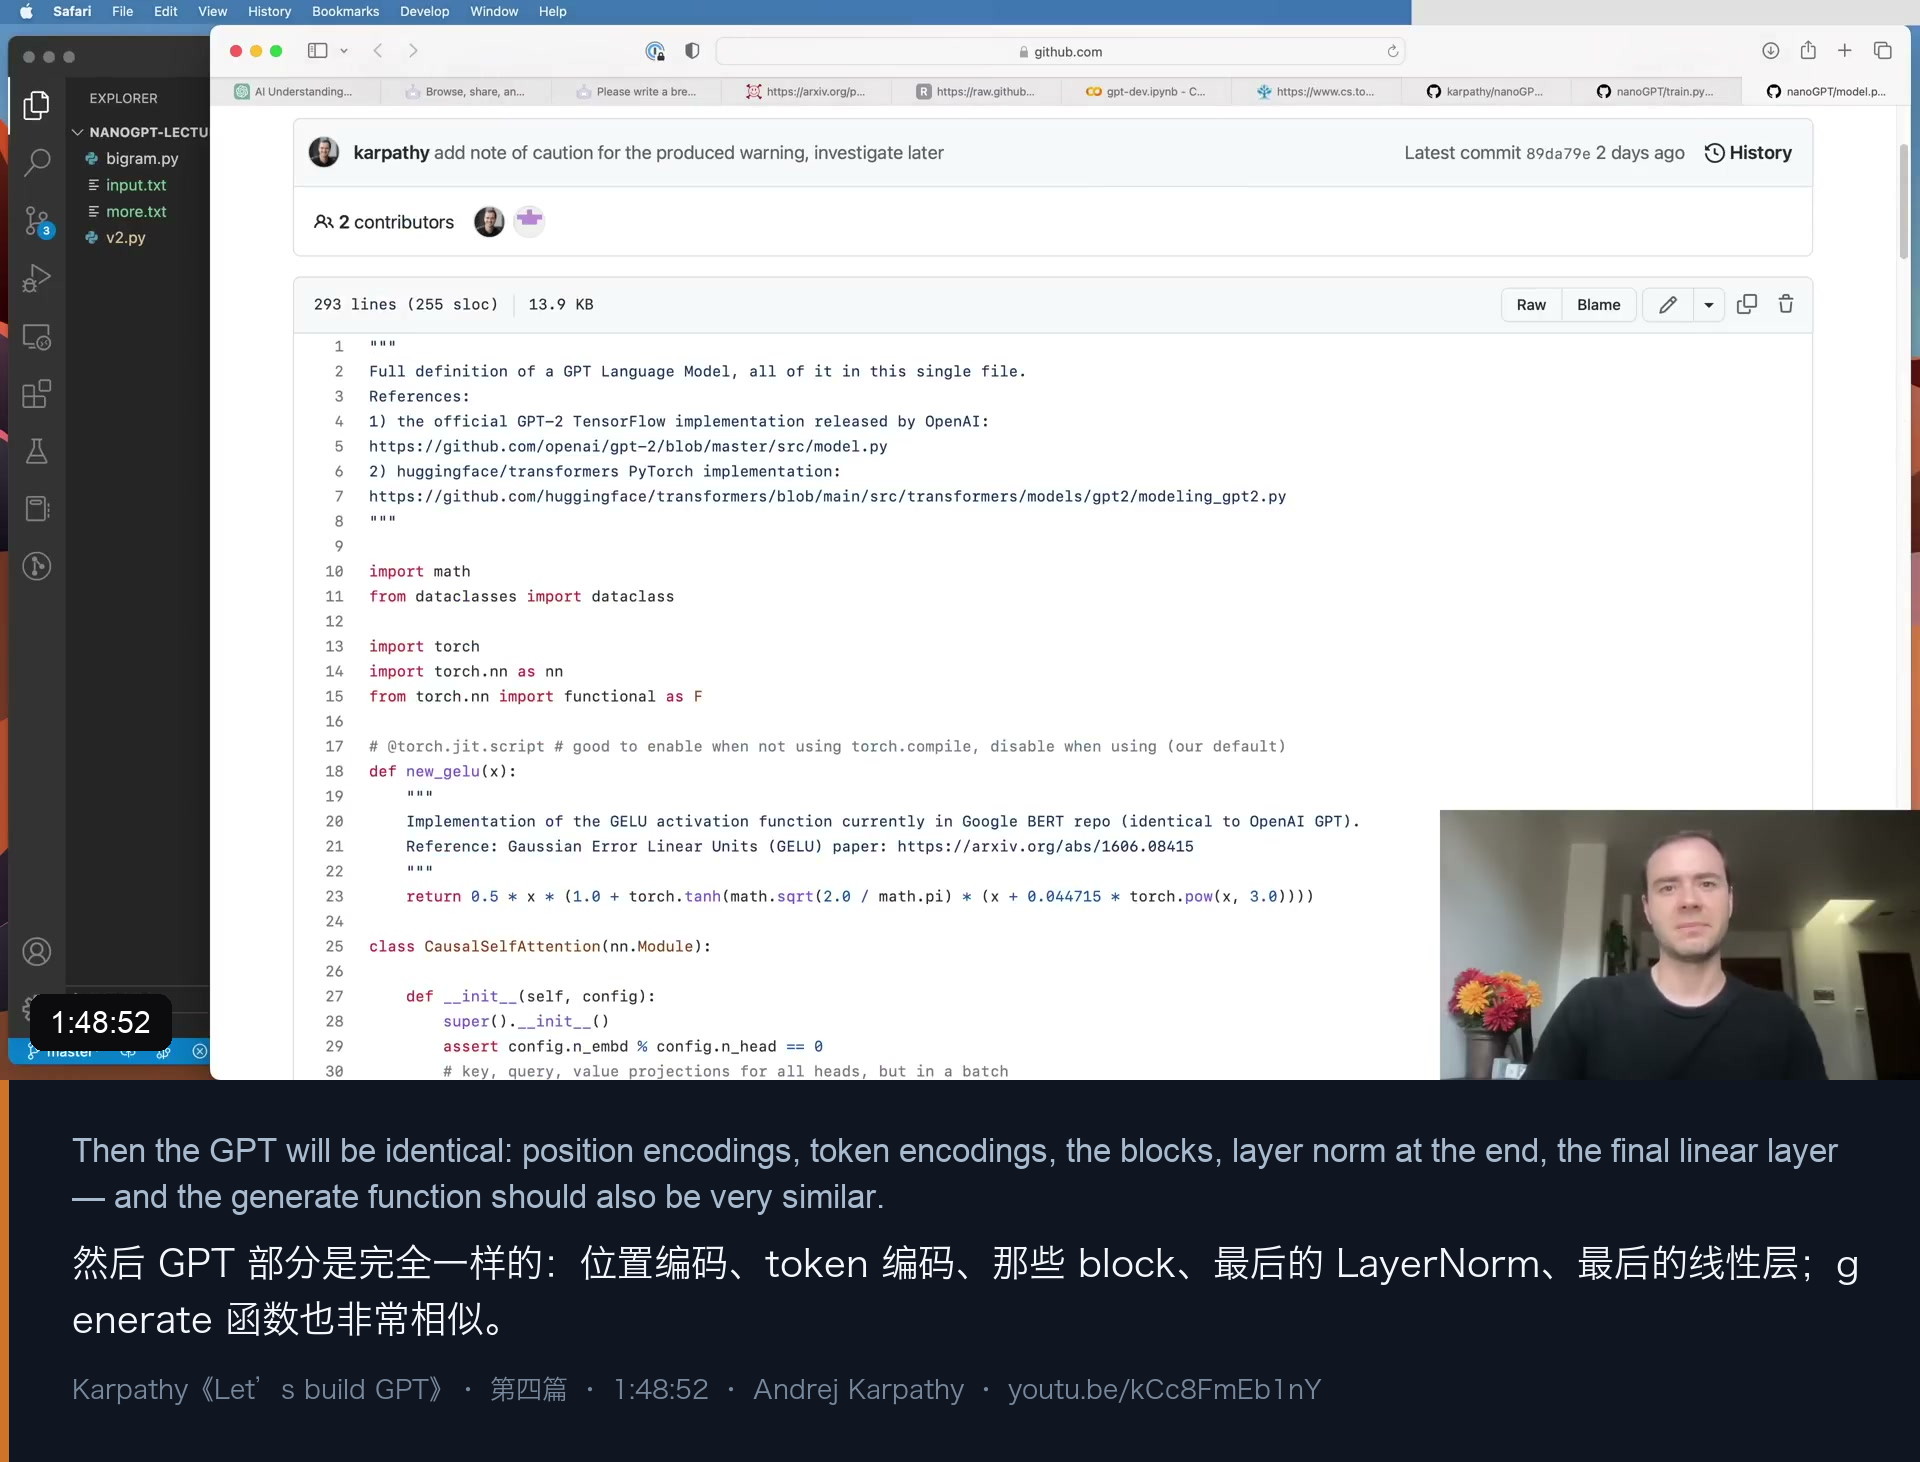
本文补充:这就是「架构相同、工程不同」最直观的一次演示。你以后读任何一个开源大模型实现(LLaMA、Qwen、DeepSeek),会发现自己能认出全部结构——剩下的差异几乎都是:位置编码的实现方式(RoPE / ALiBi)、归一化放在哪里(pre-norm / RMSNorm)、激活函数(GELU / SwiGLU)、以及注意力里的各种效率优化(GQA / MQA / FlashAttention)。骨架你已经在视频里亲手写过一遍了。
3. 从 1000 万参数到 GPT-3:差的是规模,不是结构(01–01)
3.1 我们训练出来的到底是什么
Karpathy 打印了参数量:
我这个用来生成小莎士比亚的 Transformer,大约是 1000 万参数。
然后是数据这一侧,这里有一个容易忽略的换算:
- 莎士比亚文本约 1,000,000 个字符,也就是约 100 万个 token(字符级);
- 但 OpenAI 用的不是字符级词表,而是 subword chunk,词表约 50,000 个元素,序列因此被大幅压缩;
- 所以同样这本文本,在 OpenAI 的词表下大约是 300,000 个 token。
结论:我们训练的是一个 1000 万参数的模型,用了大约 30 万个 token。
3.2 GPT-3 那一侧
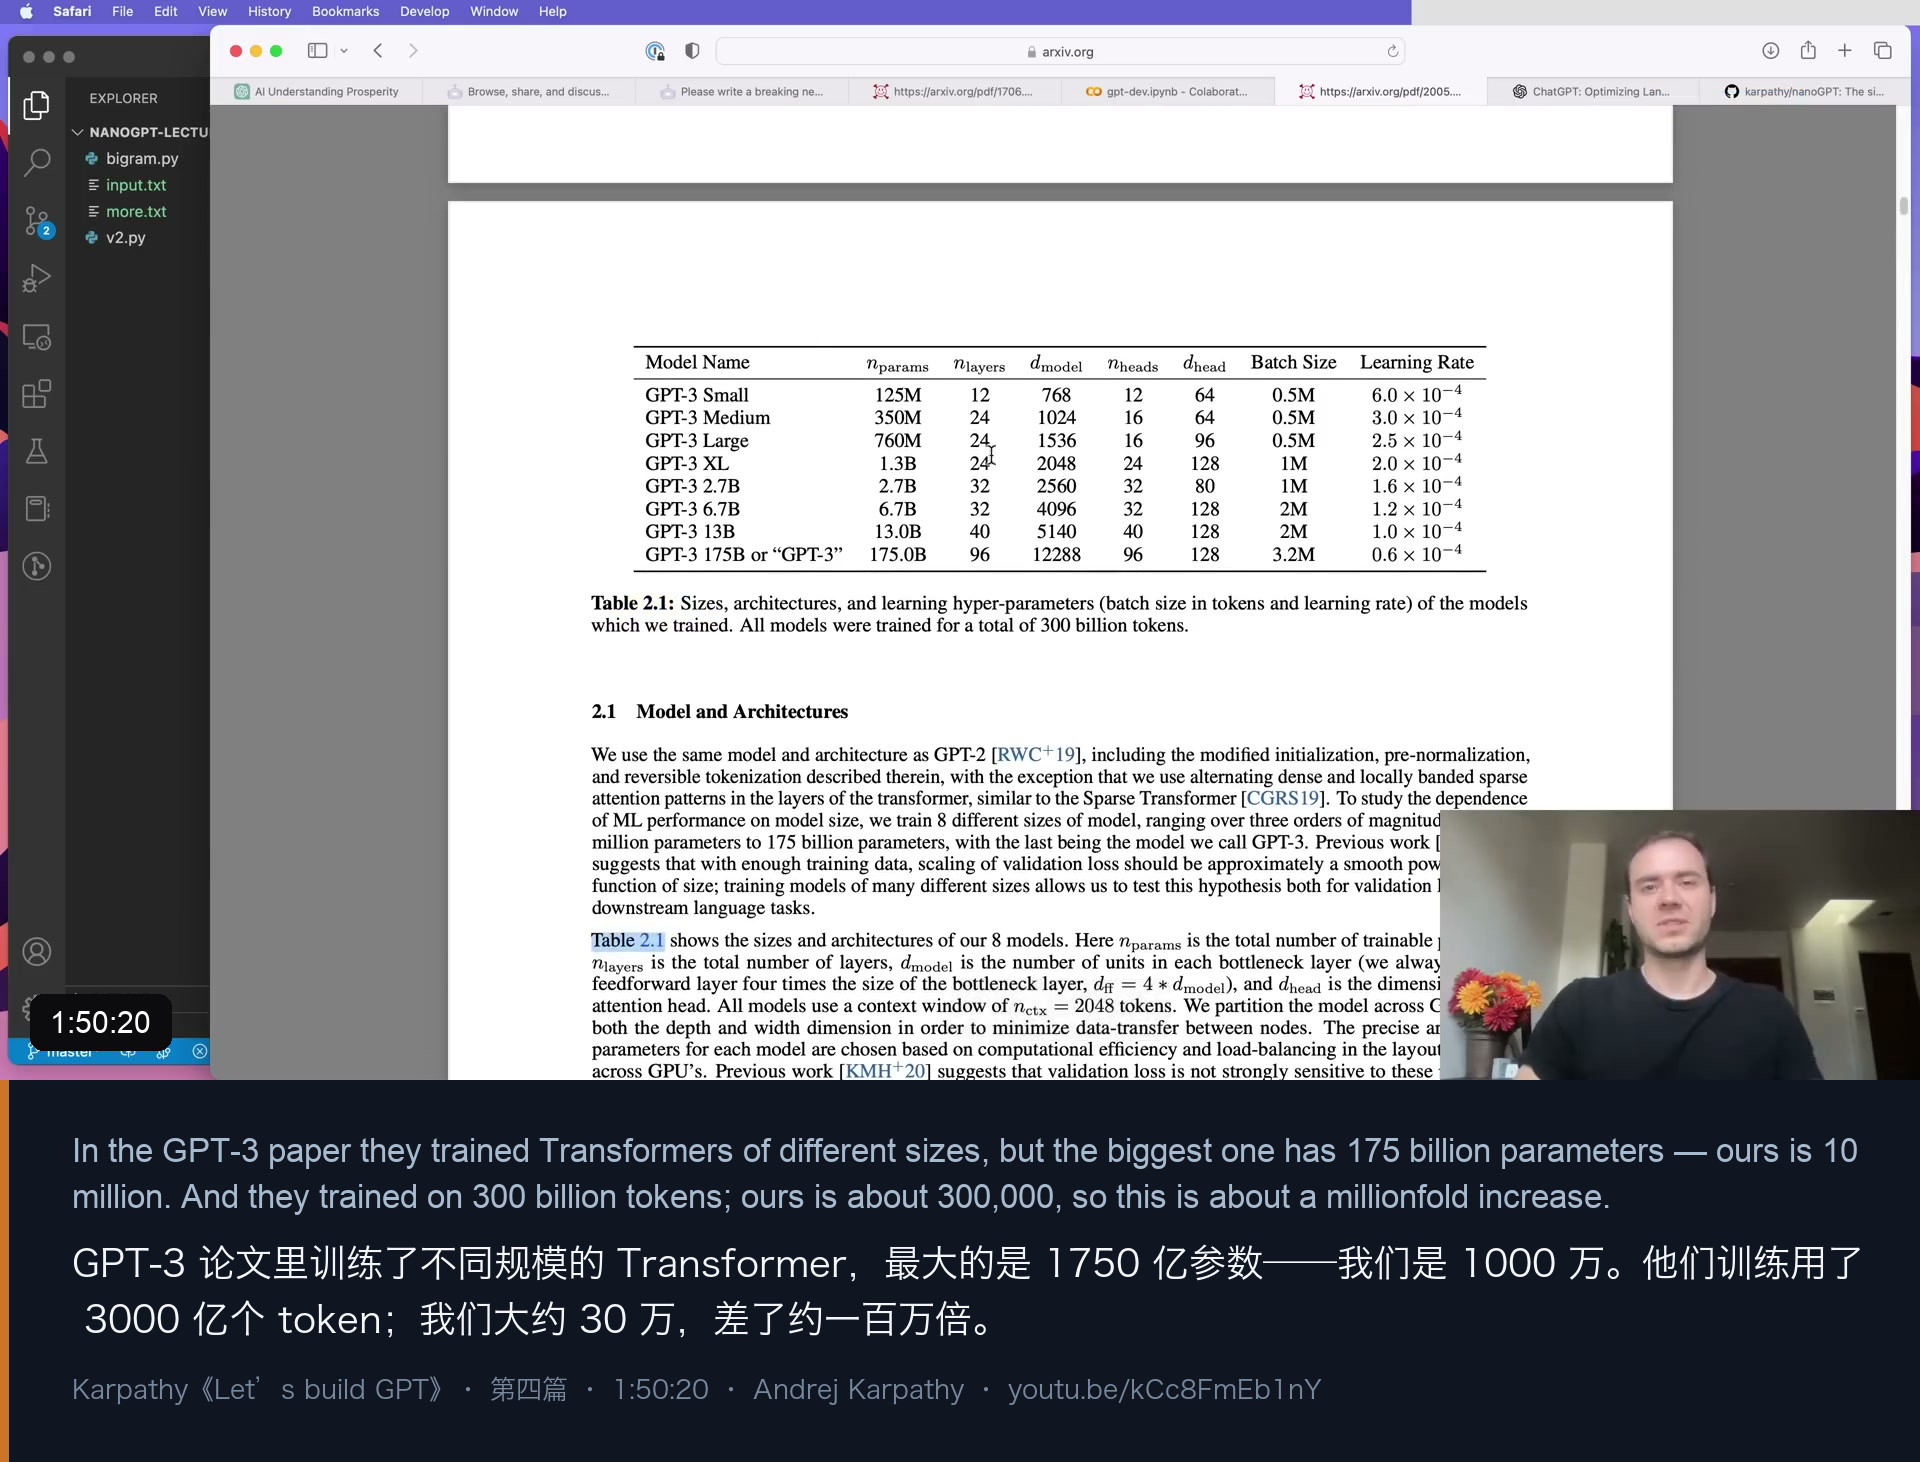
Karpathy 直接翻到 GPT-3 论文的模型表:
| 我们 | GPT-3(最大) | |
|---|---|---|
| 参数量 | ~10,000,000 | 175,000,000,000 |
| 训练 token 数 | ~300,000 | 300,000,000,000 |
| 层数 / 头数 / 头大小 / 学习率 | 我们自己设的 | 论文里逐项列出 |
注意他的说法:这些超参数你应该已经「认得出来」了——n_layer、d_model、n_head、head size、batch size、学习率,和我们调的是同一套东西。
训练 token 数从 30 万到 3000 亿,大约是 100 万倍(a millionfold increase)。
他还补了一句:这个数字按今天的标准已经不算大了——现在动辄上 1 万亿 token。
但除此之外,架构与我们实现的几乎完全相同;真正的差别在于——这是一个巨大的基础设施挑战,通常需要成千上万张 GPU 互相通信。
3.3 一句话总结这个差距
GPT-3 在架构上与我们写的基本相同,只是规模大了 10,000 到 1,000,000 倍——取决于你怎么数。
这就是为什么这个视频值得逐行看完:它把「规模」和「结构」这两件事彻底分开了。你以后再看各家模型发布,会清楚哪些是结构创新、哪些只是规模与数据工程。
4. 预训练之后:从「文档补全器」到「助手」(01–01)
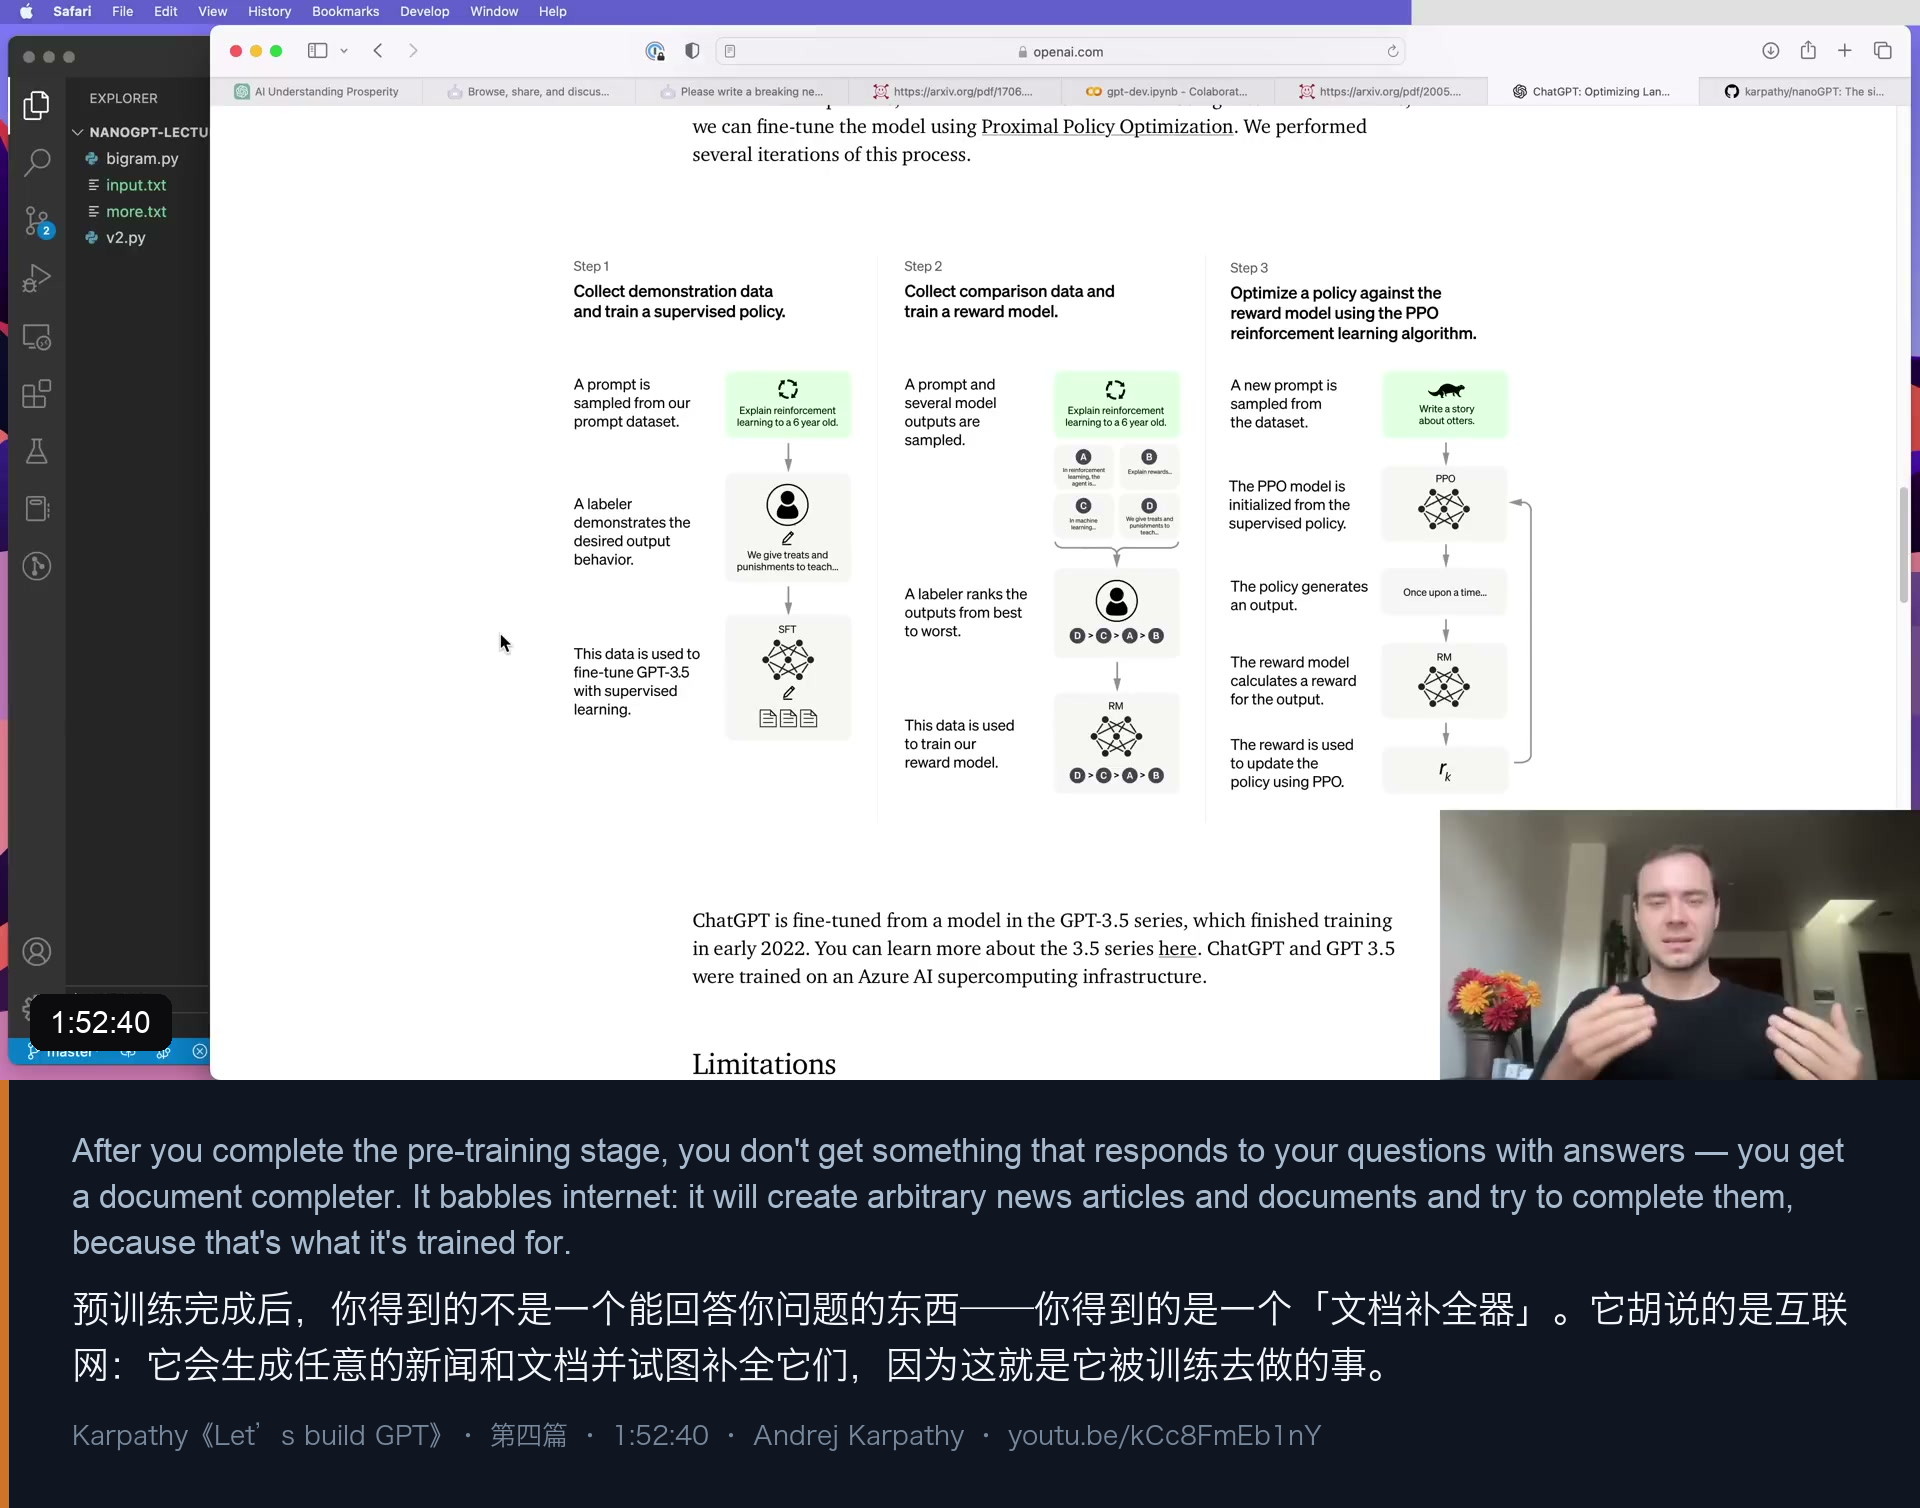
4.1 预训练给你的不是助手,是文档补全器
Karpathy 提醒了一个极其容易被忽略的事实:
完成预训练之后,你得到的不是一个「能回答你问题的东西」。你得到的是一个文档补全器(document completer)。
它的行为是:
- 胡说的是互联网,不是莎士比亚——它会生成随意的新闻文章和文档;
- 你给它一个问题,它可能回你更多问题,也可能忽略你的问题,也可能开始写一篇新闻;
- 因为它被训练的目标只是「补全序列」——所以它会做「一份训练数据里的相似文档接下来会做的事」。
他用了很重的一个词:totally undefined behavior(完全未定义的行为)。
4.2 第二阶段:对齐,大致三步
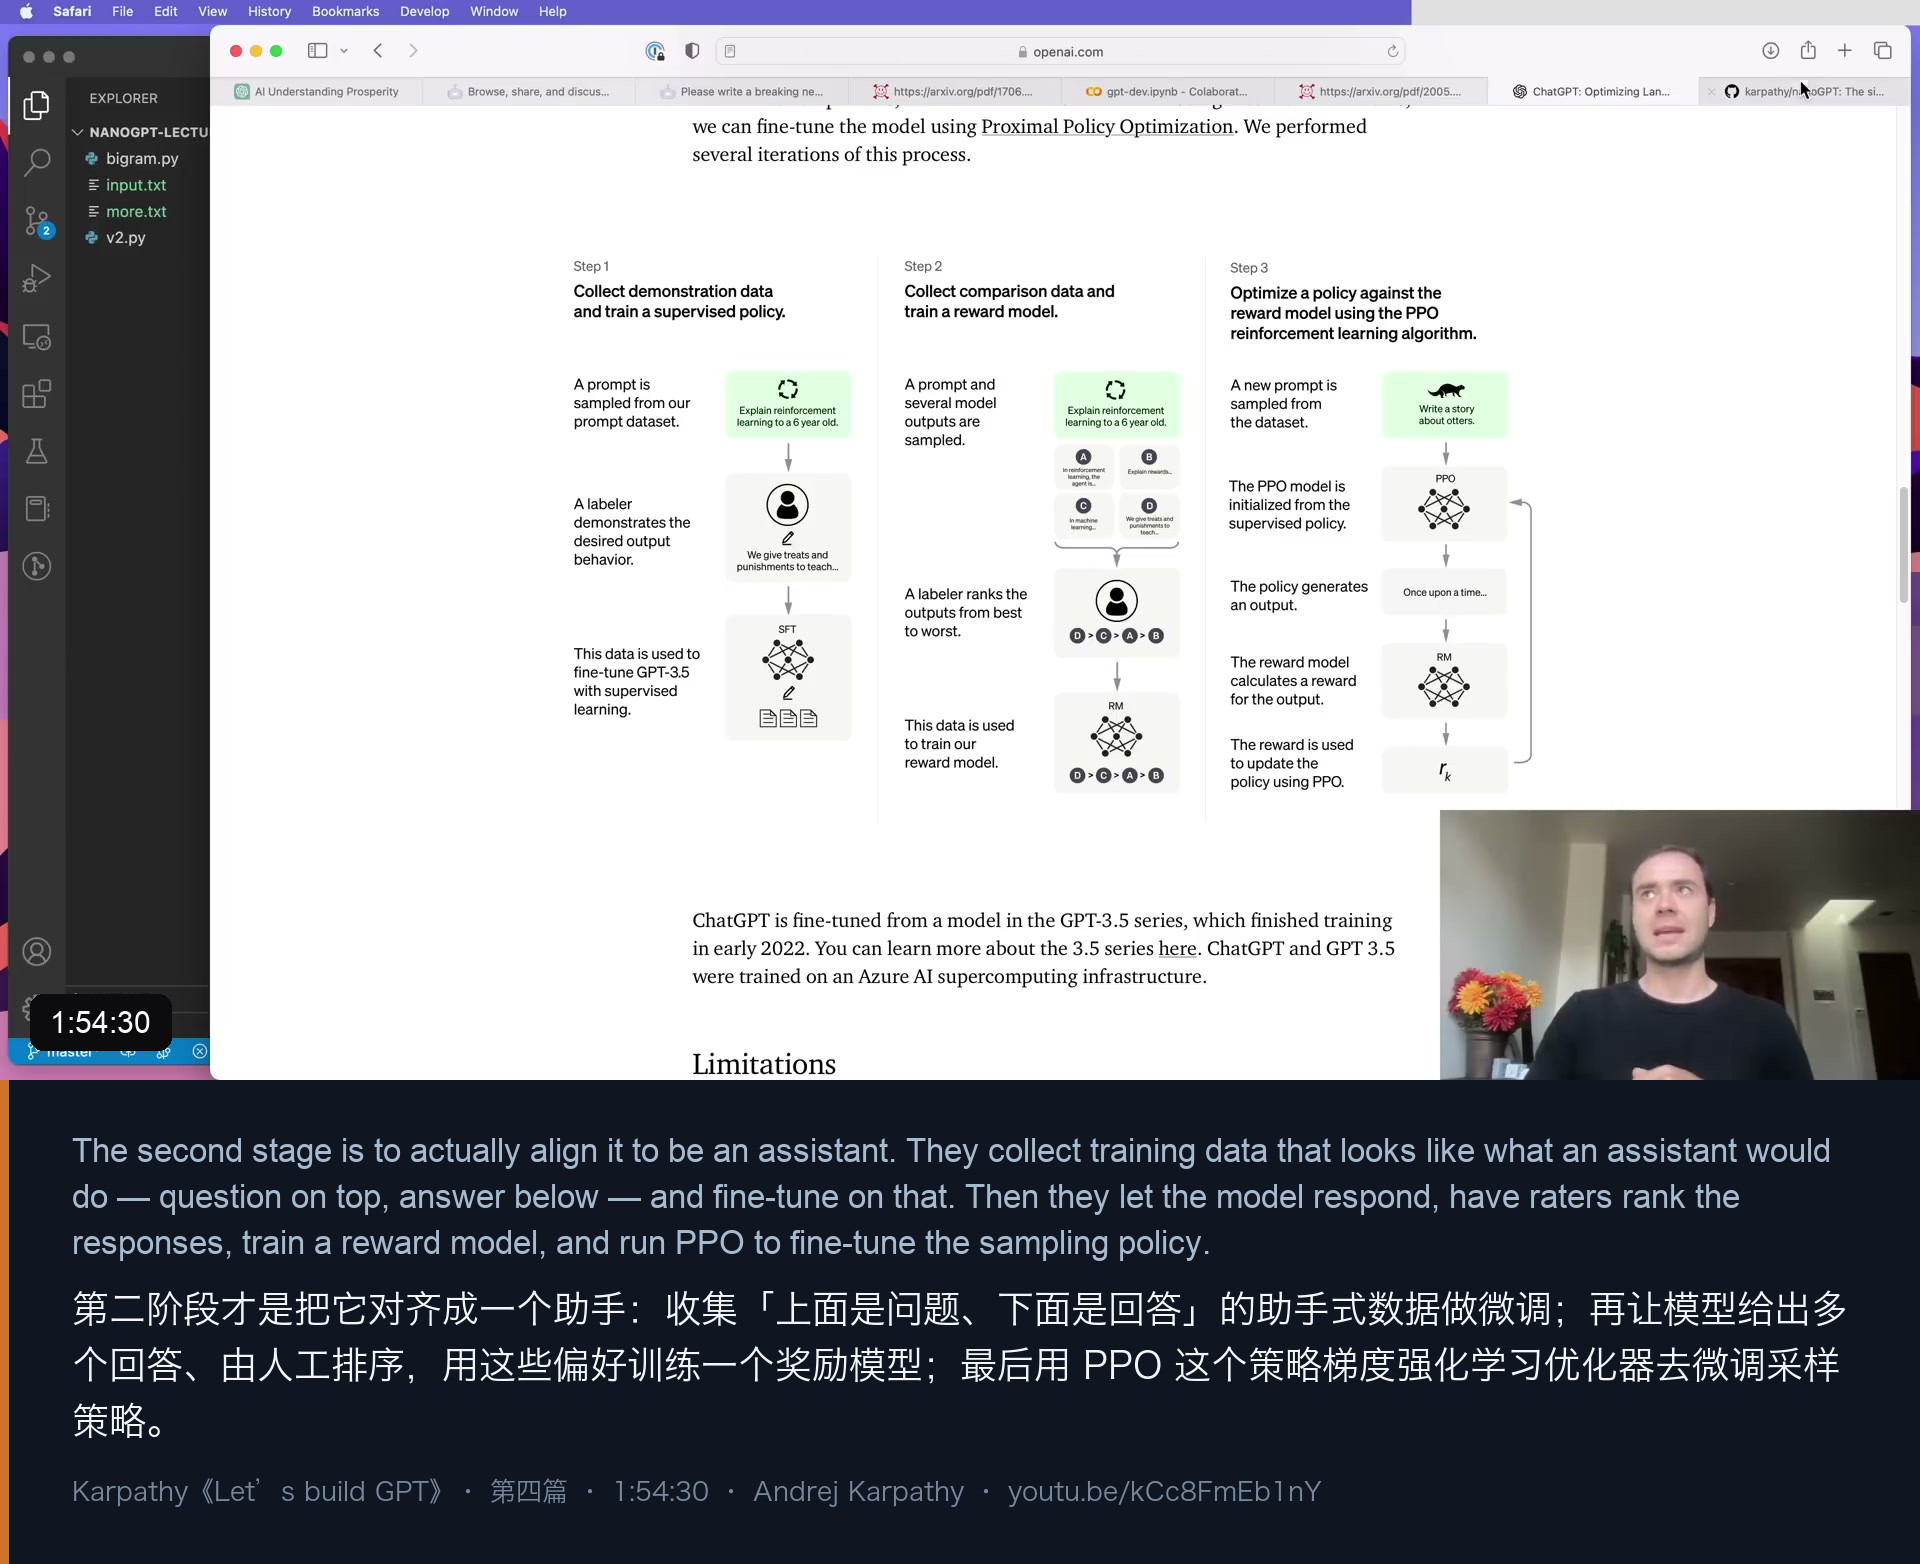
Karpathy 用 OpenAI 那篇 ChatGPT 博客把流程讲了一遍:
- 收集助手式数据并做监督微调(SFT):数据的格式就是「上面是问题,下面是回答」。这类数据规模远小于互联网——可能是几千条量级。然后在这个格式上微调,让模型开始「期待看到问题、并补全回答」。
- 他还点出一个反直觉的现象:这些超大模型在微调阶段非常「样本高效」——「这居然真的管用」。
- 训练奖励模型:让模型对同一问题生成多个回答,由人类标注者排序(哪个更好)。用这些偏好数据训练一个奖励模型,用来预测任意候选回答的「可取程度」。
- 用 PPO 做强化学习微调:有了奖励模型之后,用 PPO(一种策略梯度强化学习方法)去优化采样策略,让模型生成的回答在奖励模型下期望得分更高。
这三步把模型从「文档补全器」变成「问答助手」。
而且 Karpathy 明确划定了边界:
这个阶段的大部分数据并不公开,它是 OpenAI 内部的,也难复现得多。nanoGPT 覆盖的是预训练阶段。
4.3 视频的收尾
Karpathy 用几句话总结了整场讲座:
我们训练了一个 decoder-only 的 Transformer,遵循 2017 年那篇著名的《Attention Is All You Need》,在 tiny Shakespeare 上得到了合理的结果。全部训练代码大约 200 行——我会把这份代码库放出来,里面还带着我们一路构建过来的 git log 提交记录,另外也会放上 Colab notebook。
然后是他的临别提醒:
我们没有讲任何微调阶段。如果你想做的不是「语言建模」,而是执行任务、做特定对齐、或者情感分类——只要你不想要一个纯粹的文档补全器,你就必须走后面那些微调阶段:可能是简单的监督微调,也可能是像 ChatGPT 那样训练奖励模型、再跑若干轮 PPO。
5. 从 BERT 到 GPT:同一个 Transformer,三种用法(本文补充)
这一节不是视频内容,是写给「做过 BERT 微调、但没碰过大模型训练」的人的一页对照表。你其实已经会读 Transformer 了,只是用它的方式不一样。
| 原论文 | BERT(encoder-only) | GPT(decoder-only) | |
|---|---|---|---|
| 注意力掩码 | 编码器无掩码 / 解码器有掩码 | 无掩码(双向看全句) | 有掩码(只能看过去) |
| 训练目标 | 机器翻译 | 掩码语言模型 + 下一句预测 | 预测下一个 token |
| 输入 | 源语言 → 目标语言 | 单句 / 句对 | 一段文本 |
| 输出用途 | 生成译文 | 取 [CLS] 表示做分类 |
生成续写 |
| 典型用法 | — | 加一个头做微调 | 预训练 + 提示 / 微调 |
| 注意力里的 Q/K/V 来源 | 解码器 query 来自自身,K/V 来自编码器(cross-attention) | 三者都来自自身(self-attention) | 三者都来自自身(self-attention,带掩码) |
三个能立刻用上的结论:
nn.Embedding(vocab, n_embd)+lm_head就是 BERT 的 embedding + MLM head。 你在 BERT 里见到的「embedding 层 + 输出层权重绑定(weight tying)」,和我们在第一篇里写的token_embedding_table/lm_head是同一件事的两种形态。- BERT 的「微调」和 GPT 的「预训练」不是同一层级的概念。 同一个 Transformer,前面接不同的头、用不同的目标训练,就变成了完全不同的东西。ChatGPT 的「微调」是在预训练之上再做对齐(第三篇之外的第二阶段);而 BERT 的微调是在预训练之上接一个任务头。两者都叫 fine-tuning,但数据和目标完全不同。
- 你以前熟悉的
[CLS]、[SEP]、段落级表示,本质是「encoder 看全句」的产物。 GPT 不能这样工作——它的每个位置只能看到自己左边,所以它天然是「逐 token 生成」的,而不是「一次理解整句」。这就是为什么 GPT 需要「把任务写进提示里」,而 BERT 只需要换一个头。
如果你想沿着这条线继续走,Karpathy 在视频里给的路标是:nanoGPT(预训练)→ 复现 GPT-2 (124M) → 再往上就是基础设施问题和数据问题了。
本篇速查
| 问题 | 答案 |
|---|---|
| 原论文为什么有两个 Transformer? | 机器翻译需要 condition 在源语言上 → encoder + cross-attention |
| cross-attention 里 Q/K/V 各来自哪? | Q 来自解码器当前状态,K/V 来自编码器输出 |
| GPT 为什么是 decoder-only? | 没有条件输入,只需要自回归生成 |
| nanoGPT 与我们的代码差在哪? | 多头合并为批处理(四维张量)、MLP 用 GELU、checkpoint / DDP / lr 衰减等工程件 |
| 我们的规模? | ~10M 参数,~300,000 个 GPT-2 token |
| GPT-3 最大规模? | 175B 参数,300B tokens(差约 100 万倍) |
| 预训练的产物是什么? | 文档补全器,不是助手 |
| 对齐的三个步骤? | SFT → 训练奖励模型(人类排序)→ PPO 微调采样策略 |
| nanoGPT 覆盖哪一段? | 只覆盖预训练 |
自测题
- cross-attention 与 self-attention 的唯一区别是什么?为什么编码器不需要三角掩码?
- 如果让你做一个「中文 → 英文」的翻译模型,你会用 encoder-only、decoder-only 还是 encoder-decoder?为什么?
- nanoGPT 把多头实现在同一个批处理里,张量变成了四维。请说出这四个维度分别是什么。
- 为什么「参数量大 100 万倍」和「架构几乎相同」这两件事可以同时成立?这对你判断模型新闻有什么帮助?
- 预训练模型的输出是「文档补全器」。请举一个你在日常使用中见过、能用这个性质解释的失败案例。
- 为什么 PPO 需要先有一个奖励模型,而不是直接用人类反馈微调?
系列小结
四篇走完,你现在手上应该有这样的东西:
- 一篇完整可跑的代码心智模型:从 1MB 文本 → 65 个字符的词表 →
(B,T)的样本 → embedding + 位置编码 → 掩码多头自注意力 → 前馈 → 残差 + LayerNorm →lm_head→ 交叉熵 → 采样生成; - 一条能对上数字的损失曲线:4.87 → 2.5 → 2.4 → 2.28 → 2.24 → 2.08 → 2.06 → 1.48,每一个台阶对应一个具体的零件;
- 一个尺度坐标:我们的 10M / 300k token 与 GPT-3 的 175B / 300B token,结构相同,规模差百万倍。
如果只记一件事,我建议记 Karpathy 在视频里反复回到的那个方法论:先做一个最简单、能跑的基线,然后一次只改一个东西,并且永远知道自己在哪个数字上。 这也是这个系列四篇文章真正想传递的东西。
系列四篇
- 语言模型、字符级 tokenizer 与 bigram 基线(00–00)
- 自注意力:从「加权平均的数学技巧」到 Q / K / V(00–01)
- 多头注意力、前馈、残差与 LayerNorm:拼出完整的 Transformer Block(01–01)
- nanoGPT、encoder vs decoder,以及从 1000 万参数到 GPT-3 的距离(01–01)
讨论
这里是静态站点,没有内嵌评论区。如果这篇文章对你有用,欢迎通过 RSS 订阅后续更新。