Karpathy《Let's build GPT》第三篇:多头注意力、前馈、残差与 LayerNorm——拼出完整的 Transformer Block
Karpathy《Let's build GPT》精读系列第三篇:把 Transformer Block 剩下的零件全部装上,并首次跑出真正的 GPT 结构。多头注意力(多条并行通信频道,输出拼接后投影回 n_embd)→ 前馈网络(逐 token 独立的 Linear-ReLU-Linear,中间放大 4 倍,负责「计算」)→ 残差连接(加法把梯度等量分给两路,形成通往输入的梯度高速公路)→ LayerNorm(归一化「行」而非「列」,只改一个维度数字;本课用 pre-norm)→ dropout,最后把模型放大到 n_embd=384、6 头、6 层、dropout 0.2。验证损失沿 2.4 → 2.28 → 2.24 → 2.08 → 2.06 → 1.48 一路下降,每一个数字对应一个具体零件。文中 13 张配图均截自视频对应时刻,并把当时的完整观点句(英文原句+中文翻译)拼进图里。
来源:YouTube 原视频(Andrej Karpathy,2023-01-17,时长 1:56)·配套代码:nanoGPT
阅读说明
- 这是四篇系列的第三篇,覆盖原视频 01–01。上一篇结束时,我们只有「一个自注意力头」,验证损失卡在 2.4。
- 这一篇要做的是把剩下的零件全部装上:多头注意力 → 前馈网络 → 残差连接 → LayerNorm → dropout,然后把模型放大。最后你会看到一个完整的、只解码器的 Transformer——也就是 GPT。
- 验证损失的变化是这一篇的主线,请记住这条曲线:2.4 → 2.28(多头)→ 2.24(前馈)→ 2.08(残差 + 4 倍前馈)→ 2.06(LayerNorm)→ 1.48(放大 + dropout)。每一次改动对应一个具体的零件,这也是这个视频最好用的地方:你能把「架构里的某个东西」和「损失上的某个数字」直接对起来。
- 代码与数字均按视频整理;标记「本文补充」的是我的解释。
1. 多头注意力:多开几条通信频道(01–01)
1.1 动机:一条频道不够用
上一篇的单头注意力只有一条通信通道,head_size = n_embd = 32。Karpathy 的说法是:这些 token 有太多东西要交流了——它们各自想找辅音、想找元音、想找特定位置上的东西——一条频道装不下。
多头注意力的做法朴素得惊人:开多条并行频道,然后拼起来。
class MultiHeadAttention(nn.Module):
    """multiple heads of self-attention in parallel"""
    def __init__(self, num_heads, head_size):
        super().__init__()
        self.heads = nn.ModuleList([Head(head_size) for _ in range(num_heads)])
        self.proj = nn.Linear(n_embd, n_embd)   # 拼接之后的输出投影

    def forward(self, x):
        out = torch.cat([h(x) for h in self.heads], dim=-1)
        out = self.proj(out)
return out以视频里的配置为例:n_embd = 32、4 个头 → 每个头 8 维,4 × 8 = 32,拼回来正好等于原来的嵌入维度。
Karpathy 顺手给了一个很好用的类比:这很像卷积里的「分组卷积(group convolution)」——不是用一个大卷积核,而是分成几组各自卷积。
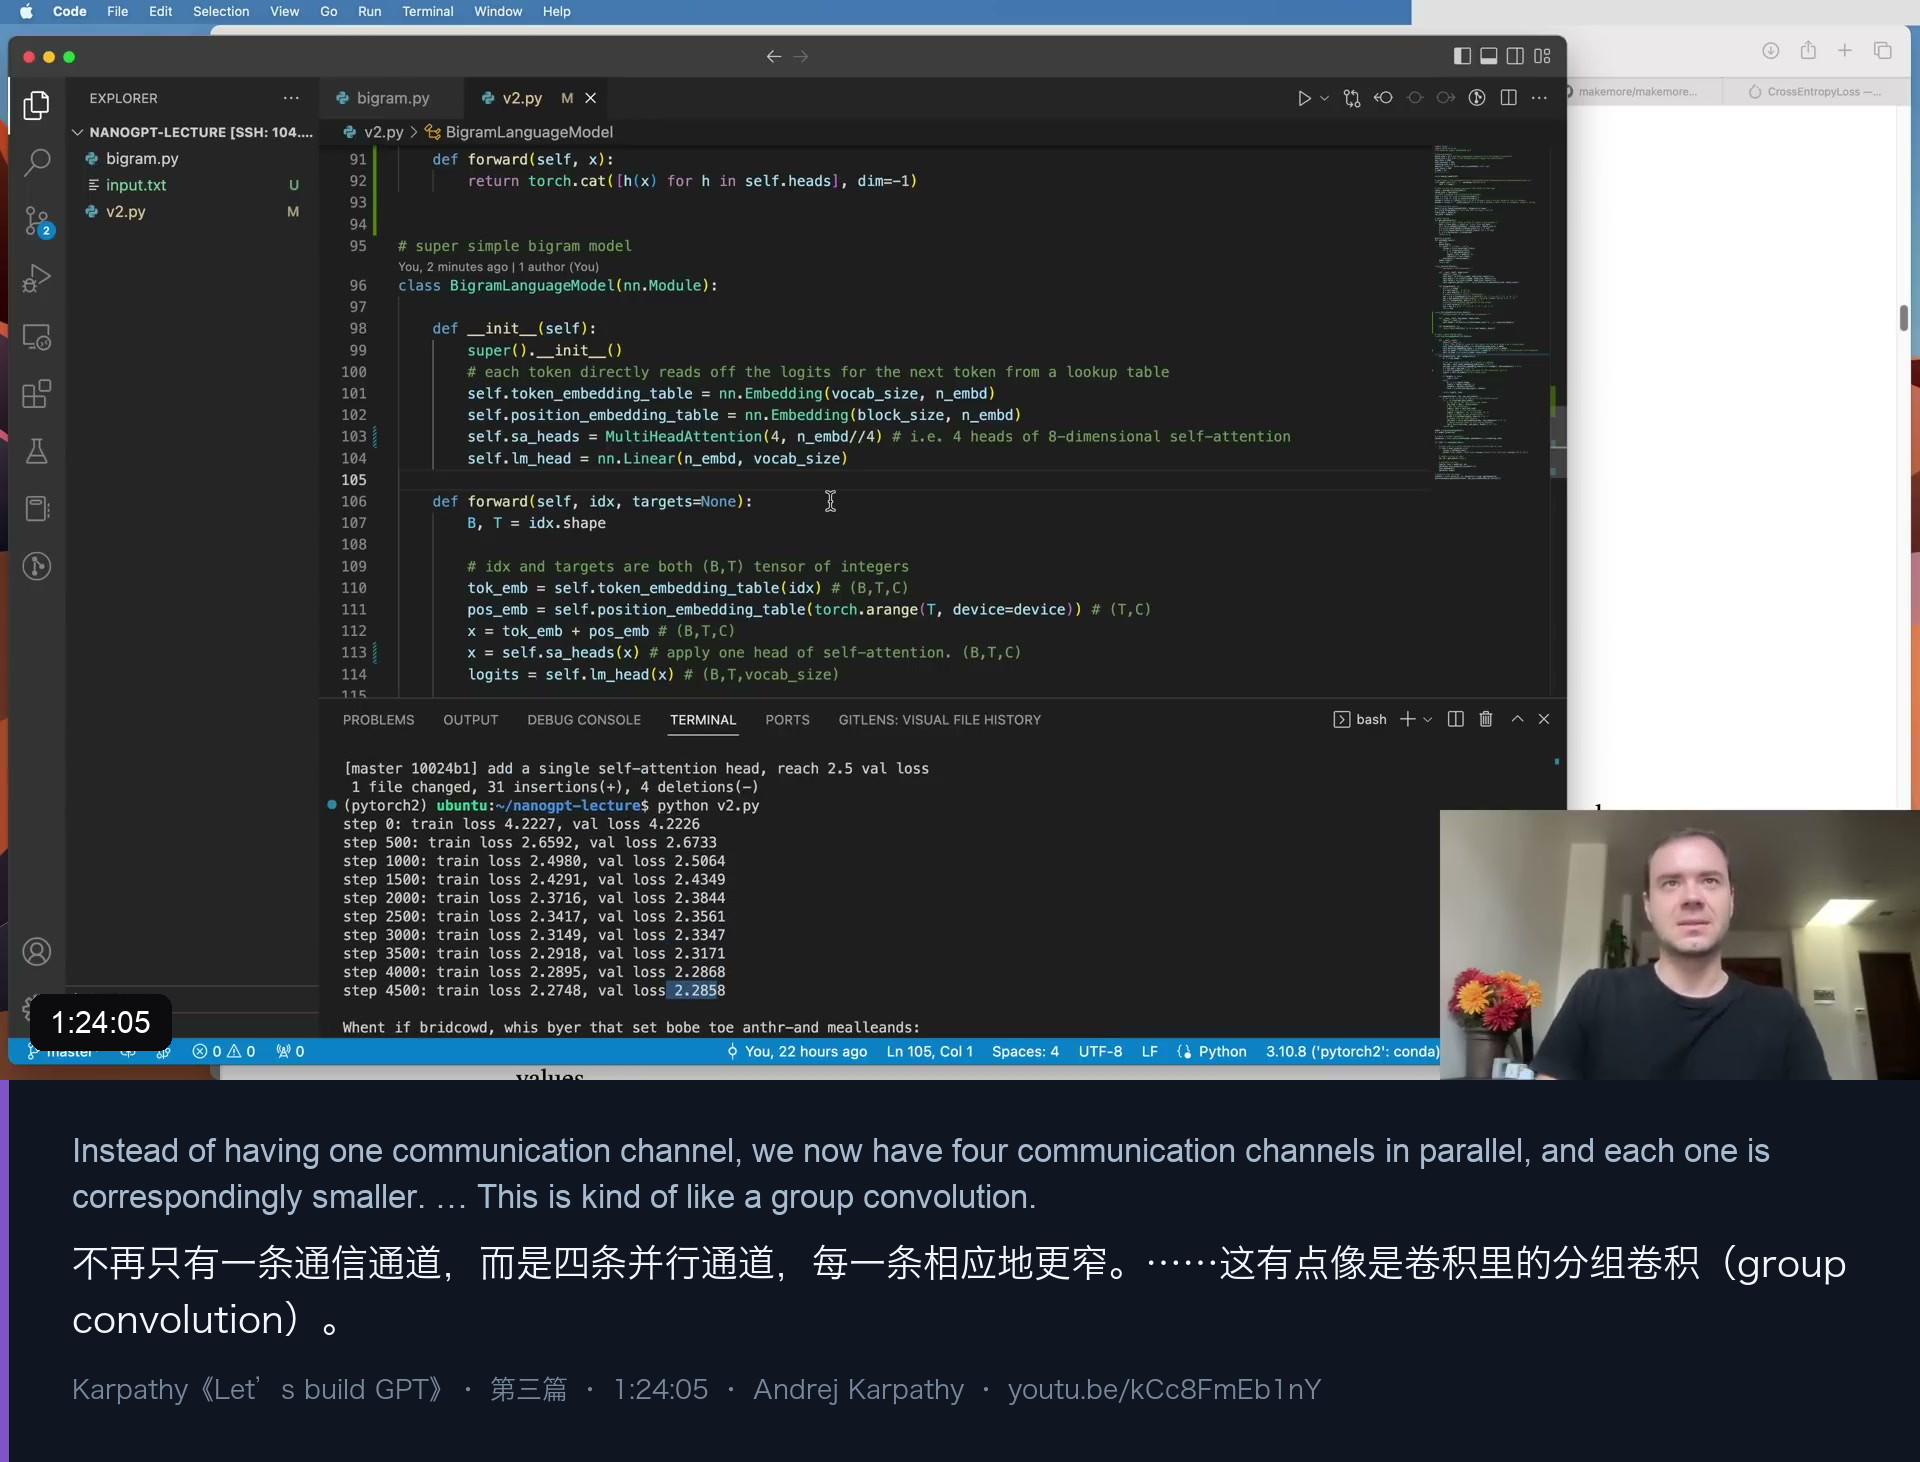
1.2 结果:2.4 → 2.28
验证损失从 2.4 降到大约 2.28。生成的文本仍然谈不上好,但验证损失明确在改善。
为什么有效?Karpathy 的解释很直观:多个独立的通信通道可以收集不同类型的信息——有的头去找元音,有的头去找特定位置的辅音——然后交给后面去解码。
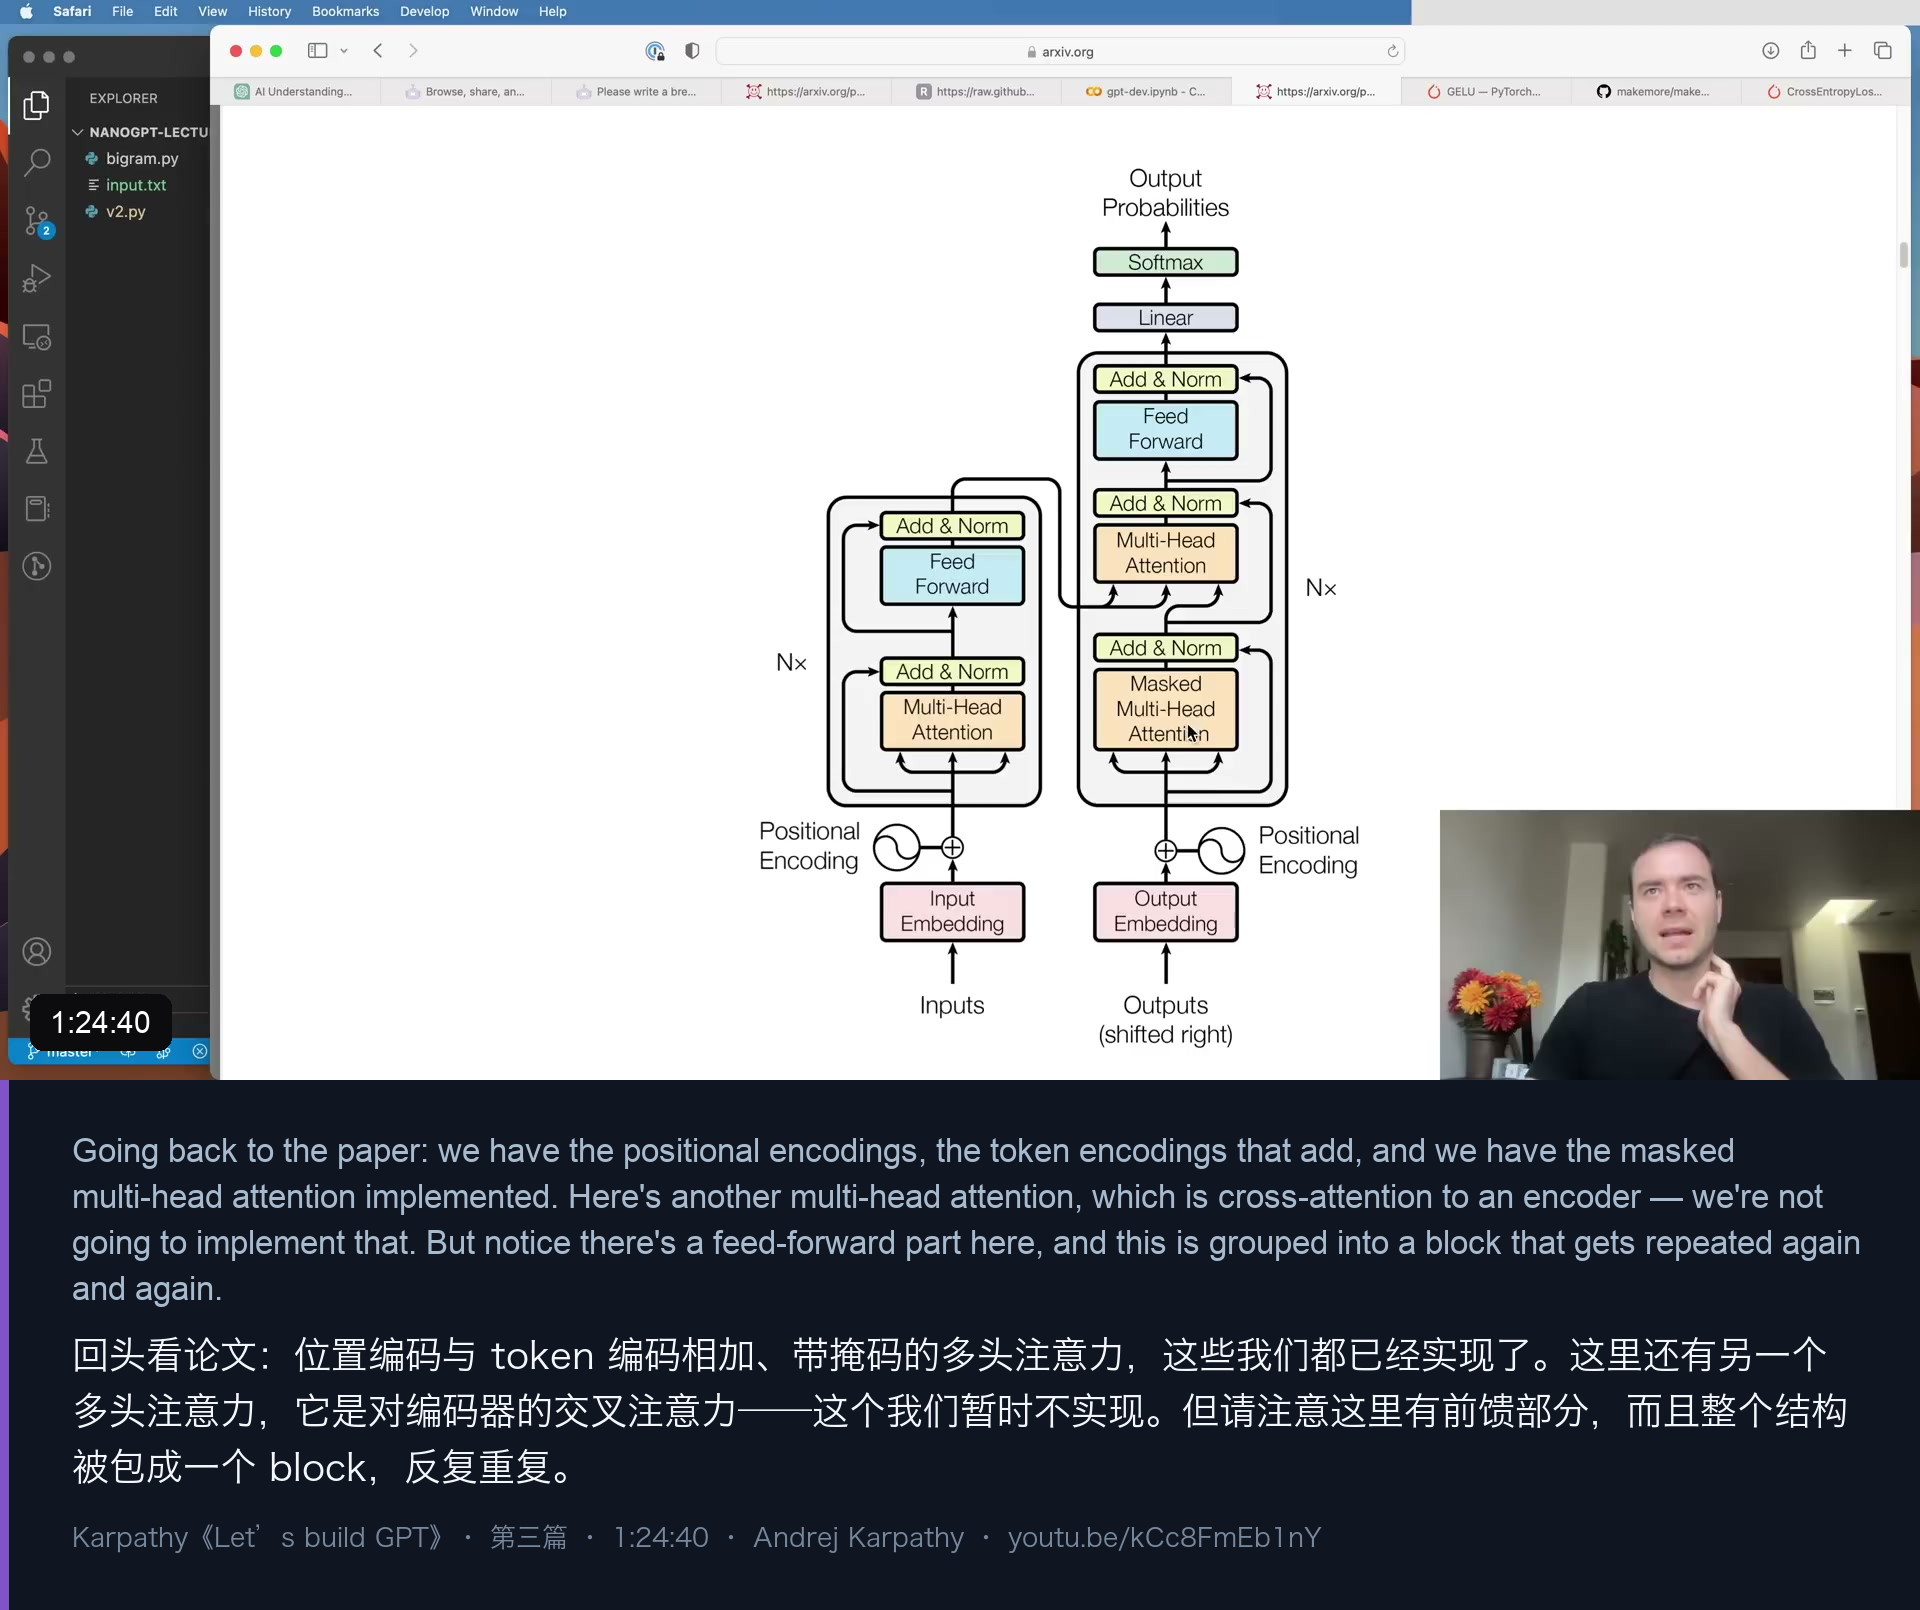
1.3 回到论文:我们走到哪一步了
到这里,Karpathy 把原论文的架构图放回屏幕上,逐块对照:
- 位置编码 + token 编码相加 ✅ 已实现
- 带掩码的多头注意力(Masked Multi-Head Attention) ✅ 已实现
- 另一个多头注意力(cross-attention,指向 encoder) ❌ 本课不实现
- 前馈网络(Feed Forward) ⬜ 下一步
- 把上面这些包成一个块,反复重复 ⬜ 下一步
2. 前馈网络:让 token 有时间「思考」(01–01)
2.1 通信 vs 计算
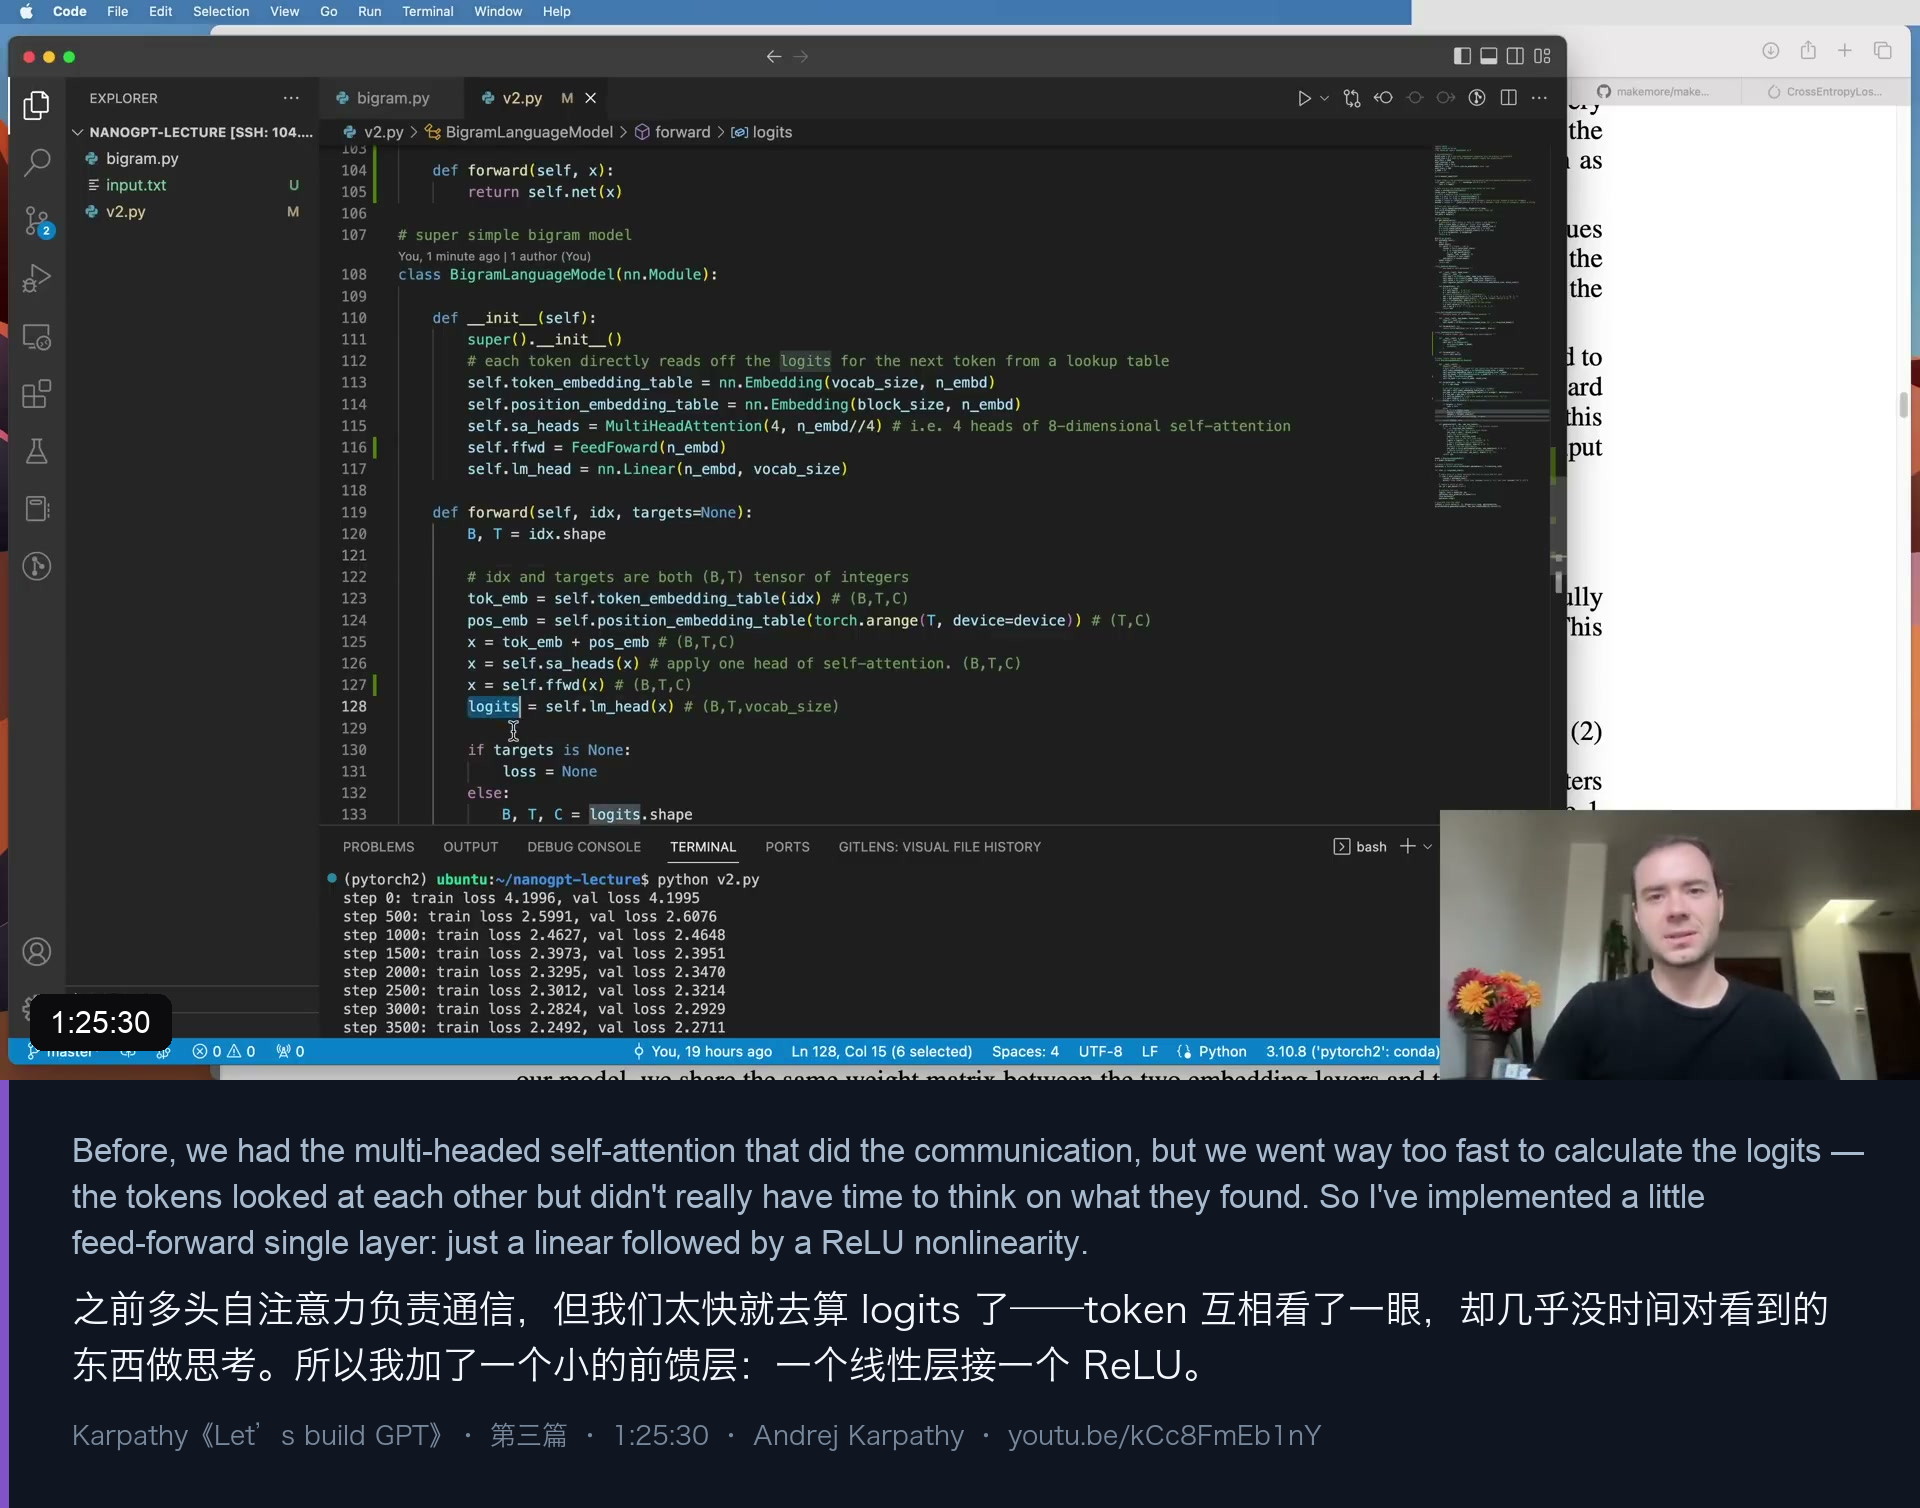
前馈网络的动机,是整段视频里最好的一句类比:
多头自注意力负责通信——token 彼此交换信息。但我们太快就去算 logits 了:token 们互相看了一眼,却没时间对看到的东西做思考。所以我要加一个小的前馈层,让每个 token 独自消化它收集到的信息。
class FeedForward(nn.Module):
    def __init__(self, n_embd):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(n_embd, 4 * n_embd),
            nn.ReLU(),
            nn.Linear(4 * n_embd, n_embd),
        )

    def forward(self, x):
        return self.net(x)
两个关键性质:
- 逐 token 独立(position-wise)。
nn.Linear作用在最后一维上,所以每个位置各自计算,token 之间不发生任何交互——交互已经在注意力里做完了。 - 中间层放大 4 倍。Karpathy 特意回论文确认:原文里模型维度是 512、前馈内层是 2048,一个 4 倍的乘法。所以这里是
n_embd → 4*n_embd → n_embd。
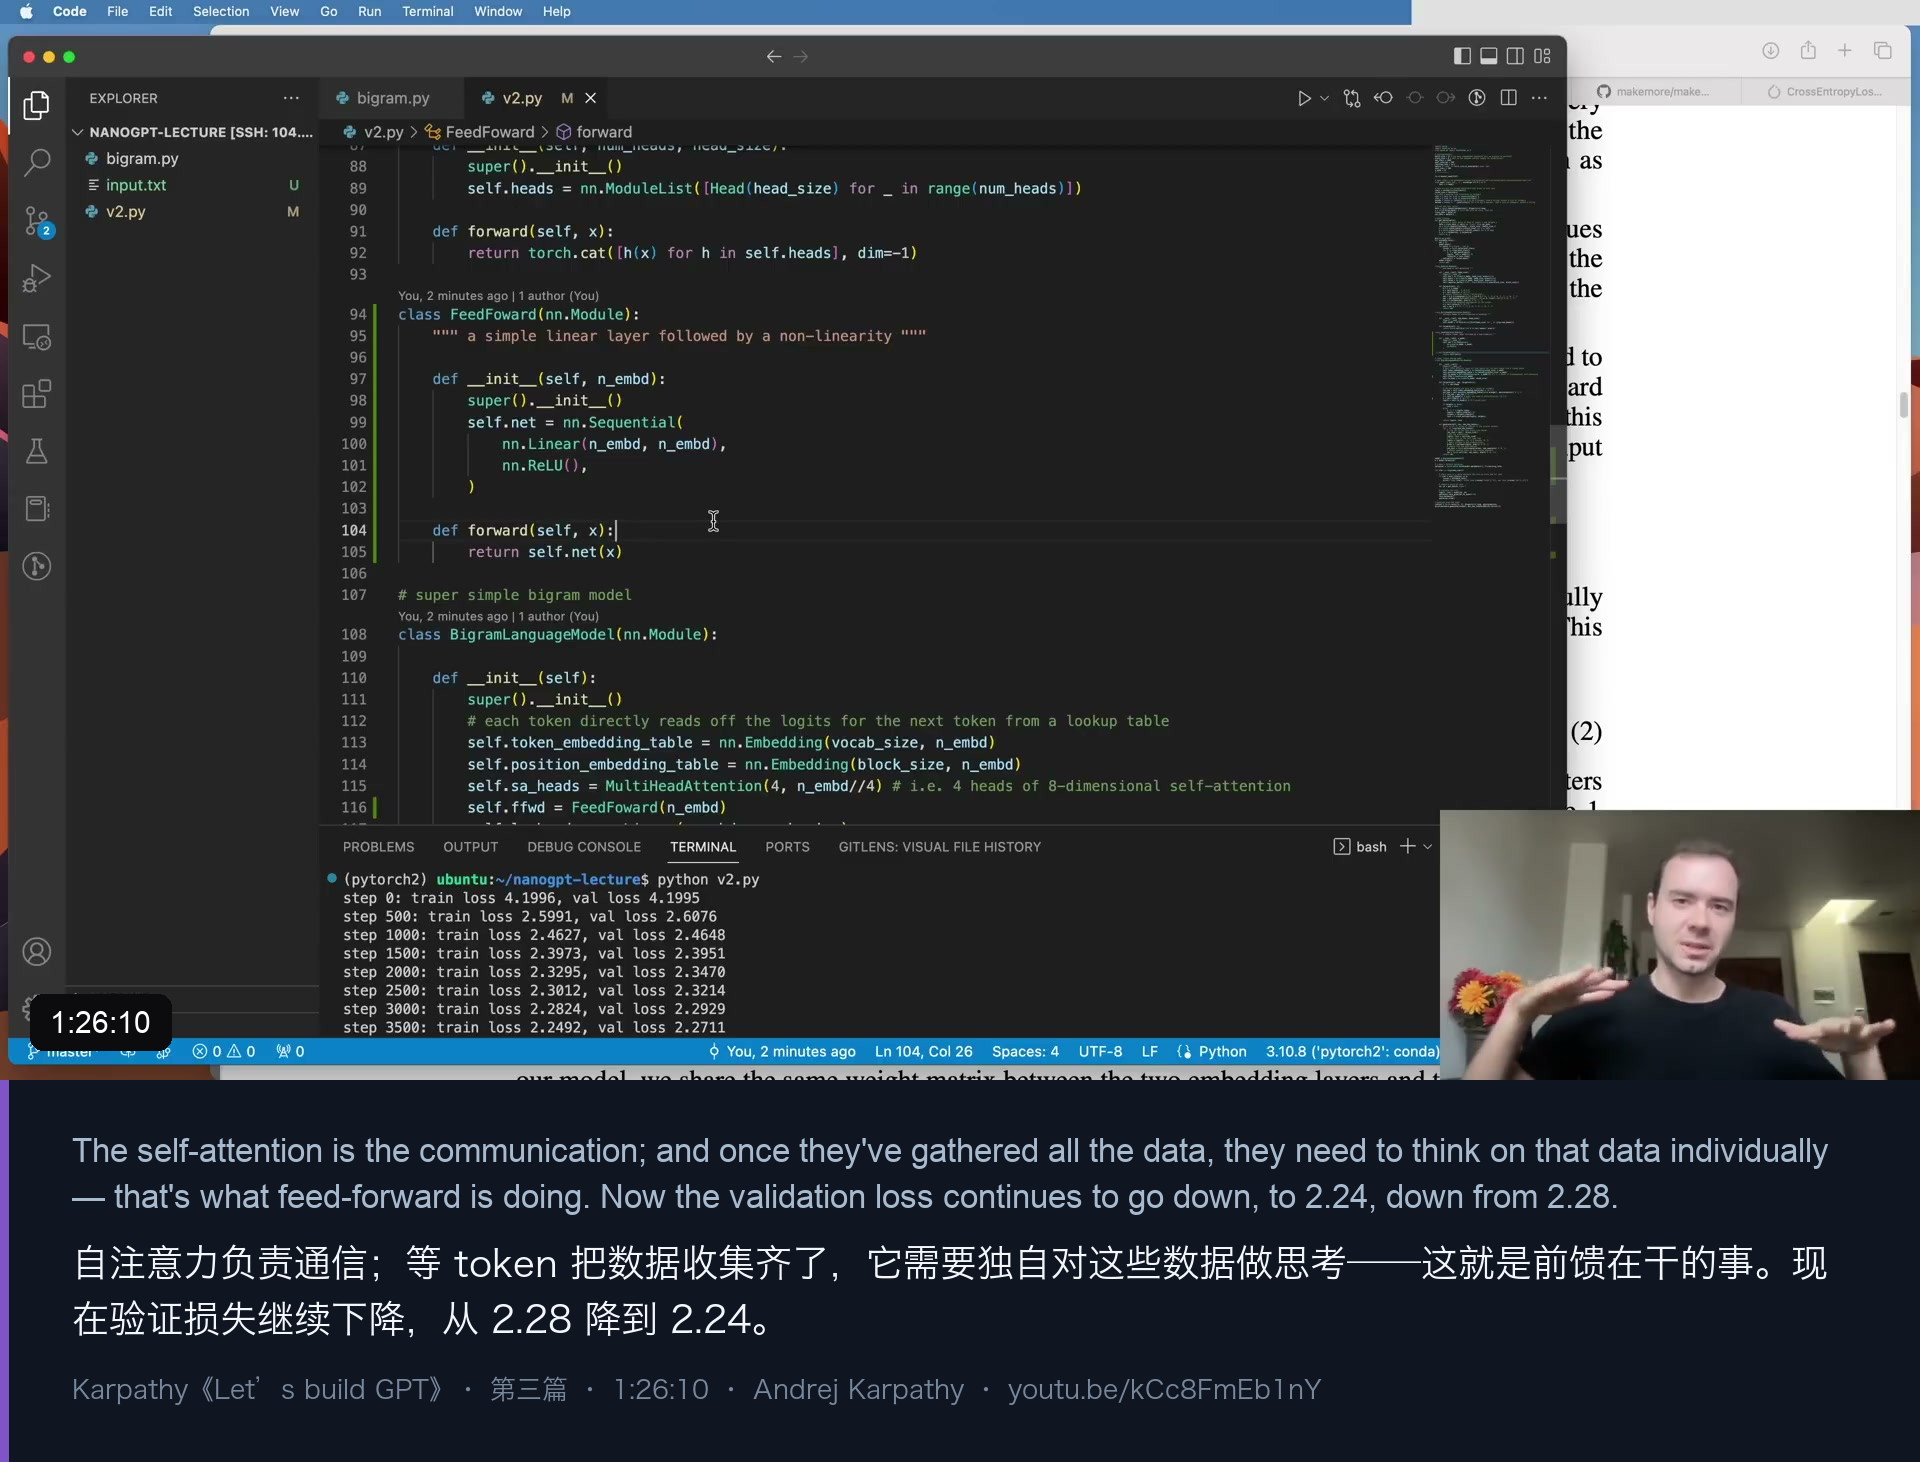
2.2 结果:2.28 → 2.24
验证损失继续下降到 2.24(之前 2.28)。输出看起来还是很糟,但情况在改善。
Karpathy 在这里给出了整个 Transformer 的结构性总结:
接下来我们要做的是把「通信」和「计算」交替穿插起来——这正是 Transformer 做的事:它把这些块分组,然后不断复制。
3. 残差连接与 Block:梯度高速公路(01–01)
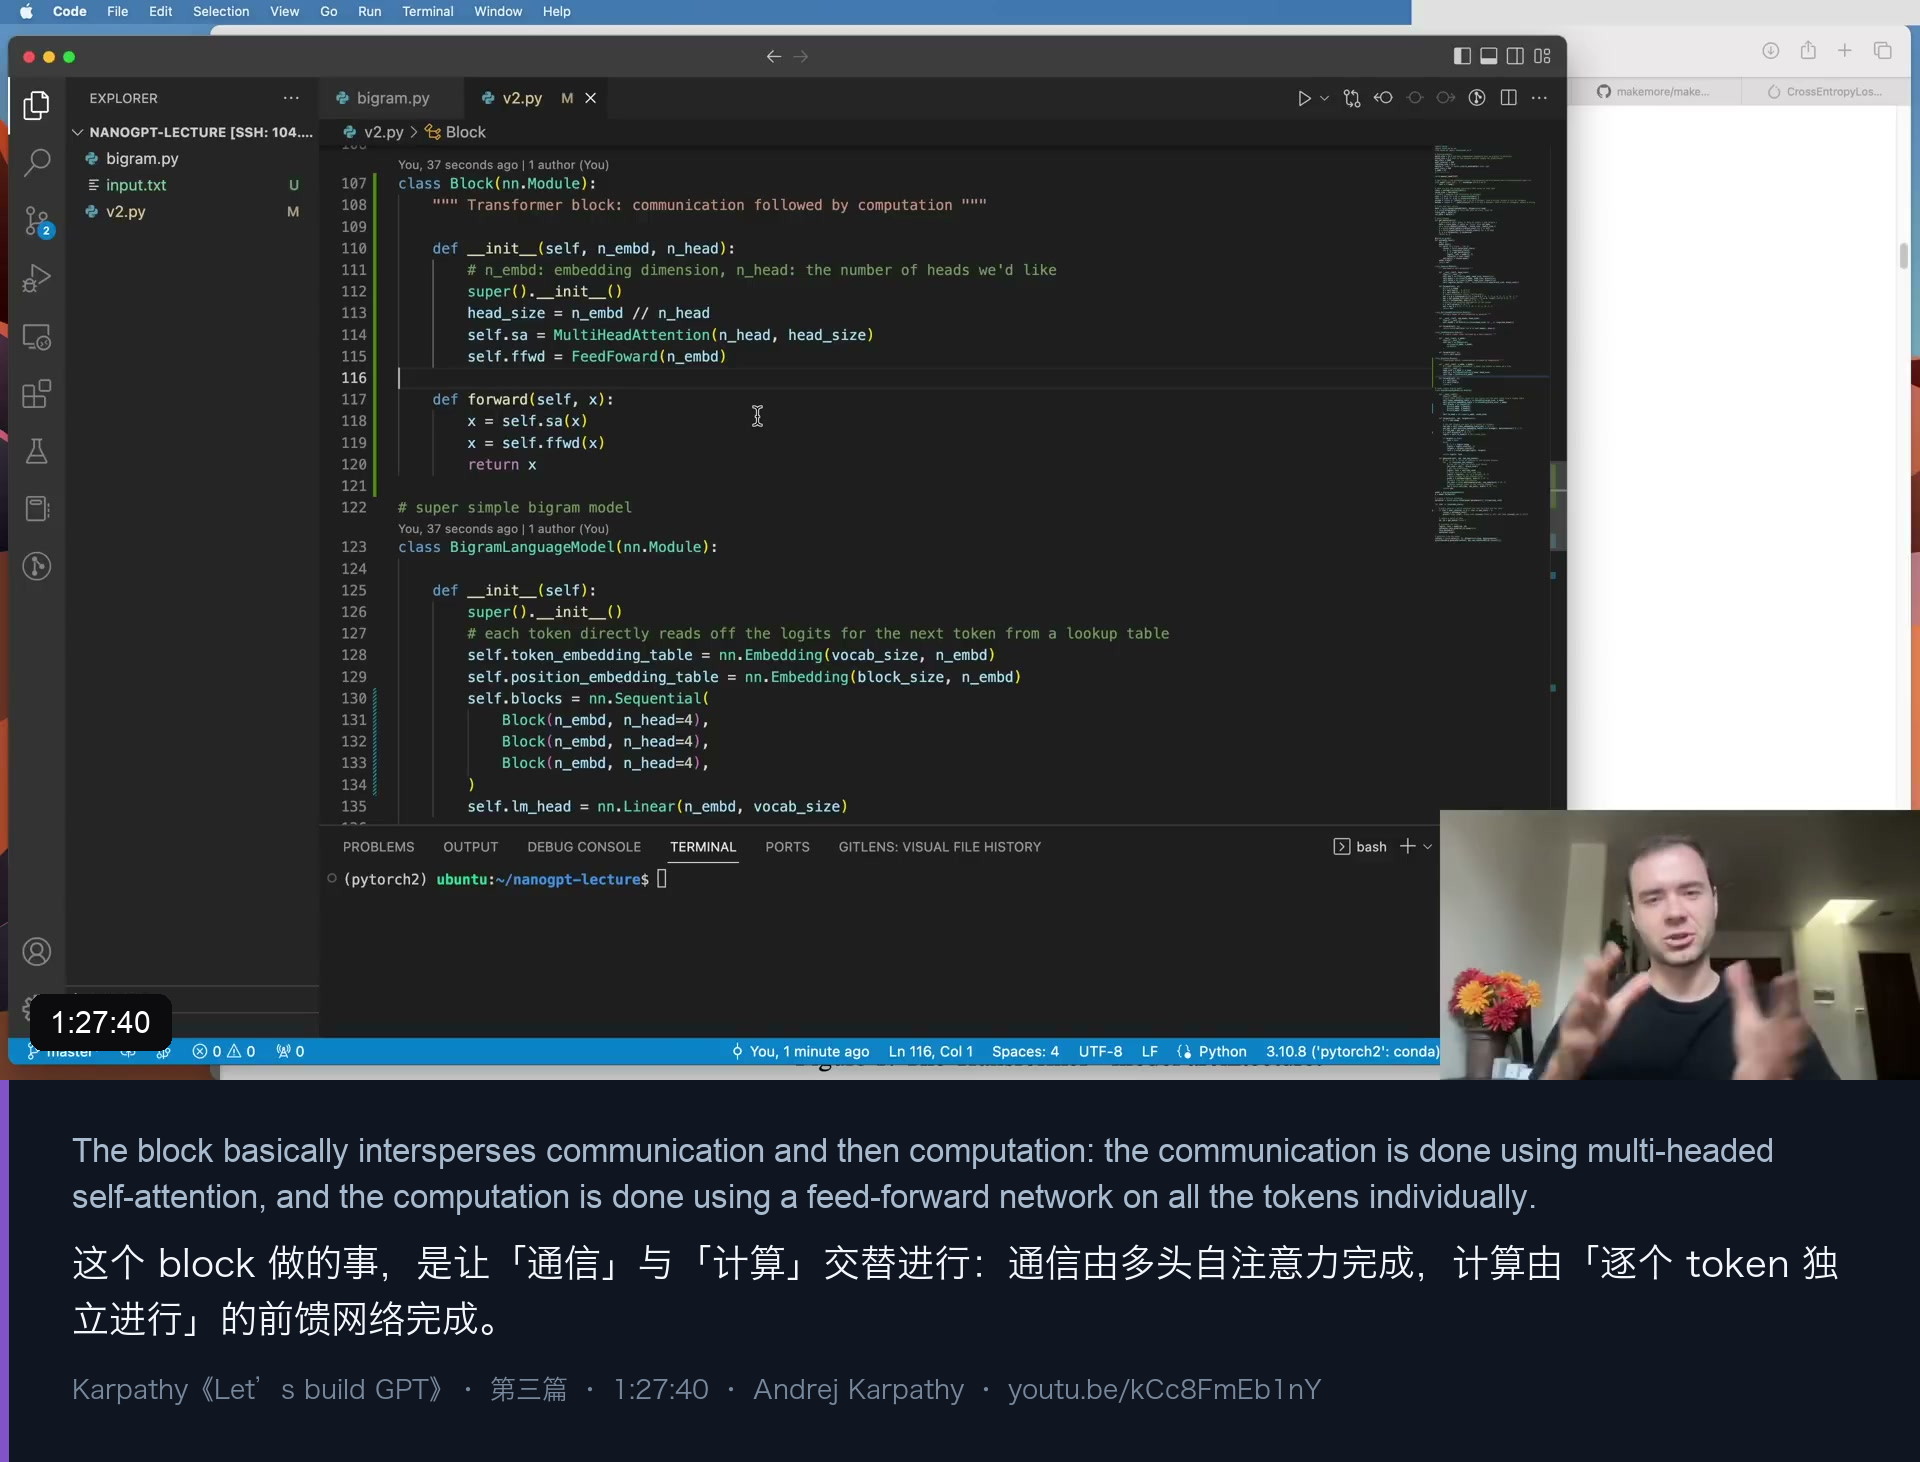
3.1 Block:把通信与计算打包
class Block(nn.Module):
    """Transformer block: communication followed by computation"""
    def __init__(self, n_embd, n_head):
        super().__init__()
        head_size = n_embd // n_head
        self.sa = MultiHeadAttention(n_head, head_size)
        self.ffwd = FeedForward(n_embd)

    def forward(self, x):
        x = x + self.sa(x)     # 通信 + 残差
        x = x + self.ffwd(x)   # 计算 + 残差
        return x
这就是 Transformer block。 一句话概括:通信 → 计算 → 再通信 → 再计算…… 而 x = x + ... 里的那个加号,就是接下来要讲的东西。
3.2 残差连接:为什么「加一下」这么重要
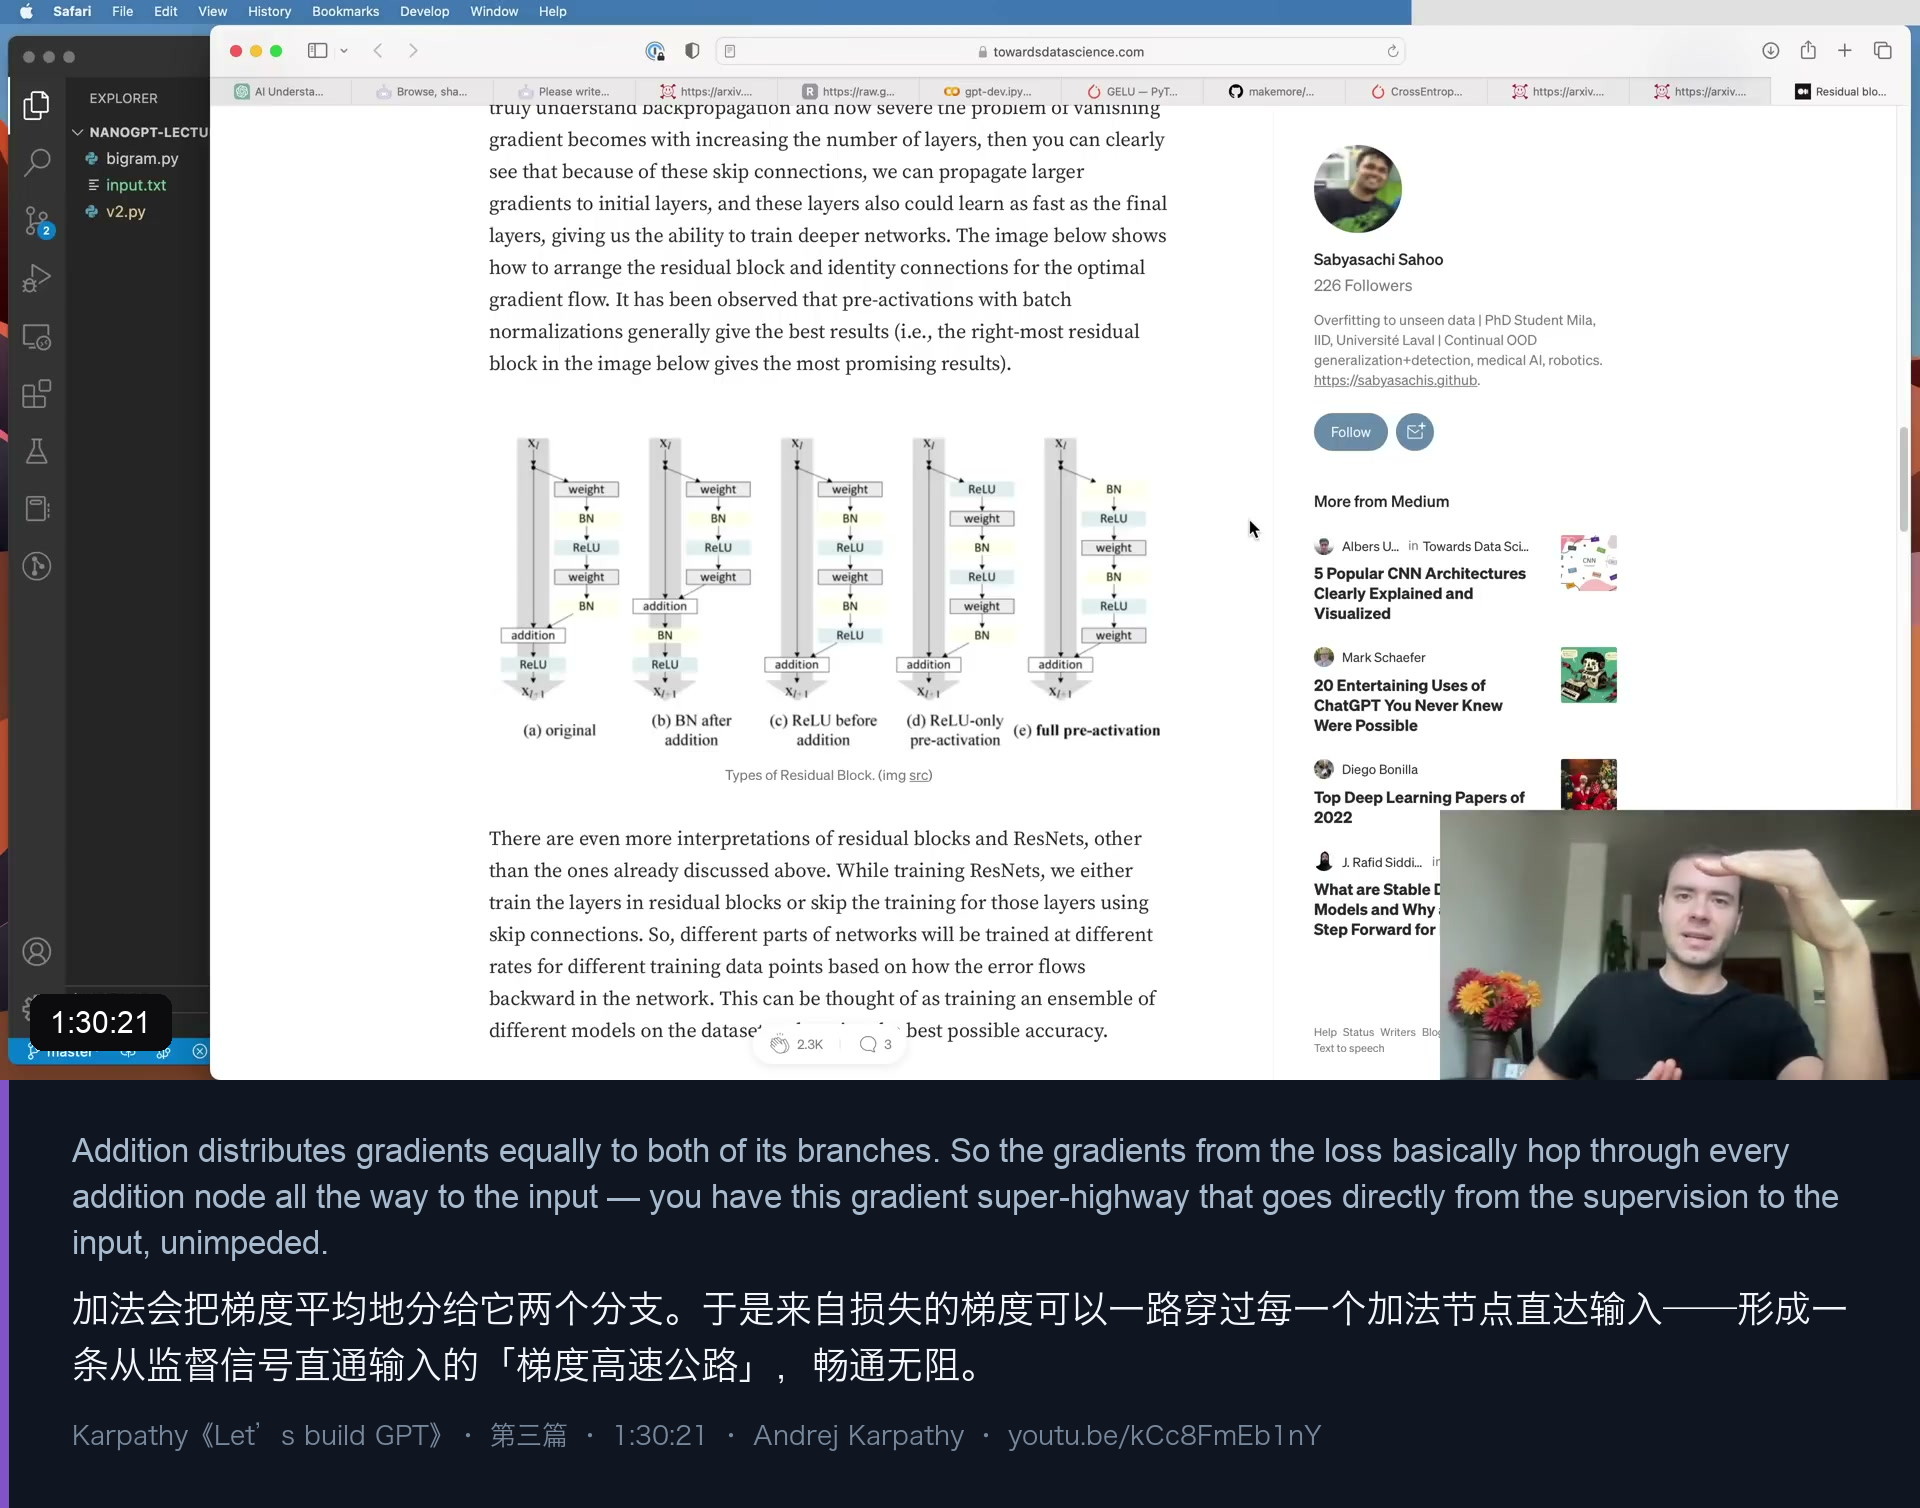
残差(skip / residual connection)来自何恺明的 ResNet 论文。Karpathy 给了一个非常清晰的可视化:
计算从数据流的上方往下方走,而残差路径是一条笔直的主干道。你可以随时从主干道「分叉」出去做一些计算,再把结果加回主干道。从输入到输出,你只经过一个个
+。
为什么这有用?回到 micrograd 那一课的关键结论:
加法会把梯度等量地分给它的两个分支。
于是损失产生的梯度可以一路穿过每一个加法节点直达输入,不受任何阻碍——Karpathy 管它叫 「梯度高速公路」(gradient super-highway)。
而且还有一层更精妙的解释:
这些残差块在初始化时几乎不贡献任何东西——它们初始状态下「约等于不存在」,所以梯度可以畅通地流过。随着优化推进,这些块才逐渐「上线」开始贡献。这对优化帮助极大。
3.3 一个容易被忽略的细节:为什么多头注意力需要一个 proj
回忆 MultiHeadAttention 里的那行 self.proj = nn.Linear(n_embd, n_embd)。
它存在的意义正是为了残差:多头注意力的输出在通道维拼接之后,需要用一次线性变换投影回残差路径所在的特征空间,再与 x 相加。Karpathy 的原话是——「这是投影回残差路径」。
本文补充:这一点在
n_embd == n_head * head_size时看不出必要性(维度本来就对得上),但请记住它是语义上的必要:残差路径是一个「所有块共享的公共通道」,每个块都必须把自己的输出投影回这个通道的语义空间,加法才有意义。后面读任何 Transformer 实现时,c_proj/o_proj/out_proj这类名字都是这个作用。
3.4 又一处与论文对齐:前馈内层放大 4 倍 → 2.08
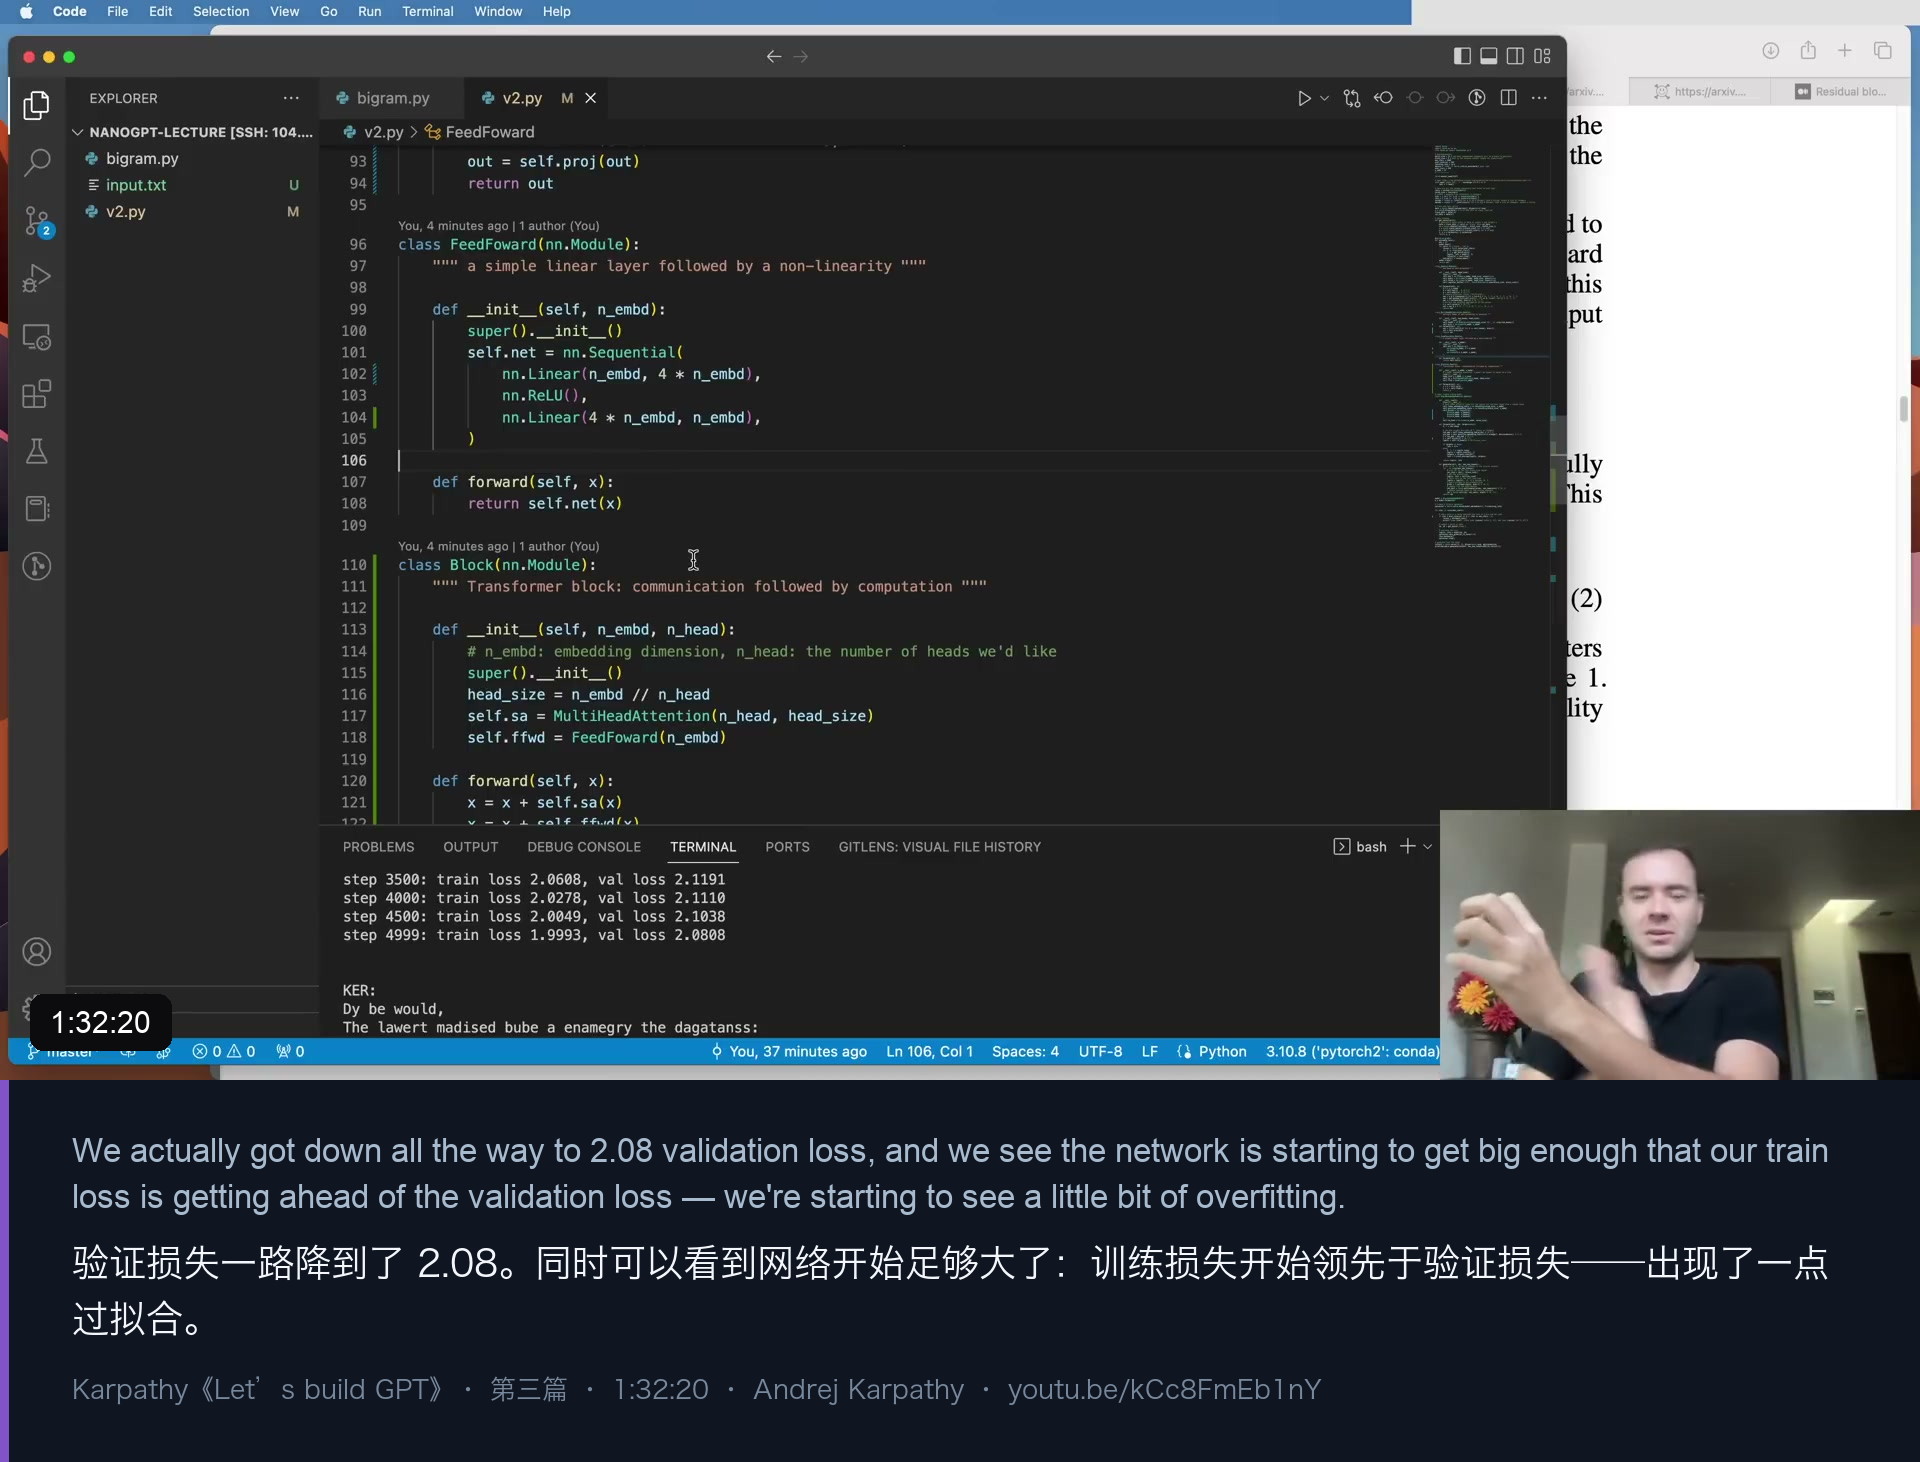
Karpathy 这一轮还做了一件事:把前馈内层确实放大到 4 倍(对齐论文的 512 → 2048)。结果是:
验证损失一路降到 2.08。而且网络开始足够大了:训练损失开始领先于验证损失——出现了一点过拟合。
生成出来的文本也开始「有点像英语」了(他形容为 “grief syn like this starts to almost look like English”)。
4. LayerNorm:把归一化从「列」搬到「行」(01–01)
4.1 从 BatchNorm 到 LayerNorm:只改一个数字
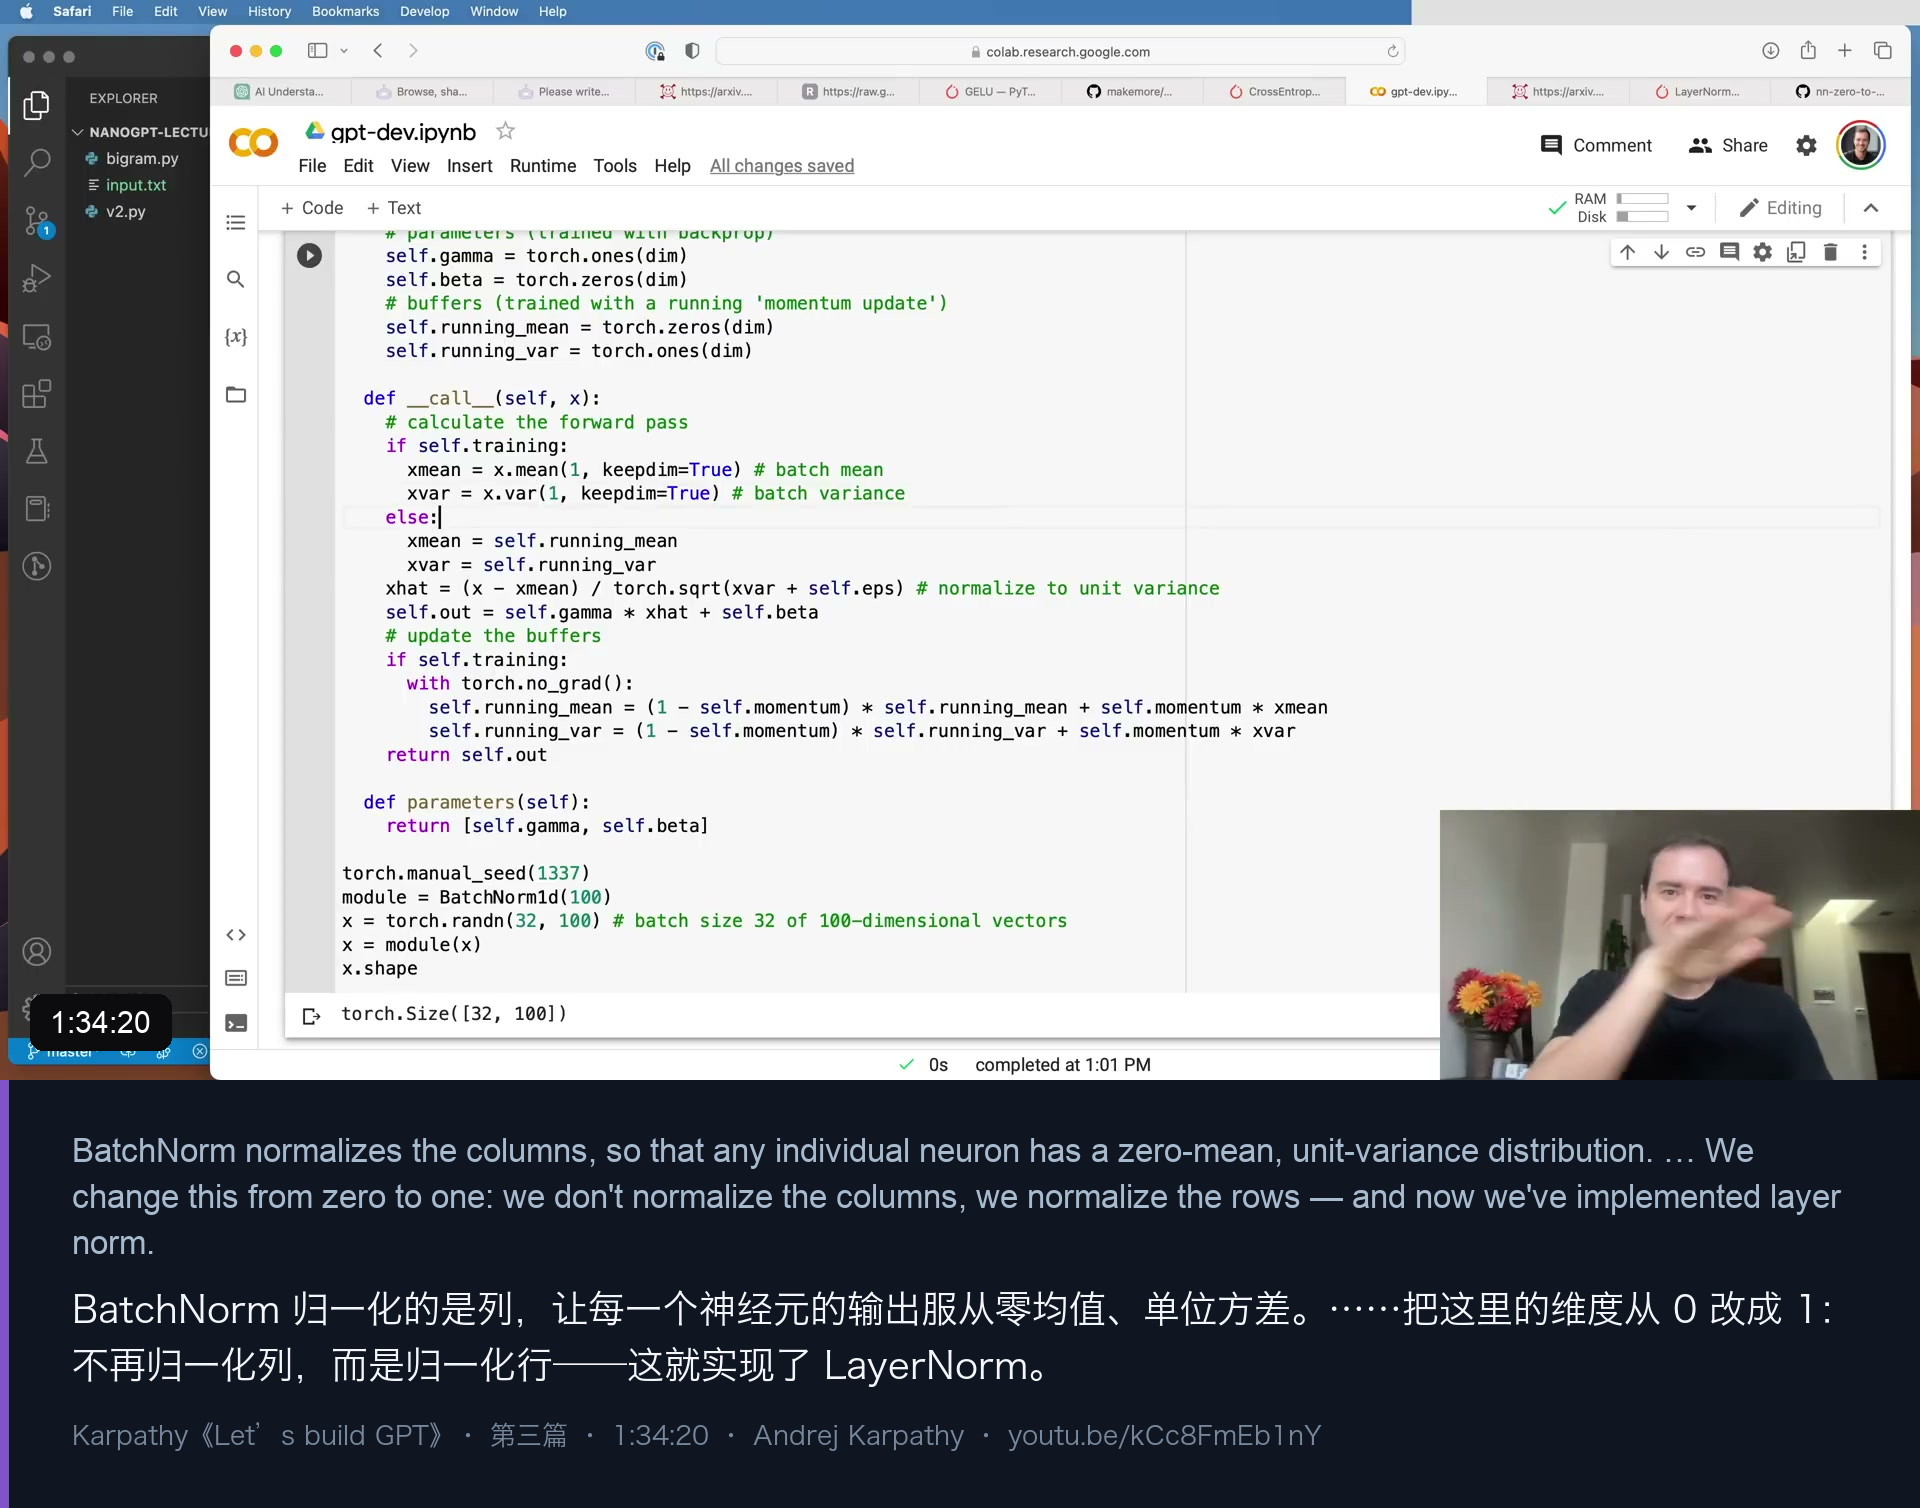
Karpathy 的讲法是直接从 makemore 系列里实现的 BatchNorm1d 出发——他当场复制粘贴过来做对比:
- BatchNorm 归一化的是「列」:它保证某一个特征维度在整个 batch 上服从零均值、单位方差;
- LayerNorm 归一化的是「行」:它保证某一个样本(某一个 token)的所有特征服从零均值、单位方差。
而他实现 LayerNorm 的方式是全场最幽默的一句:
实现 LayerNorm 非常复杂——看,我们把这里的 0 改成 1。
也就是把归一化的维度从「列」换成「行」。改完之后:
running_mean/running_var这些 buffer 全都可以删掉——因为我们每次都能现算,不需要维护滑动统计量;- 因此训练和测试时的行为没有区别——不存在「用训练时统计量还是用当前 batch 统计量」的问题。
本文补充:这正是 LayerNorm 在 NLP 里胜出的核心原因。NLP 的序列长度可变、batch 里样本长度不一,BatchNorm 依赖「同一特征维在 batch 上」的统计量,在变长序列里既不稳定也不自然。LayerNorm 只在一个样本内部计算,与 batch 大小、序列长度都无关。你之前做 BERT 微调时应该对
LayerNorm很熟——这里你终于看到它为什么长这样。
4.2 pre-norm:我们与原始论文的一处不同
论文里的写法是 Add & Norm:先做子层变换,再相加,最后归一化。
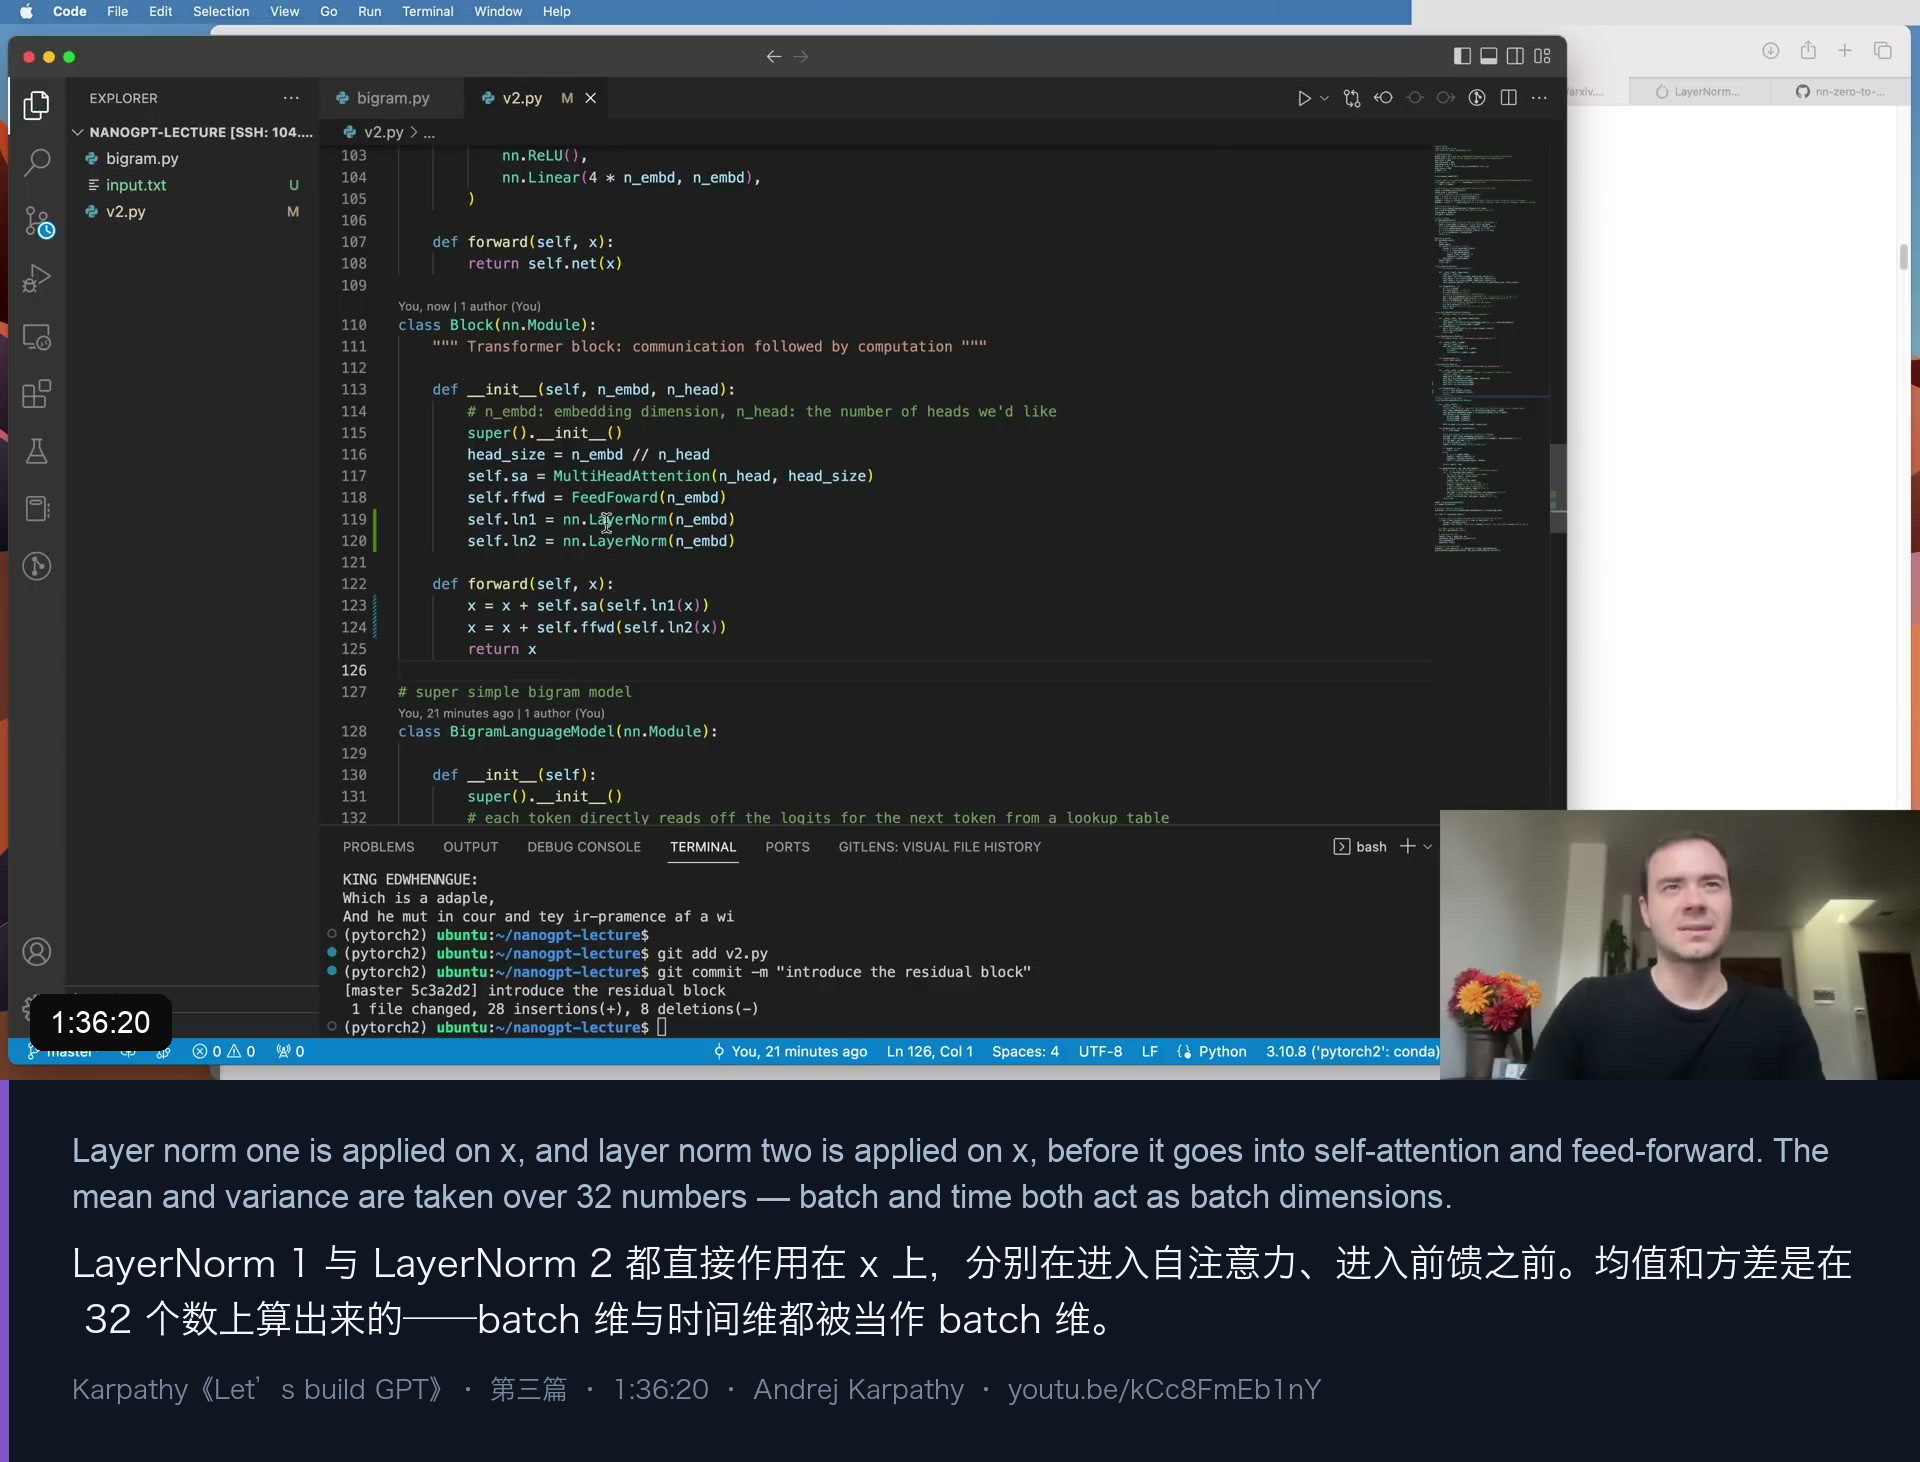
但 Karpathy 指出,五年过去,现在更常见的做法是把 LayerNorm 放在子层之前——也就是 x = x + sa(ln(x))。这个变体叫 pre-norm,本课采用的就是这一种。他明确说:「这是我们与原论文的一处(很小的)偏离。」
def forward(self, x):
    x = x + self.sa(self.ln1(x))
    x = x + self.ffwd(self.ln2(x))
    return x
上下文(batch 与时间维)都充当 batch 维,所以 LayerNorm 的均值和方差是在 32 个数上(n_embd = 32)算出来的——这是一个逐 token 的变换。
另外还有一处补丁:在最后的 lm_head 之前也要加一个 LayerNorm。Karpathy 说他一开始漏了,后来补上。
4.3 结果:2.08 → 2.06
验证损失降到 2.06,比之前的 2.08 略好。他说这个改动在更大、更深的网络上收益会更明显。
到这里,Karpathy 给出了一个里程碑式的判断:
到这一步,我们其实已经有了一个相当完整的、符合原始论文的 Transformer——而且是一个 decoder-only 的 Transformer。
5. 放大:把代码变成 nanoGPT 的形状(01–01)
5.1 把结构参数化
为了让模型能「变大」,代码做了几处修饰性改动:
- 引入
n_layer:要叠多少个 Block——blocks = nn.Sequential(*[Block(...) for _ in range(n_layer)]); - 引入
n_head:要几个注意力头; - 把 LayerNorm 从 Block 里抽出来,放到 Block 之外统一管理。
同时加上 dropout。
5.2 Dropout 放在哪里、为什么有用
self.sa = MultiHeadAttention(n_head, head_size)   # 内部输出上 dropout
# attention 的权重(softmax 之后)上也可以 dropout
self.ffwd = FeedForward(n_embd)                    # 内部输出上 dropout
# 回到残差路径之前,也要 dropout
Karpathy 特别点出 attention 权重上的 dropout 的含义:「随机地阻止一些节点通信」。
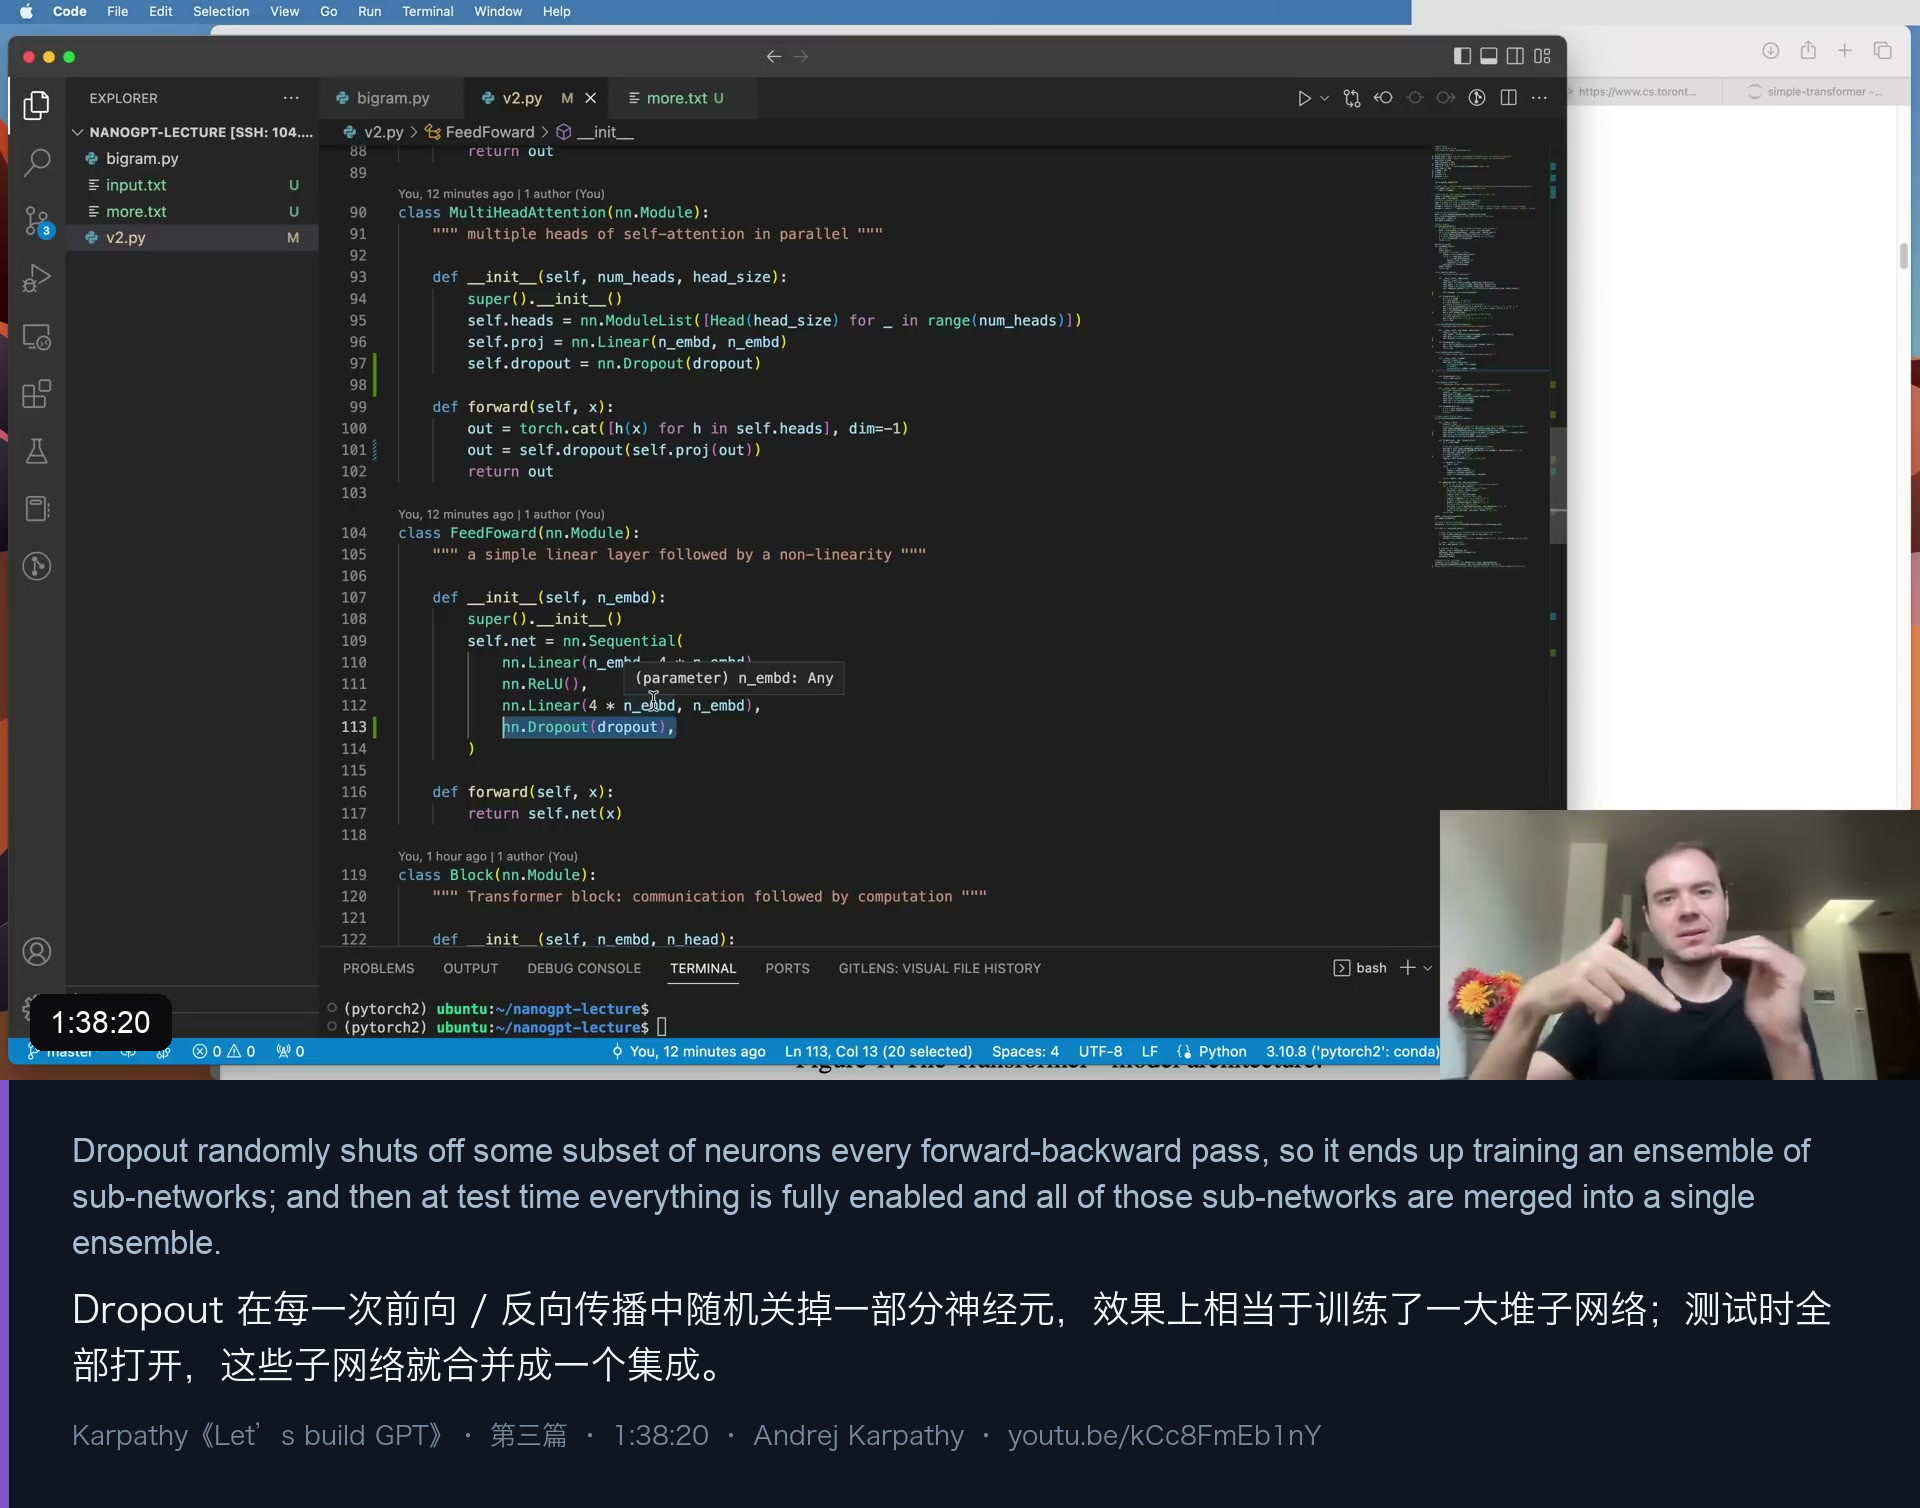
Dropout 本身来自 2014 年那篇论文,机制很简单:每一次前向/反向传播,随机把一部分神经元置零。他给的解释是:
因为每次传播时「被丢弃的神经元集合」都不一样,Dropout 实际上是在训练一大堆子网络;测试时全部打开,这些子网络就合并成一个集成模型。
5.3 完整配置与结果:2.07 → 1.48
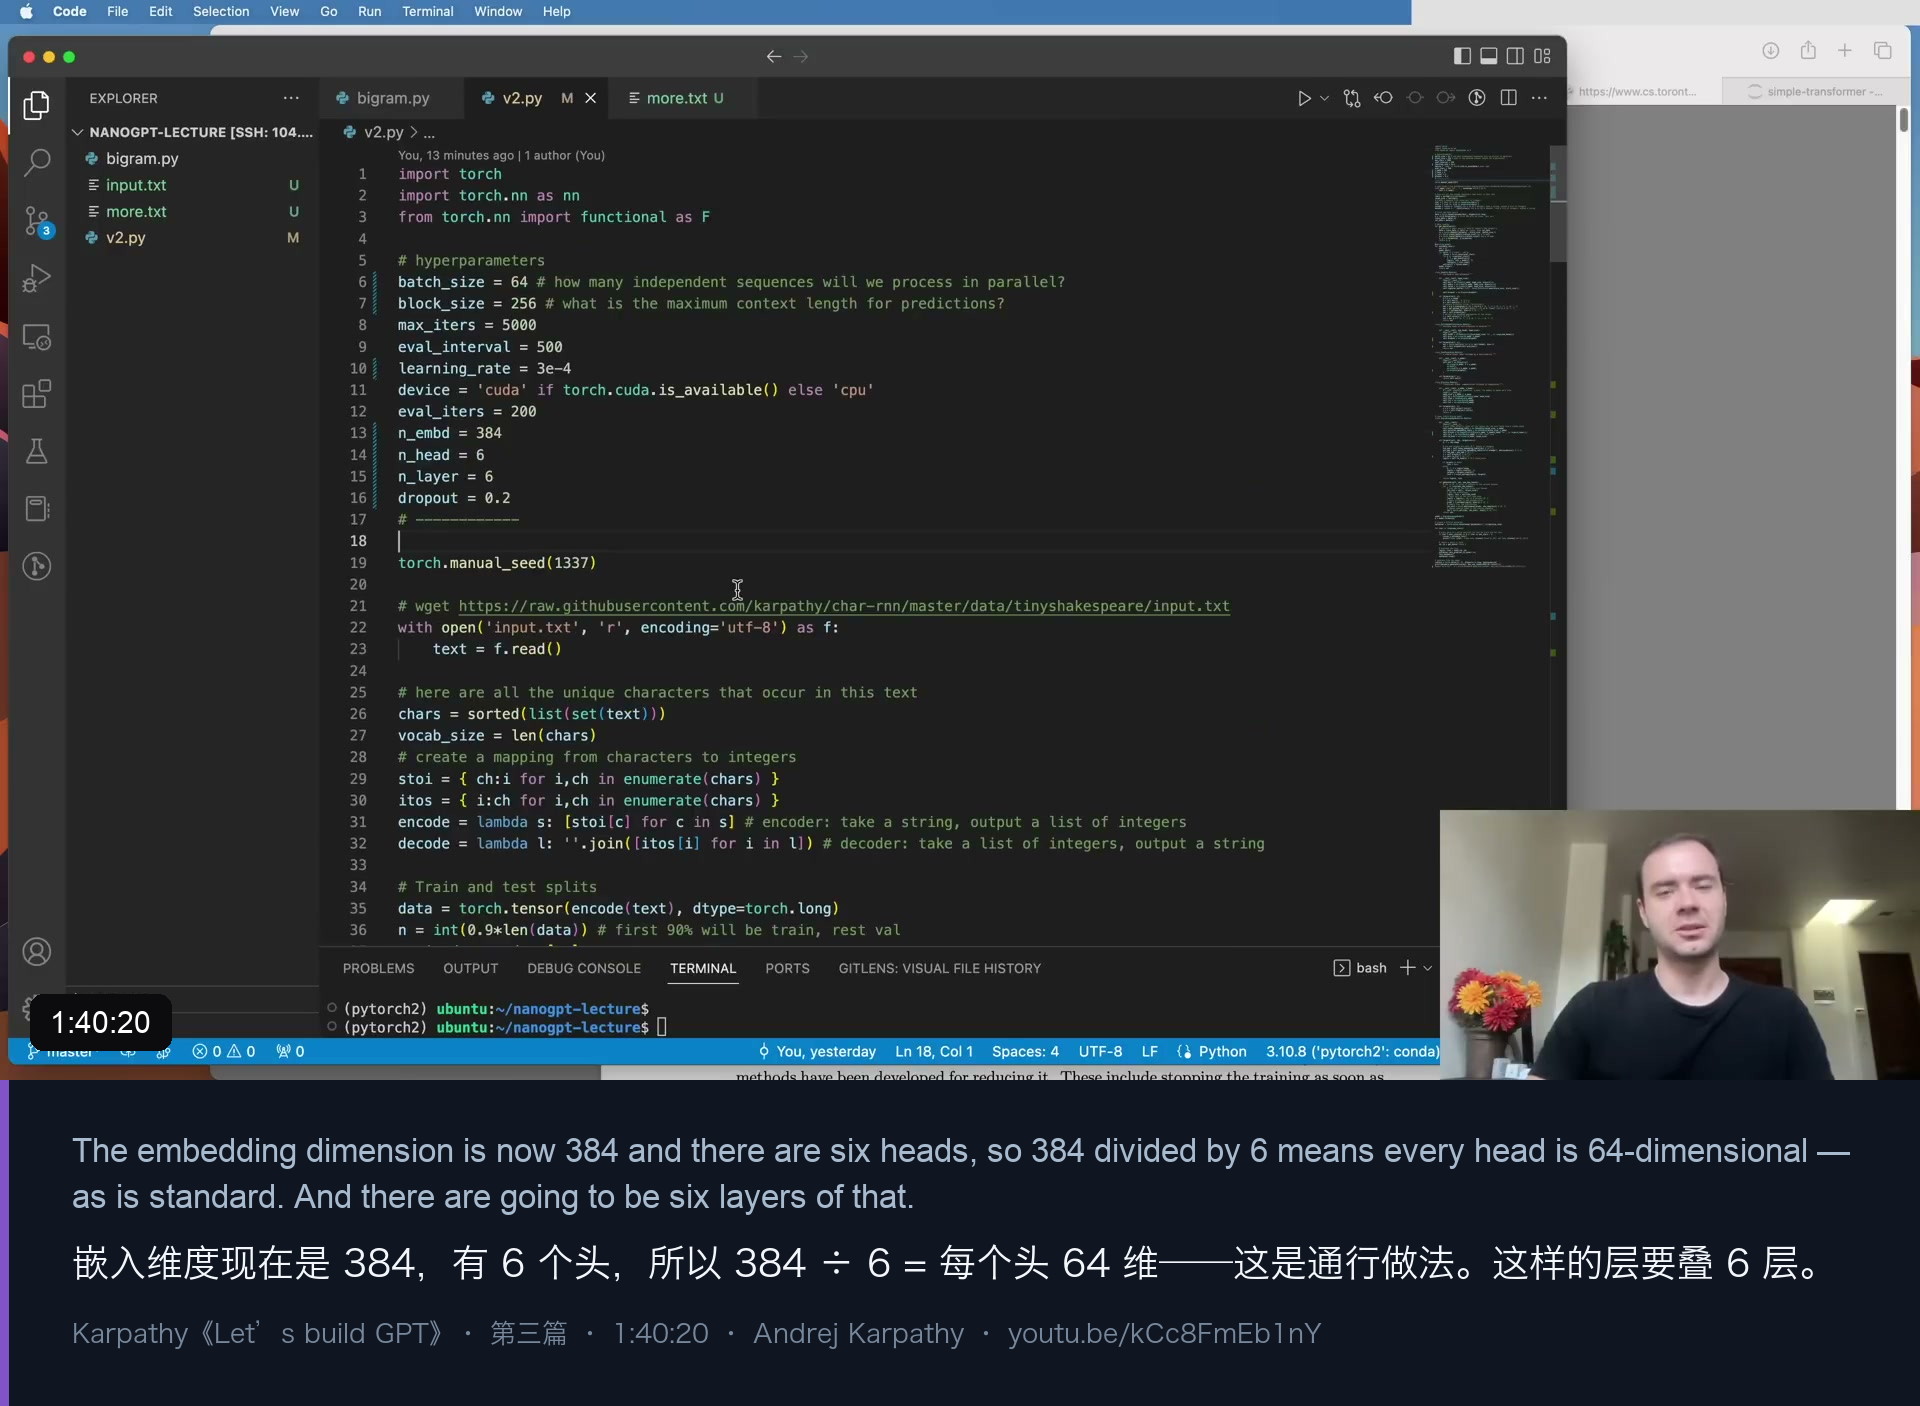
最终这一版的超参数:
| 超参数 | 取值 | 说明 |
|---|---|---|
batch_size |
64 | |
block_size |
256 | 上下文长度 |
n_embd |
384 | 嵌入维度 |
n_head |
6 | 注意力头数(384 ÷ 6 = 每头 64 维,「这是通行做法」) |
n_layer |
6 | Block 的层数 |
dropout |
0.2 | 每次传播丢弃 20% |
learning_rate |
调低 | 网络变大了 |
max_iters |
5000 |
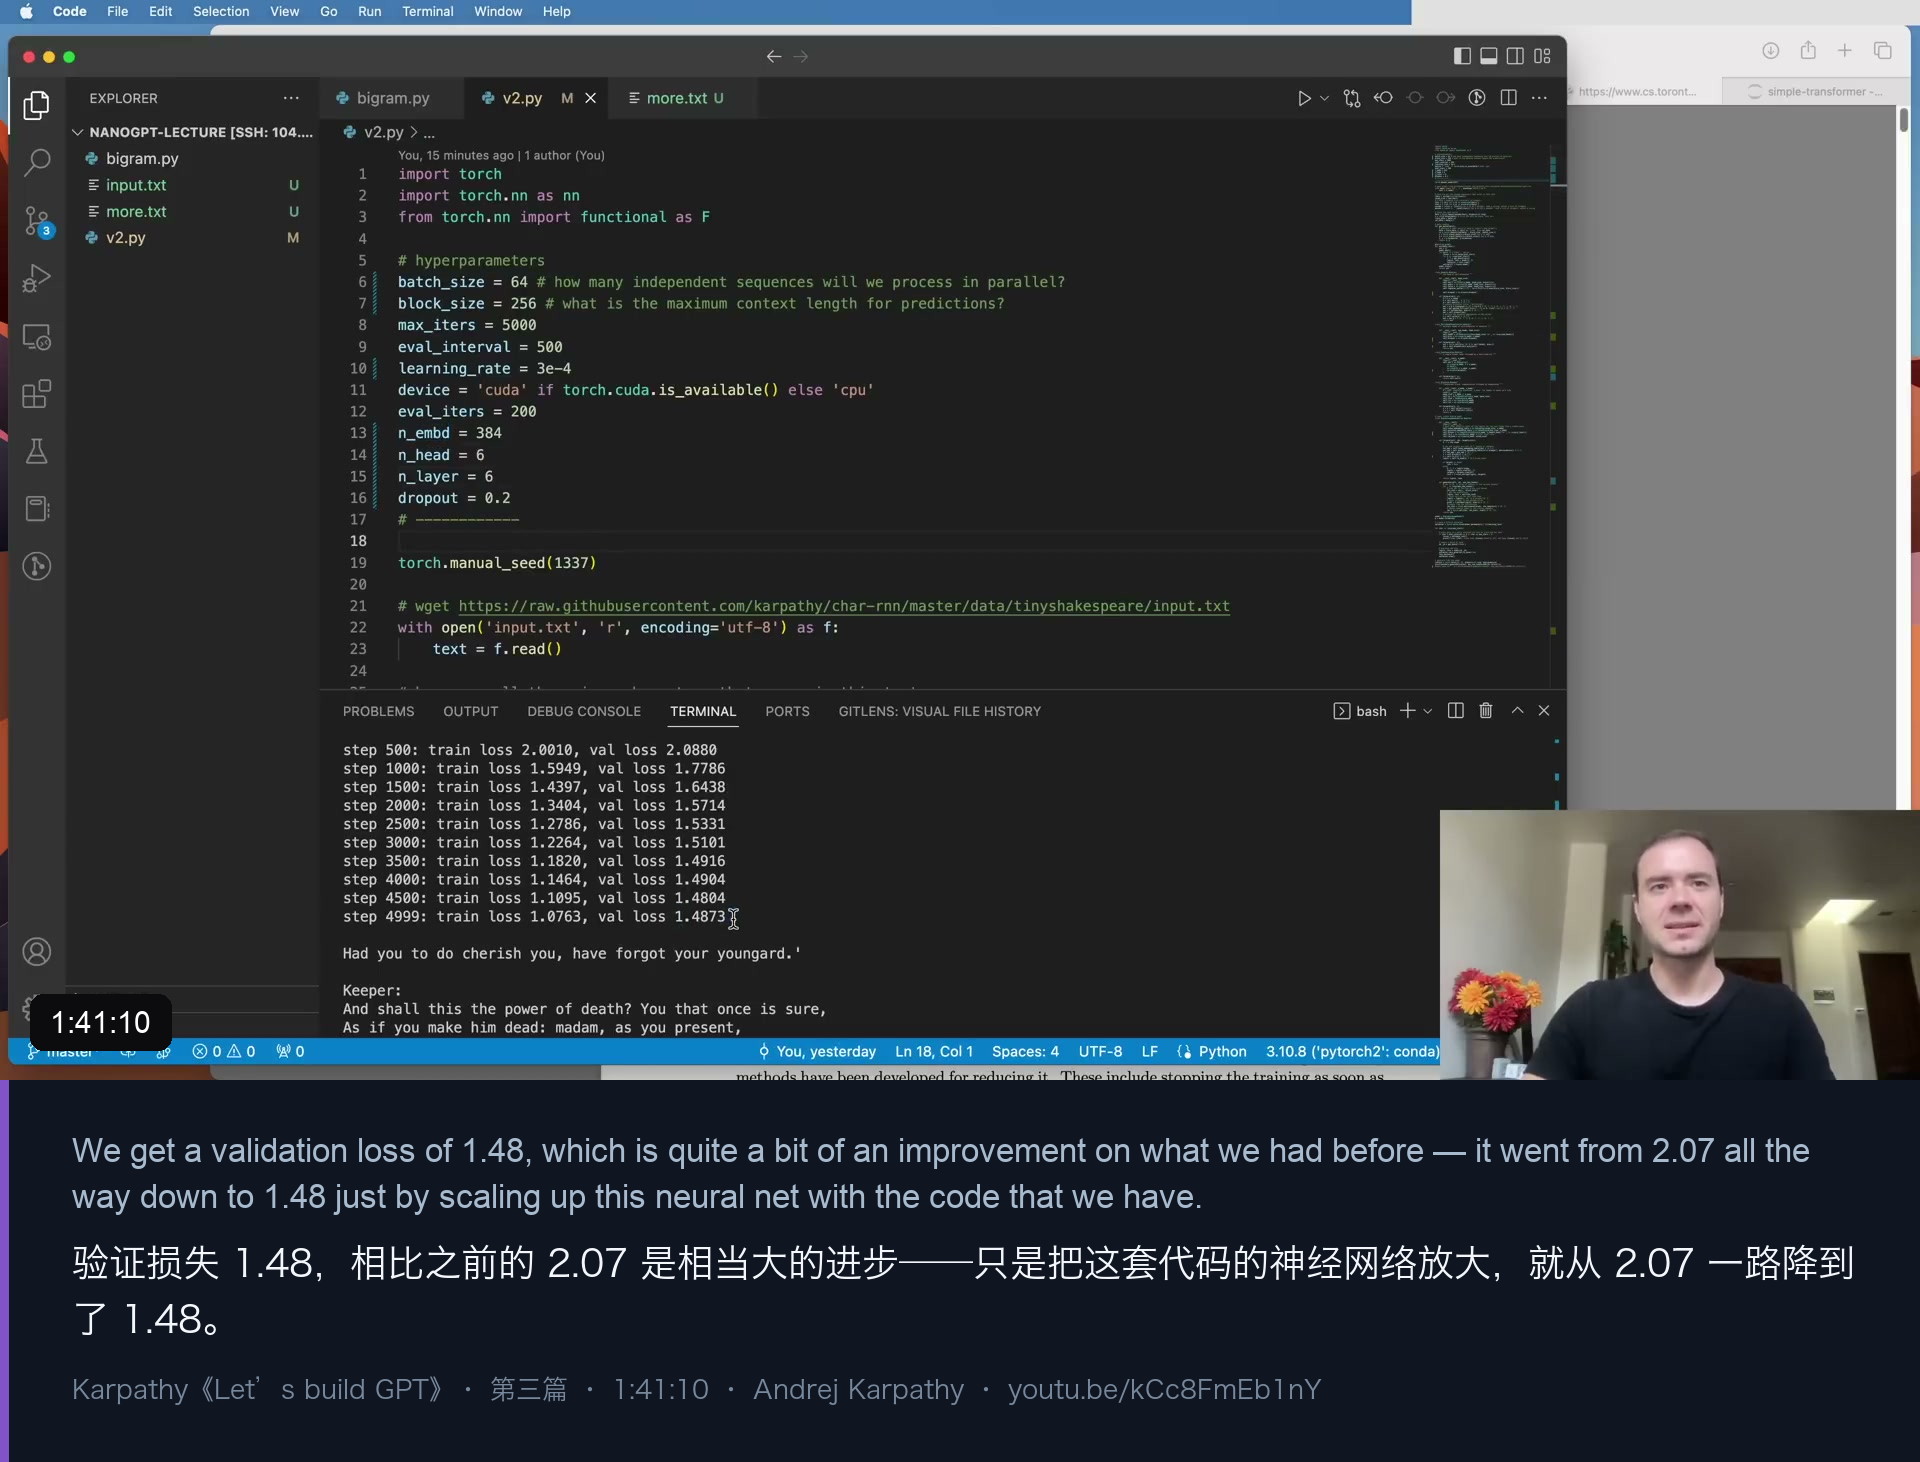
结果:验证损失 1.48(之前 2.07)。Karpathy 说这大约需要 A100 上 15 分钟;如果只有 CPU 或 MacBook,就得把层数和嵌入维度调小。
他打印了 10,000 个字符并写入文件——生成的文本已经在形式上很像输入了(有人在对白、有莎剧腔调),但读起来仍然没有意义。他的总结很克制:
这是一个在莎士比亚 100 万字符上训练的、字符级 Transformer。它用莎士比亚的腔调在胡说八道,但在这个规模下我觉得已经是一个相当好的展示了。
6. 到这里,你已经写完了一个 GPT
把这一篇的零件按顺序装起来,整个模型就是:
token 嵌入 + 位置嵌入
   ↓
[ Block × n_layer ]
     LayerNorm → 多头自注意力 → Dropout → 残差加
     LayerNorm → 前馈(4x) → Dropout → 残差加
   ↓
LayerNorm
   ↓
lm_head → logits
这就是 GPT。Karpathy 用一段话把「它到底是什么」讲定了:
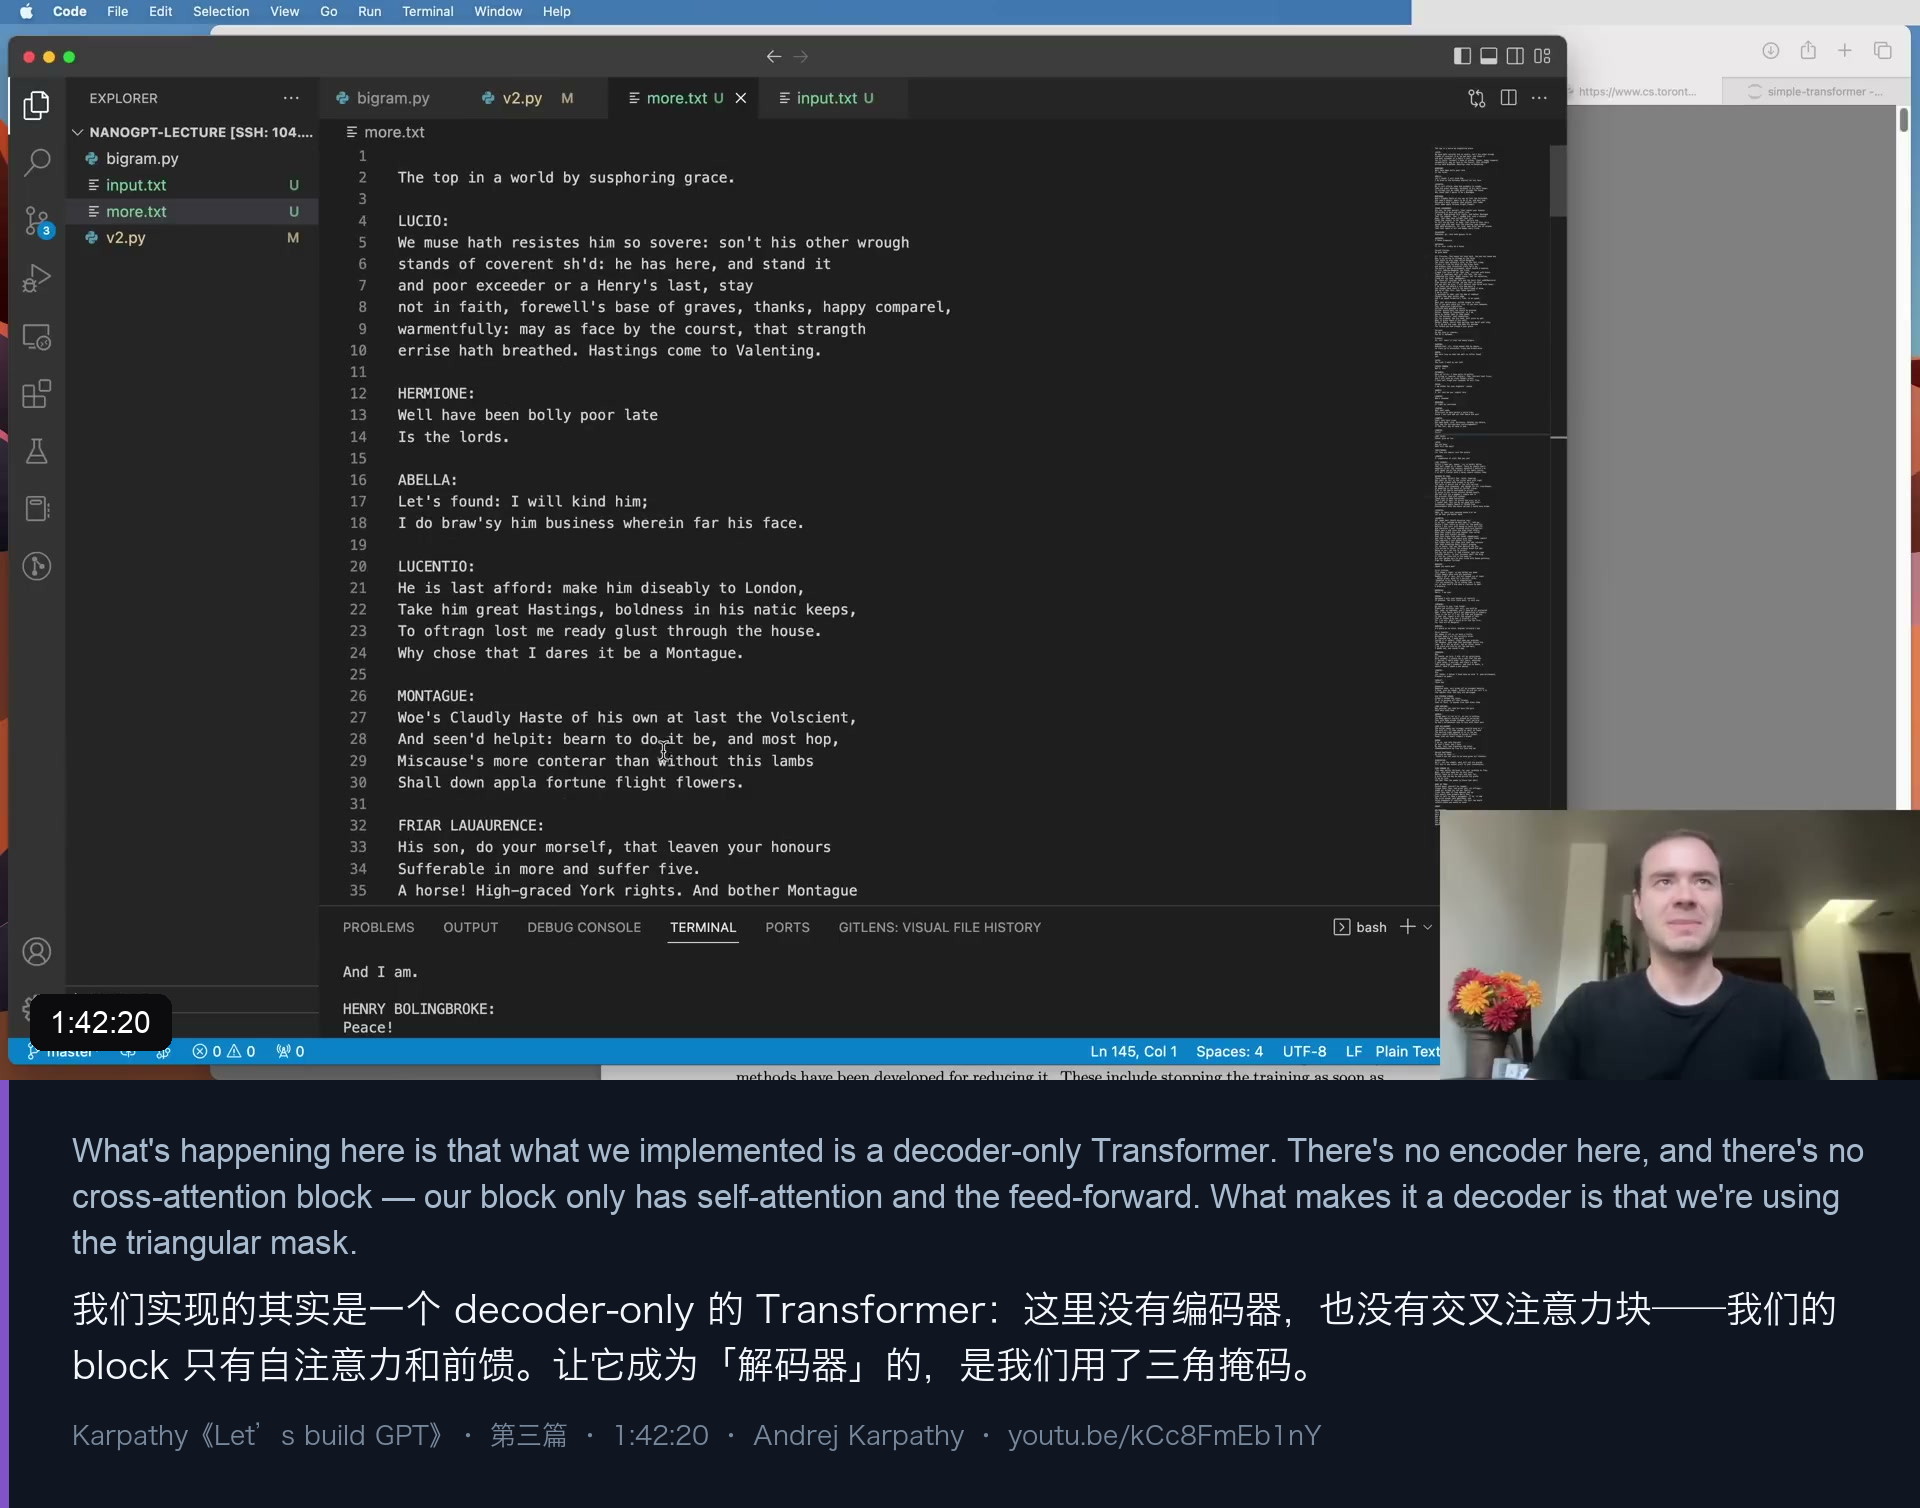
我们实现的是 decoder-only 的 Transformer:没有 encoder,没有 cross-attention。让它成为 decoder 的,是那个三角掩码——它带来自回归性质,于是我们可以从模型里采样。这种模型可以用来做语言建模。
那为什么原论文要有 encoder-decoder?因为那是一篇机器翻译论文。 它假设输入是一段法语 token,然后解码出英文翻译:用 START 开始生成,以 END 结束。它需要 cross-attention,把解码器接到编码器的输出上——这不在本课范围内。
注:论文架构图的完整解读、以及 nanoGPT 与 GPT-2 / GPT-3 的规模对照,是本系列第四篇的内容。
本篇速查
| 改动 | 验证损失 | 新增的零件 |
|---|---|---|
| 起点(单头自注意力) | 2.4 | — |
| 多头注意力 | 2.28 | 并行多频道 + 输出投影 |
| 前馈网络 | 2.24 | 通信之后的「计算」 |
| 残差 + 前馈 4 倍宽 | 2.08 | x = x + sublayer(x);开始轻微过拟合 |
| LayerNorm(pre-norm) | 2.06 | 行归一化;lm_head 前再加一个 |
| 放大 + dropout | 1.48 | n_embd=384、6 头、6 层、dropout 0.2 |
| 概念 | 一句话 |
|---|---|
| 多头注意力 | 多条并行通信频道,输出拼接后投影回 n_embd |
| 前馈网络 | 逐 token 独立的两层 MLP,中间放大 4 倍;负责「计算」 |
| Block | 通信 + 计算交替,外面套残差 |
| 残差连接 | 加法把梯度等量分给两路,形成通往输入的「梯度高速公路」 |
| LayerNorm | 归一化「行」而非「列」;不依赖 batch,train/eval 无差别 |
| pre-norm | LayerNorm 放在子层之前,是现代通行写法,与原论文不同 |
| dropout | 每次传播随机关掉一部分神经元,等效于训练子网络集成 |
| decoder-only | 由三角掩码定义;无 encoder、无 cross-attention |
自测题
- 4 个头、
n_embd = 32时,每个头的head_size是多少?拼接之后为什么还需要一个proj层? - 判断一句话对不对:「前馈网络让不同 token 之间交换信息。」——错在哪里?
- 为什么残差连接能改善深层网络的优化?请从「加法如何分配梯度」的角度解释。
- LayerNorm 与 BatchNorm 的唯一关键区别是什么?为什么 NLP 里用 LayerNorm?
- pre-norm 与论文里的 post-norm 有什么区别?本课用的是哪一种?
- 训练损失开始领先验证损失,说明发生了什么?此时你会优先调哪个超参数?
- 为什么 attention 的 softmax 权重上也做 dropout?它的物理含义是什么?
下一篇:Karpathy《Let’s build GPT》第四篇 —— nanoGPT 走读、encoder vs decoder、GPT-2 / GPT-3 的距离,以及预训练之后的微调阶段(覆盖 01–01,并收束整个系列)。
讨论
这里是静态站点,没有内嵌评论区。如果这篇文章对你有用,欢迎通过 RSS 订阅后续更新。