Karpathy《Let's build GPT》第二篇:自注意力——从「加权平均的数学技巧」到 Q / K / V
Karpathy《Let's build GPT》精读系列第二篇,也是整门课最核心的一段。先用一个玩具例子(B,T,C = 4,8,2)把「用下三角矩阵乘法做加权聚合」这个数学技巧练熟:全 1 矩阵左乘等于按行求和、tril 是「未来不许说话」的闸门、masked_fill(-inf)+softmax 让权重从常数变成亲和度。然后把这个技巧搬进真模型,推出单头自注意力:每个 token 发出 query(我在找什么)和 key(我包含什么),q@k^T 得到亲和度、除以 √head_size 控制方差、掩码、softmax、最后 out = wei @ v。并逐条讲清四个要点:注意力是通信机制、它没有空间概念(所以要位置编码)、batch 之间永不通信、encoder block 与 decoder block 只差删掉掩码那一行。文中 14 张配图均截自视频对应时刻,并把当时的完整观点句(英文原句+中文翻译)拼进图里。
来源:YouTube 原视频(Andrej Karpathy,2023-01-17,时长 1:56)·配套代码:nanoGPT
阅读说明
- 这是四篇系列的第二篇,覆盖原视频 00–01。这一段是整门课最核心的部分——Karpathy 自己说:「这可能是这个视频里最重要的一段」。
- 它的路径非常清楚:先用一个玩具例子把「用矩阵乘法做加权聚合」这个数学技巧练熟,再把它搬进真正的模型,推出 Q / K / V 和掩码注意力。这不是「先讲定义再讲实现」,而是先让你在玩具上跑通,再回去看它在真模型里长什么样。
- 代码按视频顺序整理,数字全部来自视频里当场的运行输出(
B,T,C = 4,8,2、head_size=16、wei的(B,T,T)形状、损失 2.5 → 2.4 等)。标记「本文补充」的是我的解释,不是 Karpathy 的原话。- 自动字幕的听错已按通行写法修正(
Trail→tril、way/Whey→wei、Expo→xbow、spous→ 口误)。
0. 先看 bigram 的「天花板」:4.87 → 2.5
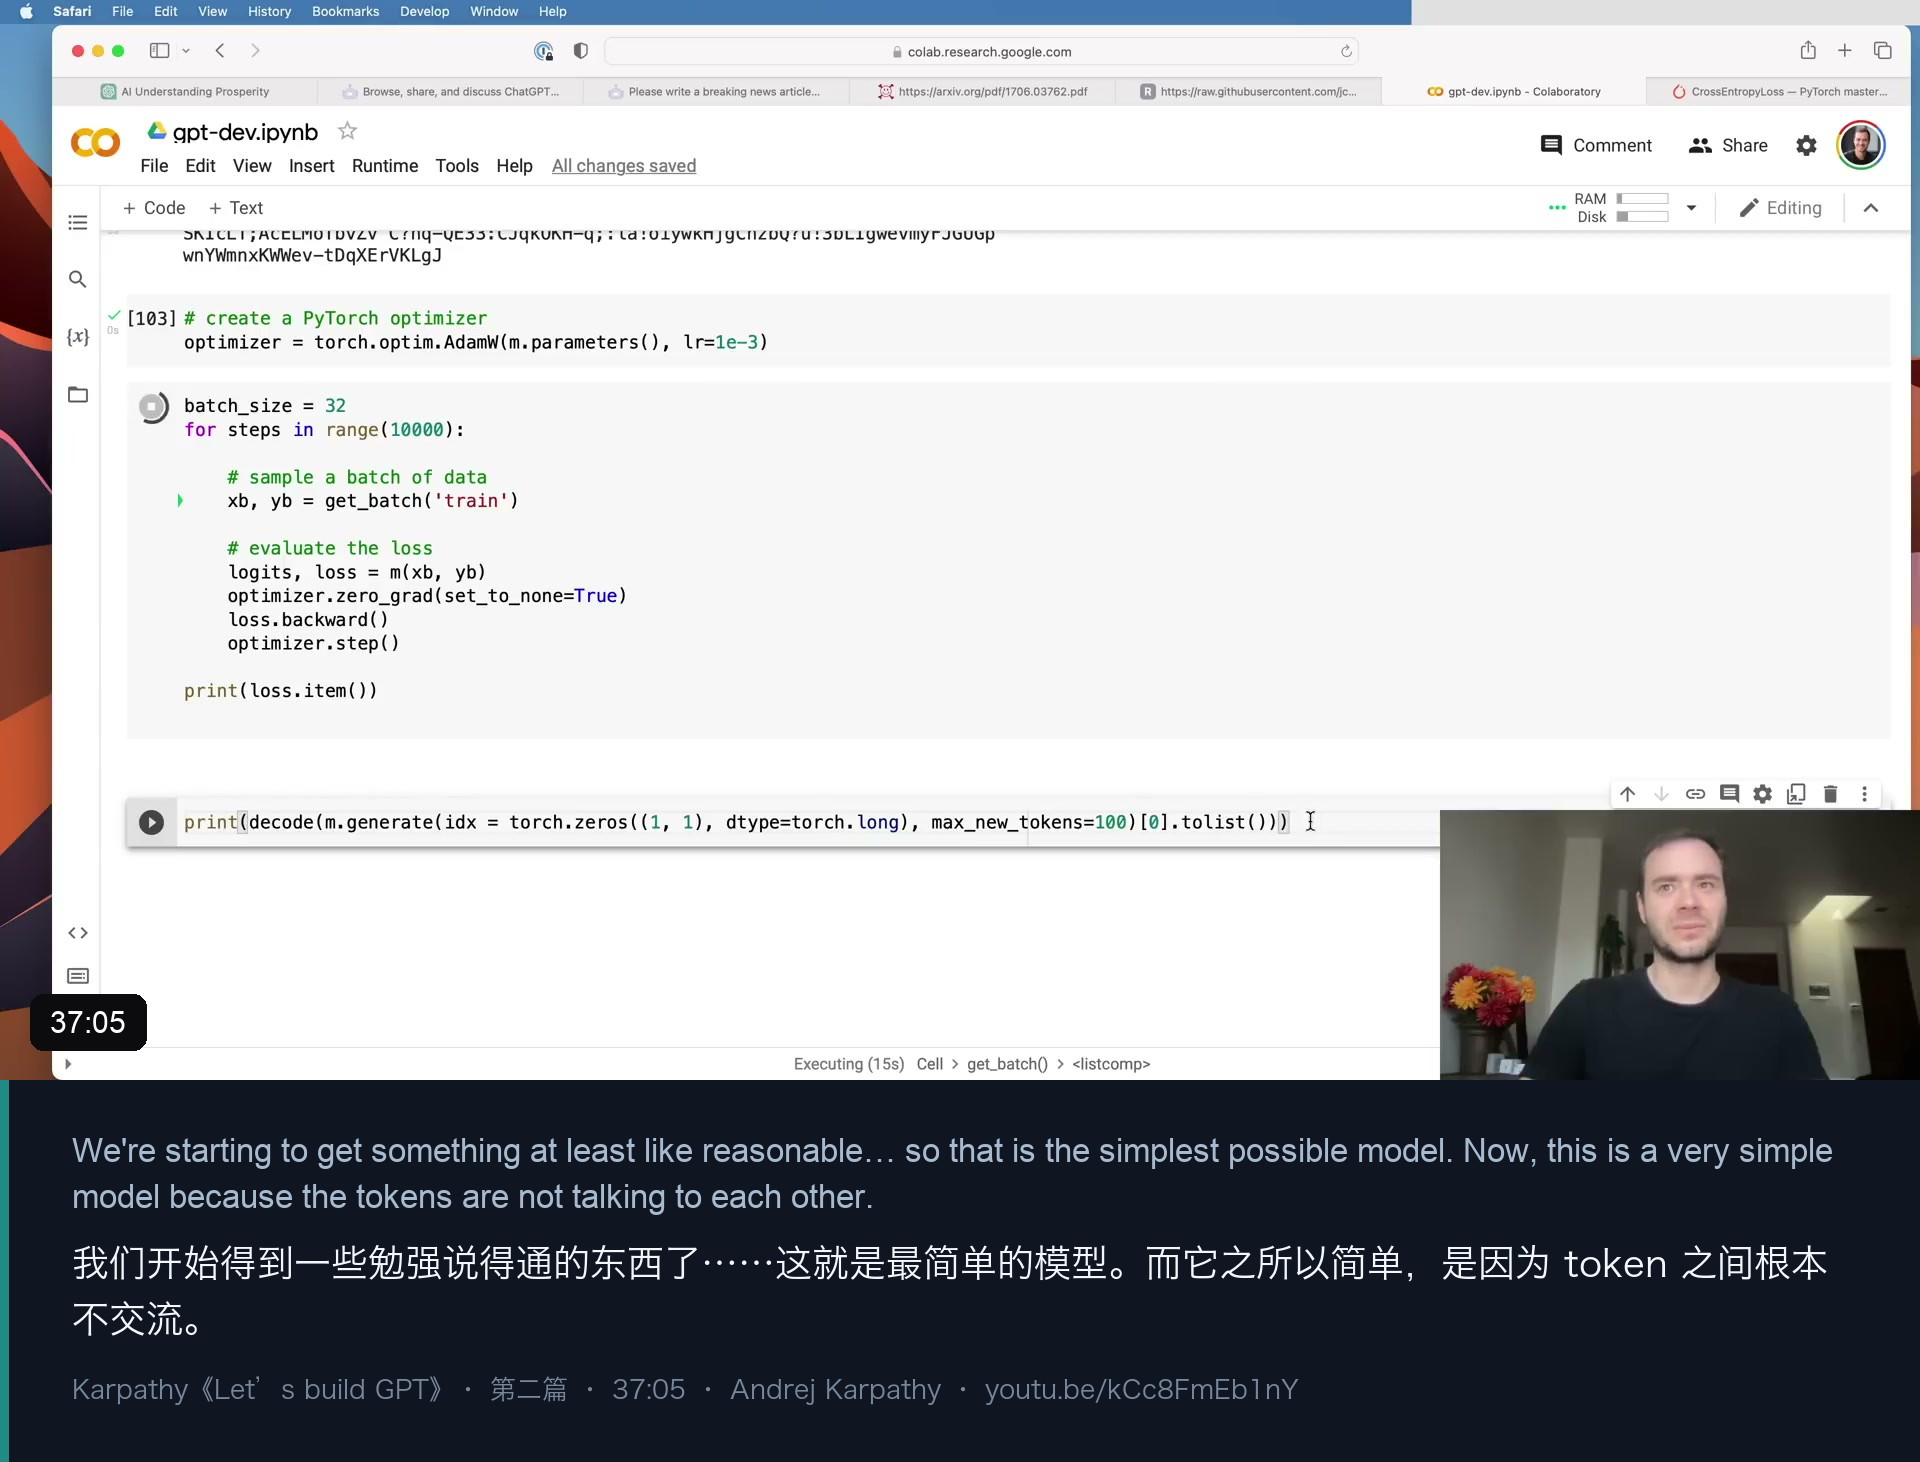
上一篇的最后,我们跑起了训练循环。这一篇开头,Karpathy 把结果摊开:
# 视频里的训练输出(节选)
step 9000: train loss 2.564307, val loss 2.569858
step 9999: train loss 2.477256, val loss 2.536498
损失从 4.87 降到了 2.5 左右——比「均匀瞎猜」的 4.17 好得多,说明它确实学到了「字符与字符之间的搭配」这种一阶统计规律。但生成的文本依然不成话:
# 视频里的采样结果
WiNTER:
VThoe te worl h hw yotfath yon t, t ches my t an s my t, t s.
Karpathy 的复盘只有一句,但非常关键:
这个模型太简单了,因为 token 之间根本不交流。
0.1 顺手把 notebook 变成脚本(三个工程改进)
在进入正题之前,Karpathy 把 Colab 里逐段实验的代码整理成一个脚本,方便后面持续迭代。他把超参数提到文件顶部,并顺手加了三个东西:
① 能在 GPU 上跑。 一个 device 变量解决所有设备迁移:数据 .to(device)、模型参数 .to(device)、生成的起始 context 也要在 device 上。
② 用 estimate_loss() 取代打印单次 loss。
@torch.no_grad()
def estimate_loss():
    out = {}
    model.eval()
    for split in ['train', 'val']:
        losses = torch.zeros(eval_iters)
        for k in range(eval_iters):
            X, Y = get_batch(split)
            logits, loss = model(X, Y)
            losses[k] = loss.item()
        out[split] = losses.mean()
    model.train()
return out他的理由很实在:训练循环里打印的单次 loss 是非常吵的测量——每个 batch 有它自己的「运气」。所以每隔一段时间,就用多个 batch 的平均损失,同时报 train 和 val 两条曲线。
③ 用 model.eval() / model.train() 和 torch.no_grad() 把「训练」与「评估」在语义上分开。
这里 Karpathy 特别强调了两个「现在看起来没用、但迟早有用」的细节:
- 当前模型里只有
nn.Embedding,它在 train / eval 模式下行为一样;但如果以后有 dropout、BatchNorm 这类层,两种模式就完全不同了——养成显式切换模式的习惯。 torch.no_grad()告诉 PyTorch「这一整段不需要反向传播」,于是它可以大幅省下显存,因为它不必保存计算图。
本文补充:这三件事看起来是「工程杂务」,其实是这一课最容易被低估的部分。它们定义了后面所有实验的可信度:噪声大的单点 loss 会让你误判一次改动的效果,而不区分 train/eval 的评估会直接给出错误的验证损失。你在对照 BERT 微调的脚本时应该也见过这一套——
model.eval()+torch.no_grad()是同一套肌肉记忆。
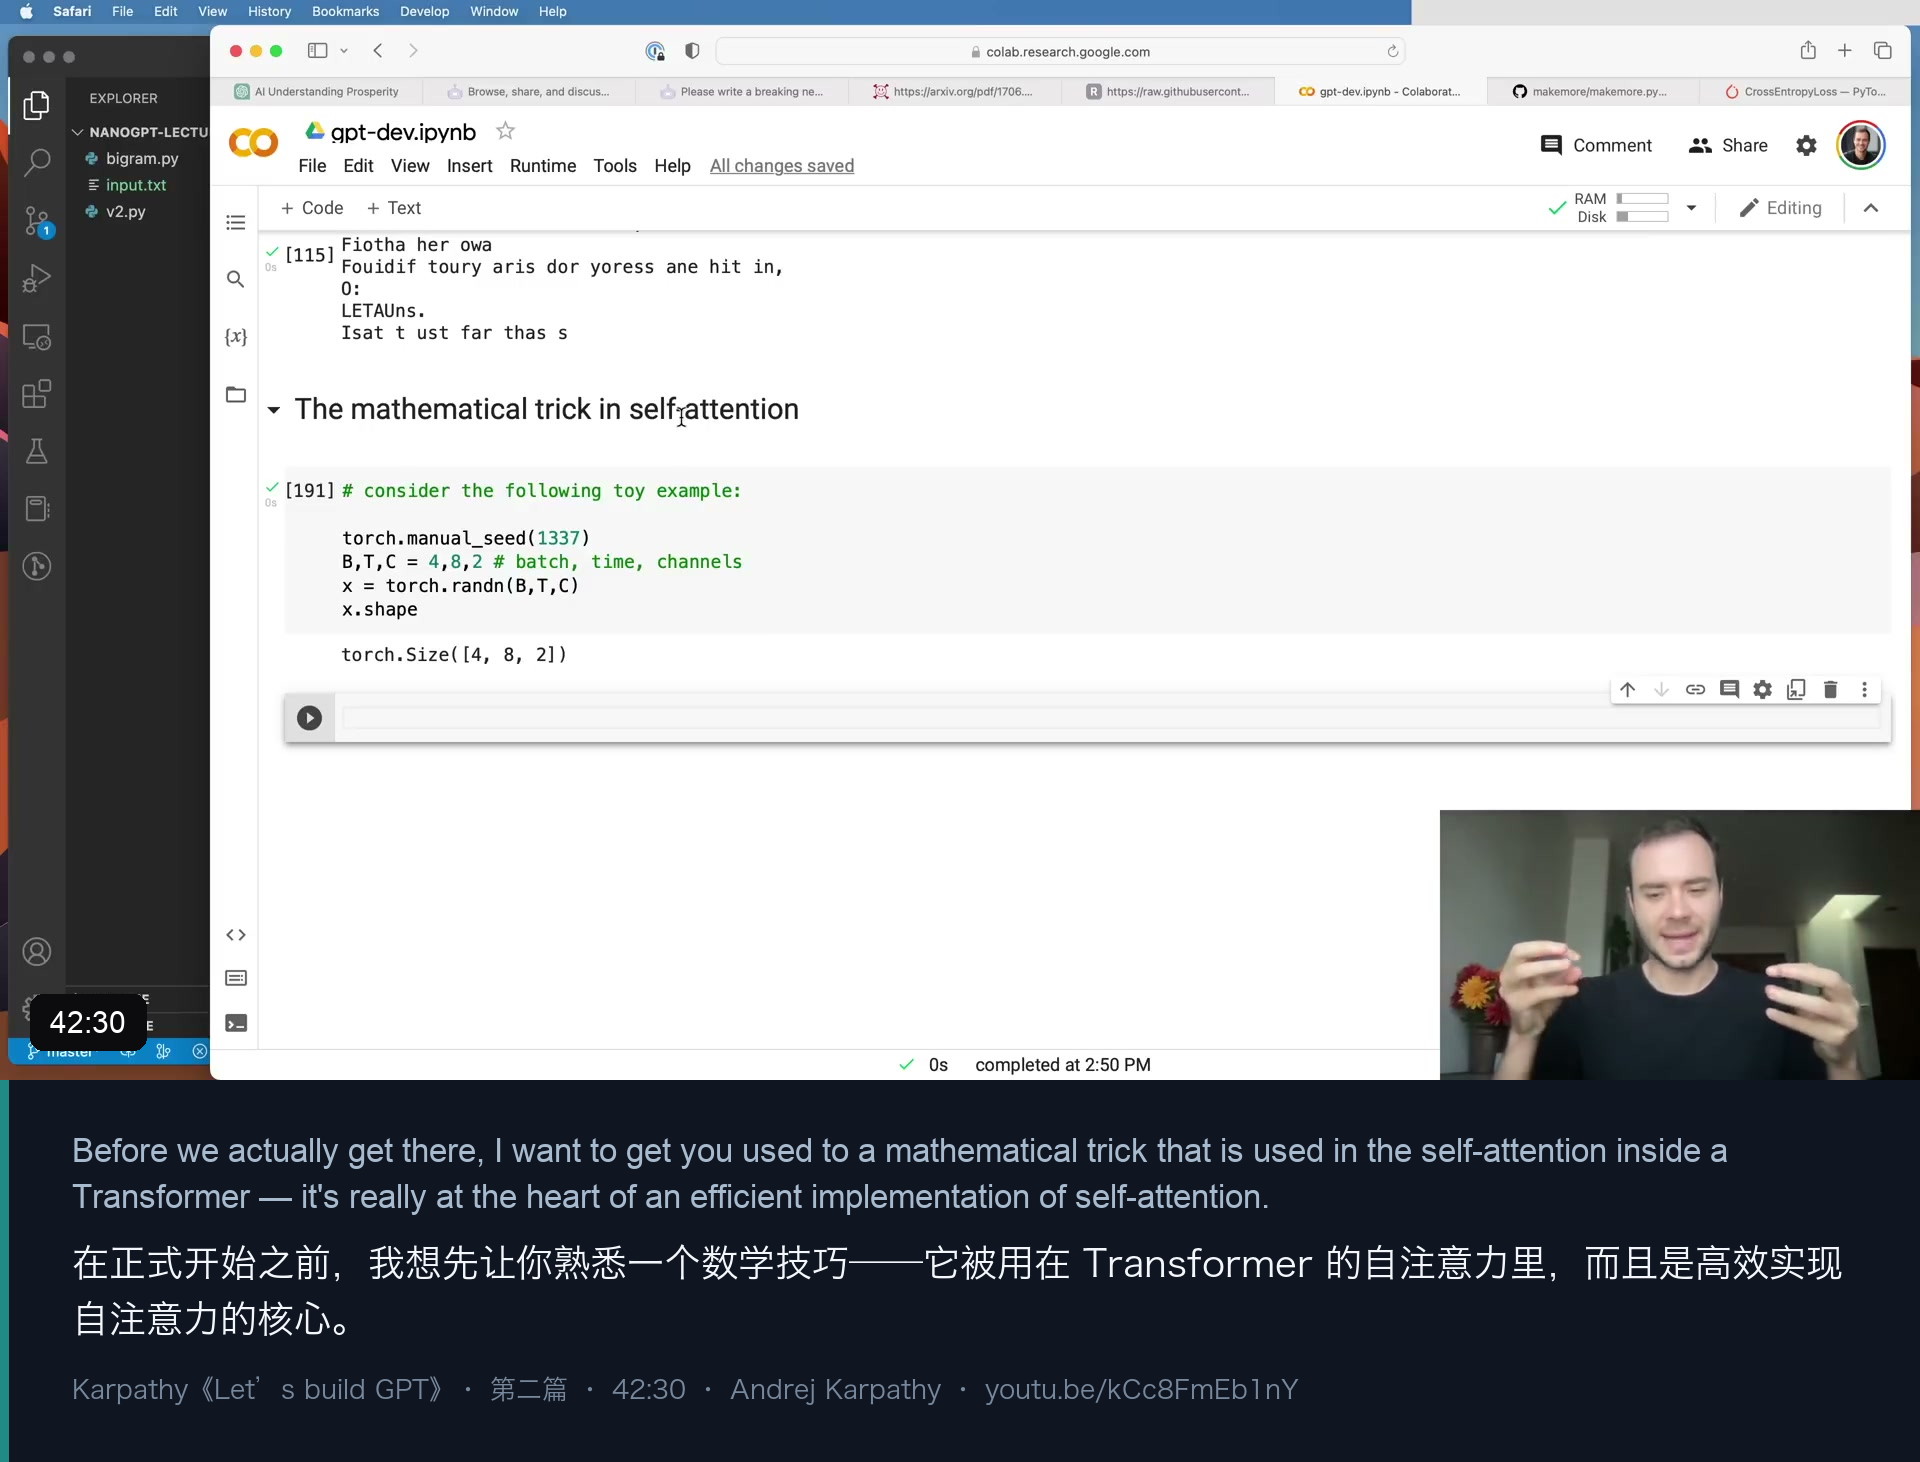
1. 那个数学技巧:用矩阵乘法做「加权平均」(00–00)
1.1 目标:让 token 彼此通信,但只能往前看
Karpathy 把需求说得很具体。假设有一个 (B, T, C) 的张量:4 个 batch、8 个时间步、每一步一个 2 维的通道向量(玩具例子里 B,T,C = 4,8,2)。
- 我们想让这 8 个 token 互相通信;
- 而且只能按特定方式通信:第 5 个 token 只能和第 4、3、2、1 个说话,不能和第 6、7、8 个说话,因为那三个是「未来」——而我们正要预测未来。
- 所以信息流的规则是:只能从过去流向当前,绝不能从未来回流。
1.2 最朴素的实现:对历史取平均
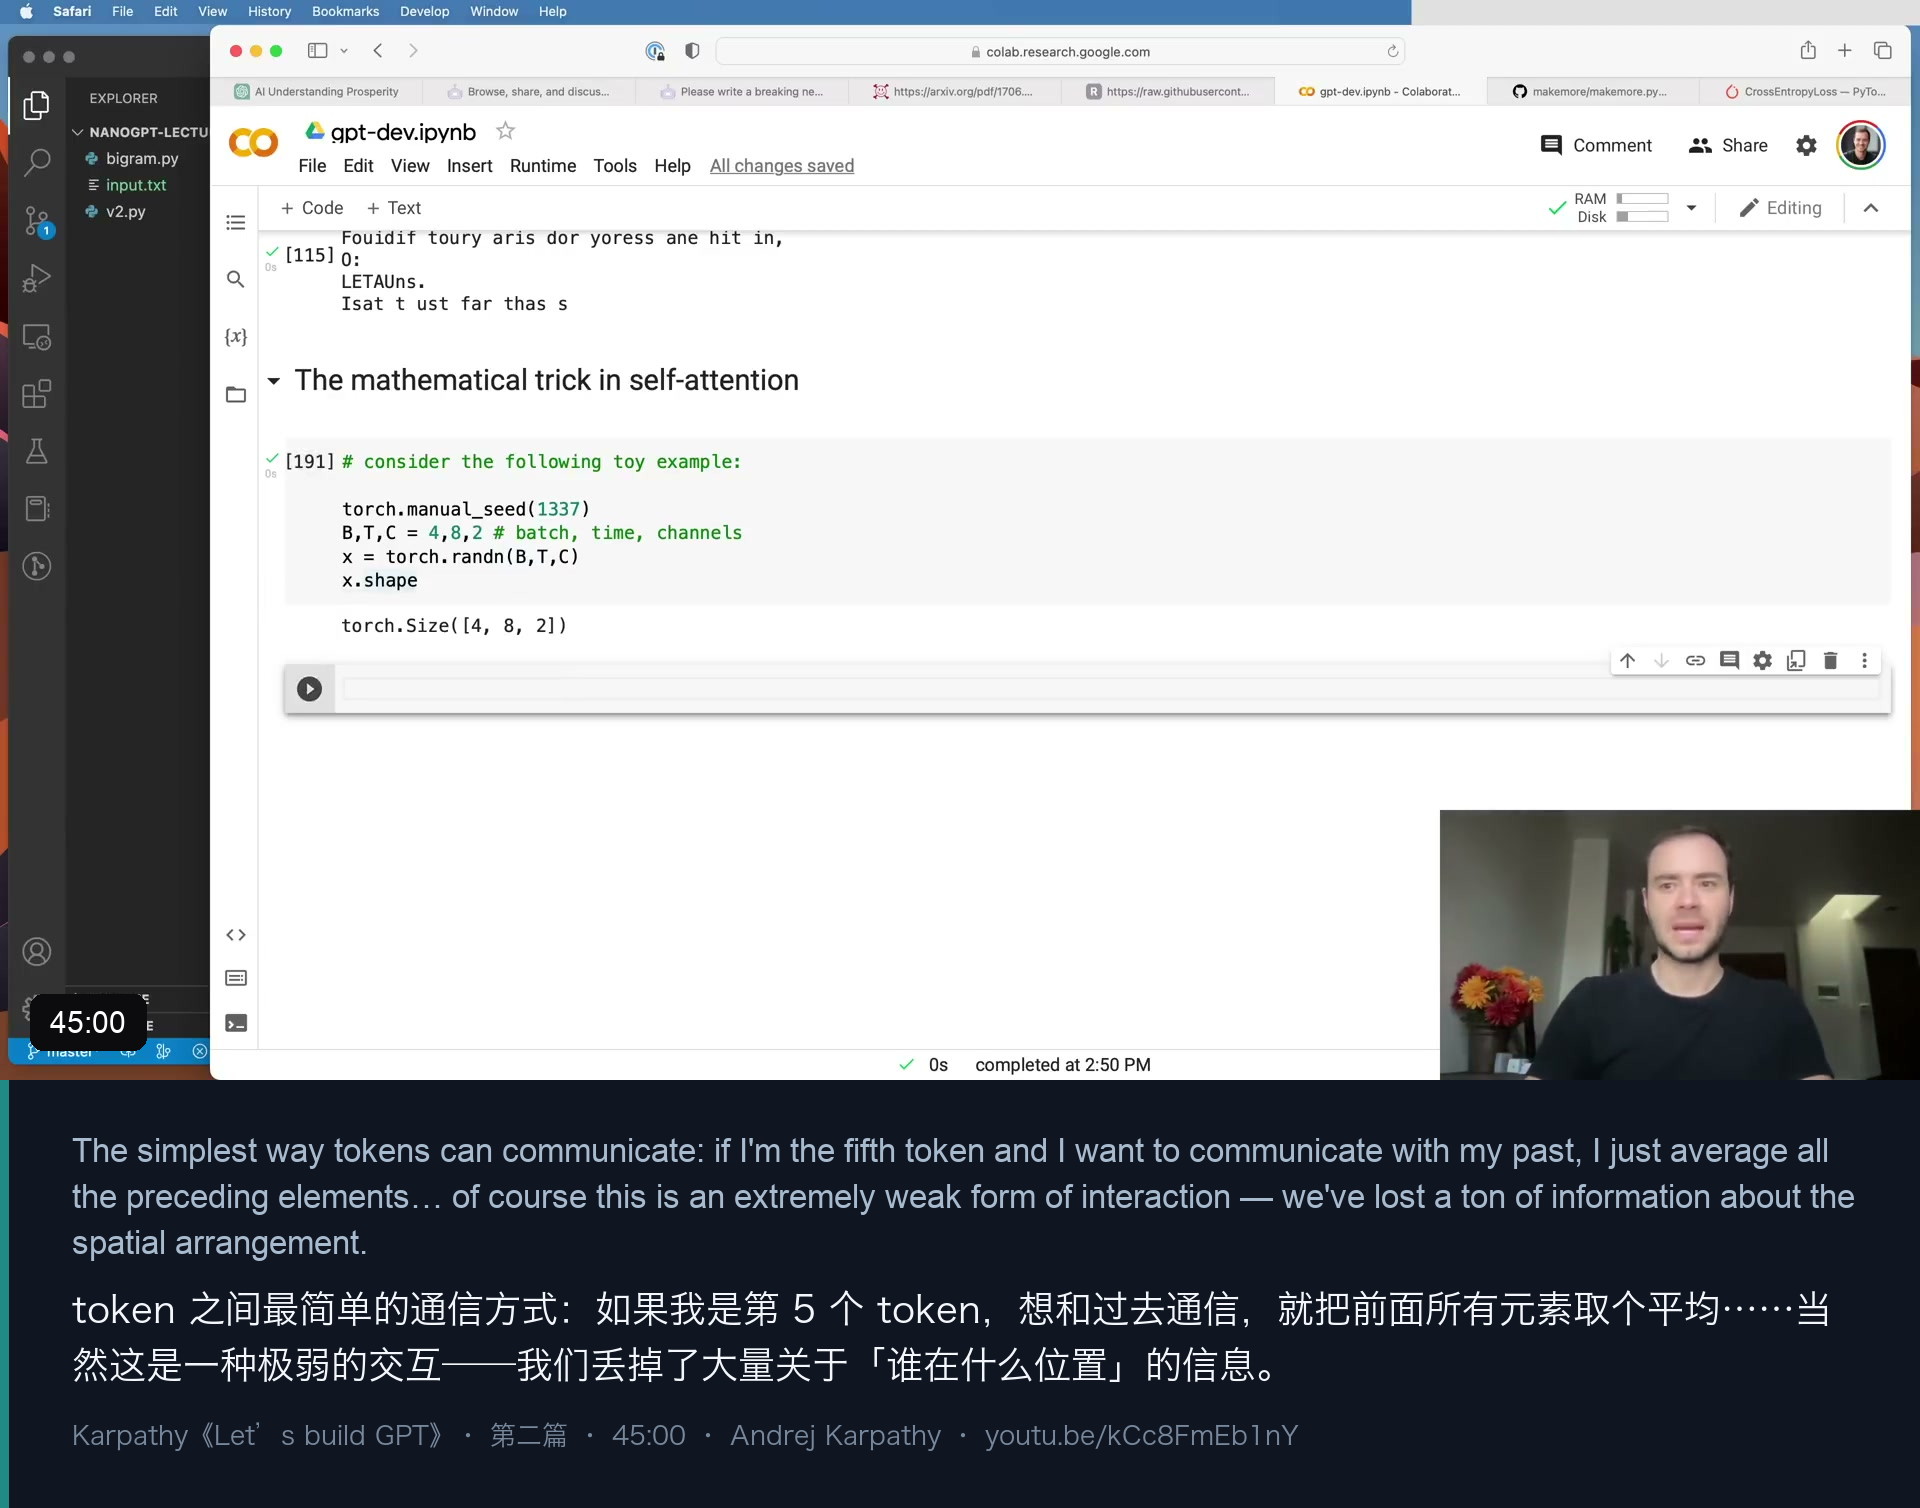
最直接的「通信」方式就是把前面的向量平均起来:
# 玩具例子:B,T,C = 4,8,2
xbow = torch.zeros((B, T, C))
for b in range(B):
    for t in range(T):
        xprev = x[b, :t+1]      # (t+1, C) —— 到当前为止的所有 token
        xbow[b, t] = torch.mean(xprev, 0)
Karpathy 管它叫 xbow = bag of words:每个位置都变成「截至目前所有信息的平均」。
他还非常坦率地评价了这种做法:
当然,这是一种极弱的交互(an extremely weak form of interaction)——我们丢掉了大量关于这些 token 空间排列的信息。但这没关系,后面我们会看到怎么把信息找回来。
1.3 数学技巧:同样的结果,用一次矩阵乘法
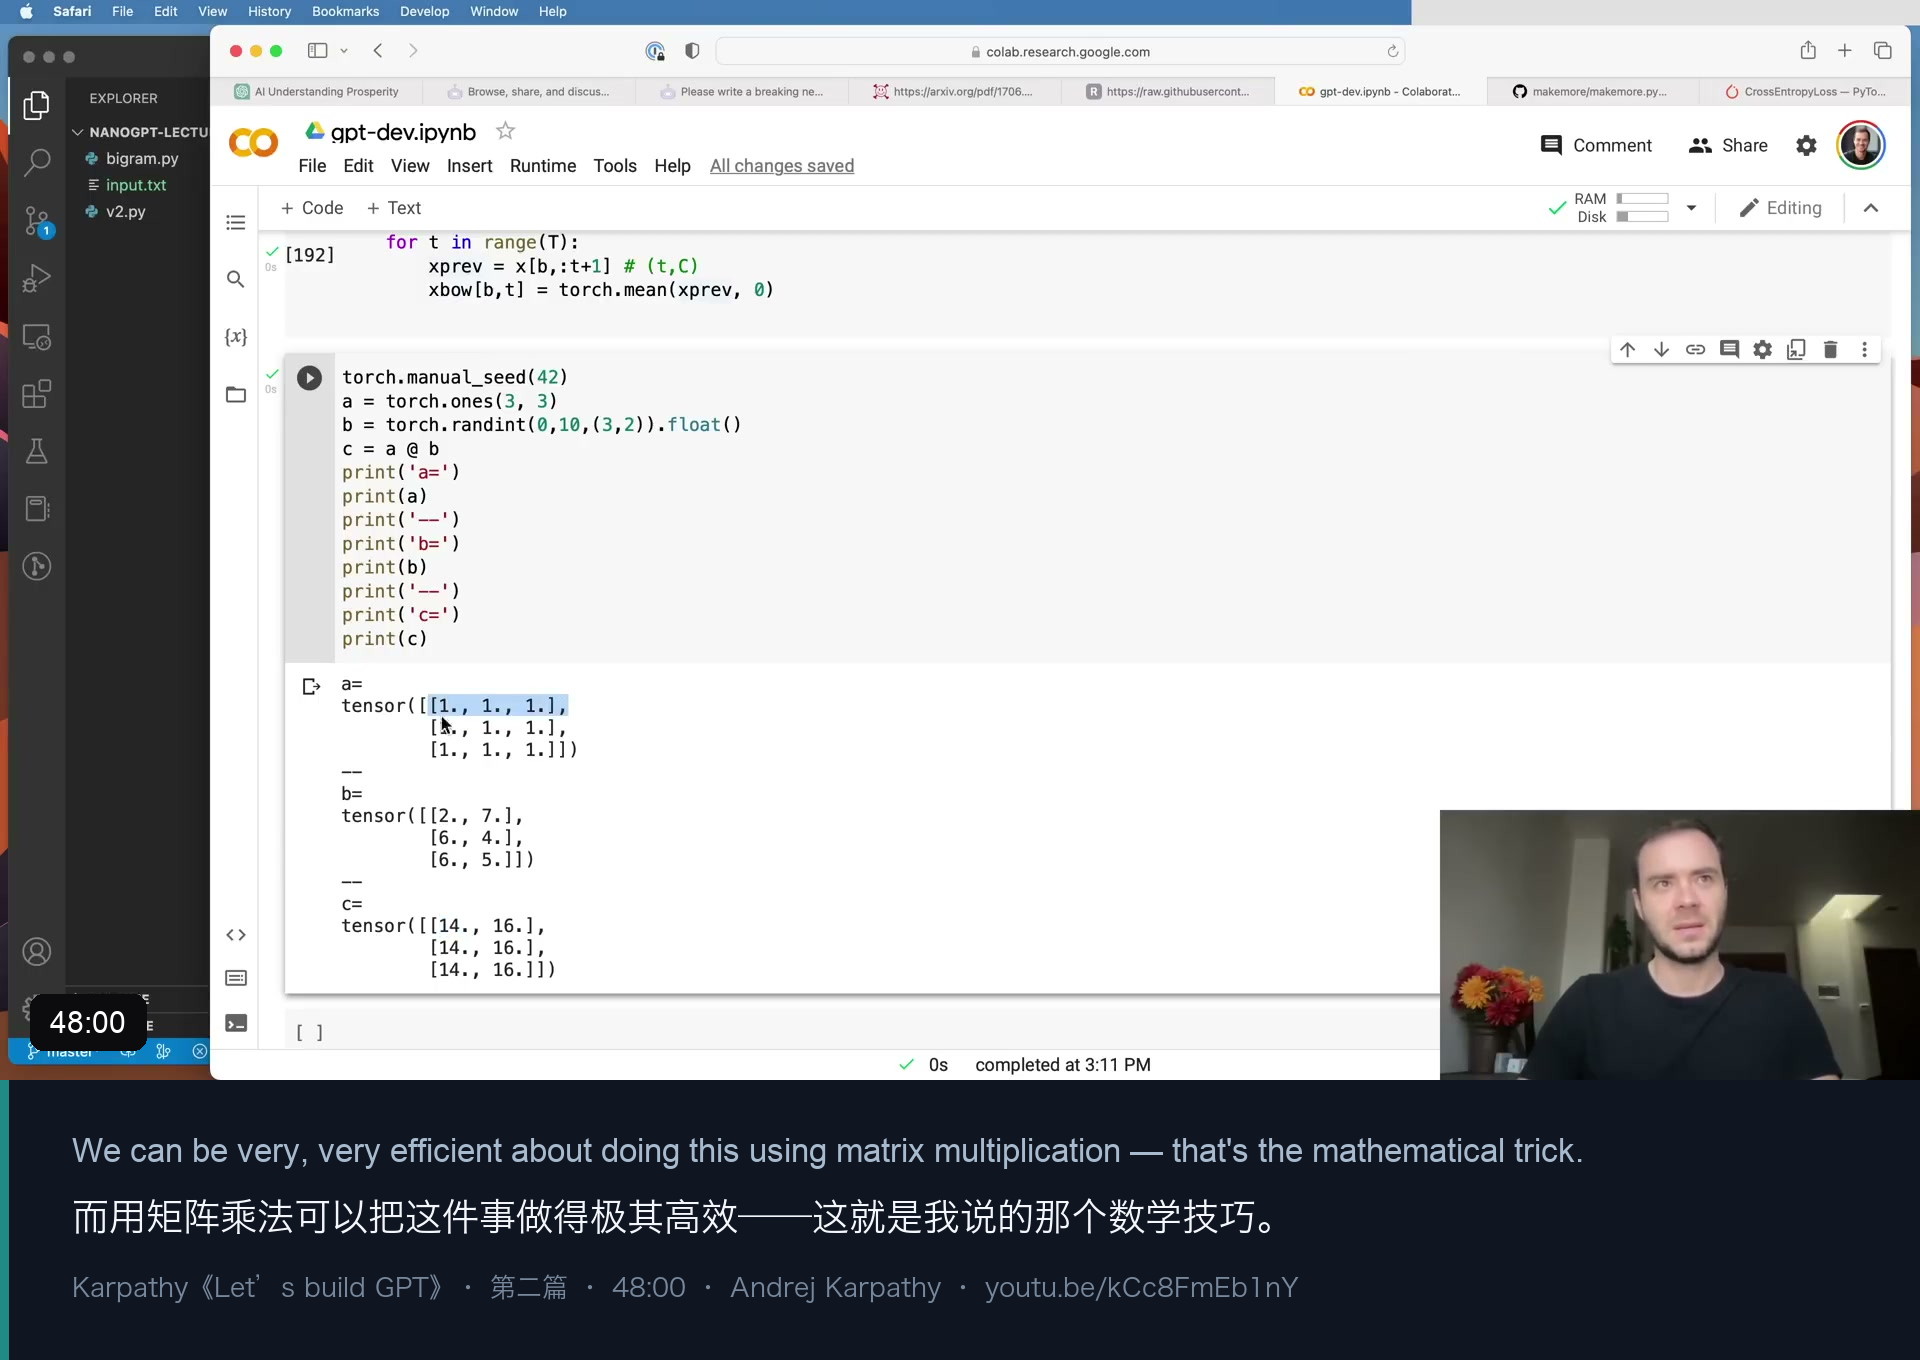
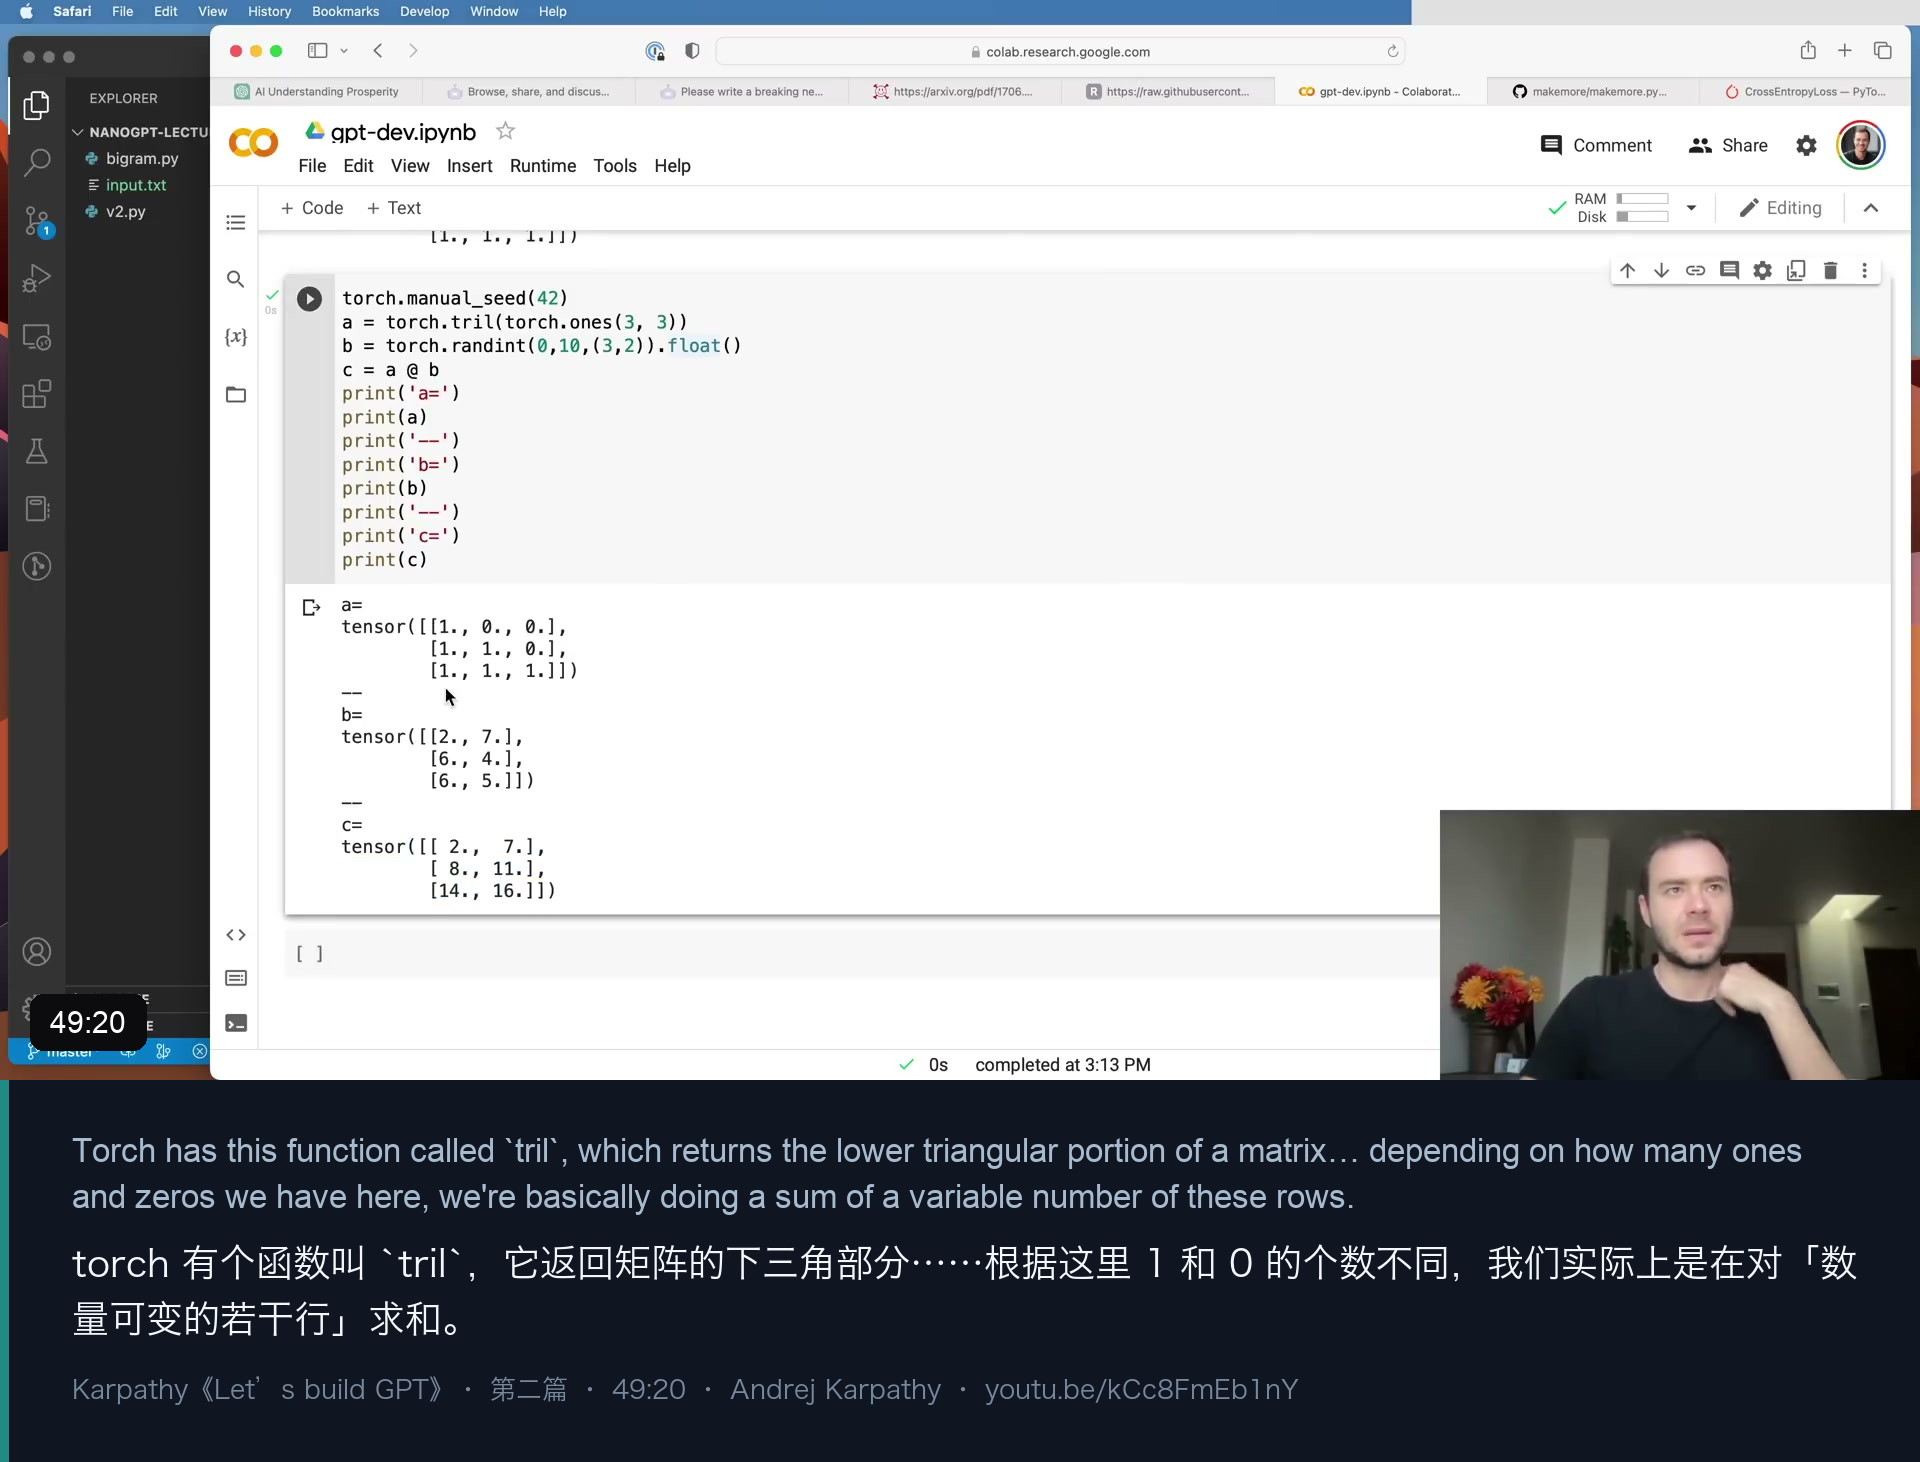
双重循环太慢了。Karpathy 用一个小例子把等价关系摆出来:
torch.manual_seed(1337)
a = torch.ones(3, 3)                                   # 全 1 矩阵
b = torch.tensor([[2., 6.], [6., 4.], [7., 5.]])       # 3x2
c = a @ b
# tensor([[15., 15.],
#         [15., 15.],
#         [15., 15.]])
为什么 a @ b 等于「把 b 的行加起来」? 因为 a 的每一行都是 1:输出的第 i 行 = a[i] 与 b 的每一列做点积 = 对 b 的各行求和。
于是「加权求和」这件事,可以完全交给一次矩阵乘法——权重写在乘数矩阵里。
1.4 tril:只让「过去」参与
但全 1 矩阵让所有行都参与,包括未来。所以要用下三角:
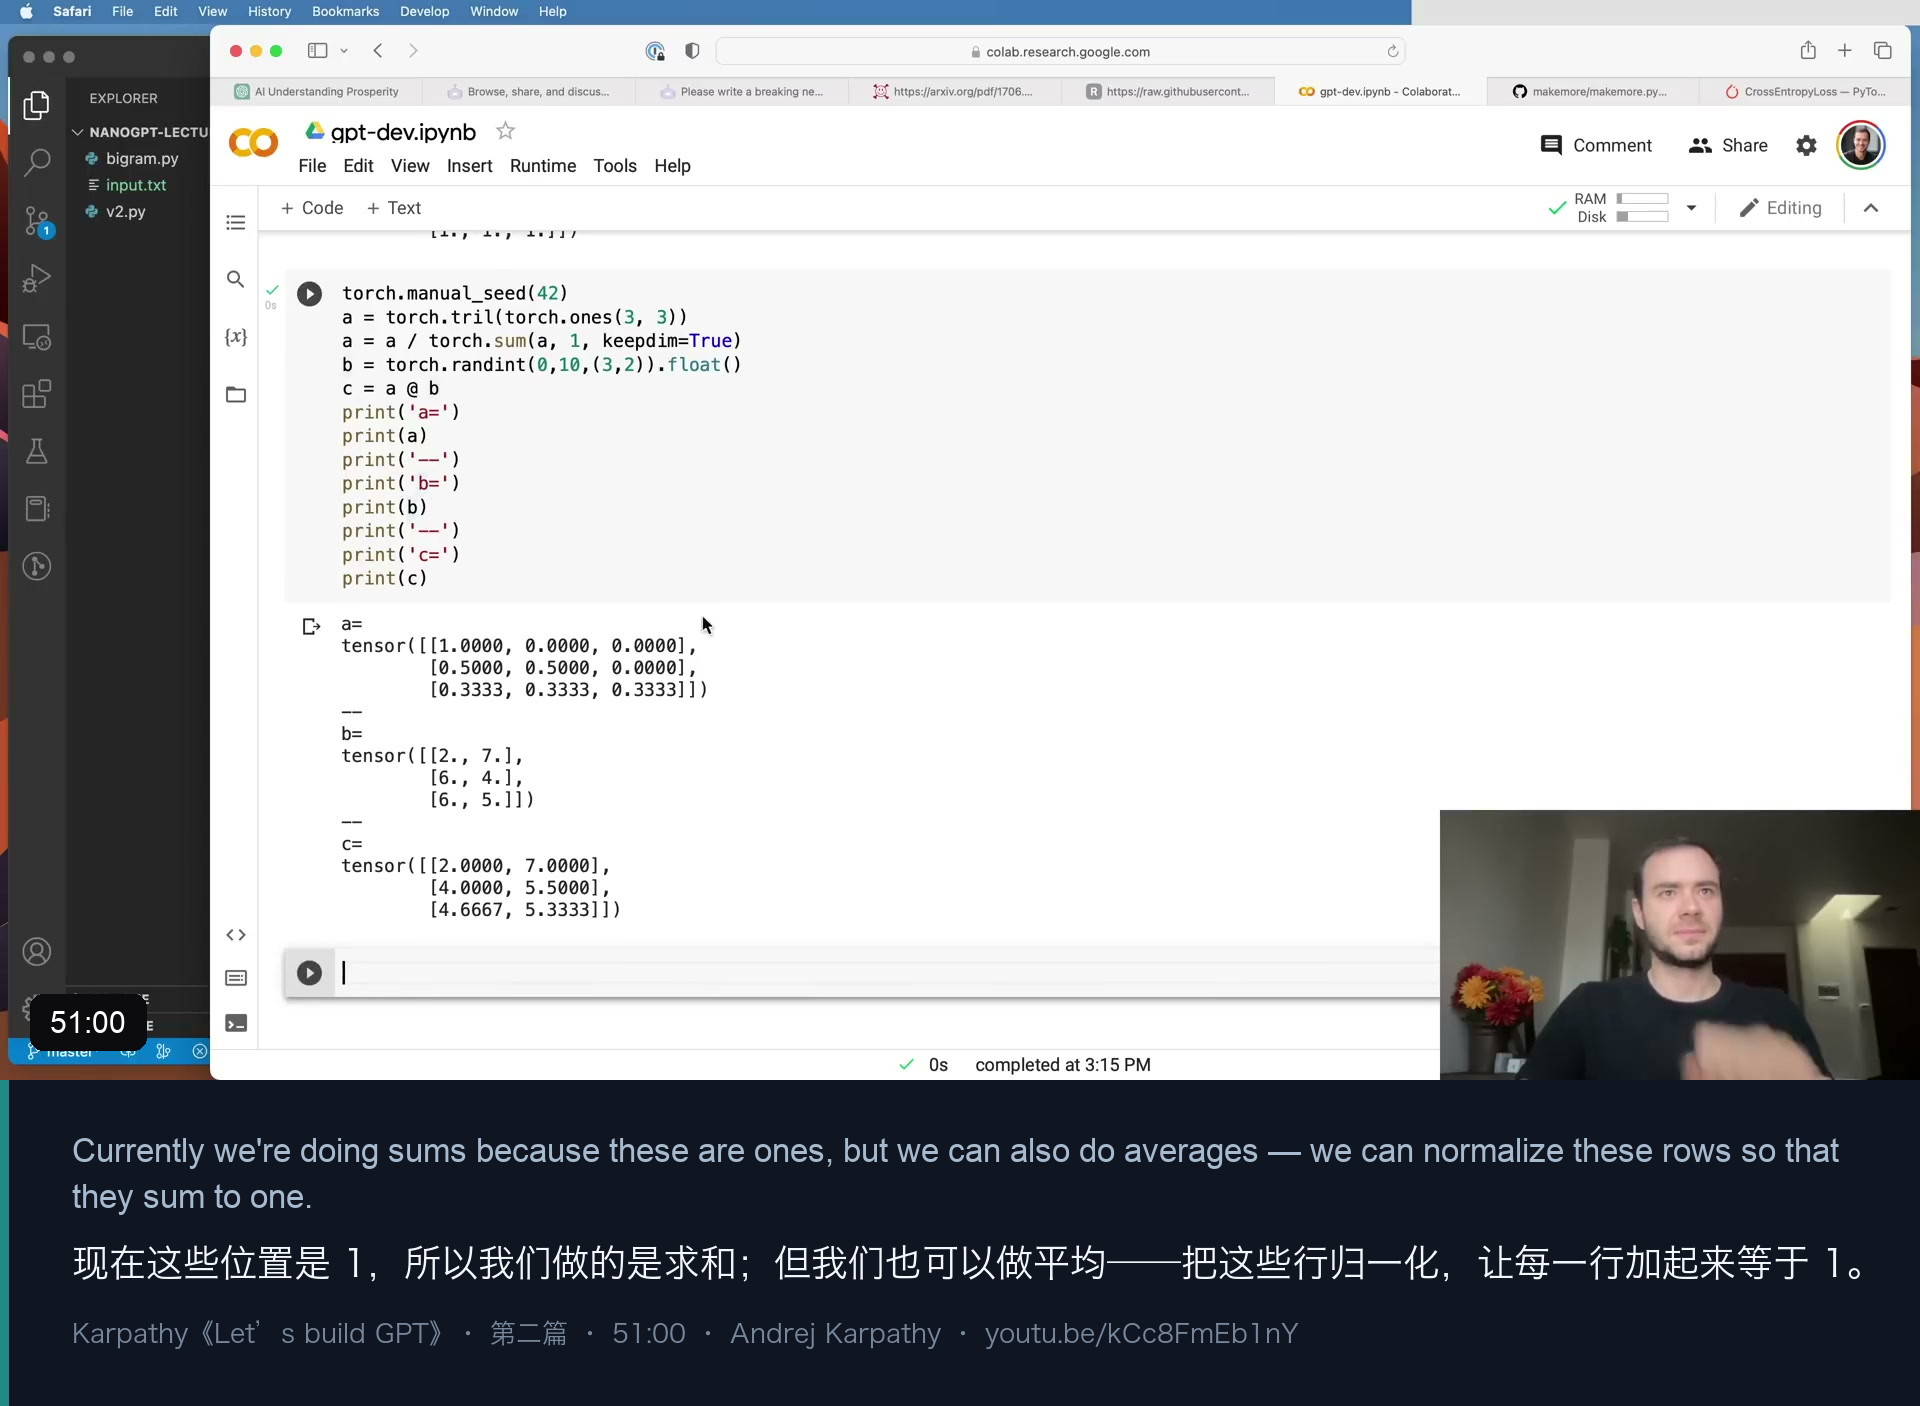
wei = torch.tril(torch.ones(T, T))   # 下三角为 1,其余为 0
wei = wei / wei.sum(1, keepdim=True) # 每行归一化,使其和为 1
xbow2 = wei @ x                      # (T,T) @ (B,T,C) -> (B,T,T) @ (B,T,C) -> (B,T,C)
torch.tril 返回下三角部分。归一化之后:
- 第 0 行是
[1, 0, 0]→ 只取第 0 个 token; - 第 1 行是
[0.5, 0.5, 0]→ 前两个 token 的平均; - 第 2 行是
[1/3, 1/3, 1/3]→ 前三个的平均。
「只能看过去」这件事,变成了矩阵右上角的那些 0。 而且 PyTorch 会自动把 (T,T) 广播到每个 batch——所以还是一句话搞定。
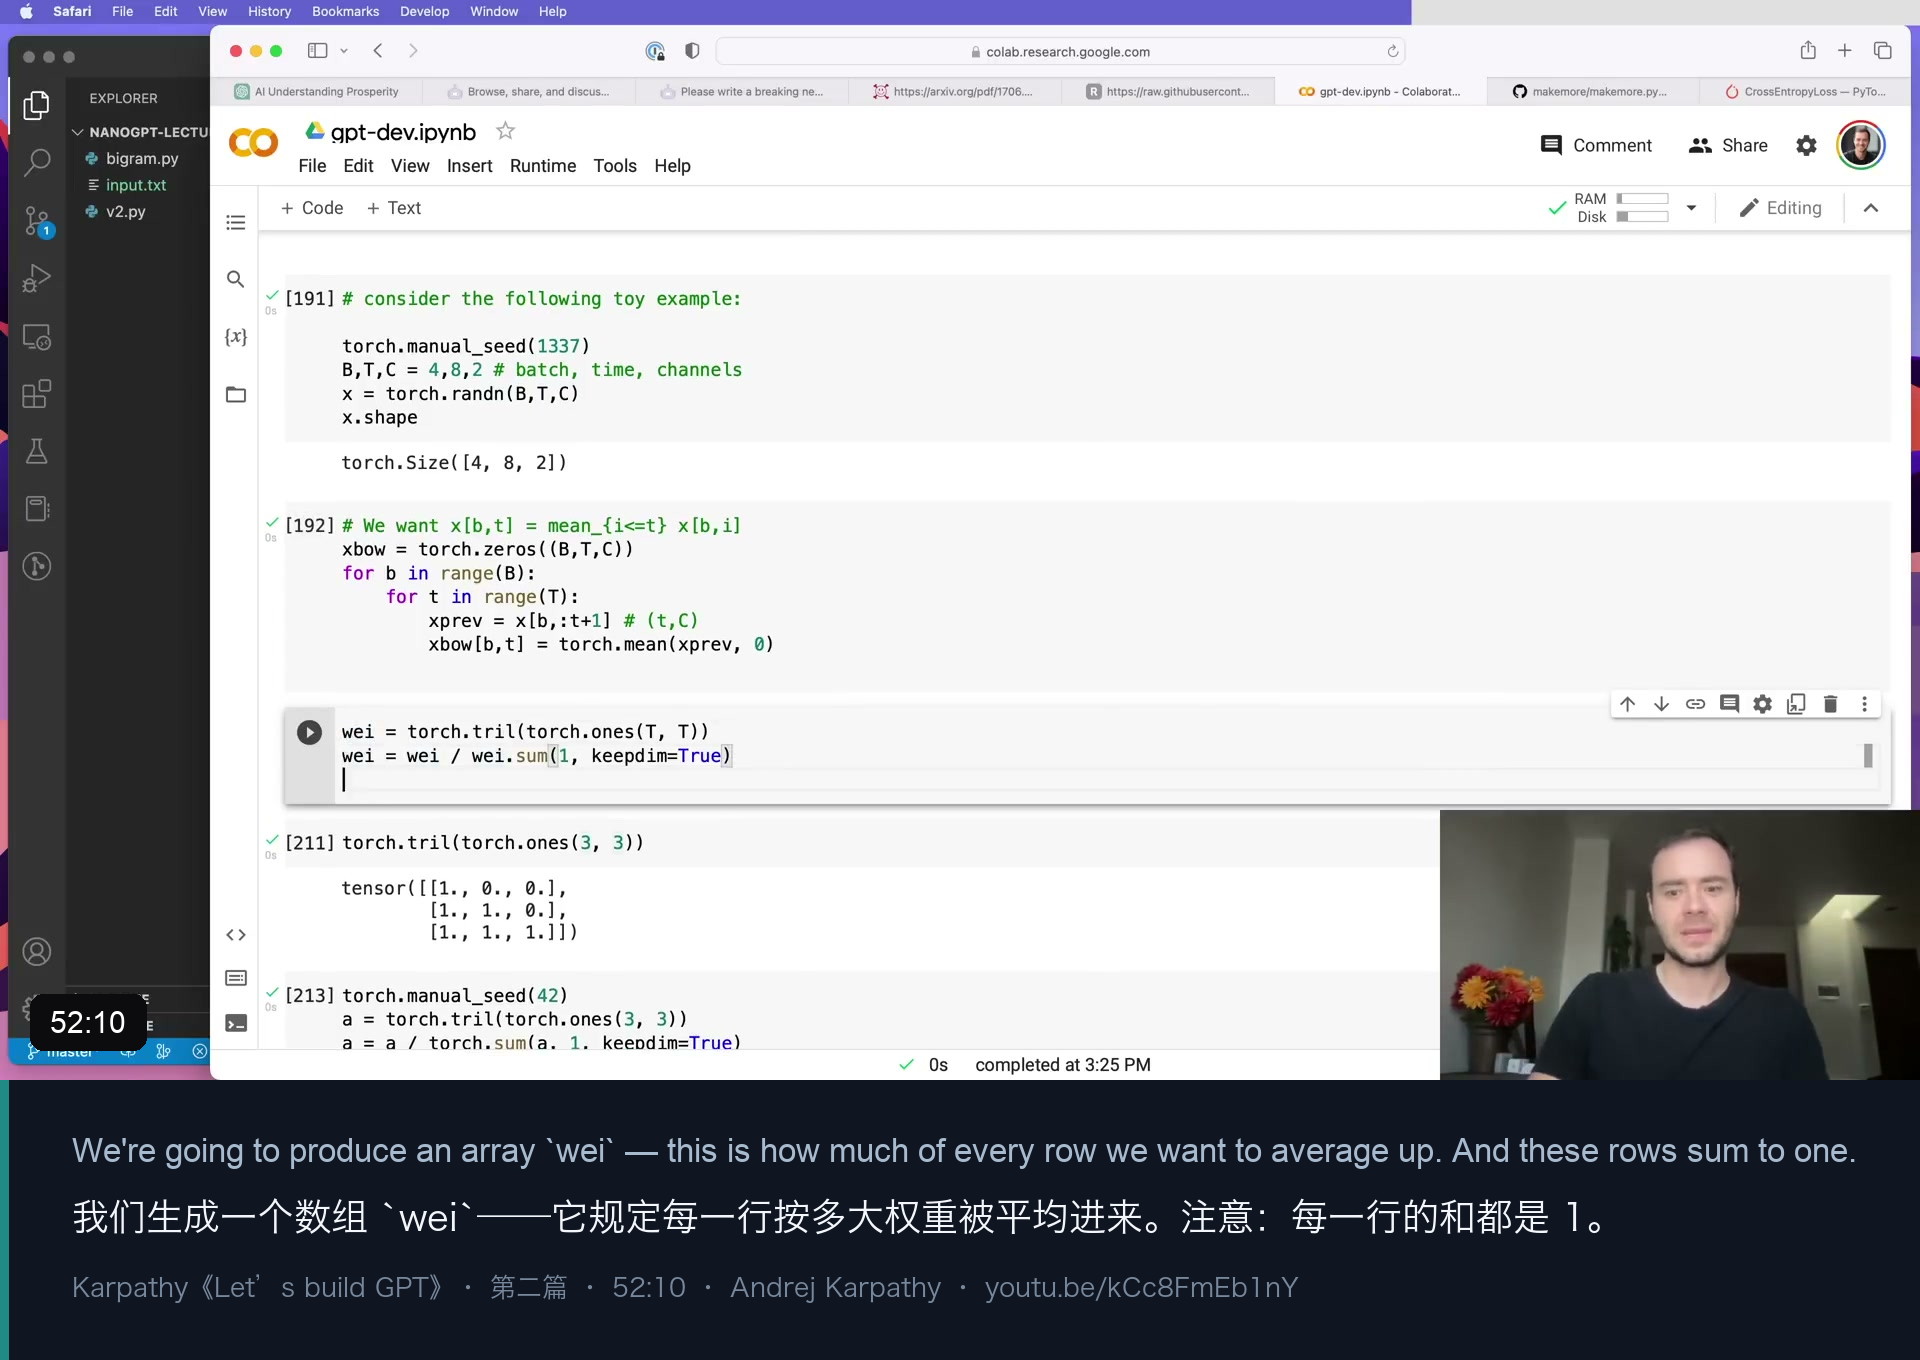
1.5 第三种写法:masked_fill(-inf) + softmax——为什么最后用它
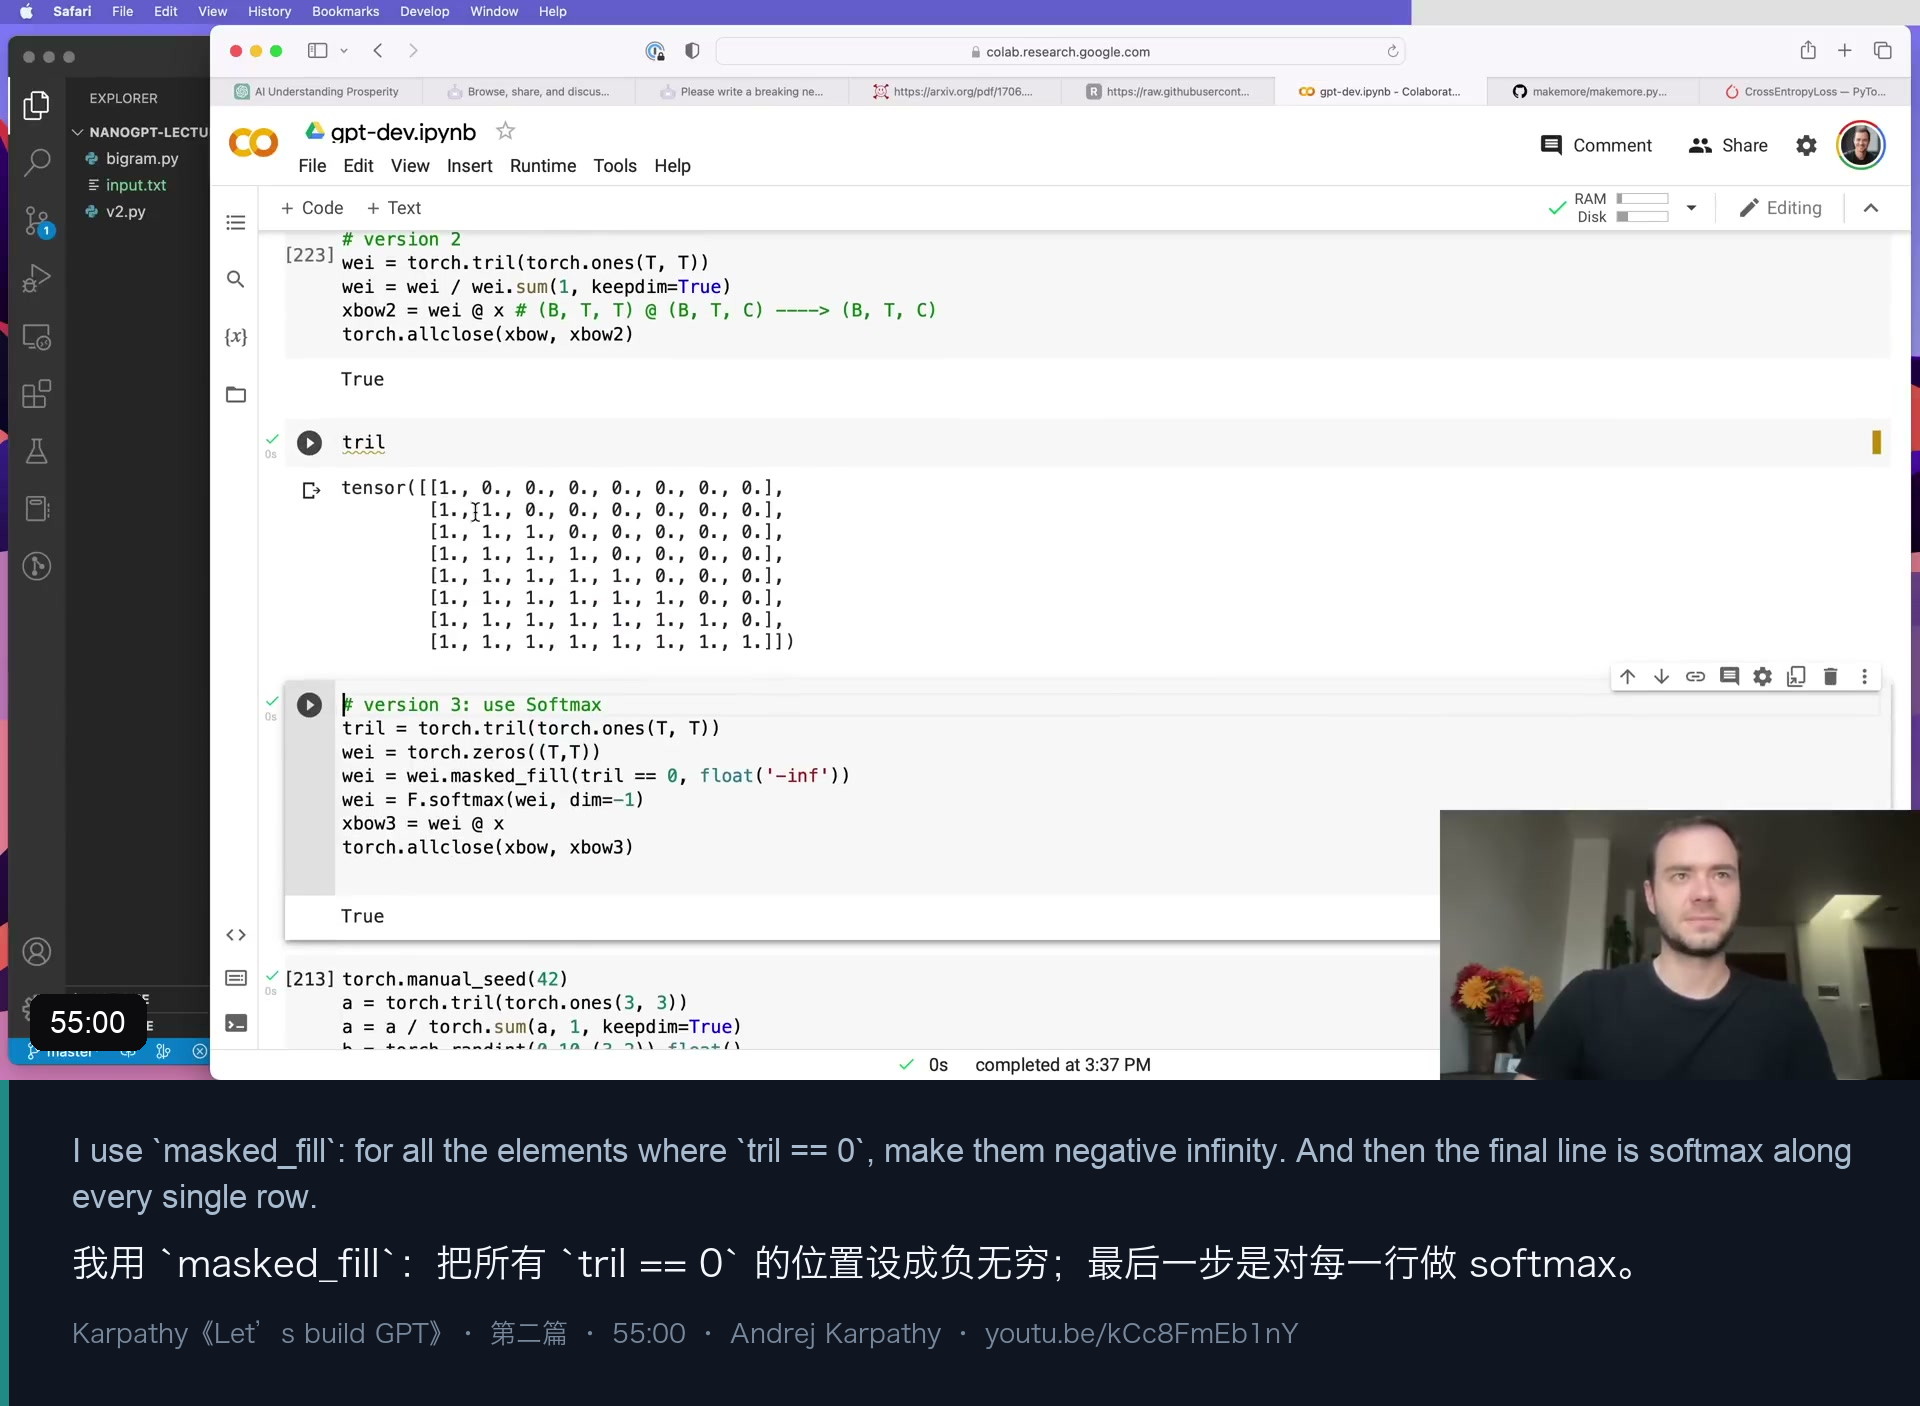
Karpathy 最后给出了第三种(也是最终保留的)写法:
tril = torch.tril(torch.ones(T, T))
wei = torch.zeros((T, T))                      # 初始:所有亲和度都是 0
wei = wei.masked_fill(tril == 0, float('-inf'))  # 未来位置 -> 负无穷
wei = F.softmax(wei, dim=-1)                   # 每行做 softmax
xbow3 = wei @ x结果与前面完全一致,但语义完全不同:
- 前面两种写法里,权重是人为写死的常数(1 或 1/3);
- 这里权重初始化为 0,可以理解为「交互强度 / 亲和度(affinity)」——「我要从过去每个 token 那里聚合多少信息」;
- 把未来位置设成
-inf,softmax 之后那里自然就是 0 概率——「不许通信」从一个 0 变成了概率语言里的一句话。
而 softmax 的作用,Karpathy 的解释是:它是一个归一化操作。指数化之后,正值变大、负值趋 0,再除以总和,就得到一个「和为 1 的分布」。
1.6 这一节真正的「伏笔」:权重可以变成数据相关
Karpathy 在这一段的结尾给出了整节课最重要的一句预告:
现在这些 0 是我们人为设成 0 的,但这些 token 之间的亲和度不会永远是常数——它们会变成数据相关的。这些 token 会开始互相打量,有的 token 会觉得别的 token 更有意思,而且不同 token 觉得「有意思」的程度也不同。
这就是自注意力的全部动机:如果「聚合权重」能被学习、能依赖数据,那模型就能自己决定「我该从谁那里、拿多少信息」。
一句话总结这一节:
用下三角矩阵做乘法,就能实现对「过去元素」的加权聚合;下三角里的数值,就是每个元素对这个位置的贡献度。
2. 位置嵌入:给「没有空间概念」的注意力一个坐标(01)
在写注意力之前,Karpathy 先补了两块地基。
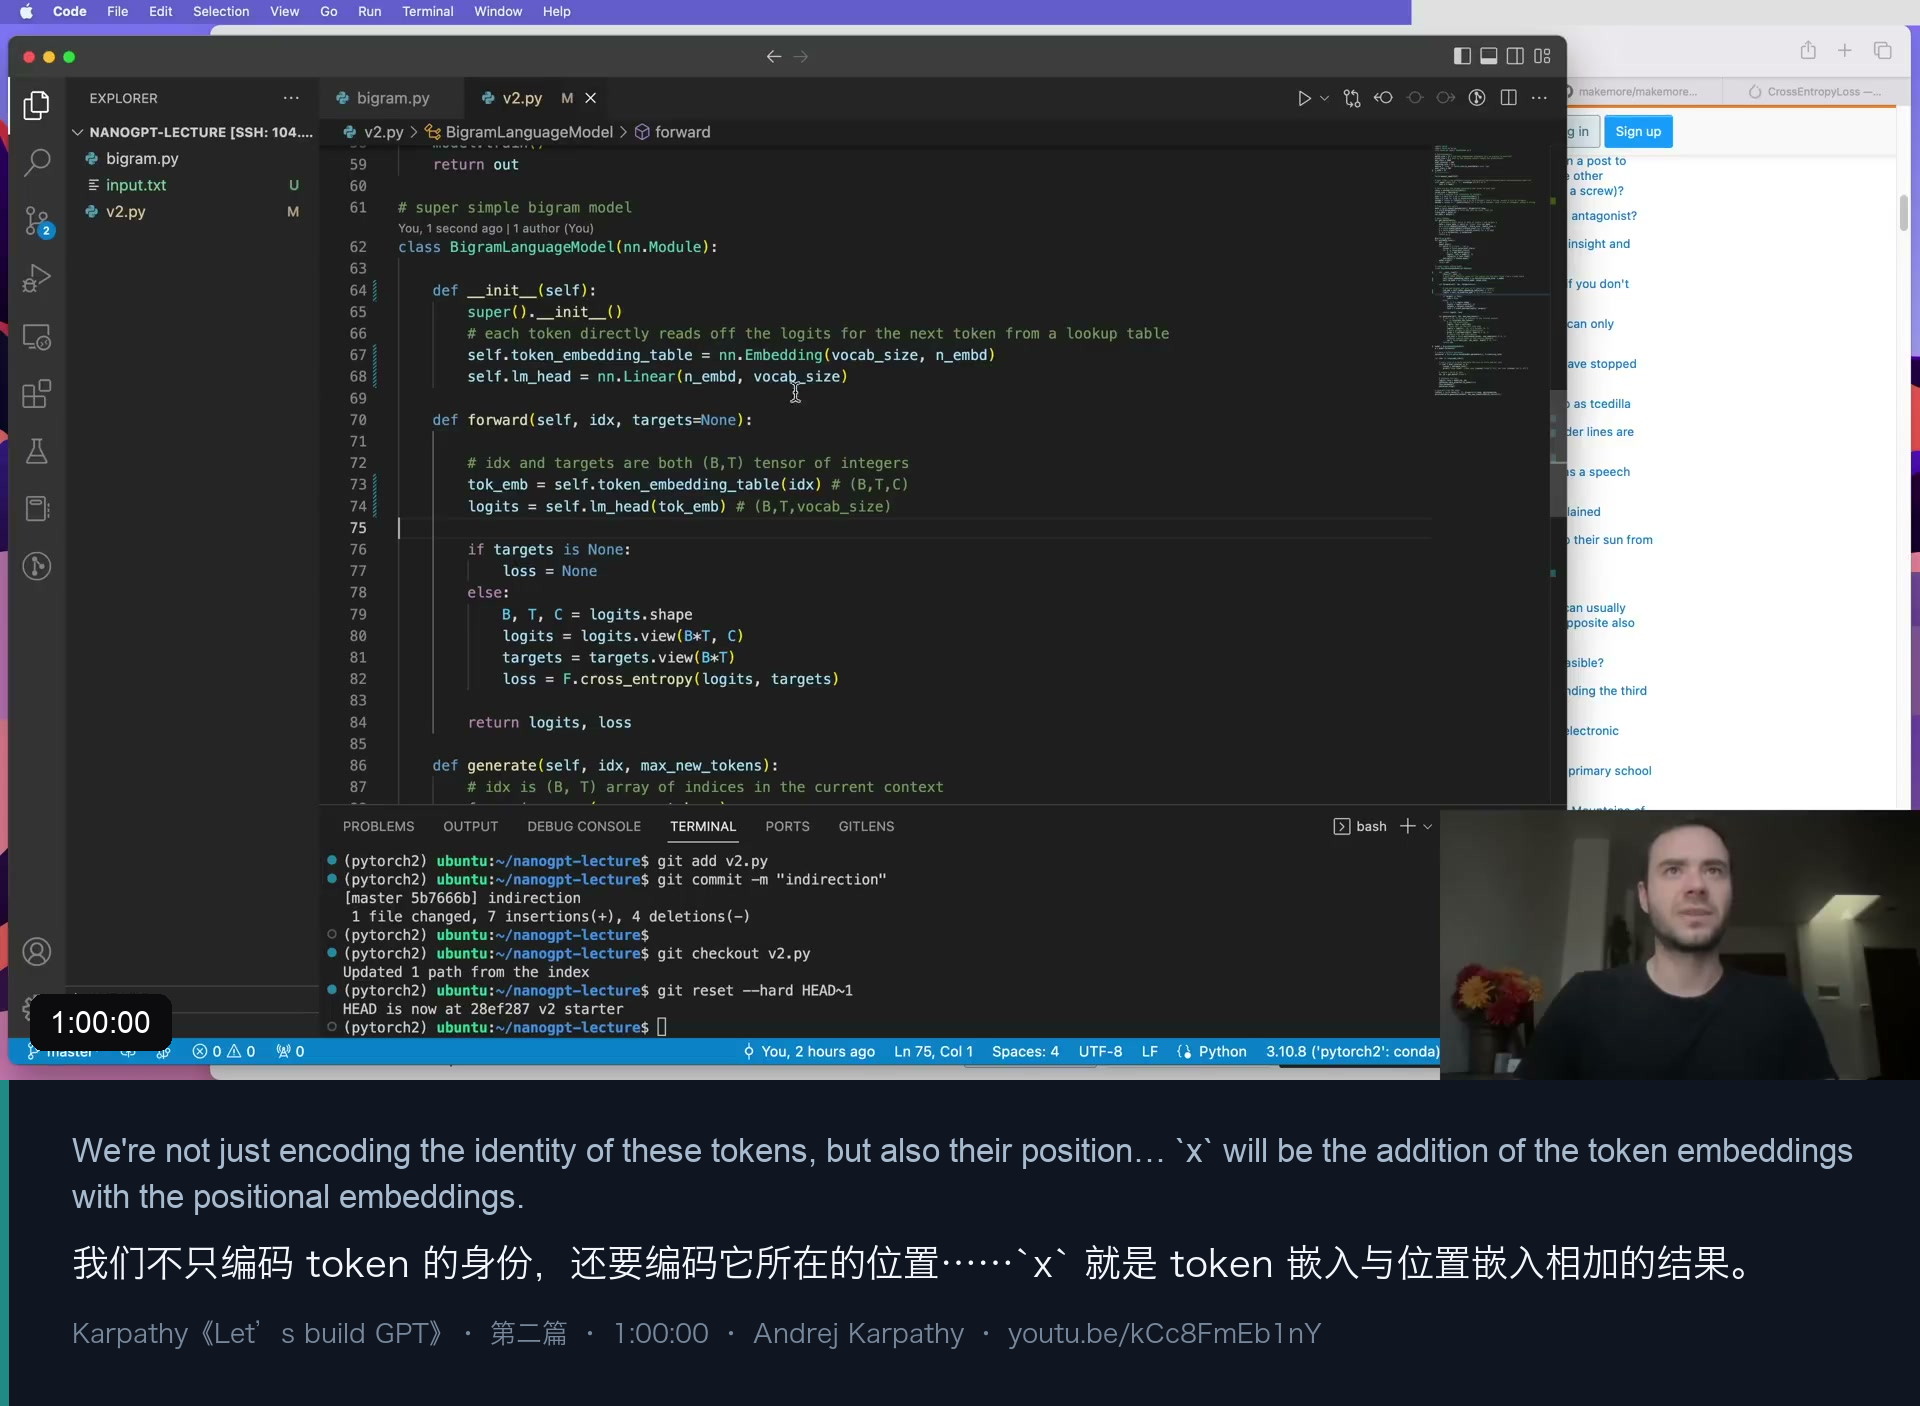
① 引入 n_embd,加一层间接。 之前 bigram 是直接从 token 嵌入表取 logits(表是 vocab×vocab)。现在改成两步:
self.token_embedding_table = nn.Embedding(vocab_size, n_embd)  # 先得到 n_embd 维表示
self.lm_head = nn.Linear(n_embd, vocab_size) # 再投影到词表他说这是为了「留一层间接(a level of indirection)」,因为嵌入维度接下来要变大、要接注意力。视频里 n_embd = 32(他顺口提到这是 GitHub Copilot 建议的数字)。
② 加入位置嵌入。
self.position_embedding_table = nn.Embedding(block_size, n_embd)
tok_emb = self.token_embedding_table(idx)                       # (B,T,C)
pos_emb = self.position_embedding_table(torch.arange(T, device=device))  # (T,C)
x = tok_emb + pos_emb                                           # 广播相加 -> (B,T,C)
(B,T,C) + (T,C) 会广播成 (B,T,C)——每个 token 的向量 = 它的身份 + 它所在的位置。
Karpathy 在这里说了一句很坦诚的话:对当前的 bigram 模型来说,位置信息完全没用(因为它是平移不变的),但等自注意力一上,这件事就立刻重要起来。
本文补充:为什么位置对注意力是刚需?因为注意力本身是一个作用在「集合」上的操作——它只看到一堆向量,不知道谁在前谁在后。你稍微想一下 1.4 节的
wei @ x:如果去掉tril掩码,把输入的所有 token 打乱顺序,输出只会跟着一起打乱,模型本身对此毫无感知。所以顺序必须被「手动注入」。这一点 Karpathy 后面会明确点名,并拿卷积做对比。
3. 单个自注意力头:Q / K / V(01–01)
3.1 核心比喻:query 与 key
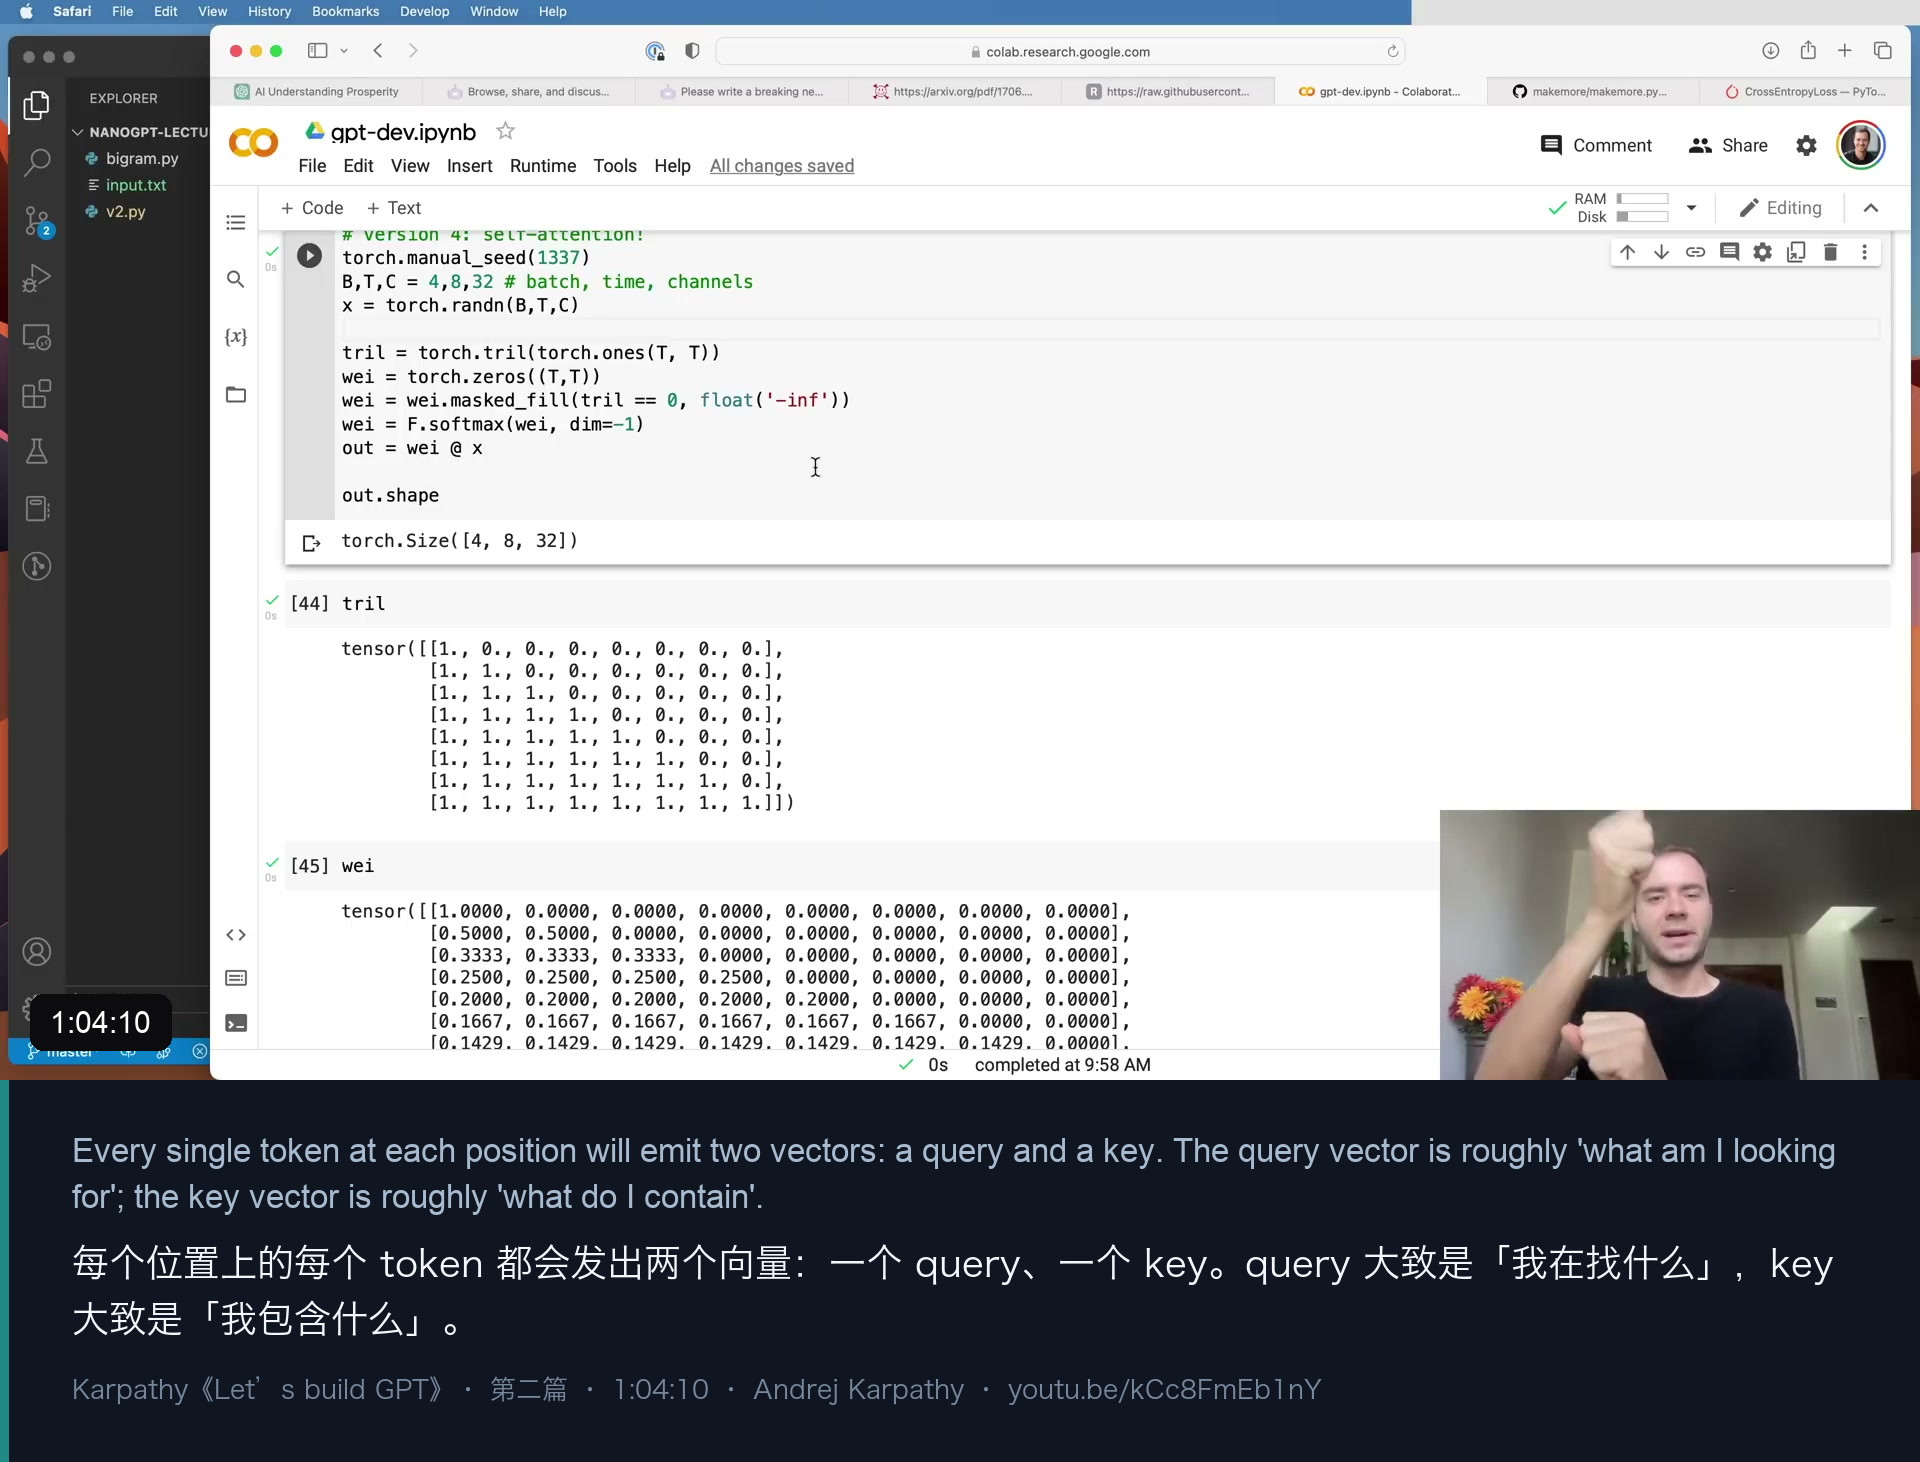
Karpathy 从「平均太弱」出发:我们想要的是数据相关的加权聚合。自注意力的解法是——每个 token 发出两个向量:
- query(查询):我在找什么;
- key(键):我包含什么。
然后query 与所有 key 做点积,得到亲和度:
- 如果某个 key 和我的 query 方向对齐,点积就大 → 它对我很重要;
- 于是 softmax 之后,我会从那个 token 聚合更多的信息。
他举的例子非常直观:「如果我是个元音,我可能在找我前面的辅音」——query 说「我在找一个辅音」,key 说「我是辅音,而且我在第几号位置」,两者点积就很高。
3.2 代码:一个 Head
class Head(nn.Module):
    """one head of self-attention"""
    def __init__(self, head_size):
        super().__init__()
        self.key   = nn.Linear(n_embd, head_size, bias=False)
        self.query = nn.Linear(n_embd, head_size, bias=False)
        self.value = nn.Linear(n_embd, head_size, bias=False)
        self.register_buffer('tril', torch.tril(torch.ones(block_size, block_size)))

    def forward(self, x):
        B, T, C = x.shape
        k = self.key(x)     # (B,T,head_size)
        q = self.query(x)   # (B,T,head_size)
        # 亲和度:query 与所有 key 的点积,缩放后 (B,T,T)
        wei = q @ k.transpose(-2, -1) * head_size**-0.5
        wei = wei.masked_fill(self.tril[:T, :T] == 0, float('-inf'))
        wei = F.softmax(wei, dim=-1)
        v = self.value(x)   # (B,T,head_size)
        out = wei @ v       # (B,T,T) @ (B,T,head_size) -> (B,T,head_size)
return out(head_size = 16,bias=False。)
整个前向只有五步,和 1.5 的玩具例子一模一样,只多了 Q/K/V 三个线性层:
- 算 q、k:把每个 token 的向量分别投影到「查询空间」和「键空间」;
q @ k.transpose(-2,-1):(B,T,16) @ (B,16,T) = (B,T,T)——每一行是这个位置对所有位置的亲和度;- 掩码:未来位置设
-inf; - softmax:每行归一化成概率;
wei @ v:按权重聚合 value。
其中两个细节值得单独记住:
register_buffer('tril', ...):tril不是需要训练的参数(parameter),所以要用 buffer 的方式注册进模块,这样它会跟着模型一起搬到 GPU,但不会被优化器更新。* head_size**-0.5(缩放):见下一小节。
3.3 为什么要除以 √head_size
这是很多人的知识盲点,Karpathy 专门花了几分钟解释:
q和k的每个元素都是均值 0、方差 1 的随机数;- 点积是 16 个乘积之和,方差会累积到 16;
- 乘上
1/√16 = 1/4,方差就被拉回 1。
为什么方差重要?因为 wei 接下来要进 softmax。 他用一段演示说得很清楚:
如果
wei里的数值都比较小、彼此接近,softmax 的输出是弥散的;但只要把这些数值放大 8 倍,softmax 就迅速尖锐化,最后逼近 one-hot。
而「one-hot」对注意力意味着灾难:每个节点只从一个节点聚合信息,其它全被忽略。在初始化阶段尤其糟糕——你希望一开始是「广泛听取意见」。所以缩放的作用是:控制初始化时的方差,避免 softmax 一开始就过度尖锐。
(注:这里说的是原始 Transformer 论文里的「scaled dot-product attention」,Karpathy 特意回头看了一眼论文里 1/√d_k 那个公式。)
3.4 四个必须记住的「注意事项」
这是这一篇里最值钱的几句总结。
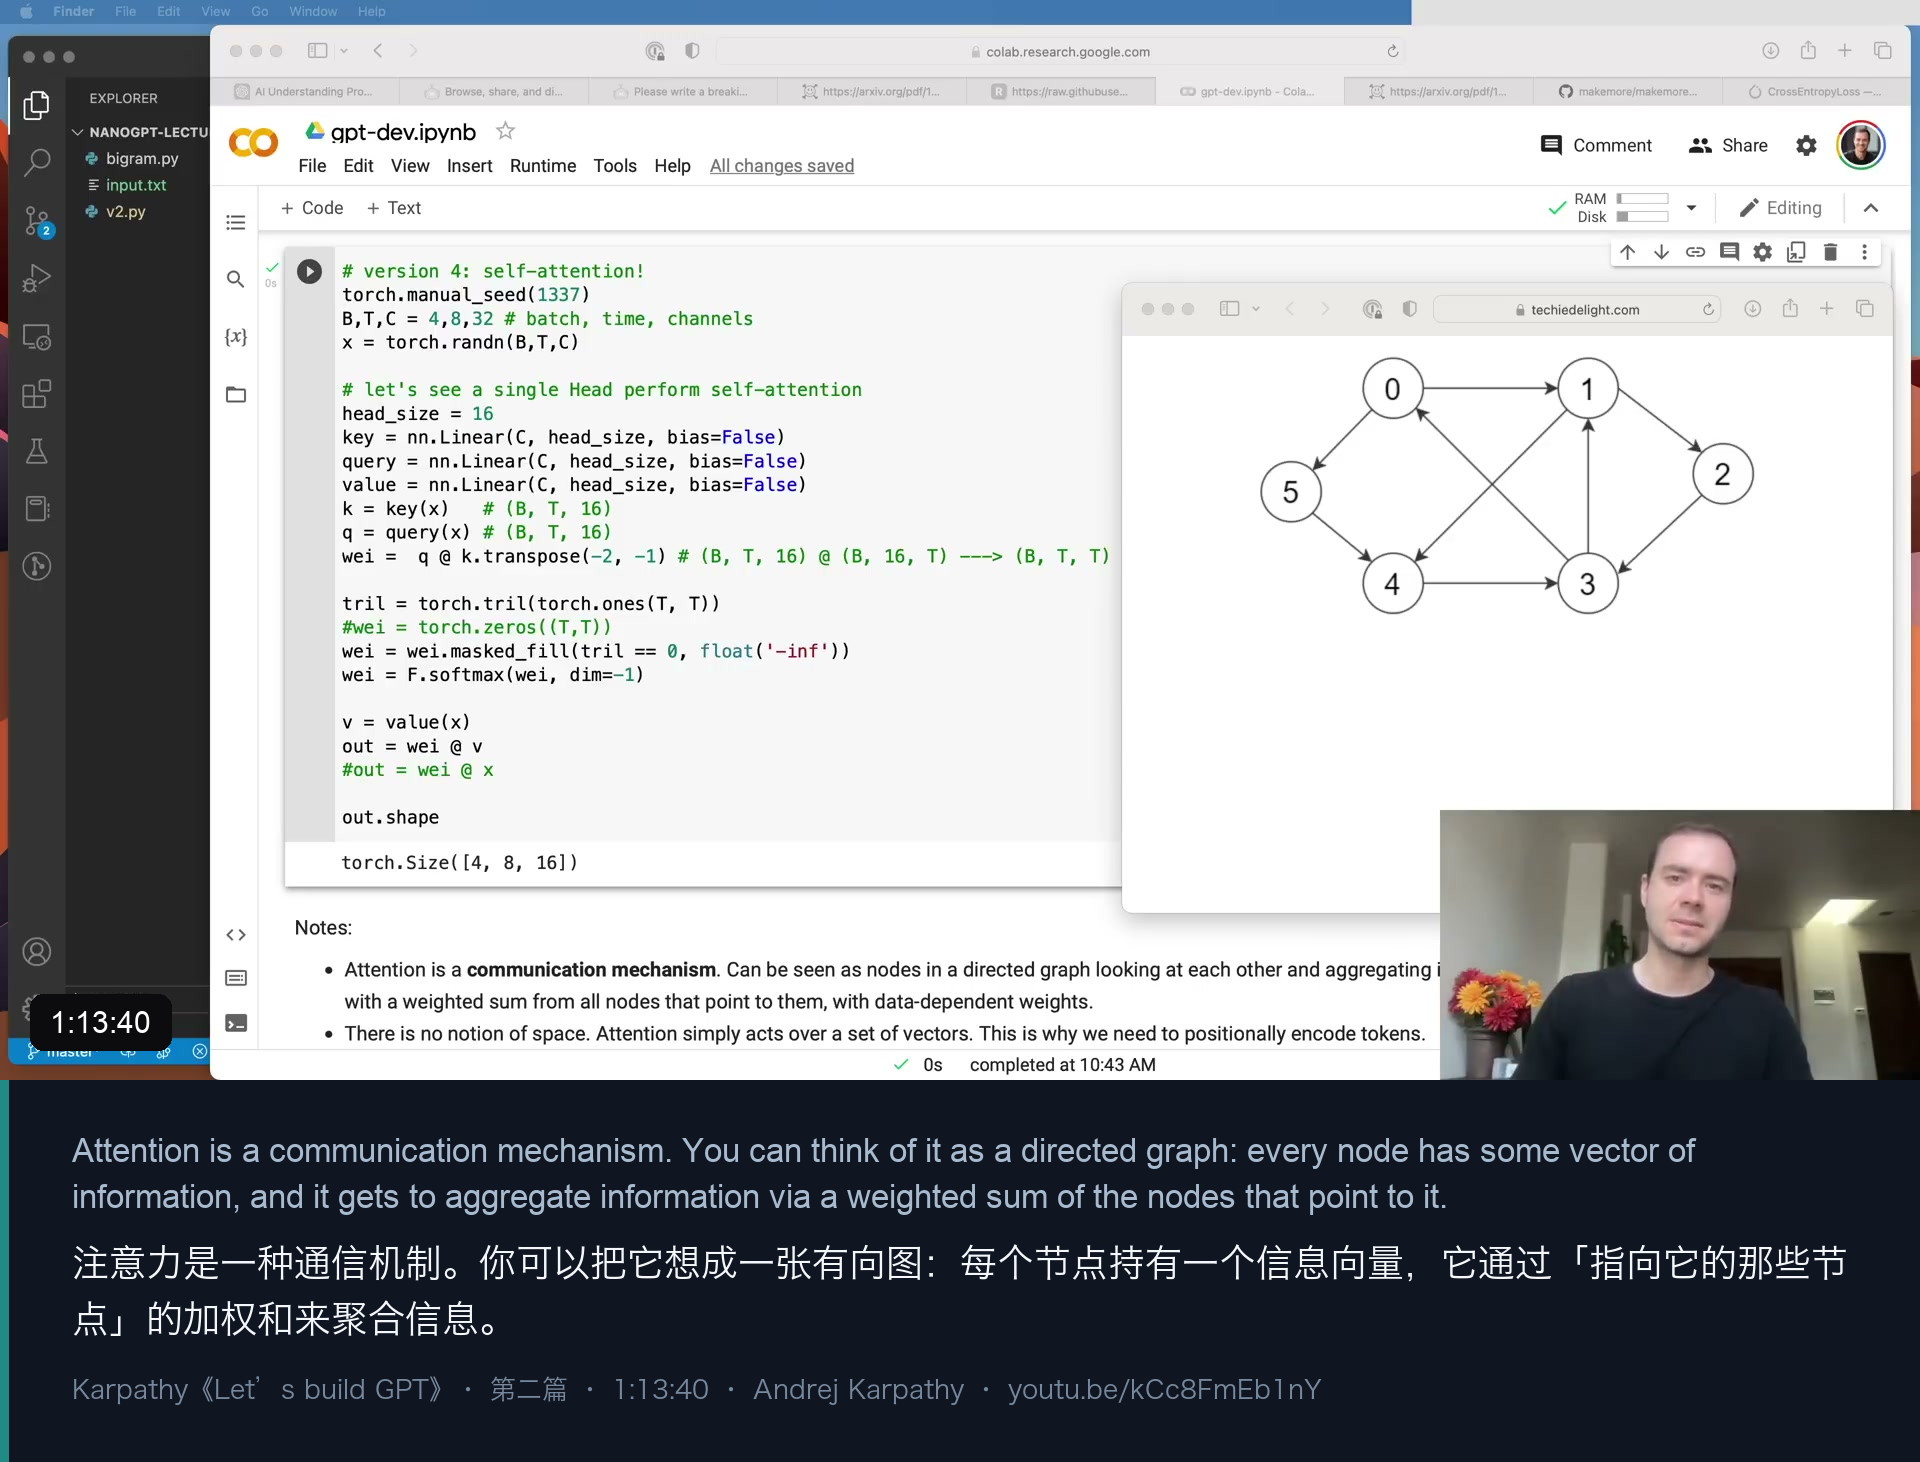
① 注意力是一种通信机制。
把它看成一张有向图:每个节点持有一个向量,通过「指向它的节点」的加权和来聚合信息,而且是数据相关的。
② 注意力没有「空间」的概念。
注意力只是作用在一堆向量上的操作,默认情况下这些节点完全不知道自己在哪儿。这就是为什么我们需要位置编码。
他特意拿卷积做对比:卷积核有明确的感受野和空间布局,它在空间里行动;而注意力是「一堆向量互相通信」,想要空间概念,就得你自己加进去。
③ batch 之间永远不通信。
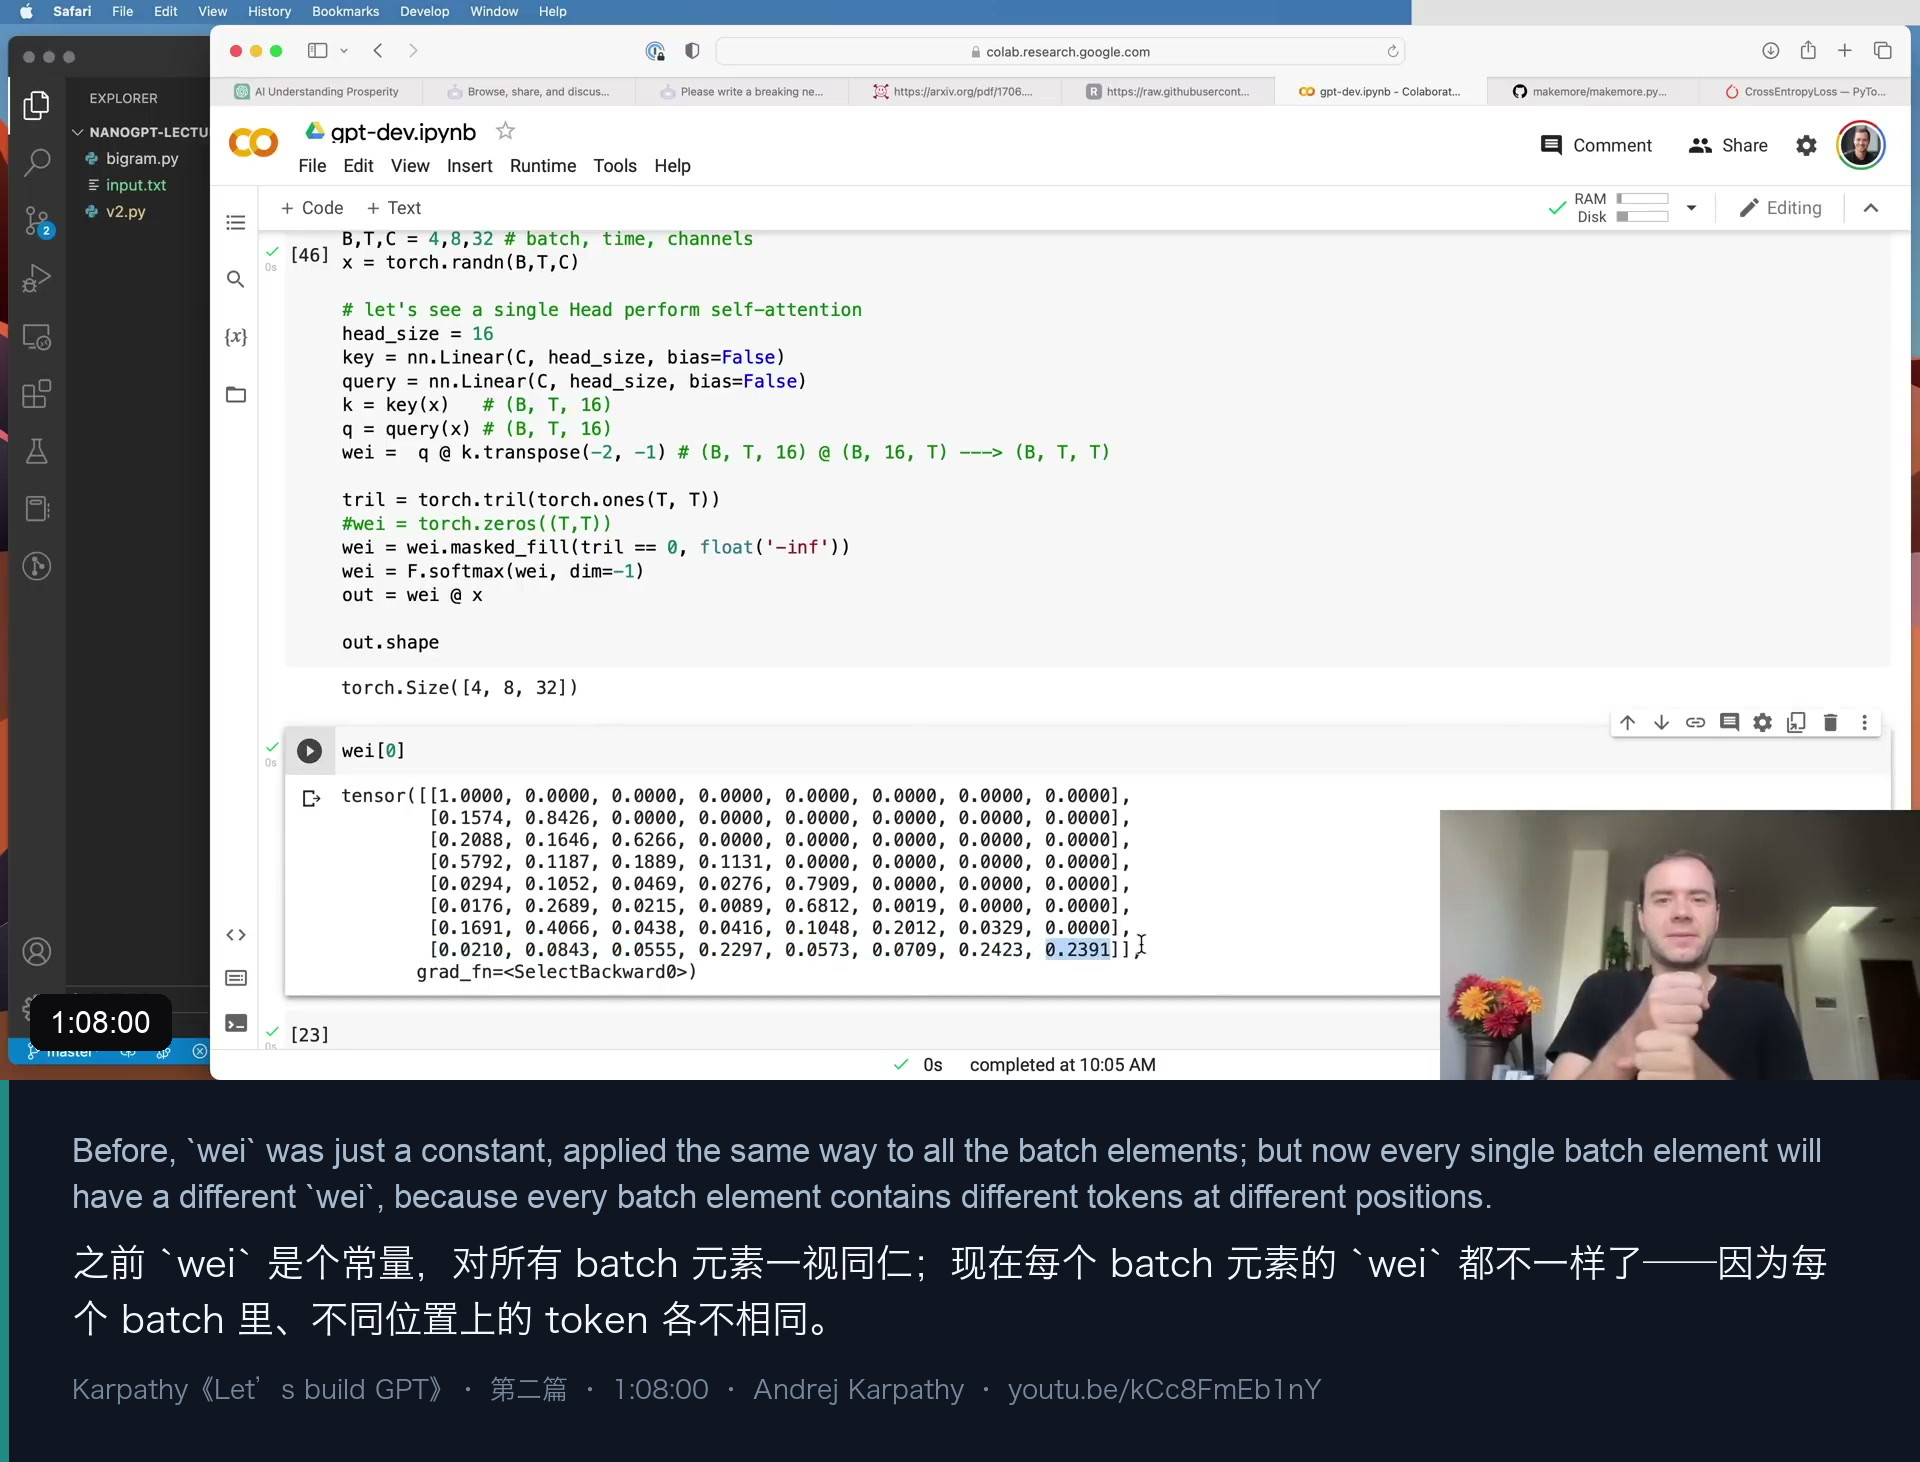
我们的图其实是 4 个独立的 8 节点池(B=4),共计 32 个节点被并行处理——但池与池之间没有任何边。这是因为 q @ k^T 是批量矩阵乘法,各 batch 独立并行。
④ 「encoder block」与「decoder block」只差一行代码。
- decoder block(我们正在实现的):保留
tril掩码,未来不能和过去通信——因为要做自回归生成,「未来」会泄露答案; - encoder block:删掉掩码那一行,让所有节点自由互相通信。情感分类这类任务就属于这种设定。
Karpathy 的说法是:注意力本身不在乎拓扑结构,它支持任意连接方式。
补充一句关于命名的:这里的 attention 叫 self-attention,是因为 Q、K、V 全部来自同一个来源 X。如果 K 和 V 来自另一个序列,就叫 cross-attention——原论文里的 encoder-decoder attention 就是 decoder 的节点去交叉查询 encoder 的输出。
3.5 V 是什么:为什么要再投影一次
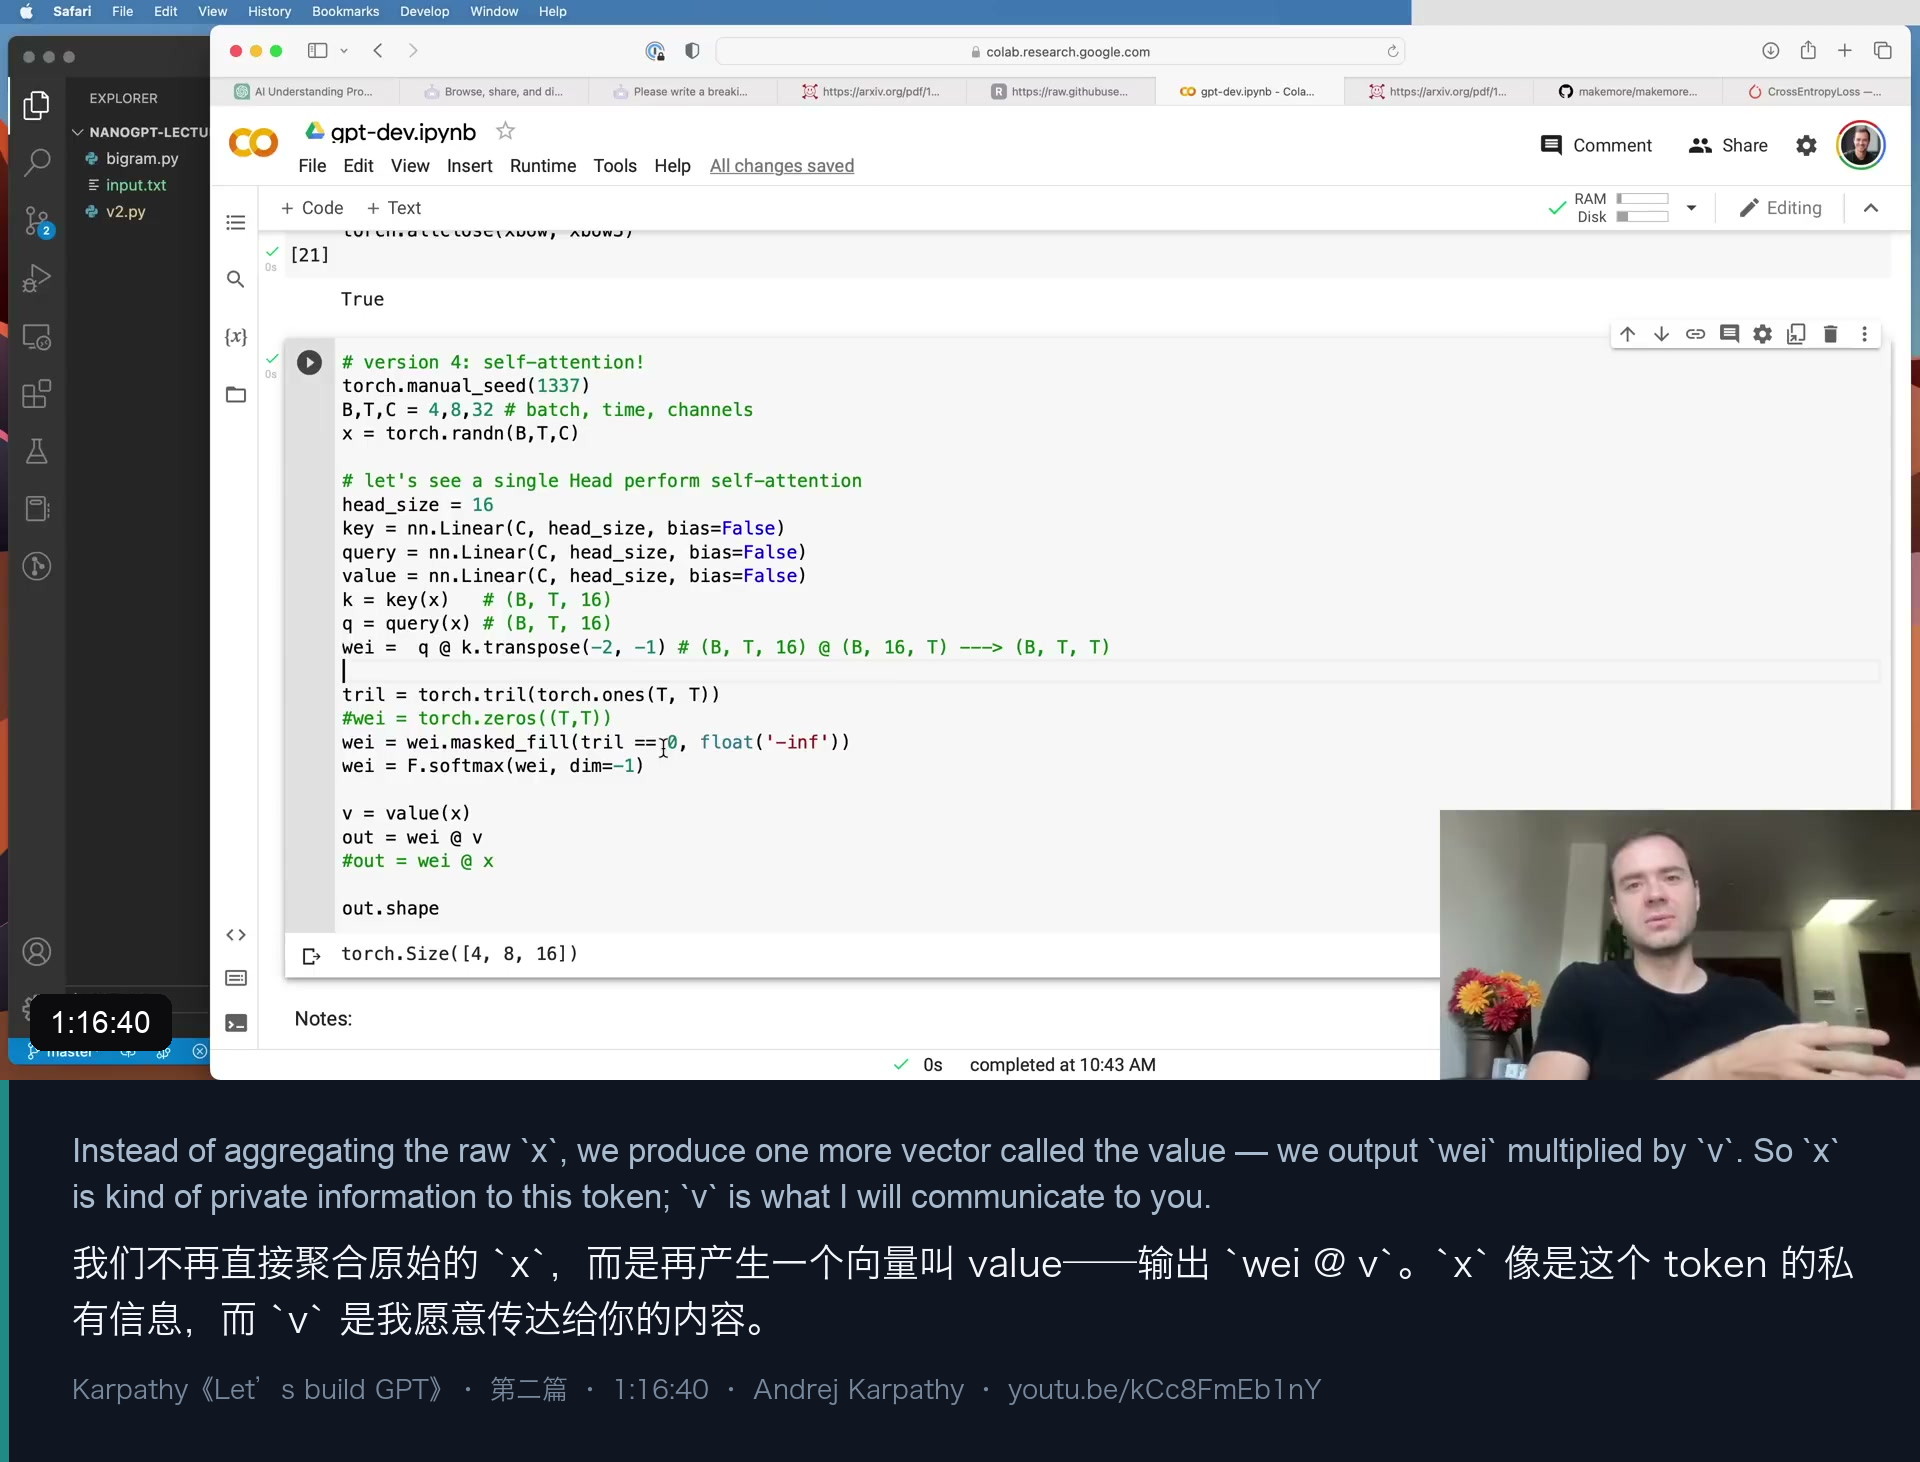
最后一块拼图:我们聚合的不是 x 本身,而是 v。
Karpathy 的说法很好记:
x是这个 token 的私有信息——我的身份、我的内容都在里面; query 是「我在找什么」,key 是「我有什么」,而v是「如果你觉得我值得关注,我愿意传给你的东西」。
也就是说:注意力的输出不是「谁的副本」,而是「按相关性加权混合出来的一份特征」。
4. 插进模型:从 2.5 到 2.4(01–01)
把 Head 接进语言模型:
self.sa_head = Head(n_embd)   # head_size 暂时取 n_embd

def forward(self, idx, targets=None):
    B, T = idx.shape
    tok_emb = self.token_embedding_table(idx)                          # (B,T,C)
    pos_emb = self.position_embedding_table(torch.arange(T, device=device))  # (T,C)
    x = tok_emb + pos_emb                                              # (B,T,C)
    x = self.sa_head(x)                                                # 通信!
    logits = self.lm_head(x)                                           # (B,T,vocab_size)
...还有一个必须补的改动:generate() 里要把喂进去的 context 裁剪到 block_size。
idx_cond = idx[:, -block_size:]为什么?因为现在有了位置嵌入表,它只有 block_size 行——一旦上下文超过 block_size,查表就越界了。
然后是训练。Karpathy 做了两处调整:
- 学习率调低——他说「self-attention 承受不了非常高的学习率」;
- 迭代步数增加(因为学习率低了)。
结果:
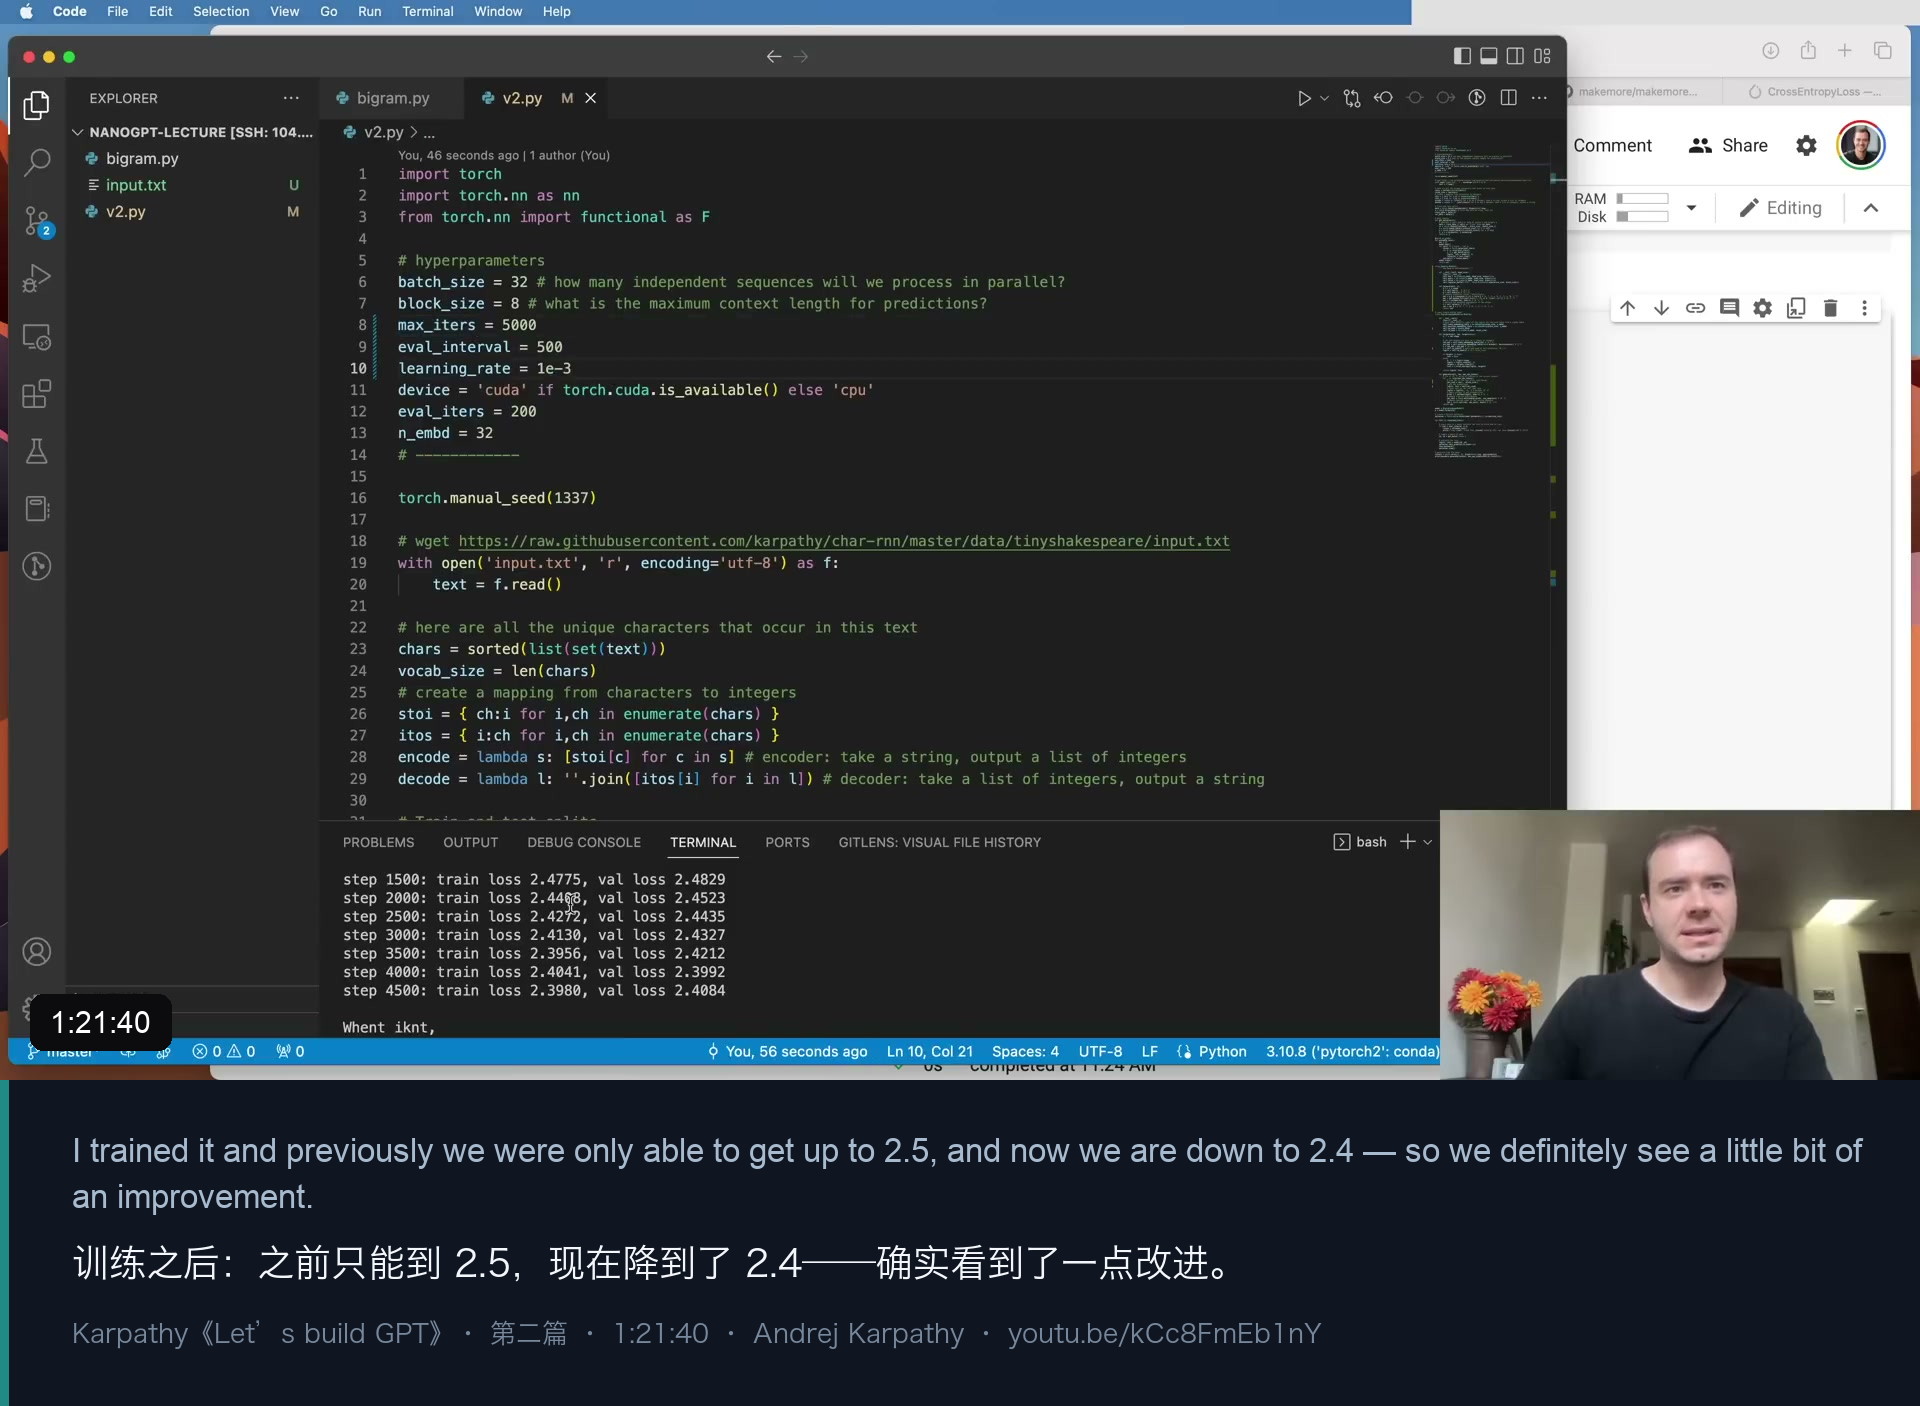
之前只能到 2.5,现在降到了 2.4。
他也如实评价:确实有一点改进,但文本依然不够好——「显然这个自注意力头在做一些有用的通信,但我们离目标还差得远」。
单头注意力只提供一个「通信频道」。下一篇要做的,是并行开多条频道(多头注意力),然后补上 Transformer block 剩下的零件:前馈网络、残差连接、LayerNorm、dropout——最后才真正把损失压下去。
本篇速查
| 概念 | 这一段里的具体值 / 代码 | 说明 |
|---|---|---|
| bigram 训练结果 | 4.87 → 2.5 | 只用一阶字符统计 |
| 玩具张量 | B,T,C = 4,8,2 |
数学技巧的练习场 |
| 下三角掩码 | torch.tril(ones(T,T)) |
「未来不许说话」 |
| 保留下来的写法 | masked_fill(tril==0, -inf) + softmax |
权重从常数变成亲和度 |
n_embd |
32 | 嵌入维度,引入间接层 |
head_size |
16 | 单个注意力头的维度 |
| Q/K/V | 三个 Linear(n_embd, head_size, bias=False) |
分别投影 |
| 亲和度 | q @ k.transpose(-2,-1) * head_size**-0.5 |
缩放点积注意力 |
| 聚合 | out = wei @ v |
聚合的是 value,不是 x |
| 结果 | 2.5 → 2.4 | 有效,但远远不够 |
自测题
- 为什么「用全 1 矩阵左乘 B」等于「把 B 的各行加起来」?把矩阵换成下三角并归一化之后,得到的是什么?
- Karpathy 为什么最终选择
masked_fill(-inf) + softmax这套写法,而不是直接用写死的下三角常数? - 如果去掉位置嵌入,把输入序列的 token 顺序打乱,模型的输出会怎么变?为什么?
q @ k.transpose(-2,-1)得到的张量形状是(B,T,T)。这个张量里第[b, i, j]个元素表示什么?- 为什么点积之后要除以
√head_size?如果不除,softmax 的输出会变成什么样,对训练有什么影响? - 同样一个
Head模块,删掉掩码那一行就成了 encoder block。这两种设定各自适合什么任务? - 为什么
tril要用register_buffer注册,而不是普通的 Python 属性?
下一篇:Karpathy《Let’s build GPT》第三篇 —— 多头注意力、前馈网络、残差连接与 LayerNorm:拼出完整的 Transformer Block(覆盖 01–01)。
讨论
这里是静态站点,没有内嵌评论区。如果这篇文章对你有用,欢迎通过 RSS 订阅后续更新。