Karpathy《Let's build GPT》第一篇:语言模型、字符级 tokenizer 与 bigram 基线
Karpathy《Let's build GPT》精读系列第一篇。这一篇把地基打好:语言模型为什么是「逐 token 预测下一个」;1MB 的 tiny Shakespeare 怎么变成 65 个字符的字符级 tokenizer;一段 9 个字符里为什么藏着 8 个训练样本;4×8 的 batch 里 32 个样本为什么互不通信;然后用一个 vocab×vocab 的查表(bigram 语言模型)跑通「取 batch → 算损失 → 反传 → 更新」的完整闭环,并亲手算出初始损失 4.87 比均匀分布的理论下界 4.17 还差意味着什么。文中 13 张配图均截自视频对应时刻,并把当时的完整观点句(英文原句+中文翻译)拼进图里。
来源:YouTube 原视频(Andrej Karpathy,2023-01-17,时长 1:56)·配套代码:nanoGPT
阅读说明(先说清哪些是视频里的、哪些是本文补的)
- 这是四篇系列的第一篇,覆盖原视频 00–00 这一段。这一段的主题是「把地基打好」:语言模型到底在做什么、数据长什么样、字符级 tokenizer 怎么写、怎么把一段文本切成训练样本、以及最重要的——先跑通一个最简单的、能训练、能出数、能生成的语言模型。
- 文中所有代码都是 Karpathy 在视频里逐行敲出来并当场运行的(Colab notebook
gpt-dev.ipynb),我按视频顺序整理,只做了必要的排版和注释。文中所有数字(文本长度 1,115,394、词表 65、block_size=8、batch=4、初始损失 4.87、理论下界 4.17 等)都是视频里当场的运行输出。- 标记为「本文补充」的段落是我的解释:把 Karpathy 的一句话展开、补上他默认你懂的背景,或者把这段代码和你熟悉的 BERT / PyTorch 习惯对照一下。这些不是他的原话。
- 视频只有英文自动字幕,专有名词有不少听错的地方(
Byram→ bigram、lit/low jits→ logits、pyour→ PyTorch、Tik token→ tiktoken、nanog GPT→ nanoGPT),本文按通行写法记录。- 配图全部截自视频对应时刻,并把那一刻的完整观点句(英文原句 + 中文翻译)拼进了图里——看图就能同时看到「当时屏幕上是什么」和「他当时在说什么」。
0. 为什么值得用四篇文章来拆这个视频
Karpathy 的《Let’s build GPT: from scratch, in code, spelled out.》是极少数把 GPT 的每一行代码都讲出来的公开材料。它的目标不是让你会调 API,而是让你能对着两个文件、几百行 PyTorch,完整说出「输入是怎么变成输出的、梯度是怎么流的、为什么这么设计」。
这个视频发布在 2023 年 1 月——ChatGPT 刚火起来的时候。视频里的 Karpathy 说得很清楚:我们不可能复现 ChatGPT(那是个工业级系统,要吃掉互联网的一大块,还有一堆预训练和微调阶段),但我们可以训练一个 Transformer 语言模型,而且是字符级的(character-level)。这一点对学习特别友好:
- 词表只有 65 个字符,所有 tokenizer 的细节都被剥掉了,注意力全在模型结构上;
- 数据是 1MB 的莎士比亚全集,单卡几十秒就能跑一轮,你可以随时改一行代码、立刻看到 loss 的变化;
- 结构是完整的:这就是 GPT,只是小了很多很多个数量级。
Karpathy 在视频结尾给了一个尺度感:GPT-3 在结构上与我们将要写出来的东西基本一致,只是参数量级上大了 10,000 到 1,000,000 倍。
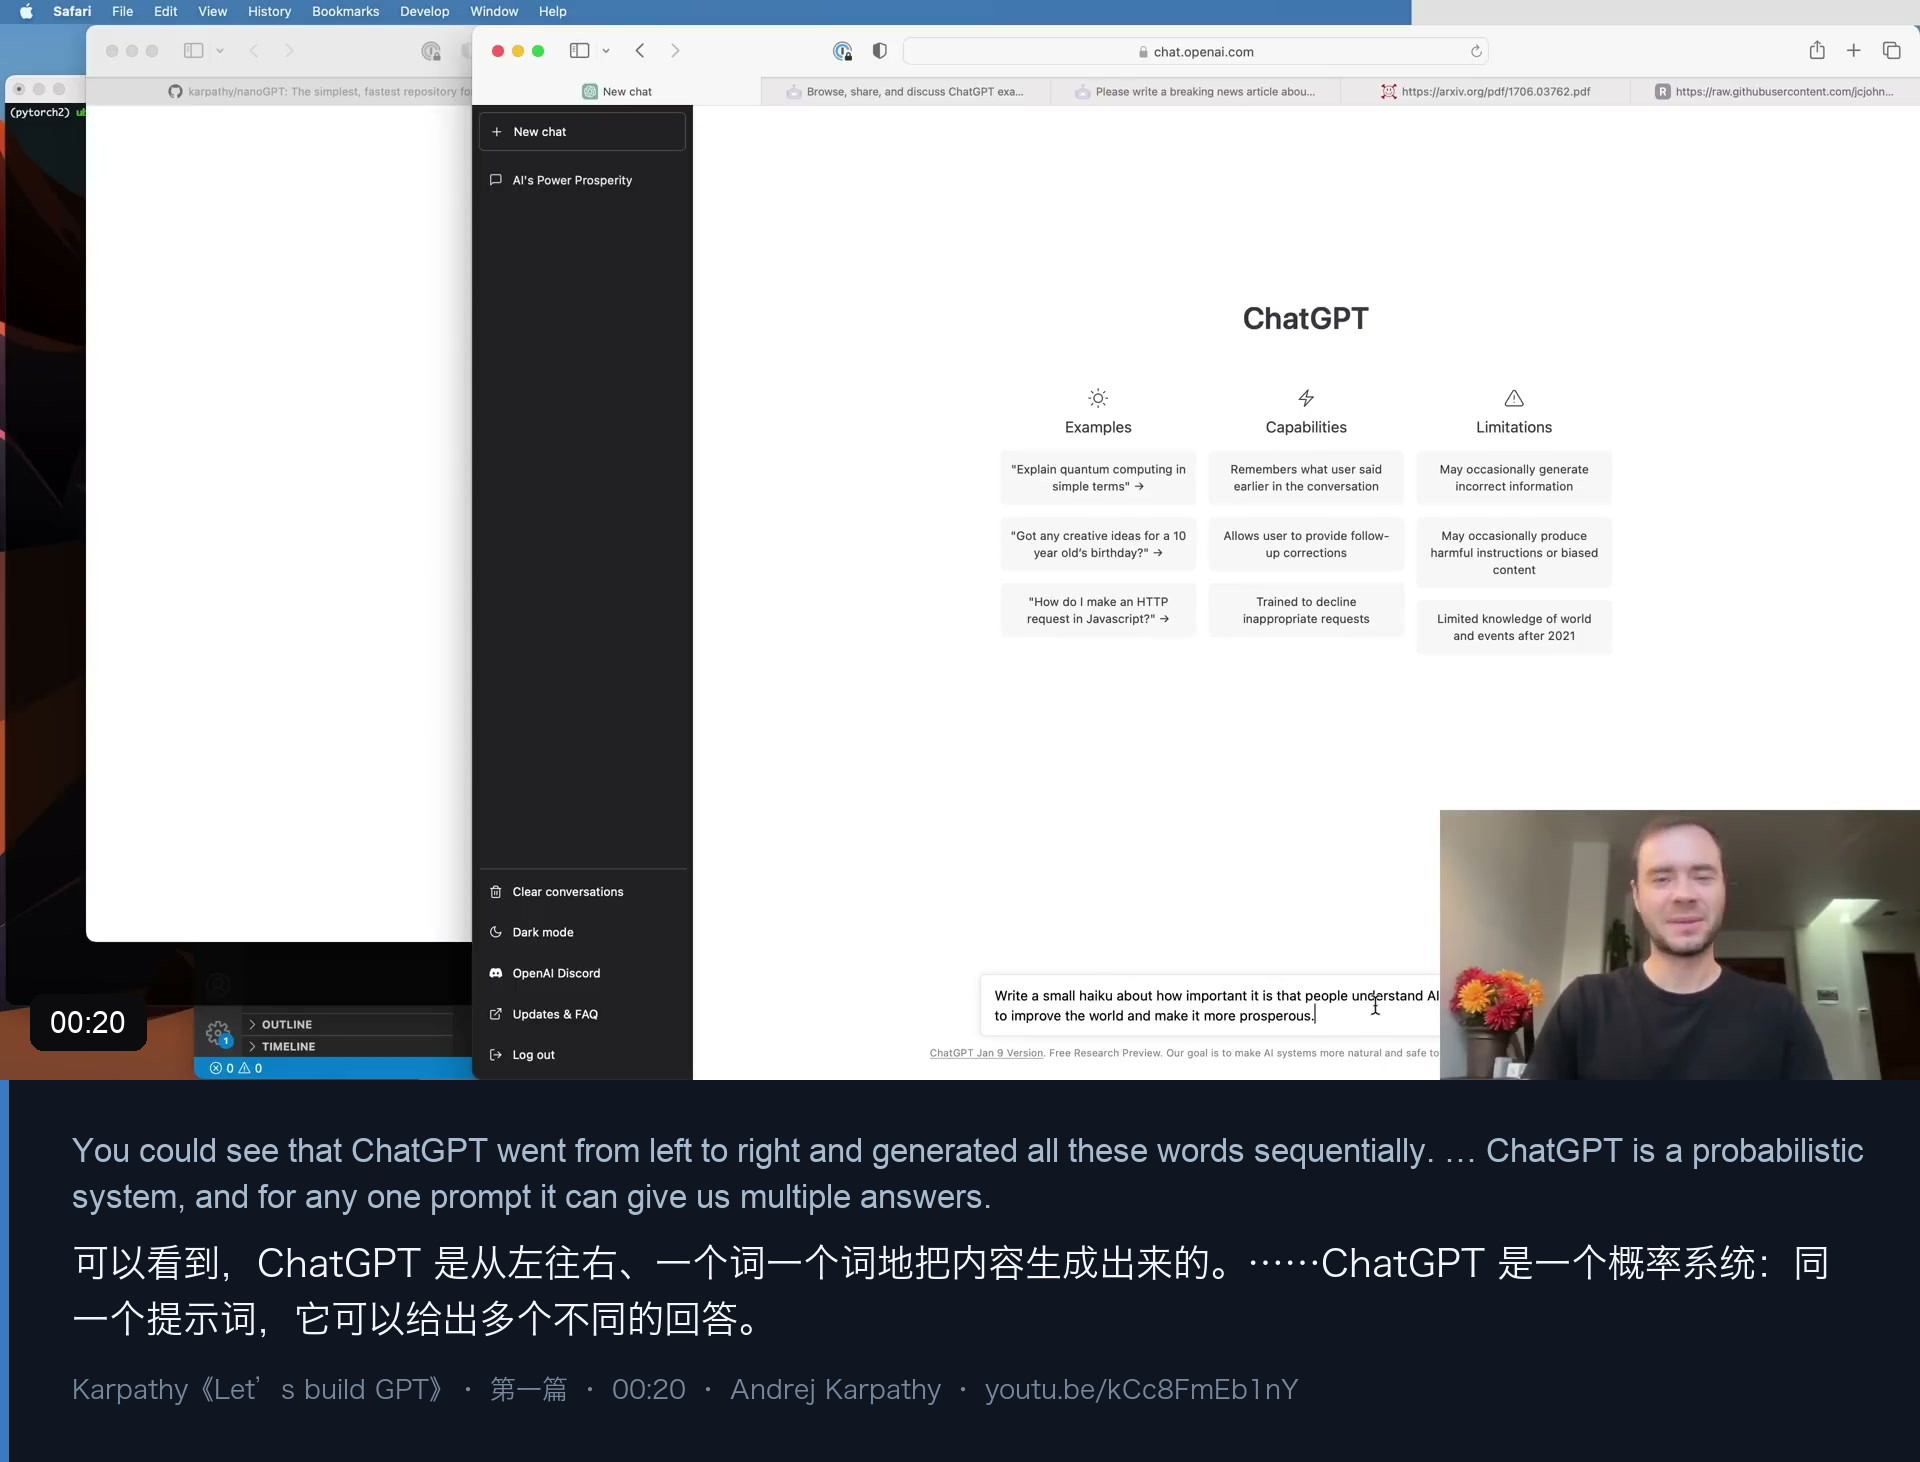
1. 00–02|先把问题说清楚:语言模型就是「预测下一个 token」
视频开场,Karpathy 没有讲架构,而是先让 ChatGPT 写一首关于「人们理解 AI 有多重要」的打油诗。同一段提示词跑两次,输出不一样。他用这个例子点出两件事:
- 它是从左到右、一个词一个词生成出来的(went from left to right and generated all these words sequentially);
- 它是一个概率系统(a probabilistic system),同一个提示词可以有多个回答。
本文补充:这两句其实是整门课的「世界观」。后面所有的代码——softmax、
torch.multinomial、采样温度——都是在实现这两句话。理解「语言模型 = 在给定前文下预测下一个 token 的概率分布」,比背 Transformer 的公式更重要。
接着他给出了语言模型的定义:模型化序列(建模词、字符或 token 的序列)。从模型自己的视角看,它做的事就是补全序列:给它一段开头,它把剩下的补上。
这也是理解你后面会看到的所有名称的钥匙:所谓「预训练」,就是拿海量文本做这件事;所谓「对话」,无非是把「对话」也编码成一个序列,让模型继续补全。
2. 02–07|骨架:Attention Is All You Need、GPT 三个字母与 nanoGPT
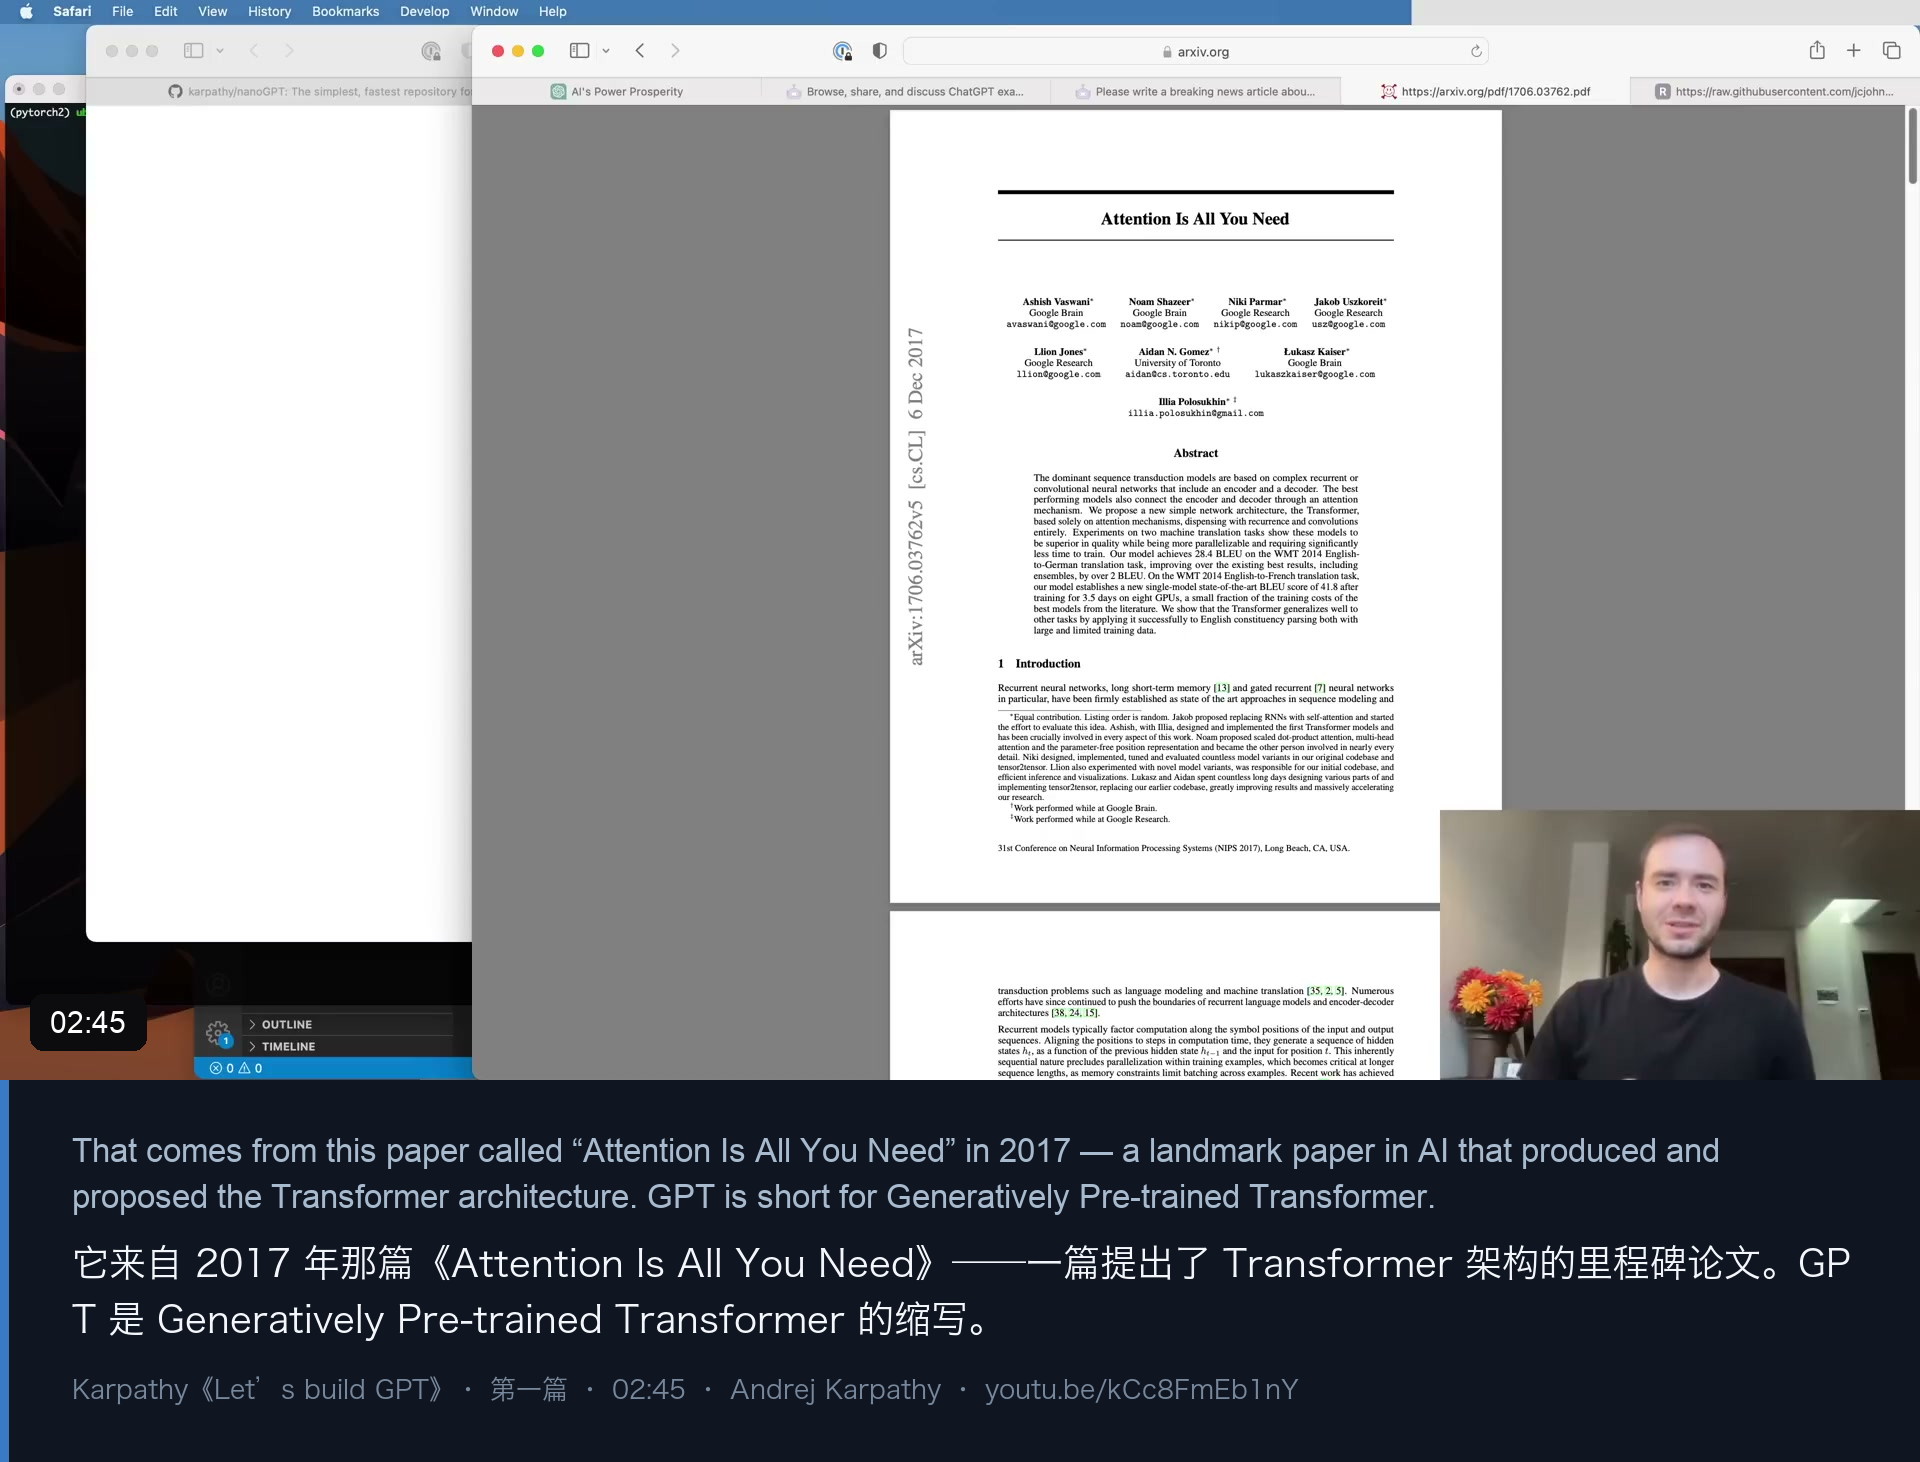
接下来镜头切到 2017 年那篇论文《Attention Is All You Need》。Karpathy 的评价很有意思:
- 这篇论文读起来像一篇很普通的机器翻译论文,因为作者当时并没有完全预见 Transformer 会给整个领域带来什么;
- 但接下来五年,这个架构被「复制粘贴」到了 AI 的各种应用里,包括 ChatGPT 的核心;
- GPT = Generative Pre-trained Transformer,Transformer 就是底下干重活的那个神经网络。
然后他交代了本课的「教学载体」:所有代码都来自他的 GitHub 仓库 nanoGPT——一个用任意文本训练 Transformer 的仓库,特点是极其简单:两个文件,每个约 300 行代码。
本文补充:对你这种「大模型前时代」的 NLP 工程师,nanoGPT 的价值怎么强调都不过分。你熟悉的 BERT 微调是把一个巨大的预训练模型当黑盒用;nanoGPT 把「预训练」这一整件事压缩到了你能一口气读完的规模。视频里的
model.py和train.py,就是后面所有大模型的骨架。
3. 07–12|数据与 tokenizer:65 个字符,而不是 50,257 个 token
3.1 数据集:tiny Shakespeare
不训练互联网,训练莎士比亚。Karpathy 说这是他的最爱玩具数据集:全部莎士比亚作品拼成一个文件,大约 1MB。视频里打印出来的长度是:
print("length of dataset in characters: ", len(text))
# length of dataset in characters:  1115394
任务定义随之变得非常具体:给模型一段字符(比如 First Citizen:),让它预测下一个字符最可能是什么(比如 g)——因为这些字符序列在训练数据里反复出现过。
3.2 第一步:字符级 tokenizer
chars = sorted(list(set(text)))
vocab_size = len(chars)
print(''.join(chars))
print(vocab_size)
# !$&',-.3:;?ABCDEFGHIJKLMNOPQRSTUVWXYZabcdefghijklmnopqrstuvwxyz
# 65注意这里的三步:set(text) 取出所有出现过的字符 → list() 变列表 → sorted() 排序。Karpathy 特别解释了为什么要排序:集合是无序的,排序之后我们有一个确定的、可复现的顺序,这个顺序就定义了「第 i 个字符的编号是 i」。
于是得到 65 个字符的词表:空格、各种标点,然后是大写字母、小写字母。
3.3 encode / decode:双向映射
stoi = { ch:i for i,ch in enumerate(chars) }
itos = { i:ch for i,ch in enumerate(chars) }
encode = lambda s: [stoi[c] for c in s]   # 字符串 -> 整数列表
decode = lambda l: ''.join([itos[i] for i in l])  # 整数列表 -> 字符串
这就是 tokenizer 的全部:一个把文本变成整数序列的编码器,和一个把整数序列变回文本的解码器。
3.4 与工业界 tokenizer 的对照:tiktoken / GPT-2 的 50,257
Karpathy 在这里专门停下来做了对照:工业界用的是 subword 编码(比如 GPT-2 用的 BPE),他用 tiktoken 演示了一遍——词表不是 65,而是 50,257。
这里的取舍是「词表大小 vs 序列长度」:
- 词表小(字符级):tokenizer 极简、序列很长;
- 词表大(subword 级):tokenizer 复杂、序列短很多。
他明确说:这一课就停在字符级,因为它是最简单的。
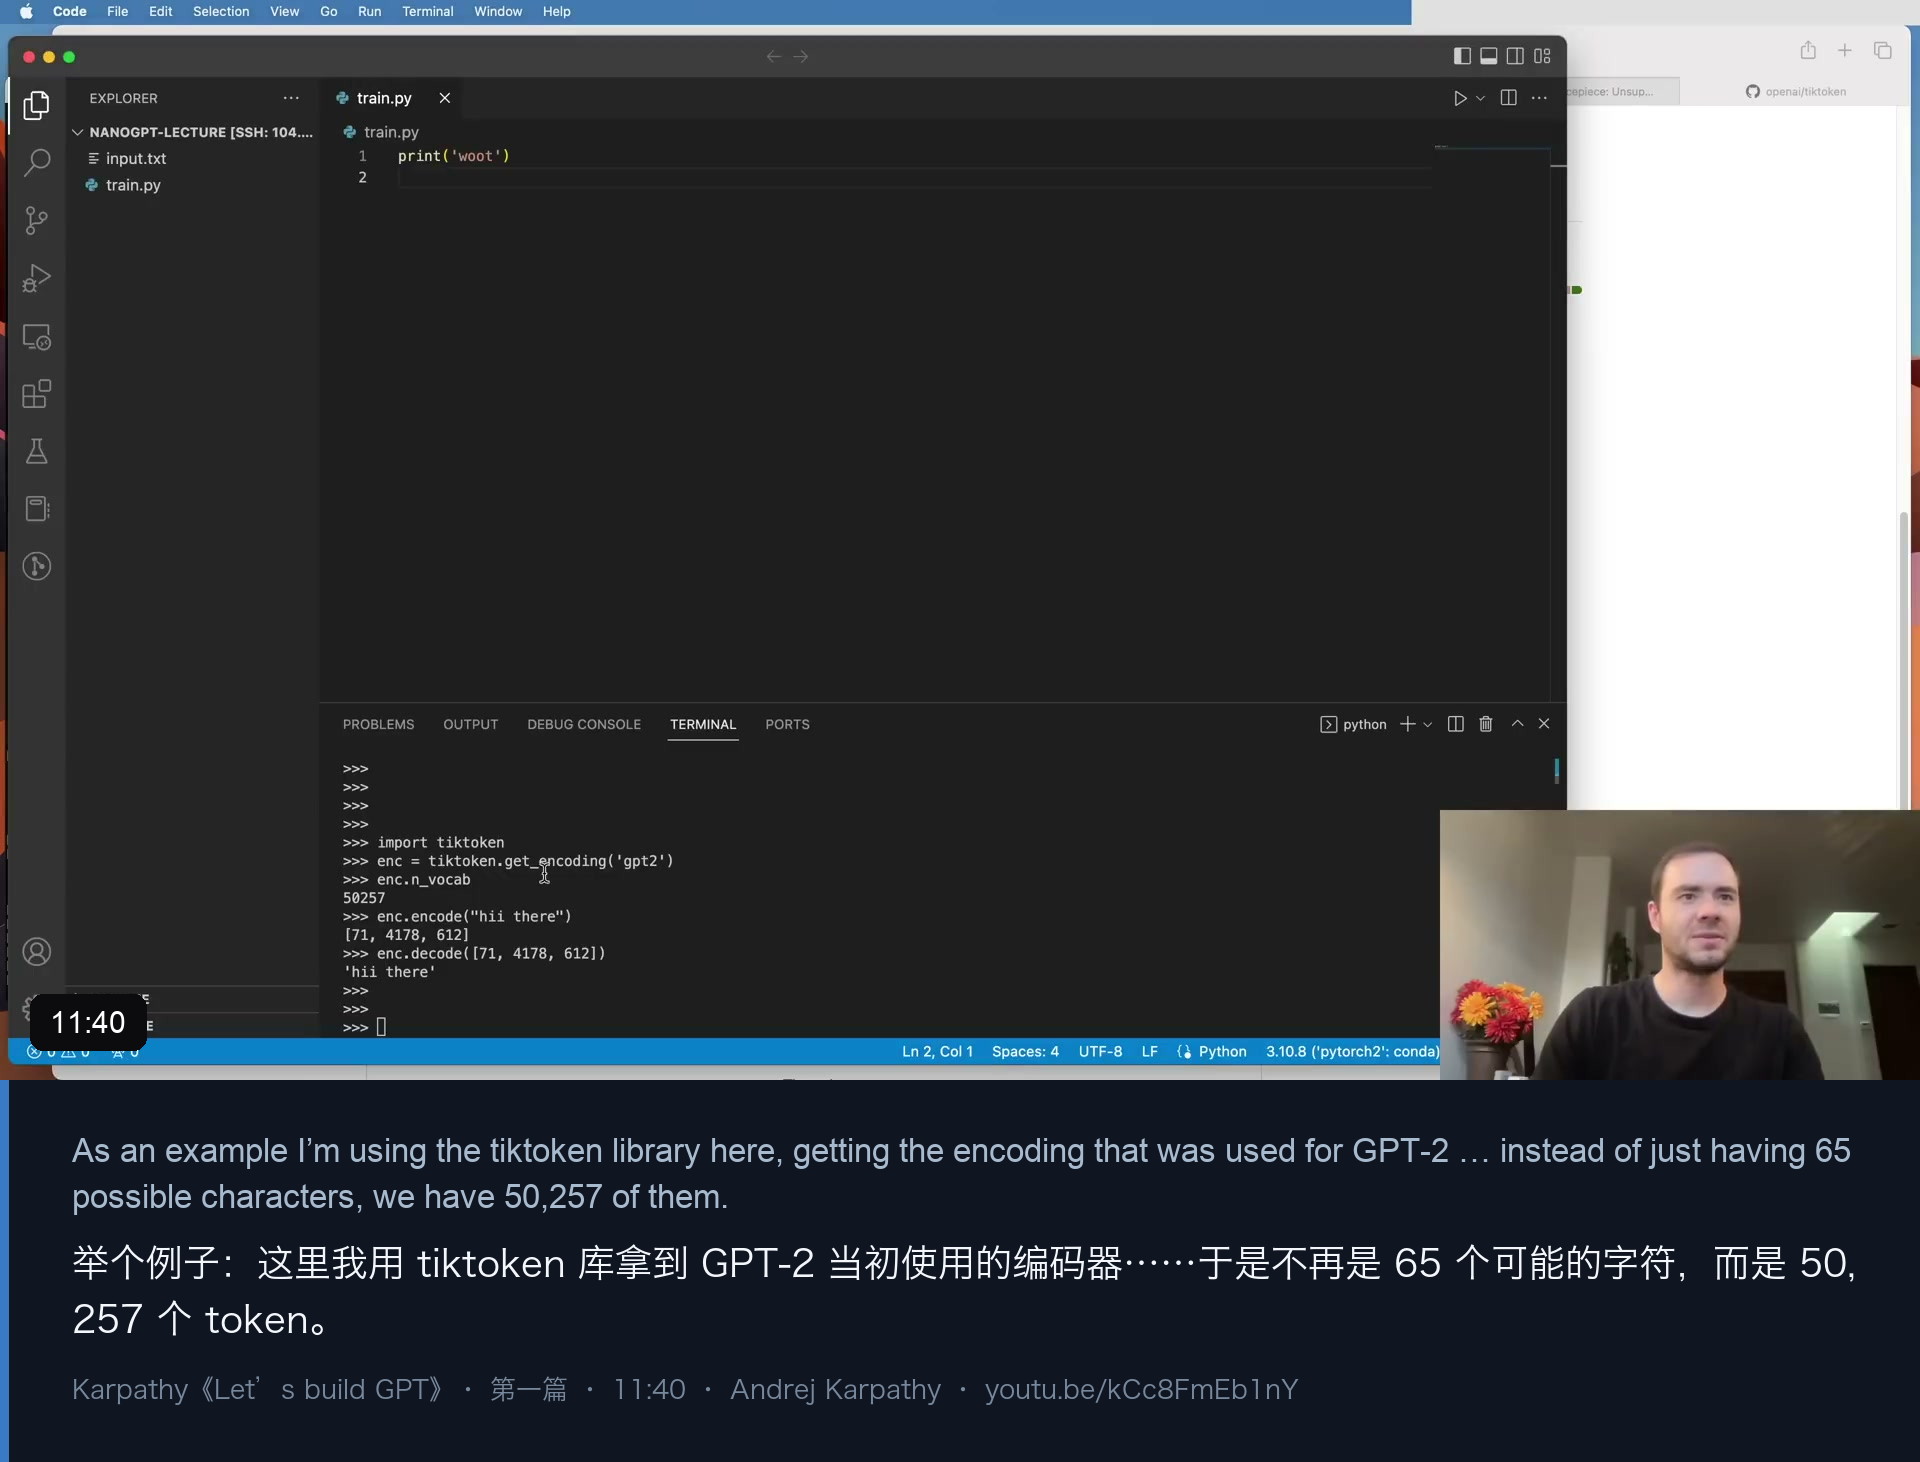
本文补充:这段对照值得你多停一会儿,因为它是「从 BERT 到大模型」最容易建立直觉的地方。你以前处理的是 WordPiece 之后的 token id;现在你看到的 65 个字符 id,其实是同一个概念的最简化版本。理解了「tokenizer 决定序列长度,序列长度决定 Attention 的计算量」,后面讲
block_size、context length、以及为什么长上下文这么贵时,你会有很实在的手感。
另外 Karpathy 提到 decode(encode(s)) 应该等于 s——encode 和 decode 必须互为逆运算,这是个很好的自检。
3.5 把整份数据变成张量
import torch
data = torch.tensor(encode(text), dtype=torch.long)
print(data.shape, data.dtype)
# torch.Size([1115394]) torch.int64
整本莎士比亚,现在是一条 1,115,394 个整数的长序列。他说到这里特别兴奋:「从现在开始,整个数据集就是一条被拉平的、巨大的整数序列」。
4. 12–14|训练集 / 验证集切分:90% / 10%
n = int(0.9*len(data))   # 前 90% 用来训练
train_data = data[:n]
val_data = data[n:]      # 后 10% 留着验证
为什么要留验证集?Karpathy 的说法很直白:我们不想要一个把这本莎士比亚背下来的模型,我们要的是一个能写出「像莎士比亚」的文本的模型。验证集就是用来观察「它到底是在学规律,还是在死记硬背」的那把尺子。
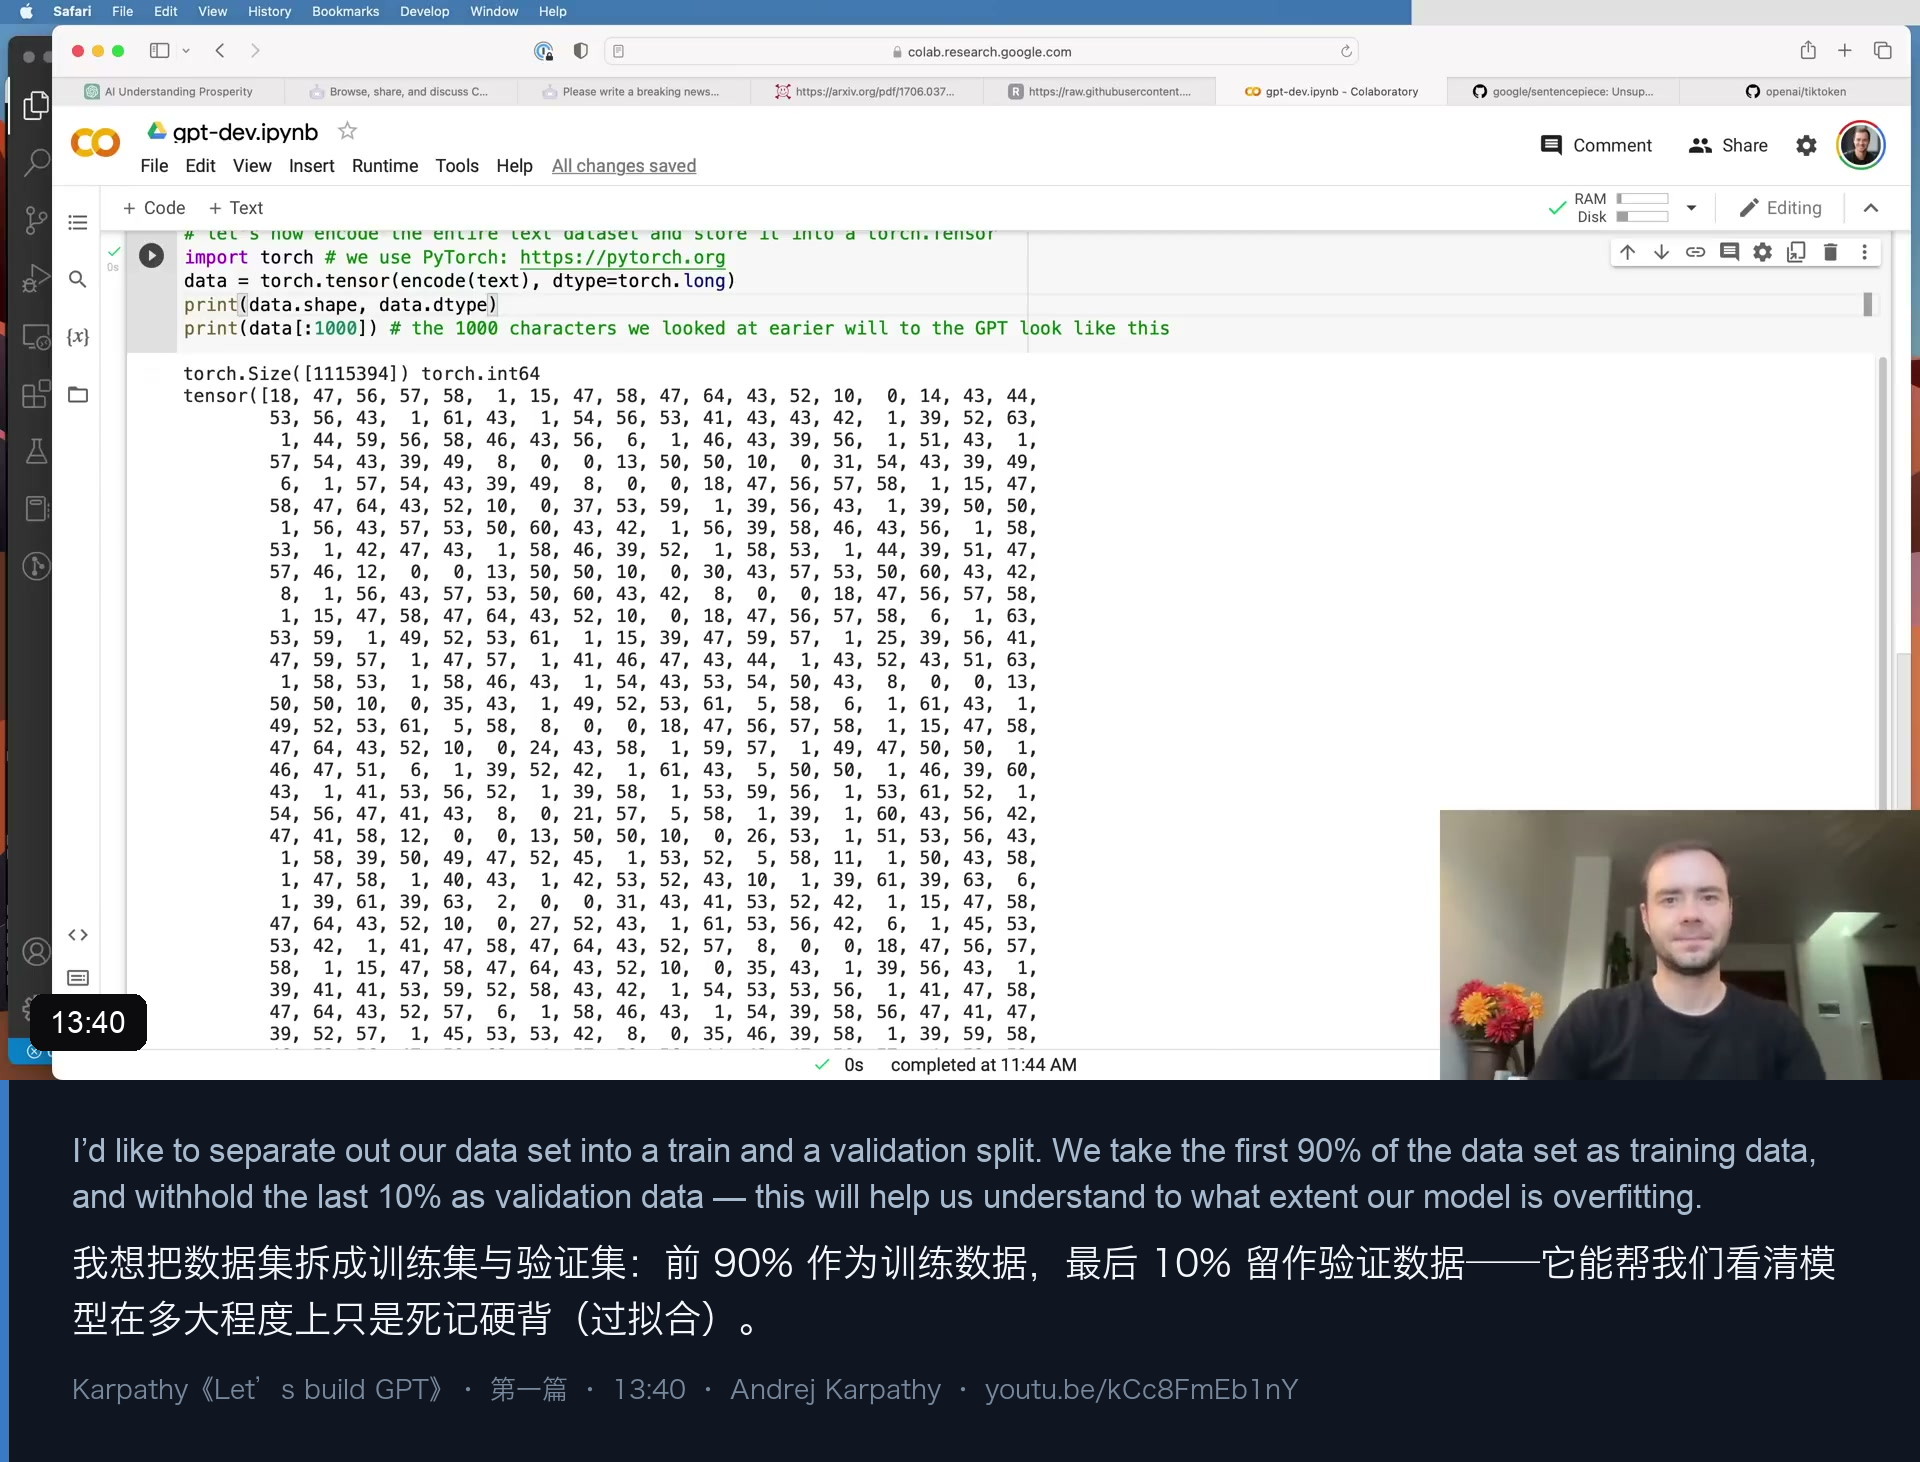
本文补充:这套 90/10 的划分看起来朴素,但后面你会看到
estimate_loss()用model.eval()/torch.no_grad()分别在两个 split 上评估——训练损失和验证损失的裂缝,就是判断过拟合的唯一依据。Karpathy 在视频后半段反复用这张表来衡量每一次架构改动到底有没有用,这是本课最重要的工程习惯之一。
5. 14–18|把一段文本切成八个训练样本:block_size 与 x / y
5.1 为什么不能一次喂整部莎士比亚
Karpathy 先讲了一个关键的约束:我们永远不会把全部文本一次性喂给 Transformer,那在计算上完全不可行。训练时我们只能一次喂一小段,这段的最大长度叫 block_size(你在别处可能见到 context length 这个名字)。
block_size = 8
x = train_data[:block_size]
y = train_data[1:block_size+1]
先看一个最简单的例子:取连续 9 个字符,前 8 个作为输入 x,偏移一位的后 8 个作为目标 y。为什么 y 要偏移一位?因为 y 是每个位置上「正确答案」,也就是下一个字符。
5.2 一段 9 个字符里其实藏了 8 个样本
# 视频里的打印(数据是 tiny Shakespeare 的前几个字符)
# when input is: 18        -> target: 47
# when input is: 18 47     -> target: 56
# when input is: 18 47 56  -> target: 57
# ...一直到 context 长度为 8这是这个视频里第一个「恍然大悟」的点:同一段文本可以同时充当多个训练样本——因为「前 1 个字符预测第 2 个」「前 2 个字符预测第 3 个」……「前 8 个字符预测第 9 个」,都成立。
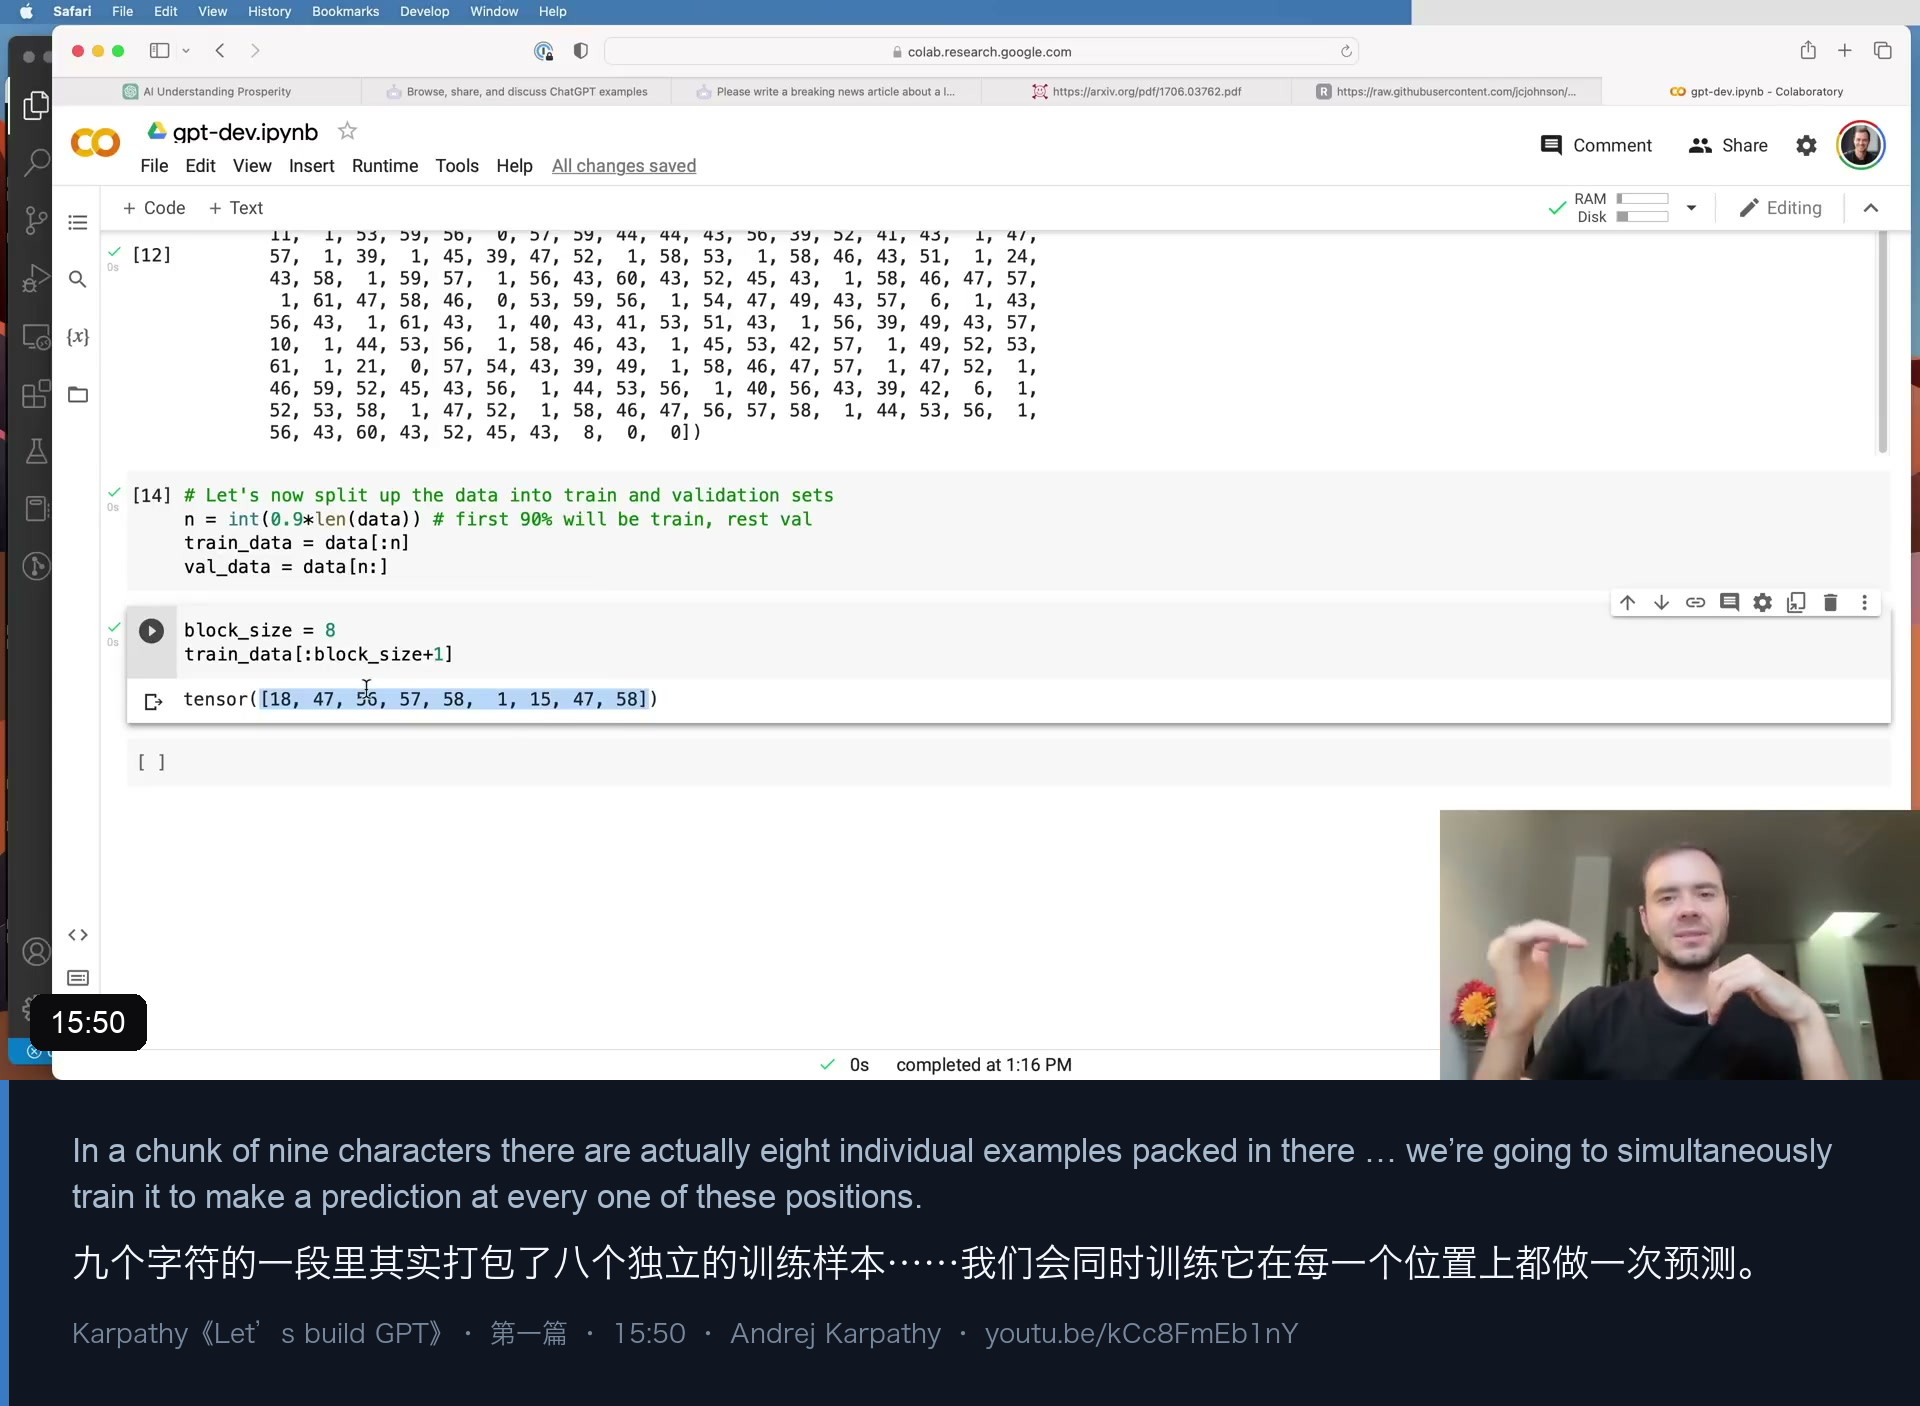
5.3 为什么这不仅仅是「为了效率」
Karpathy 特意强调了这一点,因为他知道很多人会以为这只是把数据用满。真正的理由有两个:
- 让模型习惯各种长度的上下文。因为训练时 context 从 1 到
block_size都会出现,推理时我们就能只给 1 个字符就开始生成,一路生成到block_size为止(超过block_size必须截断)。 - Transformer 的并行性。每个位置都是一次独立的预测任务,可以同时算。
本文补充:这就是 GPT 与「自回归 RNN 式生成」在训练效率上的根本差别。RNN 必须按时间步串行,而 Transformer 一次前向就把 T 个位置的预测全部算完。反过来说,这也解释了为什么 GPT 训练时那么在乎序列长度——
block_size直接决定了每步能榨出多少监督信号。
6. 18–22|batch 维度:4 × 8 = 32 个互不通信的样本
torch.manual_seed(1337)
batch_size = 4      # 多少个独立序列并行处理
block_size = 8      # 每条序列的最大上下文长度

def get_batch(split):
    data = train_data if split == 'train' else val_data
    ix = torch.randint(len(data) - block_size, (batch_size,))
    x = torch.stack([data[i:i+block_size] for i in ix])
    y = torch.stack([data[i+1:i+block_size+1] for i in ix])
    return x, y
torch.randint 生成 4 个随机起点,每个起点切一段 8 个字符,torch.stack 把它们叠成 4×8 的张量。加上偏移一位的目标,一次前向就有 32 个独立的训练样本。
Karpathy 反复强调「独立」:这 4 行之间完全互相独立、不会说话(they don’t talk to each other)。batch 维度存在的唯一目的是把 GPU 喂饱——GPU 极其擅长并行处理。
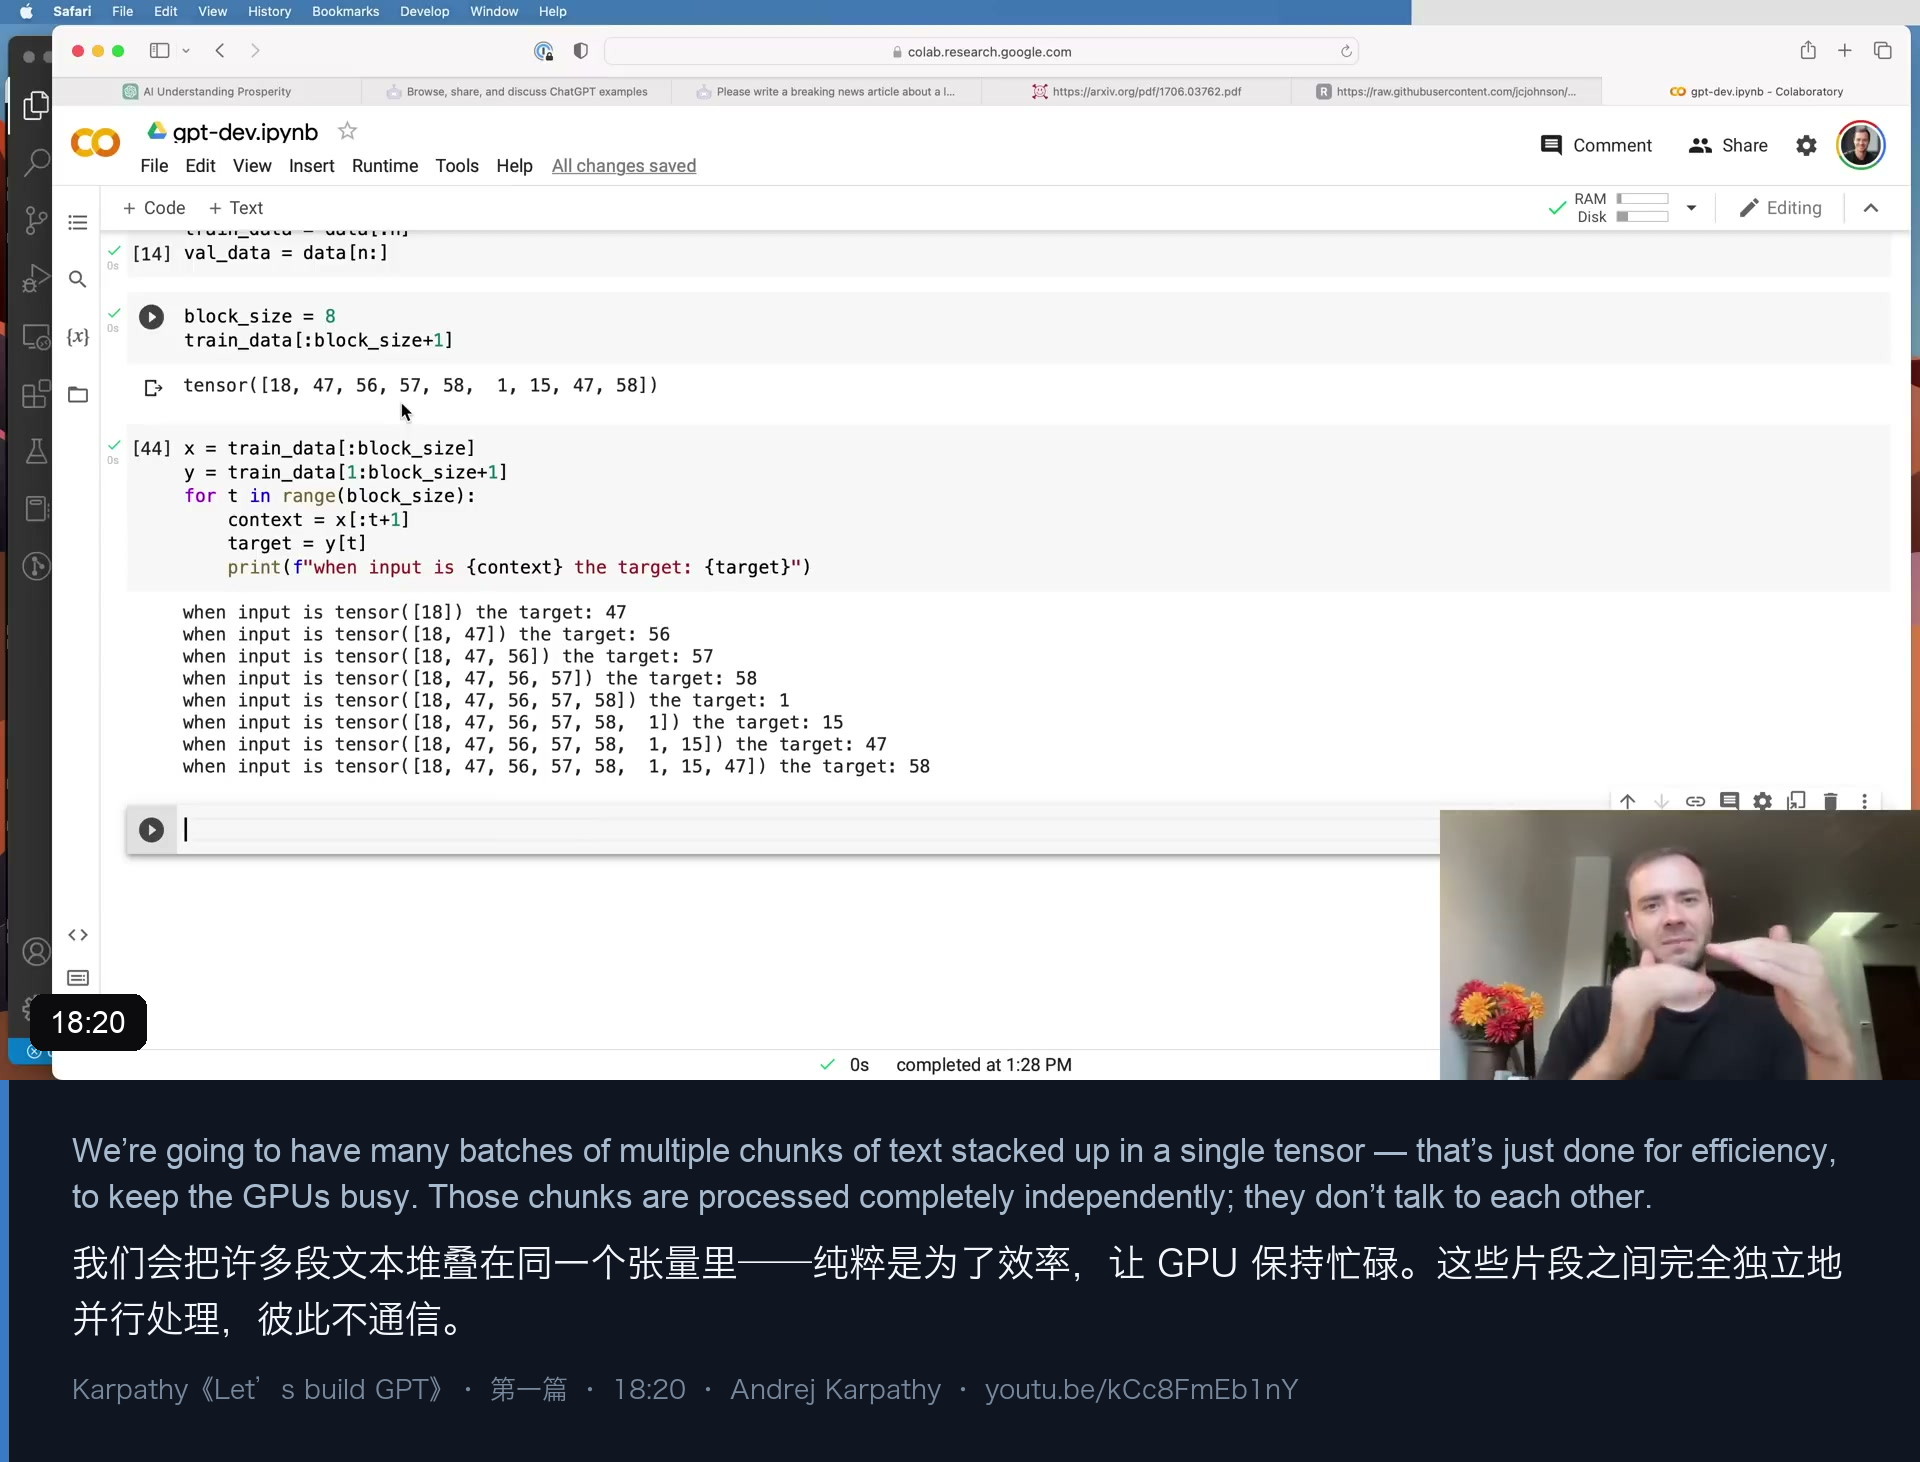
输出里 x 是 4×8、y 也是 4×8,对应关系是逐位置的「输入 → 下一个字符」:
xb, yb = get_batch('train')
print('inputs:', xb.shape, xb.dtype)
# inputs: torch.Size([4, 8]) torch.int64本文补充:
torch.manual_seed(1337)是个小细节但很关键——固定的随机种子意味着你屏幕上的数字和视频里完全一致,后面比较 loss 才有意义。另外注意这里没有 DataLoader、没有 dataset 类,就一个函数、几行索引。简单到你可以完整地在脑子里模拟它的每一步。
7. 22–26|最小基线:bigram 语言模型
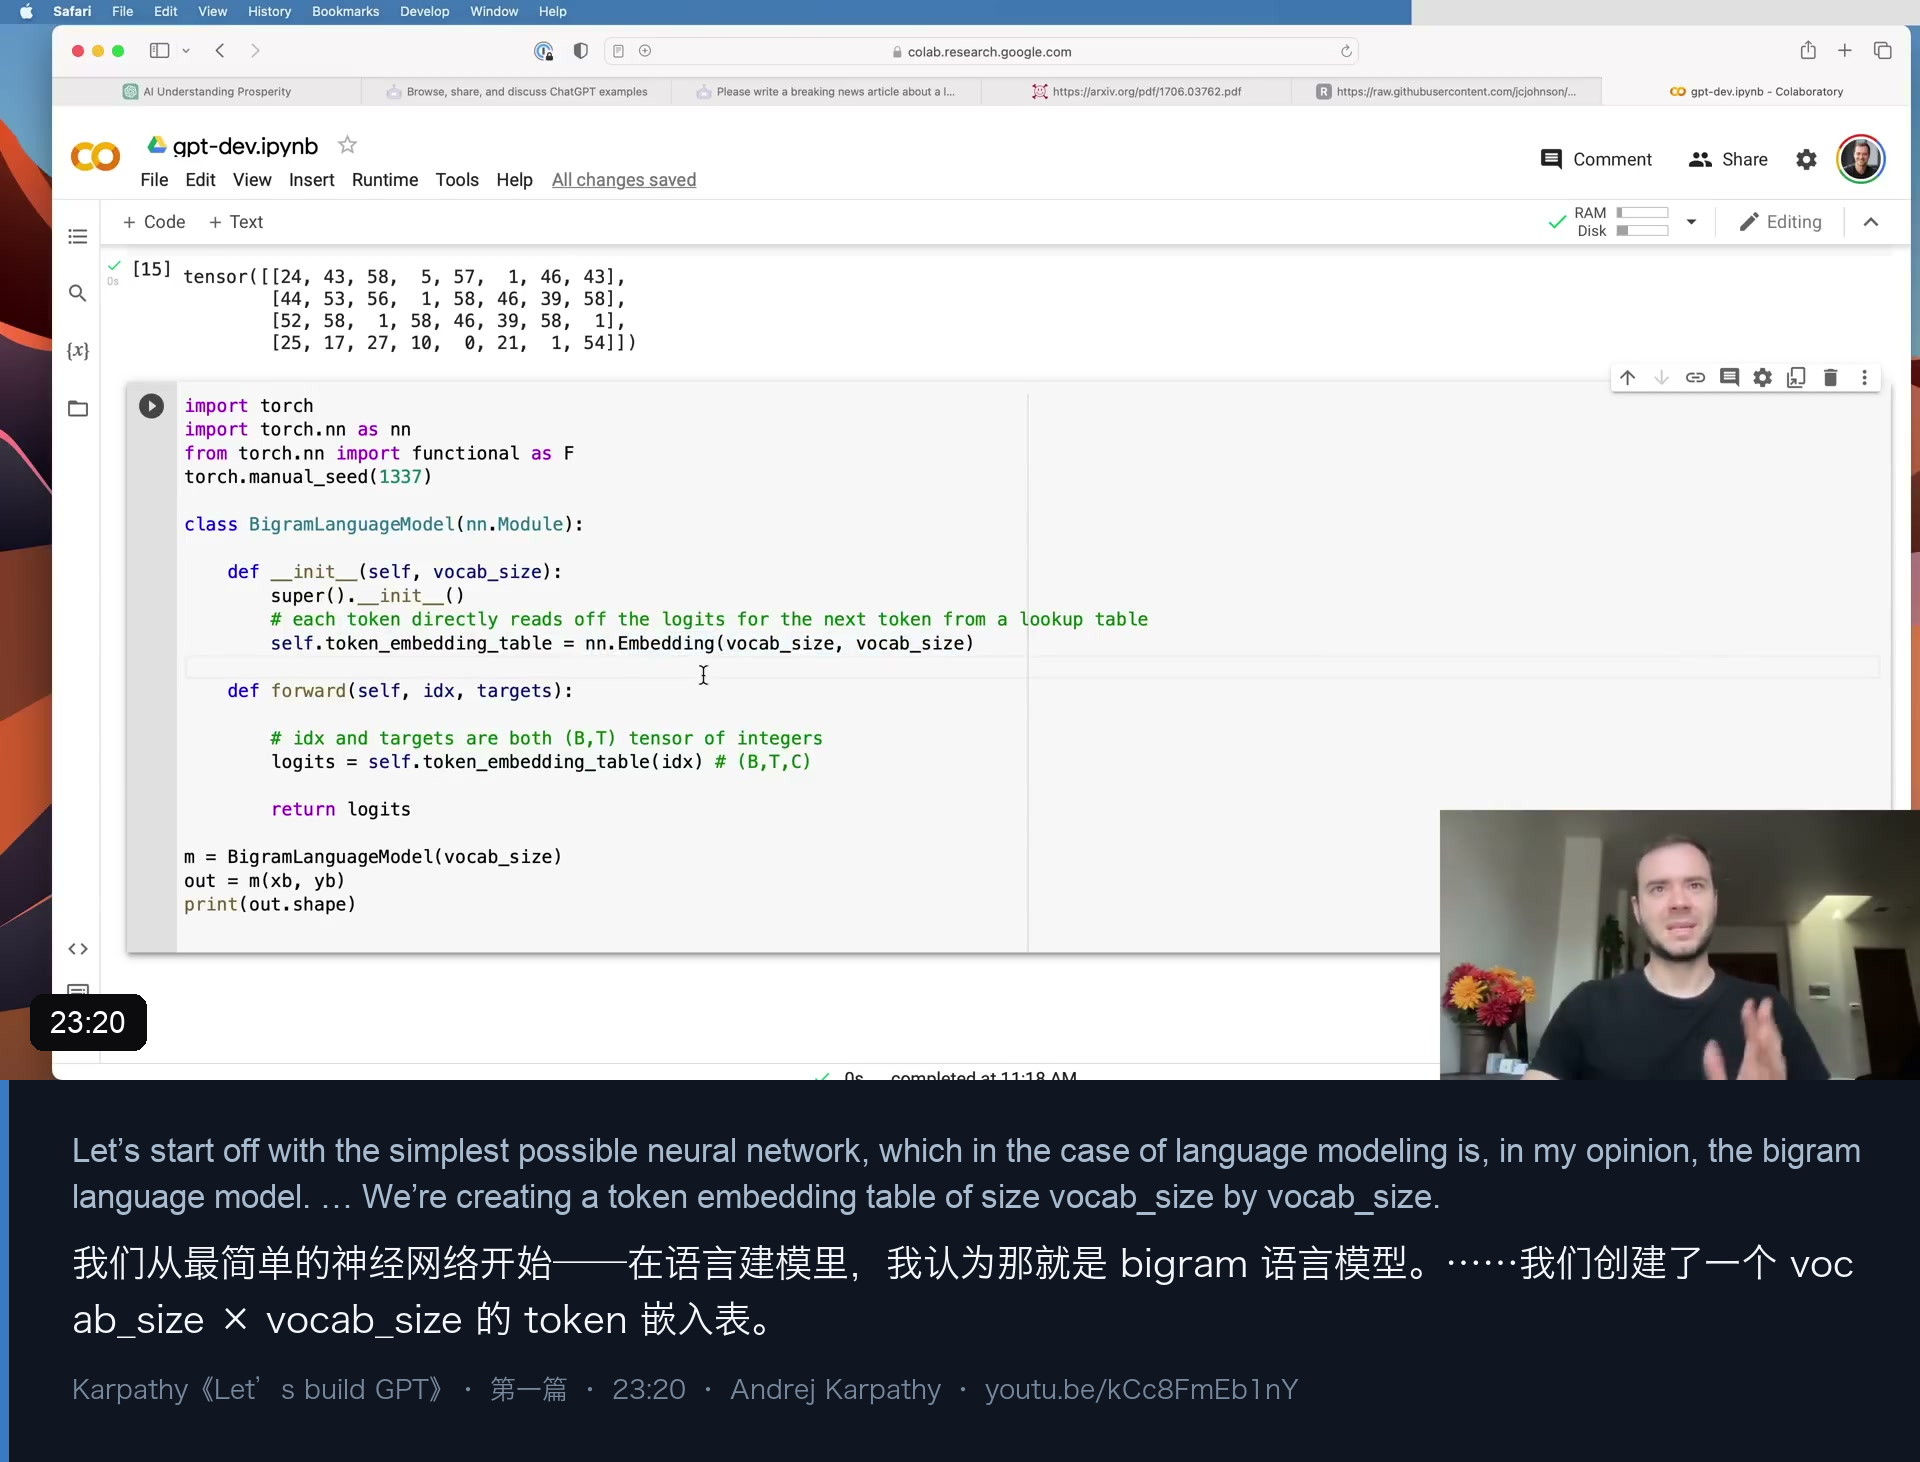
有了 batch,就可以开始接神经网络了。Karpathy 的选择非常克制:先从最简单的模型开始——bigram 语言模型。
import torch.nn as nn
from torch.nn import functional as F

class BigramLanguageModel(nn.Module):
    def __init__(self, vocab_size):
        super().__init__()
        # 每个 token 直接查表得到「下一个 token 的 logits」
        self.token_embedding_table = nn.Embedding(vocab_size, vocab_size)

    def forward(self, idx, targets=None):
        # idx 和 targets 都是 (B, T)
        logits = self.token_embedding_table(idx)  # (B, T, C),这里 C = vocab_size
        if targets is None:
            loss = None
        else:
            B, T, C = logits.shape
            logits = logits.view(B*T, C)
            targets = targets.view(B*T)
            loss = F.cross_entropy(logits, targets)
        return logits, loss
这个模型只有一张表。它的工作方式:
nn.Embedding(vocab_size, vocab_size)本质就是一个vocab_size × vocab_size的张量;- 输入里的每个整数(0–64)去表里取第 i 行(
24就取第 24 行),PyTorch 自动整理成(B, T, C); - 这一行 65 个数直接就是 logits——「我是字符 24,下一个字符最可能是谁」的分数。
Karpathy 的原话是:这个模型完全没有看上下文,它只知道「我是 token 5」,然后就预测下一个。但即便如此也已经能做出还算不错的预测,因为「哪些字符通常跟在哪些字符后面」本身就是很强的统计规律。
本文补充:为什么值得从这个「弱到可笑」的模型开始?因为它给了你一个可验证的下界。你已经知道数据的真实结构(字符级、65 类),所以你能算出「瞎猜」时的损失应该是多少——下一节马上就会用到。这种「先做一个最蠢的基线,再一步步加东西,每一步都知道自己有没有变好」的节奏,是整个视频贯穿始终的方法论。
8. 26–28|交叉熵的维度坑,与 4.87 这个数字
8.1 一个必踩的坑:cross entropy 要的是 (B, C, T)
# 直接调用会报错
loss = F.cross_entropy(logits, targets)
Karpathy 的原话:PyTorch 对多维输入要求通道在第二个维度——也就是它想要 (B, C, T),而我们的 logits 是 (B, T, C)。
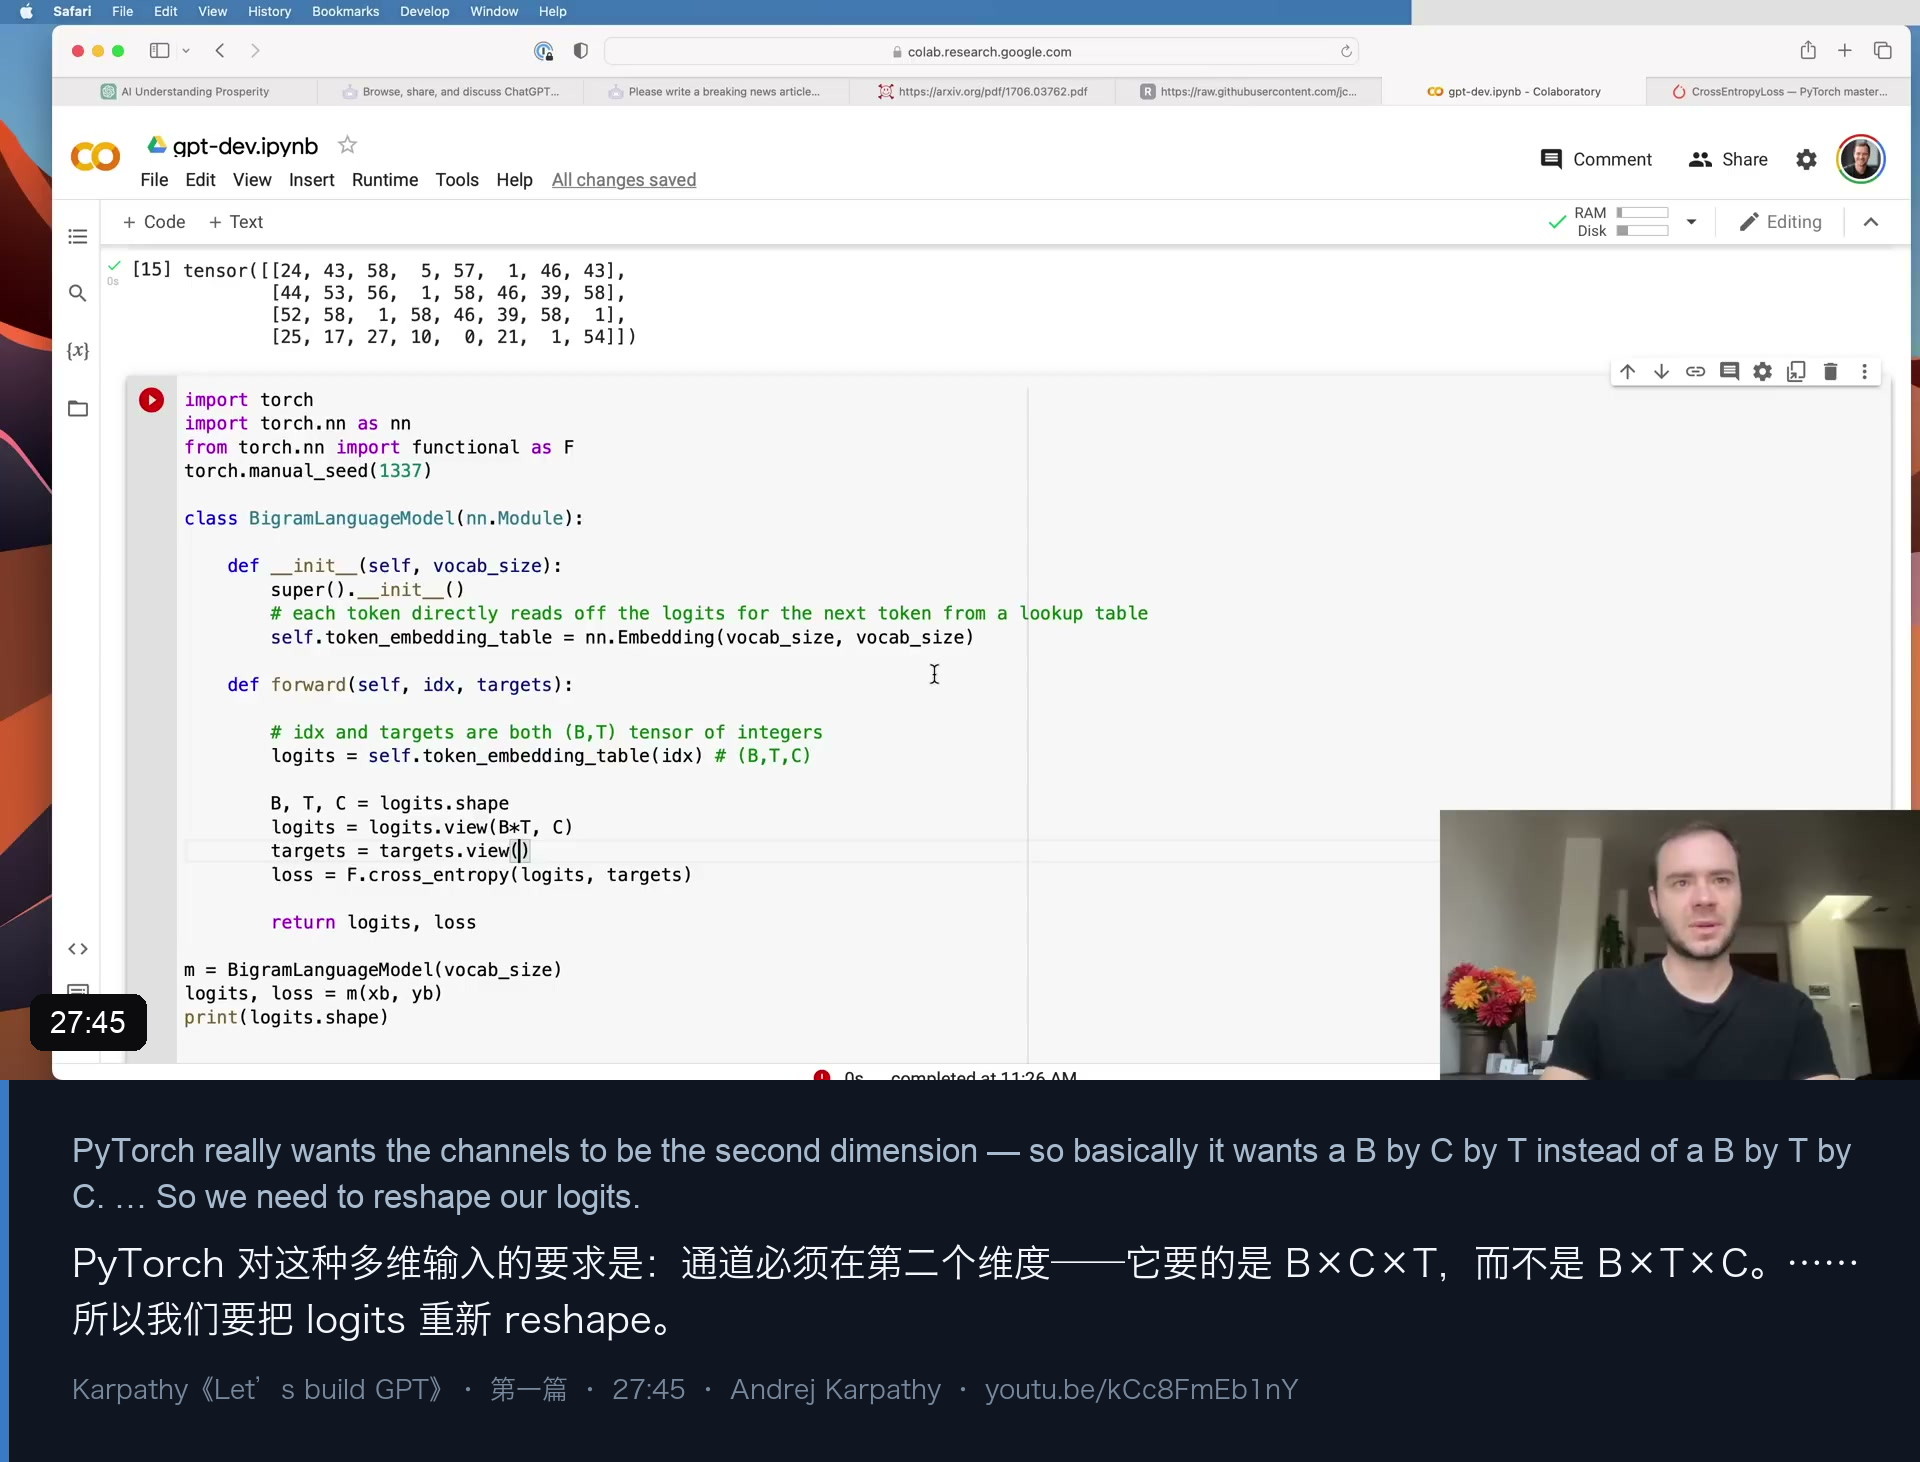
他的解法不是硬扛维度,而是把三维问题摊平成二维:
B, T, C = logits.shape
logits = logits.view(B*T, C)     # (B*T, C)
targets = targets.view(B*T)      # (B*T,)
loss = F.cross_entropy(logits, targets)这一步的真正含义:所谓「batch 里的 32 个样本」,在交叉熵眼里就是 32 行、每行 65 个分数,配 32 个正确答案。时序结构在这里被完全抹平——Transformer 的时序信息是靠位置编码带进去的,不是靠损失函数。
本文补充:
view(B*T, C)这个写法你以后会在所有 GPT 实现里反复见到。记住它背后的三件事:① embed 之后张量永远是(B, T, C);② 语言模型头lm_head输出(B, T, vocab_size);③ 算损失时永远摊平成(B*T, vocab_size)对(B*T,)。
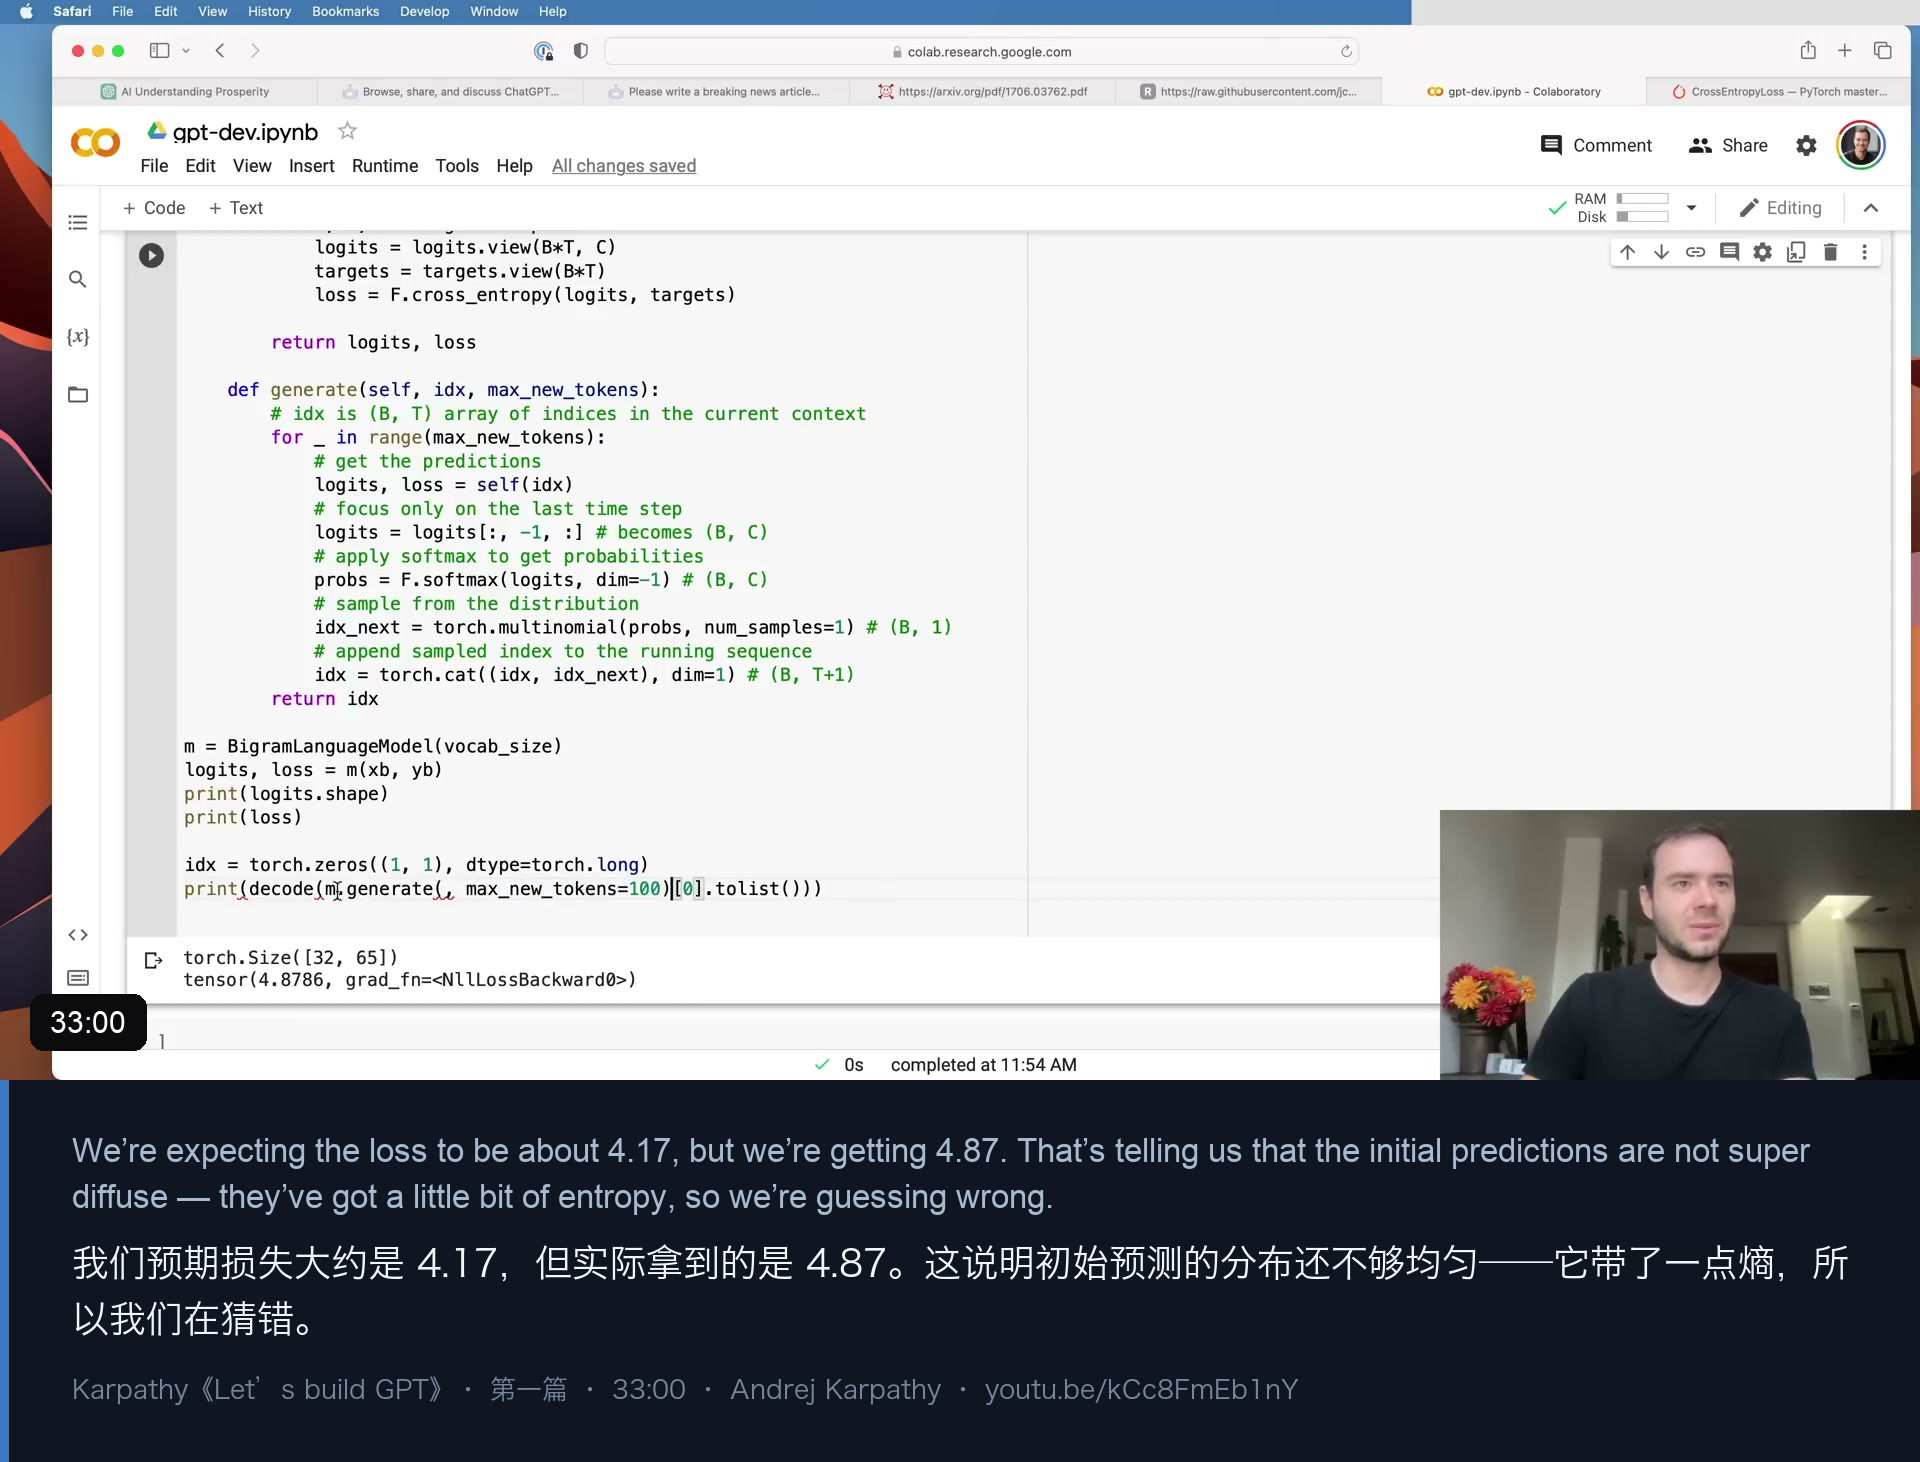
8.2 4.87 与 4.17:怎么判断一个损失是不是「离谱」
logits, loss = m(xb, yb)
print(logits.shape)
# torch.Size([32, 65])
print(loss)
# tensor(4.8786, grad_fn=<NllLossBackward0>)
Karpathy 的推理过程是整个视频里最漂亮的一段「用数学做工程判断」:
- 词表是 65,如果模型完全均匀地瞎猜,正确类的概率是
1/65; - 负对数似然损失就是
-ln(1/65)≈ 4.17; - 我们实际看到 4.87,比 4.17 还差。
这说明什么?说明初始预测不是均匀的——它带了一点熵(有的类被猜得偏高),所以在「猜错」这件事上比纯瞎猜付出更多代价。
本文补充:这个「先算理论下界,再对比实测」的习惯,请在后面每一篇里都保持。它能在你还没训练、还没画曲线的时候,就告诉你代码是不是基本正确。顺便:4.17 不是「好」的损失,它只是一个起点基准;模型能降到什么程度,取决于数据的可压缩性。
9. 28–33|生成:从随机权重得到一堆「乱码」
有了损失,接下来是生成。Karpathy 说这部分会快一点,因为在 makemore 系列里已经讲过:
def generate(self, idx, max_new_tokens):
    # idx 是当前上下文 (B, T)
    for _ in range(max_new_tokens):
        logits, loss = self(idx)
        logits = logits[:, -1, :]                      # 只看最后一个时间步 (B, C)
        probs = F.softmax(logits, dim=-1)              # 转成概率
        idx_next = torch.multinomial(probs, num_samples=1)  # 按概率采样 (B, 1)
        idx = torch.cat((idx, idx_next), dim=1)        # 拼回序列 (B, T+1)
return idx四行循环,讲清了「生成」的全部:取最后一个位置的预测 → softmax → 按概率采样 → 拼回序列 → 重复。
注意两个细节:
if targets is None分支:generate调用self(idx)时不传 targets,所以forward必须允许 targets 缺省——有 targets 就算损失,没有就只返回 logits。- 一个「看起来很傻」的地方:此刻是 bigram,预测下一个字符其实只需要最后一个字符,但
generate却把整段历史都喂进去、只取最后一个输出。Karpathy 明确说这是故意的:这个函数要一直留着不改,因为等模型真的会「回头查历史」(也就是注意力)时,历史就真的会被用到。
生成的结果,他原话是「obviously it’s garbage」:
context = torch.zeros((1, 1), dtype=torch.long)   # 0 代表换行符,把它当开头
print(decode(m.generate(context, max_new_tokens=100)[0].tolist()))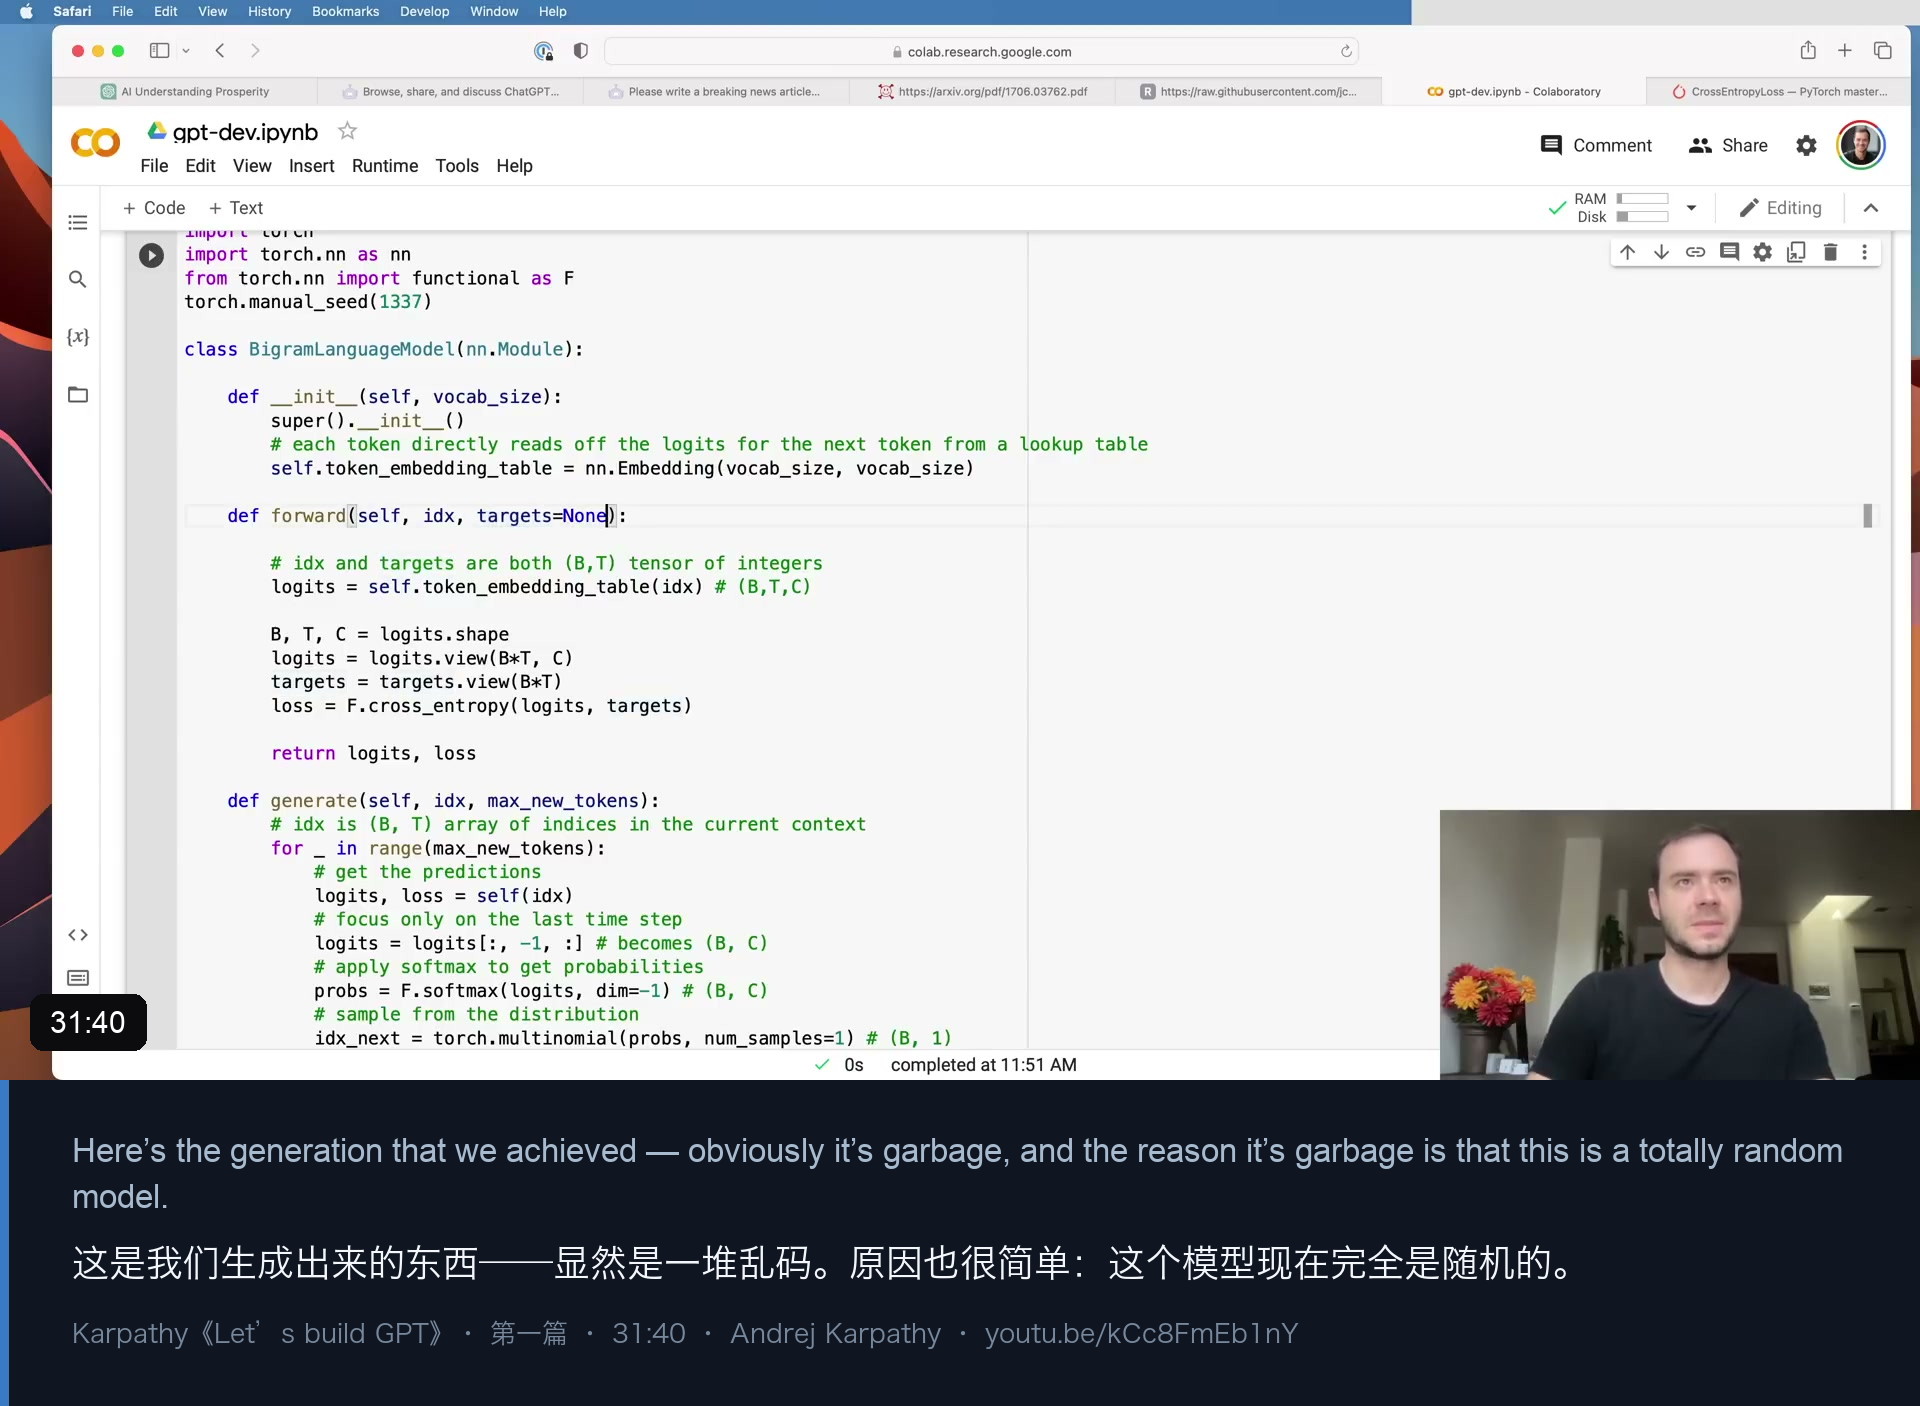
本文补充:这一步看起来「没产出」,其实是整篇最重要的里程碑——从数据到损失、从损失到采样的闭环已经跑通了。剩下的所有工作,只是在同一个闭环里不断替换
forward里面的那个模型。你在后面三篇里看到的每一次 loss 下降,都是在这套代码上发生的。
10. 33–36|训练循环:AdamW、batch 32、loss 开始下降
optimizer = torch.optim.AdamW(m.parameters(), lr=1e-3)

batch_size = 32
for steps in range(10000):
    xb, yb = get_batch('train')
    logits, loss = m(xb, yb)
    optimizer.zero_grad(set_to_none=True)
    loss.backward()
    optimizer.step()
Karpathy 交代了两点:
- 优化器:makemore 系列一直用的是最朴素的 SGD,这里改用 AdamW——更现代、更常用。他还提到学习率的经验值:常规设置大约
3e-4,而像这种非常小的网络可以承受大得多的学习率(1e-3甚至更高)。 - batch 加大:从 4 提到 32,因为现在是在真训练了。
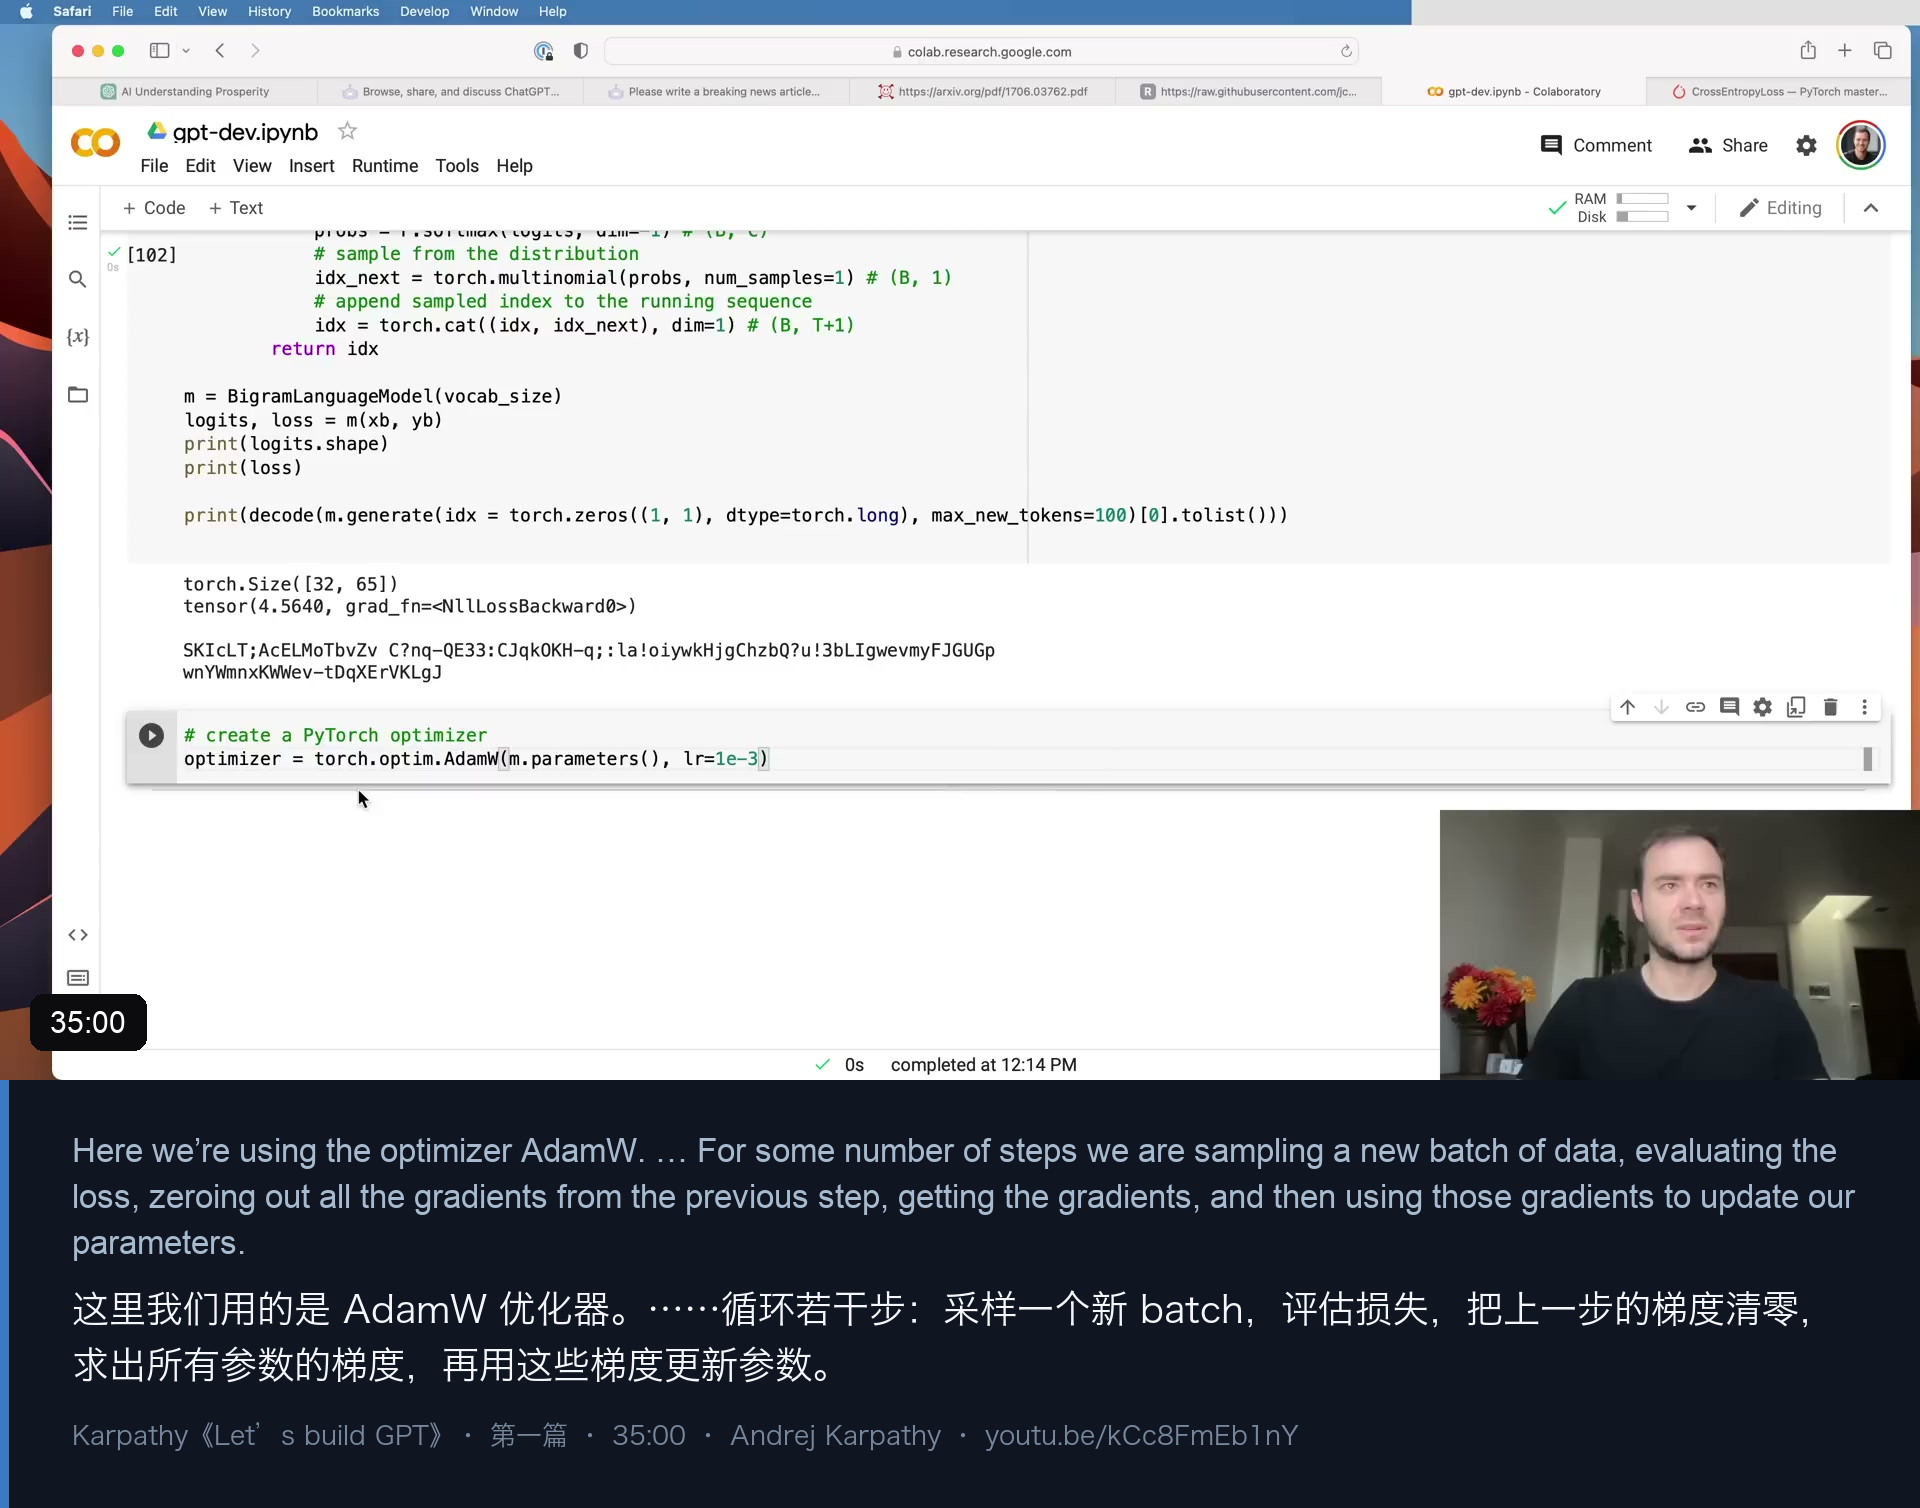
本文补充:这段代码的每一行都值得你亲手敲一遍。
zero_grad→backward→step这个顺序是所有 PyTorch 训练代码的心跳;set_to_none=True比默认的zero_grad()更省内存,也更常用。另外注意:这里还没有model.train()/model.eval(),也没有torch.no_grad()的评估循环——这些会在后面随 dropout 和estimate_loss一起出现。
11. 这一篇留下了什么伏笔
回头看这一段 36 分钟,Karpathy 其实只做了一件事:搭好一个「能训练的闭环」,然后从一个最弱的模型开始。
但他在讲解过程中埋了一条非常明确的主线,也是下一篇的全部动机:
bigram 模型完全没有利用上下文——它只知道「我是谁」,不知道「我前面是什么」。
而语言模型的价值恰恰来自上下文。视频里那句「我故意把 generate 写成通用的,因为它以后真的会用到历史」,就是在给注意力机制留位置。
下一篇要做的,就是把这张「只看自己」的查表,换成一个每个 token 都能回头去看前面所有 token 的模块——自注意力(self-attention)。我们会从「用矩阵乘法做加权平均」这个数学技巧开始,一步步推出 Q / K / V 和掩码注意力,并亲眼看到 loss 从 4.87 掉下去。
本篇速查
| 概念 | 这一篇里的具体值 | 说明 |
|---|---|---|
| 数据集 | tiny Shakespeare,1,115,394 字符 | 约 1MB |
| 词表 | 65 个字符 | sorted(set(text)) |
| 工业界对照 | tiktoken / GPT-2:50,257 | subword (BPE) |
| block_size | 8 | 最大上下文长度 |
| batch_size | 4(后面训练时改成 32) | 并行序列数 |
| 一次前向的样本数 | 4 × 8 = 32 | 完全独立 |
| 理论下界损失 | −ln(1/65) ≈ 4.17 | 均匀瞎猜 |
| 初始实测损失 | 4.8786 | 比下界更差 |
| 优化器 | AdamW,lr=1e-3 | 小网络可以更大 |
自测题(如果想确认自己真的读懂了)
- 为什么
y是x向右偏移一位?如果我把y写成train_data[2:block_size+2],模型学到的是什么? block_size = 8时,为什么一段 9 个字符能提供 8 个训练样本?如果是 1 个字符的上下文呢?- 为什么 batch 维度上的 4 段文本「互不通信」?这在实现上靠的是什么?
logits.view(B*T, C)这一步丢掉了时序结构,为什么损失函数仍然能正确训练一个「看历史」的模型?- 初始损失 4.87 > 4.17,这个现象说明初始 logits 有什么性质?
下一篇:Karpathy《Let’s build GPT》第二篇 —— 自注意力:从「加权平均的数学技巧」到 Q / K / V、掩码与多头注意力(覆盖 00–01)。
讨论
这里是静态站点,没有内嵌评论区。如果这篇文章对你有用,欢迎通过 RSS 订阅后续更新。