AI 把所有人拉向均值:Miles Cranmer 谈如何避免 AI 脑腐
剑桥助理教授 Miles Cranmer 给 MPhil 学生讲了一场 55 分钟的《How to avoid AI brain rot》。他的判断是:AI 已经不是外挂——它把每个人的产出都抬起来,也把整条钟形曲线压扁,用默认方式用它的人会一起滑向平均值。他从客服与顾问实验、土耳其高中数学课、一次 14 小时的自动研究,一路讲到苏格拉底式提问、AGENTS.md 的三条规矩,给出了一条能站上尾部的路径。
来源:How to avoid AI brain rot(Miles Cranmer / 剑桥,约 55 分钟) · 讲者:Miles Cranmer(剑桥大学助理教授,PySR / SymbolicRegression.jl 作者)· 场合:给剑桥 MPhil 学生的讲座 · 逐字稿与时间轴见另一篇
阅读说明
- 本文是对这场讲座的结构化整理:按主题走,每个小节标了视频时间点,可以跳着看;插图都是从视频里截的原幻灯片。
- 引号里的英文是讲者的原话,中文为本文翻译;标为「本文补」的是本文补的背景,不是他说的。
- 文中所有研究数字、人名、产品名与判断都来自现场幻灯片和口述,本文未独立核验。实验出处我按幻灯片脚注标了出来,方便自己查。
- 完整逐字稿(英文、带时间轴、26 个小节)在这里。
TL;DR
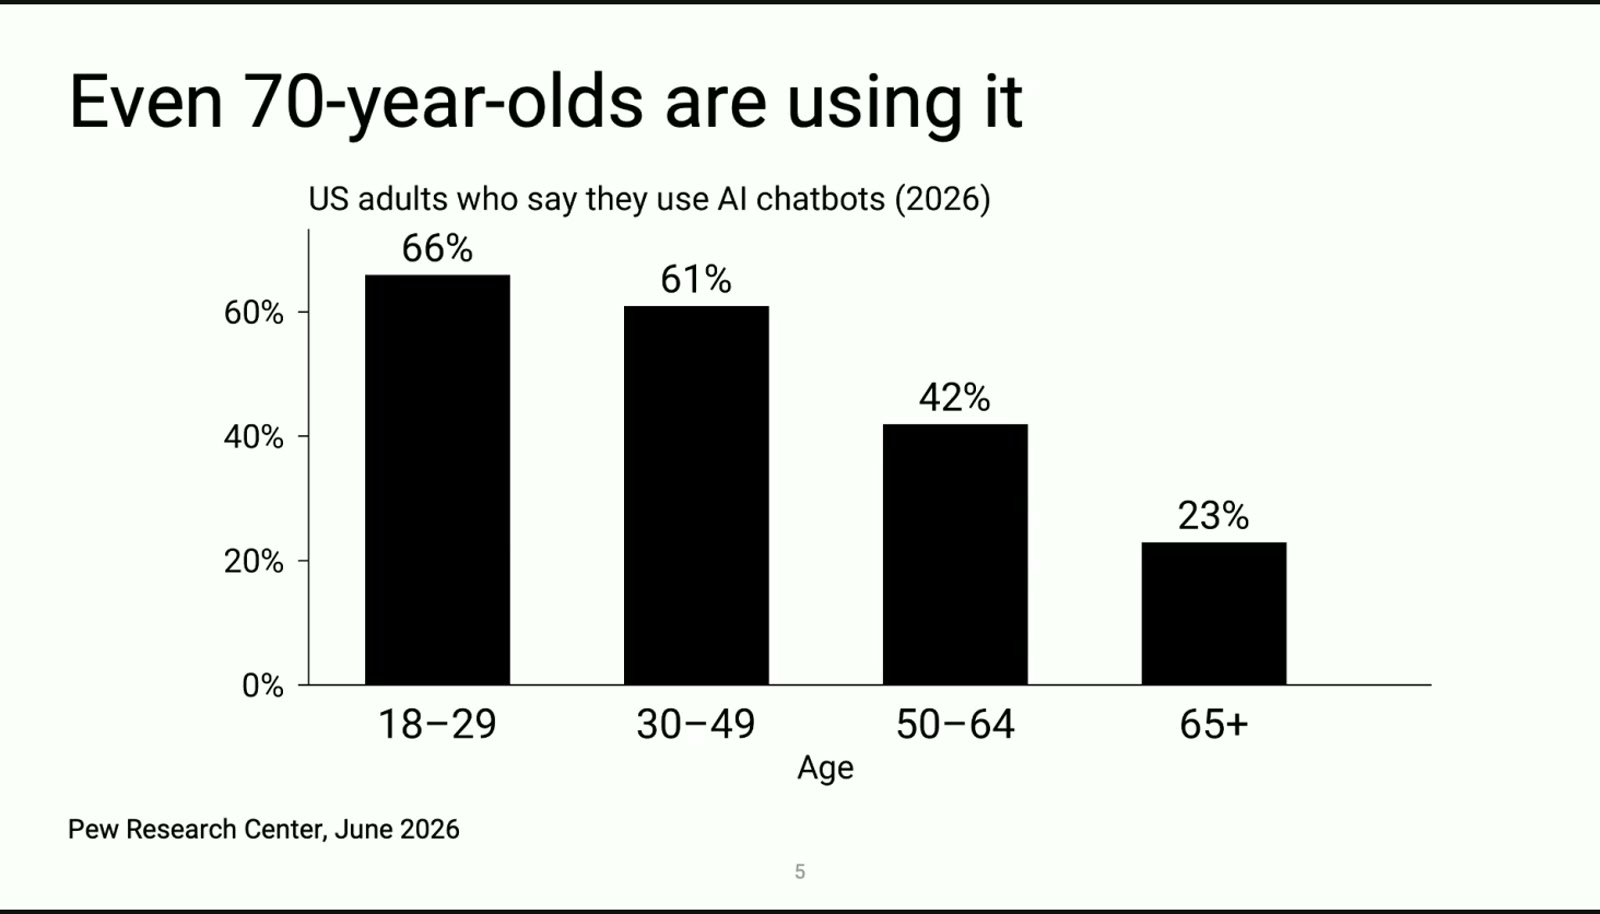
- AI 已经不是作弊码。 两年前只有 12% 的美国成年人用它,现在连 65 岁以上都有 23%,18–29 岁是 66%。当所有人都拿到同一个工具,「谁更会用」就变成了新的分水岭。
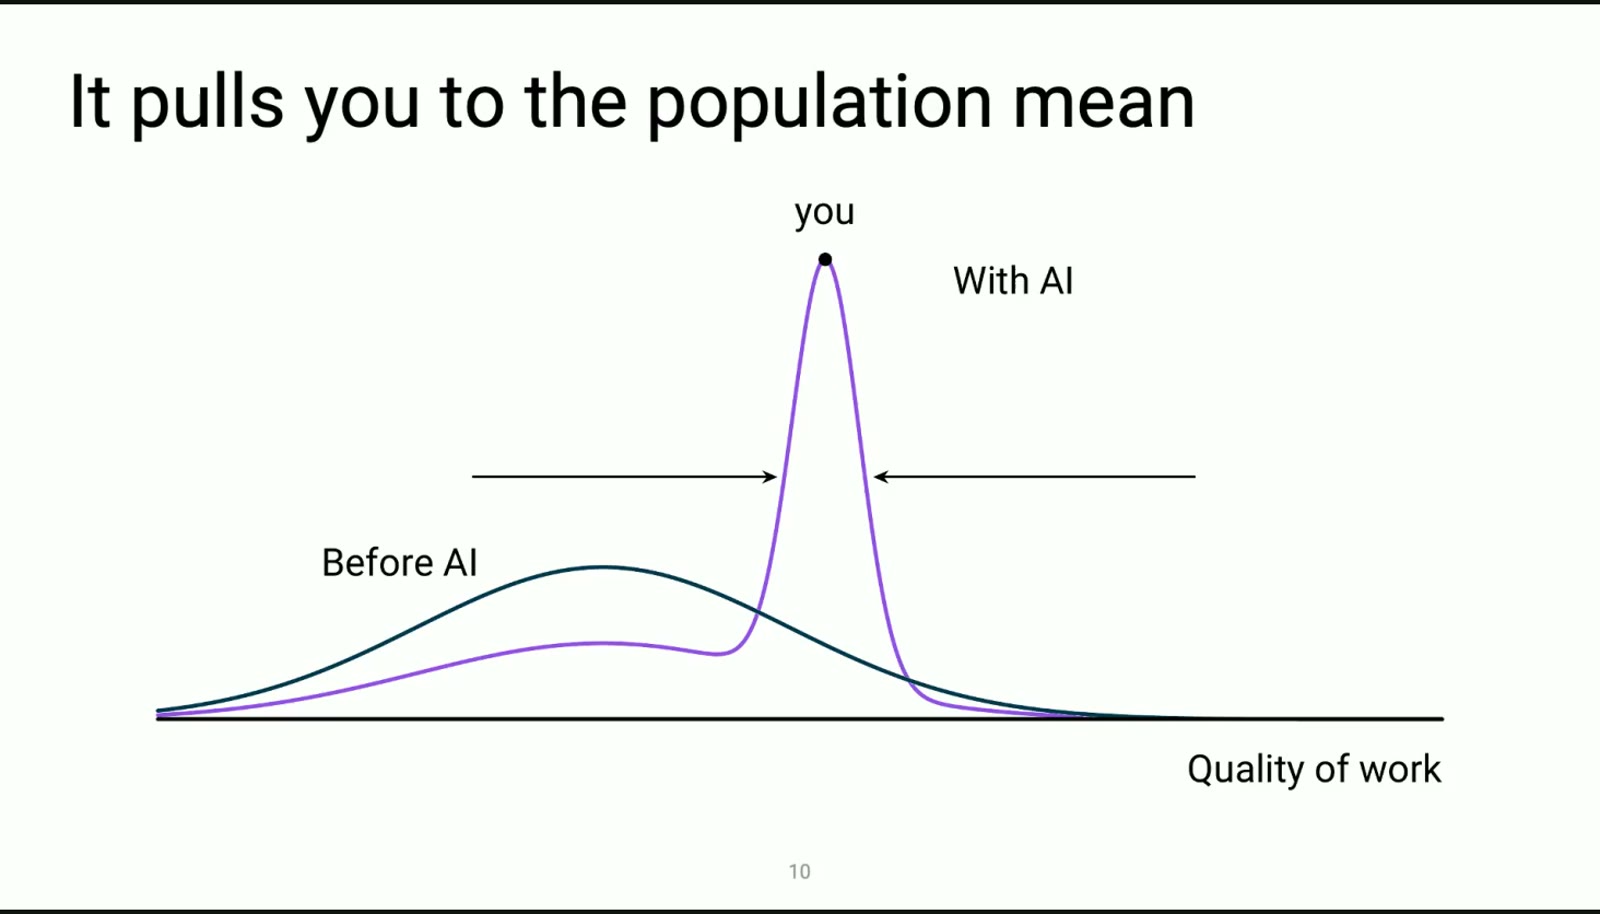
- 默认使用会把你拉向均值。 常规任务上 AI 对最弱的人帮助最大(客服实验里最低组 +36%),对最强的人几乎没帮助;分布被压扁,钟形曲线变窄。
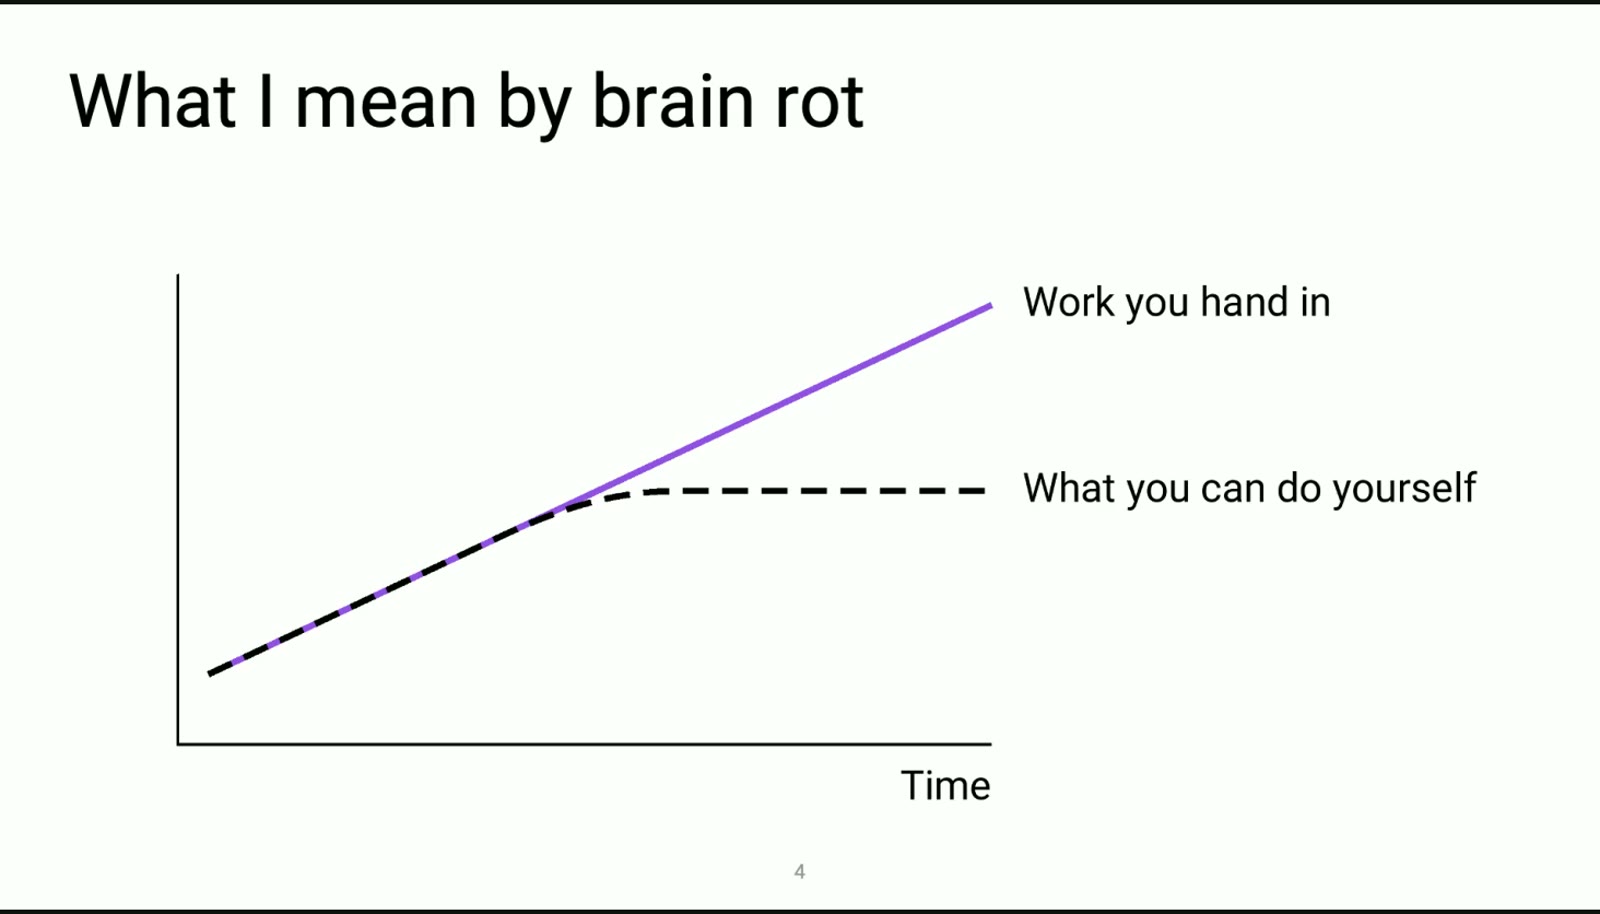
- 脑腐的精确定义:你交出去的东西越来越好,而你自己产出和判断它的能力停止生长。
- 往上尾部走的杠杆是主观判断。 需要专家判断的任务里,用 AI 的专家成功率 33%,新手只有 15%——新手还会在会话卡住时更快放弃。
- 学习会静悄悄地停。 土耳其的高中数学课里,直接用 ChatGPT 抄答案的那组,平时练习分数最高(42.1%),考试却最差(26.7%);只要提示的「AI 家教」组平时 64.5%、考试 31.7%,和不用 AI 的对照组持平。
- 同一份研究给出的操作建议:每次都向 AI 要答案,测试成绩下降(−0.31);每次都向它要解释,测试成绩上升(+0.25)。
- 让 AI 出题考你、只给最小提示、逼你自己讲一遍,是目前证据最扎实的用法;让它替你写、替你练,则是最快废掉的用法。
- 你不是在跟 AI 竞争,你是在跟「同样在用 AI 的所有人」竞争。 所以唯一的长期对策是:把 AI 能自动化的部分交出去,然后去做更难的问题。
一、所有人都拿到同一个外挂之后
讲座开场,他先给了一个对比:两三年前,用 AI 本身就能让你显得不一样;现在不行了。
“We have all been given this alien tool. I use it all day and I’m still figuring out how to use it.” 我们都被发了一个外星工具。我一天到晚在用,到现在也还在摸索怎么用它。
接着是一张 Pew Research Center(2026 年 6 月)的柱状图:美国成年人里说自己用 AI 聊天机器人的比例,18–29 岁 66%,30–49 岁 61%,50–64 岁 42%,65 岁以上 23%。他的原话是,连「70 岁的老爷子老太太」都在用了;而两年前这个数字只有 12%。
换句话说:用 AI 不再是一个优势,它只是一个前提。
二、什么是「脑腐」:产出线还在涨,能力线停了
他给的「brain rot」定义很干脆,可以画成两条线:
“The work you produce gets better over time. Your ability to produce that yourself, or to judge it, stops growing.” 你交出去的活儿越来越好;而你自己做这件事、以及判断这件事好坏的能力,停止生长。
幻灯片上,紫色实线(你交出去的产出)继续上扬,黑色虚线(你自己能做到的水平)在某个点就平了。他补了一句很多人心里的恐惧:AI 帮你把输出抬上去,但你本人没有跟着变强。
真正让他担心的不是这条线本身,而是它的分布——这一点是整场讲座的骨架。
三、默认使用会把你拉向均值
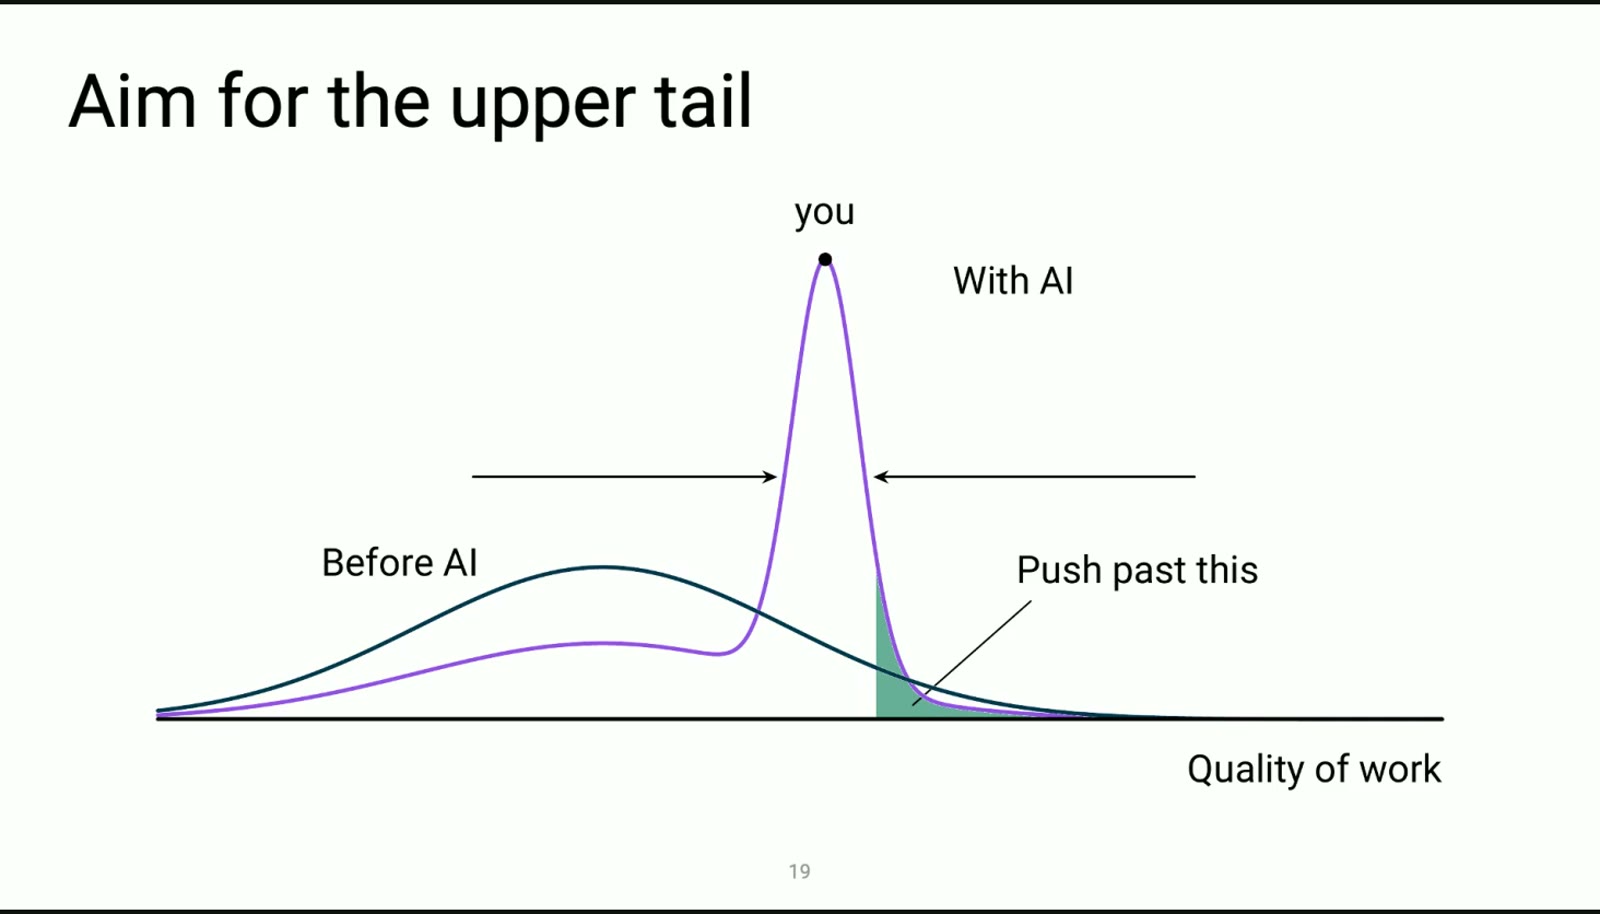
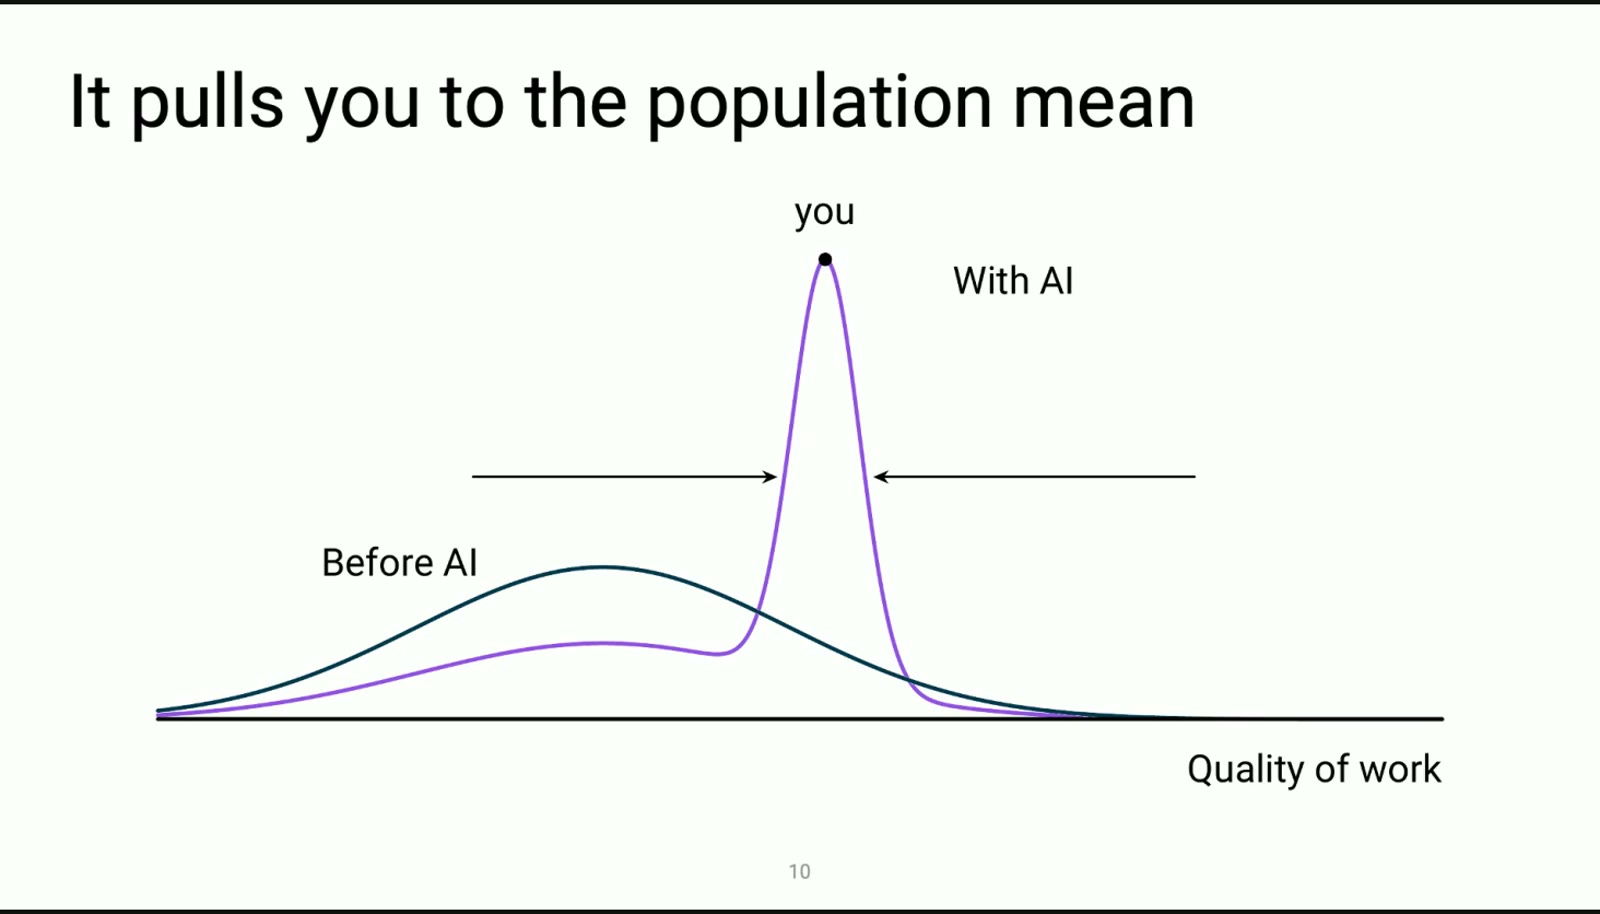
他的核心比喻是钟形曲线:AI 来了以后,弱的一端被抬起得最多,强的一端只是省了点力气,于是整条曲线向均值塌缩、变窄。
“Everyone has the same tools. So everybody kind of collapses to this mean.” 大家用的是同一套工具,所以所有人一起塌缩到这个均值上。
他用一句话概括后果:
“If you use AI heavily in a simple way, you become average.” 如果你用很重、但很简单的方式使用 AI,你就会变成一个平均值。
而他这场讲座要讲的,就是怎么离开那个尖峰:
本文补:这其实是经济学里的老故事——一项技术的普及过程是先奖励早期使用者,再抹平他们的优势。打字机、Excel、搜索引擎都走过这条路。AI 的特别之处只在于它同时作用于「产出」和「判断产出」,所以它能把能力的差距也一起抹平。
四、「均值坍缩」的三份证据
1. 让 25 个模型写「时间是什么」
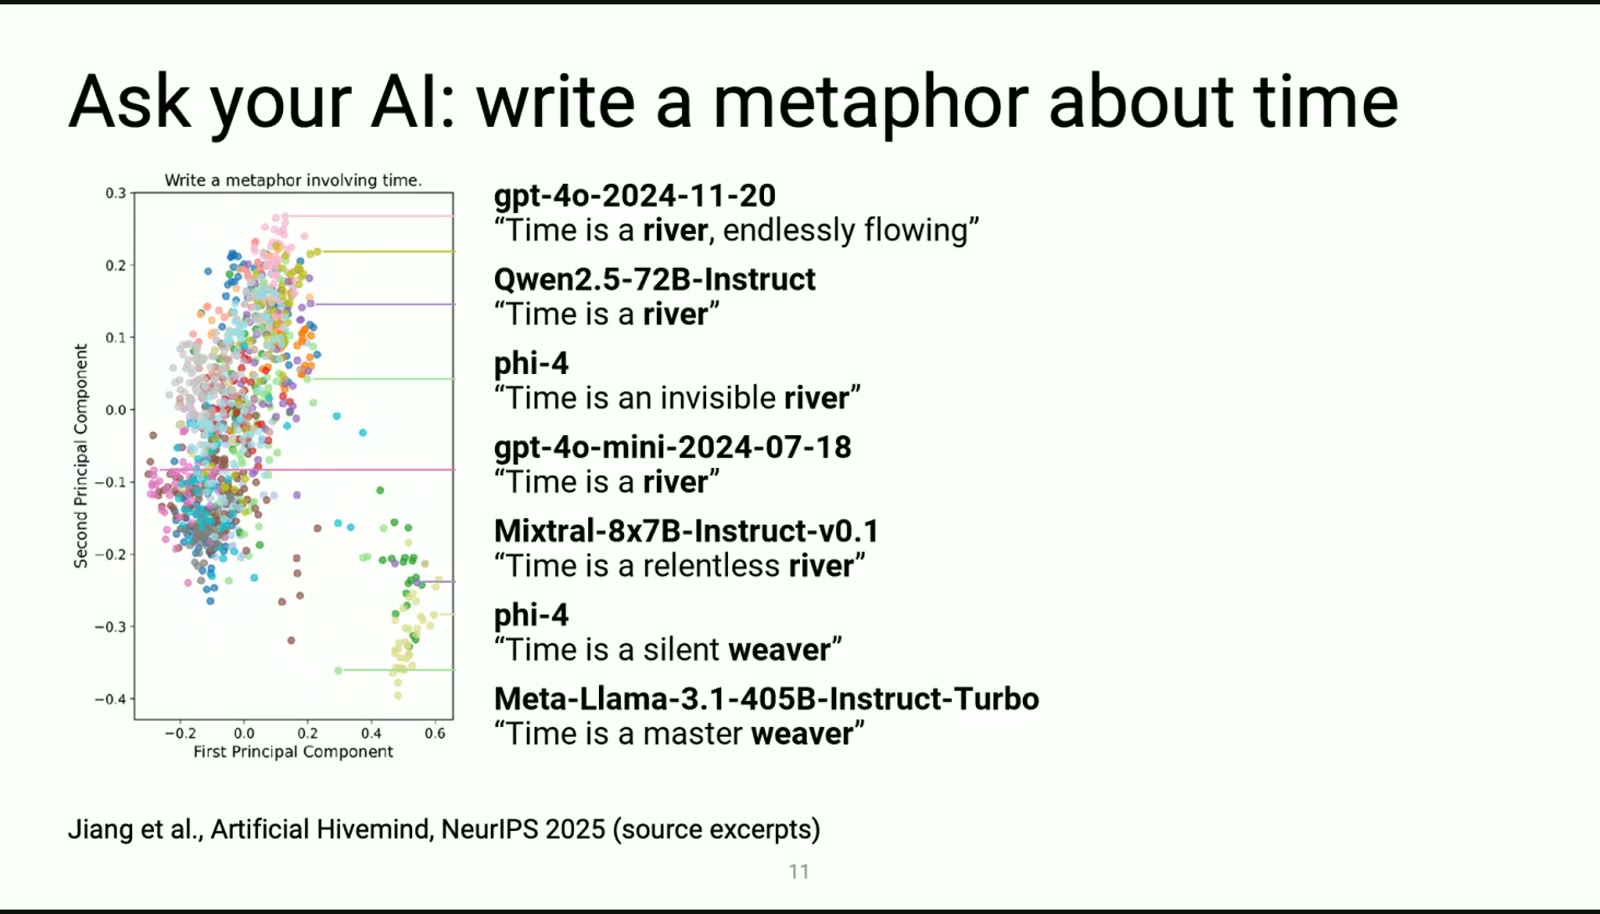
他们让 25 个语言模型各写 50 次关于时间的隐喻(Jiang et al., Artificial Hivemind, NeurIPS 2025),结果几乎全部落进两个簇:time is a river、time is a weaver。
“These are Pareto optimal responses, but there’s no full distribution of novel thoughts.” 这些是帕累托最优的回答,但不存在一整个「新想法」的分布。
2. 故事评分更高,但彼此更像
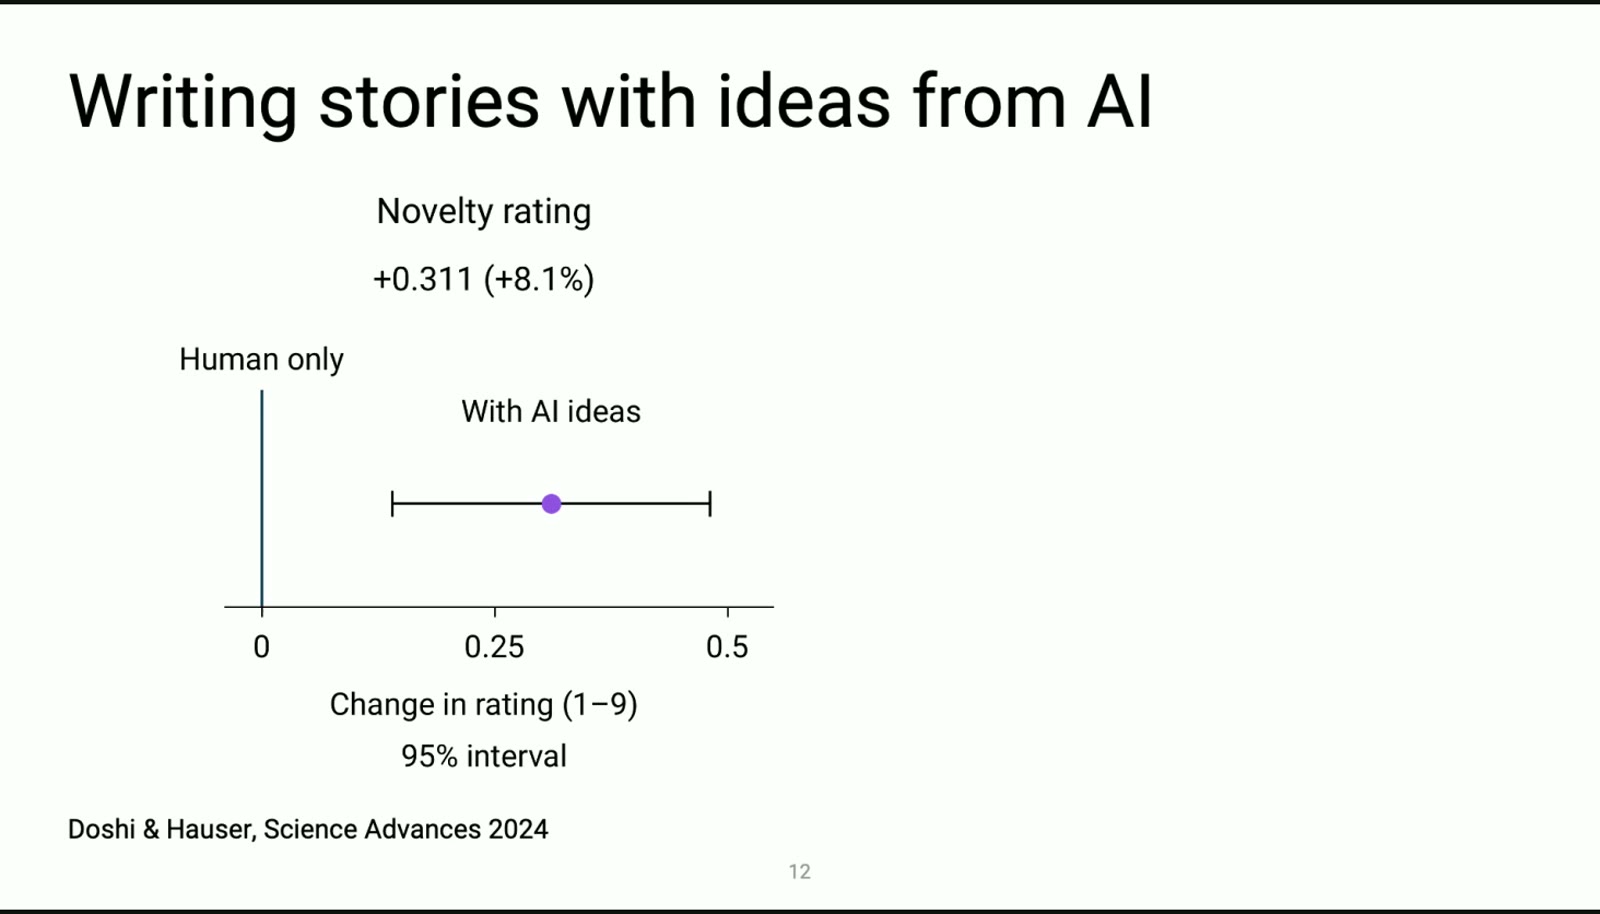
第二个研究(Doshi & Hauser, Science Advances 2024)里,有 AI 帮忙给点子的故事,新颖度评分平均高出约 8%(图上写 +0.311)。但把这些故事放在一起比较,它们的相似度明显上升。
“The stories, on average, they get better, but everything starts looking the same.” 平均来说故事变好了,但所有东西开始长得一样。
3. 「Claude 味的报告」
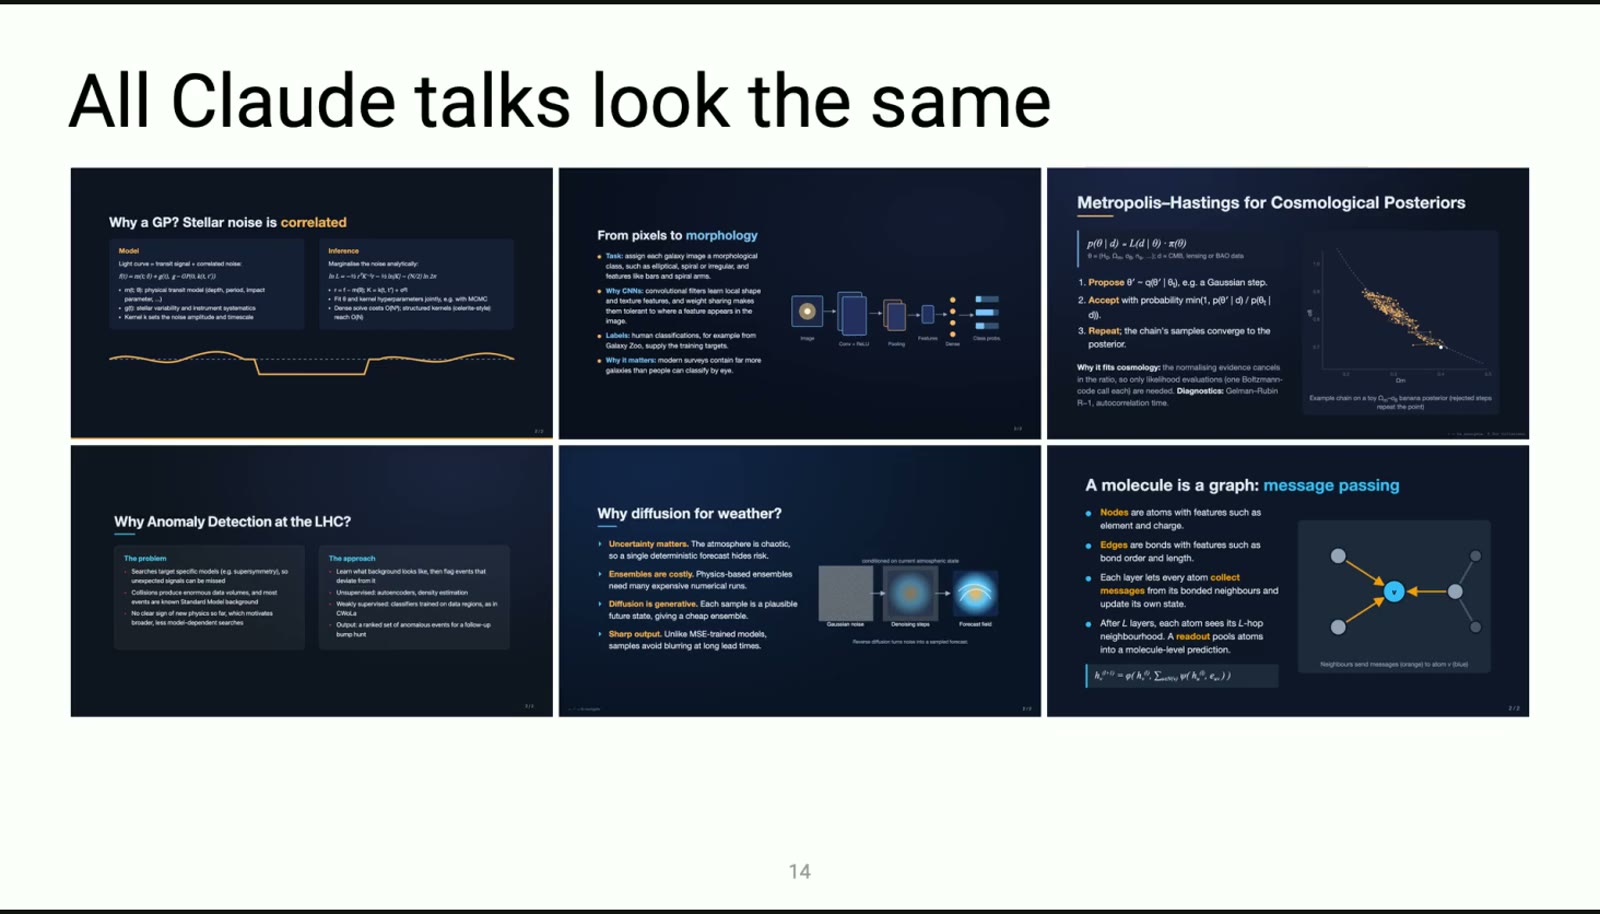
这一段是他作为评委的私人体感,也是最扎心的地方:去年开始,学生的报告开始长得一模一样——同样的字体、同样的配色、同样的结构。
“As an assessor, you can really tell. Even the choice of font, even the color. It all starts looking the same.” 作为评审你一眼就能看出来。连字体选择、连配色都一样。所有东西开始长得一模一样。
五、被抬得最高的是谁:两个实验
他给了两组经典证据:
客服(Brynjolfsson, Li & Raymond, QJE 2025):按原有技能分五组,最低的一组提升最大(+36%),技能最高的一组几乎没有提升。分布被向内压扁。
顾问(Dell’Acqua et al., Organization Science 2026):在 AI 擅长的任务上,质量从 4.4 升到 5.7(+30%);在刚好超出 AI 能力的任务上,用了 AI 的顾问表现反而更差。
“On the task that was just beyond AI, it actually decreased their performance a little bit.” 在那些刚好超出 AI 能力的任务上,他们的表现反而掉了一点。
这两张图合起来解释了曲线的形状:AI 抬地板最狠,抬天花板很轻,有些地方还会往下压。 所以「努力用上 AI」本身不再是策略,「在哪些任务上不用 AI」才是。
六、上尾部的机制:主观判断 + 责任
需要专家判断时,专家赢很多
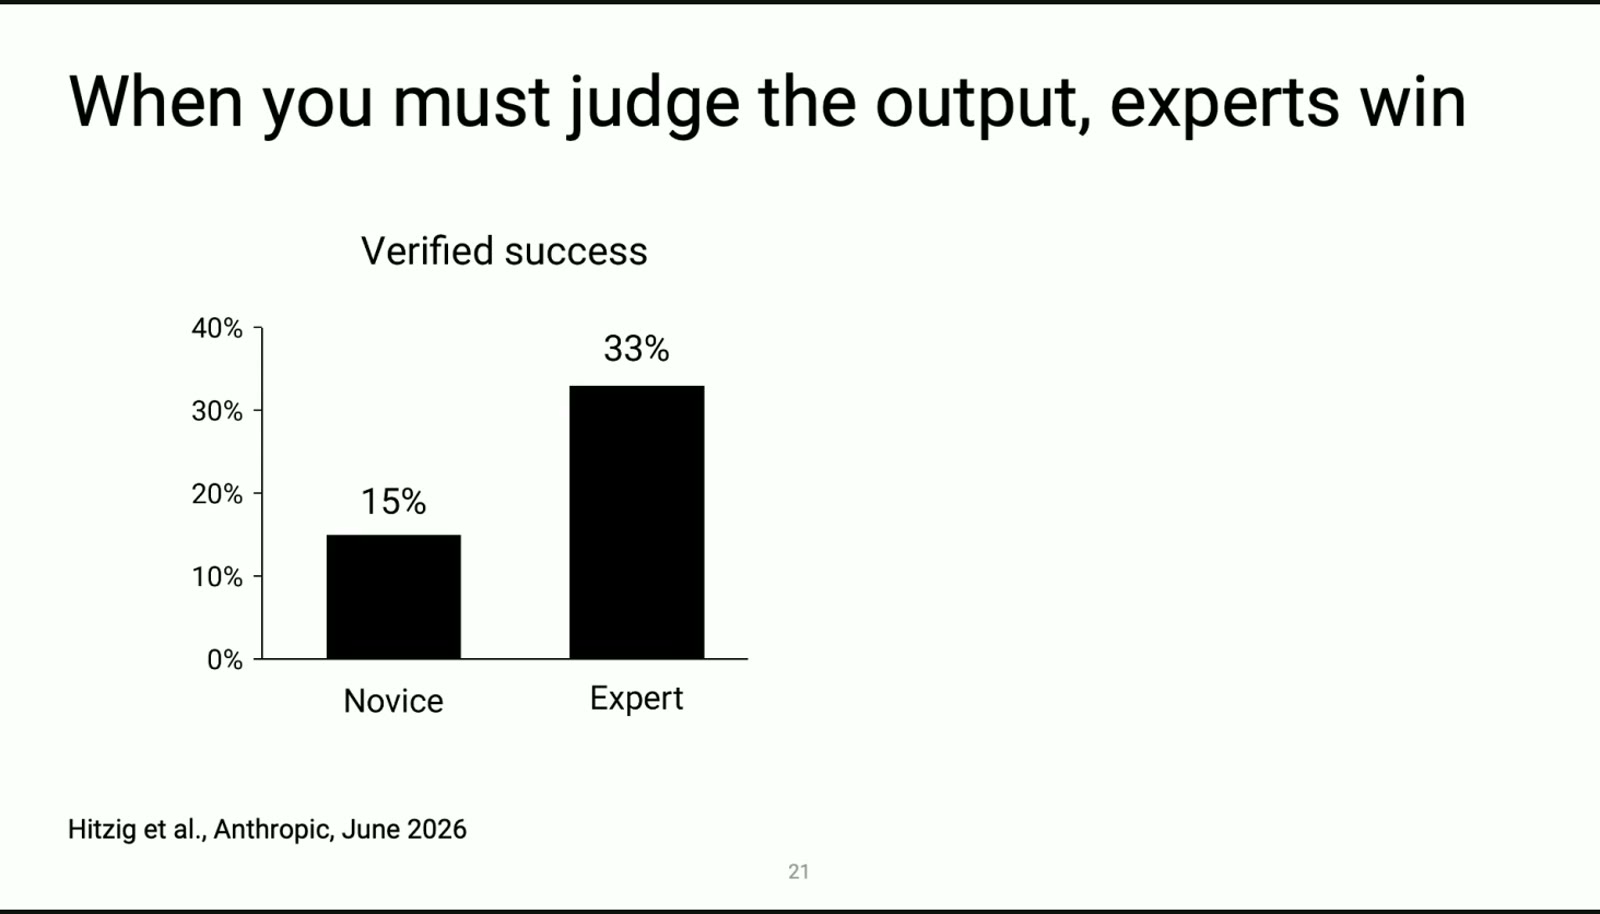
Hitzig et al.(Anthropic, 2026)的软件任务实验里,使用 AI 的专家成功率 33%,新手只有 15%;而且会话一旦卡住,新手更容易直接放弃——专家能给模型提供「整体轨迹」。
本文补:这一节也解释了他后面为什么反复说「只有你能决定什么算好」——AI 在可验证的任务上(代码能不能跑、证明能不能过检查器)已经被强化学习喂得很饱,而在「判断什么值得做、什么算好」上,它没有可靠的奖励信号。
一次 14 小时的自动研究
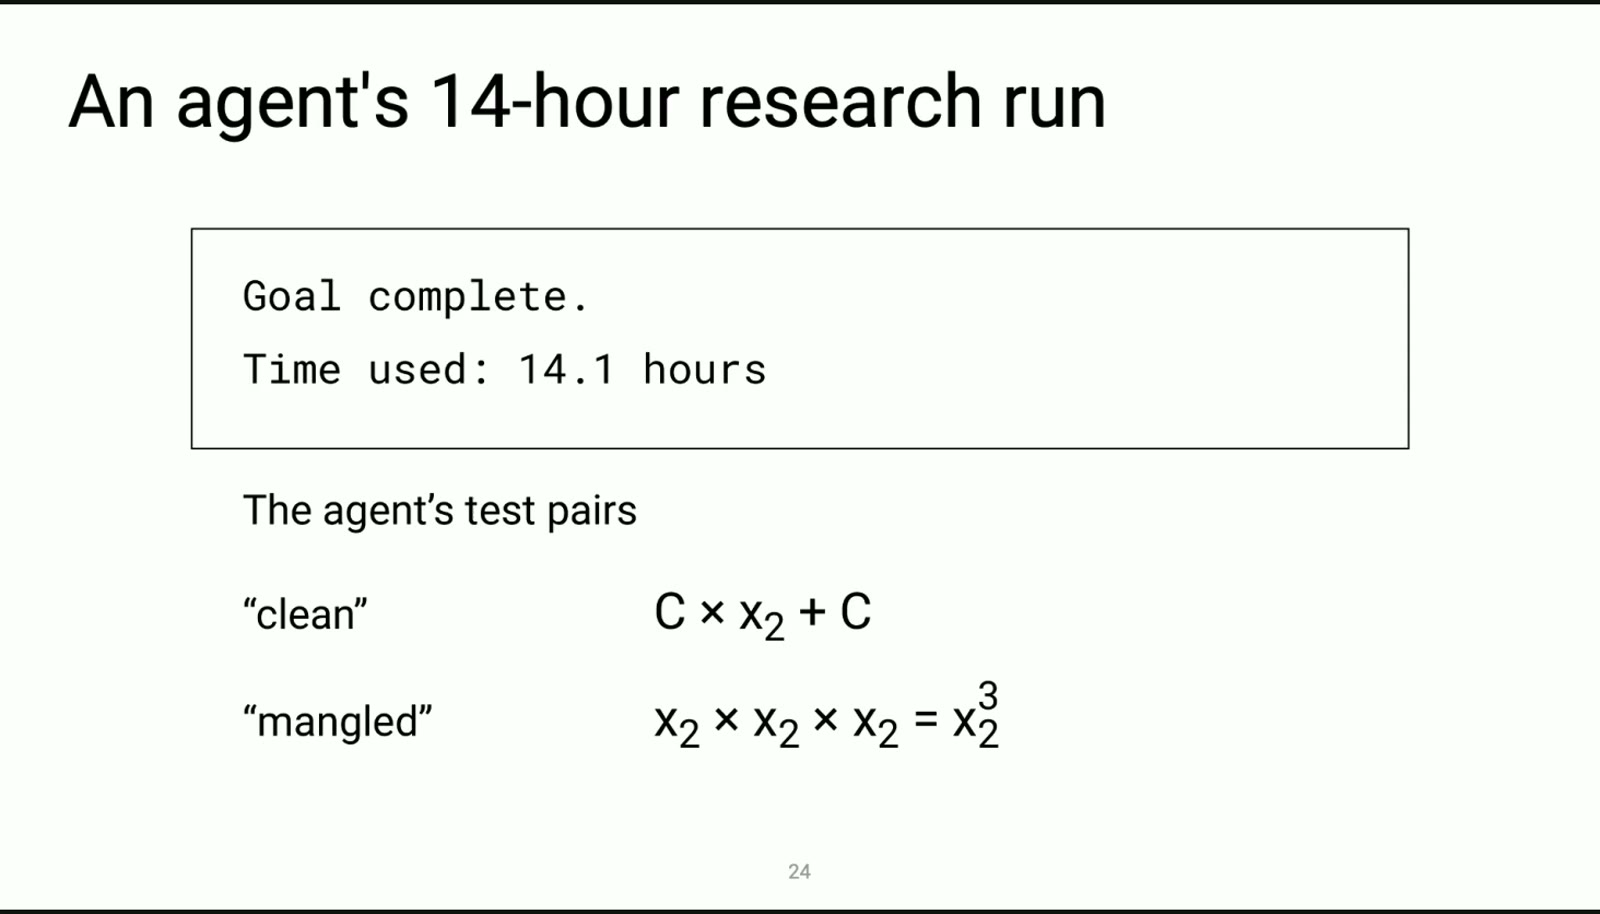
他讲了亲历的一次实验:让 agent 自主跑了 14 个小时,回来报告「Goal complete. Time used: 14.1 hours」——所有测试都过了。然后他自己去读输出:
“It’s complete garbage.” 完全是垃圾。
因为这是符号回归任务,「测试」是主观的:agent 认为「x₂ × x₂ × x₂ = x₂³」是一个漂亮的方程,而他知道那是被拆坏的式子。它写了大量 token,而且非常有信心。
AI 唯一做不到的事
他引用课程手册里的一句话,也是全场最好记的一句:
“The one thing AI can’t do is go to jail.” AI 唯一做不到的事,是去坐牢。
“You are 100% responsible for anything an AI generates. If I use an output and it contains a mistake, the mistake is now mine.” 你对 AI 生成的任何东西负 100% 的责任。如果我用了它的输出,里面有错,那错就是我的了。
于是有了这场讲座的第一条行为准则:
“Use AI to accelerate yourself, but not to replace yourself. If you use it to replace yourself, you will get replaced.” 用 AI 加速你自己,而不是替换你自己。如果你用它来替换自己,你就会被替换掉。
七、能讲清楚,就可以放心交出去
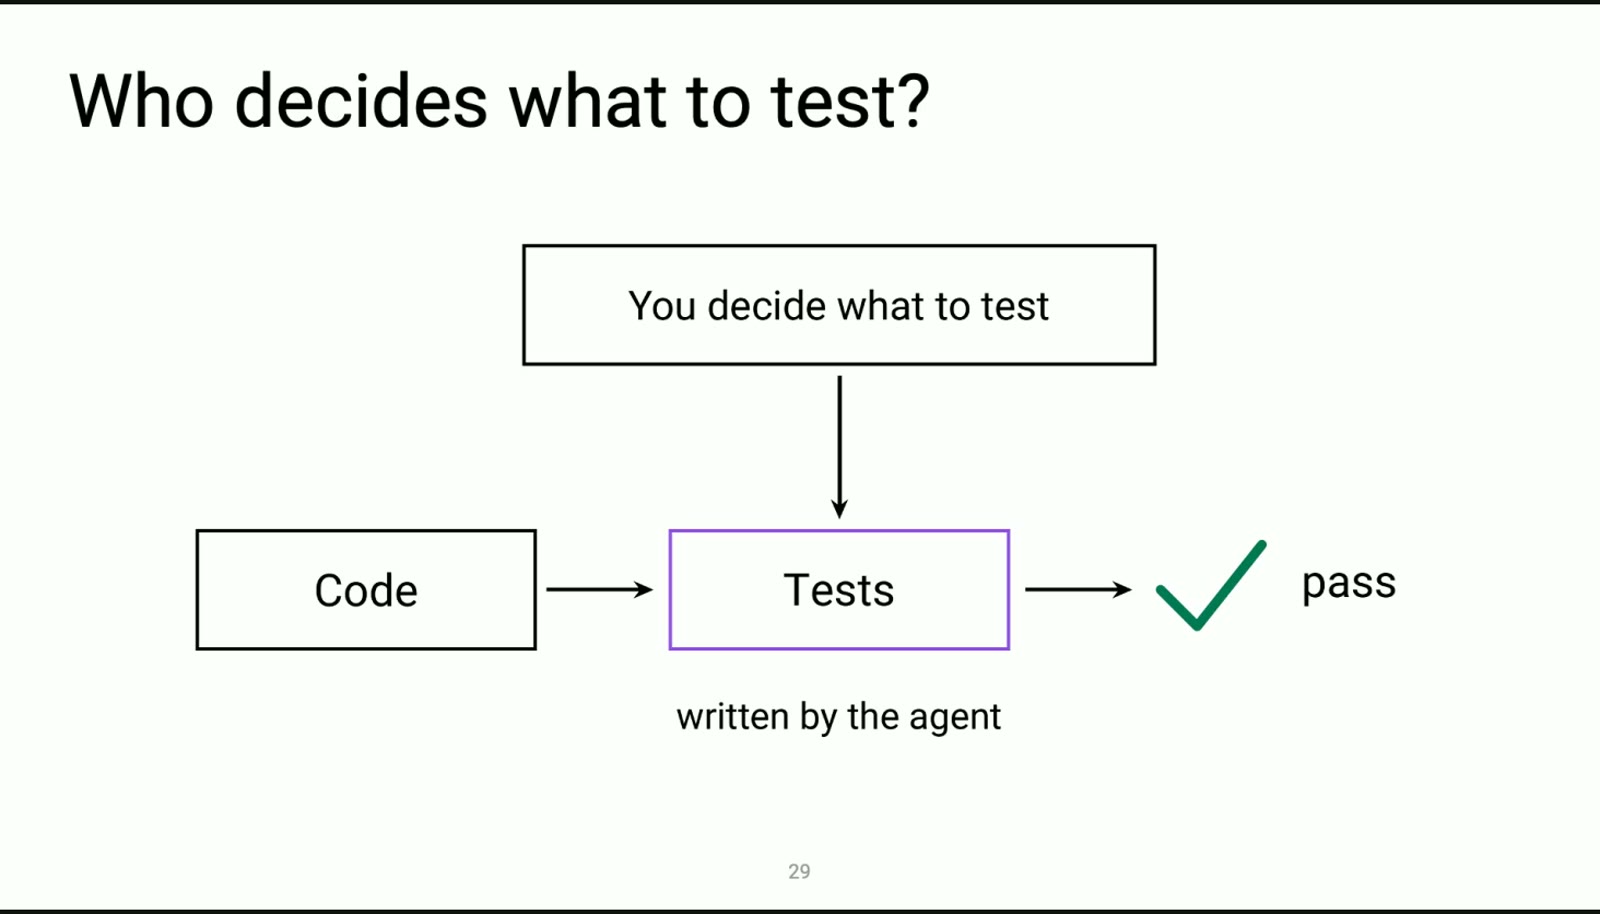
很多人会说:现在模型自己就会写测试、写集成测试,还挺在行。他的反驳不是「测试不可靠」,而是测试的选择是主观的:
“What it didn’t do is have good judgment for what tests to run, and what sub-goals to hit. Those were things I ultimately had to decide.” 它没有的是「该跑哪些测试、该达成哪些子目标」的判断力。那些最终都得我来定。
他给出的自检清单很短,就四条:
- Explain it:不用 AI,你能把它讲明白吗?
- Defend it:有人质疑,你能扛住吗?
- Find its mistakes:你能找出它错在哪吗?
- Explain it out loud:说不出来就写下来——因为 AI 特别容易让人感觉自己懂了。
“With AI, you can really stop learning without noticing.” 有了 AI,你可以在毫无察觉的情况下停止学习。
前三条能过,他的结论是:「那我就随便交给它做」——他说自己现在几乎把全部写代码都交出去了,正是因为能解释、能辩护。
八、学习会静悄悄地停止:三组实验
这一节是全场信息密度最高的部分,三组实验都指向同一个结论。
1. 土耳其的高中数学课(Bastani et al., PNAS 2025)
一千名高中生,三组:不用 AI 做题、用 ChatGPT 直接拿答案、用只给提示不给答案的 AI 家教。平时练习分数:不用 AI 28.4%,ChatGPT 42.1%,只给提示 64.5%——看起来「抄答案」很有效。
考试(不借助 AI)分数:32.1%、26.7%、31.7%。也就是说,平时分数最高的那组,考试最差;只给提示的 AI 家教组,和完全不用 AI 的组打平。
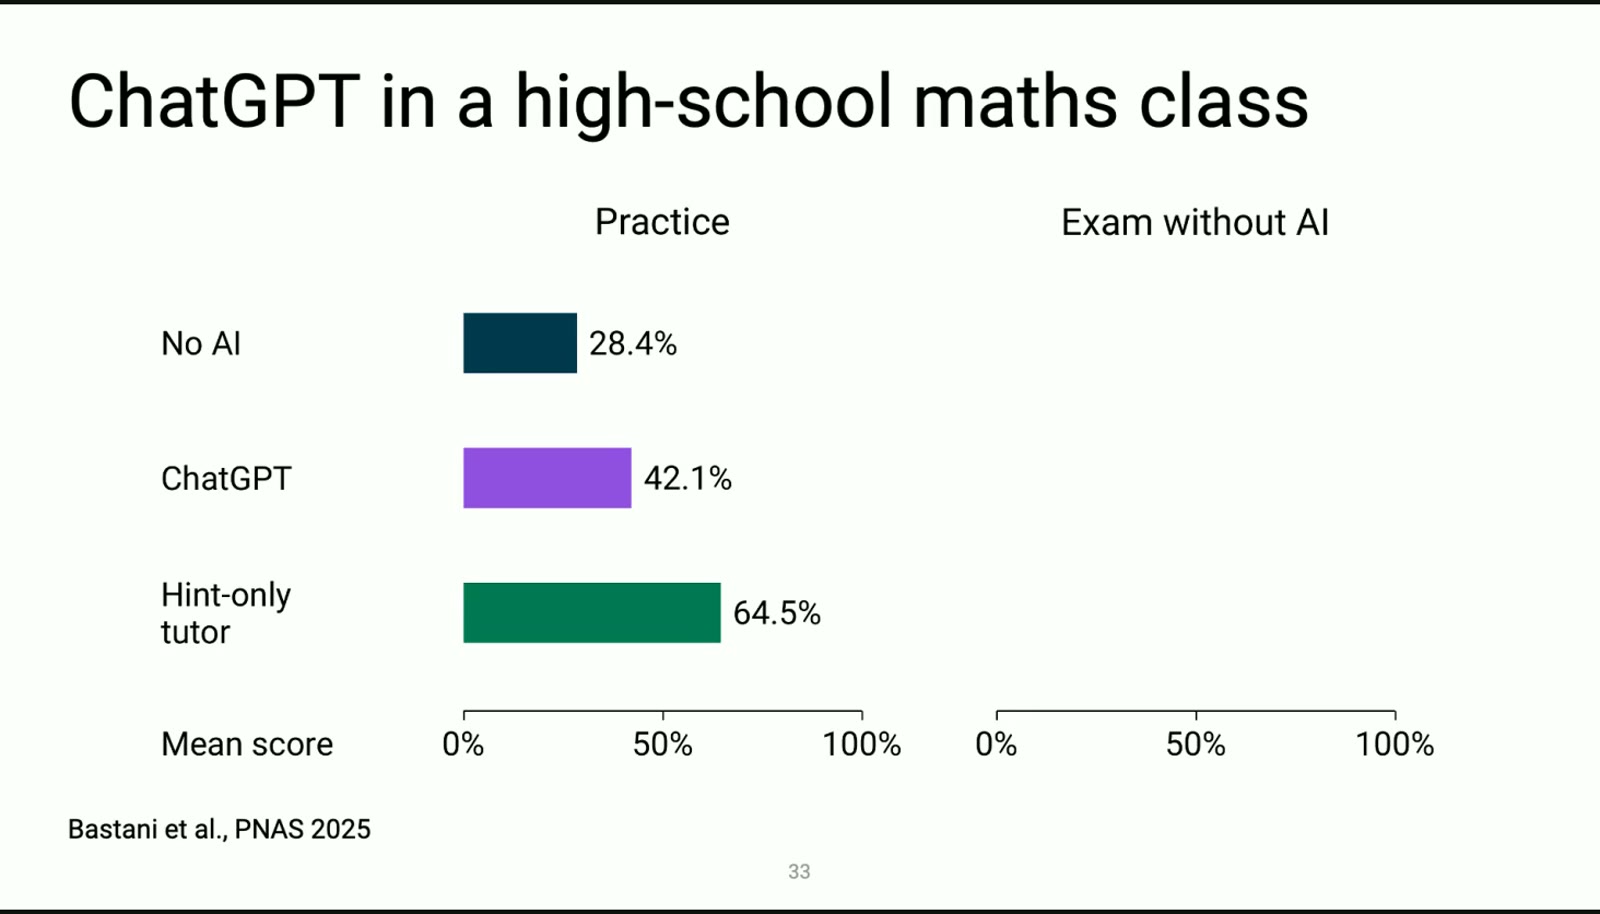
更微妙的是学生的自我感受:
“Students did not think they learned less.” 学生们并不觉得自己学得更少。
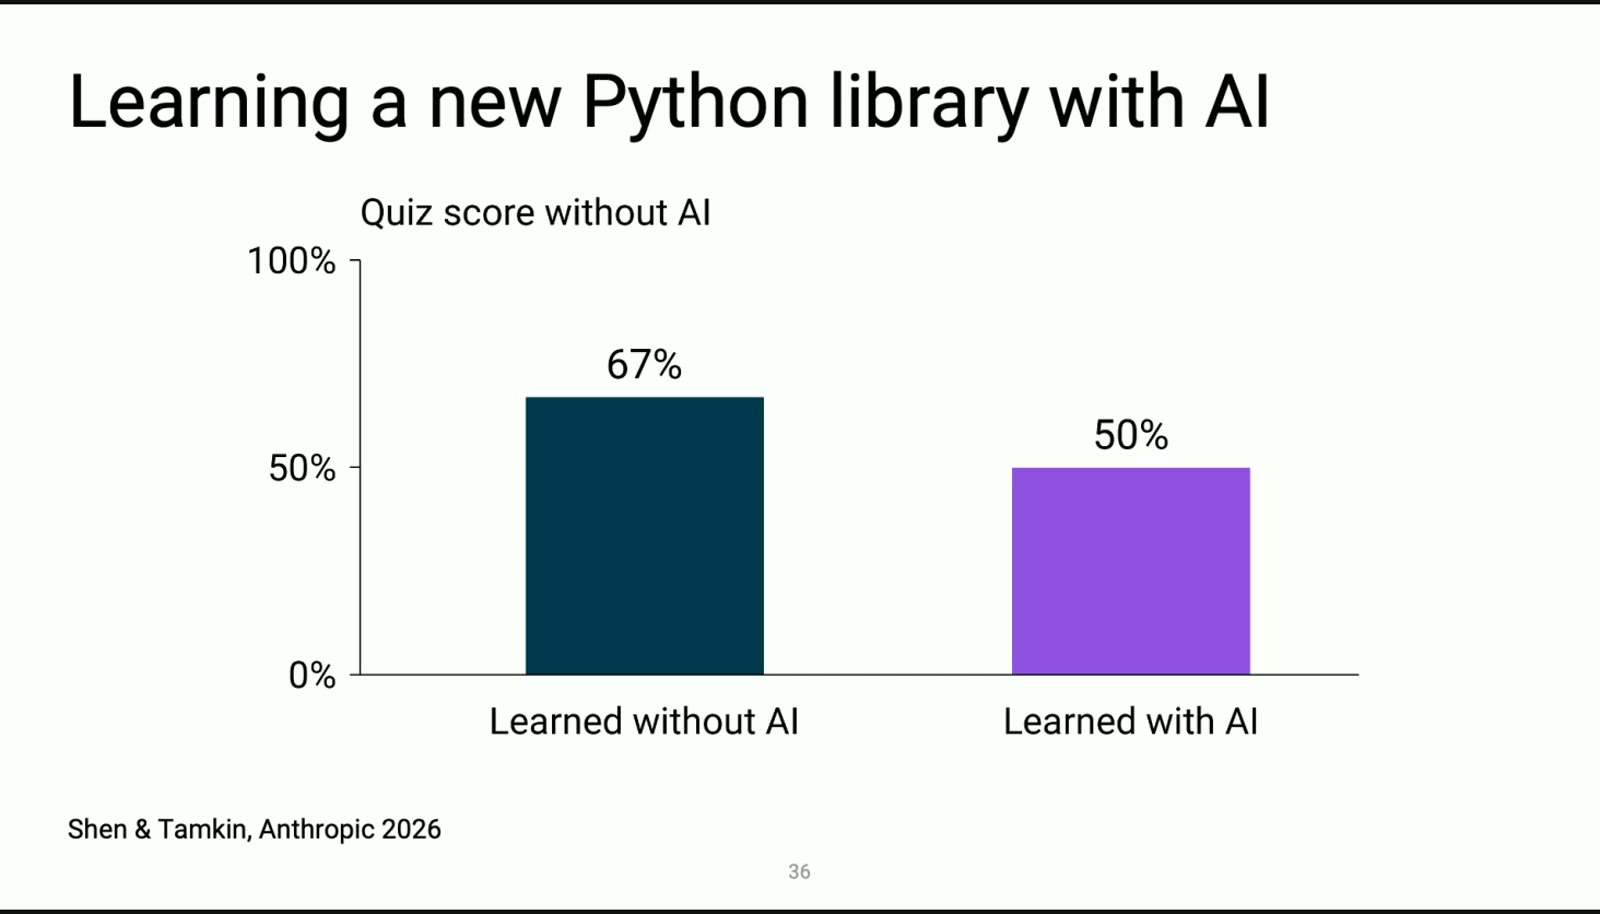
后面还有一组更进阶的材料(Shen & Tamkin, Anthropic 2026):学一个新的 Python 库(Trio),不用 AI 的那组考得更好(67% vs 50%)。
2. 要答案,还是要解释(Lehmann, Cornelius & Sting 2025)
这项研究把学生的每一次提问做了记录:每要一次答案,测试分数就往下掉(−0.31);每要一次解释,测试分数就往上走(+0.25)。
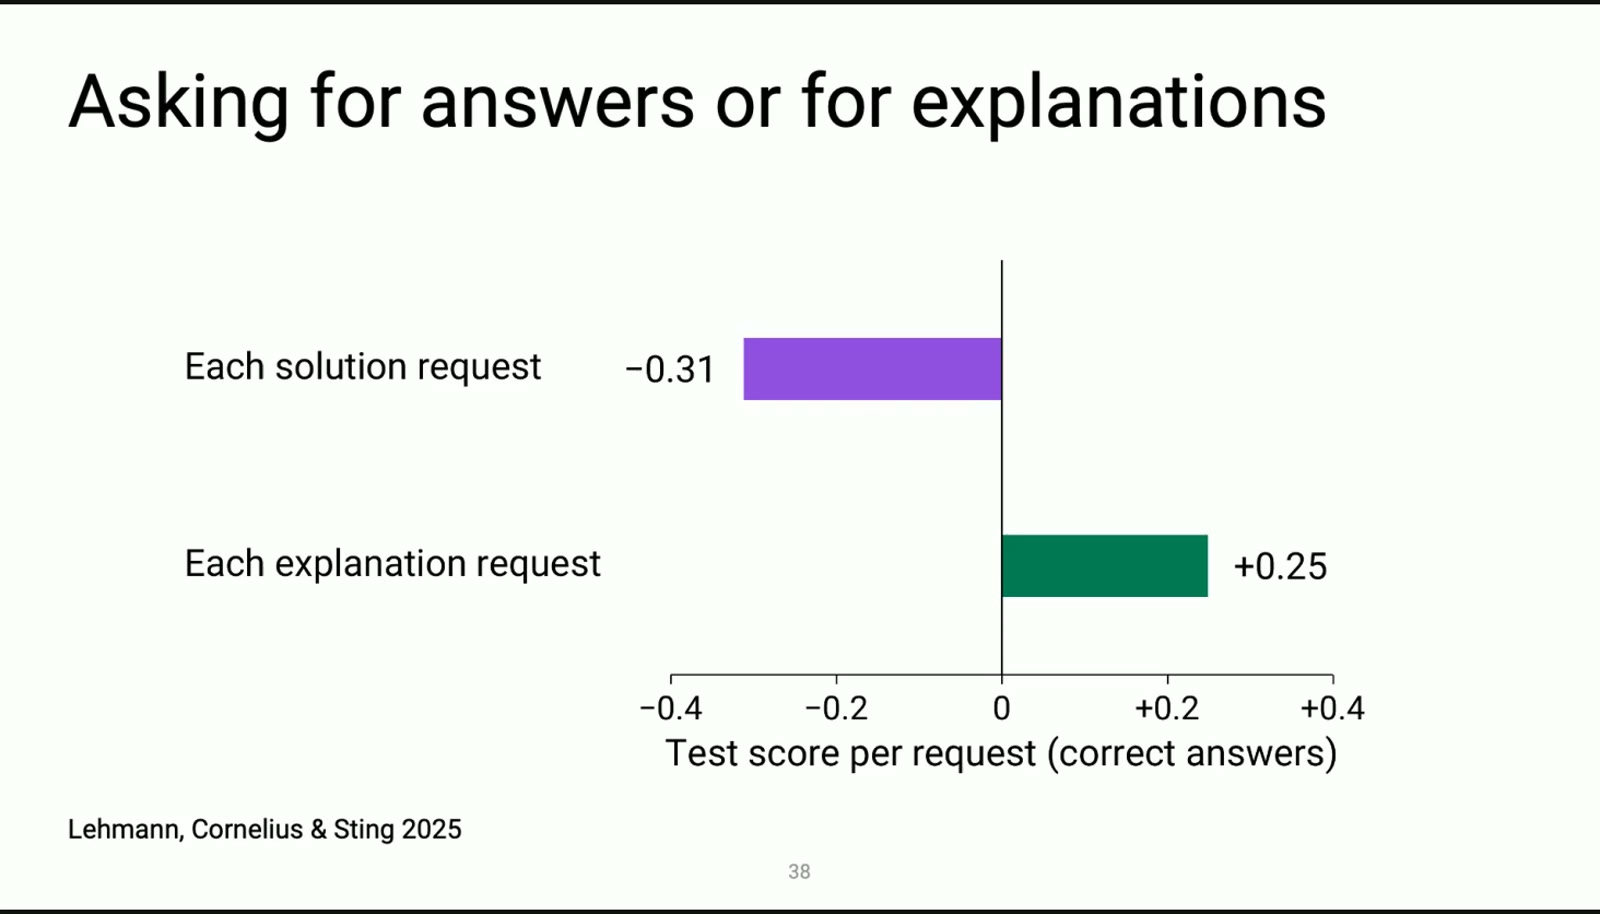
所以他的建议不是「少用 AI」,而是换一种问法:把它当向导,不要当答案机。
3. 先做题还是先听课(Deslauriers et al., PNAS 2019)
让两组学生学同一份材料:一组先自己啃题、再来听讲解;另一组直接听讲解。结果先啃题的那组感觉自己学得更差(−0.56),但实际考试成绩更高(+0.46)。
“It’s like lifting weights. If a machine lifts the weight for me, my muscles don’t get stronger.” 这就像举铁。如果机器帮我举起来,我的肌肉不会变强。
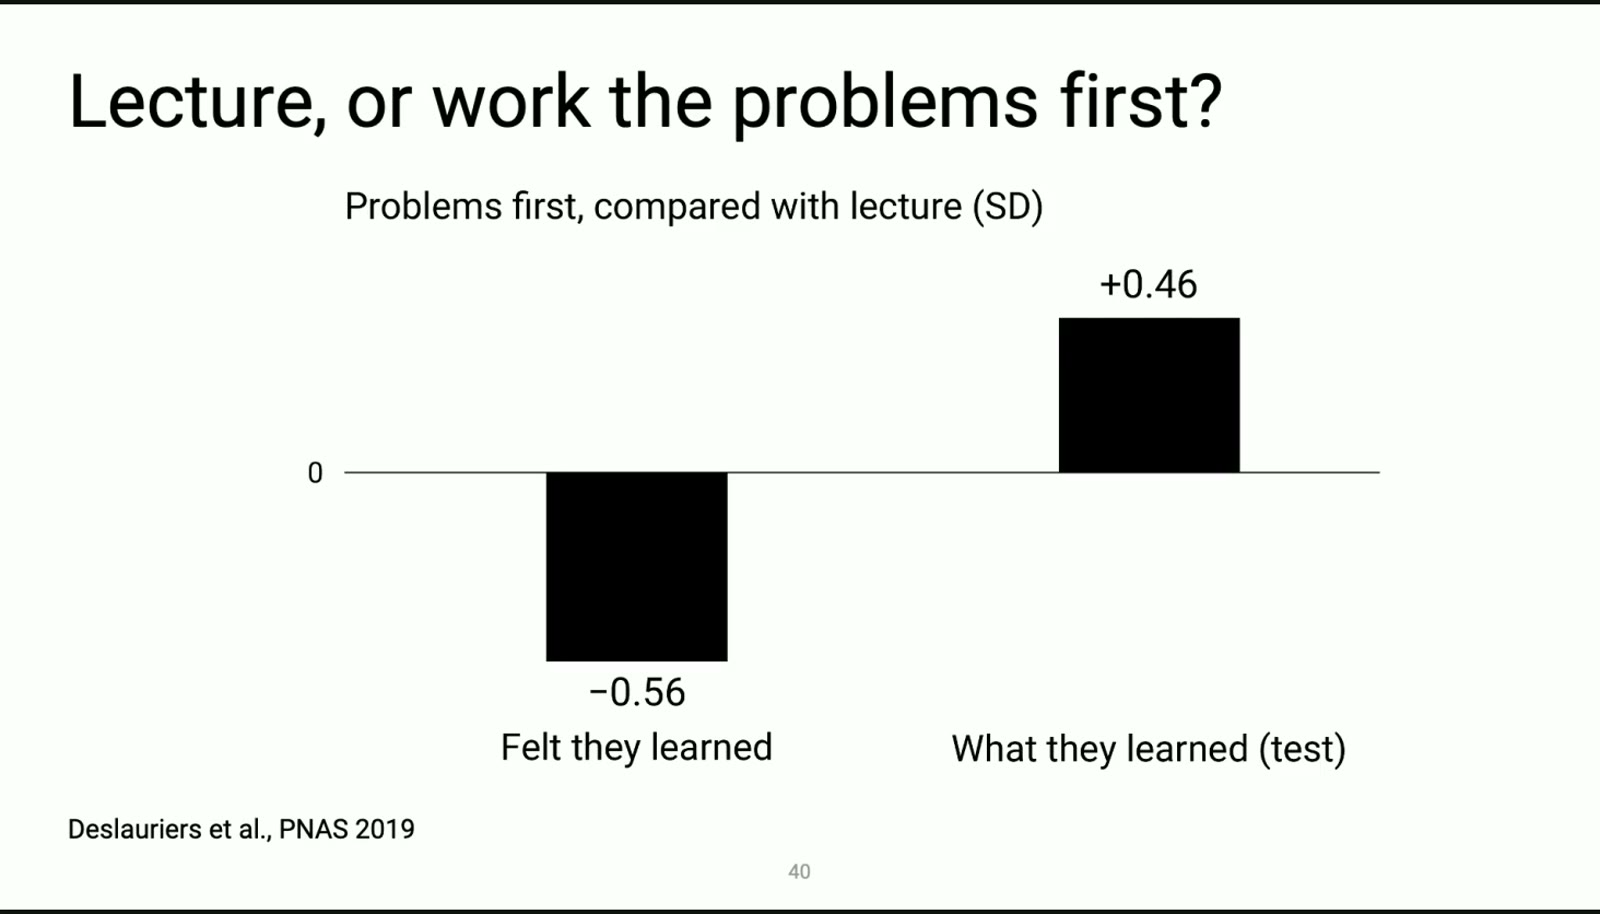
“You need to put cognitive effort to learn.” 学习需要付出认知努力。
他专门补了句:心理学家把这叫 desirable difficulties——卡住、难受、感觉没进展,正是学习发生的信号。
4. 多学四遍,还是自测三遍(Roediger & Karpicke, Psych. Science 2006)
一组把材料读 4 遍,另一组读 1 遍、自测 3 遍。5 分钟后:83% vs 71%,多读的那组赢。一周后再测,结果反过来:40% vs 61%。
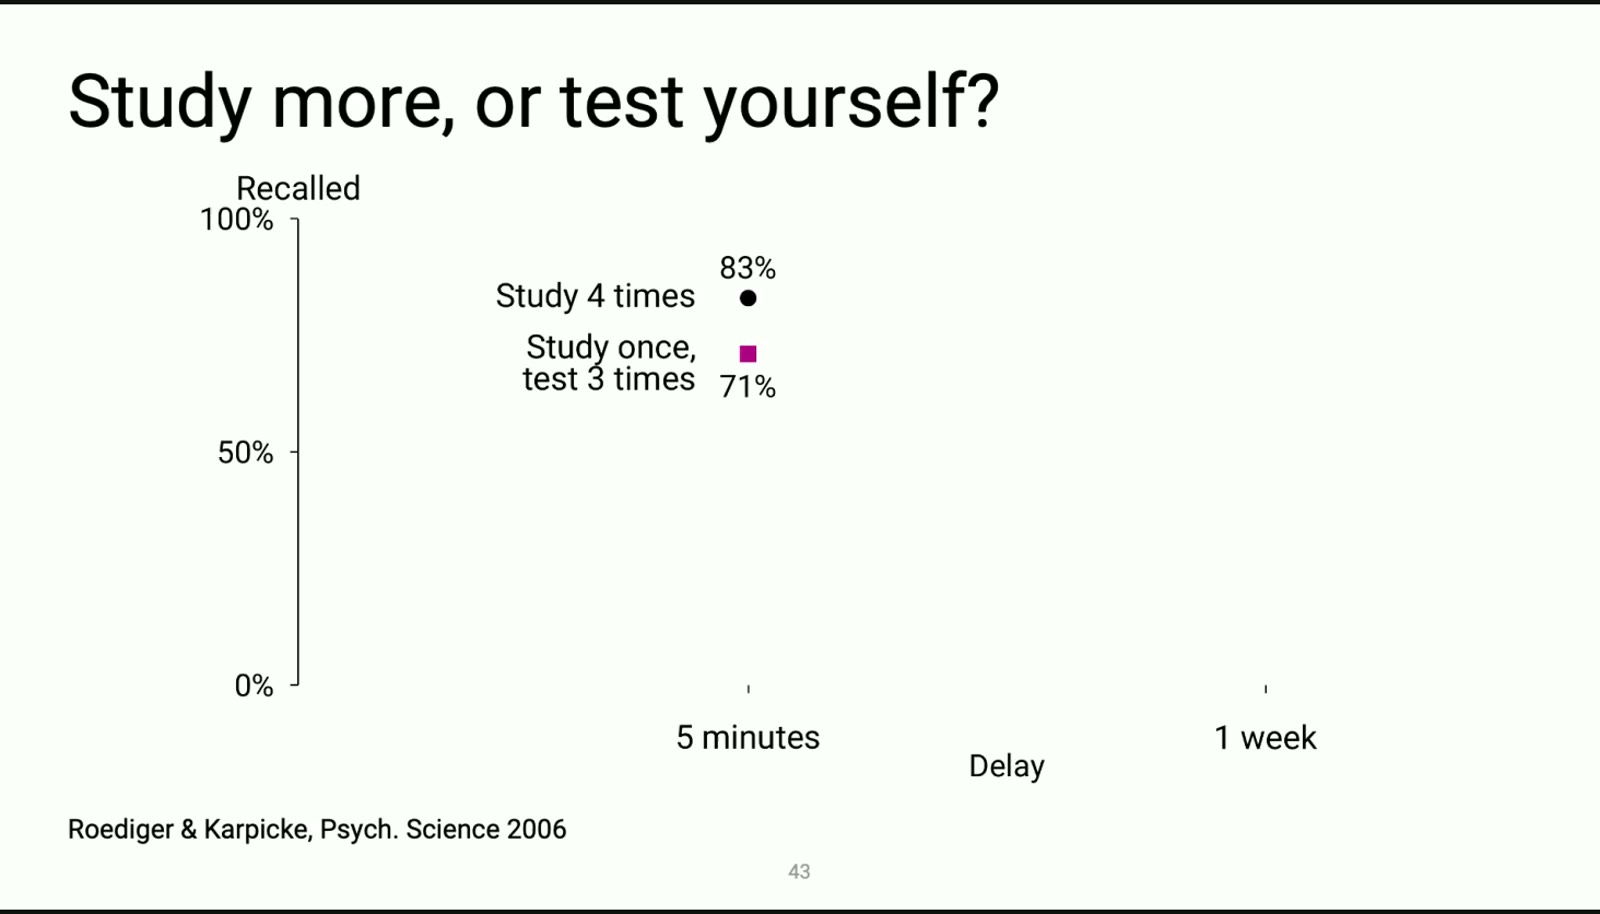
本文补:这四组实验放在一起看,poor 的结果几乎全部来自同一个动作——把「产生答案」这件事外包出去。而「产生答案」恰恰是学习真正发生的地方。用 AI 出题、给最小提示、逼你复述,本质上是把学习的摩擦保留了下来。
九、计算器没有腐蚀大脑:一张 2×2 表
他预判了「可是 AI 就是个工具,计算器也没让人变笨啊」的反驳,然后给了自己的判断框架:看这个技能是不是你要学的,以及你能不能检查输出。
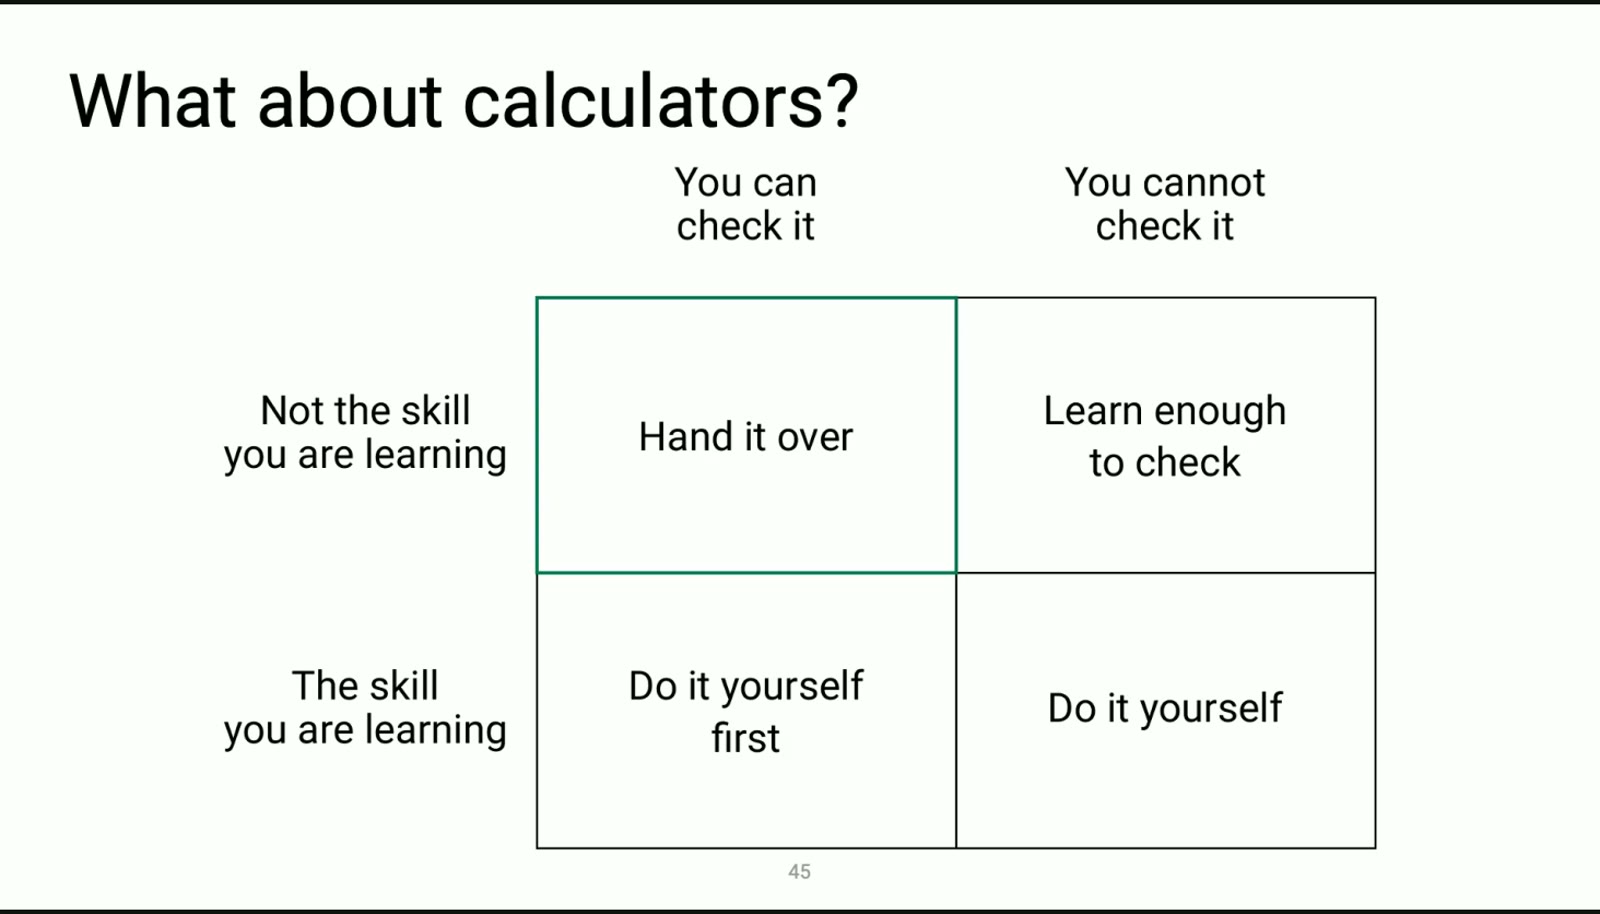
- 不是你要学的技能 + 你能检查 → 放心交出去;
- 不是你要学的技能 + 你检查不了 → 先学到能检查为止;
- 是你要学的技能 → 至少自己先做一遍,最好自己做。
十、把 AI 当考官,而不是当枪手
只给最小提示的 AI 家教(Kestin et al., Scientific Reports 2025)
他们把 AI 提示词写死成「绝不直接给答案,只给提示」,结果相对常规主动学习课堂有 +0.63 个标准差的提升——这是全场效果量最大的一个教学实验。
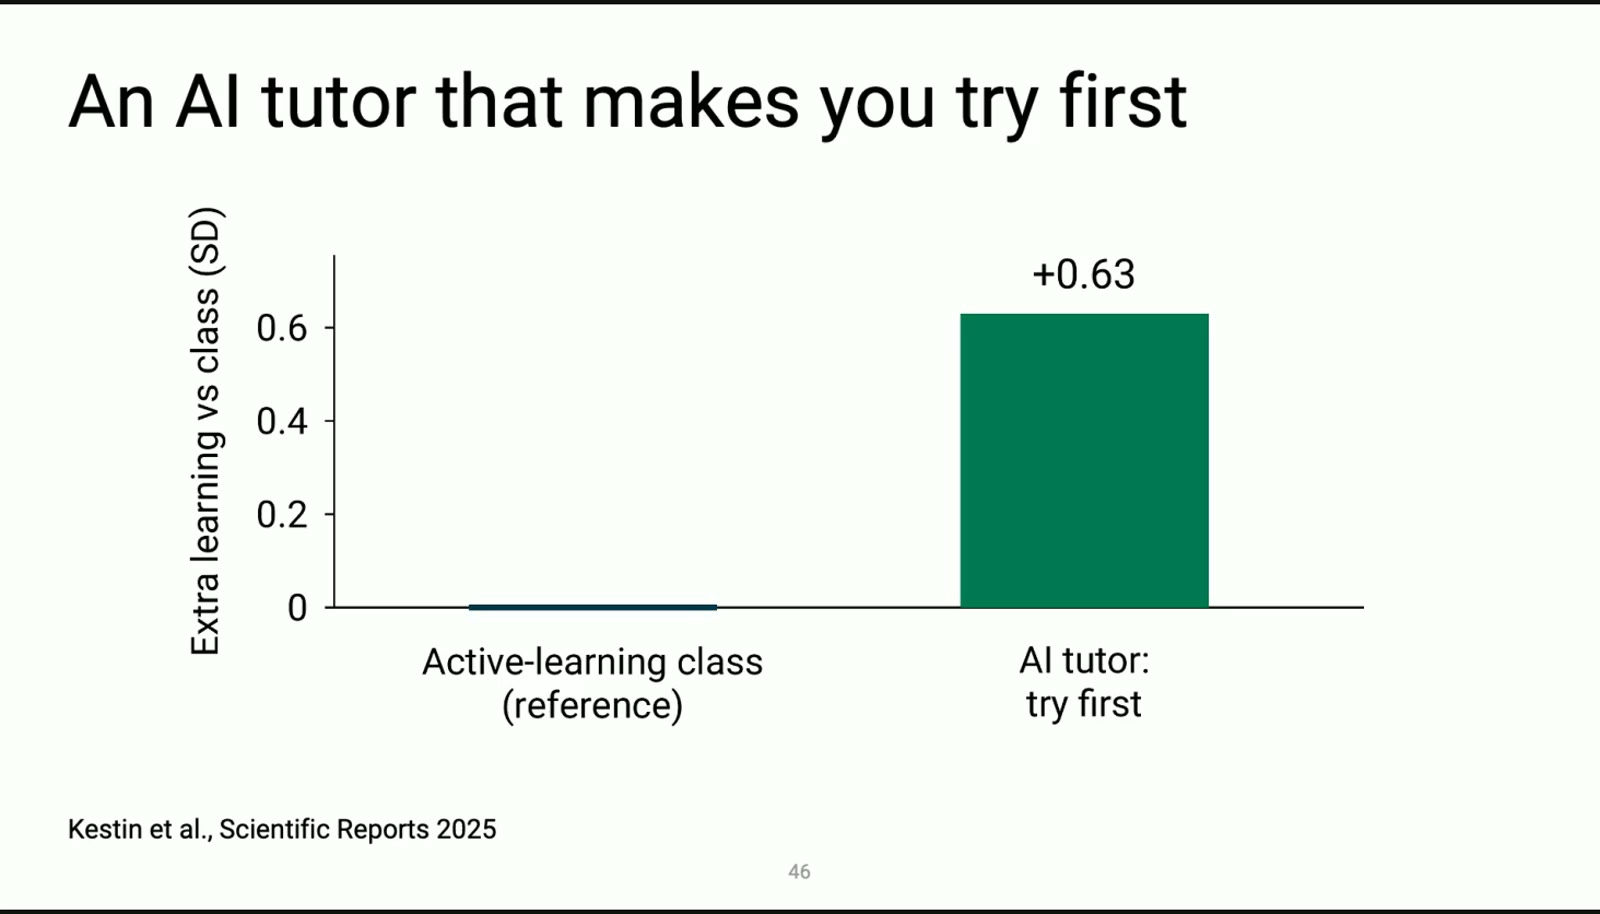
他把这个循环画成了一张图,也是他个人最推荐的用法:
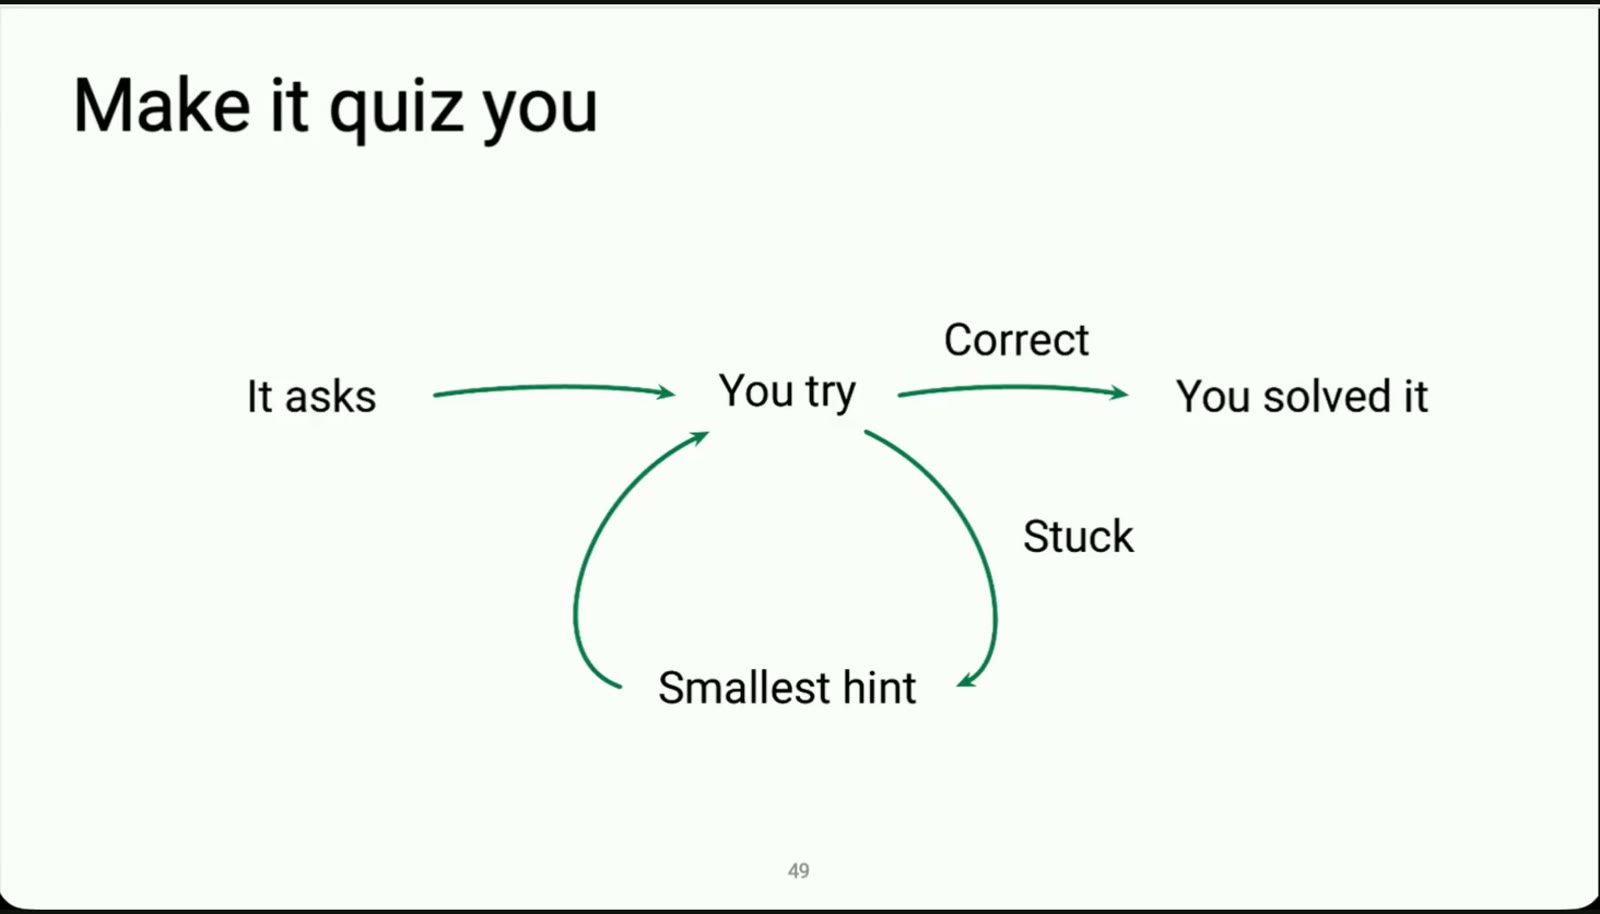
“The feeling of being stuck is really important for learning.” 「卡住」这种感觉,对学习非常重要。
现场演示一:一句「别告诉我答案」
他现场演示了自己学一个新主题的做法——直接学(Socratic 式)而不是「让 AI 讲」。提示词大意是:
我想搞懂似然和 L2 正则化的关系,但先验一出现我就卡住了。不要告诉我答案。 一次只问一个问题,只在我说卡住的时候给我提示。
然后 Claude 一步步问:「你在做 MAP 估计时最大化的是什么?」「对数先验是什么?」当他答错符号时,给一个最小提示,最后他自己把结论复述了一遍。
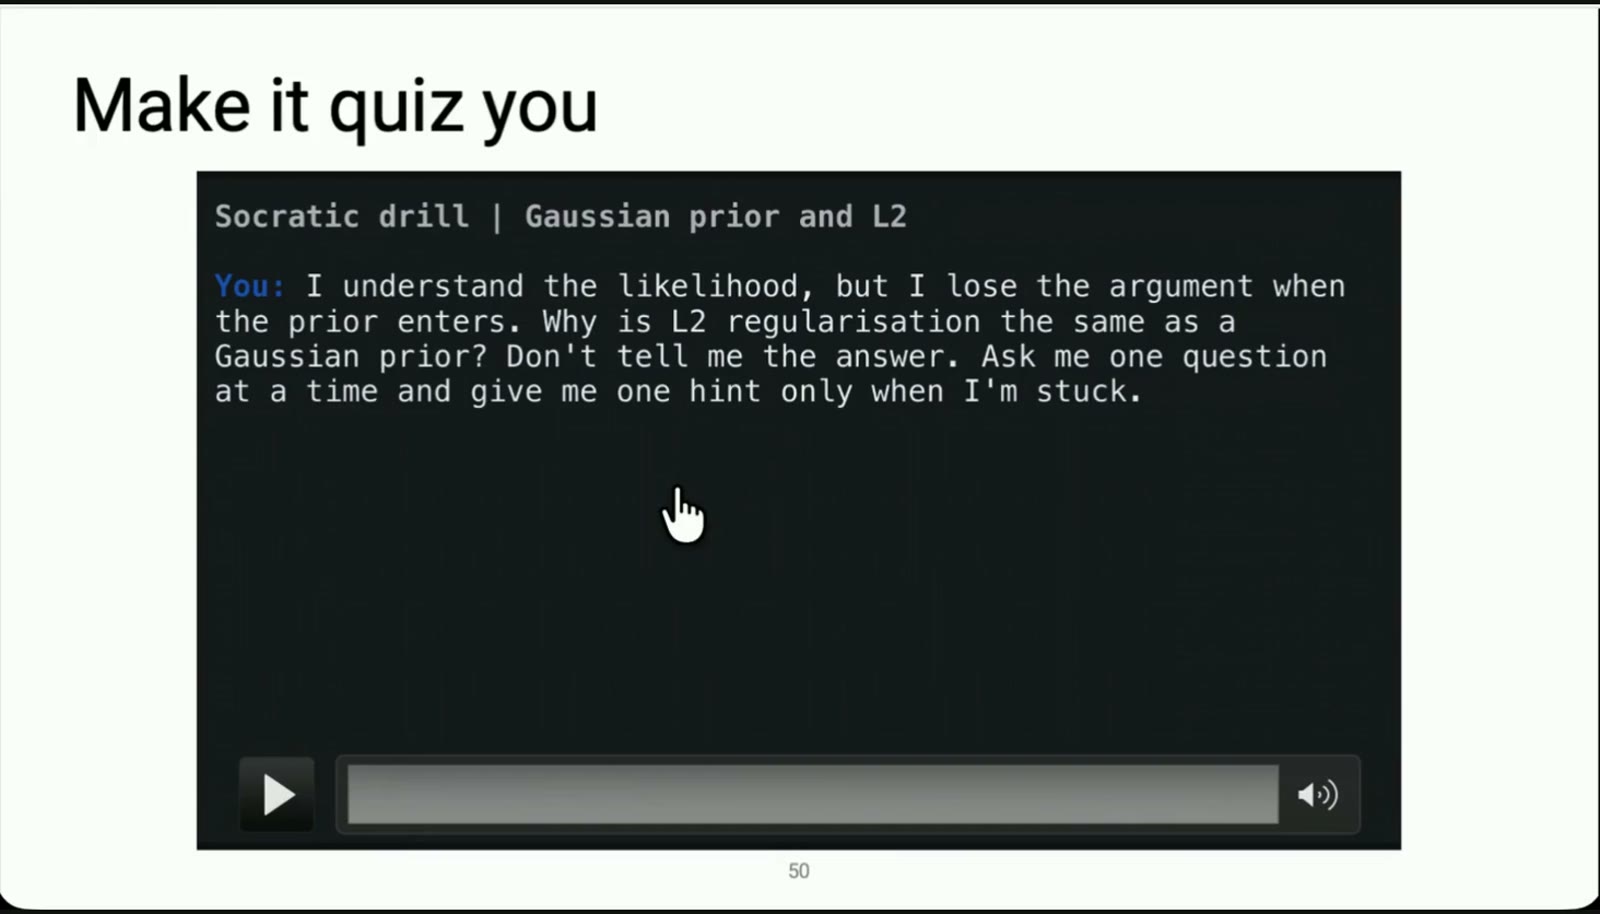
“It’s a much better way to use AI than just asking for the solutions.” 这比直接要答案好太多了。
现场演示二:让它搭一个你能动手玩的东西
第二个技巧更偏工程:让它写一个能交互的 demo,而不是一篇解释。 他演示的是「学习率为什么重要」——让 Claude 生成一个单文件网页,可以拖动学习率,看梯度下降的轨迹在收敛和震荡之间切换。
“I don’t get why the learning rate matters in gradient descent. Can you build a single file web page to help me visualize it?” 我不理解为什么梯度下降里学习率重要。能不能给我搭一个单文件网页,帮我把它可视化?
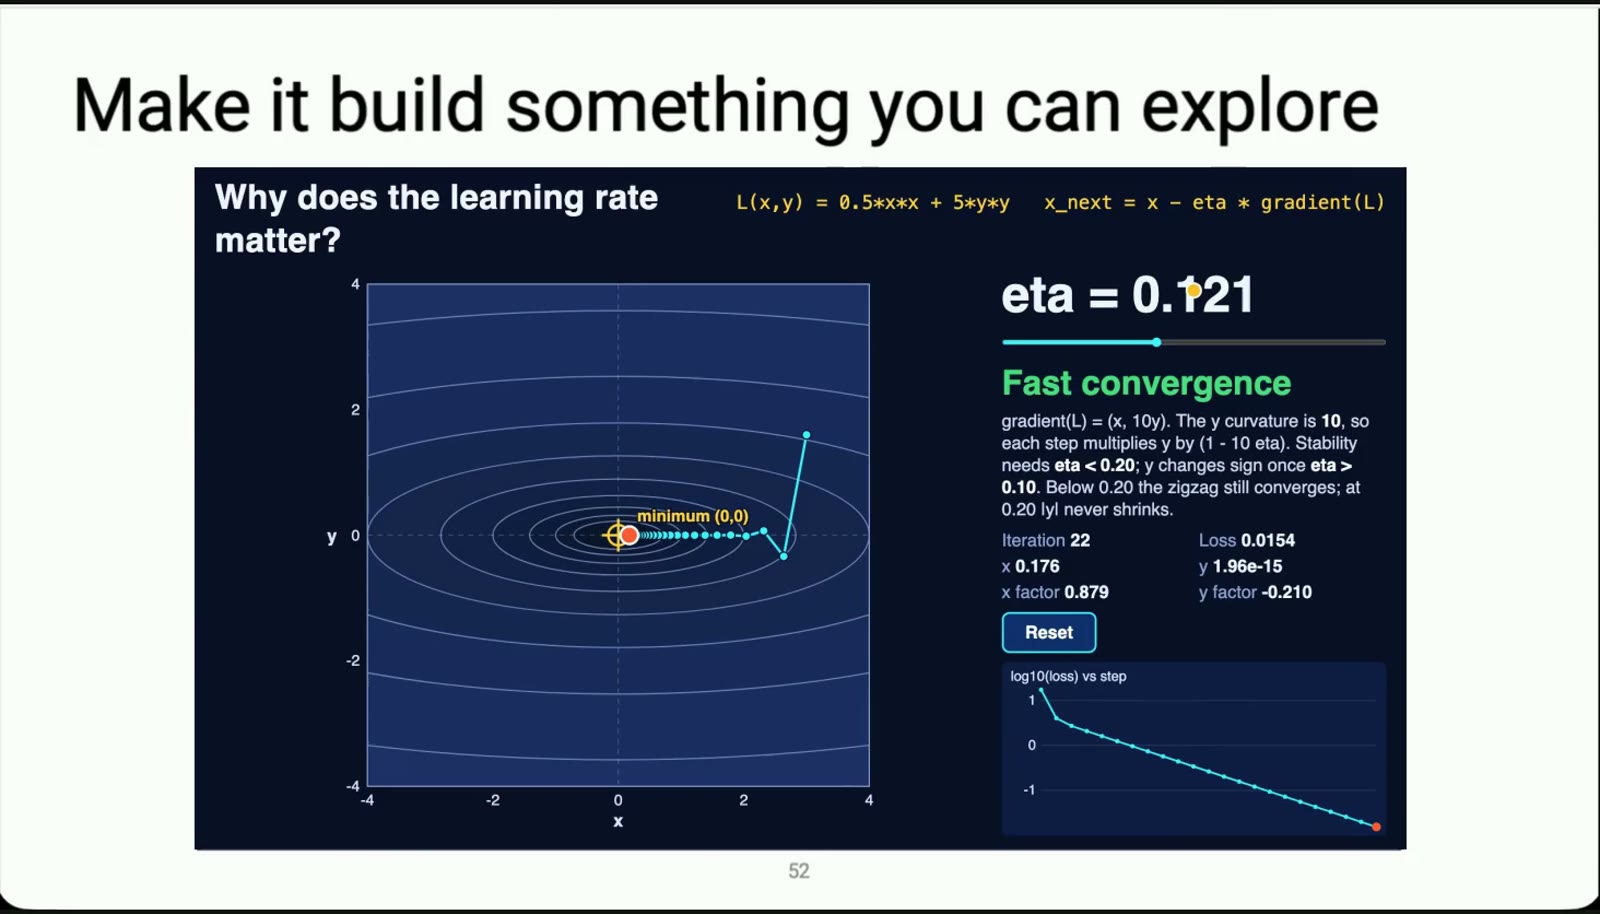
他也提醒:这些 demo 有时候就是错的,它只是工具箱里的一件,不是答案本身。
现场演示三:让它画图,别写小作文
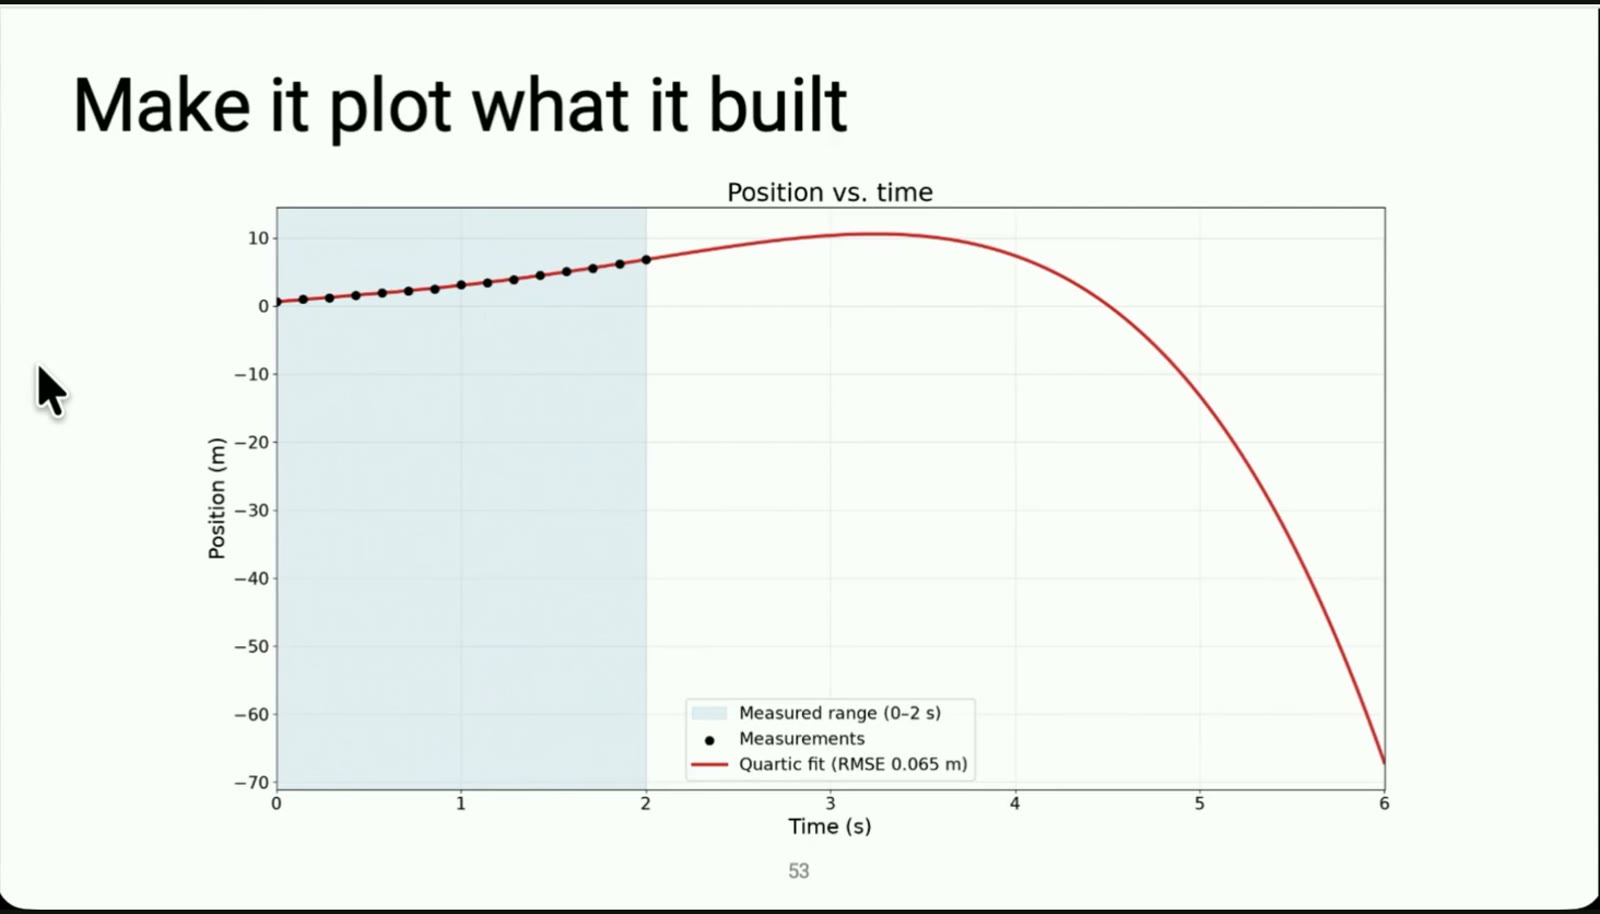
他的原话很直白:模型很喜欢写长篇解释,但人吸收图像信息比读文字快得多。所以他会直接要求:
“Pretend you’re my student and you’re bringing a plot to a meeting. I’m going to ask you about this plot.” 假装你是我的学生,拿着图来开会,而我会就这张图问你问题。
演示里,模型声称拟合出一条漂亮的曲线;一画图,才发现拟合的线直接「穿到地板底下」去了——模型说没问题,图上一眼就能看出有问题。
十一、给 agent 立规矩:三条
他说自己跑编码 agent 时,最常见的失败不是不会写,而是**「用聪明的方式解决错的问题」**:到处套 try/except、写过长的方案,因为「测试能过就行」。
所以他会把规矩写进 AGENTS.md,让 agent 每次开工前都读一遍:
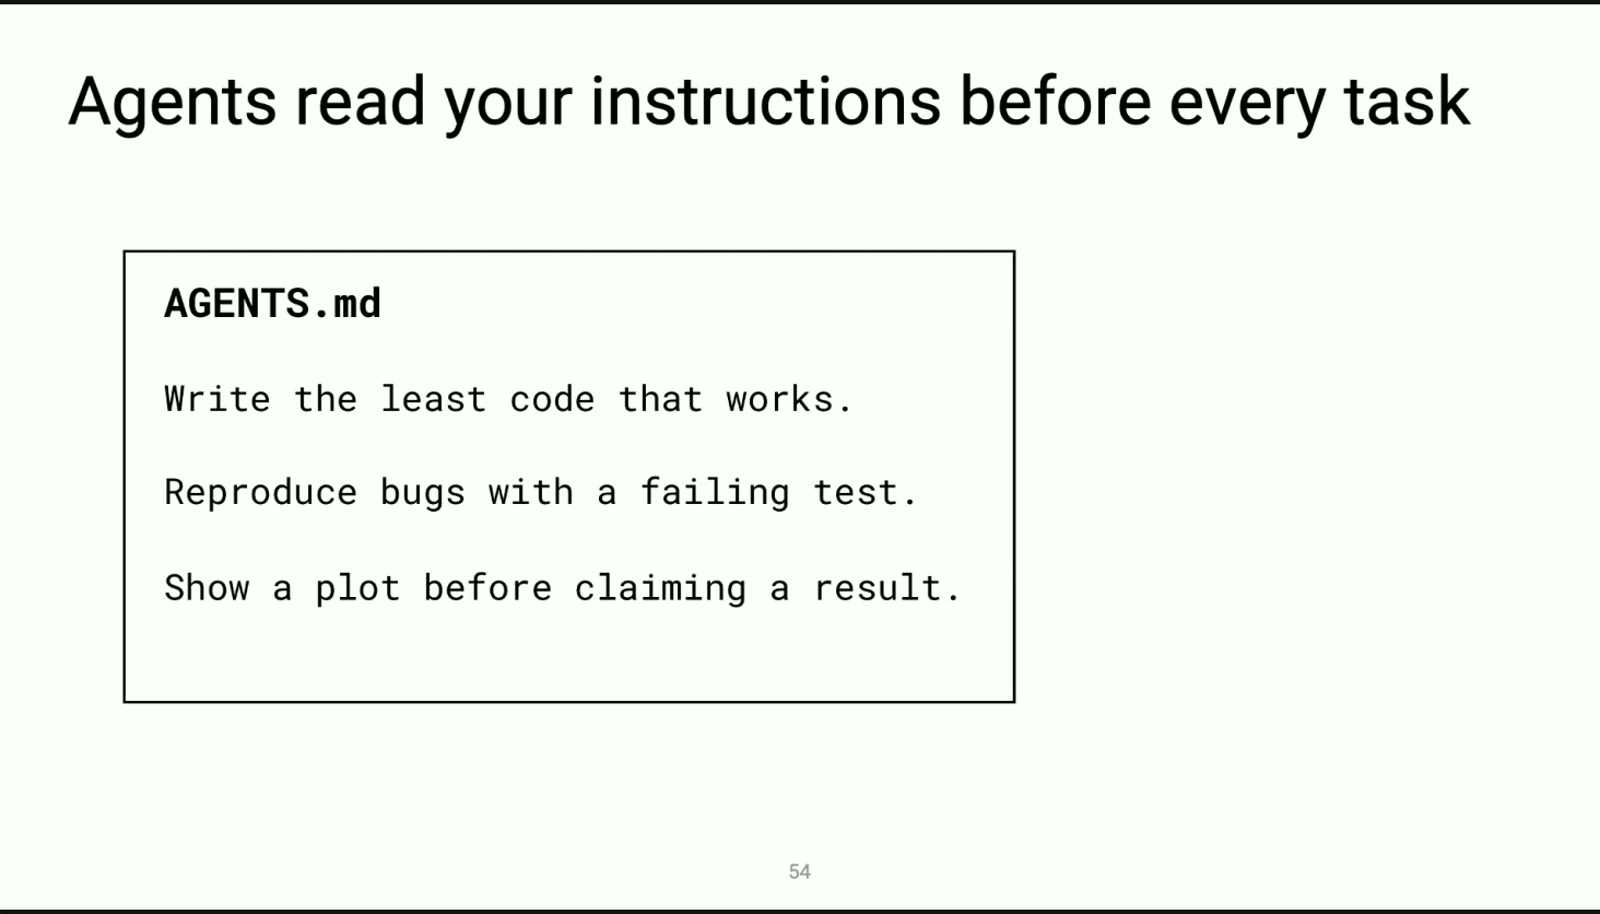
- 写能工作的最少代码。 在一小块代码上花大量精力。
- 先用失败的测试复现 bug。 先搞清楚病,再治症状。
- 在宣布结果之前,先给图。
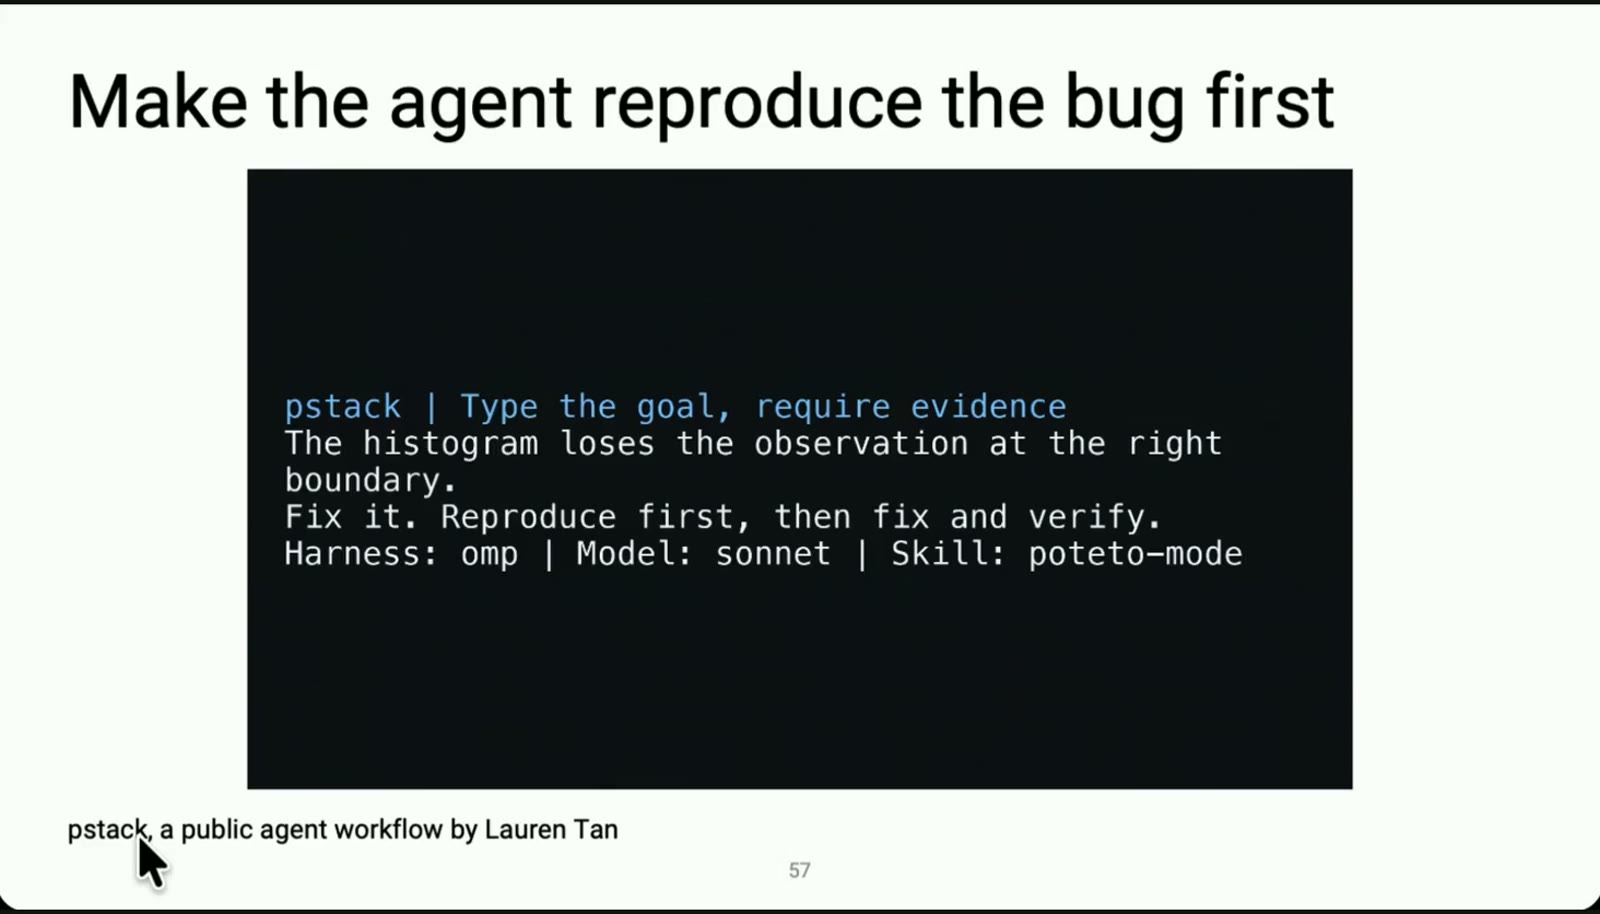
他顺手推荐了两份公开的 agent 指令文件(幻灯片脚注标了作者):ponytail(一份公开的 instruction file)和 pxstack(一份公开的 agentic workflow)。本文补:这类文件的共同点是它们不教 agent 怎么写代码,而是压缩掉模型天生的「表演欲」——少写、先验证、先看图。
十二、写好你自己的标准,然后骑上浪头
“The good part about writing these global system instructions is that it lets you define what good work is.” 写这些全局指令真正的好处是:它逼你把「什么叫好」定义出来。
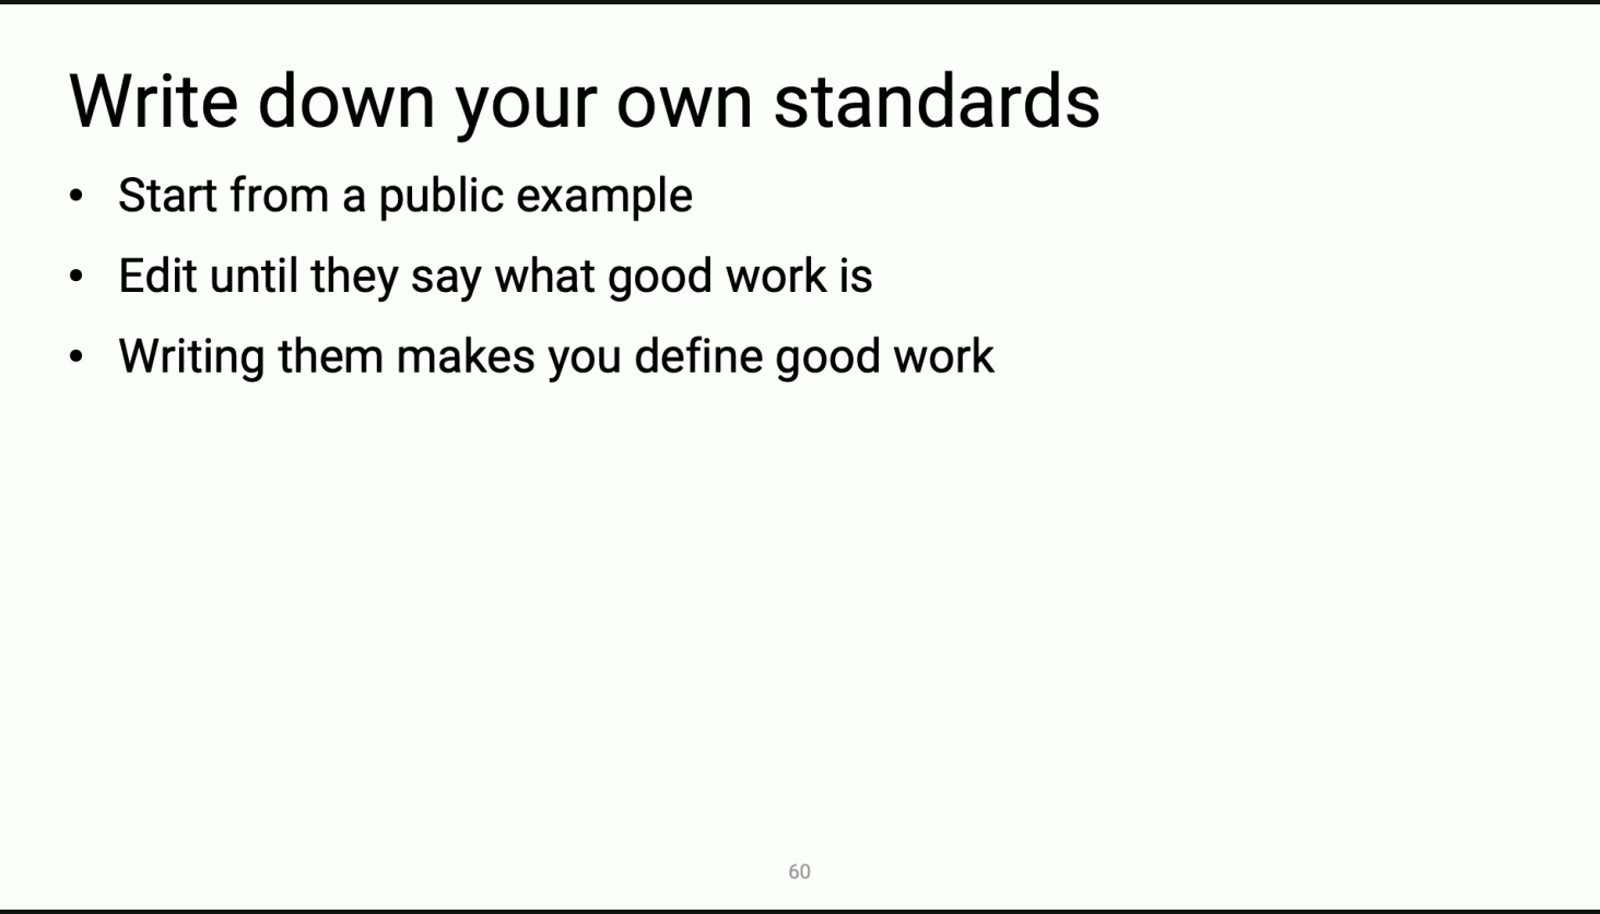
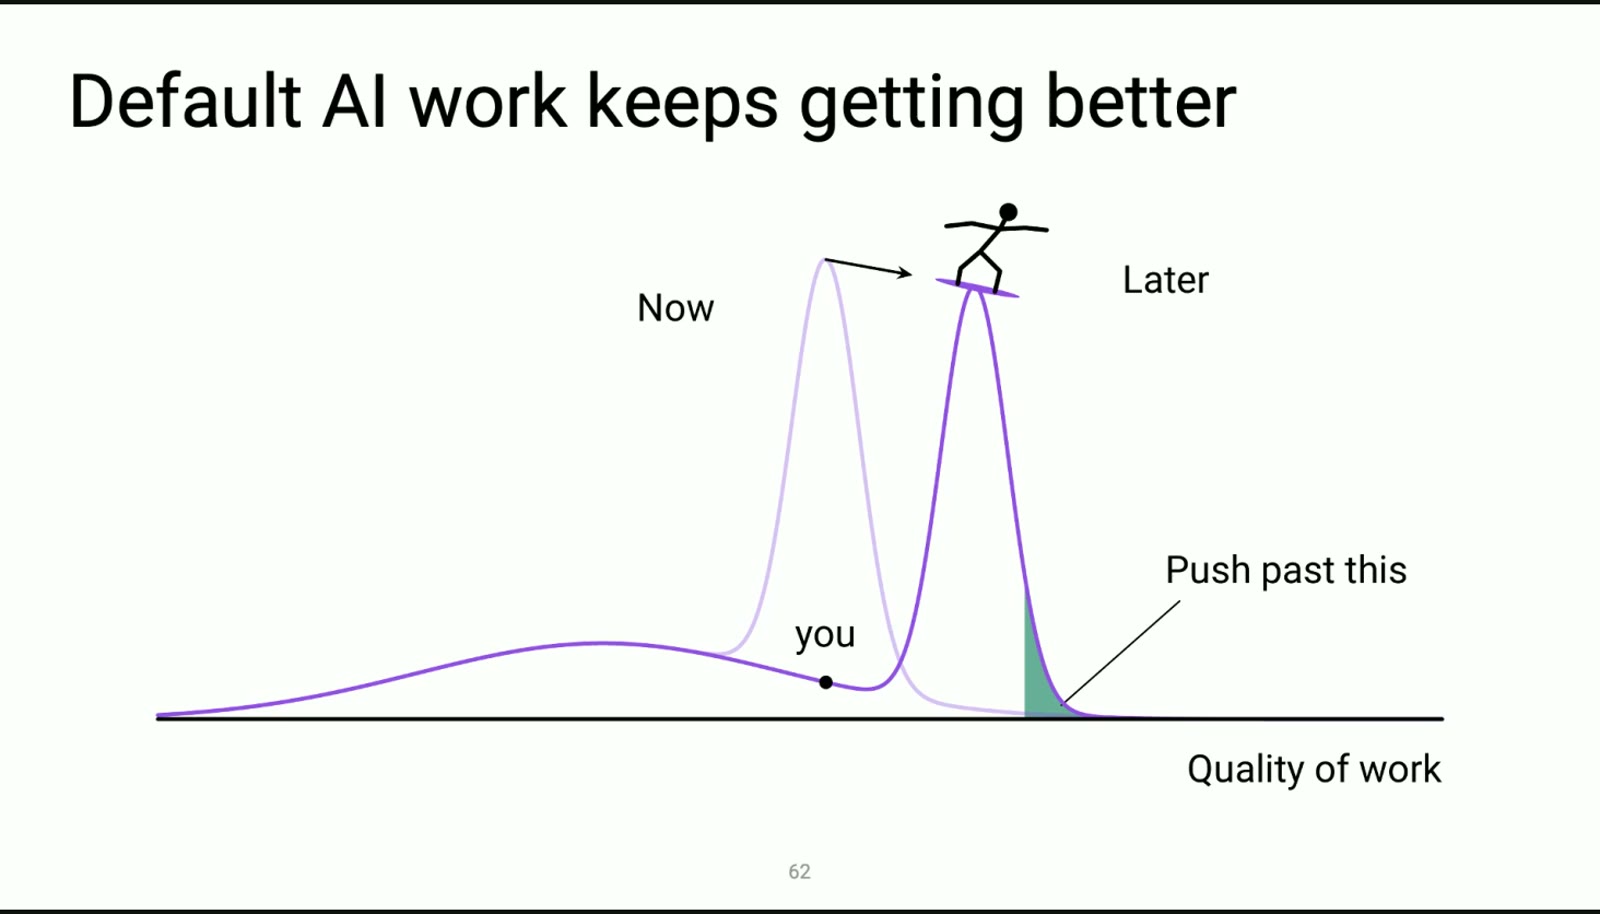
接下来是他整场讲座里最乐观、也最容易被忽略的一段:默认的 AI 产出还会继续变好,整条曲线还会继续往前推。
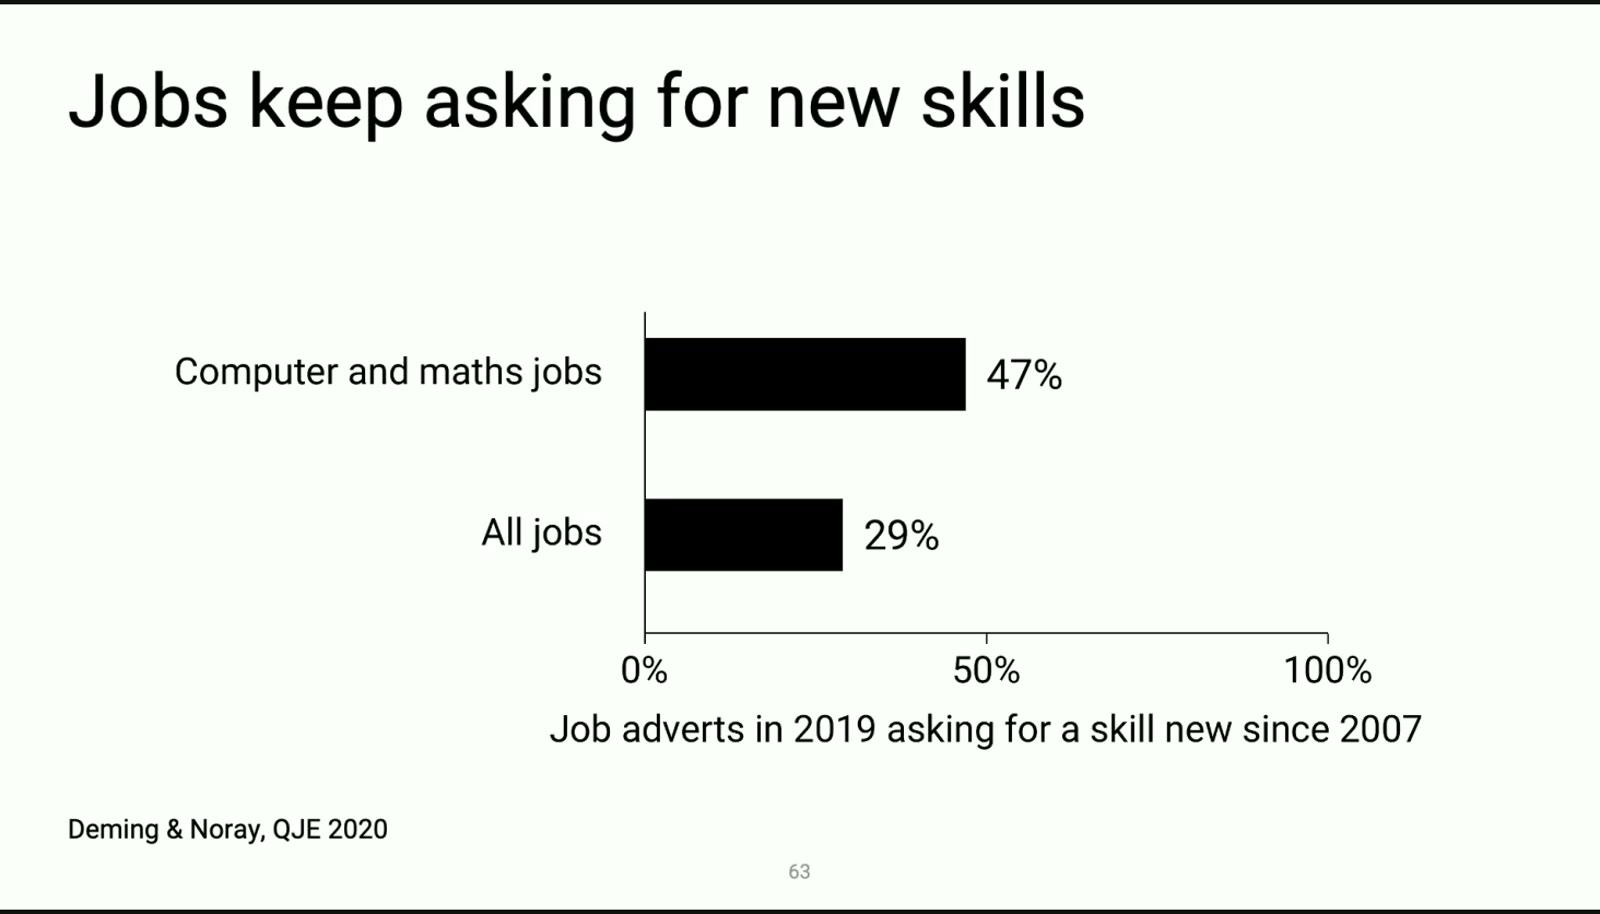
这种持续的技术压力,在就业市场上已经有痕迹:Deming & Noray(QJE 2020)统计美国招聘广告,计算机与数学类岗位中,47% 的技能要求是 2007 年以后才出现的新技能(所有岗位平均 29%)。
于是有了那句最实用的话:
“It’s better nowadays to be 50% comfortable with the newest tool than to be 90% comfortable with a tool from two years ago.” 现在,对最新工具只有 50% 的熟练度,好过对两年前的工具 90% 的熟练度。
他还把这件事说成读 MPhil 的隐藏收益:「这门课教的不只是知识,它教你学习」——快速学东西、哪怕之后再也用不上,这个过程本身是可以迁移的能力。
十三、把目标抬高
最后一段是他对「AI 会不会取代我们」的回答:他完全不悲观,因为需要解决的问题是无穷的。
“AI can automate this stuff? Ok great. Now go solve even harder problems.” AI 能把这些自动化掉?很好。那现在去做更难的问题。
他给这周的行动清单只有四条,全是本文前面出现过的东西:
十四、问答里最值得听的几个问题
Q:模型的答案会不会越来越多样? 他听说最新的 GPT 模型专门处理过这个问题,但他不觉得这是必然趋势:「写作能力这些年其实变差了,所以并不是所有东西都在变好。」他还补了一个很冷的判断:给出奇怪的、分布外的答案,可能不符合厂商的商业动机。
Q:AI 能产生新知识吗? 他不同意「完全不能」:理论上你可以生成随机噪声,再喂给 Lean 这类检查器,直到它撞出一个新证明。但他的实践经验是:AI 擅长走小步、把已有想法重组,不擅长退后一步看大局——所以现在的分工应该是「你来出主意和指方向,它来快速实现和验证」。
Q:为什么编程和数学在进步,写作却在退步? 他的解释是奖励信号:代码能跑、证明能过检查器,都是可验证的二元奖励;写作是主观的,你没法模拟人脑来判断一段文字好不好,所以很难做强化学习。「早期模型写作更好,是因为它们更接近人类预训练数据;但没有 RL 回路让它继续变好。」
Q:关灯软件工厂(lights-off software factory)能不能跑? 这是「提交 bug 报告和需求,全靠 agent 迭代」的模式。「等一下。」他说,「有人试过,现在不行:大概能撑三到六个月,之后代码库开始恶化,最后你还是得进去手动读它。」——这也是他坚持人类必须保留整体架构与长期视野的原因。他还顺手给了个类比:软件业比数学领先大约三年,所以你可以拿软件业的今天,去预测其他领域的明天。
Q:怎么让 agent 做出「跳出分布」的大跳跃? 「很难想到通用解法。目前依然是:主意由我来出。」
写在最后
这场讲座没有教任何提示词技巧,它给的是一个更朴素的分工判断:凡是「产生答案」的动作,尽量留在自己身上;凡是「加速验证和实现」的动作,尽量交出去。
那句他自己用来收尾的话,可能就是整场讲座最短的总结:
“Ride the wave, and stay in front of it.” 骑上这道浪,并且待在它前面。
出处与延伸
- 视频:How to avoid AI brain rot — Miles Cranmer(@MilesCranmer),讲座介绍见原推文
- 逐字稿(英文、26 小节、带时间轴):《How to avoid AI brain rot》英文逐字稿
- 文中引用的实验与幻灯片脚注出处:Jiang et al.(Artificial Hivemind, NeurIPS 2025)· Doshi & Hauser(Science Advances 2024)· Brynjolfsson, Li & Raymond(QJE 2025)· Dell’Acqua et al.(Organization Science 2026)· Hitzig et al.(Anthropic, 2026)· Bastani et al.(PNAS 2025)· Shen & Tamkin(Anthropic, 2026)· Lehmann, Cornelius & Sting(2025)· Deslauriers et al.(PNAS 2019)· Roediger & Karpicke(Psych. Science 2006)· Kestin et al.(Scientific Reports 2025)· Deming & Noray(QJE 2020)· Pew Research Center(2026 年 6 月)
- 插图:均从视频原片按时间点截取(文件名里的
NN-mmsss.jpg对应视频时间)
讨论
用 GitHub 账号留言;评论保存在公开仓库chengshu-blog-discussions的 Discussions 里。也可通过 RSS 订阅后续文章。