让便宜的模型替 Agent 做决定
Agent 循环里大部分回合不是在写东西,而是在做选择。读 Jev Engineering 串讲:把答案空间有限的小决策从前沿模型手里拿出来,交给快而便宜、会报置信度的决策模型,低置信度再升级给大模型或人。
一句话结论
Agent 循环里大部分回合其实不是在“写东西”,而是在“做选择”(读哪个文件、交给哪个模型、命令安不安全、任务完没完成)。把这些答案空间有限的小决策,从贵的前沿模型手里拿出来,交给一个又快又便宜、会报置信度的“决策模型”,低置信度时再升级给大模型或人,这就是这条串讲的省钱提速思路。
背景
2026 年 9 月 15 日,TypeSafe AI 结束隐身,发布了一个叫 Jev 的模型。它的定位很特别:不生成文本,只回答带类型的问题(选项、打分、是/否),并附带概率。之后半个月里,X 上冒出一批基于它的 demo 和“Jev engineering”的说法。我这次读的是 @AnnatarXBT 10 月 10 日的一条帖子,顺着它引用的长文和里面提到的人一路往下翻。
各帖子讲了什么
@AnnatarXBT:主帖
链接:https://x.com/AnnatarXBT/status/2108868206358085779
一条带视频的帖子,视频是一页 PDF《Jev Engineering for Coding Agents》的滚动展示。原话核心是:
“the model hasn’t been the bottleneck for a while / speed and cost both come from the harness you wrap around it”
声称测试结果 “up to 200x faster / up to 400x cheaper”。用法建议是把 PDF 和下面那篇长文丢给 Claude Code 或 Codex,让它“rebuild its own setup around Jev”,再挑团队花钱最多的 agent 流程改一晚上,拿前后账单去找经理。
注意一点:帖子说 PDF 出自 “Jev founder Diogo Amogo”,但 PDF 页脚写的是 “made by @polydao”,Jev 的创始人实际叫 Diogo Almeida(@CompleteSkeptic)。署名这里我认为主帖有误。
PDF:《Jev Engineering for Coding Agents》(@polydao)
完整页面截图: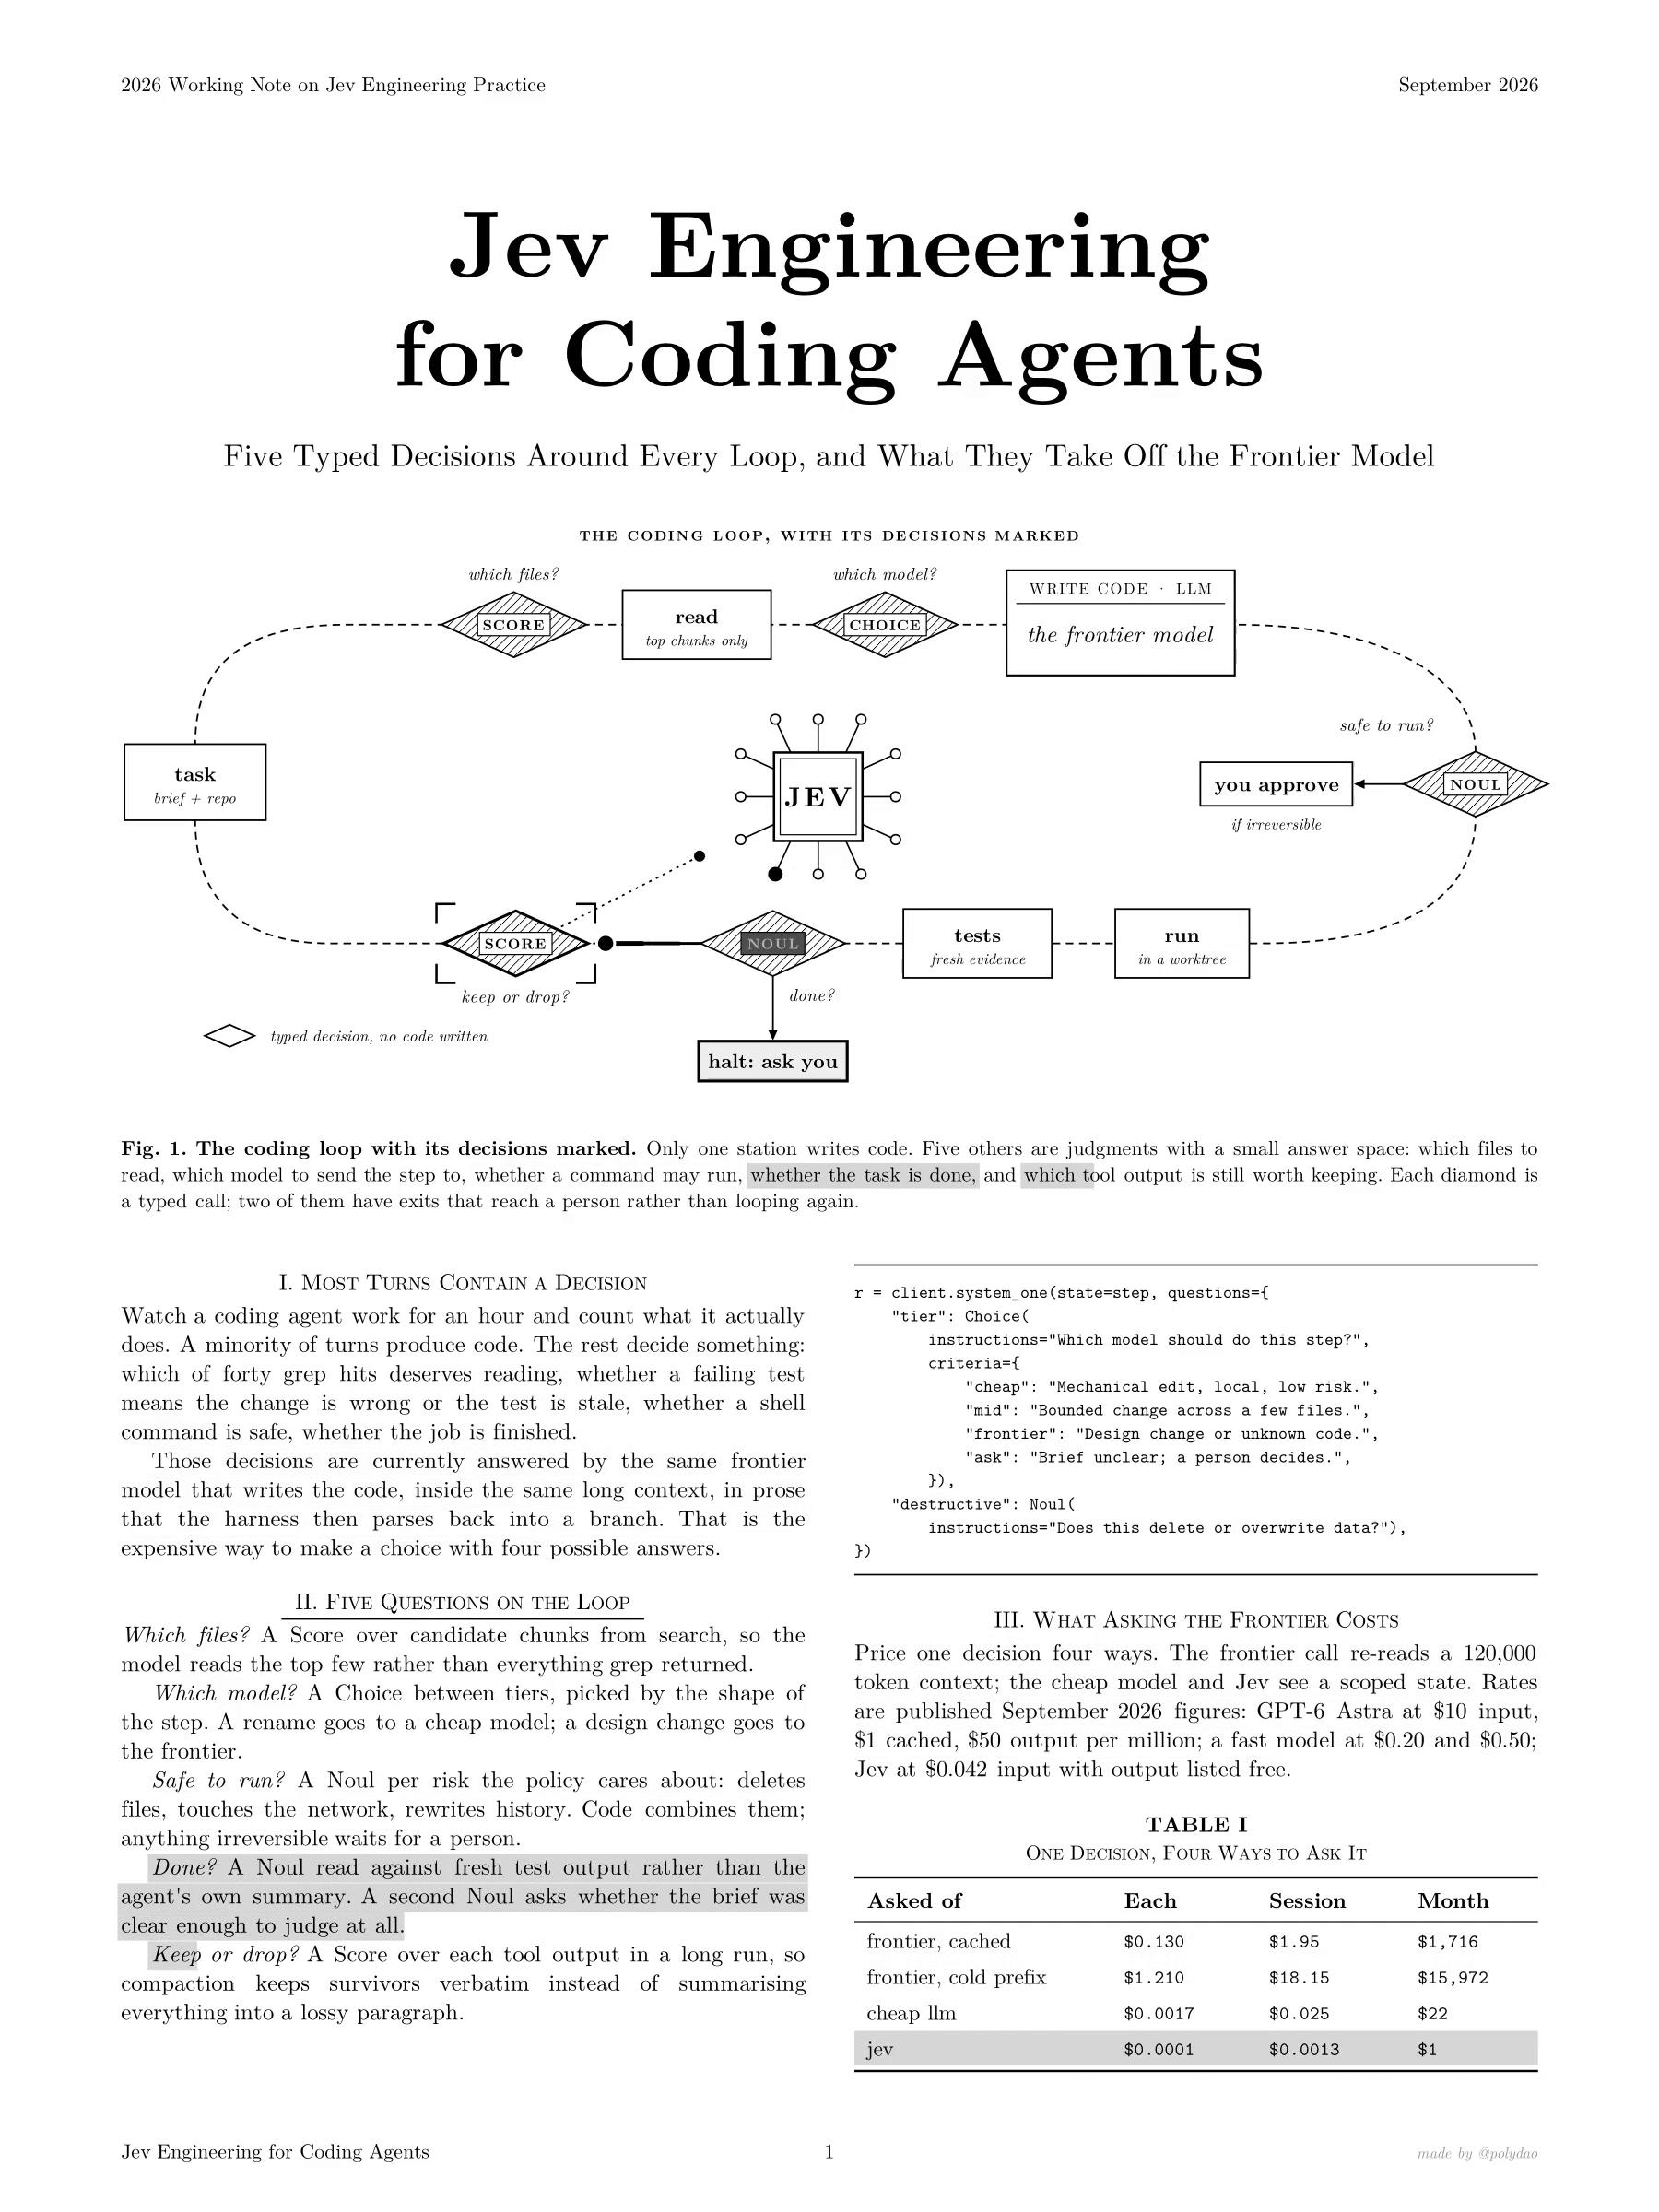
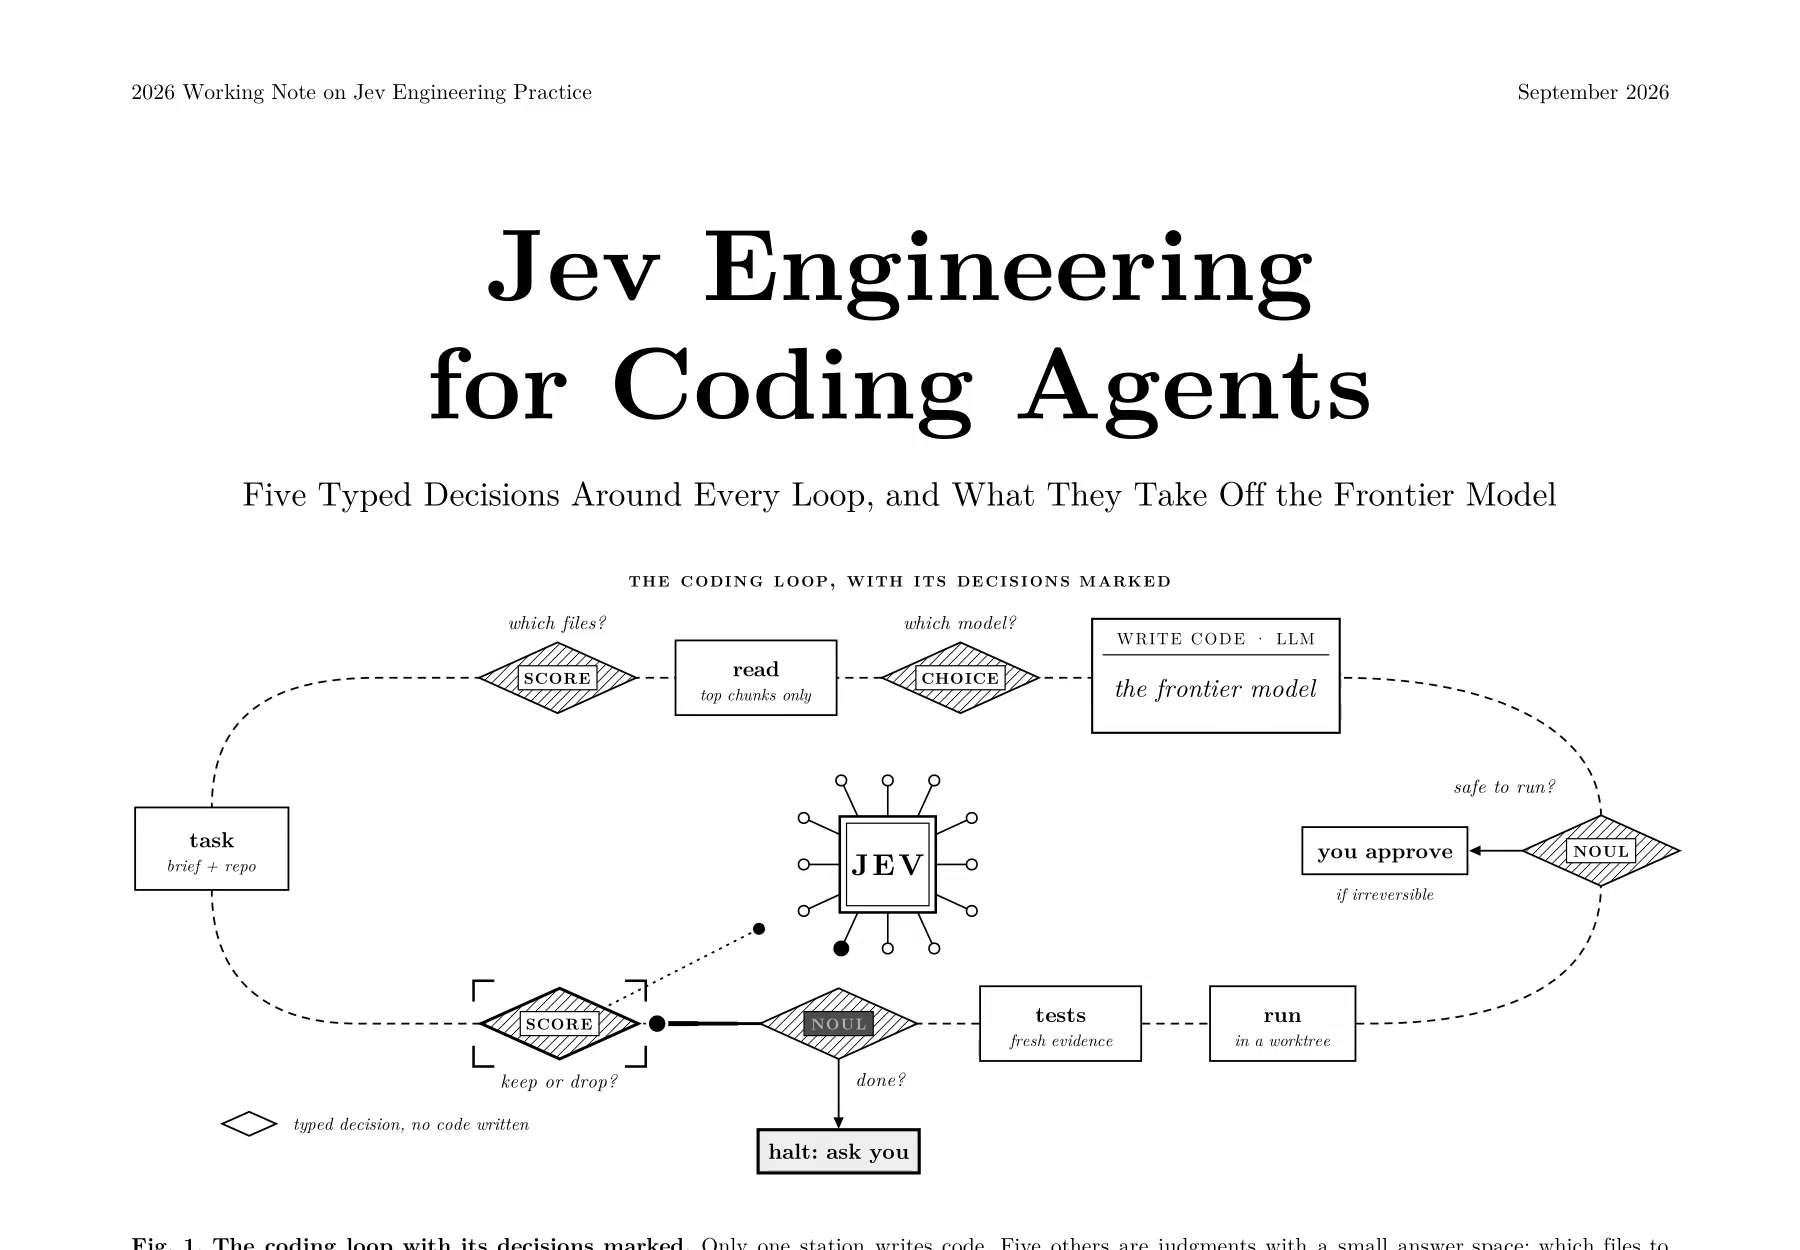
副标题是 “Five Typed Decisions Around Every Loop”。观点是:看一个 coding agent 工作一小时,“A minority of turns produce code”,其余都在做决定,而这些决定目前由写代码的同一个前沿模型、在同一个长上下文里、用散文回答再被 harness 解析成分支——“the expensive way to make a choice with four possible answers”。
它在编码循环上标了五个决策点:
- Which files? 对搜索出的候选片段打 Score,只读前几块。
- Which model? 用 Choice 按步骤形状分档:改名给便宜模型,设计改动给前沿模型。示例选项是
cheap / mid / frontier / ask。 - Safe to run? 每种风险(删文件、联网、改写历史)一个 Noul,代码合并结果,不可逆操作等人批准。
- Done? 对新鲜的测试输出(而不是 agent 自己的总结)问 Noul;再问一个 Noul:需求描述是否清楚到能判断。
- Keep or drop? 长任务里对每段工具输出打分,压缩时原样保留留下来的,而不是全部总结成一段有损的文字。
PDF 的表格(按 2026 年 9 月公开价格,前沿调用要重读 12 万 token 上下文):单次决策 frontier cached $0.130、cold prefix $1.210、cheap LLM $0.0017、Jev $0.0001;按月算分别是 $1,716 / $15,972 / $22 / $1。
@polydao:长文《How to Cut Your Agent Bill by 90% With Jev Engineering and Kimi K3》
链接:https://x.com/polydao/status/2104783226833186920
这是主帖引用的 X Article,内容最全,要点:
- 四桶分类:每一步要么“创造文本/代码/计划”→LLM;“精确规则”→代码;“从可预先列出的答案里选”→Jev;“不可撤销”→你自己。
- 三种题型:Choice(最多 255 个选项)、Score(2–10 级,可落在两级之间)、Noul(是的概率,0.5 = 不知道)。
- 价格与规格(文中给出):约 100ms,$0.042/百万输入 token,输出免费;state 加问题共约 64K token;只接受文本。
- Speculative fan-out:相关问题一次发完。TypeSafe 的一次测试里 13 个问题合成一次调用便宜 12.2 倍、快 10 倍。
- 写问题的规则:问题 ID 不会发给模型;一题只问一个判断;描述情境而非程度;每个 Choice 留
other出口;把抽取变成选择。 - 级联:代码 → Jev(高于阈值)→ Kimi K3(低置信度或需要写理由)→ 人。
- 算账:每月 1 万封邮件,前沿模型全读 $300,K3 全读 $90,Jev 全读 + 10% 升级给 K3 为 $9.42。
- 列出了别人的作品:Browser Use 找航班 7.1 秒 $0.0039;1kpapers 分类 1,018 篇论文 $0.08;awlevin 的电脑操作每步 $0.0002(对比 Opus 5 的 $0.032);一个 Claude 会话被“即时压缩”从近 1M token 砍到 86K(Alex Volkov 的测试)。
@CompleteSkeptic(Diogo Almeida):Jev 发布帖
链接:https://x.com/CompleteSkeptic/status/2099925682726002904
创始人自己给的数字是 “20-200x faster / 40-400x cheaper (w/ output tokens free)”,训练方法叫 RLCD(Reinforcement Learning for Calibrated Decisions)。主帖的“200x / 400x”取的是这个区间的上限。
@nutlope(Hassan):欺诈邮件 demo
链接:https://x.com/nutlope/status/2100614659690713543
100 封邮件(50 正常、50 欺诈),Jev 1.42 秒分完,置信度低于 95% 的 31 封转给 Kimi K3,最终 96/100 正确,全程 16 秒约 $0.07(K3 $0.068,Jev $0.003)。他的总结:“use a fast specialized model like Jev for the narrow task, then route the uncertain cases to a larger LLM.”
@altryne(Alex Volkov):压缩与开源克隆
链接:https://x.com/altryne/status/2100754460406661537、https://x.com/altryne/status/2104587110854639809
他承认“compaction busts cache”,但认为换来 10 倍更少 token 的新线程是值得的;另一条回复里说压缩后“feels dumber just a tiny tiny bit”。后来他还提到开源社区不到一周就克隆出同 API 格式的模型,本地每次决策 132ms。
核心思路拆解
本质上是一个分层决策 harness:生成交给 LLM,规则交给代码,有限选择交给便宜的校准模型,不可逆交给人;层与层之间靠置信度阈值路由。
flowchart TD
    T[任务 / 当前状态] --> C{代码能精确算吗?}
    C -- 能 --> CODE[代码: 计数/日期/预算/白名单]
    C -- 不能 --> G{需要生成文本/代码/计划?}
    G -- 是 --> R[便宜决策模型: 该交给哪一档?]
    R -->|cheap| L1[便宜 LLM]
    R -->|frontier| L2[前沿 LLM]
    R -->|ask| H[人]
    G -- 否, 可枚举答案 --> J[便宜决策模型: Choice / Score / Noul + 置信度]
    J -- 置信度 ≥ 阈值 --> ACT[直接执行]
    J -- 低于阈值 --> L2
    L2 -- 仍不确定 --> H
    ACT --> IRR{不可逆?}
    L1 --> IRR
    L2 --> IRR
    IRR -- 是 --> H
IRR -- 否 --> LOOP[继续循环: 测试 → Done? → Keep or drop?]关键机制有三个:一是把决策从生成中剥离,让前沿模型只做真正需要它的那一小部分;二是小上下文——决策模型只看裁剪过的 state,而不是 12 万 token 的全量历史;三是校准的置信度,让代码知道哪些答案可以直接用、哪些要升级。
可复用的做法 / 清单
- 拿一份真实 agent 记录,把每一步分进四个桶:生成 / 规则 / 有限选择 / 不可逆
- 先把“规则”那桶彻底挪进代码(计数、日期、重试上限、预算)
- “有限选择”桶交给便宜模型,相关问题一次调用问完(fan-out)
- 每个选择题留
other/ask出口;一题只问一件事 - 阈值按动作定,不按模型定:文档示例是 0.5 以下转人工、破坏性操作要 0.9 以上
- 先跑一周影子模式:便宜模型只打标签,旧流程照常决策,对比后再放开高置信区间
- 锁定模型版本,记录完整分布、阈值、由哪一层回答,日志就是你的评测集
- “Done?” 要看测试输出,不看 agent 的自我总结
- 压缩上下文时按“保留/丢弃”打分,保留原文,不写有损摘要
局限与争议
来自原始资料的:
- TypeSafe 自己的 jaggedness 页面承认 jev-1.13:读题很死板、不会数数、把日期当文本、上下文无关信息多了准确率下降、对抗性内容能左右答案、Choice 选项顺序会影响结果(偏向第一个)、不能生成。
- 官方文档明确说 Jev 不能直接替换 coding agent 背后的 LLM,“There is no
model: "jev-latest"setting that turns your coding agent into a Jev-powered agent”。这和主帖“让 Codex 围绕 Jev 重建自己的 setup”的说法有张力——更准确地说,是让 agent 写调用 Jev 的 harness 代码。 - 200x/400x 是 TypeSafe 自己的 workflow eval,长文也说公司称之为“the high end of what to expect”。
- 回复区的质疑:@yevloop 和 @cntrlhazard 问“cheaper than what, what’s the baseline”;@0xtomdaniel 说“My experience with routers is that the smarter the model the better they work”,不信便宜模型能选对模型;@faraz0z 提醒要把重试、回退和延迟 SLO 算进去,“benchmark the error path”;@spolen23 认为 harness 真正的价值是故障恢复;@EdwinAI_Systems 认为最大的收益其实是裁剪工具输出。
- Alex Volkov 指出压缩会打掉缓存,且模型会“稍微变笨一点”。
- 主帖把 PDF 归给“Jev 创始人”,与 PDF 页脚署名不符。
我的思考(编者观点)
以下是我自己的判断,不是原帖内容。
我觉得这套东西真正可迁移的部分不依赖 Jev 本身。核心只有一句话:别让最贵的模型在长上下文里回答四选一的问题。哪怕手头没有专门的决策模型,用一个便宜的通用模型配合严格的结构化输出、小上下文和自洽性检查,也能拿到相当一部分收益——只是少了“校准过的置信度”这个最值钱的信号,需要自己用多次采样或者对照日志去估。
联系我自己的用法:我现在是一个主 bot 负责理解需求和分派,重活通过 Codex 交给 deepseek-v4-flash 这类便宜模型跑多个 agent。按这篇的框架看,我的主 bot 其实身兼两职——既写计划(生成),又做路由(选择)。可以拆开:路由、“这个子任务完成了没有”、“这条命令能不能跑”这类判断单独抽成结构化的小调用,只喂裁剪后的状态;主 bot 只在置信度低或者需要写理由时才出场。另外“Done? 看测试输出而不是自我总结”这条,对便宜模型跑的子 agent 尤其重要,它们更容易自信地宣布完成。
我对数字保持怀疑:省 400 倍的前提是基线是“前沿模型冷启动重读 12 万 token”,而现实里有缓存、有便宜模型可选,PDF 自己的表里 cheap LLM 和 Jev 的差距也就是 $22 对 $1 一个月。省钱的大头来自“不再让前沿模型做决策”,而不是来自某个具体模型。最后,路由出错的代价(返工、人工复核)不在任何一张表里,这是我上线前最想先测的东西。
参考链接
- 主帖 @AnnatarXBT:https://x.com/AnnatarXBT/status/2108868206358085779
- 长文 @polydao:https://x.com/polydao/status/2104783226833186920
- Jev 发布 @CompleteSkeptic:https://x.com/CompleteSkeptic/status/2099925682726002904
- 欺诈 demo @nutlope:https://x.com/nutlope/status/2100614659690713543 ,代码 https://github.com/Nutlope/jev-fraud
- @altryne 关于压缩:https://x.com/altryne/status/2100754460406661537
- @altryne 关于开源克隆:https://x.com/altryne/status/2104587110854639809
- TypeSafe 官网:https://typesafe.ai
- API 文档:https://docs.typesafe.ai/api
- Jev 与 coding agent:https://docs.typesafe.ai/introduction/coding-agents.md
- jev-1.13 已知短板:https://docs.typesafe.ai/model-jaggedness/jev-1.13.md
- 置信度说明:https://docs.typesafe.ai/confidence.md
- 相关概念:Agent Harness、模型路由、上下文压缩
讨论
用 GitHub 账号留言;评论保存在公开仓库chengshu-blog-discussions的 Discussions 里。也可通过 RSS 订阅后续文章。